

Gedurende het grootste deel van de tijd dat NVIDIA in datacenters actief was, beschouwde het de CPU als weinig meer dan de chip die de GPU van gegevens voorzag. Grace, de eerste serverprocessor van NVIDIA, paste in dat plaatje. Deze processor maakte gebruik van Arm's standaard Neoverse V2-cores en werd voornamelijk geleverd als de CPU-helft van de Grace Hopper en Grace Blackwell superchips. Deze superchips introduceerden echter wel één blijvend onderdeel van het platform: NVLink-C2C, een verbinding die de CPU en GPU coherente toegang geeft tot elkaars geheugen met een veel hogere bandbreedte dan PCIe.
Its successor, Vera, is far more ambitious. It is a clean-sheet design built around Olympus, NVIDIA’s custom Arm core. Olympus implements Armv9.2, and each Vera CPU features 88 cores and 176 threads. Alongside the new cores, the memory subsystem is the other highlight. Each CPU supports up to 1.5TB of LPDDR5X on SOCAMM modules, with an advertised peak bandwidth of 1.2TB/s per socket, which gives Vera the power efficiency of mobile-class DRAM while keeping the memory field-replaceable. Across the two sockets in our test server, that rating comes to 2.4TB/s, and we measured 2,073GB/s on STREAM Triad.
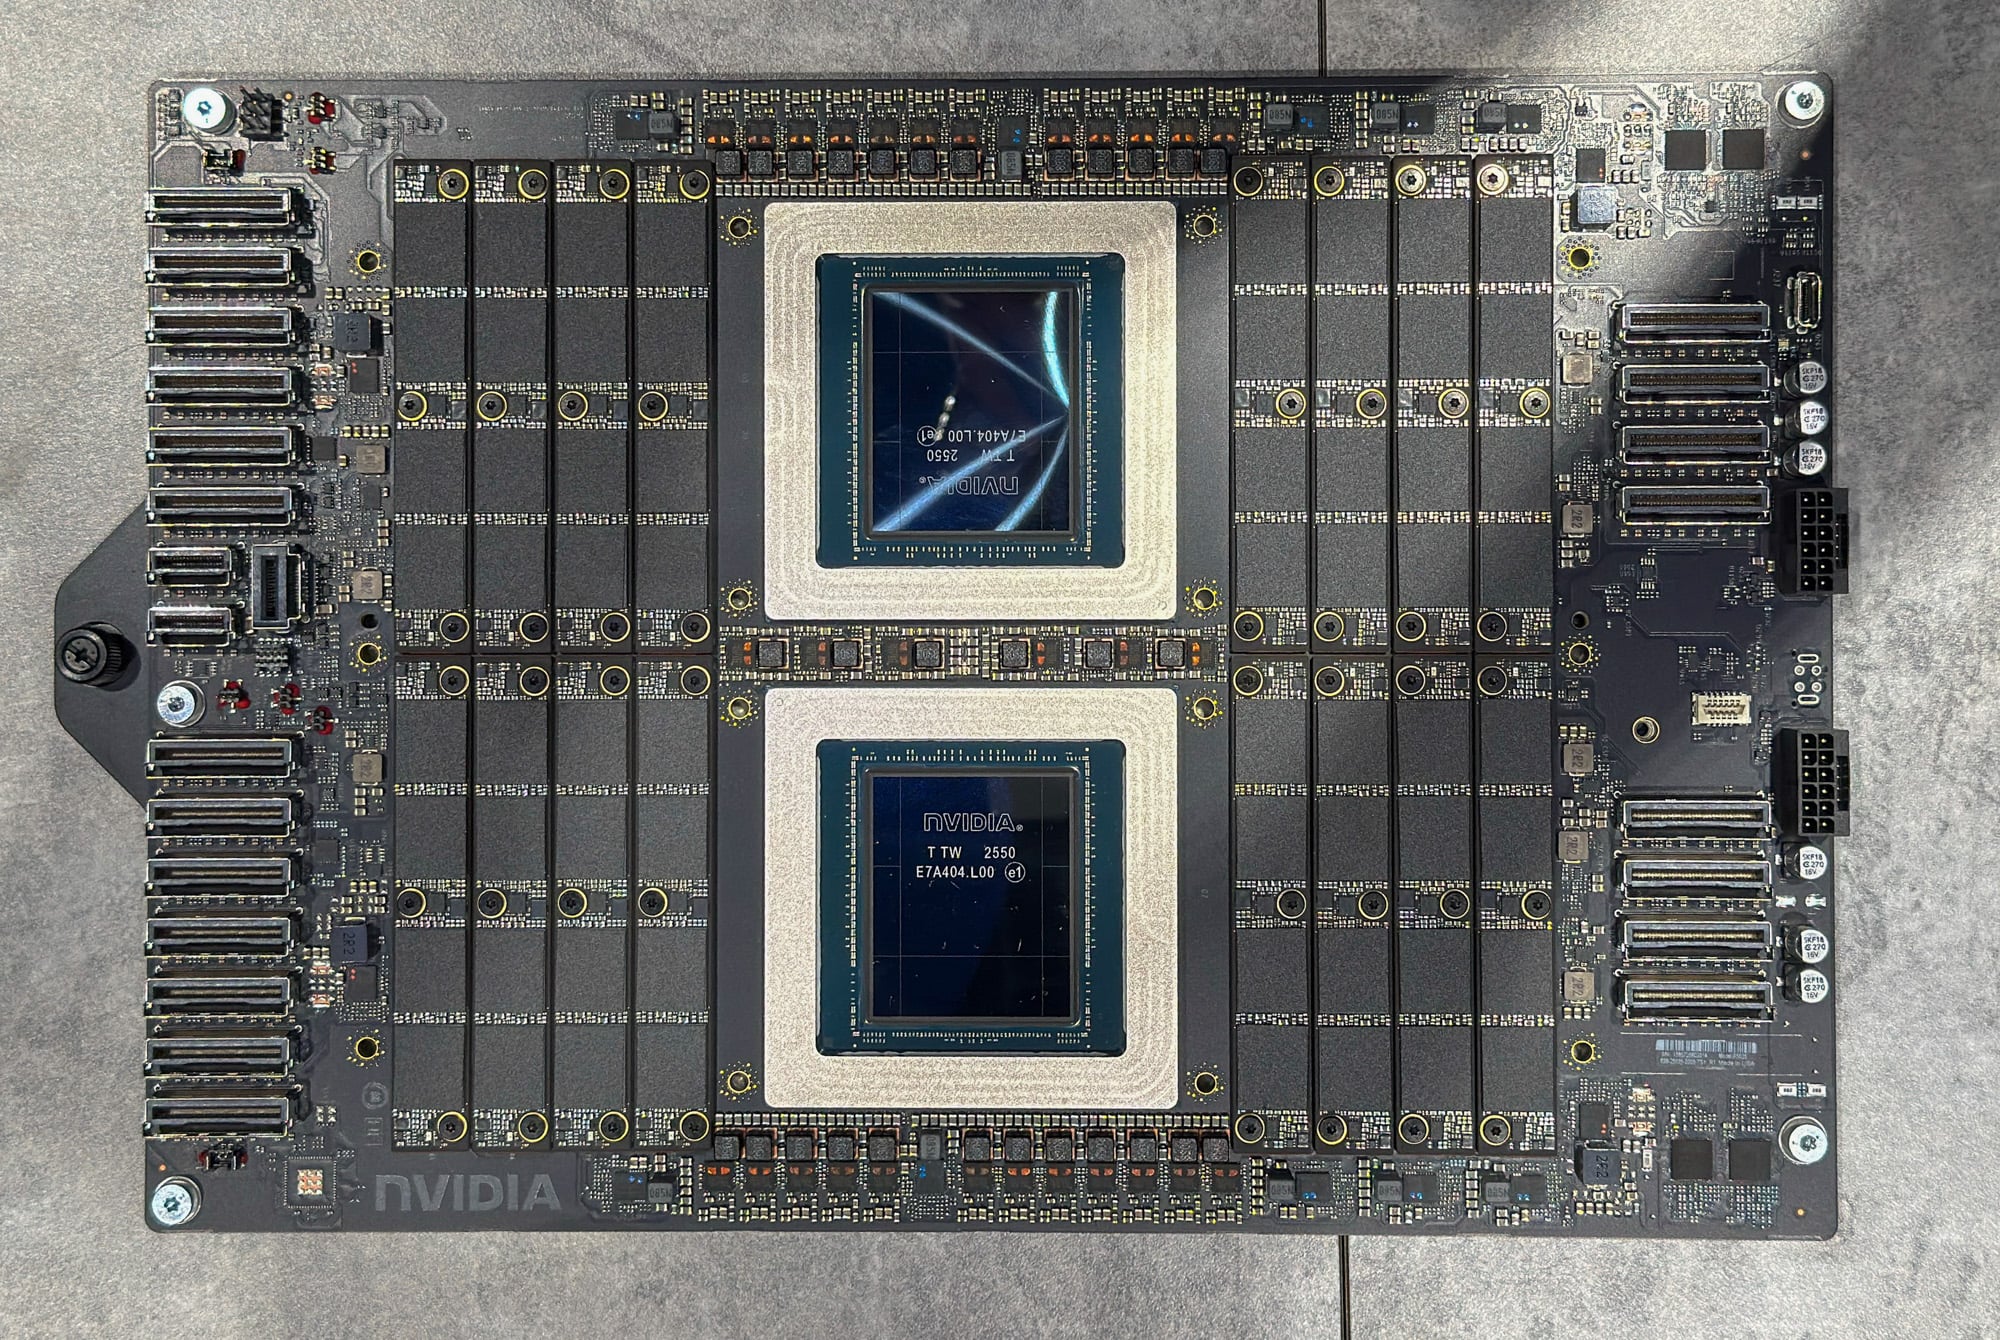
Die ambitie strekt zich uit tot de toepassingsgebieden van Vera. Het wordt nog steeds geleverd als onderdeel van de superchip in Vera Rubin-systemen, maar NVIDIA heeft het ook uitgebreid naar zijn BlueField-4 STX-opslagplatform en naar standalone CPU-servers voor agentische sandboxes. Vera wint ook aan populariteit bij OEM's, hyperscalers en NCP's: Dell, HPE en Supermicro hebben Vera-servers aan hun assortiment toegevoegd, en hyperscalers en NCP's staan klaar om het een mainstream product te maken. Die brede beschikbaarheid is belangrijk, want zoals onze resultaten zullen aantonen, is Vera een serieuze concurrent voor zijn x86-tegenhangers en biedt het organisaties een derde CPU-leverancier om hun toeleveringsketens te diversifiëren.
Key Takeaways
- De geheugenbandbreedte is bij elk x86-systeem meer dan verdubbeld. Twee Vera-sockets haalden een doorvoer van meer dan 2 TB/s op STREAM Triad, 2.3 keer de beste DDR5-server die we hebben getest. Zelfs bij het uitlezen van het geheugen van de andere socket via NVLink-C2C, haalden de cores van Vera meer bandbreedte uit het lokale geheugen dan welke x86-socket dan ook, en de lokale latentie met hugepages was 13% lager dan op de EPYC 9175F.
- Een goed uitgebalanceerde chip voor het brede middensegment van de markt. Eén 3.4 GHz Olympus-core comprimeerde 12% sneller met 7-Zip dan de 5.0 GHz EPYC 9175F en won twee van de drie single-thread Python-tests. Onder volledige belasting behaalde Vera 63% tot 72% van de 7-Zip-doorvoer van de EPYC 9965 met minder dan de helft van het aantal cores, waarmee het dicht in de buurt kwam van AMD's specialist per core op één thread en van AMD's specialist voor doorvoer over het hele systeem.
- Vector- en cryptografie zijn duidelijk de zwakke punten. Zes 128-bits SVE2-pipelines kunnen niet tippen aan 512-bits AVX-512 voor code die daarvoor geschreven is. Op een configuratie met 16 cores draaide Vera GROMACS benchMEM met de helft van de snelheid van de EPYC 9175F en tweederde van de snelheid van de EPYC 9965, en een enkele core versleutelde AES-256-GCM met ongeveer een derde van de snelheid van de 9175F. Over het gehele systeem gezien presteerde de 384-core EPYC 9965 ongeveer drie keer beter op zowel GROMACS benchPEP als AES.
- Geheugenintensieve HPC zet bandbreedte om in snelheid. Op het grote OpenFOAM-mesh was Vera 1.44 keer sneller dan de 384-core EPYC 9965 en 1.20 keer sneller dan de 240-core Xeon 6978P. Op het kleinere mesh, waar grotere x86 L3-caches een groter probleem vormen, eindigde Vera als tweede, binnen 12% van de 9965.
- Databases en analyses zijn nu al concurrerend. In HammerDB TPROC-C op één socket presteerden 88 Vera-cores 26% beter dan een EPYC 9965-socket met 192 cores op PostgreSQL en 8% beter op MariaDB, terwijl ze 19% achterbleven op MySQL en 15% op VillageSQL; de Xeon 6787P bleef achter op Vera op alle vijf engines. Vera voltooide de ClickBench hot run ook in 23% minder tijd dan de EPYC 9965 en verwerkte 34% meer verzoeken op een Valkey-werkset van 256 GB.
Specificaties
| Specificaties | NVIDIA Vera CPU |
|---|---|
| Rekenkracht en energie | |
| Kern | NVIDIA Olympus, Armv9.2 met SVE2 en FP8 |
| Kernen en threads per socket | 88 kernen, 176 threads (NVIDIA Spatial Multithreading) |
| Kloksnelheid (gemeten) | 3.41GHz |
| TDP | 250W tot 450W configureerbaar |
| Koelen | Lucht of vloeistof |
| cache | |
| L1-instructie | 64KB per kern |
| L1-gegevens | 96KB per core, 6-weg |
| L2 | 2 MB per core, privé |
| Systeemcache (L3) | 164 MB per socket, Arm MPAM-partitionering |
| Stof | Schaalbare coherentiefabric van de tweede generatie, 3.4 TB/s bisectie |
| Geheugen | |
| Type | LPDDR5X op 8 SOCAMM2-modules per socket |
| Regelaars | 8 x 128-bit (totaal 1,024-bit) |
| Snelheid | Tot 9,600MT/s |
| bandbreedte | Tot 1.2 TB/s per socket (specificatie van de fabrikant) |
| Hefvermogen | 256 GB tot 1.5 TB per socket |
| I / O | |
| PCIe | Gen6, 88 lanes per socket (platform met alleen CPU) x16, x8, x4, x2 bifurcatie |
| CXL | 3.1, Type 3 geheugenuitbreiding en pooling |
| NVLink-C2C | Tweede generatie, 1.8 TB/s bidirectionele, coherente, geauthenticeerde encryptie |
| Security | |
| Vertrouwelijk computergebruik | Arm CCA-domeinen, RME-DA en RME-CDA, TDISP, sleutels per VM |
Waarom NVIDIA de CPU-markt wil betreden
Om te begrijpen waarom Vera belangrijk is voor NVIDIA, moeten we kijken naar de groei van het bedrijf. NVIDIA bouwde zijn positie in datacenters op rond de GPU en breidde vervolgens uit naar de infrastructuur die nodig is om die GPU's draaiende te houden. Aan de hardwarekant bracht de overname van Mellanox in 2020 de netwerktechnologie met zich mee die servers verbindt en data ertussen verplaatst. Aan de softwarekant vergrootten CUDA, DOCA en de bredere softwarestack NVIDIA's invloed op de programmering en werking van die hardware. Samen gaven deze onderdelen het bedrijf controle over een groot deel van het platform voor versneld computergebruik.
Maar het platform had nog steeds een algemene CPU nodig. Iets moest het besturingssysteem draaien, data voorbereiden, applicaties beheren en de taken coördineren die naar de accelerators werden gestuurd. Gedurende een groot deel van NVIDIA's expansie vervulden Intel en AMD die rol. Dat bracht NVIDIA in een lastige positie: het kon de GPU's, het netwerk en een groot deel van de software leveren, terwijl het tegelijkertijd afhankelijk was van de processor van een ander bedrijf in het hart van de server.
Grace was de eerste grote stap om daar verandering in te brengen. Gebouwd rond Arm Neoverse V2-cores, gaf het NVIDIA een datacenter-CPU en een manier om die CPU nauwer te verbinden met zijn GPU's via NVLink-C2C. Grace liet echter nog een prestatiekloof open. De geheugenbandbreedte en efficiëntie maakten het concurrerend als AI-host-CPU, maar toonaangevende x86-processors behielden aanzienlijke voordelen bij de meeste andere workloads. Die ongelijke prestaties beperkten de argumenten om Grace te kiezen als algemene vervanging voor een EPYC- of Xeon-server.
Vera dicht een groot deel van die kloof door de Neoverse V2-cores van Grace te vervangen door NVIDIA's eigen Olympus-ontwerp en de geheugenbandbreedte en -capaciteit aanzienlijk te vergroten. Door naast de GPU's, DPU's en netwerkcomponenten ook een concurrerende CPU te leveren, kan NVIDIA een groter deel van de uitgaven per server veroveren. Het geeft het bedrijf ook meer controle over zijn ecosysteem en de manier waarop de componenten samenwerken: de CPU-cores, het geheugensubsysteem, de interconnectie en de GPU kunnen op dezelfde eisen worden ontworpen. De coherente CPU-naar-GPU-verbinding van Vera, die nu een snelheid van maximaal 1.8 TB/s haalt, is een concreet voorbeeld van die integratie.
Het beter benutten van de uitgaven van elk systeem is slechts een deel van het verhaal. Reinforcement learning (RL) en agentische AI geven NVIDIA nog een reden om een standalone CPU-systeem aan te bieden. Een agent doet meer dan alleen een reactie genereren. Hij roept tools aan, haalt informatie op, voert code uit en controleert de resultaten voordat hij besluit wat hij vervolgens moet doen. Veel van die uitvoering vindt plaats op CPU's, en wanneer de volgende modelstap afhankelijk is van het resultaat van een CPU-taak, vertraagt een trage uitvoering de hele sequentie. Prestaties per core, geheugenlatentie en voorspelbaar gedrag onder belasting worden daarom belangrijk voor de responsiviteit van de agent.
De kern van Olympus
Die eisen sluiten nauw aan bij het ontwerp van Vera's 88 Olympus-cores, die gebouwd zijn rond een duidelijke prioriteit: sterke prestaties van elke core, die behouden blijven wanneer de hele socket bezet is. Olympus is NVIDIA's implementatie van de Armv9.2-instructieset en vervangt de Neoverse V2-cores die in Grace werden gebruikt. Dat onderscheid is belangrijk: Arm definieert de instructies die de processor uitvoert, terwijl NVIDIA de mechanismen heeft ontworpen die deze instructies ophalen, inplannen en uitvoeren. Die controle stelt NVIDIA in staat de core af te stemmen op zijn doel: individuele taken snel voltooien terwijl er veel tegelijk worden uitgevoerd.
De eerste helft van dat doel begint met instructies per cyclus, of IPC: hoeveel instructies een core gemiddeld per klokcyclus voltooit. De kloksnelheid bepaalt hoe vaak die cycli plaatsvinden; de microarchitectuur bepaalt hoeveel nuttig werk erin past. NVIDIA claimt een IPC-verbetering van 1.5x ten opzichte van de vorige generatie. De hoogste kloksnelheid die we hebben waargenomen was 3.41 GHz, maar de architectuur van Vera legt de nadruk op het uitvoeren van meer werk per cyclus en het behouden van die voortgang onder belasting. Die nadruk is belangrijk, omdat extra cores alleen niet voldoende zijn om een lange reeks afhankelijke stappen in een compiler, interpreter of databasebewerking te versnellen.
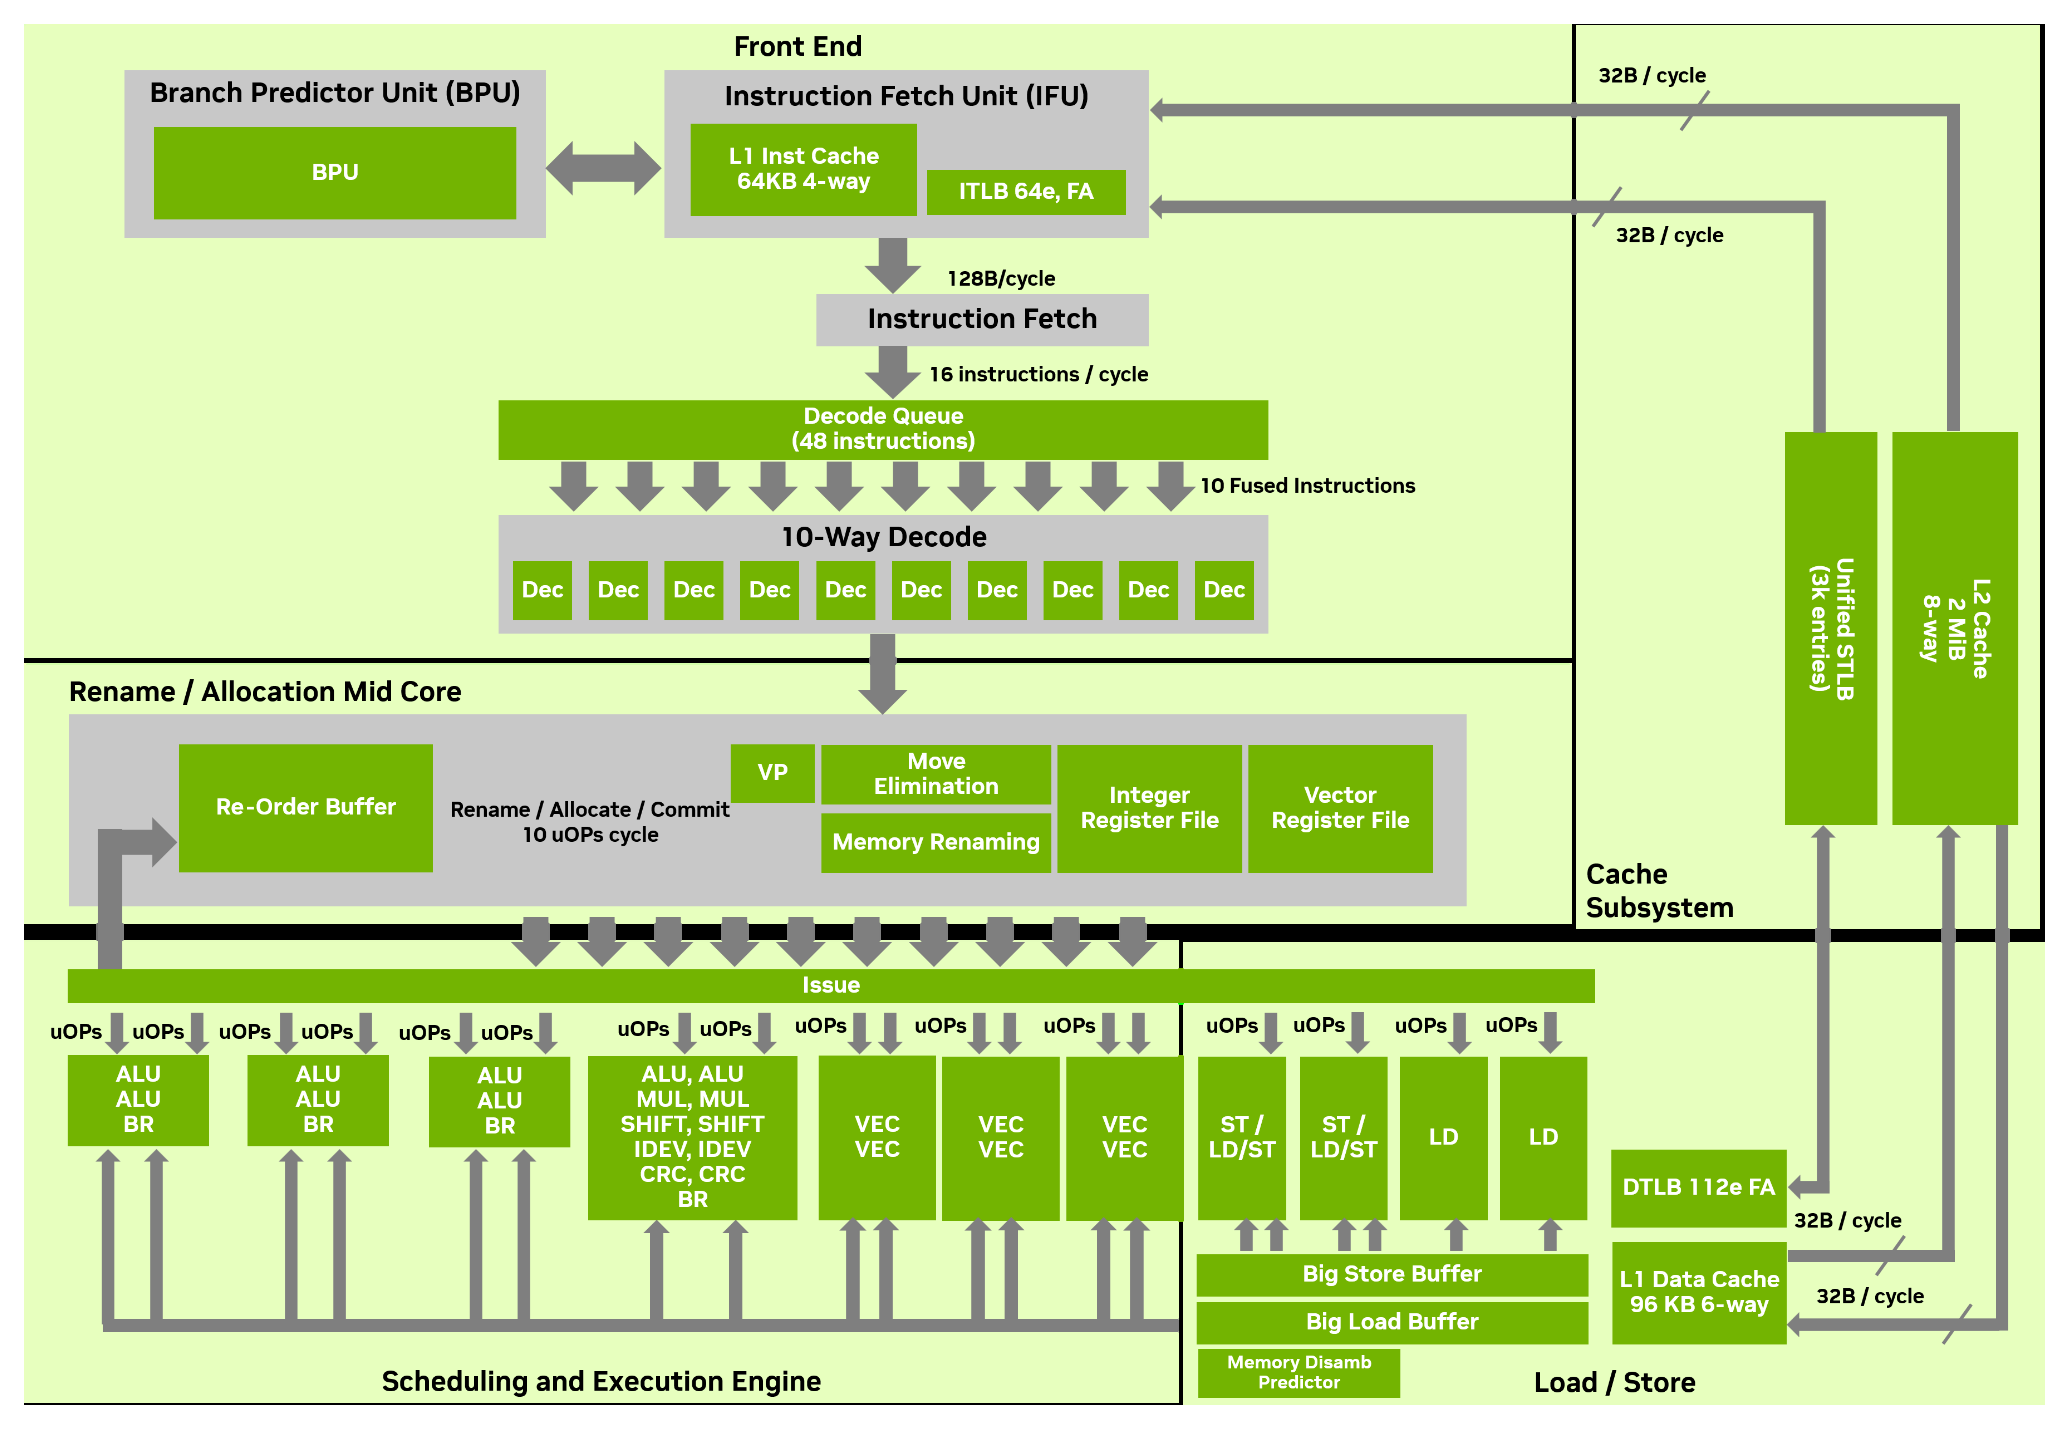
Het bereiken van die IPC (Instructions Per Cycle) begint met een constante aanvoer van bruikbare instructies. De front-end van Olympus, het deel van de core dat programma-instructies ophaalt en decodeert, kan tot tien instructies per cyclus decoderen. Die breedte is alleen van belang als er voldoende instructies worden aangeleverd, wat lastig wordt wanneer software regelmatig tussen verschillende codepaden vertakt. Olympus combineert daarom een neurale branch predictor met andere gespecialiseerde predictors en ondersteunt tot twee uitgevoerde vertakkingen per cyclus. Betere voorspellingen helpen de core de benodigde instructies op te halen, waardoor de tijd die wordt besteed aan het uitvoeren van het verkeerde pad en het herstarten na een fout wordt verminderd.
Zodra die instructies zijn opgehaald en gedecodeerd, gebruikt Olympus out-of-order execution om taken te vinden die kunnen worden uitgevoerd terwijl eerdere instructies wachten. Als een bewerking bijvoorbeeld op geheugen wacht, kan een onafhankelijke berekening ervoor in de plaats worden uitgevoerd. Een groot instructievenster geeft de processor meer mogelijkheden om die onafhankelijke taken te vinden.
Toch verzetten sommige sequenties, zoals de hierboven beschreven afhankelijke ketens, zich tegen deze aanpak omdat elke stap het resultaat van de vorige stap nodig heeft. Voor die sequenties gebruikt Olympus ook waardevoorspelling, waardoor afhankelijke bewerkingen kunnen beginnen met een voorspelde waarde. Deze waarde wordt vervolgens gecontroleerd zodra het daadwerkelijke resultaat beschikbaar is. Correcte voorspellingen kunnen de effectieve wachttijd in deze afhankelijke ketens verkorten; onjuiste voorspellingen vereisen dat het speculatieve werk wordt gecorrigeerd en opnieuw berekend.
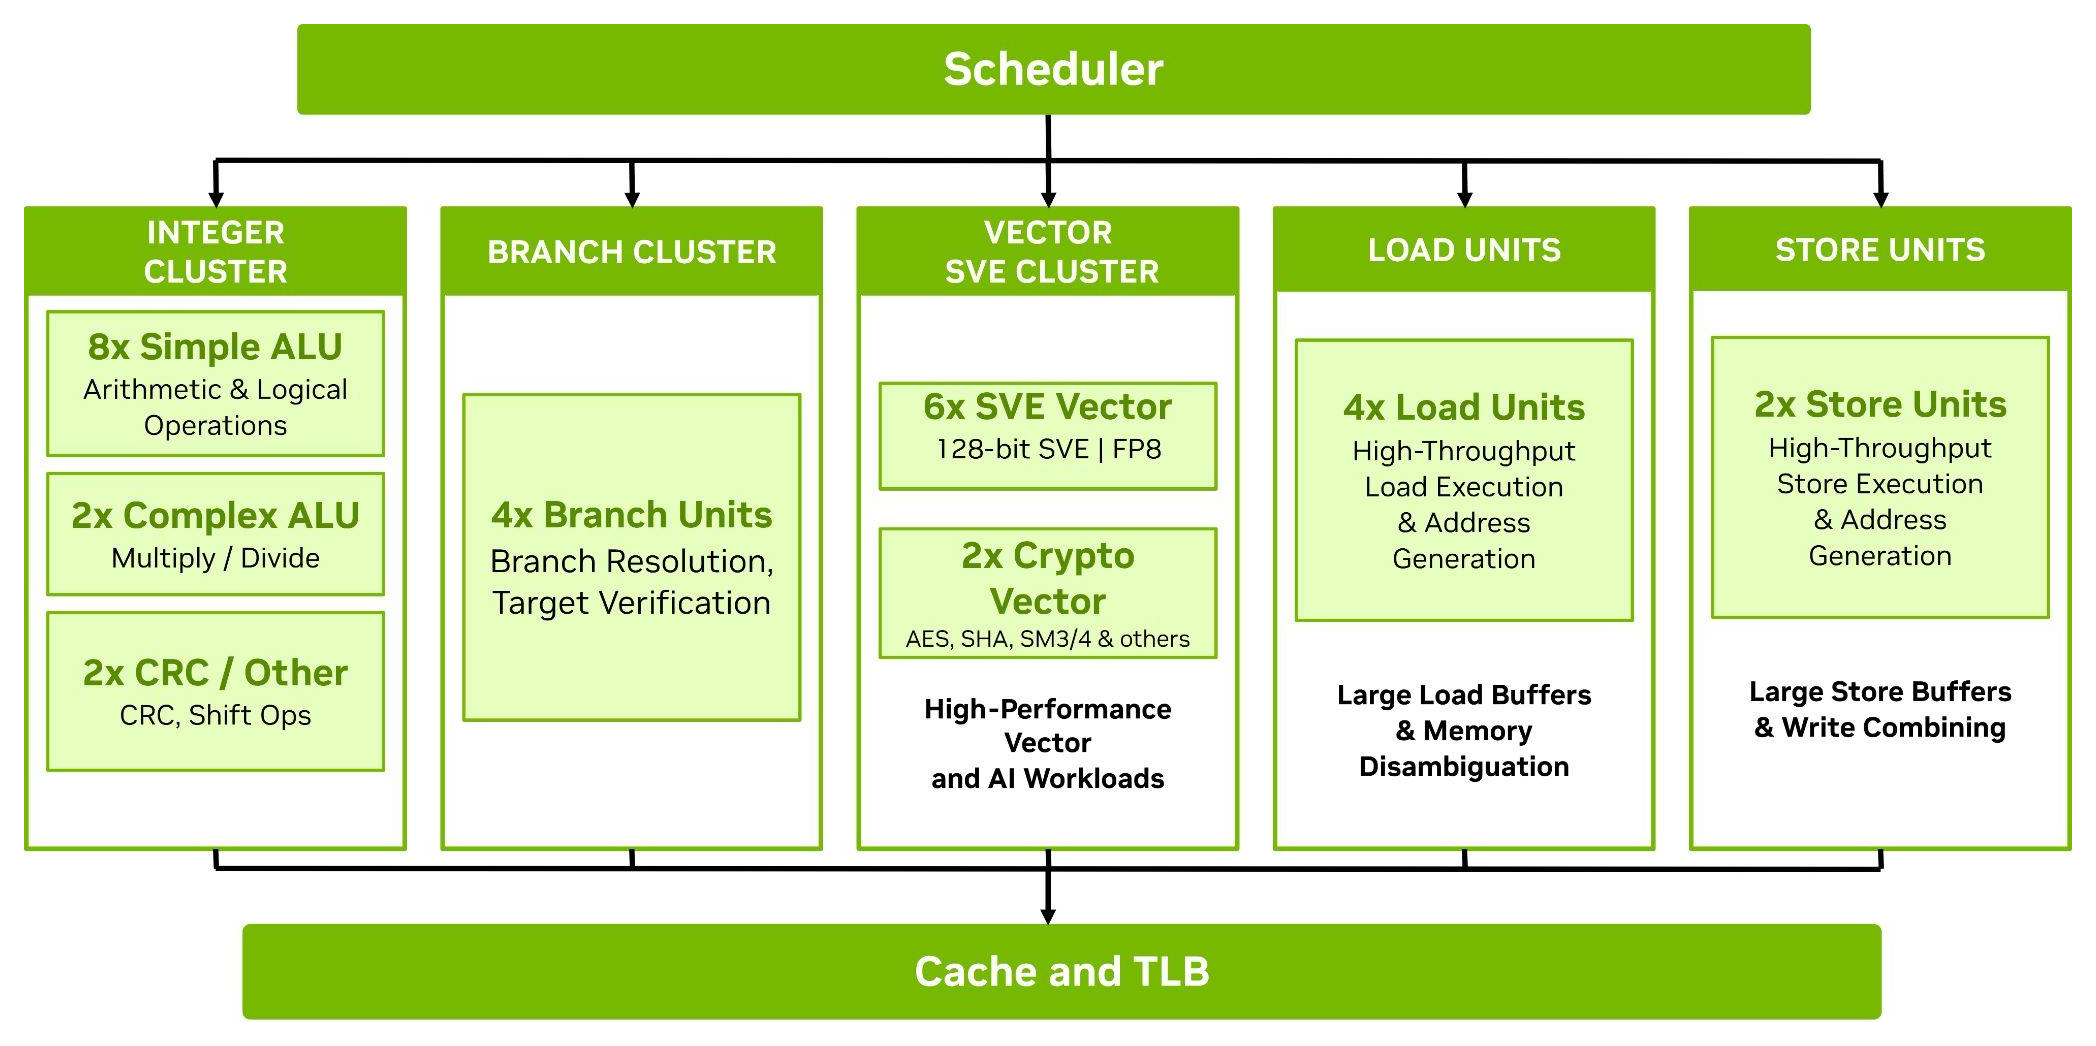
De uitvoeringsengine heeft vervolgens voldoende capaciteit nodig om die instructiestroom om te zetten in voltooide taken. Olympus combineert brede integer-uitvoeringsbronnen met speciale vertakkingseenheden, vier laadpijplijnen en twee opslagpijplijnen. Deze bronnen voldoen aan verschillende eisen: integer-eenheden verwerken rekenkundige bewerkingen, vergelijkingen en logica; vertakkingseenheden lossen de controlestroom op; en laad-/opslagpijplijnen verplaatsen gegevens tussen de core en de caches. De balans is belangrijk, omdat een bredere decoder weinig voordeel zou opleveren als instructies zich simpelweg zouden ophopen achter een uitvoerings- of geheugenknelpunt.
Naast deze scalaire resources beschikt Olympus over zes 128-bits vectorpipelines die SVE2 ondersteunen, met FP8-ondersteuning en cryptografische mogelijkheden in twee pipelines. Vectorinstructies passen een bewerking toe op meerdere gegevenselementen, waardoor ze nuttig zijn voor numerieke berekeningen, compressie en gegevensverwerking.
Dit is een gebied waar Olympus een duidelijke afweging maakt: de vectorbreedte van 128 bits is kleiner dan de 512 bits die beschikbaar zijn via AVX-512 op concurrerende x86-processors. Het verschil is van belang voor geoptimaliseerde numerieke kernels en zelfs tokenizers, hoewel de applicatieprestaties ook afhangen van de doorvoer van de specifieke instructies, de gegenereerde code en de aanvoer van data. Wetenschappelijke toepassingen zoals GROMACS blijven daarom een aparte test voor de sterke punten van het ontwerp.
Elk van deze uitvoeringsbronnen, scalair of vectorieel, is afhankelijk van de tijdige aankomst van gegevens. Het is daarom net zo belangrijk om veelgebruikte gegevens dicht bij de uitvoeringsengine te bewaren. Elke core heeft een instructiecache van 64 KB, een datacache van 96 KB en een eigen L2-cache van 2 MB. De kleine caches op het eerste niveau bieden snelle toegang tot de meest direct bruikbare instructies en gegevens; de grotere L2-cache bewaart een groter deel van de werkset van de core voordat een toegang verder door de processor moet gaan. Door elke core een substantiële eigen L2-cache te geven, wordt hetzelfde doel per core ondersteund: er kan meer werk lokaal worden afgehandeld, waardoor de druk op de gedeelde cache en het hoofdgeheugen wordt verminderd.
Prefetching vormt een aanvulling op die caches door gegevens op te halen voordat een instructie erom vraagt. Naast prefetchers voor reguliere toegangspatronen, bevat Olympus een grafiekprefetcher voor indirecte toegang, zoals A[B[i]], waarbij de ene opzoeking de index voor de volgende oplevert. Nadat de hardware die relatie heeft geleerd, kan deze beginnen met het ophalen van het tweede stukje data voordat het programma erom vraagt. Dit helpt een veelvoorkomend probleem bij grafiekverwerking en andere onregelmatige workloads op te lossen: de processor heeft voldoende uitvoeringscapaciteit, maar de voortgang hangt af van het vinden van het volgende stukje data.
Het laatste onderdeel van Olympus richt zich op de andere helft van het doel: het gelijktijdig uitvoeren van meerdere taken. Elke core ondersteunt twee hardwarethreads, waardoor Vera 176 threads per socket heeft. NVIDIA noemt dit systeem Spatial Multithreading. De core kan zijn resources toewijzen aan één actieve thread of verdelen over twee actieve threads, waardoor er een keuze is tussen het concentreren van de uitvoeringscapaciteit op één instructiestroom en het ondersteunen van meer gelijktijdige taken.
Het door NVIDIA aangegeven doel is om de interferentie tussen de twee threads te verminderen, waardoor de prestaties voorspelbaarder worden wanneer beide bezig zijn. Deze voorspelbaarheid is immers ook van belang voor agent-workloads onder belasting. De twee threads delen nog steeds een fysieke core en het bredere geheugensysteem, dus het verdelen van resources garandeert geen vaste applicatielatentie.
Fabricage, geheugen en I/O
Naast de individuele cores vereist het productief houden van 88 cores meer dan alleen een snelle verbinding met DRAM. De cores moeten ook gegevens uitwisselen, toegang hebben tot gedeelde cache en communiceren met aangesloten apparaten. Vera verbindt deze resources via de tweede generatie van NVIDIA's Scalable Coherency Fabric, een intern netwerk dat er ook voor zorgt dat gecachede kopieën van gedeelde gegevens coherent blijven. De cores, het netwerk en de 164 MB systeemcache bevinden zich op één compute-die, met geheugencontrollers en I/O op aangrenzende chiplets. NVIDIA schat de bisection-bandbreedte van het netwerk op 3.4 TB/s, een maatstaf voor de verkeerscapaciteit over het netwerk, los van de bandbreedte van het hoofdgeheugen.
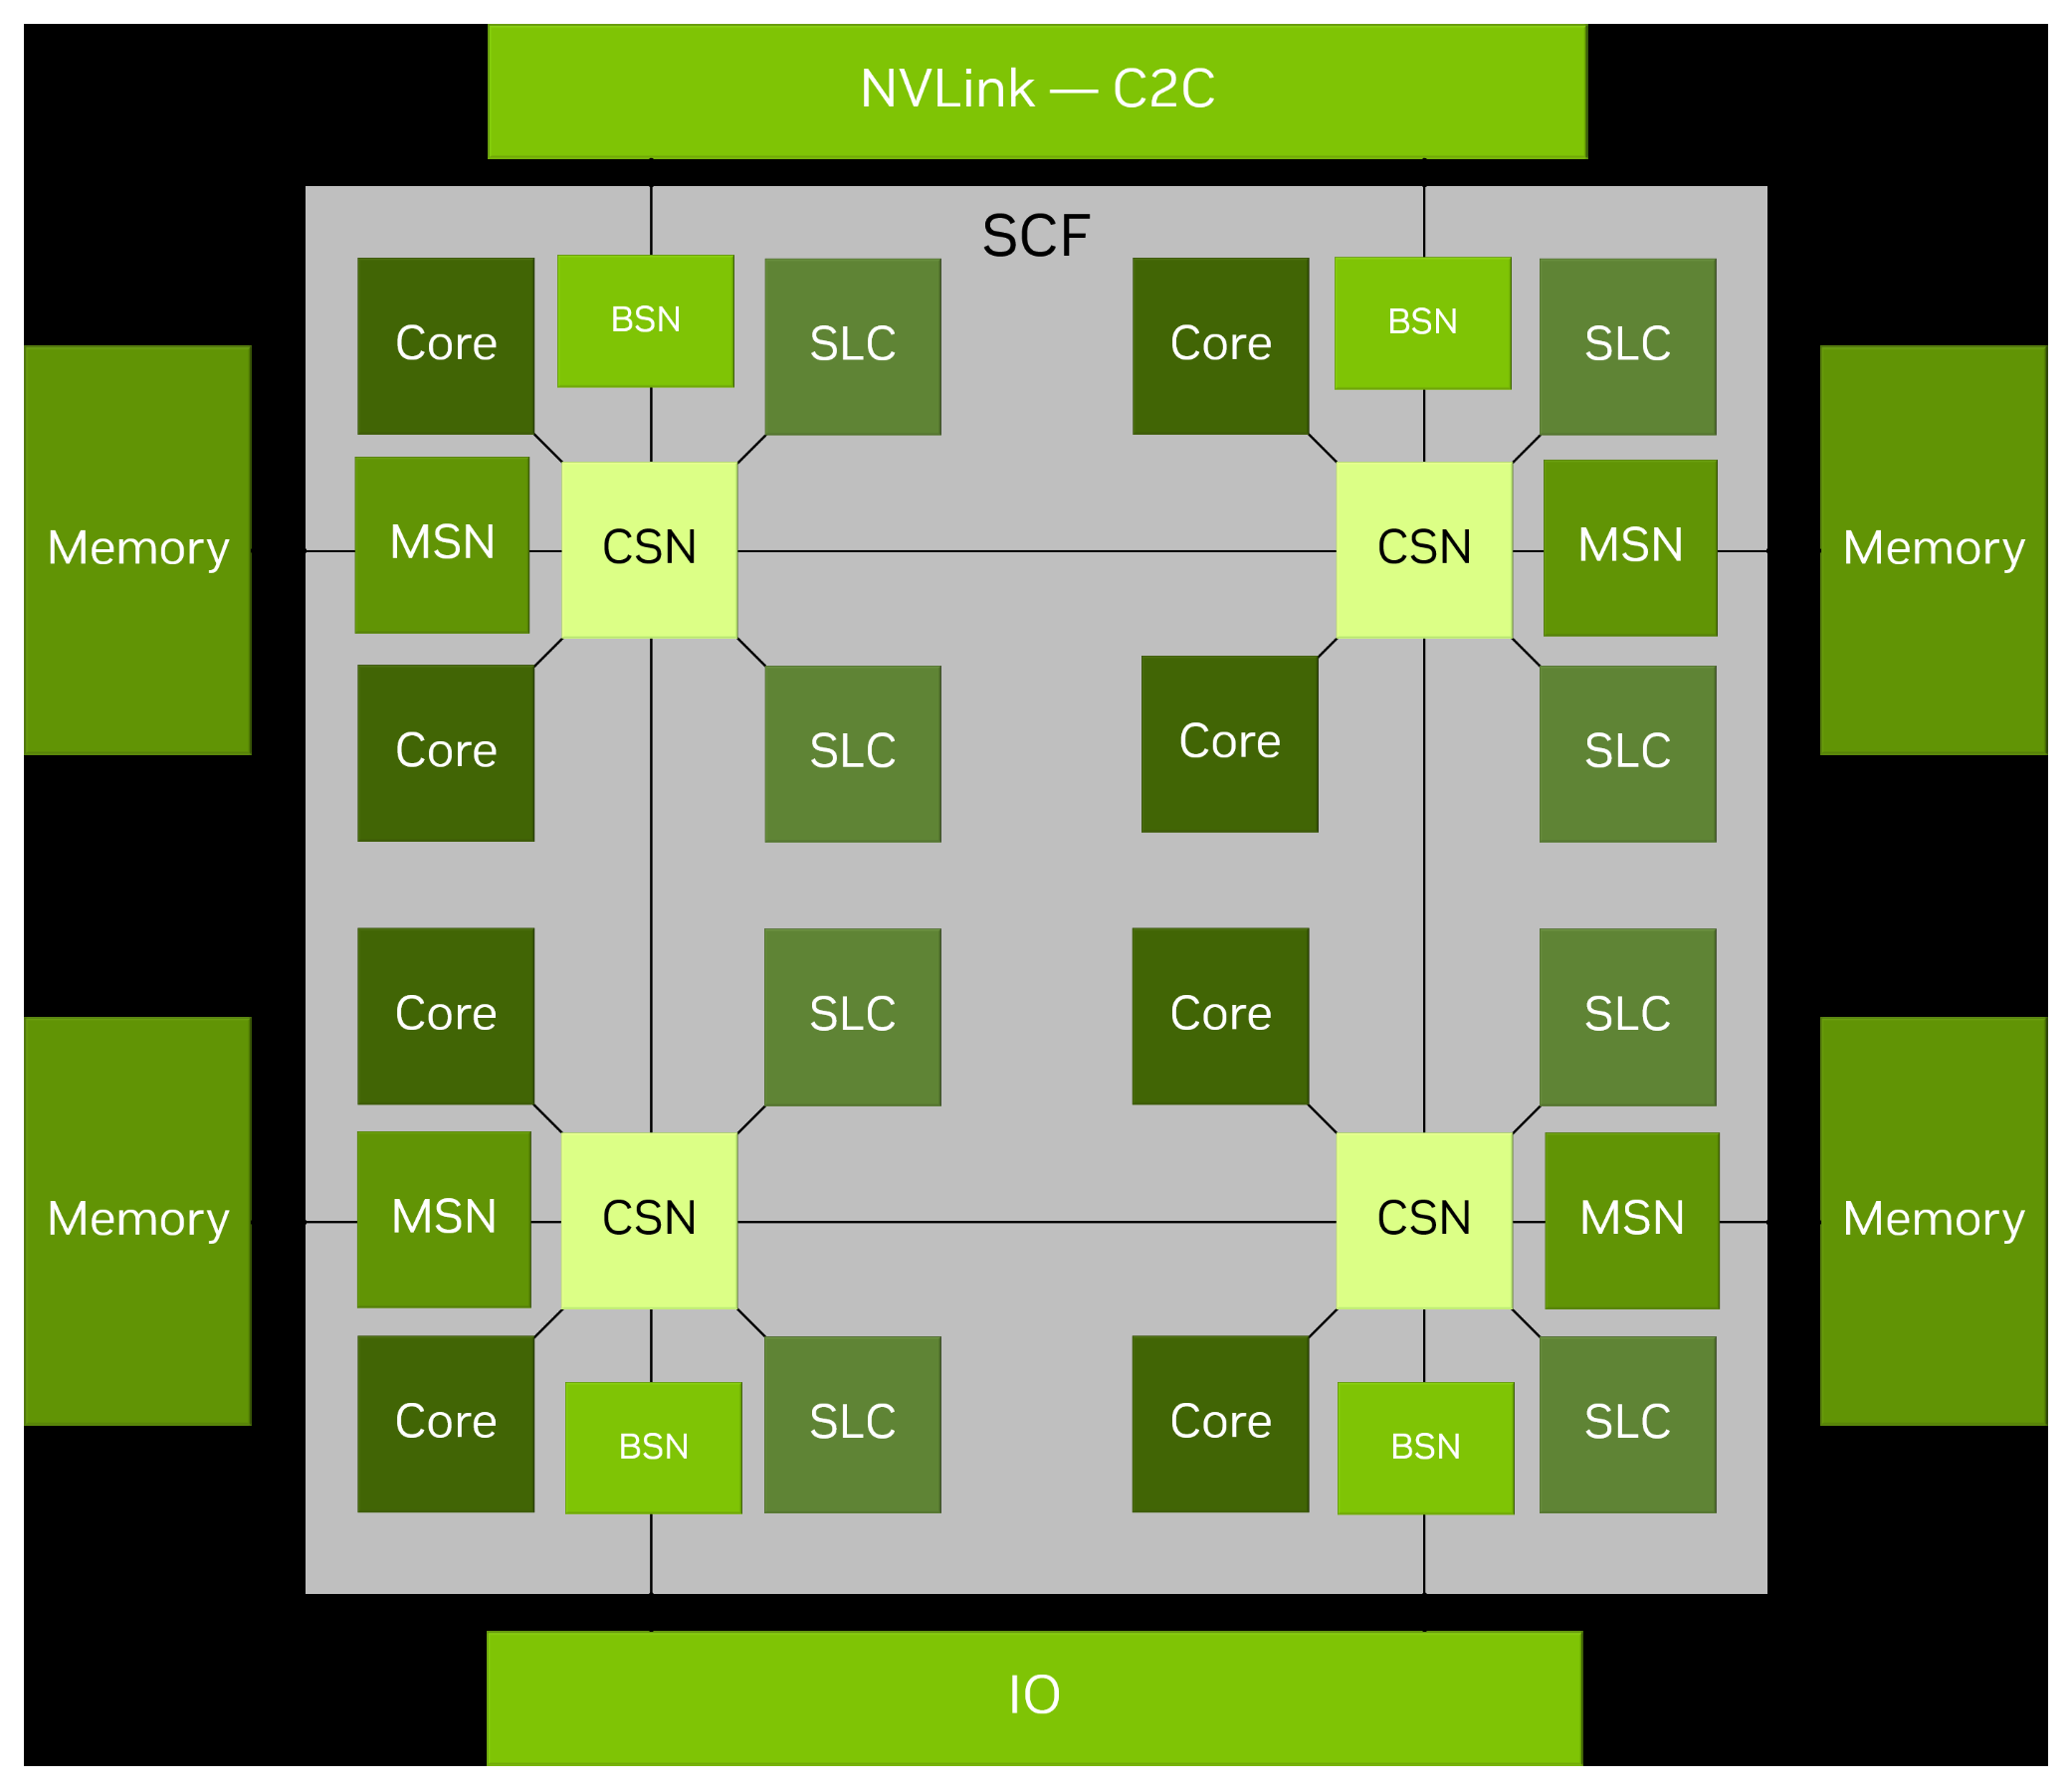
Die lay-out met één chip voorkomt gegevensoverdracht tussen afzonderlijke rekenchips wanneer cores communiceren of toegang hebben tot een gedeelde cache. Voor software presenteert Vera ook één NUMA-node per socket: het besturingssysteem ziet elke socket als één groep cores en lokaal gekoppeld geheugen. Dit vereenvoudigt de plaatsing binnen de socket, hoewel dit niet betekent dat elk pad door het mesh dezelfde latentie heeft. Een server met twee sockets heeft nog steeds twee NUMA-nodes en toegang tot het geheugen van de andere socket blijft anders dan toegang tot lokaal geheugen.
Binnen elke socket bevindt zich de gedeelde systeemcache, ofwel L3-cache, één niveau boven de eerder beschreven privé-L2-caches. Deze cache geeft de cores een extra mogelijkheid om gegevens te hergebruiken zonder direct naar het DRAM te hoeven gaan en biedt gedeelde capaciteit die toegankelijk is over de gehele socket. De 164 MB is aanzienlijk, maar sommige concurrerende processors bieden aanzienlijk meer L3-cache. Dit is van belang wanneer een herhaaldelijk geraadpleegde werkset te groot is voor de L2-cache van een core, maar wel in een grotere gedeelde cache past. Een hoge DRAM-bandbreedte is nuttig wanneer gegevens uit het geheugen moeten worden gehaald; het doet echter niets af aan het voordeel van het vermijden van die toegang.
Omdat die capaciteit gedeeld wordt, ondersteunt Vera ook Arm MPAM, waardoor systeemsoftware de gedeelde cachecapaciteit kan verdelen en de toewijzing van geheugenbandbreedte tussen workloads kan beheren.
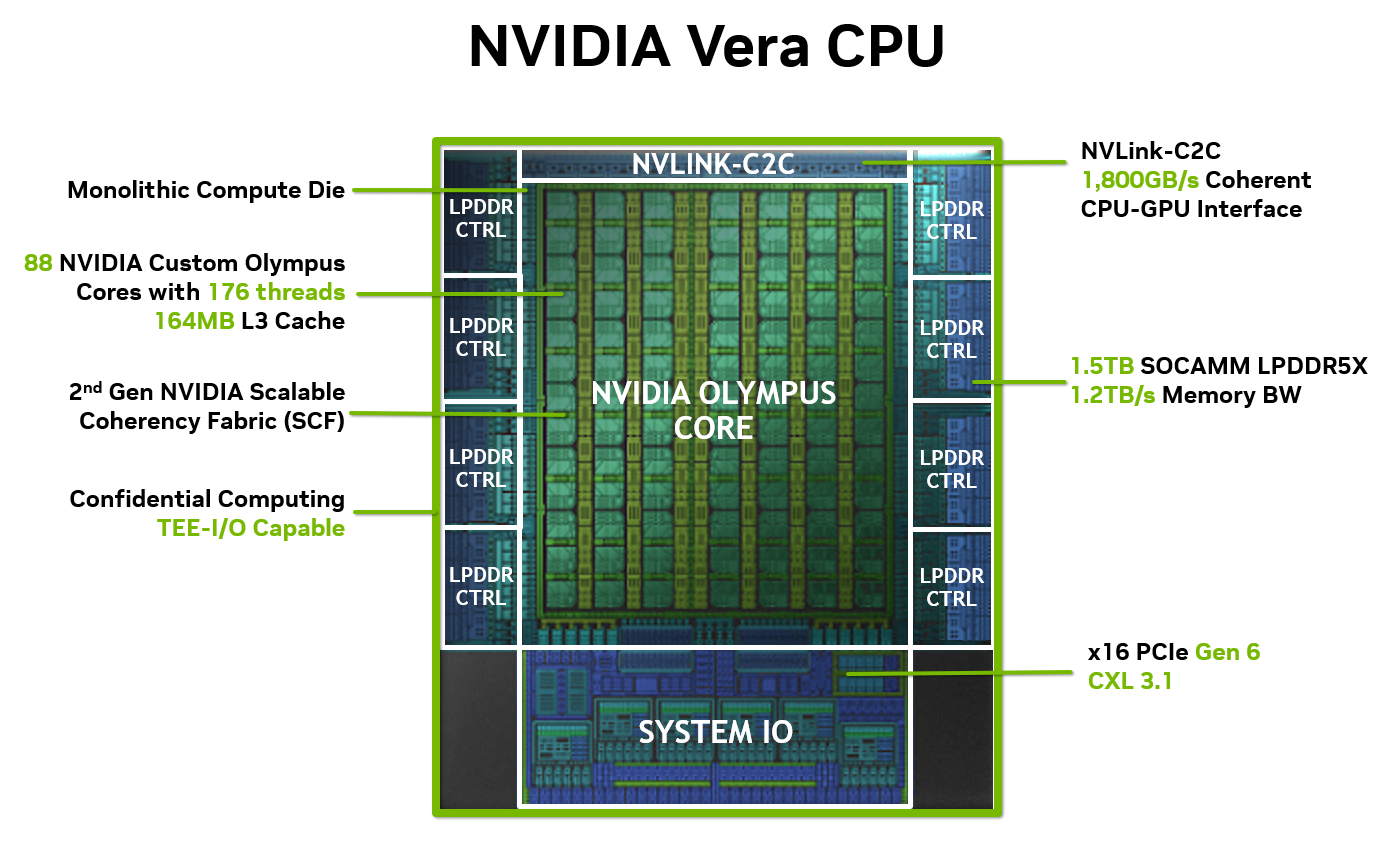
Wanneer er toegang tot het hoofdgeheugen plaatsvindt, beschikt Vera over aanzienlijke bandbreedte. Acht 128-bits LPDDR5X-controllers bieden een gecombineerde interface van 1,024 bits, met geheugensnelheden tot 9,600 MT/s, wat neerkomt op een nominale snelheid van 1.2 TB/s per socket. Het geheugen bevindt zich op acht verwijderbare SOCAMM2-modules, een combinatie van LPDDR5X en modules die in het veld kunnen worden vervangen. Dit geeft Vera een brede, snelle geheugeninterface zonder dat er geheugen hoeft te worden vastgesoldeerd.
De pure bandbreedte is echter slechts een deel van het verhaal. De nuttigere relatie is die tussen die bandbreedte en het aantal cores dat deze deelt. Door de nominale 1.2 TB/s te delen door 88 cores, krijg je ongeveer 13.6 GB/s per fysieke core. Dit is een manier om de balans van de processor te beschrijven, geen gegarandeerde toewijzing of garantie van wat elke thread krijgt. Het verhogen van het aantal cores zonder een overeenkomstige verhoging van de geheugenbandbreedte zou die verhouding verlagen.
Door onze gemeten STREAM-bandbreedte te delen door het aantal fysieke cores, krijgen we 11.8 GB/s per core op Vera, vergeleken met 3.8 GB/s op het 240-core Xeon 6978P-systeem. Dit is een concreet voorbeeld van hoe Vera een aanzienlijke geheugendoorvoer levert ten opzichte van zijn rekenkracht.
Energie-efficiëntie is onderdeel van dezelfde ontwerpkeuze. NVIDIA schat het stroomverbruik van een volledig uitgerust LPDDR5X-geheugensubsysteem op ongeveer 30 tot 40 watt, afhankelijk van de capaciteit. De aantrekkingskracht van LPDDR5X is dat het deze bandbreedte levert, terwijl de bijdrage van het geheugen aan het totale serververmogen laag blijft. Hierdoor blijft er meer van het systeemvermogen en de koelingscapaciteit beschikbaar voor berekeningen.
Bandbreedte en efficiëntie zeggen nog steeds niets over hoeveel data er precies in past, en capaciteit blijft een aparte factor. NVIDIA specificeert maximaal 1.5 TB direct aangesloten LPDDR5X per socket, of 3 TB verdeeld over twee sockets. Voor workloads waarbij de werkset zich in het geheugen moet bevinden, kunnen hogere overdrachtssnelheden een tekort aan capaciteit niet compenseren.
Waar de direct aangesloten capaciteit niet voldoende is, biedt Vera's I/O een pad naar meer capaciteit, samen met aansluitingen voor apparaten. Het standalone CPU-platform biedt 88 PCIe Gen6-lanes per socket voor netwerken, opslag en accelerators, terwijl de Vera Rubin-configuratie er 96 beschikbaar stelt. Aan de geheugenkant omvat CXL 3.1-ondersteuning Type 3-geheugenmodules en geheugenpooling, waardoor de capaciteit verder kan worden uitgebreid dan de SOCAMM2-modules. Dit uitgebreide geheugen gebruikt een ander toegangspad dan de direct aangesloten LPDDR5X, dus de prestaties ervan moeten afzonderlijk worden geëvalueerd.
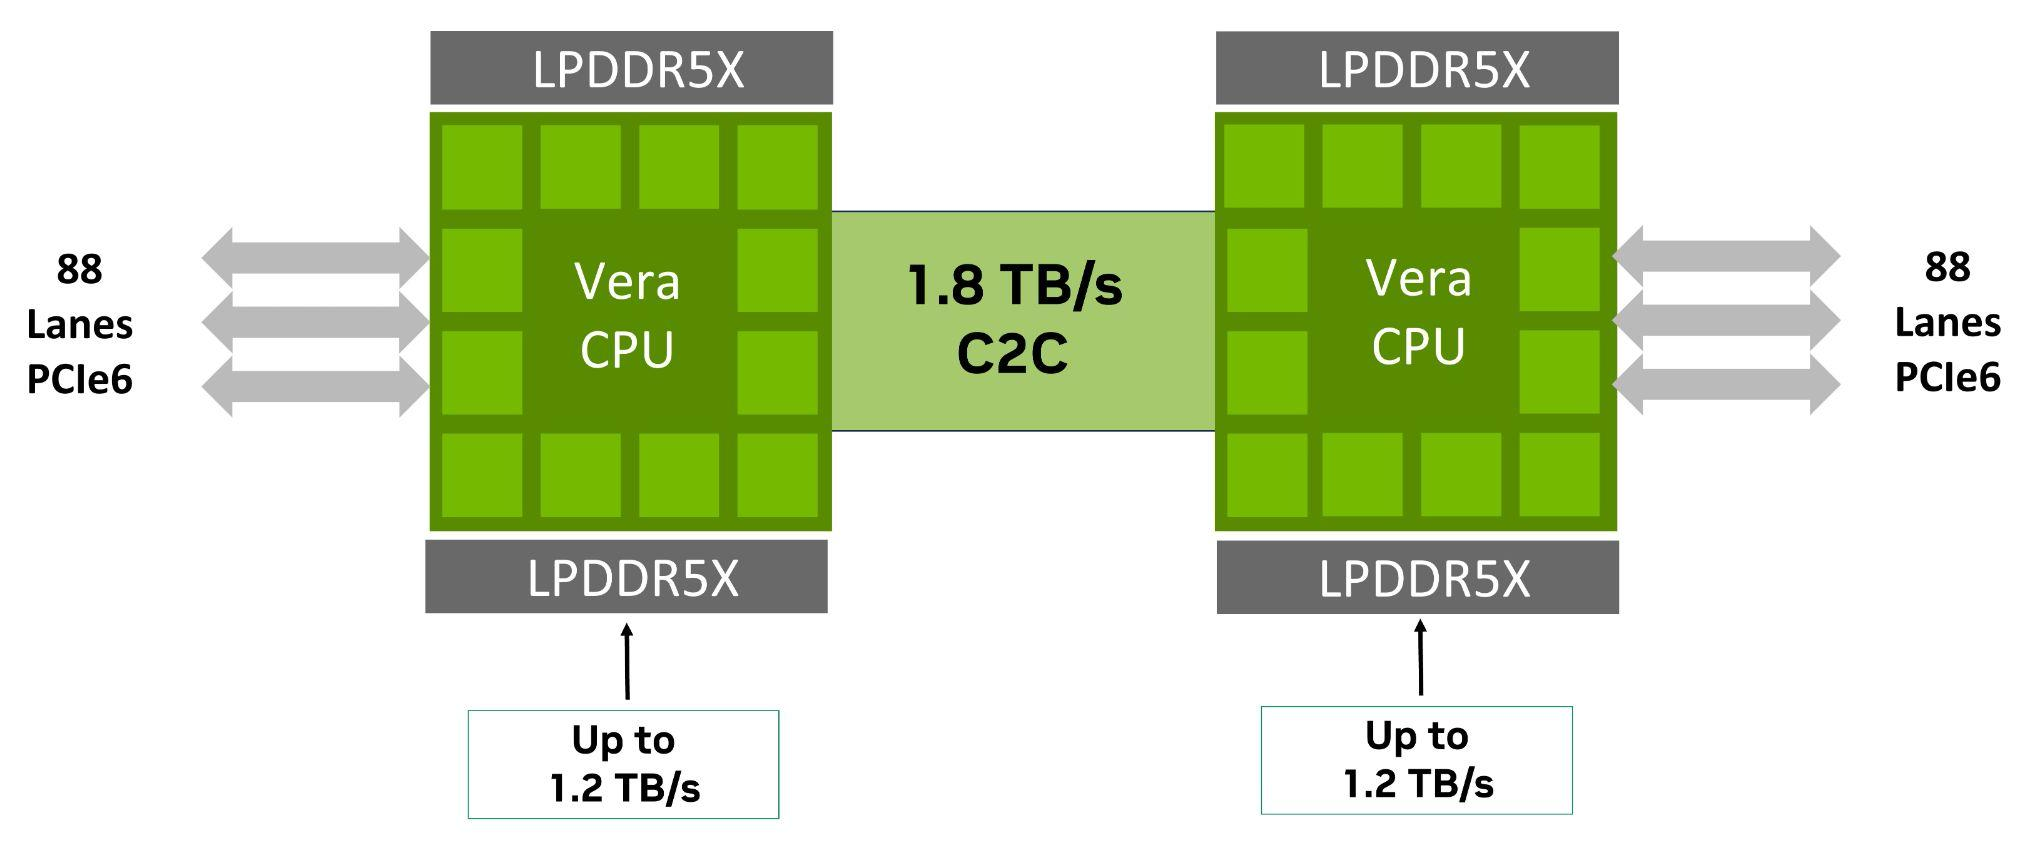
Tot slot gebruikt Vera voor de communicatie tussen processors de tweede generatie NVLink-C2C, de opvolger van de link die met Grace's superchips werd geïntroduceerd. Deze verbindt twee Vera-CPU's in een dual-socket server of koppelt Vera aan Rubin-GPU's in een superchip. De link biedt een gecombineerde bidirectionele bandbreedte van maximaal 1.8 TB/s, of 900 GB/s in elke richting, en weerspiegelt dezelfde nauwe CPU-GPU-integratie die NVIDIA in eerste instantie motiveerde om de CPU-markt te betreden.
Binnenin de MGX Vera C2 referentieserver
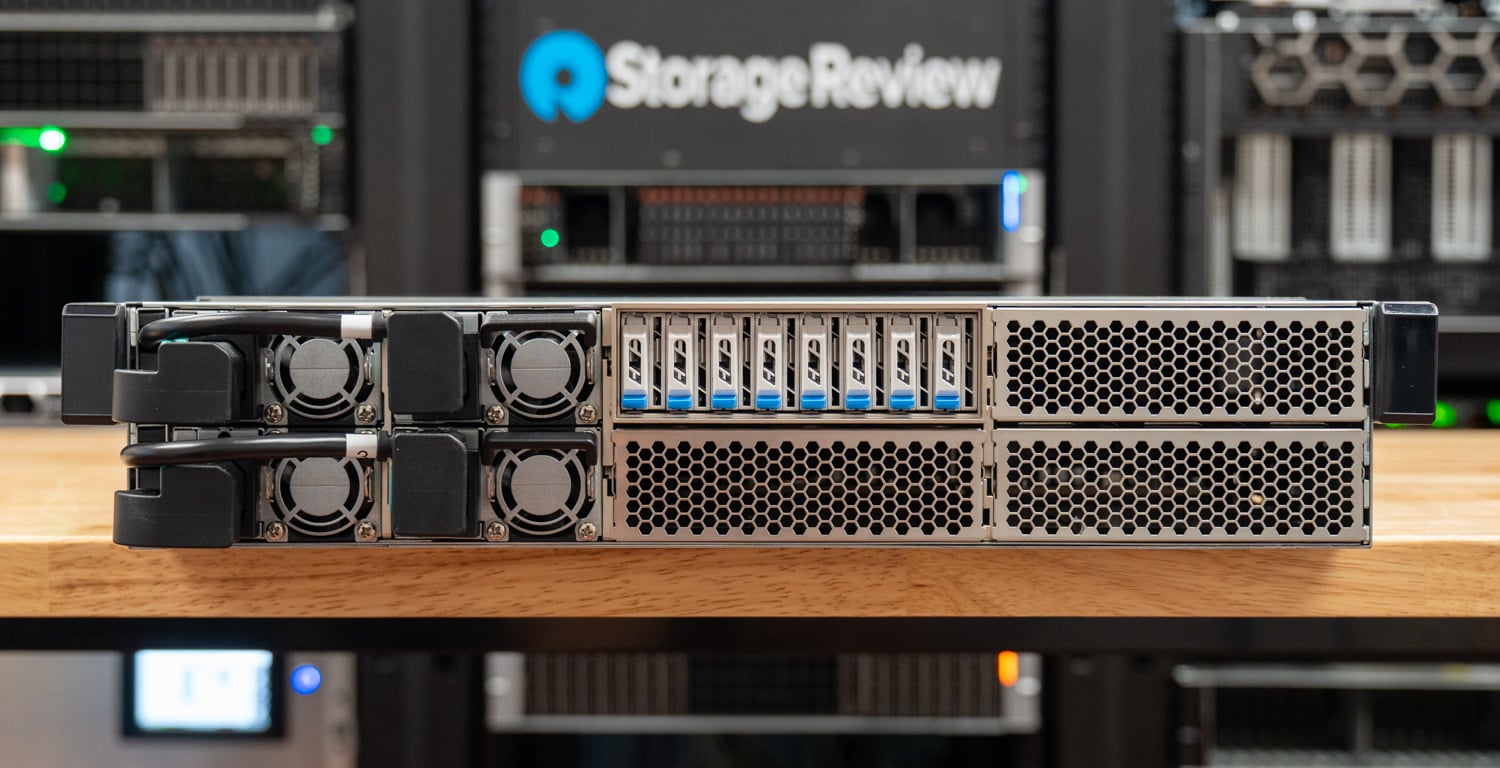
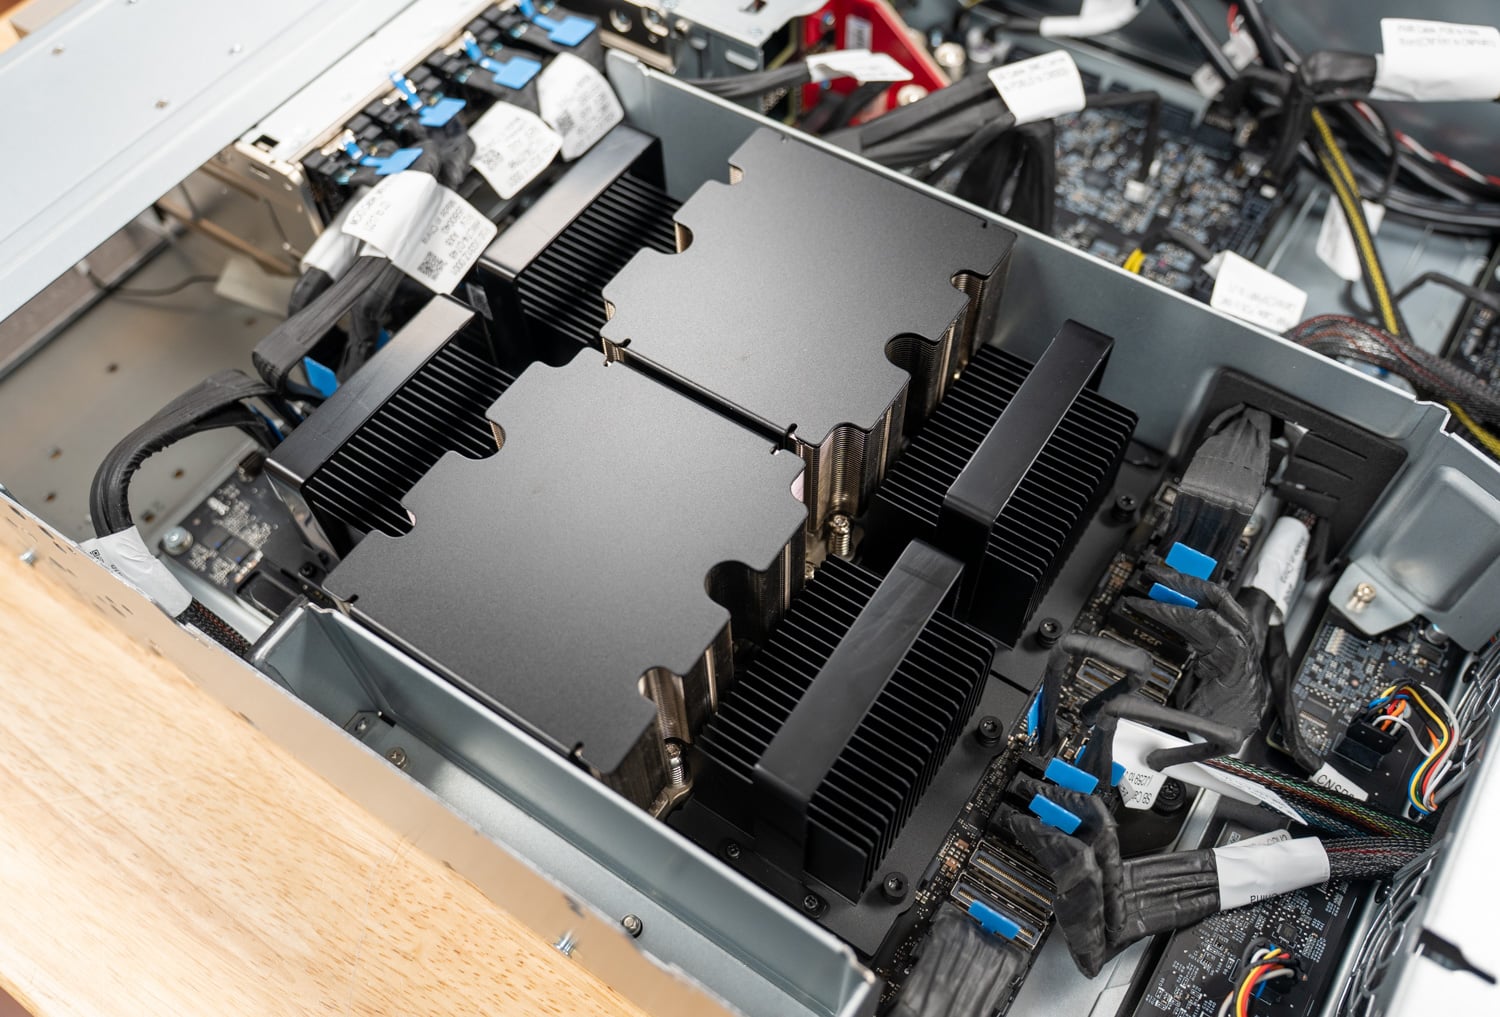
Ons testexemplaar is de NVIDIA MGX Vera C2, een dual-socket, luchtgekoelde 2U referentieserver die door NVIDIA's partners als basis wordt gebruikt voor hun eerste Vera-systemen. Acht E1.S-bays bevinden zich aan de bovenkant van het voorpaneel, naast vier hot-swap Delta-voedingen, terwijl de rest van het frontpaneel is voorzien van een honingraatvormige luchtinlaat. Omdat de voedingen aan de voorkant worden geplaatst, blijft de achterkant vrij voor I/O-bekabeling in een rack en is deze gereserveerd voor de PCIe-risers en management-I/O.
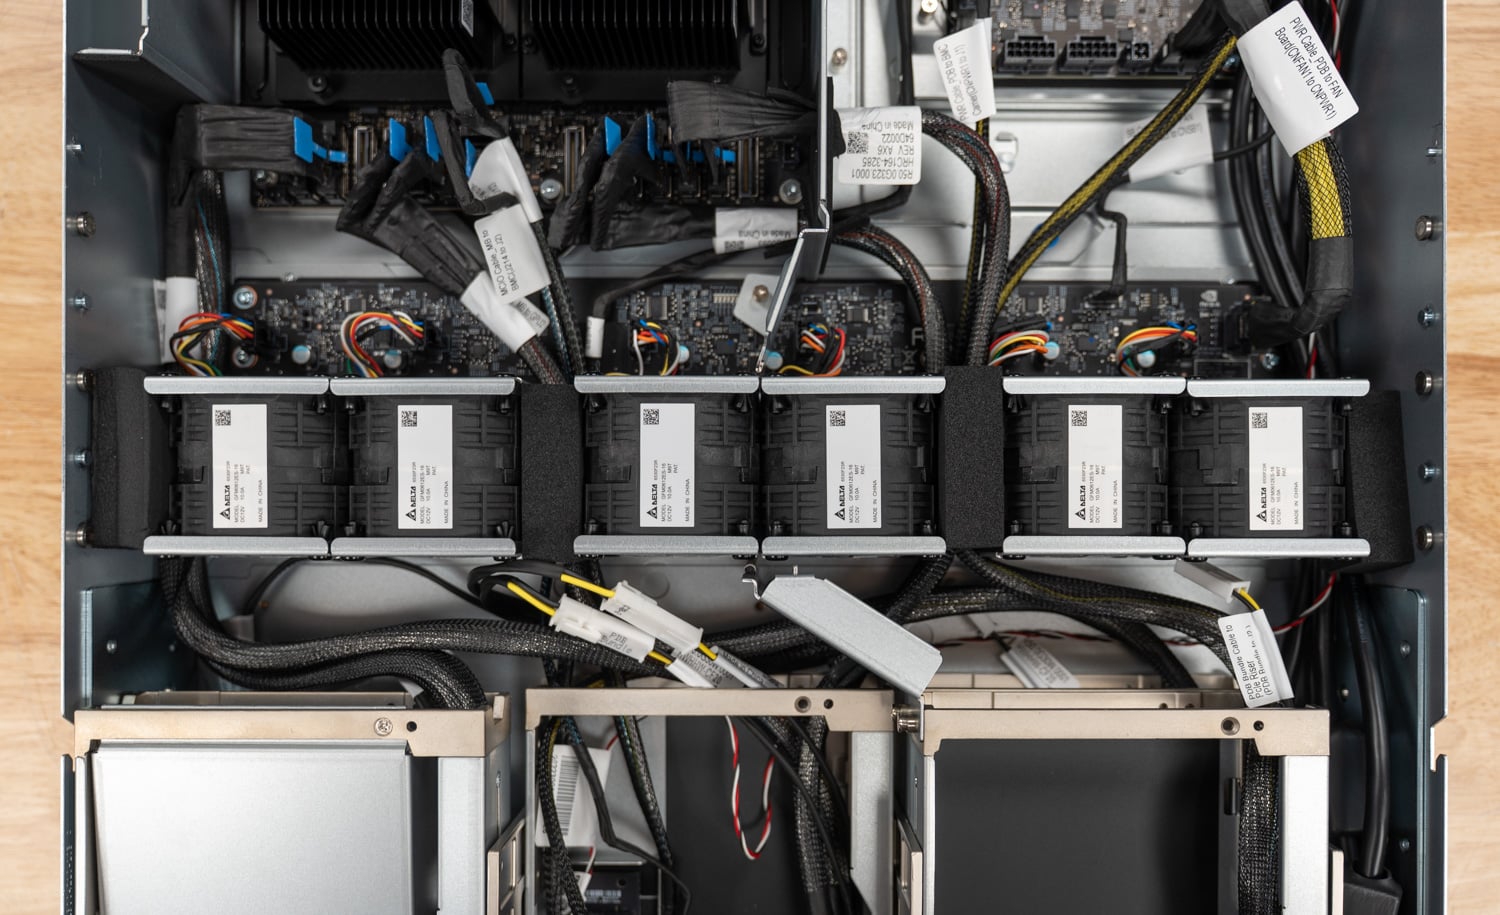
Binnenin bevinden de twee Vera CPU's zich naast elkaar onder passieve koelplaten, met SOCAMM2-modules aan weerszijden. Een wand met zes ventilatormodules in het midden van de behuizing, net achter de schijfcompartimenten, zuigt lucht over beide sockets, en schuimblokken tussen elk paar ventilatoren richten de luchtstroom. Vanuit koelingsoogpunt is de lay-out goed doordacht.
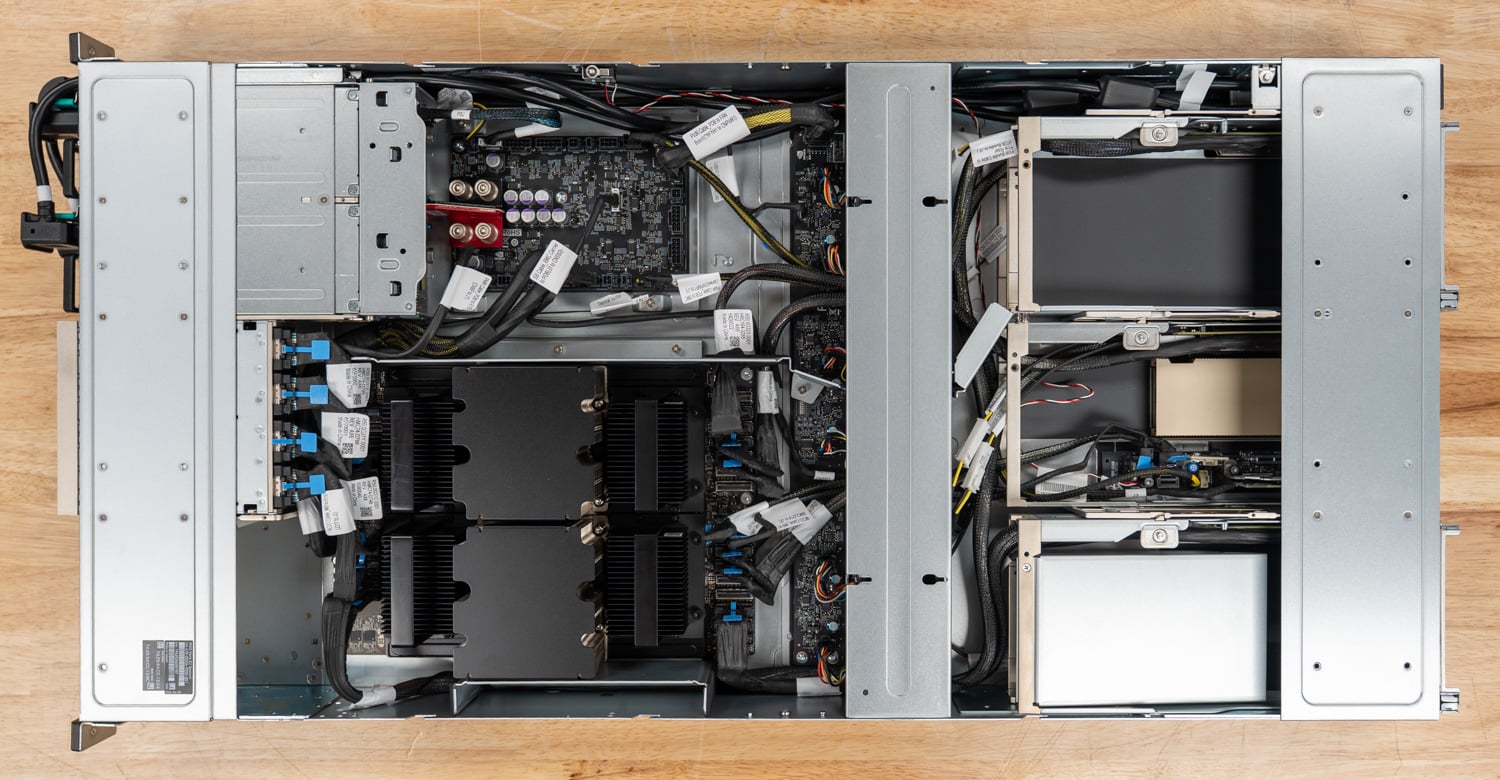
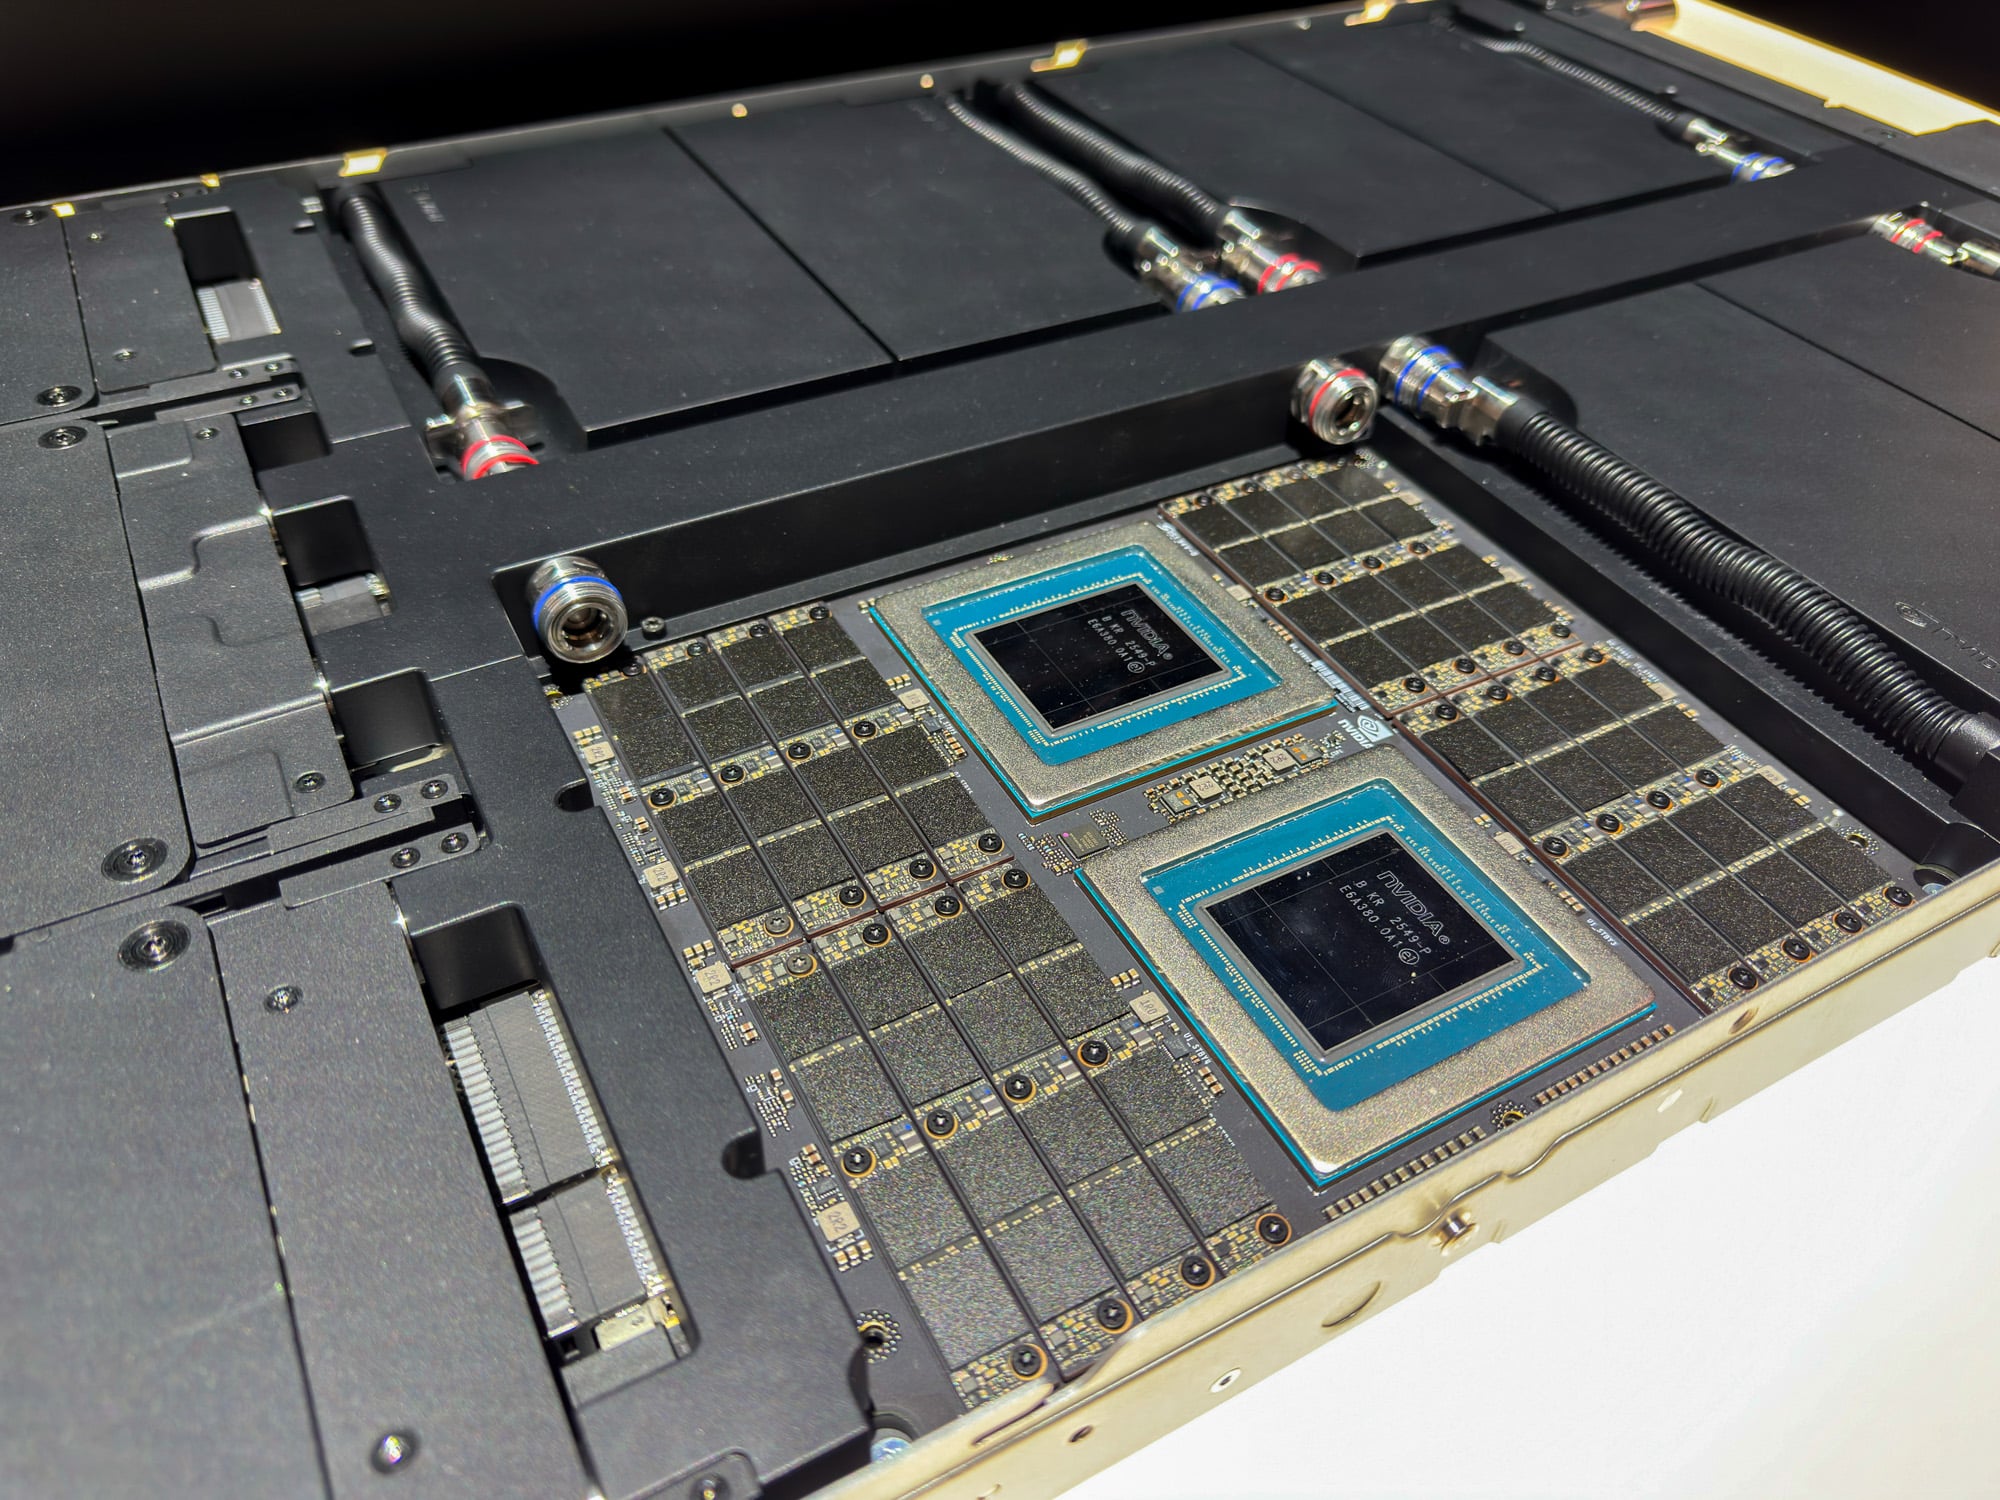
Beide processors zijn direct op de printplaat gemonteerd zonder socket, net zoals NVIDIA Vera in zijn superchips integreert. De 16 SOCAMM2-slots omringen de twee modules, waardoor het geheugen in het veld vervangbaar blijft, ook al zijn de processors dat niet; het vervangen van een CPU betekent het vervangen van de hele printplaat. Afgelopen zomer hebben we ook de vloeistofgekoelde versie van dezelfde printplaat bekeken, waarbij koelvloeistofleidingen met snelkoppelingen over de bovenkant van de printplaat naar de koelplaten van de processors lopen, terwijl de SOCAMM2-modules luchtgekoeld blijven.
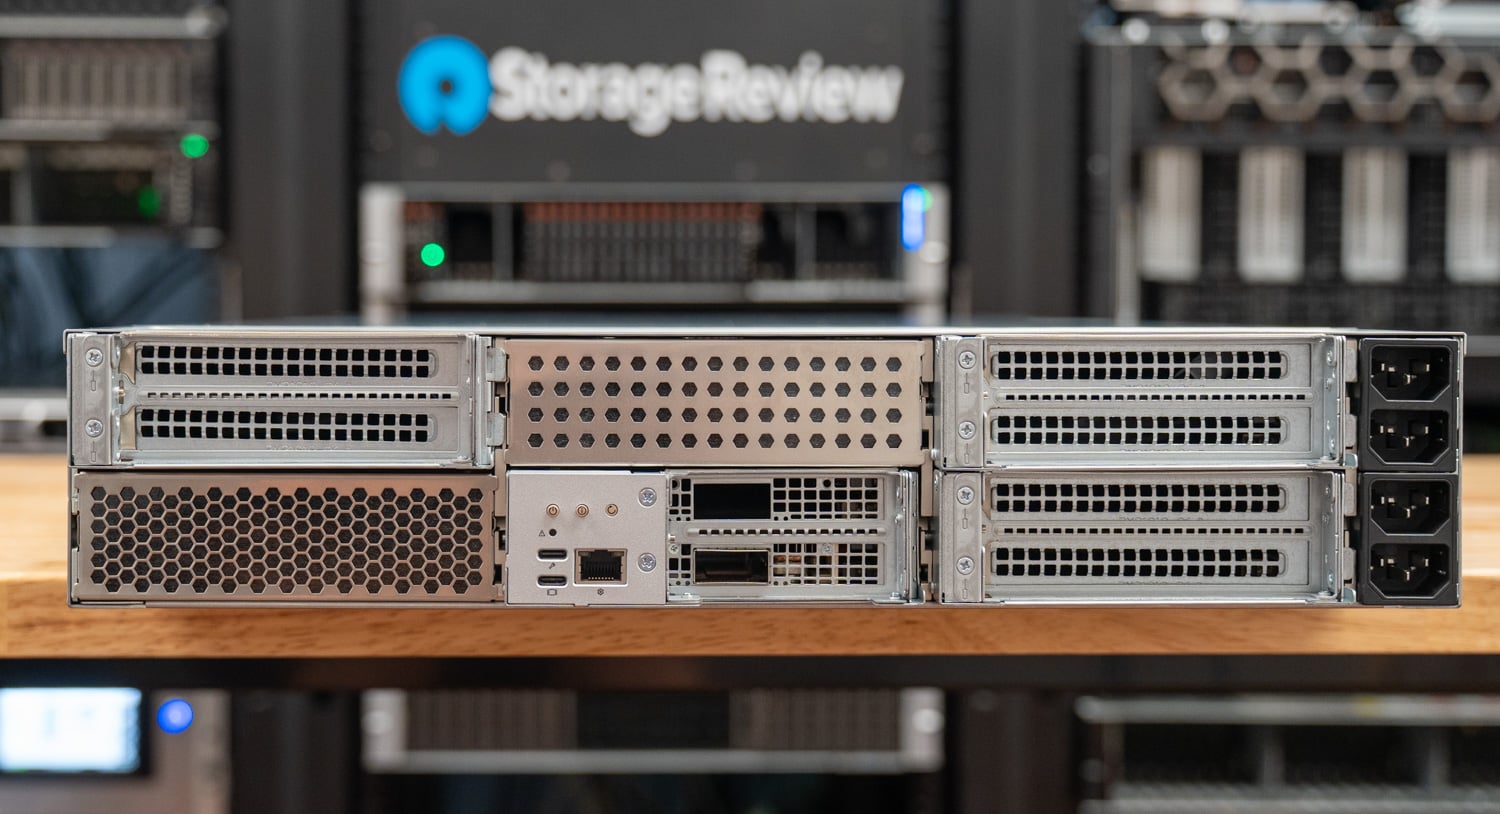
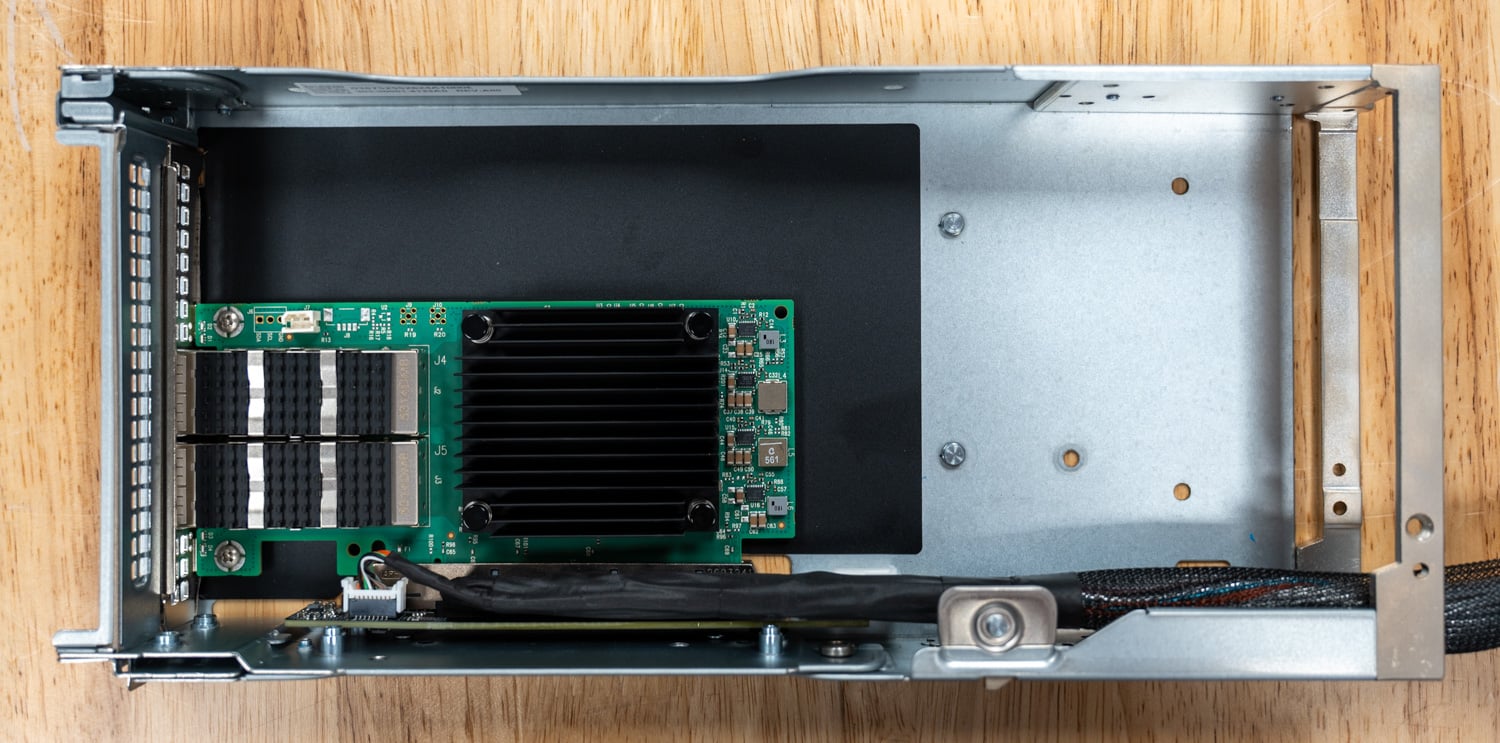
De middelste verhoging bevat een NVIDIA ConnectX-8-adapter voor netwerken tot 800G, en het achterpaneel is voorzien van USB-, DisplayPort- en een speciale netwerkpoort voor out-of-band beheer.
Het platform is zeer modulair en ondersteunt een reeks opslag- en PCIe-configuraties aan de achterzijde, maar die flexibiliteit gaat ten koste van de onderhoudstijd. De drie FHFL PCIe-risers lijken op het eerste gezicht gemakkelijk te onderhouden. In een typische server betekent het vervangen van een kaart dat je de riser losmaakt, een steunlipje uitklapt of een schroef verwijdert en de kaart eruit schuift.
Bij de Vera-server moet je eerst de ventilatorkap verwijderen, een of meer schuimblokken loskoppelen en de stroom- en PCIe-kabels van de riser loskoppelen en eruit tillen. Pas dan kan de complete riser-module via de achterkant van de behuizing naar buiten worden geschoven. Zodra de sled los is, moet deze worden gedemonteerd om bij de videokaart te komen en vervolgens weer in elkaar worden gezet na de vervanging. Een klus die bij een conventionele server slechts enkele seconden duurt, kost hier 5 tot 10 minuten per sled.
In de praktijk is onderhoud in het serverrack niet mogelijk, tenzij je bereid bent om de server heen en weer te verplaatsen. Daarom vereist het vervangen van de meeste componenten dat de server naar een werkbank wordt verplaatst voor onderhoud.
Prestaties en benchmarks
De benchmarks onderzoeken hoe het ontwerp van Vera zich vertaalt in prestaties, van individuele threads tot workloads die het volledige systeem gebruiken. Onze tests omvatten geheugenbandbreedte en -latentie, wetenschappelijke berekeningen, algemene software en databases, en laten zien hoe de processor omgaat met verschillende eisen aan zijn cores en geheugensysteem.
Testsystemen
| Systeem | NVIDIA MGX Vera C2 | Dell PowerEdge R7725 | Dell PowerEdge R7725 | Dell PowerEdge R770AP | Dell PowerEdge R770 | Dell PowerEdge R760 |
|---|---|---|---|---|---|---|
| Processoren | ||||||
| CPU | NVIDIA Vera | AMD EPYC 9965 | AMD EPYC9175F | Intel Xeon 6978P | Intel Xeon 6787P | Intel Xeon platina 8592+ |
| Sockets | 2 | |||||
| Kernen / Threads per CPU | 88 / 176 | 192 / 384 | 16 / 32 | 120 / 240 | 86 / 172 | 64 / 128 |
| Basis klok | 3.4 GHz | 2.25 GHz | 4.2 GHz | 2.1 GHz | 2.0 GHz | 1.9 GHz |
| Max Clock | 3.4 GHz | 3.7 GHz | 5.0 GHz | 3.9 GHz | 3.8 GHz | 3.9 GHz |
| Geheugen | ||||||
| Configuratie | 16x 96GB Micron SOCAMM2 | 24x 128GB | 24x 64GB | 32x 64GB | 16x 64GB | |
| Type / Snelheid | LPDDR5X-9600 | DDR5-6400 | DDR5-5200 | DDR5-4800 | ||
| Totale capaciteit | 1.5TB | 3TB | 1.5TB | 2TB | 1TB | |
| Opslag | ||||||
| SSD | Solidigm D7-PS1010 7.68 TB | Solidigm D7-PS1030 12.8 TB | Micron 9550 PRO 7.68 TB | Solidigm D7-PS1010 7.68 TB | Samsung PM1745 6.4TB | Solidigm D7-P5520 3.84 TB |
| SSD-link | PCIe Gen5 x4 | PCIe Gen5 x2 | PCIe Gen5 x4 | PCIe Gen4 x4 | ||
| firmware | ||||||
| Systeem-BIOS | NV_SBIOS 06.07.01.06 | 1.5.3 | 1.2.1 | 1.8.5 | 2.8.2 | |
| BIOS-profiel | Standaard | Prestaties | ||||
| Software-stack | ||||||
| OS | Ubuntu LTS 26.04.1 | Ubuntu LTS 24.04.5 | ||||
| pit | 7.0.0-2022-nvidia-bos | 6.8.0 142 / 6.8.0 146 | 6.8.0-147 | 6.8.0-138 | 6.8.0 142 / 6.8.0 146 | 6.8.0 142 / 6.8.0 146 |
| GCC | 15.2.0 | 13.3.0 | ||||
| glibc | 2.43 | 2.39 | ||||
| Open MPI | 5.0.10 | 4.1.6 | ||||
| OpenJDK | 11.0.32 | |||||
We hebben Vera vergeleken met vijf Dell PowerEdge-configuraties met een ideale geheugenconfiguratie en deze getest met dezelfde testsuite, waaronder AMD's EPYC-processors met het hoogste aantal cores en geoptimaliseerde frequenties, evenals Xeon-processors van de huidige en vorige generatie.
Omdat Olympus-ondersteuning pas in GCC 15 beschikbaar kwam, draaide Vera een nieuwere softwarestack dan de x86-systemen, zoals hierboven vermeld. Benchmarkversies, invoerbronnen en build-vlaggen waren verder identiek op alle systemen.
Geheugenbandbreedte
Het geheugen is waar Vera het meest afwijkt van x86, dus daar beginnen we onze tests. We hebben STREAM Triad getest, uitgevoerd met één OpenMP-thread per fysieke core op arrays van 16 GiB. De hoofdtest gebruikt alle cores in het systeem, waarbij de data van elke thread op dezelfde socket wordt geplaatst. Vervolgens herhalen we dit met de cores van socket 0 die eerst hun lokale geheugen lezen en daarna het geheugen van de externe socket, en met elke core die pagina's afwisselend over beide sockets leest. De onderstaande grafiek toont de Triad-resultaten voor het hele systeem voor elke server met SMT uitgeschakeld.
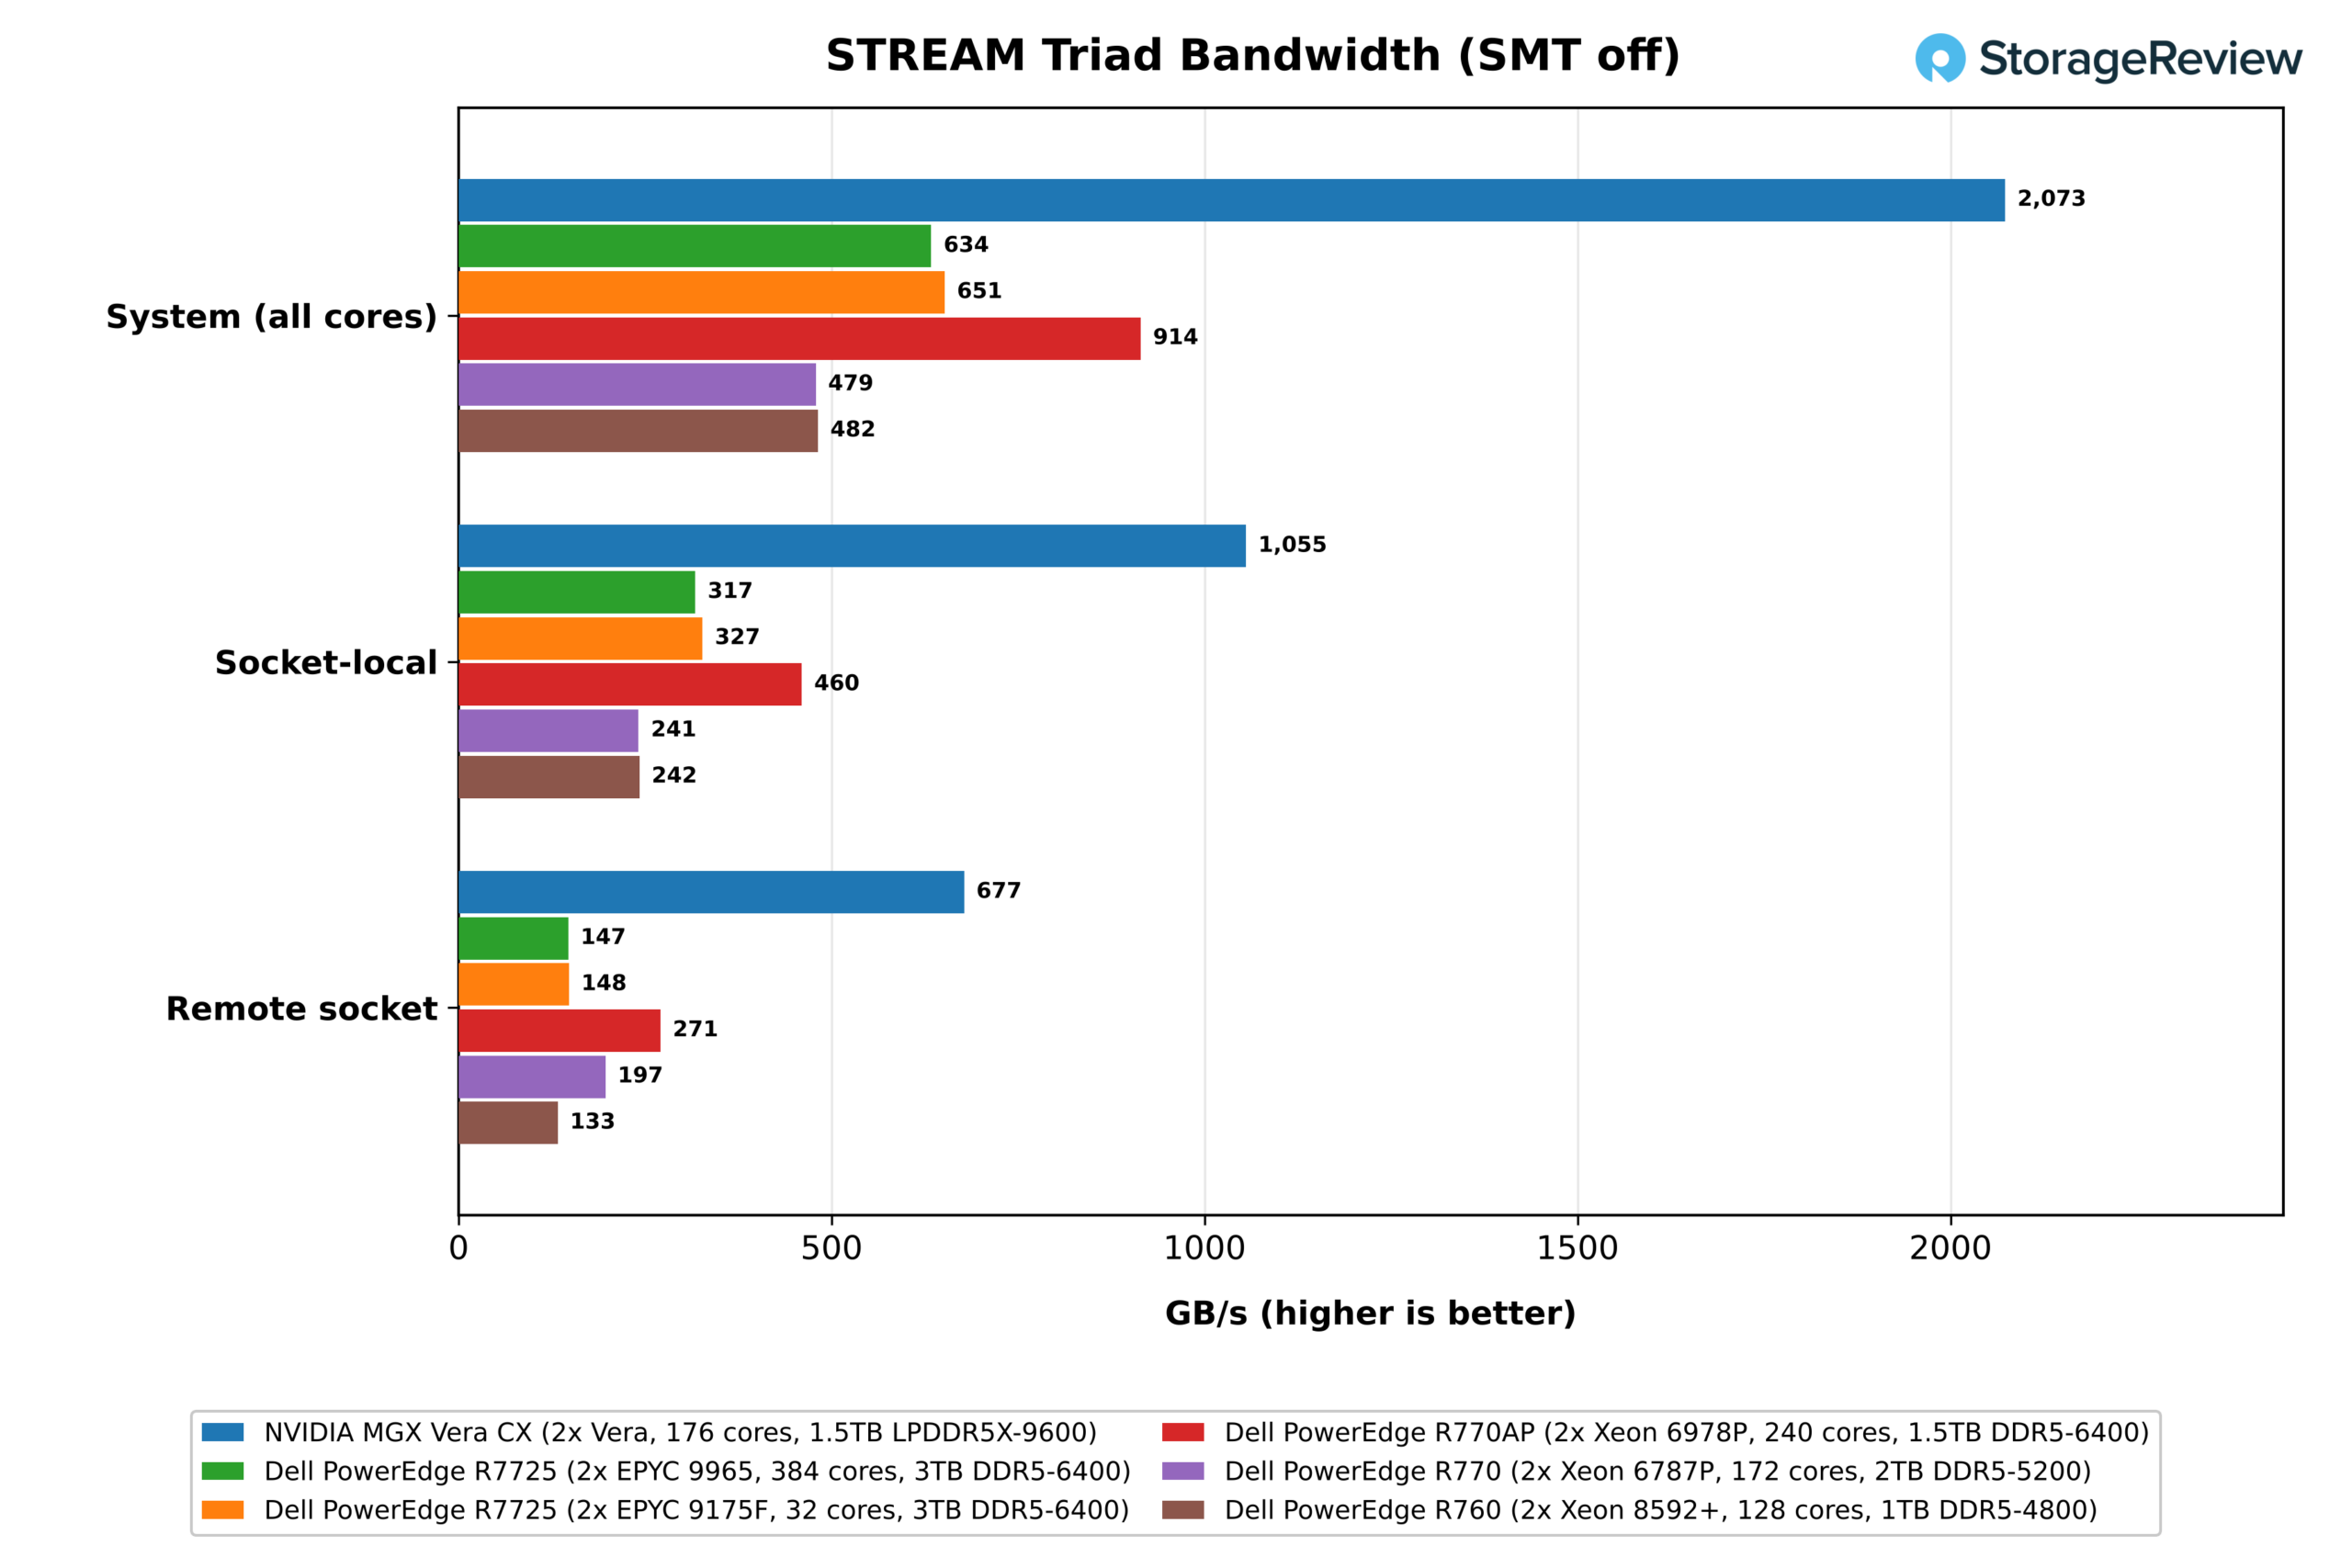
Vera haalde een doorvoersnelheid van 2,073 GB/s, 86% van zijn nominale snelheid van 2.4 TB/s met twee sockets. Het dichtstbijzijnde x86-systeem was de Xeon 6978P, waarvan de 24 kanalen DDR5-6400 914 GB/s leverden, 74% van zijn theoretische piek van 1,229 GB/s, wat Vera een voorsprong van 2.3 keer gaf. De twee EPYC-systemen draaiden ook op 24 kanalen DDR5-6400, maar bleven daar ver onder: 651 GB/s voor de 32-core 9175F en 634 GB/s voor de 384-core 9965, slechts 52% van de piek en een voorsprong van 3.3 keer op Vera. Tot slot blijven de Xeon 6787P en 8592+ achter bij de rest, met tragere DDR5-5200 en DDR5-4800 geheugen, en halen ze snelheden van respectievelijk 479 GB/s en 482 GB/s.
Een deel van het tekort van EPYC komt voort uit de manier waarop STREAM het verkeer telt. De suite bouwt STREAM met standaard GCC, dat geen streaming stores genereert. Daardoor leest een store die de cache mist eerst de bestemmingsregel uit het geheugen. STREAM telt die leesbewerking niet mee, wat betekent dat Triad het verplaatste verkeer met een kwart onderschat, waar dit ook gebeurt. AMD's Zen-cores ondervinden dit bij elke store. Arm-cores zoals NVIDIA's eerdere Grace detecteren schrijfbewerkingen over een volledige regel en slaan de leesbewerking over, en Intel's recente Xeons kunnen het grootste deel ervan overslaan wanneer het geheugen zwaar belast is.
De aparte Phoronix Test Suite-build van STREAM wijst in dezelfde richting. Met SMT uitgeschakeld bereikte het kopieerresultaat 832 GB/s op de 9965 en 873 GB/s op de 9175F, ongeveer 1.5 keer de 551 GB/s en 570 GB/s van de suite-build, en in lijn met de winst die Copy zou moeten behalen zodra de extra leesbewerking is weggevallen; op de Xeons lagen de twee builds binnen 9% van elkaar.
Gecorrigeerd voor de niet-getelde leesbewerkingen verplaatste de 9965 ongeveer 845 GB/s, ru约 69% van de pieksnelheid, en de voorsprong van Vera in verplaatste bytes neemt af tot ongeveer 2.5x. De 6978P vereist veel minder correctie, waardoor de 2.3x de meest conservatieve vergelijking in de set is.
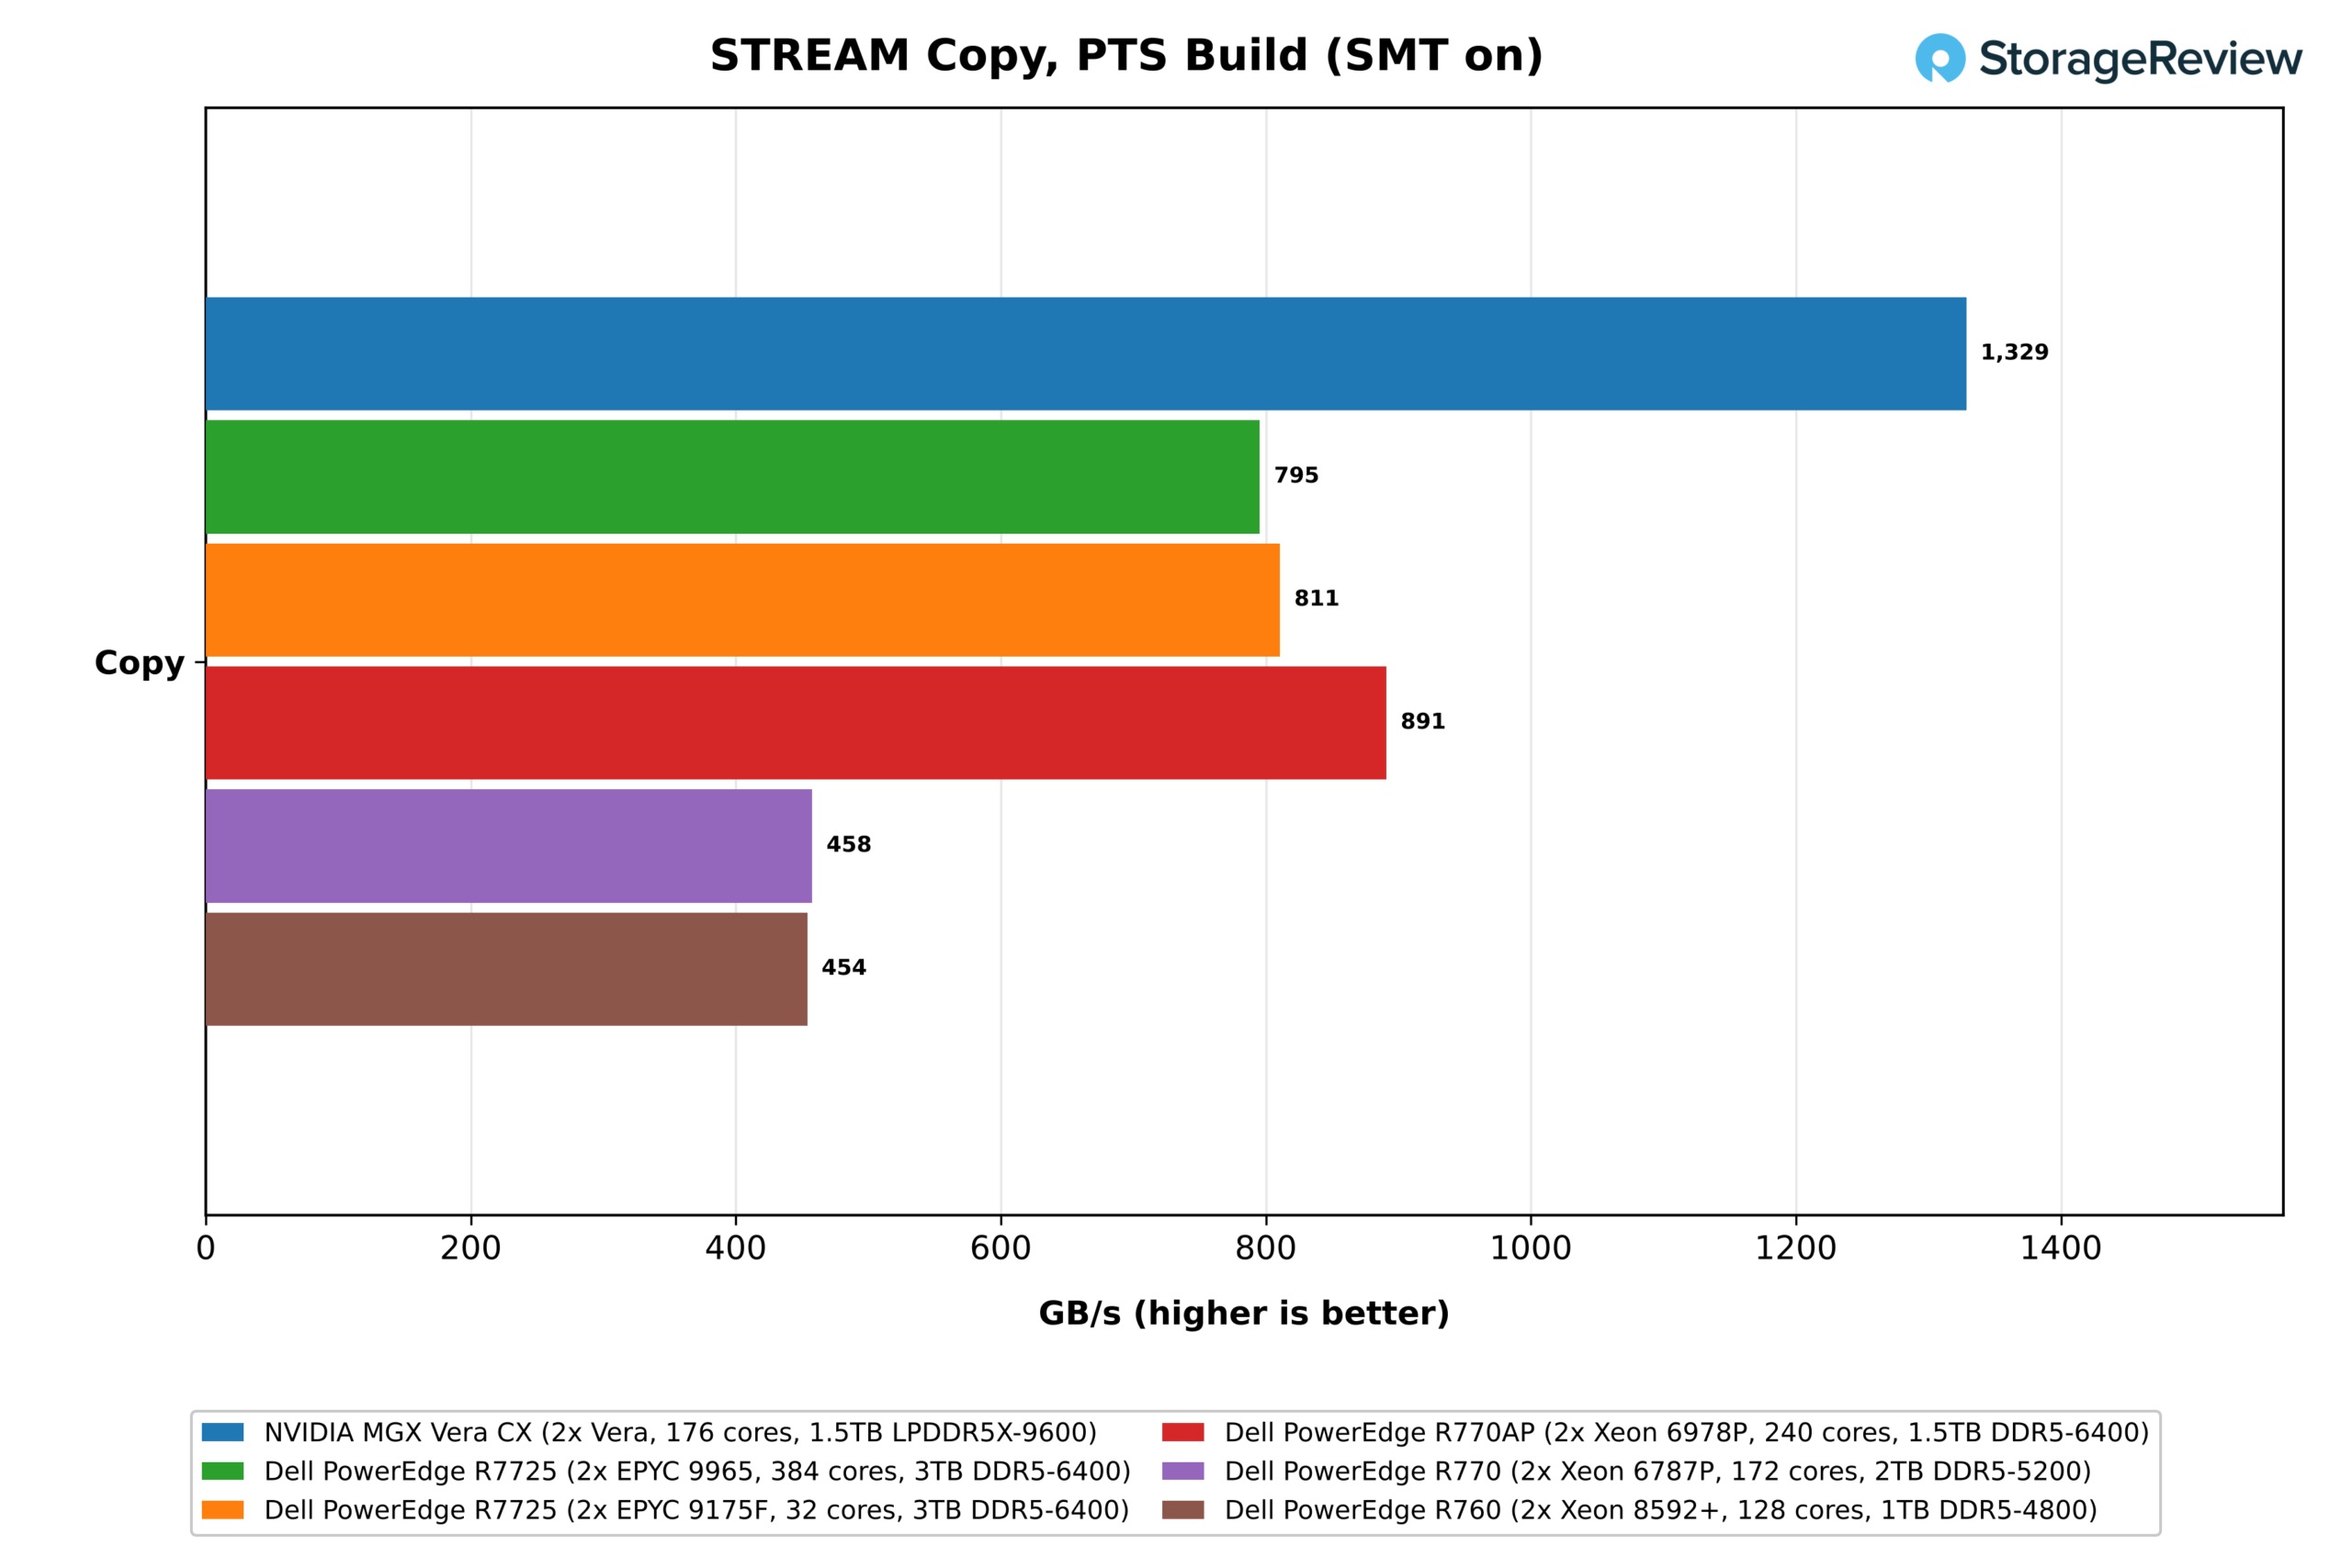
Door de test op te splitsen per socket wordt duidelijk hoe de fabric omgaat met data die niet lokaal op de cores is opgeslagen. De cores van socket 0 die lokaal geheugen lezen, halen een snelheid van 1,055 GB/s, 88% van de 1.2 TB/s per socket en meer dan elke andere x86-server in de test. Bij het lezen van het geheugen van de andere socket via NVLink-C2C haalden dezelfde cores een snelheid van 677 GB/s, 64% van de lokale snelheid, tegenover 59% op de Xeon 6978P en 45% op de EPYC 9175F (148 GB/s op afstand tegenover 327 GB/s lokaal). Zelfs een workload die op de verkeerde socket wordt geplaatst, krijgt dus meer bandbreedte dan welke x86-socket dan ook uit het lokale geheugen leest, wat op de 6978P maximaal 460 GB/s bedraagt.
Als laatste test voor Vera hebben we getest met STREAM Triad interleaved pages over beide sockets, het geval dat een applicatie zonder NUMA-ondersteuning ziet. Dit leverde Vera een snelheid op van 1,372 GB/s, 1.5 keer het resultaat van het volledige systeem van de 6978P.
Wachttijd
Bandbreedte is slechts de helft van het verhaal over geheugen. Latentie bepaalt hoe lang een core wacht telkens wanneer er een cache-miss optreedt, en dit is vooral belangrijk voor code die pointers door het geheugen volgt. We meten dit met tinymembench, dat de tijd meet die nodig is voor willekeurige leesbewerkingen over een buffer van 1 GiB vanuit één thread op socket 0. De EPYC 9175F is het enige x86-systeem in onze testset met resultaten van deze test, dus die gebruiken we hier als vergelijking.
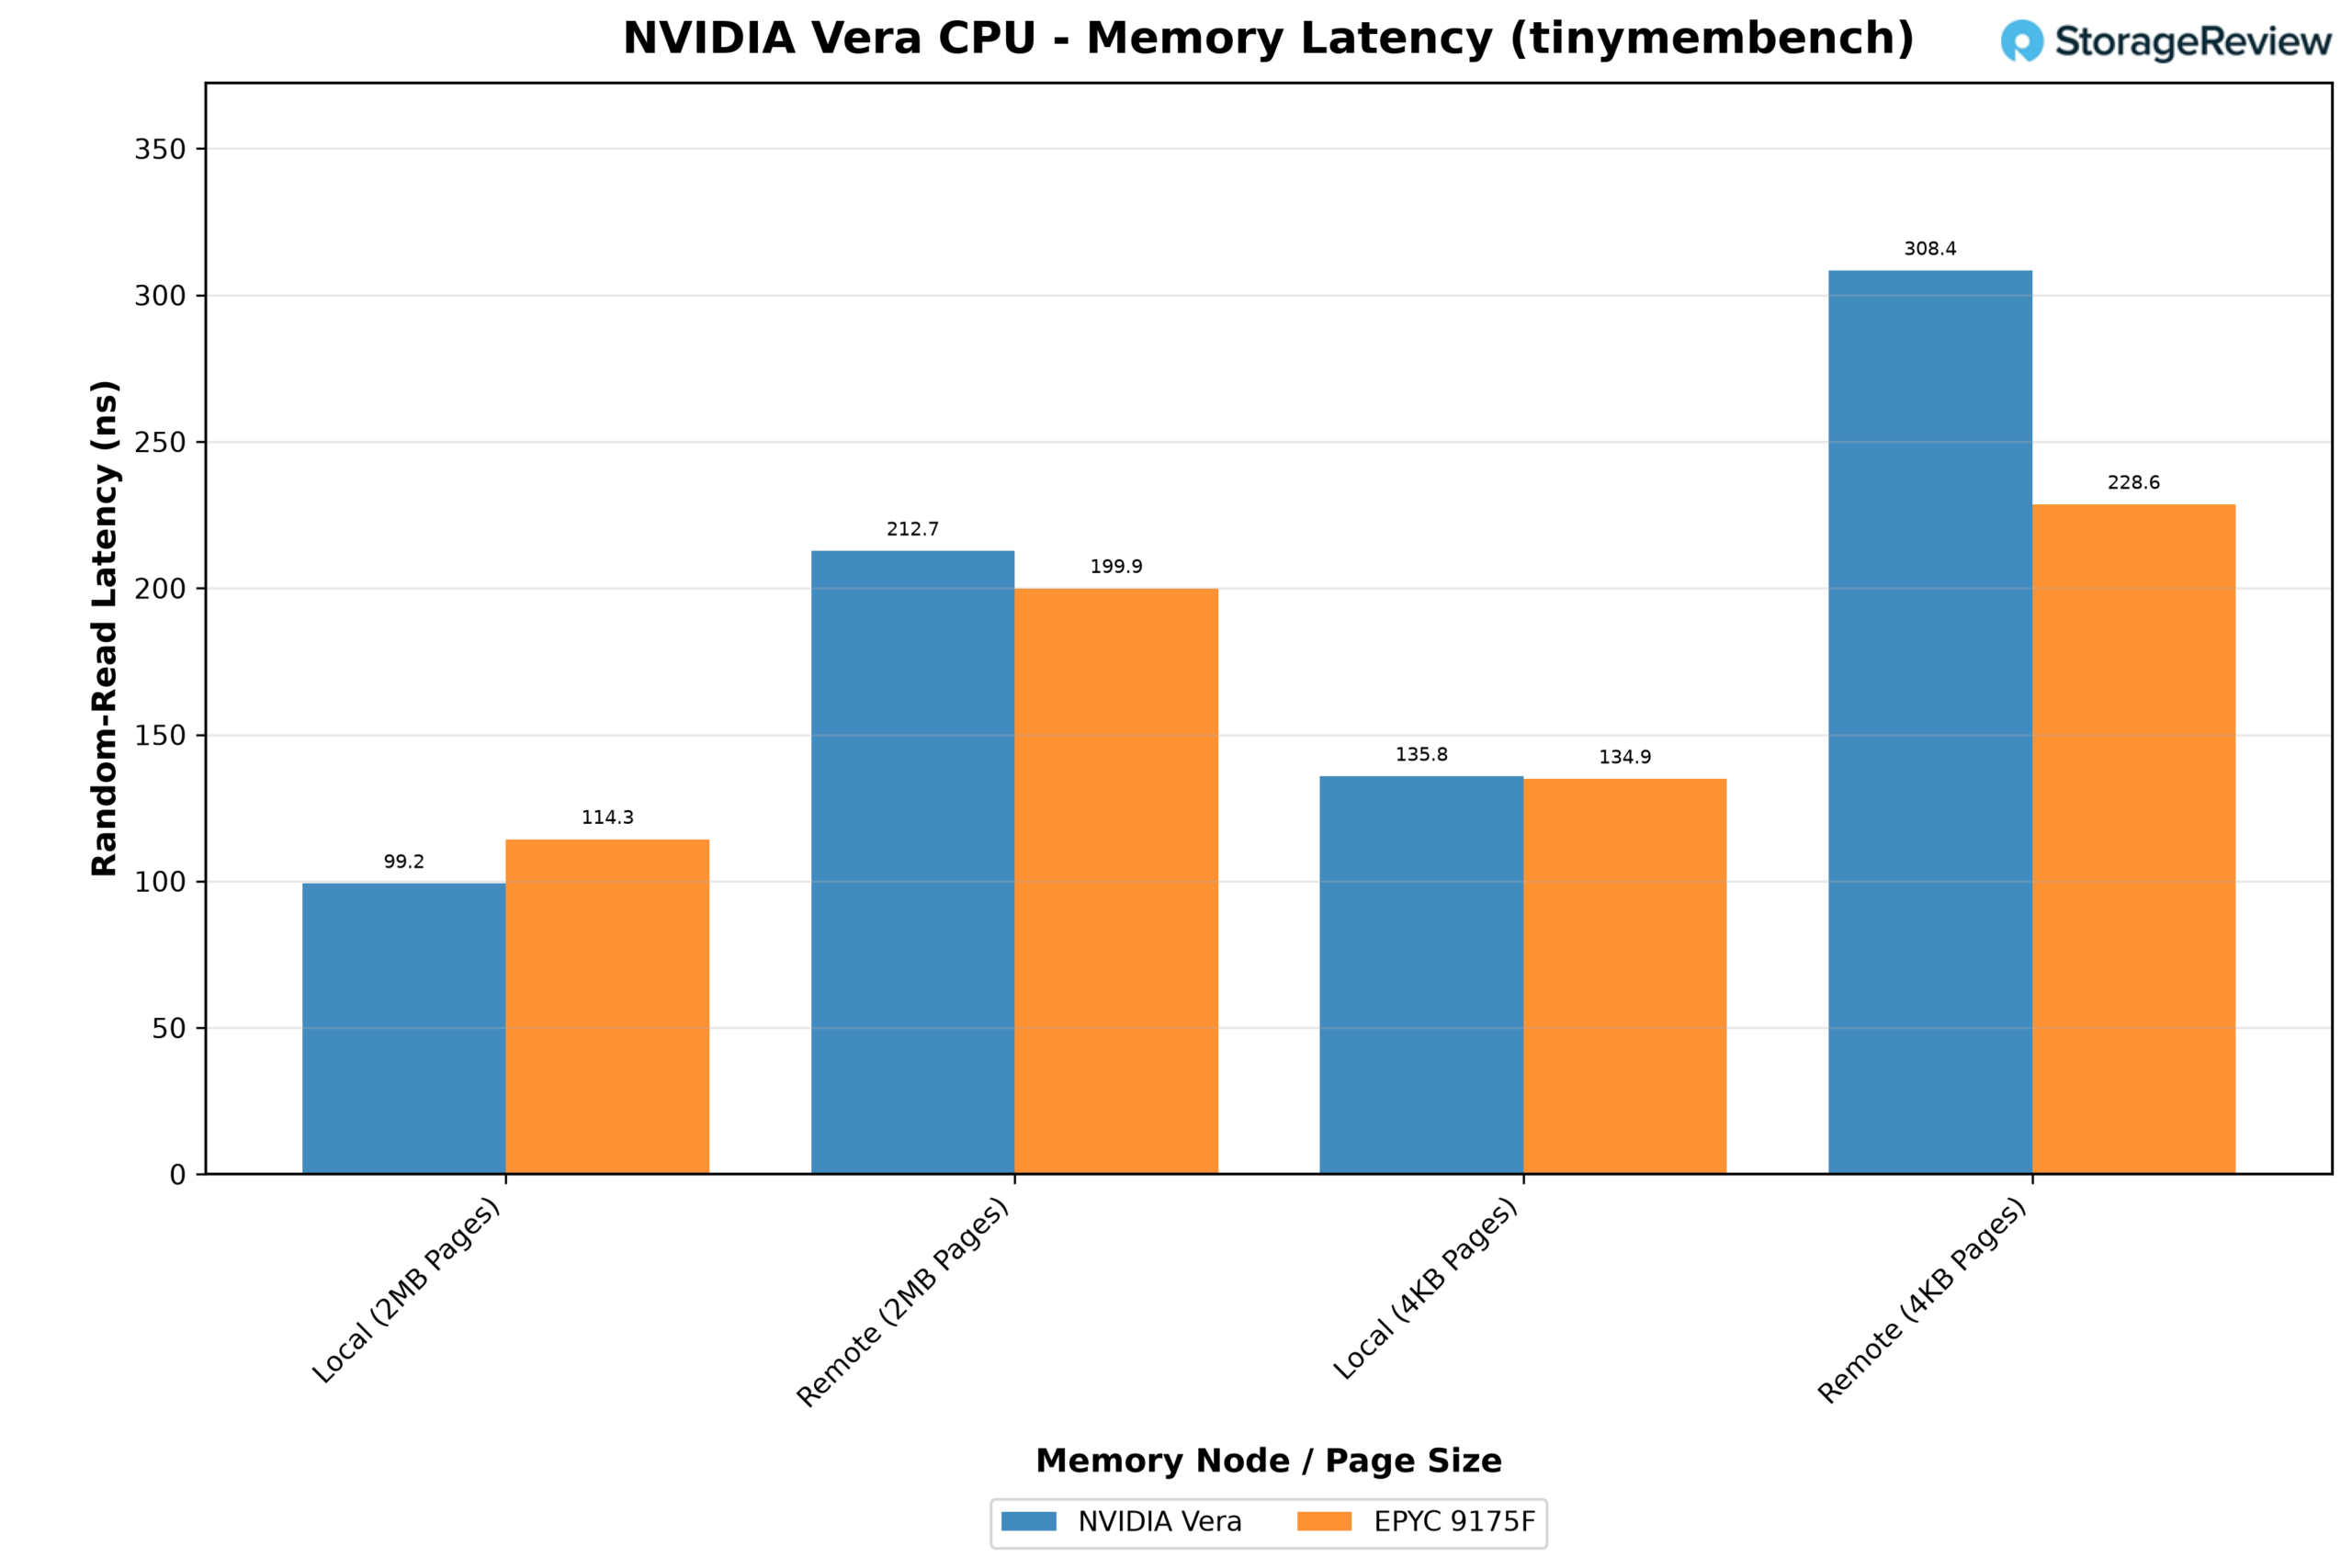
Bij het lezen van lokaal geheugen is Vera sneller dan de EPYC. Met hugepages van 2 MB duurde een lokale leesbewerking op Vera 99.2 ns, tegenover 114.3 ns op de 9175F, een verbetering van 13%. Met standaardpagina's van 4 KB waren ze gelijk, rond de 135 ns. Het bereiken van de andere socket laat echter zijn nadelen zien. Een externe leesbewerking duurde 212.7 ns op Vera, ongeveer 2.1 keer zo lang als lokaal, terwijl de 199.9 ns van de EPYC slechts 1.75 keer zo lang was.
Vera is ook gevoeliger voor paginagrootte. Bij pagina's van 4 KB, waarbij gemiste adresvertalingen elke leesbewerking beïnvloeden, steeg de lokale latentie met 37% en bereikte de externe latentie 308.4 ns, tegenover een stijging van 18% en 228.6 ns op de EPYC. Op Vera zouden we enorme pagina's gebruiken.
HPC
Bandbreedte en latentie beschrijven het geheugensysteem op zichzelf. Wetenschappelijke toepassingen laten zien wat er gebeurt wanneer dat geheugensysteem en de processorkernen moeten samenwerken, en onze twee HPC-tests zijn gebaseerd op zeer verschillende aspecten van het CPU-ontwerp.
GROMACS, een moleculaire dynamica-code, besteedt het grootste deel van zijn tijd aan vectorrekenkunde, met handmatig geschreven, tijdrovende lussen voor elke SIMD-breedte. Daarmee is het de meest directe test van de afweging die in het Olympus-gedeelte wordt beschreven: zes 128-bits SVE2-pipelines versus de 512-bits AVX-512-eenheden op de x86-onderdelen. OpenFOAM, een solver voor computationele vloeistofdynamica, werkt met grote, dunne matrices en besteedt veel tijd aan wachten op geheugen, waardoor het laat zien of de hierboven gemeten bandbreedte ook in een echte toepassing werkt.
GROMACS
We hebben GROMACS 2025.3 getest met benchPEP, een testcase met 12 miljoen atomen die over alle fysieke cores van de server is uitgevoerd. De build gebruikte ARM_SVE op Vera en AVX-512 op elk x86-systeem, en dankzij de vastgezette ingangen en uitgeschakelde PME-tuning voerde elk platform dezelfde taken uit.
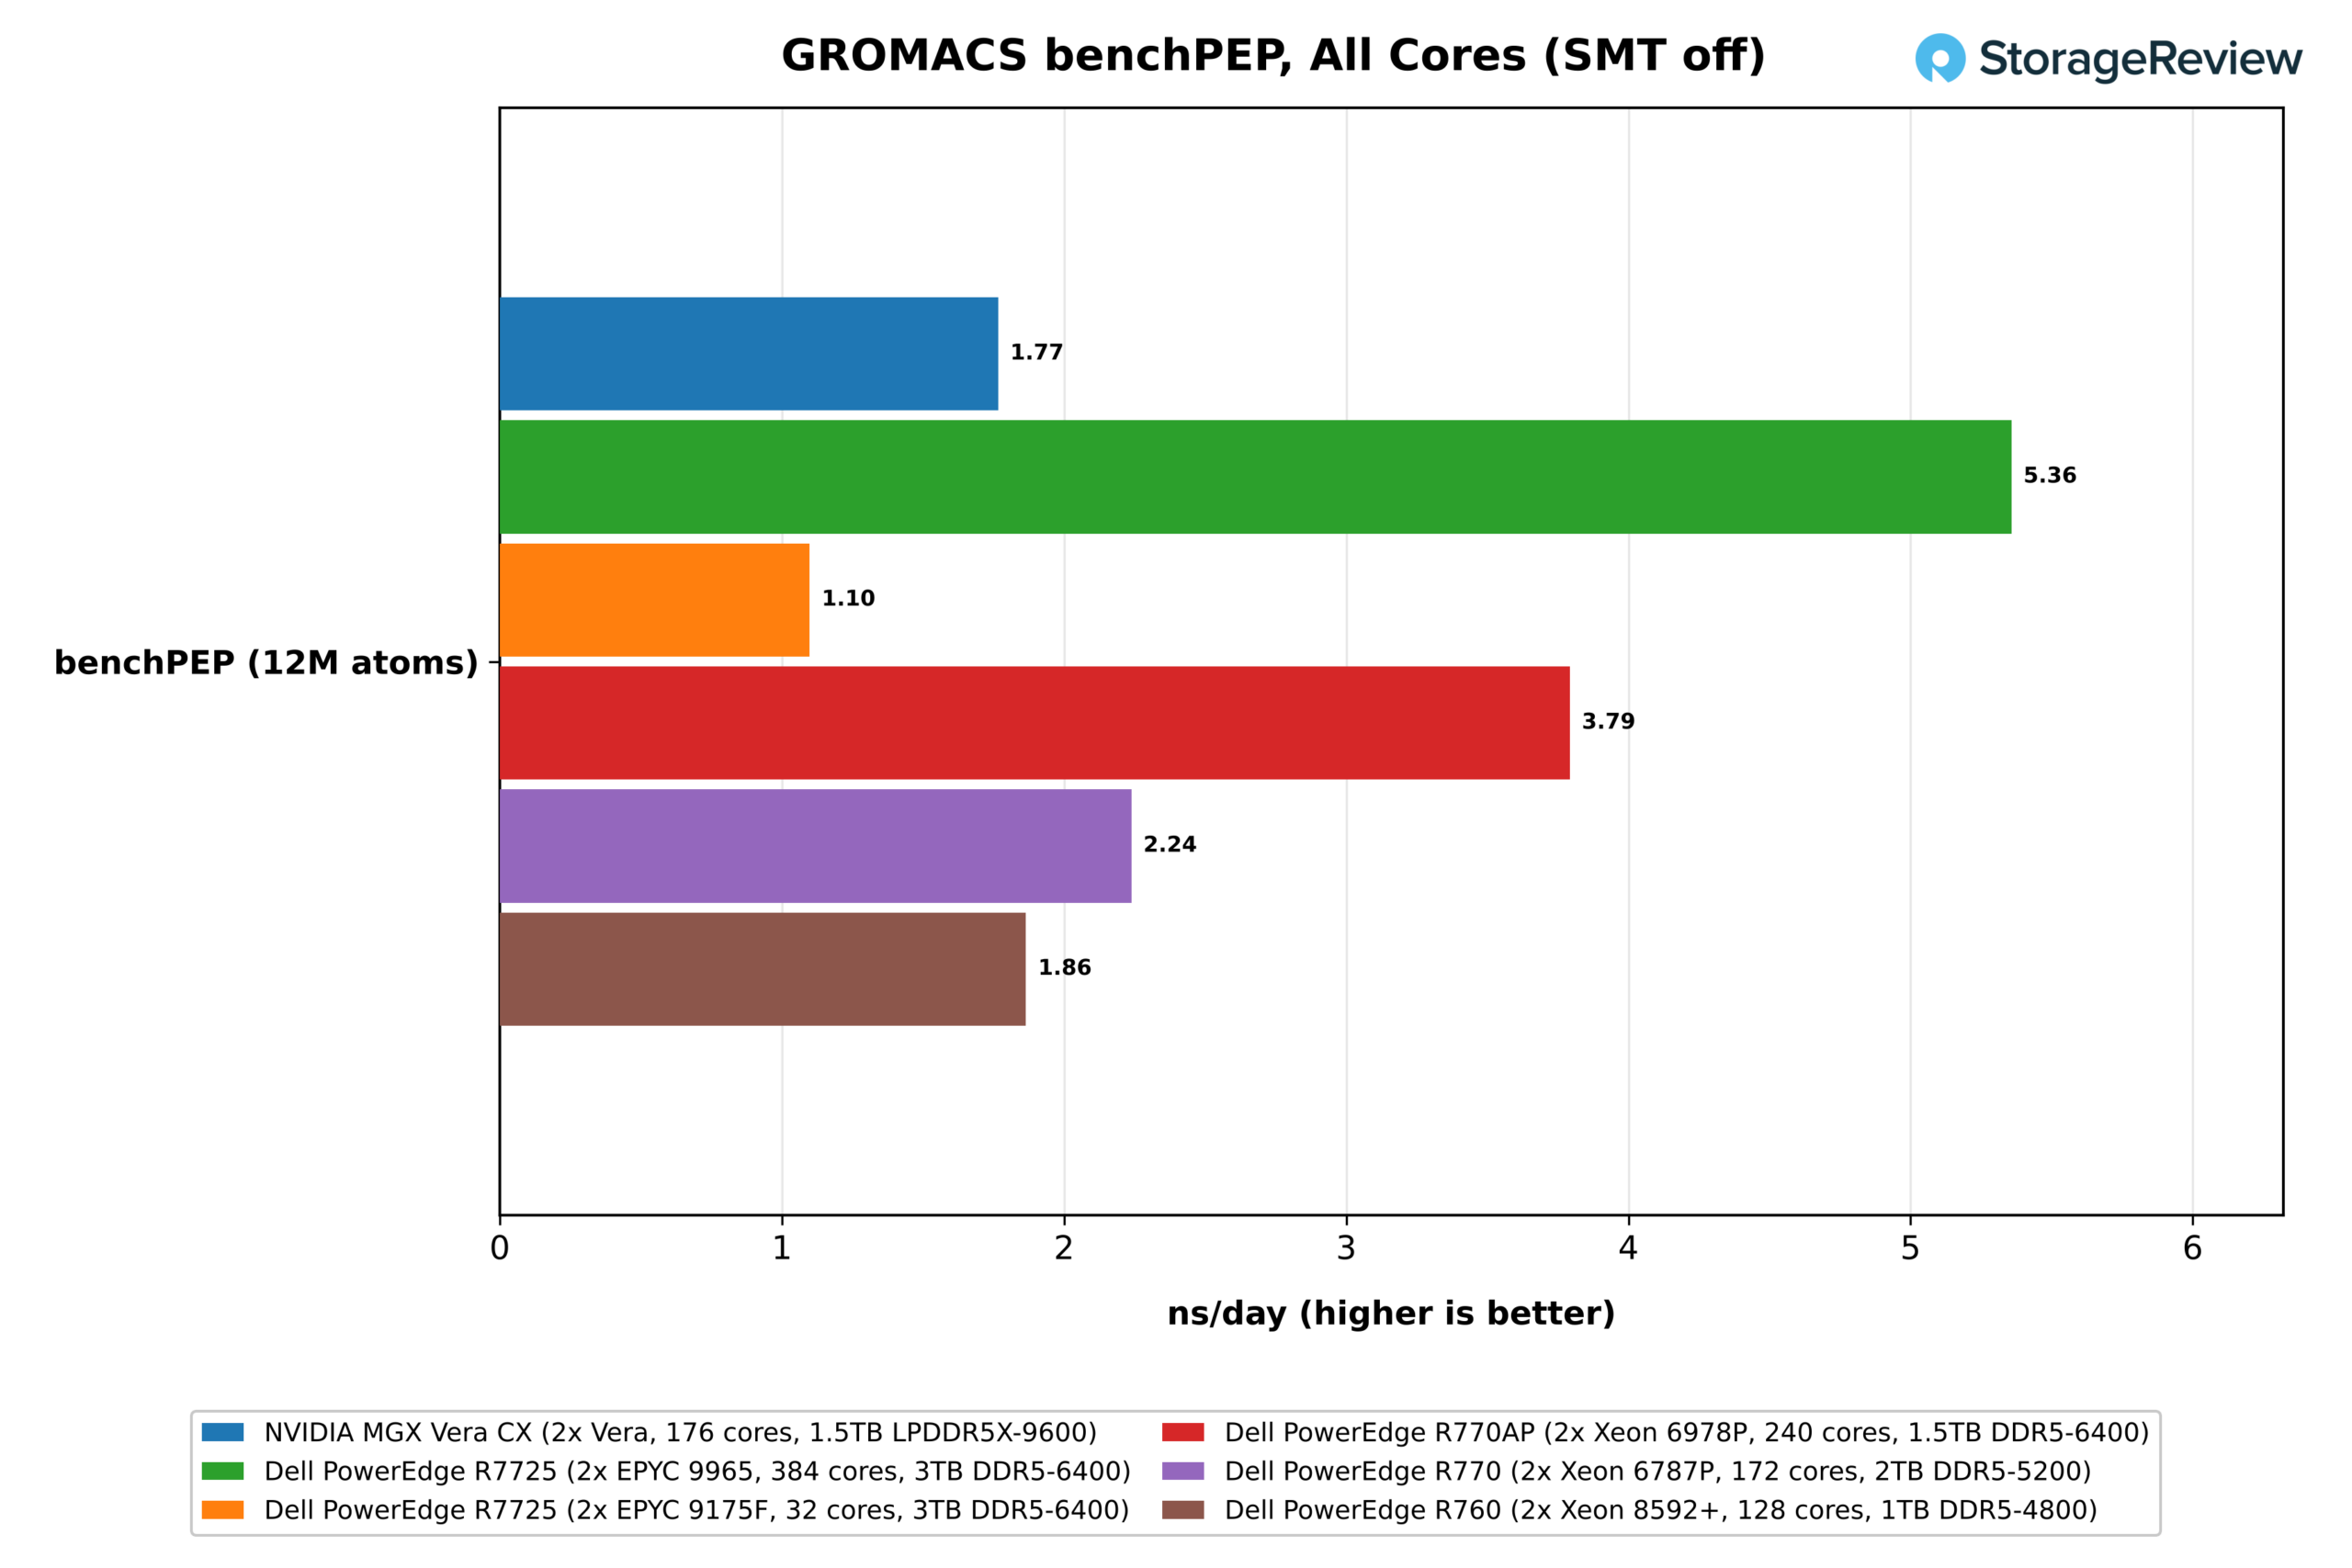
Zonder SMT voltooide Vera de benchmarkPEP-test met een tijd van 1.77 ns/dag. De 384-core EPYC 9965 was koploper met 5.36 ns/dag, 3.0x sneller dan Vera, gevolgd door de 240-core Xeon 6978P met 3.79 (2.1x) en de 172-core Xeon 6787P met 2.24 (1.27x). De 128-core Xeon 8592+ eindigde ook voor met 1.87, waardoor alleen de 32-core EPYC 9175F met 1.10 achter Vera bleef. Normalisatie op basis van het aantal cores laat zien hoeveel van dit verschil te wijten is aan de architectuur. Vera berekent een doorlooptijd van 0.0100 ns/dag per core, tegenover 0.0130 op de 6787P, 0.0140 op de 9965, 0.0146 op de 8592+ en 0.0158 op de 6978P. Het tekort ten opzichte van de grotere x86-processors is dus deels te wijten aan het aantal cores en deels aan de doorvoer per core.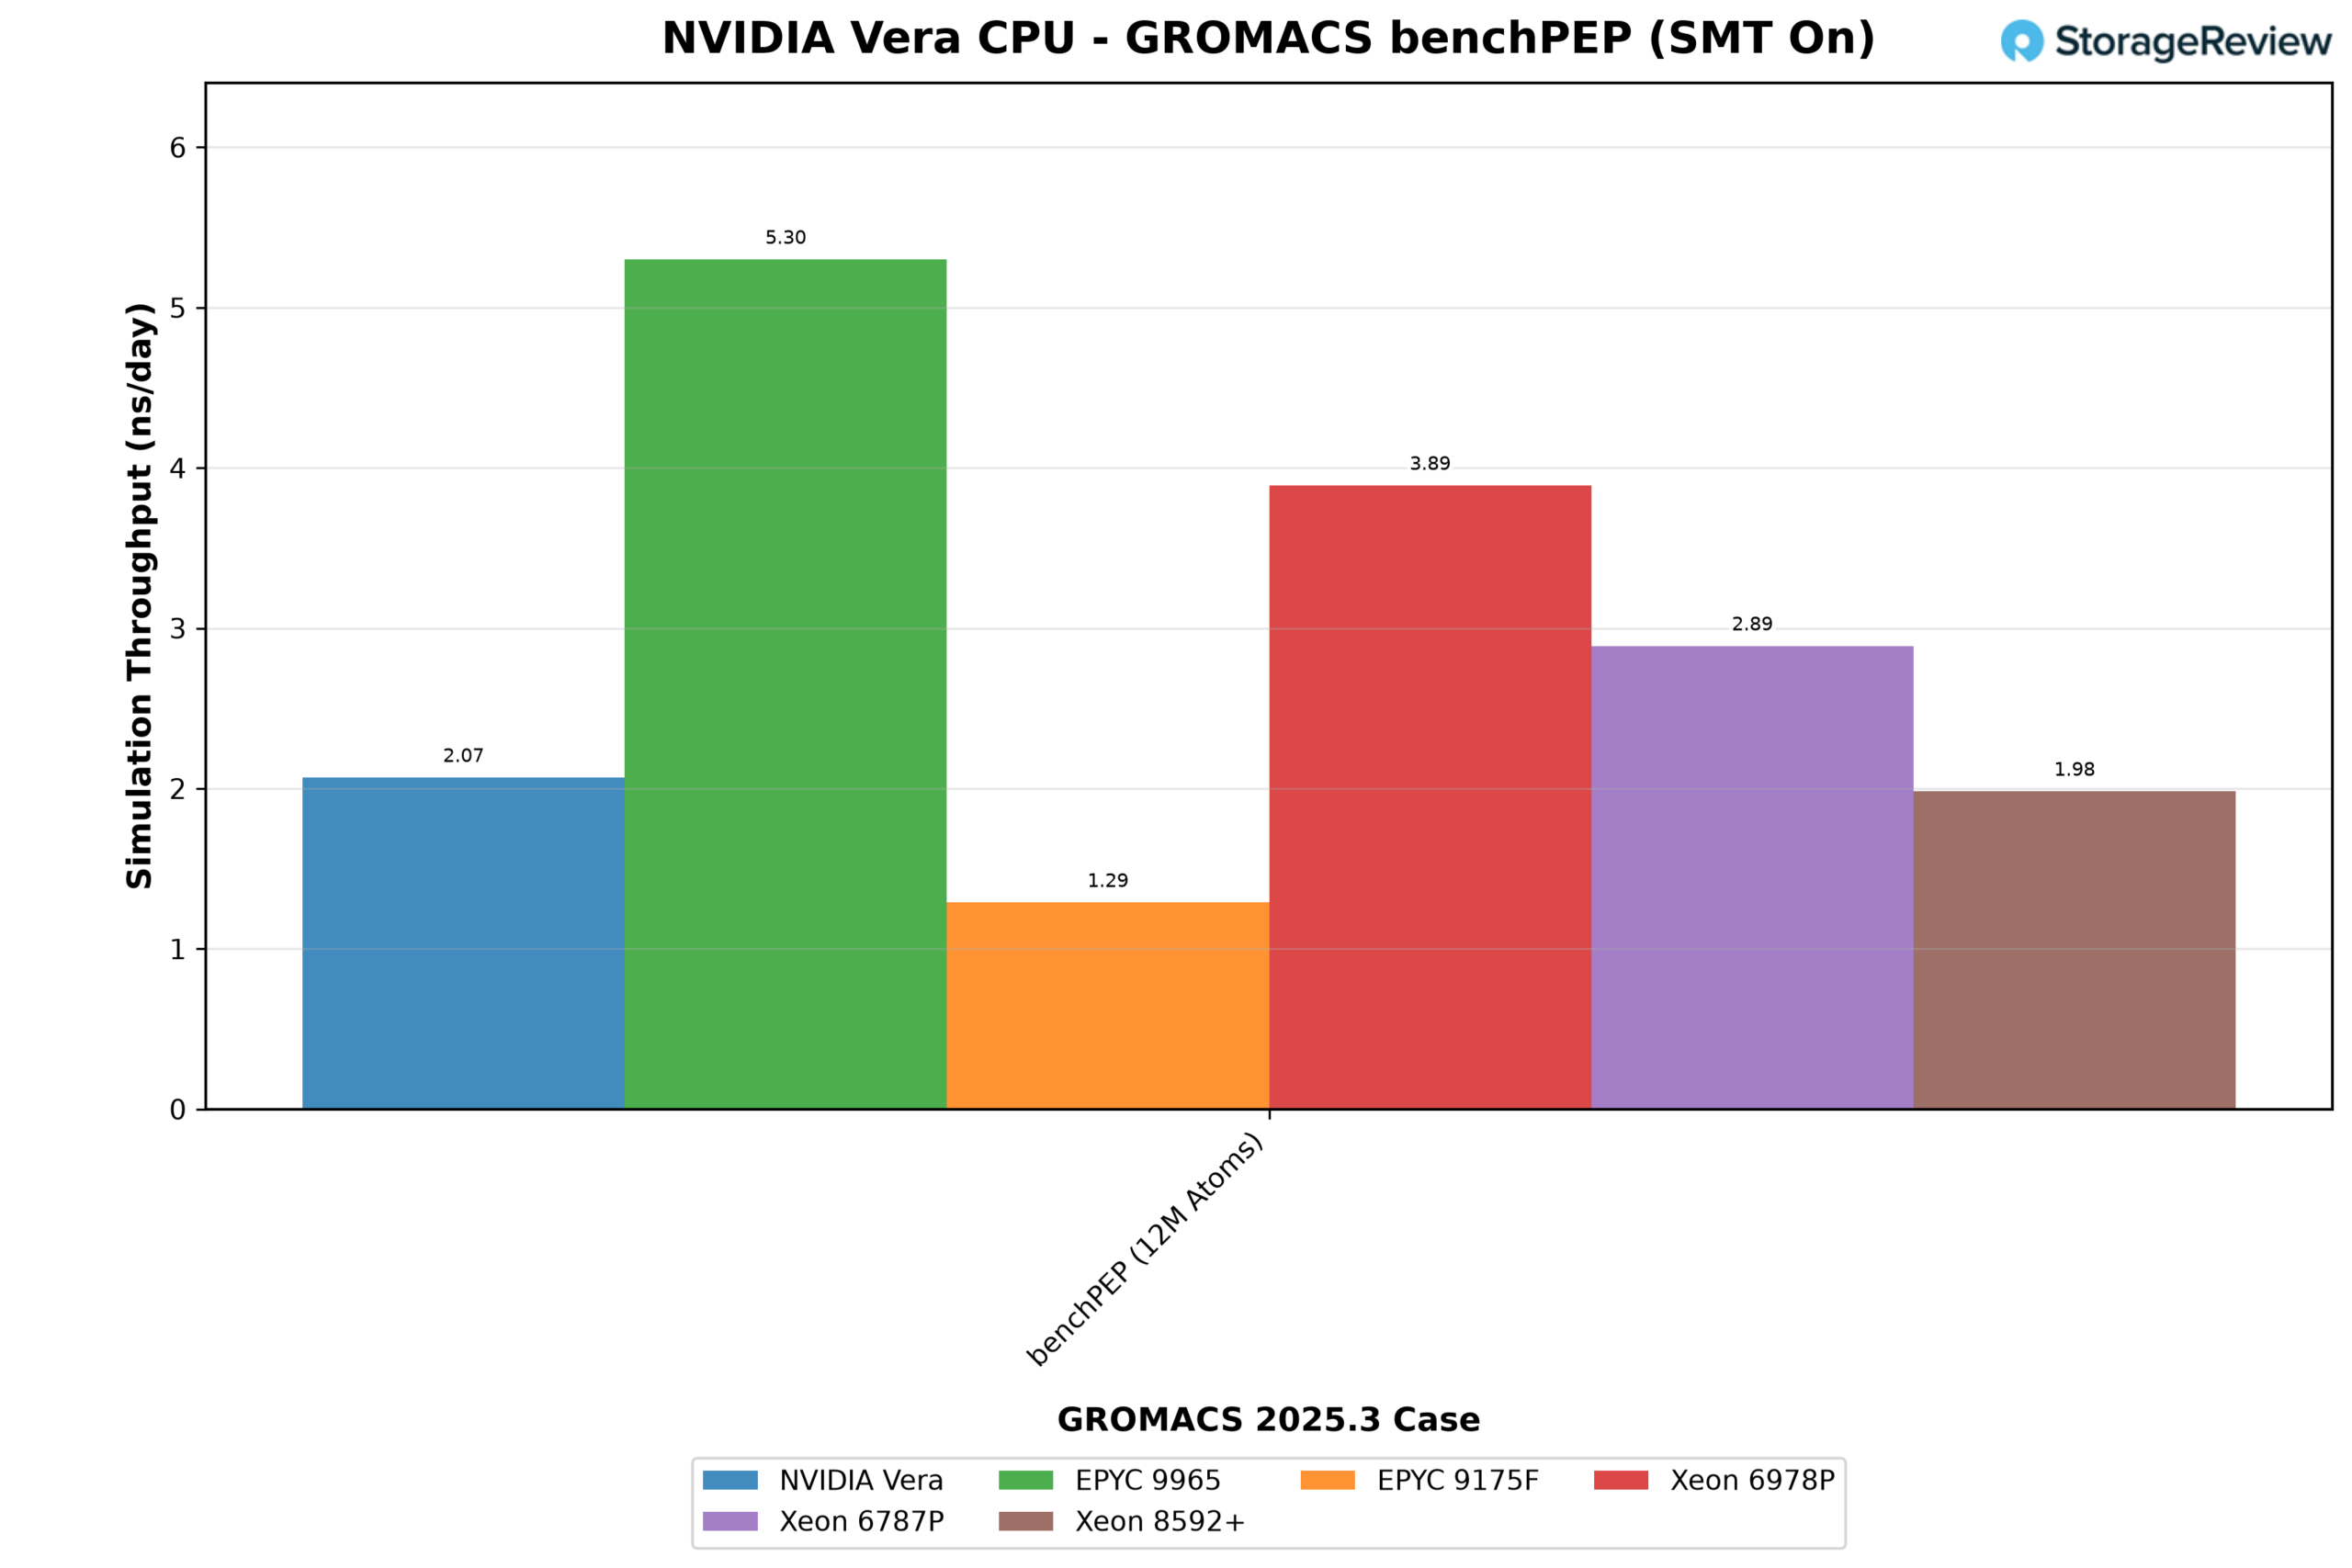
Ruimtelijke multithreading (SMT) maakt een deel van die achterstand goed, aangezien het inschakelen ervan Vera's resultaat met 17% verhoogde tot 2.07 ns/dag, waarbij de beste configuratie alle 352 hardwarethreads als thread-MPI-ranks gebruikte. Dat is een grotere winst dan SMT opleverde voor de Xeon 6978P (3%) of de 8592+ (11%) in onze eerdere tests, en de EPYC 9965 verloor 3.5% met SMT ingeschakeld. Doordat de resources verdeeld zijn over de twee threads, krijgt elke rank een deel van de core, en de combinatie van vectorberekeningen en geheugenstalls van de solver lijkt die delen beter te vullen dan een enkele rank.
De benchMEM-test isoleert het verschil per core door het systeem met 82,000 atomen te laten draaien op 16 fysieke cores van socket 0 op elk platform. Hierdoor speelt het aantal cores geen rol meer en weerspiegelt het resultaat de vectordoorvoer, cache en lokaal geheugen.
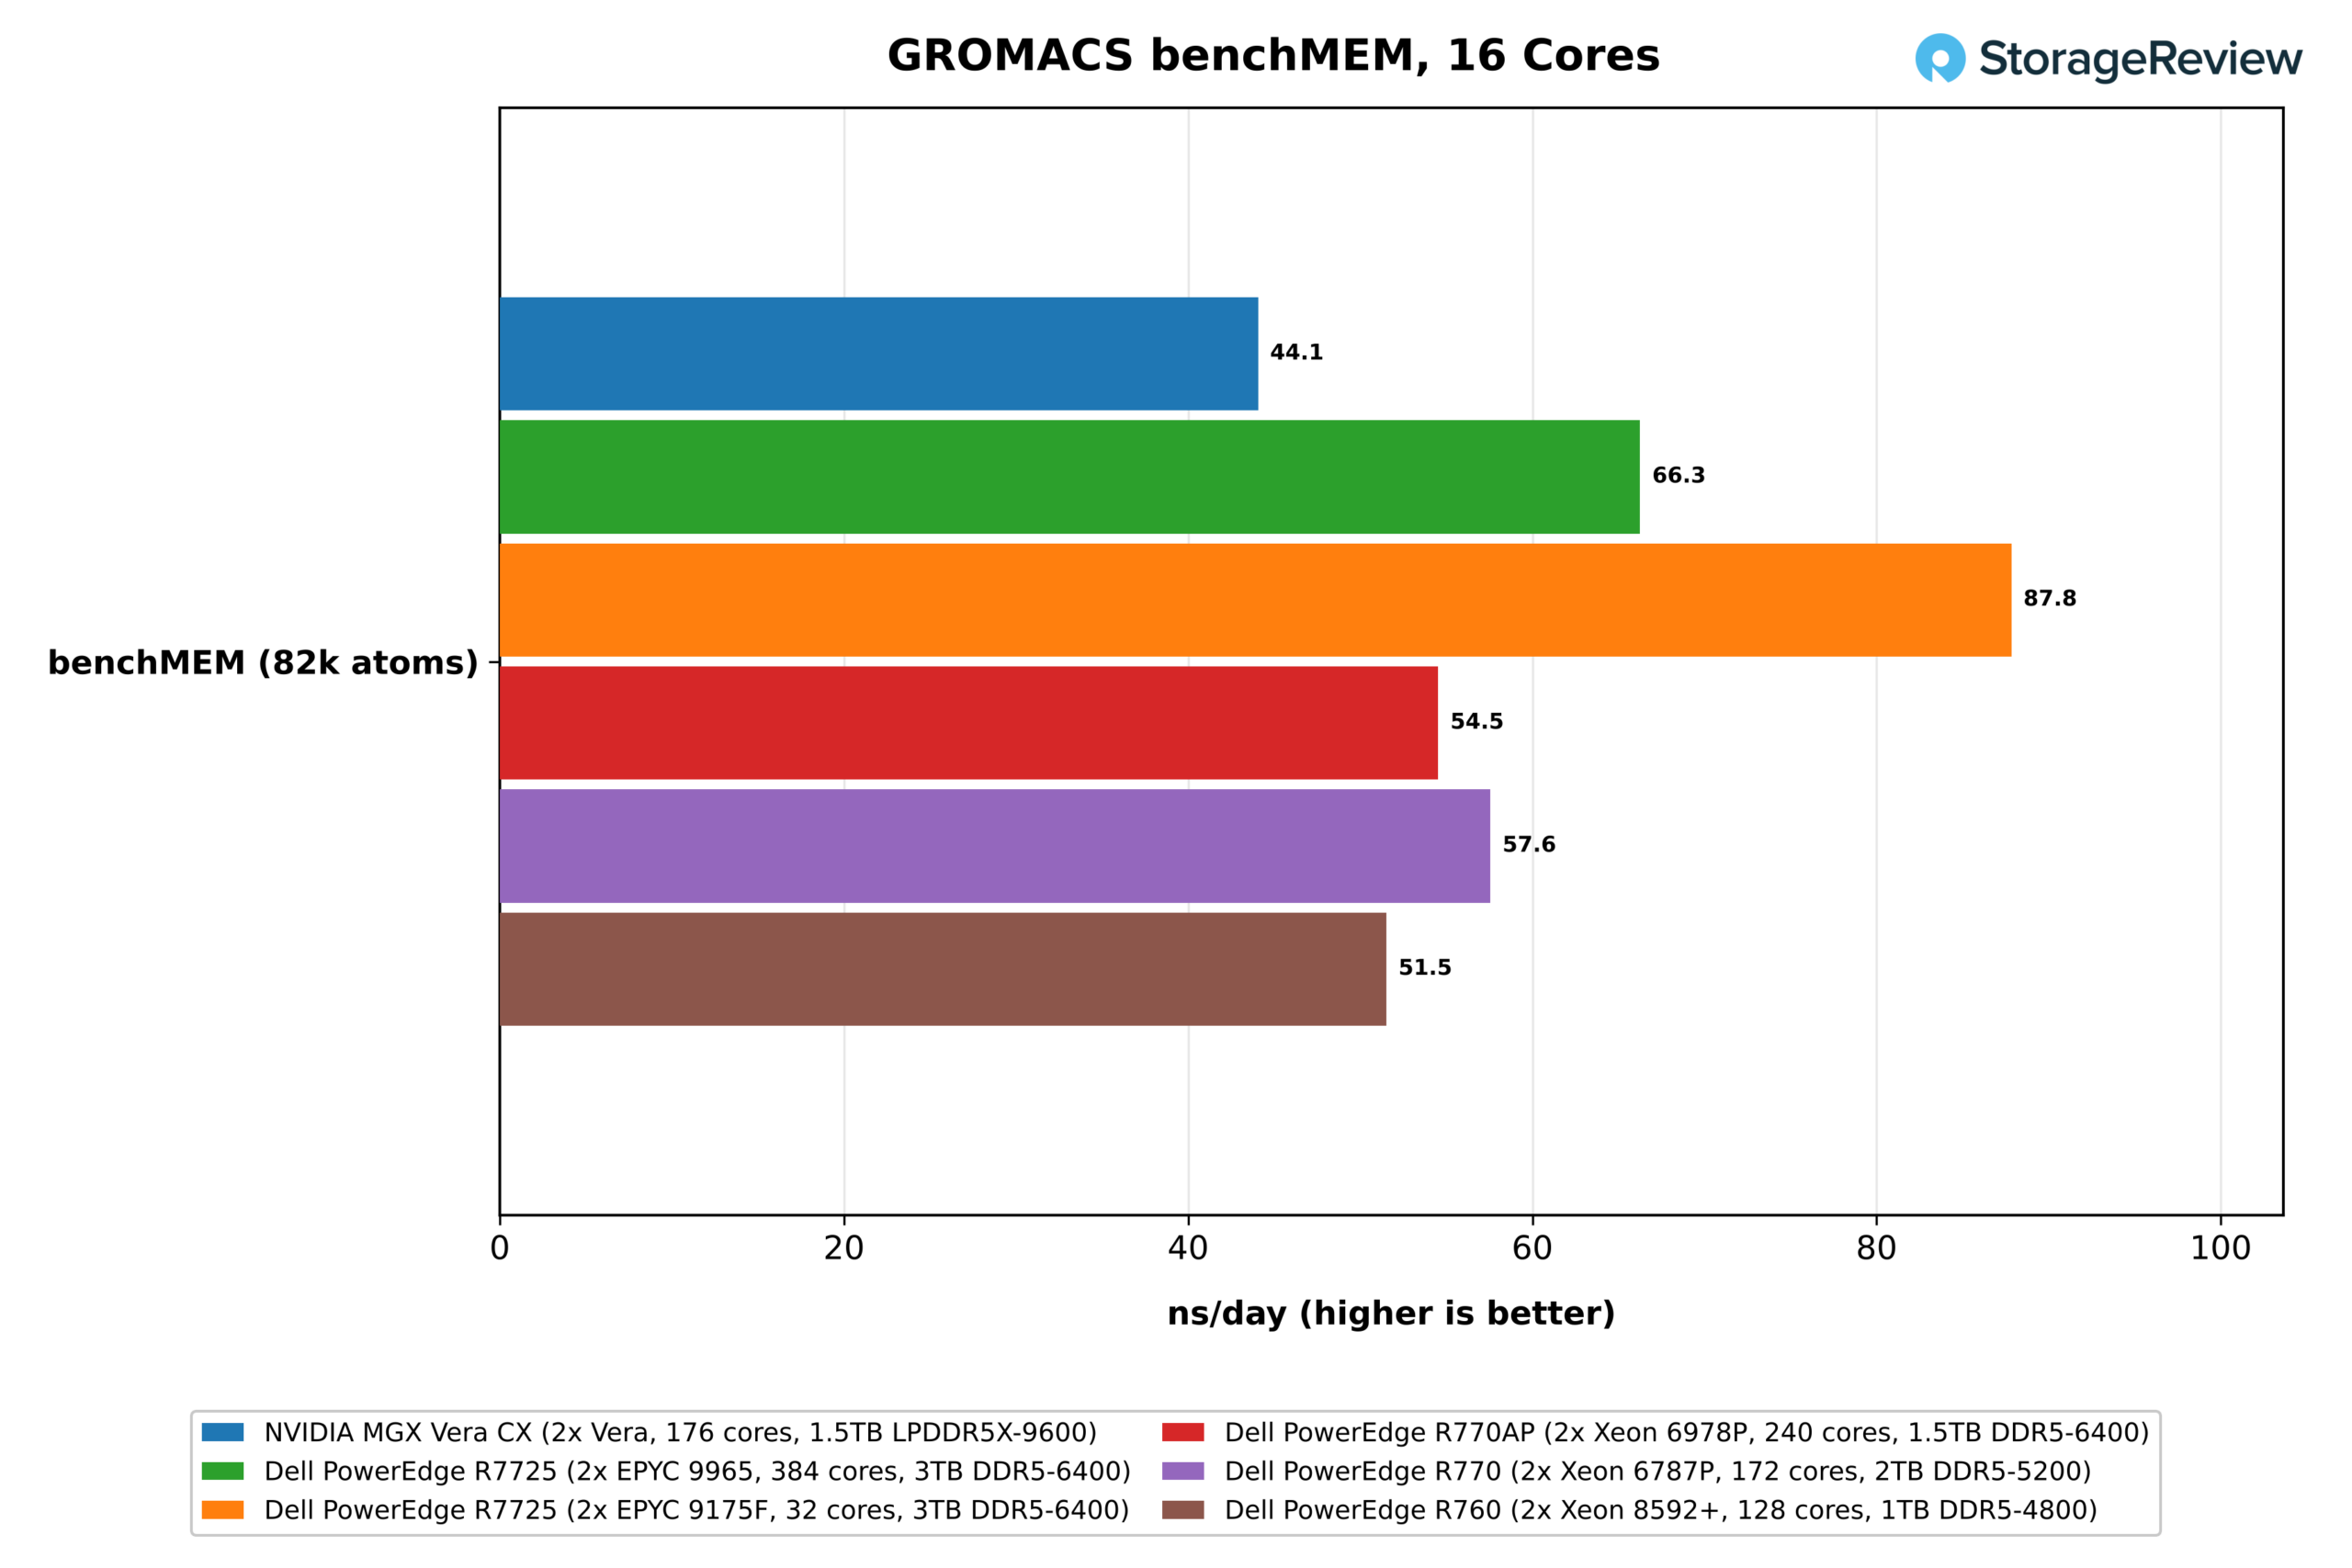
Vera behaalde hier een waarde van 44.1 ns/dag. De 5.0 GHz EPYC 9175F verdubbelde dat met 87.8, en de EPYC 9965 bereikte 66.3, 1.5 keer zo snel als Vera, vóór de Xeon 6787P met 57.6, de 6978P met 54.5 en de 8592+ met 51.5.
Een 16-core slice van Vera doet dus ongeveer twee derde van het werk van een 16-core slice van een Zen 5c-processor, ook al delen die 16 Zen 5c-cores één L3-cache van 32 MB, terwijl Vera gebruik kan maken van zijn systeemcache van 164 MB. Dit maakt het tot de duidelijkste meting die we hebben van de kosten van 128-bits vectoren in code die is geschreven voor 512-bits vectoren. De verdere voorsprong van de 9175F op de 9965 is ruwweg evenredig met het klokvoordeel, 5.0 GHz tegen 3.7 GHz.
OpenFOAM
OpenFOAM verplaatst de druk van de vectorunits naar het geheugensysteem. We draaien OpenFOAM 13 op de driverFastback-case voor auto-aerodynamica, met één MPI-rank per fysieke core, bij twee meshgroottes: een middelgrote mesh met 2.98 miljoen cellen en een grote mesh met 22.6 miljoen cellen.
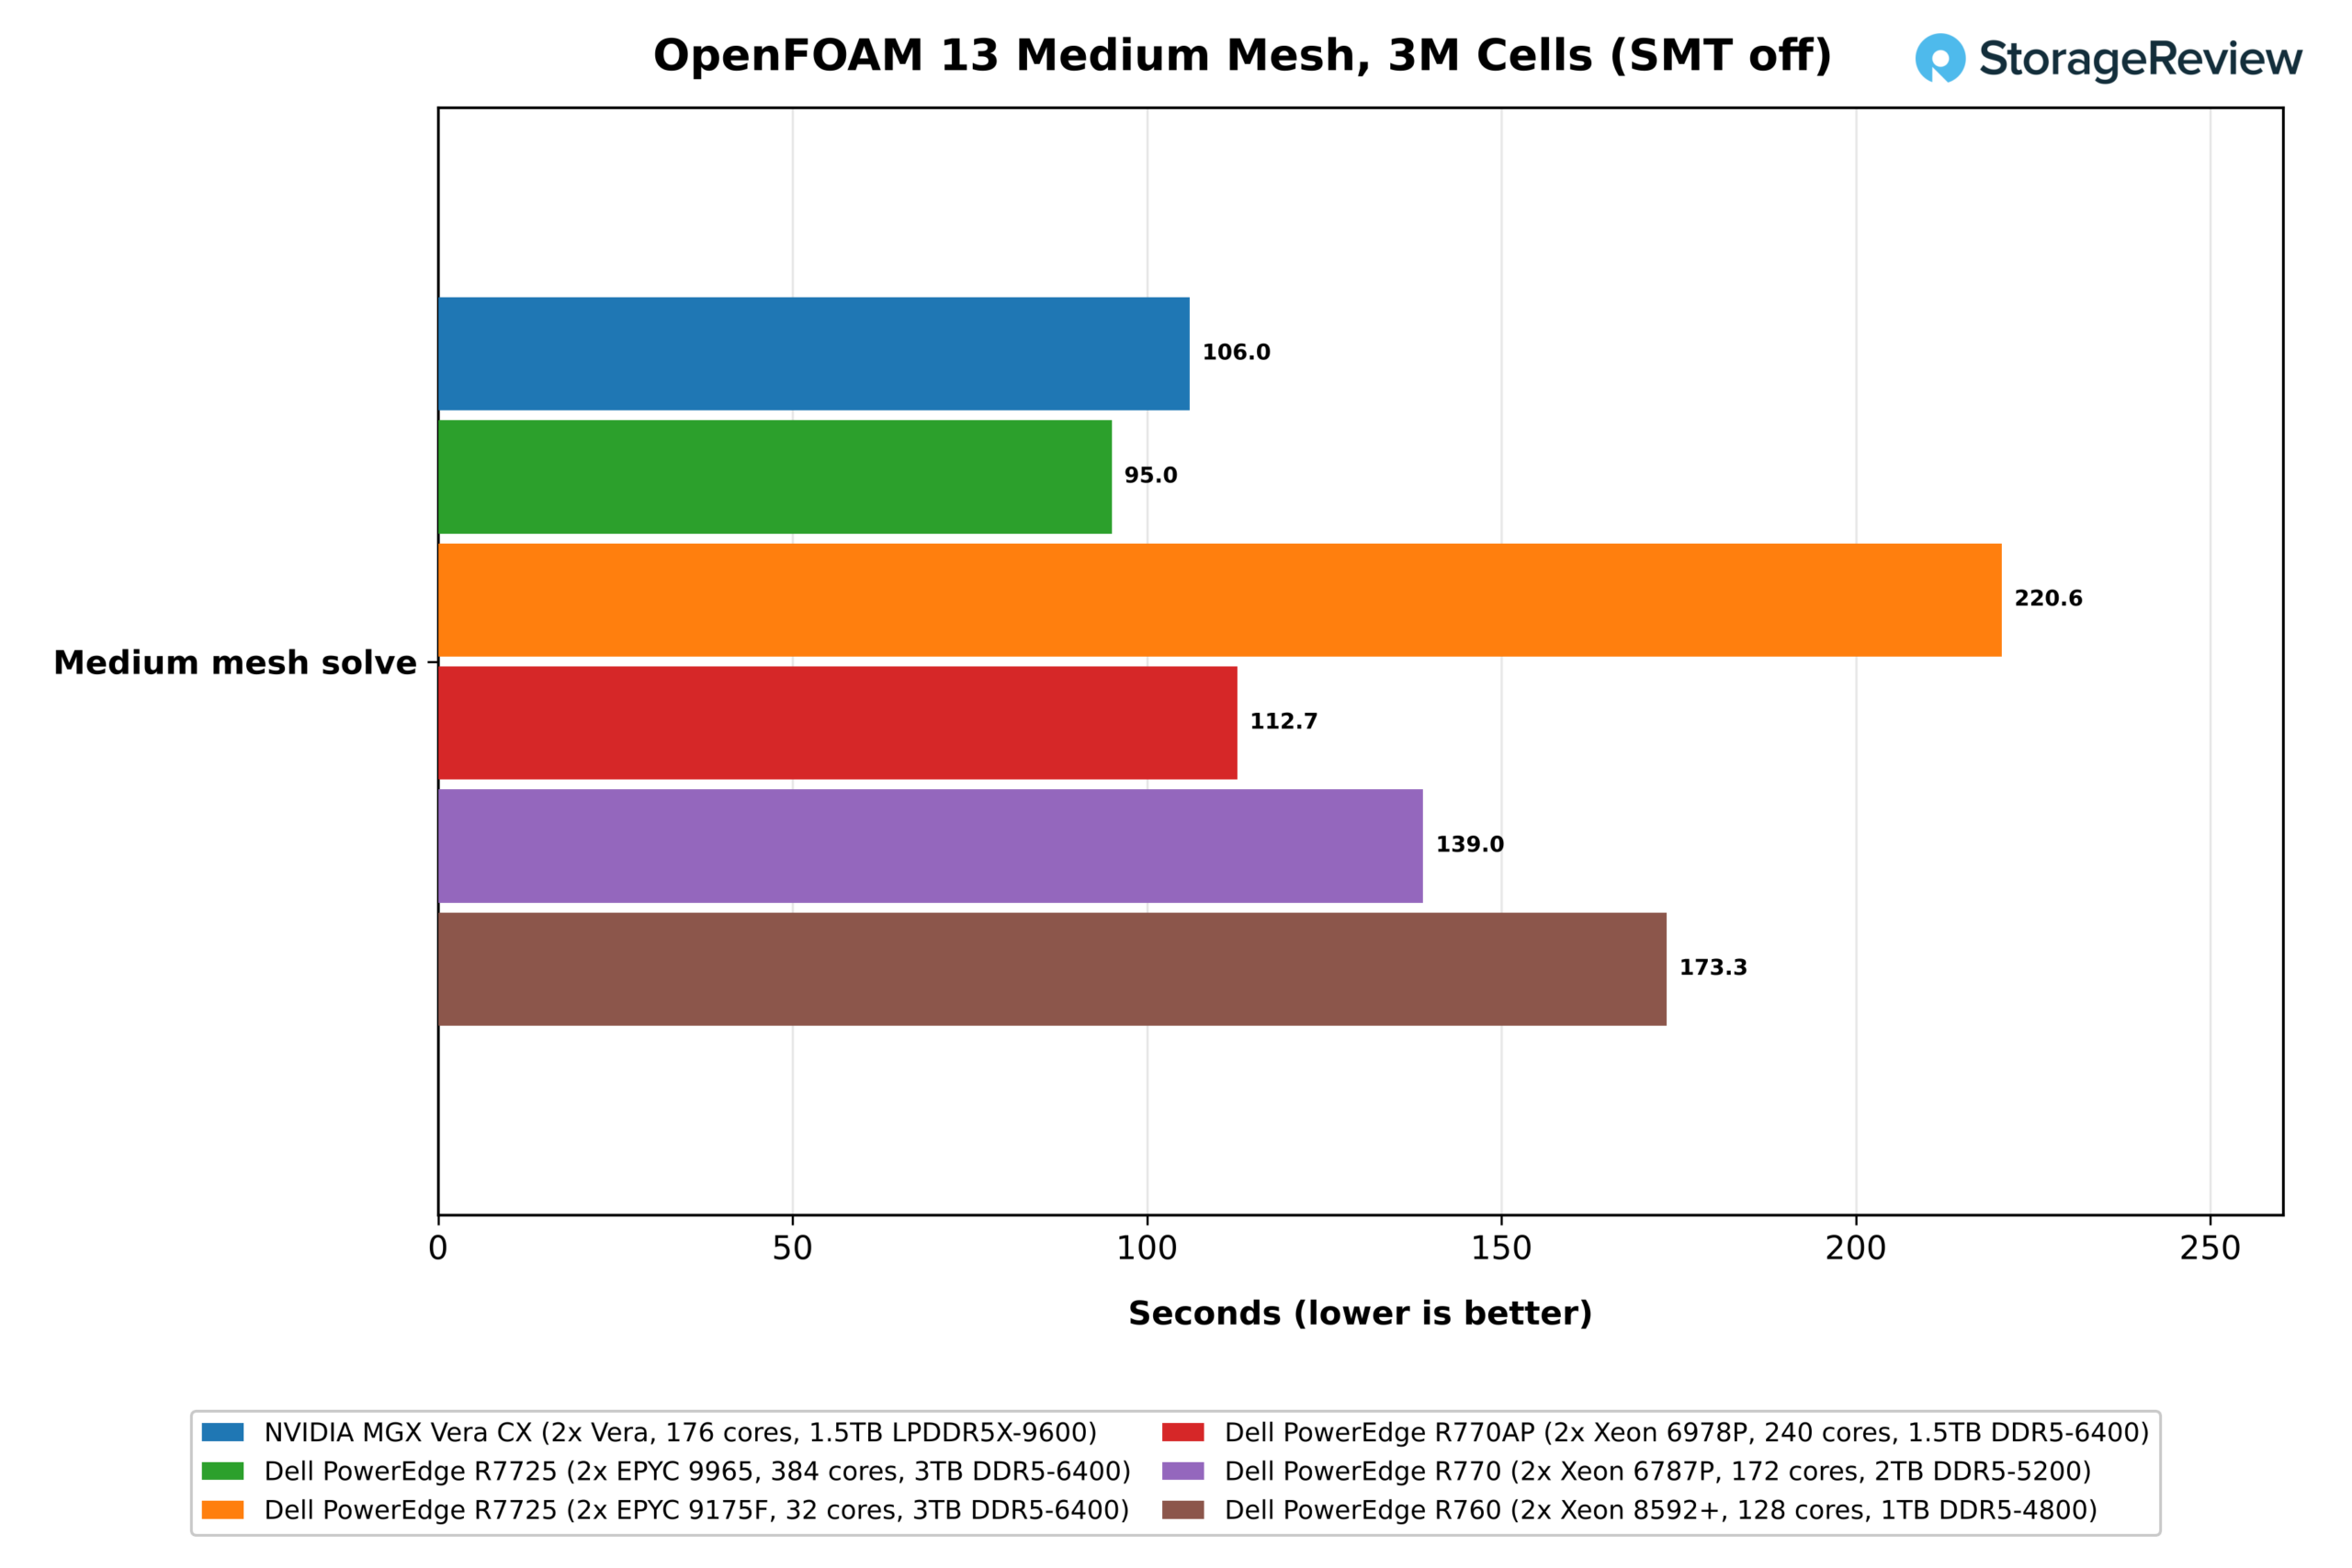
Het middelgrote mesh-probleem werd in 106.0 seconden opgelost op Vera, tegenover 95.0 seconden op de EPYC 9965, 112.7 seconden op de Xeon 6978P, 139.0 seconden op de 6787P, 173.3 seconden op de 8592+ en 220.6 seconden op de 32-core 9175F. Bij deze grootte wint de 9965 met zijn 384 cores, en Vera doet er 12% langer over, maar eindigt als tweede, 6% voor de 240-core Xeon. Met slechts 3 miljoen cellen kunnen de grotere L3-caches van de x86-processors waarschijnlijk een groter deel van het probleem oplossen, waardoor het aantal cores doorslaggevend blijft.
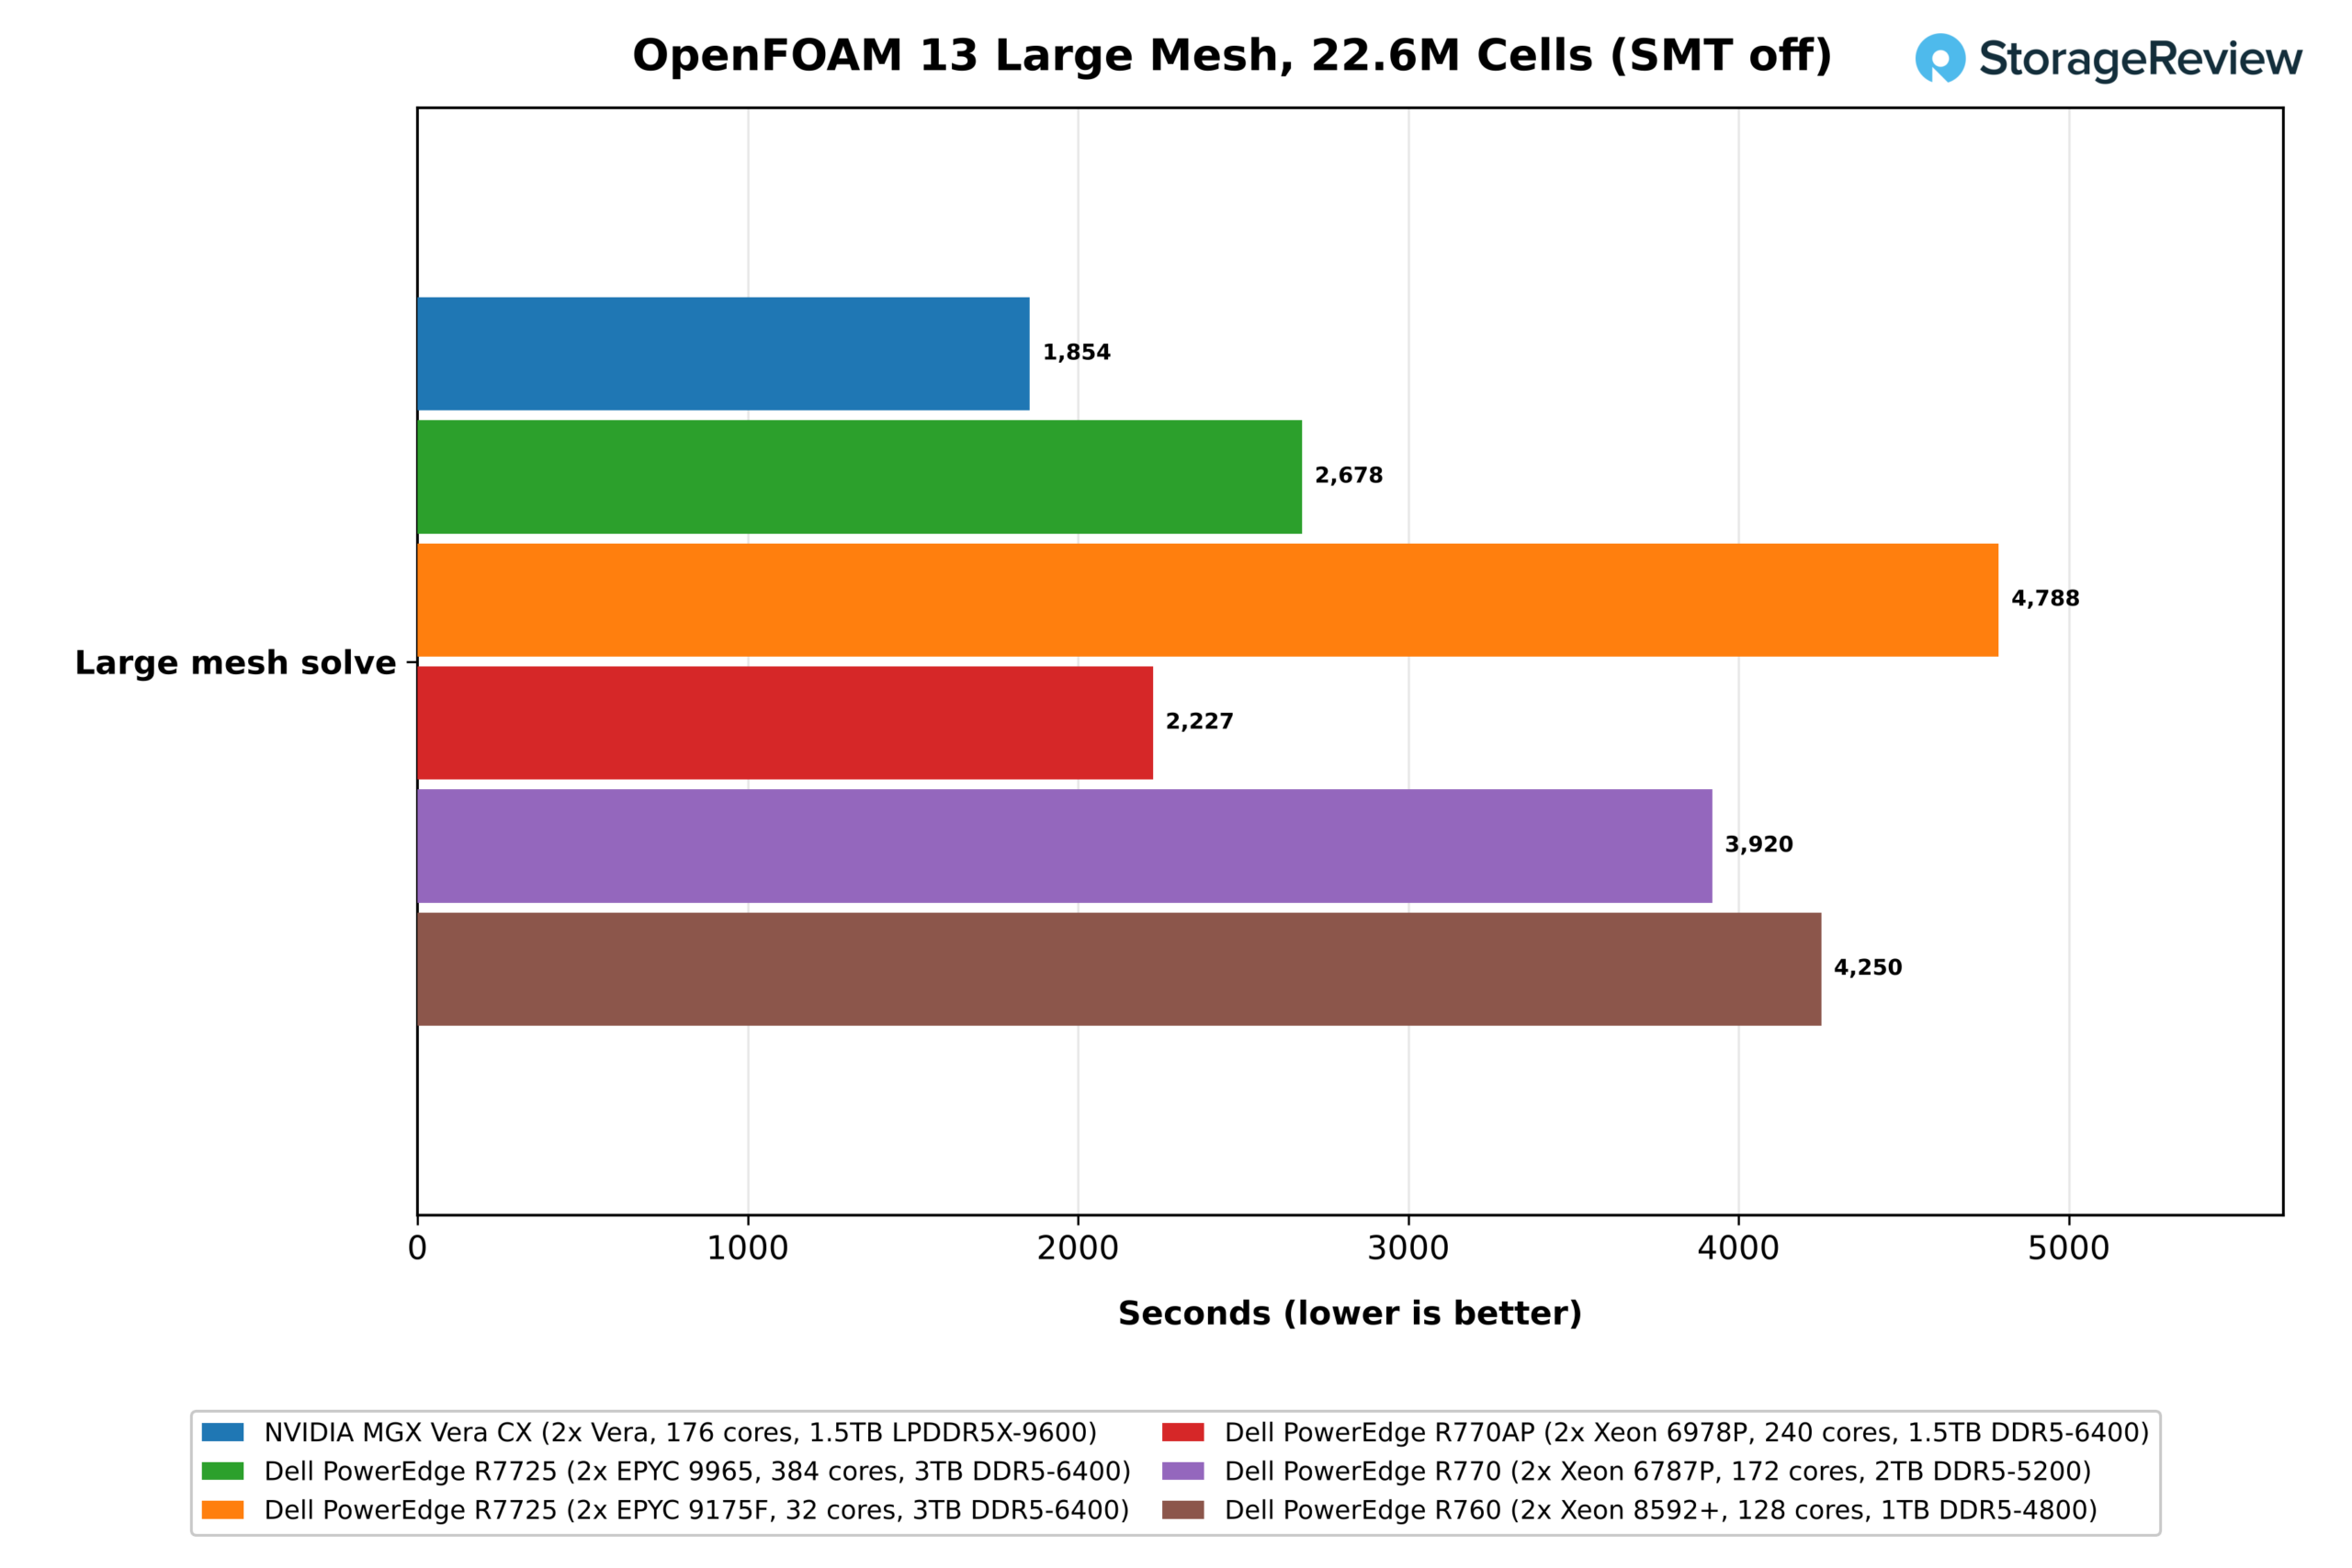
Het grote mesh-netwerk draait de volgorde om: Vera lost het probleem op in 1,854 seconden, tegenover 2,227 seconden voor de Xeon 6978P, 2,678 voor de EPYC 9965, 3,920 voor de 6787P, 4,250 voor de 8592+ en 4,788 voor de 9175F. Daarmee is Vera 1.44 keer sneller dan de AMD-server met 384 cores en 1.20 keer sneller dan de Intel-server met 240 cores. Vera blijft bovendien binnen het nominale maximum van 450W per socket, vergeleken met de 500W van de 9965.
Analyse en in-memory data
De HPC-resultaten lieten zien wat de bandbreedte van Vera doet voor een wetenschappelijke solver. Datadiensten belasten hetzelfde geheugensysteem op verschillende manieren, en onze twee tests doen er een beroep op vanuit tegengestelde hoeken. ClickBench voert analytische query's uit die grote kolommen met data scannen en aggregeren, waarbij elke query over alle cores wordt verdeeld. Dit beloont een systeem dat veel cores combineert met voldoende bandbreedte om ze te voeden. Valkey, een in-memory key-value store, verwerkt miljoenen kleine verzoeken, waarbij elk verzoek één waarde leest of schrijft. De prestaties zijn daarom meer afhankelijk van hoe snel een individuele core een verzoek verwerkt en, zodra de data de cache overstijgt, van de geheugenlatentie en bandbreedte.
KlikBench
We hebben ClickBench getest met 43 query's op een webanalysetabel met 100 miljoen rijen op ClickHouse 26.8. De 'hot sum', waarbij elke query gegevens uit de paginacache leest, meet hoeveel cores een systeem kan inzetten voor kolomscans en aggregaties en hoe goed het geheugen deze cores van gegevens voorziet. De 'cold sum' voegt een serverherstart en SSD-leesbewerkingen toe vóór de eerste uitvoering van elke query.
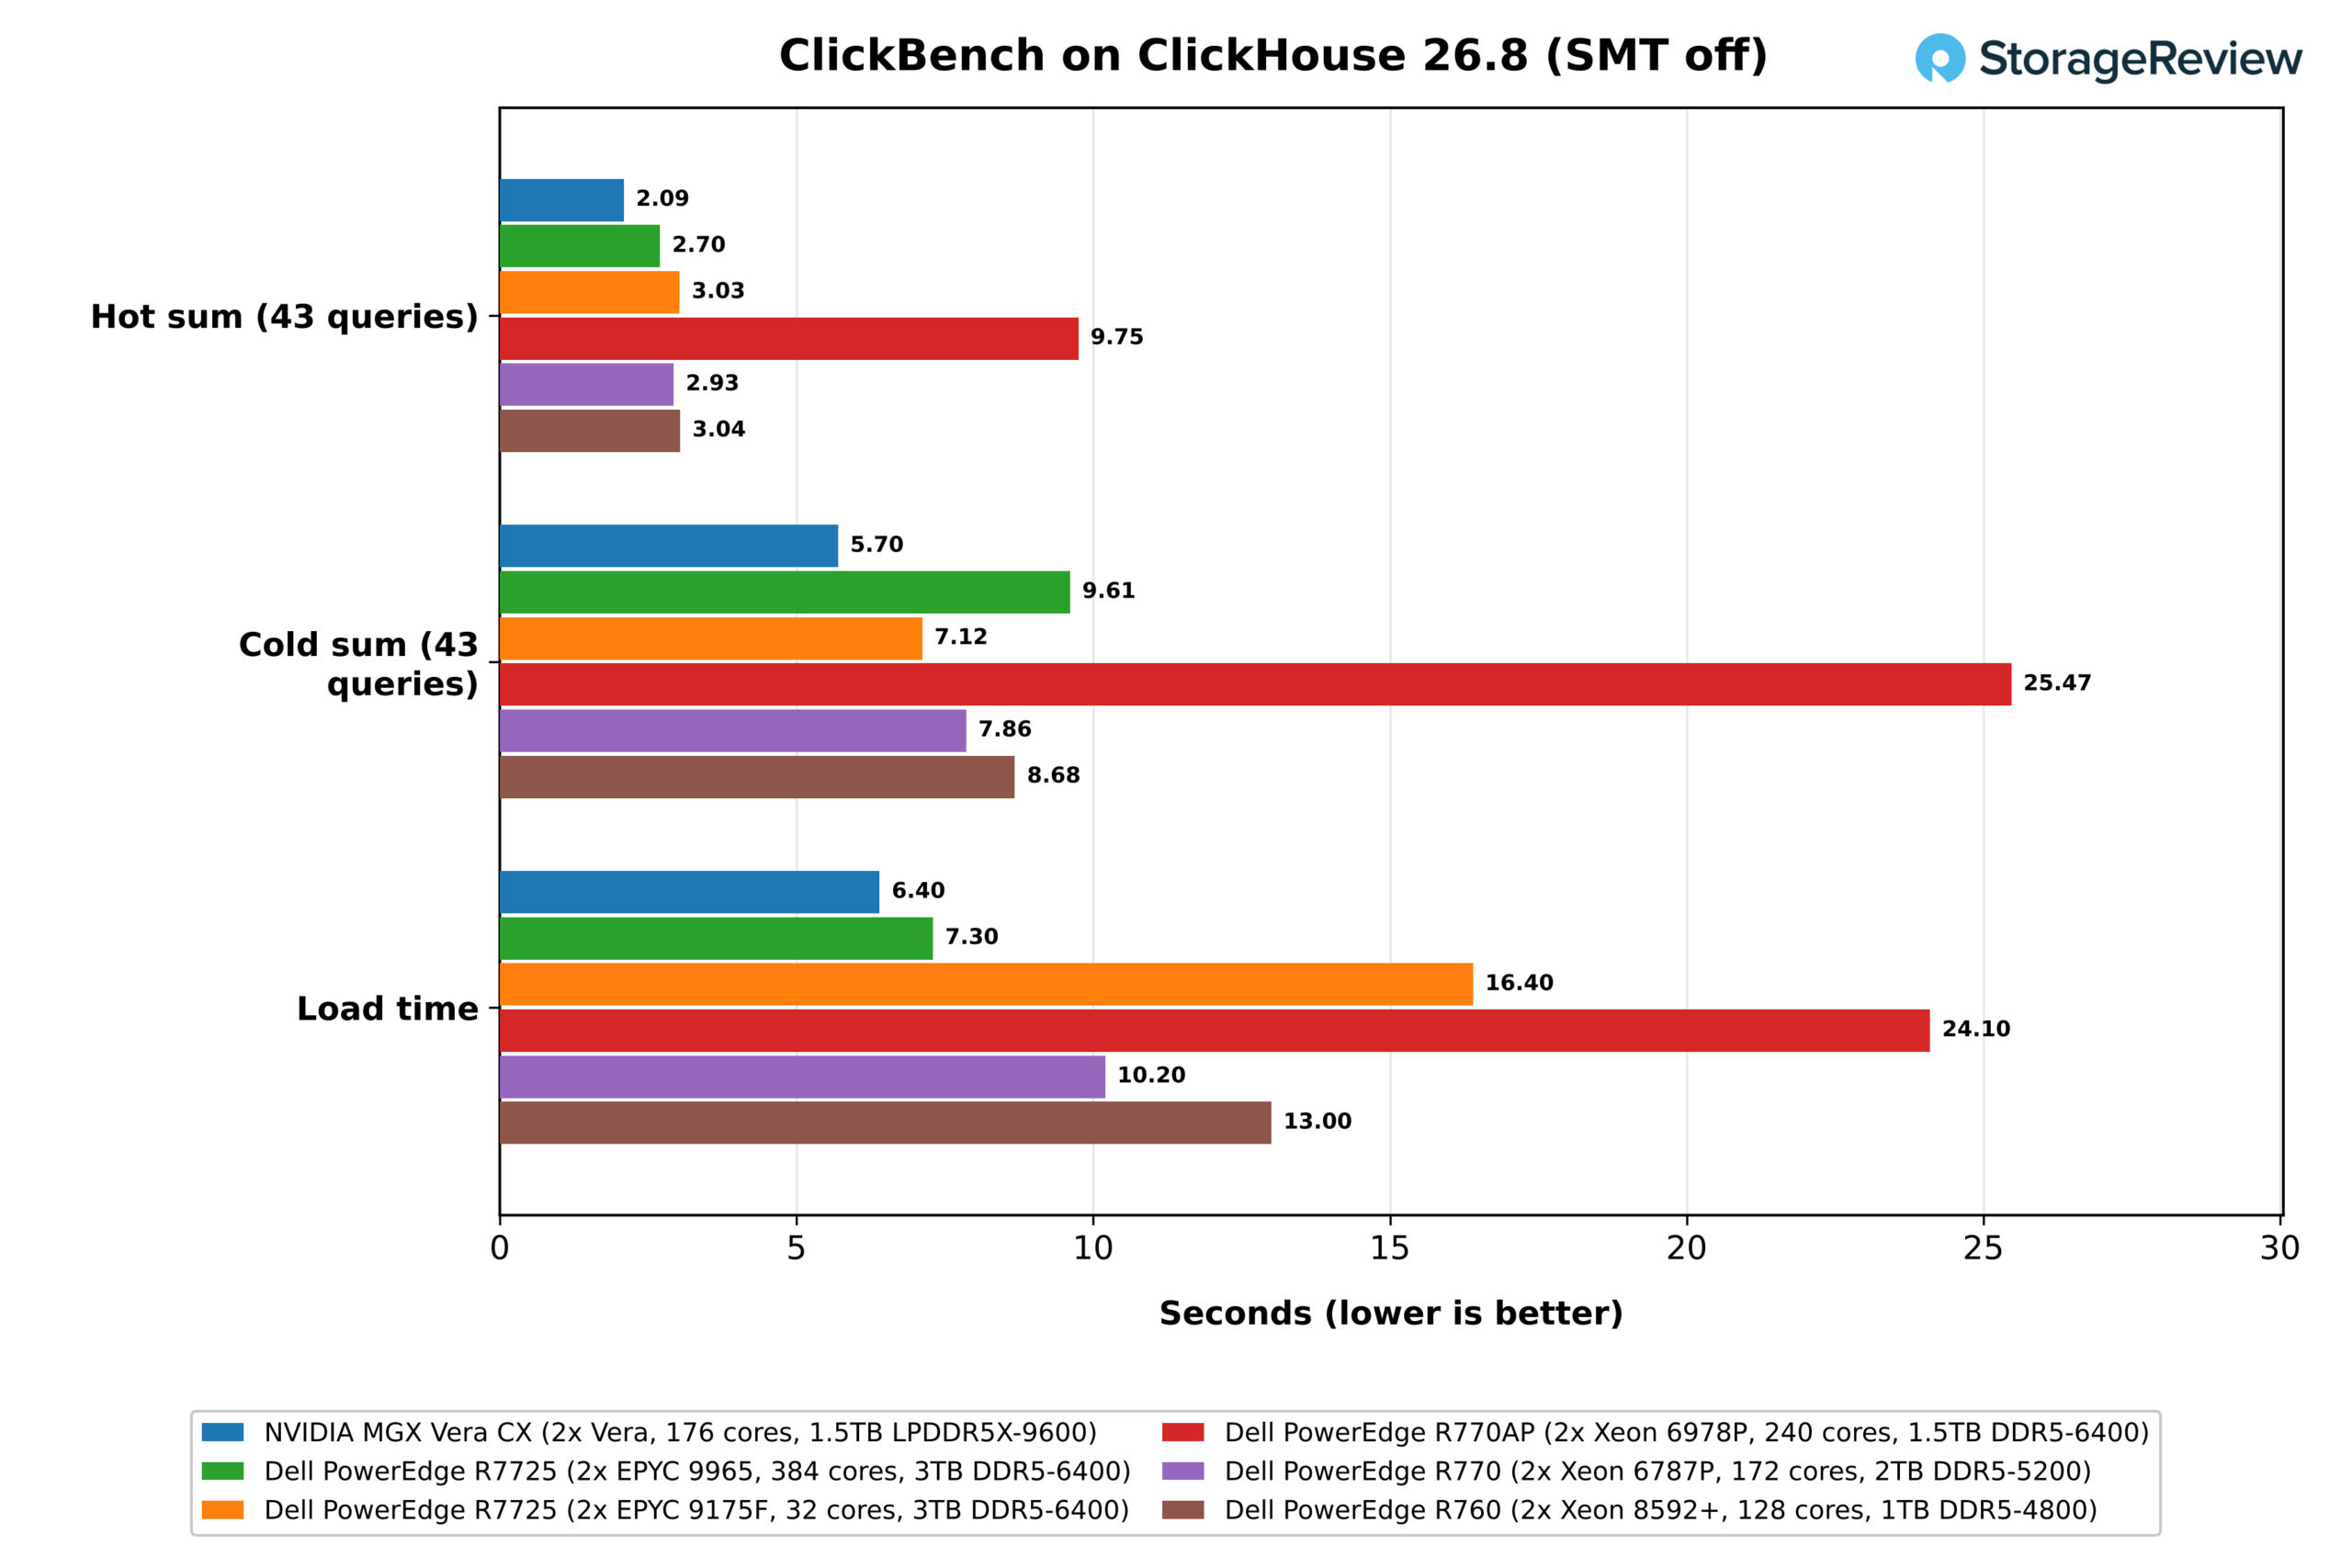
Met SMT uitgeschakeld voltooide Vera de test in 2.09 seconden, het snelste resultaat in onze test. De EPYC 9965 volgde met 2.70 seconden, 1.29 keer zo lang, terwijl de Xeon 6787P, EPYC 9175F en Xeon 8592+ vrijwel gelijk zaten tussen 2.93 en 3.04 seconden. De spreiding weerspiegelt de balans tussen cores en bandbreedte. De 384-core 9965 heeft cores over, maar weinig bandbreedte per core; de 32-core 9175F heeft het omgekeerde; en Vera combineert 176 cores met meer dan drie keer de bandbreedte van beide.
Vera was ook de snelste in de koude test met 5.70 seconden, vóór de 9175F met 7.12, de 6787P met 7.86, de 8592+ met 8.68 en de 9965 met 9.61. De koude test is meer afhankelijk van de opslagcapaciteit en de schijfconfiguratie verschilt: Gen5 x4 op Vera en de 6787P, x2 op beide EPYC-systemen en Gen4 op de 8592+.
Vera laadde de dataset van 15 GB ook het snelst, in 6.4 seconden, vergeleken met 7.3 seconden voor de 9965 en 10.2 tot 16.4 seconden voor de rest. De Xeon 6978P, met 9.75 seconden warm en 25.47 seconden koud, bleef om onbekende redenen ver achter bij de andere Xeons, dus laten we deze buiten de ranglijst.
Het inschakelen van Spatial Multithreading vertraagde Vera tot 2.31 seconden in de 'hot'-modus en 6.09 seconden in de 'cold'-modus, een verlies van 10% ten opzichte van de 'hot'-modus. Het verdelen van de resources van elke core over twee threads kostte ClickHouse meer tijd bij het scannen dan het opleverde.
Valkey
Valkey voert commando's uit op één hoofdthread, waarbij I/O-threads slechts tot op zekere hoogte ondersteuning bieden. Implementaties groeien dus door het toevoegen van shards, aangezien het toekennen van meer cores aan één instantie weinig verschil maakt. We bekijken Valkey daarom op twee manieren: wat een enkele shard levert op overeenkomende cores, en wat elke shard levert wanneer een socket ermee gevuld is. In beide tests draaien de clients op de andere socket van dezelfde machine, dus er is geen netwerkkaart bij betrokken.
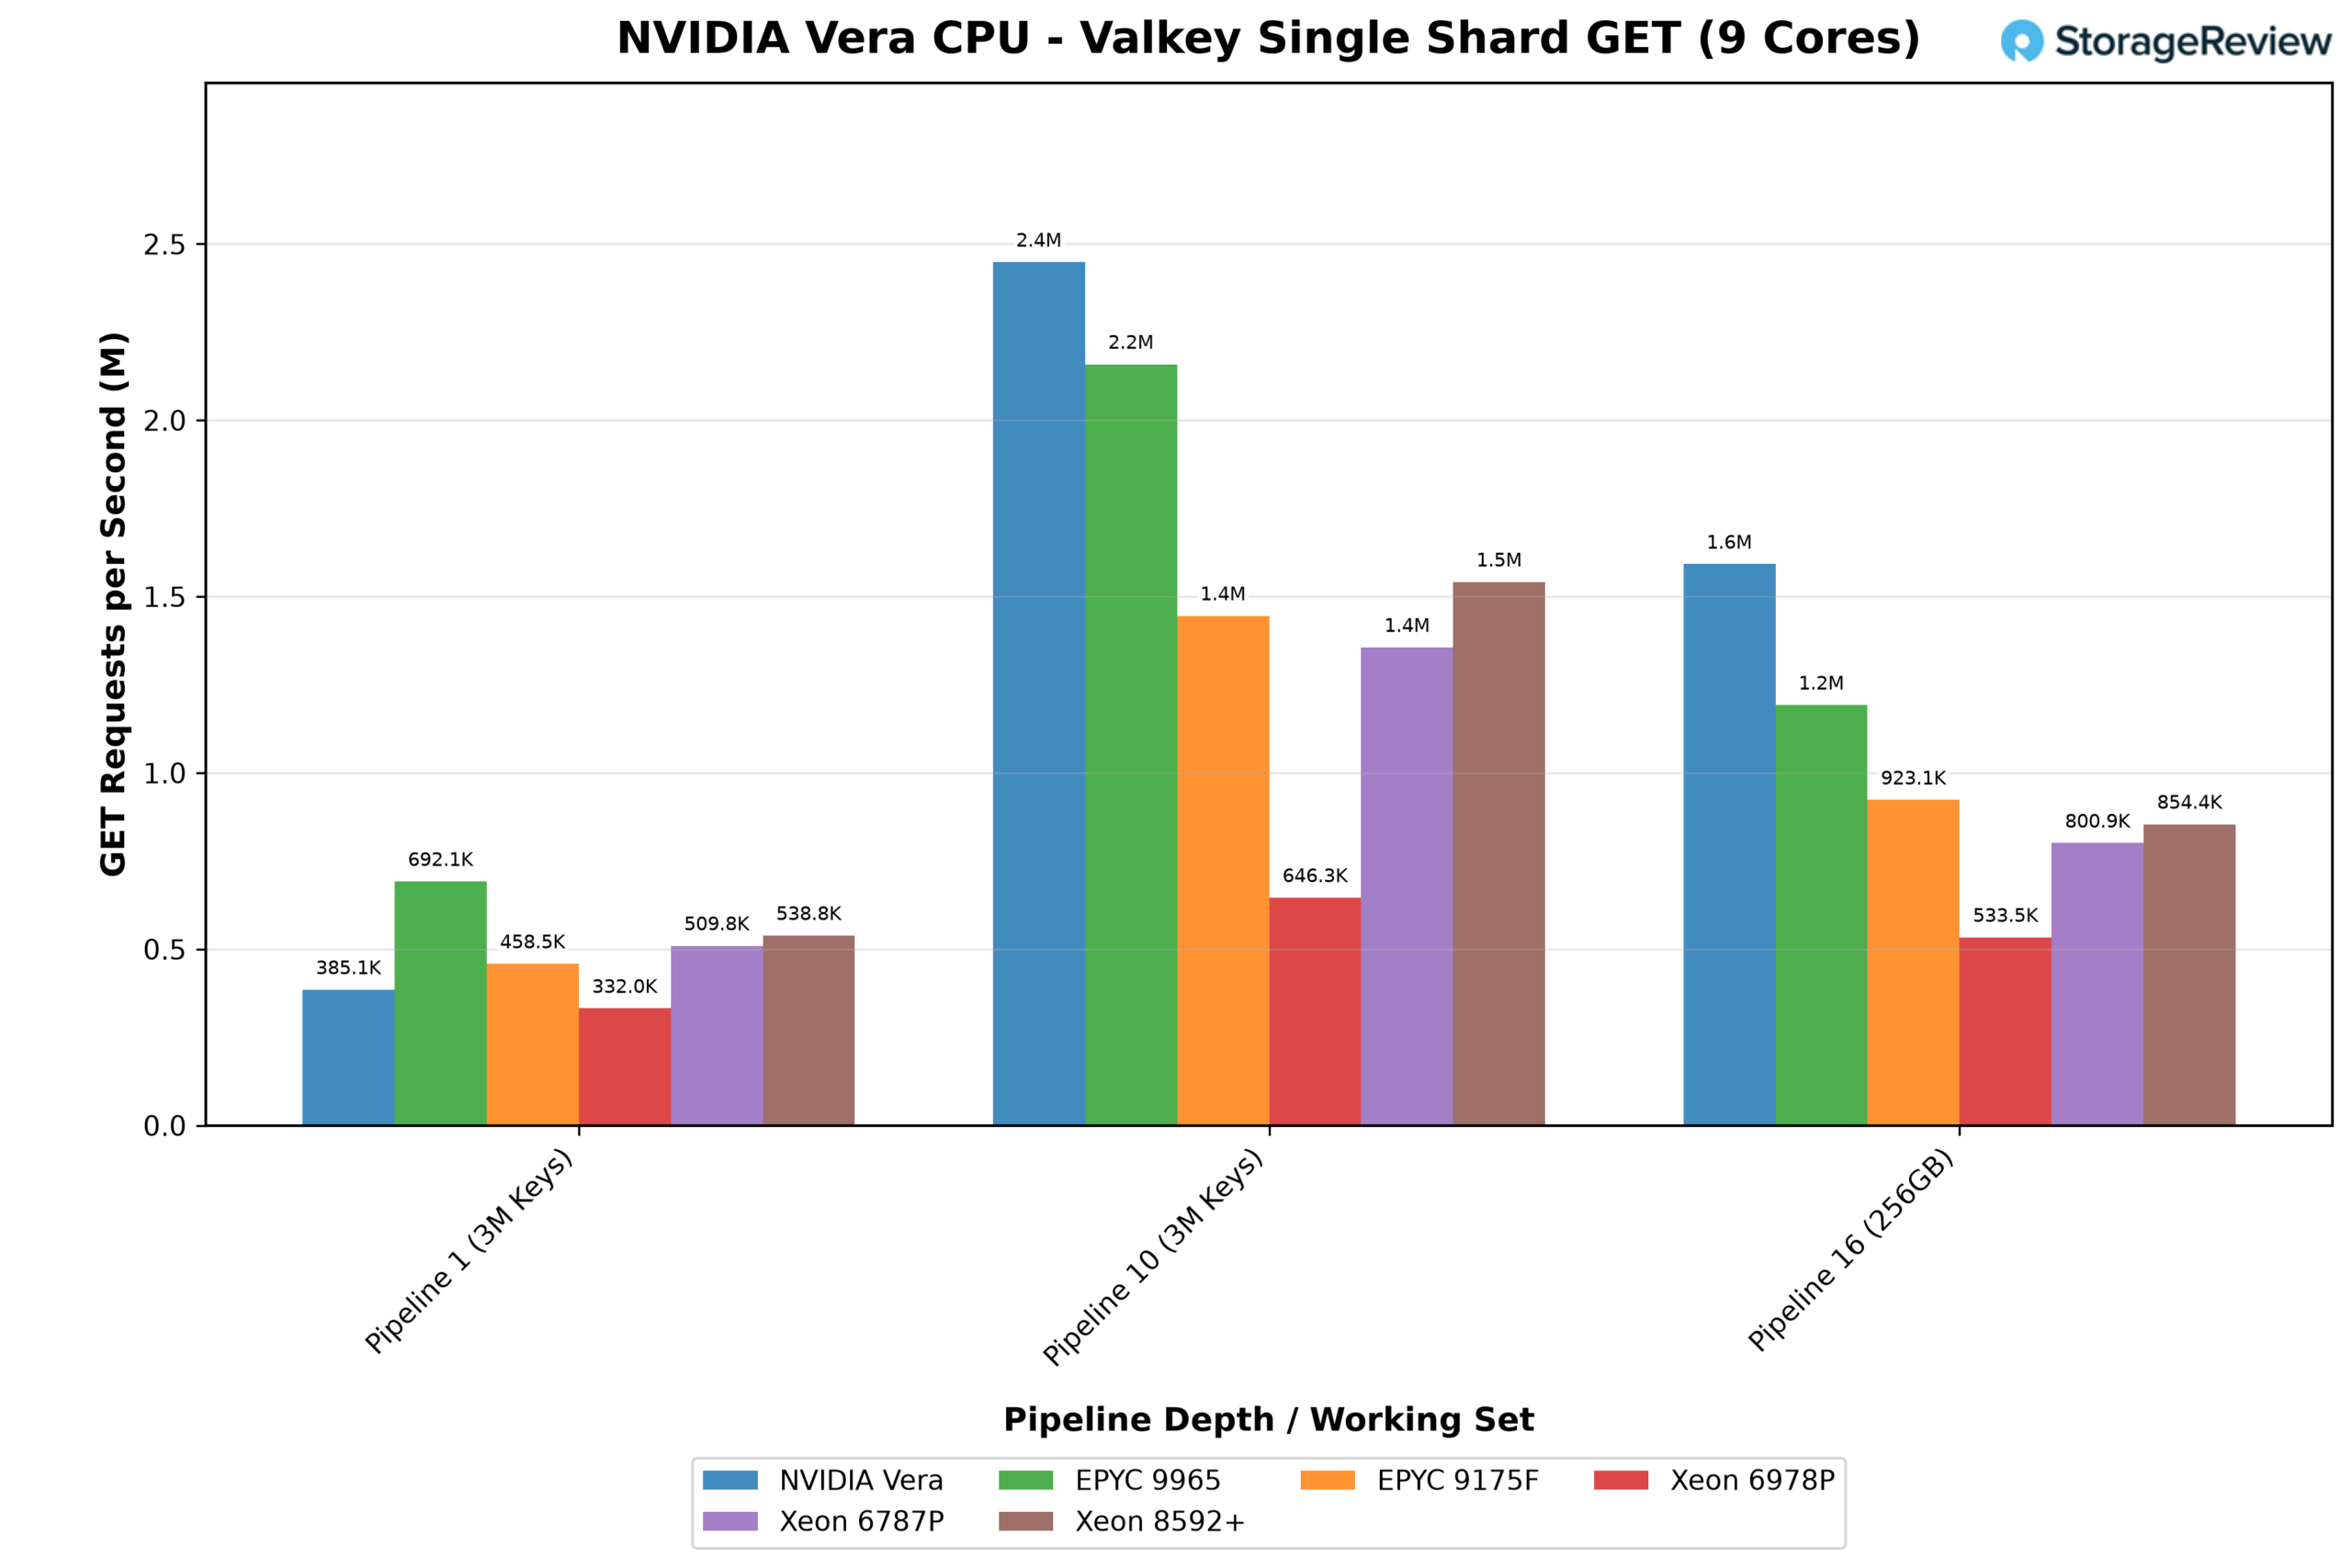
De test met één shard geeft één Valkey-server negen fysieke cores op elk platform. Deze server verwerkt een dataset van 3 miljoen sleutels, waarbij verzoeken één voor één worden verzonden, vervolgens in batches van 10, en daarna een dataset van 256 GB, te groot voor elke cache, in batches van 16. Omdat elk verzoek één voor één wordt verzonden, moet het zijn retourtraject voltooien voordat het volgende verzoek kan worden verzonden, en dit is waar Vera het zwakst presteert. De shard van Vera verwerkte 385,000 GET-verzoeken per seconde, alleen de Xeon 6978P presteerde beter, terwijl de EPYC 9965 met 692,000 verzoeken de beste was. De p99-latentie van Vera was ook hoger, namelijk 1.76 ms tegenover 1.08 ms op de 9965.
Batchverwerking elimineert het grootste deel van de retourkosten, waardoor Vera vooraan komt te staan. Met batches van 10 verwerkte de shard 2.45 miljoen GET-verzoeken per seconde, 13% meer dan de 9965 en ruim voor op elke Xeon. De dataset van 256 GB vergrootte het verschil nog verder. Doordat bijna elk verzoek naar het geheugen ging, verwerkte Vera 1.59 miljoen GET-verzoeken per seconde, 34% meer dan de 9965, terwijl de rest van de geteste systemen tussen de 0.53 en 0.92 miljoen zat. De SET-resultaten volgden hetzelfde patroon in beide tests.
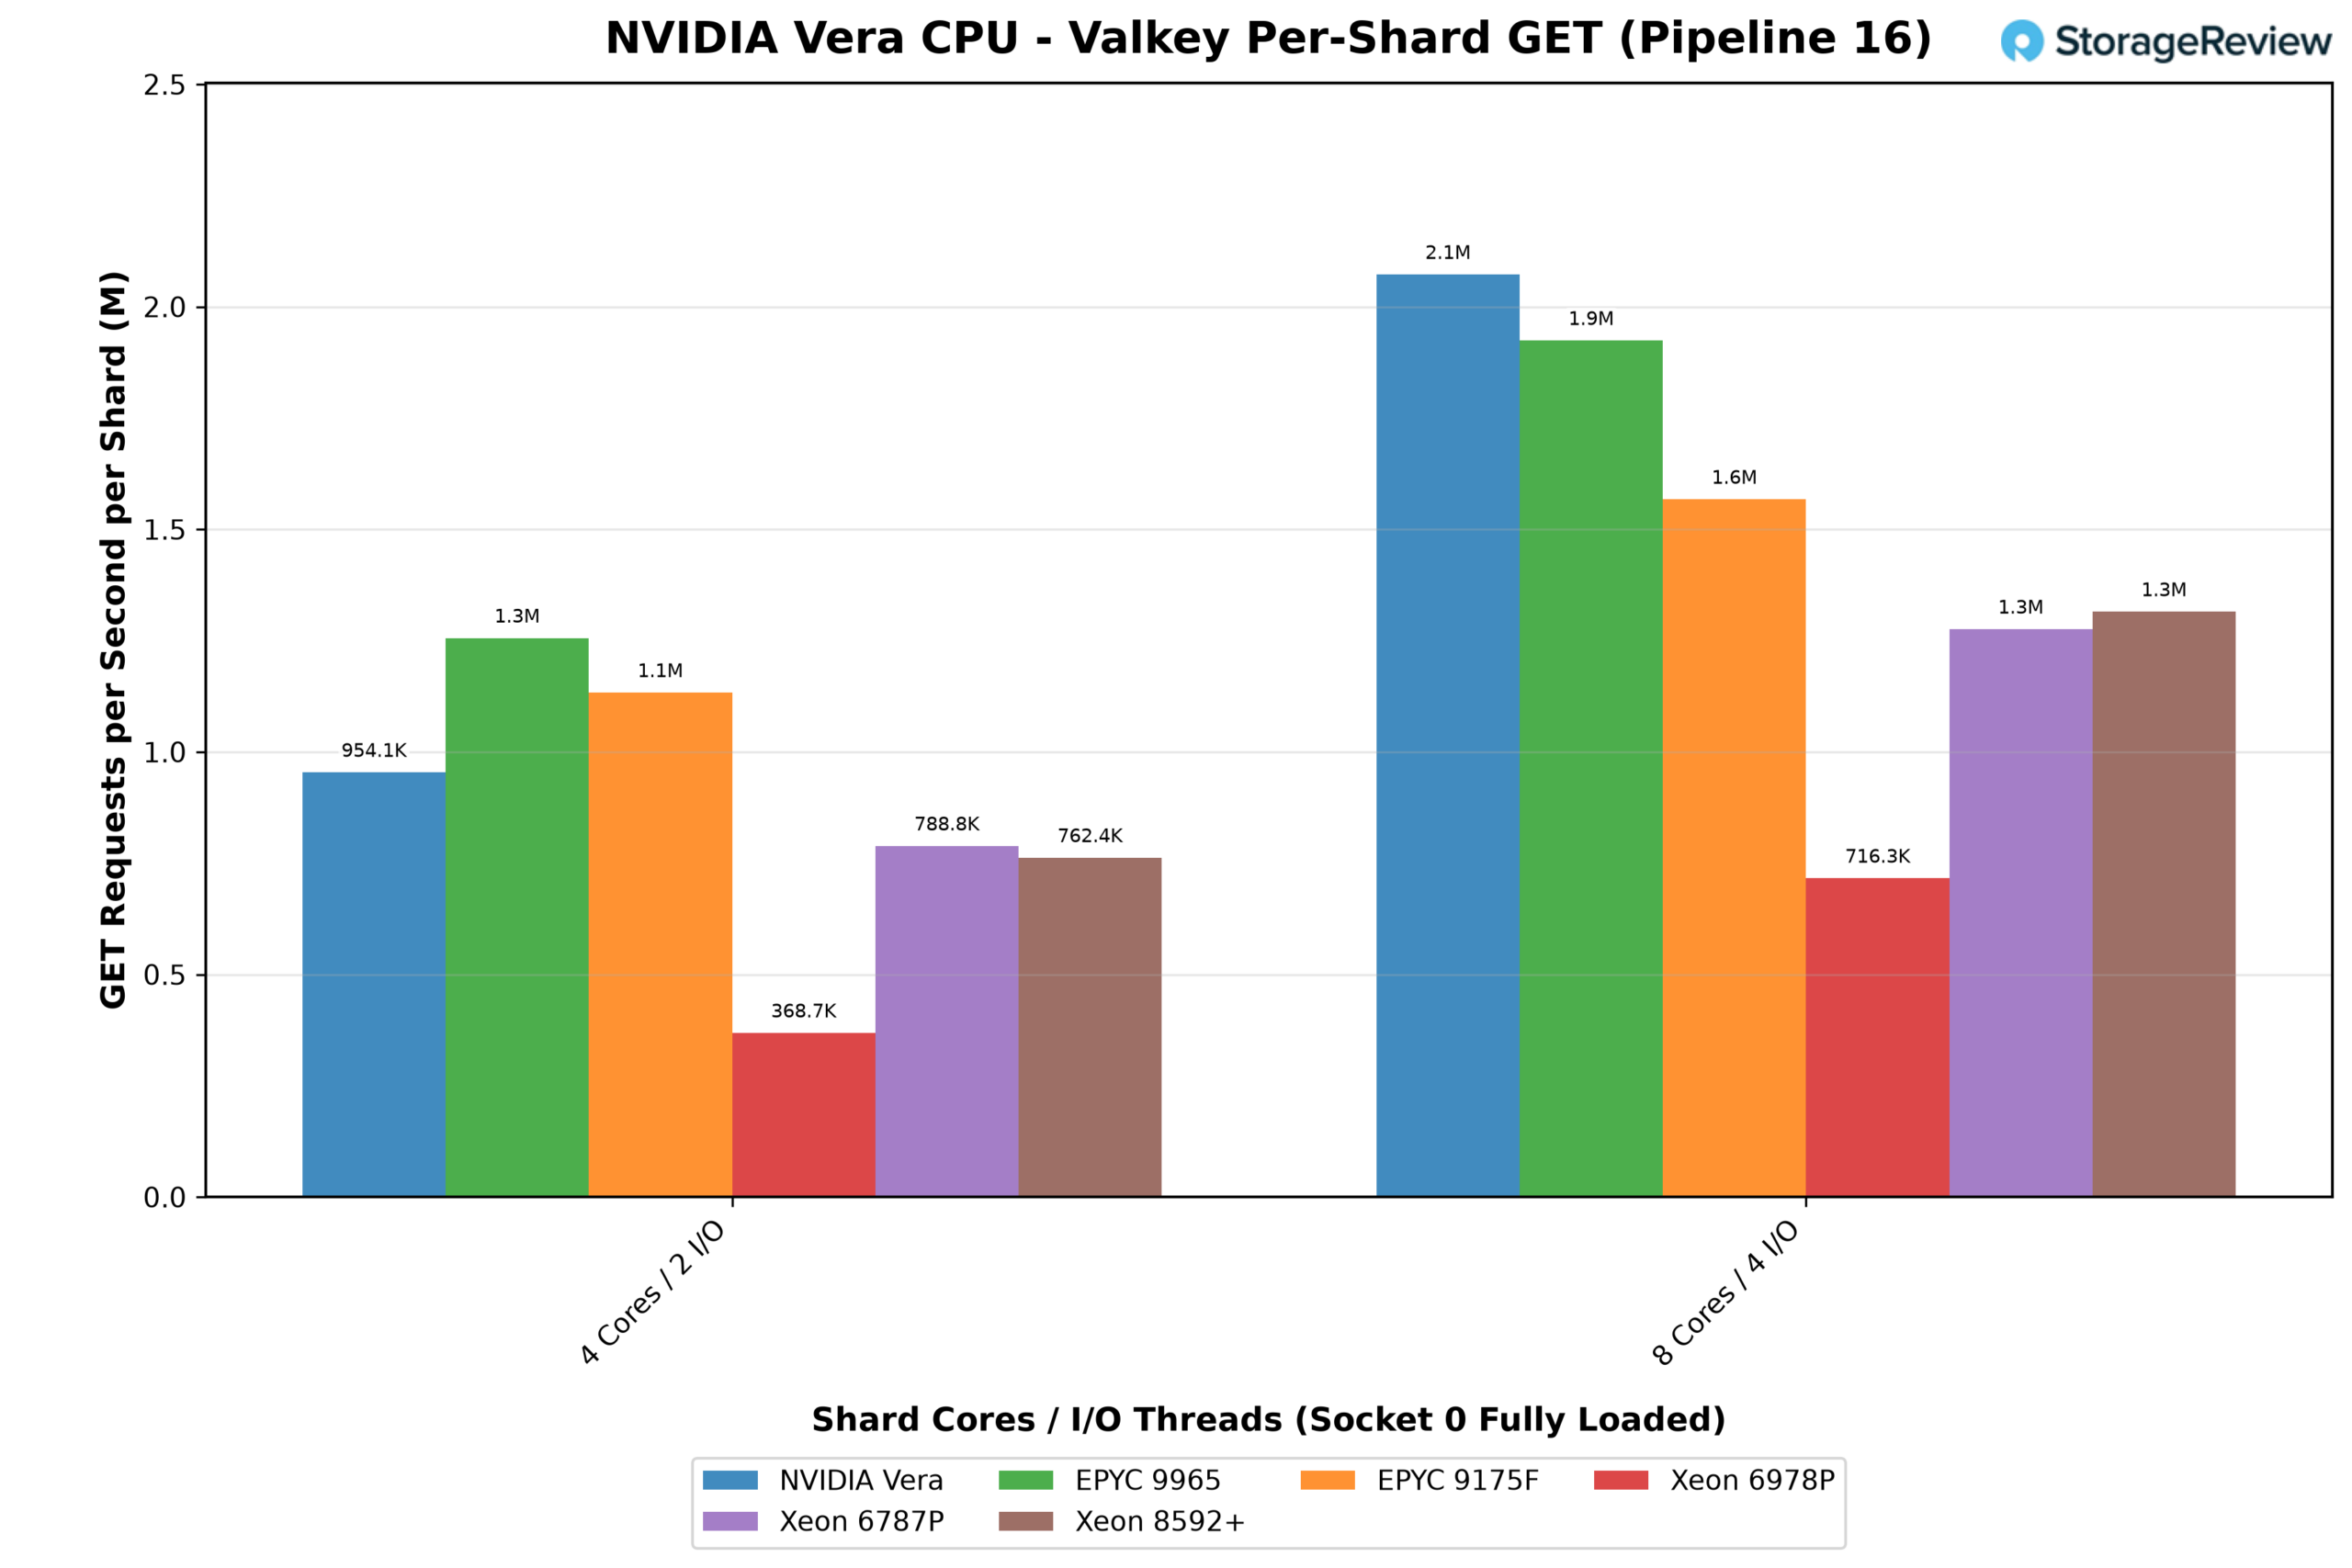
In de socketmodus wordt socket 0 gevuld met identieke shards van vier of acht cores, die allemaal tegelijk verkeer verwerken. Dit komt meer overeen met de werking van een dedicated Valkey-host. Met shards van 8 cores en batches van 16 verwerkte elke Vera-shard 2.07 miljoen GET-verzoeken per seconde, meer dan de 9965 met 1.92 miljoen en ongeveer 1.6 keer zoveel als de Xeon 6787P en 8592+. De p99-latentie steeg echter naar 2.2 ms, tegenover ongeveer 0.5 ms op de 9965.
Met kleinere 4-core shards kwam AMD als winnaar uit de bus: de 9965 haalde 1.26 miljoen GET per shard tegenover 0.95 miljoen van Vera, hoewel Vera nog steeds alle Xeon-processors voorbleef. Wanneer verzoeken één voor één werden verzonden, waren de shards van de 9965 1.5 tot 1.7 keer sneller dan die van Vera, ongeacht de grootte. Ook de 6787P en 8592+ liepen voor op 8-core shards.
De dichtheid bepaalt het totale aantal sockets: een Vera-socket bevat 11 shards met elk acht cores en verwerkt 22.8 miljoen GET-verzoeken per seconde, terwijl de 192 cores van de 9965 48 shards met elk vier cores bevatten en 60.3 miljoen verzoeken verwerken. Vera levert de snelste shards in onze test zodra elke shard acht of meer cores heeft en verzoeken worden gebundeld, maar de 9965 kan meer dan twee keer zoveel shards in een socket kwijt.
Single-thread en doorvoer
Valkey en ClickBench maakten evenveel gebruik van het geheugensysteem als van de processorkernen. In dit gedeelte richten we ons op de processorkernen zelf en op de twee eerder beschreven doelen van Olympus: individuele taken snel voltooien en die snelheid behouden wanneer de hele processor bezet is. 7-Zip, OpenSSL en Python draaien elk als een enkele thread die aan één processorkern is gekoppeld, waarmee wordt aangetoond wat een Olympus-kern op zichzelf kan doen. Vervolgens draaien 7-Zip en OpenSSL opnieuw, maar dan over alle threads in het systeem, om te laten zien hoeveel van die snelheid per processorkern behouden blijft wanneer alle kernen strijden om dezelfde caches en geheugen.
7-Zip
De LZMA-compressie van 7-Zip maakt gebruik van vertakkingsintensieve integercode met onvoorspelbare geheugentoegang, het soort werk waarvoor de 10-brede front-end en grafiekprefetcher van Olympus zijn ontworpen.
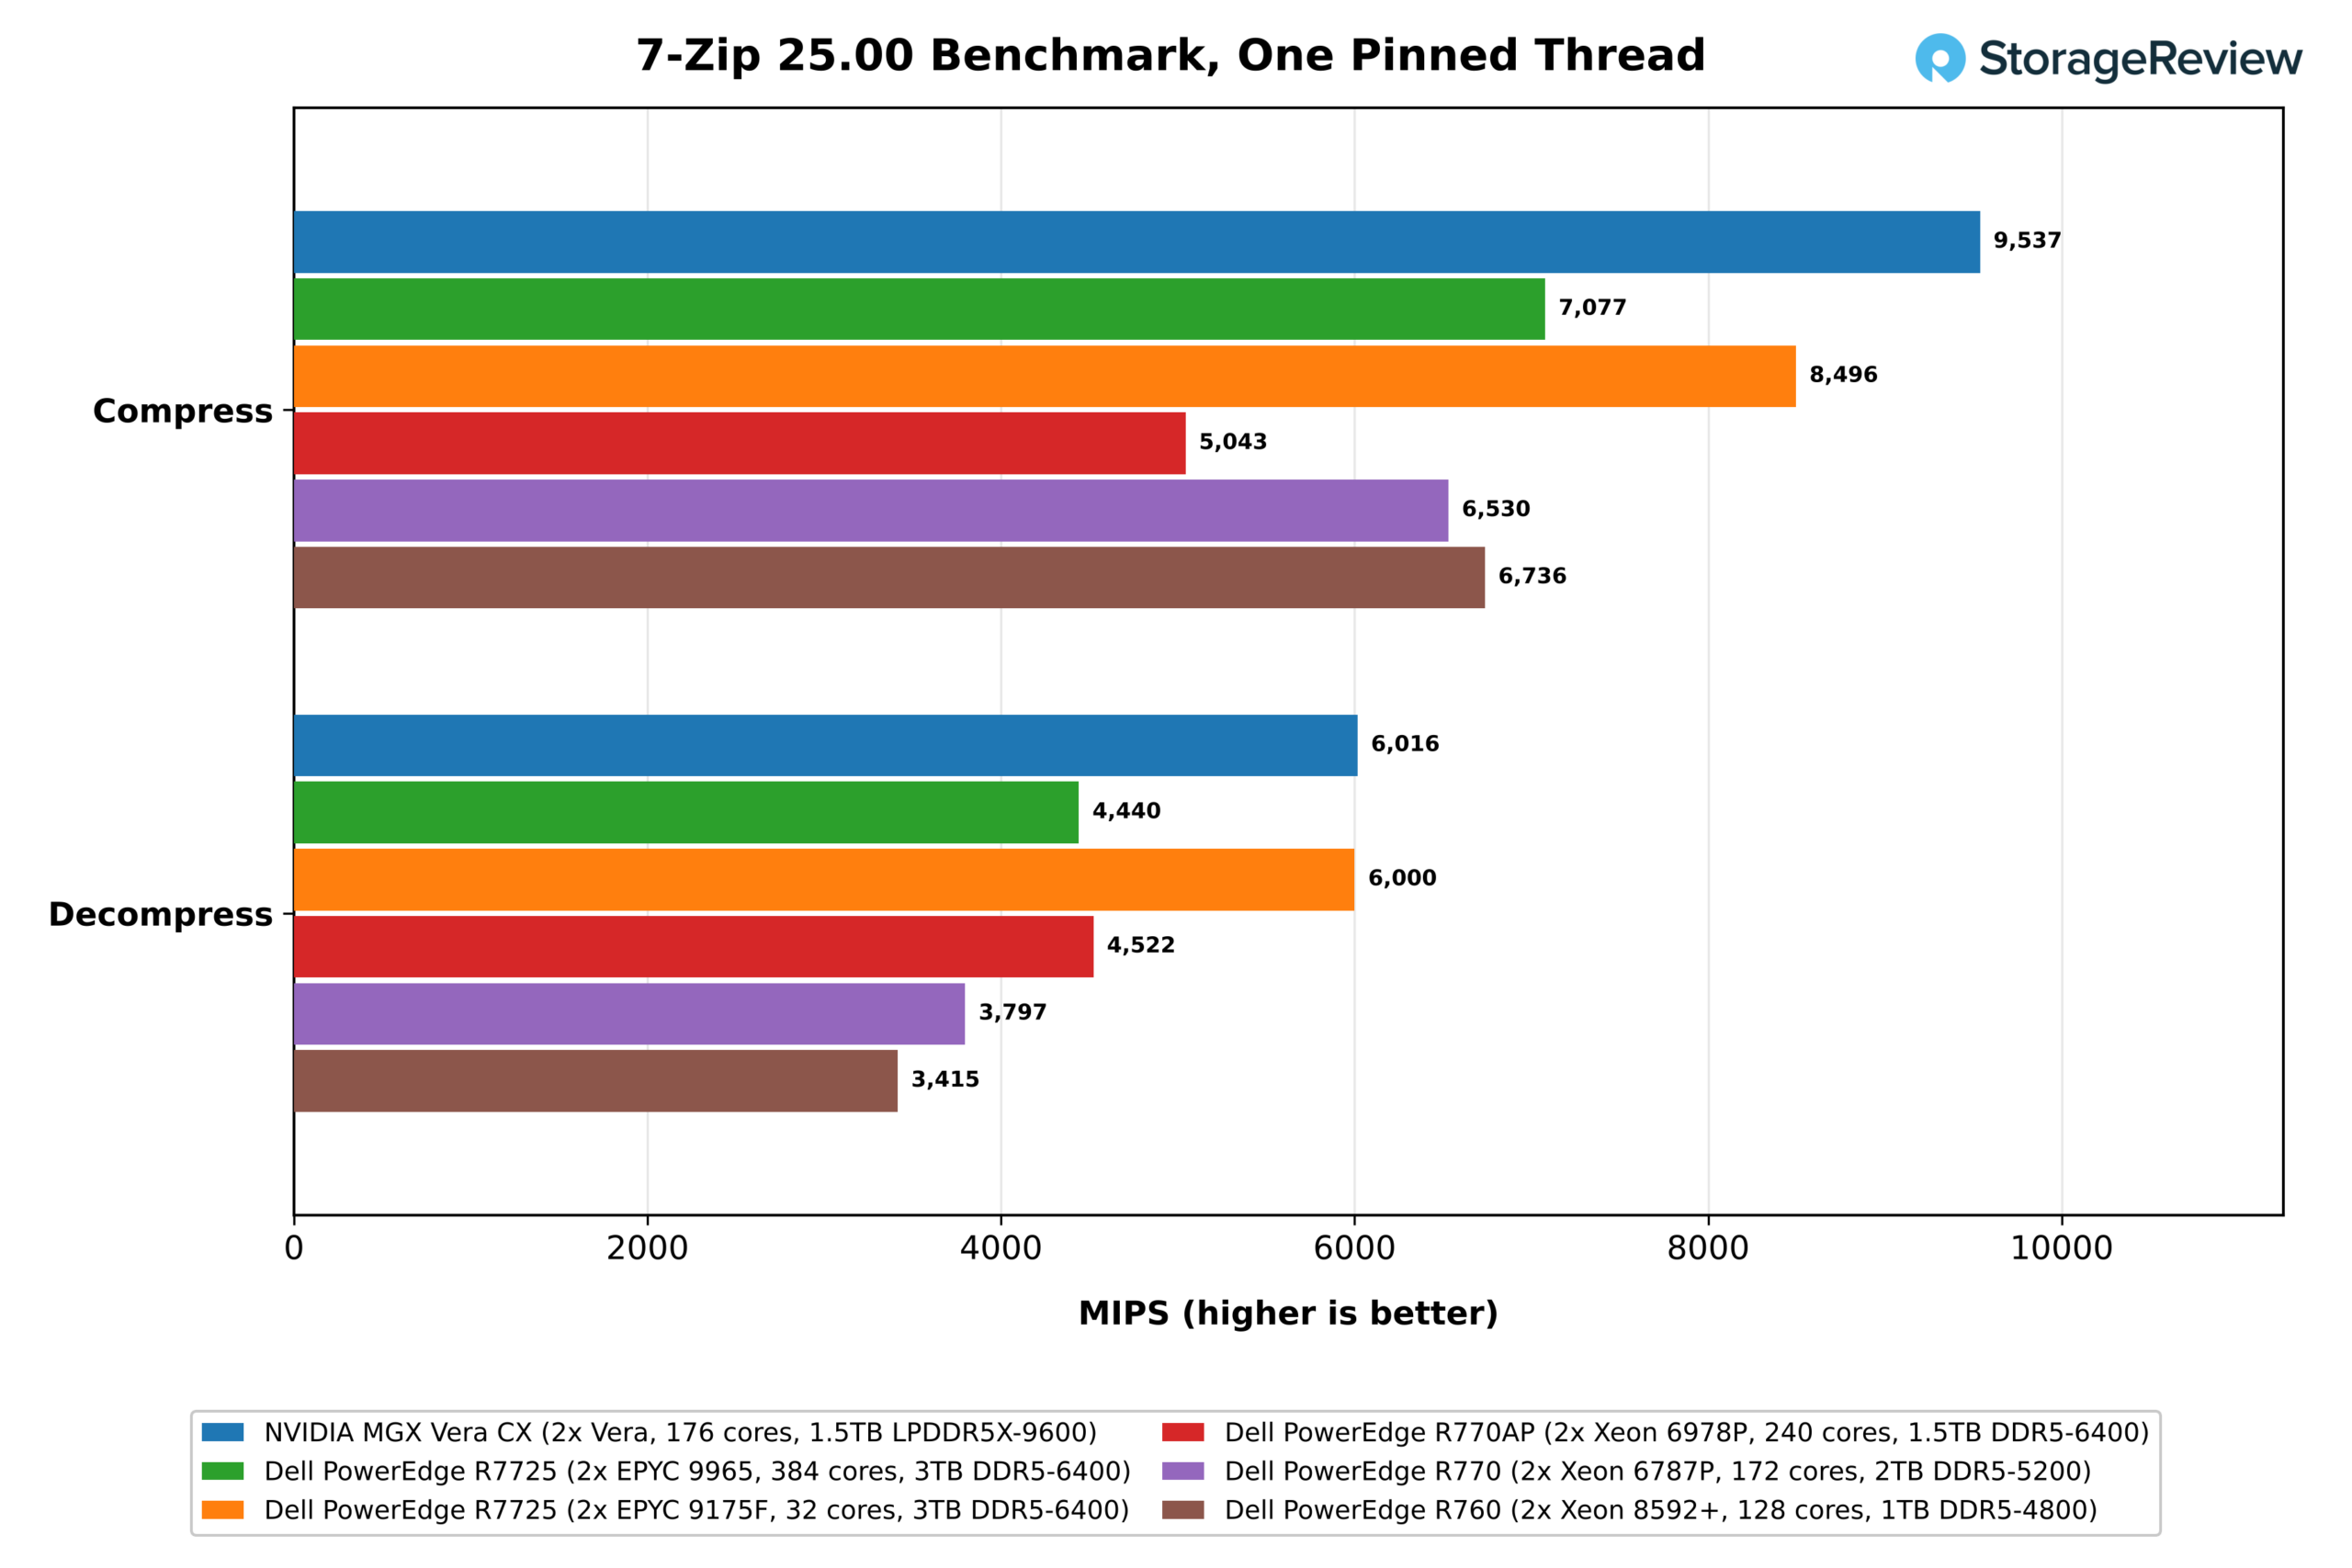
Op één thread was Olympus de snelste compressor in onze test. Hij behaalde 9,537 MIPS, 12% sneller dan de 5.0 GHz EPYC 9175F, de snelste x86-processor in deze test, en ruim voor de EPYC 9965 en alle Xeon-processors. Decompressie was een nek-aan-nekrace tussen de twee: 6,016 MIPS voor Vera en 6,000 voor de 9175F, waarbij geen enkel ander systeem binnen 20% van de waarden kwam.
Door alle threads te doorlopen, wordt duidelijk hoeveel van die voorsprong overblijft wanneer het hele systeem bezet is.
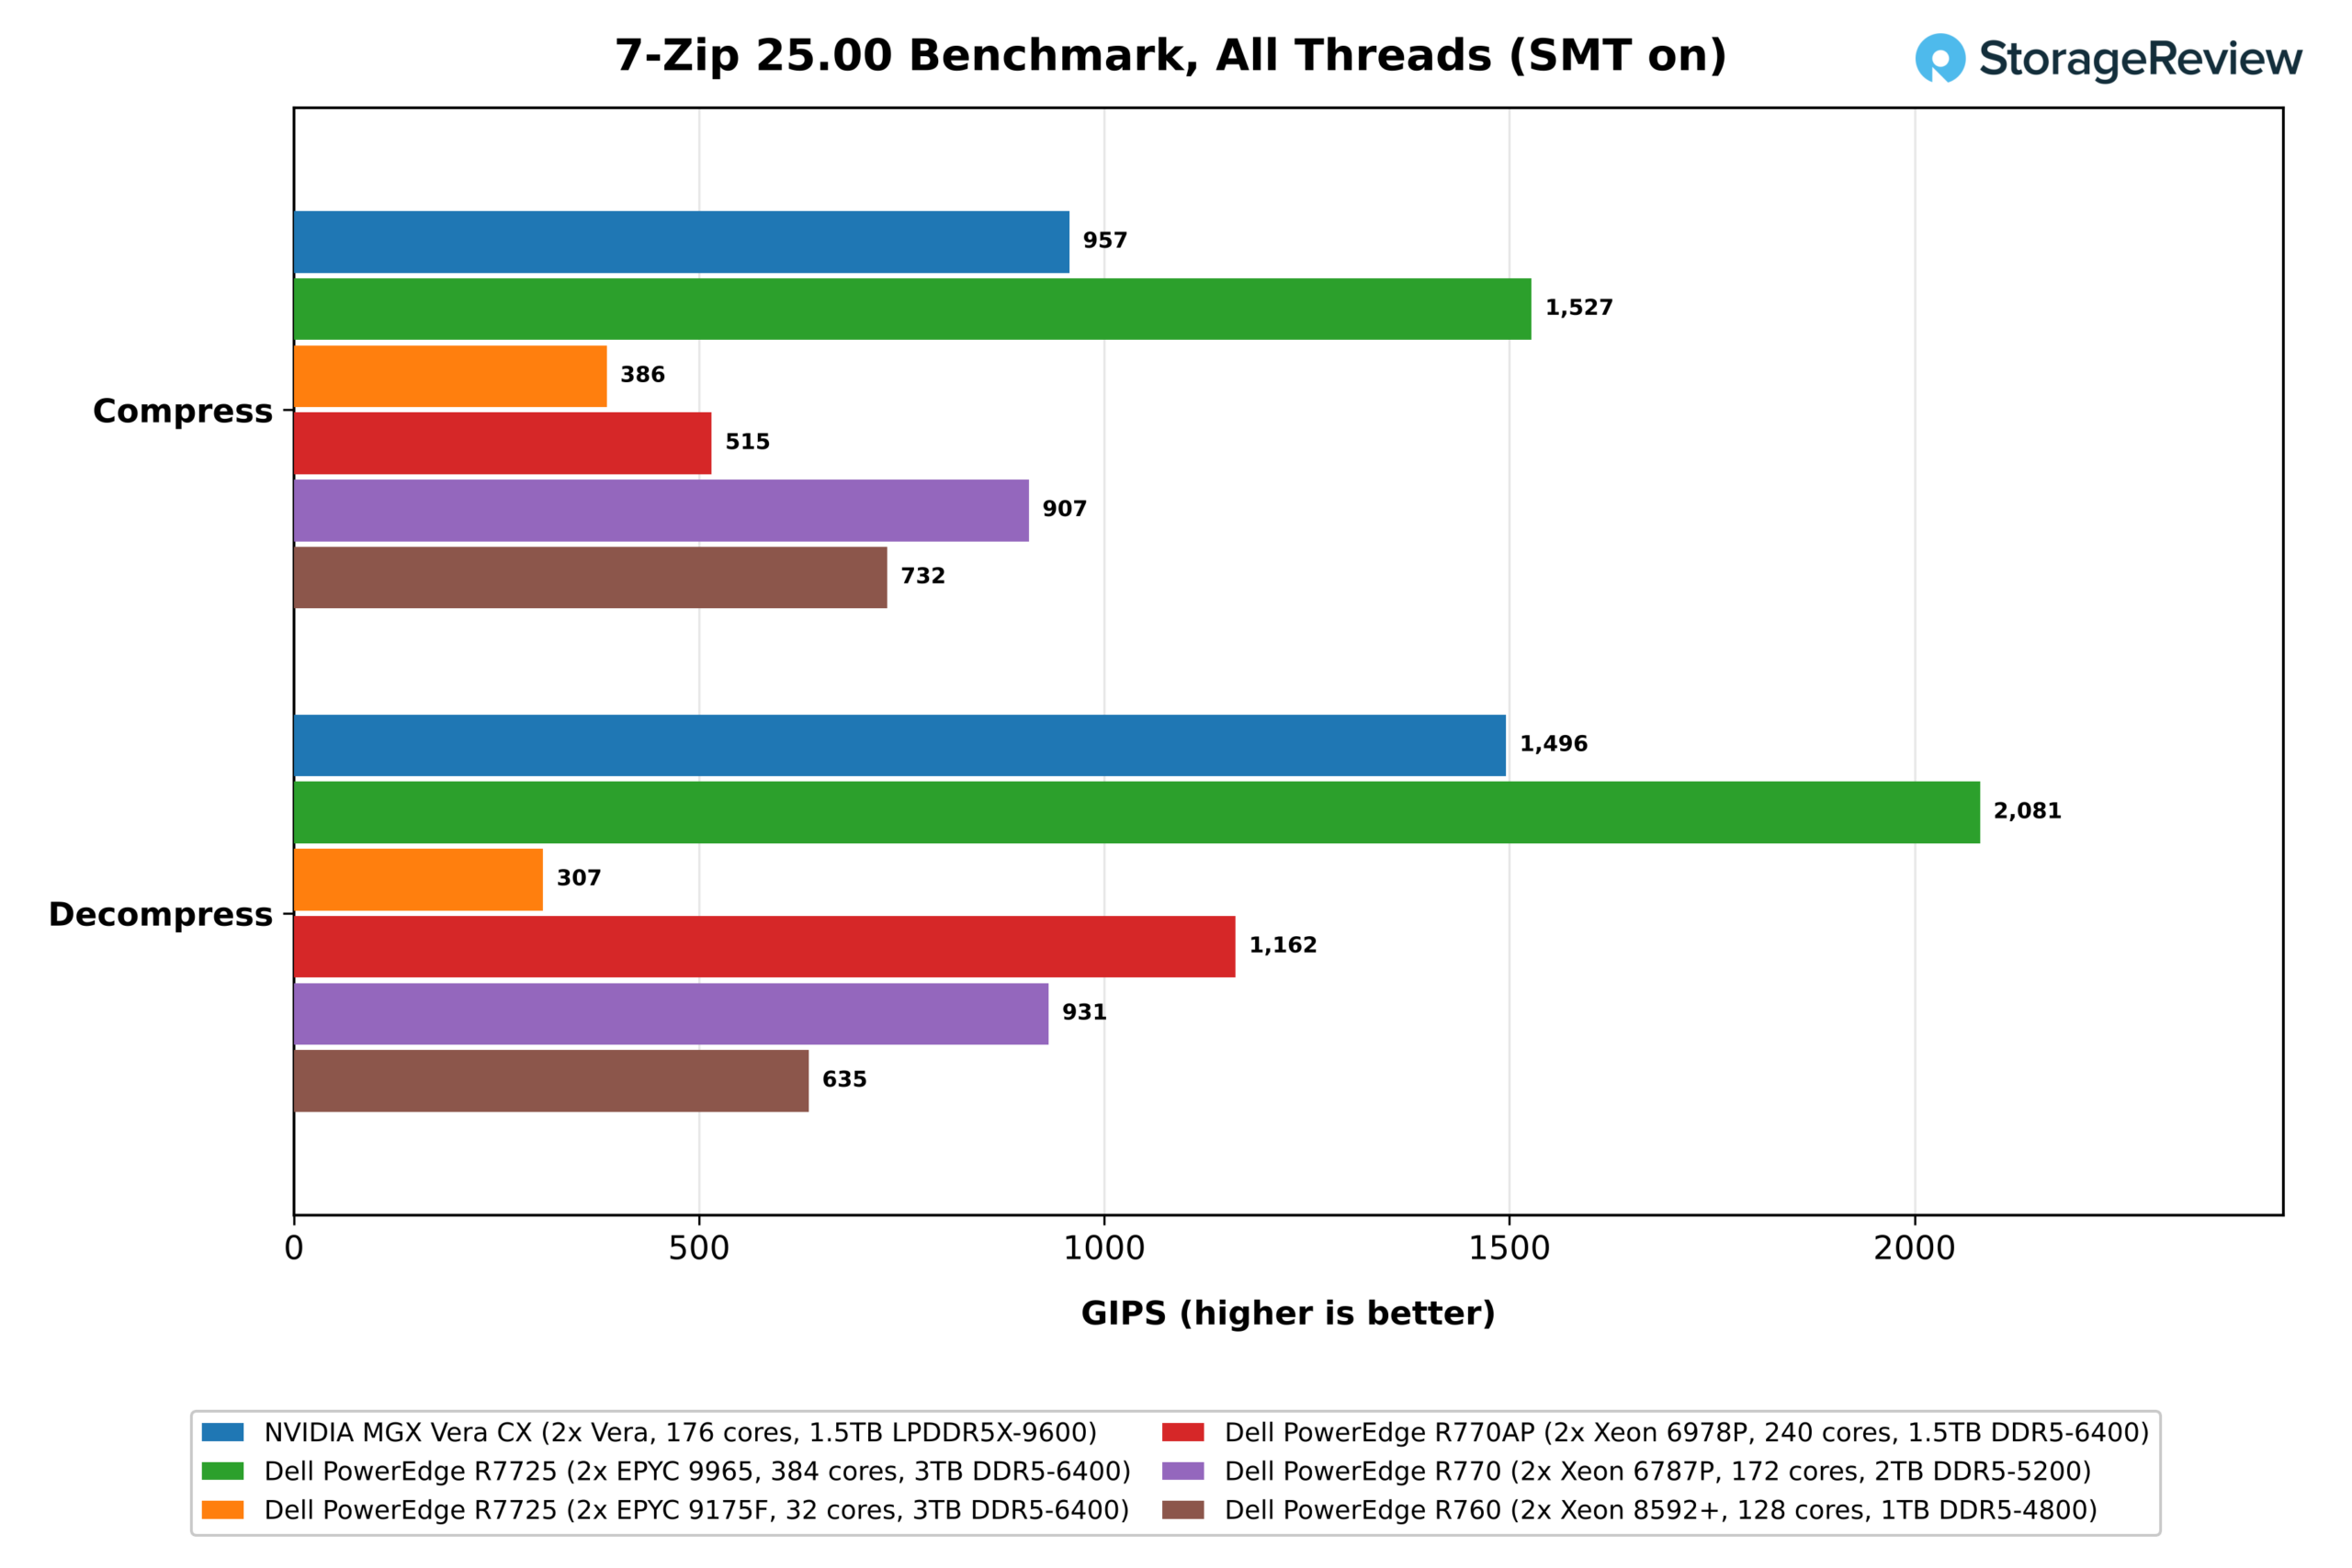
Met alle threads actief, behaalde de EPYC 9965 met 768 threads de eerste plaats met 1,527 GIPS voor compressie en 2,081 GIPS voor decompressie. De Vera kwam met 352 threads op de tweede plaats met 957 en 1,496 GIPS, vóór alle Xeon-processors, met de 6787P als dichtstbijzijnde met 907 en 931. Gemeten per fysieke core presteert de Vera goed. De compressie van 5.4 GIPS per core is gelijk aan die van de 6787P en 8592+ en overtreft de 4.0 van de 9965, en de decompressie van 8.5 GIPS per core is 57% hoger dan die van de 9965 en overtreft alle Xeon-processors. Alleen de 32-core 9175F, met veel minder cores die de caches en het geheugen van elke socket delen, presteerde per core beter op beide gebieden.
OpenSSL
De AES-256-GCM-test van OpenSSL is waar Vera het meest tekortschiet. Slechts twee van de zes 128-bits SVE2-pipes van Olympus kunnen cryptografische instructies uitvoeren, terwijl de x86-onderdelen AES op 512-bits registers met VAES kunnen uitvoeren.
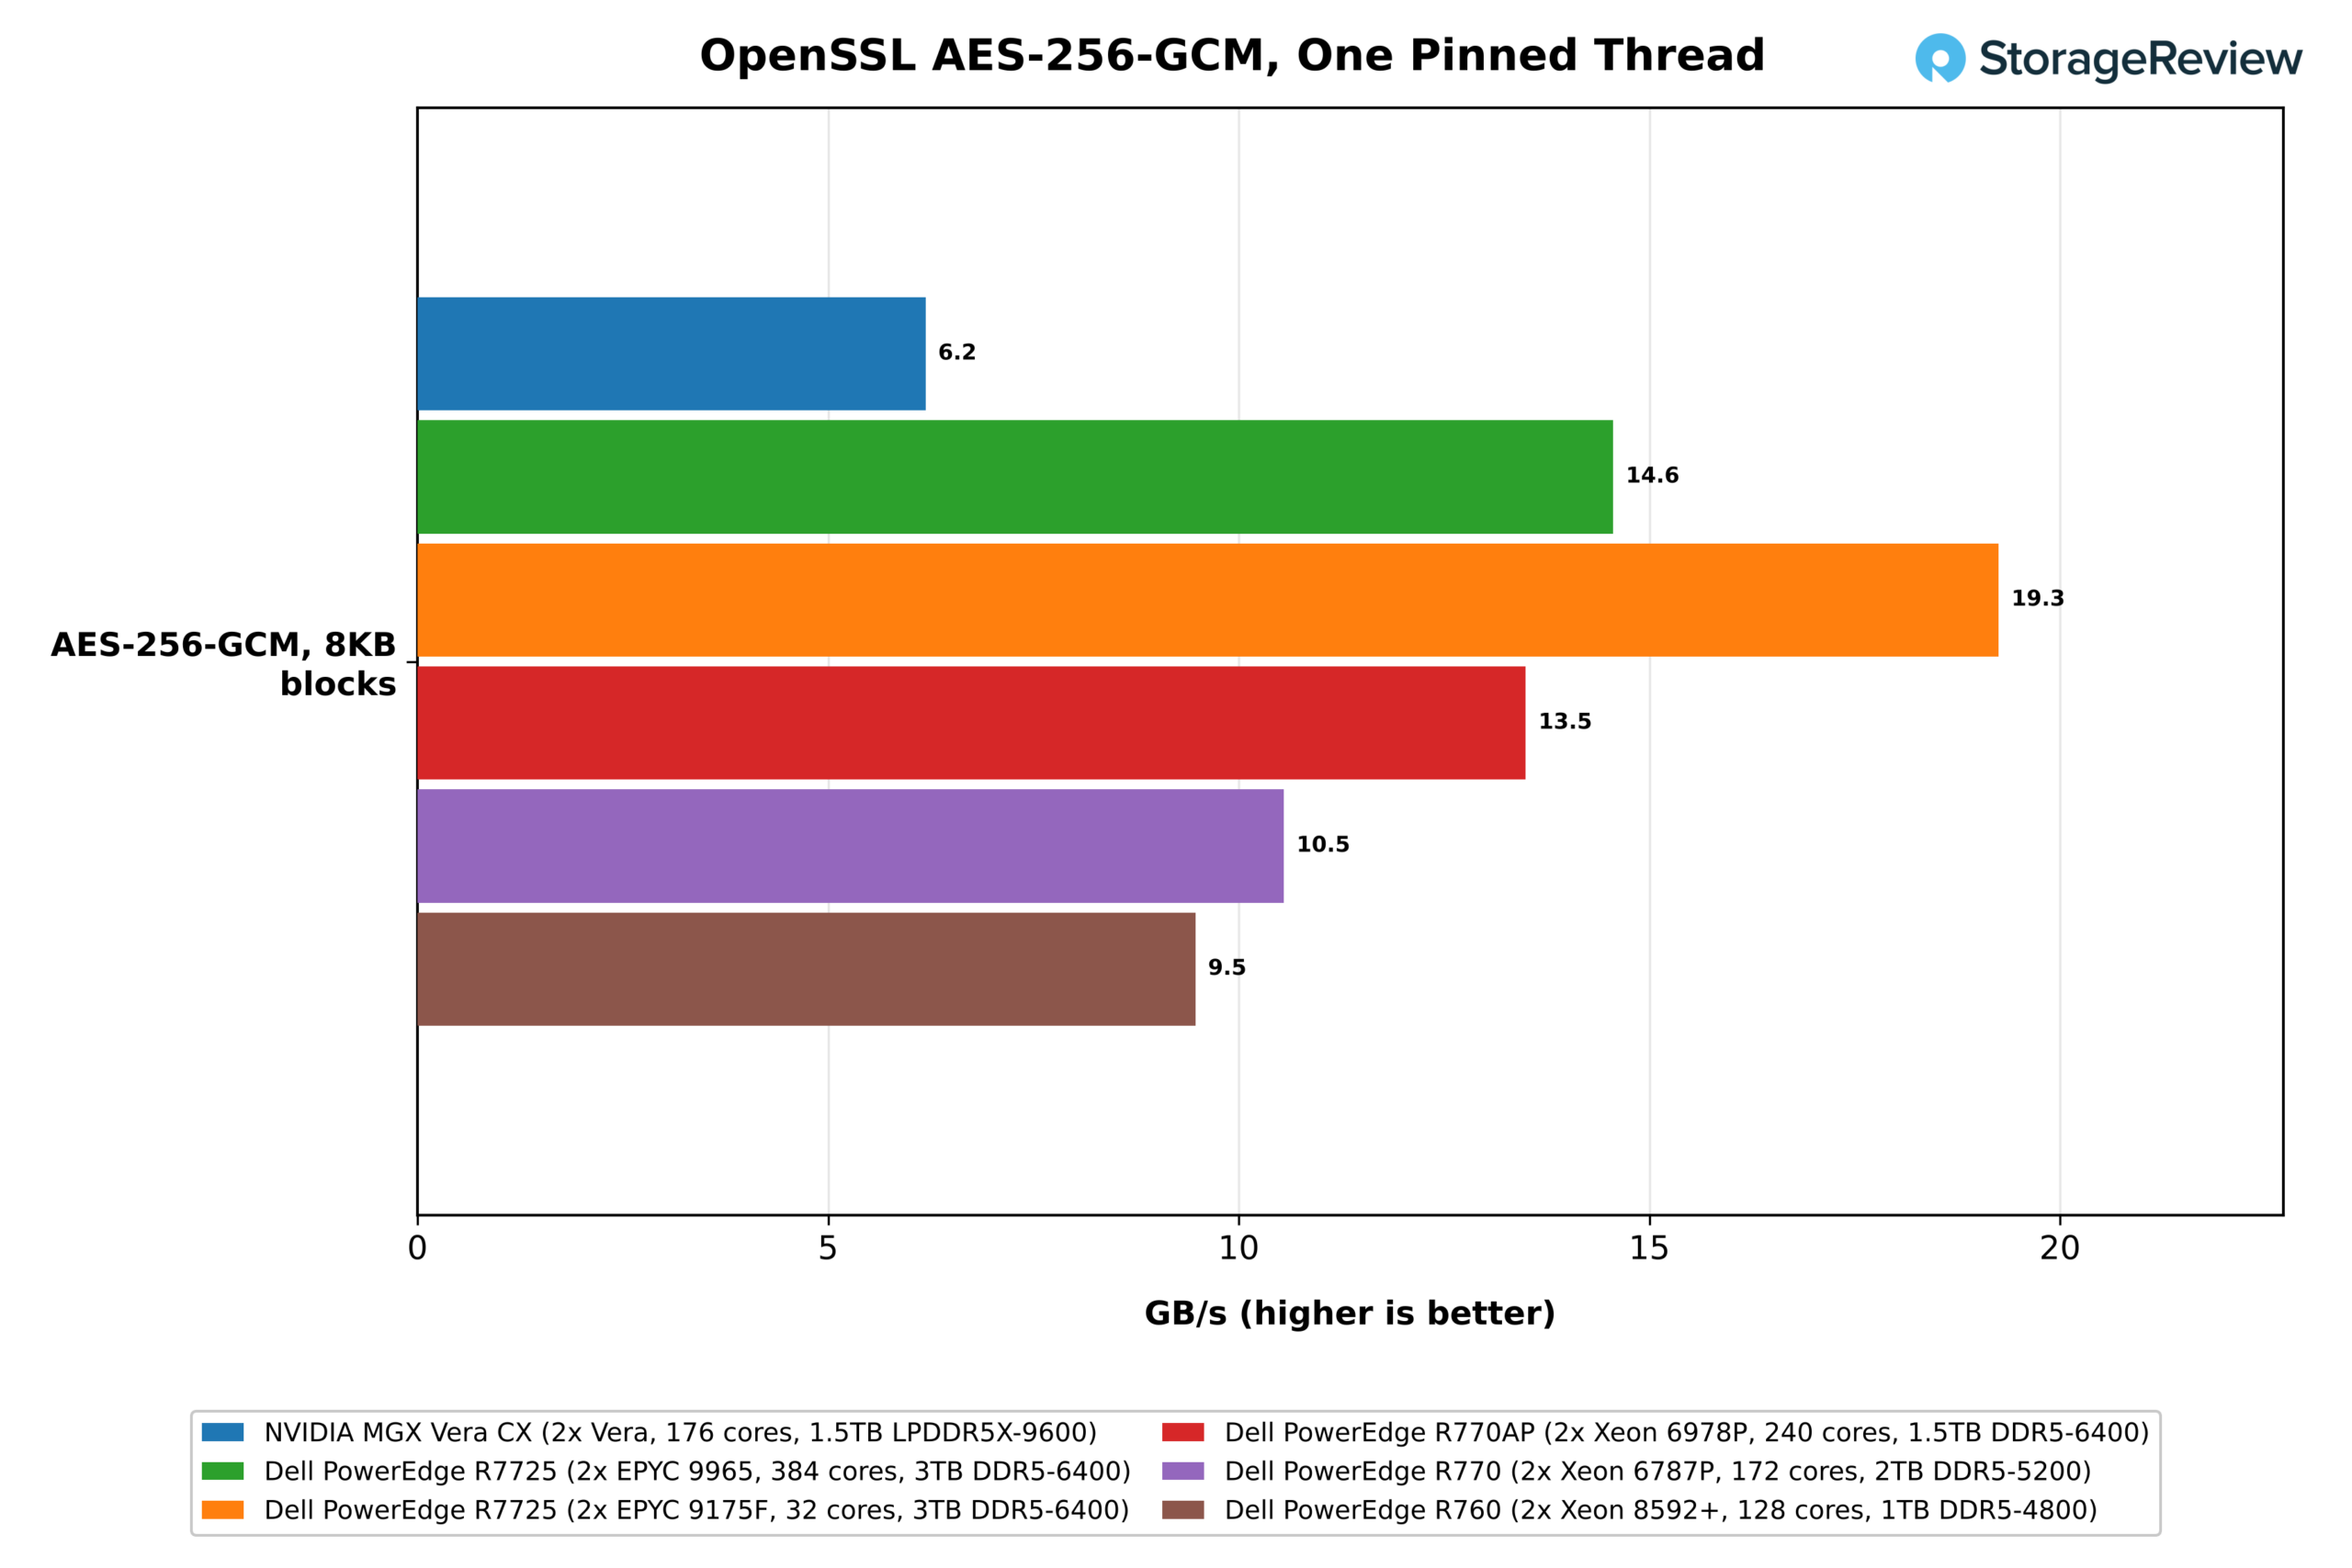
Het verschil is het duidelijkst te zien bij één enkele thread. Eén Olympus-core versleutelde met 6.2 GB/s, ongeveer een derde van de 19.3 GB/s van de EPYC 9175F, en aanzienlijk minder dan de EPYC 9965 met 14.6 GB/s en de Xeon 6978P met 13.5 GB/s.
In alle threads komen de x86-systemen overeen op basis van het aantal cores, wat aantoont waar dat tekort per core Vera treft.
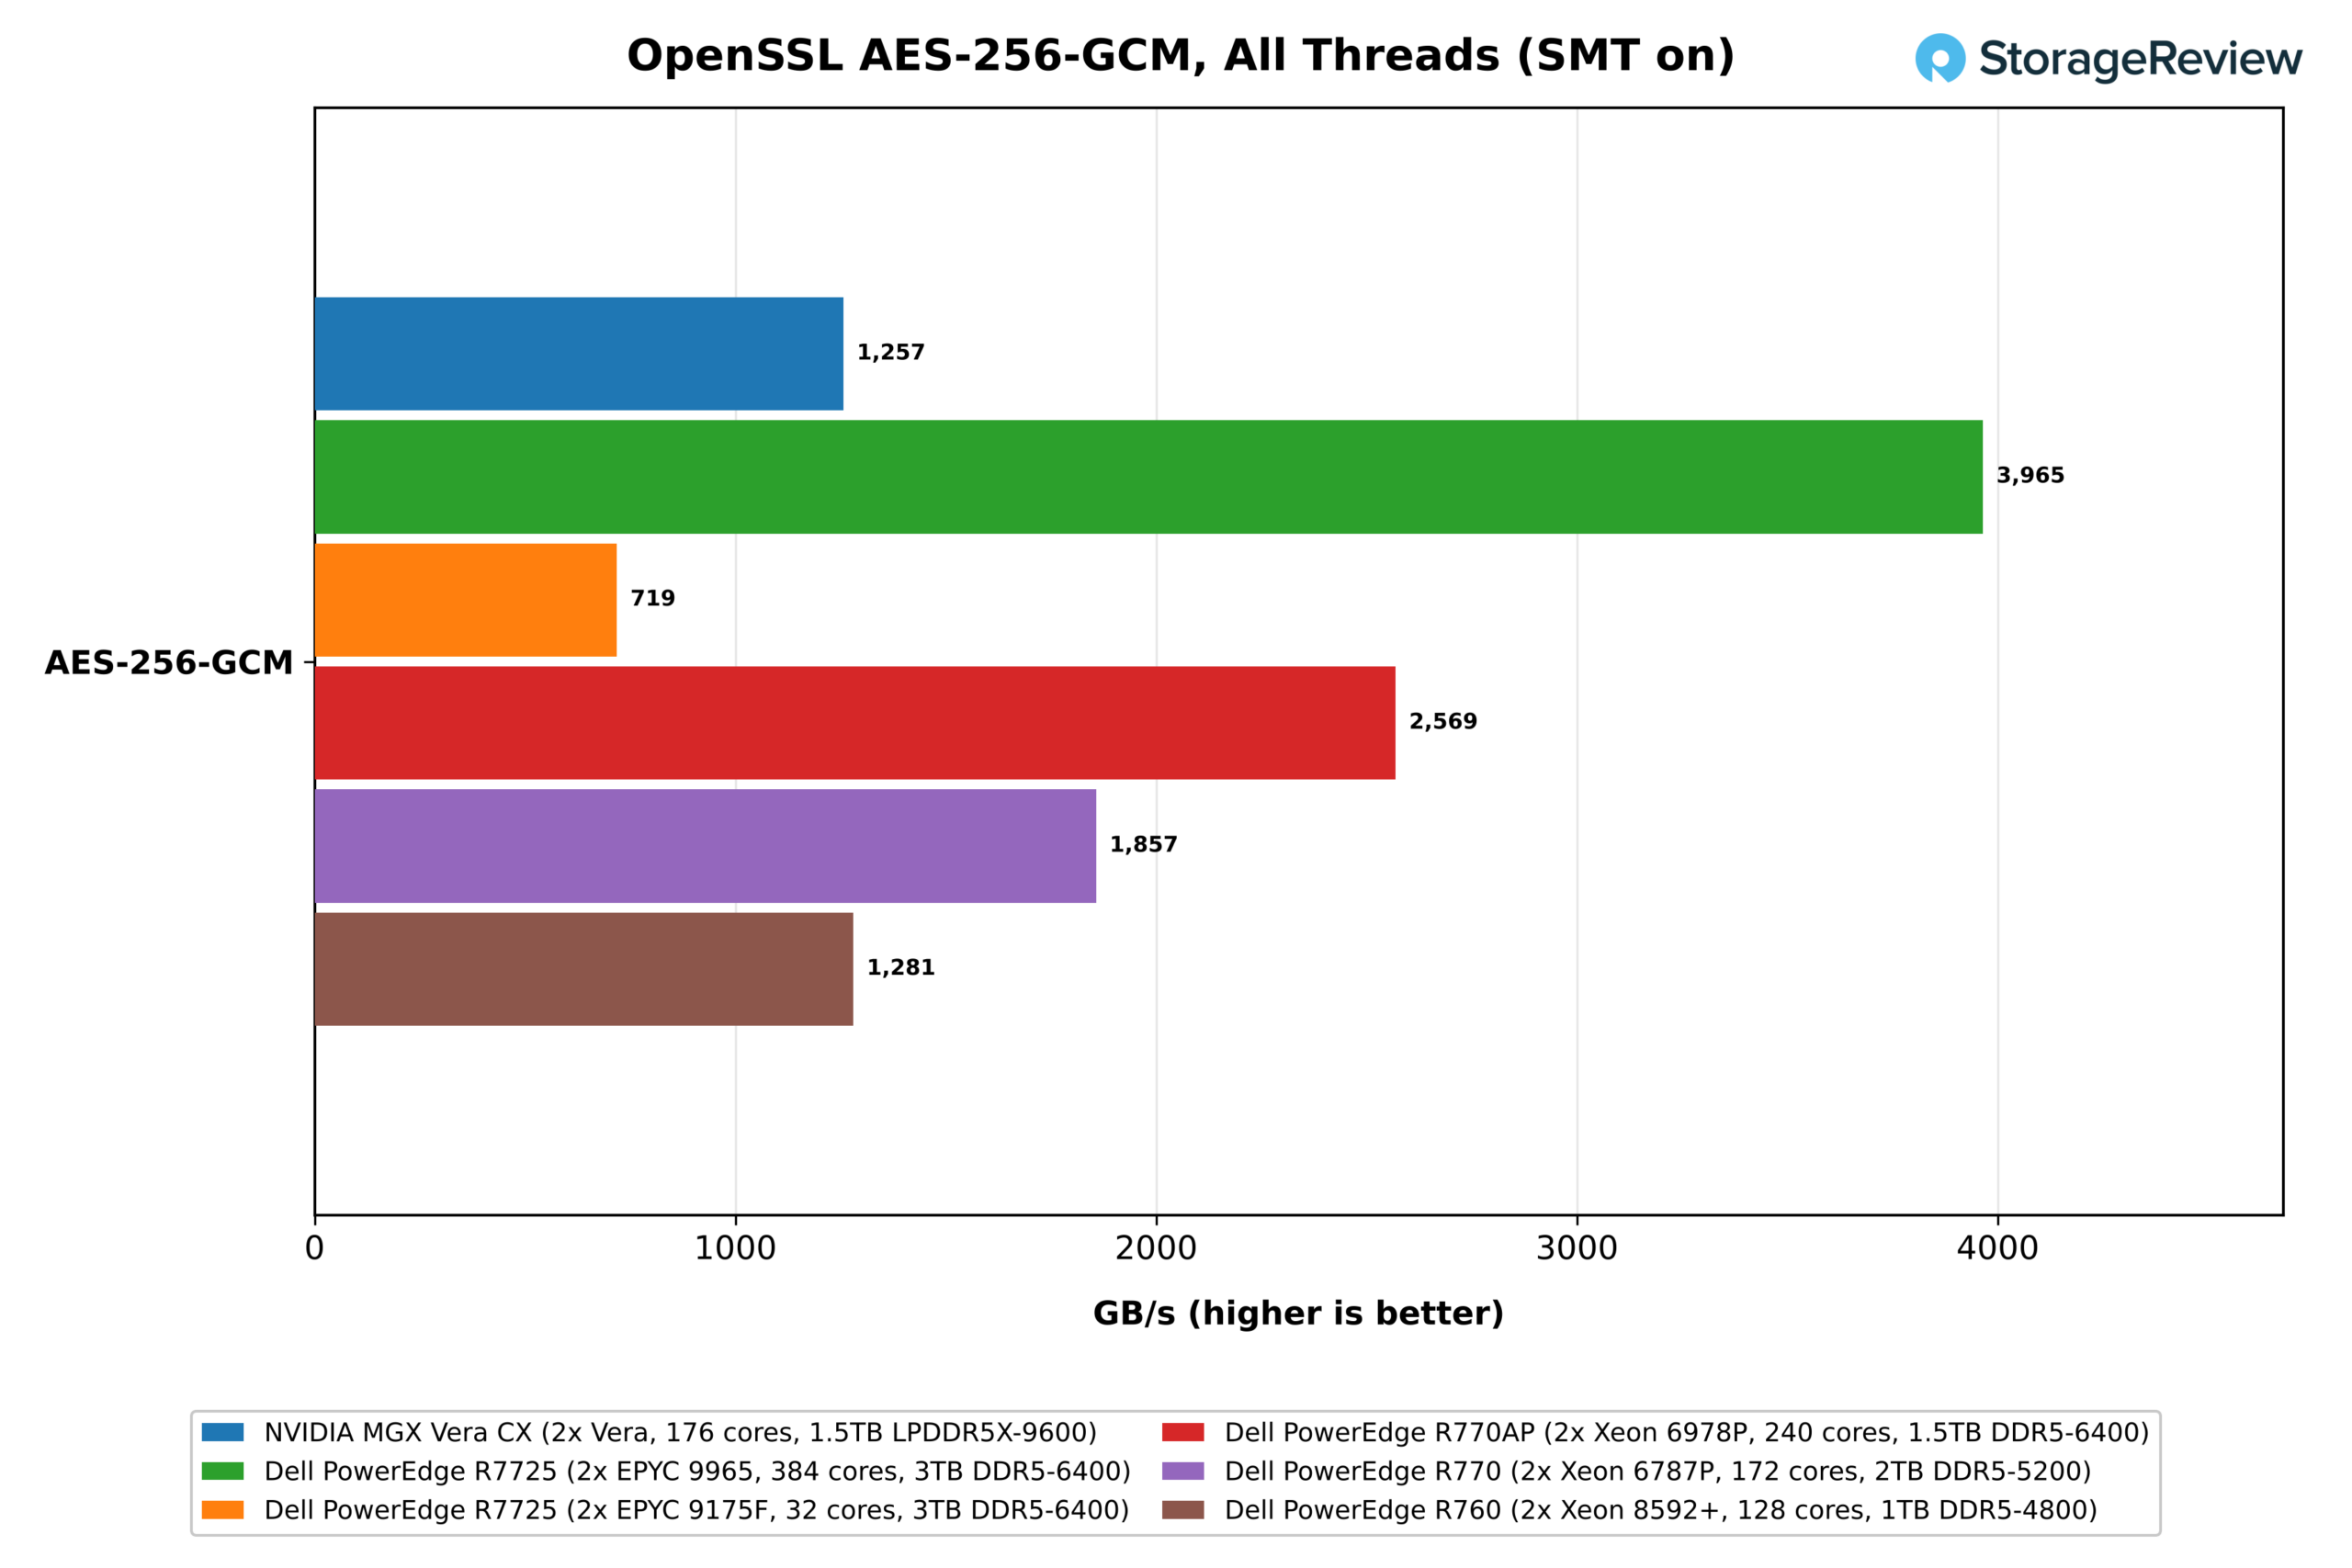
Met alle 352 threads in gebruik behaalde Vera een snelheid van 1.26 TB/s, gelijk aan de 128-core Xeon 8592+ met 1.28 TB/s en alleen sneller dan de 32-core EPYC 9175F. De EPYC 9965 was koploper met 3.96 TB/s, ongeveer drie keer zo snel als Vera, gevolgd door de Xeon 6978P met 2.57 TB/s en de 6787P met 1.86 TB/s.
Python
Python speelt een centrale rol in de agent-sandboxes waarop NVIDIA zich richt met Vera, en pyperformance biedt ons drie single-thread tests: go, een objectintensieve zoektaak in een spelboom; regex_compile, dat reguliere expressies compileert; en nbody, een drijvende-komma-fysicasimulatie. Een softwareverschil is hier van belang: Vera draaide Python 3.14.4 van Ubuntu 26.04, terwijl de x86-systemen 3.12.3 van Ubuntu 24.04 draaiden, en de nieuwere versie biedt snellere interpreters.
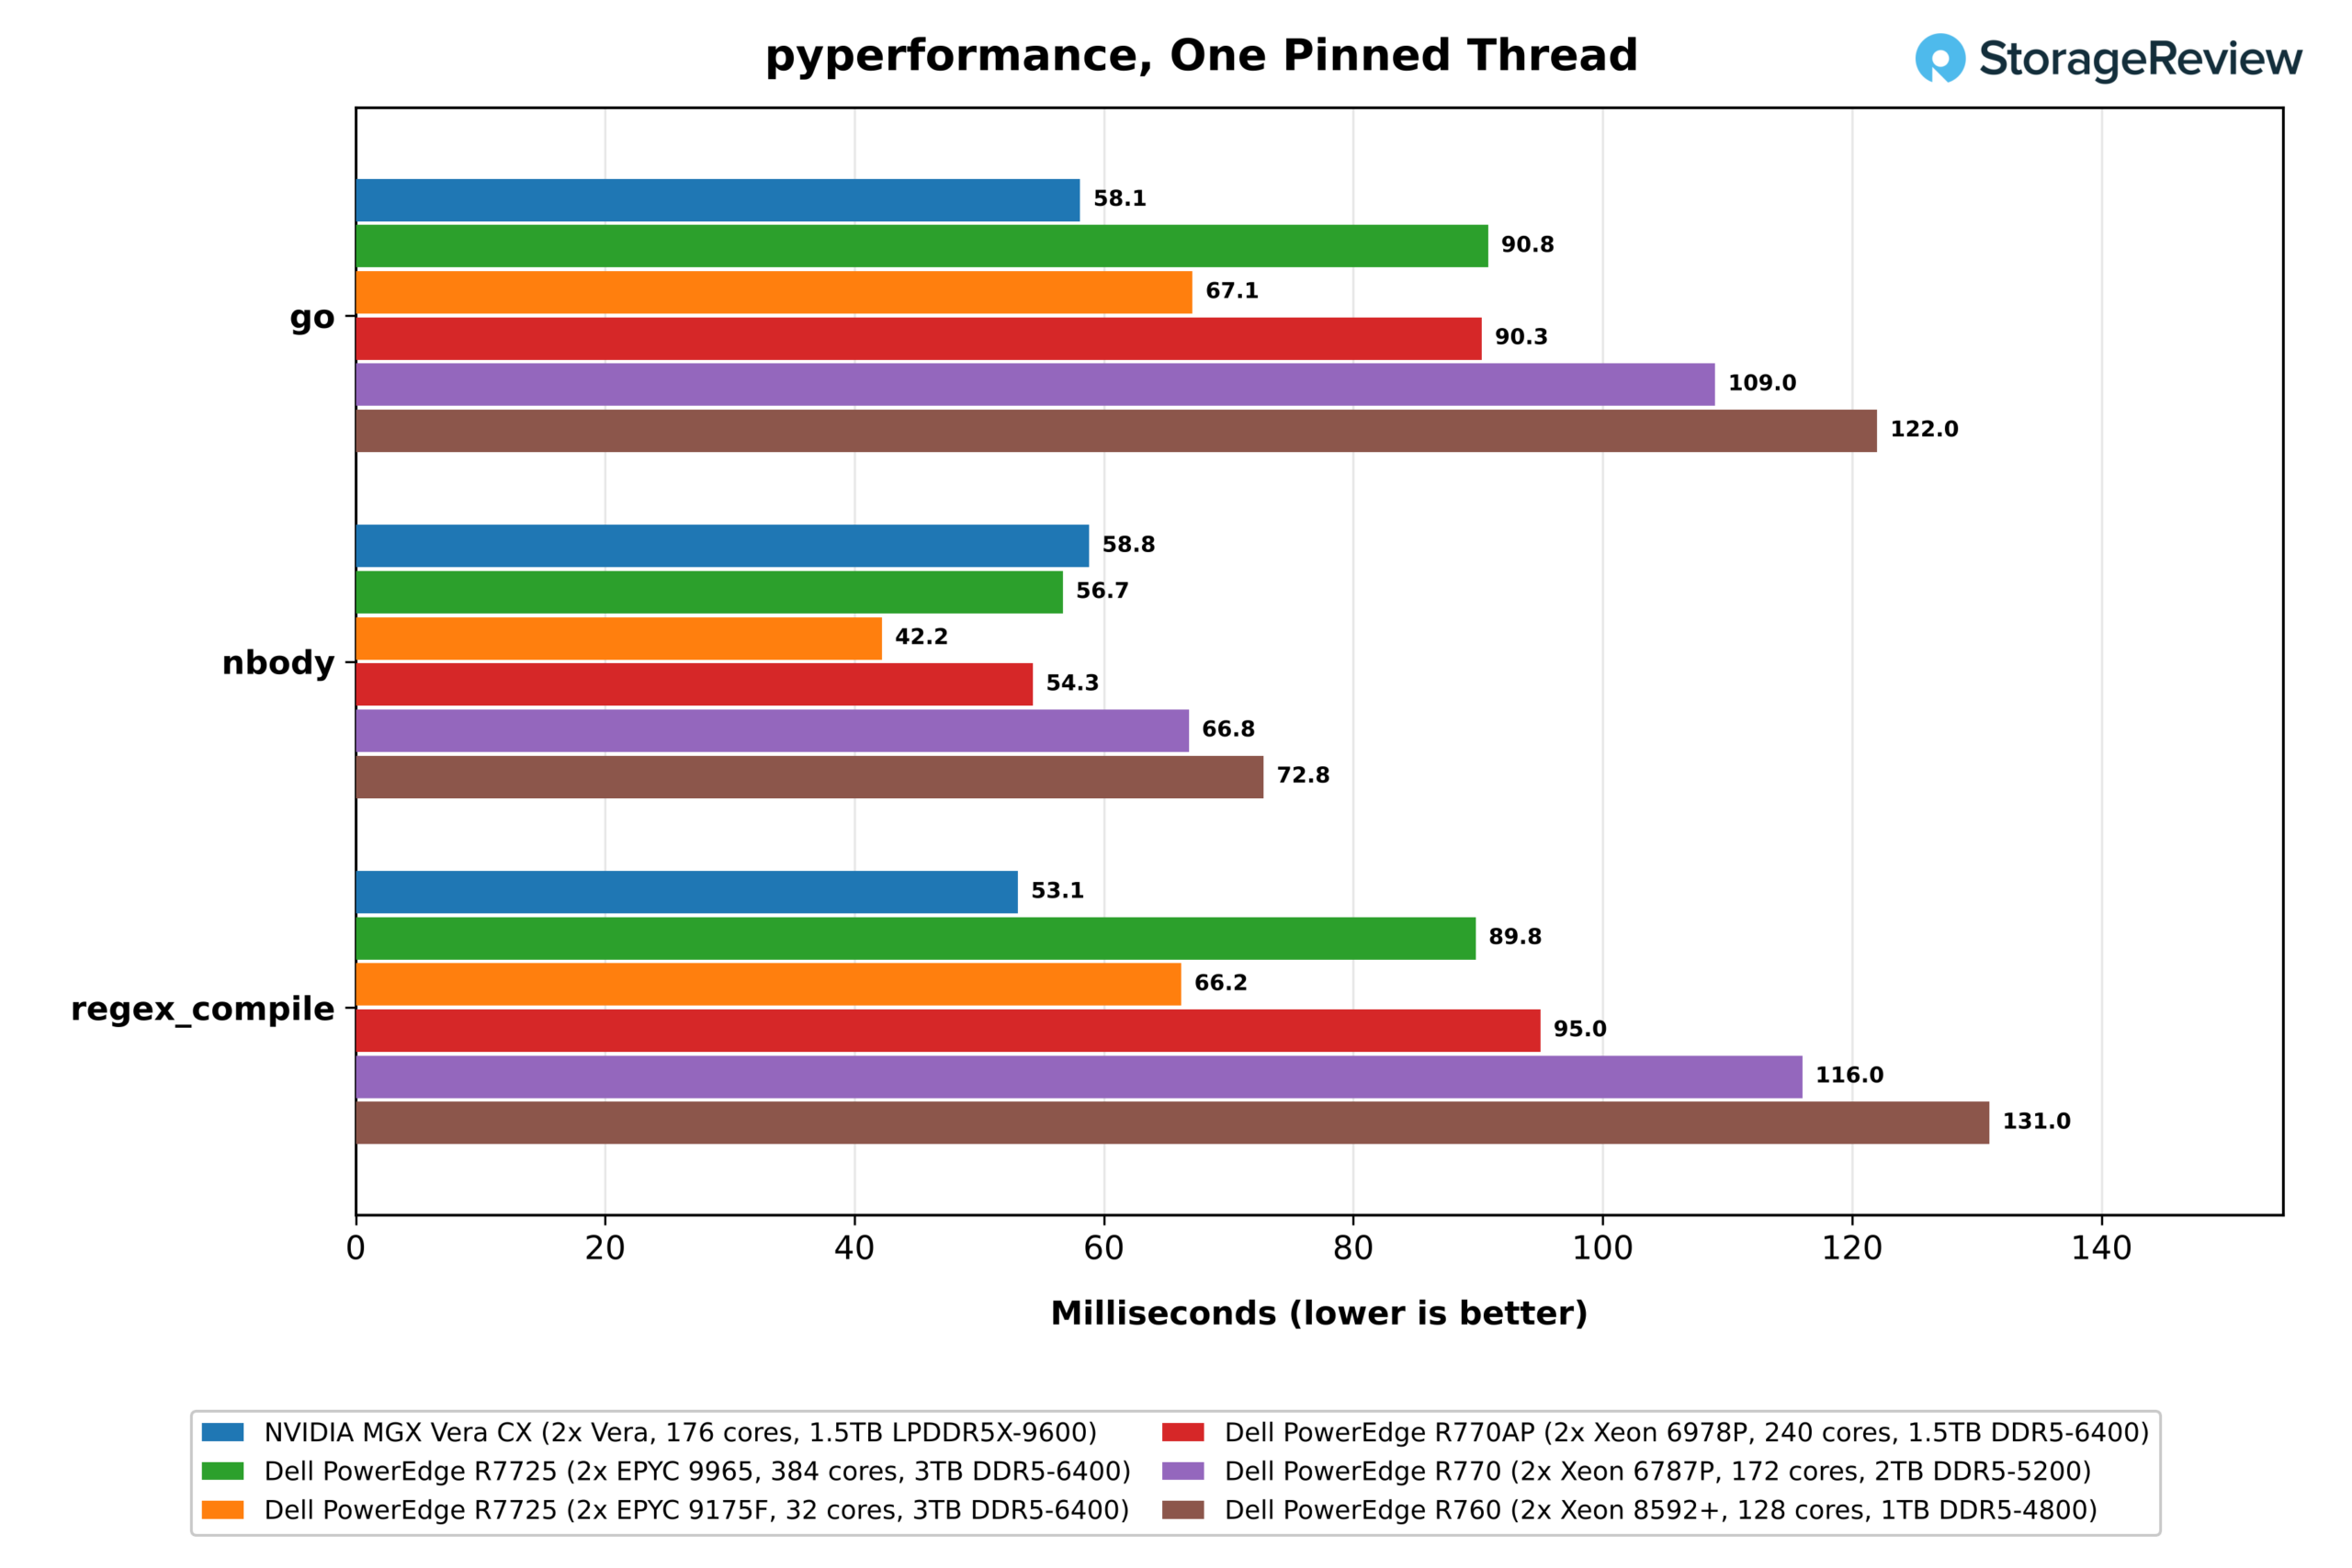
Vera won de twee tests die gebaseerd waren op complexe, objectgeoriënteerde code. Go voltooide de test in 58.1 ms, 15% sneller dan de EPYC 9175F, de snelste x86-processor in deze test, en 1.6 tot 2.1 keer sneller dan de rest. Regex_compile liet een nog grotere voorsprong zien en voltooide de test in 53.1 ms, 25% sneller dan de 9175F en 1.7 keer sneller dan de EPYC 9965. Omdat Vera ook de nieuwere Python-versie gebruikte, moeten beide marges als bovengrenzen worden beschouwd.
nbody ging de andere kant op, omdat de korte floating-point lus en de kleine werkset de voorkeur geven aan hoge kloksnelheden, en de 5.0 GHz 9175F won met 42.2 ms, 39% sneller dan Vera's 58.8 ms. De Xeon 6978P en EPYC 9965 eindigden ook voor Vera, met respectievelijk 54.3 ms en 56.7 ms, zelfs met Vera's nieuwere Python.
Latentie van webserver, JVM en scheduler
De laatste reeks tests omvat de software rondom een applicatie: de webstack, de Java virtuele machine, de Linux-scheduler en de compiler-toolchain. Deze resultaten zijn evenzeer afhankelijk van het aantal threads dat elk systeem uitvoert als van de snelheid van elke core, waardoor ze minder zeggen over Olympus zelf dan de eerdere secties, maar ze laten wel zien hoe een Vera-server zich gedraagt onder gangbare serversoftware.
NGINX
NGINX verstuurt HTTPS-verzoeken naar de wrk-loadgenerator die op dezelfde machine draait, waardoor client en server concurreren om dezelfde processorkernen. Het resultaat weerspiegelt daardoor meer de TLS- en HTTP-stack dan het absolute aantal processorkernen.
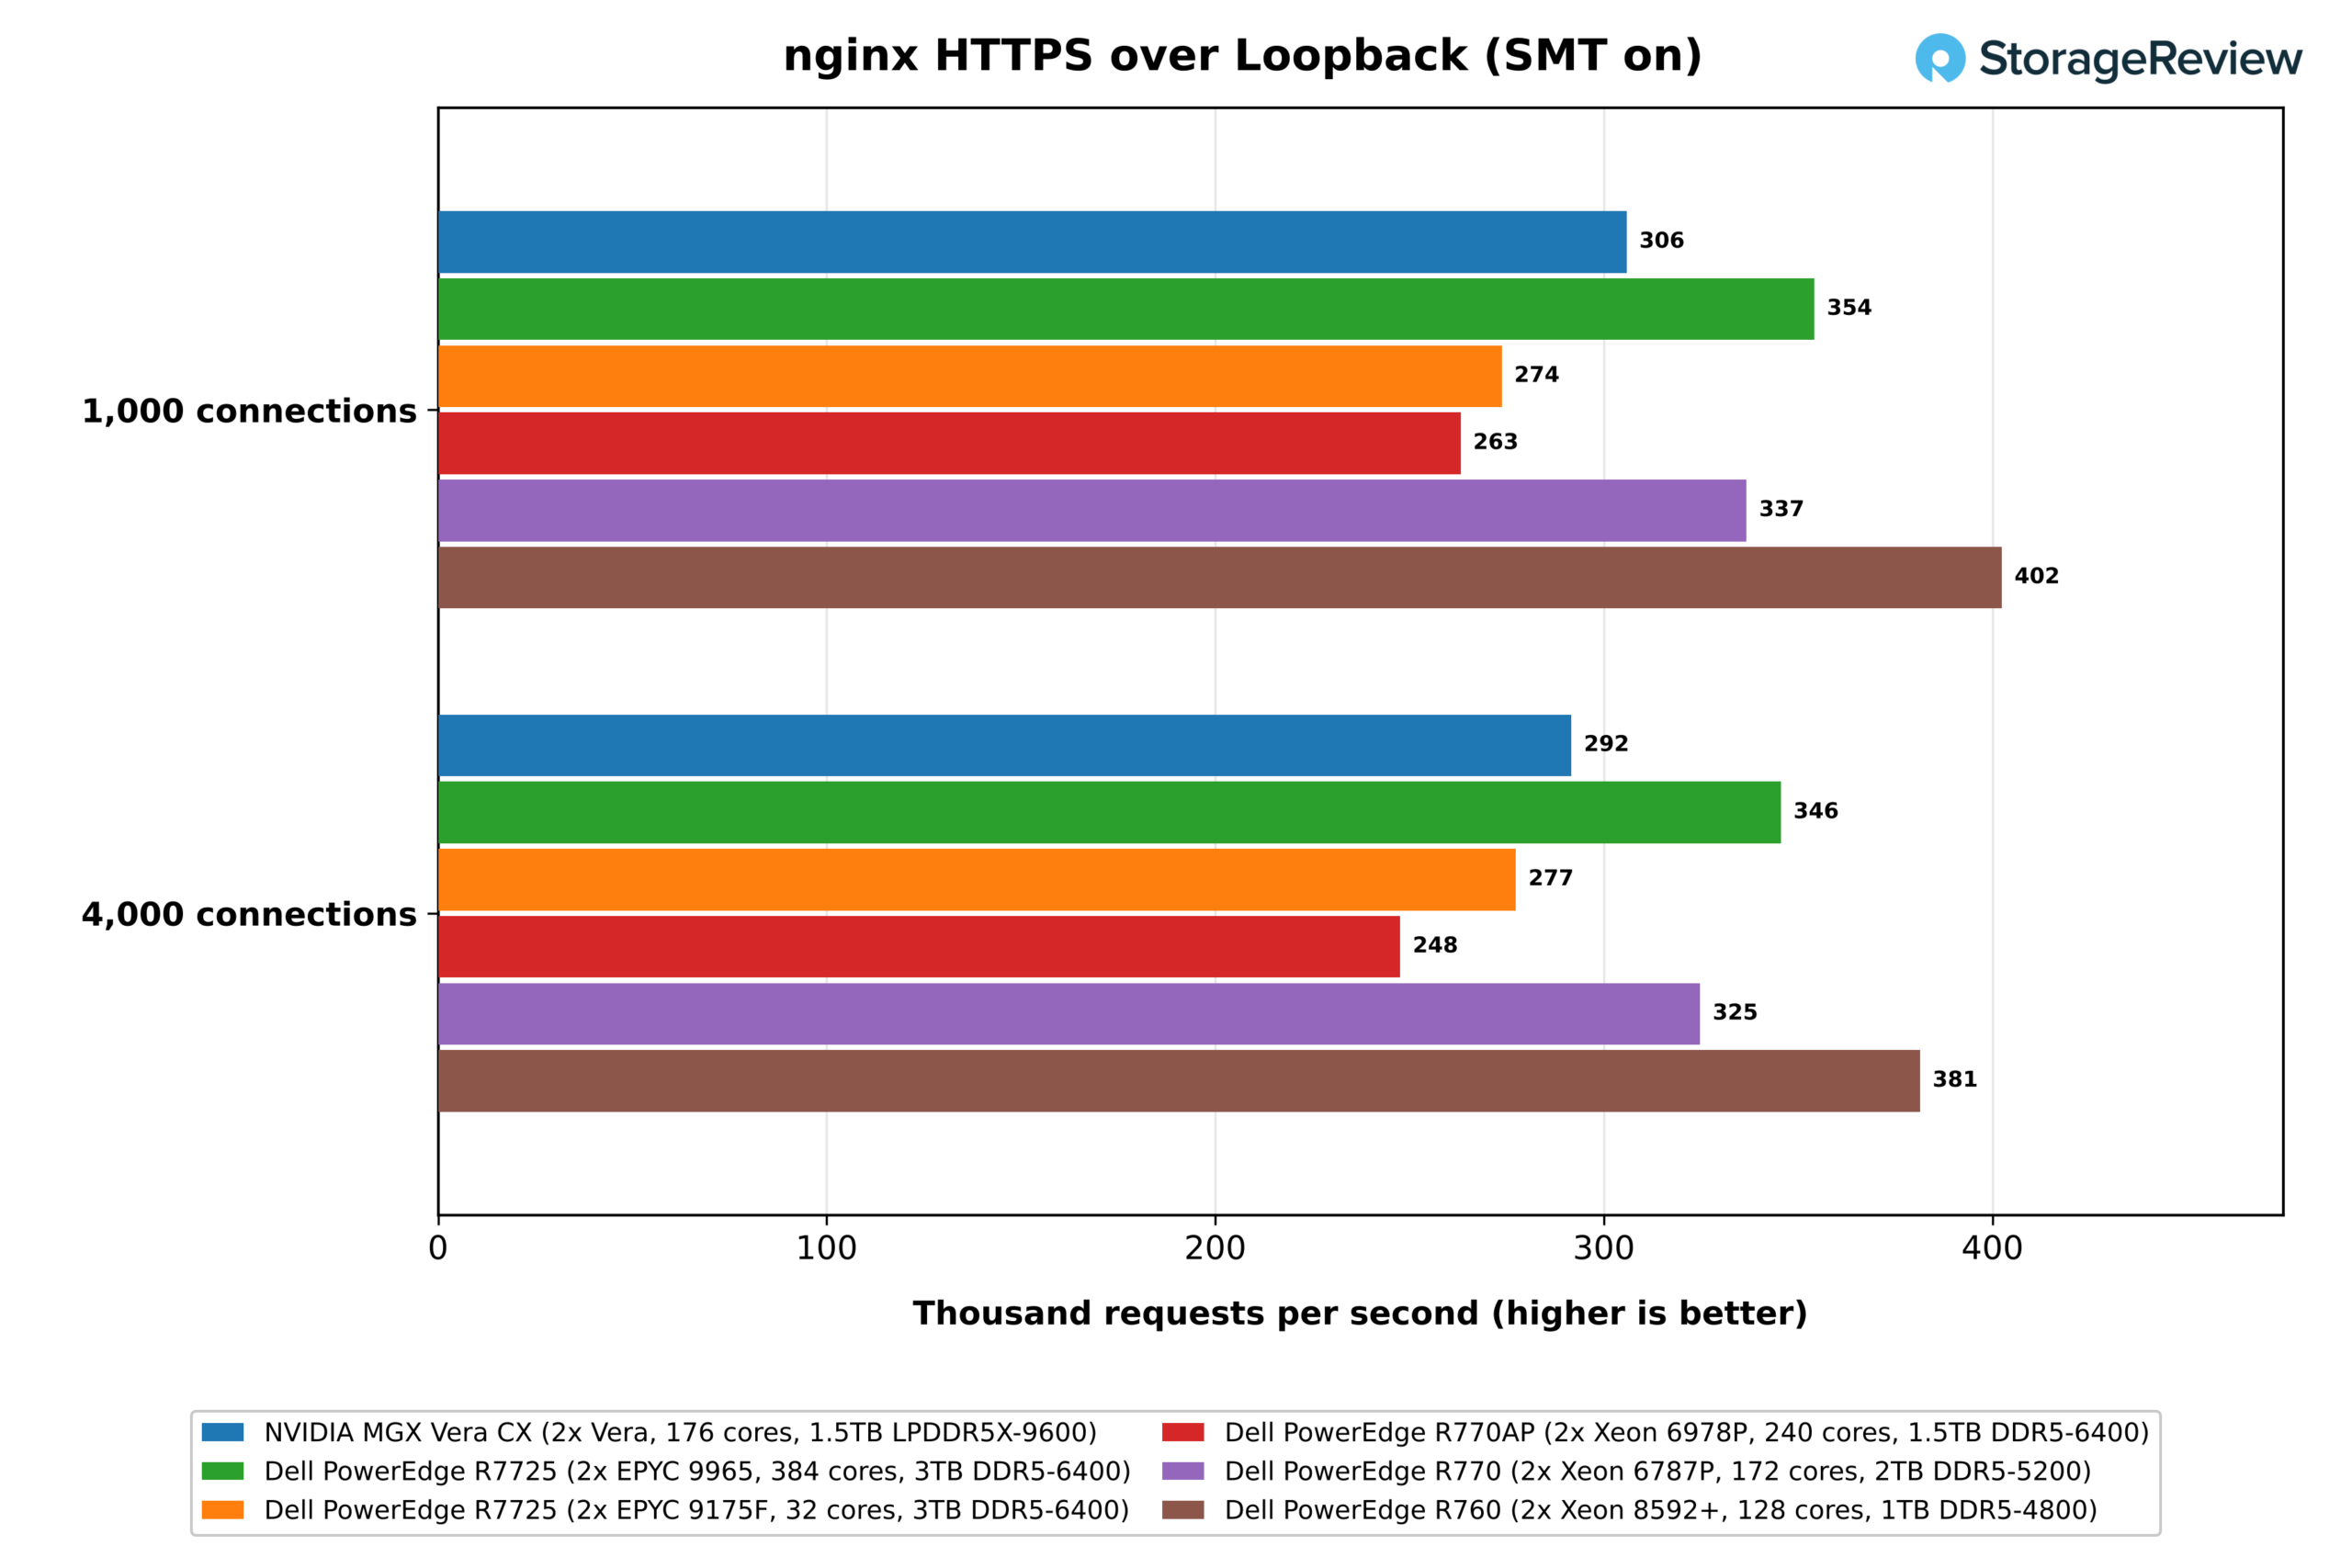
Met SMT ingeschakeld verwerkte Vera 306,000 verzoeken per seconde bij 1,000 verbindingen en 292,000 bij 4,000, in het midden van een veld dat liep van 263,000 op de Xeon 6978P tot 402,000 op de Xeon 8592+. De EPYC 9965 bereikte 354,000, de Xeon 6787P 337,000, en door SMT uit te schakelen steeg Vera naar 330,000. De netwerkstack van Vera kan prima naast de x86-systemen functioneren.
Renaissance
Renaissance voert Java-workloads uit op OpenJDK 11. De Finagle HTTP-test test een Scala-netwerkstack en de Akka-test een actor-model concurrency-framework. Beide tests verdelen de taken over elke logische CPU die de JVM kan zien, dus hebben we ze uitgevoerd met SMT aan en uit.
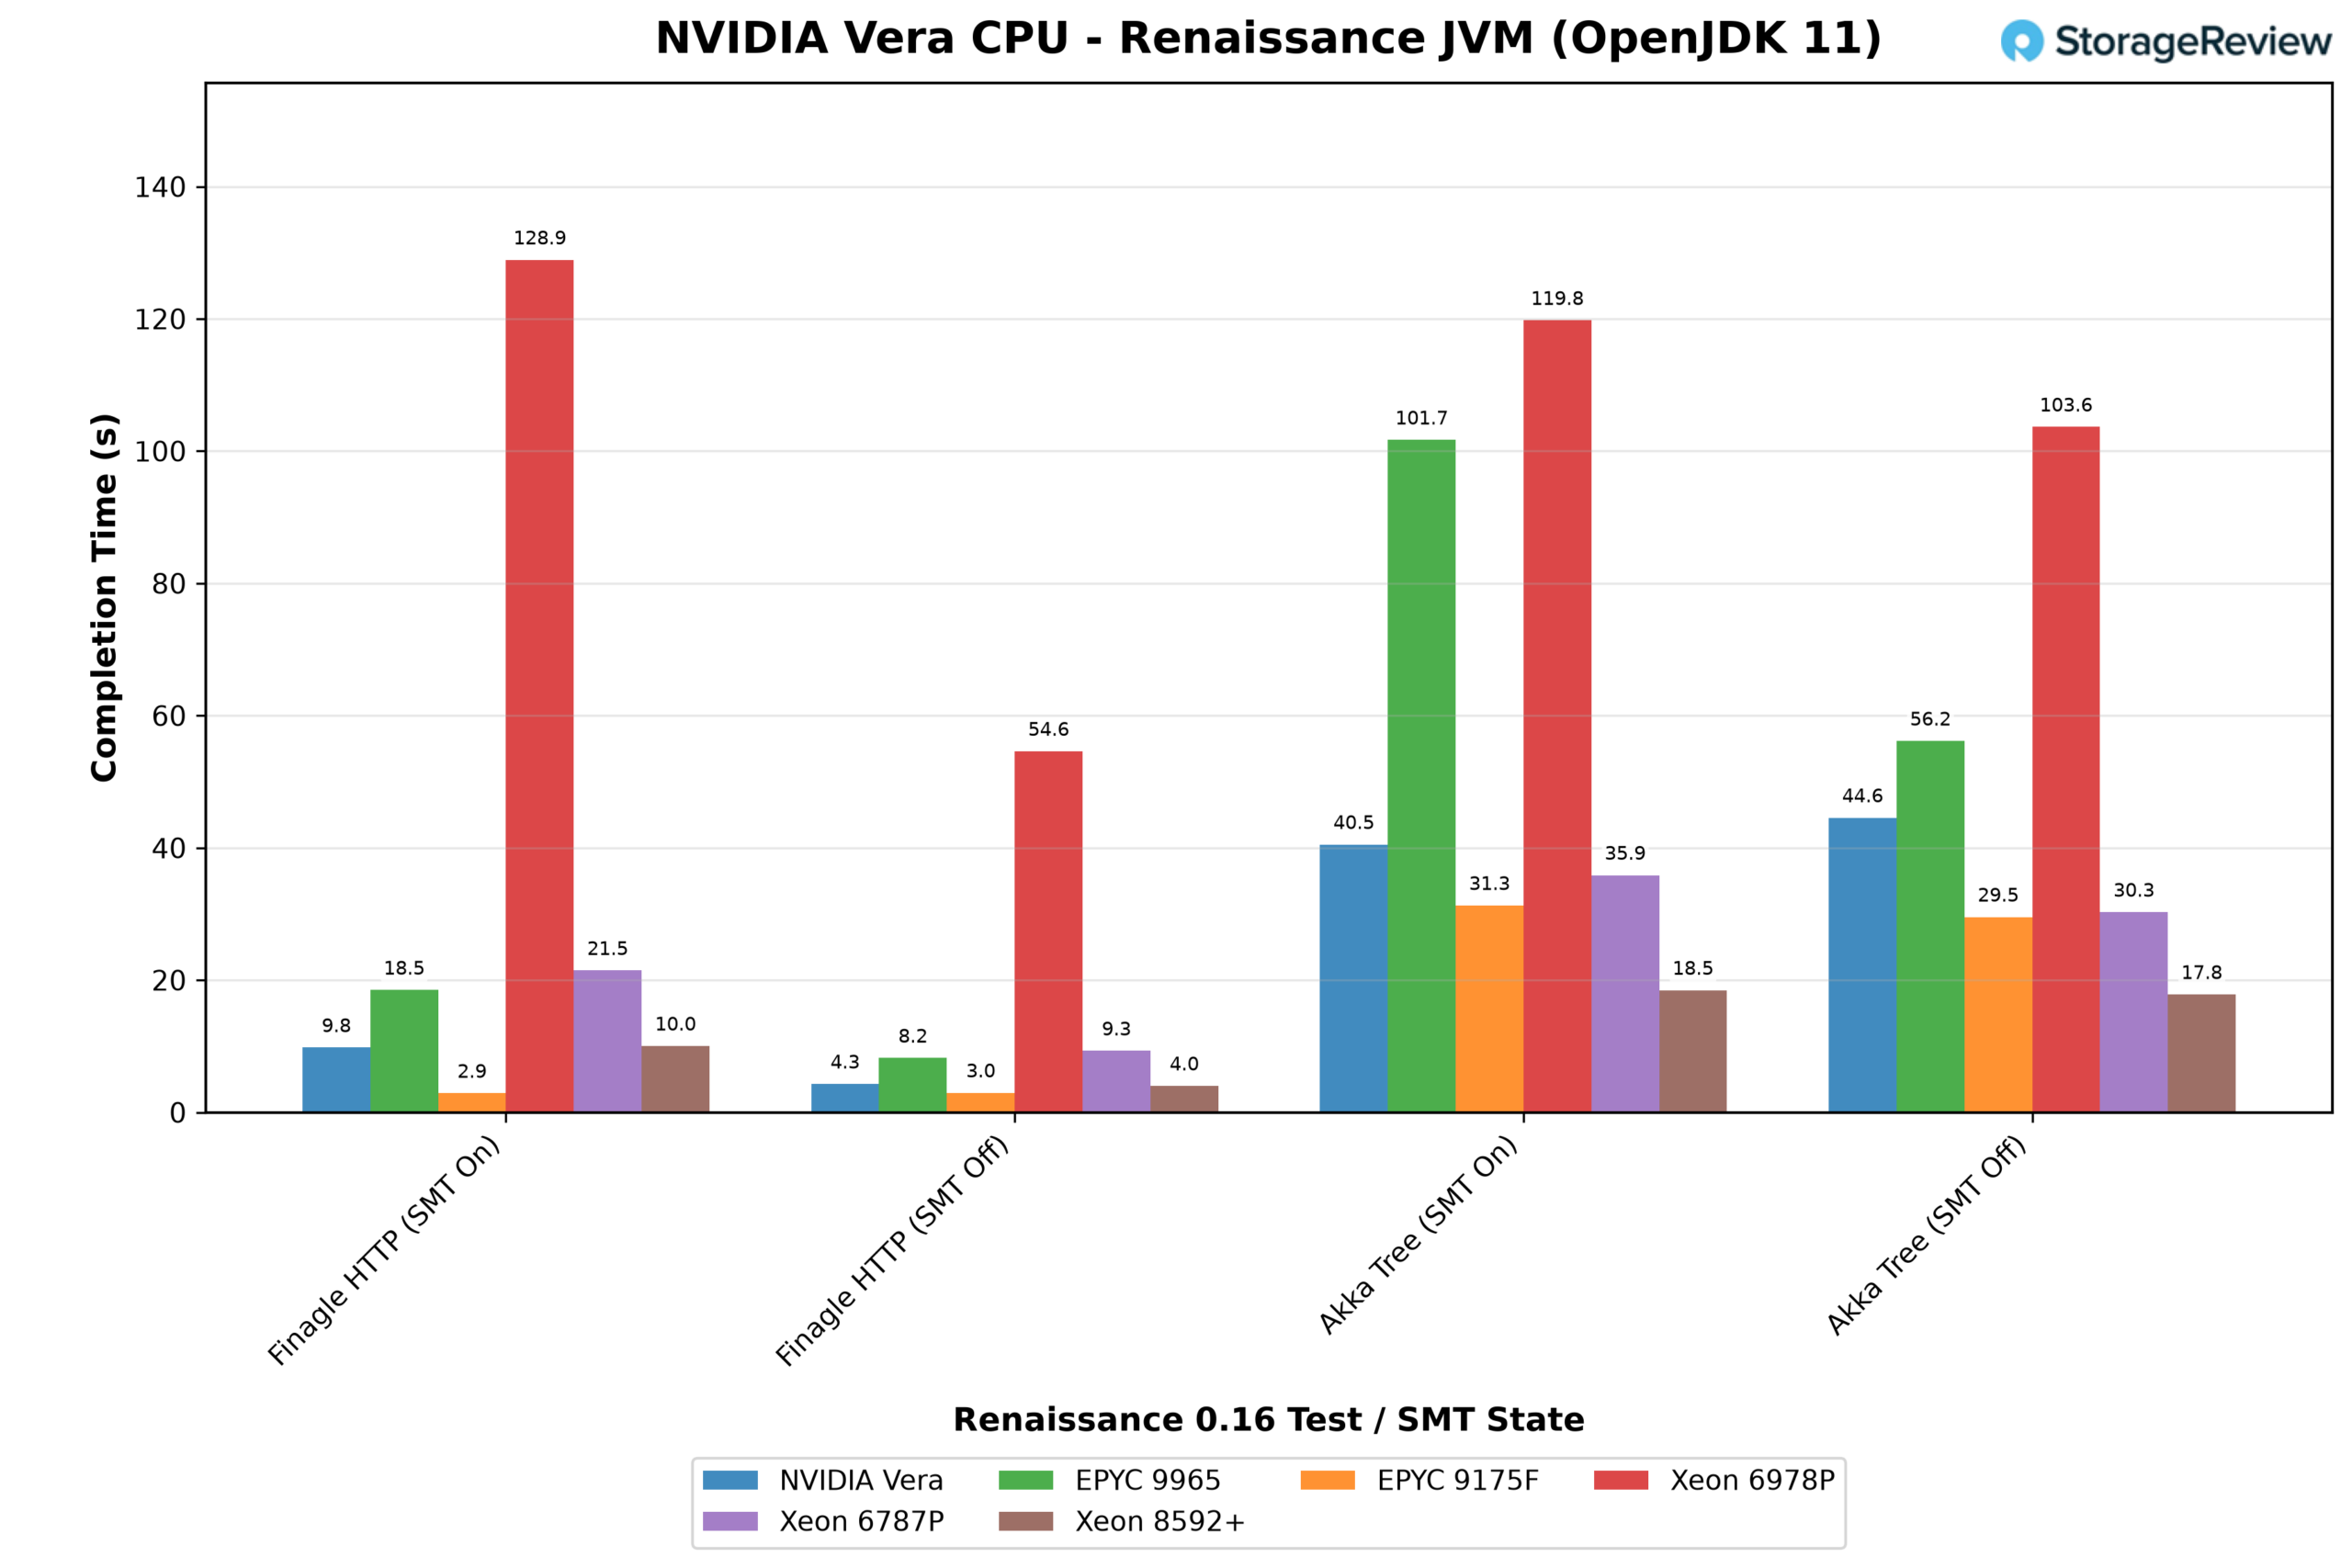
Finagle werkt sneller met minder threads. Door SMT uit te schakelen, wat het aantal threads halveert, daalde de tijd van Vera van 9.8 naar 4.3 seconden, en de grotere x86-systemen verbeterden met een vergelijkbare factor van 2.3 tot 2.5. De 32-core EPYC 9175F, die sowieso al weinig threads had, presteerde in beide gevallen het beste met ongeveer 3 seconden.
Akka gaf de voorkeur aan de Xeon 8592+, die de test in ongeveer 18 seconden voltooide met SMT aan of uit, terwijl Vera er 40.5 seconden over deed met SMT aan. De twee grootste systemen, de EPYC 9965 en de Xeon 6978P, waren het langzaamst met respectievelijk 101.7 en 119.8 seconden. De derde Renaissance-test, een genetisch algoritme, voltooide de test in 1.6 tot 2.6 seconden met SMT aan op alle systemen, behalve de 6978P, waar Vera 2.6 seconden nodig had.
schbank
Schbench meet hoe snel de Linux-scheduler workerthreads activeert. Er draait ongeveer één worker per logische CPU met 4 berichtthreads en ongeveer acht per CPU met 32. Omdat het aantal workers toeneemt met het systeem, voeren grotere servers meer werk uit. Deze resultaten beschrijven daarom de latentie onder volledige belasting op elke machine en zijn geen één-op-één vergelijking.
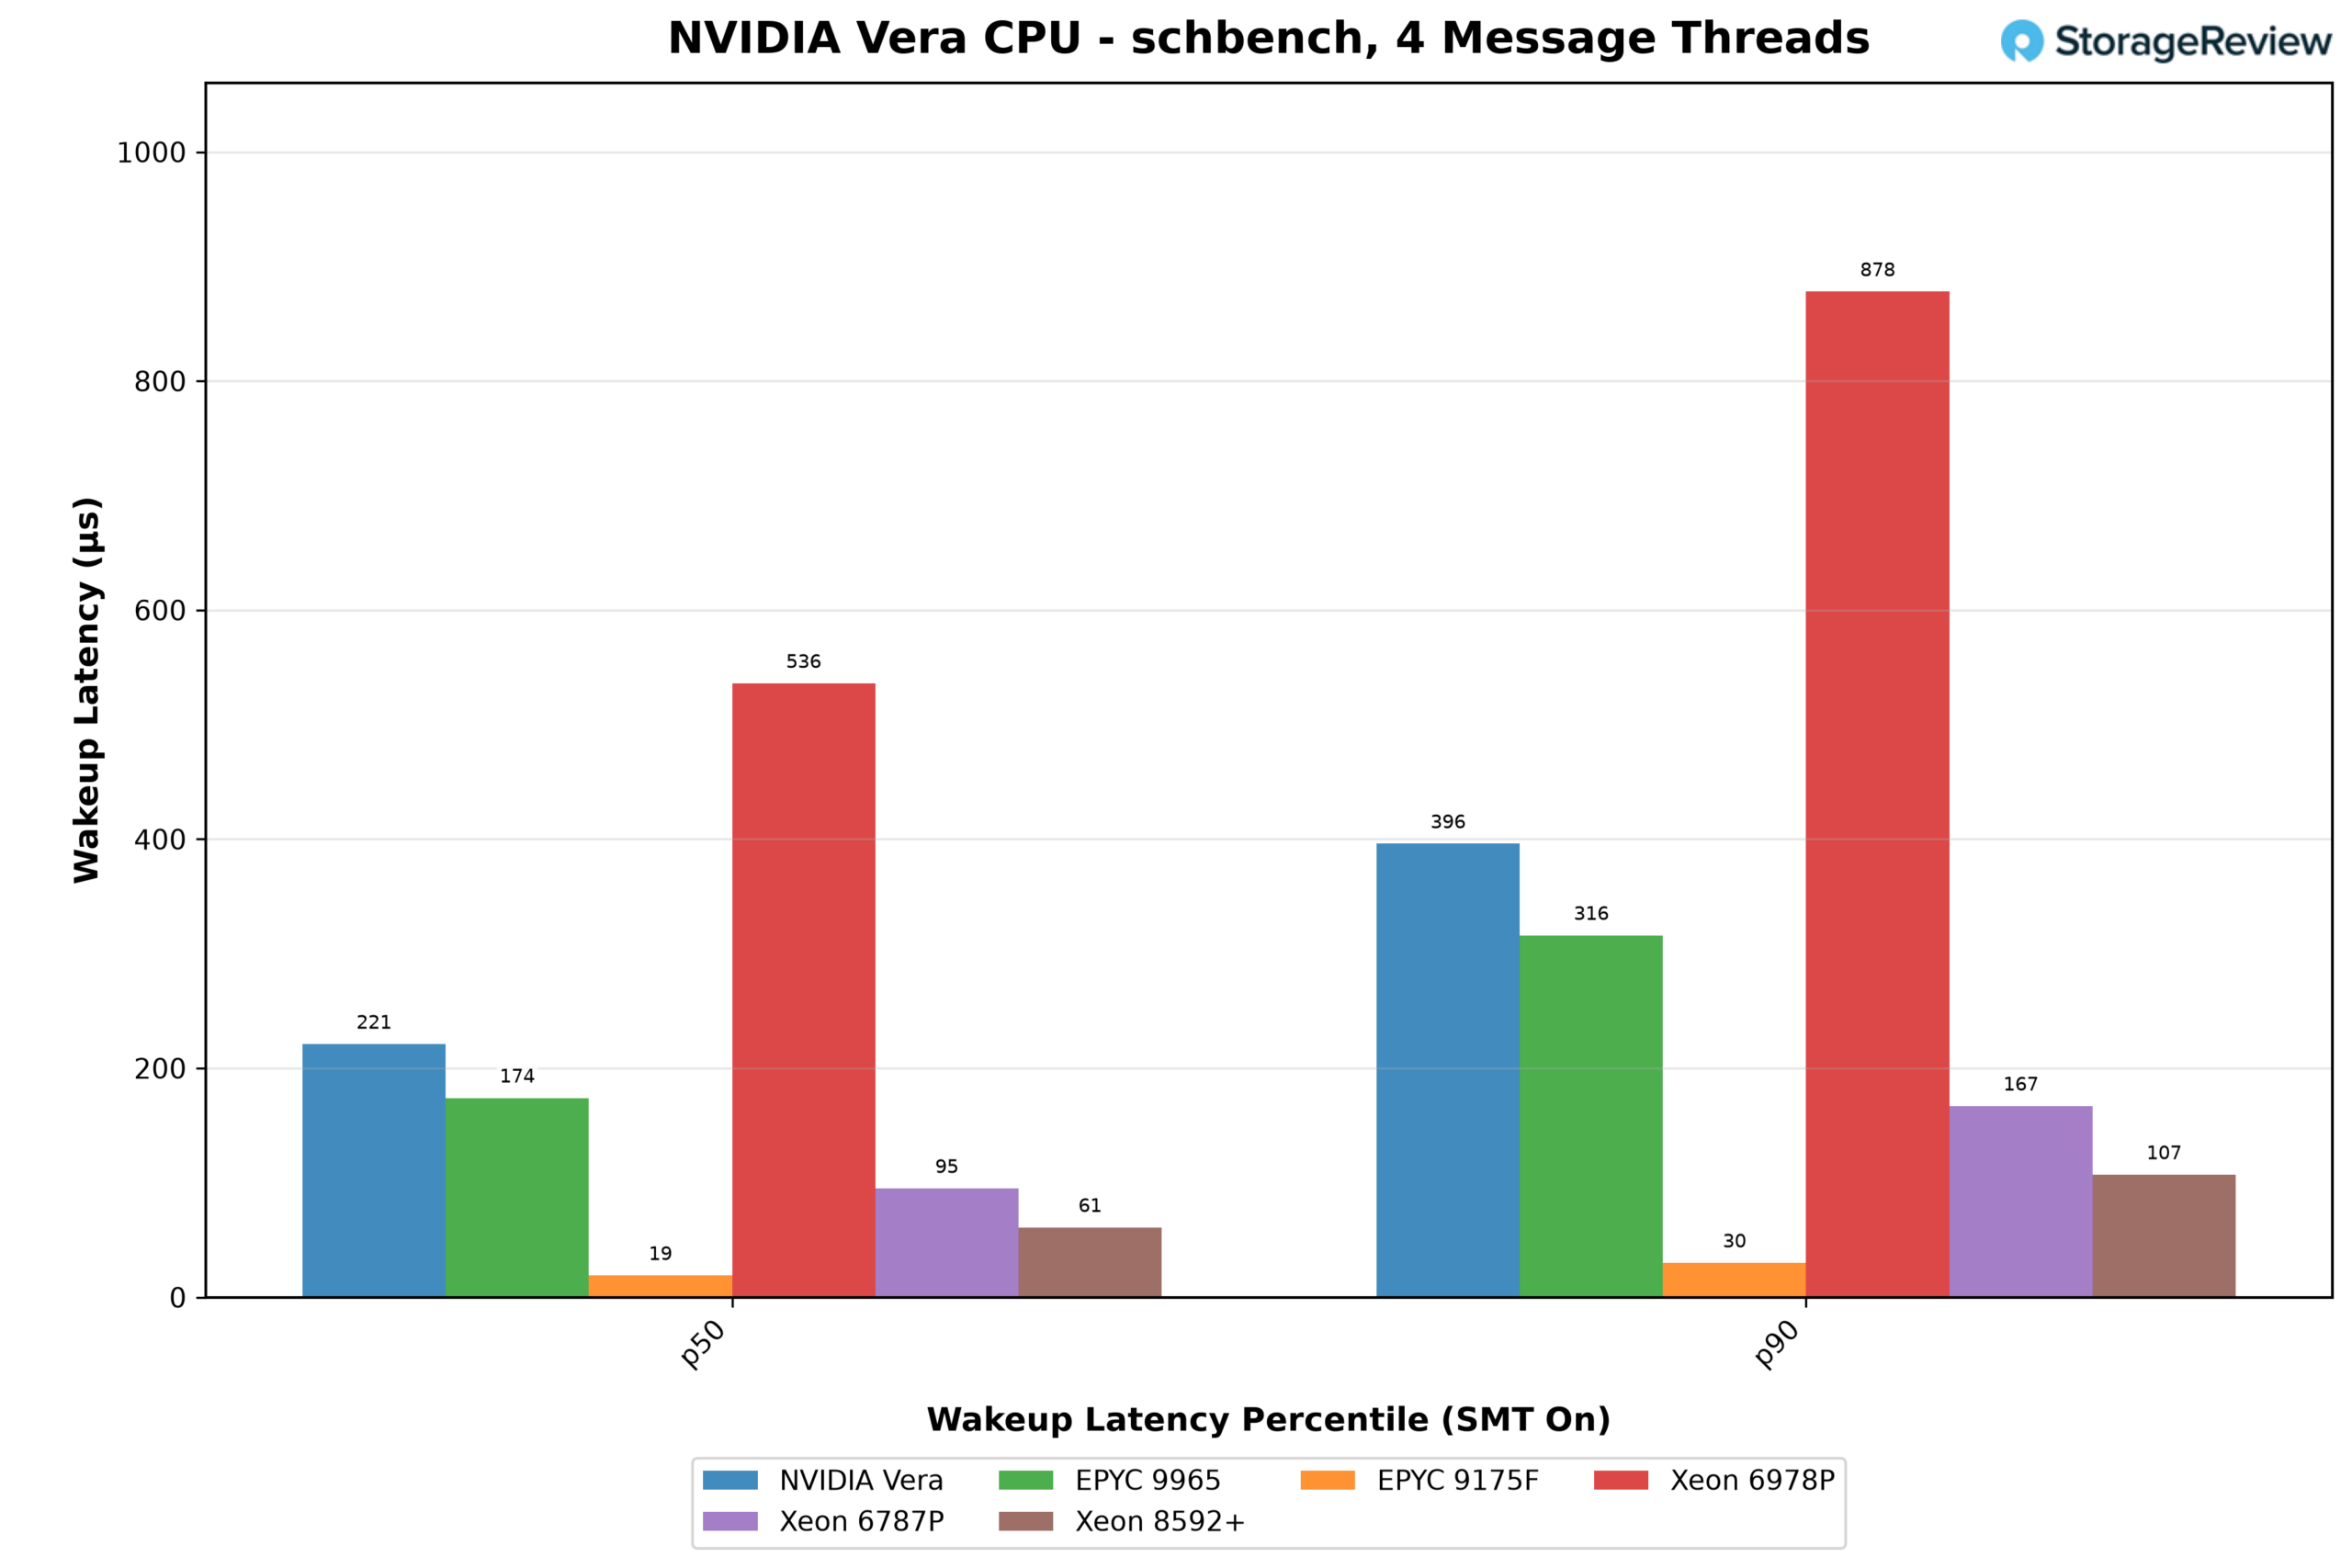
Met 4 berichtenthreads bedroeg de mediane ontwaaklatentie van Vera 221 µs en de p90 396 µs, hoger dan alle systemen behalve de Xeon 6978P met 536 µs en 878 µs. De kleinste machines ontwaakten hun threads het snelst, met de 32-core EPYC 9175F op 19 µs en de 128-core Xeon 8592+ op 61 µs.
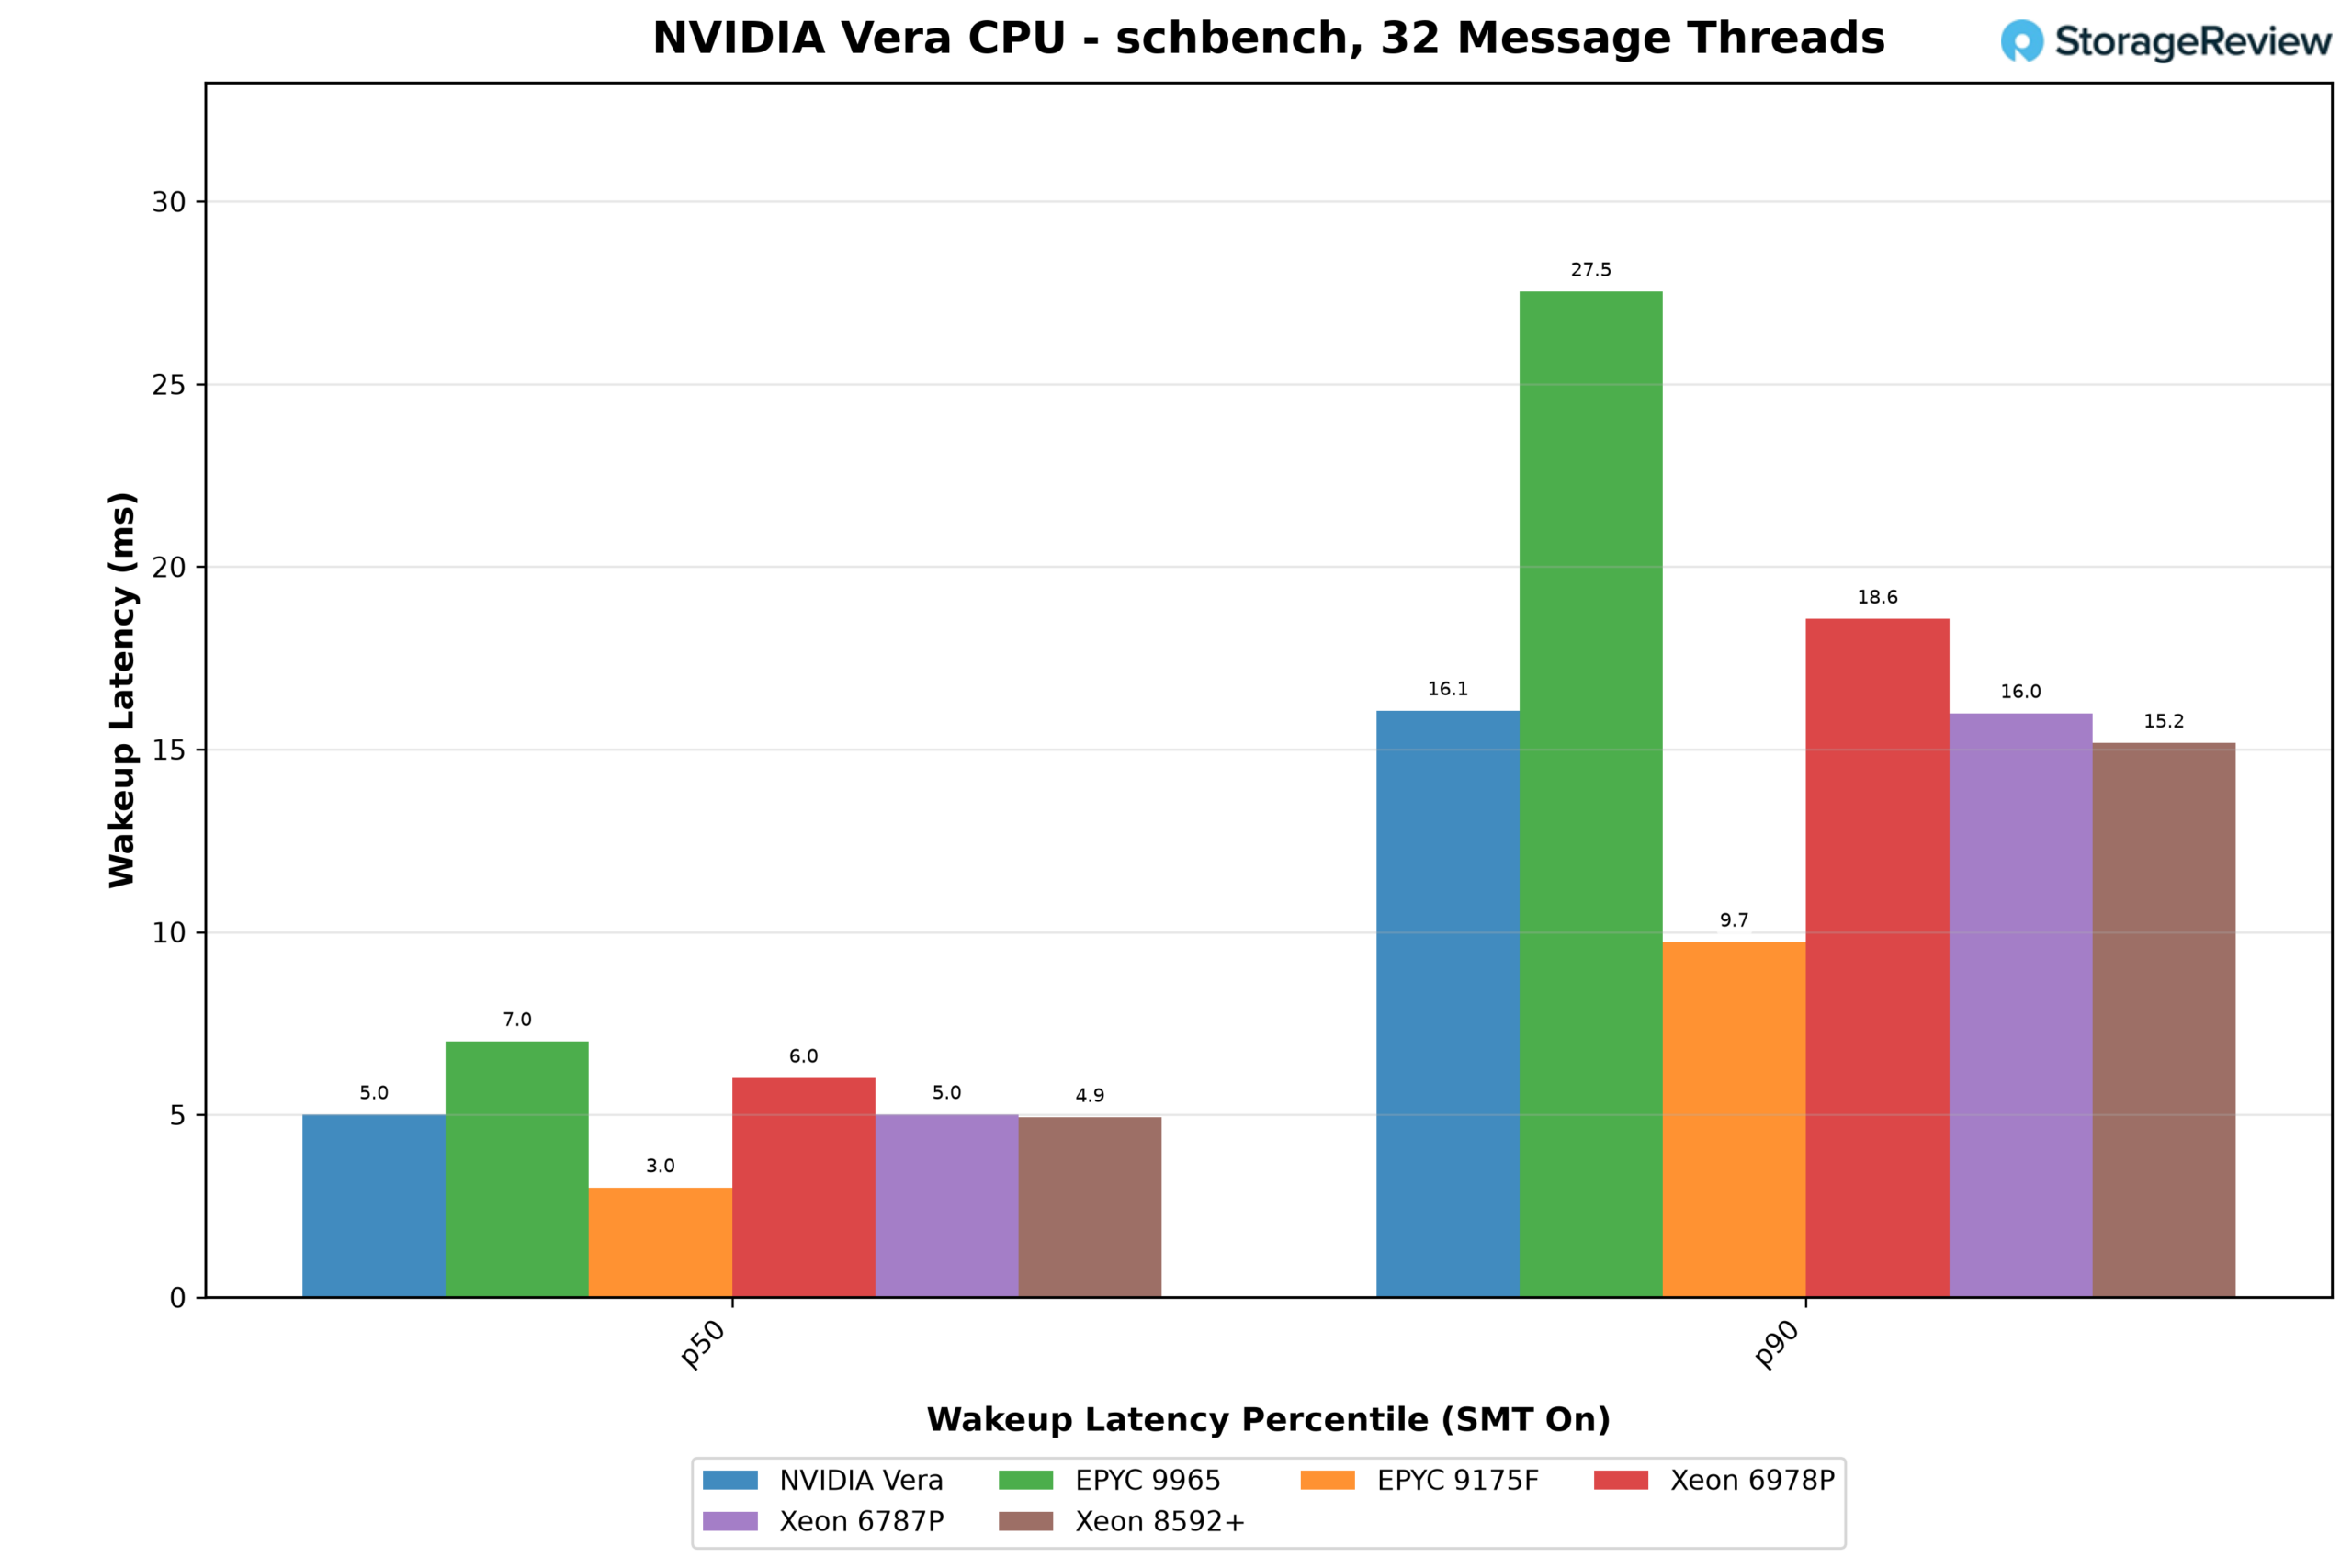
Met 32 berichtenthreads was Vera overbelast en zakte daarmee naar het midden van het peloton. De mediane responstijd van 5.0 ms en de p90-tijd van 16.1 ms waren gelijk aan die van de Xeon 6787P en 8592+ en beter dan die van de Xeon 6978P en de EPYC 9965, die een p90-tijd van 27.5 ms haalden. Alleen de 9175F was duidelijk sneller, met respectievelijk 3.0 ms en 9.7 ms.
Linux-kernel bouwen
De Linux-kernel-build met allmodconfig is het enige resultaat in deze sectie dat we niet rangschikken. Vera compileert de arm64-kernel, die een andere set modules en drivers bevat dan de x86-64-kernel die de andere systemen compileren, en we hebben geen poging gedaan tot cross-compilatie.
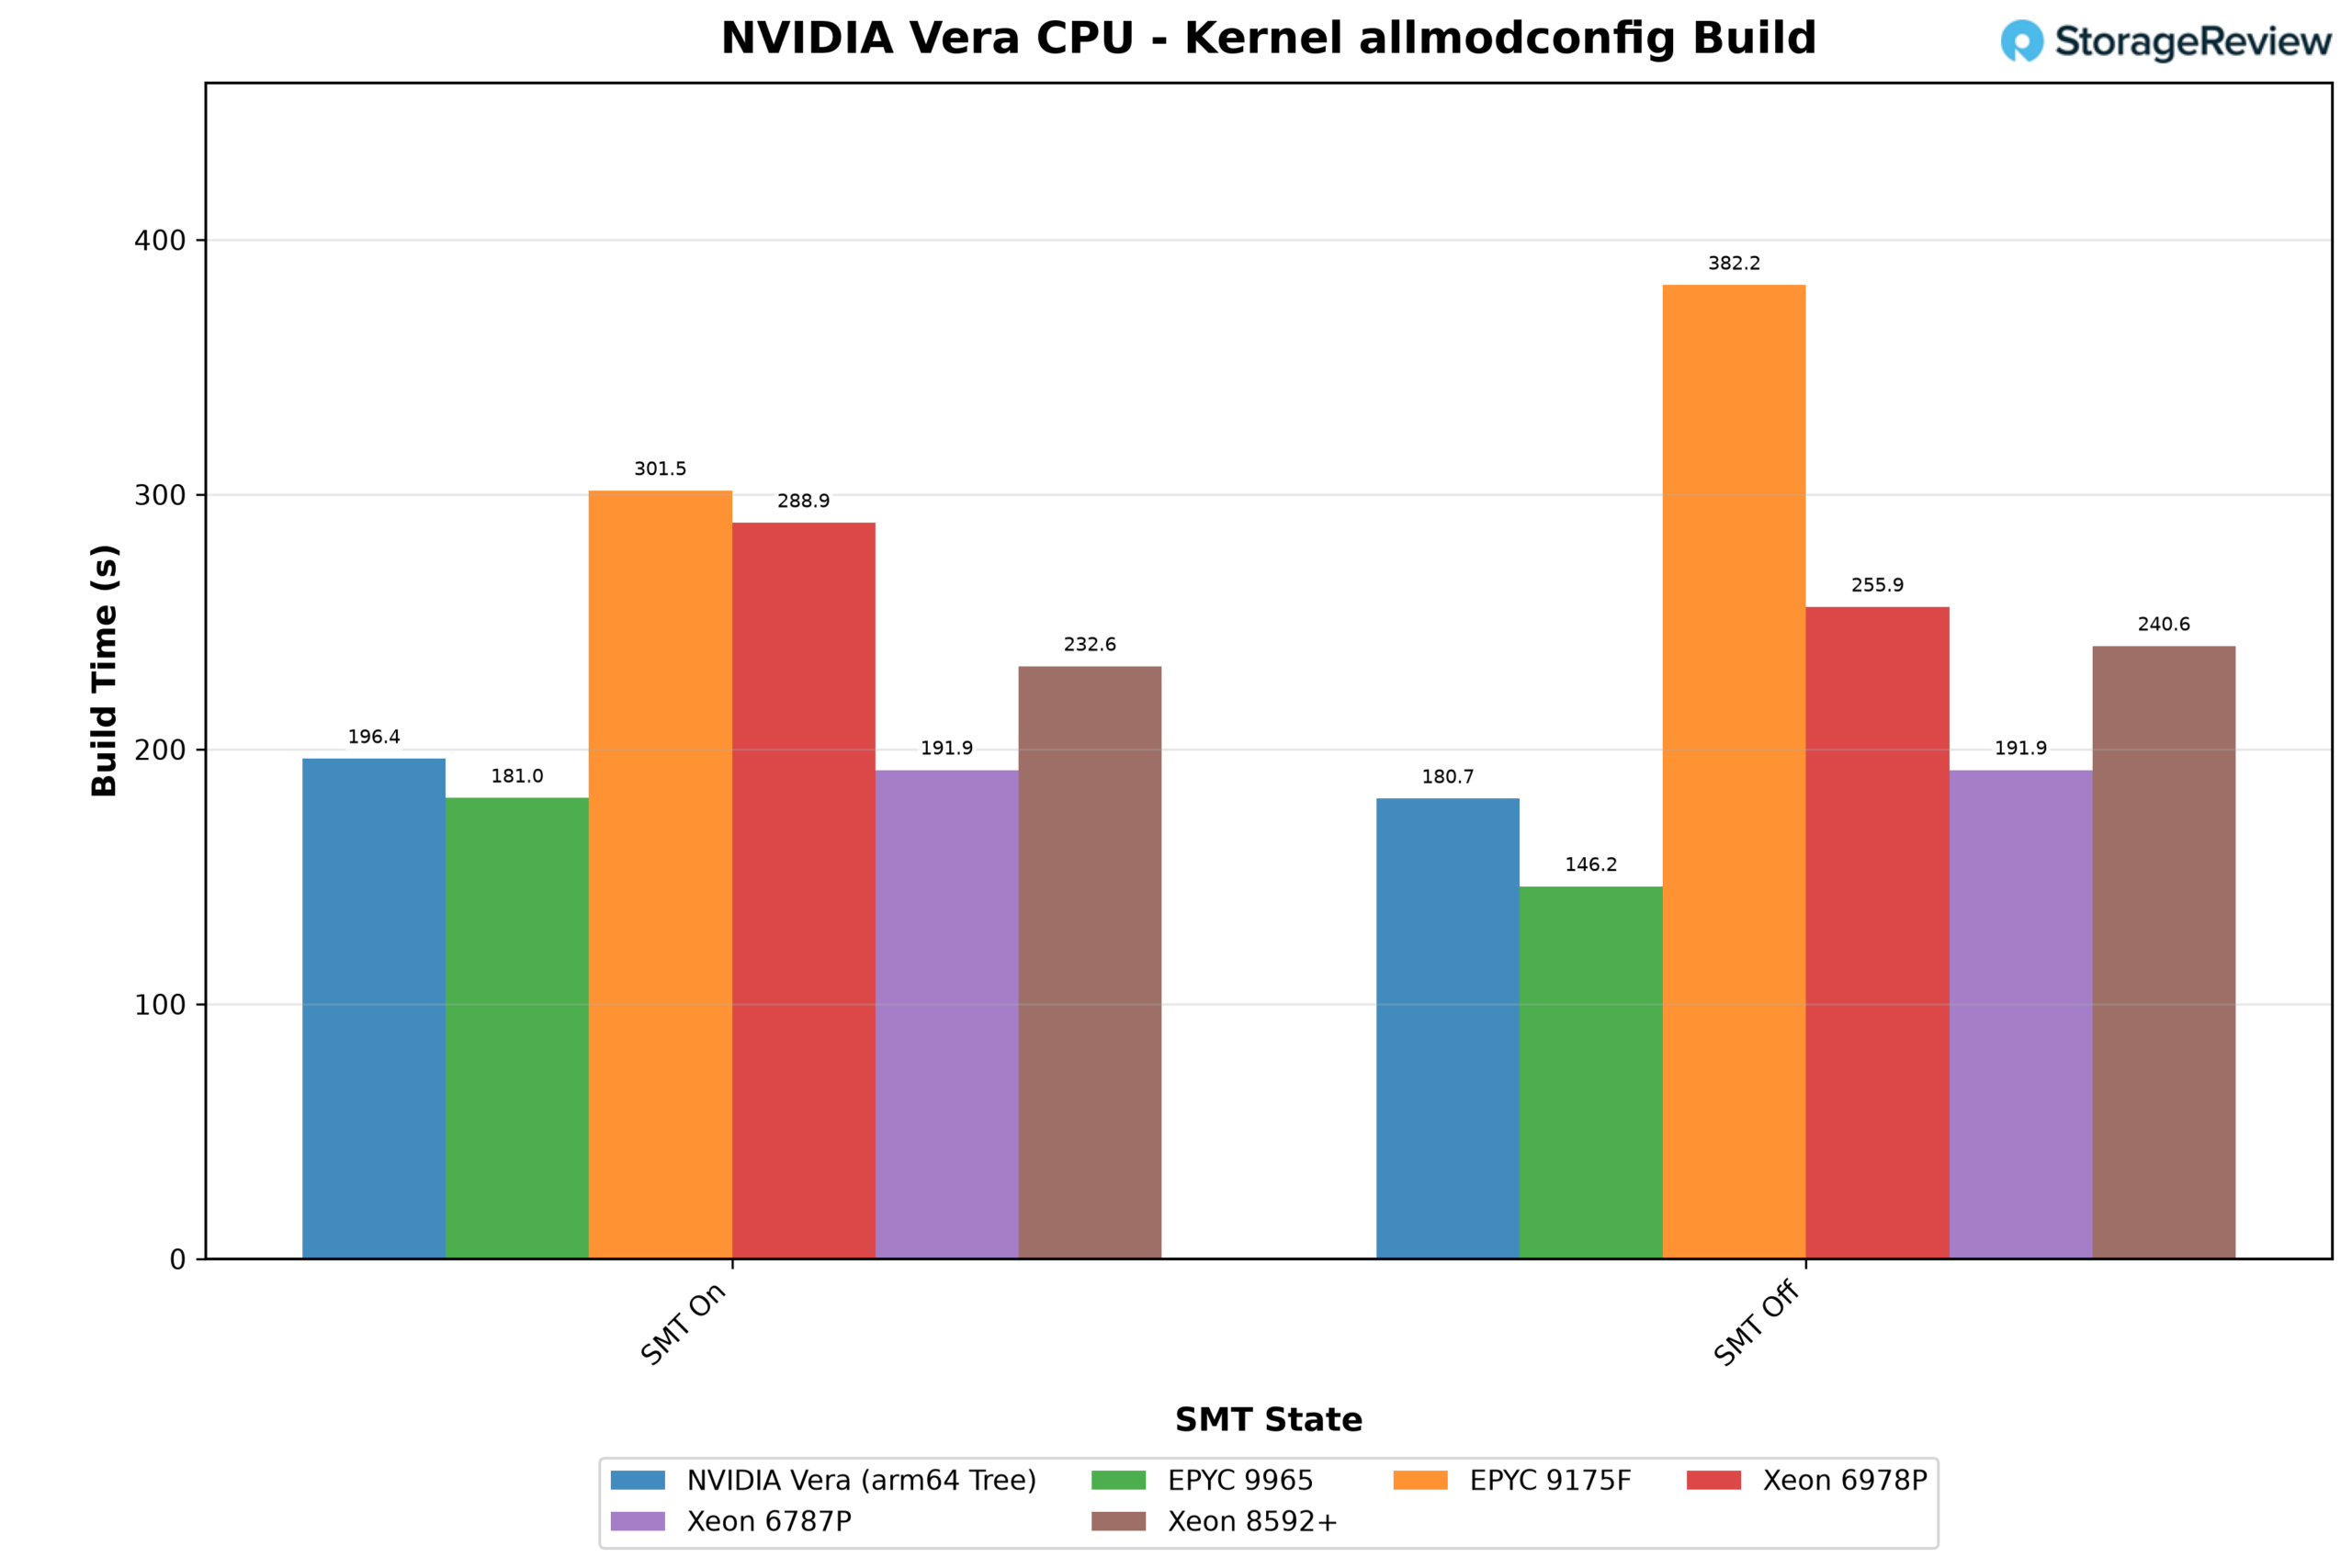
Vera bouwde zijn tree in 180.7 seconden met SMT uitgeschakeld en in 196.4 seconden met SMT ingeschakeld, dus de extra threads vertraagden het bouwproces. Over de x86-systemen heen, die elk een native tree bouwden, varieerden de tijden van 146.2 seconden op de EPYC 9965 met SMT uitgeschakeld tot 382.2 seconden op de 32-core EPYC 9175F.
HamerDB
Voor de databasetests hebben we Steve Shaw, de maker en beheerder van HammerDB, ingeschakeld. Shaw voerde HammerDB's TPROC-C-workload uit, een OLTP-benchmark afgeleid van TPC-C maar niet vergelijkbaar met gepubliceerde TPC-resultaten, op de Vera-server, de Dell PowerEdge R7725 met EPYC 9965 en de PowerEdge R770 met Xeon 6787P. Hij testte vijf open-source database-engines op elk van deze systemen: MariaDB 12.3.3 en 13.0.2, MySQL 26.7.0, VillageSQL 0.0.7 en PostgreSQL 18.6. De databasegrootte schaalde mee met het aantal cores, met 16 datawarehouses per fysieke core, oftewel 1,408 voor één Vera-socket.
Elke engine draaide op één socket en op twee, waarbij de CPU's van de tweede socket offline werden gehaald voor de tests op één socket. Elk systeem presteerde beter op één socket, wat typisch is voor databaseprestaties. Over alle 15 paren heen zorgde het toevoegen van de tweede socket voor een verlaging van de piekdoorvoer met 23% tot 47%, en met 29% tot 45% op Vera. Shaw heeft al langer vastgesteld dat open-source databases een schaalplafond bereiken voordat ze geen cores meer hebben. Voorbij dat punt kost het meer om caches consistent te houden over twee sockets dan de extra cores opleveren. We richten ons daarom op de resultaten op één socket, zoals weergegeven in de onderstaande grafiek.
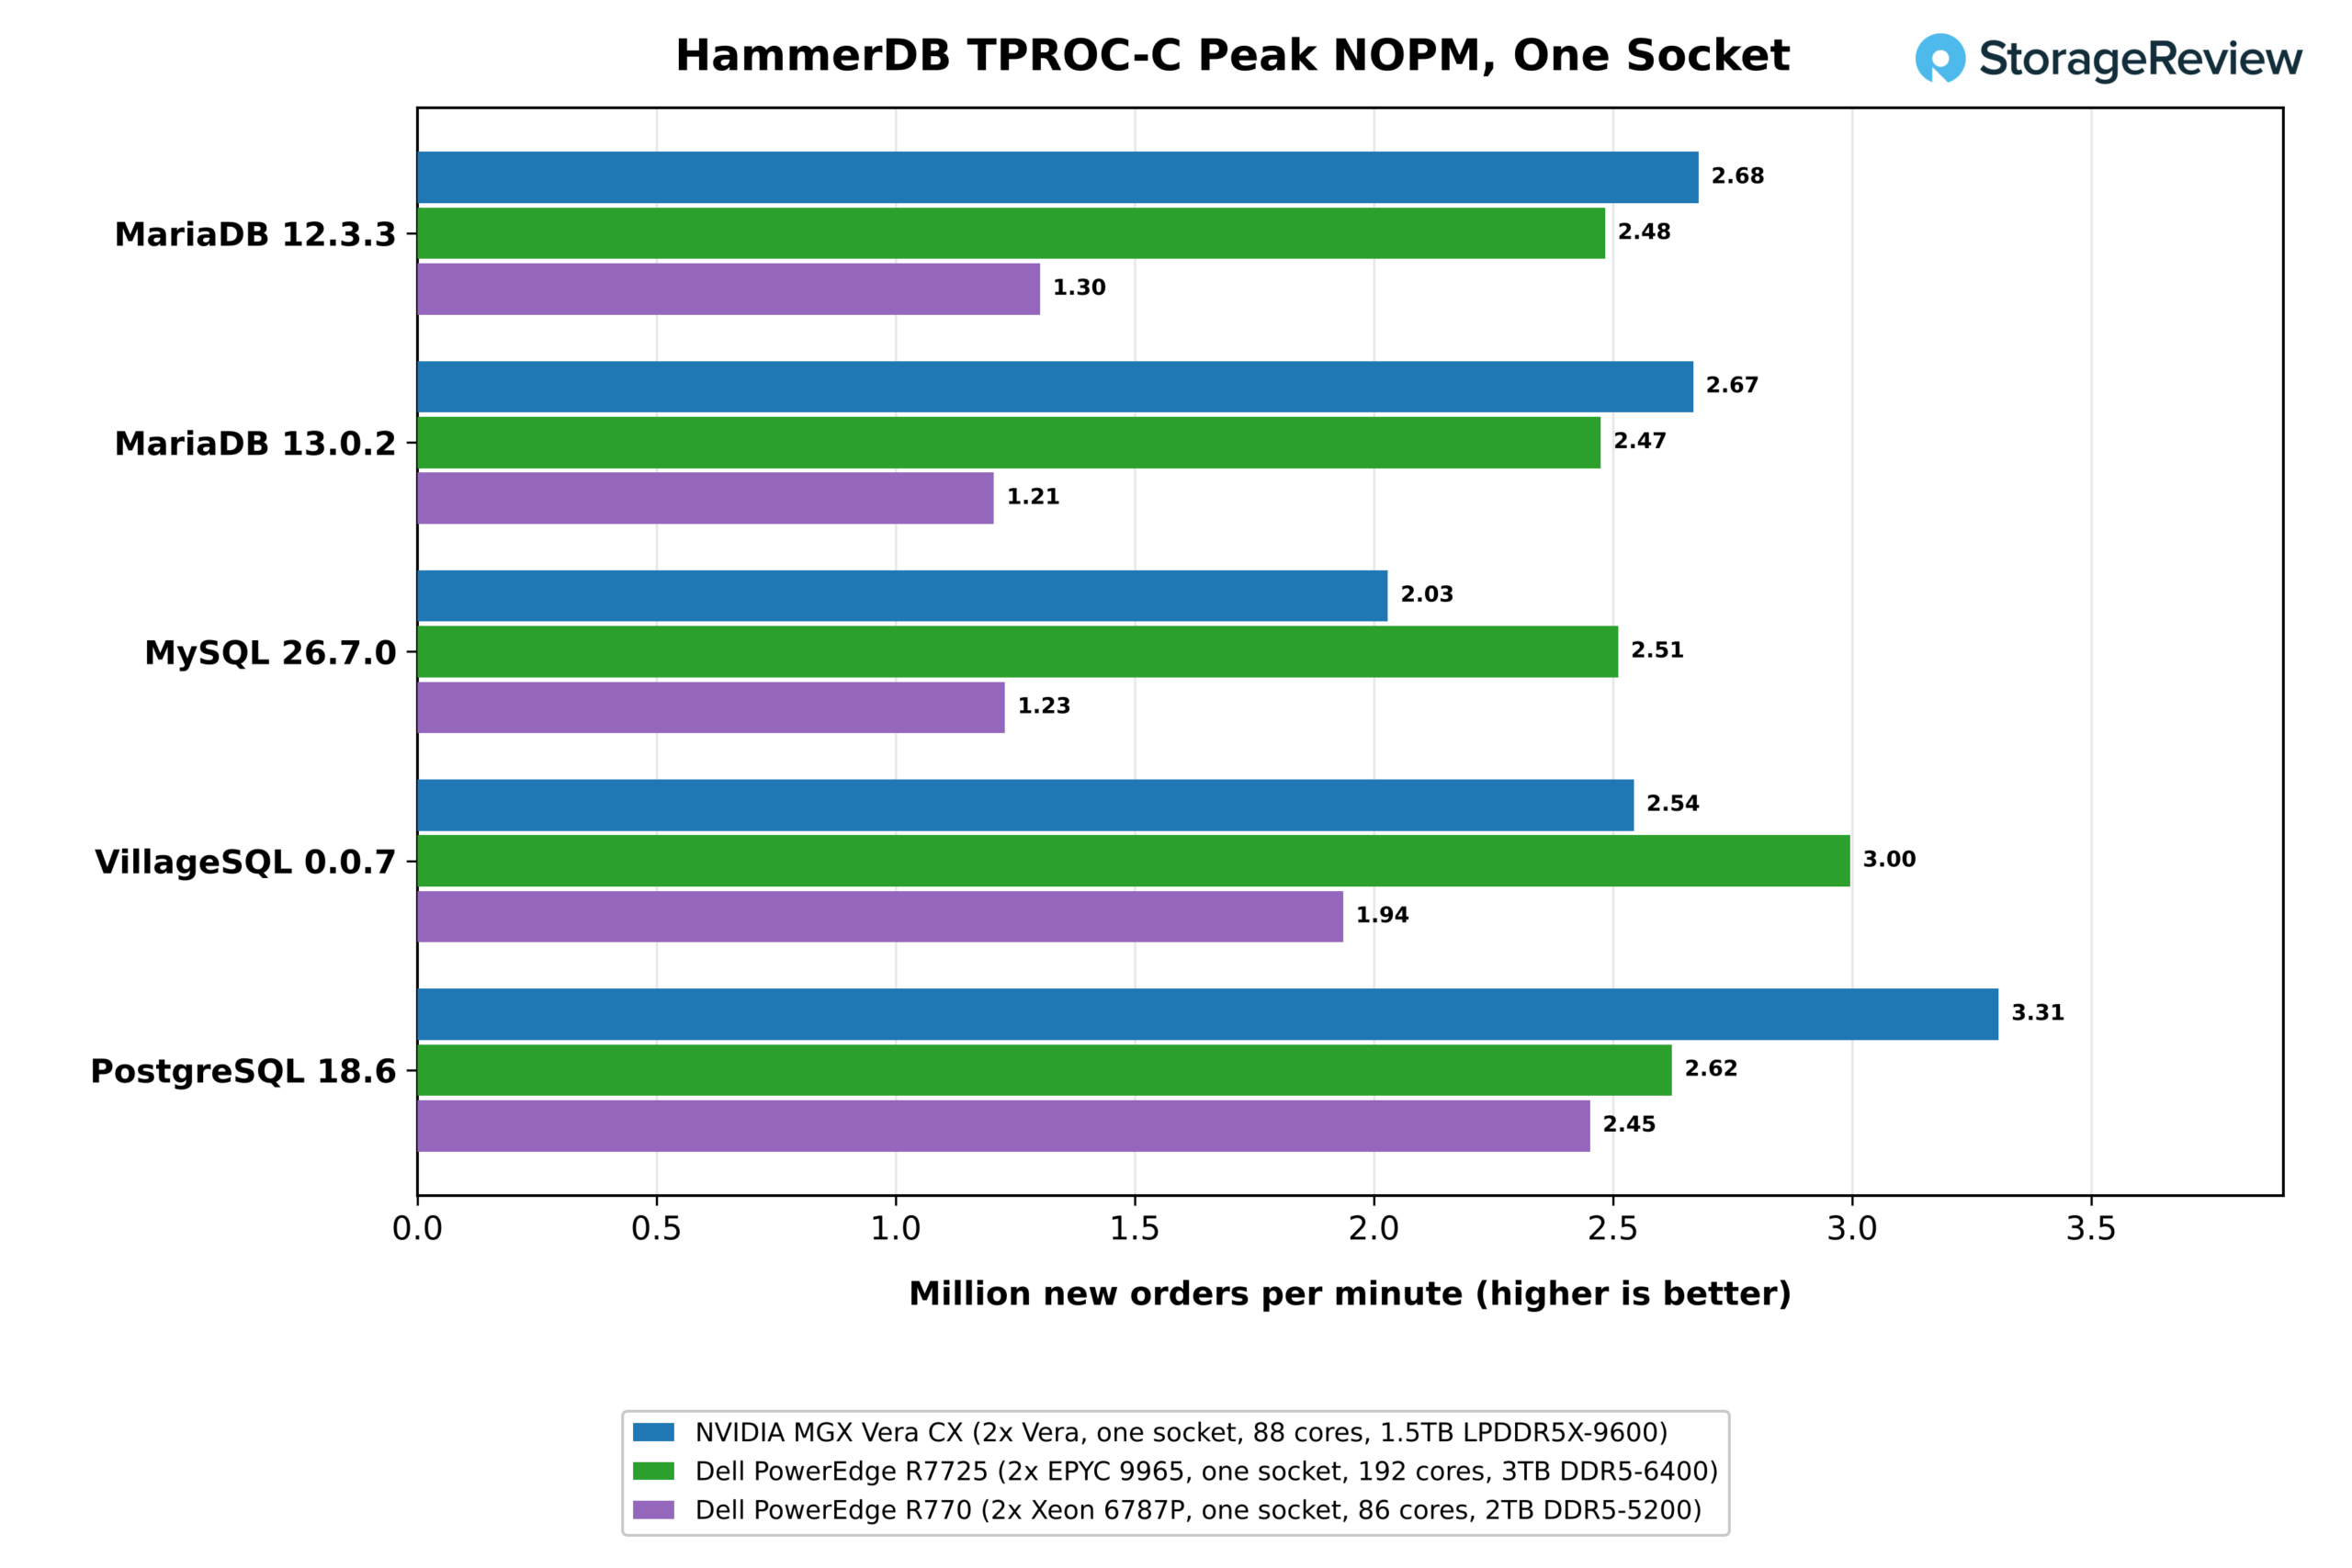
Op één socket presteerden de 88 Vera-cores het beste op drie van de vijf engines. PostgreSQL 18.6 gaf Vera de grootste voorsprong, met 3.31 miljoen nieuwe orders per minuut (NOPM) bij 128 virtuele gebruikers, vergeleken met 2.62 miljoen op de 192-core EPYC 9965-socket en 2.45 miljoen op de 86-core Xeon 6787P. Beide MariaDB-releases werden ook door Vera overtroffen, met respectievelijk 2.68 miljoen en 2.67 miljoen, vergeleken met 2.48 miljoen en 2.47 miljoen op de EPYC. AMD behield MySQL 26.7.0 op 2.51 miljoen tegenover 2.03 miljoen voor Vera, en VillageSQL op 3.00 miljoen tegenover 2.54 miljoen. De Xeon bleef op alle vijf engines achter met 1.21 miljoen tegenover 2.45 miljoen, en de MariaDB-resultaten waren minder dan de helft van die van Vera.
De verdeling hangt waarschijnlijk samen met de schaalbaarheid van elke engine. Het proces-per-verbinding-model van PostgreSQL en InnoDB van MariaDB verdelen de taken over veel cores met veel gedeeld geheugenverkeer, wat gunstig is voor de meer dan 1 TB/s aan lokale bandbreedte die elke Vera-socket in STREAM aankon. MySQL en VillageSQL krijgen eerder te maken met interne lock-conflicten, waardoor hun resultaten meer afhangen van hoe snel elke core een kritieke sectie vrijgeeft, en dat is waar de 9965 de overhand heeft. Na de testronde in oktober oordeelde Shaw dat Arm het snelste platform was en zei dat Arm "absoluut een concurrerende databaseserver is geworden", hoewel hij eraan toevoegde dat een single-socket 96-core EPYC die hij eerder had getest, mogelijk nog sneller zou zijn.
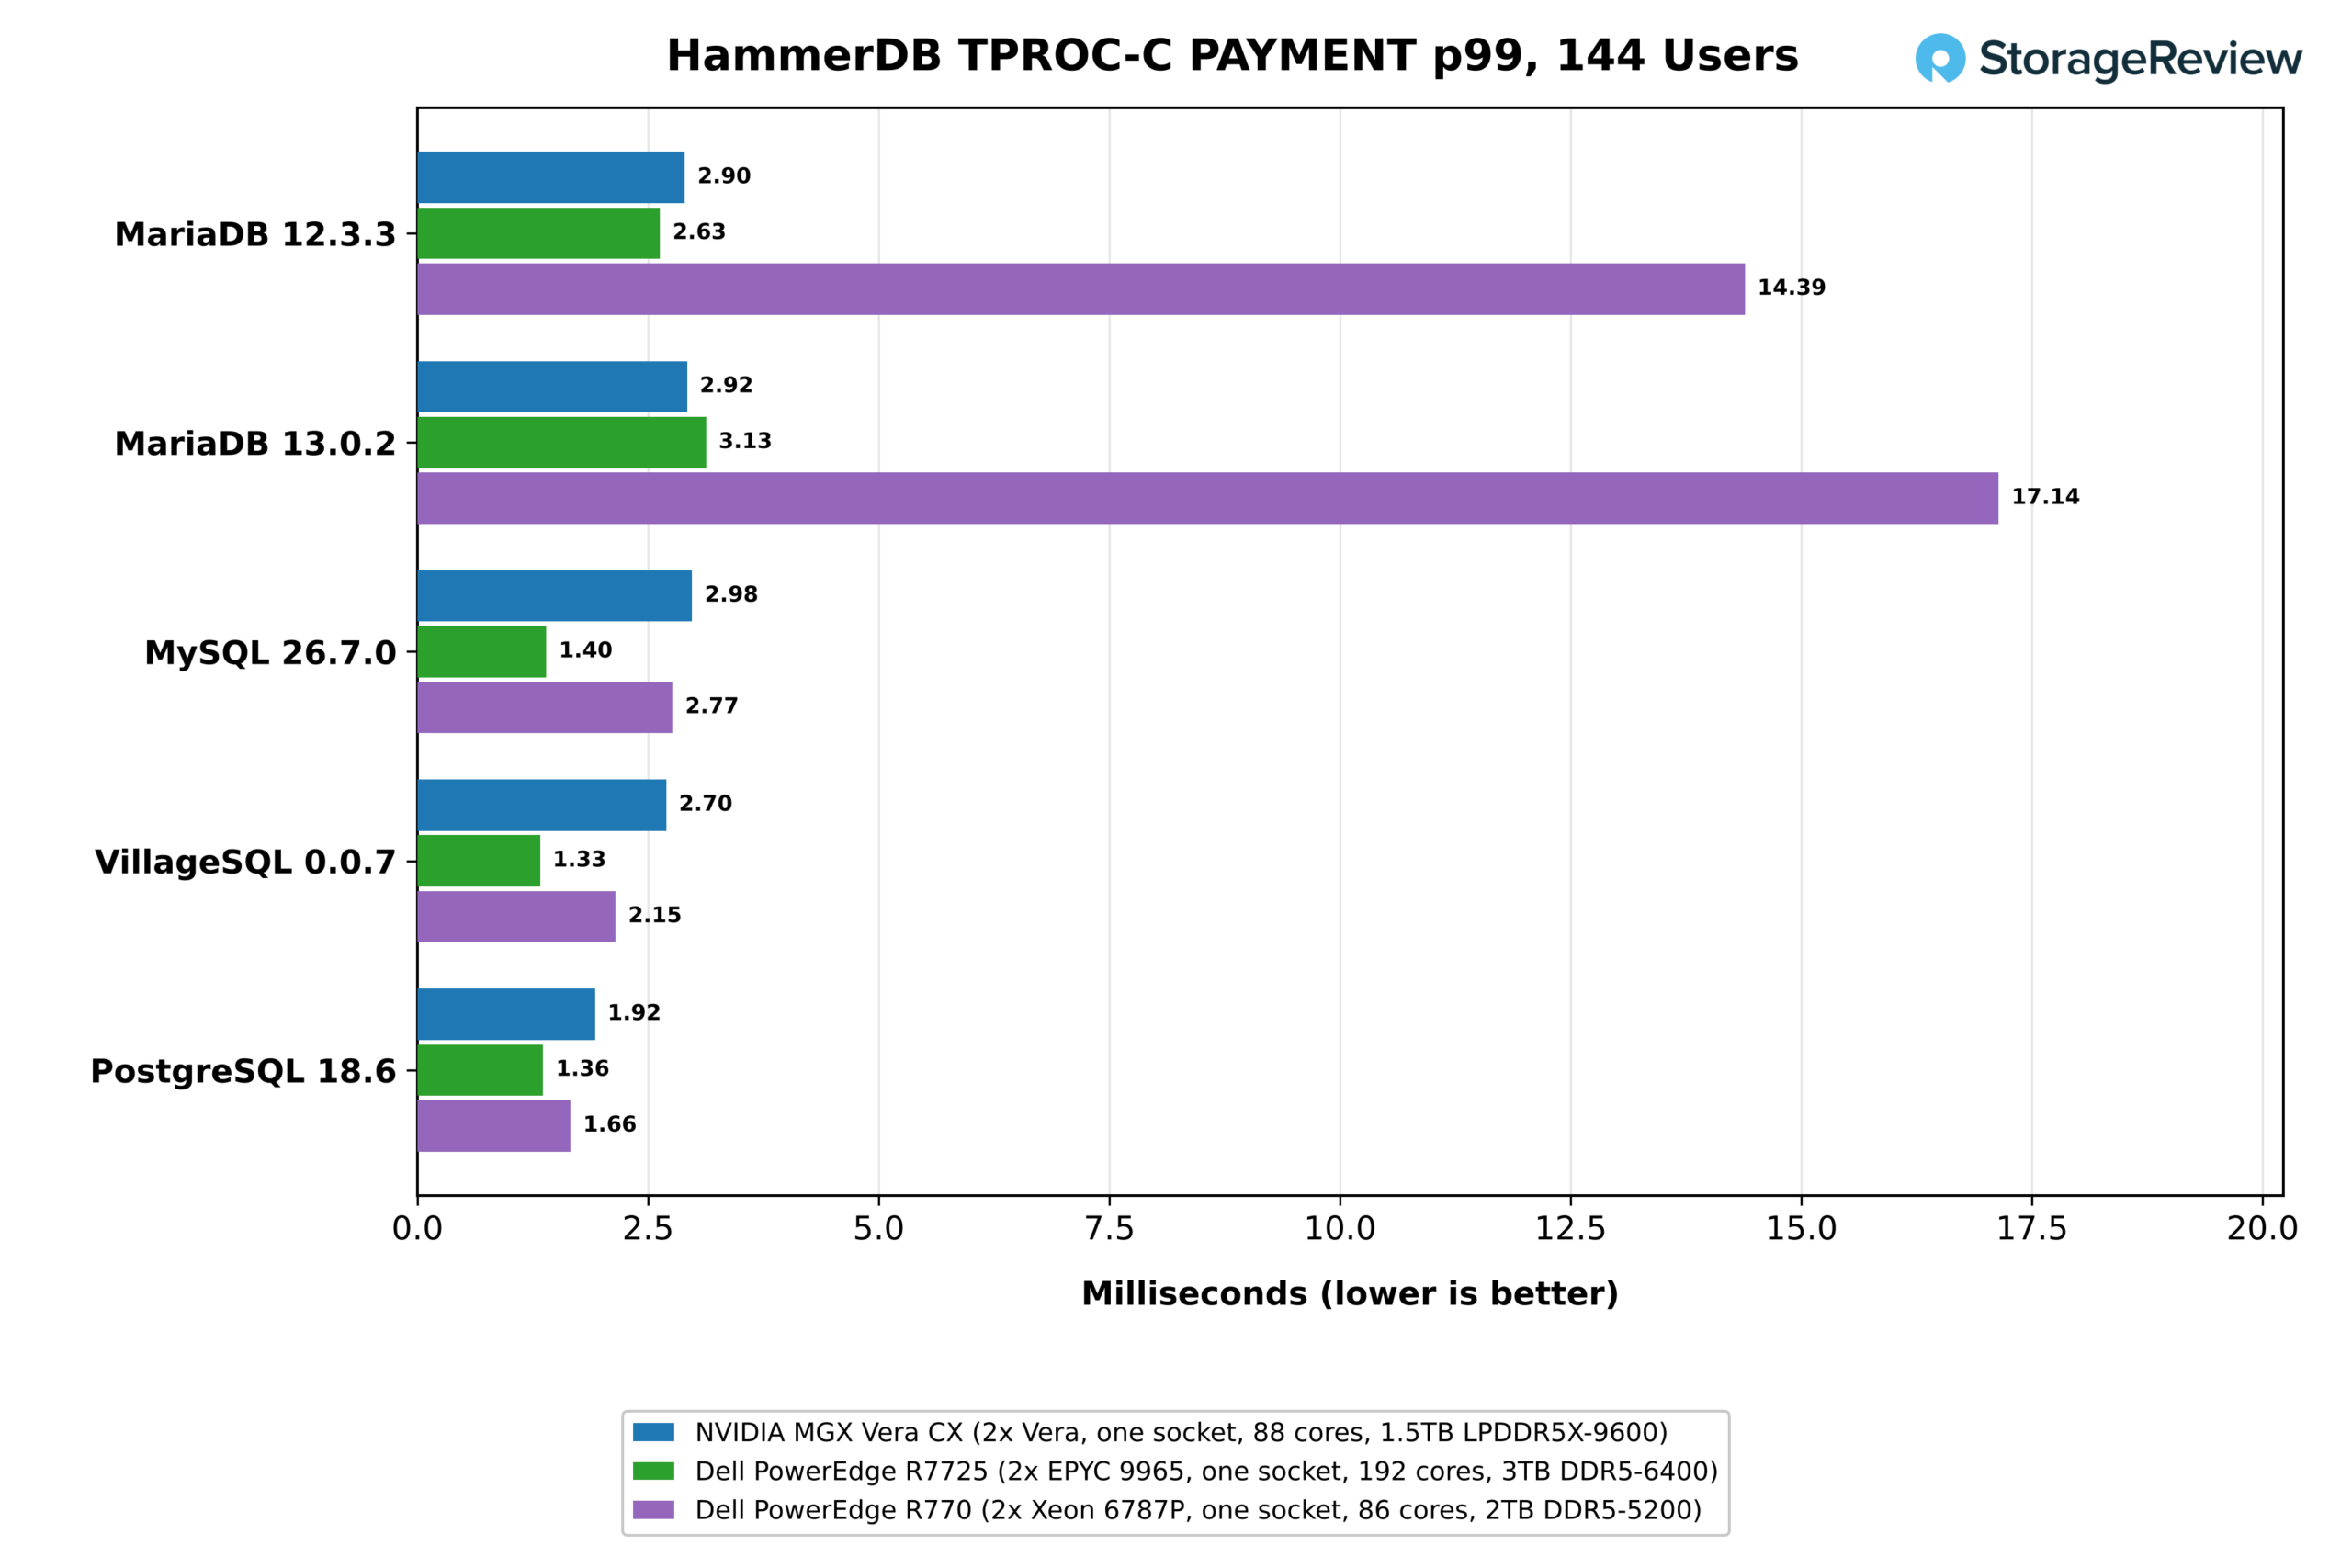
De staartlatentie bij een gelijke belasting van 144 virtuele gebruikers laat dezelfde verdeling zien. De PAYMENT p99-latentie van Vera varieerde van 1.92 ms op PostgreSQL tot 2.98 ms op MySQL. De EPYC 9965 hield MySQL, VillageSQL en PostgreSQL tussen de 1.33 ms en 1.40 ms, 29% tot 53% lager dan Vera, maar de 3.13 ms op MariaDB 13.0.2 bleef achter bij de 2.92 ms van Vera. De MariaDB-staartlatentie van de Xeon 6787P, met 14.4 ms en 17.1 ms, was vele malen hoger dan die van beide, in lijn met de veel lagere doorvoer bij dezelfde belasting. Lock handoff binnen de engines is waarschijnlijk de oorzaak van de hogere staartlatentie van Vera, wat overeenkomt met de Valkey-resultaten, waar verzoeken die één voor één werden verzonden ook in het voordeel van AMD uitvielen.
De testronde in november stelde Shaws vermoeden op de proef. Hij voerde dezelfde workload uit op één socket van AMD's nieuwe 256-core EPYC 9996 en op een 96-core EPYC 9686F, waarbij de socket van Vera in de vergelijking werd meegenomen. De 9996 en Vera wisselden van engine, waarbij Vera PostgreSQL en MariaDB bleef verwerken en de EPYC een voorsprong had op het gebied van staartlatentie. De 96-core variant presteerde nipt beter dan Vera bij PostgreSQL. De volledige resultaten zijn te vinden in onze AMD EPYC Venice review.
"Ik was oprecht onder de indruk van de prestaties van open-source databases op NVIDIA Vera. Het is geweldig om te zien dat Arm meedoet aan de top van de databaseprestaties en een aantrekkelijk alternatief biedt voor de zakelijke markt", aldus Steve Shaw, de maker en beheerder van HammerDB, na afloop van de testronde.
Conclusie
Vera is niet de snelste processor in elke categorie, omdat AMD voor elk segment van de markt een aparte variant levert. De frequentie-geoptimaliseerde EPYC 9175F is ontworpen voor snelheid per core en presteert nog steeds het beste bij taken die een hoge kloksnelheid belonen, van Python's nbody en single-thread AES tot Valkey-verzoeken die één voor één worden verwerkt. De EPYC 9965 is ontworpen voor doorvoer en presteert het beste bij taken die schalen met het aantal cores, waaronder GROMACS, all-thread 7-Zip en AES, en het aantal Valkey-shards dat in een socket past.
Waar Vera zich onderscheidt, is in het middengebied en hoe dicht het de prestaties van elk van die specialisten op hun eigen terrein benadert. Op één thread evenaarde of overtrof het de 9175F bij integerbewerkingen en twee van de drie Python-tests, comprimeerde het 12% sneller met 7-Zip en voerde het go en regex_compile respectievelijk 15% en 25% sneller uit, terwijl het achterbleef bij floating-point- en cryptografie.
Over het hele systeem behaalde de processor 63% tot 72% van de all-thread 7-Zip-prestaties van de 9965 en voltooide de medium OpenFOAM mesh binnen 12% daarvan. Vervolgens liep de processor vooruit toen het geheugen het overnam, zowel op de grote mesh als in ClickBench. Dat de Vera zo dicht bij de leider per core op één thread en bij de leider qua doorvoer over het hele systeem blijft, maakt de Vera tot zo'n sterke processor voor algemeen gebruik. Voor kopers die één platform zoeken voor het brede middensegment van de markt zonder veel in te leveren aan de uiteinden, is dit een extreem aantrekkelijk aanbod.
Vera levert een aanzienlijk hogere geheugenbandbreedte dan elk x86-systeem dat we hebben getest. Twee Vera-sockets haalden een constante snelheid van 2,073 GB/s op STREAM Triad, 2.3 keer de beste DDR5-server in deze test, en NVLink-C2C zorgt ervoor dat die bandbreedte ook tussen de sockets beschikbaar blijft: de cores van Vera lezen het geheugen van de andere socket met een snelheid van 677 GB/s, meer dan welke x86-socket dan ook uit het lokale geheugen leest.
Er volgden geheugenintensieve workloads: het grote OpenFOAM-mesh werd 1.44 keer sneller opgelost dan op de EPYC 9965, de ClickBench-test was in 2.09 seconden voltooid tegenover 2.70 seconden, de 256 GB Valkey-werkset draaide 34% sneller en op één socket presteerde Vera beter dan HammerDB op PostgreSQL en beide MariaDB-releases. De kosten van de verbinding zijn de latentie: een externe leesbewerking duurt ongeveer 2.1 keer zo lang als een lokale, tegenover 1.75 keer zo lang op de EPYC 9175F, dus NUMA-bewuste plaatsing en hugepages blijven belangrijk op Vera.
De zwakke punten zijn verrassend klein en direct terug te voeren op het ontwerp. Zes 128-bits SVE2-pipes komen niet overeen met 512-bits AVX-512-eenheden in code die ervoor geschreven is, waardoor een 16-core slice van Vera GROMACS benchMEM uitvoerde met de helft van de snelheid van de 9175F en twee derde van de snelheid van de 9965. Met slechts twee van die pipelines voor cryptografie, versleutelde een enkele Olympus-core AES-256-GCM met ongeveer een derde van de snelheid van de 9175F.
Hoe Vera zich verder ontwikkelt, hangt grotendeels af van de OEM-partners. Dell's PowerEdge R8822 is in oktober op de markt gekomen, terwijl de M9882 Vera CPU Rack in het eerste kwartaal van 2027 verschijnt. HPE's ProLiant Compute DL394 Gen12 komt dit najaar uit, Supermicro heeft zijn 256-CPU Vera rack beschikbaar voor offertes, met luchtgekoelde 1U- en 2U Vera-systemen in het assortiment. ASUS, ASRock Rack, QCT, GIGABYTE, MSI, Compal, Foxconn, Pegatron, Wistron en Lenovo hebben allemaal Vera-ontwerpen getoond. Oracle Cloud heeft Vera-instances algemeen beschikbaar , gevolgd door CoreWeave, Nebius, Lambda en andere.
Vera is de eerste Arm-serverprocessor die we hebben getest die zich kan meten met de x86-vlaggenschips voor algemene toepassingen, en de eerste processor van welke fabrikant dan ook die 2 TB/s geheugenbandbreedte in een luchtgekoelde behuizing met twee sockets weet te stoppen. Voor het brede middensegment van de markt is het vandaag de dag een geloofwaardige optie, en NVIDIA betreedt de CPU-markt met een geheugensubsysteem dat niemand anders aanbiedt. Voor vectorintensieve HPC en cryptografische toepassingen behouden de x86-specialisten hun voorsprong. We zullen de OEM-systemen aan dezelfde testsuite onderwerpen zodra ze in het lab aankomen, te beginnen met de rol van agent-sandbox waarvoor NVIDIA deze processor heeft ontworpen.
Sinds deze review is AMD's EPYC Venice in ons lab aangekomen, en in onze reviews van de AMD EPYC Venice SP7 en de Dell PowerEdge R9825 hebben we de 256-core EPYC 9996 aan dezelfde tests onderworpen als Vera, waarbij Vera de nieuwste firmware draaide.
Klassement: NVIDIA Vera staat bovenaan in ons klassement voor beste servers met de beste ARM-implementatie.


 Amazon