

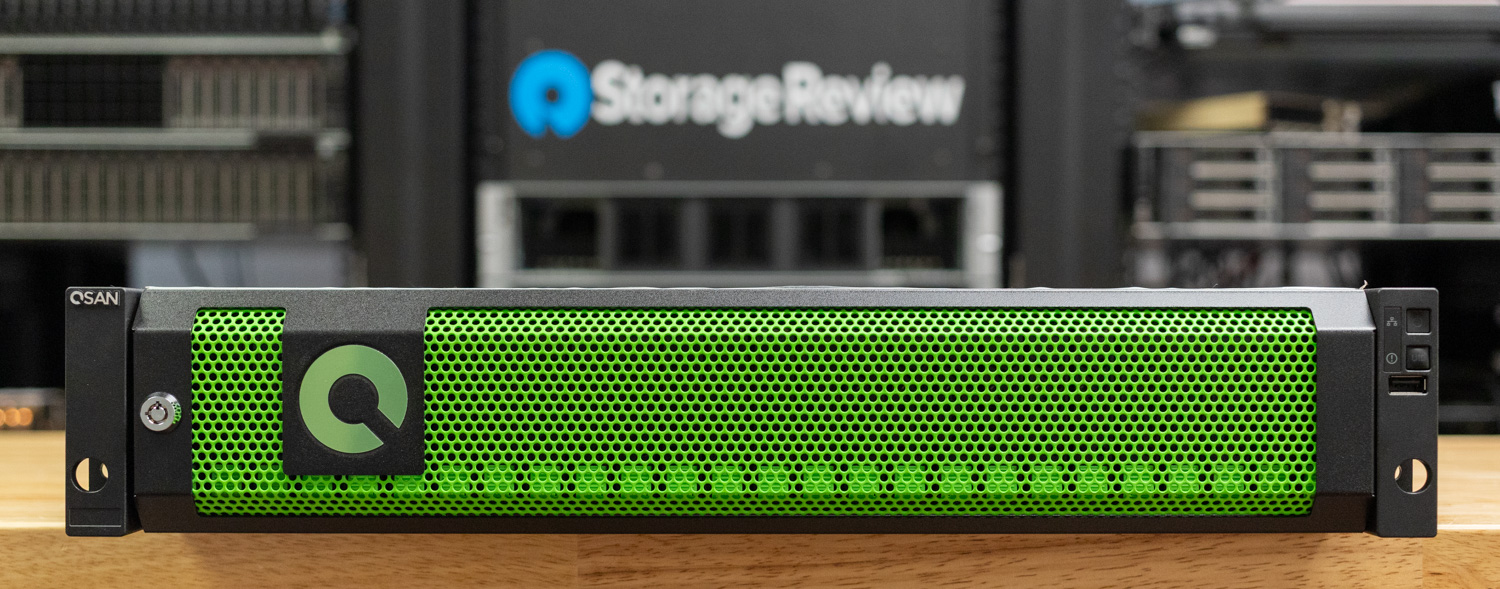
QSAN bouwt al sinds 2004 enterprise storage-oplossingen en die ervaring is duidelijk terug te zien in de XN4-lijn. De XN4226D in ons lab is een 2U, 26-bay, volledig NVMe-array met twee actieve controllers, die hoge beschikbaarheid biedt als unified block- en file-opslag. QSM 4-software voegt de verwachte dataservices toe, waaronder snapshots, replicatieopties, datareductie en een eenvoudige beheerervaring. De XN4 is ontworpen voor teams die NVMe-snelheid zoeken zonder in te leveren op multiprotocolflexibiliteit, en dat alles tegen een zeer betaalbare prijs.
Key Takeaways
- Geünificeerd blok en bestand met echte HA. Dubbele actieve controllers en QSM 4 zorgen voor hoge beschikbaarheid met één platform voor blok en bestand.
- NVMe-oF goed uitgevoerd. Volledige protocolspreiding met NVMe-oF over TCP en RDMA naast iSCSI, Fibre Channel, NFS, SMB, FTP en WebDAV.
- Bewezen doorvoer. We hebben snelheden tot 21.21 GB/s gemeten bij grote sequentiële leesbewerkingen met TCP en 11.14 GB/s bij grote sequentiële schrijfbewerkingen met RDMA.
- Gebouwd voor moderne pijpleidingen. 26 volledig NVMe-bays in 2U, eenvoudig beheer en I/O-opties die schaalbaar zijn tot 100–200 GbE voor media, bewakingsanalyses, VDI, databases en AI-inferentie.
Het platform ondersteunt NVMe-oF via TCP en RDMA, naast iSCSI, Fibre Channel, NFS, SMB, FTP en WebDAV. We hebben ook een gerichte NVMe-oF-studie uitgevoerd, waarbij we het gedrag en de schaalbaarheid van TCP en RDMA hebben vergeleken. Tijdens onze tests hebben we de unit tot het uiterste gedreven met grote sequentiële leesbewerkingen, wat een indrukwekkende doorvoer van 21.21 GB/s opleverde. De plaatsing van dit systeem is net zo belangrijk als de absolute cijfers. De XN4226D bedient gemengde omgevingen met VMware of Proxmox voor VM's, VDI en databaselagen, evenals creatieve bestandsservices, AI-inferentieknooppunten die voorspelbare NVMe-paden, mediaback-ups en hoge bandbreedte-ingest vereisen voor bewakings- en sensorworkloads. De QSAN XN4226D is geschikt voor vrijwel elke workload.
QSAN heeft een aanzienlijke groei opgemerkt in mediaproductie, waaronder live-uitzendingen, herhalingsopties, AI-videoverbetering en OTT/edge-caching, evenals in videoanalyse van bewakingsbeelden, zoals slimme stadsbewaking, anomaliedetectie en realtime herhaling. Deze workloads worden idealiter ondersteund met een doorvoer van 100-200 GbE.
Uiteindelijk is de waarde duidelijk. U krijgt uniforme hoge beschikbaarheid, NVMe in de hele behuizing en I/O-opties tot 100 GbE of 32 Gb Fibre Channel naarmate de behoeften toenemen. De prestaties komen overeen met die van veel tier 1-arrays, terwijl licenties toegankelijker blijven en de protocoldekking breed blijft voor NVMe-oF, iSCSI, Fibre Channel, SMB en NFS. Voor bedrijven die InfiniBand overwegen, maar een beperkt budget hebben, biedt de Ethernet-aanpak van QSAN een responsiviteit die bijna gelijk is aan die van IB op standaardapparatuur op een schaal van 100 tot 200 GbE.
Voor teams die prioriteit geven aan resultaten uit echte toepassingen, maken de duurzaamheid, intuïtieve software en het overzichtelijke hardwareontwerp van QSAN de XN4226D tot een betrouwbare all-flash werkpaard om op te bouwen.
QSAN XN4-hardware
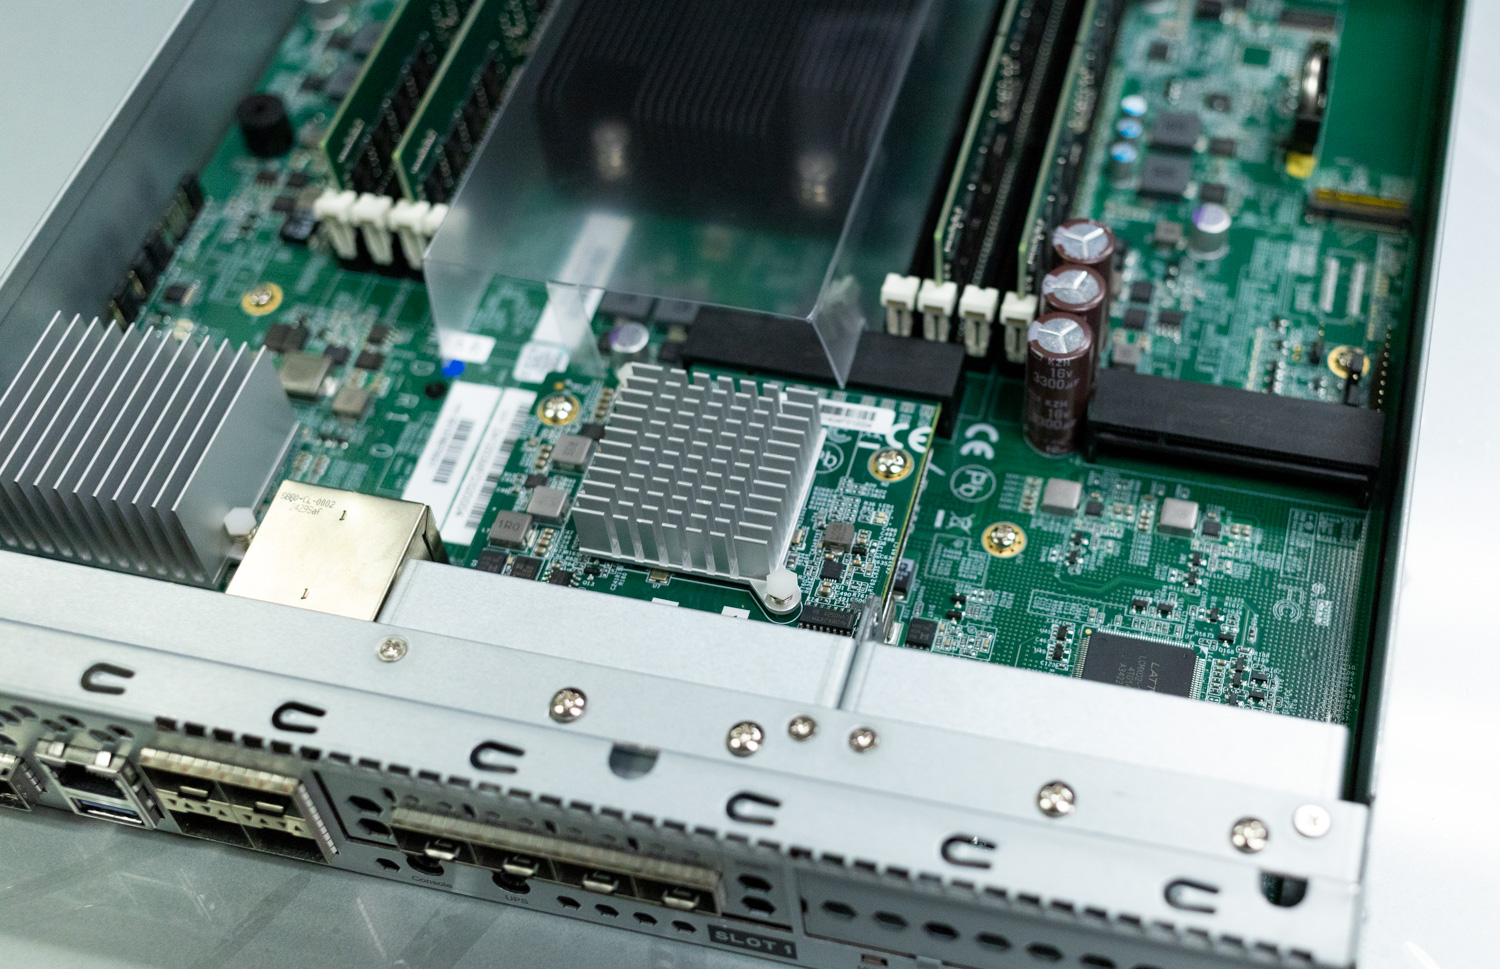
De QSAN XN4-serie storage arrays worden geleverd in een 2U, 19-inch rack-compatibele serverbehuizing met 26 bays, met opties voor één of twee controllers en 4- of 8-core Intel Xeon CPU's om te voldoen aan de redundantie- en prestatiebehoeften van zowel de kleinste als de grootste bedrijven. Met alle 26 bays gevuld, kan één behuizing uit de XN4-serie tot 798 terabyte aan data opslaan op 2.5-inch U.2/U.3 NVMe solid-state drives. Er kunnen maximaal 20 SAS-aangesloten uitbreidingseenheden worden toegevoegd, waardoor de totale capaciteit van een array toeneemt tot maar liefst 16.773 petabyte.
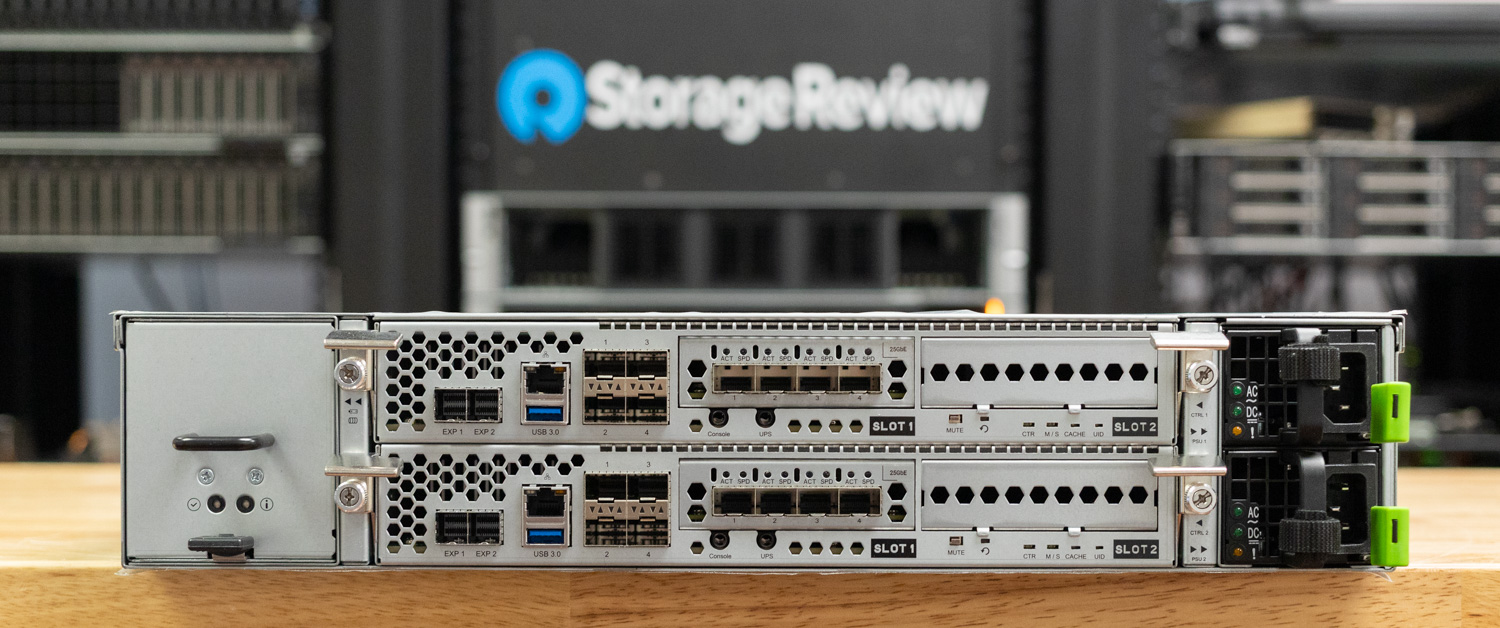
Elke controller aan boord beschikt over één 2.5 Gbps RJ45 Ethernet-poort, vier 10 Gbps SFP+-poorten en twee 12 Gbps SAS-poorten. Er zijn ook upgrademogelijkheden voor 10 Gbps RJ45-, 25 Gbps SFP28- en 100 Gbps QSFP-poorten. Fibre Channel-ondersteuning kan ook worden toegevoegd met 16 Gbps SFP+- en 32 Gbps SFP28-adapters.
De onderstaande tabel vergelijkt de specificaties van de XN4226D-4C en XN4226S-4C opslagsystemen. Dit zijn de 4C-varianten, ontworpen met dual-active of single-upgradable controllers, afhankelijk van het model. Voor implementaties die meer processorkracht vereisen, is er ook een 8C-versie van deze systemen beschikbaar.
| Specificaties | XN4226D-4C | XN4226S-4C |
|---|---|---|
| Modelnaam | XN4226D-4C | XN4226S-4C |
| Architectuur | Dual-actieve controller | Eén upgradebare controller |
| CPU | Intel® Xeon® 4-core × 2 | Intel® Xeon® 4-core |
| Geheugen | ||
| Geheugenmodule vooraf geïnstalleerd | 32 GB DDR4 RDIMM | 16 GB DDR4 RDIMM |
| Totale geheugenslots | 16 | 8 |
| Geheugen Uitbreidbaar tot | 2,048GB | 1,024GB |
| Opslag | ||
| Drive Bays | 2.5″ sleuf × 26 | 2.5″ sleuf × 26 |
| Maximale schijfposities met uitbreidingseenheid | 546 | 546 |
| Compatibel schijftype | 2.5″ dual-port U.2/U.3 NVMe SSD 2.5″ SAS SSD (voor uitbreidingseenheden) 3.5″ SAS HDD (voor uitbreidingseenheden) |
2.5″ U.2/U.3 NVMe SSD met één poort 2.5″ SAS SSD (voor uitbreidingseenheden) 3.5″ SAS HDD (voor uitbreidingseenheden) |
| Schijfinterface | U.2 NVMe (PCIe Gen 4) SAS 12 Gb/s (voor uitbreidingseenheden) |
U.2 NVMe (PCIe Gen 4) SAS 12 Gb/s (voor uitbreidingseenheden) |
| Maximale interne onbewerkte capaciteit | 798TB | 798TB |
| Maximale ruwe capaciteit met uitbreiding | 16,773TB | 16,773TB |
| Hot-swappable schijf | Ja | Ja |
| Connectiviteitspoort | ||
| PCIe-uitbreiding | (Gen 4×8-sleuf) × 4 | (Gen 4×8-sleuf) × 2 |
| 2.5 GbE RJ45 LAN-poort | 2 (aan boord) | 1 (aan boord) |
| 10 GbE SFP+ LAN-poort | 8 (aan boord) / 16 (optie) | 4 (aan boord) / 8 (optie) |
| 10 GbE RJ45 LAN-poort | 16 (optie) | 8 (optie) |
| 25 GbE SFP28 LAN-poort | 16 (optie) | 8 (optie) |
| 100 GbE QSFP LAN-poort | 8 (optie) | 4 (optie) |
| 16 Gb SFP+ Fibre Channel | 16 (optie) | 8 (optie) |
| 32 Gb SFP28 Fibre Channel | 16 (optie) | 8 (optie) |
| Uitbreiding en externe poort | ||
| 12 Gb/s SAS-brede poort | 4 (aan boord) | 2 (aan boord) |
| USB-poort | 1 (voor) / 2 (achter) | 1 (voor) / 1 (achter) |
| Andere | Consolepoort × 2, servicepoort × 2 | Consolepoort × 1, servicepoort × 1 |
| Software Specificatie | ||
| Opslag besturingssysteem | QSM 4 | QSM 4 |
| RAID-type | 0 / 1 / 5 / 6 / 10 / 50 / 60 / 5EE / 6EE / 50EE / 60EE | |
| Efficiëntie van opslag | Dunne provisioning / Compressie en deduplicatie (optie) | |
| Softwareversnelling | SSD-cache / Automatische tiering / RDMA | |
| Data Protection | Momentopname / Asynchroon / Synchroon (optie) | |
| Backup Service | Rsync / S3-back-up / Cloudback-up / XMirror* / Microsoft 365-e-mailback-up | |
| Security | SSL / SSH / iSCSI CHAP / ISE & SED / WORM / RBAC / Windows ACL / Antivirus | |
| Ondersteuningsprotocollen | CIFS / NFS / FTP / WebDAV / iSCSI / FCP / NVMe-oF | |
| Management | Web-UI / Windows AD / LDAP / RESTful API / SES / LCM | |
| het Uiterlijk | ||
| Afmetingen (H × B × D) | 88 × 438 × 573mm | 88 × 438 × 573mm |
| Netto Gewicht | 19.6 kg | 16.5 kg |
| Bruto Gewicht | 28.6 kg | 25.5 kg |
| Andere | ||
| Geheugenbescherming | Cache-naar-flashmodule (ingebouwd) | |
| Systeemventilator | 8 pcs | 4 pcs |
| Power Supply Unit | 850 W × 2 (80 Plus Platina) | |
| Opgenomen vermogen | 100 – 240 V wisselstroom, 50/60 Hz | |
| Energieverbruik | 812 W / 2,770 BTU | |
| Certificering | CE / FCC / BSMI | |
| Standaard garantie | Systeem: 5 jaar | Cache-to-Flash-module: 1 jaar | |
QSAN XN4-mogelijkheden
XN4-arrays worden standaard geleverd met de nieuwste verbindingsprotocollen die nodig zijn om high-performance computing en data-intensieve AI-modellen te ondersteunen, waaronder NVMe over Fabrics (NVMe-oF) via TCP en RDMA. Verbindingen via iSCSI, NFS, FCP, CIFS/SMB, FTP en WebDAV zijn ook mogelijk, waardoor de array voldoet aan de behoeften aan blok- en bestandsopslag van datacenters met een mix van oudere en geavanceerde systemen.
De voordelen van NVMe-oF
Hoewel protocollen zoals iSCSI, NFS en FCP nog steeds veel worden gebruikt in zakelijke opslagtoepassingen, biedt NVMe-oF aanzienlijke verbeteringen in latentie. NVMe-standaarden zijn vanaf de grond af ontworpen voor solid-state drives die rechtstreeks op de PCIe-bus van een systeem zijn aangesloten. Oudere protocollen zoals iSCSI en NFS daarentegen zijn ontwikkeld rond de beperkingen en tragere toegangstijden van traditionele harde schijven. In bijna alle gevallen presteren NVMe-oF-technologieën beter dan oudere verbindingsprotocollen, met een hogere bandbreedte en snellere toegangstijden. NVMe-oF kan ook gebruikmaken van netwerkinterfaces met Remote Direct Memory Access (RDMA), waardoor gegevens rechtstreeks naar het geheugen van een doelcomputer kunnen worden overgebracht zonder dat hiervoor CPU-verwerking nodig is.
Functies voor gegevensreductie en -optimalisatie
De krachtige hardwarestack van de XN4-opslagarray wordt verder verbeterd door talloze softwarefuncties die bekend zijn bij en gewaardeerd worden door opslagbeheerders. Thin provisioning, compressie en deduplicatie stellen bedrijven in staat hun SAN-capaciteit te maximaliseren, terwijl SSD-caching en automatische opslagtiering de toegangstijden voor veelgebruikte bestanden en objecten versnellen. Het QSM 4-besturingssysteem van het apparaat maakt het ook eenvoudig om wijzigingen te testen en terug te draaien met ingebouwde snapshottools.
Beveiligings- en beheerfuncties
QSAN heeft met de XN4-lijn rekening gehouden met de veranderende beveiligings- en beheervereisten van haar klanten. De XN4 is compatibel met Instant Secure Erase (ISE) en Self-Encrypting Drives (SED), evenals beveiligingsprotocollen zoals SSL/TLS, authenticatie via Role-Based Access Control (RBAC) en ondersteuning voor Active Directory/LDAP-servers. De array kan worden beheerd via een HTTPS-webinterface of een RESTful API, waardoor automatisering mogelijk is via een breed scala aan tools, zoals Ansible of Terraform.
QSM 4-beheer
QSM 4, het besturingssysteem van de QSAN XN4-serie, maakt de installatie en het beheer van de storage array eenvoudig voor storagebeheerders van alle ervaringsniveaus. De out-of-the-box implementatie is eenvoudig: snelle poolcreatie, intuïtieve hosttoewijzing en lichtgewicht beheer via de webinterface en REST API's – allemaal ontworpen voor kleinere IT-teams zonder diepgaande storage-expertise.
Op het Dashboard-scherm worden informatie over de systeemstatus en recente gebeurtenissen die door de server zijn geregistreerd, weergegeven.
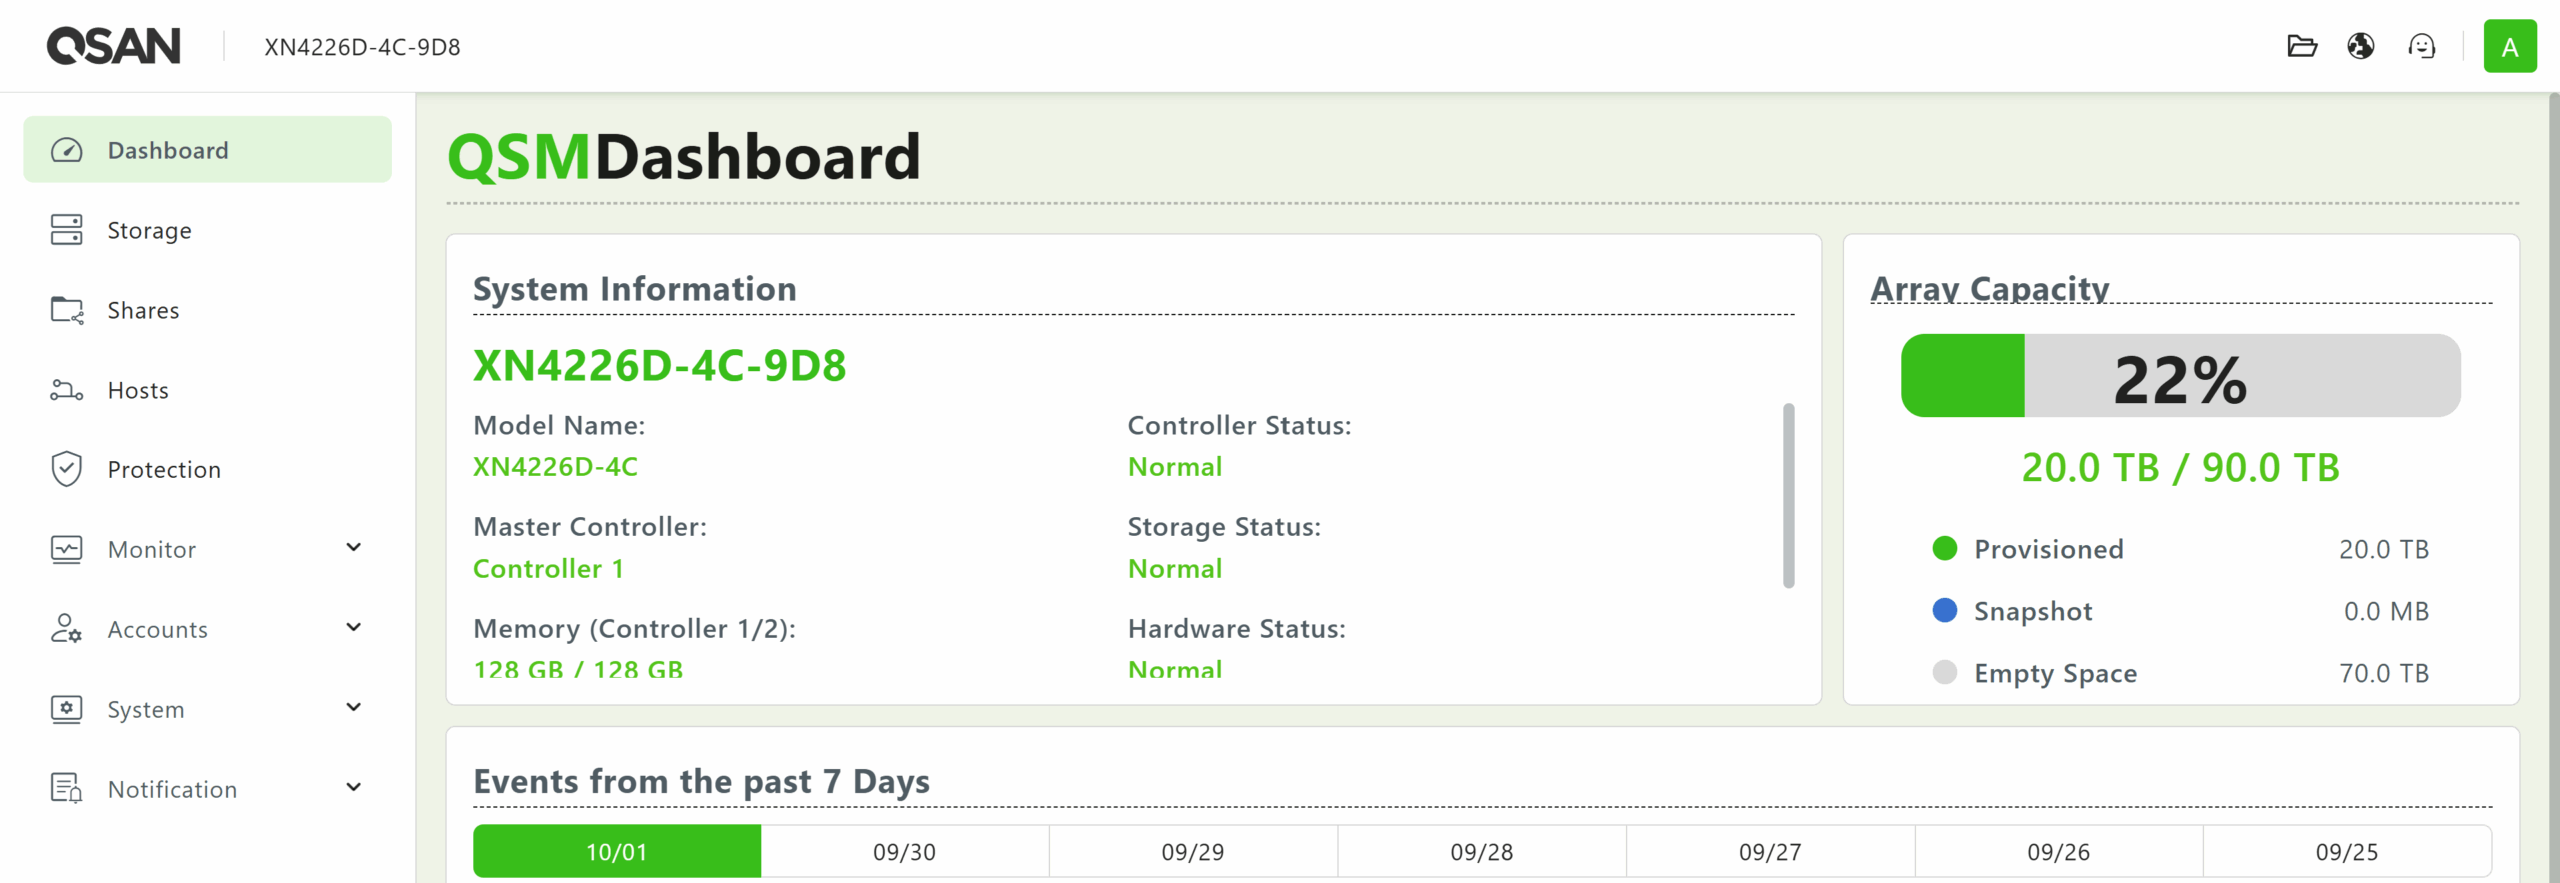
Na het inloggen krijgt de gebruiker het Dashboard te zien, dat een snel overzicht biedt van de status van het SAN. Van hieruit kunt u naar elk submenu in de lijst in het paneel aan de linkerkant gaan.
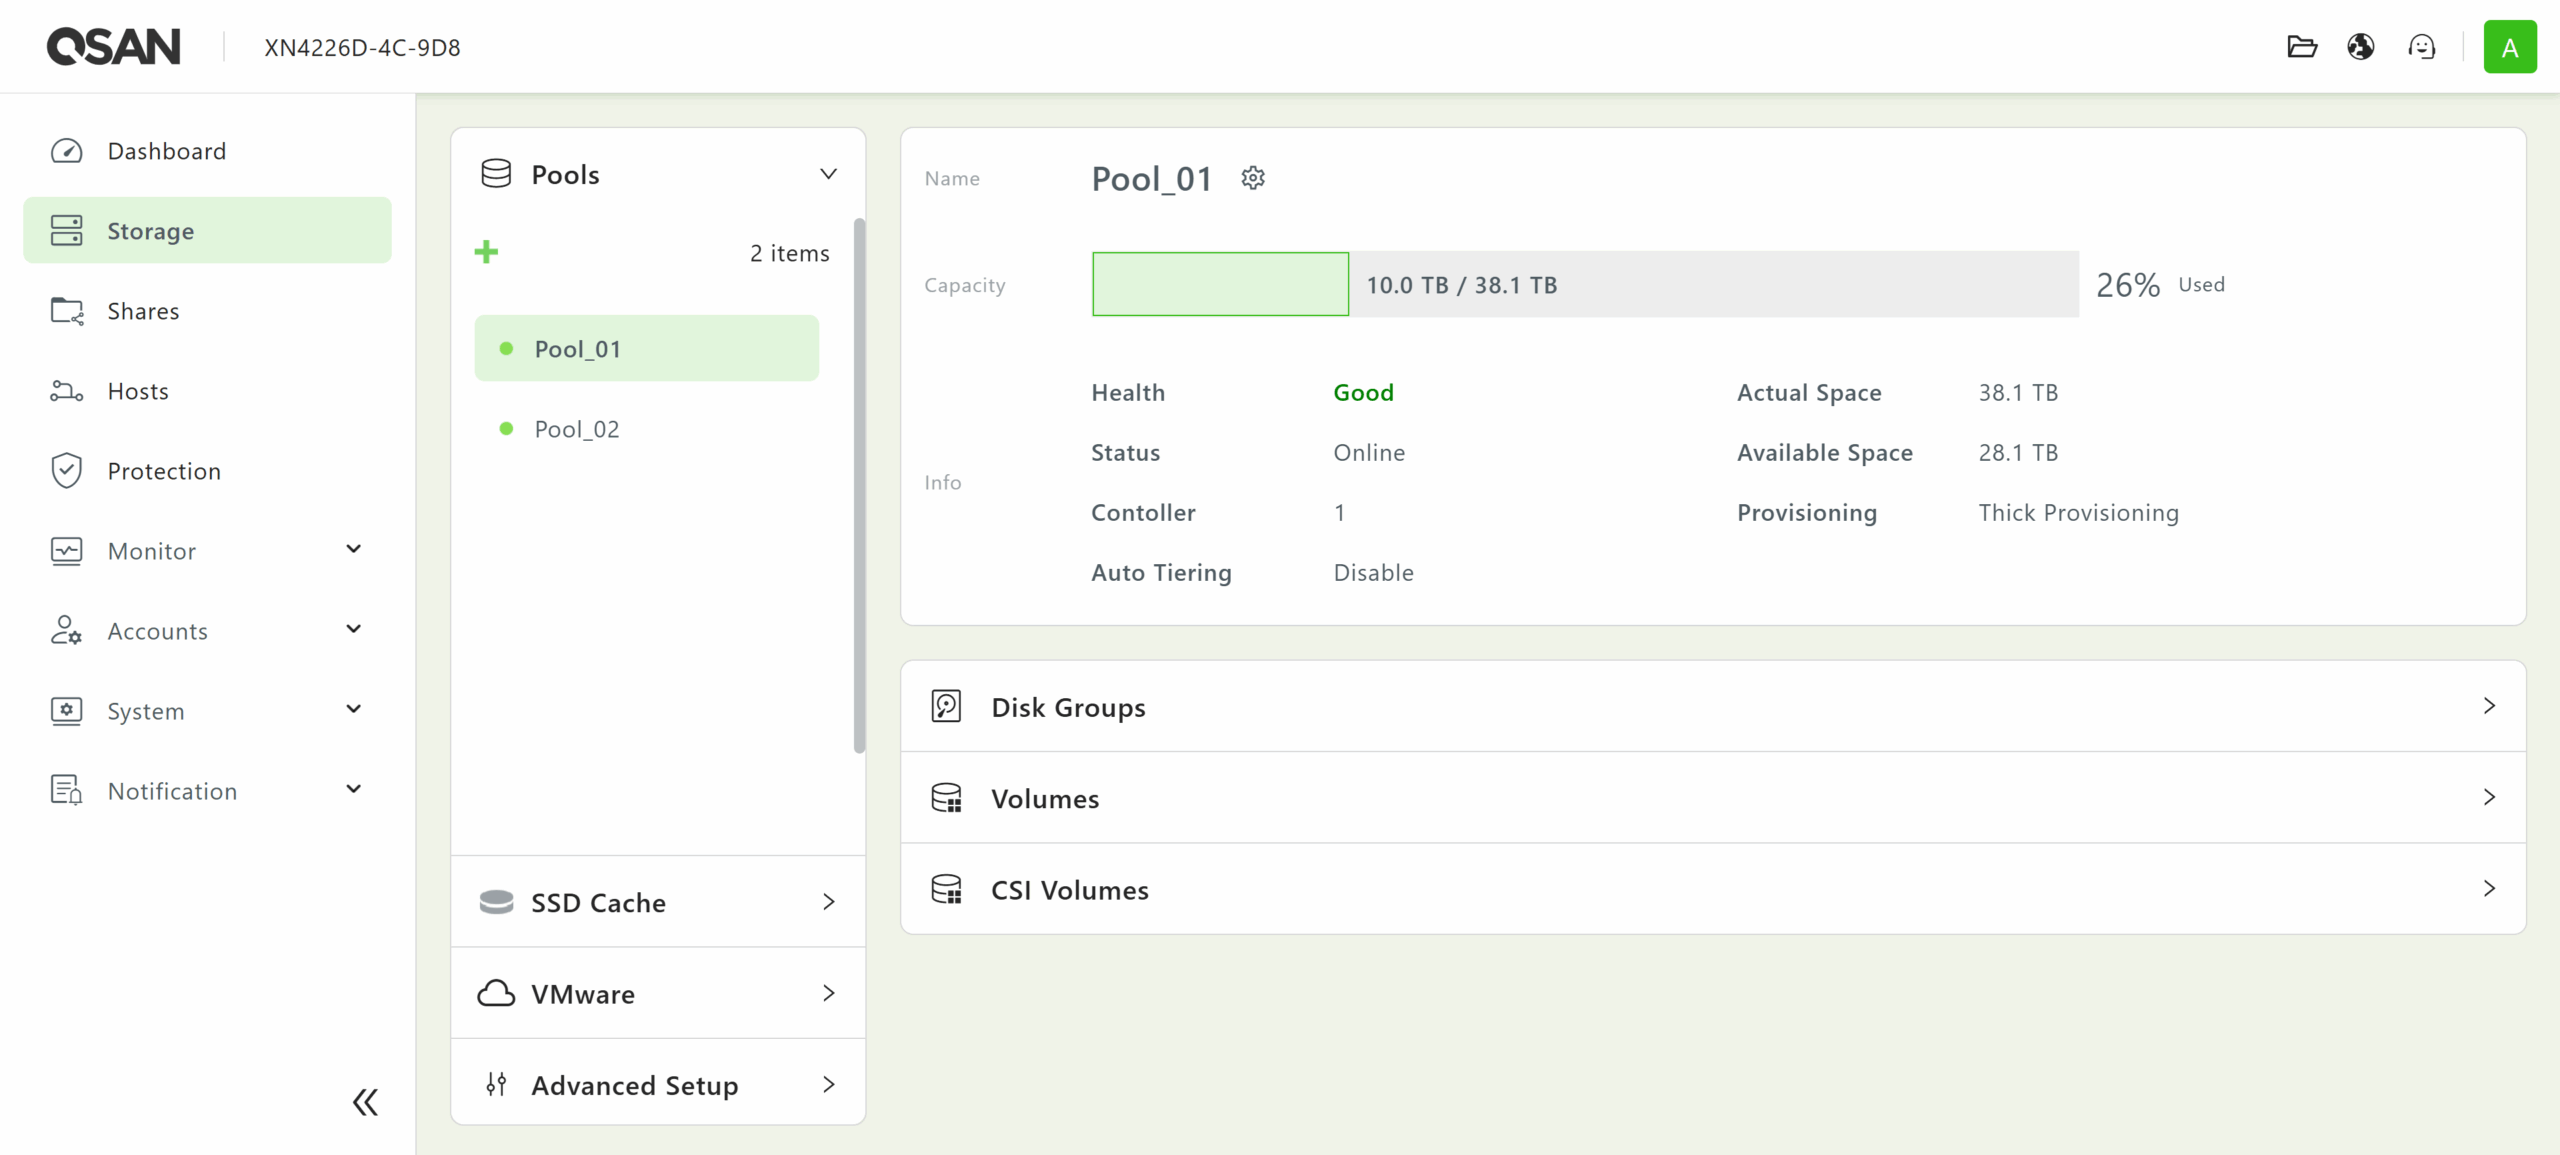
Via het menu Opslag kunnen beheerders pools van stations en de bijbehorende volumes maken en beheren.
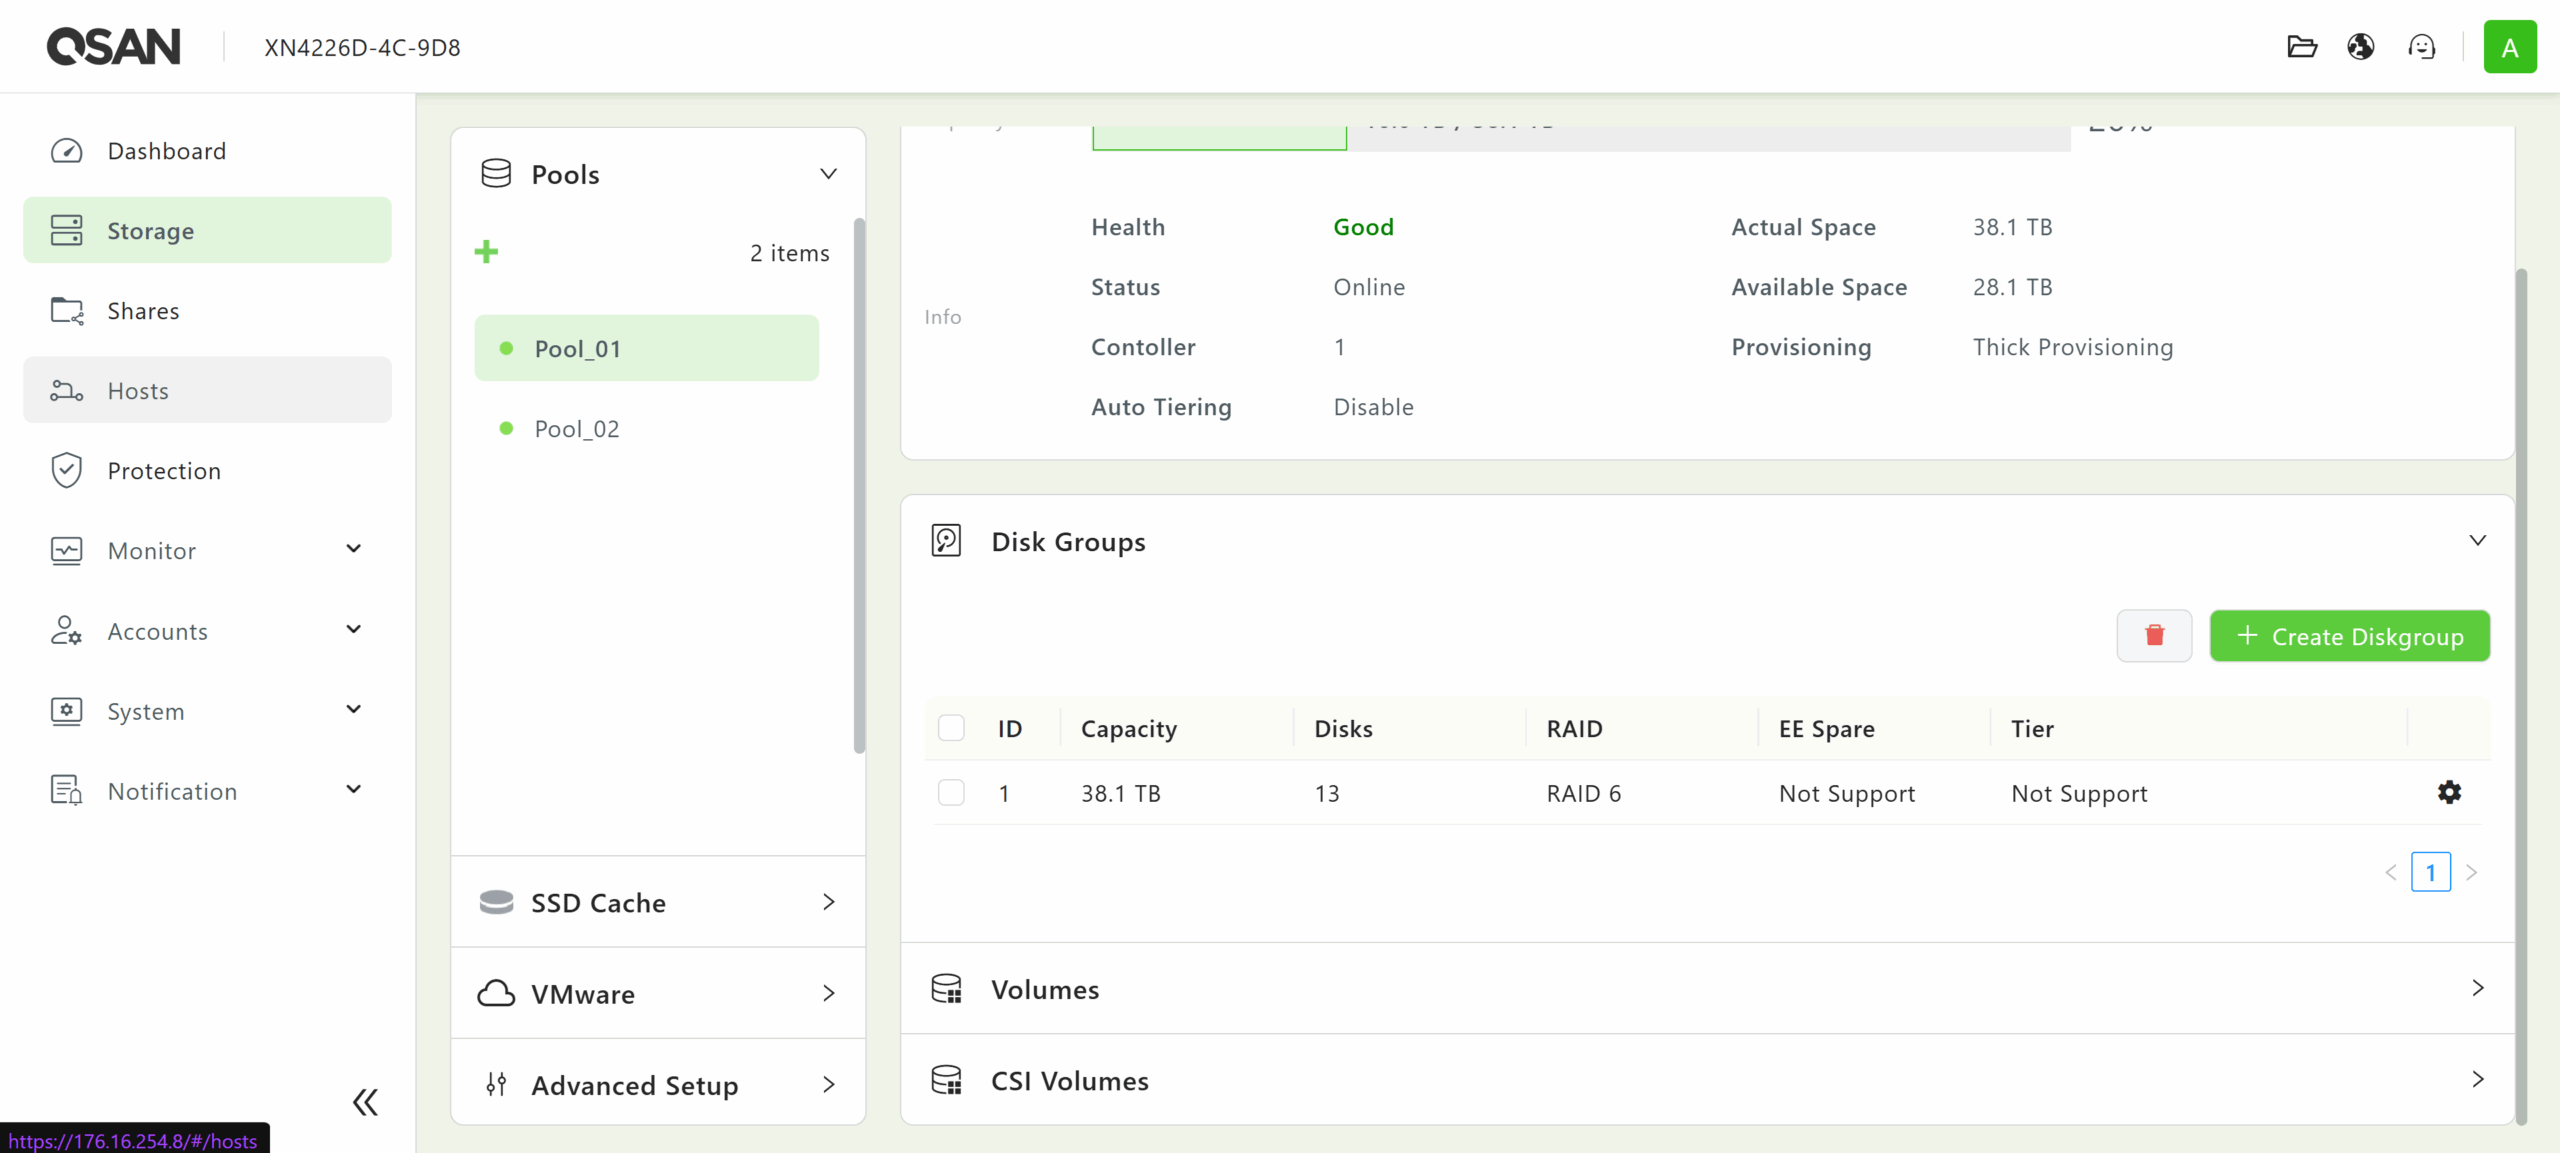
De schijfgroepen waaruit elke pool bestaat, kunnen worden beheerd op het tabblad Schijfgroepen. Deze functie ondersteunt verschillende RAID-niveaus, waaronder 0, 1, 5, 6, 10, 50, 60, 5EE, 6EE, 50EE en 60EE, afhankelijk van het aantal schijven dat al is toegewezen.
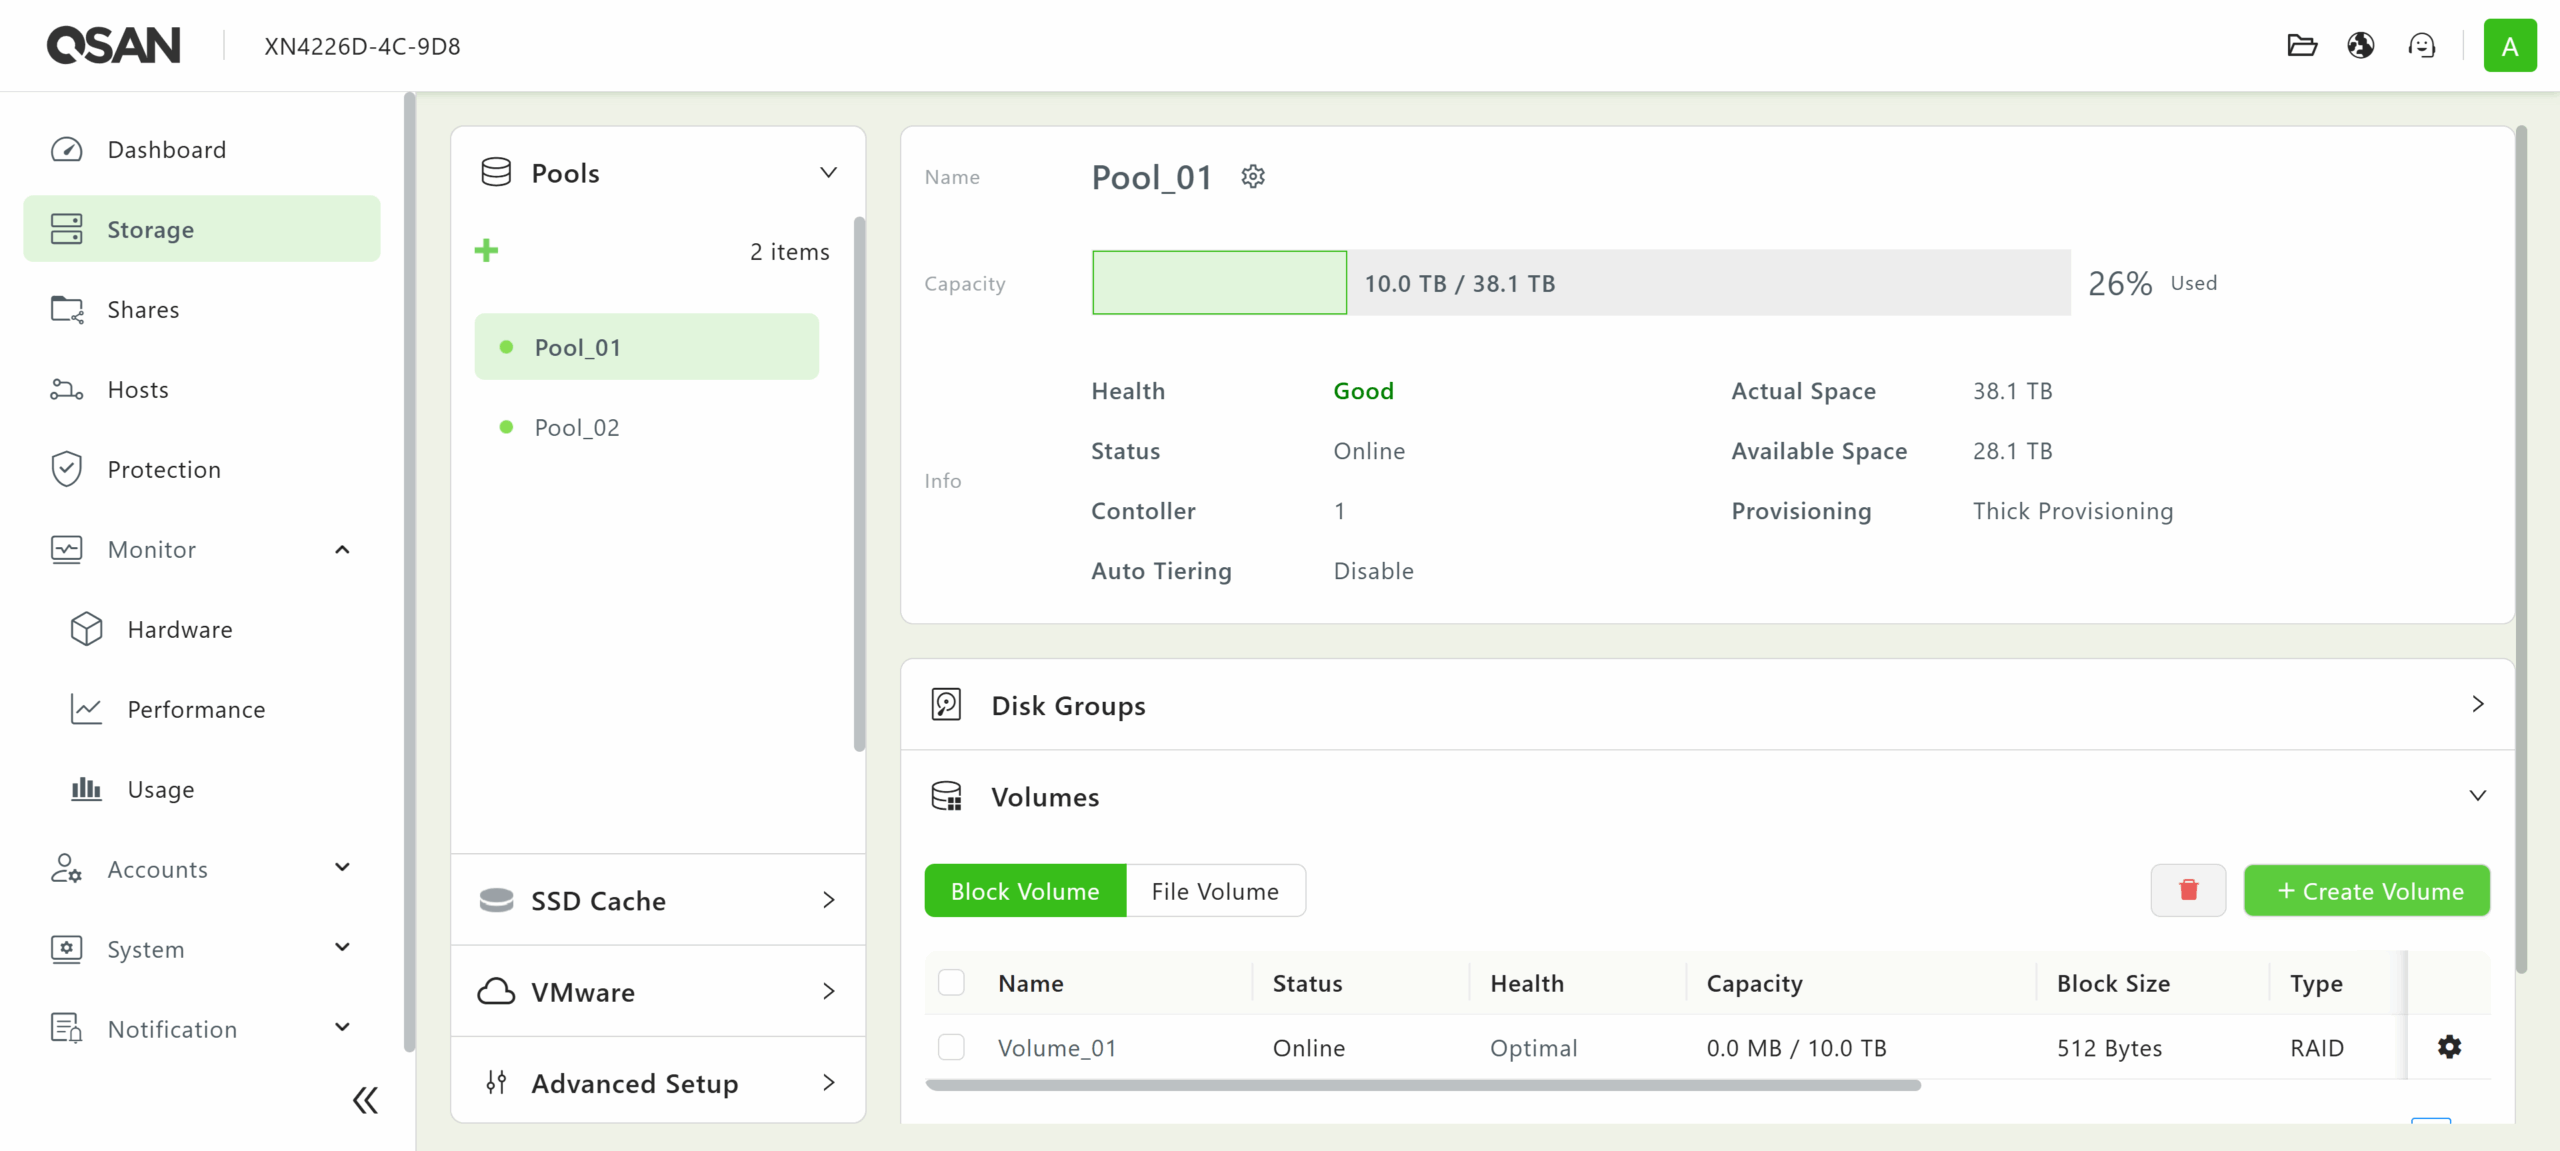
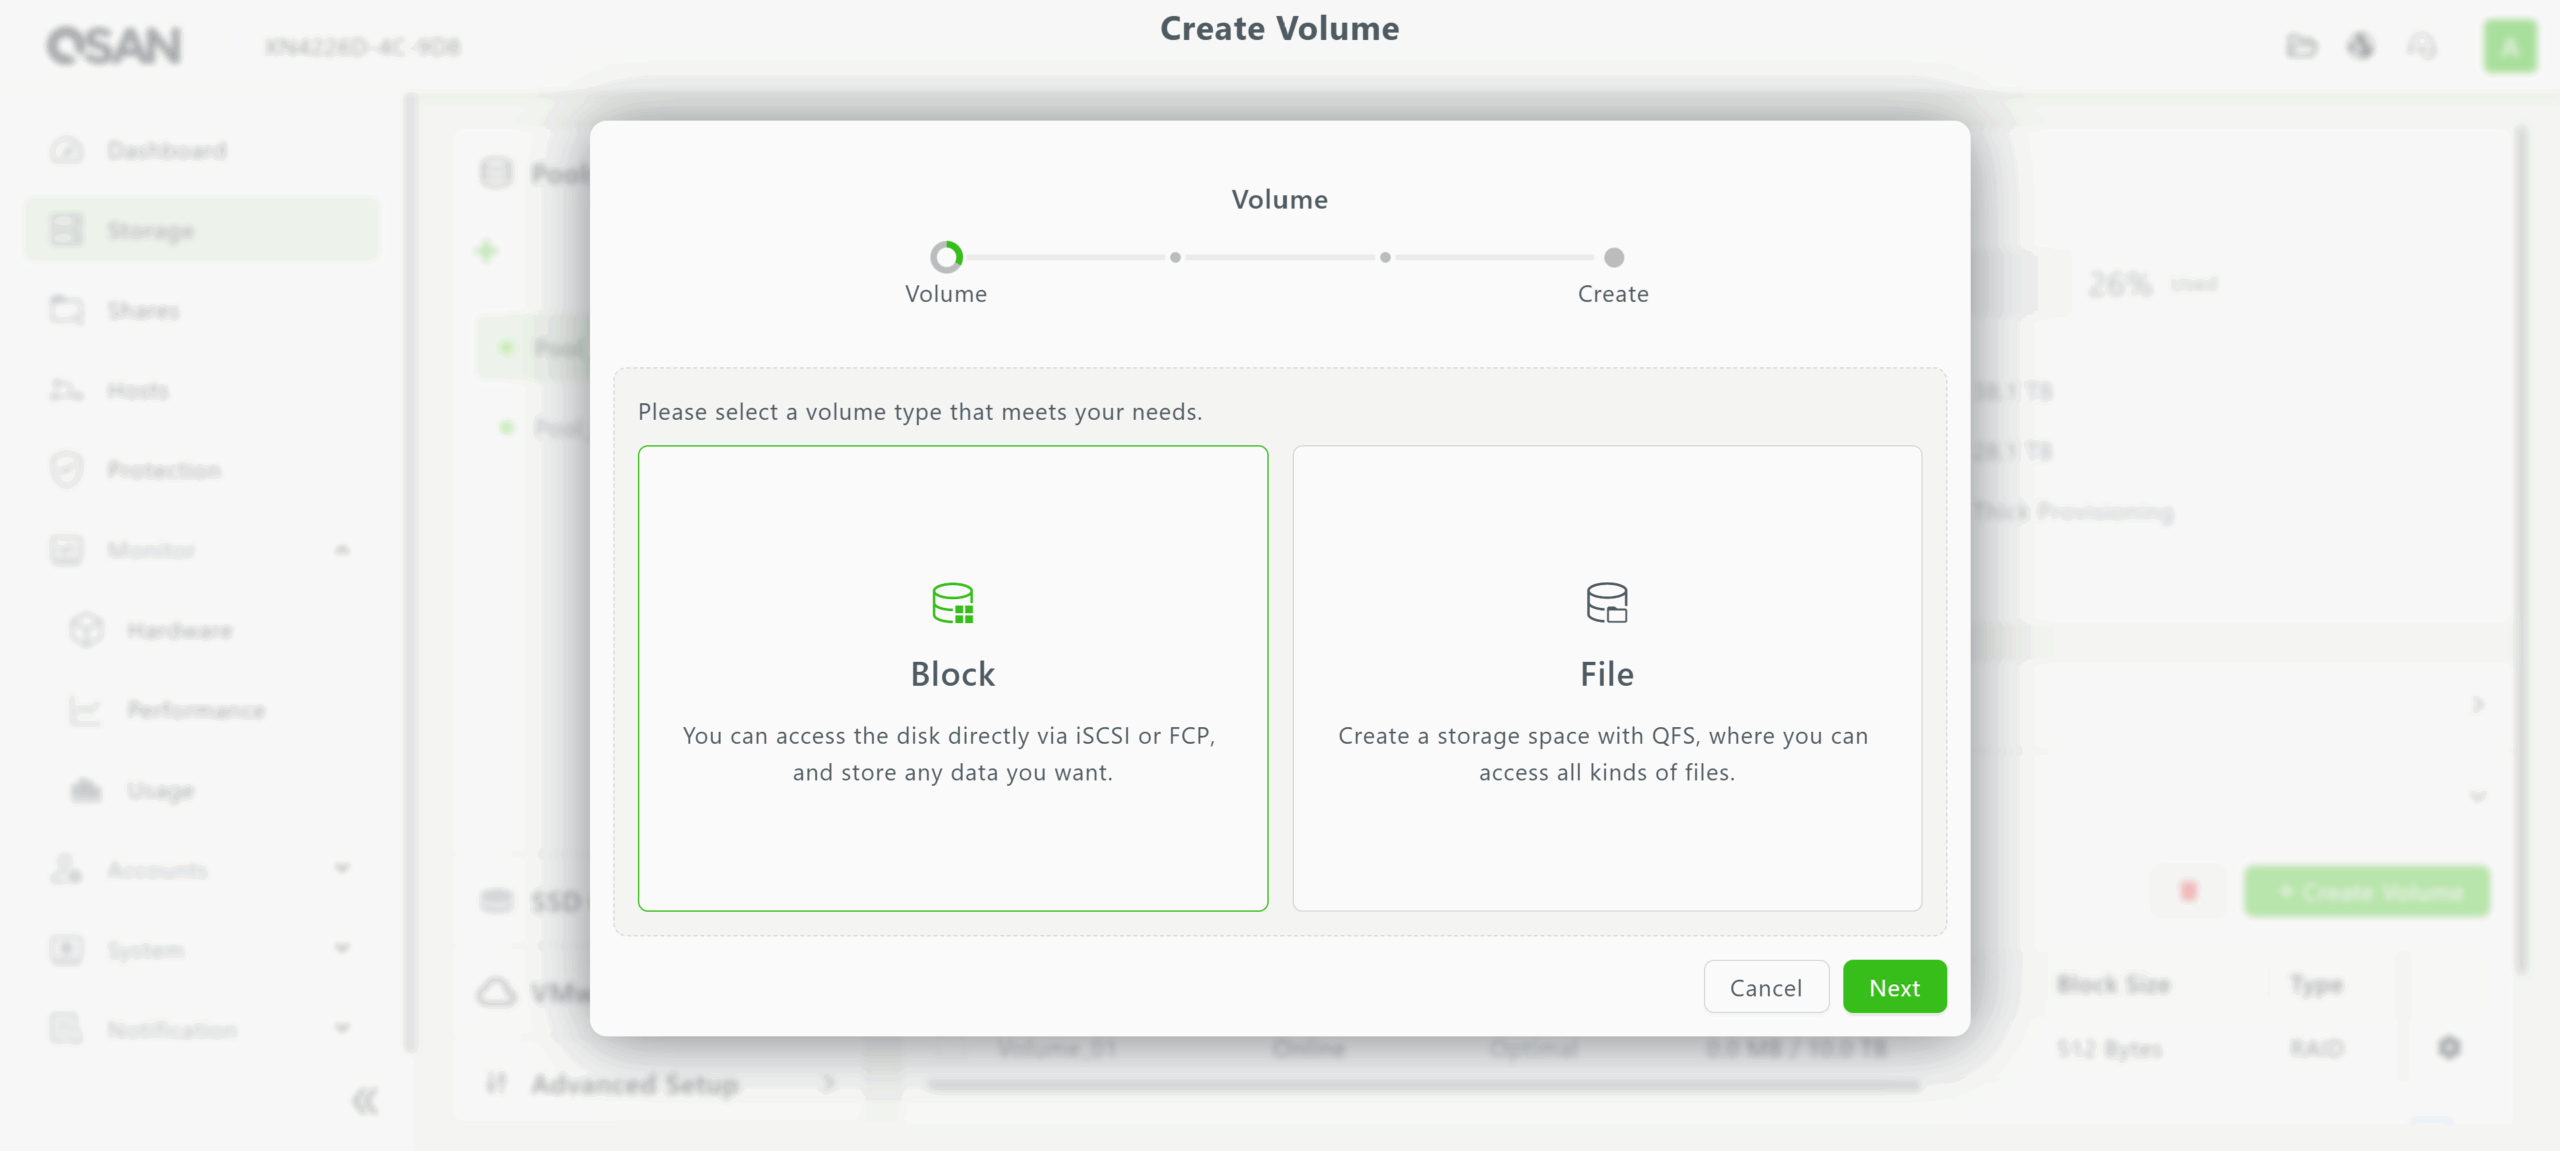
Volumes voor blok- en bestandsopslag kunnen vervolgens op pools worden gebouwd. Met behulp van de wizard kunnen de capaciteit en blokgroottes van elk volume worden aangepast aan de behoeften van de aangesloten clients.
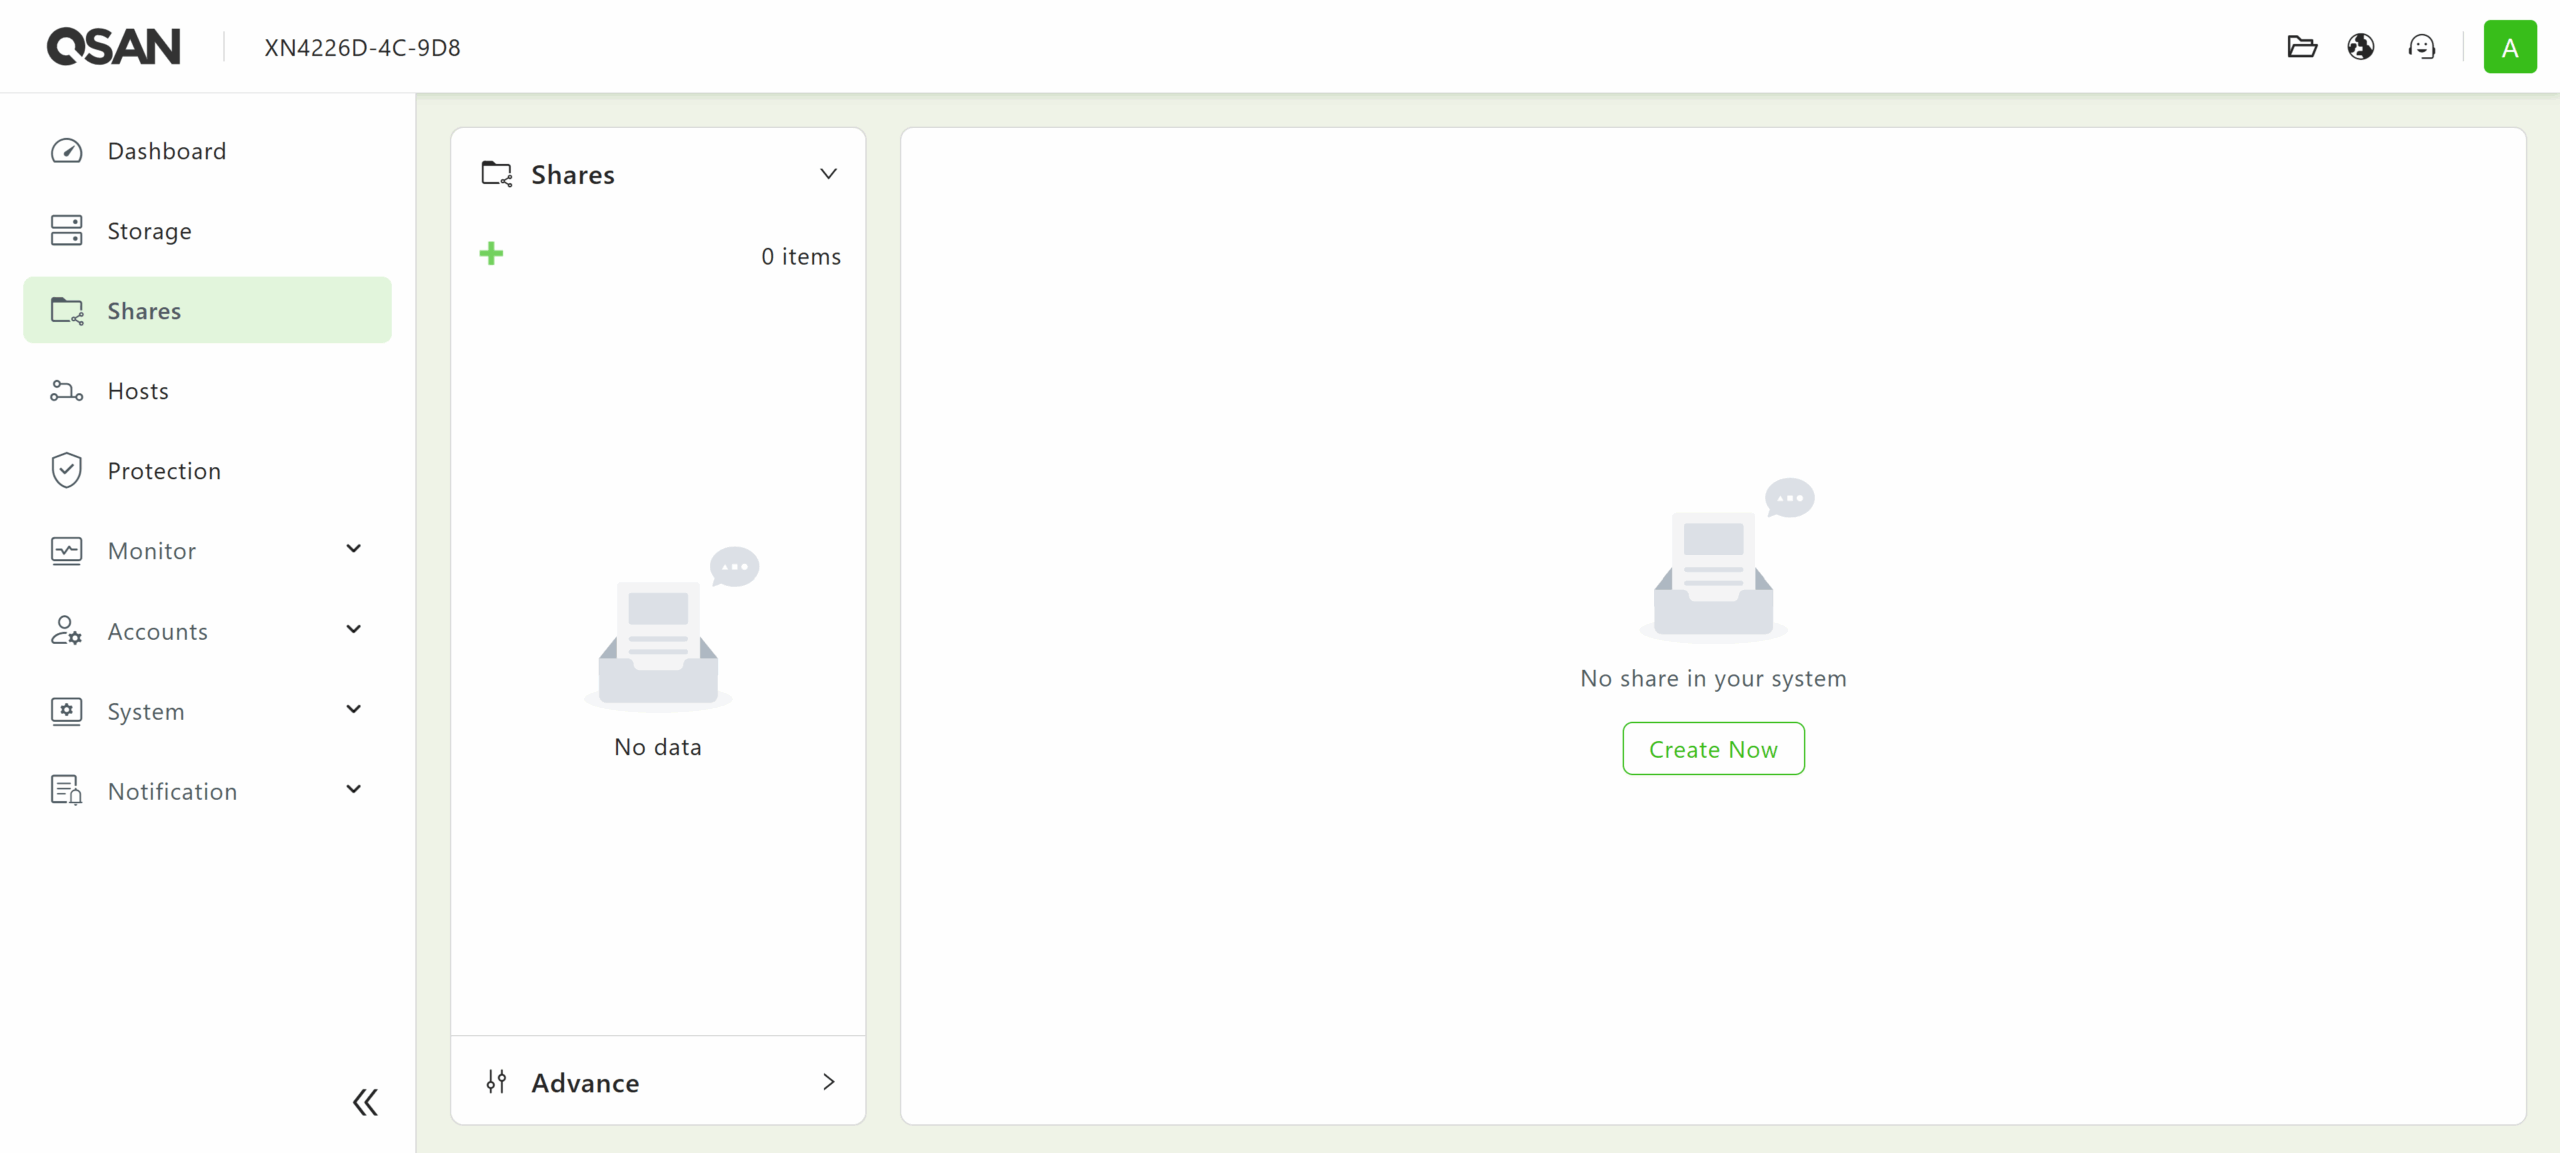
Via het menu Shares in de lijst kunt u een deelobject boven op een bestandsvolume maken. Ondersteunde deelprotocollen zijn onder andere CIFS (SMB), FTP, NFS en WebDAV.
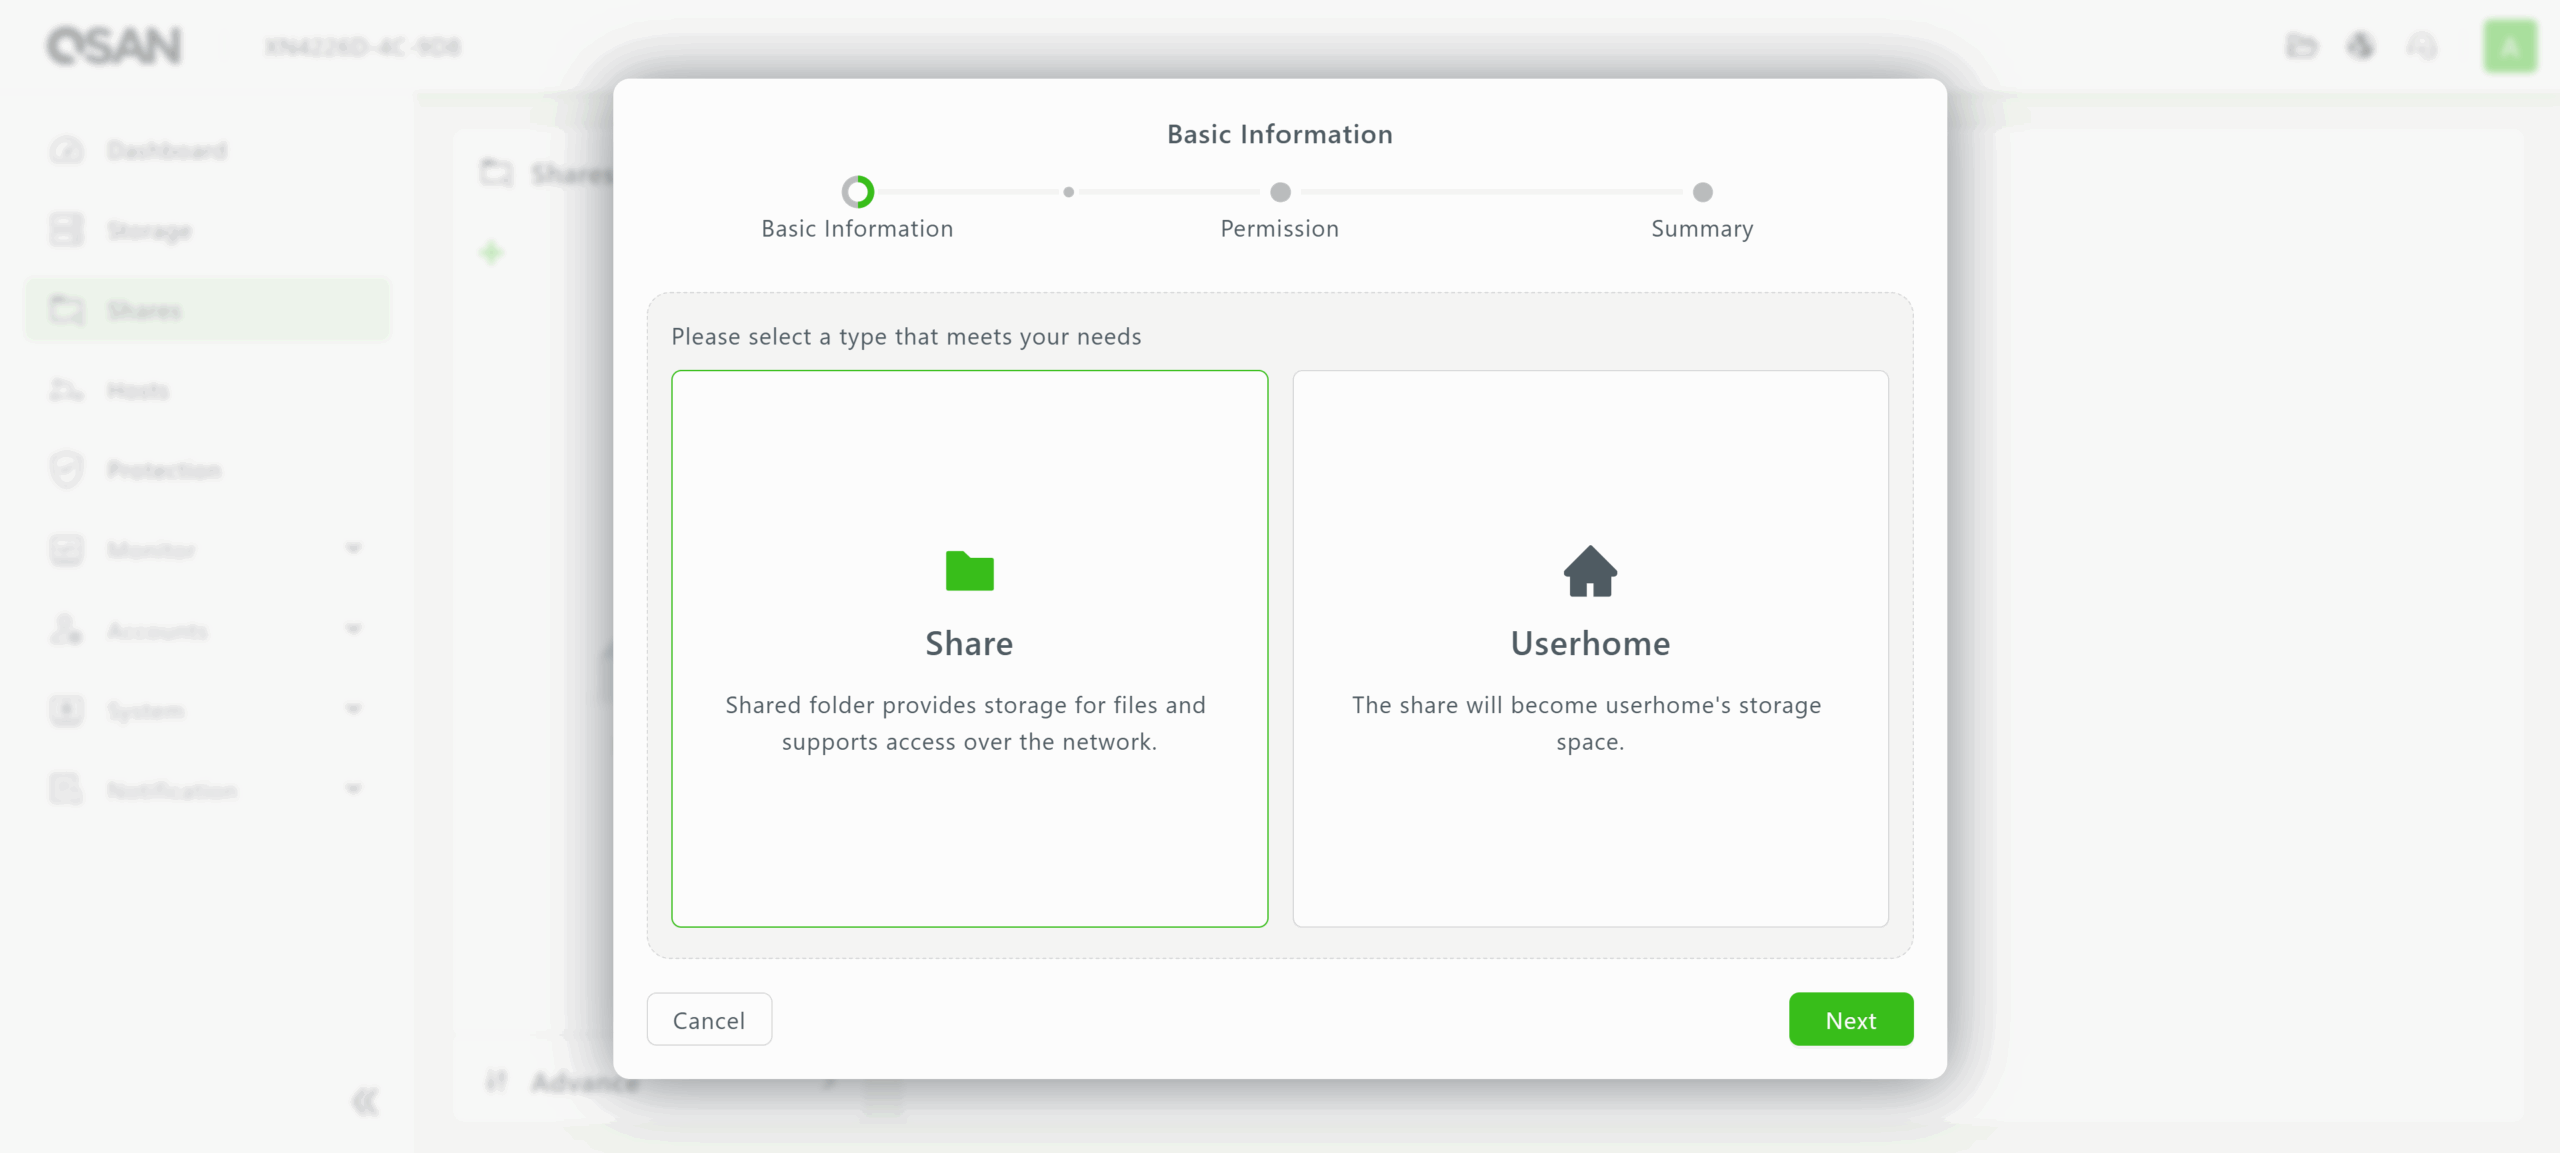
 Bij het maken van een nieuwe share biedt QSM 4 twee opties: een standaardnetwerkshare voor het hosten van bestanden waartoe meerdere gebruikers toegang hebben, en een userhomeshare, die is ontworpen om thuismappen te bevatten voor gebruikers die alleen individueel toegankelijk zijn.
Nadat een blokvolume of bestandsvolume en share is aangemaakt, moet deze worden toegewezen aan een IP-adres of hostnaam in het menu Hosts. Hosts worden geordend op basis van of ze overeenkomen met blok- of bestands(share)opslag, zoals weergegeven in de onderstaande schermafbeeldingen.
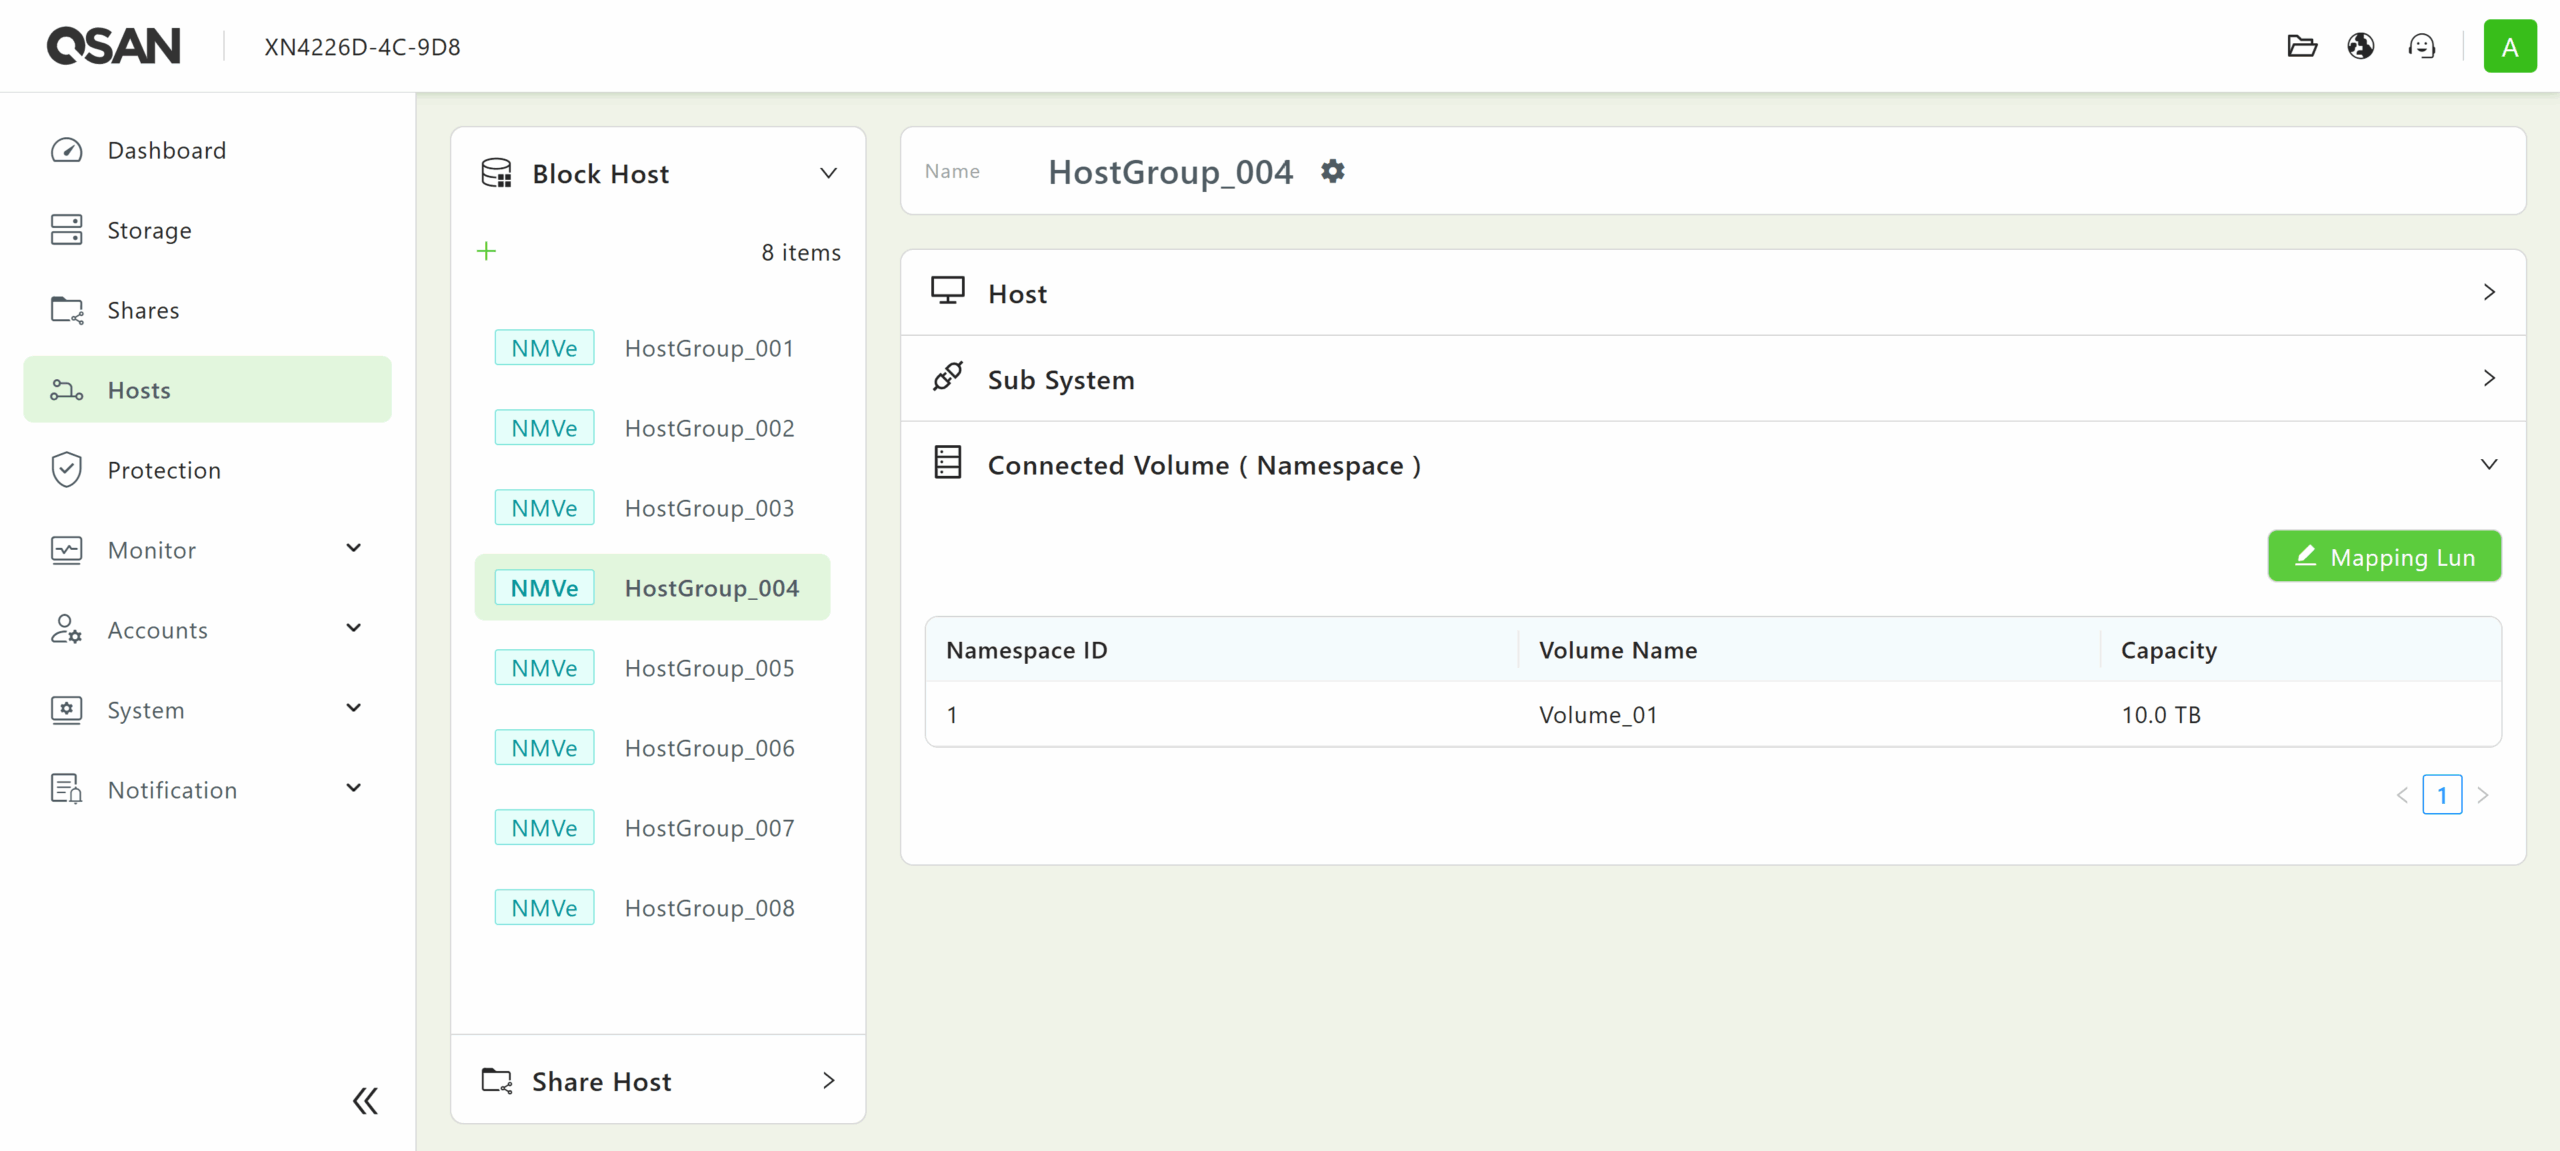
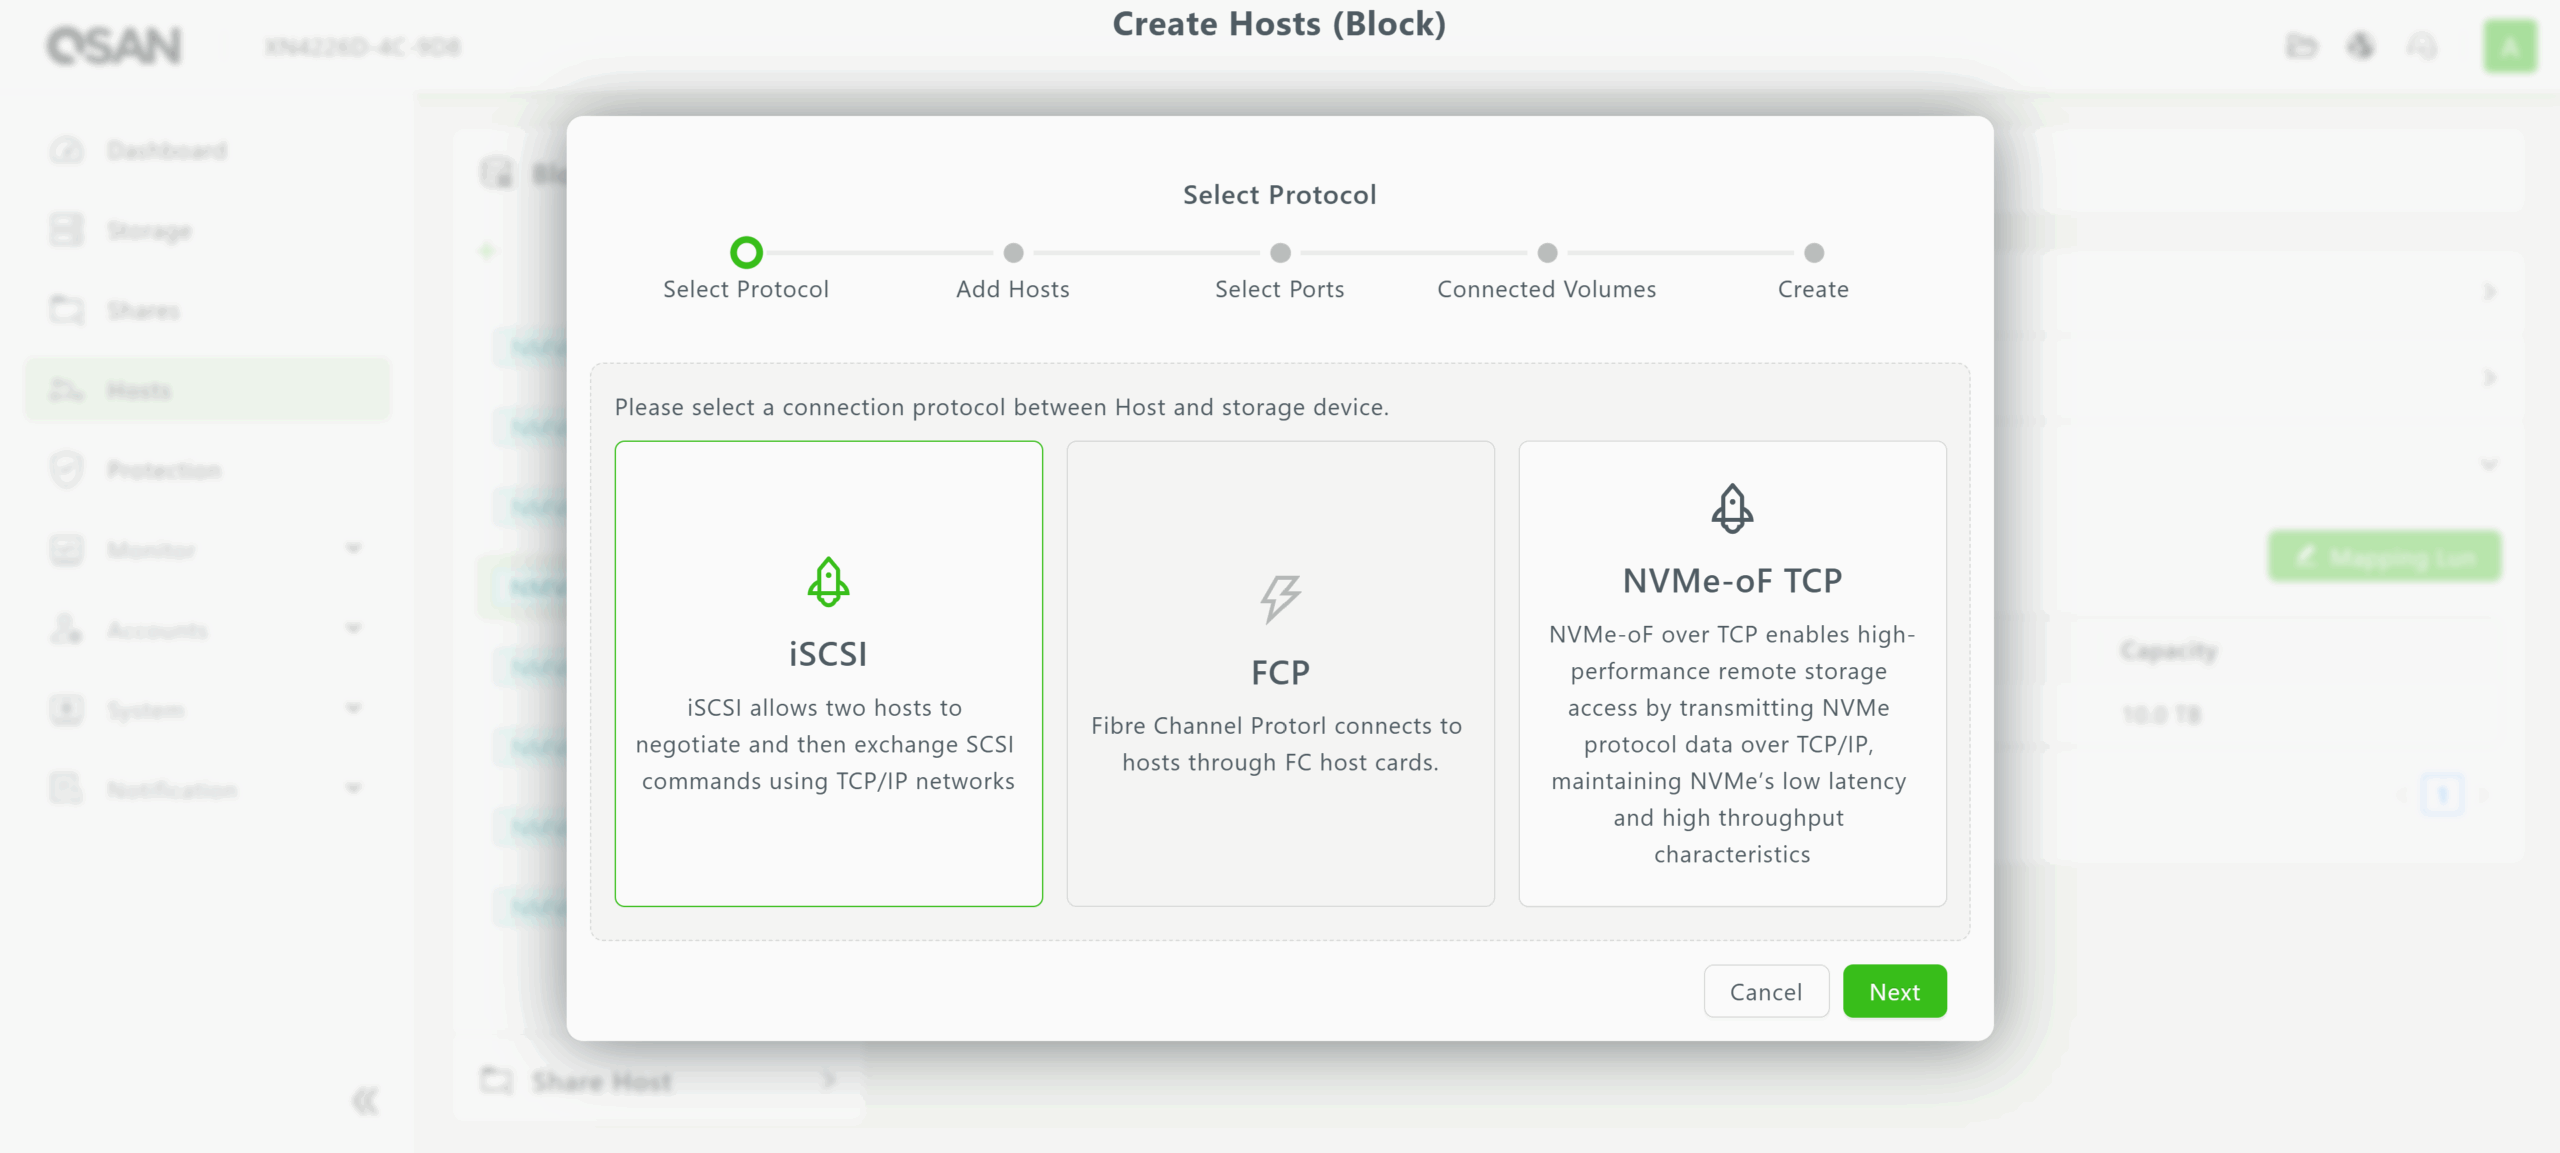
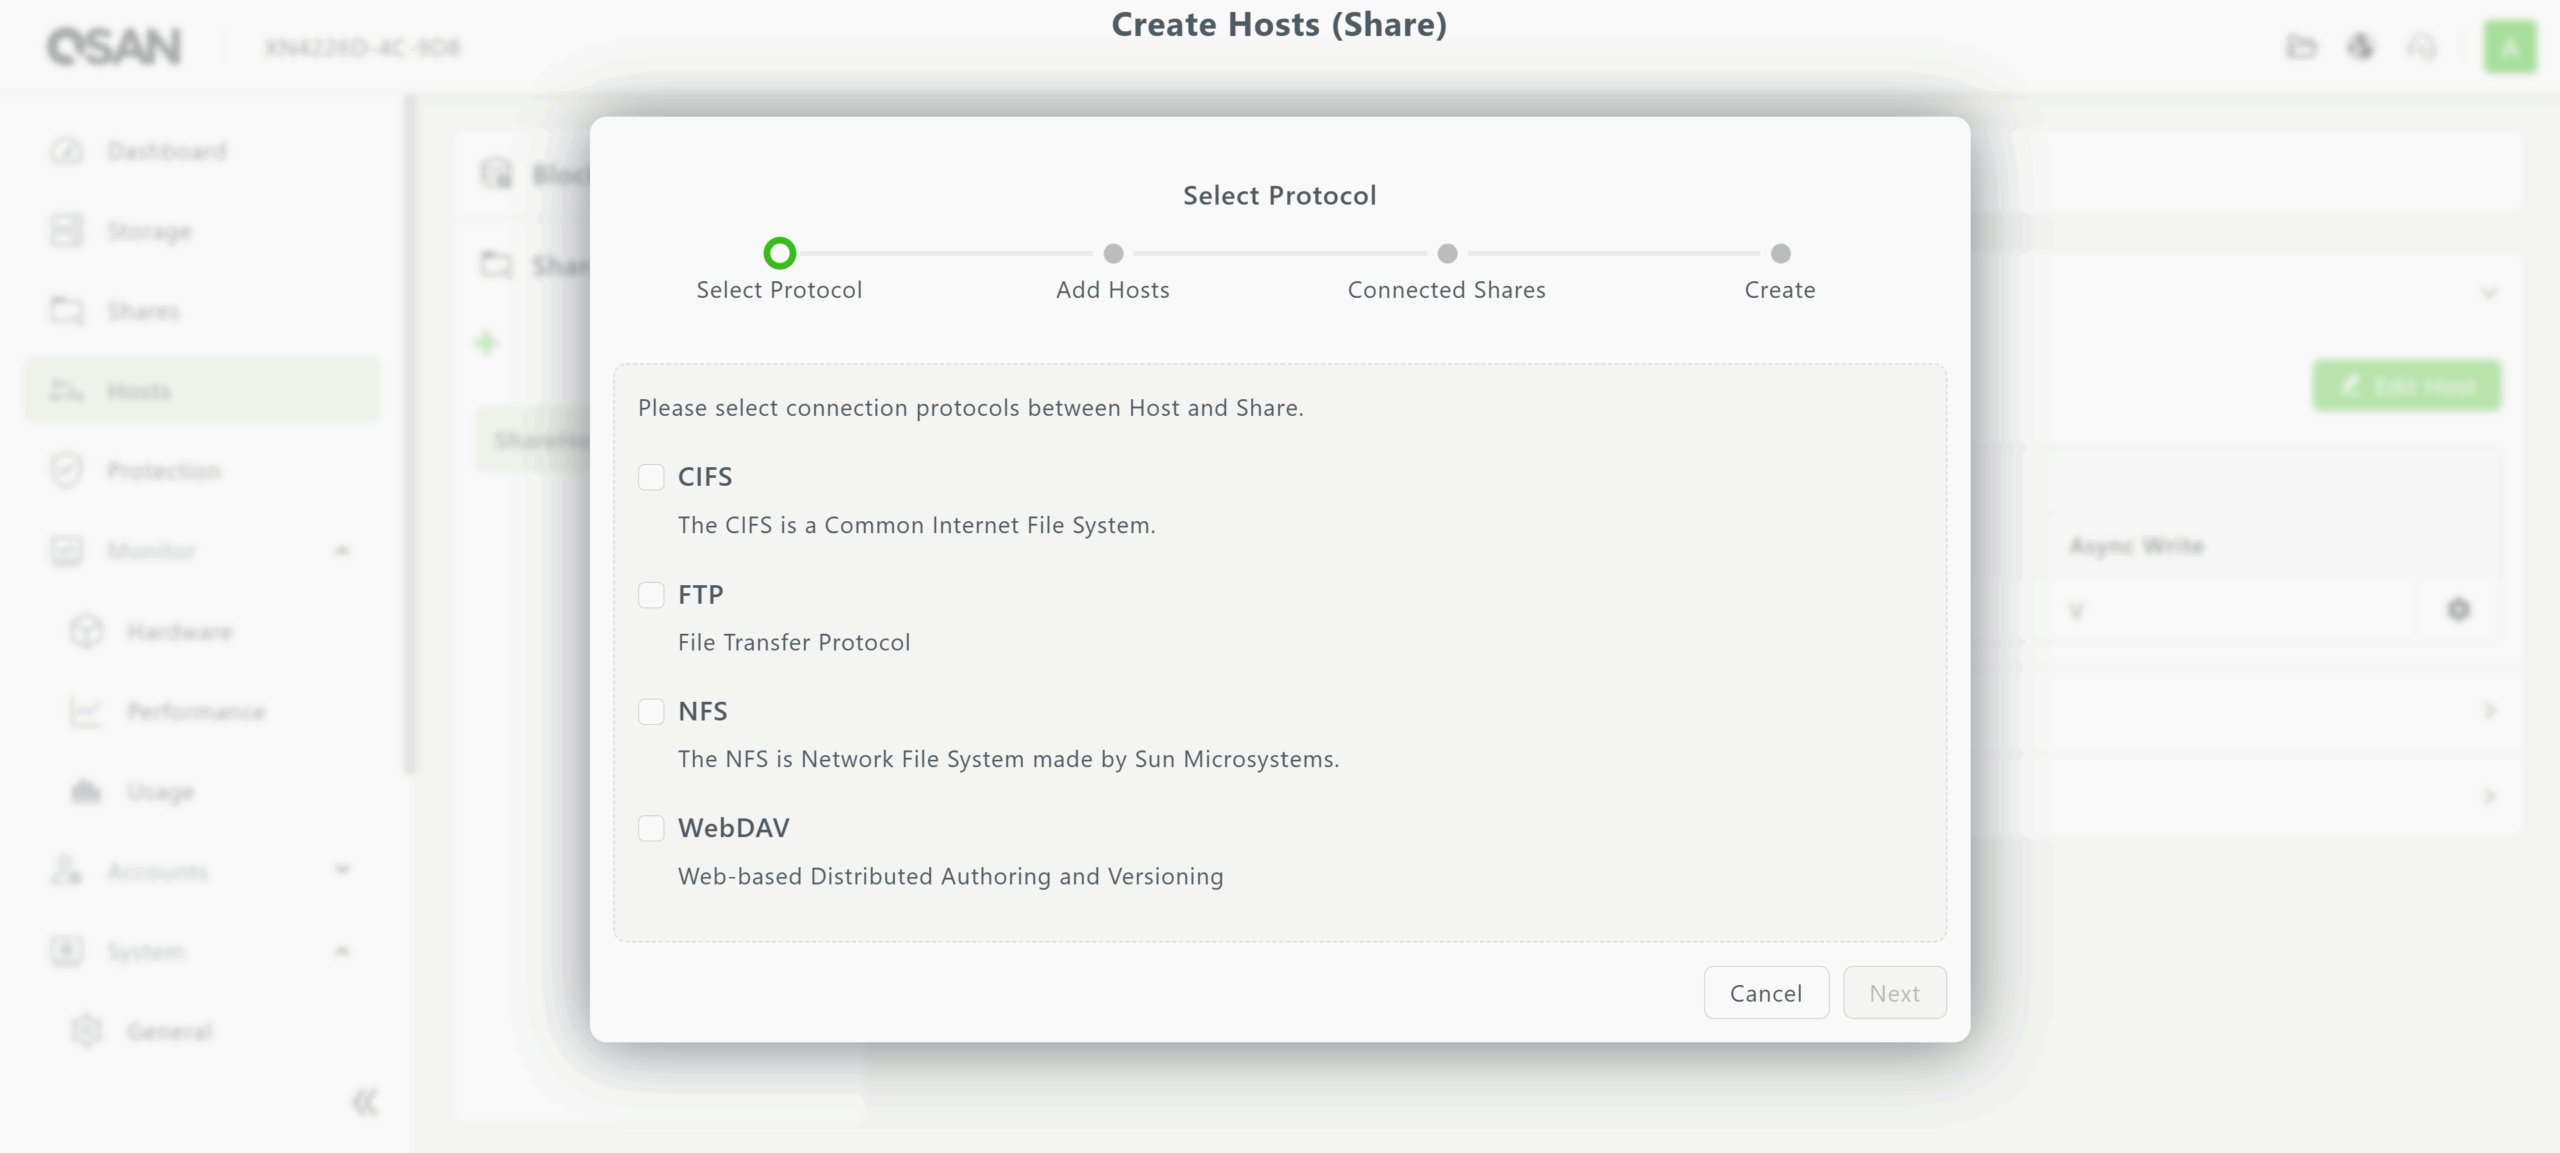
Hosts voor blokopslag kunnen iSCSI, FCP of NVMe-oF over TCP gebruiken voor een volume. Hosts voor bestands(share)opslag daarentegen kunnen meerdere protocollen tegelijkertijd ondersteunen, wat essentiële flexibiliteit biedt voor datacenters met uiteenlopende vereisten voor bestandsdeling.
QSM 4 biedt daarnaast basisbewakingsfuncties in het menu Monitor. Hiermee worden de statussen van verschillende hardwaremodules en schijven in de array weergegeven, evenals statistieken over schijf-, opslagpool-, CPU- en geheugengebruik.
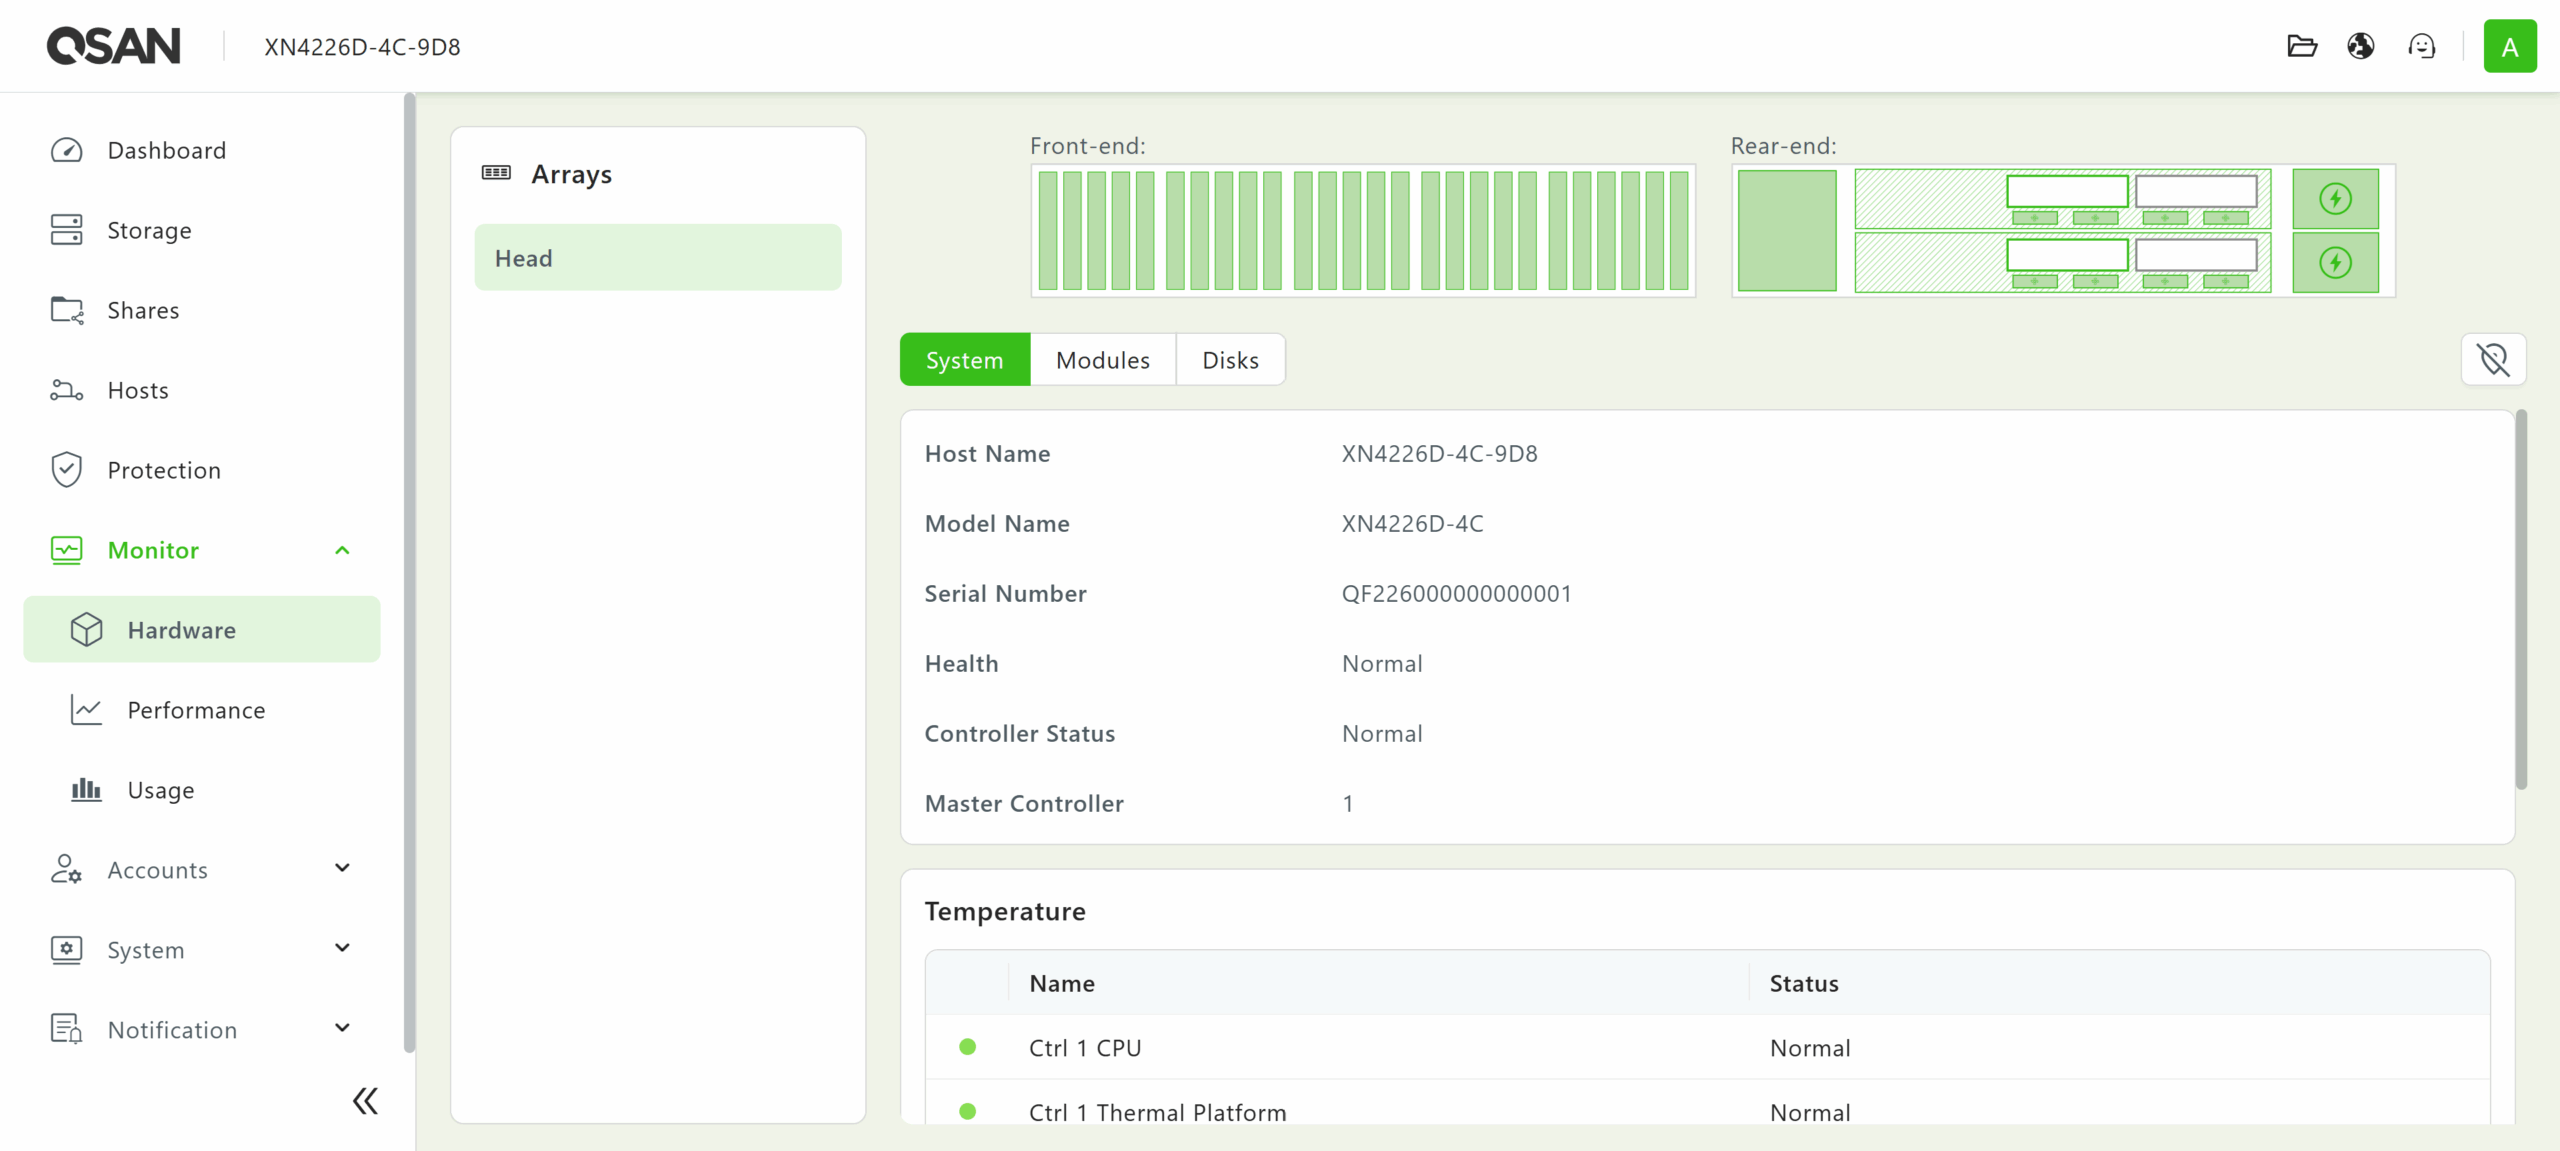
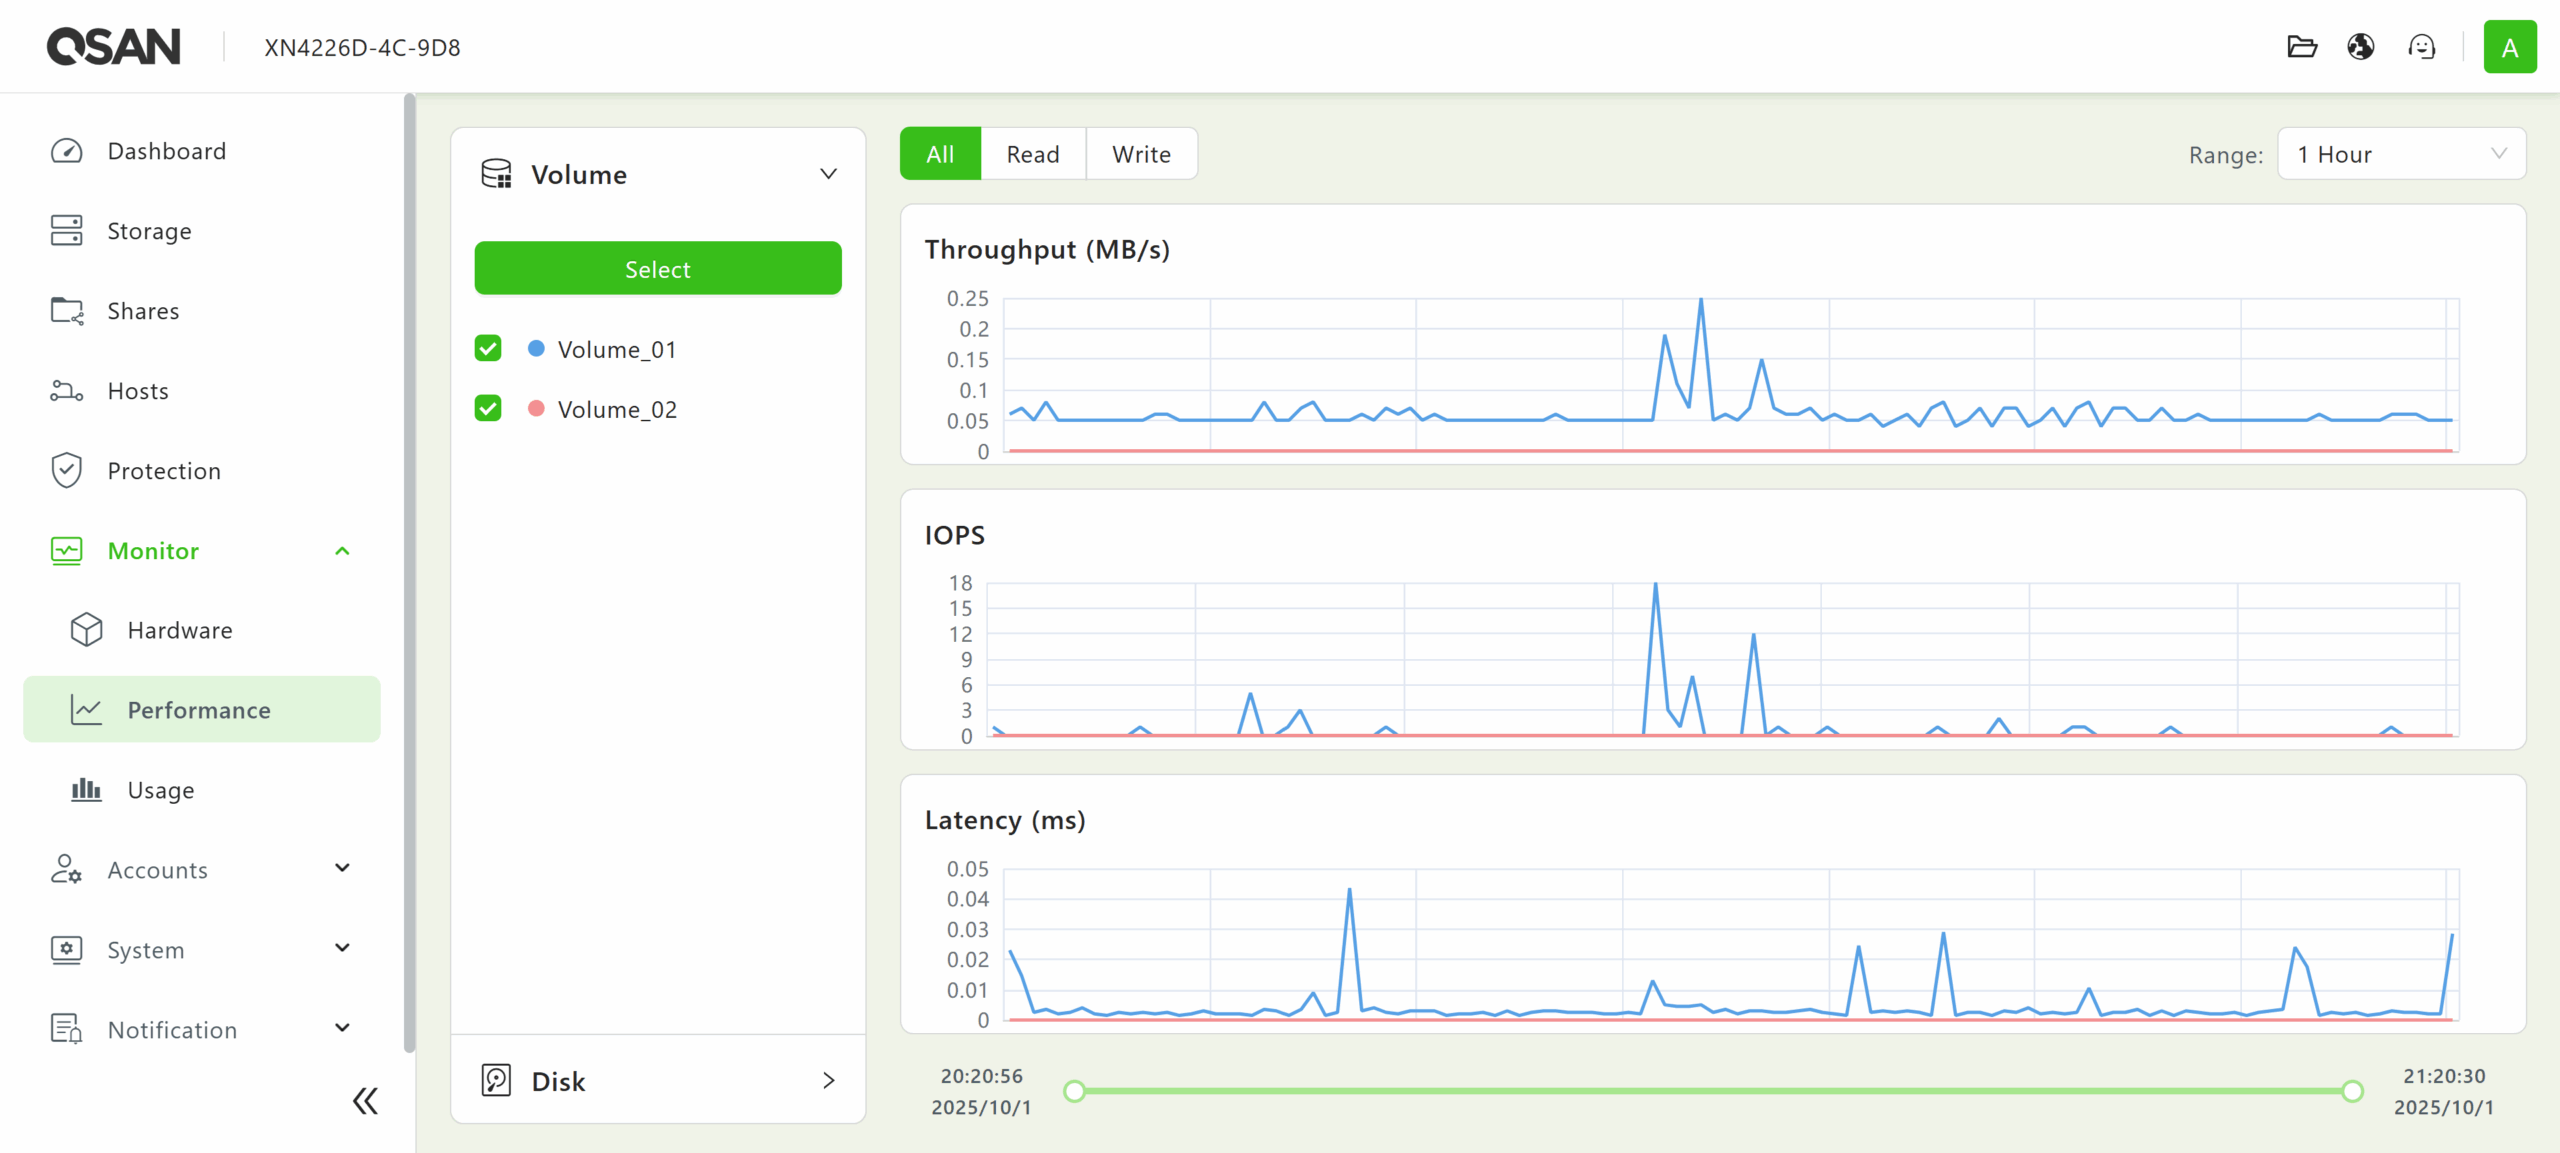
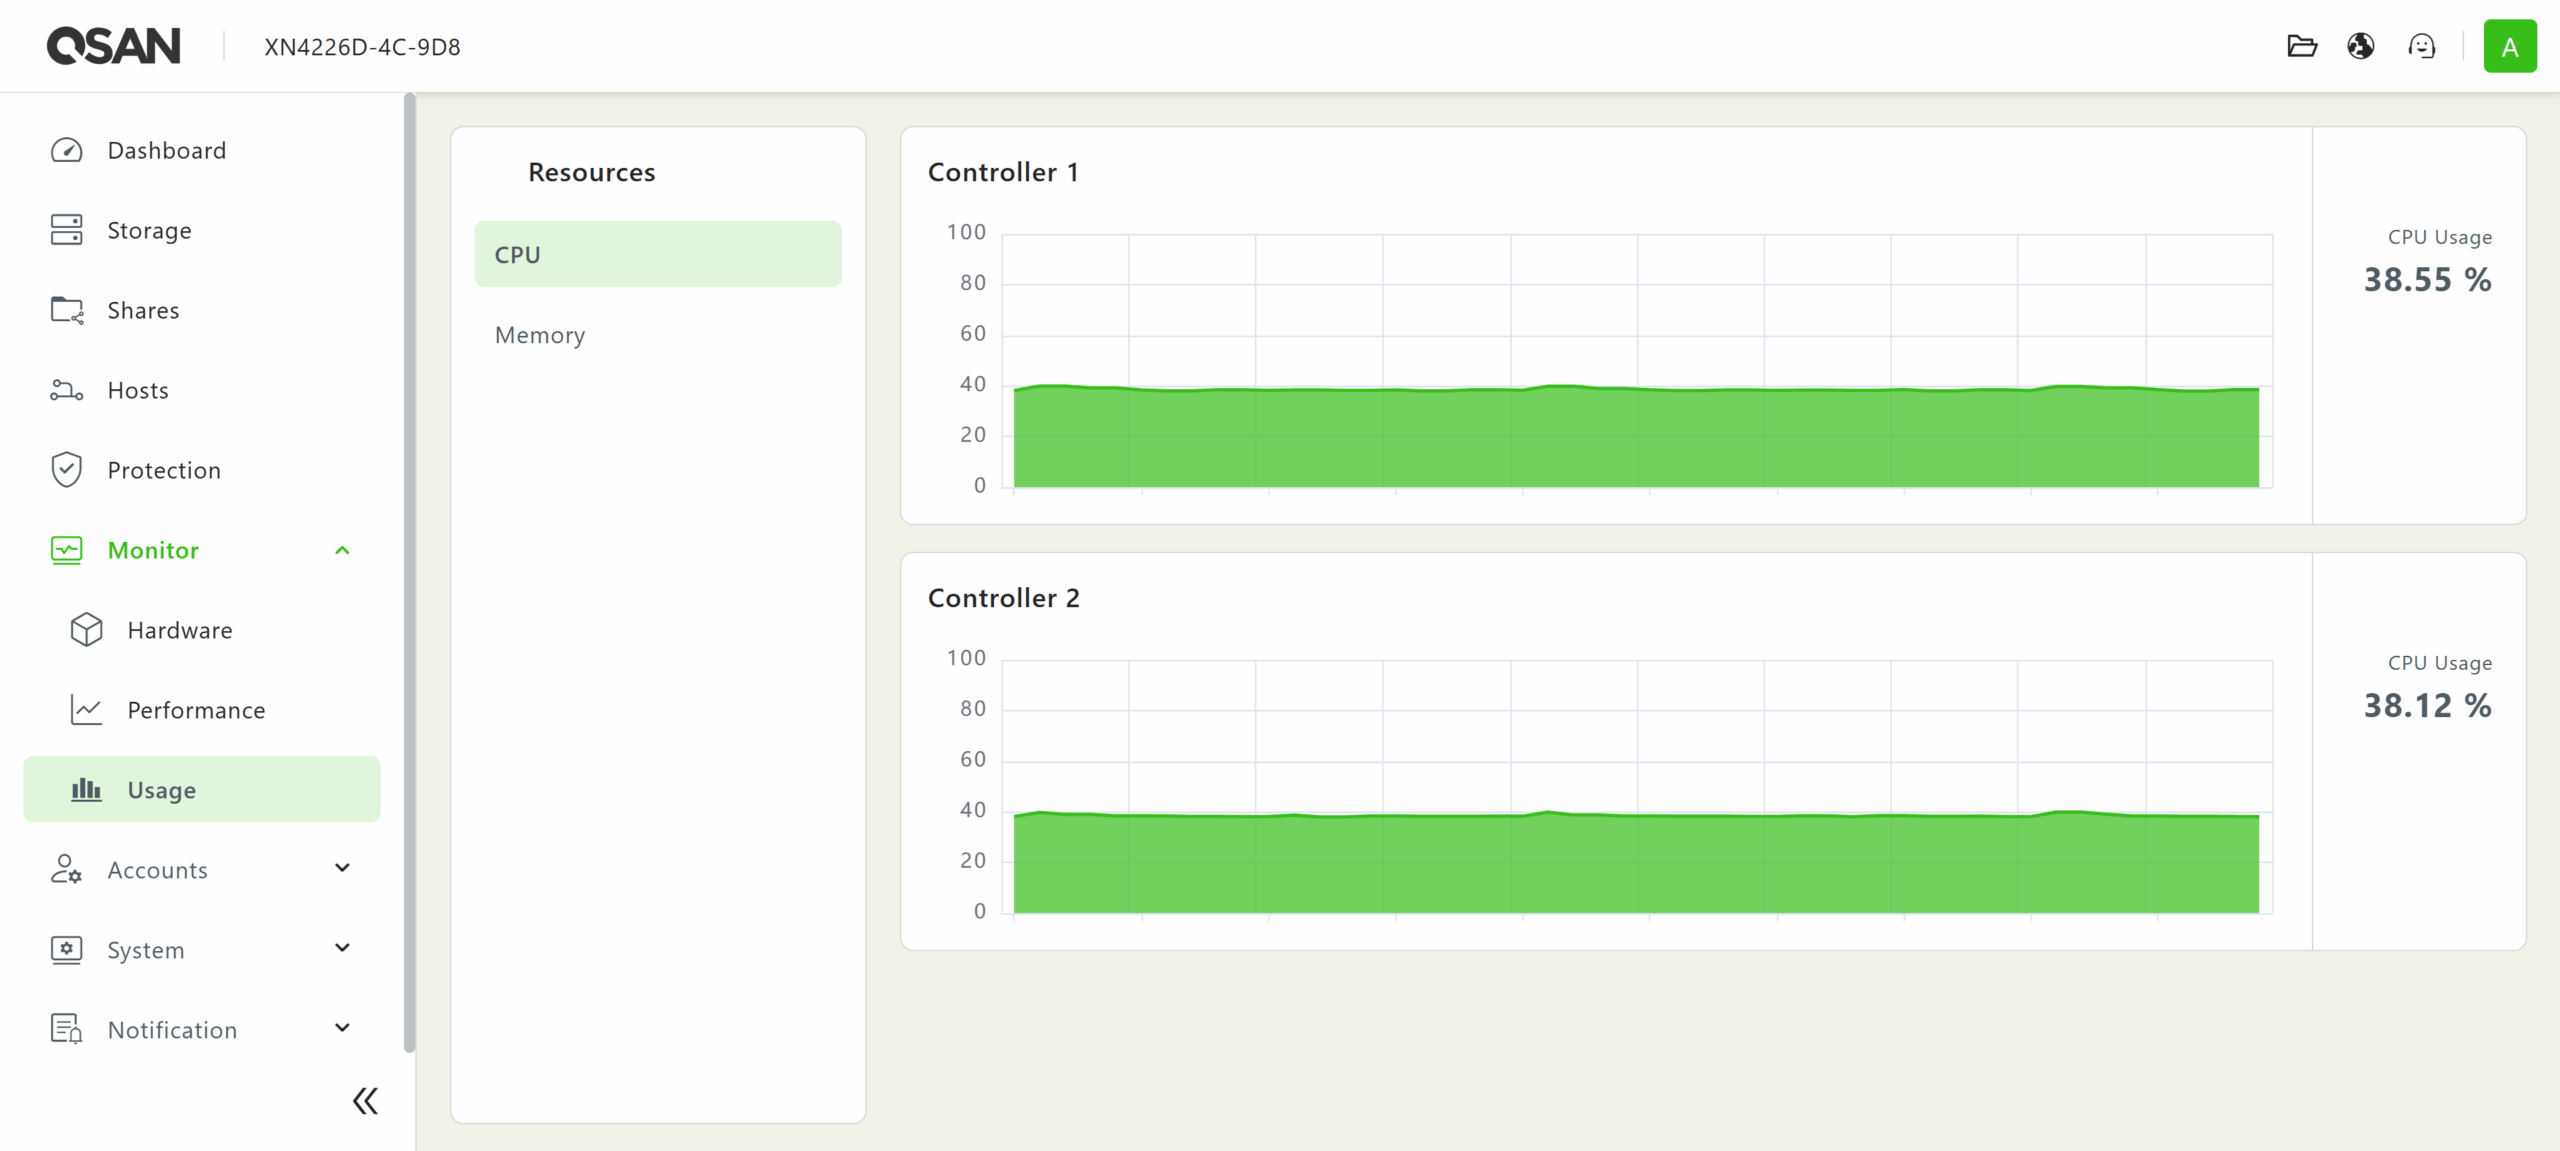
De webinterface van QSM 4 biedt ook gebruikers-, groeps- en domeinbeheer via het menu Accounts. Er zijn ook diverse SAN-brede configuratieopties beschikbaar in het menu Systeem. Logging en waarschuwingsfunctionaliteit zijn toegankelijk via het menu Meldingen. Tot slot vindt u de pictogrammen voor QSAN Bestandsbeheer, Taalondersteuning en Afmelden/Energiebeheer in de rechterbovenhoek van de menubalk.
Eenvoudige Proxmox-integratie
Proxmox ondersteunt standaard NVMe over Fabrics (NVMe-oF), waardoor krachtige storage arrays eenvoudig in een cluster kunnen worden geïntegreerd. Het proces begint met het inrichten van NVMe-oF-doelen op uw storagesysteem. Gebruik vervolgens de Proxmox-host om deze doelen te detecteren en er verbinding mee te maken. Zodra de verbinding tot stand is gebracht, moet u het systeem configureren om ervoor te zorgen dat deze verbindingen ook na het opnieuw opstarten behouden blijven.
In ons voorbeeld wordt de detectie uitgevoerd met behulp van shell-opdrachten, die het IP-adres en de servicepoort van de array specificeren.
nvme discover -t tcp -a 172.16.16.100 -s 4420
nvme discover -t tcp -a 172.13.13.100 -s 4420
Maak vervolgens verbinding met de ingerichte naamruimten door te verwijzen naar hun NQN's.
nvme connect -t tcp -n nqn.2024-11.com.qsan:dev4 -a 172.16.16.100 -s 4420
nvme connect -t tcp -n nqn.2024-11.com.qsan:dev6 -a 172.13.13.100 -s 4420
Om ervoor te zorgen dat de configuratie ook na opnieuw opstarten behouden blijft, kunnen de detectieadressen worden toegevoegd aan het NVMe-detectieconfiguratiebestand.
echo "discover -t tcp -a 172.16.16.100 -s 4420" | tee -a /etc/nvme/discovery.conf
echo "discover -t tcp -a 172.13.13.100 -s 4420" | tee -a /etc/nvme/discovery.conf
Schakel ten slotte de automatische verbindingsservice in, zodat Proxmox de NVMe-sessies automatisch opnieuw tot stand brengt bij het opstarten.
systemctl enable nvmf-autoconnect.serviceProxmox kan naadloos worden geïntegreerd met QSAN-opslag en biedt de lage latentie en hoge bandbreedteprestaties van NVMe in combinatie met de flexibiliteit van netwerkfabrics.
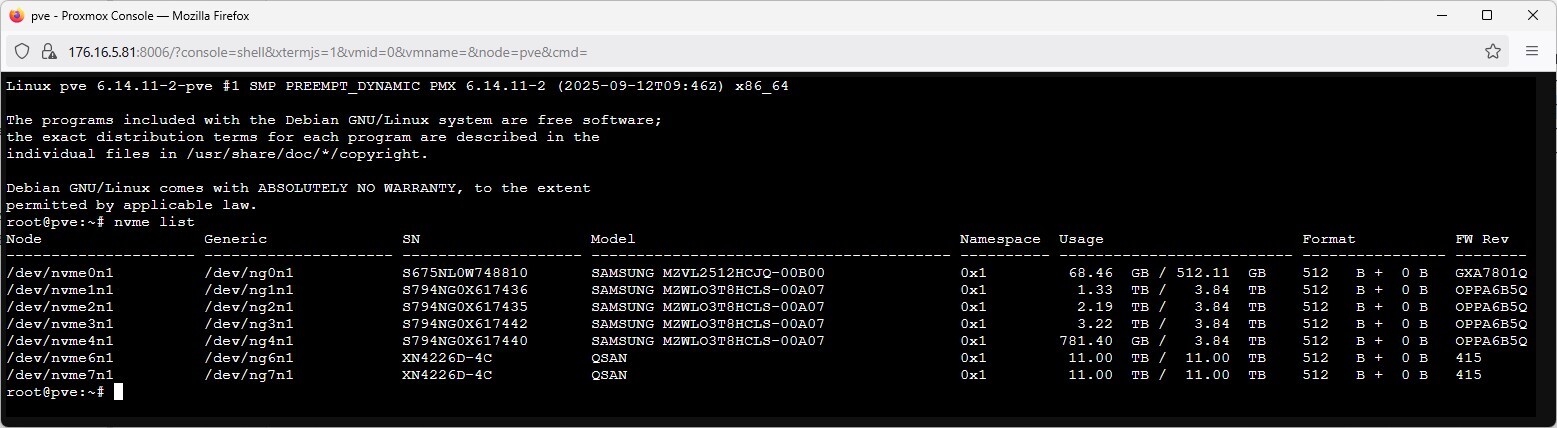
Nadat we onze QSAN hebben gekoppeld, kunnen we de opdracht "nvme list" vanuit de Proxmox-shell uitvoeren om alle NVMe-apparaten weer te geven. De nieuw toegevoegde QSAN-volumes verschijnen daarbij als /dev/nvme6n1 en /dev/nvme7n1, elk met 11 TB aan opslagruimte.
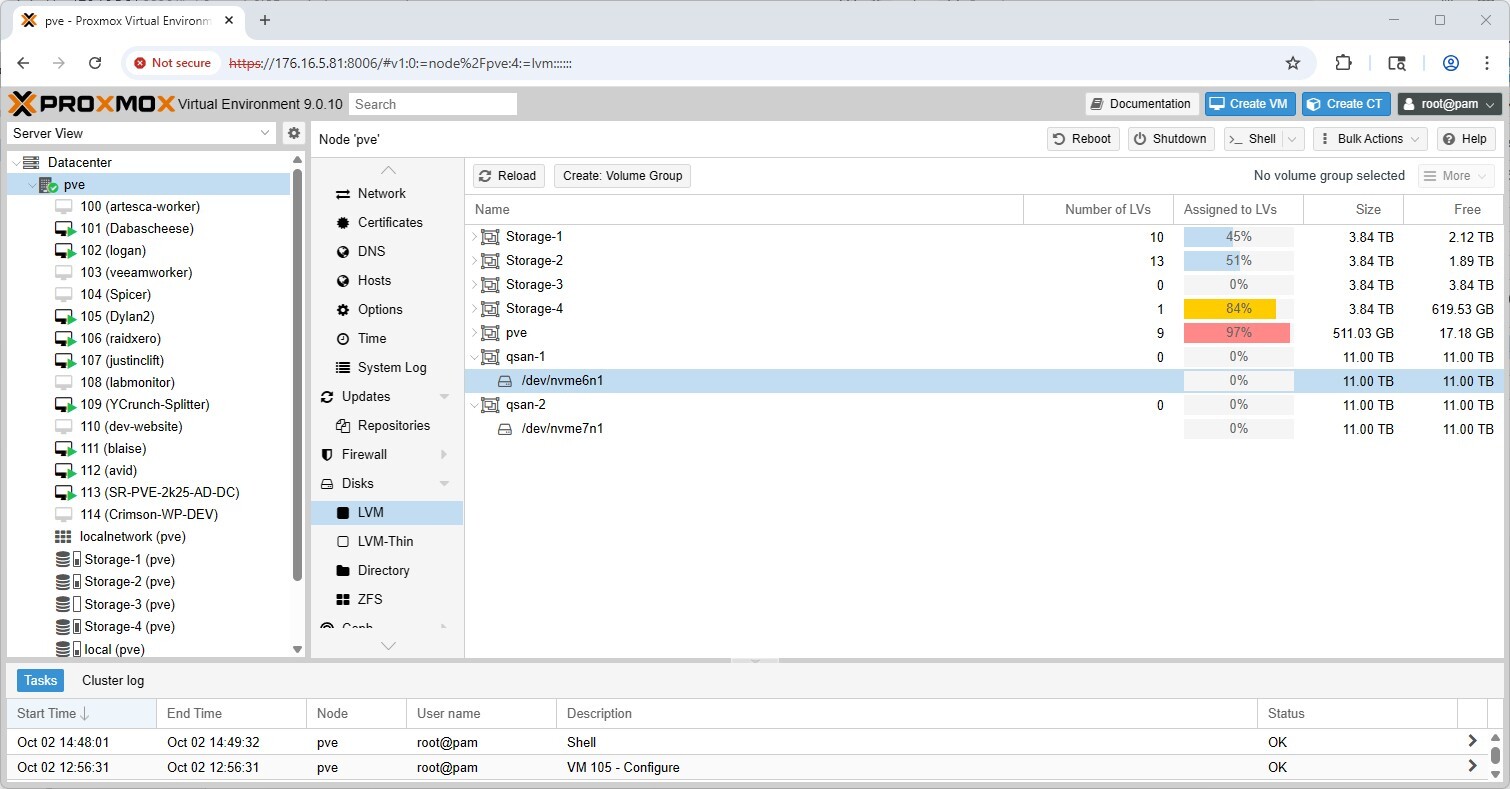
Zodra de QSAN-opslag zichtbaar is in de Proxmox GUI, kunnen we een nieuwe LVM-volumegroep maken: pve > Disks > LVM. De twee 11TB-apparaten (/dev/nvme6n1 en /dev/nvme7n1) verschijnen en kunnen worden geïnitialiseerd als afzonderlijke volumegroepen (bijv. qsan-1 en qsan-2) voor gebruik met VM's en containers.
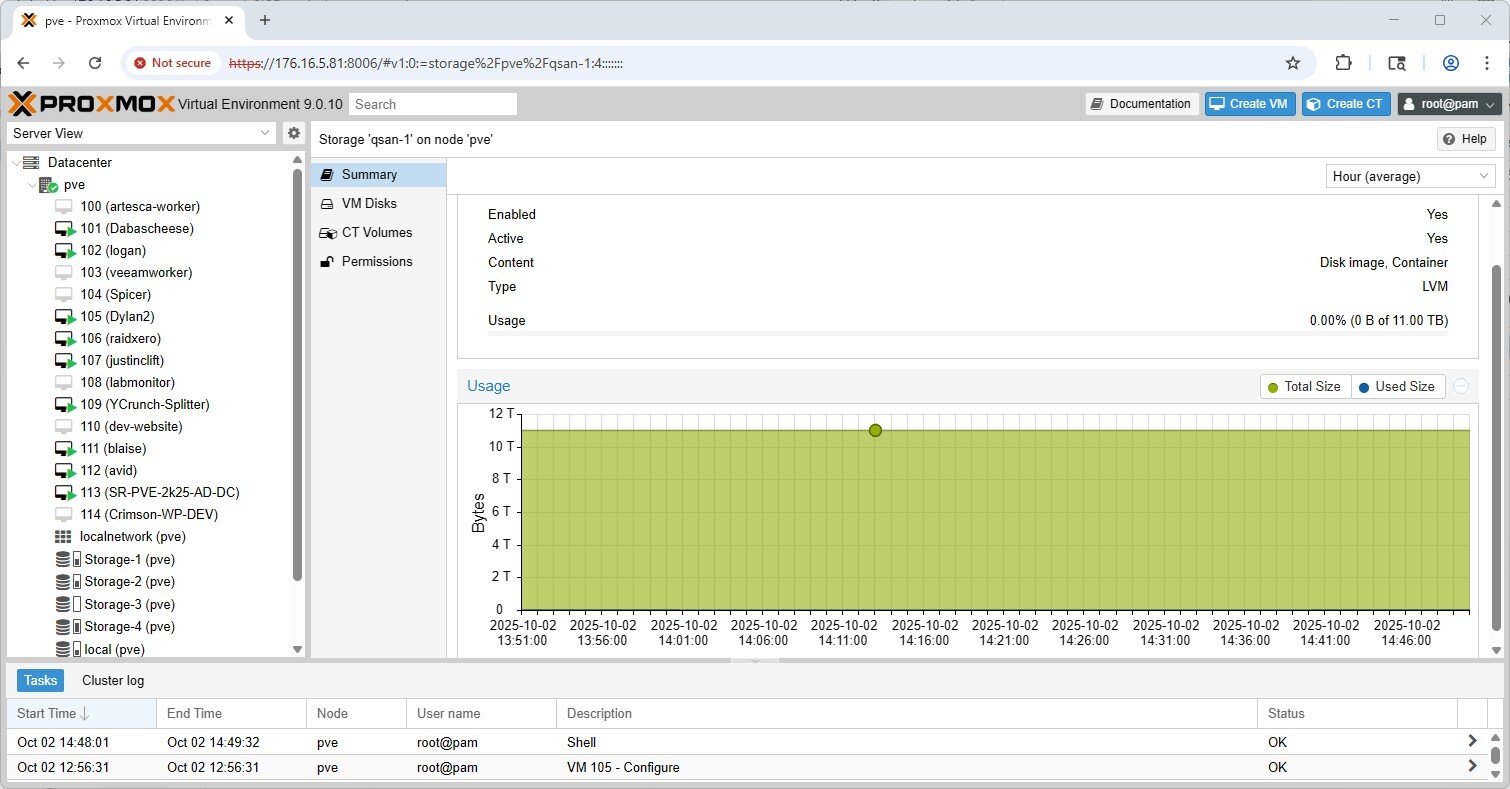
Als u op een van onze nieuwe LVM-pools (qsan-1) in het opslagvenster klikt, wordt aangegeven dat deze online, ingeschakeld en beschikbaar is voor gebruik, met de volledige capaciteit van 11 TB en gereed voor VM- en containerinrichting.
Performance Testing
We hebben de QSAN XN4226D in twee omgevingen getest, waarbij we gebruikmaakten van verschillende testplatforms. Onze eerste omgeving was opgebouwd rond een Dell PowerEdge R750, uitgerust met vier NVIDIA ConnectX-5 dual-port 25G netwerkkaarten. We hebben de QSAN XN4226D rechtstreeks op deze server aangesloten met acht DAC-kabels. Deze opstelling gebruikte alle beschikbare netwerkpoorten op de QSAN, waardoor we de hoogste piekprestaties konden demonstreren.
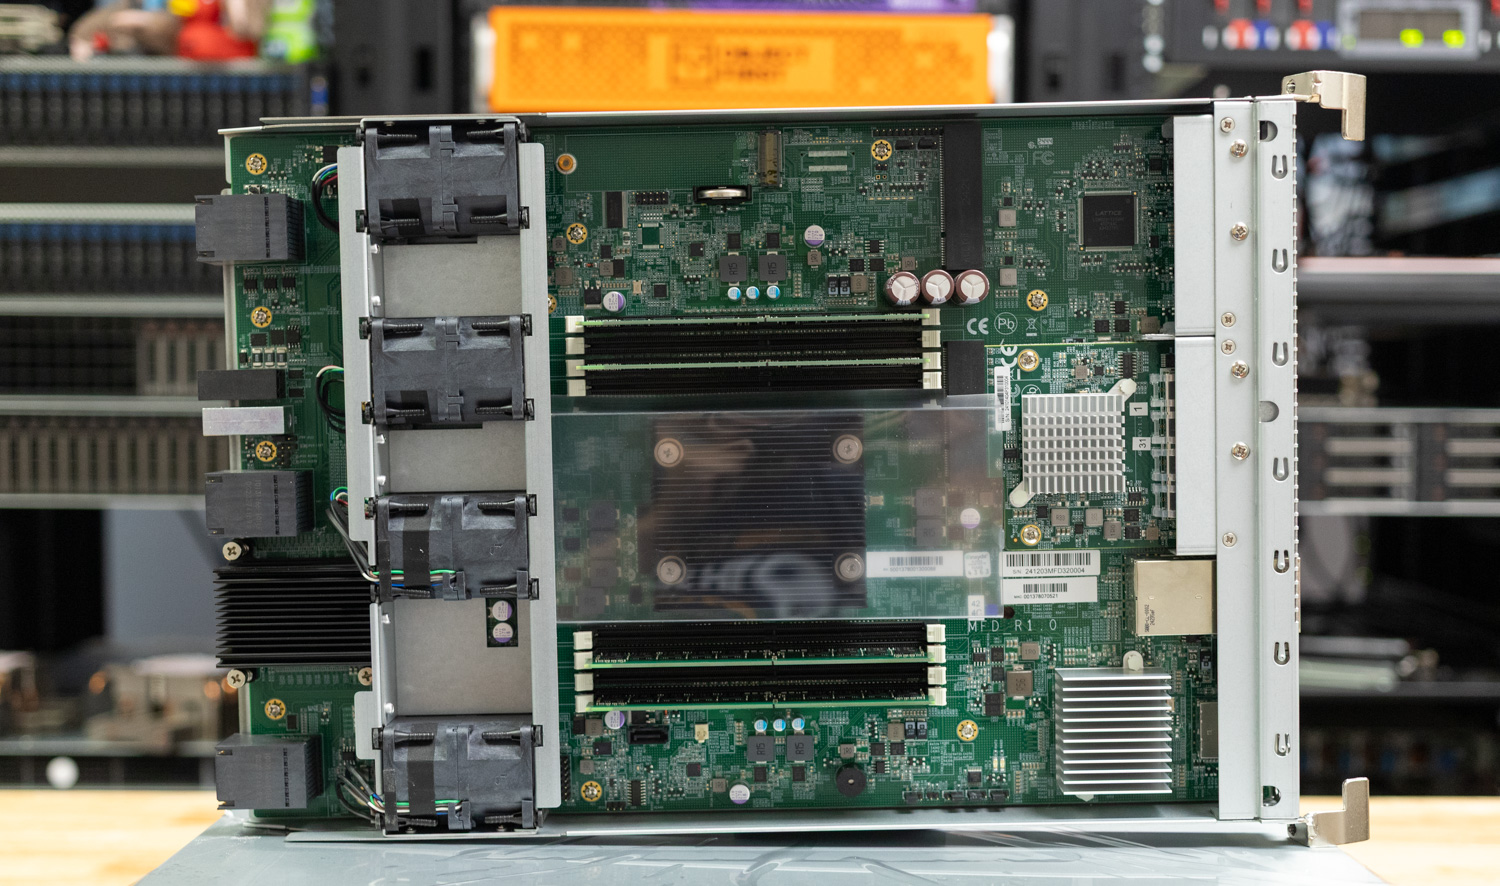
Voor de FIO-test gebruikten we twee RAID6-opslagpools, waarmee we acht blokvolumes creëerden die gelijkmatig over beide controllers waren verdeeld. Elk volume werd toegewezen aan een uniek doel, waarbij elk volume één IP-adres kreeg. We hebben zowel NVMe-oF RDMA als TCP op dit platform gemeten.
De tweede omgeving voor GDSIO maakte gebruik van een Dell PowerEdge R7715, uitgerust met twee NVIDIA H100 GPU's en een quad-port Broadcom 25G netwerkkaart. In deze omgeving handhaafden we dezelfde QSAN-volume-indeling, hoewel we het aantal volumes terugbrachten van acht naar vier. Met een quad-port netwerkkaart gebruikten we vier 25G-verbindingen om de server direct aan te sluiten op de storage array.
FIO Prestatie Benchmark
Om de opslagprestaties van de QSAN XN4226D te meten, hebben we gangbare industriële meetmethoden toegepast en de FIO-tool gebruikt. Elk opslagapparaat ondergaat hetzelfde testproces, inclusief een preconditioneringsstap waarbij de schijf twee keer volledig wordt gevuld met een sequentiële schrijfbelasting, gevolgd door een meting van de steady-state prestaties. Naarmate elk gemeten belastingstype verandert, voeren we een nieuwe preconditioneringsstap uit met die nieuwe overdrachtsgrootte.
In dit gedeelte concentreren we ons op de volgende FIO-benchmarks:
- 1M sequentieel
- 64K willekeurig
- 16K willekeurig
- 4K willekeurig
1M sequentiële schrijfbandbreedte
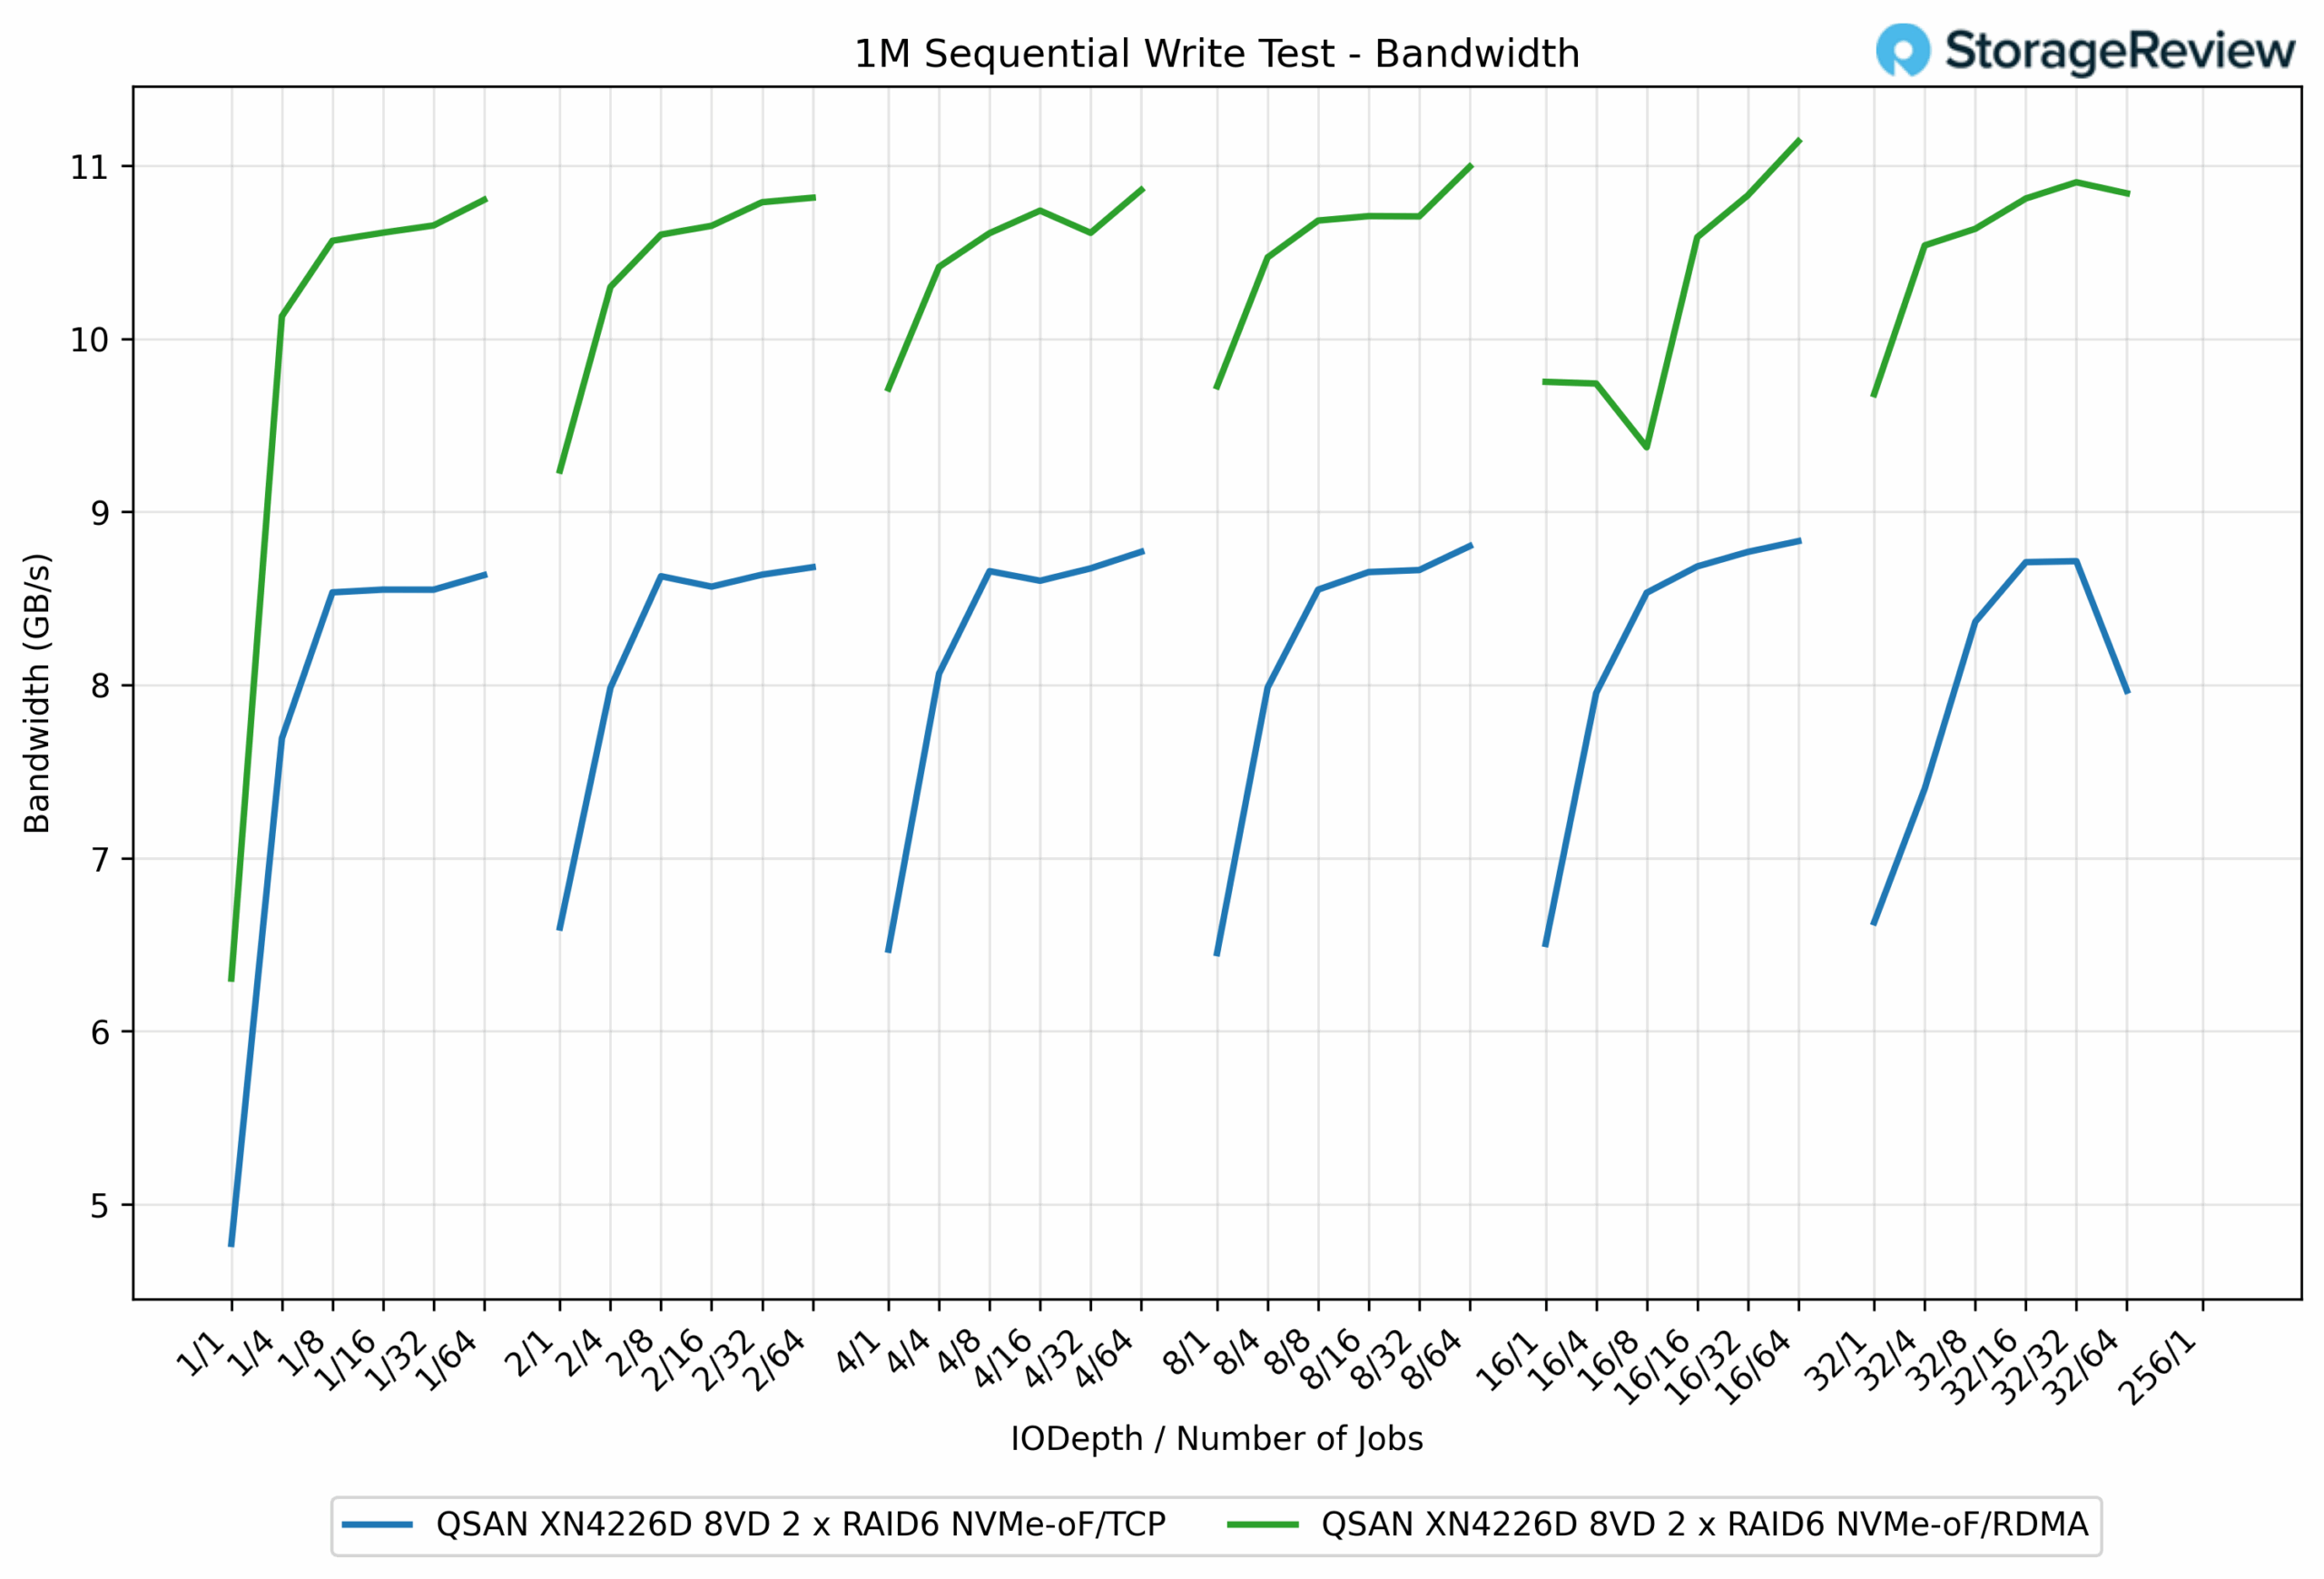
In de 1M Sequential Write-test leverde NVMe over RDMA consistent een hogere bandbreedte over bijna alle wachtrijdieptes en taakaantallen vergeleken met NVMe over TCP. Op piekniveau behaalde RDMA 11.14 GB/s, terwijl TCP uitkwam op 8.83 GB/s, een verschil van ongeveer 26% ten gunste van RDMA. Zelfs bij lagere wachtrijdieptes behield RDMA zijn voorsprong. Zo behaalde het bij de QD1/1-taak 6.30 GB/s, wat ongeveer 32% sneller was dan TCP's 4.77 GB/s.
Het prestatieverschil tussen de twee protocollen werd iets kleiner naarmate de workloads toenamen, maar RDMA bleef over het algemeen een duidelijk voordeel bieden. TCP schommelde consistent tussen de 8.5 en 8.8 GB/s op meerdere testpunten, terwijl RDMA regelmatig de 10.5 GB/s-grens overschreed, met pieken van iets meer dan 11 GB/s.
1M sequentiële schrijflatentie
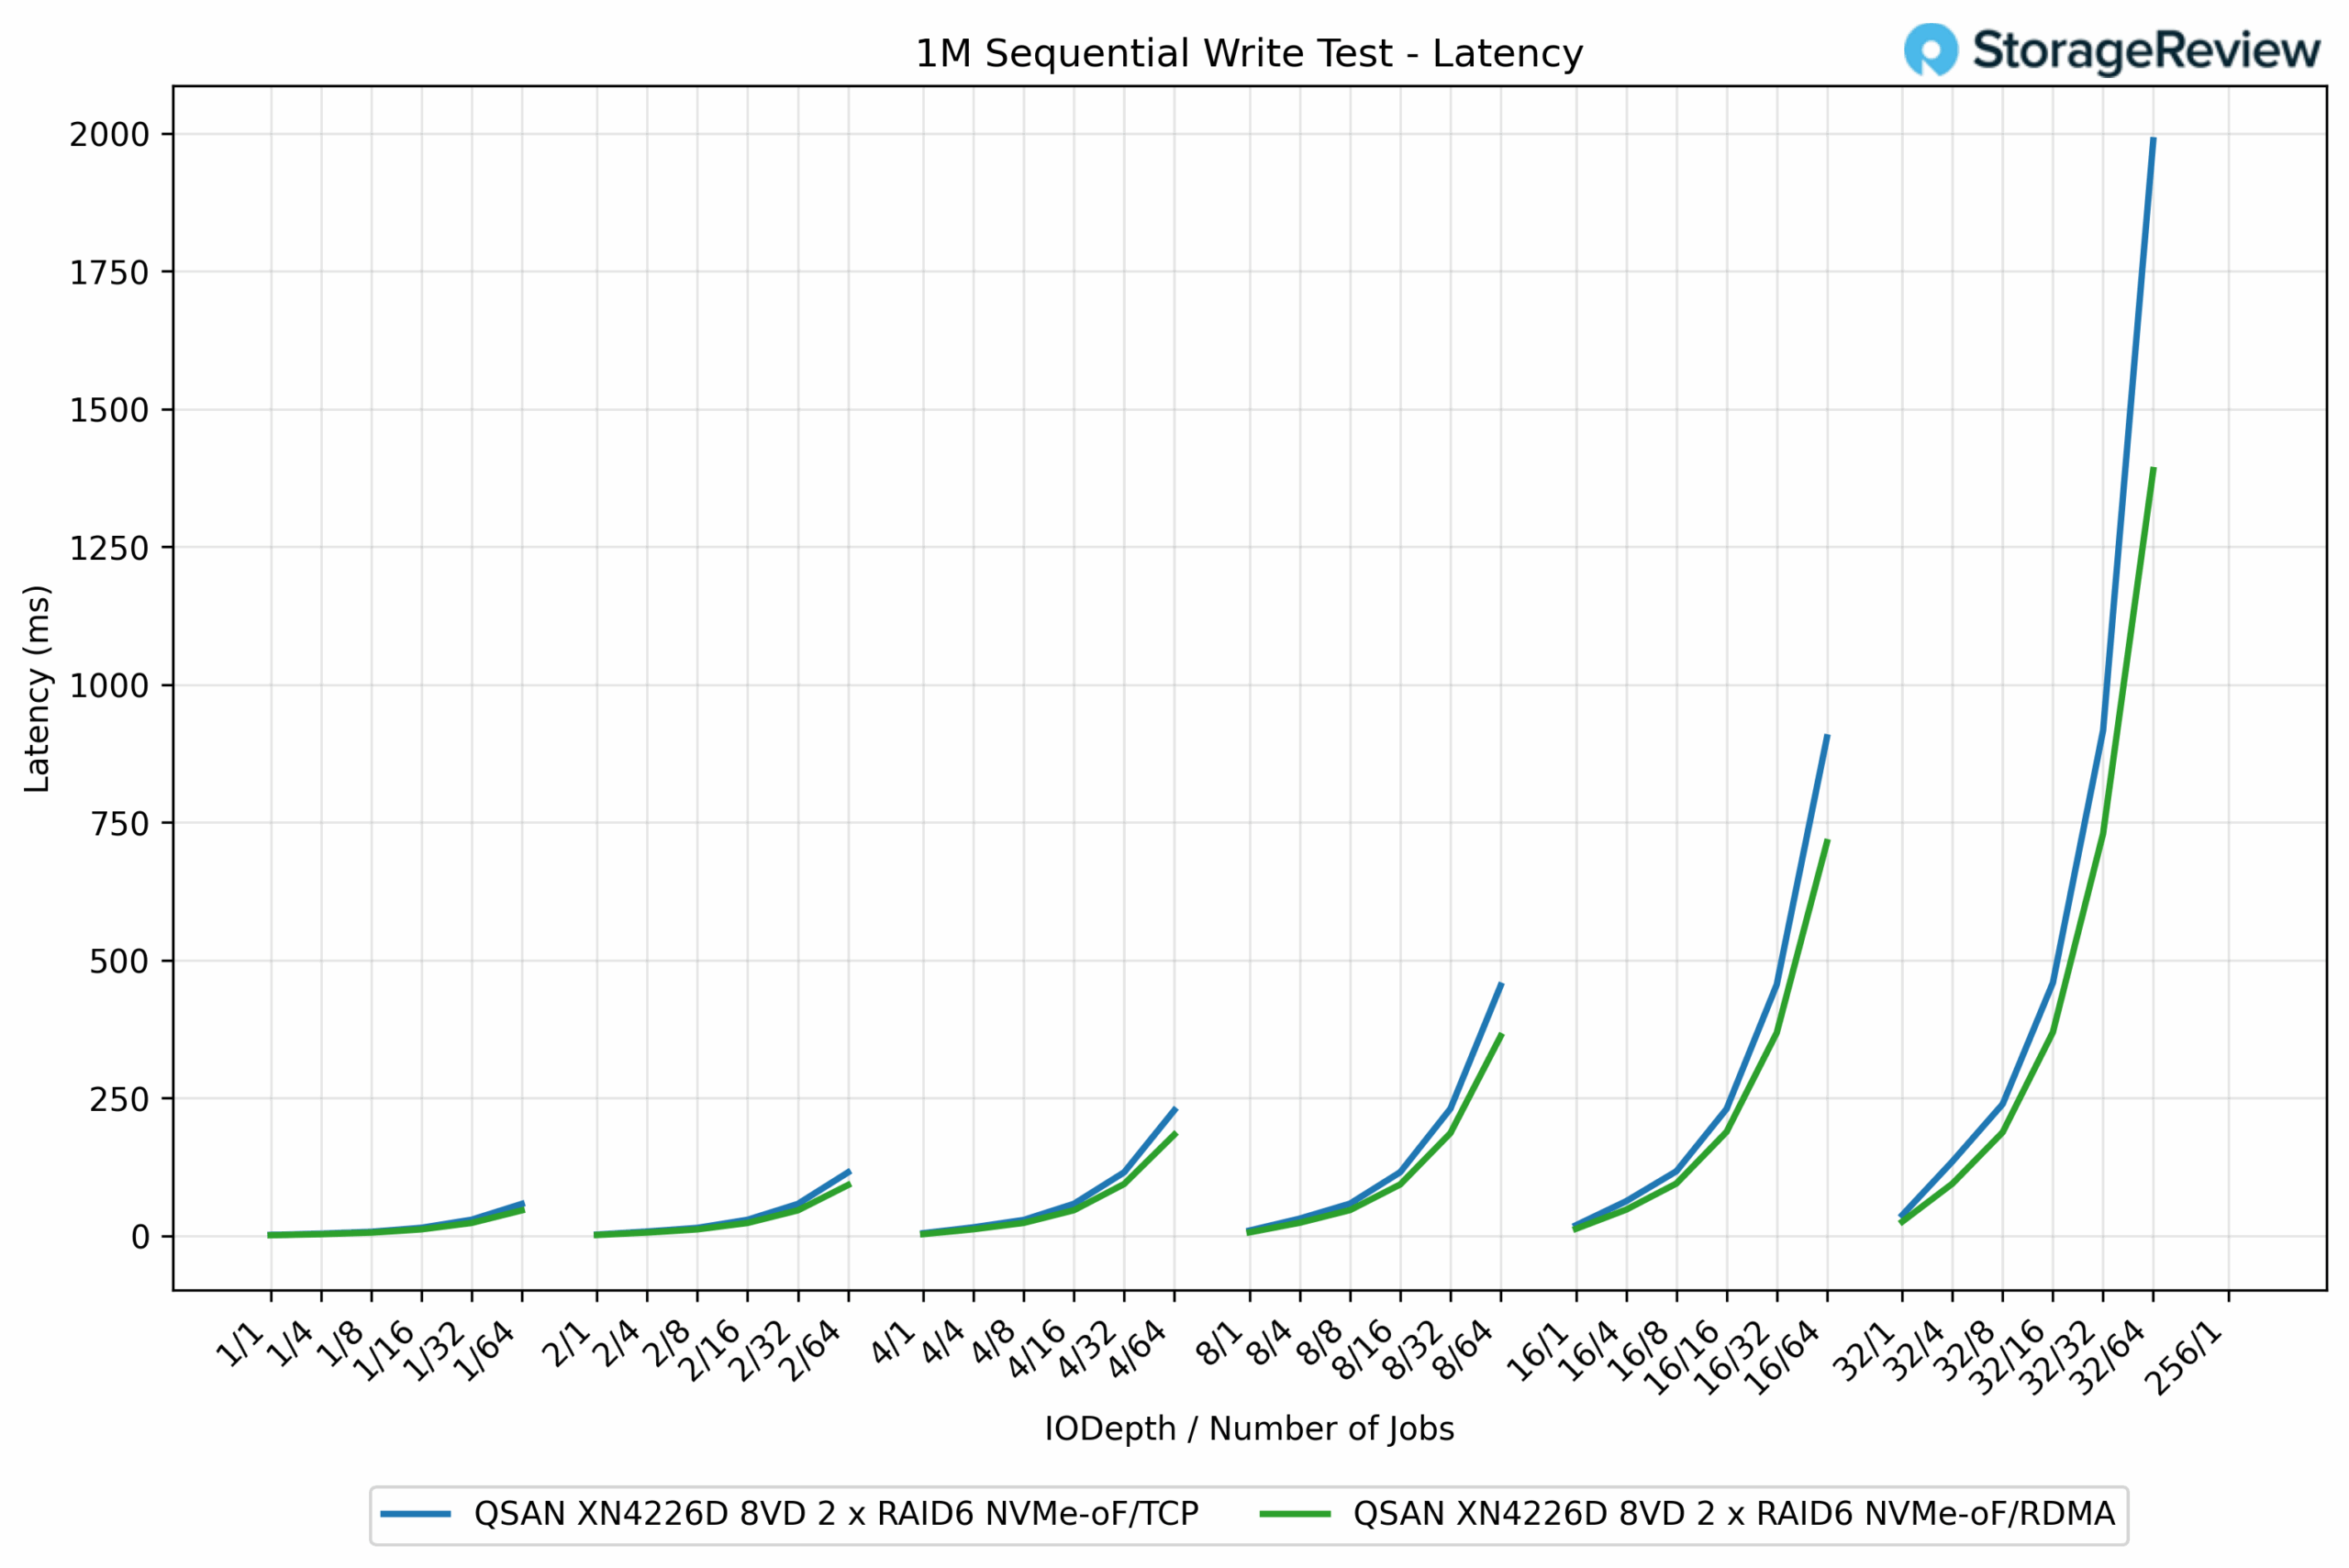
In de 1M Sequential Write-latentietest behield RDMA opnieuw een duidelijk efficiëntievoordeel ten opzichte van TCP bij de meeste wachtrijdieptes en aantallen taken. Bij lichtere workloads kwamen de twee protocollen dicht bij elkaar, met latenties van minder dan 5 ms. Naarmate de gelijktijdigheid toenam, werden de verschillen echter duidelijker. Bij QD16/16-taken noteerde RDMA bijvoorbeeld een snelheid van 368.48 ms, terwijl TCP een snelheid van 455.95 ms noteerde, een verbetering van 19% voor RDMA.
De divergentie werd nog groter op extreme schaalgroottes. Bij de QD256/1-taak werd RDMA voltooid in 1,389.16 ms, terwijl TCP steeg naar 1,987.39 ms, wat een latentiereductie van 43% ten gunste van RDMA weerspiegelt. Deze trend onderstreept het vermogen van RDMA om een hogere doorvoersnelheid te realiseren en tegelijkertijd de latentie onder controle te houden, met name in zwaar belaste scenario's.
1M sequentiële leesbandbreedte
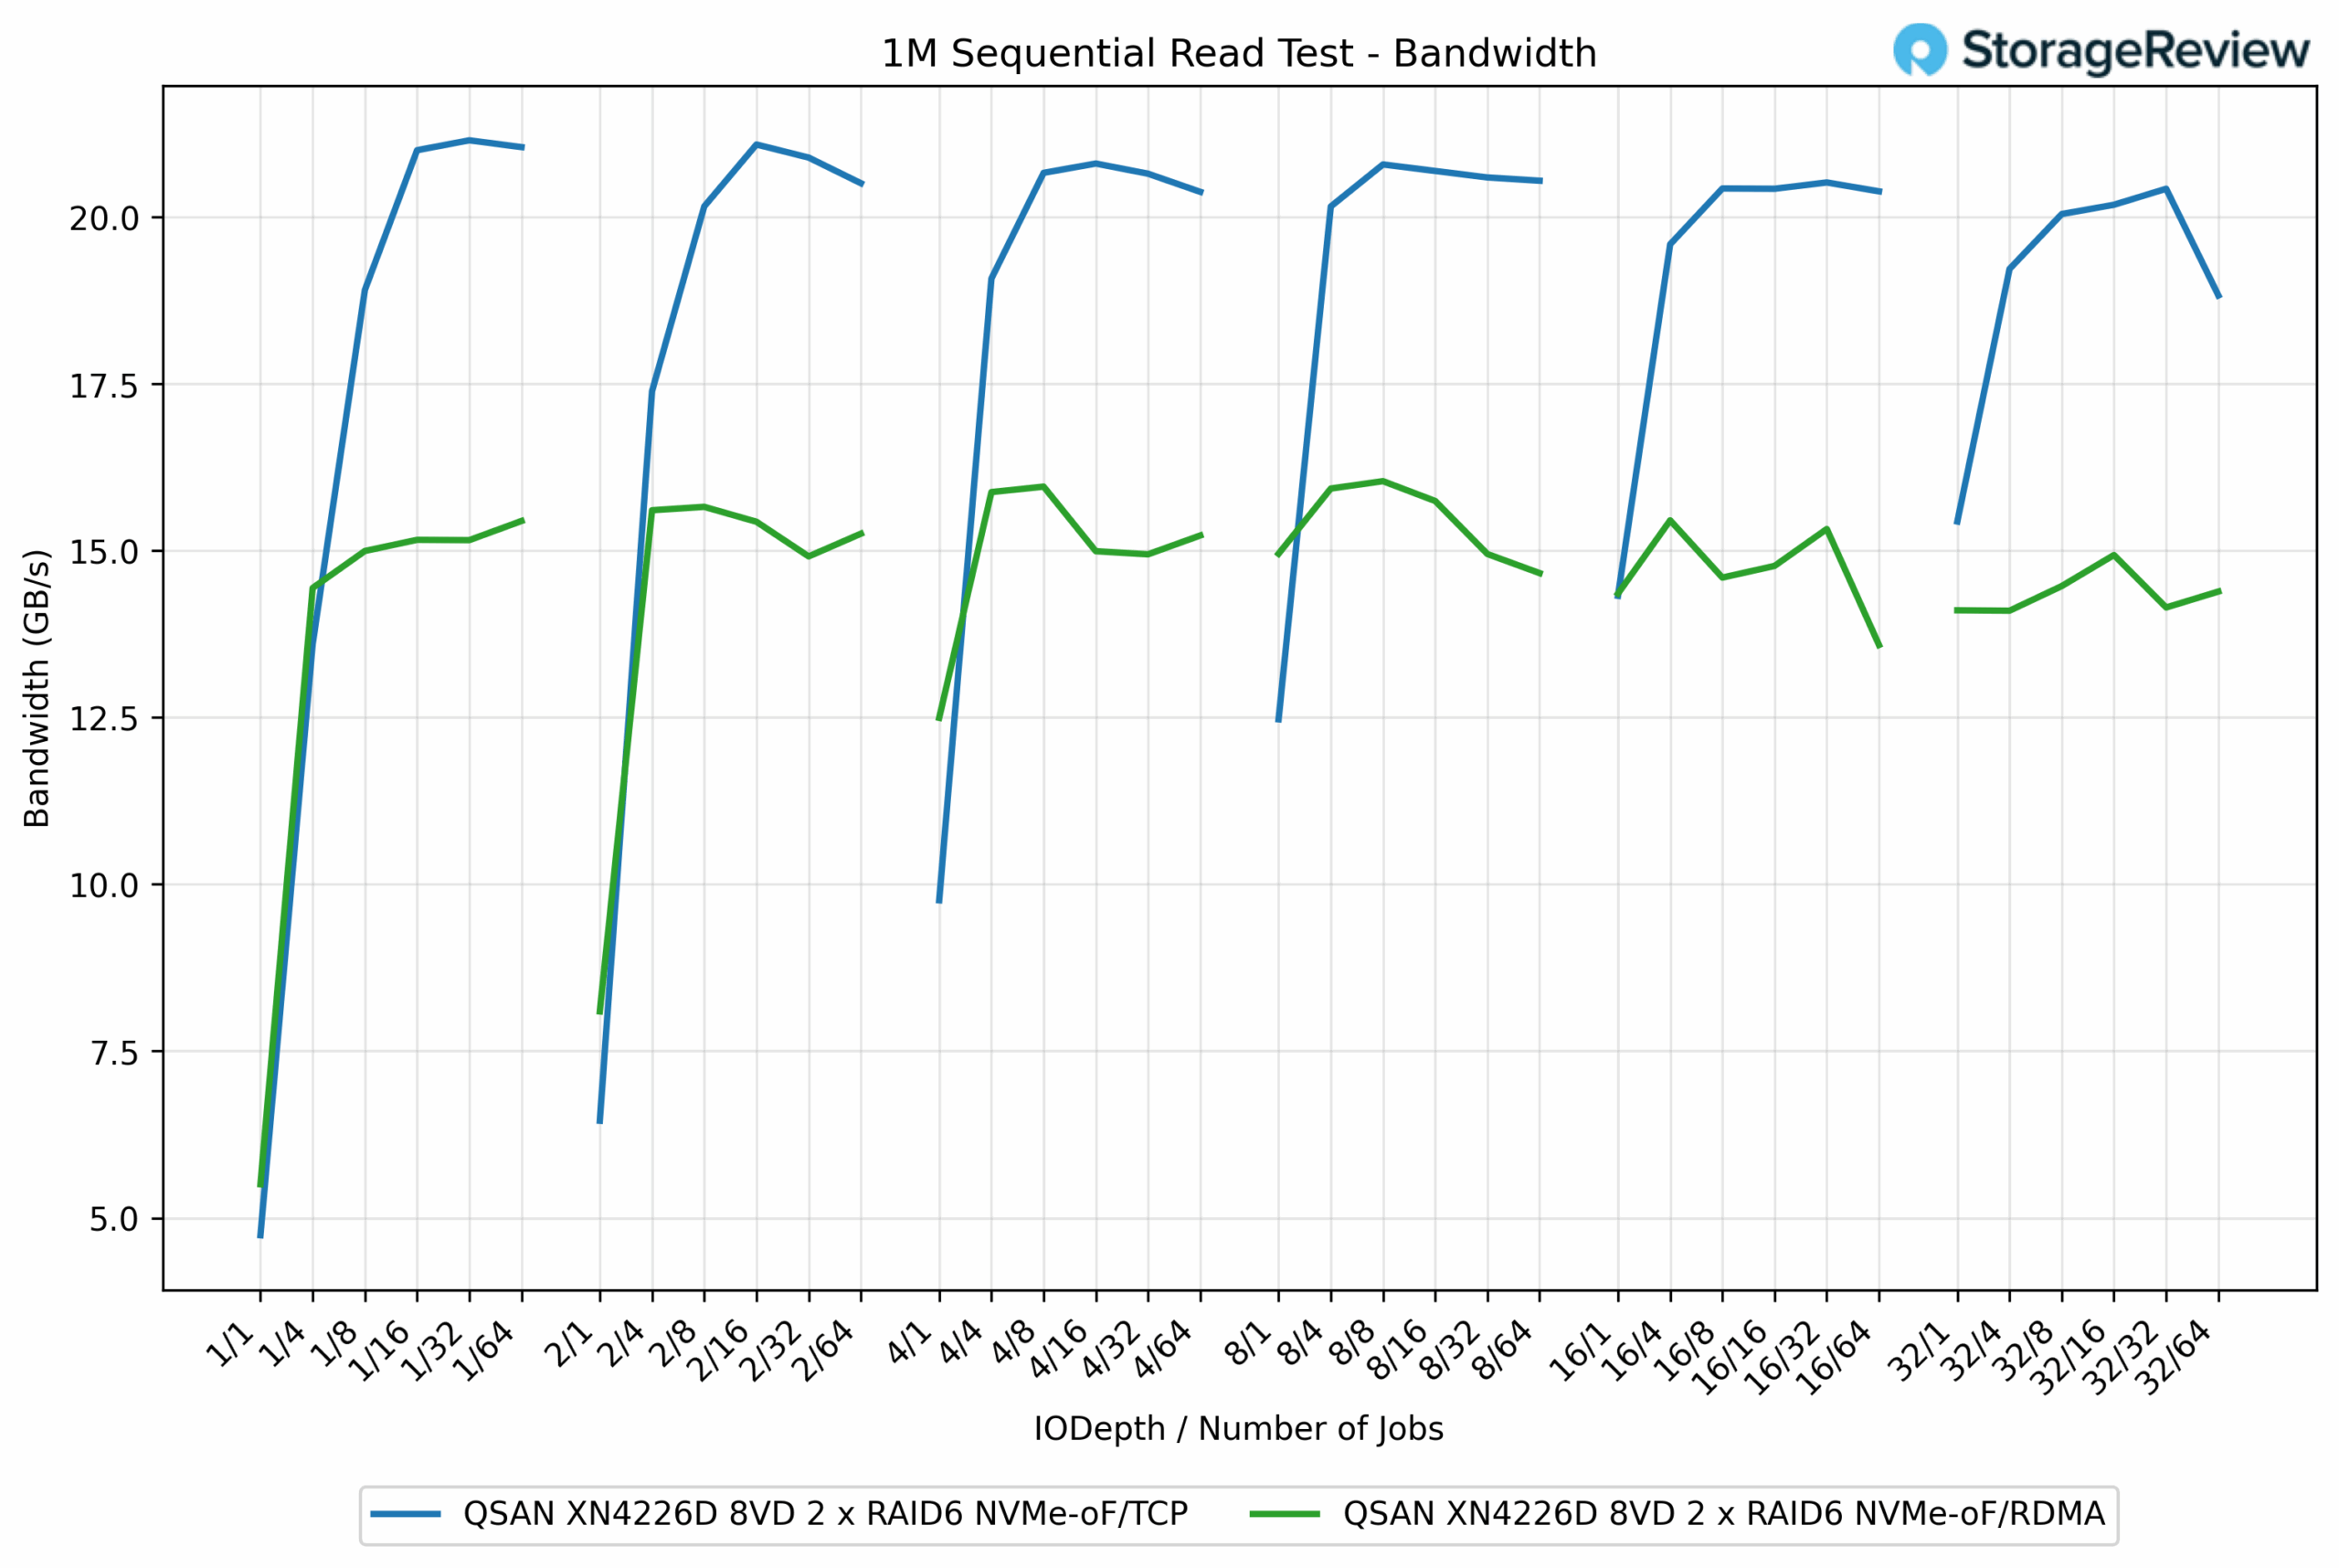
In de 1M Sequential Read-test veranderde de prestatiedynamiek, waarbij TCP RDMA over de hele linie duidelijk overtrof. TCP bereikte een piek van 21.21 GB/s, terwijl RDMA uitkwam op 15.96 GB/s, een verschil van ongeveer 33% in het voordeel van TCP. Zelfs bij lagere wachtrijdieptes nam TCP snel een voorsprong. Bij QD1/4-taken leverde TCP bijvoorbeeld 18.91 GB/s, vergeleken met 15.05 GB/s voor RDMA, een verschil van meer dan 25%.
Het voordeel van TCP was consistent over vrijwel elke workloadschaal. Zodra verzadiging optrad, behield TCP de resultaten in het bereik van 20-21 GB/s, terwijl RDMA afvlakte richting 15 GB/s. Dit geeft aan dat, hoewel RDMA uitblinkt in schrijfintensieve en latentiegevoelige bewerkingen, TCP een hogere sequentiële leesbandbreedte-efficiëntie laat zien met de geteste RAID6 NVMe-configuratie.
1M sequentiële leeslatentie
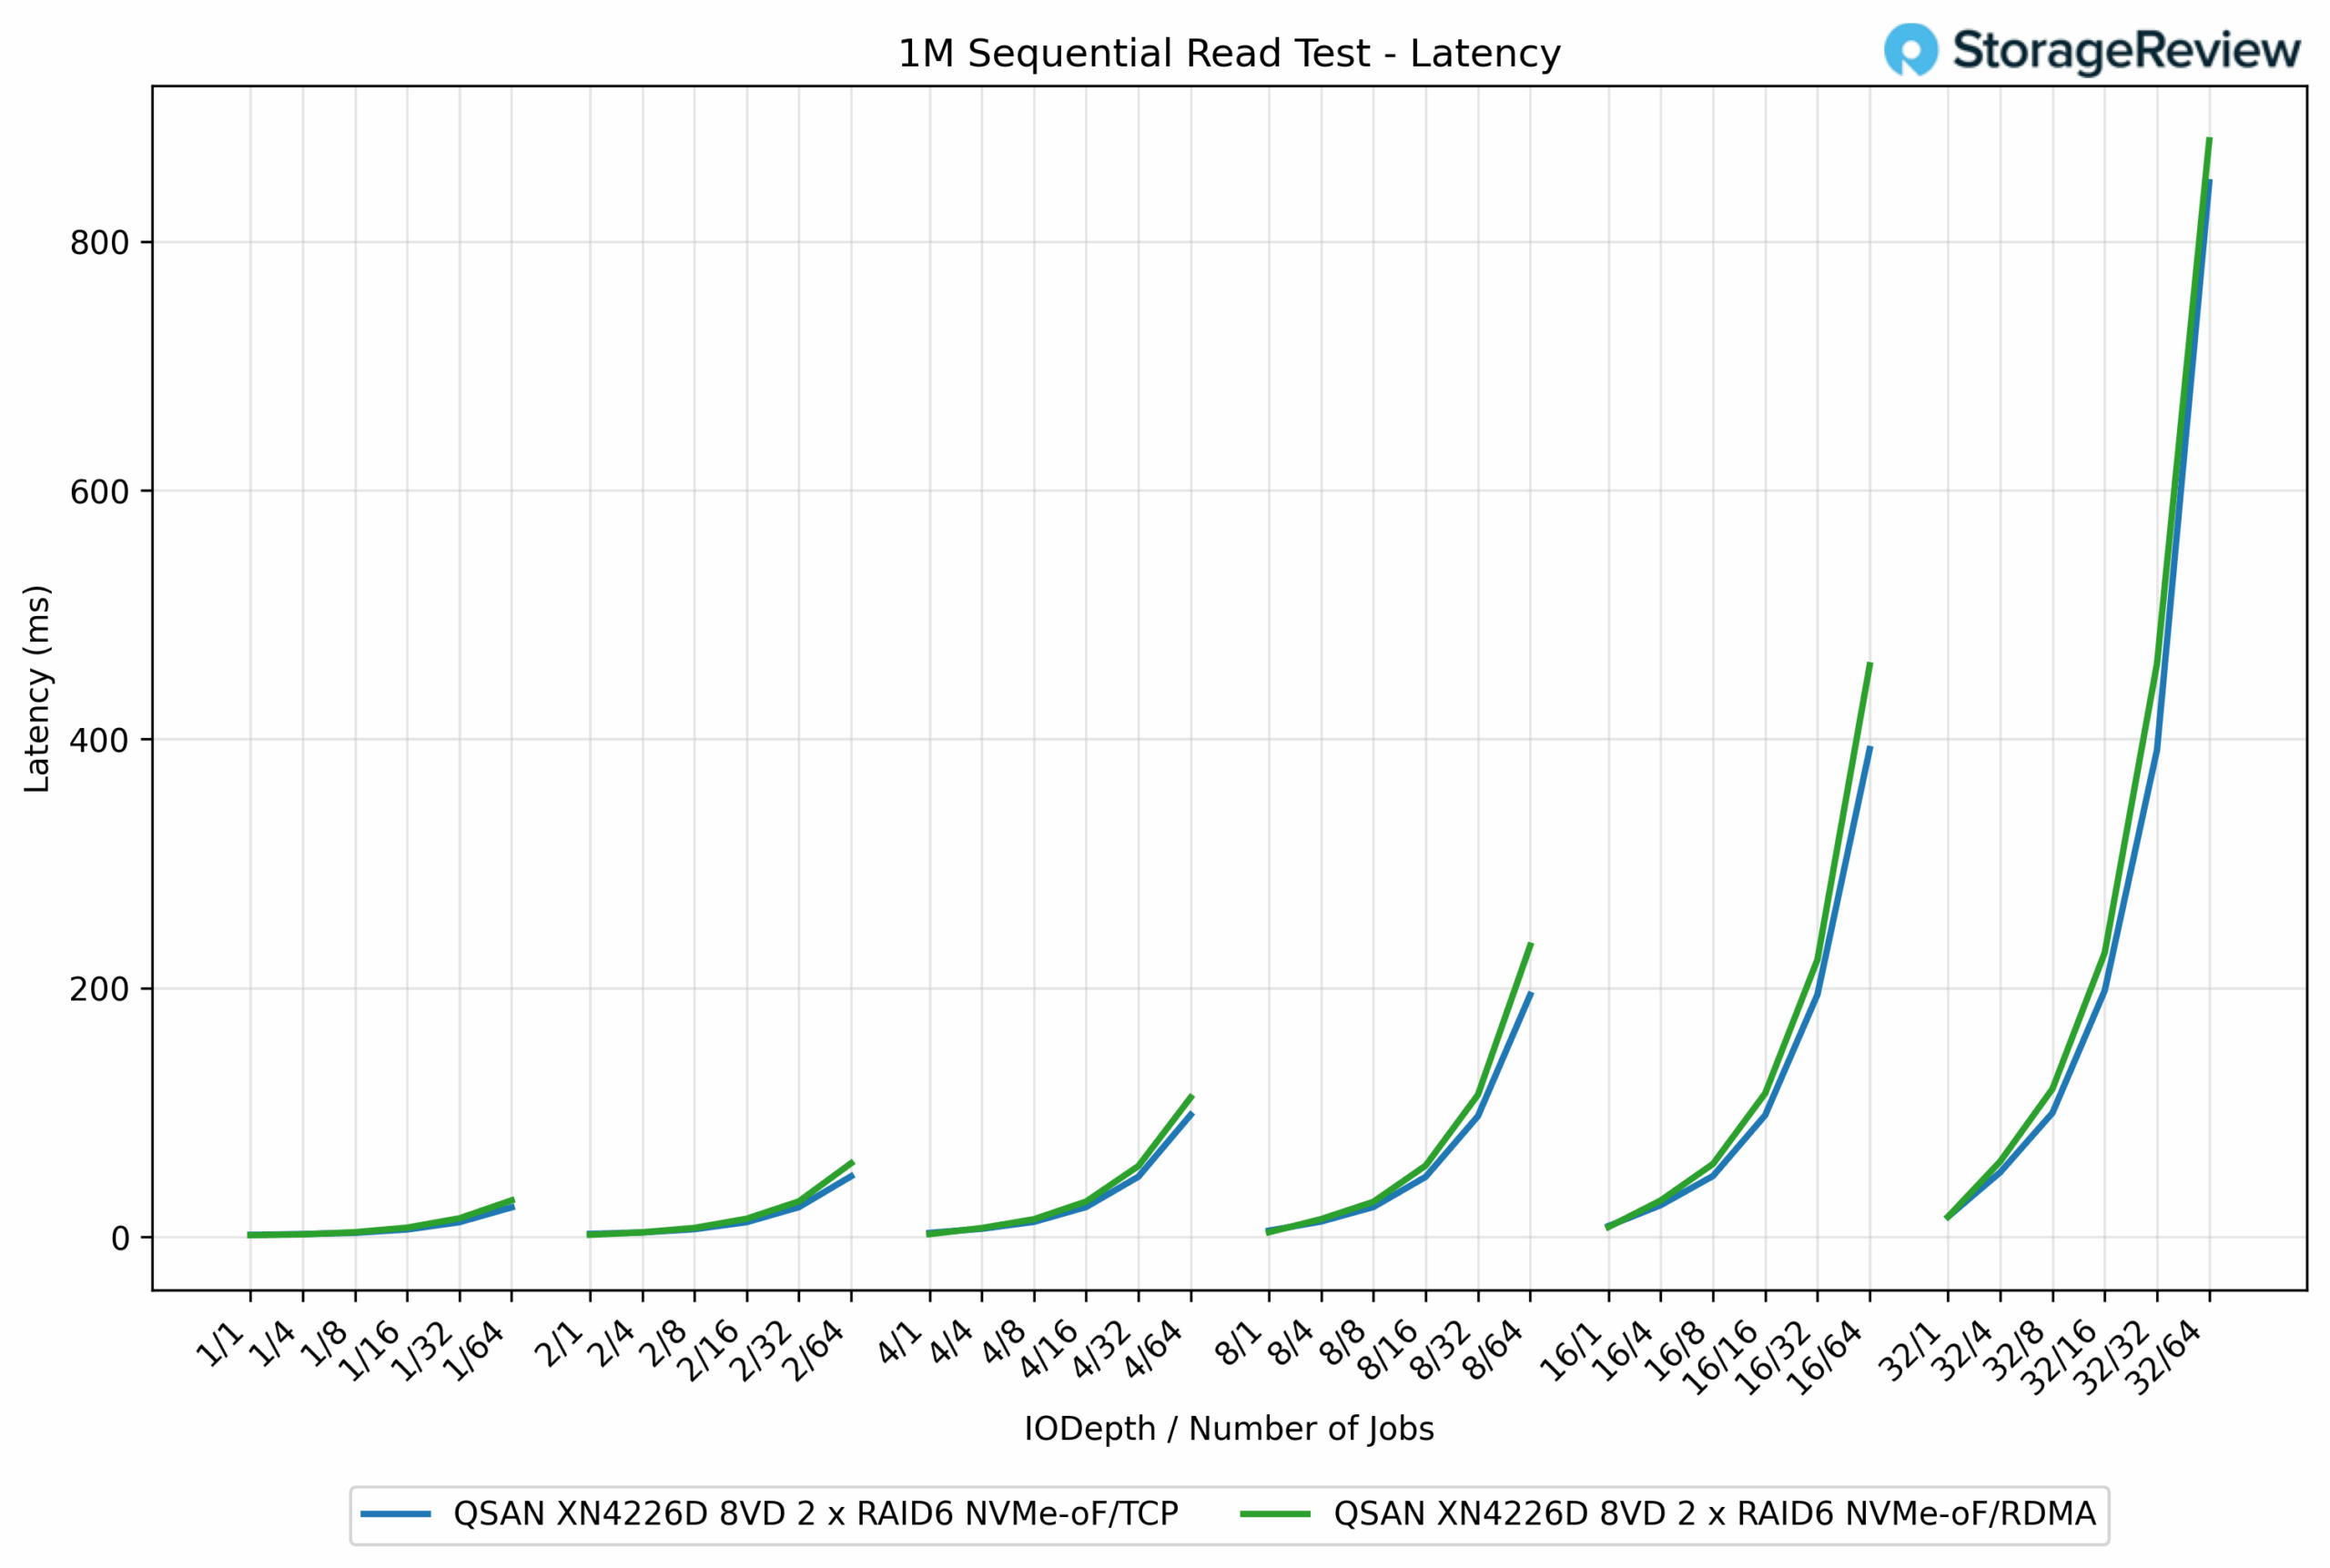
In de 1M Sequential Read-latentietest lagen de resultaten voor beide protocollen dichter bij elkaar, hoewel RDMA over het algemeen een klein voordeel had bij hogere wachtrijdieptes. Bij lichtere workloads waren de latentieprofielen vrijwel identiek; beide bleven onder de 5 ms totdat de gelijktijdigheid begon toe te nemen. Bij QD8/64-taken registreerde TCP bijvoorbeeld 234.09 ms, terwijl RDMA lager uitkwam op 194.54 ms, wat een afname van 17% betekent.
Deze trend zette zich voort bij zwaardere belasting. Bij QD32/64-taken noteerde RDMA een tijd van 847.59 ms, vergeleken met 881.31 ms voor TCP. Dit is een kleine verbetering van 3.8%, maar nog steeds consistent met de lagere stackoverhead van RDMA. Beide protocollen schaalden echter in een vergelijkbaar patroon, waarbij de latentie voorspelbaar toenam naarmate de werklast toenam.
64k willekeurige schrijf-IOPS
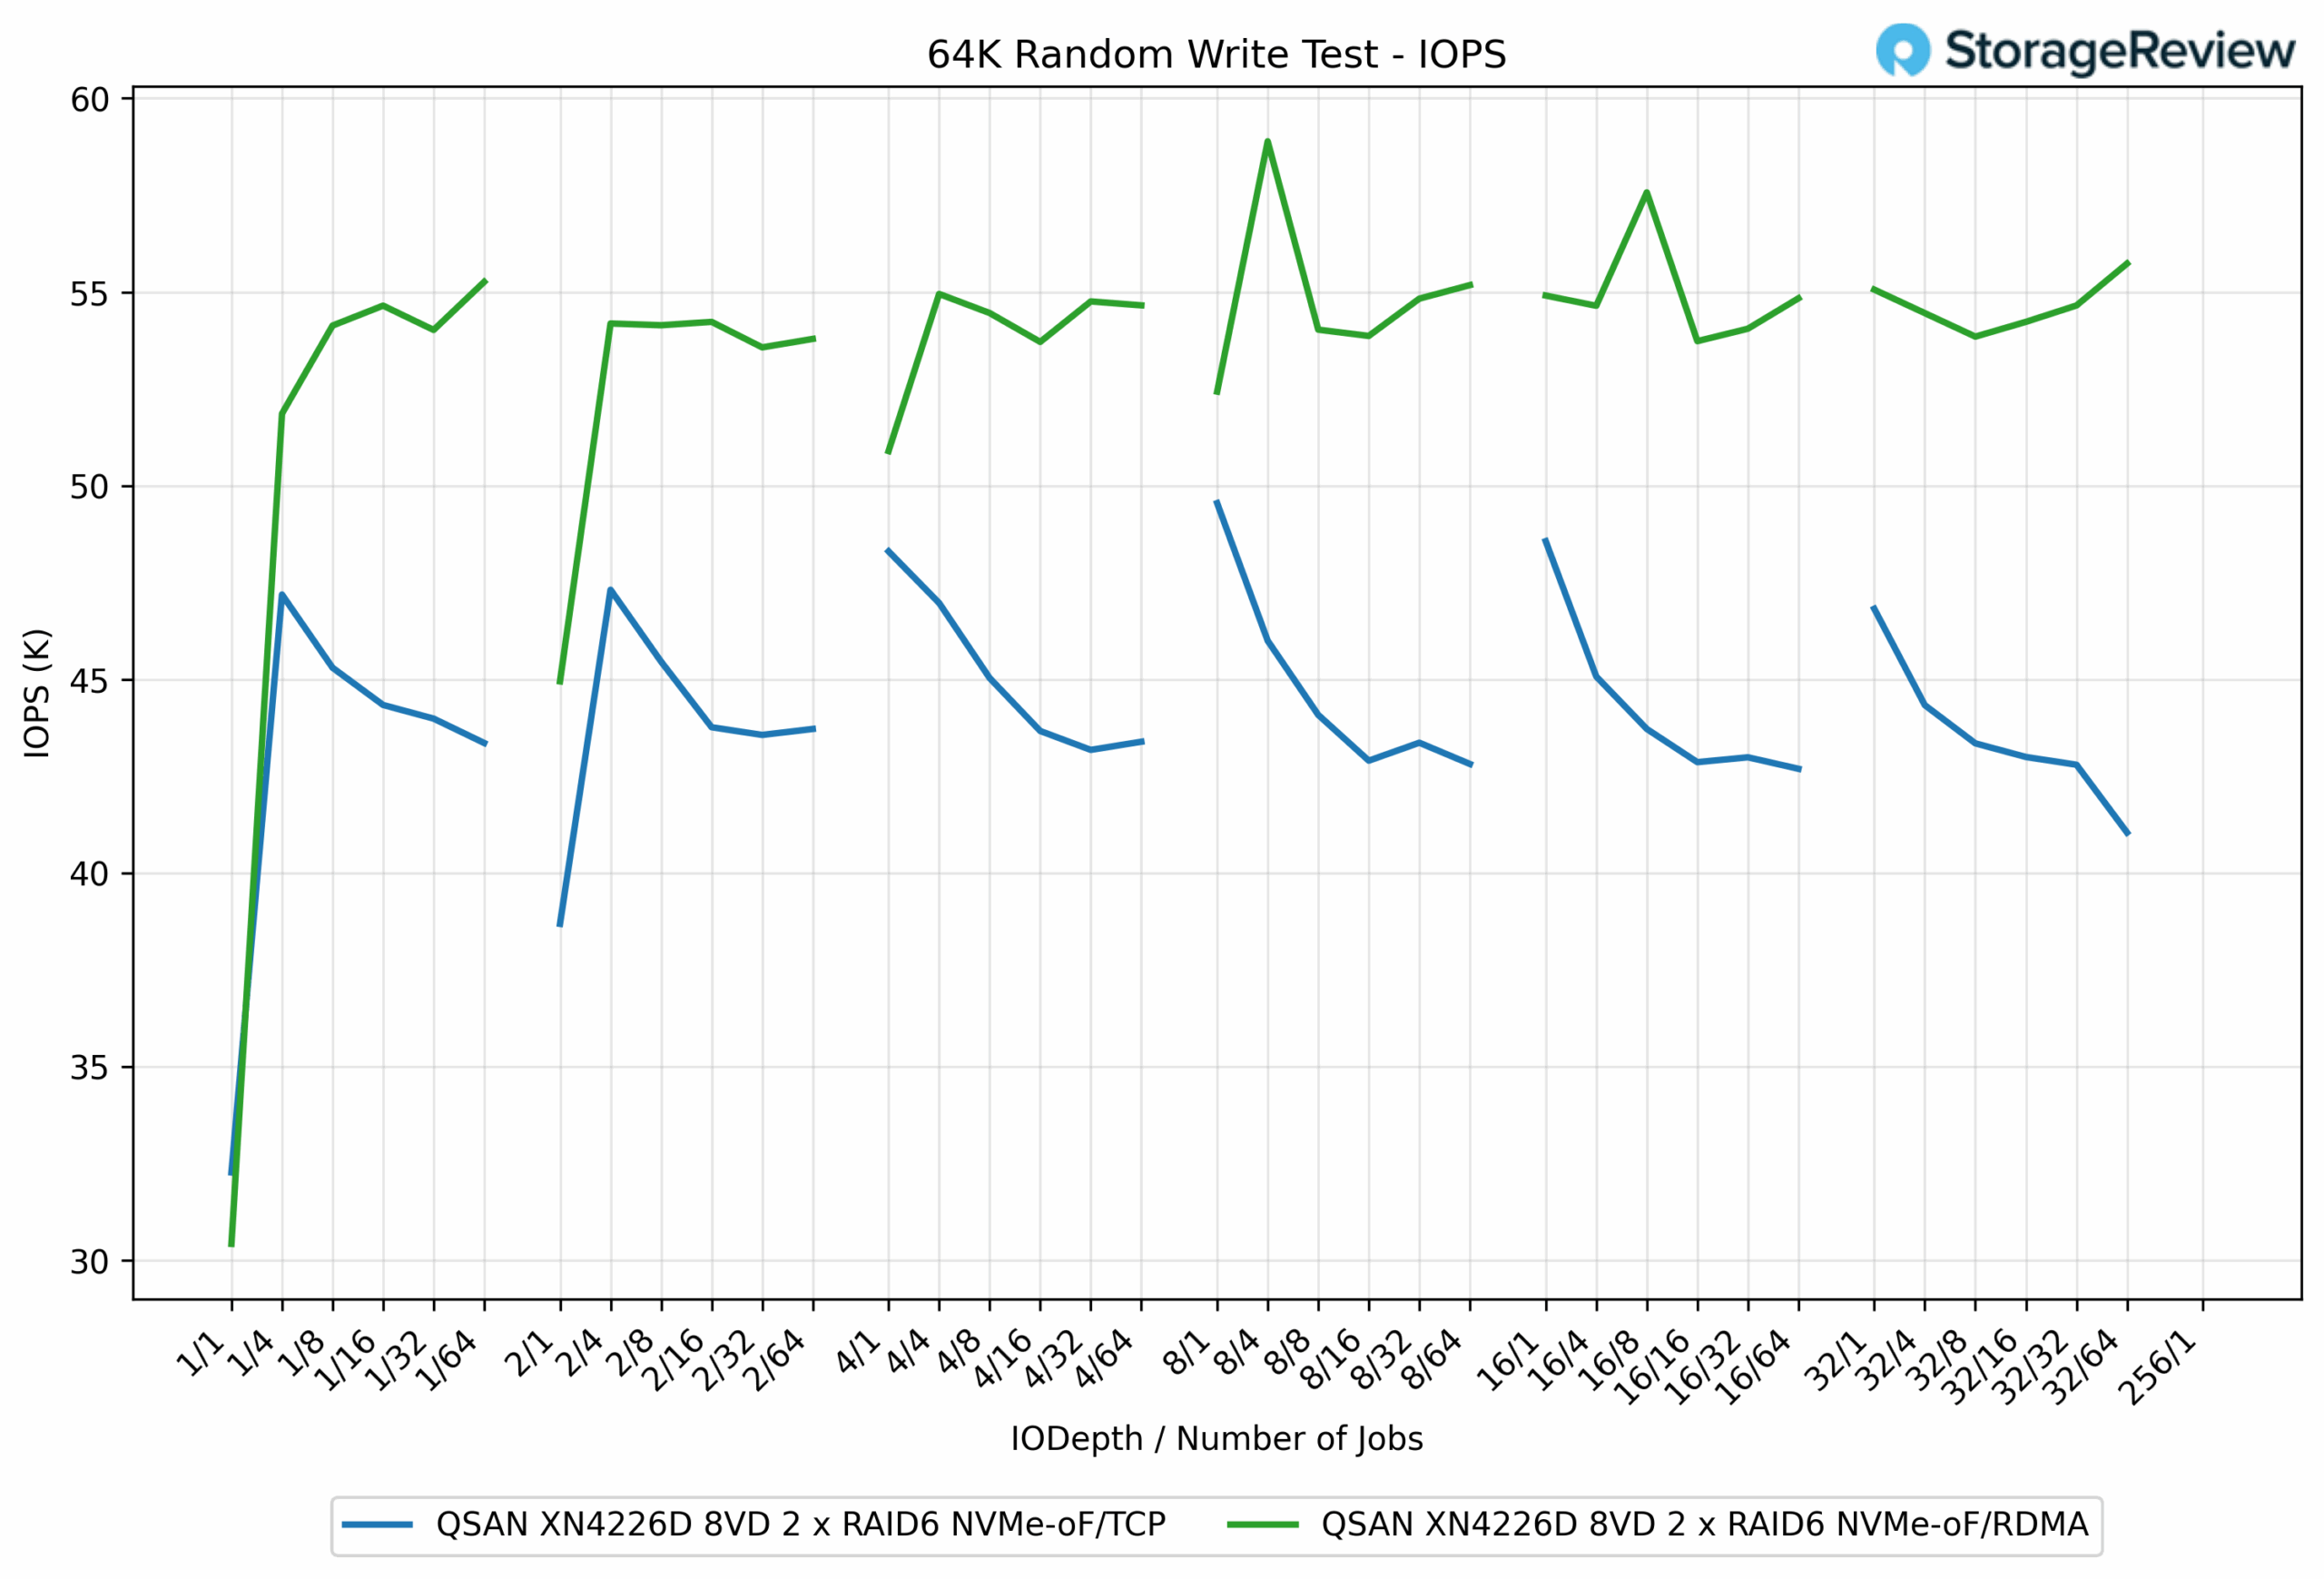
In de 64K Random Write-test leverde RDMA consistent hogere IOPS dan TCP, wat de efficiëntie bij het verwerken van geparallelliseerde willekeurige bewerkingen onderstreept. Op het hoogtepunt bereikte RDMA 58.89K IOPS, terwijl TCP achterbleef bij 48.57K IOPS, wat een prestatievoordeel van 21% betekende.
De kloof tussen de twee protocollen was gedurende de hele test aanwezig. Zo behaalde RDMA bij QD1/16-taken 54.13K IOPS, vergeleken met 45.30K IOPS voor TCP, een verschil van bijna 16%. Naarmate de werklast verder toenam, handhaafde RDMA de resultaten tussen 53K en 55K IOPS, terwijl TCP een bereik van 42K tot 46K IOPS handhaafde.
64K willekeurige schrijflatentie
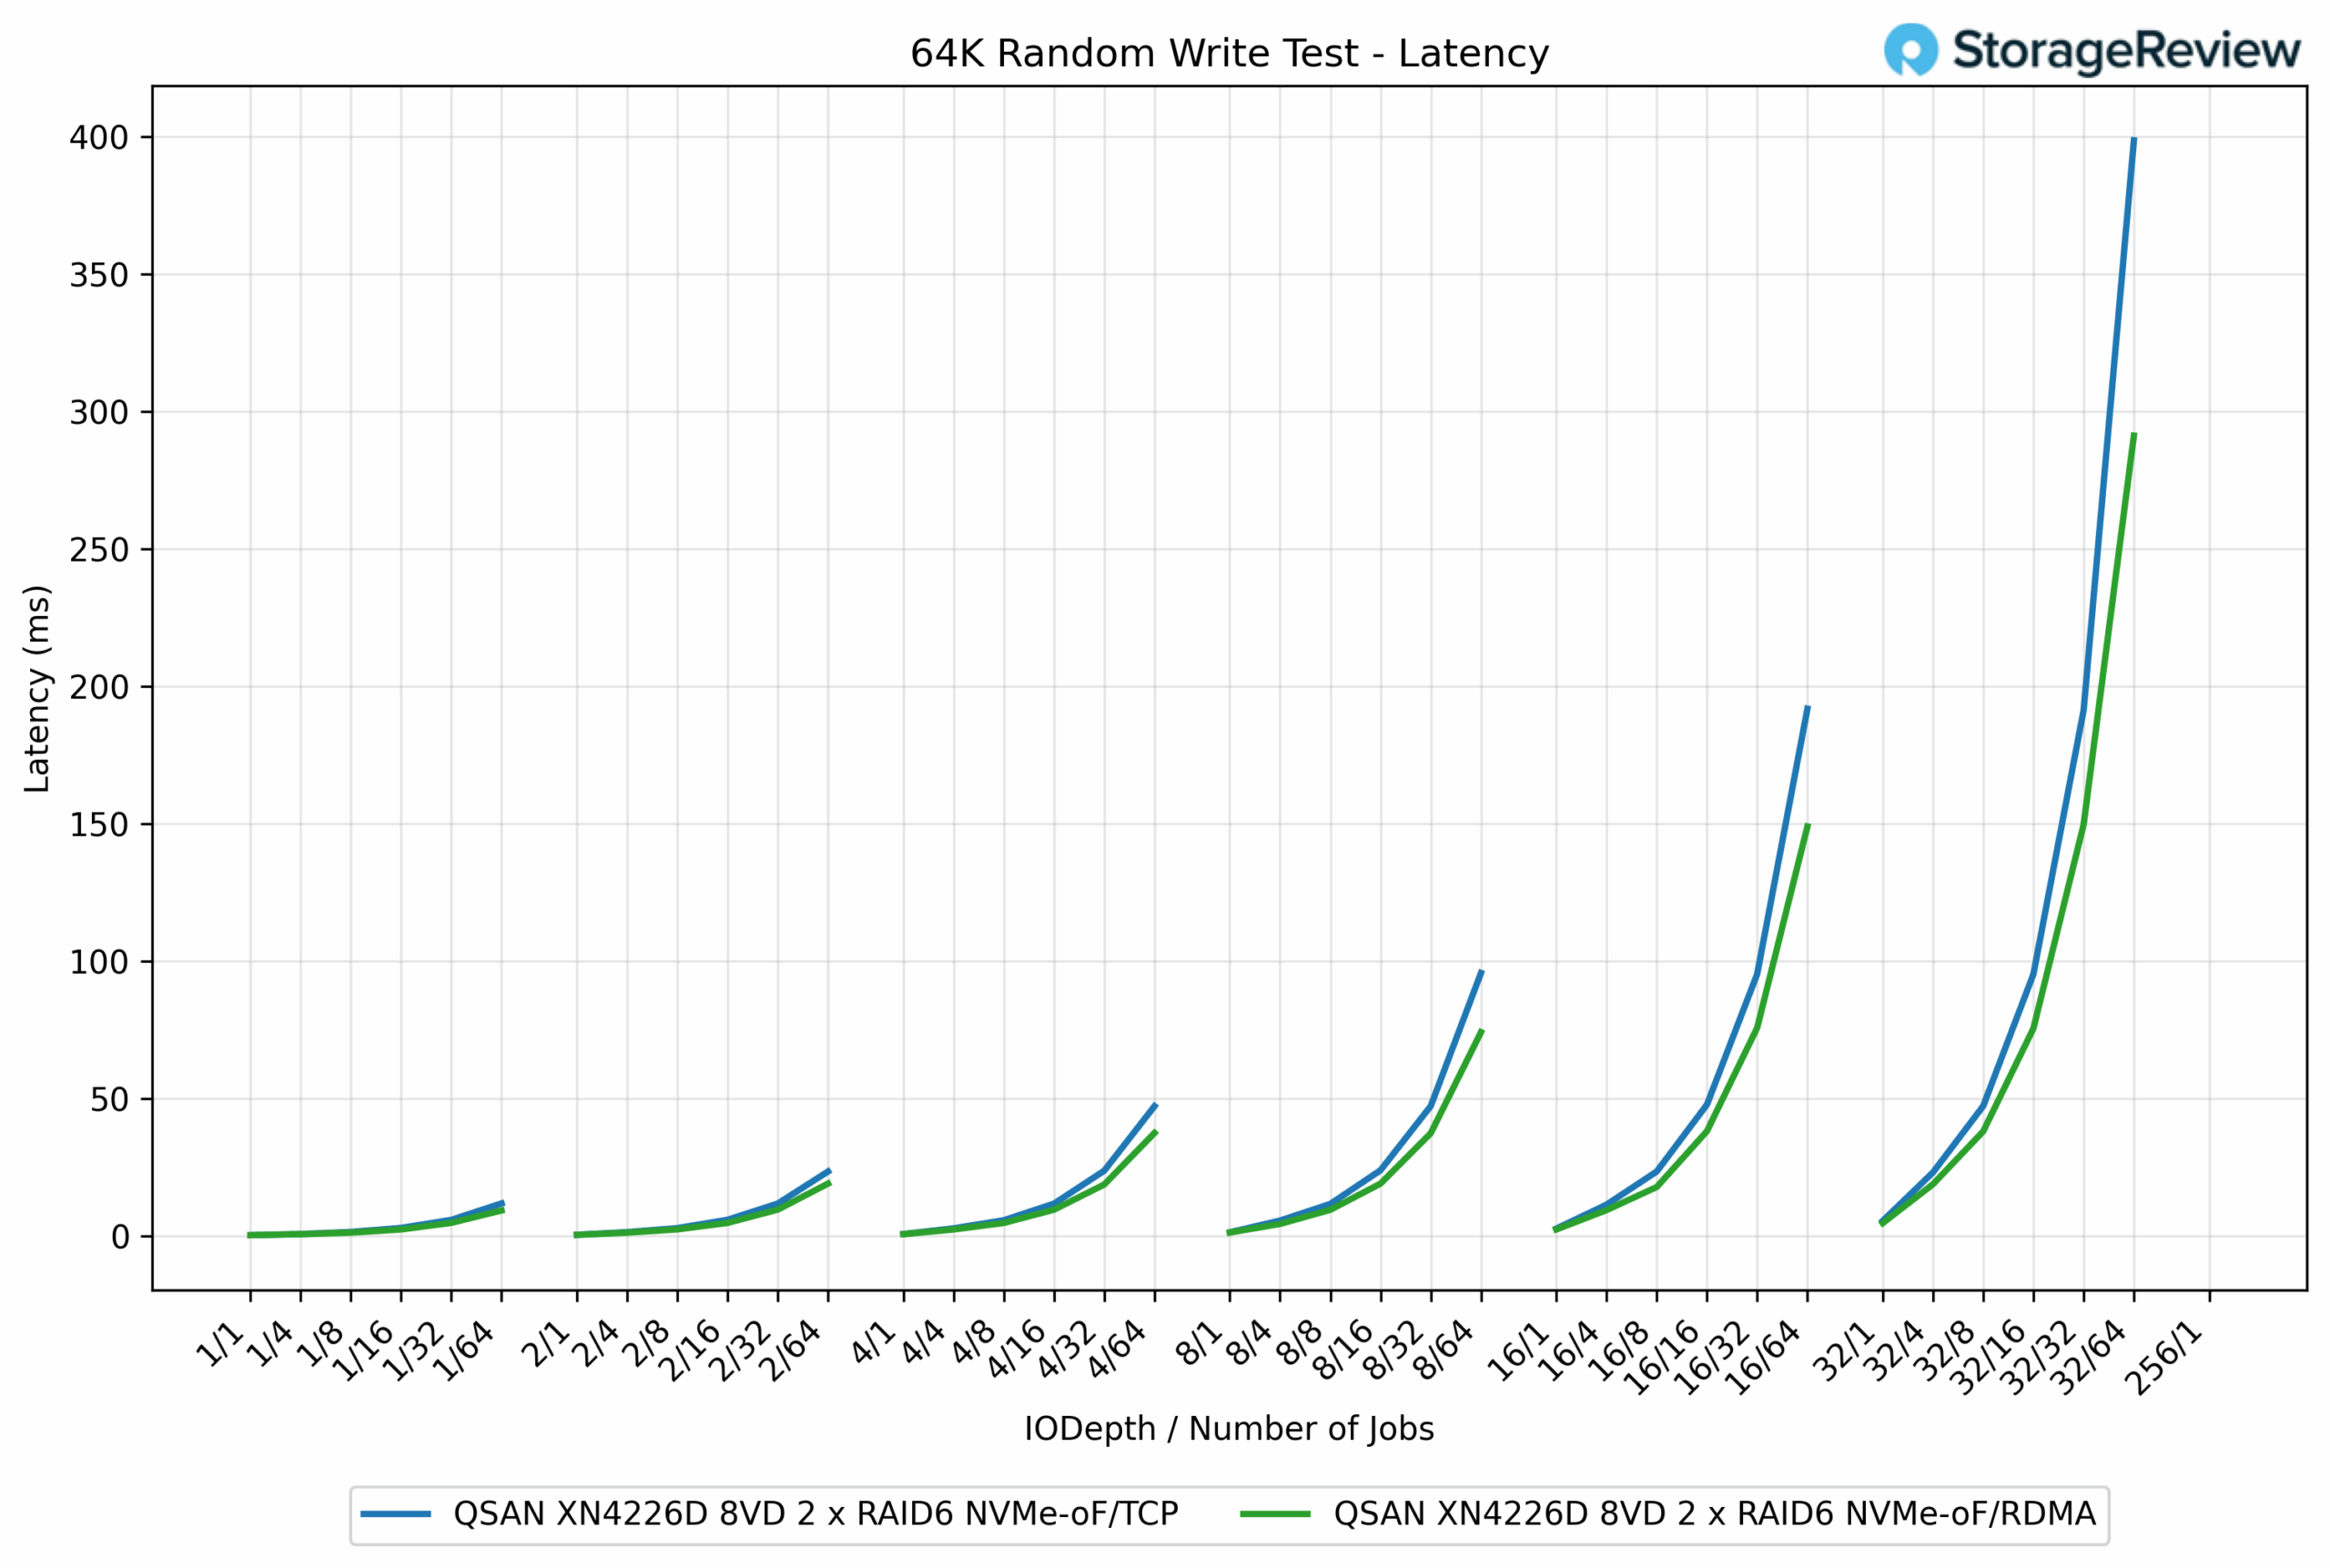
In de 64K Random Write-latentietest liet RDMA opnieuw lagere responstijden zien dan TCP, met name naarmate de wachtrijdiepte en het aantal taken toenamen. Bij lagere belasting presteerden beide protocollen vrijwel identiek en bleven ze onder de 1 ms. Bij de QD1/1-taak bijvoorbeeld, bedroeg de TCP-tijd 0.26 ms, terwijl RDMA vrijwel gelijk was met 0.25 ms.
Naarmate de werklast toenam, behield RDMA echter zijn efficiëntievoordeel. Bij QD16/64-jobs noteerde RDMA een tijd van 74.09 ms, vergeleken met 95.64 ms voor TCP, een verschil van ongeveer 23%. Het verschil werd verder vergroot onder maximale belasting bij de QD256/1-job, waar RDMA een tijd van 291.13 ms noteerde, terwijl TCP een tijd van 398.56 ms noteerde, bijna 37% hoger.
64K willekeurig lezen IOPS
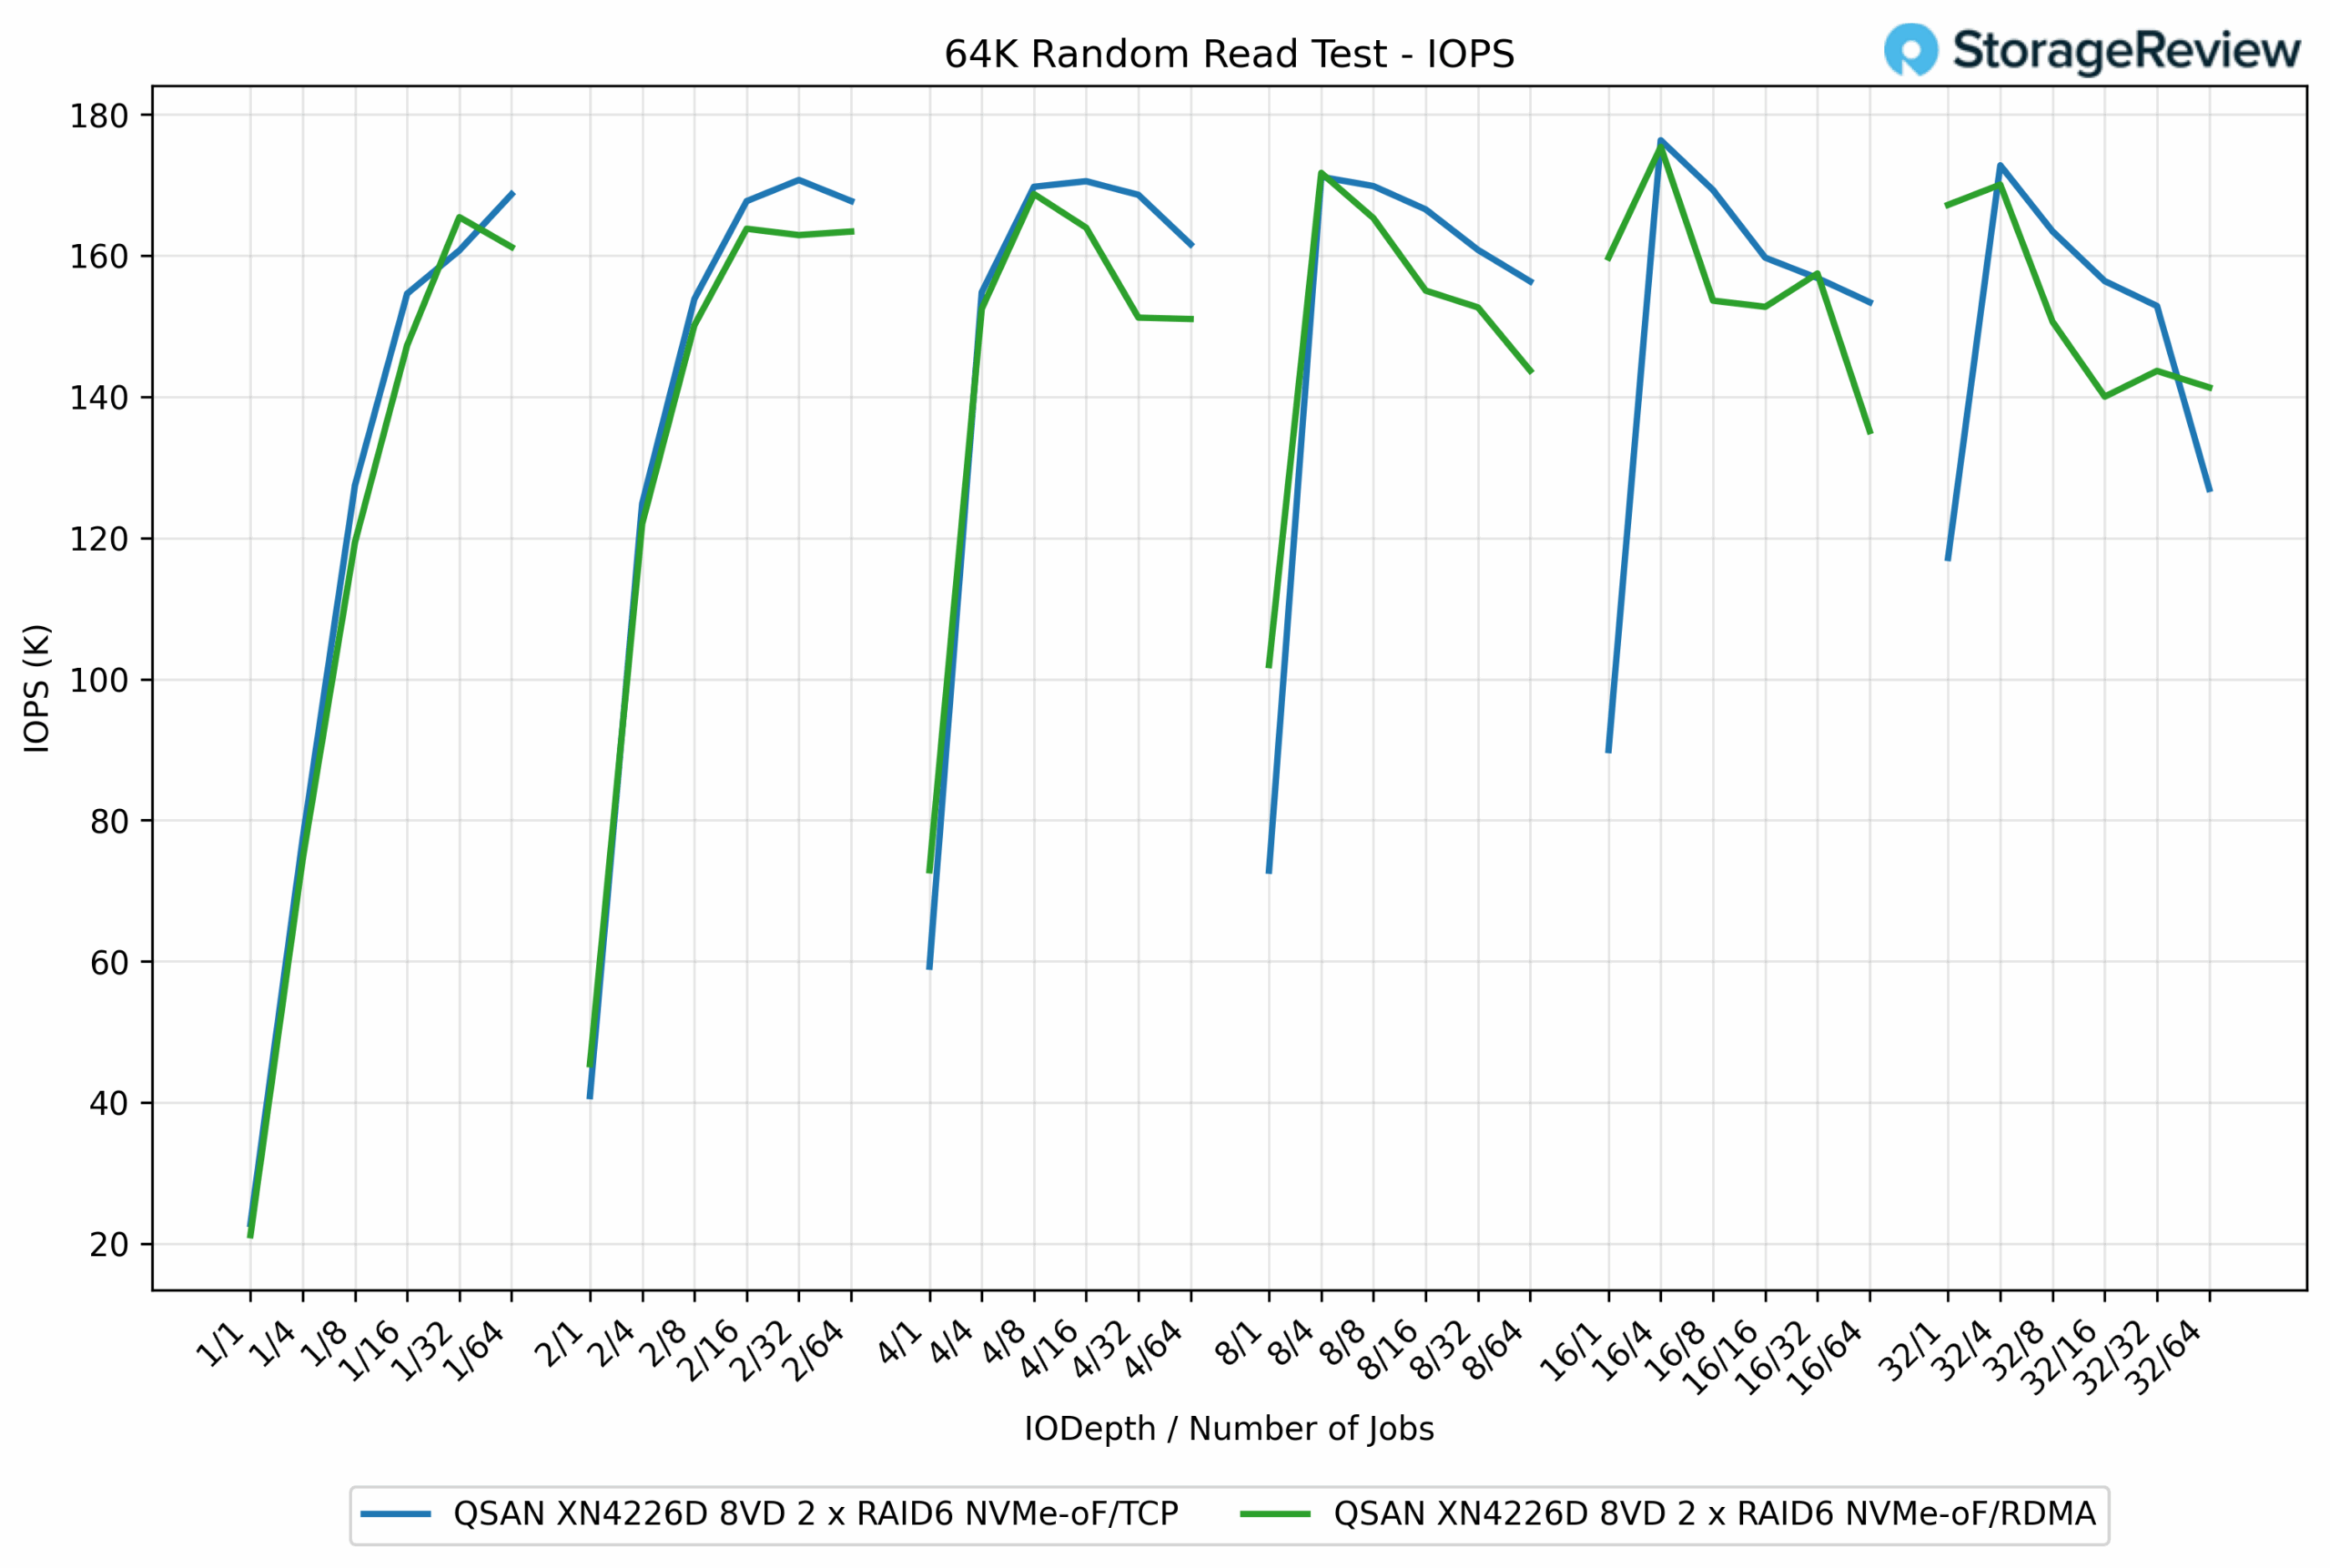
In de 64K Random Read-test leverden TCP en RDMA over het algemeen zeer vergelijkbare prestaties, waarbij de voorsprong tussen de twee protocollen lichtjes verschoof, afhankelijk van de werklast. TCP bereikte een piek van 176.33K IOPS, terwijl RDMA daar met 175.40K IOPS vlak achter zat, met een verschil van slechts 0.5%.
Op gematigde dieptes bleven de resultaten dicht bij elkaar liggen. Zo boekte TCP bij QD4/16-taken 168.60K IOPS, terwijl RDMA volgde met 163.94K IOPS, een verschil van minder dan 2.8%. Op andere punten steeg RDMA licht, zoals bij QD8/1-taken, waar het 171.71K IOPS bereikte, vergeleken met TCP's 171.15K IOPS, wat in feite een gelijkspel betekende.
64K willekeurige leeslatentie
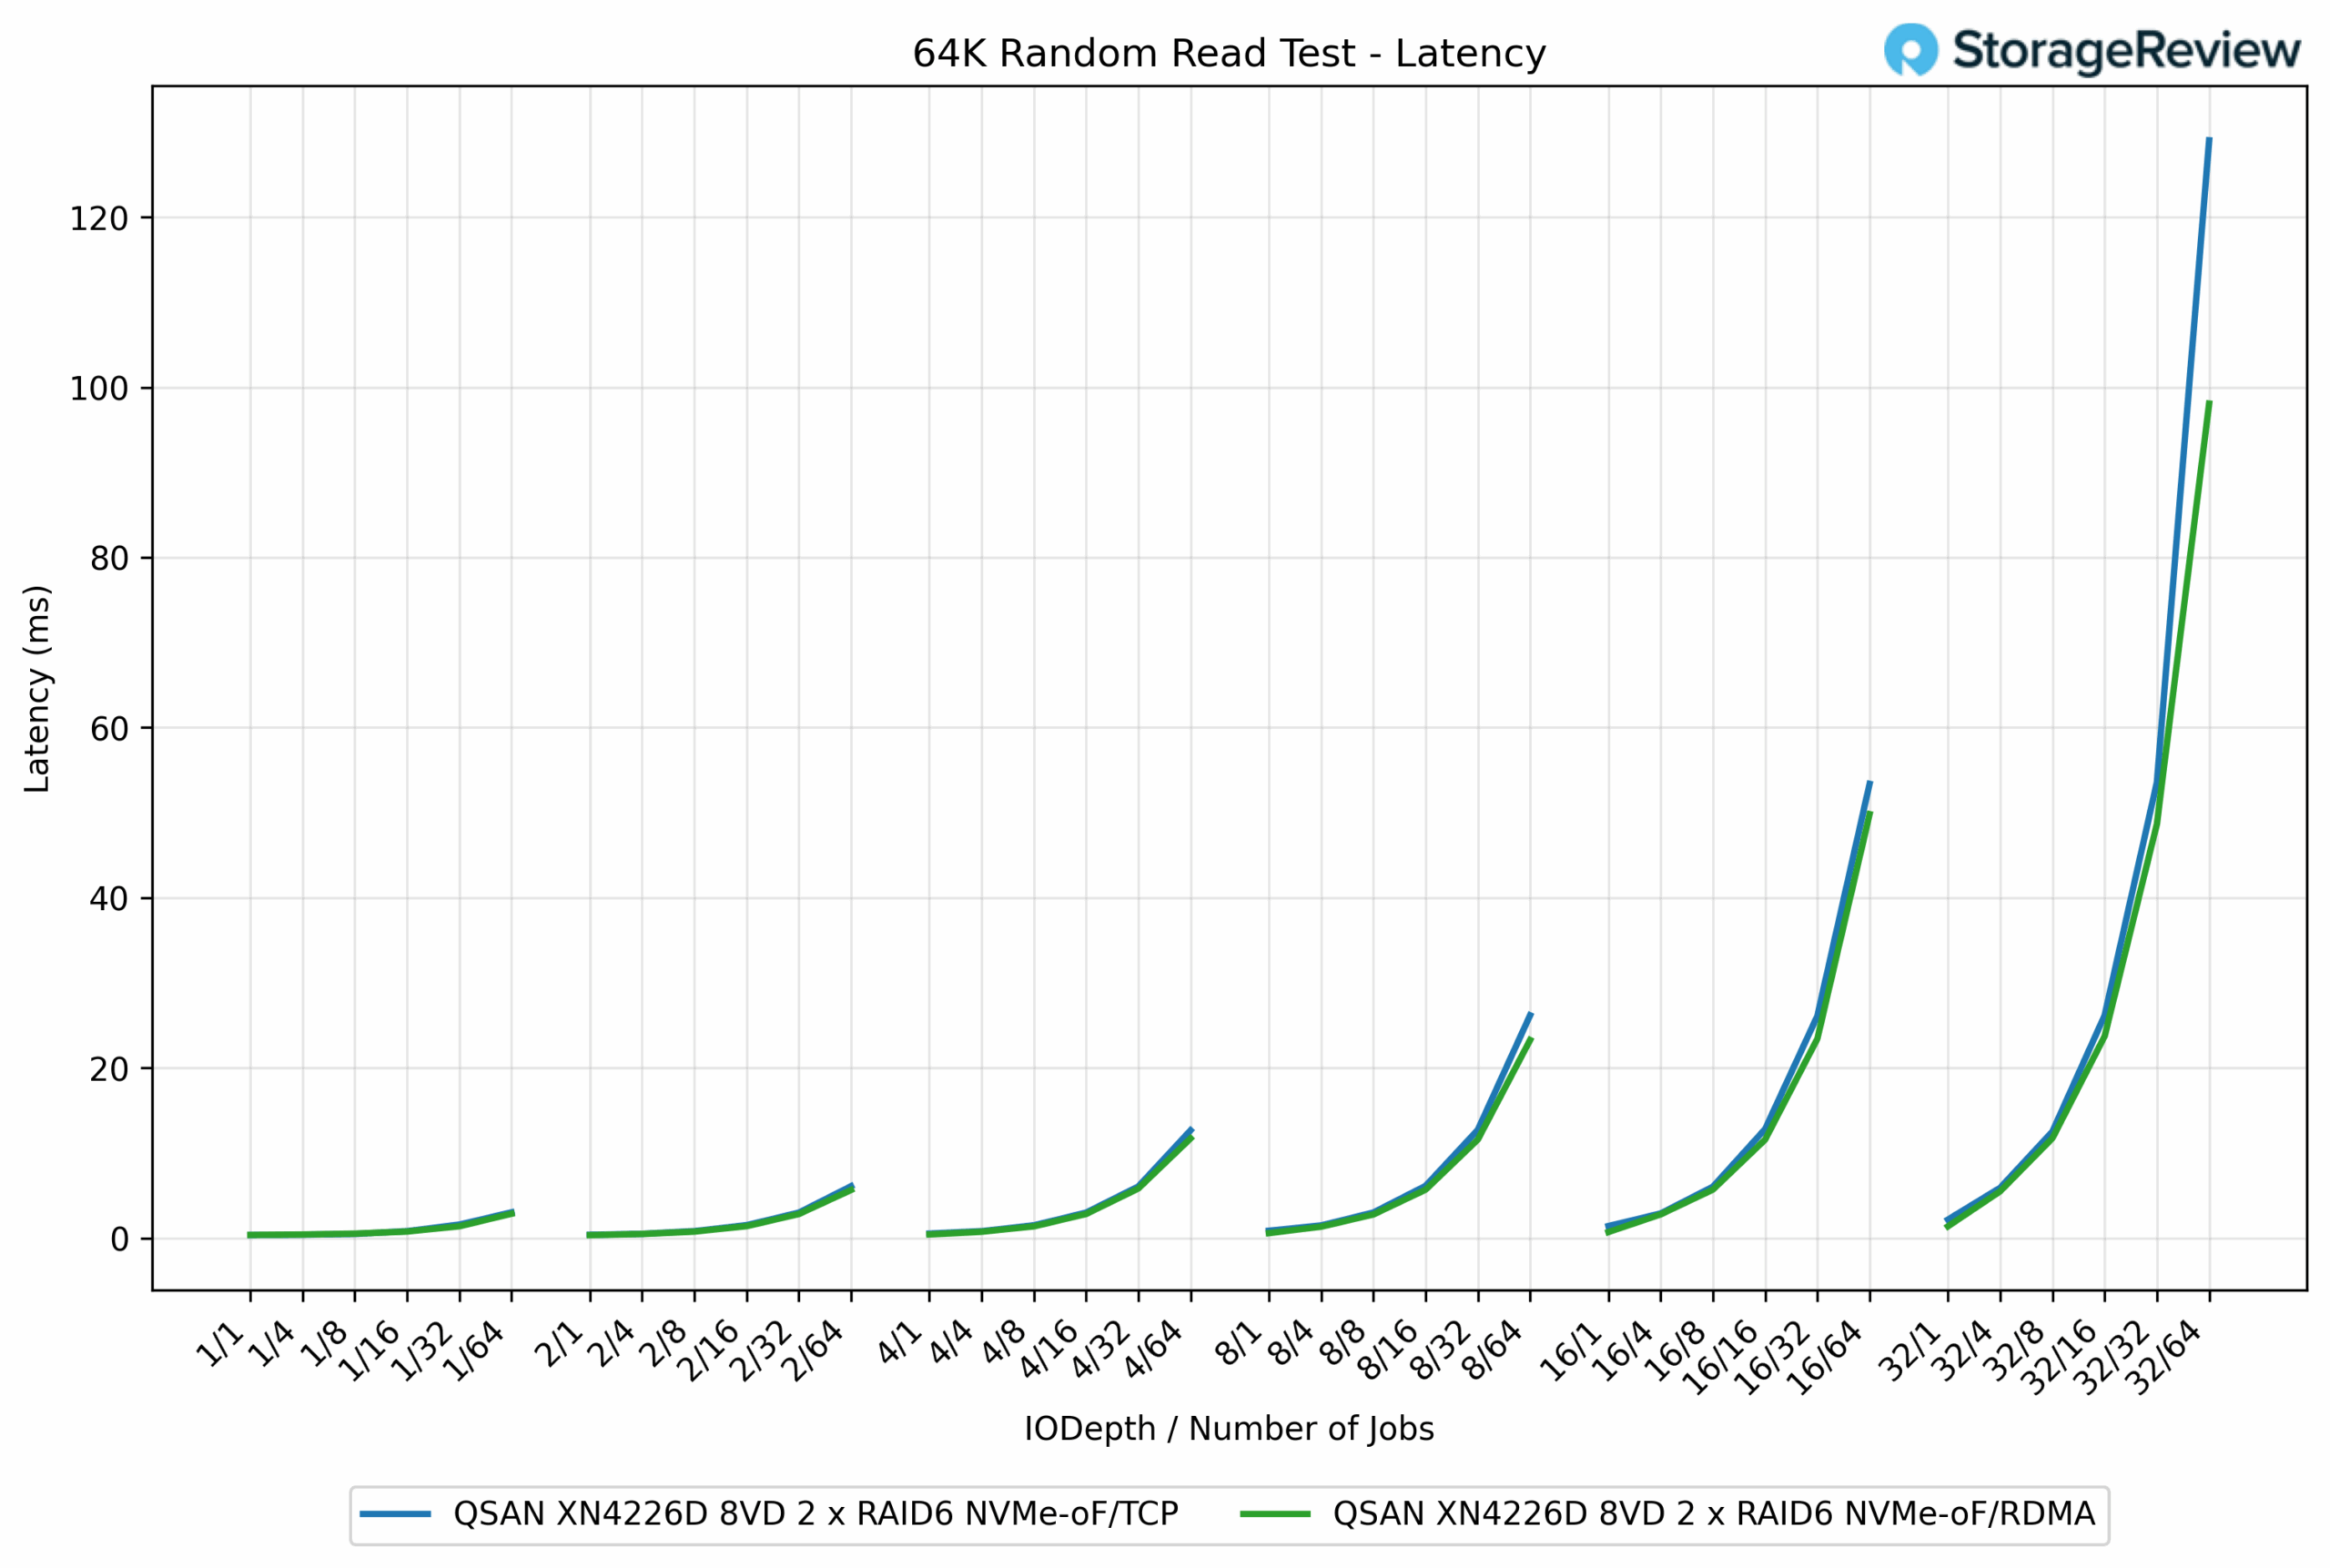
In de 64K Random Read-latentietest kwamen de twee protocollen zeer dicht bij elkaar, hoewel RDMA een bescheiden voordeel liet zien bij hogere belasting. Bij lichte workloads leverden zowel TCP als RDMA latenties van minder dan 1 ms, die in wezen niet van elkaar te onderscheiden waren. Bij de QD1/1-taak bijvoorbeeld, bedroeg de TCP-latentie 0.43 ms, vergeleken met 0.38 ms voor RDMA.
Naarmate de gelijktijdigheid toenam, werd het verschil duidelijker. Bij QD16/64-jobs noteerde RDMA 23.28 ms, terwijl TCP 26.19 ms noteerde, een verbetering van 12%. De spreiding werd groter onder maximale belasting, waarbij RDMA uitkwam op 98.08 ms versus 129.02 ms voor TCP, een afname van 24%.
16K willekeurig schrijven IOPS
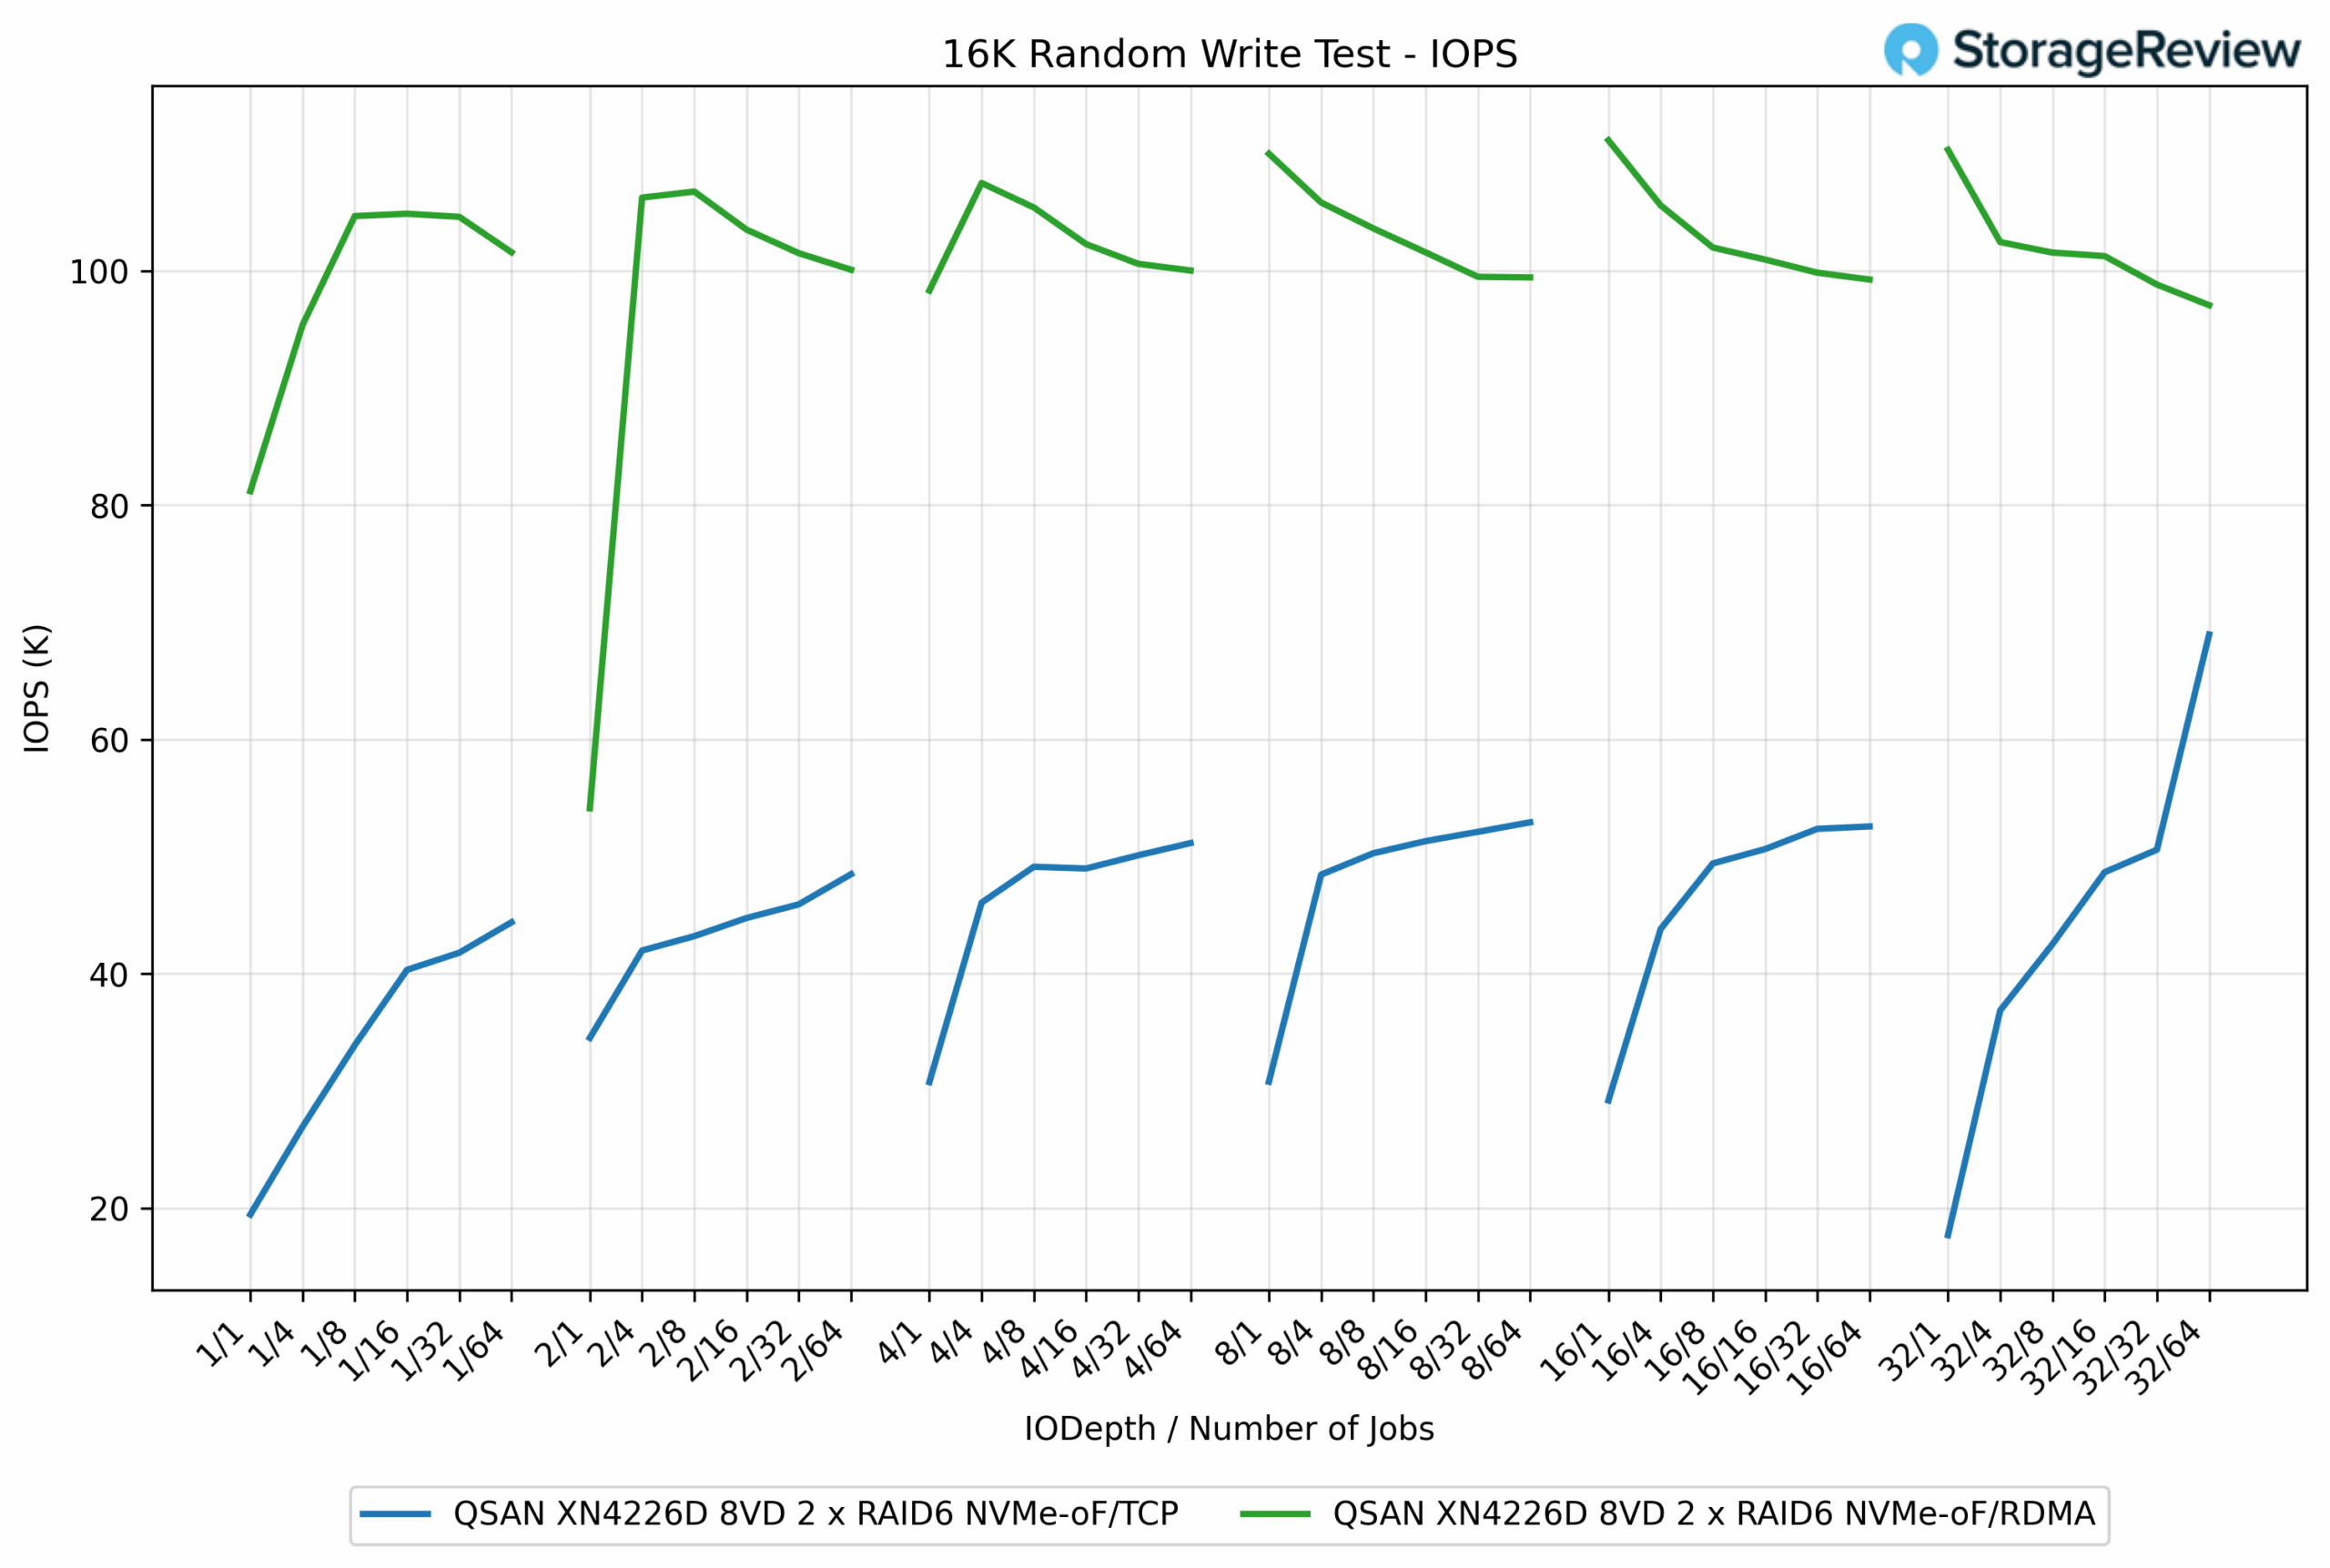
In de 16K Random Write-test was het prestatieverschil tussen de twee protocollen aanzienlijk, waarbij RDMA in de meeste gevallen meer dan het dubbele van de IOPS van TCP leverde. RDMA piekte op 111.13K IOPS, terwijl TCP uitkwam op 68.95K IOPS, wat neerkomt op een voordeel van 61% voor RDMA.
Bij lagere wachtrijdieptes was het verschil duidelijk zichtbaar. Zo bedroeg de RDMA-waarde bij QD1/16-taken 104.86K IOPS, vergeleken met 41.78K IOPS voor TCP, wat neerkomt op een toename van 151% ten gunste van RDMA. Over het gehele werklastbereik handhaafde RDMA consistent resultaten tussen 100K en 111K IOPS, terwijl TCP over het algemeen tussen 40K en 50K IOPS bleef, met uitzondering van een late piek op maximale diepte.
16K willekeurige schrijflatentie
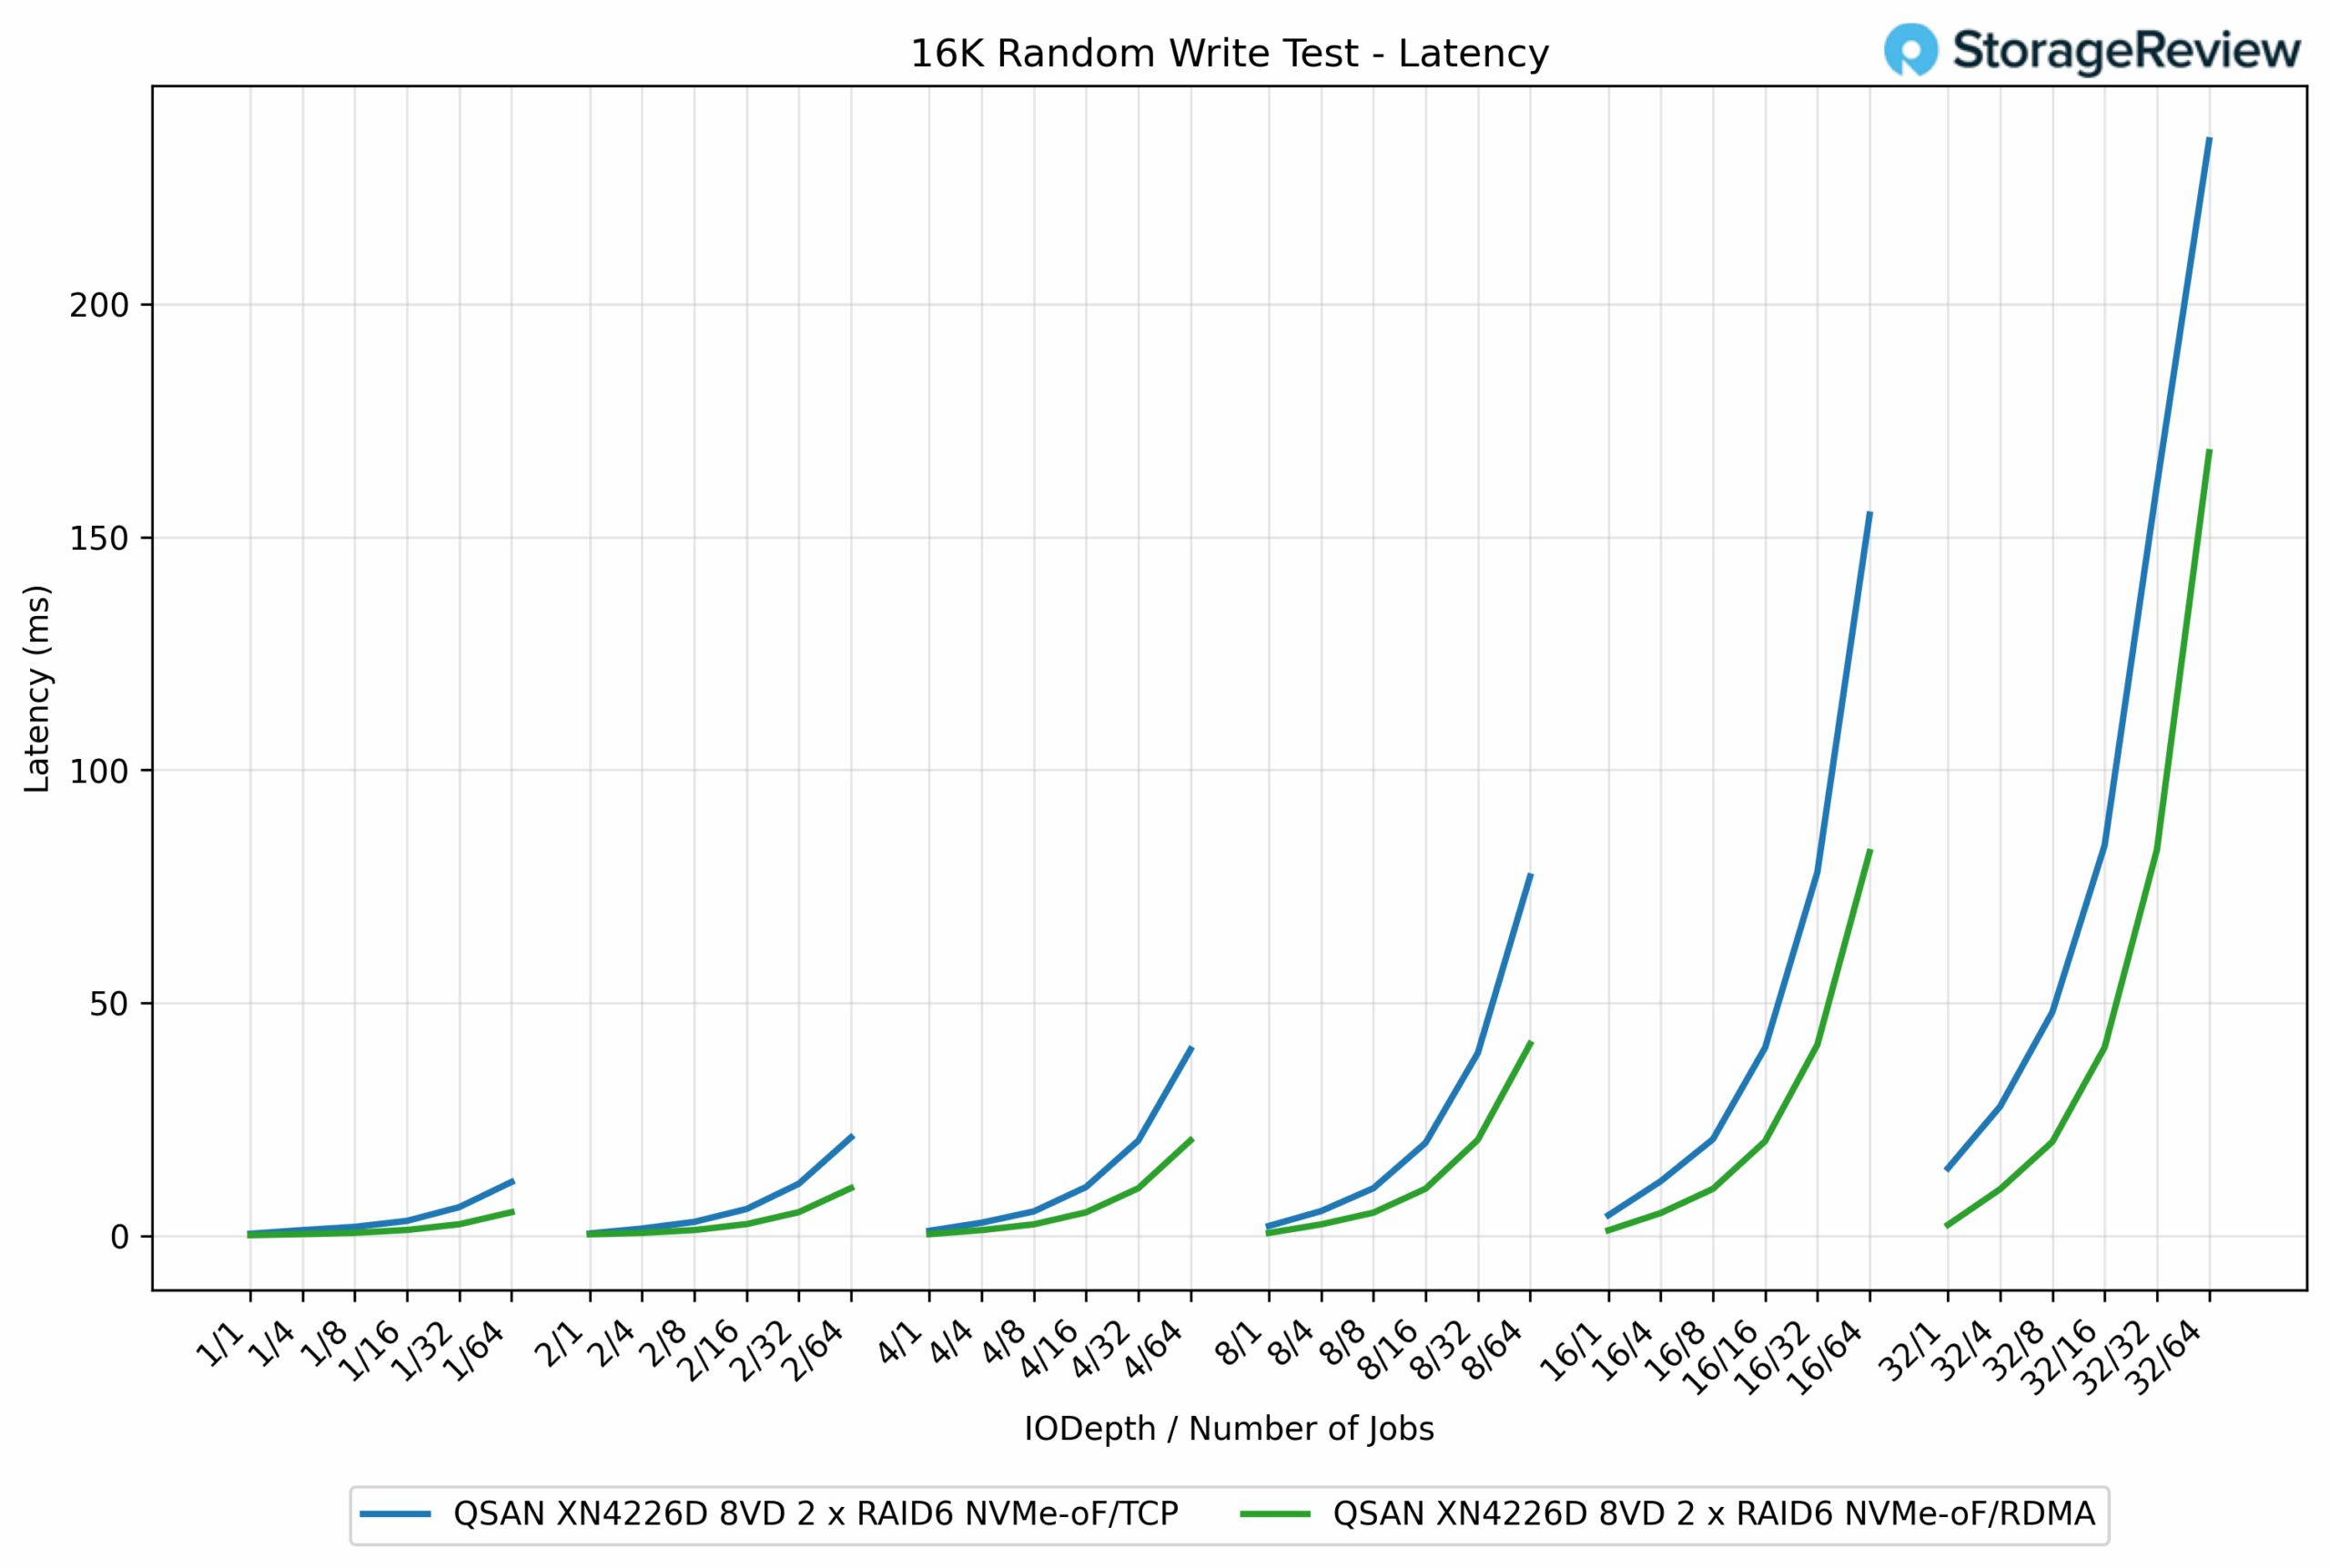
In de 16K Random Write-latentietest behield RDMA opnieuw een duidelijk voordeel ten opzichte van TCP naarmate de workloads toenamen. Bij lichtere belasting waren beide protocollen vrijwel identiek, met responstijden die onder de 2 ms bleven. Bij de QD1/1-taak bijvoorbeeld, bedroeg de TCP-tijd 0.40 ms, vergeleken met 0.41 ms voor RDMA.
Naarmate de gelijktijdigheid toenam, begon RDMA zich te splitsen. Bij QD16/64-jobs noteerde RDMA een tijd van 21.15 ms, terwijl TCP uitkwam op 77.12 ms, een dramatische afname van 72%. Dit voordeel bleef ook op de grootste dieptes bestaan. Bij QD32/64-jobs werd RDMA voltooid in 161.13 ms, vergeleken met 235.17 ms voor TCP, een verbetering van 31%.
16K willekeurig lezen IOPS
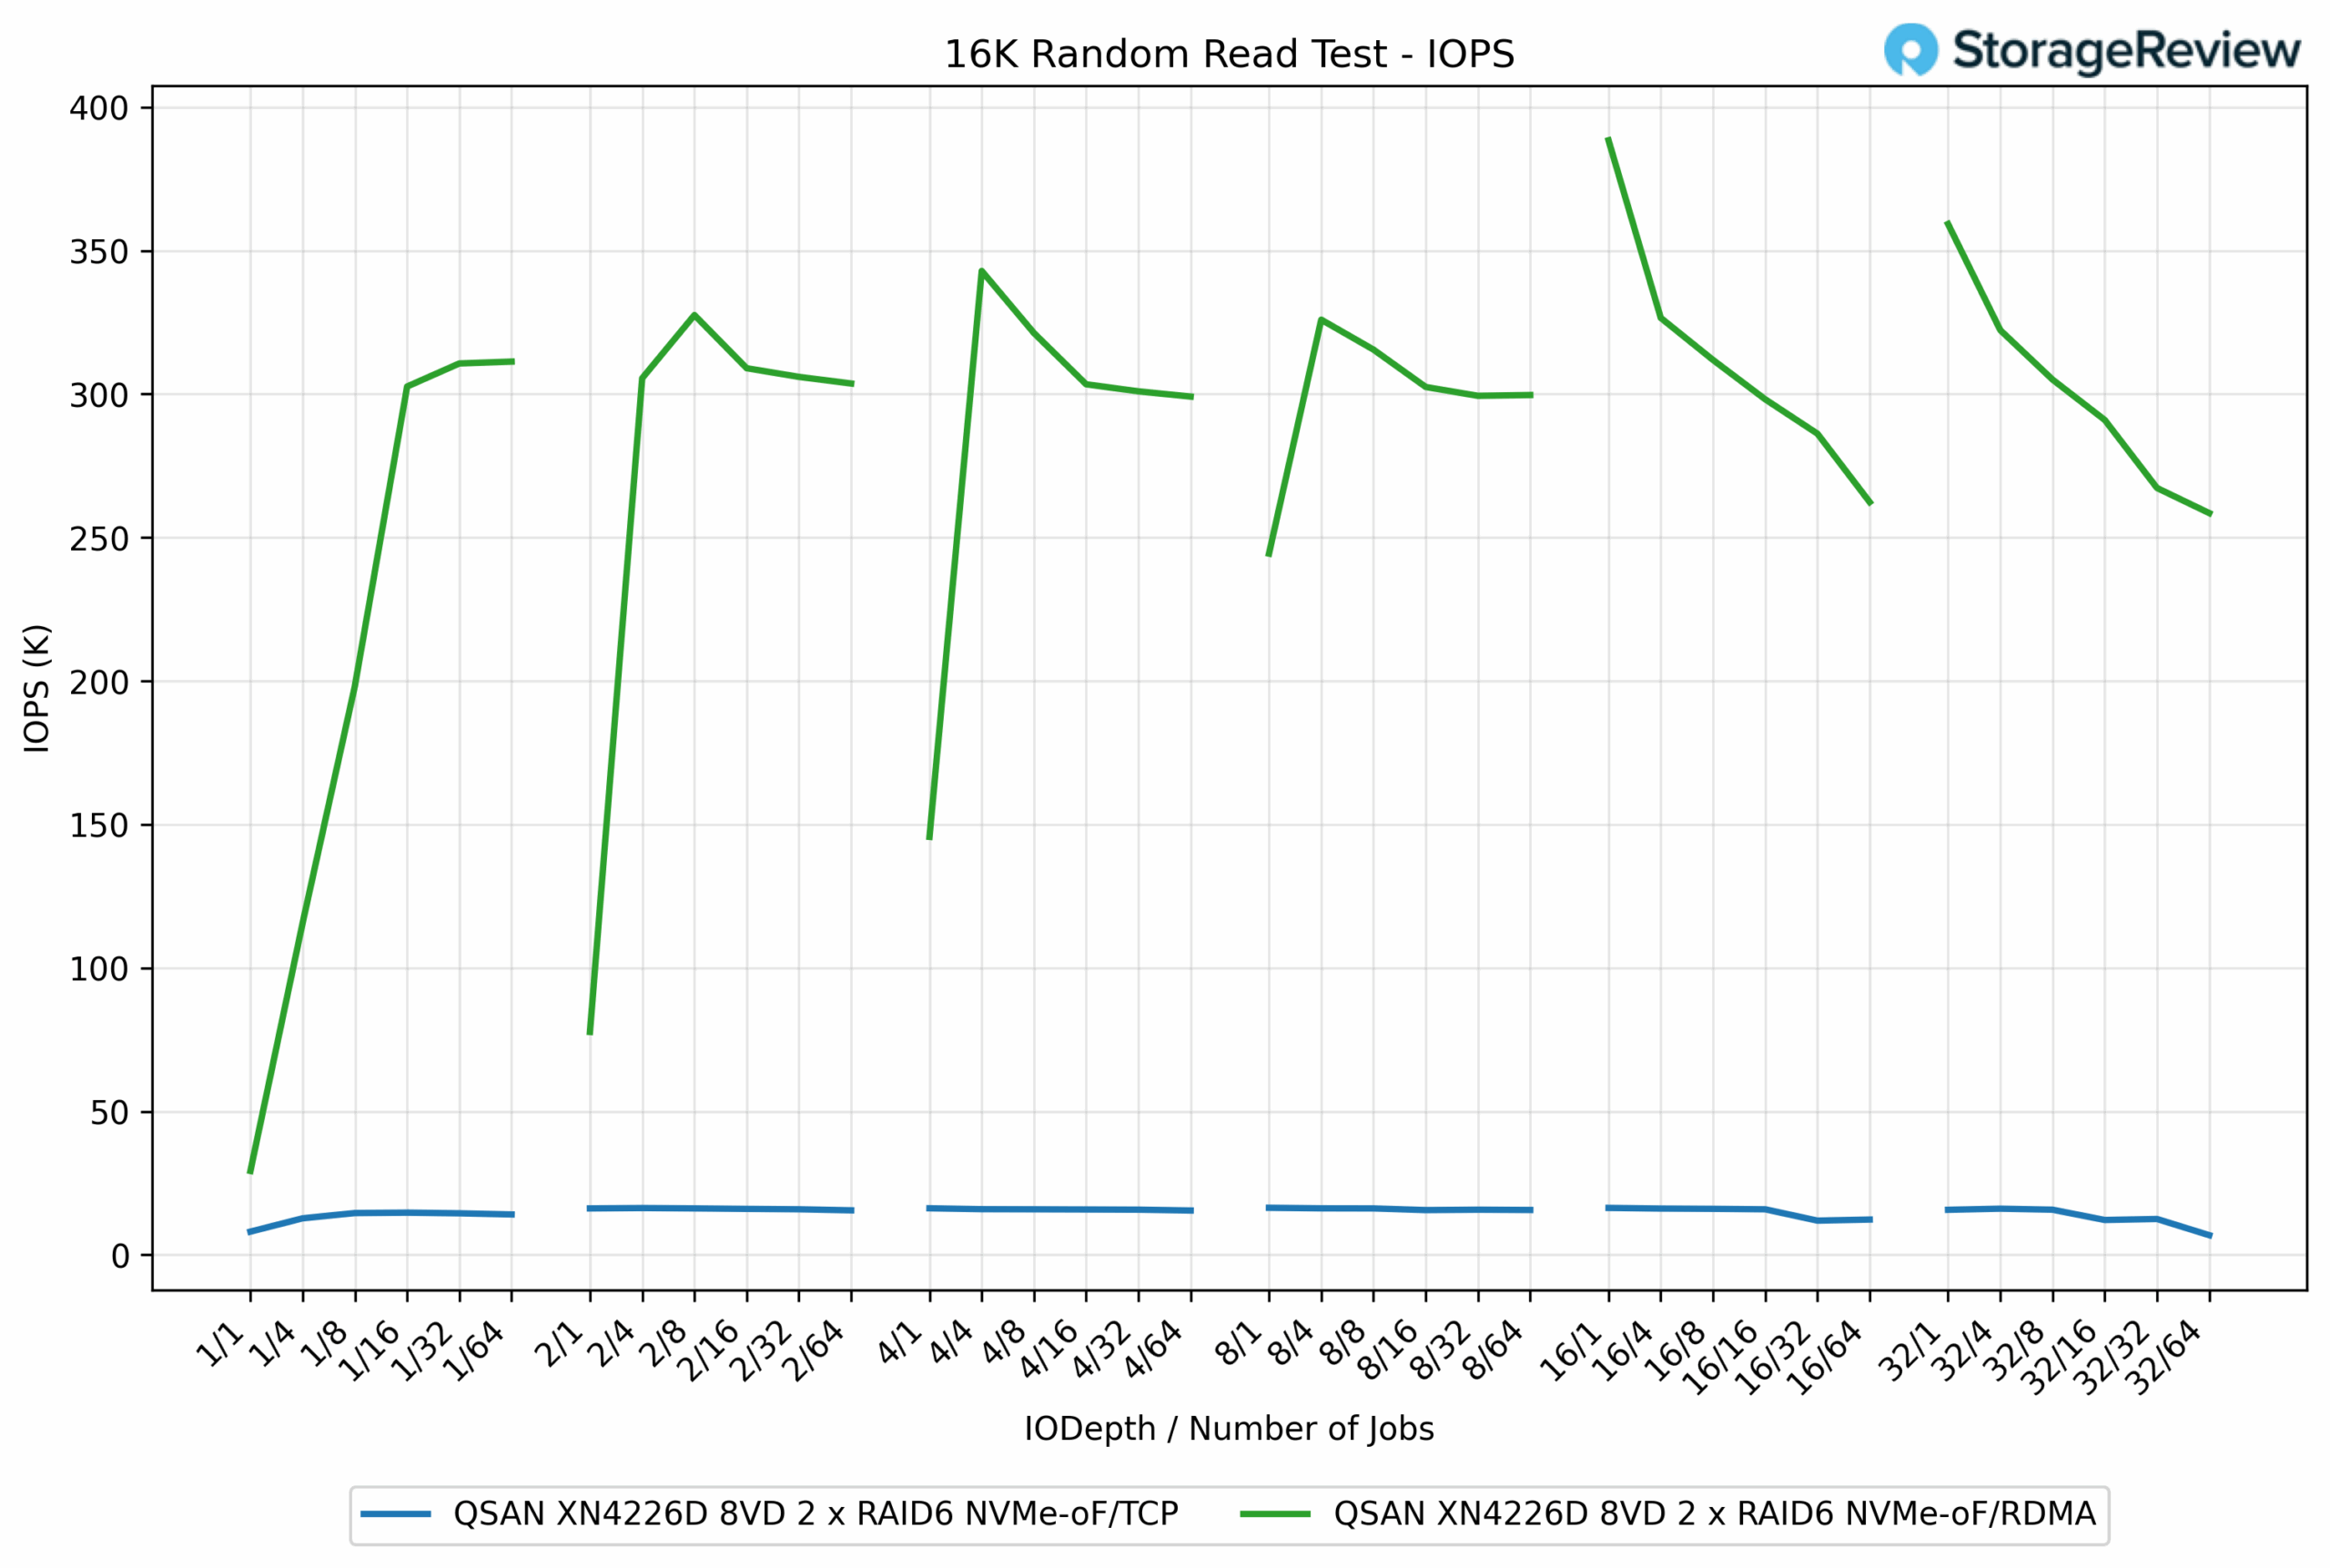
In de 16K Random Read-test overtrof RDMA TCP volledig over het gehele scala aan workloads. RDMA bereikte een piek van 388.44K IOPS, terwijl TCP uitkwam op slechts 16.42K IOPS, wat een voordeel van meer dan 23x voor RDMA aantoonde.
Het verschil was vanaf het begin zichtbaar. Bij de QD1/1-taak leverde RDMA 29.27K IOPS, terwijl TCP slechts 8.10K IOPS haalde. Naarmate de gelijktijdigheid toenam, schaalde RDMA snel op naar het bereik van 300K tot 380K IOPS, terwijl TCP rond de 15K tot 16K IOPS bleef, zelfs bij hogere wachtrijdieptes.
16K willekeurige leeslatentie
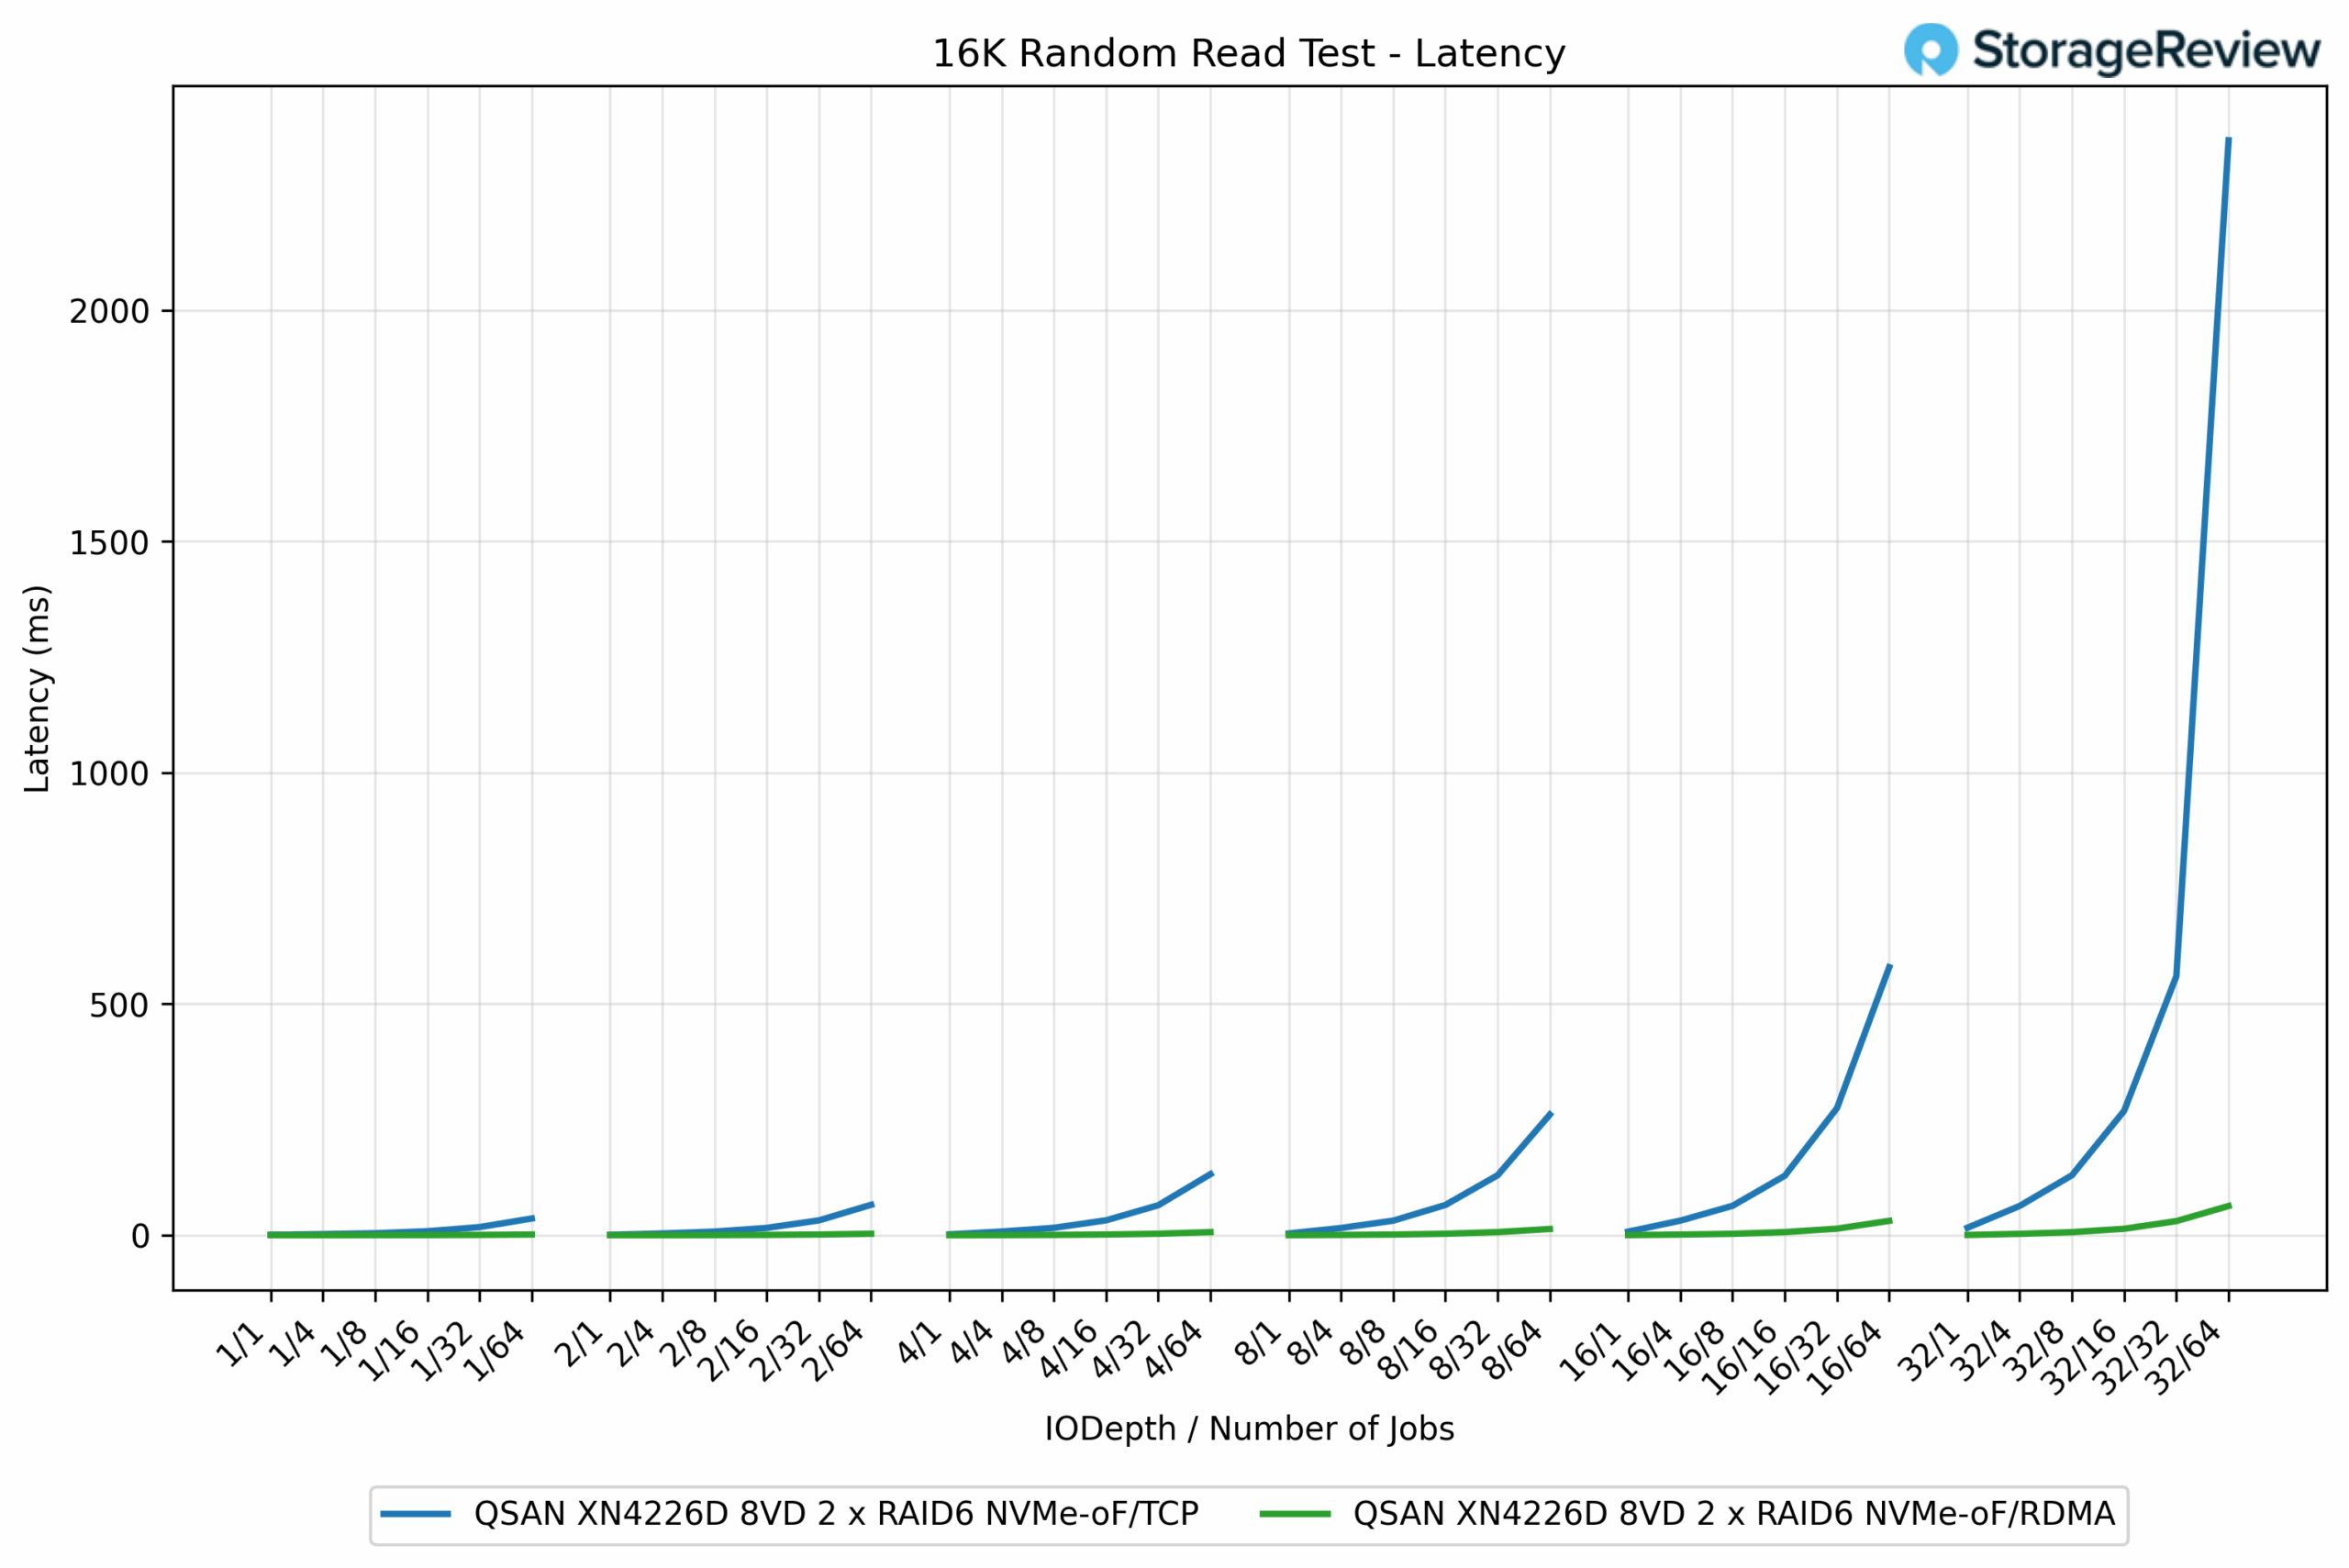
In de 16K Random Read-latentietest was het verschil tussen RDMA en TCP dramatisch, wat overeenkwam met de IOPS-resultaten. Bij lichte workloads waren de twee protocollen vrijwel identiek, met latenties variërend van 1 tot 10 ms.
Naarmate de workloads toenamen, hield RDMA de latentie goed onder controle, terwijl TCP aanzienlijk verslechterde. Bij Q8/64-taken bedroeg de RDMA-tijd 13.65 ms, vergeleken met 260.90 ms voor TCP, een verbetering van bijna 19x. Uiteindelijk voltooiden QD32/64-taken de RDMA in 63.28 ms, terwijl TCP er 2,366.99 ms over deed, bijna 37 keer langer.
4K willekeurig schrijven IOPS
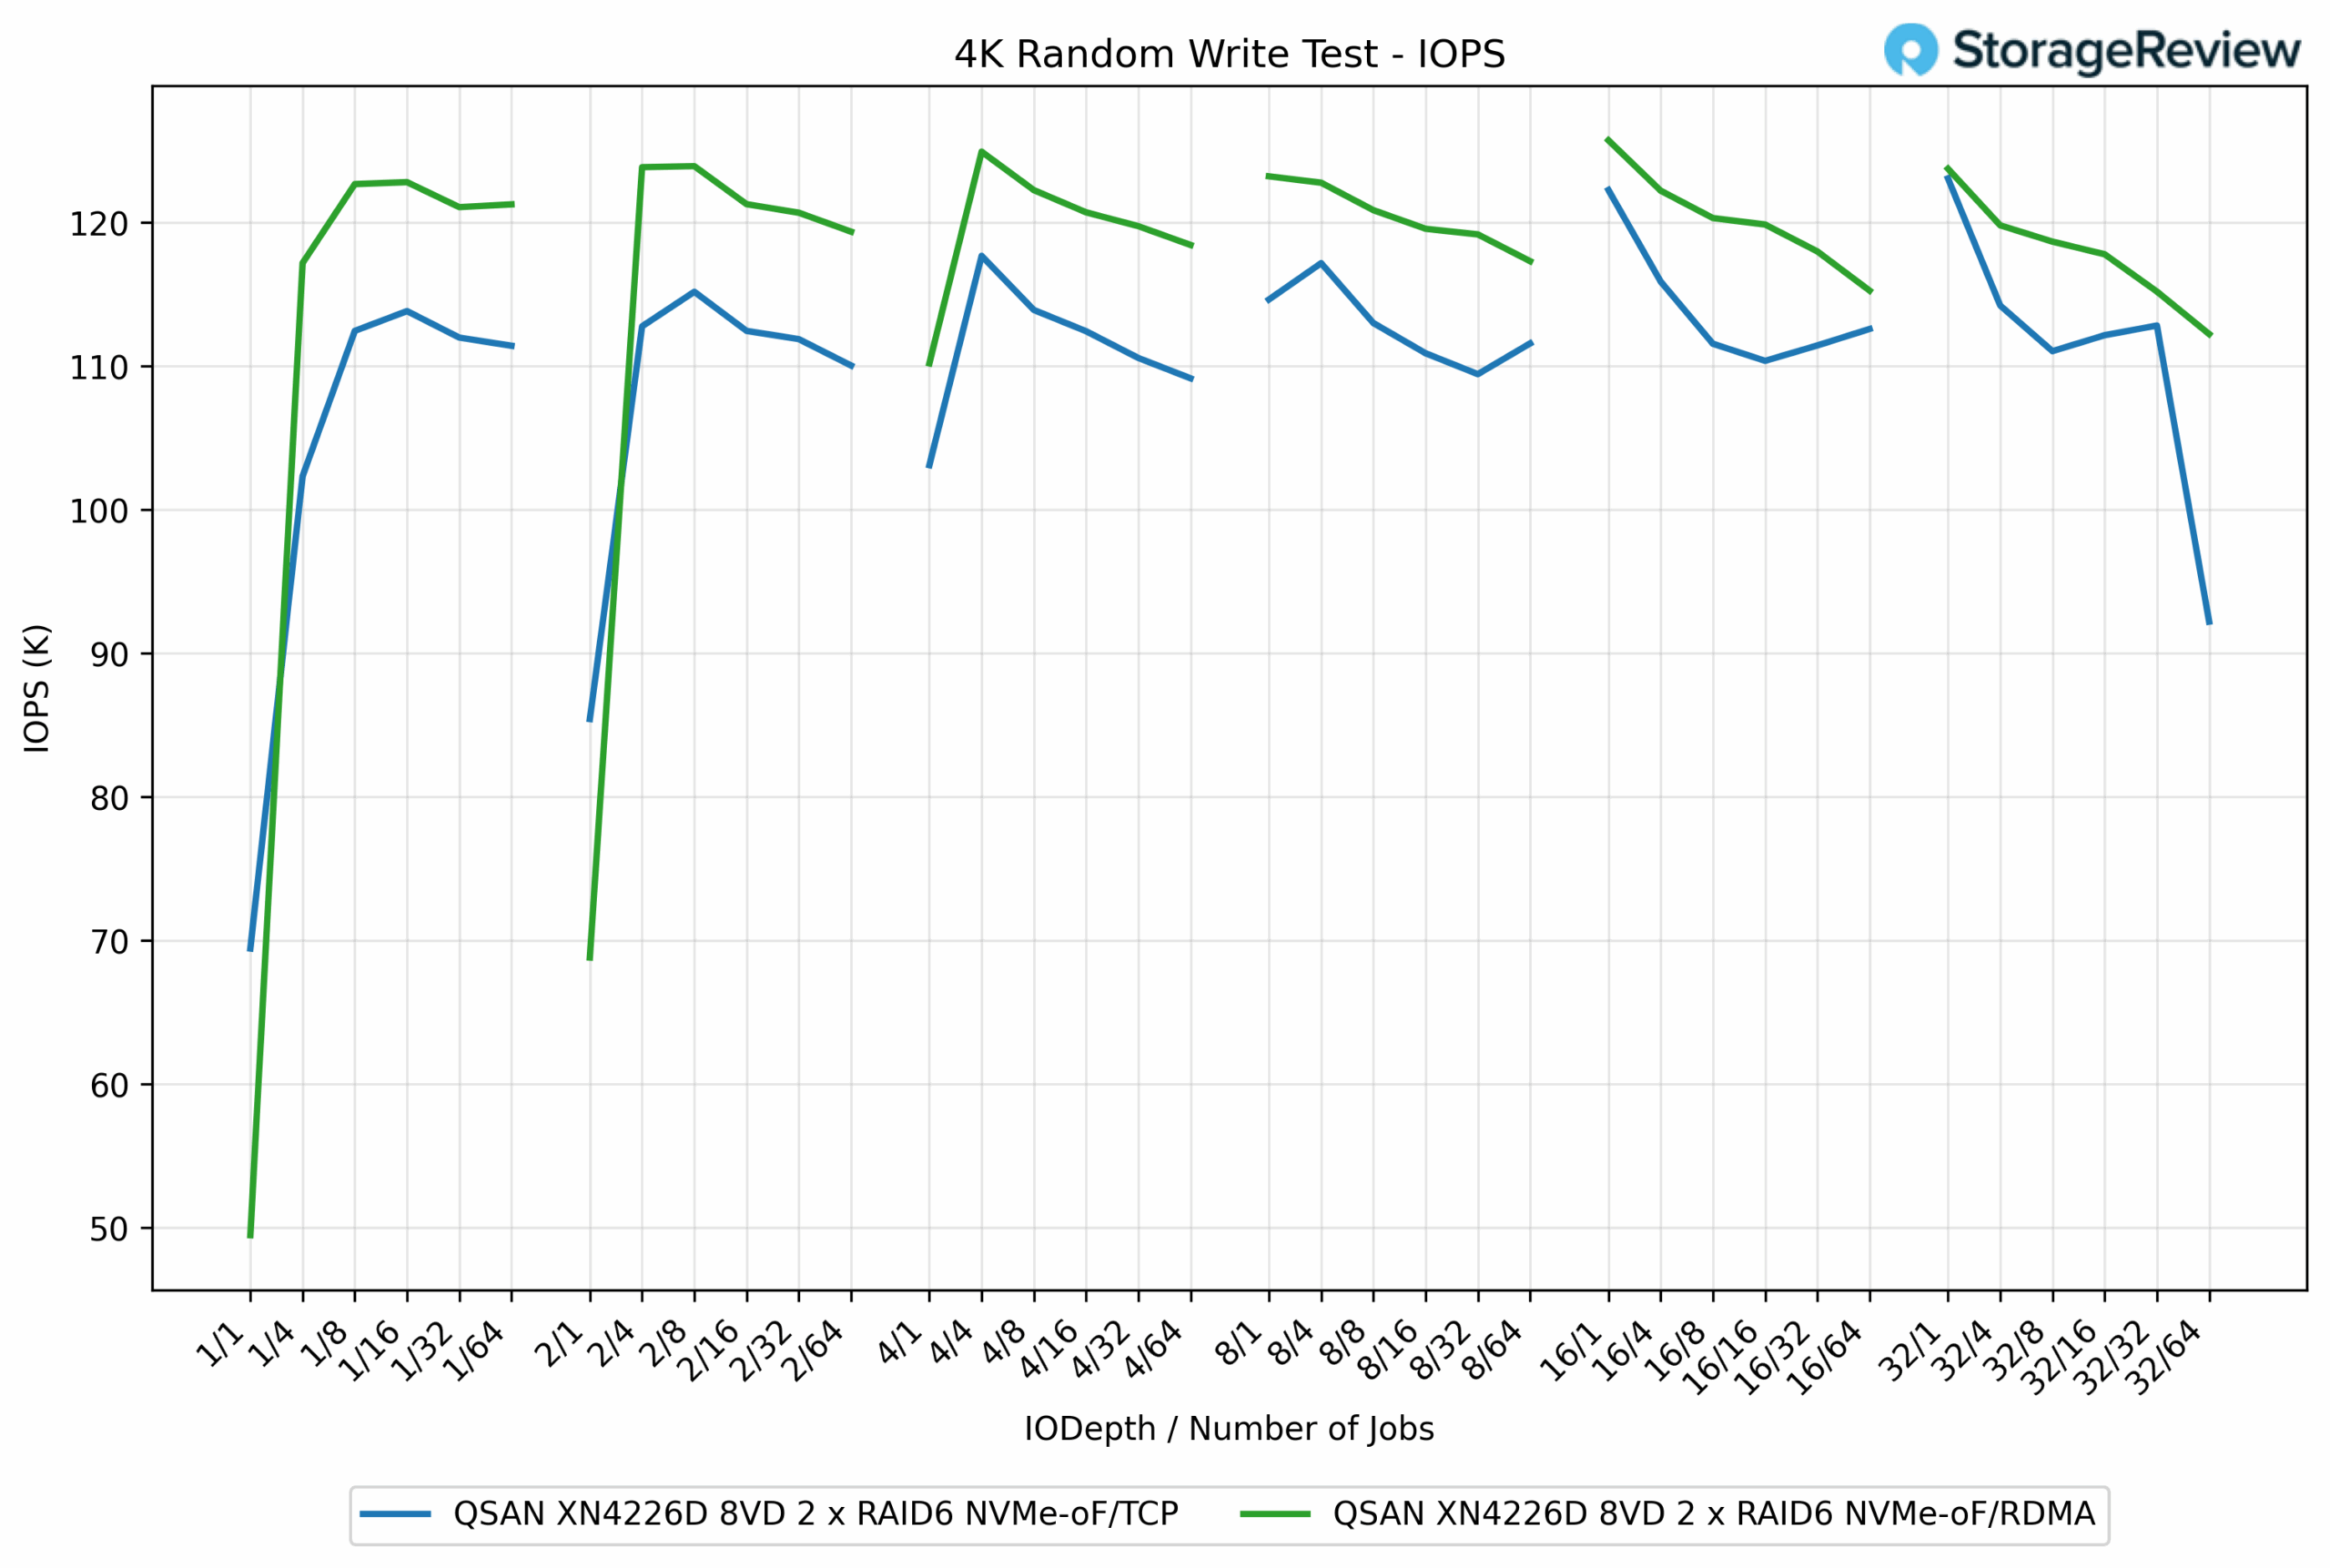
In de 4K Random Write-test presteerde RDMA consistent beter dan TCP, hoewel de marge kleiner was in vergelijking met de grotere blokgroottes. RDMA bereikte een piek van 125.73K IOPS, terwijl TCP 115.89K IOPS bereikte, wat resulteerde in een voordeel van ongeveer 8.5% voor RDMA.
Bij lagere wachtrijdieptes bleef TCP iets achter bij RDMA, maar leverde nog steeds concurrerende prestaties. Zo behaalde RDMA bij QD1/16-taken 122.82K IOPS, vergeleken met TCP's 111.91K IOPS, een verbetering van bijna 10%. Op de meeste testpunten schommelde RDMA tussen de 120K en 125K IOPS, terwijl TCP de resultaten tussen de 110K en 116K IOPS handhaafde, met een late daling bij QD32/64-taken naar 92.21K IOPS.
4K willekeurige schrijflatentie
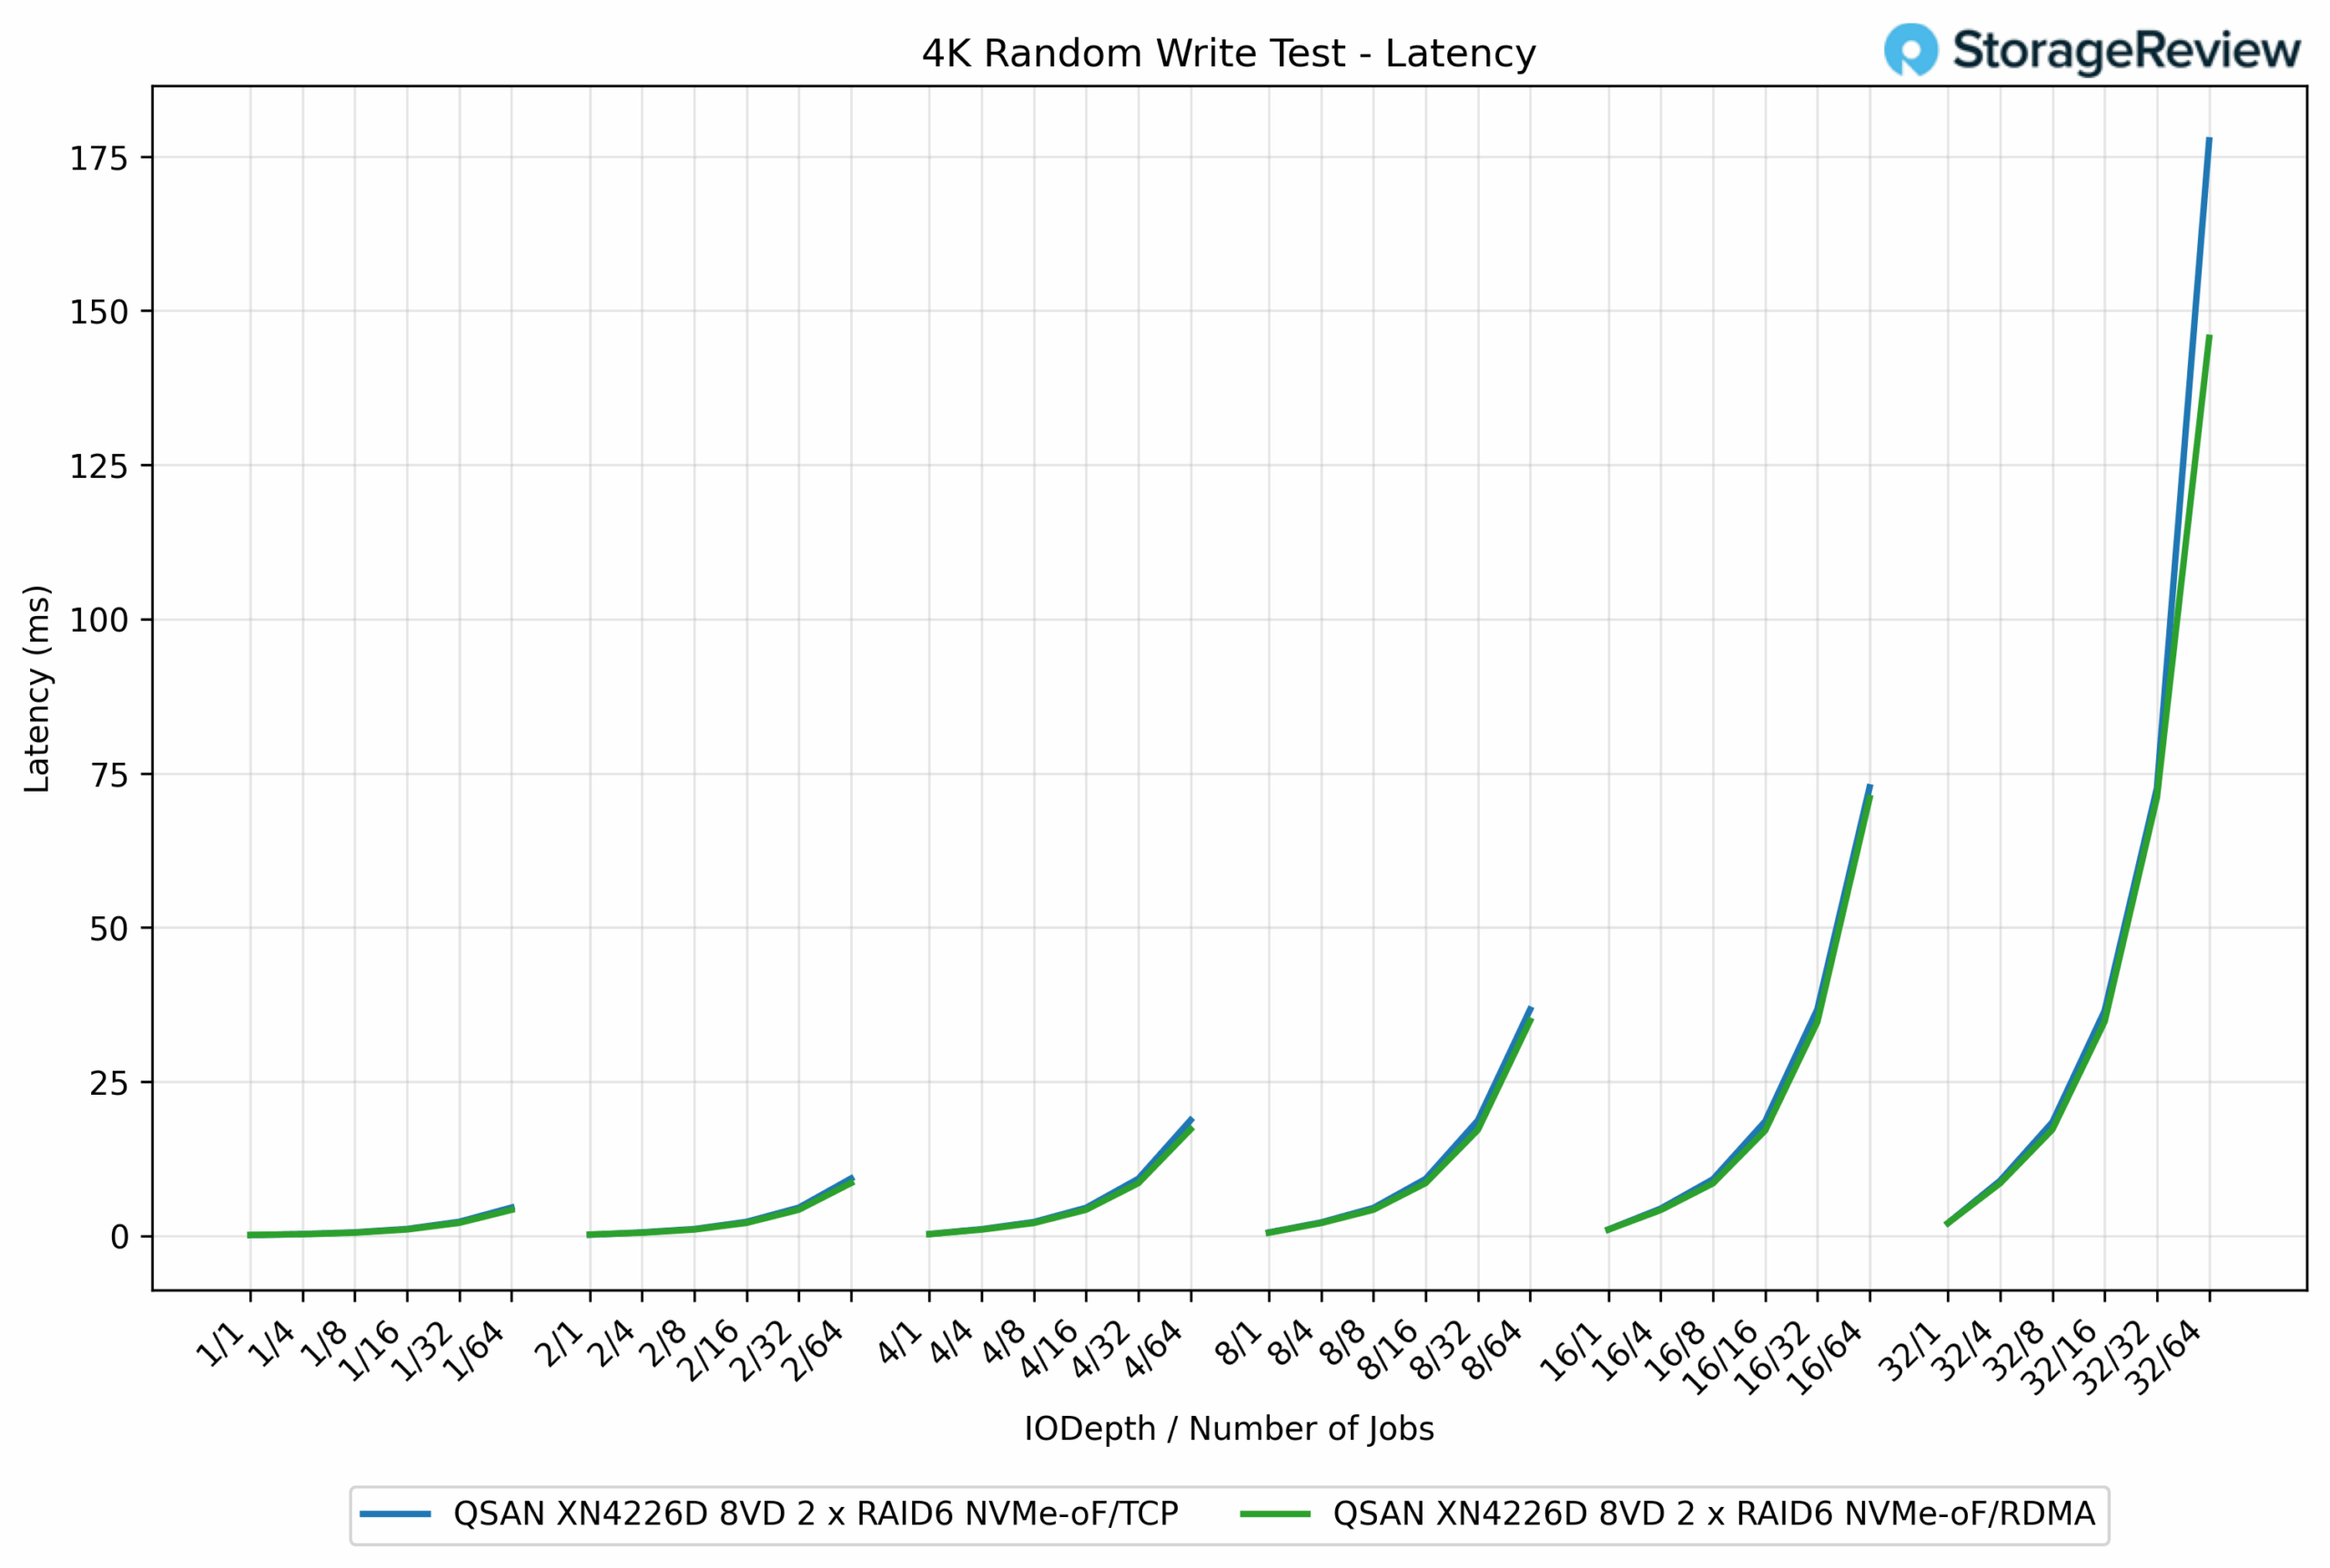
In de 4K Random Write-latentietest liet RDMA consistent lagere responstijden zien dan TCP, hoewel de marges kleiner waren in vergelijking met de grotere blokbelastingen. Bij lichtere belastingen waren beide protocollen vrijwel identiek en bleven ze allebei onder de 1 ms. Bij QD1/1 bedroeg de TCP-tijd bijvoorbeeld 0.16 ms, terwijl RDMA uitkwam op 0.21 ms.
Naarmate de gelijktijdigheid toenam, werden de verschillen duidelijker. Bij QD16/64-jobs registreerde RDMA 19.36 ms, vergeleken met 36.20 ms voor TCP, wat een latentiereductie van 46% opleverde. Op maximale diepte werd RDMA voltooid met 145.61 ms, terwijl TCP steeg tot 177.62 ms, een verbetering van 22% voor RDMA.
4K willekeurig lezen IOPS
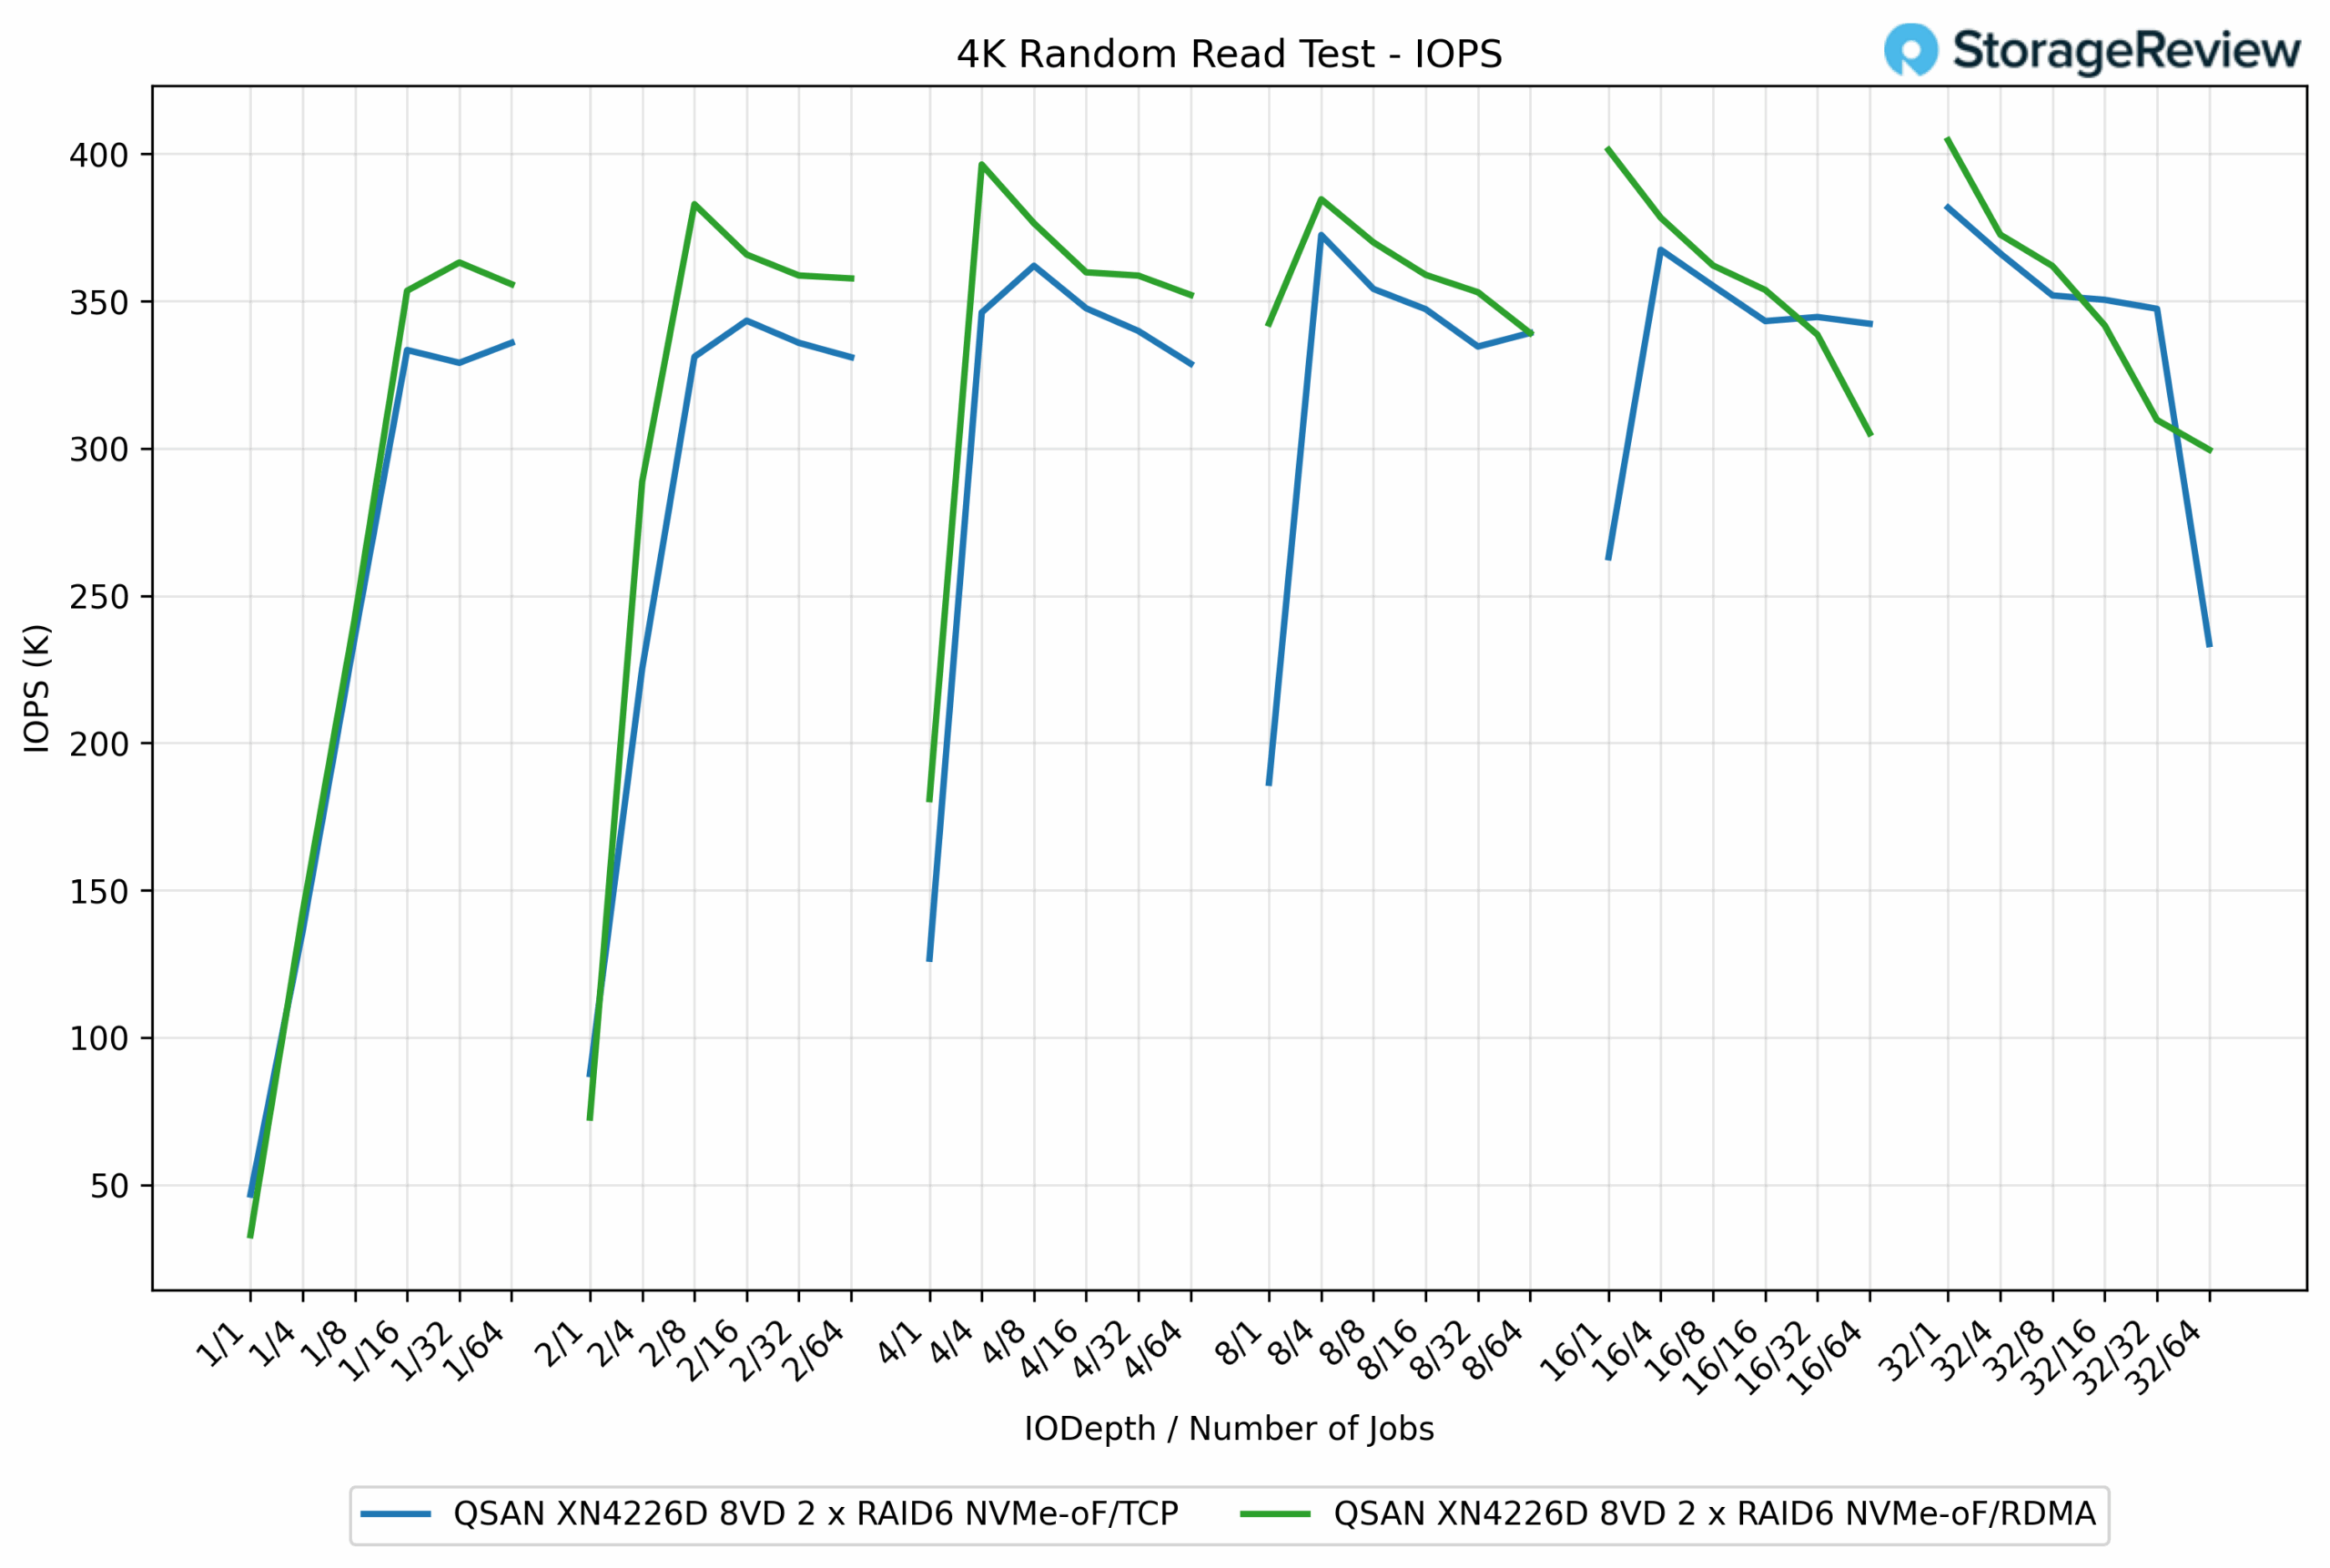
In de 4K Random Read-test leverden beide protocollen sterke prestaties, hoewel RDMA consistent een lichte voorsprong op TCP had. RDMA bereikte een piek van 404.64K IOPS, terwijl TCP uitkwam op 382.96K IOPS, wat RDMA een voordeel van 5.7% opleverde.
Op lagere dieptes waren de resultaten al in het voordeel van RDMA. Zo behaalde RDMA bij QD1/16-taken 353.57K IOPS, vergeleken met 329.10K IOPS voor TCP, een verschil van ongeveer 7.5%. Naarmate de workloads toenamen, behield RDMA zijn voorsprong, met doorgaans snelheden tussen 360K en 400K IOPS, terwijl TCP dichter bij 330K en 380K IOPS bleef.
4K willekeurige leeslatentie
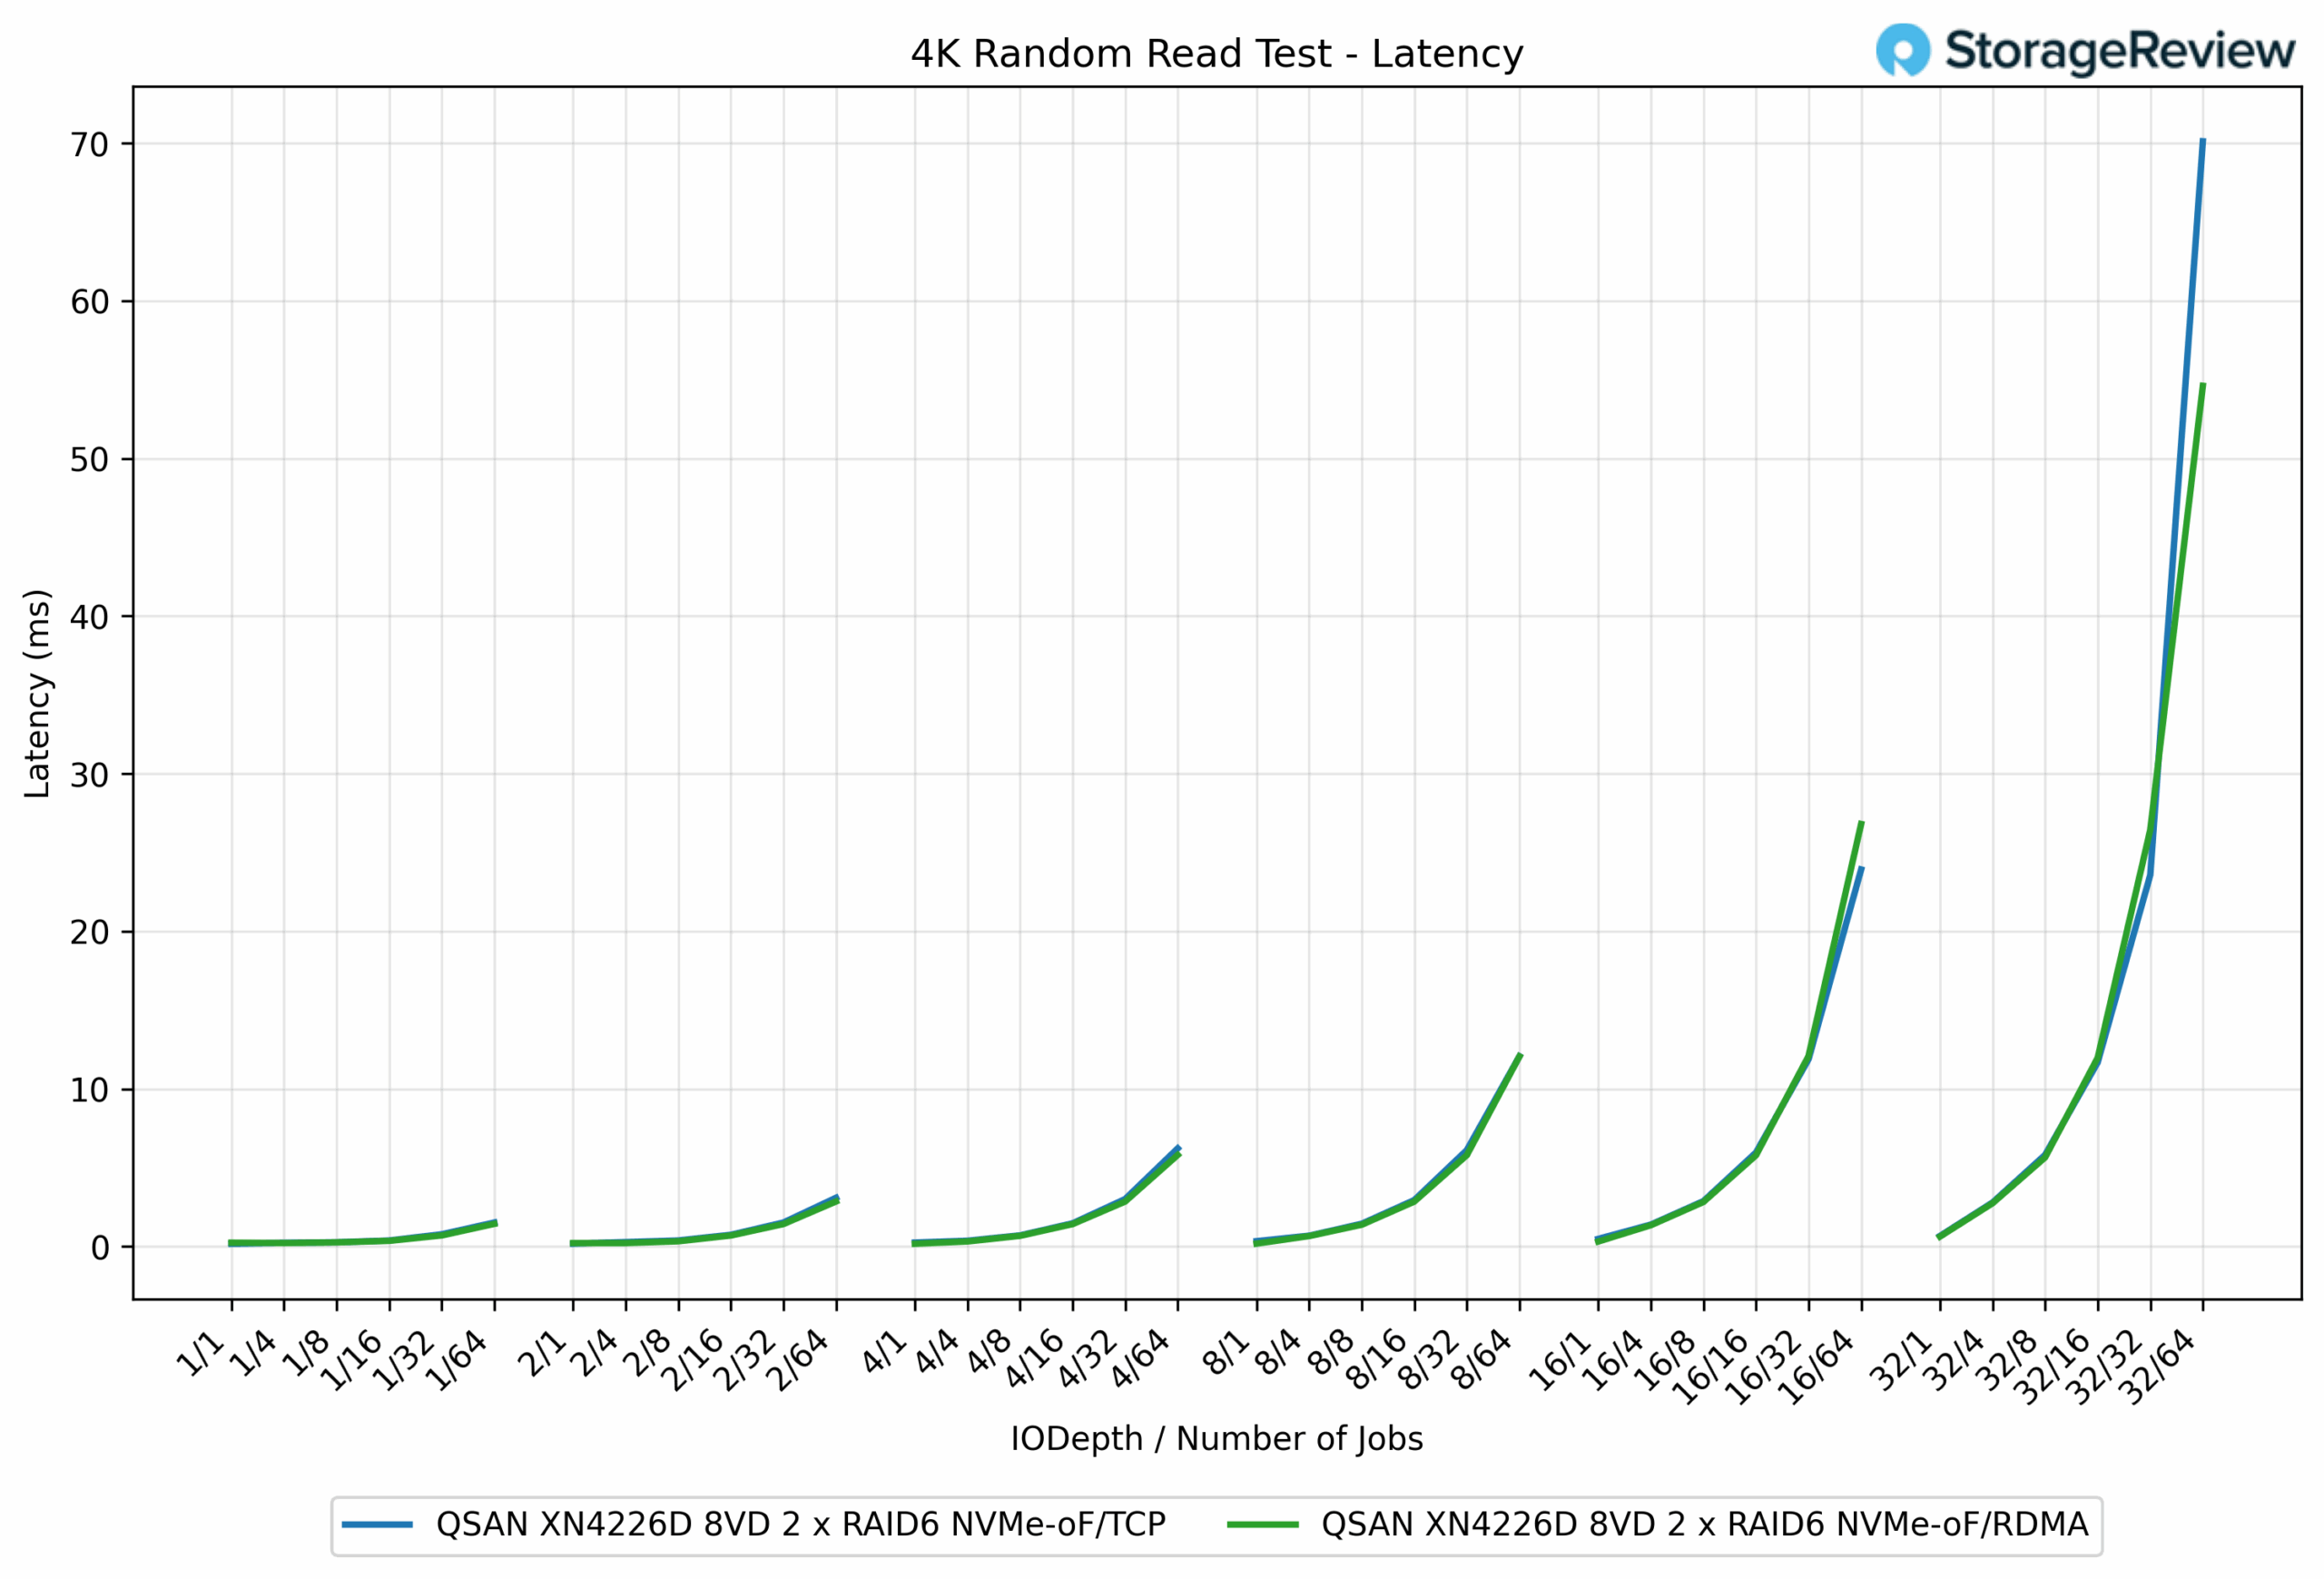
In de 4K Random Read-latentietest toonde RDMA een duidelijk efficiëntievoordeel ten opzichte van TCP, met name naarmate de workloads toenamen. Bij lage wachtrijdieptes waren de twee protocollen vrijwel identiek. Bij de QD1/1-taak noteerde TCP bijvoorbeeld een tijd van 0.24 ms, terwijl RDMA er net achter zat met 0.27 ms.
Naarmate de gelijktijdigheid toenam, nam RDMA een voorsprong. Bij QD16/64-taken bedroeg de RDMA-tijd 23.92 ms, terwijl TCP uitkwam op 26.81 ms, een verbetering van 10.8%. Bij de hoogste belasting van QD32/64-taken werd RDMA voltooid in 54.61 ms, terwijl TCP opliep tot 70.12 ms, een reductie van 22% in de latentie voor RDMA.
GPUDirect-opslagprestaties
Een van de tests die we op deze testbank hebben uitgevoerd, was de Magnum IO GPUDirect Storage (GDS)-test. GDS is een door NVIDIA ontwikkelde functie waarmee GPU's de CPU kunnen omzeilen bij het benaderen van gegevens die zijn opgeslagen op NVMe-schijven of andere snelle opslagapparaten. In plaats van gegevens via de CPU en het systeemgeheugen te routeren, maakt GDS directe communicatie tussen de GPU en het opslagapparaat mogelijk, wat de latentie aanzienlijk vermindert en de gegevensdoorvoer verbetert.
Hoe GPUDirect-opslag werkt
Traditioneel, wanneer een GPU gegevens verwerkt die zijn opgeslagen op een NVMe-schijf, moeten de gegevens eerst door de CPU en het systeemgeheugen reizen voordat ze de GPU bereiken. Dit proces creëert knelpunten, omdat de CPU als tussenpersoon fungeert, wat latentie verhoogt en waardevolle systeembronnen verbruikt. GPUDirect Storage elimineert deze inefficiëntie door de GPU in staat te stellen gegevens rechtstreeks vanaf het opslagapparaat te benaderen via de PCIe-bus. Dit directe pad vermindert de overhead die gepaard gaat met gegevensverplaatsing, wat zorgt voor snellere en efficiëntere gegevensoverdracht.
AI-workloads, met name die met deep learning, zijn zeer data-intensief. Het trainen van grote neurale netwerken vereist de verwerking van terabytes aan data, en elke vertraging in de dataoverdracht kan leiden tot onderbenutting van GPU's en langere trainingstijden. GPUDirect Storage pakt deze uitdaging aan door ervoor te zorgen dat data zo snel mogelijk naar de GPU wordt verzonden, waardoor inactieve tijd wordt geminimaliseerd en de rekenefficiëntie wordt gemaximaliseerd.
Bovendien is GDS met name gunstig voor workloads die het streamen van grote datasets omvatten, zoals videoverwerking, natuurlijke taalverwerking of realtime-inferentie. Door de afhankelijkheid van de CPU te verminderen, versnelt GDS de databeweging en maakt CPU-bronnen vrij voor andere taken, wat de algehele systeemprestaties verder verbetert.
Naast de ruwe bandbreedte levert GPUDirect met NVMe-oF (TCP/RDMA) ook I/O met extreem lage latentie. Dit zorgt ervoor dat GPU's nooit een datatekort hebben, waardoor het systeem ideaal is voor realtime AI-inferencing, analysepijplijnen en videoherhaling.
Voor veel praktische implementaties vertaalt dit zich in een bruikbare doorvoer van 100–200 GbE, wat perfect aansluit bij workloads zoals AI-inferencing (2–4 GPU's), mediaproductie (herhaling van uitzendingen, OTT edge caching), videoanalyse van bewakingsbeelden en HPC-controlepunten.
Lees doorvoer
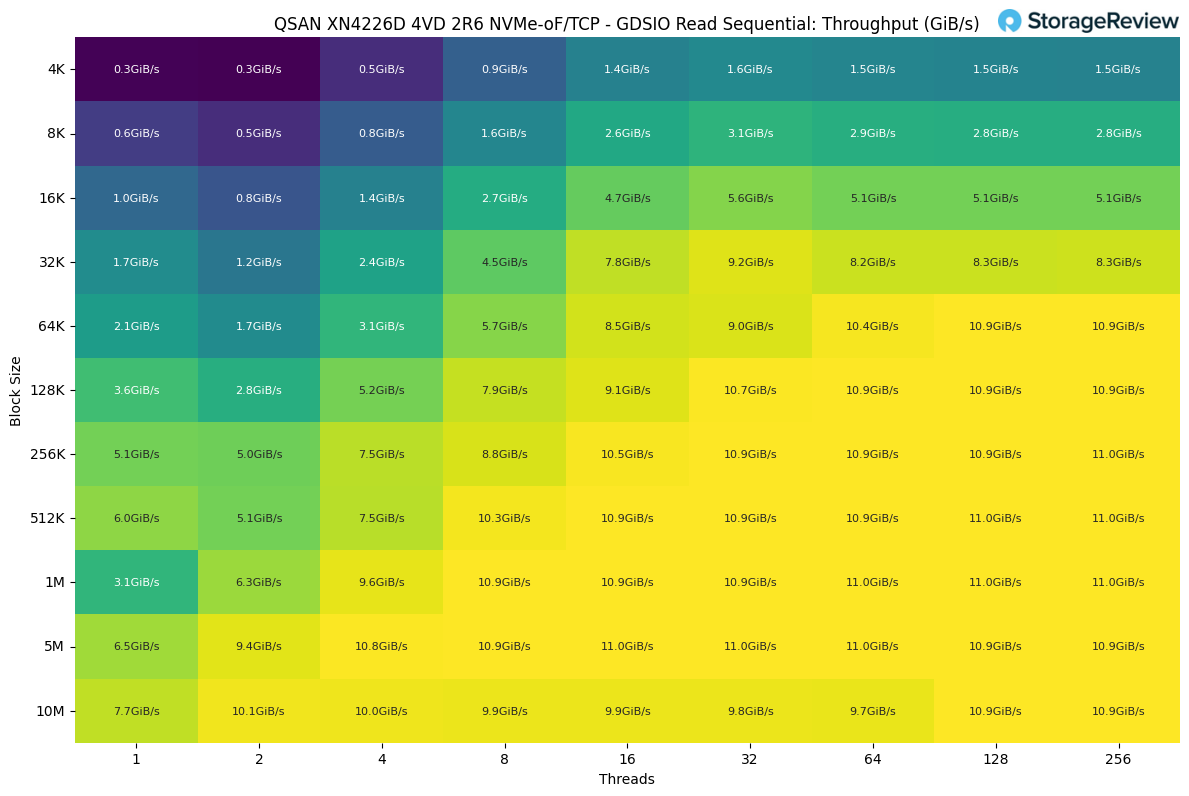
In de GDSIO Sequential Read-workload schaalde de doorvoer gestaag met zowel de blokgrootte als het aantal threads, en bereikte een maximum van 11.0 GiB/s over meerdere testpunten. De hoogste resultaten werden gehandhaafd zodra de blokgroottes 512K en hoger bereikten, waarbij de doorvoer consistent stabiliseerde tussen 10.9 en 11.0 GiB/s, ongeacht het aantal threads.
Bij kleinere blokgroottes begonnen de prestaties veel lager. Bij 4K-blokken bijvoorbeeld, begon de doorvoer bij slechts 0.3 GiB/s met één thread en stabiliseerde deze zelfs bij 256 threads op 1.5 GiB/s. Ter vergelijking: door de blokgrootte te vergroten naar 64K kon het systeem opschalen naar 10.9 GiB/s, waardoor de doorvoer bij hogere threadaantallen bijna verzadigd raakte.
De ideale bandbreedte bleek te liggen tussen 128K en 256K blokken, waarbij de doorvoer 10 GiB/s overschreed met 32 of meer threads en consistent bleef over de grootste geteste blokgroottes. Dit laat zien hoe het platform volledige bandbreedteverzadiging bereikt zodra de blokgroottes voldoende groot worden, met slechts incrementele winst boven 256K.
Lees Latency
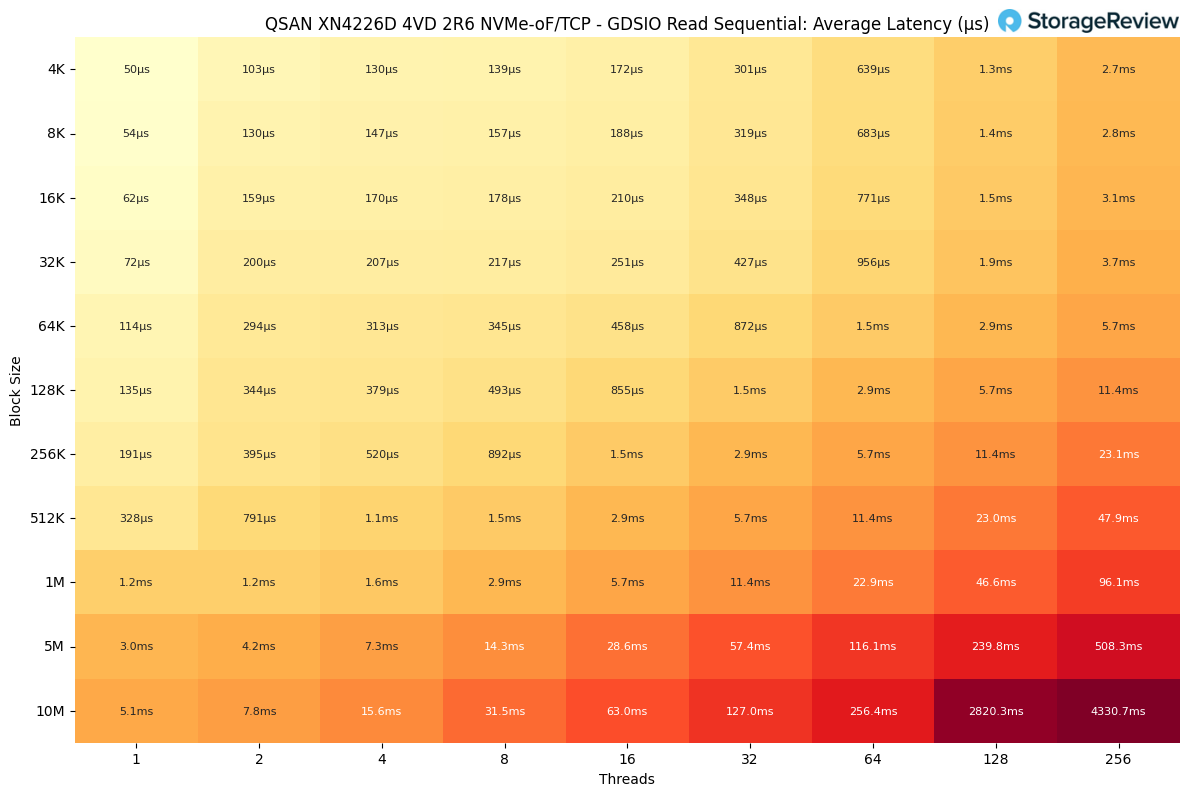
In de resultaten van de GDSIO Sequential Read-latentie schalen de responstijden voorspelbaar mee met zowel de blokgrootte als het aantal threads. Bij de kleinste workloads bleef de latentie extreem laag. Bijvoorbeeld, met 4K-blokken per thread bedroeg de latentie slechts 50 µs, en bleef onder de 200 µs tot 32K-blokgroottes met minimale gelijktijdigheid.
Naarmate het aantal threads toenam, begon de latentie merkbaarder te stijgen. Bij 64K-blokken en 64 threads bereikte de latentie 1.5 ms, verdubbelde tot 2.9 ms bij 128 threads en steeg tot 5.7 ms bij 256 threads. Kleinere blokgroottes, zoals 4K en 8K, daarentegen, bereikten slechts het bereik van 2.7–2.8 ms, zelfs bij de maximale 256 threads, wat een betere controle bij fijnere granulariteiten aantoonde.
Grotere blokgroottes zorgden voor dramatischere sprongen. Bij 1 miljoen blokken en 256 threads bereikte de latentie 96.1 ms, terwijl bij 10 miljoen blokken en 256 threads de latentie piekte tot 4.3 s, wat duidelijk de schaalbaarheidslimieten van het systeem onder extreme omstandigheden aantoonde.
Schrijf doorvoer
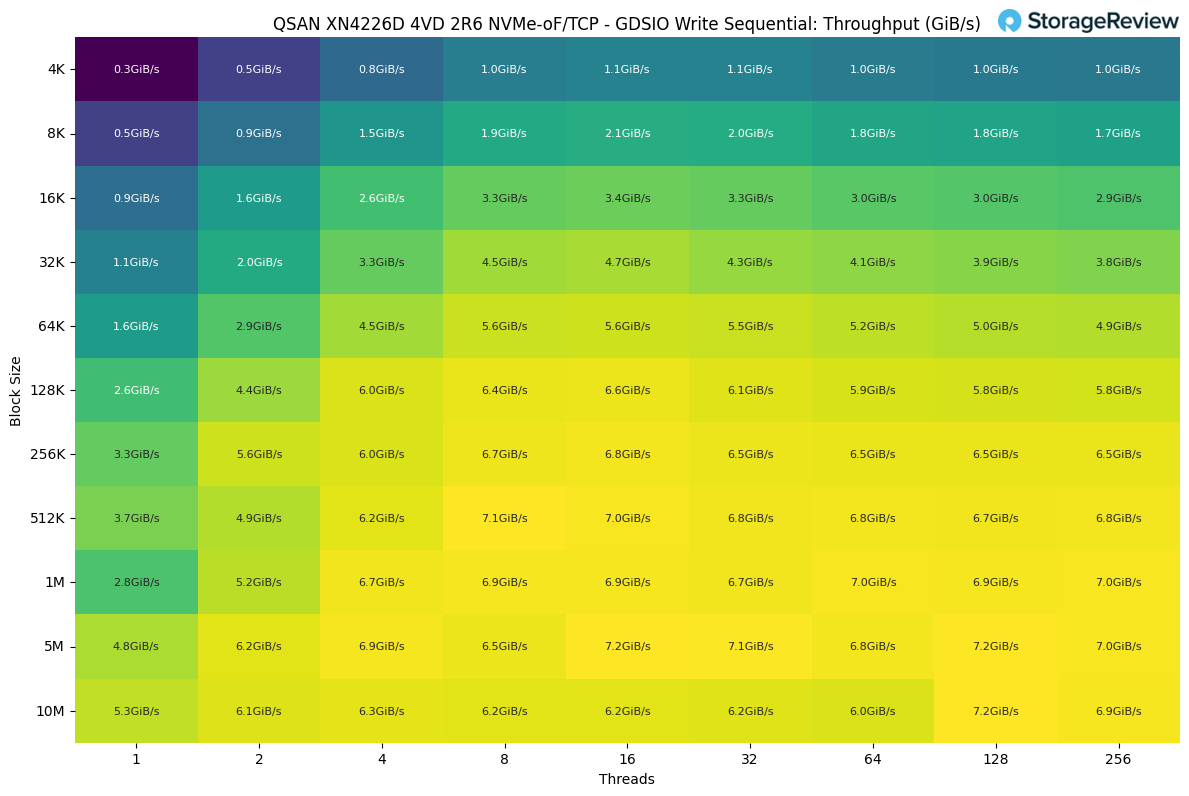
In de GDSIO Sequential Write-workload schaalde de doorvoer met zowel de blokgrootte als het aantal threads, maar bleef ruim onder het maximum voor leesprestaties. Het systeem bereikte een piek van 7.2 GiB/s bij gebruik van grotere blokgroottes, zoals 5M en 10M, met 128 threads.
Bij de kleinste blokgroottes was de doorvoer bescheiden. Met 4K-blokken begon de prestatie bij 0.3 GiB/s met één thread en schaalde op tot 1.0 GiB/s met 32 threads, waarna de snelheid stabiliseerde. Door de blokgrootte te vergroten tot 64K werd meer bandbreedte ontgrendeld, tot 5.6 GiB/s met acht threads, voordat deze licht afnam bij hogere gelijktijdigheid.
De beste balans werd bereikt rond de 512 tot 1 blokken, waarbij de doorvoersnelheid varieerde van 6.7 tot 7.1 GiB/s over verschillende threadaantallen. Dit geeft aan dat het systeem in dit bereik verzadigd is. Daarboven leverden extra threads geen noemenswaardige winst op en in sommige gevallen daalden de prestaties zelfs licht als gevolg van de toegenomen overhead.
Schrijflatentie
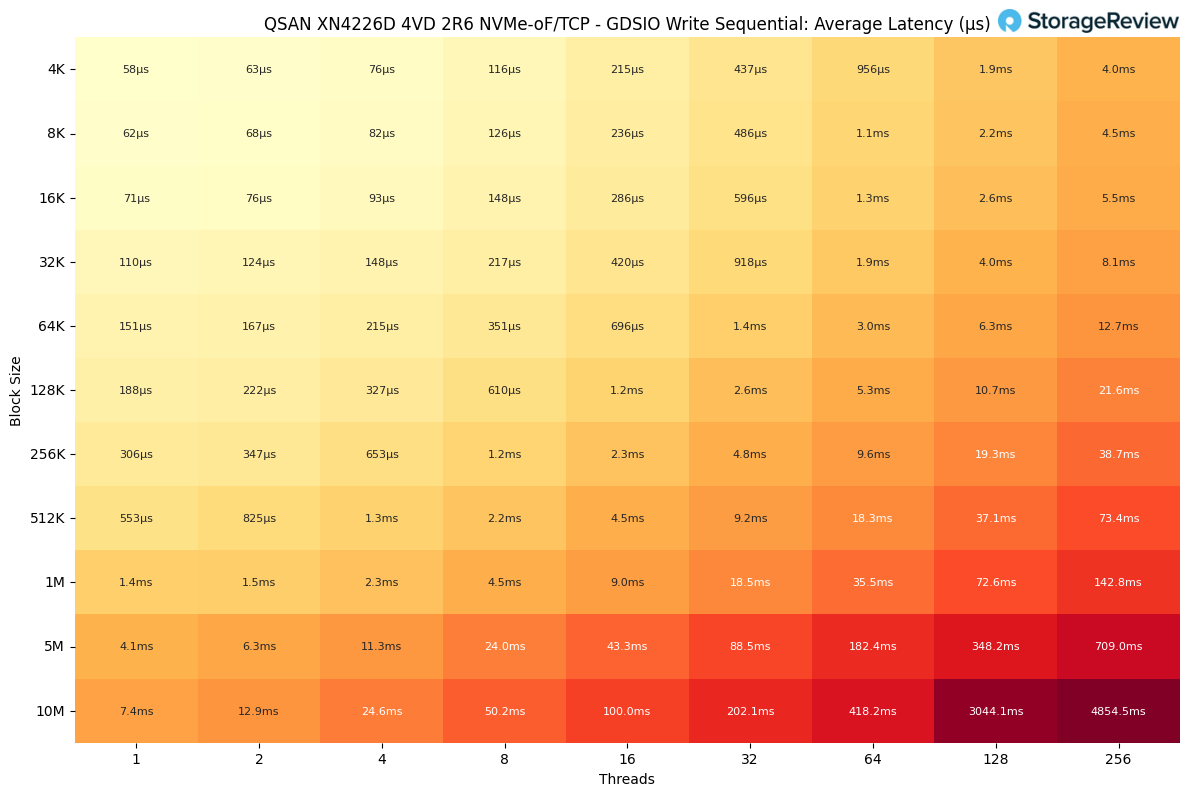
In de resultaten van de GDSIO Sequential Write-latentie schalen de responstijden soepel bij lagere blokformaten, maar nemen ze sterk toe zodra zowel de blokformaten als het aantal threads toenemen.
Bij de kleinste workloads was de latentie minimaal. Met 4K-blokken en één thread bedroeg de gemiddelde latentie slechts 58 µs en bleef onder de 200 µs bij 16K-blokken tot vier threads. Zelfs met 32K-blokken en matige gelijktijdigheid bleef de latentie onder de 1 ms.
Naarmate het systeem overging op grotere blokgroottes, werden de vertragingen groter. Bij 128 blokken en 64 threads bereikte de latentie 5.3 ms, om vervolgens te verdubbelen tot 10.7 ms bij 128 threads. Bij 512 blokken liepen de resultaten verder op, tot 73.4 ms bij 256 threads.
De zwaarste gevallen, 5M en 10M blokken bij 256 threads, ervoeren een dramatische piek in latentie tot respectievelijk 709 ms en 4.8 seconden, waarmee de bovengrenzen van sequentiële schrijfschaling werden onthuld.
Conclusie
De XN4226D van QSAN is precies wat veel IT-teams nodig hebben. Het is een uniform NVMe-platform met twee controllers dat zowel moderne als oudere protocollen ondersteunt zonder dat er architectuurwijzigingen nodig zijn. Tijdens onze tests leidde TCP tot grote sequentiële leesbewerkingen met 21.21 GB/s, terwijl RDMA de sterkste grote sequentiële schrijfbewerkingen produceerde met 11.14 GB/s en de latentie lager hield naarmate de gelijktijdigheid toenam. Bij kleinere blokgroottes verbeterde RDMA consistent de willekeurige schrijfefficiëntie en hield het tail-gedrag onder controle. De conclusie is simpel. Gebruik NVMe-oF TCP voor brede compatibiliteit en een hoge leesbandbreedte, en kies voor RDMA wanneer schrijflatentie en consistentie het belangrijkst zijn.
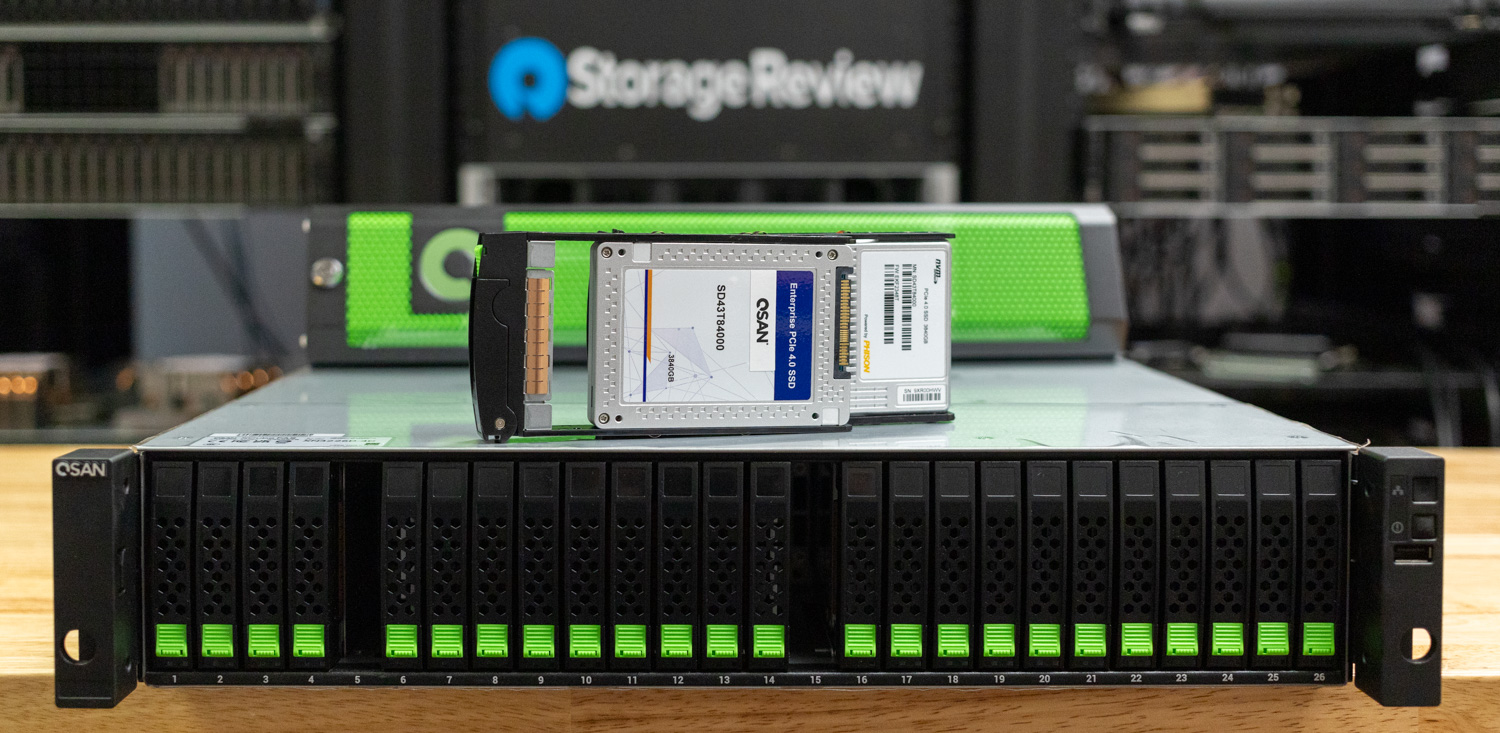
De hardware is praktisch. U krijgt 26 front bays voor U.2 of U.3 NVMe-schijven in een 2U-behuizing, met actieve hoge beschikbaarheid en eenvoudige uitbreiding naar SAS-shelfs wanneer capaciteit voorrang krijgt boven pure NVMe-snelheid. QSM 4 levert de verwachte dataservices en een overzichtelijke gebruikersinterface, samen met een REST API die naadloze integratie met bestaande automatisering mogelijk maakt. Kleine IT-teams zullen QSM 4 eenvoudig kunnen configureren en beheren. Om dit te valideren, hebben we ons Proxmox-cluster eenvoudig geïntegreerd, waardoor deze VM's toegang hebben tot supersnelle opslag. Voor geavanceerdere workloads is QSAN perfect geschikt om te voldoen aan de AI-behoeften van het MKB.
Voor organisaties die waarde hechten aan voorspelbare prestaties, overzichtelijk beheer en multiprotocolbereik, is de XN4226D een logische keuze. Hij levert echte NVMe-doorvoer, sterke schrijflatentie met RDMA en een software-ervaring die u niet zal vertragen. Voeg daar de redelijke prijs aan toe en dit QSAN-platform kan gemengde omgevingen zonder problemen verankeren.


 Amazon