

Er gaat bijna geen week voorbij dat we niet horen van een IT-leverancier over de impact van hun oplossingen op organisaties die betrokken zijn bij kunstmatige intelligentie, deep learning, machine learning of edge intelligence. Het probleem is echter dat er geen materieel inzicht is in hoe deze oplossingen de prestaties van elk van deze taken beïnvloeden. Onlangs hebben we besloten om te kijken of we daar iets aan konden doen door samen te werken met byteLAKE, een bouwer van AI- en HPC-oplossingen in Polen. Het belangrijkste doel is om de impact van opslag en GPU op AI-workloads te evalueren.
Impact van opslag op AI
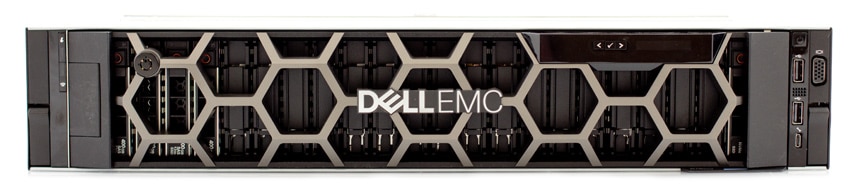
Aanvankelijk wilden we een populaire opvatting onderzoeken, namelijk dat lokale opslag de prestaties van AI-modellen beïnvloedt. We namen een van de Dell EMC PowerEdge R740xd -servers in ons lab, geconfigureerd met twee Intel Xeon Gold 6130 CPU's en 256 GB DRAM. We voerden de byteLAKE AI-test uit met drie verschillende lokale opslagalternatieven. Voor de test gebruikten we een oudere KIOXIA PX04S SSD, samen met de veel snellere Samsung 983 ZET en Intel Optane 900P.
Tijdens de benchmark hebben we de prestaties van het AI-leerproces geanalyseerd. In de tests hebben we het leerproces uitgevoerd voor een scenario uit de praktijk. In dit geval maakten de tests deel uit van de trainingsprocedure van een van de byteLAKE-producten: EWA Guard . Dit product is gebaseerd op de nieuwste versie van YOLO (You Only Look Once), een geavanceerd realtime detectiemodel. Het model bestaat uit één invoerlaag, 22 convolutielagen, 5 poolinglagen, 2 routerlagen, één reorganisatielaag en één detectielaag.
Als basismaatstaf voor prestaties hebben we de uitvoeringstijd van training voor 5000 tijdperken gebruikt. De benchmarks zijn drie keer herhaald voor elke opslagconfiguratie en de gemiddelde waarden worden hieronder weergegeven.
Resultaten:
- KIOXIA 98u 24m
- Samsung 98u 44
- Intel 98u 42
Zoals duidelijk blijkt uit de gegevens, had lokale opslag geen invloed op de prestaties. Testen varieerden van een SATA SSD tot de nieuwste en beste Optane, zonder enige impact. Dat gezegd hebbende, kan opslag een belangrijkere rol spelen als het gaat om het binnenkomen en uitgaan van gegevens, maar rekenkundig voor AI was er in dit geval geen impact.
Impact van GPU en opslag op AI
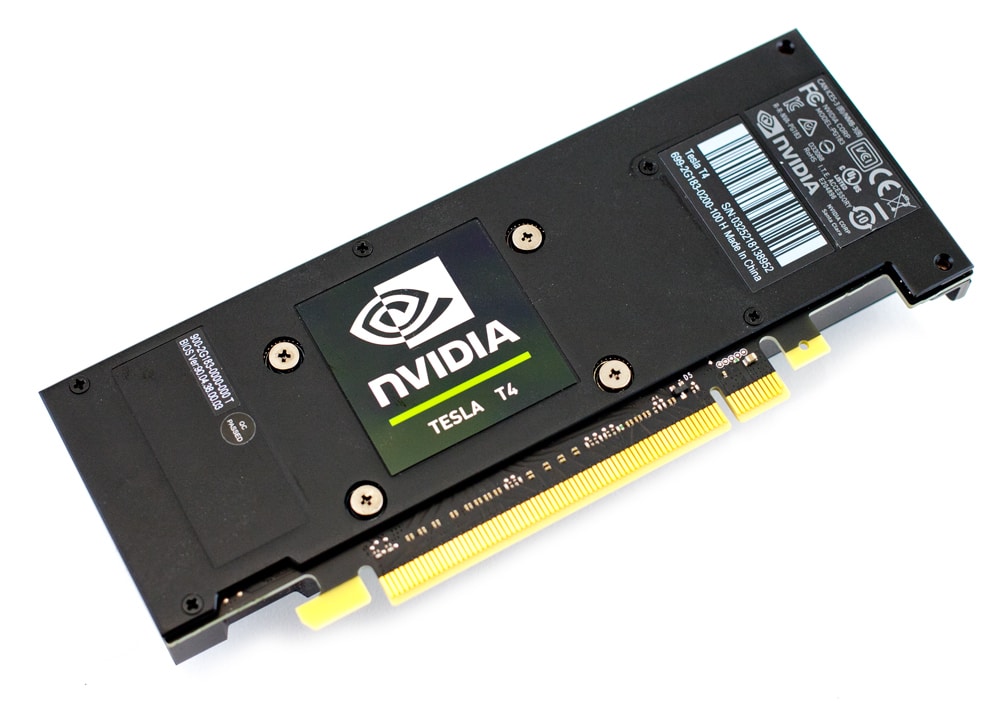
Met de opslaggegevens bij de hand, hebben we een enkele NVIDIA T4 aan de PowerEdge toegevoegd om de impact van een GPU op de AI te meten. Voor deze tests hebben we dezelfde drie opslagconfiguraties uitgevoerd.
Resultaten:
- KIOXIA 4u30
- Samsung 4u 28m
- Intel 4u 27m
Zoals verwacht had de GPU een impact, een exponentiële impact in feite, en zorgde voor een verbetering van 22x. Nu de GPU de algehele prestaties van de AI versnelt, was er enige gedachte dat de snellere opslag een impact zou kunnen hebben. Dat was echter niet het geval, aangezien de SATA-schijf precies in lijn was met de snelle NVMe.
Conclusies
Tijdens deze tests ontdekten we dat het gebruik van snellere opslagapparaten de leerprestaties niet verbeterde. De belangrijkste reden hiervoor is een complexe structuur van het AI-model. De leertijd is langer dan de tijd van het lezen van gegevens. Anders gezegd, de leertijd met de huidige reeks afbeeldingen is langer dan de tijd die nodig is om de volgende te lezen. Bijgevolg zijn de opslagbewerkingen verborgen achter de AI-berekeningen.
Bij het toevoegen van de NVIDIA T4 was er enige gedachte dat snellere verwerking door de AI ervoor zou zorgen dat de opslag een impact zou hebben op de prestaties. Dit was niet het geval in deze test, want zelfs met de T4 had het AI-model nog steeds een zwaardere leercomponent en had het geen opslag nodig om bijzonder snel te zijn.
Hoewel er meer werk moet worden verzet om de impact van specifieke componenten en systemen op AI verder te testen, zijn we van mening dat deze eerste gegevens nuttig zijn en een goed startpunt voor het gesprek. We hebben applicatiegegevens nodig om beter te begrijpen waar de juiste hefbomen zijn vanuit IT-standpunt en waar budgetuitgaven de meest impactvolle resultaten kunnen opleveren. Dit hangt natuurlijk ook voor een groot deel af van waar deze activiteit plaatsvindt, in het datacenter of in de edge. Voor nu verwelkomen we de betrokkenheid van byteLAKE en anderen aan het uiteinde van de AI-speer om nuttige gegevens te helpen verstrekken om deze prangende vragen te helpen beantwoorden.
Dit is onze eerste AI-test, maar zeker niet de laatste. Mariusz Kolanko, medeoprichter van byteLAKE, gaf aan dat ze werken aan een product genaamd CFD Suite (AI voor Computational Fluid Dynamics, oftewel "CFD", om solvers te versnellen). Het deep learning-proces vereist veel data voor elke trainingsronde. Dit model kan de opslagbelasting voor het trainen van modellen in de Big Data-omgeving verhogen en mogelijk de prestaties van het deep learning-proces zelf beïnvloeden. Uiteindelijk is het, net als bij elke andere applicatie, cruciaal om de behoeften van de applicatie te begrijpen om de juiste datacenterresources toe te wijzen. AI is duidelijk geen applicatie die voor alle toepassingen geschikt is.



 Amazon