

Od jakiegoś czasu pracujemy z węzłami EMC VxRack o wysokiej wydajności all-flash, analizując system skonfigurowany w trybie dwuwarstwowym w naszych testach wydajnościowych aplikacji SQL Server, MySQL i VMmark. W tym ostatnim segmencie testów dwuwarstwowych, przed przejściem do HCI, testowaliśmy pamięć masową w HCIbench , aby zebrać syntetyczne dane o wydajności.
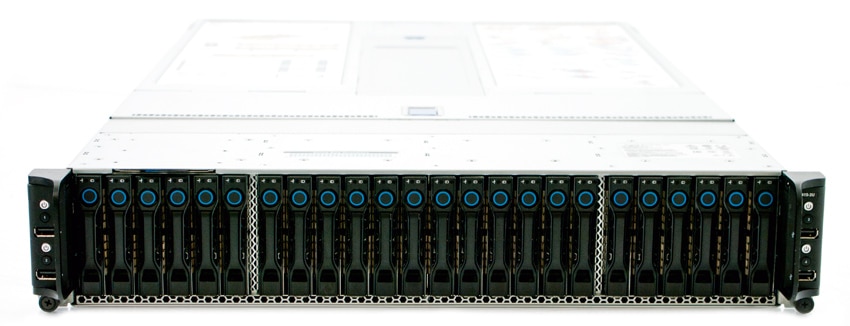
Specyfikacje węzła VCE VxRack (Performance Compute All Flash PF100)
- Podwozie – liczba węzłów: 2U-4 węzły
- Procesory na węzeł: dwa Intel E5-2680 V3, 12 rdzeni, 2.5 GHz
- Chipset: Intel 610
- Pamięć DDR4 na węzeł: 512 GB (16 x 32 GB)
- Wbudowana karta sieciowa na węzeł: dwa porty Ethernet 1 Gb/s + 1 port zarządzania 10/100
- Kontroler RAID na węzeł: 1x LSI 3008
- Dyski SSD na węzeł: 4.8 TB (6 dysków 2.5 cala 800 GB eMLC)
- SATADOM na węzeł: 32 GB SLC
- Port 10GbE na węzeł: 4 porty 10Gbps SFP+
- Zasilanie: Podwójny platynowy zasilacz AC o mocy 1600 W
- Router: Cisco Nexus C3164Q-40GE
Specyfikacje Dell PowerEdge LoadGen
- Serwery Dell PowerEdge R730 (x4)
- Procesory: osiem Intel Xeon E5-2690 v3 2.6 GHz (12 rdzeni/28 wątków)
- Pamięć: 64x 16 GB DDR4 RDIMM
- Sieć: 4x dwuportowa karta sieciowa Emulex 10G
Konfiguracja testu HCIbench
- 16 maszyny wirtualne
- 10 VMDK na maszynę wirtualną
- 40 GB VMDK (obszar 6.4 TB)
- Inicjalizacja pamięci masowej z pełnym zapisem
- 1.5-godzinne przerwy testowe (30-minutowe przygotowanie wstępne, 60-minutowy okres próbkowania testowego)
Do testowania dwuwarstwowego klastra pamięci masowej ScaleIO wdrożyliśmy jedną, bardzo intensywną konfigurację dla naszych profili obciążenia. Obejmowała ona 6.4 TB przestrzeni dyskowej z 8 TB przestrzeni użytkowej.
Profile obciążeń HCIbench firmy StorageReview
- 4K Losowo 100% odczytu
- 4K Losowy zapis 100%
- 8K losowo 70% odczytu / 30% zapisu
- 32K Sekwencyjny odczyt 100%
- 32K Sekwencyjny zapis 100%
Wydajność HCIbench
Należy od razu zaznaczyć, że testy nie mają na celu pokazania maksymalnych możliwości węzła VxRack. Przeprowadziliśmy je z użyciem czterech systemów Dell R730 loadgen, a ich głównym celem było uzyskanie podobnych danych do porównania podczas przechodzenia na testy HCI. W przypadku konfiguracji dwuwarstwowej, węzły mają dostęp do pamięci masowej za pośrednictwem czterech zewnętrznych serwerów obliczeniowych, co, choć nie jest porównywalne, daje dobry obraz tego, jak pamięć masowa będzie działać w konfiguracji dwuwarstwowej w porównaniu z HCI.
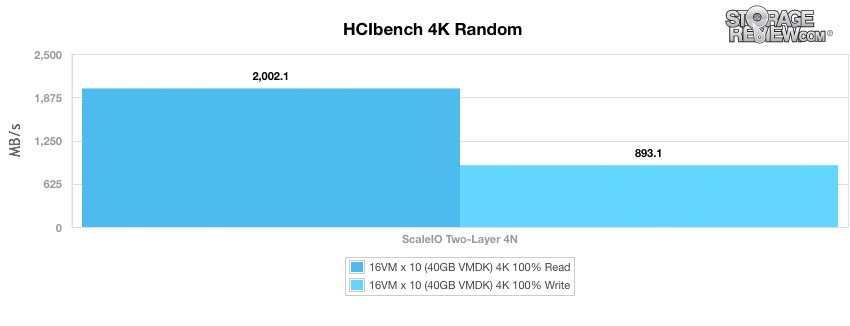
W naszym pierwszym teście mierzącym losowe transfery 4K zmierzyliśmy średnią przepustowość na poziomie 2 GB/s przy odczycie i 893 MB/s przy zapisie.
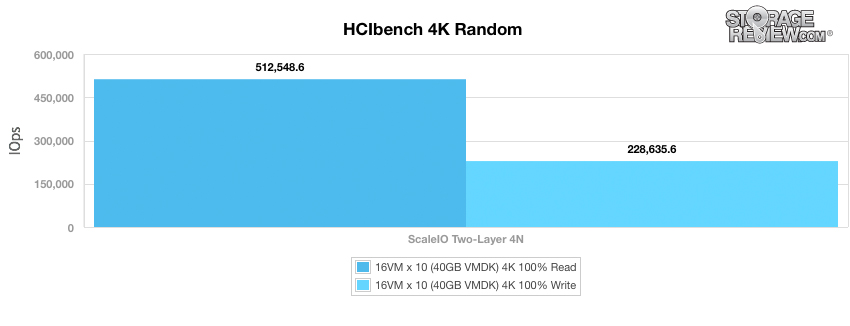
Przy obciążeniu HCIbench na 4 hostach, z których każdy miał 4 maszyny wirtualne, zmierzyliśmy średnią przepustowość na poziomie 512.5 tys. operacji wejścia/wyjścia na sekundę (IOPS) przy odczycie i 228.6 tys. operacji wejścia/wyjścia na sekundę (IOPS) przy losowym obciążeniu 4K.
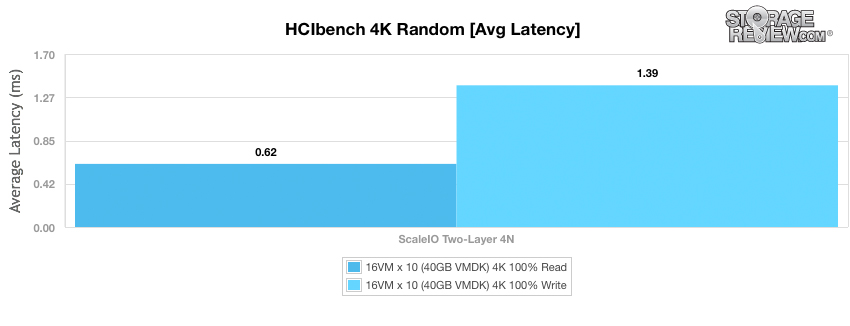
Średnie opóźnienie w naszym teście losowego transferu danych w rozdzielczości 4K wyniosło 0.62 ms przy odczycie i 1.39 ms przy zapisie.
Zmieniając punkt ciężkości na mieszane obciążenie odczytu i zapisu, przeszliśmy do testu losowego transferu 8K z mieszanką 70% odczytu i 30% zapisu. W tym teście uzyskaliśmy przepustowość 2.7 GB/s.
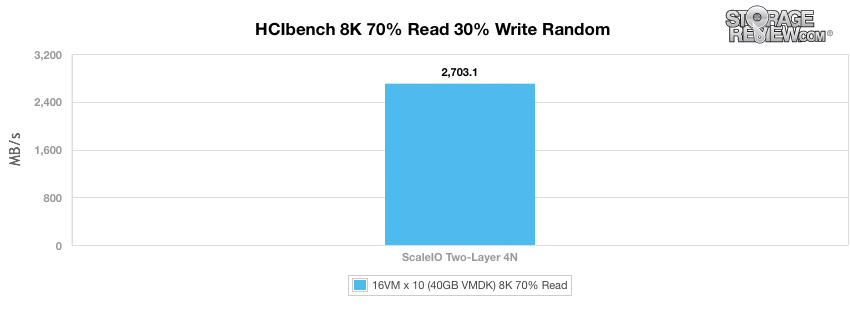
Przepustowość w naszym teście 8K 70/30 HCIbench była wysoka i wynosiła 346 tys. operacji wejścia/wyjścia na sekundę.
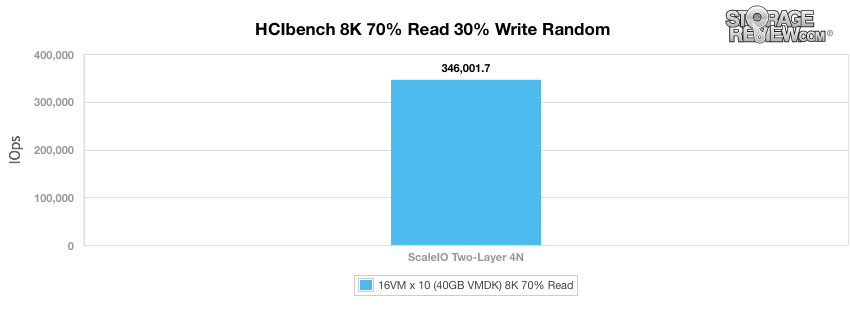
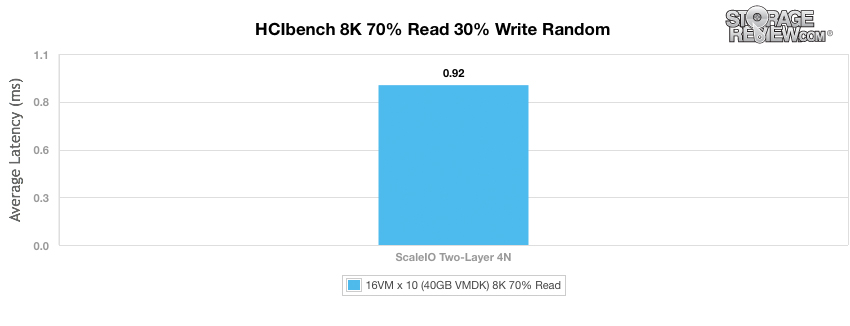
Nasza dwuwarstwowa konfiguracja ScaleIO zapewniła średnie opóźnienie na poziomie 0.92 ms przy obciążeniu 8k 70/30, osiągając jednocześnie 2.7 GB/s i 346 k IOPS.
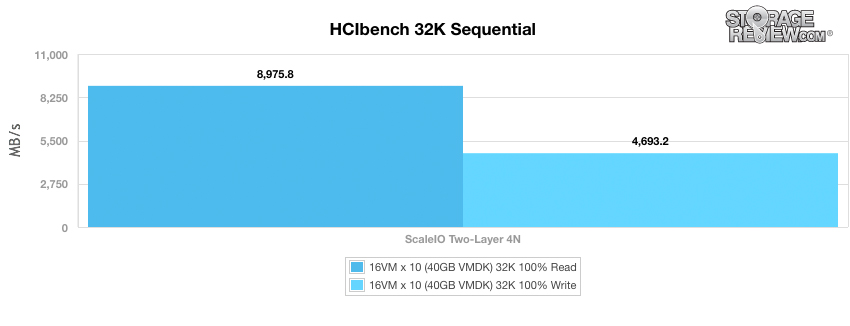
Użytkownicy poszukujący wysokiej prędkości transferu dużych bloków danych z platformy all-flash ScaleIO nie będą zawiedzeni. Przy rozmiarze bloku 32 KB zmierzyliśmy sekwencyjną przepustowość odczytu na poziomie prawie 9 GB/s i zapisu na poziomie 4.7 GB/s.
Przepustowość sekwencyjna dużych bloków 32K z naszej 4-węzłowej, dwuwarstwowej platformy ScaleIO była również bardzo wysoka, zmierzona na poziomie ponad 287K IOPS przy odczycie i 150K IOPS przy zapisie.
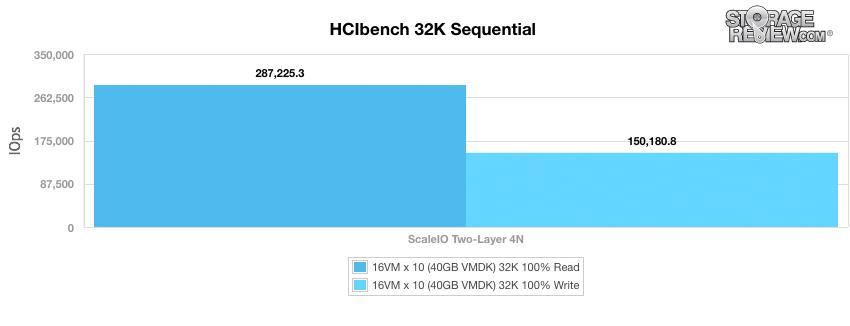
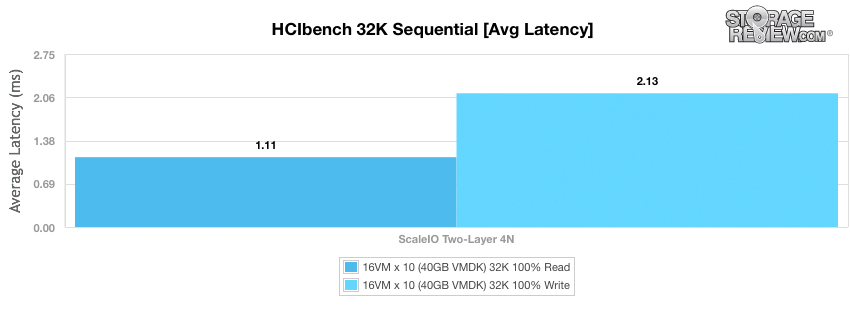
Podczas wykonywania sekwencyjnego obciążenia dużych bloków zmierzyliśmy imponujące opóźnienie odczytu wynoszące 1.11 ms i zapisu wynoszące 2.13 ms, przy przepustowości bliskiej 9 GB/s i opóźnieniu zapisu wynoszącym 4.7 GB/s.
Wniosek
Węzeł EMC VxRack kontynuuje swoją drogę ku staniu się wysokowydajną macierzą pamięci masowej, z którą należy się liczyć. W naszym ostatnim dwuwarstwowym teście uruchomiliśmy węzeł VxRack w programie HCIbench, aby sprawdzić wydajność syntetyczną zarówno przy losowych transferach małych bloków, jak i sekwencyjnych obciążeniach dużych bloków. Zmierzyliśmy szczytową przepustowość wejścia/wyjścia w naszym teście 4K na poziomie 512 tys. IOPS przy odczycie, podczas gdy losowe transfery 8K z mieszanką 70/30 R/W wyniosły 346 tys. IOPS. Przepustowość w tym scenariuszu była również bardzo wysoka, przy czym sekwencyjne transfery 32K wyniosły prawie 9 GB/s przy odczycie i 4.7 GB/s przy zapisie. Chociaż te wyniki nie są niczym szczególnym, sprzęt ScaleIO VxRack Node jest w stanie osiągać wyższe wartości syntetyczne z innymi narzędziami do testów porównawczych, takimi jak FIO, w testach na poziomie bloków. Choć nie są idealne, stanowią one punkt odniesienia, z którym można łatwo porównać węzły ScaleIO VxRack HCI w naszych nadchodzących recenzjach.
Recenzja węzła EMC VxRack: przegląd
Węzeł EMC VxRack oparty na technologii ScaleIO: Skalowany przegląd wydajności Sysbench OLTP (2-warstwowy)
Węzeł EMC VxRack oparty na technologii ScaleIO: przegląd wydajności serwera SQL (2-warstwowy)
Recenzja węzła EMC VxRack opartego na technologii ScaleIO: syntetyczny przegląd wydajności (HCI)
Węzeł EMC VxRack oparty na technologii ScaleIO: przegląd wydajności serwera SQL (HCI)
Węzeł EMC VxRack oparty na technologii ScaleIO: przegląd wydajności VMmark (HCI)


 Amazon