

Aktualizacja z 13 listopada 2026 r.: Dell Pro Precision 9 T4 dołącza do grona najlepszych serwerów Xeon Tower dla lokalnej sztucznej inteligencji. Sekcja „Wieża” grupuje teraz typy według platformy hosta, a „How We Rank” obejmuje teraz serwery Tower przetestowane w naszym pakiecie llama.cpp pod Linuksem. 24 października zaktualizowano odpowiedź Mac Studio dla modeli M5 Max i M5 Ultra, których sprzedaż Apple rozpoczęła się we wrześniu.
Każdy system sklasyfikowany na tej stronie został przetestowany w laboratorium StorageReview. Bezpośrednio porównujemy wydajność lokalnej sztucznej inteligencji: przepustowość serwerów online vLLM, czas do pierwszego tokena i czas na token wyjściowy dla modeli, w tym GPT-OSS-120B, Llama 3.1 8B, Mistral Small 3.1 24B i Qwen3 Coder 30B, a także wydajność obliczeniową MAMF i testy pamięci masowej GDSIO. Żaden system nie jest klasyfikowany na podstawie arkusza specyfikacji.
Kluczowym pytaniem dla lokalnego komputera stacjonarnego z AI w 2026 roku jest pamięć zunifikowana czy dyskretna pamięć VRAM . Urządzenia stacjonarne, takie jak DGX Spark z procesorem GB10 firmy NVIDIA i systemy Ryzen AI Max (Strix Halo) firmy AMD, oferują 128 GB zunifikowanej pamięci w jednym układzie scalonym w cenie urządzeń, oferując modele, które w przeciwnym razie wymagałyby wielu dyskretnych procesorów graficznych.
Stacje robocze typu tower zapewniają przepustowość na poziomie surowym: karty RTX PRO 6000 Blackwell zapewniają znacznie wyższą liczbę tokenów na sekundę, przy kilkukrotnie wyższych kosztach i poborze mocy. Ta strona klasyfikuje oba te parametry, w oddzielnych kategoriach, na podstawie jednego spójnego zestawu testów, ponieważ prawidłowa odpowiedź zależy od największego modelu, który zamierzasz uruchomić, i od wymaganej szybkości reakcji.
W skrócie
| Kategoria | Konfiguracja | Pamięć | Procesory graficzne (testowane / maks.) | Pełna recenzja |
|---|---|---|---|---|
| Najlepszy system sztucznej inteligencji do użytku przy biurku | NVIDIA® DGX Spark® | 128 GB zunifikowanej pamięci LPDDR5X | GB10 zintegrowany (stały) | Recenzja DGX Spark |
| Najlepsza implementacja GB10 | Acer Veriton GN100 | 128 GB zunifikowanej pamięci LPDDR5X | GB10 zintegrowany (stały) | Recenzja Veriton GN100 |
| Najlepsza alternatywa dla x86 | AMD Ryzen AI Halo (Strix Halo) | Do 128 GB zunifikowanej pamięci LPDDR5X | Zintegrowana karta graficzna Radeon 8060S (stała) | Recenzja Ryzen AI Halo |
| Najlepiej bez oddzielnego procesora graficznego | HP Z2 Mini G1a | Unified LPDDR5X (działał z GPT-OSS 120B) | Zintegrowany, bez dGPU (stały) | Recenzja Z2 Mini G1a |
| Najlepszy system GB300 | MSI XpertStation WS300 (alternatywa: ASUS ET900N G3) | 748 GB pamięci spójnej (252 GB HBM3e + 496 GB LPDDR5X) | GB300 zintegrowany (stały) | Recenzja XpertStation WS300 |
| Najlepsza wieża dla lokalnej sztucznej inteligencji | Dell Precision 7875 | 192 GB GDDR7 (2 x 96 GB) | 2× RTX PRO 6000 / 2 maks. | Recenzja Precision 7875 |
| Najlepsza wieża Xeon do lokalnej sztucznej inteligencji | Dell Pro Precision 9 T4 | 192 GB GDDR7 (2 x 96 GB) | 2× RTX PRO 6000 Max-Q / 2 maks. | Recenzja Pro Precision 9 T4 |
| Najlepsza platforma multi-GPU | HP Z8 Fury G6i | 192 GB pamięci GDDR7 zgodnie z testami / do 384 GB | Testowano 2× RTX PRO 6000 / maks. 4 | Recenzja Z8 Fury G6i |
| Ekstremalny wybór | Comino Grando RTX PRO 6000 | 768 GB GDDR7 (8 x 96 GB) | 8× RTX PRO 6000 / 8 maks. | Recenzja Comino Grando |
Urządzenia AI przy biurku
Warstwa urządzeń, którą Dell nazywa deskside AI , a NVIDIA osobistym superkomputerem AI , oferuje maksymalną przepustowość w zamian za pojemność modelu, energooszczędność i cenę. Dzięki 128 GB zunifikowanej pamięci, systemy te bez problemu obsługują modele klasy 70B przy wysokiej kwantyzacji i mogą rozszerzyć się do klasy 120B, co oznacza obciążenia, które wymagałyby wielu oddzielnych procesorów graficznych w obudowie typu tower.
Niezbędna lektura laboratoryjna dla tego poziomu: nasz test termiczny DGX Spark porównuje projekty chłodzenia OEM w systemach GB10 poniżej i ma zastosowanie do każdego urządzenia w tej klasie, dopóki platformy te nie zostaną zrewidowane.
Najlepszy system sztucznej inteligencji do zastosowań biurkowych: NVIDIA DGX Spark
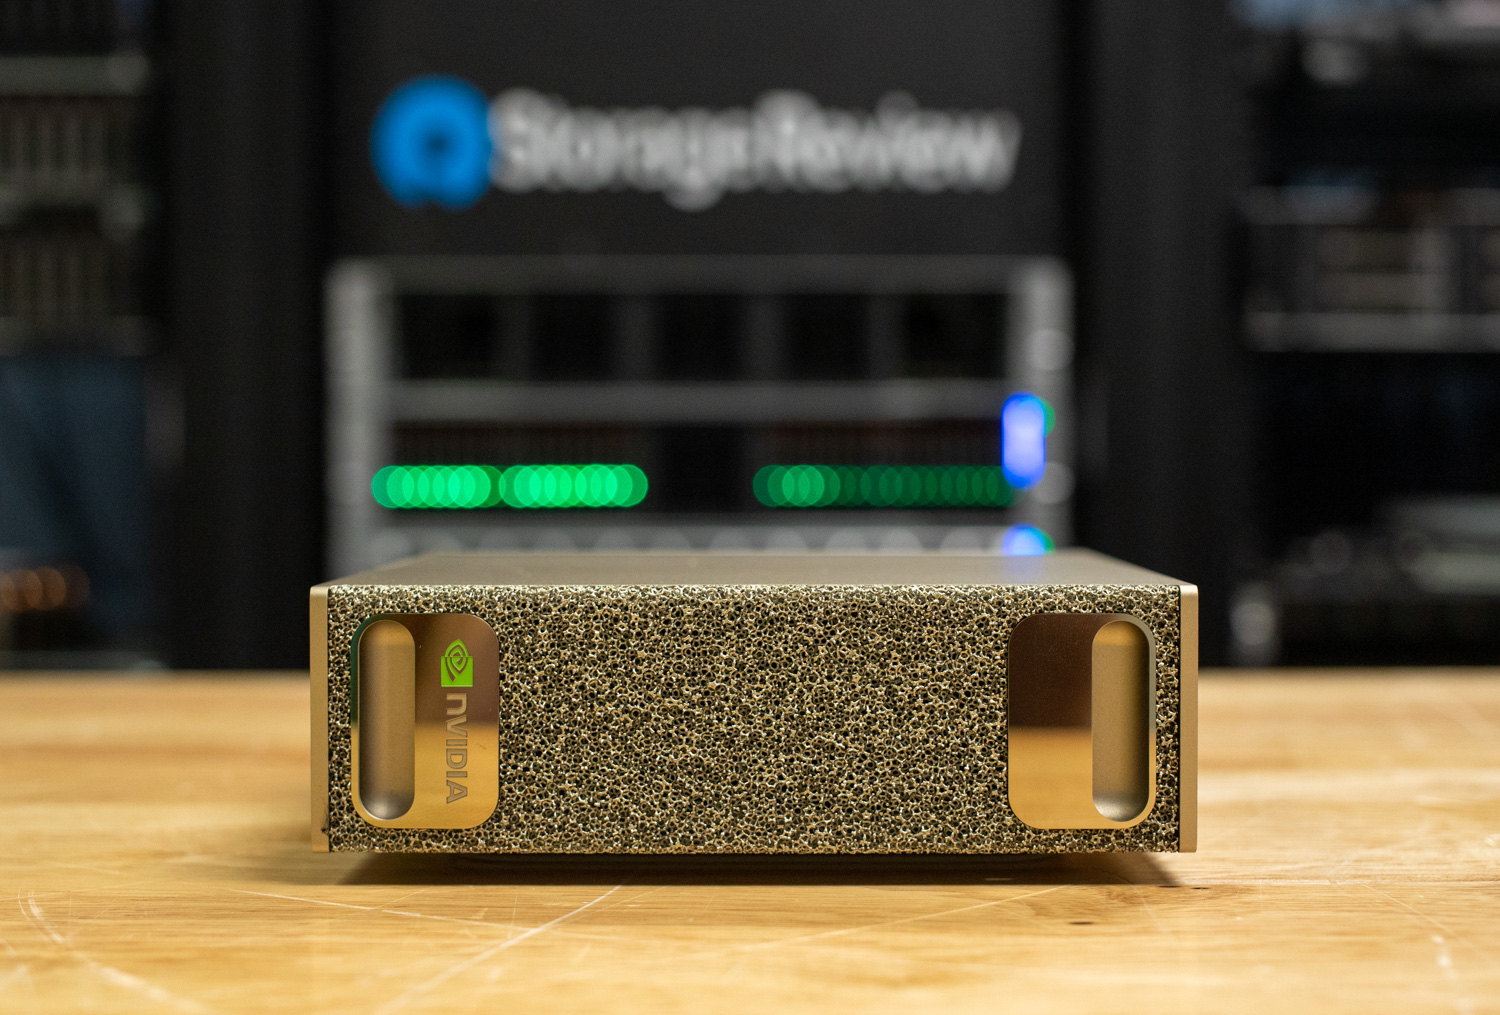
DGX Spark to punkt odniesienia, z którym porównywane są wszystkie inne urządzenia z AI przy biurku. Superchip GB10 Grace Blackwell łączy 20-rdzeniowy procesor Arm ze 128 GB zunifikowanej pamięci LPDDR5X, a dwa porty ConnectX-7 200 GbE sprawiają, że jest to jedyna klasa urządzeń, które testowaliśmy i które klastrują się od razu po instalacji: nasze dwuwęzłowe testy rozproszonego wnioskowania uruchomiły obciążenia równoległe w potokach na węzłach Dell, GIGABYTE i HP przez 200 GbE.
Ta historia klastrowania ma teraz tańszy start: NVIDIA wprowadziła na rynek 64-gigabajtową pamięć DGX Spark SKU 23 października w cenie 4,999 dolarów , sprzedawaną przez tych samych sześciu producentów OEM, a dwóch z nich łączy się za pomocą jednego kabla 200 GbE, tworząc pulę 128 GB; NVIDIA twierdzi, że połączona para pamięci może osiągnąć nawet 1.7-krotność pojemności pojedynczej jednostki 128 GB na procesorze Qwen3.8 27B, czego jeszcze nie przetestowaliśmy. Stos oprogramowania CUDA pozostaje najbogatszy w tym segmencie.
Jedynym twardym ograniczeniem platformy jest pamięć masowa: każdy system GB10 oferuje maksymalnie około 4 TB na jednym, krótkim slocie M.2. Nasza współdzielona pamięć masowa z ośmioma dyskami Spark to odpowiedź na tę potrzebę: pojedyncza, zarządzana macierz QLC obsługiwana przez porty 100 GbE, które obsługuje każdy system Spark, gdzie jeden klient odczytuje dane z prędkością 10.8 GiB/s, co odpowiada najszybszemu wewnętrznemu M.2, jakie zmierzyliśmy w systemie GB10, oraz model 78 GB hostowany centralnie, ładowany z prędkością 13% lokalnego NVMe.
Przeczytaj pełną recenzję DGX Spark
Najlepsza implementacja GB10: Acer Veriton GN100
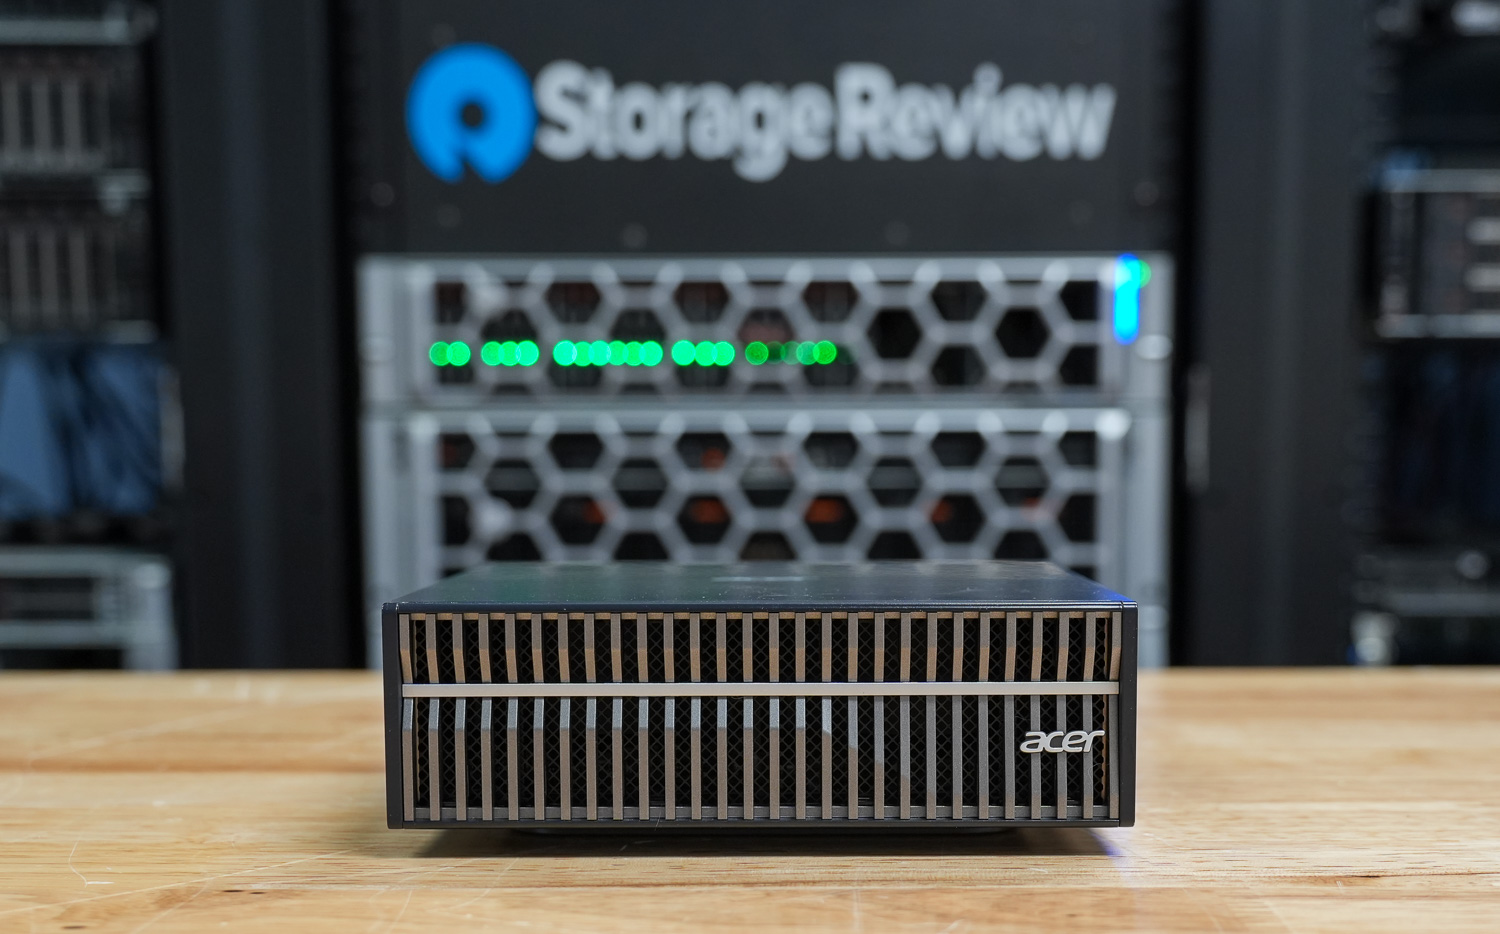
Spośród systemów GB10 OEM, to konstrukcja termiczna jest prawdziwym wyróżnikiem, a Veriton GN100 wyróżniał się w naszych testach. Wszystkie obudowy GB10 mają tę samą konfigurację krzemu i pamięci, więc utrzymanie wysokiej wydajności zależy od chłodzenia. Nasze porównanie systemów termicznych wielu producentów OEM jest, o ile nam wiadomo, jedynym tego typu opublikowanym.
Przeczytaj pełną recenzję Veriton GN100
Najlepsza alternatywa dla x86: AMD Ryzen AI Halo
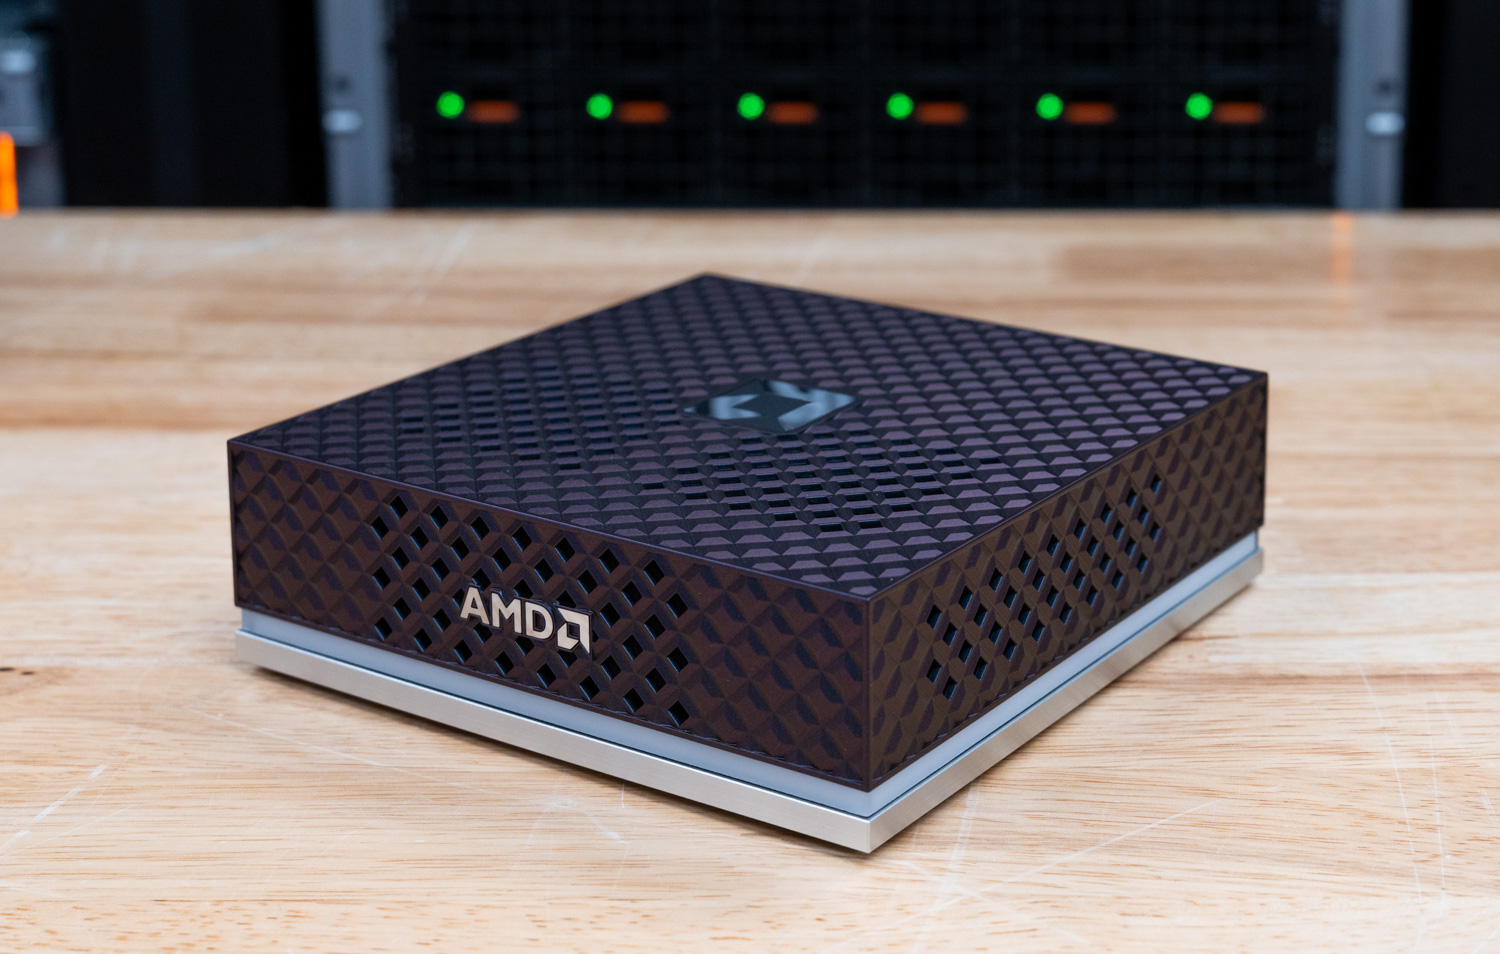
Jeśli potrzebujesz systemu Windows lub standardowego pakietu oprogramowania x86, Strix Halo to idealne rozwiązanie dla komputerów stacjonarnych. Platforma AMD Ryzen AI Max+ 395 łączy 128 GB pamięci zunifikowanej z konfiguracją dwóch systemów operacyjnych i w naszych testach obsługiwała modele o parametrach 200B, co stanowi bezpośrednią konkurencję dla DGX Spark bez konieczności angażowania systemu operacyjnego ARM/DGX.
Przeczytaj pełną recenzję Ryzen AI Halo
Najlepszy bez oddzielnego procesora graficznego: HP Z2 Mini G1a
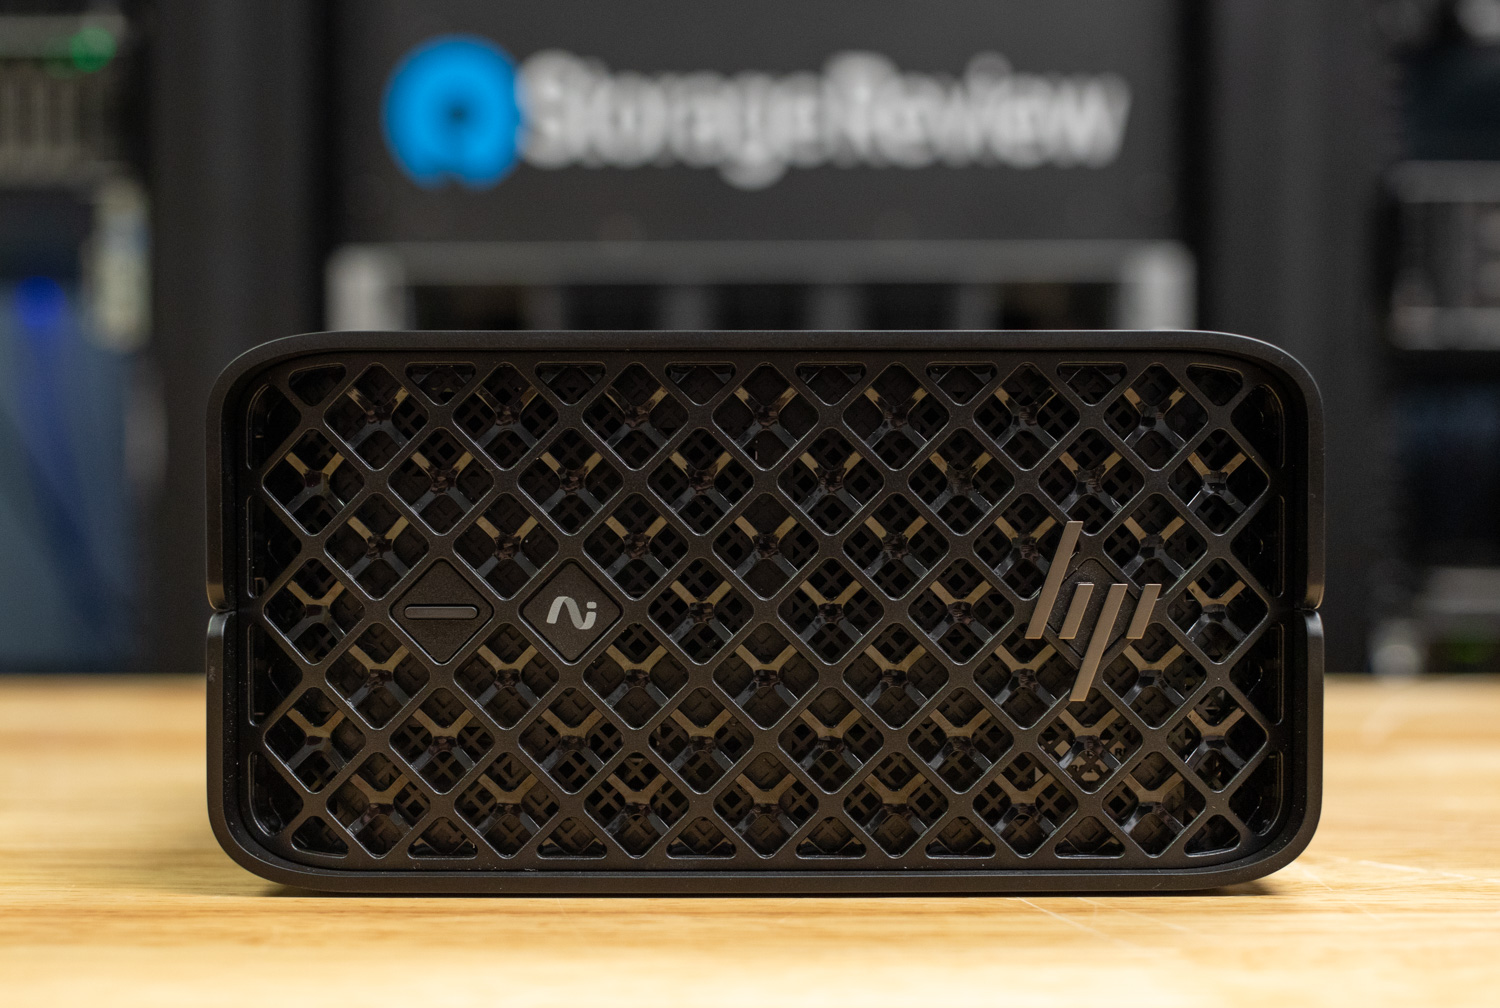
Z2 Mini G1a działał w oparciu o GPT-OSS 120B bez żadnego oddzielnego układu graficznego. Miniaturowa stacja robocza HP mieści układ scalony AMD Ryzen AI Max+ PRO w kompaktowej, cichej i przyjaznej dla IT obudowie i pozostaje najwyraźniejszym dowodem na to, że systemy x86 z pamięcią zunifikowaną zmieniły możliwości małego komputera biurowego w połączeniu z dużymi modelami.
Przeczytaj pełną recenzję Z2 Mini G1a
Najlepszy system GB300: MSI XpertStation WS300
WS300 to pierwsza stacja GB300 DGX, która przeszła przez nasze laboratorium i wyznacza nowy standard dla urządzeń. Superchip Grace Blackwell Ultra łączy 748 GB pamięci koherentnej, 252 GB pamięci HBM3e oraz 496 GB pamięci LPDDR5X, co zapewnia 20 petaflopsów mocy obliczeniowej FP4. Podczas naszych testów obsługiwał punkt kontrolny GLM-5.2 o pojemności 433 GB z 216 GB pamięci Grace – model, który nie nadaje się do pracy przy biurku. Jak każdy system klasy DGX, działa on w oparciu o system operacyjny DGX OS, a nie Windows; właśnie takiego zaangażowania wymaga tak duża ilość pamięci.
Cena i moc plasują go bliżej skrajnych modeli wieżowych niż wyżej wymienionych GB10, ale żaden inny model w tej klasie urządzeń nie oferuje tak dużego modelu. Nasuwające się pytanie, czy jednostka o mocy 1,300 W dławi się w obudowie wieżowej, ma teraz wymierną odpowiedź: nasze dogłębne badanie termiczne WS300 wykazało 2.8-godzinny, ciągły czas pracy z rdzeniem Blackwell Ultra w temperaturze 60°C, stałym taktowaniem 2.07 GHz bez spadków i marginesem termicznym około 20°C przy pełnym obciążeniu.
Alternatywa dla GB300: ASUS ExpertCenter Pro ET900N G3 to druga stacja GB300 DGX w naszych testach, potwierdzająca platformę: w 14 modelach i dwóch obciążeniach, 24 z 28 porównań przepustowości szczytowej uzyskało wynik w granicach 2% od WS300, a modele z pulą koherentną działały z parzystością lub lepszą. ASUS dodaje uchwyty do przenoszenia w obudowie o wadze 27 kg, dedykowany wentylator nad klatkami na optykę 400G oraz zasilacz 80 PLUS Titanium. Każda z obu obu obudów spełnia wymagania platformy; zapoznaj się z naszą recenzją ET900N G3 , aby zapoznać się z porównaniem obu obudów.
Skalowanie klastra: dwie z tych wież połączonych ze sobą za pomocą własnych portów 400G zostały już zmierzone, ale nie obiecane: nasz test klastra GB300 sparował stacje ASUS i HP z dwoma przetwornikami cyfrowo-analogowymi, osiągnął 98% przepustowości łącza na łączach NCCL i przekształcił GLM-5.2, model o pojemności 433 GB, który pojedyncza stacja może obsłużyć jedynie poprzez przeniesienie 215 GB obciążenia do pamięci Grace, ze 139 tokenów wyjściowych na sekundę przy 32 strumieniach do 1,525, w drodze do 3,141 przy 256.
Modele mieszczące się na jednej stacji różnią się skalą: wstępne wypełnianie/dekodowanie rozproszone potroiło przepustowość krótkich komunikatów pamięci Flash GLM-5.3, a pamięć Flash DeepSeek V4.1 osiągnęła 5,248 tokenów na sekundę, co stanowi najwyższą wartość wyjściową w zestawie.
Przeczytaj pełną recenzję XpertStation WS300
W laboratorium: stacja HP ZGX Fury AI
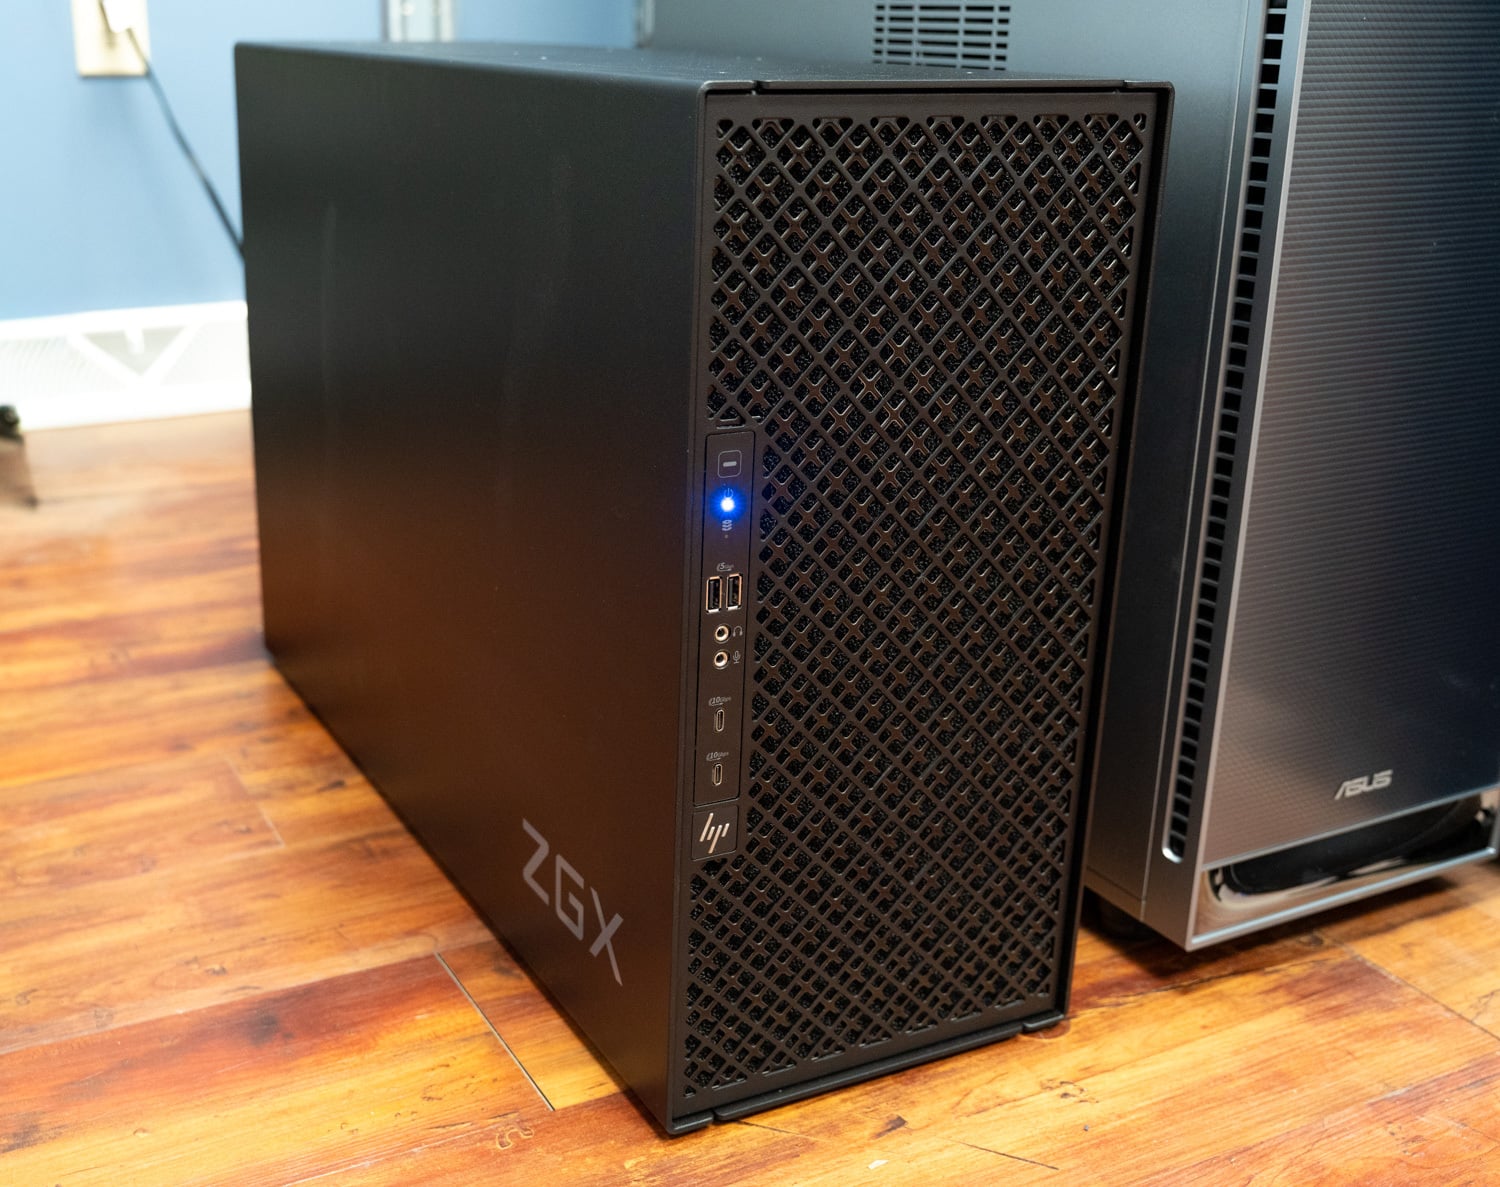
Stacja robocza HP ZGX Fury AI Station jest już w naszym laboratorium. Została zbudowana na tej samej platformie NVIDIA GB300 Grace Blackwell Ultra, co opisana powyżej stacja MSI XpertStation WS300, co daje nam pierwszą okazję do porównania implementacji architektury DGX Station przez dwóch dostawców na tym samym stanowisku: pod względem temperatury, akustyki, podtrzymania taktowania i praktycznych wrażeń z użytkowania urządzenia.
Pierwsze publiczne wyniki są już znane: wieża ZGX Fury była drugą wieżą w naszym teście klastra GB300 z dwoma stacjami , wykonując dekodowanie dla rozproszonej konfiguracji GLM-5.3 Flash i połowę każdego przebiegu równoległego z tensorem. Test indywidualny jest w toku, a wieża ZGX Fury wchodzi do rankingu po opublikowaniu własnych wyników.
ZGX Fury to również jeden z dwóch pierwszych systemów, które Microsoft nazwał DGX Station dla systemu Windows , obok Dell Pro Precision z GB300, a NVIDIA podaje wersję dla systemu Windows na czwarty kwartał. Sprzęt jest zgodny z wieżami GB300, które testowaliśmy w systemie Ubuntu, a to, czy stosy serwerów działają natywnie w systemie Windows, czy w środowisku WSL, pozostaje otwartą kwestią w przypadku tej wersji.
Na horyzoncie: stacja Halo AMD Threadripper
Zapowiedziany na targach IFA 2026 i jeszcze nieobecny w żadnym laboratorium, procesor AMD Threadripper Halo Station to pierwsza bezpośrednia odpowiedź na opisaną wyżej klasę GB300. Prezentacja odwraca strategię NVIDII: zamiast jednej dużej, spójnej puli pamięci, AMD łączy 96-rdzeniowego Threadrippera PRO z platformą z maksymalnie 2 TB ośmiokanałowej pamięci DDR5 i 128 liniami PCIe 5.0, dwoma akceleratorami Instinct MI350P o mocy 600 W, każdy z 144 GB pamięci HBM3E, a deklarowana ścieżka obejmuje cztery karty i 576 GB pamięci HBM. Cały system jest chłodzony cieczą, a host x86 omija problemy z łańcuchem narzędzi Arm, które sygnalizowaliśmy w recenzji WS300.
Otwarte pozostaje pytanie, jak dobrze modele radzą sobie z kartami PCIe w kontekście spójności NVLink-C2C. AMD nie opublikowało żadnych testów porównawczych, cen ani dostępności, więc jest to produkt warty uwagi, a nie wyboru. Szczegóły w naszym ogłoszeniu ; zostanie on uwzględniony w rankingu, jeśli i kiedy sprzęt trafi do laboratorium.
Testowano również: urządzenia ze sztuczną inteligencją do użytku przy biurku
Te systemy przeszły ten sam proces laboratoryjny i są solidnymi wyborami, które nie zajęły miejsca w żadnej kategorii: Dell Pro Max z GB10 , ASUS Ascent GX10 , GIGABYTE AI TOP ATOM , HP ZGX Nano G1n i HP EliteDesk 8 Mini G1a.
Wieże stacji roboczych dla lokalnej sztucznej inteligencji
Gdy czas reakcji ma większe znaczenie niż koszt zakupu (interaktywni asystenci kodowania, obsługa wielu użytkowników, potoki agentowe z długimi łańcuchami wywołań narzędzi), dyskretna pamięć VRAM nadal dominuje. Te wieże są klasyfikowane pod względem przepustowości wnioskowania i limitu pamięci, a dla każdej z nich podajemy przetestowaną konfigurację GPU wraz z maksymalną pojemnością obudowy, ponieważ to, co obudowa może ostatecznie pomieścić, ma równie duże znaczenie, co to, co było w zestawie; aby uzyskać wyższą pozycję w tej sekcji, wieża potrzebuje dwóch lub więcej GPU. Wieże z jednym GPU, w tym te z kartą graficzną RTX PRO 6000 o pojemności 96 GB, są klasyfikowane na naszej stronie „Najlepsze stacje robocze dla komputerów stacjonarnych” w naszym pakiecie klienckim dla systemu Windows, ponieważ odpowiadają na inne pytanie.
Grupujemy również wieże według platformy hosta, ponieważ procesor i pamięć karty decydują o tym, jak wieża obsługuje modele wykraczające poza pamięć GPU, wyszukiwanie wektorowe i symulacje, które często współdzielą maszynę. Precision 7875 prowadzi w kategorii Threadripper i zajmuje pierwsze miejsce w ogólnej klasyfikacji wież, Pro Precision 9 T4 prowadzi w kategorii Xeon, a kategoria Core Ultra otwiera się, gdy przez nasze laboratorium przechodzi wieża Core Ultra z dwoma GPU.
Najlepsza wieża dla lokalnej sztucznej inteligencji: Dell Precision 7875
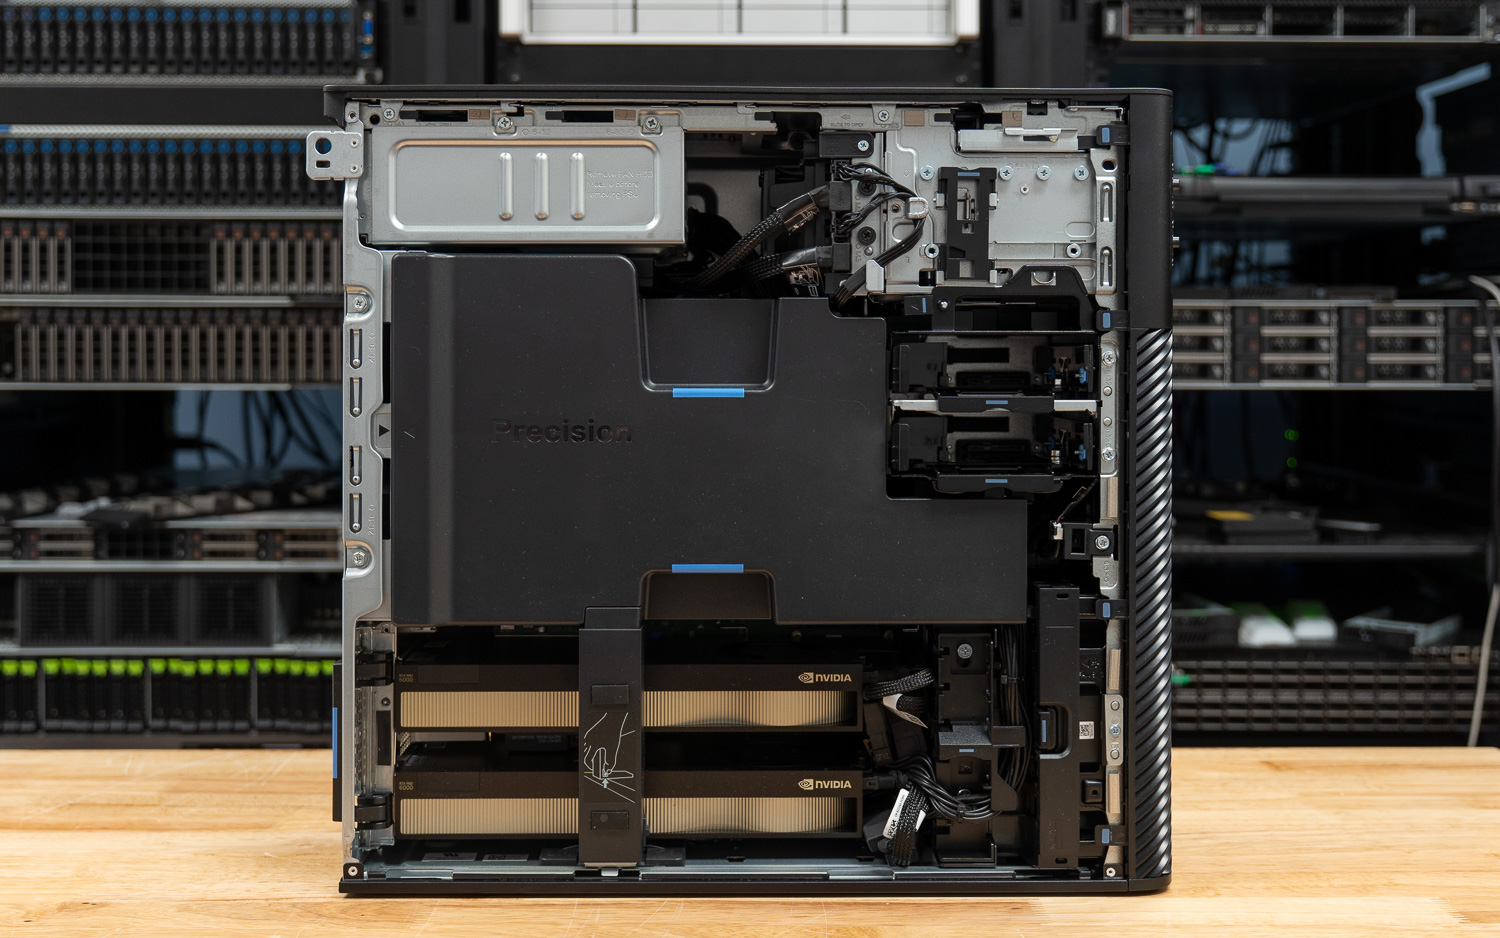
Dzięki podwójnym kartom graficznym RTX PRO 6000 Blackwell Precision 7875 to najszybszy system o standardowym współczynniku kształtu, jaki testowaliśmy pod kątem wnioskowania lokalnego. Dzięki procesorowi Threadripper PRO 9995WX i 192 GB łącznej pamięci VRAM na dwóch kartach, obsługuje on modele klasy 100B w całości w pamięci GPU, zapewniając jednocześnie interaktywny czas do pierwszego tokena, którego nie osiąga żadne urządzenie z ujednoliconą pamięcią. Należy jednak pamiętać o limicie: obudowa 7875 obsługuje maksymalnie dwie karty o podwójnej szerokości, więc nasza konfiguracja z dwoma kartami graficznymi to konfiguracja zmaksymalizowana do maksimum; nie ma możliwości późniejszego dodania trzeciej.
Przeczytaj pełną recenzję Precision 7875
Najlepsza wieża Xeon do lokalnej sztucznej inteligencji: Dell Pro Precision 9 T4
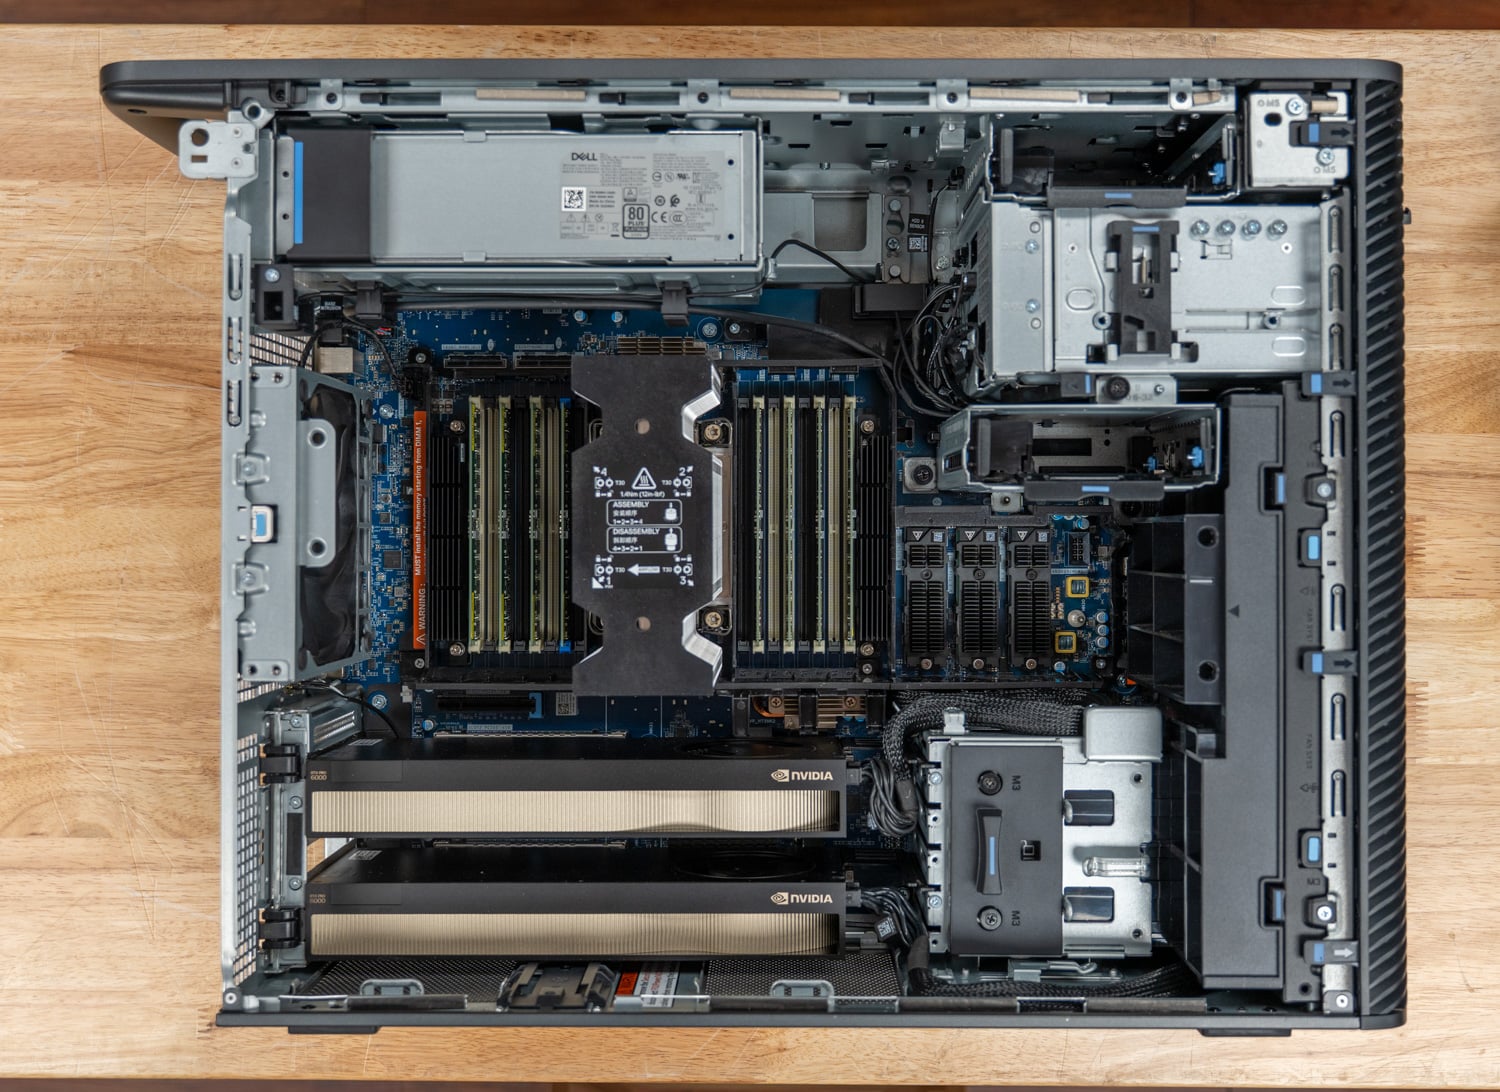
Karta Pro Precision 9 T4 dorównuje procesorowi Precision 7875 pod względem liczby procesorów graficznych i wyprzedza go pod względem wszystkich funkcji obsługiwanych przez Xeon. Dwie karty RTX PRO 6000 Max-Q działały w granicach od 1 do 9 procent w porównaniu z identyczną parą 7875 w konfiguracji z jednym procesorem graficznym i w granicach 10 procent w konfiguracji z dwoma procesorami graficznymi i precyzyjnym dostrajaniem. W przypadku obu kart, MiniMax M2.7, model o pojemności 129.3 GB, który jest zbyt duży jak na jedną kartę, wygenerował 83.7 tokena na sekundę dla jednego użytkownika, w porównaniu z 85.0 tokena na sekundę w przypadku 7875.
Różnica tkwi w hoście: osiem kanałów DDR5-6400 zapewnia 86-rdzeniowemu Xeonowi 698X przepustowość pamięci 328 GB/s, o 53 procent większą niż w 7875, co widać po pracy nad modelami. Wyszukiwanie wektorowe HNSW działało 1.51 razy szybciej niż w 7875, indeks tworzony był w 27.3 sekundy w porównaniu z 34.8, a rozwiązanie OpenFOAM drivAer trwało 293 sekundy w porównaniu z 556. Dysk rozruchowy Gen5 załadował również plik gpt-oss:120b cold w 15.2 sekundy w porównaniu z 25.8.
Model 7875 utrzymuje się w ogólnym rankingu, ponieważ przewyższa T4 w każdym teście przepustowości GPU, a jego Threadripper wykonuje renderowanie i kompilację z wykorzystaniem rdzenia o 18 do 38 procent szybciej. T4 to obudowa typu tower dla zespołów, które obsługują i osadzają modele wraz z symulacją i analizą na jednej maszynie, a konfigurator Della ogranicza ją do dwóch kart RTX PRO 6000. Cena katalogowa wynosi około 66 600 dolarów po konfiguracji na stronie Dell.com w momencie recenzji.
Przeczytaj pełną recenzję Pro Precision 9 T4
Najlepsza platforma multi-GPU: HP Z8 Fury G6i
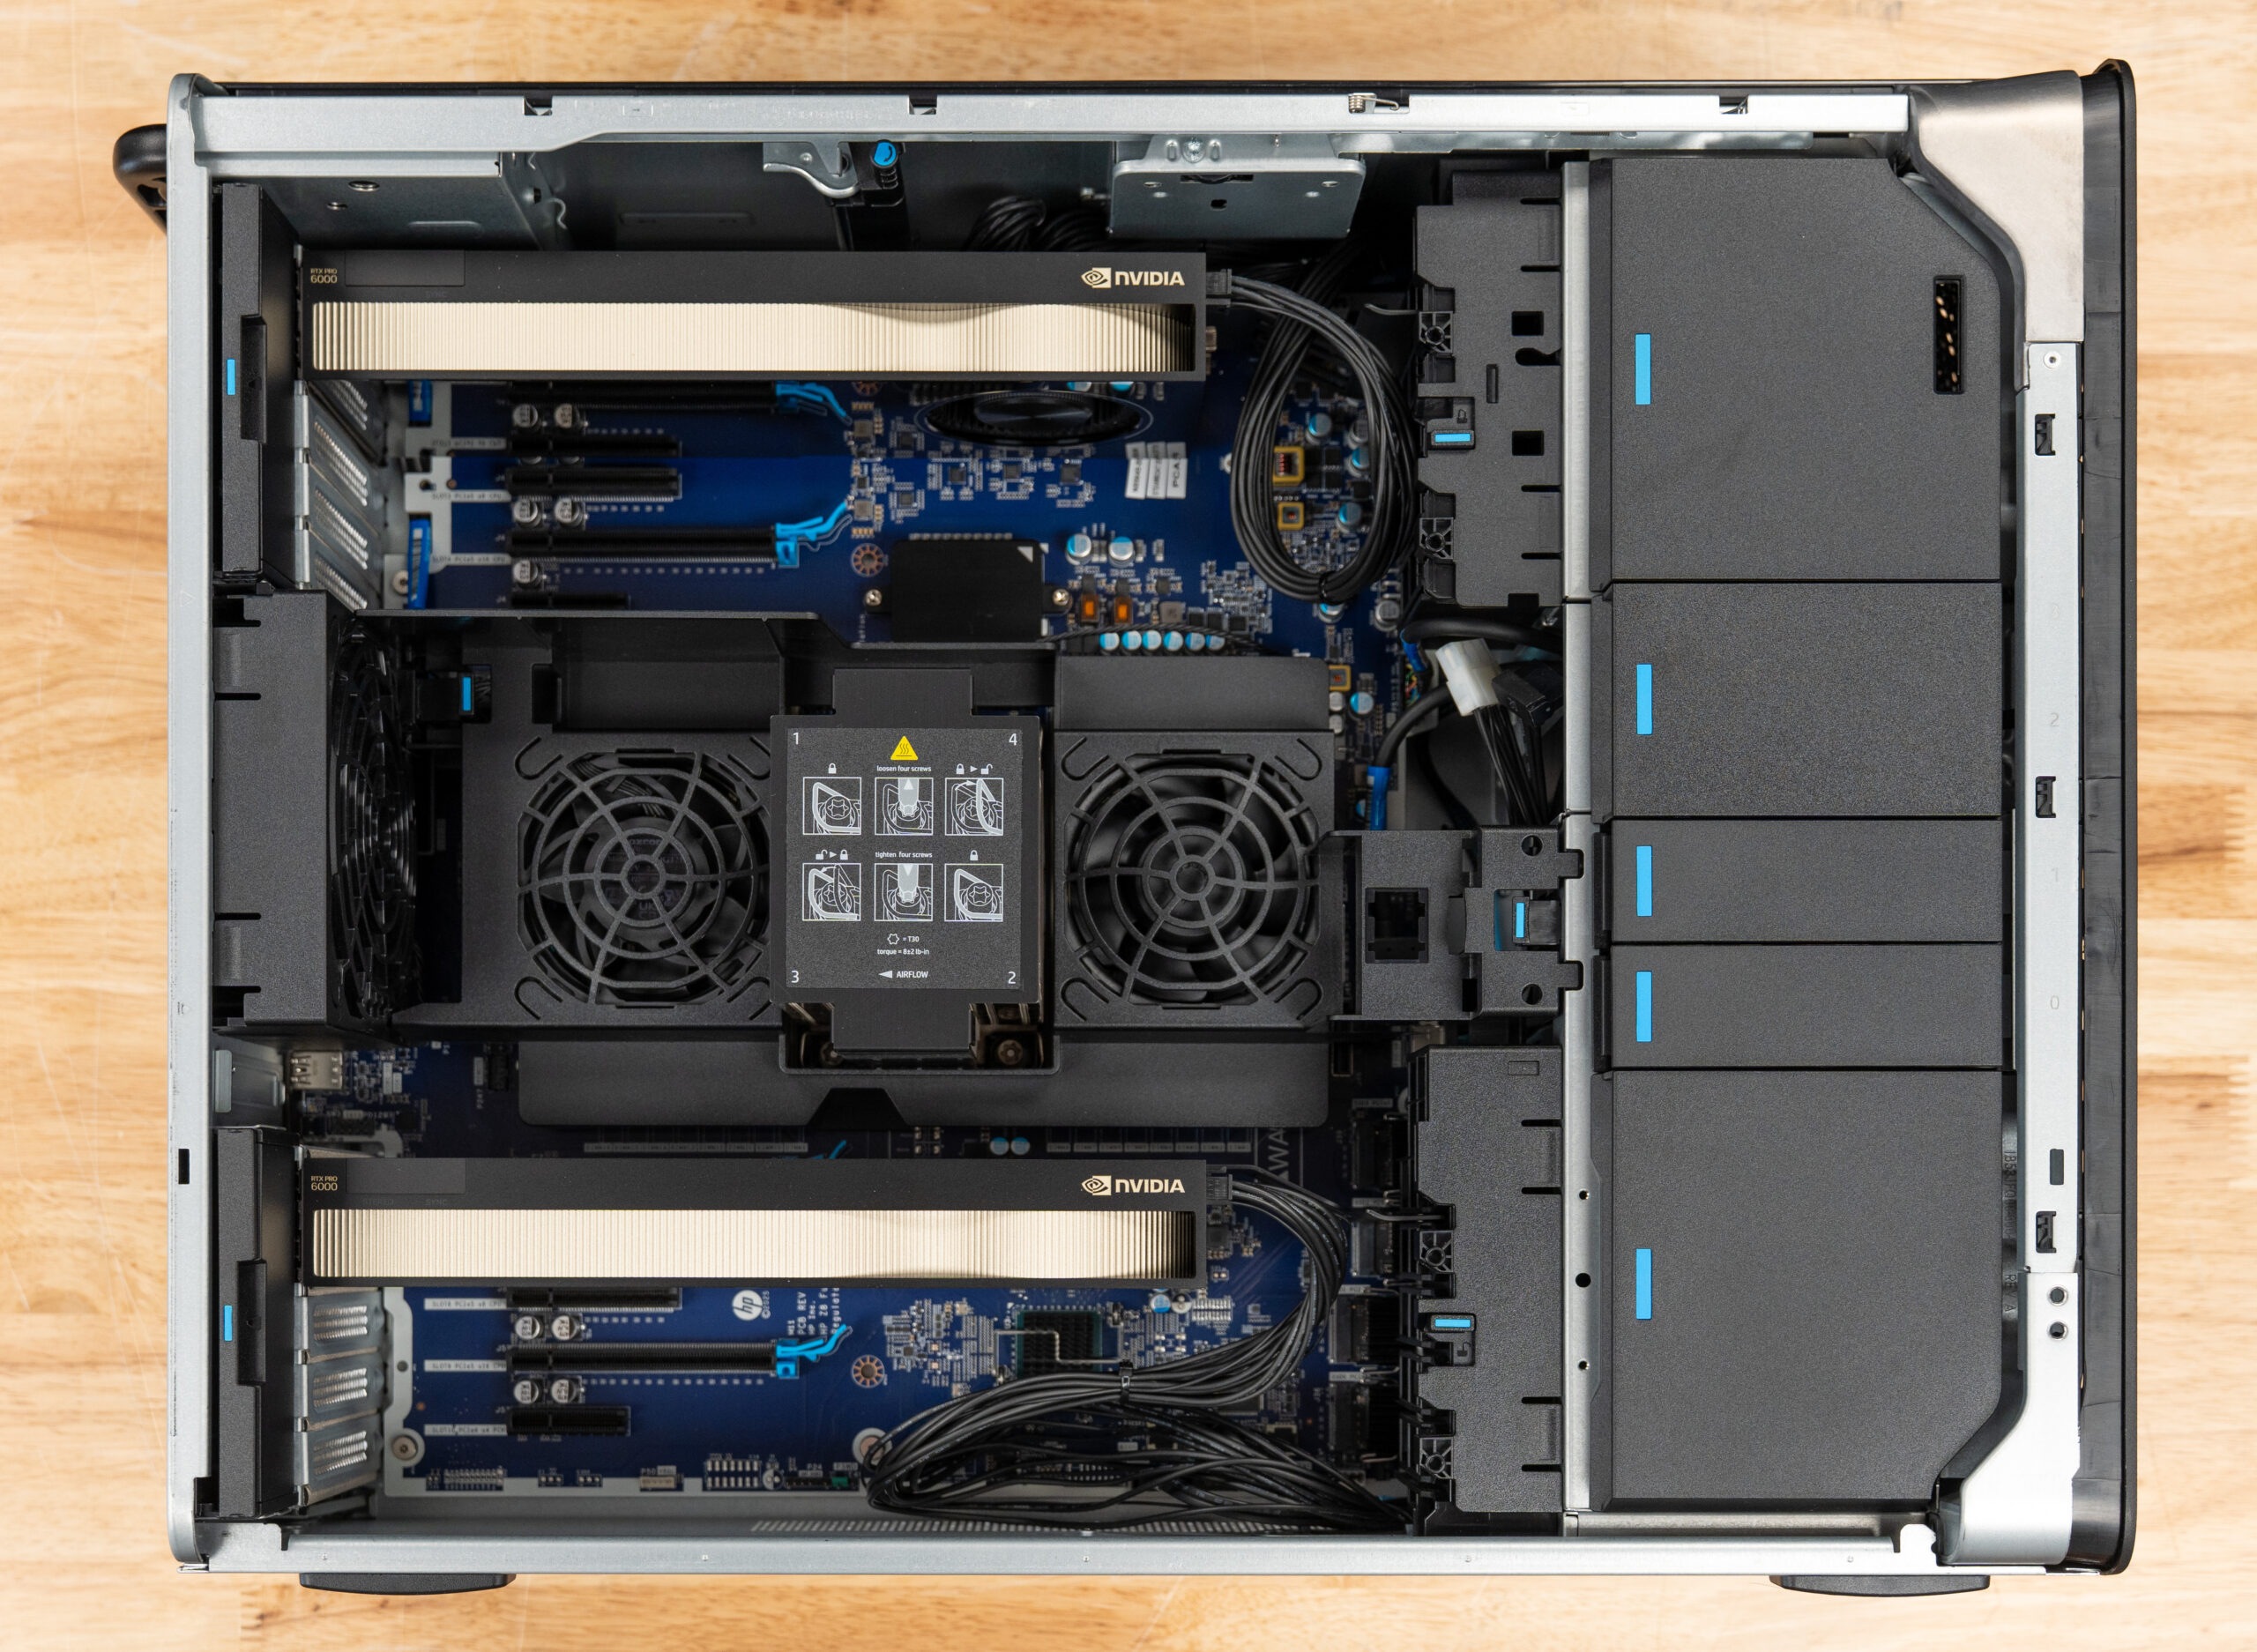
Z8 Fury G6i to obudowa, którą kupujesz, planując rozbudowę o kolejne procesory graficzne. W testowanym przez nas komputerze testowym korzystaliśmy z dwóch kart RTX PRO 6000 Max-Q, co łącznie dało 192 GB pamięci VRAM, ale obudowa, zasilana przez dwa zasilacze o łącznej mocy do 2700 W, obsługuje do czterech kart Blackwell i 384 GB pamięci VRAM. Różnica między parametrami testowanymi a maksymalnymi jest kluczowa: żadna standardowa obudowa OEM, którą testowaliśmy, nie oferuje większej przestrzeni na GPU, a przejście z dwóch kart na cztery nie wymaga zmiany obudowy.
Przeczytaj pełną recenzję Z8 Fury G6i
Ekstremalny wybór: Comino Grando RTX PRO 6000
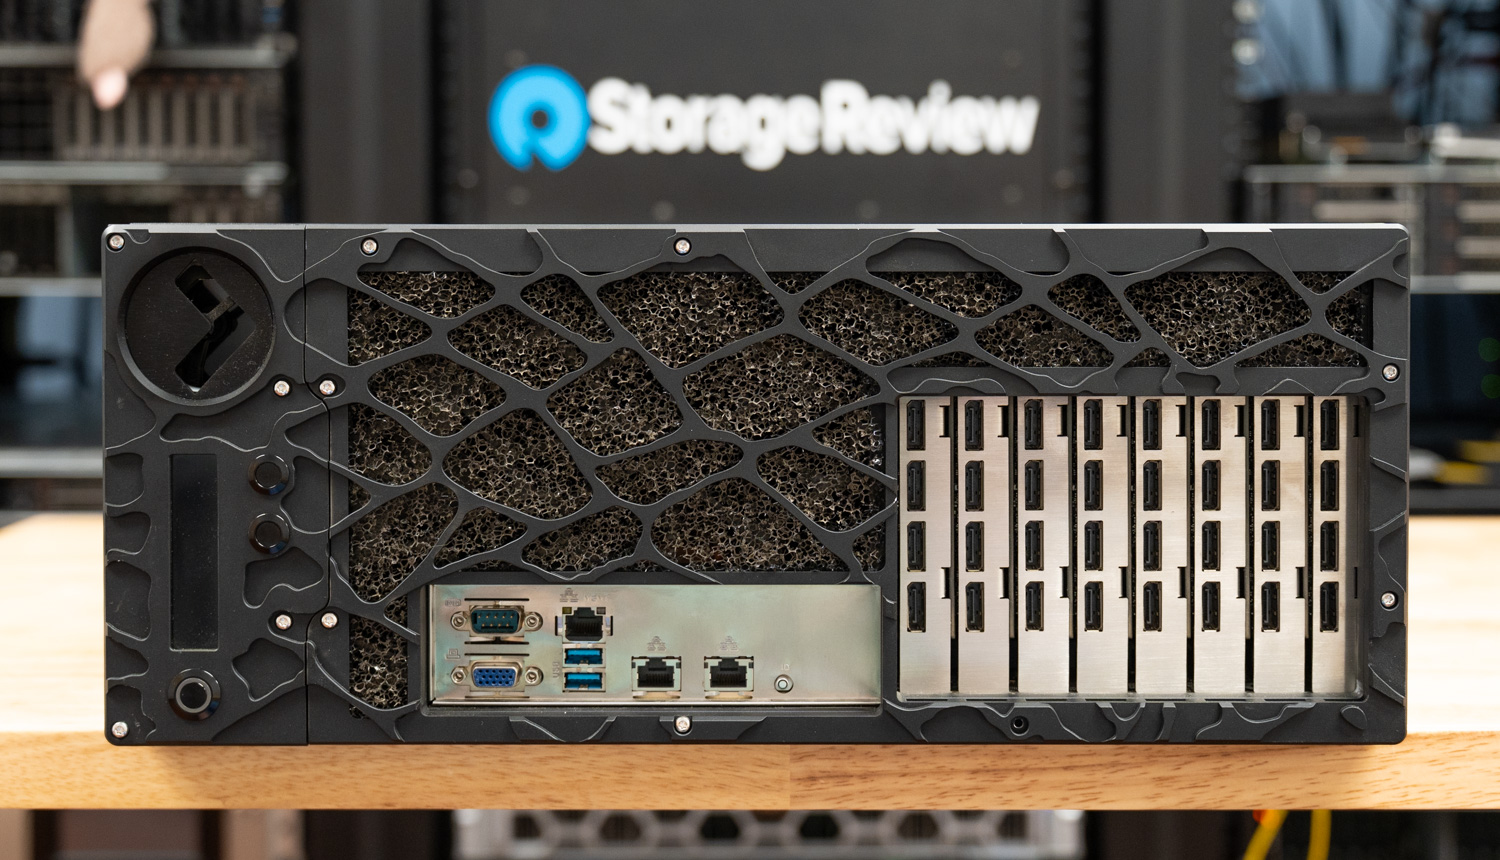
768 GB pamięci VRAM w chłodzonej cieczą obudowie 4U: Grando istnieje dla klienta, którego model nie pasuje nigdzie indziej. Nasz egzemplarz testowy został dostarczony z ośmioma kartami RTX PRO 6000 Blackwell o pojemności 96 GB każda, co jest maksymalną pojemnością obudowy, a chłodzenie cieczą Comino utrzymuje wszystkie osiem kart przy pełnym TDP przez całą dobę, bez dławienia. To więcej pamięci GPU niż w wielu serwerach rackowych, a jednocześnie coś, co nadal nadaje się do postawienia przy biurku. Jest głośny ceną, a nie akustyką, i celowo wyróżnia się na tej liście: dowód na to, gdzie znajduje się sufit przy biurku.
Przeczytaj pełną recenzję Comino Grando
Jak oceniamy
Każda tabela wyników StorageReview rządzi się trzema zasadami. Pierwsza z nich to klasyfikowanie wyłącznie systemów przetestowanych laboratoryjnie : jeśli nie zostały one poddane testom porównawczym, można o nich wspomnieć, ale nie można przypisać im żadnej kategorii. Po drugie, systemy są klasyfikowane raz na podstawie pomiaru. Powyższe wieże były również klasyfikowane w naszej tabeli wyników stacji roboczych, uwzględniającej wydajność SPECworkstation i renderowania, do października 2026 roku, kiedy to strona została przeniesiona na systemy z jednym GPU. Ich wyniki w tamtym miejscu pozostają w recenzjach, a tutaj są one klasyfikowane według przepustowości wnioskowania i limitu pamięci.
Po trzecie, istnieje bariera wejścia: system potrzebuje dwóch lub więcej procesorów graficznych (GPU), przetestowanych z serwerem vLLM lub naszym pakietem llama.cpp pod Linuksem, lub współdzielonej puli pamięci z co najmniej 96 GB dostępnymi dla modeli. Komputery stacjonarne z jednym procesorem graficznym (GPU), nawet z kartą 96 GB, są klasyfikowane na naszej stronie „Najlepsze stacje robocze dla komputerów stacjonarnych” w naszym pakiecie klienckim dla systemu Windows.
Rankingi są tworzone na podstawie zestawienia przepustowości serwerów online vLLM, czasu do pierwszego tokena, czasu na token wyjściowy, wydajności obliczeniowej MAMF, wydajności pamięci masowej GDSIO oraz ceny detalicznej. Oceny redakcyjne rozstrzygają remisy w ramach przedziałów punktacji. Wieże testowane w naszym nowszym pakiecie llama.cpp są klasyfikowane pod względem przepustowości serwerów, czasu do pierwszego tokena, obciążenia modelu, RAG oraz wyników dostrajania, a wieże porównawcze testujemy ponownie w tym pakiecie, gdy klasyfikowany jest nowy. Dostawcy nie widzą rankingów przed publikacją, a umieszczenie na tej stronie nie jest płatne.
Często zadawane pytania dotyczące lokalnego pulpitu AI
Jaki jest najlepszy pulpit dla sztucznej inteligencji opartej na agentach?
Obciążenia agentowe, takie jak agenty kodujące, potoki wywoływania narzędzi i wieloetapowe zadania autonomiczne, są wrażliwe na przepustowość i opóźnienia w sposób, w jaki nie jest to możliwe w przypadku pojedynczego czatu, ponieważ agenci łączą wiele wywołań modeli w łańcuchy o szerokim kontekście. To sprzyja warstwie Tower: dyskretna pamięć VRAM stacji roboczej Dell Precision 7875 zapewnia stały czas do pierwszego tokenu, co pozwala na szybką reakcję długich łańcuchów agentów. W przypadku ekonomicznych eksperymentów z agentami, urządzenie klasy GB10 obsługuje te same stosy z niższą prędkością. Nasze pełne wytyczne dotyczące rozmiarów znajdują się w sekcji RAM, GPU i pamięć masowa dla agentowej sztucznej inteligencji.
Ile pamięci potrzebuję do lokalnego uruchomienia modelu 70B?
Zgodnie z ogólną zasadą, model 70B z kwantyzacją 4-bitową potrzebuje około 40-48 GB pamięci dostępnej dla modelu przed kontekstem; komfortowe korzystanie z funkcji interaktywnych z długim kontekstem wymaga więcej. Właśnie dlatego urządzenia z pamięcią zunifikowaną o pojemności 128 GB dobrze radzą sobie z modelami klasy 70B, a na naszej stronie „Najlepsze stacje robocze” znajdują się wieże z jednym GPU.
Czy do uruchomienia tych systemów potrzebne jest mi jakieś specjalne zasilanie?
W przypadku urządzeń, nie: dekodery klasy GB10 i systemy Strix Halo działają komfortowo na standardowym gniazdku biurowym. Wieże zasługują na szczerą rozmowę z właścicielem budynku. W pełni skonfigurowany HP Z8 Fury G6i może obsługiwać dwa zasilacze o łącznej mocy do 2700 W, czyli więcej niż standardowy obwód 15-amperowy 120 V, a Comino Grando specyfikuje zasilacze hot-swap o mocy 2000 W, wymagające napięcia wejściowego 180–264 V, spadając do 1000 W przy zasilaniu 110 V.
Przed zakupem, o którym mowa na górze strony, sprawdź, co może zasilić ścianę; dedykowany obwód lub instalacja 208/240 V może być częścią rzeczywistego kosztu pełnego zestawu GPU. Ciepło podlega tym samym zasadom, ponieważ każdy pobrany wat trafia do pomieszczenia.
Co powiesz na Mac Studio?
Jeszcze nie, ponieważ nie przetestowaliśmy go laboratoryjnie. Apple rozpoczęło sprzedaż komputerów Mac Studio z M5 Max i M5 Ultra 22 września, przy czym M5 Max oferował do 128 GB pamięci zunifikowanej w cenie od 2,499 dolarów, a M5 Ultra do 512 GB w cenie od 5,499 dolarów. Konfiguracja 512 GB, najważniejsza w przypadku bardzo dużych modeli, pojawi się pod koniec października w cenie, której Apple nie ogłosiło. Jeśli przetestujemy jeden z nich, zostanie on sklasyfikowany na podstawie wyników pomiarów, podobnie jak każdy system na tej stronie.
Jaka stacja robocza Xeon jest najlepsza dla lokalnej sztucznej inteligencji?
Dell Pro Precision 9 T4 , nasza najlepsza obudowa Xeon Tower do lokalnej sztucznej inteligencji. Z dwiema kartami RTX PRO 6000 Max-Q, działała w tempie od 1 do 9 procent gorszym niż Precision 7875 z procesorem Threadripper w konfiguracji z jednym GPU i rozdzieliła model MiniMax M2.7 o pojemności 129.3 GB na obie karty, osiągając 83.7 tokena na sekundę. Osiem kanałów pamięci DDR5-6400 zapewniło o 53 procent większą przepustowość pamięci do wyszukiwania wektorowego i symulacji. Precision 7875 pozostaje naszym najlepszym wyborem pod względem przepustowości GPU.


 Amazon