

Aktualizacja z 19 października 2026 r.: Open WebUI zajmuje drugie miejsce w rankingu z wynikami zmierzonymi (115.32 i 75.06 tokenów na sekundę w teście RTX 5000 Ada, w porównaniu do 123 i 82 w styczniu). Jego wpis obejmuje teraz aplikację desktopową Windows i serwer w wersji 0.12.2, a kolumna „Przewodnik” zawiera linki do praktycznych testów Open WebUI. Pierwotnie opublikowano 19 sierpnia 2026 r.
Istnieją cztery powody, dla których warto uruchomić model językowy na własnym sprzęcie, a tylko jeden z nich ma charakter ideologiczny. Prywatność: dokument przekazywany lokalnemu modelowi nigdy nie opuszcza maszyny, która jest całością konwersacji dla kodu klienta, umów, danych pacjentów i nieopublikowanych produktów.
Struktura kosztów: chmurowa sztuczna inteligencja jest rozliczana, a obciążenia agentów mnożą liczbę tokenów na tyle szybko, że wydajna stacja robocza może się zwrócić; sprzęt, który posiadasz, działa po cenie prądu. Dostępność: brak limitów przepustowości, brak przerw w działaniu, brak e-maili z informacją o wycofaniu z użytku, zmieniających przepływ pracy we wtorek. I kontrola: model, który zatwierdziłeś, to model, który będziesz uruchamiać, dopóki nie zdecydujesz inaczej.
Przeciwwagą jest to, że modele chmur granicznych pozostają bardziej wydajne, a w przypadku pracy agentowej o długim horyzoncie czasowym luka jest realna. Modele lokalne osiągnęły parytet w pracy ograniczonej: czat, podsumowania, kodowanie w jednym pliku oraz pytania i odpowiedzi dotyczące dokumentów. To właśnie większość z tego, co większość ludzi robi przez cały dzień. Jeśli Twoim motorem napędowym jest maksymalna wydajność za wszelką cenę, skorzystaj z chmury. Jeśli Twoim motorem napędowym jest prywatność, koszt lub kontrola, lokalność jest dziś realna, a ta strona jest mapą.
To ujęcie powinno określić budżet na sprzęt, ponieważ lokalne wydatki na sztuczną inteligencję to decyzja dotycząca pamięci, zanim podejmiemy jakiekolwiek inne decyzje. 16 GB pamięci VRAM lub 32 GB pamięci zunifikowanej pokrywa klasę 7–8 B, która obsługuje zadania ograniczone powyżej. 24–32 GB pamięci VRAM lub 48 GB pamięci zunifikowanej osiąga klasę 30 B, gdzie kodowanie agentowe przestaje być jedynie demonstracją. 96–128 GB pamięci zunifikowanej obsługuje modele o pojemności ponad 100 B, które zbliżają się do jakości klasy premium. Nadmierny zakup zapewnia prędkość, której możesz nie zauważyć; niedostateczny zakup oznacza, że klasa modelu, którą chciałeś, w ogóle się nie załaduje.
Nasze rankingi najlepszych laptopów do lokalnej sztucznej inteligencji i najlepszych komputerów stacjonarnych do lokalnej sztucznej inteligencji klasyfikują komputery według kategorii. Na tej stronie znajdziesz informacje o tym, co na nich uruchomić.
Oprogramowanie nie rozwinęło się tak dynamicznie jak sprzęt. Około jedna trzecia narzędzi polecanych dziś w wynikach wyszukiwania jest martwa, a większość stron polecających je nie zauważyła tego.
Ta strona śledzi, co działa i na jakim sprzęcie, stan na październik 2026 roku. Na razie oceniamy narzędzia według gwiazdek GitHub, ponieważ jest to neutralny i weryfikowalny sygnał. Oznacza to, że narzędzie jest zamknięte i nie ma podanej liczby gwiazdek. Każda nazwa narzędzia w tabelach zawiera link do oficjalnego pliku do pobrania. W miarę jak każdy wybrany element przechodzi przez laboratorium, kolumna „Przewodnik” uzupełnia się o praktyczny przewodnik po konfiguracji i nasze własne statystyki, począwszy od stycznia.
Na tej stronie obowiązują trzy zasady, począwszy od rozróżnienia między modelem lokalnym a agentem lokalnym . Na komputerze działa kilka produktów, a każde wywołanie wnioskowania jest kierowane do chmury dostawcy; jest to postawa prywatności, a nie funkcja offline, a te narzędzia są wymienione osobno na dole, aby rozróżnienie było widoczne. Po drugie, każdy wpis zawiera realistyczny minimalny sprzęt, ponieważ „działa na laptopie” jest bez znaczenia bez danych dotyczących pamięci. Po trzecie, w FAQ śledzimy, co uległo awarii, wraz z datami.
Wybory
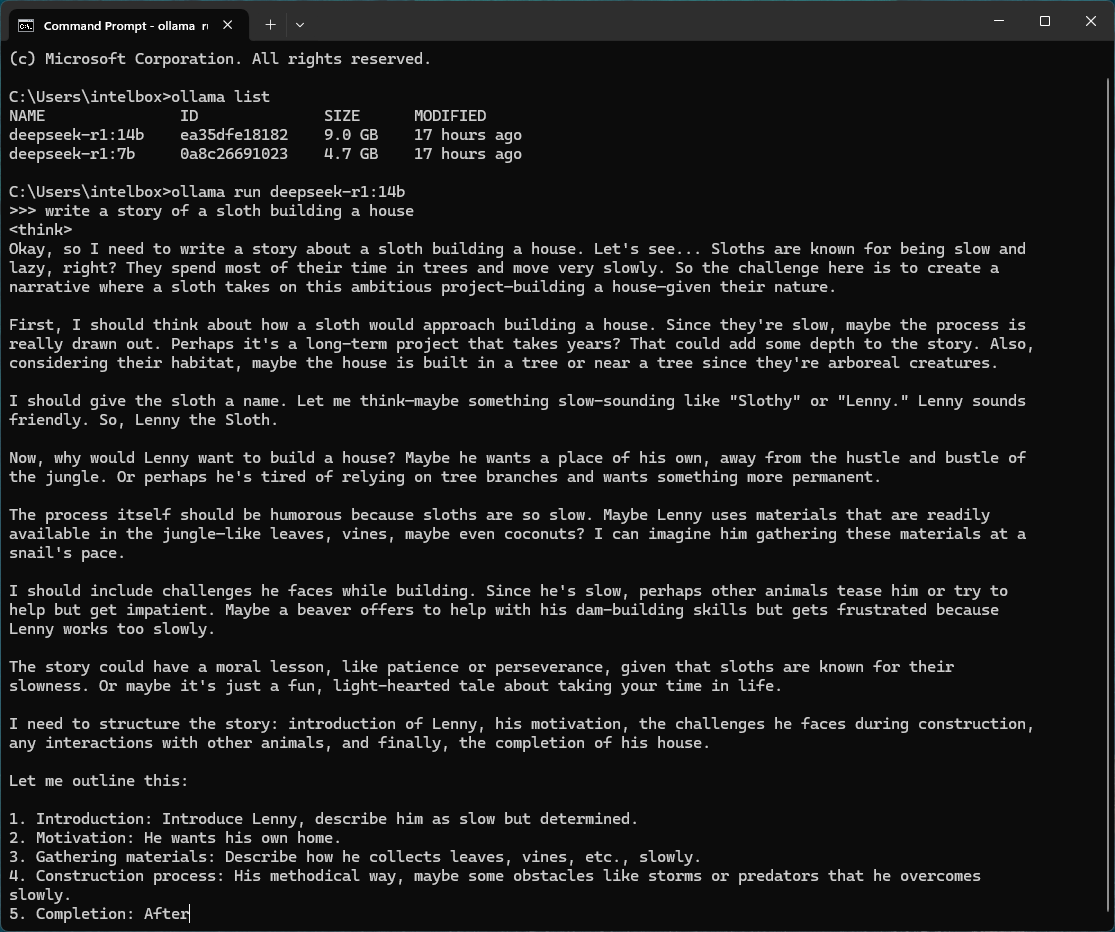
Najlepszy lokalny program nauczania LLM: Ollama
Ollama to domyślna odpowiedź, z którą komunikuje się większość innych narzędzi. Licencjonowany przez MIT, ma około 179 000 gwiazdek na GitHubie i obecnie oferuje graficzny interfejs użytkownika (GUI) dla komputerów stacjonarnych wraz z interfejsem wiersza poleceń (CLI). Pobiera modele jednym poleceniem, udostępnia punkt końcowy zgodny z OpenAI na hoście lokalnym, a w styczniu 2026 roku dodał kompatybilność z API Anthropic Messages, dzięki czemu użytkownicy mogą teraz kierować Claude Code do modelu lokalnego. Minimum: 8 GB pamięci RAM dla modelu 3B, 16 GB dla modeli 7-8B, 24 GB pamięci VRAM dla modelu 30B.
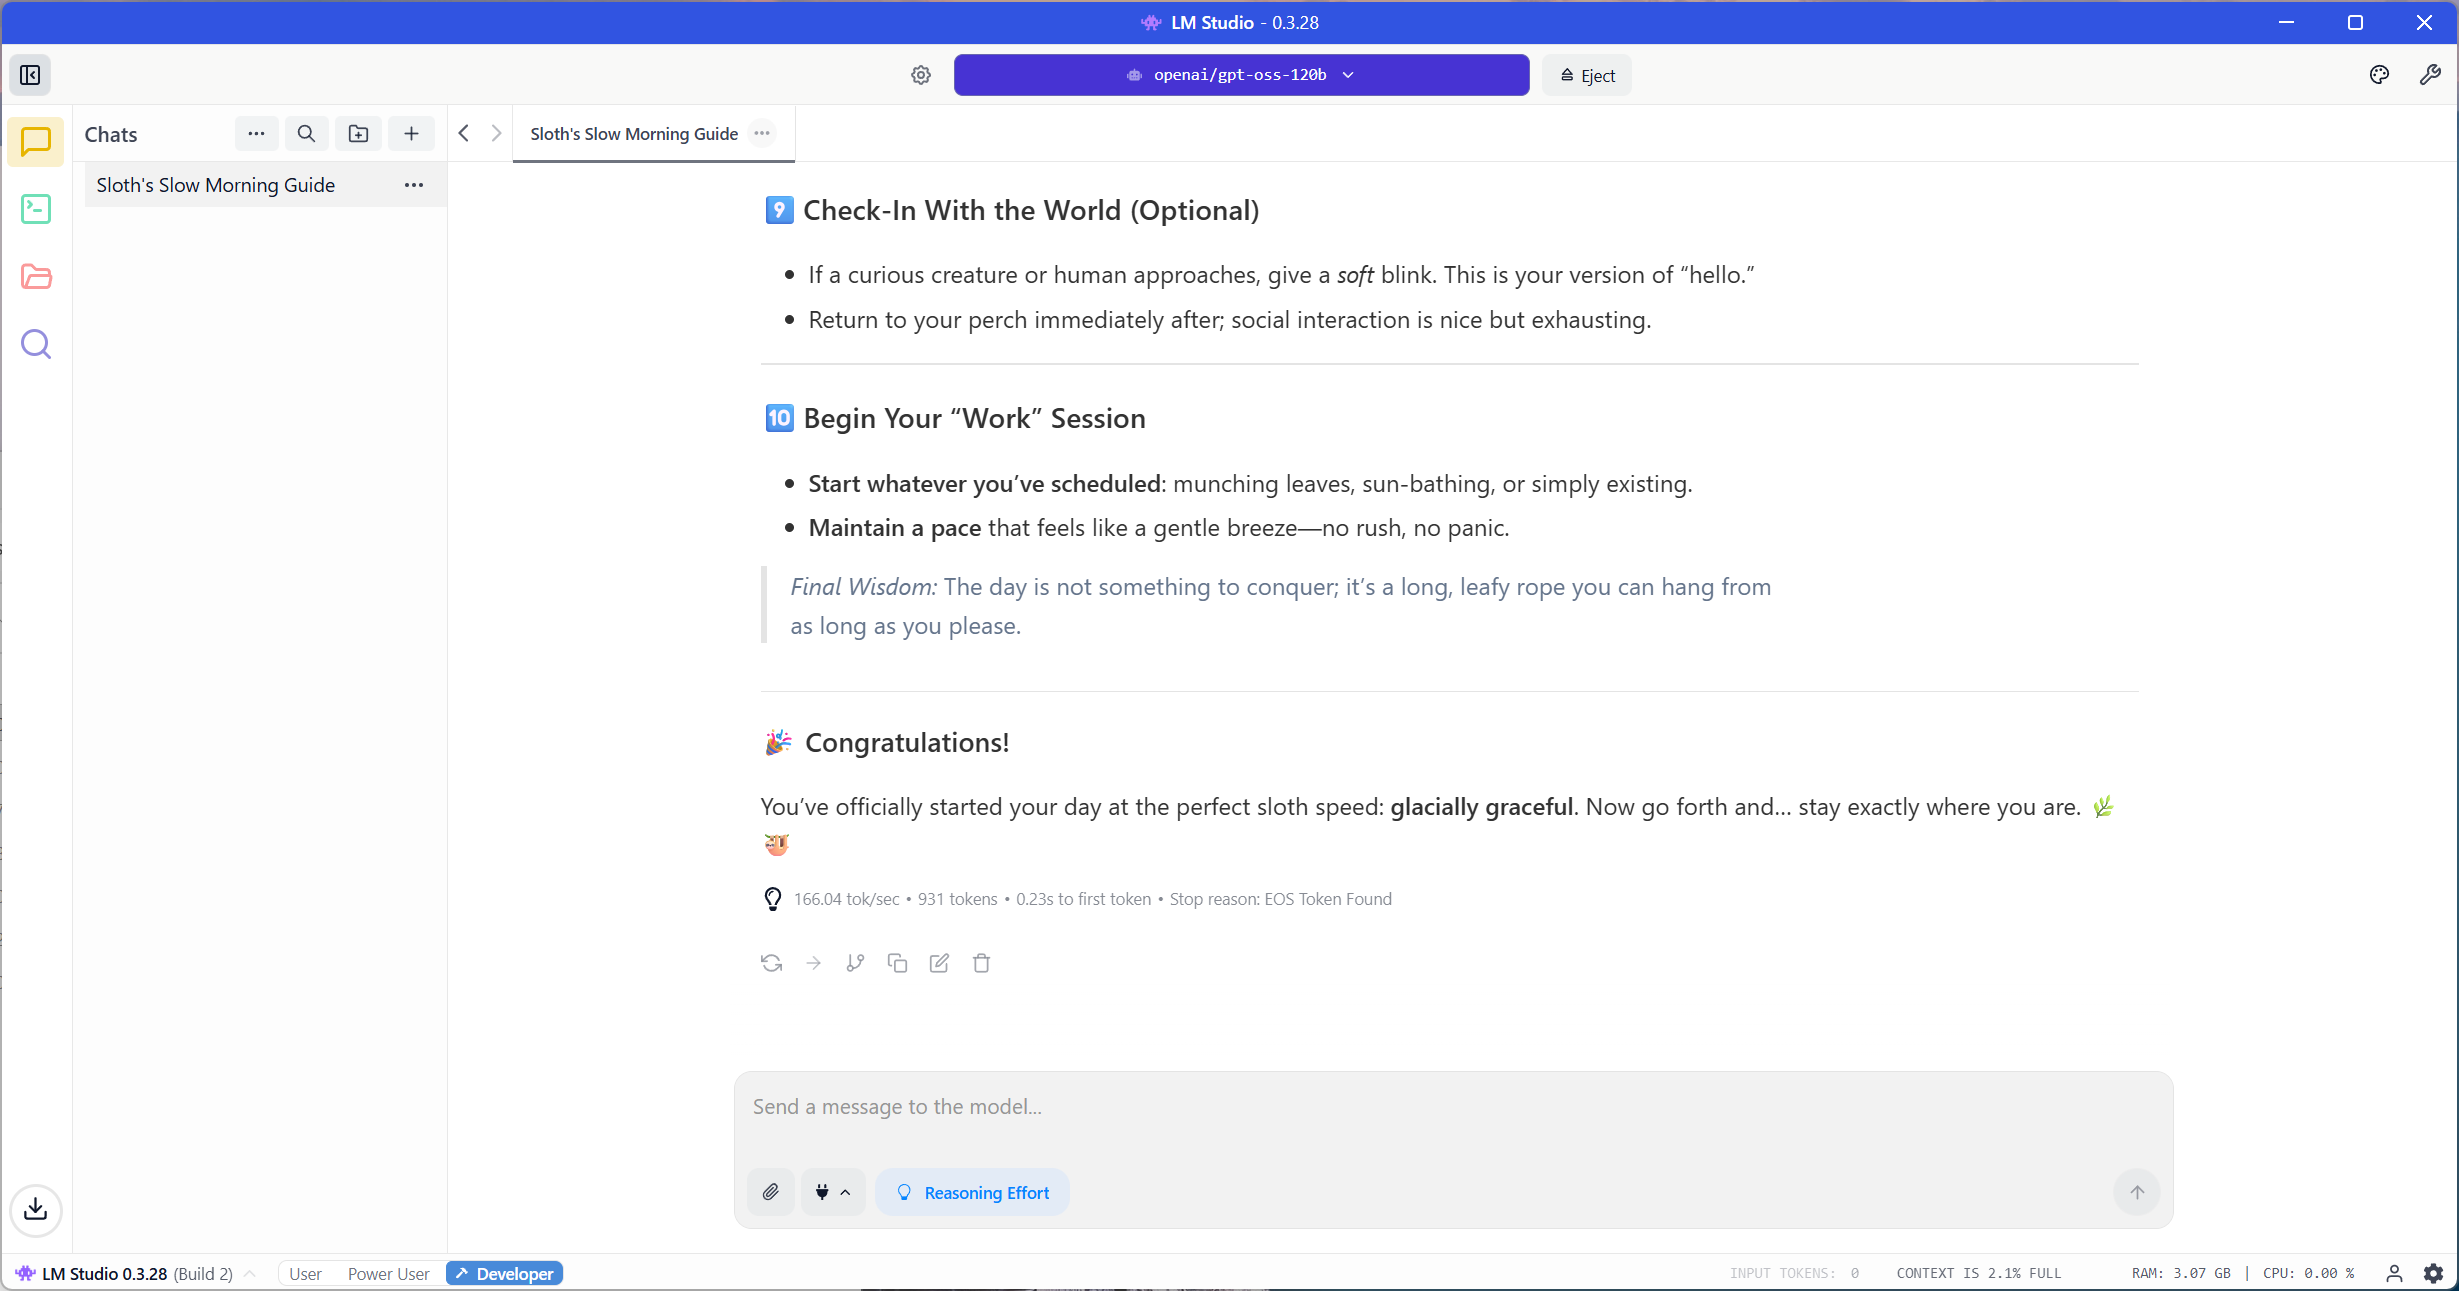
Najlepszy do benchmarkingu sprzętu: LM Studio
Oprogramowanie ma zamknięty kod źródłowy, więc nie ma licznika gwiazdek, ale i tak zasługuje na swoje miejsce. LM Studio zawiera zarówno llama.cpp, jak i MLX i udostępnia funkcje sterowania, które są istotne podczas pomiaru maszyny, a nie tylko jej używania: warstwy odciążające GPU, wybór kwantyzacji, długość kontekstu i obsługę wielu GPU. Jest darmowe do użytku komercyjnego od lipca 2025 roku. To narzędzie odpowiada za większość danych dotyczących tokenów na sekundę na naszych płytach głównych do stacji roboczych i laptopów. Minimum: 16 GB pamięci RAM; 24 GB pamięci VRAM lub 32 GB pamięci zunifikowanej, co powinno być interesujące.
Najlepszy silnik bazowy: llama.cpp
Prawie wszystko inne na tej stronie jest oparte na llama.cpp. Licencja MIT, około 124 700 gwiazdek, z wieloma otagowanymi kompilacjami publikowanymi dziennie. Ma to znaczenie dla odbiorców sprzętu z konkretnego powodu: lista zaplecza jest ogromna, obejmując CUDA, ROCm, Metal, Vulkan, SYCL, CANN i OpenCL, a inżynierowie dostawców teraz bezpośrednio dodają do niej optymalizacje. Ulepszenie prefillu Intel Arc w kompilacji 8688 było warte około 5-krotności, a każdy użytkownik Ollama i LM Studio otrzymał je bez instalowania czegokolwiek. Minimum: działa na samym procesorze; 8 GB pamięci RAM do wykorzystania.
Najlepsza aplikacja desktopowa nastawiona na lokalną obsługę: styczeń
Apache 2.0, około 44 100 gwiazdek, wersja 0.8.6 z października 2026 r. Jan dołącza llama.cpp, więc nie trzeba nic instalować, a aplikacja działa po odłączeniu kabla sieciowego. Brzmi to jak nisko zawieszona poprzeczka, dopóki nie sprawdzisz, ile aplikacji w tej kategorii to klienci chmury z polem Ollama. To jest właśnie to, co można dać koledze, który nigdy nie otworzy terminala.
To również pierwsza platforma na tej stronie, która ma nasze własne statystyki: na naszym zestawie RTX 5000 Ada, Jan V3.5 4B dekodował z medianą 123 tokenów na sekundę, a Jan V2 VL High z 82, wykorzystując 4.8 GB i 8.2 GB pamięci GPU, z włączoną akceleracją GPU przy pierwszym uruchomieniu i bez konfiguracji CUDA. Pełny przewodnik, od instalacji po API zgodne z OpenAI, znajduje się w naszym praktycznym przewodniku Jan ; dokument RAG to jedyna część aplikacji, której nie omówiono. Minimum: 8 GB pamięci RAM.
Najlepszy lokalny dokument RAG: AnythingLLM
MIT, około 64 800 gwiazdek. Zawiera bazę danych wektorów i obsługuje fragmentację i osadzanie bez konfiguracji, co czyni go najbardziej gotowym do użycia czatem dokumentowym w klasie komputerów stacjonarnych. Dwie rzeczy, których nie ukryjemy: luka w zabezpieczeniach z marca 2026 roku oznaczona kodem CVSS 9.6 umożliwiała zdalne wykonanie kodu wyzwalane przez własną odpowiedź strumieniową modelu, co zostało naprawione w wersji 1.11.2, dlatego należy ją zaktualizować przed użyciem. Telemetria jest domyślnie włączona w aplikacji reklamowanej jako local-first, którą można wyłączyć w Ustawieniach. Minimum: 16 GB pamięci RAM do pracy z dokumentami.
Najlepszy samodzielnie hostowany system wielodostępny: Open WebUI
Około 149 000 gwiazdek i najgłębsza konfigurowalność pobierania, a testowaliśmy serwer w wersji 0.12.2. Początkowo był to serwer hostowany samodzielnie z Dockerem jako punktem wejścia, a aplikacja desktopowa Windows instaluje go teraz z dołączonym środowiskiem Pythona i własnym środowiskiem wykonawczym llama.cpp. Przed rozpoczęciem tworzenia na nim warto wiedzieć: licencja została zmieniona w kwietniu 2025 roku z BSD-3 na niestandardową, niezatwierdzoną przez OSI, z klauzulą zakazującą usuwania brandingu Open WebUI, z wyłączeniem poniżej pięćdziesięciu użytkowników w ciągu trzydziestu dni. Uruchom go bez modyfikacji na małą skalę, a nic się nie zmieni.
To druga platforma na tej stronie z naszymi własnymi danymi. Na naszych plikach testowych i modelowych dla Jan, Open WebUI Desktop zdekodował Jan V3.5 4B z medianą 115.32 tokenów na sekundę, a Jan V2 VL High z 75.06, 6.2 i 8.5 procent poniżej Jan w innej kompilacji llama.cpp. Rozbieżności występują w konfiguracji: przypięliśmy kompilację llama.cpp b11612, ręcznie dodaliśmy biblioteki DLL środowiska wykonawczego CUDA i przywróciliśmy kontekst 8,192 tokenów po ponownej instalacji, która pozwoliła na przydzielenie do 169 984 tokenów na slot.
Ustawienia wstępne, wprowadzanie obrazów, wyszukiwanie w internecie DDGS i lokalne API działały, jak szczegółowo opisano w naszym praktycznym przewodniku Open WebUI . Minimum: osobne środowisko uruchomieniowe plus 4 GB na kontener lub aplikacja desktopowa z dołączonym plikiem llama.cpp.
Najlepszy lokalny agent ds. kodowania: Cline
Apache 2.0, około 63 900 gwiazdek. Cline włożył więcej wysiłku w rozwój lokalnej ścieżki niż jakikolwiek konkurent, w tym kompaktowy systemowy monit stworzony specjalnie dla Ollama i LM Studio oraz natywne wywoływanie narzędzi dla każdej rodziny modeli. Ich własna dokumentacja jest niezwykle szczera w kwestii tego, gdzie chmura nadal wygrywa. Minimum: 24 GB pamięci VRAM lub 36 GB pamięci zunifikowanej i ustawiony kontekst na 32 KB lub więcej.
Najlepsze kodowanie terminali offline: Aider
Apache 2.0, około 48 300 gwiazdek, jest architektonicznie najniezawodniejszą opcją lokalną z ważnego powodu. Aider w ogóle nie korzysta z wywołań narzędzi JSON. Analizuje pliki różnicowe i formaty edycji całych plików z poziomu zwykłego tekstu, co pozwala uniknąć trybu awarii, który powoduje awarie większości agentów w modelach lokalnych. Zastrzeżeniem jest konserwacja: jeden autor napisał 96% commitów, a częstotliwość wydań spadła do mniej więcej jednego stabilnego wydania w 2026 roku. Minimum: 24 GB pamięci VRAM lub 36 GB pamięci zunifikowanej.
Najlepsza platforma agentów hostowanych samodzielnie: OpenHands
MIT, około 84 500 gwiazdek. OpenHands poprawnie dokumentuje modele lokalne i, co bardziej przydatne, informuje, kiedy problem nie leży w konfiguracji: w dokumentacji OpenHands stwierdzono, że jeśli agent zachowuje się jak chatbot lub stale powoduje awarie narzędzi, to model stanowi ograniczenie. Wymagany jest minimalny kontekst 22 KB i zalecany jest 32 KB. Minimum: 24 GB pamięci VRAM dla modeli kwantyzowanych lub 64 GB pamięci zunifikowanej.
Najlepsza darmowa niespodzianka offline: GitHub Copilot CLI
Od kwietnia 2026 roku interfejs wiersza poleceń Copilot działa z platformami Ollama, vLLM i Foundry Local. Uwierzytelnianie GitHub jest opcjonalne i subskrypcja Copilot nie jest wymagana. Ustawienie COPILOT_OFFLINE zatrzymuje wszelkie dane telemetryczne i kontakt sieciowy, a jego podagenci dziedziczą dane lokalnego dostawcy. Większość artykułów porównawczych nadal określa go jako dostępny tylko w chmurze. Zwróć uwagę na podział: rozszerzenie IDE nadal wysyła uzupełnienia inline do chmury, nawet w trybie Bring-Your-Own-Key. Minimum: model z oknem kontekstowym 128 KB, czyli 32 GB pamięci VRAM lub 64 GB zunifikowanej pamięci.
Najlepszy serwer wspierany przez dostawcę: Lemonade
Apache 2.0, z oceną około 5,400 gwiazdek, to jedyne narzędzie, które polecilibyśmy wyłącznie ze względu na jego zalety. Zajmują się nim inżynierowie AMD, a działa on na platformach NVIDIA CUDA, Apple Metal, Vulkan i zwykłych procesorach, a także na układach NPU Radeon i Ryzen AI. Wydawany jest mniej więcej co dwa tygodnie, a jego aplikacja desktopowa została przeniesiona z Electron na Tauri w kwietniu 2026 roku. Minimum: 16 GB pamięci RAM; w przypadku układu NPU wymagana jest seria Ryzen AI 300 lub nowsza.
Najlepszy lokalny RAG w całym systemie plików: Nexa AI Hyperlink
Nexa AI Hyperlink jest darmowy i ma zamknięte źródło, indeksuje cały system plików na urządzeniu i odpowiada za pomocą cytowań. Znalazł się na tej liście, ponieważ jest jedynym nowym lokalnym narzędziem RAG z opublikowanymi danymi dotyczącymi przyspieszenia na sprzęcie konsumenckim: około 3 razy szybsze indeksowanie i 2 razy szybsze wnioskowanie na RTX 5090, a czas potrzebny na folder o rozmiarze 1 GB skrócił się z około piętnastu minut do czterech lub pięciu. Minimum: nowoczesna karta graficzna RTX; 16 GB pamięci RAM.
Środowiska wykonawcze: Co uruchamia model
Te pięć to silniki, a wszystko w kolejnych dwóch tabelach to front-end, który komunikuje się z jednym z nich, więc tabela jest uporządkowana według gwiazdek GitHub, tak jak reszta strony.
Kolumna Przewodnik w tym miejscu pokrywa się z aplikacjami, więc ma odpowiedni zakres: Ollama ma własny przewodnik, ponieważ jest wyborem i zapleczem, na które wskazuje większość innych narzędzi, LM Studio pojawia się w obu tabelach i ma jeden przewodnik, llama.cpp jest omówiony w aplikacjach, które go dołączają, zaczynając od praktycznej wersji ze stycznia, a MLX jest omówiony w LM Studio na Apple Silicon. vLLM to silnik serwerowy, a jego test został już wykorzystany w naszej recenzji dwuwieżowego klastra GB300.
| Czas pracy | Gwiazdy | Licencja | Minimalny sprzęt | Przyśpieszenie | Guide |
|---|---|---|---|---|---|
| Ollama | ~ 179,000 | MIT | 8 GB pamięci RAM (3B), 16 GB (7-8B), 24 GB pamięci VRAM (klasa 30B) | CUDA, ROCm, Metal, Wulkan | Wkrótce |
| lama.cpp | ~ 124,700 | MIT | 8 GB pamięci RAM, działa tylko na procesorze | CUDA, ROCm, Metal, Vulkan, SYCL, CANN, OpenCL | Pokryte przez Styczeń oraz Otwórz interfejs WWW praktyczne |
| MLX / mlx-lm | ~ 27,500 | MIT | Apple Silicon, 16 GB zunifikowane | Metal; zaplecze CUDA dodano w 2026 r. | Za pośrednictwem przewodnika LM Studio (wkrótce) |
| Studio LM | Zamknięte źródło | Własnościowe, bezpłatne do użytku komercyjnego | 16 GB pamięci RAM; 24 GB pamięci VRAM lub 32 GB pamięci zunifikowanej | Pakiety llama.cpp i MLX | Wkrótce |
| vLLM | Produkcja serwująca | Apache 2.0 | 24 GB VRAM realistyczny poziom | CUDA, ROCm | Przetestowano w naszym Recenzja klastra GB300 |
Aplikacje na komputery stacjonarne i lokalne RAG
Są to aplikacje instalowane przez czytelnika, a kolumnę Local-First należy przeczytać uważnie: oddziela ona oprogramowanie, które uruchamia model na Twoim komputerze, od oprogramowania, które dodało pole dla adresu URL Ollama.
| aplikacji | Gwiazdy | Licencja | Lokalnie-Najpierw | Minimalny sprzęt | Guide |
|---|---|---|---|---|---|
| Otwórz interfejs WWW | ~ 149,000 | Niestandardowe, niezatwierdzone przez OSI | Zdolny; serwer, plus aplikacja na komputery stacjonarne Windows zawierająca llama.cpp | Osobne środowisko wykonawcze + 4 GB na kontener lub aplikację komputerową | Praktyczny przewodnik po Open WebUI |
| CokolwiekLLM | ~ 64,800 | MIT | Zdolny; telemetria włączona domyślnie | RAM 16GB | Wkrótce |
| Styczeń | ~ 44,100 | Apache 2.0 | Tak, pakiet llama.cpp | RAM 8GB | Praktyczny przewodnik po Janie |
| Studio LM | Zamknięte źródło | Własność | Tak | 16 GB pamięci RAM; 24 GB pamięci VRAM – to może być interesujące | Wkrótce |
| Msty | Zamknięte źródło | Własnościowa, bezpłatna wersja | Tak, pakiety Ollama, MLX, llama.cpp | RAM 8GB | Wkrótce |
| Hiperłącze Nexa AI | Zamknięte źródło | Własnościowy, bezpłatny | Tak, indeksowanie na urządzeniu | Nowoczesny procesor graficzny RTX, 16 GB pamięci RAM | Wkrótce |
Narzędzia kodowania i agentowe
To najbardziej wymagające sprzętowo wpisy na stronie, ponieważ praca agentowa wymaga dużego okna kontekstowego i długich sesji. 32 GB pamięci VRAM lub 64 GB pamięci zunifikowanej to punkt, w którym przestaje to być demonstracją.
| Narzędzie | Gwiazdy | Licencja | Ścieżka lokalna | Minimalny sprzęt | Guide |
|---|---|---|---|---|---|
| Otwarte Dłonie | ~ 84,500 | MIT | LM Studio, Ollama, vLLM, SGLang | 24 GB pamięci VRAM lub 64 GB zunifikowanej; kontekst 32 KB | Wkrótce |
| Cline | ~ 63,900 | Apache 2.0 | Ollama, LM Studio, zgodne z OpenAI | 24 GB pamięci VRAM lub 36 GB zunifikowanej | Wkrótce |
| Gęś | ~ 52,900 | Apache 2.0 | Ollama pierwsza klasa, teraz Linux Foundation | 24 GB pamięci VRAM lub 36 GB zunifikowanej | Wkrótce |
| pomoc | ~ 48,300 | Apache 2.0 | Ollama, zgodny z OpenAI; brak konieczności wywoływania narzędzi | 24 GB pamięci VRAM lub 36 GB zunifikowanej | Wkrótce |
| Zed | v1.0, kwiecień 2026 | Apache 2.0 | LM Studio, Ollama, llama.cpp | 24 GB pamięci VRAM lub 36 GB zunifikowanej | Wkrótce |
| Interfejs wiersza polecenia GitHub Copilot | Zamknięte źródło | Własnościowe, nie wymaga subskrypcji | Ollama, vLLM, Odlewnia Lokalna | 32 GB pamięci VRAM lub 64 GB zunifikowanej; kontekst 128 KB | Wkrótce |
Inicjatywy dostawców
Każdy dostawca układów scalonych i systemów operacyjnych oferuje coś dla lokalnej sztucznej inteligencji, a ta kategoria zasługuje na osobną pozycję, ponieważ nazewnictwo jest mylące, a wskaźnik śmiertelności jest wysoki. Wzorzec w 2026 roku jest spójny: dostawcy przestali konkurować ze stosem rozwiązań innych firm i zaczęli go wspierać. NVIDIA zrezygnowała z obu swoich lokalnych produktów AI i teraz publikuje optymalizacje dla Ollama, llama.cpp i ComfyUI. AMD tworzy wspólną markę z LM Studio. Qualcomm wprowadził możliwości NPU, przenosząc cudzą aplikację.
Jedną rzecz, którą narzędzia dostawców potrafią, a której Ollama i LM Studio nie potrafią, jest dotarcie do NPU . llama.cpp nie ma zaplecza NPU, więc na maszynach ze Snapdragonem lub Ryzen AI narzędzia te pozostawiają silnik neuronowy na zerowym poziomie wykorzystania. Jeśli zapłaciłeś za 40–60 TOPS, korzysta z niego tylko ścieżka dostawcy. Ustaw odpowiednio oczekiwania, ponieważ NPU osiągają obecnie około 7 miliardów modeli, a przewagą jest czas pracy na baterii w trybie ciągłego działania na małych modelach, a nie przepustowość. Oddzielny procesor graficzny zawsze przewyższa NPU pod względem szybkości.
| Sprzedawca | Co to jest | Typ | Wymagany sprzęt | Status | Guide |
|---|---|---|---|---|---|
| Lemoniada AMD | Serwer, interfejs graficzny i zestaw SDK; ~5,400 gwiazdek, Apache 2.0 | Aplikacja + serwer | 16 GB pamięci RAM; Ryzen AI 300+ dla NPU. Działa również na procesorach NVIDIA i Apple. | Aktywny, wysyłka ~co dwa tygodnie | Wkrótce |
| Intel OpenVINO GenAI | Środowisko wykonawcze i SDK; ~10 700 gwiazdek | SDK | Core Ultra, seria Arc A/B; 16 GB pamięci RAM | Aktywny, 2026.3 w sierpniu 2026 | Śledzone, nie zaplanowano żadnego przewodnika |
| Modele Fundacji Apple | Modele na urządzeniu udostępniane przez system operacyjny | Struktura systemu operacyjnego | Apple Silicon; już zainstalowany | Aktywne; otwarte dla każdego dostawcy na WWDC 2026 | Śledzone, nie zaplanowano żadnego przewodnika |
| Microsoft Foundry Local | Lokalny zestaw SDK wnioskowania i interfejs wiersza poleceń; ~2,400 gwiazdek | SDK | Windows, macOS, Linux; NPU/GPU/CPU | GA kwiecień 2026; starannie dobrany katalog modeli | Śledzone, nie zaplanowano żadnego przewodnika |
| AMD GAIA | Lokalna aplikacja LLM dla Ryzen AI; ~1,400 gwiazdek, MIT | Aplikacja + SDK | Co najmniej seria Ryzen AI 300; 16 GB pamięci RAM, zalecane 64 GB | Aktywne, v0.20.0 czerwiec 2026 | Śledzone, nie zaplanowano żadnego przewodnika |
| Plac zabaw Intel AI | Aplikacja na komputer; ~900 gwiazdek | aplikacji | Arc seria A 8 GB+, Arc seria B, Core Ultra | Aktywny, ale nadal beta po dwóch latach | Śledzone, nie zaplanowano żadnego przewodnika |
| Qualcomm GenieX | Środowisko wykonawcze GGUF na urządzeniu dla procesora NPU Snapdragon | Czas pracy | Snapdragon X / X Elite, 8 Elite | Wersja zapoznawcza dla deweloperów, lipiec 2026 r. | Śledzone, nie zaplanowano żadnego przewodnika |
| Projekt NVIDIA G-Assist | Asystent 8B na urządzeniu do sterowania systemem | aplikacji | Seria RTX 20 lub nowsza, 6 GB pamięci VRAM | Aktywny, ale nadal oznaczony jako przedpremierowy | Śledzone, nie zaplanowano żadnego przewodnika |
Nazewnictwo potęguje zamieszanie, ponieważ „RTX AI Garage” firmy NVIDIA brzmi jak produkt, a nim nie jest; to seria blogów. Stos Microsoftu był wielokrotnie zmieniany: interfejsy API środowiska uruchomieniowego Copilot stały się interfejsami API Windows AI, Azure AI Foundry stało się Microsoft Foundry, a DirectML jest teraz w trybie konserwacji, obejmującym jedynie poprawki zabezpieczeń. Qualcomm AI Hub to usługa w chmurze, która zdalnie udostępnia urządzenia fizyczne, a nie jest czymś, co można uruchomić lokalnie.
Co zwykle się psuje
Większość zgłoszeń o „niedziałaniu” modeli lokalnych wynika z problemów konfiguracyjnych, a nie z problemów z modelem. Cztery z nich w szczególności odpowiadają za znaczną część z nich i wszystkie cztery są informacjami, które odbiorcy sprzętu powinni znać, zanim zrzucą winę na krzem.
1. Ollama domyślnie używa kontekstu 4,096 tokenów. Nie zgłasza błędu po jego przekroczeniu. Po cichu kończy działanie, a pętla agenta kończy działanie bezgłośnie. Każda poważna uprząż potrzebuje więcej: OpenHands wymaga co najmniej 22 KB i zaleca 32 KB, Codex wymaga 32 KB, Copilot CLI wymaga 128 KB, a Cline ustawia 262 144. To pojedyncze ustawienie jest prawdopodobnie najczęstszą przyczyną raportów o błędach, które można znaleźć w Internecie.
2. Kwantyzacja pamięci podręcznej KV pogarsza w szczególności wywoływanie narzędzi , zanim ogólna jakość wyników ulegnie widocznemu pogorszeniu. Dokumentacja llama.cpp ostrzega o tym bezpośrednio. Jeśli używasz agenta, wyłącz go.
3. Liczba narzędzi to klif, a nie zbocze. Powyżej około pięciu lub sześciu narzędzi w zakresie, niektóre modele po cichu przestają emitować prawidłowe wywołania narzędzi JSON i zamiast tego zaczynają osadzać XML w treści odpowiedzi, co w uprzęży jest interpretowane jako „brak użytego narzędzia”. Jeden z popularnych agentów domyślnie dostarczał jedenaście narzędzi i psuł swój własny zalecany model aż do początku 2026 roku. Natknęliśmy się na wersję tego problemu podczas naszych testów Open WebUI, gdzie wbudowane instrukcje narzędziowe przesunęły krótkie żądanie benchmarku poza kontekst 8,192 tokenów. Praktyczna konsekwencja jest sprzeczna z intuicją: obciążenie wielu serwerów MCP jest szkodliwe dla modeli lokalnych w sposób, w jaki nie jest szkodliwe dla modeli granicznych.
4. Q4_K_M to próg praktyczny. Poniżej niego niezawodność wywołań narzędzi spada szybciej niż ogólna jakość, więc model nadal brzmi dobrze, choć po cichu nic nie robi.
Pamięć jest ograniczeniem
W przypadku każdego narzędzia na tej stronie, pytanie, które decyduje o tym, co można uruchomić, to ilość pamięci, jaką akcelerator może zobaczyć. To są pary, które najczęściej pojawiają się w kontekście pracy agentów i które zamierzamy zweryfikować w laboratorium.
| sprzęt komputerowy | Model | Ślad stopy | Zgłoszona przepustowość |
|---|---|---|---|
| RTX 5090, 32 GB | Qwen3.6-35B-A3B Q4_K_M | ~ 21GB | 160-180 tok/s, 262 tys. kontekstu |
| RTX 5090, 32 GB | Qwen3-Coder-30B-A3B Q4_K_M | ~ 19GB | 50-90 tok/s na karcie 24 GB |
| RTX 5090, 32 GB | Devstral Small 24B Q4_K_M | ~ 14GB | Zbudowany specjalnie do wywoływania narzędzi |
| RTX PRO 6000, 96 GB | GPT-OSS 120B MXFP4 | ~ 63GB | Klasa 100B na pojedynczej karcie stacji roboczej; procesor graficzny z naszej recenzji laboratoryjnej |
| Laptop RTX PRO 5000, 24 GB GDDR7 | Qwen3-Coder-30B-A3B Q4_K_M | ~ 19GB | Największy procesor graficzny do laptopów, jaki testowaliśmy (ThinkPad P16 Gen 3); klasa 30B idealnie pasuje do kontekstu |
| 96-128 GB zunifikowane, seria M | gpt-oss-120b Q6_K | ~ 93GB | 14-20 tok/s; najczystszy kod JSON wywołania narzędzia spośród wszystkich modeli o otwartej wadze |
Warto o tym wspomnieć, bo marketing tego nie potwierdza: największe modele open-weight nie są stacjami roboczymi. GLM-5.2 ma około 744 B parametrów i potrzebuje około 744 GB w FP8, który jest węzłem centrum danych z ośmioma GPU. Kimi K2 i DeepSeek V4 należą do tej samej kategorii. Wszelkie instrukcje dotyczące uruchamiania ich na komputerach stacjonarnych są błędne.
Powyższe dane dotyczące przepustowości pochodzą z opublikowanych testów zewnętrznych i materiałów dostawców i nie odzwierciedlają jeszcze wyników badań laboratoryjnych StorageReview, z wyjątkiem danych z dekodowania Jan i Open WebUI w powyższych typach. Zastąpimy je naszymi własnymi danymi, gdy każdy typ przejdzie przez proces Przewodnika.
Narzędzia w chmurze i dlaczego nie są tu klasyfikowane
Agent lokalny nie jest modelem lokalnym . Poniższe narzędzia pokazują różnicę: każdy z nich działa na Twojej maszynie, jednocześnie wysyłając każde wywołanie wnioskowania do chmury dostawcy.
| Narzędzie | Wsparcie modelu lokalnego | Note |
|---|---|---|
| Kursor | Nie | Oficjalna dokumentacja podaje, że wszystkie żądania przechodzą przez serwery Cursor; niestandardowe klucze działają tylko z głównymi dostawcami usług chmurowych, a uzupełnianie za pomocą klawisza Tab zawsze korzysta z modeli Cursor. Przejęty przez SpaceX w 2026 roku. |
| Devin Desktop (był Windsurf) | Nie | Zmiana nazwy w czerwcu 2026 r. Każdy model jest hostowany w chmurze |
| Google Antygrawitacja | Nie | W dokumentacji wyraźnie podano, że nie można używać Ollama, LM Studio ani niestandardowego punktu końcowego |
| Interfejs wiersza poleceń Gemini | Nie | Lokalne wsparcie istnieje tylko w forkach społecznościowych |
| Qodo | Nie | „Na miejscu” odnosi się do infrastruktury hostowanej samodzielnie, która nadal nazywana jest modelami chmurowymi |
| GitHub Copilot w IDE | Częściowa | Czat może korzystać z modeli lokalnych; uzupełnianie w trybie inline pozostaje w chmurze nawet w przypadku korzystania z własnego klucza |
| ChatGPT | Nie | Aplikacje desktopowe i mobilne są klientami modeli chmurowych OpenAI. Otwarte modele gpt-oss OpenAI działają lokalnie, ale za pośrednictwem powyższych środowisk wykonawczych, a nie za pośrednictwem aplikacji ChatGPT. |
| Claude | Nie | Aplikacje Claude i Cowork działają w oparciu o modele chmurowe Anthropic. Kod Claude można skierować do modelu lokalnego za pośrednictwem kompatybilnego z Anthropic API Ollama, co działa, ale jest to nieobsługiwana konfiguracja. |
| Asystenci agentów ogólnych | Nie | Narzędzia w tej klasie działają na Twoim komputerze, ale do wnioskowania wykorzystują model chmury |
Istnieje szeroko rozpowszechniony rodzaj poradników „połącz Cursora z Ollamą”. Własna dokumentacja Cursora im przeczy. Jeśli praca w trybie offline jest dla Ciebie wymagana, to rozróżnienie jest kluczowe.
A co z generowaniem obrazów i filmów?
Lokalne generowanie obrazów to jedna z największych społeczności w lokalnej sztucznej inteligencji. Już samo ComfyUI góruje nad większością narzędzi wymienionych wyżej przez gwiazdy GitHuba, a lokalne generowanie wideo wyłania się jako najbardziej wymagające zadanie dla użytkowników, jakie istnieją. Zasługuje na własną tabelę wyników i ją zdobędzie; dodanie czwartej kategorii do tej strony pogrzebałoby ją. Do tego czasu logika sprzętowa na tej stronie przenosi się bezpośrednio: przetwarzanie obrazów i wideo jest jeszcze bardziej ograniczone pamięcią niż modele językowe, a obowiązują te same poziomy.
Jak działa ta strona
Rankingiem rządzą trzy zasady. Pierwsza z nich to, że na razie kolejność jest ustalana na podstawie gwiazdek GitHub. Nie jest to rozwiązanie idealne, ale neutralne, weryfikowalne i nie wymaga od nas udawania, że przetestowaliśmy rzeczy, których nie przetestowaliśmy. Narzędzia o zamkniętym kodzie źródłowym są oznaczone jako takie i nie otrzymują żadnej wymyślonej oceny. Ponieważ nasze własne testy generują wyraźne faworyty, kolejność ulegnie zmianie, aby odzwierciedlać zmierzone wyniki, o czym poinformujemy; Jan i Open WebUI mają teraz za sobą numery laboratoryjne, więc ta zmiana już się rozpoczęła. Po drugie, każdy wpis ma minimalną ilość pamięci, ponieważ to ona decyduje o załadowaniu modelu.
Po trzecie, kolumna „Przewodnik” to zobowiązanie dotyczące wybranych opcji: każda wybrana opcja jest omawiana w praktyce, z uwzględnieniem naszych danych na naszym sprzęcie, środowisko uruchomieniowe dostarczane w ramach aplikacji jest omówione w tym przewodniku, a inicjatywy dostawców są śledzone w ich tabeli bez przewodnika. Link pojawia się tutaj po publikacji każdego przewodnika.
Często zadawane pytania dotyczące lokalnych narzędzi LLM
Od którego lokalnego narzędzia LLM powinienem zacząć?
Ollama, jeśli czujesz się komfortowo w terminalu, LM Studio, jeśli wolisz okno z kontrolkami, i Jan, jeśli chcesz czegoś, co działa od razu i nigdy nie wymaga instalacji niczego dodatkowego. Wszystkie trzy są darmowe, wszystkie działają całkowicie offline i wszystkie korzystają z llama.cpp, więc model działania jest taki sam. Różnica tkwi w interfejsie, a nie w szybkości.
Co się stało z NVIDIA ChatRTX, GPT4All i Continue.dev?
Zniknęły, podobnie jak zaskakująco duża liczba ich konkurentów, i to jest najważniejsza informacja, jaką należy znać, zanim zastosuje się starsze zalecenie. NVIDIA ChatRTX została wycofana 21 stycznia 2026 roku, jej repozytorium zostało zarchiwizowane, a forum wsparcia zablokowane, bez podania nazwy następcy.
GPT4All to najtrudniejszy przypadek: nie miał żadnych commitów od dwunastu miesięcy, a jego ostatnia wersja ukazała się w lutym 2025 roku, ale repozytorium nie jest zarchiwizowane i nadal wyświetla dużą liczbę gwiazdek, więc wygląda na żywe. Obsługiwał tylko wąski zestaw formatów kwantyzacji i nie może załadować większości aktualnych wersji modeli.
Usługa Continue.dev , przez dwa lata standardowa rekomendacja dla kodowania w modelu lokalnym, została przejęta przez Cursor i zamknięta w czerwcu 2026 roku. Usługa Roo Code została zamknięta w maju 2026 roku, usługa Void została zarchiwizowana w czerwcu 2026 roku, usługa Twinny w listopadzie 2025 roku, a usługa Reor w marcu 2026 roku. Usługa Khoj została zakończona w kwietniu 2026 roku, choć wersja hostowana samodzielnie nadal istnieje. Po stronie dostawcy, usługa Intel IPEX-LLM została zarchiwizowana w styczniu 2026 roku i oznaczona jako znana luka w zabezpieczeniach bez opublikowanej ścieżki migracji, a pakiet NVIDIA RTX AI Toolkit został wycofany w listopadzie 2025 roku.
Ile pamięci VRAM potrzebuję do przeprowadzenia lokalnego egzaminu LLM?
W przypadku czatu, 8 GB pamięci RAM obsługuje model 3B, a 16 GB obsługuje model 7-8B, co jest akceptowalne, korzystając wyłącznie z procesora. Aby uzyskać użyteczną szybkość, model powinien być wyposażony w pamięć VRAM lub pamięć zunifikowaną: 16 GB obsługuje klasę 7-14B, 24 GB osiąga klasę 30B w Q4, a 32 GB lub więcej to miejsce, w którym kodowanie agentowe przestaje być frustrujące. Powyżej tej wartości pojemność ma większe znaczenie niż przepustowość, dlatego komputery z pamięcią zunifikowaną o pojemności 96-128 GB obsługują modele, których nie obsługuje żadna karta graficzna dla użytkowników indywidualnych.
Czy lokalne narzędzia LLM korzystają z mojego NPU?
Zazwyczaj nie, ponieważ llama.cpp nie ma zaplecza NPU, więc Ollama i LM Studio pozostawią silnik neuronowy na poziomie zerowym na maszynie AI opartej na Snapdragonie lub Ryzen i będą działać na procesorze CPU lub GPU. Osiągnięcie NPU wymaga obecnie ścieżki od dostawcy: Qualcomm GenieX, AMD Lemonade z jego środowiskiem uruchomieniowym NPU, Intel OpenVINO lub Neural Engine firmy Apple za pośrednictwem frameworków systemu operacyjnego. Korzyścią jest żywotność baterii i energooszczędna praca w trybie ciągłym, ponieważ NPU osiągają obecnie poziom około 7 miliardów modeli, a oddzielny GPU zawsze przebije go pod względem przepustowości.
Czy powinienem uruchomić lokalną sztuczną inteligencję w systemie Windows czy Linux?
W przypadku aplikacji desktopowych wymienionych na tej stronie, systemy Windows i macOS działają płynniej. LM Studio, Jan, AnythingLLM i Ollama instalują się natywnie, sterowniki GPU pochodzą ze standardowych lokalizacji i nic nie wymaga terminala. Linux zasługuje na utrzymanie o jeden poziom niżej: silniki obsługujące produkcję, vLLM i SGLang, są zorientowane na Linuksa, co skutecznie zakłada obsługę wielu GPU, a niektóre z najnowszych ścieżek akceleracji trafiają tam przed innymi, w tym obsługa NPU Ryzen AI firmy AMD, która pojawiła się w Linuksie i wymaga bardzo nowego jądra.
Różnica jest mniejsza niż kiedyś. AMD ujednoliciło swoje wersje ROCm dla systemów Windows i Linux w 2026 roku, a WSL2 obejmuje większość pozostałych, dzięki czemu narzędzia oparte na Dockerze, takie jak Open WebUI, działają bezproblemowo na komputerach z systemem Windows. Praktyczna zasada: jeśli instalujesz aplikacje z tabeli aplikacji desktopowych, pozostań przy swoim systemie operacyjnym; jeśli budujesz dedykowaną maszynę serwerową lub podążasz za każdą ścieżką przyspieszenia, zbuduj ją na Linuksie.
Czy modele lokalne są wystarczająco dobre, aby zastąpić model chmurowy w kodowaniu?
Zależy to całkowicie od zadania, a podział jest ostrzejszy, niż pozwala na to większość pokrycia. W przypadku pracy ograniczonej, generowania pojedynczych plików, testów jednostkowych, szablonów i objaśniania kodu, obecne modele otwarte na dobrej stacji roboczej są mniej więcej na równi z modelami chmur granicznych. W przypadku pracy agentowej o długim horyzoncie czasowym, refaktoryzacji wielu plików w dużym repozytorium, wyraźnie przegrywają, a tryby awarii są nieprzyjemne: ciche operacje bezczynności i pewnie raportowane prace, które nigdy nie miały miejsca. Jeśli powodem przejścia na model lokalny jest prywatność, wymagania dotyczące izolacji powietrznej lub koszty, jest to wykonalne już dziś. Jeśli powodem są możliwości, to jeszcze nie.
Czy uruchamianie modelu lokalnie jest bezpieczniejsze niż korzystanie z usługi w chmurze?
Jeśli chodzi o rezydencję danych, tak, i to właśnie dlatego większość osób wybiera rozwiązania lokalne. Jeśli chodzi o bezpieczeństwo oprogramowania, domyślnie odpowiedź brzmi: nie: lokalna aplikacja AI z oceną CVSS 9.6 z marca 2026 roku może zostać zmuszona do wykonania kodu na hoście przez strumieniowe dane wyjściowe modelu, ponieważ aplikacja desktopowa została spakowana z niebezpiecznymi domyślnymi ustawieniami. Lokalność oznacza, że dane pozostają na swoim miejscu, ale nie oznacza to, że oprogramowanie jest zabezpieczone, ponieważ ta kategoria zawiera dużo szybko zmieniającego się kodu.
Czym jest piaskownica agenta AI i czy potrzebuję jej do lokalnej sztucznej inteligencji?
Sandbox to odizolowane środowisko, zazwyczaj kontener lub lekka maszyna wirtualna, w którym agent AI wykonuje generowane polecenia i kod, dzięki czemu błąd lub złośliwa instrukcja nie może wpłynąć na system hosta. Istnieje, ponieważ agenci robią więcej niż tylko odpowiadają na pytania: uruchamiają polecenia powłoki, edytują pliki i przeglądają, a każda z tych czynności jest sterowana danymi wyjściowymi modelu, którymi można manipulować. Lokalne uruchomienie modelu w ogóle nie zmienia tej matematyki.
Sandboxing polega na izolowaniu tego, co robi agent, a nie tego, gdzie znajduje się model, a luka w zabezpieczeniach umożliwiająca wykonanie kodu opisana powyżej dokładnie to potwierdza w przypadku aplikacji lokalnych. Niektóre narzędzia opisane na tej stronie mają wbudowaną funkcję sandboxingu, a te, które uruchamiają agentów z nieograniczonym dostępem do hosta, zasługują na bliższe przyjrzenie się, zanim zetkną się z maszyną, na której Ci zależy. Wraz z rozwojem aplikacji dla agentów w środowisku biznesowym, spodziewaj się, że sandboxing stanie się kluczową funkcją i zaczniemy brać go pod uwagę przy ocenie tych narzędzi.
Czy sprzęt lokalny może obsługiwać obciążenia agentów z dziesiątkami podagentów?
To jest granica, a krótka odpowiedź brzmi: pojedyncza stacja robocza szybko się wyczerpuje. Obciążenia wieloagentowe generują pod-agenty, z których każdy zawiera własny kontekst, a po stronie wnioskowania, każdy aktywny kontekst oznacza własną pamięć podręczną KV w pamięci, więc rozmiar skaluje się wraz z współbieżnością, a także rozmiarem modelu. To, gdzie te pamięci podręczne trafią, gdy przekroczą limit pamięci, stanowi odrębny problem inżynieryjny; nasza dogłębna analiza odciążania pamięci podręcznej KV do pamięci flash , oparta na sprzęcie Dell i Solidigm, jest najlepszym opublikowanym przez nas omówieniem tego tematu.
Maszyna, która komfortowo obsługuje jedną sesję agenta klasy 30B, zazwyczaj może obsłużyć kilka sesji równoległych za pośrednictwem serwera wsadowego, zanim opóźnienie spadnie; dziesiątki współbieżnych subagentów to obszar działania serwera, z wystarczającą ilością pamięci, aby pomieścić wiele aktywnych kontekstów i silnikiem obsługującym, takim jak vLLM, zbudowanym do ciągłego wsadowego przetwarzania. Istnieje również pułap jakości, ponieważ modele lokalne tracą niezawodność wraz ze wzrostem liczby narzędzi, a orkiestracja mnoży narzędzia i przekazania.
Naszym zdaniem praca z jednym agentem lub kilkoma agentami to obecnie legalne zadanie dla stacji roboczych, a duże floty podagentów to zadanie infrastrukturalne. Tę granicę i sprzęt potrzebny do jej przekroczenia planujemy zbadać znacznie dokładniej.


 Amazon