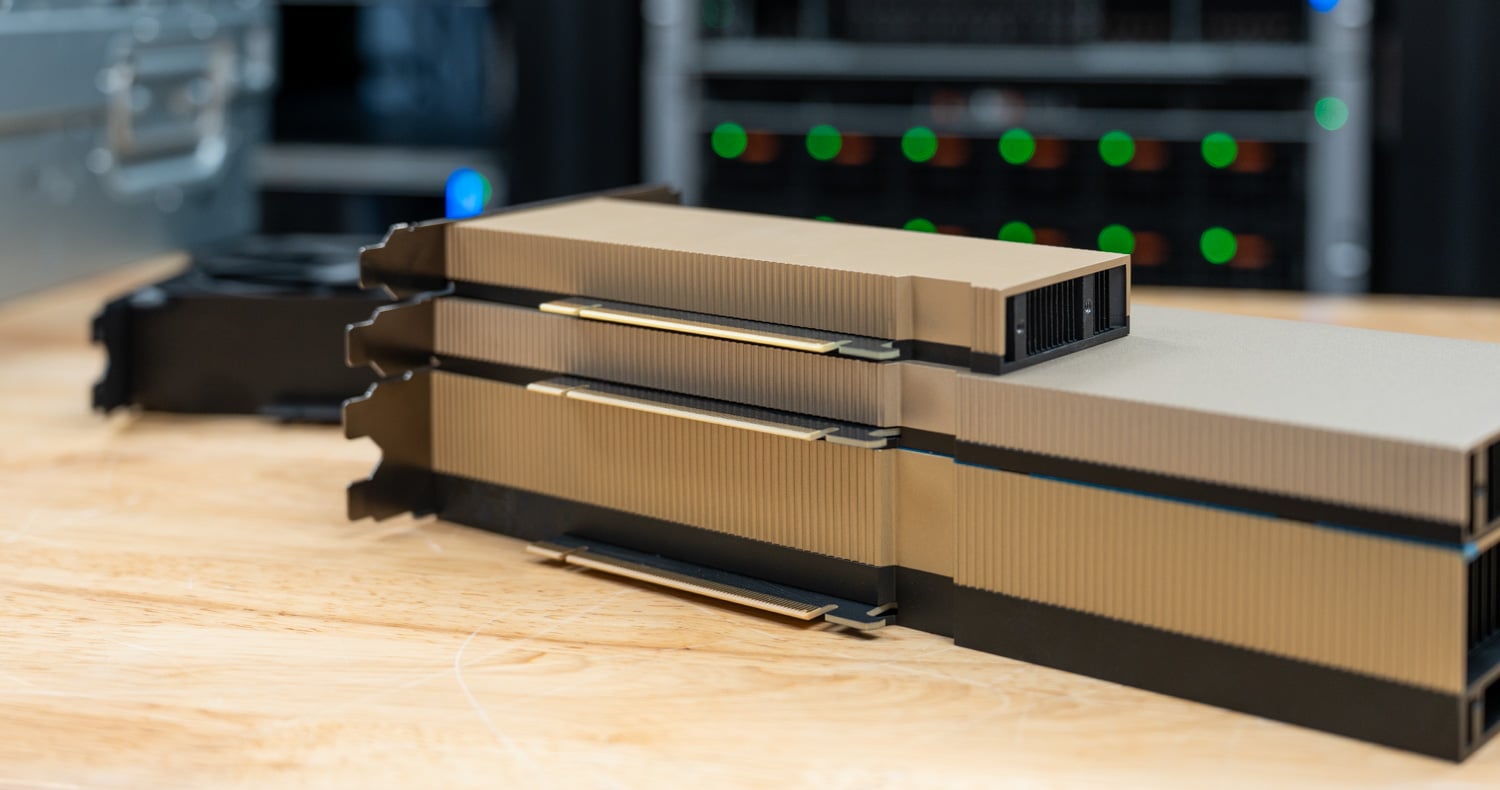
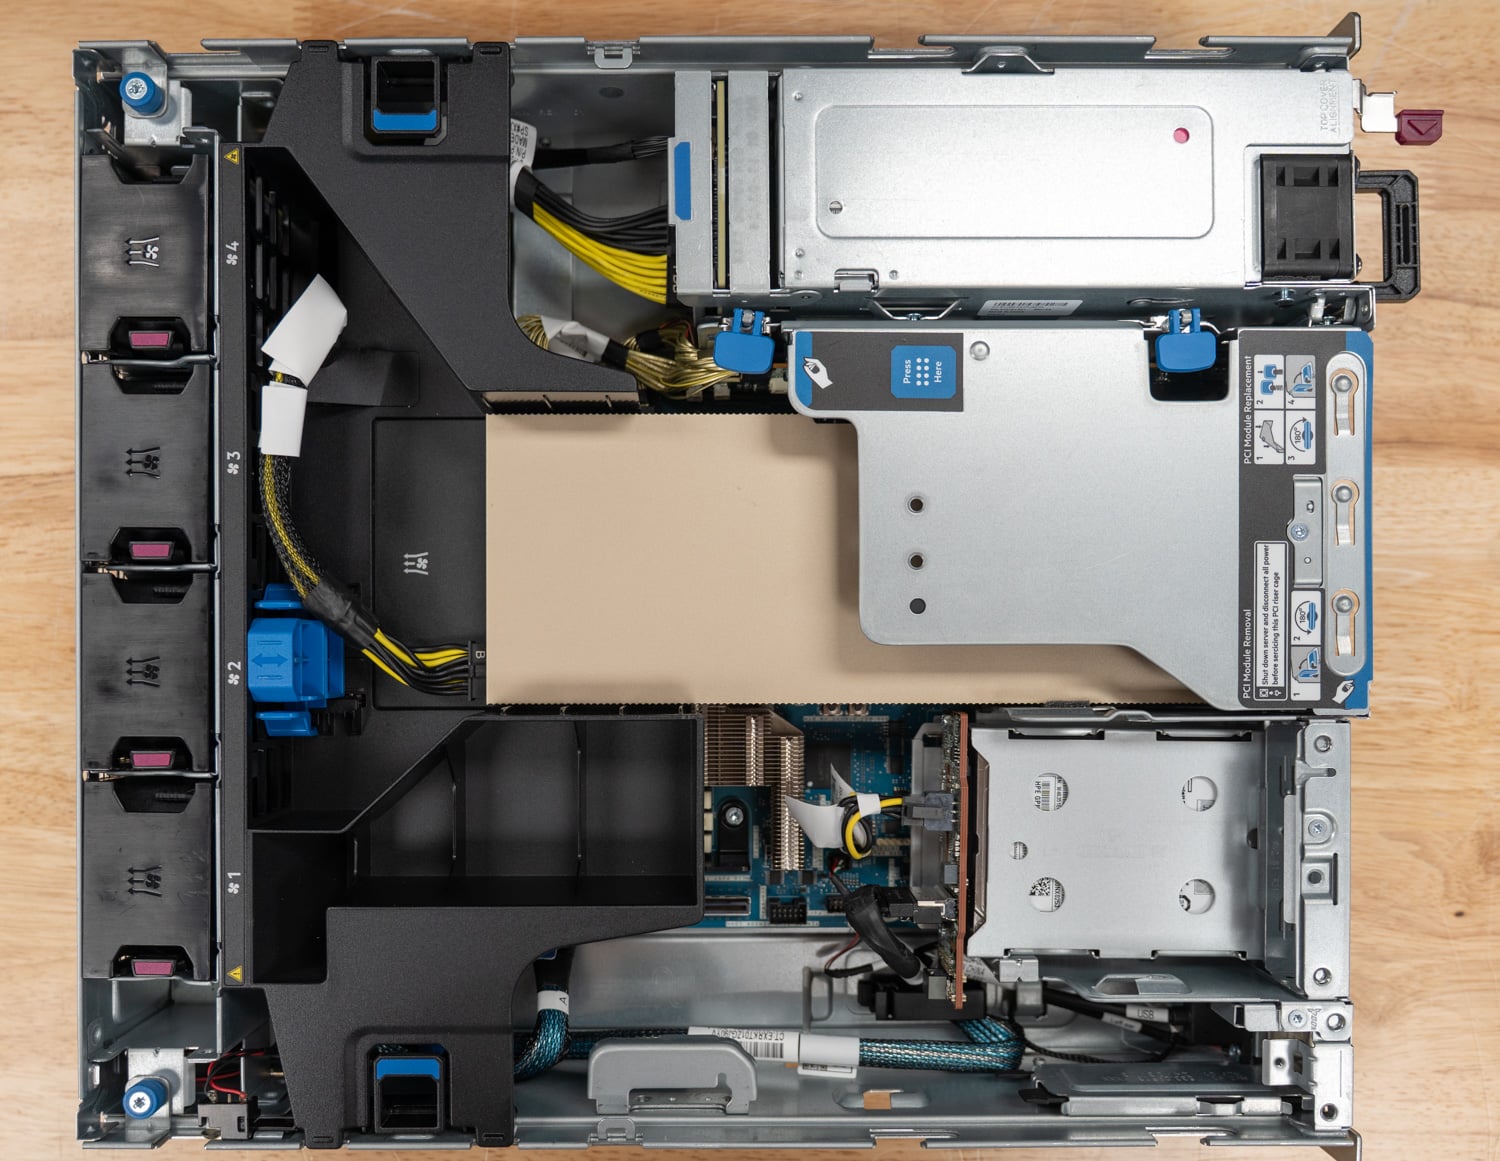
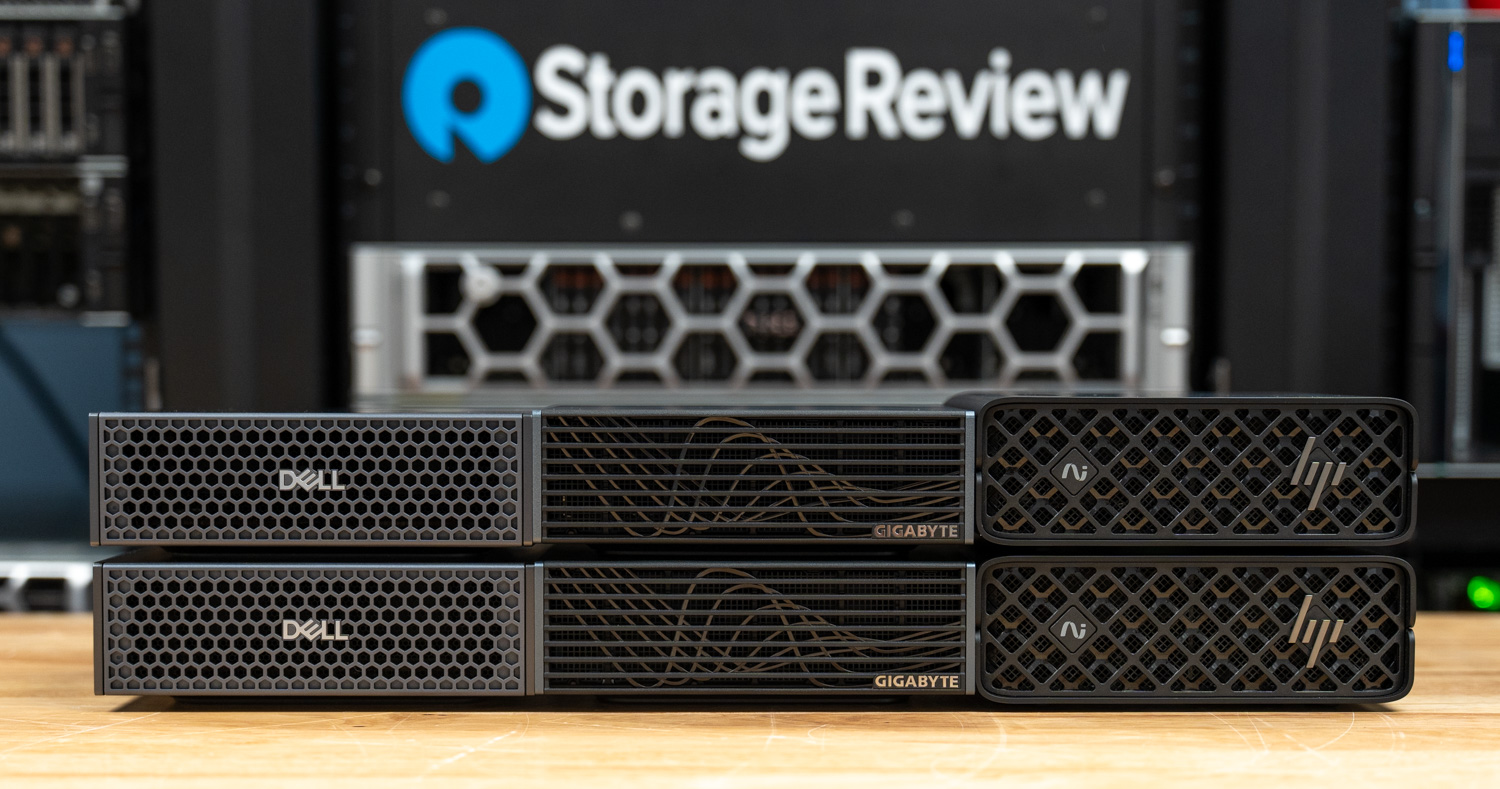
Nasze obecne przeglądy systemów AI koncentrują się na wnioskowaniu laboratoryjnym, z modelami o otwartej wadze z rodzin Llama, Qwen, DeepSeek i gpt-oss, działającymi w vLLM lub SGLang i mierzonymi pod kątem przepustowości wyjściowej i opóźnienia pierwszego tokena. Pokrycie rozciąga się od brzegu sieci do pełnego węzła GPU: karta NVIDIA RTX PRO 4500 Server Edition zapewniła medianę 2.7 razy większą liczbę tokenów wyjściowych na sekundę niż L4, którą miała zastąpić w serwerze HPE ProLiant DL145 Gen11, przy około 105 W większym zużyciu energii na wyjściu; wersje DGX Spark firmy Dell, GIGABYTE i HP uruchomiły rozproszone wnioskowanie jako dwuwęzłowe klastry w strukturze 200 Gb; a Supermicro JumpStart umożliwił nam praktyczne testy z systemami NVIDIA HGX B200 i AMD Instinct MI350X. Pamięć masowa traktowana jest w ten sam sposób, ponieważ ścieżka danych decyduje o tym, jak zajęte są poszczególne procesory GPU. Dlatego mierzymy przepustowość pamięci masowej GPUDirect za pomocą GDSIO i testujemy odciążanie pamięci podręcznej KV do pamięci flash w przypadku obciążeń długokontekstowych i agentowych.
Jeśli planujesz wielkość sprzętu pod kątem sztucznej inteligencji, strona Best Servers przedstawia nasze aktualne wnioski dotyczące sztucznej inteligencji oraz wybrane rozwiązania brzegowe na podstawie danych z tych recenzji; Best Enterprise SSDs obejmuje dyski zasilające procesory GPU, a Best Storage Arrays omawia platformy pamięci masowej dla sztucznej inteligencji, na których opierają się klastry szkoleniowe i neochmury.




 Amazon