

Fio to skrót od Flexible IO, wszechstronnego generatora obciążeń IO. W 2005 roku Jens Axboe, twórca i autor stosu IO w jądrze Linuksa, był zmęczony ciągłym pisaniem jednorazowych programów testowych do benchmarkingu lub weryfikacji zmian w podsystemie IO Linuksa. W rezultacie powstało fio, które miało znacznie ułatwić pracę. Było wystarczająco elastyczne, aby umożliwić szczegółowe konfiguracje obciążeń, i zawierało niezbędne raporty, pozwalające na interpretację danych po ich zakończeniu. Jens kontynuował pracę nad fio, gdy dołączył do Oracle, a później do Fusion-io. Obecnie społeczność użytkowników fio jest aktywna i zaangażowana w rozwój, w związku z czym stale rozwija fio i wdraża nowe funkcje. Ponad 100 osób przyczyniło się do rozwoju fio, a wiele z nich robiło to wielokrotnie. Dzięki temu zaangażowaniu nowa wersja fio jest wydawana mniej więcej co 4-6 tygodni, a fio jest szeroko wykorzystywane jako standard branżowy, narzędzie do testów obciążeniowych oraz do weryfikacji IO.
Główny zestaw funkcji i możliwości
Dwiema głównymi cechami dobrego benchmarku są możliwość uruchomienia żądanego obciążenia i uzyskania pożądanych jednostek wyjściowych. Elastyczność była (i nadal jest) głównym celem fio. Obsługuje ono opcje obciążenia, których nie ma w innych benchmarkach, wraz z rygorystycznie szczegółowymi statystykami wejścia/wyjścia. Łatwo jest zdefiniować dowolny rodzaj losowej i sekwencyjnej kombinacji wejścia/wyjścia, lub kombinacji odczytu/zapisu. Wewnętrzna konstrukcja fio jest również elastyczna. Definiowanie obciążenia jest całkowicie niezależne od silnika wejścia/wyjścia (termin używany przez fio do określenia sposobu dostarczania wejścia/wyjścia do jądra). Na przykład, aby uruchomić obciążenie z natywnym asynchronicznym przetwarzaniem w systemie Linux, a następnie porównać to samo obciążenie w systemie Windows, wystarczy zmienić pojedynczą linię silnika wejścia/wyjścia na wersję natywną w systemie Windows. Lub, jeśli chcesz uzyskać bardziej szczegółowe statystyki percentyli opóźnień na końcu rozkładu, to również jest proste. Wystarczy określić interesujące Cię percentyle, a fio będzie je śledzić.
Choć początkowo program fio został opracowany dla systemu Linux, obszary w fio, które nie są powiązane z funkcjami specyficznymi dla systemu operacyjnego, działają na każdej platformie, od Windowsa, przez HP-UX, po Androida. Dostępne są również natywne silniki wejścia/wyjścia (IO) dla systemów Linux, Windows, Solaris i innych. Jest to kluczowa funkcja w środowiskach mieszanych, w których chcesz móc uruchamiać (jak najbardziej zbliżone) obciążenia w różnych systemach operacyjnych. Co więcej, fio jest zazwyczaj uruchamiane bezpośrednio na komputerze docelowym, ale obsługuje również połączenia sieciowe. Możesz uruchomić serwer back-end na komputerze docelowym (lub komputerach docelowych), a front-end do gromadzenia danych na komputerze klienckim. Ułatwia to zarządzanie fio, zwłaszcza jeśli jest często używane na wielu komputerach.
Fio to przede wszystkim tekstowa aplikacja CLI, choć początkowo istniało wsparcie dla wieloplatformowego interfejsu graficznego opartego na gtk (gfio). W momencie publikacji, gfio jest dołączone do najnowszej wersji fio, v2.1, i powinno być dość stabilne. Może ono służyć jako interfejs graficzny dla dowolnego obciążenia obsługiwanego przez klienta CLI. Zapewnia również podstawowe wsparcie dla zadań edycji GUI i obciążeń, choć pełne wsparcie jest wciąż w fazie rozwoju, ponieważ prace nad gfio są w toku.
Fio obsługuje również trzy różne formaty wyjściowe. Domyślnym formatem jest „klasyczny”, który generuje statystyki obciążenia na końcu zadania. Dostępny jest również format CSV, choć jego popularność stopniowo maleje na rzecz formatu wyjściowego opartego na JSON. Ten drugi jest znacznie bardziej elastyczny i ma tę zaletę, że jest łatwy do analizy zarówno dla ludzi, jak i komputerów.
Fio dynamicznie się rozwija dzięki synergii dynamicznej społeczności użytkowników i programistów. Jest łatwiejsze w obsłudze niż konkurencyjne projekty, wystarczająco elastyczne, aby sprostać zadaniom użytkowników, a jego narzut jest na tyle niski, że pozwala na pełną wydajność dowolnego systemu pamięci masowej. Dodaj do tego bogatsze opcje i funkcje raportowania niż w przypadku innych rozwiązań dostępnych na rynku, a otrzymasz doskonałe narzędzie.
Dlaczego StorageReview.com korzysta z FIO
Wraz ze wzrostem liczby i szczegółowości naszych testów pamięci masowej dla przedsiębiorstw, potrzebowaliśmy lepszego narzędzia do testów porównawczych, aby precyzyjnie mierzyć wydajność różnych produktów pamięci masowej w różnych systemach operacyjnych. Tradycyjne oprogramowanie do generowania obciążeń, takie jak Iometer czy Vdbench, oferuje ograniczoną kompatybilność z systemami operacyjnymi, które nie są ich natywnymi wersjami, lub ma trudności ze skalowaniem obciążeń dla wysokowydajnych urządzeń pamięci masowej, takich jak akceleratory aplikacji PCIe czy wydajne sieciowe pamięci masowe. Od momentu wdrożenia FIO rozwiązało ono wiele z tych problemów, a nawet poszło o krok dalej, wspierając skryptowanie w długich okresach testowania. Ta ogólna funkcjonalność sprawia, że jest to nasz syntetyczny benchmark pierwszego wyboru we wszystkich testach korporacyjnych.
W naszych recenzjach używamy FIO do pomiaru wydajności urządzenia pamięci masowej w danym okresie czasu. W przypadku większości produktów obejmuje to 6 godzin kondycjonowania wstępnego przed przejściem do testów głównych. W przypadku większych urządzeń pamięci masowej PCIe, które mogą nie osiągnąć stanu ustalonego przez wiele godzin testów, kondycjonujemy je dwukrotnie dłużej – przez 12 godzin przed rozpoczęciem testów głównych. Nasz syntetyczny proces testowania pamięci masowej dla przedsiębiorstw rozpoczyna się od analizy działania dysku podczas dokładnej fazy kondycjonowania wstępnego. Każdy z porównywalnych produktów jest najpierw bezpiecznie kasowany za pomocą narzędzi producenta, a następnie kondycjonowany do stanu ustalonego z tym samym obciążeniem, z jakim urządzenie będzie testowane, przy dużym obciążeniu 16 wątków i kolejce oczekującej na 16 wątków na wątek. Na zakończenie procesu testujemy w ustalonych odstępach czasu, wykorzystując wiele profili głębokości wątków/kolejek, aby pokazać wydajność przy lekkim i intensywnym użytkowaniu.
Wstępne kondycjonowanie i podstawowe testy stanu stacjonarnego:
- Przepustowość (łączna liczba operacji wejścia/wyjścia na sekundę odczytu i zapisu)
- Średnie opóźnienie (średnie opóźnienie odczytu i zapisu)
- Maksymalne opóźnienie (maksymalne opóźnienie odczytu lub zapisu)
- Odchylenie standardowe opóźnienia (uśrednione odchylenie standardowe odczytu i zapisu)
Nasza analiza syntetycznego obciążenia przedsiębiorstwa obejmuje różne profile odzwierciedlające niektóre zadania w warunkach rzeczywistych. Profile te zostały opracowane, aby ułatwić porównywanie z naszymi poprzednimi testami porównawczymi, a także z powszechnie publikowanymi wartościami, takimi jak maks. prędkość odczytu i zapisu 4k oraz 8k 70/30, powszechnie stosowana w sprzęcie korporacyjnym.
- 4k
- 100% odczytu lub 100% zapisu
- 100% 4k
- fio –filename=/dev/sdx –direct=1 –rw=randrw –refill_buffers –norandommap –randrepeat=0 –ioengine=libaio –bs=4k –rwmixread=100 –iodepth=16 –numjobs=16 –runtime=60 –group_reporting –name=4ktest
- 8k 70/30
- 70% czytania, 30% pisania
- 100% 8k
- fio –filename=/dev/sdx –direct=1 –rw=randrw –refill_buffers –norandommap –randrepeat=0 –ioengine=libaio –bs=8k –rwmixread=70 –iodepth=16 –numjobs=16 –runtime=60 –group_reporting –name=8k7030test
Obecnie do testów wydajności systemu Linux wykorzystujemy wersję FIO 2.0.7 (x64) w systemie CentOS 6.3, a do testów wydajności systemu Windows — wersję FIO 2.0.12.2 (x64) w systemie Windows Server 2008 R2 SP1.
Platformy testowe StorageReview Enterprise
Rozwiązania pamięci masowej są testowane syntetycznym testem FIO w laboratorium testowym StorageReview Enterprise, wykorzystując serwery autonomiczne. Wykorzystujemy serwery HP ProLiant DL380/DL360 Gen9, aby wykazać realistyczną wydajność, zmieniając jedynie adapter pamięci masowej lub interfejs sieciowy, aby połączyć nasze serwery DL380/DL360 z różnymi produktami pamięci masowej. Serwery DL380/DL360 udowodniły swoją doskonałą kompatybilność z urządzeniami innych firm, co czyni je doskonałą platformą do tego zróżnicowanego środowiska testowego.
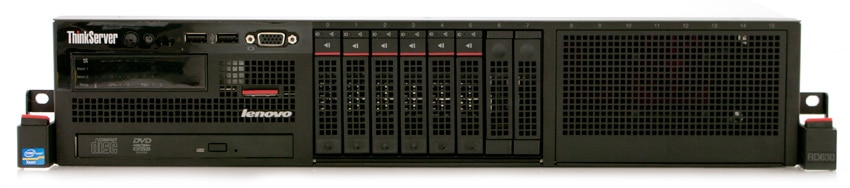
(Gen1) Lenovo ThinkServer RD240
- 2 x Intel Xeon X5650 (2.66 GHz, pamięć podręczna 12 MB)
- Chipset Intel 5500+ ICH10R
- Pamięć – 8 GB (2 x 4 GB) 1333 MHz DDR3 Registered RDIMM
- Windows Server 2008 Standard Edition R2 SP1 64-bit i CentOS 6.2 64-bit
- Karta HBA LSI 9211 SAS/SATA 6.0 Gb/s
(Gen2) Lenovo ThinkServer RD630
- 2 x Intel Xeon E5-2620 (2.0 GHz, pamięć podręczna 15 MB, 6 rdzeni)
- Chipset Intel C602
- Pamięć – 16 GB (2 x 8 GB) 1333 MHz DDR3 Registered RDIMM
- Windows Server 2008 R2 SP1 64-bitowy, Windows Server 2012 Standard, CentOS 6.3 64-bitowy
- 100GB Micron RealSSD P400e Dysk SSD rozruchowy
- Karta HBA LSI 9207-8i SAS/SATA 6.0 Gb/s (do testowania dysków SSD lub HDD)
(Gen 3) HP ProLiant DL380 / DL360 Gen9
- Dwa procesory Intel E5-2667 v3 (3.2 GHz, 8 rdzeni, pamięć podręczna 20 MB)
- 256 GB pamięci RAM (16 GB x 16 DDR4, 128 GB na procesor)
- Windows Server 2012 R2, CentOS 7.0
- Dysk SSD rozruchowy 400 GB – Windows
- Dysk twardy rozruchowy 300 GB – Linux
- Karta HBA LSI 9300-8e SAS/SATA 12.0 Gb/s (Do testowania dysków SSD lub HDD)
- Supermicro SuperChassis 846BE1C-R1K28B SAS3 JBOD (do podłączania dysków SSD lub HDD)


 Amazon