

Jeśli regularnie śledzisz StorageReview, być może widziałeś na żywo relację z badania oceanów przeprowadzonego przez Uniwersytet Stanowy Oregonu. Porozmawialiśmy z Chrisem Sullivanem, dyrektorem ds. badań i informatyki akademickiej na Uniwersytecie Stanowym Oregonu, aby lepiej zrozumieć, jak technologia pomaga naukowcom badać życie oceaniczne i jaki ma to wpływ na środowisko globalne.
Brian spotkał się z Chrisem na SC25, aby omówić ten temat. Rzadko piszemy o tym, jak technologia jest wykorzystywana w rzeczywistych sytuacjach, takich jak badania planktonu na Uniwersytecie Stanowym Ohio, więc ten artykuł i podcast dały nam taką możliwość.
Kiedy Brian i Chris rozmawiają o badaniach prowadzonych na Uniwersytecie Stanowym Oregonu, widać autentyczną ekscytację postępem technologii wspierających trwające badania oceaniczne. Chris pracuje na Uniwersytecie Stanowym Oregonu od ponad 24 lat, a od trzech lat pełni funkcję dyrektora ds. bioinformatyki.
Ten podcast na żywo pokazuje entuzjazm Chrisa dla nauki i technologii. Nazywał SC25 „krainą słodyczy”.
To żywa i szczera dyskusja (z odrobiną humoru), która oferuje rzetelne spostrzeżenia na temat tego, jak badania naukowe wykorzystują technologię, by dostarczać wyniki w czasie rzeczywistym.
To krótki podcast wart wysłuchania, ale jeśli masz mało czasu, przygotowaliśmy transkrypcję, która pozwoli Ci przejść bezpośrednio do najistotniejszych fragmentów.
0:00 – 5:00
Przekształcenie statku badawczego w pływający superkomputer
Chris Sullivan z Oregon State University wyjaśnia, w jaki sposób nowe technologie radykalnie zmieniają sposób prowadzenia badań oceanograficznych, w szczególności szeroko zakrojonych badań planktonu prowadzonych ze statków, które w zasadzie są małymi, pływającymi centrami danych.
- Technologia to nie tylko „fajny sprzęt”, ona bezpośrednio zmienia jaka nauka jest możliwa i stopień błędu systematycznego w wynikach.
- Błąd naukowy: ograniczone lub przekłamane próbki prowadzące do błędnych wniosków; lekarstwem jest więcej punktów danych w większej liczbie lokalizacji.
- Cel: Zbieranie ogromnych, zróżnicowanych zbiorów danych, aby analizy statystyczne nie były zniekształcane przez próbkowanie tylko jednego miejsca lub jednego zestawu warunków.
- Tradycyjne konfiguracje HPC wymuszały kompromis: szybkie lokalne dyski NVMe/SSD o ograniczonej pojemności kontra duże, ale wolniejsze systemy pamięci masowej pierwszej warstwy.
- W przypadku dużych eksperymentów Chris musiał korzystać z pamięci masowej warstwy pierwszej w całym klastrze, ponieważ pamięć masowa na poziomie węzła (warstwy zerowej) była zbyt mała, aby pomieścić ogromne zestawy danych.
- Duże, współdzielone „superpody” stały się niezbędne do zasilania procesorów GPU, ale są drogie i ich wdrożenie w terenie lub na morzu jest nierealne.
5:00 – 10:00
Ocean Robots, Plankton i rejs za milion dolarów
W tej sekcji zagłębimy się w to, co faktycznie dzieje się na statku — w jaki sposób holowane są instrumenty, jak przechwytywane są ogromne ilości danych obrazowych i dlaczego przetwarzanie w czasie półrzeczywistym jest tak istotne, skoro czas spędzony na statku kosztuje około 1 mln dolarów za 10-dniowy rejs.
- Nowy statek badawczy, wspierany przez NSF, zbudowano na wzór „miniaturowego Enterprise ze Star Treka”, wyposażono w najnowocześniejszy sprzęt i ułożono na nim około 200 mil kabli na łodzi o długości 200 stóp.
- Wcześniej Chris musiał toczyć swoje własny instalować sprzęt komputerowy na statku, prowadzić światłowody korytarzami i działać bez odpowiedniego pokładowego centrum danych.
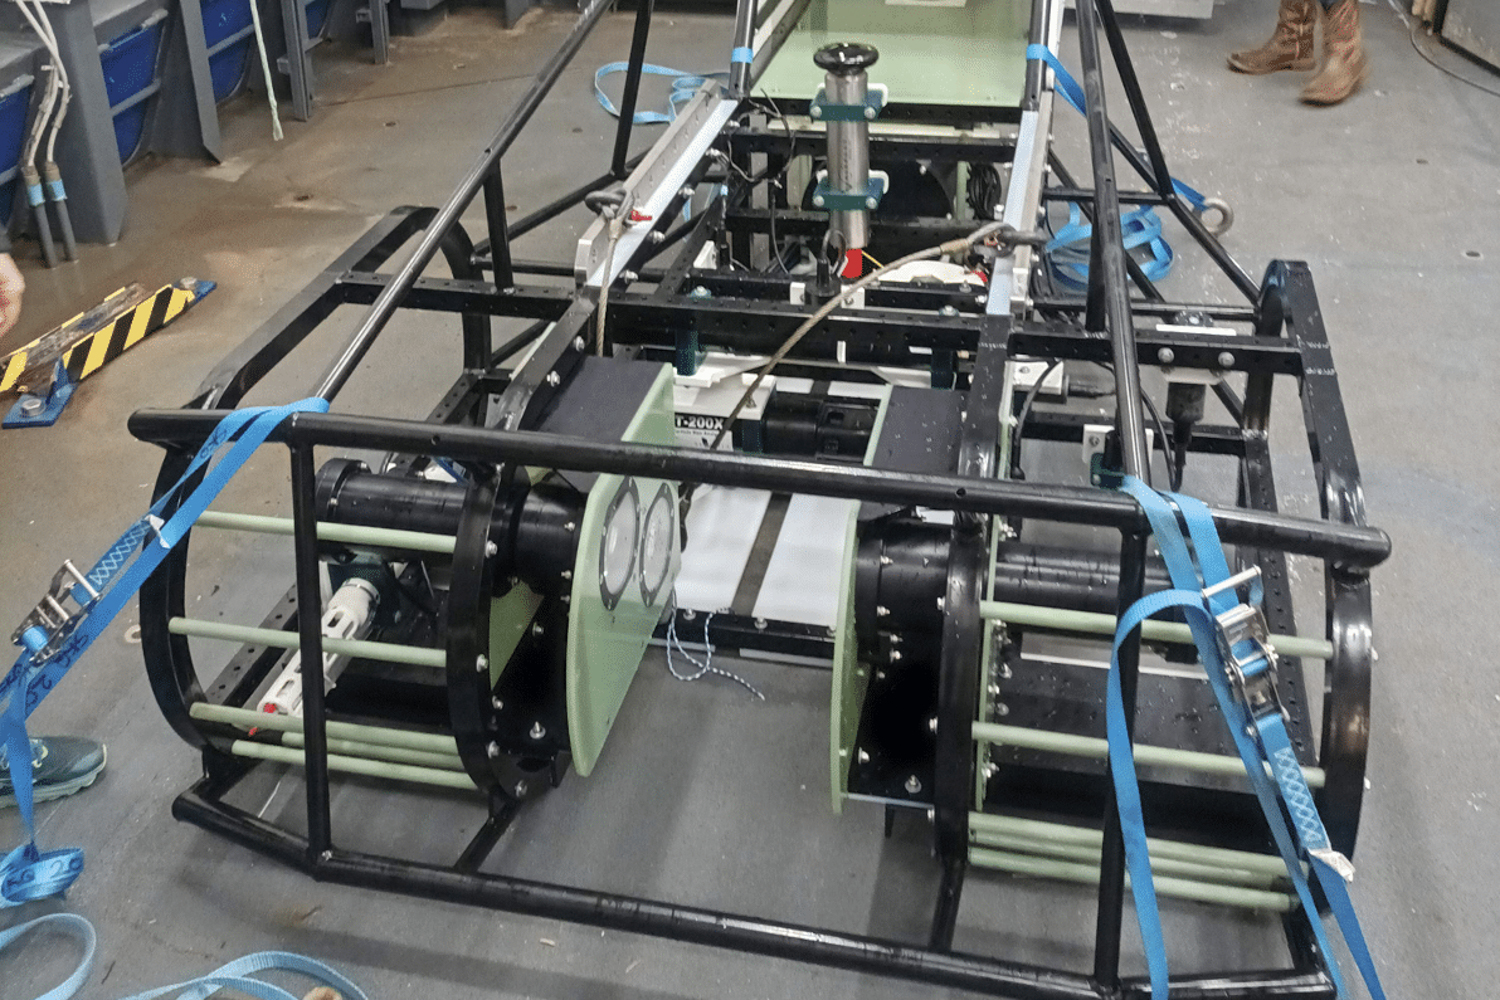
- System planktonu: holowane urządzenie porusza się w górę i w dół w wodzie z prędkością 5 węzłów, pobierając około 162 litrów wody na sekundę i generując około 10 GB danych obrazowych na minutę.
- Pojedynczy 10-dniowy eksperyment z planktonem: ok. 100 TB surowych danych; po przetworzeniu, segmentacji i klasyfikacji ilość ta zwiększa się do ok. 300–400 TB użytecznych danych.
- Muszą przetwarzać te informacje w czasie niemal rzeczywistym; w przeciwnym razie 10-dniowy rejs o wartości 1 mln dolarów może powrócić z błędnymi lub bezużytecznymi danymi i bez możliwości zmiany kursu statku.
- Plankton w dużej mierze podlega wpływom prądów (nie jest dobrym pływakiem), a mimo to ma kluczowe znaczenie: odpowiada za ok. 50% tlenu na Ziemi, ok. 25% pochłaniacza dwutlenku węgla, ok. 17% globalnej żywności na mieszkańca i stanowi podstawę morskiej sieci pokarmowej.
10:00 – 15:00
Sztuczna inteligencja Edge na morzu i w lesie
Teraz uwaga skupia się na szerszym problemie „brzegu”: jak przenieść obliczenia bliżej miejsca, w którym powstają dane — na łodziach, w stacjach straży i w lasach wypełnionych autonomicznymi czujnikami.
- Nowe systemy oparte na dyskach SSD o dużej pojemności pozwalają im budować prawdziwy poziom zero na jednym urządzeniu: przechowuj setki TB danych, przetwarzaj je w czasie półrzeczywistym i nigdy więcej ich nie przenoś.
- Wcześniejsze testy z mniejszymi dyskami NVMe wymagały ciągłego odciążania w celu zwolnienia miejsca, co marnowało cenną przepustowość wejścia/wyjścia i spowalniało obliczenia.
- Na statku nie ma praktycznie żadnego personelu IT; jedną osobą zarządzają systemy statku i nie zajmują się eksperymentami, więc studenci studiów podyplomowych i doktoranci muszą sami zarządzać sprzętem i procesami.
- Wynika z tego wymóg projektowy: proste, solidne potoki i autonomiczne urządzenia — bez kruchej sieci macierzy, mocowań i woluminów.
- Na skraju lasu (np. w projekcie Owl) działa około 5,000 autonomicznych jednostek nagrywających i jest w stanie zidentyfikować około 130 gatunków ptaków wyłącznie na podstawie dźwięku.
- Problem: ludzie nadal muszą zbierać karty SD; zanim dane powrócą, znaczna część wartości czasowej zniknie. Przetwarzanie brzegowe ma na celu wydobycie spostrzeżeń. natychmiast w punkcie przejęcia.
15:00 – 20:00
Dopasowanie odpowiednich procesorów graficznych i pamięci masowej do zadania
W tym artykule autorzy omawiają strategię GPU, szkolenie oparte na Omniverse i wyjaśniają, dlaczego pamięć flash o dużej pojemności jest tak samo ważna jak surowe dane obliczeniowe dla sztucznej inteligencji i wizualizacji naukowej.
- Chris podkreśla użycie właściwy Procesor graficzny do tego zadania: duże, drogie akceleratory (np. H100/Hopper, „grasshoppers”) powinny skupić się na szkoleniu, podczas gdy bardziej ekonomiczne karty, takie jak RTX 6000, zajmują się wnioskowaniem na dużą skalę.
- Historycznie rzecz biorąc, panowało zamieszanie: zbyt wiele nakładających się na siebie jednostek SKU GPU, niejasne „ścieżki pływackie” i mnóstwo pieniędzy marnowanych na przesadnie wydajny sprzęt służący do prostego wnioskowania.
- Karty RTX 6000 pełnią podwójną rolę: umożliwiają wydajne wnioskowanie oraz oferują funkcje graficzne i renderujące, których brakuje procesorom graficznym przeznaczonym wyłącznie do centrów danych.
- Budują cyfrowego bliźniaka statku Omniverse, aby:
- Prowadź wirtualne szkolenia dla studentów i doktorantów, podczas gdy statek jest na morzu.
- Zaplanuj rozmieszczenie urządzeń i załadunek sprzętu w ciasnych, ruchomych przestrzeniach.
- Unikaj marnowania kosztownego czasu na statku na podstawowe szkolenia i konfiguracje metodą prób i błędów.
- Na poruszającym się statku wszystko, co ma ruchome części, stanowi zagrożenie. Ze względu na niezawodność i odporność preferowane jest przechowywanie danych w pamięci półprzewodnikowej.
- Dyski SSD o dużej pojemności i małej mocy pozwalają na wykorzystanie większej liczby procesorów GPU, zmniejszają potrzebę stosowania oddzielnych macierzy i zmniejszają całkowitą ilość zajmowanego miejsca na sprzęcie.
20:00 – 25:00
Od szafek na dokumenty do oceanów połączonych światłowodami
Oddalając się od tematu, w jaki sposób tanie przechowywanie danych umożliwiło rozwój nowoczesnej sztucznej inteligencji, w jaki sposób obserwatoria oceaniczne przesyłają dane na brzeg oraz dlaczego połączenie sieci i przechowywania danych umożliwia rozwój nowych dziedzin nauki.
- Chris twierdzi, że prawdziwym odkryciem sztucznej inteligencji nie była nowa matematyka – większość modeli pochodzi z lat 1950. i 70. XX wieku – ale tani dysk twardy z lat 1990. XX wieku, w wyniku którego dane zostały przeniesione z szafek na nośniki umożliwiające wyszukiwanie i przetwarzanie.
- W „erze szafek na dokumenty” dysponowaliśmy tonami danych, ale brakowało nam informacji — nie było możliwości wyszukiwania, redundancji i skalowalnego przetwarzania.
- Zawsze istniał wyścig zbrojeń między szybkością przetwarzania a dostępnością danych; dyski SSD o dużej pojemności znów przechylają szalę, dostarczając nowoczesnym procesorom graficznym o wiele więcej danych.
- Oregon State pełni funkcję lidera w zakresie infrastruktury cybernetycznej w ramach inicjatywy Ocean Observatories Initiative (OOI), wartego miliard dolarów projektu NSF/WHOI, w ramach którego do przesyłania strumieniowego danych oceanicznych wykorzystuje się szybowce, boje i mocowania na dnie morskim.
- Znajdują się w nich ~9 PB danych OOI, a magistrala światłowodowa została zmodernizowana z 200 Gb/s do 400 Gb/s poprzez Link Oregon, co umożliwia przesyłanie danych z oceanu do centrum danych w czasie rzeczywistym.
- Nawet w przypadku projektów Starlink na statku i na lądzie (takich jak projekt Sowa), przepustowość satelitów i koszty ograniczają możliwości przesyłania danych, dlatego testowane są sieci LoRaWAN i inne sieci kratowe w celu przesyłania danych do pojedynczej stacji pomiarowej podłączonej do Starlink.
25:00 – 27:52
Lekcje dla przedsiębiorstw: Twoje centrum danych jest teraz granicą
Rozmowa kończy się przełożeniem wniosków z badań na przedsiębiorstwa i wskazaniem sprzętu, który Chris „kradł” z hali wystawowej.
- Kluczowy przekaz dla przedsiębiorstw: jeśli nie przetwarzasz danych na brzegu sieci, marnujesz czas i pracę, przesyłając surowe dane w obie strony. I tracisz możliwości działania w czasie rzeczywistym.
- Sztuczna inteligencja brzegowa i agenci powinni wstępnie przetwarzać, filtrować i analizować dane lokalnie, aby przekierować wysiłek ludzki z logistyki na zadania o większej wartości i podejmowanie decyzji.
- Analogie ze świata rzeczywistego:
- Handel detaliczny wykorzystuje analitykę brzegową w sklepach, aby śledzić ruch, tworzyć rekomendacje i dostarczać dynamiczne doświadczenia, podobnie jak leśnictwo wykorzystuje analizę brzegową, aby chronić zagrożone gatunki, umożliwiając jednocześnie wycinkę drzew.
- Rybacy potrzebują „inteligentnych pułapek” i boi, dlatego wysyłają łodzie tylko wtedy, gdy w pułapkach faktycznie znajdują się kraby.
- Dla Chrisa idealnym wzorcem są lokalne centra danych, które stają się krawędź obiekty zintegrowane z chmurą na potrzeby dużych szkoleń i dłuższych obciążeń roboczych.
- Ulubiony sprzęt z programu: Dell PowerEdge 7745; chce ich więcej do laboratoriów VR i zastosowań w terenie, ponieważ zapewniają odpowiednią równowagę między mocą obliczeniową i rozmiarem, elastycznością i możliwościami (renderowanie + wnioskowanie + praca na brzegu sieci).
- Uważa, że systemy takie jak 7745 są wzorem: wystarczająco elastycznym, aby można go było zastosować w centrum danych lub w trudnych warunkach terenowych, obsługującym zarówno tradycyjne rozwiązania HPC, jak i zaawansowaną sztuczną inteligencję/wizualizację na brzegu sieci.


 Amazon