

Acer Veriton GN100 AI Mini Workstation to jeden z kilku systemów opartych na technologii Spark, które testujemy. Wszystkie z nich zbudowano na bazie superukładu GB10 Grace Blackwell firmy NVIDIA. Podobnie jak pozostałe, GN100 został zaprojektowany z myślą o przeniesieniu mocy obliczeniowej AI klasy centrum danych do kompaktowego, stacjonarnego komputera, umożliwiając programistom i badaczom uruchamianie i udoskonalanie modeli lokalnie, bez konieczności polegania wyłącznie na infrastrukturze chmurowej.
W tej konfiguracji GN100 łączy 20-rdzeniowy procesor GB10 oparty na architekturze ARM ze zintegrowaną grafiką Blackwell, zapewniając wydajność AI FP4 na poziomie 1 petaFLOP. Wyposażony jest w 128 GB pamięci zunifikowanej LPDDR5x oraz dysk SSD PCIe Gen5 NVMe o pojemności 4 TB, co zapewnia przepustowość pamięci i pamięci masowej niezbędną do obsługi dużych modeli językowych, generatywnych przepływów pracy AI oraz eksperymentów wymagających dużej ilości danych.
Podobnie jak inne systemy Spark z tej grupy, GN100 obsługuje lokalne wykonywanie funkcji AI, umożliwiając jednocześnie rozbudowę między systemami za pośrednictwem zintegrowanej karty sieciowej NVIDIA ConnectX-7 SmartNIC. Dwie jednostki można połączyć, aby obsługiwać większe obciążenia modelowe wykraczające poza jedno urządzenie.
System dostarczany jest z zainstalowanym systemem operacyjnym NVIDIA DGX OS i pełnym pakietem oprogramowania AI, dzięki czemu jest gotowy do natychmiastowego wdrożenia w środowiskach badawczych i programistycznych.
Specyfikacja Acer Veriton GN100 AI
| Specyfikacja | Acer Veriton GN100 AI (GB10) |
|---|---|
| Wymiary i waga | |
| Wysokość | 2 w |
| Szerokość | 5.9 w |
| Głębokość | 5.9 w |
| Waga | 2.65 lb |
| Procesor | |
| Typ procesora | NVIDIA GB10 (Grace Blackwell Superchip) (20 rdzeni) |
| Zintegrowana karta graficzna | Procesor graficzny NVIDIA Blackwell (zintegrowany) |
| Pamięć | |
| Typ pamięci | LPDDR5x (zunifikowana pamięć systemowa) |
| Konfiguracja pamięci | 128 GB LPDDR5x, ujednolicona pamięć systemowa |
| Przepustowość pamięci | 273 GB/s (8533 MT/s) |
| System operacyjny | |
| obsługiwane systemy operacyjne | System operacyjny NVIDIA DGX |
| Zewnętrzne porty i gniazda | |
| Porty sieciowe | Jedno złącze RJ45 (10GbE) Karta sieciowa NVIDIA ConnectX-7 (200 Gb × 2 QSFP) |
| Porty USB | Trzy porty USB 3.2 Gen 2×2 typu C (20 Gb/s) Jeden port USB 3.2 Gen 2×2 typu C z wejściem PD |
| Port(y) wideo | Jedno złącze HDMI 2.1a |
| Port zasilacza | USB typu C (PD IN) |
| Gniazdo bezpieczeństwa | Jedna blokada Kensington |
| Bezprzewodowy | |
| WiFi | Wi-Fi 7 (AW-EM637, 2×2) |
| Bluetooth | Bluetooth 5.4 |
| Dyski | |
| Opcje bagażu | Dysk SSD NVMe o pojemności do 4 TB (PCIe Gen5) |
| Zasilacz | |
| Typ | Zasilacz zewnętrzny 240 W (USB typu C) |
Acer Veriton GN100 AI Budowa i projekt
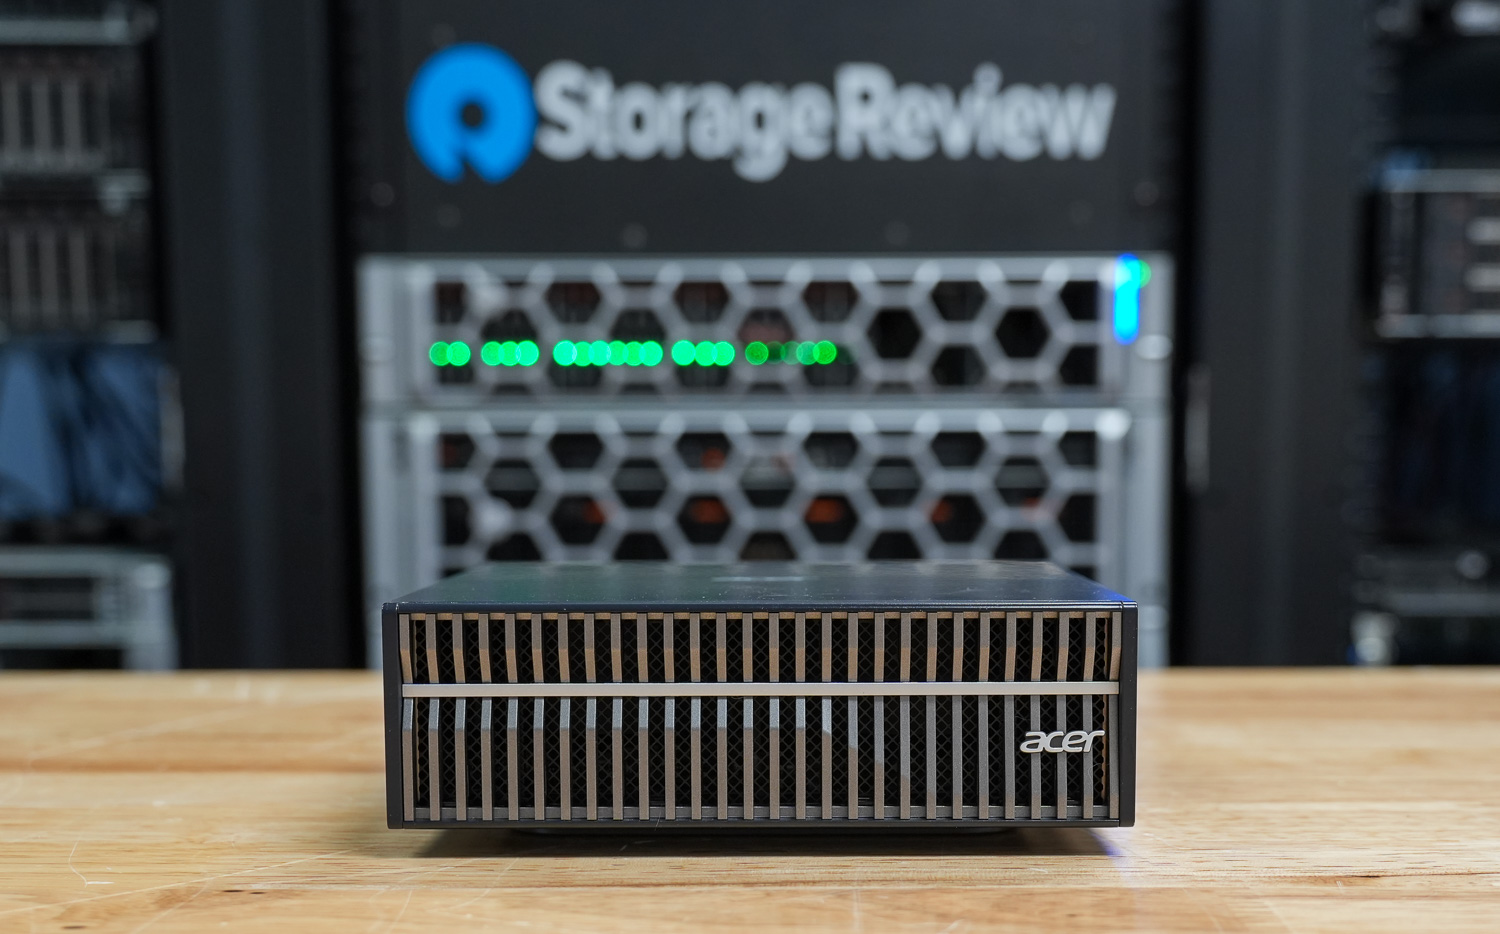
Przód Veritona GN100 zdominowany jest przez ścianę pionowych listew, które rozciągają się na całą szerokość obudowy. Pozioma linia akcentowa przecina grill, nadając mu niepowtarzalny wygląd w porównaniu z innymi systemami opartymi na Sparku, które testowaliśmy.
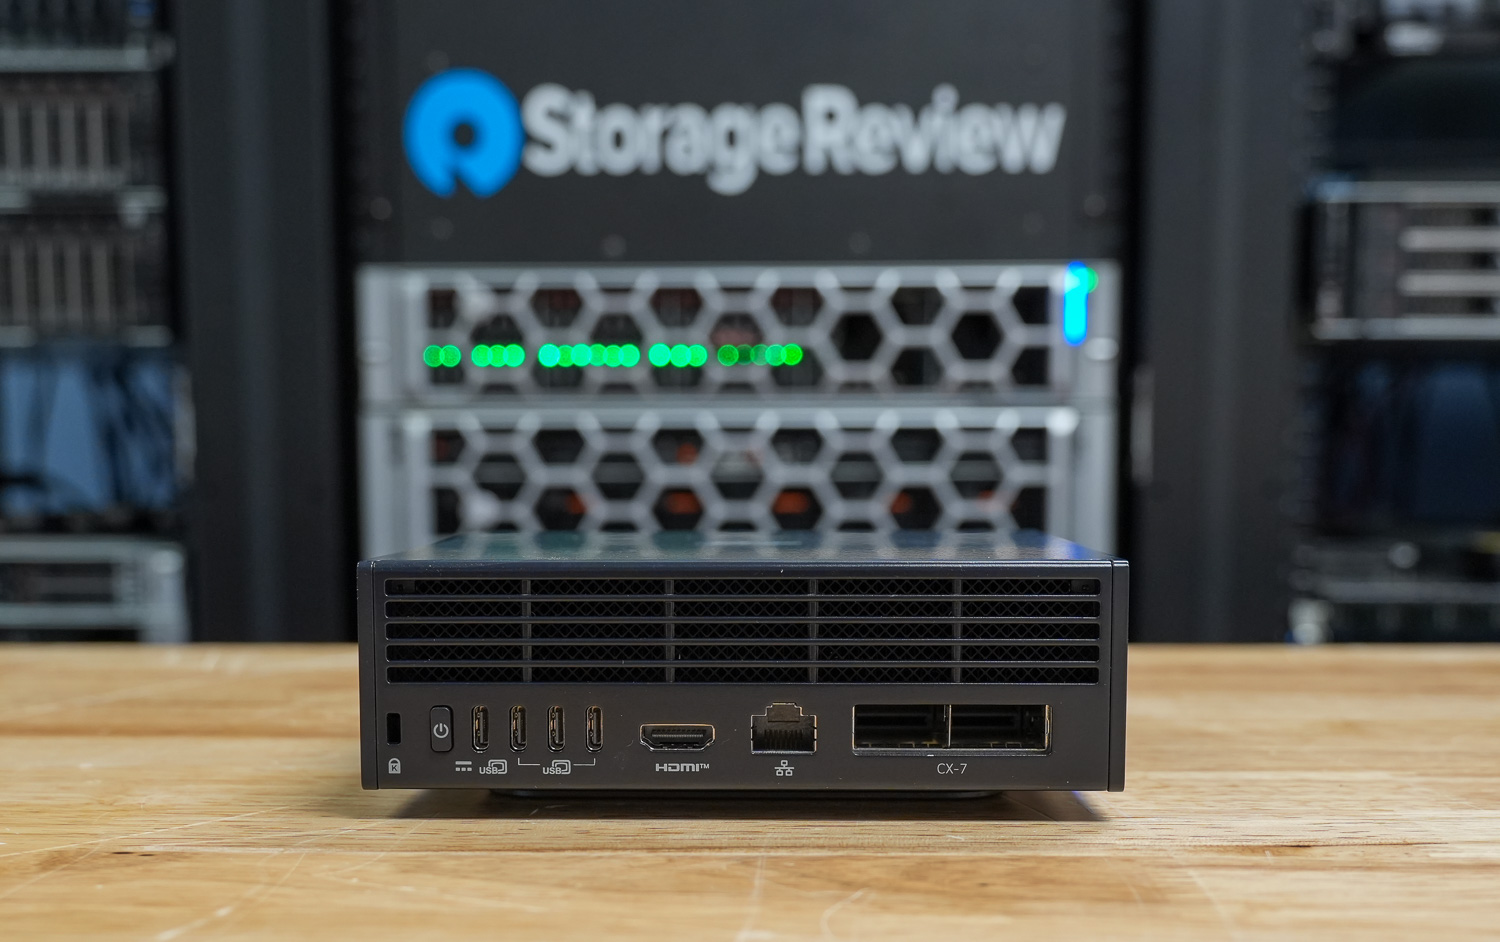
Wszystkie główne wejścia/wyjścia znajdują się z tyłu systemu. Acer oferuje cztery porty USB 3.2 typu C, z których jeden obsługuje zasilanie, a także port HDMI 2.1b do wyświetlania obrazu. Sieć obejmuje port Ethernet RJ-45 i inteligentną kartę sieciową NVIDIA ConnectX-7, umożliwiającą łączność o wysokiej przepustowości i integrację systemów. Obsługa łączności bezprzewodowej obejmuje Wi-Fi 7 i Bluetooth 5.1 lub nowszy. Gniazdo blokady Kensington zapewnia bezpieczeństwo fizyczne.
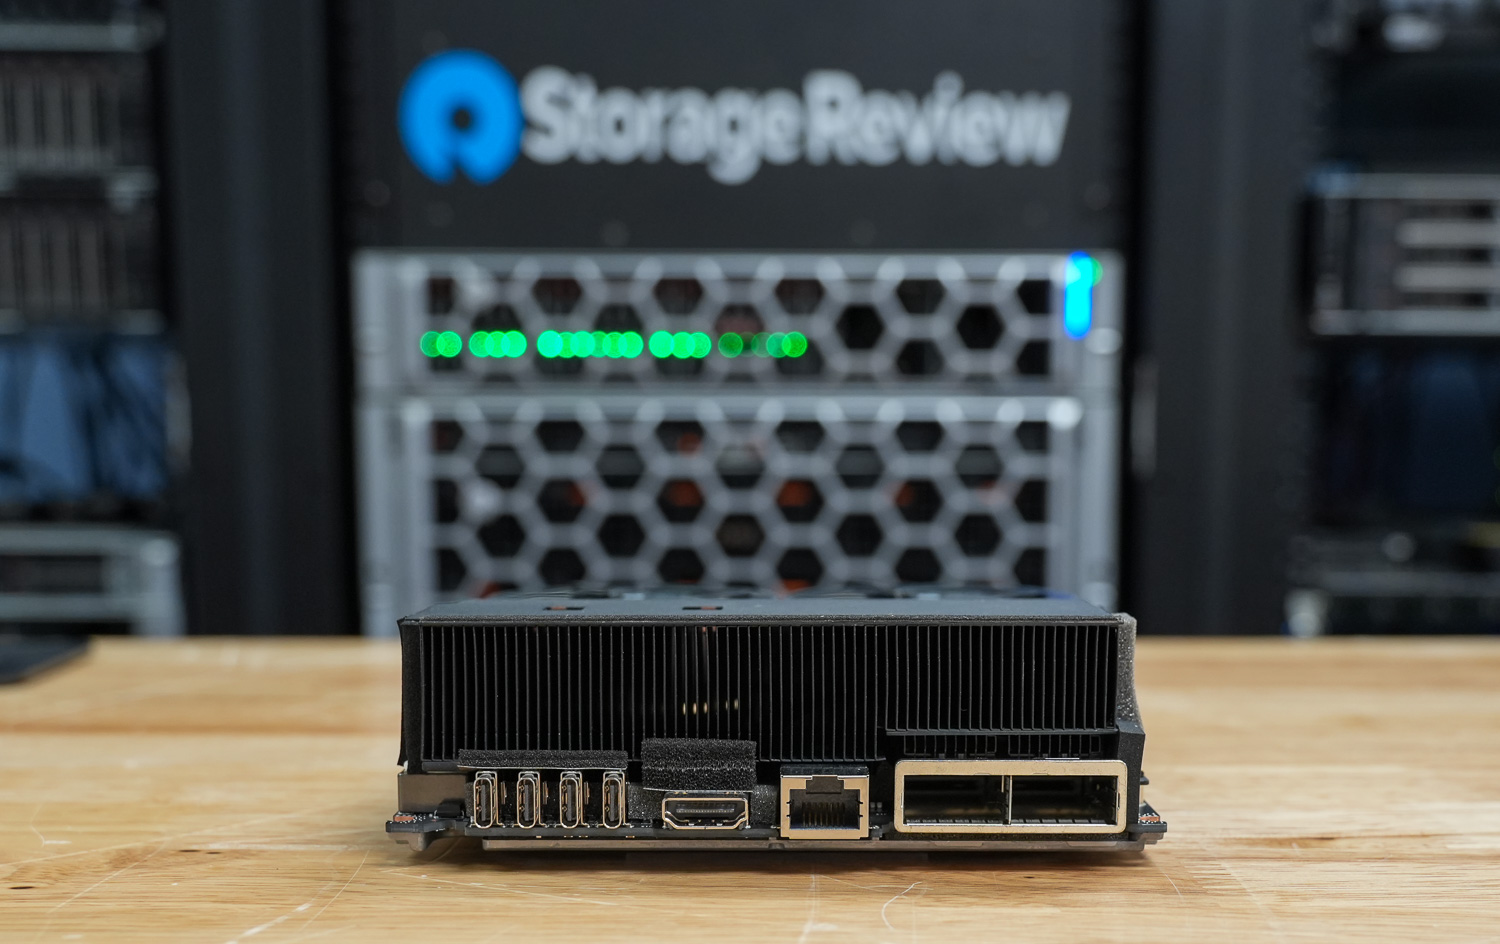
Tutaj widać metalową osłonę i płytę konstrukcyjną, która pokrywa całą obudowę, pełniąc jednocześnie funkcję ramy wzmacniającej i rozpraszacza ciepła. W lewym dolnym rogu znajduje się łatwo dostępne gniazdo dysku SSD M.2 2242 NVMe, zabezpieczone jedną śrubą i częściowo schowane pod metalową płytą.
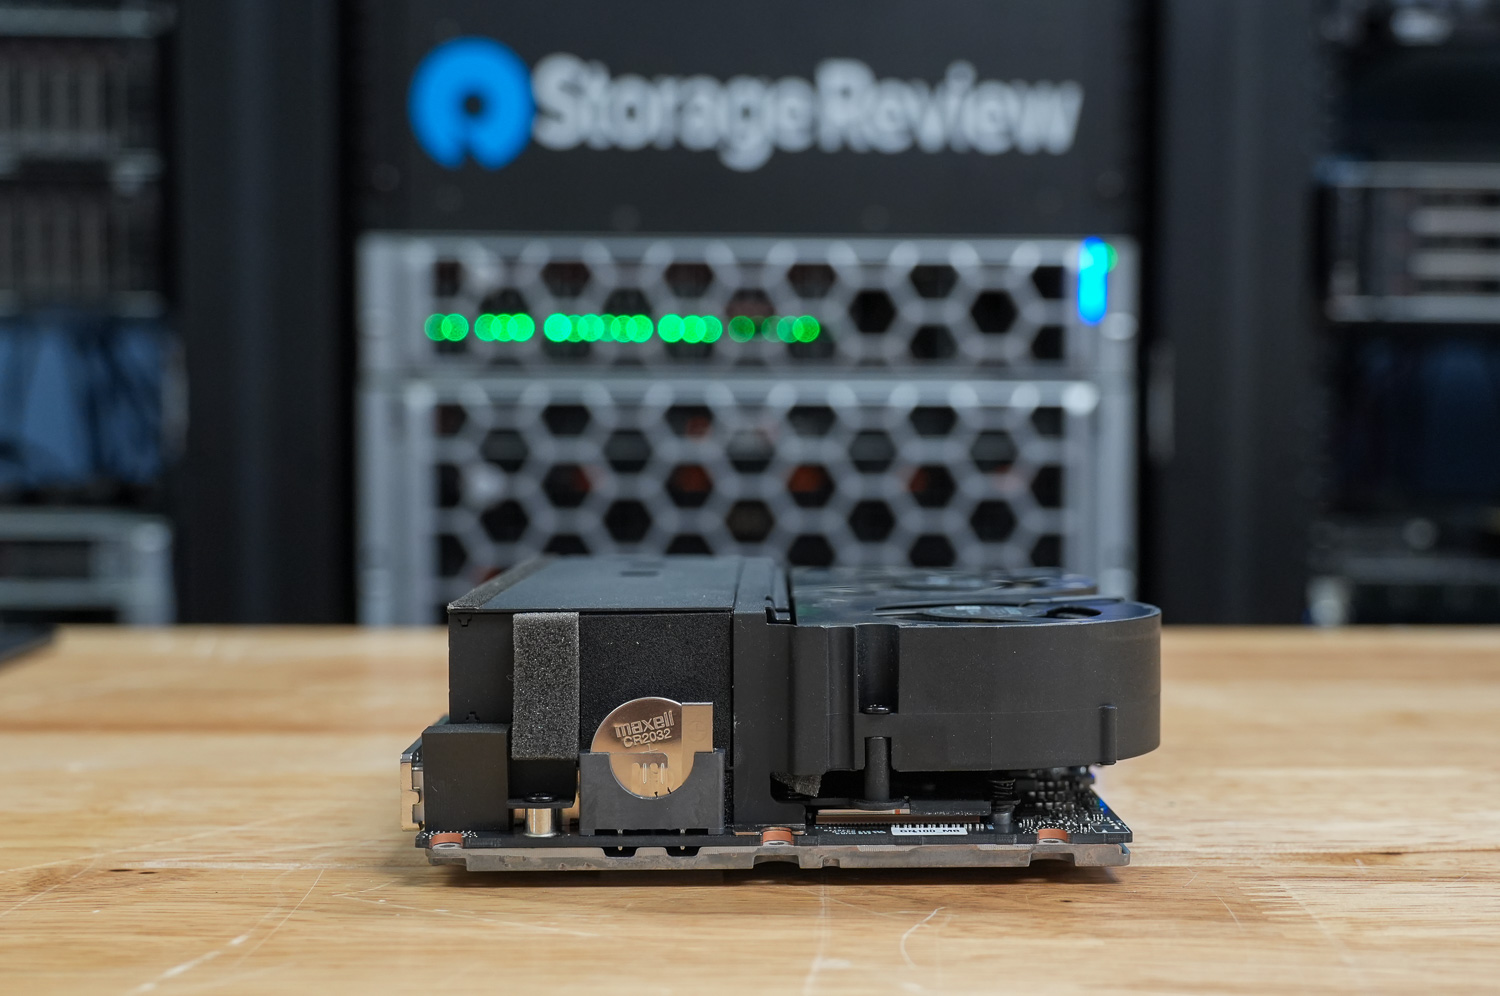
Aby uzyskać dostęp do dolnej części jednostki Acer, należy odkręcić śruby obwodowe i zdjąć dolny panel. Po umieszczeniu w środku, układ jest przejrzysty i dobrze zorganizowany, zapewniając bezpośredni dostęp do układu chłodzenia, schowka i podzespołów płyty głównej. Sama płyta dolna sprawia wrażenie solidnej i przyczynia się do ogólnej sztywności obudowy.
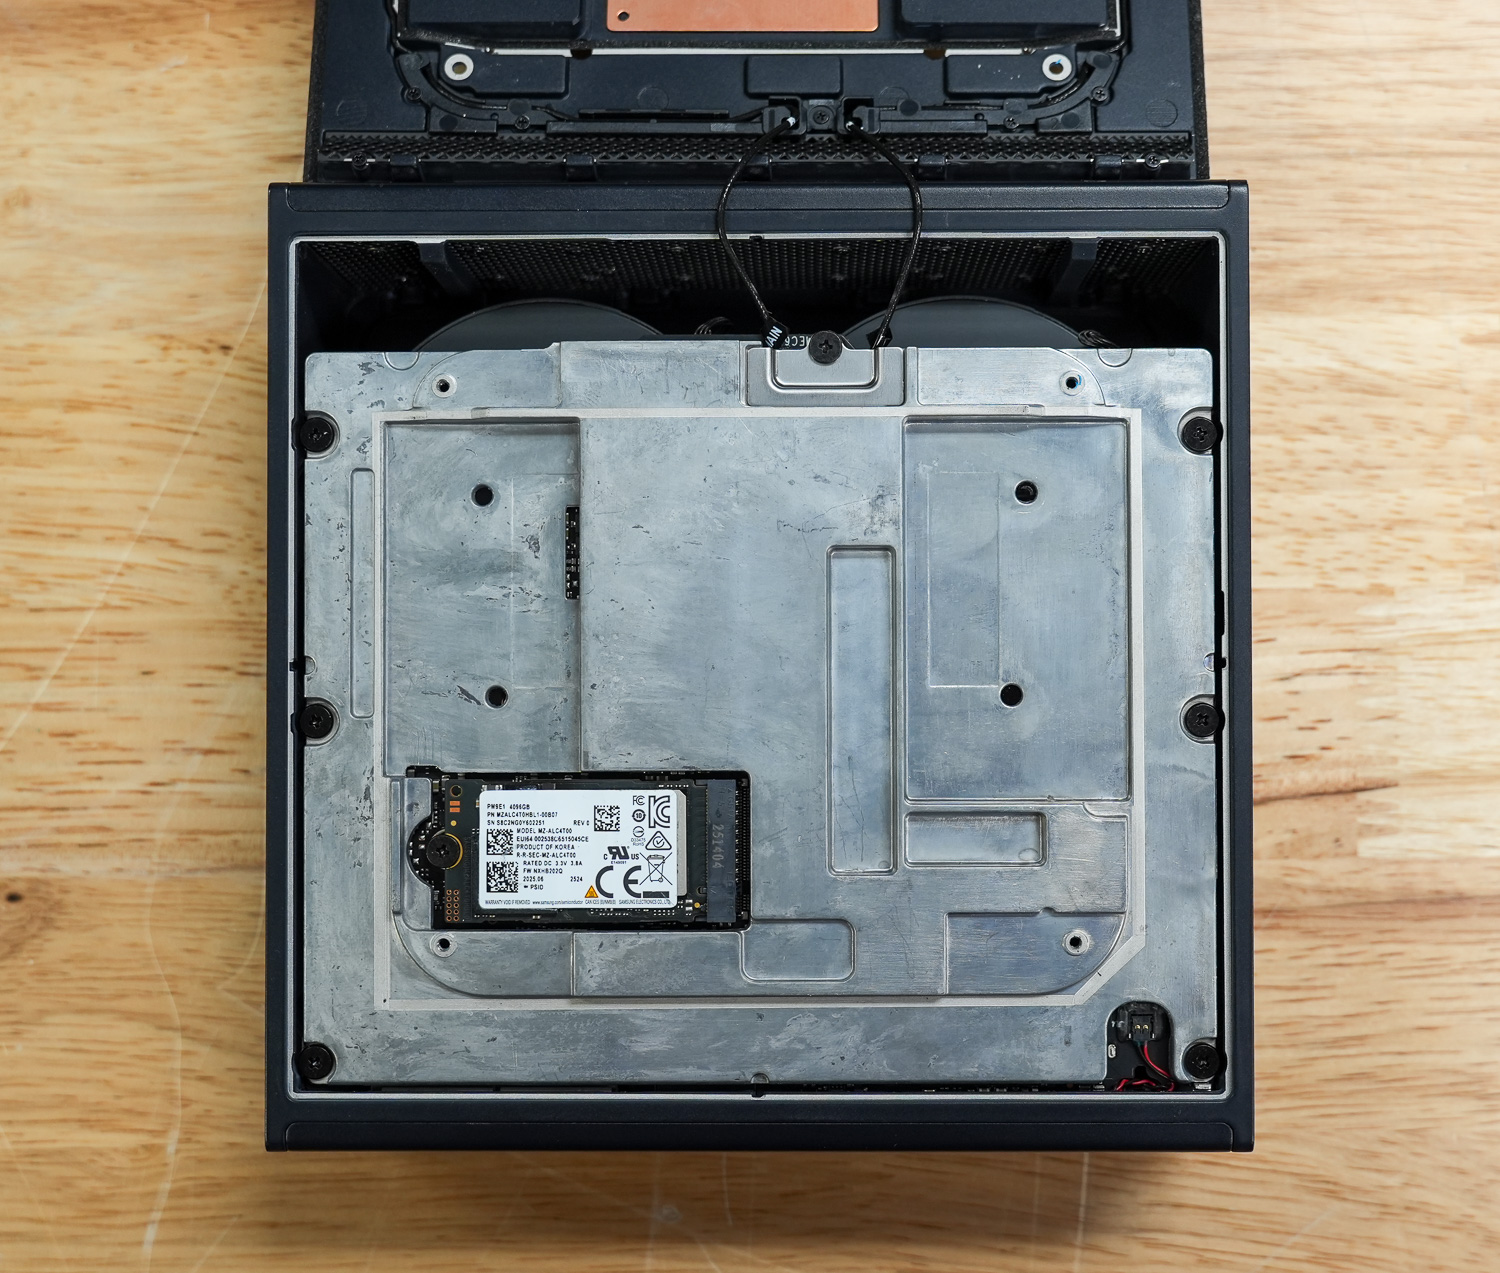
W porównaniu z innymi systemami Spark, które testowaliśmy, Acer stosuje tutaj nieco inne podejście. Zamiast bardziej wyrafinowanej, malowanej, metalowej płyty dolnej, którą widzieliśmy w Founders Edition i kilku wdrożeniach OEM, Acer stosuje surową, niewykończoną, odlewaną płytę dolną. Wykończenie jest mniej wypolerowane, z widoczną fakturą odlewu, ale pozostaje grube i solidne. Funkcjonalnie nadal pełni tę samą funkcję, co rama wzmacniająca i dodatkowy rozpraszacz ciepła, choć wybór producenta wyraźnie odzwierciedla inną filozofię projektowania i kosztów.
Testy termiczne Acer Veriton GN100 AI
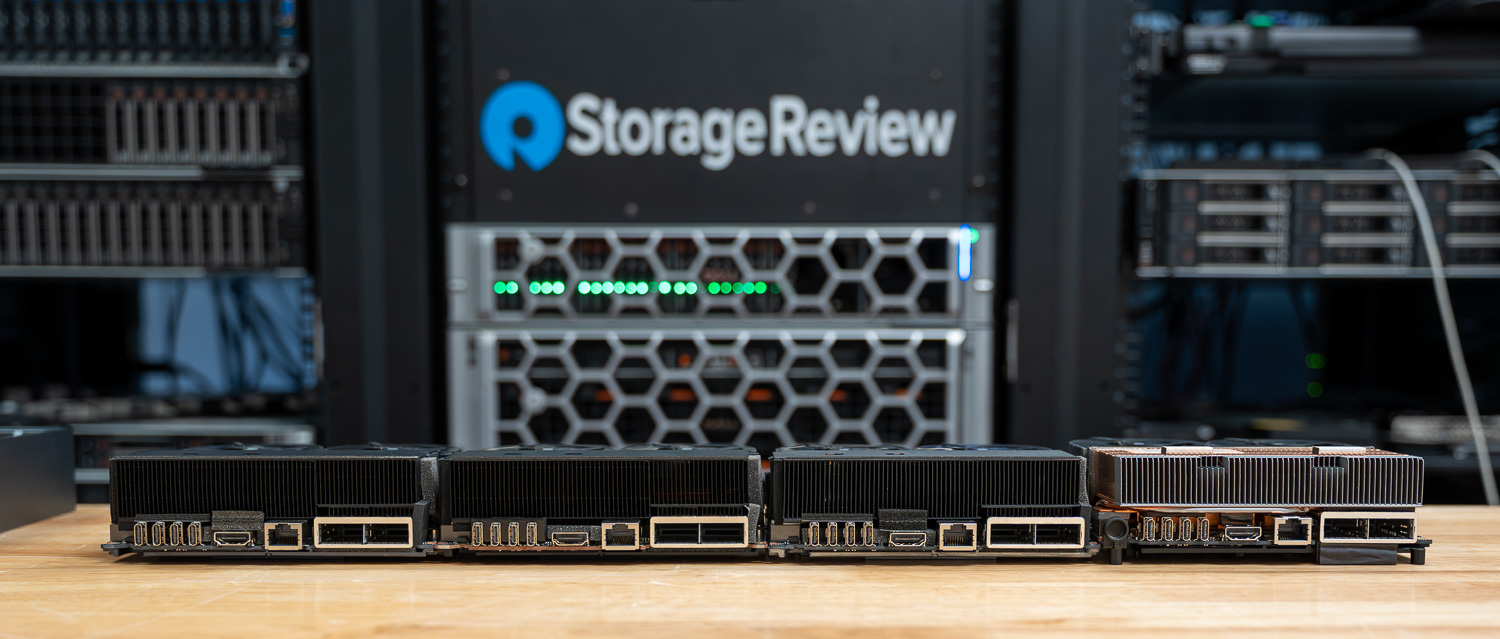
Aby przetestować system chłodzenia Acer Veriton GN100 AI, porównaliśmy go z systemem Founders Edition oraz systemami OEM, takimi jak Dell, ASUS i GIBABYTE. Zagłębiliśmy się w ten temat w naszym artykule „Spark Thermal Testing”.
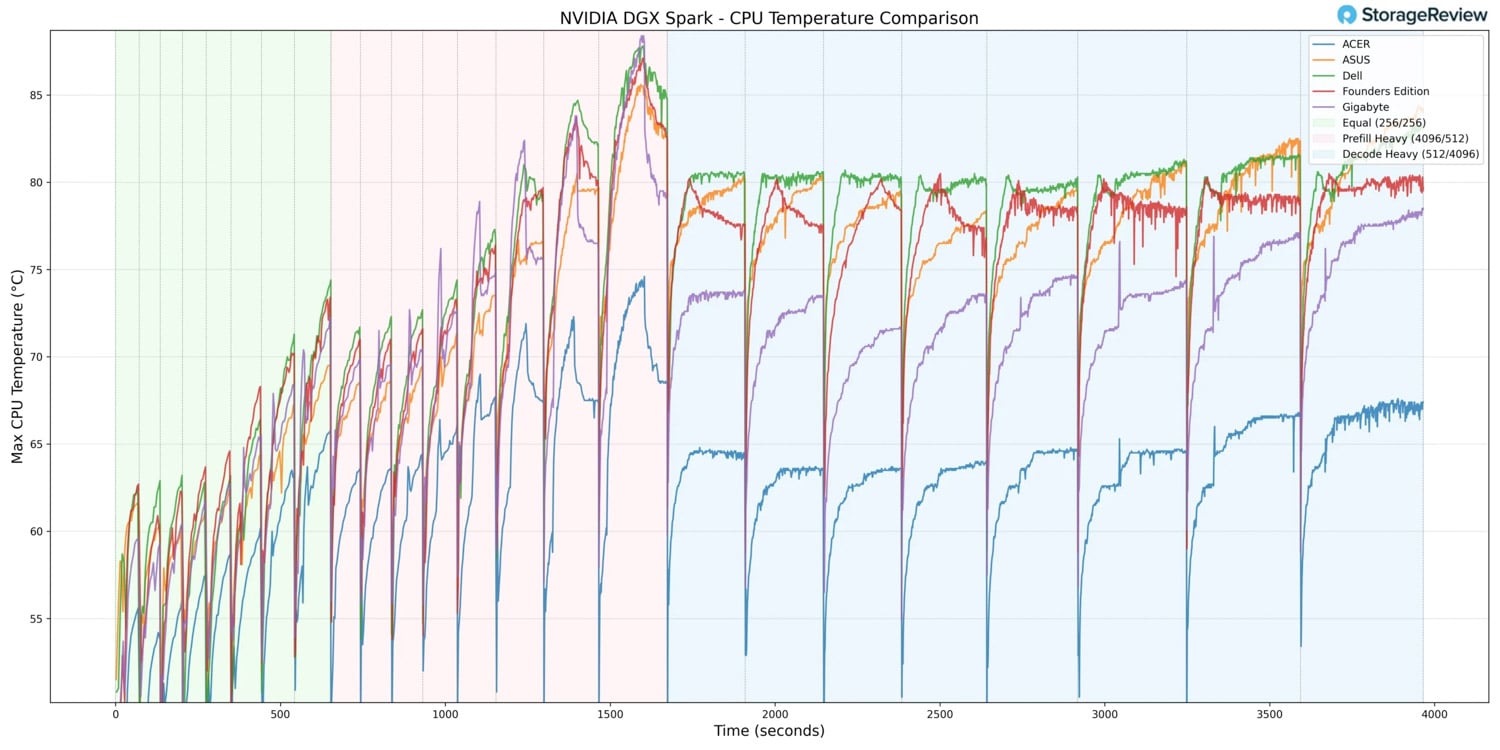
Monitorowaliśmy komponenty w całym stosie w określonym przedziale czasowym, z trzema etapami obciążenia, zwiększając wykorzystanie w ciągu około godziny. Pozwoliło nam to zaobserwować urządzenie w trakcie intensywnego użytkowania i na różnych etapach obciążenia. Monitorowaliśmy temperatury procesora, karty graficznej, sieci, dysków NVMe oraz całkowite zużycie energii.
Temperatura procesora
Podczas testów termicznych procesora, system Acer osiągnął szczytową temperaturę 74.7°C podczas intensywnej aktywności Prefill. Jest to jedna z najniższych maksymalnych temperatur procesora zaobserwowanych w grupie porównawczej, co wskazuje na wyjątkowo konserwatywne lub efektywne wdrożenie systemu termicznego.
Wraz z przejściem obciążenia na Equal ISL/OSL i utrzymaniem faz Decode Heavy, temperatura procesora pozostała pod dobrą kontrolą bez agresywnego wzrostu. Zamiast osiągnąć górny zakres 80°C, obserwowany w niektórych konkurencyjnych systemach, Acer utrzymał niższy, stabilny zakres roboczy, co odzwierciedla dużą rezerwę chłodzenia przy rozszerzonym obciążeniu obliczeniowym.
W najniższym zakresie temperatury procesor odnotował temperaturę minimalną 37.8°C w stanie spoczynku lub przy niewielkim obciążeniu. Ten wynik jest zgodny z wynikami dla szerszego stosu i potwierdza, że rozwiązanie chłodzące firmy Acer pozostaje skuteczne zarówno w stanie spoczynku, jak i pod obciążeniem.
Ogólnie rzecz biorąc, Acer dostarczył jeden z najchłodniejszych profili termicznych procesora w grupie, zarówno w fazie szczytowej, jak i długotrwałej.
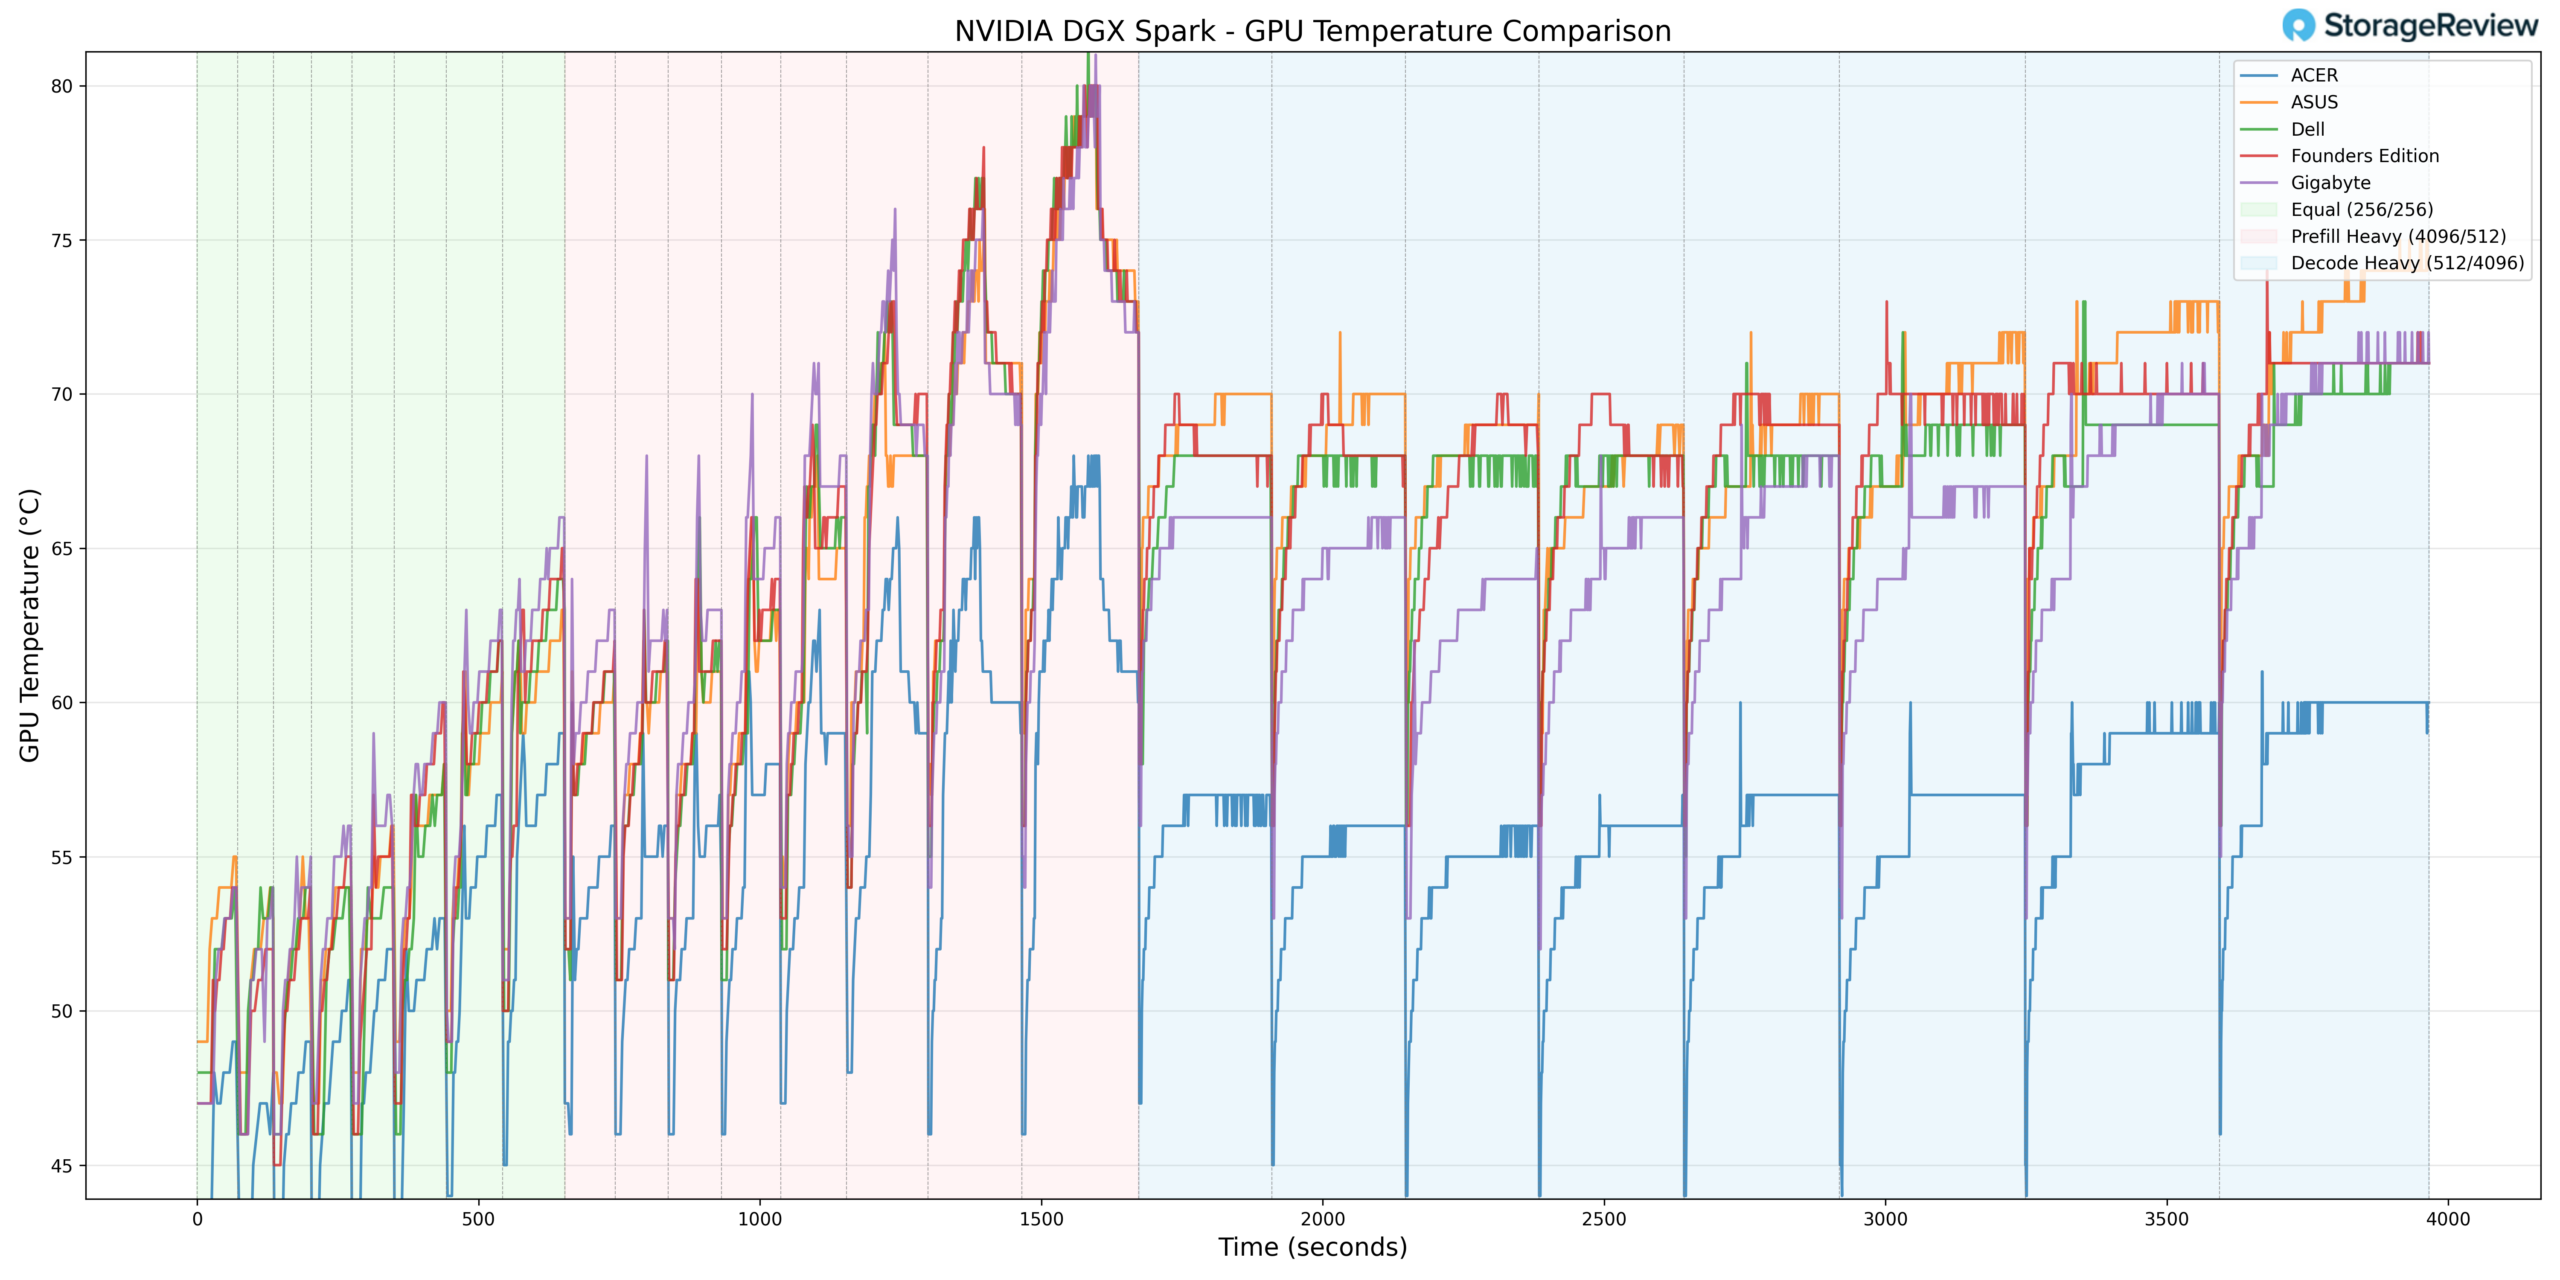
Temperatura GPU
Temperatura GPU wykazywała podobny trend spadkowy. Podczas przyspieszenia w trybie Prefill Heavy GPU osiągnął maksymalną temperaturę 69°C, co jest znacznie niższą temperaturą niż w przypadku kilku konkurencyjnych implementacji podczas aktywności burst.
W miarę jak obciążenia przechodziły w fazy Equal ISL/OSL i Decode Heavy, procesor graficzny ustabilizował się w kontrolowanym zakresie bez znaczących skoków temperatury. System wykazywał spójne zachowanie podczas ciągłego dekodowania, utrzymując szeroki margines poniżej górnych limitów operacyjnych.
Minimalna zarejestrowana temperatura procesora graficznego wyniosła 35°C w fazach o mniejszej intensywności, co stanowi jedną z najniższych wartości bazowych w stanie bezczynności w stosie.
Podsumowując, Acer zaprezentował jedną z najfajniejszych implementacji GPU, zarówno przy intensywnych, jak i długotrwałych obciążeniach.
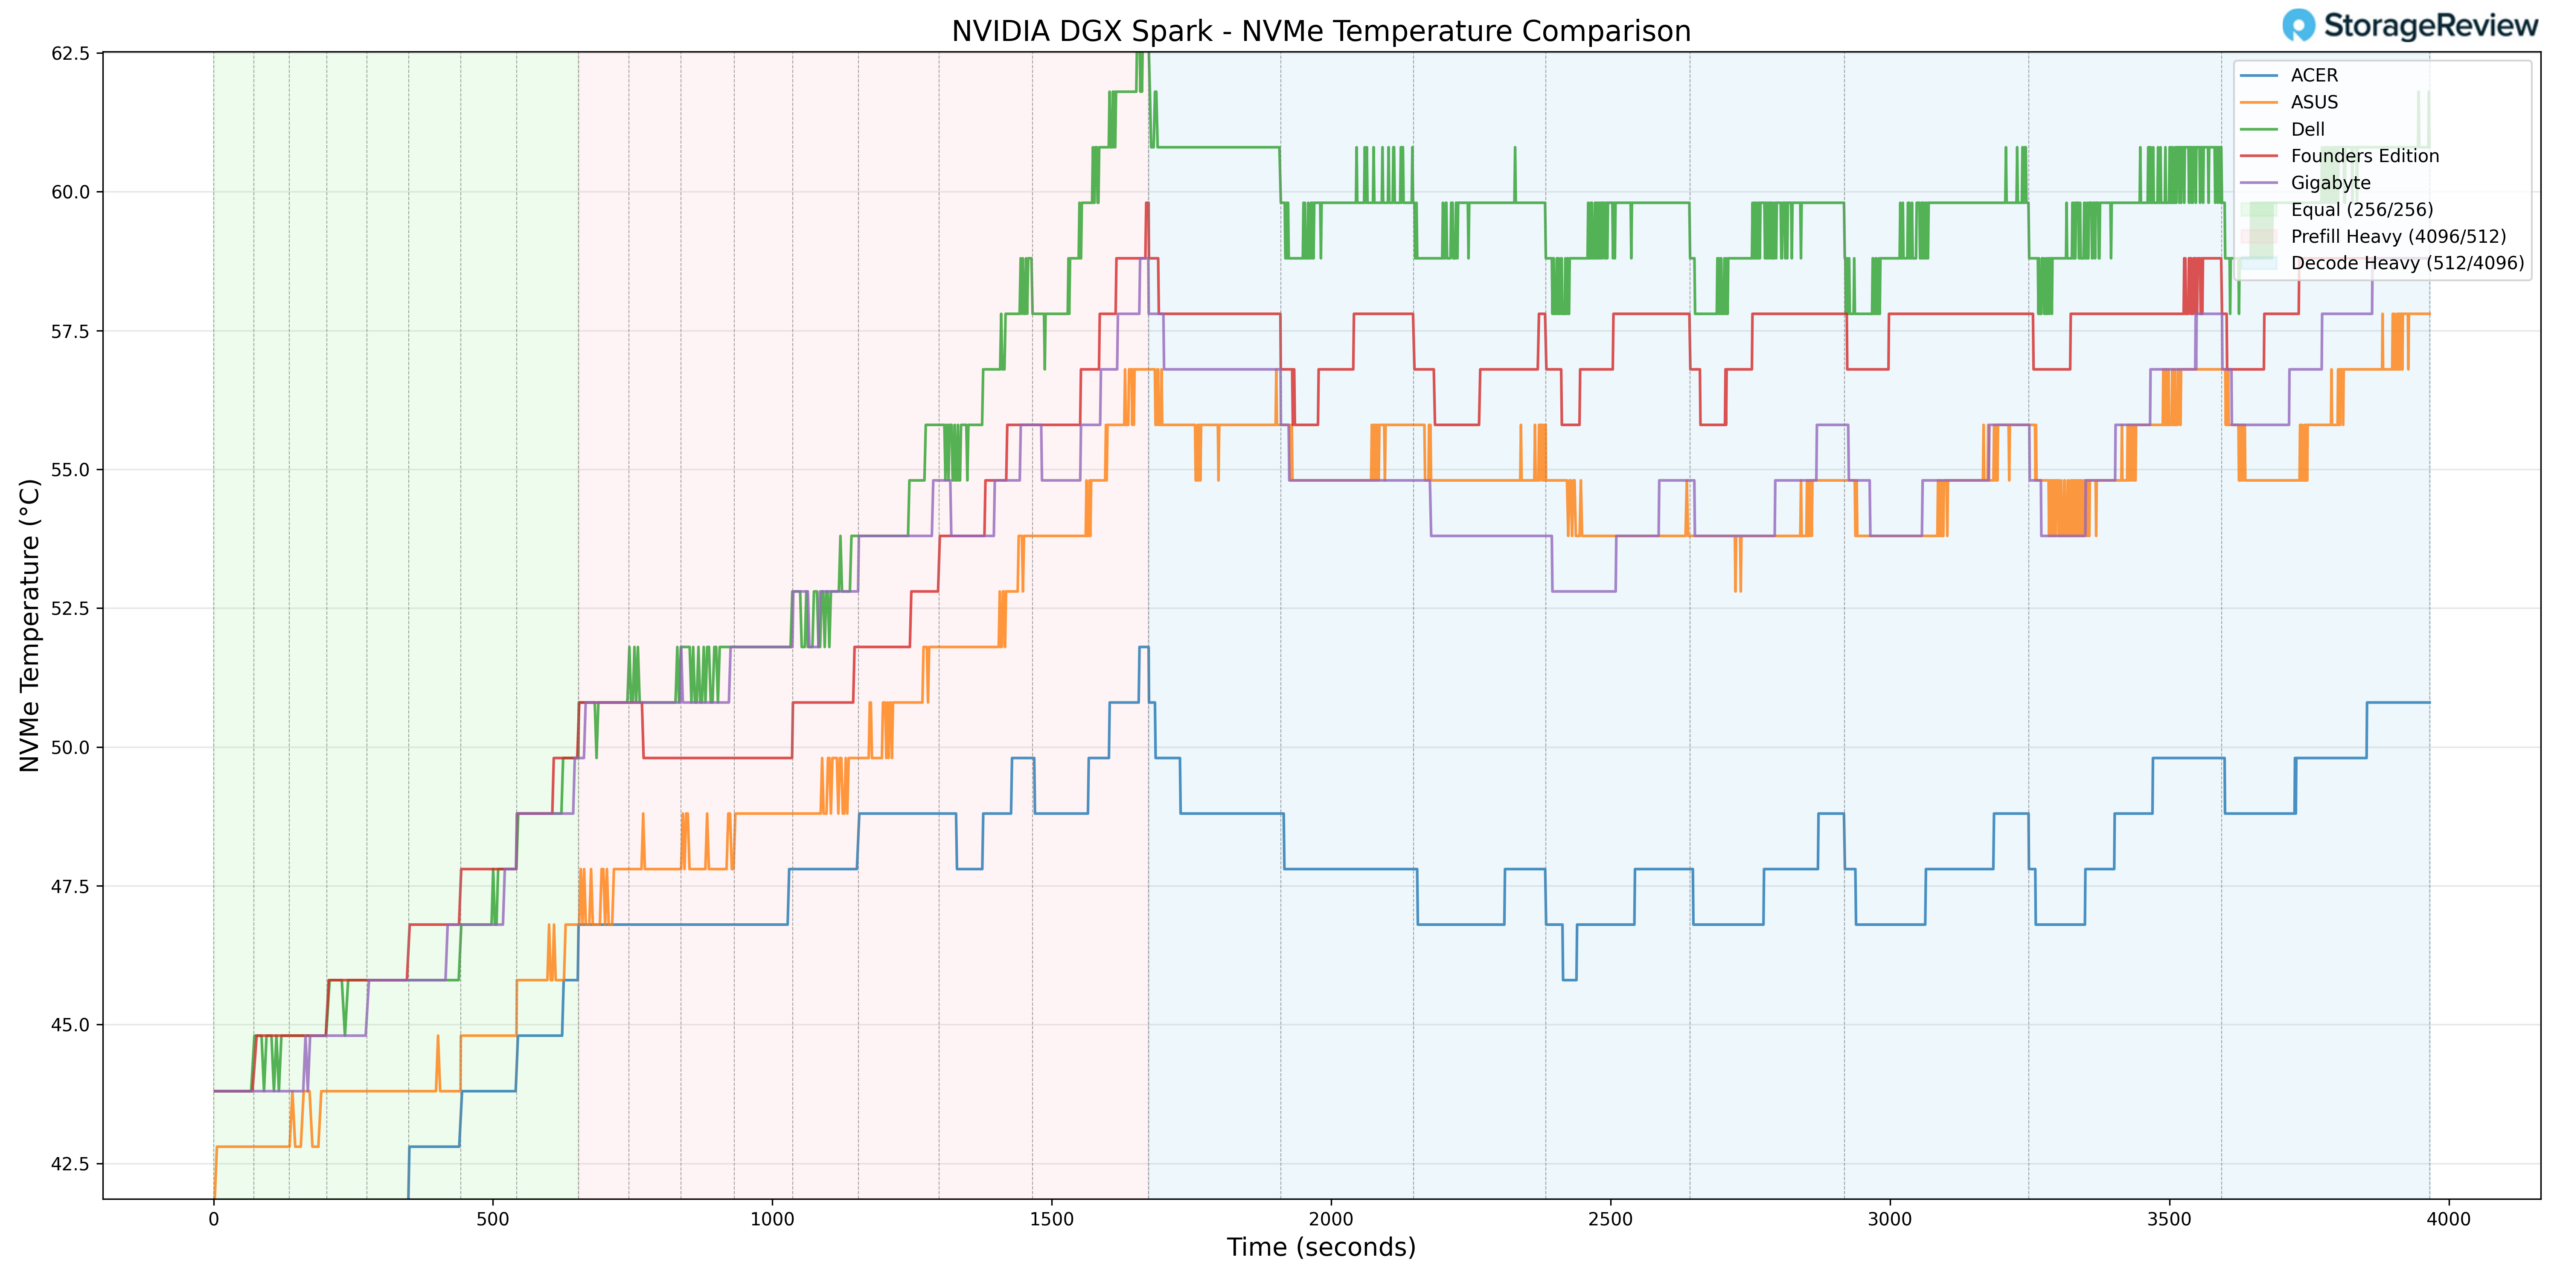
Temperatura NVMe
Temperatura pamięci masowej pozostawała zgodna ze specyfikacją przez cały czas testów. Dysk NVMe osiągnął temperaturę szczytową 56.8°C w fazach większego obciążenia, utrzymując się komfortowo poniżej typowych progów dławienia i dorównując bardziej umiarkowanym wynikom grupy w zakresie pamięci masowej.
W stanie spoczynku lub przy niewielkim obciążeniu temperatura dysku NVMe spadła do 36.8°C, co wskazuje na to, że podsystem pamięci masowej nie jest ograniczony termicznie przy niskim obciążeniu.
Ogólnie rzecz biorąc, Acer utrzymał konkurencyjne parametry termiczne NVMe, łącząc niskie, stałe temperatury ze stabilnym zachowaniem bazowym.
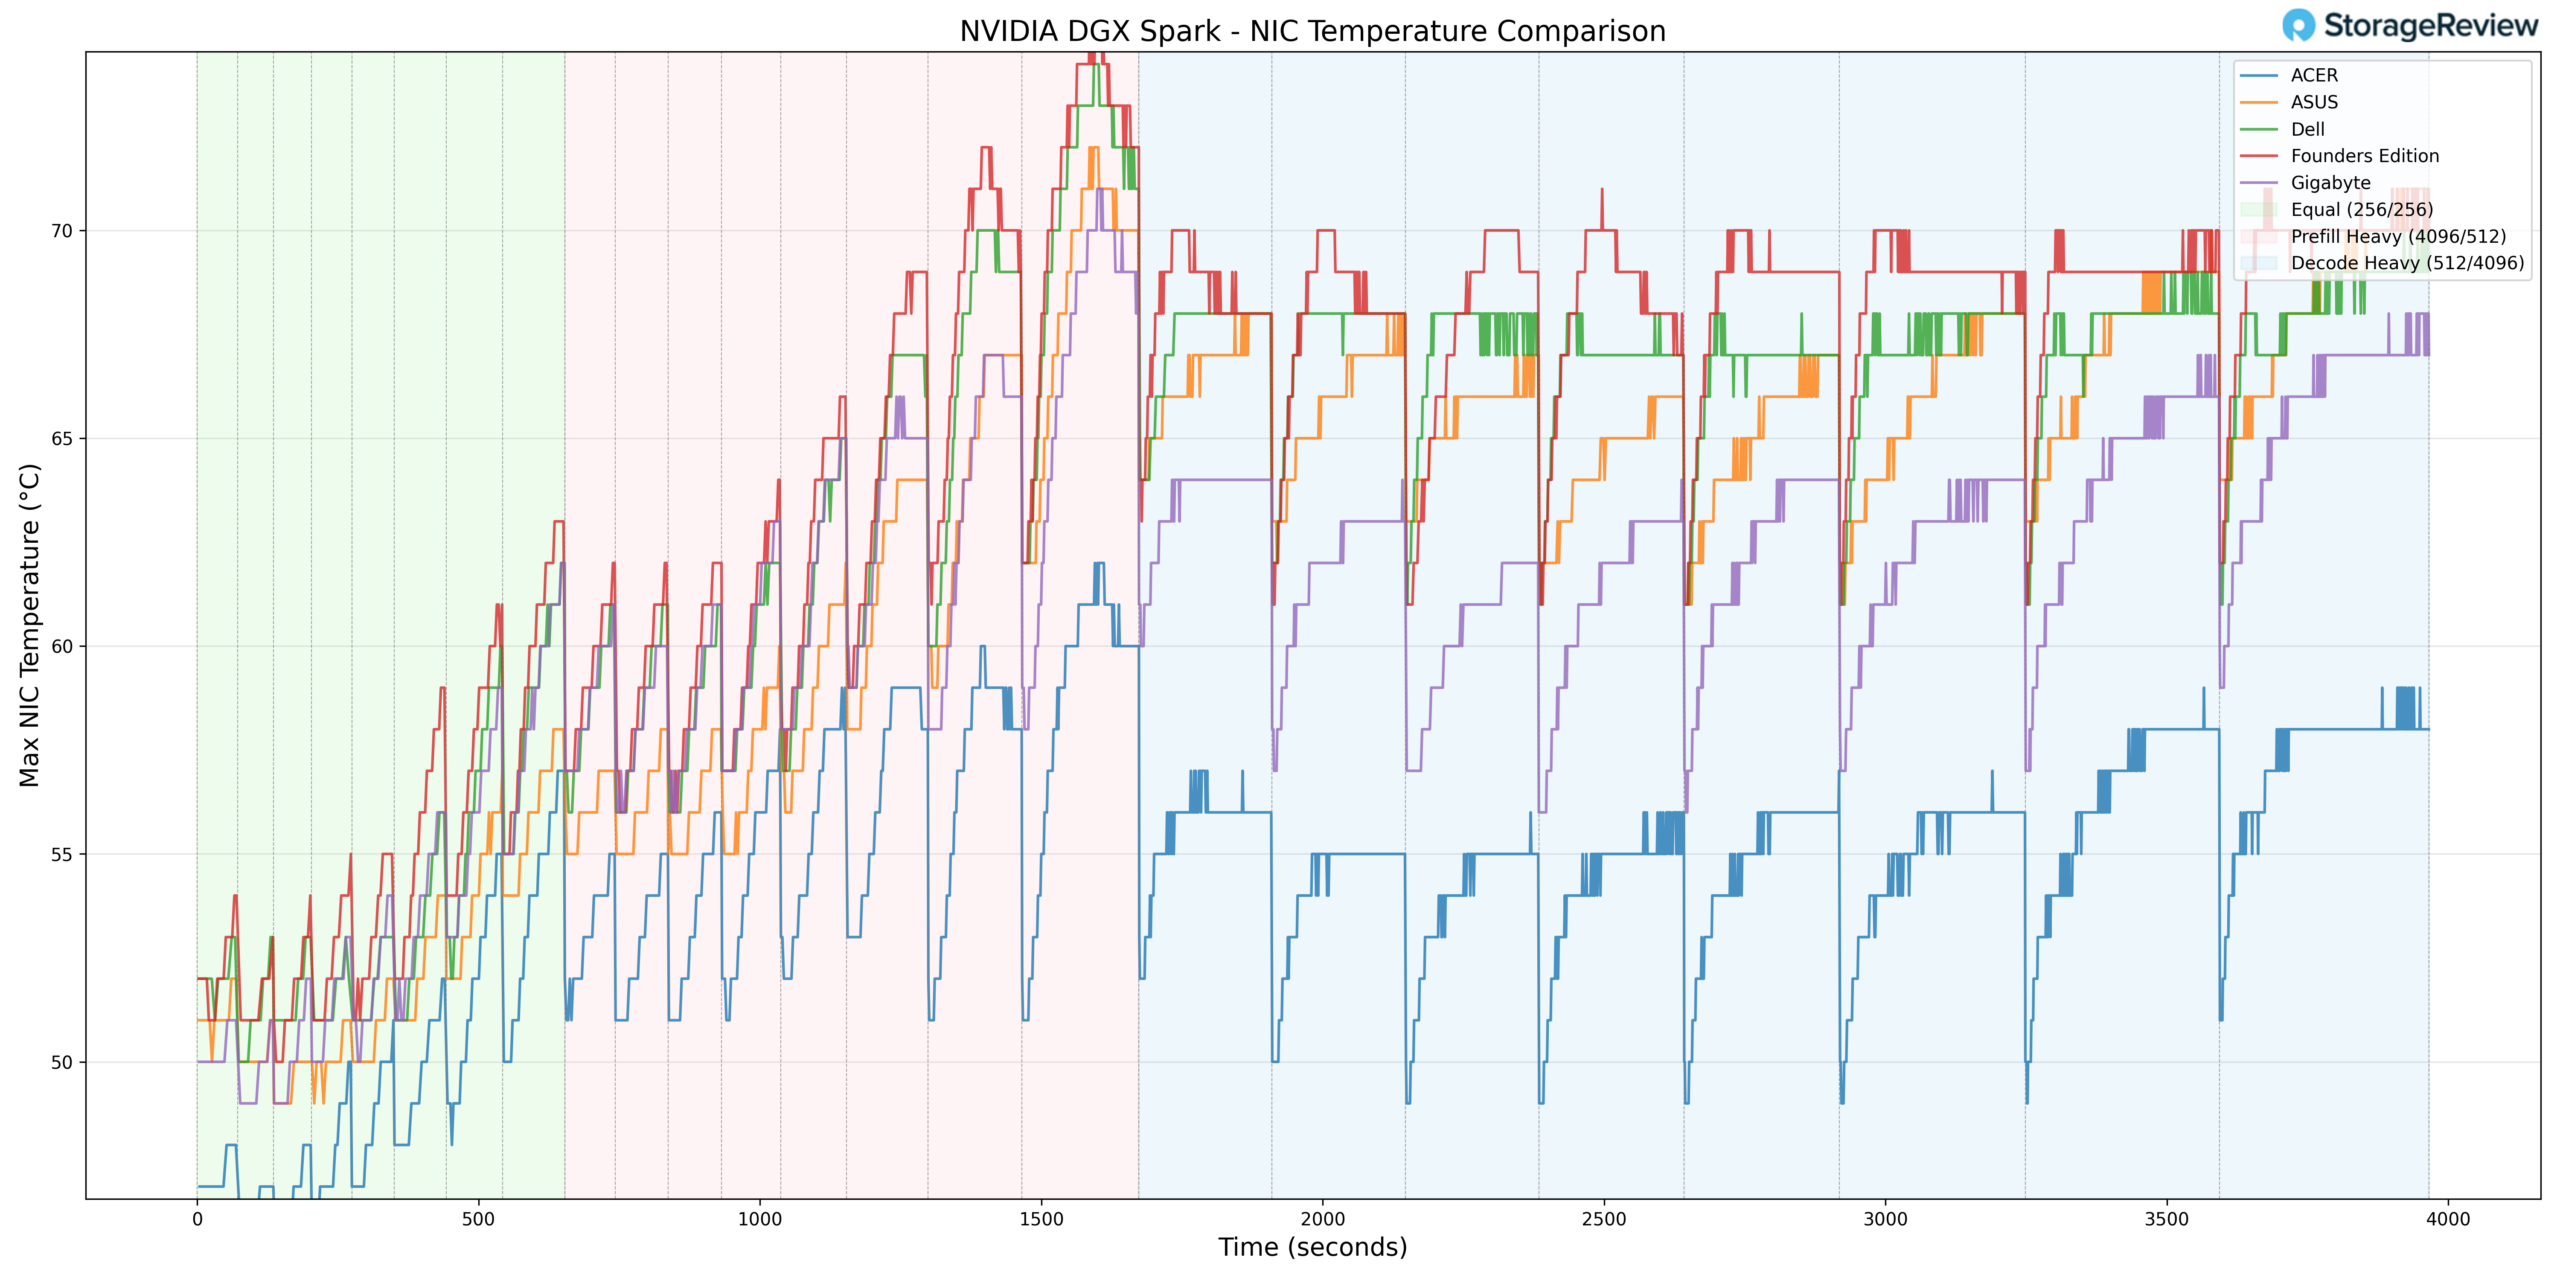
Temperatura karty sieciowej
Temperatura termiczna karty sieciowej osiągnęła szczyt 61°C podczas faz większego obciążenia. Jest to jedna z najniższych maksymalnych temperatur karty sieciowej zaobserwowanych w grupie porównawczej, co sugeruje efektywny przepływ powietrza lub rozmieszczenie komponentów w obudowie.
Minimalna zarejestrowana temperatura NIC wyniosła 39°C w lżejszych fazach, co ponownie odzwierciedla silne zachowanie termiczne linii bazowej.
Podczas testów kontroler sieciowy proporcjonalnie dostosowywał się do zapotrzebowania na pracę, nie powodując nadmiernego skalowania.
Pobór mocy GPU
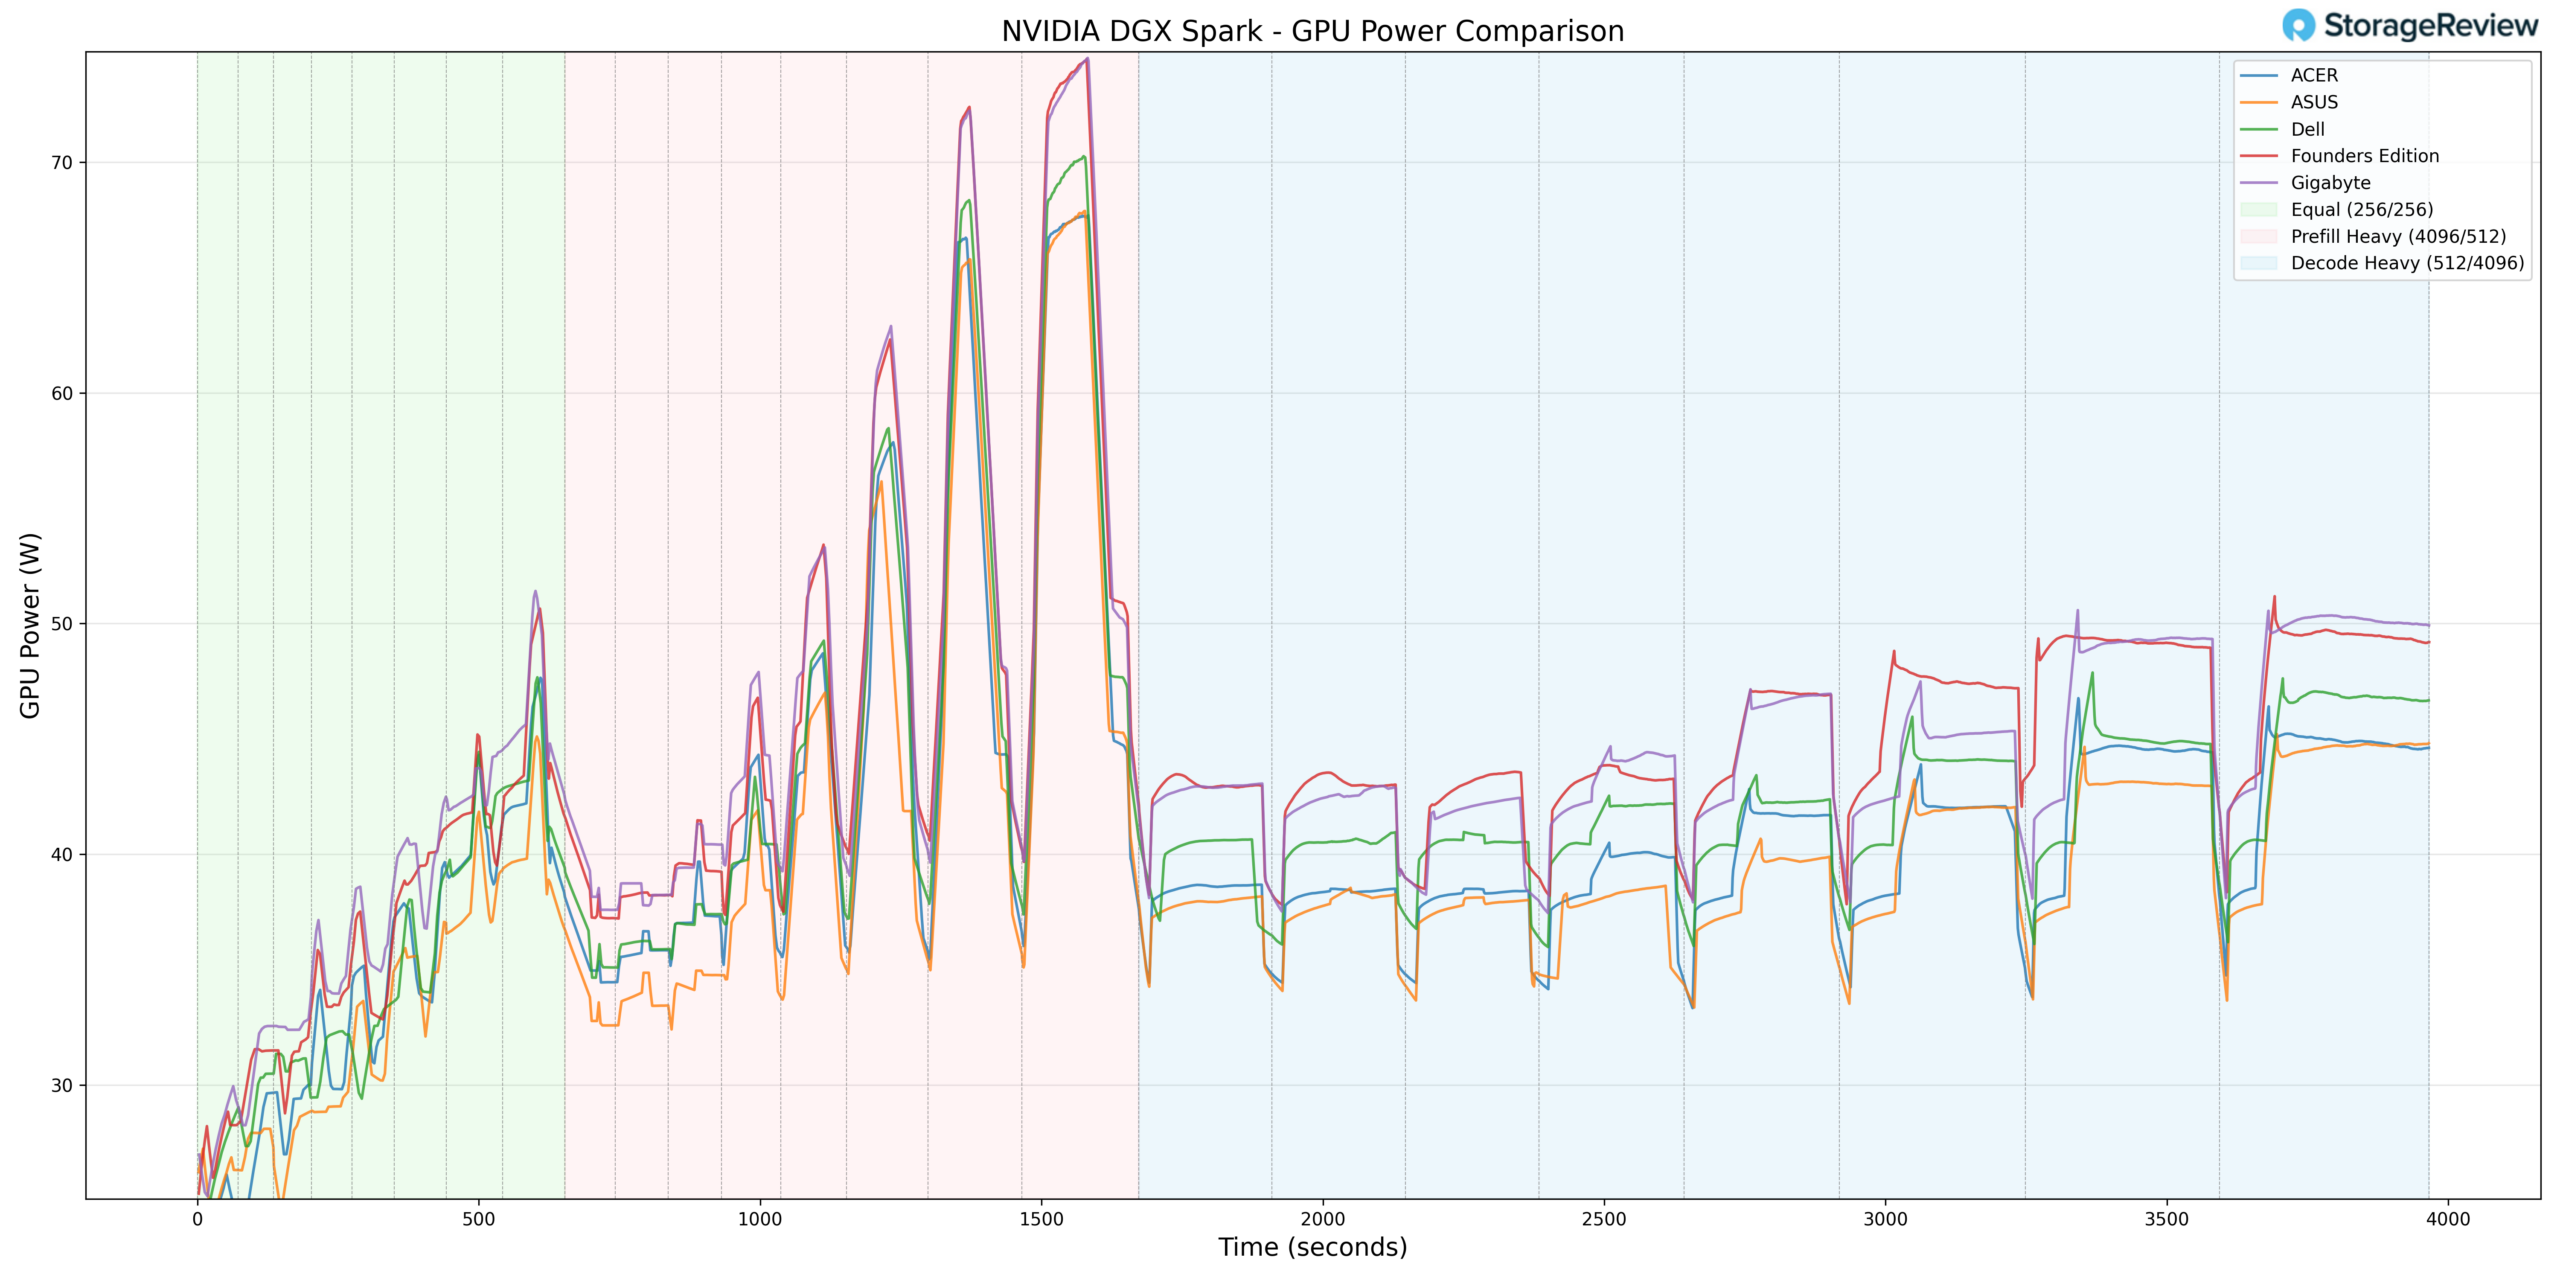
Pobór mocy GPU osiągnął szczyt na poziomie 69.18 W podczas przejść z trybem Prefill High. To plasuje Acer nieco poniżej najwyższych limitów mocy obserwowanych w stosie GB10.
Niższy szczytowy przydział mocy jest bezpośrednio skorelowany z chłodniejszym profilem termicznym procesora graficznego firmy Acer. Zamiast agresywnie dążyć do górnej granicy zakresu mocy, Acer wydaje się równoważyć wydajność i sprawność termiczną, co przekłada się na konsekwentnie niższe temperatury podzespołów w fazach szczytowego obciążenia.
Podczas długotrwałych obciążeń Decode pobór mocy ustabilizował się zgodnie z zapotrzebowaniem i pozostał przewidywalny.
Podsumowanie termiczne
Monitorując procesor, kartę graficzną, dysk NVMe i kartę sieciową, Acer GB10 wykazał się najniższą temperaturą w grupie porównawczej. Podczas intensywnych zmian temperatury procesor osiągnął 74.7°C, a karta graficzna 69°C, podczas gdy temperatura NVMe utrzymywała się poniżej 57°C, a karty sieciowej 61°C. Pobór mocy karty graficznej osiągnął szczyt 69.18 W, nieco poniżej najwyższych wartości obserwowanych w stosie.
Ogólnie rzecz biorąc, implementacja firmy Acer kładzie nacisk na wydajność cieplną i stałą stabilność, zachowując znaczny zapas mocy podczas agresywnych zmian obciążenia, a jednocześnie zapewniając spójną wydajność przy dłuższym obciążeniu.
Testy wydajności Acer Veriton GN100
Aby ocenić Acer Veriton GN100, przetestowaliśmy jednostki Spark za pomocą testu porównawczego vLLM Online Serving, najpopularniejszego silnika wnioskowania i obsługi o wysokiej przepustowości dla dużych modeli językowych. Test porównawczy vLLM Online Serving symuluje rzeczywiste obciążenia produkcyjne poprzez wysyłanie współbieżnych żądań do działającego serwera vLLM, mierząc kluczowe wskaźniki, takie jak całkowita przepustowość tokenów (liczba tokenów na sekundę), czas do pierwszego tokena i czas na token wyjściowy, w zmiennych warunkach obciążenia.
Nasze testy obejmowały szereg modeli, od gęstych architektur po mikroskalowe typy danych. Testy oceniały wydajność w trzech scenariuszach obciążenia: Equal ISL/OSL, Prefill Heavy i Decode Heavy. Scenariusze te odzwierciedlają różne wzorce obsługi w świecie rzeczywistym, od zrównoważonych obciążeń wejścia i wyjścia, przez intensywne obliczeniowo przetwarzanie natychmiastowe, po generowanie tokenów z ograniczoną przepustowością pamięci.
Oprócz Acer Veriton GN100, przeprowadziliśmy testy wydajności NVIDIA Founders Edition Spark jako punktu odniesienia, obok systemów OEM firm ASUS, Dell i GIGABYTE. Pozwoliło nam to umiejscowić wyniki Acera w szerszym kontekście konkurencji i zrozumieć, gdzie firma przoduje, dotrzymuje kroku konkurencji, a gdzie wypada gorzej w porównaniu z różnymi modelami i typami obciążeń.
GPT-OSS-120B
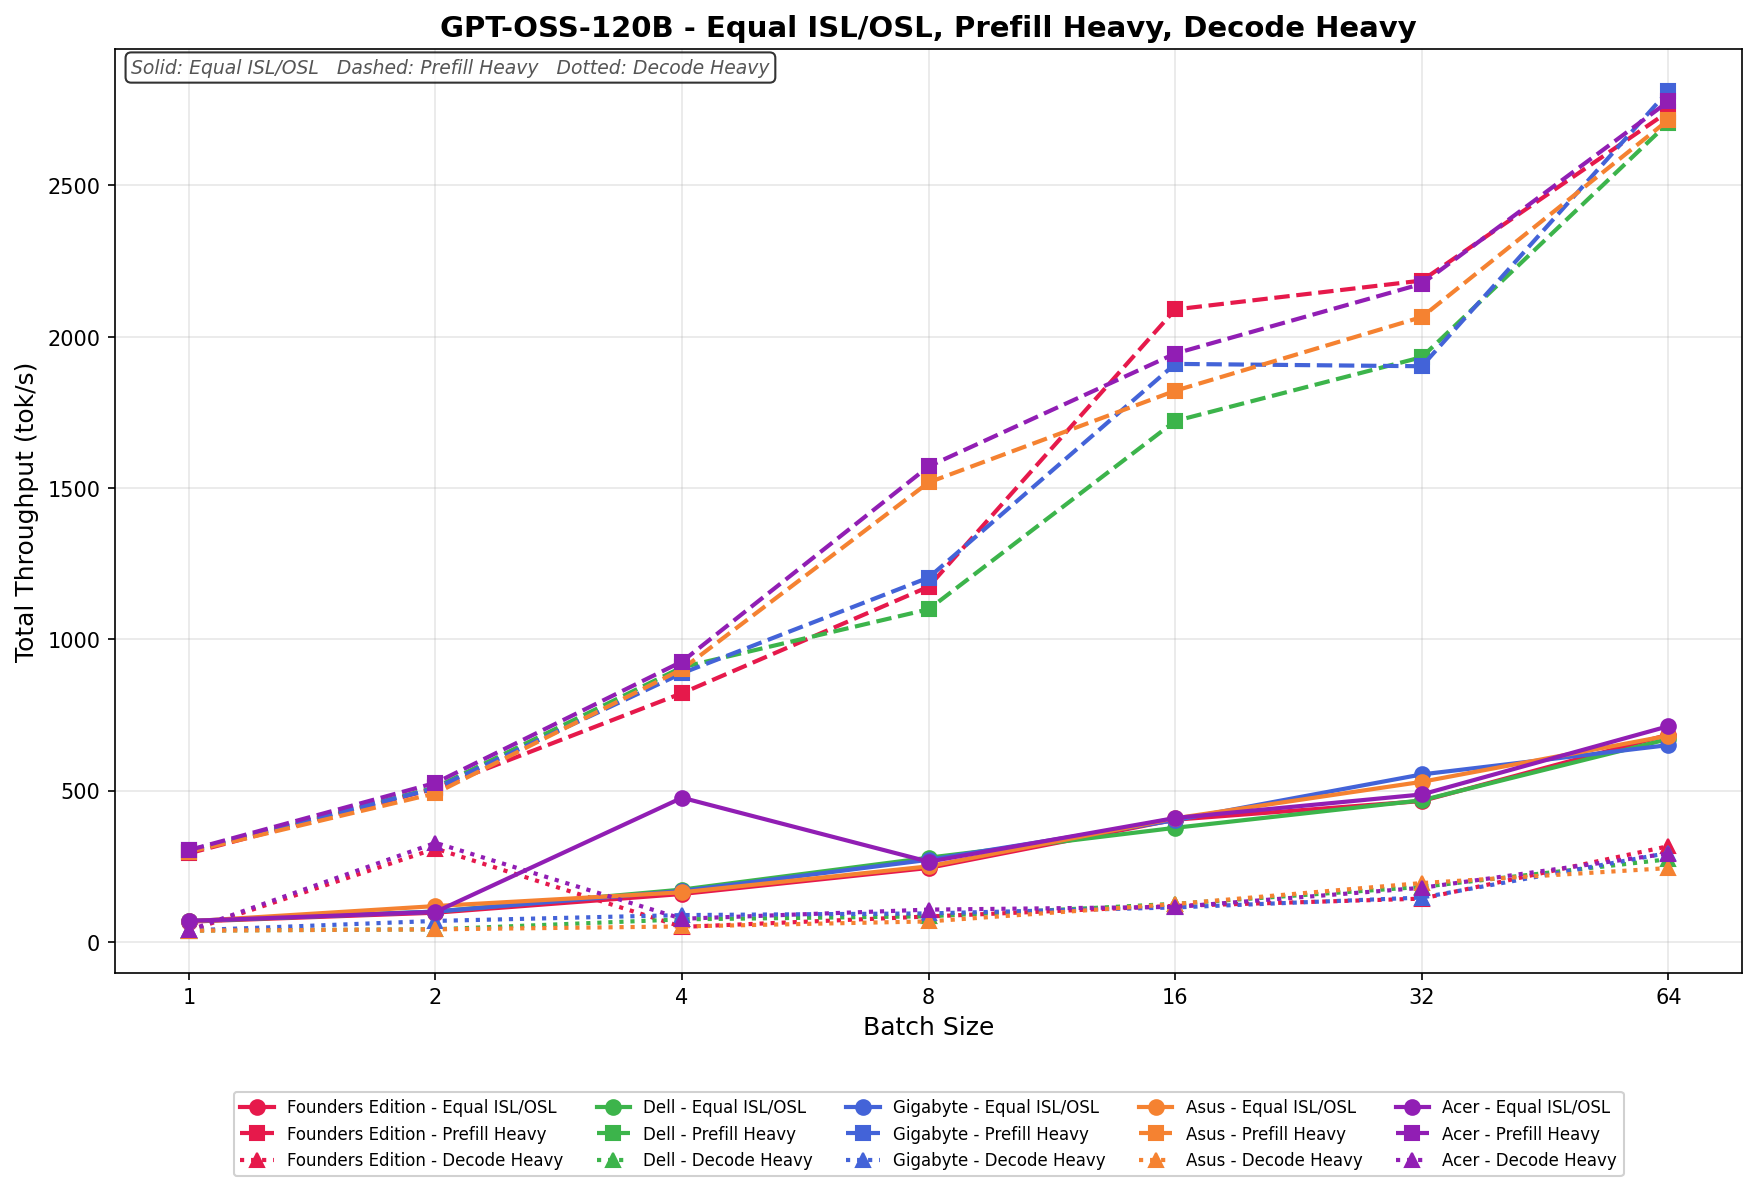
W Equal ISL/OSL, Acer skaluje się od 69.65 do 713.18 tok/s w całym cyklu przetwarzania partii. Przepustowość wykazuje pewną zmienność przy mniejszych rozmiarach partii, zanim ustabilizuje się i będzie stale rosła od partii 8 do partii 64.
Prefill Heavy rozpoczyna się od 303.61 tok/s i wzrasta do 2,777.56 tok/s przy wielkości partii 64. Skalowanie jest silne i progresywne w całym procesie, ze szczególnie agresywnym wzrostem w partii 8 i ciągłymi zyskami przy większych wielkościach partii.
Przepustowość Decode Heavy waha się od 38.38 do 292.41 tok/s, ze stopniowym i spójnym skalowaniem w całym cyklu przetwarzania wsadowego. Mniejsze rozmiary wsadów wykazują pewną zmienność, zanim przepustowość się ustabilizuje i będzie stale rosła od 16. wsadu.
GPT-OSS-20B
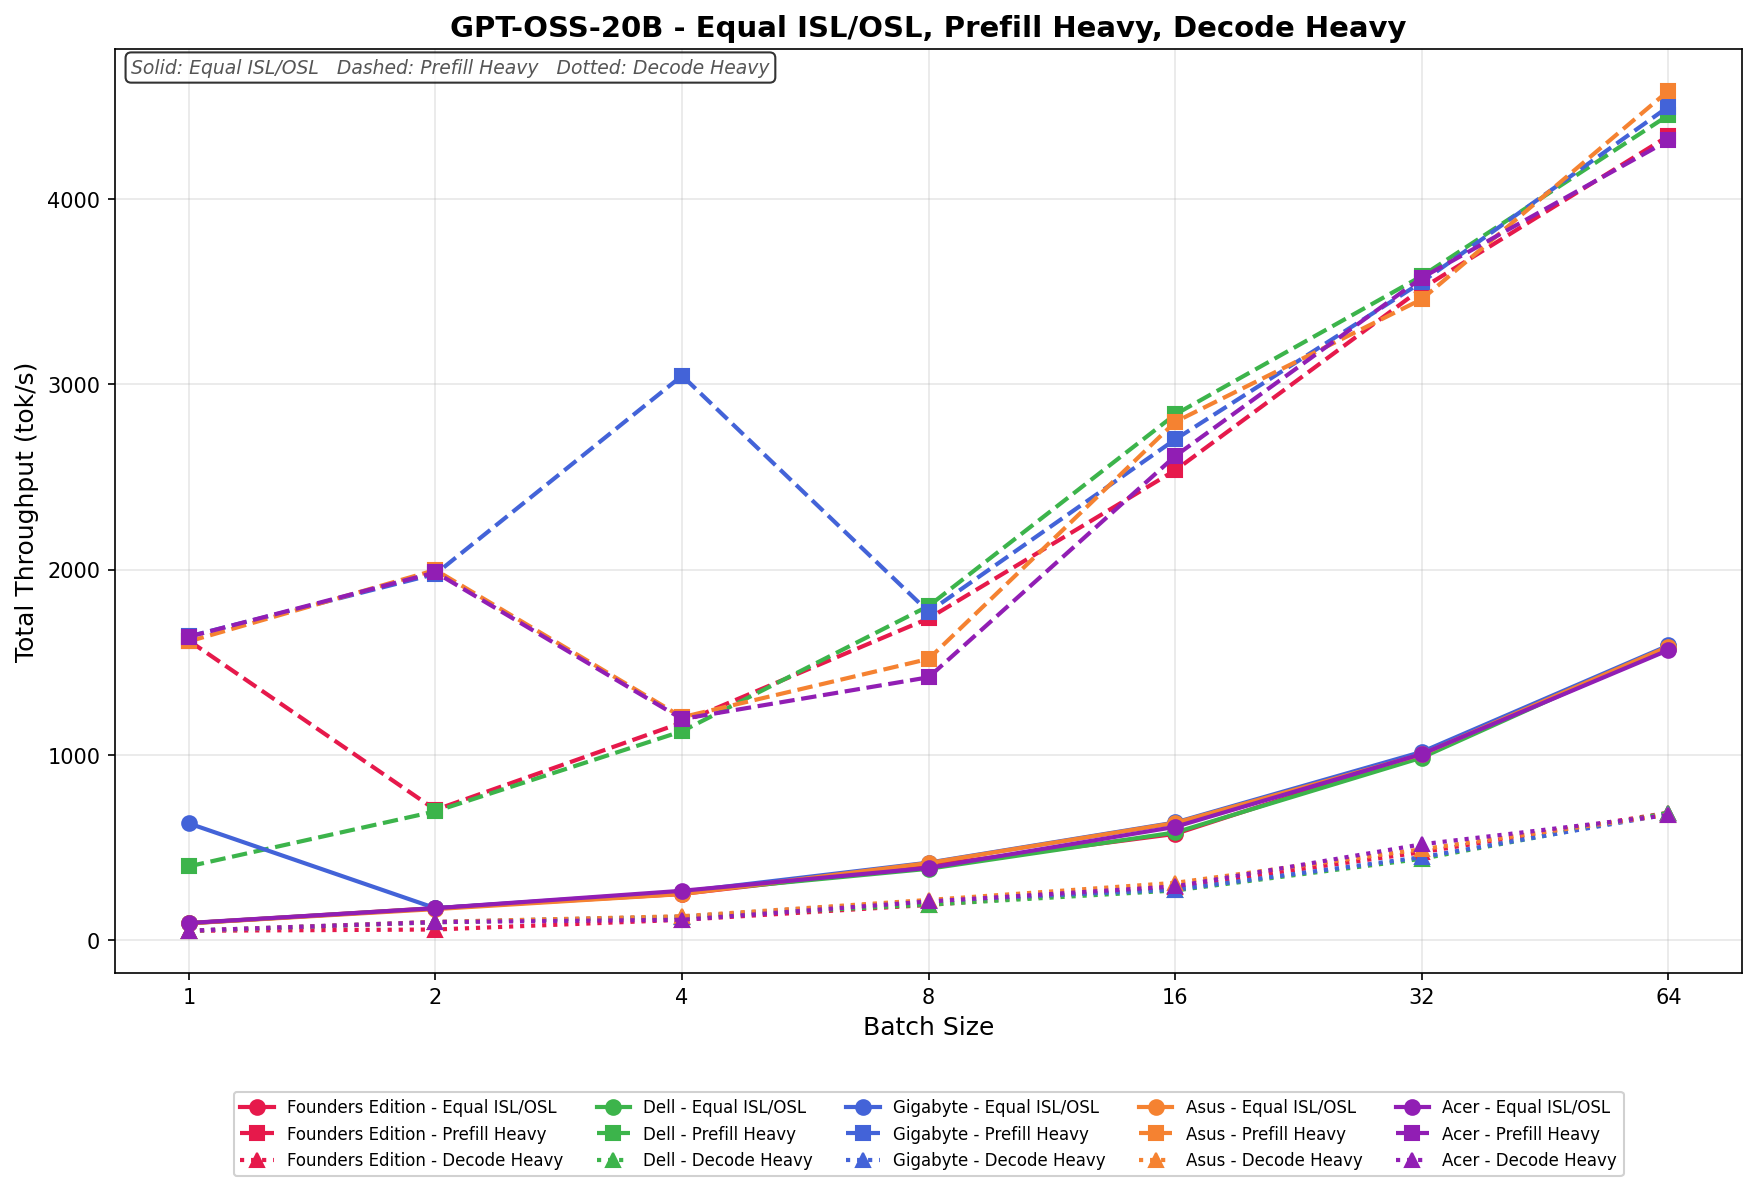
W trybie Equal ISL/OSL, Acer skaluje się z 91.91 do 1,565.62 tok/s, zapewniając silny i stały wzrost w całym cyklu przetwarzania partii. Przepustowość wzrasta w przybliżeniu dwukrotnie od partii 1 do partii 4, a następnie kontynuuje wzrost w partiach 32 i 64.
Prefill Heavy rozpoczyna się od 1,637.72 tok/s i wzrasta do 4,317.73 tok/s w miarę zwiększania rozmiaru partii do 64. Wzrost jest silny w partii 2, słabnie w średnim zakresie, a następnie ponownie przyspiesza w partii 32 i 64.
Decode Heavy ma zakres od 50.55 do 674.26 tok/s, ze stopniowym i spójnym skalowaniem w całym cyklu przetwarzania wsadowego.
Koder Qwen3 30B A3B FB8
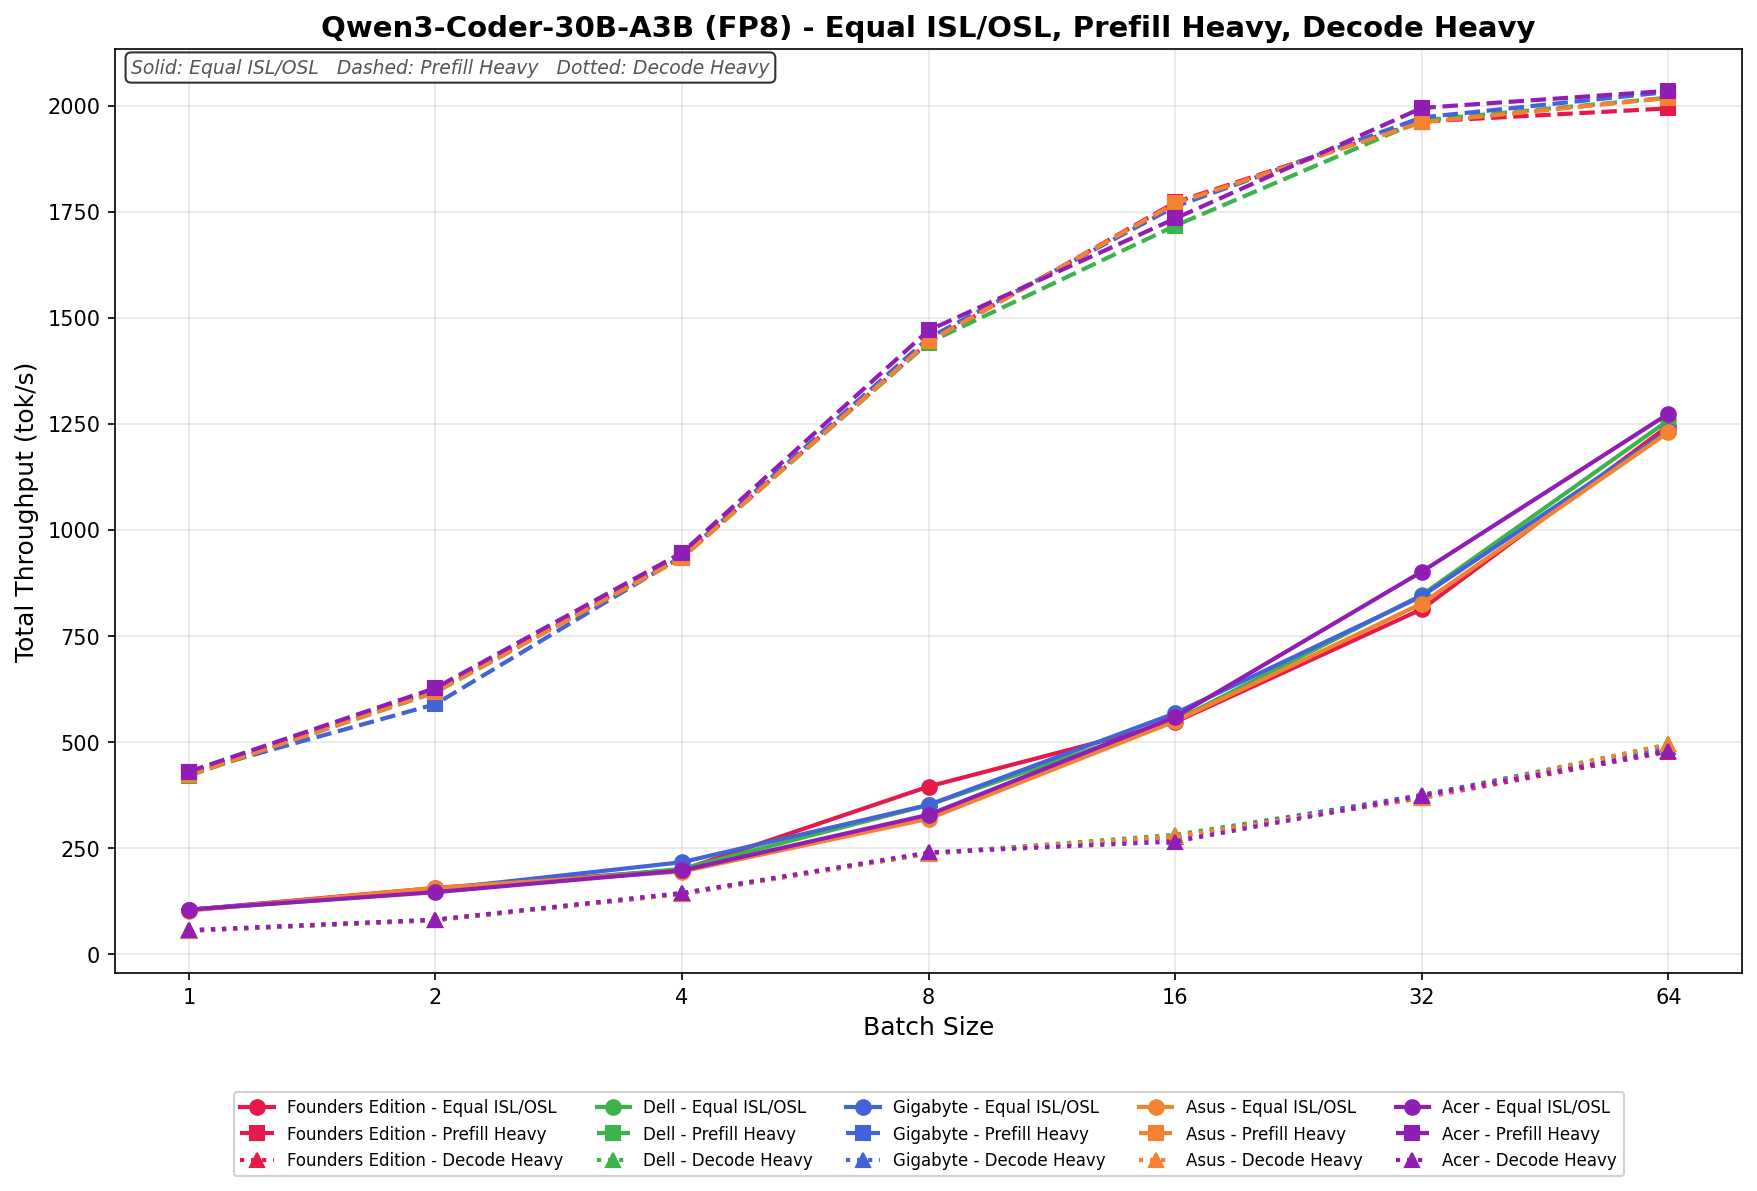
W Equal ISL/OSL, Acer skaluje się od 104.64 do 1,273.47 tok/s, ze stałym, równomiernym wzrostem w całym cyklu partii. Przepustowość podwaja się na każdym etapie do partii 16, a następnie nadal rośnie w partiach 32 i 64.
Prefill Heavy rozpoczyna się od 429.86 tok/s i wzrasta do 2,034.76 tok/s przy rozmiarze partii 64. Skalowanie jest silne do partii 8, a następnie maleje, gdy obciążenie pracą zbliża się do plateau przy partii 32 i 64.
Decode Heavy ma zakres od 55.94 do 478.59 tok/s, ze stopniowym i spójnym skalowaniem w całym cyklu przetwarzania wsadowego.
Koder Qwen3 30B A3B Base
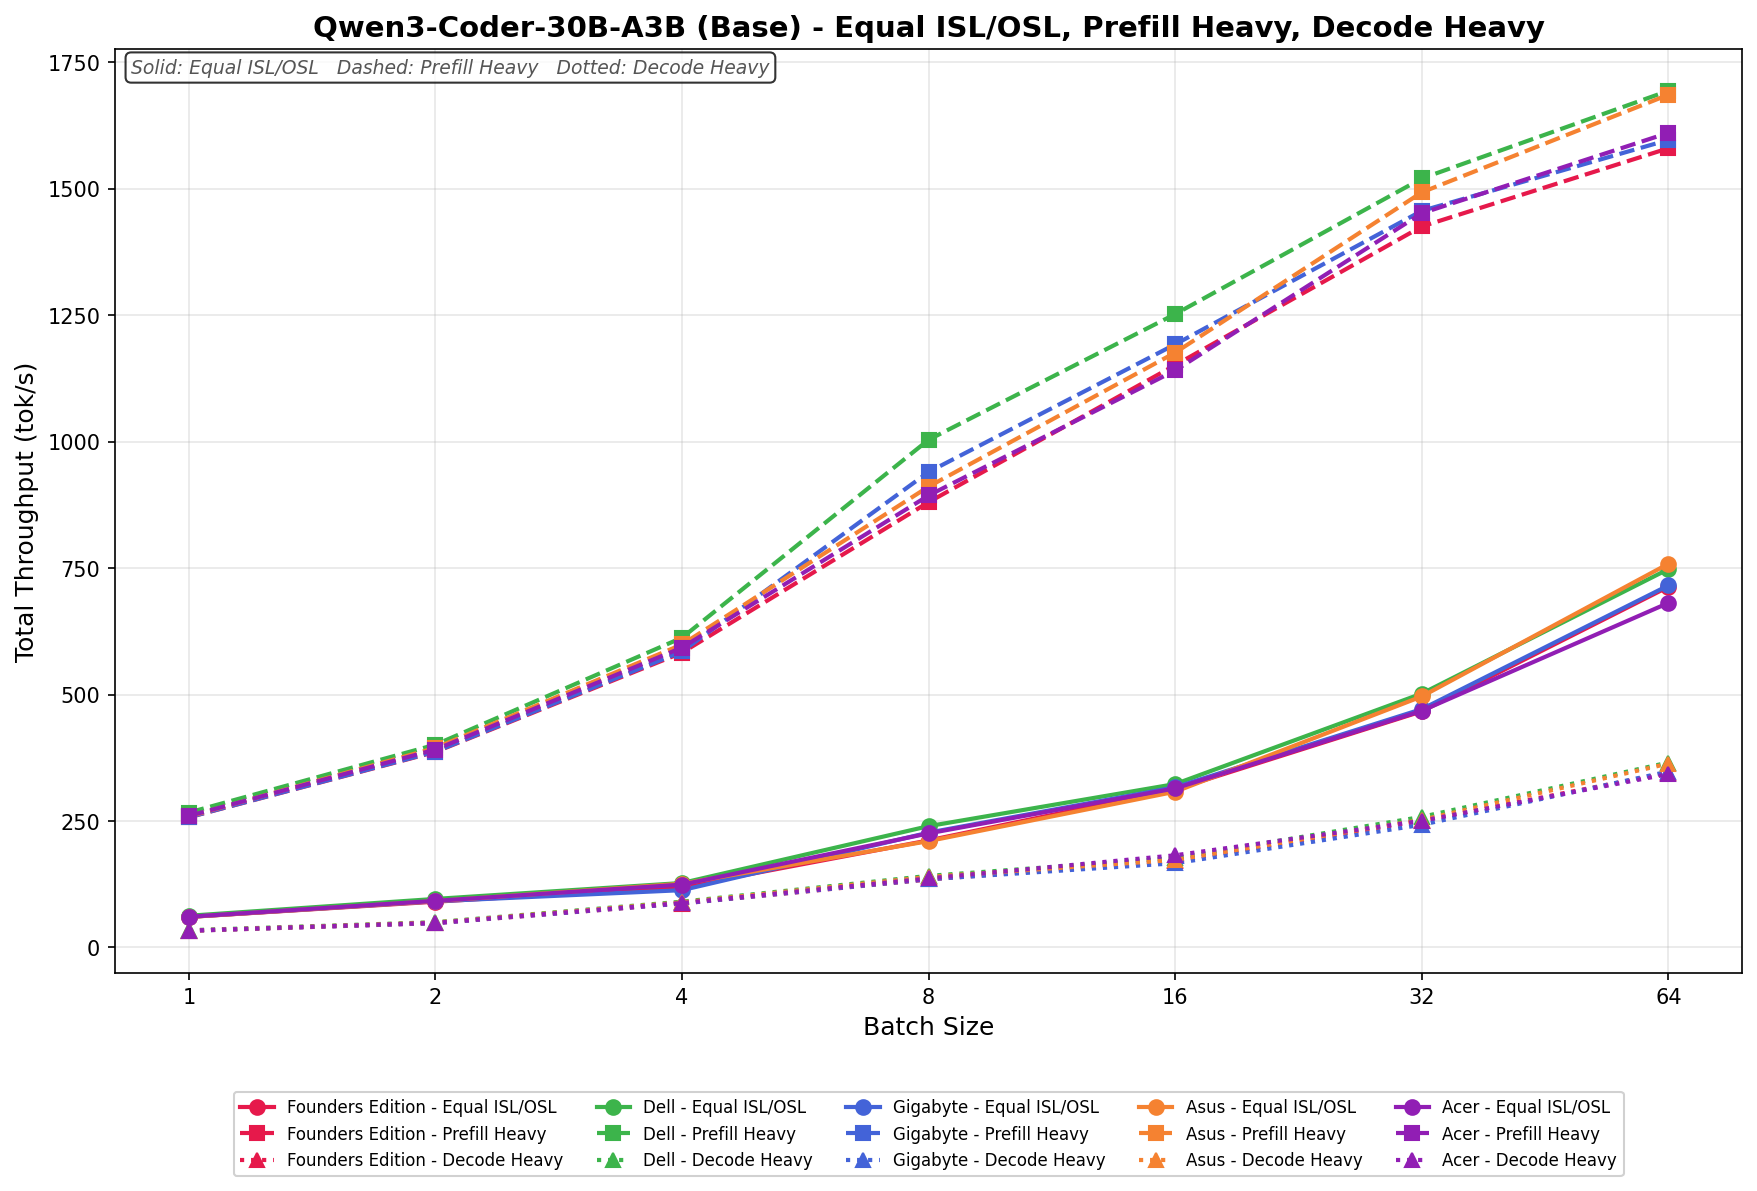
W Equal ISL/OSL, Acer skaluje się z 60.71 do 681.18 tok/s, zapewniając znacząco niższą przepustowość niż wariant FP8 dla wszystkich wielkości partii. Wzrost jest stabilny w całym okresie testowym, choć różnica w stosunku do FP8 powiększa się przy większych wielkościach partii.
Prefill Heavy zaczyna się od 260.11 tok/s i wzrasta do 1,610.56 tok/s przy każdej wielkości partii 64. Skalowanie jest spójne w całym zakresie, chociaż przepustowość jest znacznie niższa niż w przypadku FP8 przy każdej wielkości partii.
Decode Heavy osiąga zakres od 33.31 do 342.79 tok/s, z niższą wydajnością niż wariant FP8 w całym cyklu. Wzrost jest stopniowy i spójny dla wszystkich wielkości partii.
Llama 3.1 8B Instrukcja FP4
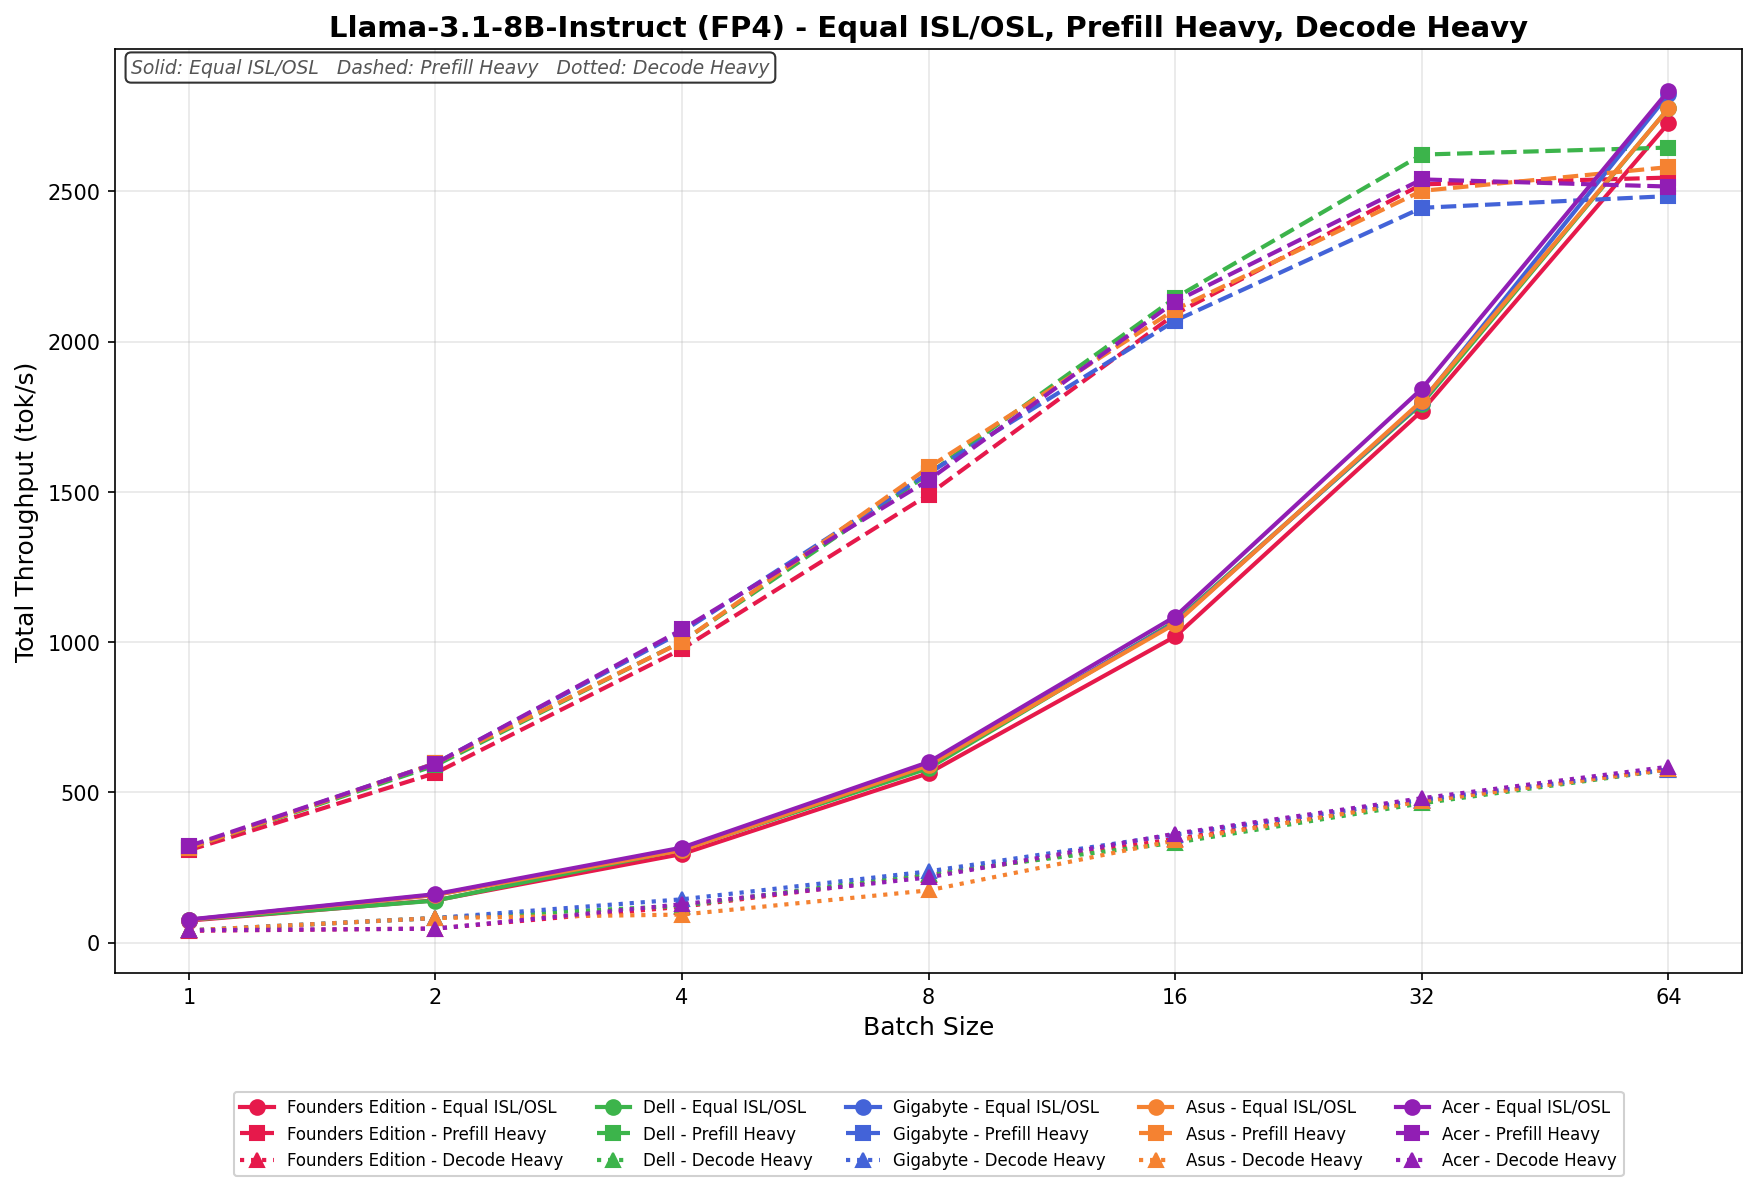
W Equal ISL/OSL, Acer skaluje się z 77.15 do 2,834.70 tok/s, zapewniając wyraźną przewagę przepustowości nad wariantem FP8 we wszystkich rozmiarach partii. Skalowanie jest płynne i liniowe do partii 32, z ciągłym, znacznym wzrostem w partii 64.
Prefill Heavy rozpoczyna się od 321.54 tok/s i wzrasta do 2,539.85 tok/s w partii 32, po czym nieznacznie osiąga plateau na poziomie 2,516.13 tok/s w partii 64. Model FP4 utrzymuje wyższą przepustowość niż jego odpowiednik FP8 w przypadku średnich i dużych partii.
Decode Heavy osiąga zakres od 41.21 do 585.63 tok/s, ze znacznie wyższą wydajnością niż wariant FP8 we wszystkich wielkościach partii. Wzrost jest stały w całym zakresie.
Llama 3.1 8B Instrukcja FP8
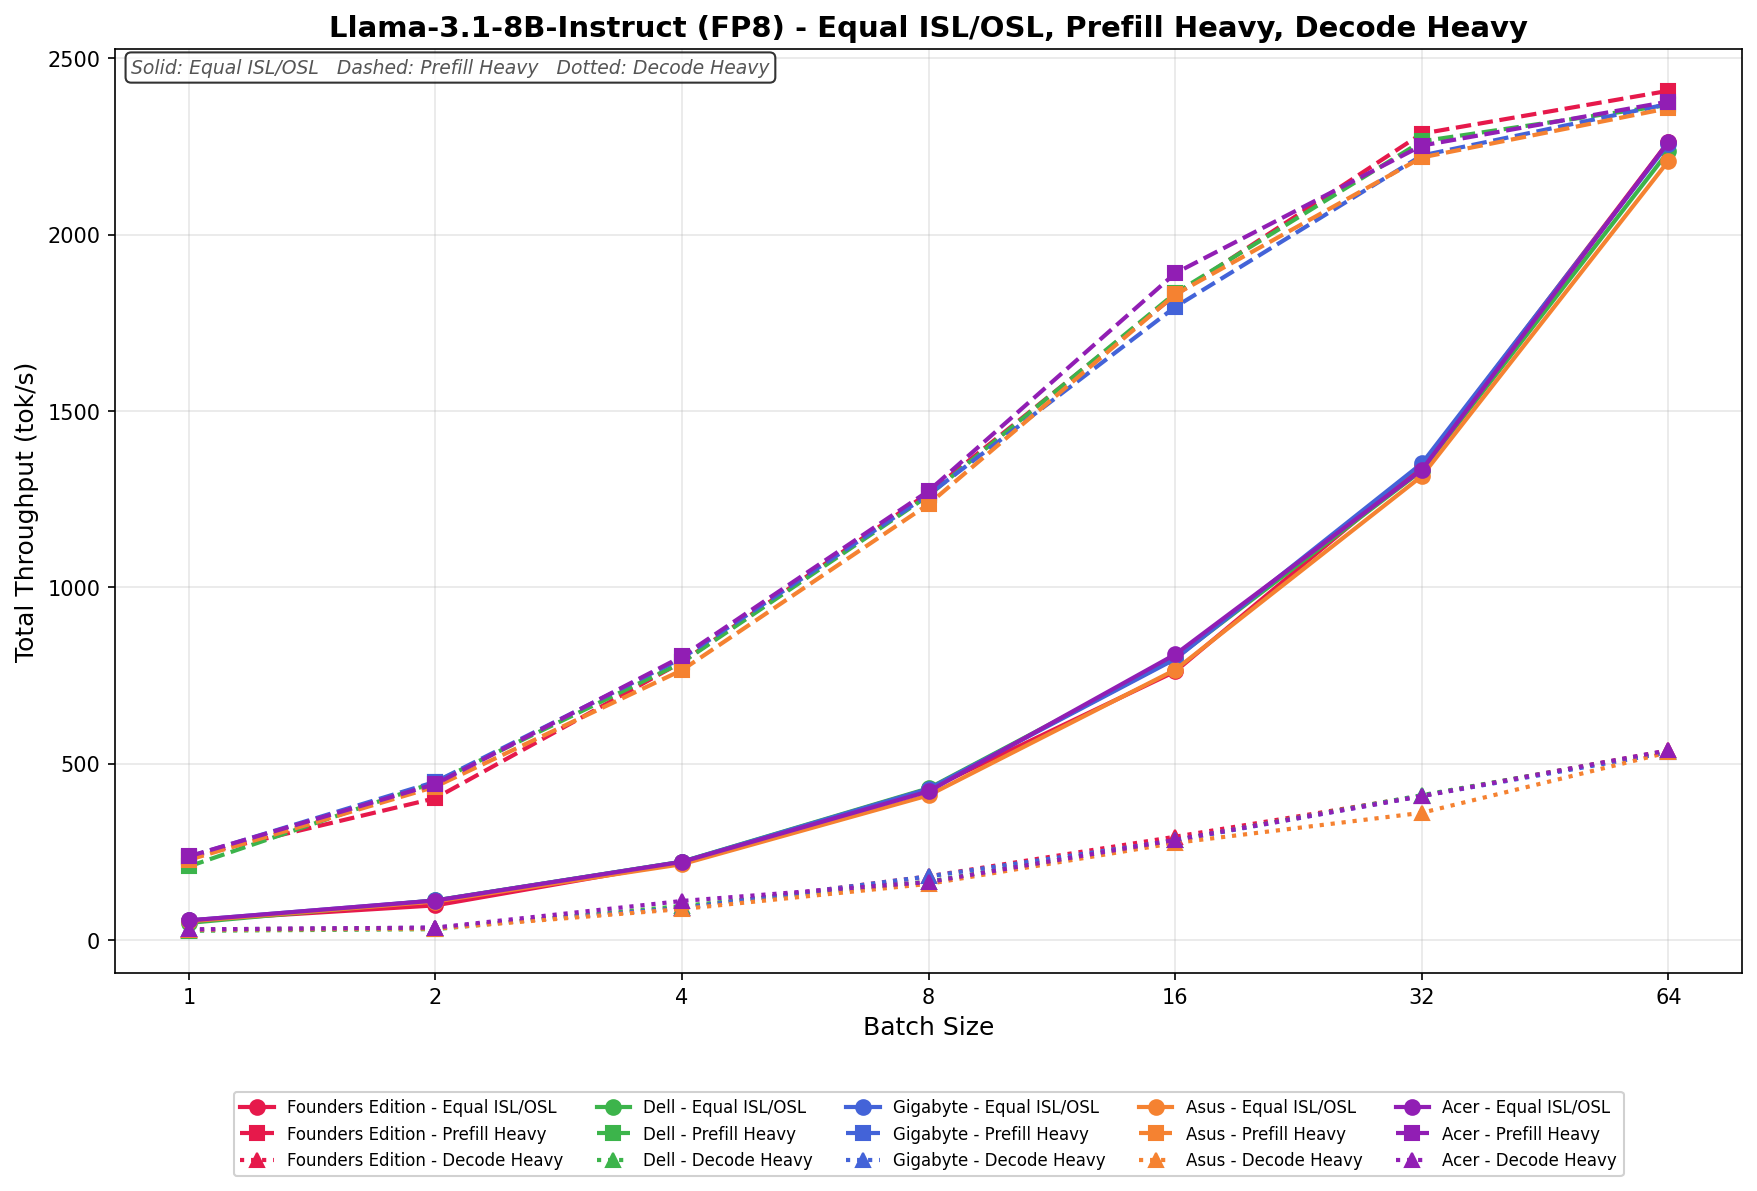
W Equal ISL/OSL, Acer skaluje się z 55.93 do 2,262.73 tok/s w całym cyklu przetwarzania wsadowego, ze stałym i spójnym wzrostem na każdym kroku. Przepustowość niemal podwaja się od partii 1 do partii 8 i nadal rośnie w partiach 32 i 64 bez oznak nasycenia.
Prefill Heavy zaczyna się od 237.62 tok/s i wzrasta do 2,376.88 tok/s przy wielkości partii 64. Skalowanie jest silne i progresywne w całym cyklu, a przepustowość rośnie konsekwentnie w całym cyklu partii.
Wartości Decode Heavy mieszczą się w przedziale od 30.39 do 538.18 tok/s, przy czym ich wzrost jest stały w całym cyklu przetwarzania wsadowego.
Bezpośrednie przechowywanie GPU
Jednym z testów, jakie przeprowadziliśmy na Sparku, był test MagnumIO GPU Direct Storage (GDS). GDS to funkcja opracowana przez firmę NVIDIA, która pozwala procesorom graficznym ominąć procesor główny (CPU) podczas uzyskiwania dostępu do danych przechowywanych na dyskach NVMe lub innych szybkich urządzeniach pamięci masowej. Zamiast kierować dane przez procesor i pamięć systemową, GDS umożliwia bezpośrednią komunikację między procesorem graficznym a urządzeniem pamięci masowej, znacznie redukując opóźnienia i poprawiając przepustowość danych.
Acer wykorzystuje dysk SSD Samsung PM9E1 Gen5 o pojemności 4TB w obudowie Veriton GN100 AI. Jest to jak dotąd najszybszy dysk M.2 o pojemności 2242 cali, jaki widzieliśmy na rynku.
Jak działa bezpośrednie przechowywanie danych GPU
Tradycyjnie, gdy procesor graficzny (GPU) przetwarza dane przechowywane na dysku NVMe, dane muszą najpierw przejść przez procesor (CPU) i pamięć systemową, zanim dotrą do procesora graficznego (GPU). Proces ten wprowadza wąskie gardła, ponieważ procesor (CPU) działa jako pośrednik, zwiększając opóźnienia i zużywając cenne zasoby systemowe. Technologia GPU Direct Storage eliminuje ten problem, umożliwiając procesorowi graficznemu bezpośredni dostęp do danych z urządzenia pamięci masowej za pośrednictwem magistrali PCIe. Ta bezpośrednia ścieżka zmniejsza obciążenie związane z przesyłaniem danych, umożliwiając szybsze i bardziej wydajne przesyłanie danych.
Obciążenia sztucznej inteligencji, zwłaszcza te wykorzystujące uczenie głębokie, charakteryzują się wysoką intensywnością przetwarzania danych. Trenowanie dużych sieci neuronowych wymaga przetwarzania terabajtów danych, a każde opóźnienie w transferze danych może prowadzić do niewykorzystania procesorów graficznych (GPU) i wydłużenia czasu trenowania. Technologia GPU Direct Storage rozwiązuje ten problem, zapewniając jak najszybsze dostarczanie danych do procesora graficznego (GPU), minimalizując czas przestoju i maksymalizując wydajność obliczeniową.
Ponadto GDS jest szczególnie przydatny w przypadku obciążeń wymagających strumieniowego przesyłania dużych zbiorów danych, takich jak przetwarzanie wideo, przetwarzanie języka naturalnego czy wnioskowanie w czasie rzeczywistym. Zmniejszając zależność od procesora, GDS przyspiesza przesyłanie danych i uwalnia zasoby procesora do innych zadań, co dodatkowo zwiększa ogólną wydajność systemu.
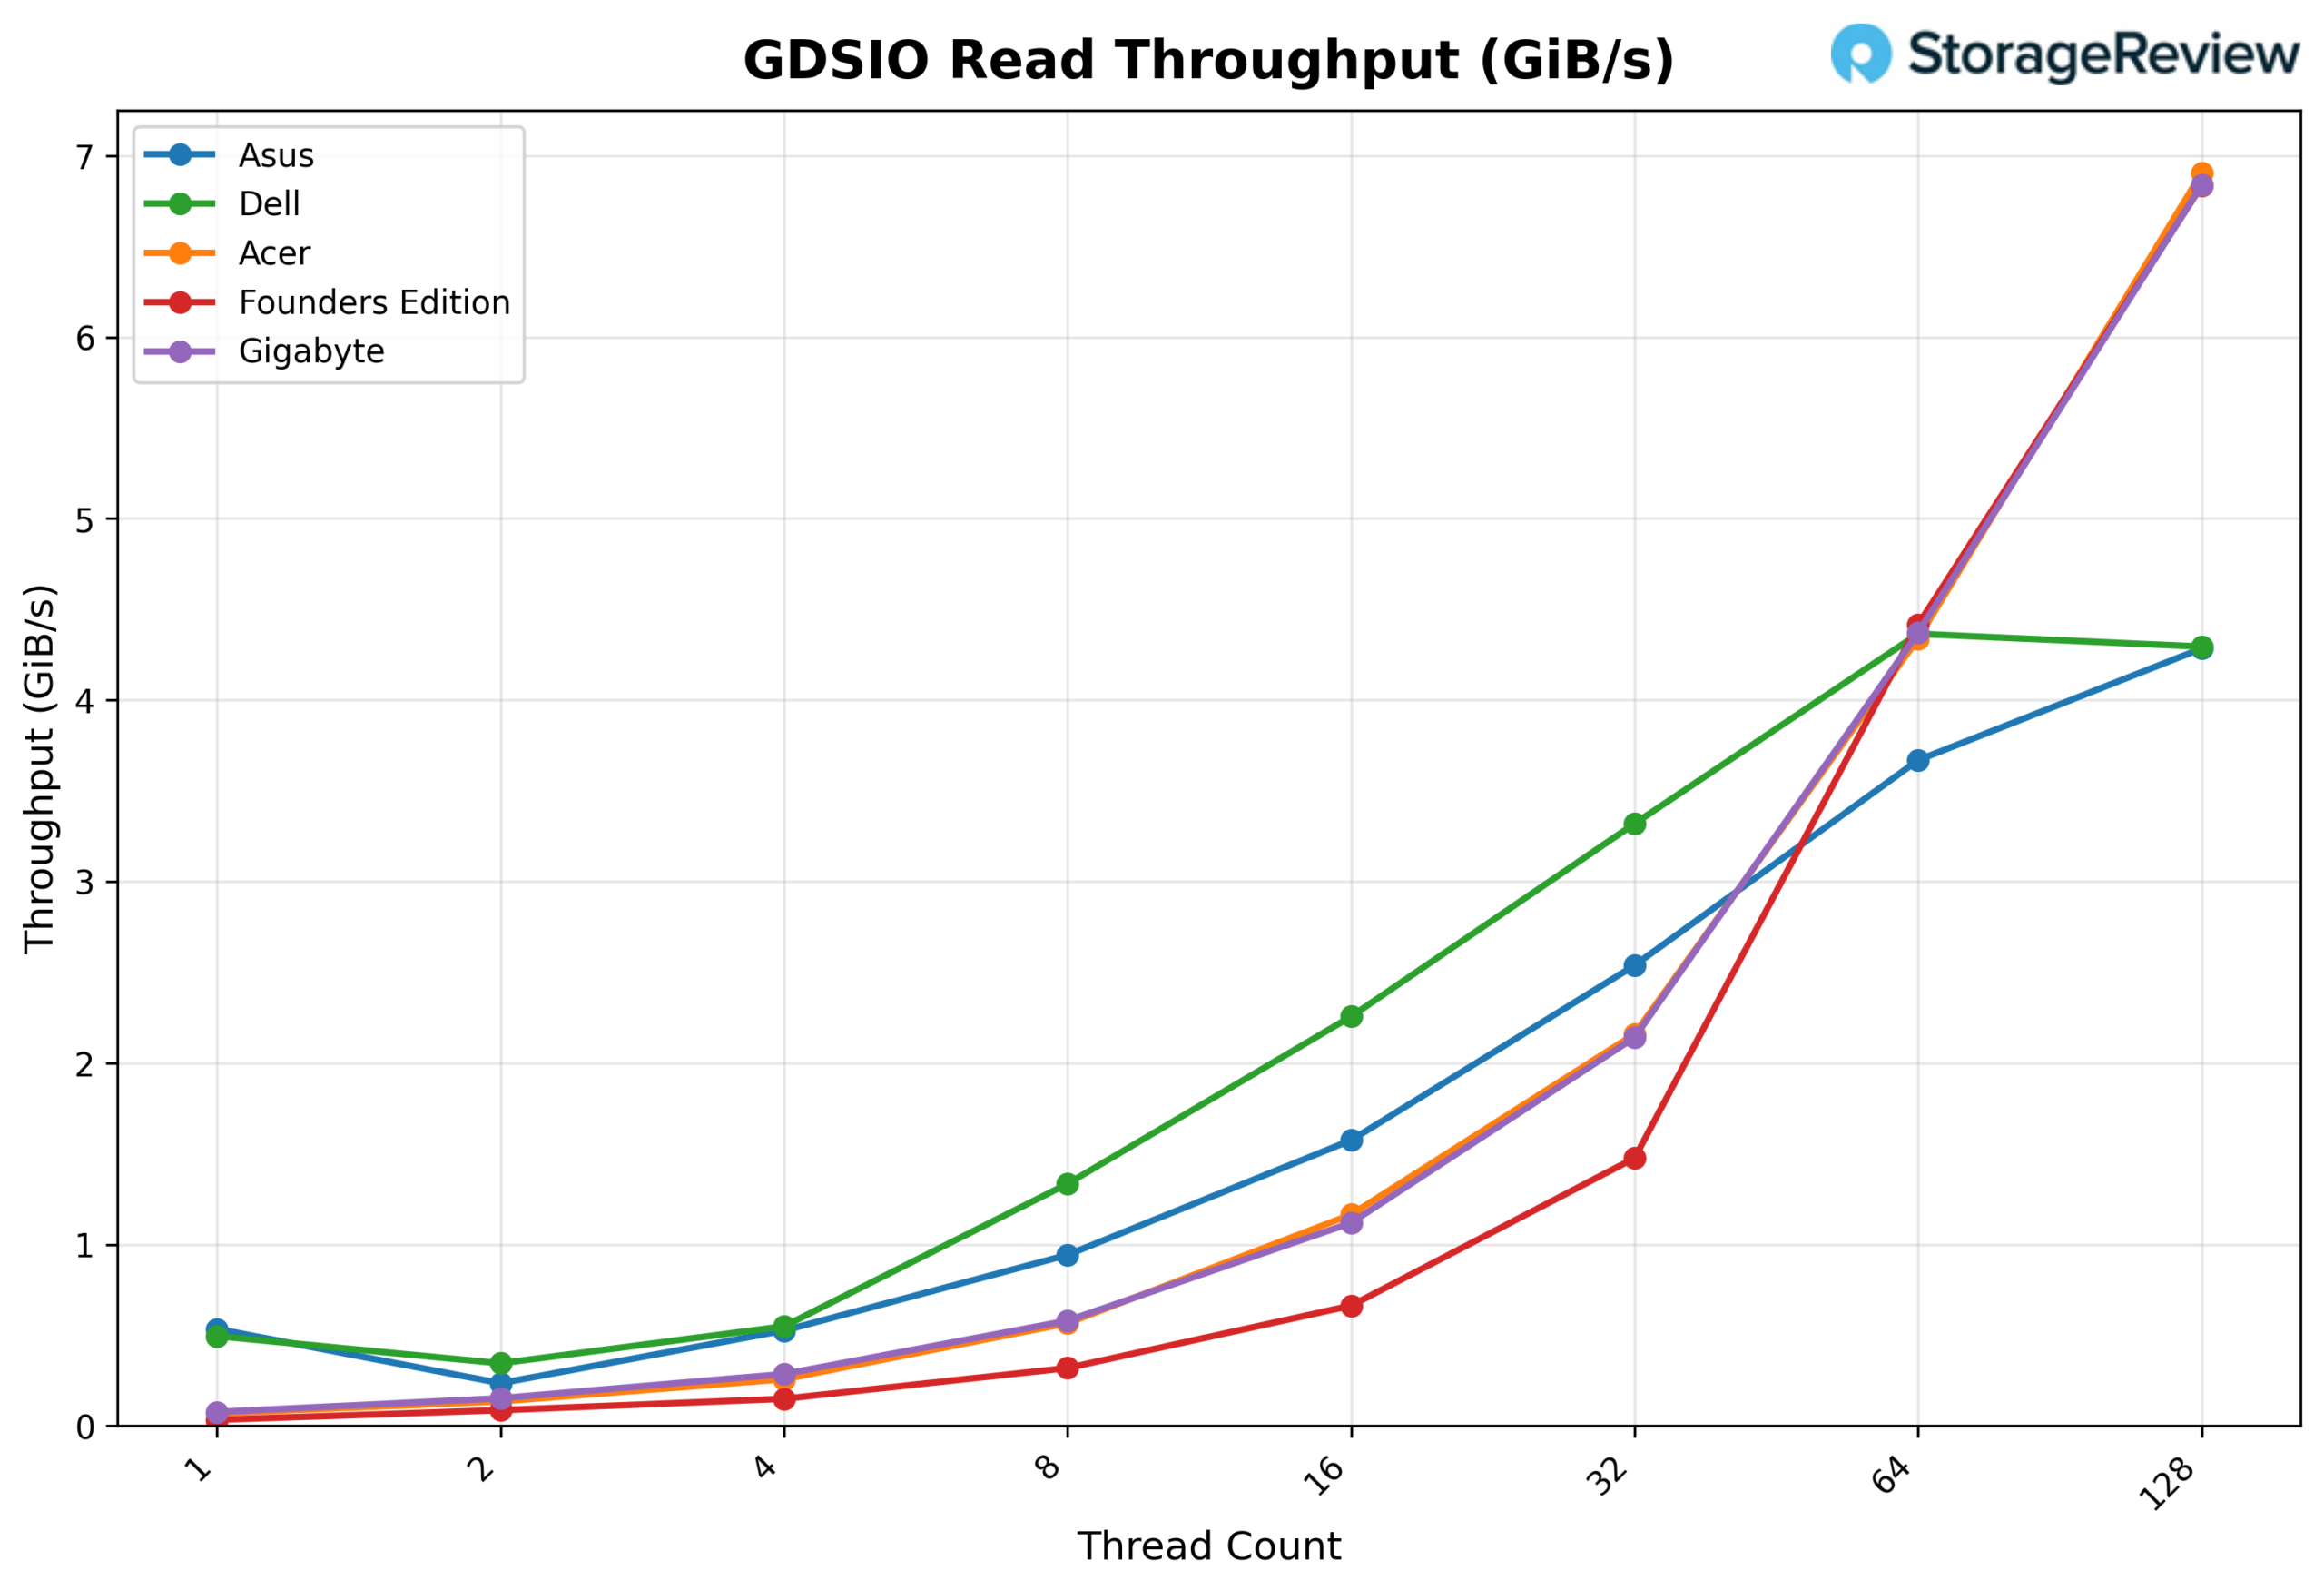
Przepustowość odczytu GDSIO 16k
Patrząc na przepustowość odczytu GDSIO 16K, Acer rozpoczyna od 0.07 GiB/s przy 1 wątku i skaluje się liniowo przez 2 wątki (0.13 GiB/s), 4 wątki (0.26 GiB/s) i 8 wątków (0.57 GiB/s). Przepustowość nadal rośnie do 16 wątków (1.16 GiB/s), 32 wątków (2.16 GiB/s) i 64 wątków (4.34 GiB/s). Przy 128 wątkach przepustowość osiąga 6.91 GiB/s, najwyższy zaobserwowany wynik w tym badaniu, bez wyraźnego punktu nasycenia, co wskazuje na to, że platforma nadal skaluje się przy małych rozmiarach wejścia/wyjścia.
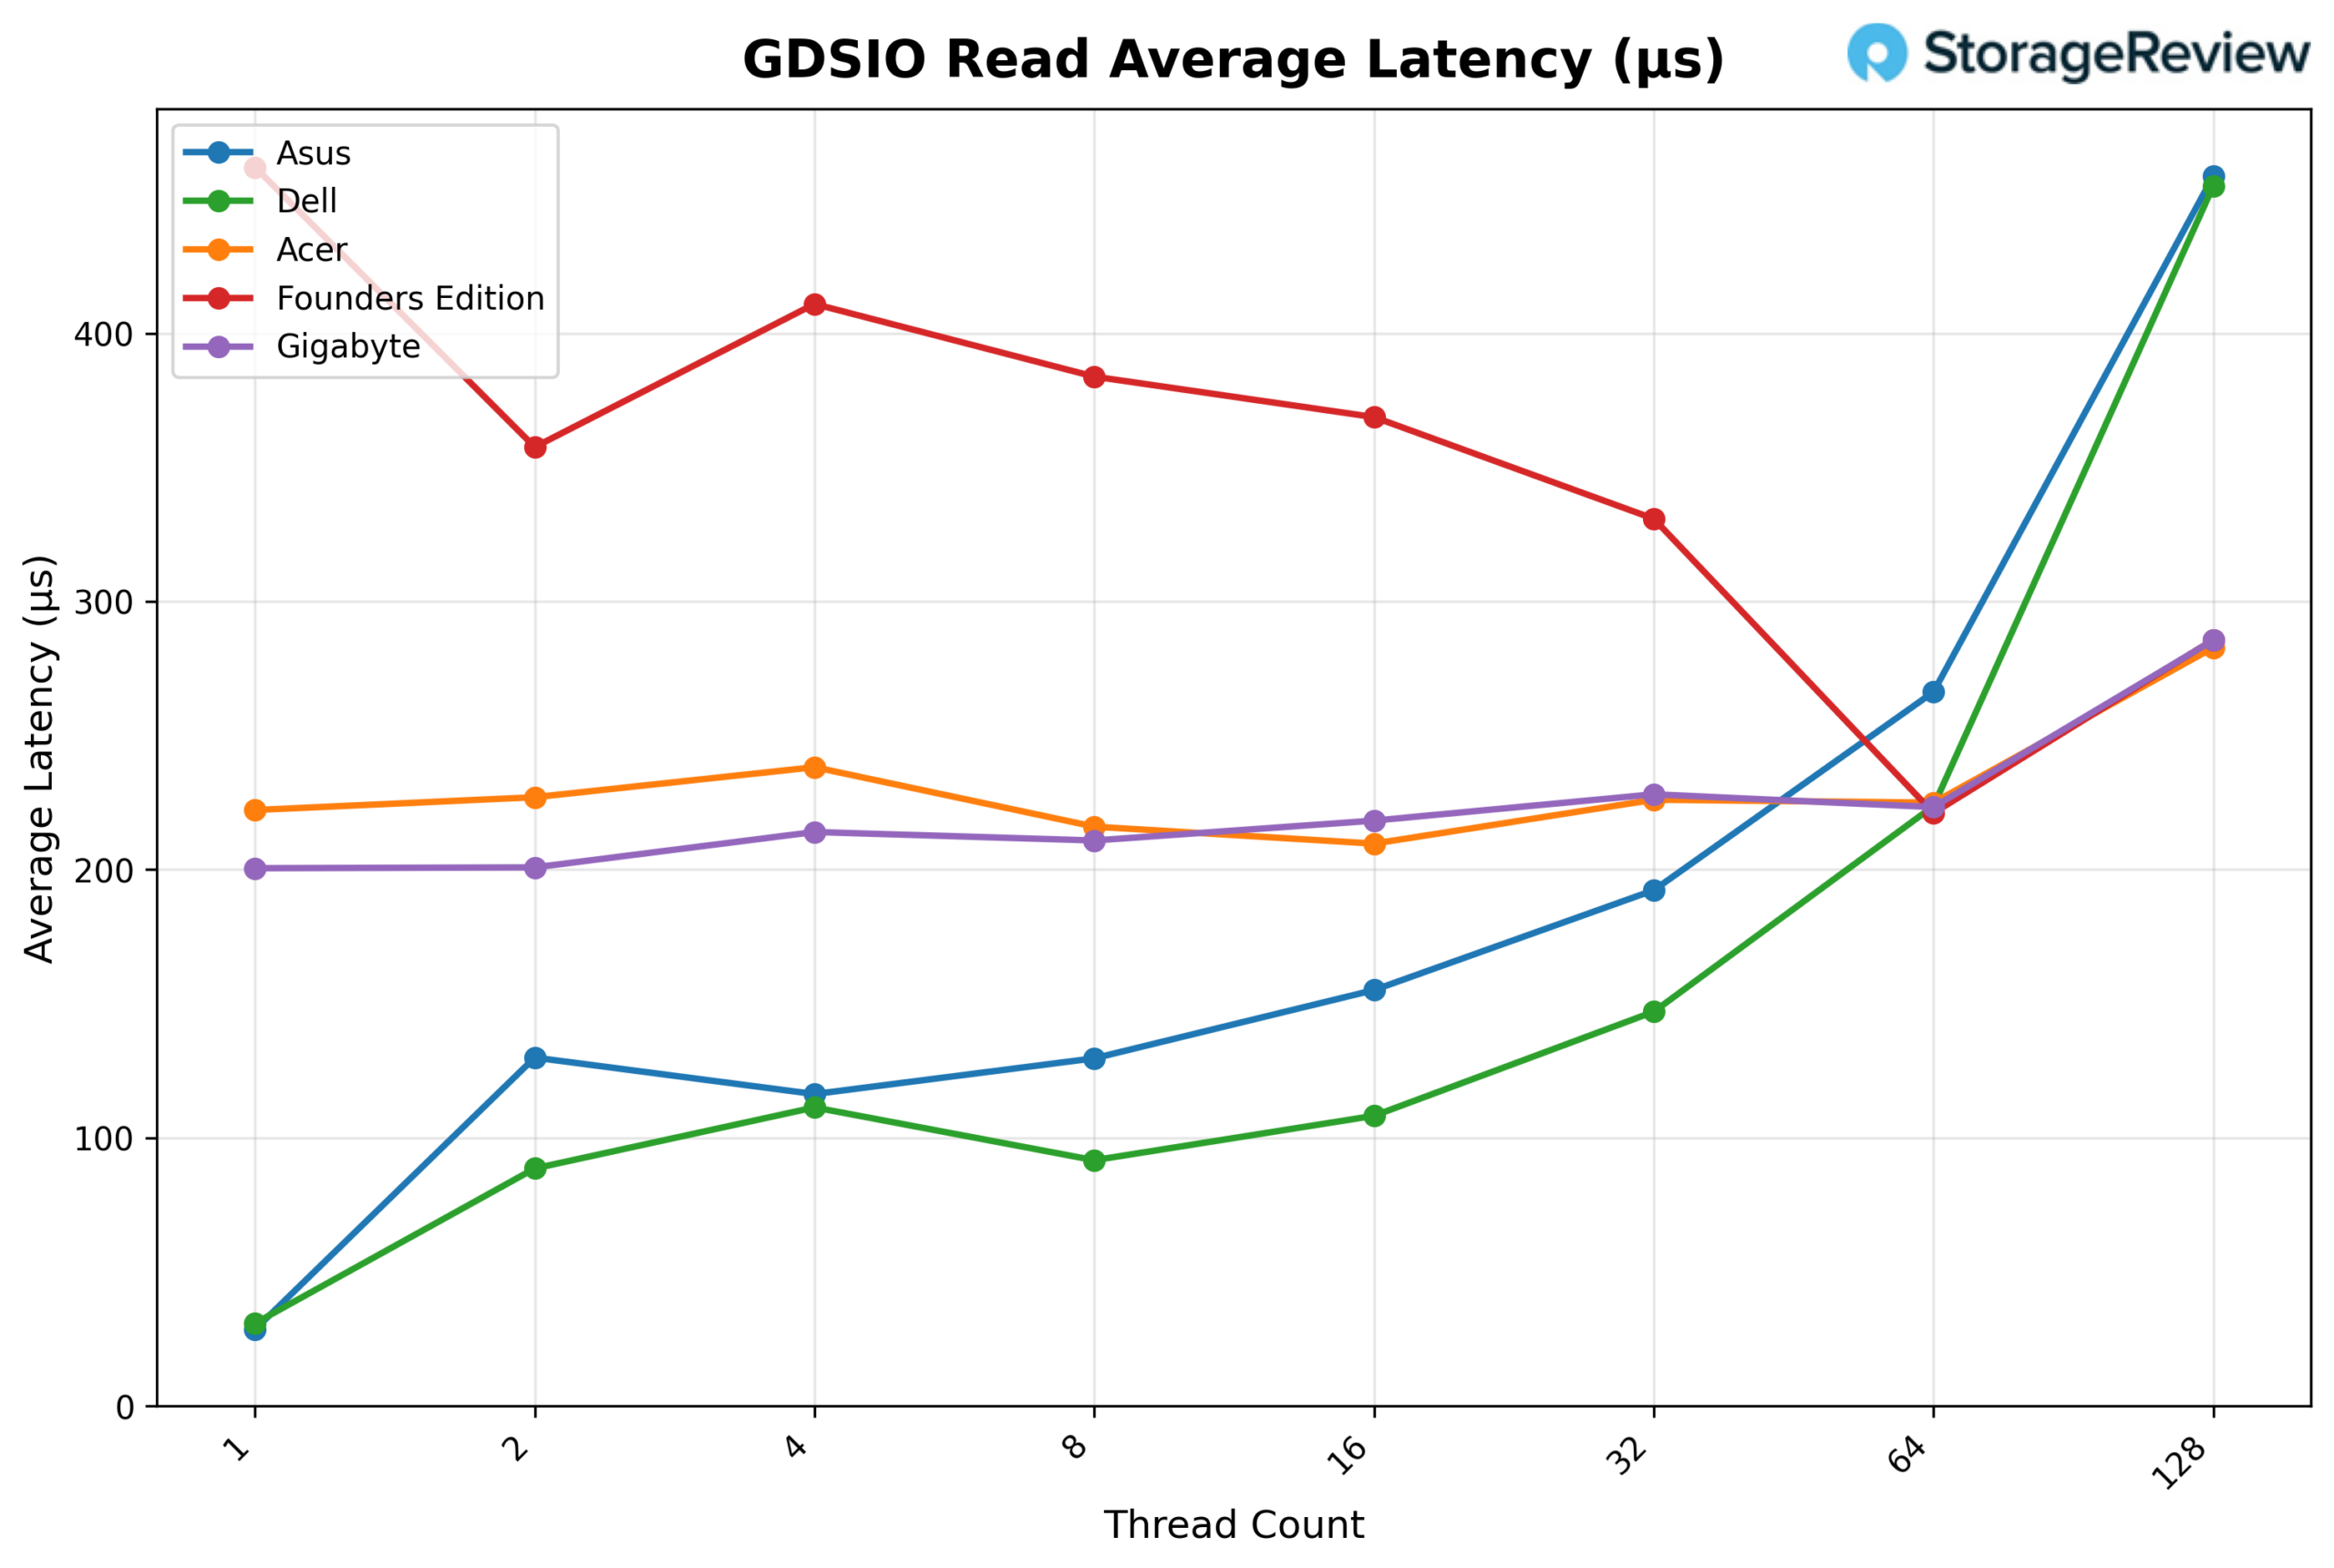
Średnie opóźnienie odczytu GDSIO: 16 tys.
Patrząc na średnie opóźnienie odczytu GDSIO (16 KB), Acer rozpoczyna od około 0.22 ms przy 1 wątku i pozostaje zadziwiająco stabilny w całym zakresie: 0.23 ms przy 2 wątkach, 0.24 ms przy 4 wątkach i 0.22 ms przy 8 wątkach. Opóźnienie pozostaje podobnie płaskie przy 16 wątkach (0.21 ms), 32 wątkach (0.23 ms) i 64 wątkach (0.22 ms), a następnie nieznacznie wzrasta do 0.28 ms przy 128 wątkach. Ten niemal płaski profil opóźnienia dla wszystkich wątków odzwierciedla ciągłe skalowanie obserwowane w przepustowości.
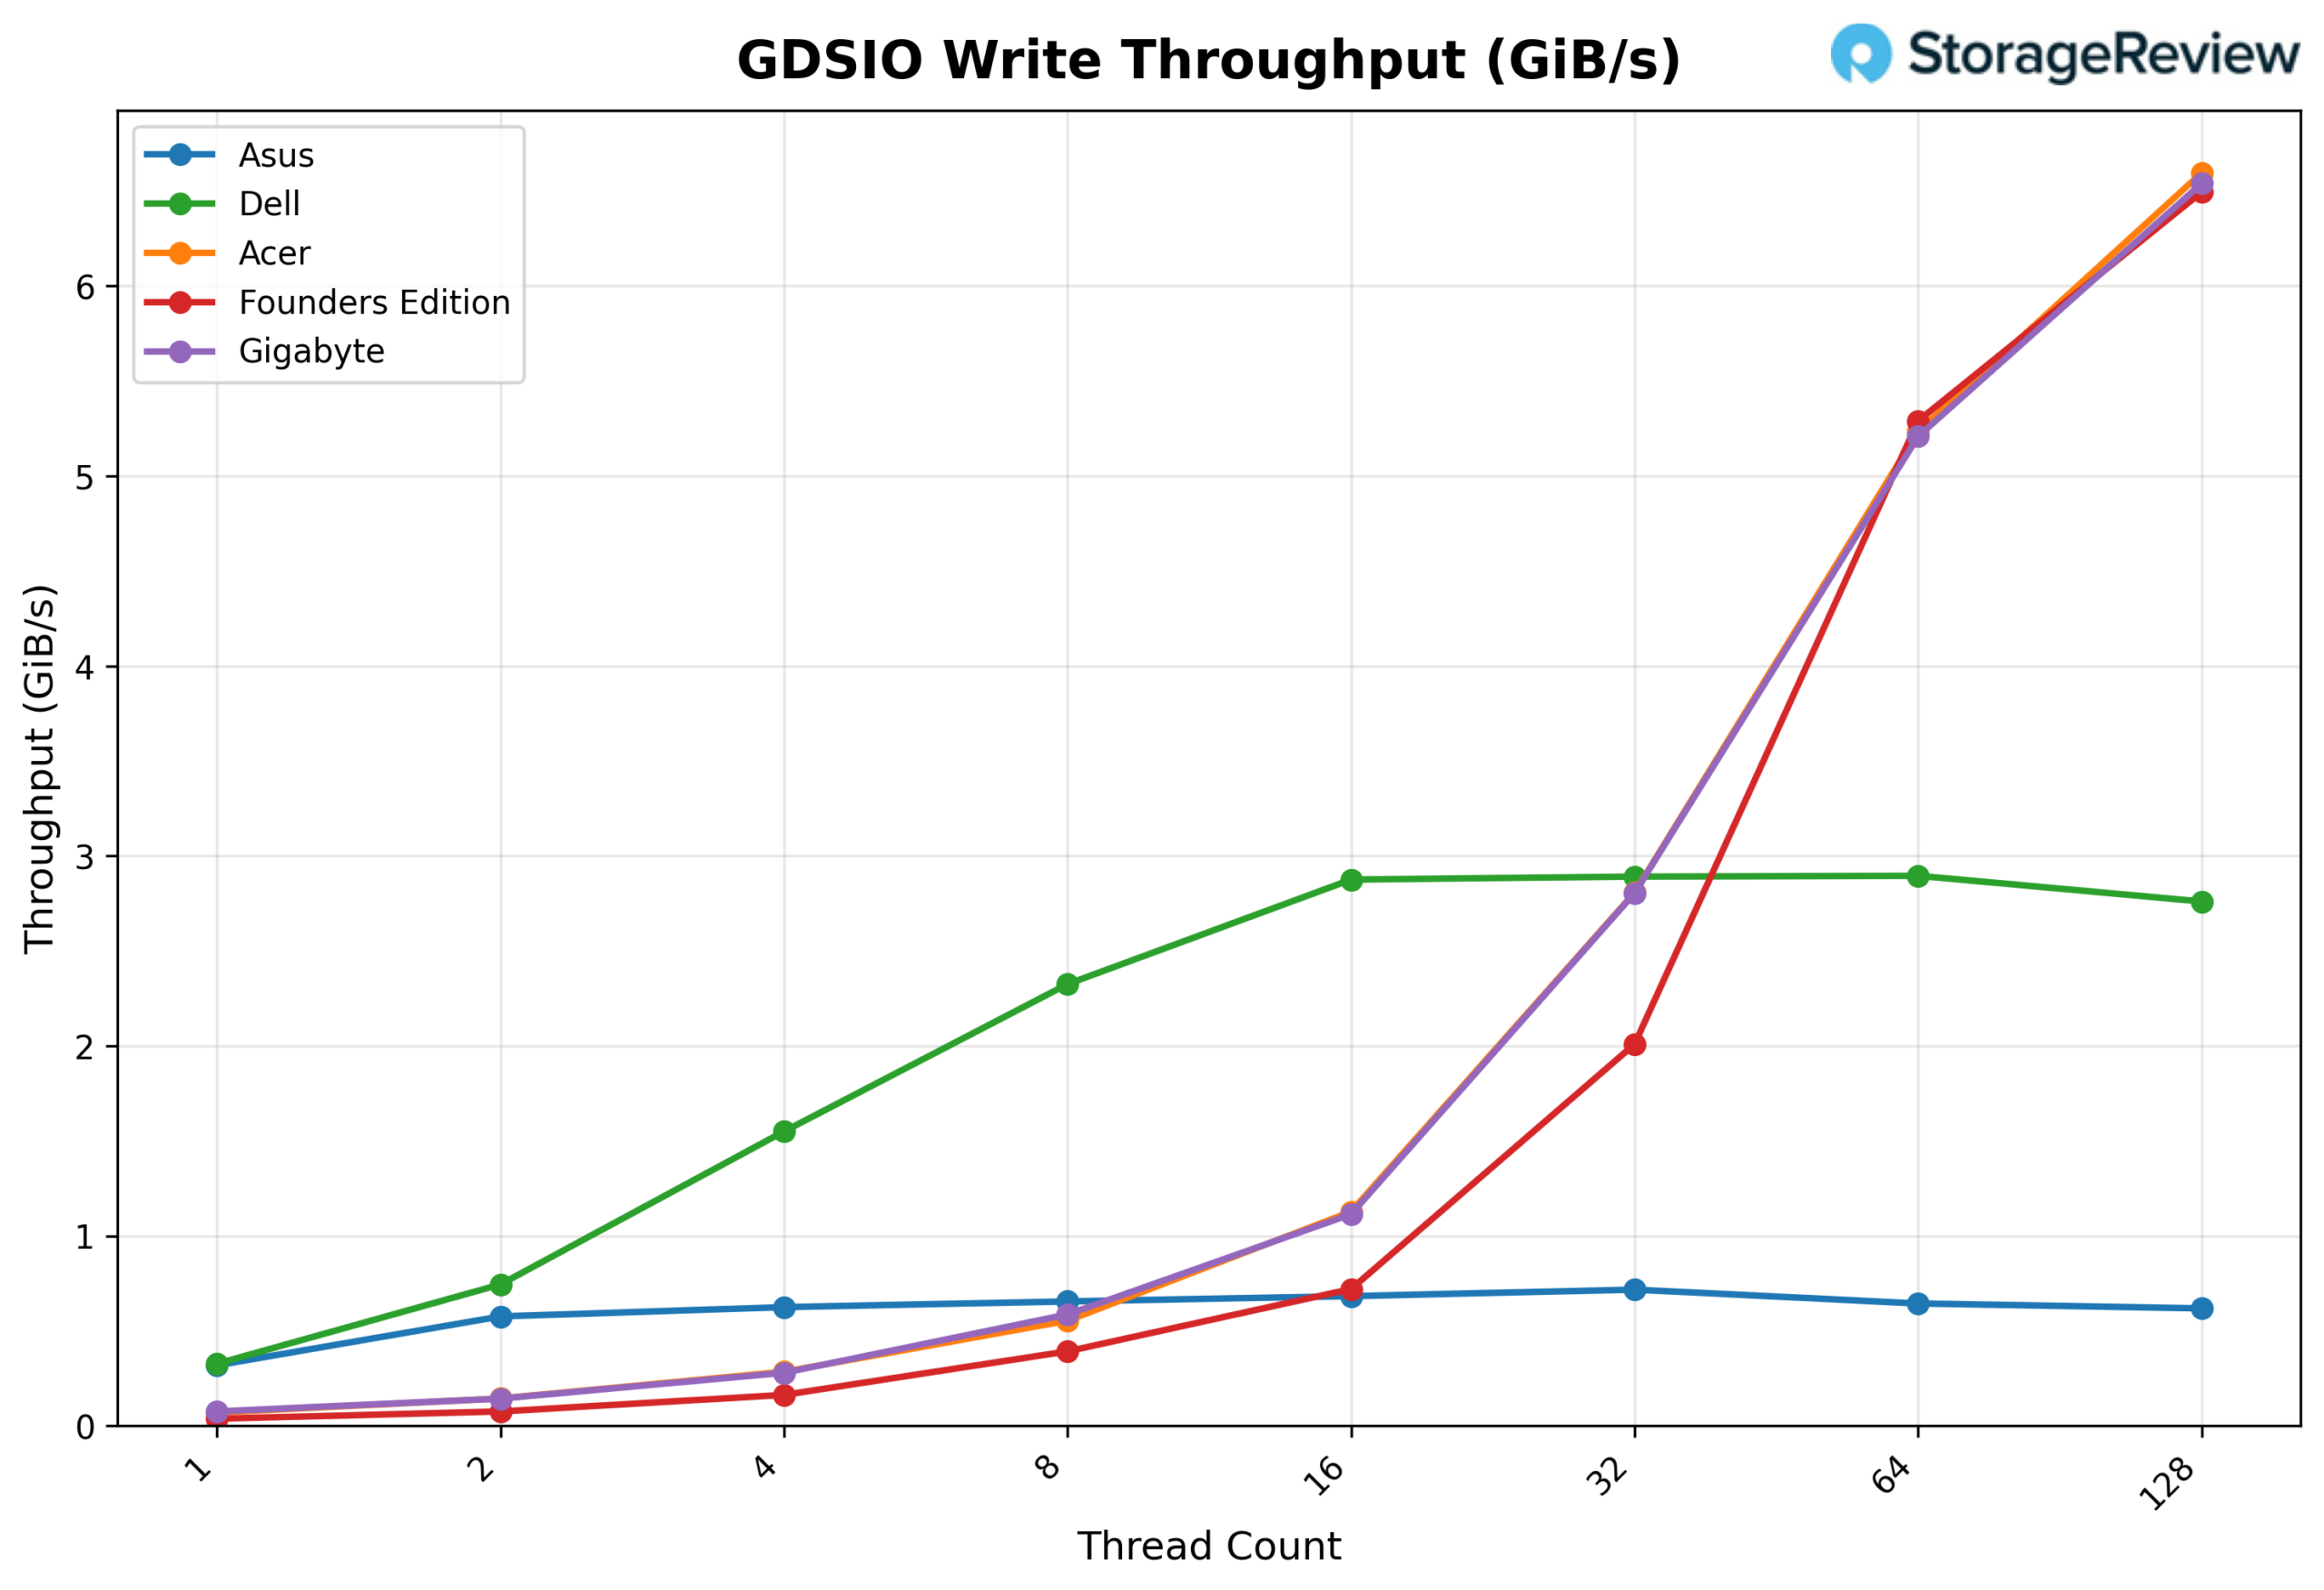
Przepustowość zapisu GSDIO 16K
Patrząc na przepustowość zapisu GDSIO 16K, Acer zaczyna od 0.07 GiB/s przy 1 wątku i skaluje się do 2 wątków (0.14 GiB/s), 4 wątków (0.28 GiB/s) i 8 wątków (0.55 GiB/s). Wzrost przyspiesza przy 16 wątkach (1.13 GiB/s), 32 wątkach (2.81 GiB/s) i 64 wątkach (5.23 GiB/s). Przy 128 wątkach przepustowość osiąga 6.60 GiB/s, szczytowy punkt przechyłu, ponownie nie wykazując wyraźnego nasycenia i kontynuując skalowanie przy małych rozmiarach bloków.
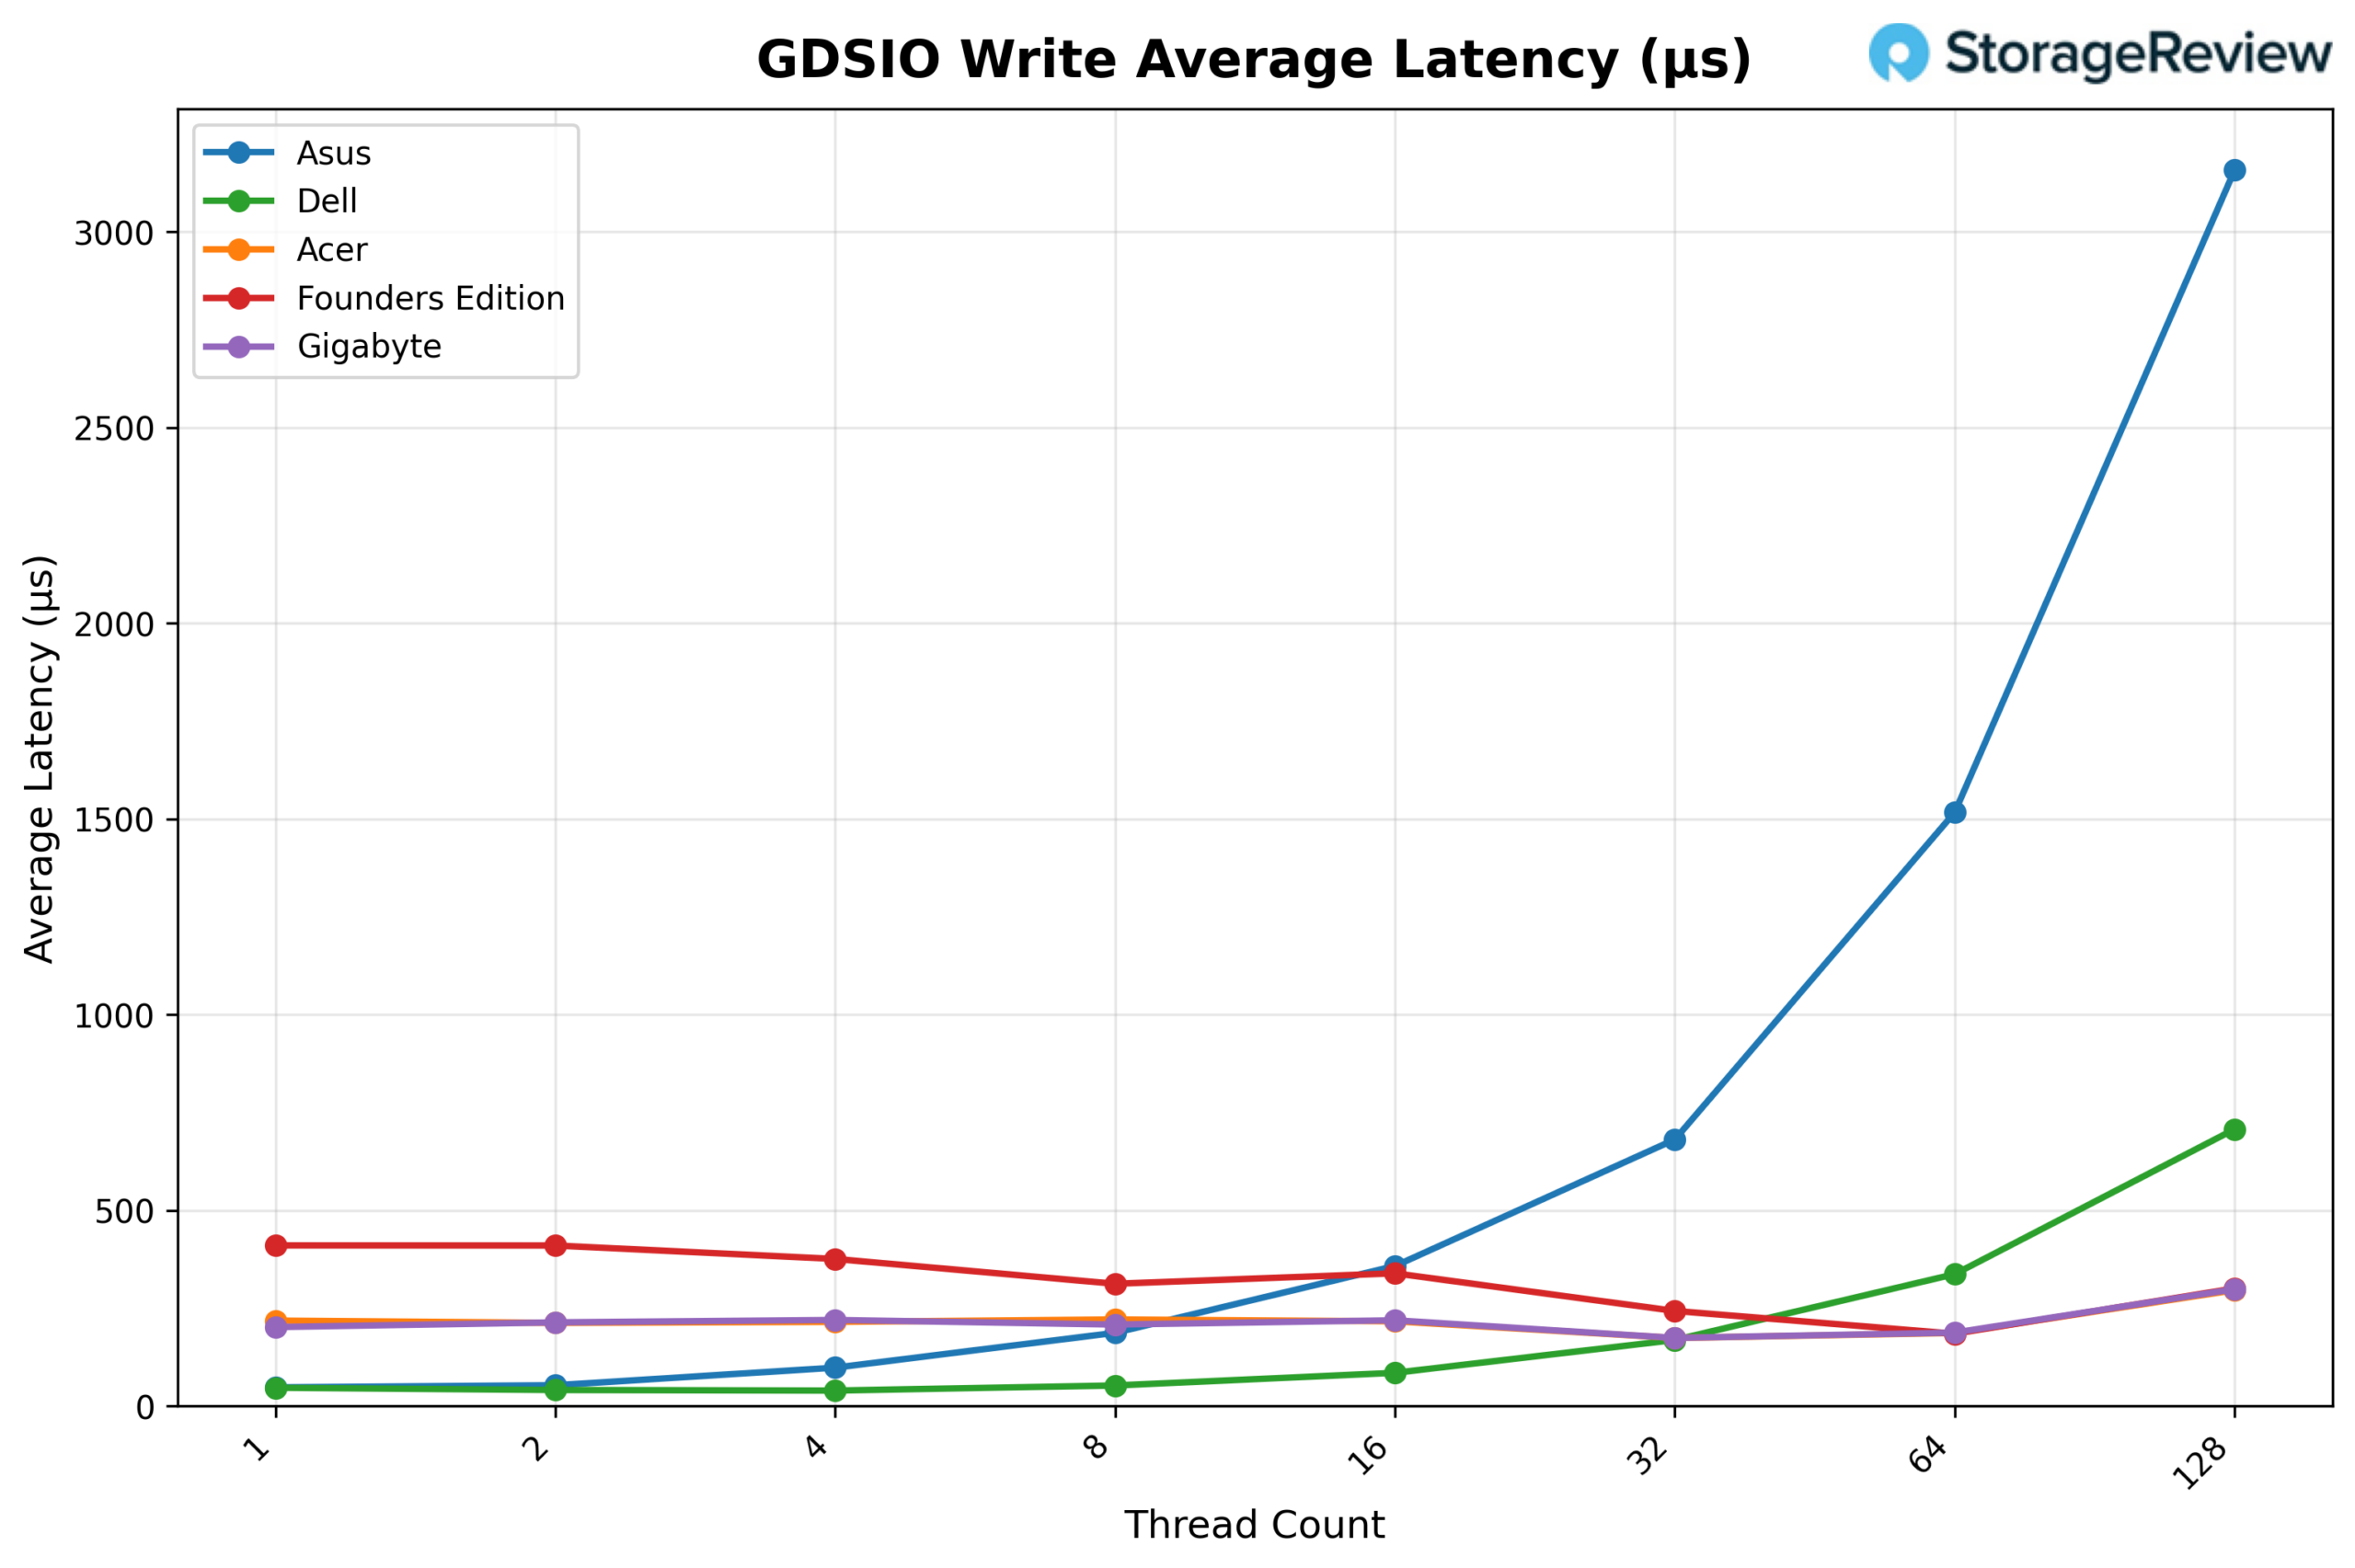
Średnie opóźnienie zapisu GDSIO 16 tys.
Patrząc na średnie opóźnienie zapisu GDSIO (16 KB), Acer zaczyna od około 0.22 ms z 1 wątkiem i utrzymuje je na stabilnym poziomie przy 2 wątkach (0.21 ms), 4 wątkach (0.22 ms) i 8 wątkach (0.22 ms). Opóźnienie nieznacznie spada do 0.17 ms przy 32 wątkach, a następnie nieznacznie wzrasta do 0.19 ms przy 64 wątkach. Przy 128 wątkach opóźnienie wzrasta do 0.30 ms, co nadal jest stosunkowo niskie w porównaniu z wynikami dla 1 mln wątków, co jest zgodne z ciągłym skalowaniem przy tej mniejszej pojemności wejścia/wyjścia.
Przepustowość odczytu GDSIO 1M
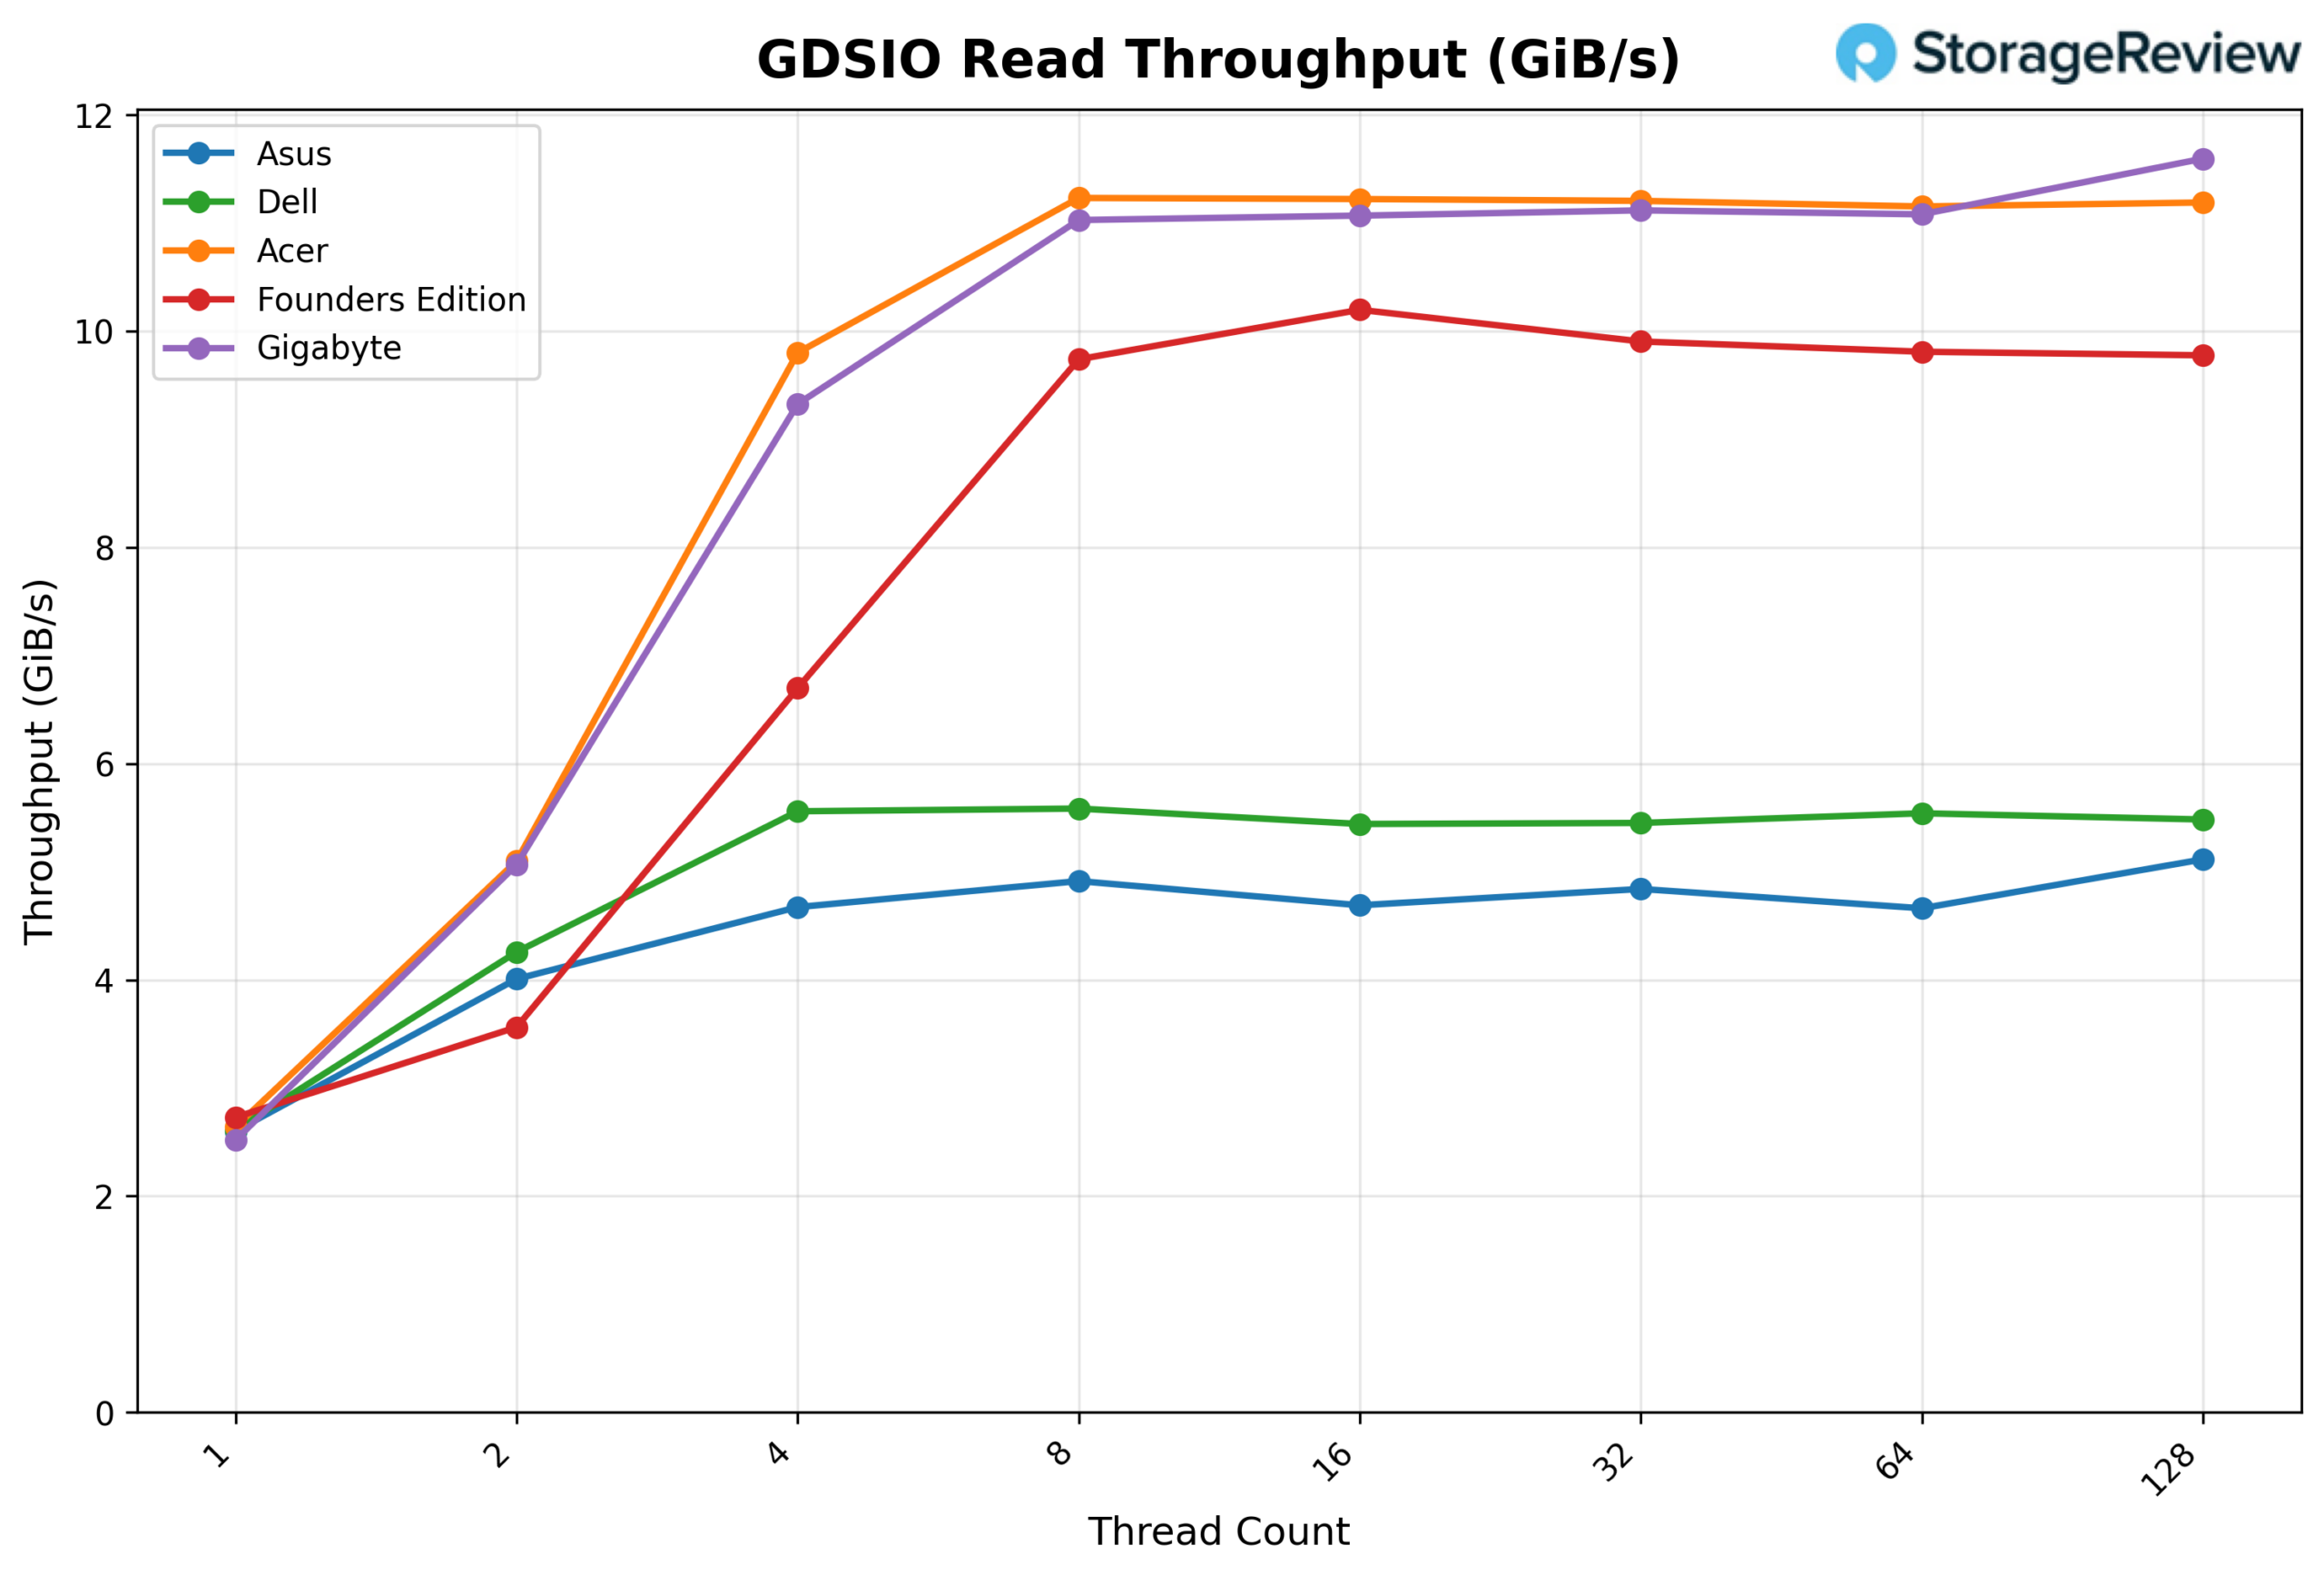
Patrząc na przepustowość odczytu GDSIO 1M, Acer rozpoczyna od 2.64 GiB/s na 1 wątku, skaluje się do 5.10 GiB/s na 2 wątkach i 9.80 GiB/s na 4 wątkach. Przy 8 wątkach przepustowość osiąga 11.23 GiB/s, po czym platforma skutecznie się nasyca. Wydajność pozostaje stabilna przy 16 wątkach (11.22 GiB/s), 32 wątkach (11.21 GiB/s) i 64 wątkach (11.15 GiB/s), wykazując stabilny plateau. Przy 128 wątkach przepustowość utrzymuje się na stałym poziomie 11.19 GiB/s, co potwierdza pułap nasycenia w całym zakresie.
Średnie opóźnienie odczytu GDSIO: 1M
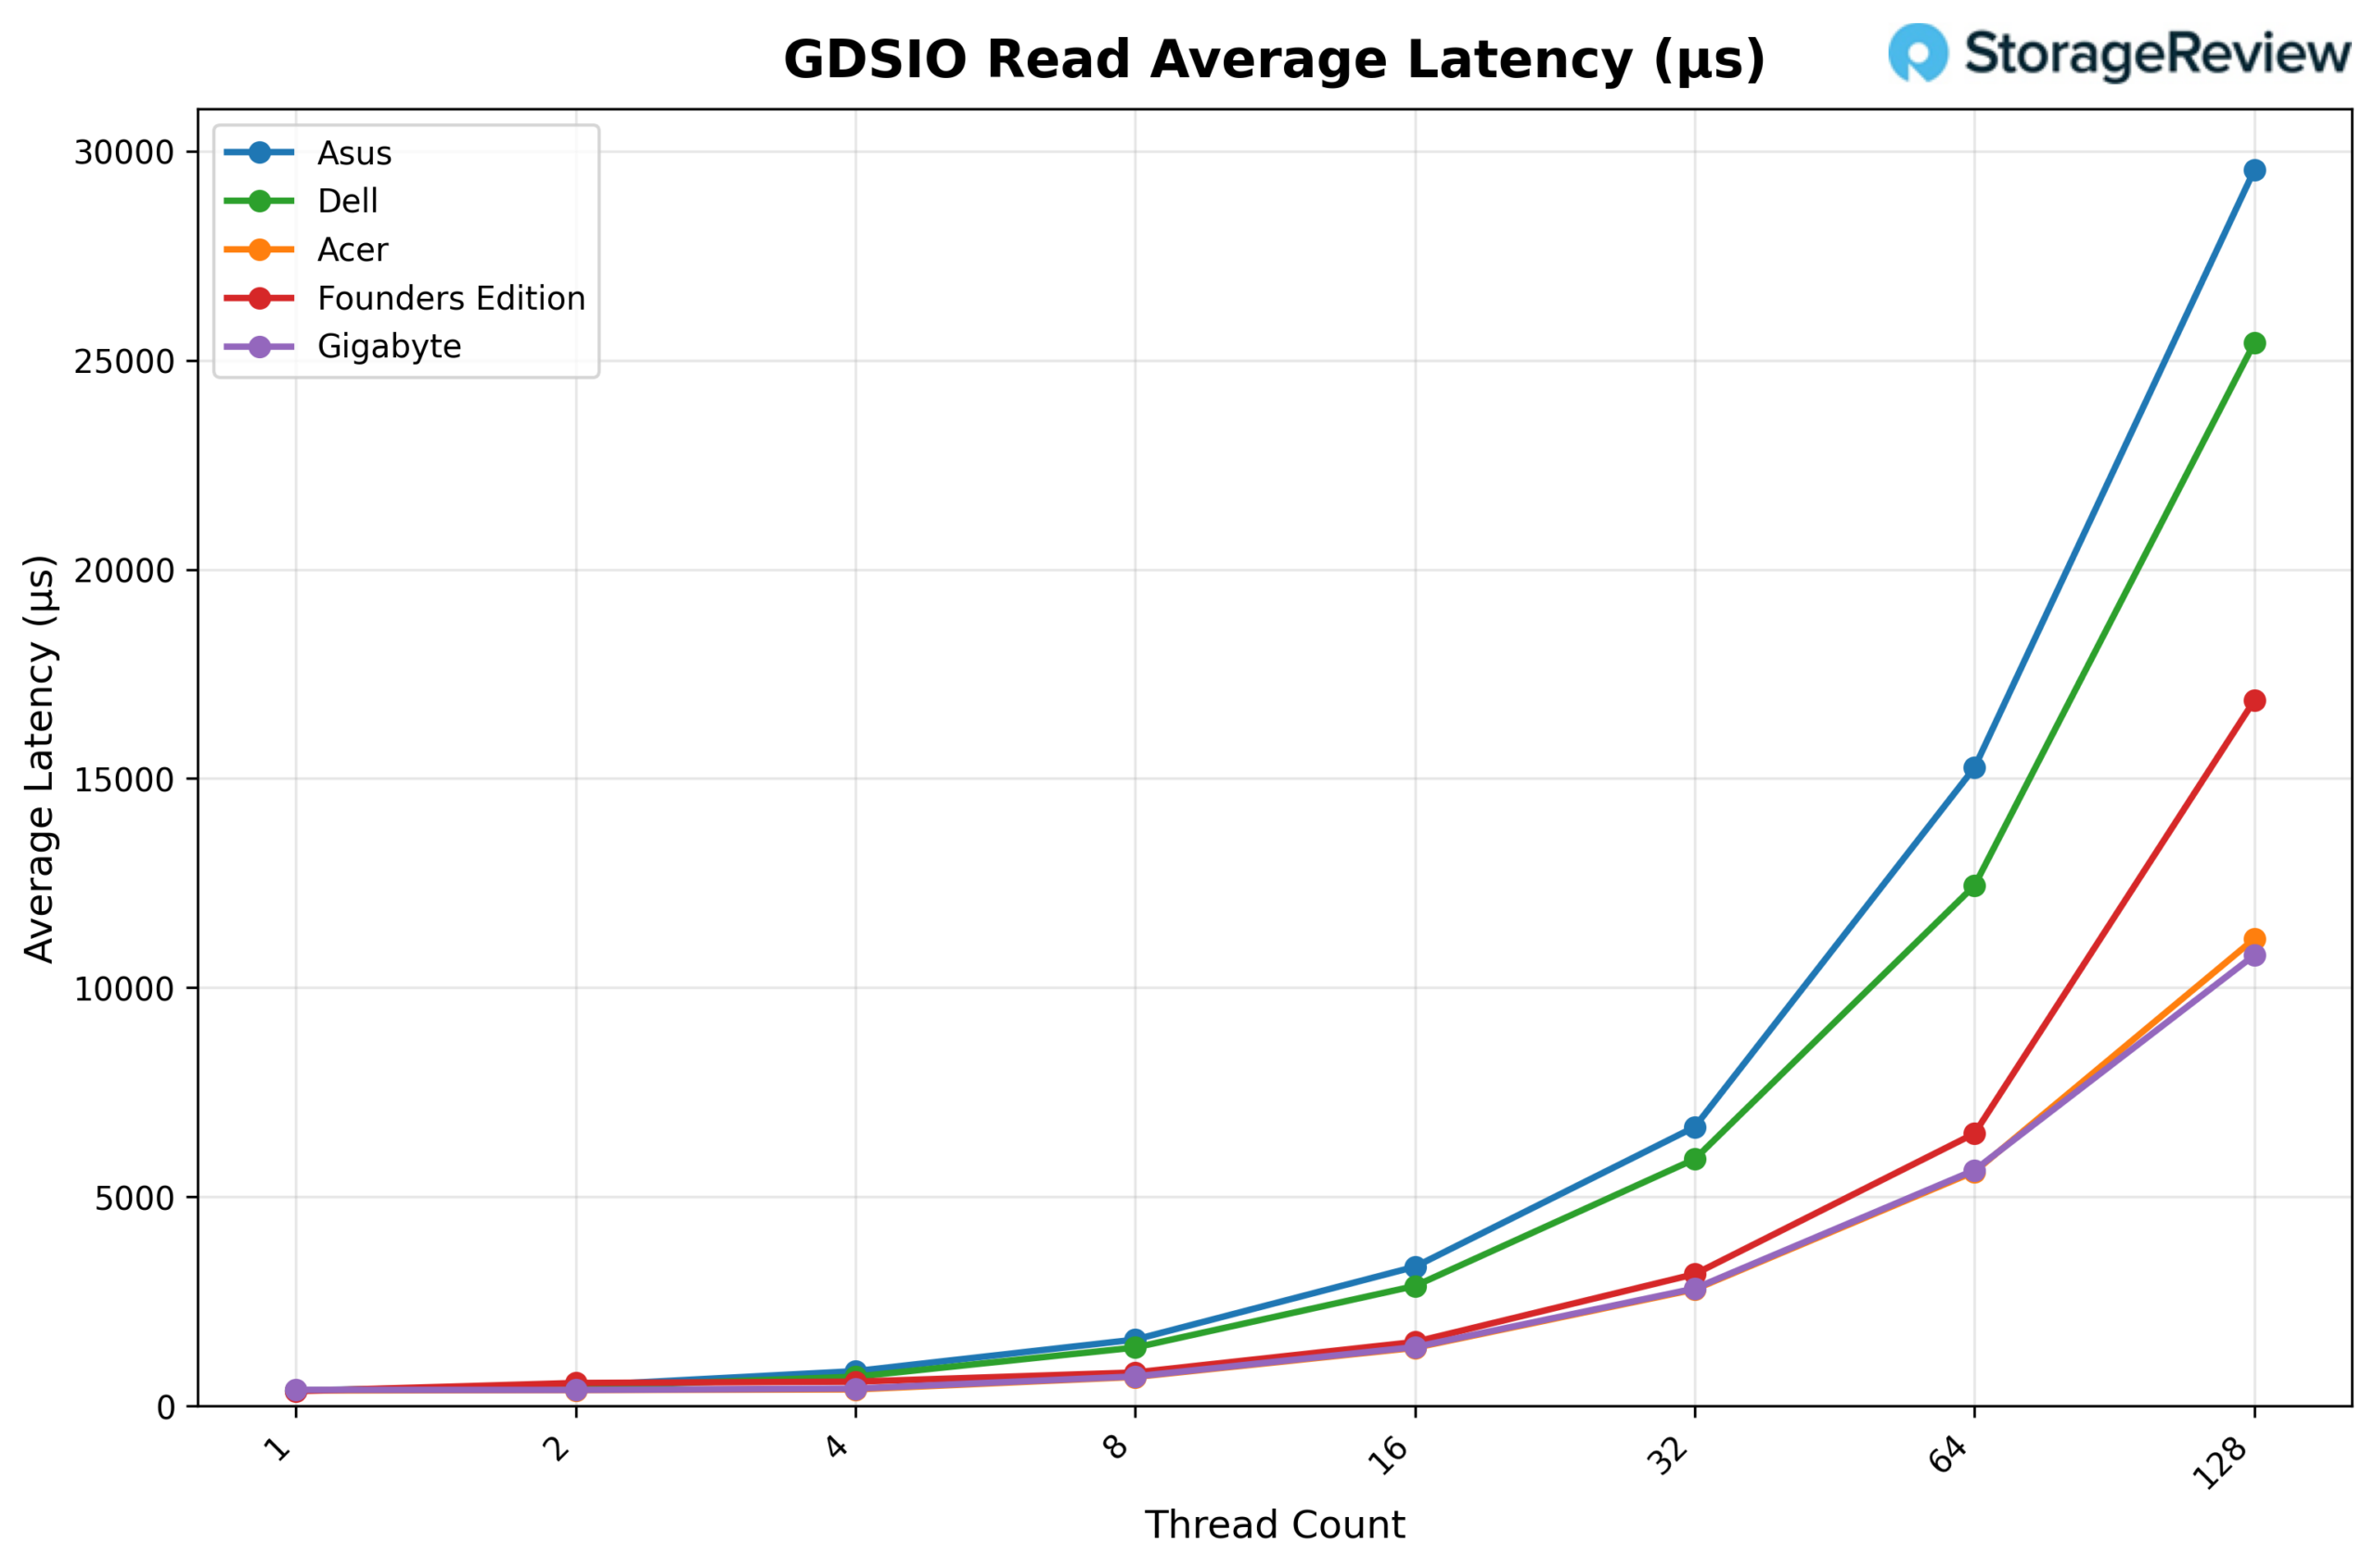
Patrząc na średnie opóźnienie odczytu GDSIO (1M), Acer rozpoczyna od około 0.37 ms przy 1 wątku i utrzymuje się na podobnym poziomie przy 2 wątkach (0.38 ms) i 4 wątkach (0.40 ms). Opóźnienie rośnie wraz ze współbieżnością, osiągając 0.70 ms przy 8 wątkach, 1.39 ms przy 16 wątkach i 2.79 ms przy 32 wątkach. Trend wzrostowy utrzymuje się przy 64 wątkach (5.60 ms) i osiąga 11.17 ms przy 128 wątkach, co odpowiada szczytowym poziomom współbieżności, podczas gdy przepustowość pozostaje w dużej mierze stabilna.
Przepustowość zapisu GDSIO 1M
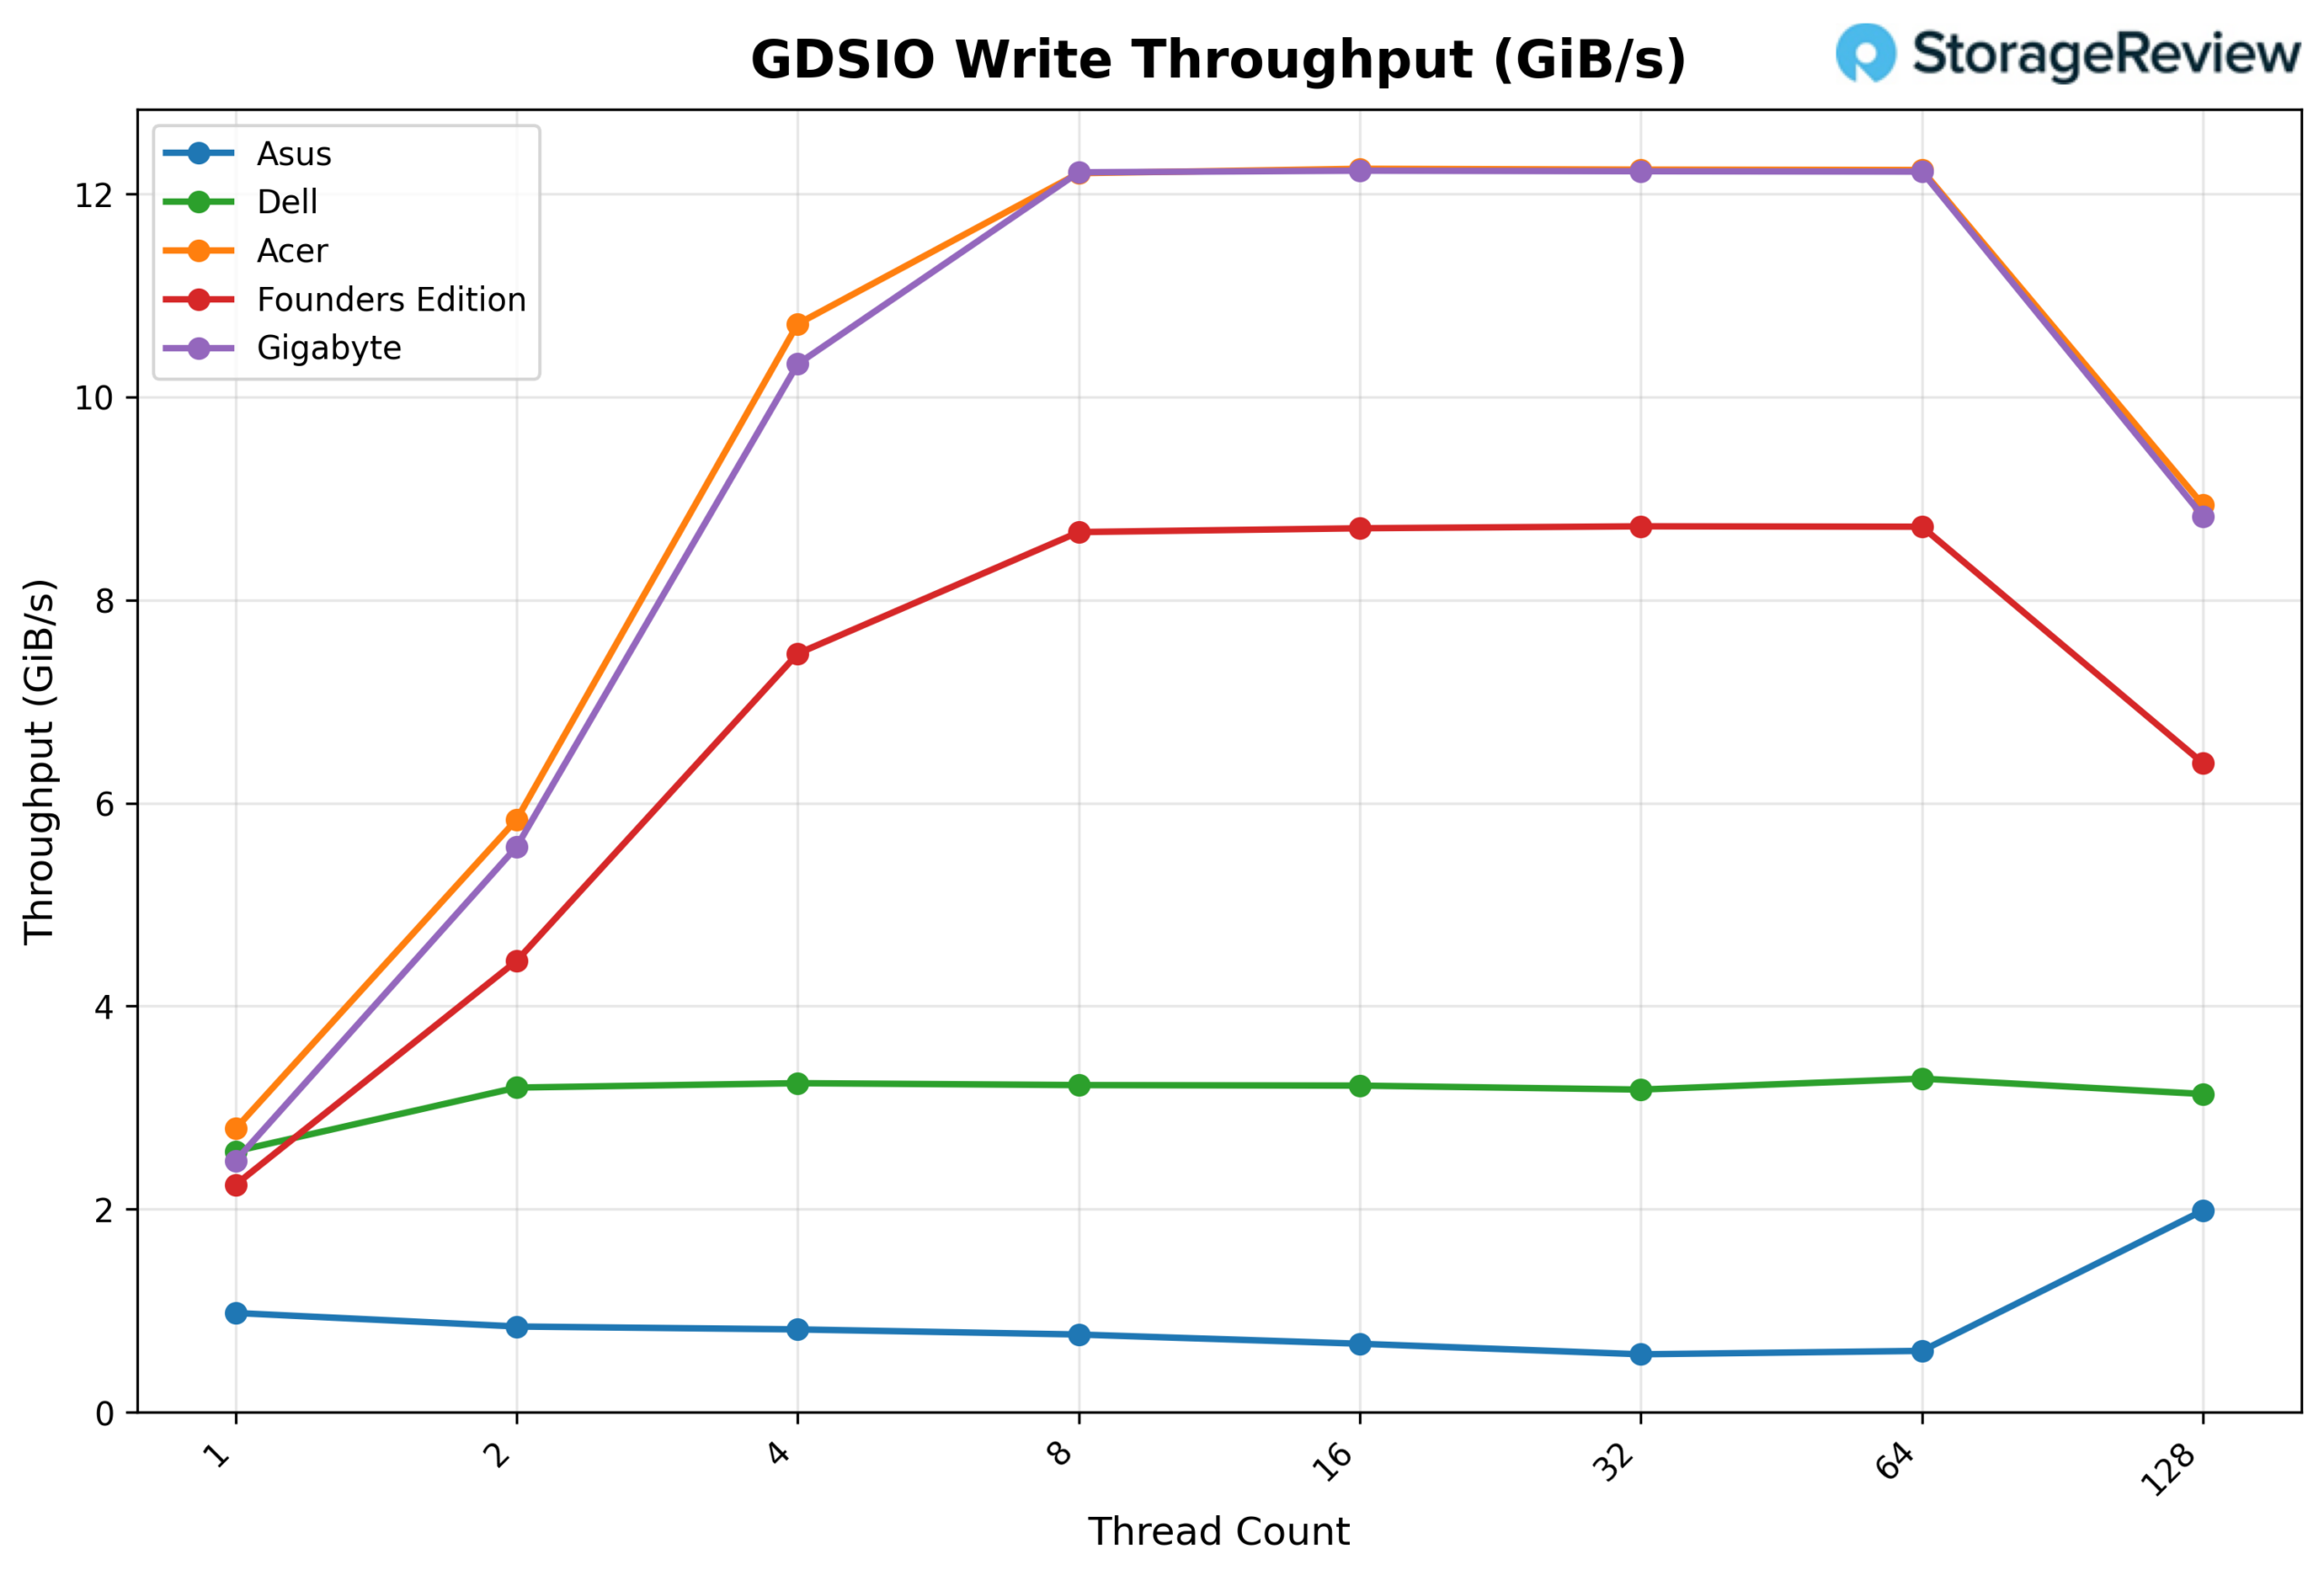
Patrząc na przepustowość zapisu GDSIO 1M, Acer zaczyna od 2.79 GiB/s na 1 wątku i dynamicznie skaluje się do 5.84 GiB/s na 2 wątkach i 10.72 GiB/s na 4 wątkach. Przy 8 wątkach przepustowość osiąga 12.20 GiB/s, co skutecznie nasyca platformę. Wydajność pozostaje stabilna przy 16 wątkach (12.25 GiB/s), 32 wątkach (12.24 GiB/s) i 64 wątkach (12.23 GiB/s), wykazując stabilny plateau. Przy 128 wątkach przepustowość spada wyraźnie do 8.94 GiB/s, co sugeruje rywalizację lub wyczerpanie zasobów na najwyższym poziomie współbieżności.
Średnie opóźnienie zapisu GDSIO 1M
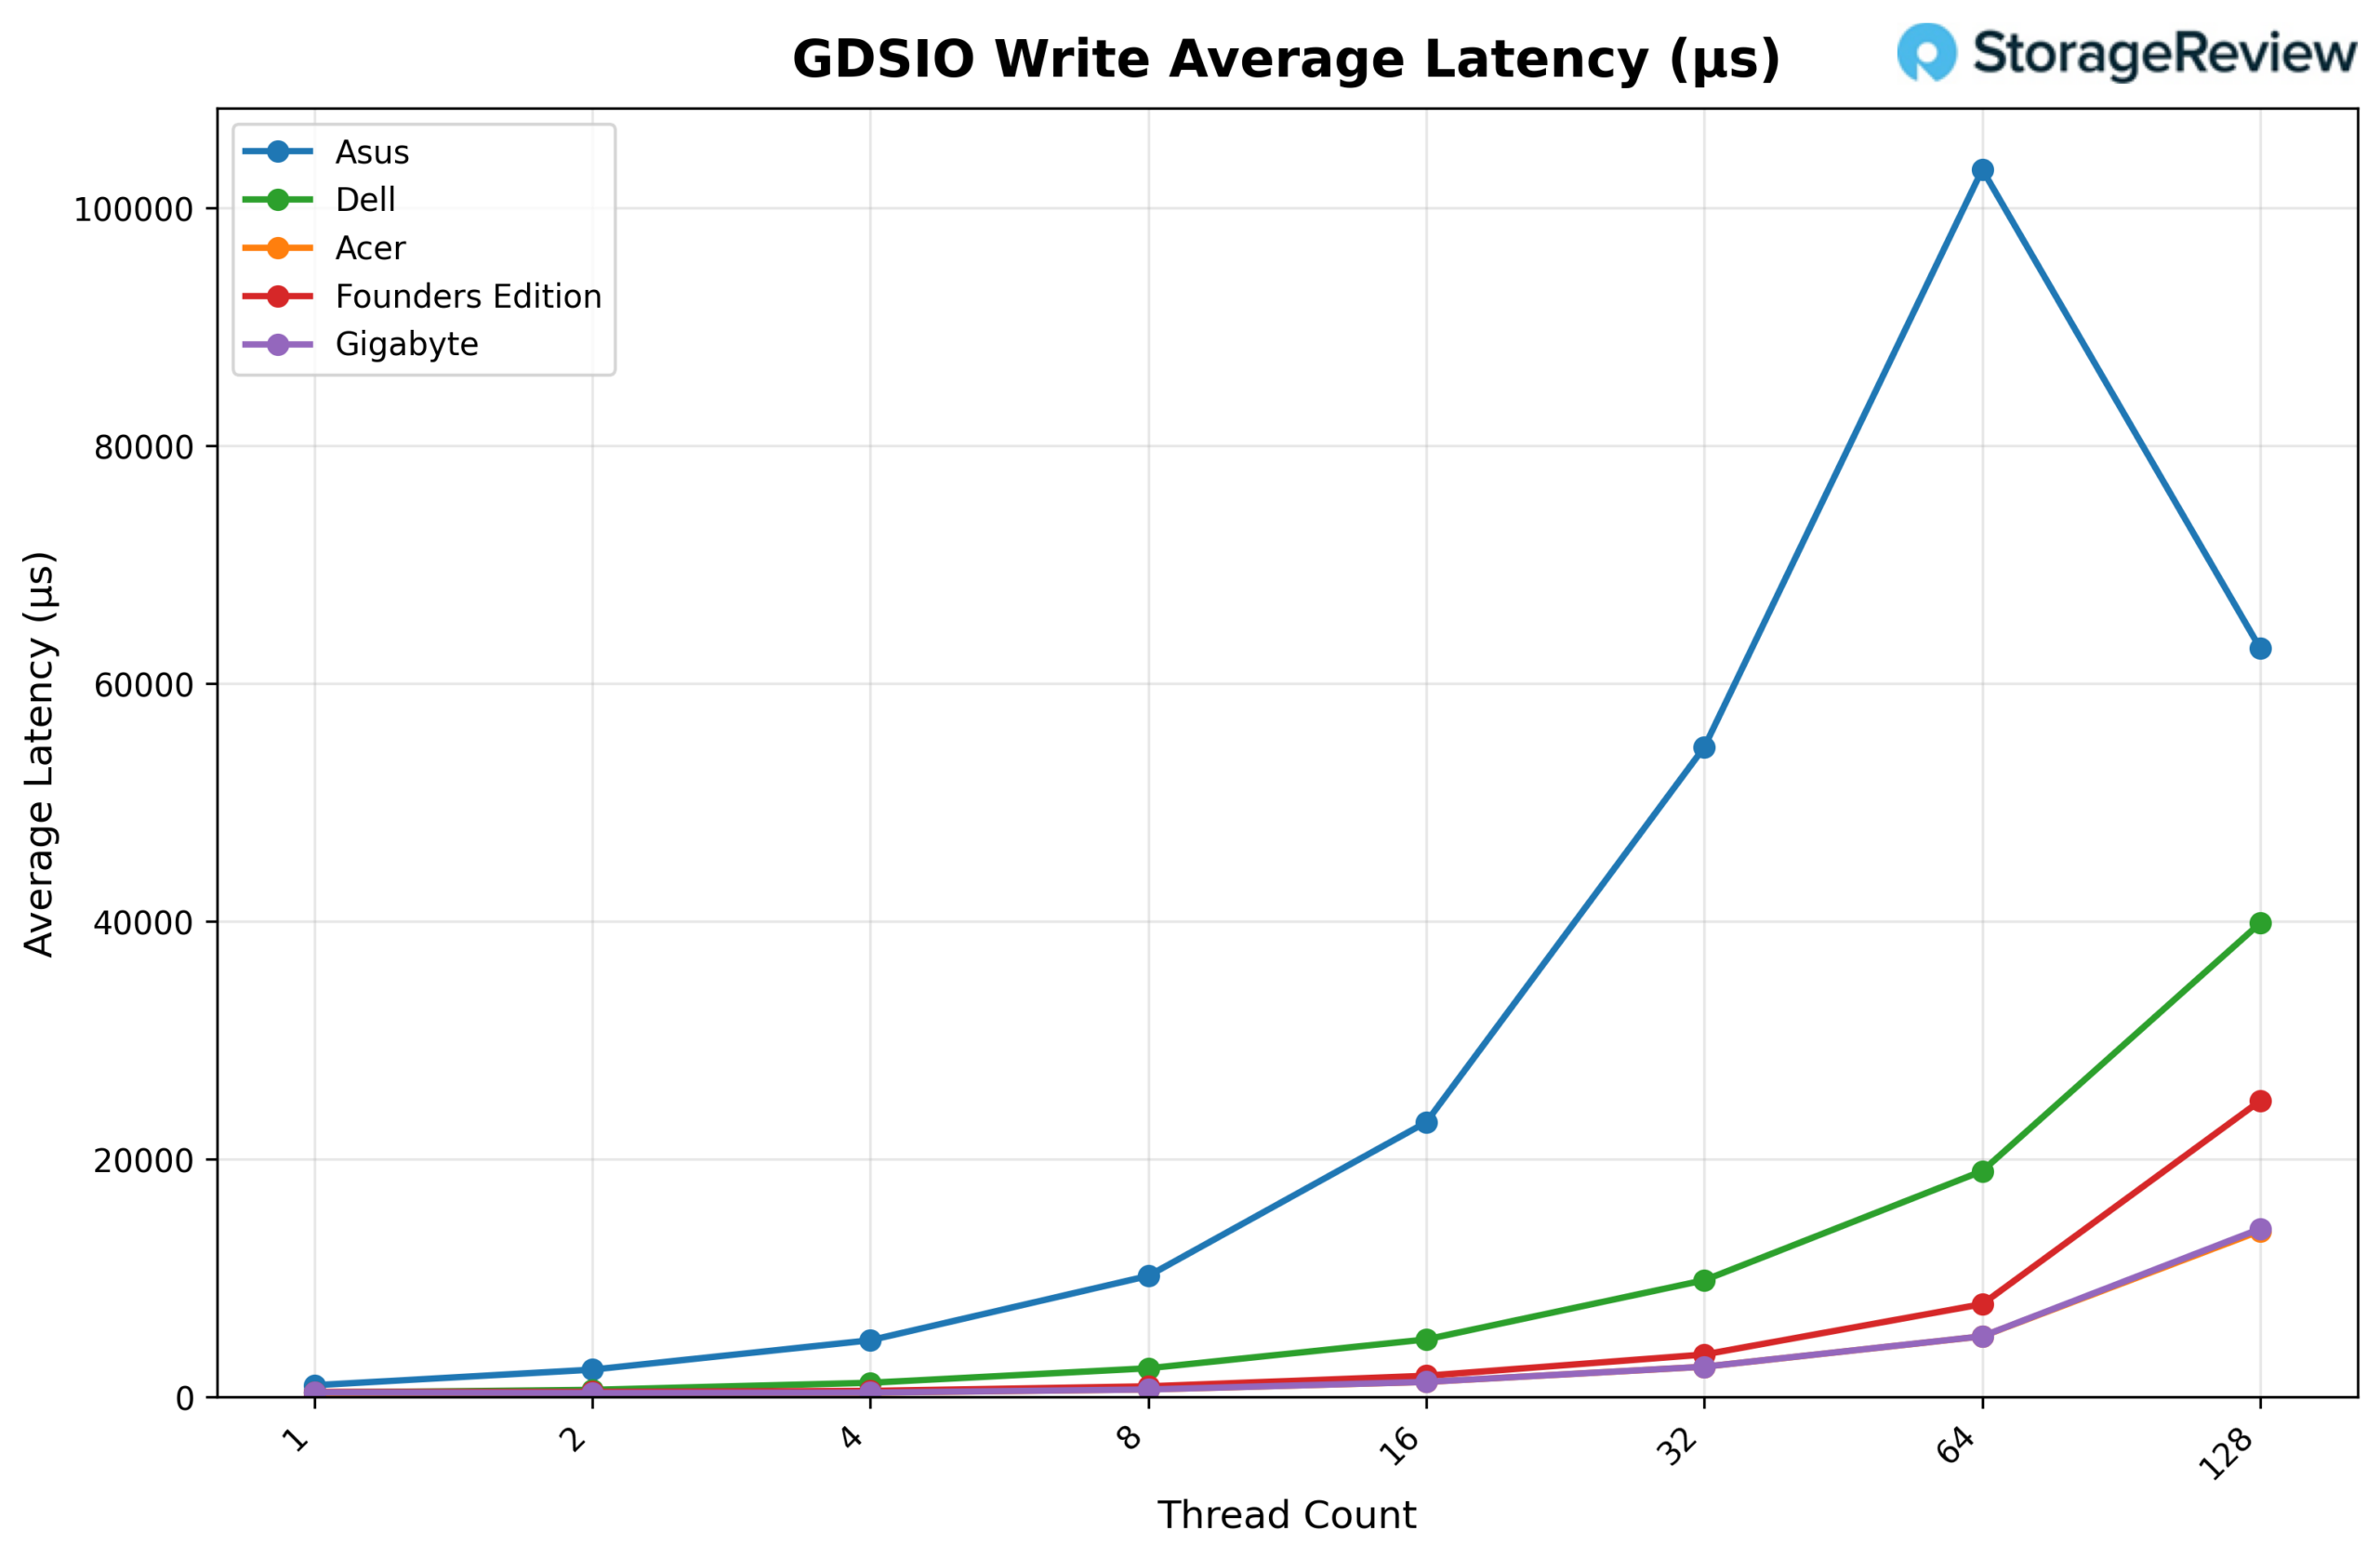
Patrząc na średnie opóźnienie zapisu GDSIO (1M), Acer zaczyna od około 0.35 ms przy 1 wątku i utrzymuje się na niskim poziomie przy 2 wątkach (0.33 ms) i 4 wątkach (0.36 ms). Opóźnienie rośnie wraz ze wzrostem współbieżności, osiągając 0.64 ms przy 8 wątkach, 1.28 ms przy 16 wątkach i 2.55 ms przy 32 wątkach. Trend wzrostowy utrzymuje się przy 64 wątkach (5.11 ms) i gwałtownie rośnie do 13.98 ms przy 128 wątkach, co jest zgodne z degradacją przepustowości obserwowaną przy maksymalnej współbieżności.
Wniosek
Acer Veriton GN100 uzyskał najchłodniejszy profil temperaturowy w naszym porównaniu Spark . Podczas intensywnych przejść Prefill i długotrwałych obciążeń dekodowania, konsekwentnie utrzymywał niższe temperatury szczytowe procesora i karty graficznej niż reszta grupy. Zamiast pracy w górnym zakresie 80°C pod obciążeniem, utrzymywał się w bardziej kontrolowanym paśmie roboczym przez dłuższy czas, co wskazuje na efektywny przepływ powietrza i zrównoważone dostrajanie mocy.
Kolejnym wyraźnym atutem była wydajność pamięci masowej. Wyposażony w dysk SSD Samsung PM9E1 Gen5 o pojemności 4 TB, GN100 oferował najmocniejsze skalowanie pamięci masowej GPU Direct Storage w segmencie small-block w grupie. Przy blokach o rozmiarze 16 tys., opóźnienia odczytu i zapisu pozostały wyjątkowo stabilne niezależnie od liczby wątków, a przepustowość skalowała się płynnie do najwyższego poziomu w tabeli. Przy transferach na poziomie 1 mln, platforma szybko osiągnęła nasycenie i utrzymała konkurencyjne pułapy w zakresie współbieżności na średnim poziomie, zanim spadła przy największej liczbie wątków.
W testach wnioskowania vLLM wydajność pozostała ściśle powiązana z wydajnością szerszego ekosystemu Spark, zgodnie z oczekiwaniami, biorąc pod uwagę wspólną bazę GB10. Separacja ujawniła się nie w surowych danych obliczeniowych, ale w parametrach termicznych i zachowaniu pamięci masowej pod obciążeniem.
W całej linii produktów Spark, spójność architektoniczna zapewnia ścisłe dopasowanie wydajności wnioskowania. Tym, co wyróżnia GN100 w tej rundzie, jest chłodniejszy, stabilny profil pracy w połączeniu z wysoką wydajnością NVMe Gen5, co czyni go jedną z najbardziej wydajnych termicznie i zorientowanych na pamięć masową implementacji, jakie do tej pory testowaliśmy.
Strona produktu – Acer Veritron GN 100 AI
Tabela wyników: Acer Veriton GN100 zajmuje pierwsze miejsce w rankingu najlepszych komputerów stacjonarnych do lokalnej sztucznej inteligencji w kategorii „Najlepsza implementacja GB10”.


 Amazon