

Kiedy po raz pierwszy pojawiła się pamięć trwała Intel® Optane™ (PMem), wiedzieliśmy, że radykalnie zmieni sposób prowadzenia działalności w centrach danych, ale nie mogliśmy w pełni przewidzieć, jak wiele to będzie miało zastosowań. Jak w przypadku wszystkich nowych technologii, znaliśmy początkowe przypadki użycia pamięci trwałej, ale rozumieliśmy również, że pojawią się kolejne, gdy tylko staną się one powszechnie dostępne.
W rozmowach z przedsiębiorstwami wiedzieliśmy, że potrzebują one wzrostu wydajności, jaki oferują systemy pamięci masowej, aby utrzymać konkurencyjność. Wykorzystanie pamięci DRAM w tym celu wiązało się z ograniczeniami kosztów i rozmiaru, co utrudniało to zadanie, biorąc pod uwagę rozmiar danych, które chcieli przechowywać w pamięci. W niniejszym artykule przyjrzymy się, w jaki sposób Hazelcast i MemVerge wykorzystują technologię Intel Optane PMem do przezwyciężenia ograniczeń pamięci DRAM i stworzenia infrastruktury obsługującej szybkie aplikacje czasu rzeczywistego, wykorzystujące duże zbiory danych.
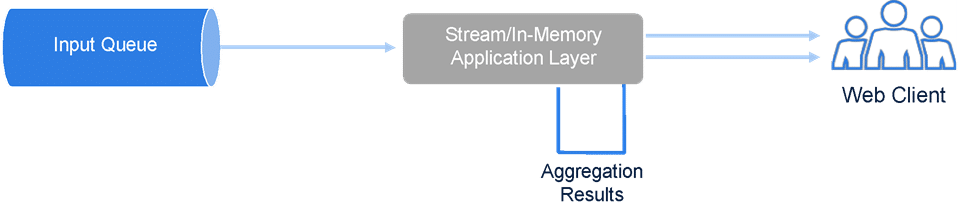
Połączyliśmy siły z firmami MemVerge, Hazelcast, Intel i Dell Technologies, aby zademonstrować, jak wdrożyć infrastrukturę umożliwiającą analitykę w czasie rzeczywistym. W szczególności skonfigurowaliśmy środowisko, w którym szybko napływał strumień danych w czasie rzeczywistym, który był przetwarzany i przetwarzany przed zapisaniem w hurtowni danych w pamięci. Głównym celem było pokazanie, jak kluczowa jest technologia Intel Optane PMem dla tworzenia systemów czasu rzeczywistego na dużą skalę oraz jak potrzebne jest dodatkowe oprogramowanie, aby technologia Intel Optane PMem mogła w pełni wykorzystać swój potencjał.
Zanim przejdziemy do testów , które przeprowadziliśmy, pokrótce przypomnimy sobie informacje na temat Intel Optane PMem, Hazelcast i MemVerge.
Intel Optane PMem
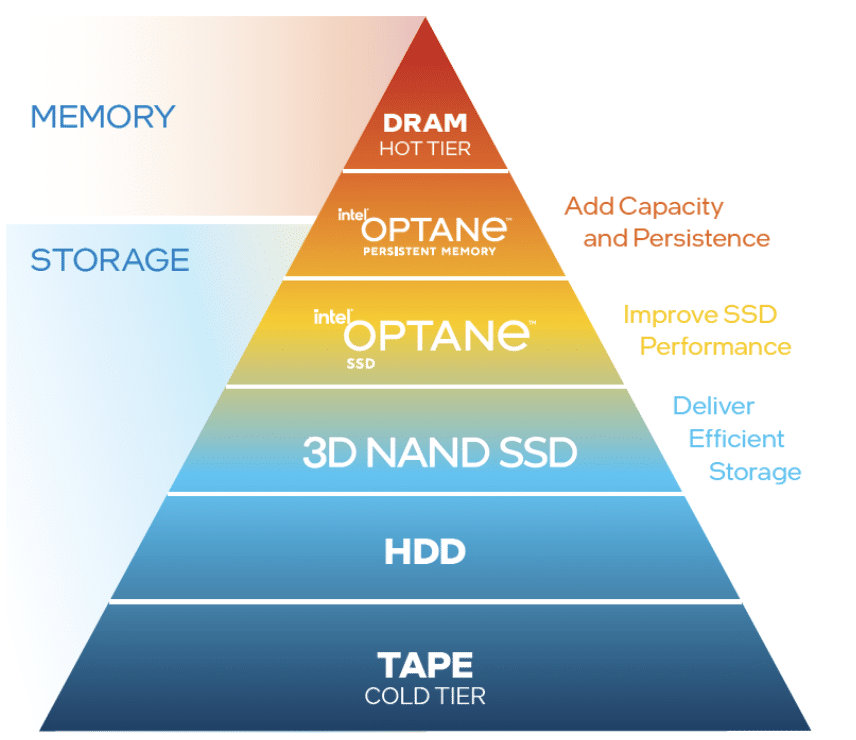
Koncepcja pamięci trwałej istnieje od połowy lat 1980. XX wieku, ale stała się ona rzeczywistym, użytecznym produktem dla komercyjnych centrów danych dopiero w 2018 roku, kiedy Intel zaczął wprowadzać na rynek moduły pamięci trwałej Intel Optane (PMM). Moduły pamięci trwałej Intel Optane to przełom w branży, ponieważ są nieco wolniejsze niż DRAM, ale znacznie szybsze niż dyski SSD.
Mimo że jest wolniejsza od pamięci DRAM, pamięć Intel Optane PMem ma nad nią kilka wyraźnych zalet. Jest znacznie tańsza, ma większą pojemność niż tradycyjna pamięć DRAM i, jak sama nazwa wskazuje, po włączeniu trybu bezpośredniego w aplikacji jest trwała – oznacza to, że dane na niej zapisane przetrwają przerwę w dostawie prądu lub ponowne uruchomienie urządzenia, na którym się znajdują.
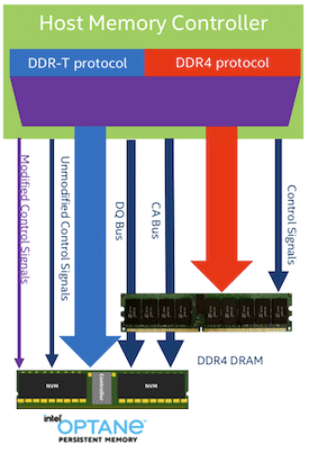
Jednym z sekretów niskich opóźnień pamięci Intel Optane PMem jest to, że znajduje się ona na magistrali pamięci, co umożliwia jej dostęp do danych na poziomie pamięci DRAM.
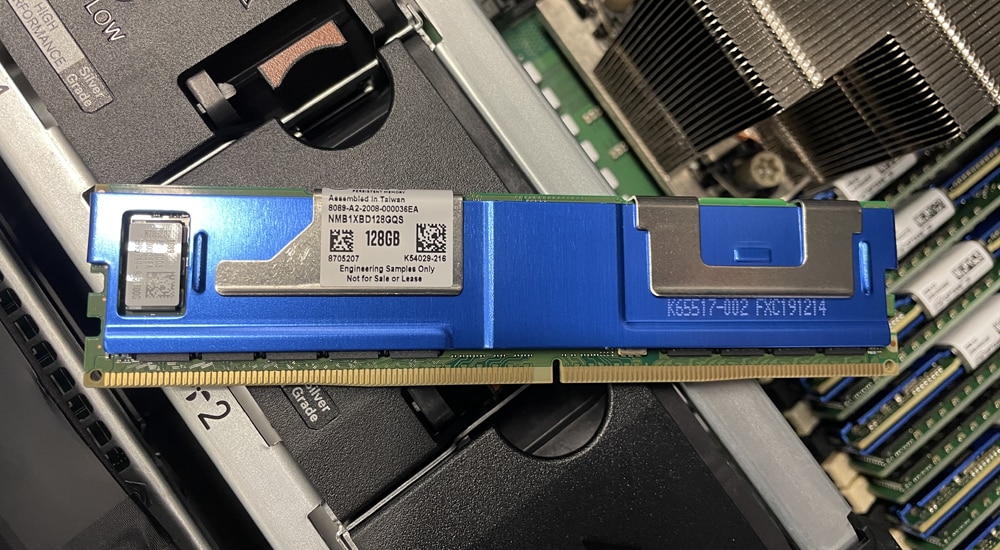
Chociaż teoretyczna maksymalna pojemność modułu DDR4 wynosi 128 GB, najczęściej używane pojemności mieszczą się w przedziale od 4 GB do 64 GB (choć moduły 64 GB, choć dostępne, nie są powszechnie używane).
Intel oferuje obecnie moduły Intel Optane PMem o pojemności 128 GB, 256 GB i 512 GB. Zapewniają one nawet 16-krotnie większą pojemność niż pamięć DRAM.
W przeliczeniu na GB, koszt pamięci Intel Optane PMem jest o połowę niższy niż koszt pamięci DRAM. Dzięki większej pojemności i niższej cenie serwer może udostępniać aplikacjom więcej danych o niskim opóźnieniu przy niższym koszcie niż serwer z samą pamięcią DRAM. Jak wynika z naszych testów, w wielu aplikacjach różnica w opóźnieniu między pamięcią DRAM a PMem w rzeczywistych warunkach użytkowania jest znikoma.
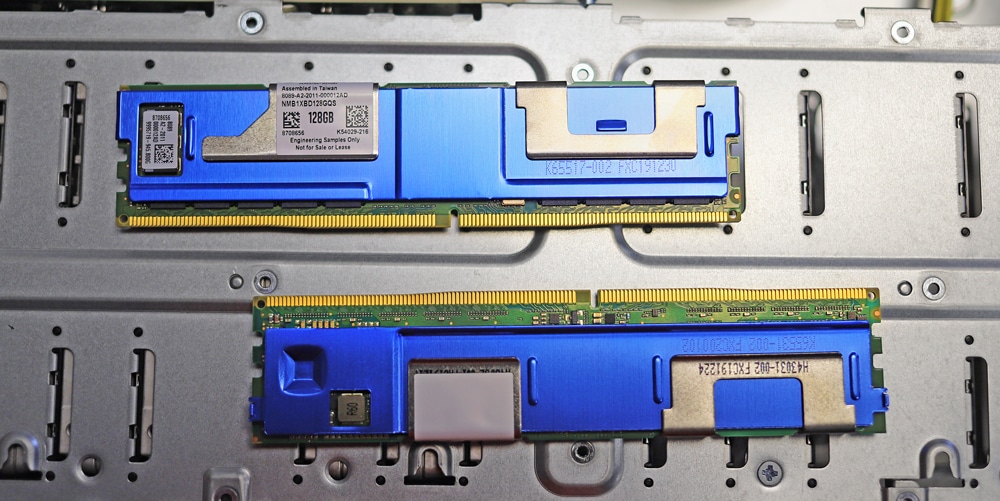 Chociaż nazwa technologii zawiera słowo „trwałość”, trwałość danych przechowywanych w pamięci Intel Optane PMem jest często pomijana i w przeszłości nie była w pełni wykorzystywana. Firma MemVerge opracowała jednak sposoby wykorzystania trwałości danych do oferowania przedsiębiorstwom dodatkowych usług.
MemVerge
Ogromna moc pamięci Intel Optane PMem wiąże się z odpowiedzialnością za jej mądre wykorzystanie. I tu właśnie pojawia się MemVerge. Podczas gdy większość narzędzi do monitorowania i zarządzania serwerami analizuje starszy sprzęt, taki jak metryki procesora, dysku i sieci, MemVerge® Memory Machine™ koncentruje się wyłącznie na monitorowaniu, zarządzaniu i wykorzystaniu pamięci DRAM oraz pamięci Intel Optane PMem.
Jednym z pierwszych wyzwań związanych z pamięcią Intel Optane PMem było określenie sposobu, w jaki aplikacje będą mogły z niej korzystać. Bez MemVerge Memory Machine można używać pamięci Intel Optane PMem jako alternatywy dla pamięci DRAM, ale nie jako bezpośredniego zamiennika, ponieważ pamięć Intel Optane PMem korzysta ze specjalistycznego interfejsu API. MemVerge abstrahuje od tego interfejsu API, dzięki czemu pamięć Intel Optane PMem wygląda dla wszystkich aplikacji jak pamięć DRAM. Dzięki Memory Machine pamięć Intel Optane PMem jest prezentowana aplikacjom w taki sam sposób, w jaki pamięć DRAM jest prezentowana aplikacjom. Dzięki temu istniejące aplikacje mogą korzystać z pamięci Intel Optane PMem bez konieczności przeprojektowywania, oszczędzając firmie koszty przeprogramowania aplikacji, a co ważniejsze, czas, jaki by to zajęło. Dzięki opatentowanej technologii Memory Machine tworzy pulę pamięci, a następnie warstwuje pamięć Intel Optane PMem i pamięć DRAM, aby zmaksymalizować jej wpływ na aplikacje poprzez przesyłanie danych między nimi w razie potrzeby w celu optymalizacji wydajności aplikacji.
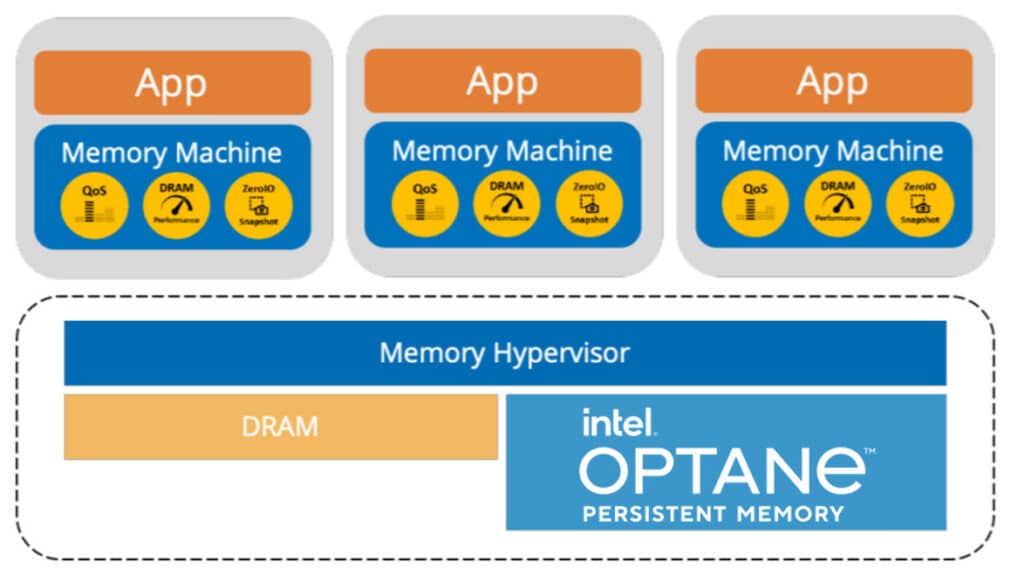
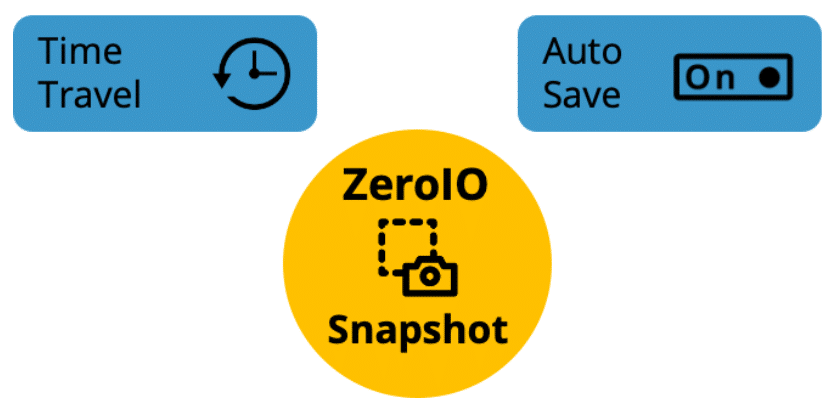
Innowacyjna technologia ZeroIO firmy Memory Machine umożliwia wykonywanie migawek pamięć-pamięć (tzn. migawek danych zapisanych w pamięci DRAM na pamięci Intel Optane PMem), co w efekcie sprawia, że pamięć DRAM jest trwała.
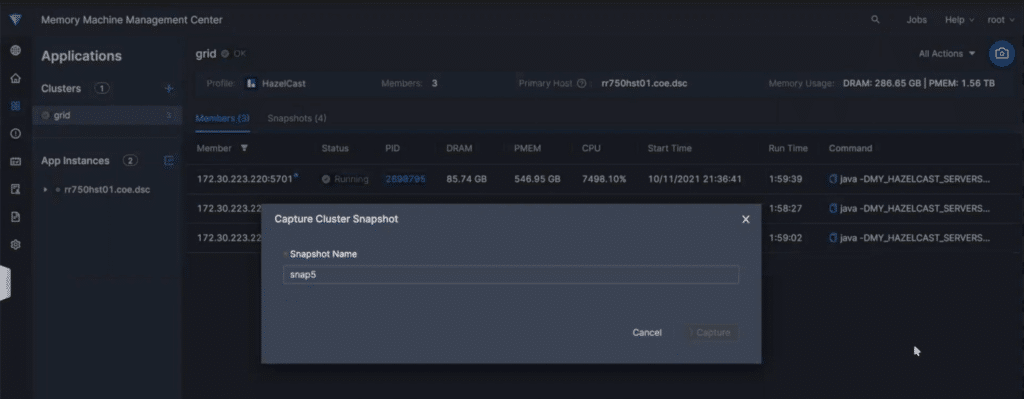
W przeszłości byliśmy zmuszeni przechowywać migawki w pamięci na tradycyjnych nośnikach, co mogło trwać nawet godzinę. Jednak dzięki ZeroIO ta sama operacja może zostać wykonana bez zakłóceń w ciągu kilku sekund.
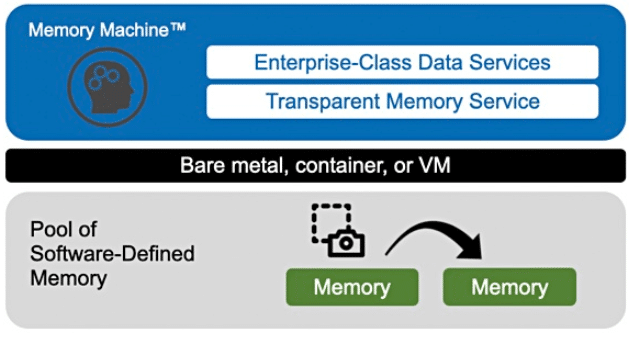
MemVerge wykorzystuje ZeroIO do świadczenia innych usług związanych z danymi w pamięci. Funkcja Time Travel umożliwia aplikacji powrót do wcześniej wykonanych migawek, a ściśle powiązana z tą funkcją jest funkcja AutoSave, która automatycznie tworzy migawki w określonych odstępach czasu. W przypadku konieczności przeniesienia danych przechowywanych w pamięci na inny serwer fizyczny, można na niego przenieść migawkę ZeroIO.
Monitorowanie pamięci oraz udostępnianie powyższych usług odbywa się za pośrednictwem Centrum Zarządzania Maszyną Pamięci MemVerge (M3C).
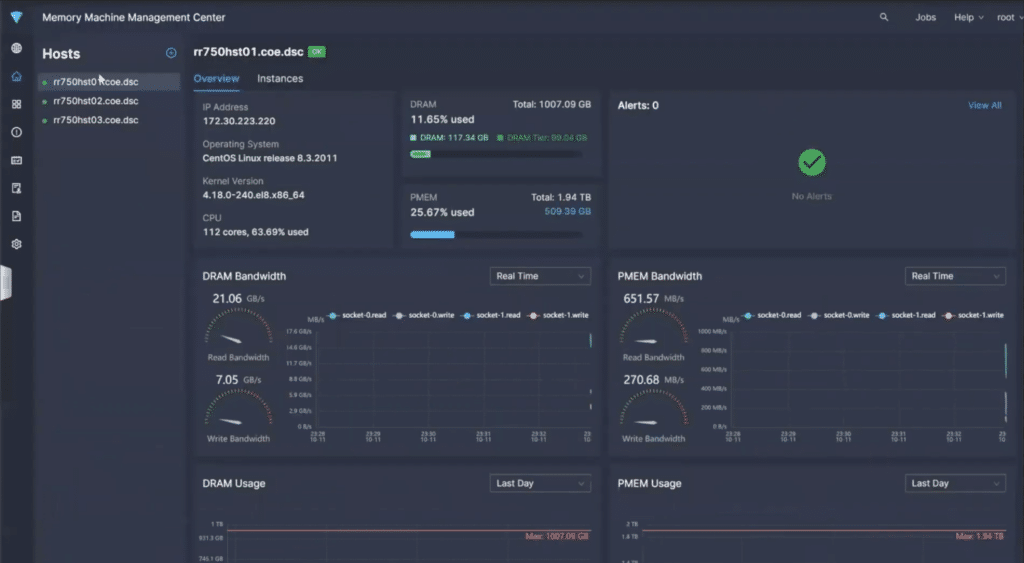
Chociaż wspomnieliśmy, że Memory Machine jest używane z bazami danych, obsługuje ono również szeroką gamę aplikacji: od Maya 3D firmy Autodesk do animacji i renderowania po TensorFlow (platformę uczenia maszynowego), a także inne aplikacje, w tym Hazelcast, produkt, który omówimy w tym artykule.
Leszczyna
Hazelcast jest kluczowym innowatorem i liderem w rozwijającej się dziedzinie platform obliczeniowych w pamięci operacyjnej (in-memory computing). Z ich platformy korzystają organizacje finansowe, e-commerce i inne, w których dostęp do informacji w czasie rzeczywistym ma kluczowe znaczenie, na przykład do wykrywania oszustw i wspomagania podejmowania decyzji handlowych.
Hazelcast obsługuje szybkie aplikacje na dwóch poziomach. Po pierwsze, oferuje magazyn w pamięci, który dystrybuuje dane pomiędzy wieloma serwerami w klastrze, umożliwiając skalowalną wirtualną pulę szybkiej pamięci. Proces dodawania danych polega po prostu na dodaniu kolejnego serwera do klastra. Po drugie, Hazelcast zawiera silnik obliczeniowy, który obsługuje logikę aplikacji podzieloną na podzadania, które następnie są dystrybuowane pomiędzy wszystkie procesory w klastrze serwerów. Pozwala to nie tylko wykorzystać zbiorczą moc obliczeniową klastra, ale także umożliwia wydajne i szybkie równoległe przetwarzanie danych (obejmuje to transformację, wzbogacanie, agregację i analizę). Ponieważ Hazelcast może przetwarzać dane natychmiast po ich utworzeniu dzięki możliwościom strumieniowego przesyłania danych, jest przydatny do tworzenia aplikacji czasu rzeczywistego nowej generacji.
Analiza danych w czasie rzeczywistym
Systemy czasu rzeczywistego opierają się przede wszystkim na dwóch głównych cechach: szybkości i skalowalności. Podczas gdy szybkość zapewnia nadążanie za tworzonymi danymi, skalowalność gwarantuje, że poradzisz sobie z ich wolumenem. Co więcej, dane mogą pochodzić z wielu różnych źródeł. Oczywiście, wyższe prędkości i większa skalowalność oznaczają wyższe koszty, chyba że zostaną zastosowane innowacyjne rozwiązania, takie jak wymiana drogiej pamięci DRAM na tańszą pamięć masową Intel Optane PMem.
Możliwości analizy danych w czasie rzeczywistym zapewniają natychmiastowy wgląd w różnorodne sytuacje, z którymi mogą się spotkać firmy i organizacje, i dostarczają im informacji niezbędnych do reagowania na nie. Na przykład, zgodność z inicjatywami takimi jak Bazylea III, która nakłada na banki obowiązek utrzymywania wyższej płynności niż dotychczas, oznacza, że dysponują one mniejszą ilością środków na generowanie przychodów. Jednocześnie muszą one udowodnić, że rozumieją swoje codzienne ryzyko, aby uniknąć kar nakładanych przez audytorów i organy nadzoru w postaci jeszcze wyższych wymogów dotyczących płynności. Dzięki systemom zarządzania ryzykiem i zgodności w czasie rzeczywistym banki mogą mieć natychmiastowy wgląd w swoje pozycje handlowe, co pozwala im skuteczniej rozumieć i raportować swoją ekspozycję na ryzyko.
Jako przykład można podać systemy analizy obrotu akcjami, które śledzą transakcje i prezentują je w formie umożliwiającej analizę w czasie rzeczywistym. Systemy te mogą uzasadniać swój wysoki koszt ze względu na wyraźny zwrot z inwestycji (ROI) uzyskiwany z przychodów z obrotu akcjami.
Scenariusz testowy
Aplikacja, którą wybraliśmy do zbadania tych technologii, opiera się na bazie kodu do monitorowania handlu stworzonej przez Hazelcast w celu pokazania, w jaki sposób opłacalna „analityka na żądanie” stanowi dobrą alternatywę dla drogich systemów w czasie rzeczywistym.
Ponieważ był to projekt badawczy na niewielką skalę, poszliśmy na pewne kompromisy, które sprawiły, że nasze środowisko testowe nie w pełni odzwierciedlało typowe środowisko produkcyjne. Na przykład, moc obliczeniowa serwerów Dell EMC, których używaliśmy, była znacznie większa niż zapotrzebowanie naszego dostępnego źródła danych, dlatego nie wykorzystaliśmy w pełni dostępnej mocy obliczeniowej ich procesorów. Ponadto, dla uproszczenia, nie optymalizowaliśmy zewnętrznego systemu dostarczania danych. W systemie produkcyjnym wszystkie komponenty zostałyby zoptymalizowane i dostrojone w celu poprawy wydajności i opłacalności tej konfiguracji.
Cele testowania
Najważniejszym aspektem naszych testów było ustalenie, czy Intel Optane PMem może obsługiwać przesyłanie danych w czasie rzeczywistym.
Pominęliśmy testowanie szybkości dostępu do zagregowanych/indeksowanych danych w hurtowni danych w pamięci, obsługiwanej przez Intel Optane PMem; w poprzednich testach MemVerge i Hazelcast testy porównawcze wykazały, że szybkość dostępu do danych była bardzo zbliżona do szybkości pamięci DRAM (w wielu przypadkach wykazano identyczną prędkość odczytu i zapisu), a zatem znacznie szybsza niż w przypadku dostępu do danych z dysków twardych lub SSD. Ponieważ wiedzieliśmy, że szybkość dostępu do danych zapewnia przewagę nad innymi konfiguracjami architektonicznymi, skupiliśmy się w testach wyłącznie na pobieraniu danych.
Na potrzeby naszych testów wygenerowaliśmy fikcyjne dane na serwerze źródłowym danych. Każdy element danych w przychodzącym strumieniu danych reprezentował transakcję giełdową. Symbol giełdowy, ilość, cena i czas były najważniejszymi wartościami. Każdy symbol giełdowy został użyty wielokrotnie w wygenerowanym zbiorze danych, aby zasymulować wiele transakcji w ciągu dnia dla danej akcji. Te oddzielne transakcje zostały następnie zagregowane, aby uzyskać sumę transakcji dla danego symbolu giełdowego.
Wygenerowane dane były przechowywane w Apache Kafka ze względu na jego zdolność do przechwytywania szybkiego strumienia danych. Każdy rekord z Kafki wymagał 210 bajtów, wliczając wszystkie metadane w treści. Kafka została skonfigurowana do uruchamiania trzech oddzielnych brokerów, wszystkich na jednym komputerze ze źródłem danych, z czterema partycjami na każdym brokerze. Taka konfiguracja oczywiście nie byłaby używana w środowisku produkcyjnym, ponieważ posiadanie jednego komputera ze źródłem danych w technologii rozproszonej jest nierealne; jednak nadawała się do celów naszych testów.
Środowisko testowe
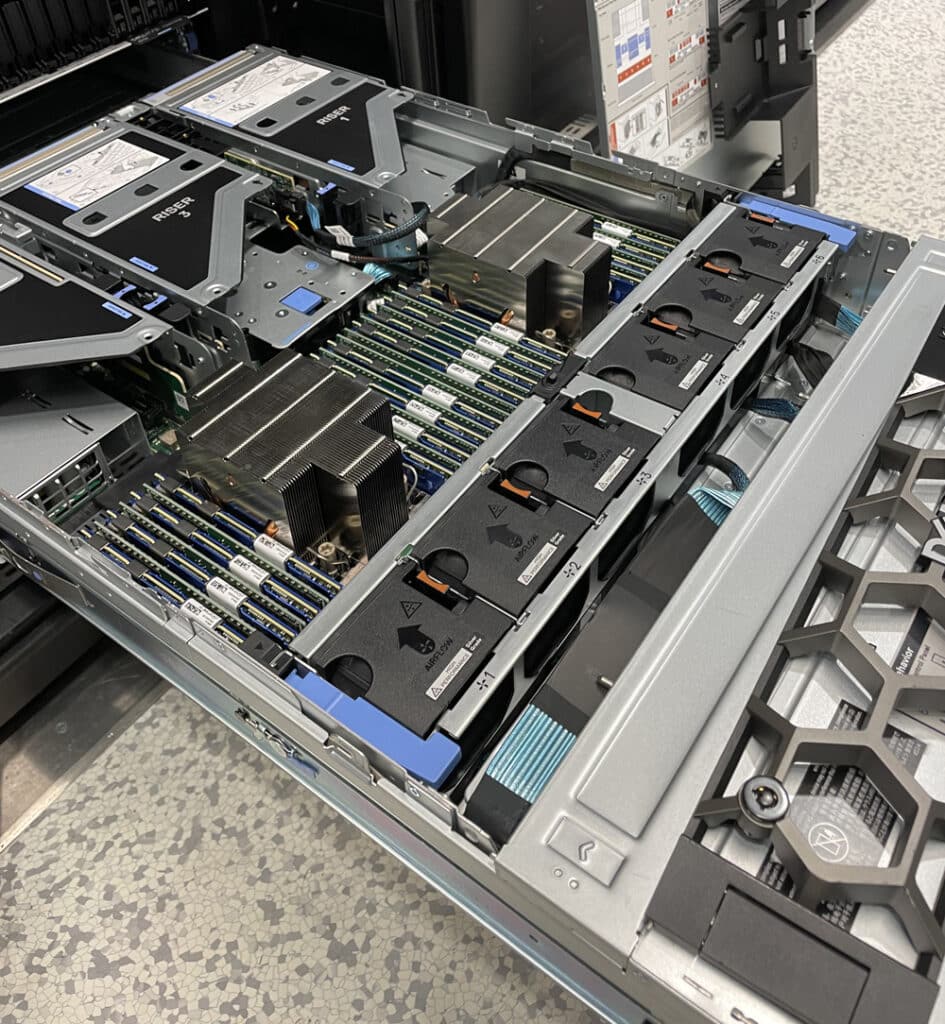
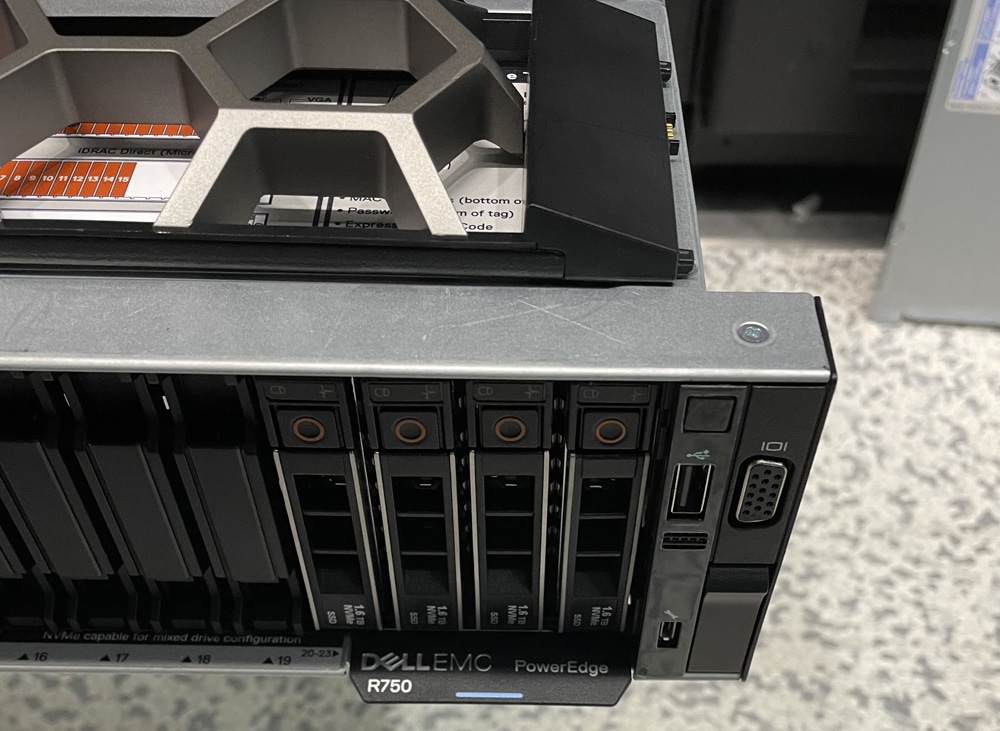
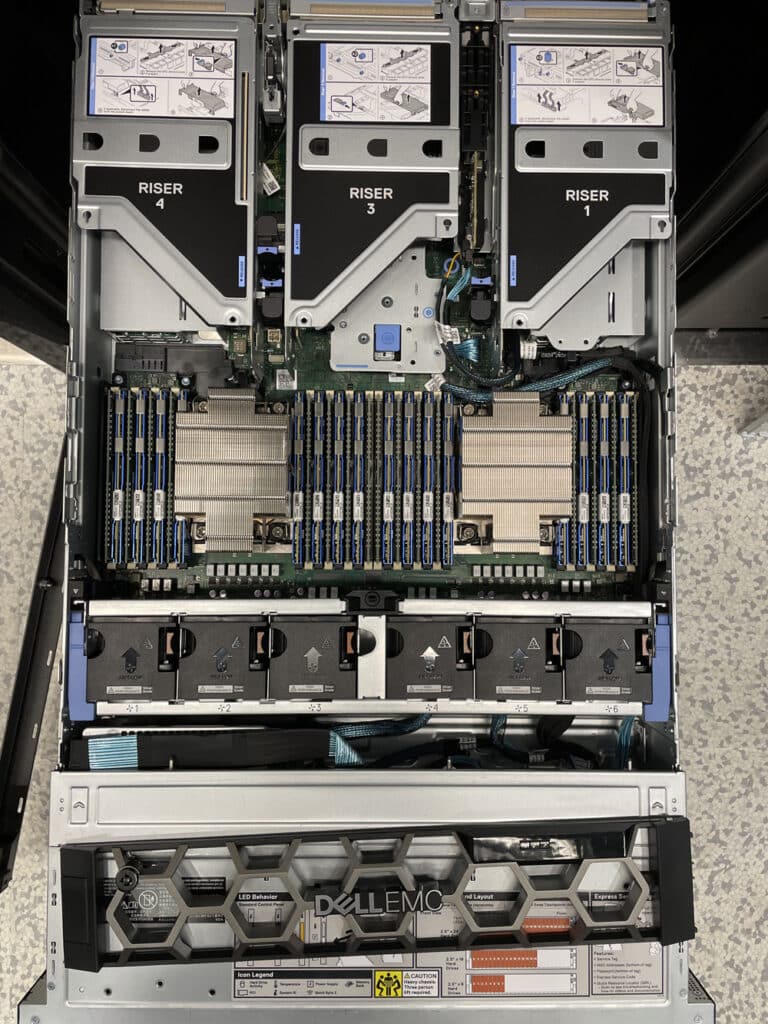
Do testów wykorzystaliśmy trzy serwery Dell EMC PowerEdge R750 i jeden serwer Dell EMC PowerEdge R74xd; na trzech z nich uruchomiono aplikacje analityczne, wykorzystując MemVerge Memory Machine i Hazelcast, natomiast na czwartym utworzono i zapisano dane testowe.
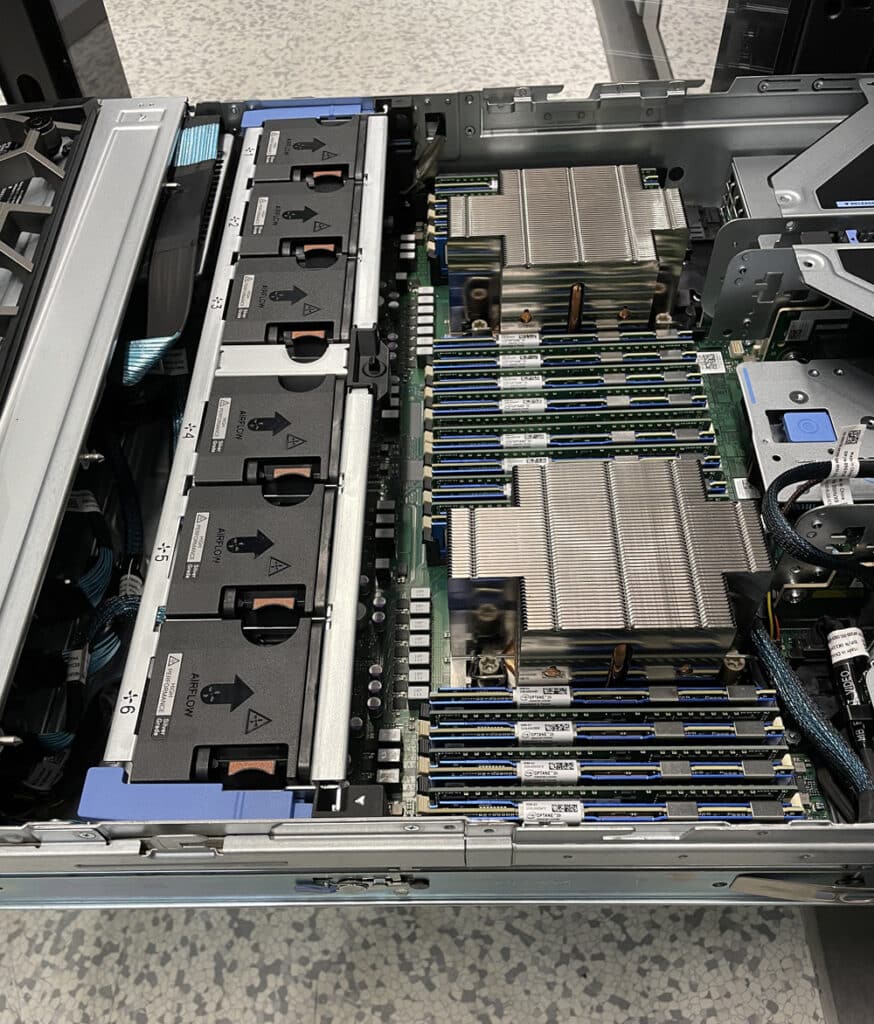
Serwery analityczne
| Model | Dell EMC PowerEdge R750 |
| procesory | Dwa procesory Intel® Xeon® Gold 6330 @ 2 GHz (Ice Lake)
28 rdzeni każdy (łącznie 56, 112 z technologią Intel® Hyper-Threading) |
| DRAM | 16 modułów DIMM 64 GB pamięci DRAM DDR4
1 TB na serwer |
| Intel Optane PMem | 16 modułów DIMM 128 GB z interfejsem Intel Optane PMem DDR-T
2 TB na serwer |
| Interfejs sieciowy | 10 GbE |
| Oprogramowanie | Maszyna pamięci MemVerge 1.2
Platforma Hazelcast 5.0 |
Serwer źródła danych
| Model | Dell EMC PowerEdge R740xd |
| procesory | Dwa procesory Intel® Xeon® Gold 6140 @ 2.3 GHz (Skylake)
18 rdzeni każdy (łącznie 36; 72 z technologią Intel® Hyper-Threading) |
| DRAM | 12 modułów DIMM 32 GB pamięci DRAM DDR4 (384 GB)
2 moduły DIMM 16 GB NVDIMM DDR4 (32 GB) |
| Intel Optane PMem | Nie są potrzebne |
| Interfejs sieciowy | 10 GbE |
| Oprogramowanie | Apache Kafka2.8
Narzędzie do generowania danych dostarczone przez Hazelcast |
Podczas naszych testów odkryliśmy, że ilość pamięci DRAM w serwerach analitycznych mogłaby być znacznie mniejsza; podczas gdy pamięć DRAM była wykorzystywana głównie przez system operacyjny, aplikacja korzystała głównie z pamięci Intel Optane PMem z niewielką ilością pamięci DRAM. Aby zoptymalizować koszty, rozsądną konfiguracją byłoby absolutne minimum pamięci DRAM na serwerze.
Wyniki testu
Stworzyliśmy około 5 miliardów rekordów, które zostały zapisane w Kafce w celu utworzenia źródła danych. Następnie uruchomiliśmy aplikacje do pobierania danych działające na trzech serwerach aplikacji, aby pobrać dane z trzech instancji Hazelcast (jeden serwer Hazelcast na serwer Dell Technologies).
Przetestowaliśmy aplikację korzystającą wyłącznie z pamięci DRAM i porównaliśmy to z pamięcią Intel Optane PMem z oprogramowaniem MemVerge. Wyniki naszych testów pokazały, że w przypadku obciążeń, w których przeważały zapisy, zaobserwowaliśmy spadek wydajności o 32% w przypadku użycia wyłącznie pamięci Intel Optane PMem w porównaniu z czystą pamięcią DRAM (242 KB w porównaniu z 357 KB). Natomiast w konfiguracji Intel Optane PMem + DRAM zaobserwowaliśmy spadek wydajności jedynie o 9%. Spadek ten można by jeszcze bardziej zmniejszyć, zwiększając liczbę serwerów w klastrze, co pozwoliłoby na jeszcze lepsze rozłożenie zapisów. Dodatkowy koszt dodatkowych serwerów można by zrekompensować, kupując procesory o niższej mocy, ponieważ dane obciążenie niekoniecznie wykorzystałoby całą moc obliczeniową testowanej konfiguracji sprzętowej.
| Konfiguracja | Wydajność (liczba rekordów na sekundę) |
| Tylko DRAM | 357,000 |
| Procesor Intel Optane PMem wspomagany przez maszynę z 50 GB pamięci DRAM i pamięcią masową | 325,000 |
| Tylko maszyna z pamięcią Intel Optane PMem + Memory | 242,000 |
Rozważaliśmy wycenę każdej z testowanych konfiguracji, ale zrezygnowaliśmy z tego ze względu na potencjalne wahania kosztów i inne czynniki, które mogłyby sprawić, że te szacunki wkrótce staną się nieaktualne. Niezależnie od ustalonych kosztów, serwer Intel Optane PMem wspomagany pamięcią DRAM będzie znacznie tańszy niż serwer oparty wyłącznie na pamięci DRAM.
Interpretacja testu
Najważniejszym wnioskiem z testów było to, że klaster serwerów obsługujących technologię Intel Optane PMem mógł działać niemal z taką samą prędkością jak klaster korzystający wyłącznie z pamięci DRAM – ale przy znacznie niższych kosztach.
Kolejnym ważnym wnioskiem dla nas było to, że za pomocą technologii Intel Optane PMem można rejestrować i przechowywać dane z tygodni, a nawet miesięcy, co daje firmom możliwość nie tylko analizowania danych w czasie rzeczywistym, ale także udostępniania danych historycznych do szybkiej analizy. Otwiera to możliwości analizy trendów i wzorców, które mogą ujawnić dodatkowe informacje za pomocą zaawansowanych narzędzi analitycznych, takich jak uczenie maszynowe (ML).
Innymi słowy, przedsiębiorstwa mogą wdrożyć środowisko analiz w czasie rzeczywistym obejmujące szeroki zakres czasowy i odkrywać nowe formy analiz, bez kompromisów w zakresie kosztów i szybkości, jakie wiążą się z wdrażaniem magazynów danych lub jezior danych.
Inne testy
Mając już skonfigurowane środowisko, chcieliśmy również przetestować inne możliwości MemVerge Memory Machine, w szczególności funkcje tworzenia migawek i odzyskiwania. Na szczęście Memory Machine integruje się z klastrem Hazelcast, dzięki czemu migawkami i ich odtwarzaniem można zarządzać bezpośrednio w M3C.
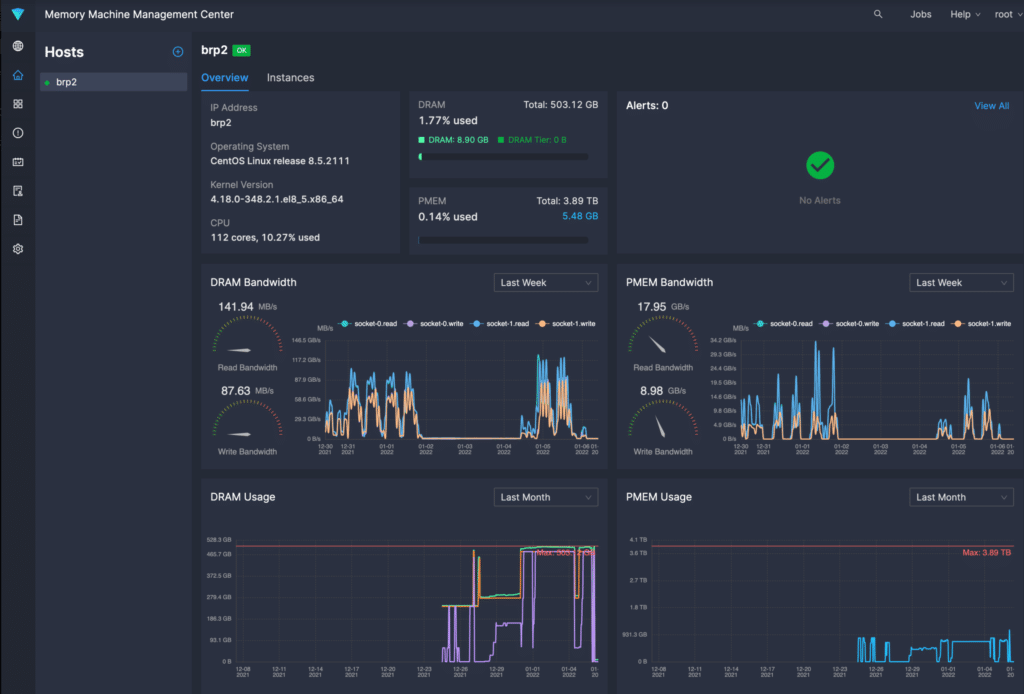
Migawki można wykonywać w dowolnym momencie, na żądanie lub według ustalonego harmonogramu. Obie metody testowaliśmy w szczytowym momencie pracy naszego klastra. Migawki zostały wykonane w ciągu kilku sekund, bez żadnych problemów i bez wpływu na wydajność analiz. Gdyby z klastrem Hazelcast coś się stało, na przykład awaria zasilania, dane można by odzyskać za pomocą jednej z naszych migawek.
Funkcja migawki jest nie tylko przydatna w celach bezpieczeństwa, ale może również zwiększyć wykorzystanie serwerów. W instytucjach finansowych serwery są intensywnie eksploatowane w typowych godzinach handlu, ale pozostają stosunkowo bezczynne poza nimi. Dzięki zastosowaniu schematu gorącego startu, wykorzystanie serwerów może zostać znacząco zwiększone. Na przykład, pod koniec dnia handlowego można wykonać migawkę bazy danych transakcyjnych. Następnie, po wyłączeniu bazy danych transakcyjnych, serwery mogą zostać przełączone na inne zadania przetwarzania danych, takie jak eksploracja danych. Na początku dnia handlowego baza danych transakcyjnych może zostać szybko przywrócona, a operacje handlowe wznowione.
Wniosek
Intel Optane PMem to ekscytująca i rewolucyjna technologia, która zaczyna zmieniać oblicze centrów danych, ale jak w przypadku wszystkich innych technologii, na szczęście nie funkcjonuje w próżni. Wiodące, przyszłościowe firmy, takie jak Dell Technologies, Intel, MemVerge i Hazelcast, odkrywają synergię i zaczynają wykorzystywać tę nową technologię, aby odkryć jej prawdziwy potencjał w centrach danych: moduły Intel Optane PMem są oferowane w cenie około połowy ceny pamięci DRAM; Dell Technologies oferuje serwery obsługujące ogromne ilości pamięci o niskim opóźnieniu, oferowane przez Intel Optane PMem; Hazelcast umożliwia aplikacjom wykorzystanie tych technologii na szeroką skalę; MemVerge zapewnia monitorowanie, zarządzanie i usługi transmisji danych dla Intel Optane PMem, a poprzez abstrakcję API DRAM sprawia, że Intel Optane PMem jest postrzegany jako DRAM dla istniejących aplikacji, umożliwiając im działanie bez konieczności modyfikacji lub przeprojektowywania.
Gdyby wszystko inne pozostało bez zmian, firmy wybrałyby działania w czasie rzeczywistym zamiast działań wsadowych. Ponieważ jednak nie wszystko jest takie samo, przetwarzanie wsadowe jest często wybieranym sposobem na uniknięcie kosztów związanych z przetwarzaniem w czasie rzeczywistym. Jednak wraz ze wzrostem oczekiwań klientów w świecie coraz bardziej zorientowanym na czas rzeczywisty, firmy muszą znaleźć nowe sposoby na budowanie przewagi konkurencyjnej. Wykorzystując prędkości w czasie rzeczywistym bez ponoszenia tradycyjnych kosztów przetwarzania w pamięci, wiodące firmy mogą dokonać skoku dzięki technologiom takim jak Intel Optane PMem, MemVerge i Hazelcast, aby tworzyć rozwiązania, które pomogą im reagować na potrzeby własne i klientów szybciej niż kiedykolwiek wcześniej.
Niniejszy raport jest sponsorowany przez MemVerge. Wszystkie poglądy i opinie wyrażone w niniejszym raporcie opierają się na naszej obiektywnej ocenie omawianego produktu/produktów. Intel, logo Intel i Intel Optane są znakami towarowymi firmy Intel Corporation lub jej spółek zależnych.


 Amazon