

Technologia rozwija się cyklicznie, a żaden cykl nie jest obecnie bardziej widoczny niż nacisk na sztuczną inteligencję na brzegu sieci. W szczególności obserwujemy ogromny wzrost zainteresowania inferencją brzegową. NVIDIA odgrywa ważną rolę w tym procesie, dążąc do przyspieszenia wdrażania swoich procesorów graficznych poza centrami danych. Mimo to przedsiębiorstwa muszą podejmować więcej decyzji szybciej, dlatego infrastruktura sztucznej inteligencji musi być bliżej danych.
Pamiętasz Hub-and-Spoke?
W „dawnych czasach” mówiliśmy o krawędzi sieci w kontekście tworzenia danych i o tym, jak szybko i sprawnie przesyłać je z powrotem do centrum danych, stosując tradycyjną metodologię hub-and-spoke. Projekt ten ustąpił miejsca hierarchicznej strukturze opartej na rdzeniu, dostępie i dystrybucji, z dużą redundancją i sprzętem, której jedynym celem było przesyłanie danych z powrotem do głównego centrum danych. Wszystkie te dane gromadzone na krawędzi sieci, a następnie przesyłane z powrotem do głównego centrum danych w celu przetworzenia, a następnie przesyłane z powrotem do urządzeń brzegowych, okazały się nieefektywne, kosztowne i czasochłonne.
Być może jednak ta koncepcja hub-and-spoke nie była taka zła. W obliczu dążenia do zapewnienia większej inteligencji na brzegu sieci dzięki sztucznej inteligencji i rewolucji w chmurze obliczeniowej, wydaje się, że projektowanie znacząco wpływa na projektowanie sieci, wdrożenia brzegowe i miejsca przetwarzania danych. W rzeczywistości tegoroczna konferencja HPE Discover miała slogan, który byłby bardzo znajomy w każdym roku przed szaleństwem chmury, gdyby po prostu zamienić rdzeń na chmurę: „Konferencja Edge-to-Cloud”.
Skakanie na krawędzi pędu
HPE nie było jedynym dostawcą, który dostrzegł znaczenie przetwarzania brzegowego w chmurze dla branży. Podobną historię przedstawił Dell Technologies podczas konferencji Dell Technologies World. IBM, Lenovo, NetApp i Supermicro również głośno mówiły o potrzebie zwiększenia wydajności na brzegu sieci przy jednoczesnym efektywniejszym wykorzystaniu zasobów chmury.
Co napędza rosnący nacisk na przetwarzanie brzegowe? Klienci generują ogromne ilości danych na brzegu sieci, gromadzonych z czujników, urządzeń IoT i pojazdów autonomicznych. Bliskość danych u źródła przyniesie korzyści biznesowe, w tym szybsze analizy z trafnymi prognozami i krótszy czas reakcji, a także lepsze wykorzystanie przepustowości. Wnioskowanie AI na brzegu sieci (umożliwiające podjęcie działań analizy wykorzystujące techniki AI) poprawia wydajność, skraca czas wnioskowania i zmniejsza zależność od łączności sieciowej, co ostatecznie przekłada się na poprawę wyników finansowych firmy.
Dlaczego nie przeprowadzać wnioskowania brzegowego w chmurze?
Dlaczego wnioskowanie brzegowe nie może odbywać się w chmurze? Można, a w przypadku aplikacji, które nie są wrażliwe na czas i nie są uznawane za krytyczne, rozwiązaniem może być wnioskowanie oparte na sztucznej inteligencji w chmurze. Wnioskowanie w czasie rzeczywistym wiąże się jednak z wieloma wyzwaniami technicznymi, z których najważniejszym jest opóźnienie. Co więcej, wraz z ciągłym wzrostem liczby urządzeń IoT i powiązanych aplikacji wymagających przetwarzania na brzegu sieci, zapewnienie szybkiego połączenia w chmurze dla wszystkich urządzeń może być niemożliwe.
Edge computing niesie ze sobą wyzwania, takie jak wsparcie lokalne, bezpieczeństwo fizyczne i aplikacji oraz ograniczona przestrzeń, co przekłada się na ograniczone zasoby pamięci masowej. Dzisiejsze serwery edge zapewniają wystarczającą moc obliczeniową dla tradycyjnych obciążeń edge, a procesory graficzne zwiększają moc obliczeniową bez zwiększania złożoności.
Rozwój opcji brzegowych
Co ciekawe, na rynku infrastruktury brzegowej dominują przede wszystkim mniejsi dostawcy systemów. Na przykład Supermicro od lat mówi o 5G i centrach danych na słupach telefonicznych, a Advantech i wielu innych dostawców specjalistycznych serwerów robi to samo. Jednak wraz z udoskonaleniem procesorów graficznych i, co ważniejsze, oprogramowania do ich obsługi, koncepcja sztucznej inteligencji na brzegu sieci staje się coraz bardziej realna.
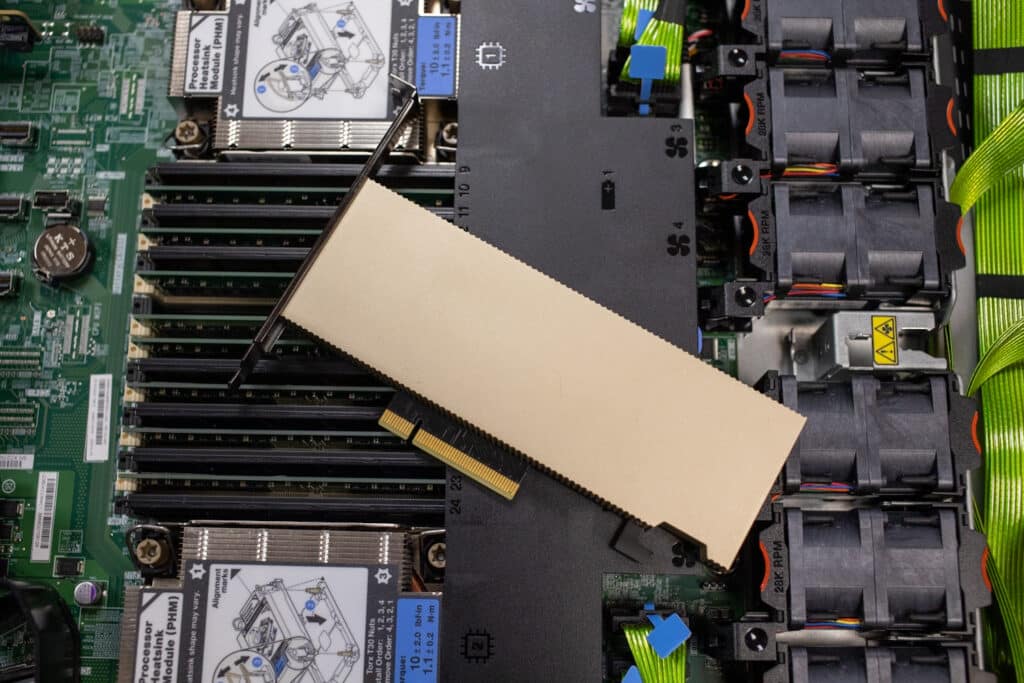
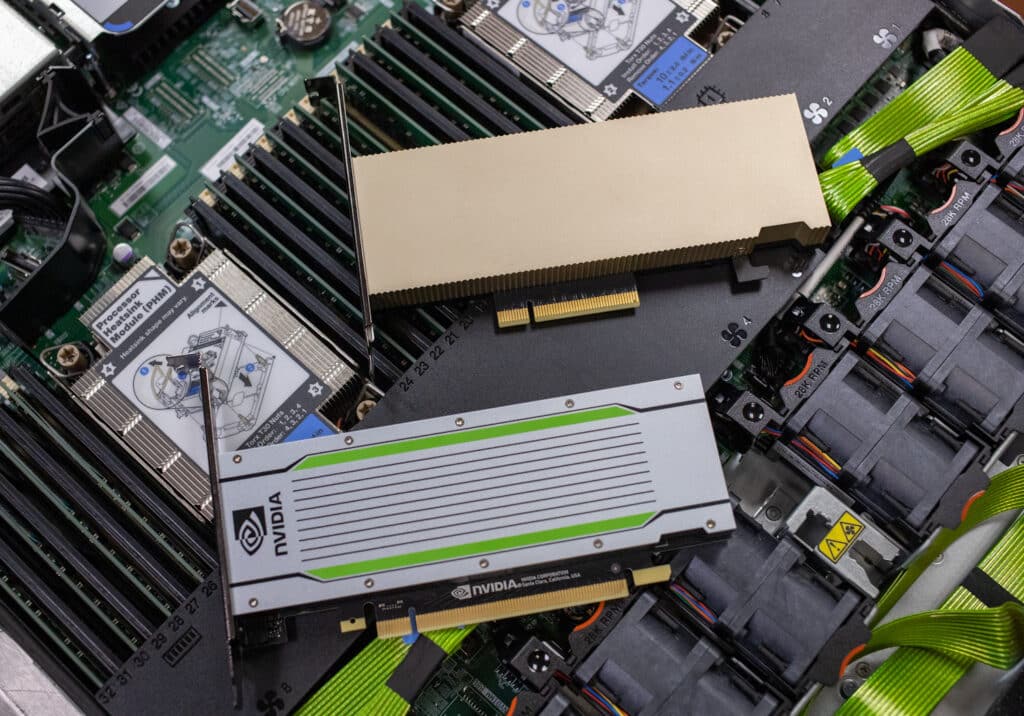
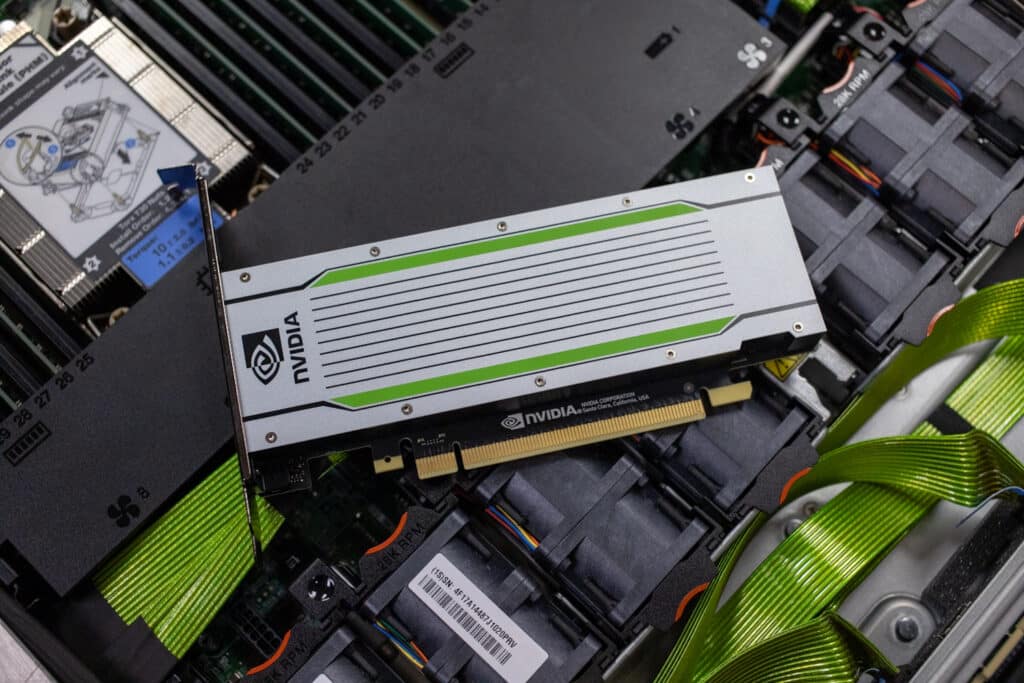
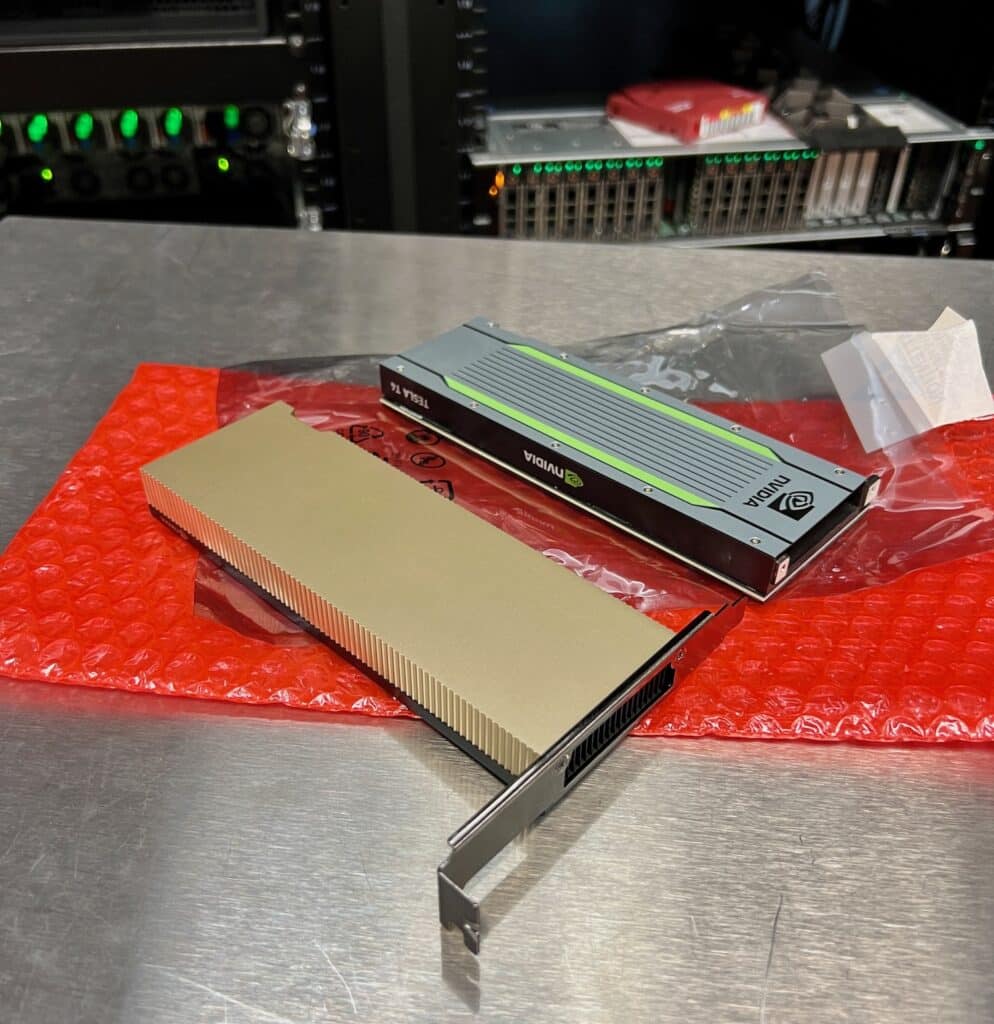
Ostatnio obserwowaliśmy tę zmianę w naszym laboratorium na kilka różnych sposobów. Po pierwsze, nowe projekty serwerów wykorzystują jednoslotowe, energooszczędne procesory graficzne NVIDIA, takie jak A2 i niezwykle popularny T4. Niedawno Lenovo i Supermicro przesłały nam do oceny serwery z wbudowanymi tymi procesorami graficznymi, a ich wydajność była imponująca.
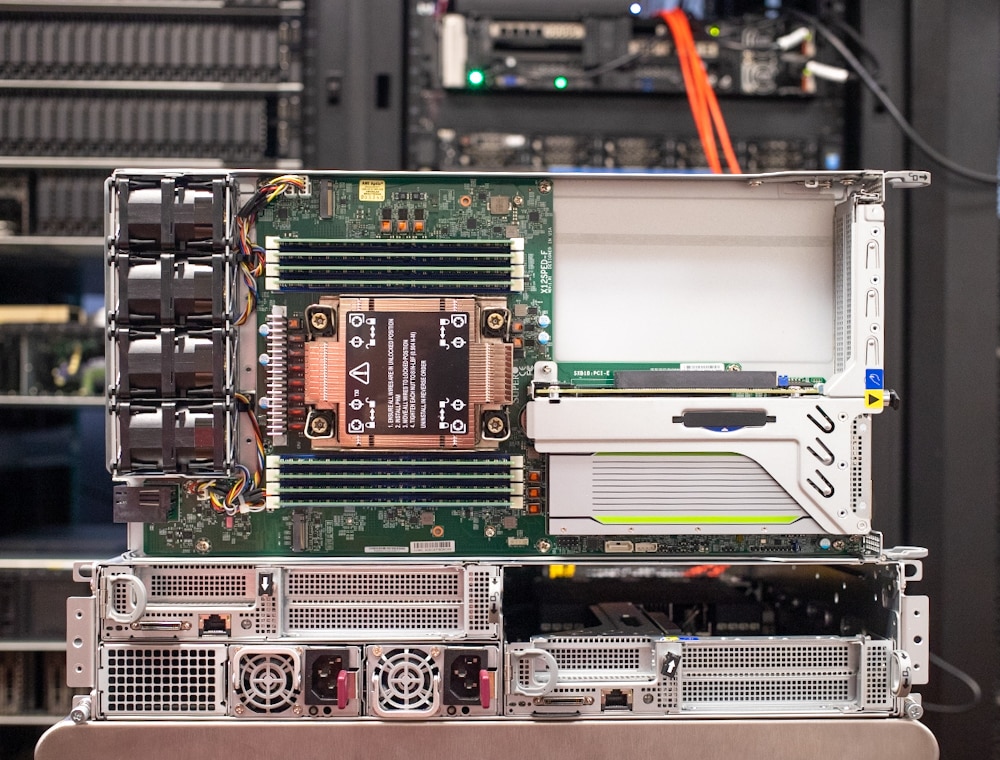 SuperMicro IoT SuperServer SYS-210SE-31A z NVIDIA T4
Po drugie, dostawcy infrastruktury kładą duży nacisk na dostarczanie rozwiązań brzegowych z metrykami bezpośrednio powiązanymi z podstawowymi cechami centrum danych, takimi jak niskie opóźnienia i bezpieczeństwo. Niedawno przyjrzeliśmy się niektórym z tych przypadków użycia z wykorzystaniem Dell PowerVault ME5 . Chociaż ME5 jest promowane jako rozwiązanie pamięci masowej dla małych i średnich firm, generuje duże zainteresowanie w zastosowaniach brzegowych ze względu na stosunek ceny do wydajności.
Ostatecznie jednak historia inferencji brzegowej jest dość prosta. Sprowadza się ona do zdolności procesora graficznego do przetwarzania danych, często „w locie”. Pracowaliśmy nad rozszerzeniem naszych testów, aby lepiej zrozumieć, jak te nowe serwery i procesory graficzne mogą sprawdzić się w roli inferencji brzegowej. W szczególności przyjrzeliśmy się popularnym obciążeniom brzegowym, takim jak rozpoznawanie obrazu i modele przetwarzania języka naturalnego.
Testowanie tła
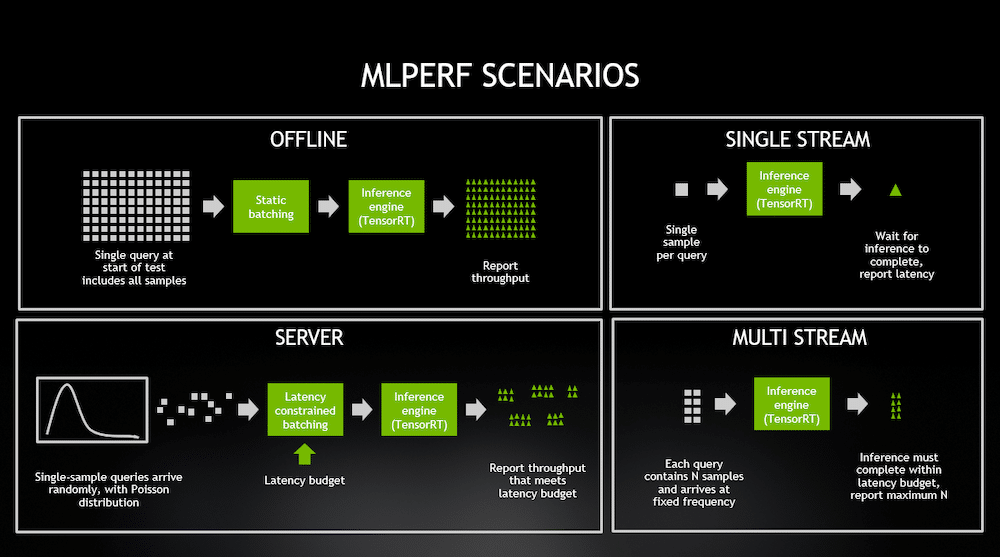
Pracujemy z pakietem narzędzi MLPerf Inference: Edge benchmark. Ten zestaw narzędzi porównuje wydajność wnioskowania popularnych modeli DL w różnych rzeczywistych scenariuszach brzegowych. W naszych testach uzyskaliśmy wyniki dla modelu klasyfikacji obrazów ResNet50 oraz modelu BERT-Large NLP dla zadań typu „pytanie-odpowiedź”. Oba są uruchamiane w konfiguracji offline i SingleStream.
Scenariusz offline ocenia wydajność wnioskowania w „trybie wsadowym”, gdy wszystkie dane testowe są natychmiast dostępne, a opóźnienie nie ma znaczenia. W tym zadaniu skrypt wnioskowania może przetwarzać dane testowe w dowolnej kolejności, a celem jest maksymalizacja liczby zapytań na sekundę (QPS = przepustowość). Im wyższa wartość QPS, tym lepiej.
Konfiguracja pojedynczego strumienia przetwarza natomiast jedną próbkę testową na raz. Po przeprowadzeniu wnioskowania na pojedynczym wejściu (w przypadku ResNet50 wejściem jest pojedynczy obraz), mierzone jest opóźnienie, a kolejna próbka jest udostępniana narzędziu wnioskowania. Celem jest minimalizacja opóźnienia przetwarzania każdego zapytania; im niższe opóźnienie, tym lepiej. 90. percentyl opóźnienia strumienia zapytania jest mierzony jako docelowa metryka zwięzłości.
Poniższy obraz pochodzi z wpisu na blogu firmy NVIDIA dotyczącego wnioskowania MLPerf 0.5, który bardzo dobrze wizualizuje te scenariusze. Więcej informacji o różnych scenariuszach można znaleźć w oryginalnym artykule na temat wnioskowania MLPerf tutaj.
Wnioskowanie brzegowe – Lenovo ThinkEdge SE450
Po przetestowaniu ThinkEdge SE450 , nawiązaliśmy współpracę z Lenovo, aby uruchomić MLPerf na kartach NVIDIA A2 i T4 w systemie. Celem było sprawdzenie możliwości SE450 z wykorzystaniem tylko jednego procesora graficznego. Należy zauważyć, że system obsługuje do czterech energooszczędnych procesorów graficznych NVIDIA, a logiczne jest, aby te liczby przenieść na liczbę potrzebnych kart.
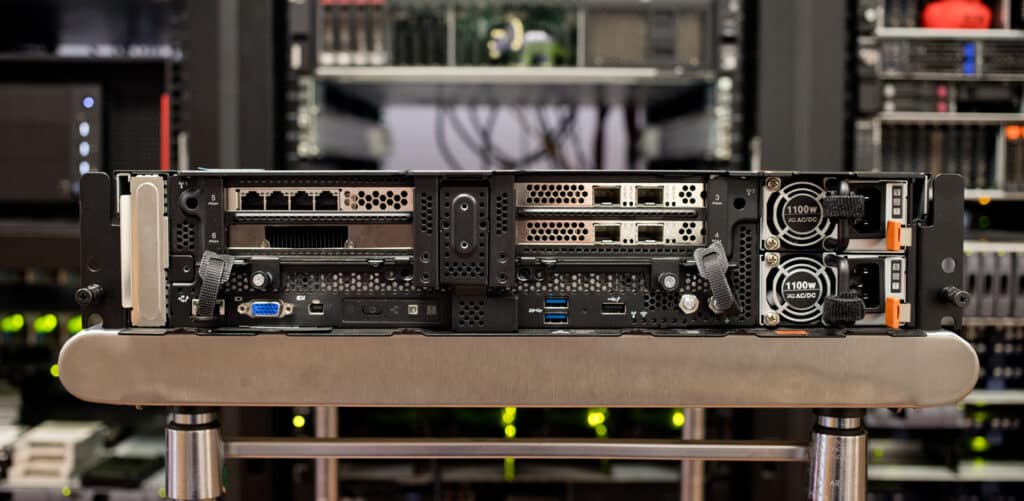
W ramach tych testów współpracowaliśmy bezpośrednio z Lenovo, testując różne konfiguracje w naszym laboratorium, zarówno z NVIDIA A2, jak i T4. Dzięki MLPerf dostawcy dysponują specjalnym zestawem testowym, który został dostrojony do ich konkretnej platformy. Wykorzystaliśmy zestaw testowy Lenovo do tego benchmarku opartego na wnioskowaniu brzegowym, aby zorientować się, jak te popularne procesory graficzne wypadają w testach.
Wyniki testów A2 i T4 w SE450 w naszym laboratorium:
| Benchmark | NVIDIA A2 (40–60 W TDP) | NVIDIA T4 (70 W TDP) |
|---|---|---|
| ResNet50 SingleStream | Opóźnienie 0.714 ms | Opóźnienie 0.867 |
| ResNet50 offline | 3,032.18 próbek/s | 5,576.01 próbek/s |
| BERT SingleStream | Opóźnienie 8.986 ms | Opóźnienie 8.527 ms |
| BERT Offline | 244.213 próbek/s | 392.285 próbek/s |
Co ciekawe, NVIDIA T4 radziła sobie naprawdę dobrze, co jest zaskakujące dla niektórych, biorąc pod uwagę jej wiek. Profil wydajnościowy T4 jest dość oczywistym powodem, dla którego T4 wciąż cieszy się ogromną popularnością. Niemniej jednak, A2 ma znaczną przewagę w zakresie opóźnień nad T4 w wnioskowaniu obrazu w czasie rzeczywistym.
Ostatecznie decyzja o wyborze karty graficznej jest podejmowana pod kątem konkretnego zadania. Starszy model NVIDIA T4 zużywa więcej energii (70 W) i korzysta ze złącza PCIe Gen3 x16, podczas gdy nowszy model A2 został zaprojektowany do pracy przy mniejszym poborze mocy (40–60 W) i korzysta ze złącza PCIe Gen4 x8. W miarę jak organizacje będą lepiej rozumieć, czego oczekują od swojej infrastruktury brzegowej, wyniki będą bardziej miarodajne, a projekty inferencyjne na brzegu sieci będą miały większe szanse na powodzenie.
Uwagi końcowe
Dostawcy prześcigają się w tworzeniu mniejszych, szybszych i bardziej wytrzymałych serwerów dla rynku rozwiązań brzegowych. Organizacje, od handlu detalicznego, przez fabryki, po opiekę zdrowotną, domagają się szybszego wglądu w dane zebrane u źródła. Skrócenie czasu wnioskowania, zmniejszenie opóźnień, opcje poprawy wydajności oraz wykorzystanie nowych technologii szybko oddzielą zwycięzców od przegranych.
Rynek rozwiązań brzegowych nie stoi w miejscu, ponieważ organizacje znajdują nowe sposoby na wykorzystanie danych zbieranych z ciągle rosnącej liczby urządzeń IoT. Nasz zespół dostrzega ogromną szansę dla tych, którzy potrafią szybko reagować w swoich branżach, na wykorzystanie sztucznej inteligencji na brzegu sieci, co obejmuje również ten przypadek użycia wnioskowania brzegowego.
Oczekujemy, że czołowi gracze na rynku infrastruktury IT odpowiedzą innowacyjnymi rozwiązaniami dla tego konkretnego przypadku użycia w ciągu najbliższego roku. Co więcej, a może nawet ważniejsze, spodziewamy się wielu postępów w oprogramowaniu, które pomogą w demokratyzacji wykorzystania procesorów GPU w tych zastosowaniach brzegowych. Aby ta technologia miała charakter rewolucyjny, jej wdrożenie musi być łatwiejsze niż obecnie. Biorąc pod uwagę prace, które obserwujemy nie tylko ze strony firmy NVIDIA, ale także firm zajmujących się oprogramowaniem, takich jak Vantiq , Viso.ai i wiele innych, jesteśmy optymistycznie nastawieni do możliwości wdrożenia tej technologii w kolejnych organizacjach.



 Amazon