

Od lat automatyczne warstwowanie pamięci masowej (ang. storage tiering) jest niezbędnym rozwiązaniem dla przedsiębiorstw, które chcą efektywnie zarządzać powierzchnią swoich centrów danych, jednocześnie obniżając całkowity koszt posiadania (TCO). Strategia jest prosta: stosować algorytmy i reguły automatycznego warstwowania oraz utrzymywać aktywne dane w pamięci głównej, a jednocześnie przenosić dane nieaktywne do niedrogich kategorii pamięci masowej. W ostatnich latach warstwowanie w chmurze (ang. cloud tiering) stało się solidnym i ekonomicznym rozwiązaniem, które zarządza przenoszeniem nieaktywnych danych do niedrogiej pamięci obiektowej w chmurze. Dzięki serii ThinkSystem DM, Lenovo umożliwia przedsiębiorstwom zarządzanie danymi i alternatywami w chmurze za pomocą inteligentnego rozwiązania pamięci masowej. Ta strategia chmurowa skutecznie zapewnia pojemność, elastyczność i bezpieczeństwo w środowiskach chmury hybrydowej, bez kompromisów w zakresie łatwości zarządzania, bezpieczeństwa i wydajności.
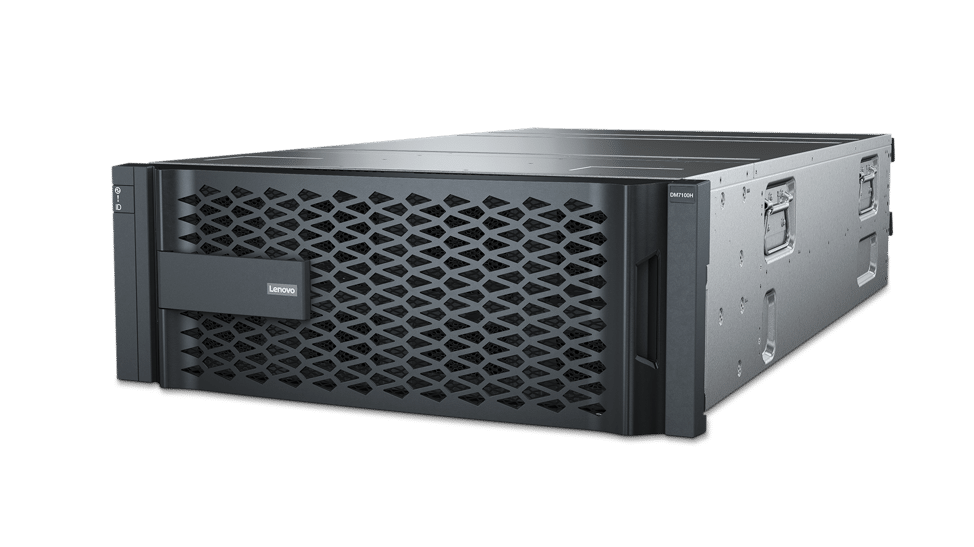
W tym artykule omówiono, w jaki sposób rozwiązania Lenovo ThinkSystem Storage Solutions i seria DM oferują kompleksową strategię centrum danych, od lokalnego do chmury. Najpierw omówimy podstawowe pojęcia dotyczące przechowywania danych, warstwowania w chmurze oraz nowych wyzwań w zarządzaniu pamięcią masową. Przyjrzymy się ekosystemowi zarządzania danymi Lenovo i temu, jak firma wyróżnia się na rynku pamięci masowej dzięki serii DM. Przyjrzymy się również bliżej oprogramowaniu ONTAP i zasadom warstwowania pamięci masowej FabricPool. Na koniec, w naszym laboratorium, zaprezentujemy konfigurację i walidację rozwiązania warstwowania w chmurze Lenovo.
W tradycyjnym modelu centrum danych, wraz z rozwojem firmy, zaczyna ona gromadzić krytyczne dane i pliki w swojej siedzibie. Jednak dane te z czasem się starzeją i są rzadko wykorzystywane, co pochłania cenną wydajność i pojemność pamięci masowej (zarówno podstawowej, jak i dodatkowej), wpływając na krytyczne obciążenia. Archiwizacja tych danych w przeszłości była praktycznym rozwiązaniem dla przedsiębiorstw; jednak w ten sposób dane nie są natychmiast dostępne w przypadku nagłej potrzeby.
Ten problem uświadomił organizacjom IT konieczność rozważenia poziomów pamięci masowej o różnej pojemności, kosztach i parametrach wydajności. Muszą one również uznać i być przygotowane na spełnienie rosnących wymagań dotyczących danych w wielu środowiskach, w tym chmurowych. Odpowiedzią jest warstwowanie w chmurze, które należy uwzględnić w nowoczesnych architekturach pamięci masowej. W przeciwnym razie rosnąca ilość danych przewyższy inwestycje firmy w wydajną pamięć podstawową w centrum danych.
Chmura jako warstwa pamięci masowej
Wraz z rozwojem zaawansowanych technologii, istniejące poziomy pamięci masowej można w razie potrzeby przekształcać, a kolejne można dodawać, aby jeszcze bardziej zróżnicować wielowarstwową architekturę pamięci masowej. Chmura otworzyła nowe możliwości dla organizacji IT, umożliwiając korzystanie z rozwiązań pamięci masowej od dostawców chmury publicznej jako dodatkowej (niższej) warstwy. Dobrze zaprojektowana i wdrożona, chmura będzie doskonałym i tańszym rozwiązaniem niż niższy poziom lokalny.
W podstawowych warstwach pamięci masowej, które wykorzystują technologię flash do zapewnienia ekstremalnie wysokiej wydajności, około 50% zimnych danych można by przypisać do chmury. Kopie migawkowe i dane nieustrukturyzowane często zaliczają się do tej kategorii, w tym aplikacje o znaczeniu krytycznym. W warstwach dodatkowych, zimne dane przechowywane w pamięci masowej mogą pochodzić nawet w 90% z kopii zapasowych. Wszystkie te cenne, ale rzadko używane dane można by również przenieść do chmury. Popularni dostawcy chmury i usługi gotowe do warstwowego łączenia nieaktywnych danych to Azure Blob Storage, AWS S3 i Google Cloud Storage.
Podobnie jak w przypadku automatycznego warstwowania pamięci masowej w chmurze lokalnej, możemy tworzyć polityki i reguły do administrowania danymi w chmurze. Warunki pozwalają nam przesyłać pliki bezpośrednio z chmury lokalnej do chmury publicznej. Polityki są stosowane na kilka sposobów. Na przykład, dane mogą być przenoszone na podstawie rozszerzenia pliku, wzorców zawartych w jego nazwie lub częstotliwości dostępu do pliku w danym okresie. Ta ostatnia opcja jest prawdopodobnie najlepszym scenariuszem, w którym pliki i bloki pamięci masowej otrzymują wartości temperatury, oznaczając nowo zapisane dane jako gorące, a nieaktywne jako zimne. Po wdrożeniu zestawu polityk warstwowania pamięci masowej, zimne dane można szybko przenieść do chmury, uruchamiając reguły na żądanie lub zgodnie z harmonogramem.
Nowe wyzwania w zakresie zarządzania magazynem
Główne wyzwania, z jakimi obecnie mierzy się rynek w zakresie zarządzania danymi w chmurze hybrydowej, dotyczą objętości i różnorodności, szybkości przesyłania danych oraz integralności danych.
Ilość danych rośnie niemal wykładniczo. Organizacje IT muszą radzić sobie nie tylko ze wzrostem ilości danych, ale także z ich wzrostem i zarządzaniem nimi w wielu środowiskach. Ilość i różnorodność generowanych danych wciąż są przytłaczające. Bez możliwości przechowywania, kategoryzowania i przetwarzania tych danych w hybrydowym rozwiązaniu chmurowym, organizacje tracą kluczowe informacje o swoich klientach i działalności. Co więcej, przewiduje się, że do 2025 roku ilość danych wzrośnie dziesięciokrotnie (około 163 ZB), napędzana przez IoT i technologie brzegowe. Jeśli dane są najcenniejszym zasobem, należy traktować je z ostrożnością i muszą one dostarczać informacji niezbędnych do podejmowania trafnych decyzji, umożliwiając jednocześnie spojrzenie w przyszłość. Co więcej, znalezienie bardziej efektywnych sposobów przetwarzania tych danych, aby przekształcić je w wartość, ma kluczowe znaczenie dla decyzji zakupowych klientów.
Zagrożenia IT również ewoluują – a utrzymanie bezpieczeństwa infrastruktury to nieustanna walka. Dobra strategia bezpieczeństwa polega na zbudowaniu solidnych fundamentów opartych na dokładnej wiedzy o tym, kiedy, gdzie i jak przechowywane są dane. Taka strategia pomaga firmom uniknąć rosnących kosztów związanych z naruszeniami bezpieczeństwa danych, a także z nowym złośliwym oprogramowaniem, katastrofami i przepisami, które stanowią poważne zagrożenie dla działalności. Bezpieczeństwo danych ma absolutne znaczenie dla przedsiębiorstw, niezależnie od tego, czy chodzi o ochronę przed utratą danych, czy zapewnienie ich integralności. W tym obszarze Lenovo oferuje wszystkie możliwe opcje i gwarantuje, że dane swoich klientów będą zawsze chronione.
Rozwiązania pamięci masowej Lenovo ThinkSystem
Przewidywanie nowych rozwiązań jest również wyzwaniem, podobnie jak nadążanie za najlepszą strategią dotyczącą pamięci masowej i chmury. Jednak branża poczyniła już ogromne inwestycje w ekosystemy badawcze i platformy, które zapewniają przedsiębiorstwom wartość i możliwości. Podejmując kolejny strategiczny krok w branży pamięci masowej, Lenovo dostosowało swoje rozwiązanie do głównych wyzwań w zarządzaniu danymi. Ten przemyślany krok Lenovo ma na celu zapewnienie klientom najlepszych rozwiązań i zaoferowanie unikalnego połączenia produktów i usług, które umożliwią firmom optymalne wykorzystanie chmury hybrydowej.
Lenovo to jedna z unikatowych firm technologicznych na rynku, która oferuje kompleksowe rozwiązania dla centrów danych za pośrednictwem Lenovo Data Center Group (DCG). Co więcej, Lenovo zapewnia kompleksowe bezpieczeństwo i zarządzanie oprogramowaniem dzięki ekosystemowi Intelligent Device Group (IDG). Dzięki tym rozwiązaniom i serii ThinkSystem DM firmy Lenovo przedsiębiorstwa mogą ulepszyć swoją infrastrukturę i obsłużyć dowolne obciążenie w swoich środowiskach.
Seria ThinkSystem DM to flagowe rozwiązanie Lenovo do przechowywania danych, które oferuje wszechstronny pakiet do zarządzania danymi ustrukturyzowanymi i nieustrukturyzowanymi. Obejmuje ono zarówno systemy klasy podstawowej, jak i średniej, oferując bogate możliwości przetwarzania danych, takie jak wbudowana redukcja danych, ich ochrona i bezpieczeństwo. Każda z serii DM oferuje zintegrowane możliwości chmury hybrydowej dla rozwiązań dostawców chmury publicznej. Jednocześnie Lenovo rozszerza swoją kompleksową ofertę rozwiązań NVMe o niedawno wprowadzoną serię DM7100F , a jeszcze w tym roku planuje rozszerzyć ofertę kompleksowych rozwiązań NVMe na obciążenia klasy podstawowej, aby umożliwić klientom stworzenie infrastruktury NVMe dla całego przedsiębiorstwa.
Baseny z tkanin
Pakiet DM Series Data Management Suite ujednolica zarządzanie danymi w pamięci flash, na dyskach i w chmurze, aby uprościć środowiska pamięci masowej. To kompleksowe oprogramowanie jest proste w obsłudze i niezwykle elastyczne, zaprojektowane z myślą o wydajnej pamięci masowej, a także oferuje zaawansowane funkcje zarządzania danymi oraz płynną integrację z chmurą. Ogólnie rzecz biorąc, DM Series ma na celu uproszczenie wdrażania i zarządzania danymi oraz usprawnienie działania aplikacji korporacyjnych, tj. jest gotowe na przyszłość w zakresie infrastruktury danych.
Oprócz wbudowanej funkcji zarządzania danymi dostępna jest technologia FabricPool Cloud Tiering. Umożliwia ona automatyczne warstwowanie danych na niedrogich warstwach pamięci masowej obiektów S3, zlokalizowanych lokalnie lub w chmurze publicznej. W przeciwieństwie do rozwiązań z ręcznym warstwowaniem, FabricPool automatyzuje warstwowanie danych, aby obniżyć koszty przechowywania. Aktywne dane pozostają na dyskach o wysokiej wydajności, a dane nieaktywne są warstwowane na warstwie pamięci masowej obiektów, zachowując jednocześnie funkcjonalność i wydajność przetwarzania danych DM Series.
FabricPool obsługuje szeroką gamę dostawców chmury publicznej i ich usług przechowywania danych. Należą do nich Amazon S3, Alibaba Cloud Object Storage Service, Microsoft Azure Blob Storage, Google Cloud Storage, IBM Cloud Object Storage oraz chmury prywatne. Klienci skorzystają również z możliwości zachowania wbudowanych funkcji redukcji danych podczas przenoszenia danych do i z chmury. Pozwala to zaoszczędzić na kosztach transportu w przypadku konieczności przeniesienia danych z powrotem do chmury. Dodatkowo, wbudowane szyfrowanie danych chroni dane zarówno podczas przenoszenia do chmury, jak i po jej przeniesieniu. Gwarantuje to brak luk w zabezpieczeniach podczas całego procesu warstwowania w chmurze.
Zasady FabricPool
FabricPool ma dwa główne zastosowania: odzyskiwanie pojemności w pamięci głównej lub zmniejszanie rozmiaru pamięci dodatkowej. W tym artykule skupiamy się na możliwości odzyskiwania pojemności w pamięci głównej. Istnieją trzy różne i unikalne zasady dotyczące warstwowania w chmurze pamięci głównej: automatyczne warstwowanie, tylko migawki i warstwowanie wszystkich warstw.
Przechowywanie rzadko używanych danych związanych z oprogramowaniem biurowym, ukończonymi projektami i starymi zestawami danych w pamięci głównej to nieefektywne wykorzystanie wysokowydajnej pamięci flash. Przenoszenie tych danych do magazynu obiektów to prosty sposób na odzyskanie istniejącej pojemności pamięci flash i zmniejszenie wymaganej pojemności w przyszłości. Zasada automatycznego warstwowania przenosi wszystkie bloki zimne w woluminie do warstwy chmury. W przypadku odczytu losowego, bloki zimnych danych w warstwie chmury stają się gorące i są przenoszone do warstwy lokalnej. W przypadku odczytu sekwencyjnego, takiego jak te związane ze skanowaniem indeksów i antywirusem, bloki zimnych danych w warstwie chmury pozostają zimne i nie są zapisywane w warstwie lokalnej.
Kopie migawek często zużywają ponad 10% typowego środowiska pamięci masowej. Chociaż są niezbędne do ochrony danych i odzyskiwania po awarii, te kopie punktowe są rzadko używane i stanowią nieefektywne wykorzystanie pamięci flash o wysokiej wydajności. Zasada „Tylko-migawkowa” dla puli FabricPool to prosty sposób na odzyskanie miejsca w pamięci flash. Podczas naszych testów, zasada „Tylko-migawkowa” była używana do testowania operacji warstwowania w chmurze. Bloki zimnych migawek w woluminie, które nie są współdzielone z aktywnym systemem plików, są przenoszone do warstwy chmury. W przypadku odczytu, zimne bloki danych w warstwie chmury stają się gorące i są przenoszone do warstwy lokalnej.
Jednym z najczęstszych zastosowań FabricPool jest przenoszenie całych wolumenów danych do chmury. Ukończone projekty, starsze raporty lub archiwa to idealne kandydatury do przeniesienia do niedrogiej pamięci masowej. Przenoszenie całych wolumenów odbywa się poprzez ustawienie polityki „All Tiering Policy” na woluminie. Polityka ta jest używana głównie w przypadku danych dodatkowych i woluminów ochrony danych. Można jej jednak również użyć do warstwowania wszystkich danych w woluminach do odczytu/zapisu.
Dane w wolumenach korzystających z polityki All Tiering są natychmiast oznaczane jako „zimne” i przesyłane do chmury tak szybko, jak to możliwe. Nie trzeba czekać na minimalną liczbę dni, zanim dane zostaną „zimne” i przeniesione do chmury. Po odczytaniu, bloki danych „zimnych” w warstwie chmury pozostają „zimne” i nie są zapisywane z powrotem do warstwy lokalnej.
Czwarta opcja polityki warstwowania jest również dostępna w Lenovo i trafnie nazywa się polityką warstwowania „Brak”. Dzięki tej polityce żadne dane nie są warstwowane, co pozwala na przechowywanie wszystkiego w pamięci flash. Dobrym przykładem jej zastosowania są migawki w środowiskach DevOps, gdzie często wykorzystywane są poprzednie kopie z określonego punktu w czasie.
Konfiguracja warstwowania chmury pamięci masowej Lenovo
Aby przetestować możliwości i niektóre funkcje rozwiązania pamięci masowej Lenovo przeznaczonego do pracy w chmurze, w naszym laboratorium zainstalowaliśmy model DM7000F.
Najpierw utworzyliśmy kontener pamięci masowej, korzystając z Azure Blob Storage – naszego rozwiązania chmurowego na potrzeby tego testu. Warto również zwrócić uwagę na szeroki wachlarz dostępnych opcji Lenovo, takich jak Alibaba Cloud, Amazon S3, Google Cloud, IBM Cloud i inne. Celem testu było wykorzystanie Microsoft Azure Blob Storage dla chmury jako warstwy chmury dla FabricPool. Po zakończeniu konfiguracji pamięci masowej w chmurze nadszedł czas na zalogowanie się do interfejsu graficznego DM7000.
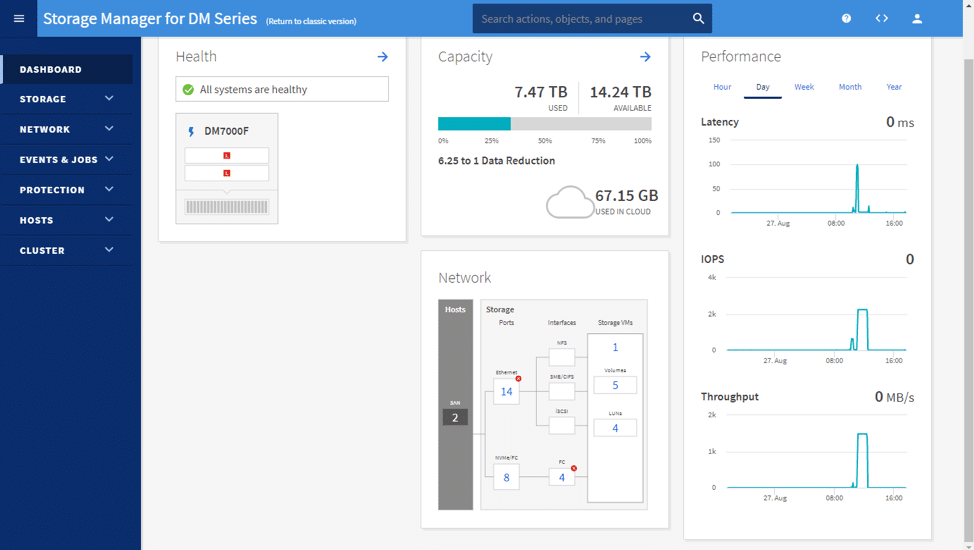
Po zalogowaniu pojawi się domyślna strona Panelu. Panel wyświetla informacje o stanie, pojemności, wydajności i sieci danej macierzy.
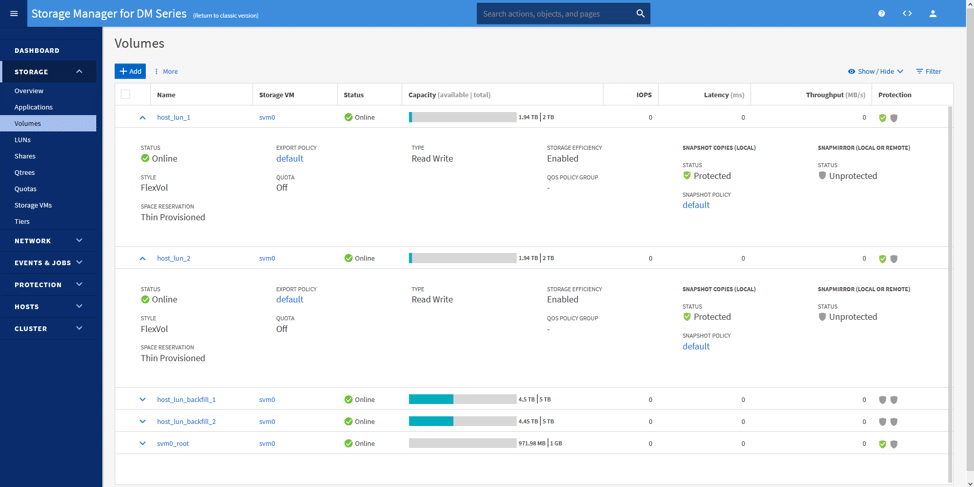
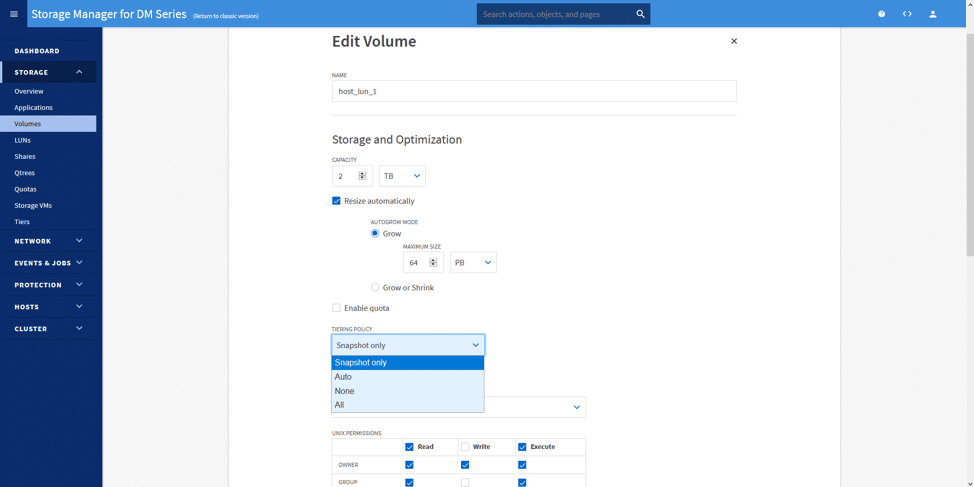
Następnie utworzyliśmy dwa woluminy (po jednym na kontroler) i dwie maszyny wirtualne (po jednej na każdy wolumin). Plan zakładał uruchomienie tych maszyn wirtualnych, a następnie pozostawienie ich na jakiś czas w stanie bezczynności. Poniższy obraz przedstawia użyte woluminy: host_lun_1 i host_lun_2.
Podczas edycji lub tworzenia woluminu możemy wybrać żądaną politykę warstwowania. W tym przypadku wybraliśmy opcję „Tylko migawka”. Po wybraniu tej polityki warstwowania nasze dane (postrzegane jako „zimne” po każdej migawce) są przesyłane do magazynu Azure Blob Storage tworzonego w interwale w tle. Interwał działa w swoim własnym tempie, przewidując, kiedy obciążenia będą najmniej obciążone.
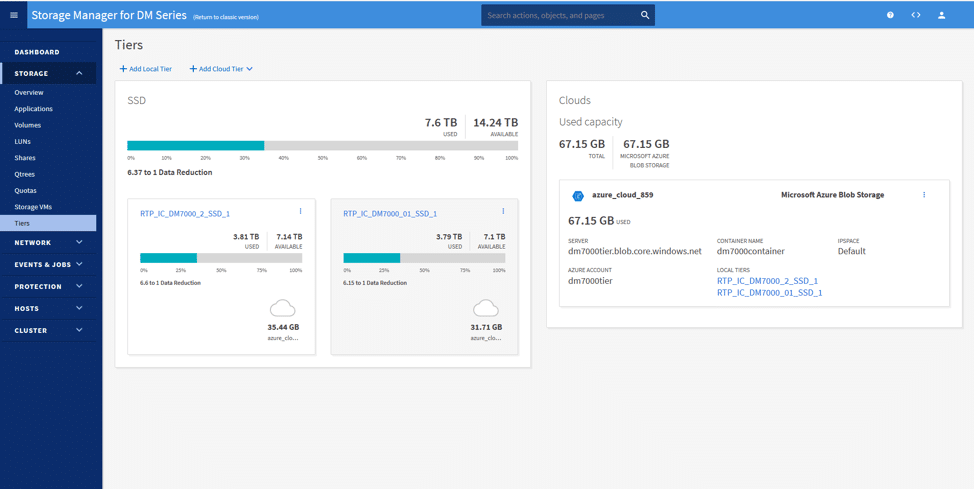
Na stronie „Tiers” możemy dodać warstwę chmury z chmur publicznych. Tutaj dołączyliśmy zasób Azure Blob Storage i połączyliśmy go z dwoma lokalnymi warstwami pamięci masowej. Na poniższym obrazku widać dwa zasoby podłączone do platformy Azure.
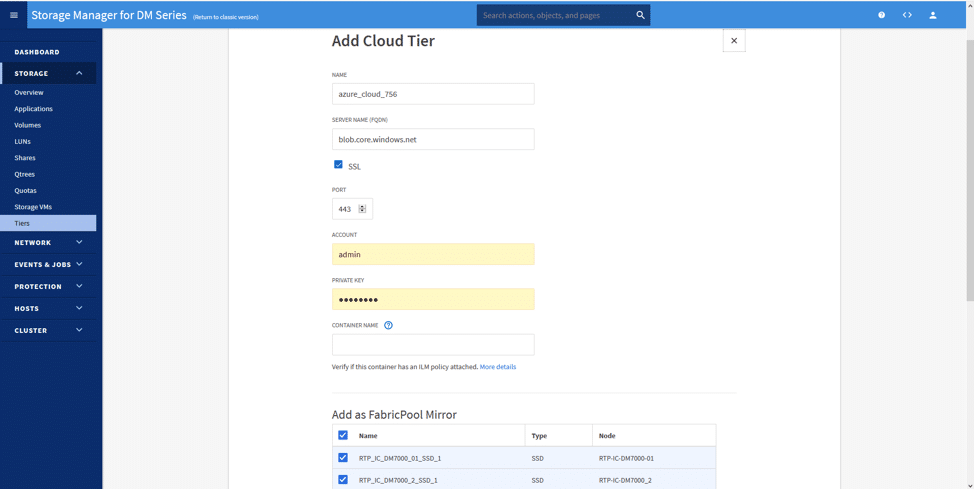
Konfiguracja jest prosta; klikając Dodaj warstwę chmury i wybierając żądaną chmurę (w tym przypadku Azure), możemy natychmiast skonfigurować warstwę chmury.
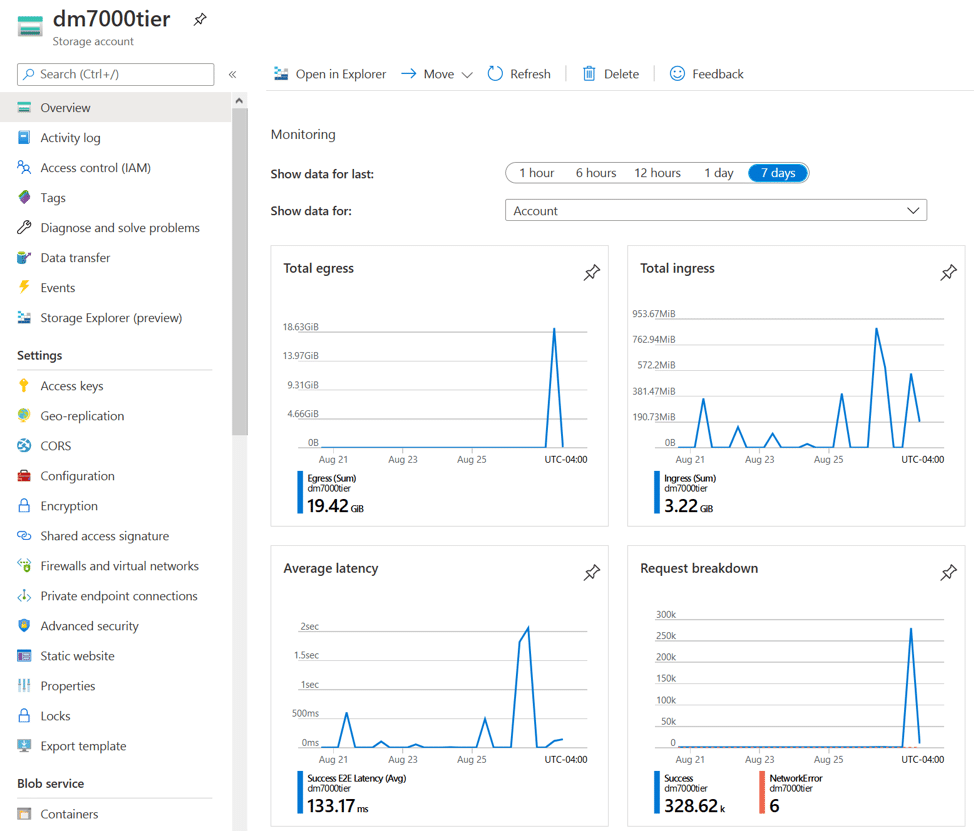
Na koniec, na pulpicie nawigacyjnym naszego konta usługi Azure Storage, chcieliśmy pokazać zarówno dane przychodzące do platformy Azure (dane przychodzące), jak i wychodzące (dane wychodzące). Małe szczyty wyświetlane każdego dnia to nowe migawki danych przesyłanych do platformy Azure. Z kolei szczyty danych wychodzących pokazują dane wychodzące, ilustrując przywracanie migawki z woluminu w celu wycofania.
Uwagi końcowe
Ogólnie rzecz biorąc, chmura i zarządzanie danymi to szeroki, ewoluujący temat wśród przedsiębiorstw. Lenovo chce oferować klientom rozwiązania, które przygotują ich na zmieniające się potrzeby, zarówno w centrum danych, jak i w środowiskach chmury hybrydowej. W StorageReview jesteśmy pod wrażeniem podejścia Lenovo do macierzy pamięci masowej. Dzięki tej ocenie przekonaliśmy się, jak działa warstwowanie danych w chmurze z poziomu oprogramowania Storage Manager dla serii DM oraz jak cenna pojemność pamięci flash jest odzyskiwana lub rozszerzana w chmurze. Co ważne, system pamięci masowej DM7000F zapewnia tę elastyczność bez konieczności wprowadzania zmian w infrastrukturze. Co więcej, funkcjonalność jest łatwa do wdrożenia.
Dzięki wsparciu DCG i IDG, Lenovo zajmuje silną pozycję na rynku pamięci masowej. Ich rozwiązania pamięci masowej pozwalają klientom kupować to, czego potrzebują dzisiaj, jednocześnie wykorzystując chmurę, aby sprostać rosnącym wymaganiom dotyczącym danych w przyszłości. W rezultacie, warstwowanie chmury Lenovo obniży koszty i zapewni firmom pożądaną elastyczność przy rozważaniu inwestycji w pamięć masową.
Macierze pamięci masowej Lenovo ThinkSystem serii DM
Niniejszy raport jest sponsorowany przez Lenovo. Wszystkie poglądy i opinie wyrażone w niniejszym raporcie opierają się na naszej obiektywnej ocenie rozpatrywanych produktów.


 Amazon