

NVIDIA DGX Spark stanowi przełomowy moment w dostępnej infrastrukturze AI. W 2017 roku przełomowy artykuł „Attention is All You Need” („Uwaga to wszystko, czego potrzebujesz”), który przedstawił architekturę Transformer, opierał się na konfiguracji serwera P100 z ośmioma procesorami GPU, zużywając dziesiątki kilowatogodzin i zajmując znaczną powierzchnię w centrach danych. Obecnie DGX Spark oferuje doskonałą wydajność obliczeniową w kompaktowej, 240-watowej obudowie typu desktop. Ta radykalna ewolucja w zakresie energooszczędności i kompresji formatu sprawia, że możliwości AI, wcześniej dostępne wyłącznie w centrach danych, są dostępne dla indywidualnych badaczy, małych zespołów i rozproszonych organizacji programistycznych.
Cechą wyróżniającą Spark na tle poprzednich rozwiązań AI dla komputerów stacjonarnych jest kompleksowe podejście do pełnego cyklu rozwoju. Zamiast wymuszać kompromisy między eksperymentowaniem, dostrajaniem i wdrażaniem, Spark zapewnia rzeczywiste możliwości na wszystkich etapach. Zunifikowana architektura pamięci o pojemności 128 GB umożliwia pełne dostrajanie parametrów modeli, co na konwencjonalnych stacjach roboczych wymagałoby zasobów chmurowych, zapewniając jednocześnie przepustowość rzędu setek tokenów na sekundę, odpowiednią do obciążeń wnioskowania wsadowego, w tym generowania danych syntetycznych. Zastosowanie sieci ConnectX-7 z przepustowością 200 Gb/s oznacza, że organizacje mogą klastrować wiele systemów Spark w celu jeszcze większej eksploracji modeli, choć, jak pokażemy, nawet pojedyncza jednostka okazuje się niezwykle wydajna.
Na wynos
Moc centrum danych zamknięta w komputerze stacjonarnym : GB10 Grace Blackwell w obudowie o pojemności 1.13 litra i mocy 240 W, w cenie 3,999 USD, oferującej wydajność do 1 petaFLOP FP4 w trybie rozrzedzonym.
Pamięć, która zmienia przepływy pracy : 128 GB zunifikowanej pamięci umożliwia pełne, lokalne dostrajanie parametrów modeli 8B i wnioskowanie o wysokiej przepustowości. Podczas testów Llama 3.1 8B FP4 osiągnęła ~924 tok/s przy 128 współbieżnościach, a Qwen3 Coder 30B-A3B FP8 osiągnął ~483 tok/s w partii 64.
Gotowy do skalowania i szybkiego podłączania pamięci masowej : Zintegrowany ConnectX-7 zapewnia przepustowość 200 Gb/s do klastrowania lub NVMe-oF. Wewnętrzny moduł 2242 Gen5 NVMe jest wygodny, ale ma ograniczenia w przypadku dużego obciążenia wejścia/wyjścia, dlatego zewnętrzny moduł NVMe-oF przez RDMA to lepsza ścieżka do utrzymania stałej przepustowości.
Oprogramowanie gotowe do użycia od pierwszego dnia : dostarczane z systemem operacyjnym DGX OS, CUDA, cuDNN, TensorRT, AI Workbench, kontenerami i podręcznikami przepływu pracy, dzięki czemu zespoły mogą od razu uruchamiać rzeczywiste obciążenia.
Sprawdzona wydajność w warunkach rzeczywistych : MAMF zmierzył ~99.8 TFLOP-ów w modelu BF16 i ~207.7 TFLOP-ów w modelu FP8. Odczyty GDSIO osiągnęły szczyt ~11.4 GiB/s wewnętrznie, przy czym wyższy limit oczekiwano w przypadku struktury 200G.
Czym jest DGX Spark i kto powinien się nim zainteresować?
NVIDIA DGX Spark to zasadniczo kompletna platforma do rozwoju sztucznej inteligencji (AI), a nie tylko komponent GPU. Jej sercem jest układ GB10 Grace Blackwell Superchip, który integruje architekturę GPU Blackwell z rdzeniami Tensor piątej generacji z 20-rdzeniowym procesorem ARM (10x Cortex-X925 + 10x Cortex-A725) połączonym za pomocą protokołu NVLink-C2C. Ta spójna architektura połączeń, według firmy NVIDIA, zapewnia nawet 5-krotnie większą przepustowość w porównaniu z PCIe Gen 5, tworząc ujednoliconą infrastrukturę obliczeniową zamiast oddzielnych domen przetwarzania.
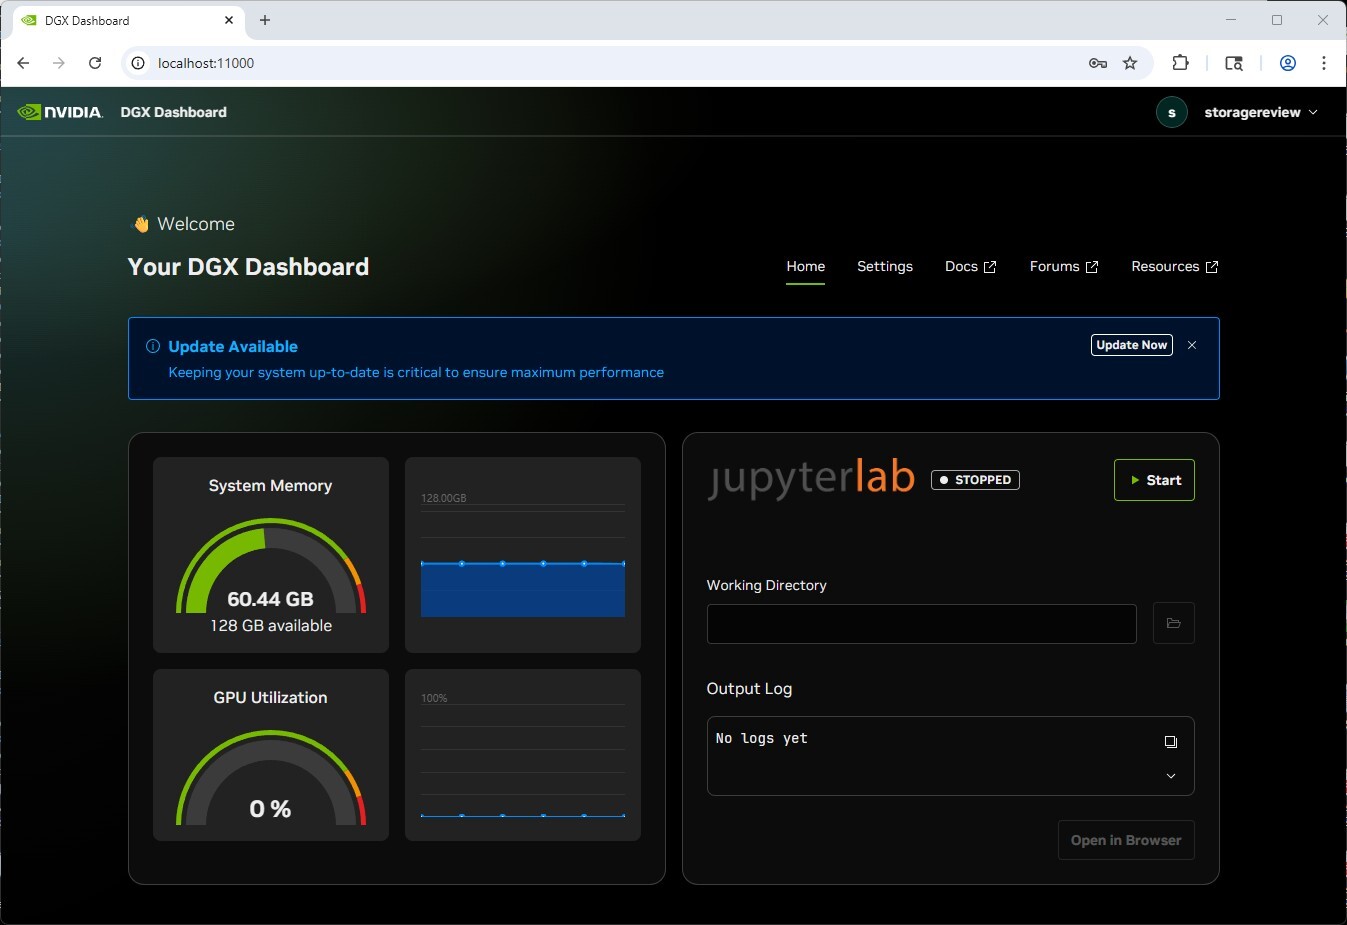
Aby ułatwić użytkownikom rozpoczęcie pracy, NVIDIA dostarcza system operacyjny DGX OS oparty na Ubuntu Desktop z kompletnym, wstępnie skonfigurowanym stosem oprogramowania AI, obejmującym CUDA, cuDNN, TensorRT, środowisko uruchomieniowe kontenerów NVIDIA i AI Workbench, eliminując typowe problemy ze sterownikami i narzut związany z konfiguracją środowiska, które występują w przypadku niestandardowych konfiguracji stacji roboczych. System oferuje elastyczne paradygmaty wdrożenia: wystarczy podłączyć urządzenia peryferyjne i używać go jako kompaktowej stacji roboczej z pełnym środowiskiem pulpitu Ubuntu lub wdrożyć jako bezobsługowe urządzenie sieciowe dostępne za pośrednictwem NVIDIA Sync, co zapewnia bezproblemową integrację z JupyterLab, VS Code, środowiskiem IDE Cursor i terminalami SSH.
To infrastruktura stworzona specjalnie dla specjalistów AI, badaczy dopracowujących modele językowe, analityków danych przyspieszających przepływy pracy RAPIDS, programistów wdrażających systemy agentowe oraz zespołów eksperymentujących z architekturami z modelami ablacyjnymi na małą skalę. Spark jest skierowany do profesjonalistów, którzy potrzebują poważnych możliwości obliczeniowych AI bez konieczności stosowania skomplikowanych rozwiązań w centrach danych.
Specyfikacja techniczna NVIDIA DGX Spark
| Specyfikacja | Szczegóły |
|---|---|
| Architektura | |
| GPU | Architektura NVIDIA Blackwell |
| CPU | 20-rdzeniowy procesor Arm (10x Cortex-X925 + 10x Cortex-A725) |
| Rdzenie tensora | 5th Generation |
| Rdzenie RT | 4th Generation |
| NVENC / NVDEC | 1×/1× |
| Pamięć | |
| Pamięć systemowa | 128 GB LPDDR5X (zunifikowana pamięć systemowa) |
| Interfejs pamięci | 256-bit |
| Przepustowość pamięci | 273 Gb / s |
| Wydajność | |
| FP4 | do 1 petaFLOP (z Sparsity) |
| Dyski | |
| Dyski | 1 TB lub 4 TB NVMe M.2 (samoszyfrujące) |
| Łączność | |
| USB | 4× USB 3.2 typu C Gen 2×2 (20 Gb/s) |
| Ethernet | 1× 10GbE RJ-45 |
| NIC | Karta sieciowa ConnectX-7 Smart NIC – 2x 200G QSFP (maksymalna przepustowość 200G) |
| Bezprzewodowy | Wi-Fi 7, Bluetooth 5.3 |
| Wyjście audio | Wyjście audio wielokanałowe HDMI |
| Złącza wyświetlacza | 1× HDMI 2.1a |
| Mechaniczny | |
| Wymiary | 150 × 150 × 50.5 mm (5.9 × 5.9 × 1.98 cala) |
| Waga | 1.2 kg |
| Pobór energii | W 240 |
Projekt i budowa NVIDIA DGX Spark
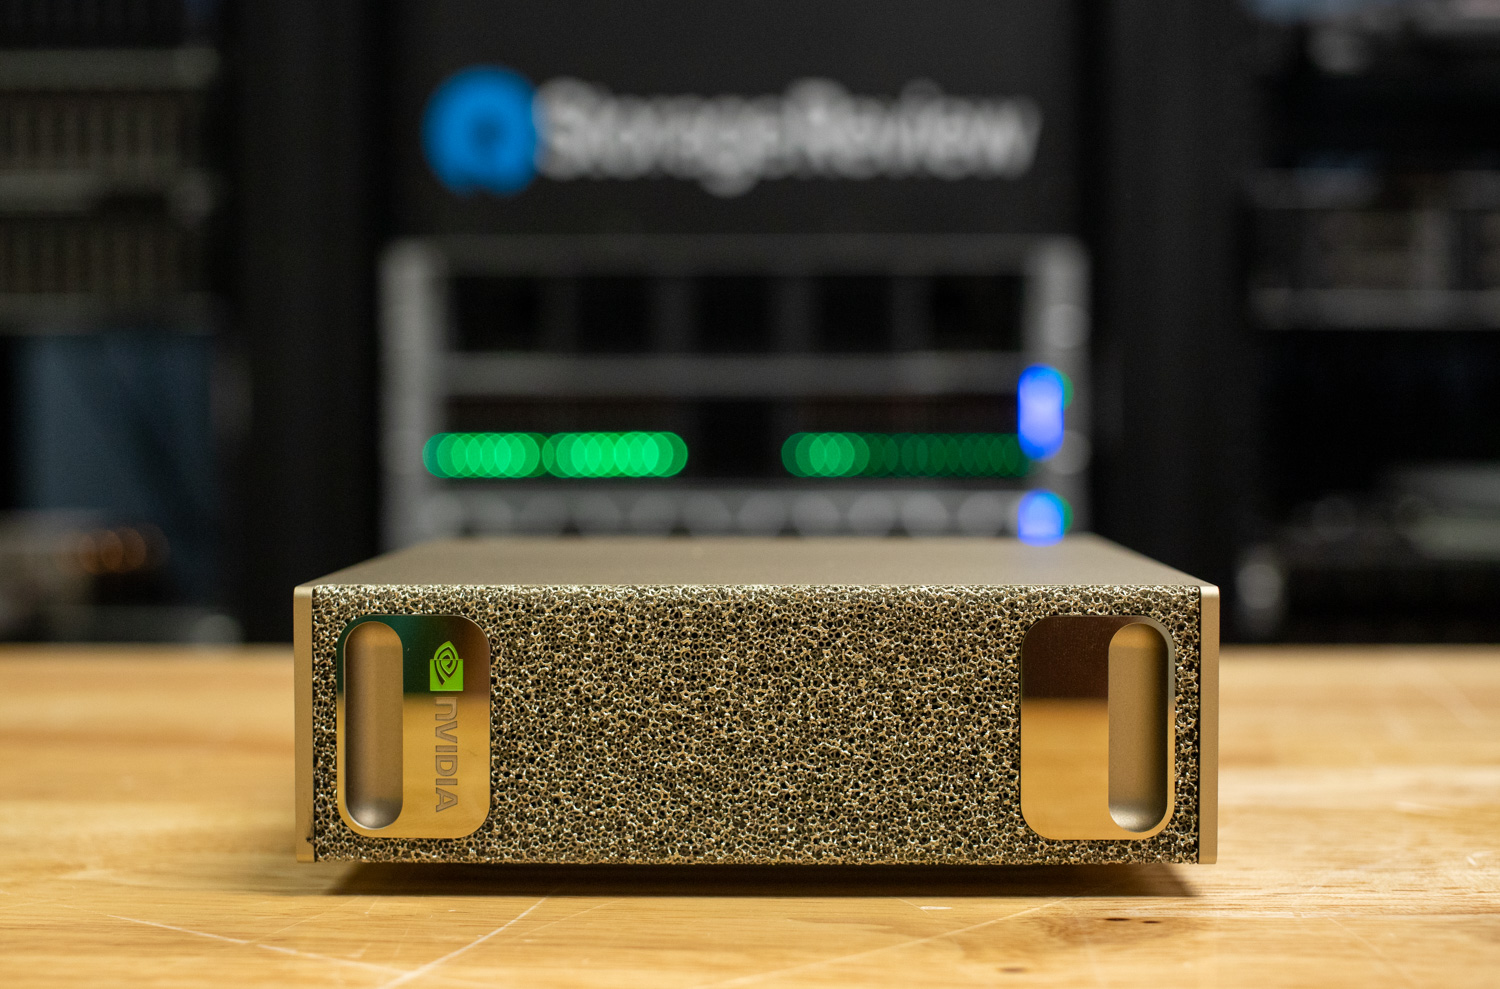
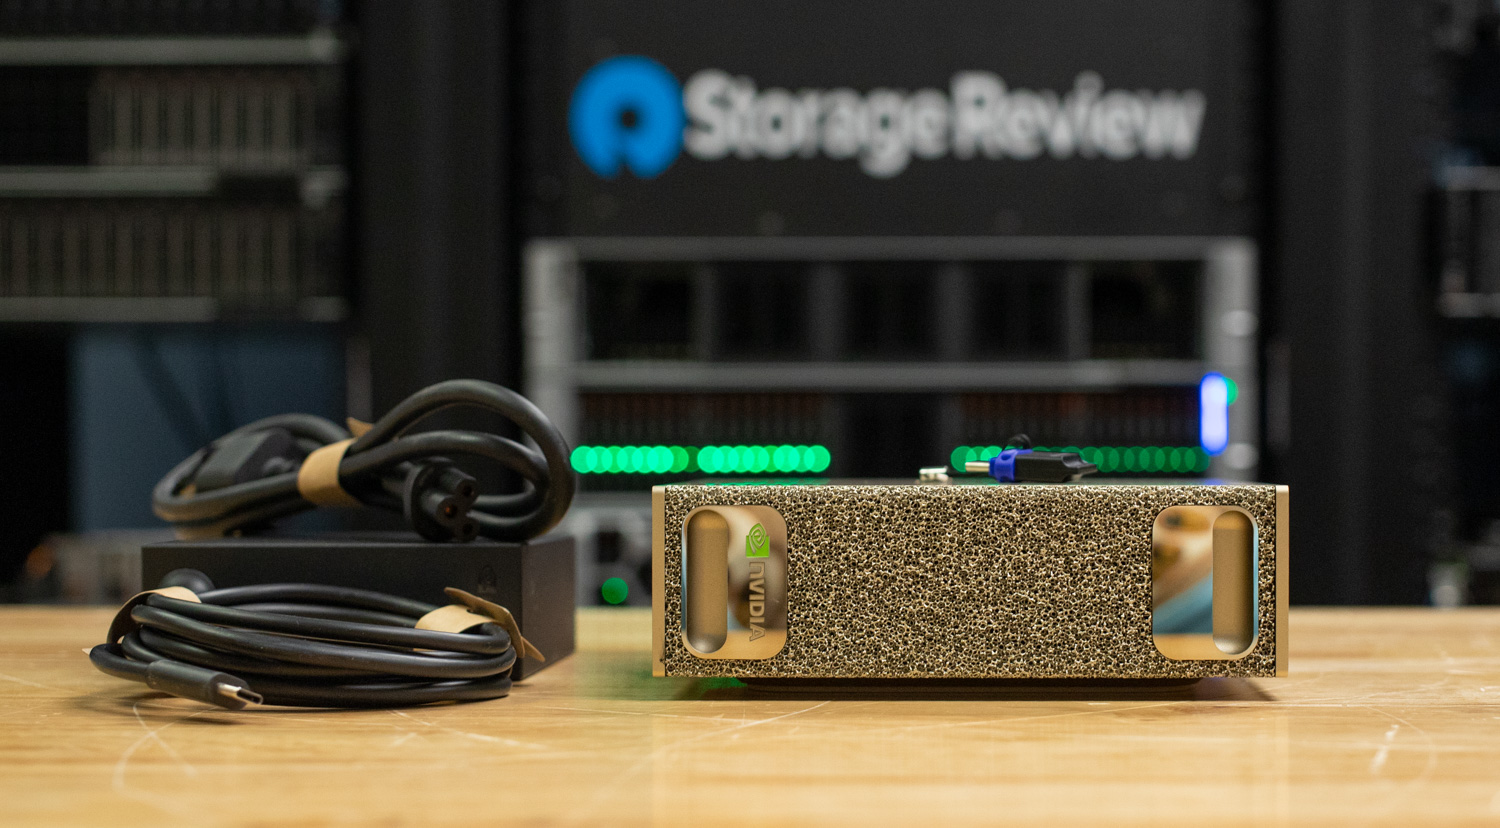
NVIDIA DGX Spark kontynuuje niepowtarzalny styl wzornictwa przemysłowego firmy NVIDIA, charakteryzując się kompaktową obudową, która wyglądem i funkcjonalnością nawiązuje do większych systemów DGX. Panel przedni wyróżnia się miniaturowymi wycięciami na dłonie, nawiązaniem do uchwytów z oryginalnych, pełnowymiarowych jednostek DGX, a metaliczne wykończenie w złote kropki nadaje mu wyrafinowaną, wysokiej jakości fakturę, podkreśloną kultowym zielonym logo NVIDIA.
Pod względem fizycznym DGX Spark ma wymiary 5.9 × 5.9 × 1.98 cala (150 × 150 × 50.5 mm) i waży 2.6 funta (1.2 kg), co daje całkowitą objętość wewnętrzną 1.13 litra. To plasuje go zdecydowanie w klasie komputerów o małym współczynniku kształtu i pojemności 1 litra. Pomimo niewielkich rozmiarów, system sprawia wrażenie gęstego i wytrzymałego dzięki obudowie wykonanej w całości ze stopu metalu, która pełni również funkcję pasywnego rozpraszacza ciepła, zachowując jednocześnie spójność formy i funkcjonalności.
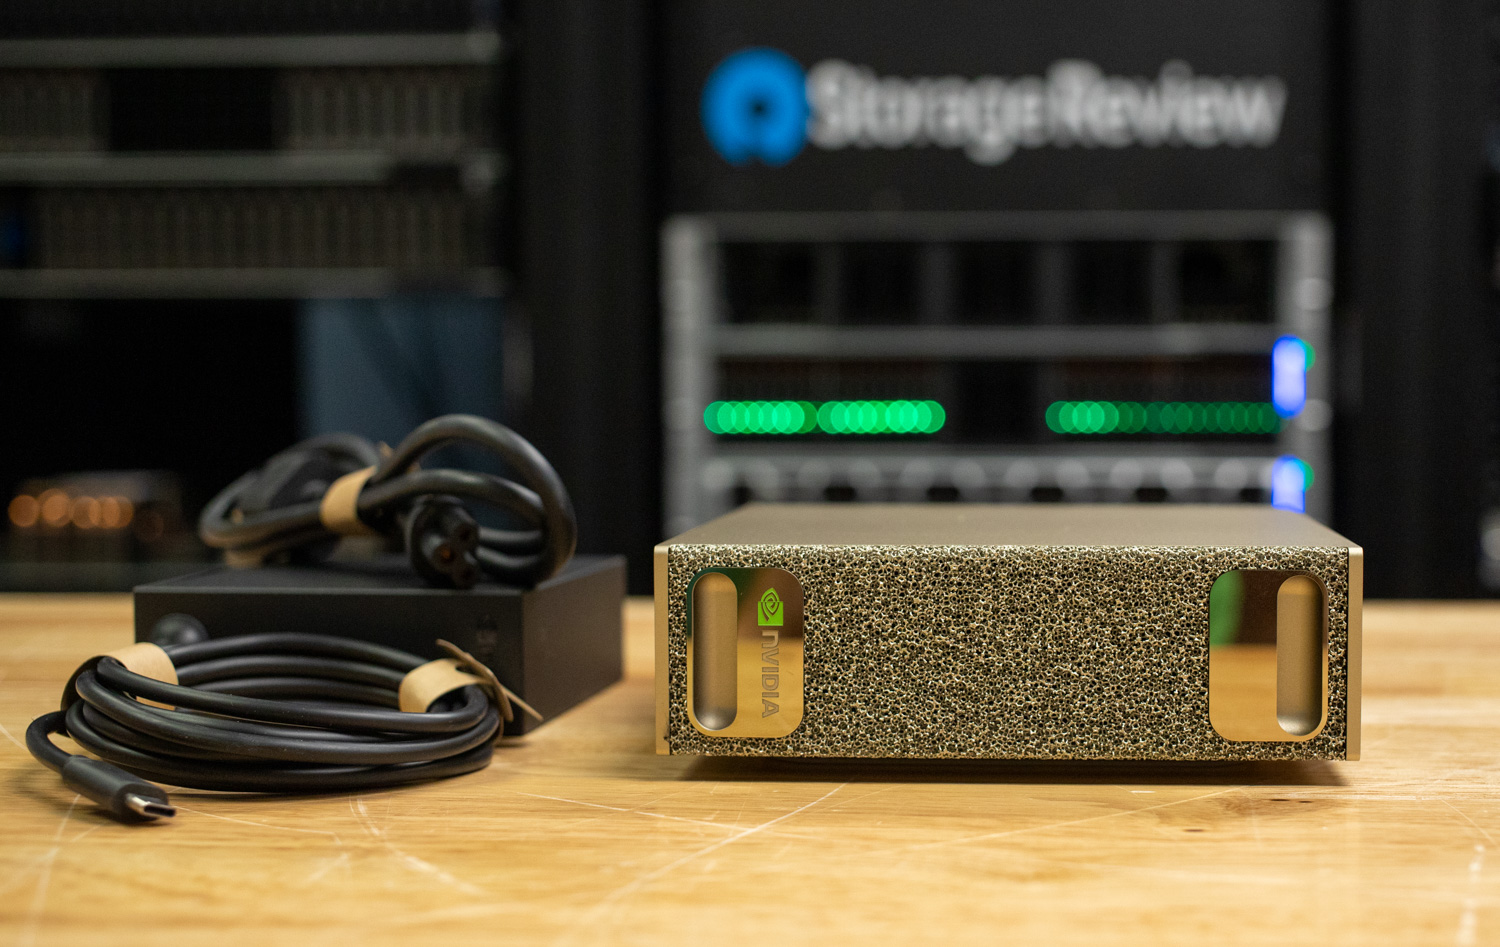
Zasilanie zapewnia zewnętrzny zasilacz USB-C o mocy 240 W, widoczny obok jednostki głównej na zdjęciu. Zasilacz jest kompaktowy i solidnie wykonany, wykorzystuje standardowe złącze C5 (koniczynka) do wejścia AC i pasuje do czystej, wydajnej konstrukcji DGX Spark.
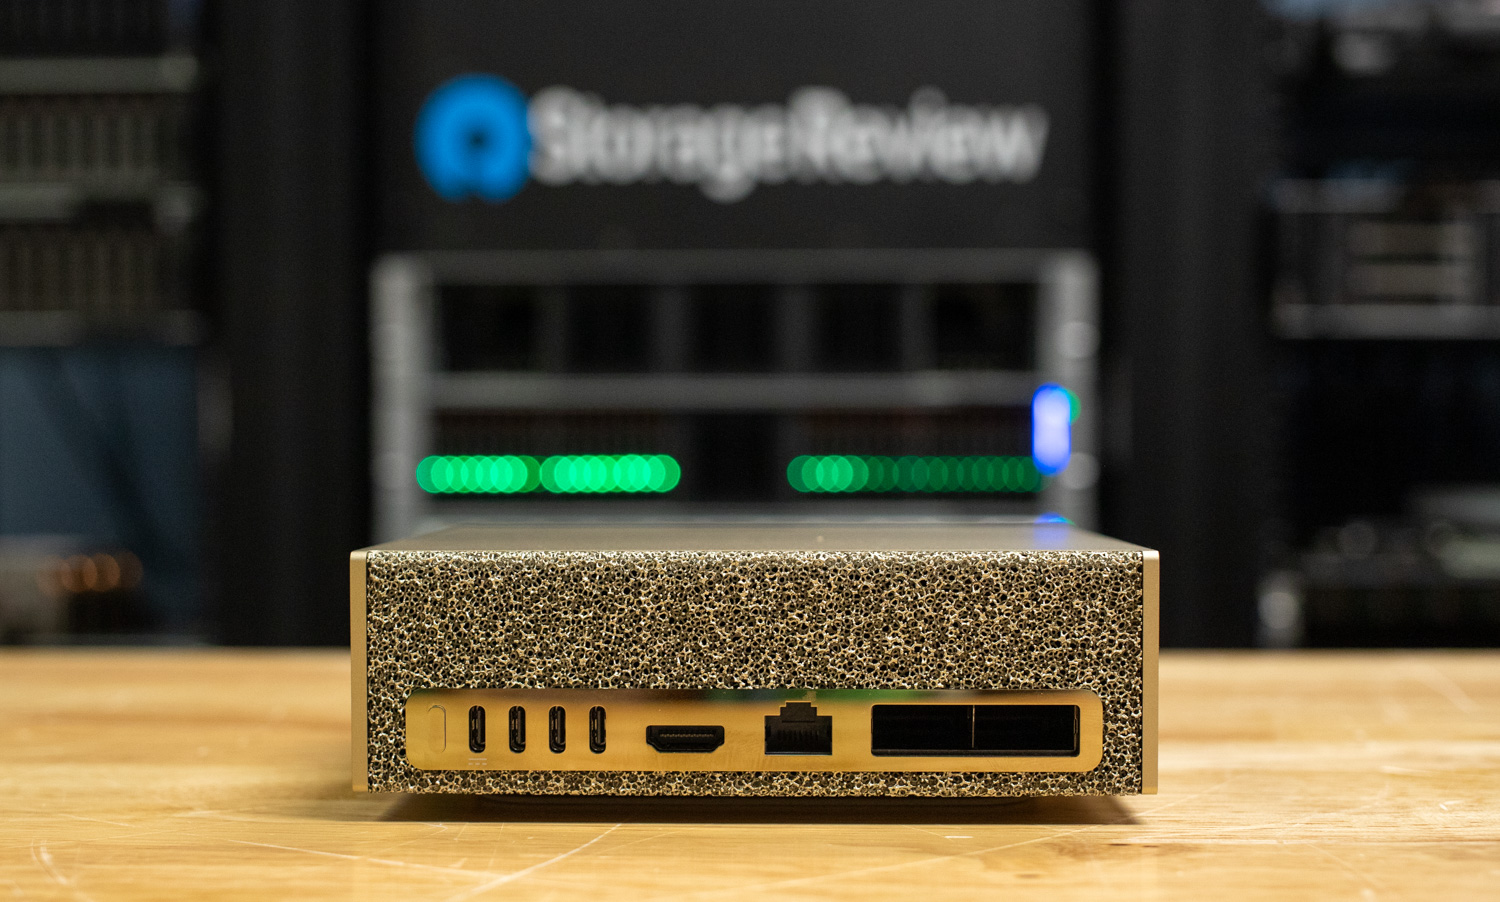
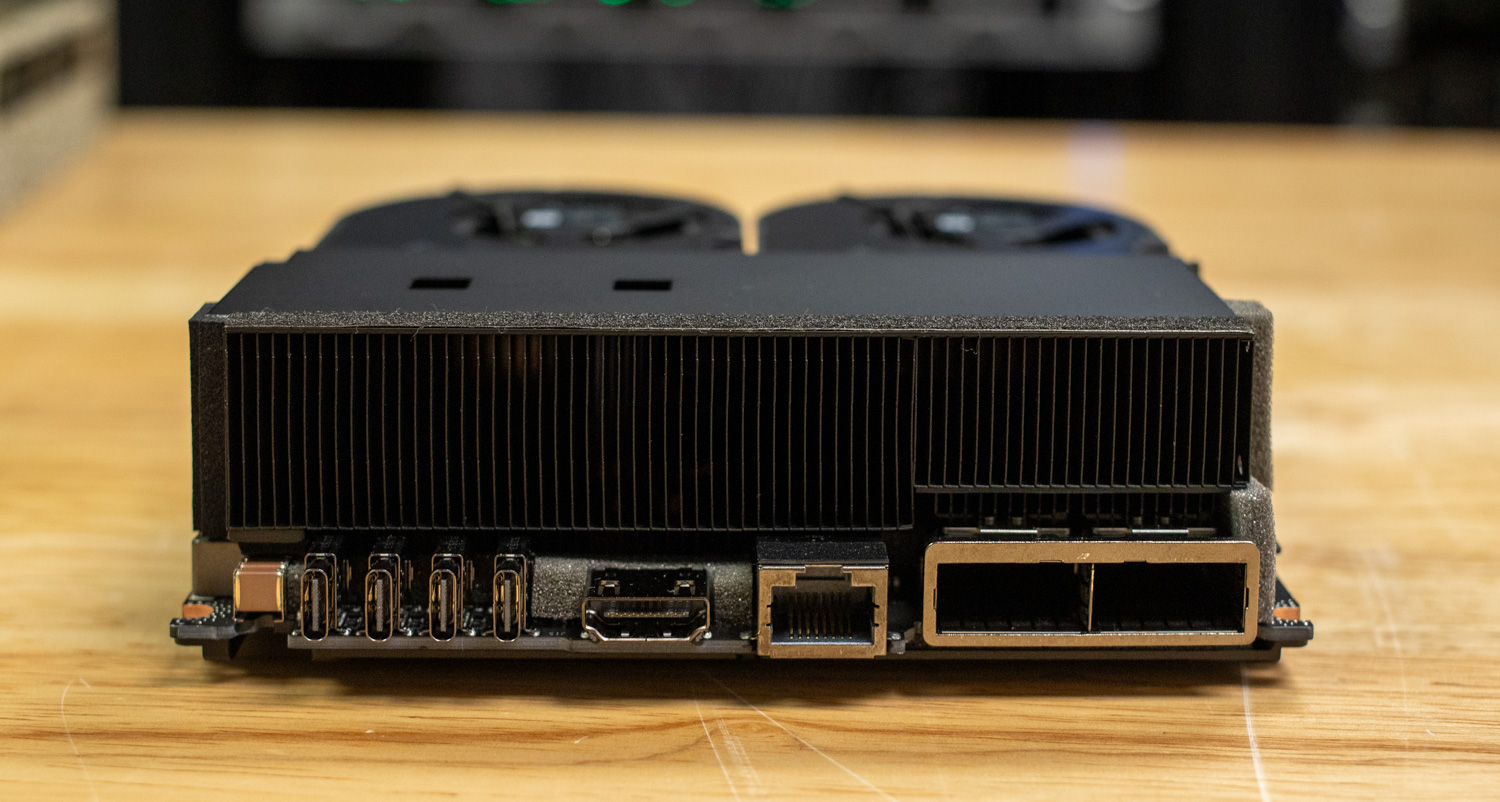
Patrząc na tył, DGX Spark prezentuje tę samą teksturowaną, złotą powierzchnię, co przód, zachowując spójny design całej obudowy. Zaczynając od lewej strony, przycisk zasilania znajduje się obok czterech portów USB-C, z których jeden odpowiada za zasilanie urządzenia. Dalej znajduje się pojedyncze wyjście HDMI 2.1a, port RJ-45 10 GbE, a tym, co czyni to urządzenie interesującym, są dwa interfejsy QSFP56 200 GbE, obsługiwane przez zintegrowaną kartę sieciową NVIDIA ConnectX-7 SmartNIC.
Na pierwszy rzut oka można by wnioskować, że Spark oferuje łączność 400 Gb/s; niestety, ze względu na ograniczenia PCIe, Spark oferuje łączność tylko 200 Gb/s. Chcąc dowiedzieć się więcej, zagłębiliśmy się w topologię Sparka:
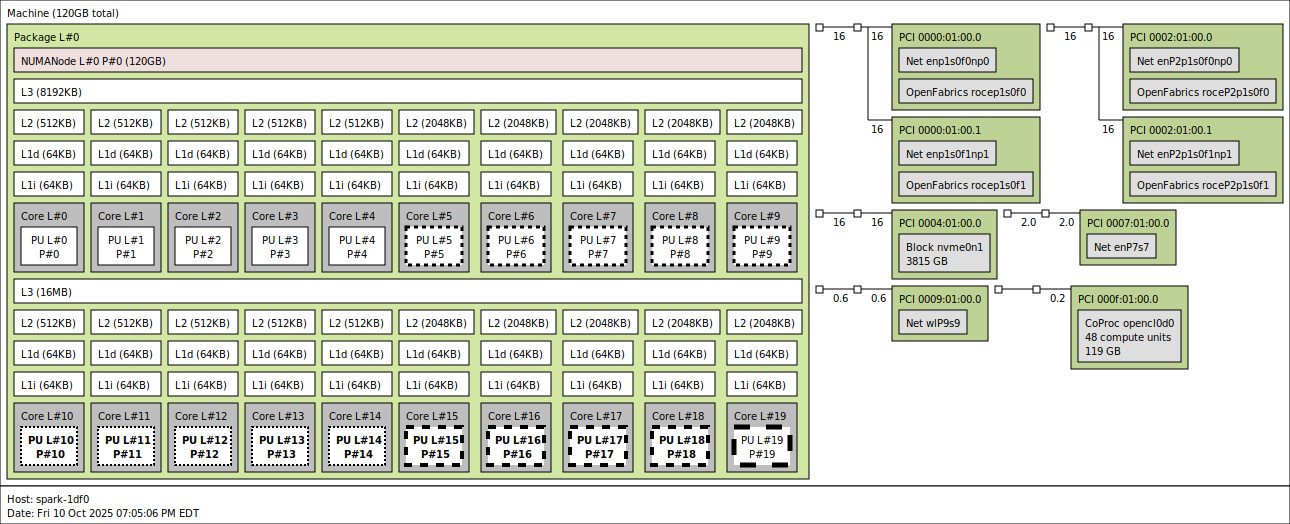
Za pomocą lstopo obserwujemy dwa połączenia międzysystemowe z karty sieciowej CX7. Elektrycznie CX7 jest połączony dwoma łączami Gen5 x4. W systemie operacyjnym połączenia te są widoczne jako cztery interfejsy, z których każdy obsługuje maksymalną przepustowość 200 Gb/s. Ze względu na ograniczony czas testów nie byliśmy w stanie odkryć wszystkich osobliwości sieciowych tej platformy poza naszymi testami NVMe-oF, które zostaną szczegółowo opisane w dalszej części artykułu. Planujemy jednak dokładniej zbadać tę platformę i opublikujemy kolejne artykuły, które dogłębniej omówią jej możliwości, takie jak grupowanie wielu urządzeń Spark w miniklaster.
Jeśli chodzi o inne podłączone urządzenia, następnym w kolejności jest niewielki dysk SSD M.2 o formacie 2242 podłączony do łącza Gen5 x4, a następnie kontroler Realtek RJ45 10GbE podłączony do łącza PCIe Gen4 x1 i kontroler MediaTek Wi-Fi podłączony do łącza PCIe Gen3 x1.
Przechodząc do szczegółów procesora, Spark zawiera 20-rdzeniowy procesor Arm o heterogenicznej architekturze Big Little, podobnej do najnowszych procesorów Intela, składającej się z 10 rdzeni Cortex-A725 o wysokiej wydajności i 10 rdzeni Cortex-X925 o wysokiej wydajności, podzielonych na dwa klastry pamięci podręcznej L3. Pierwszy klaster (8 MB L3) zawiera procesory 0-4 (Cortex-A725, maks. 2808 MHz) i 5-9 (Cortex-X925, maks. 3900 MHz), natomiast drugi klaster (16 MB L3) zawiera procesory 10-14 (Cortex-A725, maks. 2860 MHz) i 15-19 (Cortex-X925, maks. 3978-4004 MHz). Każdy rdzeń ma prywatną pamięć podręczną L1 o pojemności 64 KB danych i 64 KB instrukcji L1, ale pamięć podręczna L2 różni się znacząco w zależności od typu rdzenia: rdzenie Cortex-A725 o wysokiej wydajności mają 512 KB pamięci podręcznej L2, podczas gdy rdzenie Cortex-X925 o wysokiej wydajności mają znacznie większą pamięć podręczną L2 o pojemności 2 MB (4-krotnie większą). Najszybszymi rdzeniami są procesory CPU 15–19, które korzystają zarówno z większej pamięci podręcznej L3 o pojemności 16 MB, jak i wyższych częstotliwości, przy czym procesor CPU 19 jest rdzeniem o szczytowej wydajności, taktowanym zegarem 4004 MHz. Te różne poziomy mocy/częstotliwości są oznaczone liniami przerywanymi na rdzeniu w powyższej topologii.
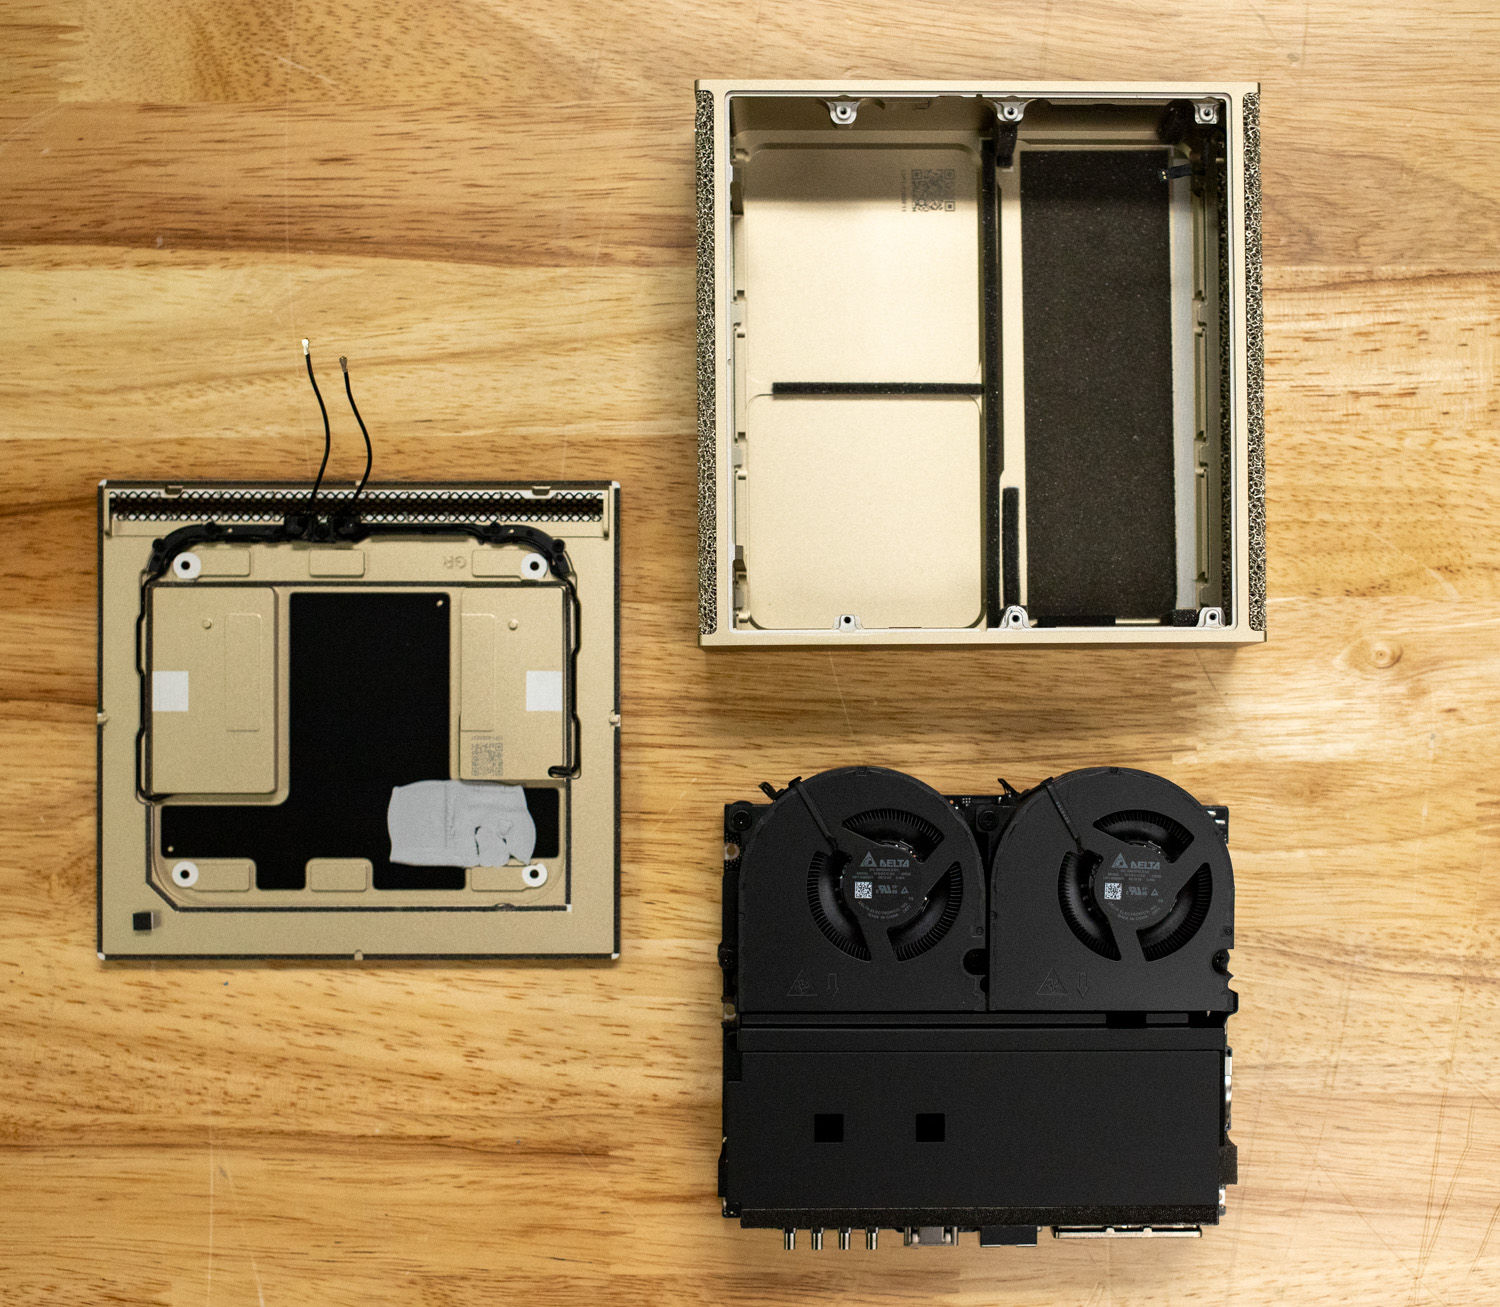
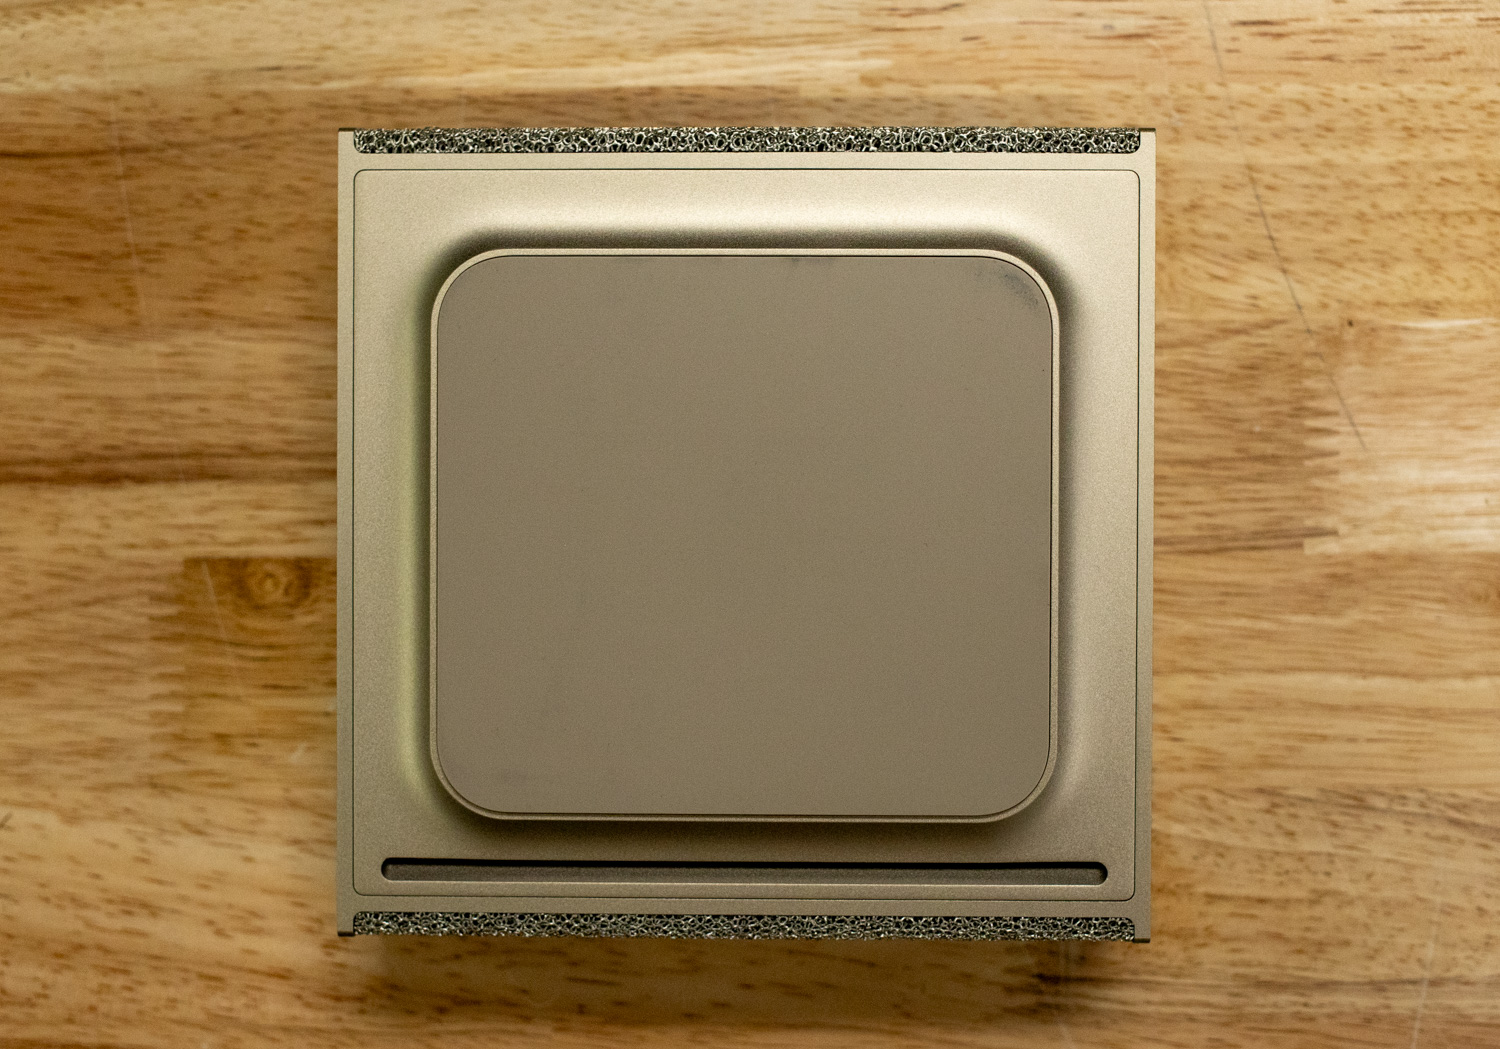
Oddalając się, odwracamy DGX Spark; jedynym widocznym plastikowym elementem jest pokrywa dolna, która mocowana jest magnetycznie do spodu obudowy. Taka konstrukcja pozwala zachować czystość obudowy, a jednocześnie umożliwia szybki dostęp do podzespołów wewnętrznych. Po zdjęciu magnetycznej podstawy odsłaniają się cztery śrubki, umożliwiające dostęp do głównej komory wewnętrznej.
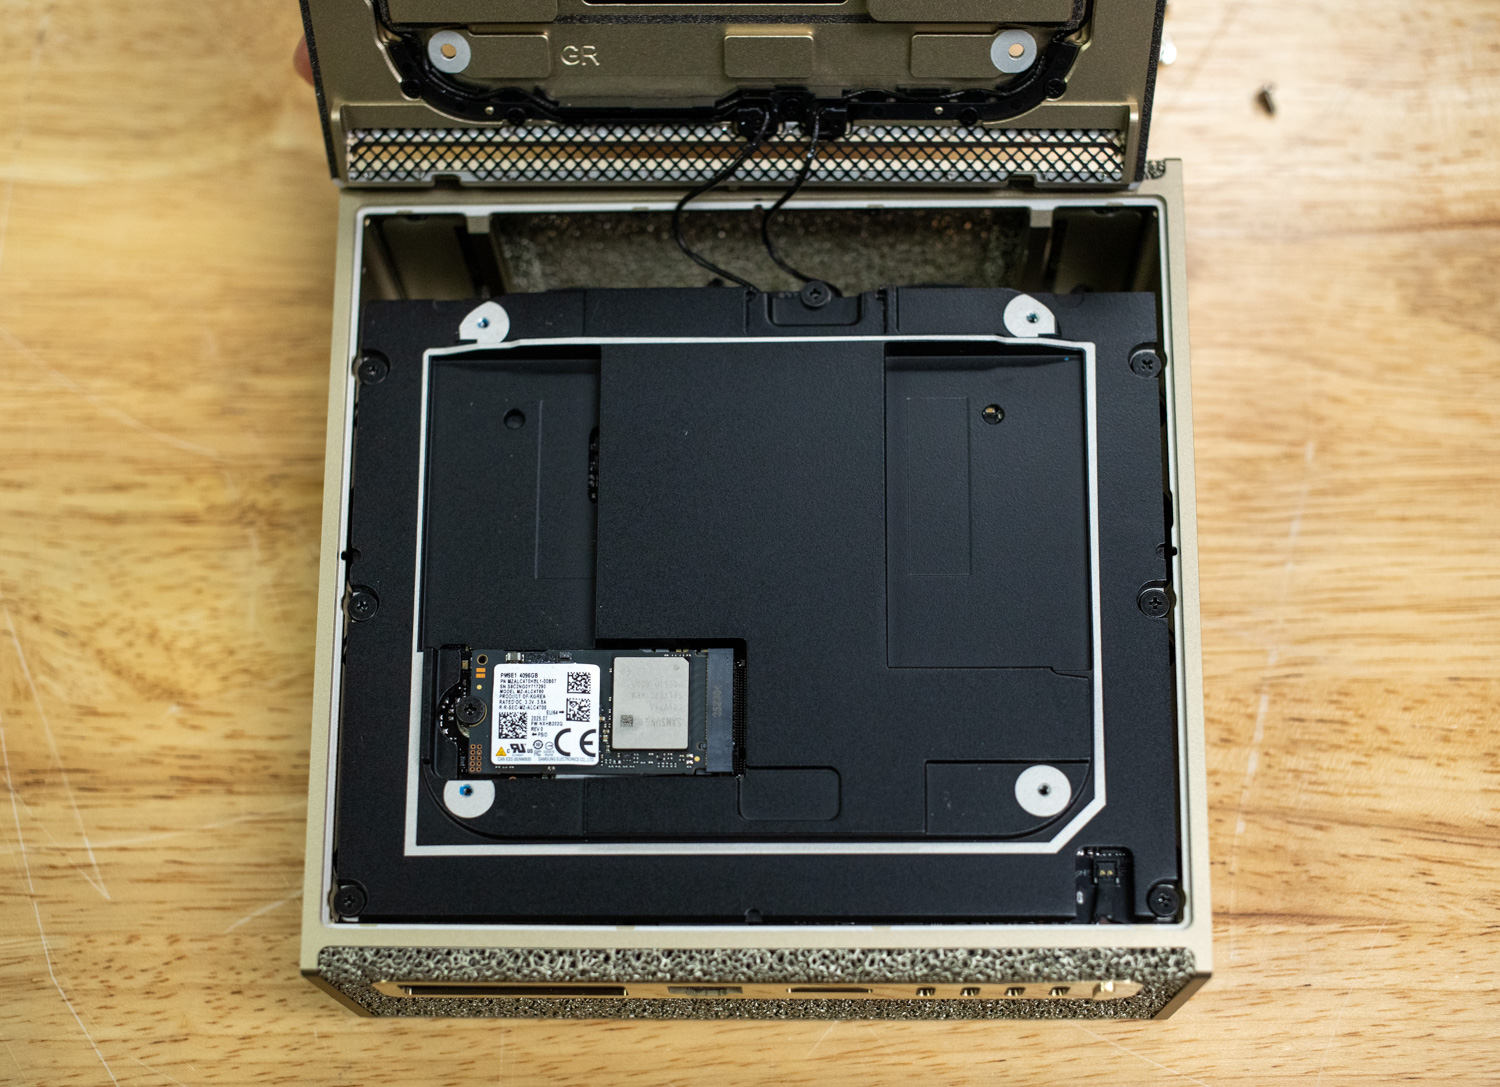
Wewnątrz widzimy przewody antenowe poprowadzone w kierunku górnej części urządzenia, co potwierdza obecność łączności Wi-Fi 7 i Bluetooth 5.3. Zapewnia to elastyczne opcje sieciowe, szczególnie przydatne w zastosowaniach mobilnych lub laboratoryjnych, gdzie dostęp przewodowy może być niedostępny.
Widoczne jest również rozwiązanie pamięci masowej urządzenia – dysk SSD PCIe Gen5 2242 M.2, o mniej powszechnym formacie w przypadku tak wydajnego sprzętu. Przedstawiona tutaj konfiguracja zawiera dysk Samsung NVMe o pojemności 4 TB.
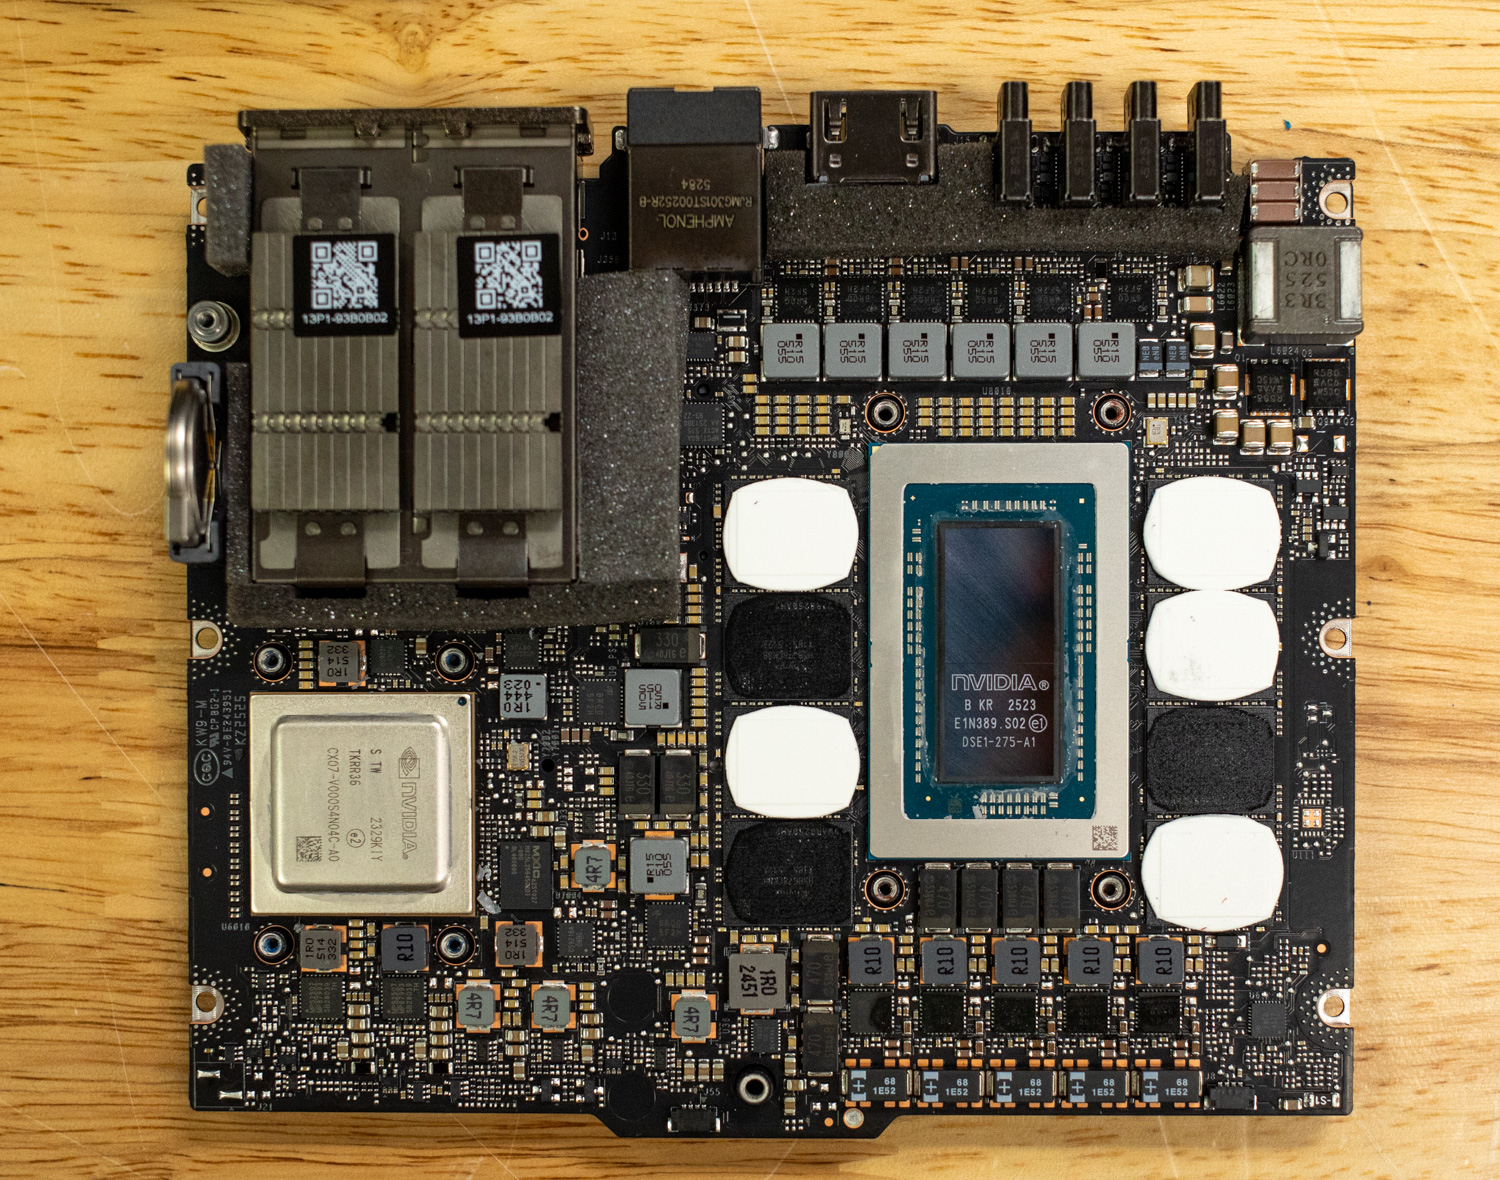
Głębsze zagłębienie się w DGX Spark ujawnia serce systemu – układ GB10 Superchip firmy NVIDIA Grace Blackwell. Obok GB10 Superchip znajduje się 8 lutowanych, zunifikowanych pamięci systemowych LPDDR5X o przepustowości 273 GB/s, gwarantujących szybki dostęp do danych zarówno w przypadku procesora, jak i karty graficznej.
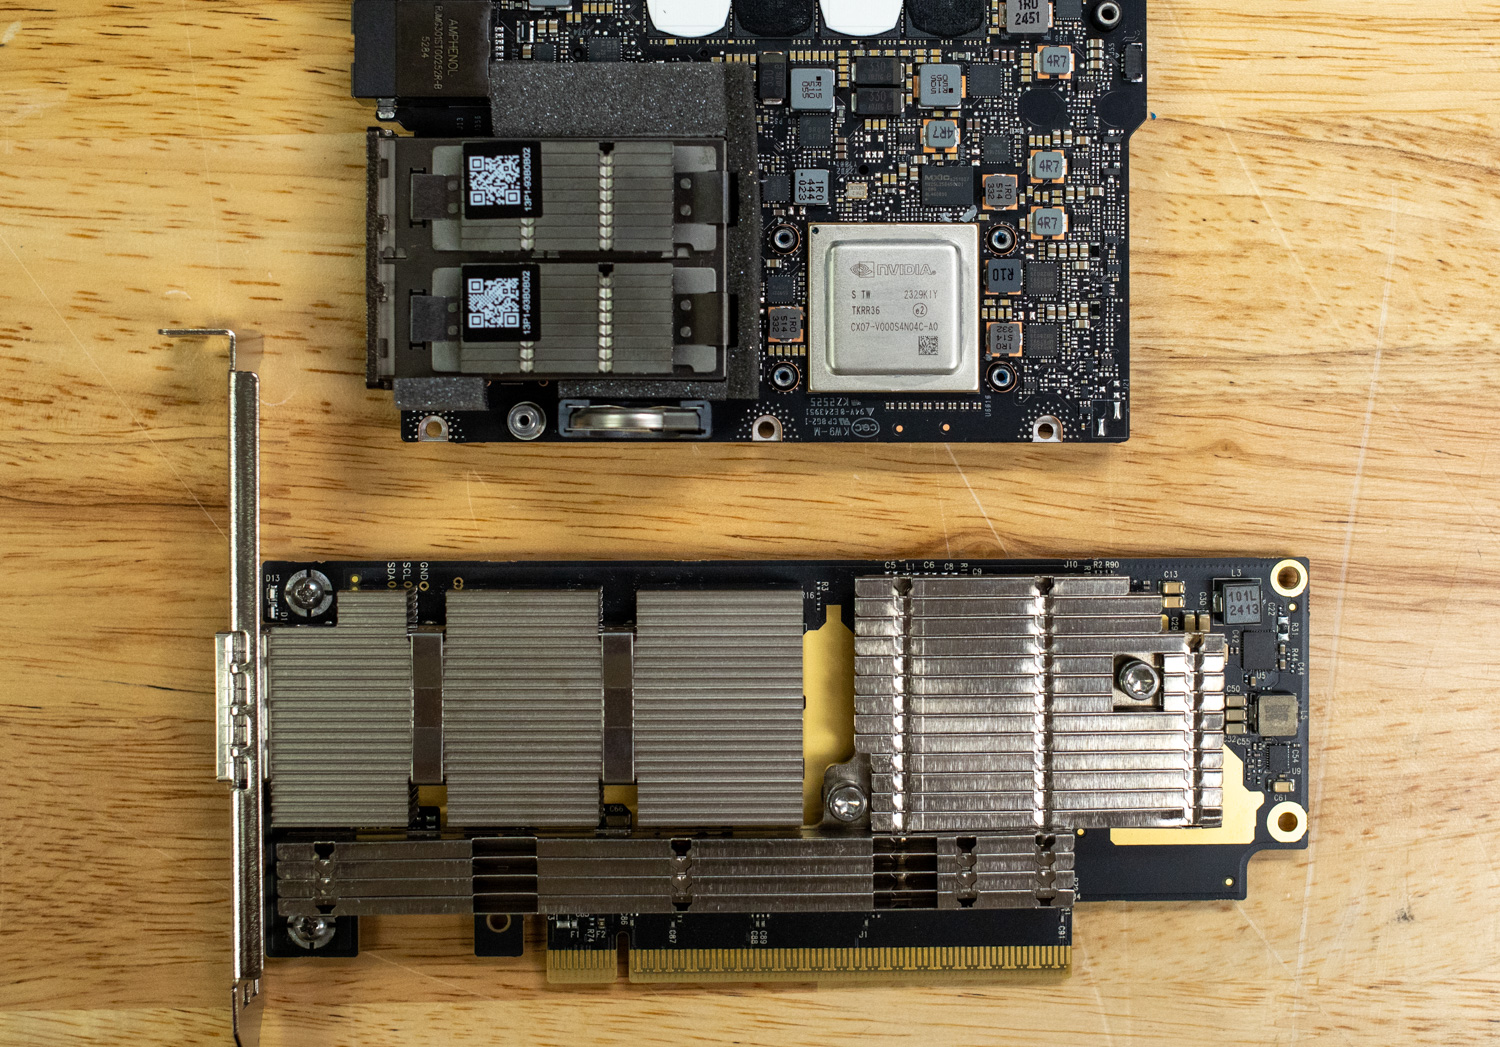
Tuż obok układu znajduje się karta sieciowa CX7, która, jak wspomniano wcześniej, zapewnia łączność 200 Gb/s. Pozwala to użytkownikom na podłączenie Sparka do szybkiej pamięci masowej, a nawet łączenie wielu instancji Sparka w klaster. NVIDIA zweryfikowała i sprzedaje klaster składający się z dwóch instancji Spark, które można bezpośrednio połączyć, aby obsługiwać jeszcze większe modele AI.
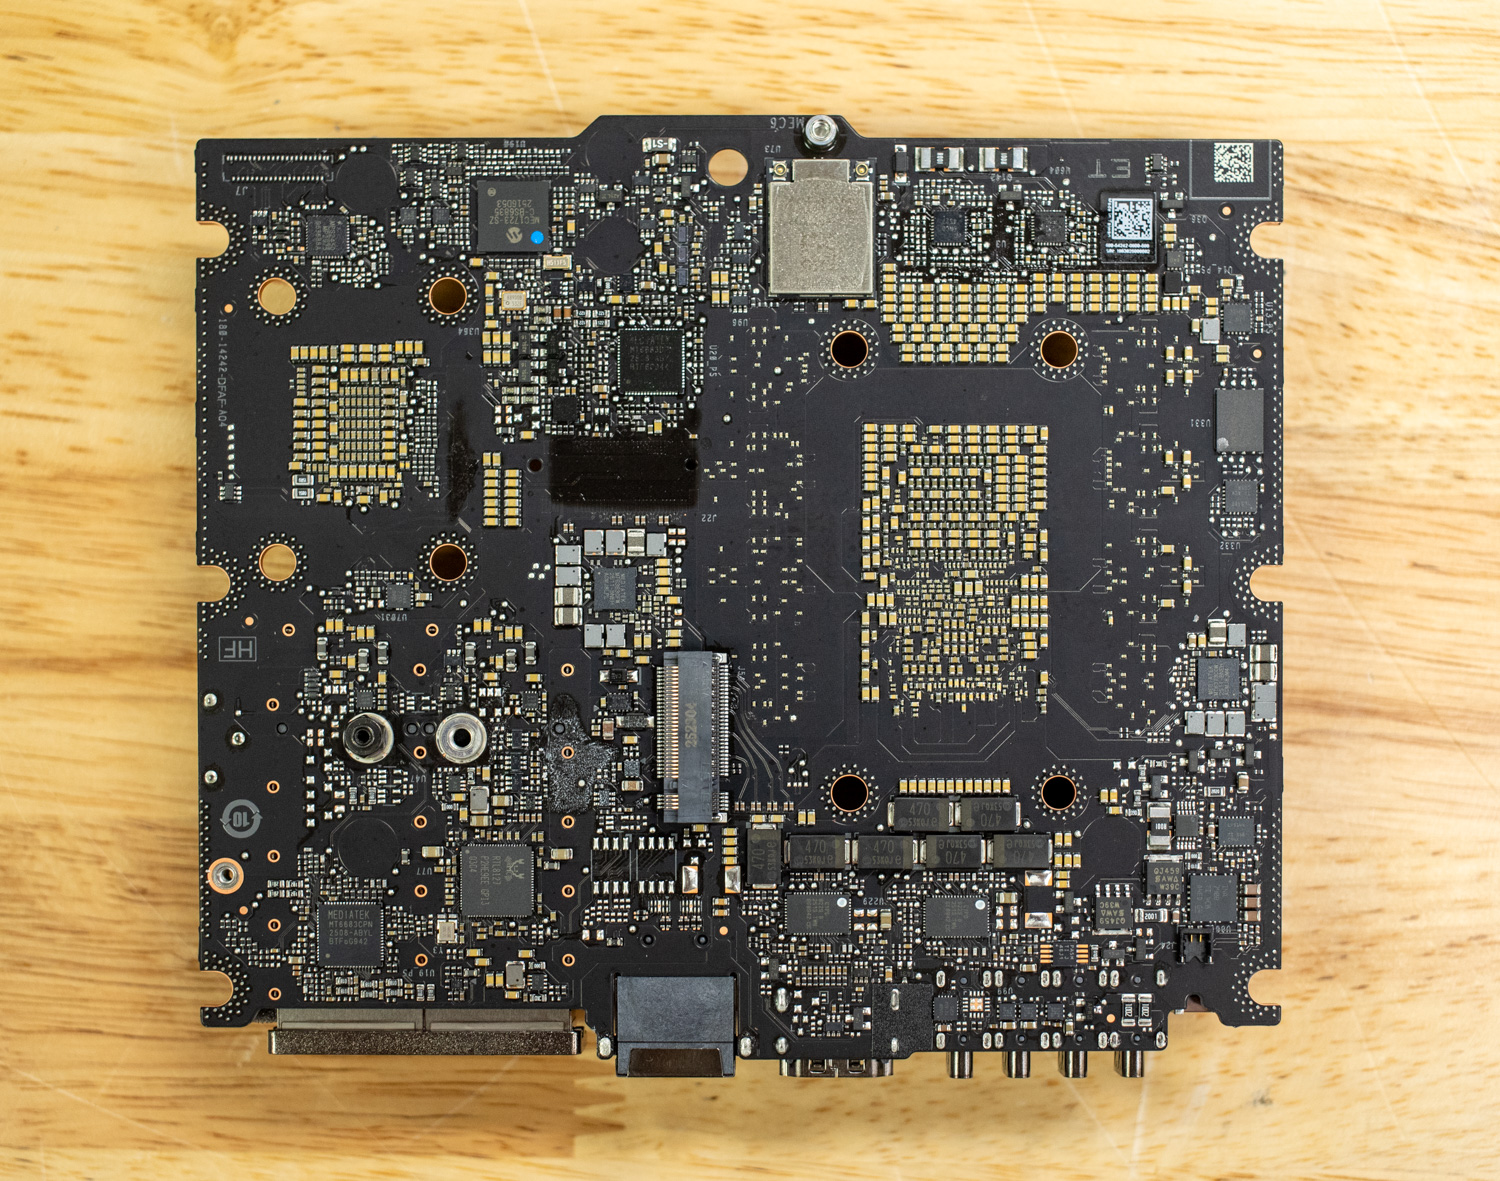
Na koniec, po odwróceniu płytki, naszym oczom ukazuje się cała łączność PCIe, w tym dysk SSD PCIe Gen5 x4 2242 M.2 i kartę Wi-Fi PCIe Gen3x1 MediaTek.
Gdzie Spark staje się niezbędny: nowoczesne urządzenie do tworzenia sztucznej inteligencji
Dysk DGX Spark sprawdza się szczególnie dobrze w różnych zastosowaniach profesjonalnych, z których każde korzysta z unikalnego połączenia zunifikowanej pamięci, kompaktowego formatu i kompleksowej integracji oprogramowania.
Przyspieszenie nauki o danych: od Pandas do produkcji
Dla analityków danych NVIDIA DGX Spark oznacza znaczną poprawę szybkości i komfortu pracy. Sieć ConnectX-7 o przepustowości 200 Gb/s w połączeniu z bibliotekami akcelerowanymi przez CUDA X usprawnia proces wstępnego przetwarzania danych. Sztuczna inteligencja i nauka o danych opierają się na zasadzie „dobrych danych wejściowych i wyjściowych”. Tradycyjnie, najbardziej czasochłonnym etapem każdego konwencjonalnego projektu uczenia maszynowego jest czyszczenie danych i ekstrakcja cech. Konwencjonalne procesy zazwyczaj obejmują ładowanie zbiorów danych do narzędzi takich jak Pandas i przeprowadzanie transformacji na rdzeniach procesora, co zazwyczaj jest powolne. Ręczna eksploracja i inżynieria cech również mogą stanowić istotną przeszkodę. Spark umożliwia kompleksową akcelerację GPU za pomocą technologii RAPIDS.
Typowy scenariusz korporacyjnej analizy danych obejmuje inżynierię cech na zbiorach danych o rozmiarze 40–80 GB: łączenie wielu tabel, obliczanie agregacji w oknach czasowych, obsługę kodowania kategorialnego i normalizację rozkładów. W przypadku infrastruktury opartej na procesorach, takie wstępne przetwarzanie może zająć wiele godzin. Dzięki RAPIDS cuDF ładującym cały zbiór danych do 128 GB zunifikowanej pamięci Spark, operacje te są wykonywane w ciągu kilku minut z przyspieszeniem 10-krotnym lub większym. Późniejsze trenowanie modelu przynosi takie same korzyści, niezależnie od tego, czy chodzi o klasyczne uczenie maszynowe z wykorzystaniem cuML, czy głębokie uczenie z wykorzystaniem PyTorch, eliminując tradycyjne wąskie gardło, w którym analitycy danych czekają na infrastrukturę zamiast iterować hipotezy.
Generowanie danych syntetycznych: robotyka i symulacja
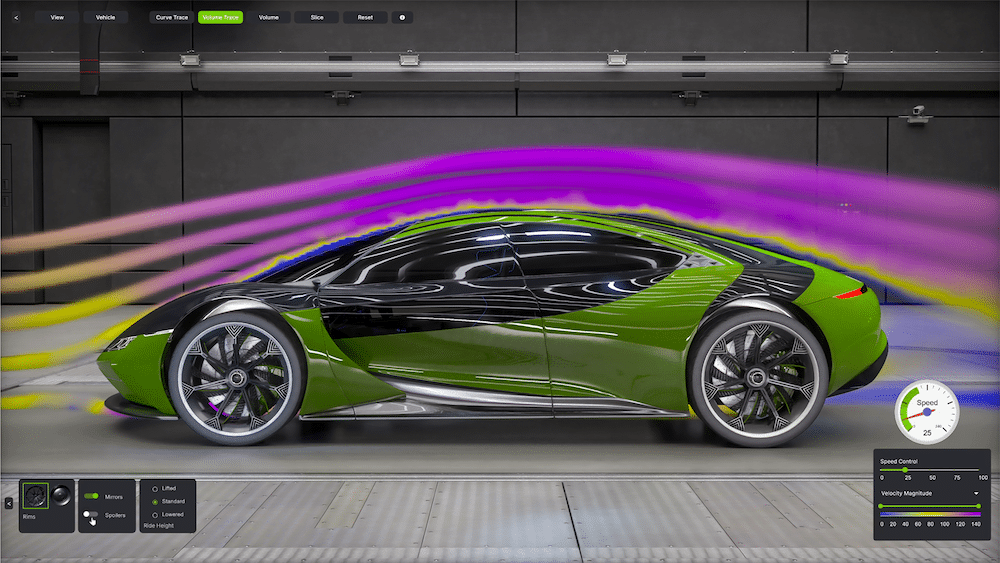
Wprowadzenie rdzeni RT czwartej generacji pozycjonuje Sparka w wyjątkowy sposób w nowym procesie pracy: generowaniu danych syntetycznych do trenowania modeli świata. Trenowanie solidnych strategii manipulacji tradycyjnie wymaga dziesiątek tysięcy demonstracji w warunkach rzeczywistych, co jest niezwykle kosztowne i czasochłonne. Fotorealistyczna symulacja na platformach takich jak Isaac Sim czy Omniverse stanowi alternatywę, ale renderowanie obrazów z wykorzystaniem ray tracingu z fizycznie dokładnym oświetleniem, odbiciami i materiałami historycznie wymagało drogich procesorów graficznych do stacji roboczych, takich jak NVIDIA L40S i RTX 6000 Ada.
Źródło: NVIDIA
Spark konsoliduje ten przepływ pracy. Rdzenie RT umożliwiają obciążeniem OpenUSD obsługę generowania danych syntetycznych, podczas gdy rdzenie Tensor służą do wnioskowania AI w projekcie/przepływie pracy. Wcześniej organizacje mogły wdrażać wiele maszyn do renderowania i oddzielny serwer zoptymalizowany pod kątem wnioskowania. Teraz jest to możliwe w jednym urządzeniu o mocy 240 W. Dla startupów z branży robotyki, laboratoriów uniwersyteckich lub producentów samochodów badających możliwości autonomicznej manipulacji, ta integracja znacznie skraca czas rozwoju i nakłady inwestycyjne.
Wcześniej, w naszym wcześniejszym omówieniu NVIDIA L40S, badaliśmy podobne procesy generowania danych syntetycznych, wykorzystujące dedykowane systemy renderujące L40S w połączeniu z H100 do wnioskowania . Konsolidacja architektoniczna tych możliwości w GB10 w ramach zunifikowanego urządzenia programistycznego stanowi przekonującą ewolucję tego przepływu pracy. Planujemy przeprowadzić dodatkowe testy wydajności rdzenia RT Spark w odniesieniu do tych dyskretnych konfiguracji w ramach nadchodzącej analizy, badając renderowanie i inne obciążenia dla reprezentatywnych scenariuszy manipulacji robotami.
Rewolucja w kodowaniu wibracji
Andrej Karpathy, były dyrektor ds. sztucznej inteligencji w firmie Tesla i członek-założyciel OpenAI, ukuł termin „kodowanie wibracji” (vibe coding), aby opisać nowe podejście do szybkiego tworzenia oprogramowania z wykorzystaniem sztucznej inteligencji. Zamiast skrupulatnego pisania kodu linia po linii, kodowanie wibracji wykorzystuje LLM jako interaktywnych programistów par: opisują funkcjonalność w języku naturalnym, generują rusztowania implementacji, iterują proces udoskonalania konwersacji i szybko prototypują funkcje. Ten obieg pracy przekształca kodowanie z celowego konstruowania w sterowaną konwersację ze sztuczną inteligencją, która rozumie kontekst, interfejsy API i wzorce architektoniczne, umożliwiając indywidualnym programistom tworzenie niezwykle zaawansowanych systemów z niespotykaną dotąd szybkością.
Skalę adopcji kodowania wspomaganego sztuczną inteligencją potwierdzają rankingi wykorzystania OpenRouter , gdzie modele skoncentrowane na kodowaniu konsekwentnie dominują w zakresie wnioskowania. Specjaliści techniczni, czyli główna grupa demograficzna zajmująca się kodowaniem, zazwyczaj działają jako zaawansowani użytkownicy, uruchamiając równolegle wiele agentów kodowania w różnych kontekstach. Ponieważ modele o otwartej strukturze coraz częściej dorównują zastrzeżonym alternatywom w kluczowych testach porównawczych , programiści rozważają lokalne wdrożenia wnioskowania, aby wyeliminować ograniczenia przepustowości, zapewnić dostępność w krytycznych okresach rozwoju i zachować poufność kodu w projektach zastrzeżonych.
Społeczność r/LocalLLaMA prezentuje naprawdę imponujące, niestandardowe konfiguracje, od stacji roboczych z wieloma procesorami graficznymi, przez serwery spięte taśmą klejącą, obsługujące modele lokalne, po rozproszone wnioskowanie w sprzęcie konsumenckim, a także zaawansowane rozwiązania chłodzące, które umożliwiają generowanie dużej przepustowości. Konfiguracje te wiążą się jednak z istotnymi barierami: nakłady inwestycyjne często przekraczające dziesiątki tysięcy dolarów, znaczne zużycie energii, problemy z zarządzaniem temperaturą, wymagające dedykowanych przestrzeni, a nie standardowych biur, oraz znaczna wiedza techniczna w zakresie konfiguracji, optymalizacji i rozwiązywania problemów.
Spark radykalnie zmienia tę propozycję wartości. W cenie 3,999 USD, z 128 GB pamięci zunifikowanej, oferuje imponującą wydajność wnioskowania modeli w cichym, kompaktowym i energooszczędnym urządzeniu, zużywając zaledwie 240 W. Użytkownicy chcący wdrożyć lokalną infrastrukturę asystenta kodowania nie potrzebują już rozbudowanych laboratoriów domowych, które zużywają kilowatogodziny i generują znaczną ilość ciepła. Zweryfikowane podejście do urządzeń z prekonfigurowanym systemem operacyjnym DGX eliminuje złożoność konfiguracji, która wcześniej ograniczała lokalne wdrożenie LLM do użytkowników z dogłębną znajomością Linuksa i CUDA.
Oprócz eliminacji tarcia infrastrukturalnego, Spark rozwiązuje kluczowe problemy związane z prywatnością kodu i personalizacją modeli. Asystenci kodowania w chmurze z konieczności przesyłają kod źródłowy na serwery zdalne, co jest nie do przyjęcia dla organizacji obsługujących zastrzeżone algorytmy, infrastrukturę krytyczną dla bezpieczeństwa lub dane regulowane. Lokalne wnioskowanie w Spark gwarantuje, że kod nigdy nie opuści środowiska programistycznego. Co więcej, 128 GB pamięci umożliwia pełne dostrajanie parametrów modeli kodowania, pozwalając doświadczonym programistom specjalizować modele w wewnętrznych bazach kodu. Ta możliwość jest szczególnie cenna dla organizacji z językami dziedzinowymi, niestandardowymi frameworkami lub wzorcami architektonicznymi, które są niedostatecznie reprezentowane w publicznych danych szkoleniowych.
Dostrajanie za pomocą NVIDIA NeMo na DGX Spark
Zunifikowana pamięć DGX Spark o pojemności 128 GB umożliwia pełne dostrajanie parametrów modeli 8B, które tradycyjnie wymagały kosztownych konfiguracji w chmurze z wieloma procesorami graficznymi. Pełne dostrajanie Qwen3 8B ze standardową optymalizacją Adam wymaga około 132 GB (16 GB na wagi modeli, 96 GB na stany optymalizatora, 16 GB na gradienty i aktywacje), przewyższając konfiguracje z dwoma procesorami H100 o pojemności 80 GB. Wykorzystanie 8-bitowego procesora Adam, który oszczędza pamięć, zmniejsza wymagania do około 70 GB, w zależności od rozmiaru wsadu, co pozwala na wygodne dopasowanie do puli pamięci Spark. Ma to znaczenie, ponieważ pełne dostrajanie zapewnia o 4-6% lepszą dokładność niż LoRA w przypadku złożonych zadań wnioskowania. Podczas gdy konfiguracje 2× H100 o pojemności 80 GB w chmurze kosztują około 5 dolarów za godzinę z rozproszoną złożonością treningu, Spark oferuje szkolenie pojedynczego systemu za jednorazową inwestycję w wysokości 3,999 dolarów.
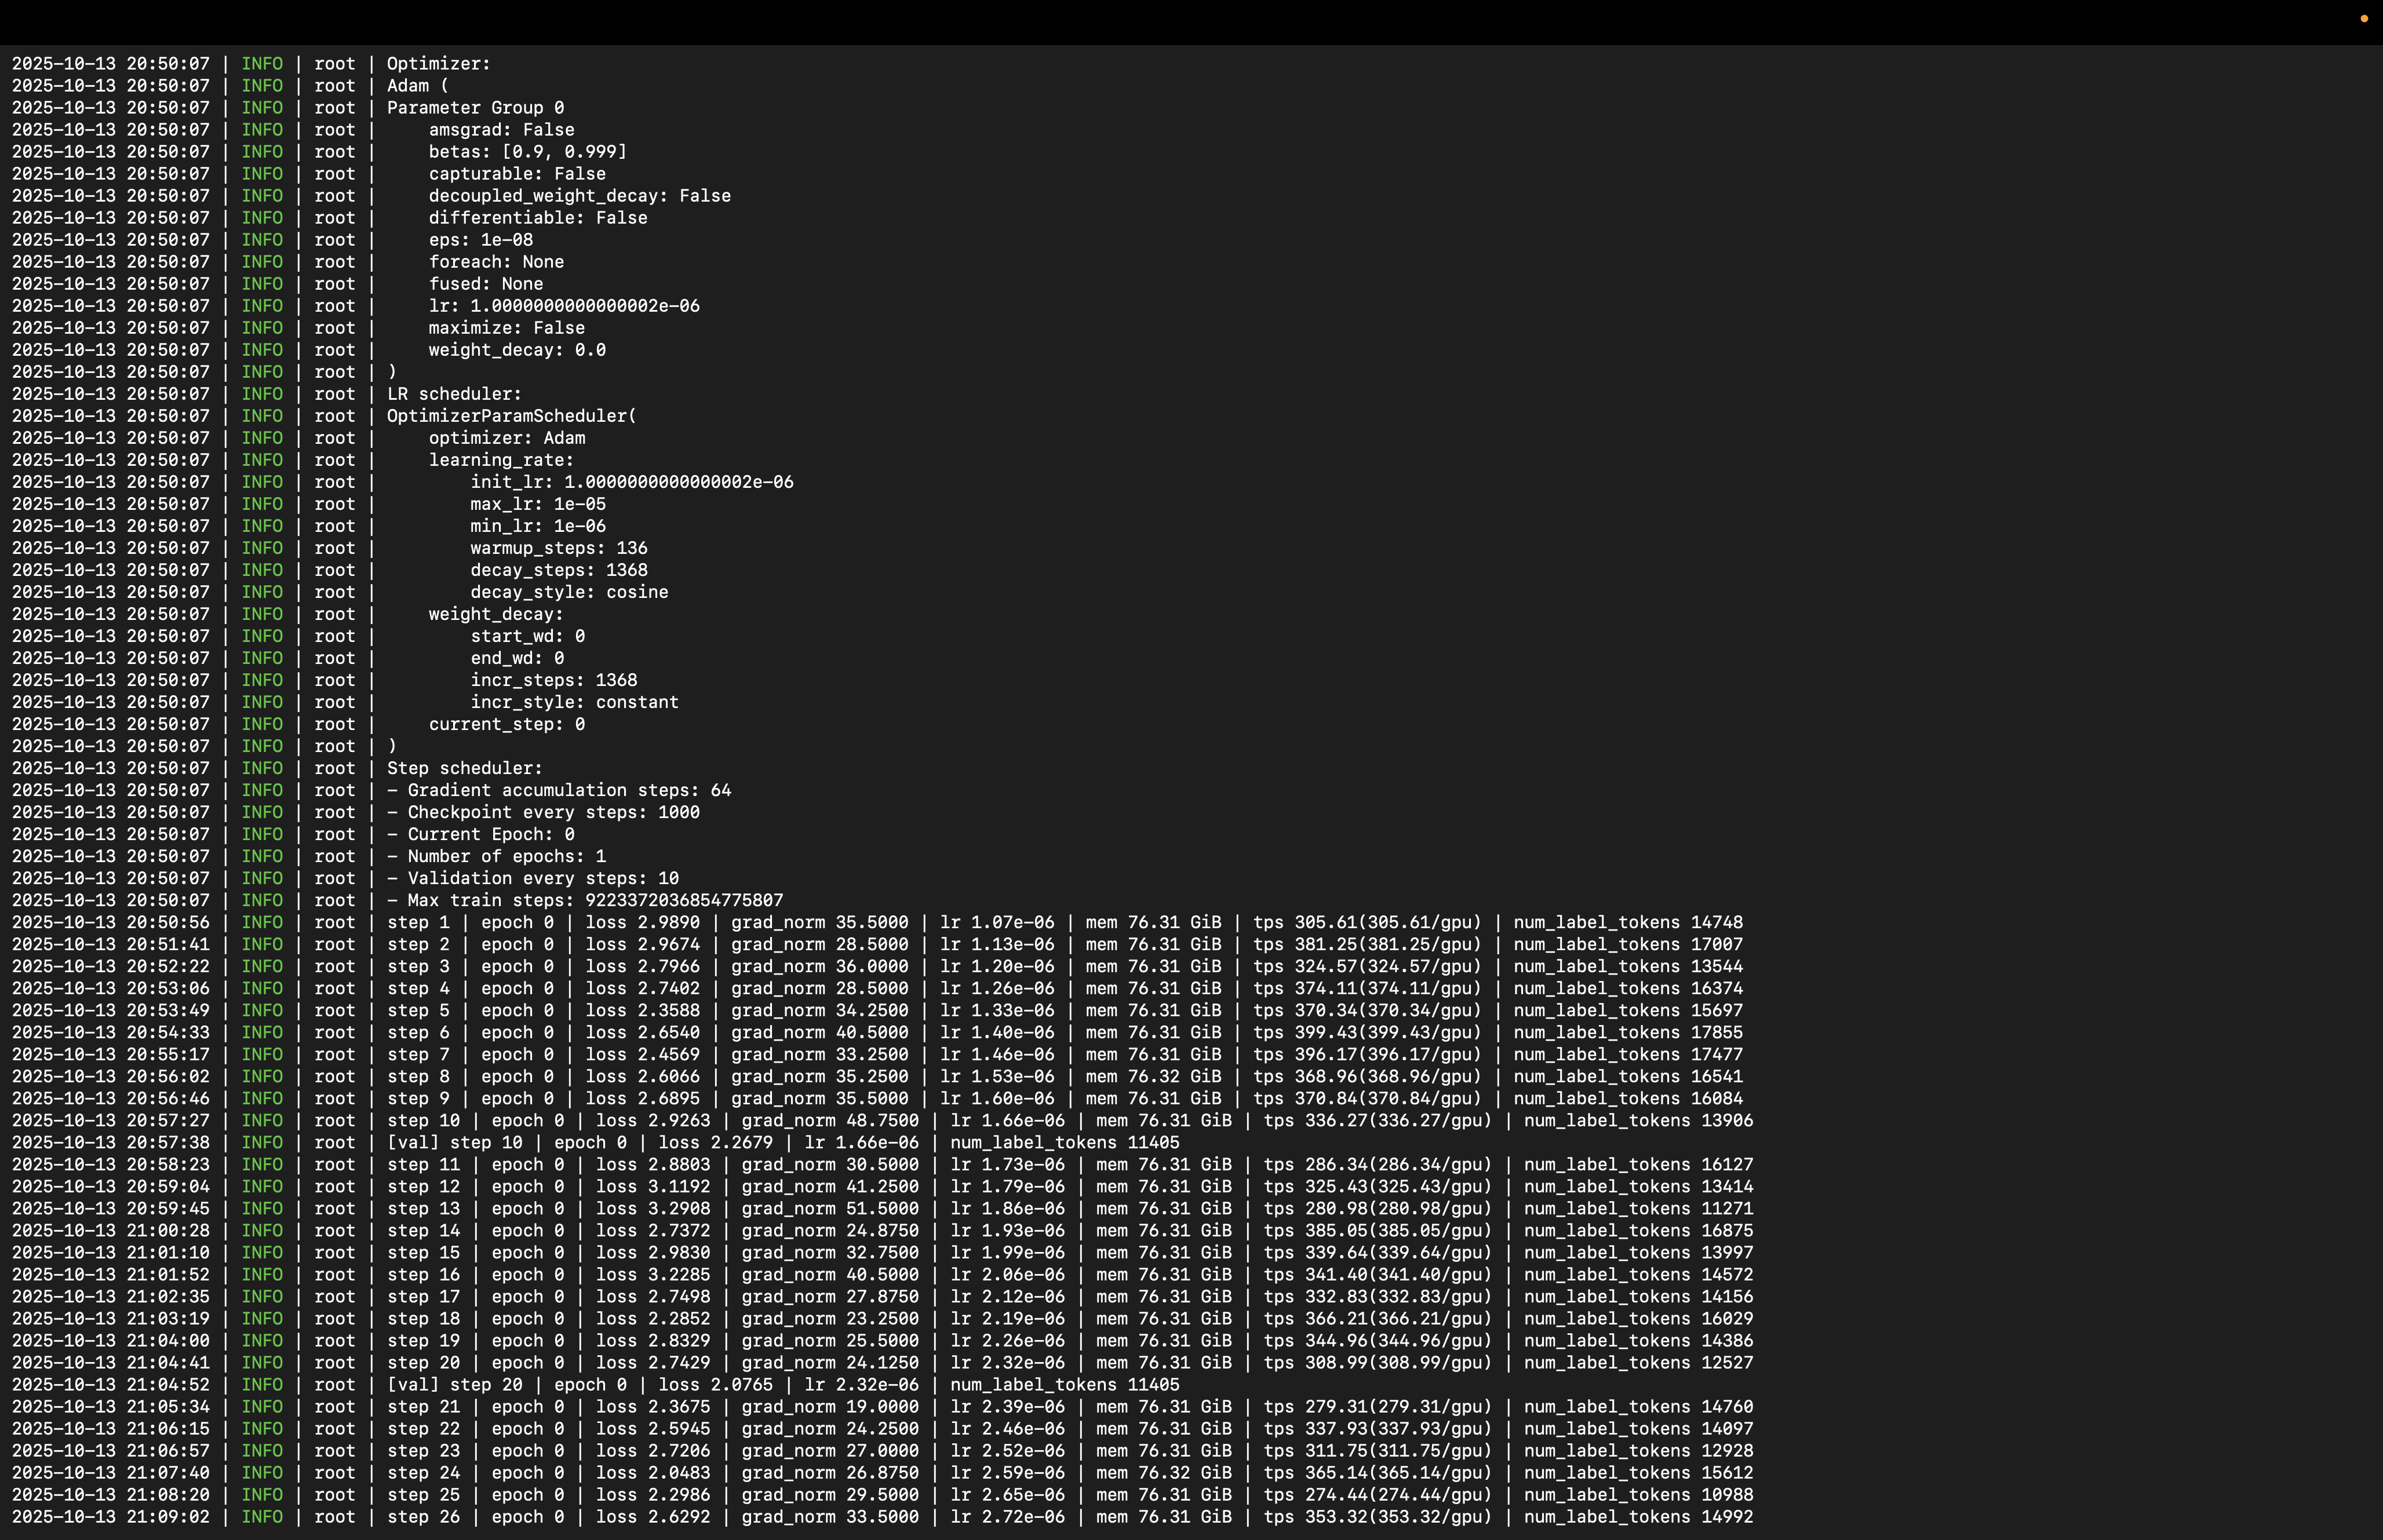
NVIDIA NeMo Automodel eliminuje problemy związane z platformą szkoleniową dla przedsiębiorstw, zapewniając obsługę modelu Hugging Face od dnia 0 dla dowolnego modelu Hugging Face bez konwersji punktów kontrolnych. Załaduj Qwen3 8B bezpośrednio z HuggingFace Hub i skonfiguruj dostrajanie za pomocą plików YAML, określając źródła danych, ustawienia optymalizatora i cele LoRA. NeMo automatyzuje rozproszone punkty kontrolne, zapewniając kompatybilność z safetensorami, implementuje połączone jądra CUDA, co zapewnia 2-5-krotne przyspieszenie, oraz obsługuje akumulację gradientów.
Generowanie obrazu z wygodnym interfejsem użytkownika
ComfyUI oferuje graficzny interfejs oparty na węzłach, który przekształca model Stable Diffusion i powiązane z nim modele dyfuzji w wysoce konfigurowalne, kreatywne potoki obliczeniowe. W przeciwieństwie do tradycyjnych interfejsów internetowych, które abstrahują złożoność za pomocą uproszczonych suwaków parametrów, ComfyUI wykorzystuje wizualną architekturę grafową, w której użytkownicy konstruują przepływy pracy, łącząc dyskretne węzły funkcyjne, z których każdy reprezentuje określone operacje, takie jak ładowanie modelu, kodowanie podpowiedzi, próbkowanie dyfuzji ukrytej, dekodowanie VAE czy transformacje skalujące. Ta modułowa konstrukcja umożliwia szczegółową kontrolę nad całym potokiem generowania, dzięki czemu każdy krok obliczeniowy jest transparentny i konfigurowalny. Pozwala również użytkownikom na łączenie wielu modeli, implementację niestandardowych harmonogramów próbkowania lub integrację zaawansowanych technik, takich jak sterowanie ControlNet, co byłoby niemożliwe w uproszczonych interfejsach.
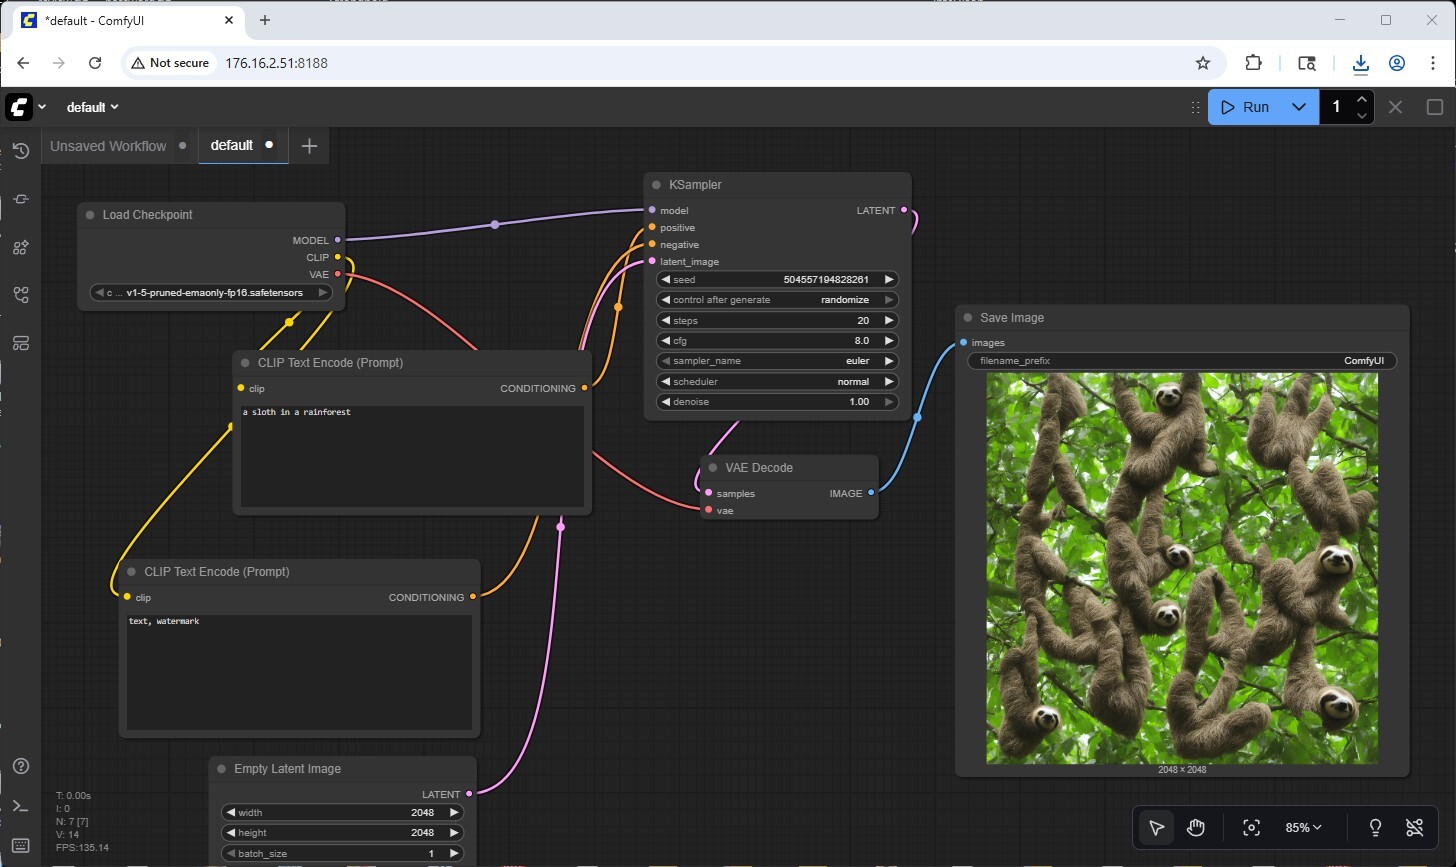
W systemie DGX Spark, ComfyUI wykorzystuje rdzenie Tensor GPU Blackwell do przyspieszonego próbkowania dyfuzyjnego, zazwyczaj kończąc generacje w ciągu 15–30 sekund, w zależności od złożoności próbkowania. Zunifikowana architektura pamięci o pojemności 128 GB okazuje się szczególnie korzystna, utrzymując jednocześnie w pamięci wiele modeli punktów kontrolnych, adapterów LoRA i dekoderów VAE, eliminując narzut związany z przeładowywaniem, który jest problemem systemów z ograniczoną pamięcią VRAM. Użytkownicy mogą generować lokalnie praktycznie nieograniczoną liczbę grafik AI, bez ograniczeń przepustowości API, kosztów chmury na generację i obaw o prywatność związanych z zastrzeżonymi procesami pracy twórczej. Model trwałości procesu pracy dodaje wartość operacyjną: kompletne potoki są serializowane do plików JSON, które można kontrolować pod kątem wersji, udostępniać między zespołami lub osadzać bezpośrednio w generowanych obrazach jako metadane, co umożliwia powtarzalność, kluczową dla organizacji budujących syntetyczne potoki danych lub utrzymujących spójny styl artystyczny w generowanych zasobach.
Testy wydajności NVIDIA DGX Spark
vLLM Online Serving – Test wnioskowania LLM
vLLM to najpopularniejszy silnik wnioskowania i obsługi o wysokiej przepustowości dla systemów LLM. Test porównawczy obsługi online vLLM to narzędzie do oceny wydajności, zaprojektowane do pomiaru rzeczywistych możliwości obsługi tego silnika wnioskowania podczas obsługi współbieżnych żądań. Symuluje obciążenia produkcyjne poprzez wysyłanie żądań do działającego serwera vLLM z konfigurowalnymi parametrami, takimi jak częstotliwość żądań, długość wejścia/wyjścia i liczba współbieżnych klientów. Test mierzy kluczowe wskaźniki, takie jak przepustowość, tj. liczbę tokenów na sekundę, czas do pierwszego tokena i czas na token wyjściowy, pomagając użytkownikom zrozumieć, jak vLLM działa w różnych warunkach obciążenia.
Przetestowaliśmy wydajność wnioskowania na podstawie kompleksowego zestawu modeli reprezentujących najpopularniejsze architektury i typy modeli stosowane obecnie w środowiskach produkcyjnych.
Modele mieszane ekspertów
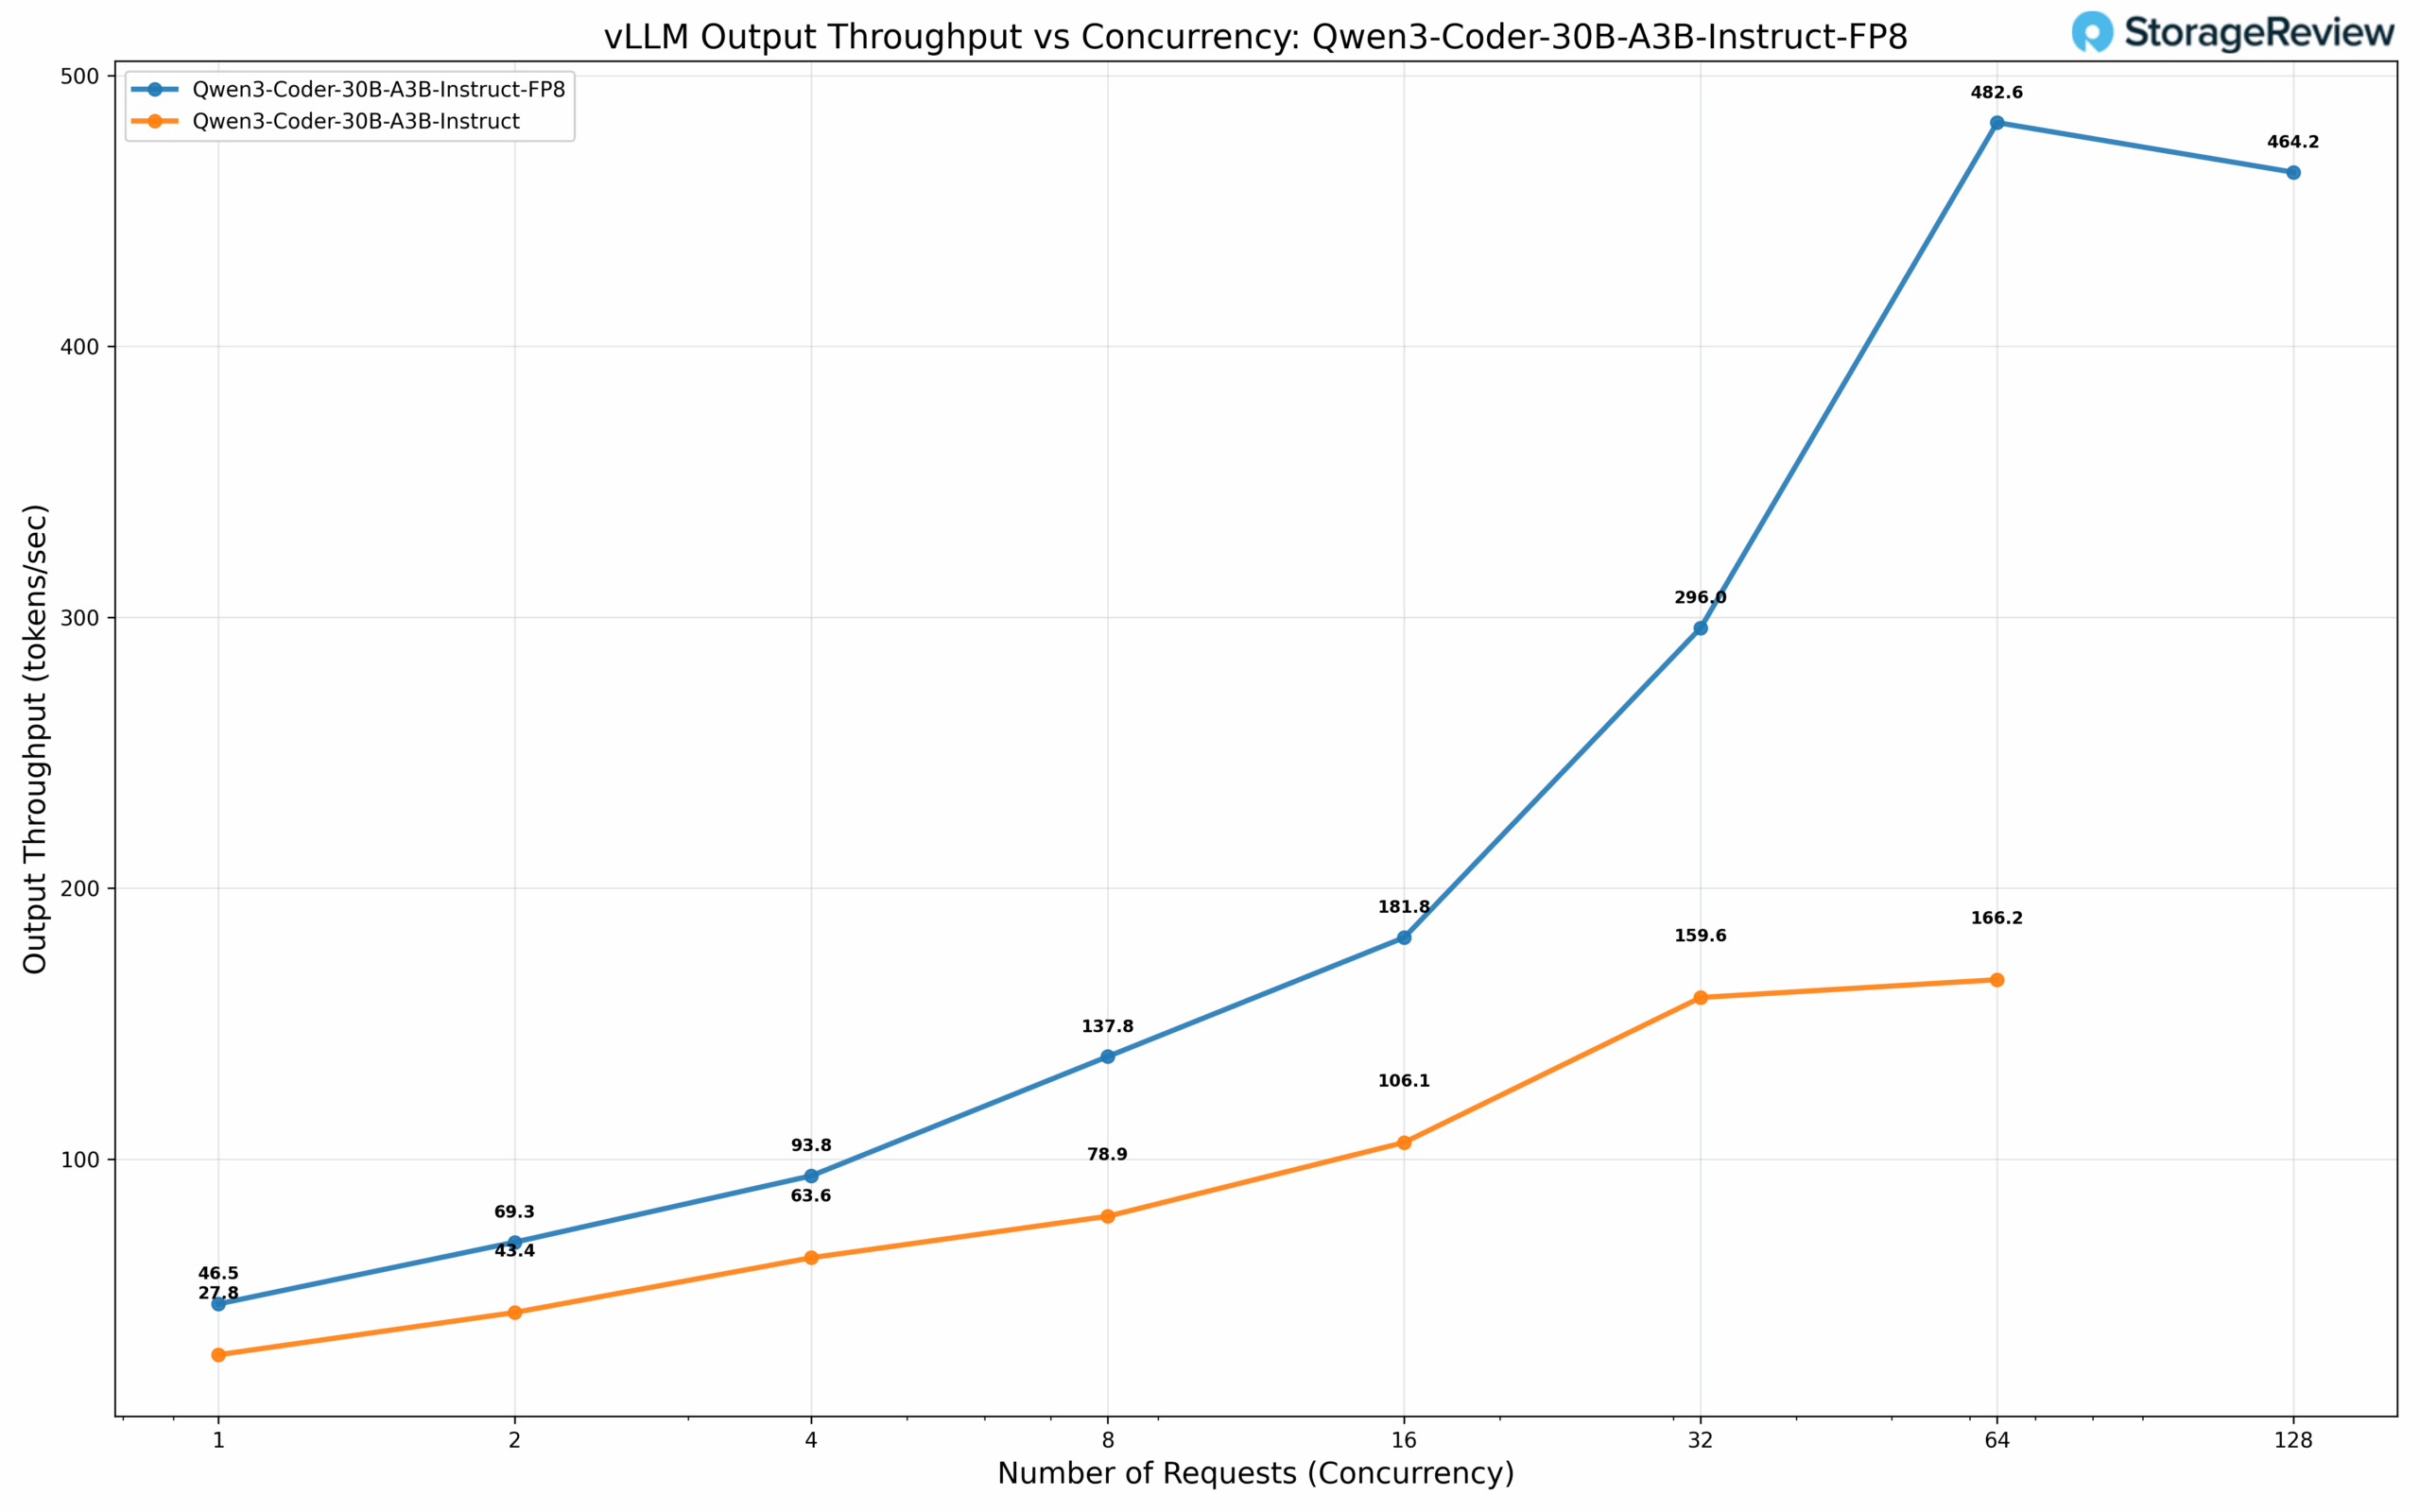
Oceniliśmy Qwen3 Coder 30B-A3B, jeden z najpopularniejszych modeli kodowania do lokalnych wdrożeń wnioskowania. Ta rzadka architektura utrzymuje pełną wielkość modelu, wynoszącą 30 miliardów parametrów przy precyzji BF16, jednocześnie aktywując tylko 3 miliardy parametrów na wygenerowany token. Przeprowadziliśmy testy porównawcze zarówno modelu podstawowego, jak i skwantyzowanej wersji FP8 firmy Qwen. Skwantyzowany model FP8 wykazuje znaczny wzrost wydajności: osiągając 46.5 tok/s przy współbieżności 1, skalując się do imponujących 482.6 tok/s przy rozmiarze partii 64. Standardowy model BF16 zapewnia 27.8 tok/s przy współbieżności 1, osiągając 166.2 tok/s przy rozmiarze partii 64, co stanowi prawie 3-krotną różnicę w wydajności.
Gęste modele
Modele gęste reprezentują konwencjonalną architekturę LLM, w której wszystkie parametry i aktywacje są uwzględniane podczas wnioskowania, co skutkuje bardziej intensywnym obliczeniowo przetwarzaniem w porównaniu z ich rzadkimi odpowiednikami. Aby kompleksowo ocenić charakterystykę wydajności w różnych skalach modeli i strategiach kwantyzacji, przeprowadziliśmy testy porównawcze pięciu gęstych konfiguracji modeli.
Nasz zestaw testowy obejmował procesor Mistral Small 3.1 24B firmy Mistral AI o precyzji BF16 oraz dynamicznie kwantyzowany wariant procesora Mistral Small 3.1 24B FP8 firmy RedHat AI. Dynamiczna kwantyzacja wykorzystuje techniki selektywnej kwantyzacji wagowej, aby zoptymalizować kompromis między wydajnością a dokładnością, strategicznie zmniejszając precyzję przy jednoczesnej minimalizacji degradacji modelu. Uzupełniliśmy te bardziej gęste modele o testy Meta Llama 3.1 8B w trzech formatach precyzji: standardowej konfiguracji BF16 oraz skwantyzowanych wersjach FP8 i FP4 firmy NVIDIA. Ta strategia doboru modelu umożliwia bezpośrednie porównanie wydajności w różnych skalach modeli, jednocześnie izolując wpływ kwantyzacji progresywnej na przepustowość wnioskowania.
Analiza wydajności: duże, gęste modele
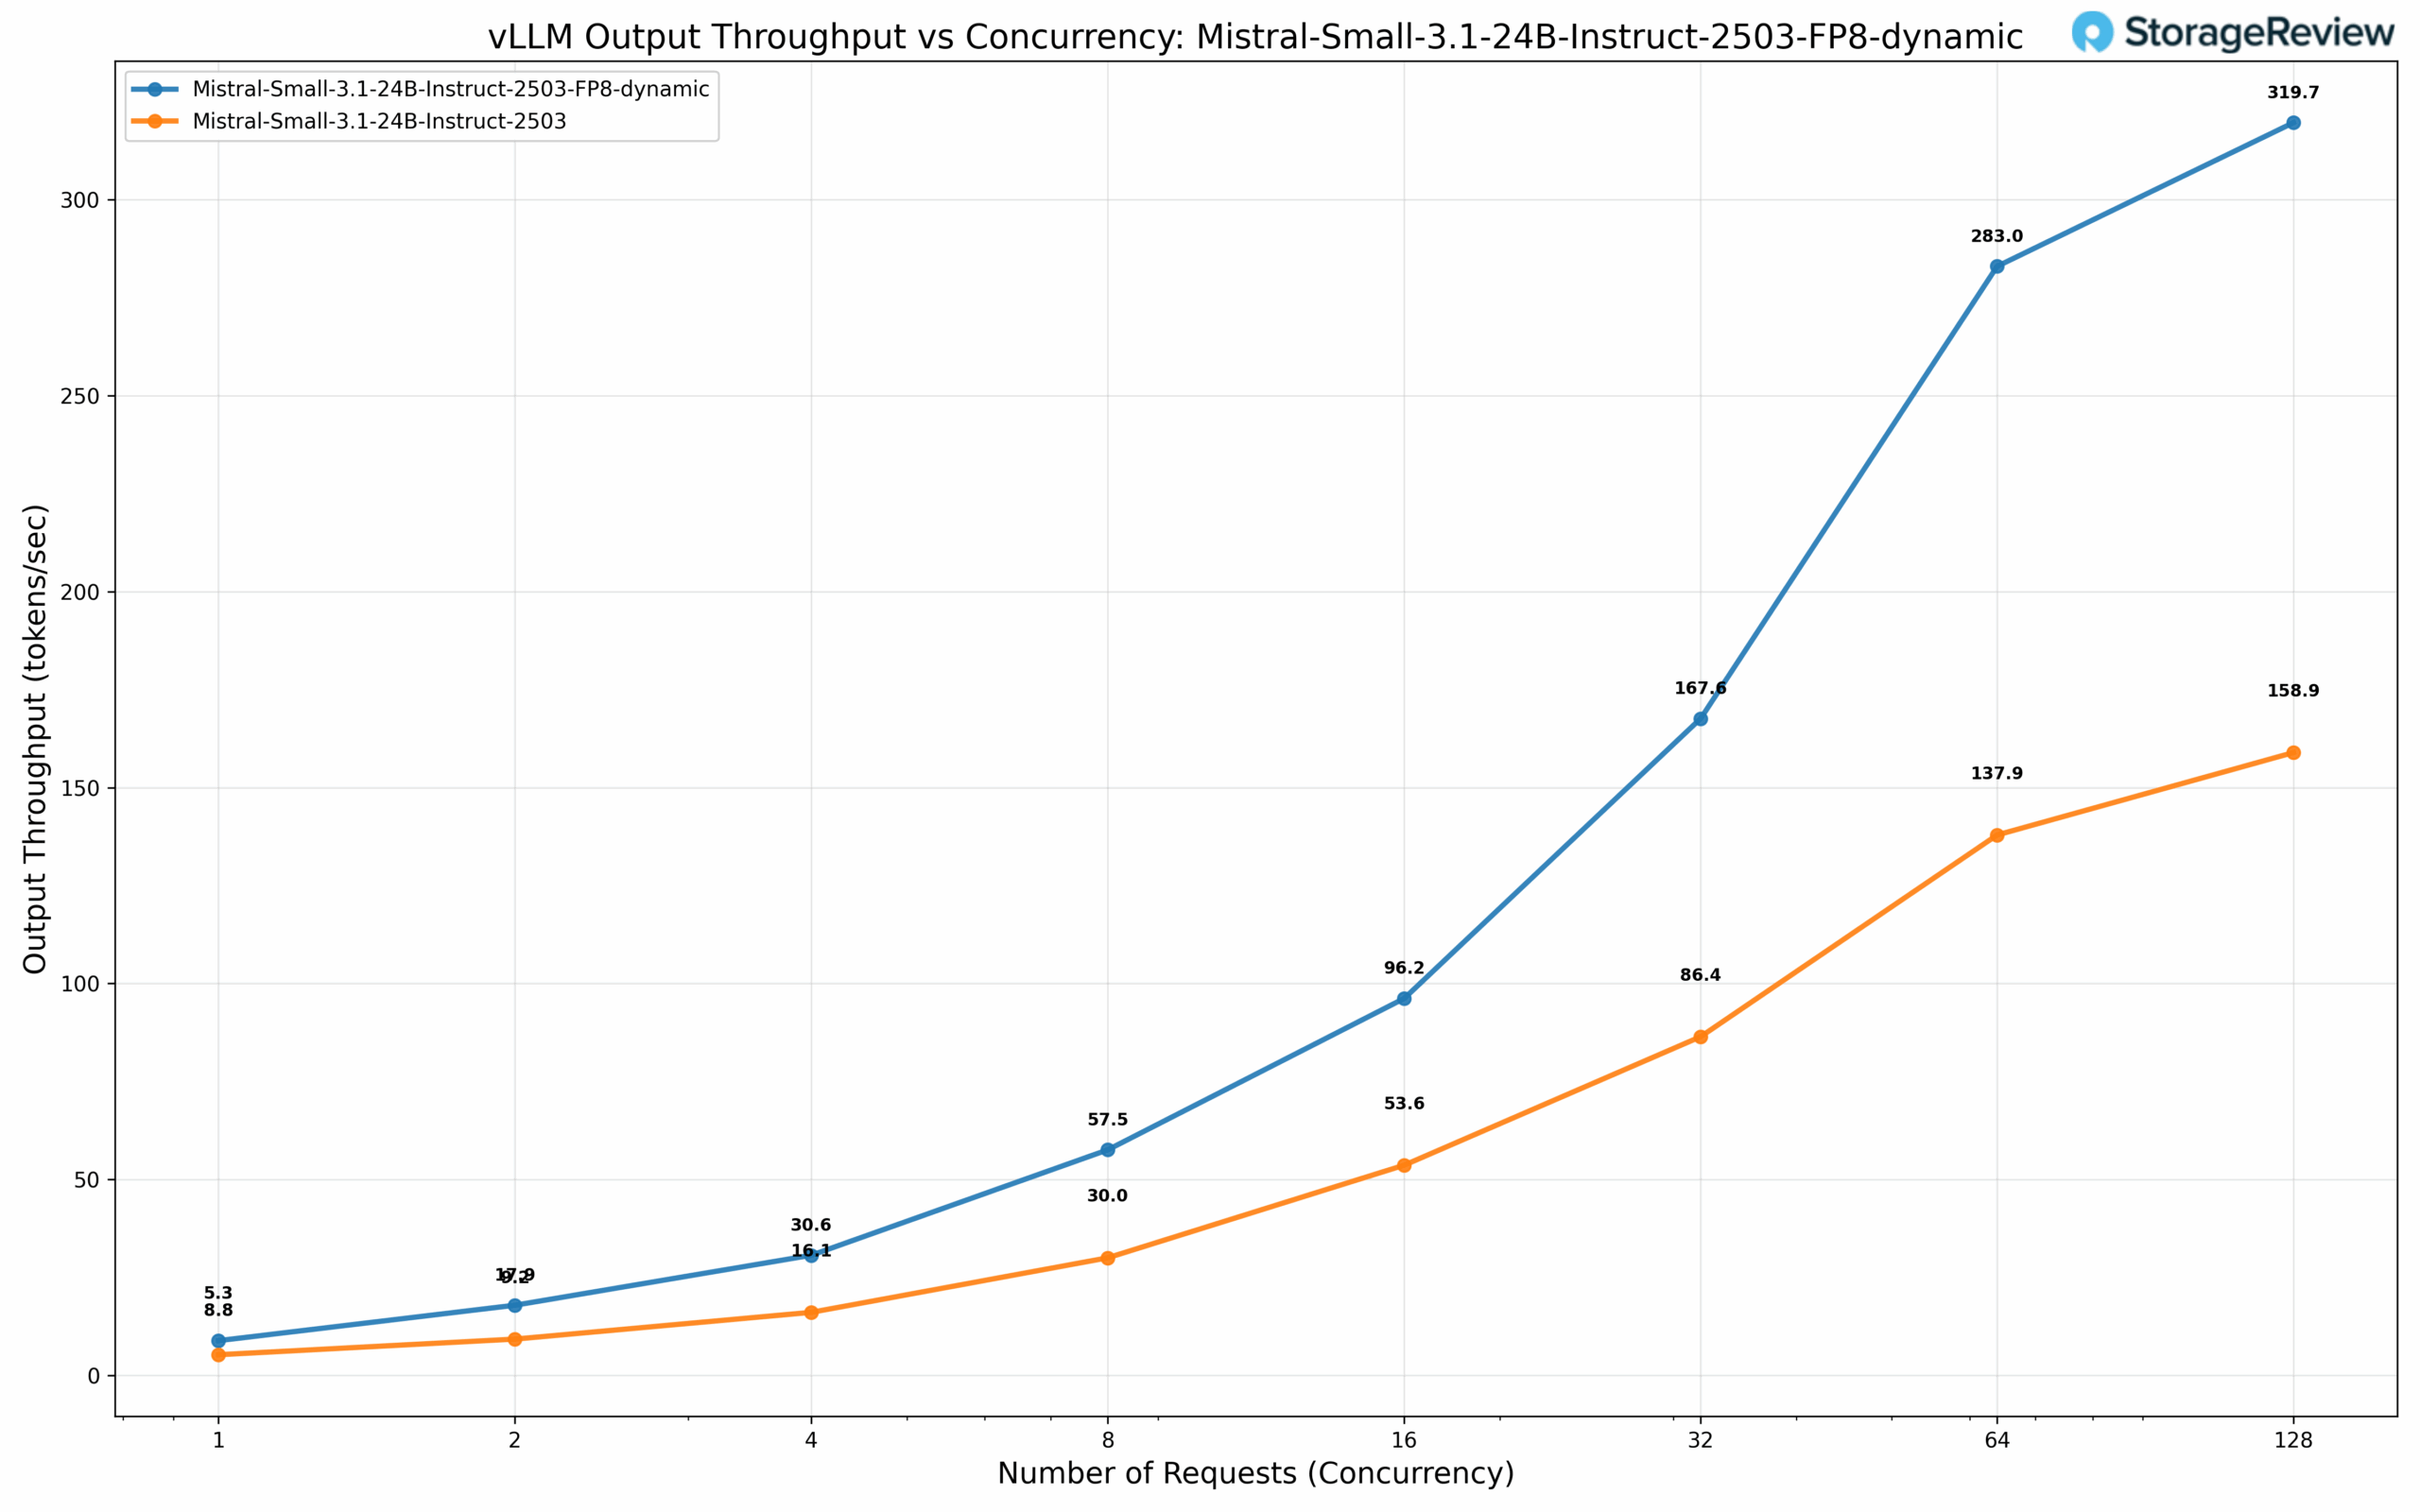
Mistral Small 3.1 24B o precyzji BF16 charakteryzuje się bazową przepustowością 5.3 tok/s przy współbieżności 1, skalując się do imponujących 158.9 tok/s przy 128 równoczesnych żądaniach. Dynamicznie kwantyzowany wariant FP8 wykazuje niewielkie korzyści przy niższej współbieżności, wynoszącej 8.8 tok/s, ale zapewnia imponujący, dwukrotny wzrost wydajności w skali, osiągając 319.7 tok/s przy 128 równoczesnych żądaniach – co podkreśla skuteczność dynamicznej kwantyzacji w scenariuszach obsługi o wysokiej przepustowości.
Analiza wydajności: kompaktowe, gęste modele
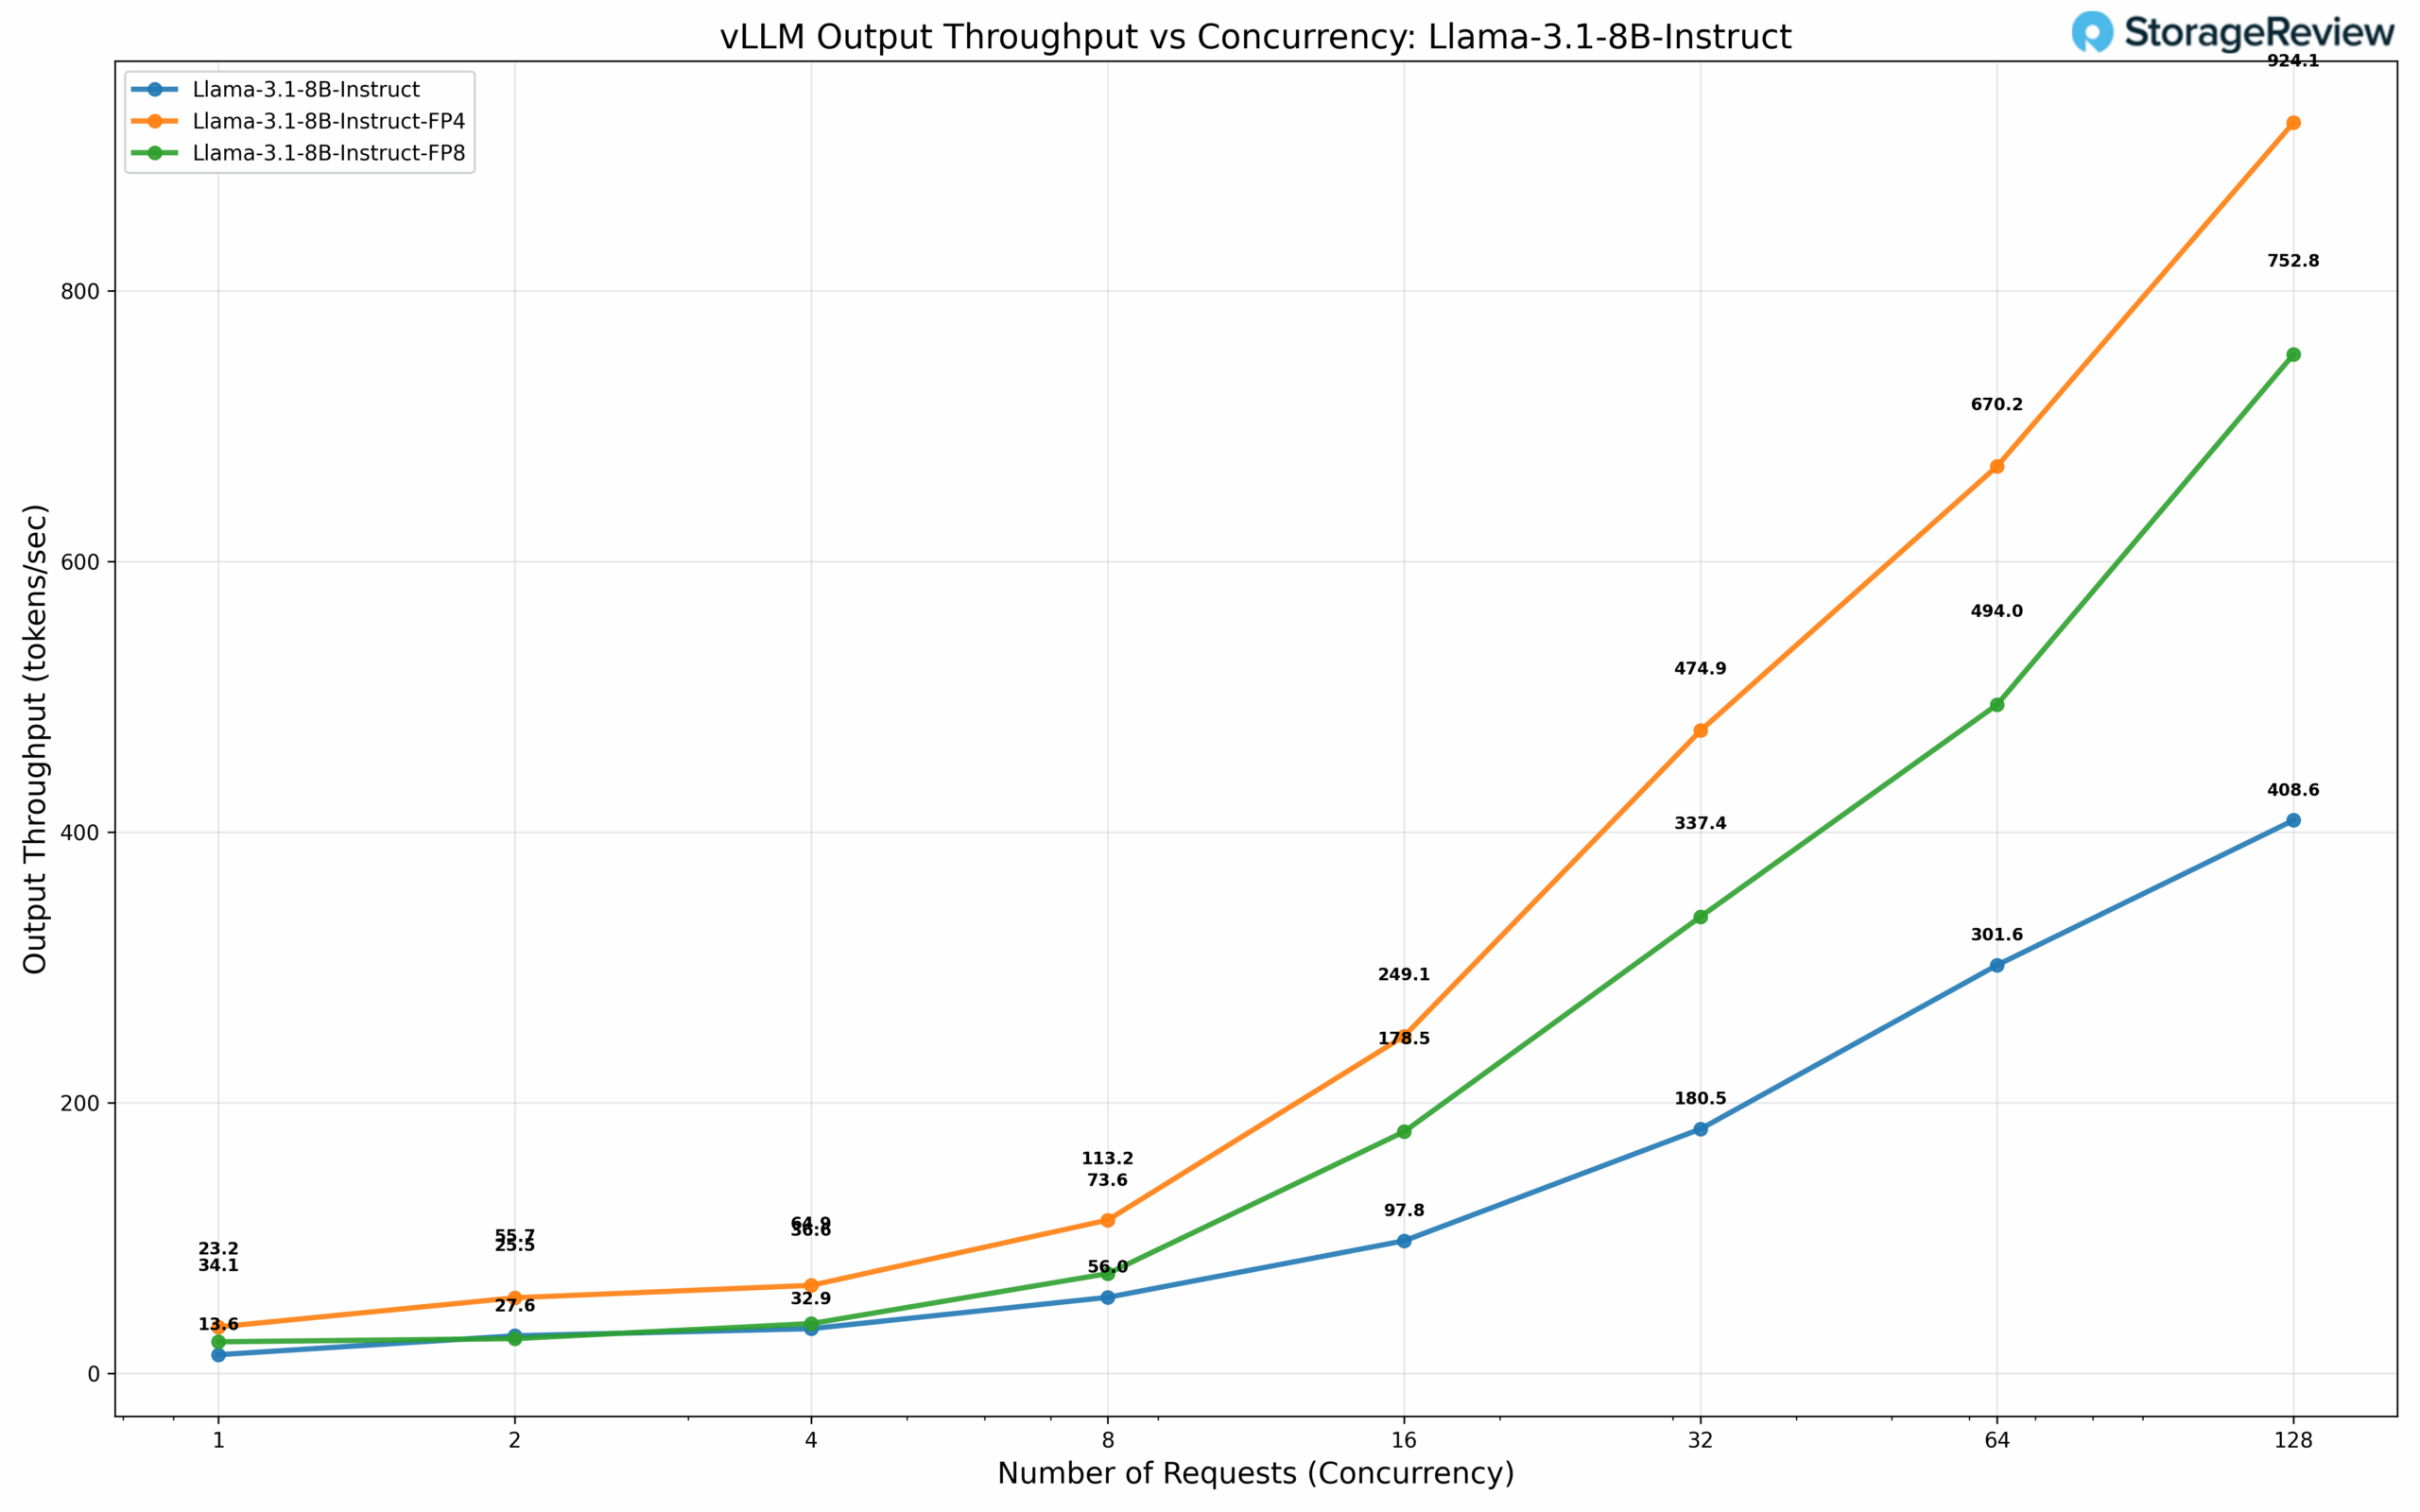
Architektura Llama 3.1 8B wykazuje wyraźnie zróżnicowane parametry wydajnościowe w zależności od strategii kwantyzacji. Przy precyzji BF16 model zapewnia 13.6 tok/s przy współbieżności 1, zwiększając ją do 408.6 tok/s przy 128 równoczesnych żądaniach. Przejście na kwantyzację FP8 daje odpowiednio 23.2 tok/s i 752.8 tok/s przy poziomach współbieżności 1 i 128 – co oznacza 84% wzrost przepustowości w skali. Konfiguracja FP4 dodatkowo zwiększa wydajność, osiągając 34.1 tok/s i 924.1 tok/s przy tych samych poziomach współbieżności, co dowodzi, że agresywne strategie kwantyzacji mogą zapewnić 2.3-krotny wzrost wydajności w porównaniu z precyzją bazową, zachowując jednocześnie akceptowalną jakość modelu dla wielu obciążeń produkcyjnych.
Typ danych mikroskalowych
Mikroskalanie to zaawansowane podejście do kwantyzacji, które stosuje drobnoziarniste współczynniki skalowania do małych bloków wag, zamiast jednorodnej kwantyzacji w dużych grupach parametrów. Format NVFP4 firmy NVIDIA implementuje tę technikę poprzez blokową reprezentację zmiennoprzecinkową, w której każdy mikroblok o wartościach od 8 do 32 ma wspólny wykładnik jako współczynnik skalowania. To granularne podejście zachowuje precyzję numeryczną, jednocześnie osiągając 4-bitową reprezentację, utrzymując zakres dynamiczny krytyczny dla architektur transformatorowych. Format integruje się z architekturą Tensor Core firmy NVIDIA, umożliwiając wydajne obliczenia o mieszanej precyzji z dekompresją „w locie” podczas operacji na macierzach.
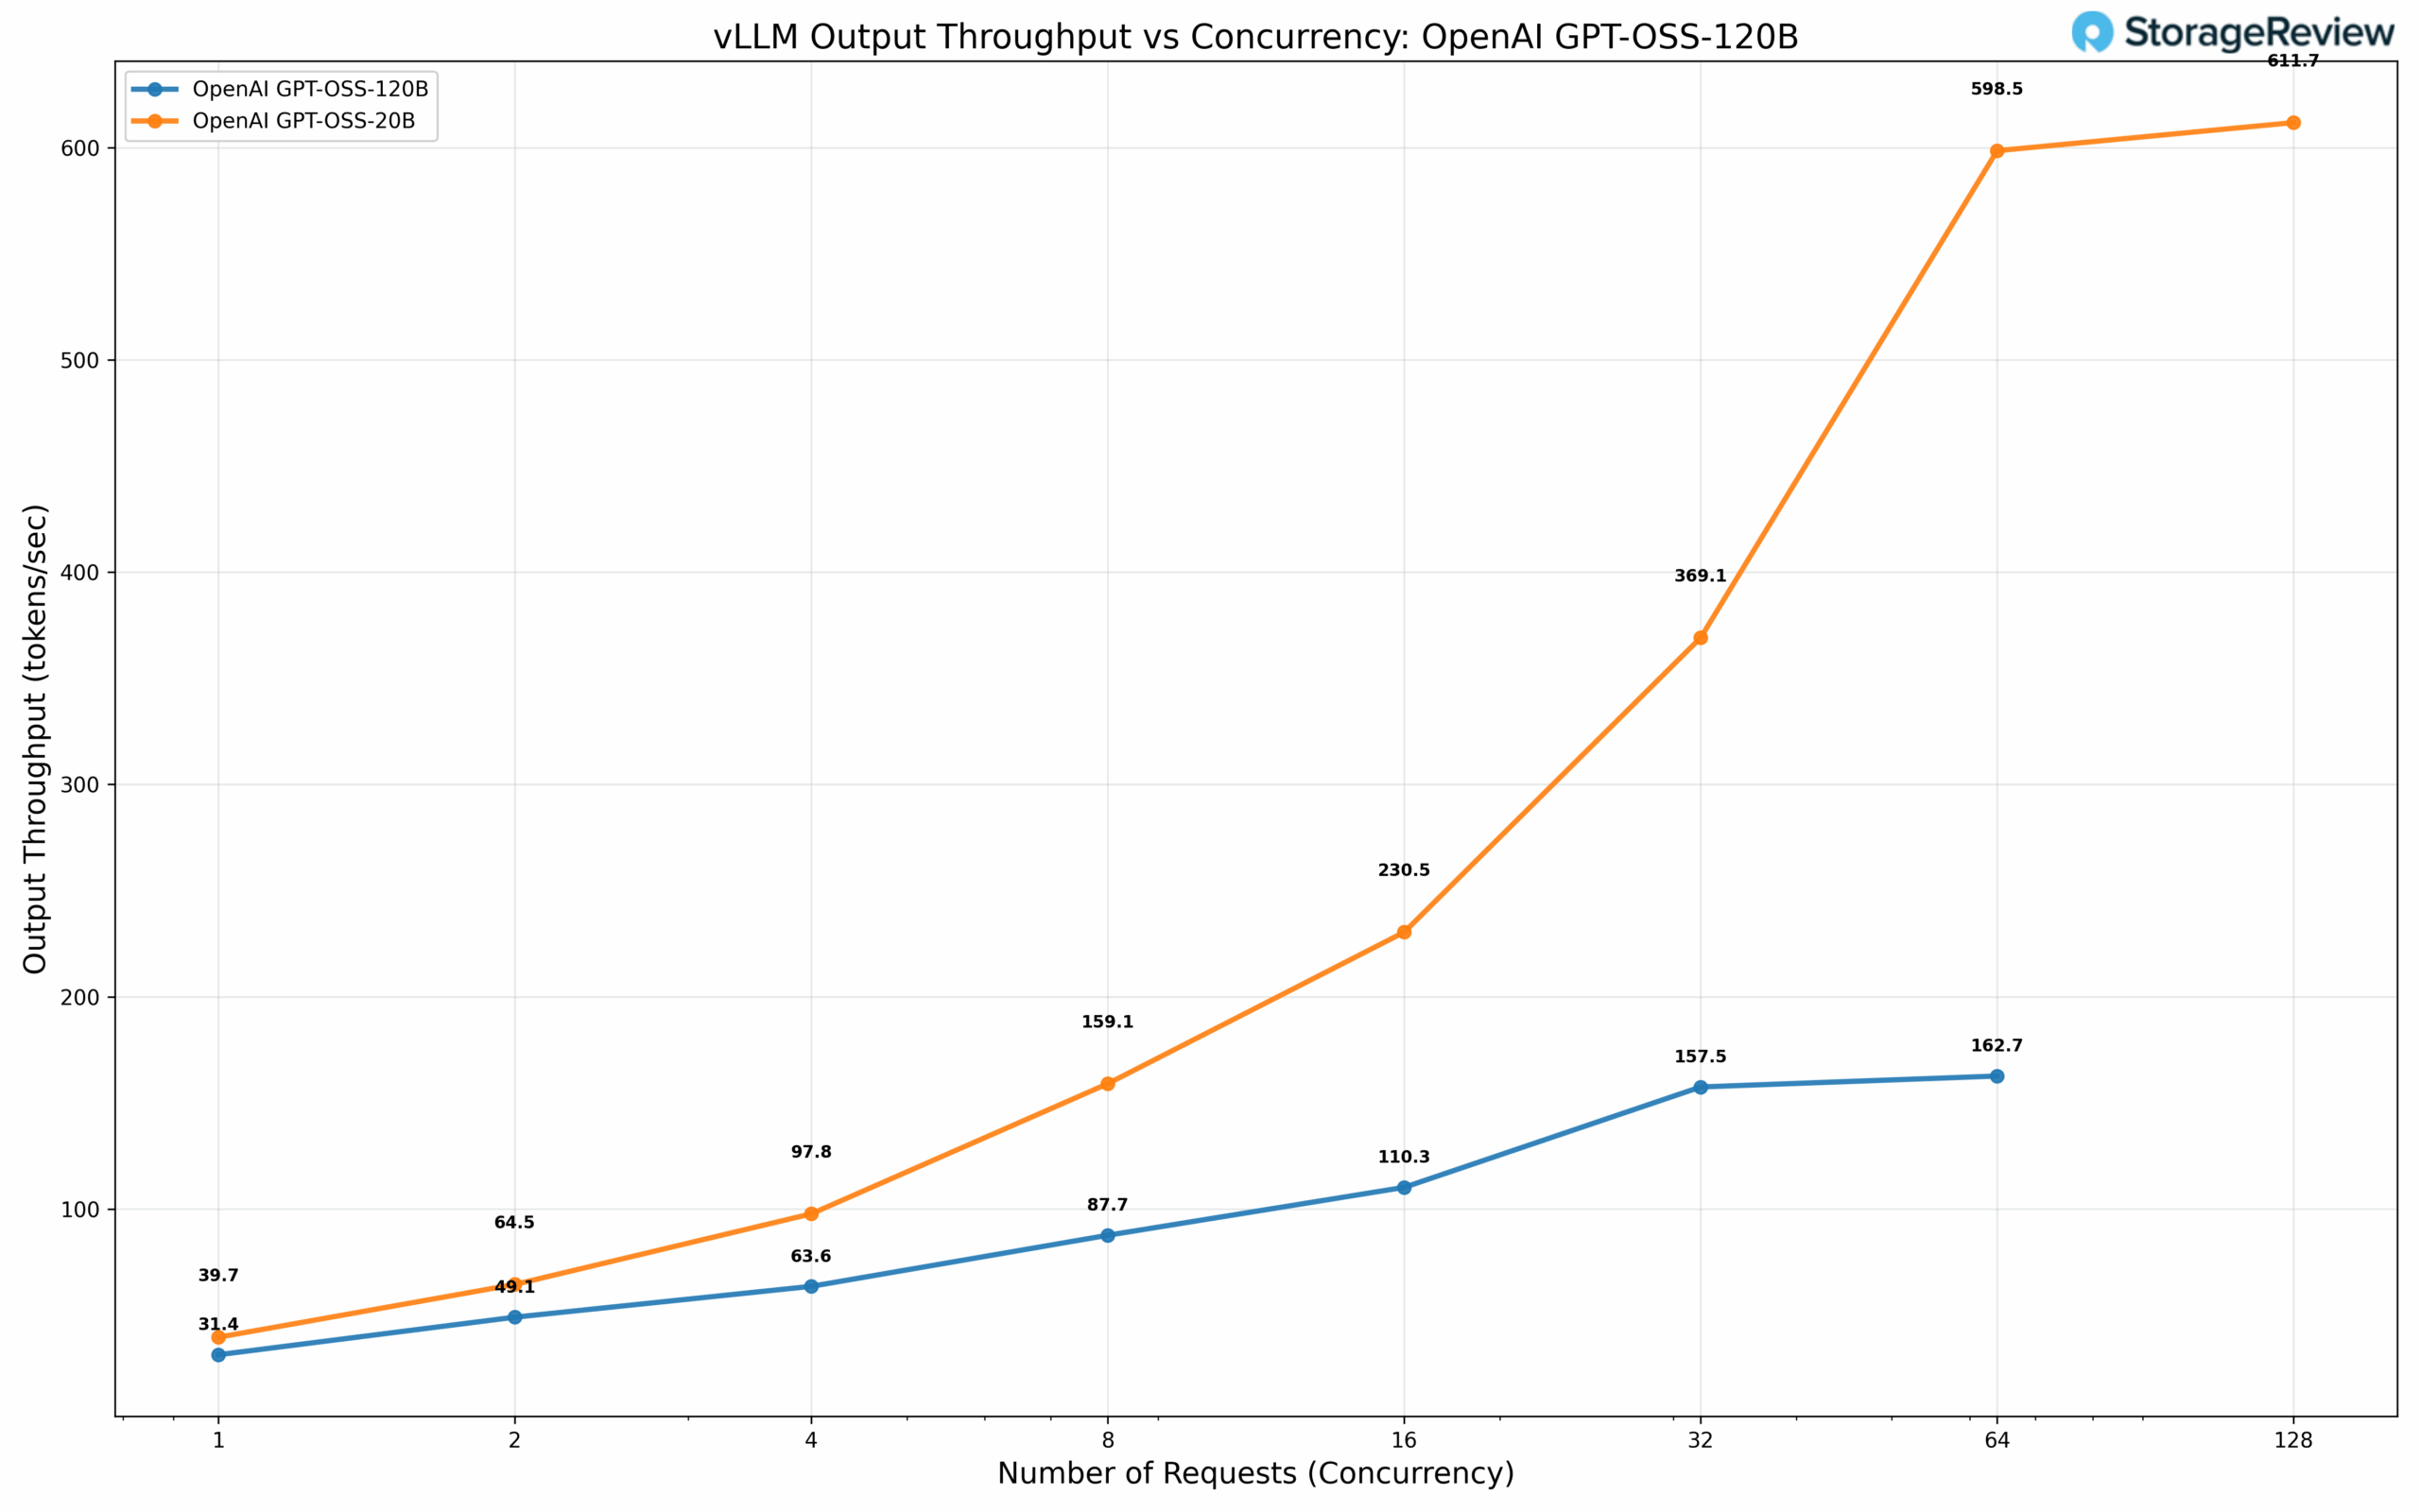
Oceniliśmy modele GPT OSS OpenAI w skalach parametrów 20 B i 120 B, wykorzystując kwantyzację NVFP4. Model 20 B osiąga 39.7 tok/s przy współbieżności 1, skalując się do 611.7 tok/s przy 128 równoczesnych żądaniach. Wariant 120 B zapewnia 31.4 tok/s przy współbieżności 1 i 162.7 tok/s przy 64 równoczesnych żądaniach.
Uwaga: Przepustowość wyjściowa to przepustowość pomiędzy żądaniami, a nie przepustowość na żądanie.
Z powodu ograniczonego czasu nie udało nam się ukończyć testów TensorRT. Bądźcie czujni, wkrótce opublikujemy kolejne części na Spark, w których zajmiemy się badaniem wydajności w większej liczbie ram wnioskowania.
Wstępne wypełnianie i dekodowanie ciężkich wniosków
Wnioskowanie LLM można zasadniczo rozłożyć na dwie odrębne fazy obliczeniowe, z których każda charakteryzuje się wyraźnie odmiennymi parametrami wydajności i wzorcami wykorzystania zasobów. Faza wstępnego wypełniania przetwarza cały monit wejściowy w jednej równoległej operacji, jednocześnie obliczając mechanizmy uwagi dla wszystkich tokenów wejściowych – operacja wymagająca dużych nakładów obliczeniowych, która w pełni nasyca rdzenie tensorowe i jednostki obliczeniowe. Natomiast faza dekodowania generuje tokeny wyjściowe autoregresywnie, generując jeden token na raz poprzez sekwencyjne operacje, które charakteryzują się niższą intensywnością obliczeniową, ale stawiają znaczne wymagania dotyczące przepustowości pamięci, ponieważ model musi wielokrotnie uzyskiwać dostęp do wag i rosnącej pamięci podręcznej klucz-wartość. Tworzy to zasadniczo różne profile wąskich gardeł: operacje wstępnego wypełniania są zazwyczaj ograniczone obliczeniowo, podczas gdy operacje dekodowania stają się intensywne pod względem przepustowości pamięci, co czyni je szczególnie podatnymi na ograniczenia podsystemów pamięci.
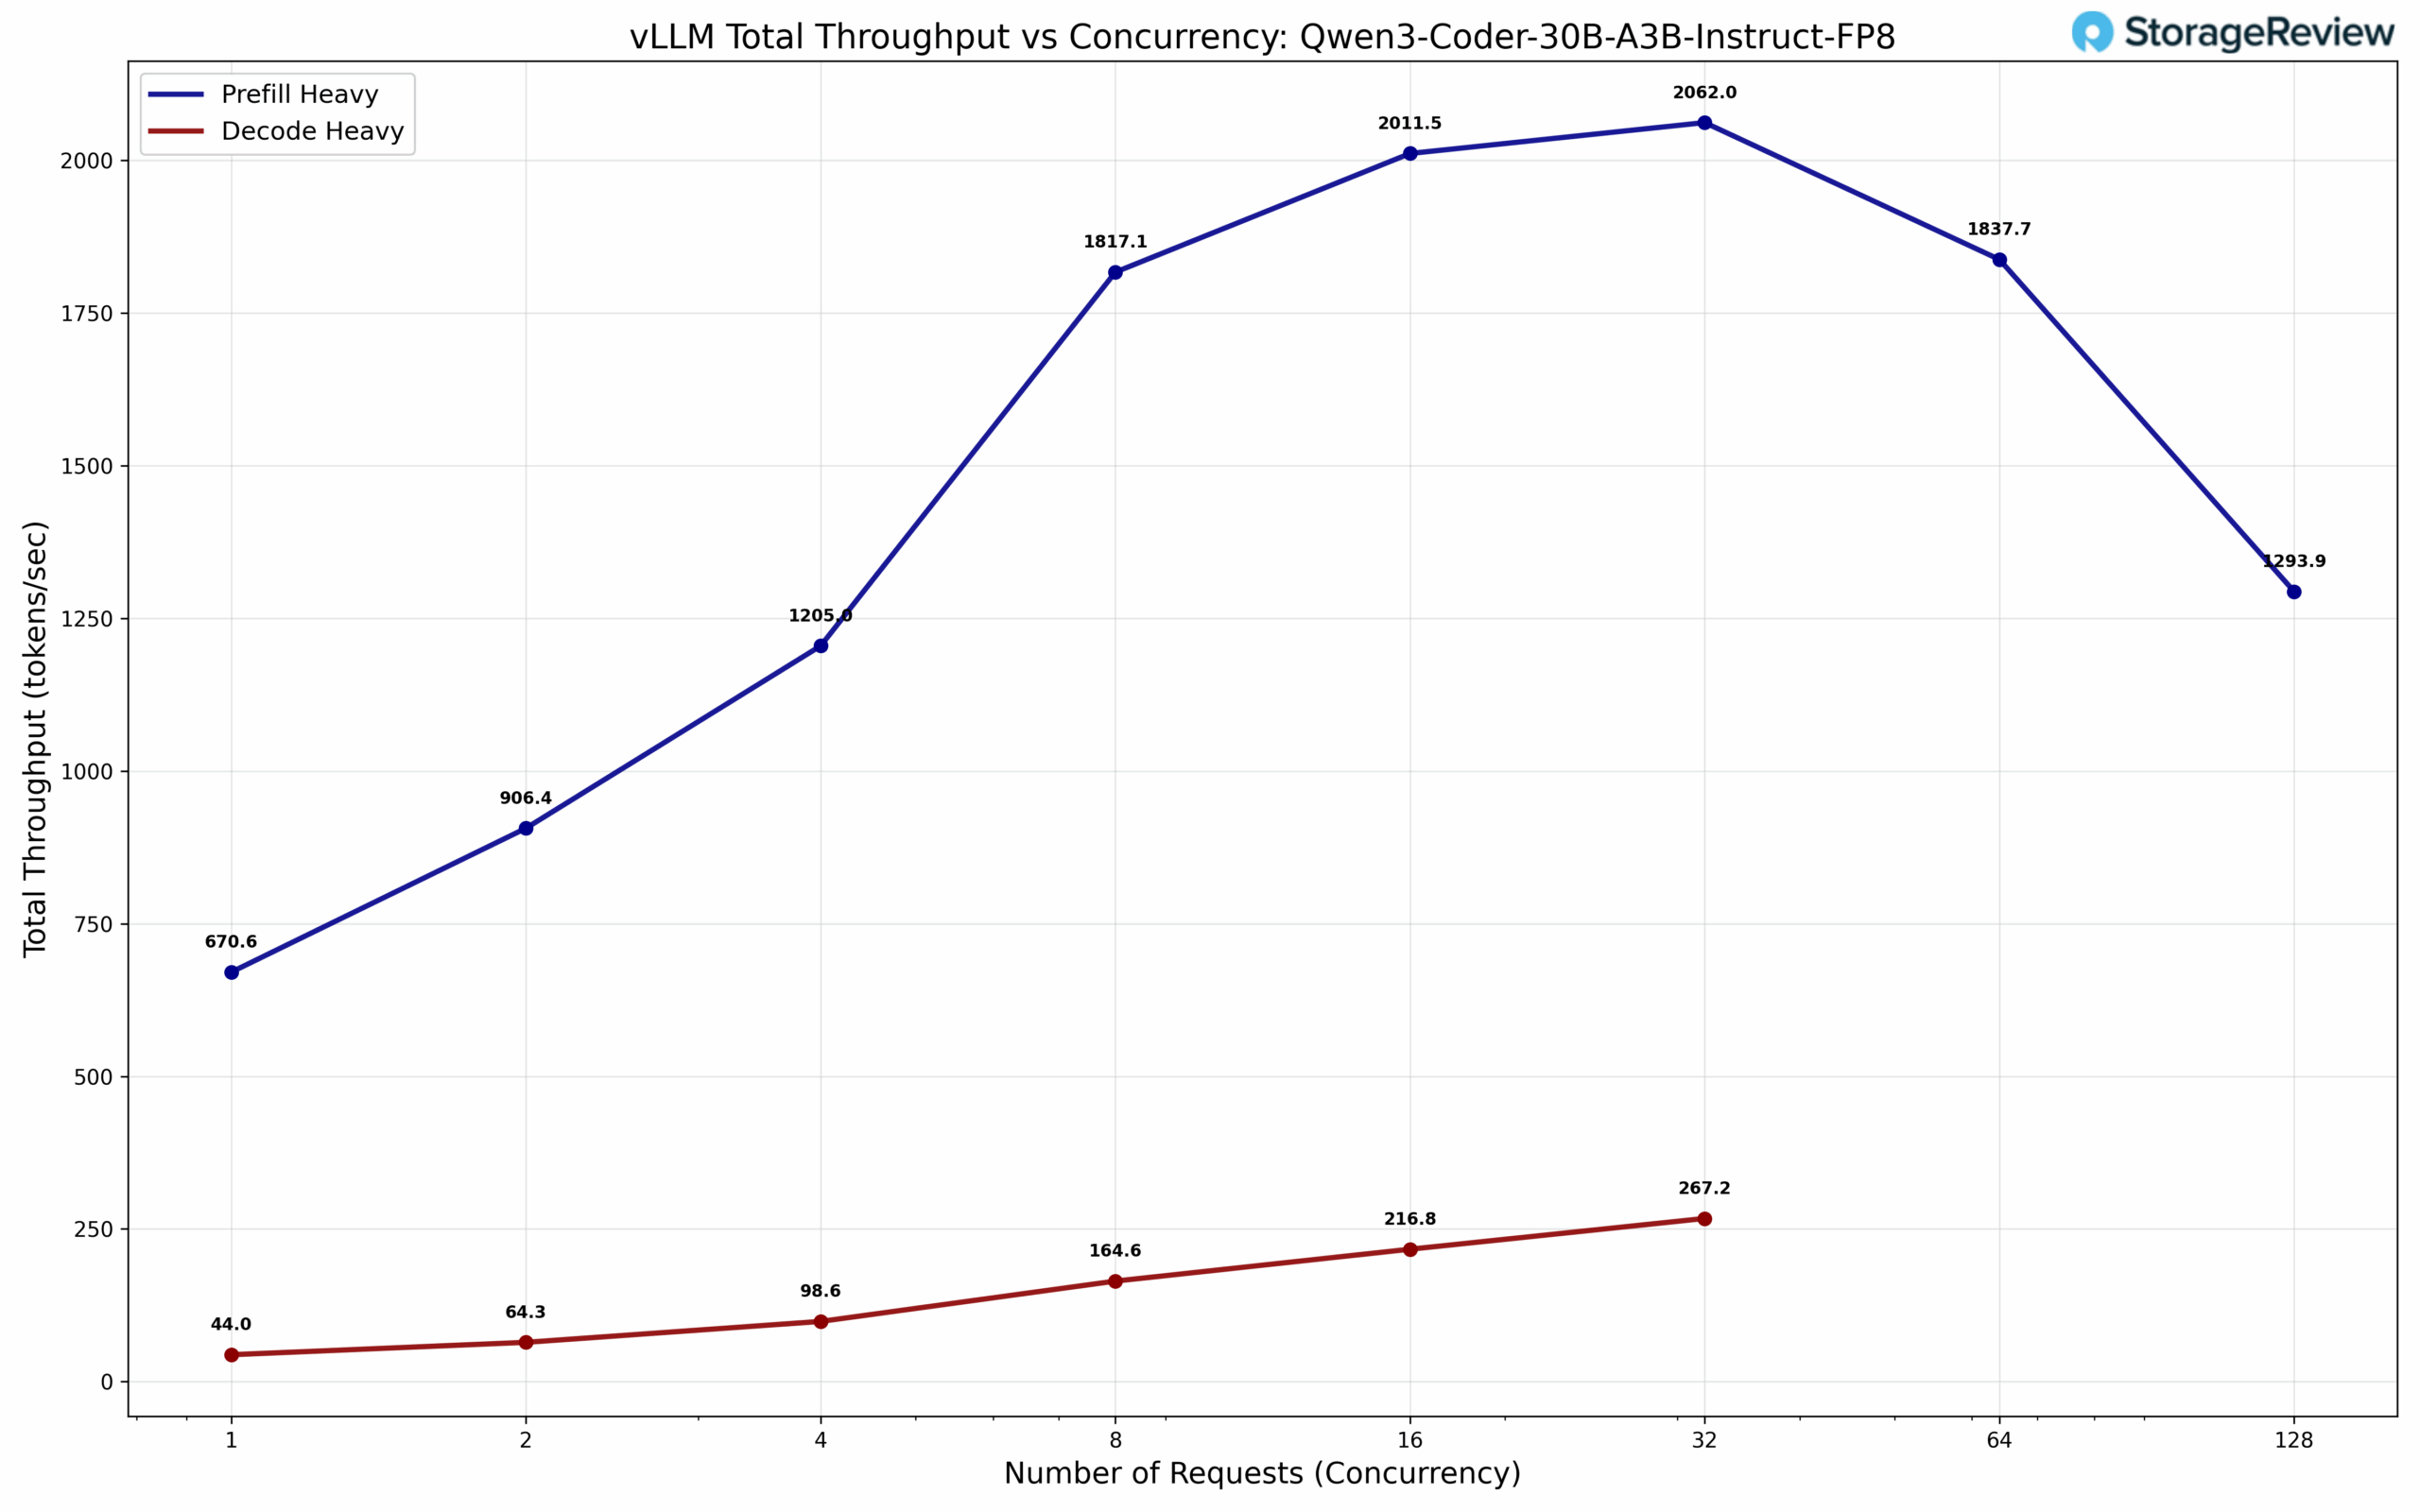
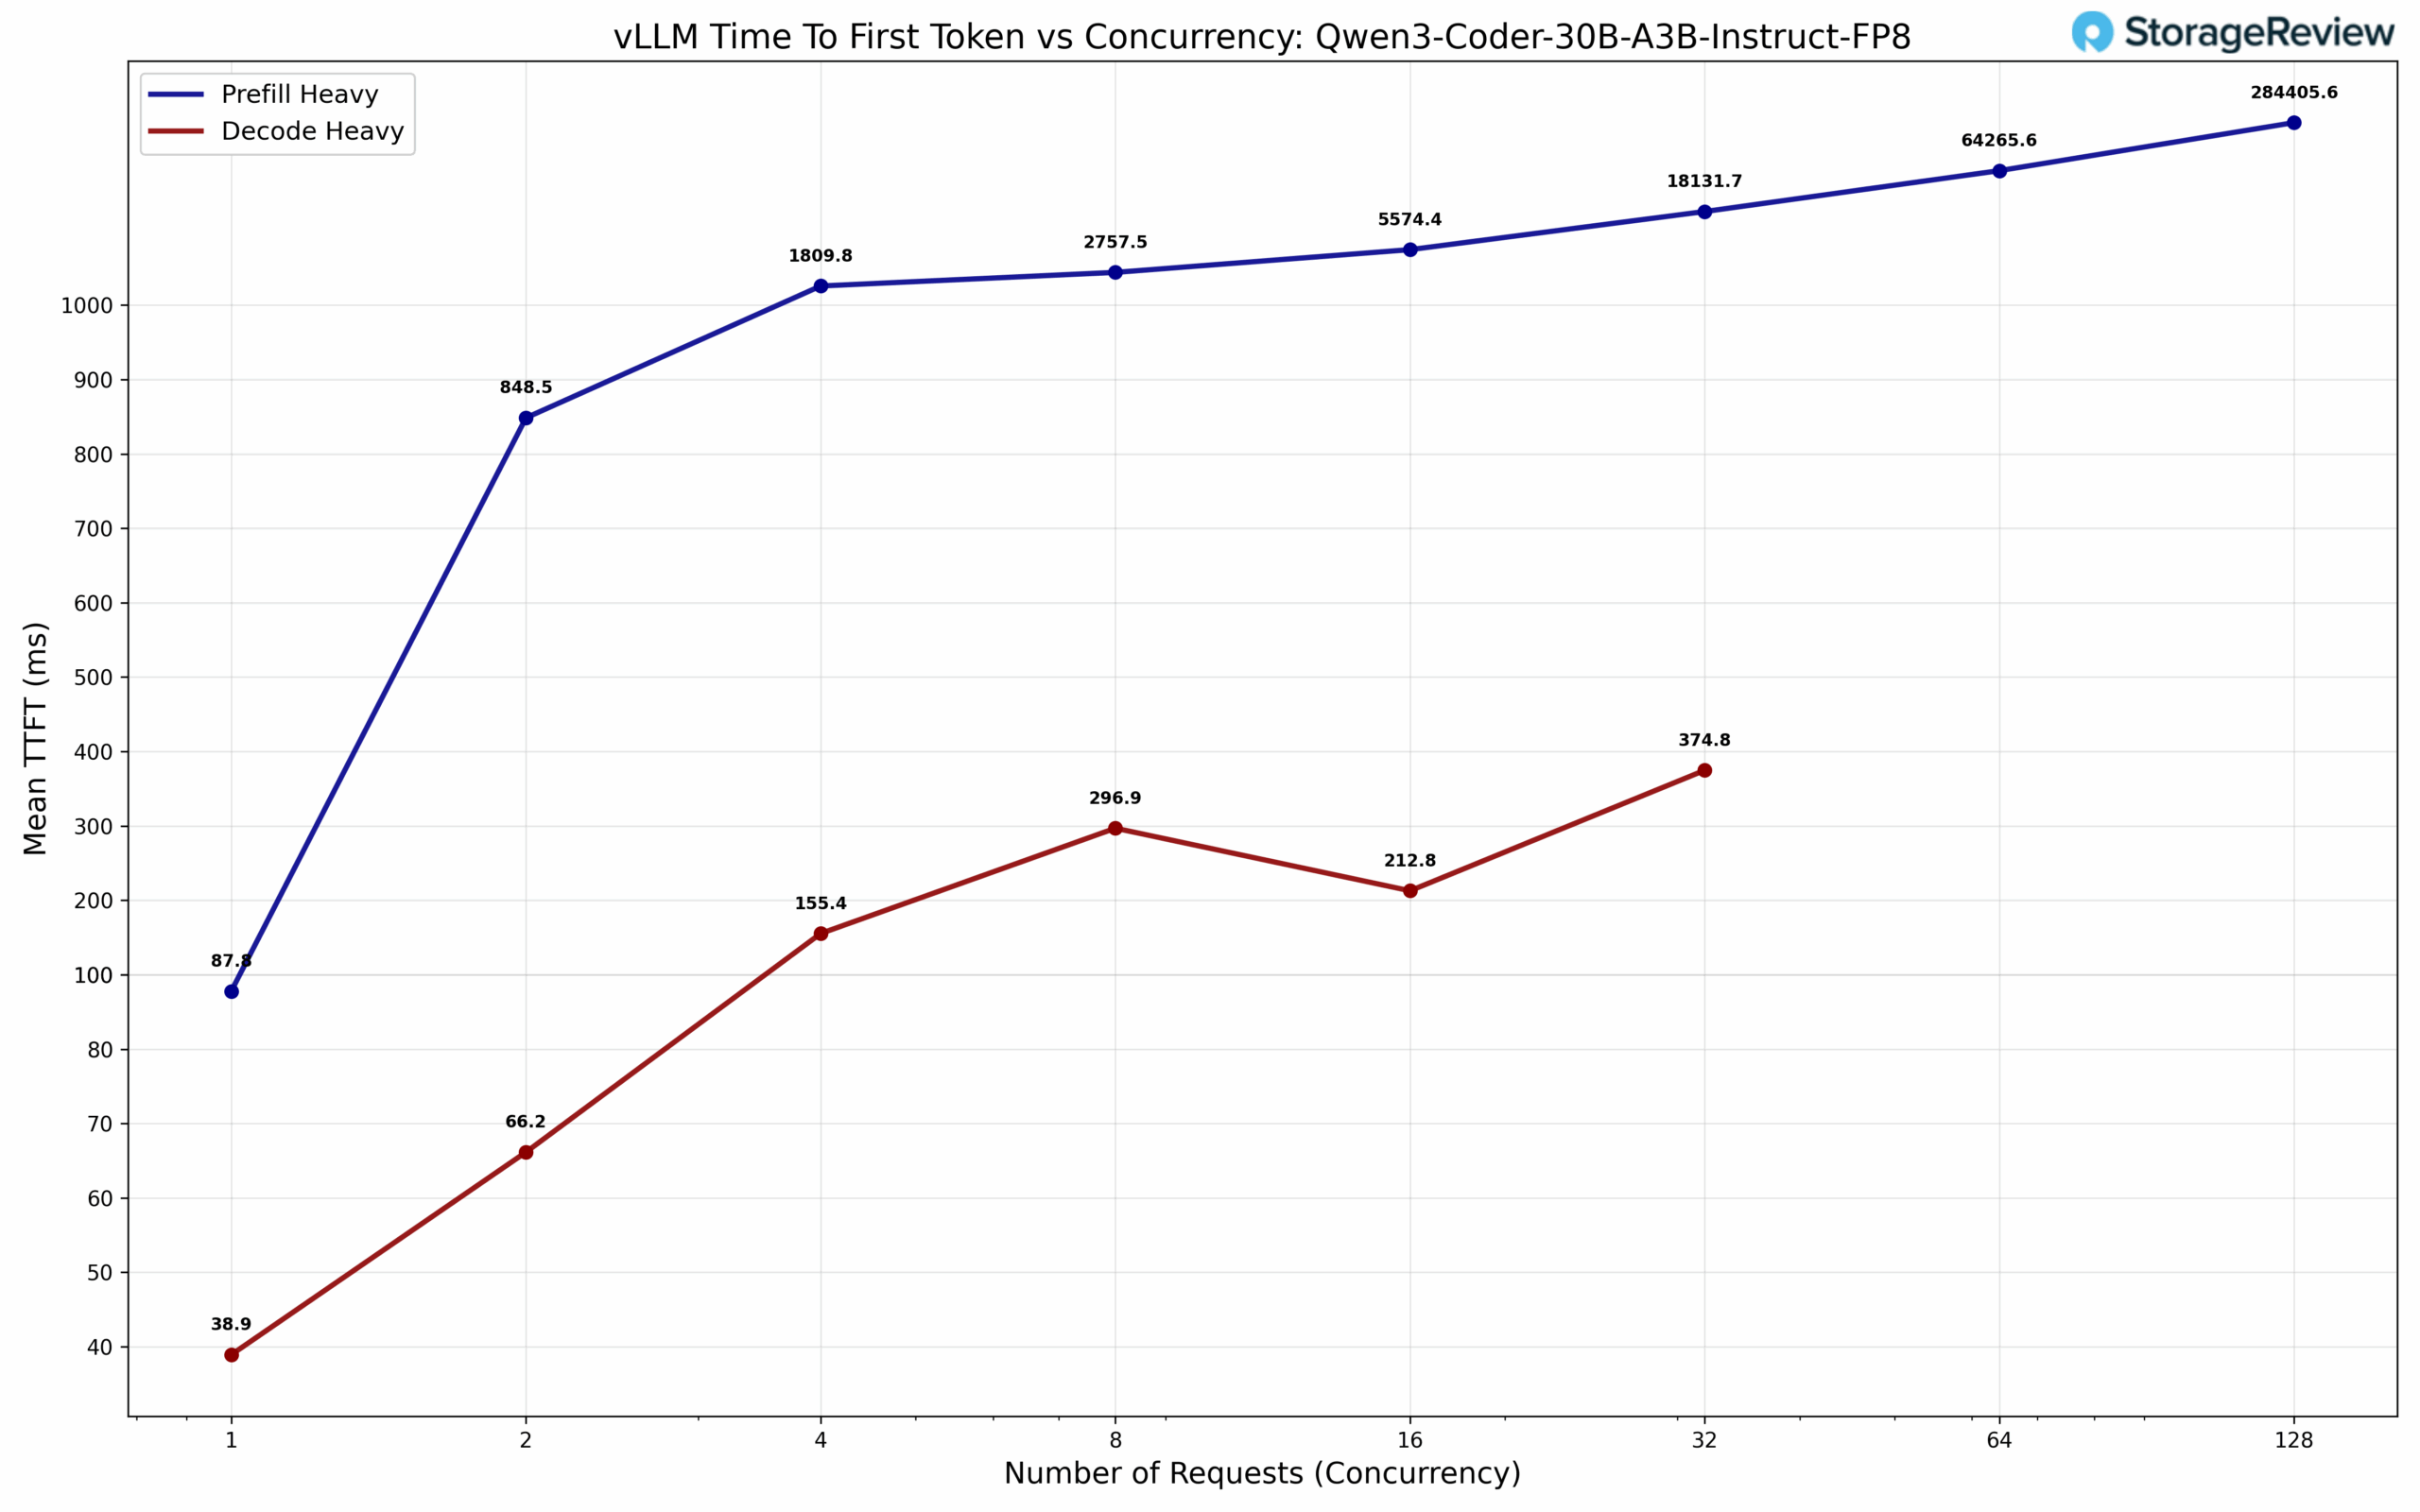
Przeprowadziliśmy kompleksowe testy w dwóch różnych profilach obciążenia: wnioskowanie z dużą ilością dekodowania z 512 tokenami wejściowymi i 8,192 tokenami wyjściowymi oraz wnioskowanie z dużą ilością wstępnego wypełniania z 8,192 tokenami wejściowymi i 512 tokenami wyjściowymi. Charakterystyka wydajności ujawnia oczekiwane kompromisy architektoniczne: Spark wykazuje konkurencyjną przepustowość w obciążeniach z dużą ilością wstępnego wypełniania, gdzie zasoby obliczeniowe pozostają głównym wąskim gardłem, ale wykazuje gorszą wydajność w scenariuszach z dużą ilością dekodowania. Ta różnica w wydajności jest precyzyjnie zgodna z ograniczeniami przepustowości pamięci. Sekwencyjny charakter operacji dekodowania i intensywne wzorce dostępu do pamięci bezpośrednio ujawniają ograniczenia przepustowości nieodłącznie związane z architekturą Spark. Wyniki te stanowią kluczowy kontekst do interpretacji pomiarów MAMF w następnej sekcji, ponieważ oba zestawy testów porównawczych konsekwentnie wskazują przepustowość pamięci jako fundamentalny czynnik ograniczający wydajność w rzeczywistych wdrożeniach wnioskowania.
Maksymalna osiągalna liczba flopów Matmul (MAMF)
MAMF (Maximum Achievable Matmul FLOPS) to praktyczna miara wydajności zaprojektowana do pomiaru realnej szczytowej liczby operacji zmiennoprzecinkowych na sekundę, jaką można osiągnąć w akceleratorach uczenia maszynowego podczas operacji mnożenia macierzy. Oferuje ona dokładniejszy benchmark niż teoretyczna szczytowa liczba FLOPS często podawana w specyfikacjach sprzętowych. Korzystamy z benchmarku mamf-finder autorstwa Stasa Beckmana.
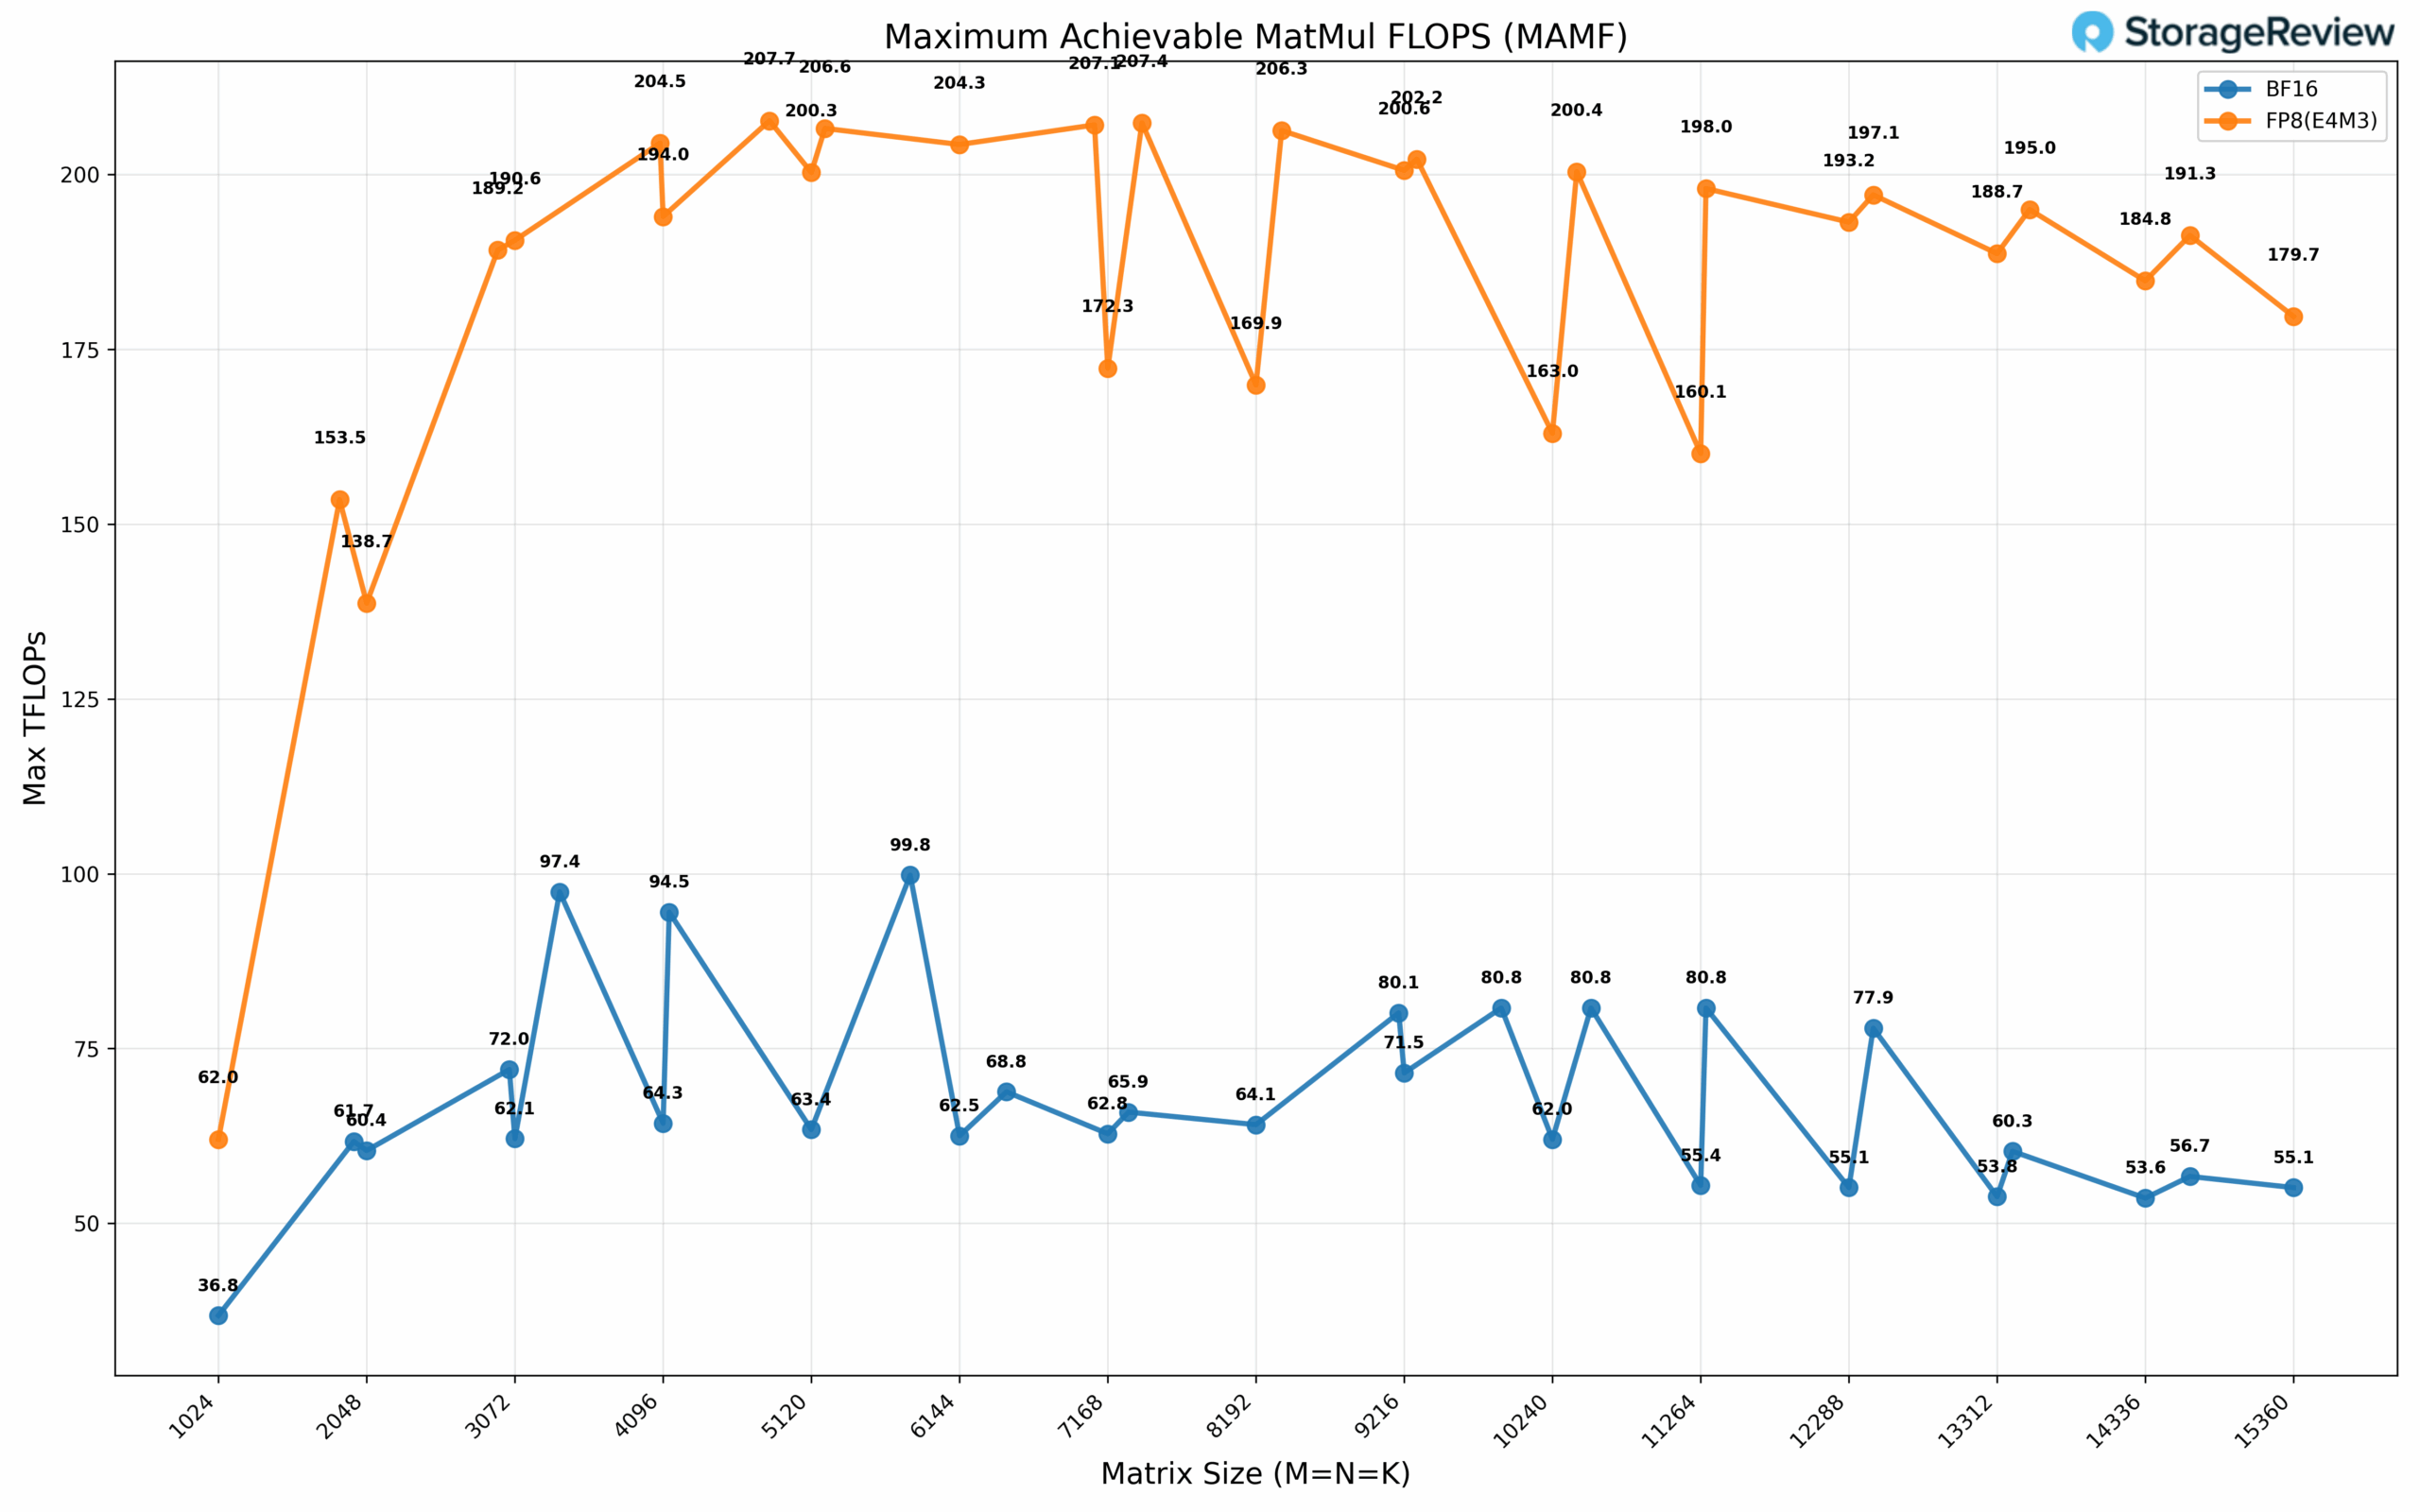
Przy precyzji BF16 obserwujemy MAMF na poziomie 99.8 TFLOP-ów, podczas gdy FP8 (E4M3) wykazuje MAMF na poziomie 207.7 TFLOP-ów. Ze względu na ograniczenia czasowe nie byliśmy w stanie przeprowadzić kompleksowej charakterystyki MAMF dla FP4; jednak ekstrapolując z zaobserwowanych wzorców skalowania opartych na precyzji, przewidujemy dodatkowy dwukrotny wzrost wydajności w porównaniu z FP8, co daje około 400 TFLOP-ów dla gęstych operacji FP4. Po uwzględnieniu optymalizacji rzadkości strukturalnej 2:1, przekłada się to na około 80% teoretycznych możliwości wydajnościowych FP4, osiągając około 800 TFLOP-ów przy rzadkich obciążeniach obliczeniowych. Należy zauważyć, że te pomiary MAMF mogą być niższe od teoretycznie deklarowanych specyfikacji z wielu powodów, których nie będziemy omawiać w tym przeglądzie.
Bezpośrednie przechowywanie GPU
Jednym z testów, jakie przeprowadziliśmy na Sparku, był test MagnumIO GPU Direct Storage (GDS). GDS to funkcja opracowana przez firmę NVIDIA, która pozwala procesorom graficznym ominąć procesor główny (CPU) podczas uzyskiwania dostępu do danych przechowywanych na dyskach NVMe lub innych szybkich urządzeniach pamięci masowej. Zamiast kierować dane przez procesor i pamięć systemową, GDS umożliwia bezpośrednią komunikację między procesorem graficznym a urządzeniem pamięci masowej, znacznie redukując opóźnienia i poprawiając przepustowość danych.
Jak działa bezpośrednie przechowywanie danych GPU
Tradycyjnie, gdy procesor graficzny (GPU) przetwarza dane przechowywane na dysku NVMe, dane muszą najpierw przejść przez procesor (CPU) i pamięć systemową, zanim dotrą do procesora graficznego (GPU). Proces ten wprowadza wąskie gardła, ponieważ procesor (CPU) staje się pośrednikiem, zwiększając opóźnienia i zużywając cenne zasoby systemowe. Technologia GPU Direct Storage eliminuje ten problem, umożliwiając procesorowi graficznemu bezpośredni dostęp do danych z urządzenia pamięci masowej za pośrednictwem magistrali PCIe. Ta bezpośrednia ścieżka zmniejsza obciążenie związane z przesyłaniem danych, umożliwiając szybsze i bardziej wydajne przesyłanie danych.
Obciążenia sztucznej inteligencji, zwłaszcza te wykorzystujące uczenie głębokie, charakteryzują się wysoką intensywnością przetwarzania danych. Trenowanie dużych sieci neuronowych wymaga przetwarzania terabajtów danych, a każde opóźnienie w transferze danych może prowadzić do niewykorzystania procesorów graficznych (GPU) i wydłużenia czasu trenowania. Technologia GPU Direct Storage rozwiązuje ten problem, zapewniając jak najszybsze dostarczanie danych do procesora graficznego (GPU), minimalizując czas przestoju i maksymalizując wydajność obliczeniową.
Ponadto GDS jest szczególnie przydatny w przypadku obciążeń wymagających strumieniowego przesyłania dużych zbiorów danych, takich jak przetwarzanie wideo, przetwarzanie języka naturalnego czy wnioskowanie w czasie rzeczywistym. Zmniejszając zależność od procesora, GDS przyspiesza przesyłanie danych i uwalnia zasoby procesora do innych zadań, co dodatkowo zwiększa ogólną wydajność systemu.
GDSIO – Wewnętrzny dysk M.2 o pojemności 4 TB
NVIDIA DGX Spark oferuje interesującą opcję przechowywania danych. Ze względu na rozmiar w małej obudowie, NVIDIA wybrała mniej popularny dysk SSD Gen5 2242 M.2. Dla czytelników niezaznajomionych z tym typem dysku SSD, jest to krótsza, 42-milimetrowa wersja w porównaniu z 80-milimetrową, która jest bardziej popularna w komputerach stacjonarnych. Dostępnych jest mniej dysków, a maksymalna pojemność w tym rozmiarze to 4 TB. Głównym problemem jest jednak wydajność. Małe dyski SSD, takie jak modele 2242 i 2230, mają priorytet w kwestii rozmiaru, a prędkość napędu jest drugorzędna. Są one powszechnie stosowane w przenośnych konsolach do gier, tabletach i niektórych notebookach.
Na płytce drukowanej dysków SSD 2230 i 2242 nie ma dużo miejsca, co skutkuje mniejszą ilością miejsca na kontrolery, pamięć DRAM i pakiety NAND. Podczas testów zaobserwowaliśmy niektóre z tych kompromisów. Podczas obciążenia GDSIO na dysku o pojemności 1 TB lub 128 GB, dysk SSD blokował się i wymagał ponownego obrazowania serwera Spark. Zmniejszenie rozmiaru testowego do 64 GB, a także zmniejszenie liczby wątków o wyższej liczbie wątków, rozwiązało ten problem. Problemy te zazwyczaj nie występują w przypadku bardziej popularnych, wydajnych dysków SSD 80 mm.
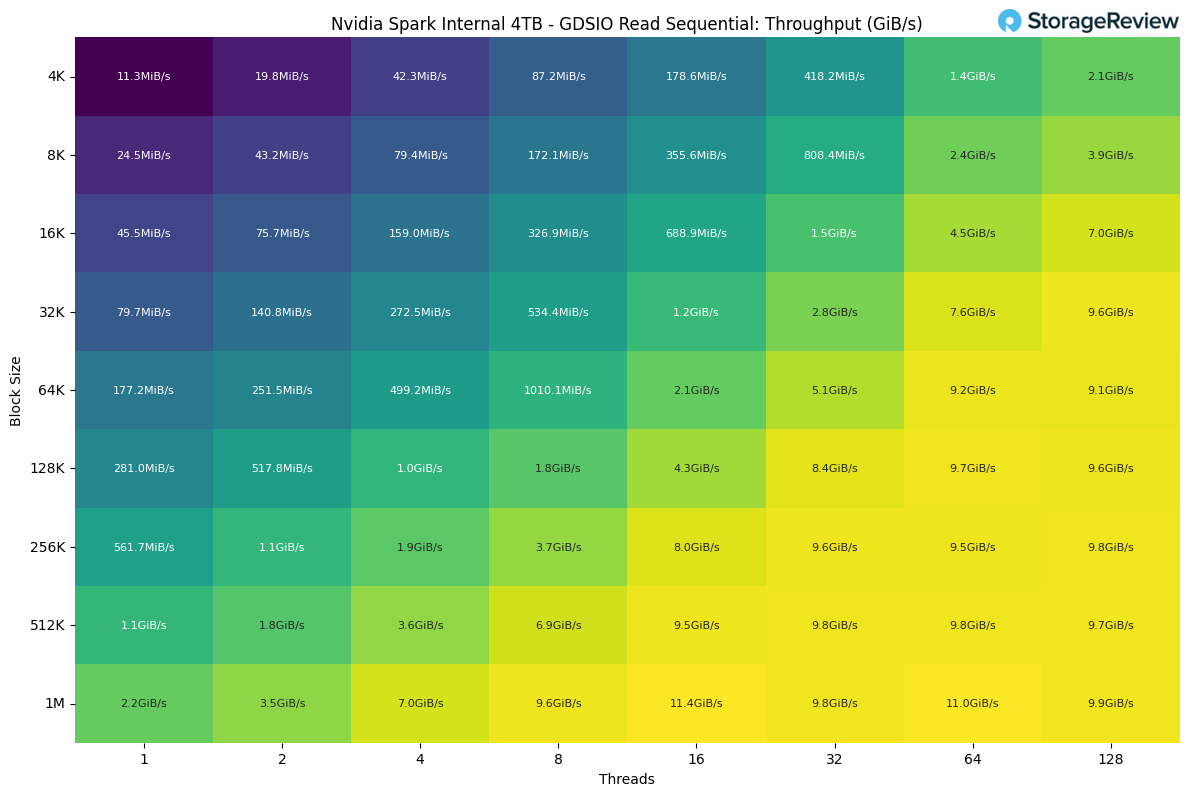
Analizując wydajność odczytu sekwencyjnego dysku wewnętrznego, widzimy, że najwyższą przepustowość osiągnięto przy rozmiarze bloku 1 MB i 16 wątkach, osiągając 11.4 GiB/s.
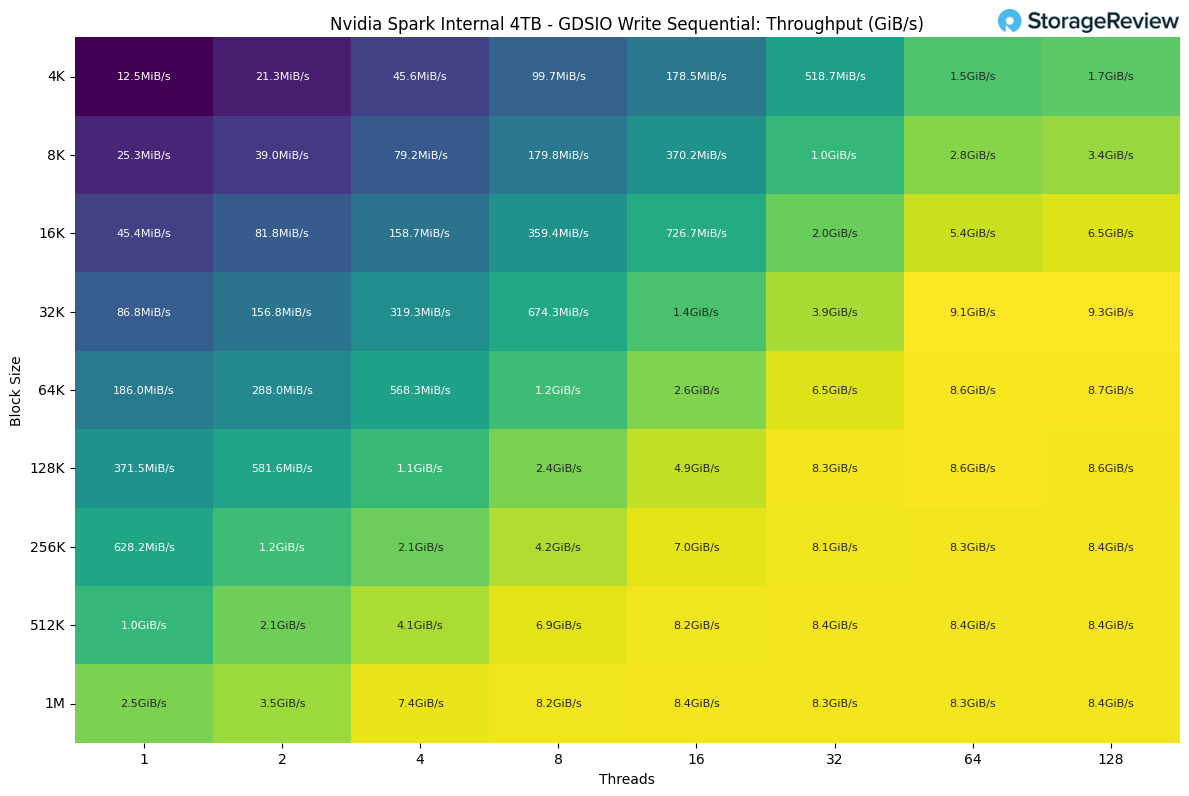
Patrząc na wydajność zapisu sekwencyjnego, dysk osiąga najwyższą przepustowość przy rozmiarze bloku 32 KB i 128 wątkach. Przy większych rozmiarach bloków wydajność wydaje się osiągać poziom plateau, osiągając średnio około 8.3 GiB/s.
Nabywcom, którzy chcą nabyć kartę NVIDIA DGX Spark do bardziej wymagających prac programistycznych, zwłaszcza firmom, które mogą tworzyć na jej podstawie niewielkie klastry, zdecydowanie polecamy wykorzystanie zintegrowanej karty sieciowej NVIDIA ConnectX-7 o przepustowości 200 Gb/s.
GDSIO – NVMe-oF przez RDMA
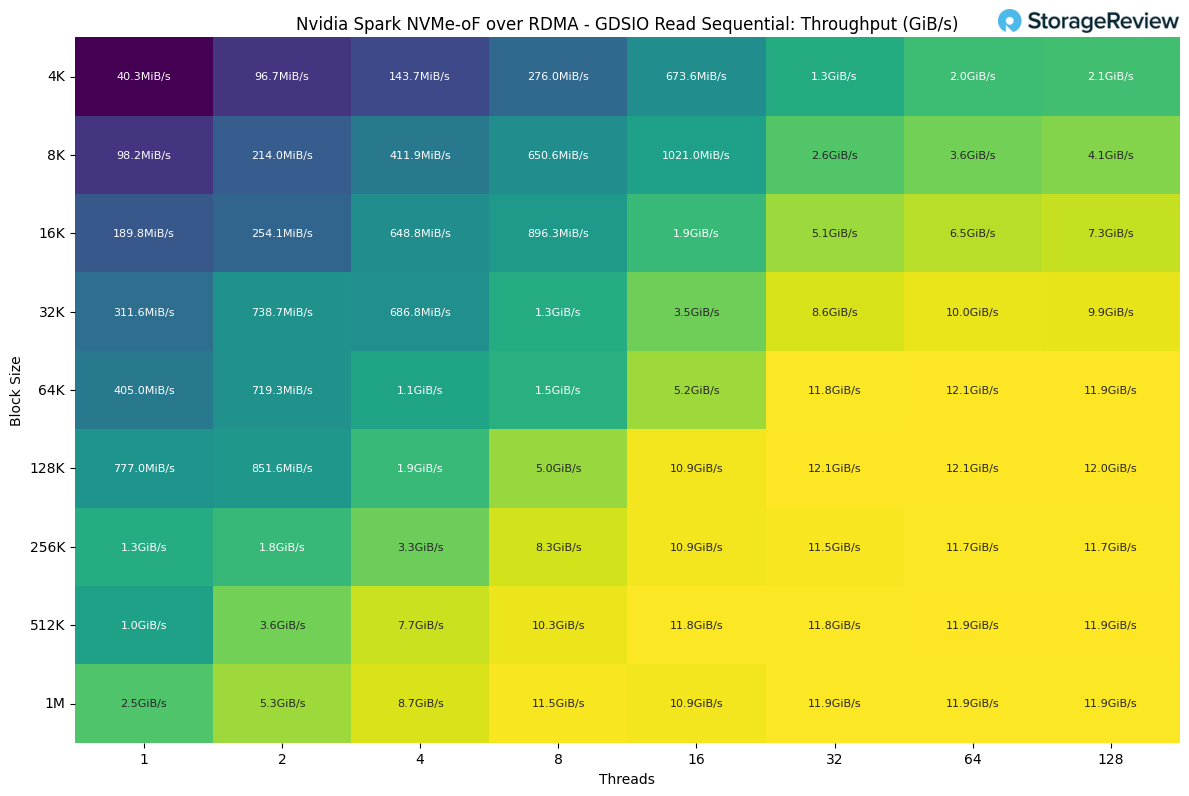
Do testów NVMe-oF RDMA z kartą NVIDIA DGX Spark wykorzystaliśmy oprogramowanie PEAK:AIO do utworzenia docelowego rozwiązania NVMe-oF na serwerze Dell PowerEdge R770 z sześcioma dyskami SSD Micron 9550 o pojemności 3.84 TB i połączeniem RDMA. Jak już wspomnieliśmy, karta sieciowa CX7 serwera Spark ma swoje wady i ze względu na ograniczenia czasowe mogliśmy przetestować serwer Spark tylko z łącznością 100G. Zarówno Spark, jak i PEAK:AIO osiągają znacznie wyższe wartości. W kolejnych częściach przeprowadzimy dodatkowe testy pamięci masowej i sieci z serwerem Spark.
Analizując wydajność odczytu sekwencyjnego dysku wewnętrznego, widzimy, że najwyższą przepustowość osiągnięto przy rozmiarze bloku 128 KB z 32 wątkami, osiągając 12.1 GiB/s.
Patrząc na wydajność zapisu sekwencyjnego, dysk osiąga najwyższą przepustowość przy rozmiarze bloku 128 KB i 16 wątkach. Przy większych rozmiarach bloków wydajność wydaje się osiągać poziom plateau, osiągając średnio około 11.3 GiB/s.
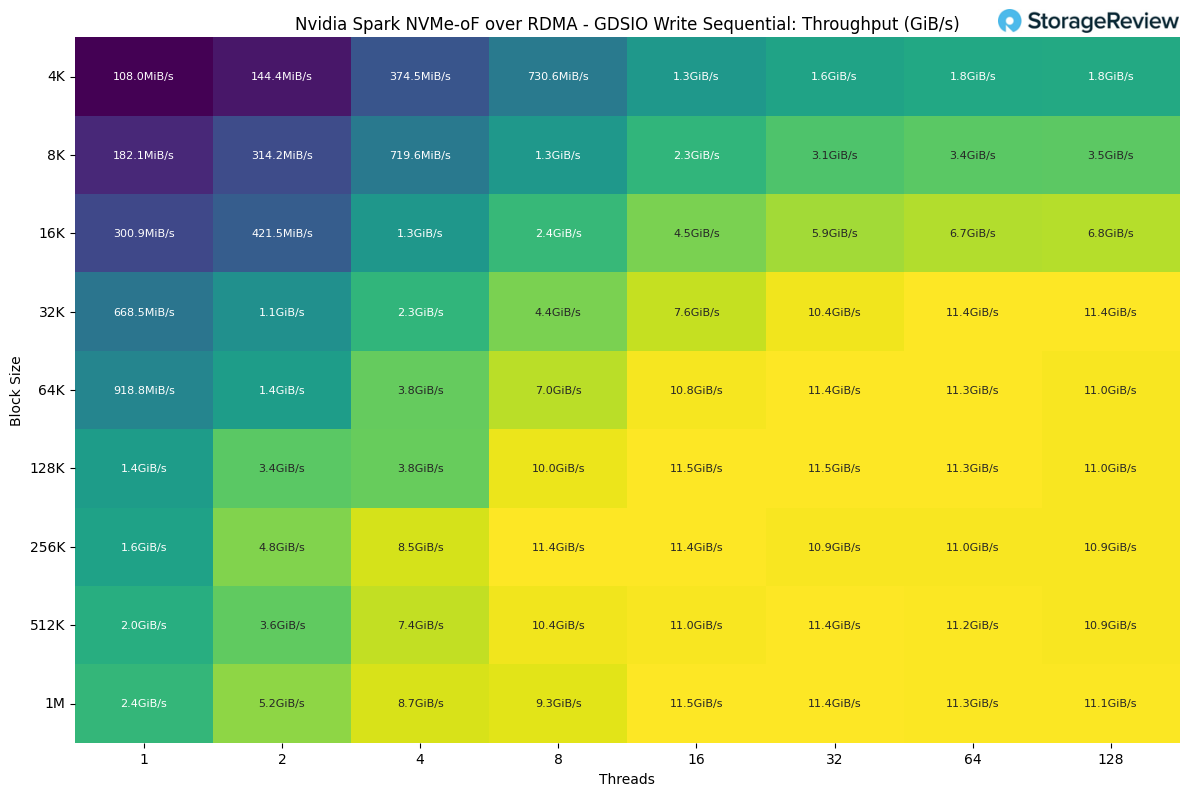
Te wyniki są bardzo zróżnicowane – widzimy tylko połowę teoretycznego maksimum ze względu na wspomniane wcześniej czynniki związane z czasem i siecią. Dodatkowo, najwyższa przepustowość przy rozmiarze bloku 128 KB zależy od wielu czynników, takich jak wykorzystane przez nas dyski klasy enterprise lub sposób, w jaki PEAK:AIO obsługuje to wejście/wyjście. Uzyskane rezultaty mogą się różnić i zamierzamy w przyszłości przeprowadzić więcej testów z wykorzystaniem Spark.
Ekosystem oprogramowania Day-One
NVIDIA i inni dostawcy zainwestowali znaczne środki w gotowość oprogramowania, co stanowi wyraźne odejście od typowych premier sprzętowych, gdzie pierwsi użytkownicy borykają się z niekompletną dokumentacją i brakującymi narzędziami. Platforma Spark wprowadza na rynek kompleksowe podręczniki obejmujące typowe procesy pracy: ComfyUI dla modeli dyfuzyjnych, TRT-LLM dla zoptymalizowanego wnioskowania, Ollama z Open WebUI do obsługi modeli lokalnych, Unsloth do precyzyjnego dostrajania oraz architektury wieloagentowe z LangGraph.
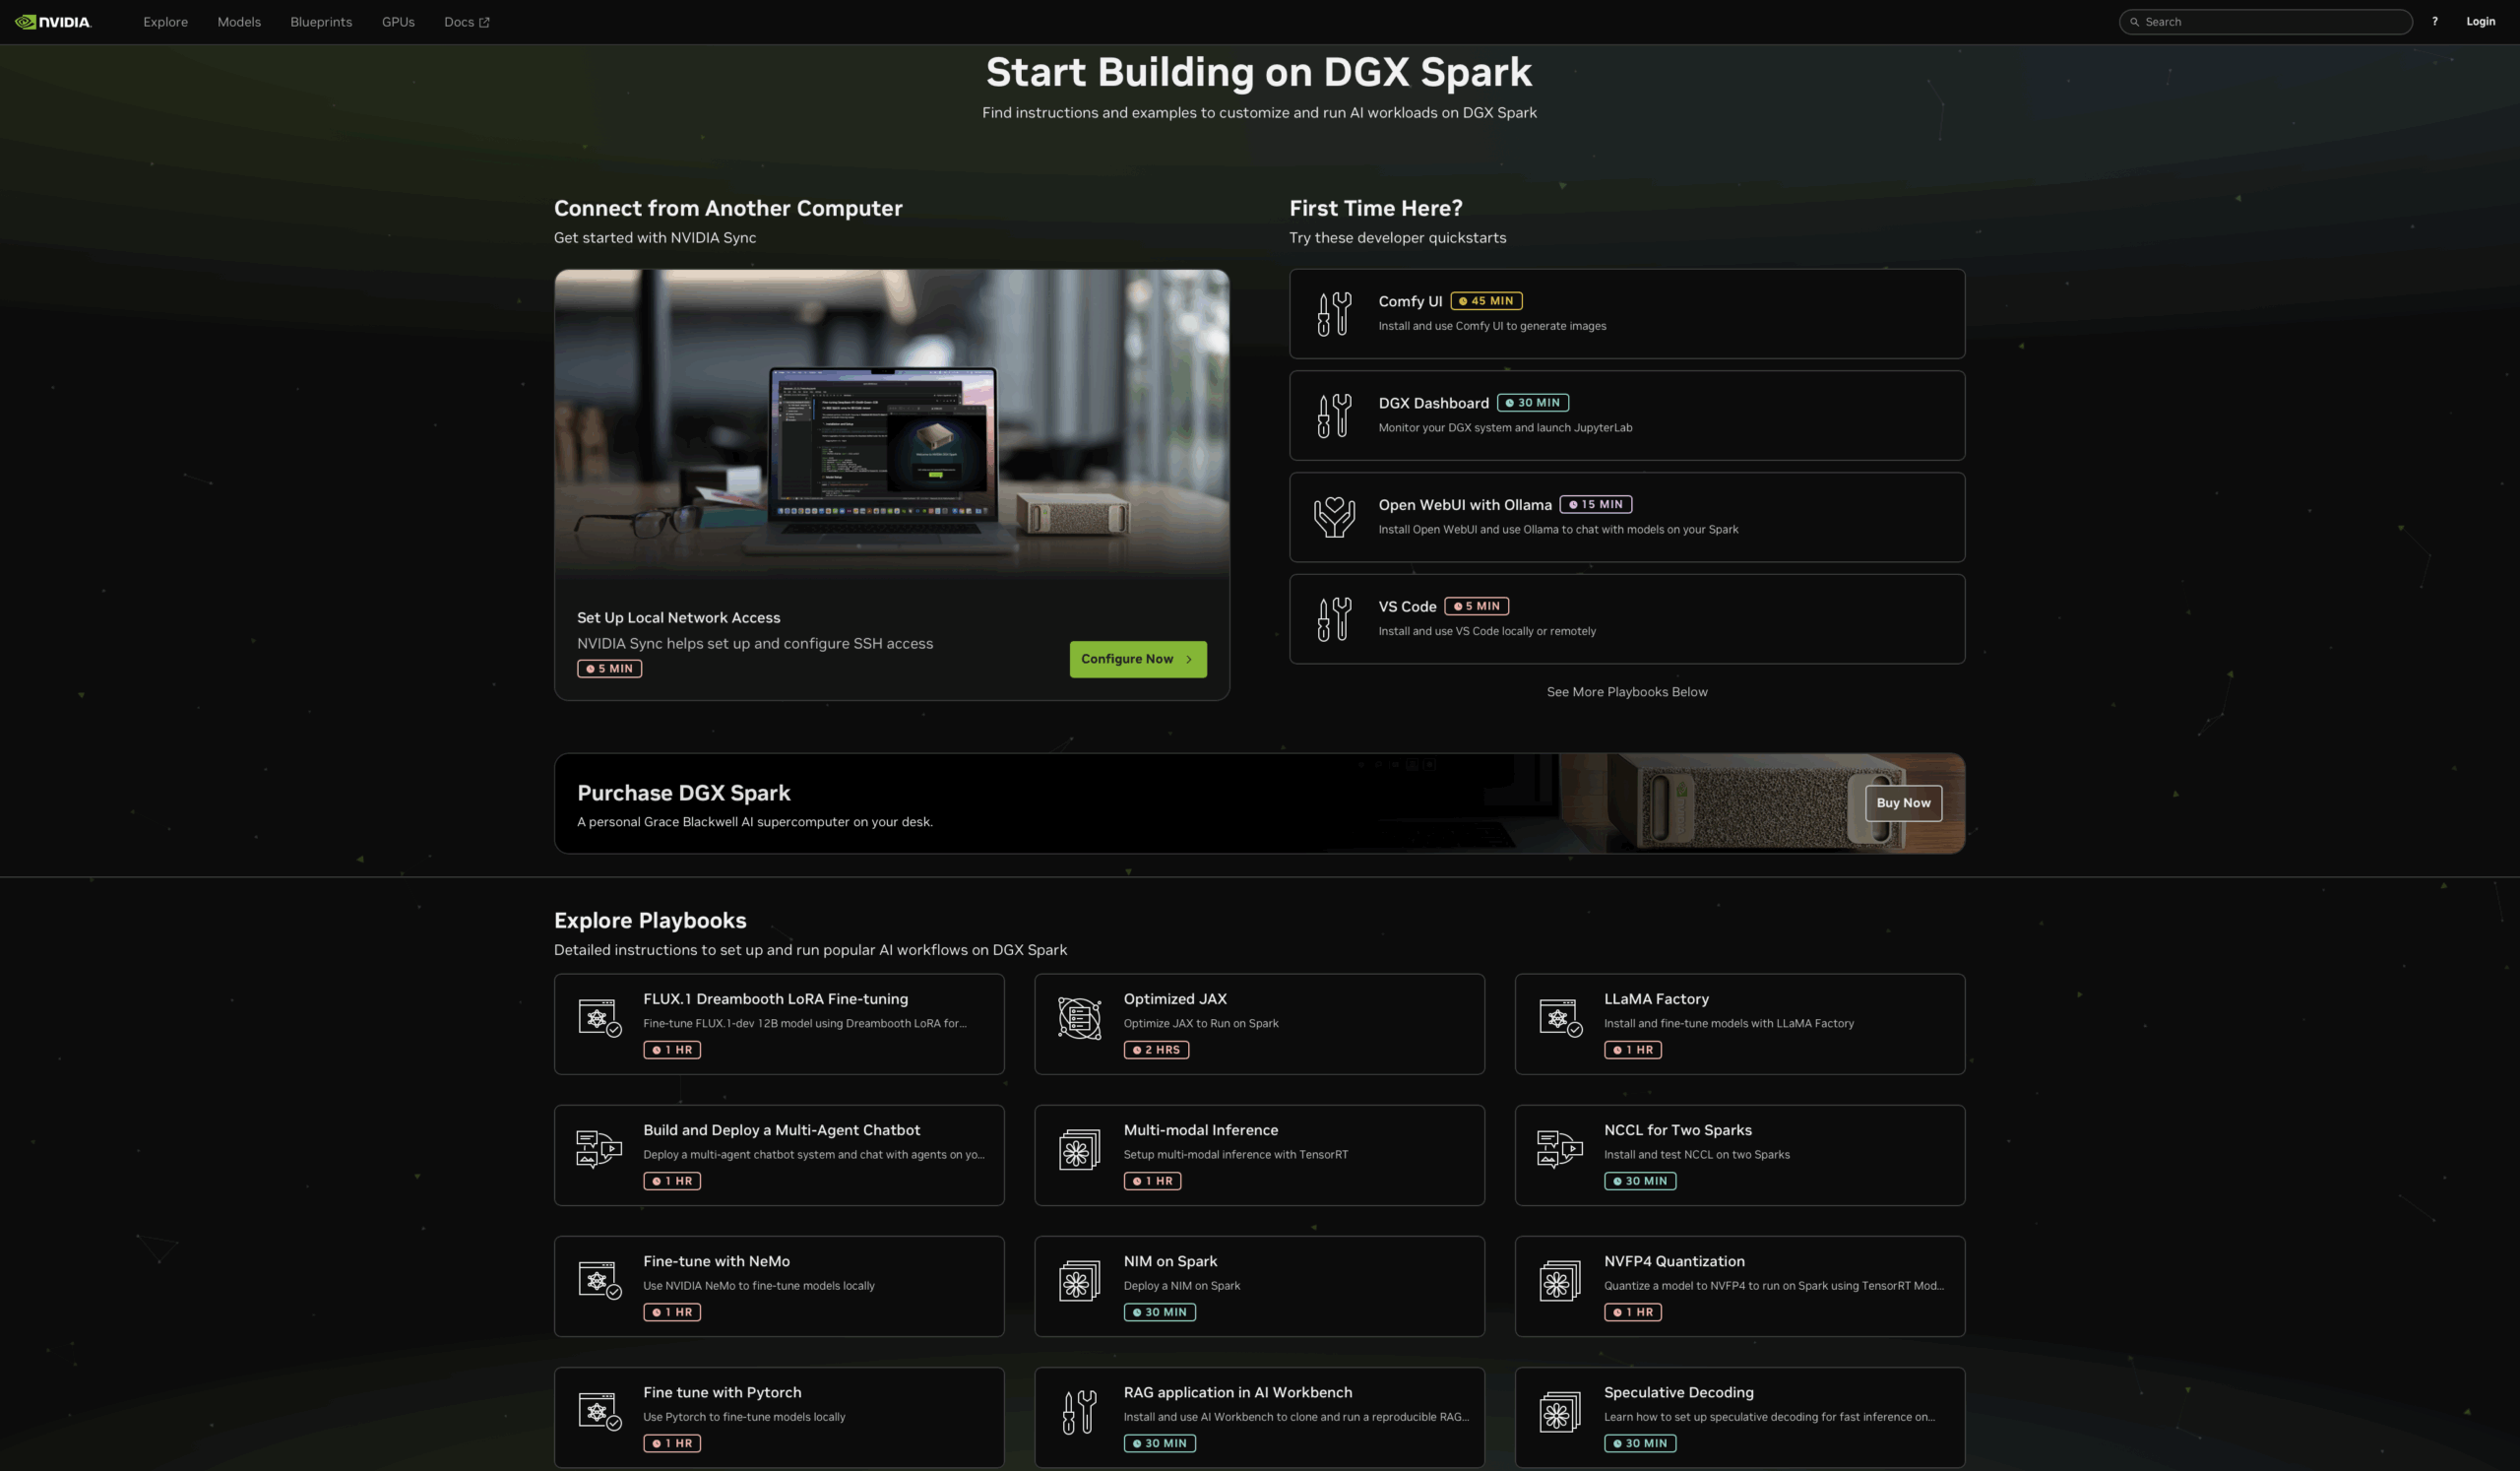
Dojrzałość oprogramowania zmienia proces ewaluacji. Zamiast spędzać dni na konfigurowaniu środowisk, programiści mogą natychmiast ocenić, czy Spark spełnia ich wymagania, uruchamiając reprezentatywne obciążenia. Playbooki zawierają nie tylko instrukcje, ale także środowiska konteneryzowane, przykładowe zestawy danych i oczekiwane metryki wydajności.
Dostępność i systemy OEM
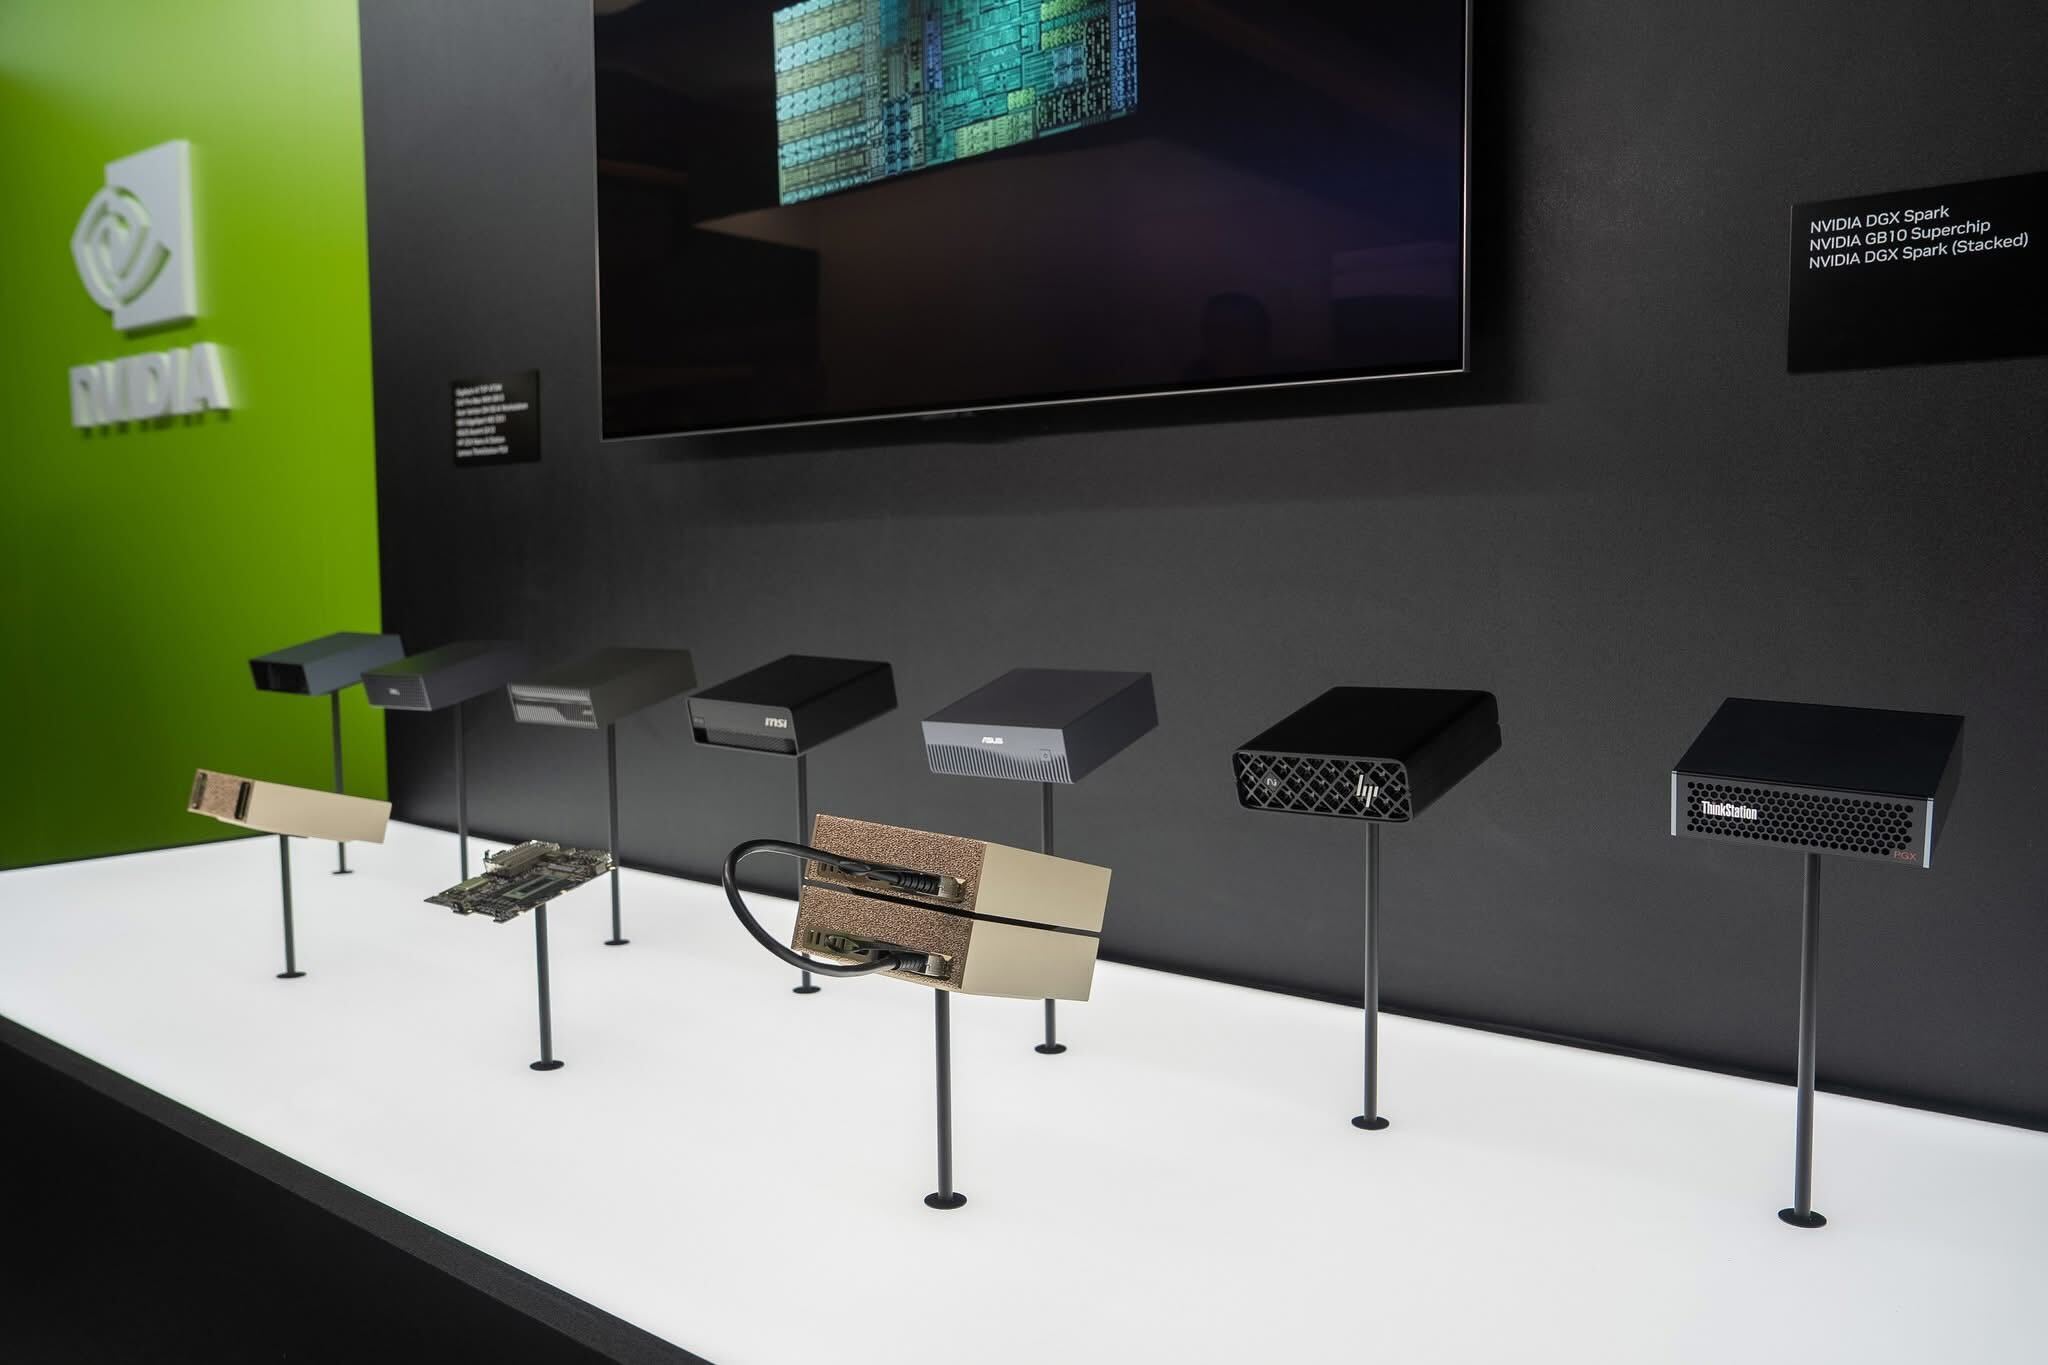
Wersja Founders Edition firmy NVIDIA jest dostępna w cenie 3,999 dolarów za konfigurację 4 TB, a ogólna dostępność rozpocznie się 15 października. Oprócz własnego modelu firmy NVIDIA, pojawi się kilka komputerów stacjonarnych GB10 od dużych producentów OEM. Podstawowy sprzęt będzie dość podobny u wszystkich producentów OEM, ale mogą oni mieć pewne pole manewru w kwestii różnic, choć większość różnic cenowych prawdopodobnie będzie wynikać z wyboru pamięci masowej. Widzieliśmy już wiele zapowiedzi, w tym Dell Pro Max z GB10, Lenovo ThinkStation PGX, Acer Veriton GN100 i ASUS Ascent GX10.
Źródło: Nvidia
Wniosek
NVIDIA DGX Spark stanowi fundamentalny punkt zwrotny w paradygmacie dostępności zaawansowanej infrastruktury obliczeniowej AI. Konsolidując możliwości układu GB10 Grace Blackwell Superchip: 128 GB zunifikowanej pamięci, wydajność FP4 rzędu 1 petaFLOP-a w trybie rozproszonym, rdzenie RT czwartej generacji i sieć ConnectX-7 w urządzeniu o mocy 240 W i pojemności 1.13 litra, wycenionym na 3,999 dolarów, NVIDIA skutecznie przełamała bariery, które historycznie oddzielały możliwości AI klasy centrów danych od indywidualnych badaczy i małych zespołów programistycznych.
Podejście oparte na sprawdzonych urządzeniach rozwiązuje uporczywy problem we wdrażaniu infrastruktury AI: obciążenie operacyjne związane z utrzymaniem niestandardowych konfiguracji. Organizacje wdrażające urządzenia Spark korzystają z kompleksowych testów i walidacji całego stosu firmy NVIDIA, w tym systemu operacyjnego DGX, zestawu narzędzi CUDA, kontenerów frameworków i oprogramowania sprzętowego, eliminując w ten sposób problem z konfiguracją, który jest problemem w przypadku niestandardowych kompilacji stacji roboczych. Zintegrowane zarządzanie aktualizacjami, monitorowanie systemu i udostępnianie JupyterLab w panelu DGX Dashboard dodatkowo redukują obciążenie operacyjne, a automatyczna dystrybucja kluczy SSH i zarządzanie tunelami w NVIDIA Sync sprawiają, że zdalny dostęp jest naprawdę bezproblemowy. W przypadku skalowalnych organizacji przekłada się to na mierzalnie szybsze wdrażanie: nowi badacze otrzymują standardowy sprzęt, łączą się z istniejącą infrastrukturą za pośrednictwem sprawdzonej konfiguracji klastra dwuwęzłowego i rozpoczynają produktywną pracę w ciągu kilku godzin, a nie dni od rozwiązania konfliktów sterowników lub konfiguracji sieci szkieletowej.
DGX Spark oferuje już prawdziwą moc sztucznej inteligencji w kompaktowym, cichym urządzeniu, a nasze wstępne wyniki pokazują, dlaczego jest to ważne dla zespołów, które oczekują dużej wydajności bez obciążenia centrum danych. To dopiero początek. Planujemy rozszerzyć nasze testy o infrastrukturę 200G, docelowe interfejsy NVMe-oF i klastrowanie wielowęzłowe, aby zbadać wydajność skalowania, większe rozmiary modeli i architektury współdzielonej pamięci masowej. Wraz z dojrzewaniem oprogramowania i ekosystemu partnerów, spodziewamy się, że wdrożenia Spark będą ewoluować od wydajnych konfiguracji jednowęzłowych do ściśle zintegrowanych, wysokoprzepustowych miniklastrów, które jeszcze bardziej udoskonalą tę platformę.
Tabela wyników: NVIDIA DGX Spark zajmuje pierwsze miejsce w rankingu najlepszych komputerów stacjonarnych do lokalnej sztucznej inteligencji w kategorii „Najlepszy system sztucznej inteligencji przy komputerze stacjonarnym ”.
Tabela wyników: Wskazówki dotyczące rozmiaru systemów tej klasy można znaleźć w naszym poradniku RAM, GPU i pamięć masowa dla agentowej sztucznej inteligencji.


 Amazon