

A IBM apresentou uma arquitetura de armazenamento com reconhecimento de conteúdo (CAS) que integra o processamento de dados de IA diretamente na camada de armazenamento. A abordagem visa fluxos de trabalho de geração aumentada por recuperação (RAG) incorporando a vetorização de documentos no sistema de armazenamento, reduzindo a necessidade de pipelines de pré-processamento externos.
O CAS transfere uma função essencial do RAG, a incorporação de documentos usando técnicas baseadas em modelos de linguagem de grande porte, para a infraestrutura de armazenamento. Isso permite que as empresas processem e indexem dados localmente, alinhando os sistemas de armazenamento com cargas de trabalho orientadas por IA e reduzindo a movimentação de dados entre as camadas da infraestrutura. A IBM apresenta isso como uma forma de simplificar a implementação, ao mesmo tempo que melhora o desempenho e a localidade dos dados para aplicações de IA.
Banco de dados vetorial em escala
No centro da implementação do CAS da IBM está um banco de dados vetorial otimizado para busca semântica. Bancos de dados vetoriais suportam busca aproximada por vizinho mais próximo, permitindo que sistemas de IA recuperem blocos de dados relevantes com base em métricas de similaridade, como similaridade de cosseno ou distância L2. Essa capacidade é fundamental para o RAG, onde as consultas do usuário são convertidas em vetores e comparadas com dados corporativos indexados para fornecer respostas contextuais.
Fonte: IBM
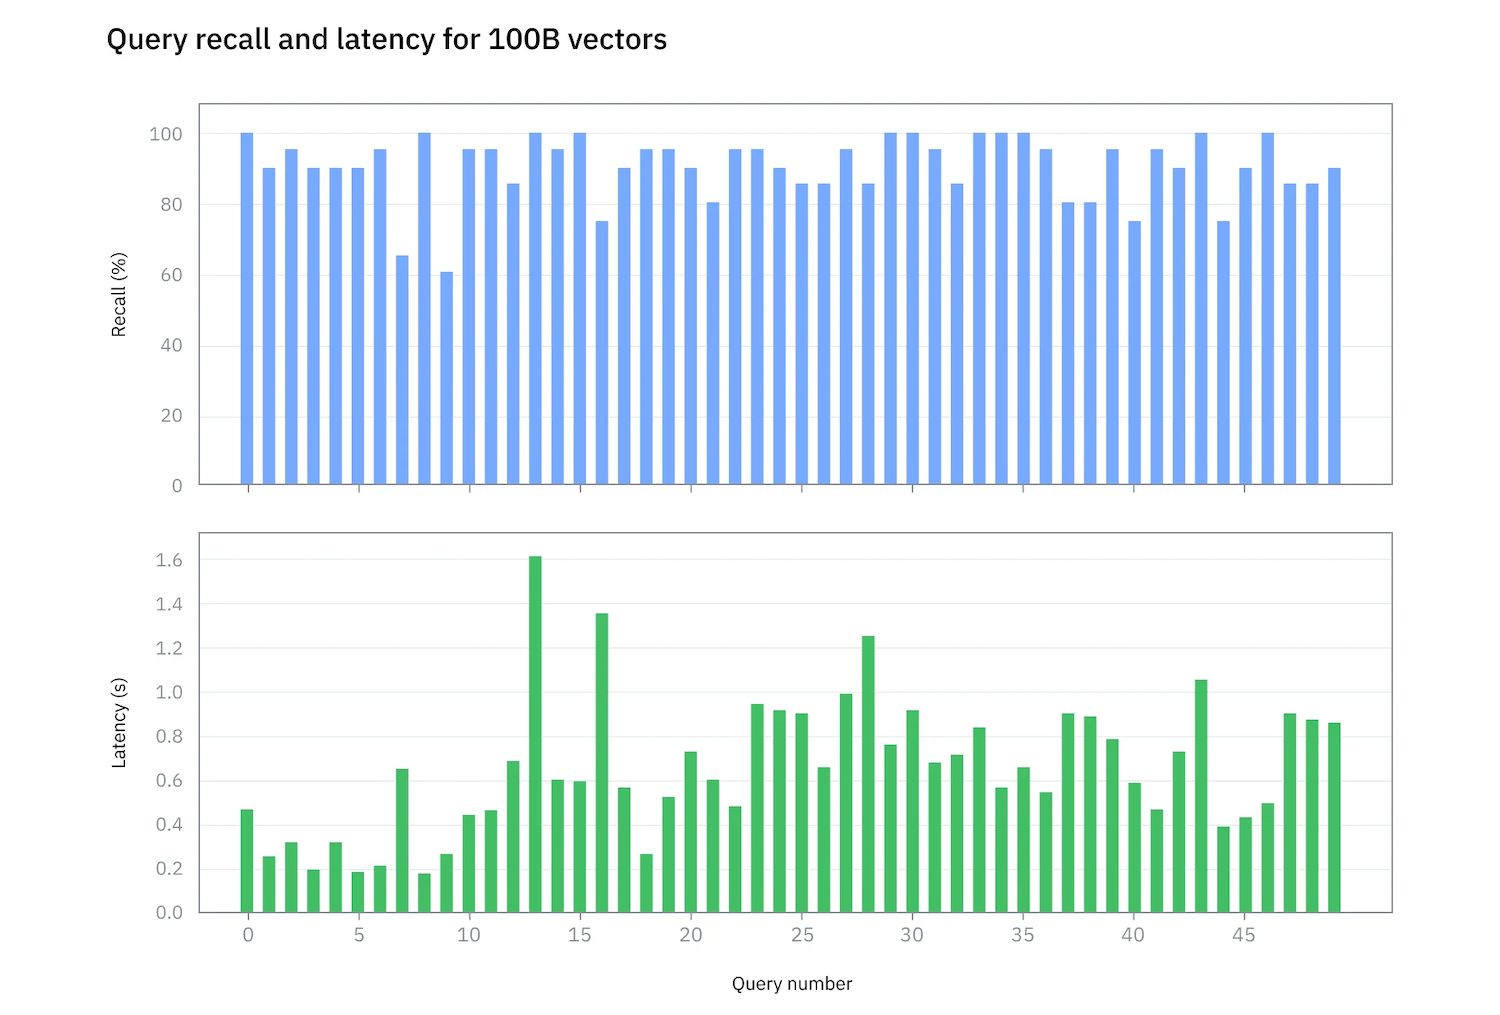
A IBM Research, em parceria com a Samsung e a NVIDIA, demonstrou um sistema protótipo capaz de escalar para 100 bilhões de vetores em um único servidor. O sistema alcançou mais de 90% de recall e precisão, com uma latência média de consulta inferior a 700 milissegundos. Essa escalabilidade é voltada para ambientes corporativos onde os conjuntos de dados podem abranger bilhões de arquivos e, uma vez totalmente indexados, atingir centenas de bilhões de vetores.
Integração de gasoduto RAG
A RAG (Request for Ability and Generation) está se consolidando como uma abordagem preferencial para IA empresarial, pois melhora a precisão dos resultados sem exigir o retreinamento do modelo. Ela opera aumentando as solicitações com dados específicos da empresa, obtidos de um banco de dados vetorial.
O processo começa com a ingestão de dados, onde documentos como PDFs e apresentações são analisados, divididos em partes e convertidos em representações vetoriais (embeddings). Essas representações são armazenadas em um banco de dados vetorial que organiza os dados para uma busca eficiente por similaridade. Durante a consulta, a entrada do usuário é incorporada e comparada com os vetores armazenados, com o conteúdo relevante sendo passado para o modelo de linguagem como contexto. Esse mecanismo de ancoragem reduz as alucinações e aumenta a confiança nas saídas geradas por IA.
O CAS da IBM integra esse pipeline diretamente no armazenamento, consolidando a ingestão, a indexação e a recuperação mais perto dos dados.
Abordando os desafios de escala e custo
Os sistemas de armazenamento corporativos já operam na escala de petabytes. Quando expandidos para CAS (Sistemas de Armazenamento de Dados), cada arquivo pode gerar centenas de vetores, aumentando rapidamente o tamanho do conjunto de dados. Os bancos de dados vetoriais tradicionais normalmente escalam horizontalmente em vários servidores, introduzindo custos e complexidade operacional. A indexação e reindexação de grandes conjuntos de dados também se tornam tarefas demoradas.
A abordagem da IBM concentra-se em melhorar a densidade de vetores e reduzir a sobrecarga de indexação para limitar a expansão da infraestrutura. A arquitetura desacopla o armazenamento de vetores e índices do processamento de consultas, permitindo o dimensionamento independente dos recursos de armazenamento e computação. Isso é possível graças ao IBM Storage Scale e seu sistema de arquivos paralelo de alto desempenho.
Arquitetura de armazenamento e hardware
A implementação do CAS utiliza o IBM Storage Scale System 6000 (ESS 6000), uma plataforma totalmente flash projetada para IA e cargas de trabalho de alto desempenho. O sistema suporta até 48 unidades NVMe por gabinete 4U, com capacidades que variam de 7 TB a 60 TB por unidade. Ele integra conectividade PCIe Gen5, InfiniBand de 400 Gb ou Ethernet de 200 Gb e oferece taxas de transferência de leitura de até 340 GB/s e de gravação de até 175 GB/s por nó, com até 7 milhões de IOPS.
A plataforma também oferece suporte ao NVIDIA GPUDirect Storage, permitindo caminhos de dados diretos entre o armazenamento e as GPUs, bem como DPUs BlueField-3 para descarregar o processamento de rede e dados.
Os SSDs Samsung PM9D3a PCIe Gen5 NVMe oferecem armazenamento de alta densidade e alto desempenho. Baseados na oitava geração de memória V-NAND TLC, esses drives oferecem até 30.72 TB por unidade, com velocidades de leitura sequencial de até 12 GB/s e velocidades de gravação de até 6.8 GB/s. O uso de SSDs corporativos disponíveis comercialmente permite que a arquitetura seja escalável utilizando componentes padrão.
Indexação Hierárquica e Aceleração por GPU
Para lidar com a indexação em grande escala, a IBM desenvolveu um modelo de indexação hierárquica composto por múltiplos subíndices que podem ser otimizados independentemente. Essa estrutura permite atualizações incrementais e reindexação localizada sem interromper todo o conjunto de dados, melhorando tanto a disponibilidade quanto a eficiência operacional.
A aceleração por GPU reduz significativamente o tempo de indexação em comparação com abordagens que utilizam apenas a CPU. Tarefas que levariam horas em CPUs podem ser concluídas em minutos usando GPUs NVIDIA. Em testes, a criação de índices para 100 bilhões de vetores levou 4 dias com 6 GPUs NVIDIA H200, em comparação com uma estimativa de 120 dias em um sistema com dois processadores.
O conjunto de dados completo, incluindo vetores e índices, consumiu aproximadamente 153 TiB de armazenamento. O carregamento e particionamento iniciais dos dados levaram nove dias. O sistema resultante apresentou uma latência média de consulta de 694 ms com 90% de recall, validada por meio de cálculos de força bruta com dados de referência.
Roadmap
A IBM e a NVIDIA continuam a otimizar a plataforma, com foco na redução da latência de indexação e consulta. As metas atuais incluem indexar 100 bilhões ou mais vetores em um único dia, reduzir o tempo de ingestão de dados de nove dias para um dia e diminuir a latência de consulta para a faixa de 50 a 100 milissegundos, mantendo uma taxa de recuperação de 90%.
A integração da indexação vetorial em sistemas de arquivos padrão visa simplificar a implementação e reduzir as barreiras à adoção de IA empresarial. Ao incorporar recursos RAG diretamente no armazenamento, a IBM posiciona o CAS como uma camada fundamental para infraestrutura habilitada para IA.


 Amazon