

A NVIDIA adicionou uma configuração de memória unificada de 64 GB ao DGX Spark , com preço inicial de US$ 4,999 e vendida exclusivamente pela Acer, ASUS, Dell, Gigabyte, HP e MSI a partir de 23 de outubro. A nova configuração possui o mesmo Superchip GB10 Grace Blackwell, rede ConnectX-7, sistema operacional DGX e conjunto de software de IA da NVIDIA que o modelo de 128 GB. Segundo a NVIDIA, a unidade de 64 GB executa modelos com até 100 bilhões de parâmetros para inferência local, ajuste fino e fluxos de trabalho de agentes sem enviar dados para a nuvem.
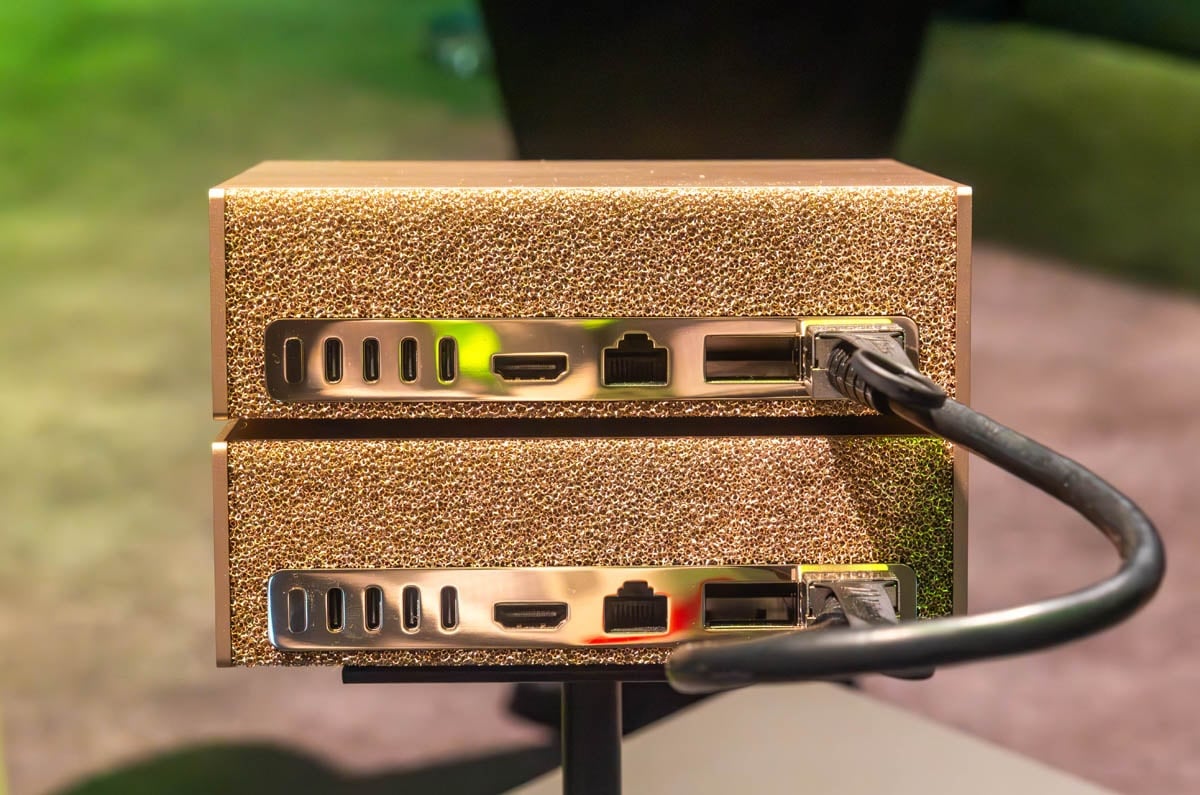
Dois módulos Spark de 64 GB para um cluster de 128 GB
O argumento de venda do modelo mais barato (em comparação com os preços de mercado do modelo maior) é que duas unidades em cluster funcionam muito bem. Cada DGX Spark possui uma placa de rede ConnectX-7 integrada, portanto, um par se conecta diretamente por meio de um cabo QSFP em um link de 200 GbE, sem switch intermediário. O NVIDIA Sync Cluster Assistant cuida da descoberta, valida a configuração do dispositivo e configura a rede ConnectX-7. Duas unidades de 64 GB compartilham 128 GB de memória unificada, o que, segundo a NVIDIA, é suficiente para executar modelos com até 200 bilhões de parâmetros.
Os números internos da NVIDIA para o emparelhamento usam o Qwen3.8 27B: dois sistemas clusterizados de 64 GB ofereceram até 1.7 vezes o desempenho de um único sistema de 128 GB. Como cada nó executa as mesmas bibliotecas CUDA, mecanismos de inferência e imagem do sistema operacional DGX, uma carga de trabalho abrange ambas as unidades sem a necessidade de recompilar o ambiente de software. As estruturas de inferência suportadas incluem llama.cpp, Ollama, vLLM e LM Studio. A NVIDIA possui um vídeo curto sobre como conectar dois Sparks com o NVIDIA Sync.
Executamos um cluster de inferência distribuída em unidades Spark DGX da Dell, Gigabyte e HP e, mais recentemente, implementamos armazenamento compartilhado por trás de um cluster Spark em uma rede 100GbE . A versão de 64 GB reduz o preço inicial para esse tipo de configuração, com a desvantagem de que uma única unidade agora comporta metade da memória da versão original.
O NVIDIA Sync Model Launcher chega no final de outubro.
A segunda parte do anúncio diz respeito ao software. O NVIDIA Sync Model Launcher, previsto para o final de outubro, baixa e executa um modelo em um único Spark ou em um cluster de dois Sparks, usando o Qwen3.8 27B como exemplo, e expõe o endpoint resultante para as máquinas dos desenvolvedores na rede. Ele também pode configurar o OpenCode com base nesse modelo, permitindo que os desenvolvedores programem a partir de um navegador, com o cluster Spark realizando a inferência.
Os sistemas de 64 GB são fornecidos com o mesmo software do modelo de 128 GB: sistema operacional DGX, bibliotecas de IA CUDA-X, NVIDIA Agent Toolkit, modelos abertos Nemotron e runtimes, incluindo Ollama, vLLM e PyTorch com CUDA. A NVIDIA posiciona o dispositivo como uma plataforma local para agentes, inferência, ajuste fino, ciência de dados e desenvolvimento na borda, e a porta ConnectX-7 permite a adição de uma segunda unidade posteriormente. Para desenvolvedores de agentes, a NVIDIA indica seus playbooks para NemoClaw, OpenClaw, Hermes Agent e OpenShell em build.nvidia.com como pontos de partida.


 Amazon