

Os provedores de hiperescala e operadores de infraestrutura focados em IA estão desenvolvendo cada vez mais aceleradores de IA e XPUs proprietários para acompanhar os grandes modelos de linguagem e as cargas de trabalho de raciocínio complexas. Para lidar com os desafios físicos, de memória e de rede da implantação em escala de silício proprietário, a NVIDIA detalhou sua interconexão NVLink Fusion e a arquitetura de memória NVHBM personalizada para o chip base . O portfólio unificado foi projetado para integrar o silício personalizado com as plataformas de rede escaláveis e de rack MGX existentes da NVIDIA.
A primeira empresa a aderir foi a Annapurna Labs da Amazon, cujos planos para NVHBM surgiram juntamente com a expansão da parceria com a AWS para 2 milhões de GPUs ; este anúncio fornece a arquitetura por trás dessa parceria e nomeia o Trainium4 como a primeira geração do Trainium com suporte a NVLink Fusion. A NVIDIA também está estabelecendo uma implementação padrão de NVHBM disponível em vários fornecedores de memória, o que, segundo a empresa, reduz o esforço de engenharia necessário para integrar e qualificar memórias de diferentes fornecedores. "O NVHBM representa uma nova abordagem arquitetônica para promover o desempenho e a eficiência de memórias de alta largura de banda", disse Nafea Bshara, vice-presidente da Annapurna Labs na Amazon. "Esperamos que essa colaboração tecnológica beneficie os futuros projetos de infraestrutura da AWS."
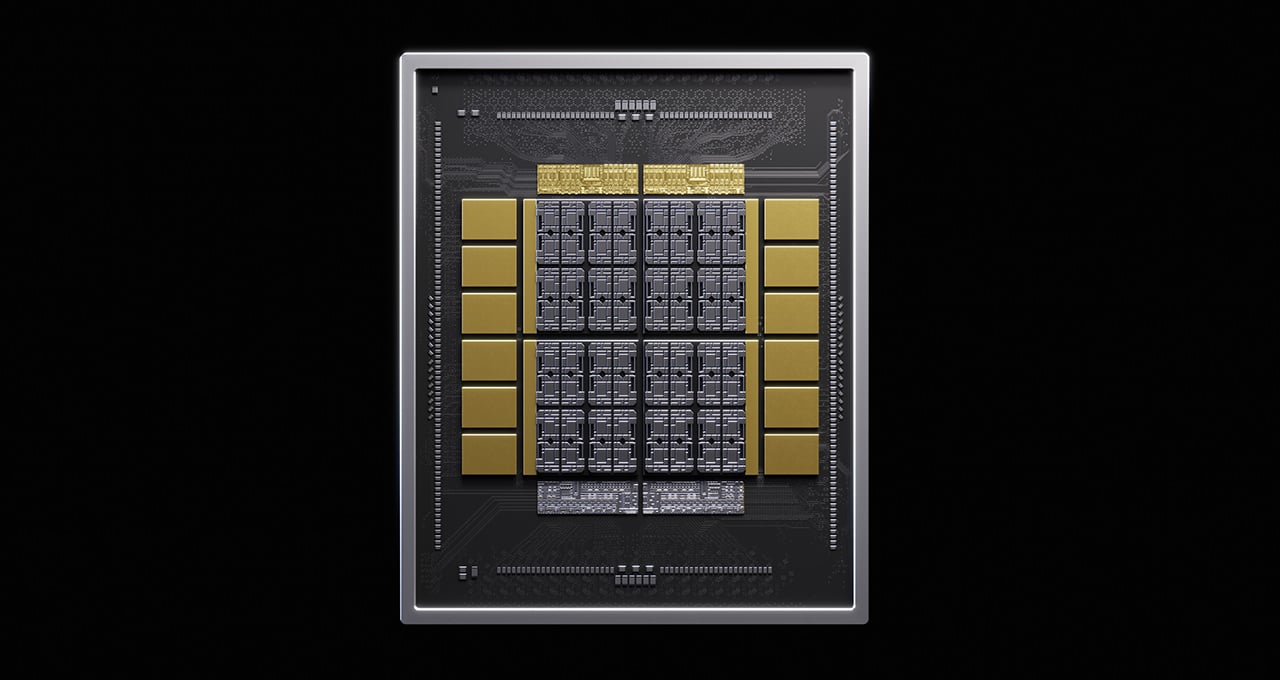
A implementação de XPUs personalizadas em data centers de alta densidade exige o equilíbrio entre lógica de computação, distribuição de energia, dissipação térmica e memória de alta largura de banda. A integração e qualificação de stacks de memória de ponta frequentemente criam gargalos significativos de empacotamento e desenvolvimento. Por meio do NVLink Fusion e do NVHBM, os projetistas podem aproveitar chips base e IPs de interface pré-validados, reduzindo a complexidade de integração e acelerando o tempo de lançamento no mercado.
Otimização da largura de banda e latência da memória
As cargas de trabalho modernas de IA, particularmente a inferência de modelos complexos e os pipelines de agentes, exigem alta taxa de transferência de memória para leitura de pesos de modelos, ativações e entradas de cache de chave-valor (KV). O NVHBM oferece um chip base personalizado, desenvolvido em conjunto com fabricantes de memória, que proporciona até 30% mais largura de banda de memória por pilha em comparação com a especificação padrão JEDEC HBM4E.
| Característica | benefício NVHBM |
| Largura de Banda | Até 30% mais largura de banda de memória em comparação com o HBM4e padrão. |
| Área | Conexões de interface mais eficientes permitem até 25% mais área de processamento para capacidades adicionais de XPU (Unidade de Processamento Gráfico). |
| Energia | Uma redução de até 15% no consumo de energia da HBM em comparação com a HBM4e padrão resulta em economia para milhares de XPUs. |
Tabela 1. A NVHBM traz três principais vantagens em nível de plataforma para programas de aceleradores de IA: maior largura de banda de memória, maior área de encapsulamento e silício e menor consumo de energia da HBM.
Esse aumento de largura de banda minimiza a escassez de recursos do mecanismo de computação durante as fases de execução com uso intensivo de memória. Ao acelerar as transferências de dados entre as pilhas HBM e a lógica de computação integrada, os aceleradores podem sustentar uma utilização mais alta e melhorar as taxas de geração de tokens por usuário durante cargas de trabalho de inferência densas.
Realocação da área do chip e otimização da camada física
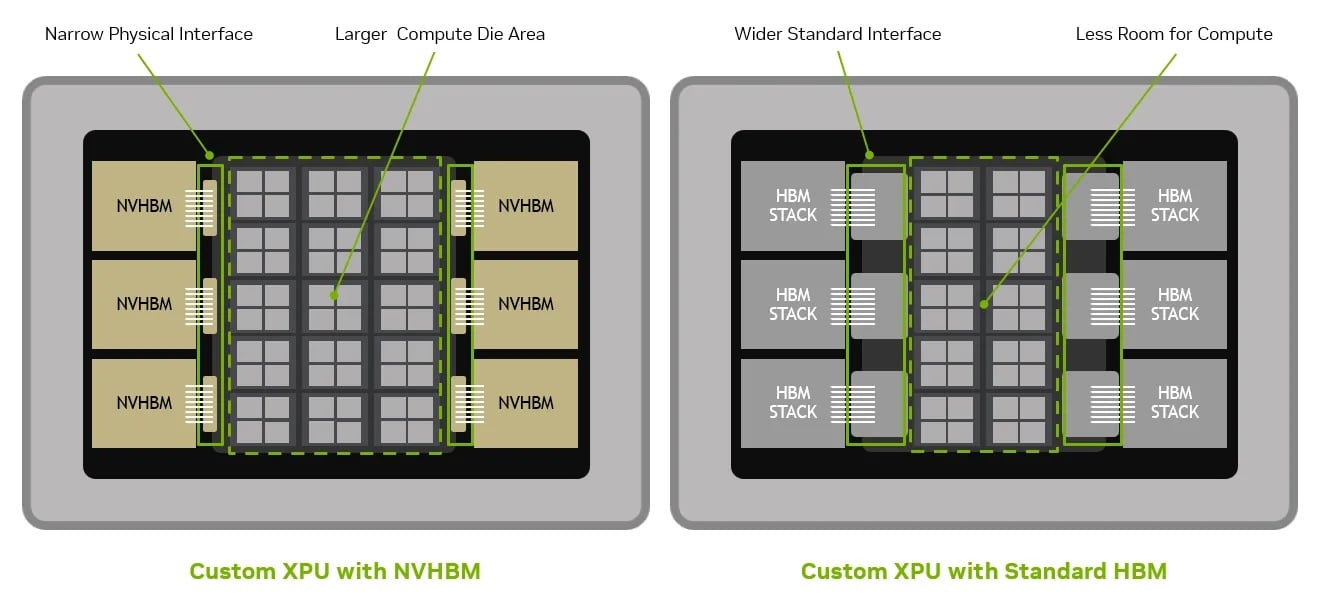
O espaço físico disponível nos circuitos integrados de aceleradores modernos é estritamente limitado, exigindo que os projetistas equilibrem o espaço entre as unidades lógicas de computação (ALUs), os mecanismos de matrizes, a SRAM integrada e as interfaces periféricas. As arquiteturas HBM padrão requerem interfaces físicas amplas que consomem uma área considerável do layout.
A NVHBM resolve esse problema movendo o controlador de memória diretamente para a pilha HBM 3D e utilizando uma camada física (PHY) personalizada. Essa abordagem resulta em uma redução de até 67% na área de suporte da PHY e dos periféricos em comparação com as implementações HBM4E padrão, além de simplificar o roteamento das trilhas do interposer para recuperar até 80% mais silício utilizável em todo o layout. A interface de memória mais estreita libera espaço no encapsulamento, permitindo que os projetistas expandam o chip de computação de IA central em até 30% para adicionar mais núcleos de matriz, unidades vetoriais ou hierarquia de cache dentro de um envelope físico fixo.
Eficiência energética e margem de segurança em escala de instalação
A distribuição de energia continua sendo uma das restrições mais rigorosas nas operações de data centers de hiperescala, impactando diretamente o projeto térmico dos aceleradores e os requisitos de refrigeração. O NVHBM reduz o consumo de energia da HBM em 15% em comparação com a HBM4E padrão.
No nível do silício, a redução do consumo de energia da memória diminui a pressão térmica, proporcionando margem elétrica adicional para operar os núcleos de computação em frequências sustentadas mais altas. Em escala de infraestrutura, essa economia de energia se multiplica significativamente. Em um data center teórico de 1 gigawatt com XPUs de 2,000 watts, o perfil de consumo de energia da memória reduzido pode liberar capacidade térmica e elétrica suficiente para suportar até 15,000 XPUs adicionais.
Integração em escala de rack via NVLink Fusion
Enquanto o NVHBM otimiza o desempenho no nível de cada pacote individual, o NVLink Fusion serve como ponte no nível do sistema. Utilizando chiplets NVLink Fusion dedicados, as XPUs personalizadas podem se conectar diretamente à estrutura de expansão NVLink de sexta geração , unindo todos os aceleradores dentro de um rack em um único domínio coerente de memória e computação.
Essa estrutura de escalonamento é fundamental para esquemas avançados de paralelização, como o paralelismo especializado (EP) e o WideEP, nos quais modelos distribuídos de mistura de especialistas exigem sincronização de baixa latência de ativações e estados ocultos em vários dispositivos físicos. Processadores personalizados também podem se conectar a CPUs do host via NVLink-C2C.
Ao integrar silício semicustomizado ao ecossistema mais amplo de hardware e software da NVIDIA, o NVLink Fusion permite que os operadores implementem ambientes heterogêneos que combinam XPUs personalizadas com GPUs NVIDIA padrão em uma arquitetura de rack MGX padronizada, simplificando as operações e o provisionamento de cargas de trabalho.


 Amazon