

A NVIDIA anunciou uma nova GPU para computação científica na SC26. A Rubin HPC faz parte da plataforma Vera Rubin, que reúne mais de 50,000 núcleos CUDA em uma única GPU, e a NVIDIA espera que ela esteja disponível em 2028. O restante dos anúncios da empresa na SC26 inclui um rack Vera com 192 CPUs para simulação, previsto para o início de 2027, o pacote de modelo aberto Nemotron for Science, novas bibliotecas CUDA-X, uma plataforma de codesign quântico com a IBM e o Fermilab, e a implementação de switches ópticos co-empacotados pela Lambda.
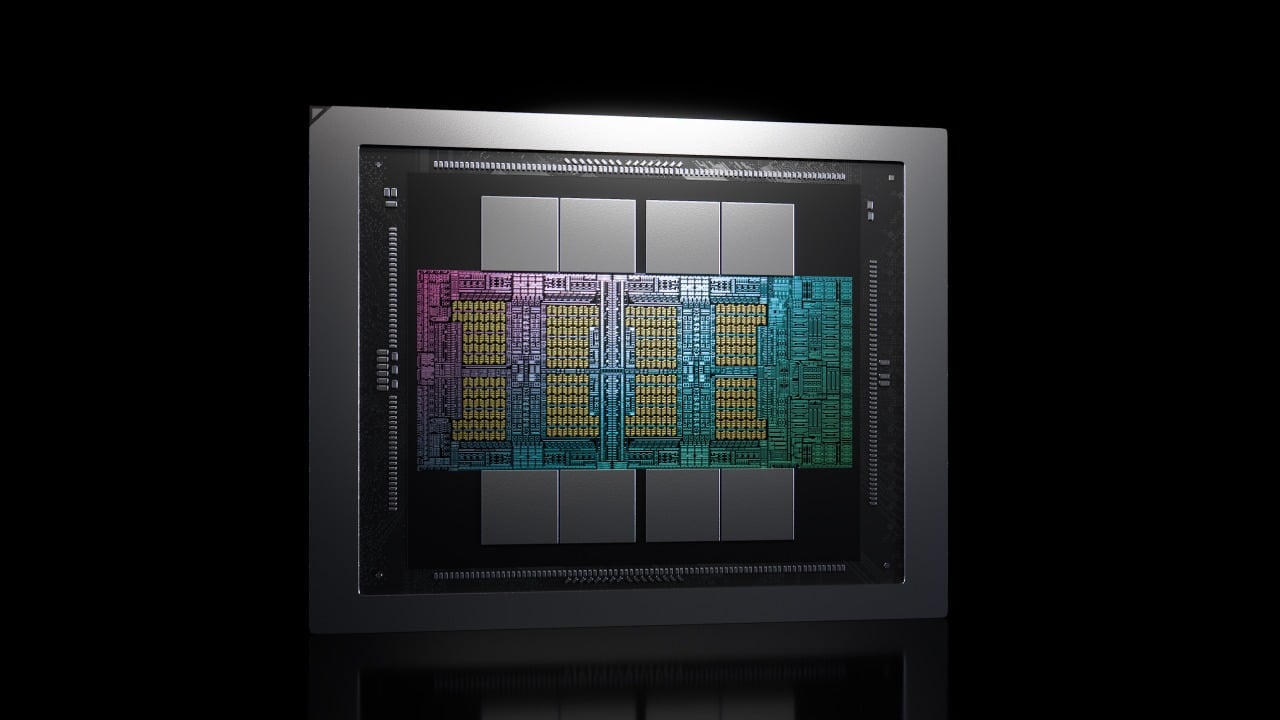
GPU Rubin HPC
A NVIDIA descreve o Rubin HPC como uma GPU para simulação e processamento de dados em ciência, engenharia e análise, projetada para escalar a movimentação de dados juntamente com a capacidade de computação. Além da quantidade de núcleos, que a NVIDIA considera um recorde, a empresa destaca um recurso de aceleração de dados esparsos que mantém esses núcleos alimentados com dados e conexões GPU-para-GPU por meio da NVLink de sétima geração. As cargas de trabalho-alvo incluem operações com matrizes esparsas, computação de estêncil, classificação e redução, padrões em modelos climáticos, simulação de engenharia, análise genômica e risco financeiro.

No palco da SC26, a NVIDIA afirmou que o Rubin HPC triplica o desempenho de simulação e análise, suportando todas as precisões de FP64 a FP4. A empresa não divulgou o valor base para o aumento de 3x, nem publicou informações sobre capacidade de memória, taxa de transferência em FP64, consumo de energia ou configurações do sistema. Ian Buck, vice-presidente de computação de hiperescala e alto desempenho da NVIDIA, relacionou o componente à pesquisa com agentes, afirmando que "simulação mais rápida significa descoberta mais rápida" para agentes que trabalham em problemas científicos e de engenharia. A Intel está apresentando sua GPU D270 , compatível com FP64, para as mesmas cargas de trabalho de simulação no evento.
Racks de CPU Vera para HPC
A plataforma de CPUs Vera para HPC consiste em um rack NVIDIA MGX com refrigeração líquida, que comporta 192 CPUs Vera conectadas por InfiniBand Quantum-X800, com aproximadamente 300 TB de memória, 1 PB de armazenamento e mais de 200 TB/s de largura de banda de memória agregada de pico. Cada bandeja 1U acomoda oito CPUs, juntamente com armazenamento NVMe e gerenciamento, e o rack reutiliza o chassi, a distribuição de energia e o sistema de refrigeração dos sistemas NVL72. Cada CPU possui 88 núcleos Olympus, 176 threads e memória SOCAMM2 LPDDR5X com velocidade de até 1.2 TB/s.

Essa configuração difere dos racks Vera de 256 CPUs anunciados pela Dell e Supermicro para ambientes de teste de agentes na GTC Berlin, com a adição de InfiniBand e computação em rede SHARP para simulação altamente acoplada. A NVIDIA afirma que a Dell Technologies, a HPE, a Lenovo e a Supermicro oferecerão os racks de HPC a partir do início de 2027. O DKRZ, Centro Alemão de Computação Climática, selecionou CPUs Vera para seu supercomputador HLRE-5, construído pela Bull, que também inclui sistemas GB200 e InfiniBand Quantum-2 e tem previsão de lançamento para o início de 2028.
A NVIDIA afirma que a Vera oferece o dobro da eficiência energética dos processadores x86. Em seus testes, a Vera apresentou desempenho 1.9 vezes superior e 2.4 vezes mais eficiência por watt do que sistemas x86 no modelo OpenFOAM motorBike Large, além de projetar desempenho 1.6 vezes superior e eficiência 2 vezes maior no modelo de Pesquisa e Previsão do Tempo. Esses resultados são de fornecedores, não foram executados ou auditados por nós, e a NVIDIA não divulgou os nomes dos processadores x86. Em nossa análise da CPU Vera , um sistema Vera de dois soquetes concluiu um teste de malha OpenFOAM Large 1.44 vezes mais rápido do que um sistema com EPYC 9965 de 384 núcleos e 1.20 vezes mais rápido do que um sistema com Xeon 6978P de 240 núcleos.
Em termos de software, o NVIDIA HPC SDK 26.11 já está disponível com compiladores e bibliotecas otimizados para Vera, e um compilador Fortran de última geração, desenvolvido em parceria com centros de HPC e laboratórios nacionais, está em versão beta pública. A NVIDIA afirma que o compilador executa programas Fortran existentes mais rapidamente em suas plataformas, sem a necessidade de reescrever o código.
Nemotron para Ciência e Bibliotecas CUDA-X
O Nemotron for Science inclui o modelo aberto Nemotron 3.5 Super VL com avaliações científicas, receitas pós-treinamento e o LitmusBench v0.2, um conjunto de dados aberto com quase 50,000 questões de raciocínio lógico em química. O modelo e o conjunto de dados já estão disponíveis no Hugging Face, e a NVIDIA afirma que o modelo foi otimizado para ser executado localmente em um DGX Spark de 128 GB. O Laboratório Nacional de Argonne está integrando-o ao seu sistema multiagente StructBioReasoner para terapias baseadas em proteínas, e o RIKEN o disponibilizou em sua plataforma de supercomputação de IA RIKYU.
Entre os clientes que realizaram o pós-treinamento do modelo, a Lila Sciences quase dobrou a precisão da síntese de pontos quânticos para 61%, o que, segundo a NVIDIA, supera os 54% do GPT-6 da Astra, com um custo de inferência de 10 a 20 vezes menor. A Terray Therapeutics recuperou cerca de 76% das reações anotadas no teste RxnScribe para leitura de diagramas de reações químicas. Um agente do Instituto Real de Tecnologia KTH reparou 81% das configurações de dinâmica molecular GROMACS quebradas em uma única execução noturna em um único DGX Spark.
Entre as novidades do CUDA-X, o kit de ferramentas cuPhoton correlaciona observações do Event Horizon Telescope em oito minutos, enquanto a análise anteriormente levava mais de um mês. O cuPotential acelera o software de simulação molecular existente em até 3 vezes, e o Daviator, um conjunto de kernels de GPU em lote para o Vienna Ab initio Simulation Package (VASP), executa cálculos de mecânica quântica até 22 vezes mais rápido, com um custo até 75% menor. A NVIDIA não divulgou os valores de referência para os resultados do cuPotential e do Daviator.
O cuSpa e uma biblioteca HMMER acelerada por GPU agora são de código aberto. O cuSpa apresentou um aumento de velocidade de 900 vezes em relação às CPUs nos cálculos de polígonos celulares no Memorial Sloan Kettering Cancer Center, e a biblioteca HMMER executou buscas de benchmark até 84 vezes mais rápidas do que o HMMER padrão no Basecamp Research. A biblioteca rapids-singlecell, desenvolvida em conjunto com o scverse, agora é distribuída em um único contêiner criado para agentes, e a 10x Genomics a integrou à sua plataforma Sentira.
Projeto conjunto quântico com a IBM e o Fermilab
Na área da computação quântica, a NVIDIA e a IBM estão instalando sistemas NVIDIA DGX B200 em conjunto com computadores quânticos da IBM, incluindo sistemas que utilizam o processador IBM Quantum Nighthawk, para dar suporte a uma plataforma modular de codesign quântico desenvolvida em parceria com o Fermilab. Os pesquisadores usarão essa plataforma para avaliar códigos de correção de erros, algoritmos de decodificação e aplicações quântico-clássicas para física de altas energias e física nuclear. A IBM estabeleceu um acordo semelhante com a AMD e o Laboratório Nacional de Oak Ridge , combinando o Nighthawk com um cluster Instinct MI355X. A NVIDIA não divulgou o número de sistemas, a localização ou o cronograma.
Em outra notícia, a NVIDIA lançou o TCBP-JOBS, um algoritmo de decodificação na biblioteca CUDA-Q QEC 0.9.0 que, segundo a empresa, decodifica até 13,000 vezes mais rápido do que os principais algoritmos existentes e reduz o tempo de computação por trás de novos projetos de computadores quânticos de 12 semanas para 45 minutos. A plataforma CUDA-Q também ganha um servidor de decodificação, um conjunto expandido de primitivas tolerantes a falhas, uma biblioteca de algoritmos CUDA-Q com componentes de aplicação reutilizáveis e o CUDA-Q Pulse para moldar os pulsos de controle que acionam os qubits.
A NVIDIA afirma que a implantação de processadores quânticos em centros de supercomputação cresceu quase sete vezes em cinco anos, com quase 30 centros agora implantando mais de 50 processadores. O Slurm 26.11, previsto para novembro, adiciona uma interface quântica que permite que um construtor de QPU descreva seu hardware uma única vez, em um único arquivo, e reutilize essa integração em todos os centros. Ele suporta as interfaces quânticas de HPC QRMI e QDMI, com a IBM contribuindo por meio de sua Interface de Gerenciamento de Recursos Quânticos (QRMI), para que os centros possam agendar processadores quânticos juntamente com CPUs e GPUs. Alice & Bob, IBM, IQM, Pasqal, Quantinuum e MQSC estão adotando a tecnologia, e a NVIDIA adquiriu a SchedMD, desenvolvedora do Slurm, no final de 2025.
A NVIDIA também destacou o trabalho de química quântico-clássica realizado pela IBM e pelo RIKEN, finalista do Prêmio Gordon Bell da ACM de 2026, que calculou as energias de ligação para complexos proteína-ligante de até 12,635 átomos. Isso representa mais de 40 vezes o limite anterior de 303 átomos para cálculos quântico-clássicos. A parte clássica foi executada no supercomputador ROQUO do RIKEN, que utiliza sistemas NVIDIA GB200 e InfiniBand Quantum-X800.
Entre os projetos do ecossistema na plataforma, a Altera e a Oxford Quantum Circuits construíram um controlador quântico baseado em FPGA que conecta o controle e a leitura de qubits a GPUs por meio do NVQLink, e a Quantum Motion integrou sua estrutura de química QUICHE com CUDA-Q. A QunaSys usou o cuQuantum e 1,024 GPUs NVIDIA da geração Hopper no ABCI-Q para simular mais de 300 milhões de operações quânticas, alcançando precisão química para um modelo de quatro átomos de hidrogênio. Pesquisadores da NVIDIA usaram o supercomputador JUPITER para simular 104 qubits sob ruído realista.
Lambda implementa óptica co-embalada
A Lambda está utilizando switches de óptica co-embalada (CPO) da NVIDIA Photonics para conectar racks GB300 NVL72 em uma implementação com mais de 10,000 GPUs. Cada switch possui 144 portas a 800 Gb/s e 18 fontes de luz externas que os técnicos podem substituir em campo, enquanto que uma falha no laser de uma óptica plugável significa a troca de todo o módulo. Testes citados pela NVIDIA mostraram uma latência de rede cerca de 4% menor em escala de rack e até 10% menor em escala de pod, com a mesma taxa de transferência que as ópticas plugáveis.

A temperatura média dos componentes ópticos na implementação foi de 36 °C, contra 51 °C para componentes ópticos plugáveis convencionais. A NVIDIA classifica seus switches fotônicos com eficiência energética até 5 vezes maior, confiabilidade até 15 vezes maior e 4 vezes menos lasers do que os designs plugáveis. A NVIDIA também aproveitou o evento para comemorar os 20 anos do CUDA, que, segundo a empresa, agora conta com mais de 11 milhões de desenvolvedores e mais de 1,000 bibliotecas CUDA-X.


 Amazon