

Ao longo de diversas gerações de hardware, os fornecedores de memória e de redes identificaram diferentes gargalos em clusters de computação de alto desempenho. Os fabricantes de memória focaram na largura de banda da memória integrada, enquanto os provedores de infraestrutura de rede abordaram a taxa de transferência entre chassis e entre racks. Hoje, essas duas perspectivas convergiram para o mesmo gargalo: a barreira de largura de banda que restringe a movimentação de dados entre nós de computação distribuídos e pools de memória.
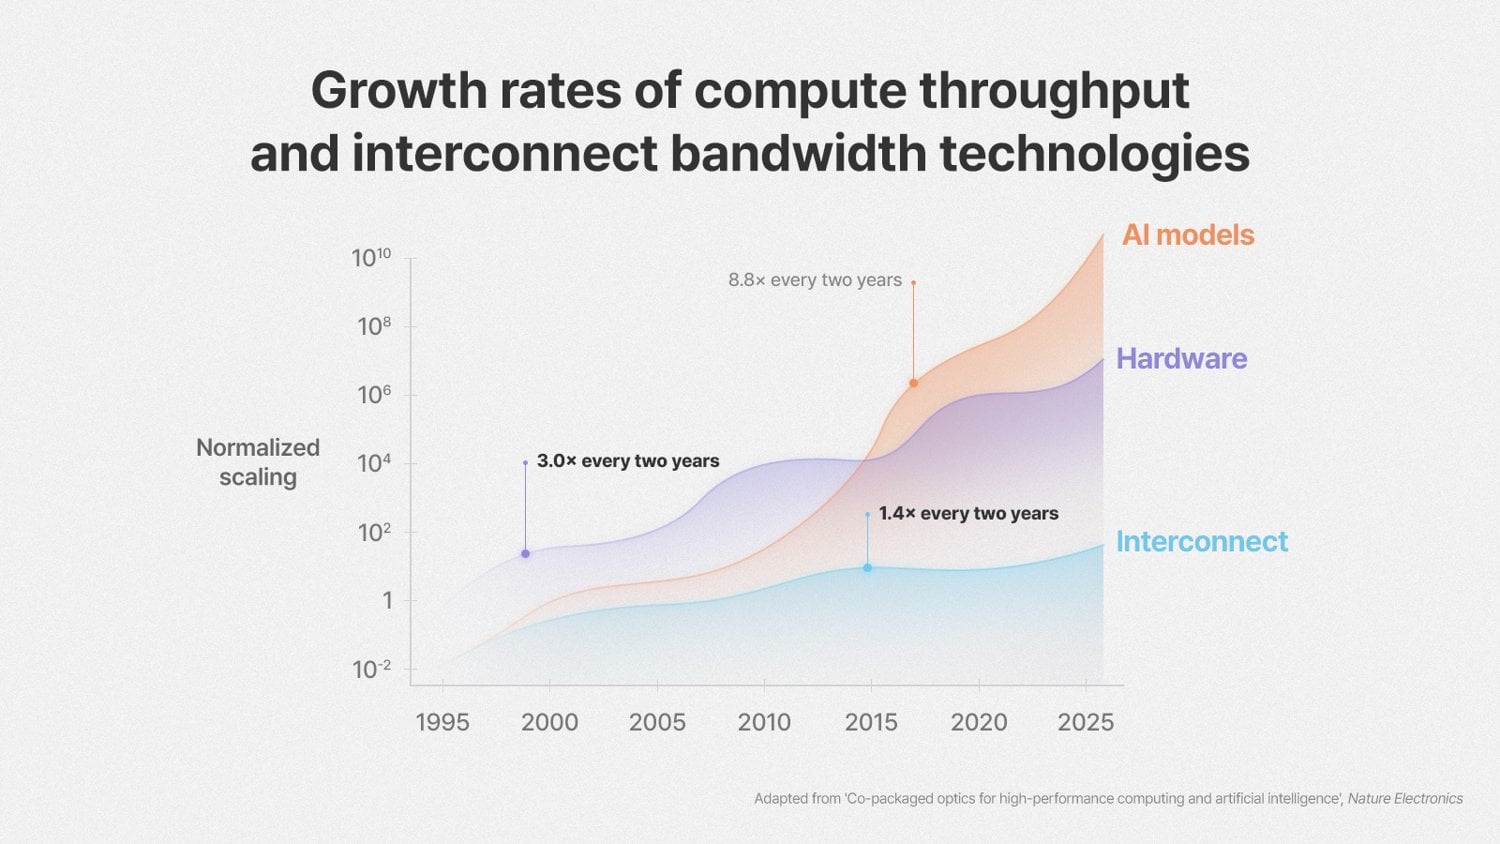
Embora a memória de alta largura de banda (HBM) tenha resolvido efetivamente as limitações de largura de banda em nível de pacote para aceleradores de IA individuais, as cargas de trabalho modernas de treinamento e inferência em hiperescala agora escalam em dezenas de milhares de processadores distribuídos em racks e pods. Nessas topologias distribuídas, a taxa de transferência computacional historicamente aumentou cerca de 3 vezes a cada 2 anos, enquanto a largura de banda de interconexão aumentou aproximadamente 1.4 vezes no mesmo período. O desequilíbrio resultante coloca o principal gargalo de escalabilidade diretamente na camada de interconexão física.
A avaliação provém de um artigo de perspectiva publicado em 20 de agosto na Nature Electronics , intitulado "Óptica co-embalada para computação de alto desempenho e inteligência artificial", coescrito pela SK hynix e pesquisadores da Universidade da Virgínia, da Universidade de Illinois Urbana-Champaign, do MIT, da Universidade Tecnológica de Nanyang e da Universidade Yonsei. O líder da equipe de infraestrutura de IA da SK hynix, Seunghoon Hong, e o professor da UVA, Kyusang Lee, atuaram como autores correspondentes.
| Etapa | Resultado |
|---|---|
| Mudança no gargalo de escalabilidade de clusters de IA | |
| HBM na embalagem | Resolvido o gargalo de memória no chip/pacote |
| Traços de cobre | Atenuação física atingida / limite de potência fora do chip |
| Integração de CPO | Converge o tecido óptico diretamente sobre o substrato. |
Para lidar com essa limitação, a SK hynix, em colaboração com pesquisadores da Universidade da Virgínia, UIUC, NTU, MIT e Universidade Yonsei, publicou um estudo na Nature Electronics intitulado "Óptica co-embalada para computação de alto desempenho e inteligência artificial". O artigo detalha como a óptica co-embalada (CPO) e as interconexões ópticas de computação (OCIs) devem coevoluir juntamente com as arquiteturas de memória e de encapsulamento para suportar a escalabilidade futura dos clusters.
Limitações físicas das interconexões de cobre
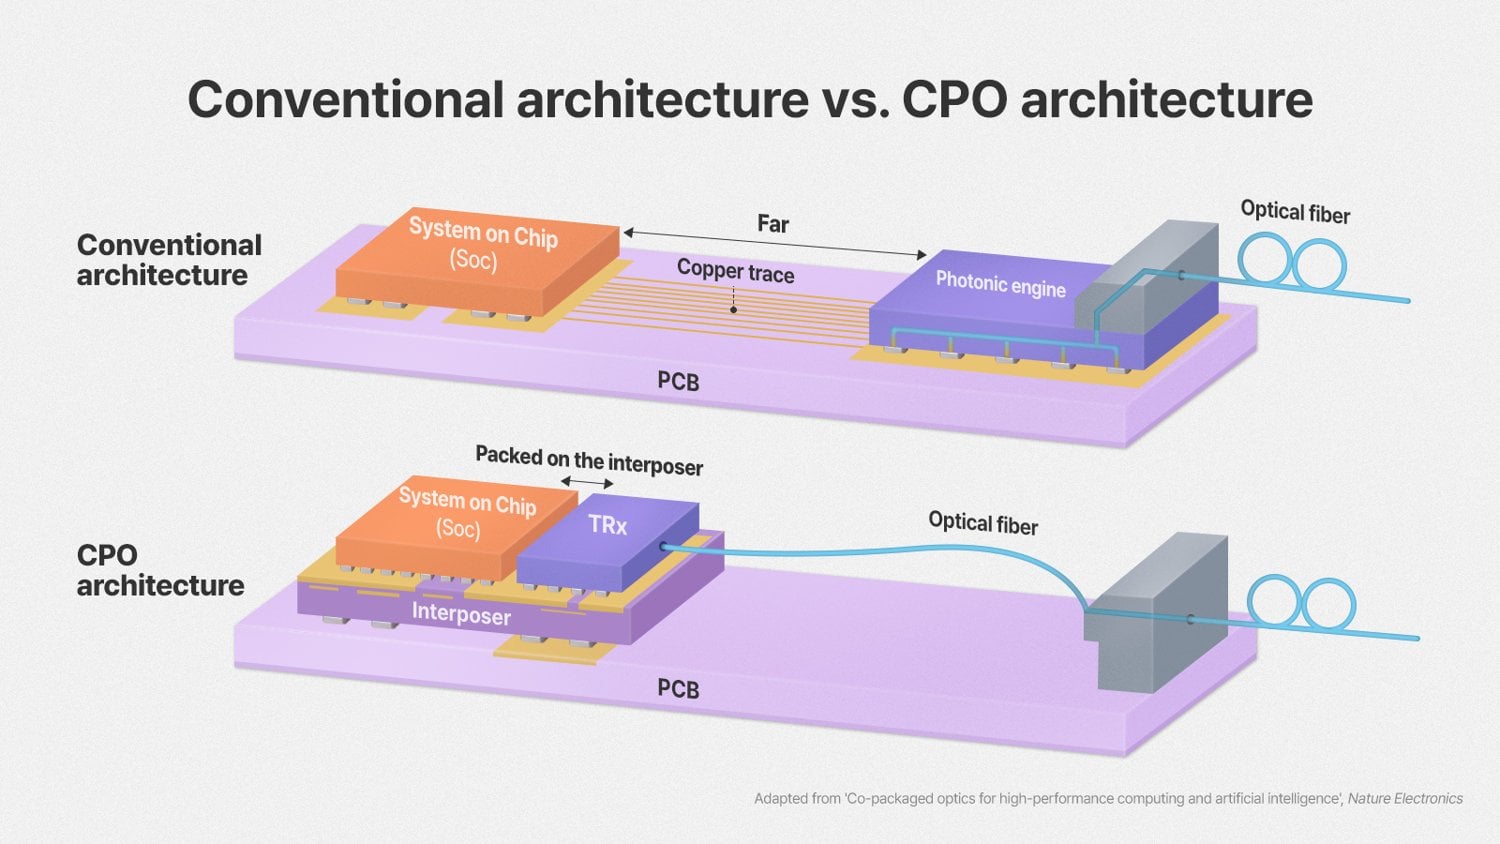
As interconexões elétricas padrão, baseadas em trilhas de cobre e cabos de cobre de conexão direta, continuam práticas em curtas distâncias físicas. No entanto, à medida que as taxas de dados aumentam, a sinalização elétrica sofre com atenuação severa do sinal, perda de inserção e consumo elevado de energia. O gerenciamento de sinais de alta velocidade em trilhas de placa e backplanes mais longos exige circuitos complexos de equalização e retemporização, o que introduz latência adicional e consome uma quantidade substancial de energia.
Como a óptica co-embalada muda o caminho
A tecnologia CPO supera essas limitações físicas montando transceptores ópticos diretamente no mesmo substrato do encapsulamento que os processadores ou aceleradores. A conversão de sinais elétricos de alta velocidade em canais fotônicos adjacentes ao silício de computação minimiza o comprimento das trilhas elétricas, mitigando a capacitância parasita e a degradação do sinal. Essa arquitetura permite a transmissão óptica de baixa perda e alta largura de banda em placas, racks e pods, mantendo maior densidade de largura de banda e melhor imunidade à interferência eletromagnética.
| métrico | Especificação alvo |
|---|---|
| Especificações de destino para nós CPO | |
| Densidade de largura de banda do nó | > 100 Tb/s por nó |
| Eficiência energética | < 1 pJ/bit |
| Latência de interconexão chip-a-chip | <10 ns |
| Via de Integração | Interconexão 2.5D para heterogêneo 3D |
O roteiro projeta uma progressão arquitetônica que vai de módulos multichip 2D padrão e integração de interpositores de silício 2.5D em direção ao empilhamento heterogêneo 3D. O marco arquitetônico final envolve a extensão de links ópticos diretamente para o próprio subsistema de memória.
Ao utilizar um interpositor fotônico para interligar diretamente as pilhas de memória com os motores de computação, os sistemas podem contornar as limitações convencionais de roteamento em nível de placa. Essa abordagem possibilita pools de memória compartilhada desagregados e de baixa latência, nos quais múltiplos motores de computação podem acessar a capacidade compartilhada através de um backplane óptico sem as penalidades de serialização e desserialização típicas das redes tradicionais.
Desafios de engenharia para implantação comercial
A transição de CPO (Central Power Packaging) de demonstrações de embalagens avançadas para hardware de data center de produção apresenta diversos obstáculos de engenharia ainda não resolvidos. A integração de dispositivos fotônicos de silício de baixo consumo com lógica de host de alto consumo exige isolamento térmico sofisticado e projetos avançados de resfriamento microfluídico ou direto no pacote.
Além disso, a indústria precisa desenvolver protocolos de coerência padronizados e de baixa latência, capazes de orquestrar transações de memória acopladas opticamente sem a sobrecarga de software proprietário. A comercialização confiável exigirá o projeto conjunto de hardware de ponta a ponta, abrangendo topologias de chips DRAM, controladores de memória personalizados, motores fotônicos e embalagens de substrato heterogêneas. Para a SK hynix, o roteiro óptico segue em paralelo com o convencional; a empresa detalhou o HBM4 de 16 camadas e o NAND de 375 camadas com ligação por wafer na FMS 2026.


 Amazon