

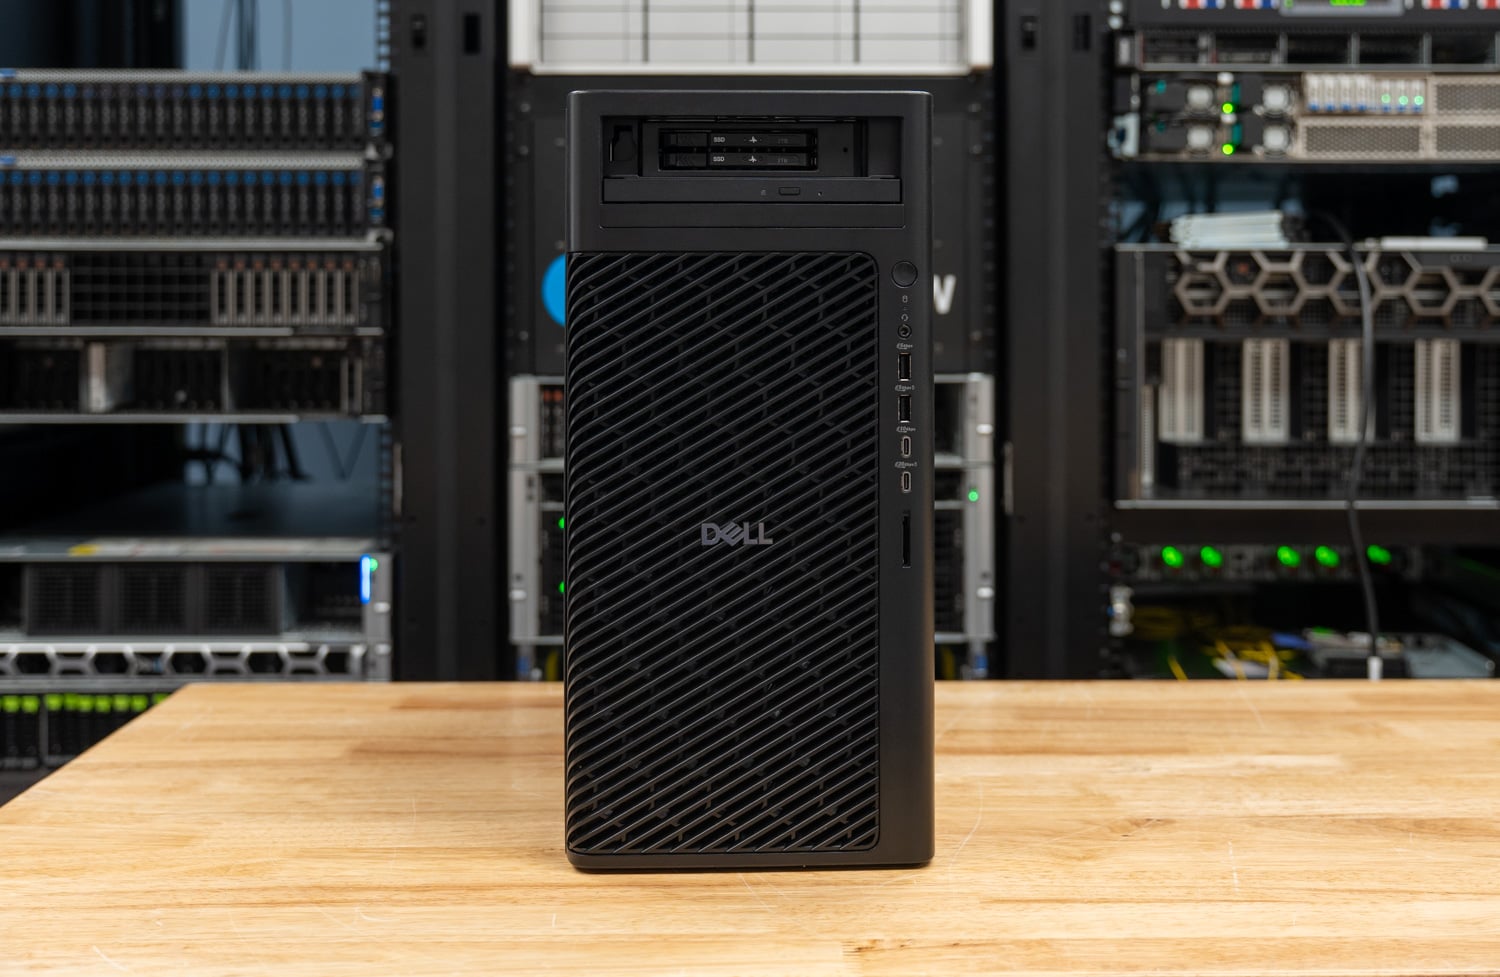
O Dell Pro Precision 9 T2 é a versão Xeon da torre com GPU única que analisamos há um ano como Dell Pro Max Tower T2 , e chega com duas mudanças simultâneas: um novo nome, já que a Dell está reposicionando suas estações de trabalho sob a marca Precision, e uma nova plataforma, com o Intel Xeon 6 substituindo o Core Ultra 9 285K dentro do mesmo chassi de 32 litros. Nossa unidade veio com o Xeon 658X de 24 núcleos, 128 GB de memória DDR5-6400 RDIMM ECC, a placa de vídeo RTX PRO 6000 Blackwell Max-Q de 300 W e dois discos rígidos E3.S Gen5 de 2 TB em RAID 0 (striping) no compartimento FlexBay frontal. Configurado da mesma forma no site da Dell, o preço sugerido é de aproximadamente US$ 28,300.
Testamos o sistema em formato de matriz: o Pro Precision 9 T2 executou nosso conjunto completo de testes com a placa Max-Q que veio de fábrica e também com a RTX PRO 6000 Blackwell de 600 W retirada do nosso Pro Max Tower T2. O T2 com processador Core também executou ambas as placas, portanto, todos os resultados abaixo possuem quatro colunas, e cada par isola uma variável: a plataforma da CPU ou o limite de energia da GPU. O conjunto de testes é o mesmo que foi executado nos notebooks RTX Spark da semana passada , com algumas adições que estreiam aqui.
O Xeon oferece maior desempenho em troca de menor latência. O Pro Precision 9 T2 obteve 12,322 pontos no Cinebench 2026 multi-core, contra 8,856 do Core T2, compilou o LLVM em 140.2 segundos contra 182.5 e leu 122,233 MB/s no STREAM Triad, contra 33,003. Sua pontuação no Cinebench single-core, de 454.1, fica atrás dos 564.4 do 285K, e sua pontuação no Speedometer, de 36.8, fica atrás dos 46.3. A placa de 600W adiciona cerca de 7 a 20% no desempenho de decodificação do LLM e de 20 a 39% no processamento de prompts e difusão em ambos os modelos, enquanto no modelo Xeon, ela reduz o desempenho da CPU em 4 a 5% no trabalho com todos os núcleos.
Principais lições
- Xeon 6 é uma plataforma de alto desempenho em um gabinete torre de um único soquete: 12,322 no Cinebench 2026 multi-core, 39% à frente do Core Ultra 9 285K no mesmo chassi, 289.6 GIPS no 7-Zip contra 174.8, DGEMM com 1,638 GFLOPS contra 768 e 3.7 vezes a largura de banda da memória com quatro canais de DDR5-6400.
- O 285K ainda detém a maior velocidade por thread: O Xeon fica 20% atrás no Cinebench single-core, 21% no Speedometer e de 20 a 31% atrás no Python single-threaded, com latência de núcleo a núcleo de 56.2 ns contra 38.1.
- A GPU determina os resultados da IA, e a placa de 600 W gera sua potência mediante comandos: O MLPerf Llama 3.1 8B gera 230.9 tokens por segundo com a placa Max-Q e 252.8 com a placa de 600W, enquanto o tempo até o primeiro token cai de 0.082 para 0.059 segundos e o Qwen-Image 20B renderiza uma imagem de 1024×1024 em 19.7 segundos contra 26.1.
- A placa de 600 W exige de 4 a 5% do desempenho da CPU do Xeon: A pontuação multi-core do Cinebench caiu de 12,322 para 11,705 e a pontuação em loop sustentado de 30 minutos caiu de 12,328 para 11,764, com a frequência em estado estável reduzida de 4,274 para 4,178 MHz; a mesma troca não alterou nada no Core T2.
- E3.S no FlexBay, listrado por VROC da Graid: O compartimento frontal comporta dois SSDs E3.S Gen5, uma novidade para uma estação de trabalho torre em nosso laboratório, e a opção de inicialização RAID 0 da Dell os integra em um volume de 4,097 GB com VROC da Graid Technology. A taxa de leitura sequencial é de 9,332 MB/s e atinge um pico de 840.1 IOPS em leituras aleatórias de 4K, contra 1.78 milhão de IOPS do SSD M.2 Gen5 único no Core T2.
De Pro Max a Pro Precision
A Dell aposentou a linha Precision no início de 2025, quando todas as estações de trabalho passaram a ser Dell Pro Max, e agora a trouxe de volta. Em 7 de outubro, a Dell renomeou seus desktops GB10 e GB300 de Dell Pro Max para Dell Pro Precision, e o site Dell.com lista o Pro Precision 9 T2 ao lado dos novos modelos T4 e T6 sob a mesma marca. A linha Pro Max permanece para as máquinas com processadores Core, então o modelo Core Ultra que analisamos no ano passado ainda é vendido como Dell Pro Max Tower T2, e o modelo Xeon analisado aqui é o Dell Pro Precision 9 T2, modelo PW9T2260.
Os modelos T4 e T6 também adotaram o Xeon 6 com a mudança de nome, e a Dell posiciona os três modelos de torre de acordo com a capacidade de expansão. O Pro Precision 9 T4 (PW9T4260) utiliza a mesma lista de processadores, incluindo o Xeon 698X de 86 núcleos, adiciona 16 slots DIMM para até 4 TB de memória DDR5-6400 em todos os oito canais de memória e aceita uma única placa de vídeo RTX PRO 6000 de 600 W ou duas placas Max-Q com uma fonte de 1500 W, com a opção de um chassi de 2400 W.
O Pro Precision 9 T6 (PW9T6260) é o modelo topo de linha, com seis slots, uma fonte de alimentação de 2400W e espaço para duas placas RTX PRO 6000 de 600W, três placas Max-Q ou até cinco RTX PRO 5000. O T2 é a opção de entrada da família, com uma única GPU e quatro canais.
A precisão da nomenclatura é importante porque as duas torres são idênticas externamente, compartilhando o mesmo chassi de 32 litros com dimensões de 387 x 187.7 x 438 mm, a mesma moldura e FlexBay frontal, e as mesmas opções de RTX PRO 6000 Blackwell no configurador da Dell. Portanto, a diferença está na placa-mãe. Enquanto a Pro Max Tower T2 combina o processador Core Ultra 9 285K de 24 núcleos com quatro slots DIMM de memória DDR5 sem buffer, a Pro Precision 9 T2 utiliza o Xeon 6 para estações de trabalho da Intel, a plataforma Granite Rapids-WS que analisamos em junho, com memória ECC registrada, mais pistas PCIe e um processador de 250 W na configuração mais avançada.

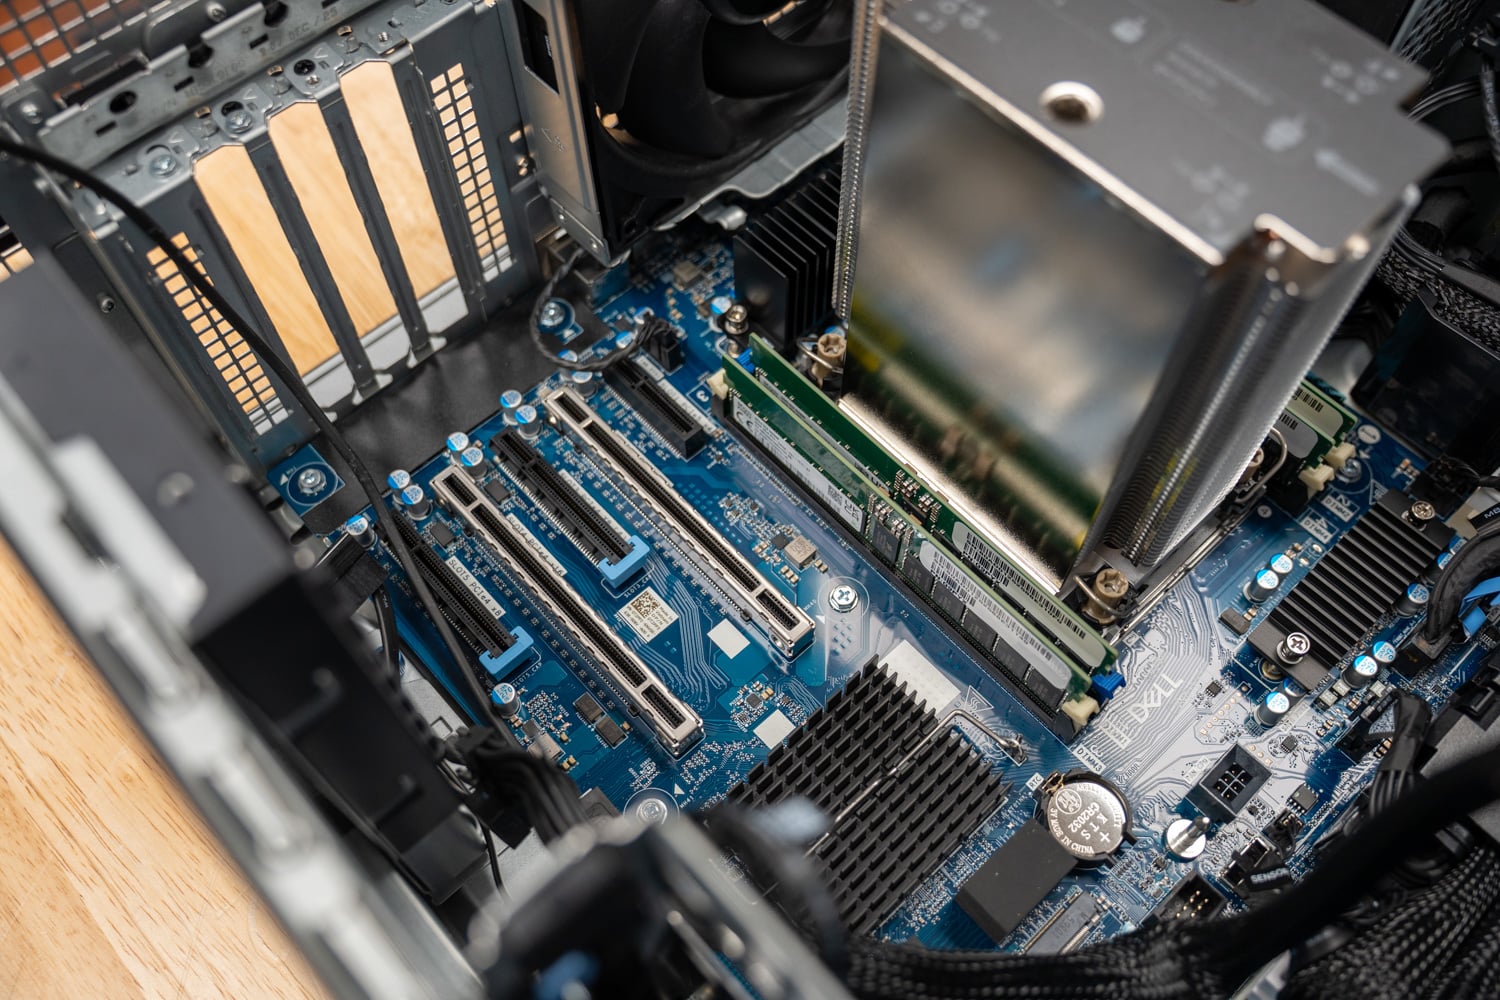
A Dell oferece seis processadores Xeon 6 no Pro Precision 9 T2, desde o Xeon 634 de 12 núcleos com 150 W até o 658X de 24 núcleos com 250 W (presente na nossa unidade), sendo que a transição do 634 para o 658X custa US$ 1,560 a mais. O 658X possui 24 núcleos e 48 threads com clock base de 3.0 GHz e turbo de 4.9 GHz, além de 144 MB de cache L3 (três vezes mais que os 36 MB do 285K) e suporte a AVX-512 e AMX, recursos ausentes no 285K. O chip conta com oito canais DDR5-6400 e 128 linhas Gen5; o T2 disponibiliza quatro slots DIMM e cinco slots de expansão, enquanto os modelos maiores T4 e T6 disponibilizam os slots restantes.
| Plataforma | Dell Pro Precision 9 T2 (conforme testado) | Dell Pro Max Tower T2 (conforme testado) |
|---|---|---|
| Subcontratante | Intel Xeon 658X, 24 núcleos / 48 threads, 3.0 a 4.9 GHz, 144 MB de cache L3, 250 W | Intel Core Ultra 9 285K, 24 núcleos / 24 threads (8P + 16E), até 5.7 GHz, 36 MB de cache L3, 125 W |
| Conjuntos de instruções | AVX-512, AMX | AVX2 (sem AVX-512), Intel AI Boost NPU |
| Memória | 4 x 32GB DDR5-6400 RDIMM ECC (quatro canais; 1TB máximo) | 4 x 32GB DDR5-4400 ECC UDIMM |
| Expansão | Gen5 x16, Gen5 x4, Gen4 x16, dois Gen4 x8 (um x4 elétrico) | Gen5 x16, um Gen4 x4 e dois Gen3 x4 |
| Armazenamento de inicialização conforme testado | 2 SSDs NVMe E3.S Gen5 de 2 TB no compartimento FlexBay frontal, RAID 0 (VROC da Graid Technology), 4,097 GB | SSD SK hynix PCB01 M.2 Gen5 de 2 TB (unidade única) |
| M.2 interno | 3 x M.2 2280 Gen5 | 1 x Gen5 e 2 x Gen4 M.2 |
| Fonte de energia | 750 W padrão; 500 W ou 1500 W opcionais (1500 W conforme testado) | 360 W, 500 W ou 1500 W (80 Plus Platinum) |
| Gráficos conforme testado | RTX PRO 6000 Blackwell Max-Q (300W) conforme enviada; placa de 600W também testada. | RTX PRO 6000 Blackwell (600 W) conforme enviada; placa Max-Q também testada. |
| Chassi | 387 x 187.7 x 438 mm, 11.6 a 21.8 kg | 387 x 187.7 x 438 mm, 8.17 a 23 kg |
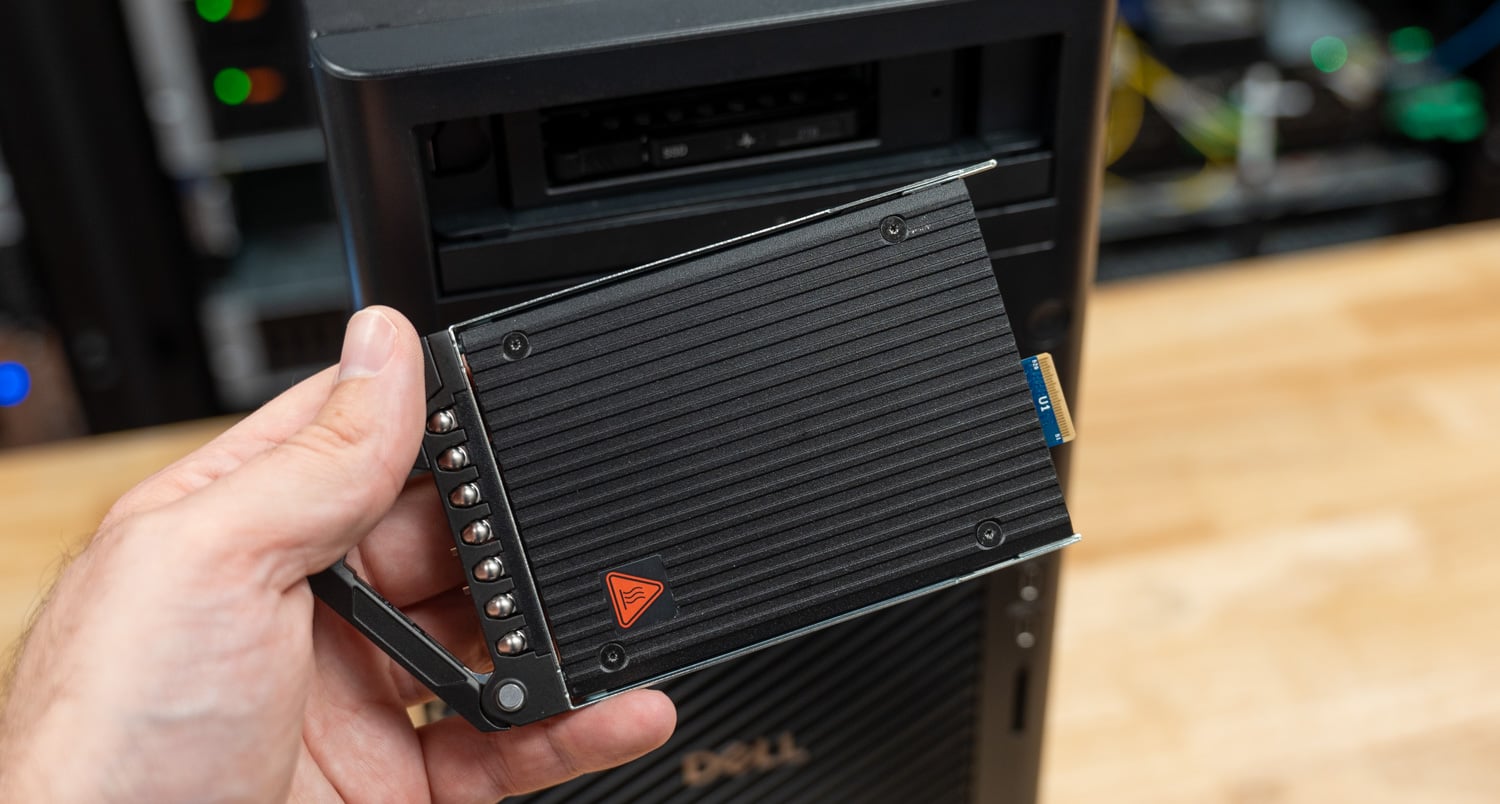
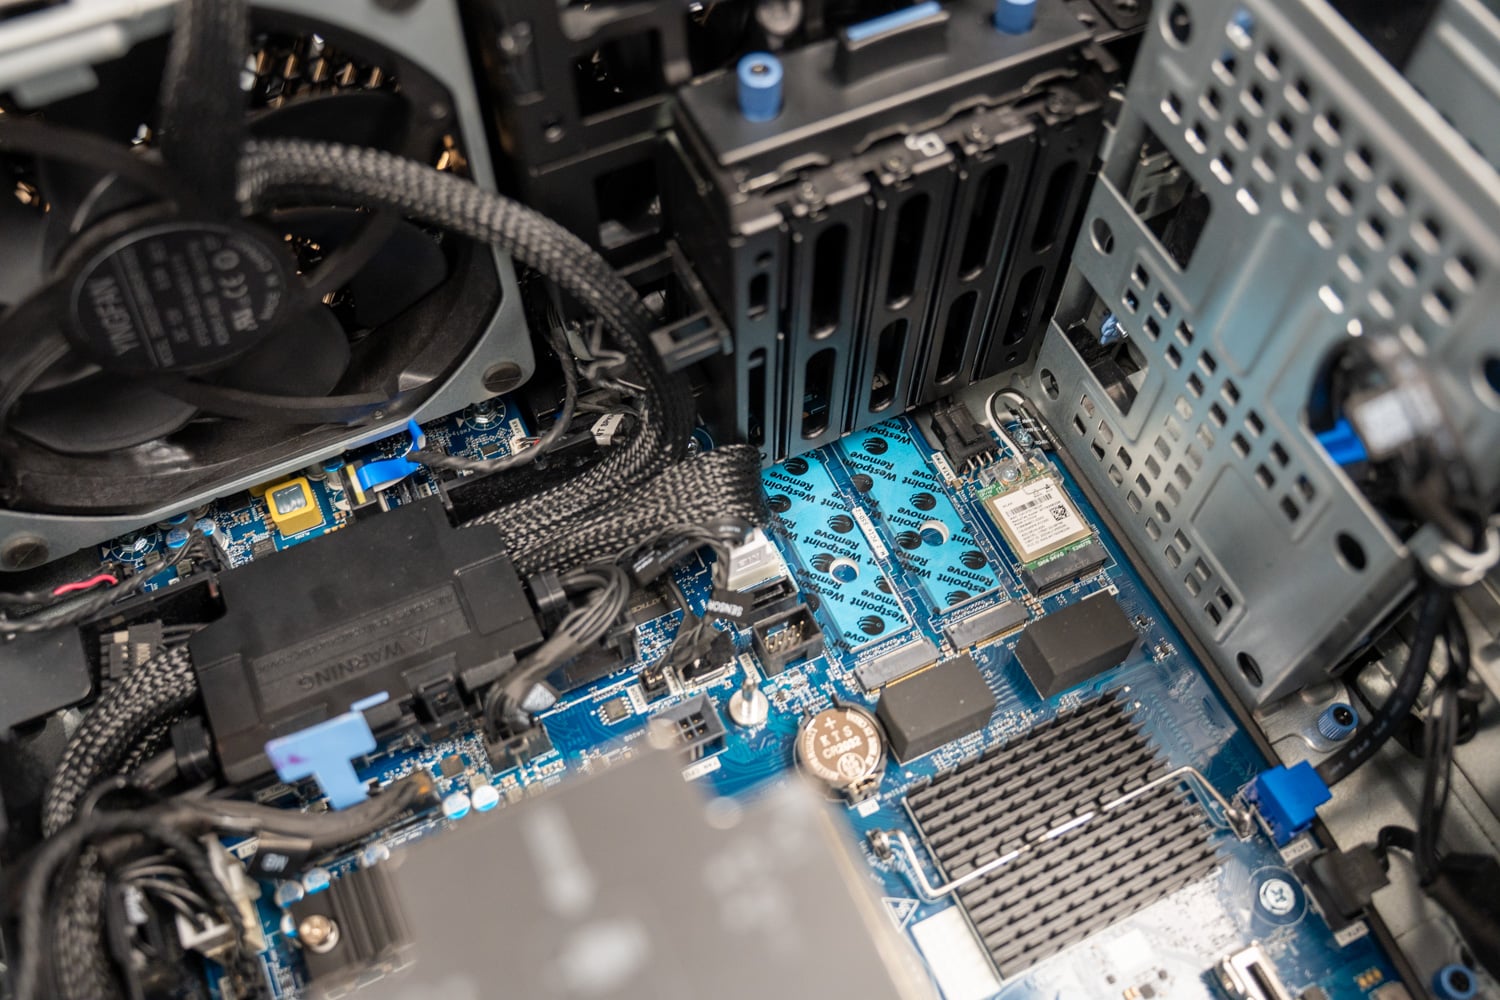
O Core T2 inicializava a partir de um único SSD M.2, enquanto o nosso Pro Precision 9 T2 vinha com a configuração de inicialização FlexBay NVMe da Dell: dois SSDs E3.S Gen5 hot-pluggable atrás do painel frontal, agrupados em um único volume de 4,097 GB pela opção de inicialização RAID 0. O E3.S é o formato empresarial que temos solicitado aos fabricantes de gabinetes torre, pois eleva o limite de capacidade muito além do M.2 e os SSDs ficam acessíveis pela frente sem a necessidade de abrir o chassi. A camada RAID é VROC da Graid Technology , o código Intel VROC que a Graid assumiu no ano passado e relançou na Computex, e esta é a primeira estação de trabalho em nosso laboratório a ser enviada com ele.

A placa de 600 W precisa de um pouco mais de espaço; a Max-Q não. Nossa unidade veio com um adaptador Intel E810-XXV de duas portas 25GbE no slot ao lado da GPU, e para instalar a RTX PRO 6000 de 600 W, tivemos que removê-lo; o cooler da placa ocupa o espaço do slot adjacente, bem como a alimentação do slot. Os compradores que desejam a placa de potência máxima e uma placa de rede de alta velocidade devem planejar o layout dos slots antes de fazer o pedido, e uma fonte de 1500 W é a única combinação razoável para ela; nossa unidade tinha a opção de 1500 W, um upgrade de US$ 40 em relação à fonte padrão de 750 W.
Construir e projetar
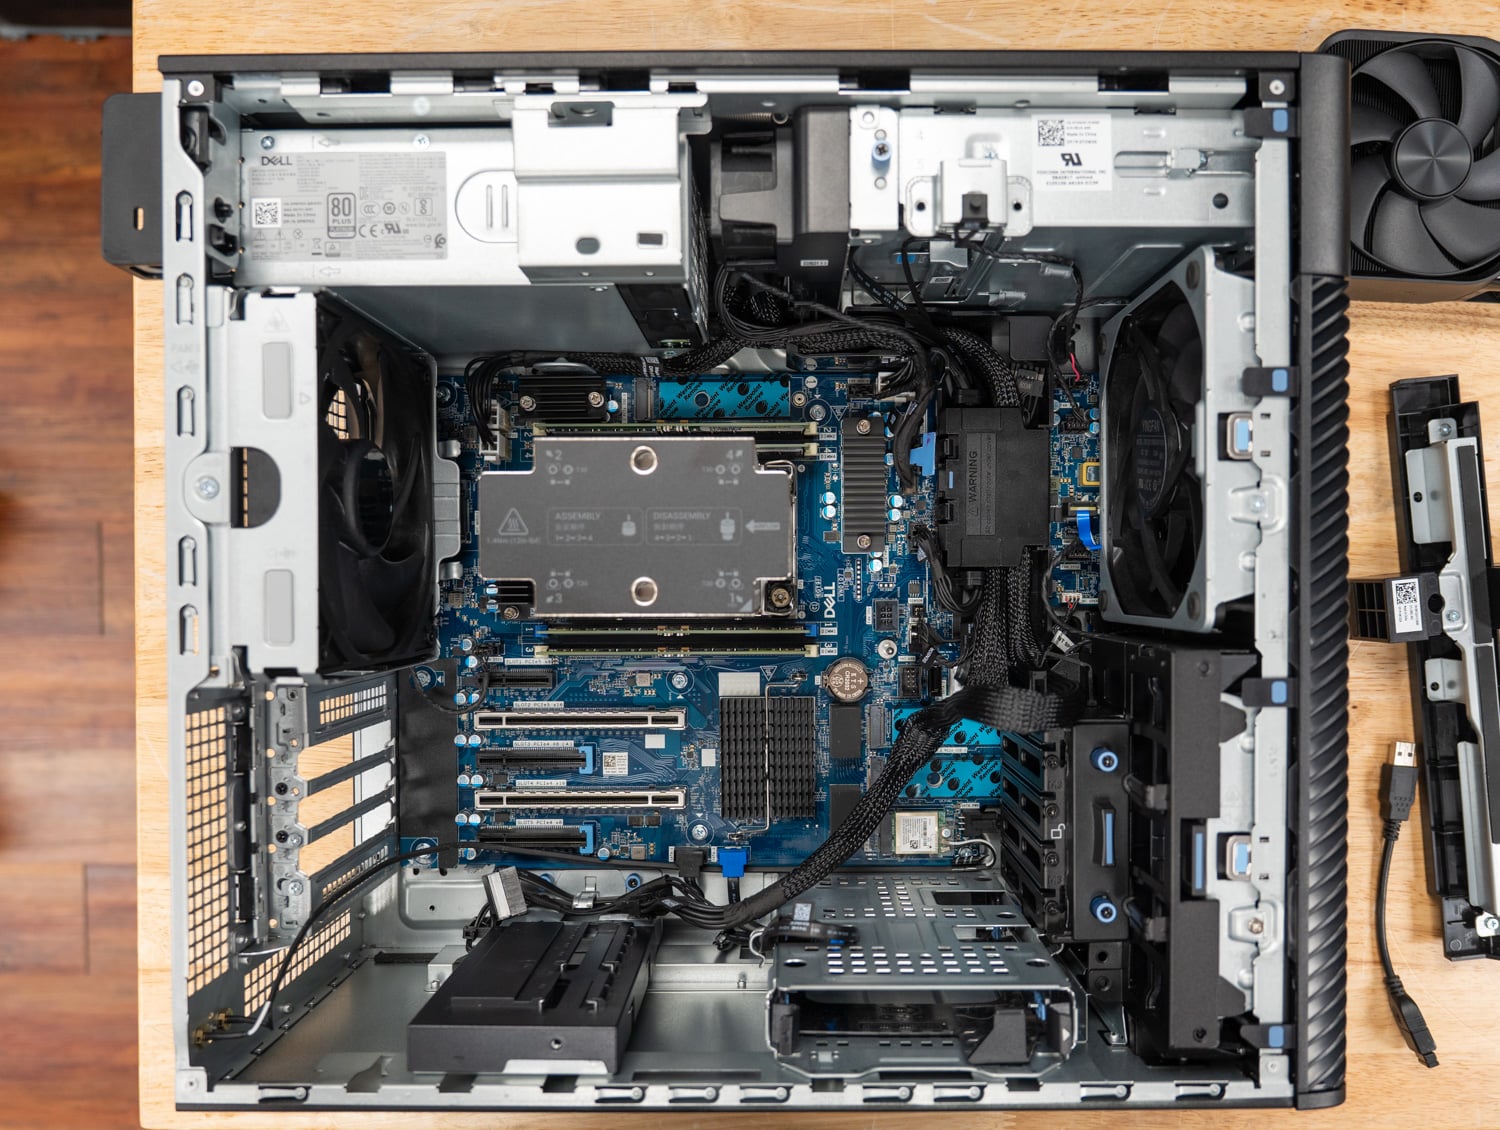
O Pro Precision 9 T2 utiliza a mesma torre sem ferramentas da versão Pro Max, com uma grade frontal de malha de altura total para entrada de ar, uma trava lateral e um parafuso de aperto manual para o painel lateral, além do FlexBay e da unidade óptica slim opcional atrás da moldura inferior. A Dell indica que o chassi pesa 11.6 kg vazio e até 21.8 kg configurado, e o nosso, com a fonte de 1500 W, o cooler do 658X e uma GPU de dois slots, está próximo do limite superior dessa faixa de peso.

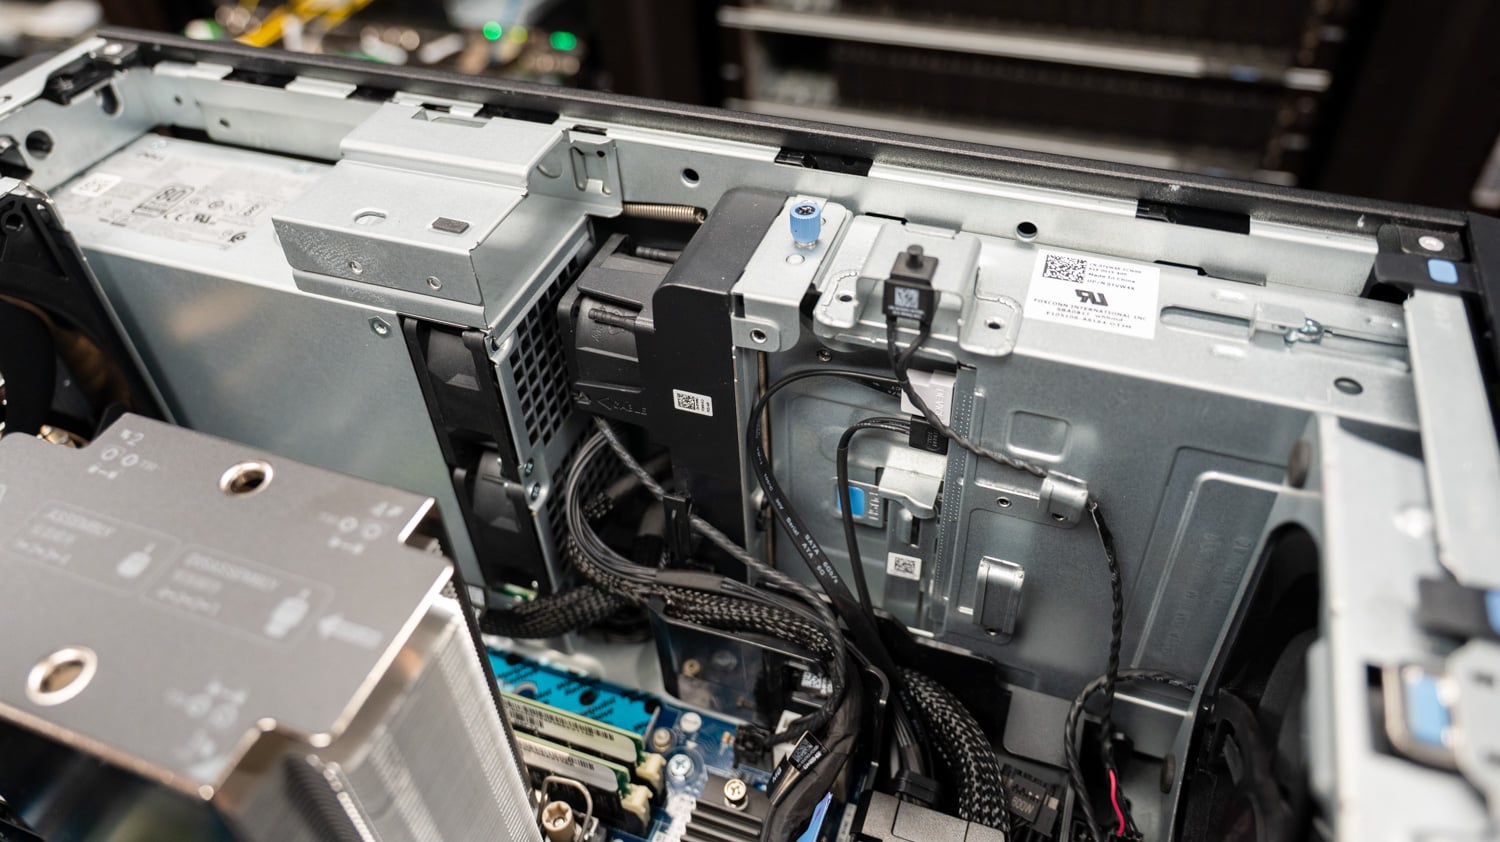
O interior do chassi foi projetado para otimizar o fluxo de ar, e a Dell direciona o ar exatamente para onde ele precisa ir. A grande cobertura de resfriamento, que mantém os módulos de memória DIMM resfriados e expulsa o ar quente da CPU diretamente para fora do chassi, possui uma ventoinha integrada. Com o gabinete aberto, é possível observar como a cobertura se encaixa na estrutura do chassi, apoiando sua borda inferior no suporte da placa de vídeo e se encaixando perfeitamente na tampa lateral.
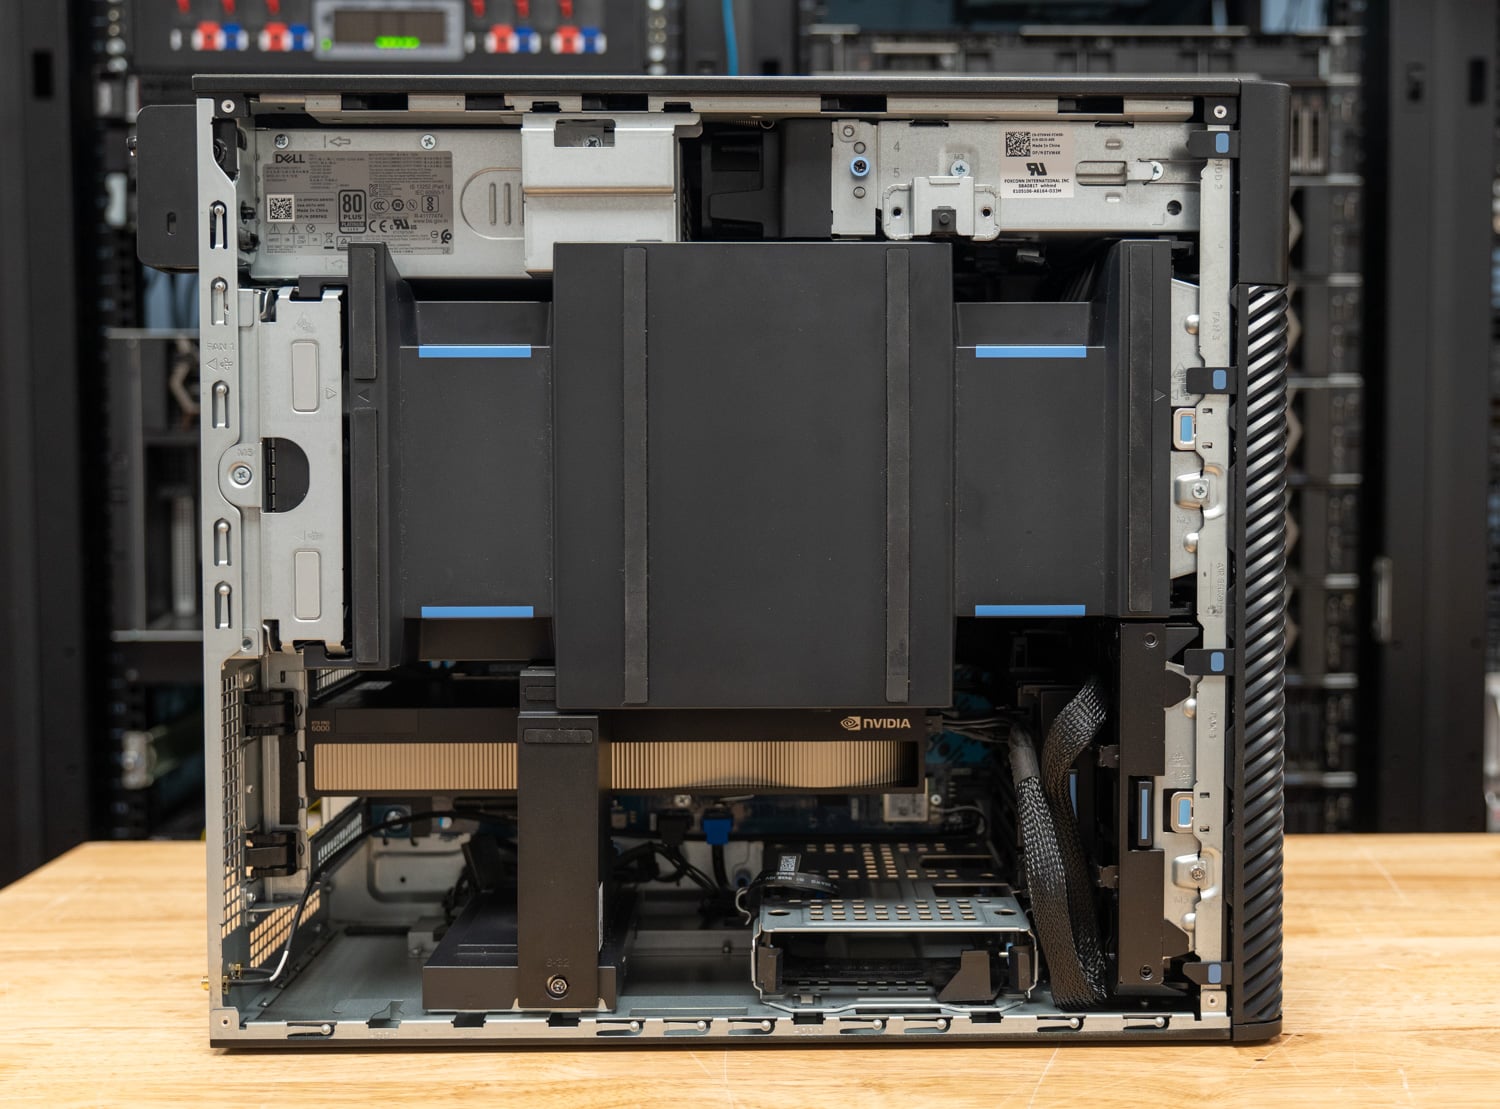
Por dentro, o layout segue o da torre Pro Max: o processador e quatro slots DIMM ficam acima da área de expansão, a GPU no slot Gen5 x16 é suportada em sua extremidade por um suporte de retenção, e a fonte de alimentação é montada na parte traseira com uma alça para remoção sem ferramentas. Todos os cinco slots são de altura total: o slot 2 é o Gen5 x16 para a GPU, o slot 1 é Gen5 x4 e os outros três são Gen4, um x16 e dois x8 abertos, para uma placa de rede, uma placa de armazenamento ou uma segunda GPU. Três slots M.2 2280 Gen5 internos e duas baias SATA de 3.5 polegadas ficam atrás da baia frontal E3.S.
O painel frontal de E/S inclui uma entrada para fone de ouvido, uma porta USB-C de 20 Gbps com PowerShare, uma porta USB-C de 10 Gbps, duas portas USB-A e um slot para cartão SD (opcional). Na parte traseira, encontramos saída de áudio, portas USB-C de 20 Gbps e 10 Gbps, duas portas USB 2.0 com SmartPower, duas portas USB-A de 5 Gbps, uma porta 1GbE, um slot para módulo opcional que aceita uma placa de rede 5GbE ou mais duas portas USB-A, e uma porta serial (opcional). Nossa unidade contava com a placa MediaTek MT7925 Wi-Fi 7 instalada no slot M.2 2230 interno e a placa Intel E810-XXV 25GbE, a mesma utilizada com a GPU de 600 W.

Especificações do Dell Pro Precision 9 T2
| Especificação | Dell Pro Precision 9 T2 (PW9T2260) |
|---|---|
| Visão geral da plataforma | |
| opções de processadores | Intel Xeon 634 (12 núcleos, 150 W), 636 (12 núcleos, 170 W), 638 (16 núcleos, 180 W), 654 (18 núcleos, 200 W), 656 (20 núcleos, 210 W), 658X (24 núcleos / 48 threads, 144 MB de cache L3, 250 W) Xeon 658X conforme testado |
| Memória | DDR5 RDIMM ECC, 5600 ou 6400 MT/s, quatro slots, até 1 TB (4 x 256 GB) 128 GB (4 x 32 GB) DDR5-6400 conforme testado |
| Opções gráficas | NVIDIA RTX A400, A1000, RTX PRO 2000 / 4000 / 4500 / 5000 / 6000 Blackwell (600W) / 6000 Blackwell Max-Q (300W), A800 Active; AMD Radeon Pro W7400; configurações duplas e triplas em placas selecionadas. RTX PRO 6000 Blackwell Max-Q Workstation Edition, 96 GB GDDR7, conforme testado |
| Armazenamento | FlexBay frontal: até duas unidades E3.S / NVMe mais uma unidade óptica slim opcional, ou uma baia SATA de 3.5 polegadas. Interno: 3 x M.2 2280 Gen5 NVMe, 2 x SATA de 3.5 polegadas RAID: Intel VMD com VROC da Graid Technology (inicialização RAID0, RAID0 interno) 2 x 2 TB E3.S Gen5 NVMe em RAID 0 (4,097 GB) conforme testado |
| Expansão | Slot 1: Gen5 x4; Slot 2: Gen5 x16; Slot 3: Gen4 x8 (4 conexões elétricas, aberto); Slot 4: Gen4 x16; Slot 5: Gen4 x8 (aberto); M.2 2230 para Wi-Fi |
| I / O | |
| Portas frontais | 1 x USB-C 20Gbps com PowerShare, 1 x USB-C 10Gbps, 1 x USB-A 5Gbps com PowerShare, 1 x USB-A 5Gbps, entrada para fone de ouvido, slot para cartão SD opcional |
| Portas traseiras | 1 x USB-C 20Gbps, 1 x USB-C 10Gbps, 2 x USB 2.0 (SmartPower), 2 x USB-A 5Gbps, saída de áudio, 1 x RJ45 1GbE, módulo opcional de 5GbE ou USB-A duplo, porta serial opcional. |
| Redes testadas | Intel E810-XXV DA2 dual-port 25GbE SFP28 (removido para as configurações da GPU de 600W); MediaTek MT7925 Wi-Fi 7, Bluetooth 5.4 |
| Poder e Físico | |
| Fonte de energia | 750 W padrão; 500 W ou 1500 W opcionais; 1500 W conforme testado |
| Dimensões | 387 x 187.7 x 438 mm (15.23 x 7.38 x 17.24 pol.) |
| Peso | Peso mínimo: 11.6 kg (25.57 lb) a peso máximo: 21.8 kg (48.06 lb) |
| Sistema operacional | Windows 11 Pro para Estações de Trabalho (conforme testado) ou Ubuntu Linux 24.04 LTS |
| Gestão e segurança | Intel vPro, TPM 2.0, interruptor de intrusão no chassi, opções de moldura com trava, slot Kensington |
| Preço | Dell.com Configuração básica: US$ 3,978 (Xeon 634, 16 GB, RTX A400, 256 GB, 750 W); aproximadamente US$ 28,300 na configuração testada (Xeon 658X, 128 GB DDR5-6400, RTX PRO 6000 Max-Q, 2 HDs Gen5 FlexBay de 2 TB em RAID 0, 1500 W, 25 GbE, Wi-Fi 7), preços da Dell.com em 19 de outubro de 2026. |
Esse preço vem com duas ressalvas. O configurador da Dell.com lista os drives FlexBay como módulos M.2 2280 Gen5 de 2 TB a US$ 1,700 cada, enquanto os drives em nossa unidade são E3.S, e perguntamos à Dell quando a opção E3.S estará disponível online. A Dell admite que poucas estações de trabalho empresariais são compradas pelo preço da web, então considere os US$ 28,300 como um teto, abaixo do qual os preços para grandes volumes e contratos se enquadram. A memória e a GPU representam US$ 19,090 desse valor, e a opção de GPU custa o mesmo, independentemente de você escolher a placa de 300 W ou a de 600 W.
A Dell define o preço desta unidade de teste em US$ 31,700, valor que inclui o adaptador E810-XXV 25GbE, Wi-Fi 7, unidade óptica e três anos de ProSupport na configuração que calculamos.
Configuração e metodologia de teste
Todos os resultados desta análise provêm do sr-client 1.2, nosso conjunto de testes de benchmark para clientes Windows, executado em seu perfil completo, utilizando a imagem de fábrica do Windows da Dell com os drivers da Dell e o driver NVIDIA 596.71 em todas as quatro configurações. O conjunto de testes aplica as mesmas configurações em todos os ambientes: modo de energia do Windows em "Melhor desempenho", todos os temporizadores de suspensão e desligamento da tela desativados, Firewall do Windows e avisos do UAC desativados, VBS e Integridade da Memória ativados conforme as configurações de fábrica. Cada resultado representa a mediana de execuções repetidas, e o conjunto de testes executa novamente um teste cuja dispersão exceda 2% antes de aceitá-lo.
As quatro configurações abaixo são compostas por duas torres e duas GPUs. O Pro Precision 9 T2 executou o conjunto completo de testes com sua placa Max-Q e novamente com a RTX PRO 6000 Blackwell de 600W da nossa Pro Max Tower T2. A Pro Max Tower T2, por sua vez, executou ambas as placas alternadamente. Portanto, as colunas de GPU dentro de uma torre diferem apenas na placa, e as colunas de torre dentro de uma GPU diferem apenas na plataforma. O disco do Core T2 é o SSD M.2 Gen5 de 2 TB que acompanha o sistema, enquanto o do Xeon T2 é o seu RAID 1 com dois discos E3.S. Assim, as linhas de armazenamento e carregamento de modelos comparam essas configurações.
| Configuração | CPU | Memória | GPU | Unidade de inicialização | SO e modo de energia |
|---|---|---|---|---|---|
| Dell Pro Precision 9 T2 (PW9T2260), Max-Q | Intel Xeon 658X, 24 núcleos / 48 threads, 250 W | 128 GB DDR5-6400 RDIMM ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 300 W, 96 GB | 2 x 2 TB E3.S Gen5 NVMe, VROC RAID0 (volume de inicialização de 4,097 GB) | Windows 11 Pro para Estações de Trabalho 25H2, Melhor desempenho |
| Dell Pro Precision 9 T2 (PW9T2260), 600W | Intel Xeon 658X, 24 núcleos / 48 threads, 250 W | 128 GB DDR5-6400 RDIMM ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Workstation Edition, 600W, 96GB | 2 x 2 TB E3.S Gen5 NVMe, VROC RAID0 (volume de inicialização de 4,097 GB) | Windows 11 Pro para Estações de Trabalho 25H2, Melhor desempenho |
| Dell Pro Max Tower T2 (FCT2250), Max-Q | Intel Core Ultra 9 285K, 24 núcleos/24 threads, 125 W | 128 GB DDR5-4400 ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 300 W, 96 GB | SK hynix PCB01 2TB, Gen5 x4 | Windows 11 Pro 26H2, Melhor desempenho |
| Dell Pro Max Tower T2 (FCT2250), 600W | Intel Core Ultra 9 285K, 24 núcleos/24 threads, 125 W | 128 GB DDR5-4400 ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Workstation Edition, 600W, 96GB | SK hynix PCB01 2TB, Gen5 x4 | Windows 11 Pro 26H2, Melhor desempenho |
Diversos testes estreiam aqui, começando com o teste de serviço LLM, que executa o llama-server com quatro modelos e varia a concorrência de uma única requisição até o máximo que cabe na memória da GPU, relatando a taxa de transferência total e por usuário, o tempo até o primeiro token e o tempo por token de saída. O teste de geração de imagens renderiza imagens de 1024×1024 com FLUX.2 klein 4B, Z-Image Turbo 6B e Qwen-Image 20B nos pesos Q4_0, Q8_0 e BF16, e avalia as saídas quantizadas em relação ao BF16 com PSNR e SSIM, de modo que velocidade e fidelidade sejam comparadas. O teste do agente de codificação agora é executado no Crush, e o teste do agente ao lado do usuário usa um método revisado que limita o benchmark do navegador a três passagens completas.
Três rótulos se repetem nas tabelas, começando com N/A, o que significa que um teste não se aplica ao hardware: SMT single-core no 285K, que não possui SMT, e as linhas OpenBLAS top-core-class no Xeon, cujos 24 núcleos pertencem a uma única classe. Parcial indica um resultado aceito pelo conjunto de testes com uma observação, geralmente referente a um nível de agente de codificação em que uma das três execuções falhou nos testes. Nenhum dos desktops expôs as temperaturas da CPU ou da GPU ao caminho do sensor do conjunto de testes, portanto, esta análise apresenta as frequências médias da CPU por teste em vez de uma tabela térmica.
Desempenho de IA local
Com 96 GB de GDDR7 em todas as configurações, a capacidade de modelagem é garantida, e todos os níveis do nosso conjunto de testes de IA local são executados nas quatro placas. Os resultados, portanto, se dividem de acordo com o limite de potência da GPU: quando um teste é limitado pela largura de banda da memória, as placas Max-Q e de 600 W apresentam desempenho semelhante, e quando o limite é a capacidade de processamento, a placa de 600 W se destaca. A plataforma da CPU raramente importa, e quando importa, a diferença é digna de nota.
Cliente MLPerf v2.0
O cliente MLPerf executa o Llama 3.1 8B e o Phi-4-mini em cinco categorias de prompts e registra o tempo até o primeiro token e a taxa de tokens subsequentes, como uma média geométrica entre as categorias, com o llama.cpp em CUDA como mecanismo em todas as configurações. Os cenários de agentes executam o Llama 3.1 8B como um agente de análise de dados e um agente de engenharia de software que invocam ferramentas em várias etapas.

| Cliente MLPerf v2.0 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Llama 3.1 8B, tempo até o primeiro token, média geométrica (s, quanto menor, melhor) | 0.082 | 0.059 | 0.082 | 0.060 |
| Llama 3.1 8B, taxa de tokens, média geométrica (tok/s) | 230.9 | 252.8 | 230.0 | 246.7 |
| Phi-4-mini, tempo até o primeiro token, média geométrica (s, quanto menor, melhor) | 0.045 | 0.034 | 0.044 | 0.034 |
| Phi-4-mini, taxa de tokens, média geométrica (tok/s) | 345.9 | 379.0 | 351.0 | 374.3 |
| Agente de Análise de Dados, ponta a ponta (s, quanto menor, melhor) | 17.5 | 15.7 | 16.2 | 14.4 |
| Agente Analista de Dados, taxa de tokens (tok/s) | 202.9 | 223.9 | 202.3 | 218.4 |
| Agente SWE, ponta a ponta (s, quanto menor, melhor) | 16.2 | 14.9 | 14.6 | 13.5 |
| Agente SWE, taxa de tokens (tok/s) | 197.5 | 214.6 | 195.5 | 210.2 |
A placa Max-Q gerou Llama 3.1 8B a 230.9 tokens por segundo na torre Xeon e 230.0 na torre Core, e Phi-4-mini a 345.9 e 351.0, que é a mesma GPU realizando o mesmo trabalho. A placa de 600W elevou esses valores para 252.8 e 379.0 tokens por segundo na torre Xeon, um ganho de cerca de 9%, e reduziu o tempo para o primeiro token em Llama de 0.082 para 0.059 segundos, uma redução de 28%. O processamento de prompts é limitado pela capacidade computacional, e a decodificação é limitada pela largura de banda, e as duas placas compartilham a mesma memória, portanto, a limitação de energia se manifesta muito mais no primeiro token do que nos subsequentes.
Os cenários de agentes são onde a plataforma de CPU se destaca. O agente de análise de dados terminou em 16.2 segundos no Core T2 com a placa Max-Q e em 17.5 segundos no Xeon T2, enquanto o agente de engenharia de software levou 14.6 segundos contra 16.2 segundos, com as fases de chamada de ferramentas do Xeon demorando cerca de 1.5 segundo a mais em cada caso. As taxas de tokenização coincidem dentro de 1%, portanto a diferença reside nas ferramentas executadas na CPU entre as chamadas de modelo, onde os núcleos mais rápidos do 285K terminam mais cedo.
Carregamento do modelo
Este teste mede o tempo de execução de um modelo local no Ollama, desde a inicialização do disco até a geração do primeiro token, tanto a frio (cache de arquivos limpo) quanto a quente (arquivo já na memória). O teste também registra a velocidade de leitura do disco durante o carregamento a frio, a velocidade de leitura quando os pesos chegaram à memória da GPU e um índice de eficiência de carregamento que compara a taxa de leitura durante o carregamento com o limite sequencial de 1 MB do disco. Com 96 GB de VRAM, os três níveis de teste foram executados: gpt-oss:20b com 12.8 GB, Qwen3.6-35B-A3B com 21.1 GB e gpt-oss:120b com 60.9 GB.

| Carregamento do modelo (mapeamento de memória ativado) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| gpt-oss:20b, carregamento a frio para o primeiro token (s, quanto menor, melhor) | 9.68 | 9.02 | 7.41 | 7.23 |
| gpt-oss:20b, carregamento a quente para o primeiro token (s, quanto menor, melhor) | 7.52 | 7.18 | 6.60 | 6.61 |
| gpt-oss:20b, chegada na memória da GPU, frio (s, quanto menor, melhor) | 4.44 | 4.33 | 3.00 | 2.95 |
| Qwen3.6-35B-A3B, carregamento a frio para o primeiro token (s, quanto menor, melhor) | 13.31 | 12.32 | 11.62 | 11.01 |
| Qwen3.6-35B-A3B, carga quente até o primeiro token (s, quanto menor, melhor) | 11.63 | 10.75 | 10.35 | 9.99 |
| gpt-oss:120b, carregamento a frio para o primeiro token (s, quanto menor, melhor) | 32.06 | 32.44 | 28.54 | 28.11 |
| gpt-oss:120b, carregamento a quente para o primeiro token (s, quanto menor, melhor) | 27.18 | 26.49 | 25.58 | 25.73 |
| gpt-oss:120b, taxa de transferência de leitura durante carga a frio (MB/s) | 9,875 | 9,106 | 11,633 | 11,248 |
| gpt-oss:120b, chegada na memória da GPU, frio (s, quanto menor, melhor) | 11.33 | 11.57 | 7.74 | 7.63 |
| gpt-oss:120b carregar após troca de gpt-oss:20b (s, quanto menor, melhor) | 14.30 | 13.97 | 11.89 | 11.93 |
| Limite de unidade, DiskSpd 1MB leitura sequencial (MB/s) | 11,306 | 11,296 | 11,563 | 11,646 |
O Core T2 carrega todos os modelos mais rapidamente, e o motivo é o disco. O gpt-oss:120b atingiu seu primeiro token em 28.54 segundos no Core T2, contra 32.06 segundos no Xeon T2, com os 61 GB de pesos chegando à memória da GPU em 7.74 segundos, contra 11.33 segundos. O único disco PCB01 alimentou a carga a 11,633 MB/s, exatamente no seu limite de 11,563 MB/s do DiskSpd, enquanto o stripe E3.S alimentou a 9,875 MB/s, contra um limite próprio de 11,306 MB/s. O volume RAID lê blocos grandes quase tão rápido quanto o disco único, mas não mantém essa taxa no caminho de carregamento mapeado em memória do Ollama.
Carregamentos a quente reduzem a diferença para um ou dois segundos, já que o arquivo já está na memória do sistema e o que resta é a transferência para a VRAM e a configuração do llama.cpp: 27.18 segundos no Xeon T2 contra 25.58 para gpt-oss:120b e 7.52 contra 6.60 para gpt-oss:20b. O limite de energia da GPU não faz diferença consistente no carregamento, como esperado.
Agente de codificação
Crush, um agente de codificação de terminal, executa um modelo local hospedado no Ollama por meio de uma tarefa de codificação fixa em um repositório específico, com até três rodadas para que os 11 testes do repositório sejam aprovados; relatamos o tempo médio de execução de três execuções, quantas foram bem-sucedidas e a taxa de geração. O tempo de execução depende de quantas chamadas de ferramentas e tokens o modelo decide gastar, o que varia de execução para execução; portanto, a taxa de geração é a comparação de hardware mais precisa. O teste de interação entre o agente e o usuário executa o agente e o Speedometer simultaneamente e relata o quanto cada um afeta o desempenho do outro.

| Agente de codificação Crush | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Nível S, gpt-oss:20b, contexto de 64K | ||||
| Tempo de parede, mediana (s, quanto menor, melhor) | 55.1 | 99.8 | 57.2 | 43.2 |
| Sucessos (de 3) | 3 | 2 | 3 | 2 |
| Taxa de geração (tok/s) | 214.1 | 237.9 | 218.0 | 237.7 |
| Nível M, Qwen3.6-35B-A3B, contexto 64K | ||||
| Tempo de parede, mediana (s, quanto menor, melhor) | 35.2 | 27.0 | 86.7 | 32.1 |
| Sucessos (de 3) | 3 | 3 | 3 | 3 |
| Taxa de geração (tok/s) | 234.5 | 242.9 | 223.3 | 245.8 |
| Nível L, Qwen3.6-35B-A3B, contexto de 128K | ||||
| Tempo de parede, mediana (s, quanto menor, melhor) | 38.1 | 30.6 | 74.1 | 58.8 |
| Sucessos (de 3) | 3 | 3 | 3 | 3 |
| Taxa de geração (tok/s) | 222.9 | 237.0 | 231.1 | 252.8 |
| Nível W, gpt-oss:120b, contexto de 128K | ||||
| Tempo de parede, mediana (s, quanto menor, melhor) | 49.1 | 37.9 | 56.6 | 30.8 |
| Sucessos (de 3) | 3 | 3 | 3 | 3 |
| Taxa de geração (tok/s) | 160.9 | 177.1 | 158.5 | 174.4 |
| Agente ao lado do usuário (gpt-oss:20b e velocímetro juntos) | ||||
| Velocímetro ao lado do agente (pontuação) | 36.6 | 36.7 | 43.2 | 45.2 |
| Redução da velocidade do velocímetro (x, quanto menor, melhor) | 1.005 | 1.011 | 1.053 | 1.044 |
| Taxa de geração de agentes ao lado do velocímetro (tok/s) | 218.2 | 231.6 | 212.4 | 229.2 |
| Redução de velocidade do agente (x, quanto menor, melhor) | 1.006 | 1.009 | 1.023 | 0.998 |
Todas as configurações completaram as três execuções da tarefa de nível W com gpt-oss:120b, o maior modelo do conjunto, gerando de 160.9 a 177.1 tokens por segundo na torre Xeon e de 158.5 a 174.4 na torre Core, com a placa de 600W representando cerca de 10% em cada caso. As tarefas do Qwen3.6 também foram aprovadas em todas as três execuções, com taxas de 223 a 253 tokens por segundo. O modelo gpt-oss:20b apresentou problemas: a tarefa de nível S perdeu uma das três execuções em duas das quatro configurações, e sua tarefa de nível M com 128 mil contextos (não mostrada) perdeu pelo menos uma execução em todas as configurações, um comportamento do modelo que não é alterado pelo hardware.
Executar o agente e um benchmark do navegador simultaneamente tem um custo quase nulo em um computador com uma GPU dedicada e 24 núcleos disponíveis. O Speedometer apresentou uma queda de desempenho de 1.005x no Xeon T2 e de 1.053x no Core T2 com o agente em execução, e a taxa de geração do agente variou em 2% ou menos em todos os casos. A pontuação de 36.6 no Speedometer do Xeon T2, juntamente com o agente, é inferior à pontuação de 43.2 do Core T2 pelo mesmo motivo que a torna inferior quando executado sozinho: a velocidade por núcleo do 285K.
Geração Aumentada de Recuperação
Nosso teste RAG incorpora 20,963 trechos do SQuAD v1.1 com o nomic-embed-text, recupera os cinco trechos principais para cada uma das 2,000 perguntas e responde a 400 delas com o Phi-4-mini, avaliando a correspondência exata e o F1 em relação às respostas de referência. Os modelos são pequenos, portanto o teste mede todo o pipeline, incluindo a busca vetorial no lado da CPU entre as fases da GPU.

| RAG | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Tempo de ingestão na parede, 20,963 passagens (s, quanto menor, melhor) | 128.5 | 125.5 | 108.1 | 103.0 |
| Taxa de incorporação (tok/s) | 29,875 | 30,592 | 35,165 | 37,508 |
| Tempo de consulta de recuperação, p50 (ms, quanto menor, melhor) | 30.6 | 27.2 | 23.4 | 18.7 |
| Resposta: Tempo Phi-4-mini até o primeiro token, p50 (s, quanto menor, melhor) | 0.099 | 0.087 | 0.089 | 0.083 |
| Resposta, processamento imediato (tok/s) | 20,318 | 26,549 | 21,356 | 26,619 |
| Resposta: taxa de geração (tok/s) | 296.4 | 337.8 | 324.3 | 344.1 |
| Pergunta a responder, p50 (s, quanto menor, melhor) | 0.152 | 0.133 | 0.130 | 0.120 |
| Recall@5 (%) | 82.7 | 82.7 | 82.7 | 82.7 |
| Resposta F1 (%) | 74.65 | 74.65 | 74.65 | 74.65 |
O Core T2 é mais rápido nesse processo. Ele processou o corpus em 108.1 segundos, contra 128.5 segundos no Xeon T2 com a mesma placa Max-Q; recuperou os dados em 23.4 ms, contra 30.6 ms na mediana; e respondeu a uma pergunta em 0.130 segundos, contra 0.152 segundos. Tanto a incorporação quanto a recuperação de dados possuem etapas que exigem mais processamento da CPU, e essas etapas favorecem o processador de 285K. A placa de 600W aumentou o processamento de consultas em 25 a 30% em ambas as plataformas, de 20,318 para 26,549 tokens por segundo no Xeon T2, e a precisão foi idêntica em todas as quatro configurações, como esperado para os mesmos modelos na temperatura 0.
LLM Servindo
O teste de serviço executa o llama-server com Ministral 3 3B e 8B (prompts de 4,096 tokens, outputs de 1,024 tokens), Qwen3.8 27B e gpt-oss 120B (prompts de 8,192 tokens), alocando tantos slots quanto couberem na memória da GPU após os pesos e, em seguida, variando a concorrência de uma requisição até esse limite. Relatamos a taxa de transferência total (tokens de prompt e output juntos), a taxa de transferência de output, o tempo até o primeiro token e o tempo por token de output na mediana. Em uma placa de 96 GB, o gpt-oss 120B ocupa 64 slots com 22.5 GiB de cache KV, o Qwen3.8 27B ocupa oito e os dois modelos Ministral ocupam quatro em seus respectivos contextos.

| llama-server, gpt-oss 120B, 8,192 prompts de token, 1,024 saídas de token | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| 1 concorrente: taxa de transferência de saída (tok/s) | 160.6 | 182.7 | 158.4 | 179.0 |
| 1 concorrentes: tempo até o primeiro token, mediana (ms, quanto menor, melhor) | 1,241 | 918 | 1,238 | 923 |
| 1 concorrentes: tempo por token de saída, mediana (ms, quanto menor, melhor) | 5.03 | 4.58 | 5.11 | 4.70 |
| 8 simultâneos: taxa de transferência total (tok/s) | 2,088 | 2,460 | 2,154 | 2,534 |
| 8 simultâneos: saída por usuário (tok/s) | 29.0 | 34.2 | 29.9 | 35.2 |
| 8 concorrentes: tempo até o primeiro token, mediana (ms, quanto menor, melhor) | 2,847 | 2,152 | 2,856 | 2,121 |
| 64 simultâneos: taxa de transferência total (tok/s) | 3,296 | 3,805 | 3,531 | 4,220 |
| 64 simultâneos: saída por usuário (tok/s) | 5.7 | 6.6 | 6.1 | 7.3 |
| 64 concorrentes: tempo até o primeiro token, mediana (ms, quanto menor, melhor) | 4,315 | 3,491 | 4,607 | 3,622 |
| 64 concorrentes: tempo por token de saída, mediana (ms, quanto menor, melhor) | 163.0 | 141.3 | 152.7 | 126.3 |
Um único usuário recebe gpt-oss 120B a 160.6 tokens por segundo na placa Max-Q e 182.7 na placa 600W, com o primeiro token chegando em 1,241 e 918 ms após uma solicitação de 8,192 tokens. Carregar a placa com 64 solicitações simultâneas aumentou a taxa de transferência total para 3,296 tokens por segundo na Max-Q e 3,805 na placa 600W, ao custo de 5.7 e 6.6 tokens por segundo por usuário e tempos de espera para o primeiro token de 4.3 e 3.5 segundos. A curva se estabiliza entre 4 e 32 solicitações simultâneas e sobe novamente em 64, onde o processamento em lote finalmente amortiza as longas esperas.

| llama-server, taxa de transferência de saída na maior concorrência possível (tok/s) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Ministral 3 3B Raciocínio, 4 simultâneos | 562.5 | 600.4 | 576.8 | 625.3 |
| Ministral 3 8B Raciocínio, 4 simultâneos | 375.8 | 445.1 | 377.9 | 446.3 |
| Qwen3.8 27B, 8 simultâneos | 153.1 | 189.6 | 152.2 | 187.3 |
| gpt-oss 120B, 64 concorrentes | 366.3 | 422.8 | 392.3 | 468.9 |
| Taxa de transferência de saída de solicitação única (tok/s) | ||||
| Ministral 3 3B Raciocínio | 232.1 | 241.8 | 232.1 | 246.0 |
| Ministral 3 8B Raciocínio | 165.0 | 183.3 | 164.1 | 180.4 |
| Qwen3.8 27B | 54.0 | 63.7 | 54.1 | 63.0 |
| gpt-oss 120B | 160.6 | 182.7 | 158.4 | 179.0 |
O modelo denso Qwen3.8 27B é o mais lento para um único usuário, com 54.0 tokens por segundo no Max-Q, porque cada token acessa todos os 27 bilhões de parâmetros, enquanto o modelo gpt-oss 120B, com uma combinação de especialistas, é 3.0 vezes mais rápido, apesar de ocupar quatro vezes mais espaço em disco. A vantagem da placa de 600W é maior no modelo denso, com 24% em oito requisições simultâneas, e menor no Ministral 3B, com cerca de 7%. Os dois servidores ficam dentro de uma margem de aproximadamente 3% em todos os casos, exceto no caso gpt-oss com 64 requisições, onde o Core T2 apresentou uma vantagem de 7 a 11% com qualquer uma das placas. Portanto, o trabalho do lado da CPU do servidor nesse tamanho de lote favorece os núcleos mais rápidos.
Geração de Imagem
O teste de geração de imagens renderiza imagens de 1024×1024 com três modelos de difusão em três precisões de peso e registra o tempo por imagem, a taxa de redução de ruído e a memória da GPU ocupada pelos pesos. Ele também renderiza a mesma imagem inicial com BF16 e compara as saídas Q4_0 e Q8_0 com PSNR e SSIM, o que quantifica o custo da quantização na imagem.

| Geração de imagem, 1024×1024 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| FLUX.2 klein 4B, 4 passos | ||||
| Q8_0: segundos por imagem (quanto menor, melhor) | 1.66 | 1.37 | 1.59 | 1.30 |
| Q8_0: imagens por minuto | 36.2 | 43.7 | 37.6 | 46.0 |
| BF16: segundos por imagem (quanto menor, melhor) | 1.60 | 1.34 | 1.55 | 1.27 |
| Z-Image Turbo 6B, 8 etapas | ||||
| Q8_0: segundos por imagem (quanto menor, melhor) | 3.82 | 2.89 | 3.78 | 2.82 |
| Q8_0: imagens por minuto | 15.7 | 20.7 | 15.9 | 21.3 |
| BF16: segundos por imagem (quanto menor, melhor) | 3.61 | 2.76 | 3.56 | 2.68 |
| Qwen-Imagem 20B, 20 passos | ||||
| Q4_0: segundos por imagem (quanto menor, melhor) | 25.60 | 19.11 | 25.57 | 18.97 |
| Q8_0: segundos por imagem (quanto menor, melhor) | 26.08 | 19.66 | 26.02 | 19.42 |
| BF16: segundos por imagem (quanto menor, melhor) | 26.17 | 20.45 | 26.05 | 20.28 |
| Q8_0: imagens por minuto | 2.30 | 3.05 | 2.31 | 3.09 |
| BF16: Memória da GPU para pesos (GiB) | 45.3 | 45.3 | 45.3 | 45.3 |
A difusão é limitada pelo poder computacional, e a placa de 600W demonstra isso: o teste Qwen-Image 20B em Q8_0 levou 26.1 segundos por imagem na Max-Q e 19.7 segundos na placa de 600W no servidor Xeon, um ganho de 33% em imagens por minuto. O teste Z-Image Turbo apresentou um ganho de 32% e o FLUX.2 klein, de 21%. A plataforma da CPU é irrelevante neste caso, com os dois servidores apresentando uma diferença de apenas 1% em todas as linhas, exceto na inicialização do servidor, onde o volume RAID do Xeon T2 leva alguns segundos a mais para carregar os pesos.
| Fidelidade de quantização em relação ao BF16 (mesma semente) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| PSNR (dB, quanto maior, melhor) / SSIM (quanto maior, melhor) | ||||
| FLUX.2 klein 4B, Q4_0 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 |
| FLUX.2 klein 4B, Q8_0 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 |
| Z-Image Turbo 6B, Q4_0 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 |
| Z-Image Turbo 6B, Q8_0 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 |
| Qwen-Imagem 20B, Q4_0 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 |
| Qwen-Imagem 20B, Q8_0 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 |
As linhas de fidelidade são idênticas nas quatro configurações, visto que a saída depende dos pesos e não do hardware. O modelo Q8_0 reproduz a imagem BF16 com um SSIM de 0.938 a 0.987 e um PSNR de 28 a 36 dB, enquanto o modelo Q4_0 apresenta um SSIM de 0.75 a 0.79 e um PSNR de 18 a 22 dB, o que resulta em uma imagem diferente. Em um cartão de 96 GB, não há necessidade de memória para executar esses modelos abaixo de Q8_0; os pesos BF16 do Qwen-Image ocupam 45.3 GiB, e a renderização em BF16 foi tão rápida quanto em Q8_0 ou ligeiramente mais rápida em todos os três modelos, já que o caminho Q8_0 dedica tempo à desquantização.
Desempenho da CPU
Os dois processadores dividiram nosso conjunto de testes de CPU em uma linha clara. Quando um teste utiliza todos os núcleos, o Xeon 658X vence por 27 a 150% na maioria deles, e quanto maiores os vetores e maior o tráfego de memória, maior sua margem. Quando um teste é executado em um ou poucos threads, o Core Ultra 9 285K vence por 13 a 31%, graças ao seu núcleo P de 5.7 GHz contra um núcleo Xeon de 4.9 GHz com maior cache e latência de memória. O efeito da GPU de 600 W nos resultados de todos os núcleos do Xeon é abordado em cada tabela e resumido na seção de clock.
Cinebench 2026 e Carga Sustentada
O Cinebench 2026 renderiza uma cena com o motor Redshift da Maxon na CPU e mede o desempenho em núcleo único, núcleo único SMT (dois threads em um núcleo físico) e múltiplos núcleos. Em seguida, realizamos um loop contínuo que repete a execução em múltiplos núcleos por cerca de 30 minutos e comparamos o estado estável com a primeira execução.

| Cinebench 2026 (pontos, quanto maior, melhor) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Único nucleo | 454.1 | 455.6 | 564.4 | 564.5 |
| SMT de núcleo único | 599.1 | 601.0 | N/A (sem SMT) | N/A (sem SMT) |
| Multi-core | 12,322 | 11,705 | 8,856 | 8,838 |
| Loop sustentado, primeira passagem | 12,201 | 11,731 | 8,717 | 8,788 |
| Loop sustentado, estado estacionário | 12,328 | 11,764 | 8,825 | 8,844 |
| Estado estacionário / primeira passagem | 1.010 | 1.003 | 1.012 | 1.006 |
| Loop sustentado, clock da CPU em estado estacionário (MHz) | 4,274 | 4,178 | 4,669 | 4,690 |
O 658X obteve 12,322 pontos em multi-core com a placa Max-Q instalada, 39% à frente dos 8,856 pontos do 285K, e manteve 12,328 pontos durante o ciclo de 30 minutos, um resultado estável 1% acima da sua primeira passagem. Em um único núcleo, a ordem se inverte: o 285K obteve 564.4 pontos contra os 454.1 do Xeon, e são necessários dois threads em um núcleo do Xeon, com 599.1 pontos, para superar o resultado de um único thread do 285K.
A troca pela placa de 600W elevou a pontuação multi-core do Xeon para 11,705 e sua pontuação em estado estável para 11,764, uma queda de 5%, com a frequência em estado estável reduzida de 4,274 para 4,178 MHz. O Core T2 não apresentou essa alteração, registrando 8,856 e 8,838 pontos, respectivamente. O conjunto de testes não registrou as temperaturas da CPU ou da GPU em nenhum dos gabinetes, portanto, não podemos afirmar se o processador de 250W está perdendo desempenho devido ao calor da placa de 600W ou a um orçamento de energia compartilhado, apenas que ele perde de 4 a 5% em todos os testes de todos os núcleos com a placa maior instalada.
7-Zip
O benchmark integrado do 7-Zip reporta a taxa de transferência de compressão e descompressão LZMA em giga-instruções por segundo, uma vez em cada thread e uma vez fixada em um único núcleo. O LZMA depende da taxa de transferência de inteiros, da previsão de desvios e da latência de cache e memória, portanto, prioriza a quantidade de núcleos e um caminho de memória rápido em detrimento da largura do vetor.

| 7-Zip (GIPS, quanto maior, melhor) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Todos os tópicos | ||||
| Segurança | 289.6 | 288.9 | 174.8 | 175.7 |
| Comprimir | 276.4 | 273.5 | 151.5 | 151.9 |
| Descomprimir | 303.0 | 304.4 | 198.1 | 199.4 |
| Um fio | ||||
| Segurança | 8.74 | 8.05 | 10.82 | 10.83 |
| Comprimir | 8.66 | 7.80 | 9.31 | 9.31 |
| Descomprimir | 8.83 | 8.30 | 12.33 | 12.34 |
Em 48 threads, o Xeon atingiu 289.6 GIPS contra 174.8 do 285K em 24 threads, uma vantagem de 66%, com compressão 82% superior e descompressão 53% à frente. Em uma thread, o 285K liderou com 10.82 GIPS contra 8.74, e a diferença aumentou com a placa de 600W na torre Xeon, para 8.05, em linha com os clocks mais baixos em que essa configuração operava.
Blender, HandBrake e LLVM
O Blender 4.5 renderiza as cenas Monster, Junkshop e Classroom com Cycles na CPU. O HandBrake codifica 60 segundos de um clipe 4K60 em software com x265 (HEVC, predefinição média, qualidade 22) e SVT-AV1 (predefinição 8, qualidade 30). O teste LLVM compila a árvore completa do LLVM 21.1.4 com Clang e Ninja, a carga de trabalho com todos os núcleos mais longa do conjunto.

| Testar | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Blender 4.5 Monster (amostras/min, quanto maior, melhor) | 366.2 | 339.0 | 259.6 | 257.7 |
| Blender 4.5 Junkshop (amostras/min) | 238.1 | 228.0 | 166.2 | 166.8 |
| Blender 4.5 Sala de Aula (amostras/min) | 187.2 | 169.2 | 132.5 | 132.3 |
| HandBrake x265, médio, q22 (fps, quanto maior, melhor) | 46.9 | 46.1 | 47.0 | 47.2 |
| Freio de mão SVT-AV1, predefinição 8, q30 (fps) | 64.0 | 65.0 | 117.5 | 118.6 |
| LLVM 21.1.4 build (s, quanto menor, melhor) | 140.2 | 142.1 | 182.5 | 182.5 |
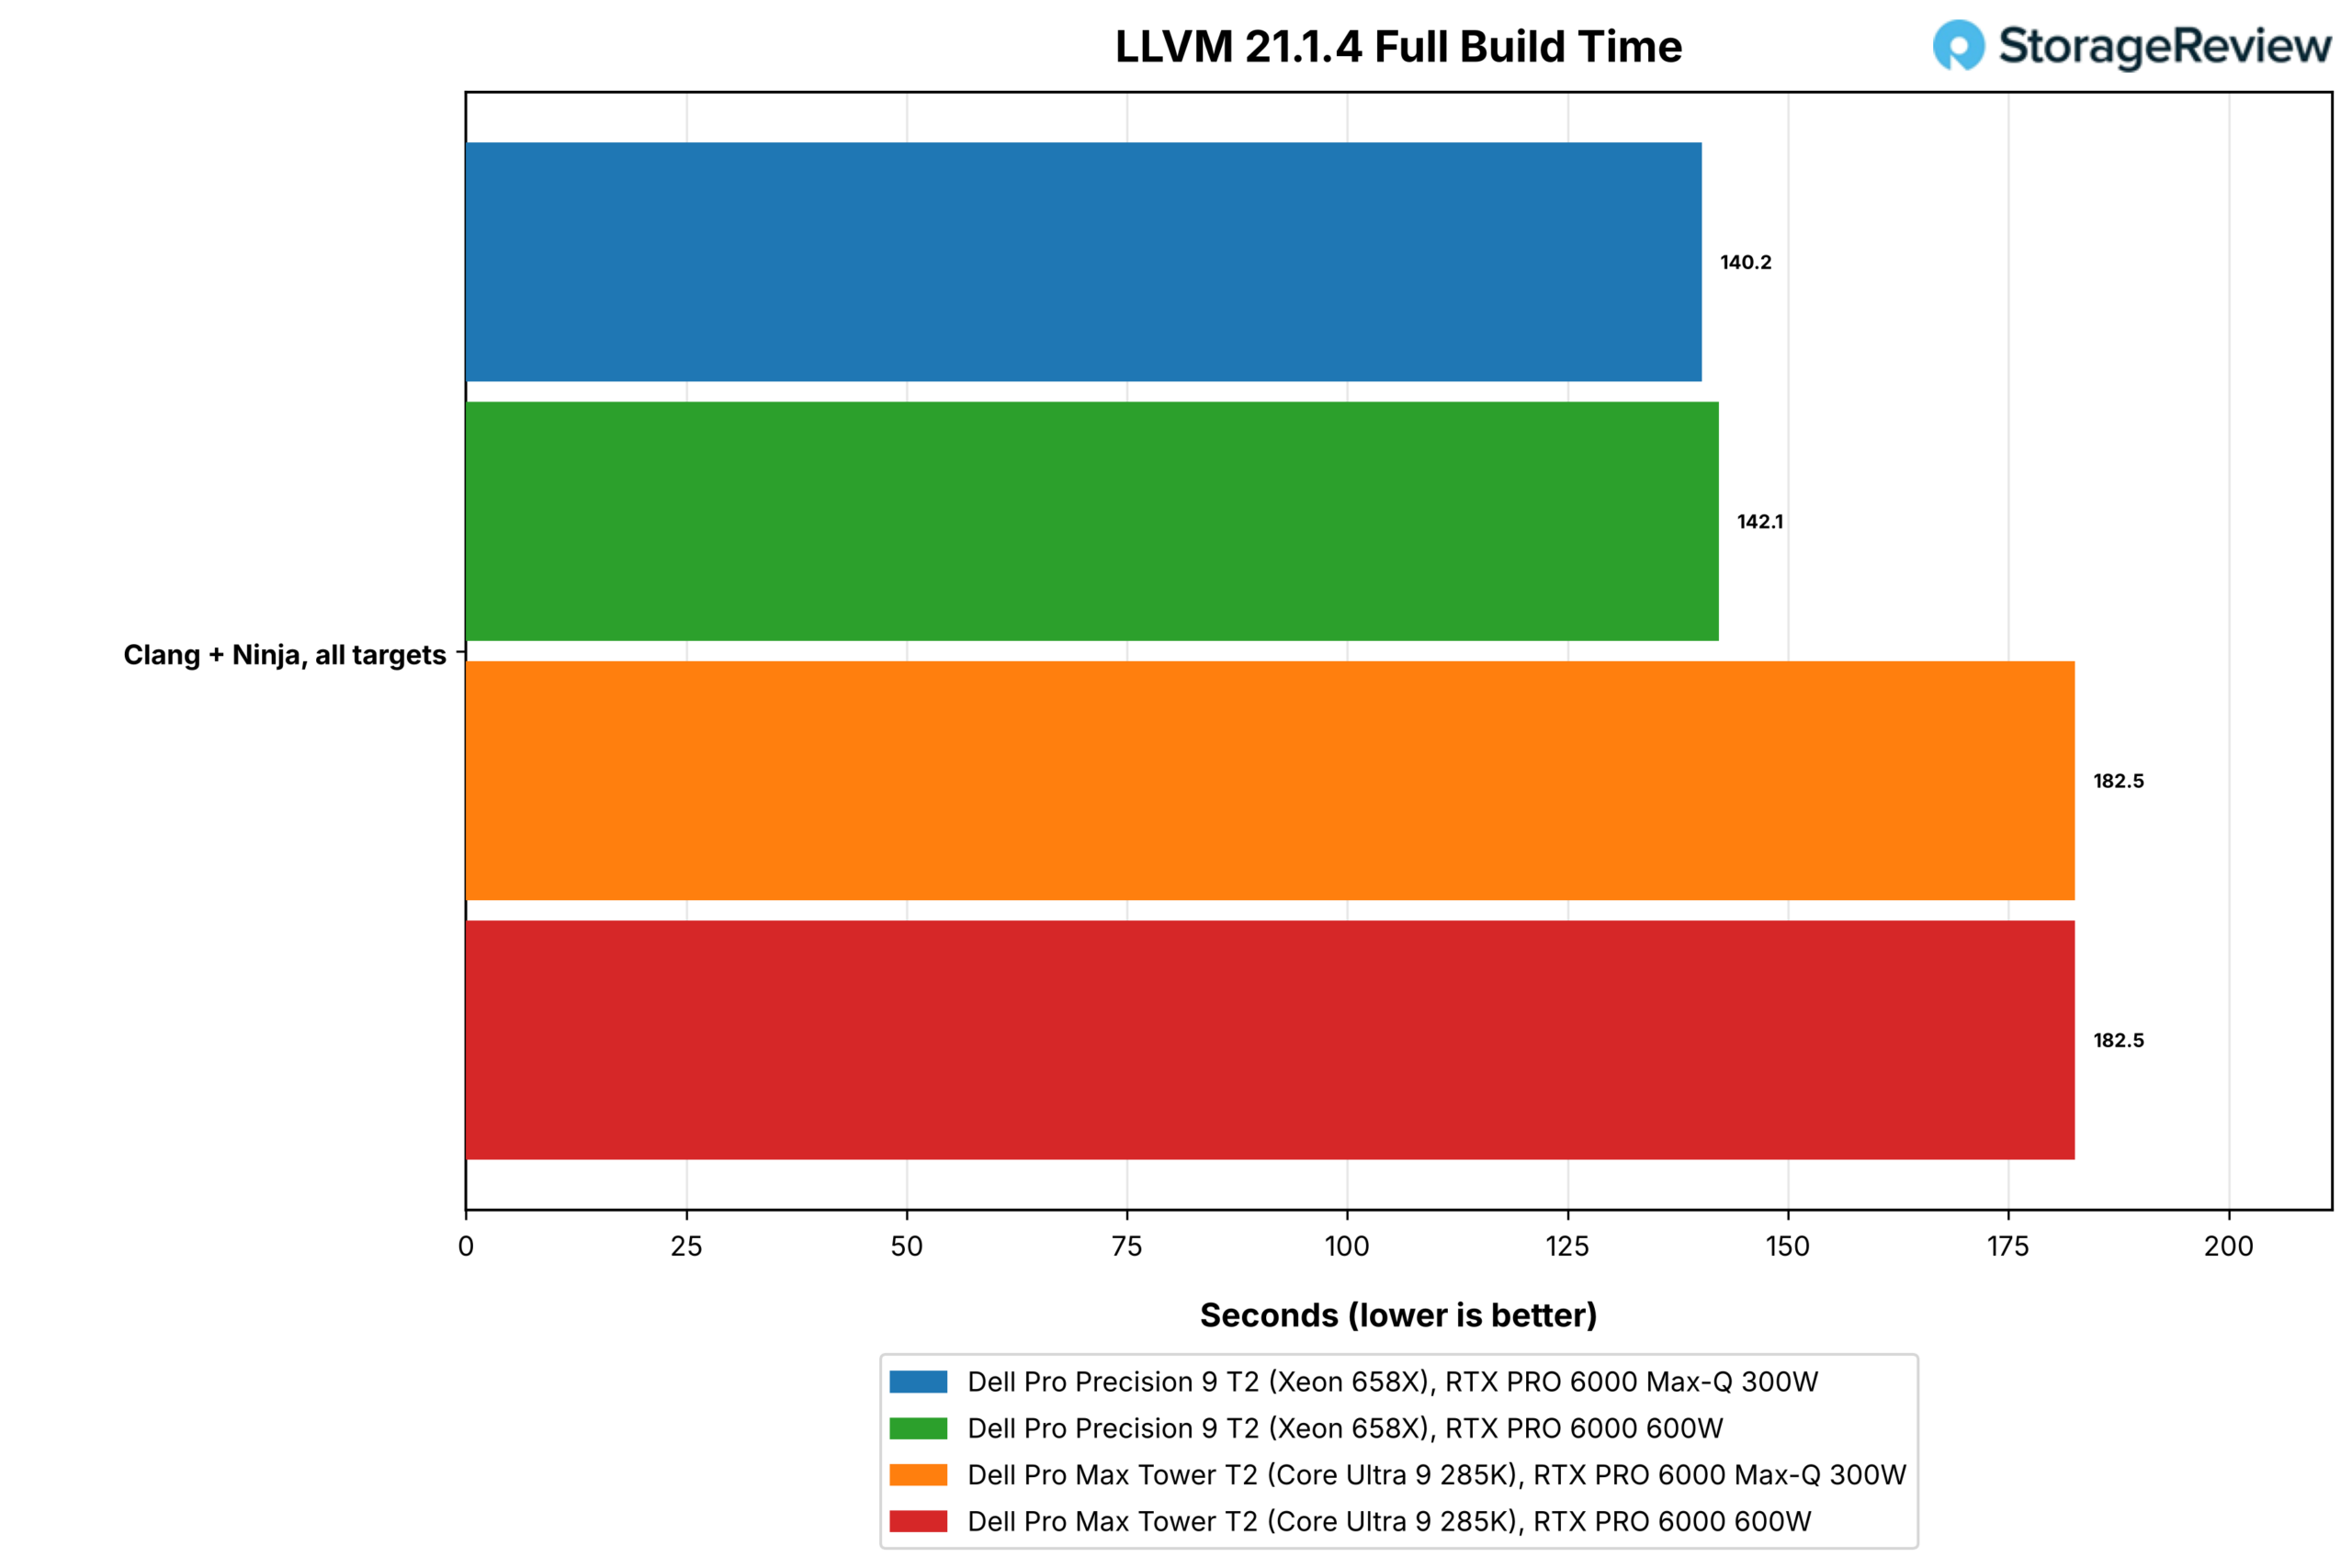
O Xeon renderizou o Monster a 366.2 amostras por minuto contra 259.6 no 285K, uma vantagem de 41% que se manteve dentro de dois pontos percentuais em todas as três cenas, e compilou o LLVM em 140.2 segundos contra 182.5, 23% menos tempo. Com a placa de 600W instalada, as pontuações do Xeon no Blender caíram de 7 a 10%, o maior custo da placa em todo o conjunto de CPUs.
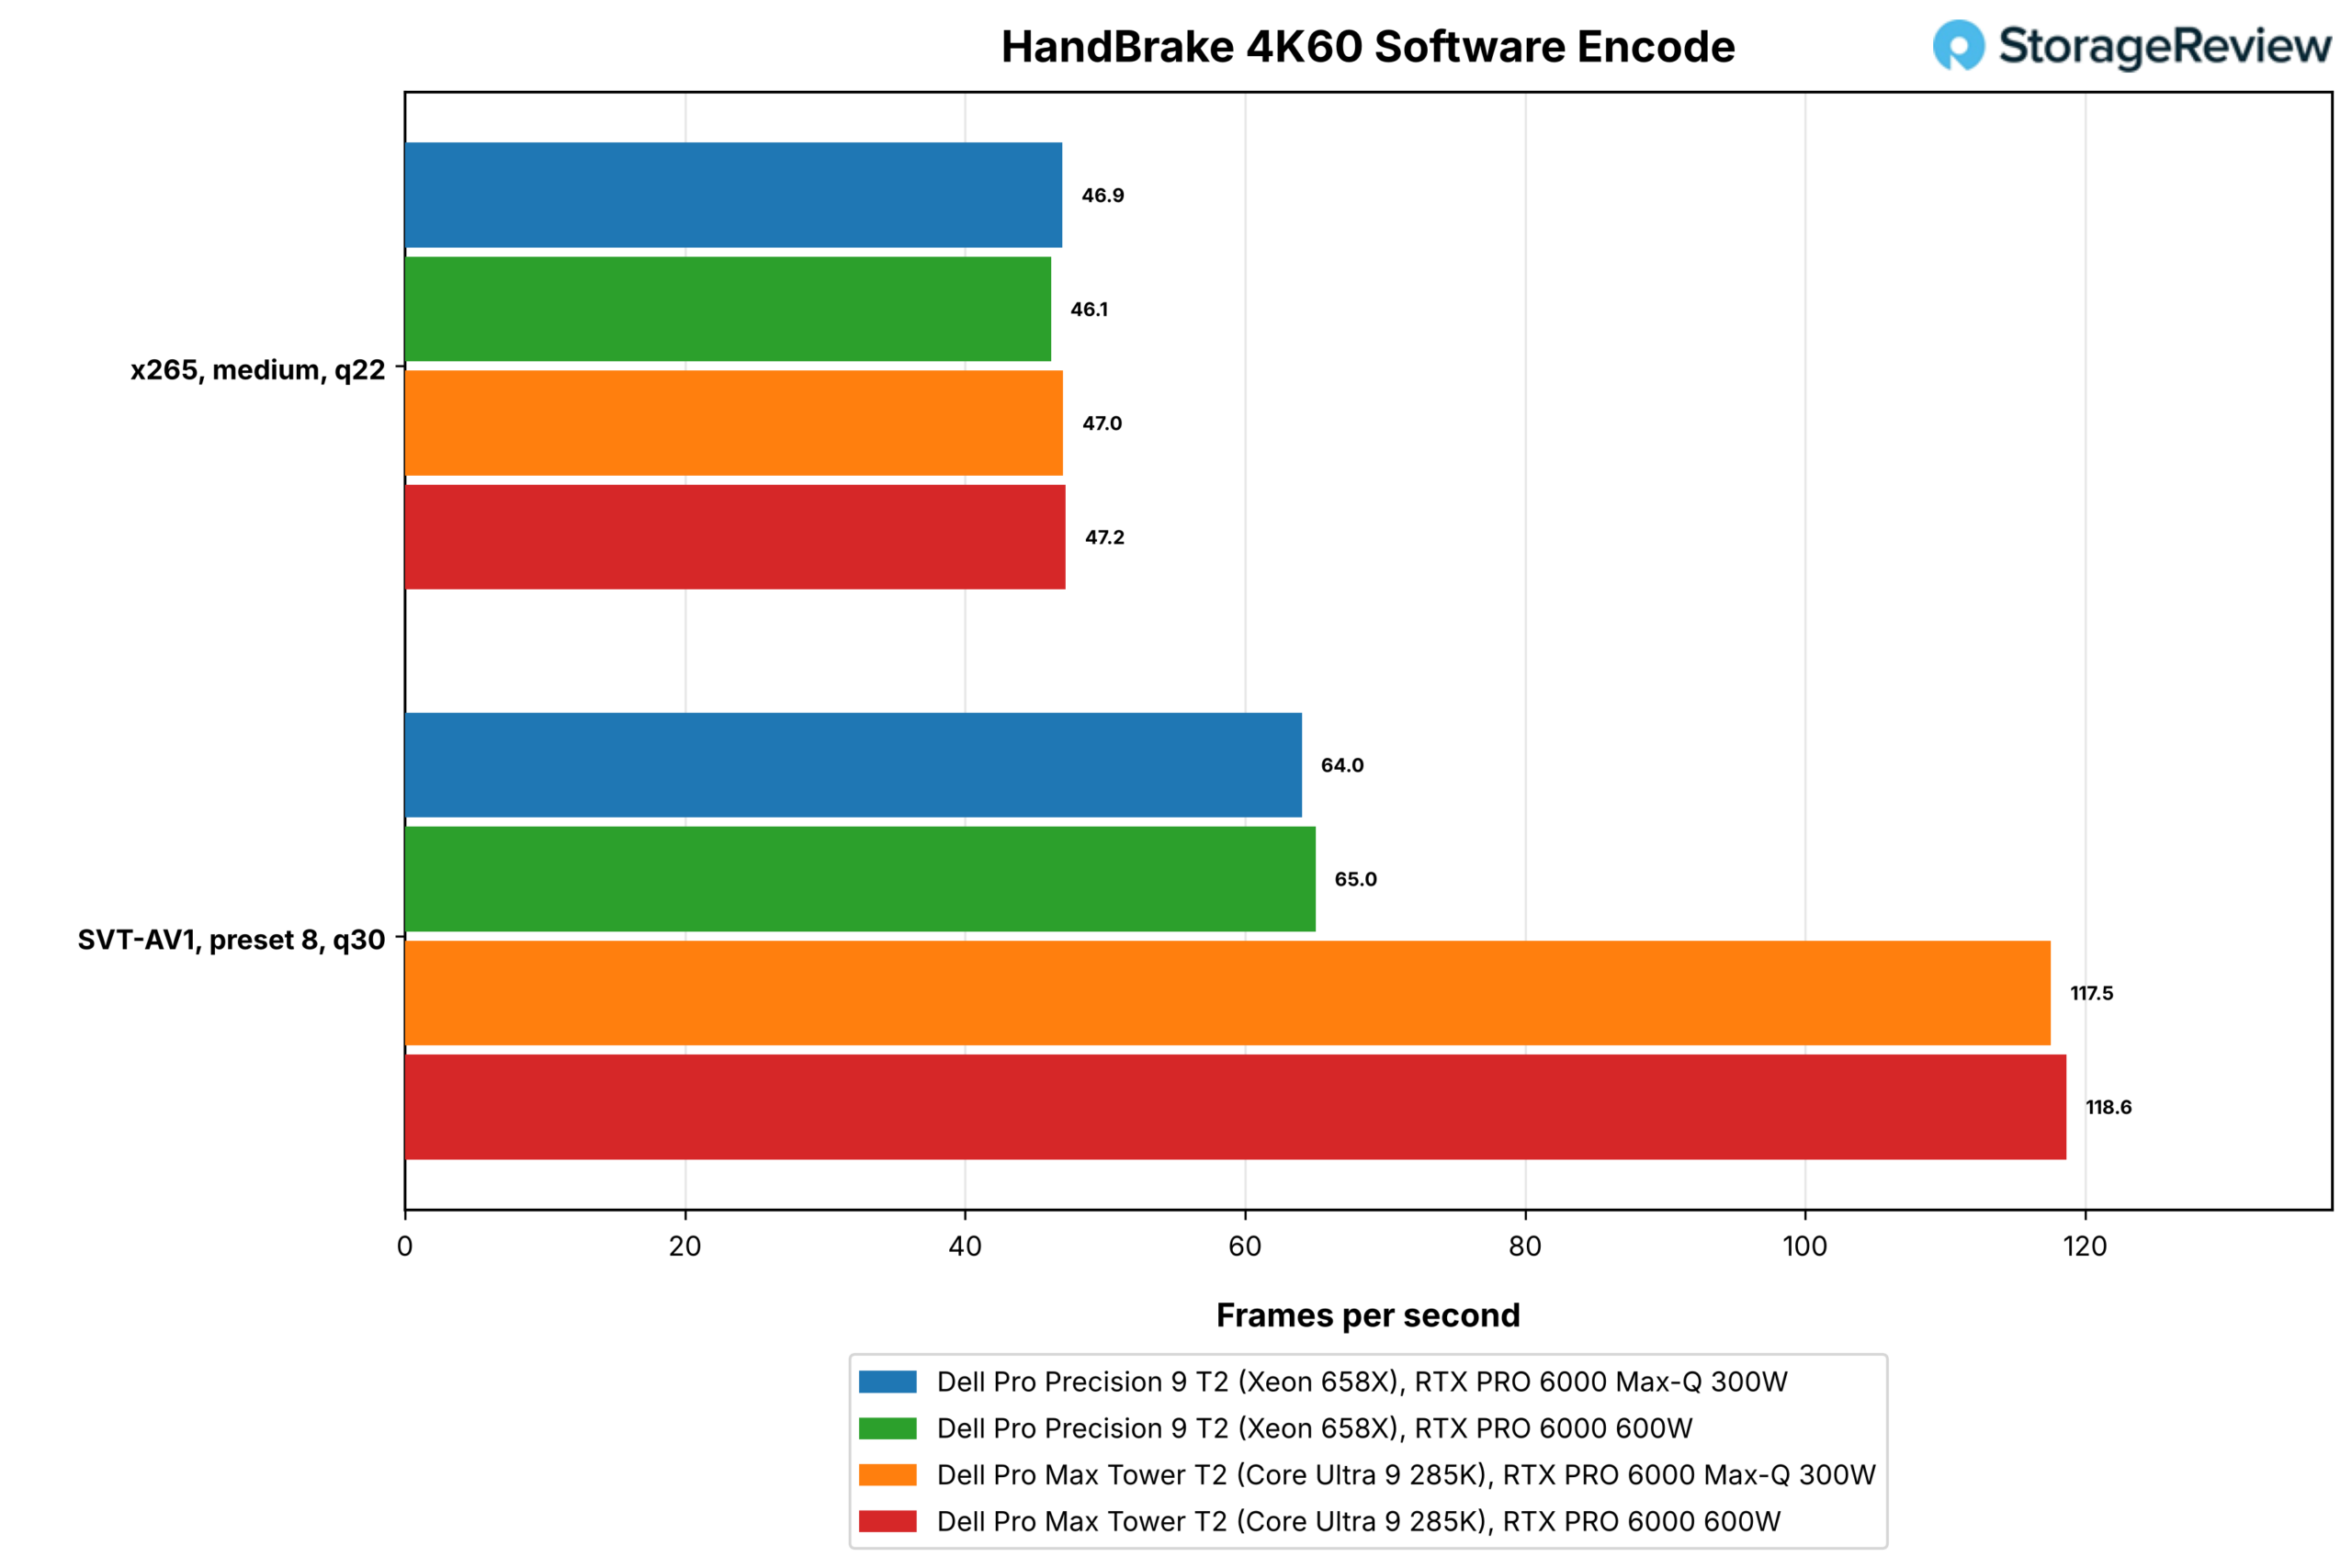
O HandBrake apresentou resultados diferentes de acordo com o encoder: o x265 na predefinição média rodou a 46.9 fps no Xeon e a 47.0 no 285K, um empate, enquanto o SVT-AV1 na predefinição 8 rodou a 64.0 fps no Xeon contra 117.5 no 285K.
Passamos uma tarde analisando essa diferença, e o resultado é por thread. O codificador atinge o nível máximo de paralelismo 6 nessa configuração e mantém o equivalente a nove processadores lógicos ocupados no Xeon; forçar o uso de kernels AVX2 em vez de AVX-512 não alterou nada (63.8 contra 63.9 fps), e limitar a uma thread por núcleo físico resultou em uma queda de desempenho de 2% (62.6 fps), portanto, nem o caminho vetorial nem o agendamento SMT são a causa. O que resta é o próprio núcleo Xeon e a interconexão entre os núcleos, que um codificador pipelined aguardando transferências entre estágios sente a cada quadro.
Stockfish, PrimeSieve, Python e o navegador
O benchmark integrado do Stockfish reporta a velocidade de busca em xadrez em milhões de nós por segundo. O primesieve conta os números primos abaixo de 10^12 em todas as threads e abaixo de 10^11 em uma thread. O PyPerformance executa três benchmarks do CPython (go, nbody e regex_compile) alocados a um núcleo de alto desempenho, e o Speedometer 3.1 mede a responsividade de aplicações web no Microsoft Edge.
| Testar | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Banco Stockfish, todos os fios (Mnps, quanto maior, melhor) | 40.87 | 39.17 | 30.10 | 30.63 |
| Banco de bacalhau seco, um fio (Mnps, quanto maior, melhor) | 1.65 | 1.60 | 1.99 | 1.99 |
| primesieve 1e12, todos os fios (s, quanto menor, melhor) | 7.69 | 7.51 | 6.77 | 6.84 |
| primesieve 1e11, um fio (s, quanto menor, melhor) | 10.09 | 10.76 | 8.72 | 8.72 |
| PyPerformance go (ms, quanto menor, melhor) | 91.4 | 91.0 | 64.8 | 64.9 |
| PyPerformance nbody (ms, quanto menor, melhor) | 68.3 | 68.8 | 54.3 | 53.8 |
| PyPerformance regex_compile (ms, quanto menor, melhor) | 88.6 | 90.5 | 61.1 | 61.2 |
| Velocímetro 3.1, Edge (pontuação, quanto maior, melhor) | 36.8 | 37.3 | 46.3 | 46.5 |
O Stockfish, executado em 48 threads, alcançou 40.87 Mnps no Xeon contra 30.10 no 285K. Já em um teste com apenas uma thread, o 285K liderou com 1.99 contra 1.65. O primesieve foi o único teste com todas as threads em que o 285K saiu vitorioso, com um tempo de execução de 6.77 segundos contra 7.69, visto que sua peneira cabe no cache e escala tanto com o clock quanto com o número de núcleos. Os testes com uma única thread apresentaram um desempenho superior ao do 285K, com uma vantagem de 13% a 31%: PyPerformance em 64.8 ms contra 91.4, regex_compile em 61.1 contra 88.6 e Speedometer em 46.3 contra 36.8.
Esse número do navegador é o que o comprador sente ao usar o computador. Uma pontuação de 36.8 no Speedometer ainda é rápida em termos absolutos, mas é um quinto abaixo da torre Core no mesmo chassi, e qualquer pessoa que escolha o Xeon por seu desempenho deve esperar que a parte interativa da máquina seja um pouco mais lenta do que um desktop Core Ultra.
GROMACS, OpenBLAS e Memória
O GROMACS executa o caso de dinâmica molecular benchMEM em 16 núcleos, distribuídos em quatro configurações de rank-and-thread, e reporta nanossegundos de tempo simulado por dia para a melhor configuração. Nosso teste OpenBLAS executa uma resolução LU de dupla precisão no estilo HPL em três tamanhos de problema e uma multiplicação de matriz DGEMM em todos os núcleos, e no 285K novamente apenas em seus oito núcleos P; os 24 núcleos do Xeon são de uma única classe, portanto, essas linhas não se aplicam. O STREAM mede a largura de banda de memória sustentada, e as linhas de latência medem um único acesso à memória e entre núcleos.

| Teste (quanto maior, melhor) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| GROMACS benchMEM, melhor layout (ns/dia) | 47.39 | 47.91 | 37.30 | 37.07 |
| OpenBLAS LU N=10000, todos os núcleos (GFLOPS) | 570.3 | 517.3 | 519.7 | 523.1 |
| OpenBLAS LU N=20000, todos os núcleos (GFLOPS) | 1,208.6 | 1,100.6 | 633.2 | 631.8 |
| OpenBLAS LU N=40000, todos os núcleos (GFLOPS) | 1,659.2 | 1,613.7 | 667.9 | 669.5 |
| OpenBLAS LU N=20000, somente núcleos P (GFLOPS) | N/A (uma aula principal) | N/A (uma aula principal) | 515.2 | 517.7 |
| OpenBLAS DGEMM M=8000, todos os núcleos (GFLOPS) | 1,637.8 | 1,750.9 | 768.2 | 767.6 |
| OpenBLAS DGEMM M=8000, somente núcleos P (GFLOPS) | N/A (uma aula principal) | N/A (uma aula principal) | 565.3 | 566.5 |
Aqui entra o AVX-512, 144 MB de cache L3 e quatro canais de memória composta DDR5-6400. O DGEMM atingiu 1,638 GFLOPS no Xeon contra 768 no 285K, e a resolução LU com N=40000, que utiliza 11.9 GB de memória, alcançou 1,659 GFLOPS contra 668 GFLOPS, 2.5 vezes o desempenho do Core Tower. O resultado do 285K praticamente não se altera de N=20000 para N=40000, pois já está limitado pela largura de banda, enquanto o Xeon continua escalando. O GROMACS em 16 núcleos favoreceu o Xeon em 27%, com 47.39 ns/dia.

| Testar | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Cópia de STREAM (MB/s, quanto maior, melhor) | 106,698 | 106,512 | 39,477 | 39,426 |
| Escala STREAM (MB/s) | 105,368 | 105,180 | 39,788 | 39,801 |
| Adicionar STREAM (MB/s) | 119,520 | 119,332 | 36,324 | 36,306 |
| STREAM Triad (MB/s) | 122,233 | 122,135 | 33,003 | 33,014 |
| Latência de memória, buffer de 1 GiB, páginas de 4 KiB (ns, quanto menor, melhor) | 148.3 | 147.8 | 135.2 | 135.4 |
| Latência núcleo a núcleo, média de todos os pares (ns, quanto menor, melhor) | 56.2 | 56.0 | 38.1 | 38.2 |
| Latência núcleo a núcleo, par mínimo (ns) | 4.6 | 4.6 | 18.6 | 18.6 |
| Latência núcleo a núcleo, número máximo de pares (ns) | 65.7 | 66.8 | 44.7 | 44.5 |
O teste STREAM Triad atingiu 122,233 MB/s no Xeon T2 e 33,003 MB/s no Core T2, 3.7 vezes a largura de banda, utilizando quatro canais de memória DDR5-6400 RDIMM contra quatro canais de DDR5-4400 UDIMM em uma plataforma que não consegue acompanhar a velocidade de seus módulos DIMM. O custo disso é a latência: 148.3 ns para a memória no Xeon contra 135.2 ns no 285K, e 56.2 ns entre núcleos em média contra 38.1 ns. O mínimo de 4.6 ns do Xeon corresponde a um par de núcleos SMT em um mesmo núcleo, e seu máximo de 65.7 ns corresponde a uma travessia pela malha de memória.
Gaming
O SuperTuxKart 1.5 executa seu benchmark integrado em tela cheia a 1080p na configuração mais alta com V-Sync desativado, e relatamos a taxa de quadros média e estável. Nessa resolução, a GPU tem folga de sobra, então o resultado acompanha o da CPU, e o teste representa muitas das telas de visualização profissionais que são limitadas da mesma forma. A etapa NVENC do nosso teste de codificação não foi concluída nesses sistemas e foi omitida.

| SuperTuxKart 1.5, 1080p Ultra, vsync desligado (fps, quanto maior, melhor) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Média | 304.6 | 323.2 | 359.1 | 383.5 |
| Típica | 304 | 322 | 354 | 376 |
| Estável | 161 | 174 | 122 | 135 |
O Core T2 atingiu uma média de 359.1 fps com a placa Max-Q, contra 304.6 fps no Xeon T2, novamente com diferença significativa em desempenho de um único núcleo. Já o Xeon apresentou uma taxa de quadros estável superior, de 161 fps contra 122 fps, com menos quedas. A placa de 600W adicionou cerca de 6% à média em ambos os sistemas.
Relógios sob carga
Nenhuma das torres reportou temperaturas da CPU ou da GPU através do sensor do conjunto de testes, então a tabela térmica que normalmente publicamos é substituída aqui pela frequência média da CPU durante cada teste, que é o valor que explica o efeito da placa de 600W no Xeon. Com a Max-Q instalada, o 658X manteve 4,269 MHz durante o teste contínuo de 30 minutos e entre 4,040 e 4,480 MHz nos testes mais curtos com todos os núcleos em execução. Com a placa de 600W no gabinete, a maioria desses testes apresentou frequências mais baixas, em até 300 MHz, e todos tiveram pontuações inferiores.
| Clock médio da CPU durante o teste (MHz) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Cinebench 2026 | 4,477 | 4,470 | 4,789 | 4,786 |
| Loop sustentado | 4,269 | 4,182 | 4,663 | 4,682 |
| 7-Zip | 4,414 | 4,307 | 4,854 | 4,837 |
| Bacalhau | 4,291 | 3,995 | 4,749 | 4,741 |
| liqüidificador | 4,258 | 4,253 | 4,582 | 4,552 |
| HandBrake | 4,188 | 4,180 | 4,601 | 4,622 |
| compilação LLVM | 4,202 | 4,258 | 4,582 | 4,585 |
| GROMACS | 4,288 | 4,290 | 4,664 | 4,694 |
| Abrir BLAS | 4,039 | 3,979 | 4,766 | 4,761 |
| STREAM | 4,321 | 4,326 | 4,687 | 4,676 |
| primazia | 4,441 | 4,268 | 4,814 | 4,810 |
| Cliente MLPerf | 4,191 | 4,138 | 3,814 | 3,686 |
| Agente de codificação | 4,134 | 4,100 | 4,239 | 4,213 |
| LLM em serviço | 4,261 | 4,169 | 4,229 | 4,209 |
| Geração de imagem | 4,044 | 4,008 | 3,702 | 3,837 |
| RAG | 4,178 | 4,197 | 4,172 | 4,108 |
| Super Tux Kart | 4,239 | 4,211 | 4,637 | 4,649 |
O Stockfish apresentou uma queda de 4,291 para 3,995 MHz, o PrimeSieve de 4,441 para 4,268, o 7-Zip de 4,414 para 4,307 e o loop sustentado de 4,269 para 4,182, enquanto o 285K apresentou uma variação de apenas 20 MHz em todos os testes de todos os núcleos, independentemente da placa.
A frequência média não explica tudo. Os testes Cinebench e Blender apresentaram médias dentro de 10 MHz dos valores Max-Q, mas ainda perderam de 5 a 10% do desempenho, o que indica pequenas variações que a média por teste suaviza. O processador 658X consome até 250 W, a placa de 600 W consome outros 600 W, e ambos dissipam o calor para o mesmo volume de 32 litros atrás de uma entrada frontal; se o limitador é a margem térmica do processador ou um limite de energia da plataforma é uma questão que nosso próximo teste com registro externo de energia e temperatura responderá. Por enquanto, os compradores que executam tarefas que exigem muito do processador devem saber que a configuração Max-Q é a mais rápida no quesito CPU.
Desempenho de Armazenamento
Nosso teste de armazenamento executa o fio four corners no disco de inicialização com footprints de 5 GB e 25 GB, percorrendo o sistema de arquivos e novamente no dispositivo bruto, e apresenta aqui os resultados de 25 GB. No Core T2, o disco de inicialização é um único SK hynix PCB01 de 2 TB em Gen5 x4; no Pro Precision 9 T2, são os dois discos E3.S Gen5 no FlexBay, agrupados em um volume RAID 0 de 4,097 GB pelo VROC da Graid Technology. O BitLocker estava desativado em todas as quatro configurações, portanto, as linhas do sistema de arquivos medem o NTFS e a camada RAID, não a criptografia.


| fio, 25 GB de espaço ocupado, QD32 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Leitura sequencial de 128 KB, sistema de arquivos (MB/s) | 9,332 | 9,255 | 11,377 | 11,406 |
| Leitura sequencial 128K, dispositivo bruto (MB/s) | 10,782 | 10,675 | 11,186 | 11,444 |
| Gravação sequencial 128K (MB/s) | 6,507 | 6,496 | 7,401 | 7,371 |
| Leitura de pré-preenchimento de 1 MB, QD32 (MB/s) | 4,617 | 4,679 | 6,440 | 6,346 |
| Leitura aleatória de 4K, sistema de arquivos, pico (IOPS) | 840,075 | 853,615 | 1,778,576 | 1,756,968 |
| Leitura aleatória 4K, dispositivo bruto, pico (IOPS) | 1,107,862 | 1,120,737 | 2,297,681 | 2,294,800 |
| Gravação aleatória de 4K, pico (IOPS) | 557,512 | 550,505 | 957,461 | 921,774 |
| Leitura aleatória bruta/do sistema de arquivos | 1.32x | 1.31x | 1.29x | 1.31x |
| Leitura aleatória de 4K, 4 tarefas, latência p99 (µs, quanto menor, melhor) | 506 | 485 | 183 | 185 |
| Leitura aleatória de 4K, 16 tarefas, latência p99.99 (µs, quanto menor, melhor) | 15,270 | 23,462 | 676 | 676 |
| Escrita aleatória de 4K, 4 tarefas, latência p99 (µs, quanto menor, melhor) | 610 | 594 | 228 | 228 |
| Temperatura máxima de acionamento (°C) | N/A (atrás do RAID) | N/A (atrás do RAID) | 50 | 57 |
A faixa de dados não é mais rápida que a unidade única e, em blocos pequenos, fica bem atrás. As duas unidades E3.S leram 9,332 MB/s sequencialmente via NTFS e 10,782 MB/s do volume bruto, contra 11,377 MB/s e 11,186 MB/s para a PCB01, e gravaram 6,507 MB/s contra 7,401 MB/s. Em leituras aleatórias de 4K, o volume atingiu um pico de 840.1 mil IOPS através do sistema de arquivos e 1.11 milhão de IOPS brutos, contra 1.78 milhão e 2.30 milhão de IOPS para a unidade única, e gravações aleatórias atingiram 557.5 mil IOPS contra 957.5 mil. A proporção entre o volume bruto e o sistema de arquivos é de cerca de 1.3x em ambos, portanto o custo do NTFS é o mesmo em cada um; a diferença está na camada VROC subjacente a ambos os caminhos.
A latência de cauda é a seguinte: com 16 tarefas, os 0.01% mais lentos das leituras aleatórias levaram 15.3 ms no volume, contra 0.68 ms na unidade individual, e a latência de leitura p99 de 4 tarefas foi de 506 µs contra 183 µs. O RAID por software em dois dispositivos NVMe adiciona um salto de CPU a cada E/S, e as leituras de CPU do fio mostram isso, com 80% nas passagens sequenciais contra 40% no Core T2. O volume também oculta os dados SMART das unidades, portanto, o conjunto de testes não pôde registrar suas temperaturas.
Nada disso torna o FlexBay uma escolha errada. Ele oferece ao T2 unidades com acesso frontal e hot-plug em um formato que se adapta a capacidades que o M.2 não alcança, e um volume de inicialização de 4 TB a partir de duas unidades é conveniente. Isso significa que um comprador cuja carga de trabalho envolva E/S aleatória de blocos pequenos, um banco de dados local ou um diretório de modelos com cache pesado, deve considerar uma única unidade E3.S sem o stripe, ou os slots M.2 internos, onde os resultados do Core T2 mostram o que uma unidade Gen5 consegue fazer neste chassi.
Conclusão
O Dell Pro Precision 9 T2 é o Pro Max Tower T2 com um processador de estação de trabalho, e os dados de análise confirmam que é exatamente isso que os compradores podem esperar. No mesmo chassi de 32 litros, o Xeon 658X oferece 39% mais desempenho multi-core no Cinebench, 3.7 vezes mais largura de banda de memória, o dobro da taxa DGEMM e um processador de 24 núcleos e 48 threads com AVX-512, AMX, memória ECC registrada e suporte para até 1 TB de armazenamento. A perda de desempenho em tarefas de thread único, como PrimeSieve e Python, é de 13% a 31%, e os compradores que passam o dia em frente a um computador ou terminal notarão a diferença.
A decisão sobre a placa de vídeo é o principal objetivo desta análise, que visa ajudar os compradores a entenderem melhor o processo. As placas Max-Q e RTX PRO 6000 de 600W compartilham 96 GB de memória e apresentam desempenho de decodificação com uma diferença de 7 a 20%. A placa de 600W se destaca no processamento rápido, onde o tempo até o primeiro token é reduzido em um terço ou mais, e na difusão, onde as imagens chegam de 20 a 34% mais rápido.
Na torre Xeon, a placa de 600 W também consome de 4 a 5% do processador em tarefas que exigem todos os núcleos e requer o slot adjacente, o que, em nossa unidade, significou remover o adaptador de 25 GbE. Para uma torre cujo usuário executa renderizações e simulações na CPU, além de modelos locais, a placa Max-Q fornecida pela Dell é a escolha equilibrada; para uma torre que fornece modelos para uma equipe ou renderiza imagens o dia todo, a placa de 600 W vale o slot e a fonte de 1500 W.
O E3.S no FlexBay é o formato que desejávamos em um gabinete torre há anos; o VROC da Graid Technology é uma combinação confiável para o RAID. Ele é mais lento em operações de E/S aleatórias de pequeno porte do que um único SSD M.2 no Core T2, com uma redução de aproximadamente metade no desempenho em leituras e gravações de 4K. Um comprador que não precisa de um volume de inicialização em RAID pode optar por um SSD E3.S ou pelos slots M.2 internos.
Por outro lado, com os SSDs E3.S atingindo agora mais de 60 TB, os usuários com casos de uso de dados extremos têm acesso a um mundo totalmente novo que, antes, significaria gabinetes externos ou a instalação de um volume de armazenamento compartilhado, com o preço do flash como limite prático.
Com um preço aproximado de US$ 28,300 na configuração anunciada no Dell.com, antes dos descontos por volume aplicados à maioria dos compradores corporativos, o Pro Precision 9 T2 custa cerca de US$ 4,500 a mais que um Pro Max Tower T2 configurado da mesma forma atualmente: um processador 285K, 128 GB de memória DDR5-4400 ECC, a placa de vídeo RTX PRO 6000, um disco rígido Gen5 de 2 TB e a fonte de 1500 W totalizam cerca de US$ 23,800, com as opções de GPU e memória dos dois modelos apresentando uma diferença de apenas US$ 900. O segundo disco rígido FlexBay representa US$ 1,700 dessa diferença, e o restante corresponde à plataforma Xeon.
O que ele oferece é um processador torre com um único soquete que se comporta como um pequeno servidor sob carga total, no mesmo tamanho de um desktop, e é por isso que o nome Precision está de volta.
Classificação geral: O Dell Pro Precision 9 T2 ocupa o primeiro lugar na nossa classificação de Melhores Estações de Trabalho Desktop , e os seus resultados com a RTX PRO 6000 também aparecem na nossa classificação de Melhores GPUs Empresariais.



 Amazon