

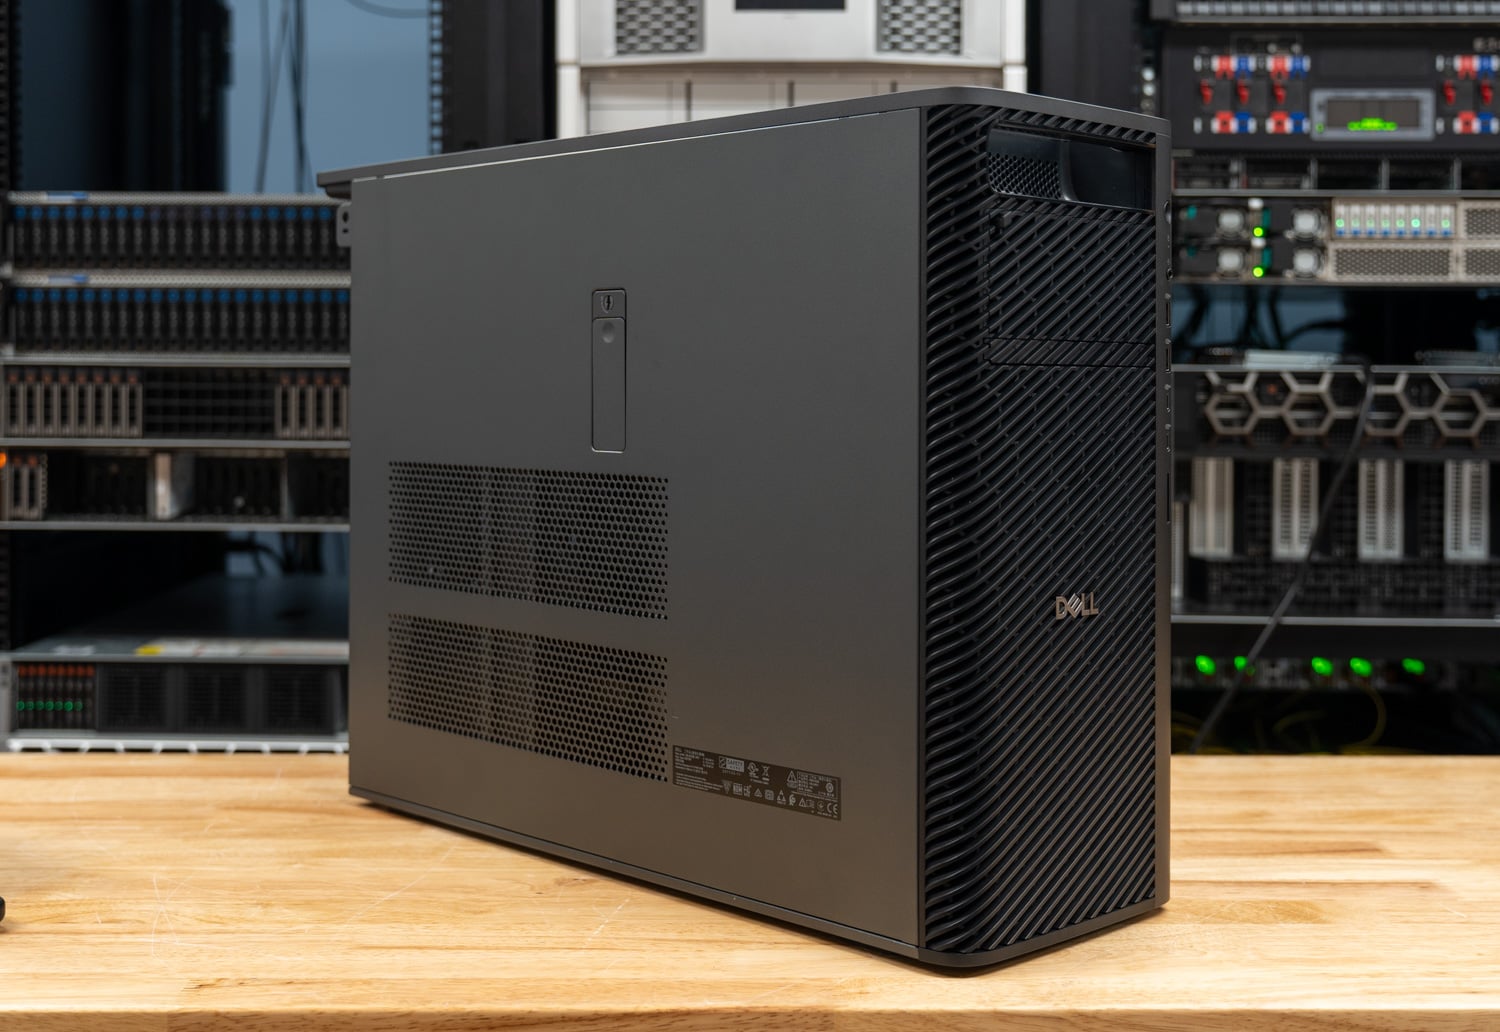
O Dell Pro Precision 9 T4 é o modelo torre de soquete único no topo da linha Pro Precision da Dell, e nossa unidade de teste está configurada para IA local em uma escala que a maioria das estações de trabalho não consegue alcançar. Ele combina o processador Intel Xeon 698X de 86 núcleos com 256 GB de memória DDR5-6400 ECC, duas placas de vídeo NVIDIA RTX PRO 6000 Blackwell Max-Q de 300 W com 96 GB de GDDR7 cada, dois SSDs Gen5 de 2 TB e um adaptador de 25 GbE de duas portas, alimentado por uma fonte de 2400 W. Configurado da mesma forma no site da Dell, ele custa cerca de US$ 66,600.
Principais lições
- Duas GPUs transformam um modelo que não cabe em uma única placa em um modelo utilizável. O MiniMax M2.7 com 129.3 GB gerou 83.7 tokens por segundo para um usuário quando divididos entre as duas placas RTX PRO 6000, 2.8 vezes os 30.3 tokens por segundo com apenas uma placa e o restante do modelo na memória do sistema.
- A segunda GPU aumentou a capacidade de servir conteúdo de 1.85 a 2.02 vezes e a capacidade de incorporação em 1.92 vezes. O pico de produção do llama.cpp aumentou de 582.5 para 1,176.1 tokens por segundo no Ministral 3 3B e de 424.8 para 787.9 no gpt-oss 120B com um servidor por GPU, e o tempo para incorporar um milhão de trechos da Wikipédia caiu de 890 para 464 segundos.
- Uma segunda GPU reduziu o tempo de resposta do LoRa em 37%. Uma época de LoRA no Ministral 3 8B levou 31.5 minutos em uma GPU e 19.7 minutos em duas, terminando com perdas de 1.169 e 1.167.
- A largura de banda da memória é o ponto forte do Xeon do T4. O STREAM Triad atingiu 328 GB/s, 53% acima do Threadripper PRO 9995WX no Precision 7875, e o T4 concluiu a resolução do OpenFOAM drivAer em 293 segundos contra 556 e uma execução do y-cruncher de 10 bilhões de dígitos em 53.9 segundos contra 83.7.
- O Precision 7875 é líder em tarefas de CPU que dependem muito do núcleo do processador. O Threadripper de 96 núcleos apresentou um desempenho 37% superior no 7-Zip e 30% superior no Blender Monster, e concluiu a compilação do LLVM em 43.7 segundos, contra 58.4 segundos do processador.
Onde o Pro Precision 9 T4 se encaixa
A Dell posiciona a T4 como sua principal estação de trabalho torre de soquete único para organizações que precisam de máxima densidade de computação e capacidade de expansão, com desenvolvimento de IA, simulação de engenharia e computação científica no topo da lista de cargas de trabalho. Ela se posiciona acima da Dell Pro Precision 9 T2 , que usa a mesma plataforma de estação de trabalho Granite Rapids-WS Xeon 6 em um chassi menor com uma GPU. A T4 adiciona processadores de oito canais no topo da linha, até 86 núcleos, e espaço para até quatro placas gráficas, dependendo do modelo.
As opções de processador no Dell.com começam com o Xeon 634 de 12 núcleos e vão até o Xeon 696X de 64 núcleos, chegando ao Xeon 698X de 86 núcleos presente em nossa unidade, que possui 336 MB de cache, clock base de 2.0 GHz, clock máximo de 4.8 GHz e potência de 350 W. A memória RAM chega a 4 TB de DDR5 RDIMM em 16 slots, e nossa unidade utiliza oito deles com módulos de 32 GB a 6400 MT/s. A placa de vídeo começa com uma única RTX A400, e a quantidade de placas varia conforme o modelo: o configurador da Dell lista quatro placas RTX A1000, três placas RTX PRO 4000 Blackwell, duas placas RTX PRO 6000 Max-Q de 300 W ou uma placa RTX PRO 6000 de 600 W.
A configuração básica está listada por US$ 5,925 no Dell.com. Nossa configuração adiciona US$ 8,300 pelo Xeon 698X, US$ 15,000 pelos 256 GB de memória e US$ 30,820 pelo par de placas RTX PRO 6000 Max-Q, antes de incluir armazenamento, rede e a atualização de 36 meses do ProSupport que a Dell adiciona automaticamente a uma configuração desse nível.
Construir e projetar
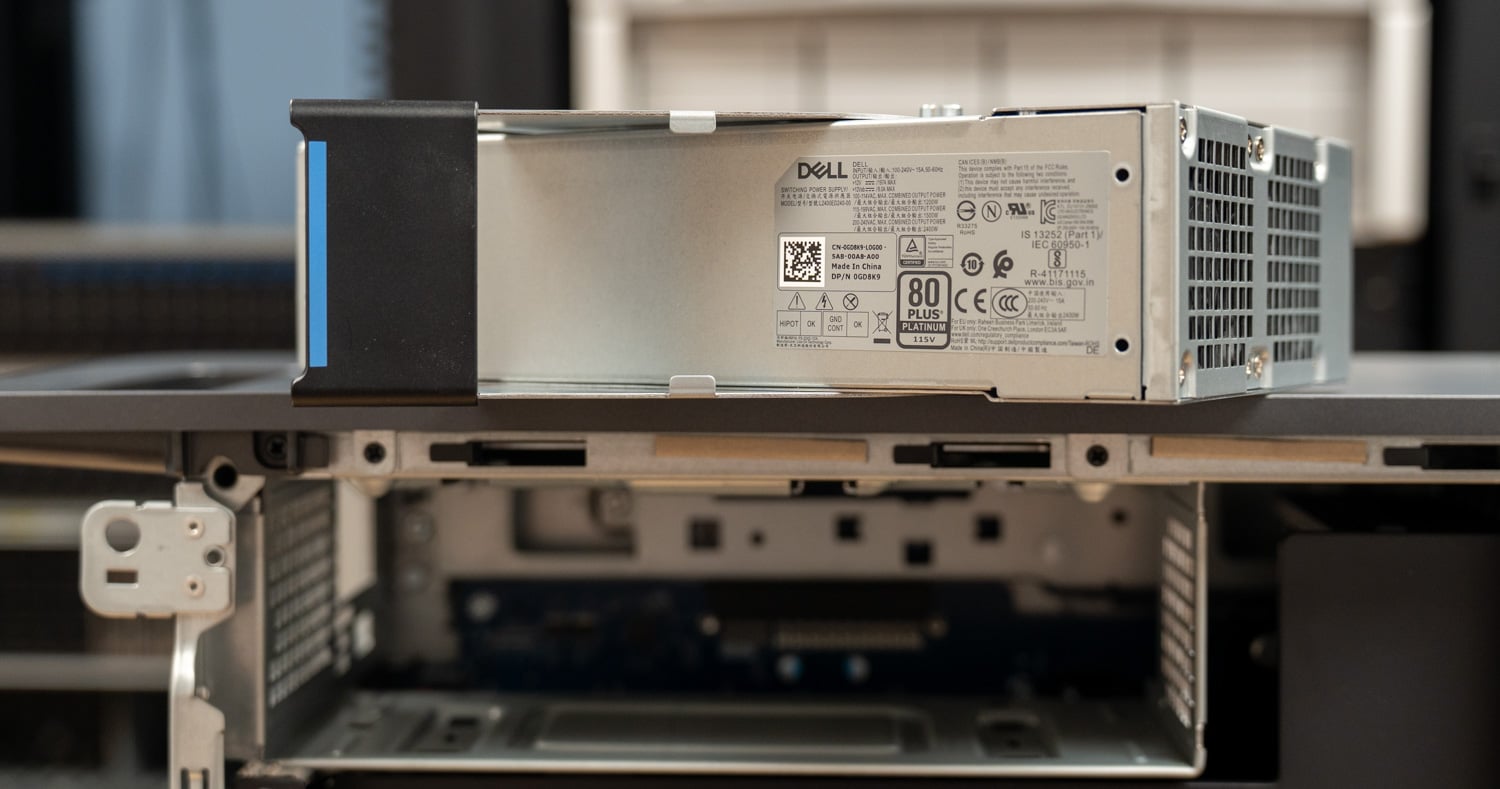
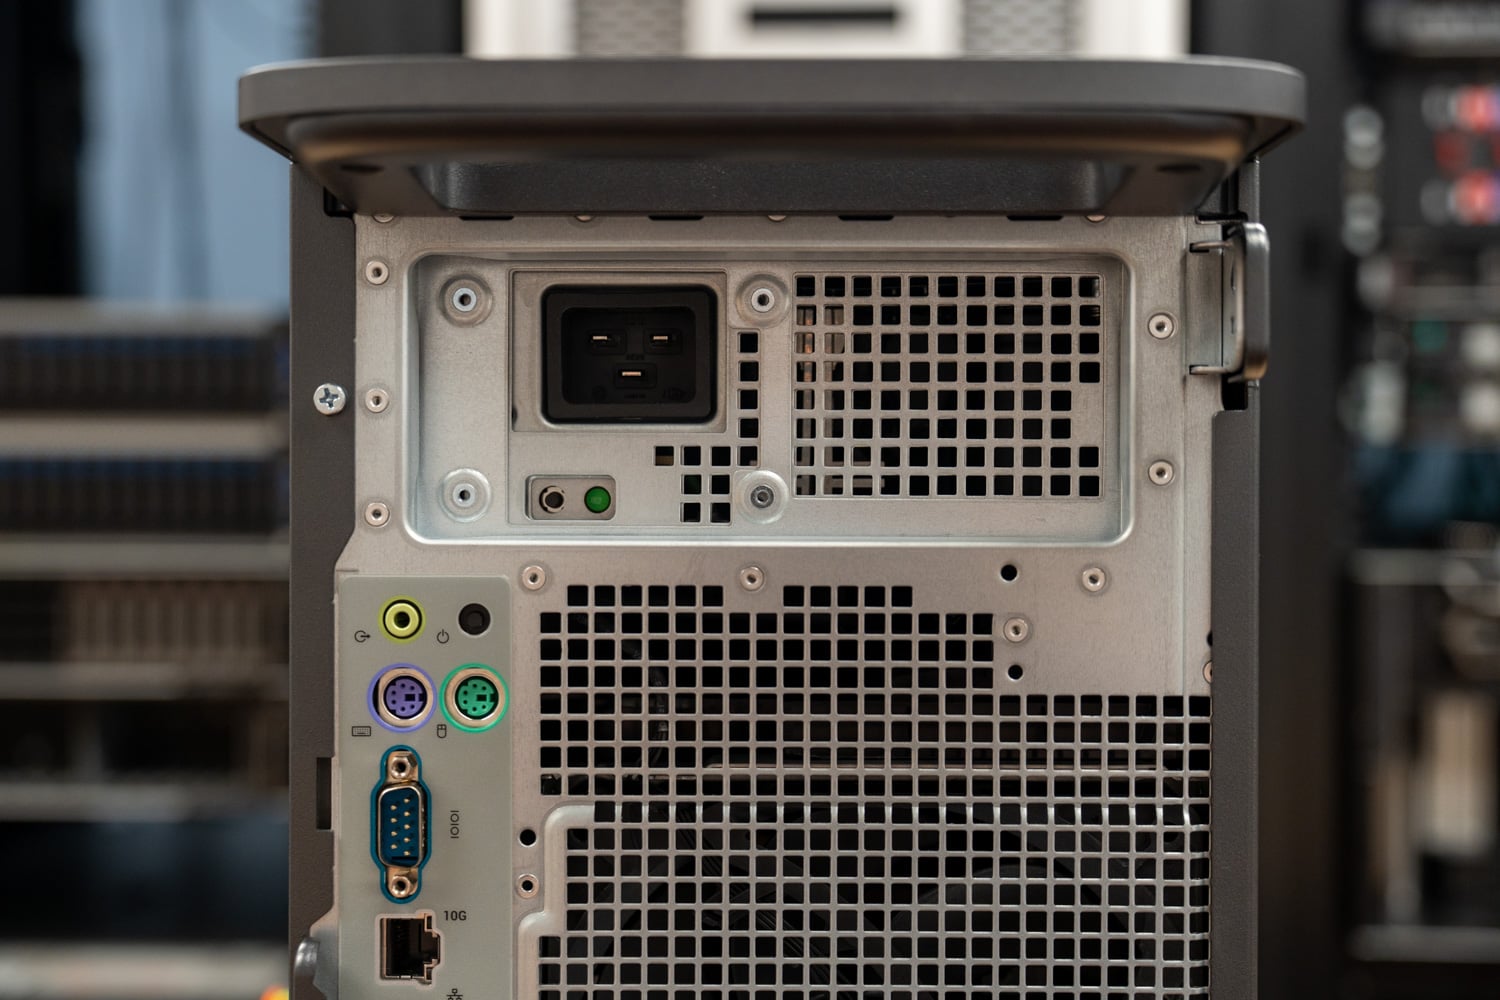
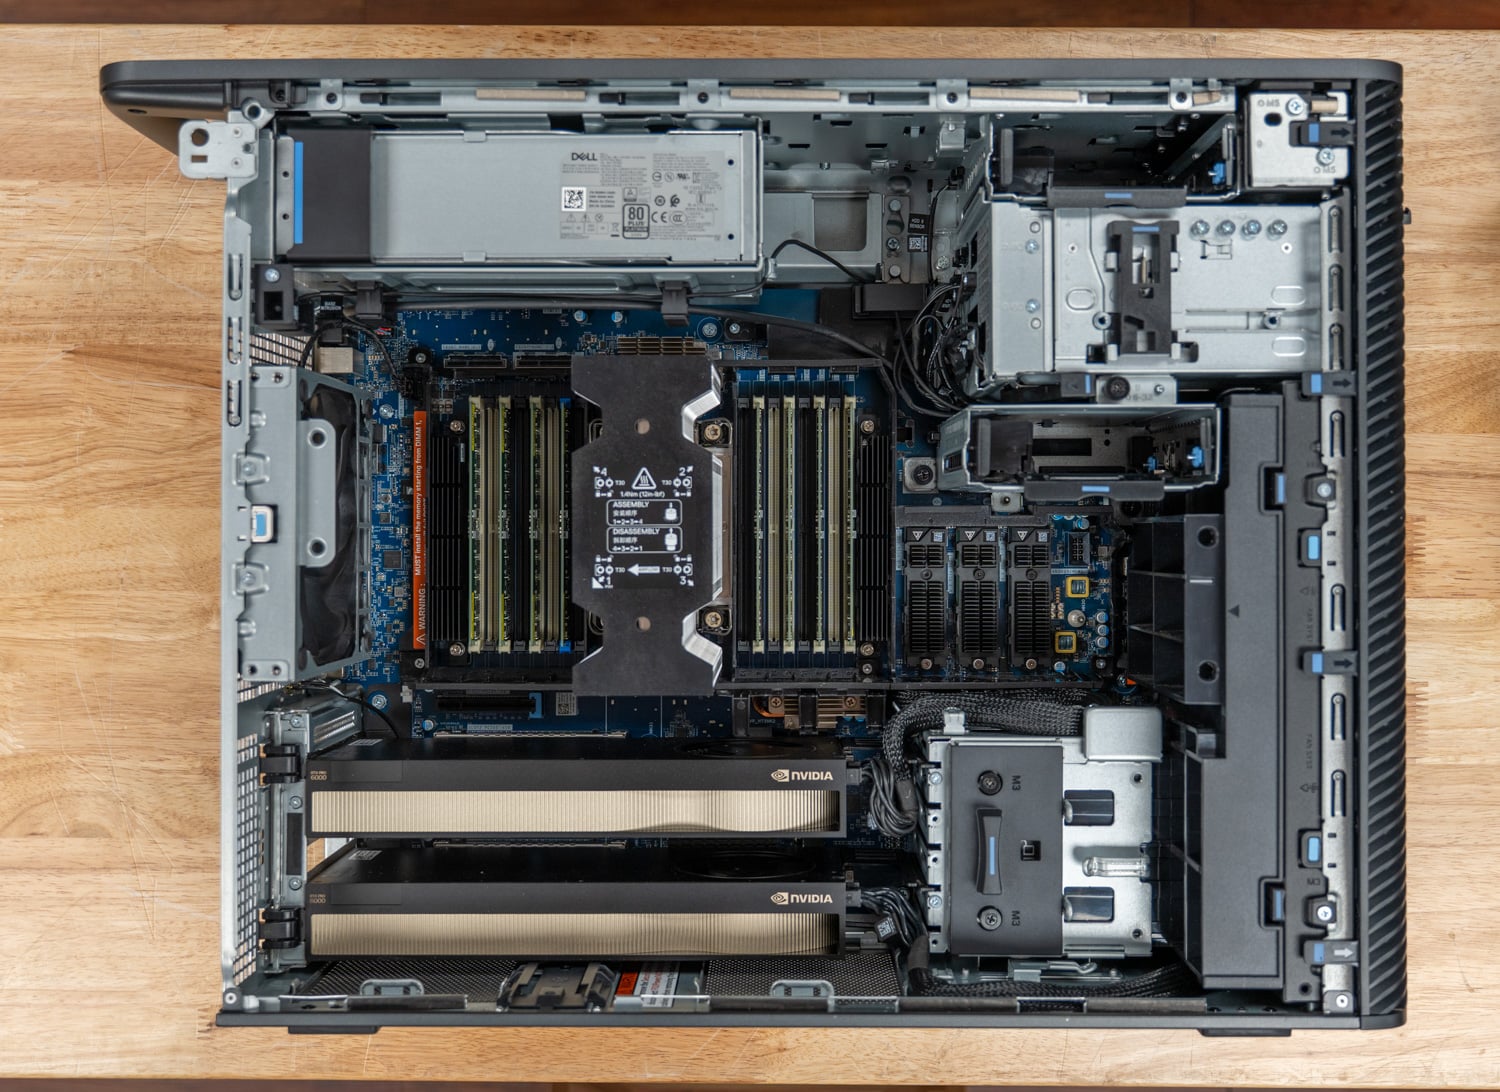
O T4 é um gabinete full tower com 449.8 mm de altura, 203.7 mm de largura e 617.5 mm de profundidade, e a Dell indica um peso mínimo de 24.1 kg e máximo de 33.6 kg, dependendo da configuração. Nossa unidade utiliza a fonte de alimentação Platinum de 2400 W, que o configurador da Dell seleciona para a configuração com duas placas de vídeo RTX PRO 6000, sendo que uma fonte de 1500 W é a padrão para configurações mais leves.
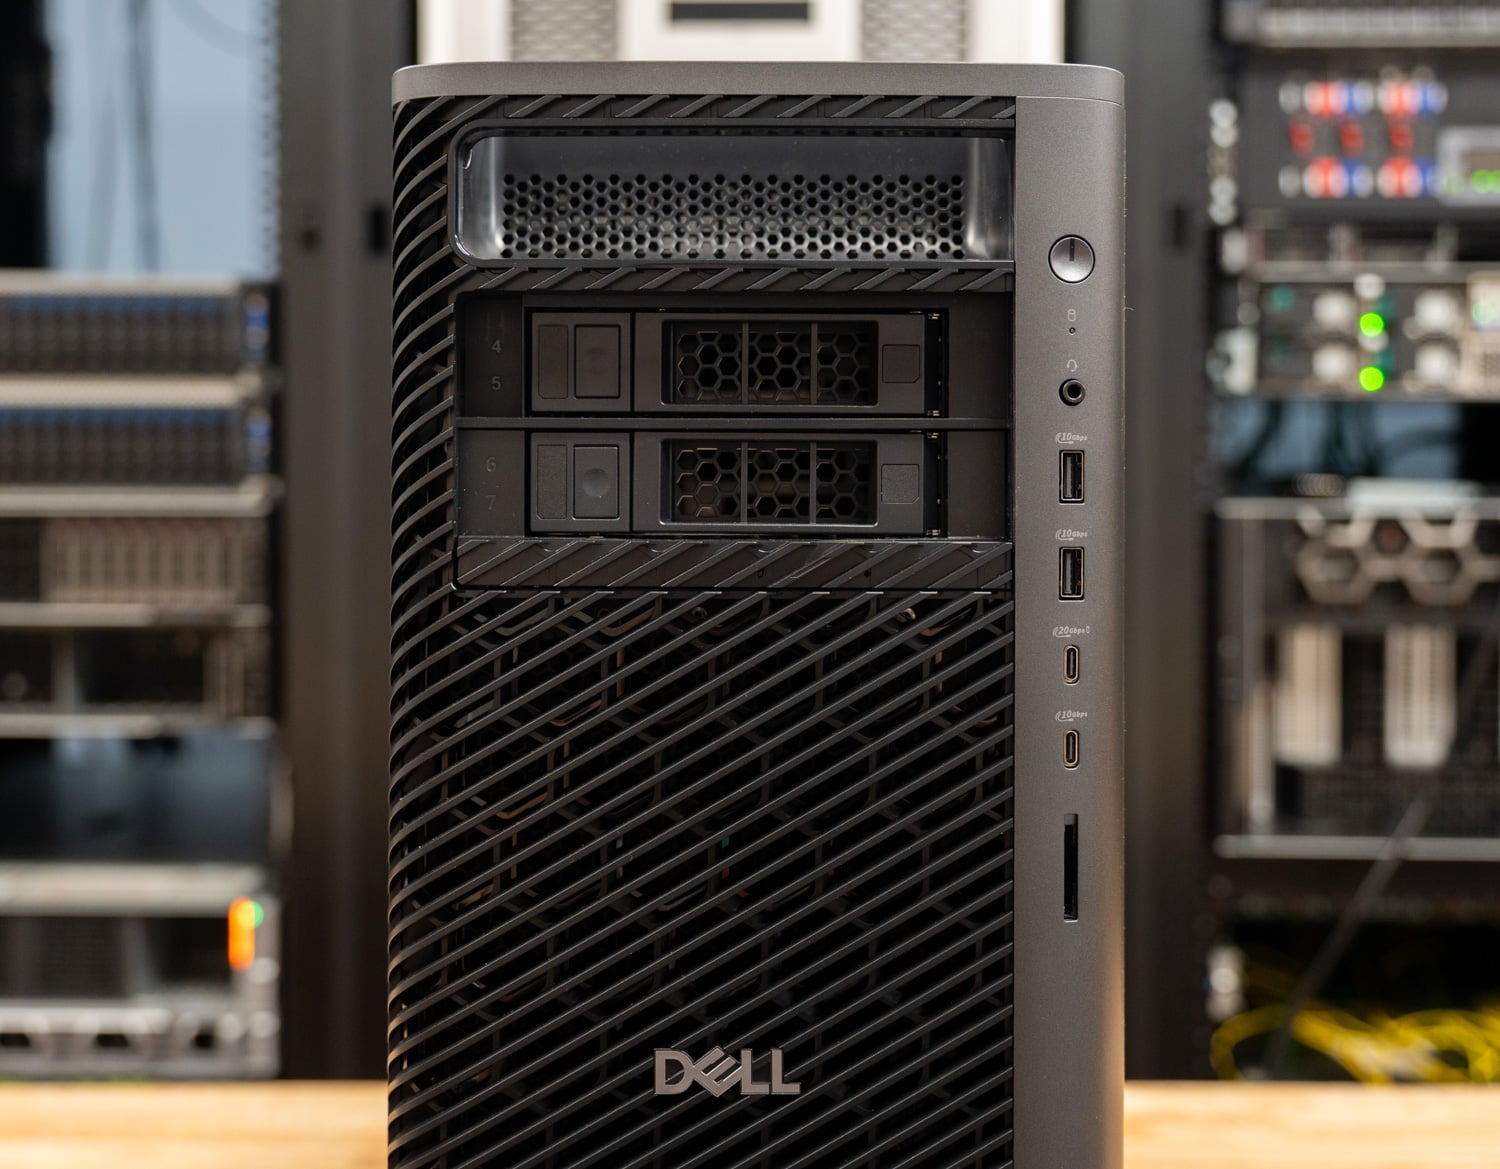
A facilidade de manutenção é um ponto forte do T4, começando pelo acesso sem ferramentas através de uma trava no painel lateral e uma fonte de alimentação de 2400 W que desliza para fora da parte superior traseira do chassi manualmente. Todos os outros componentes, incluindo as placas gráficas e os SSDs, são removidos com uma chave de fenda Phillips, e os pontos de contato azuis da Dell marcam as peças que devem ser removidas manualmente. O laboratório constatou que a plataforma é fácil de reparar em campo, o que é importante para uma estação de trabalho nessa faixa de preço.
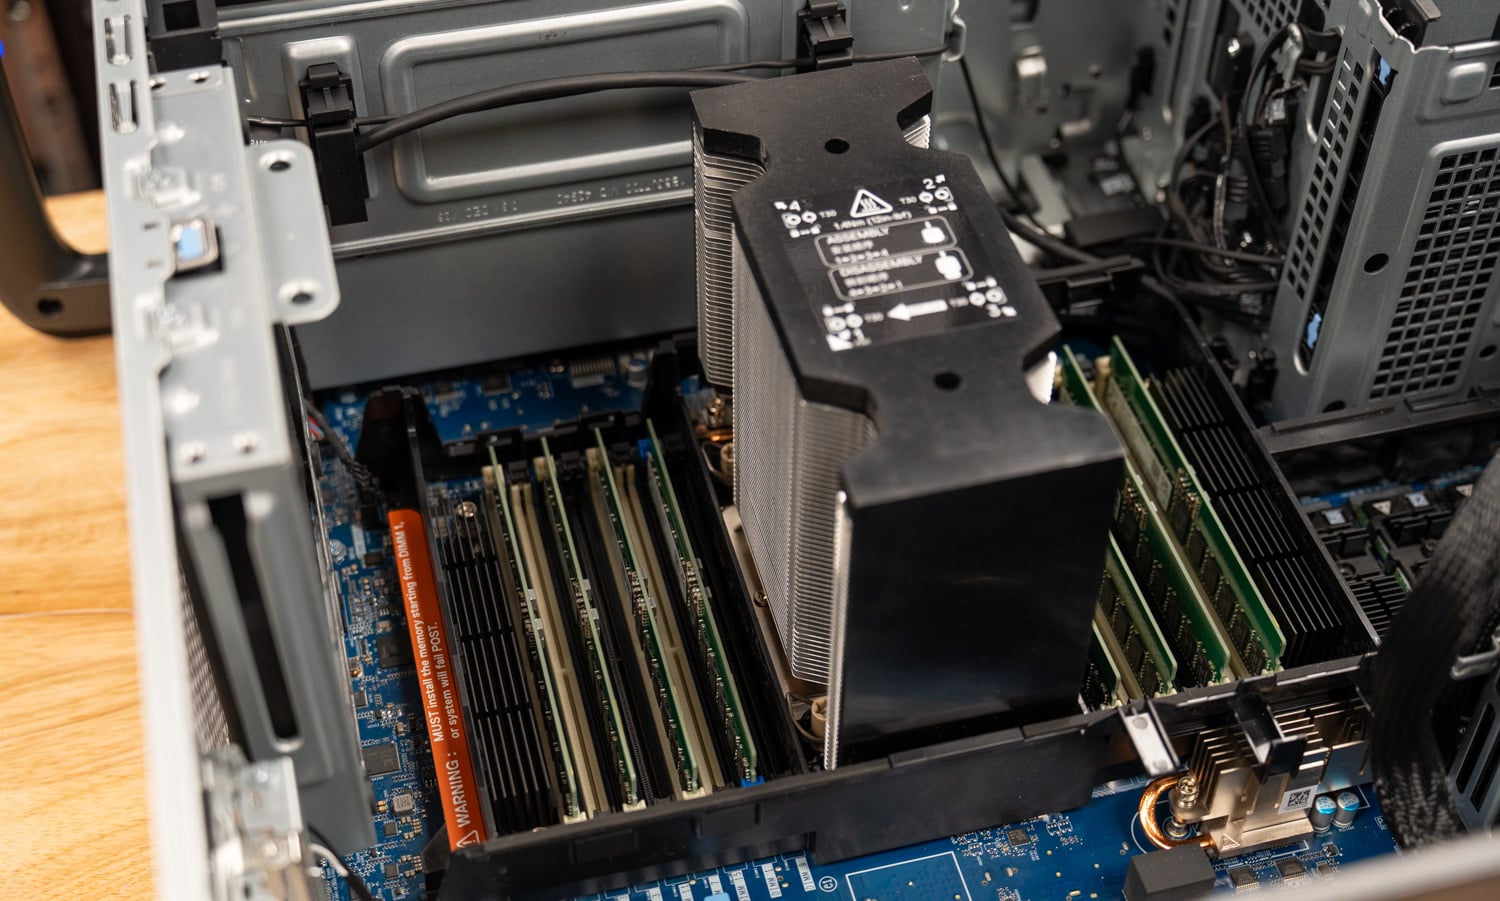
O sistema de refrigeração é o melhor que já vimos da Dell nesta categoria de gabinetes torre. O ar circula da frente para trás, e grandes defletores moldados o direcionam para baixo e através do processador e da memória, mantendo esse fluxo separado da área PCIe. As duas placas de vídeo de 300 W, portanto, utilizam um fluxo de ar separado e não herdam o calor do Xeon de 350 W. Com os defletores instalados, duas ventoinhas ficam posicionadas entre a área do processador e o compartimento das placas de vídeo, e o conjunto apresenta os mesmos pontos de contato azuis e pode ser removido para acesso à memória.
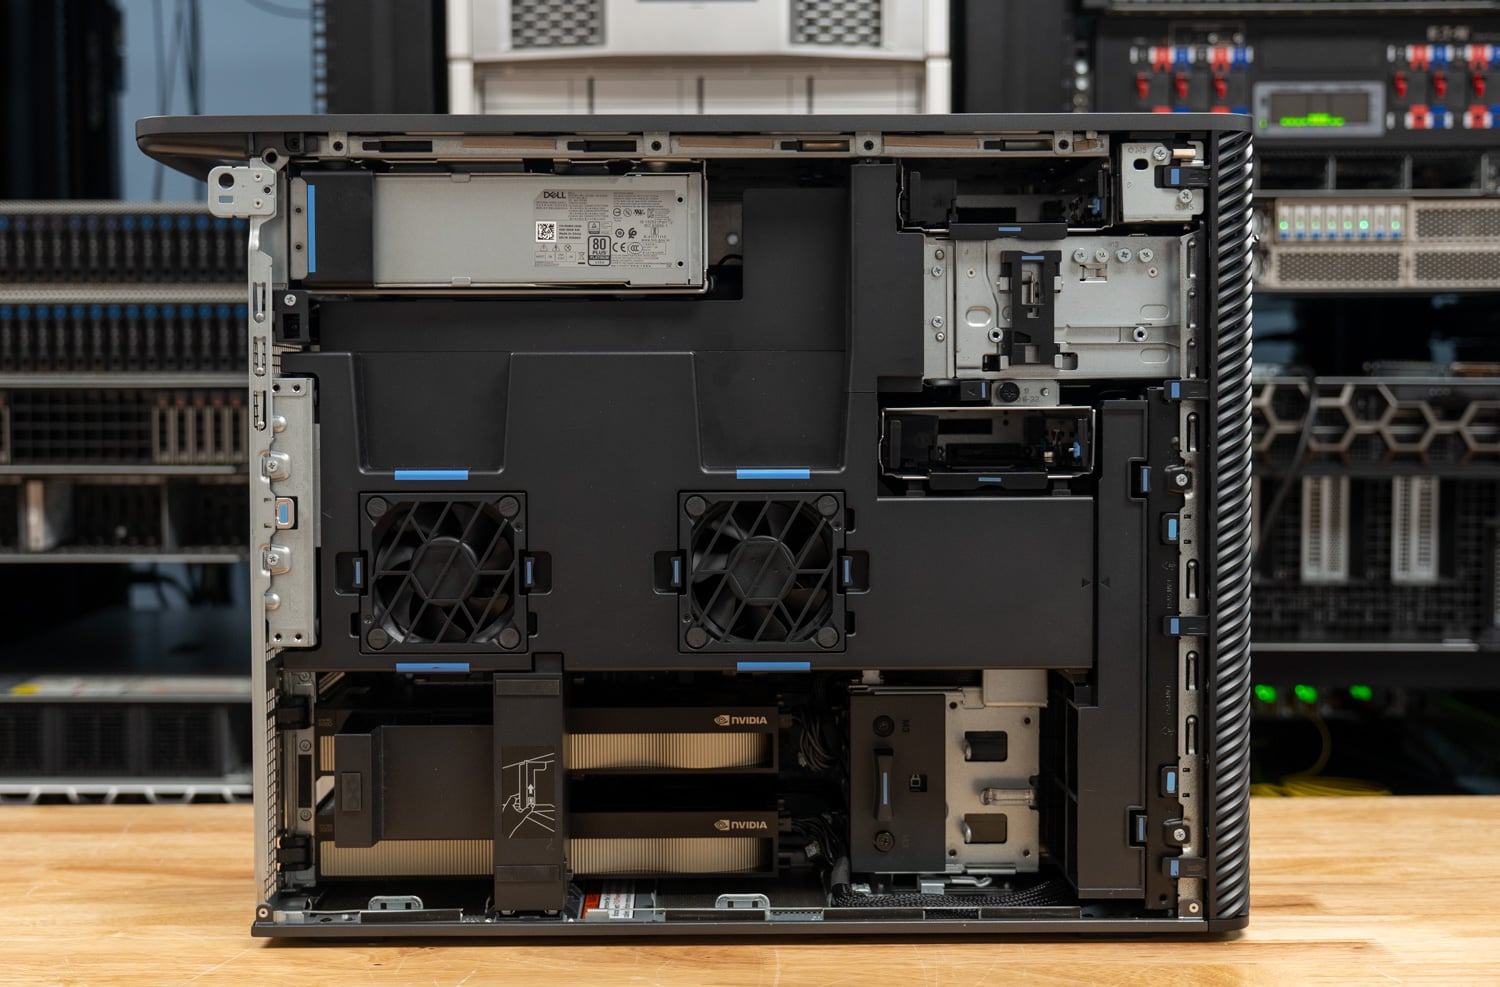
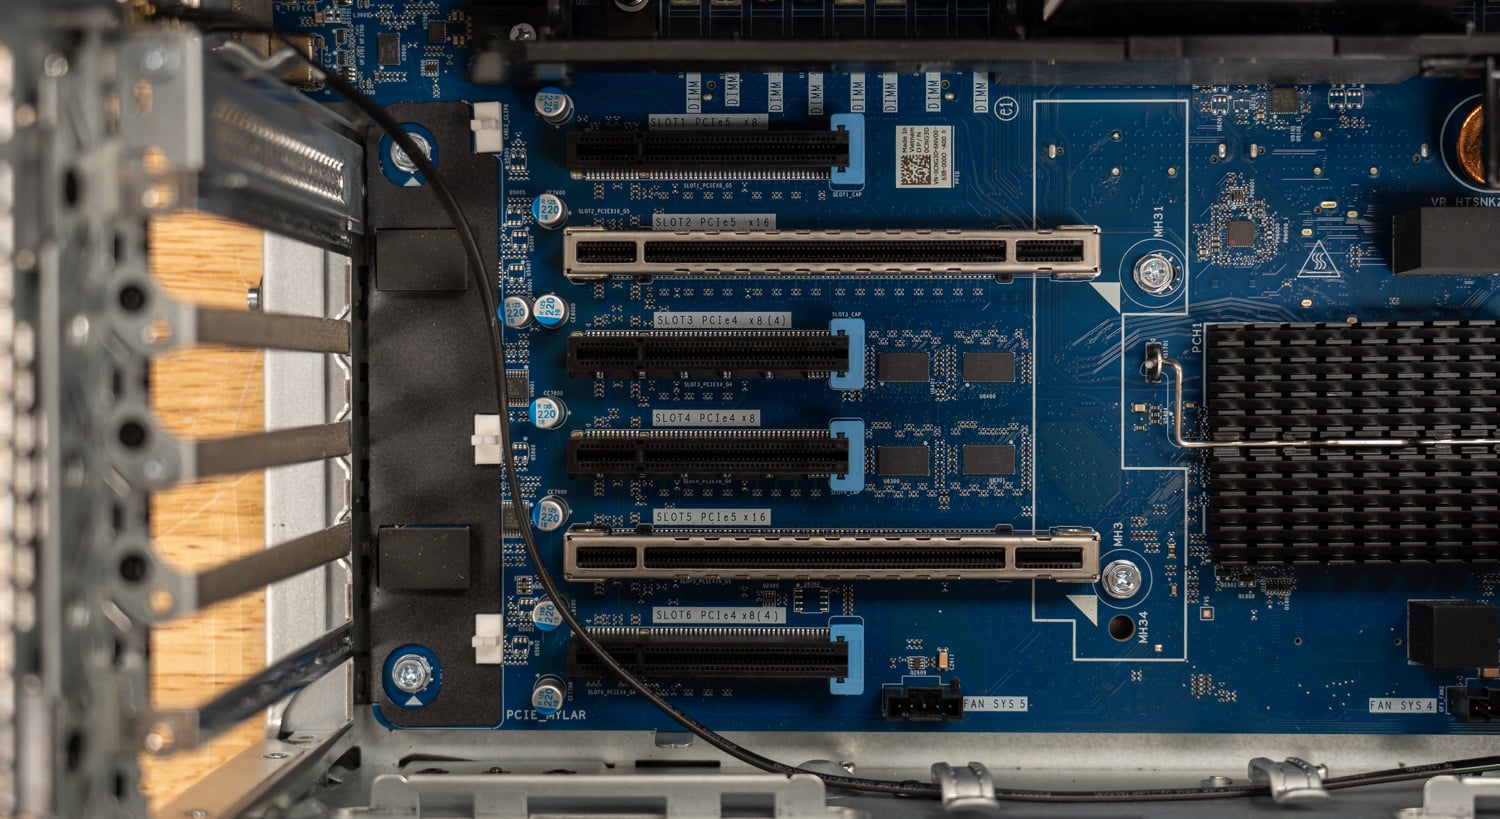
A expansão é feita através de seis slots PCIe de altura total: dois slots Gen5 x16 que suportam as GPUs, um Gen5 x8, um Gen4 x8 e dois slots Gen4 com conectores x8 e cabeamento x4. O armazenamento inclui três slots M.2 Gen5 internos e um slot Gen4, duas baias SATA internas de 3.5 polegadas e um FlexBay frontal que comporta até quatro unidades NVMe ou duas unidades de 3.5 polegadas, com uma unidade óptica slim opcional. Nossa unidade inicializa a partir de uma unidade Gen5 interna de 2 TB e possui outra unidade Gen5 de 2 TB em um slot M.2 interno.
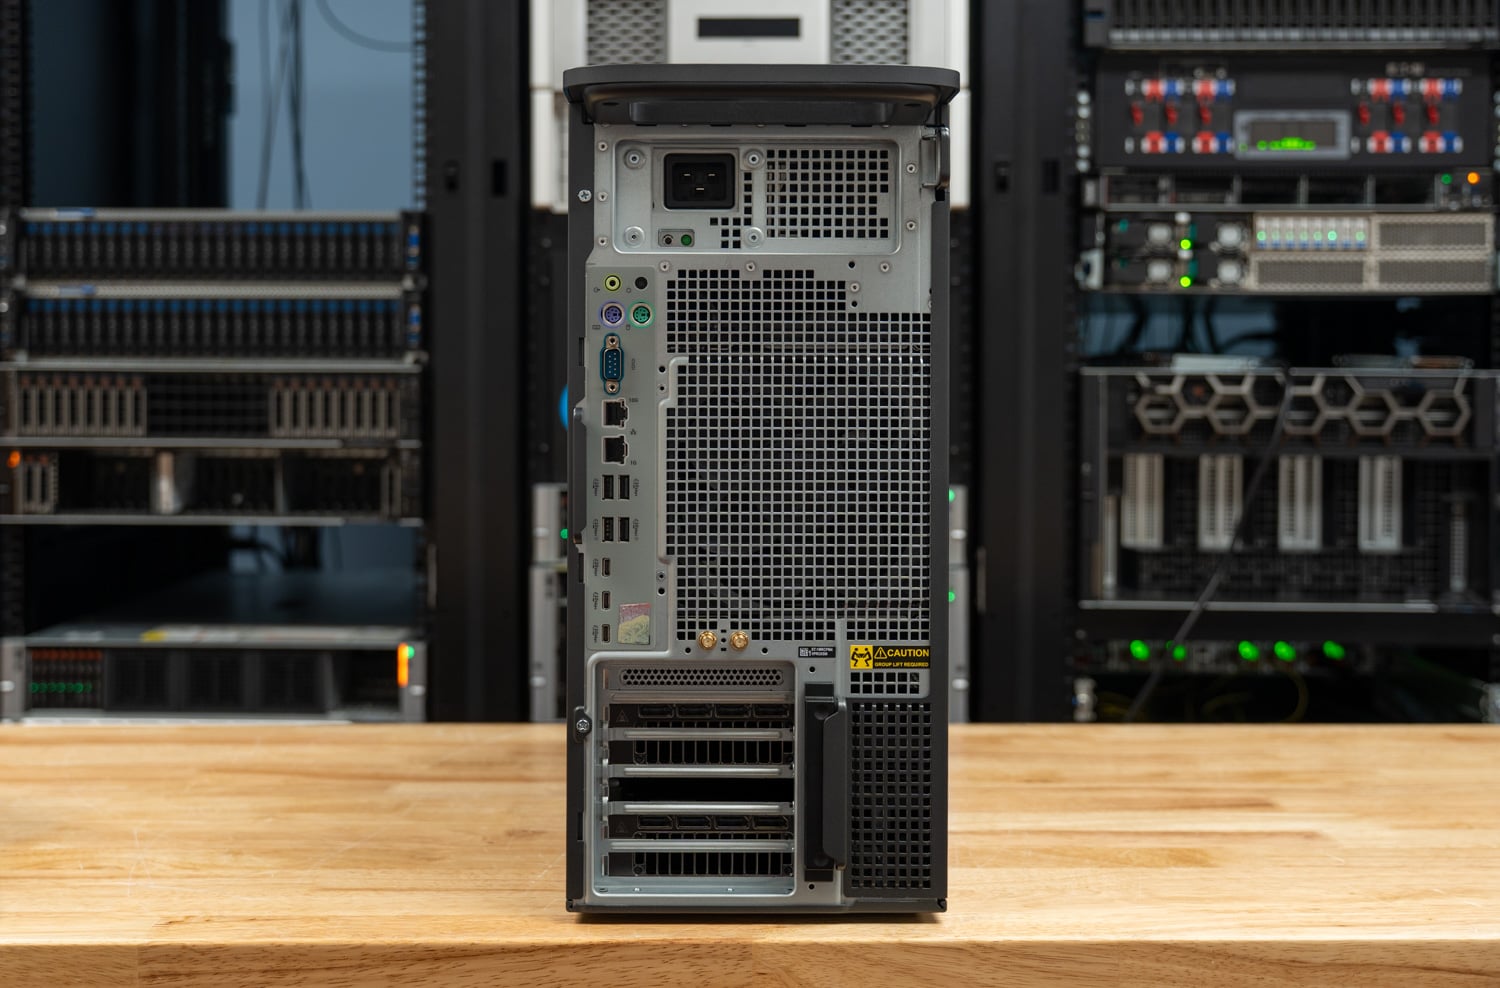
O painel frontal possui uma entrada para fone de ouvido, duas portas USB-A de 10 Gbps, uma porta USB-C de 20 Gbps com PowerShare, uma porta USB-C de 10 Gbps e um slot opcional para cartão SD. A parte traseira adiciona portas RJ-45 de 10 GbE e 1 GbE, quatro portas USB-A de 10 Gbps, duas portas USB-C de 10 Gbps, uma porta USB-C de 20 Gbps, uma porta serial, duas portas PS/2 e uma saída de áudio. Nossa unidade inclui o adaptador Intel E810-XXV de duas portas 25 GbE SFP28, o MediaTek Wi-Fi 7 MT7925 com Bluetooth 5.4, um leitor de cartão de memória e a placa adicional USB-C dupla da Dell.
A segurança e o gerenciamento incluem TPM 2.0, Dell SafeBIOS, detecção de intrusão no chassi, suporte para criptografia automática de unidades, apagamento seguro da BIOS e Intel vPro Enterprise. A Dell informa que o T4 utiliza até 85% de plástico reciclado em componentes principais, 90% de alumínio reciclado nas alças e 11% de aço reciclado no chassi, e a configuração atende aos requisitos do programa ENERGY STAR.
Especificações do Dell Pro Precision 9 T4
| Especificação | Dell Pro Precision 9 T4 (conforme testado) |
|---|---|
| Plataforma | |
| Modelo | Dell Pro Precision 9 T4 (PW9T4260) |
| Subcontratante | Intel Xeon 698X, 86 núcleos, 172 threads, 336 MB de cache, frequência base de 2.0 GHz, até 4.8 GHz, 350 W |
| Opções de processador | Xeon 634 (12 núcleos) até Xeon 698X (86 núcleos) |
| Memória | 256 GB (8 x 32 GB) DDR5-6400 RDIMM ECC 16 slots, até 4 TB |
| Gráficos | 2x NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 96 GB GDDR7 cada, 300 W cada |
| Sistema Operacional | Windows 11 Pro para Estações de Trabalho (testado no Ubuntu 26.04.1 LTS) |
| Armazenamento | |
| Conforme configurado | 2x 2TB M.2 2280 Gen5 x4 TLC SED (ambos em slots M.2 internos) |
| Slots internos | 3x M.2 2230/2280 Gen5 NVMe 1x M.2 2230/2280 Gen4 NVMe 2 x SATA de 3.5 polegadas |
| FlexBay | Até 4 unidades NVMe mais uma unidade óptica slim opcional, ou 2 unidades SATA de 3.5 polegadas. |
| Expansão e conectividade | |
| Slots PCIe | 2x Gen5 x16 1x Gen5 x8 1x Gen4 x8 2x Gen4 x8 (x4 elétricos) |
| Networking | Intel E810-XXV dual-port 25GbE SFP28 (complemento) Conexões RJ-45 de 10GbE e 1GbE integradas. MediaTek Wi-Fi 7 MT7925, Bluetooth 5.4 |
| Portas da frente | 1 porta USB-C de 20 Gbps com PowerShare 1 portas USB-C de 10 Gbps 2x USB-A 10 Gbps Fone de ouvido Slot opcional para cartão SD |
| Portas traseiras | 1 portas USB-C de 20 Gbps 2 portas USB-C de 10 Gbps 4x USB-A 10 Gbps Serial, 2x PS/2, saída de linha |
| Poder e Físico | |
| Fonte de alimentação do laboratório | 2400W Platinum (opção de 1500W) |
| Dimensões | 449.8 x 203.7 x 617.5mm (17.70 x 8.01 x 24.31in) |
| Peso | De 24.1 kg a 33.6 kg (53.1 a 74.1 lb) por configuração. |
| Garantia | ProSupport com atendimento presencial após diagnóstico remoto, 36 meses |
| Preço | $ 5,925 base Aproximadamente US$ 66,600 na configuração especificada (Dell.com) |
Configuração e metodologia de teste
Testamos estações de trabalho de alto desempenho em Linux, e todos os quatro sistemas desta análise executaram Ubuntu 26.04.1 LTS com kernel 7.0.0-43, driver NVIDIA 595.99.02, CUDA 13, llama.cpp build b11716 e Ollama 0.40.3, no perfil de desempenho do Linux. Os resultados são provenientes de três ferramentas: sr-client para cargas de trabalho locais de IA e cliente; sr-harness para compilação, compressão, criptografia, servidor web e y-cruncher; e sr-suite r5.28 para GROMACS, OpenFOAM, ClickHouse, Valkey e largura de banda de memória. Cada resultado representa a mediana de execuções repetidas.
Todos os quatro sistemas foram executados com o modo térmico da BIOS configurado para Ultra Performance, e o T4 utilizou a BIOS 1.2.0. O teste com o chicote de cabos do T4 utilizou o sr-harness 3.3, o do Precision 7875 utilizou o 3.5 e ambos os T2 utilizaram o 3.6, com a mesma configuração de testes em todas as versões.
Todos os sistemas de comparação são torres Dell com placas gráficas RTX PRO 6000 Blackwell. O Dell Precision 7875 combina o Threadripper PRO 9995WX de 96 núcleos com as mesmas duas placas RTX PRO 6000 Max-Q e 512 GB de memória DDR5-5600, o que o torna o modelo mais semelhante. O Dell Pro Precision 9 T2 utiliza o Xeon 658X de 24 núcleos com uma placa Max-Q, e o Dell Pro Max Tower T2 utiliza o Core Ultra 9 285K de 24 núcleos com a RTX PRO 6000 de 600 W, o que demonstra o impacto positivo do limite de potência mais alto por GPU.
| Configuração | CPU | Memória | GPU | test drive | Modo térmico da BIOS |
|---|---|---|---|---|---|
| Dell Pro Precision 9 T4 | Xeon 698X, 86 núcleos | 256 GB DDR5-6400 (8 canais) | 2x RTX PRO 6000 Max-Q (300W) | SK hynix PCB01 Gen5 de 2 TB | Desempenho Ultra |
| Dell Precision 7875 | Threadripper PRO 9995WX, 96 núcleos | 512 GB DDR5-5600 (8 canais) | 2x RTX PRO 6000 Max-Q (300W) | Samsung Gen4 de 2 TB | Desempenho Ultra |
| Dell Pro Precision 9 T2 | Xeon 658X, 24 núcleos | 128 GB DDR5-6400 (4 canais) | 1x RTX PRO 6000 Max-Q (300W) | Samsung PM9E1 Gen5, discos de 2 TB em um array striped. | Desempenho Ultra |
| Torre Dell Pro Max T2 | Core Ultra 9 285K, 24 núcleos | 128 GB DDR5-4400 (2 canais) | 1x RTX PRO 6000 (600W) | Samsung PM9F1 Gen4 de 2 TB | Desempenho Ultra |
Desempenho de IA local
Todos os sistemas aqui apresentados possuem pelo menos uma RTX PRO 6000 Blackwell com 96 GB de GDDR7, portanto, os resultados com uma única GPU medem a placa, seu limite de energia e a velocidade com que a plataforma a alimenta. O diferencial do T4 está em suas duas placas, e nossos testes com duas GPUs executam cada modelo de três maneiras, quando aplicável: dois servidores independentes, um para cada GPU, para medir a taxa de transferência; um modelo dividido por camada entre as duas placas; e, para o MiniMax M2.7, uma placa com o restante do modelo na memória do sistema.
LLM em execução em uma GPU
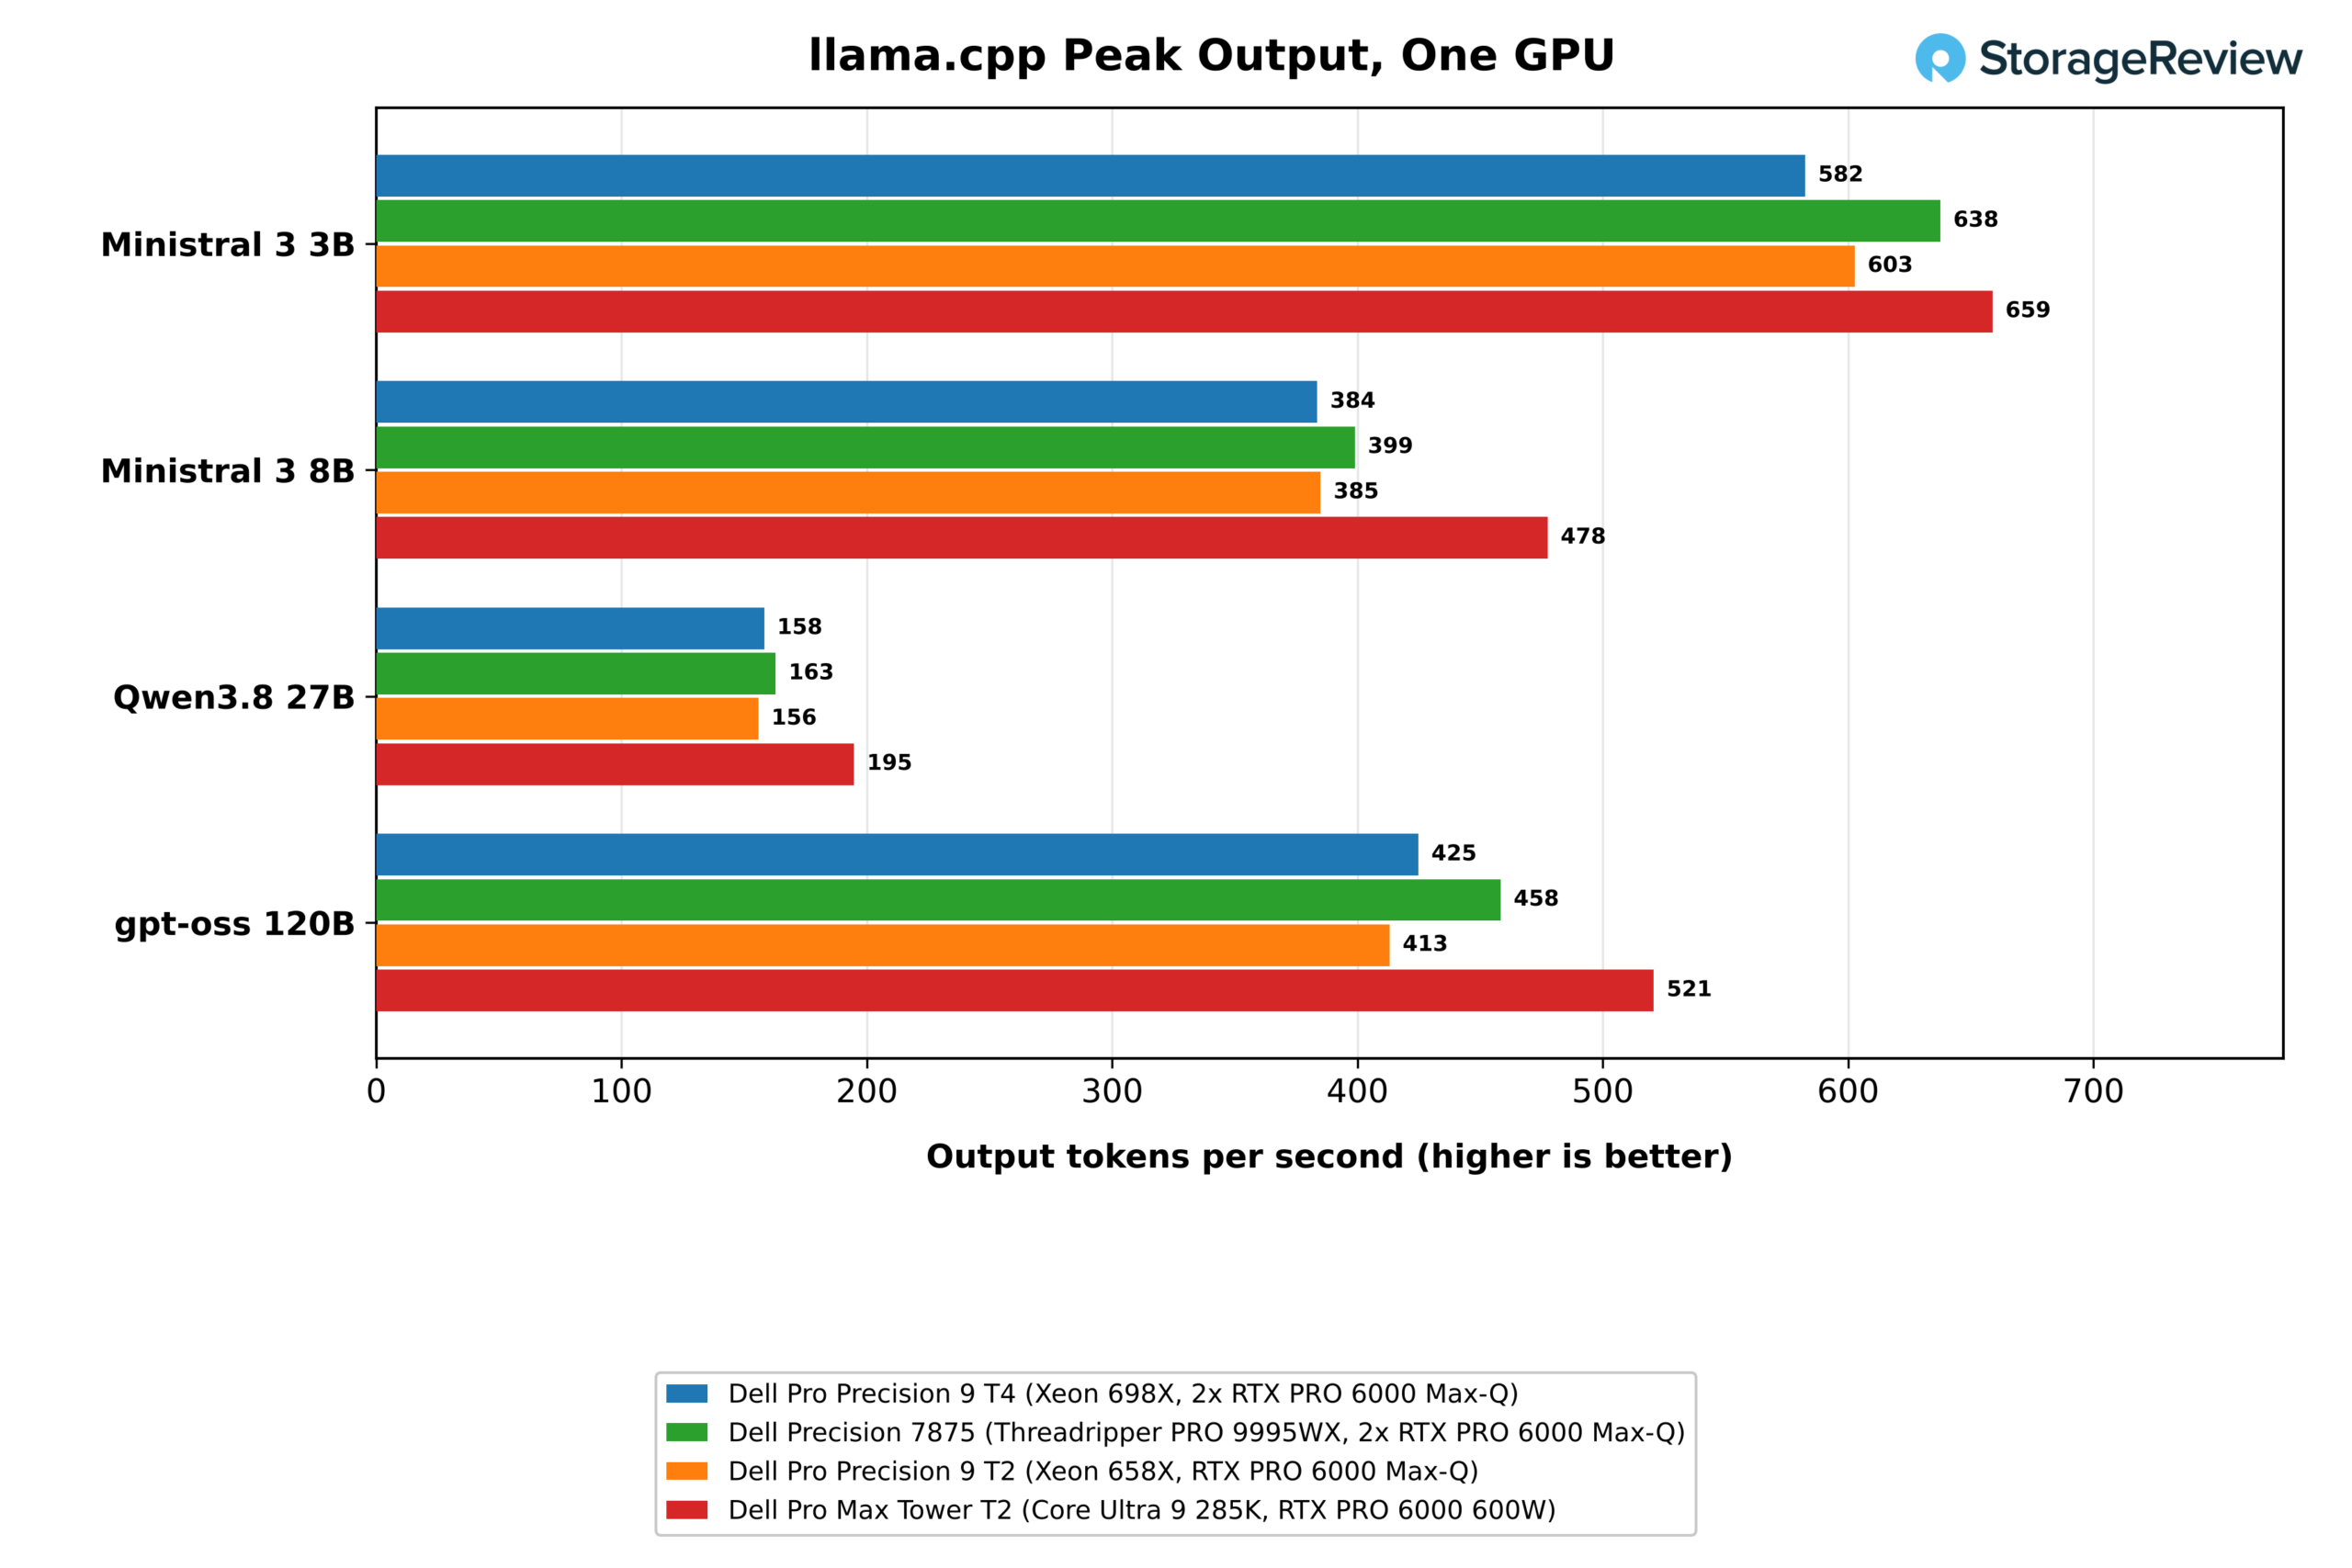
| Servidor llama.cpp, uma GPU (tokens de saída/s, quanto maior, melhor) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| Ministral 3 3B, um pedido | 240.5 | 252.6 | 243.8 | 261.6 |
| Ministral 3 3B, pico | 582.5 | 637.6 | 602.6 | 658.8 |
| Ministral 3 8B, um pedido | 166.8 | 171.1 | 167.3 | 194.5 |
| Ministral 3 8B, pico | 383.6 | 398.9 | 384.9 | 477.5 |
| Qwen3.8 27B, uma solicitação | 54.9 | 55.4 | 53.8 | 64.5 |
| Qwen3.8 27B, pico | 158.1 | 162.8 | 155.8 | 194.7 |
| gpt-oss 120B, uma solicitação | 166.9 | 171.2 | 164.5 | 193.0 |
| gpt-oss 120B, pico | 424.8 | 458.4 | 413.1 | 520.7 |
| gpt-oss 120B, uma requisição, tempo para o primeiro token (ms, quanto menor, melhor) | 1,189 | 1,181 | 1,213 | 844 |
Em uma GPU, a T4 atinge o limite de 300W da placa. Ela gerou 166.9 tokens por segundo para um usuário no gpt-oss 120B e alcançou um pico de 424.8 em 64 requisições simultâneas, ficando entre 1% e 9% abaixo da placa Max-Q idêntica do Precision 7875 em todos os quatro modelos e no mesmo nível do Pro Precision 9 T2. A placa de 600W do Pro Max Tower T2 é de 13% a 25% mais rápida no pico em todos os modelos, atingindo 520.7 tokens por segundo no gpt-oss 120B.
Duas GPUs: Réplicas e Modelos Divididos
| Servidor llama.cpp, duas GPUs (tokens de saída/s, quanto maior, melhor) | Dell Pro Precision 9 T4 | Dell Precision 7875 |
|---|---|---|
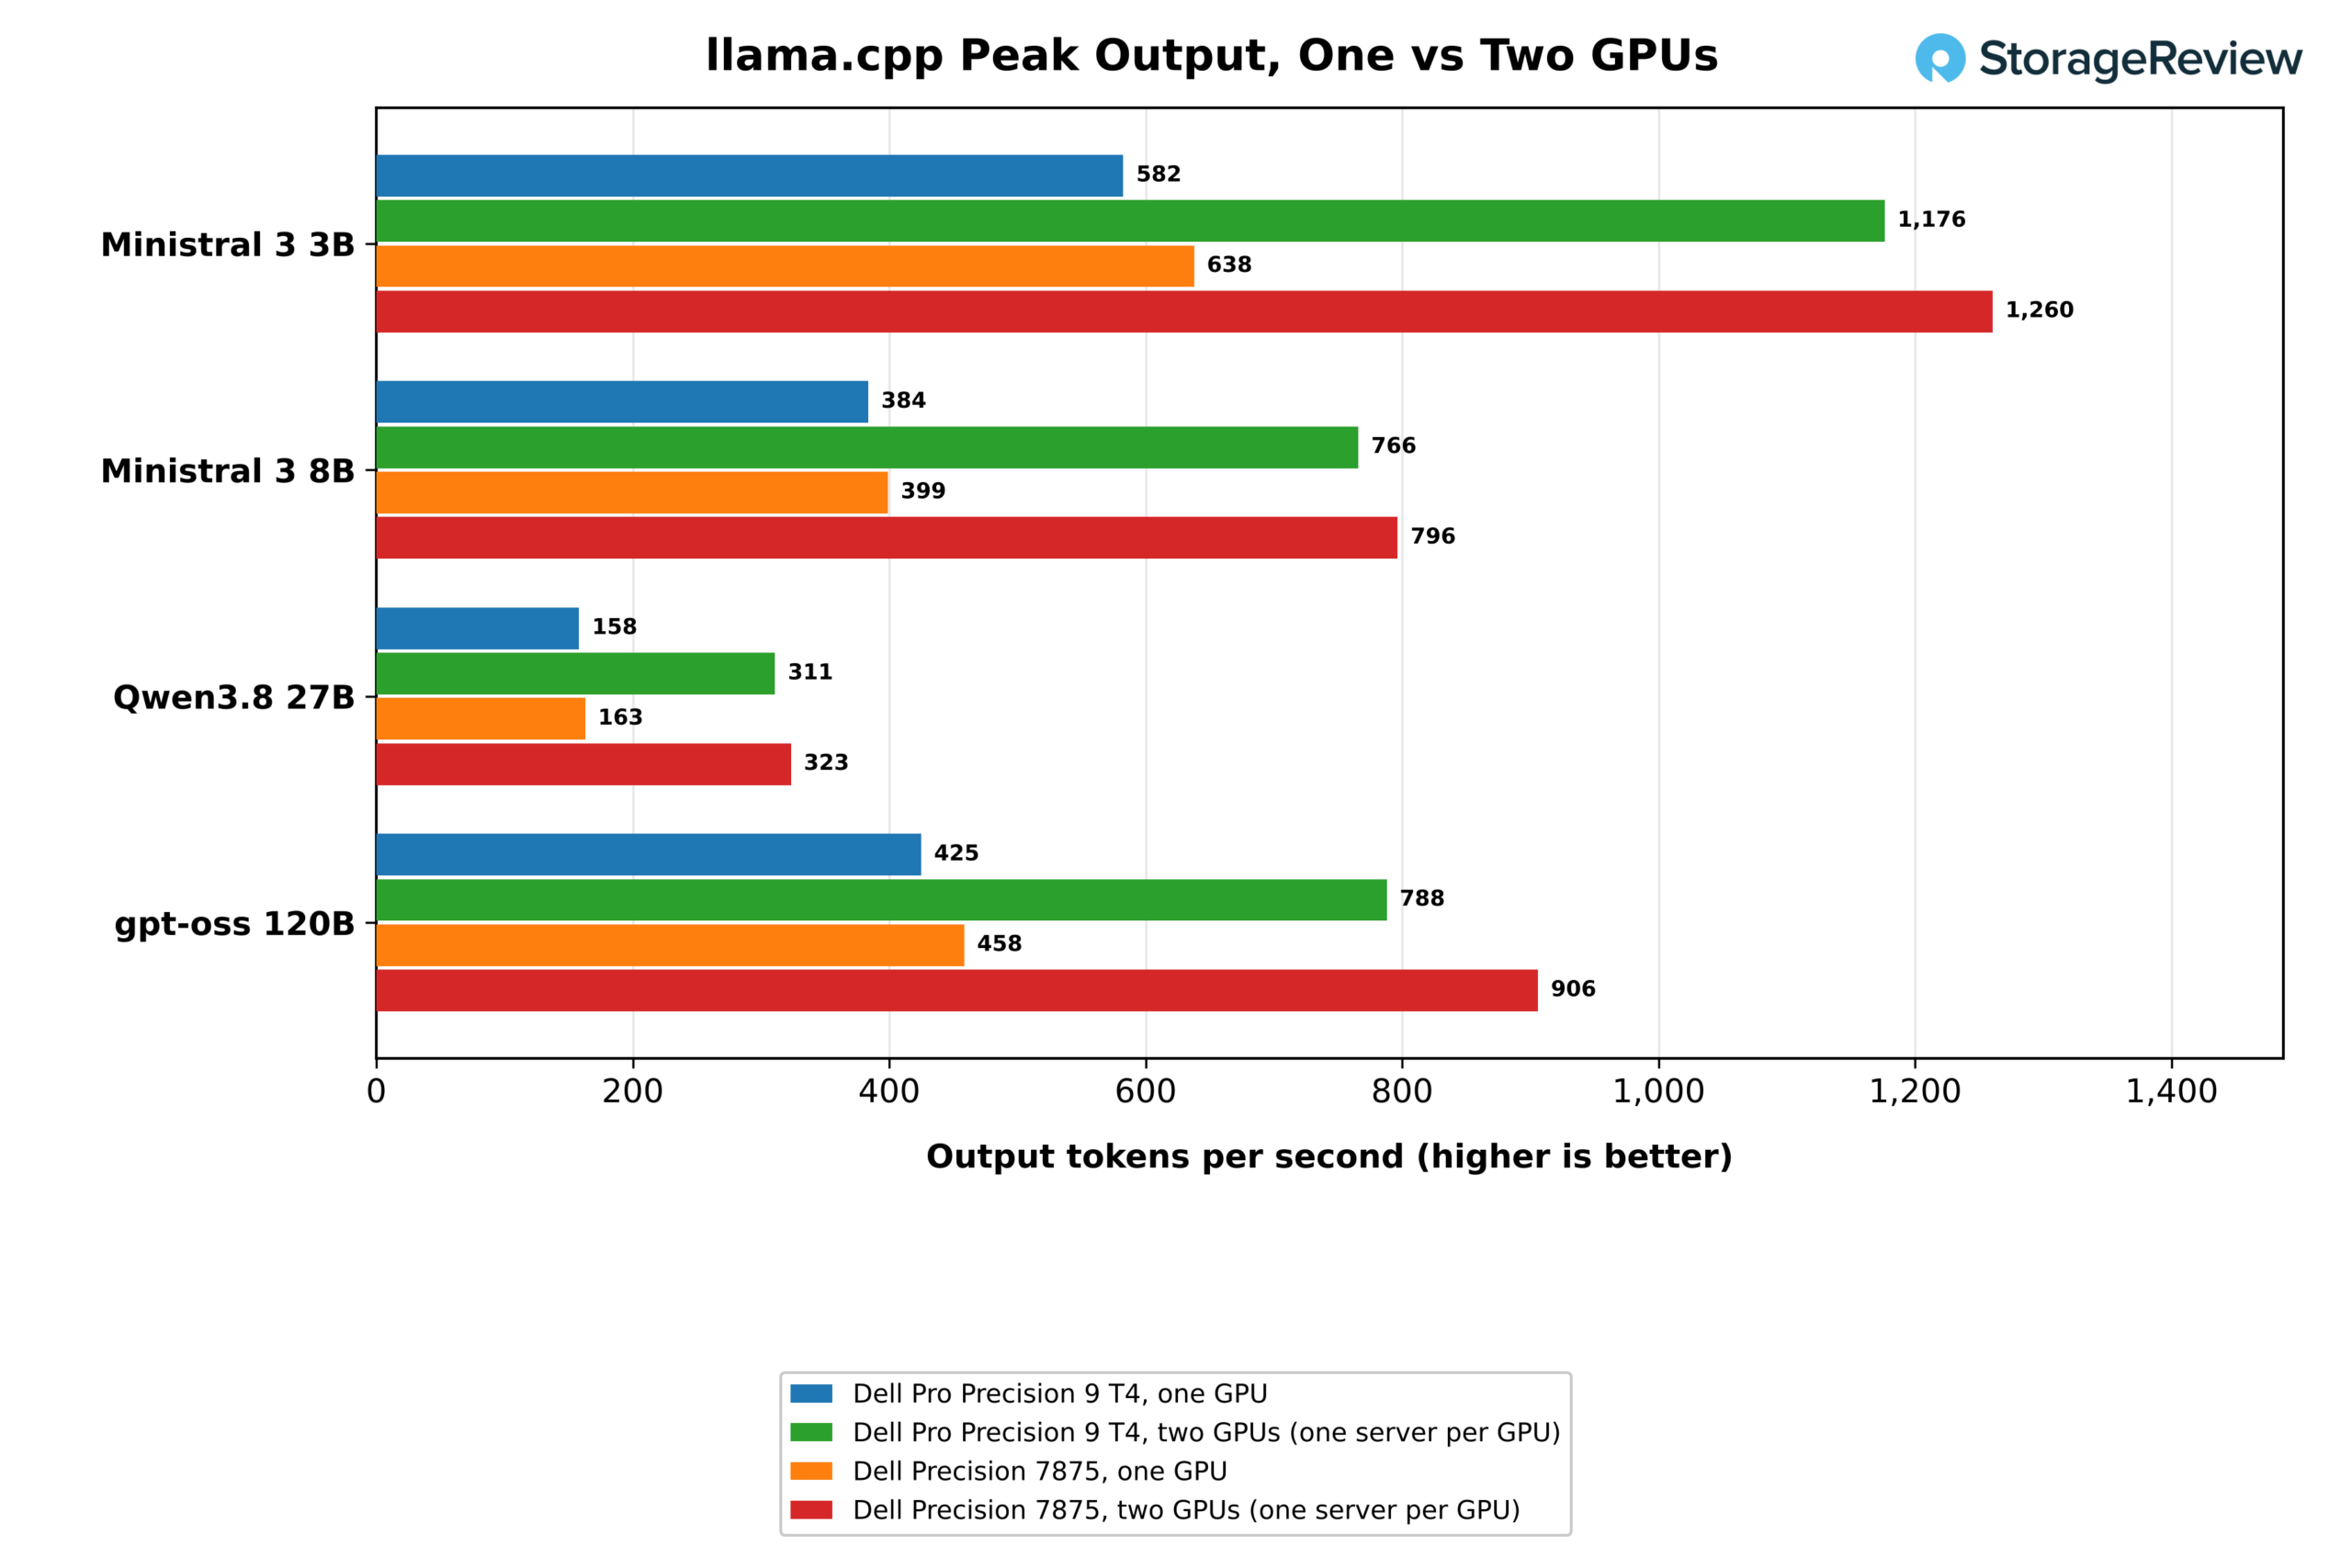
| Ministral 3 3B, pico, um servidor por GPU | 1,176.1 | 1,260.2 |
| Ministral 3 8B, pico, um servidor por GPU | 765.7 | 796.4 |
| Qwen3.8 27B, pico, um servidor por GPU | 310.8 | 323.2 |
| gpt-oss 120B, pico, um servidor por GPU | 787.9 | 905.8 |
| gpt-oss 120B, uma solicitação, dividida por camada | 170.6 | 182.4 |
| gpt-oss 120B, pico, dividido por camada | 539.2 | 619.4 |
Executar um servidor por GPU aumentou a produção máxima do T4 em 1.85 a 2.02 vezes nos quatro modelos. A produção máxima subiu de 582.5 para 1,176.1 tokens por segundo no Ministral 3 3B, de 383.6 para 765.7 no modelo 8B e de 158.1 para 310.8 no Qwen3.8 27B, escalando de 1.97 a 2.02 vezes. O gpt-oss 120B escalou 1.85 vezes para 787.9 tokens por segundo no T4 e 1.98 vezes para 905.8 no Precision 7875, que atingiu seu pico com 128 requisições simultâneas, enquanto o T4 atingiu o pico com 64.
Dividir o gpt-oss 120B por camada entre as duas placas é a maneira mais lenta de usar a segunda GPU quando o modelo já cabe em uma só. Atendeu um usuário a 170.6 tokens por segundo, apenas 3% do desempenho de uma única placa, e atingiu um pico de 539.2, 27% acima de uma GPU e bem abaixo dos 787.9 alcançados por duas réplicas. O layout dividido justifica sua utilização com modelos que não cabem em uma única placa, e é aí que entra o MiniMax M2.7.
| Servidor llama.cpp, gpt-oss 120B, prompts de 8,192 tokens, saídas de 1,024 tokens | T4, uma GPU | T4, duas GPUs, um servidor por GPU | T4, duas GPUs, divididas por camada | Precision 7875, duas GPUs, um servidor por GPU |
|---|---|---|---|---|
| 1 simultâneos: taxa de transferência total (tokens/s) | 1,502 | 1,504 | 1,536 | 1,530 |
| 1 concorrentes: tempo até o primeiro token, mediana (ms, quanto menor, melhor) | 1,189 | 1,180 | 719 | 1,189 |
| 8 simultâneos: taxa de transferência total (tokens/s) | 2,760 | 4,820 | 3,300 | 4,949 |
| 8 simultâneos: saída por usuário (tokens/s) | 38.3 | 66.9 | 45.8 | 68.7 |
| 8 concorrentes: tempo até o primeiro token, mediana (ms, quanto menor, melhor) | 2,654 | 2,523 | 1,622 | 2,472 |
| 64 simultâneos: taxa de transferência total (tokens/s) | 3,823 | 7,091 | 4,853 | 7,557 |
| 64 simultâneos: saída por usuário (tokens/s) | 6.6 | 12.3 | 8.4 | 13.1 |
| 64 concorrentes: tempo até o primeiro token, mediana (ms, quanto menor, melhor) | 3,874 | 3,226 | 2,852 | 2,867 |
A análise completa do gpt-oss 120B mostra como a segunda placa de vídeo altera a curva de desempenho, com a taxa de transferência total contabilizando os tokens de solicitação e de saída em conjunto. Uma GPU apresentou um aumento de 1,502 tokens por segundo para uma única solicitação, chegando a 2,760 com oito solicitações e 3,823 com 64 solicitações, onde cada usuário recebeu 6.6 tokens de saída por segundo. Com um servidor por GPU, oito solicitações atingiram 4,820 tokens por segundo e 64 solicitações alcançaram 7,091 tokens por segundo, 1.85 vezes o desempenho com uma placa de vídeo, resultando em 12.3 tokens por segundo por usuário. A divisão do modelo apresentou um pico menor, de 4,853 tokens por segundo, mas o primeiro token de um único usuário foi retornado em 719 ms, contra 1,189 ms do modelo anterior.

MiniMax M2.7: Um modelo grande demais para uma única placa.
| MiniMax M2.7 Q4_K_M, 129.3 GB (quanto maior, melhor, salvo indicação em contrário) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
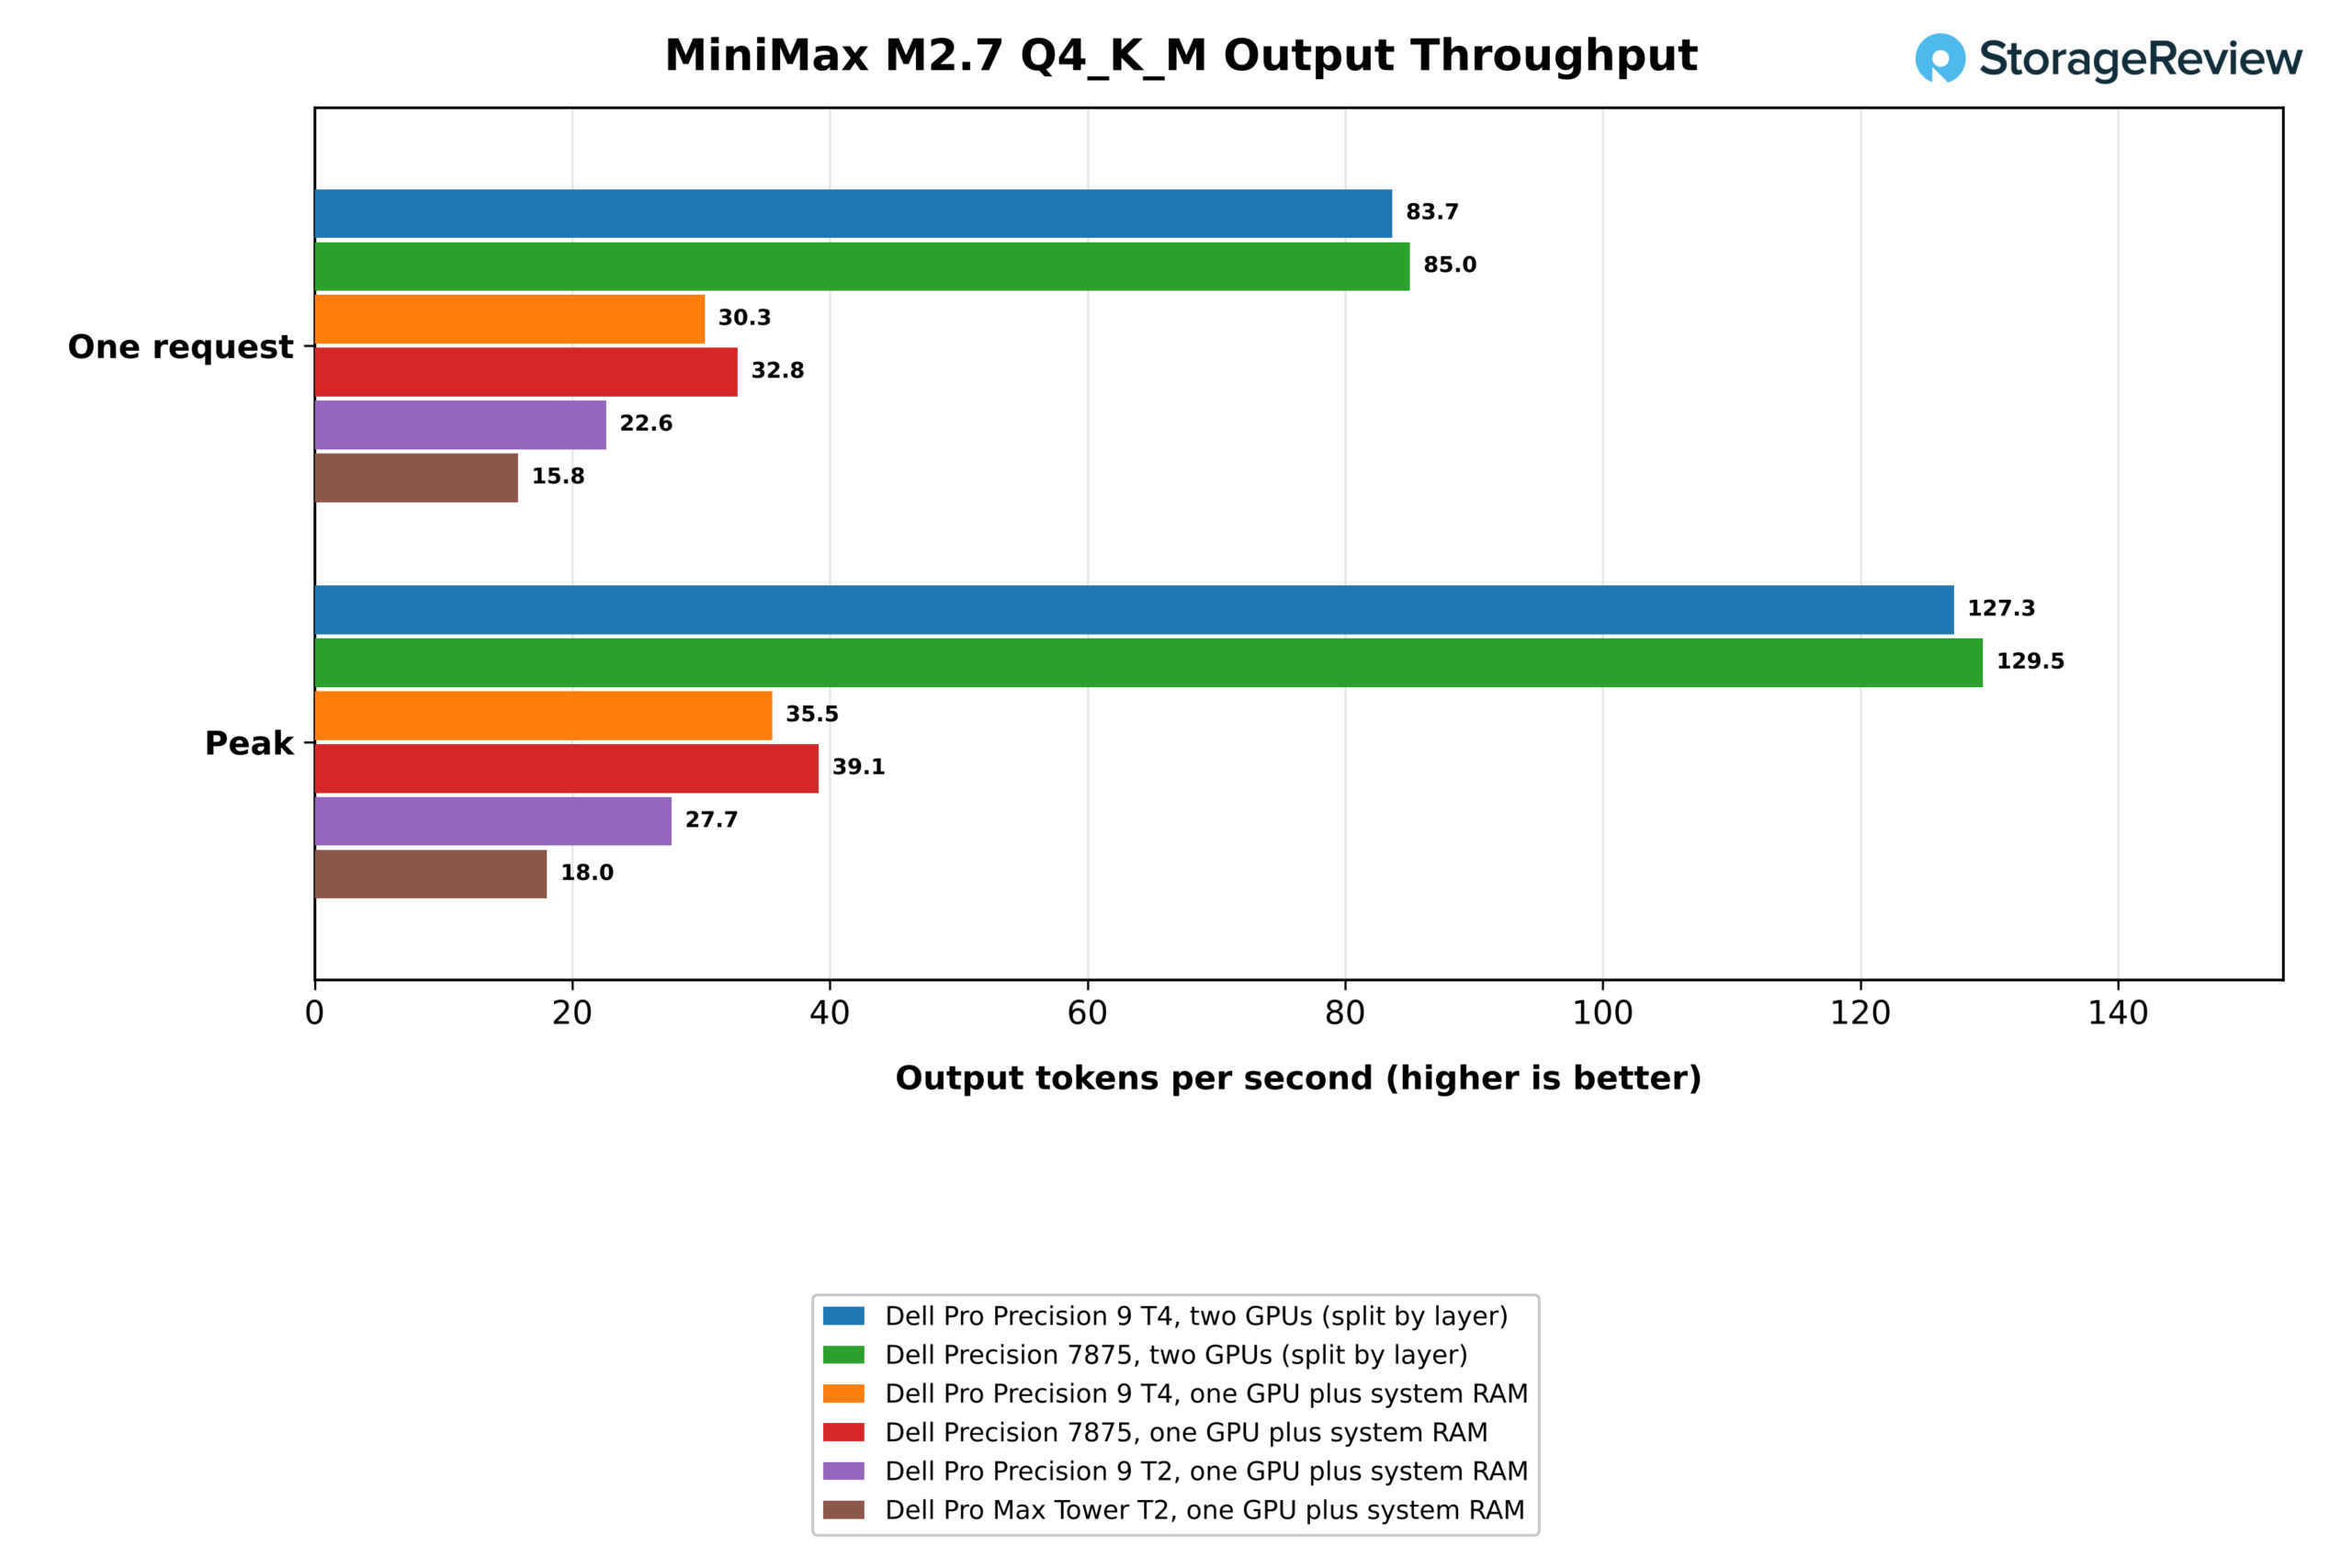
| Uma GPU mais RAM do sistema, uma requisição (tokens/s) | 30.3 | 32.8 | 22.6 | 15.8 |
| Uma GPU mais RAM do sistema, pico (tokens/s) | 35.5 | 39.1 | 27.7 | 18.0 |
| Uma GPU mais RAM do sistema, tempo para o primeiro token (em milissegundos, quanto menor, melhor) | 16,224 | 16,143 | 16,216 | 18,522 |
| Duas GPUs divididas por camada, uma requisição (tokens/s) | 83.7 | 85.0 | GPU única | GPU única |
| Duas GPUs divididas por camada, pico (tokens/s) | 127.3 | 129.5 | GPU única | GPU única |
| Duas GPUs divididas por camada, tempo até o primeiro token (ms, quanto menor, melhor) | 3,138 | 3,162 | GPU única | GPU única |
| Em carga fria, uma GPU mais RAM (quanto menor, melhor). | 40.5 | 65.8 | 37.6 | 81.1 |
| Carga fria, duas GPUs divididas (s, quanto menor, melhor) | 27.6 | 50.7 | GPU única | GPU única |
O MiniMax M2.7 é um modelo de mistura de especialistas com 230 bilhões de parâmetros, e nossa quantização de 4 bits ocupa 129.3 GB, mais do que os 96 GB de uma RTX PRO 6000. Com uma placa e o restante na memória do sistema, o T4 gerou 30.3 tokens por segundo para um usuário e levou 16.2 segundos para retornar o primeiro token. Dividindo os dados entre as duas placas, gerou 83.7 tokens por segundo, 2.8 vezes mais rápido, retornou o primeiro token em 3.1 segundos e atingiu um pico de 127.3 tokens por segundo contra 35.5.
Os resultados com uma única GPU mostram o quanto a plataforma host importa quando um modelo utiliza a memória do sistema. Os oito canais de DDR5-6400 do T4 o colocam 34% à frente do Pro Precision 9 T2 de quatro canais, com 22.6 tokens por segundo, e 1.9 vezes à frente do Pro Max Tower T2 de dois canais, com 15.8, mesmo que a placa de 600W do Pro Max Tower T2 seja mais rápida em todos os modelos compatíveis. O Precision 7875 superou o T4 por pouco, com 32.8 tokens por segundo, com 35% menos largura de banda de memória, portanto, a largura de banda por si só não determina esse resultado. Apresentamos a vantagem do 7875 conforme medida e não isolamos sua causa.
Carregamento do modelo
| Carga do modelo Ollama 0.40.3 e llama.cpp (s, quanto menor, melhor) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| gpt-oss:20b (12.8 GB), frio | 5.79 | 7.61 | 5.57 | 7.95 |
| gpt-oss:20b, quente | 3.45 | 2.50 | 3.47 | 3.05 |
| gpt-oss:120b (60.9 GB), frio | 15.16 | 25.80 | 15.16 | 28.18 |
| gpt-oss:120b, quente | 7.49 | 5.01 | 7.87 | 6.81 |
| gpt-oss:120b, frio, uma cópia em cada GPU | 26.47 | 35.55 | GPU única | GPU única |
| MiniMax M2.7 (129.3 GB), frio, uma GPU mais RAM | 40.5 | 65.8 | 37.6 | 81.1 |
| MiniMax M2.7, quente, uma GPU mais RAM | 28.6 | 15.2 | 36.7 | 80.5 |
Os carregamentos a frio favorecem os drives Gen5, com o T4 carregando gpt-oss:120b de seu SSD SK hynix Gen5 em 15.2 segundos, igualando o Pro Precision 9 T2 e bem à frente dos 25.8 e 28.2 segundos do Precision 7875 e do Pro Max Tower T2, ambos equipados com Gen4. Os carregamentos a quente do cache de páginas invertem essa ordem, com o 7875 levando 5.0 segundos contra 7.5 do T4, e o carregamento de uma cópia em cada GPU simultaneamente levou 26.5 segundos no T4.
Geração Aumentada por Recuperação em Escala
| RAG em mais de 1,002,067 trechos da Wikipédia | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
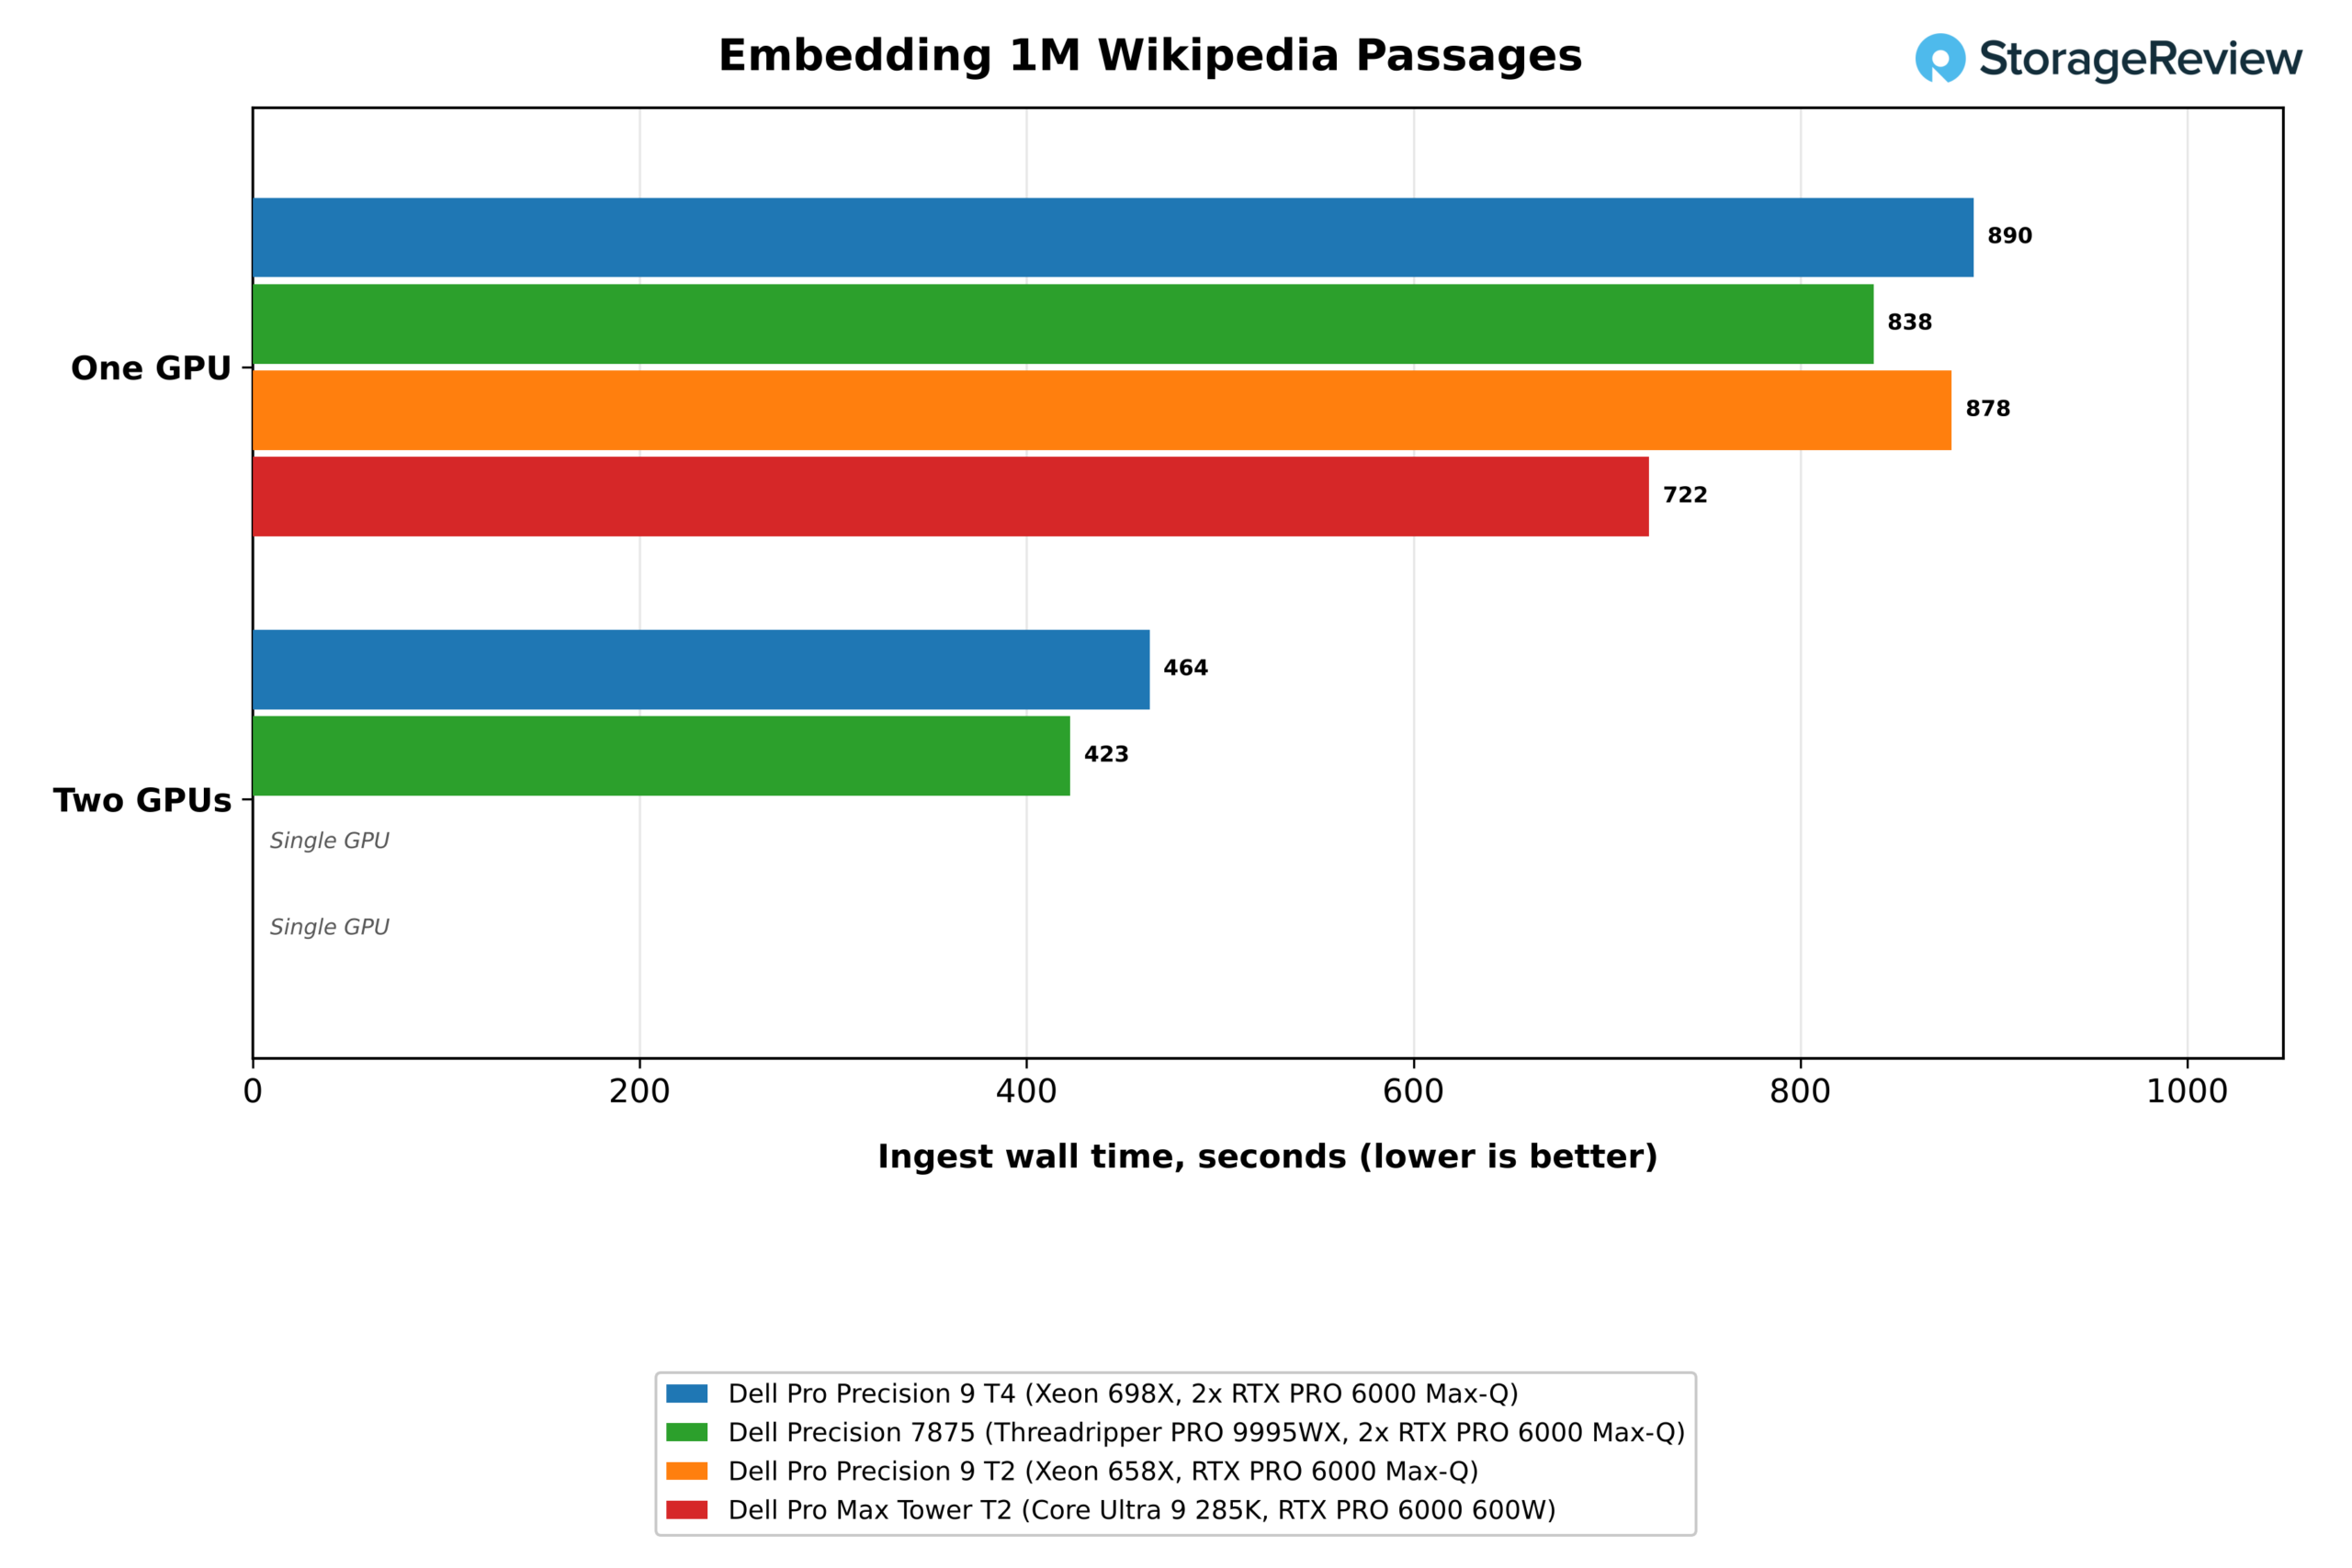
| Incorporação, uma GPU (passagens/s) | 1,126 | 1,196 | 1,141 | 1,388 |
| Tempo de execução de incorporação, uma GPU (s, quanto menor, melhor) | 890 | 838 | 878 | 722 |
| Incorporação, duas GPUs (passagens/s) | 2,162 | 2,371 | GPU única | GPU única |
| Tempo de execução da incorporação, duas GPUs (s, quanto menor, melhor) | 464 | 423 | GPU única | GPU única |
| Índice HNSW (s, quanto menor, melhor) | 27.3 | 34.8 | 46.3 | 118.6 |
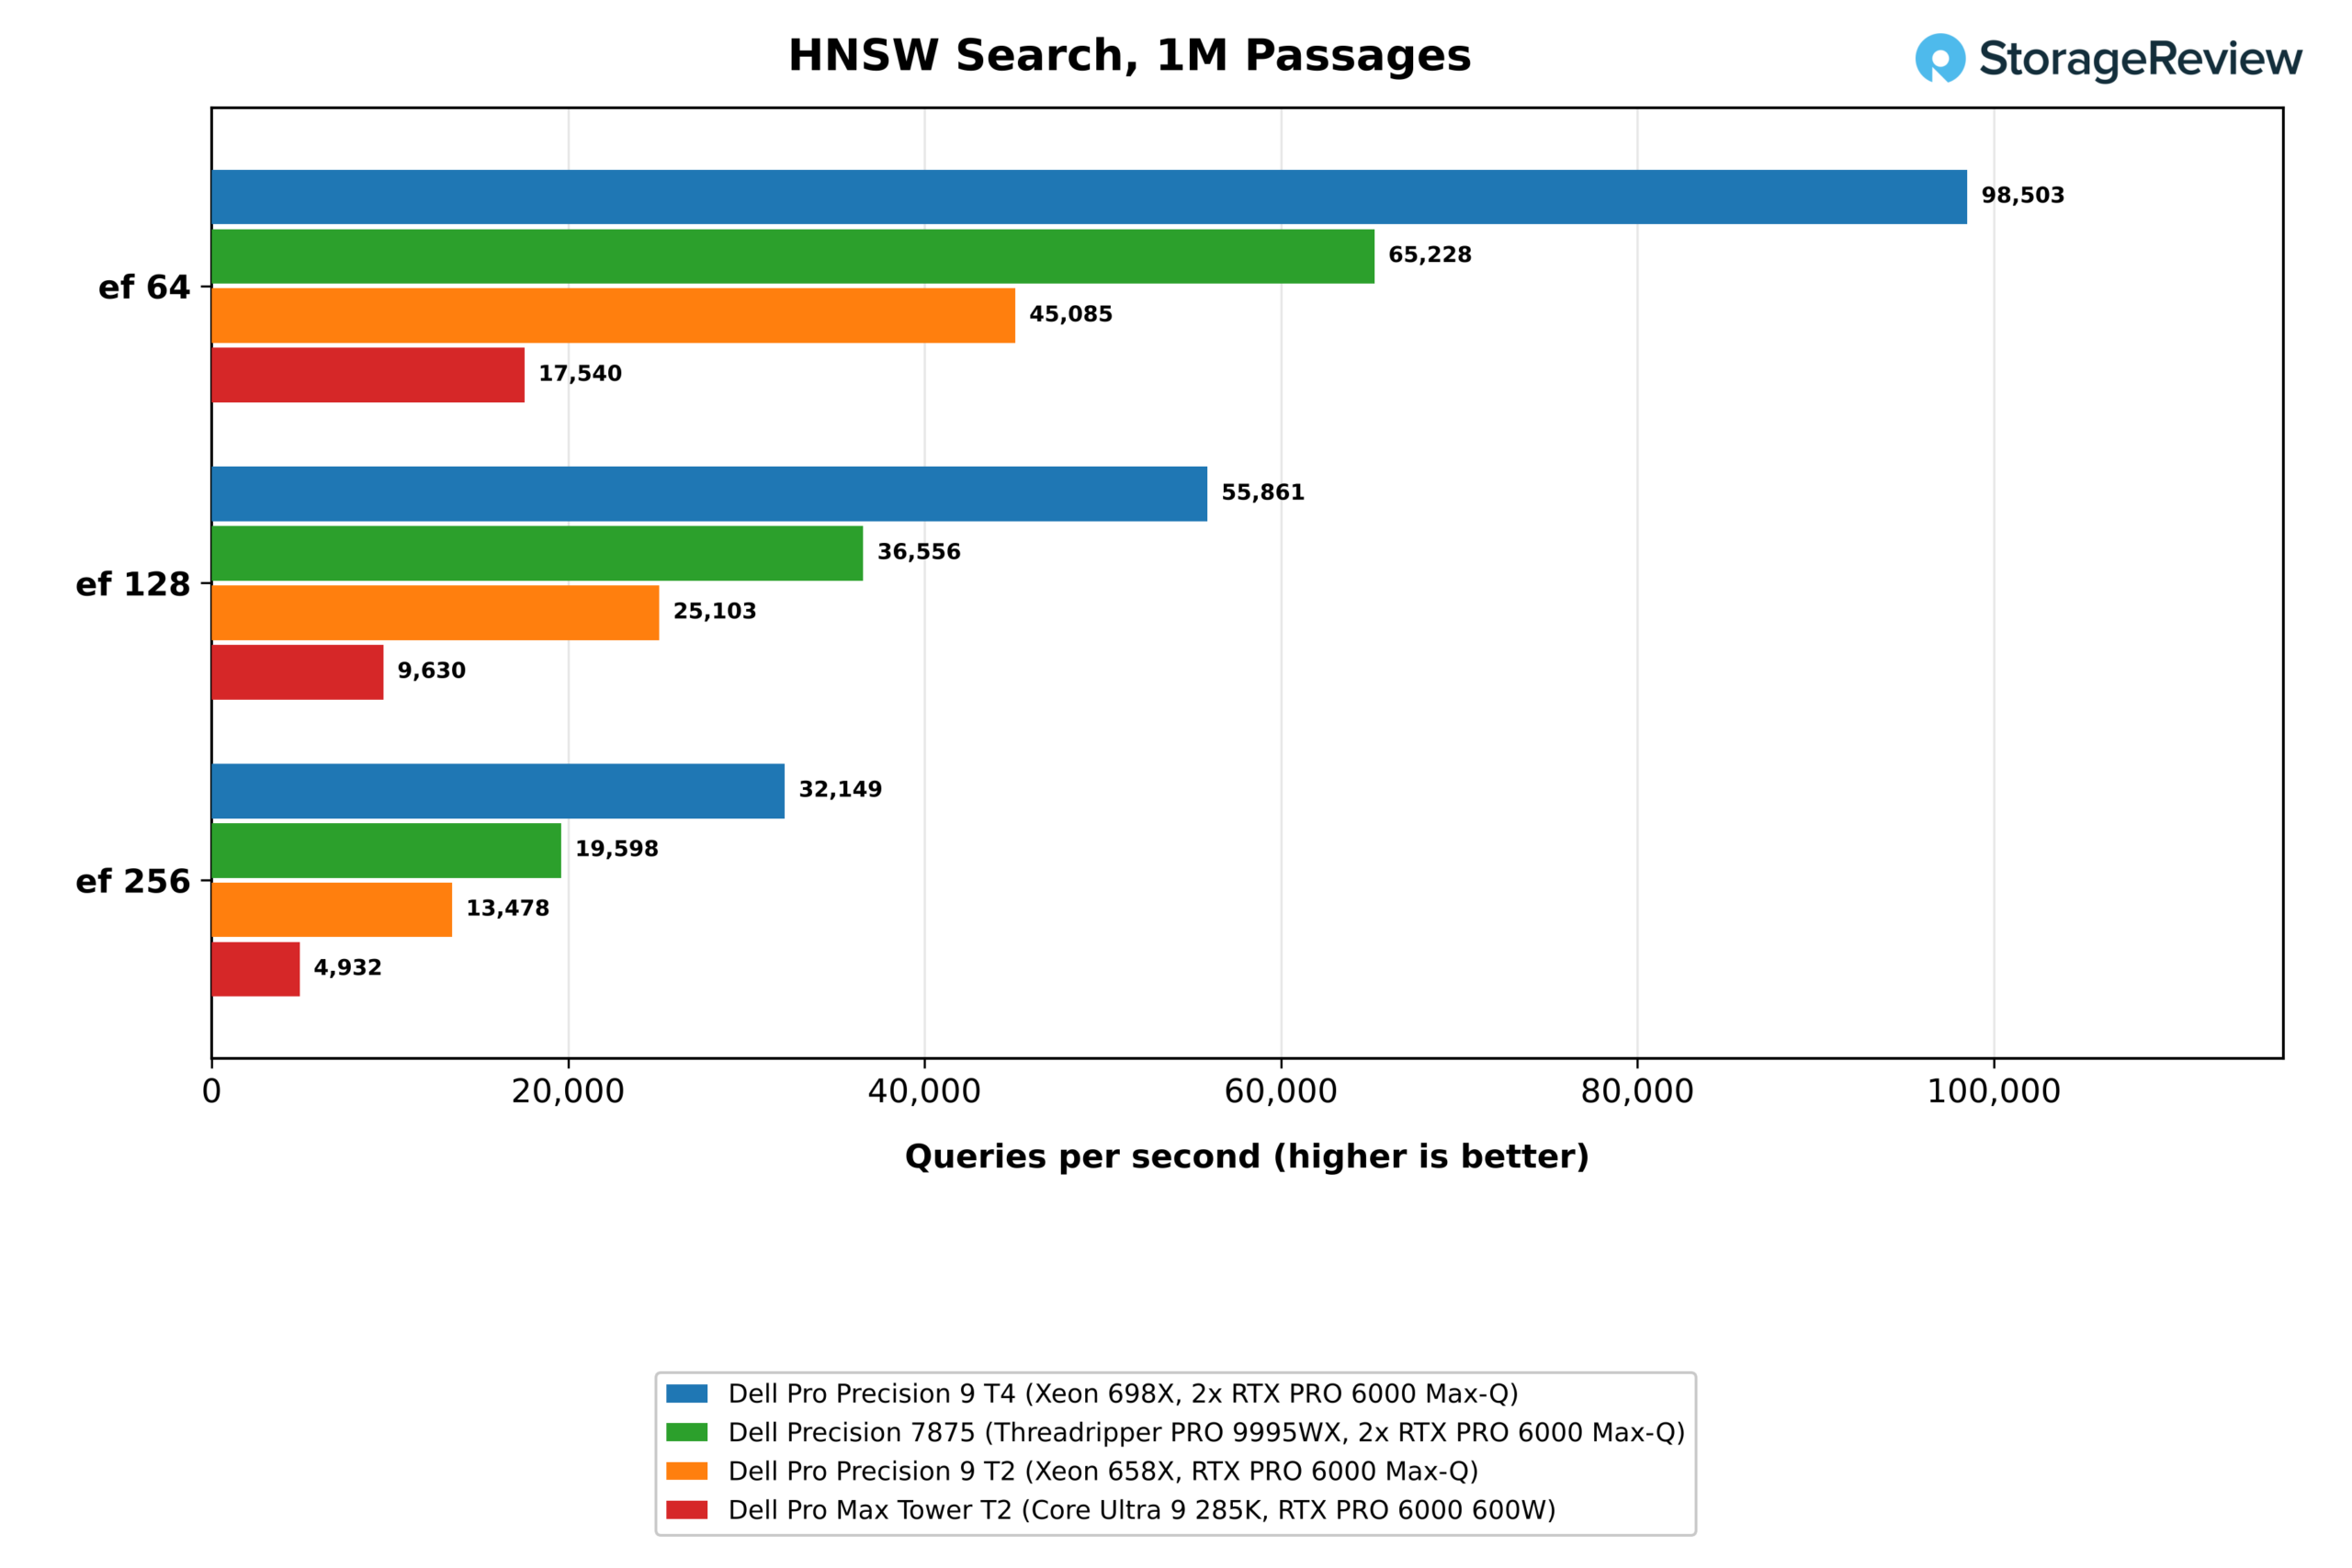
| Pesquisa HNSW, ef 64 (consultas/s) | 98,503 | 65,228 | 45,085 | 17,540 |
| Pesquisa HNSW, ef 256 (consultas/s) | 32,149 | 19,598 | 13,478 | 4,932 |
| Recall@5 vs busca exata, ef 256 (%) | 97.59 | 97.67 | 97.26 | 97.70 |
| Pergunta para responder p50 (s, quanto menor, melhor) | 0.123 | 0.082 | 0.117 | 0.095 |
O teste RAG-at-scale oculta perguntas do SQuAD em um milhão de trechos da Wikipédia, incorpora-as com o nomic-embed-text, cria um índice HNSW e responde com o Phi-4-mini. A incorporação levou 890 segundos em uma GPU T4 e 464 segundos em duas, um aumento de velocidade de 1.92x, e o Precision 7875 terminou em 423 segundos com duas placas. A placa de 600W no Pro Max Tower T2 é a GPU individual mais rápida aqui, com 722 segundos.
A criação do índice e a busca vetorial são executadas na CPU, e é nesse quesito que o T4 se destaca. Ele criou o índice HNSW em 27.3 segundos, contra 34.8 segundos no Precision 7875 e 118.6 segundos no Pro Max Tower T2, e realizou 98,503 consultas por segundo com ef 64, 1.51 vezes mais rápido que o 7875 e 5.6 vezes mais rápido que o sistema Core Ultra. Com ef 256, ele realizou 32,149 consultas por segundo com 97.6% de recall em buscas exatas, e as respostas foram retornadas em uma mediana de 0.12 segundos.
Afinação
| Ministral 3 8B LoRA, BF16, uma época de Dolly 15k | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| Tempo de treinamento por época, uma GPU (minutos, quanto menor, melhor) | 31.5 | 27.2 | 30.6 | 22.3 |
| Taxa de transferência, uma GPU (tokens/s) | 1,584 | 1,834 | 1,631 | 2,236 |
| Perda retida antes e depois do treinamento, uma GPU | 1.534 a 1.169 | 1.534 a 1.172 | 1.534 a 1.167 | 1.534 a 1.167 |
| Tempo de treinamento por época, duas GPUs (minutos, quanto menor, melhor) | 19.7 | 18.1 | GPU única | GPU única |
| Taxa de transferência, duas GPUs (tokens/s) | 2,528 | 2,754 | GPU única | GPU única |
| Aumento de velocidade proporcionado pela segunda GPU | 1.60x | 1.50x | GPU única | GPU única |
| Perda mantida após treinamento, duas GPUs | 1.167 | 1.168 | GPU única | GPU única |
O teste LoRa de uma época ajusta o Ministral 3 8B no BF16 no Dolly 15k ao longo de 1,849 passos e pontua 200 exemplos reservados a cada 100 passos. Cada sistema começou com uma perda reservada de 1.534 e terminou entre 1.167 e 1.172, portanto, o resultado que os diferencia é o tempo que a época leva. Uma GPU T4 terminou em 31.5 minutos a 1,584 tokens por segundo, dentro de 3% do Pro Precision 9 T2 com a mesma placa Max-Q. O Precision 7875 levou 27.2 minutos e a placa de 600W no Pro Max Tower T2 levou 22.3 minutos.
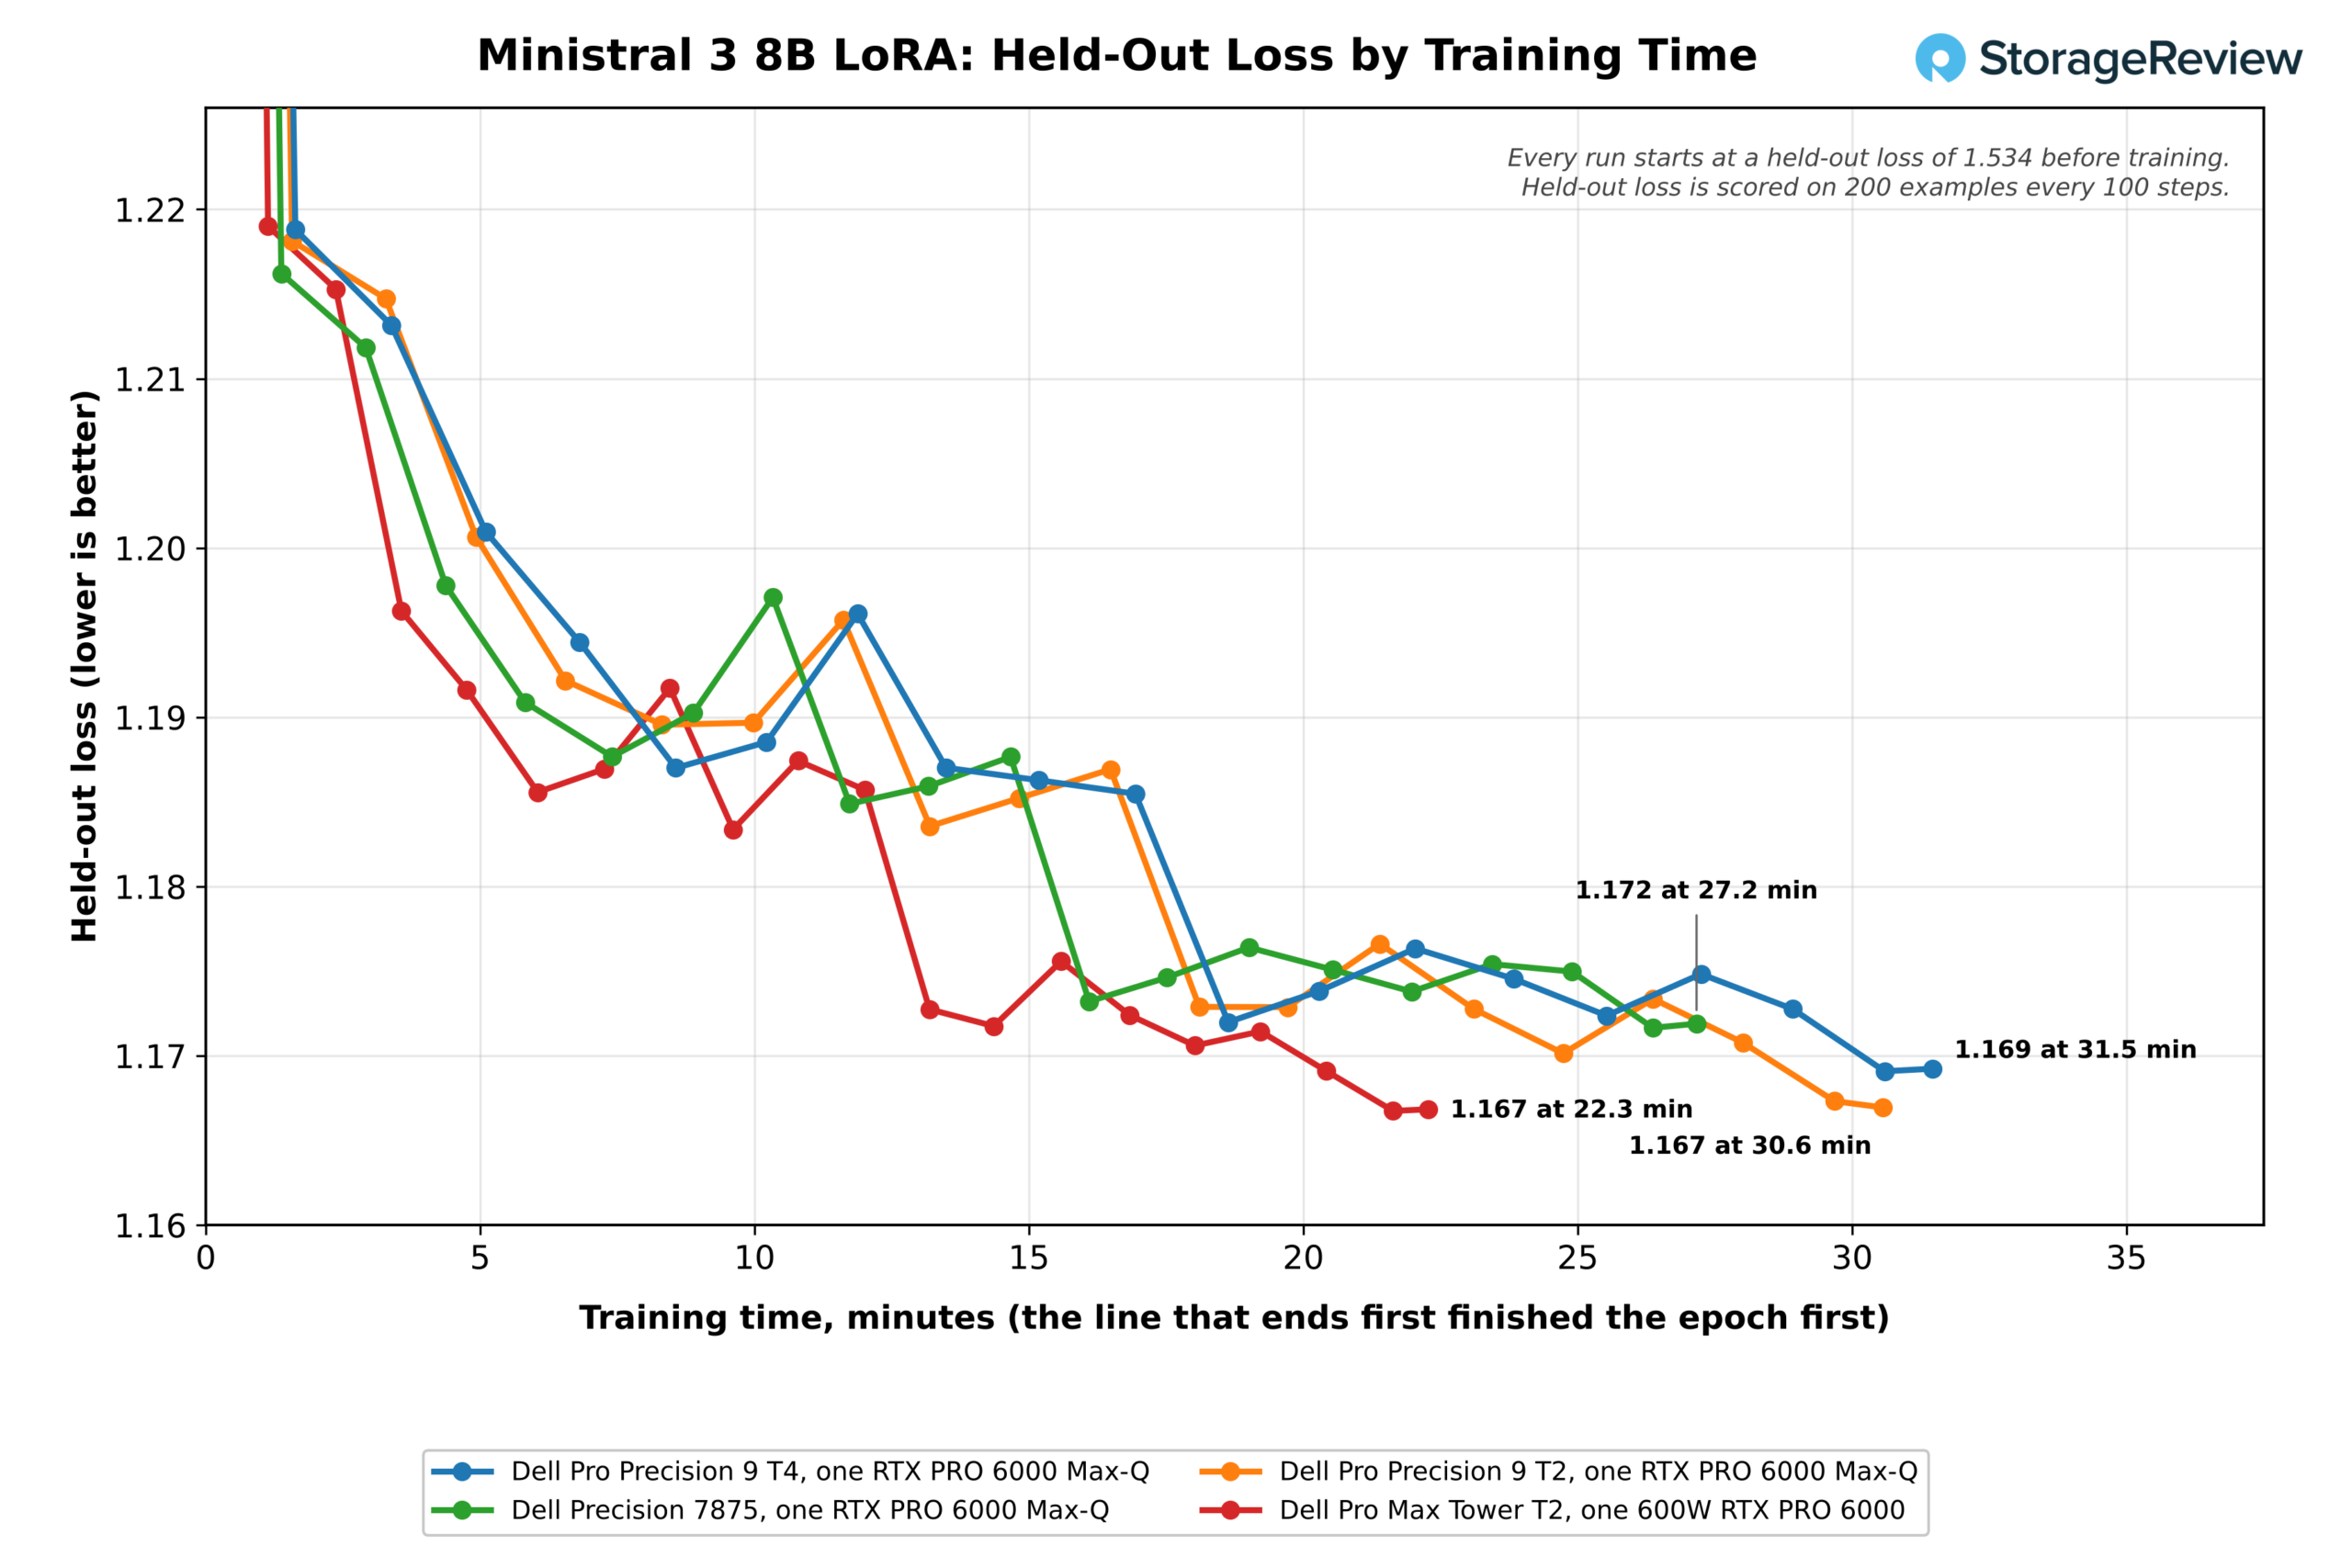
A perda de dados (holded-out loss) no T4 caiu de 1.534 para 1.219 nos primeiros 100 passos, 1.6 minutos após o início do treinamento, e depois estabilizou em 1.169 ao longo do restante da época. A adição da segunda GPU reduziu a época do T4 para 19.7 minutos a 2,528 tokens por segundo, um aumento de velocidade de 1.60x, superando os 22.3 minutos da placa única de 600W. O Precision 7875 completou sua época com duas GPUs em 18.1 minutos, um aumento de velocidade de 1.50x, e as execuções com duas GPUs terminaram com perdas de dados de 1.167 e 1.168.
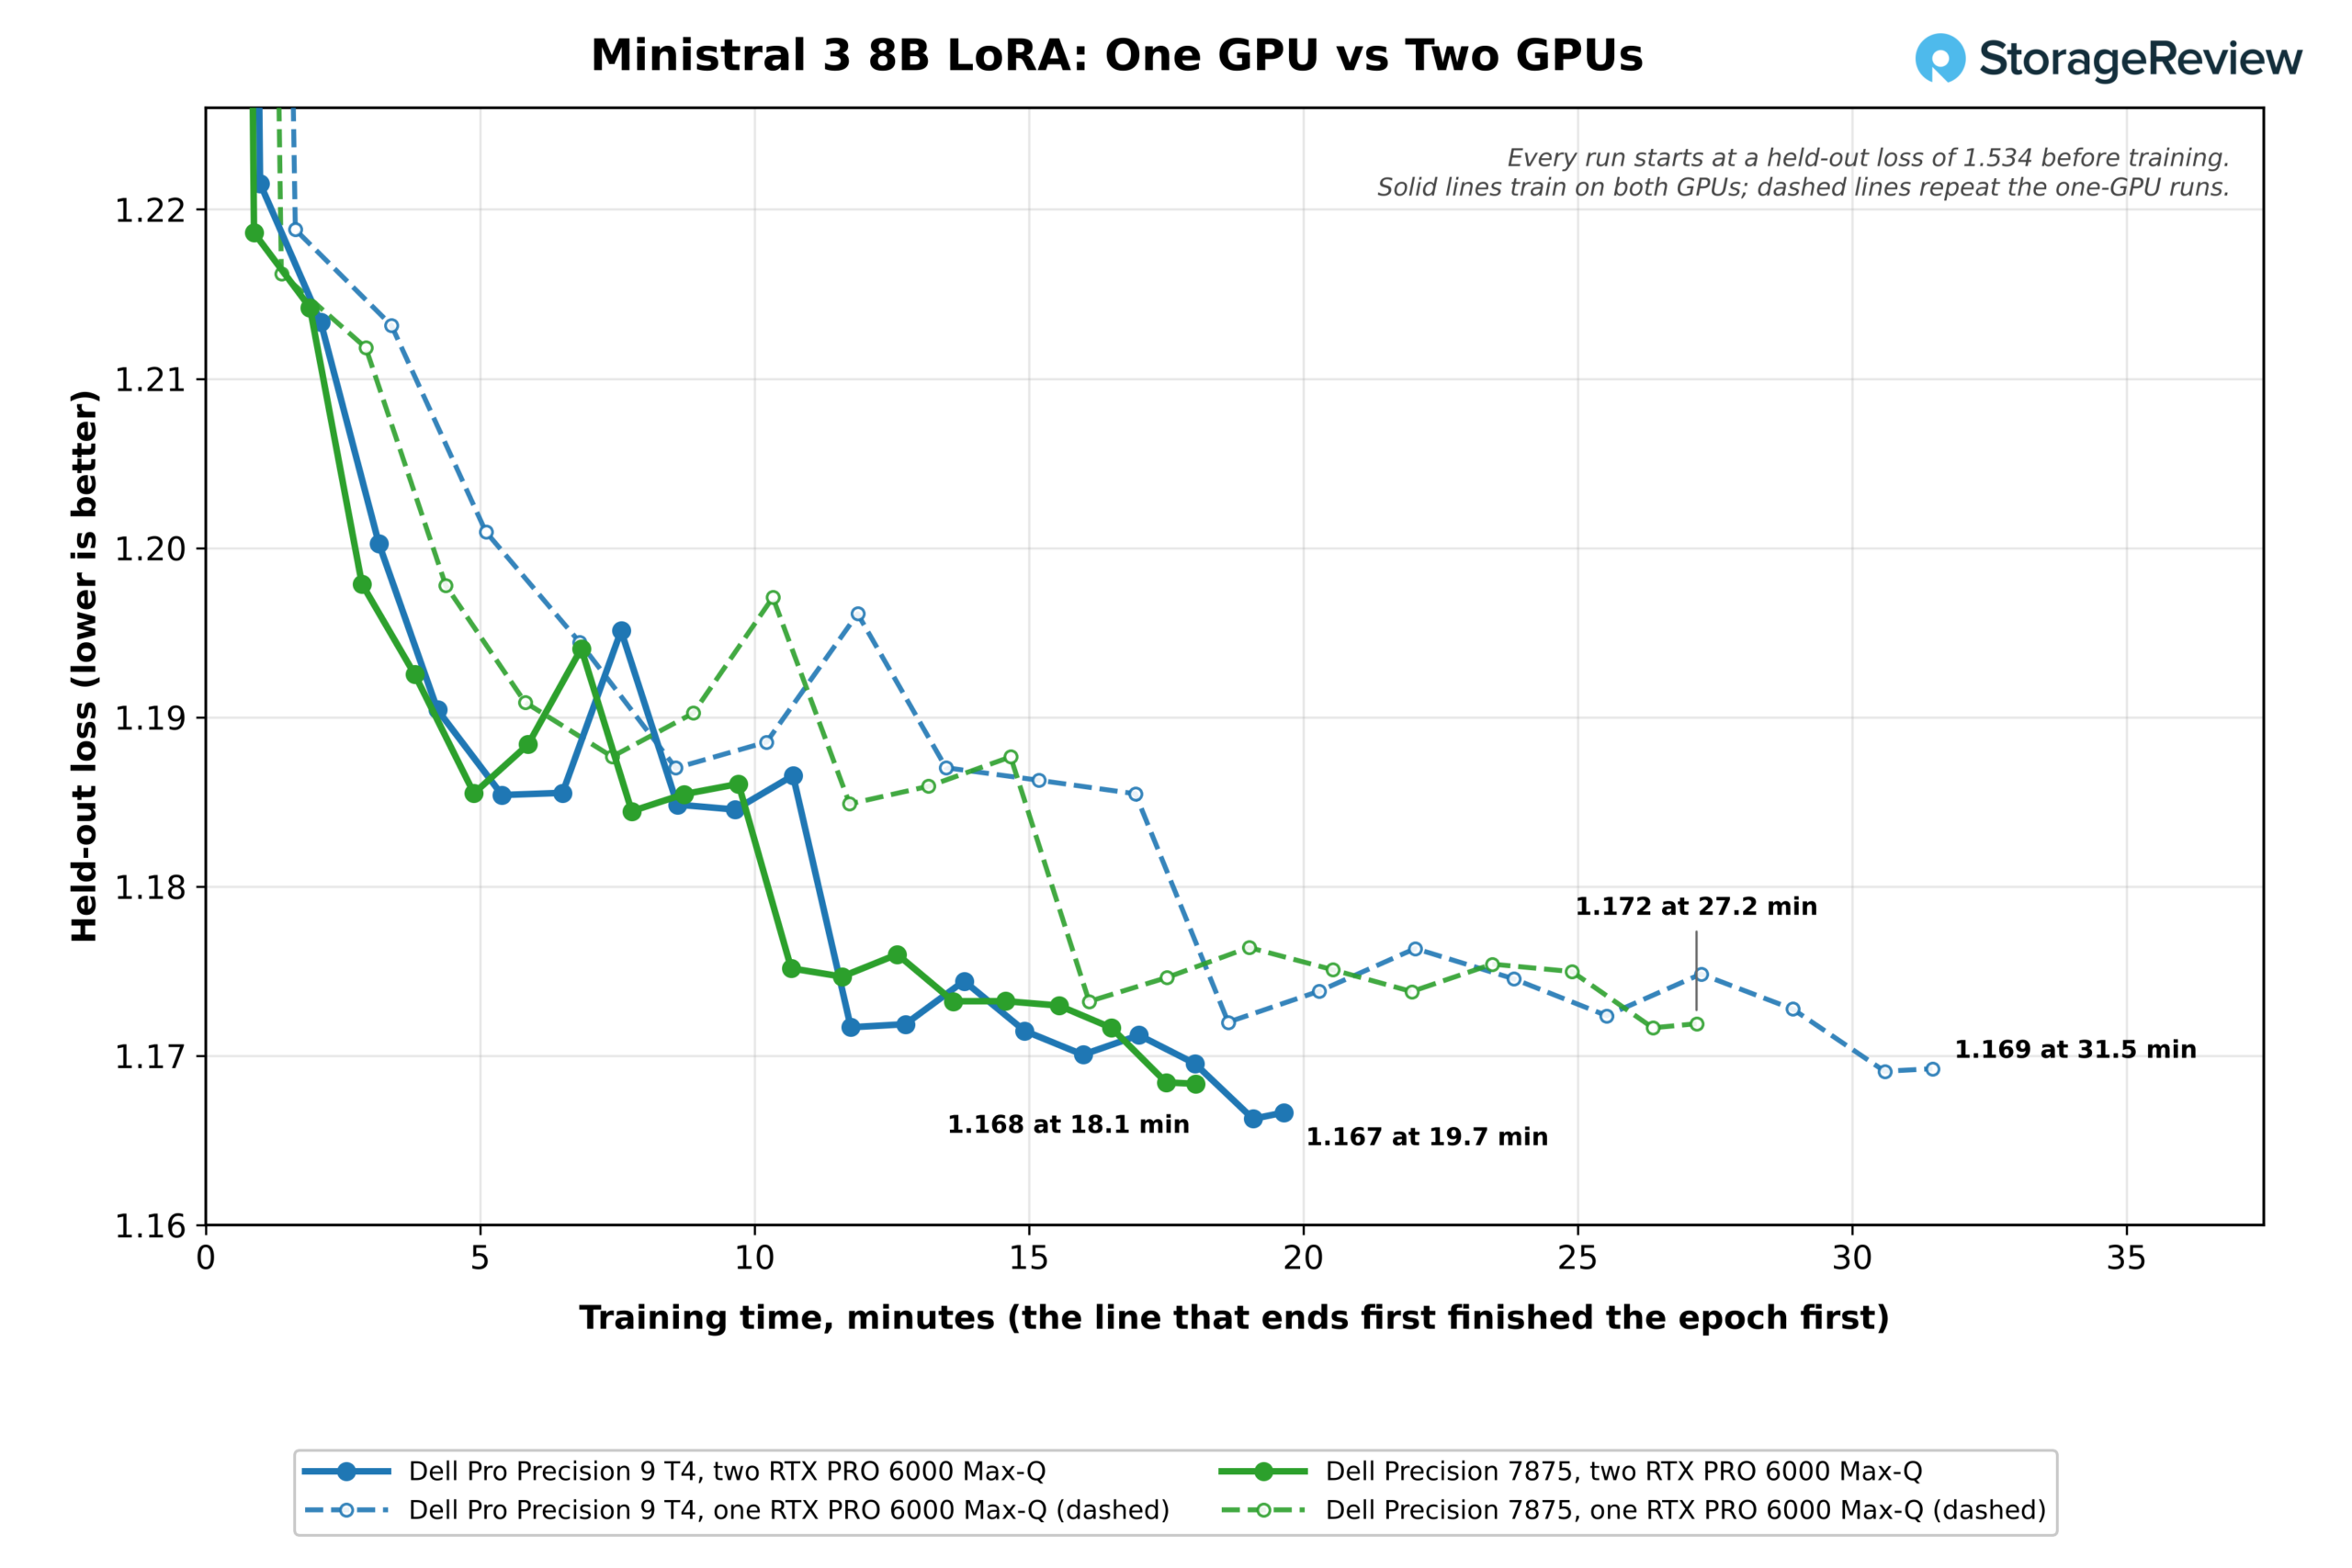
Ambas as placas executam processamento paralelo de dados com dois exemplos por GPU e gradientes acumulados no mesmo lote global de oito, em quatro passagens em uma GPU e duas passagens em um par de GPUs. Assim, a execução com duas GPUs processa os mesmos exemplos em cada etapa e chega à mesma perda. Com dois exemplos curtos por GPU em cada passagem, a segunda placa tem pouco trabalho a absorver e a troca de gradientes ocupa uma parcela maior de cada etapa. O pico de uso de memória da GPU por época foi de 19.5 GiB em uma placa e 19.7 GiB por placa em duas, uma fração dos 96 GB de cada RTX PRO 6000.
Agente de Codificação, RAG em Pequena Escala e Geração de Imagens
| Agente de codificação, RAG e geração de imagem (quanto maior, melhor, salvo indicação em contrário) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| Agente de codificação, gpt-oss:20b 64K, execuções bem-sucedidas (de 3) | 3 | 2* | 2* | 2* |
| Agente de codificação, gpt-oss:120b 128K, execuções bem-sucedidas (de 3) | 3 | 3 | 3 | 3 |
| Agente de codificação, gpt-oss:120b, taxa de geração (tokens/s) | 161.5 | 167.9 | 166.7 | 183.2 |
| RAG, 20,963 passagens, ingerir (passagens/s) | 304.6 | 433.8 | 392.1 | 371.6 |
| Geração de respostas RAG, Phi-4-mini (tokens/s) | 372.5 | 410.0 | 402.8 | 415.8 |
| FLUX.2 klein 4B BF16, 1024×1024 (imagens/min) | 40.96 | 43.03 | 41.32 | 54.25 |
| Z-Image Turbo 6B BF16 (imagens/min) | 17.29 | 17.67 | 17.27 | 23.83 |
| Qwen-Image 20B BF16 (imagens/min) | 2.43 | 2.45 | 2.39 | 3.20 |
*Sinalizado pelo conjunto de testes: uma das três execuções do agente neste sistema não passou em todos os 11 testes.
O T4 passou em todas as execuções do agente de codificação em todos os níveis de modelo, incluindo todas as três execuções do gpt-oss:20b em um contexto de 64K, enquanto os outros três sistemas passaram em duas das três, e gerou 161.5 tokens por segundo no gpt-oss:120b. A geração de imagens é executada em uma GPU, portanto, as 40.96 imagens por minuto do T4 no FLUX.2 klein em BF16 o colocam no mesmo nível dos outros sistemas Max-Q e atrás da placa de 600W, com 54.25.
Desempenho da CPU
Os resultados da CPU colocam os 86 núcleos Xeon do T4 contra os 96 núcleos Threadripper do Precision 7875, com os dois T2 de 24 núcleos como pontos de referência. O Threadripper tem dez núcleos a mais e oferece 192 threads contra 172 do Xeon. O T4 se destaca onde a largura de banda da memória é determinante, enquanto o 7875 se destaca onde o número de núcleos e a frequência são fatores decisivos.
Compressão, renderização e compilação
| Testar | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| 7-Zip, todas as threads (GIPS) | 619.8 | 850.0 | 285.1 | 172.7 |
| 7-Zip, um único fio (GIPS) | 8.85 | 10.58 | 9.27 | 11.04 |
| Blender 4.5 Monster (amostras/min) | 961.8 | 1,253.8 | 400.7 | 303.0 |
| Blender 4.5 Junkshop (amostras/min) | 641.9 | 849.7 | 266.9 | 191.9 |
| Blender 4.5 Sala de Aula (amostras/min) | 442.8 | 612.2 | 187.2 | 147.1 |
| HandBrake x265 (fps) | 31.4 | 41.7 | 41.5 | 40.0 |
| Freio de mão SVT-AV1 (fps) | 159.4 | 255.8 | 198.5 | 122.6 |
| LLVM 21 build (s, quanto menor, melhor) | 58.4 | 43.7 | 106.4 | 155.9 |
| Kernel Linux allmodconfig (s, quanto menor, melhor) | 312 | 264 | 537 | 843 |
| OpenSSL AES-256-GCM, todos os threads (GB/s) | 882.6 | 1,139.1 | 371.2 | 137.0 |
| nginx, 1,000 conexões (requisições/s) | 414,468 | 467,128 | 323,567 | 153,732 |
O T4 alcançou 619.8 GIPS no 7-Zip e 961.8 amostras por minuto no Blender Monster, 2.2 e 2.4 vezes o desempenho do Pro Precision 9 T2 de 24 núcleos, respectivamente. O Precision 7875 apresentou um desempenho 37% superior no 7-Zip e 30% superior no Blender, concluindo a compilação do LLVM em 43.7 segundos contra 58.4 segundos, e a compilação do kernel Linux com o comando allmodconfig em 264 segundos contra 312 segundos. A velocidade por núcleo é o ponto fraco do T4, com a menor pontuação em um único núcleo no 7-Zip neste grupo, de 8.85 GIPS.
A codificação x265 do HandBrake é o ponto fora da curva nesta tabela, e a causa é o codificador, mais do que o processador. Os outros três sistemas atingiram entre 40.0 e 41.7 fps com 24 ou 96 núcleos, portanto, o x265 nesta configuração não está escalando com a quantidade de núcleos, e os 31.4 fps do T4 são consistentes com sua menor velocidade por núcleo nos threads que o x265 utiliza. Durante a codificação, o T4 apresentou uma média de cerca de 1 GHz em seus 172 threads, com temperaturas entre 51°C e 64°C, o que mostra a maior parte do chip ocioso. O SVT-AV1 apresentou melhor desempenho, com 159.4 fps no T4 contra 255.8 no 7875.


Largura de banda da memória, simulação e matemática
| Testar | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| STREAM Triad (MB/s) | 328,329 | 215,177 | 141,832 | 45,102 |
| OpenFOAM 13 drivAer, células 3M, resolver (s, quanto menor, melhor) | 293 | 556 | 826 | Não terminei |
| GROMACS benchPEP, todos os núcleos (ns/dia) | 1.243 | 1.034 | Não funciona | Não funciona |
| GROMACS benchMEM, 16 núcleos (ns/dia) | 68.09 | 84.94 | 78.03 | 54.26 |
| OpenBLAS DGEMM, todos os núcleos (GFLOPS) | 3,664 | 4,745 | 2,319 | 1,063 |
| OpenBLAS LU resolve N=20000 (GFLOPS) | 1,660 | 1,172 | 1,616 | 858 |
| y-cruncher Pi, 1B dígitos (s, quanto menor, melhor) | 4.01 | 7.45 | 8.51 | 24.61 |
| y-cruncher Pi, 10B dígitos (s, quanto menor, melhor) | 53.9 | 83.7 | 119.2 | 347.9 |
| y-cruncher Pi, 25B dígitos (s, quanto menor, melhor) | 155.6 | 259.6 | Não funciona | Não funciona |
Oito canais de DDR5-6400 proporcionam ao T4 328 GB/s no teste STREAM Triad, 53% a mais que o Precision 7875 com DDR5-5600 e 2.3 vezes mais que o Pro Precision 9 T2 de quatro canais. Em seguida, vieram os testes com alta demanda de largura de banda: o T4 resolveu o caso OpenFOAM drivAer de 3 milhões de células em 293 segundos, contra 556 segundos do 7875 e 826 segundos do Pro Precision 9 T2, enquanto o Pro Max Tower T2 não conseguiu concluir o teste dentro do limite de 150 minutos. O T4 também executou o caso de 22.6 milhões de células em 6,851 segundos.

O benchmark GROMACS benchPEP, o grande caso de dinâmica molecular com todos os núcleos, foi executado a 1.243 ns/dia no T4 contra 1.034 no 7875, e a resolução LU atingiu 1,660 GFLOPS contra 1,172. O y-cruncher calculou 10 bilhões de dígitos de Pi em 53.9 segundos contra 83.7 no 7875 e 25 bilhões em 155.6 segundos contra 259.6. O poder computacional denso que permanece no cache favorece o Threadripper, que liderou o OpenBLAS DGEMM com 4,745 GFLOPS contra 3,664.


Bancos de dados e serviços
| Testar | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| Execução rápida do ClickBench, 43 consultas (s, quanto menor, melhor) | 3.21 | 2.88 | 4.80 | 10.44 |
| Execução a frio do ClickBench, 43 consultas (s, quanto menor, melhor) | 6.45 | 7.09 | 6.92 | 14.22 |
| Cache Valkey, DEFINIR (requisições/s) | 666,714 | 1,138,696 | 914,832 | 1,719,108 |
| Cache Valkey, GET (requisições/s) | 865,353 | 1,279,429 | 991,576 | 1,648,278 |
| Bacalhau seco, todos os fios (Mnps) | 68.21 | 168.27 | 45.44 | 37.42 |
| PyPerformance go (ms, quanto menor, melhor) | 74.3 | 66.0 | 72.1 | 56.7 |
O ClickHouse executou as 43 consultas do ClickBench em 3.21 segundos com o processador em uso intenso (hot run) e 6.45 segundos com o processador em uso frio (cold run) no T4, ficando 0.33 segundos atrás do 7875 no teste com o processador em uso intenso e 0.64 segundos à frente no teste com o processador em uso frio. O Valkey prioriza núcleos rápidos em detrimento de muitos núcleos, e as 666,714 solicitações SET por segundo do T4 ficam atrás de todos os três sistemas de comparação, com o Core Ultra 9 285K no Pro Max Tower T2 liderando com 1.72 milhão. Esse padrão corresponde aos resultados de um único núcleo do T4 e vale a pena ser considerado para serviços com alta latência.
Com todos os 172 threads carregados e o processador a uma temperatura média de 87°C, o T4 pesquisou 68.21 milhões de nós por segundo no Stockfish, 1.5 vezes mais que o Pro Precision 9 T2 de 48 threads e bem menos da metade dos 168.27 milhões de nós por segundo do 7875 com 192 threads. O teste também expirou na primeira execução completa do T4, antes de um novo teste independente produzir esse resultado. Apresentamos o resultado conforme medido e não isolamos a causa da baixa escalabilidade.
Desempenho de Armazenamento
| fio, 25 GiB de espaço ocupado (quanto maior, melhor) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| Leitura sequencial 128K (MB/s) | 14,152 | 7,089 | 20,914 * | 7,234 |
| Gravação sequencial 128K (MB/s) | 10,078 | 5,265 | 12,564 | 6,772 |
| Leitura aleatória 4K, pico (IOPS) | 2,306,346 | 993,569 | 3,214,066 | 1,538,387 |
| Gravação aleatória de 4K, pico (IOPS) | 1,830,776 | 787,388 | 2,353,766 | 1,326,030 |
*Sinalizado pelo conjunto de testes devido à variação entre execuções após uma nova execução.
O disco de inicialização SK hynix Gen5 de 2 TB do T4 apresentou taxas de leitura de 14,152 MB/s e de gravação de 10,078 MB/s, aproximadamente o dobro da taxa de leitura sequencial dos discos Gen4 do Precision 7875 e do Pro Max Tower T2. Seu desempenho atingiu um pico de 2.31 milhões de IOPS de leitura aleatória e 1.83 milhão de IOPS de gravação aleatória. A taxa de leitura sequencial de 20,914 MB/s do Pro Precision 9 T2 supera a capacidade de um link Gen5 x4, o que se adequa ao volume de teste desse sistema, um array striped de discos Samsung PM9E1 Gen5. Testamos apenas o disco de inicialização do T4; o segundo disco de 2 TB não foi incluído neste teste.

Temperaturas e relógios sob carga
| Dell Pro Precision 9 T4 | CPU Máx. (C) | Média de CPU (C) | Clock médio da CPU (MHz) |
|---|---|---|---|
| 7-Zip | 93 | 80.6 | 1,967 |
| liqüidificador | 91 | 85.7 | 2,587 |
| GROMACS | 96 | 81.3 | 1,313 |
| compilação LLVM | 83 | 74.5 | 2,127 |
| Abrir BLAS | 80 | 62.9 | 1,325 |
| LLM em serviço | 84 | 65.0 | 924 |
| Afinação | 71 | 61.2 | 854 |
| RAG em escala | 74 | 64.4 | 987 |
| Armazenamento | 64 | 55.4 | 942 |
Com a BIOS no modo Ultra Performance, o Xeon 698X atingiu um pico de 93°C no 7-Zip e 96°C no GROMACS, e os valores de clock na tabela são médias de todos os 172 núcleos lógicos da CPU. O Blender e o Stockfish utilizaram todos os núcleos físicos e mantiveram a frequência entre 2.5 GHz e 2.6 GHz, acima da frequência base de 2.0 GHz do chip. O GROMACS e o OpenBLAS utilizaram 64 e 86 núcleos físicos, respectivamente, e deixaram os demais núcleos ociosos próximos a 0.8 GHz, o que explica suas médias em torno de 1.3 GHz. Tarefas com uso intensivo da GPU mantiveram o processador mais frio, com uma média de 61°C a 65°C durante o processamento de LLM, ajuste fino e RAG, já que esses testes exigem bastante da placa de vídeo.

Conclusão
O Dell Pro Precision 9 T4 foi projetado para trabalho local de IA, e a segunda RTX PRO 6000 é onde isso fica evidente. Duas placas Max-Q aumentaram a taxa de transferência máxima de serviço de 1.85 a 2.02 vezes em quatro modelos e a taxa de transferência de incorporação em 1.92 vezes, reduziram uma época LoRa no Ministral 3 8B de 31.5 para 19.7 minutos e aumentaram a taxa de transferência de tokens por segundo para um único usuário no MiniMax M2.7, um modelo grande demais para uma única placa. No gpt-oss 120B, um servidor por GPU atingiu 7,091 tokens por segundo com 64 solicitações, enquanto dividir o modelo entre as duas placas resultou em um primeiro token para um único usuário retornado em 719 ms, contra 1,189 ms do modelo anterior.

Oito canais de DDR5-6400 deram ao Xeon 698X uma vantagem de 53% na largura de banda da memória em relação ao Threadripper PRO 9995WX. Essa largura de banda permitiu que o T4 apresentasse resultados mais rápidos nos testes OpenFOAM, GROMACS benchPEP, y-cruncher e HNSW do que o Precision 7875, e o armazenamento Gen5 do T4 carregou modelos grandes mais rapidamente. O chassi também merece destaque, com o melhor sistema de refrigeração que já vimos da Dell nessa categoria e acesso à fonte de alimentação sem a necessidade de ferramentas.
O 7875 continua à frente em tarefas que exigem muito do núcleo, como renderização, compressão e compilação, com uma vantagem de 18 a 38%, e de 60% no SVT-AV1. A velocidade por núcleo do Xeon ficou atrás de todos os outros sistemas deste grupo, o que ficou evidente no Valkey e em outros serviços com poucos threads. O ajuste fino em uma única GPU também foi mais lento no T4, onde a época LoRa levou 31.5 minutos, contra 27.2 minutos no 7875 e 22.3 minutos na placa de 600W do Pro Max Tower T2, com todos os sistemas terminando dentro de 0.005 segundos da mesma perda.
Com um preço aproximado de US$ 66,600 na configuração oferecida pela Dell.com, o T4 é ideal para equipes que desejam executar, incorporar e otimizar modelos localmente, incluindo modelos que exigem mais de 96 GB de memória de GPU, além de simulação e análise com uso intensivo de memória, tudo na mesma máquina. Usuários cujo trabalho envolve principalmente renderização e compilação encontrarão na plataforma Threadripper um desempenho superior, e aqueles que precisam apenas de uma GPU podem optar pela mesma placa no modelo Pro Precision 9 T2, de tamanho menor.

Classificação: O Dell Pro Precision 9 T4 ocupa o primeiro lugar na nossa classificação de Melhores Desktops para IA Local com processador Xeon Torre para IA Local.


 Amazon