

Já analisamos algumas estações GB300 DGX e, recentemente, tivemos duas delas fisicamente em nosso laboratório simultaneamente: a ASUS ExpertCenter Pro ET900N G3 e a HP ZGX Fury AI Station . Com as duas torres lado a lado, queríamos conectá-las e ver o que uma segunda GB300 poderia adicionar ao desempenho de uma única máquina para cargas de trabalho de IA mais coordenadas na mesa de trabalho.
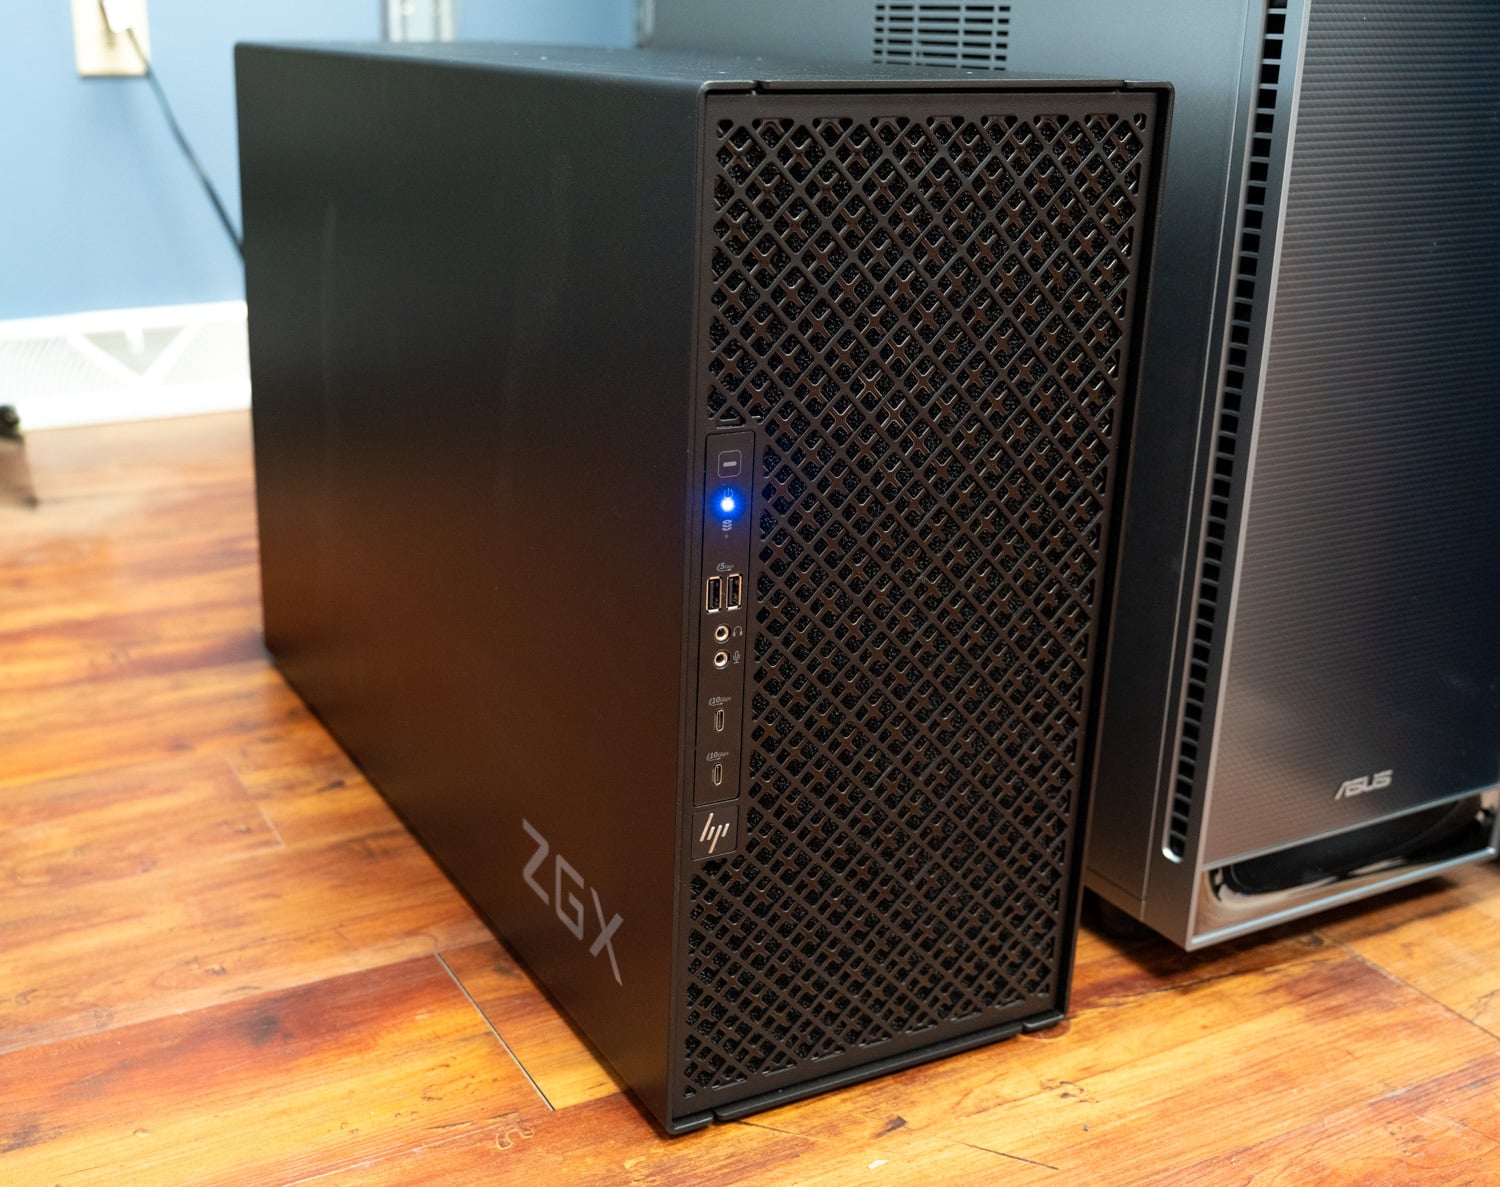
Expandir uma configuração de desktop um computador por vez não é uma ideia nova; a NVIDIA apresentou isso explicitamente com a plataforma GB10. Um dos aspectos que tornava o DGX Spark tão especial era a capacidade de começar com um sistema e conectar mais à medida que suas cargas de trabalho aumentassem. O GB300 já começa com um desempenho consideravelmente maior, mas executar modelos maiores ou atender a mais usuários pode sobrecarregar até mesmo uma das máquinas desktop mais rápidas que testamos. Era isso que queríamos destacar em nossa análise original da MSI : se suas cargas de trabalho justificam uma dessas estações, é fácil entender como elas poderiam justificar a aquisição de várias delas.
Para muitos compradores, o custo determinará quando essa expansão se tornará viável. Entender agora como duas estações funcionam bem juntas oferece a quem está começando com apenas uma uma ideia mais clara do que poderá ganhar com uma expansão posterior.
Principais lições
- Dois cabos, 98% da taxa de transmissão: Dois DACs de 400G entre as portas ConnectX-8 do ASUS ET900N G3 e do HP ZGX Fury forneceram ao NCCL 98 GB/s em broadcast, reduce e send/receive, contra os 100 GB/s que o par pode suportar. O GPUDirect RDMA atingiu 392 Gb/s em cada trilho, e uma gravação RDMA de 8 bytes teve um tempo médio de 1.46 µs. O playbook da NVIDIA cuidou da configuração.
- O GLM-5.2 apresenta ganhos de 11x com concorrência equivalente: O checkpoint NVFP4 de 433 GB despeja cerca de 215 GB de pesos de especialistas na memória Grace em uma estação, que forneceu 139 tokens de saída por segundo em 32 fluxos; divididos entre dois B300s em paralelo tensorial, atingiu 1,525 em 32 fluxos e 3,141 em 256.
- O GLM-5.3 passa de 188 para 5,018 tokens por segundo: O maior ganho no conjunto, 27x, veio do outro modelo que ultrapassa 252 GB de HBM3e, com o par ainda atingindo 256 fluxos na mesma carga de trabalho e mantendo cerca de 600 tokens de saída por segundo em solicitações de 8,192 tokens, cerca de cinco vezes a torre única.
- Os avisos longos do MiniMax-M3 param em oito fluxos em uma estação: A torre única caiu para 103 tokens de saída por segundo em oito fluxos, à medida que o cache KV se esgotava; o par serviu 736 no mesmo ponto, 7.1x, e continuou até 1,801 em 256 fluxos.
- Os modelos que se encaixam recebem uma segunda cópia e uma divisão de pré-preenchimento/decodificação: Com uma estação em pré-carregamento e a outra em decodificação, o GLM-5.3 Flash triplicou a taxa de transferência de mensagens curtas em 32 fluxos (de 828 para 2,721) e dobrou a taxa de transferência de mensagens longas (de 1,219 para 2,448), e o DeepSeek V4.1 Flash apresentou a maior taxa de transferência de saída de todos os modelos testados, 5,248 tokens por segundo em 256 fluxos.
Conexão em rede na estação DGX
Antes de entrarmos no cluster, vamos recapitular os recursos de rede que abordamos em nossa análise da MSI. A placa de rede ConnectX-8 SuperNIC faz mais do que fornecer a conexão de rede. Seu switch PCIe integrado também gerencia parte das E/S internas da Station, conectando-se ao Grace, bem como aos 2 slots de armazenamento PCIe Gen 6 x4.
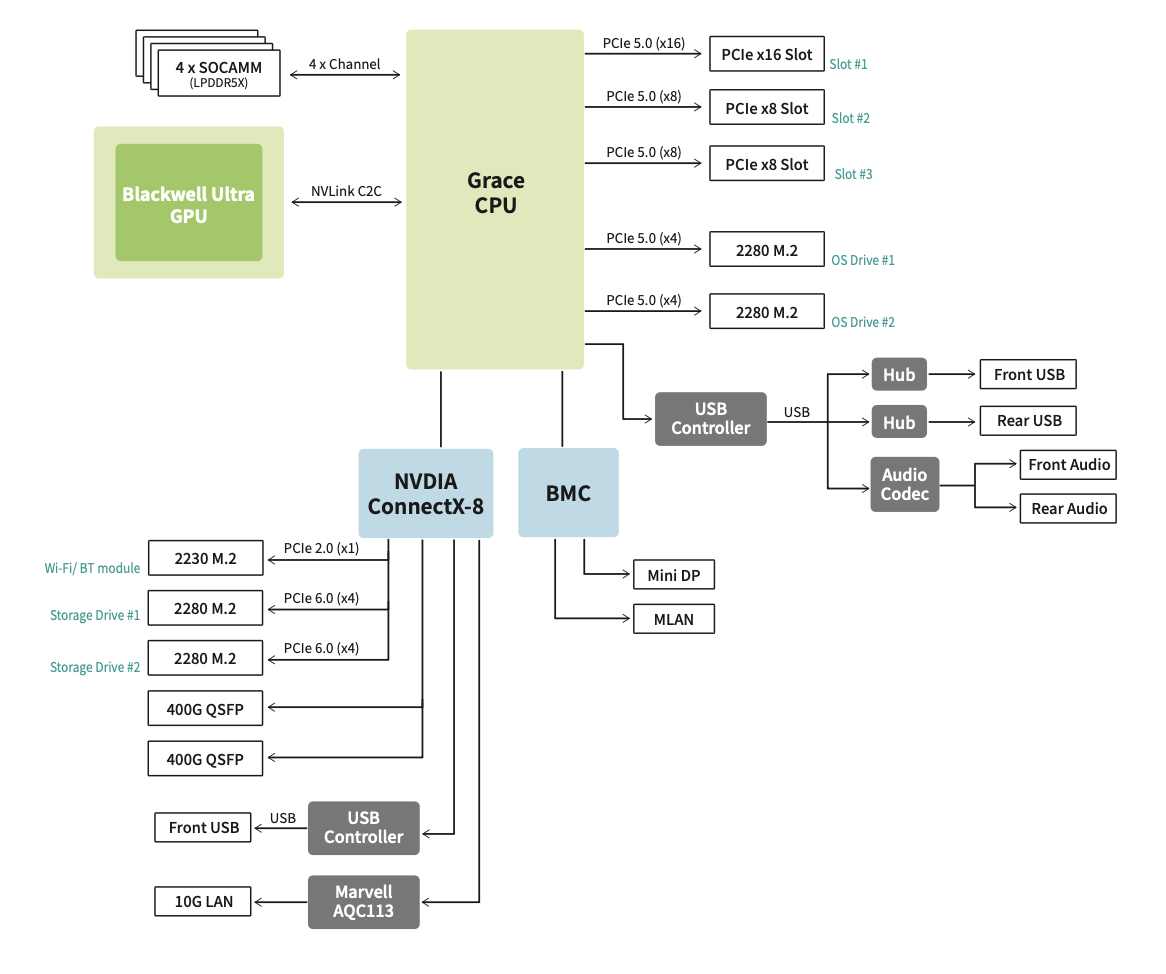
Para a conexão de rede propriamente dita, o sistema disponibiliza duas portas QSFP112 com capacidade de 400 Gb/s cada, fornecendo 800 Gb/s de largura de banda agregada para conectar estações entre si ou a uma rede maior.
Em comparação com a implementação do DGX Spark, que abordamos em nossa análise original do DGX Spark , o ConnectX-7 de 400 Gb/s do Spark era mais capaz do que a conectividade PCIe do GB10 conseguia utilizar plenamente. O controlador estava localizado atrás de dois links PCIe 5.0 x4 separados, limitando a taxa de transferência de rede agregada útil a cerca de 200 Gb/s. Suas duas portas físicas também apareciam como quatro interfaces Ethernet lógicas no Linux. Para obter a largura de banda total, era necessário mapear essas interfaces de volta para o gabinete conectado, configurar ambas as interfaces lógicas atrás dele e garantir que o tráfego RDMA pudesse usar ambos os caminhos PCIe.
A Station oferece uma configuração mais simples, com duas portas de 400 Gb/s que podem funcionar como trilhos de rede independentes.
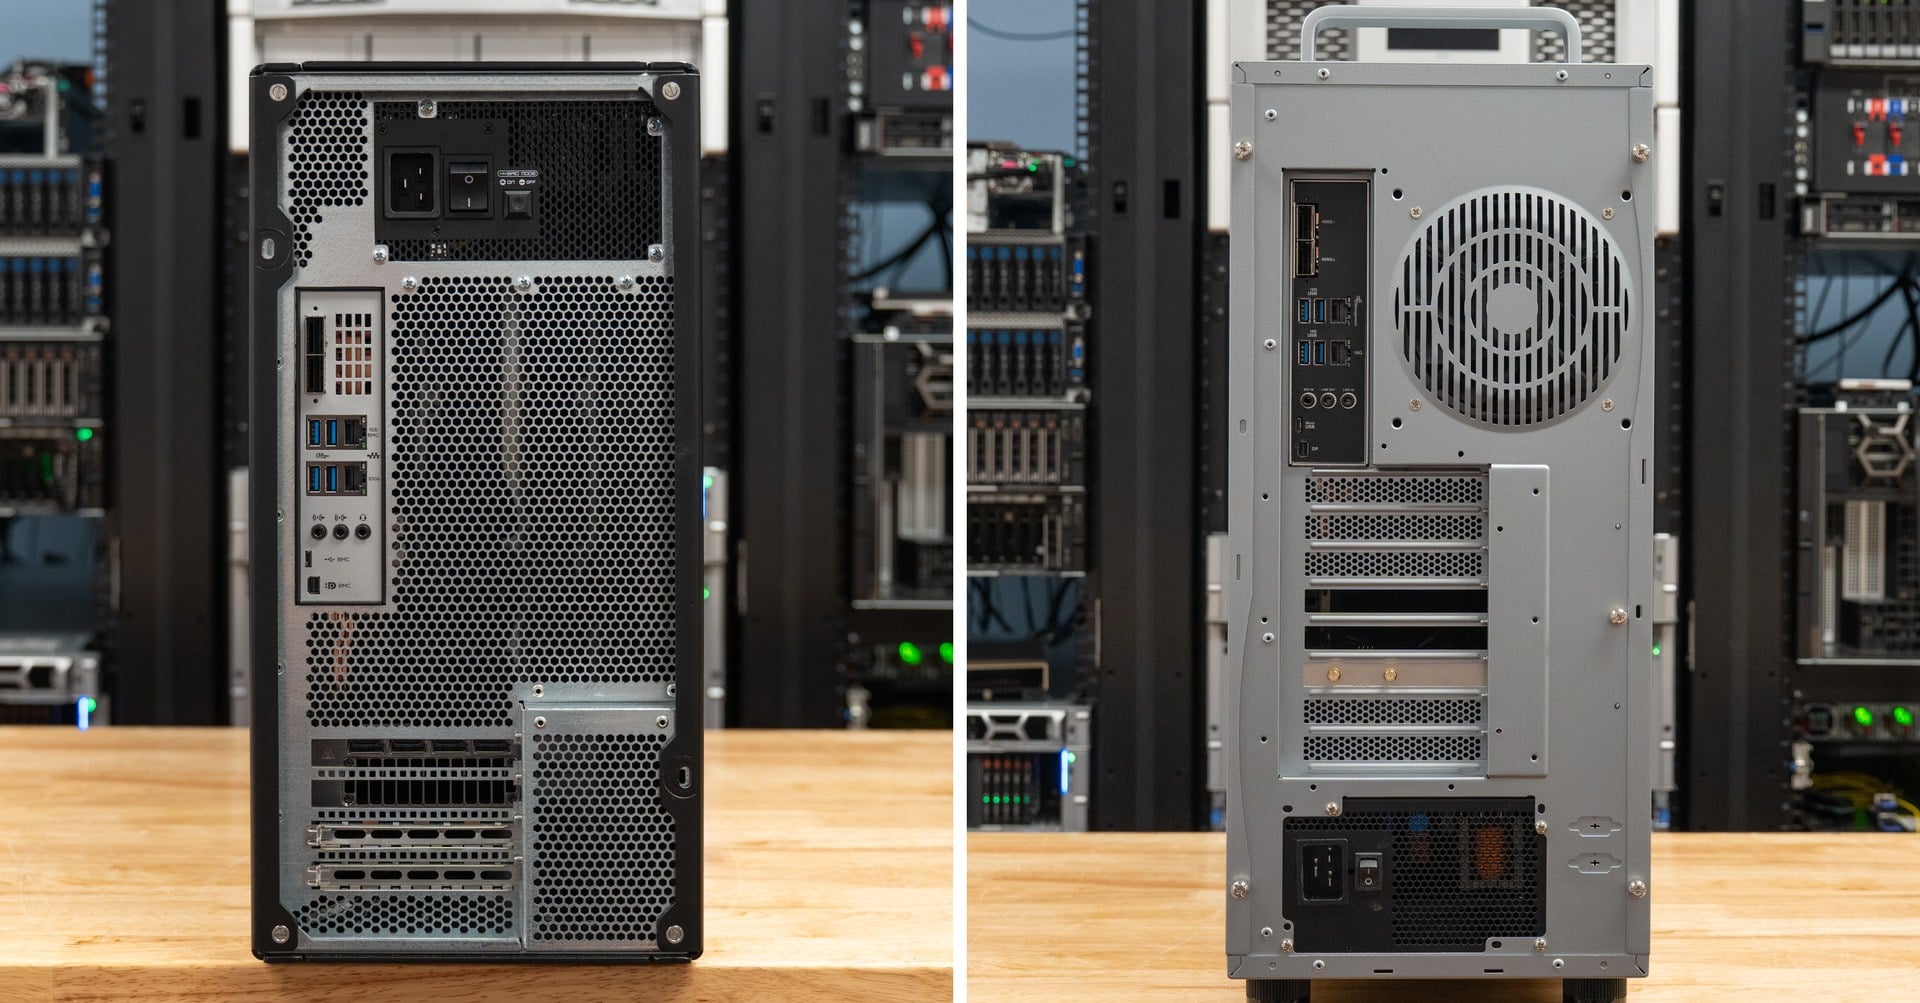
Transmitir quatro vezes a largura de banda utilizável do Spark através de um par de slots QSFP também aumenta a carga de refrigeração, e durante nossos testes, todas as unidades lidaram bem com isso. O próprio ConnectX-8 possui refrigeração líquida, e alguns fabricantes estendem essa refrigeração aos slots QSFP, como a MSI, enquanto outros sistemas usam dissipadores de calor e ventoinhas dedicadas sobre os slots, como vimos em nossa análise da ASUS. Essa refrigeração é especialmente útil para módulos ópticos, que geram mais calor do que DACs passivos. Ambas as abordagens funcionaram bem em nossos testes e não encontramos problemas de refrigeração com a rede.
Conectando duas estações
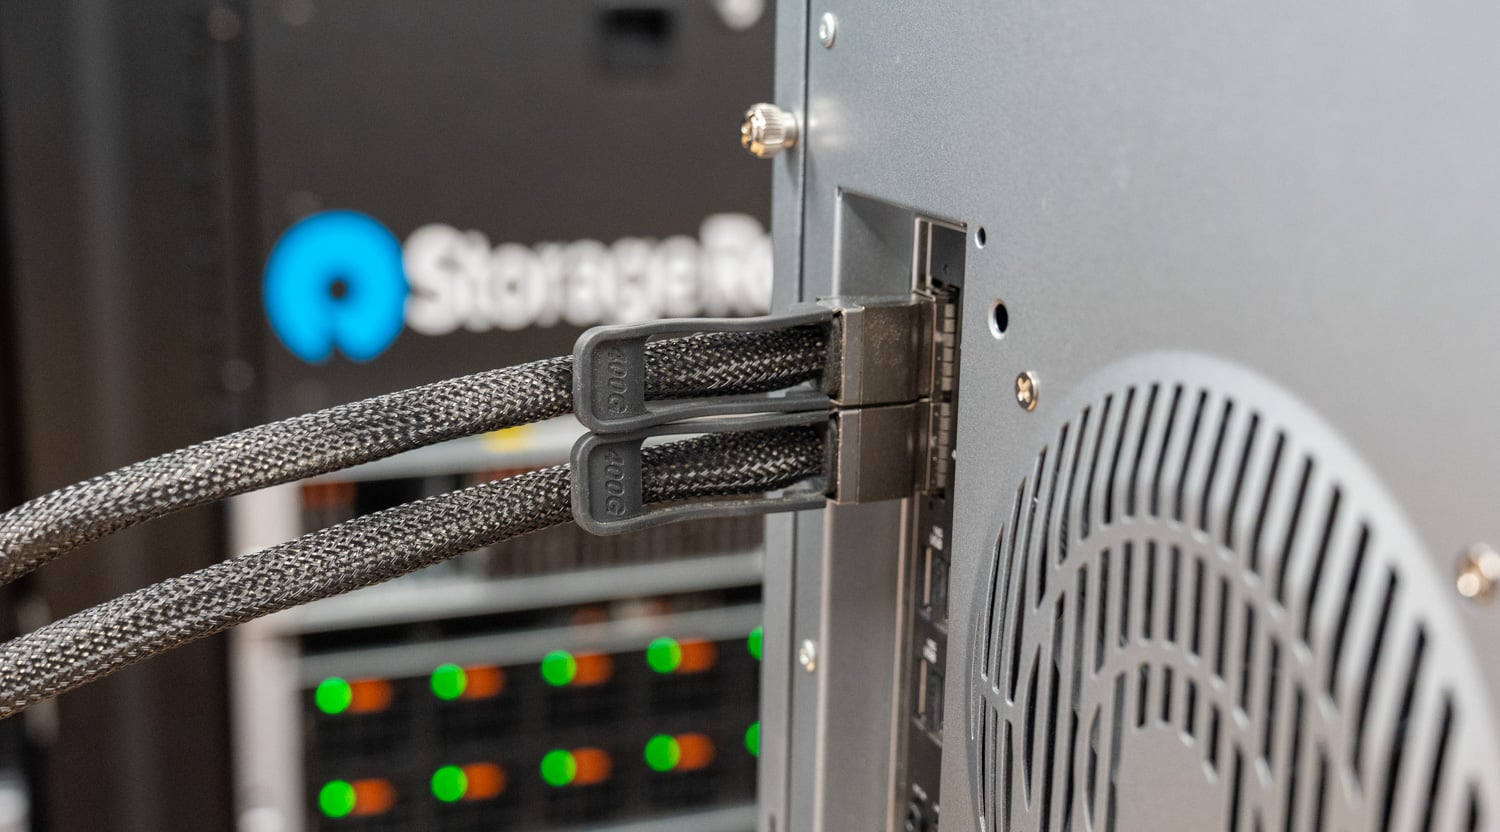
Agrupar duas estações DGX foi simples: conectamos a ASUS e a HP diretamente usando dois cabos de cobre de conexão direta (DAC) de 400G entre suas respectivas portas QSFP112, obtendo assim duas conexões independentes de 400Gb/s.
No que diz respeito ao software, a NVIDIA fornece um guia passo a passo para a criação de clusters dos sistemas, e as instruções eram tão claras que simplesmente compartilhamos o link com o Claude Code e deixamos que ele cuidasse da configuração. Ele configurou a rede entre as duas estações, executou testes de largura de banda do NCCL e nos forneceu um relatório com os resultados.
O guia é um playbook numerado executado a partir de uma terceira máquina que se conecta a ambas as estações via SSH. As portas são cabeadas como trilhas correspondentes, QSFP0 para QSFP0 e QSFP1 para QSFP1, e cada trilha se torna seu próprio link RoCEv2 ponto a ponto: os scripts ativam as duas interfaces ConnectX-8 com um MTU de 9,000 bytes, atribuem a cada trilha um /24 privado próprio e aplicam as configurações de tempo de execução do RoCE e do GPUDirect.
Uma validação confirma que ambos os links foram treinados a 400G, que os pings jumbo atravessam cada barramento e que os dois dispositivos RDMA, mlx5_0 e mlx5_1, estão ativos. Uma execução de ib_write_bw em cada barramento comprova que a malha encaminha tráfego RDMA e não apenas pings. Após isso, o NCCL é configurado para ambos os barramentos com NCCL_IB_HCA=mlx5_0,mlx5_1, e a tarefa é iniciada como qualquer outra execução de dois nós. Os resultados abaixo foram obtidos a partir dessa sequência.
A primeira tabela é proveniente do nccl-tests, que mostra os coletivos de uma tarefa de inferência ou treinamento distribuído, executada nos dois B300 com ambos os barramentos em uso. Com uma GPU por estação, cada coletivo se resume à troca de dados entre as duas GPUs através do par de links de 400G, portanto, a coluna de largura de banda do barramento corresponde diretamente aos 100 GB/s (800 Gb/s) fornecidos pelos dois cabos. O valor de pico representa o melhor resultado para todos os tamanhos de mensagem; a coluna de 16 GiB corresponde à maior mensagem testada, onde a largura de banda se estabilizou.
| Divisão de | Tamanho máximo | Largura de banda de pico do barramento | Largura de banda do barramento de 16 GiB |
|---|---|---|---|
| Redução total | 1 GiB | 92.242 GB / s | 91.346 GB / s |
| Todos reunidos | 16 GiB | 87.893 GB / s | 87.893 GB / s |
| Reduzir a dispersão | 2 GiB | 93.930 GB / s | 92.905 GB / s |
| Transmissões | 16 GiB | 97.975 GB / s | 97.975 GB / s |
| Reduzir o | 16 GiB | 97.978 GB / s | 97.978 GB / s |
| Todos para todos | 8 GiB | 80.522 GB / s | 80.512 GB / s |
| Enviar/receber, unidirecional | 16 GiB | 97.953 GB / s | 97.953 GB / s |
| Envio/recebimento bidirecional | 16 GiB | 83.748 GB/s por direção | 167.496 GB/s agregado |
Os padrões de transmissão, redução e envio/recebimento unidirecional atingiram 98 GB/s, o que corresponde a 98% da capacidade de transmissão dos dois cabos. Os padrões com dados se movendo em ambas as direções simultaneamente apresentaram taxas menores: 92 GB/s para redução total e 80 GB/s para transmissão total. O resultado do envio/recebimento bidirecional serve como ponto de referência: com ambas as GPUs transmitindo ao mesmo tempo, cada direção atingiu 84 GB/s, totalizando 167 GB/s na conexão.
A segunda tabela mostra o caminho RDMA bruto, abaixo do NCCL, usando ib_write_bw em uma linha por vez. As linhas GPUDirect registram transferências de 1 MiB da HBM de uma B300 para a da outra, com a placa de rede lendo e escrevendo diretamente na memória da GPU; ambas as linhas atingiram 392 Gb/s, 98% da taxa de linha. As linhas de memória do host são o teste básico do guia, um único par de filas originado da memória Grace, que o playbook da NVIDIA classifica entre 220 e 230 Gb/s em uma linha de 400G; observamos 228 Gb/s. A linha de latência representa uma gravação de 8 bytes: 1.46 µs em média.
| Testar | Largura de Banda | Utilização de links |
|---|---|---|
| GPUDirect RDMA, memória da GPU, ib_write_bw, transferências de 1 MiB | ||
| Trilho 0 | 392.15 Gb / s | 98.04% |
| Trilho 1 | 392.15 Gb / s | 98.04% |
| RDMA de memória do host, ambos os trilhos | ||
| Escrita RDMA, unidirecional | 228.15 Gb / s | |
| Leitura RDMA, unidirecional | 228.23 Gb / s | |
| Envio RDMA, unidirecional | 228.16 Gb / s | |
| Escrita RDMA, bidirecional | 447.10 Gb/s agregados | |
| Latência de escrita RDMA: 8 bytes | Média de 1.46 µs; percentil 99 de 1.63 e 1.66 µs por trilho. | |
Como testamos o cluster
O tempo com a dupla foi limitado, então nos concentramos na inferência, a carga de trabalho de IA mais popular atualmente. Planejamos expandir este trabalho para clusters maiores. Para este artigo, concentramo-nos em modelos maiores e comparamos uma única Estação com duas Estações usando paralelismo tensorial (TP) e desagregação de pré-preenchimento/decodificação (PD).
O paralelismo de tensores divide os tensores de peso e os cálculos dentro do modelo entre várias GPUs. Em nossa configuração de duas estações, ou TP2, cada B300 armazena uma parte do modelo, e ambas trabalham em cada requisição. Isso nos proporciona mais memória de alta largura de banda (HBM) para alocar os pesos, além de mais poder computacional para executá-los. Também exige que as GPUs troquem resultados intermediários e se sincronizem por meio do NCCL durante a inferência, de modo que a sobrecarga de comunicação passa a fazer parte do custo de execução do modelo.
A inferência desagregada atribui as etapas de preenchimento e decodificação de uma solicitação a trabalhadores separados. O preenchimento processa a solicitação de entrada e constrói o cache de chave/valor (KV), o estado de atenção que o modelo reutiliza durante a geração. A decodificação, então, usa esse estado para gerar tokens de saída um de cada vez. As duas etapas têm requisitos de processamento diferentes: o preenchimento exige alto poder computacional, enquanto a decodificação exige alta largura de banda de memória. Em configurações maiores, desagregar a inferência dessa forma permite que o operador dimensione esses trabalhadores de forma independente, de acordo com a demanda, como demonstrado em nosso artigo sobre descarregamento do cache KV.
Em uma configuração de nó único, quando ambas as fases compartilham um trabalhador, o vLLM pode intercalar o processamento de pré-preenchimento para solicitações recebidas com o processamento de decodificação de solicitações já em andamento. Esse processamento de solicitações pode aumentar o tempo entre os tokens de saída. Em nossa configuração PD, uma Estação lida com o pré-preenchimento e transfere o cache KV da solicitação para a outra Estação, que lida com a decodificação. Cada trabalhador tem acesso à sua própria cópia do modelo, incluindo quaisquer dados colocados na memória Grace. O trabalhador de decodificação não precisa mais agendar o processamento de novas solicitações juntamente com a geração de tokens, acelerando a taxa de transferência de inferência.
Para nossos testes, os requisitos de memória do modelo determinaram a abordagem utilizada. Para os checkpoints maiores, onde uma única Estação precisava descarregar uma quantidade substancial de pesos do modelo para a memória Grace, o TP (Transparência de Pontos) apresentou o melhor desempenho. Distribuir os pesos entre duas GPUs permitiu que uma maior parte do modelo permanecesse na HBM (Memória de Alta Memória) e reduziu a penalidade de descarregamento. Para modelos que se ajustavam razoavelmente bem a uma única Estação, seja inteiramente na HBM ou com descarregamento limitado para a Grace, utilizamos a desagregação PD (Deep Data). Isso incluiu o DeepSeek V4.1 Flash, com suas tabelas de consulta de engramas alocadas na DRAM da Grace.
Para manter a comparabilidade com nossa cobertura anterior, mantivemos nossa metodologia legada com comprimentos de sequência de entrada (ISL) e comprimentos de sequência de saída (OSL) fixos. A carga de trabalho equilibrada utiliza 512 tokens de entrada e 512 tokens de saída, enquanto a carga de trabalho com preenchimento prévio intensivo utiliza 8,192 tokens de entrada e 1,024 tokens de saída. Variamos o número de solicitações simultâneas, mantendo esses comprimentos de sequência fixos.
A linha de base de estação única em cada gráfico é o ASUS ET900N G3 da nossa análise, com varredura de 32 fluxos; as varreduras de duas estações chegam a 256 fluxos. Cada ponto representa uma única passagem, portanto, uma queda em um nível de simultaneidade é registrada como coletada.
Configuração de inferência
| Modelo | Modo cluster | Software | Decodificação especulativa | Memória da graça |
|---|---|---|---|---|
| DeepSeek V4.1 Flash (FP8) | Desagregação de pré-preenchimento/decodificação, cópia completa por estação. | vllm/vllm-openai:deepseekv41-flash-0909 | Desenhista próprio do modelo, fixo em 5 tokens. | Duas tabelas de engramas FP8 (188.84 GiB) fixadas na memória Grace, além de 131.97 GB de pesos de especialistas descarregados em cada estação. |
| GLM-5.3 NVFP4 | Tensor paralelo (TP2) | Contêiner NVIDIA vLLM 26.08 NGC (vLLM 0.27.1) | MTP, rascunho fixo de 5 tokens | Nenhum no cluster; 215 GB de pesos de especialistas descarregados em uma única estação. |
| GLM-5.3 Flash NVFP4 | Desagregação de pré-preenchimento/decodificação, pré-preenchimento ASUS, decodificação HP | vLLM 0.28.1 RC1 | MTP, rascunho fixo de 5 tokens | nenhum |
| GLM-5.2 NVFP4 | Tensor paralelo (TP2) | Contêiner NVIDIA vLLM 26.08 NGC (vLLM 0.27.1) | MTP, rascunho fixo de 3 tokens | Nenhum no cluster; cerca de 215 GB de pesos de especialistas descarregados em uma única estação. |
| MiniMax-M3 NVFP4 | Tensor paralelo (TP2) | Contêiner NVIDIA vLLM 26.08 NGC (vLLM 0.27.1) | EAGLE3, rascunho fixo de 3 fichas | Nenhum no cluster; uma parcela de especialistas alocada em uma única estação. |
Desempenho de inferência
Flash DeepSeek V4.1
O DeepSeek V4.1 Flash foi executado de forma desagregada, com uma Station responsável pelo preenchimento e a outra pela decodificação, cada Station contendo uma cópia completa do modelo: as duas tabelas de Engramas FP8, totalizando 188.84 GiB, armazenadas na memória Grace, além de 131.97 GB de pesos de especialistas descarregados para a Grace. Isso faz dele a única configuração do conjunto com memória Grace em uso em ambas as máquinas. É também o único modelo aqui sem uma linha de Station única, pois a análise da ASUS utilizou a versão anterior, V4 Flash, e as duas não são diretamente comparáveis.
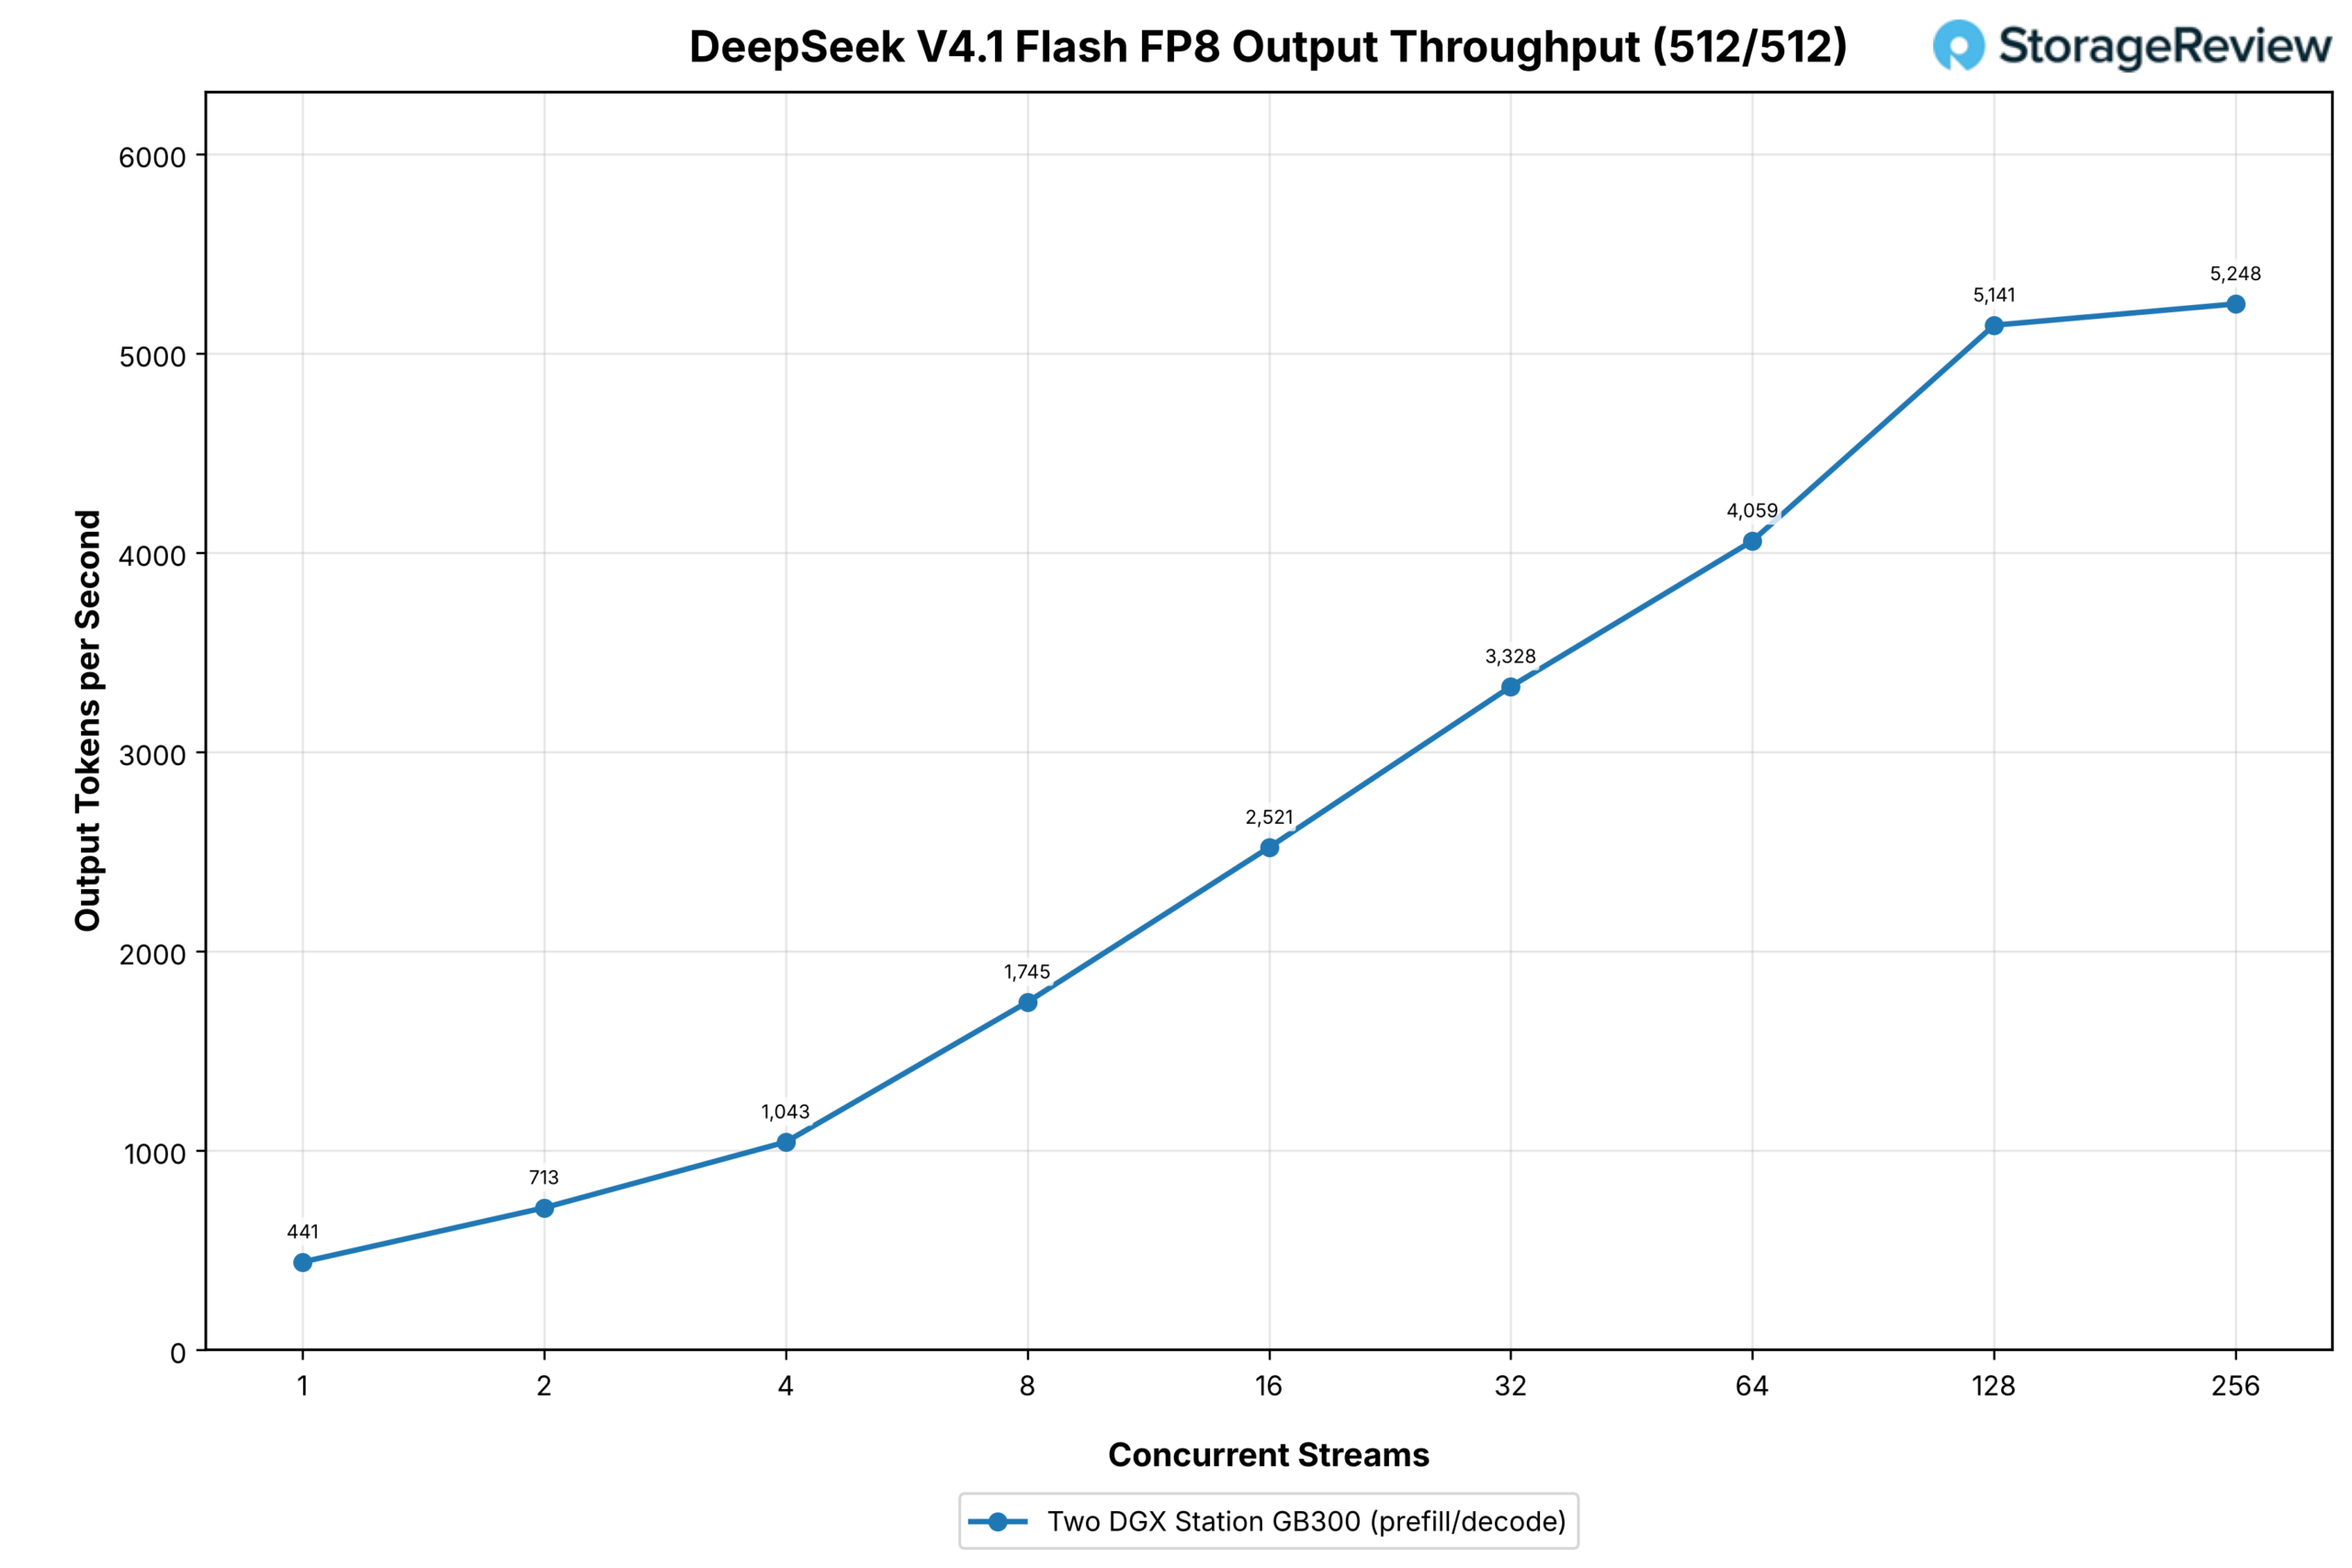
No cluster de duas estações, o modelo FP8 nativo apresentou taxas de transferência de 441 tokens de saída por segundo com um fluxo, 3,328 com 32 fluxos, 5,141 com 128 fluxos e 5,248 com 256 fluxos, o maior rendimento de saída de qualquer modelo neste conjunto, com a curva se estabilizando apenas no pico da varredura. Para referência, a única estação ASUS serviu V4 Flash a 1,766 tokens de saída por segundo com 32 fluxos em nossa análise.
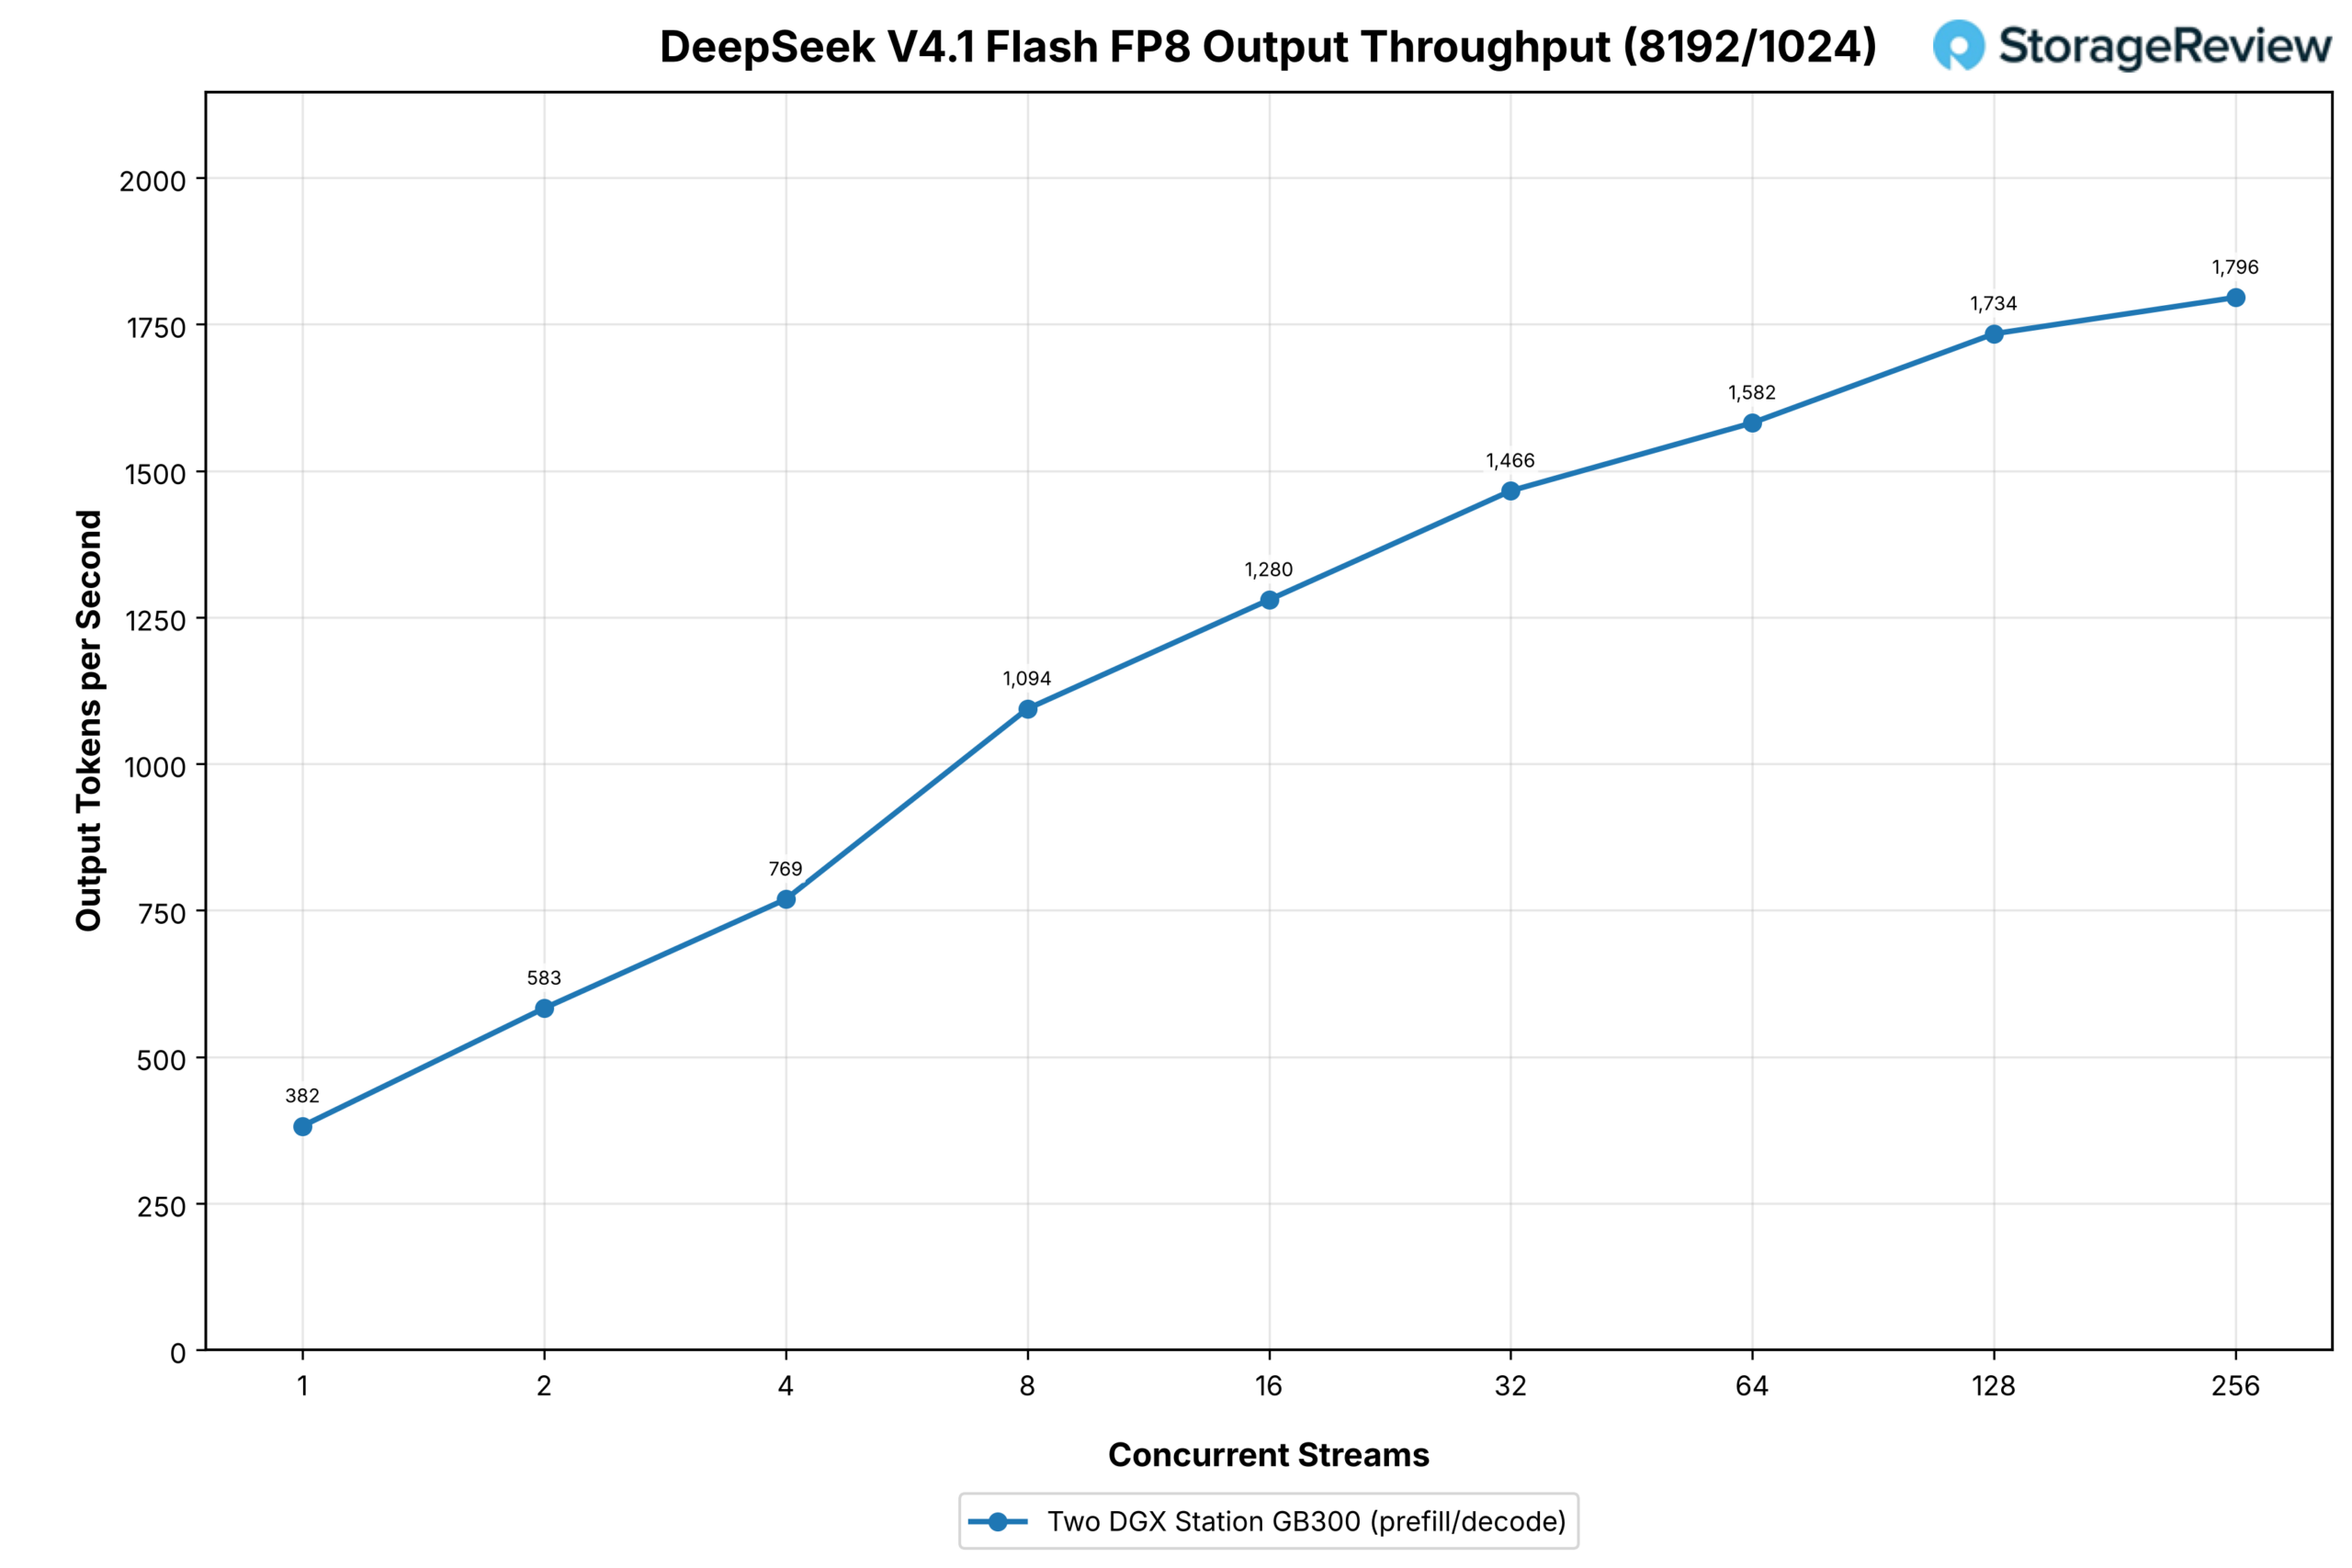
No perfil com uso intensivo de pré-preenchimento, o cluster passou de 382 tokens de saída por segundo em um fluxo para 1,466 em 32 e 1,796 em 256. Como cada solicitação carrega 8,192 tokens de entrada, a taxa de transferência total atingiu 16,163 tokens por segundo no pico da varredura. Com as tabelas de Engramas e 131.97 GB de pesos de especialistas armazenados na memória Grace em cada Estação, as curvas permaneceram suaves durante toda a varredura.
GLM-5.3
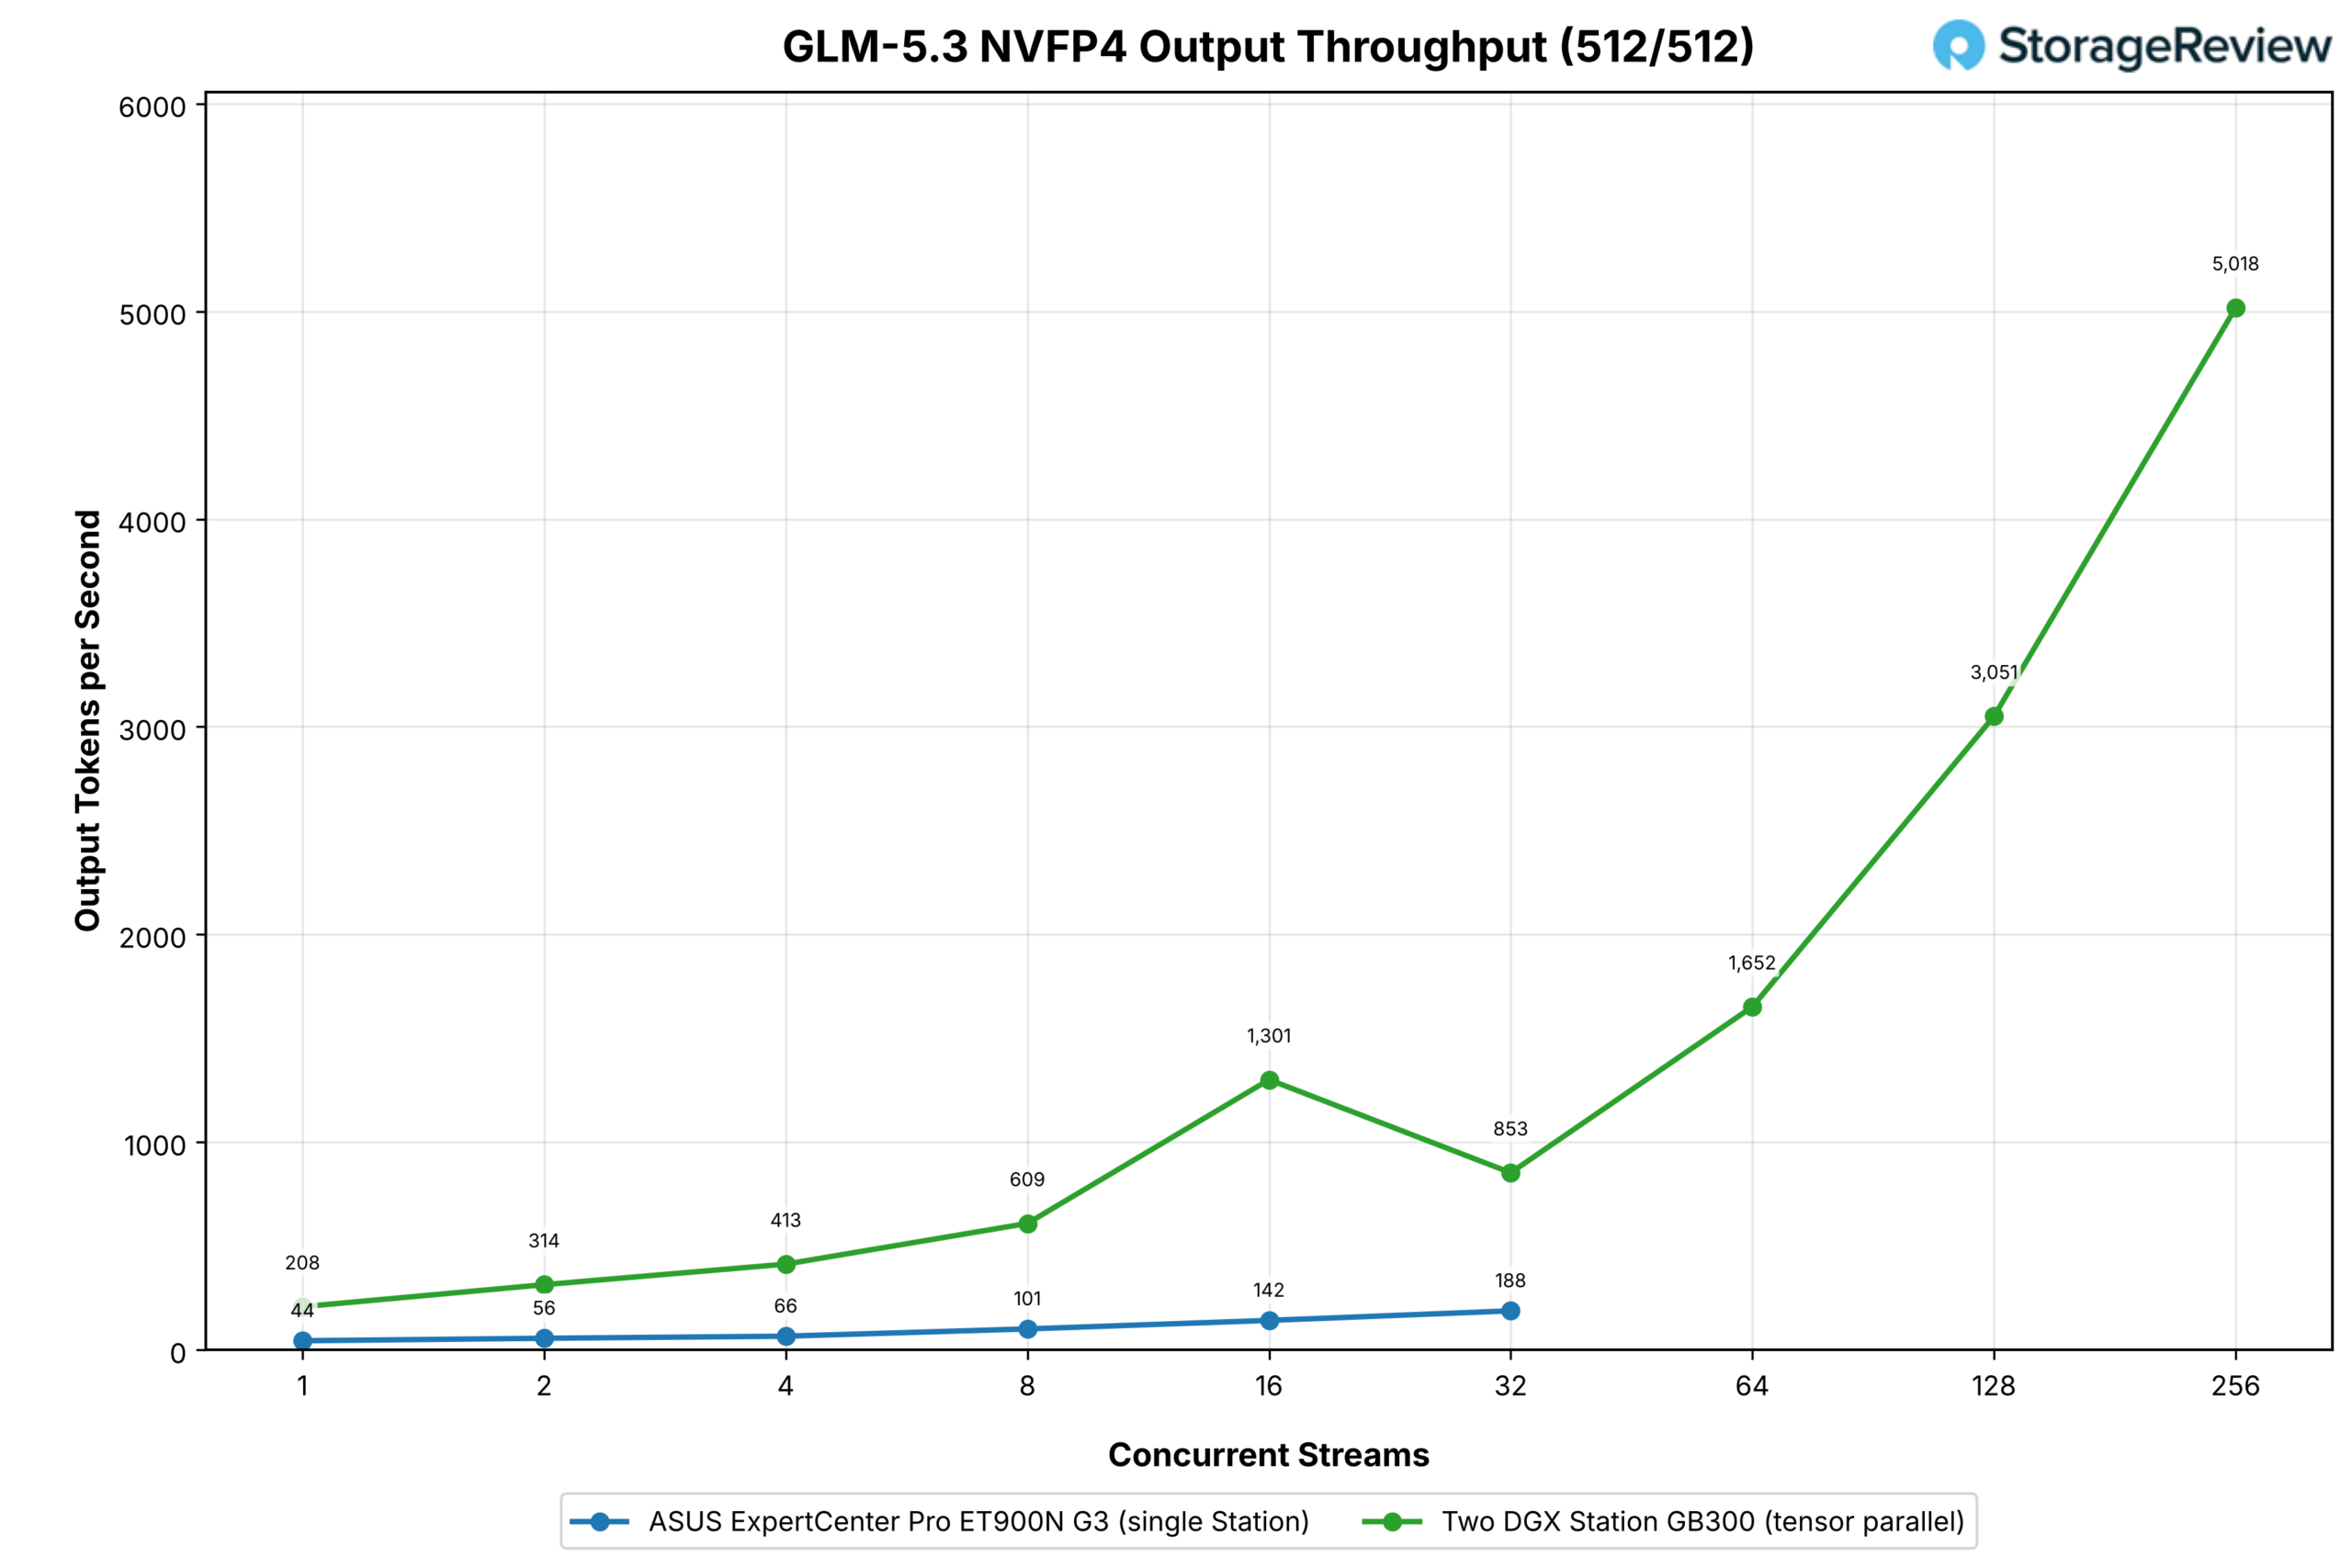
O GLM-5.3 foi executado no TP2 sem descarregamento para o Grace. Em uma única estação, ele descarrega 215 GB de pesos especialistas para a memória do Grace, e o resultado do cluster segue o GLM-5.2 durante a maior parte da varredura antes de se tornar desigual. Uma estação passou de 44 tokens de saída por segundo em um fluxo para 188 em 32 fluxos com carga de trabalho igual.
O cluster de duas estações passou de 208 com um fluxo para 1,301 com 16, entre 4.7 e 9.2 vezes o desempenho de uma única estação, caiu para 853 com 32 fluxos e, em seguida, voltou a subir para 1,652 com 64 fluxos, 3,051 com 128 e 5,018 com 256. O ponto de 32 fluxos está nos dados coletados; as decisões de agrupamento e a seleção do kernel mudam conforme a concorrência aumenta, e uma implementação tensorial paralela adiciona uma operação coletiva em cada camada que precisa ser concluída antes da próxima etapa, portanto a curva não é uma linha reta, mas o limite máximo com 256 fluxos é 27 vezes maior do que o alcançado por uma única estação com 32 fluxos.
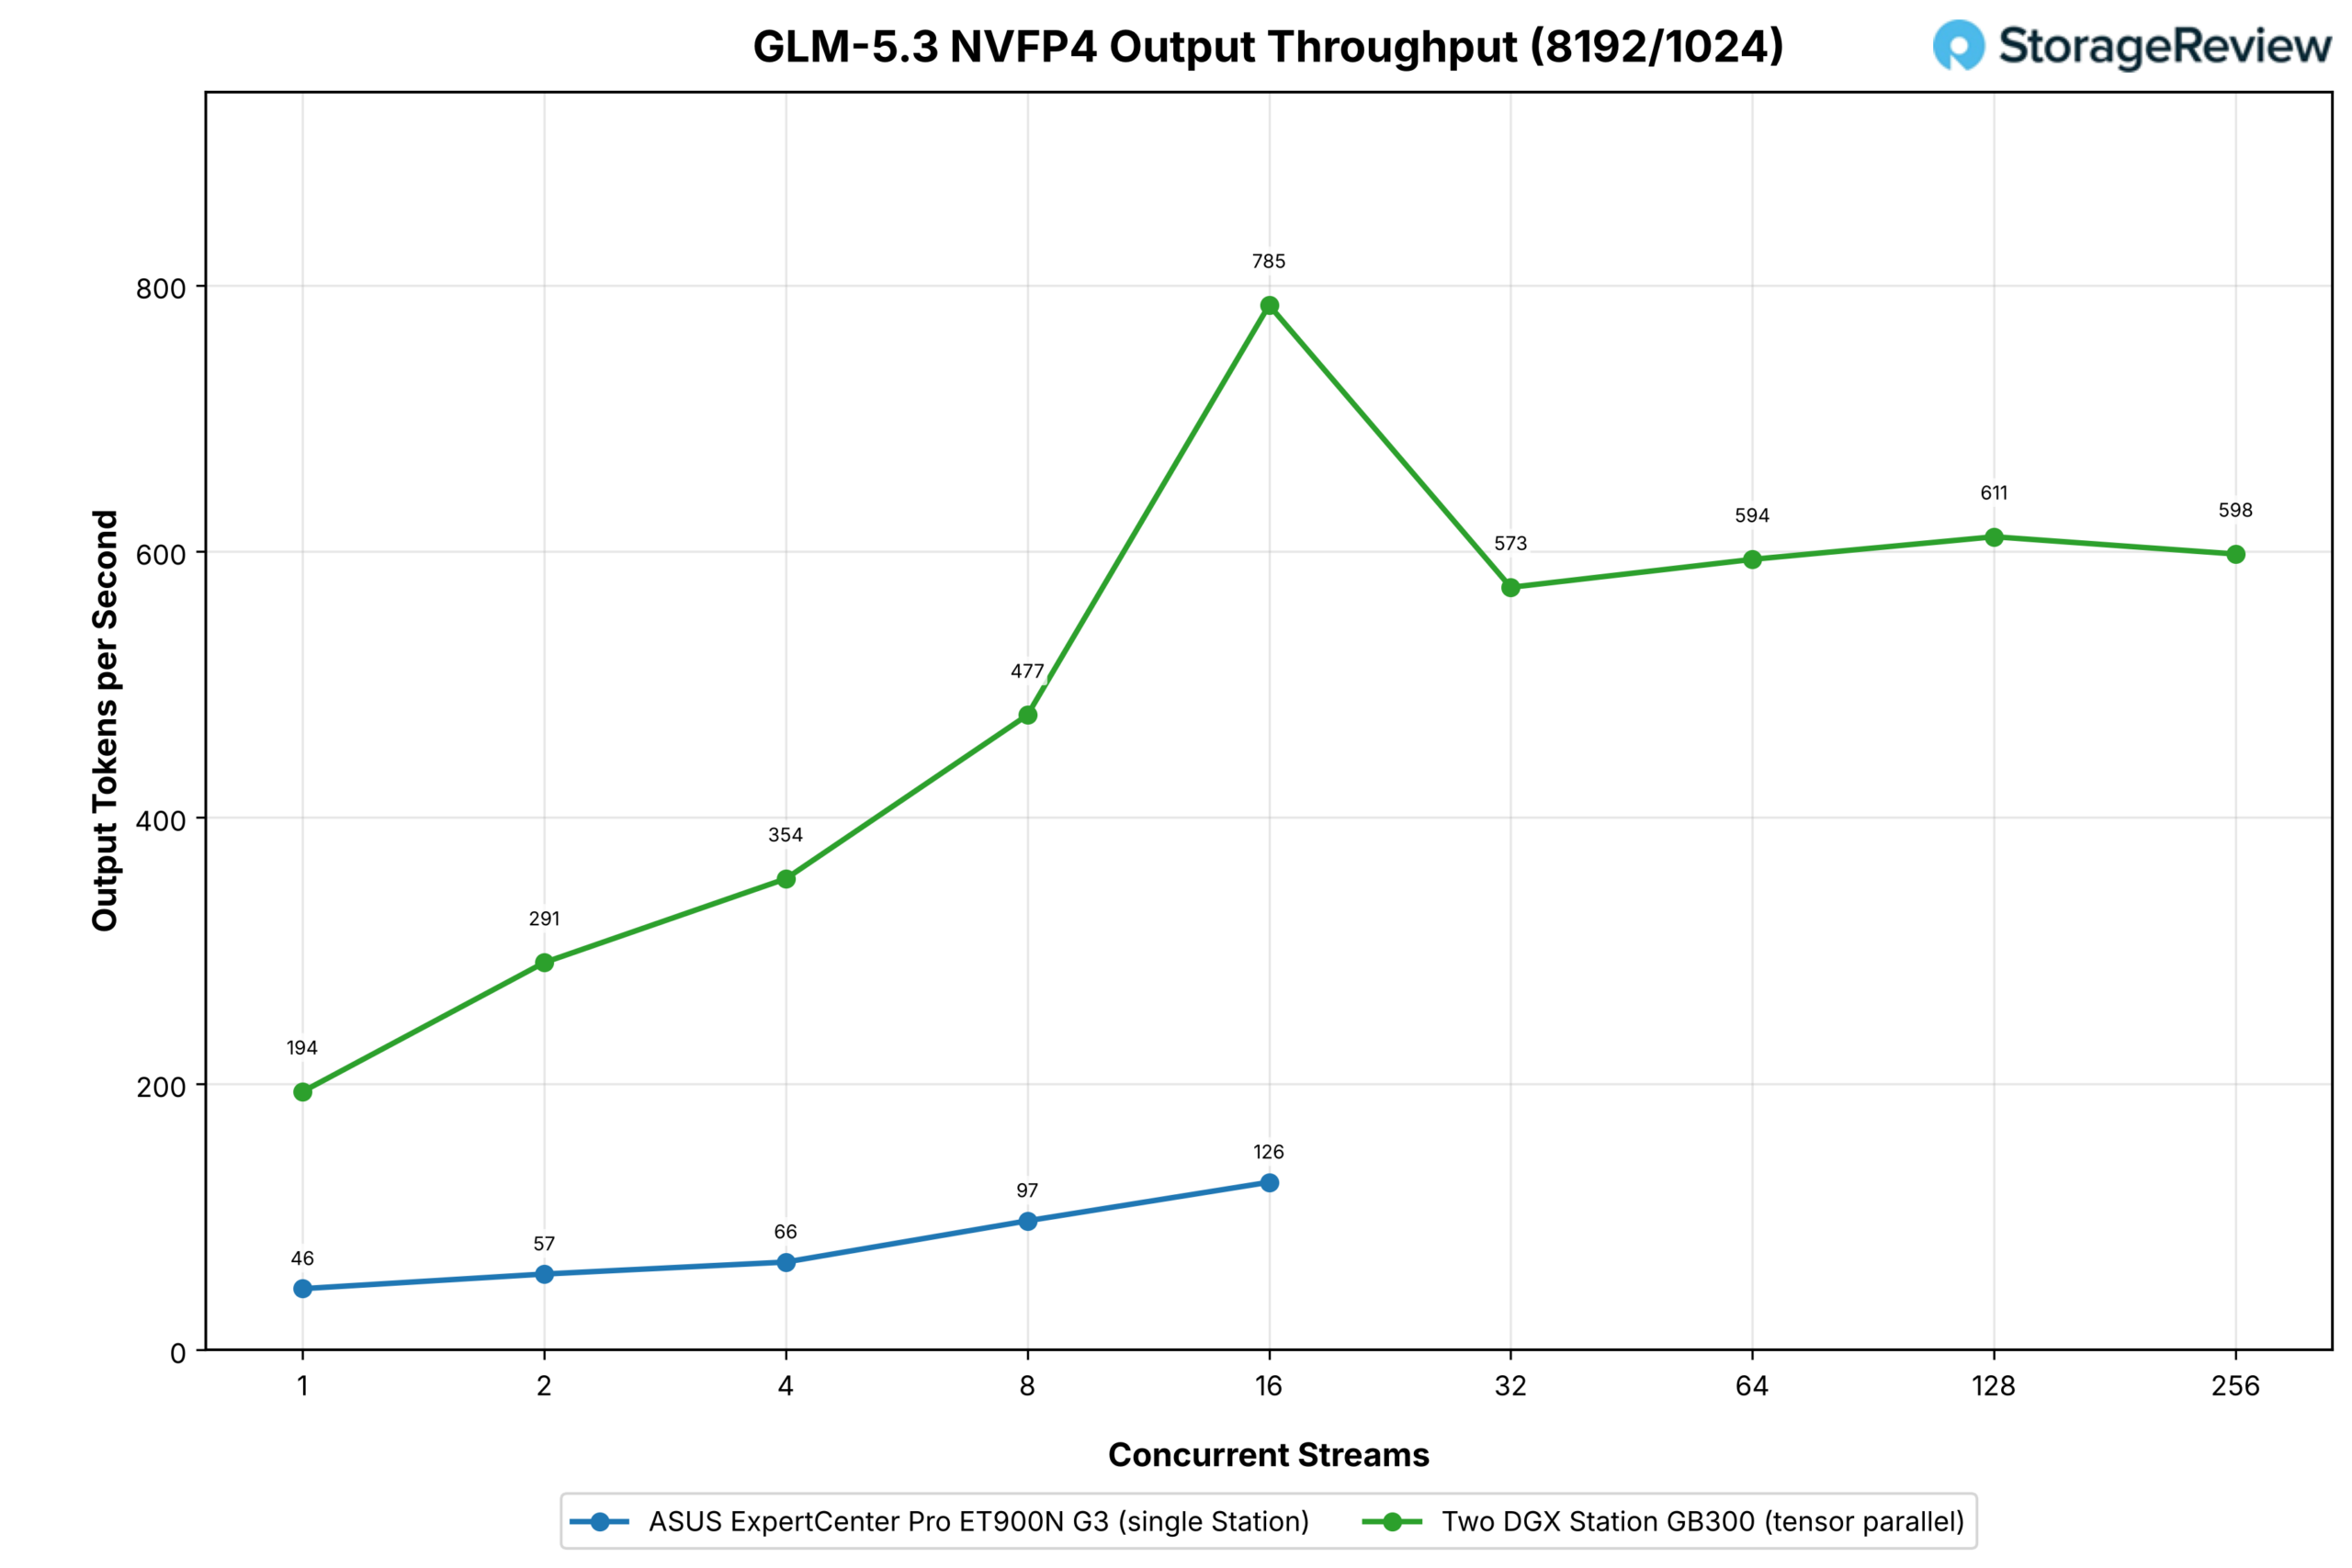
No perfil com alta demanda de pré-preenchimento, a Estação única parou em 16 fluxos, por projeto: um modelo descarregado se estabiliza rapidamente e há pouco a aprender aumentando a concorrência. Ela passou de 46 tokens de saída por segundo com um fluxo para 126 com 16. O cluster passou de 194 para 785 na mesma faixa, um aumento de 6.2 vezes no pico, e depois se estabilizou entre 573 e 611 de 32 a 256 fluxos, um teto de prompt longo próximo a 600 tokens de saída por segundo, que ainda é cerca de cinco vezes o melhor desempenho da Estação única.
Flash GLM-5.3
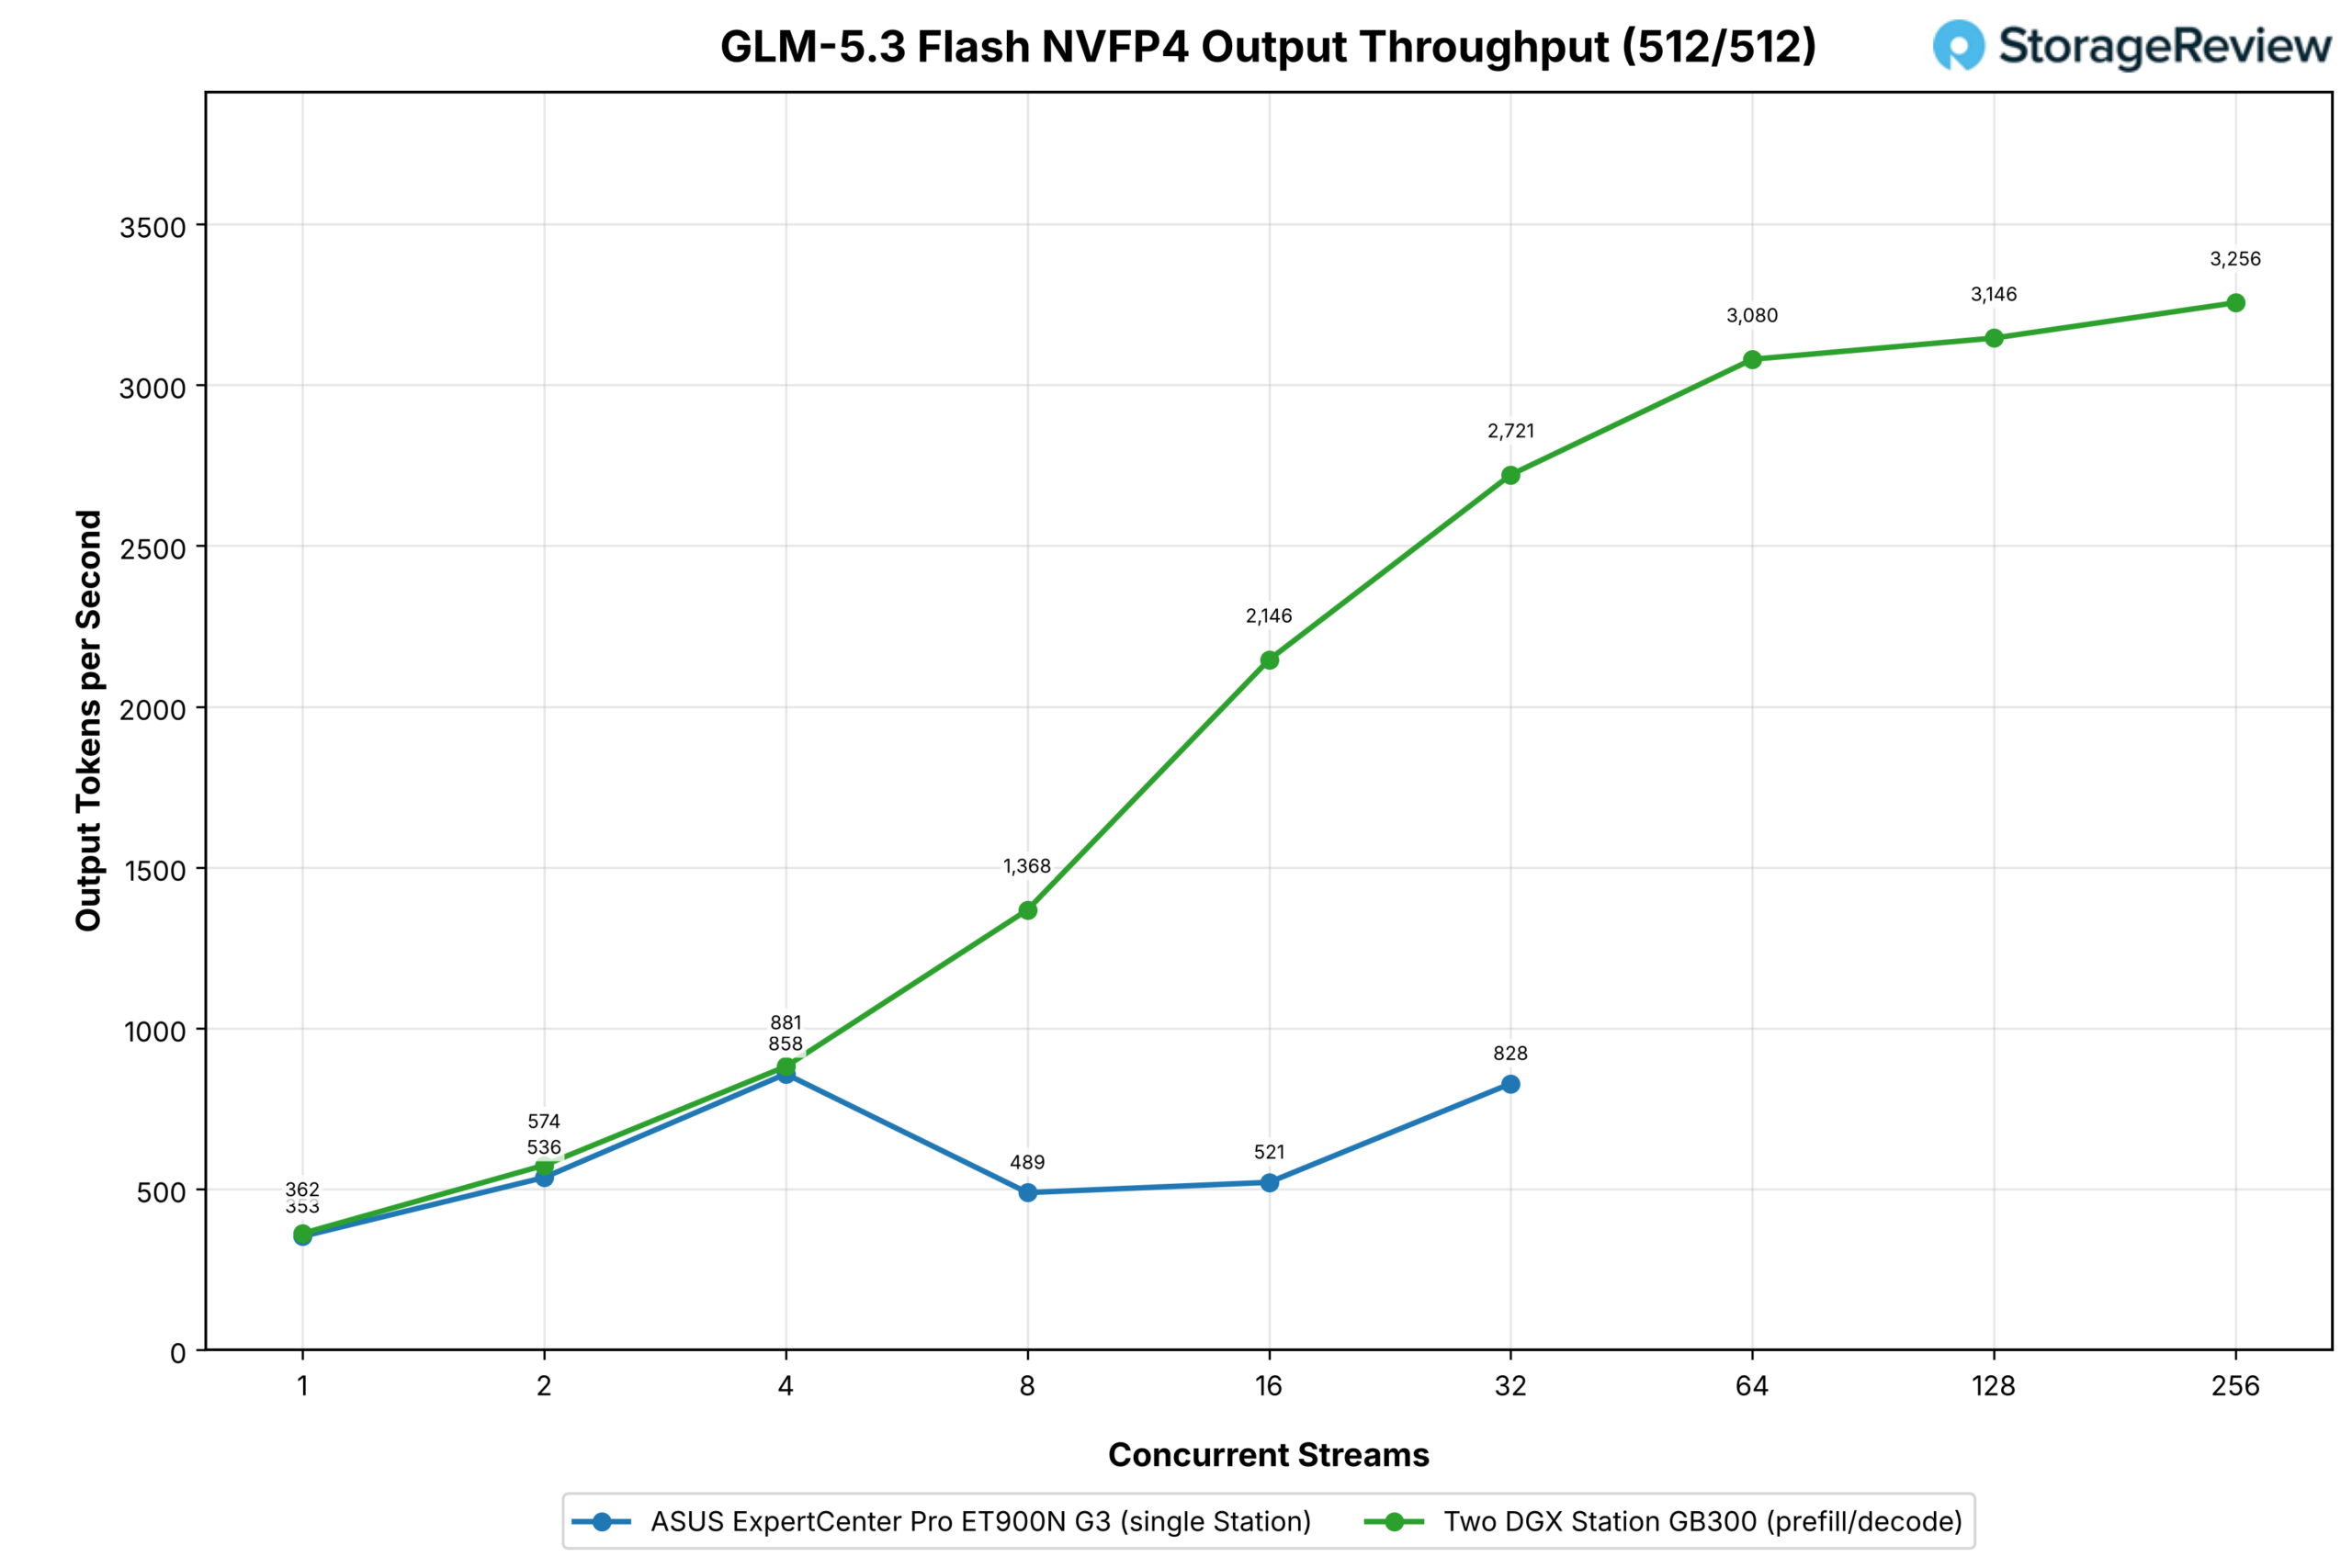
O GLM-5.3 Flash é pequeno o suficiente para que cada Estação possa armazenar uma cópia completa, então ele foi executado de forma desagregada, com a ASUS cuidando do preenchimento automático e a HP da decodificação. O Flash tem um número pequeno de parâmetros ativos, então em uma única Estação ele já funciona rápido: 353 tokens de saída por segundo em um fluxo e 828 em 32 fluxos com a mesma carga de trabalho, com uma variação intermediária (858 em quatro fluxos, 489 em oito fluxos) que estamos relatando conforme coletado.
No par desagregado, a carga de trabalho igual variou de 362 tokens de saída por segundo em um fluxo para 2,721 em 32 fluxos, 3.3 vezes a torre única, e para 3,256 em 256 fluxos.
Com um e dois fluxos, o par corresponde quase exatamente a uma única Estação, o que é esperado quando a Estação de decodificação está realizando o mesmo trabalho sozinha; o ganho surge quando há solicitações suficientes em andamento para que a Estação de pré-carregamento permaneça ocupada e para que a Estação de decodificação se beneficie por nunca precisar pausar para pré-carregar.
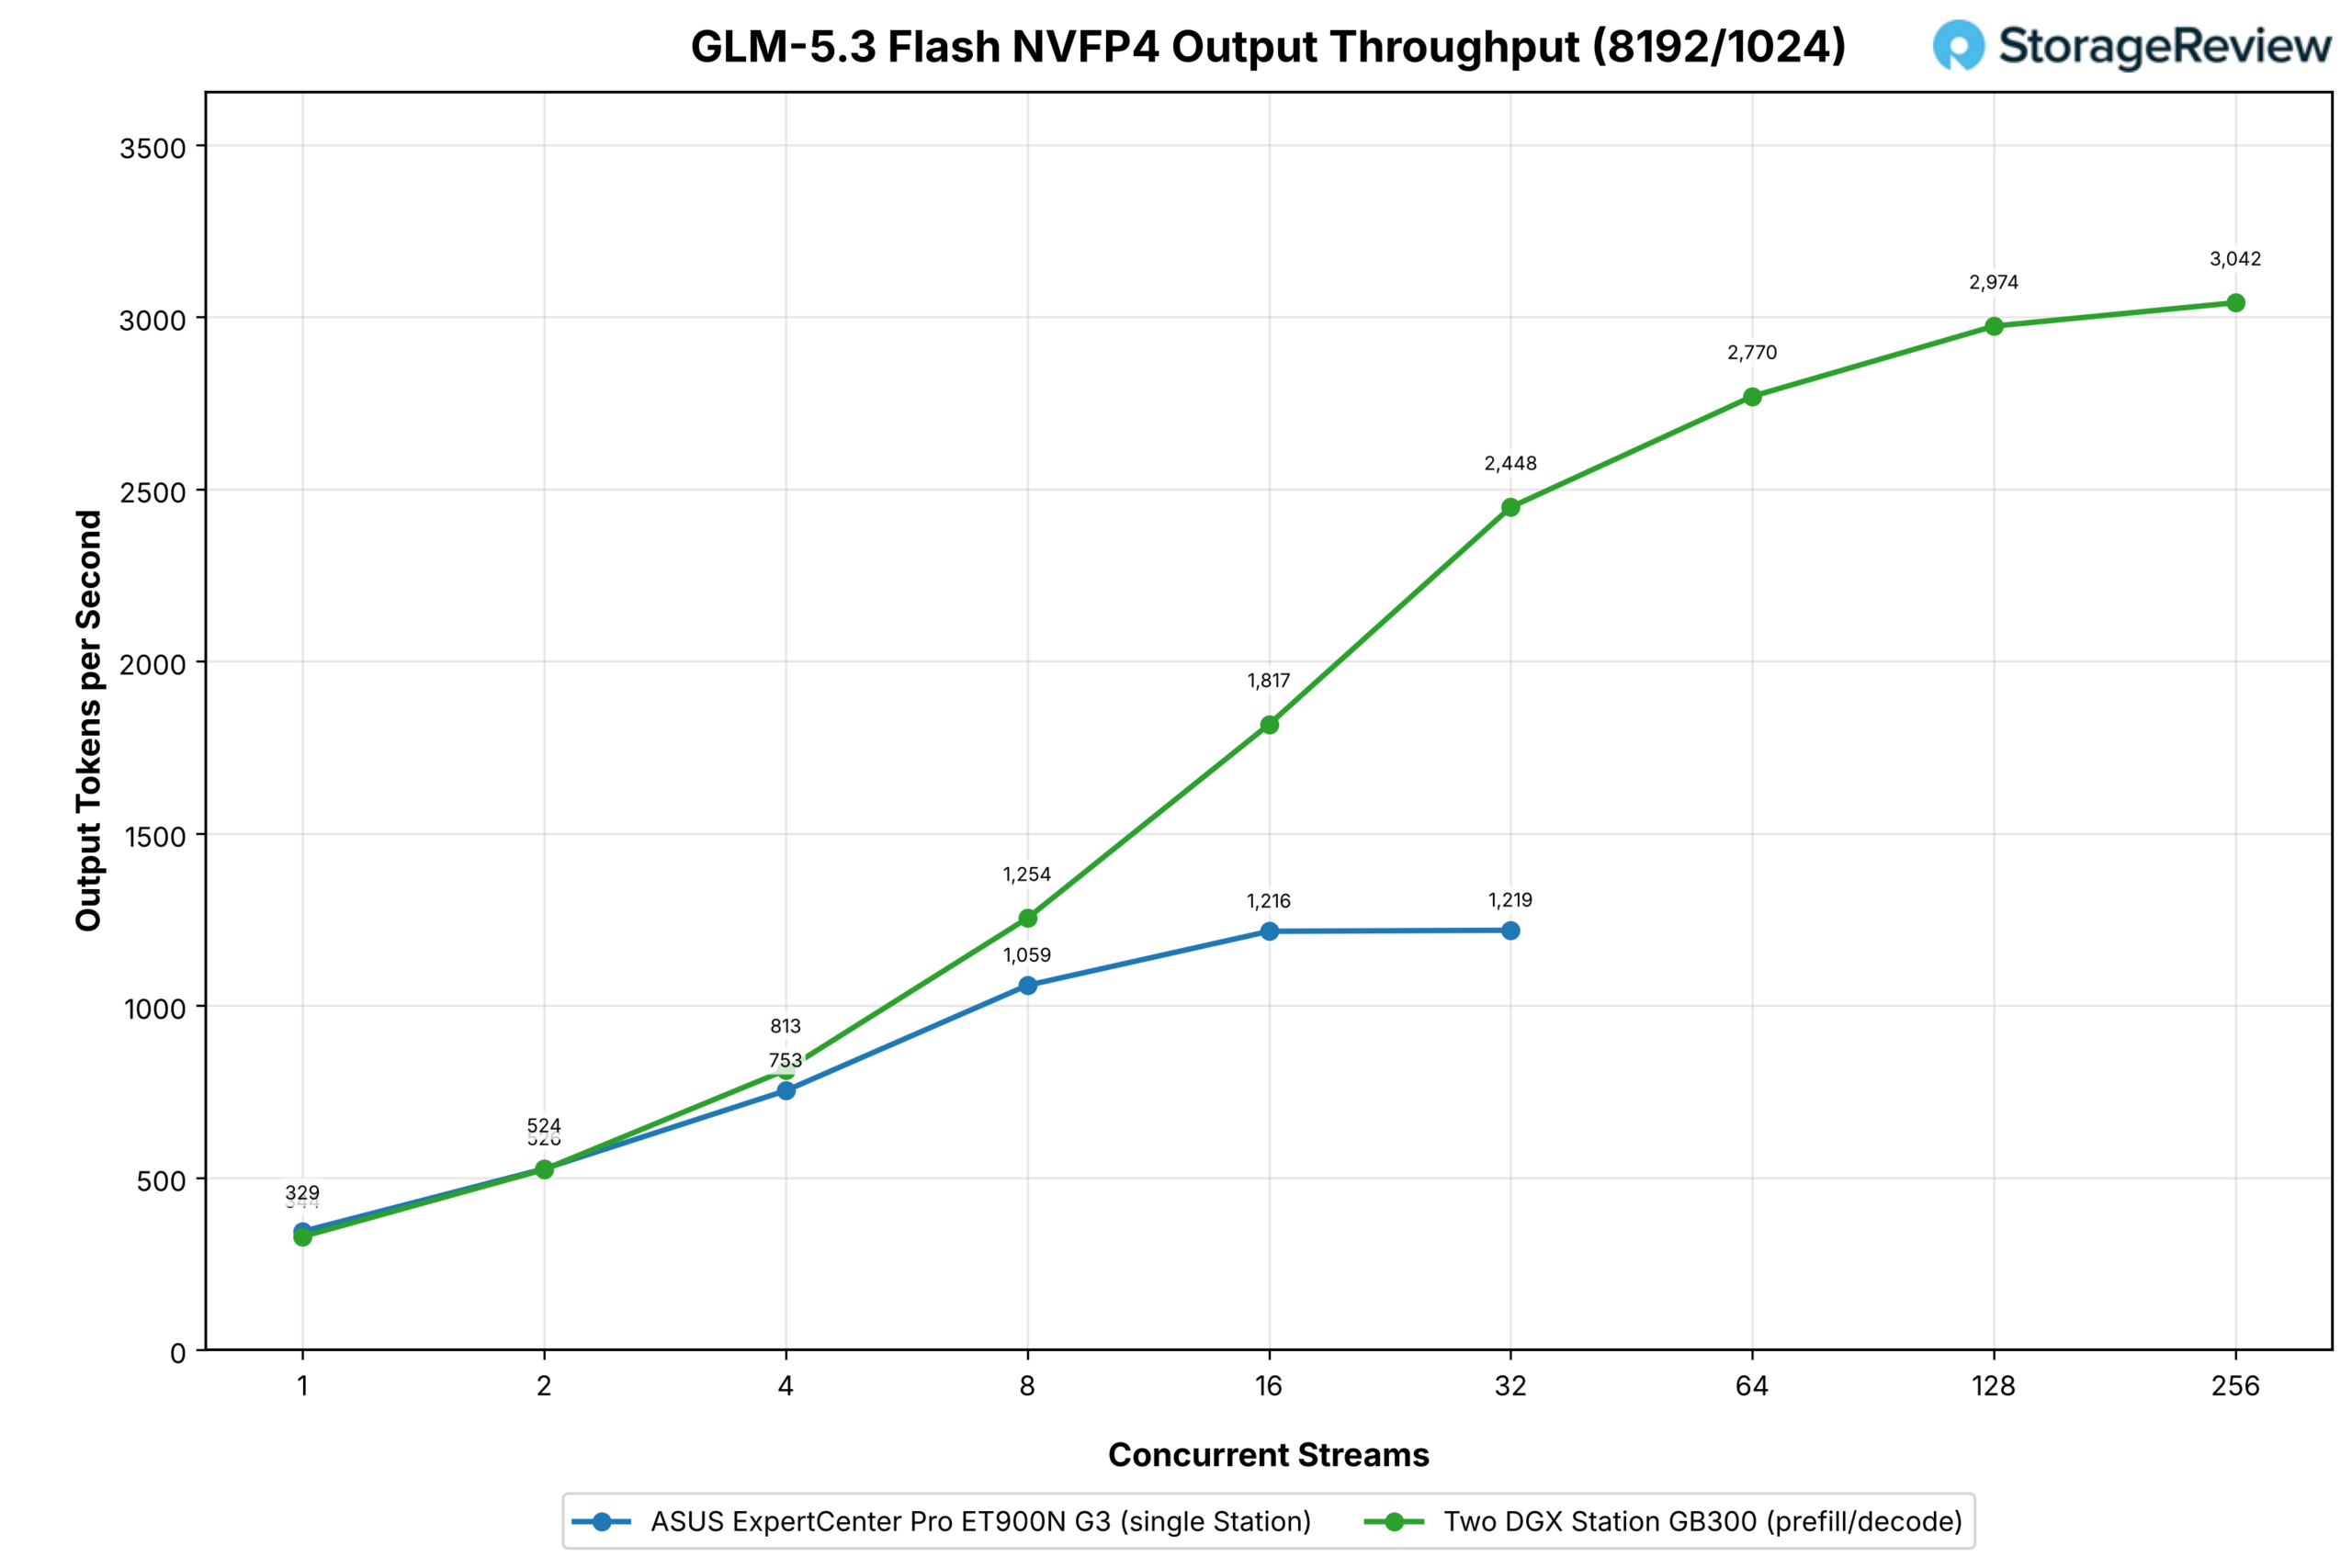
No perfil com alta demanda por pré-preenchimento, a Estação única passou de 344 tokens de saída por segundo com um fluxo para 1,216 com 16 fluxos, mantendo-se em 1,219 com 32 fluxos, estável a partir de 16 fluxos. O par pré-preenchimento/decodificação continuou a subir, de 329 com um fluxo para 2,448 com 32 fluxos, o dobro da Estação única onde havia se estabilizado, e chegando a 3,042 com 256 fluxos. Este sistema foi projetado para prompts longos, pois a Estação de pré-preenchimento absorve os prompts de 8,192 tokens enquanto o cache KV e o poder computacional da Estação de decodificação permanecem em geração.
GLM-5.2
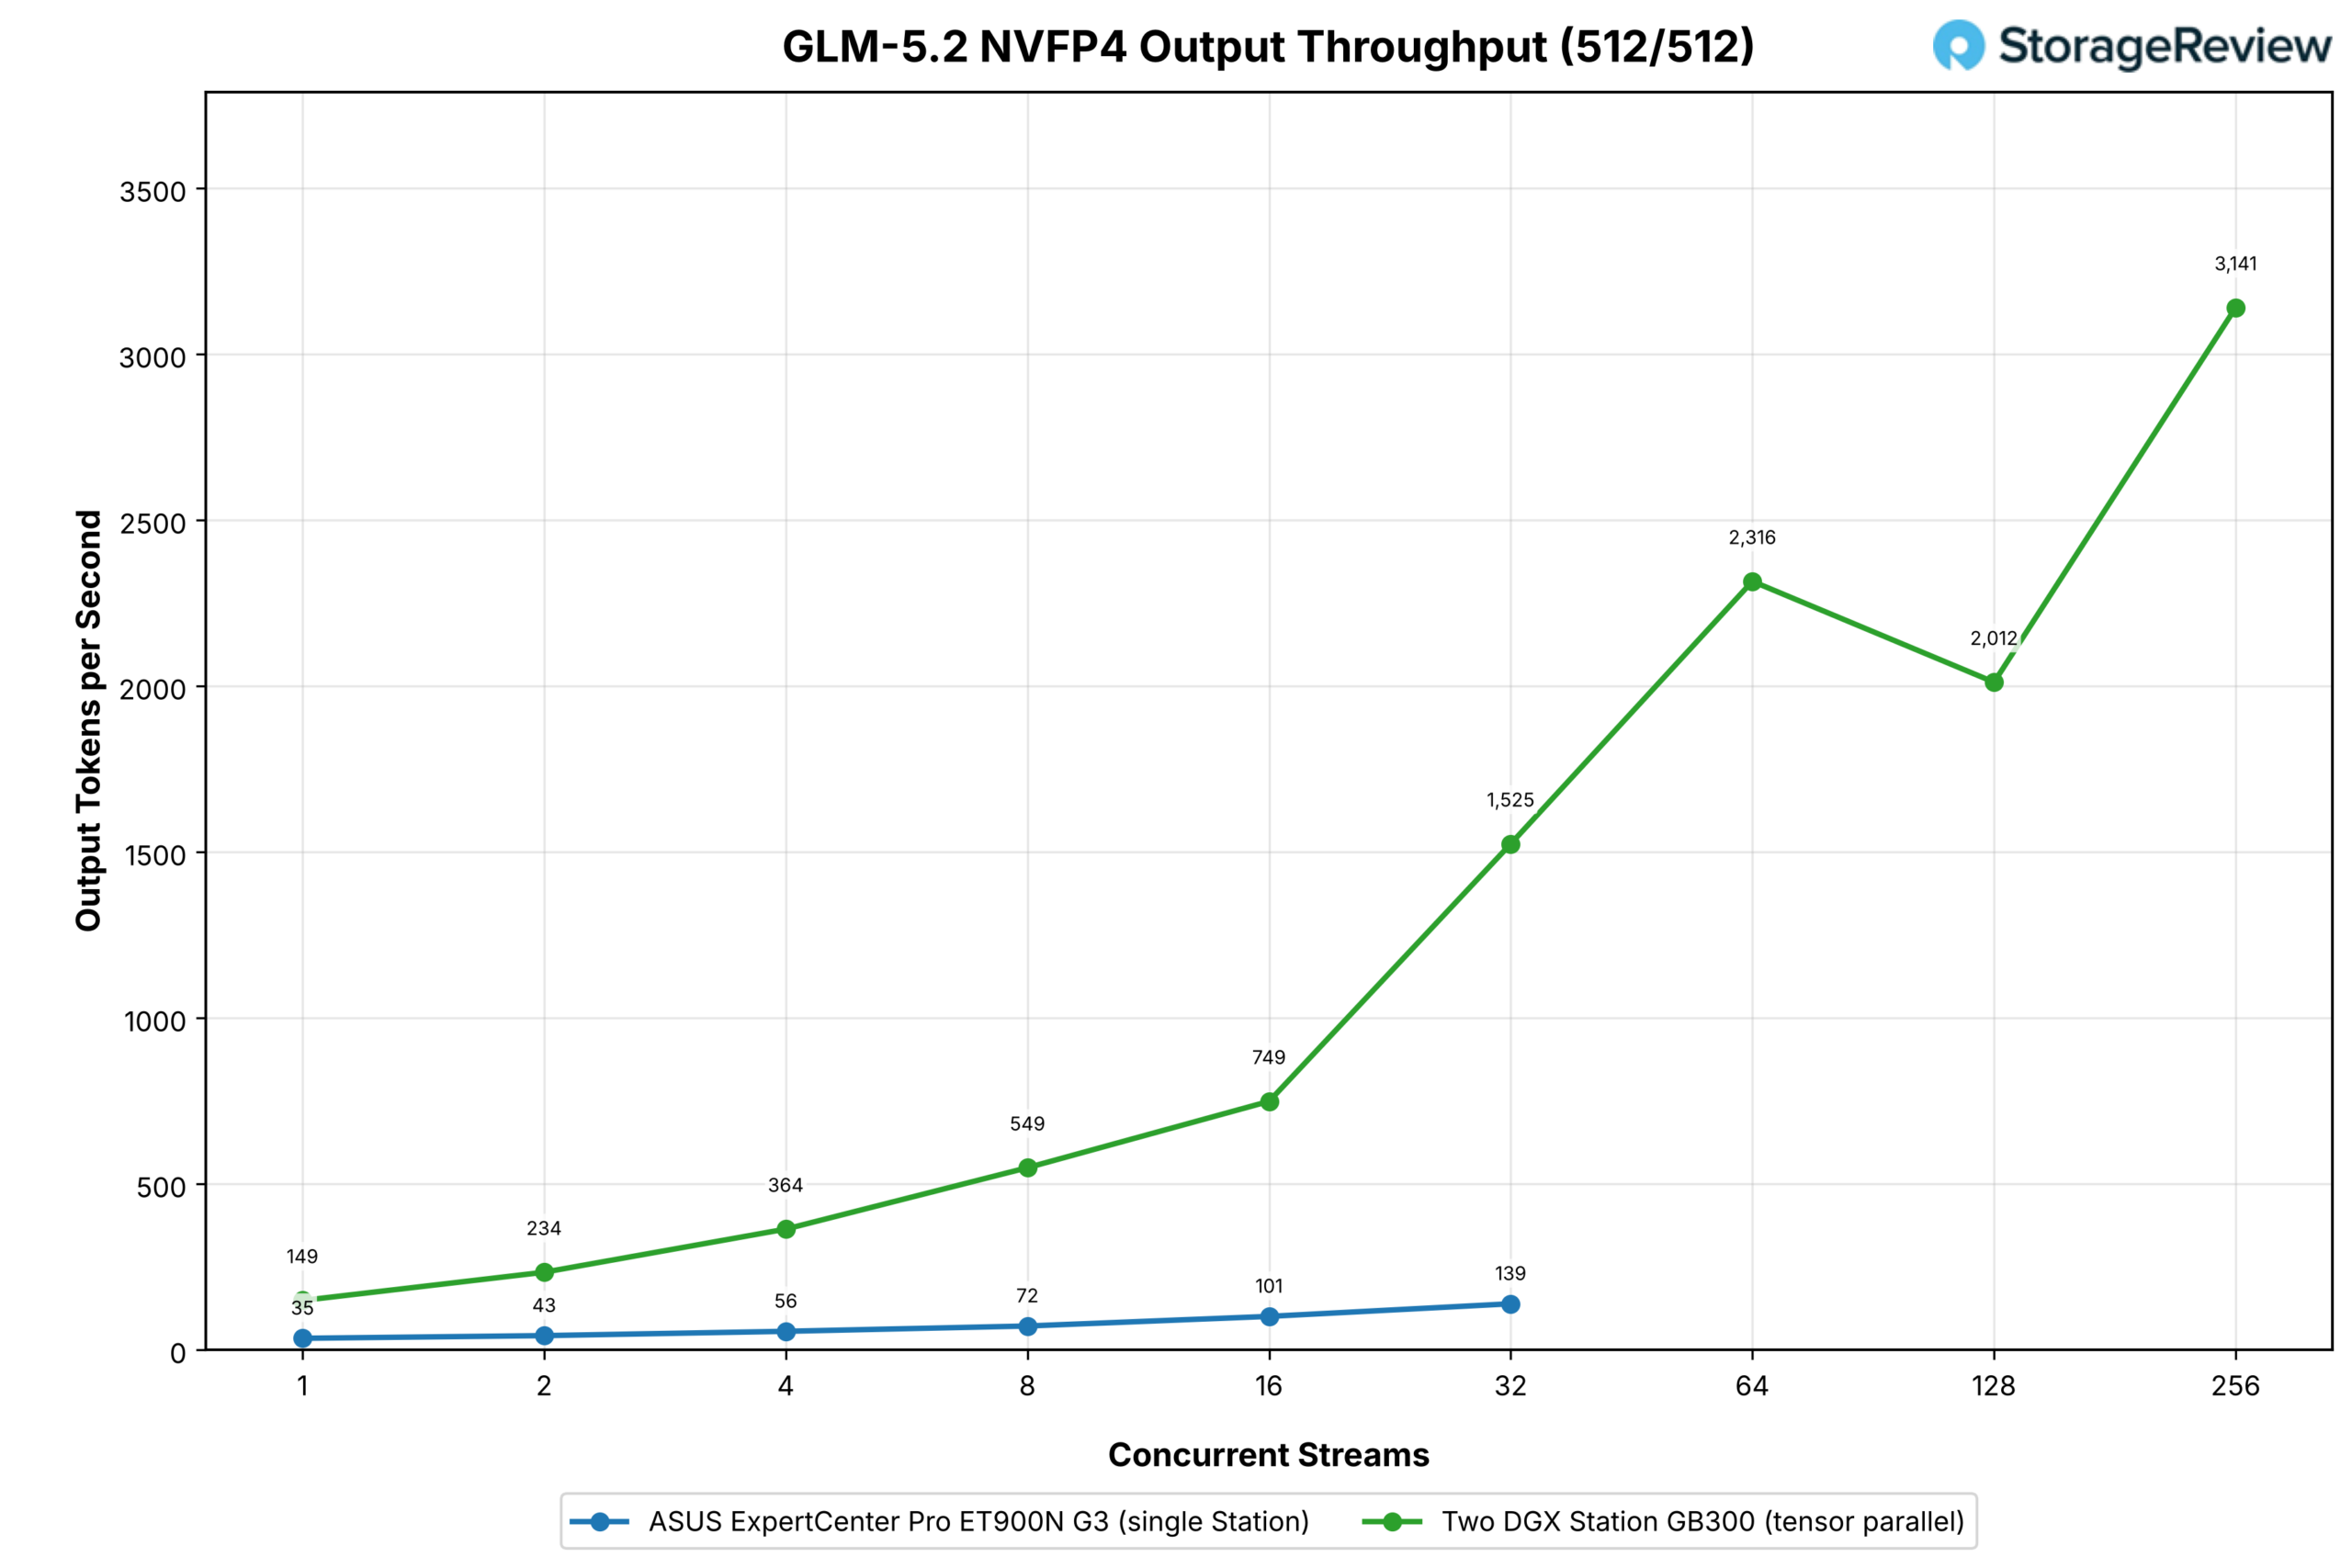
O GLM-5.2 foi executado no TP2 sem descarregamento Grace no cluster, e é o modelo que melhor justifica a utilização de uma segunda Station. O checkpoint NVFP4 tem cerca de 433 GB, portanto, em um GB300, aproximadamente 215 GB de pesos especialistas residem na memória Grace, e cada etapa de decodificação que os acessa utiliza a interface NVLink-C2C para transferência de dados via LPDDR5X a 396 GB/s. Dividido entre duas Stations, cada B300 armazena cerca de metade do modelo em HBM3e.
Com a mesma carga de trabalho, o ET900N G3 individual forneceu 35 tokens de saída por segundo em um fluxo e 139 em 32. O cluster de duas estações começou com 149 tokens por segundo em um fluxo, 4.3 vezes o desempenho da estação individual, atingiu 1,525 em 32 fluxos, 11 vezes mais, e continuou a subir, ultrapassando o desempenho da estação individual, para 2,316 em 64 fluxos e 3,141 em 256, com uma queda para 2,012 em 128. Um modelo em que uma estação atende a uma velocidade conversacional para um pequeno grupo de usuários se transforma em um modelo em que duas estações podem atender a um departamento inteiro.
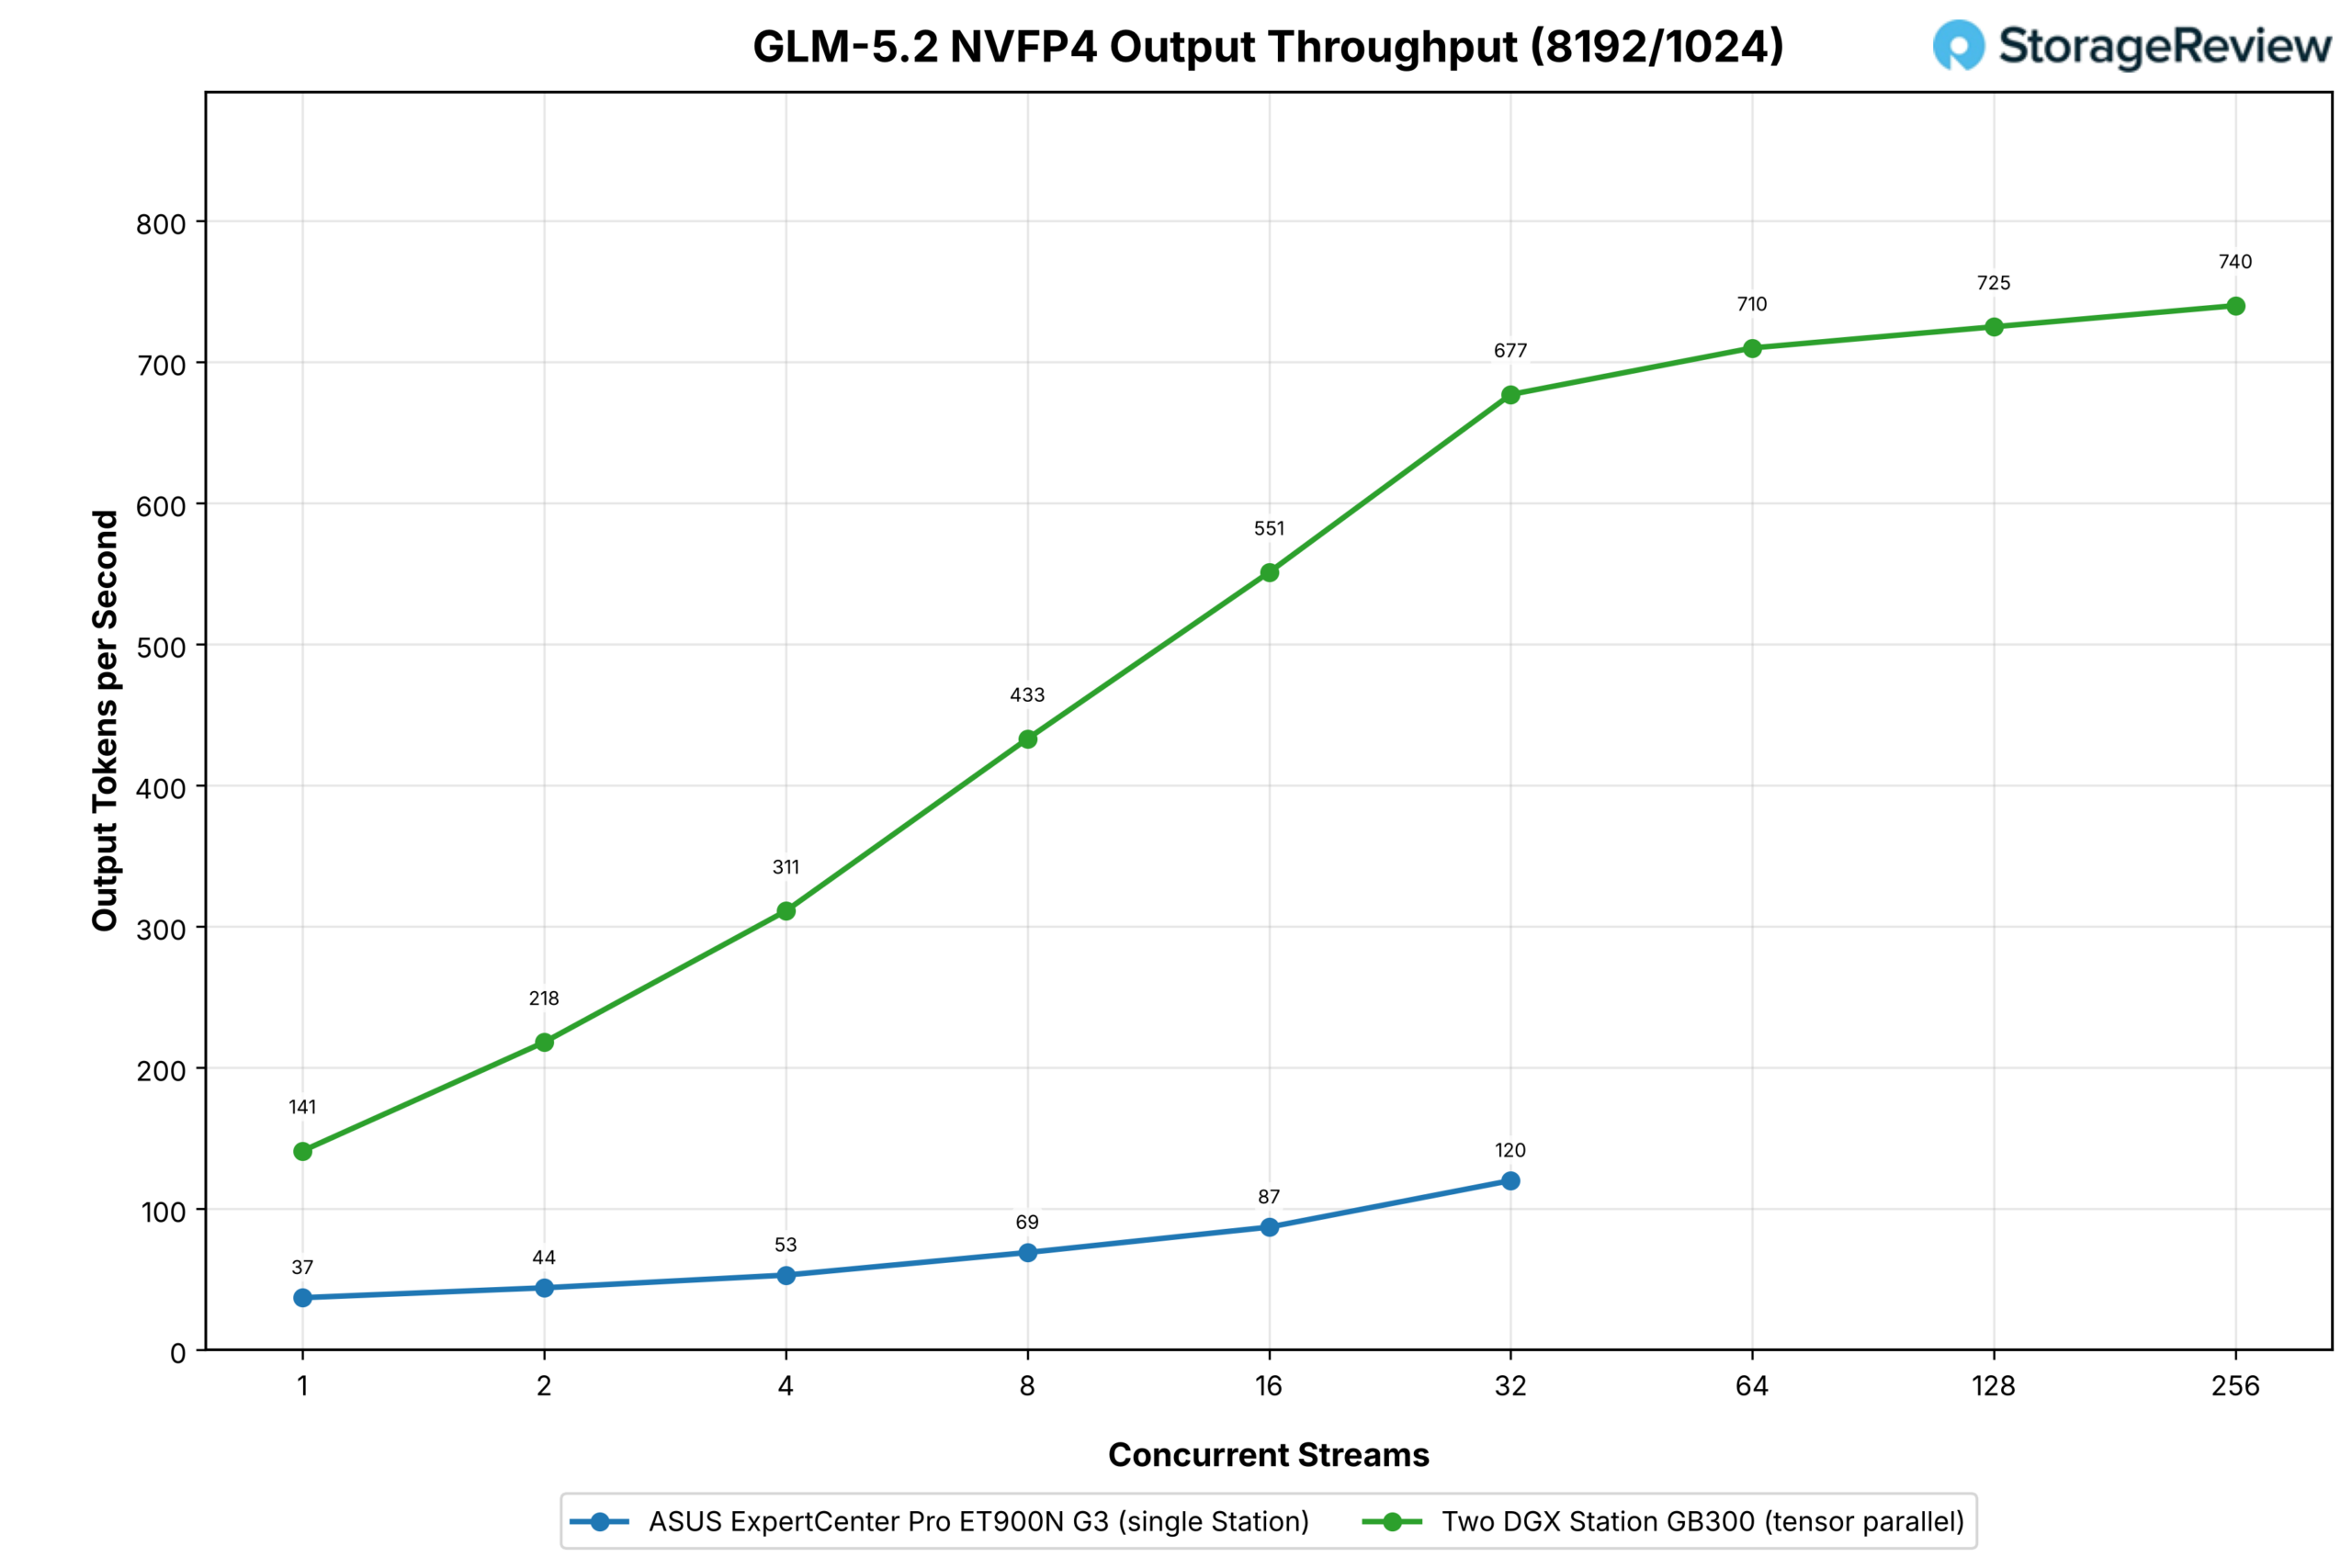
O perfil com alta carga de pré-carregamento conta a mesma história em uma altura menor, com uma Estação passando de 37 tokens de saída por segundo em um fluxo para 120 em 32, e o cluster passando de 141 para 677 na mesma faixa, 3.8x na parte inferior da varredura e 5.6x na parte superior, depois se estabilizando em 710, 725 e 740 em 256 fluxos.
Os prompts longos concentram mais trabalho no pré-preenchimento, onde ambas as configurações são limitadas pela capacidade computacional. Portanto, a penalidade de descarregamento que a segunda Station elimina representa uma parcela menor do total do que nos prompts curtos. O ganho ultrapassa o dobro em ambos os perfis, pois a segunda Station utiliza um modelo de 433 GB de LPDDR5X e o aloca totalmente em HBM, o que é mais relevante neste caso do que a capacidade computacional da segunda B300.
MiniMax-M3
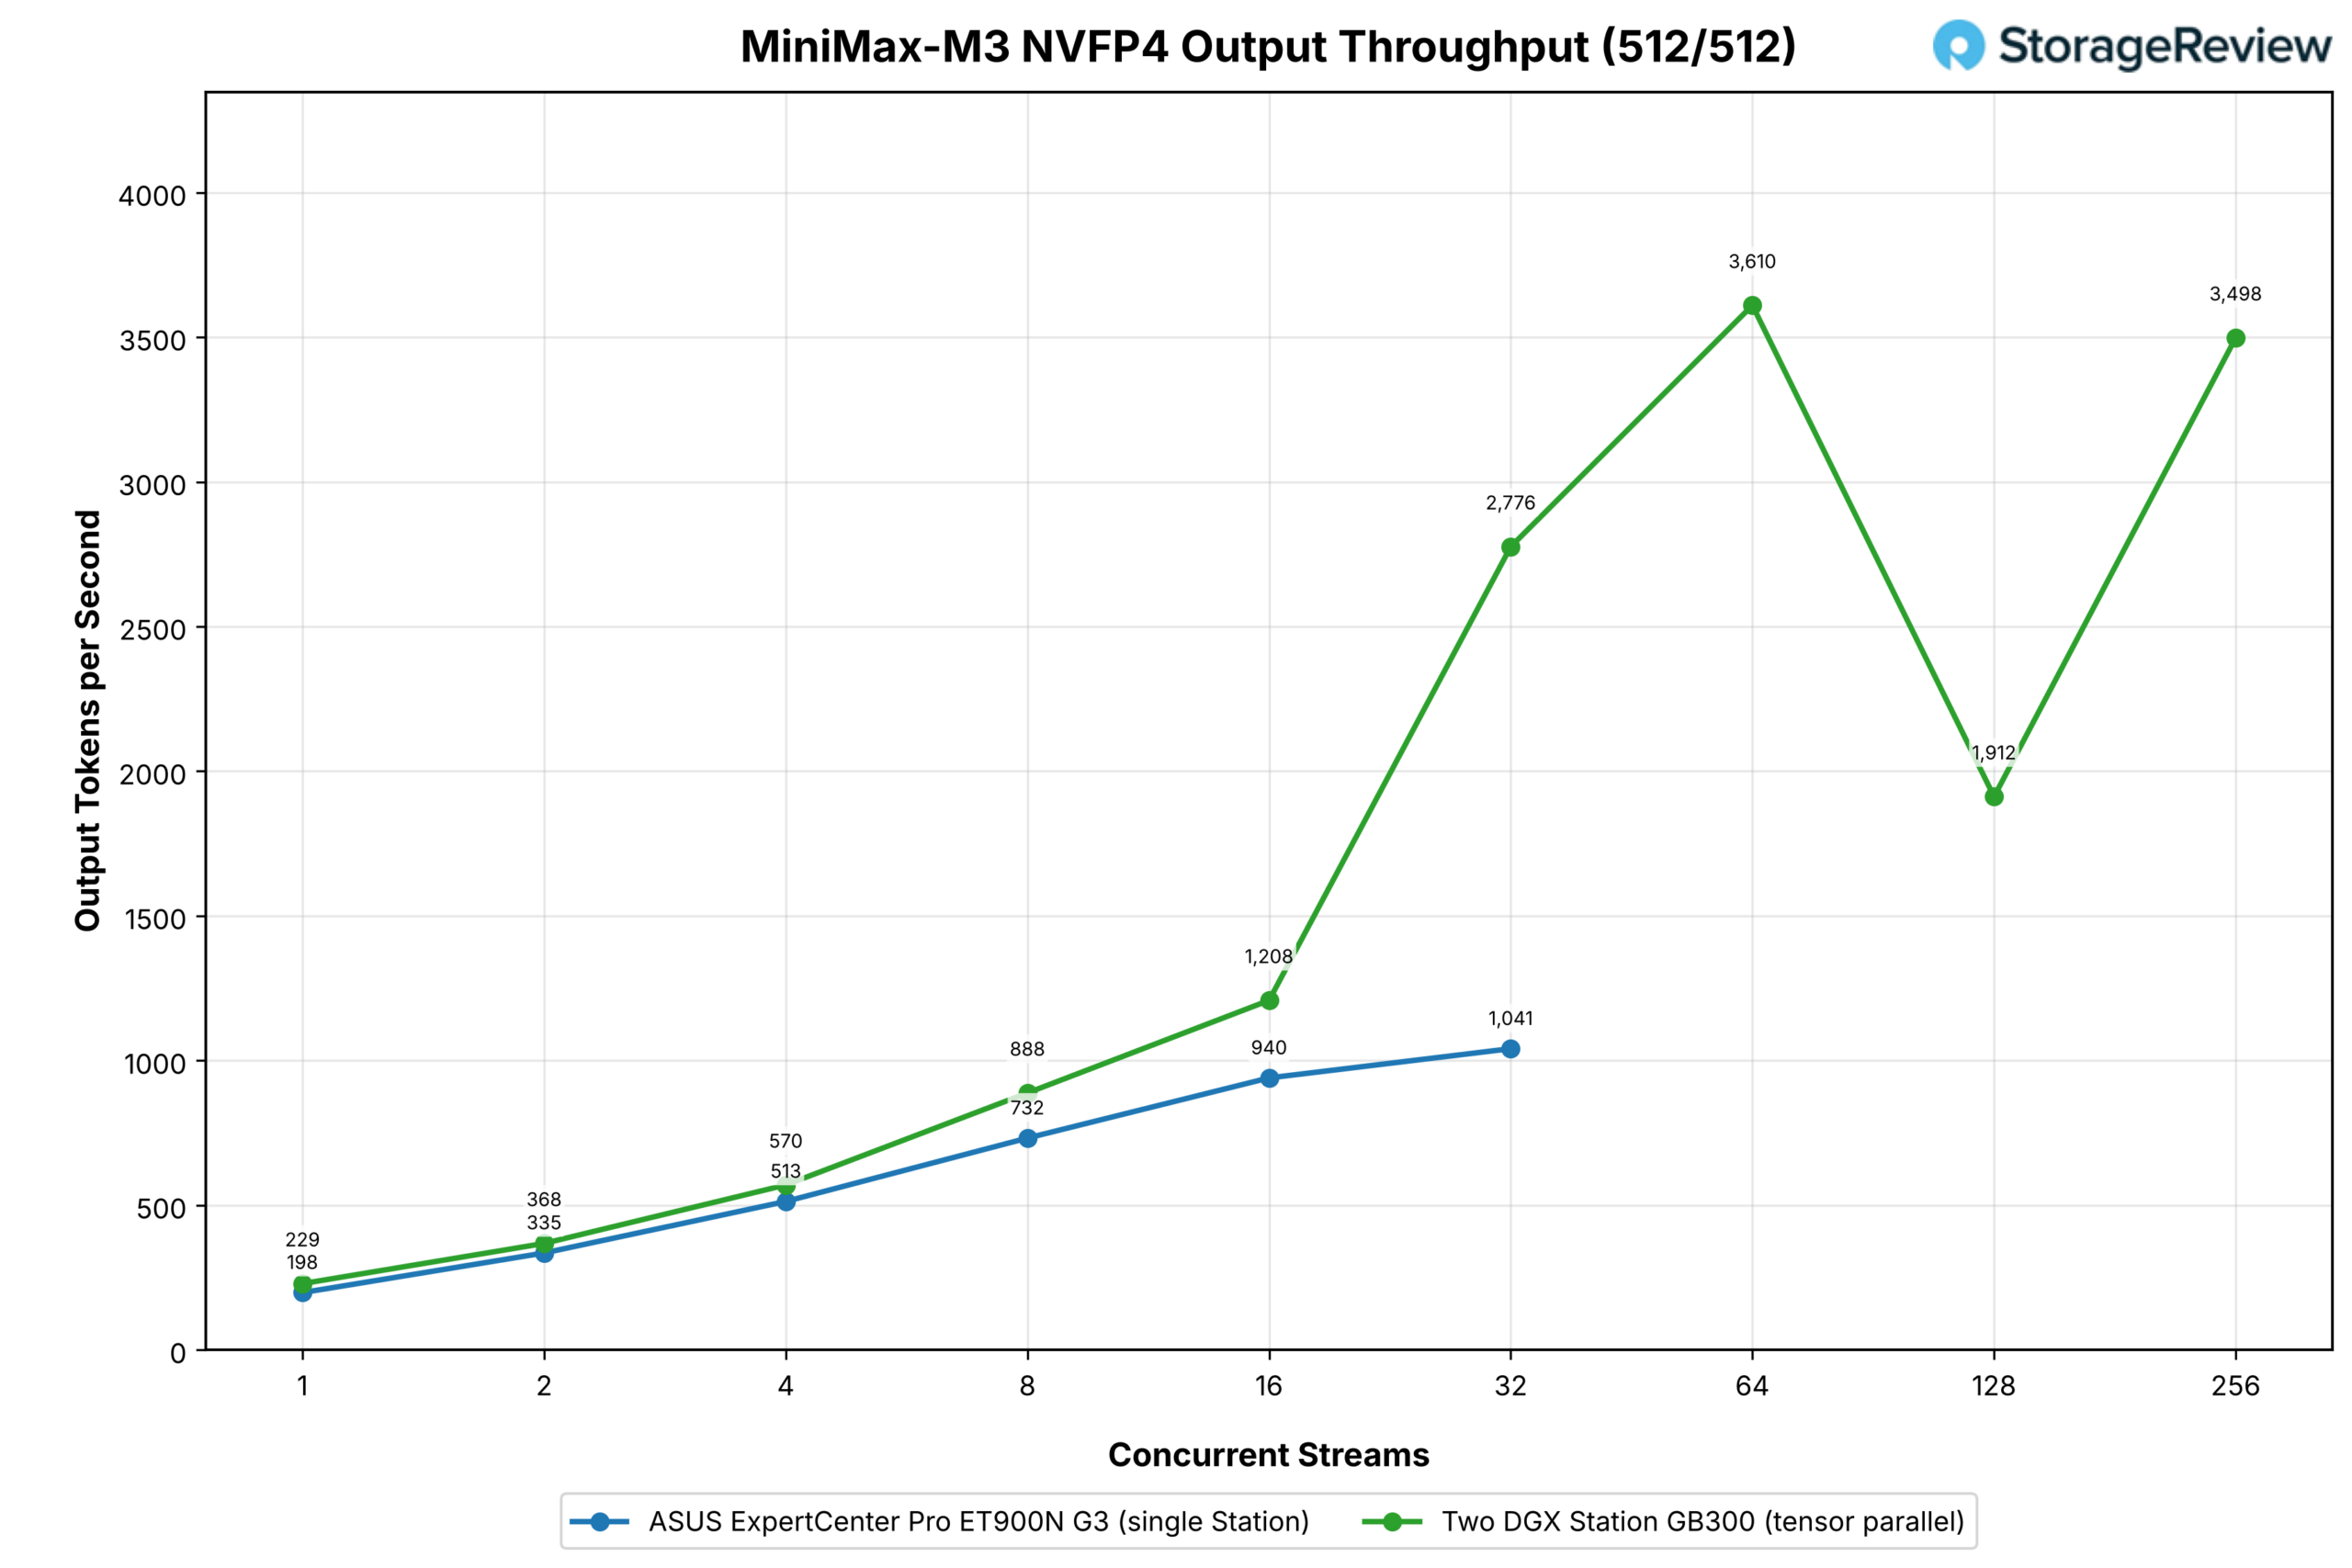
O MiniMax-M3 foi executado no TP2 sem descarregamento Grace. Em uma estação, ele fica exatamente no limite da HBM, com uma parte de seus recursos na memória Grace, e na análise da ASUS atingiu 1,041 tokens de saída por segundo em 32 fluxos com a mesma carga de trabalho usando o EAGLE3.
O cluster acompanha de perto a Estação única ao longo de 16 fluxos (1,208 contra 940) e depois se distancia: 2,776 em 32, 2.7 vezes o desempenho da torre única, 3,610 em 64, uma queda para 1,912 em 128 e 3,498 em 256. Duas Estações adicionam menos aqui do que no GLM-5.2 porque uma Estação já mantém a maior parte deste modelo na HBM, então a contribuição da segunda GPU é mais próxima do escalonamento computacional simples, com espaço adicional no cache KV.
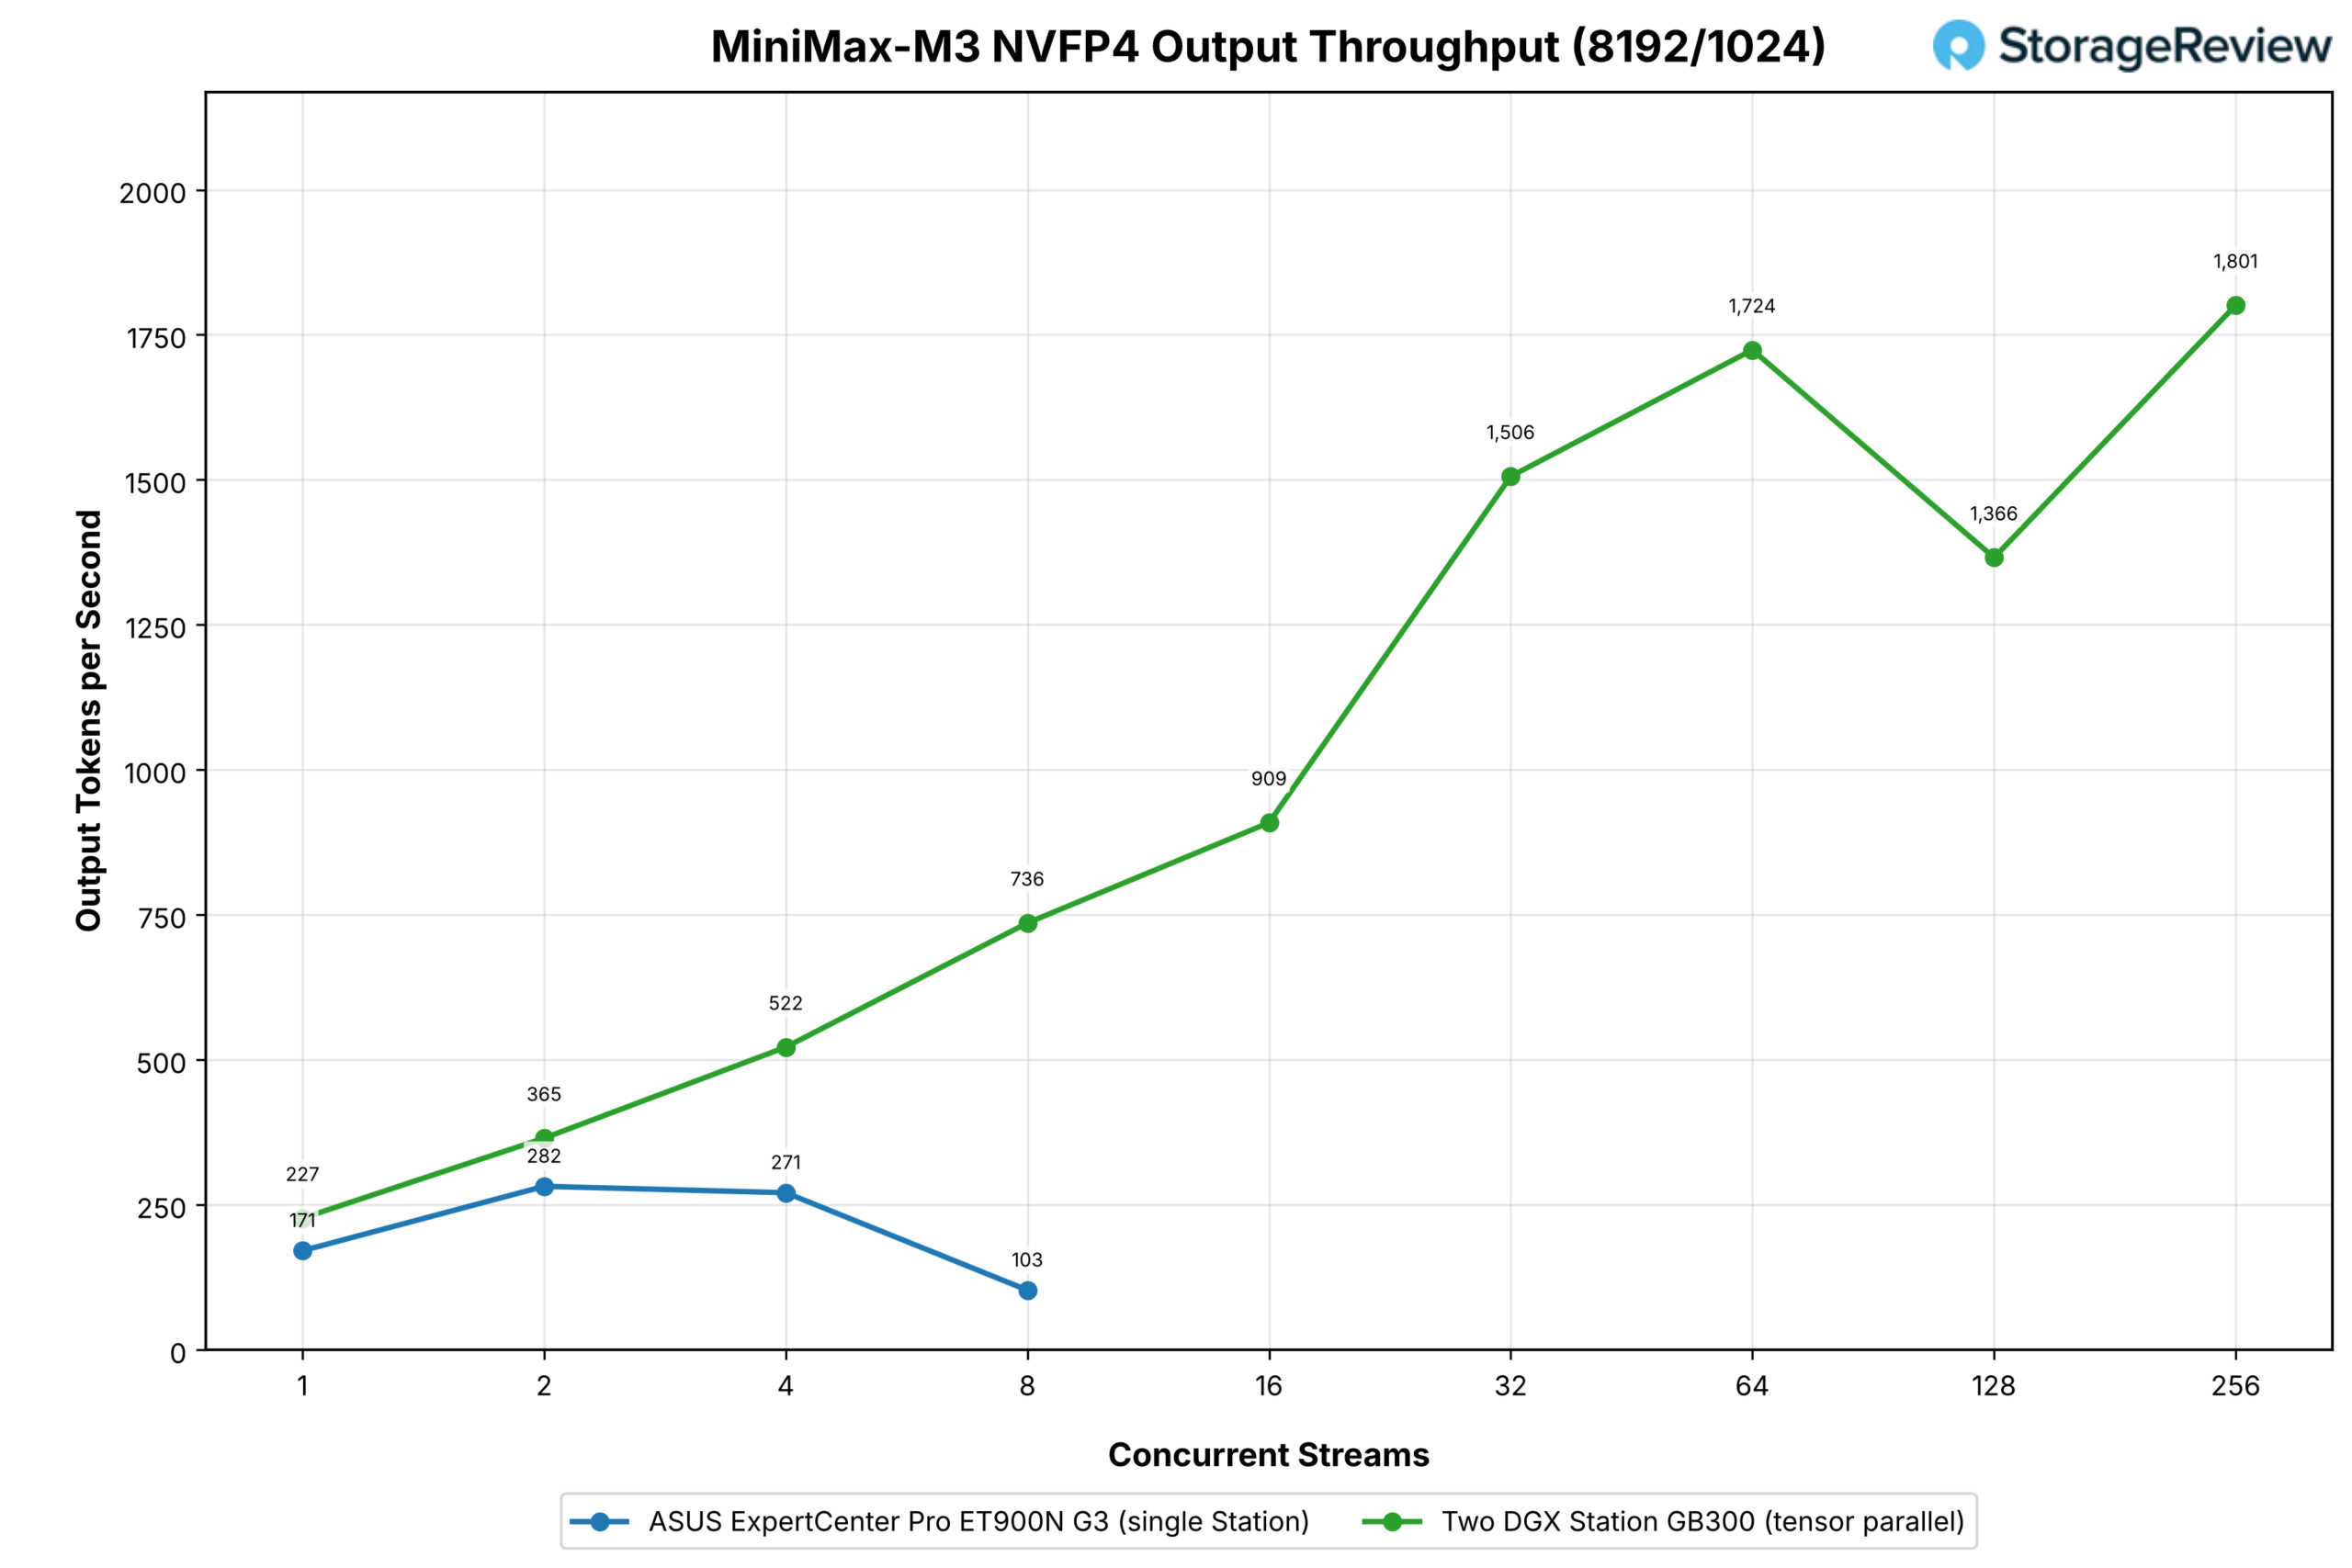
O perfil com uso intensivo de pré-carregamento foi onde o MiniMax-M3 ficou sem espaço em uma única estação: solicitações de 8,192 tokens consumiram rapidamente o cache KV restante, de modo que a torre única atingiu um pico de 282 tokens de saída por segundo com dois fluxos, manteve 271 com quatro e caiu para 103 com oito, onde a varredura terminou porque não havia mais nada para medir.
Com o modelo dividido em duas Estações, os mesmos pontos foram registrados como 365, 522 e 736, um ganho de 30% com dois fluxos, onde ambas as configurações têm cache disponível, e 7.1x com oito, onde um deles ficou sem cache. O cluster então continuou para 909 com 16 fluxos, 1,506 com 32, 1,724 com 64, 1,366 com 128 e 1,801 com 256, uma faixa que uma única Estação não consegue alcançar neste perfil.
Conclusão
Duas estações GB300 DGX interligadas por meio de suas respectivas portas ConnectX-8 funcionam conforme o prometido na documentação da NVIDIA; a configuração foi simples e estes são os primeiros dados de throughput que vimos para a configuração de sistema duplo.
A segunda estação justifica sua utilização com modelos que excedem os 252 GB de HBM3e: o GLM-5.2 passa de 139 tokens de saída por segundo com 32 fluxos em uma estação para 1,525 com duas, e para 3,141 com 256 fluxos, porque a divisão retira um modelo de 433 GB do LPDDR5X; o GLM-5.3 atinge 5,018 com 256 fluxos, partindo de um limite de 188 com uma única estação; o MiniMax-M3, em prompts longos, passa de uma torre que perde velocidade com oito fluxos para um par que continua a crescer com 256.
Nos dois modelos que cabem em uma única Estação, GLM-5.3 Flash e DeepSeek V4.1 Flash, a melhor maneira de usar o segundo dispositivo é fornecer uma cópia completa para cada Estação, separar o preenchimento da decodificação e deixar o processo de decodificação gerar os dados sem pausas; no GLM-5.3 Flash, isso dobrou a taxa de transferência de prompts longos para 32 fluxos e triplicou a taxa de transferência de prompts curtos, e o DeepSeek V4.1 Flash apresentou a maior taxa de transferência de saída do conjunto, com 5,248 tokens por segundo.
Nossa opinião sobre o produto não mudou desde a análise do MSI XpertStation WS300 : esta é uma máquina interessante para um mercado específico, e se você precisar de uma, poderá precisar de mais uma.
A melhor maneira de executá-los é como infraestrutura fungível: um conjunto no qual uma equipe agenda o trabalho e o reconfigura conforme os projetos mudam, e a NVIDIA detém os componentes para que isso aconteça. Ela adquiriu a Run:ai para agendamento, a Brev para ambientes de desenvolvimento e a Lepton para um mercado de computação, e qualquer uma das três, combinada com um rack de Stations, tornaria o produto mais atraente, caso você tenha acesso a elas.
A configuração com duas caixas apresentou boa escalabilidade; o melhor ganho que medimos foi com o GLM-5.3, passando de 188 tokens de saída por segundo em uma única Station para 5,018 no par (um ganho de 27x), e com concorrência equivalente, o GLM-5.2 apresentou um ganho de 11x com 32 fluxos, ambos em modelos que uma única Station só consegue atender transferindo pesos para a memória Grace. Isso representa um resultado de 300 GB em 2x 400 GB, e nos deixa curiosos para ver como será uma Vera Rubin Station quando a NVIDIA lançar uma, com a próxima geração de HBM e NVLink-C2C.
O papel dessa solução não mudou: duas Stations em uma mesa, sem um rack ou data center atrás delas, agora executam os modelos que antes justificavam um servidor com GPU e os recursos que o acompanham. Assim, uma equipe que não consegue uma vaga no data center, ou não quer esperar por uma, tem agora acesso à inferência de ponta bem ao lado. A NVIDIA elevou o padrão para essa categoria, preço à parte. A classe GB300 está classificada em nosso ranking de Melhores Desktops para IA Local , e os dados desse cluster agora comprovam a escolha.



 Amazon