

A maior decisão de infraestrutura de IA que muitas empresas tomarão no próximo ano não será um investimento em GPUs, mas sim uma atualização de banco de dados. O Oracle AI Database 26ai é a versão com suporte de longo prazo para a qual a Oracle está direcionando sua base instalada da versão 19c. O 26ai coloca a busca vetorial no mesmo mecanismo que armazena as transações. Quando o índice vetorial reside no banco de dados, o array de blocos e a rede SAN subjacente se tornam infraestrutura de IA, transportando o tráfego de recuperação juntamente com as transações que já atendem.
Principais lições
- OLTP e busca vetorial compartilham uma mesma matriz: Com uma limitação de 45,000 IOPS em cada volume vetorial, o FlashSystem manteve 870,000 IOPS a 377 microssegundos e 6.9 GB/s com 25% de uso da CPU, enquanto o Swingbench sustentou cerca de 19,500 TPS constantes durante toda a execução; sem a limitação, a carga de trabalho vetorial consumiu 37% do OLTP.
- A tecnologia Fibre Channel de 64G praticamente dobra a taxa de transferência de busca vetorial: O mesmo host, array e Emulex LPe38102 SecureHBAs entregaram 85.0 consultas por segundo a 64G contra 43.7 a 32G, um aumento de 95%, com a latência p99 em 80 threads caindo de 4.08 segundos para 1.14 e a construção do índice IVF_FLAT terminando 28.8% mais rápido.
- O ransomware direcionado ao backup do RMAN foi detectado em menos de 60 segundos: O FlashSystem sinalizou todos os 31 volumes do grupo, criou um snapshot imutável da Cópia Protegida por conta própria e estendeu a retenção da última cópia válida conhecida, sem nenhum agente host no caminho.
- A capacidade vetorial é um item orçamentário do primeiro dia: Um milhão de embeddings de 1,024 dimensões transformaram 0.90 GB de texto original em 16.24 GB na SAN, 18 vezes o tamanho original, com 15 a 23 GB de espaço temporário necessário durante a criação do índice e um multiplicador que varia de 4.8x a 32.5x, dependendo do modelo de embedding.
- As operações do segundo dia permanecem no conjunto: O AutoZoning com zoneamento orientado a alvos da Brocade adiciona um host sem a necessidade de um ticket de zoneamento, as partições de armazenamento oferecem às equipes de DBA e IA tenants separados em um único sistema, e os Emulex SecureHBAs criptografam o tráfego entre host e array em trânsito por meio de uma estrutura Brocade Gen 8 com criptografia pós-quântica.
O banco de dados mudou sob a IA.
A Oracle construiu o 26ai em torno dessa ideia: um tipo de dados VECTOR nativo, funções de busca vetorial SQL, execução de modelos no banco de dados por meio do ONNX e SELECT AI para consultas em linguagem natural, tudo em uma versão LTS que a empresa enumera em mais de 300 novos recursos. Na prática, um DBA pode gerar embeddings, armazená-los ao lado das linhas que descrevem e executar uma busca por similaridade dentro do mesmo escopo de transação que uma consulta de pedido. Não há armazenamento vetorial separado para executar, nenhum pipeline de sincronização para manter e nenhuma segunda cópia de dados regulamentados fora do registro de auditoria.
A IBM cita a IDC sobre a tendência: "Bancos de dados vetoriais integrados são a plataforma de escolha óbvia para armazenar e consultar embeddings vetoriais, já que as organizações preferem ambientes unificados e governados para IA agente." Os clientes da IBM e da Broadcom querem expandir o banco de dados em que já confiam antes de implementar um novo em paralelo.
A Oracle não está sozinha nessa direção. O ranking de popularidade da DB-Engines de outubro de 2026 lista os quatro principais mecanismos relacionais e multimodelo: Oracle, MySQL, Microsoft SQL Server e PostgreSQL, e todos os quatro adicionaram tipos vetoriais ou pesquisa vetorial, nativamente ou por meio de extensões como o pgvector. A IBM optou por iniciar seu trabalho de validação com a Oracle principalmente devido à sua liderança de mercado, embora o argumento de armazenamento neste artigo também se aplique aos outros.

Os argumentos para manter o armazenamento em blocos localmente não mudaram com a entrada da IA no cenário: os dados que tornam uma implementação de IA útil, como registros de pacientes, solicitações de reembolso, pedidos e transações, não podem sair. Copiá-los para uma plataforma de IA dedicada significa pagar pelo armazenamento duas vezes, aceitar que a cópia se desvie do cluster de produção e perder os controles de governança que tornavam o original legalmente defensável. Manter a recuperação dentro do banco de dados evita todos esses três problemas. O array que realiza uma busca de linha em menos de um milissegundo agora também serve para uma varredura de similaridade vetorial para um médico e como um fluxo de backup simultaneamente.
A IBM Storage e o grupo Fibre Channel (FC) da Broadcom decidiram validar esse cenário de carga de trabalho mista e construíram um ambiente em torno do Oracle AI Database 26ai no IBM FlashSystem com a SAN Brocade Gen 8 da Broadcom e HBAs SecureHBA de 64G da Emulex . Em seguida, analisaram as questões que uma equipe de infraestrutura vinha levantando: qual o impacto na latência transacional quando uma carga de trabalho vetorial é iniciada em seguida, o efeito da velocidade da SAN na taxa de transferência de busca vetorial, a capacidade consumida por embeddings, a eficácia da detecção de ransomware ao atacar um volume de backup do RMAN e quais os requisitos para adicionar um host à SAN sem um ticket de zoneamento?
Os dados já residem em armazenamento em blocos, e agora a IA chega até eles.
Nada disso significa que as cargas de trabalho de IA em geral devam ser armazenadas em blocos. As empresas manterão arrays de arquivos e objetos para o conjunto de dados não estruturados: documentos, imagens, vídeos, conjuntos de treinamento e pontos de verificação de modelos que nunca estiveram em um banco de dados e provavelmente nunca estarão. Na demonstração na área da saúde que se segue, a IBM mantém as imagens brutas de raios X em armazenamento de objetos, enquanto armazena apenas os embeddings e os metadados do caso no Oracle. O que muda é a carga sobre o array, que agora suporta várias cargas de trabalho com perfis de E/S muito diferentes simultaneamente.
A camada relacional é a mais familiar: milhões de operações de E/S aleatórias de 4 KB a 16 KB por segundo, consultas e confirmações de linhas que precisam ser concluídas em microssegundos, alta concorrência de escrita devido ao tráfego de refazer, desfazer e checkpoint, e uma latência residual que permanece previsível porque um aplicativo voltado para o usuário está aguardando sua conclusão. O RMAN, utilitário de backup da Oracle, é o oposto: um fluxo sequencial que precisa de margem de segurança para terminar dentro de sua janela sem interromper a primeira carga de trabalho. Ambos são bem compreendidos, e os arrays da IBM são otimizados para eles.
A camada vetorial é mais difícil de caracterizar porque grandes tabelas de incorporações vetoriais podem fazer com que a busca vetorial pareça uma carga de trabalho com uso intensivo de largura de banda: uma grande varredura sequencial. A caracterização do caminho vetorial do Oracle 26ai feita pela IBM se aproxima mais do OLTP. Cada salto pelo índice é uma leitura aleatória de aproximadamente 4 KB; o caminho da consulta é limitado por IOPS e sensível à latência, e as leituras predominam porque as gravações ocorrem em uma fase separada de ingestão e construção de índice.
A largura de banda é importante em picos de demanda, quando um índice é criado ou um corpus é re-incorporado, e esses picos tendem a ser bastante grandes. Essa divisão é o cerne do problema de E/S mista: no caminho da consulta, a carga de trabalho vetorial compete com as transações pelas mesmas filas, tornando o isolamento uma preocupação de qualidade de serviço. E as fases de pico são onde a largura de banda da malha se torna o limite, como mostram os resultados de 32G versus 64G mais adiante neste artigo.
A arquitetura validada
A IBM e a Broadcom criaram um ambiente para essa validação no laboratório de IA da Broadcom no Colorado. O armazenamento é um array IBM FlashSystem série 9000 executando o IBM Storage Virtualize 9.1.3 com 24 módulos FlashCore, apresentando portas Fibre Channel de 64G para um par de switches SAN Brocade Gen 8 G820. O host do banco de dados é um servidor Intel Xeon 6767P de dois soquetes com dois SecureHBAs Emulex LPe38102 de 64G de duas portas, executando o Oracle AI Database 26ai em ASM sem GPU no caminho de armazenamento; o IBM Storage Insights monitora o array.

Executamos os testes de estrutura e capacidade, a comparação de busca vetorial de 32G versus 64G e as medições de pegada usando o VectorDBBench no conjunto de dados BioASQ 1M, exclusivamente nesse host. A mesma configuração também suporta a carga de trabalho do aplicativo. Um Supermicro 821GE-TNHR com dois processadores Xeon Platinum 8470 e oito GPUs NVIDIA H100 de 80 GB hospeda o aplicativo de saúde e seu modelo de linguagem. O conjunto de software inclui o ONNX embutido no banco de dados da Oracle, o Ollama servindo Llama 3 e o NVIDIA cuVS. Um switch Broadcom Tomahawk 5 e placas de rede Thor 2 de 400 GbE conectam os dois servidores. As demonstrações de QoS de E/S, multilocação, detecção de ransomware e aplicação na área da saúde foram executadas nesse ambiente.

De acordo com a IBM, a família FlashSystem ( 5300 e 5600, 7300 e 7600, e 9500 e 9600) utiliza o mesmo software Storage Virtualize, e as funções demonstradas aqui, incluindo limitação de E/S, AutoZoning, detecção de ransomware, alta disponibilidade baseada em políticas e migração de partições de armazenamento, funcionam da mesma maneira com o Oracle AI Database 26ai em qualquer um desses arrays, no mesmo nível de código. O desempenho e a densidade variam conforme o modelo e a geração do módulo FlashCore; portanto, todos os dados apresentados neste artigo referem-se ao sistema em que foram medidos.
Garantindo o desempenho ideal de cargas de trabalho OLTP e vetoriais com QoS de E/S.
A primeira pergunta que a IBM e a Broadcom se propuseram a responder é a que todo DBA faz quando uma carga de trabalho vetorial é proposta para o array de produção: o que acontece com as transações principais? A IBM executou duas demonstrações no array FlashSystem série 9000 usando limitação de E/S em nível de volume, o mecanismo por trás do que a IBM chama de QoS de E/S. O banco de dados foi distribuído em 30 volumes: 15 para os tablespaces OLTP (ORCL16 a ORCL30) sob o Swingbench Order Entry com 192 usuários, e 15 para as tabelas vetoriais (ORCL31 a ORCL45) sob um gerador sintético de 200 threads executando consultas de similaridade top-k 500, com o Storage Insights mapeando cada grupo de volumes.
Com o OLTP em execução isoladamente, cada volume OLTP mantinha uma taxa constante de 20,500 operações por segundo. Quando o gerador de vetores foi iniciado, a taxa de operações nos volumes de vetores subiu para cerca de 73,000 operações por segundo cada, em um minuto, enquanto a dos volumes OLTP caiu para cerca de 13,000, uma queda de 37% sem nenhuma alteração no lado transacional. O caminho de busca do vetor consiste em leituras aleatórias de 4 KB no mesmo tamanho de bloco das transações, portanto, ele acessa as mesmas filas e utiliza o que o array disponibiliza.

Um limite de 45,000 IOPS em cada volume vetorial, uma linha de mkthrottle Na CLI, os volumes vetoriais foram levados ao limite e o OLTP voltou a atingir cerca de 17,000 operações/s. A remoção do limite reverteu a situação e, quando a execução vetorial terminou, o OLTP retornou a 20,500. O painel de controle registrou o mesmo resultado agregado: 1.28 milhão de IOPS sem limitação e aproximadamente 950,000 abaixo do limite, o que, com uma pequena margem de erro, corresponde à taxa por volume multiplicada por 30 volumes.

A segunda demonstração representa a configuração que a IBM espera implementar em produção: limites definidos inicialmente, 45,000 IOPS por volume vetorial e 20,000 por volume OLTP, e então ambas as cargas de trabalho foram executadas simultaneamente. Os volumes vetoriais operaram em sua capacidade máxima, os volumes OLTP estabilizaram em cerca de 12,200 operações/s e permaneceram estáveis durante toda a execução, e o array manteve 870,000 IOPS (800,000 de leitura, 70,000 de gravação) em 377 microssegundos e 6.9 GB/s com 25% de uso da CPU. O limite do OLTP ficou acima da demanda da carga de trabalho e nunca foi acionado; ele existe para que um desempenho descontrolado em qualquer um dos lados não prejudique o outro.
O Swingbench manteve seus 192 usuários a cerca de 1.19 milhão de transações por minuto, aproximadamente 19,500 TPS, durante toda a execução. O gerador foi configurado para saturar seus volumes, portanto, sua latência por consulta não é um benchmark de aplicação. Ao longo dos 30 minutos de execução, foram concluídas 35,672 consultas a uma taxa de 19.8 por segundo, com uma latência mediana de cerca de 10 segundos e um p99 de 14.3 segundos, contra um tempo limite de aplicação de 15 segundos; 99 consultas (0.28%) atingiram esse tempo limite, e as transações não foram afetadas.


A limitação de volume do FlashSystem é um limite máximo imposto no array, independentemente do host ou caminho, com um limite de largura de banda opcional além do limite de IOPS; ela limita o volume do vizinho e não reserva nada. O limite é um exercício de dimensionamento: 15 volumes vetoriais a 45,000 IOPS resultam em 675,000 IOPS de margem livre para vetores, o que deixou os volumes OLTP deste array com a capacidade necessária. Um array diferente ou uma combinação de arrays diferentes pode alterar esse número. Defina o limite de volume vetorial onde as transações mantêm sua latência, e a carga de trabalho vetorial receberá tudo o que estiver acima desse limite.
Detecção de ransomware em volumes Oracle em produção
Uma pesquisa da Sophos de 2024 com 2,974 organizações atingidas por ransomware revelou que 94% delas viram os invasores tentarem atingir seus backups, que a tentativa foi bem-sucedida em 57% dos casos e que os custos médios de recuperação foram oito vezes maiores quando isso aconteceu. A IBM construiu o teste com base na mesma premissa: backups em primeiro lugar e produção em segundo, direcionando o ataque ao backup do RMAN, sem afetar os volumes do banco de dados. O RMAN gravou seus conjuntos de backup em volumes FlashSystem, um simulador de ransomware foi executado contra eles e o array foi deixado em modo de segurança, sem nenhum agente host no caminho.
A detecção ocorre dentro das unidades: os módulos FlashCore FCM4 e FCM5 calculam a entropia e a compressibilidade a cada gravação, juntamente com o tamanho do bloco, o endereço e os padrões de reescrita. A cada dois segundos, um resumo por volume é enviado para um mecanismo de inferência dentro do Storage Virtualize (versão 8.6.3 ou posterior com firmware FCM 4.1 ou posterior). O modelo gera alertas na GUI do FlashSystem e no IBM Storage Insights Pro, encaminha-os para o Storage Defender ou um SIEM e pode ser corrigido independentemente. Assim, um modelo reconfigurado é distribuído como uma pequena atualização de segurança, sem necessidade de atualização de firmware.
Como a análise é executada no módulo, ela continua funcionando mesmo quando o host é o sistema comprometido. A saída criptografada possui alta entropia e para de ser comprimida, o que fica evidente nas estatísticas, independentemente de o atacante alterar as extensões de arquivo, criptografar apenas um bloco sim, um bloco não, ou diminuir a taxa de transferência para se esconder de um agente no endpoint.
Durante a validação, o RMAN gravou o backup em 16 canais paralelos, com cada conjunto de backup limitado a 150 GB, e o banco de dados estava em 15 discos de 200 GB por grupo de discos ASM para dados OLTP e vetoriais. A IBM executou o ataque contra esse alvo de backup e o alerta chegou ao Storage Insights em menos de 60 segundos, o que está dentro da janela de detecção que a IBM publica para o recurso. O Storage Insights sinalizou todos os 31 volumes no grupo de volumes, já que um alerta em um volume marca todo o grupo como uma ameaça.
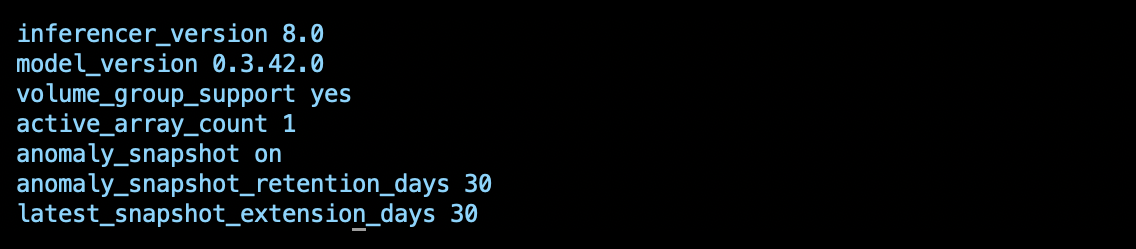
A resposta é "Cópia Protegida" e o array lidou com a situação sem intervenção do operador: o FlashSystem criou um snapshot imutável do grupo de volumes afetado no momento em que a ameaça foi detectada e estendeu a retenção do último snapshot válido conhecido simultaneamente. lsanomalydetection A saída do array mostra a configuração subjacente: mecanismo de inferência 8.0 com modelo 0.3.42.0, snapshot de anomalia ativado, 30 dias de retenção no novo snapshot e 30 dias adicionados ao último snapshot válido. O Storage Virtualize também marca o snapshot suspeito para que ninguém restaure a partir dele, deixando um ponto de restauração limpo de antes do início da criptografia.
A estrutura também inclui uma camada de segurança. A Broadcom incorpora criptografia pós-quântica nas plataformas Brocade Gen 8, os SecureHBAs da Emulex criptografam os dados em trânsito do host para o array de armazenamento através dessa estrutura, e o novo padrão FC-SP-3 da FCIA estabelece a base de segurança preparada para computação quântica para o Fibre Channel como um todo.
Crescimento de SAN sem necessidade de licenças de zoneamento: Zoneamento automático do IBM FlashSystem usando o zoneamento orientado a alvos da Broadcom
Adicionar um host a um SAN Fibre Channel geralmente requer um chamado e duas equipes: o administrador de servidores coleta os WWPNs dos HBAs, o administrador do SAN cria as zonas em ambas as redes manualmente e o administrador de armazenamento mapeia o host para as portas de destino corretas. Um WWPN digitado incorretamente deixa um novo nó do Oracle RAC sem seus caminhos. O AutoZoning transfere essa tarefa para o array: o FlashSystem se comunica diretamente com a rede, identifica os WWPNs iniciadores, seleciona as portas de destino e cria as zonas automaticamente, sem que ninguém precise acessar um switch.

O recurso é baseado no Brocade Target Driven Zoning (TDZ) e foi introduzido no software FlashSystem 9.1.2. Ele requer switches Brocade executando o Fabric OS 9.1.1 ou posterior, com o TDZ habilitado pelo administrador da malha nas portas do switch voltadas para as portas de destino do FlashSystem. Essa habilitação é a única etapa que permanece sob responsabilidade da equipe de SAN, e o AutoZoning não executa nenhuma ação em uma porta até que ela seja concluída. A partir daí, o FlashSystem cria zonas pares, permitindo que os iniciadores de host alcancem a porta de destino, mas não uns aos outros, sob um nome IBM_SV_ previsível que os identifica como gerenciados pelo array.
A configuração começa na visualização da porta Fibre Channel, que agora mostra o switch ao qual cada porta está conectada, se a porta é compatível com AutoZone e se sua conectividade é simétrica, ou seja, se o mesmo ID de porta em todos os nós está na mesma malha. Uma visualização da topologia mapeia isso em cores, e somente as portas verdes que estão ativas, compatíveis com AutoZone e simétricas suportam AutoZoning. Portas assimétricas permanecem desativadas, mesmo que sejam compatíveis, pois a interface gráfica avisa que isso pode comprometer a redundância e o failover.

A criação de hosts começa a partir de uma lista de hosts não configurados, preenchida via FDMI, que reporta o nome do host, o sistema operacional e as portas de cada HBA para a malha. No passo a passo da IBM, a caixa de diálogo Adicionar Host foi aberta com o nome do servidor, o sistema operacional e as duas portas HBA de um host que ainda não tinha zonas configuradas; o administrador selecionou um conjunto de portas com AutoZone habilitado, que define as portas de destino que o host pode alcançar, e clicou em Adicionar. O FlashSystem emparelhou suas portas de destino com os iniciadores do host, enviou as zonas para ambos os switches e o host ficou online com quatro caminhos em duas malhas.

Para a Oracle, a IBM posiciona o AutoZoning para adicionar nós RAC e substituir HBAs, visto que o recurso rastreia alterações na conectividade do host ou do armazenamento e adapta as definições de zona para corresponder, de modo que a troca de um HBA não exija um rezoneamento manual. A mesma automação se aplica quando os hosts precisam de caminhos para um segundo array para migração de partições de armazenamento ou Alta Disponibilidade Baseada em Políticas (PBHA). A equipe de SAN ainda controla quais portas de destino participam, já que nada acontece em uma porta até que o TDZ seja habilitado. Consequentemente, adicionar um host não depende mais de uma alteração de zoneamento.
Envoltório Operacional: PBHA, Migração da Rede Elétrica, Multilocação e Alocação
A Alta Disponibilidade Baseada em Políticas (PBHA) replica de forma síncrona uma partição de armazenamento entre dois arrays FlashSystem em distância metropolitana, com acesso ativo-ativo em ambos os sites. A IBM afirma que o recurso foi projetado para RPO zero e para uma recuperação de failover de armazenamento que uma implementação Oracle devidamente clusterizada pode suportar sem perda de dados. Quando o site com falha retorna, os dados são ressincronizados e a carga de trabalho retorna sem interrupção.
O recurso FlashSystem Grid federa até 32 arrays FlashSystem sob uma única visão de gerenciamento, e a migração de partições de armazenamento move uma partição, com seus volumes, grupos de volumes e hosts, de um array para outro sem interrupção do aplicativo. Para a Oracle, a IBM destaca a atualização de hardware, o esvaziamento de um sistema antes de uma atualização de firmware e a movimentação de uma partição vetorial para um sistema com mais capacidade à medida que o conjunto de incorporação cresce. Um sistema migra uma partição por vez via Fibre Channel ou Ethernet de alta velocidade; os hosts podem se conectar via Fibre Channel, iSCSI ou NVMe/TCP, e uma partição já configurada para PBHA não é elegível para migração.
O consultor de posicionamento do Storage Insights gerencia o planejamento para a mesma grade. Com base na capacidade, taxa de crescimento, perfil de E/S e meta de latência de uma carga de trabalho, ele avalia cada sistema na grade, classifica a melhor opção antes de qualquer provisionamento e também pode recomendar uma migração quando detecta um desequilíbrio de CPU ou IOPS. Tanto a migração quanto o posicionamento utilizam o Storage Insights Pro, com todos os sistemas da grade registrados no mesmo tenant do Storage Insights.

A multilocação permite que uma equipe de DBA e uma equipe de IA compartilhem a mesma grade sem compartilhar a administração. No passo a passo da IBM, um administrador criou dois tenants no mesmo array (Tenant_Scale e Tenant_oracle_ai) e atribuiu a cada um um sistema, um grupo de usuários com a função de tenant e um primeiro usuário. Em seguida, criou uma partição de armazenamento para cada tenant com um grupo de volumes, volumes e mapeamentos de host separados. A interface gráfica oferece a opção de configurar a replicação assim que uma nova partição é criada. Ao fazer login como o usuário Tenant_Scale, a interface gráfica exibiu apenas a partição e os recursos desse tenant, sem nada pertencente ao Tenant_oracle_ai, e a mesma verificação feita a partir do Tenant_oracle_ai retornou o mesmo resultado.
A Vantagem da Fibra Óptica: Fibre Channel 32G vs. 64G sob Busca Vetorial
A única variável que a IBM e a Broadcom alteraram propositalmente neste teste foi a malha de interconexão. O mesmo array, host e HBAs SecureHBA Emulex LPe38102 executaram o VectorDBBench no conjunto de dados BioASQ 1M (um milhão de vetores de 1,024 dimensões do corpus de perguntas e respostas biomédicas) duas vezes: uma com as duas portas HBA em 32G e outra em 64G, através dos mesmos switches Brocade G820. Todo o resto, dos 16 volumes ASM à SGA de 4 GB, permaneceu inalterado, portanto a diferença entre as duas execuções é a geração do Fibre Channel e nada mais.

A fase de busca deste benchmark é uma varredura somente leitura: o índice IVF_FLAT do Oracle direciona cada consulta para um cluster de partições e as lê integralmente. Com vetores FLOAT32 de 1,024 dimensões, isso representa uma carga de trabalho que exige muita largura de banda. Em duas portas de 32G, as leituras no host atingiram 6.3 GB/s, a taxa de linha do par, e a curva de busca se estabilizou em 43.7 consultas por segundo com 20 threads. Em duas portas de 64G, o mesmo host leu a 12.5 GB/s e continuou escalando para 85.0 QPS com 80 threads, um aumento de 95% na taxa de transferência com o mesmo armazenamento.

A latência revela a outra parte da história do 64G: em um único thread, as duas redes estão dentro de uma margem de 8% uma da outra, 0.107 segundos contra 0.099, porque uma única consulta nunca preenche nenhum dos pipes. A partir de cinco threads, no entanto, a rede de 32G entra em fila de espera: a latência média dobra o valor do 64G a cada passo, e com 80 threads, o p99 atinge 4.08 segundos contra 1.14. Uma rede FC saturada não falha; ela enfileira todas as consultas, e essa espera se manifesta como latência residual.

A fase de carregamento também mudou; a ingestão de um milhão de vetores levou 94.1 segundos na rede de 32G e 84.5 segundos na de 64G, e a construção do índice IVF_FLAT levou 139.6 segundos contra 108.4 segundos, 28.8% a mais na rede mais lenta, para um carregamento total de 233.7 segundos contra 193.0 segundos. O recall e o NDCG apresentaram uma diferença de apenas 0.1% entre as duas execuções (83.81% e 84.42% na rede de 32G, 83.95% e 84.56% na de 64G), portanto, a rede influenciou a velocidade com que as respostas chegavam. Para um banco de dados que está em uma rede de 32G desde a implantação, a atualização do HBA e do switch representa uma oportunidade óbvia para obter mais desempenho.
Planejamento para o Crescimento da Capacidade Vetorial
A busca vetorial altera os cálculos de capacidade antes de afetar o desempenho. Um vetor de incorporação é uma cópia numérica de largura fixa de um bloco de dados de origem e, para textos, essa cópia geralmente é maior do que o bloco que descreve: uma passagem de 1,000 bytes se torna um vetor FLOAT32 de 1,024 dimensões e 4,096 bytes antes que o banco de dados adicione uma linha para armazená-lo. A equipe chama isso de amplificação de armazenamento vetorial e a mediu no mesmo conjunto de dados BioASQ 1M usado na comparação de tecidos.
O texto original por trás do milhão de vetores ocupa 0.90 GB. No Oracle 26ai, ele se tornou uma tabela de vetores de 7.67 GB, incluindo cerca de 0.3 GB de sobrecarga de linhas, e o índice IVF_FLAT adicionou 8.57 GB, pois mantém uma segunda cópia agrupada de cada vetor, além de aproximadamente 4 MB de centroides. A pegada persistente no SAN é de 16.24 GB, 18 vezes o texto original, antes do espaço operacional que o Oracle precisa ao redor: de 15 a 23 GB de TEMP enquanto o índice é construído, e de 4 a 8 GB de UNDO e cerca de 15 GB de REDO durante a ingestão.

O multiplicador escala com o modelo de incorporação: a Broadcom extrapola a partir do mesmo método, colocando um modelo Cohere v3 de 768 dimensões (também medido) em 4.8 vezes a fonte, um MiniLM de 384 dimensões em 9.6 vezes e um modelo Mistral de 4,096 dimensões em 32.5 vezes. O tamanho do bloco é tão importante quanto a largura, já que um vetor largo em uma passagem longa amplifica menos do que o mesmo vetor em uma passagem curta, e os índices quantizados reduzem a participação do índice.
Nada disso é específico do FlashSystem ou da Oracle. A amplificação ocorre dentro do banco de dados antes que o array veja um byte, e cada índice vetorial em cada plataforma carrega uma cópia dos vetores, portanto, ele deve ser incluído no orçamento de capacidade no dia em que um projeto vetorial é aprovado, juntamente com as GPUs. O que o array decide é quanto desse crescimento ele pode suportar: o módulo FlashCore de quinta geração da IBM chega a 105.6 TB por módulo, o que resulta em 3.3 PB brutos em um gabinete 2U nos maiores modelos FlashSystem, e 11.8 PB efetivos, segundo os dados da IBM. Assim, uma camada vetorial pode crescer no mesmo local por anos antes que uma partição precise ser movida.
O modelo de dimensionamento da IBM para o aplicativo de saúde descrito a seguir funciona de maneira oposta para imagens: 100 GB de radiografias resultam em aproximadamente 2 GB no banco de dados, já que apenas os embeddings e os metadados dos casos residem lá. O texto é o caso mais custoso: 100 GB de texto clínico fragmentado ocupam de 860 GB a 1.2 TB, a maior parte indexada pelo HNSW. Os parâmetros de entrada para o dimensionamento são a contagem de fragmentos e a largura do modelo; o corpus de origem não é um bom indicador. Os embeddings também são comprimidos menos do que as linhas, de 1.2x a 2x, em comparação com 2x a 4x para dados relacionais, segundo a experiência da IBM. Portanto, a redução de dados do FlashCore Module recupera menos do crescimento, e cada reembedding exige o espaço TEMP novamente.
A regra prática da IBM é medir antes de se comprometer. Carregue de 1 a 5% do corpus real com o modelo de embedding de produção e as configurações de chunking, meça os bytes reais por vetor, depois escale linearmente e repita o exercício sempre que o modelo, a contagem de dimensões ou a política de chunking mudar.
Inferência de IA de ponta a ponta: a aplicação na área da saúde
A IBM desenvolveu o aplicativo para essa validação como um assistente de radiologia e gastroenterologia chamado RAD-AI. Trata-se de um aplicativo de exemplo com requisitos semelhantes aos de produção, e neste artigo demonstra-se um pipeline de inferência completo na mesma matriz e estrutura medidas nas seções anteriores. O médico insere a idade, o sexo e a queixa principal do paciente, carrega uma radiografia de tórax ou uma imagem de endoscopia e recebe um relatório estruturado, construído a partir dos casos anteriores mais semelhantes no arquivo.
O arquivo contém 112,120 radiografias de tórax do conjunto de dados NIH ChestX-ray14 e mais de 10,000 imagens de endoscopia gastrointestinal do HyperKvasir, incluindo vetores por quadro de 367 vídeos completos de endoscopia, para mais de 172,000 casos pré-incorporados. Cada imagem se torna um vetor de 768 dimensões a partir de um modelo CLIP ViT-L/14 executado no Oracle AI Database 26ai por meio de seu ambiente de execução ONNX, de modo que a incorporação seja armazenada na mesma transação que a linha que a contém. As imagens brutas permanecem no armazenamento de objetos; os vetores e os metadados dos casos residem no Oracle.

No momento da consulta, o Oracle executa uma busca aproximada por vizinho mais próximo, utilizando a distância de cosseno, em todo o arquivo e retorna os casos mais próximos, juntamente com seus achados, diagnósticos e desfechos originais. Esse conjunto recuperado serve de contexto para o Llama 3, executado pelo Ollama em uma das GPUs H100 do servidor Supermicro, que gera o relatório: uma prioridade clínica, um resumo dos achados, um diagnóstico diferencial classificado e ações recomendadas, com os casos correspondentes listados abaixo. A endoscopia segue o mesmo caminho e adiciona uma nota clínica; para vídeos, o pipeline incorpora os quadros para que seja possível rastrear uma lesão ao longo do trato gastrointestinal.
O aplicativo executa duas cargas de trabalho nos mesmos volumes do FlashSystem. A carga de trabalho transacional abrange logins, armazenamento de relatórios, registro de auditoria e sessões; a carga de trabalho vetorial realiza leituras aleatórias de alta frequência nas tabelas de incorporação e metadados de casos, correspondendo ao perfil do gerador na demonstração de QoS de E/S. A implementação da IBM define as limitações de volume descritas anteriormente para que um trabalho de re-incorporação em lote não impeça um médico de acessar um caso, e a detecção de ransomware e a migração de partições mostradas acima se aplicam a esses volumes sem alterações.

A etapa que demanda muitos recursos é a construção do arquivo, que a IBM mediu incorporando o conjunto completo de 112,120 imagens de raio-X do tórax duas vezes com o mesmo modelo e o mesmo alvo VECTOR(768, FLOAT32). Com o modelo ONNX em execução dentro do banco de dados nas CPUs do host, o pipeline manteve 3.41 imagens por segundo a 0.272 segundos por incorporação, e o conjunto completo levou 9.1 horas. A migração do modelo para o contêiner do Oracle Private AI Services no segundo servidor aumentou a taxa de transferência para 8.55 imagens por segundo (0.097 segundos por imagem), e a mesma ingestão foi concluída em 3.6 horas.

O pré-processamento (cerca de 0.019 segundos por imagem) e a inserção no Oracle (menos de um milissegundo) foram idênticos em ambas as execuções, portanto, o ganho de 2.5x provém inteiramente do local onde o modelo é executado. O serviço de incorporação da Private AI Services é executado em um ambiente de execução ONNX na CPU, então as GPUs H100 desse servidor não participaram deste teste; o ganho veio da remoção do modelo do host do banco de dados, e a parte da GPU no pipeline é a construção do índice, que será abordada a seguir.
A IBM mediu esses valores no laboratório do Colorado; não realizamos nem auditamos o teste. A conclusão prática é que a primeira incorporação de um arquivo, e cada reincorporação após uma alteração de modelo, é um processo em lote medido em horas, enquanto a recuperação subsequente é um processo de CPU e armazenamento medido em milissegundos.
O mesmo contêiner também lida com a construção do índice. O Oracle 26ai pode enviar uma construção HNSW para o Vector Index Service do contêiner, que usa o NVIDIA cuVS na GPU para construir o grafo de vizinhança antes de retornar o índice completo para o banco de dados. As buscas são então executadas sem a participação da GPU. Na gravação da IBM, a construção HNSW básica (32 vizinhos, efConstruction 200) levou 8.47 segundos no banco de dados e 2.26 segundos com o offload, uma redução de 3.7 vezes. Essa execução usou uma pequena tabela de demonstração, então confirma que o caminho funciona nessa configuração; ainda precisamos medir o número em escala clínica.
A aplicação demonstra a divisão de trabalho que é o cerne deste artigo. O servidor de GPU hospeda o modelo de linguagem e, durante a criação ou reconstrução do arquivo, os serviços de incorporação e indexação. O banco de dados armazena vetores juntamente com os registros que eles descrevem, enquanto o array e a malha lidam com as leituras e transações de recuperação. Nenhuma etapa no caminho de recuperação utiliza uma API externa, e os dados do paciente nunca saem do centro de dados.
A IBM escolheu o setor de saúde como área de atuação para comprovar o conceito, e nada no padrão é específico para ele. Troque o arquivo de raios-X por históricos de sinistros, registros de manutenção ou um catálogo de produtos e os mesmos três elementos se mantêm: vetores armazenados junto aos registros que descrevem, geração no servidor de GPU e recuperação e transações em um único array. Qualquer setor que execute inferência em dados que já possua se beneficiará da mesma arquitetura.
O que vem depois
A validação continua no mesmo hardware: a Fase 2 move o cache KV do mecanismo de inferência da memória da GPU para o FlashSystem sobre a mesma estrutura Fibre Channel, permitindo que um modelo de contexto longo mantenha uma parcela maior do seu conjunto de trabalho acessível; o próximo artigo desta série aborda esse trabalho. A IBM também está construindo um pipeline de atualização com reconhecimento de conteúdo, com o IBM Storage Scale AFM e o Kafka alimentando a vetorização ONNX no banco de dados com novos documentos à medida que chegam, para que o índice vetorial rastreie suas fontes sem a necessidade de uma re-incorporação em lote. A IBM também planeja estender a mesma validação de armazenamento para outros bancos de dados multimodelos que adicionaram busca vetorial.
A Fase 2 também coloca a camada de segurança para trabalhar com novos dados. Quando o cache KV passa para o FlashSystem, o contexto de trabalho de um modelo de saúde (incluindo o histórico do paciente) atravessa os mesmos links Fibre Channel que o índice vetorial e os registros transacionais. Os SecureHBAs da Emulex criptografam o tráfego de ponta a ponta, do adaptador do host ao array de armazenamento, com a estrutura Brocade Gen 8 transportando o tráfego criptografado de forma transparente, ao mesmo tempo que oferece criptografia pós-quântica para links entre switches (ISL) e tráfego de longa distância. Cada fase adiciona uma carga de trabalho à estrutura sem adicionar um caminho onde os dados trafeguem em texto não criptografado.
Classificação: O perfil da IBM em nossa página de Melhores Arrays de Armazenamento agora inclui o armazenamento em blocos FlashSystem, além do Storage Scale.
Este relatório é patrocinado pela Broadcom. Todas as visões e opiniões expressas neste relatório são baseadas em nossa visão imparcial do(s) produto(s) em consideração.


 Amazon