

CoreWeave använde sin Fully Connected 2026-konferens i San Francisco för att sätta NVIDIA Vera Rubin NVL72 i produktion, med Cognition som den första kunden som körde live-arbetsbelastningar på den. Cognitions ingenjörer rapporterar upp till 4.8 gånger den totala token-genomströmningen per GPU för en GB200 NVL72-baslinje på SWE-2-inferens vid matchad interaktivitet, och 3.8 gånger utdata-token-genomströmningen per GPU på förstärkningsinlärning. Båda är Cognitions egna riktmärken på CoreWeave Cloud, som körs på agentiska arbetsbelastningar i produktionsstil, utan att några modellstorlekar, kontextlängder eller batchinställningar avslöjas.
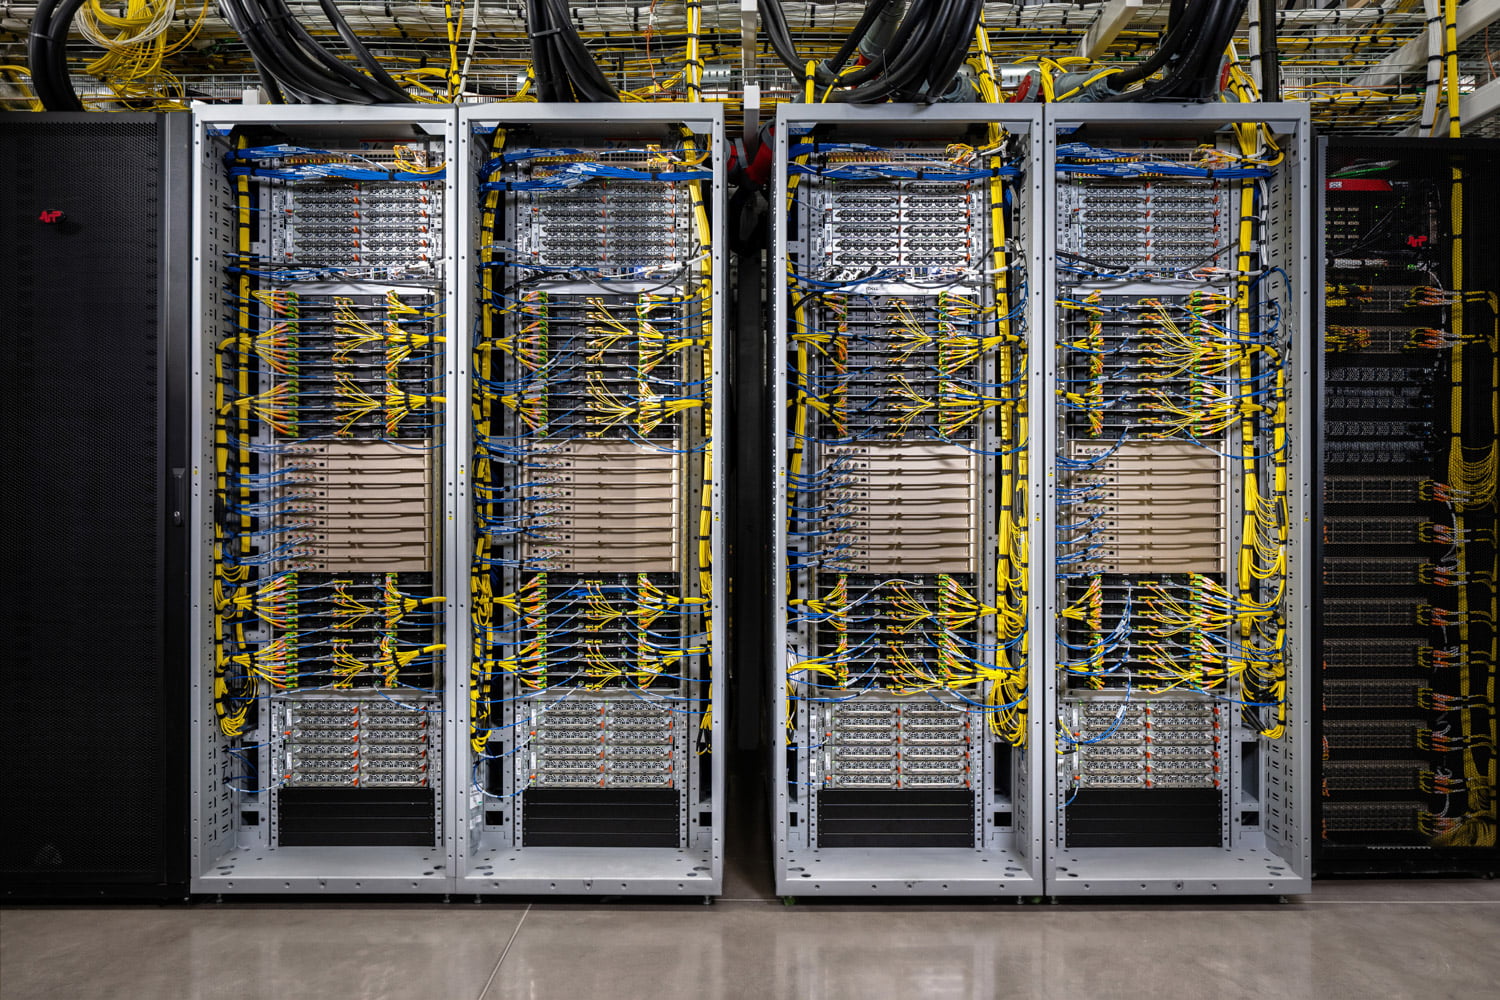
Vera Rubin NVL72 går in i CoreWeave-produktion
Cognition kör träning, förstärkningsinlärning och produktionsinferens för Devin på CoreWeave. CoreWeave säger att de satte igång Vera Rubin NVL72-klustret i början av september och hade Cognitions arbetsbelastningar igång inom några dagar efter racköverlämningen, och de kallar Cognitions körning för det första kundexekverade Vera Rubin-inferensriktmärket. Cognitions uppfattning är att SWE-2-resultatet innebär fler samtidiga Devin-sessioner per GPU och snabbare forskningsomgångar.
CoreWeaves pressmeddelande säger att Vera Rubin NVL72 nu är tillgänglig; deras eget blogginlägg om Cognition-distributionen kallar den begränsad tillgänglighet, så förvänta dig att allokeringen kommer att vara begränsad för tillfället. Kunder kör den genom samma programvara och driftsmodell som CoreWeaves GB200 NVL72- och GB300 NVL72-flottor: CoreWeave Kubernetes Service, SUNK, Mission Control, Sandboxes och serverlös inferens.
Själva racken, de Dell-byggda NVL72-processorerna med två ConnectX-9 SuperNIC-kort per GPU och den stegvisa valideringen som CoreWeave körs innan ett rack når produktion är vad vi tog upp i september-nyheten om flera rack . Det som är nytt är att de är betalande kunder.
NVIDIA Vera-processor siktar på agent-sandboxdensitet
CoreWeave kommer också att lägga till NVIDIA Vera-processorn i sin portfölj som en fristående beräkningsnivå för agentarbete: sandlådekörning, förstärkningsinlärningsmiljöer, verktygsanrop, kodkörning och databehandling som omger GPU-träning och resonemangsjobb. Inget datum gavs utöver "kommer snart".
En Vera-nod på CoreWeave parar ihop två 88-kärniga Vera-processorer med 1.5 TB RAM, 15.36 TB lokal NVMe och en BlueField-4 DPU med 800 Gbps. Ett komplett rack rymmer 128 processorer och 11 264 kärnor med BlueField-4 DPU:er och Spectrum-X Ethernet-switching, vilket CoreWeave säger stöder mer än 11 000 samtidiga isolerade miljöer. I sina egna tester rapporterar CoreWeave mer än 3 gånger snabbare agent-sandbox-start på Vera än på en x86-processor de inte namnger. Vera kommer att köras bare metal under samma plattform och förbrukningsmodeller som GPU-flottan, inklusive spotkapacitet.
CoreWeave Forge kopplar samman utveckling och produktion
CoreWeave Forge, som lanserades på mässan, sammanför Weights & Biases Models, OpenPipes arbete efter träning och det öppna källkoden för marimo notebook-projektet till ett utvecklingslager för modeller och agenter. Det täcker experimentspårning, utvärderingar, agentspår, kontrollpunkter, sandlådebaserad exekvering, efterträning och inferensdistribution, och CoreWeave säger att det är öppet för modeller, ramverk och andra moln. MasterClass och Canva bygger redan vidare på det.
Forge finns i Free-, Pro- och Enterprise-utgåvor, där Pro börjar på 60 dollar per månad och har en 30-dagars provperiod. Allmänt tillgängliga idag: ARIA, Sandboxes, Weights & Biases Models, Serverless SFT, Serverless RL, Registry, Notebooks och både Serverless och Dedicated Inference. I förhandsvisning: Agent Lens, Model Distillation och RL Rollouts, som låter en kontrollpunkt laddas in i en live-distribution medan träningsloopen körs.
CoreWeaves pressmeddelande säger att Agent Lens upptäcker 20 procent fler kritiska fel och åtgärdar problem till en tiondel av kostnaden, jämfört med en icke namngiven generell frontier LLM; företagets eget blogginlägg anger kostnadssiffran till hälften, så ta siffran löst. Serverlös RL påstås träna 1.4 gånger snabbare till 40 procent lägre kostnad än en självhanterad installation. Arbetsbelastning, modell, hårdvara och metodik tillhandahölls inte heller.
Partnernätverk och implementering av klinisk inferens
CoreWeave Partner Network, som är tillgängligt idag, grupperar integrationer som CoreWeave säger sig ha testat under produktionsbelastning och kvalificerat sig utifrån kundernas efterfrågan, över infrastruktur, datatjänster, ISV:er, säkerhet samt modeller och inferens. Namngivna partners inkluderar CrowdStrike, VAST Data, Reflection, ClickHouse, LanceDB, Inferact, RadixArk, IBM och Red Hat. Exa, Parallel Web Systems och You.com går samman genom en delad sökintegration för agenter som hostas på CoreWeave, och som lanseras veckorna efter tillkännagivandet. Tanken är att kunderna ska behålla sina befintliga serverlager, observerbarhet, runbooks och säkerhetsverktyg när arbetsbelastningar flyttas till molnet.
Ennoble Care, som erbjuder hembaserad primärvård, palliativ vård och hospicevård till ungefär 50 000 patienter per år i 15 stater, har valt CoreWeave Cloud för klinisk AI-inferens. Distribueringen körs på reserverade NVIDIA RTX PRO 6000 Blackwell Server Edition-noder via CoreWeave Kubernetes Service, med hårdvarubaserad isolering och nollförtroendekontroller för klinisk data och direkt teknisk support. CoreWeave hävdar att CKS startar containrar 8 till 10 gånger snabbare än ett generellt molnalternativ, utan att namnge plattform, arbetsbelastning eller testkonfiguration.


 Amazon