

NVIDIA har lagt till en 64 GB Unified-minneskonfiguration av DGX Spark , med startpris på 4 999 dollar och säljs exklusivt via Acer, ASUS, Dell, Gigabyte, HP och MSI från och med den 23 oktober. Den nya SKU:n har samma GB10 Grace Blackwell Superchip, ConnectX-7-nätverk, DGX OS och NVIDIA AI-programvarustack som 128 GB-modellen. NVIDIA säger att 64 GB-enheten i sig kör modeller upp till 100 miljarder parametrar för lokal inferens, finjustering och agentarbetsflöden utan att skicka data till molnet.
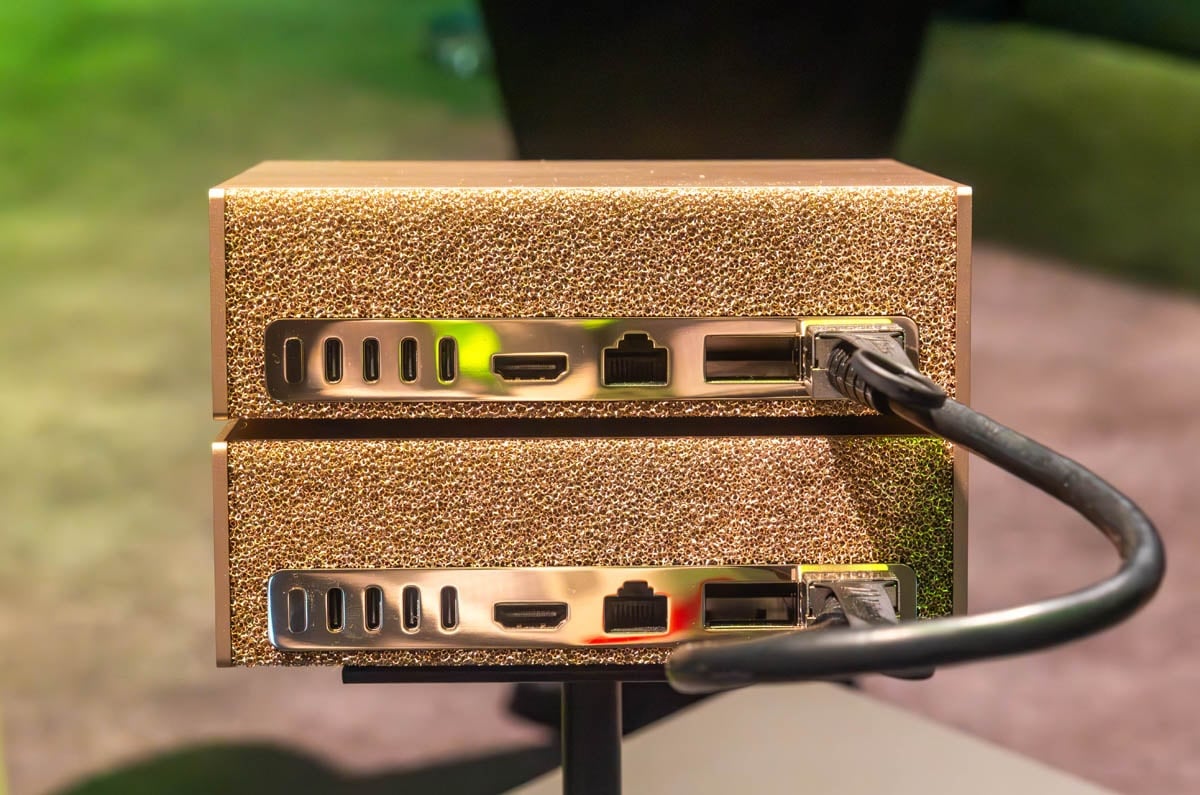
Två 64 GB Sparks för ett 128 GB kluster
Fördelen med den billigare boxen (jämfört med marknadspriserna för den större modellen) är att två av dem i ett kluster klarar sig ganska bra. Varje DGX Spark har ett inbyggt ConnectX-7 NIC, så ett par ansluts direkt via en QSFP-kabel på en 200GbE-länk, utan någon switch emellan. NVIDIA Sync Cluster Assistant hanterar identifiering, validerar enhetskonfigurationen och konfigurerar ConnectX-7-nätverket. Två 64 GB-enheter samlar 128 GB enhetligt minne, vilket NVIDIA säger är tillräckligt för att köra modeller upp till 200 miljarder parametrar.
NVIDIAs interna siffror för parkopplingen använder Qwen3.8 27B: två klustrade 64 GB-system levererade upp till 1.7 gånger prestandan jämfört med ett enda 128 GB-system. Eftersom varje nod kör samma CUDA-bibliotek, inferensmotorer och DGX OS-avbildning, sträcker sig en arbetsbelastning över båda enheterna utan att programvarumiljön behöver byggas om. Stödda inferensramverk inkluderar llama.cpp, Ollama, vLLM och LM Studio. NVIDIA har en kort video om hur man ansluter två Sparks med NVIDIA Sync.
Vi körde ett distribuerat inferenskluster över Dell-, Gigabyte- och HP DGX Spark-enheter , och nyligen placerade vi delad lagring bakom ett Spark-kluster över 100 GbE . 64 GB SKU sänker instegspriset för den typen av installation, med den avvägningen att en enda enhet nu rymmer hälften så mycket minne som originalet.
NVIDIA Sync Model Launcher anländer i slutet av oktober
Den andra halvan av tillkännagivandet handlar om programvara. NVIDIA Sync Model Launcher, som ska släppas i slutet av oktober, laddar ner och startar en modell över ett enda Spark-program eller ett klustrat par, med Qwen3.8 27B som exempel, och exponerar den resulterande slutpunkten för utvecklarmaskiner i nätverket. Den kan också konfigurera OpenCode mot den modellen så att utvecklare kan koda från en webbläsare med Spark-klustret som utför inferensen.
64 GB-systemen levereras med samma programvara som 128 GB-modellen: DGX OS, CUDA-X AI-bibliotek, NVIDIA Agent Toolkit, Nemotron öppna modeller och runtimes inklusive Ollama, vLLM och PyTorch med CUDA. NVIDIA positionerar boxen som en lokal plattform för agenter, inferens, finjustering, datavetenskap och edge-utveckling, och ConnectX-7-porten innebär att en andra enhet kan läggas till senare. För agentbyggare pekar NVIDIA på sina playbooks för NemoClaw, OpenClaw, Hermes Agent och OpenShell på build.nvidia.com som utgångspunkter.


 Amazon