

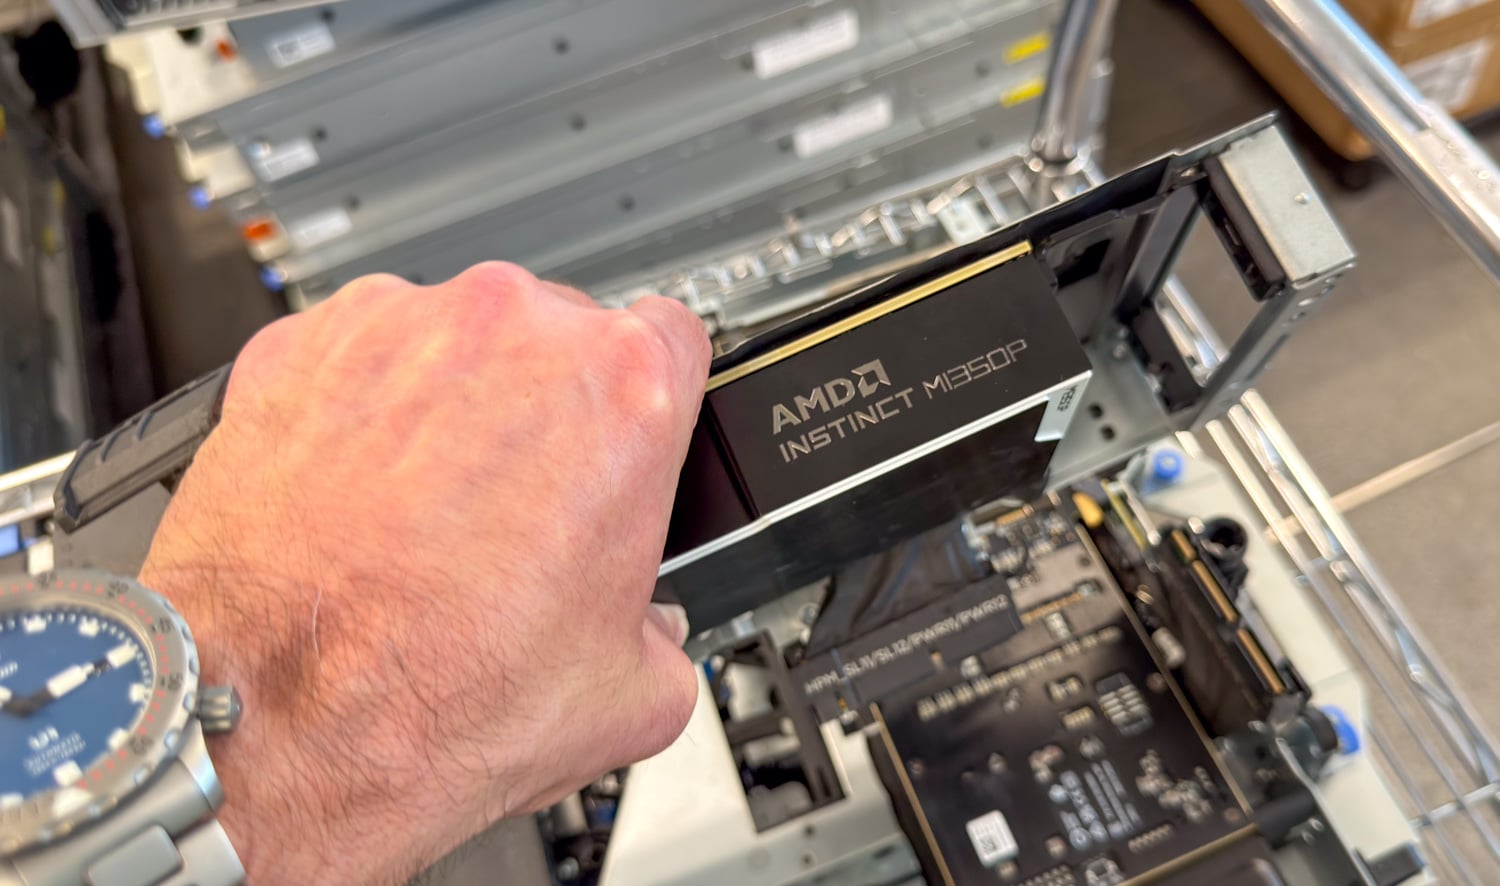
AMD Instinct MI350P är AMD:s första nya PCIe Instinct GPU på fyra år, efter MI210 från 2022. Den tar företagets CDNA 4-arkitektur till ett konventionellt tilläggskort, med upp till 4.6 PFLOPS MXFP4-prestanda, 144 GB HBM3E och 4 TB/s minnesbandbredd. Allt detta får plats i ett luftkylt kort med dubbla kortplatser och 600 W, vilket ger kunderna ett annat sätt att driftsätta Instinct GPU:er utan att behöva byta till den större OAM MI350/5X-plattformen med 8 GPU:er.
Key Takeaways
- 144 GB i en PCIe-kortplats är rubriken. MI350P har mest minne av alla nuvarande PCIe-acceleratorer, 3 GB över H200 NVL och 48 GB över RTX PRO 6000 Blackwell, med 4 TB/s HBM3E bakom sig, och tio av de fjorton modell- och precisionkombinationerna i den här recensionen kördes på ett och samma kort.
- Uppmätt beräkningsförmåga hamnar mellan de två NVIDIA-korten. Vid 450W nådde MAMF 580 TFLOPS i BF16, 1 120 i FP8 och 2 228 i blockskalad FP4, 36 till 38 procent över ett 600W RTX PRO 6000 vid varje precision och bakom H200 NVL i BF16 och FP8, som inte har någon FP4-väg.
- GPT-OSS är MI350P:s starkaste resultat. På AMDGPU 31.60, ROCm 10.1.0 och vLLM 0.32.0 nådde GPT-OSS-120B 5 057 utdatatokens per sekund vid 128 strömmar på chattarbetsbelastningen, 65 procent före RTX PRO 6000 och 50 procent före H200 NVL, och kurvan fortsätter att klättra genom 128 strömmar på båda promptformerna.
- Chattstora uppmaningar gynnar MI350P; långa uppmaningar är blandade. På 512-token-prompter slår kortet RTX PRO 6000 på alla FP8-, BF16- och GPT-OSS-modeller med 35 till 65 procent vid 128 strömmar, och de två FP4-mot-NVFP4-matchningarna ligger inom 5 och 21 procent, medan det på 8 192-token-prompter leder på GPT-OSS och Mistral Small och släpar efter på Llama, Qwen FP8 och MiniMax-M2.7, där kurvan planar ut tidigt.
- Tvåkortsresultaten är på ROCm 7.2.3. DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2 och GLM-5.3 Flash rapporteras från körningar på den stacken, eftersom ROCm 10.1-överföringarna på dessa modeller använde CPU-expertavlastning och, på DeepSeek, en spekulativ avkodare som NVIDIA-körningarna inte gjorde.
- 600W är fortfarande den öppna frågan. Dell dokumenterar åtta MI350P-modeller på 600W i PowerEdge XE7745, och en uppföljare med full effekt är planerad.
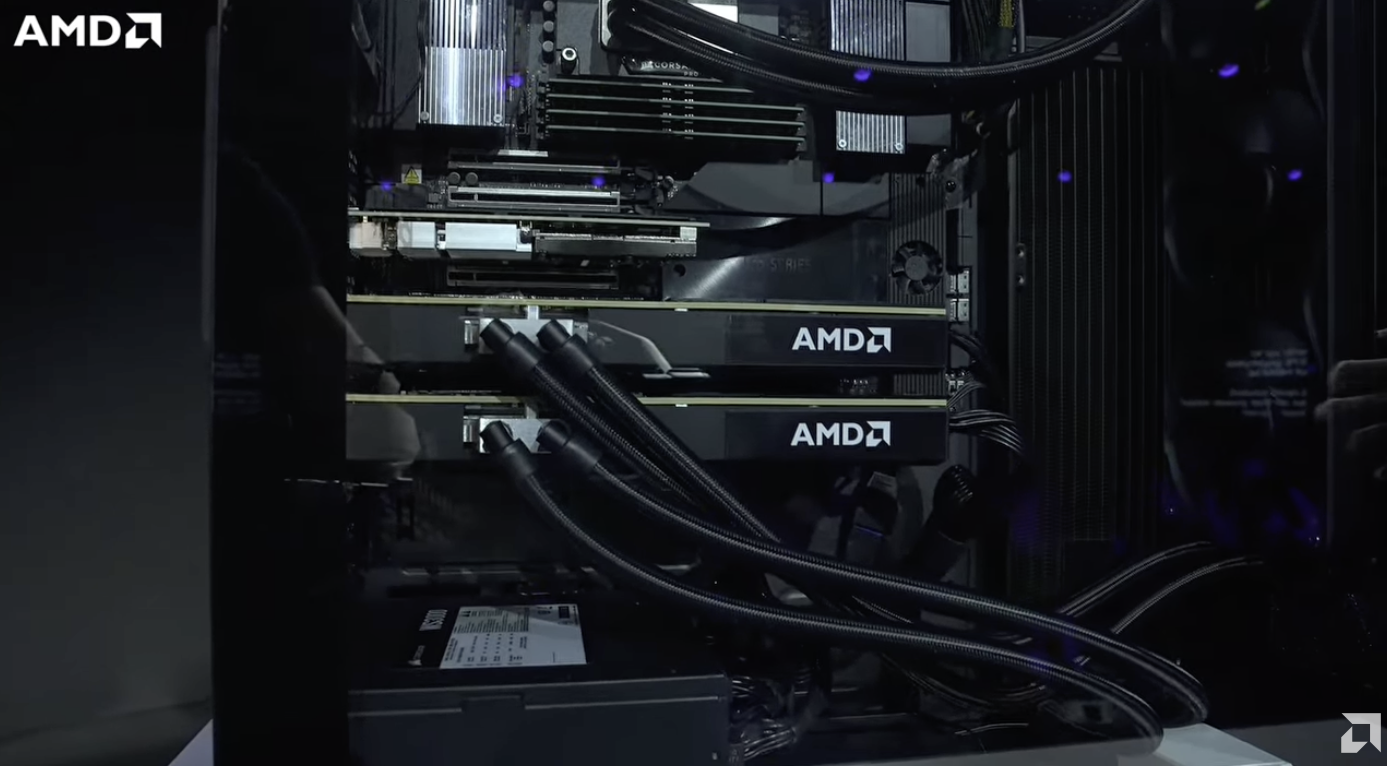
AMD visade också upp MI350P på IFA 2026 i sin Threadripper Halo Station-prototyp, där samma acceleratorer var vätskekylda. Arbetsstationskonceptet stöder upp till fyra MI350P:er tillsammans med en 96-kärnig Threadripper PRO-processor, vilket ger 576 GB sammanlagd HBM3E-kapacitet i en enda maskin; AMDs produktsida, som uppdaterades i oktober, listar nu systemet som kommande 2027. Det ger oss två sätt att se på MI350P: som en PCIe-accelerator för servrar, och som byggstenen för ett större skrivbordsbaserat AI-system som konkurrerar med maskiner som GB300 DGX Station.
Denna första titt tar serverperspektivet, så den jämförelse som är viktig för en köpare som specificerar en PCIe-accelerator är NVIDIA RTX PRO 6000 Blackwell, kortet som sitter i samma effektklass och samma platser, och H200 NVL finns med på listorna som det mest kapabla NVIDIA-tilläggskortet för arbetsbelastningar där minnesbandbredd avgör resultatet. En enda GB300 DGX Station står för skrivbordsvyn; det är en annan klass av maskin till ett annat pris, och den är där för att visa hur mycket en komplett Blackwell Ultra GPU står sig över något av PCIe-korten.
AMD Instinct MI350P Specifikationer
AMD:s publicerade siffror sätter MI350P:s vikt på låg precision: 4.6 PFLOPS vid MXFP4 och MXFP6, 2.3 PFLOPS vid FP8 och 1.15 PFLOPS vid FP16 eller BF16, alla täta siffror. Minnessystemet är den andra halvan av kortet: 144 GB HBM3E på ett 4 096-bitars gränssnitt med 4 TB/s, bakom en 128 MB Infinity Cache, vilket är vad single-stream-resultaten nedan lutar sig mot. Kortets effekt är 600 W med ett konfigurerbart läge på 450 W; vår testenhet kördes på 450 W.
MI350P använder samma CDNA 4-arkitektur som de större, kraftfullare MI350/5X-grafikprocessorerna. MI350P kan betraktas som i praktiken hälften av en MI350X. För att förstå varför är det bra att titta på hur den större grafikprocessorn är monterad.
MI350X är en 3D-staplad chiplet-design byggd på TSMC:s CoWoS-kapsling, eller Chip-on-Wafer-on-Substrate, utan en enda monolitisk chip. Åtta acceleratorkomplexa chips, eller XCD, sitter ovanför två I/O-chips, med fyra XCD på varje I/O-chippe. AMD:s Infinity Fabric ansluter chipsen, medan åtta HBM3E-stackar tillhandahåller GPU:ns minne. CoWoS beskriver integrationen på paketnivå; compute-over-I/O-arrangemanget är designens vertikala, 3D-staplade komponent.

MI350P använder hälften av det arrangemanget: fyra XCD:er, en I/O-chip och fyra HBM3E-stackar. Varje XCD har 32 aktiva beräkningsenheter, vilket ger kortet 128 CU:er jämfört med MI350X:s 256. Minnesresurserna är också halverade: 144 GB HBM3E mot 288 GB, 4 TB/s bandbredd mot 8 TB/s och 128 MB Infinity Cache mot 256 MB.

| Specifikation | AMD Instinct MI350P |
|---|---|
| Plattformöversikt | |
| arkitektur | CDNA 4 |
| Beräkna enheter | 128 |
| Stream processorer | 8,192 |
| Matriskärnor | 512 |
| Behandla | TSMC 3nm och 6nm |
| Transistorer | 73 miljarder |
| Toppmotorklocka | 2,200MHz |
| Minne | |
| Kapacitet | 144 GB HBM3E |
| Gränssnitt | 4,096-bitars |
| Bandbredd | 4 TB/s |
| Sista nivåns cache | 128MB |
| ECC | Fullchip |
| Topprestanda (enligt AMD) | |
| MXFP4 | 4.6 PFLOPS |
| MXFP6 | 4.6 PFLOPS |
| MXFP8 | 2.3 PFLOPS |
| OCP FP8 | 2.3 PFLOPS; 4.6 PFLOPS med strukturerad gleshet |
| FP16 | 1.15 PFLOPS; 2.3 PFLOPS med gleshet |
| BF16 | 1.15 PFLOPS; 2.3 PFLOPS med gleshet |
| FP32 | 72 TFLOPS |
| FP64 | 36 TFLOPS |
| Effekt, kylning och formfaktor | |
| Typisk kortström | Maximalt 600 W; konfigurerbar 450 W |
| Strömkontakt | 12V-2×6 |
| Kylning | Passiv |
| Formfaktor | PCIe-tilläggskort, full höjd, dubbel kortplats |
| Brädets längd | 10.5 mm (267 tum) |
| Värdgränssnitt | PCIe 5.0 x16 |
| Funktioner | |
| SR-IOV | Ja |
| Infinity cache | Ja |
| RAS | Ja |
| Sidborttagning och undvikande | Ja |
600W-siffran är ett maximum, och AMD låter kortet konfigureras ner till 450W, vilket är där det kördes i vår 2U-värd. H200 NVL matchade den på 450W i R770, men RTX PRO 6000 kördes på sina fulla 600W i XE7740, så NVIDIA-kortet hade 150W mer att arbeta med i varje jämförelse mot det. Resultaten för full effekt väntar på ett chassi som kan kyla ett 600W passivt kort, och Dells XE7745 tekniska guide listar åtta MI350P på 600W.
Den andra anmärkningen: den enda 12V-2×6-kontakten och 10.5-tumskortet med dubbla kortplatser, vilket är det som gör att kortet går in i samma riser-kort som håller ett RTX PRO 6000 eller ett H200 NVL idag.

Tabellen nedan placerar MI350P bredvid de tre NVIDIA-systemen i våra diagram: RTX PRO 6000 Blackwell Server Edition, som delar sin plats, sitt effektområde och sin PCIe 5.0 x16-värdlänk; H200 NVL, Hopper-kortet med matchande minnesbandbredd; och GB300 DGX Station, en enda Blackwell Ultra GPU i kombination med en Grace-processor via NVLink-C2C.
Raderna att läsa först är minneskapacitet, där MI350P:s 144 GB är det största av de tre PCIe-korten, 3 GB över H200 NVL och 48 GB över RTX PRO 6000; minnesbandbredd, där dess 4 TB/s ligger mellan de två; och FP4-linjen, där AMD anger en tät siffra och NVIDIA anger gles.
| Specifikation | AMD Instinct MI350P | NVIDIA RTX PRO 6000 Blackwell Server Edition | NVIDIA H200 NVL PCIe | NVIDIA GB300 DGX-station |
|---|---|---|---|---|
| GPU-arkitektur | CDNA 4 | Blackwell | Ficka | Blackwell Ultra |
| Formfaktor | PCIe-accelerator | PCIe-accelerator | PCIe-accelerator | En Blackwell Ultra GPU i kombination med en 72-kärnig Grace-processor |
| GPU-minne | 144 GB HBM3E | 96GB GDDR7 ECC | 141 GB HBM3E | 252 GB HBM3E |
| GPU-minnesbandbredd | 4 TB/s | 1.6 TB/s | 4.8 TB/s | 7.1 TB/s |
| FP4 | 4.6 PFLOPS MXFP4 (Tät) | 4 PFLOPS NVFP4 (Gles) | Ingen inbyggd FP4 | 20 PFLOPS NVFP4 (Gles) |
| FP8 | 2.3 PFLOPS (tät) | 2 PFLOPS (glesa) | 3.3 PFLOPS (glesa) | 10 PFLOPS (glesa) |
| BF16 | 1.15 PFLOPS (tät) | 1 PFLOPS (glesa) | 1.6 PFLOPS (glesa) | 5 PFLOPS (glesa) |
| FP32 | 72 TFLOPS (tät) | 120 TFLOPS (gles) | 60 TFLOPS (gles) | 80 TFLOPS (gles) |
| Värdanslutning | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 | NVLink-C2C mellan Grace och GPU, 900 GB/s (BiDi) |
| Multi-GPU-anslutning | PCIe-baserad | PCIe-baserad | Två- eller fyrvägs NVLink, upp till 900 GB/s per GPU (BiDi) | 800 Gb/s ConnectX-8-nätverk mellan stationer |
| Effekt | 450 till 600W konfigurerbar | 300 till 600W konfigurerbar | 450 till 600W konfigurerbar | Upp till 1200W GPU med strömsloshing |
Jämfört med RTX PRO 6000 är MI350P:s minnessystem den mest omedelbara skillnaden. Det har 50 procent mer GPU-minne och ungefär 2.5 gånger mer minnesbandbredd. För en modell som inte bekvämt får plats inom 96 GB kan den extra kapaciteten avgöra om den körs på en GPU eller behöver fördelas över flera.
RTX PRO 6000 hanterar dock ett bredare utbud av arbetsbelastningar, med hårdvara för grafik, strålspårning och video vid sidan av sina AI-funktioner. Valet väger mer än två toppberäkningssiffror; det beror också på vad systemet i övrigt behöver göra.
H200 NVL är den mer direkta jämförelsen för MI350P bland PCIe-acceleratorer med högt minne; de större Blackwell-datacenter-GPU:erna tillhör en annan klass. Minneskapaciteten är nästan identisk med H200:s 141 GB, där båda använder HBM3E, och H200 erbjuder 20 procent mer minnesbandbredd vid 4.8 TB/s. De två skalar också olika: alla tre PCIe-kort ansluts till värden via PCIe, men H200 NVL lägger till dedikerad GPU-till-GPU-anslutning via NVLink-bryggor som ansluter upp till fyra GPU:er.
De större MI350X och MI355X byggdes för att konkurrera med Blackwell, men MI350P halverar den hårdvarukonfigurationen. Det för den närmare H200 NVL i minnesattribut och i övergripande positionering. En punkt där MI350P fortfarande utmärker sig är inbyggt stöd för MXFP4 och MXFP6, vilket är viktigare när inferensen går mot lägre precision.
Det mindre minnesundersystemet är ytterligare en kompromiss, eftersom AMD inte har kompenserat minskningen av HBM-stackar med snabbare HBM3E, vilket lämnar MI350P på 4 TB/s bandbredd och ligger efter H200 NVL på detta mått. Det kan begränsa prestandan i minnesbandbreddsbundna arbetsbelastningar, oavsett tillgänglig beräkningsmängd, vilket minnesbandbredden och resultaten av långtidsinferens visar senare i recensionen.
Jämförelsen med DGX Station går åt andra hållet, eftersom GB300 Station har en komplett B300 GPU med en HBM-stack inaktiverad, ett datacenter-klasschip med en budget för datacenterkraft, medan MI350P är hälften av ett datacenter-klasschip monterat i 600W-höljet hos ett PCIe-tilläggskort. AMD behöver två eller fyra MI350P för att klara den enda GPU:n, och på pappret gör två av dem det: 288 GB och 8 TB/s mot Stationens 252 GB och 7.1 TB/s. Dessa resurser sitter dock på två kort, och en arbetsbelastning som sträcker sig över båda utbyter data via PCIe peer-to-peer, vilket begränsar hur mycket det andra kortet lägger till.
Prestanda
Testplattform
MI350P-testenheten är en Dell PowerEdge R7725 med två AMD EPYC 9555-processorer (64 kärnor vardera), 1.5 TB DDR5-6400 fördelat på 24 DIMM-moduler och två MI350P-kort inställda på 450W, maxeffekten för en 2U-server. RTX PRO 6000 Blackwell Server Edition-korten (600W) kördes i Dell PowerEdge XE7740 som har vår fyrakortsversion, en enda H200 NVL (450W) kördes i Dell PowerEdge R770 från vår recension, och GB300-siffrorna kommer från ASUS ExpertCenter Pro ET900N G3 DGX Station som vi recenserade i september.

iDRAC-inventeringen nedan visar hur de två korten är placerade. De sitter i PCIe-kortplatser 2 och 7, båda Gen5 x16 och båda rapporterar felfria, och enhetsnycklarna, 0-139-0 och 1-199-0, läses för oss som ett kort bakom varje EPYC-sockel, så tensorparallell trafik mellan de två MI350P:erna korsar sockellänken på sin väg mellan rotkomplex. Det är den layouten som en tvåkortsdistribution i en 2U-server får som standard, och det är värt att ha i åtanke vid tvåkortsresultaten senare.

Minnesvyn visar resten av värden: 24 DIMM-moduler med 64 GB DDR5-6400, dual rank, för 1 536 GB i en server som når upp till 6 TB, alla med multi-bit ECC. Headroom är viktigt för GLM-5.2-körningen, där MXFP4-kontrollpunkten inte får plats med två korts 288 GB och vLLM avlastar en del av expertvikterna till värdens minne.

Maximalt uppnåeliga Matmul FLOPS (MAMF)
För att sätta MI350P:s beräkningar i ett sammanhang körde vi MAMF över de fyra systemen. MAMF (Maximum Achievable Matmul FLOPS) är ett praktiskt prestandamått utformat för att mäta de realistiska toppflyttalsoperationerna per sekund som en accelerator når under matrismultiplikation, ett mer användbart riktmärke än de teoretiska toppflyttalsoperationerna i specifikationsbladet. Vi sveper varje system i BF16, FP8 och blockskalad FP4 och rapporterar det bästa resultatet med bibehållen täthet per precision; de skuggade staplarna multiplicerar varje PCIe-korts resultat med kortantalet som används i de stora modellserverkörningarna och beräknas utan några mätningar bakom dem.

Vid 450W når ett MI350P 580 TFLOPS i BF16, 1 120 i FP8 och 2 228 i FP4. RTX PRO 6000 Blackwell följer efter med 419, 820 och 1 634, så MI350P har en ledning på 36 till 38 procent över NVIDIA-kortet vid varje precision medan det kör 150W under det, med det största gapet i BF16 på 38.4 procent.
H200 NVL:s 652 TFLOPS i BF16 och 1 205 i FP8 placerar den före MI350P på båda, och den har ingen FP4-väg. GB300 DGX Station ligger över alla tre PCIe-korten med 1 924, 3 802 och 6 024, ungefär 3.3 gånger MI350P vid BF16 och 2.7 gånger vid FP4; två MI350P på pappret nära 1 160 och 4 456, fortfarande mindre än Stationens enda GPU. NVIDIA MAMF-siffrorna i den här recensionen kommer från våra senaste körningar på varje kort och ersätter resultaten från våra tidigare tester.
GPU-minnes bandbredd
Rå beräkningsgenomströmning är bara användbar om acceleratorn kan hålla sina exekveringsenheter försedda med data. Detta är viktigast för inferens, där tokengenerering under avkodningsfasen begränsas mer av minnesbandbredd än av tillgängliga FLOPS. Bandbreddstestet läser, skriver och kopierar GPU-minne genom beräkningskärnor och kopieringsmotorn, och visar den tillgängliga bandbredden inuti varje GPU mot dess nominella värde.

En MI350P läser sin HBM3E med 3 291 GB/s och skriver med 3 204 GB/s, ungefär 80 procent av 4 TB/s-gränsen, med kopior på 1 276 till 1 283 GB/s; en kopia förbrukar bandbredd två gånger, en gång för att läsa källan och en gång för att skriva destinationen. RTX PRO 6000:s GDDR7 klarar 1 540 GB/s vid läsning och 1 483 GB/s vid skrivning, så MI350P har ungefär 2.1 gånger den användbara bandbredden per kort.
H200 NVL:s läshastigheter på 4 472 GB/s och skrivhastigheter på 4 156 GB/s ligger 36 respektive 30 procent före MI350P, i linje med dess 4.8 TB/s-klassificering jämfört med 4 TB/s, och GB300 DGX Station når 6 869 GB/s. Två MI350P mätta tillsammans når 6 529 GB/s vid läsning, nära Stationen, men den bandbredden sitter i två PCIe-kortplatser, och en modell som sträcker sig över båda betalar för varje utbyte över PCIe.
Slutledning
Med lågnivåtesterna täckta går vi vidare till LLM-inferens. Vårt vLLM-onlineservertest driver en OpenAI-kompatibel slutpunkt med ett fast antal samtidiga strömmar och registrerar utdatatokens per sekund över hela körningen. Vi rapporterar två former: 512 tokens in och 512 ut, vilket är chattstort och avkodningstungt, och 8 192 in och 1 024 ut, vilket är RAG- och dokumentstort och lutar sig mot förfyllning. Samtidigheten fördubblas från en ström och uppåt, och varje diagram stannar vid den högsta samtidigheten där varje kort i det slutfördes. Varje punkt är två förfrågningar per ström, så siffror för en enda ström vilar på två förfrågningar och har mer varians från körning till körning än poängen med högre samtidighet.
Varje modell kördes på så få kort som möjligt: ett MI350P för allt genom GPT-OSS-120B och MiniMax-M2.7, och två för DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2 och GLM-5.3 Flash. RTX PRO 6000-körningarna följer samma regel, som sätter två RTX-kort mot ett MI350P på MiniMax-M2.7 och fyra mot två på MiniMax-M3 och GLM-5.2. Lågprecisionsbyggen skiljer sig åt mellan leverantörer: AMD:s är MXFP4 genom Quark, NVIDIA:s är NVFP4, och FP4-parningarna är märkta på det sättet genomgående. GPT-OSS levereras som MXFP4 och kör samma vikter på varje kort. H200 NVFP4-byggena ingår inte.
| Modell | MI350P | RTX PRO 6000 Blackwell | H200 NVL | GB300 DGX-station |
|---|---|---|---|---|
| GLM-5.3 Blixt | 2 kort, MXFP4 | Inte kört | Inte kört | NVFP4 |
| GLM-5.2 | 2 kort, MXFP4 (avlastar till värdminne) | 4 kort, NVFP4 | Inte kört | NVFP4 (cirka 215 GB expertminne i Grace) |
| MiniMax-M3 | 2 kort, MXFP4 | 4 kort, NVFP4 | Inte kört | NVFP4 (en del av experternas minne i Grace) |
| DeepSeek-V4-Flash | 2 kort, FP8 | 2 kort, FP8 | Inte kört | FP8 |
| MiniMax-M2.7 | 1 kort, MXFP4 | 2 kort, NVFP4 | Inte kört | NVFP4 |
| GPT-OSS-120B | 1 kort, MXFP4 | 1 kort, MXFP4 | 1 kort, MXFP4 | MXFP4 |
| GPT-OSS-20B | 1 kort, MXFP4 | 1 kort, MXFP4 | 1 kort, MXFP4 | MXFP4 |
| Qwen3-Kodare-30B-A3B | 1 kort, FP8 och BF16 | 1 kort, FP8 och BF16 | 1 kort, FP8 och BF16 | FP8 och BF16 |
| Mistral Small 3.1 24B | 1 kort, FP8 och BF16 | 1 kort, FP8 och BF16 | 1 kort, FP8 och BF16 | FP8 och BF16 |
| Lama 3.1 8B | 1 kort, MXFP4, FP8 och BF16 | 1 kort, NVFP4, FP8 och BF16 | 1 kort, FP8 och BF16 | NVFP4, FP8 och BF16 |
Läs ner MI350P-kolumnen, så är kortantalet det första du får med 144 GB. Sex av de tio modellerna körs på en MI350P, där RTX PRO 6000:s 96 GB behöver ett andra kort för MiniMax-M2.7, och de två MXFP4-kontrollpunkterna som stannar kvar på ett par MI350P, MiniMax-M3 och GLM-5.2, behöver fyra RTX PRO 6000. GLM-5.2 är den som växer ur till och med 288 GB, och vLLM avlastar en del av sina expertvikter till R7725:s värdminne för den körningen; GB300 gör detsamma med cirka 215 GB expertminne i Grace.
MI350P-siffrorna för modellerna med ett enda kort kördes den 27 oktober på AMDGPU 31.60, ROCm 10.1.0 och vLLM 0.32.0. Dells validerade kombination är vLLM 0.27 med ROCm 10.0 och AMDGPU 31.5, och vi gick ett steg längre än det till ROCm 10.1-utgåvan den 5 oktober. NVIDIA-korten körde vLLM 26.08-containern på CUDA 13.4.1 genomgående. Tabellen listar build bakom varje körning.
| Modell | vLLM-bild |
|---|---|
| AMD Instinct MI350P | |
| DeepSeek-V4-Flash-0731 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GLM-5.2 MXFP4 | vllm/vllm-openai-rocm:v0.27.1 (ROCm 7.2.3) |
| GLM-5.3 Flash MXFP4 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GPT-OSS-120B MXFP4 | vLLM 0.32.0 på ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| GPT-OSS-20B MXFP4 | vLLM 0.32.0 på ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| Llama 3.1 8B BF16 | vLLM 0.32.0 på ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| Llama 3.1 8B FP8 | vLLM 0.32.0 på ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| Llama 3.1 8B MXFP4 | vLLM 0.32.0 på ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| MiniMax-M2.7 MXFP4 | vLLM 0.32.0 på ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| MiniMax-M3 MXFP4 | vllm/vllm-openai-rocm:nightly-2a02f6efe319c885e3ccbcecde402e0028f9ec1e (ROCm 7.2.3) |
| Mistral Small 3.1 24B BF16 | vLLM 0.32.0 på ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| Mistral Small 3.1 24B FP8 | vLLM 0.32.0 på ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| Qwen3-kodare-30B BF16 | vLLM 0.32.0 på ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| Qwen3-kodare-30B FP8 | vLLM 0.32.0 på ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| NVIDIA RTX PRO 6000 Blackwell Server Edition (CUDA 13.4.1.012) | |
| DeepSeek-V4-Flash-0731 | nvcr.io/nvidia/vllm:26.08-py3 |
| GLM-5.2 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M2.7 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M3 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-kodare-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-kodare-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| NVIDIA H200 NVL (CUDA 13.4.1.012) | |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-kodare-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-kodare-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
De fyra tvåkortsmodellerna, DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2 och GLM-5.3 Flash, rapporteras från körningar på ROCm 7.2.3. Våra ROCm 10.1-genomgångar på dessa modeller använde CPU-expertavlastning genomgående och, på DeepSeek-V4-Flash, en spekulativ avkodare som NVIDIA-körningarna inte använde, vilket gör dem till ett annat test, så de sparas för ett rent genomgång på den aktuella stacken, och tabellerna märker varje MI350P-rad med dess stack.
AMDs föredragna väg för dessa modeller är deras AIM-containrar; Enterprise AI Suite 2.5-utgåvan från 9 oktober är validerad på ROCm 10 och har AIM:er för GPT-OSS-120B, Llama 3.3 70B och Gemma 3 27B, men AMDs acceleratortabell visar en optimerad MI350P-profil endast för Wan2.2 hittills. Standard vLLM är därför fortfarande den väg en MI350P-köpare tar idag, och är vad vi mätte.
Inferensresultat i korthet
Det finns 28 diagram nedan, så här är den korta versionen i två tabeller: utdatatokens per sekund för varje modell vid den högsta samtidigheten som varje kort slutfört, med den chattstora arbetsbelastningen 512 in, 512 ut först. MI350P-siffrorna är ett kort på 450W om inte raden anger annat, med en kolumn för stacken varje rad kommer från; GB300 DGX Station är en enda B300.
| Modell | Kort (MI350P / RTX PRO 6000) | MI350P-stack | Streams | MI350P | RTX PRO 6000 | H200 NVL | GB300 DGX-station |
|---|---|---|---|---|---|---|---|
| GLM-5.3 Flash (MXFP4 vs NVFP4) | 2 / ingen | ROCm 7.2.3 | 32 | 1,462 | Inte kört | Inte kört | 828 |
| GLM-5.2 (MXFP4 jämfört med NVFP4) | 2 / 4 | ROCm 7.2.3 | 32 | 59 | 40 | Inte kört | 139 |
| MiniMax-M3 (MXFP4 jämfört med NVFP4) | 2 / 4 | ROCm 7.2.3 | 32 | 1,509 | 759 | Inte kört | 1,041 |
| DeepSeek-V4-Flash | 2 / 2 | ROCm 7.2.3 | 32 | 1,081 | 829 | Inte kört | 1,766 |
| MiniMax-M2.7 (MXFP4 jämfört med NVFP4) | 1 / 2 | ROCm 10.1 | 128 | 1,524 | 1,932 | Inte kört | 4,793 |
| GPT-OSS-120B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 5,057 | 3,064 | 3,376 | 9,280 |
| GPT-OSS-20B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 10,726 | 7,937 | 6,022 | 22,041 |
| Qwen3-kodare-30B FP8 | 1 / 1 | ROCm 10.1 | 128 | 6,451 | 3,995 | 7,459 | 12,439 |
| Qwen3-kodare-30B BF16 | 1 / 1 | ROCm 10.1 | 128 | 4,696 | 2,881 | 5,240 | 10,000 |
| Mistral Small 24B FP8 | 1 / 1 | ROCm 10.1 | 128 | 4,458 | 3,242 | 4,624 | 11,075 |
| Mistral Small 24B BF16 | 1 / 1 | ROCm 10.1 | 128 | 3,065 | 2,026 | 3,373 | 7,861 |
| Llama 3.1 8B (MXFP4 mot NVFP4) | 1 / 1 | ROCm 10.1 | 128 | 8,383 | 8,869 | Inte kört | 28,400 |
| Llama 3.1 8B FP8 | 1 / 1 | ROCm 10.1 | 128 | 11,045 | 8,073 | 11,054 | 25,602 |
| Llama 3.1 8B BF16 | 1 / 1 | ROCm 10.1 | 128 | 6,819 | 4,740 | 8,069 | 17,074 |
Två resultat sticker ut i chattabellen: MI350P slår RTX PRO 6000 på alla FP8-, BF16- och GPT-OSS-modeller, med 35 till 65 procent vid 128 strömmar, ligger efter NVIDIAs NVFP4-byggen endast högst upp på Llama- och MiniMax-M2.7-kurvorna, och fördubblar ungefär NVIDIA-kortet vid en enda ström på Llama 3.1 8B och Mistral Small 24B, där 4TB/s HBM3E gör jobbet.
H200 NVL, med 20 procent mer bandbredd, ligger kvar med 4 till 18 procents ledning på de täta FP8- och BF16-modellerna vid 128 strömmar och delar Llama 3.1 8B FP8; på de två GPT-OSS-modellerna är ordningen omvänd, och MI350P slutar med 50 respektive 78 procents ledning.
Den andra tabellen upprepar övningen på prompterna med 8 192 tokens, där förifyllning dominerar körningen och balansen mellan beräknings- och minnesbandbredd förskjuts mot NVIDIA-korten.
| Modell | Kort (MI350P / RTX PRO 6000) | MI350P-stack | Streams | MI350P | RTX PRO 6000 | H200 NVL | GB300 DGX-station |
|---|---|---|---|---|---|---|---|
| GLM-5.3 Flash (MXFP4 vs NVFP4) | 2 / ingen | ROCm 7.2.3 | 32 | 760 | Inte kört | Inte kört | 1,219 |
| GLM-5.2 (MXFP4 jämfört med NVFP4) | 2 / 4 | ROCm 7.2.3 | 16 | 6 | 9 | Inte kört | 87 |
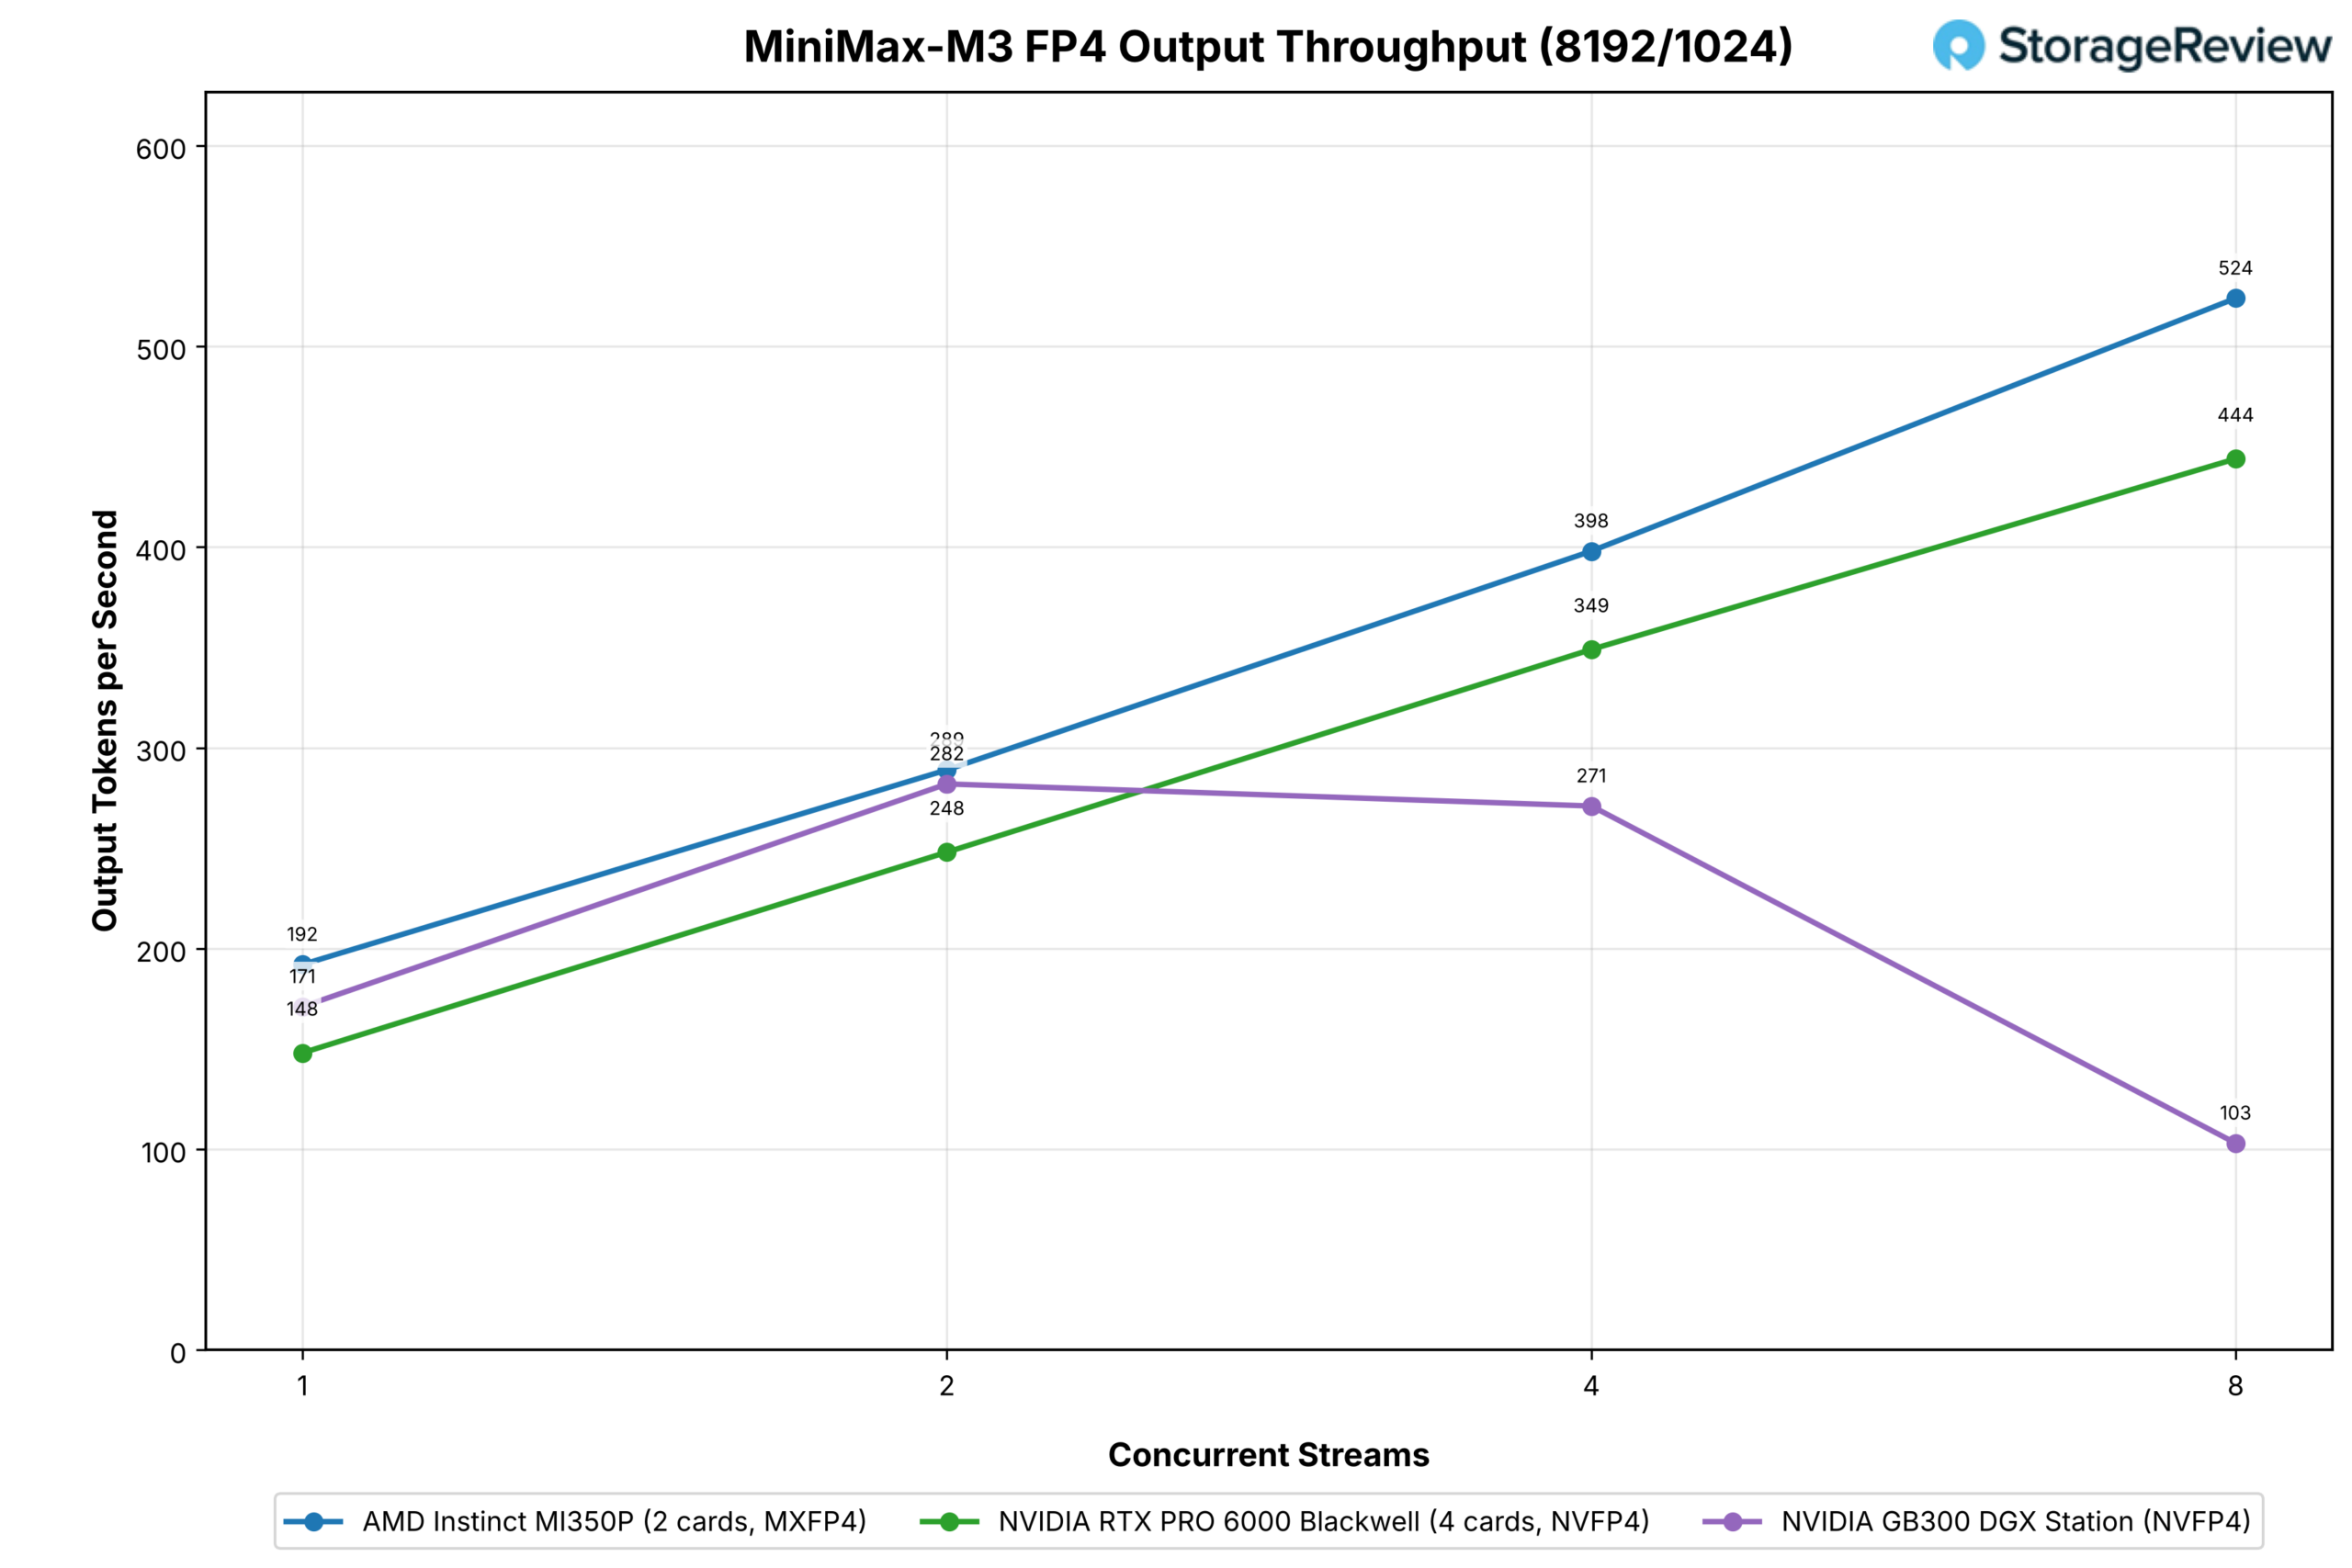
| MiniMax-M3 (MXFP4 jämfört med NVFP4) | 2 / 4 | ROCm 7.2.3 | 8 | 524 | 444 | Inte kört | 103 |
| DeepSeek-V4-Flash | 2 / 2 | ROCm 7.2.3 | 32 | 621 | 345 | Inte kört | 954 |
| MiniMax-M2.7 (MXFP4 jämfört med NVFP4) | 1 / 2 | ROCm 10.1 | 64 | 331 | 501 | Inte kört | 1,744 |
| GPT-OSS-120B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 2,101 | 1,169 | 1,825 | 5,023 |
| GPT-OSS-20B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 3,603 | 2,482 | 3,419 | 9,555 |
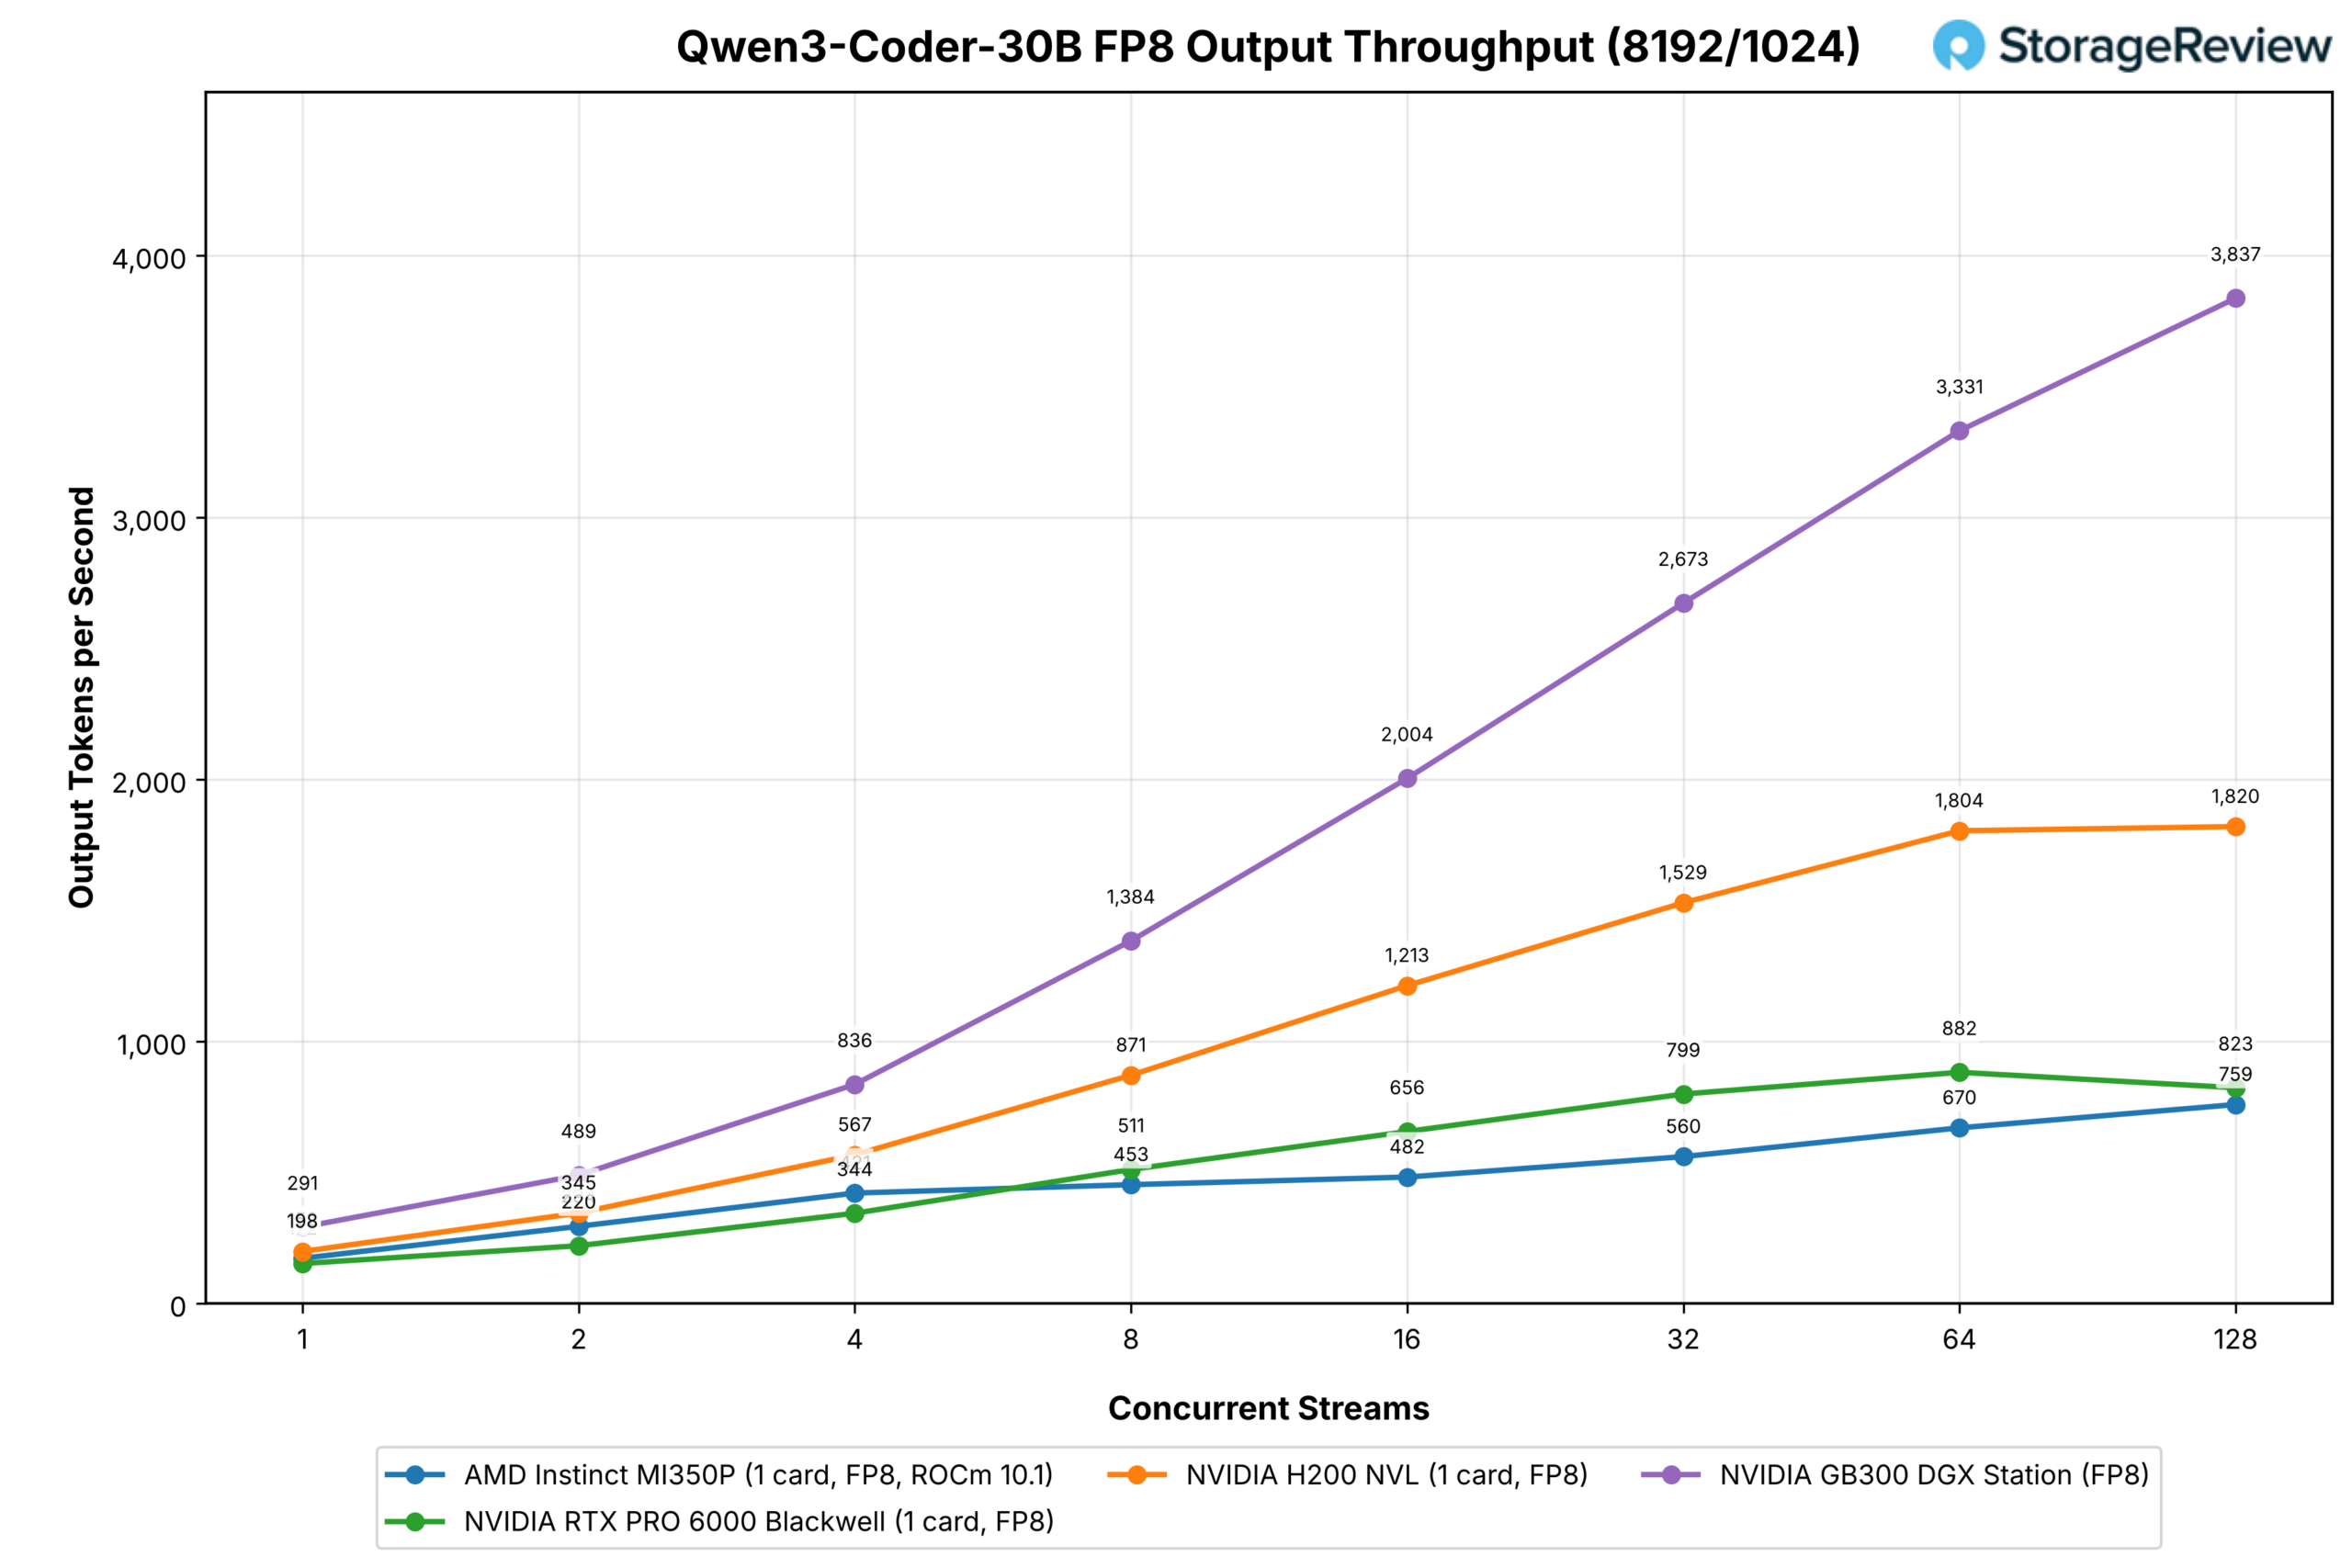
| Qwen3-kodare-30B FP8 | 1 / 1 | ROCm 10.1 | 128 | 759 | 823 | 1,820 | 3,837 |
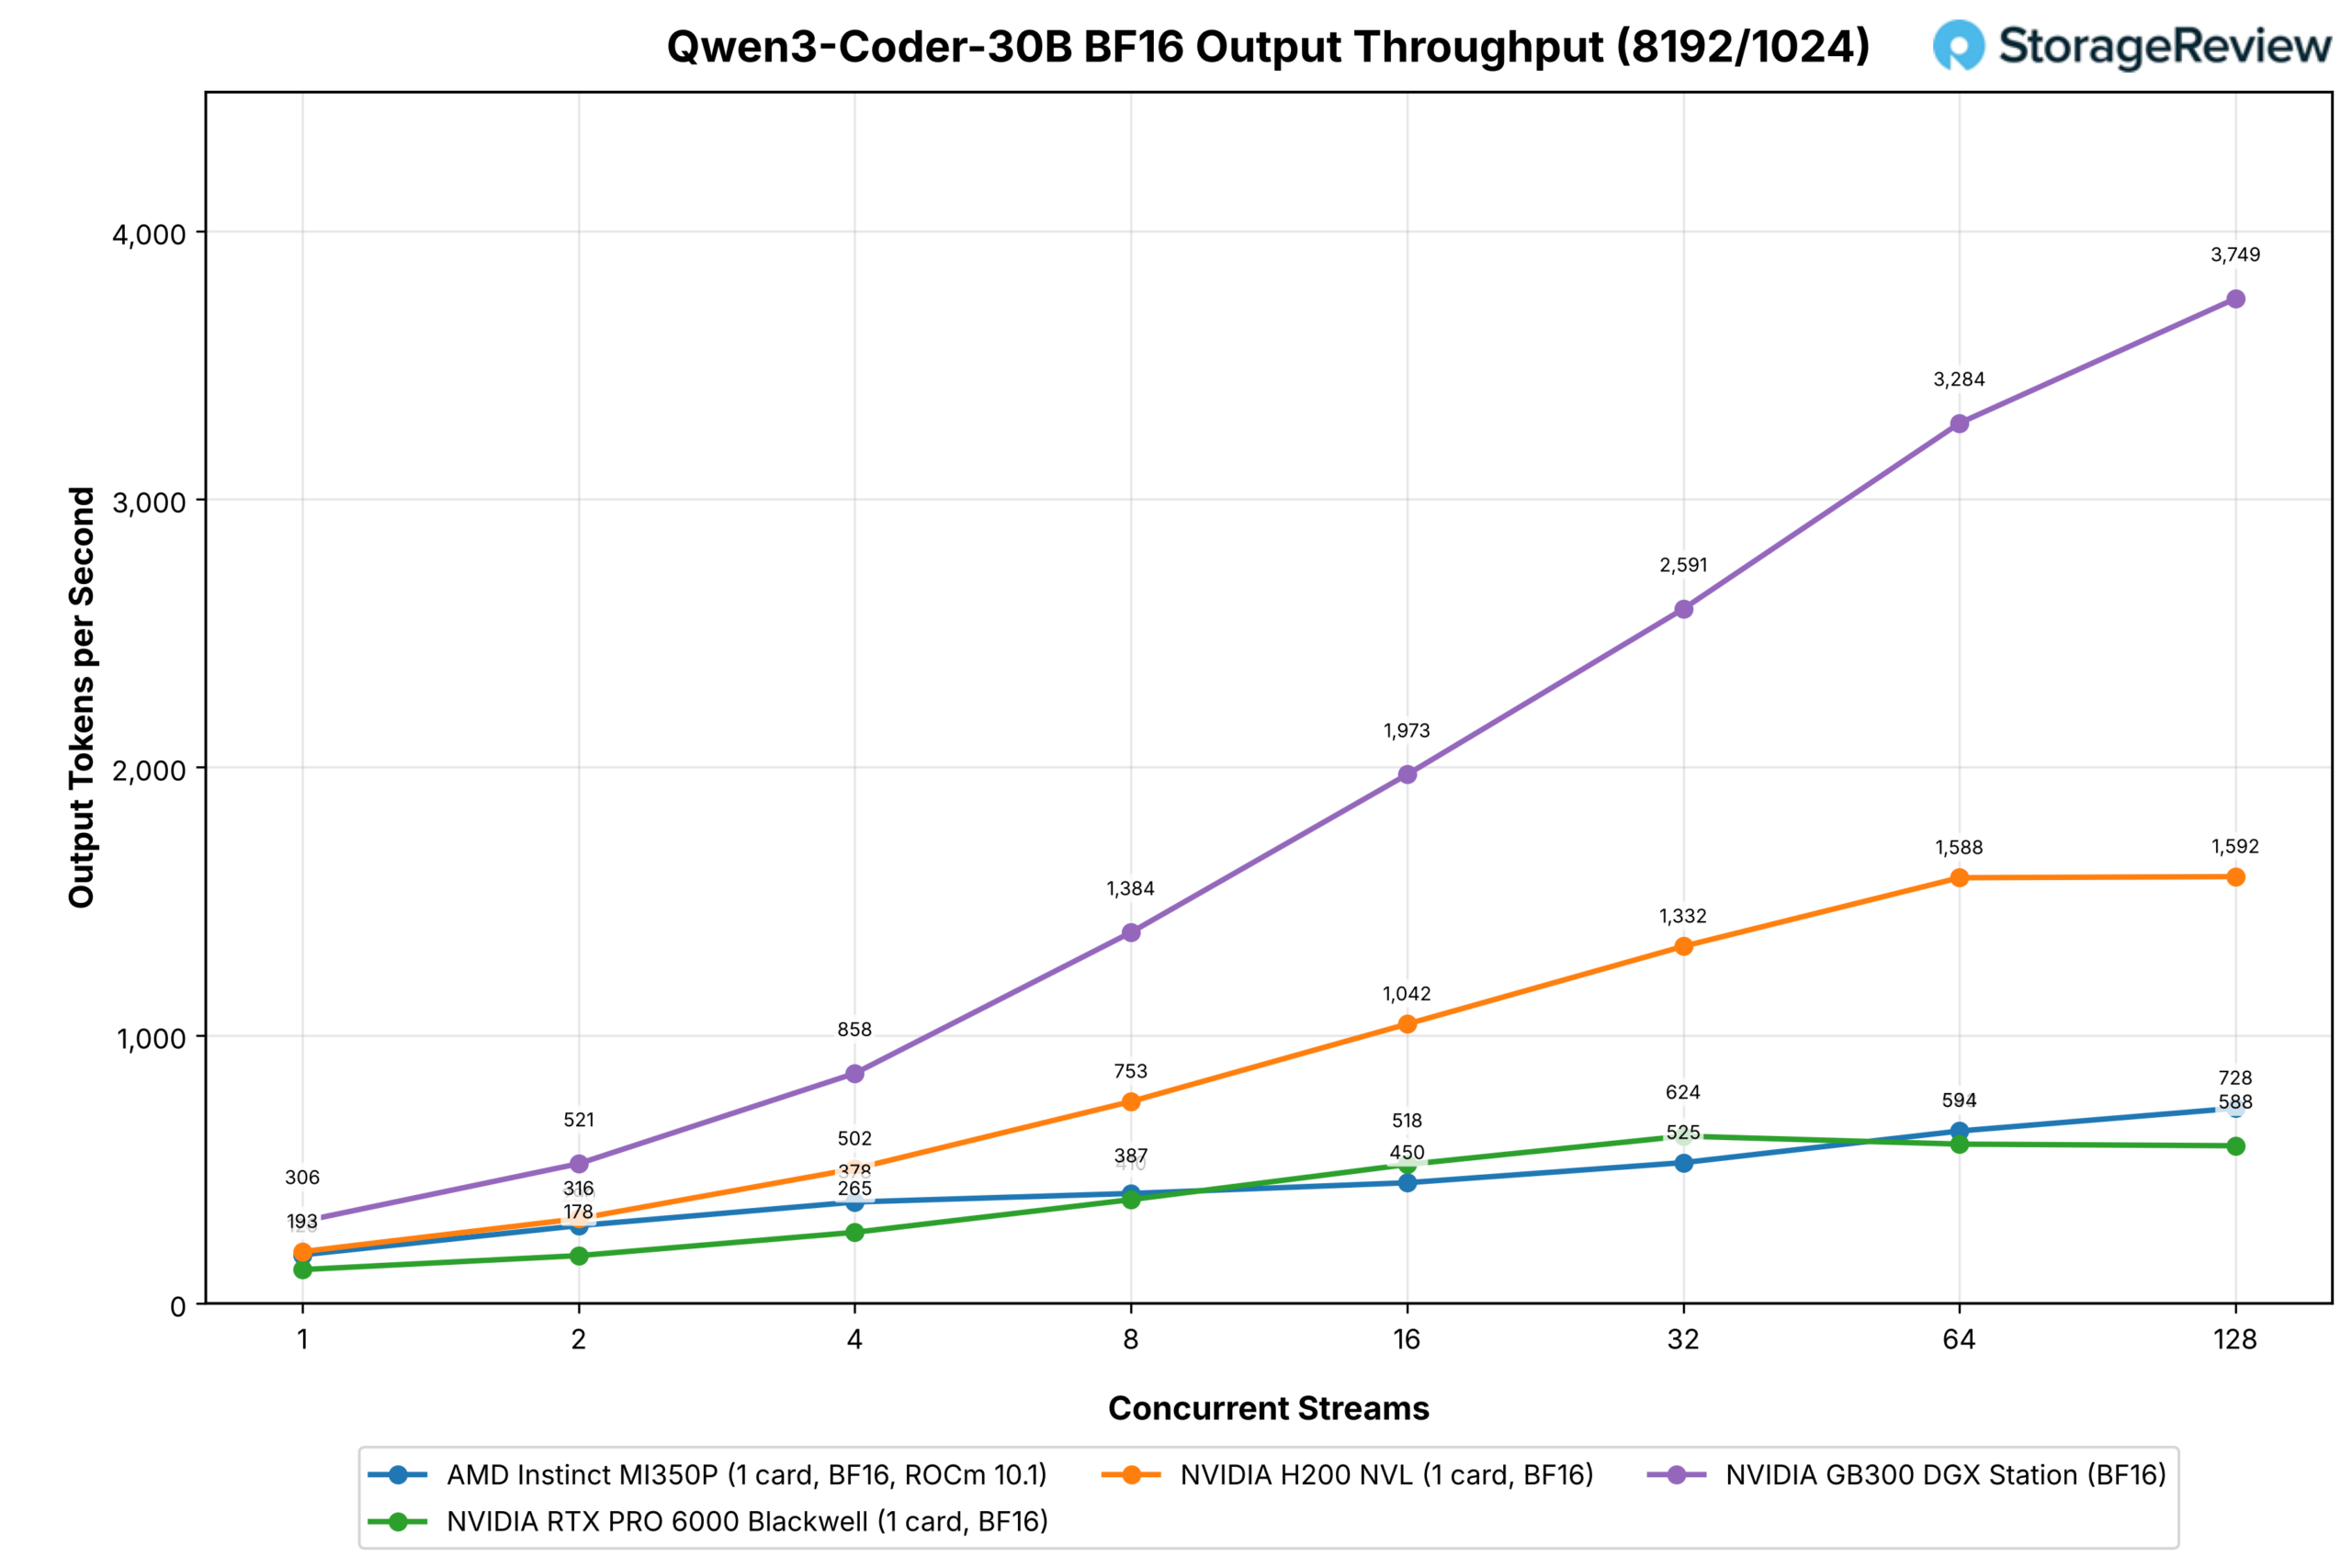
| Qwen3-kodare-30B BF16 | 1 / 1 | ROCm 10.1 | 128 | 728 | 588 | 1,592 | 3,749 |
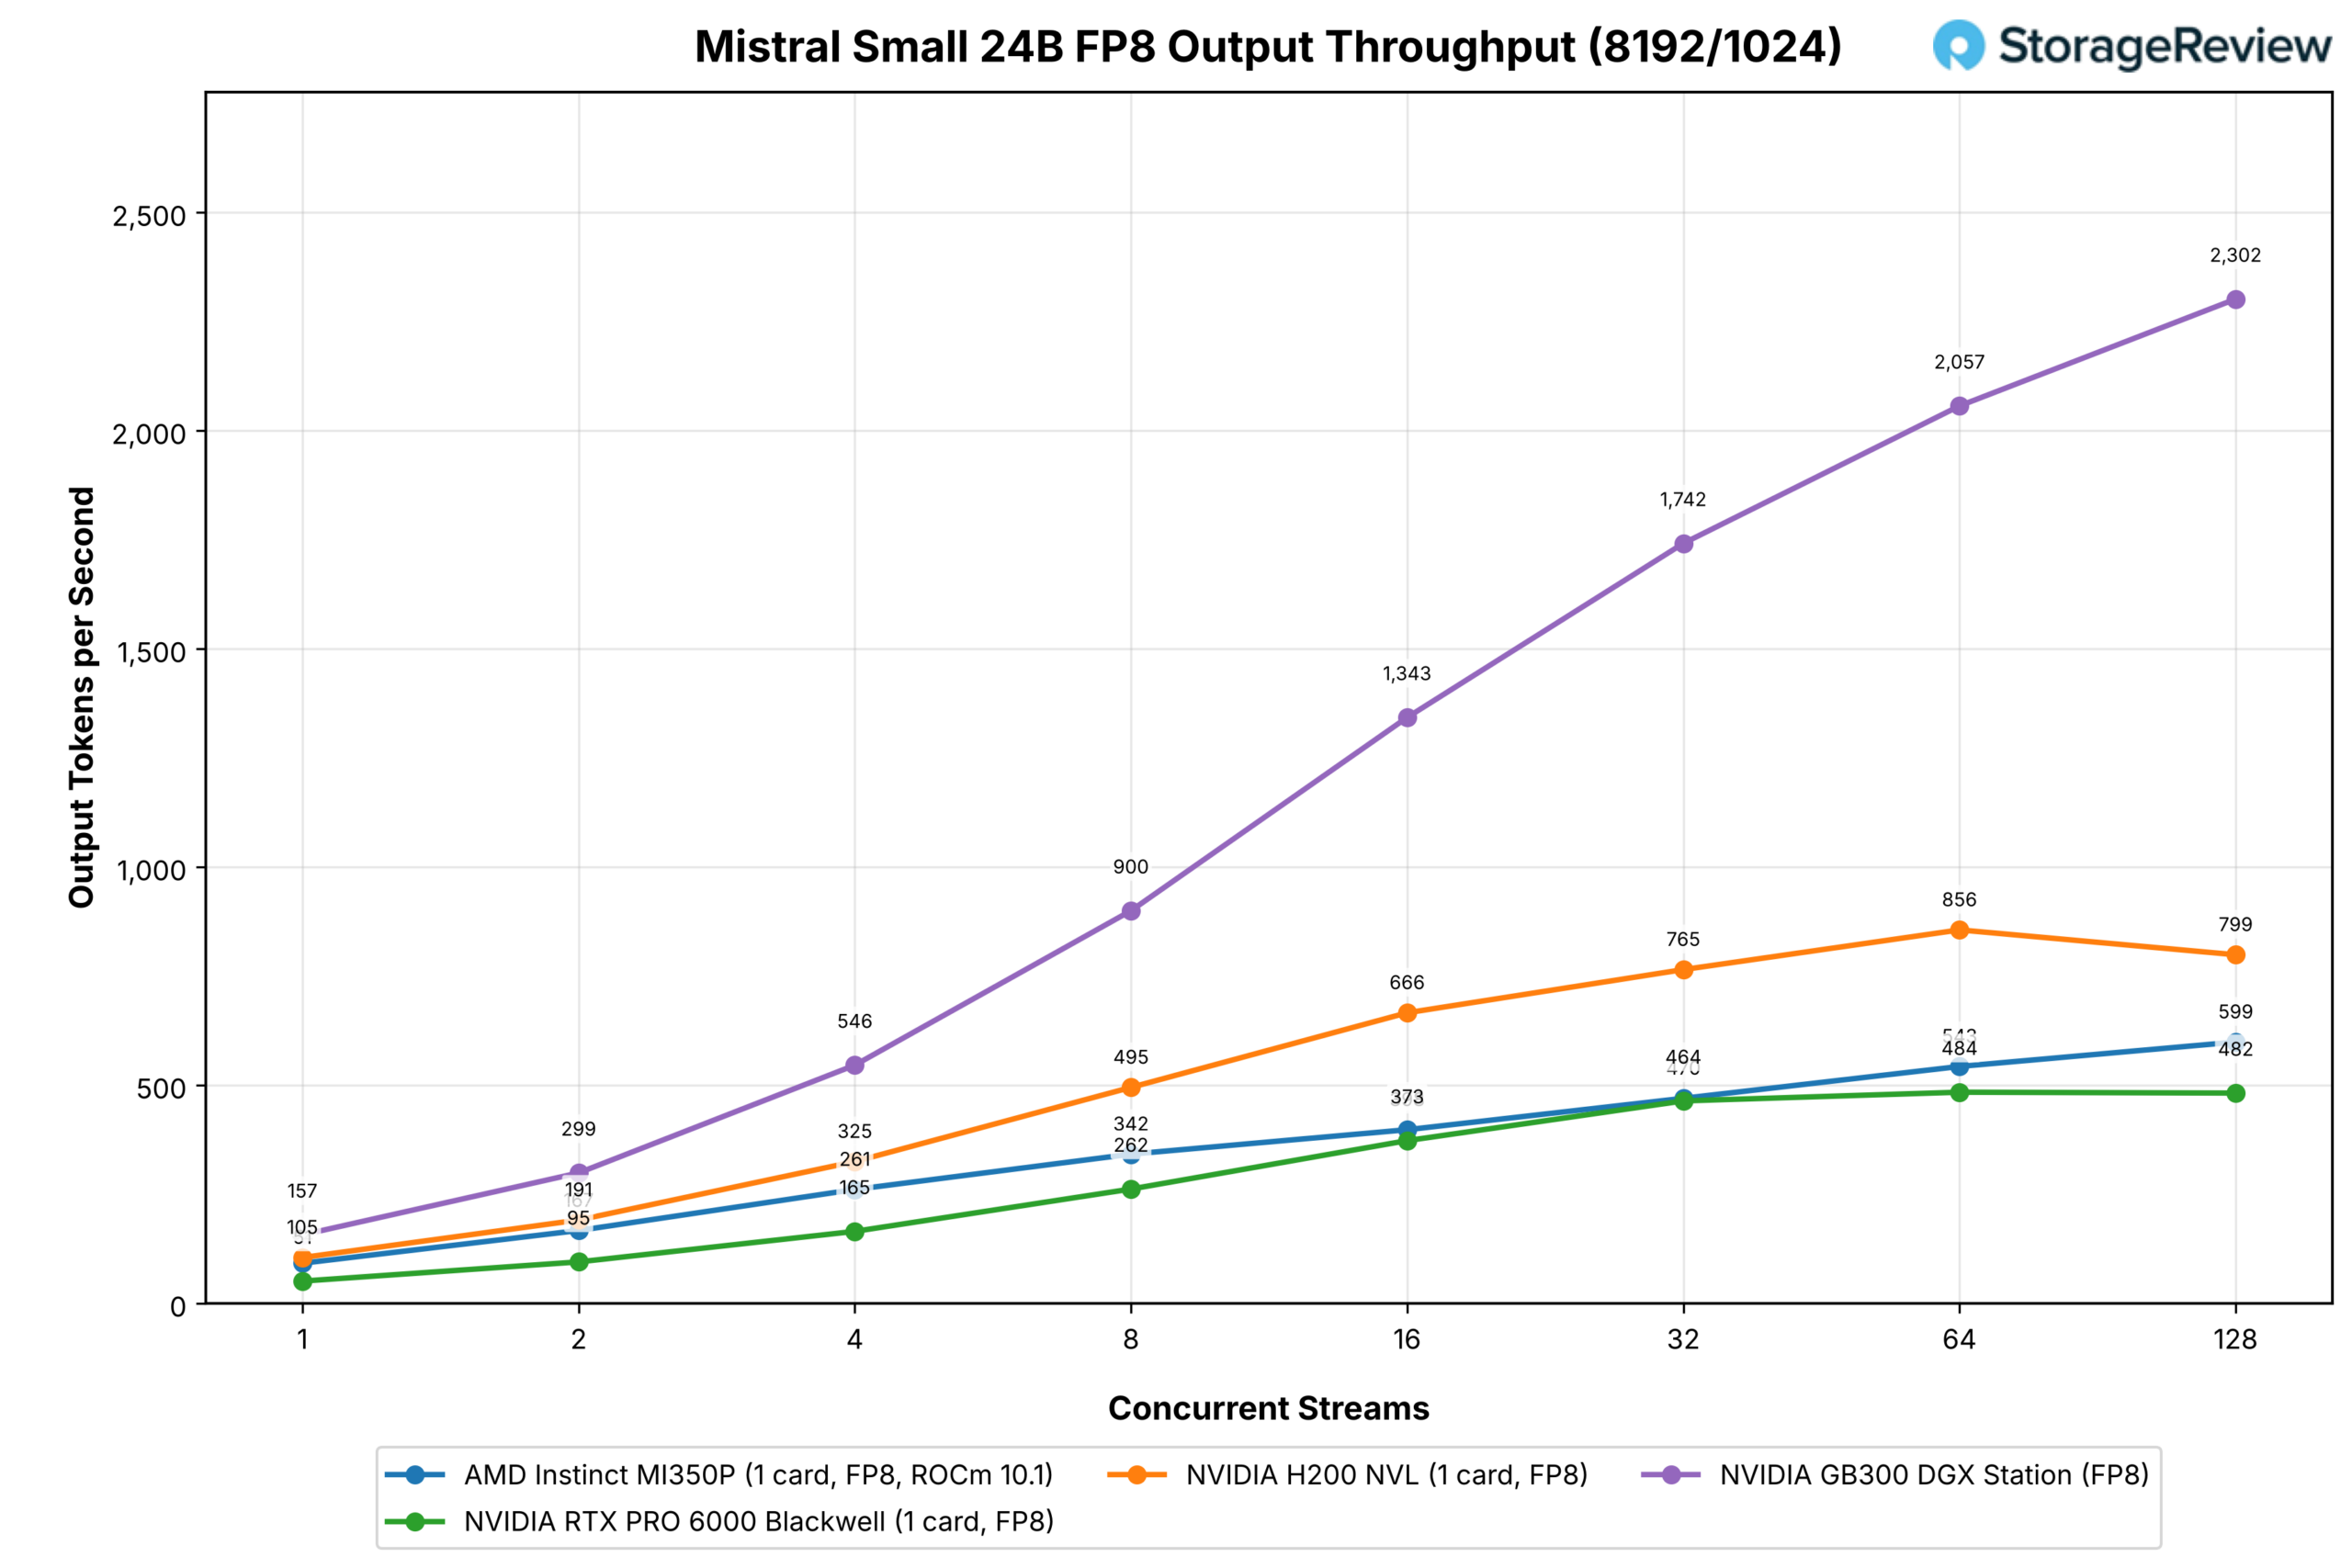
| Mistral Small 24B FP8 | 1 / 1 | ROCm 10.1 | 128 | 599 | 482 | 799 | 2,302 |
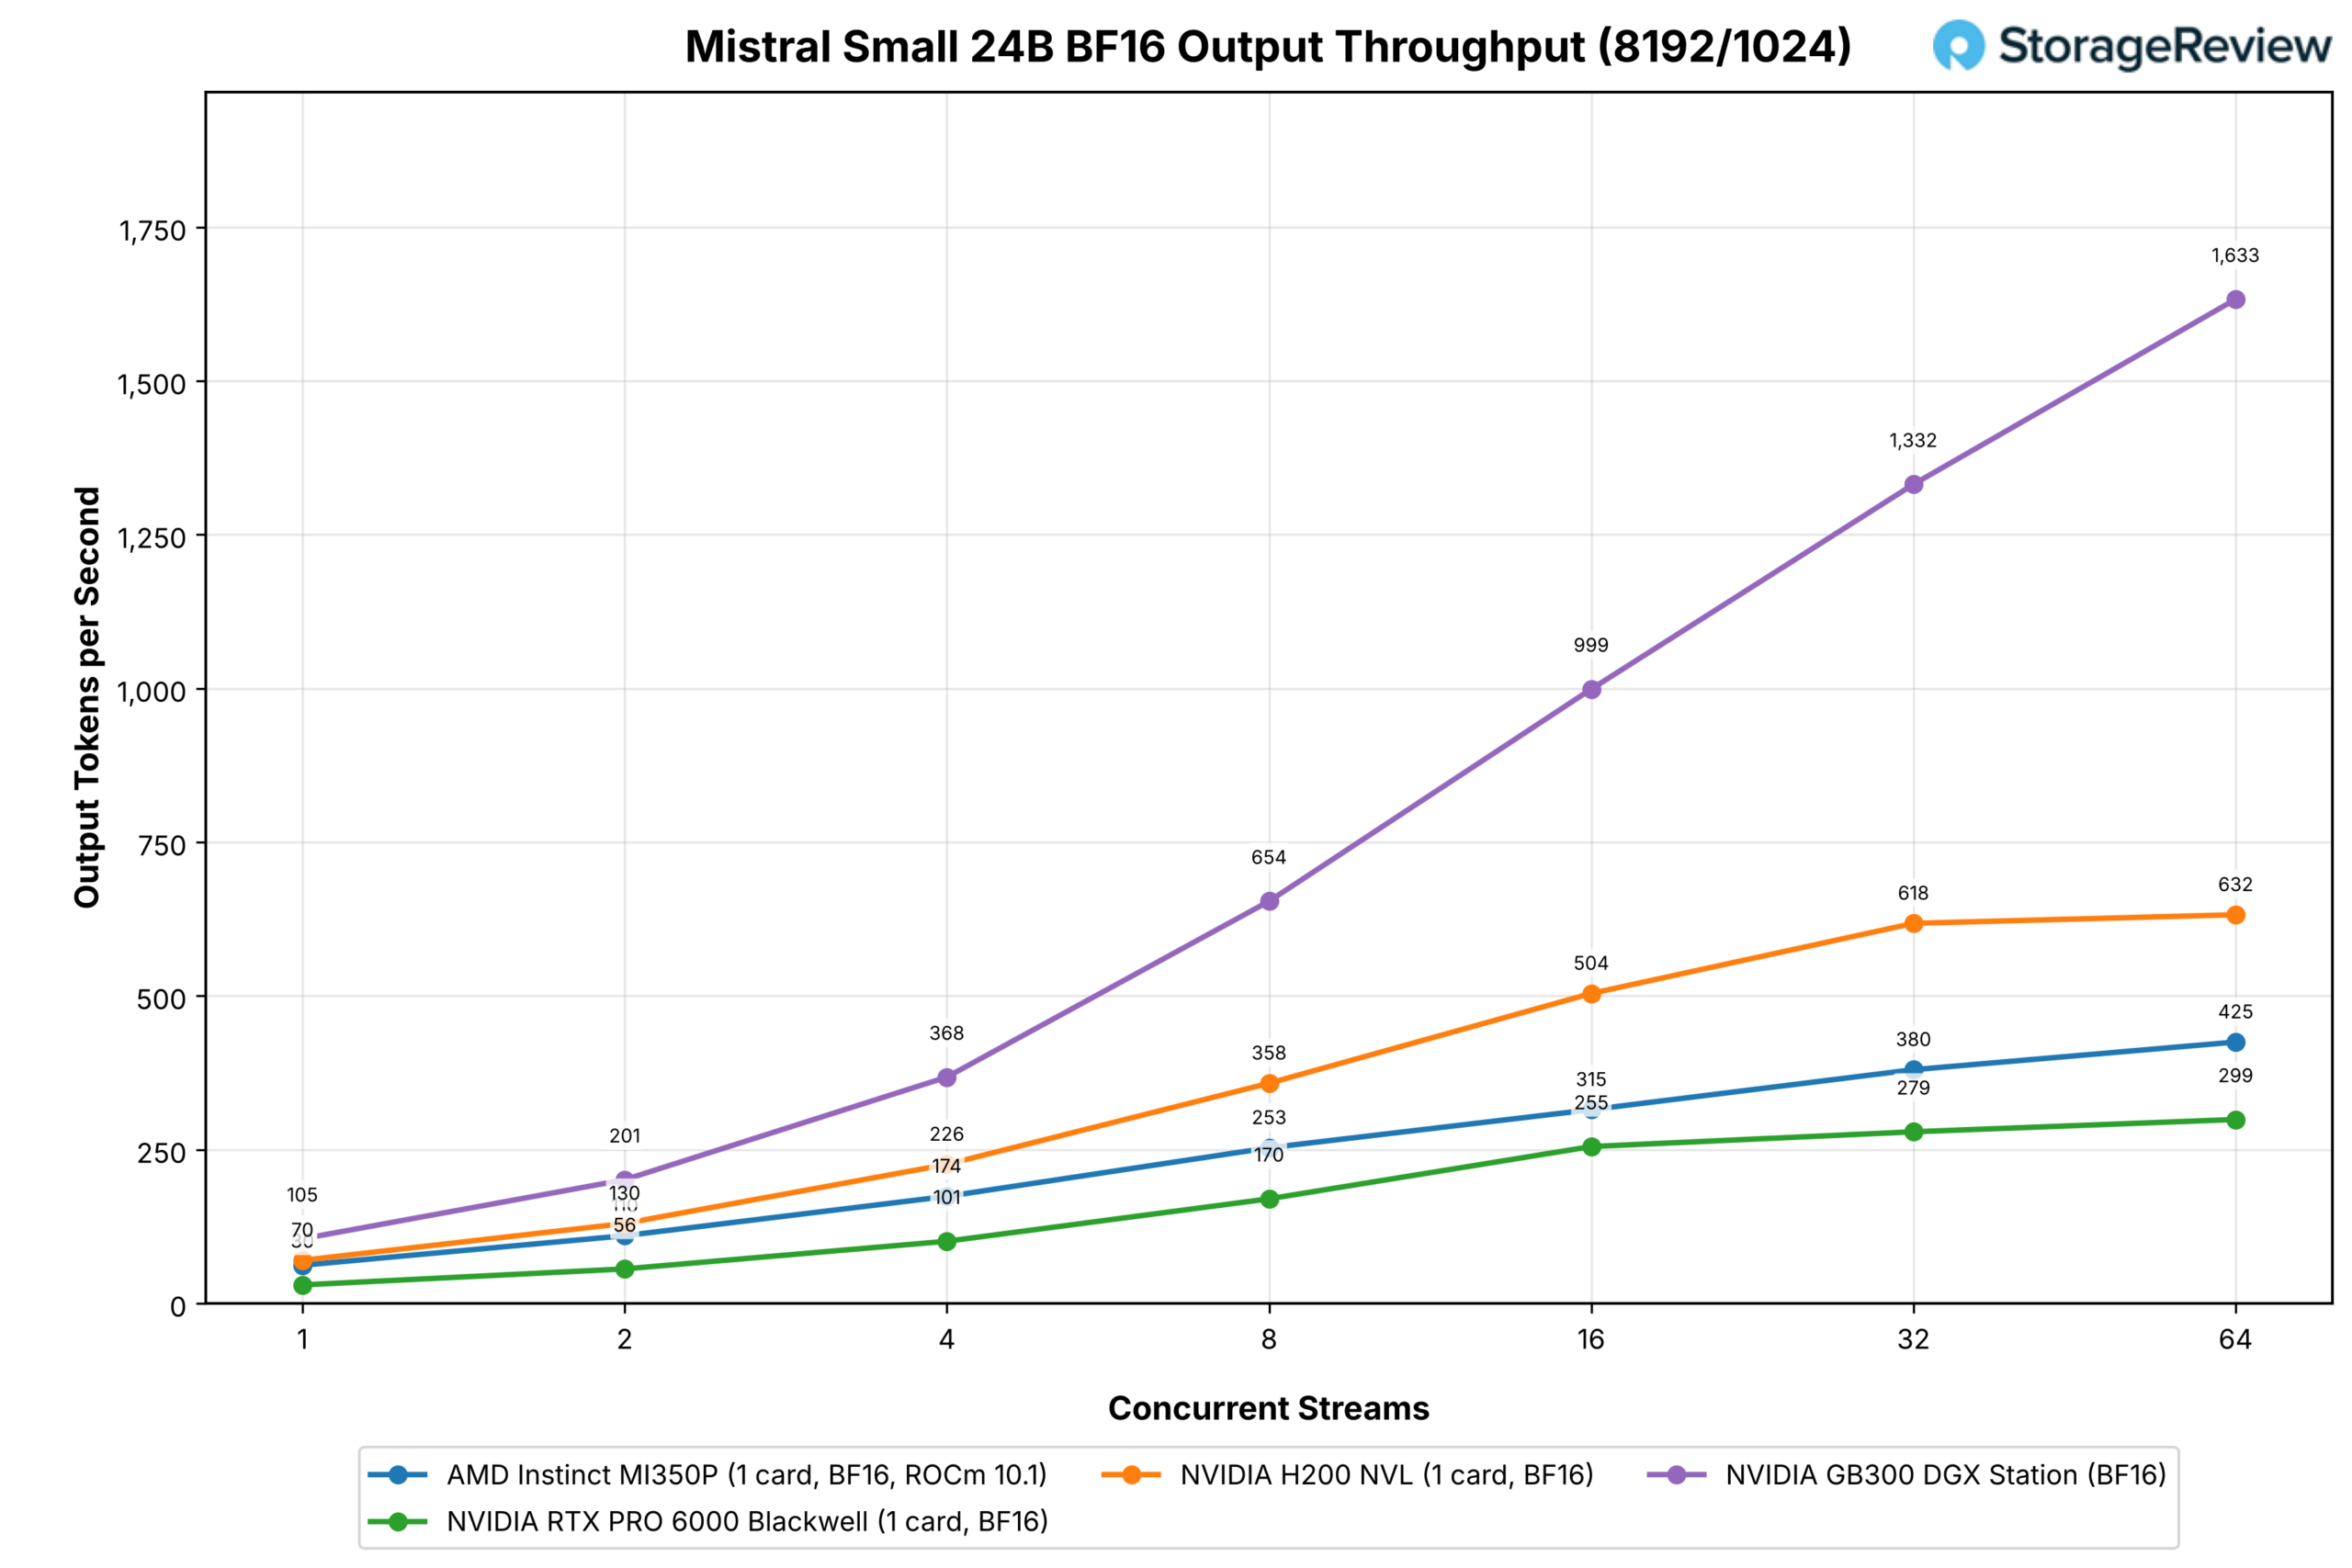
| Mistral Small 24B BF16 | 1 / 1 | ROCm 10.1 | 64 | 425 | 299 | 632 | 1,633 |
| Llama 3.1 8B (MXFP4 mot NVFP4) | 1 / 1 | ROCm 10.1 | 128 | 964 | 1,644 | Inte kört | 6,737 |
| Llama 3.1 8B FP8 | 1 / 1 | ROCm 10.1 | 128 | 1,211 | 1,481 | 2,045 | 6,164 |
| Llama 3.1 8B BF16 | 1 / 1 | ROCm 10.1 | 128 | 686 | 716 | 1,358 | 3,498 |
På förfyllningstunga uppmaningar är bilden blandad: MI350P leder RTX PRO 6000 på båda GPT-OSS-modellerna vid varje strömräkning och på Mistral Small, delar Qwen3-Coder vid 128 strömmar (24 procent före på BF16, 8 procent efter på FP8), och planar ut med 16 strömmar på Llama och MiniMax-M2.7, där den slutar bakom NVIDIA-kortet. Mot H200 leder den på GPT-OSS med 15 procent på 120B-modellen och 5 procent på 20B vid 128 strömmar och ligger 25 till 58 procent efter på de kompakta modellerna.
På de största modellerna, där två MI350P möter fyra RTX PRO 6000, leder NVIDIA-serien GLM-5.2 genom 16 strömmar på chattarbetsbelastningen med 384 GB GDDR7 mot 288 GB HBM3E, medan på MiniMax-M3 alla tre konfigurationer håller sig inom 10 procent genom åtta strömmar innan RTX-fyran tar ledningen vid 16. Den enda GB300 klarar alla PCIe-konfigurationer med god marginal på allt som får plats i dess 252 GB.
GLM-5.3 Blixt
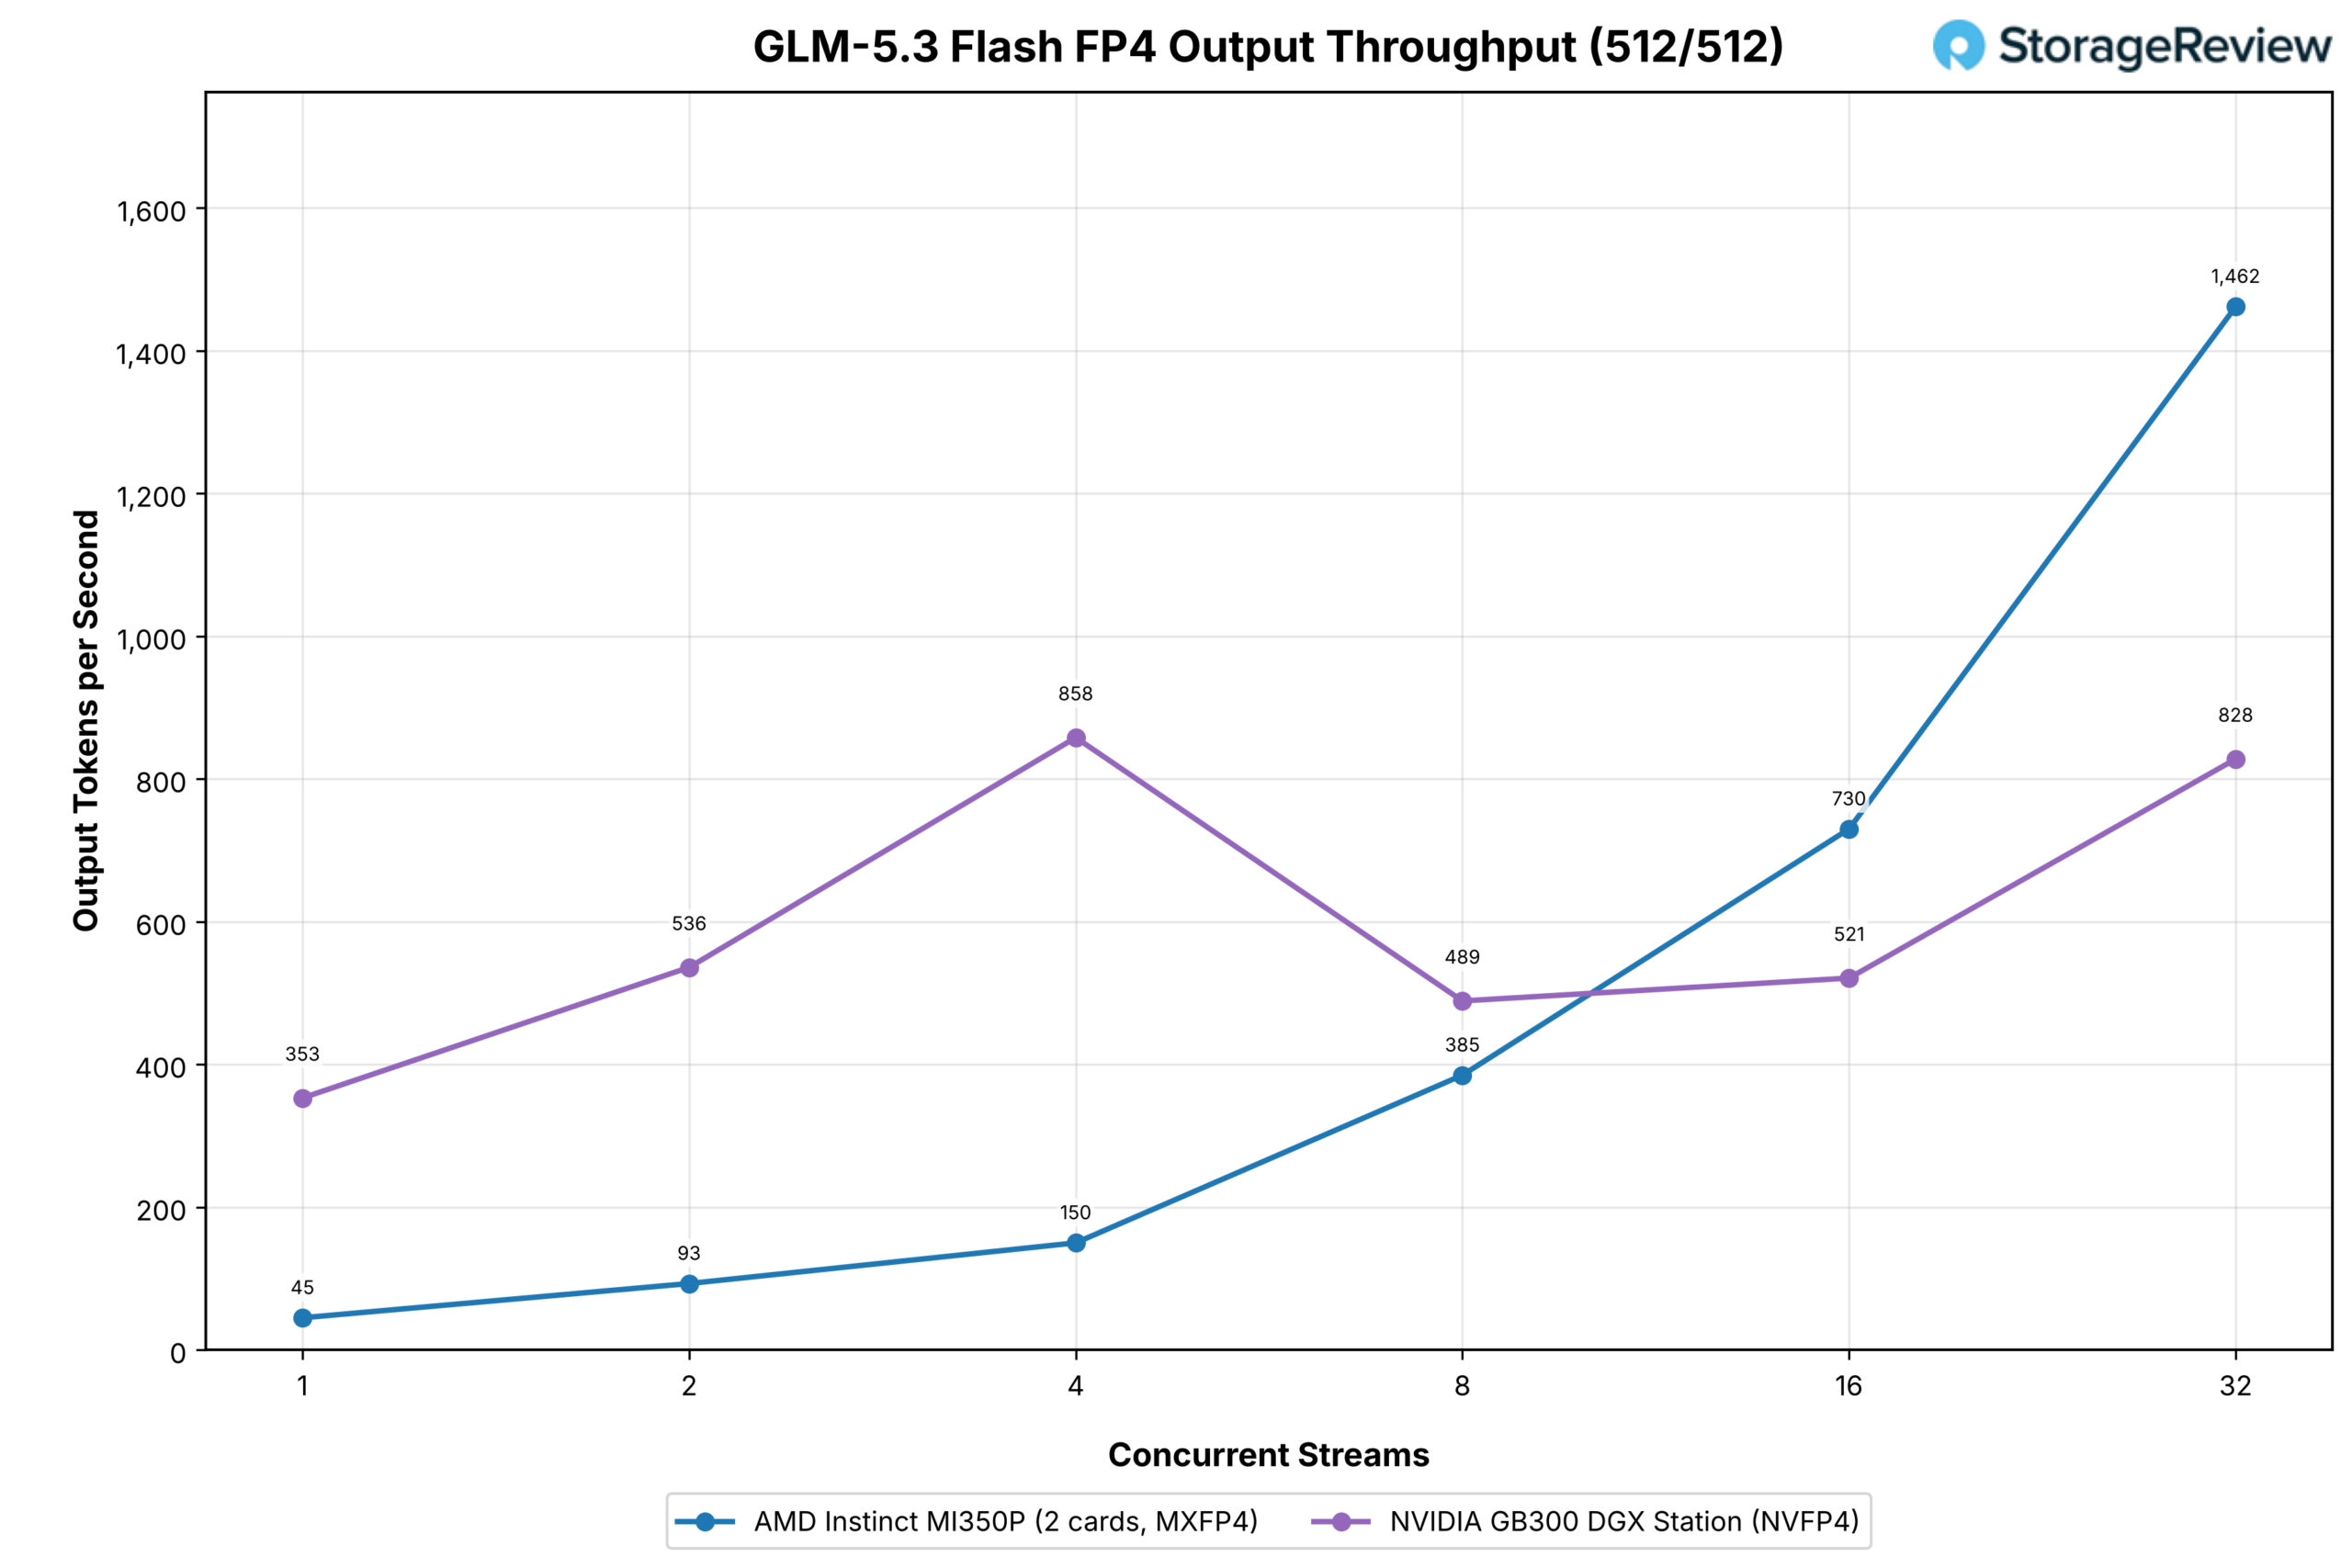
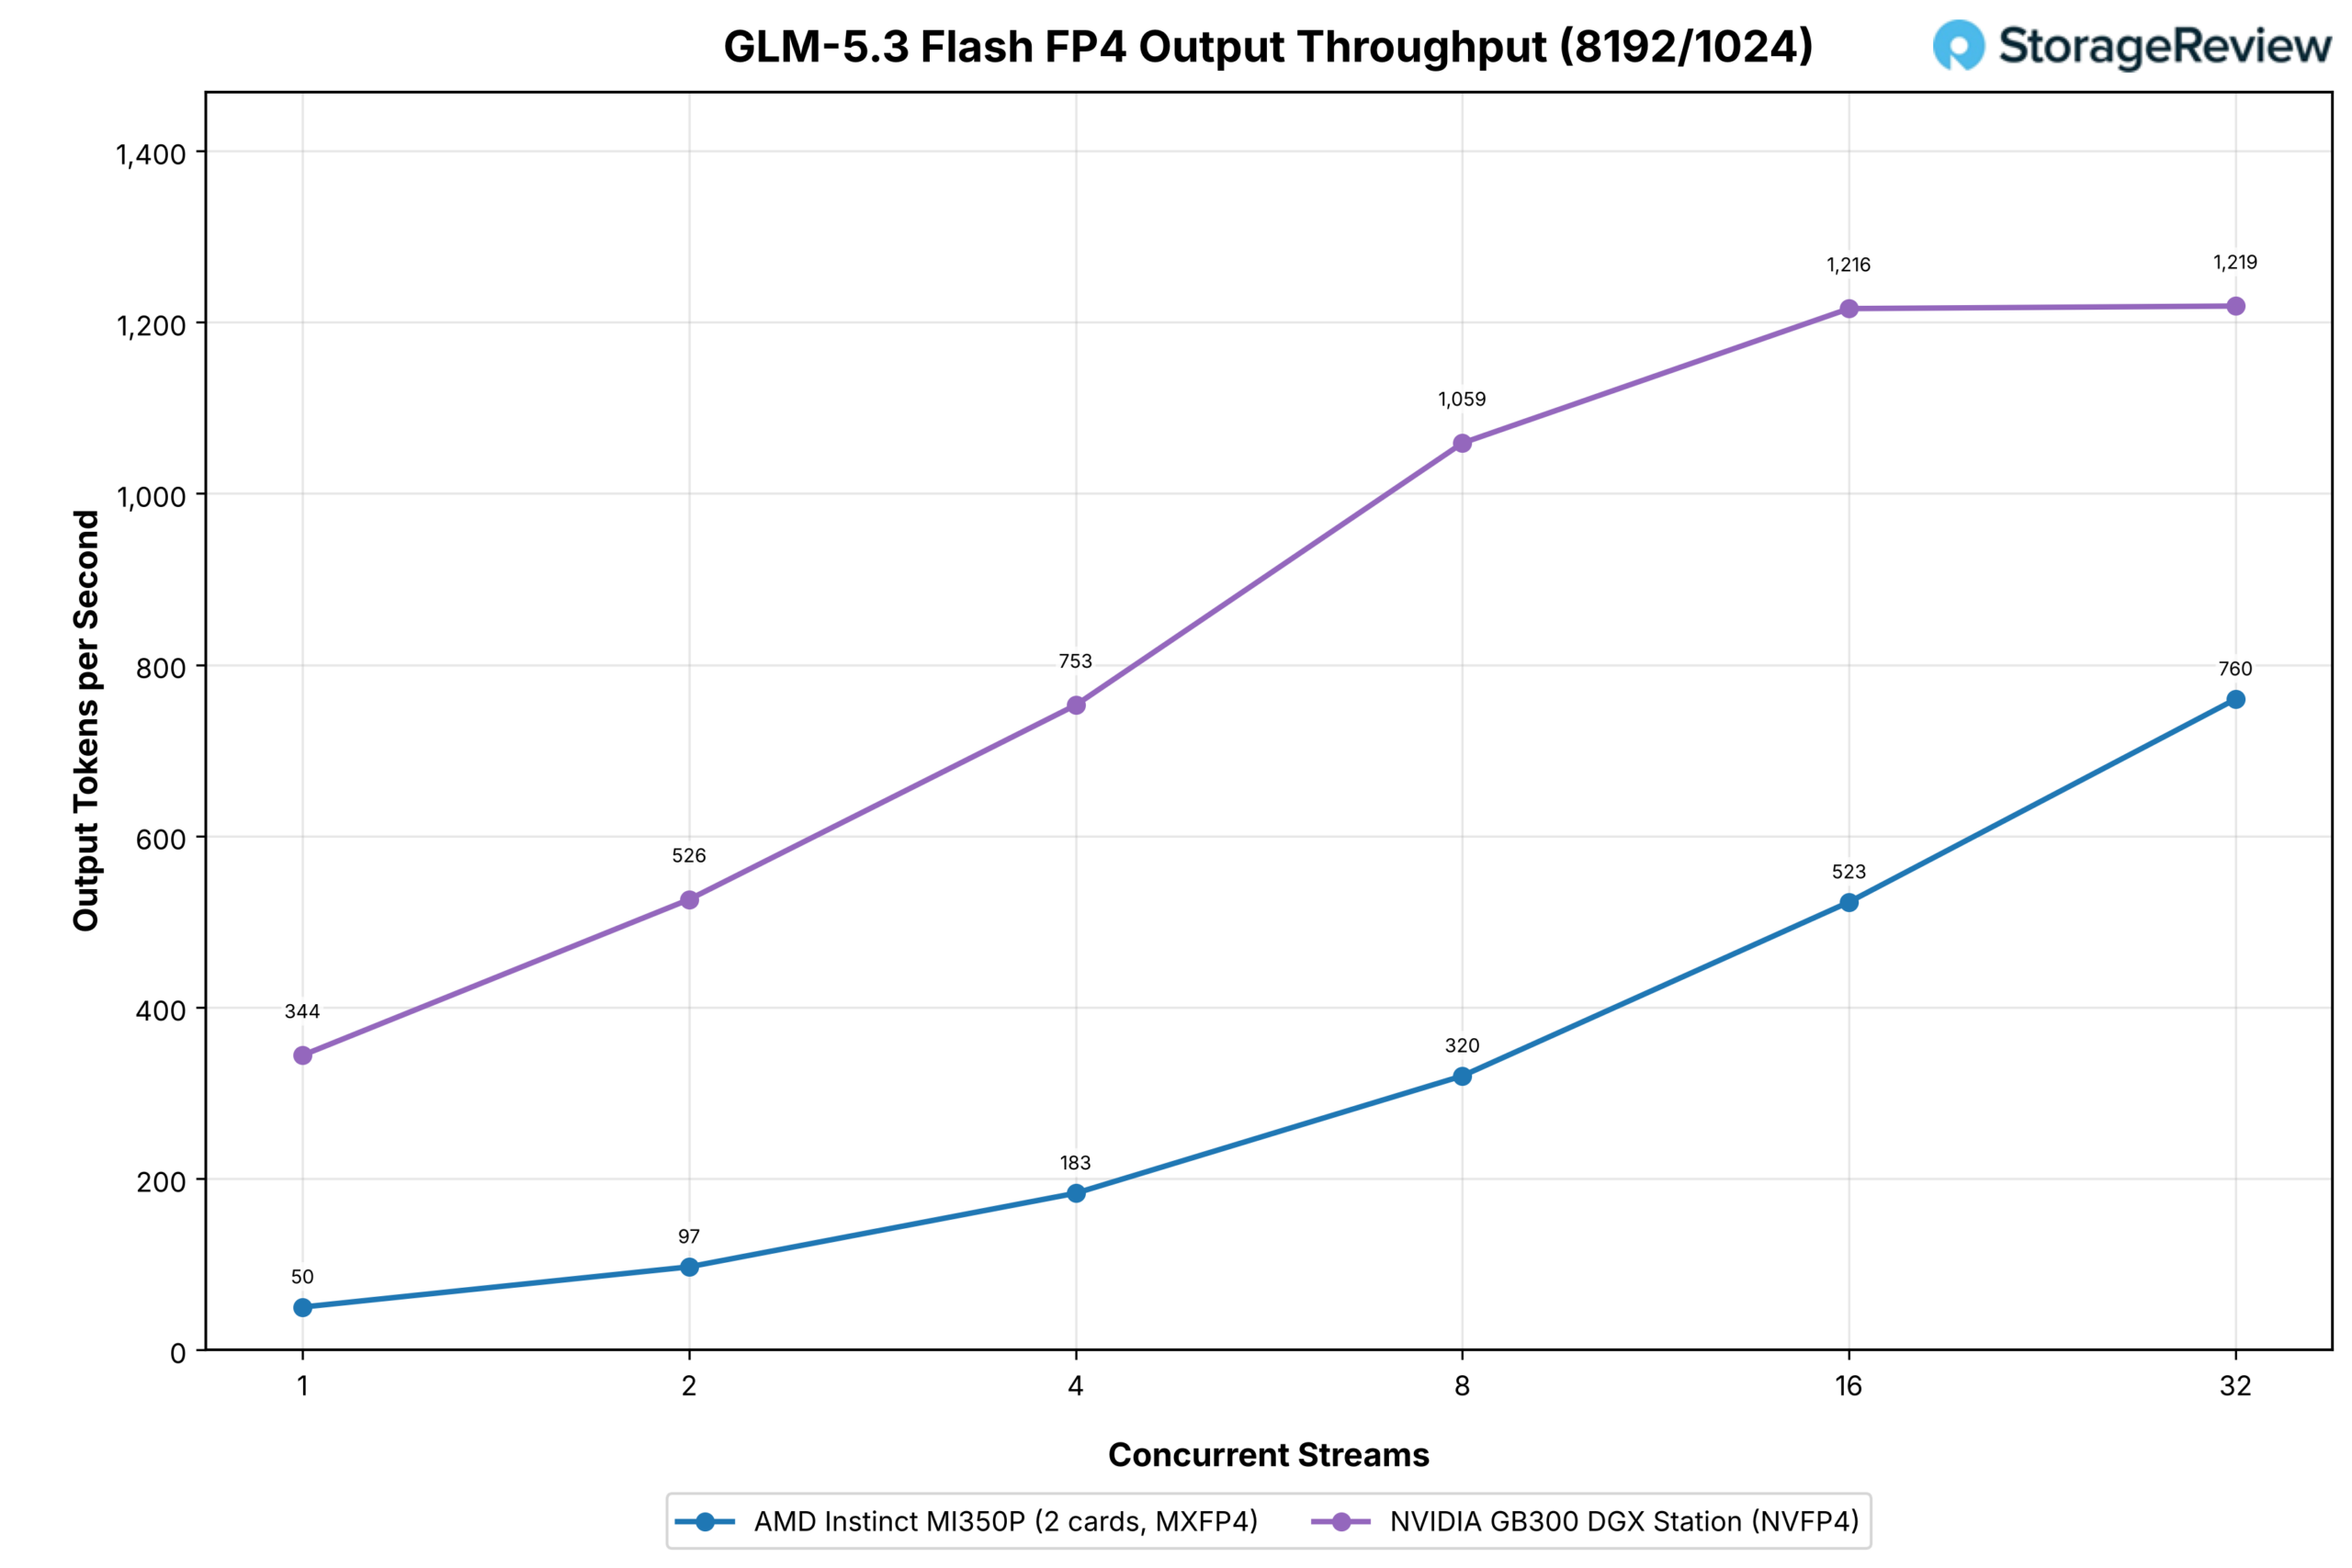
GLM-5.3 Flash kördes inte på RTX PRO 6000, så jämförelsen är två MI350P-kort mot den enda GB300 Station genom 32 strömmar. På chattarbetsbelastningen börjar MI350P-paret efter, 45 mot 353 utdatatokens per sekund vid en ström, och korsar Station med åtta strömmar på väg till 1 462 vid 32, mot 828 för Station. På den förfyllningstunga arbetsbelastningen leder Station genomgående, 1 219 mot 760 vid 32 strömmar, där parets förfyllning måste korsa PCIe mellan de två korten och B300 gör allt i en enda HBM.
GLM-5.2
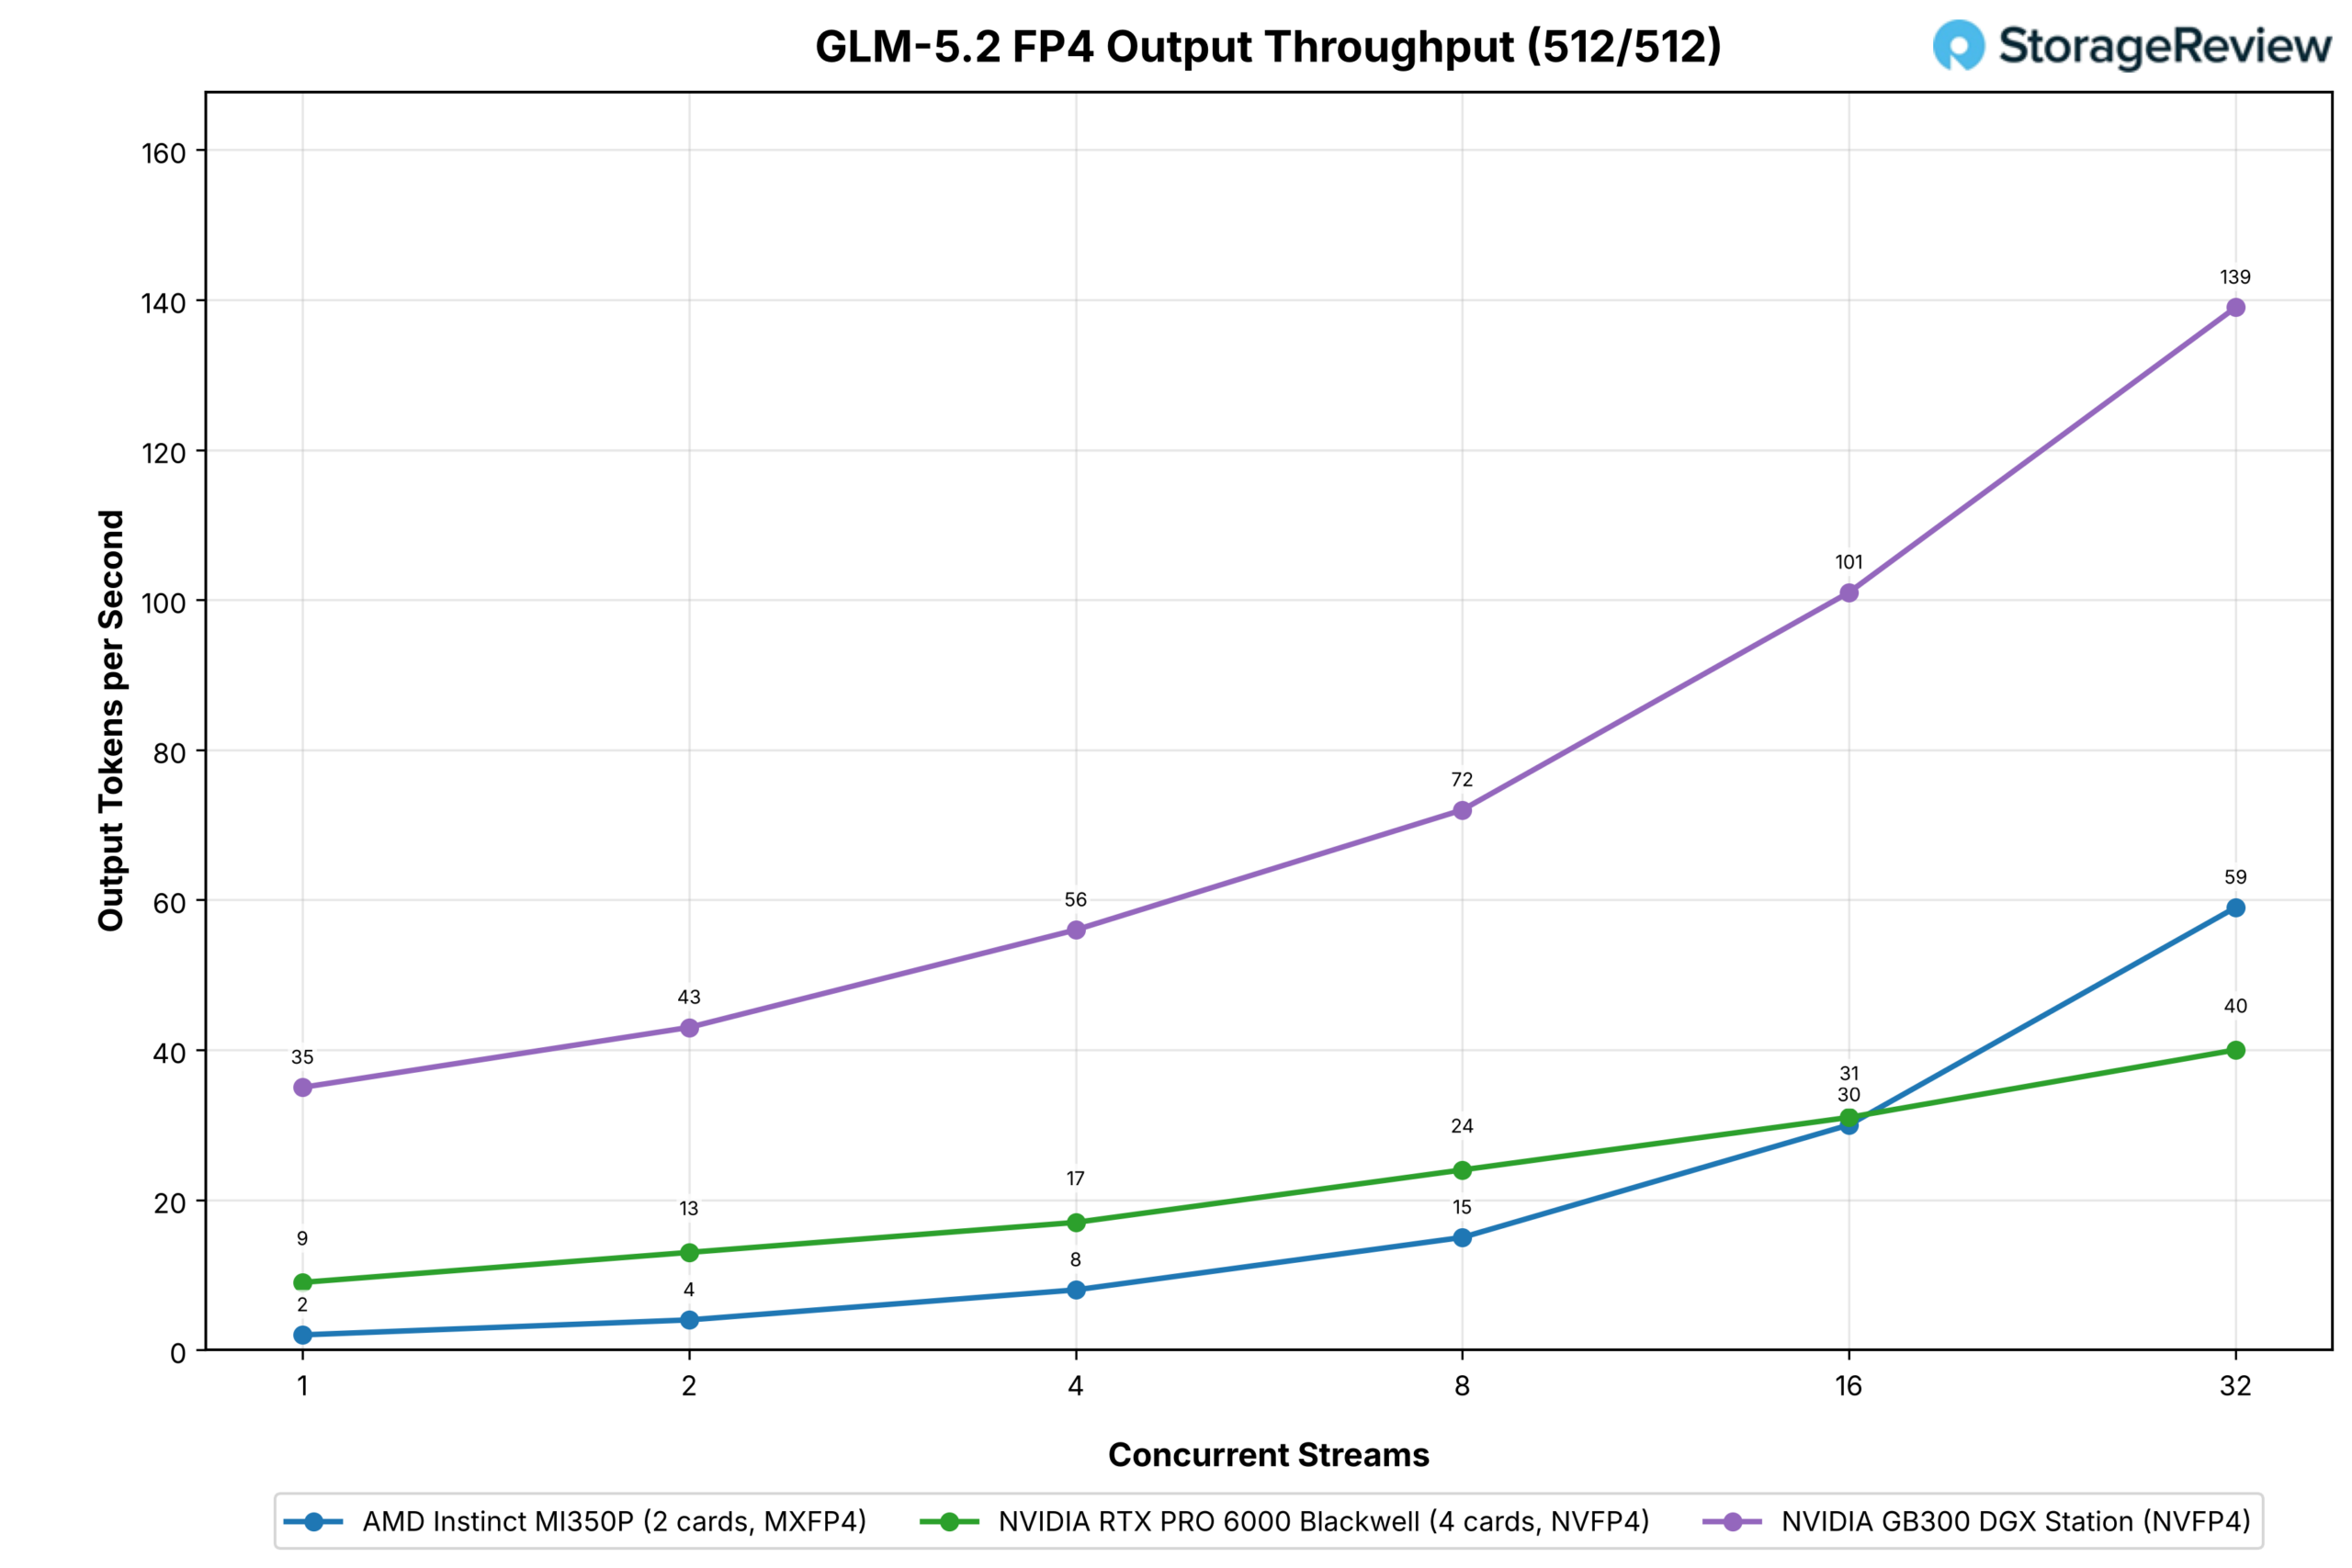
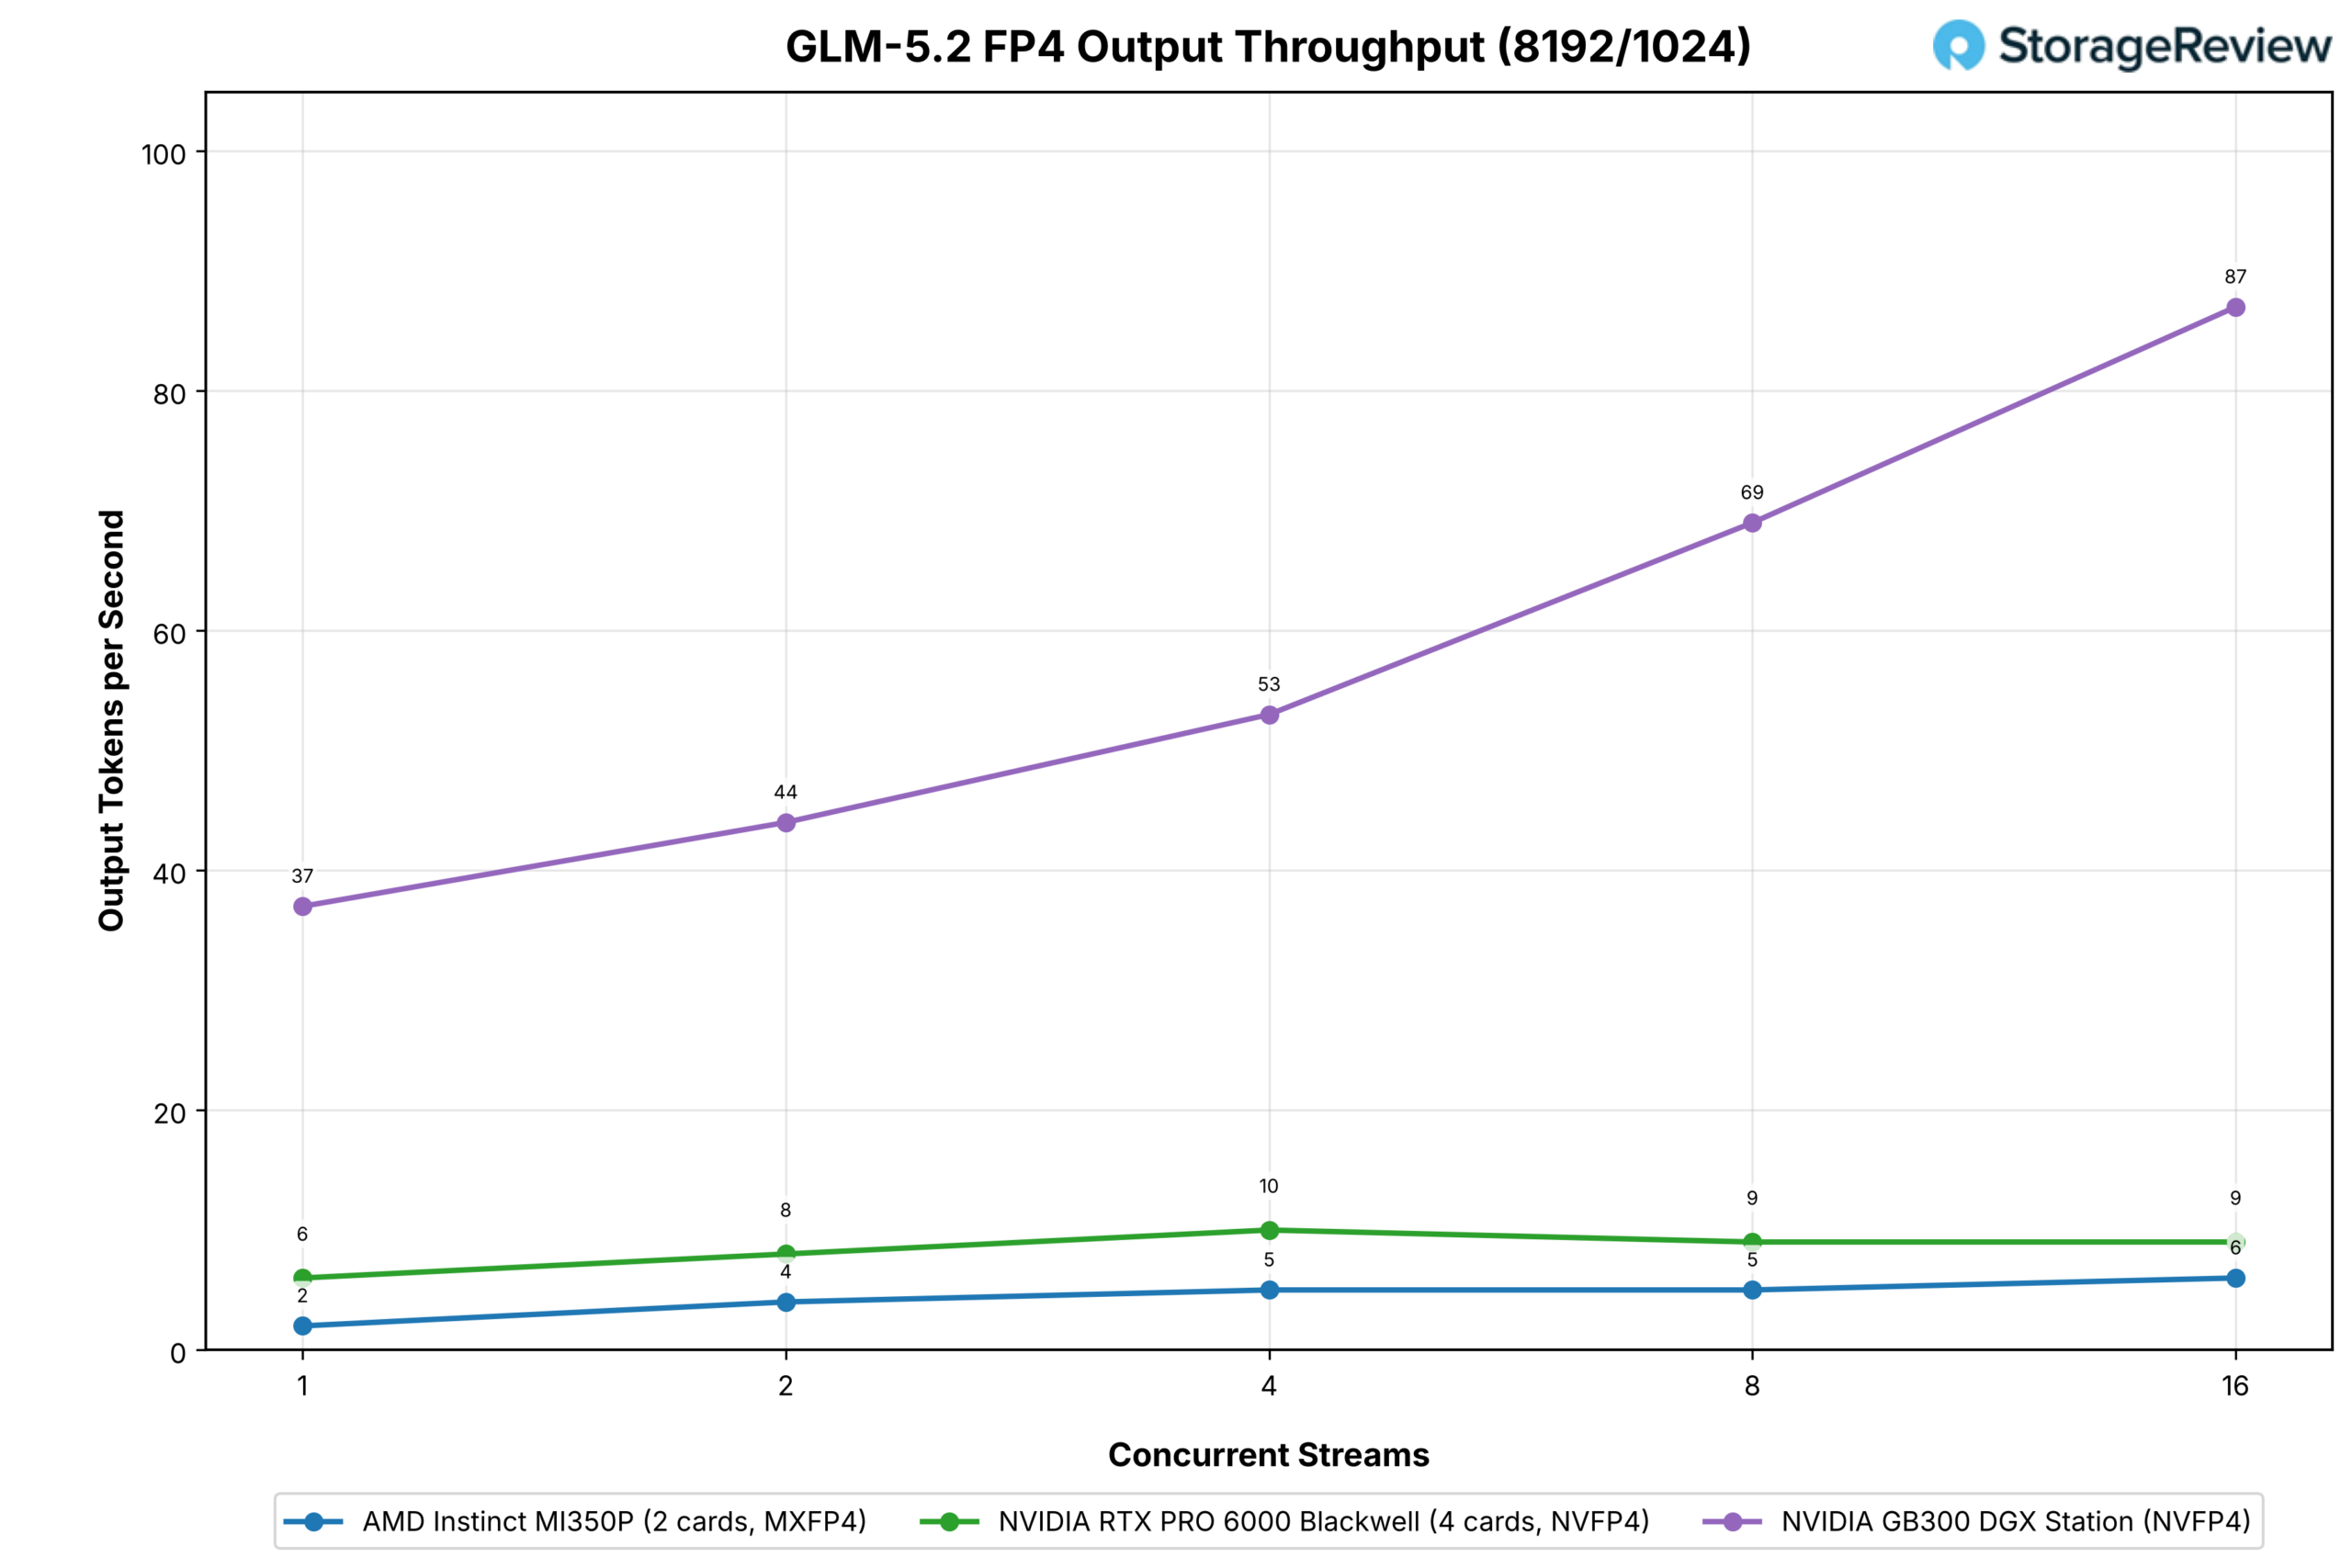
GLM-5.2 är minneshistorien i den här uppsättningen. MXFP4-kontrollpunkten går förbi de två MI350P-kortens 288 GB till värdminnet, så genomströmningen för en enda ström är 2 utdatatokens per sekund för paret mot 9 för fyra RTX PRO 6000-kort som innehåller NVFP4-inbyggt minne på 384 GB GDDR7 och 35 för Station, vilket avlastar cirka 215 GB expertvikter till Grace-minne. RTX-fyran leder igenom 16 strömmar på chattarbetsbelastningen; vid 32 når MI350P-paret 59 mot 40, och Station når 139. Vid förfyllningstunga prompter kommer ingen av PCIe-konfigurationerna förbi enstaka siffror genom 16 strömmar, mot 87 för Station.
MiniMax-M3
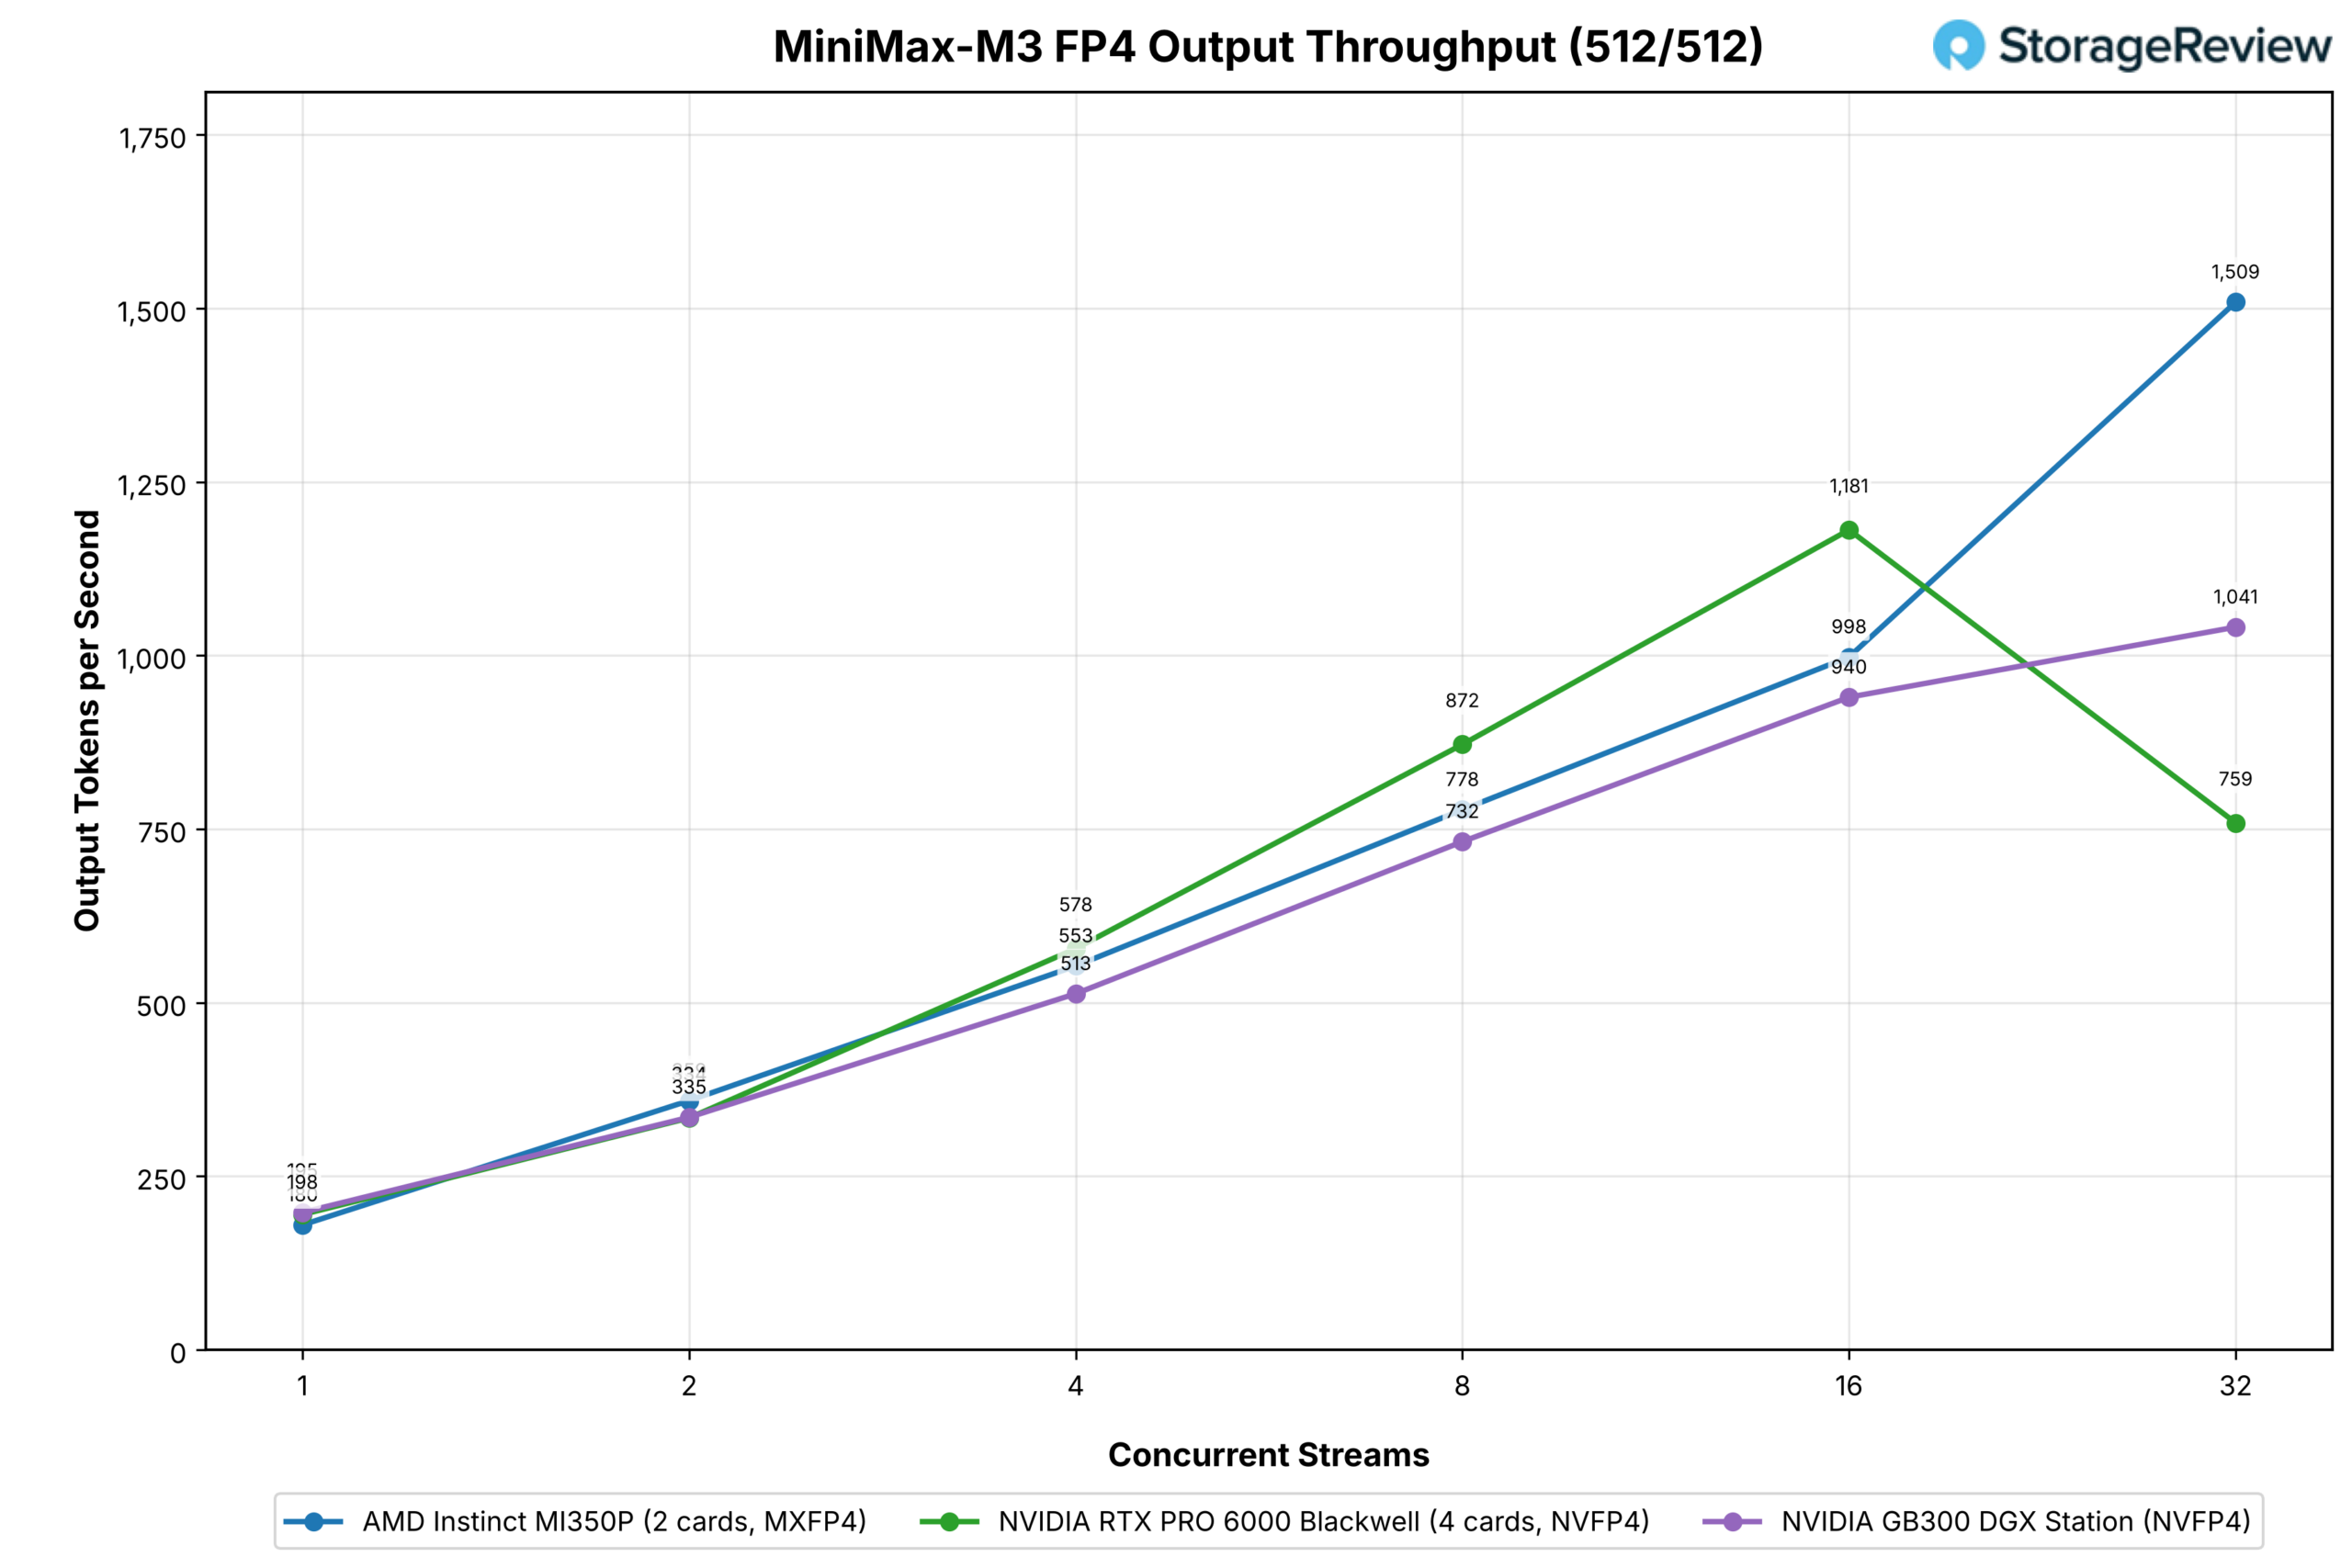
Två MI350P-kort har MXFP4-versionen av MiniMax-M3 på 288 GB; NVIDIA-sidan behöver fyra RTX PRO 6000-kort. De tre konfigurationerna körs inom 10 procent av varandra genom åtta strömmar på chattarbetsbelastningen; RTX-fyran ligger före vid 16 (1 181 mot 998 för paret och 940 för Station), och vid 32 visar MI350P-paret 1 509 mot 759 för fyran och 1 041 för Station.
På förfyllningstunga uppmaningar leder MI350P-paret vid varje punkt genom åtta strömmar, 524 mot 444 för fyrhjulingen, medan Station, som har en del av den här modellens experter i Graces minne, faller till 103.
DeepSeek-V4-Flash
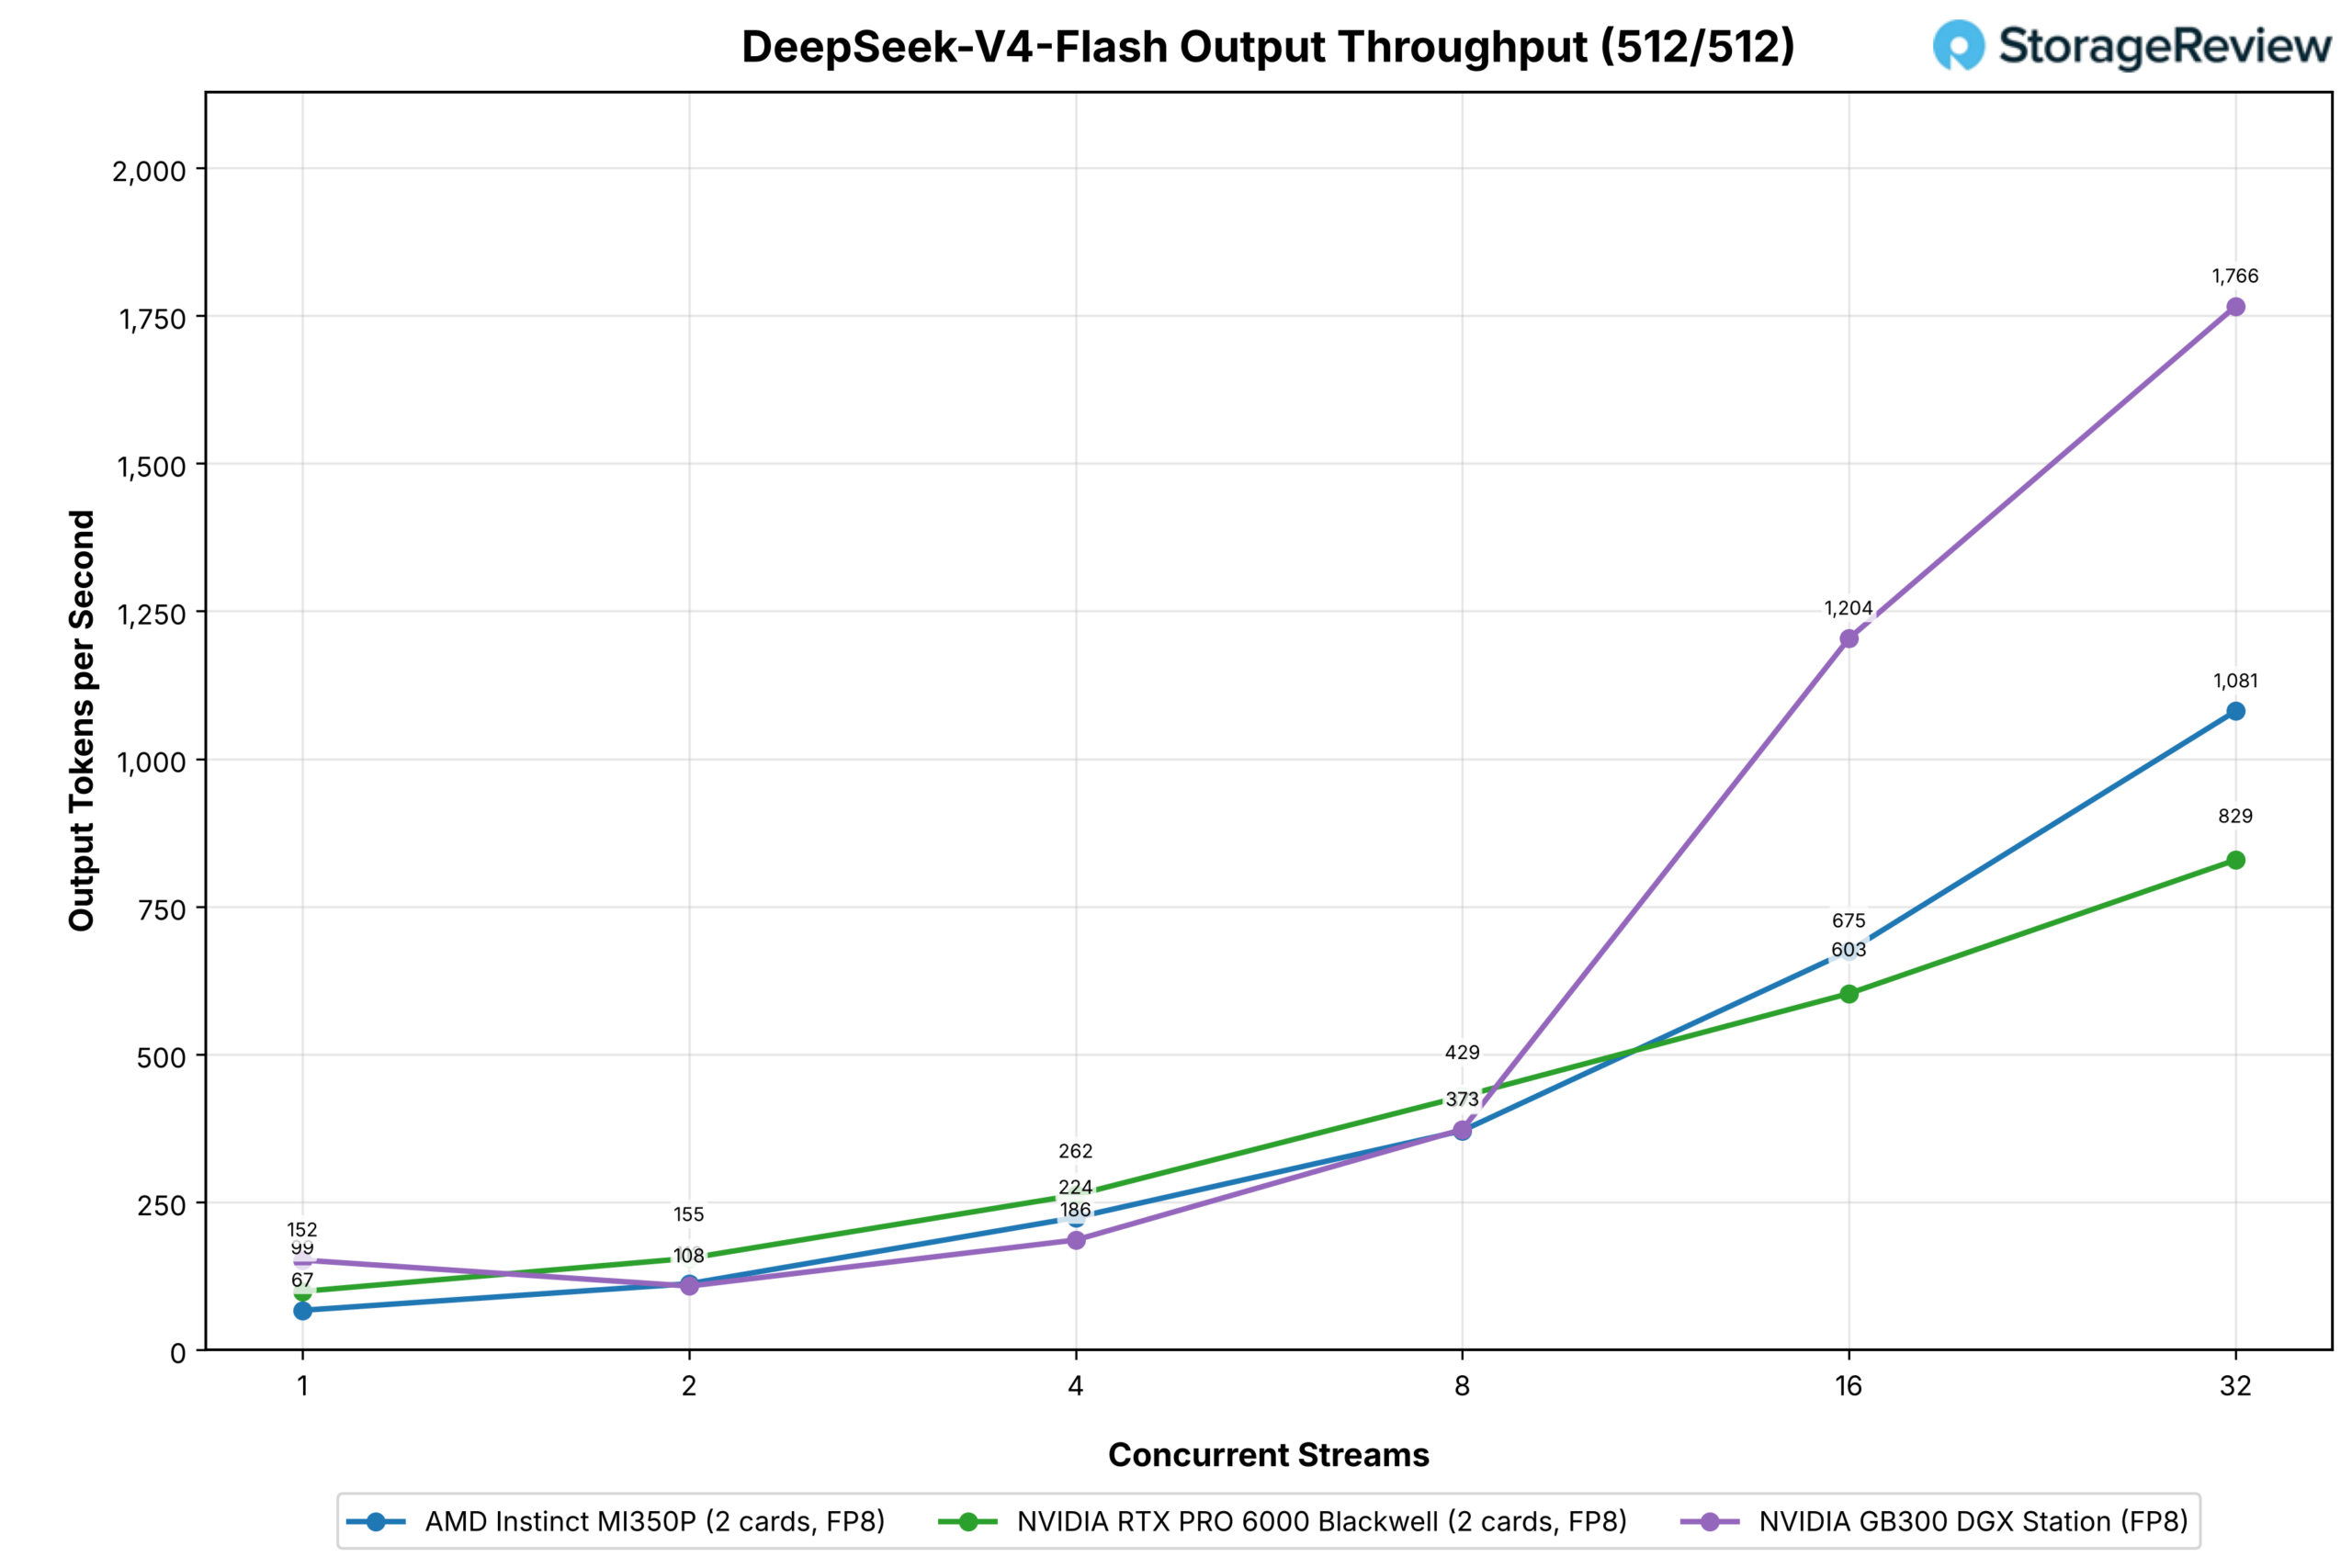
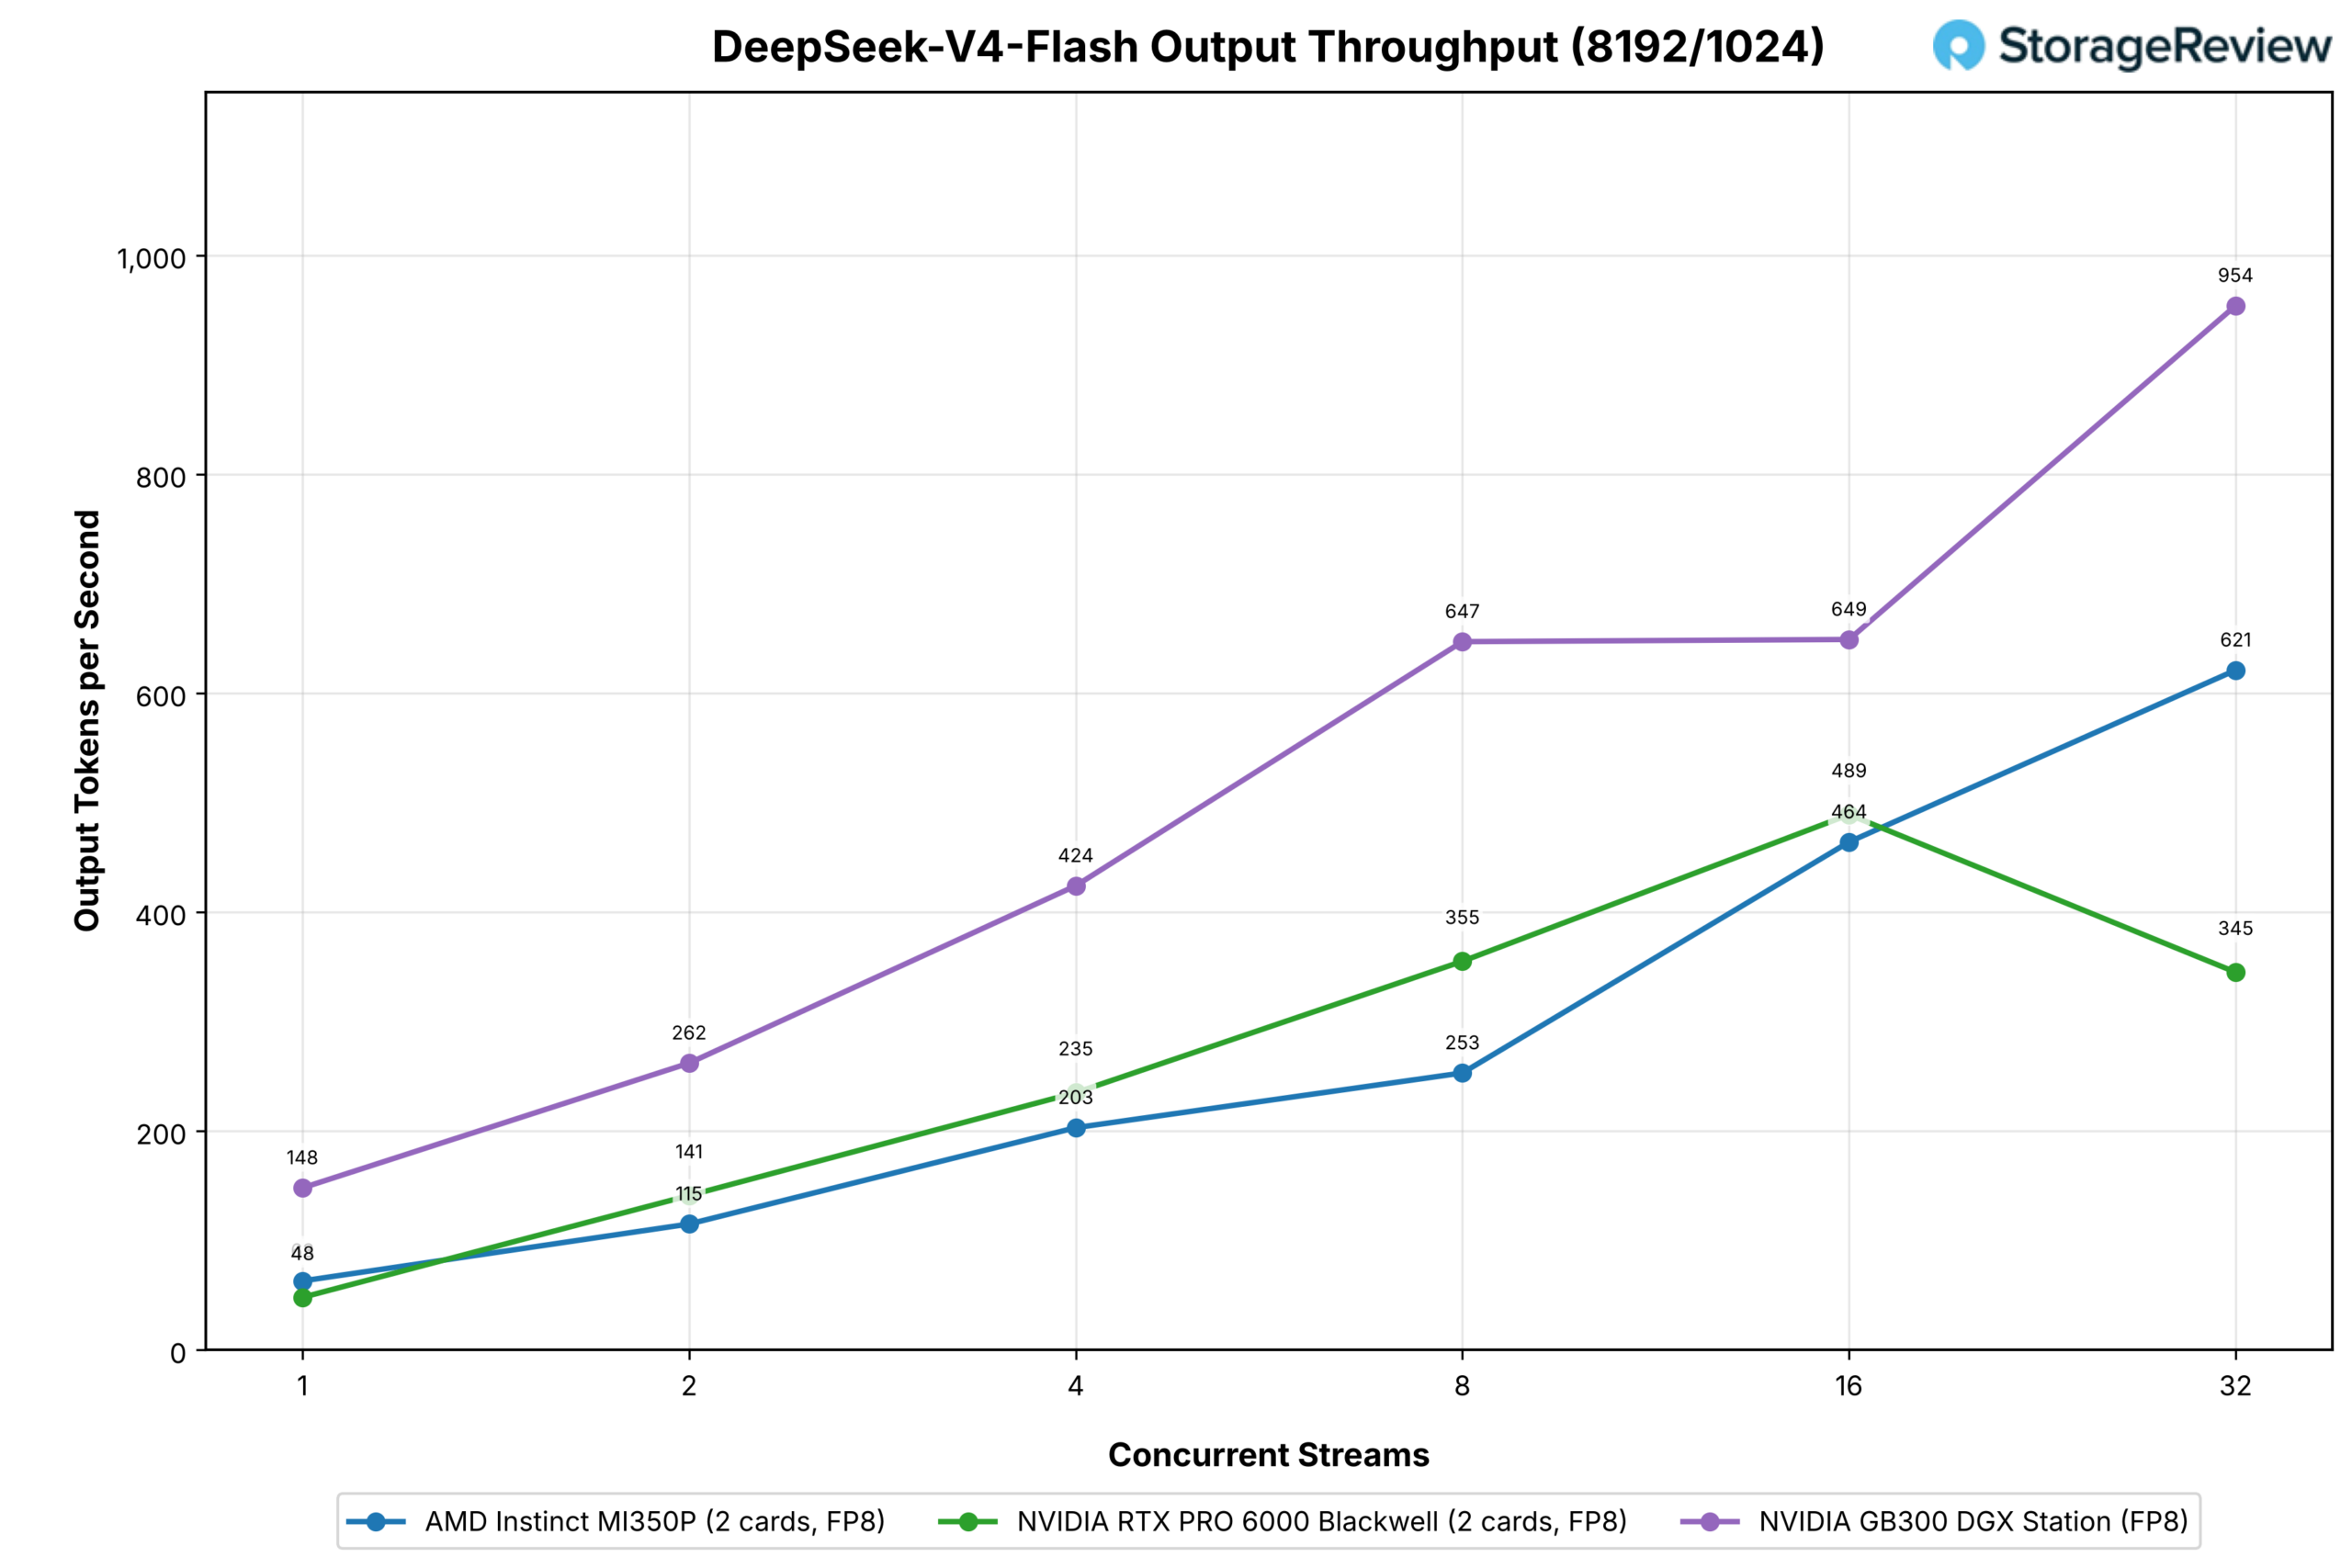
Med två kort på varje sida och den inbyggda FP8-kontrollpunkten leder RTX PRO 6000-paret genom åtta strömmar på chattarbetsbelastningen och MI350P-paret tar över från 16 och slutar på 1 081 mot 829 vid 32 strömmar; den enskilda Stationen når 1 766 vid samma tidpunkt. Körningen med hög förfyllning följer samma form, MI350P-paret på 621 mot 345 för RTX-paret vid 32 strömmar och 954 för Stationen.
MiniMax-M2.7
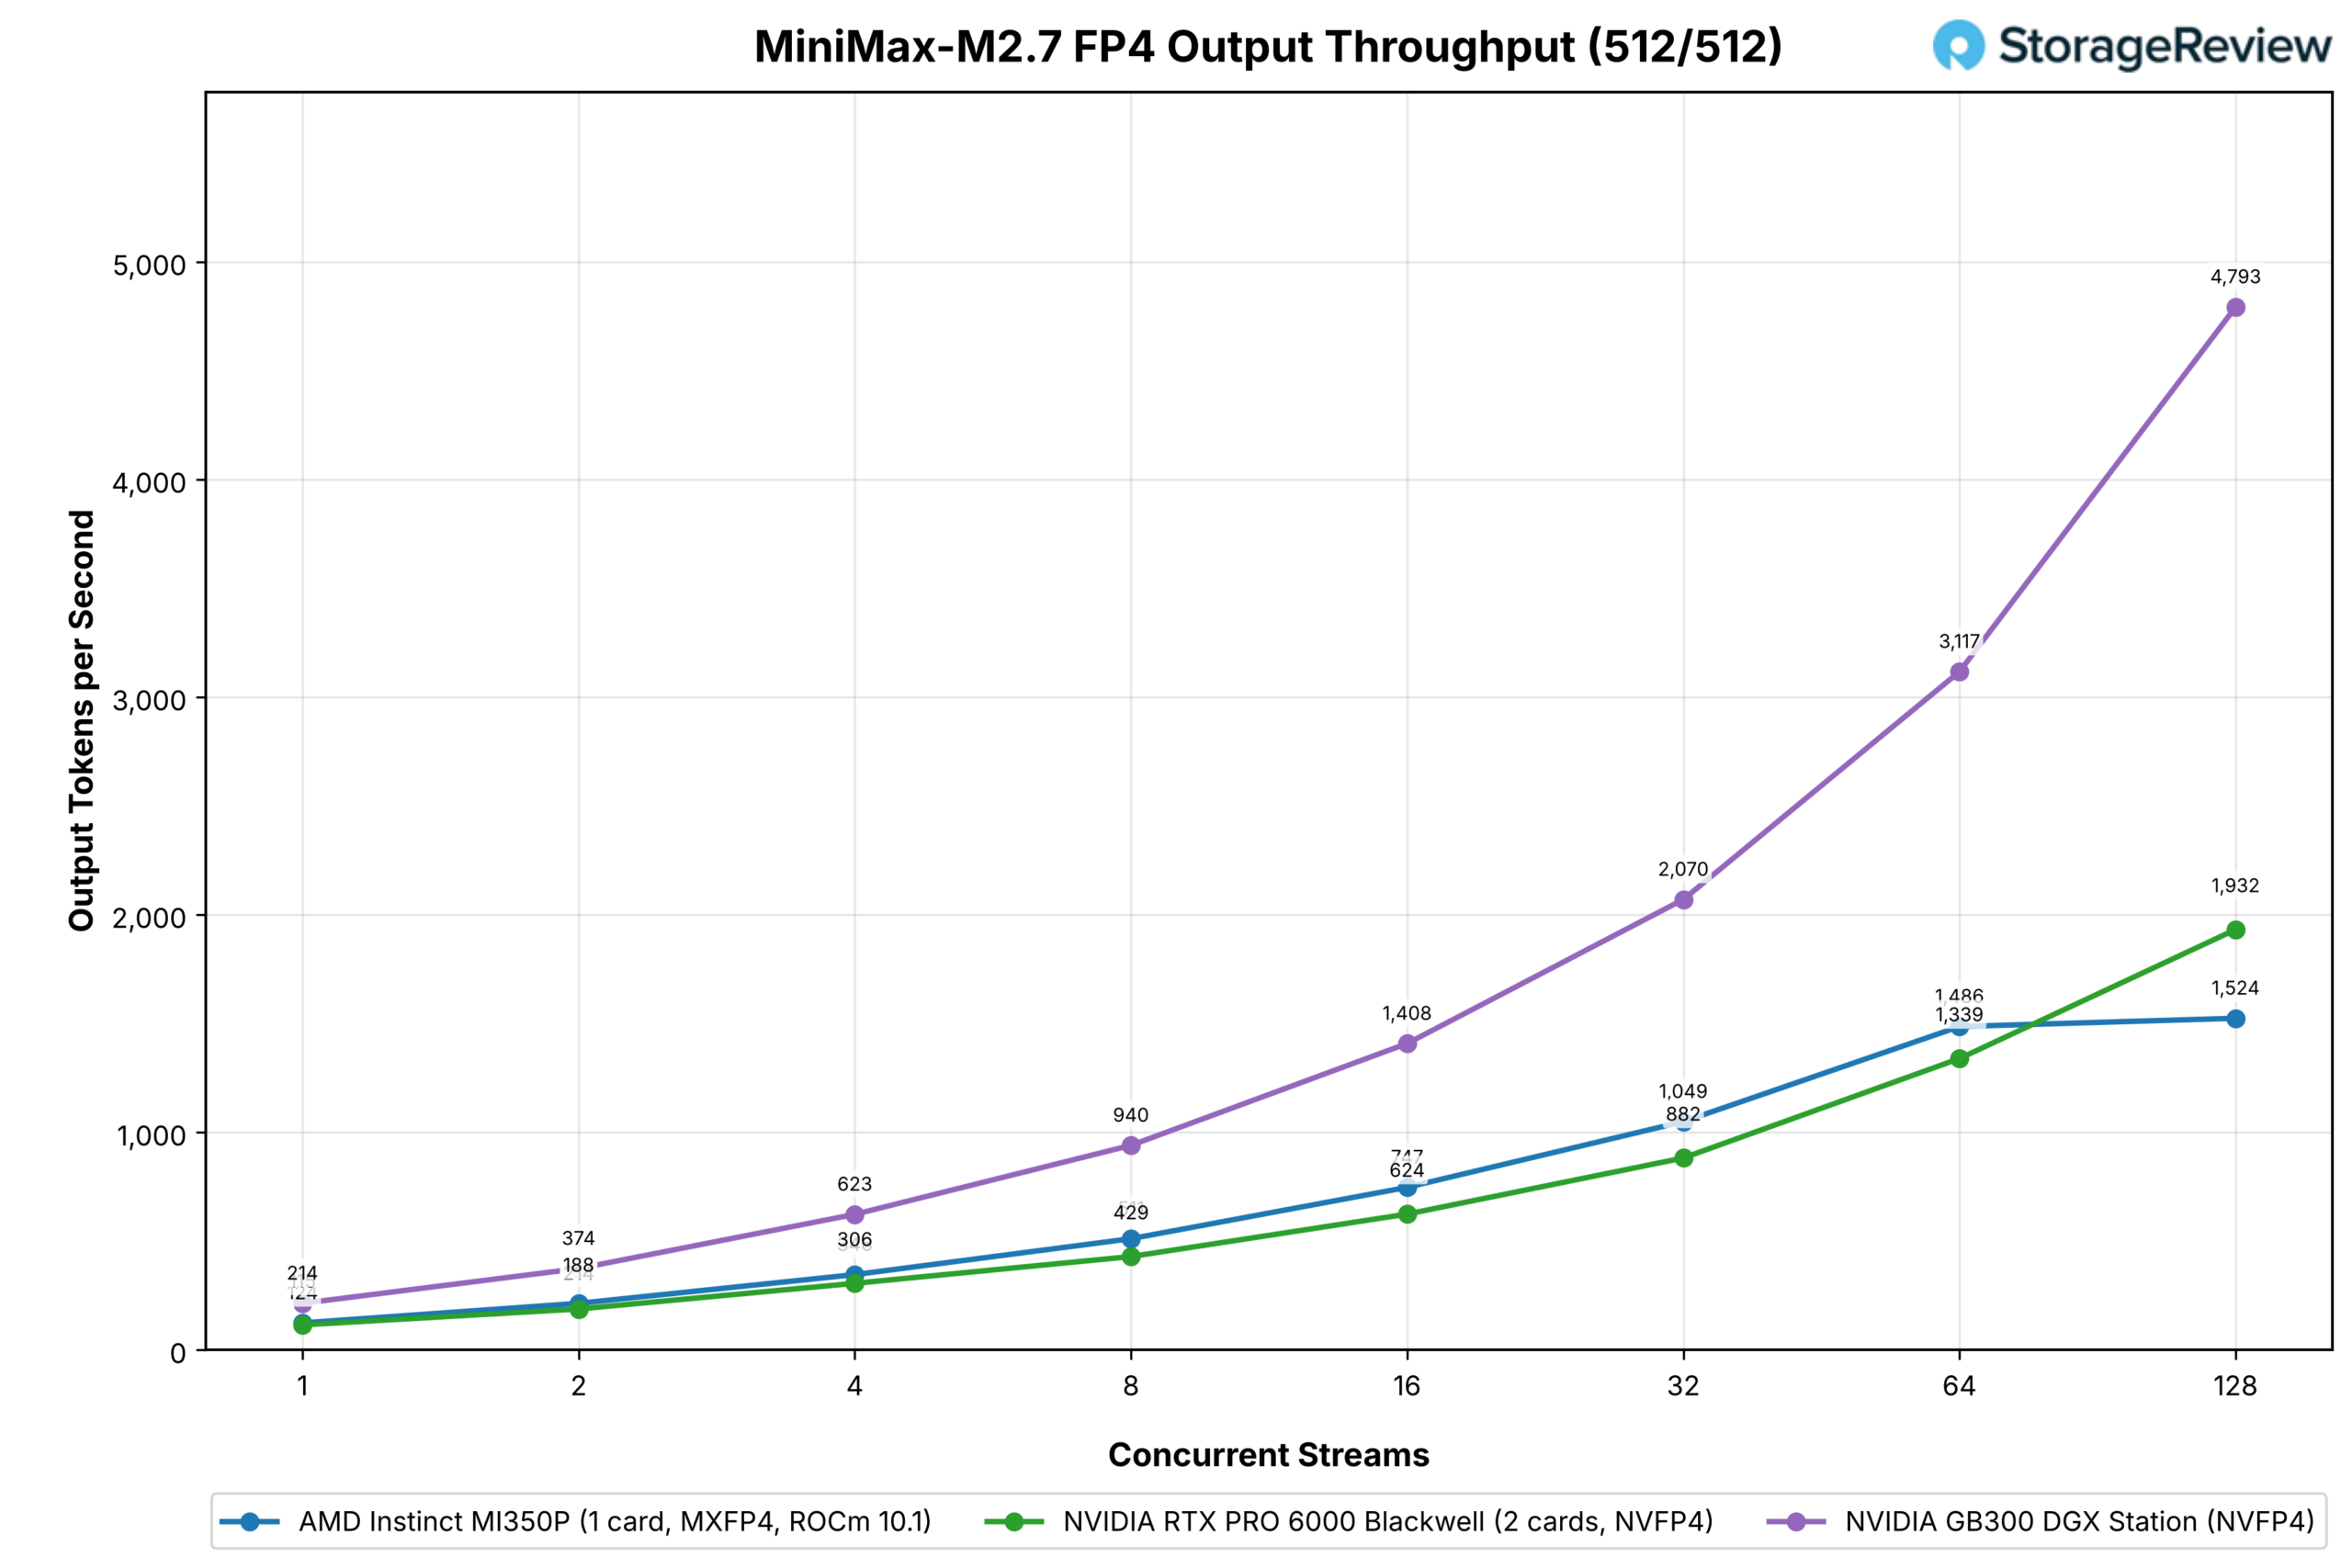
En MI350P har MXFP4-versionen av MiniMax-M2.7 mot två RTX PRO 6000-kort på NVFP4. Den enda MI350P leder paret vid en ström (124 mot 115), ligger kvar 8 till 20 procent före genom 64 strömmar, 1 486 mot 1 339, och planar sedan ut vid 1 524 vid 128 och 1 557 vid 256, medan RTX-paret fortsätter till 1 932 och 2 842; Station når 4 793.
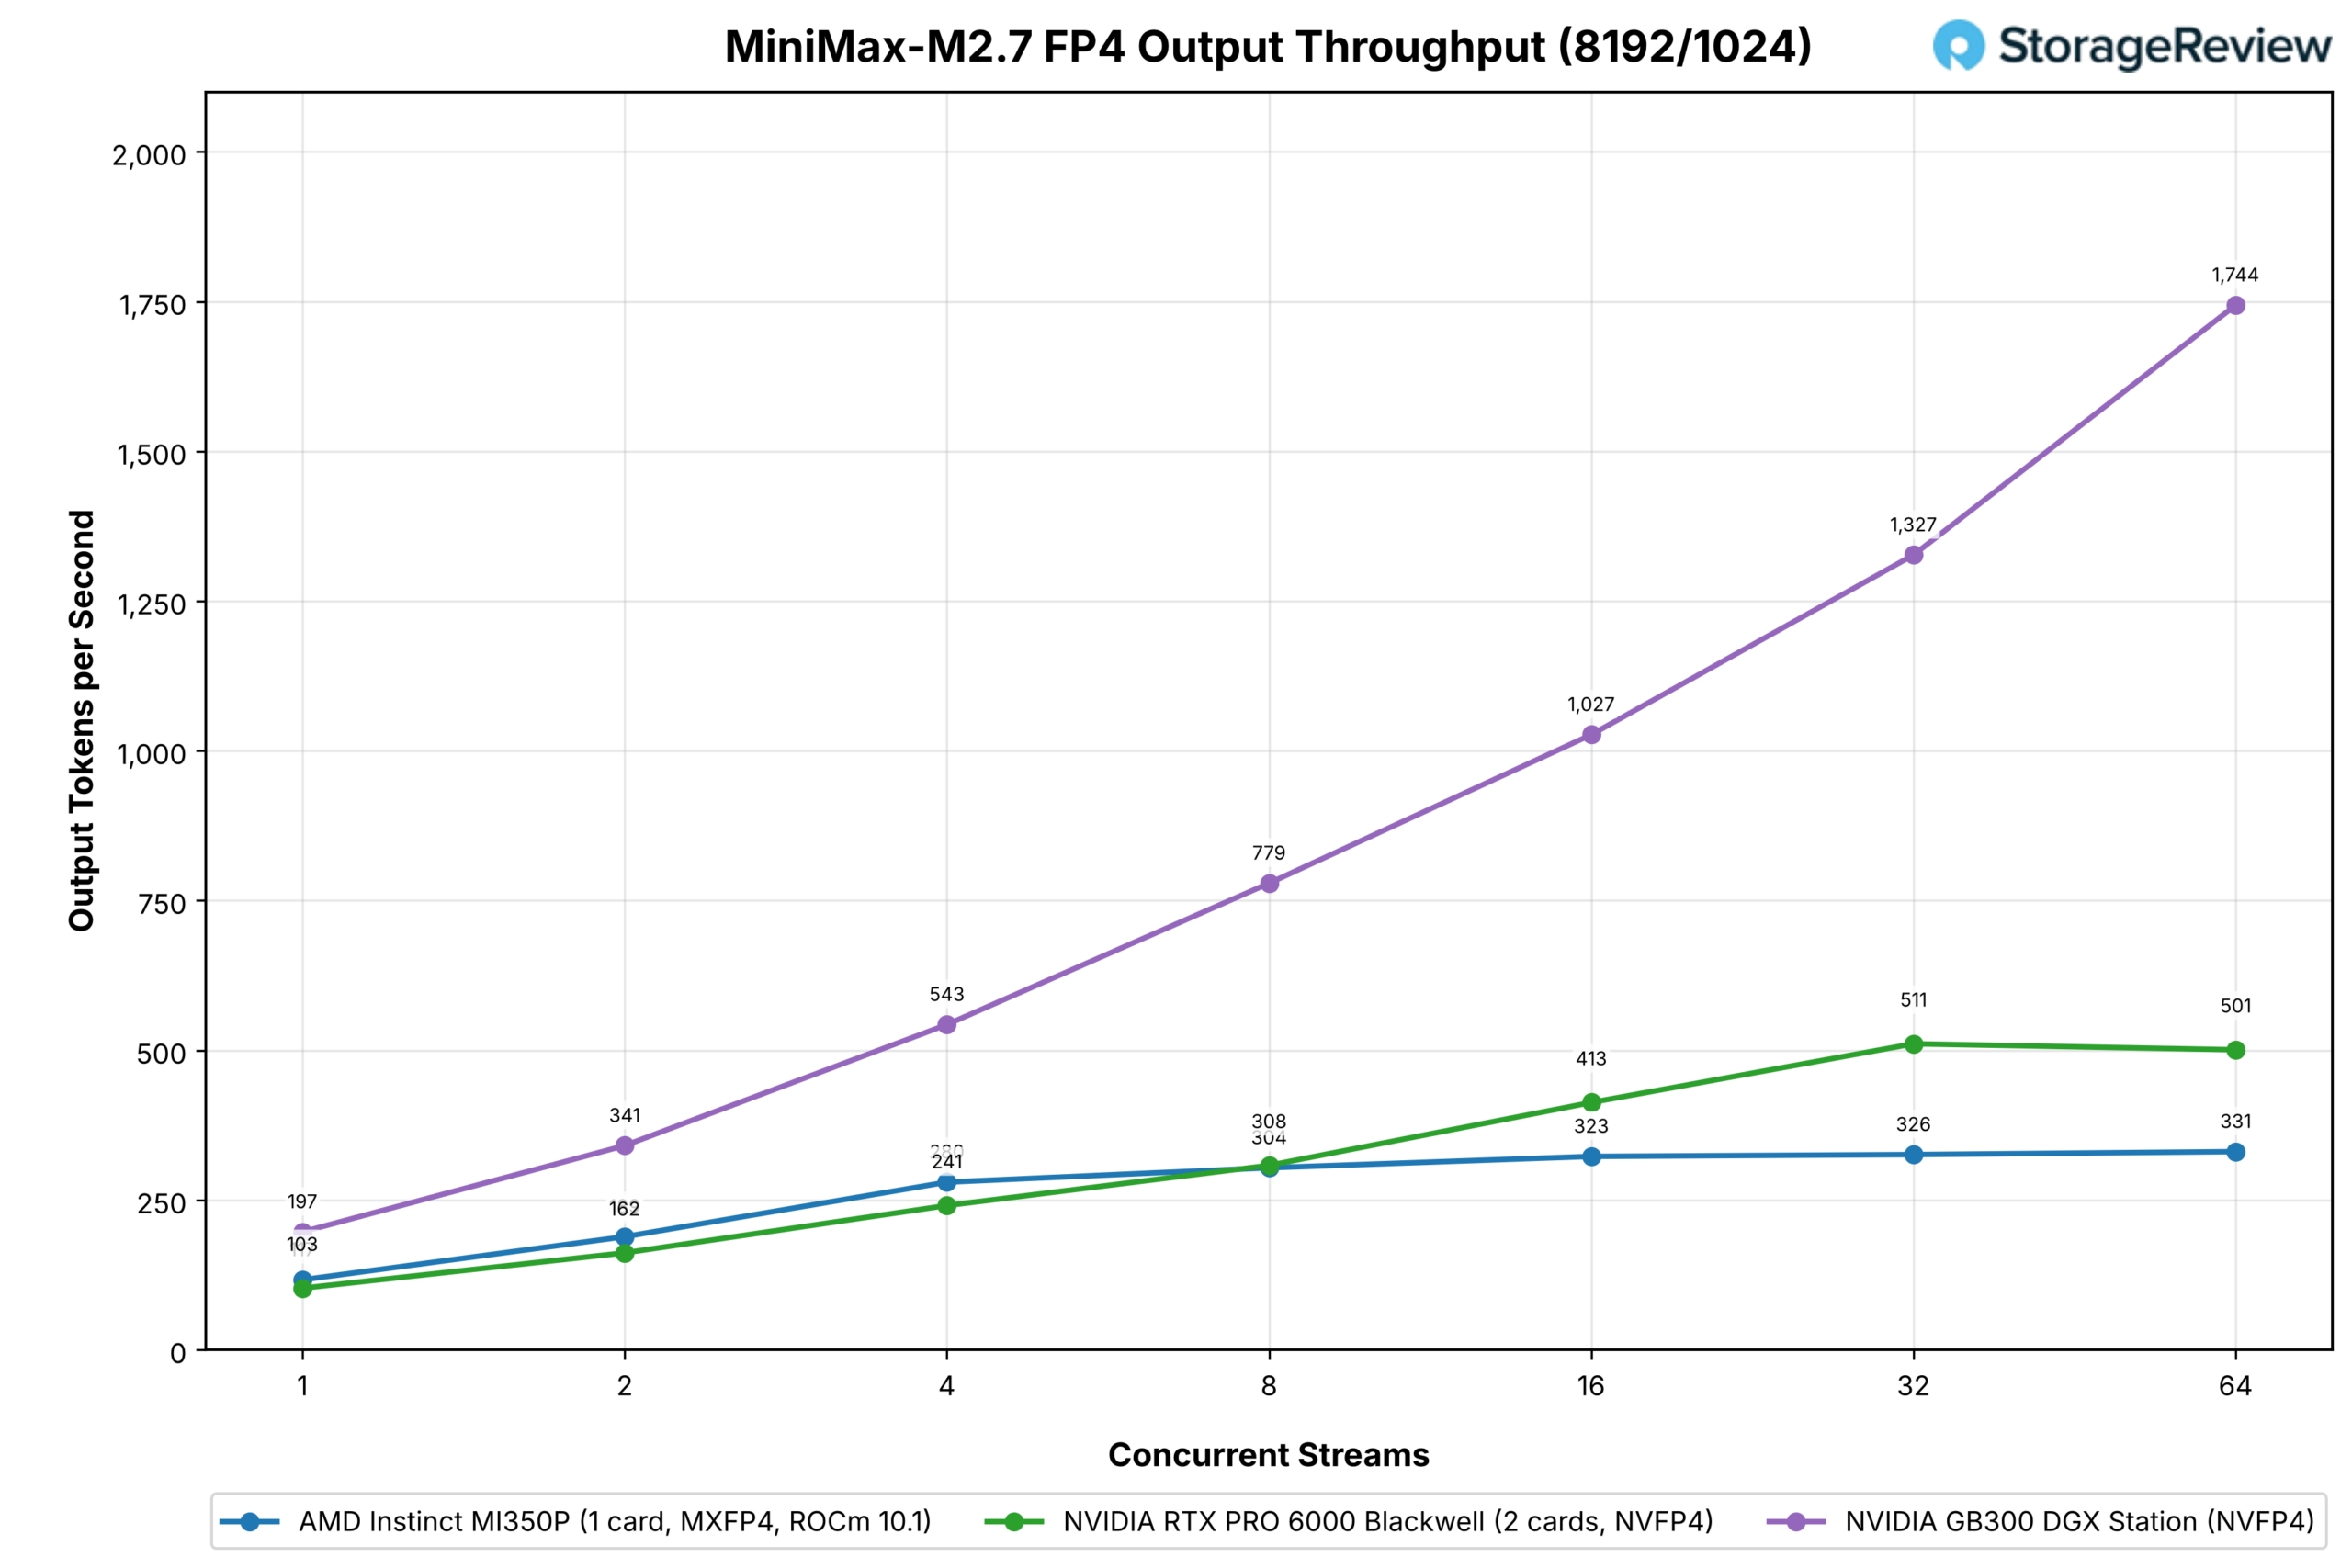
På den förfyllningstunga arbetsbelastningen håller MI350P 304 till 331 utdatatokens per sekund från åtta strömmar till 64, jämfört med 501 för RTX-paret och 1 744 för Stationen.
GPT-OSS-120B
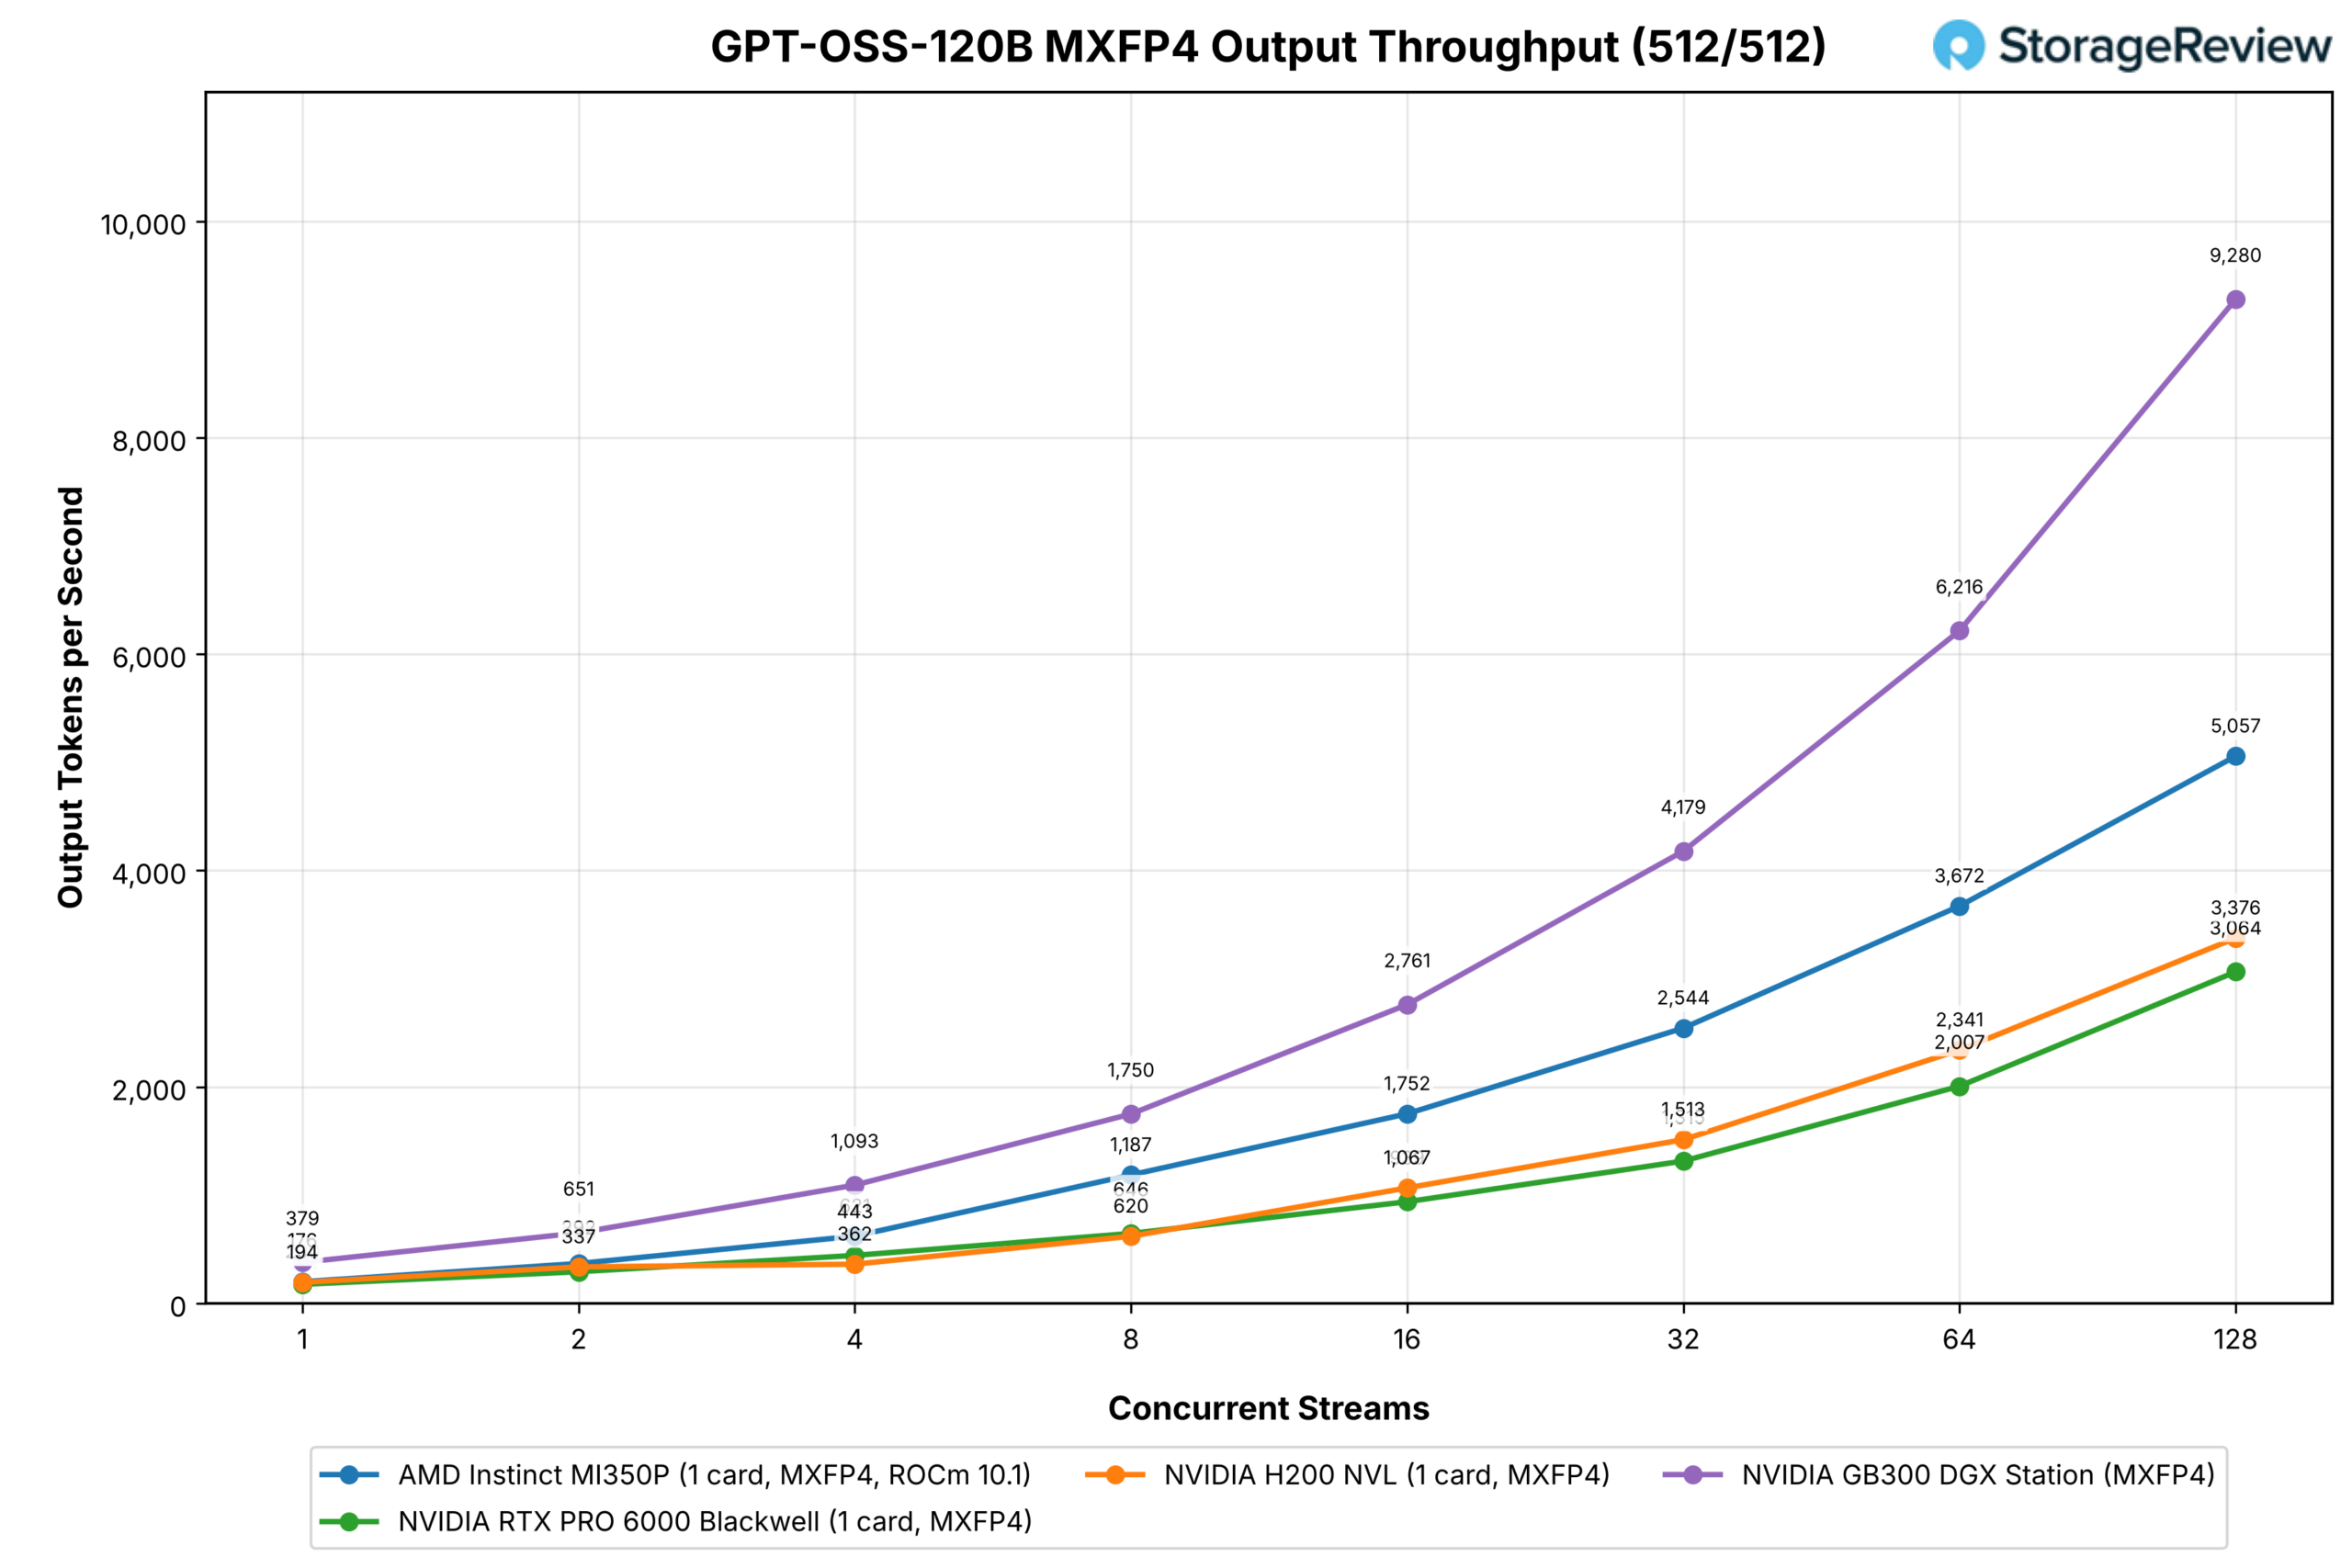
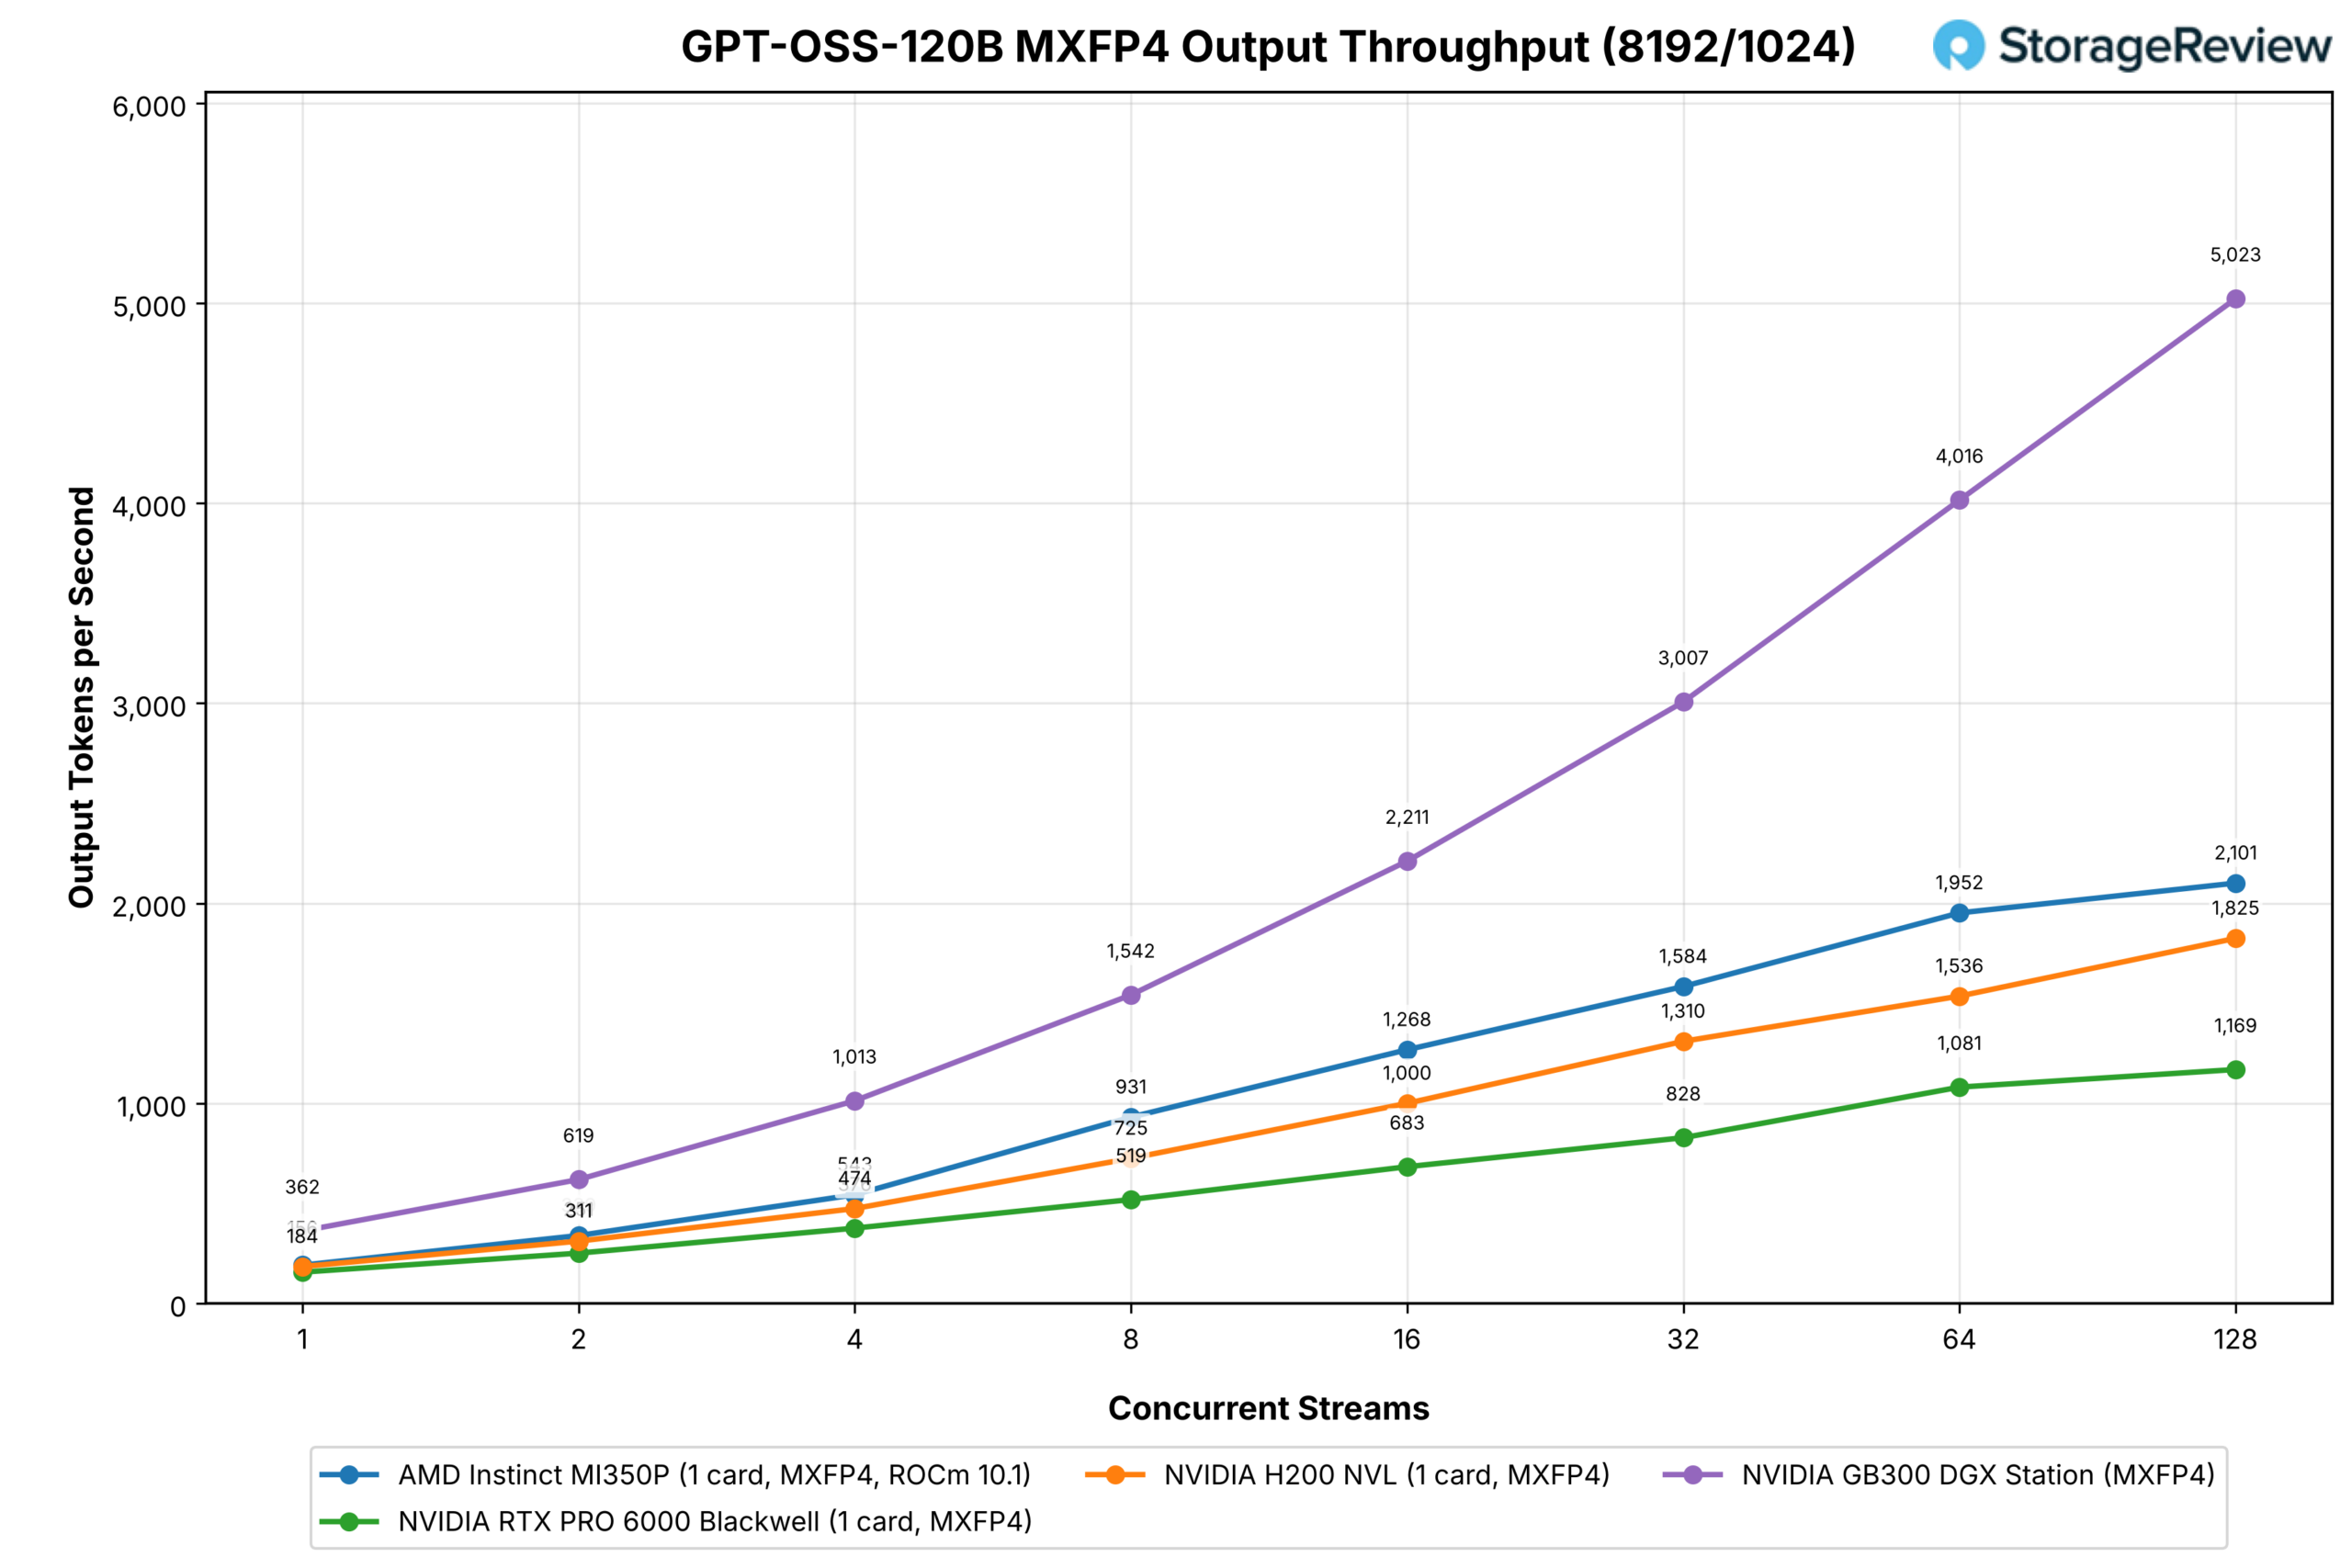
GPT-OSS levereras som MXFP4, så varje kort kör samma vikter. Ett MI350P leder ett RTX PRO 6000 vid varje strömräkning på båda arbetsbelastningarna, med 40 till 93 procent från fyra strömmar och uppåt, och slutar på 5 057 utdatatokens per sekund på chattarbetsbelastningen och 2 101 på förfyllningstunga prompter vid 128 strömmar, jämfört med 3 064 och 1 169 för RTX PRO 6000 och 3 376 och 1 825 för H200 NVL; Stationen når 9 280 och 5 023.
AMD och Dells MLPerf Inference v6.1-inlämning den 16 september sätter ett tak för samma modell: åtta MI350P:er i en PowerEdge XE7745 producerade 48 971 tokens per sekund offline och 40 868 i serverscenariot på GPT-OSS-120B, vilket är 6 121 och 5 108 per GPU, på en trimmad submissionsstack. Den här serien och vår är inte likadana, men de 5 057 vi mätte vid 128 strömmar på standard vLLM ligger längst ner i det intervallet.
GPT-OSS-20B
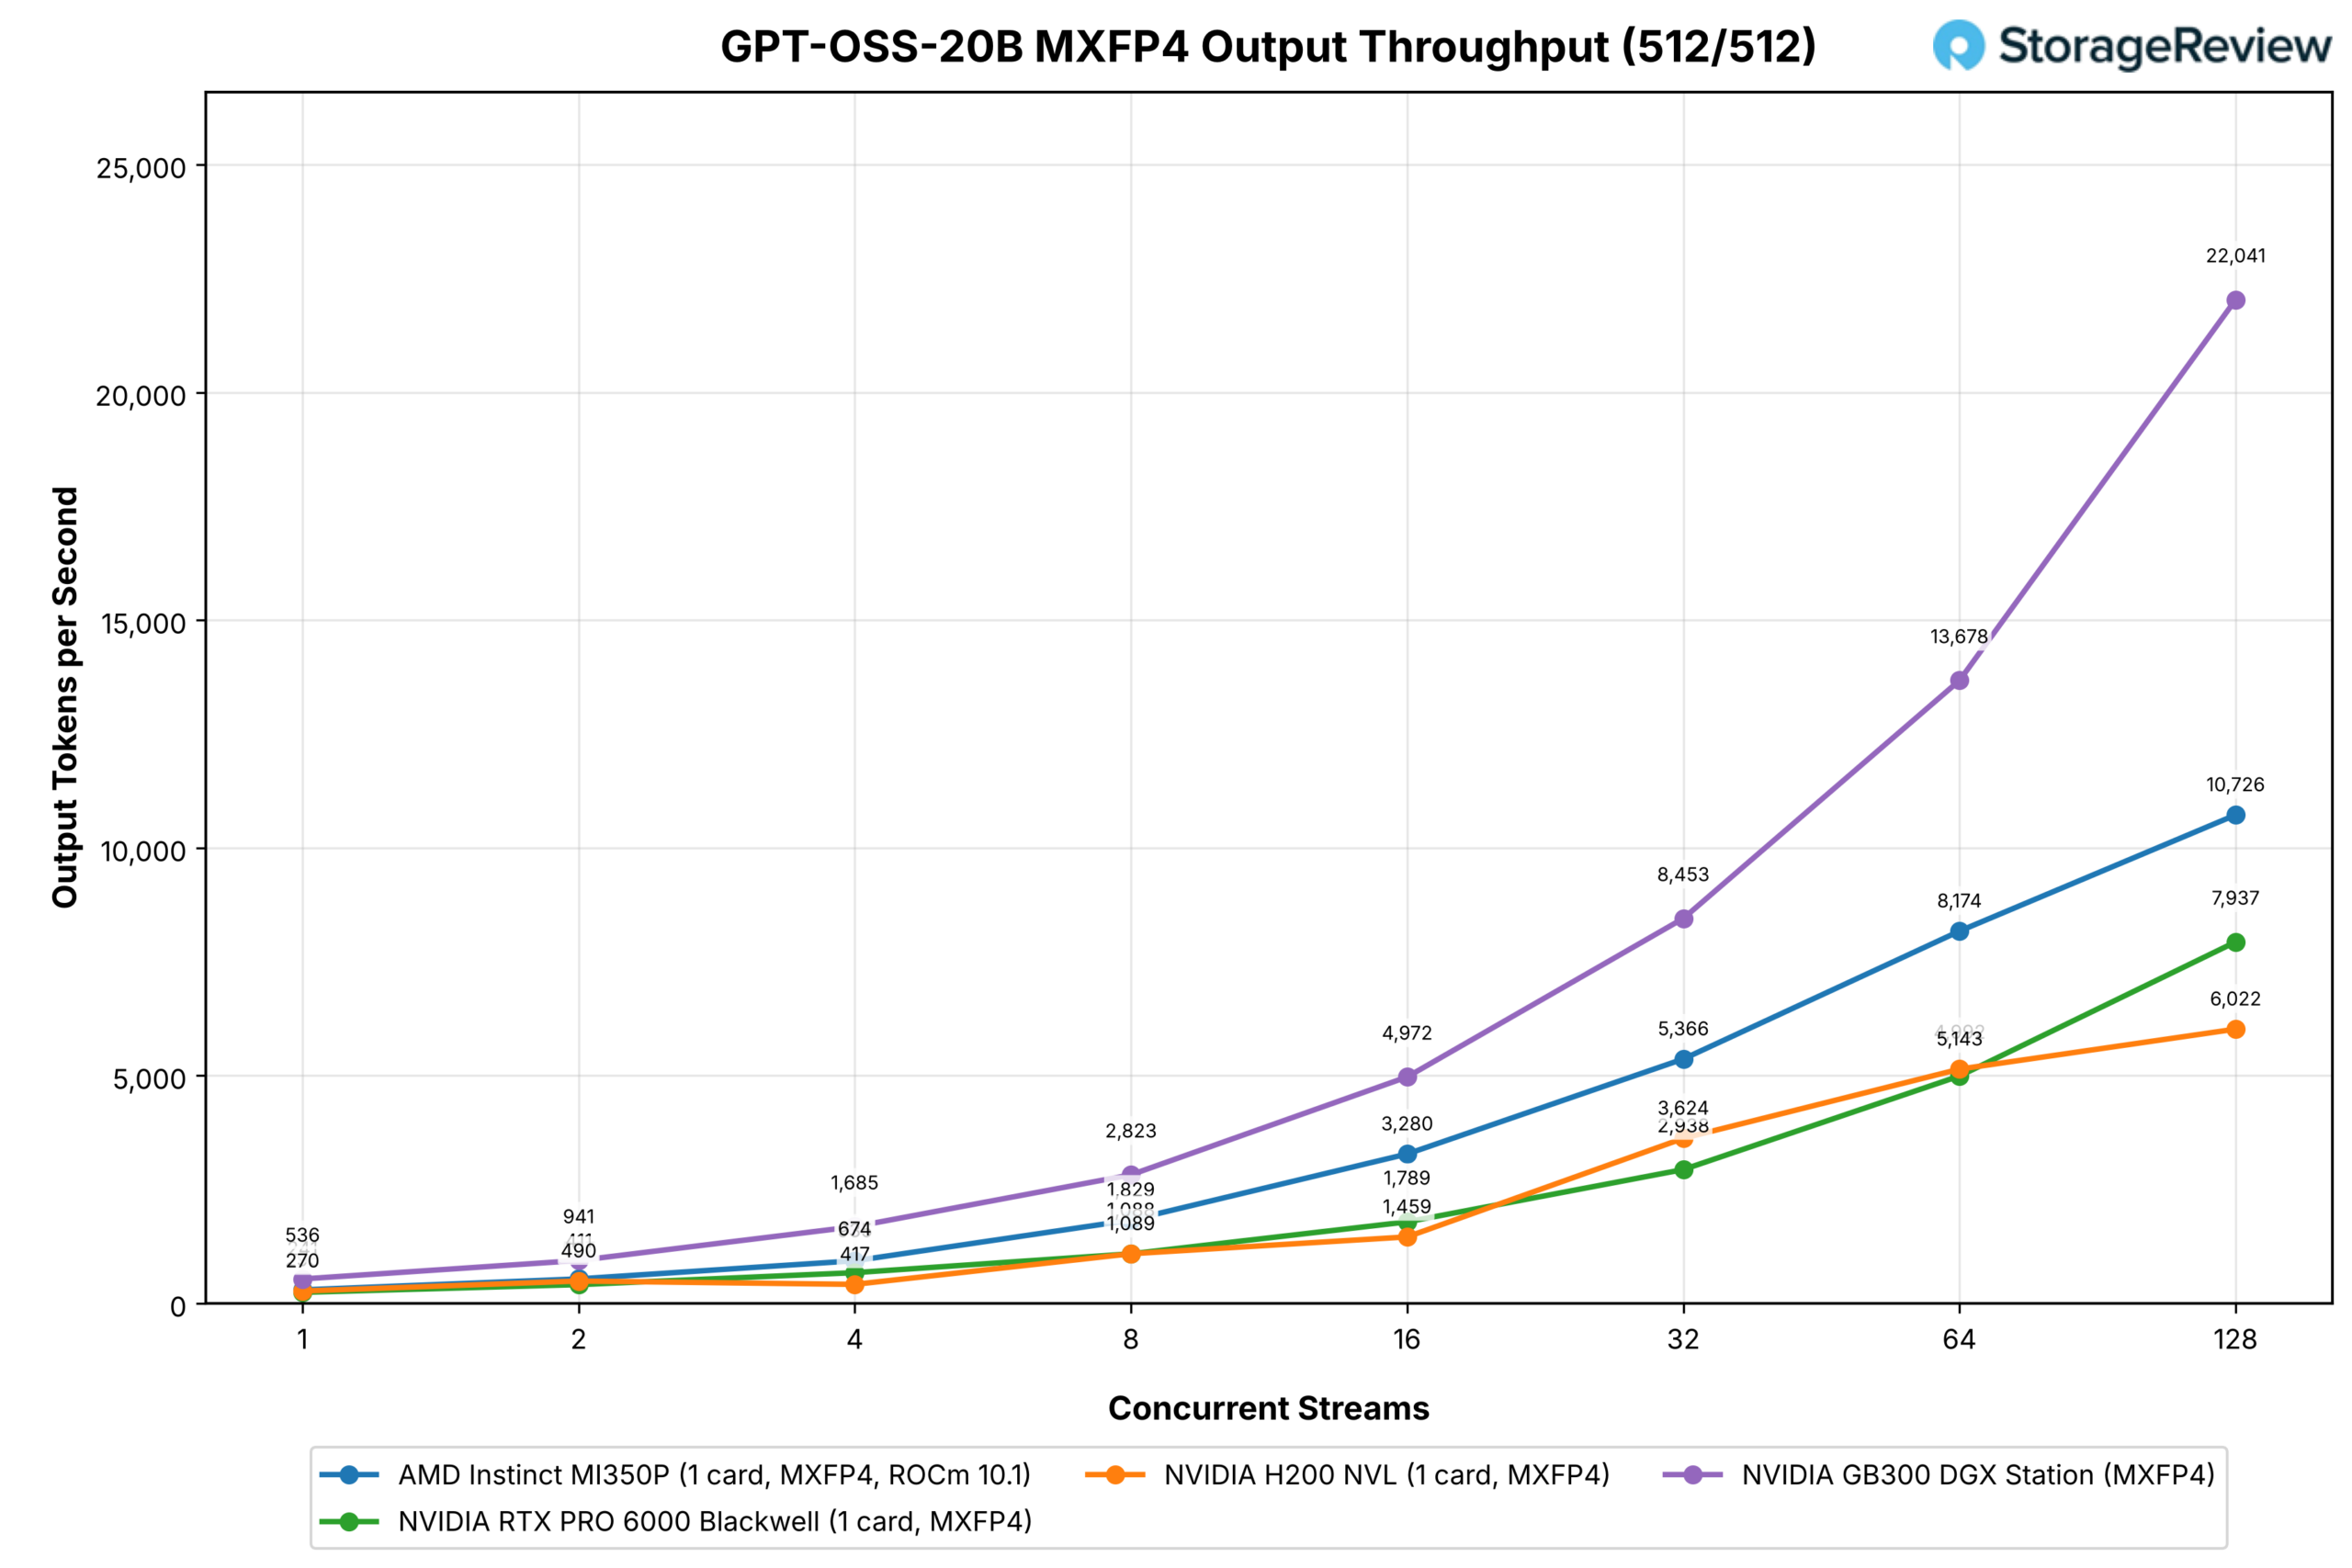
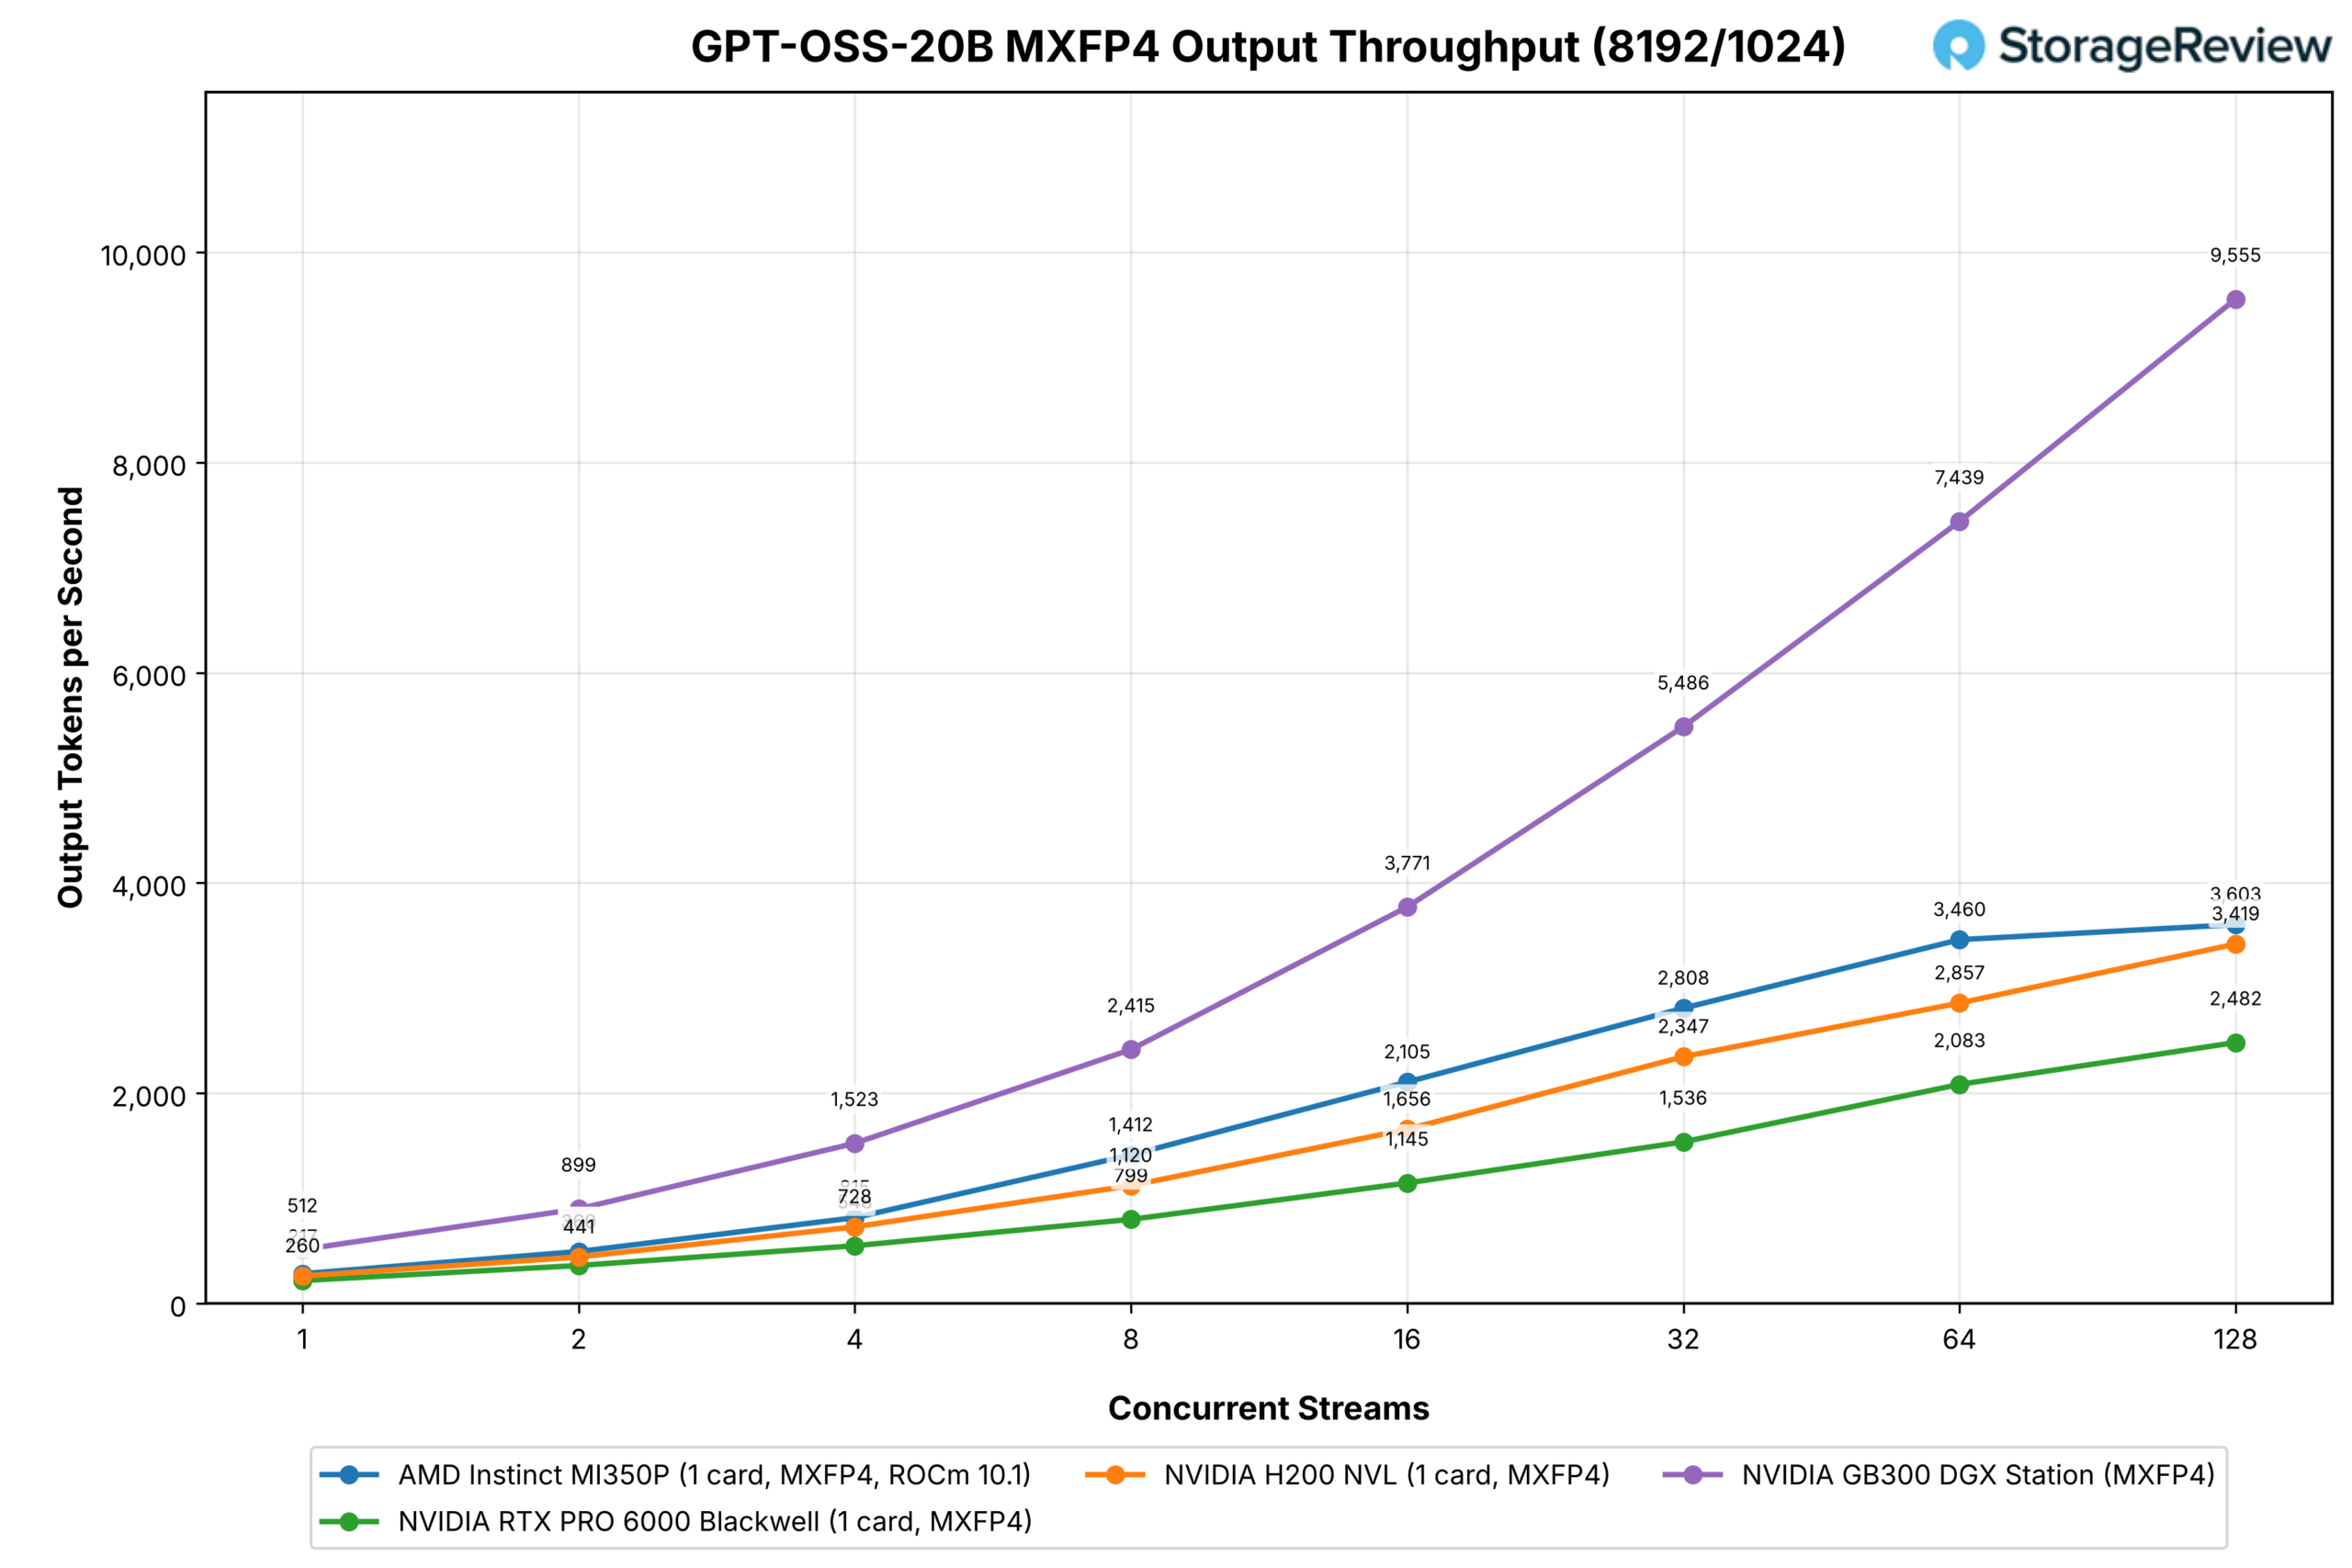
Den mindre OpenAI-modellen följer samma kurva. MI350P leder RTX PRO 6000 på varje punkt, 8 174 mot 4 992 vid 64 strömmar och 10 726 mot 7 937 vid 128 på chattarbetsbelastningen, och 3 460 mot 2 083 och 3 603 mot 2 482 på förfyllningstunga prompter, och den går till 16 406 vid 256 strömmar där RTX PRO 6000 läser 11 077. H200 NVL ligger efter MI350P på båda formerna, med 6 022 och 3 419 vid 128 strömmar, och Station ligger på 22 041 och 9 555.
Qwen3-Kodare-30B-A3B
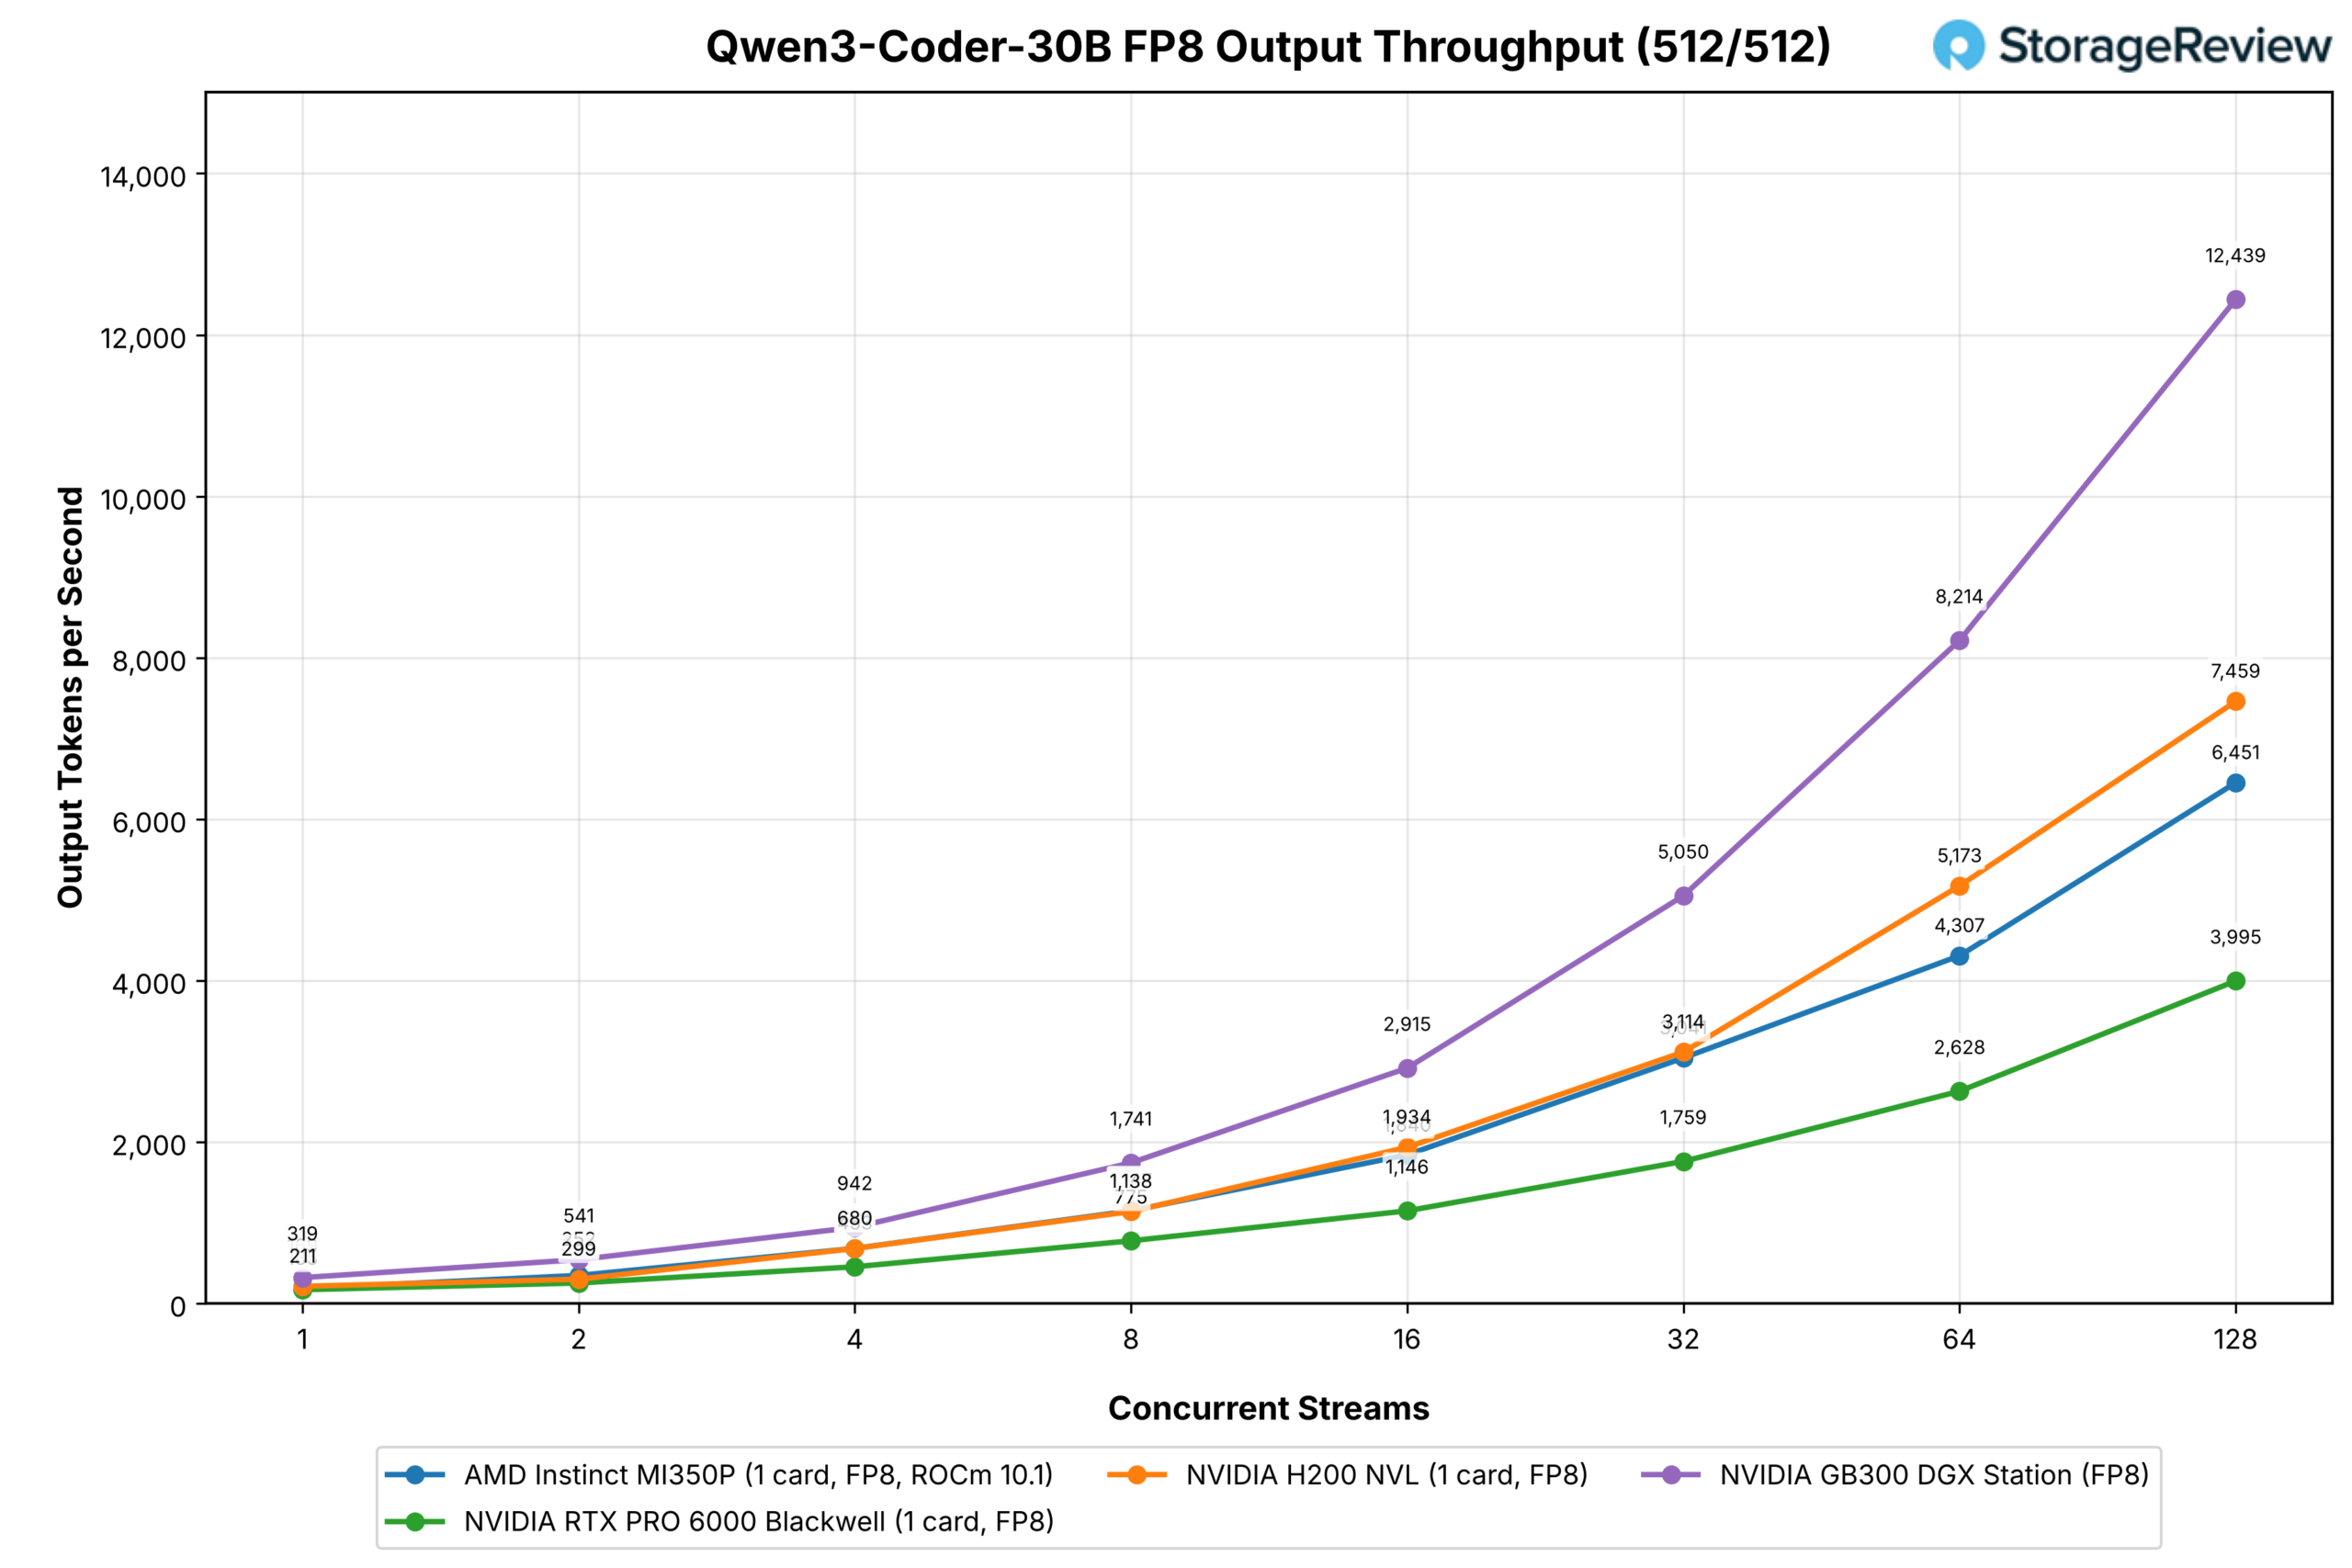
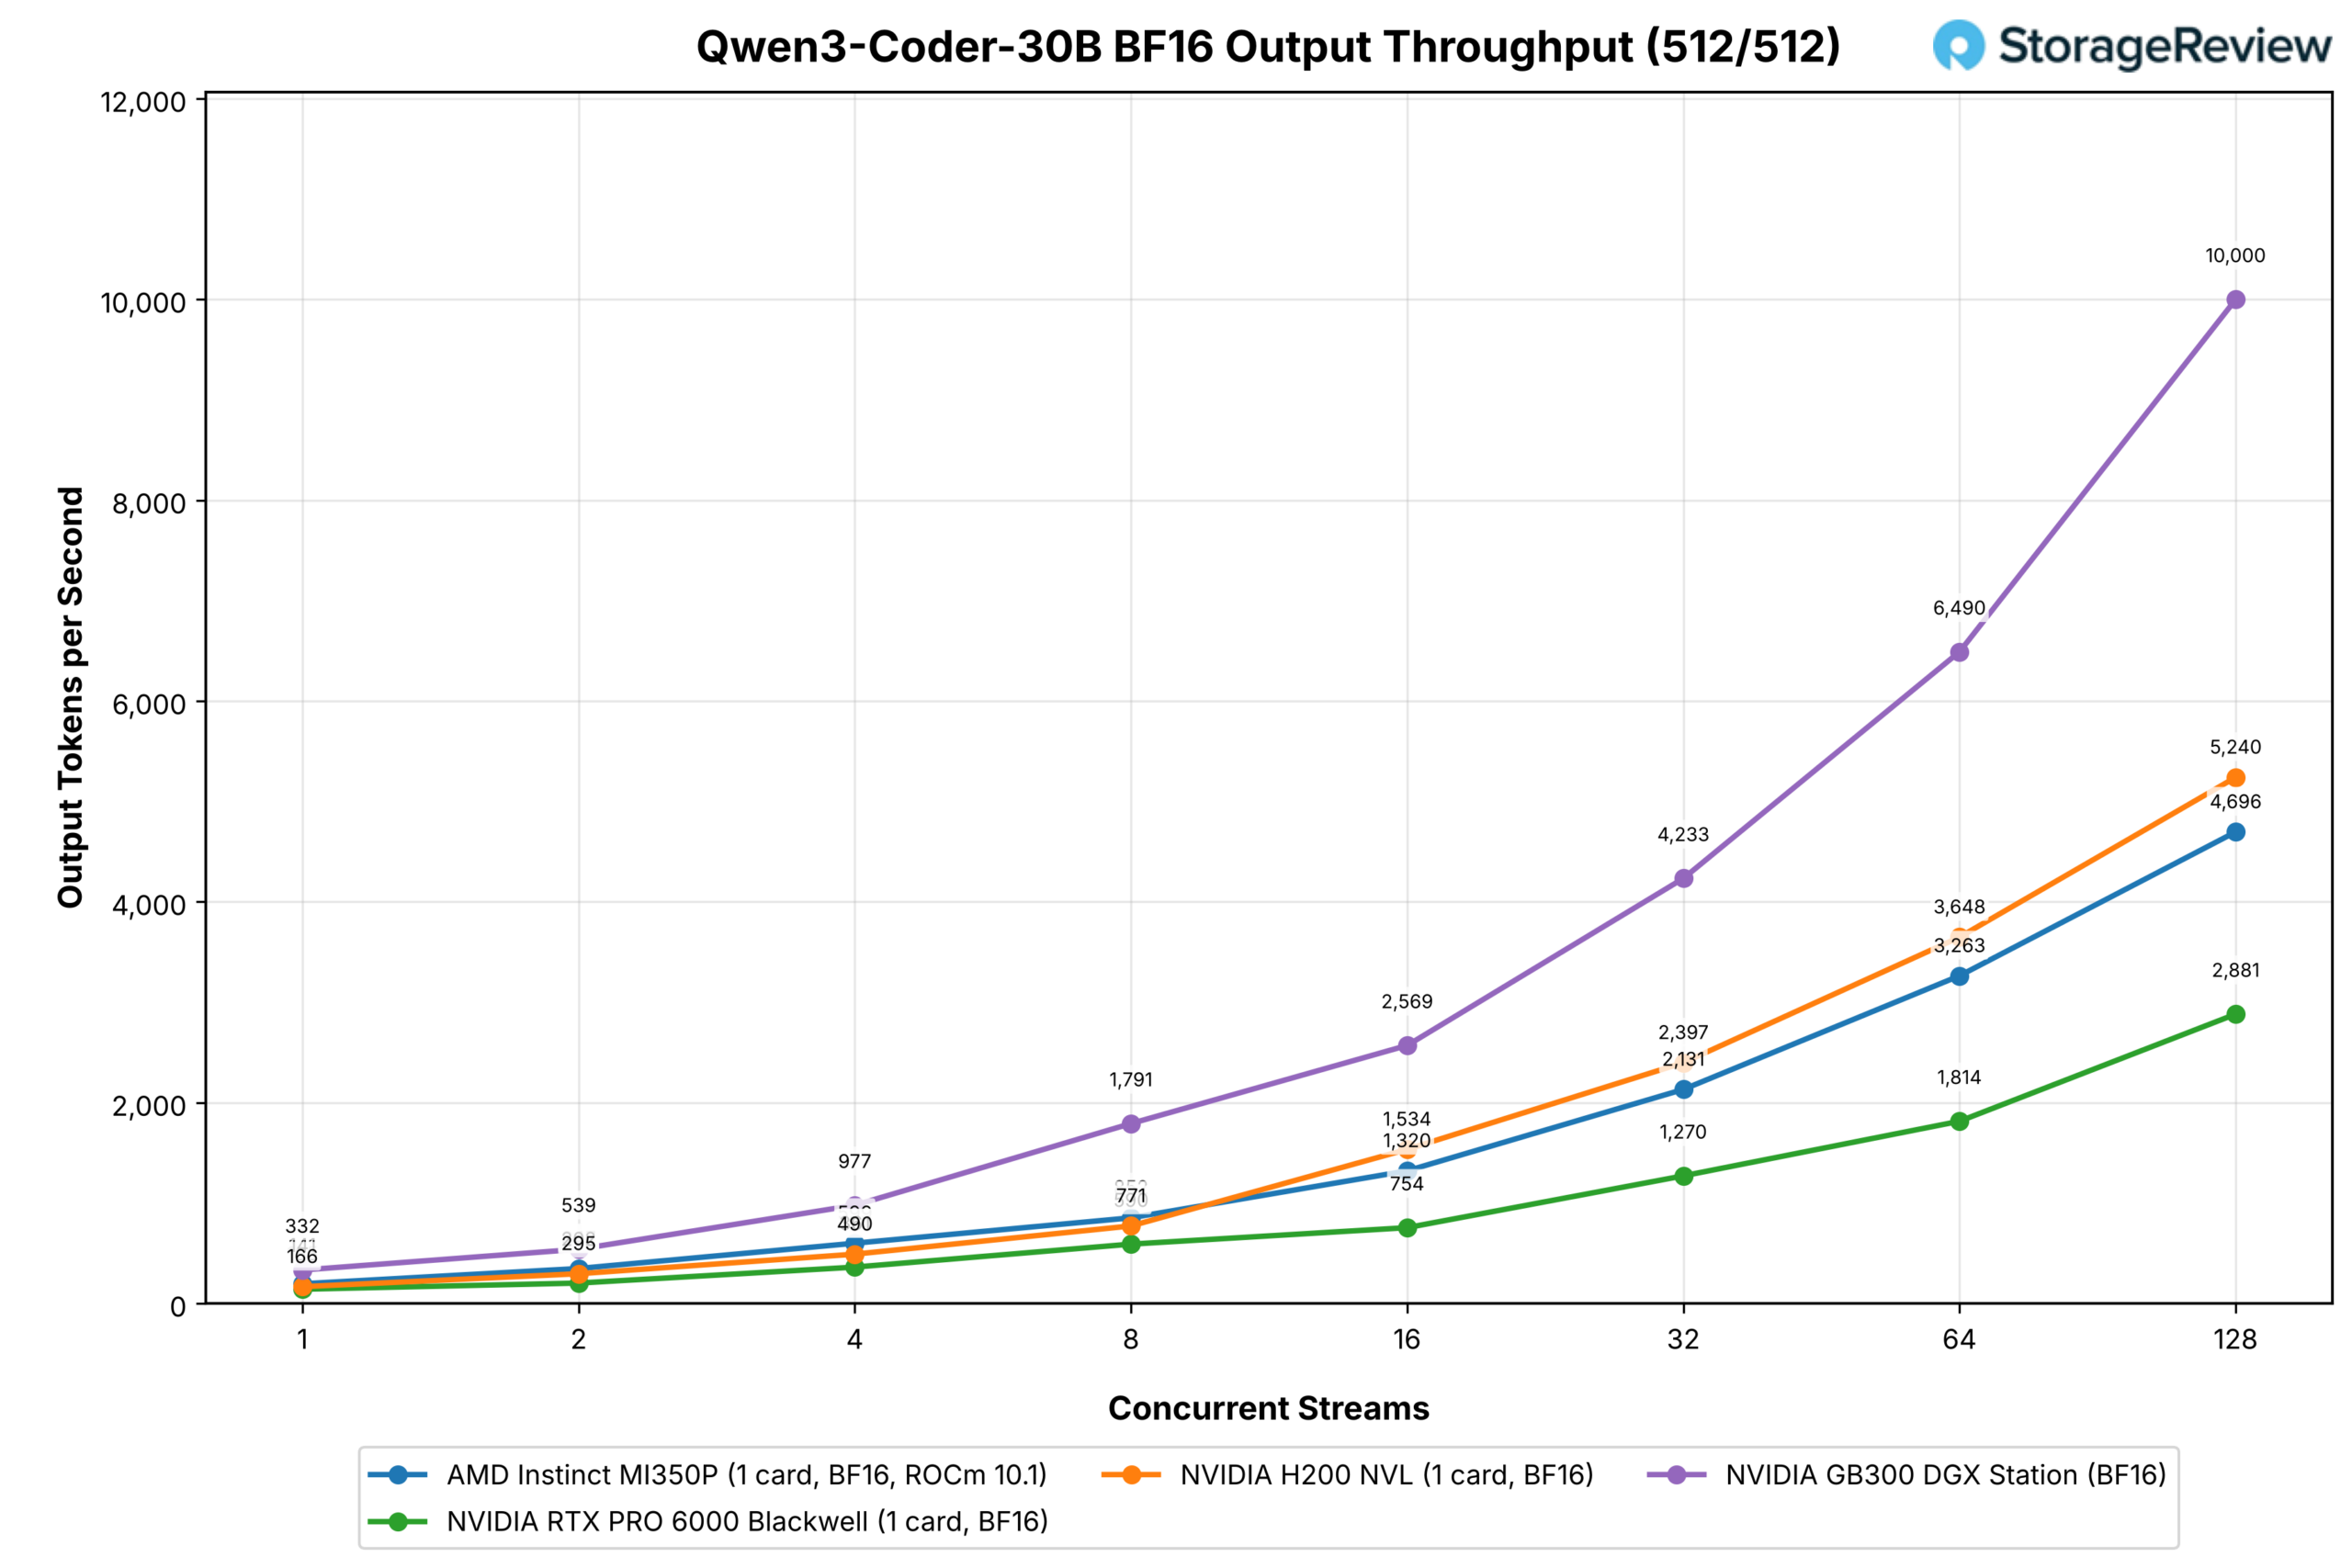
30B MoE med 3B aktiva parametrar ger MI350P en ledning över RTX PRO 6000 vid varje samtidighet i chattarbetsbelastningen, och slutar på 6 451 mot 3 995 på FP8 och 4 696 mot 2 881 på BF16 vid 128 strömmar, med H200 på 7 459 och 5 240.
På förfyllningstunga uppmaningar leder FP8-körningen endast genom fyra strömmar och ligger sedan efter RTX PRO 6000 från åtta till 128, 759 mot 823 i toppen, med H200 på 1 820; BF16-körningen klättrar till 728 vid 128 strömmar mot 588 och 1 592.
Mistral Small 3.1 24B
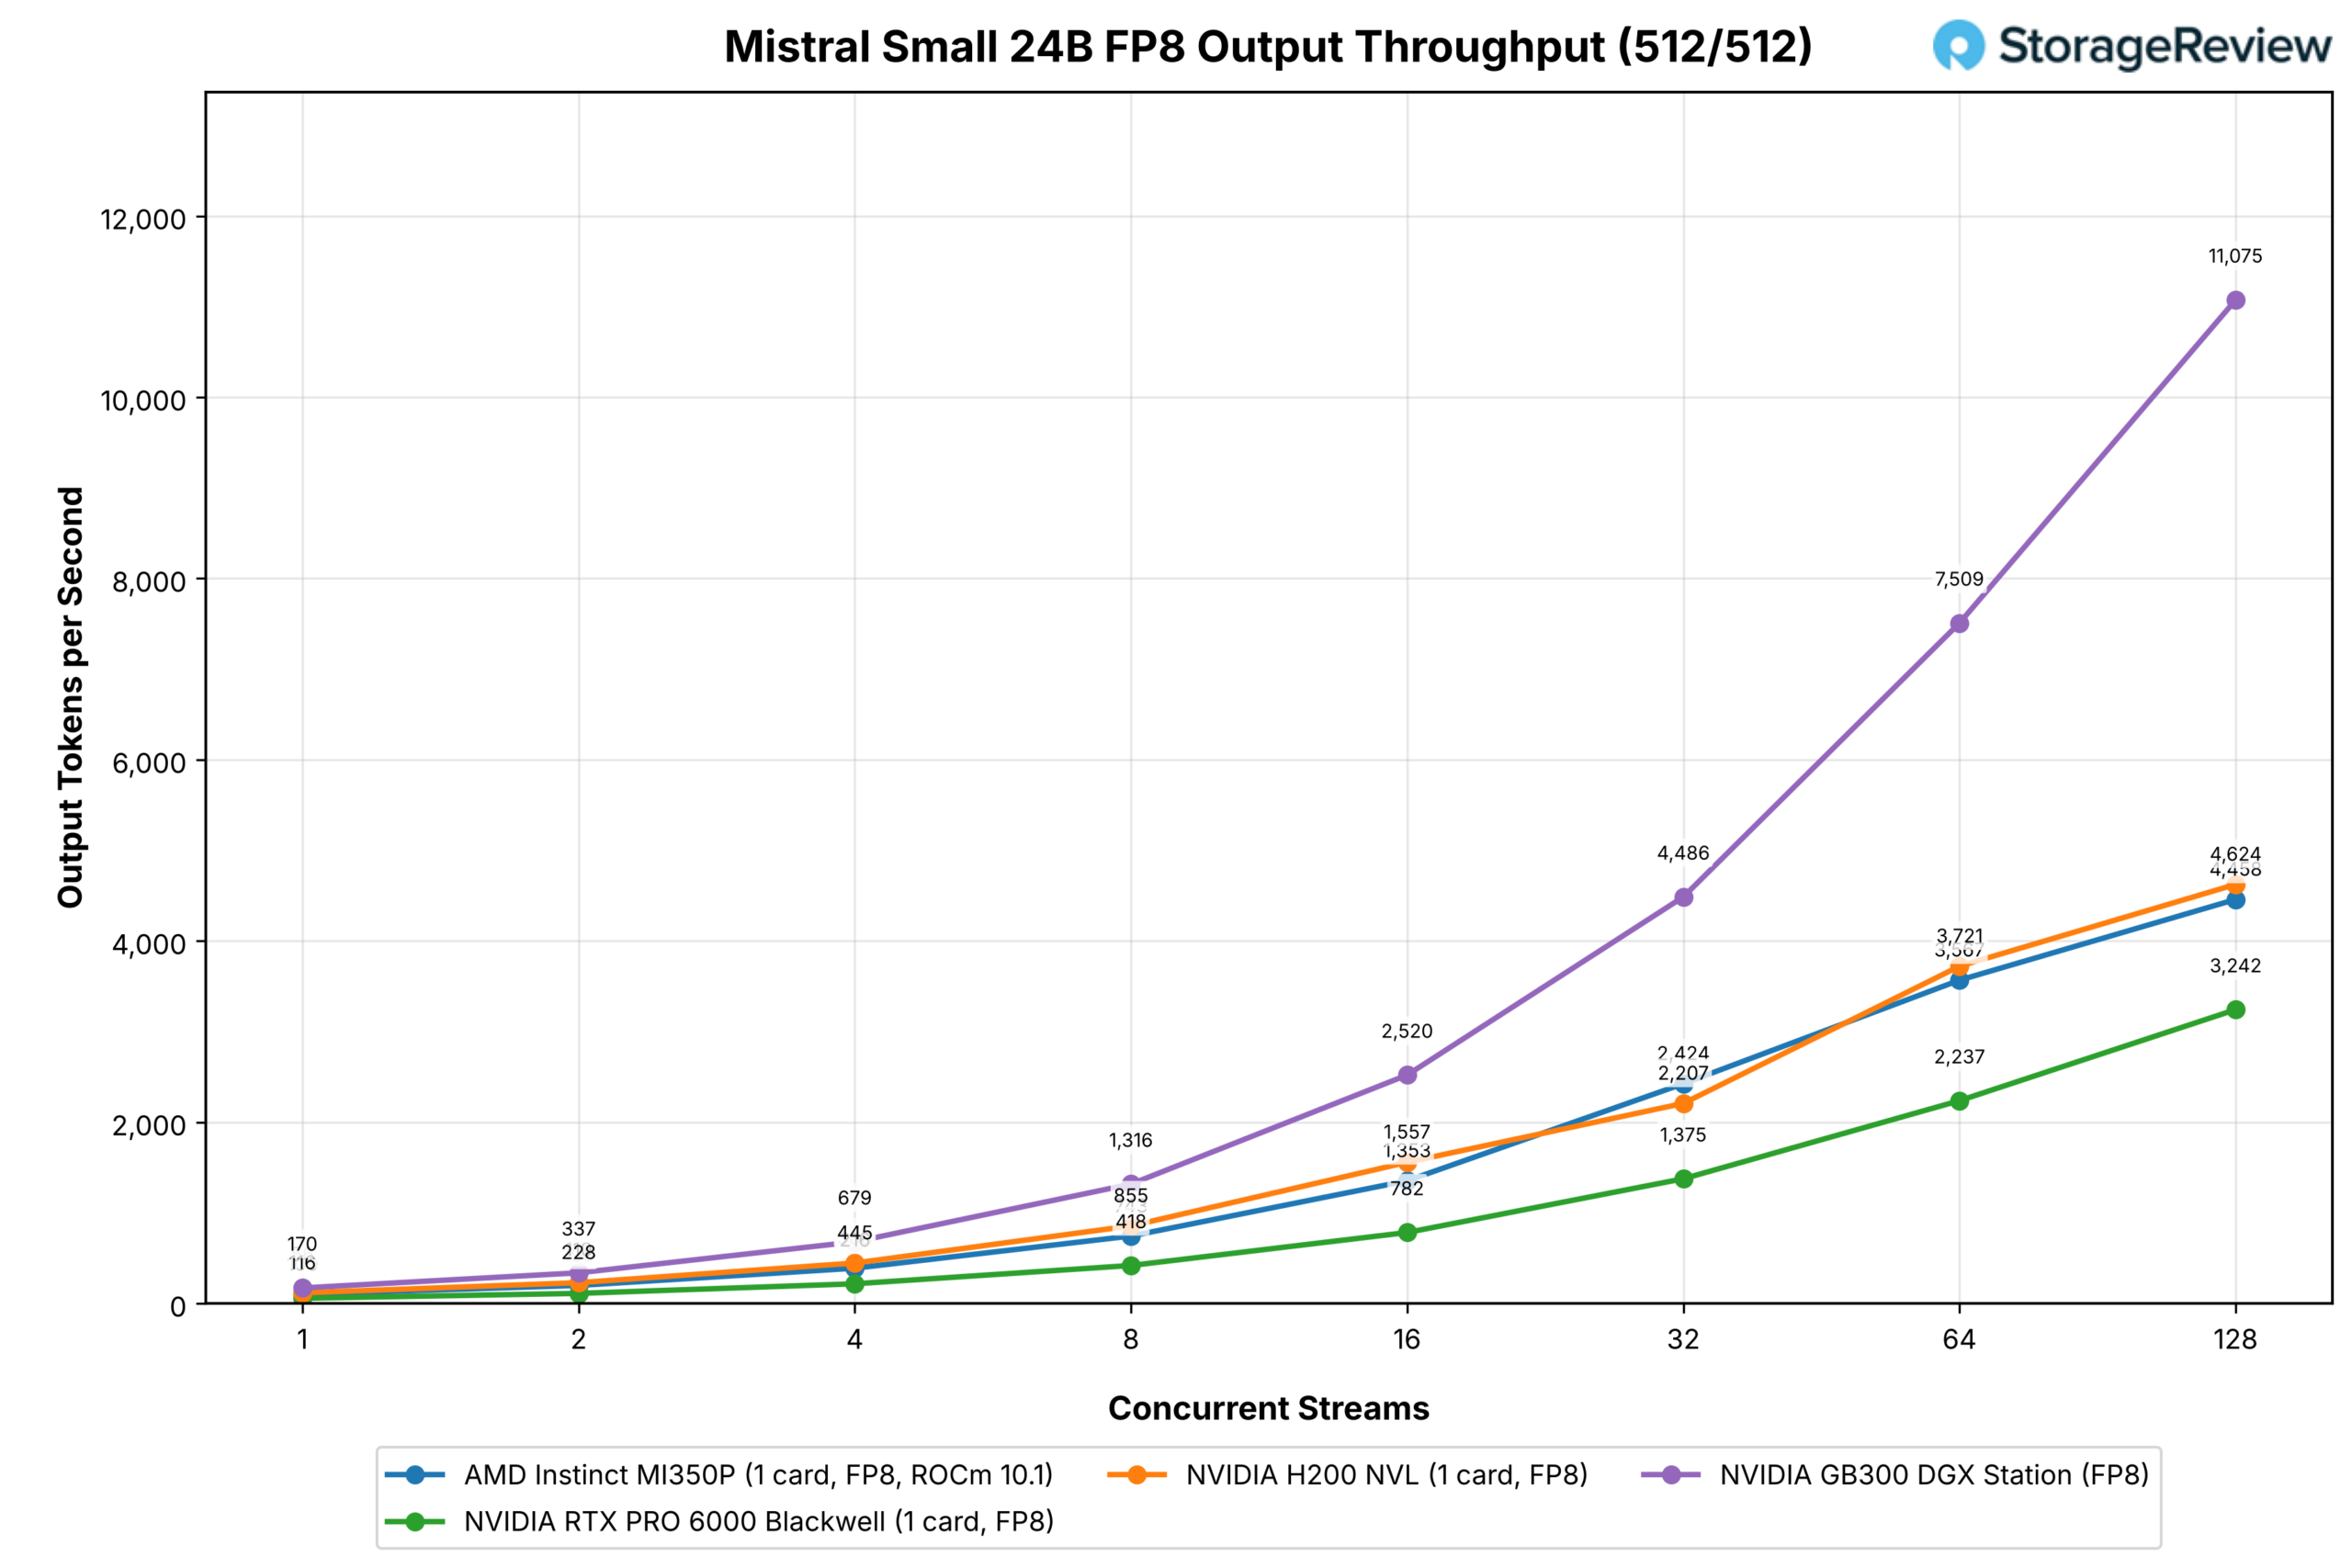
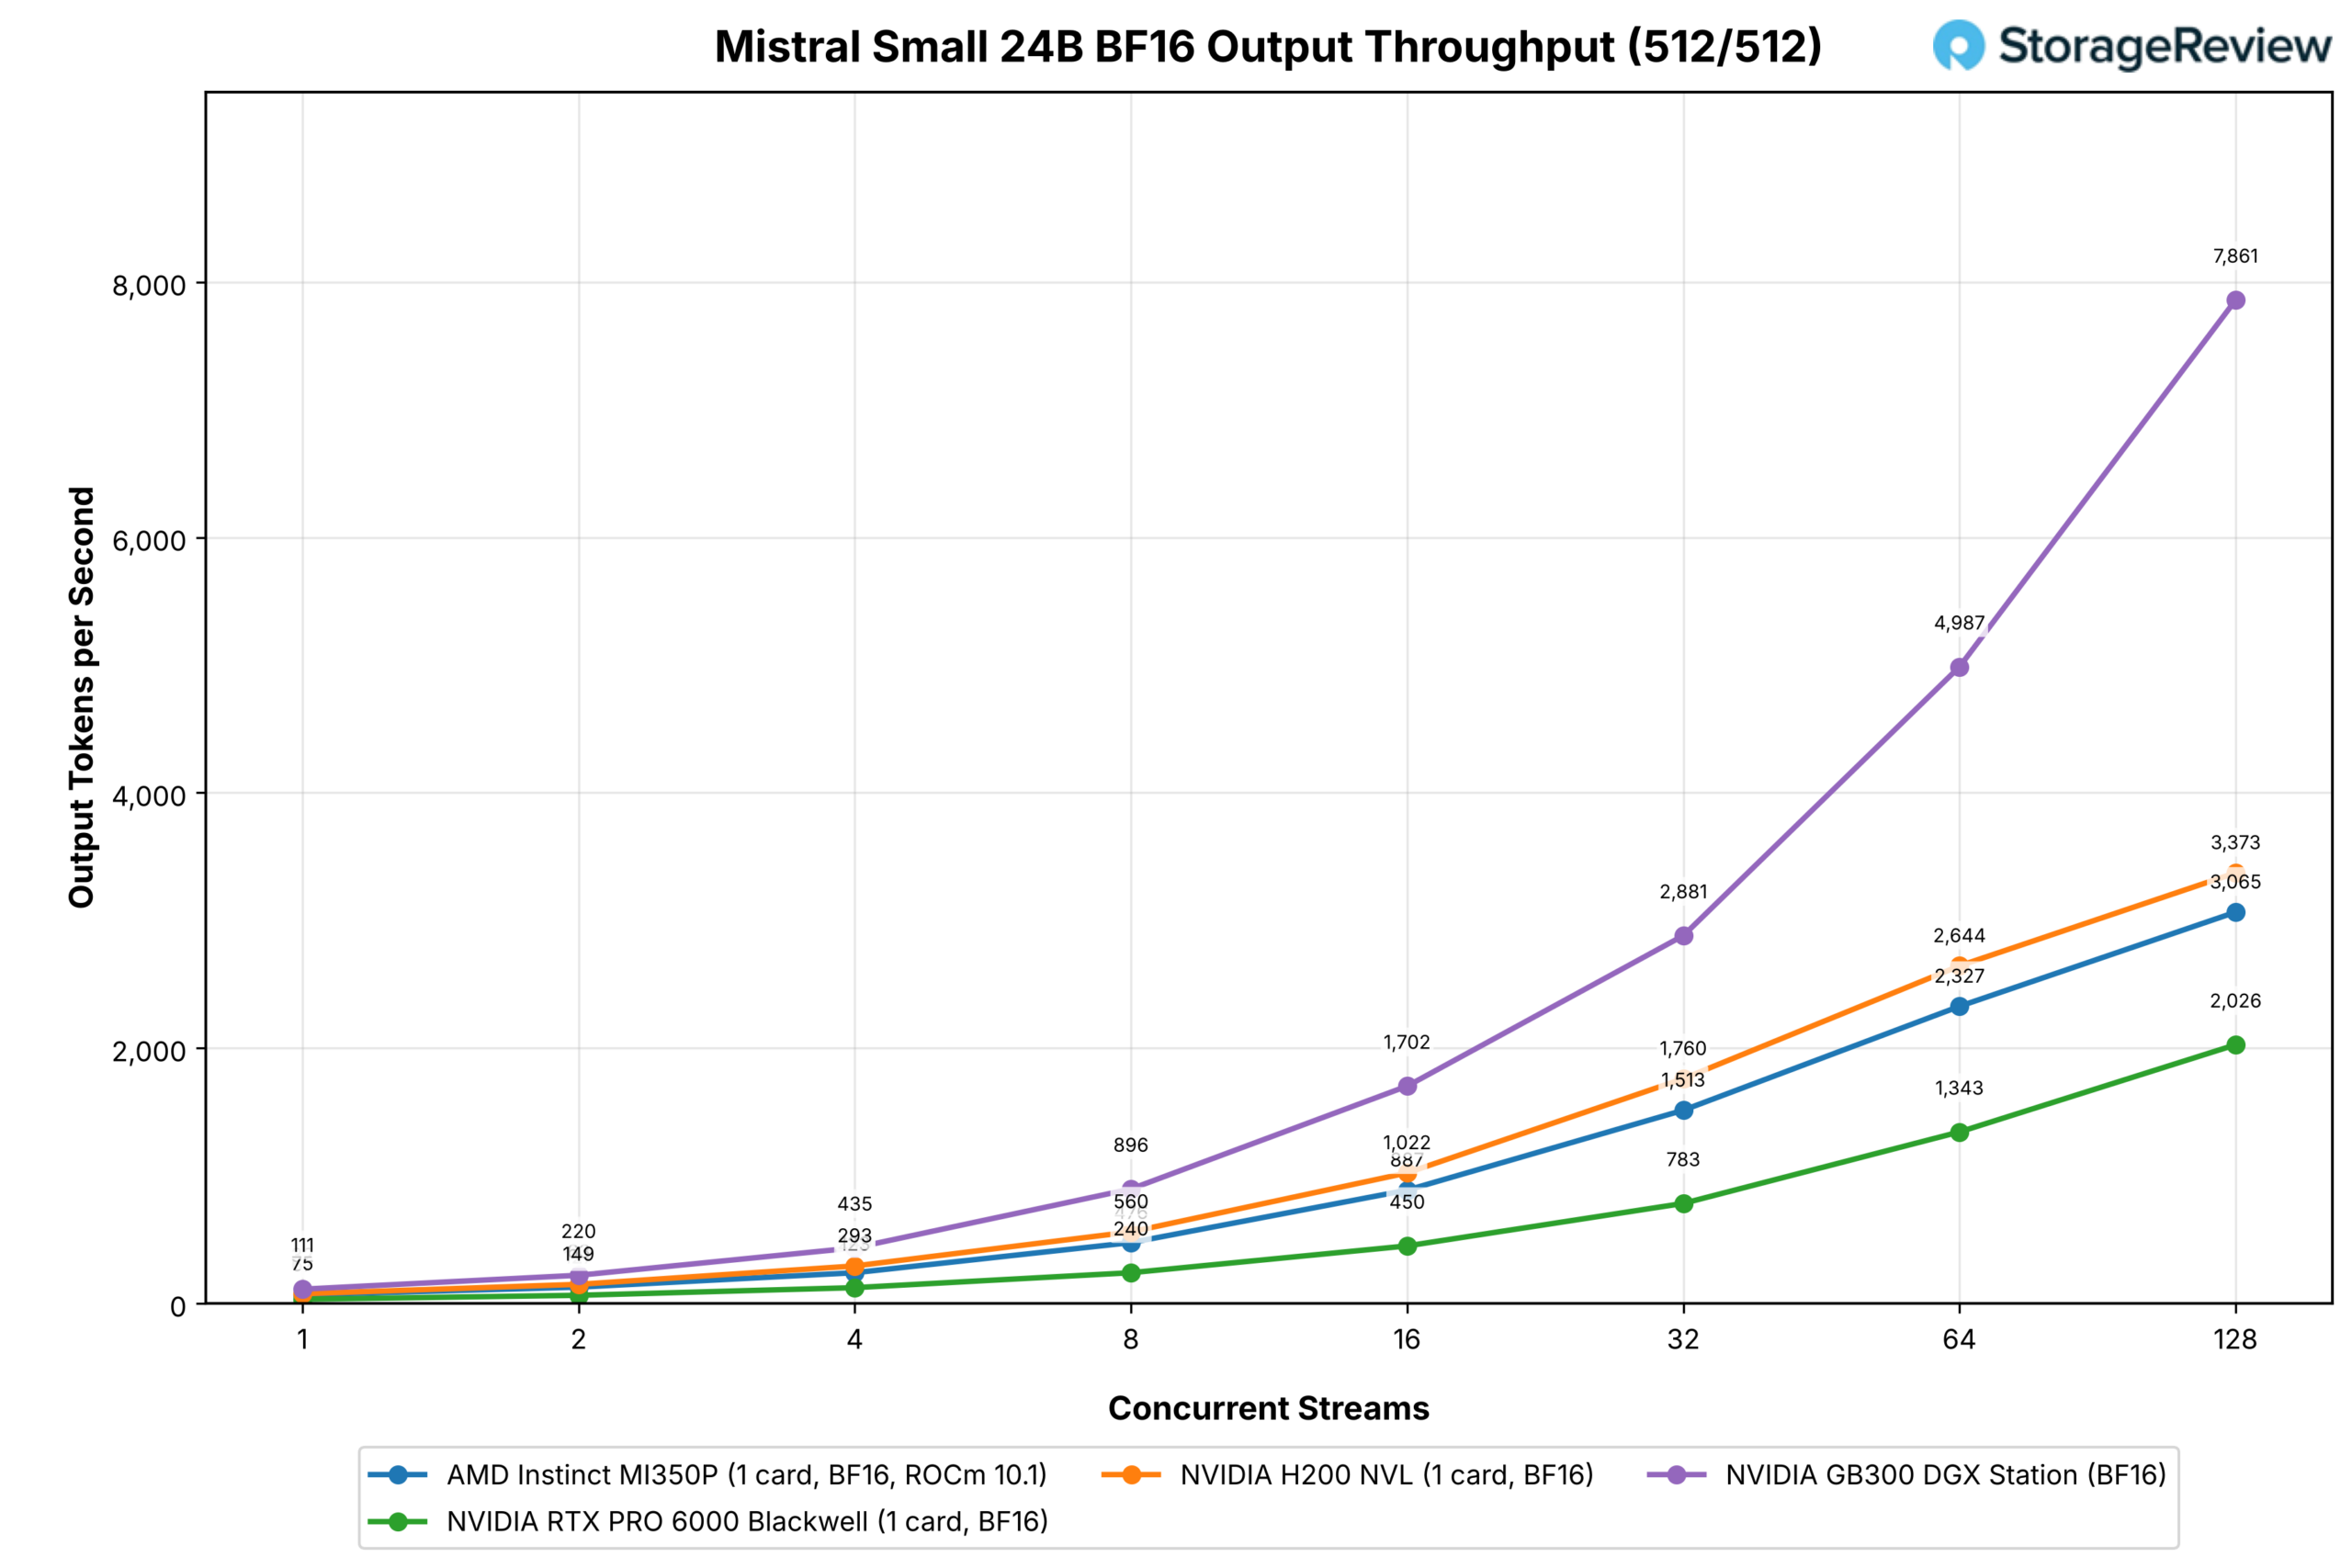
Mistral Small är MI350P:s starkaste densitetsresultat mot RTX PRO 6000: 4 458 mot 3 242 på FP8 och 3 065 mot 2 026 på BF16 vid 128 strömmar på chattarbetsbelastningen, och vid en ström fördubblar MI350P ungefär NVIDIA-kortet (100 mot 56 på FP8, 67 mot 32 på BF16).
Det är också den täta modellen där MI350P leder på förfyllningstunga prompter, 599 mot 482 på FP8 vid 128 strömmar och 425 mot 299 på BF16 vid 64, även om H200 når 799 och 632 vid samma tidpunkter.
Lama 3.1 8B
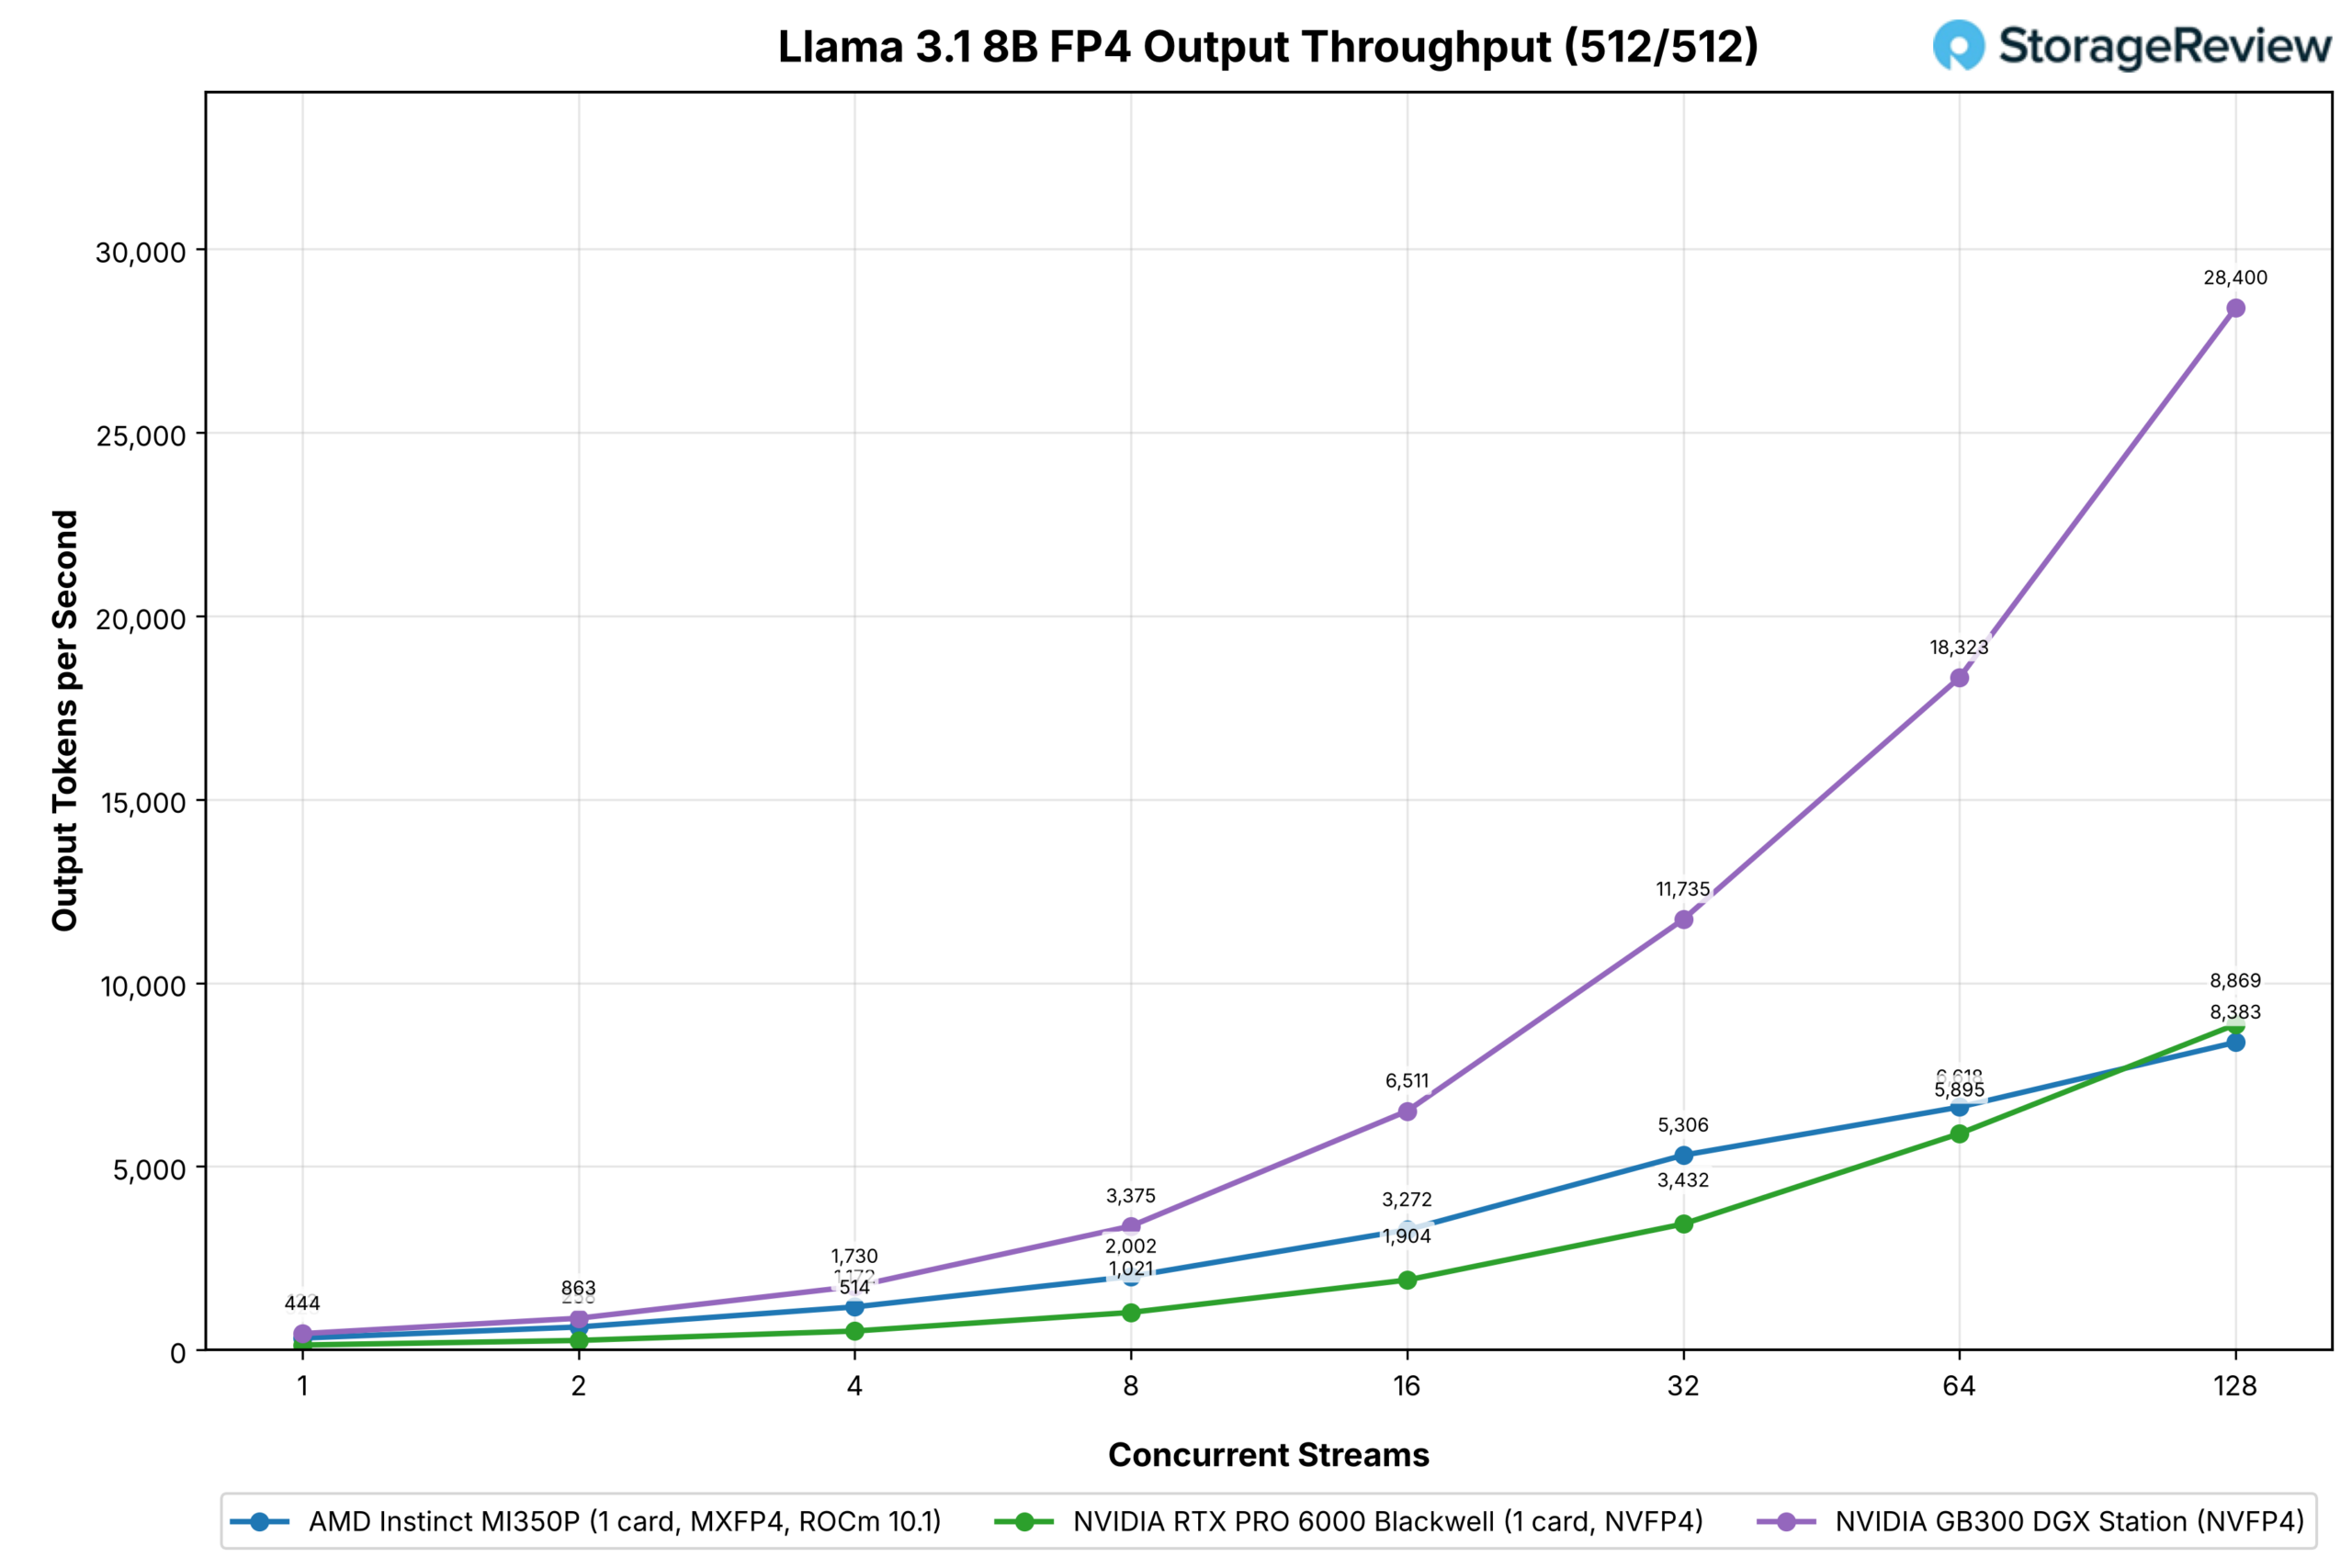
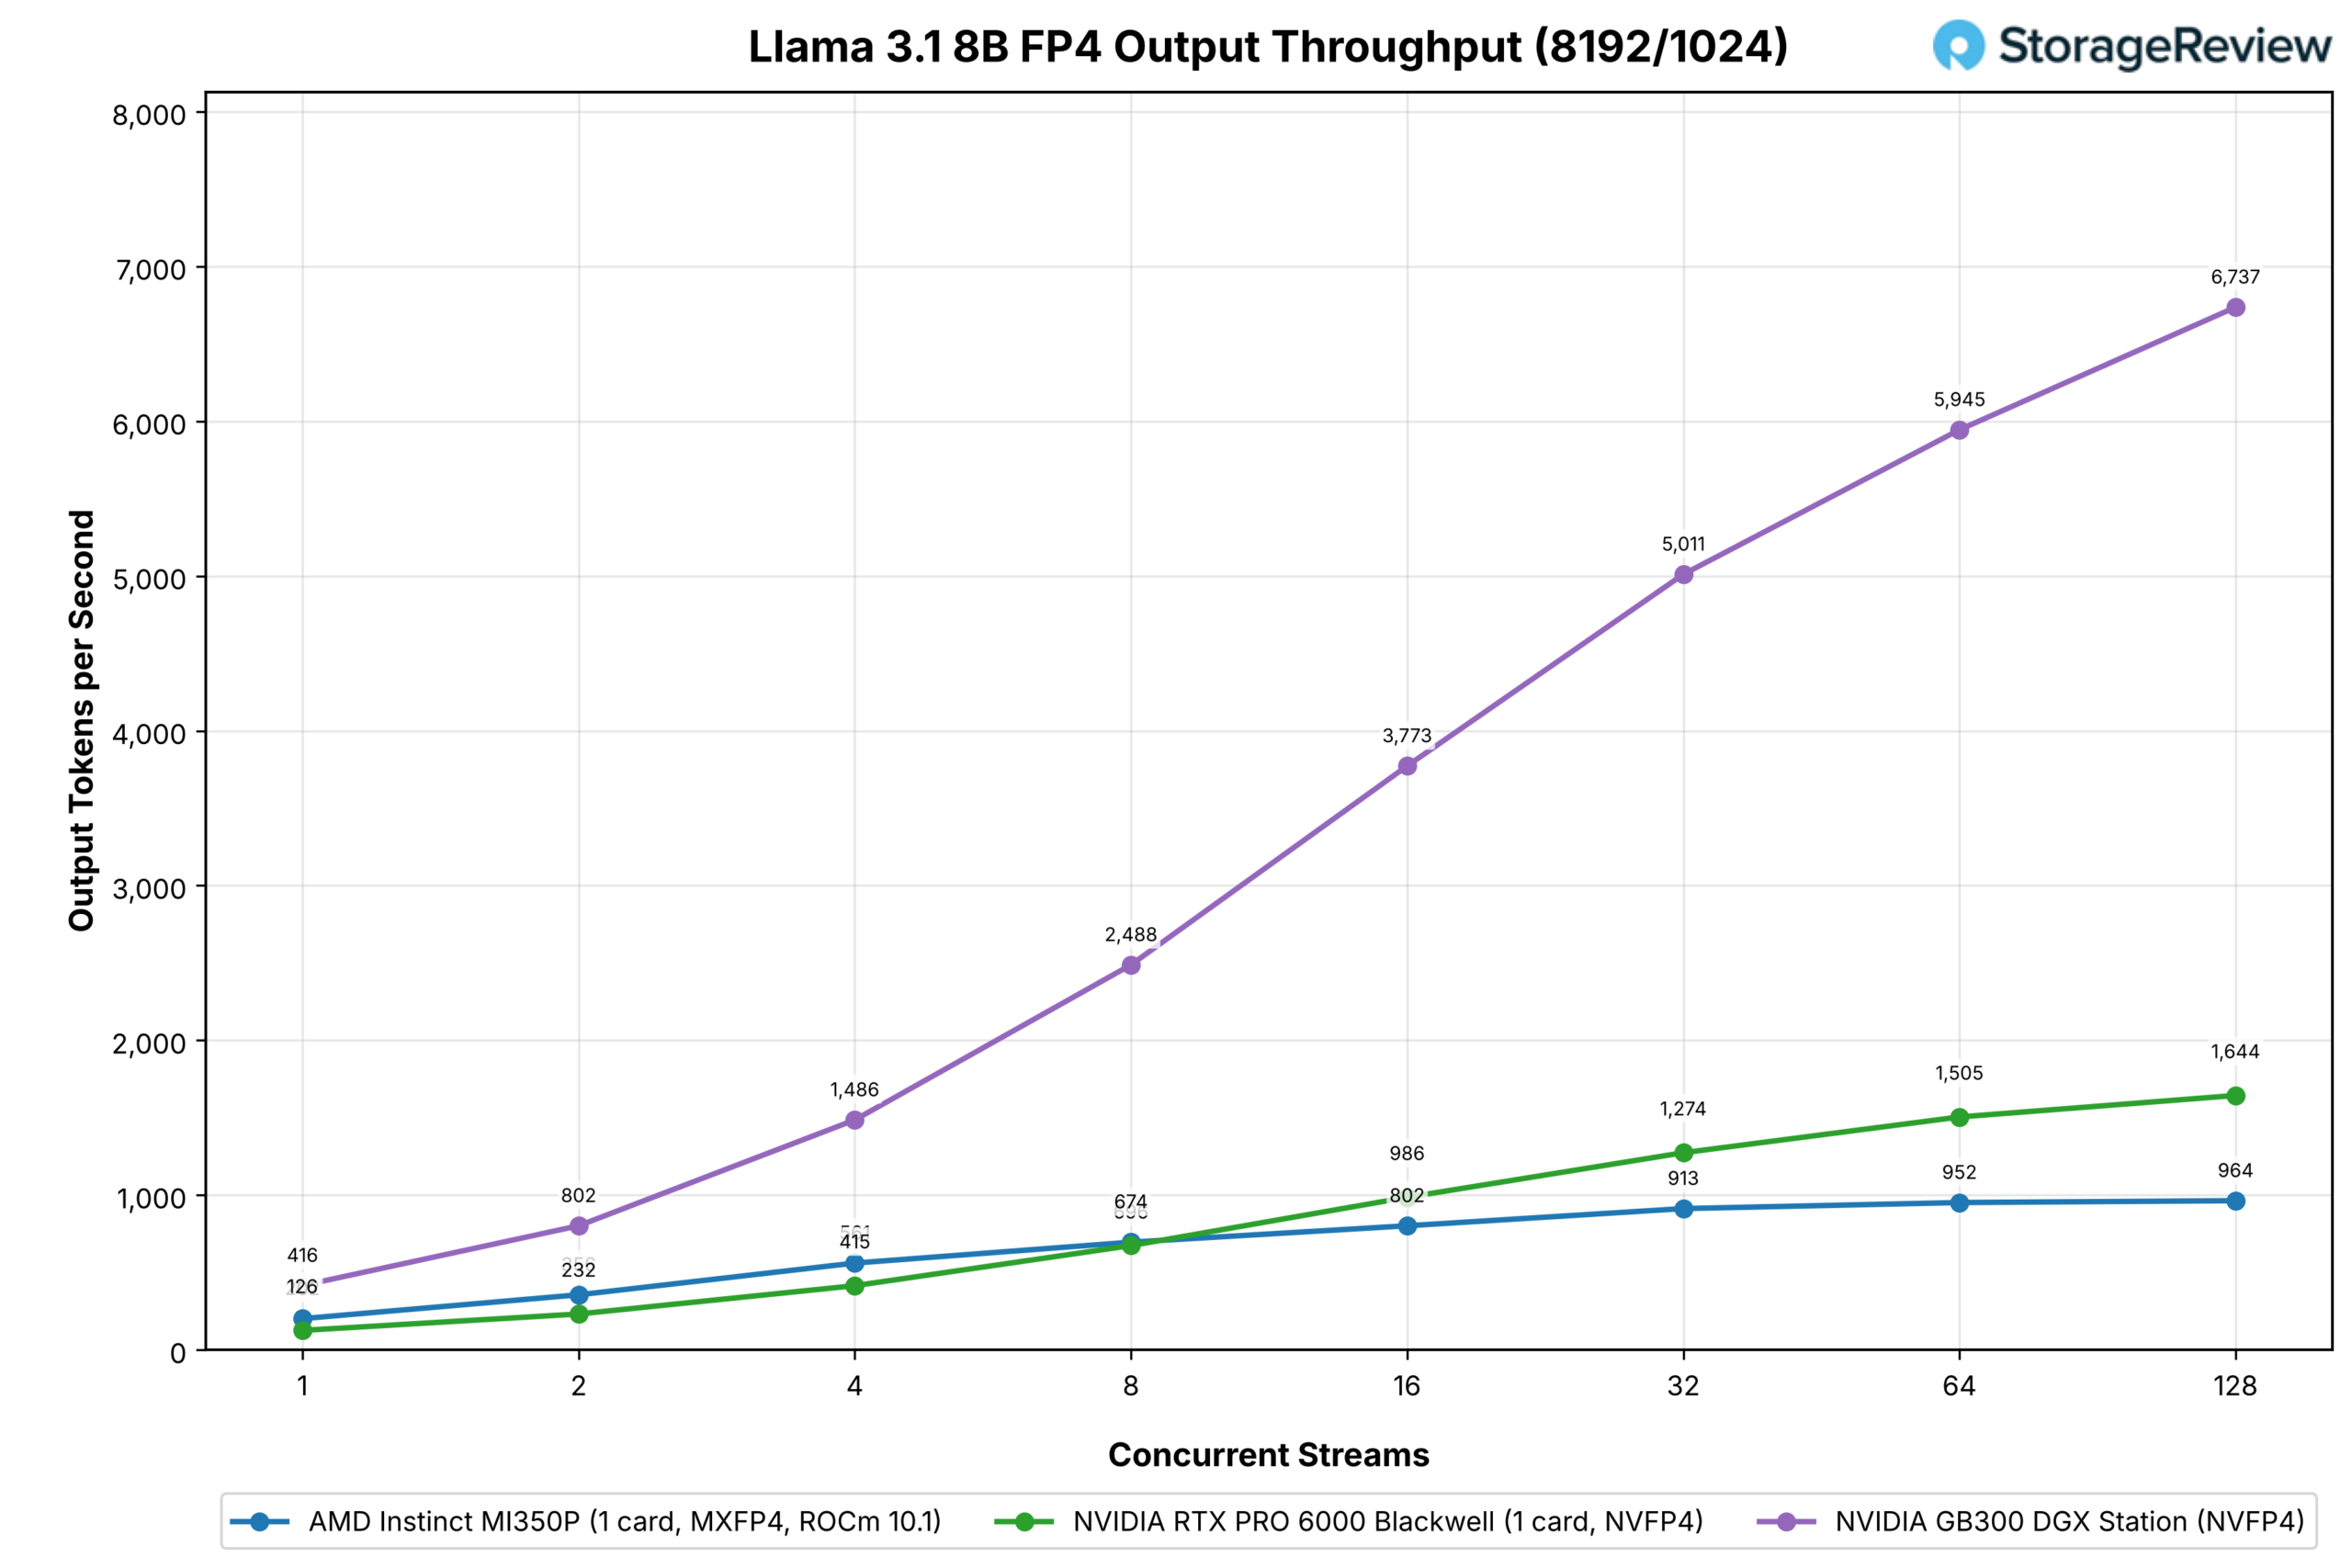
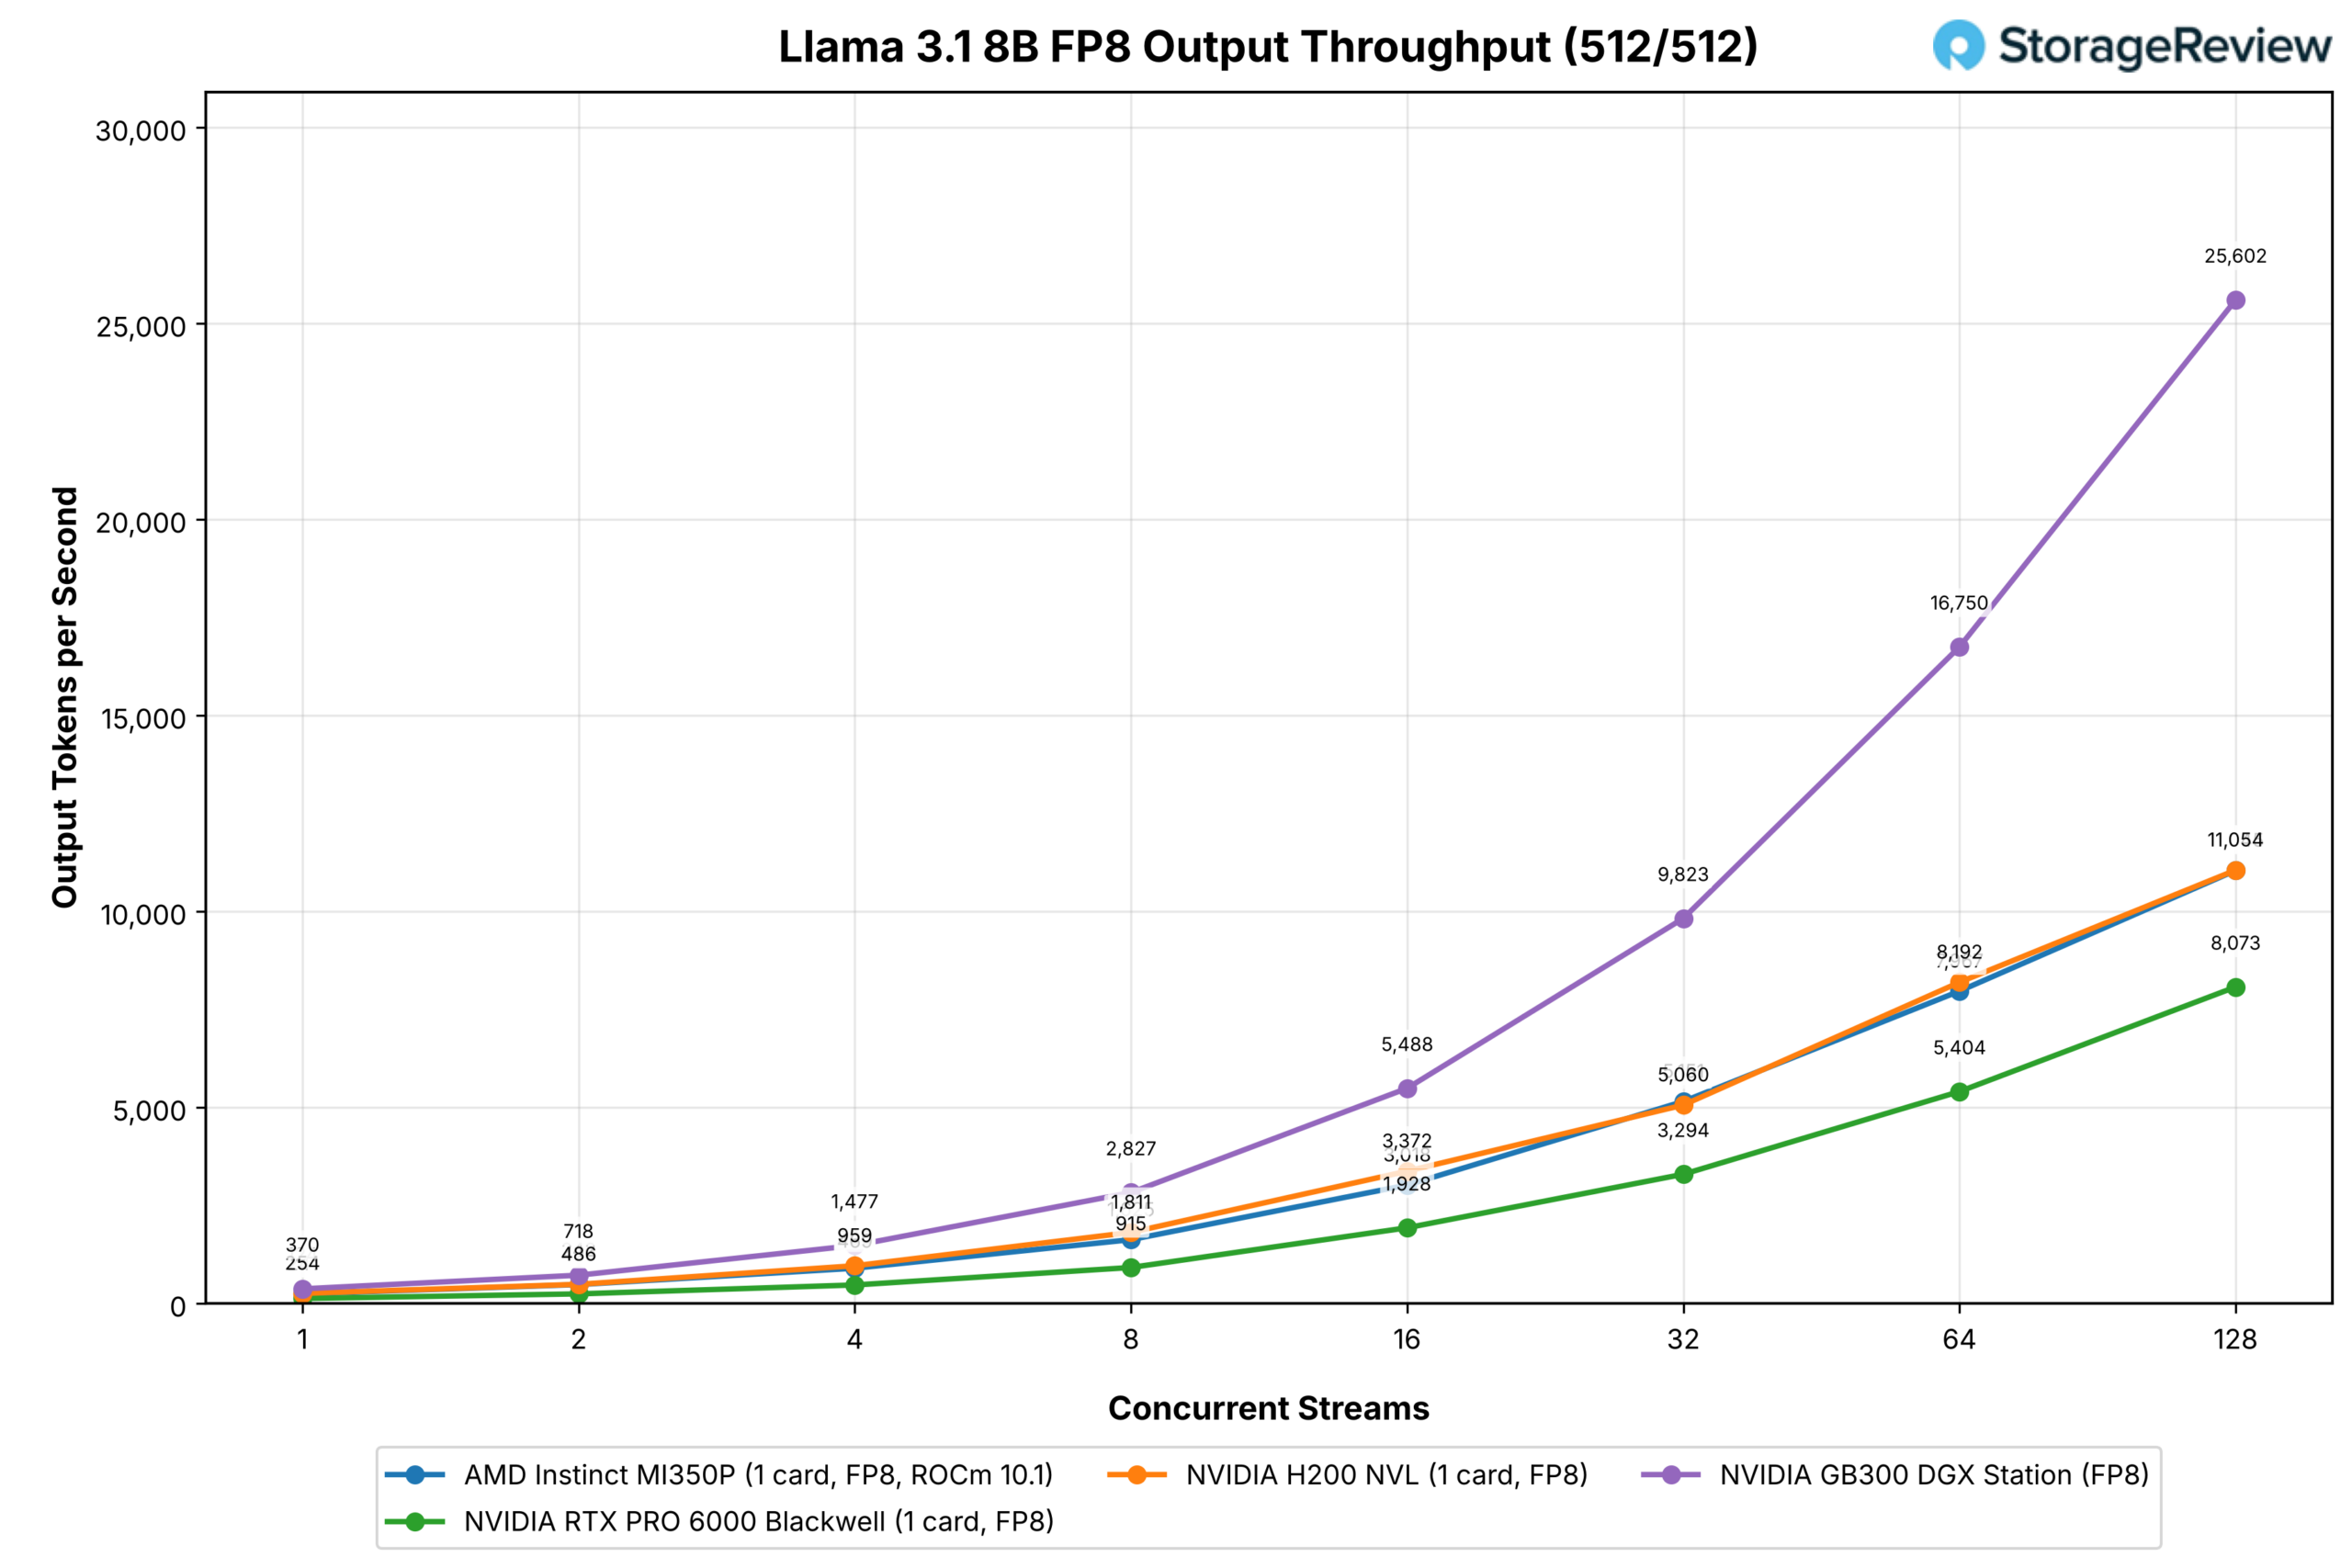
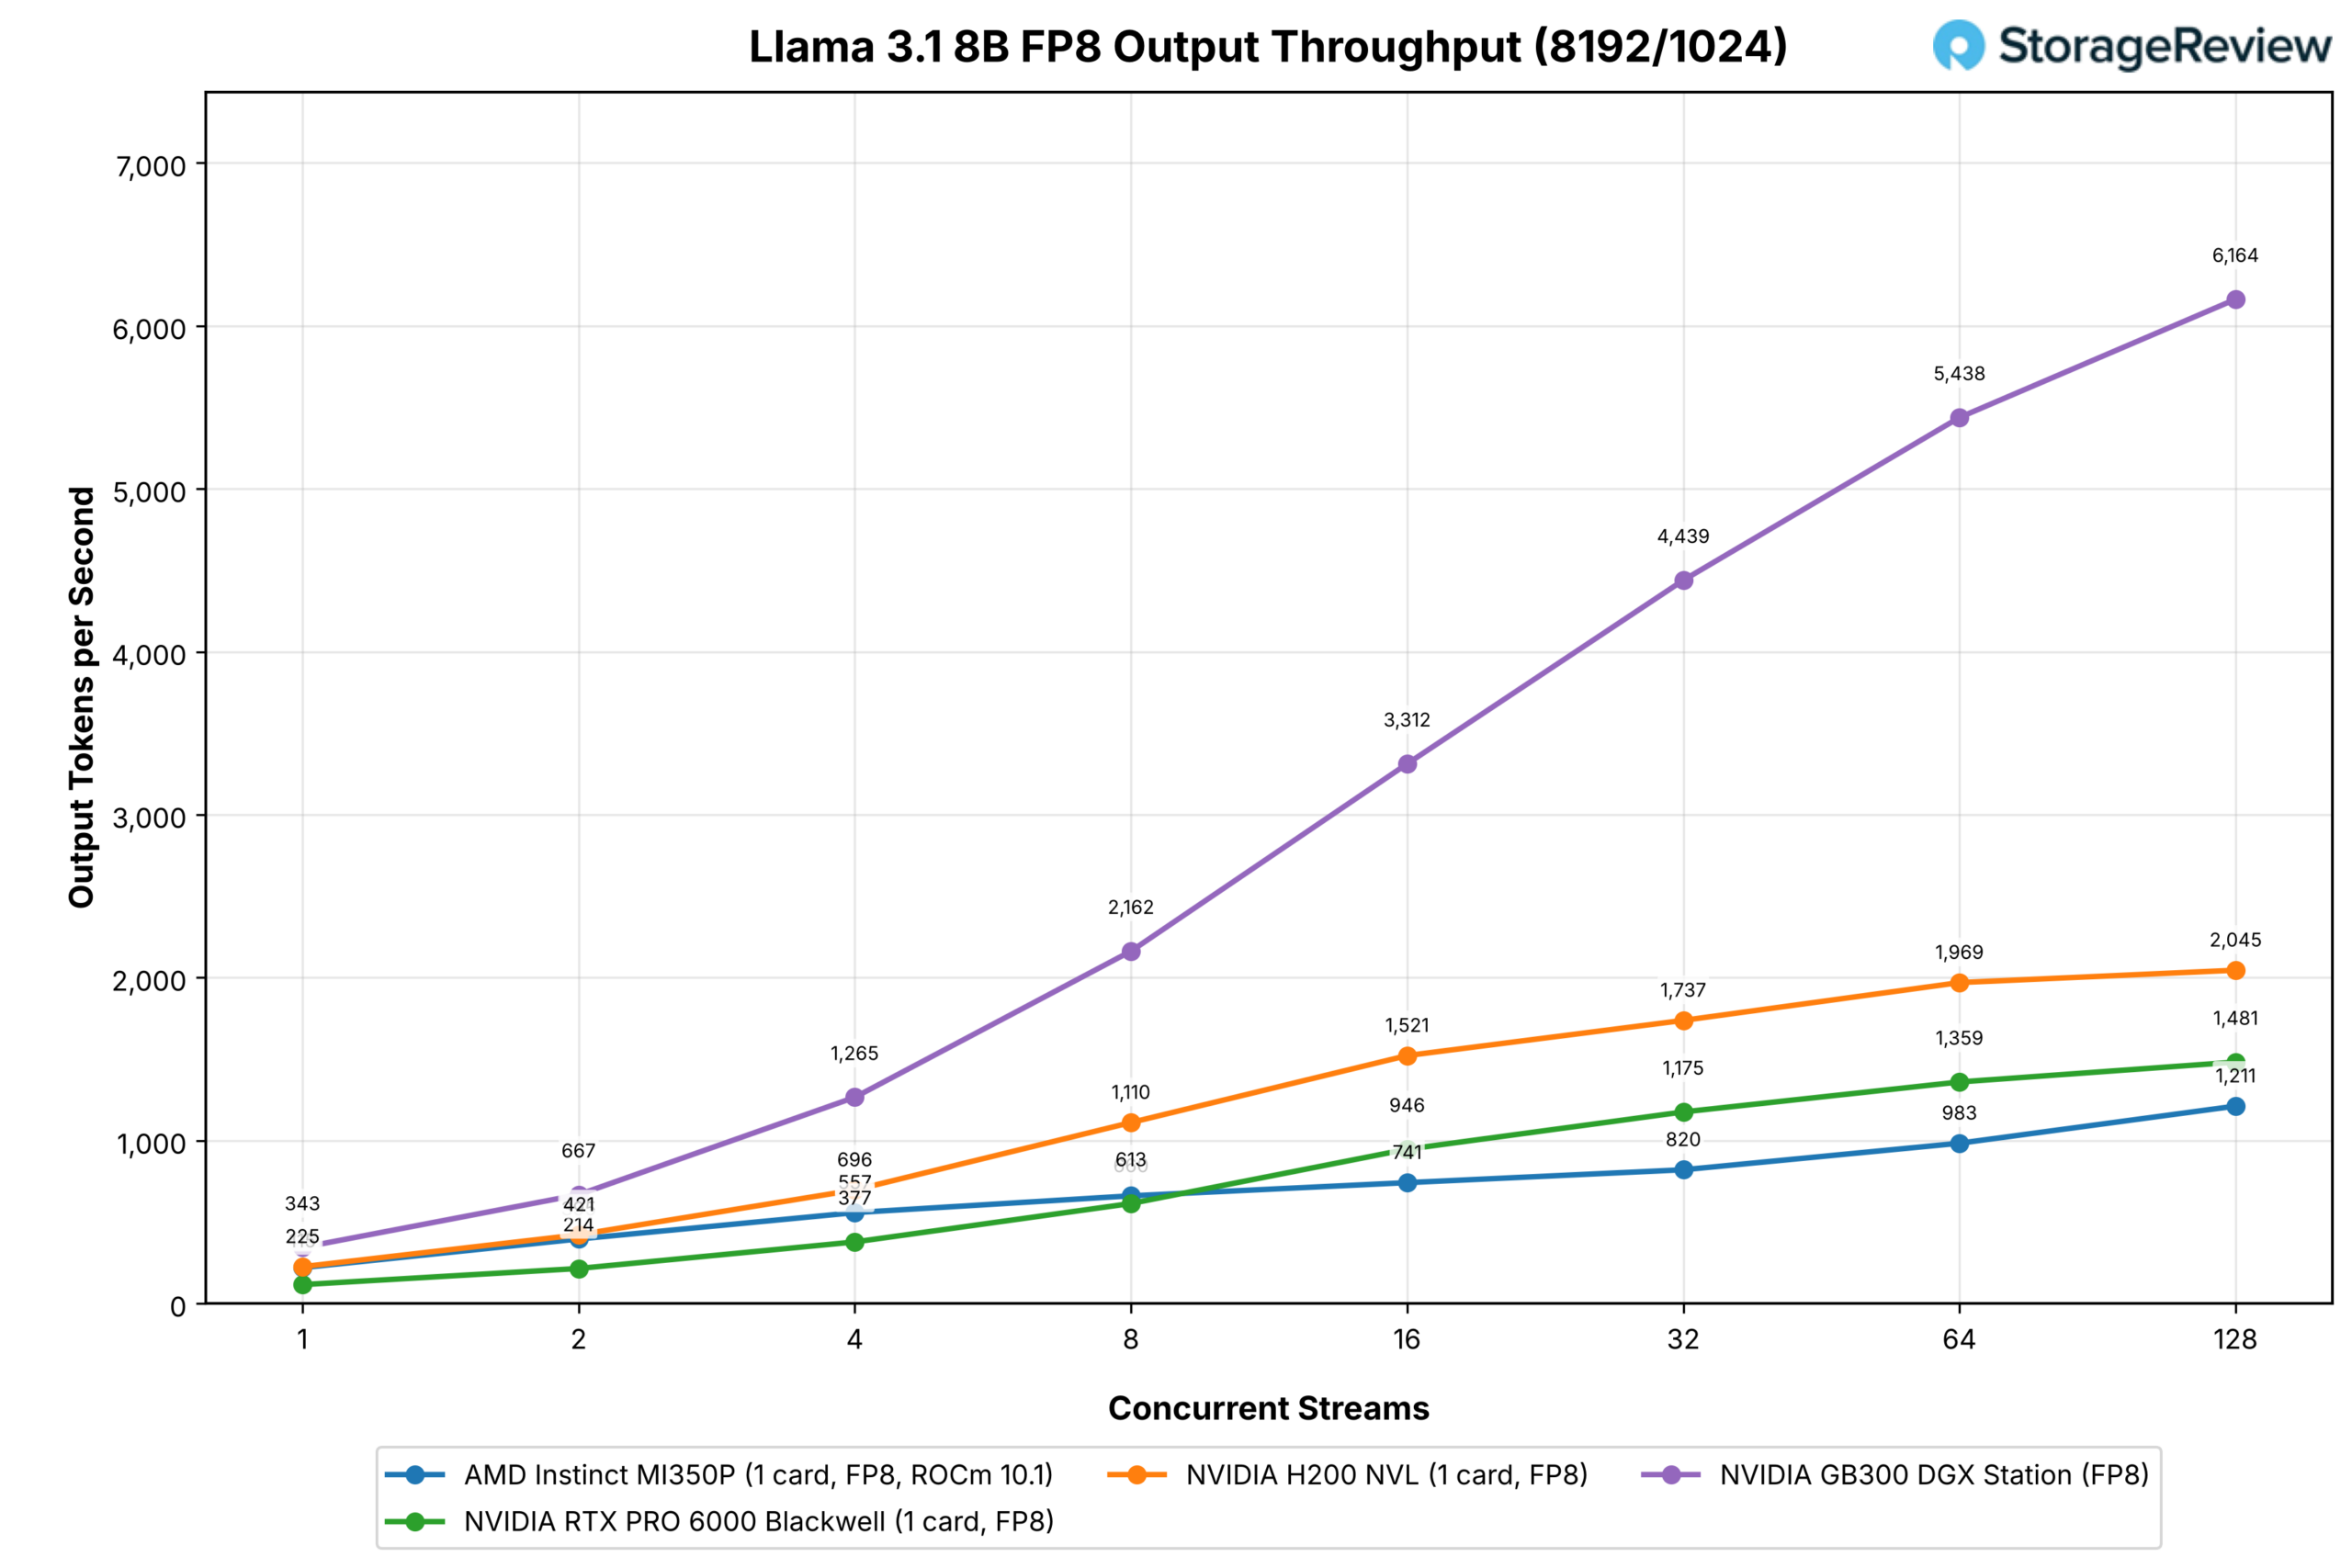
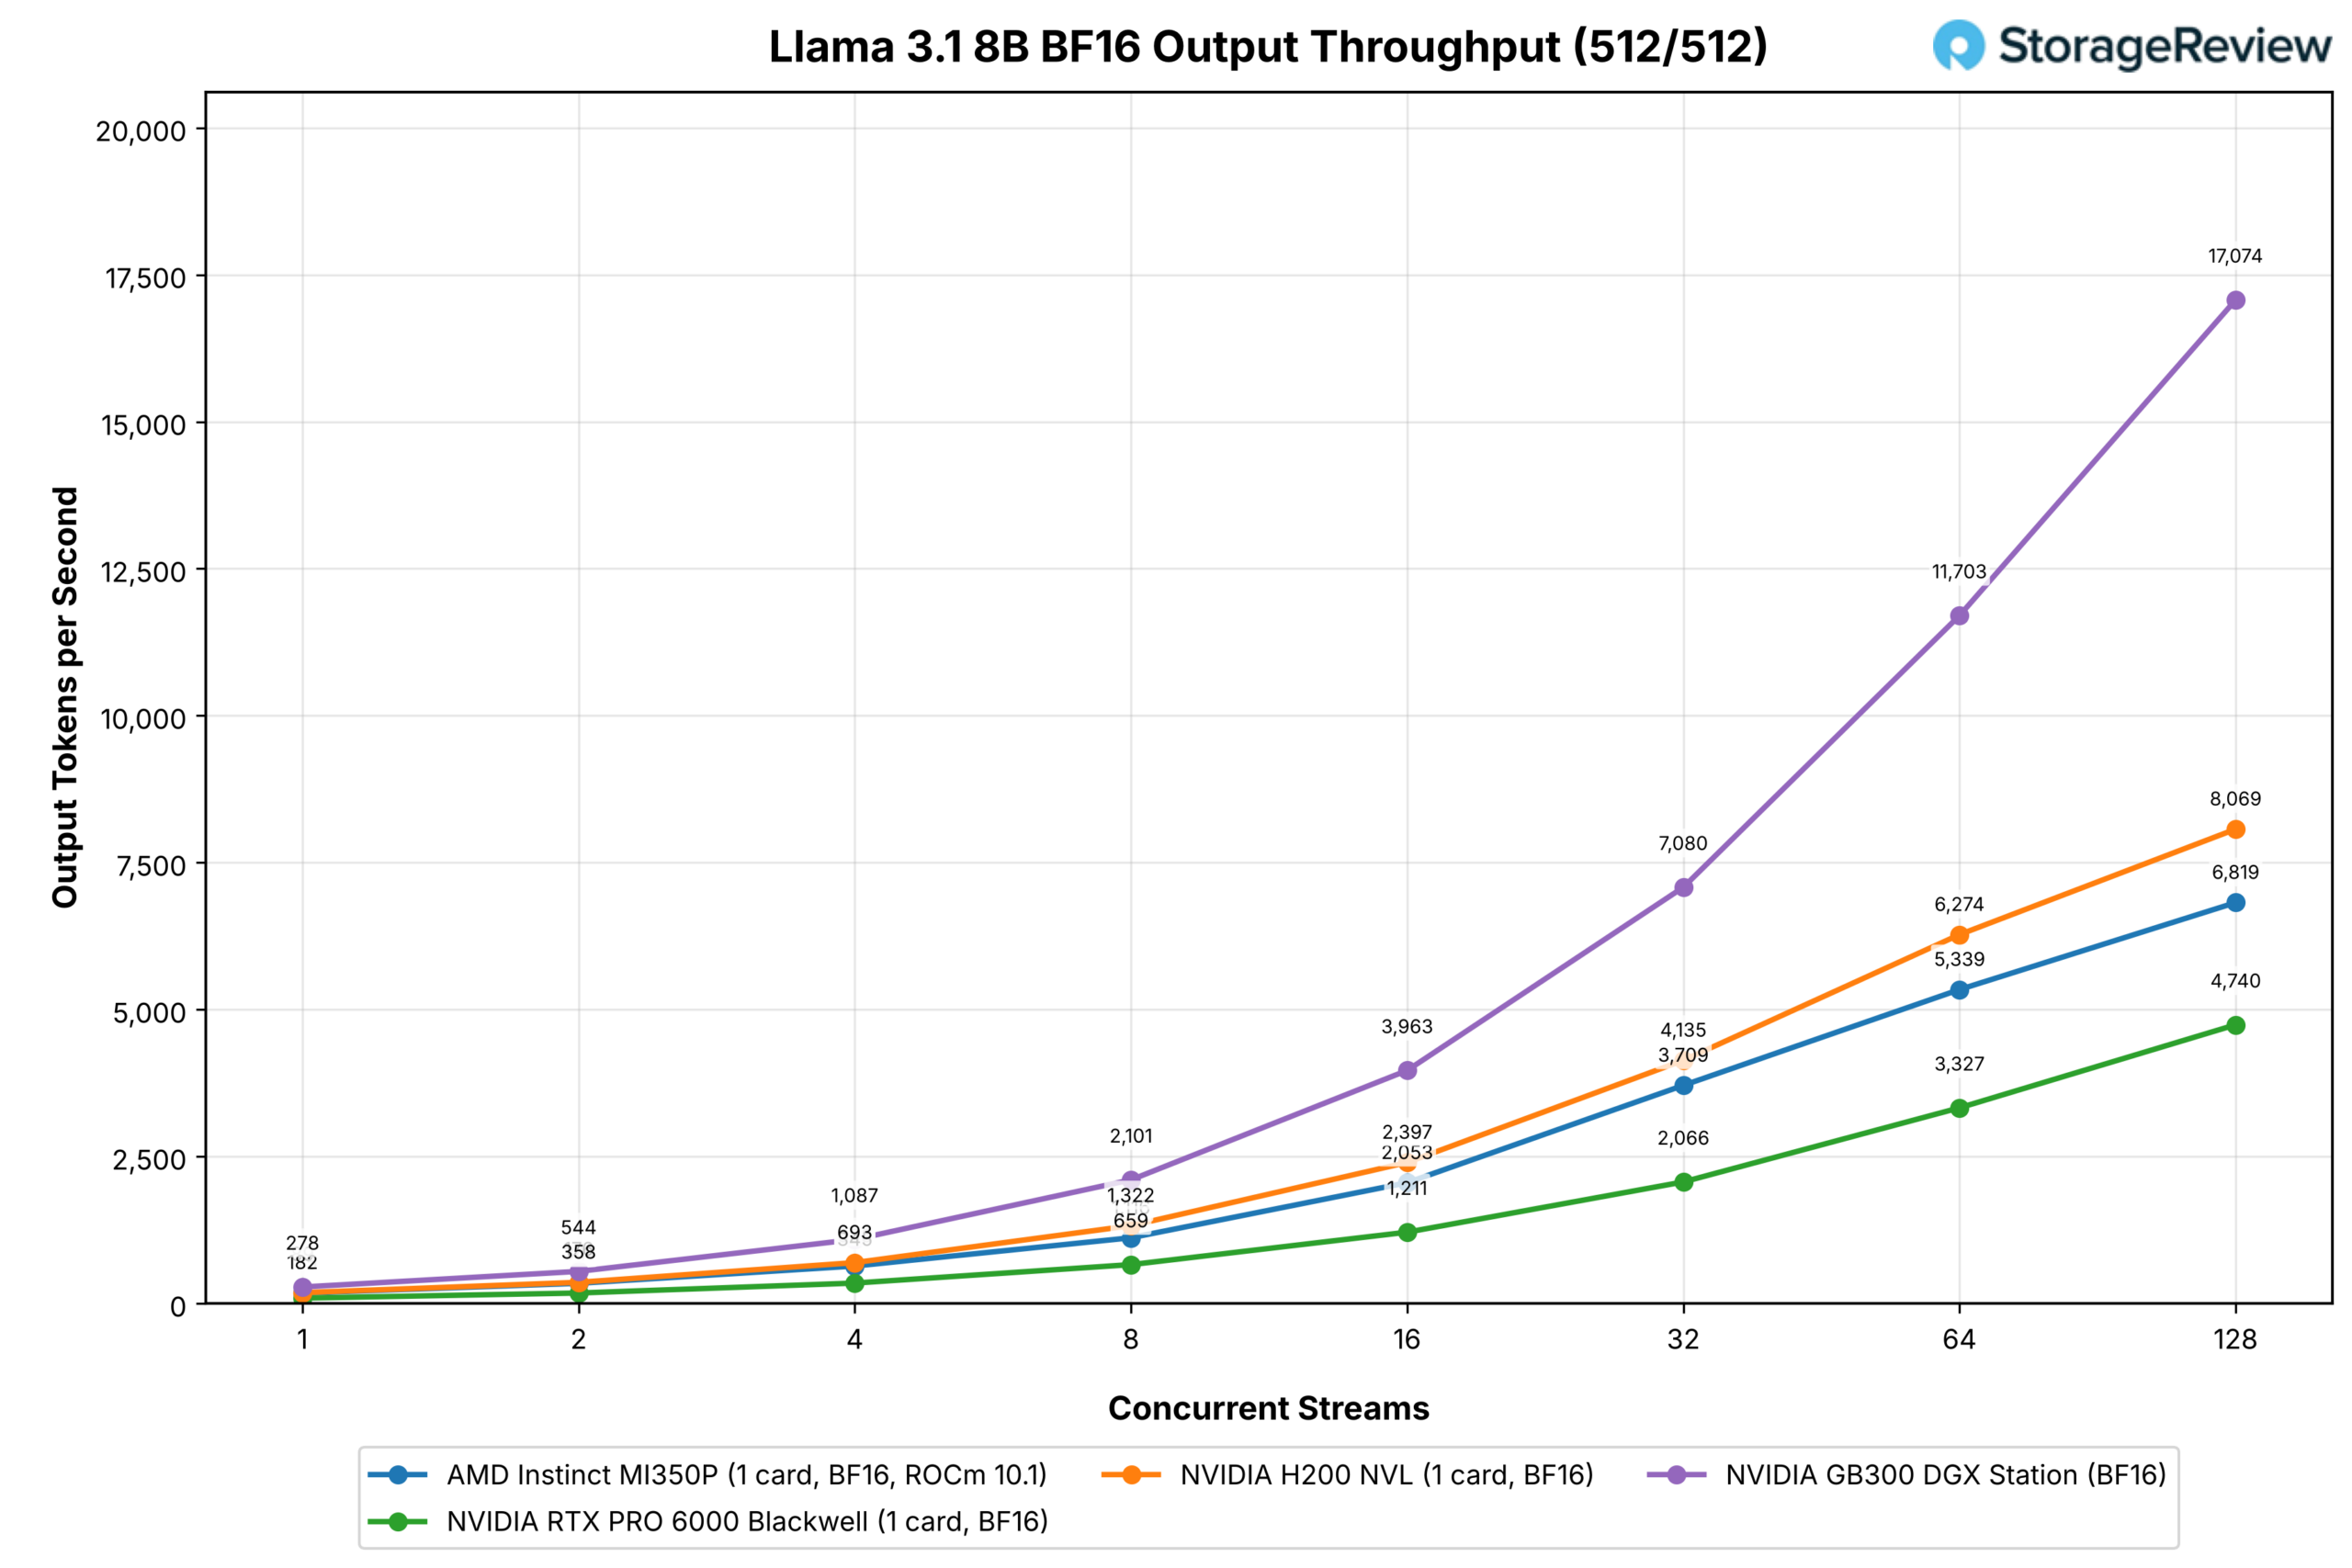
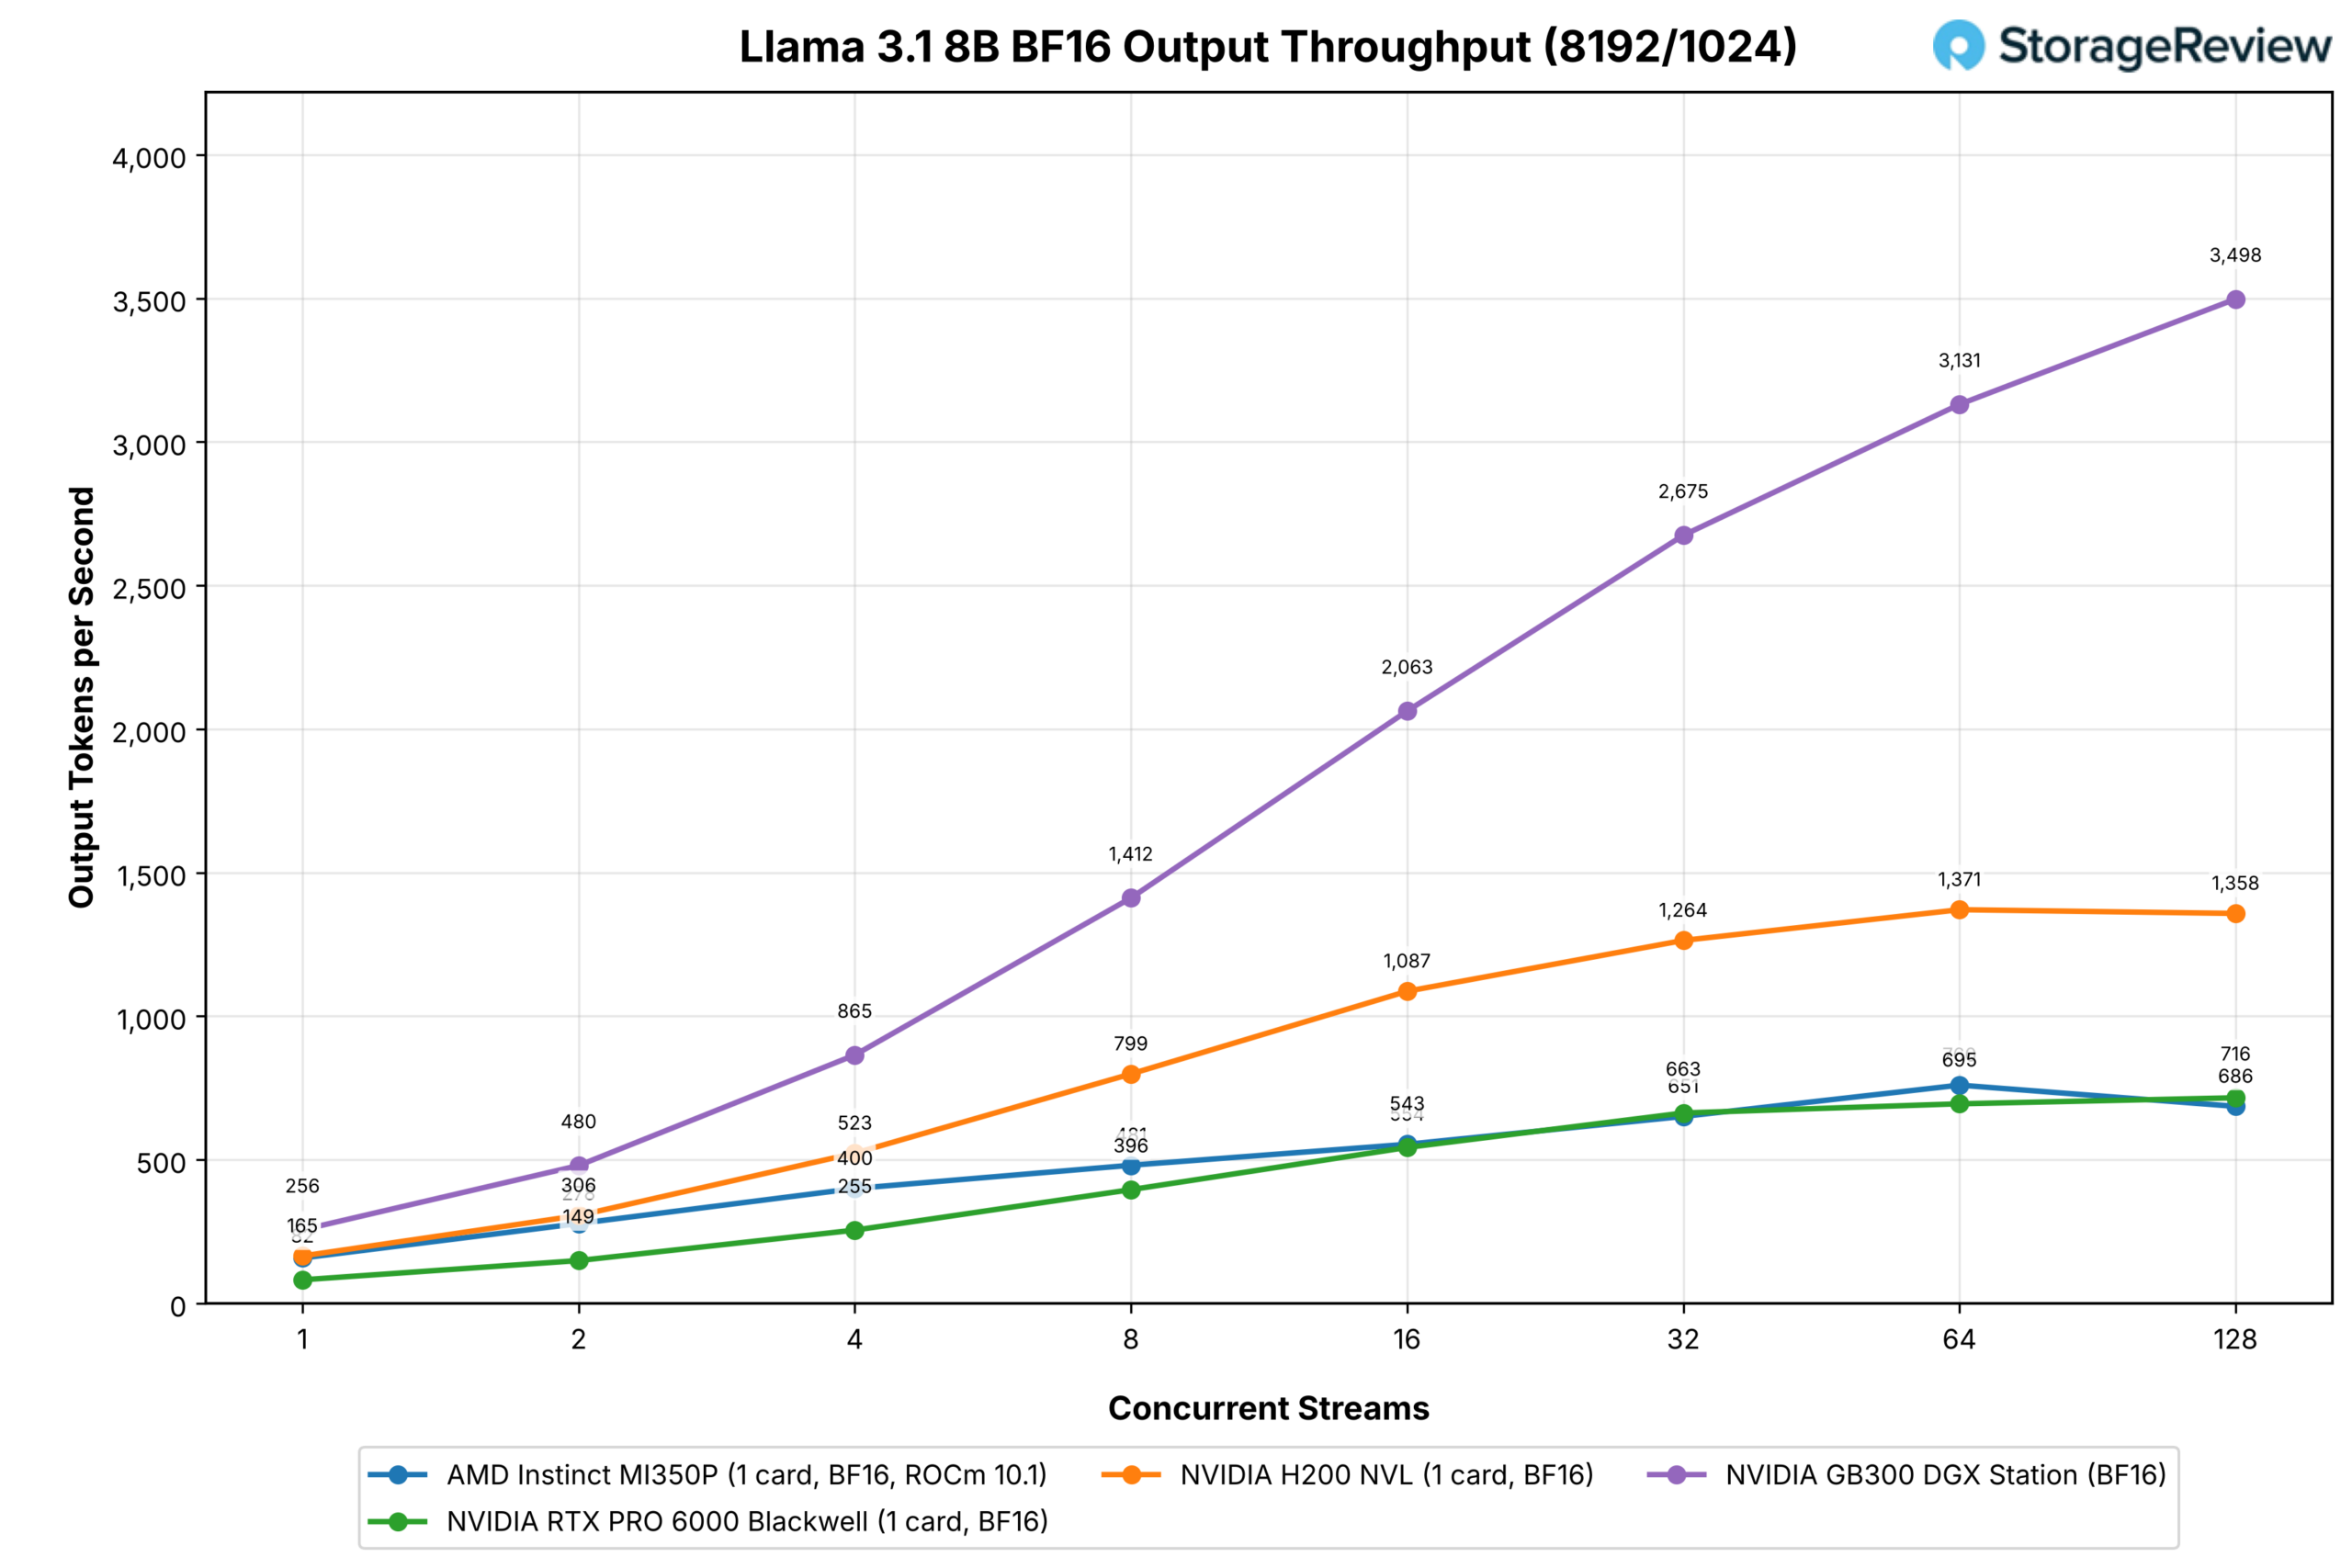
Llama 3.1 8B finns här för att skapa en kontinuitet med vår äldre GPU-täckning. Med 128 strömmar på chattarbetsbelastningen levererar MI350P 11 045 utdatatokens per sekund på FP8 mot 8 073 för RTX PRO 6000 och 11 054 för H200, vilket är lika med Hopper-kortet, och 6 819 på BF16 mot 4 740 och 8 069. AMDs MXFP4-version når 8 383 vid 128 strömmar, 5 procent efter NVIDIAs NVFP4-version på RTX PRO 6000 (8 869), efter att ha lett den med 12 till 143 procent vid varje lägre strömräkning; vid en enda ström visar MXFP4-körningen 323 mot 133.
De körningar som kräver mycket förfyllning inverterar resultatet: MI350P FP8 planar ut med 16 strömmar och slutar på 1 211 mot 1 481 för RTX PRO 6000 och 2 045 för H200, trots att MI350P börjar 90 procent före RTX PRO 6000 vid en ström, och MXFP4-versionen ligger 41 procent efter NVFP4 vid 128 strömmar.
Slutsats
MI350P är det första Instinct-kortet på fyra år som placeras i en vanlig server, och med 450W i en 2U-låda håller det som en PCIe-accelerator: 144 GB HBM3E vid 4 TB/s, 1 120 TFLOPS FP8 och 2 228 blockskalad FP4 i MAMF mot 820 och 1 634 för RTX PRO 6000 Blackwell, och cirka 2.1 gånger NVIDIA-kortets användbara minnesbandbredd.

Jämfört med RTX PRO 6000 var MI350P snabbare på chattstora prompter på alla FP8-, BF16- och GPT-OSS-modeller, med 35 till 65 procent vid 128 strömmar, där HBM3E:s bandbredd och kapacitet slår ett 96 GB GDDR7-kort, och den leder på båda GPT-OSS-modellerna vid varje strömningsantal på båda promptformerna.
H200 NVL slog den fortfarande i de täta FP8- och BF16-testerna, med 4 till 18 procent vid 128 strömmar på chattprompter och med fler på långa prompter, med 20 procent mer bandbredd och ingen FP4-sökväg; på GPT-OSS slutade MI350P 50 respektive 78 procent före Hopper-kortet. De större modellerna är mindre stabila, eftersom fyra RTX PRO 6000 leder MI350P-paret på GLM-5.2 genom 16 strömmar, med 384 GB mot 288 GB och mer aggregerad bandbredd och beräkningskapacitet att använda.
MiniMax-M3 är närmare: de tre konfigurationerna håller sig inom 10 procent genom åtta strömmar på chattprompter, RTX-fyran leder vid 16, och MI350P-paret leder på långa prompter genom åtta strömmar. Per kort är MI350P:s uppmätta FP4-frekvens 36 procent högre än RTX PRO 6000:s, så fördelen är kortantalet. Dessa tvåkortsresultat finns på ROCm 7.2.3-stacken och kommer att köras igen på ROCm 10.1 tillsammans med 600W-testningen.
Vi kan ännu inte ge en definitiv uppfattning om MI350P utan att testa den till sin fulla potential vid 600W, vilket vi planerar att göra i en PowerEdge XE7745; Dell stöder åtta MI350P på 600W i det chassit. Vi har hört att AMD:s uppskattning för de extra 150W är cirka 10 procent mer prestanda.
AMD har kommit långt, och MI350/5X-serien visar hur kapabel arkitekturen är. Vi kör en MI300X-låda i vårt labb för utveckling, och tempot på programvarupaketet visade hur mycket av sviten som kördes på standard vLLM utan problem.
Med tanke på vad vi såg i den här installationen är MI350P för köpare som letar efter ett alternativ till NVIDIA-grafikprocessorer, antingen på grund av ledtider, prissättning eller för att undvika att förlita sig på en enda tillverkare, och Dells stöd för den i PowerEdge-serien ger den kiseldiversiteten hos mainstream-servrar som passar behovet.
För att vara rättvis är vårt arbete här långt ifrån klart. Även om många köpare kanske installerar dessa kort i 2U-servrar, finns det mer prestanda att vänta när de placeras i ett större chassi designat för 600W-kort. Oavsett hur de används är detta en utmärkt första titt på AMD:s återkomst till marknaden för tilläggskortsservrar, och i takt med att programvaruutvecklingen fortsätter att mogna har MI350P, och vad som kommer härnäst, en lovande framtid. Idag, för en köpare vars modeller finns i bandet 96 GB till 144 GB, är MI350P ett av två PCIe-kort som har en enda GPU, och det enda över 141 GB.
Topplista: AMD Instinct MI350P visas under Även testad på vår topplista för bästa företags-GPU: er, med sina resultat med två kort under Skalbara konfigurationer.



 Amazon