

Ollama 0.40.11 ger Windows-användare en chattapplikation på skrivbordet och en lokal modellkörningstid för annan programvara. Ollama har också gått bortom sitt ursprungliga kommandoradsgränssnitt och lagt till en sökbar modellväljare, bildbilagor och länkar till kodningsverktyg. Vissa kontroller vi behövde för testning finns fortfarande kvar i PowerShell och modellkonfigurationsfiler.
Vi installerade Ollama på vår HP Z4 Rack G5 med Windows 11 Pro för arbetsstationer, 128 GB RAM och ett NVIDIA RTX 5000 Ada Generation GPU. Med våra befintliga Jan V3.5 4B och Jan V2 VL High GGUF:er testade vi genereringshastighet, chatt, bilder, onlinesökning och det lokala API:et. Ollama körde våra lokala modeller bra, men importen av GGUF:erna och insamlingen av prestandadata tog oss bort från skrivbordschatten. Det är den tredje applikationen i vår lokala LLM-serie, efter Jan och Open WebUI , och resultaten ligger på vår sida om de bästa lokala LLM-verktygen .
Testsystem
| Komponent | konfiguration |
|---|---|
| Operativ system | Windows 11 Pro för arbetsstationer |
| CPU | Intel Xeon w5-2465X, 16 kärnor |
| Minne | 128GB |
| GPU | NVIDIA RTX 5000 Ada Generation |
| VRAM | 32 GB (32 760 MiB rapporterat) |
| NVIDIA Driver | 597.06 |
| CUDA-kompatibilitet | 13.2 (rapporterat av nvidia-smi) |
| Ollama | 0.40.11 |
| Inferenskörning | Ollama llama.cpp runner (byggnummer ej registrerat) |
Installera Ollama och komma igång
Att installera Ollama på vår Windows-arbetsstation var en välkommen förändring från en del av installationsproblemen vi stötte på med andra program i den här serien. Vi laddade ner standardinstallationsprogrammet för Windows, startade programmet och behövde inte installera en separat inferenskörning eller spåra CUDA-paket. En snabb PowerShell-kontroll bekräftade att Ollama 0.40.11 kördes och att dess lokala tjänst redan svarade på http://127.0.0.1:11434.
Ollamas välkomstskärm introducerar dess lokala AI-funktioner och kopplingar till kodningsverktyg innan huvudgränssnittet öppnas.
När vi hade passerat välkomstskärmen öppnades Ollama till ett välbekant chattgränssnitt med senaste konversationer, appar och inställningar i den vänstra sidofältet. Meddelandefältet håller bifogad fil, webbsökning och modellväljare samlade. Vi kunde börja chatta med våra importerade lokala modeller utan att skapa ett konto, även om Ollama bad oss att logga in när vi senare försökte aktivera webbsökning under testningen.
Bläddra bland och lägga till modeller
Ollama håller modellvalet ganska enkelt, med en rullgardinsmeny som visar både installerade modeller och andra tillgängliga för nedladdning. Vi kunde se våra importerade Jan-modeller och Qwen3-VL tillsammans med flera molnbaserade alternativ, vilka identifierades med en liten molnikon. Det finns också ett sökfält för att hitta andra modeller, även om vi skulle ha velat se mer information här, såsom modellstorlekar, kvantisering och hårdvarukrav. Jan tillhandahåller dessa detaljer via sin modellhubb, medan Ollama håller det mesta av den informationen borta från huvudchattgränssnittet.
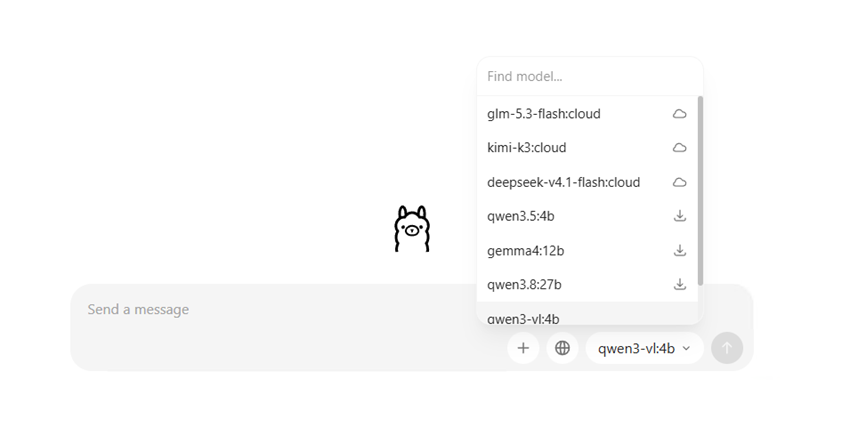
Modellväljaren sammanför nedladdningsbara och molnbaserade modeller med de installerade lokala modellerna.
Att få in våra två benchmarkmodeller i Ollama krävde mer arbete eftersom vi ville använda exakt samma GGUF-filer från våra tidigare recensioner, för att hålla prestandatesterna så jämförbara som möjligt. Medan Ollama låter dig ladda ner modeller direkt via sitt skrivbordsgränssnitt, kunde vi inte hitta ett alternativ för att importera GGUF-filer som redan lagrats på arbetsstationen. Vi var tvungna att använda PowerShell istället och skapa en modellfil för varje modell som pekade på dess befintliga GGUF och inkluderade samplingsparametrarna som användes i våra tidigare tester. Vi använde sedan ollama create kommandot för att lägga till dem i Ollamas modellbibliotek.
Båda importerna fungerade utan problem, med Jan V3.5 som visades jan-v35-sr och Jan V2 VL High som jan-v2-srVi laddade också ner Qwen3-VL 4B direkt via Ollama för ett separat bildanalystest.
Efter att ha importerat modellerna kontrollerade vi hur Ollama identifierade dem och om deras inställningar hade överförts korrekt. Jan V2 VL High kändes igen som en Qwen3-VL-modell med 8.2 miljarder parametrar med hjälp av Q4_K_M-kvantisering, vilket matchade vår originalfil. Jan V3.5 var undantaget, eftersom den GGUF vi importerade fick namnet Jan-v3.5-4B-Q4_K_XL.gguf, men Ollama rapporterade dess kvantisering som Q4_K_M. Vi lämnade originalfilen oförändrad; den troliga anledningen är att Q4_K_XL är Unsloths dynamiska kvantisering, mestadels byggd från Q4_K_M-lager, och filens metadata registrerar den bastypen.
Modellinställningar och GPU-användning
Ollamas inställningssida inkluderar molnåtkomst, automatiska uppdateringar, nätverksåtkomst, en modelllagringssökväg och en skjutreglage för kontextlängd, som visade 32K när vi först granskade den. Våra prestandatester begärde uttryckligen 8 192 tokens via API:et, så benchmarkresultaten nedan använde den kontexten, inte skrivbordets standard.
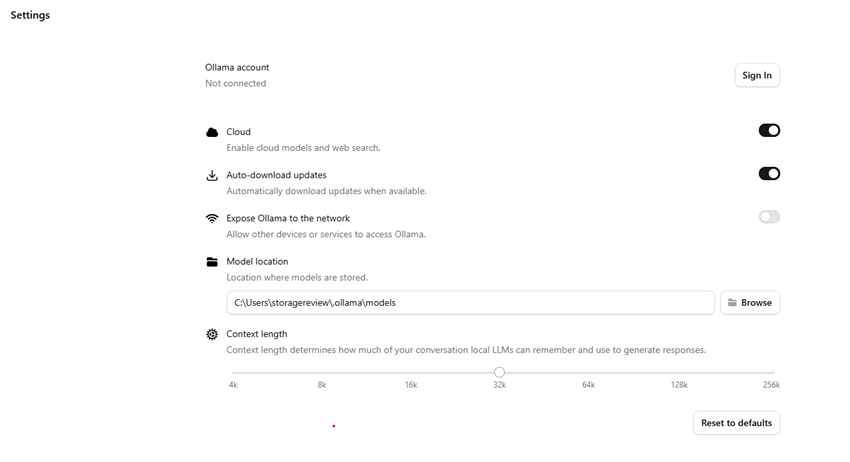
Inställningssidan erbjuder alternativ för moln, uppdatering, nätverk, modelllagring och kontextlängd. Den ursprungliga kontextinställningen som visas här var 32K.
Eftersom Ollama inte erbjuder samma nivå av modellkonfiguration via sitt skrivbordsgränssnitt som Jan, gjorde vi de flesta justeringar via Modelfiles och API-förfrågningar. För att hålla våra riktmärken jämförbara använde vi samma inställningar som i våra tidigare tester: temperatur 0.8, Top K 40, Top P 0.95, Min P 0.05 och en repetitionsstraff på 1.0. Vi begärde också en batchstorlek på 2 048, men vi kunde inte oberoende verifiera om Ollama tillämpade den under genereringen.
GPU-konfigurationen var också annorlunda, eftersom det inte fanns någon skrivbordsinställning motsvarande de 100 GPU-lager vi använde i januari. Ollama hanterade GPU-avlastning automatiskt, och en snabb kontroll med ollama ps bekräftade att båda importerade modellerna kördes helt på RTX 5000 Ada.
Vi verifierade den rapporten mot NVIDIAs egna avläsningar. Jan V3.5 ökade VRAM-allokeringen med flera gigabyte efter laddning, och en live-avläsning nådde 93 procents GPU-utnyttjande under genereringen. Jan V2 rapporterade också full GPU-residentitet och visade 96 procents utnyttjande i vår diagnostikkörning. Åtminstone på den här arbetsstationen behövde vi inte arbeta igenom en separat CUDA-variant eller GPU-lagerinstallation för att få accelererad generering.
Lokal generations prestanda
För generationstestning använde vi samma uppmaning från vår publicerade hands-on från januari : ”Förklara RAID 5 och RAID 6 för någon som bygger sin första NAS. Inkludera de viktigaste fördelarna och nackdelarna med var och en, med cirka 400 ord.” Vi inaktiverade webbsökning, satte kontexten till 8 192 tokens och inkluderade endast det enskilda användarmeddelandet i varje API-förfrågan. Vi ignorerade ett uppvärmningssvar per modell och samlade sedan in tre mätkörningar.
Båda modellerna genomförde alla tre uppmätta körningar utan genereringsfel, och GPU-utnyttjandet förblev högt under hela testningen. Ollama krävde ingen ytterligare CUDA-konfiguration eller manuella GPU-lagerjusteringar för att få båda modellerna att köras med full GPU-acceleration, vilket inte var fallet i Open WebUI, där vi lade till CUDA runtime-DLL:er manuellt.
| Modell | kvantisering | Output tokens | Avkodningshastighet | GPU-minne |
|---|---|---|---|---|
| Jan V3.5 4B | Q4_K_XL-fil* | 529 | 145.48 tok/s | 5,082 MiB |
| Jan V2 VL Hög | Q4_K_M | 1,696 | 92.87 tok/s | 7,124 MiB |
Obs: Antal utdatatokens, avkodningshastigheter och GPU-minnesvärden är medianvärden för tre uppmätta körningar efter en kasserad uppvärmningskörning. GPU-minne är medianvärdet för den maximala GPU-omfattande minnesanvändningen som registrerats under varje uppmätt körning.
*Filnamnet för Jan V3.5 GGUF identifierar Q4_K_XL, medan Ollamas modellinformation rapporterar Q4_K_M; se importanteckningarna ovan.
Januari V3.5 registrerade 145.48, 145.73 och 145.44 tokens/sek över sina uppmätta körningar, medan Januari V2 registrerade 92.87, 92.22 och 92.97 tokens/sek. Båda uppsättningarna låg nära varandra från körning till körning, och de uppmätta GPU-minnestopparna var oförändrade inom varje uppsättning. Januari V2 producerade betydligt fler rapporterade utdatatokens, tydligen inklusive resonemangsaktivitet, så dessa totaler är inte en direkt jämförelse av synlig svarslängd.
På samma arbetsstations- och modellfiler är det de snabbaste resultaten i den här serien hittills. Jan V3.5 avkodade 18 procent snabbare än i själva Jan (123 tokens/sek) och 26 procent snabbare än i Open WebUI Desktop (115.32), och Jan V2 låg 13 procent före Jan (82) och 24 procent före Open WebUI (75.06). Varje applikation kör sin egen llama.cpp-version och hanterar GPU-avlastning på sitt eget sätt, så jämförelsen återspeglar hela paketet som varje applikation levererar, inte bara modellen.
Vi publicerade inte medianvärden för promptbearbetning eftersom upprepade förfrågningar gav mycket korta tider som cachning kan ha påverkat. Inte heller kan körtidsinställningarna vara identiska i alla avseenden: Jan exponerade GPU-lager direkt, medan Ollama hanterade avlastningen automatiskt.
Använda Ollama för lokal chatt
Med modellerna installerade valde vi Jan V3.5 eller Jan V2 från rullgardinsmenyn och öppnade RAID-prompten. Svaren visades med rubriker och listor, medan de senaste konversationerna stannade kvar i sidofältet. Ollama visade inte genereringshastighet eller antal tokens under svaren, så vi samlade in dessa siffror via dess API.
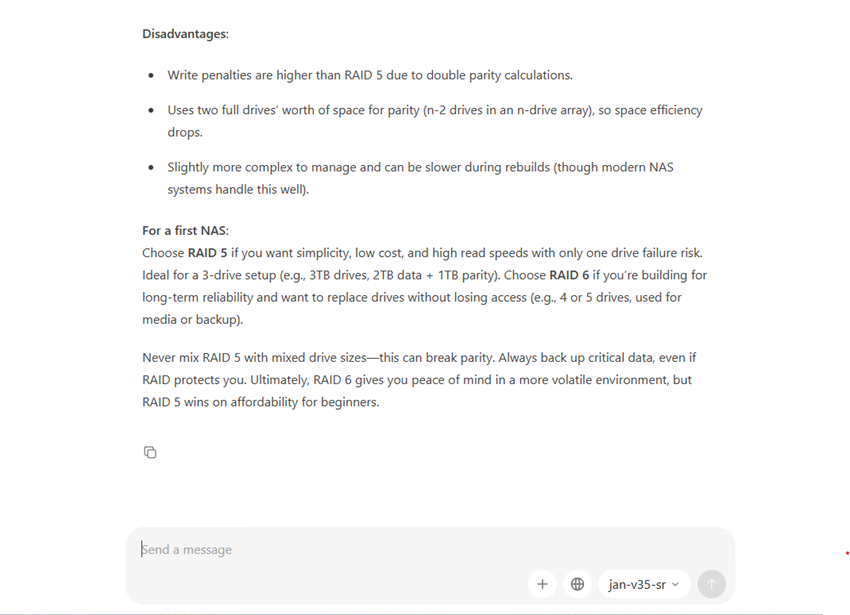
Jan V3.5 besvarar frågan om RAID 5 kontra RAID 6 i Ollamas skrivbordschatt, utan att någon token-hastighet visas under svaret.
Att hantera konversationer i Ollama var enkelt nog, eftersom högerklick på en tidigare konversation gav upp alternativ för att byta namn på eller ta bort den, med ett Dela-alternativ tillgängligt under Fler verktyg. Vi kunde också gå tillbaka och redigera prompter vi redan hade skickat, även om det inte fanns lika många alternativ för modellens svar. Den enda knappen vi hittade var Kopiera, som förblir synlig under varje svar även när du inte håller muspekaren över det. Vi kunde inte hitta ett sätt att generera ett svar eller visa dess genereringsstatistik från chattfönstret, åtminstone inte i den version vi testade.
Ollama har också en App-sektion med kodningsassistenter, inklusive Codex CLI, Claude Code, OpenCode och Cline. Vi ville se hur dessa integrationer fungerade, så vi klickade på Codex CLI för att se vad installationen innebar. Ollama öppnade inte en konfigurationsskärm; den kopierade ett startkommando till urklippet och bad oss klistra in det i en terminal. Vi slutförde inte hela installationen eller körde Codex, men det gav oss en bättre uppfattning om hur Ollama kopplar lokala modeller till externa applikationer.
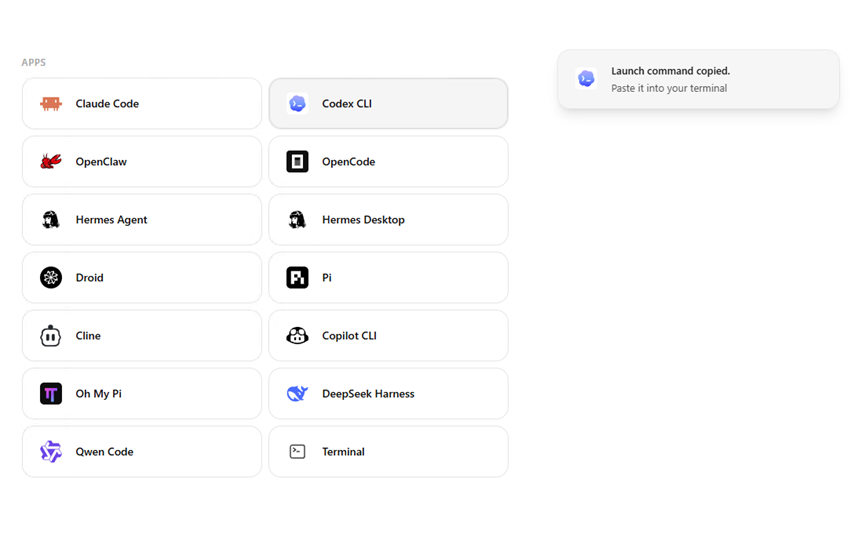
Genom att välja Codex CLI på appsidan kopierades ett startkommando för terminalen; vi körde inte själva integrationen.
Webbsökning
Ollama placerar en jordglobsknapp bredvid bilagekontrollen i chatten, men om man väljer den visas ett meddelande om att webbsökning kräver ett Ollama-konto. Efter att ha registrerat ett gratis konto och aktiverat funktionen använde vi vår befintliga testfråga som frågade efter den senaste stabila Open WebUI-versionen från och med den 15 oktober 2026, med en källhänvisning.
Vi stötte på ett annat problem när vi testade Ollamas webbsökningsfunktion: applikationen försökte hämta resultat men returnerade istället meddelandet "search API error (status 402)". HTTP 402 är koden "Payment Required", vilket antyder att söktjänsten behöver en betald plan, även om Ollama inte sa det. Modellen föreslog att problemet kunde vara relaterat till kontopriser eller användningsgränser, men vi kunde inte fastställa den exakta orsaken. Eftersom våra lokala modeller fungerade normalt bestämde vi oss för att inte lägga mer tid på att felsöka söktjänsten. Det var fortfarande en besvikelse att vi inte kunde slutföra samma webbsökningstest som vi hade försökt med de andra applikationerna i den här serien.
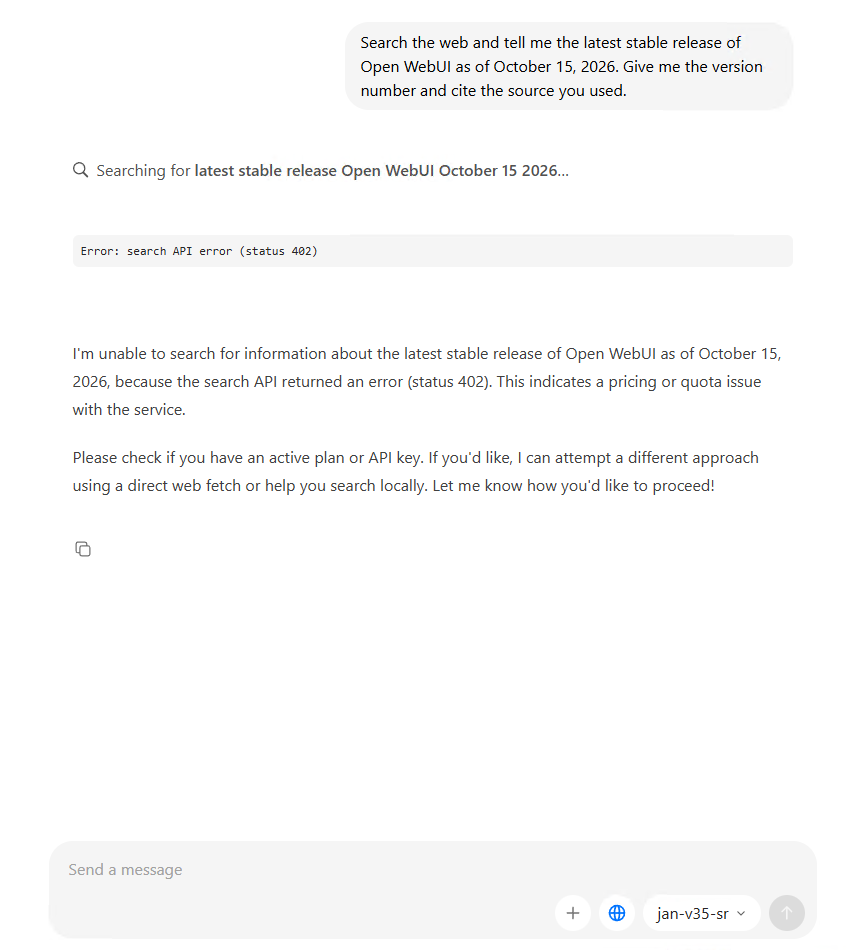
Ollama försökte göra vår onlineversionsfråga men returnerade ett HTTP 402-fel från sök-API:et.
Multimodal ingång
Vårt första bildtest använde samma Jan V2 VL High GGUF som fungerade med en separat bildprojektor i januari. Ollama accepterade språkmodellfilen, men vår importprocedur associerade inte den medföljande mmproj-filen. När vi försökte bifoga NVIDIA-skärmdumpen till en Jan V2-konversation visade skrivbordsapplikationen "Denna modell stöder inte bilder" innan vi kunde skicka prompten.
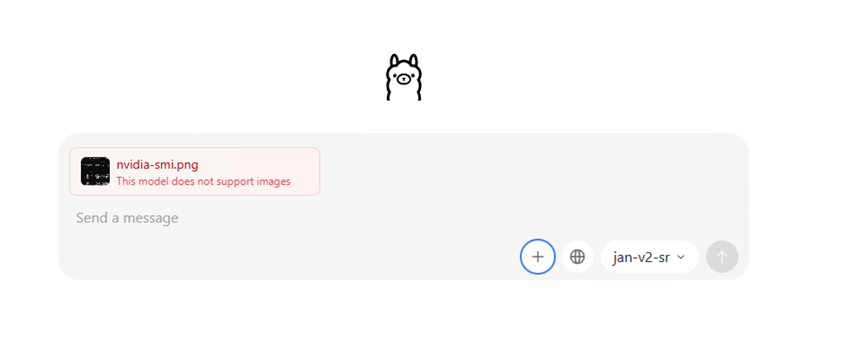
Vår importerade Jan V2 VL High-modell avvisade NVIDIA-skärmdumpen och rapporterade att den inte stödde bilder i den här konfigurationen.
Vi testade sedan Qwen3-VL 4B, som laddats ner via Ollama, med samma prompt som frågade efter GPU-modell, drivrutinsversion, VRAM, användning, temperatur och effekt. Den modellen accepterade skärmdumpen och slutade med de korrekta sex värdena: RTX 5000 Ada Generation, drivrutin 597.06, 32 760 MiB, 0 procents användning, 39C och 40W. Dess respons var inte perfekt rakt igenom, eftersom den kort visade en felaktig användningsavläsning på 8 procent innan den korrigerade det värdet i den slutliga sammanfattningen.
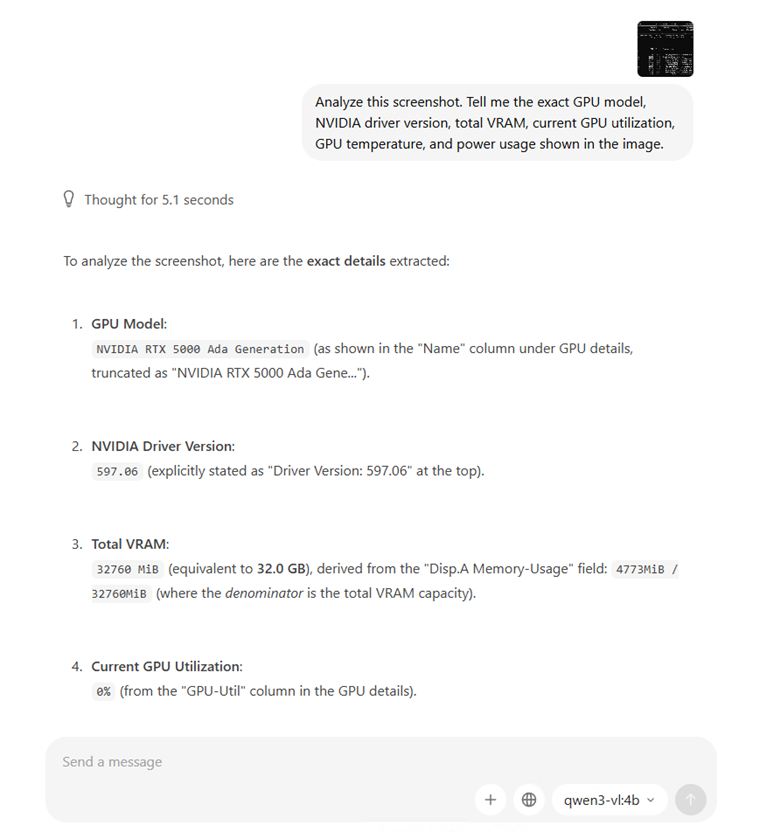
Ollamas Qwen3-VL 4B bearbetade den bifogade NVIDIA-skärmdumpen och identifierade hårdvarudetaljerna; den slutliga sammanfattningen gav alla sex avläsningar korrekt.
I Ollama kunde vi inte klistra in en bild direkt från Windows Snipping Tool i chattfönstret som vi kunde med de andra programmen. Istället var vi tvungna att spara skärmdumpen först och sedan ladda upp den med hjälp av +-knappen bredvid meddelandefältet. Det fungerade utan problem, och Ollamas Qwen3-VL-modell analyserade bilden framgångsrikt. Vår importerade Jan V2-modell kunde inte acceptera samma bilaga, vilket begränsade vår möjlighet att upprepa det ursprungliga multimodala testet.
Lokal API-server
Ollamas lokala API var tillgängligt så snart dess Windows-tjänst startade, utan att en separat server behövde startas från skrivbordsgränssnittet. En begäran till http://127.0.0.1:11434/v1/models returnerade våra installerade Jan V3.5- och Qwen3-VL-modeller, och en begäran om att /v1/chat/completions Med hjälp av Jan V3.5 genererades en förklaring på en mening av RAID 6.
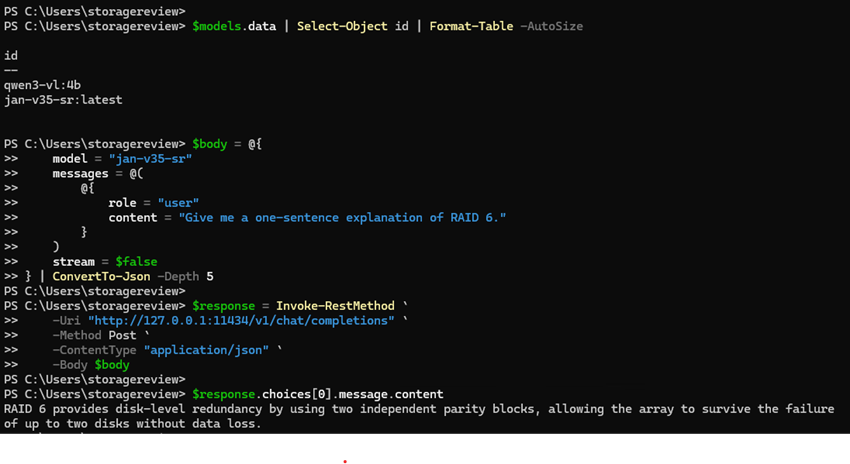
Det OpenAI-kompatibla lokala API:et returnerade Ollamas lista över installerade modeller och ett RAID 6-chattsvar via PowerShell.
Svaret använde något oprecisa RAID 6-paritetsformuleringar, vilket var ett problem med modellens utdata, inte ett API-fel. Den fungerande slutpunkten gjorde det möjligt för oss att fråga lokala modeller direkt från PowerShell utan att använda skrivbordschatt.
Vad gick fel
Det mest frustrerande problemet vi stötte på var att få vår importerade Jan V2 VL High-modell att fungera med bilder. Vi hade inga problem med att importera GGUF eller köra textmeddelanden med full GPU-acceleration, men saker och ting förändrades när vi försökte bifoga vår NVIDIA-skärmdump. Ollama berättade för oss att modellen inte stödde bilder eftersom vår import inte inkluderade den separata bildprojektorn som Jan V2 kräver. Vi kunde fortfarande slutföra bildanalystestet med hjälp av Ollamas Qwen3-VL-nedladdning, vilket fungerade utan problem. Detta visade att Ollama kunde bearbeta bilder, men att få vår befintliga Jan V2-modell att göra detsamma var inte lika enkelt som att importera dess GGUF-fil.
För att använda webbsökningsfunktionen var vi tvungna att skapa ett Ollama-konto innan vi kunde aktivera den. När vi väl hade loggat in och skickat in vår testfråga returnerade tjänsten ett HTTP 402-fel och inga sökresultat. Vi kunde inte avgöra vad som orsakade felet, och det fanns inte mycket anledning att fortsätta ändra kontoinställningar eller prova olika abonnemang utan att veta om det skulle hjälpa.
Vi märkte också hur ofta vi var tvungna att återvända till PowerShell för uppgifter som att importera våra befintliga modeller, justera deras inställningar och samla in prestandamätningar. Skrivbordsapplikationen var enkel att använda för daglig chatt, men den erbjöd inte samma kontrollnivå som vi hade genom Jans gränssnitt. Bortsett från dessa problem gav Ollama oss väldigt få problem under testningen: båda modellerna importerades utan problem, alla sex uppmätta benchmarkkörningar slutfördes och det lokala API:et fungerade som förväntat.
Slutsats
Våra tester med Ollama 0.40.11 gick generellt sett bra, särskilt att få lokala modeller att köras på RTX 5000 Ada. Båda våra importerade GGUF:er fungerade med full GPU-acceleration utan att kräva ytterligare CUDA-inställningar, och prestandan ledde serien, med Jan V3.5 som nådde en median på 145.48 tokens/sek och Jan V2 VL High som nådde 92.87 tokens/sek, de snabbaste resultaten i denna serie och 13 till 18 procent före Jan på samma arbetsstation. När allt var konfigurerat hade vi inga problem med att växla mellan skrivbordets chattgränssnitt och det lokala API:et, och alla uppmätta benchmarkkörningar slutfördes utan problem.
Även om vi gillade hur enkelt Ollama var för vardaglig chatt, hade vi föredragit mer kontroll över enskilda modeller i skrivbordsapplikationen. Att behöva använda PowerShell och skapa Modelfiles för att importera våra befintliga GGUF:er lade till några extra steg, särskilt jämfört med Jan, där de flesta av dessa inställningar är tillgängliga direkt i gränssnittet. Detta kommer inte nödvändigtvis att störa någon som redan är bekant med att köra lokala modeller, men nybörjare som vill hantera allt via ett grafiskt gränssnitt kan tycka att Ollama är begränsande. Vi stötte också på några problem med webbsökning och vår importerade visionsmodell, men ingetdera påverkade normal textgenerering.
Det vi gillade mest med Ollama var hur enkelt det kunde hantera lokala modeller i andra applikationer utan att vi behövde konfigurera en separat server. Skrivbordschatt är lätt att komma igång med, medan det lokala API:et och stödet för externa kodningsverktyg låter användare göra mycket mer än att bara chatta med lokala modeller. Vi skulle fortfarande vilja se bättre modellhanteringskontroller i skrivbordsgränssnittet, men Ollama presterade bra på vår arbetsstation och gav oss ett pålitligt sätt att köra båda våra testmodeller med GPU-acceleration.
Topplista: Ollama innehar bästa övergripande lokala LLM-körtid på vår sida om bästa lokala LLM-verktyg , där dessa resultat nu ligger bredvid våra siffror för januari och Open WebUI.


 Amazon