

Open WebUI kombinerar chatt, modellhantering, filer, webbsökning, verktygsanrop, bildstöd, kunskapsfunktioner och API-åtkomst i ett lokalt AI-gränssnitt. För denna praktiska granskning fokuserade vi på Windows-skrivbordsversionen och använde samma hårdvara och modellfiler från vår tidigare testning i januari v0.8.6 så att vi kunde jämföra de två applikationerna under liknande förhållanden.
Detta är den andra posten i vår topplista över bästa lokala LLM-verktyg , där vi lägger till repeterbara prestandaresultat från samma testhårdvara allt eftersom vi arbetar oss igenom plattformarna på listan.
Open WebUI är en öppen källkod, självhostad AI-plattform utformad för att ge lokala och fjärrstyrda AI-modeller ett webbläsarbaserat gränssnitt som ser ut och fungerar ungefär som de kommersiella AI-chatttjänster som folk redan är bekanta med. Den kan ansluta till olika inferensbackends och OpenAI-kompatibla tjänster, medan skrivbordsapplikationen vi testade kan köra GGUF-modeller lokalt genom den medföljande llama.cpp-miljön. Det ger den ett mycket bredare omfång än en grundläggande lokal chattapplikation, särskilt när verktyg, modellförinställningar, webbsökning, filer och API-åtkomst är aktiverade.
För testningen använde vi samma HP Z4 Rack G5- arbetsstation, NVIDIA RTX 5000 Ada Generation GPU och två Jan GGUF-modeller som användes i vår granskning av Jan v0.8.6. Vi behöll kontexten med 8 192 tokens, batchstorleken 2 048, GPU-lagerna 100 och matchande samplingsvärden för de uppmätta textkörningarna, samtidigt som vi använde Open WebUIs modellförinställningar, multimodal inmatning, DDGS-webbsökning, URL-hämtning och lokalt API.
Att få igång Open WebUI korrekt tog betydligt längre tid än vi förväntade oss, och det mesta av den tiden gick åt till den lokala llama.cpp- och CUDA-installationen innan vi ens nådde normal modelltestning. Vi fick så småningom allt att fungera, men längs vägen stötte vi på en trasig standardnedladdning i runtime, saknade CUDA-filer, extremt stora kontextallokeringar och några problem med det inbyggda verktygssystemet.
Testsystem
Vi behöll systemkonfigurationen oförändrad från våra tester i januari så att modellresultaten skulle vara enklare att jämföra mellan applikationer, samtidigt som vi registrerade de skrivbords-, server-, Python- och llama.cpp-versioner som användes för denna Open WebUI-körning.
| Komponent | konfiguration |
| Operativ system | Windows 11 Pro för arbetsstationer |
| CPU | Intel Xeon w5-2465X, 16 kärnor |
| Minne | 128GB |
| GPU | NVIDIA RTX 5000 Ada Generation |
| VRAM | 32 760 MB (31.99 GB) |
| NVIDIA Driver | 597.06 |
| CUDA-kompatibilitet | 13.2 rapporterad av nvidia-smi |
| Öppna WebUI-skrivbord/server | v0.0.20 / v0.12.2 |
| Python / llama.cpp | 3.12.13 / b11612, CUDA 12.4 |
Installera Open WebUI Desktop
Windows-skrivbordsinstallationsprogrammet börjar med en miljöinställningsskärm där llama.cpp kan installeras lokalt, Open Terminal kan aktiveras och installationsplatsen kan ändras under Avancerat. Vi lämnade Open Terminal inaktiverat, aktiverade llama.cpp, behöll standardmappen under Windows-användarprofilen och fortsatte med den lokala installationen.
När paketen och den medföljande Python-miljön var installerade bad Open WebUI oss att välja en anslutning och öppnade sedan det lokala webbläsargränssnittet. En ny installation visade Open WebUI som tillgänglig anslutning, följt av skärmen Skapa administratörskonto som etablerar den första lokala administratören innan huvudchattfönstret öppnas.
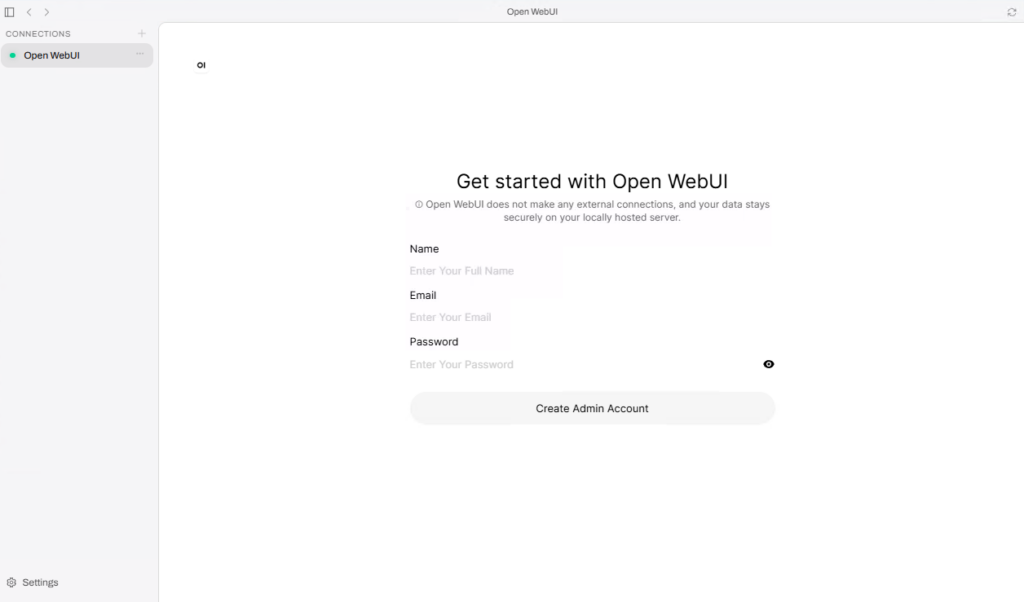
En ny lokal Open WebUI-installation frågar efter det första administratörskontot innan det huvudsakliga chattgränssnittet öppnas.
En detalj som kan vara förvirrande till en början är att Open WebUI Desktop och den lokala Open WebUI-servern använder separata versionsnummer. Vår slutliga installation använde Desktop v0.0.20 med Open WebUI-server v0.12.2, där servern kördes från den medföljande Python 3.12.13-miljön under Windows-användarens roamingprofil.
Lägga till modeller och konfigurera llama.cpp
Skrivbordsapplikationen separerar modellfiler från inferenskörningen, så sidan Modeller hanterar lokala GGUF:er medan Inferenskörningen styr llama.cpp. Vi kopierade in samma Jan V3.5 4B Q4_K_XL- och Jan V2 VL High Q4_K_M-filer som användes för våra tidigare tester, tillsammans med V2 multimodala projektionsfilen, och båda modellerna dök upp i väljaren efter att körningen var aktiv.
Det första runtime-problemet uppstod så fort vi försökte installera llama.cpp. Att lämna fältet Version senast med CUDA 12.4 valt orsakade att installationen misslyckades nästan omedelbart. En titt på skrivbordsloggen visade att Open WebUI hade löst den senaste versionen av llama.cpp v0.6.0 och försökte ladda ner ett Windows CUDA-arkiv som inte var tillgängligt under den versionen, så vi låste version b11612 och försökte igen.
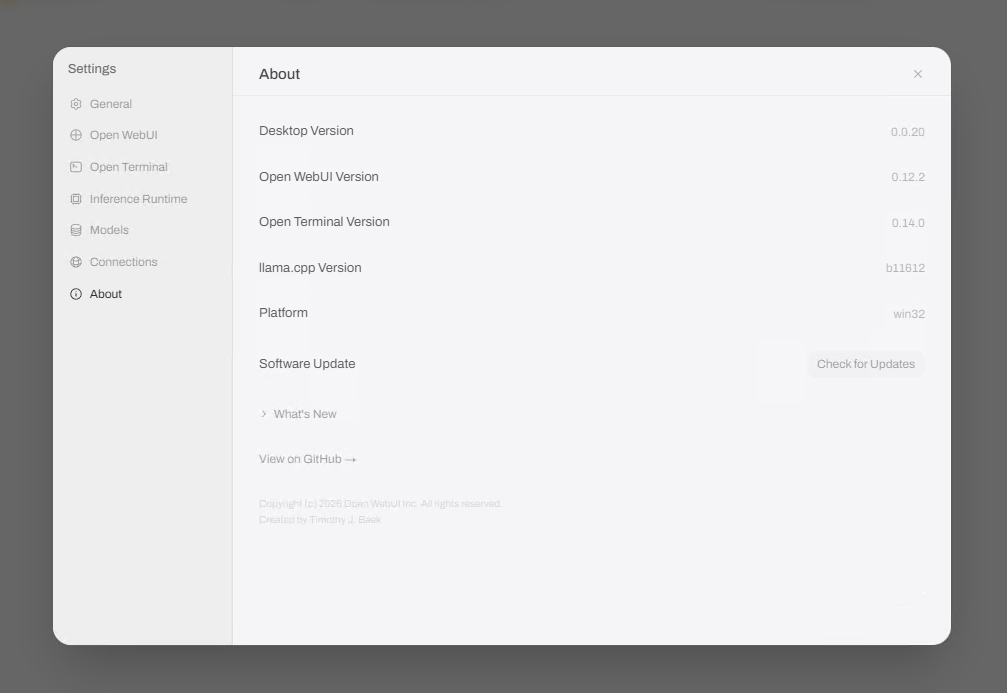
På sidan Om listas de separata versionerna av skrivbordet, Open WebUI, Open Terminal och llama.cpp som användes under testningen.
Det löste det första problemet, men llama.cpp startade fortfarande inte eftersom det separata CUDA runtime DLL-paketet inte hade laddats ner med huvudarkivet. Vi lade manuellt till cudart64_12.dll, cublas64_12.dll och cublasLt64_12.dll från det officiella CUDA 12.4-paketet till b11612-katalogen, varefter llama-server startade normalt på port 18881 och modellerna dök upp i chattgränssnittet.
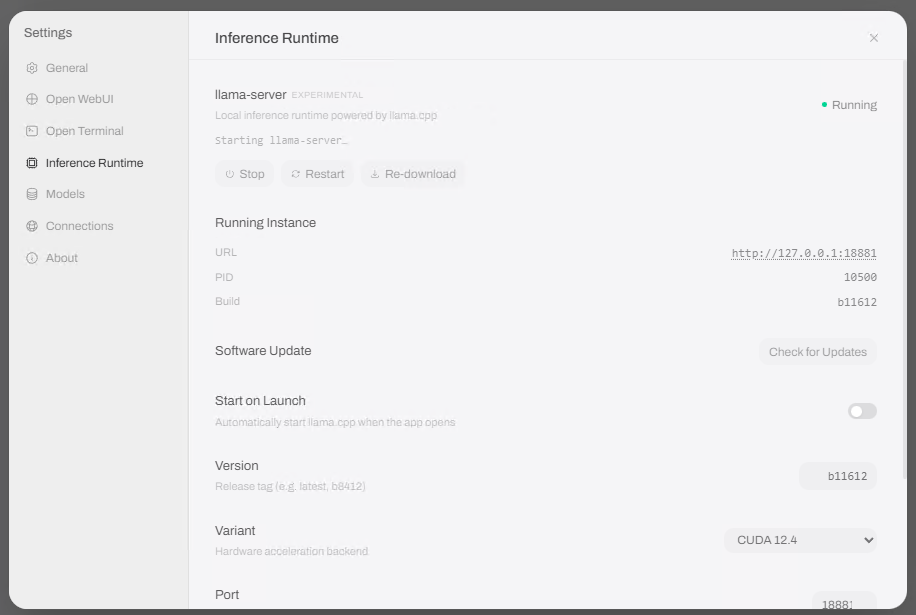
Efter att ha fäst build b11612 och lagt till de nödvändiga CUDA runtime-DLL:erna, kördes llama.cpp lokalt på port 18881.
Modellinställningar och GPU-användning
Open WebUI sprider sina modellinställningar över både skrivbordsapplikationen och det huvudsakliga webbgränssnittet, så det är lite av en inlärningskurva när man först börjar ändra saker. Skrivbordssidan täcker GGUF-filerna och llama.cpp-körtiden, medan huvudgränssnittet lägger till parametrar per chatt, förinställningar för arbetsytemodeller, funktioner, inbyggda verktyg, webbsökningsalternativ och serveradministration.
För våra uppmätta textkörningar använde llama.cpp en kontext med 8 192 tokens, batchstorlek 2 048 och 100 GPU-lager, med prompt cachning inaktiverad via –no-cache-prompt, så upprepad användning av samma benchmark-prompt skulle fortfarande producera en riktig förfyllningsmätning. Körtidsloggen bekräftade också att Open WebUI skickade det konfigurerade GPU-värdet till varje modellprocess som –n-gpu-layers 100.
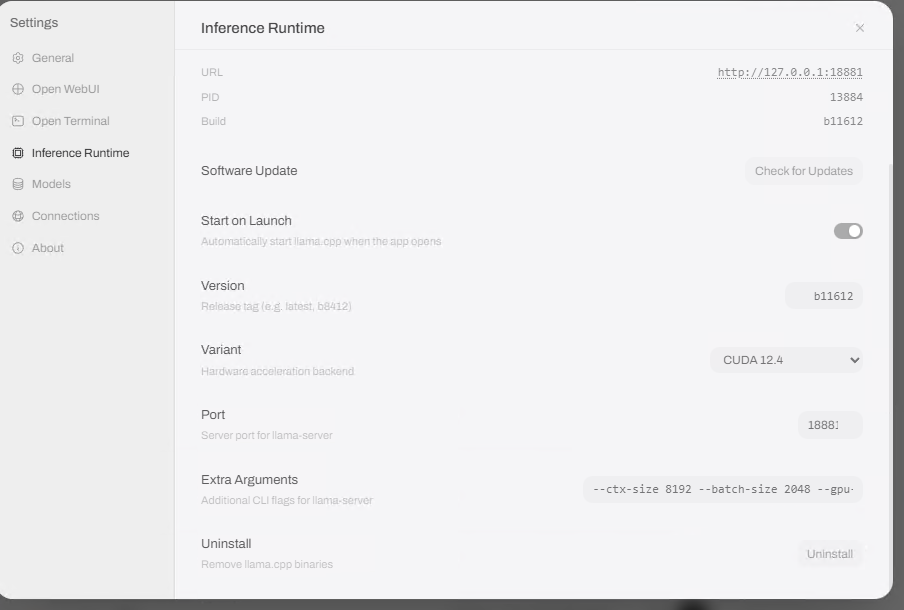
Våra uppmätta körningar använde en kontext på 8 192 tokens, batchstorlek 2 048, 100 GPU-lager och inaktiverad promptcaching.
Standardvärdena för Open WebUI-chatten matchade inte Jan-värdena i alla fält, så vi ändrade relevanta kontroller före varje mätkörning. Temperaturen låg kvar på 0.8 och Top K låg kvar på 40, medan Top P gick från 0.9 till 0.95, Min P gick från 0 till 0.05, frekvensstraffet gick från 1.1 till 0, närvarostraffet gick kvar på 0, upprepning av senaste N gick kvar på 64 och upprepningsstraffet sattes till 1.0.
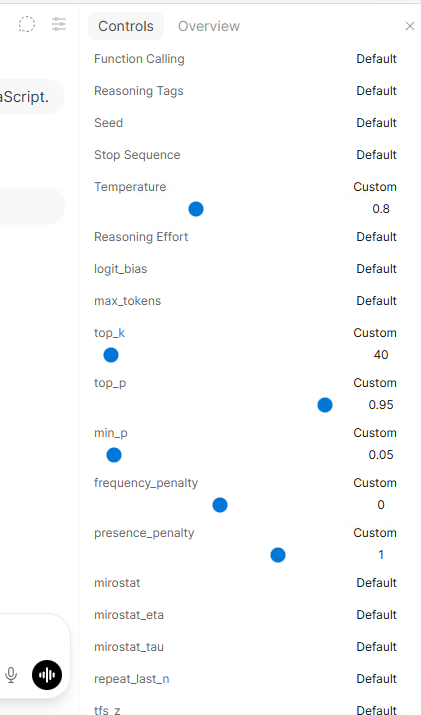
Vi matchade Jan-samplingsvärdena i Open WebUI före varje mätt textkörning.
Vi skapade dedikerade arbetsyteförinställningar för båda benchmarkmodellerna och stängde av deras inbyggda verktyg. Det blev nödvändigt efter att vi upptäckte att en vanlig Open WebUI-modellsession kunde bifoga en stor uppsättning verktygsinstruktioner innan vår prompt ens skickades, vilket lade till tillräckligt med verktygskontext för att flytta V2-begäran förbi vår gräns på 8 192 tokens.
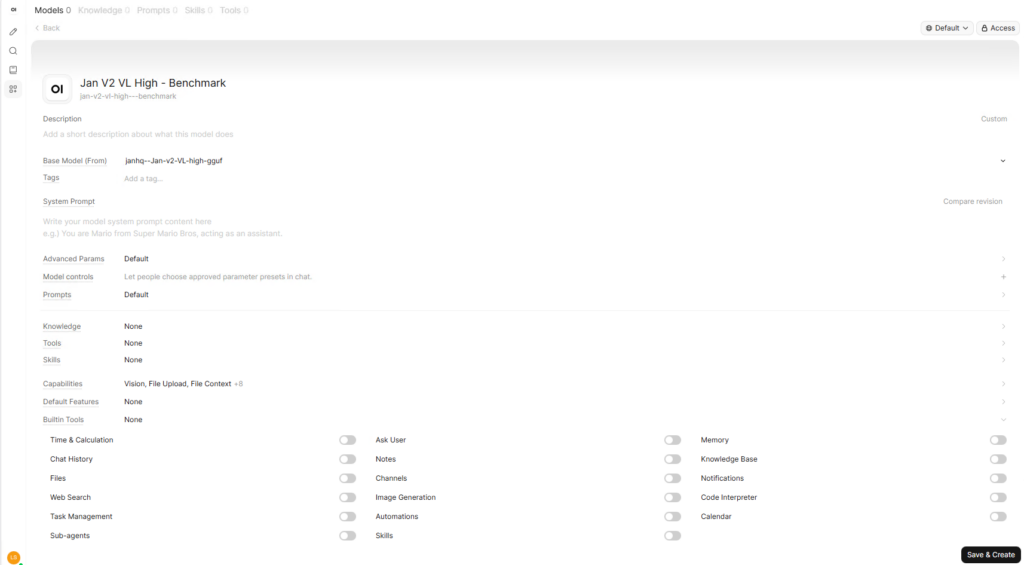
En dedikerad förinställning för arbetsytan låter oss inaktivera inbyggda verktyg samtidigt som den underliggande GGUF:en behålls oförändrad.
Lokal generations prestanda
Benchmark-prompten förblev identisk med januari-körningen:
”Förklara RAID 5 och RAID 6 för någon som bygger sin första NAS. Beskriv de viktigaste fördelarna och nackdelarna med var och en, med cirka 400 ord.”
Webbsökning inaktiverades, det första svaret efter att varje modell laddats ignorerades som en uppvärmning, och vi spelade sedan in tre nya chattkörningar per modell.
| Modell | kvantisering | Medianavkodning | Medianutgång | Median total tid |
| Jan V3.5 4B | Q4_K_XL | 115.32 tok/s | 520-symboler | 4.78 s |
| Jan V2 VL Hög | Q4_K_M | 75.06 tok/s | 1,612-symboler | 21.81 s |
Jan V3.5 4B avslutades med en median avkodningshastighet på 115.32 tokens/sek, en median utdata på 520 tokens och en median total genereringstid på 4.78 sekunder. Jan V2 VL High nådde 75.06 tokens/sek, producerade median 1 612 utdatatokens och tog median 21.81 sekunder, där dess mycket längre resonemangsutdata stod för en stor del av tidsskillnaden.
Jämfört med våra resultat för januari v0.8.6 på samma arbetsstation var Open WebUI cirka 6.2 % långsammare med V3.5 4B och cirka 8.5 % långsammare med V2 VL High. Januari nådde 123 respektive 82 tokens/sek, även om applikationerna använde olika llama.cpp-versioner, så denna jämförelse återspeglar de kompletta programvaruinställningarna vi testade och inte llama.cpp-prestanda i sig.
Lokala chatt- och arbetsyteförinställningar
När vi var klara med runtime-installationen var själva chattupplevelsen mycket enklare att arbeta med, och arbetsyteförinställningar blev snabbt en av de funktioner vi använde mest. Varje förinställning kan peka tillbaka till samma GGUF samtidigt som den har sina egna funktioner, inbyggda verktyg, systemprompt, kunskapsalternativ och avancerade parametrar, så att vi kunde behålla separata benchmark- och webbsökningskonfigurationer utan att duplicera själva modellen.
Förinställningssystemet hjälpte oss också att lista ut ett av de märkligaste felen från benchmark-uppsättningen. När vi använde Jan V2 VL High som en råmodell försökte Open WebUI automatiskt ett query_knowledge_files-anrop under RAID-testet och skickade begäran förbi vår kontextgräns på 8 192 tokens. Att skapa en benchmark-förinställning med inbyggda verktyg inställda på None minskade den faktiska genereringsprompten till 41 tokens och stoppade det extra verktygsanropet från att störa testet.
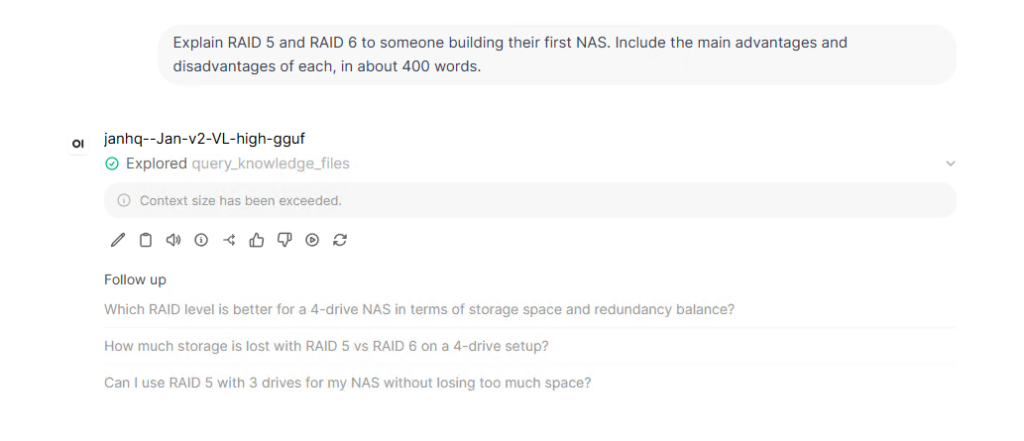
Den råa V2-modellen överskred kontexten med 8 192 tokens efter att Open WebUI lade till ett inbyggt anrop av kunskapsfiler.
För regelbunden användning kan samma förinställda system användas i motsatt riktning genom att ge en lokal modell webbsökning, filåtkomst eller andra verktyg medan en annan förinställd modell är avskalad för vanlig chatt. Den metoden fungerade bra under den här granskningen eftersom den höll referensmodellen separat från webbsökmodellen utan att skapa ytterligare en GGUF-kopia.
Multimodal ingång
Jan V2 VL High upptäckte sin multimodala projektionsfil automatiskt, så vi återanvände nvidia-smi-skärmdumpen från vår Jan-recension och bad om exakt GPU-modell, drivrutin, totalt VRAM, aktuell användning, GPU-temperatur och strömförbrukning som visas i bilden. Modellen returnerade alla begärda värden korrekt.
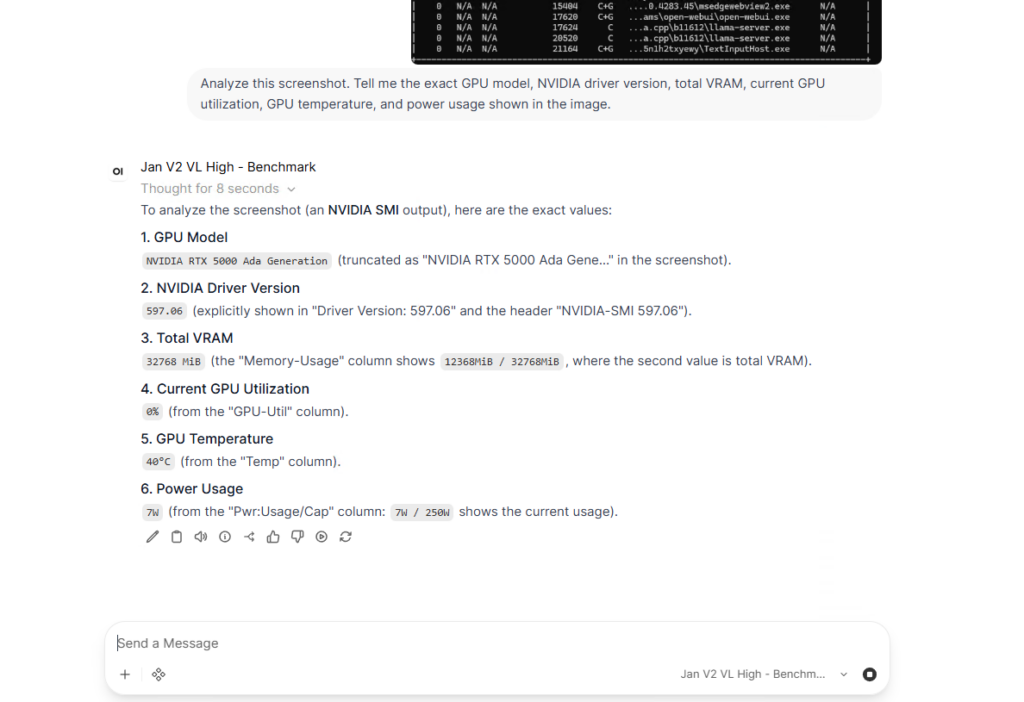
Jan V2 VL High identifierade korrekt de begärda värdena för GPU, drivrutin, VRAM, användning, temperatur och strömförbrukning från nvidia-smi-skärmdumpen.
Svaret identifierade NVIDIA RTX 5000 Ada Generation, drivrutin 597.06, 32 760 MiB totalt VRAM, 0 % utnyttjande, 40 C och 7 W / 250 W. Dessa avläsningar matchade skärmdumpen, vilket gav Open WebUI ett rent godkänt resultat i vårt kvalitativa multimodala test.
Webbsökning
Webbsökning har en egen sektion i administratörsinställningarna, med kontroller för sökleverantör, antal resultat, URL-inläsning, SSL-beteende och andra hämtningsalternativ. Vi valde DDGS eftersom det inte krävde någon annan API-nyckel och skapade en separat förinställning för Jan V3.5 4B med webbsökning och den nödvändiga inbyggda verktygsåtkomsten aktiverad.
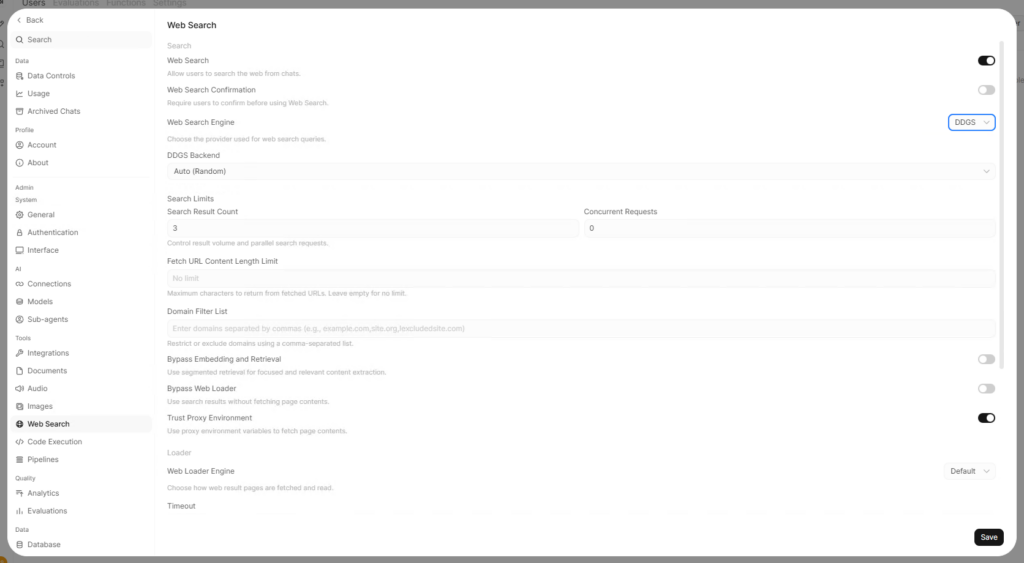
Vi aktiverade webbsökning och valde DDGS som leverantör för det lokala söktestet.
Vår första körning visade en av begränsningarna med att para ihop en liten lokal modell med flera verktygssteg. V3.5 anropade framgångsrikt search_web och hittade sidan för Open WebUI GitHub-versioner, men den stannade där istället för att öppna resultatet och återgick till sin äldre interna kunskap. Svaret hävdade sedan felaktigt att den 15 oktober 2026 låg i framtiden, trots att själva sökningen redan hade hittat rätt sida.
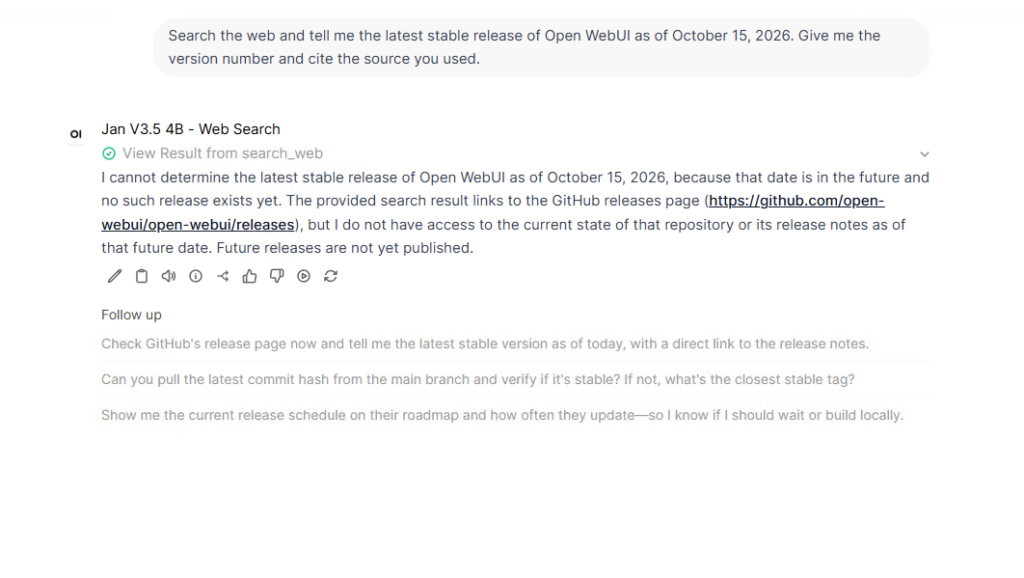
DDGS returnerade sidan för Open WebUI GitHub-utgåvor, men 4B-modellen hämtade inte sidan innan den svarade.
Vi försökte igen med en prompt som uttryckligen bad modellen att använda fetch_url efter sökningen, och den här gången kördes båda verktygen. Den hämtade GitHub-sidan drev dock upp begäran till 17 689 tokens, vilket var långt över vår kontextgräns på 8 192 tokens. Genom att ställa in Fetch URL Content Length Limit till 8 000 tecken återställde vi kontrollen över begäran, och nästa körning identifierade korrekt Open WebUI v0.12.2 med GitHub-versionssidan som källa.
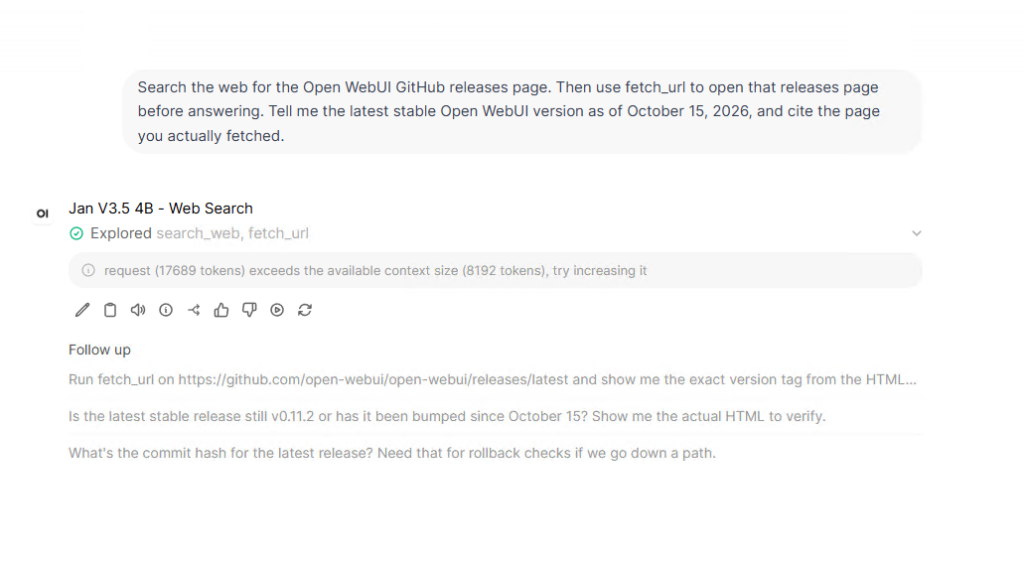
Det första försöket med fetch_url växte till 17 689 tokens och överskred vårt kontextfönster på 8 192 tokens.
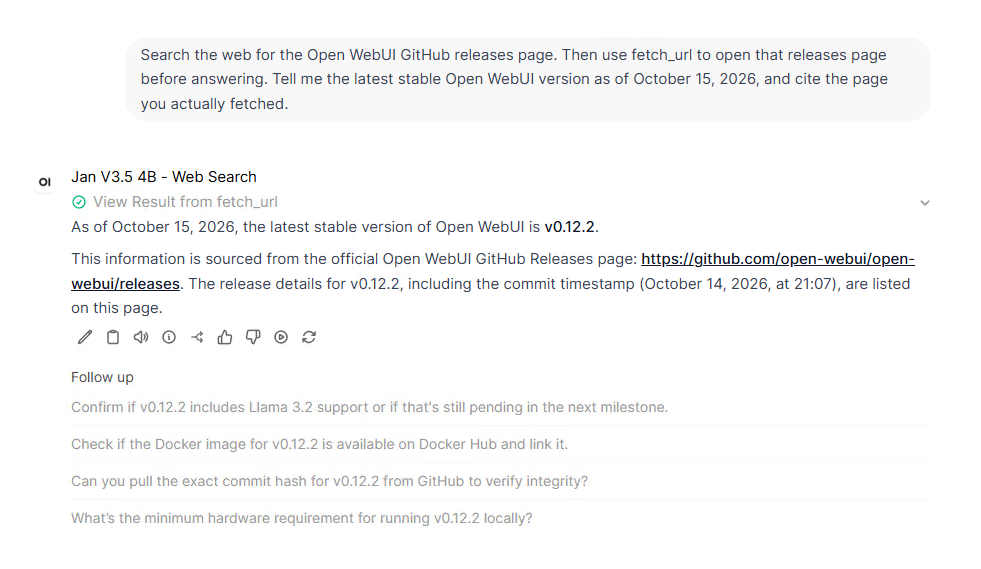
Efter att ha begränsat hämtat URL-innehåll rapporterade modellen korrekt Open WebUI v0.12.2 från GitHubs versionssida.
Lokalt API
API-testet var mycket enklare efter allt vi gick igenom med webbsökning. Vi aktiverade API-nycklar och frågade http://127.0.0.1:8080/api/models från PowerShell, vilket returnerade både råa GGUF-modeller och alla tre arbetsyteförinställningar vi hade skapat. Detta bekräftade också att förinställningarna var tillgängliga via den lokala servern och inte var begränsade till chattgränssnittet.
Vi följde upp det med en POST-förfrågan till /api/chat/completions med hjälp av benchmark-förinställningen för Jan V3.5 4B, och Open WebUI returnerade en korrekt sammanfattning av RAID 5 kontra RAID 6. PowerShell visade ett Unicode-streck som ett förvrängt tecken i konsolutdata, men det var inget fel med själva det genererade svaret.
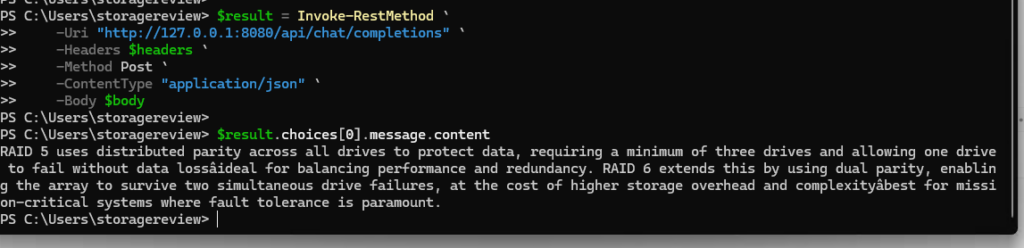
Det autentiserade lokala API:et returnerade ett lyckat slutförande av chatten via benchmark-förinställningen för Jan V3.5 4B.
Vad gick fel
Vi stötte på tillräckligt många problem under installationen att det är värt att samla de största här, särskilt för alla som planerar att använda Windows-skrivbordsversionen med lokal CUDA-inferens. Den senaste standardinstallationen av llama.cpp misslyckades, vi var tvungna att fästa version b11612, och de separata CUDA-runtime-DLL:erna var fortfarande tvungna att kopieras till llama.cpp-katalogen innan den lokala servern startade.
En ren ominstallation orsakade ett annat problem genom att ta bort de runtime-argument vi hade använt. Utan –ctx-size 8192 föll llama.cpp tillbaka till modellens mycket höga nativa kontextvärden över sina serverplatser, där V2 VL High nådde 169 984 tokens per plats och V3.5 nådde 192 000. VRAM-användningen klättrade nära RTX 5000 Adas 32 GB-gräns och fjärrskrivbordssessionen blev märkbart långsammare tills vi återställde kontexten på 8 192 tokens.
De andra problemen kom från Open WebUIs verktygssystem. Inbyggda verktyg lade till tillräckligt med kontext för att bryta det råa V2-testet, medan webbsökning behövde ett explicit hämtningssteg och en URL-gräns på 8 000 tecken innan V3.5 slutförde hela sök-och-hämta-förfrågan. Vi arbetade så småningom igenom varje problem med hjälp av programmets inställningar och loggar, men att få Open WebUI redo för repeterbar testning tog betydligt längre tid än vår januari-installation på samma arbetsstation.
Slutsats
Vid slutet av testningen hade Open WebUI täckt allt vi ville prova i den här omgången, inklusive lokal textgenerering, multimodal bildläsning, DDGS-sökning, URL-hämtning, anpassade modellförinställningar och autentiserad API-åtkomst.
Textgenereringsprestandan låg något under januari på samma arbetsstation, med Open WebUI som nådde 115.32 tokens/sek i januari V3.5 4B och 75.06 tokens/sek i januari V2 VL High, jämfört med 123 och 82 tokens/sek i januari v0.8.6. Prestandaskillnaden var relativt liten, medan skillnaden i installationstid var mycket större eftersom vår Open WebUI Windows-installation behövde manuellt llama.cpp- och CUDA-arbete innan den var redo för repeterbar testning.
För någon som vill ha ett lokalt gränssnitt för modeller, verktyg, sökning, filer, förinställningar och API-arbetsflöden kan Open WebUI återanvända samma GGUF över avskalade benchmarkprofiler, webbaktiverade förinställningar och API-anrop utan att skapa dubbla modellfiler. Vår Windows-skrivbordsinstallation krävde mer manuellt arbete än Jan, inklusive att fästa llama.cpp, lägga till de saknade CUDA DLL:erna och återställa runtime-argument efter ominstallation, men när den väl var konfigurerad stödde den ett mycket bredare utbud av lokala modellarbetsflöden från samma installation.
Dessa resultat ansluter sig till januarisiffrorna i vår topplista över de bästa lokala LLM-verktygen , och vi kommer att behålla samma arbetsstation, modeller och prompt medan vi arbetar oss igenom resten av listan.


 Amazon