

戴爾科技集團宣布對其戴爾人工智慧平台(Dell AI Platform)進行兩項重大更新,該平台由戴爾與AMD合作開發,旨在幫助企業從試點人工智慧部署擴展到全面生產環境。此次更新重點在於高效能訓練基礎設施和模組化架構,以平衡成本、可擴展性和維運控制。
此次更新引入了一種大規模配置,採用配備AMD Instinct MI355X GPU和 AMD EPYC CPU 的戴爾 PowerEdge XE9785 伺服器節點。它專為要求嚴苛的 AI 工作負載而設計,包括模型訓練、預訓練和高吞吐量推理。該平台整合了戴爾 PowerSwitch 網路和 PowerScale 存儲,確保跨部署的基礎架構堆疊一致。
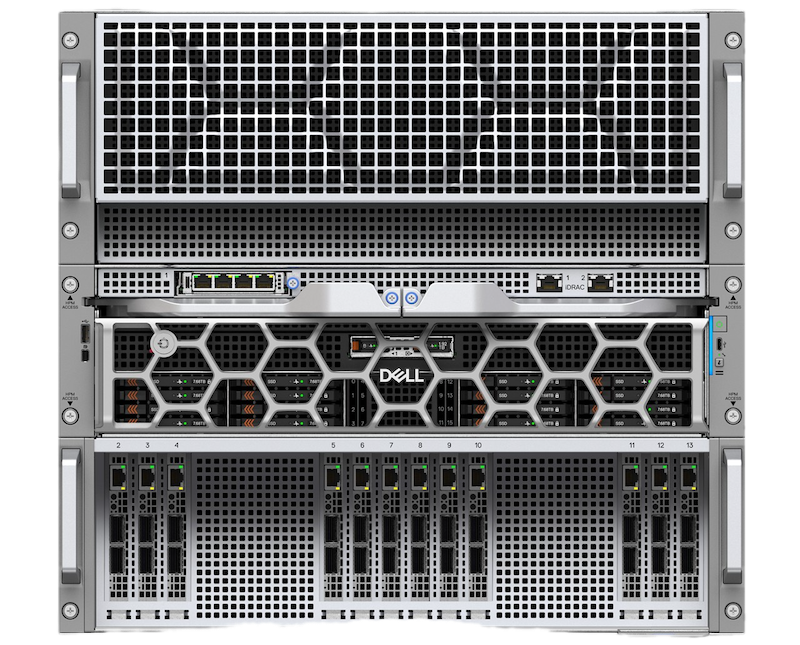
採用 AMD Instinct MI355X GPU 可提升單節點記憶體容量,進而支援更大規模的機型,並實現更高效的叢集擴充。此配置面向擁有持續性 AI 工作負載且需要可預測的大規模效能的企業和服務提供者。
第二項增強功能擴展了戴爾的模組化 AI 工廠架構,使其支援AMD Instinct MI350P PCIe GPU和 AMD EPYC CPU。此配置採用戴爾 PowerEdge XE7745和 R7725 伺服器、PowerSwitch 網路和 PowerScale 存儲,並與戴爾 AI 資料平台整合。對於正在從試點階段過渡到生產階段的企業而言,這是一種經濟高效的方案,能夠根據具體瓶頸逐步擴展計算、記憶體、儲存和網路資源。
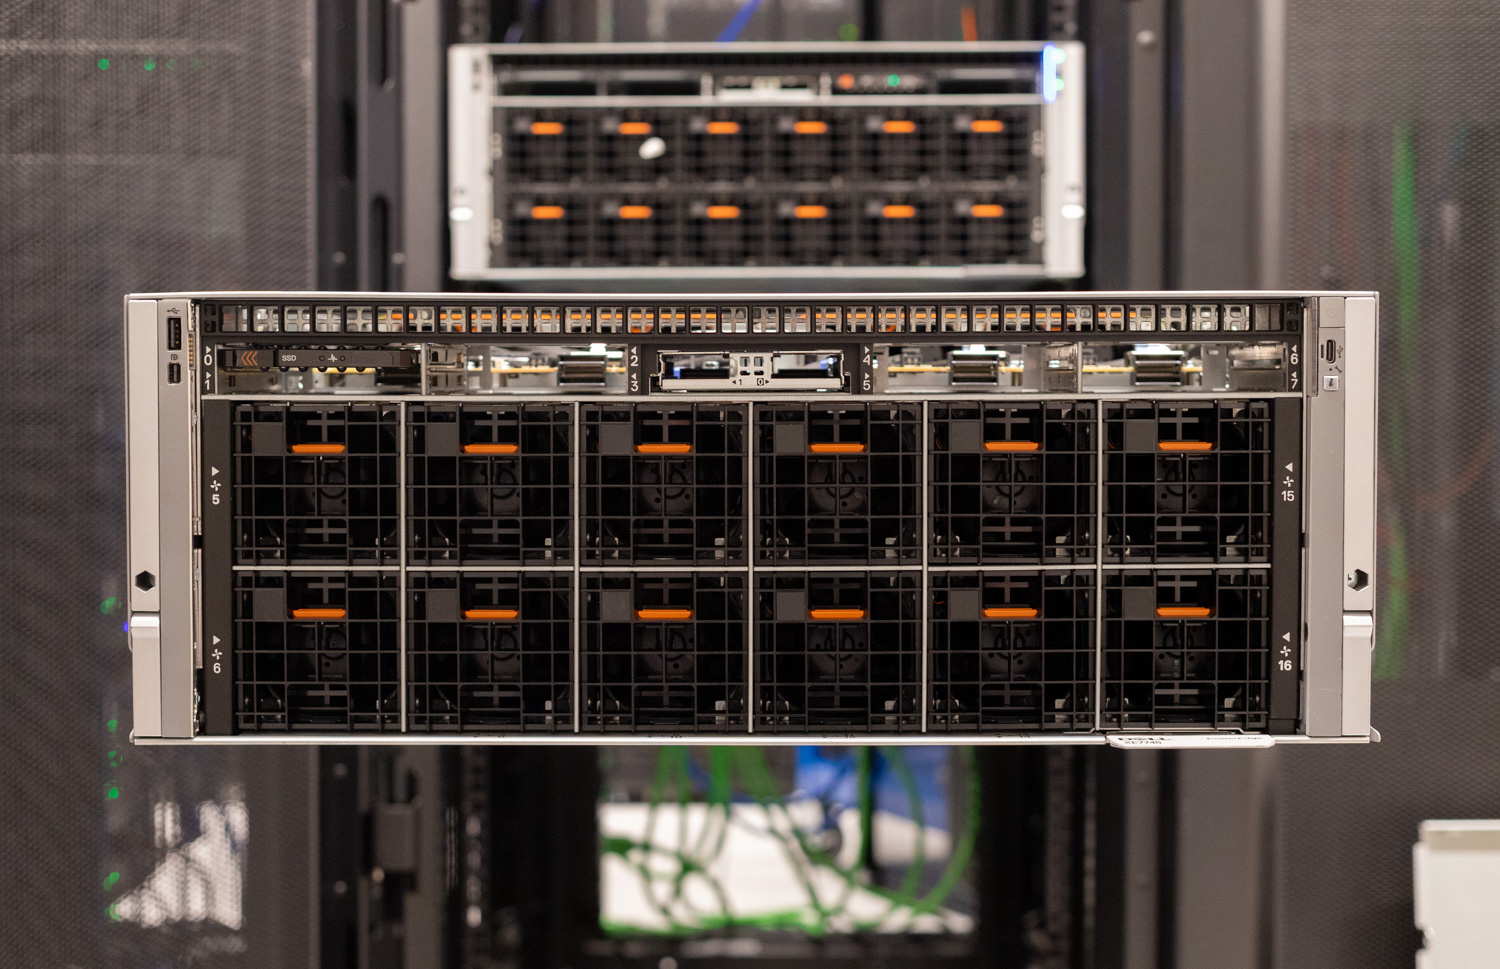
兩種配置均基於 AMD ROCm 軟體棧,並支援 PyTorch 和 vLLM 等開放框架。與戴爾自動化平台的整合提供了部署和生命週期管理功能,從而簡化了叢集的配置和擴展。
戴爾也引用了Omdia 的一項研究結果,該研究比較了本地部署和公有雲方案。報告顯示,採用配備 AMD Instinct MI355X GPU 的 PowerEdge XE9785 伺服器的配置方案,憑藉基礎設施效率和開放的軟體生態系統,可實現高達 65% 的整體擁有成本降低。
模組化設計旨在實現可預測的人工智慧擴展
戴爾將更新的平台定位為模組化設計,支援從小規模測試到企業級生產的統一部署路徑。企業可以從僅使用兩塊GPU的單節點配置開始,然後隨著需求的增長,透過添加運算節點、GPU容量、儲存和網路頻寬進行擴展。這種方法既能重複利用初始基礎設施投資,又能以可控的增量進行擴展。
該平台的設計也充分考慮了工作負載的靈活性。透過採用 AMD 的企業級 AI 軟體堆疊和開放框架,無需建立專用基礎設施,即可支援多種 AI 應用場景。這不僅提高了模型的可移植性,也降低了管理多個環境的維運成本。
安全性和治理仍然是這個平台設計的核心。透過優先考慮本地部署,戴爾降低了外部風險敞口,並保持了對資料本地性的控制。 AMD 的企業級 AI 資源管理器提供了額外的治理功能,包括策略控制和存取管理,以協助企業強制執行資料保護和合規性要求。


 Amazon