

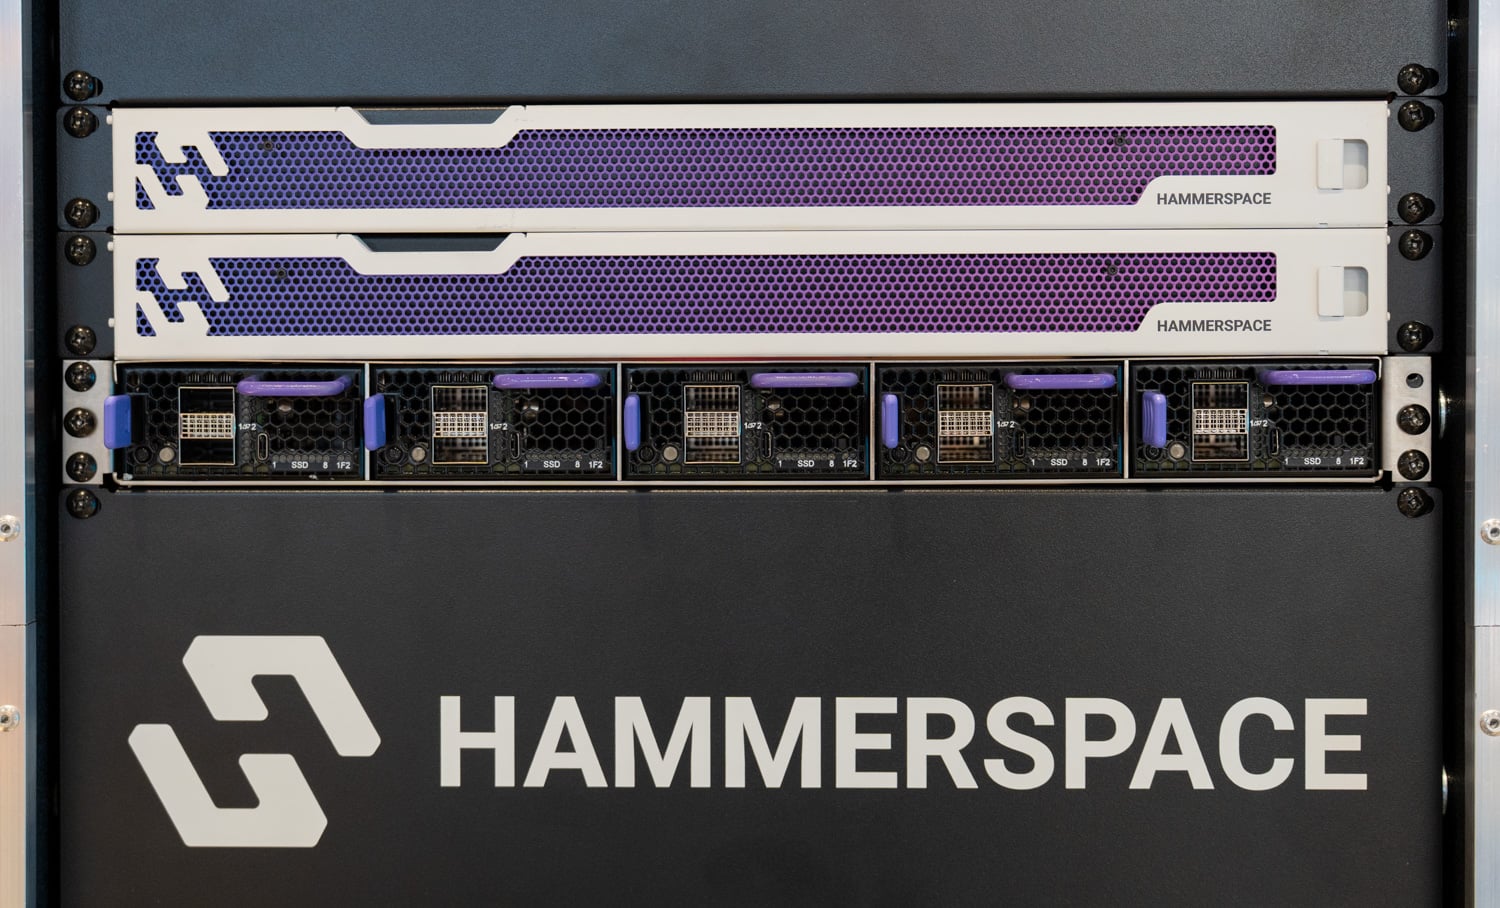
Hammerspace 已將其軟體定義資料平台升級為 Hammerspace 資料系統,並首次將其作為包含硬體的完整系統進行銷售。該系統的核心是 Hammerspace 開放式快閃記憶體平台 (OFP),這是一個 1U 機架式機架,可容納五個基於 DPU 的快閃記憶體節點,無需 x86 儲存伺服器。據該公司稱,OFP 的寫入速度為 390GB/s,每機架單元的 IOPS 為 15 萬,原始容量高達 9.83PB。此次發布也新增了資料智慧層和 GPU 本地端 NVMe 的 KV 快取功能。 OFP 現已開始接受報價,預計將於 2027 年上半年出貨。
從數據平台到數據系統
Hammerspace 的核心產品是一個平行全域檔案系統,它將元資料與資料路徑分離,並透過 pNFS、NFS、SMB 和 S3 等協定將現有的 NAS、物件儲存和雲端儲存整合為統一的命名空間。用戶端可以透過標準 Linux 發行版內建的 NFSv4.2 用戶端存取系統,無需任何專有代理,並使用 Hammerspace 為其專為 NFS 規格設計的 Flex Files 佈局。該公司將數據系統描述為該軟體的擴展,圍繞五大功能構建:數據統一、智能、編排、加速和存儲,其中智能和存儲是新增功能。
商業模式的改變在於,使用者可以從 Hammerspace 購買整套系統,包括軟體、元資料節點和儲存設備的安裝和支援。 Hammerspace 將元資料節點稱為“Anvils”,它們是 1U x86 伺服器,提供標準型和大型 M 系列配置,配備兩個 100GbE 資料端口,每個站點部署一對高可用性節點,用於運行控制平面,該控制平面管理命名空間並執行放置策略。除了軟體部署外,Hammerspace 還提供基於客戶硬體的純軟體部署,以及來自 Dell、Supermicro 和 Hitachi Vantara 的 Hammerspace Ready Nodes 節點,以及 AWS、Azure、Google Cloud 和 Oracle Cloud 上的市場鏡像。
這個系統選項解決了 Hammerspace 在銷售中遇到的一個問題:軟體雖然贏得了技術評估,但客戶最終還是為了簡化購買流程而選擇了其他供應商的整合產品。軟體採用訂閱許可模式,以管理容量定價。 Hammerspace 儲存通常用於新建 GPU 叢集需要高效能存儲,而客戶現有資料儲存在 NetApp、PowerScale 或其他物件儲存系統上的情況,這些系統可以由命名空間直接接管。
每個站點的叢集都將 Anvil 設備與一組資料服務節點配對,所有群集合併成一個全域檔案系統。元資料在站點間持續複製,遠距離站點之間的延遲約為一秒,而資料本身僅在策略或存取請求需要時才會移動。作業排程器可以透過 API 和原生連接器啟動資料移動。該公司舉例說明,生命科學領域的客戶透過 SMB 協定接收儀器數據,透過 pNFS 協定處理數據,然後從同一系統透過 S3 提供服務。
評估通常以概念驗證的形式進行,並採用自備許可證的雲端鏡像作為自助服務方案。磁碟容量來自硬碟供應商建構的 JBOD 和儲存伺服器;OFP 是 Hammerspace 的設計,由代工廠商製造,系統由經銷商和整合合作夥伴交付。區塊陣列只有在能夠透過 NFS 掛載時才能加入命名空間。
「僅僅增加儲存空間並不能解決問題,」Hammerspace創始人兼執行長大衛弗林表示。弗林將此次發布定義為將人工智慧工廠設計為計算領域帶來的整合模式引入數據領域。
在開放式 Flash 平台內部
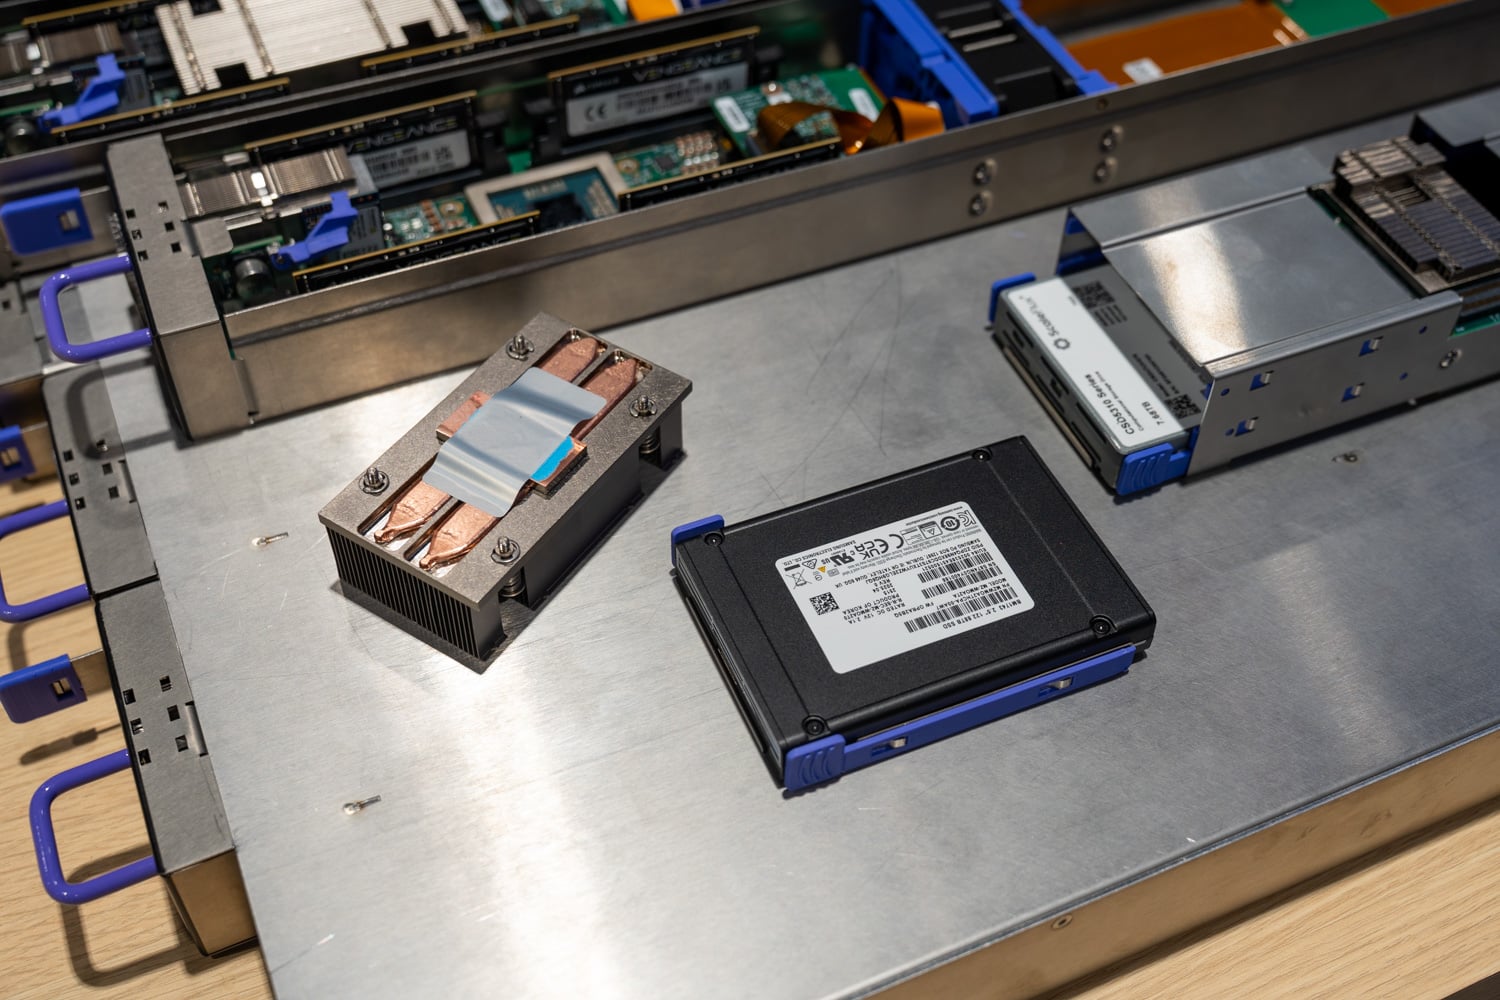
每個 OFP 儲存單元都是一個完整的儲存節點,寬度為機架單元的五分之一,配備八個 U.2 或 U.3 NVMe SSD(分裝在兩個可拆卸的四盤位硬碟包中)、兩個 400GbE QSFP-DD 端口,以及一個 64 核 Arm DPU(數位處理單元),取代了傳統的 x86 主機板。該 DPU 為 Xsight Labs E1,採用台積電 5nm 製程製造,擁有 64 個 Arm Neoverse N2 核心、兩個 400G MAC、PCIe Gen5,典型功耗為 70W。它運行標準 Linux 系統,每個儲存單元在 Hammerspace 檔案系統中都顯示為 NFS 伺服器。
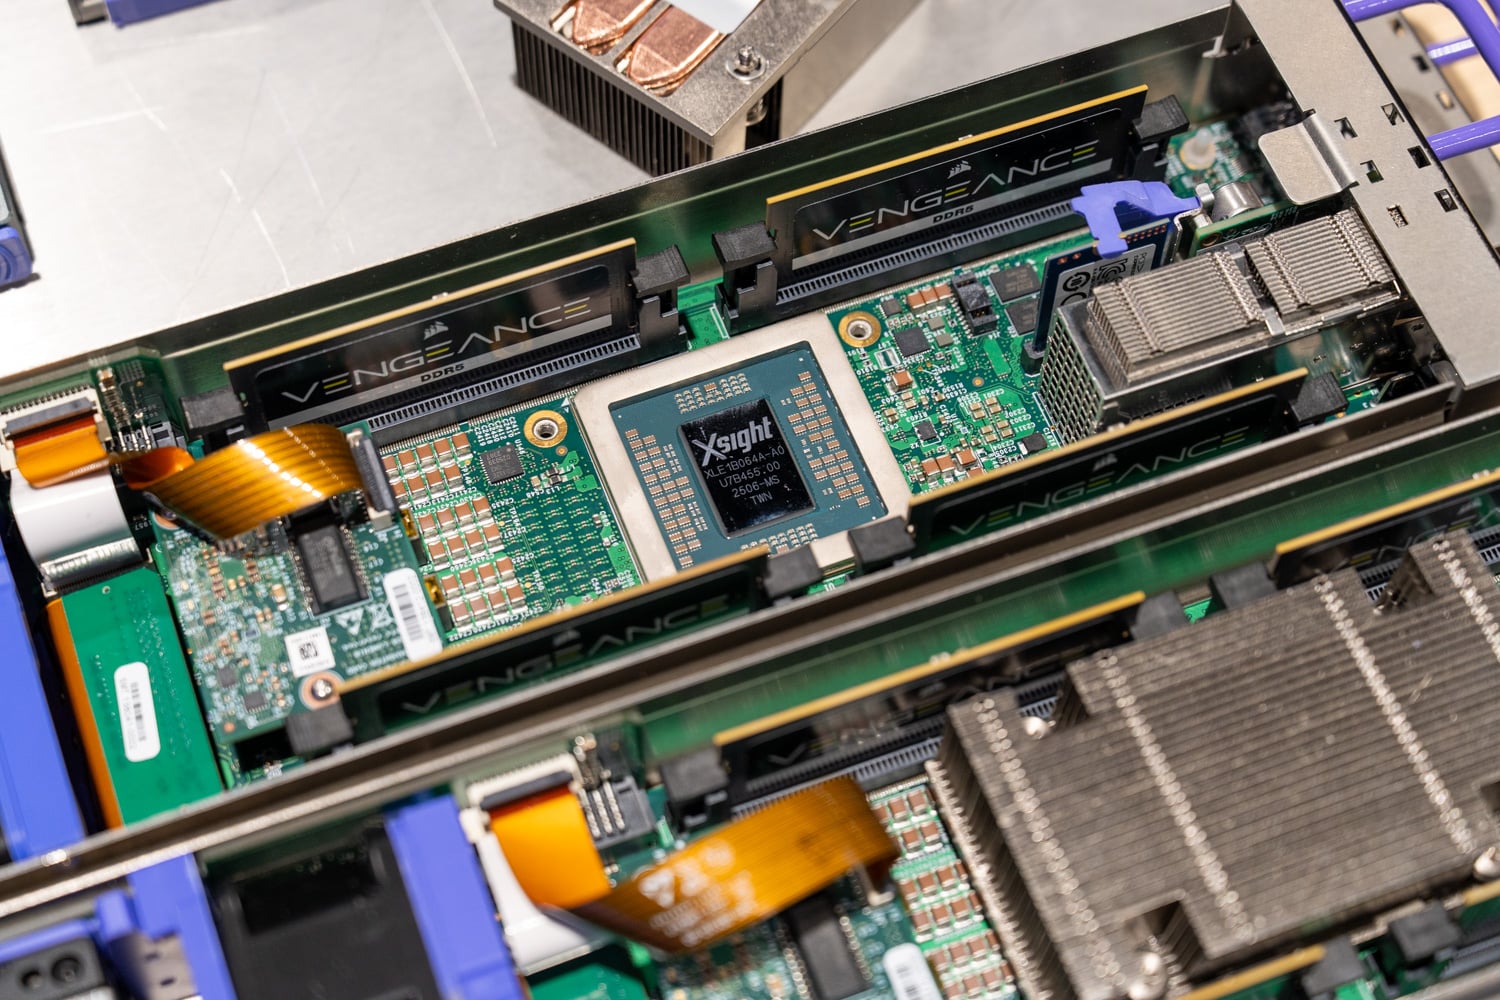
一個 1U 機架托架可容納一到五個硬碟托架,每個機架單元最多可容納 40 個硬碟、320 個 Arm 核心和 10 個 400GbE 連接埠。 Hammerspace 標稱,每個硬碟托架最大功率為 360W,每個機架托架最大功率為 1,800W(使用雙 2,160W 鈦金電源),硬碟托架和硬碟組支援免工具維護,並可透過 IPMI 和 Redfish 進行管理。該托架深度為 106.64 厘米,需要 1,200 毫米的機架,因此不適用於較淺的企業級機櫃。 Hammerspace 表示,該 4U 機架的硬碟密度是典型 2U 24 碟位 NVMe 伺服器的 3.3 倍,即 4U 機架可容納 160 個 SSD,而後者僅為 48 個。
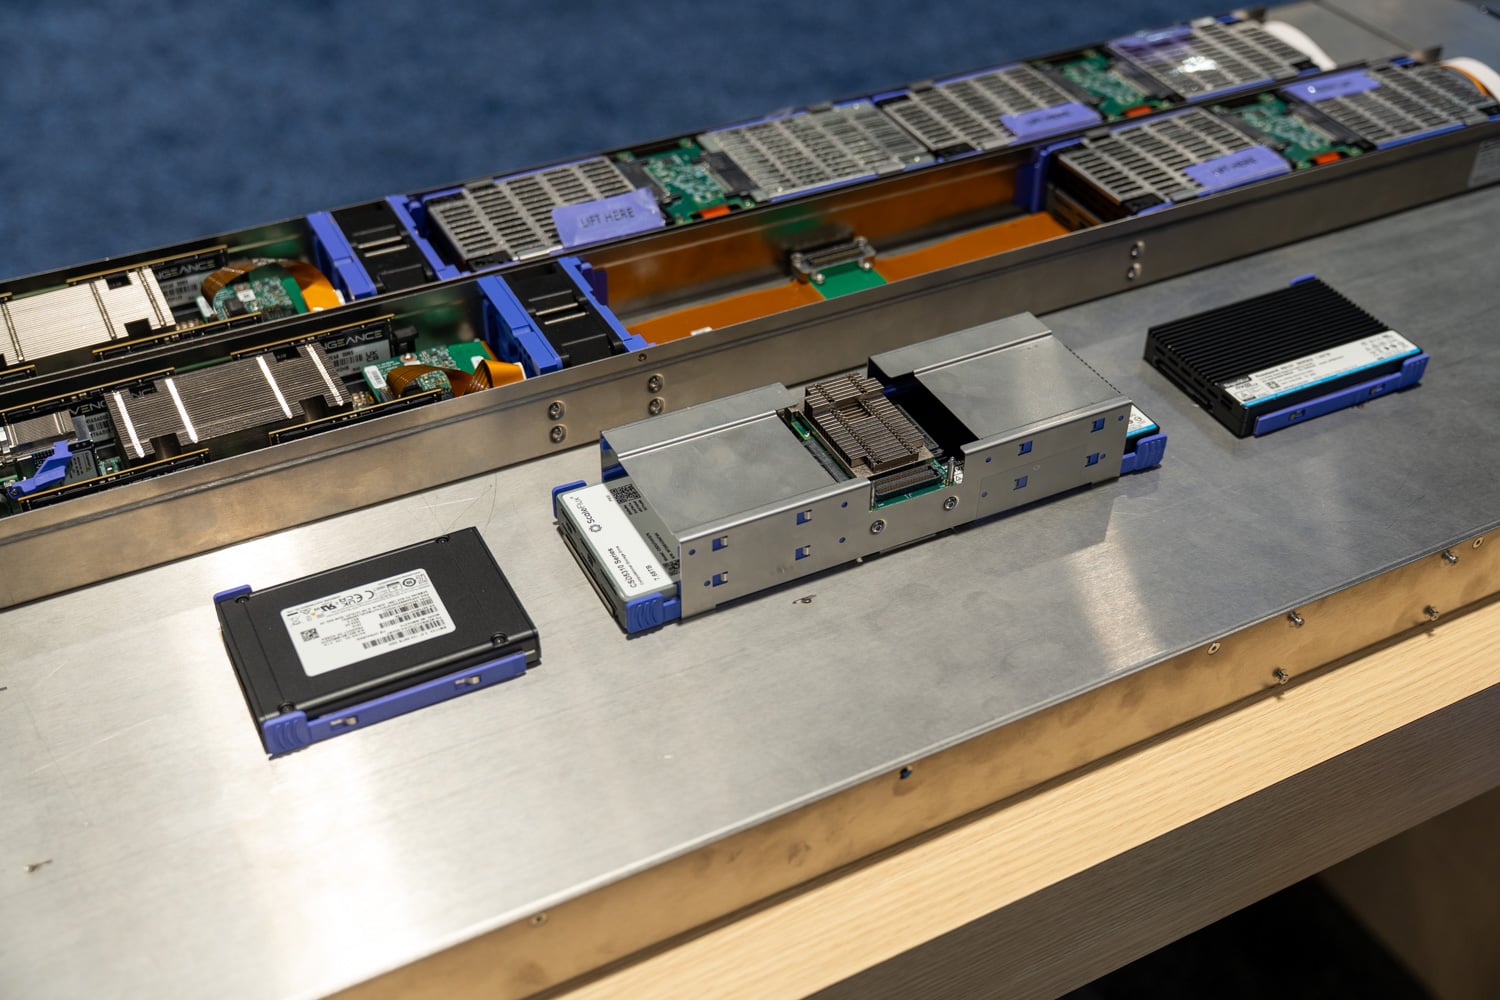
配備八塊 245.76TB QLC SSD(Hammerspace 列出的最大容量以及KIOXIA LC9等硬碟的容量),一個托架可容納 1.97PB 原始容量,一個完整的托架可容納 9.83PB。托架最大功耗為 1,800W,這意味著每 PB 原始容量的功耗約為 183W。托架可相容於 PCIe Gen5 或更早版本的 TLC 或 QLC 硬碟,Hammerspace 將 TLC 定位為高效能硬碟,將 QLC 定位為高容量硬碟。一個裝滿托架的 42U 機架可容納約 413PB 容量,功耗高達 75.6kW。
該設計源自於Hammerspace於2025年發起的開放快閃記憶體平台計劃,Xsight Labs和洛斯阿拉莫斯國家實驗室等機構也參與其中。 Hammerspace在2025年10月表示,量產系統將於2026年初上市,因此計畫延後了大約一年。此儲存託架採用U.2和U.3介面的硬碟,因為這些介面的硬碟目前已實現量產,而且Hammerspace在設計時就考慮到了更高密度的外形尺寸。 Hammerspace和Xsight曾表示,他們計劃實現每個機架1EB的容量,這比目前最大容量的42U硬碟的容量高出兩倍以上。
Hammerspace表示,該滑橇式儲存設備的原型研發工作大約兩年前就開始了,早期採用者主要是超大規模資料中心,他們在每個GPU機架頂部放置一到兩個托盤,更看重機架和效能密度而非功耗節省。在這種佈局中,Hammerspace將GPU伺服器內部的NVMe固態硬碟對應到NVIDIA標註的G3層,並將每個機架中裝滿TLC快閃記憶體的OFP托盤對應到G4層。
性能聲明和測試條件
Hammerspace 官方數據顯示,五槽位硬碟托架在不啟用鏡像的情況下,寫入吞吐量可達 390GB/s,4K 隨機讀取 IOPS 可達 15 萬。測試條件為:NFSv4.2 檔案系統,採用 pNFS over TCP 協議,連接 400GbE 網絡,使用企業級 Gen5 TLC SSD。讀取速度最高可達每槽 80GB/s,即每個托架 400GB/s。這意味著每槽位的兩個 400GbE 連接埠分別提供約 40GB/s 的讀取速度,考慮到協定開銷,這幾乎達到了鏈路飽和狀態,因此網路連接埠限制了讀取吞吐量的上限。
保護機制採用鏡像技術,可依檔案或目錄透過策略進行設置,並可在線上變更。雙向鏡像下,每個托盤的寫入速度降至 195GB/s;三向鏡像下,寫入速度降至 130GB/s。此外,雙向鏡像還會使可用容量減半,滿載 QLC 托盤的可用容量約為 4.9PB。 Hammerspace 建議對於可以重新產生的資料(例如 KV 快取),不要使用鏡像。該公司聲稱其產品每機架單元的性能是其未具名的最接近競爭對手的 2 到 5 倍。 Hammerspace 尚未公佈 OFP 的延遲、用戶端數量或 IO500 和 MLPerf Storage 測試結果,我們也沒有進行或審核這些測試。
| 規格 | Hammerspace 開放快閃記憶體平台 |
|---|---|
| 平台概述 | |
| 卓越的建築 | 基於DPU的快閃儲存節點,不含x86儲存伺服器 |
| 雪橇 | 8 個 U.2/U.3 NVMe SSD,分成兩組 4 個硬碟。 64 核心 Arm DPU(Xsight Labs E1) 2 x 400GbE QSFP-DD |
| 1U托盤 | 1至5輛雪橇 最多 40 個固態硬碟 最多可達 320 個 Arm 核心 高達 10 個 400GbE |
| 驅動器支持 | 符合標準的 U.2/U.3 SSD,PCIe Gen5 或更早版本 TLC 或 QLC |
| 最大原始容量 | 每輛雪橇 1.97 磅 每托盤 9.83 磅 基於 245.76TB QLC SSD |
| 協議 | NFSv4.2 與 pNFS |
| 資料保護 | 依檔案或目錄的策略進行鏡像:無鏡像、雙向鏡像或三向鏡像 |
| 效能(Hammerspace 資料、第五代 TLC 固態硬碟、400GbE、TCP) | |
| 讀取吞吐量 | 每個滑槽 80GB/s 每托盤 400GB/s |
| 寫入吞吐量,無鏡像 | 每個滑槽 78GB/s 每托盤 390GB/s |
| 寫入吞吐量,三向鏡 | 每個滑槽 39GB/s 每托盤 195GB/s |
| 寫入吞吐量,三向鏡 | 每個滑槽 26GB/s 每托盤 130GB/s |
| 4K 隨機讀取 | 每艘雪橇 3 萬 IOPS 每個托盤 15 萬 IOPS |
| 力量和體能 | |
| 最大功率 | 每個雪橇 360 瓦 每托盤1,800瓦 |
| 電源供應器 | 每托盤雙2,160瓦鈦金燈 |
| 外形 | 1U 托架,深度 106.64 厘米 需要一個 1,200 毫米的機架 |
| 散熱 | 空氣,海平面最高入口溫度40攝氏度 |
| 管理 | IPMI,紅魚 |
| 庫存情況 | 現在報價 預計2027年上半年出貨 |
0 層和 KV 緩存
Hammerspace 將 OFP 定位為 Tier 1,位於 Tier 0 之後。 Tier 0 由 GPU 伺服器內部已有的 NVMe 所構成,並透過 NFS 匯出,聚合到一個共享的叢集級層級,運算節點上無需客戶端或代理程式。寫入該層級的資料會在叢集內進行鏡像以保護,並根據策略移動到其他層級。 Hammerspace 表示,常見的模式是將訓練檢查點寫入本機,然後讓系統將較舊的檢查點移至物件儲存。 Hammerspace 聲稱,與外部共用儲存相比,Tier 0 的順序頻寬提高了 4.4 倍,延遲降低了 56%,但並未公佈測試配置。
KV快取角色使用同一層級,理由是推理伺服器可以從共享儲存中重新載入已計算的對話上下文,而無需在GPU上重新計算這些標記。 Hammerspace不充當快取管理器,它將池化的Tier 0 NVMe(其後有OFP)作為POSIX儲存提供給推理軟體的快取管理器使用。
資料智能:目錄、深度掃描和自然語言查詢
資料智慧層始於一個目錄,該目錄無需移動資料即可索引命名空間內所有儲存系統中的檔案和物件元資料。第二層 DeepScan 可按需或按計劃開啟文件,查找個人、財務和受保護的健康資訊,並將查找結果轉換為可搜尋的標籤。客戶可以透過其選擇的語言學習管理 (LLM) 以自然語言編寫查詢。查詢結果會提供給現有的策略引擎(Hammerspace 稱之為目標),因此管理員可以尋找所有標記為「訓練就緒」或「僅限特定國家/地區」的文件,並針對這些文件設定放置規則。
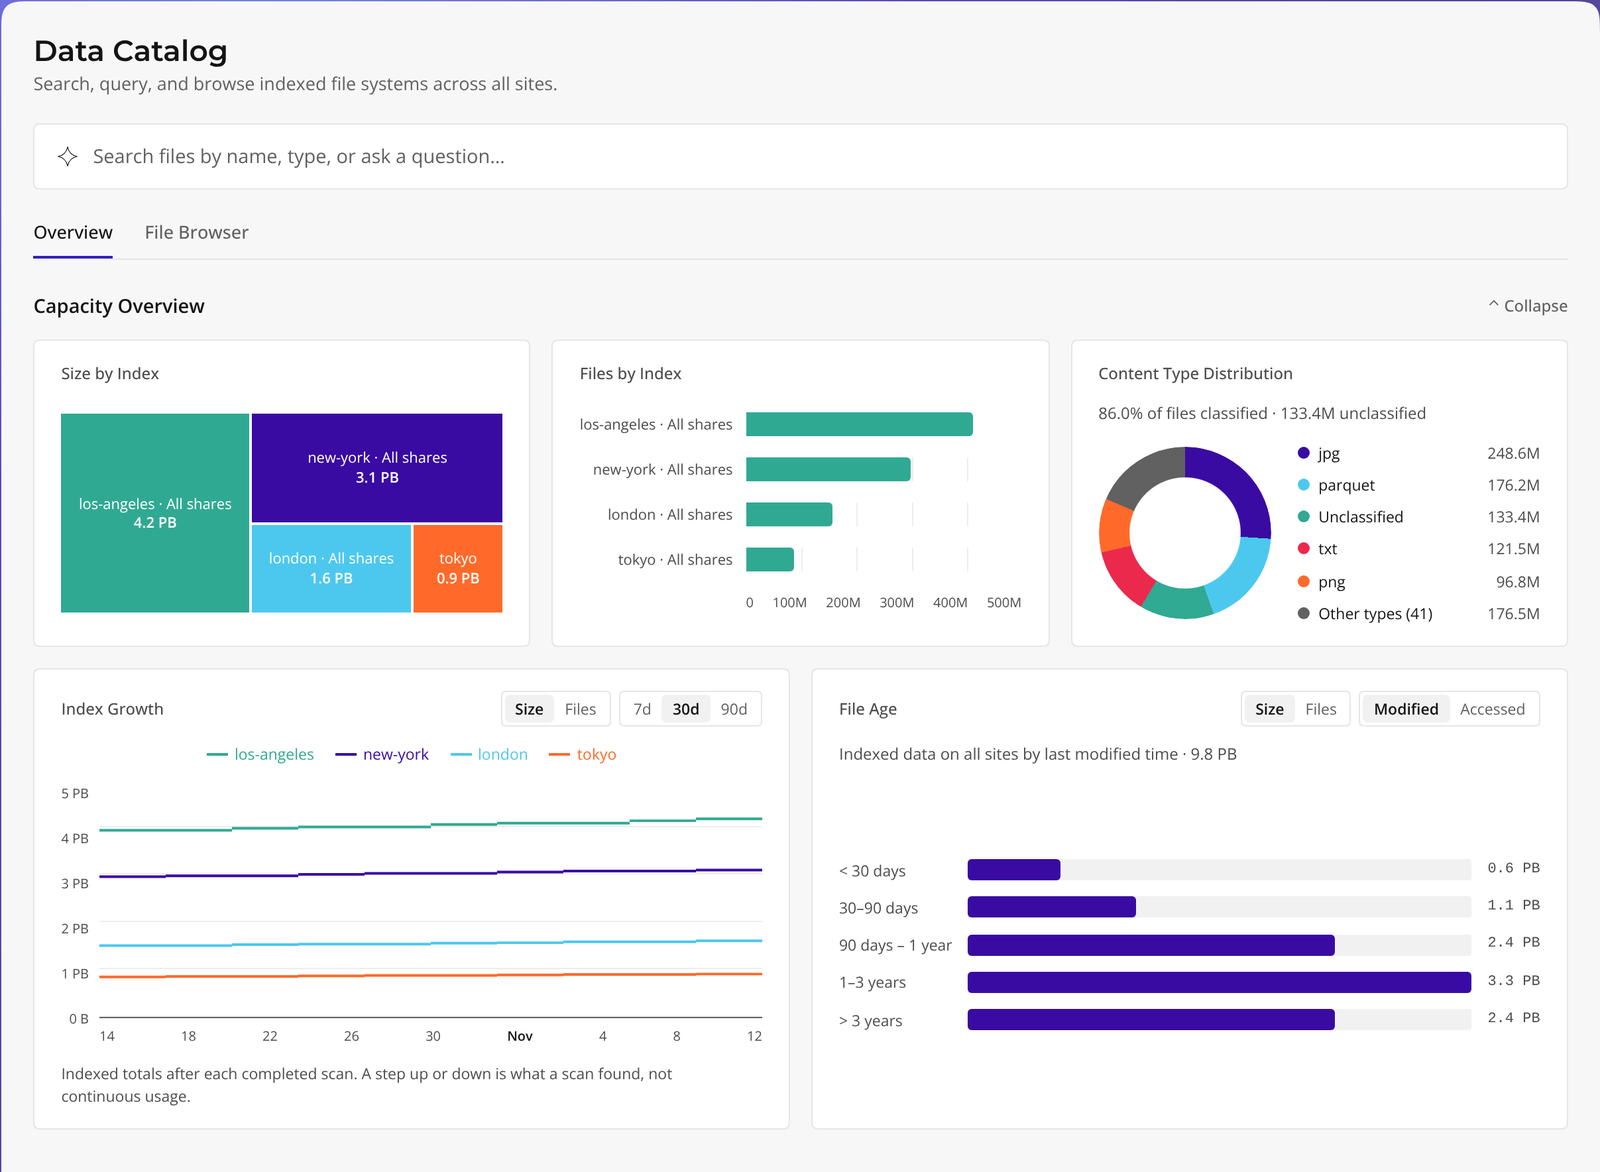
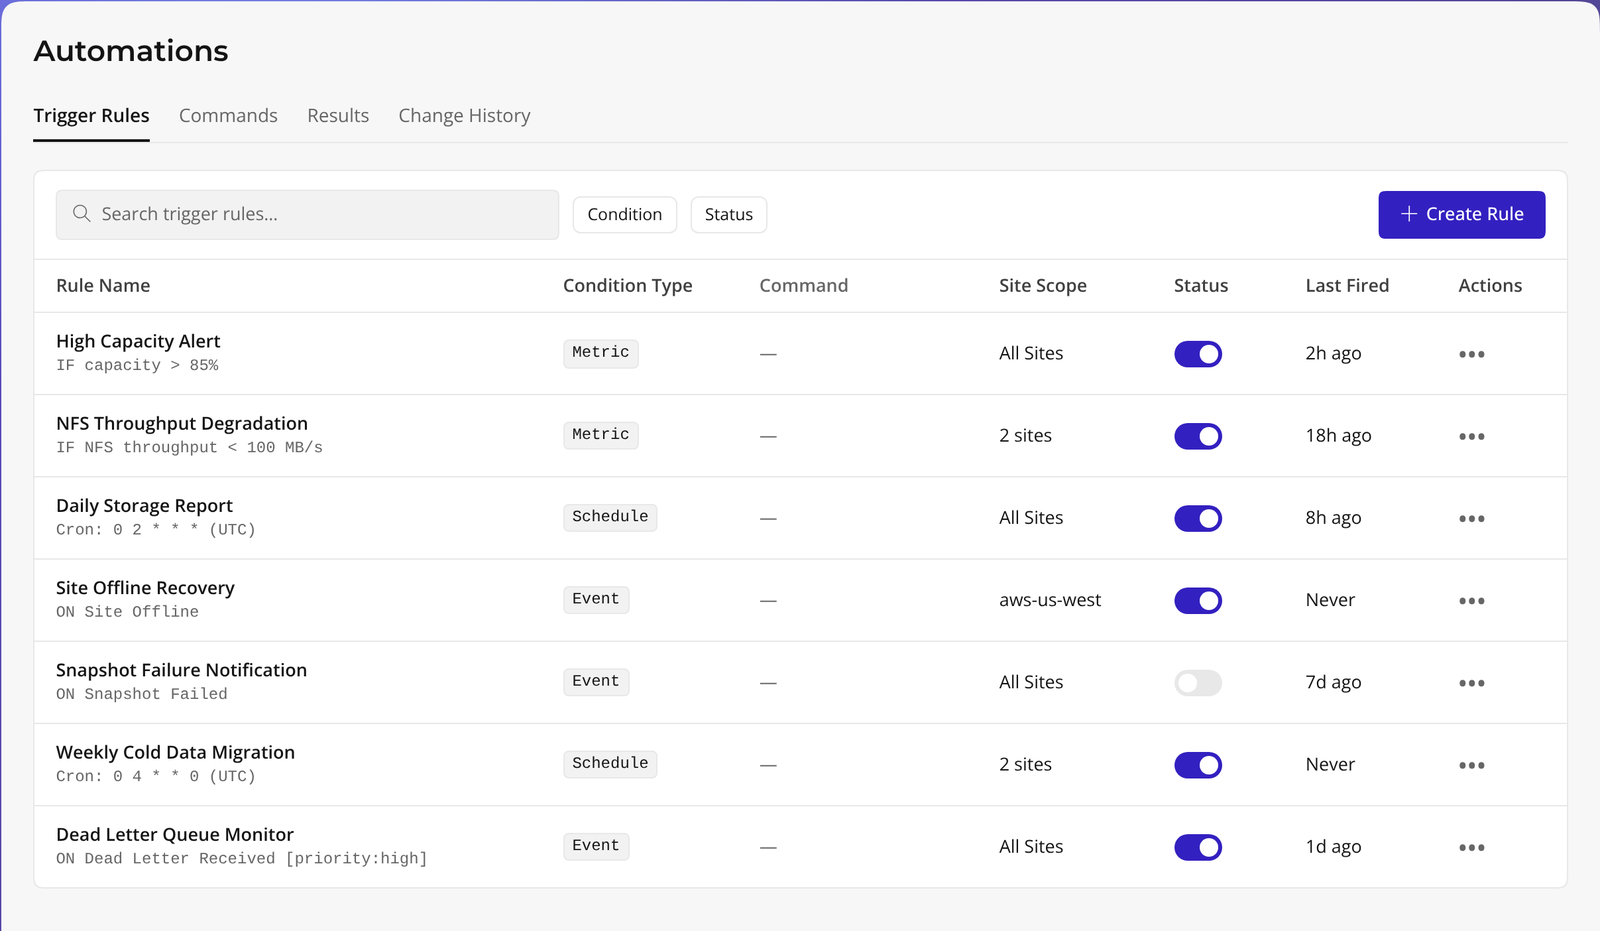
目標是附加到共用、磁碟區、目錄或檔案的聲明性規則,例如將資料保持 30 天不變或在三個網站保留三個副本。新的自動化功能會根據容量閾值、計劃和事件等條件觸發這些規則,並在變更獲得批准之前進行預覽。標籤會沿著目錄樹向下繼承,並隨檔案在儲存系統和雲端之間移動。該軟體支援任何供應商的文件和物件存儲,但不管理結構化資料。
早期客戶及前景
發佈時的參考客戶是 kaiko,一家在阿姆斯特丹和蘇黎世設有辦事處的臨床人工智慧公司,該公司利用影像和病理資料訓練模式。 kaiko 將 Hammerspace 部署在 Microsoft Azure 以及 Nebul 和 Nebius GPU 雲端上,作為統一的命名空間,並使用其 GPU 節點中的 NVMe 作為 Tier 0 進行訓練,同時根據政策在 Azure Blob 儲存體上設定了檢查點。 Hammerspace 表示,kaiko 在這三個叢集上的所有機器學習工程工作流程都已移轉到該系統。此案例研究不涉及 OFP 硬體。
Hammerspace告訴我們,kaiko在Nebius平台上從大約128個GPU擴展到1,000多個GPU的過程中採用了該系統,並且其在Nebul雲端平台上現有的全快閃NAS也已就地遷移到了該命名空間。該公司還介紹了一家未具名的超大規模人工智慧研究實驗室,該實驗室在Lustre成為其最大支援工單來源的一年後,用AWS上的30PB Hammerspace集群取代了用於Lustre的Amazon FSx,現在正將該命名空間擴展到其本地資料中心。 Hammerspace表示,該資料中心的大檔案操作速度提高了約三倍。
OFP 與其他將 DPU 置於儲存伺服器原處理器位置的設計類似,例如NVIDIA 在 GTC 大會上推出的BlueField-4 STX 參考架構。 Hammerspace的版本與之不同之處在於,它搭配了一個無需硬體即可運行的檔案系統。 Hammerspace 將在 SC26 大會上展示該硬件,但尚未公佈價格。
我們在 SC26 展會上與 Hammerspace 一起拍攝了 OFP 滑橇和托盤的演示視頻,我們將在文章發佈時將該視頻添加到本文中。


 Amazon