

在聖荷西舉行的 GTC 2026 大會上,NVIDIA 執行長黃仁勳發表了主題演講,概述了公司下一代 AI 基礎設施平台,並發布了一系列涵蓋晶片、系統、軟體和生態系統合作的重大公告。 GTC 2026 吸引了來自 190 多個國家和地區的 3 萬多名與會者,是 NVIDIA 自 Blackwell 平台發布以來最全面的平台更新的舞台,其核心是 Vera Rubin 架構的全面量產部署以及 Groq 30,000 LPU 技術與 NVIDIA 資料中心生態系統的整合。正如黃仁勳在演講中所說,智慧 AI 的轉折點已經到來,Vera Rubin 的發布標誌著 NVIDIA 歷史上最大的基礎設施建設的開端。
主題演講的核心是第四條人工智慧擴展定律的出現:智能體擴展。在智慧體擴展中,人工智慧系統不僅與人類通信,還與其他人工智慧智能體通信,從而對低延遲、大上下文推理以及前所未有的規模提出了指數級的需求。 NVIDIA 將 Vera Rubin 平台定位為服務此新領域的基礎架構基礎。該平台整合了七款共同設計的晶片,並部署在五個專為人工智慧工廠打造的全新機架式系統中。該平台也獲得了前沿人工智慧實驗室的認可:Anthropic 執行長兼聯合創始人 Dario Amodei 指出:「企業和開發人員正在使用 Claude 進行日益複雜的推理、智能體工作流程和關鍵任務決策。這需要能夠跟上步伐的基礎設施。NVIDIA 的 Vera Rubin 平台為我們提供了提升表示:“NVIDIA 的基礎設施是我們不斷推進人工智慧前沿發展的基石。借助 NVIDIA Vera Rubin,我們將能夠大規模運行更強大的模型和智能體,並為數億用戶提供更快、更可靠的系統。”
Vera Rubin平台:開啟智能體人工智慧的前沿
基於在 CES 2026 上首次亮相的 Vera Rubin NVL72 架構,GTC 2026 將其擴展為全面的 POD 等級 AI 工廠生態系統。 NVIDIA 將此定義為從獨立晶片和獨立伺服器轉向完全整合的機架級系統、Pod 級部署和自主 AI 工廠的轉變。 Vera Rubin 平台整合了 NVIDIA Vera CPU、Rubin GPU、NVLink 6 乙太網路交換器、ConnectX-9 SuperNIC、BlueField-4 DPU、Spectrum-6 乙太網路交換器以及新整合的 NVIDIA Groq 3 LPU,所有這些元件都旨在作為一個統一的 AI 電腦以及新整合的 NVIDIA Groq 80 LPU,所有這些元件都旨在作為一個統一的 AI 電腦合作夥伴組成的生態系統提供支援。

NVIDIA 聲稱,與 Blackwell 世代相比,該平台在所有 AI 工作負載下,每瓦推理吞吐量最高可提升 10 倍,每個代幣的成本僅為其十分之一。對於訓練大型混合專家模型,Vera Rubin 只需四分之一的 GPU 即可達到相同的效能。 NVL72 可與 NVIDIA Quantum-X800 InfiniBand 和 Spectrum-X 乙太網路無縫擴展,從而在大規模 GPU 叢集中保持高利用率,同時縮短訓練時間並降低整體擁有成本。
世代對比:Blackwell Ultra 與 Vera Rubin NVL72
| 規格 | GB300 NVL72(Blackwell Ultra) | VR NVL72(維拉魯賓) |
|---|---|---|
| 運算架構 | ||
| GPU 數量 | 72塊Blackwell Ultra GPU | 72 個 Rubin GPU |
| CPU數量 | 36 個 Grace CPU | 36個Vera CPU |
| CPU內核 | 每個CPU配備72個ARM核心 | 每個CPU配備88個奧林巴斯ARM核心 |
| 人工智能性能 | ||
| FP4推理性能 | 1.44 百億億次浮點運算 | 3.6 百億億次浮點運算 |
| 每個 GPU 的 NVFP4(推理) | 20 浮點數 | 50 浮點數 |
| 每個 GPU 的 NVFP4(訓練) | 10 浮點數 | 35 浮點數 |
| 記憶體應用 | ||
| GPU記憶體型 | HBM3e | HBM4 |
| GPU內存帶寬 | 約 8 TB/秒 | 約 22 TB/秒 |
| 互連線 | ||
| NVLink 世代 | NVLink 5 | NVLink 6 |
| NVLink頻寬(每個GPU) | 1.8 TB / s | 3.6 TB / s |
| 機架級 NVLink 頻寬 | 130 TB / s | 260 TB / s |
| 網路相關 | ||
| 橫向擴展網卡 | ConnectX-8(800 Gb/s) | ConnectX-9(1.6 TB/s) |
| CPU-GPU互連 | NVLink-C2C(900 GB/s) | NVLink-C2C(1.8 TB/s) |
基於 Vera Rubin 架構的產品將於 2026 年下半年起透過合作夥伴管道發售。這些合作夥伴包括領先的雲端服務供應商 Amazon Web Services、Google Cloud、Microsoft Azure 和 Oracle Cloud Infrastructure,以及 NVIDIA 雲端合作夥伴 CoreWeave、Crusoe、Lambda、Nebius、Nscale 和 Together AI。全球系統製造商戴爾科技、HPE、聯想和超微預計也將推出基於 Vera Rubin 架構的伺服器,此外還有華碩、富士康、技嘉、英業達、和碩、QCT、緯創和 Wiwynn 等廠商。
從 CPX 到 LPX:NVIDIA 收購 Groq 如何重塑解碼加速
去年在人工智慧基礎設施高峰會上,NVIDIA 發布了 CPX 機架,並推出了兩種配置,旨在加速長上下文推理查詢。當時我們報告了這項消息,也因此對 CPX 的實際功能產生了一些疑問。乍一看,雖然 CPX 的架構概念很有趣,但除了可能對注意力機制進行額外加速之外,它似乎並沒有在 Rubin GPU 本身的基礎上提供任何實質的功能。
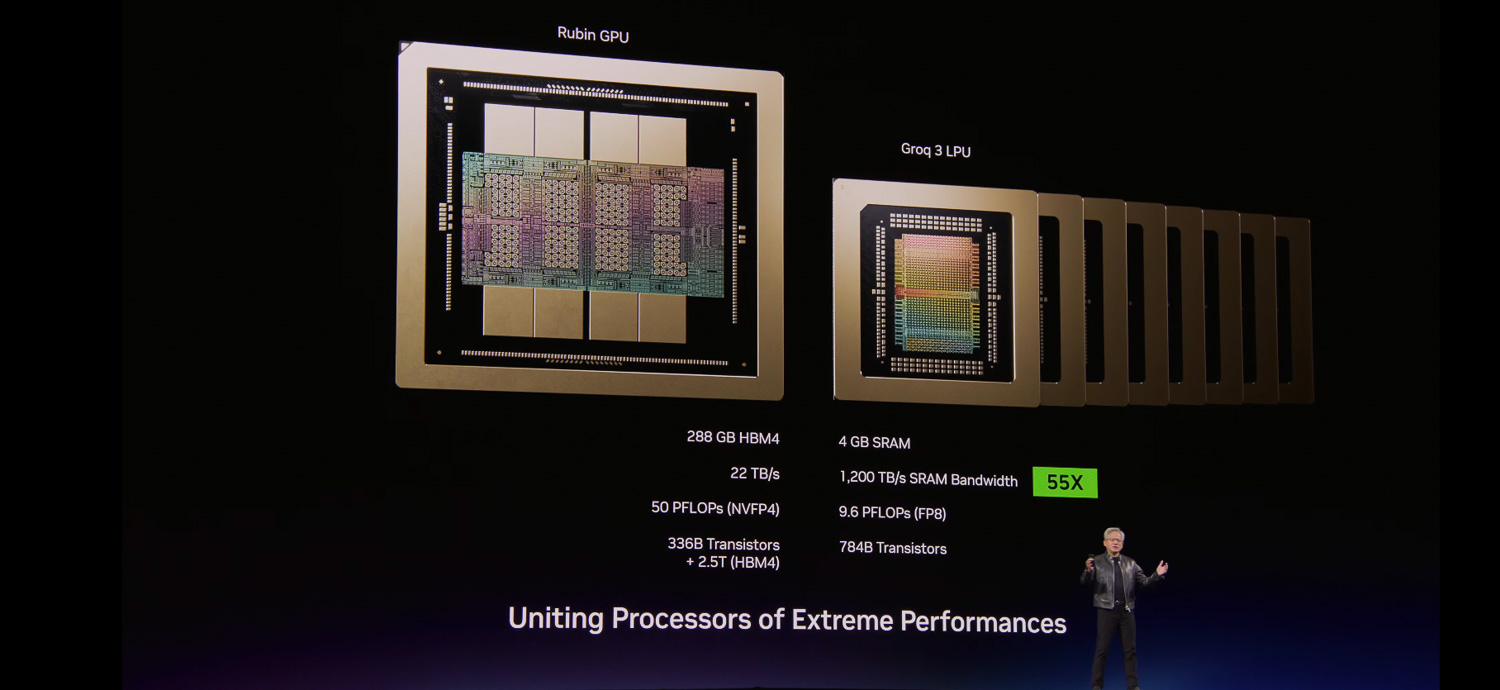
隨後,NVIDIA 收購了 Groq,這在業界引起了巨大反響,並引發了人們對 NVIDIA 將如何將 Groq 的 LPU 技術整合到更廣泛的 Vera Rubin 平台中的猜測。在 2026 年 GTC 大會上,NVIDIA 透過發布 LPX 澄清了這些猜測。從展示的內容來看,CPX 機架的概念已經演變為 Groq 3 LPX 機架,原 CPX 專注於上下文處理的架構被基於 Groq 晶片構建的全新解碼加速架構所取代。
Rubin GPU 與 Groq 3 LPU:互補的架構
| 規格 | 魯賓GPU | Groq 3 LPU (LP30) |
|---|---|---|
| 內存類型 | HBM4 | 堆疊式SRAM |
| 內存容量(每晶片) | GB 288 | 500 MB |
| 內存帶寬 | 22 TB / s | 150 TB / s |
| 強度 | 高通量訓練和預填充 | 超低延遲令牌解碼 |
| 部署 | VR NVL72(每架 72 個) | LPX機架(每架256個) |
| 聚合機架內存 | 約20.7 TB HBM4 | 128 GB 內存 |
| 擴充頻寬(機架) | 260 TB/s NVLink 6 | 640 TB / s |
單一 LPX 機架可容納 256 個 Groq 3 LPU。每個 LPU 包含約 500 MB 的堆疊式 SRAM,該機架可提供約 128 GB 的片上 SRAM 和 640 TB/s 的擴展頻寬,專為超低延遲解碼加速而設計。兩種處理器類型之間的差異十分顯著:Rubin GPU 提供 288 GB 的 HBM4 顯存,頻寬為 22 TB/s;而 LPU 則以容量換取原始頻寬,每個晶片的 SRAM 池可提供 150 TB/s 的頻寬。當透過客製化的基於 Spectrum X 的互連與 VR NVL72 協同部署時,這兩個機架將協同處理每個解碼命令,其中註意力解碼由 Rubin 負責,而前饋層則卸載到 LPU。針對萬億參數模型和百萬令牌上下文進行了最佳化,協同設計的 LPX 架構與 Vera Rubin 配合使用,可最大限度地提高功耗、記憶體和運算效率。 LPX 機架採用全液冷設計,基於 MGX 基礎設施,將於 2026 年下半年上市,與 Vera Rubin 的全面推廣同步進行。

重要的是,NVIDIA 確認無需對 CUDA 進行任何更改。 LPU 作為現有 CUDA 堆疊的加速器運行在 Vera 和 NVL72 平台上,以透明的方式按令牌卸載計算任務。在 GTC 問答環節,NVIDIA 將 LPU 描述為“解碼模型加速器”,並解釋說他們將“與正在部署這些萬億參數模型的 AI 實驗室和 AI 前沿模型構建者深入合作”,以實現下一代高端和超高端模型服務。 Groq 的許多創辦人和工程師已加入 NVIDIA,據報道,兩支團隊之間的合作非常出色,他們正攜手推進 Groq 的路線圖,將其融入 MGX 基礎設施。 LPX 的部署初期將專注於模型建構者和服務供應商,而非針對廣泛的 OEM 廠商。我們期待看到 NVIDIA 和 Groq 的整合帶來的實際效能提升。
Vera CPU 機架:專為強化學習與智慧體工作負載打造的運算平台
為什麼智能體人工智慧需要一種新型CPU
要理解英偉達為何打造專用的CPU機架,首先需要了解強化學習(RL)在現代人工智慧開發中訓練後階段的工作原理。訓練後階段是指模型在大規模資料集上完成預訓練之後,對模型進行最佳化和定制,使其更適用於特定應用場景。
在強化學習框架中,訓練循環包含三個核心組件:策略模型(即被訓練的模型)、模型執行動作並接收回饋的環境,以及用於評估這些動作品質的獎勵訊號。策略模型產生候選輸出,這些輸出隨後在環境中執行,由獎勵模型進行評分,並利用所得梯度更新策略。
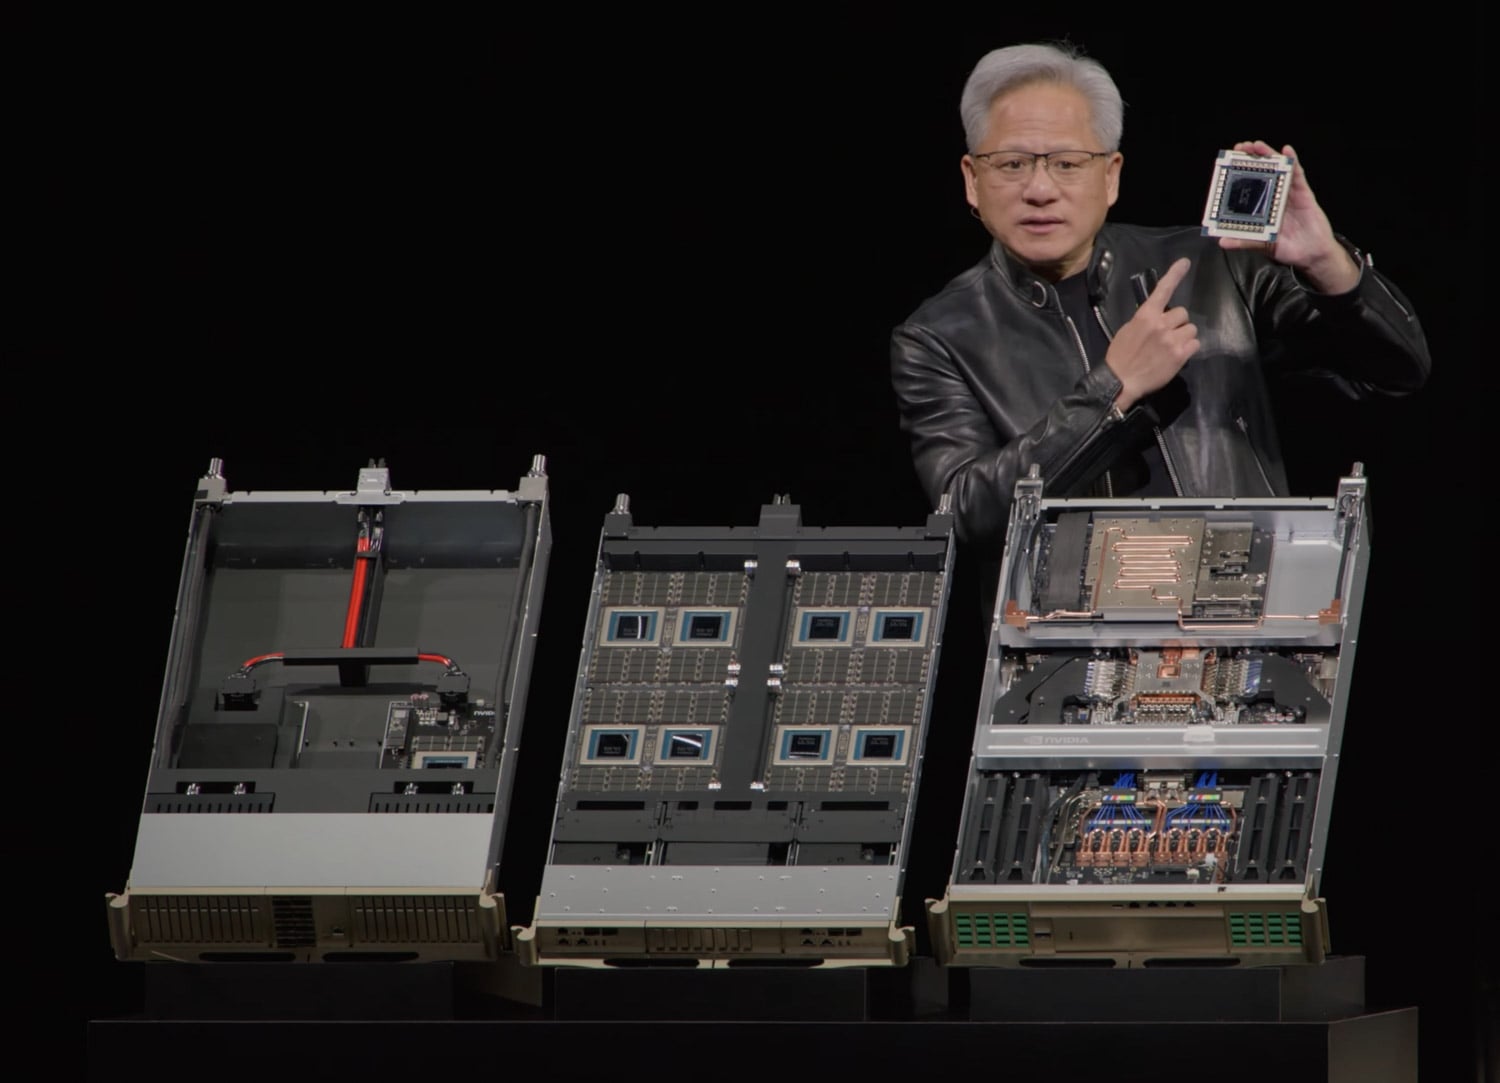
對於智慧體人工智慧工作負載而言,這種強化學習環境並非抽象的模擬環境,而是真實的運算沙箱。例如,考慮使用 Claude Code 或類似的自主編碼代理工具對智能體編碼模型進行後訓練。在這種情況下,需要三個不同的計算池同時運作。首先,有一個由 GPU 加速器組成的訓練池,用於更新策略模型的權重。其次,推理加速器運行目前策略模型的檢查點,大規模產生候選動作(程式碼編輯、工具呼叫、檔案操作)。第三,也是至關重要的,還有一個龐大的傳統 CPU 運算池,用於運行實際的強化學習環境。在這些環境中,智能體執行其產生的程式碼、執行測試套件、執行工具呼叫、發出 SQL 查詢、編譯二進位檔案、與檔案系統交互,以及執行所有產生獎勵訊號的沙箱操作,這些獎勵訊號會回饋到訓練循環中。
這種傳統計算需求規模龐大。策略模型的每次執行都可能觸發數十個順序工具調用,每個工具調用都必須執行、評估並返回結果,下一步才能進行。當在訓練過程中並行產生數千個資料點時,需要龐大的高速 CPU 叢集來防止 GPU 訓練叢集在環境執行過程中停滯。 CPU 沙箱池中的任何延遲都會直接導致 GPU 週期閒置和訓練運算資源浪費。同樣的情況也適用於已部署的智能體系統的推理階段。智能體執行的每一次工具呼叫、程式碼編譯和沙箱執行都是 CPU 運作,必須夠快才能保持端到端智慧體管道的回應速度。正如 NVIDIA 的新聞稿所述,CPU 不再只是模型的支撐,而是模型的驅動者。
Vera CPU機架:NVIDIA的答案
為了滿足這項需求,NVIDIA 推出了 Vera CPU,該公司稱之為全球首款專為智慧體人工智慧和強化學習時代打造的處理器。 Vera CPU 機架是一個專用的機架級系統,包含 256 個液冷 Vera 處理器,能夠支援超過 22,500 個並發 CPU 環境,每個環境均可獨立運作並達到全效能。人工智慧工廠可以快速部署並擴展到單一機架中數萬個並發實例和智慧體工具。該機架提供 400 TB 的總記憶體、300 TB/s 的聚合記憶體頻寬和 64 個 BlueField-4 DPU,所有這些都與 Vera Rubin 和 DGX 生態系統相容,並基於 NVIDIA MGX 模組化參考架構建置。
Vera CPU 本身由 88 個 NVIDIA 客製化設計的 Olympus 核心所構成,完全相容於 Armv9.2 架構。每個核心都支援使用 NVIDIA 空間多執行緒技術同時執行兩個任務。第二代低功耗記憶體子系統基於 LPDDR5X 構建,可提供高達 1.2 TB/s 的頻寬,與通用 CPU 相比,頻寬翻倍,功耗只有一半。
除了卓越的效能之外,Vera Rack 還解決了供應鏈中的一個實際問題:營運規模達數萬 GPU 的 AI 工廠需要同樣龐大的 CPU 叢集來執行環境任務,而從 AMD 或 Intel 採購如此大量的高性能 x86 處理器,並按所需規模和時間交付,會帶來巨大的採購和供貨挑戰。而垂直整合的 NVIDIA CPU 機架則簡化了這種依賴性。
與 NVIDIA 合作部署 Vera CPU 的客戶包括阿里巴巴、位元組跳動、Meta 和 Oracle 雲端基礎設施,以及 CoreWeave、Crusoe、Lambda、Nebius、Nscale、Cloudflare、Together AI 和 Vultr。製造合作夥伴包括戴爾科技、HPE、聯想、超微、華碩、思科、富士康、技嘉和 QCT 等。
BlueField-4 STX 和 NVIDIA CMX:推理上下文記憶體儲存背後的參考架構
在 2026 年國際消費電子展 (CES) 上,NVIDIA 發布了推理上下文記憶體儲存 (ICMS) 平台,這是專為大規模 LLM 推理中的鍵值快取管理而建置的全新 AI 原生儲存基礎架構。在 2026 年全球技術大會 (GTC) 上,NVIDIA 發布了為其支援的參考架構:BlueField-4 STX。此模組化設計能夠無縫擴展 GPU 內存,以儲存代理上下文和鍵值快取資料。 STX 的首個機架級實作是全新的 NVIDIA CMX 上下文內存儲存平台,它透過高效能上下文層擴展 GPU 內存,從而支援可擴展的推理和代理系統。
當你考察基於Transformer的推理的擴展性時,專用儲存層的必要性就顯而易見了。每個產生的token必須透過注意力機制關注所有先前的token,而鍵值(KV)快取儲存預先計算的注意力矩陣以供重用,從而避免重複計算。問題在於,KV快取的大小會隨著序列長度和批次大小的增加而成長。在多租戶環境中,當處理跨越百萬級token上下文視窗的數千個並發請求時,GPU HBM就會耗盡。維運人員必須要麼減小批次大小、縮短上下文窗口,要麼增加GPU數量,而所有這些措施都會降低經濟效益或效能。
BlueField-4 STX 透過提供一個高頻寬的共享儲存層來解決這個問題,該儲存層專為 KV 快取存取模式而設計,位於 GPU HBM 和傳統儲存之間。它由 Vera Rubin 平台加速,並利用了針對儲存最佳化的 BlueField-4 處理器,該處理器將 Vera CPU 與 ConnectX-9 SuperNIC、Spectrum-X 乙太網路、NVIDIA DOCA 和 NVIDIA AI 企業軟體結合。 NVIDIA 聲稱,與傳統儲存相比,CMX 平台每秒可提供高達 5 倍的代幣處理速度;與傳統 CPU 架構相比,高效能儲存的能源效率提高了 4 倍;企業級 AI 資料的資料攝取速度提高了 2 倍。
NVIDIA 也推出了 DOCA Memos,這是一個全新的 DOCA 框架,它利用專用的 KV 快取處理能力來增強 BlueField-4 存儲,從而提高推理吞吐量並顯著提升能源效率。其結果是實現了 POD 範圍內的上下文信息,從而能夠更快地與 AI 代理進行多輪交互,提供更具可擴展性的 AI 服務,並提高整體基礎設施的利用率。這與開源的 NVIDIA Dynamo 專案緊密相關,後者為分離式預填充/解碼階段、智慧路由和分層儲存卸載提供了軟體框架。
STX 是 NVIDIA 不直接銷售,而是提供給儲存生態系統合作夥伴的參考架構。參與基於 STX 架構的下一代基礎設施聯合設計的儲存供應商包括 Cloudian、DDN、戴爾科技、Everpure、日立 Vantara、HPE、IBM、MinIO、NetApp、Nutanix、VAST Data 和 WEKA。建構基於 STX 架構系統的製造合作夥伴包括 AIC、Supermicro 和 QCT。計劃採用 STX 架構進行情境記憶儲存的領先 AI 實驗室和雲端供應商包括 CoreWeave、Crusoe、IREN、Lambda、Mistral AI、Nebius、Oracle 雲端基礎設施和 Vultr。基於 STX 架構的平台將於 2026 年下半年由合作夥伴提供。
Vera Rubin DSX AI 工廠參考設計和 Omniverse DSX 藍圖
除了單一機架和擴展艙之外,NVIDIA 還發布了 Vera Rubin DSX AI Factory 參考設計以及 NVIDIA Omniverse DSX Blueprint 的正式發布,二者共同構成了一個全面的框架,用於設計、構建和運營協同設計的 AI 基礎設施,從而最大限度地提高每瓦特的令牌數,並加快首次投產的速度。透過緊密整合式運算、網路、儲存、電源和冷卻,該架構提高了能源效率,並確保 AI 工廠能夠在持續、高強度的工作負載下可靠擴展,同時保持最高的正常運作時間。
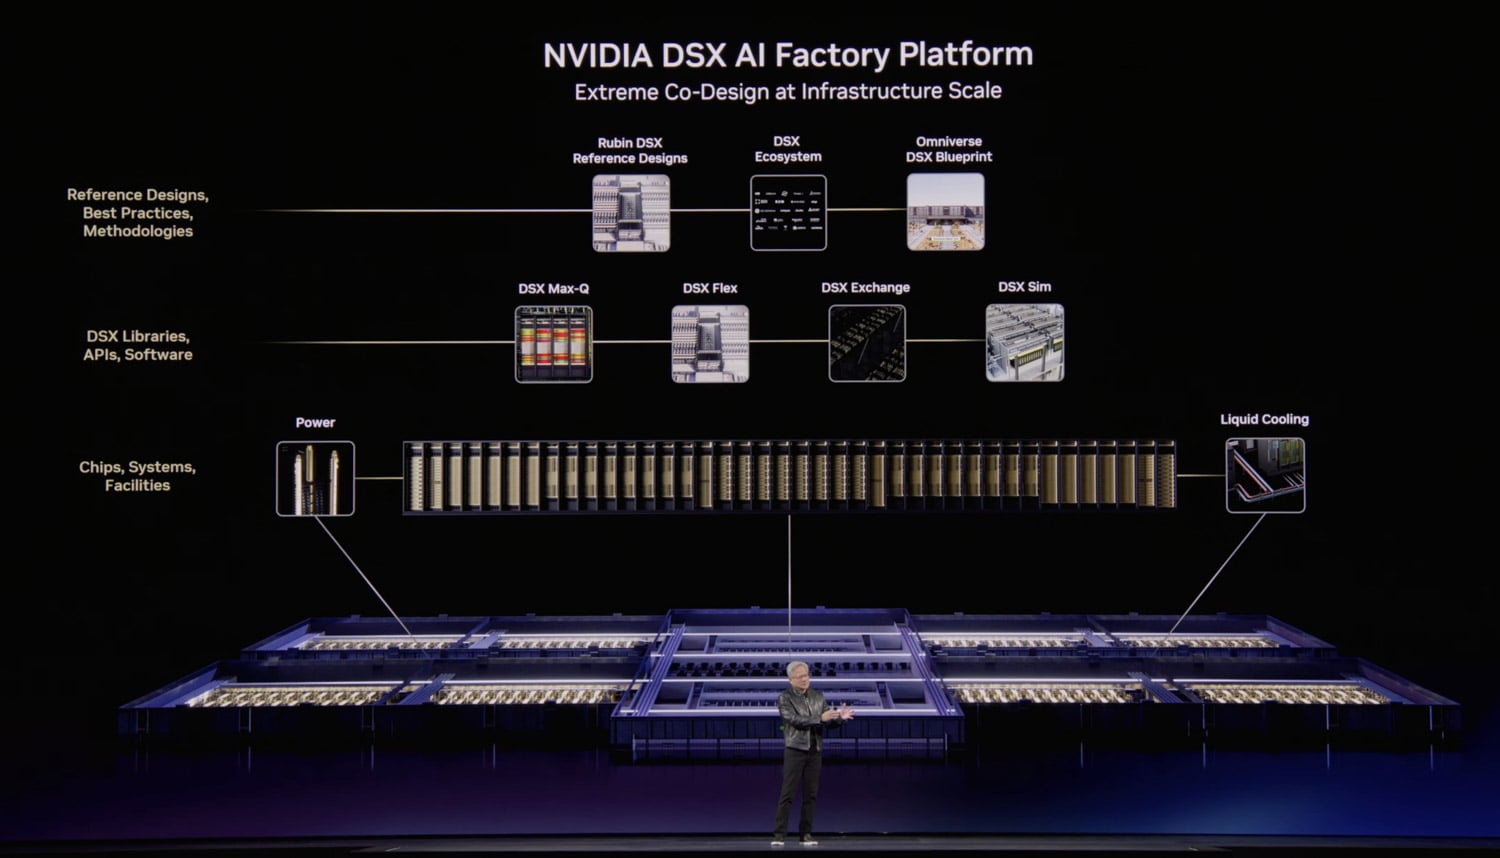
Rubin DSX 軟體堆疊採用開放式、模組化和可組合的設計,將叢集硬體與電力和冷卻系統連接起來。它包含多個元件庫:DSX Max-Q 支援在整個 AI 工廠內實現動態電力配置,從而在固定功率的資料中心內部署多 30% 的 AI 基礎設施。 DSX Flex 使 AI 工廠成為電網靈活的資產,釋放 NVIDIA 估計的 100 吉瓦閒置電網電力。鑑於能源目前是 AI 基礎設施建設的最大瓶頸,這項功能至關重要。目前,美國有超過 300 億美元的設備積壓,以及超過 200 吉瓦的計畫等待互聯。 DSX Exchange 支援在 IT、營運技術和營運代理之間實現運算、網路、能源、電力和冷卻訊號的可擴展且安全的整合。 DSX Sim 模型使用 NVIDIA DSX Air 平台驗證 AI 工廠作為高保真數位孿生體的功能。
Omniverse DSX Blueprint 現已在 build.nvidia.com 上正式發布,並與 Vera Rubin DSX 參考設計完全相容。它允許開發人員建立其 AI 工廠的實體精確數位孿生模型,即時模擬運行,並在建造或部署開始之前優化性能。此藍圖將電源、冷卻、網路和運維整合到一個統一的環境中,從而加快產品實現盈利的速度並提高 AI 效率。
參與 DSX 架構和藍圖開發的行業領導者包括 Cadence、達梭系統、伊頓、Jacobs、Nscale、Phaidra、Procore Technologies、PTC、施耐德電機、西門子、Switch、特靈科技和 Vertiv。值得一提的是,Nscale 和卡特彼勒正在西維吉尼亞州一個數吉瓦的園區內,將 DSX Vera Rubin 參考設計付諸實踐,該園區被譽為全球最大的 AI 工廠之一。在能源方面,Emerald AI、GE Vernova、日立和西門子能源正在利用 DSX 參考架構釋放電網容量,為新建 AI 工廠提供所需的電力。 Phaidra 已將 DSX Max-Q 整合到自學習 AI 代理程式中,該代理程式透過減少冷卻峰值,在確保安全性的前提下,可提供約 10% 的額外運算能力。
NVIDIA Agent Toolkit 和 OpenCLAW:自主代理的軟體棧
TC 2026 也重點關注了智慧體 AI 工作負載的快速成長,NVIDIA 將自主代理描述為該公司迄今為止成長最快的工作負載。軟體發布的核心是 OpenCLAW,它被譽為可能是歷史上最重要的軟體版本,是一個用於編排名為 CLAW 的長期運作、自我演化的代理的框架。 CLAW 是一種自主系統,能夠規劃、行動並執行整個任務,而不僅僅是單一任務。 NVIDIA 將 CLAW 定義為 AI 的全新應用層,並指出我們已經從詢問「什麼、如何或為什麼」轉變為詢問「建置、建立或製作」。
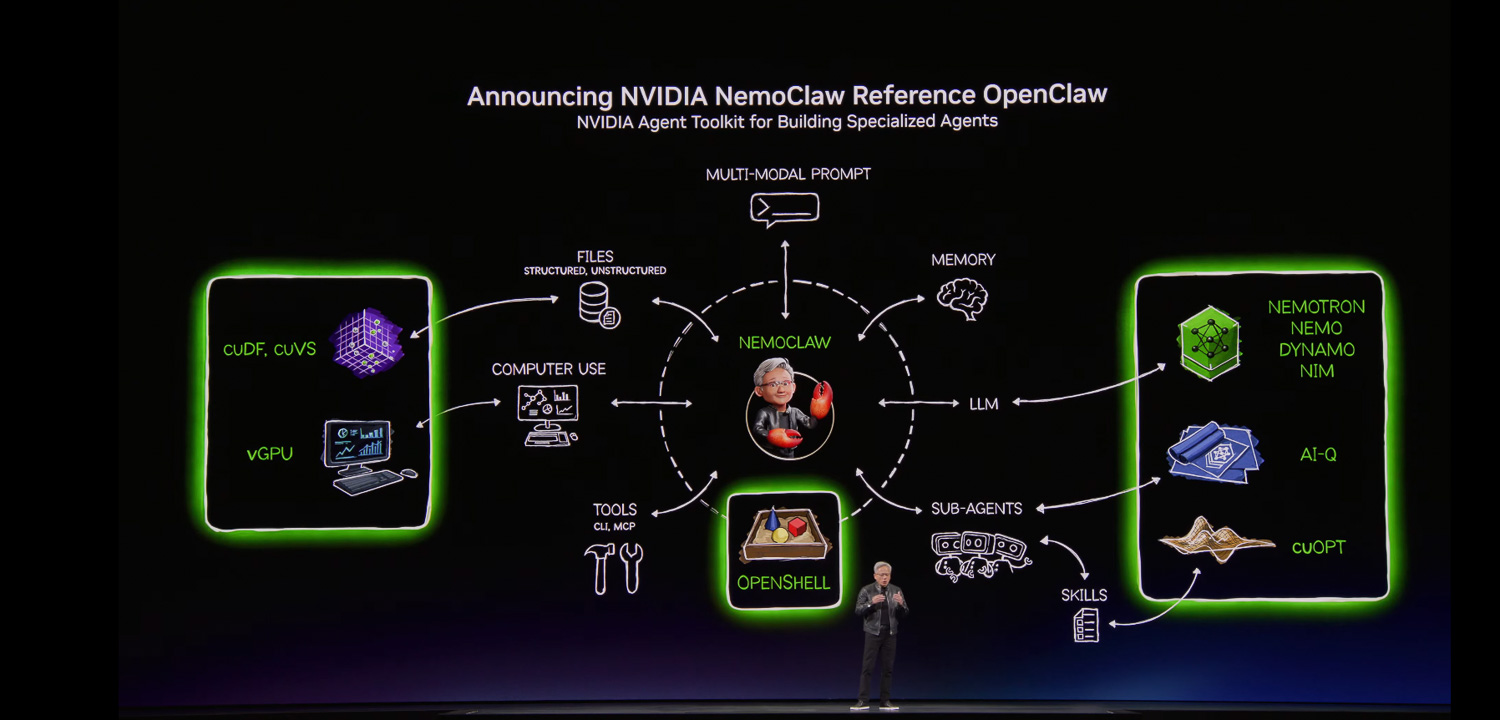
NVIDIA 發布了 NVIDIA Agent Toolkit,這是一個完全開源的模型、執行時間和藍圖集合,用於建立、評估和最佳化長時間運行的自主代理。其關鍵組件包括用於推理、編碼和語音的 Nemotron 開放模型;用於代理分析和定制的 Nemo;用於模型推理的 NIM;以及用於橫向擴展服務的 Dynamo 1.0。新增元件包括 NVIDIA OpenShell,這是一個開源的安全運行時,為代理執行提供基於策略的網路、隱私和安全防護;以及 IQ,這是一個開源藍圖,結合了前沿模型和開放模型的智能,用於深度研究代理,它是首個同時在深度研究基準測試 1 和復雜深度研究基準測試 2 中名列前茅的研究系統。新增的 cuOPT 技能則帶來了處理以自然語言描述的最佳化問題的專業知識。
NVIDIA 也發布了 Nemo CLAW,這是其對 OpenCLAW 社群的貢獻,由 NVIDIA 與 OpenCLAW 建構者 Peter Steinberger 合作開發。 Nemo CLAW 只需一條指令即可安裝 OpenCLAW、Nemotron 模型和 OpenShell 執行階段環境,為智慧體在預設的隱私和安全防護範圍內開發和學習新技能奠定了基礎。它可以在任何平台上運行,從雲端基礎設施到本地 RTX PC、DGX Station 和 DGX Spark。
DGX Spark 和 DGX Station:本地 CLAW 開發平台
鑑於許多開發者更傾向於使用能夠完全掌控運算資源的本地開發環境,NVIDIA 推出了兩款專為 CLAW 智能體開發而打造的全新平台。 DGX Spark 是一款高效能、高能源效率的平台,可運作安全可靠、始終在線的自主智慧體。目前,基於 DGX Spark 和 GB10 的 OEM 合作夥伴系統已在全球上市。 DGX Station 定位為終極本地 CLAW 開發平台,使開發者能夠在完全本地運行具有前沿智慧的模型,而無需雲端連接。這對於開發至關重要,因為所有操作都保留在本地,從而實現完全控制和安全性。 DGX Station 系統將於 2026 年 3 月 16 日起透過 OEM 合作夥伴接受預訂。
維拉·魯賓太空艙:地球之外的人工智慧基礎設施
NVIDIA宣布,其最新的加速運算平台正在開啟太空創新的新時代,將人工智慧運算引入軌道資料中心(ODC)、地理空間智慧和自主太空作業。 NVIDIA Vera Rubin太空模組的AI運算能力比NVIDIA H100 GPU高出25倍,可用於太空推理,使大型語言模型和高階基礎模型能夠在軌道上直接運行。其緊密整合的CPU-GPU架構提供了即時處理來自太空儀器的海量資料流所需的效能和記憶體。
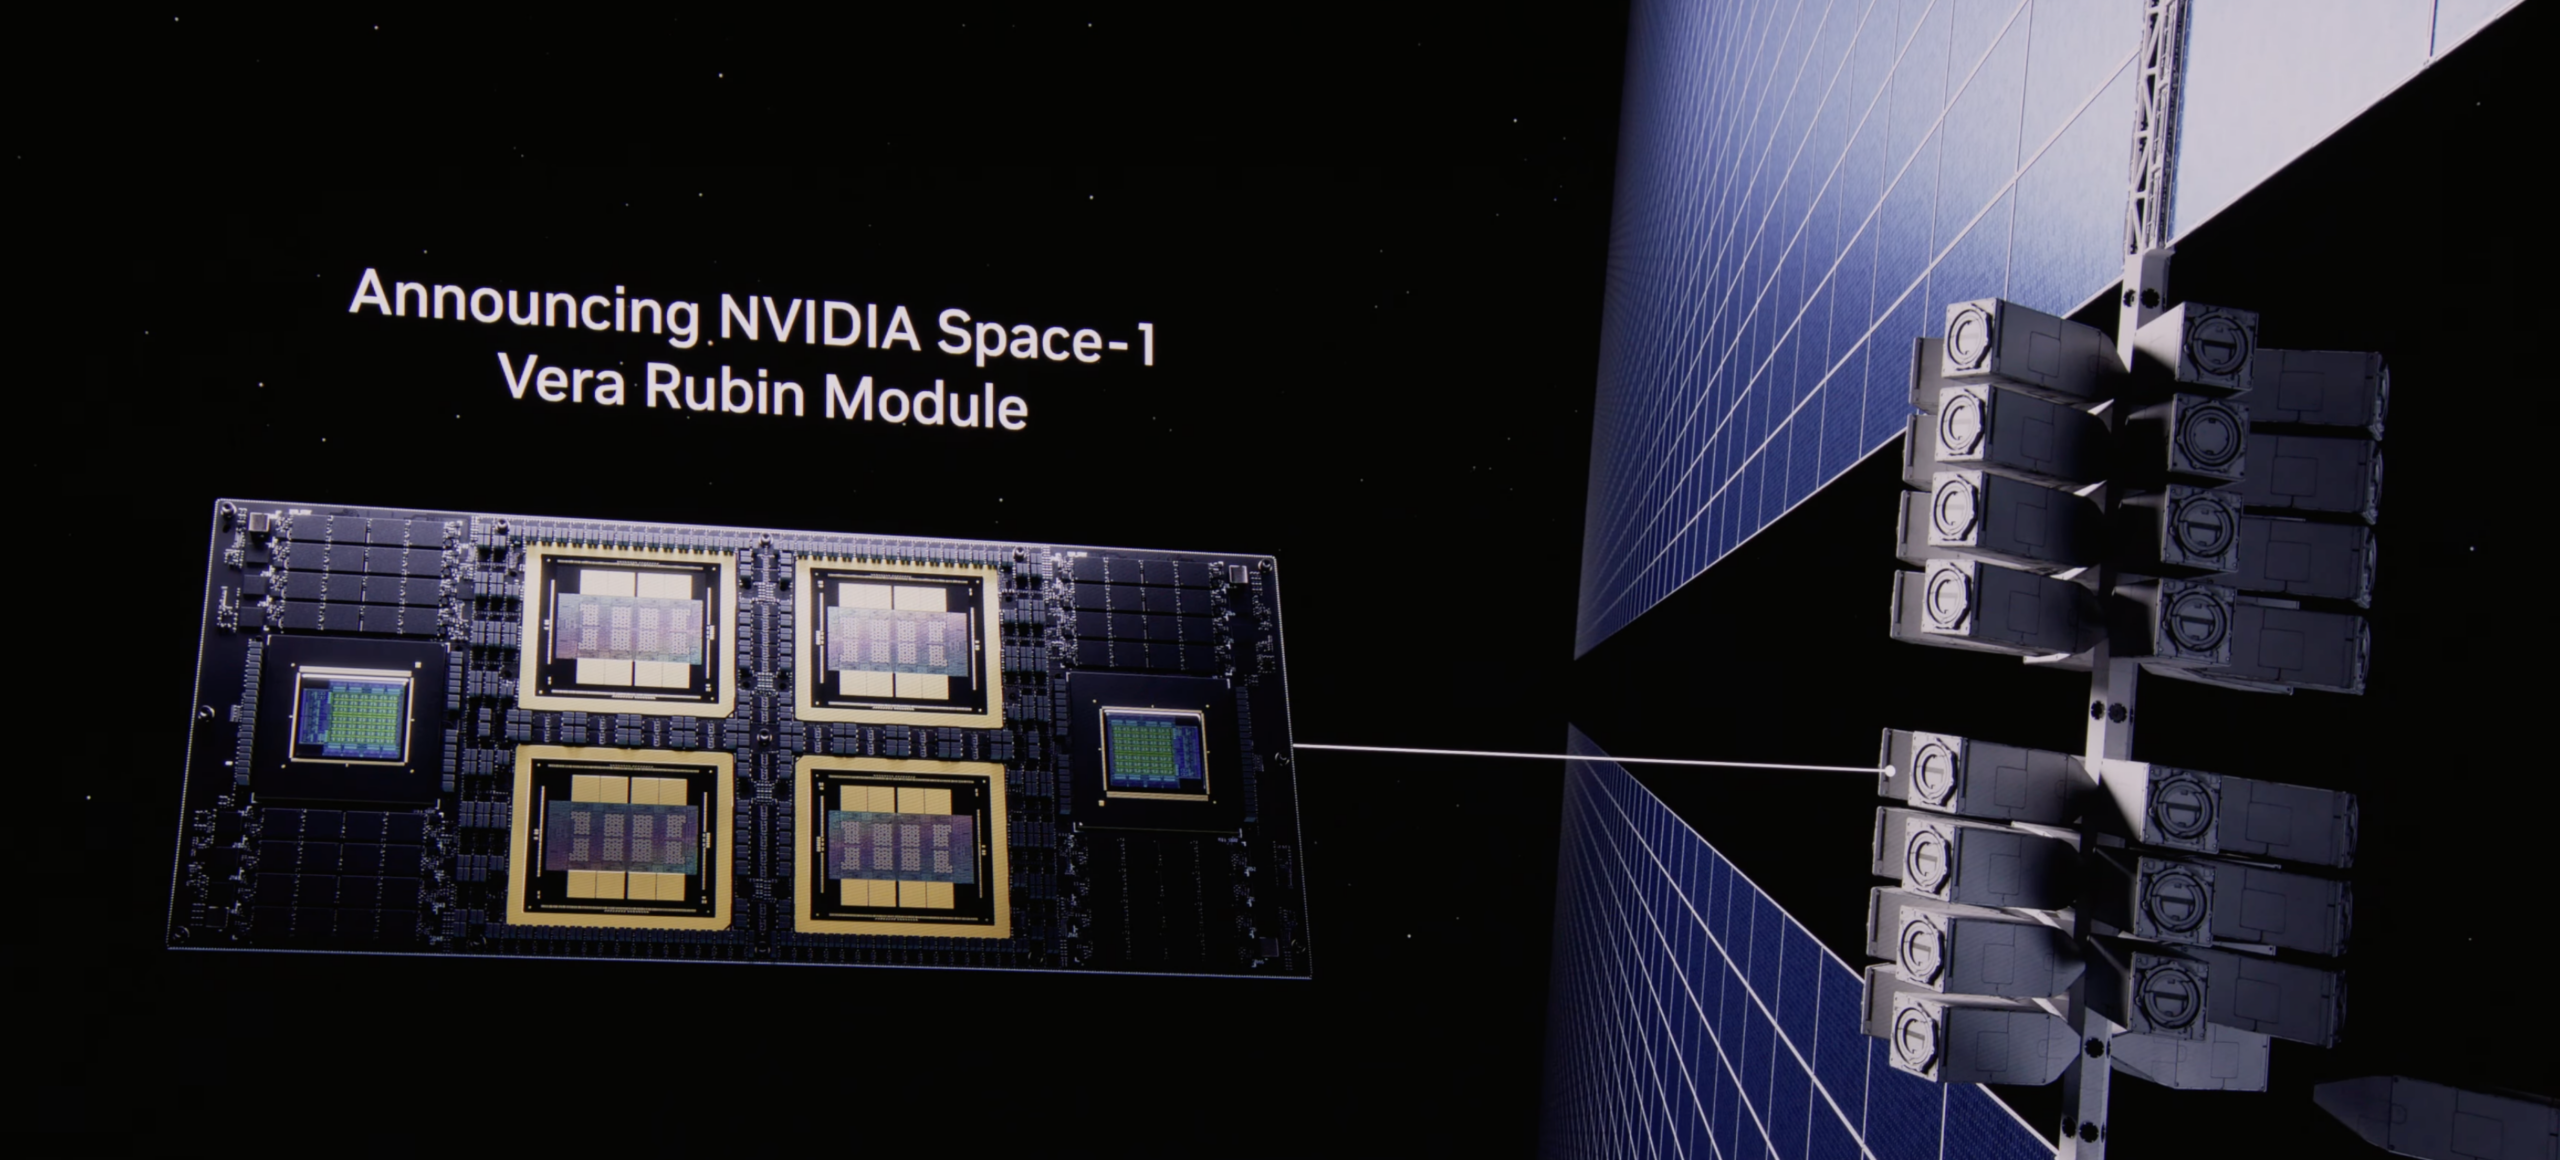
與 Vera Rubin 空間模組相輔相成,NVIDIA IGX Thor 為軌道上的關鍵任務邊緣環境提供工業級耐用性;而 Jetson Orin 則在一個超緊湊的模組中提供高性能 AI 推理,該模組針對受 SWaP 限制的航天器進行了優化。在地面上,RTX PRO 6000 Blackwell 伺服器版 GPU 的效能比傳統的基於 CPU 的批次系統快 100 倍,可用於地理空間智慧處理。包括 Aetherflux、Axiom Space、Kepler Communications、Planet Labs、Sophia Space 和 Starcloud 在內的合作夥伴正在基於這些平台建立下一代太空任務,涵蓋軌道資料中心、自主太空操作和即時地球觀測等領域。
NVIDIA Dynamo 1.0:人工智慧工廠的推理作業系統
在 GTC 2026 大會上,NVIDIA 發布了開源軟體 Dynamo 1.0,並將其正式投入生產。 NVIDIA 將其定位為首個用於 AI 工廠推理的分散式作業系統。就像電腦作業系統協調硬體和應用程式一樣,Dynamo 1.0 作為 AI 工廠的分散式編排層,能夠無縫管理叢集中的 GPU 和記憶體資源,從而大規模地支援複雜、異質的 AI 工作負載。
Dynamo 1.0 透過智慧路由和在 GPU 與低成本儲存層之間移動資料的功能,將推理工作分配到多個 GPU 上,從而減少運算浪費並緩解記憶體限制。對於智慧型體 AI 和長上下文工作負載,Dynamo 可以將請求路由到已保存先前步驟中最相關鍵值快取資料的 GPU,並在不需要時卸載這些內存,此功能與 BlueField-4 STX/ICMS 儲存架構直接整合。在最近的行業基準測試中,Dynamo 將 NVIDIA Blackwell GPU 的推理性能提升了高達 7 倍,降低了代幣成本,並為數百萬已部署的 GPU 增加了收入機會,所有這些都基於免費的開源軟體。
NVIDIA 透過將 Dynamo 和 TensorRT-LLM 最佳化整合到包括 LangChain、llm-d、LMCache、SGLang 和 vLLM 在內的常用推理框架中,加速了開源生態系統的發展。 Dynamo 的核心建置模組,例如用於記憶體管理的 KVBM、用於快速 GPU 間資料傳輸的 NIXL 以及用於簡化擴充功能的 Grove,也以獨立模組的形式提供。此外,NVIDIA 也為 FlashInfer 專案貢獻了 TensorRT-LLM CUDA 內核,以便將其原生整合到開源框架中。
該平台的應用範圍十分廣泛。 NVIDIA 推理平台現已與包括 AWS、Microsoft Azure、Google Cloud 和 Oracle Cloud Infrastructure 在內的雲端服務供應商,以及 NVIDIA 雲端合作夥伴阿里雲、CoreWeave、Crusoe、DigitalOcean、Nebius、Nscale 和 Together AI 在內的多家雲端服務商整合。人工智慧原生公司 Cursor、Hebbia 和 Perplexity 以及推理終端供應商 Baseten、Deep Infra 和 Fireworks 也已採用此平台。包括 Amazon、AstraZeneca、BlackRock、ByteDance、Coupang、Instacart、Meituan、PayPal、Pinterest、Shopee 和 SoftBank Corp. 在內的全球企業也已採用 NVIDIA 推理技術堆疊。 Dynamo 1.0 現已開放給全球開發者。


 Amazon