

HPE 發布了 NVIDIA AI Computing by HPE 產品組合的更新,旨在支援大規模 AI 工廠和下一代超級電腦。這些產品將運算、GPU、網路、液冷、軟體和服務整合到全端解決方案中,專為大規模和自主環境而設計。 NVIDIA AI 已整合到HPE 百億億次級超級運算平台。阿貢國家實驗室、HLRS、Hudson River Trading 和韓國科學技術資訊研究院均已採用整合 NVIDIA 技術的 HPE AI 基礎設施,以加速科學和產業創新。
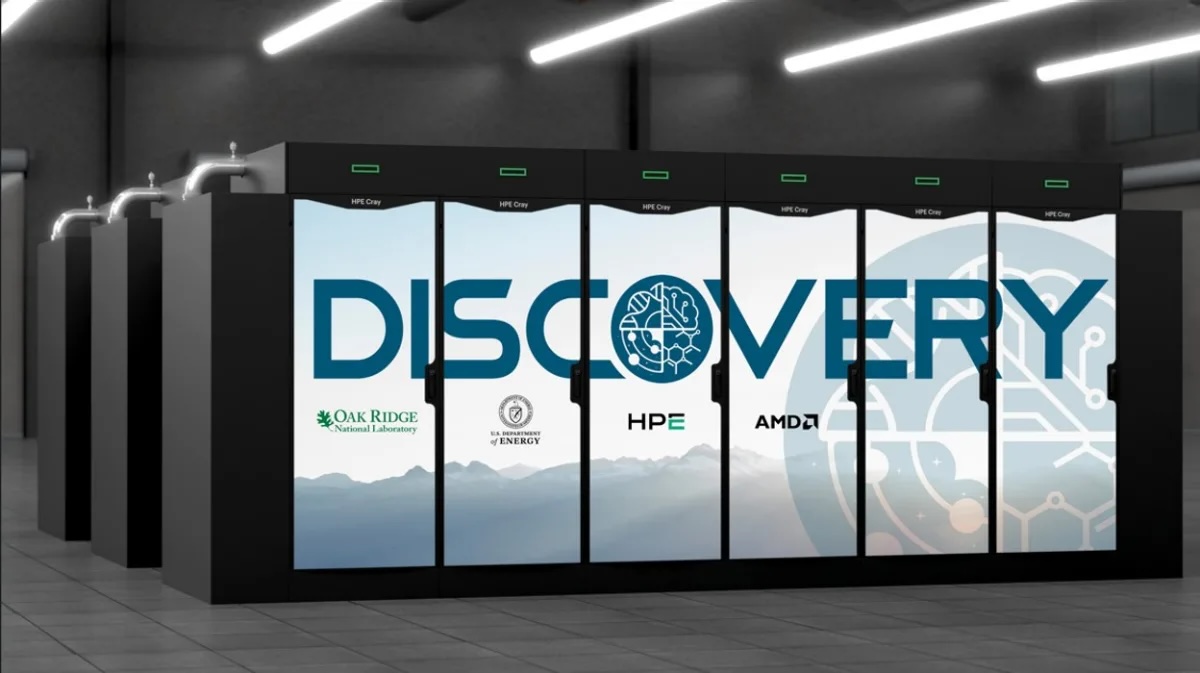
HPE 正在將 NVIDIA 技術擴展到其第二代百億億次級平台 HPE Cray 超級運算 GX5000 中,該平台將人工智慧 (AI) 和高效能運算 (HPC) 整合於單一架構中。研究實驗室、主權實體和企業正日益將 AI 模型與傳統的 HPC 模擬結合,而 HPE 正在調整該平台以滿足這些整合的需求。
HPE產品線新增了一款基於NVIDIA Vera CPU的計算刀鋒伺服器。每台液冷式HPE Cray超級運算GX240計算刀鋒伺服器最多可配備16顆NVIDIA Vera CPU。一個完整的機架最多可支援40台刀鋒伺服器,總計640顆CPU和56,320個Arm相容核心。 GX240的目標應用是需要持續高吞吐量的高密度、高效能AI運算環境。
HPE 也正在擴展大規模系統的網路選項,增加了對NVIDIA Quantum-X800 InfiniBand 的支援。這些交換機提供 144 個端口,運行速度為 800 Gb/s,並整合了節能功能,這在百億億次級運算中變得越來越重要。
HPE 資深副總裁兼高效能運算和人工智慧基礎設施解決方案總經理 Trish Damkroger 表示,公司在百億億次級超級運算領域的經驗正在影響其將高階人工智慧工作負載與傳統高效能運算相結合的方式。她指出,與 NVIDIA 的持續合作有助於客戶實現更高的性能密度,並推動醫療、生命科學、工程和製造等領域的發展。
針對大規模且自主部署的 HPE AI Factory 的增強功能
除了超級運算產品組合外,HPE 還在擴展其 HPE AI Factory,以支援採用 NVIDIA Vera Rubin 和 NVIDIA Blackwell 平台的服務供應商、主權政府和大型企業。
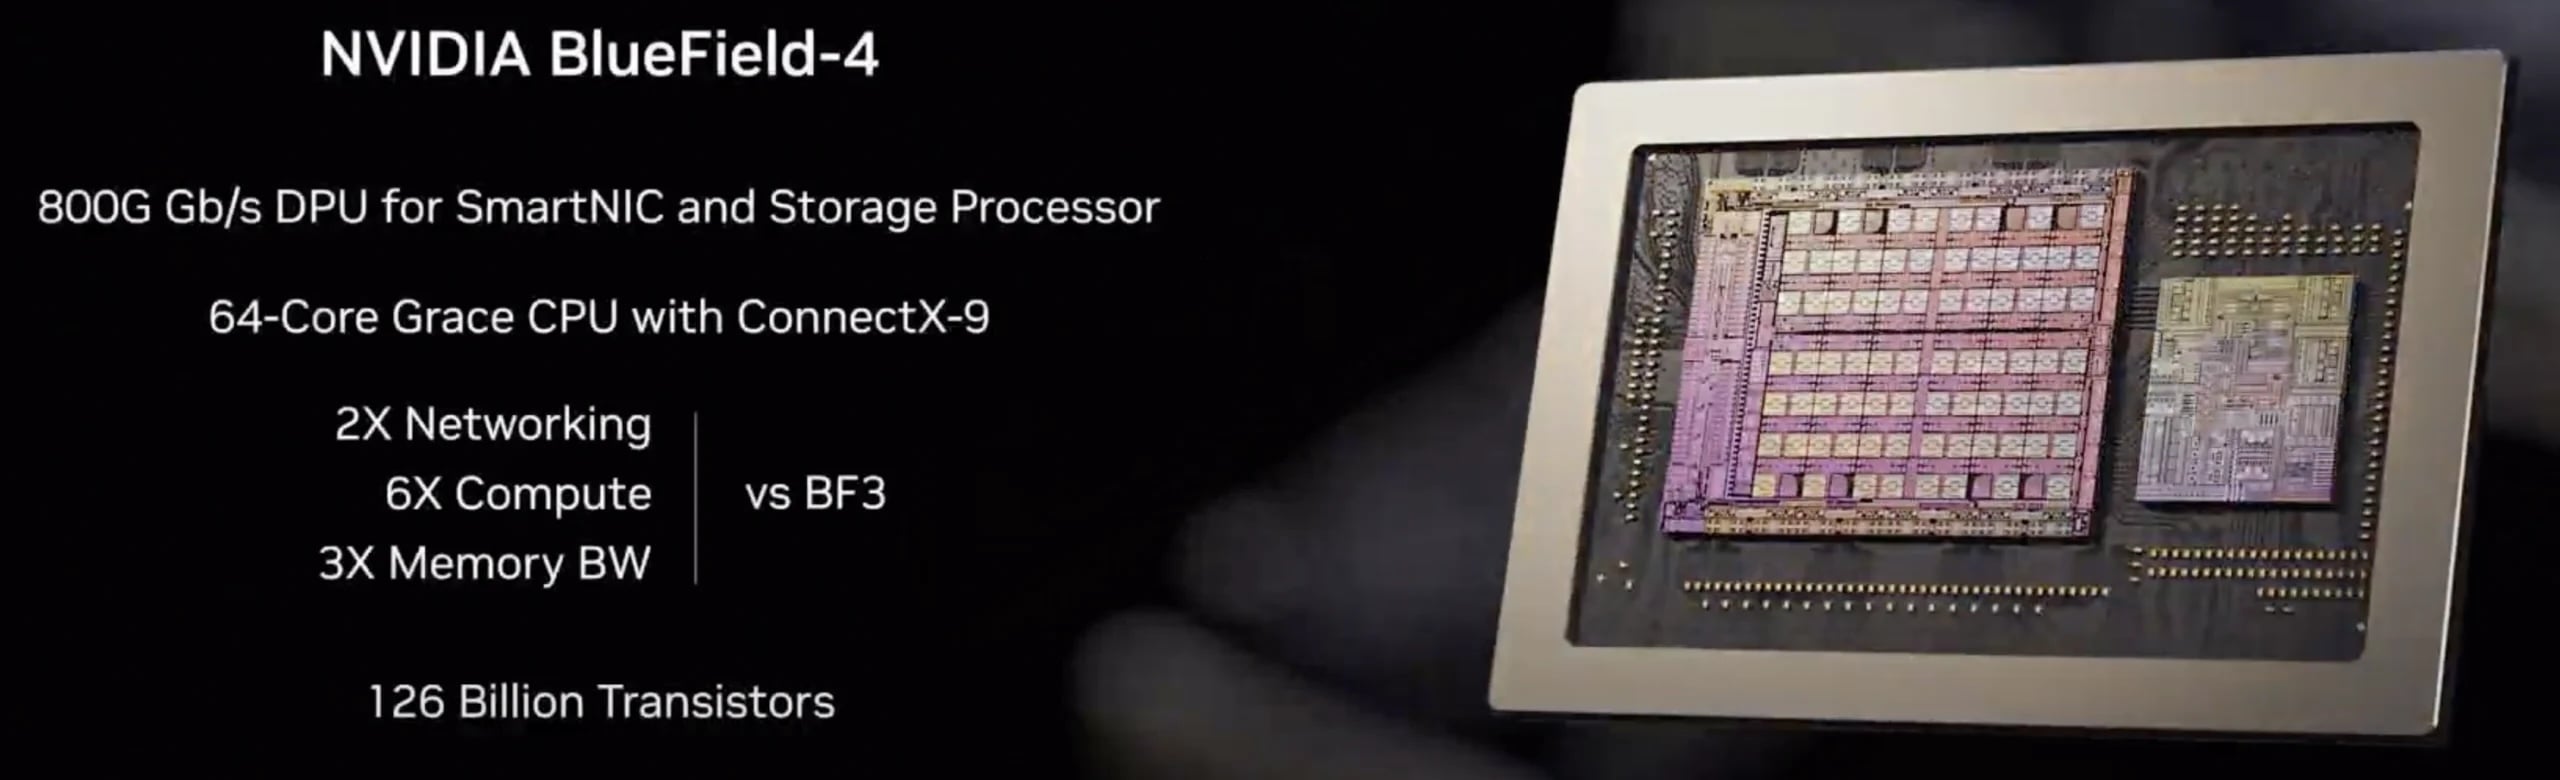
HPE推出的新一代NVIDIA Vera Rubin NVL72是此次發表會的重頭戲。這款機架級系統專為參數量超過兆的超大規模模型而設計,可高效部署於新雲端環境中。它包含36個NVIDIA Vera CPU、72個NVIDIA Rubin GPU、第六代NVIDIA NVLink縱向擴充網路、NVIDIA ConnectX-9 SuperNIC以及NVIDIA BlueField-4 DPU。 HPE將該平台與其液冷技術和資料中心設計服務結合,從而簡化大規模部署流程。
HPE 同時推出了 HPE Compute XD700,這是一款基於 NVIDIA HGX Rubin NVL8 的 OCP 系統。 XD700 專為高密度 AI 訓練和推理而設計,每個機架最多可支援 128 個 Rubin GPU。該系統在降低空間佔用、功耗和散熱的同時,GPU 密度比上一代產品翻了一番。
此外,HPE 正在擴大 NVIDIA Blackwell 的存取權限,使所有 HPE AI Factory 系統都能使用 NVIDIA RTX PRO 6000 Blackwell 伺服器版 GPU。
軟體和服務更新,加速人工智慧部署
HPE 的更新涵蓋了支援大規模 AI 工廠的軟體和服務堆疊。 HPE AI 工廠產品組合現已獲得 NVIDIA 雲端合作夥伴計畫的認可,這簡化了雲端營運商的 NVIDIA 雲端供應商認證流程。這有助於加快驗證週期,並簡化服務提供者建構多租戶 AI 環境的整合。
HPE 還透過支援虛擬機器 GPU 直通和使用 NVIDIA 多執行個體 GPU (MIG) 的安全 Kubernetes 命名空間,擴展了多租用戶選項。這些功能得益於與 SUSE Virtualization 和 SUSE Rancher Prime 的集成,使服務提供者能夠在嚴格和靈活的租戶模型之間進行選擇。
Red Hat Enterprise Linux 和 Red Hat OpenShift 作為 Red Hat AI Enterprise 的一部分繼續得到支持,並與 NVIDIA AI Enterprise 軟體無縫集成,為採用企業級 Linux 的客戶提供服務。
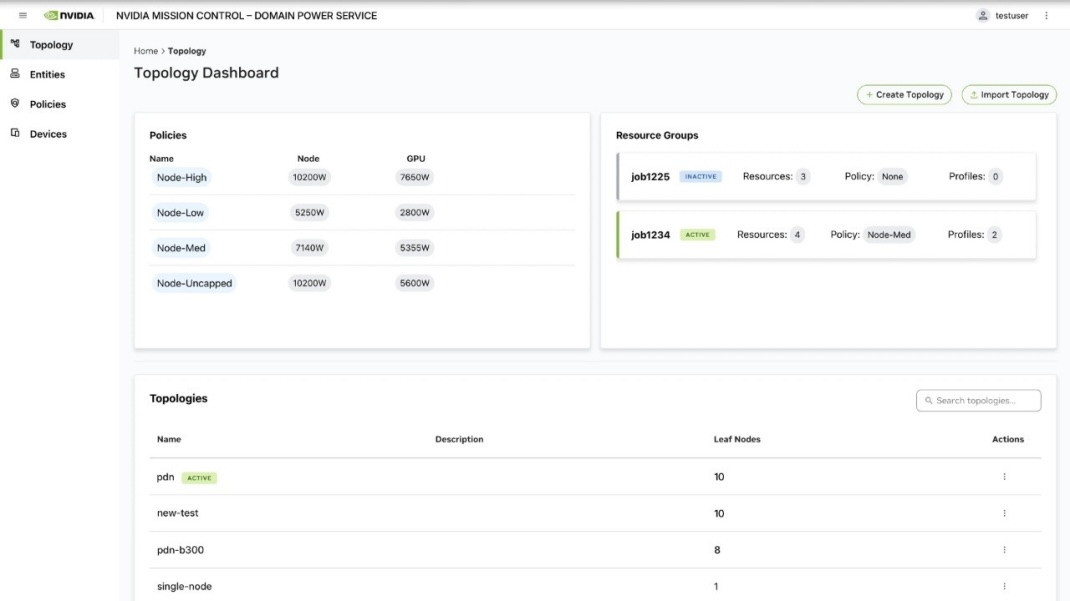
HPE AI Factory at scale 和 HPE AI Factory Sovereign 也將整合 NVIDIA Mission Control 軟體。 Mission Control 為 AI 工廠提供統一的運維層,透過NVIDIA Run:ai簡化編排流程,並添加來自 NVIDIA Dynamo 的監控和自主恢復功能。其目的是簡化管理,並提高運行大型 AI 叢集的平台團隊的運維一致性。
NVIDIA企業平台副總裁克里斯·馬裡奧特強調,人工智慧的開發依賴強大的基礎設施。他重點介紹了HPE和NVIDIA在加速運算、先進網路和液冷技術方面的聯合工程合作,旨在支援大規模自主部署中更快地獲得洞察。
庫存情況
NVIDIA RTX PRO 6000 Blackwell 伺服器版 GPU 現已加入 HPE AI Factory 產品組合。 Red Hat Enterprise Linux 和 Red Hat OpenShift 與 NVIDIA 的整合也已於今日推出。
HPE AI Factory 的多租戶和 GPU 直通功能將於 2026 年春季推出。 NVIDIA Mission Control 對 HPE AI Factory 的大規模和自主支援計劃於 2026 年稍後推出。 NVIDIA Vera Rubin NVL72 by HPE 機架式系統將於 2026 年 12 月上市。
HPE Compute XD700 將於 2027 年初上市。配備多達 16 個 NVIDIA Vera CPU 和 NVIDIA Quantum-X800 InfiniBand 網路的 HPE Cray Supercomputing GX240 超級運算刀片伺服器(適用於 HPE Cray Supercomputing GX5000)也將於 2027 年上市。


 Amazon