

IBM 持續改善其 Storage Scale System 6000 平台,以解決現代資料中心中一個常見的難題:資料孤島會拖慢 AI 專案進度、增加基礎架構複雜度並導致寶貴資訊滯留。 Storage Scale System 6000透過單一的全域命名空間和主動檔案管理 (AFM) 將邊緣、核心和雲端的資料統一起來,旨在為企業提供一個一致的高效能資料平台,能夠大規模地為 GPU 和 CPU 提供資料支援。最終,此儲存基礎架構能夠讓 AI 管線立即啟動並更快地交付結果,而無需再受制於傳統儲存的限制。
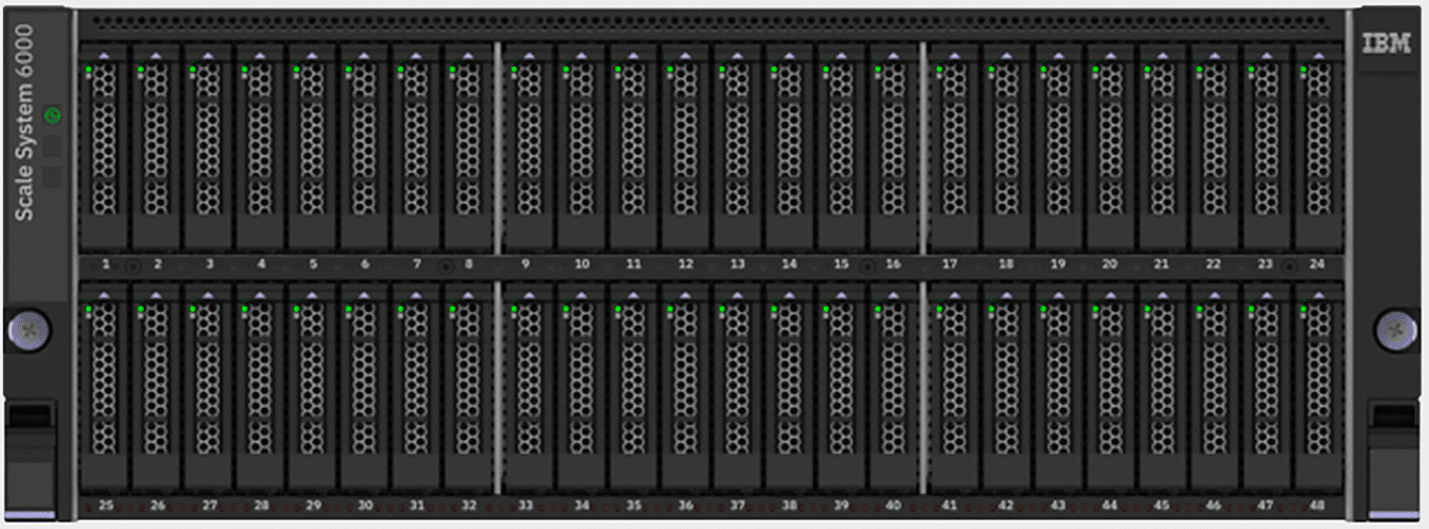
此次更新主要圍繞在企業當前最關注的兩大主題:釋放暗數據潛力以及消除 AI 推理和訓練瓶頸。 IBM 透過全新的全快閃擴充機殼、對高容量 QLC NVMe 媒體的支援以及旨在提升效能和效率的升級版軟體堆疊來應對這些挑戰。這些改進使 Storage Scale System 6000 成為一款高密度、可擴展且支援 AI 的儲存平台,適用於企業、高效能運算 (HPC) 和 AI 即服務 (AIaaS) 環境。
採用高密度QLC閃存,機架級容量提升三倍
IBM 最新推出的 Storage Scale System 6000 儲存系統,最大容量提升至每機架 47PB,是之前的 3 倍。此次容量提升得益於對 30TB、60TB 和 122TB 三種配置的業界標準 QLC NVMe SSD 的支援。客戶可以根據工作負載需求,更靈活地選擇合適的儲存介質,從對效能要求較高的應用場景到容量導向的 AI 儲存庫,都能輕鬆應對。
擴展的驅動器選項對於人工智慧和分析管道尤其重要,這些管道必須儲存和處理海量資料集,同時避免將其分散在多個孤島或平台上。透過將容量整合到單一全域命名空間中,Storage Scale System 6000 有助於降低管理開銷,同時仍能提供 GPU 密集型工作負載所需的效能。
IBM Storage Scale System 7.0.0:以 AI 與資料服務為導向的軟體增強功能
IBM Storage Scale System 7.0.0 軟體的發布引入了多項關鍵增強功能,以提高混合工作負載環境下的資料管理效率、效能和彈性。
首先,該平台現在支援在同一系統中採用符合業界標準的 NVMe TLC 和 QLC 隨身碟進行多快閃分層。此功能使企業能夠根據工作負載特性,靈活地兼顧成本、效能和耐用性。對延遲敏感的熱資料可以保存在基於 TLC 的層級中,而對容量要求較高或冷資料的儲存則可以保存在高密度 QLC 媒體上。這種分層模型提供了一種更精細的方式來優化整體擁有成本 (TCO),同時保持可預測的效能。
其次,IBM 推出了專用的資料加速層,該加速層採用高效能 NVMe-oF 為大規模應用程式提供資料。此加速層可提供高達 340GB/s 的吞吐量和高達 28 萬 IOPS 的效能。它旨在實現高壓縮效率和資料密度,同時降低單位效能的功耗。對於需要充分利用昂貴運算資源的 AI 和 HPC 團隊而言,此加速層尤其有助於最大限度地減少因儲存瓶頸而導致的 GPU 空閒時間。
第三,資料保護框架透過更廣泛的糾刪碼選項得到增強,包括支援 16+2/3P 配置。這些更廣泛的糾刪碼提高了磁碟效率和整體儲存利用率,同時也提升了效能和寫入吞吐量。最終形成的資料保護方案能夠隨著平台容量和吞吐量的提升而擴展,而不是成為瓶頸。
最後,該軟體堆疊整合了 NVIDIA Spectrum-X 乙太網路技術,以加速 AI 訓練工作流程。 Spectrum-X 可以顯著減少 AI 基礎模型訓練期間的檢查點時間,從而縮短訓練週期並提高基礎設施利用率。對於大規模訓練環境而言,這是一種在保持乙太網路架構的同時縮短洞察時間的有效方法。
全快閃擴充櫃
為了滿足處理海量資料集的工作負載需求,IBM 推出了 IBM Storage Scale System 全快閃擴充機箱。該機箱針對高效能 AI 訓練、推理、高效能運算 (HPC) 以及其他需要高吞吐量和大型連續資料集的資料密集型工作負載進行了最佳化。
透過整合 122TB QLC NVMe SSD,配備全快閃擴充櫃的 Storage Scale System 6000 可在單一 42U 機架中提供超過 47PB 的高密度、高性價比快閃記憶體容量。對於希望建構 AI 工廠或大規模 HPC 叢集的企業而言,這提供了一條清晰的路徑,能夠在不犧牲效能的前提下,將儲存整合到更小的空間中。
機殼也經過精心設計,可與 NVIDIA BlueField-3 DPU 集成,實現大規模加速。解決方案中的網路介面卡可提供高達 400Gb/s 的高效能網路吞吐量,並為儲存擴充系統提供 NVMe-oF 卸載功能。此卸載功能可降低 CPU 開銷,使更多主機資源能夠用於 AI、分析或 HPC 處理,而不是儲存和協定處理。
每個擴充櫃均採用 2U 機架式設計,可提供高達 100 GB/s 的吞吐量和超過 3PB 的原始快閃記憶體容量。這種高密度和高性能使其非常適合機架空間、電力和散熱條件高度受限,但性能要求卻不容妥協的環境。
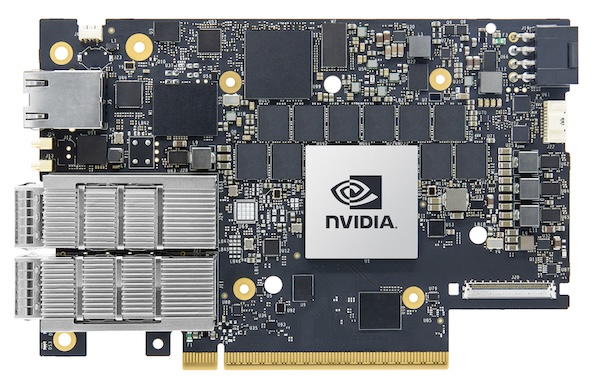
此機殼最多可支援 4 個NVIDIA BlueField-3 DPU和 26 個雙埠QLC SSD。此組合可實現高聚合頻寬、豐富的連接選項,並可根據工作負載的成長靈活擴展容量和卸載加速能力。
多租用戶和服務提供者用例
全新全快閃擴充櫃的可擴充性也符合更大快取配置和多租戶服務供應商的需求。 IBM Storage Scale System 6000 支援在叢集、檔案系統或檔案集層級進行高度可設定的多租用戶。
對於服務提供者和大型人工智慧工廠而言,這種設計提供了隔離工作負載、實施差異化安全策略以及將資源精確分配給租戶或內部業務部門的工具。隔離的實作不會犧牲效能或使營運模式複雜化。
無論環境是大型超級運算部署、傳統高效能運算集群,或是人工智慧即服務平台,此架構都旨在支援安全、可擴展且經濟高效的多租戶運作。各種資料密集型工作負載可以在同一基礎架構上共存,同時滿足合規性、效能和服務等級預期。
在支援現有工作負載的同時,大規模部署人工智慧
IT 基礎架構團隊面臨著巨大的壓力,既要擴展 AI 專案規模,又要繼續支援現有的企業工作負載和傳統應用程式。增強型 IBM Storage Scale System 6000 旨在透過單一平台滿足這兩種需求。
透過統一不同協定、位置和格式的數據,該系統使全球分散的團隊能夠直接協作處理共享數據,而無需將其複製或暫存到單獨的環境中。 IBM 的全球快取和資料編排層 AFM 憑藉三倍的容量和擴展的機箱選項,現在可以將更大的工作資料集快取到更靠近 GPU 的位置。這種近距離快取有助於消除資料孤島並減少資料移動開銷,從而實現更快、更有效率的 AI 管線。
企業無需為傳統工作負載和人工智慧維護獨立的儲存孤島,而是可以採用 Storage Scale System 6000 作為通用資料平面進行標準化。這種方法簡化了操作,支援多種協定和存取方式,同時也能提供現代人工智慧和高效能運算工作流程所需的效能。
庫存情況
IBM Storage Scale System 7.0.0 軟體預定於 12 月 9 日發布。全新 IBM Storage Scale System 全快閃擴充櫃將於 12 月 12 日正式上市。


 Amazon