

在 SC25 大會上,WEKA 推出了新一代 WEKApod 設備,旨在滿足那些需要在控製成本、功耗和空間佔用的同時,擴展 AI 和高效能運算規模的企業的需求。全新的 WEKApod Prime 和 WEKApod Nitro 平台旨在解決日益嚴峻的基礎設施效率危機,即 GPU 投資往往超過了維持其充分利用所需的儲存和網路系統。
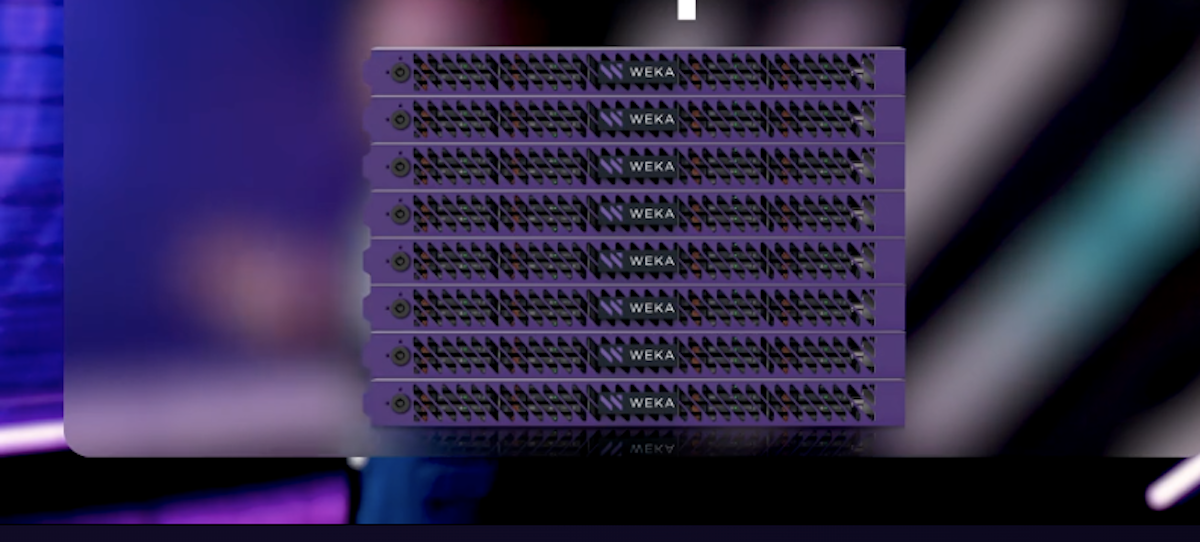
這一代產品的設計目標很明確:消除性能和成本之間的傳統權衡,同時提高密度和效率,使每個機架單元和每千瓦都能提供更多可用的 AI 容量。
基礎設施效率危機
企業和人工智慧雲端服務供應商面臨巨大的壓力,需要證明其在快速成長的人工智慧基礎設施投資方面能夠獲得回報。由於儲存瓶頸,昂貴的GPU往往利用率不足;訓練週期延長了價值實現時間;推理成本侵蝕了利潤;而隨著非結構化資料量的增長,雲端支出也在攀升。
同時,資料中心在機架空間、電力供應和冷卻能力方面都面臨嚴峻的挑戰。簡單地增加硬體並非可持續的策略。需要在極致效能和可控成本之間做出選擇的儲存系統,已不再符合大規模人工智慧部署的經濟效益。人工智慧工廠中的每個節點都必須有助於提高GPU利用率,並降低每個訓練和服務模型的成本。
新一代 WEKApod 系列旨在直接解決這個問題,它將高密度、高能源效率的硬體與 WEKA 的 NeuralMesh 軟體堆疊相結合,以保持 GPU 的高效運作並控制基礎設施成本。
WEKApod Prime:混合快閃記憶體經濟性,效能無損失
WEKApod Prime定位為企業提升儲存經濟效益而不犧牲效能的主要解決方案。據稱,它透過智慧地將資料分佈在多種快閃記憶體媒體上,並根據工作負載特徵優化寫入操作,實現了高達65%的性價比提升。
Prime 採用 WEKA 的 AlloyFlash 技術,將多種磁碟機類型整合到單一配置中。與建構傳統的多層快取層次結構(需要明確資料移動和常見的寫入懲罰)不同,AlloyFlash 可在各種操作中提供一致的效能。寫入操作旨在保持全速運行,而不會在負載下受到限制,這對於訓練檢查點、日誌記錄和其他寫入密集型 AI 工作流程至關重要。
從實體設計角度來看,WEKApod Prime 在 1U 伺服器中最多可支援 20 個硬碟,在 2U 伺服器中最多可支援 40 個硬碟。這在有限的空間內實現了高容量和高性能密度。 WEKA 報告稱,其容量密度比上一代產品提高了 4.6 倍,每機架單元的寫入 IOPS 提高了 5 倍。能源效率也是其重點關注領域,其功率密度提高了 4 倍,每千瓦時 IOPS 約為 23,000,每千瓦時 1.6 PB,每 TB 的功耗降低了 68%。
對於設計現代 AI 叢集的維運人員而言,這意味著儲存層能夠在現有功耗和空間限制內,跟上 GPU 的吞吐量。對於模型訓練、檢查點和資料預處理等寫入密集任務,儲存系統不太可能成為瓶頸,導致加速器閒置。
丹麥人工智慧創新中心 (DCAI) 等早期採用者正在使用 WEKApod Prime,以在緊湊的佔地面積內實現他們所說的超大規模資料中心層級的吞吐量和效率。 DCAI 強調,提高每千瓦和每平方公尺的 AI 容量,直接提升了其基礎設施的經濟可行性,並加快了客戶 AI 部署速度。
WEKApod Nitro:面向人工智慧工廠的效能密度
Prime系列產品著重於性價比和容量效率,而WEKApod Nitro則專為運作數百甚至數千個GPU、需要極致性能密度的AI工廠而設計。 Nitro採用升級後的硬件,與上一代產品相比,性能提升約2倍,性價比提高60%。
Nitro 配置包含 NVIDIA ConnectX-8 SuperNIC,在 1U 機架式機箱內配備 20 個 TLC SSD,可提供 800 Gb/s 的網路吞吐量。這種高頻寬設計旨在滿足網路和儲存必須與 GPU 叢集的橫向擴展特性相符的環境,從而避免在大規模訓練和高吞吐量推理過程中出現瓶頸。
Prime 和 Nitro 皆可作為 NVIDIA DGX SuperPOD 和 NVIDIA 雲端合作夥伴 (NCP) 認證的交鑰匙設備提供。對於技術銷售團隊和解決方案架構師而言,這意義重大,因為它可以縮短部署週期。客戶無需花費數週時間進行整合、調優和驗證工作,即可將 WEKApod 作為預驗證組件整合到基於 DGX 和 NCP 的架構中,從而縮短上線時間,並加快新 AI 服務實現盈利的速度。
NVIDIA 將其 Spectrum-X 乙太網路和 ConnectX-8 網路定位為 WEKApod 架構的核心基礎。從系統設計的角度來看,這強化了消除儲存、交換矩陣和 GPU 節點之間的資料瓶頸,從而優化整體 AI 效能的概念。
神經網格和軟體定義靈活性
在硬體平台方面,WEKApod 由 NeuralMesh 提供支援。 WEKA 將 NeuralMesh 描述為首個專為大規模加速 AI 而建構的儲存系統。 NeuralMesh 負責提供軟體定義的儲存層,以及現代環境中所需的企業級功能。
WEKApod 設備透過即用型預先驗證配置和增強型設定實用程序,提供 NeuralMesh 功能,旨在提供即插即用的體驗,而非複雜的整合專案。企業可以從少至八台伺服器起步,並隨著需求的成長擴展到數百台,而無需重新架構儲存環境。
NeuralMesh 包含分散式資料保護、即時快照、多重協定存取、自動分層、加密和混合雲支援等核心企業級功能。這意味著 AI 優化的效能和密度不會以犧牲資料彈性、治理或維運靈活性為代價。
WEKApod 將這些軟體功能與高密度硬體相結合,旨在不僅作為高效能文件或物件存儲,而且作為 AI 工廠、大規模物件儲存和 AI 資料湖部署的基礎資料平台。
針對不同客戶群實現業務成果
新一代 WEKApod 系列產品對不同目標受眾的商業影響各不相同,但其核心在於提高基礎設施投資報酬率和更有效地利用現有投資。
對於人工智慧雲端供應商和新興的新型雲端平台而言,65% 的性價比提升旨在直接轉化為更高的 GPU 即服務利潤率。在保持性能 SLA 的前提下,能夠在相同的基礎設施上支援更多客戶,從而提高盈利能力和容量規劃效率。 WEKApod 部署的交鑰匙特性也縮短了新客戶的上線時間,加快了獲利速度。
對於部署內部 AI 工廠的企業而言,WEKApod 可以將部署週期從數月縮短至數天。其開箱即用的整合、預先驗證和企業級功能,使 IT 團隊無需具備並行檔案系統或效能調優方面的深厚專業知識,即可輕鬆建立 AI 工作負載的儲存環境。同時,更高的密度和效率可將每 TB 的功耗降低高達 68%,並避免隨著 AI 能力的成長而一對一擴展資料中心規模。
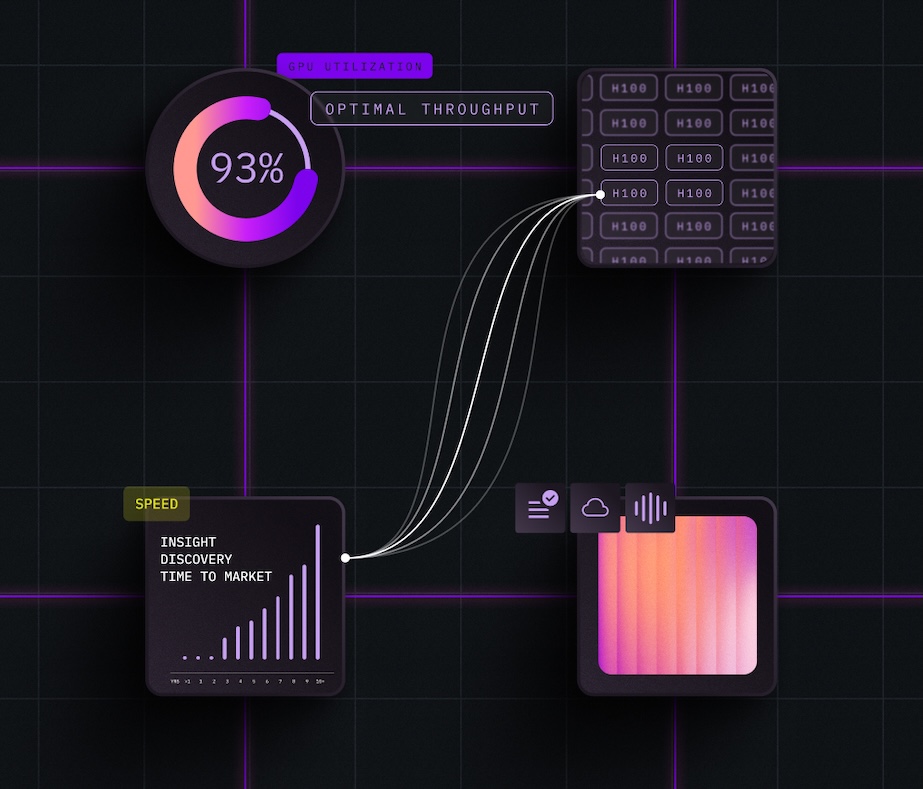
對於人工智慧開發者和研究人員而言,關鍵價值在於更高的GPU利用率和更短的訓練週期。 WEKApod的設計旨在透過確保儲存層和網路架構不會成為瓶頸,從而支援90%以上的GPU利用率。更快的模型訓練速度和更短的迭代時間,在實驗速度決定業務成果的環境中,能夠帶來競爭優勢。高效的儲存和網路支援更低的推理成本,也能使原本可能因成本過高而難以大規模部署的新型人工智慧應用在經濟上可行。
WEKA首席產品長Ajay Singh認為,這些更新對於確保AI投資獲得回報至關重要。他指出,WEKApod Prime在不犧牲吞吐量的前提下,顯著提升了性價比;而WEKApod Nitro則提高了性能密度,從而更好地利用GPU。總而言之,這些更新將有助於加快模型開發速度,提高推理吞吐量,並提升計算基礎設施的投資報酬率。
全新的 WEKApod Prime 和 Nitro 設備鞏固了 WEKA 在人工智慧和高效能運算 (HPC) 儲存市場的地位,旨在實現高效能、高密度和高效率的完美結合。 Prime 專注於打破效能與成本之間的傳統關聯,採用智慧混合快閃記憶體管理和 AlloyFlash 技術。同時,Nitro 則憑藉其高效能網路和緊湊的外形尺寸,瞄準了 GPU 密集型人工智慧工廠。
WEKApod 結合 NeuralMesh 軟體套件和即用型 NVIDIA 認證配置,旨在解決技術和業務難題:保持 GPU 高效運作、管理資料中心電力和空間,並縮短 AI 服務上市時間。對於技術銷售團隊和解決方案架構師而言,其價值主張在於更高的利用率、更優的利潤和更快的部署速度,並輔以密度、效率和性價比的顯著提升。


 Amazon