

歐洲人工智慧雲端服務供應商 Verda 選擇採用 Supermicro 的液冷式、NVIDIA Blackwell 加速機架級系統,為其垂直整合的人工智慧雲端平台提供支援。該平台專為前沿模型開發者、人工智慧原生企業和受監管企業打造。該基礎設施正在歐洲各地部署,服務於歐洲、美國和亞洲的客戶。
部署的核心是Supermicro基於NVIDIA Blackwell和Blackwell Ultra GPU架構建構的機架級基礎架構。這些系統旨在滿足日益增長的大規模AI訓練和推理需求,尤其適用於開發前沿模型和部署生產級AI服務的機構。 Verda平台的目標客戶包括AI原生新創公司、研究機構以及在資料主權和效能至關重要的監管環境下運作的企業。
為現代工作負載打造的機架級人工智慧基礎設施
Verda 的部署方案包含一系列針對不同層級 AI 工作負載最佳化的 Supermicro 系統。該基礎設施配備了NVIDIA GB300 NVL72機架式系統,專為高密度 GPU 集群和大型模型訓練而設計;同時還配備了 NVIDIA HGX B300 和 HGX B200 平台,可為訓練和推理提供靈活的擴展能力。此外,RTX PRO 6000 Blackwell Server Edition GPU也提供了額外的處理能力,適用於企業級 AI 應用、視覺化和邊緣運算等工作負載。
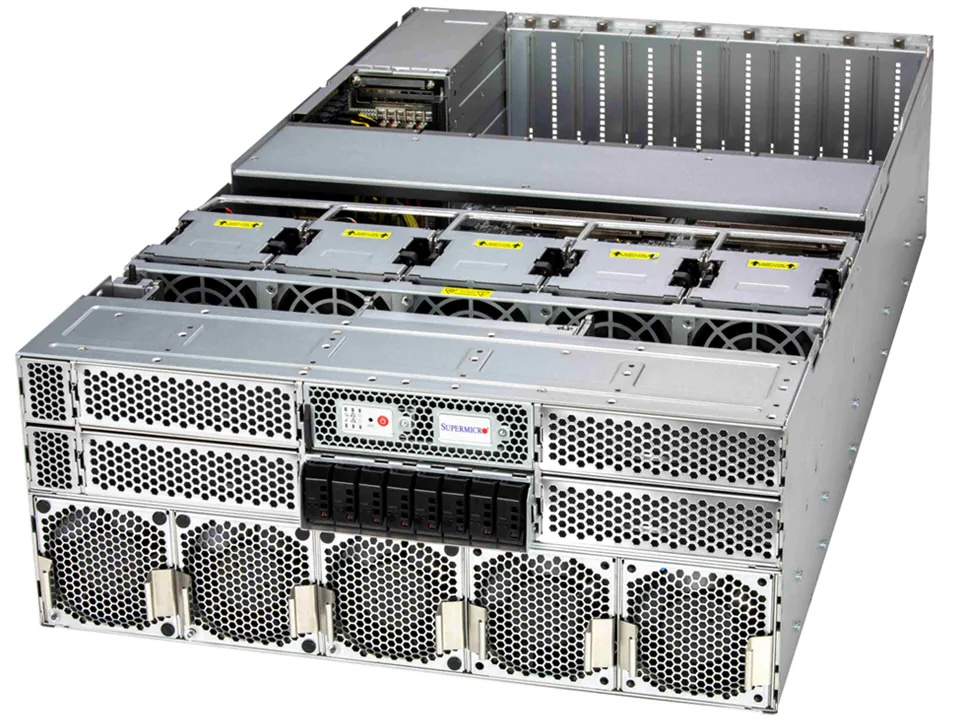
這種系統組合使 Verda 能夠支援廣泛的 AI 應用場景,包括大型語言模型訓練、多模態 AI 管線、機器人開發和企業級推理工作負載。透過在統一平台上整合多種 GPU 架構,Verda 能夠在保持高利用率的同時,使基礎設施資源與工作負載需求相符。
具有靈活消費模式的全端式人工智慧雲
Verda 將其平台定位為全端式 AI 雲,將基礎設施、編排和服務交付整合到單一產品中。該環境透過多種消費模式提供對 GPU 資源的訪問,包括自助式實例和叢集、無伺服器容器環境以及託管推理端點。
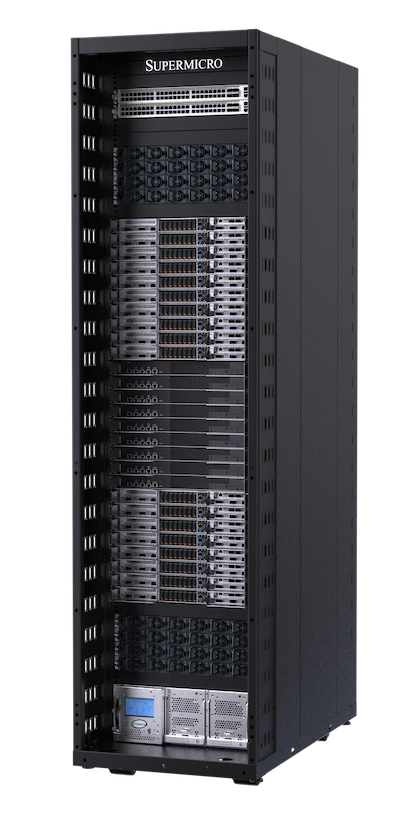
這種方法反映了人工智慧基礎設施市場向按需存取高效能運算的更廣泛轉變。企業越來越需要能夠在無需管理底層硬體的情況下動態擴展 GPU 資源。 Verda 的平台抽象化了這種複雜性,同時保留了對高效能 NVIDIA 基礎架構的直接存取。
透過預驗證系統加速部署
Supermicro 在部署過程中扮演的角色遠不止於硬體供應。其資料中心建置模組解決方案 (DCBBS)框架提供預先驗證的模組化基礎設施,簡化了機架和資料中心層面的整合。這包括經過驗證的計算、儲存、網路和軟體組件組合。
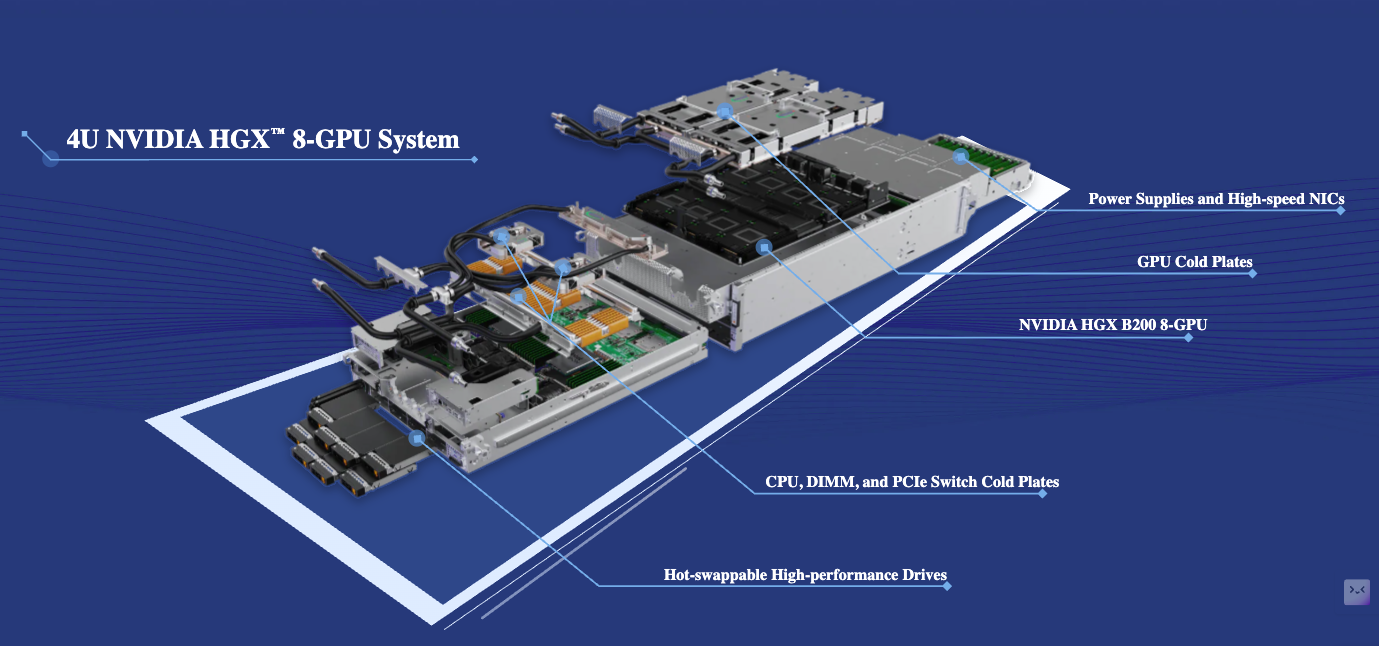
透過利用這些預先測試過的配置,Verda 縮短了部署時間並降低了整合風險。機架級整合也透過優化電源傳輸、散熱管理和互連拓撲結構,提升了系統級效能。這對於基於 Blackwell 的系統尤其重要,因為功率密度和散熱效率是此類系統的關鍵設計考量。
效率和永續性作為設計優先考慮因素
能效是部署的核心。基於 Blackwell 架構的系統旨在提供比以往 GPU 更高的每瓦效能,從而直接影響營運成本和可擴展性。 Supermicro 的系統級優化透過提高利用率和降低基礎設施開銷,進一步降低了整體擁有成本。
Verda公司在提高效率的同時,也採用了以永續發展為核心的營運模式。該公司表示,其資料中心100%使用再生能源。此外,Verda還與區域公用事業公司合作,將設施產生的廢熱重新利用,為多達15,000戶家庭提供暖氣。這種熱能再利用方式在高密度人工智慧部署中日益普遍,因為這些部署會產生大量的熱能。
使基礎設施與人工智慧市場需求保持一致
此次合作凸顯了人工智慧基礎設施市場向垂直整合的機架級解決方案發展的更廣泛趨勢。隨著模型規模的擴大和工作負載的日益複雜,傳統的基於伺服器的部署方式正被緊密整合的系統所取代,這些系統能夠優化計算、網路和電源方面的效能。
Supermicro 的 DCBBS 方案體現了這種轉變,它使企業能夠部署模組化基礎設施,從而實現從單一伺服器到完整資料中心的擴展。對於 Verda 等供應商而言,這種靈活性支援快速擴展,同時保持跨區域的一致性。
隨著對GPU加速基礎設施的需求持續超過供應,系統供應商和雲端服務供應商之間的合作變得至關重要。 Verda的部署展示了基於Blackwell的預先整合平台如何在滿足營運效率和永續性要求的同時,大規模地提供高效能AI服務。


 Amazon