

在NVIDIA GTC 2026 大會上,英特爾宣布其至強 6 處理器將作為 NVIDIA DGX Rubin NVL8 系統的主機 CPU。此次設計合作進一步拓展了至強處理器在 NVIDIA GPU 平台中的應用,並凸顯了該處理器在建構大規模 GPU 加速 AI 基礎架構方面的重要作用。隨著 AI 工作負載向大規模即時推理轉型,主機 CPU 仍然是系統級可擴展性和架構連續性的關鍵元件。
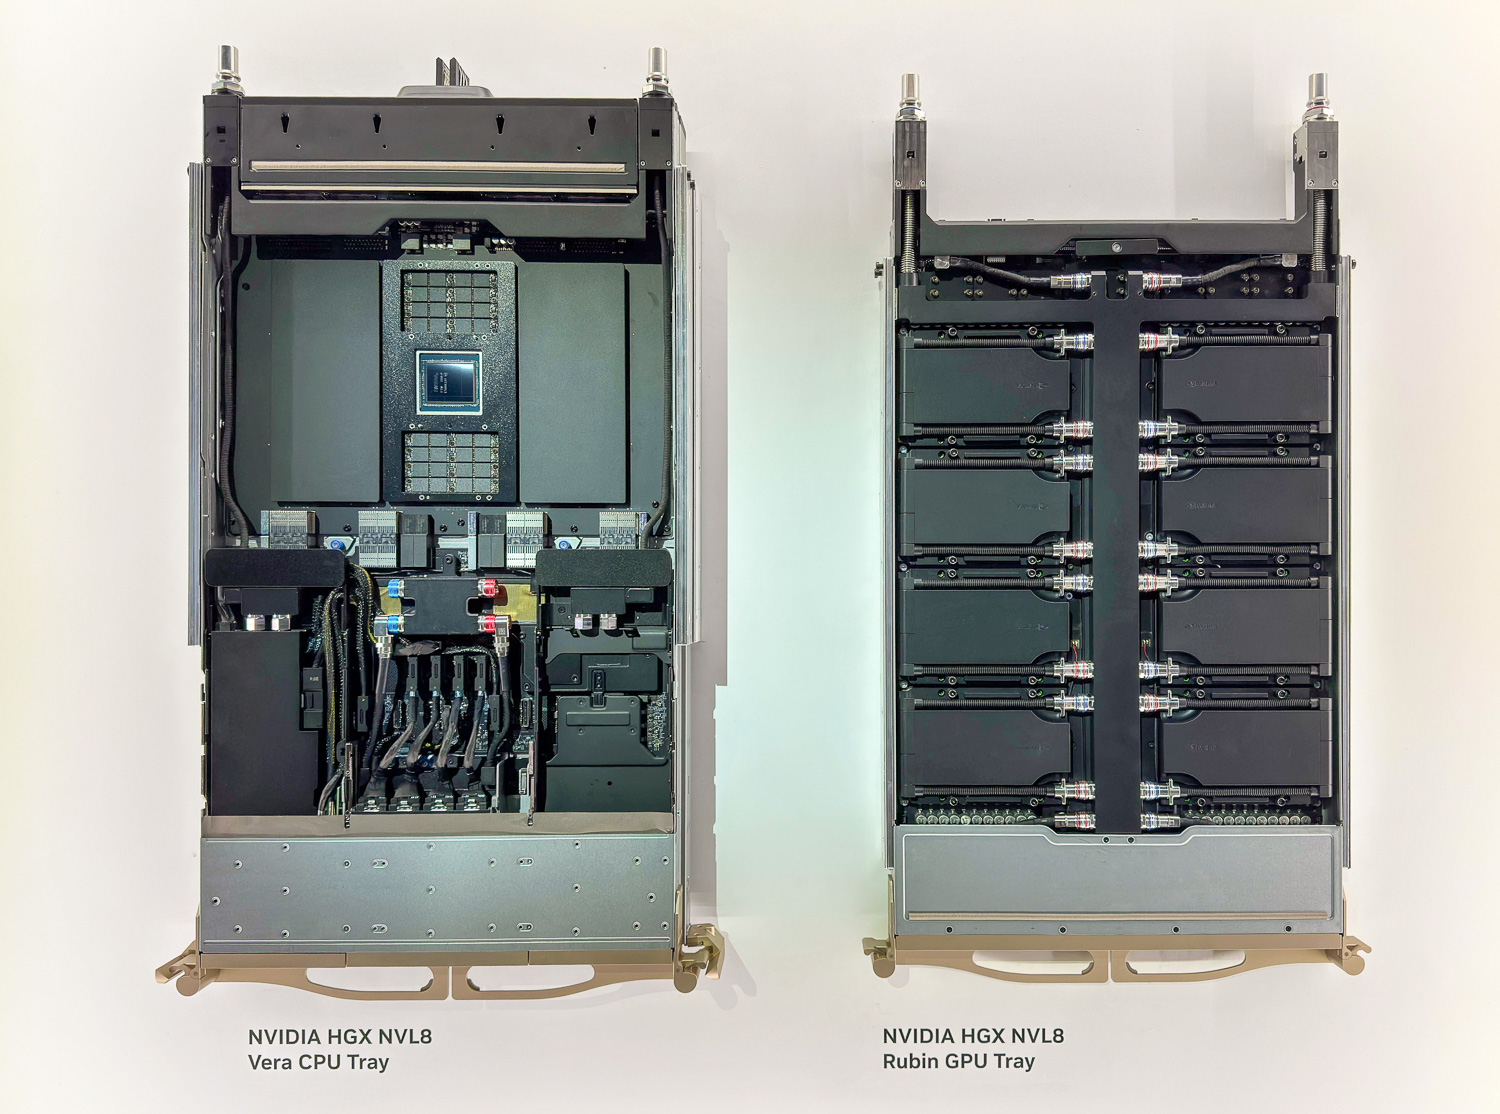
NVIDIA HGX NVL8 搭配 Vera 和 Xeon 6,並支援 DGX NVL8。
主機CPU在人工智慧推理中不斷演變的角色
從大規模模型訓練到即時、智慧AI和推理系統的轉變,提升了主機CPU的重要性。在這些環境中,CPU不再是輔助元件,而是負責編排、記憶體存取和模型安全的關鍵引擎。英特爾表示,Xeon 6處理器旨在提供管理這些複雜的GPU加速系統所需的吞吐量和效率,同時保持與企業客戶賴以擴展推理能力的龐大x86軟體生態系統的兼容性。
推理效能越來越取決於以 CPU 為主導的系統編排,而不僅僅是 GPU 的原始吞吐量。主機 CPU 透過管理記憶體管理和工作負載調度等關鍵功能,直接影響叢集的整體效率和整體擁有成本。 Xeon 6 透過確保運作的連續性和可靠性,為資料中心、雲端和邊緣環境中的現代 AI 基礎設施奠定了必要的基礎。
DGX Rubin Systems 中 Xeon 6 的技術優勢
將英特爾® 至強® 6 處理器整合到DGX Rubin NVL8系統中,是基於目前 NVIDIA Blackwell 平台(包括 DGX B300 系統)中英特爾® 至強® 6776P 處理器所建立的架構基礎。這種架構的延續性使得企業能夠將現有的效能最佳化和系統級專業知識應用到下一代 AI 硬體中。據英特爾稱,至強® 處理器經過精心設計,可透過諸如 Priority Core Turbo 等功能最大限度地提高 GPU 利用率,從而保持與加速器之間穩定的資料流。
記憶體容量和頻寬是 Xeon 6 面向 AI 應用的核心價值所在。該平台支援高達 8 TB 的系統內存,足以容納大型模型和不斷擴展的鍵值快取。此外,MRDIMM 技術的應用使記憶體頻寬逐代提升 2.3 倍,顯著提高了向 GPU 傳輸資料的速率。同時,大量的 PCIe 5.0 通道也提供了高頻寬、低延遲的 I/O,足以支援多個 AI 加速器和高速網路連線。
安全與保密計算
隨著人工智慧推理規模的擴大,端到端保密計算對於保護敏感資料和專有模型至關重要。英特爾® 至強® 6 透過英特爾® 信任域擴展 (TDX) 滿足這些需求,提供基於硬體的隔離和認證。這為現代人工智慧叢集建立了安全的基礎,確保資料在系統中傳輸過程中始終受到保護。
CPU 到 GPU 資料路徑的安全性進一步提升。諸如加密反彈緩衝區之類的功能,可在整個處理流程中實現機密運算,從而在使用過程中保護 AI 資料和模型。這種基於硬體的隔離對於維護關鍵任務環境的完整性以及在異質推理工作負載中保護智慧財產權至關重要。
生態系整合與效率
英特爾® 至強® 6 處理器針對整個 AI 軟體堆疊進行了最佳化支持,包括新增對 NVIDIA Dynamo 的兼容性。這使得 CPU 和 GPU 之間的異質推理更加高效,從而實現更優的資源分配。該平台專注於提升每瓦效能,幫助企業管理現代 AI 叢集的功耗密度,在不犧牲有效編排和調度所需的單線程效能的前提下,降低長期總擁有成本 (TCO)。
透過對 GPU 加速系統的協調,Intel® 至強® 6 處理器確保即使推理工作負載日益複雜,資料傳輸也能保持流暢高效。憑藉久經考驗的可靠性、成熟的軟體支援和先進的 I/O 功能,至強® 鞏固了其作為現代 AI 基礎設施基石的地位,從而能夠在全球範圍內部署安全且可擴展的 AI 解決方案。


 Amazon