

最新的MLPerf 測試結果已經發布,NVIDIA 在從雲端到邊緣的 AI 推理方面均展現出最高的效能和效率。作為獨立的第三方基準測試,MLPerf 仍然是衡量 AI 效能的有效指標。自 MLPerf 誕生以來,NVIDIA 的 AI 平台在訓練和推理方面一直名列前茅,包括最新的 MLPerf Inference 3.0 基準測試。
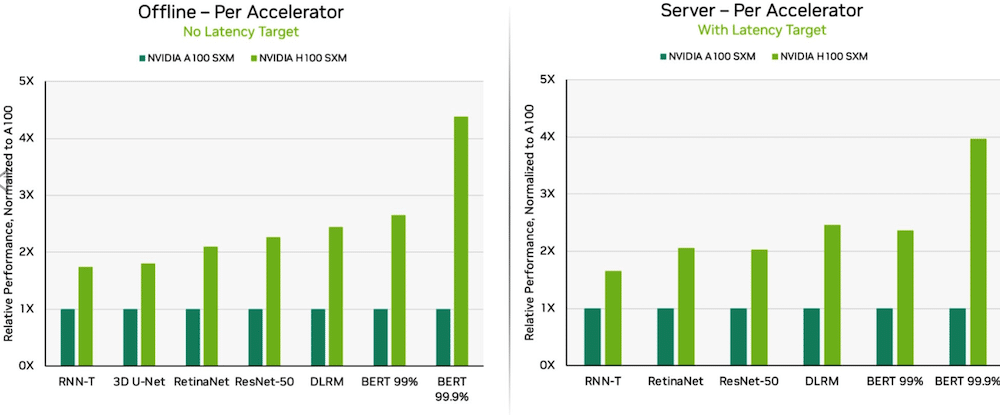
由於軟件優化,在 DGX H100 系統中運行的 NVIDIA H100 Tensor Core GPU 在每次 AI 推理測試中都提供了最高性能,比 54 月份首次亮相時提高了 100%。 在醫療保健領域,H31 GPU 在 3D-UNet(醫學成像的 MLPerf 基準)上實現了 XNUMX% 的性能提升。
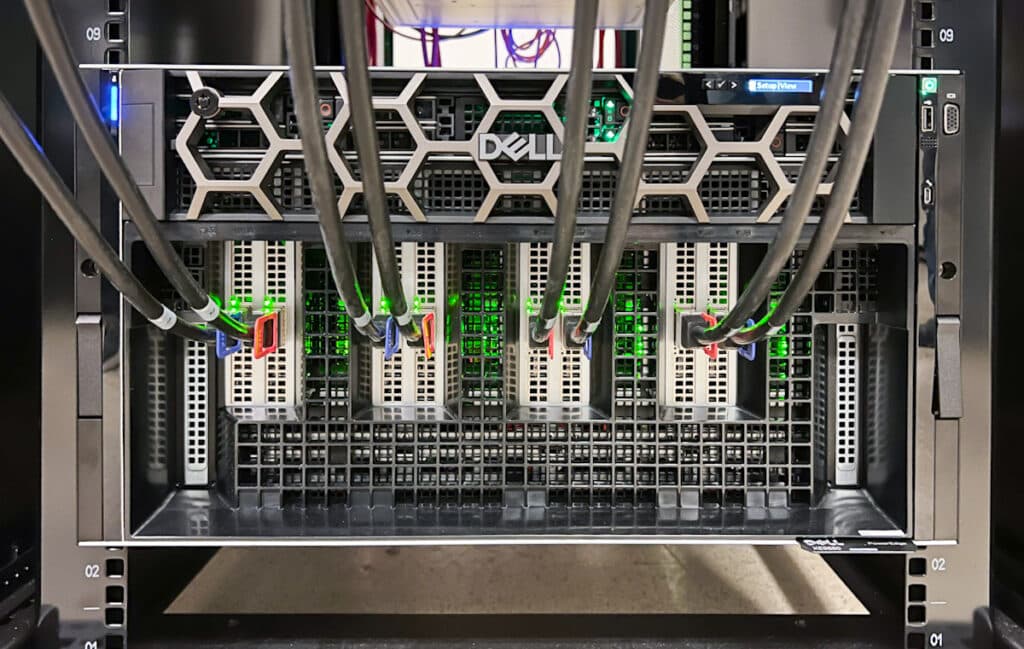
配備 9680 個 H8 GPU 的戴爾 PowerEdge XE100
基於 Hopper 架構的 H100 GPU 由其 Transformer Engine 提供支持,在 BERT 上表現出色。 BERT 是谷歌開發的一種自然語言處理模型,它學習文本的雙向表示,以顯著提高在許多不同任務中對未標記文本的上下文理解。 它是整個類 BERT 模型系列(例如 RoBERTa、ALBERT 和 DistilBERT)的基礎。
借助生成式 AI,用戶可以快速創建文本、圖像、3D 模型等。 從初創公司到雲服務提供商,公司都在採用生成式人工智能來支持新的商業模式並加速現有的商業模式。 最近出現在新聞中的一種生成式 AI 工具是 ChatGPT,數百萬人使用它,希望在查詢和輸入後立即得到響應。
隨著深度學習無處不在,推理性能至關重要,從工廠車間到在線推薦系統。
L4 GPU 提供驚人的性能
NVIDIA L4 Tensor Core GPU在首次測試中,速度比上一代 T4 GPU 快 3 倍以上。這些採用低矮封裝的 L4 GPU 加速器旨在為幾乎所有伺服器平台提供高吞吐量和低延遲。 L4 Tensor GPU 運行了所有 MLPerf 工作負載,並且由於支援 FP8 格式,在對效能要求極高的 BERT 模型上也取得了優異的成績。
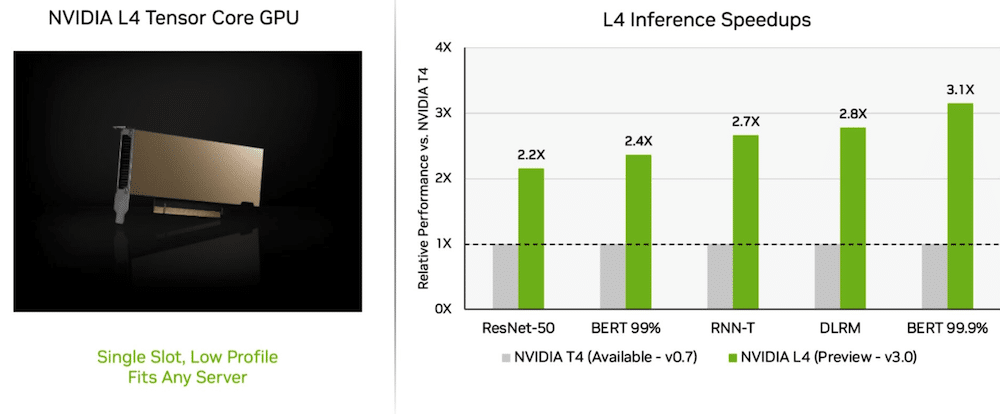
除了極致的 AI 性能,L4 GPU 還提供高達 10 倍的圖像解碼速度、高達 3.2 倍的視頻處理速度以及超過 4 倍的圖形和實時渲染性能。 幾週前在 GTC 上宣布的加速器可從系統製造商和雲服務提供商處獲得。
什麼網絡部門?
NVIDIA 的全棧 AI 平台在新的 MLPerf 測試中展示了它的價值:網絡劃分基準測試!
網絡劃分基準將數據流式傳輸到遠程推理服務器。 它反映了企業用戶在雲中運行 AI 作業並將數據存儲在企業防火牆後面的普遍場景。
在 BERT 上,遠程 NVIDIA DGX A100 系統提供了其最大本地性能的 96%,但在等待 CPU 完成某些任務時會部分變慢。 在僅由 GPU 處理的計算機視覺 ResNet-50 測試中,它們達到了 100%。
NVIDIA Quantum Infiniband 網絡、NVIDIA ConnectX SmartNIC 和 NVIDIA GPUDirect 等軟件在測試結果中發揮了重要作用。
Orin 在邊緣得到改善
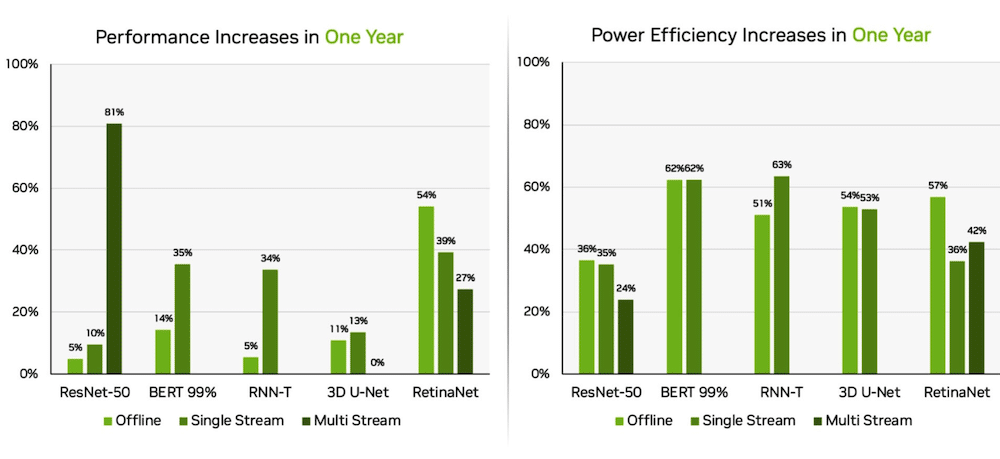
另外,與去年的結果相比,NVIDIA Jetson AGX Orin 系統級模塊的能效提高了 63%,性能提高了 81%。 Jetson AGX Orin 在密閉空間需要低功率水平的 AI 時提供推理,包括電池供電系統。
Jetson Orin NX 16G 是一個更小的模塊,需要更少的功率,在基準測試中表現良好。 它的性能是 Jetson Xavier NX 處理器的 3.2 倍。
NVIDIA 人工智能生態系統
MLPerf 結果表明,NVIDIA AI 得到了廣泛的機器學習生態系統的支持。 本輪3家企業提交了NVIDIA平台的成果,包括微軟Azure雲服務和系統廠商、華碩、戴爾科技、技嘉科技、新華三、聯想、Nettrix、超微、xFusion。 他們的工作表明,用戶可以在雲端和在他們自己的數據中心運行的服務器中使用 NVIDIA AI 獲得出色的性能。


 Amazon