

為了應對大型語言模型和複雜推理工作負載,超大規模資料中心營運商和專注於人工智慧的基礎設施營運商正日益開發專有的人工智慧加速器和擴展處理器 (XPU)。為了解決大規模部署專有晶片在實體、記憶體和網路方面面臨的挑戰,NVIDIA 詳細介紹了其NVLink Fusion 互連和 NVHBM 客製化基底片記憶體架構。這項統一的產品組合旨在將客製化晶片與 NVIDIA 現有的縱向擴展網路和 MGX 機架級平台連接起來。
率先採用 NVHBM 技術的是亞馬遜旗下的 Annapurna Labs,其 NVHBM 計劃與AWS 2 萬 GPU 的合作夥伴關係擴展計劃同時公佈;此次公告揭示了該合作背後的架構,並指出 Trainium4 是首款支持 NVLink Fusion 的 Trainium 架構產品。 NVIDIA 也正在製定一項可供多家記憶體供應商使用的標準 NVHBM 實現方案,該公司表示,這將減少跨供應商整合和驗證記憶體的工程工作量。亞馬遜 Annapurna Labs 副總裁 Nafea Bshara 表示:“NVHBM 代表了一種提升高頻寬內存性能和效率的全新架構方法。我們期待這項技術合作能夠惠及未來的 AWS 基礎設施設計。”
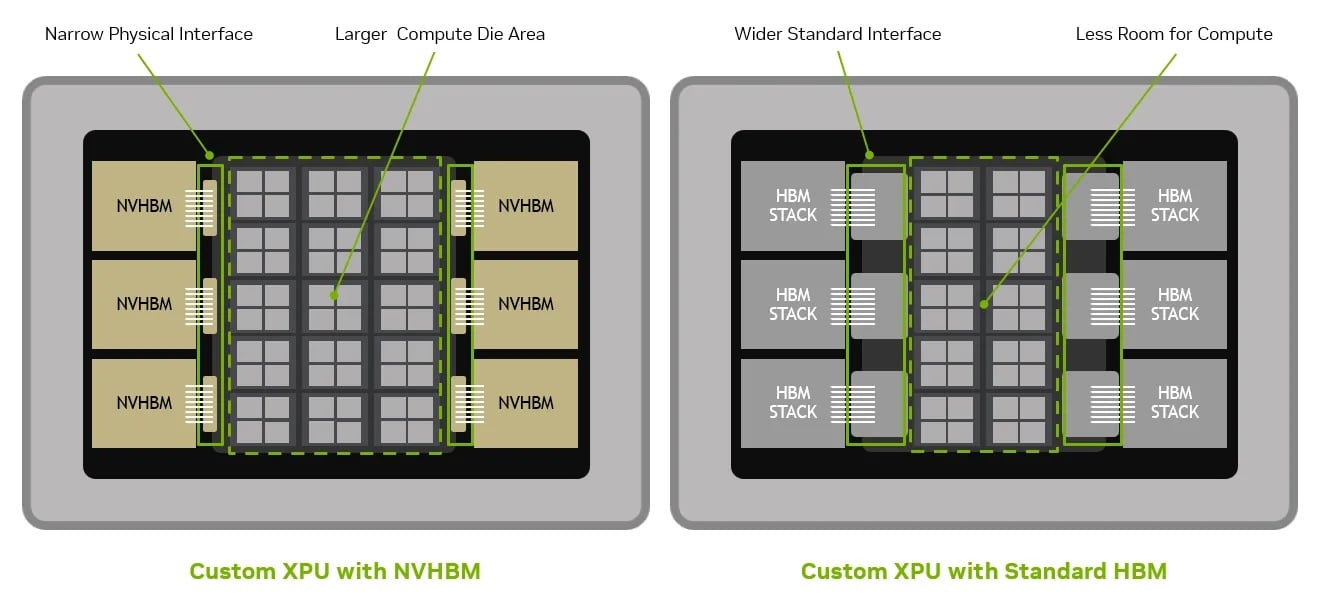
在高密度資料中心部署客製化 XPU 需要平衡運算邏輯、電源分配、散熱開銷和高頻寬記憶體。整合和驗證前沿記憶體堆疊通常會造成嚴重的封裝和開發瓶頸。透過 NVLink Fusion 和 NVHBM,設計人員可以利用預先驗證的基礎晶片和介面 IP,從而降低整合複雜性並加快產品上市速度。
記憶體頻寬和延遲優化
現代人工智慧工作負載,尤其是大型模型推理和智慧體管線,對讀取模型權重、啟動值和鍵值 (KV) 快取條目的記憶體吞吐量提出了很高的要求。 NVHBM 採用與記憶體製造商合作開發的客製化基片,與標準的 JEDEC HBM4E 規格相比,每個堆疊的記憶體頻寬最多可提高 30%。
| 獨特之處 | NVHBM 福利 |
| 頻寬 | 與標準 HBM4e 相比,記憶體頻寬最多可提升 30%。 |
| 區域 | 更有效率的介面連接可使運算晶片面積增加高達 25%,從而實現額外的 XPU 功能。 |
| 電力 | 與標準 HBM4e 相比,HBM 功耗可降低高達 15%,這在數千個 XPU 上累積可節省大量成本。 |
表 1. NVHBM 為 AI 加速器專案帶來三大平台級優勢:更高的記憶體頻寬、更大的封裝和矽片面積以及更低的 HBM 功耗
頻寬的提升最大限度地減少了執行過程中記憶體密集型階段的計算引擎資源不足問題。透過加速HBM堆疊和板載運算邏輯之間的資料傳輸,加速器可以維持更高的利用率,並在密集推理工作負載期間提高每個使用者的令牌產生速率。
晶片面積重新分配與PHY優化
現代加速器封裝上的矽片空間非常有限,設計人員需要在計算ALU、矩陣引擎、片上SRAM和外圍介面之間權衡空間。標準的HBM架構需要寬大的實體介面,這會佔用大量的佈局面積。
NVHBM 透過將記憶體控制器直接移至 3D HBM 堆疊並採用客製化的實體層 (PHY) 來解決此問題。與標準 HBM4E 實作相比,此方法可將 PHY 和周邊支援面積減少高達 67%,同時簡化中介層走線,從而在整個佈局中回收高達 80% 的可用矽片。更窄的記憶體介面釋放了封裝空間,使設計人員能夠在固定的實體封裝內將中央 AI 運算晶片擴展高達 30%,從而添加更多矩陣核心、向量單元或快取層次結構。
電力效率和設施規模餘裕
電力分配仍然是超大規模資料中心運作中最嚴格的限制因素之一,它直接影響加速器的熱設計和冷卻需求。與標準 HBM4E 相比,NVHBM 可將 HBM 功耗降低 15%。
在晶片層面,降低記憶體功耗可以降低熱壓力,從而為運算核心提供額外的電力餘裕,使其能夠以更高的持續頻率運作。在資料中心規模上,這些節能效果將會倍增。在一個理論上的 1 吉瓦資料中心中,如果部署了 2,000 瓦的 XPU,那麼降低記憶體功耗可以釋放足夠的散熱和電力容量,從而支援多達 15,000 個額外的 XPU。
透過 NVLink Fusion 實現機架級集成
NVHBM 在單一封裝層級優化效能,而 NVLink Fusion 則充當系統級橋樑。利用專用的 NVLink Fusion 晶片,客製化的 XPU 可以直接連接到第六代 NVLink 擴展架構,將機架內的所有加速器整合到一個統一的記憶體和運算域中。
這種可擴展架構對於專家並行(EP)和 WideEP 等高級並行化方案至關重要,在這些方案中,分散式混合專家模型需要跨多個實體設備實現激活值和隱藏狀態的低延遲同步。客製化處理器也可以透過 NVLink-C2C 連接到主機 CPU。
透過將半客製化晶片整合到更廣泛的 NVIDIA 硬體和軟體生態系統中,NVLink Fusion 使營運商能夠在標準化的 MGX 機架架構下部署混合了客製化 XPU 和標準 NVIDIA GPU 的異質環境,從而簡化操作和工作負載配置。


 Amazon