

NVIDIA 推出了 Helix Parallelism,這是一種為其 Blackwell GPU 架構開發的新方法,旨在提升處理超大資料集的即時 AI 效能。該技術滿足了 LLM 日益增長的對數百萬個 token 上下文的處理需求。 NVIDIA 證明,與傳統方法相比,這種方法可將處理速度提高高達 32 倍,從而支援更複雜、響應速度更快的 AI 應用程式。
百萬代幣挑戰:為什麼人工智慧需要新方法
人工智慧的前沿已經從簡單的查詢發展到複雜的長期推理。高級應用程式極其需要廣泛的上下文才能有效運作。例如,AI 助理可以記住數月的對話,法律工具可以一次性分析數 GB 的案例,或者程式設計夥伴可以理解整個儲存庫。這些任務需要處理數百萬個 token。
然而,擴展到這個水平會暴露出兩個根本的瓶頸。
- 鍵值快取瓶頸:在自迴歸 token 產生過程中,模型會計算先前產生 token 的注意力,以避免二次方縮放因子。為了實現這一點,先前產生的 token 會被緩存,這個過程稱為鍵值快取。當上下文包含數百萬個 token 時,這個快取會變得非常龐大,耗盡 GPU 的記憶體頻寬,並顯著降低迴應時間。
- FFN 權重瓶頸:模型每產生一個新 token,都必須從記憶體載入大量的前饋網路 (FFN) 權重。在互動式、低延遲的應用中,這種持續的載入過程是延遲的主要來源。
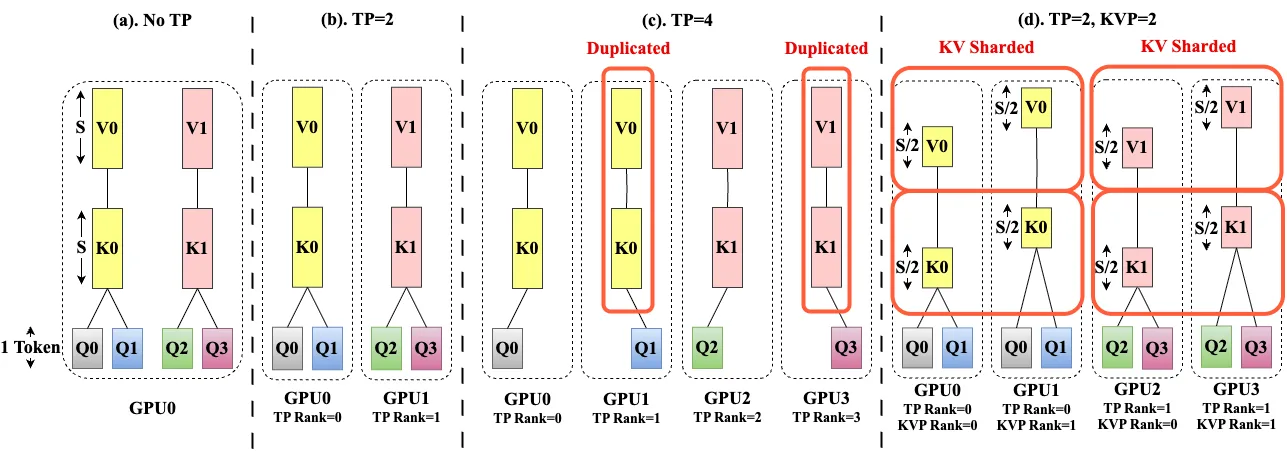
目前,我們依賴類似張量並行 (Tensor Parallelism) 的方法,將模型的張量(從而將所需的記憶體和計算工作)拆分到多個 GPU 上。雖然這種方法對某些任務有效,但隨著新的注意力機制的出現,其優勢逐漸減弱。在 GQA(分組查詢注意力)或 MLA(多潛在註意力)等注意力機制中,為了減少記憶體佔用,多個查詢頭共享一組較小的鍵值頭。然而,當張量並行的規模超過鍵值頭的數量時,由於每一步跨 GPU 通訊都會引入顯著的延遲,因此需要複製鍵值頭。這種複製會抵消張量並行的一些優勢。
螺旋平行度
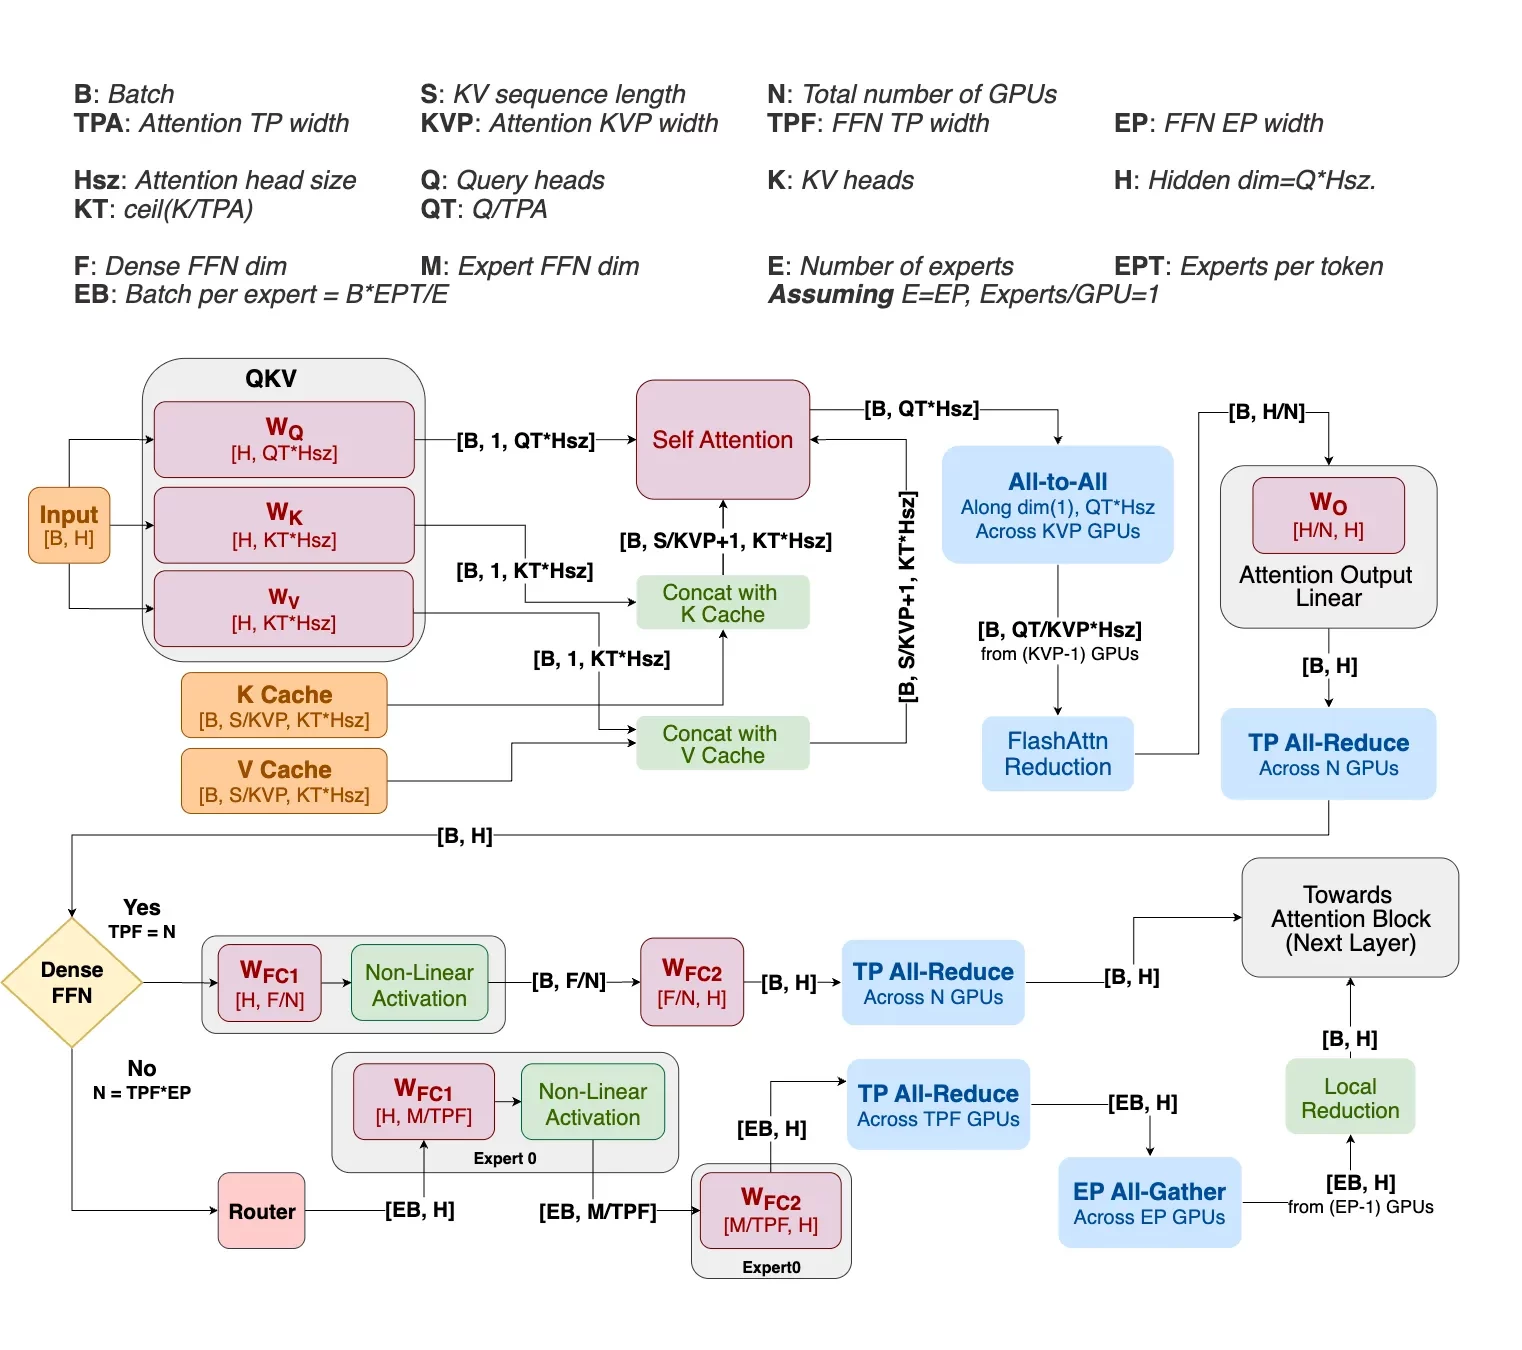
為了解決這個難題,NVIDIA 的 Helix Parallelism 引入了一種混合策略,將兩個瓶頸視為獨立的問題,並在無縫的時間流水線中加以解決。 Helix 並非在整個過程中使用單一的平行方法,而是動態地重新配置同一個 GPU 池,以便在每個運算階段使用最佳策略。
過程可分為模型每一層的兩個主要階段。
第一階段:注意力階段(處理KV快取)
Helix 透過結合兩種平行機制,直接解決了鍵值快取瓶頸問題。首先,它採用鍵值平行機制,將鍵值快取本身沿著序列維度分片到多個 GPU 上。這意味著每個 GPU 僅保存整個上下文的一部分,從而減輕了記憶體負擔。
同時,它使用張量並行 (Tensor Parallelism) 來分割注意力頭,確保分割數量不超過鍵值頭的數量。這種組合避免了傳統張量並行帶來的快取重複問題。最終形成了一個二維 GPU 網格,能夠在海量上下文中高效計算注意力,並且不會讓任何一個 GPU 不堪重負。這些 GPU 之間的通訊由一個高效的全對全交換器處理,其成本與上下文長度無關,因此具有高度的可擴展性。
第二階段:FFN 階段(解決 FFN 權重)
注意力階段結束時的全對全通訊也會將輸出資料在各個 GPU 之間進行劃分。這意味著數據已經完美排列,可以立即開始 FFN 計算。
同一 GPU 池被重新配置為一個大型張量並行組。由於資料已預先分區,每個 GPU 都可以使用其海量 FFN 權重的分片執行本地矩陣乘法。此初始計算並行進行,無需跨 GPU 通信,從而最大限度地提高速度。只有在此本地計算步驟之後,GPU 才會參與高效的全歸約通信,將其部分結果合併為最終輸出。
最後一個難題是 Helix 如何管理不斷增長的鍵值快取。當模型產生新的令牌時,必須將它們追加到快取中。一種簡單的方法可能會將所有新令牌寫入單一 GPU,從而造成記憶體熱點。 Helix 透過巧妙的循環更新系統來避免這種情況。例如,第一個新令牌區塊可能寫入 GPU 0,下一個區塊寫入 GPU 1,依此類推。這種交錯方法可確保記憶體使用量在鍵值平行組中的所有 GPU 上均勻成長,從而無論上下文大小如何都能保持均衡的效能和一致的吞吐量。
Blackwell 的全新性能前沿
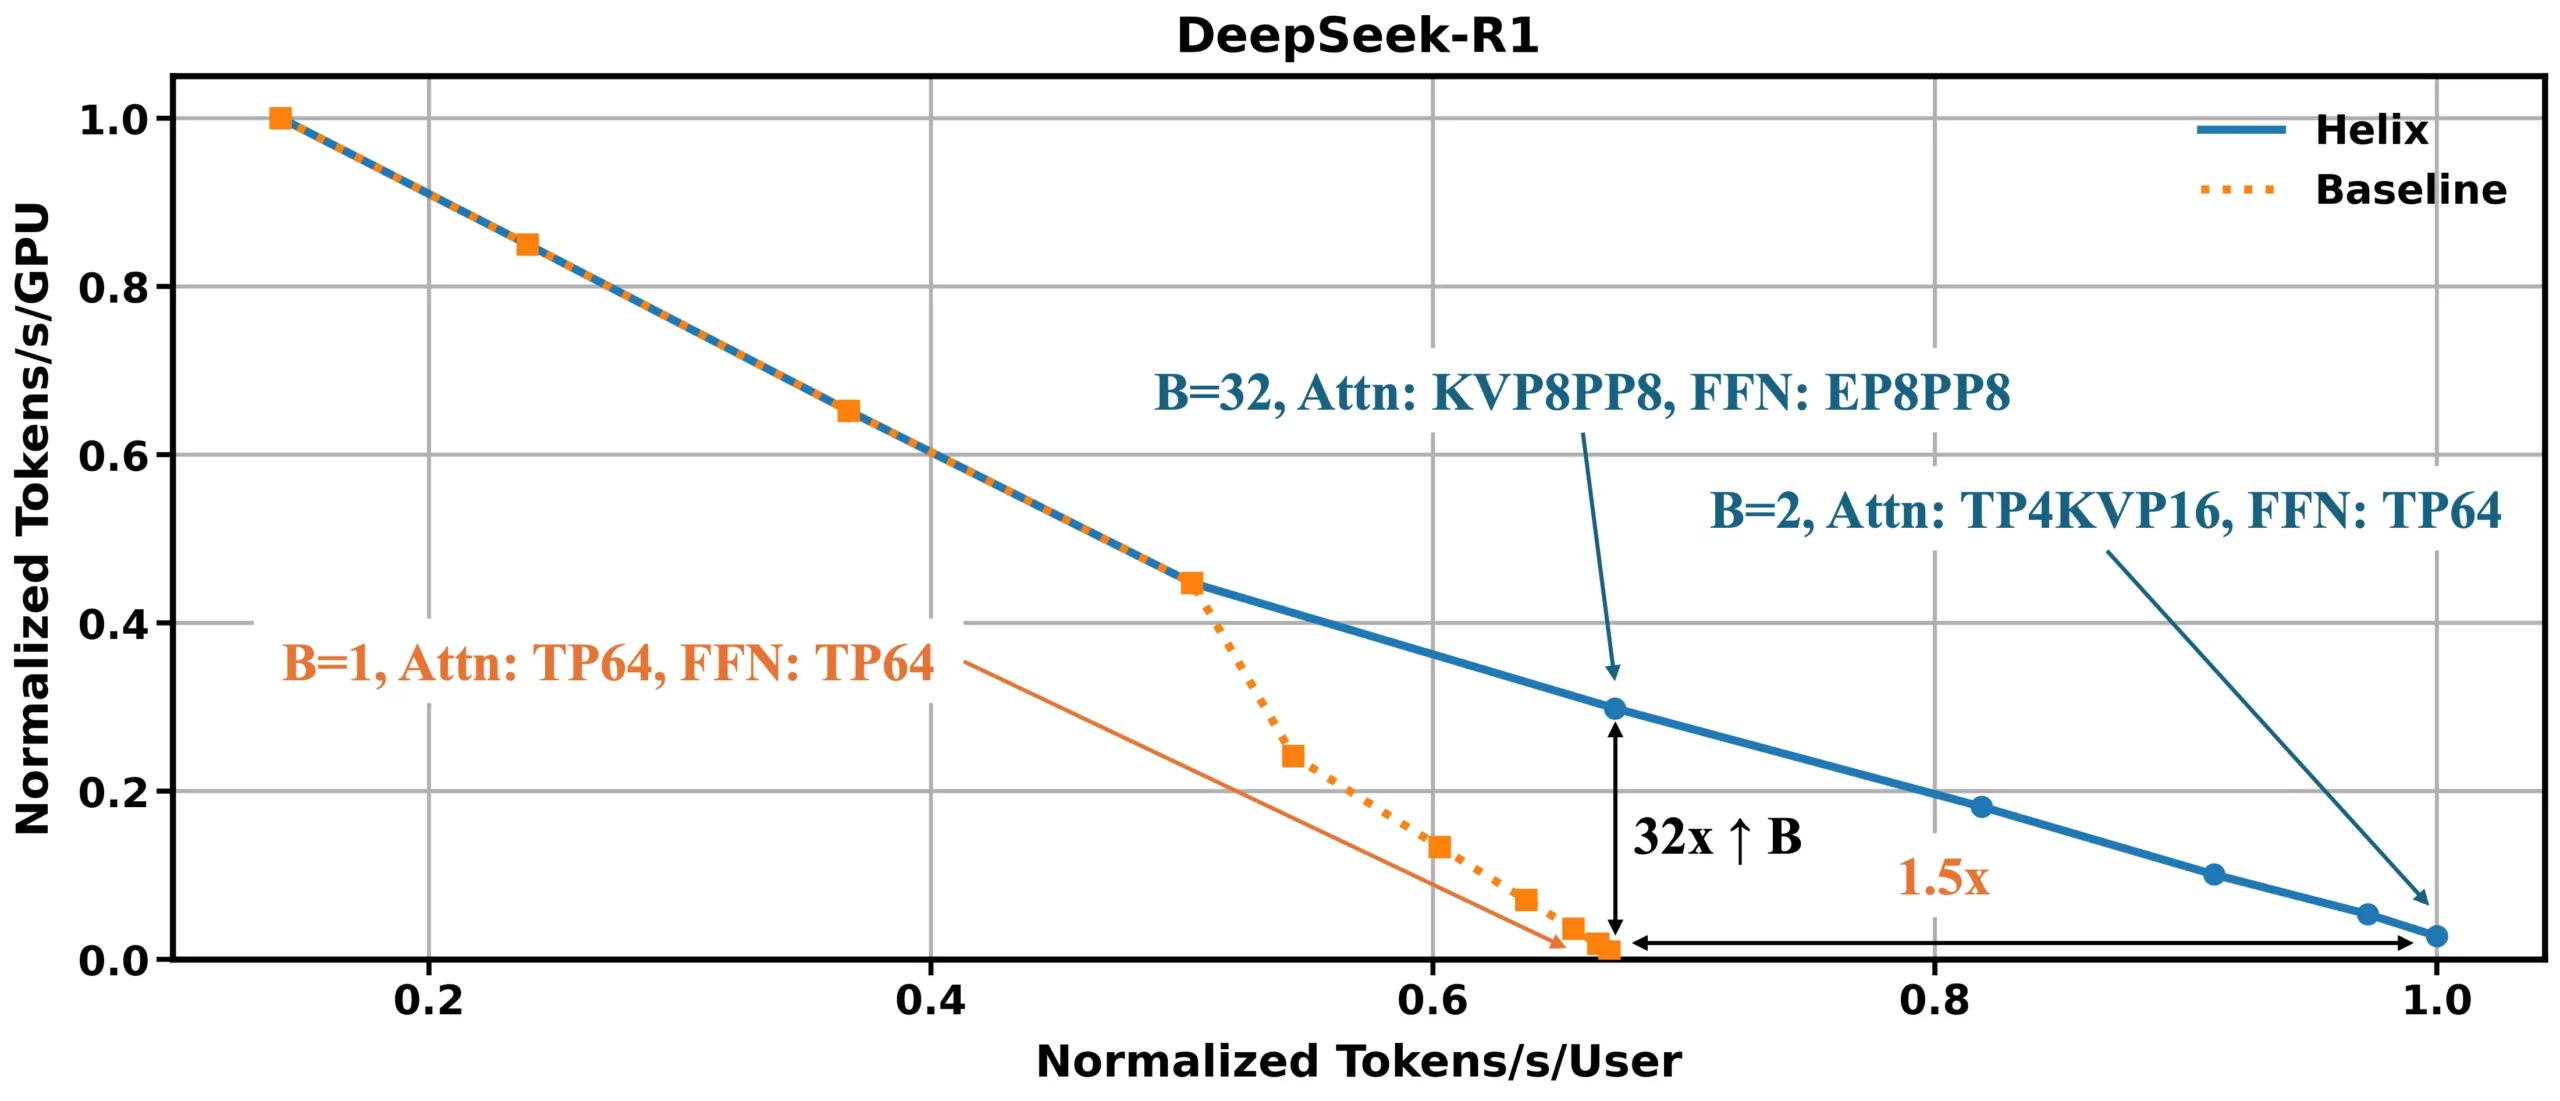
Helix 為長上下文 LLM 解碼樹立了新的性能標竿。結果基於在 Blackwell NVL72 上使用 DeepSeek R1 671B 參數模型 (FP4) 進行的詳盡仿真,該模型假設上下文包含一百萬個令牌,系統地調整分區策略和批次大小,以找到最佳的吞吐量-延遲權衡。對於需要大規模可擴展性的應用程式(例如同時服務眾多用戶),Helix 可以在給定延遲預算的情況下將並髮用戶數量提高高達 32 倍。對於單用戶回應至關重要的低並發設置,該技術可以透過降低可實現的最小令牌到令牌延遲,將用戶互動性提高高達 1.5 倍。這些提升是透過在所有可用裝置上分片鍵值快取和前向尋址網路 (FFN) 權重來實現的,這顯著降低了 DRAM 壓力並提高了運算效率。
如需深入了解方法論和模擬結果,請點擊此連結查看完整報告。


 Amazon