

本週在聖荷西舉行的OCP全球高峰會上,三星展示了一款與AMD合作驗證的CXL記憶體池。此記憶體池基於三星的CMM-D CXL記憶體模組構建,旨在支援智慧AI推理。兩家公司合作驗證了CXL記憶體作為一種能夠隨著CPU核心數量的增加而擴展記憶體容量和頻寬的方法。其前提是,智慧工作負載會導致CPU利用率急遽上升,而記憶體容量卻無法跟上核心數的成長。三星的記憶體池演示表明,與靜態分配相比,首次令牌獲取時間最多可縮短38%,吞吐量最多可提高3.3倍。
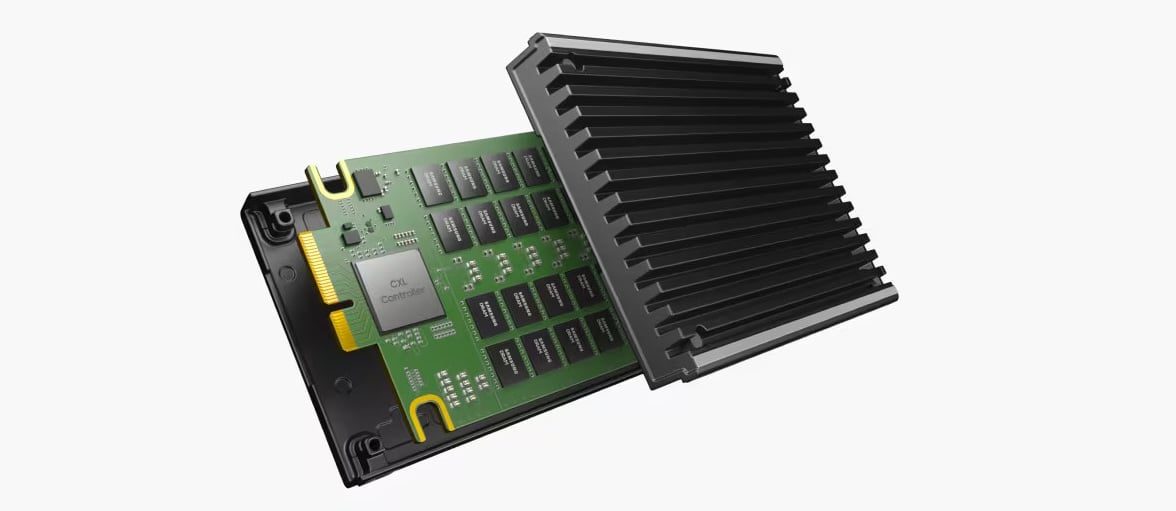
三星在展廳C41展位上展示了其記憶體和儲存產品線,分為令牌化解決方案和KV快取解決方案兩部分。令牌化解決方案涵蓋HBM4E和LPDDR5X-PIM,而KV快取解決方案則涵蓋CMM-D MD310 CXL模組、SOCAMM2 LPDDR伺服器模組、PM1763 PCIe Gen6 SSD以及BM1773-三星稱其為首款256TB E3.S QLC SSD。這種產品線劃分遵循LLM管線的兩個階段:預填和令牌產生階段運行在高頻寬記憶體中,而上下文資訊則需要在模型產生過程中保存。
CXL記憶體池架構和多節點共享
此池化演示在 GPU 伺服器上運行 AI 代理程式工作負載,使用基於動態容量設備 (DCD) 語義構建的 CXL 記憶體池。 DCD 語義是 CXL 的一種機制,允許池將記憶體提供給主機並在運行時收回。多個 LLM 實例透過彈性分配從池中獲取內存,因此,當實例遇到上下文或參數峰值時,它會借用容量,並在作業完成後歸還,而不是像通常那樣,每個節點都根據其峰值容量分配容量,剩餘容量則閒置。
三星的演示數據顯示,與靜態分配相比,TTFT 降低了 38%,吞吐量提高了 3.3 倍;這些是廠商提供的結果,我們沒有運行或審核這些結果。
與 AMD 的合作驗證了 AMD 運算平台上的相同方法,該平檯面臨的問題是,隨著智能體工作負載的擴展,CPU 會出現效能瓶頸,而記憶體容量和頻寬卻無法隨核心數量的增加而成長。三星表示,CMM-D 透過讓 CPU 和記憶體容量都隨 CPU 擴展,最大限度地提高了並發智能體 AI 用戶數量。兩家公司均未公佈聯合部署的伺服器配置、CXL 交換器拓撲結構或互連延遲和頻寬數據,而該架構的多主機共享部分將在 10 月 15 日與 XCENA 舉辦的關於動態池化、共享和近內存處理卸載的會議上進行詳細討論。
三星還擁有該儲存池所創建層級的生產數據點。其搭載 CMM-D 的 AI 記憶體節點運行於三星半導體美國園區,為內部 AI 編碼代理和其他應用提供服務。三星表示,在添加所謂的 L3.5 可組合記憶體層級後,KV 快取利用率提高了 5 到 7 倍。這項工作由三星記憶體解決方案實驗室、其 AI 平台整合團隊以及 SGLang 共同完成。
人工智慧基礎設施擴展
三星儲存業務應用工程團隊負責人兼企業副總裁沈浩俊 (Hojun Shim) 於 10 月 12 日發表了題為“面向人工智慧時代的創新擴展:利用高度可擴展的內存保持計算全速運行”的高管演講。正如三星在展位上所闡述的那樣,其論點是,僅靠原始記憶體速度無法在模型規模擴大時保證計算資源的持續運行,而解決方案在於構建一個層級結構:高頻寬記憶體用於活躍計算,CXL 架構可按需擴展容量,而 SSD 支援的層級則用於 KV 快取和模型持久化。
10月13日,三星記憶體業務的Jinin So和Youngha Choi進行了第二場演講,他們用一個標題概括了這種記憶體分層結構:「代理記憶體分層:從CXL池化到SSD支援的KV快取卸載」。這與我們先前在KV快取卸載到快閃記憶體的工作中測試的分層結構相同。三星的相關演示涵蓋了靈活的資料放置、LMCache中更大的NVMe最大資料傳輸容量(用於KV快取儲存)以及將距離運算轉移到SSD的向量資料庫概念驗證。
符號化
在令牌化方面,三星展示了HBM4E(該公司於5月開始提供樣品,並在8月的FMS展會上與HBM5一同展出)和LPDDR5X-PIM(將內存處理單元整合到每個DRAM存儲體中)。三星聲稱,PIM部分的有效頻寬是標準LPDDR5X的8倍,在其邊緣AI加速器上的令牌處理速度是標準LPDDR5X的3倍(基於三星在Llama 3.1 8B上運行的評估結果)。其理念是在DRAM封裝內部執行推理過程中記憶體密集的部分,從而減少透過互連的資料量,進而降低功耗和時間。
硬體和架構
展廳裡展示的所有產品要么是演示產品,要么是現有產品:三星尚未公佈AMD產品的CXL內存池控制器SKU、上市日期或功耗等級,而HBM4E和LPDDR5X-PIM的展示也未透露除已公佈的HBM4E樣品之外的任何產品上市時間信息。 CMM-D MD310、PM1763和BM1773是已上市的晶片。
| 項目 | 三星亮相2026年OCP全球高峰會 |
|---|---|
| CXL演示 | |
| AMD 合作 | CXL 記憶體已通過 AMD 驗證,可根據 CPU 核心數量擴展記憶體容量和頻寬,並減少智慧體 AI 中的 CPU 阻塞。 |
| CMM-D 池化演示 | 基於 DCD 的 CXL 記憶體池,可在 GPU 伺服器上的多個 LLM 執行個體之間進行彈性分配 與靜態分配相比,TTFT 最多可降低 38%,吞吐量最多可提高 3.3 倍(三星資料)。 |
| 帶有 CMM-D 的 AI 儲存節點 | 在三星半導體美國園區進行生產部署 L3.5 可組合記憶體層,KV 快取利用率提高 5 到 7 倍(三星資料) |
| 代幣化解決方案 | |
| HBM4E | 自五月起開始出貨的12層樣品 |
| LPDDR5X-PIM | 每家銀行的PIM單元 與 LPDDR5X 相比,有效頻寬最高可達 8 倍;在三星邊緣 AI 加速器 Llama 3.1 8B 上,TPS 最高可達 3 倍(三星資料)。 |
| KV-Cache 解決方案 | |
| CMM-D MD310 | CXL 記憶體擴充模組 |
| SOCAMM2 | 基於LPDDR的伺服器記憶體模組 |
| PM1763 | PCIe Gen6 SSD,順序讀取速度高達 28.4GB/s,圖中所示為液冷散熱方案。 |
| BM1773 | 256TB E3.S QLC SSD |
| 其他演示 | AiSIO 加速器直接儲存(100M IOPS,冷啟動模型載入速度提升高達 10 倍,資料來自三星) LMCache 中的 FDP 和更大的 NVMe MDTS SSD中的NCVS向量距離計算 支援即時遷移的可組合存儲,基於標準 NVMe |
| 庫存情況 | |
| CXL Pooling with AMD | 技術展示;未公佈產品型號、日期或功率等級。 |


 Amazon