

企業級人工智慧基礎設施已從優化訓練模型轉向服務這些模型,這改變了其經濟模式。訓練是一項有終點的資本項目。推理則是一項生產性工作負載,只要服務在線就會運行,其產出以代幣(token)衡量。這就是人工智慧業者目前面臨的代幣經濟學問題:一旦GPU安裝完畢,電力預算設定完成,業務就取決於硬體產生的代幣數量。
在長時間、多輪的工作負荷中,隨著對話次數的增加,相同的情境會重複經過模型。 GPU 已經為處理這些令牌付費一次,但當鍵值快取被清空時,系統必須再次預先填入該上下文。這會導致系統重複計算。無論規模大小,這都不是可以忽略的誤差。這實際上是以電力、GPU 時間、佇列增長或額外硬體的形式返還給用戶的額外成本。
最直接的解決方法是購買更多機架上最昂貴的資源:更多的GPU,更多的DRAM。但重計算已經產生了一些可重複使用的東西。鍵值快取只是資料;它可以低成本地儲存和檢索,只需付出少量的重新載入成本,就能避免昂貴的預填計算。因此,問題不在於是否保留緩存,而在於將其放在哪裡,這既是一個成本問題,也是一個效能問題。顯存(VRAM)是速度最快的層級,也是最稀缺的;一旦飽和,推理伺服器就會開始淘汰快取。 DRAM可以提供額外的效能空間,但價格高昂且快速上漲。快閃記憶體則可能帶來不同的結果:速度肯定比DRAM慢,但每TB的價格要低得多,而且容量足夠大,可以保存速度更快的層級被迫丟棄的上下文信息,這決定了是重新處理整個對話還是簡單地將其讀回。
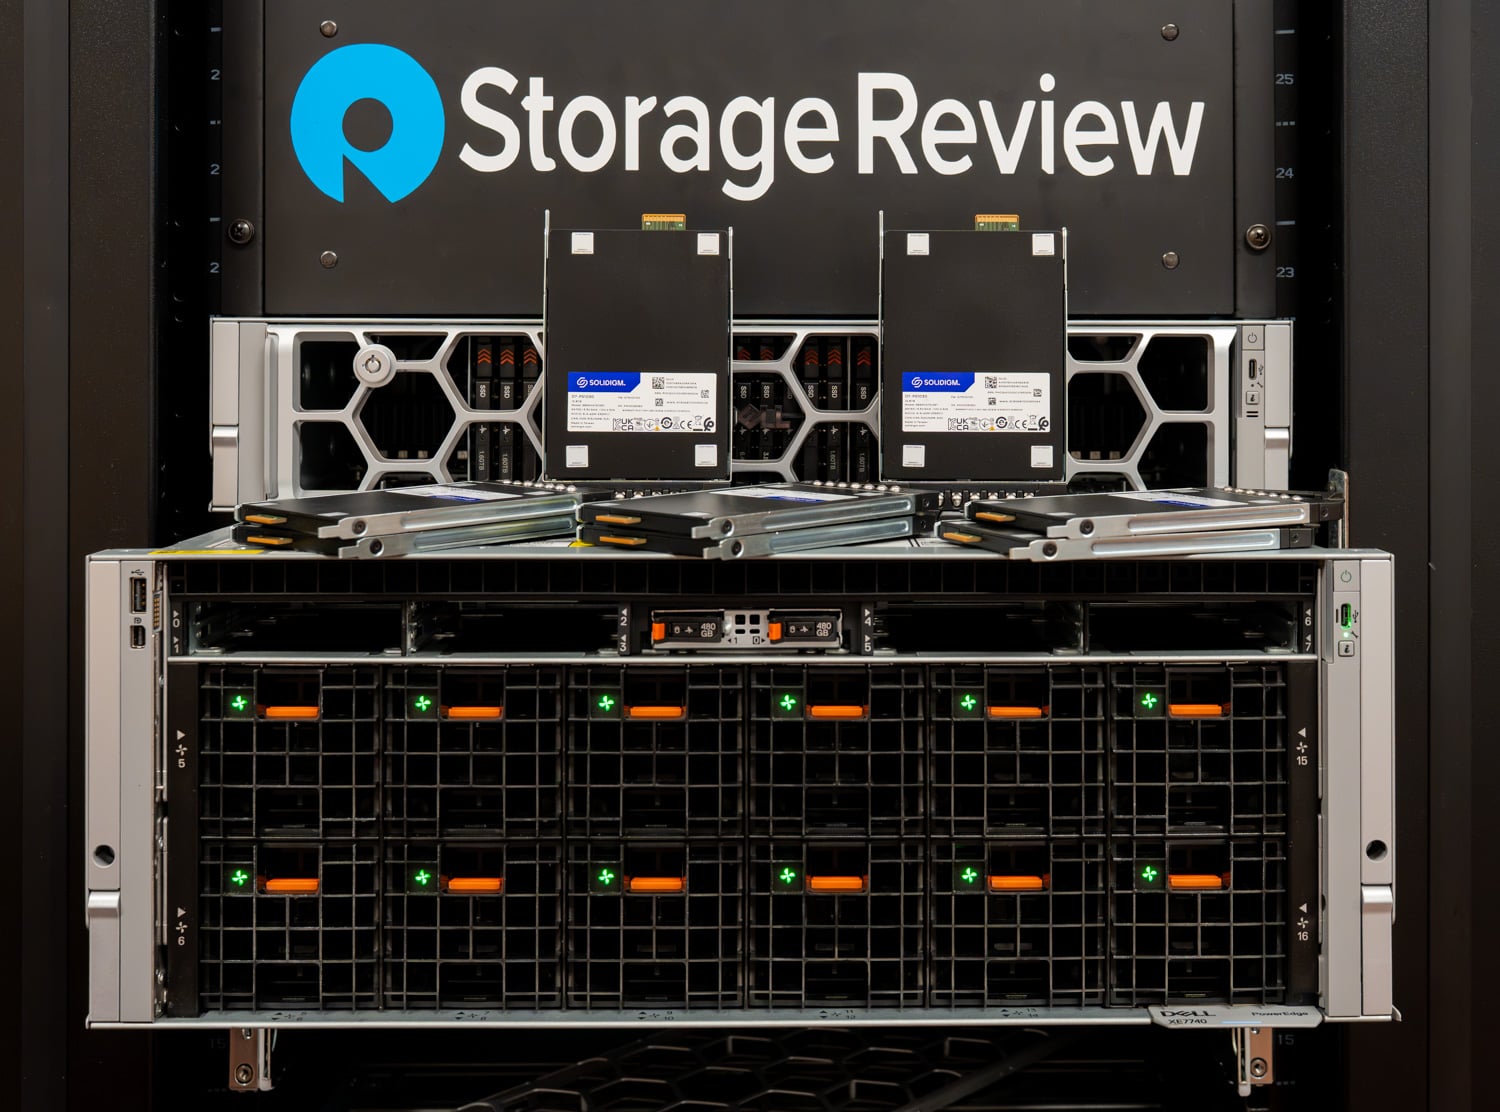
為了衡量其影響,我們在一台戴爾 PowerEdge XE7740 伺服器上建置了一個多輪代理測試工作負載,並保持模型、GPU 和服務堆疊不變。對於任何需要進行系統規模調整的人來說,真正重要的是記憶體層填滿之後的情況。超過這個點後,快閃記憶體每秒可處理約 30,000 個總令牌,而 DRAM 則為 17,000 個,快閃記憶體保持了自身峰值容量的 94%,而 DRAM 層則下降到 42%。兩個卸載層在峰值時都大幅超越了僅使用 VRAM 的基準(DRAM 為 2.9 倍,快閃記憶體為 2.2 倍),但峰值恰好是 DRAM 層即將耗盡的臨界點。最昂貴的記憶體用於應對峰值;而快閃記憶體則在上下文不斷增長的情況下保持效能。
在深入探討結果之前,有必要明確 KV 快取是什麼,為什麼它會被填滿,以及為什麼當系統沒有更便宜的地方來保存它時,推理效能會開始崩潰。
關鍵要點
- 快閃記憶體能夠承載DRAM無法承載的內容: 三種配置在記憶體壓力迫使記憶體驅逐之前效能完全相同。顯存首先飽和,512GB DRAM 層在運作約 45 分鐘後填滿並開始驅逐。此後,快閃記憶體每秒可維持約 30,000 個令牌,而 DRAM 為 17,000 個,快閃記憶體仍能保持其峰值容量的 94%,而 DRAM 則降至 42%。
- 卸載作業可以恢復因重新計算而損失的吞吐量: 在峰值情況下,KV快取卸載使DRAM層的總服務吞吐量比僅使用VRAM的基準提高了2.9倍,快閃記憶體層提高了2.2倍。效能提升源自於跳過了重新預填充,因為GPU已計算的上下文資訊直接從卸載層讀取,而無需重新建構。
- 老用戶感受到的變化最大: 在僅使用顯存的基準測試中,恢復會話時最壞情況下的首令牌延遲為 13.9 秒,而使用快閃記憶體的基準測試中該延遲僅為 3.2 秒。卸載機制使得延遲時間控制在互動式使用者可接受的範圍內。
- 代理流量使驅逐成本高昂: 一週的 Claude Code 流量偵測結果顯示,98.16% 為快取讀取,只有 0.02% 為真正的冷輸入。
- KV卸載是一種寫入密集型工作負載,需要高耐久性硬碟: 此模型產生的每個令牌都會寫入一個鍵值對 (KV) 條目,TTL 的頻繁更新會持續不斷地重寫該層級。在我們持續的寫入速率下,我們測試的鏡像 RAID10 陣列每塊硬碟每天大約需要寫入 3.2 次,而條帶化為 RAID0 時則降至每天大約 1.6 次寫入,與 D7-PS1030 的 3 次寫入額定值相近。快閃記憶體層級的決定性限制因素是耐用性,而非容量或速度,而且由於快取是可消耗的,因此對一塊以寫入為主的硬碟進行如此高強度的使用是可以接受的。
推理是如何運作的
大型語言模型是自回歸的:每個輸出詞元都以其先前的每個詞元為條件。注意力機制透過計算序列中每個詞元的查詢向量 (Q) 來實現這種條件化,該查詢向量與先前每個詞元的鍵向量 (K) 和值向量 (V) 進行匹配。注意力機制的輸出就是這些數值的加權組合,權重來自 QK 點積。
當請求到達時,只有當請求中的每個詞元都存在 K 和 V 張量時,才能回應該提示。第一步是預填:引擎透過模型單次並行處理該提示,並將產生的 K 和 V 張量寫入記憶體。因此,預填充受運算資源限制,其延遲隨提示長度的增加而增加。
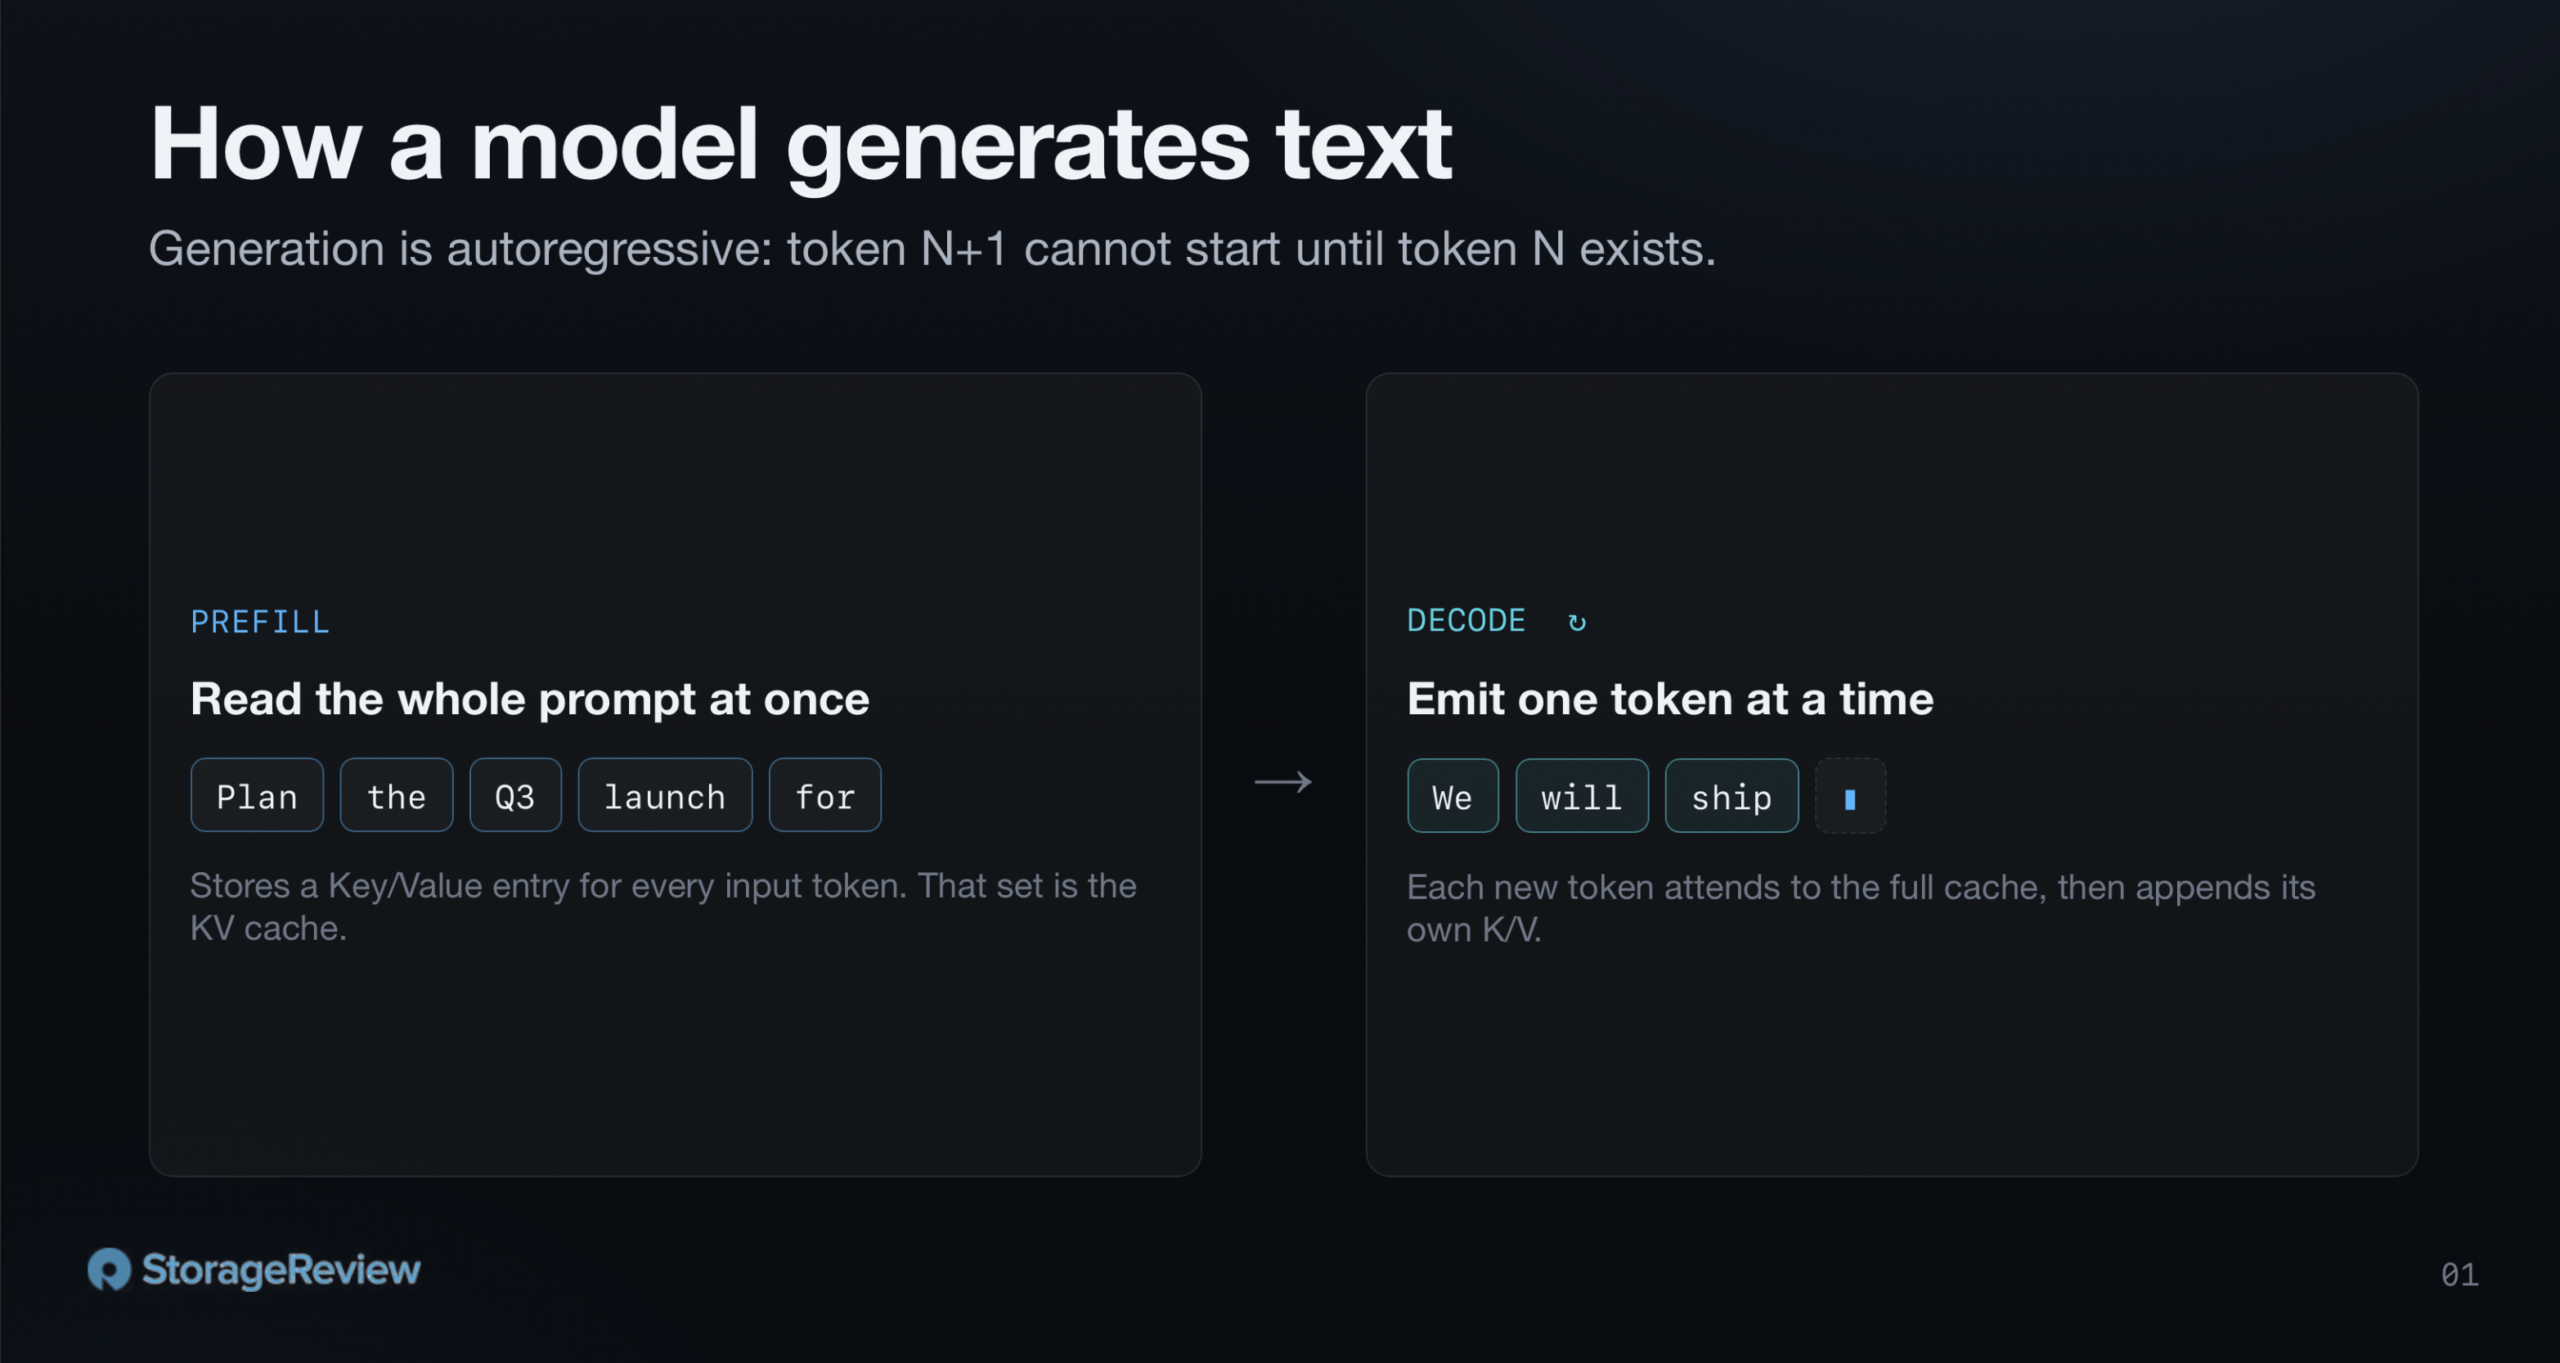
預填完成後,引擎會逐一輸出響應詞元。每個新詞元都會讀取先前所有詞元的 K 和 V 值,計算自身的注意力輸出,並將自身的 K 和 V 值寫入記憶體以供下一步使用。第二階段是解碼階段。由於產生每個詞元都需要從記憶體中載入先前所有詞元的快取 K 和 V 張量,並基於這些張量計算注意力,然後才能將新詞元的 K 和 V 張量寫入記憶體以供後續步驟使用,因此該階段是順序執行且受限於記憶體頻寬的。
兩個階段的 K 和 V 張量構成了 KV 快取。如果沒有它們,產生第 n+1 個 token 時,每一步都需要重新計算之前所有 n 個 token 的鍵和值,計算複雜度為二次方級。有了緩存,每個新 token 只需計算自身的 K 和 V,其餘資訊從記憶體讀取,因此每個 token 的計算成本保持線性。
代理流量是什麼樣子的
人們通常將推理描述為受限於記憶體頻寬,因為解碼佔據了回應中使用者可見的部分。這兩個階段之間的實際平衡取決於工作負載。一個要求撰寫長篇論文的簡短提示會消耗大量解碼資源;一個要求進行少量 JSON 編輯的冗長提示則會消耗大量預填充資源。哪一方占主導地位決定了緩存管理不善時哪些部分會承受壓力。
重新計算問題的形狀取決於這種平衡,而「代理」涵蓋了廣泛的使用模式。代理程式編碼是目前最受歡迎的模式之一,在OpenRouter 排行榜上,它佔據了相當大比例的代幣。為了量化一個典型案例,我們使用 OpenTelemetry (OTEL) 日誌記錄功能對 Claude Code 進行了插樁,並將一週的追蹤資料匯出到 Grafana。以下顯示了按類型劃分的令牌流量。注意:此 Claude Code 使用情況是基於 Claude Opus 4.8 模型,上下文長度為 1M,同時處理多個編碼項目。
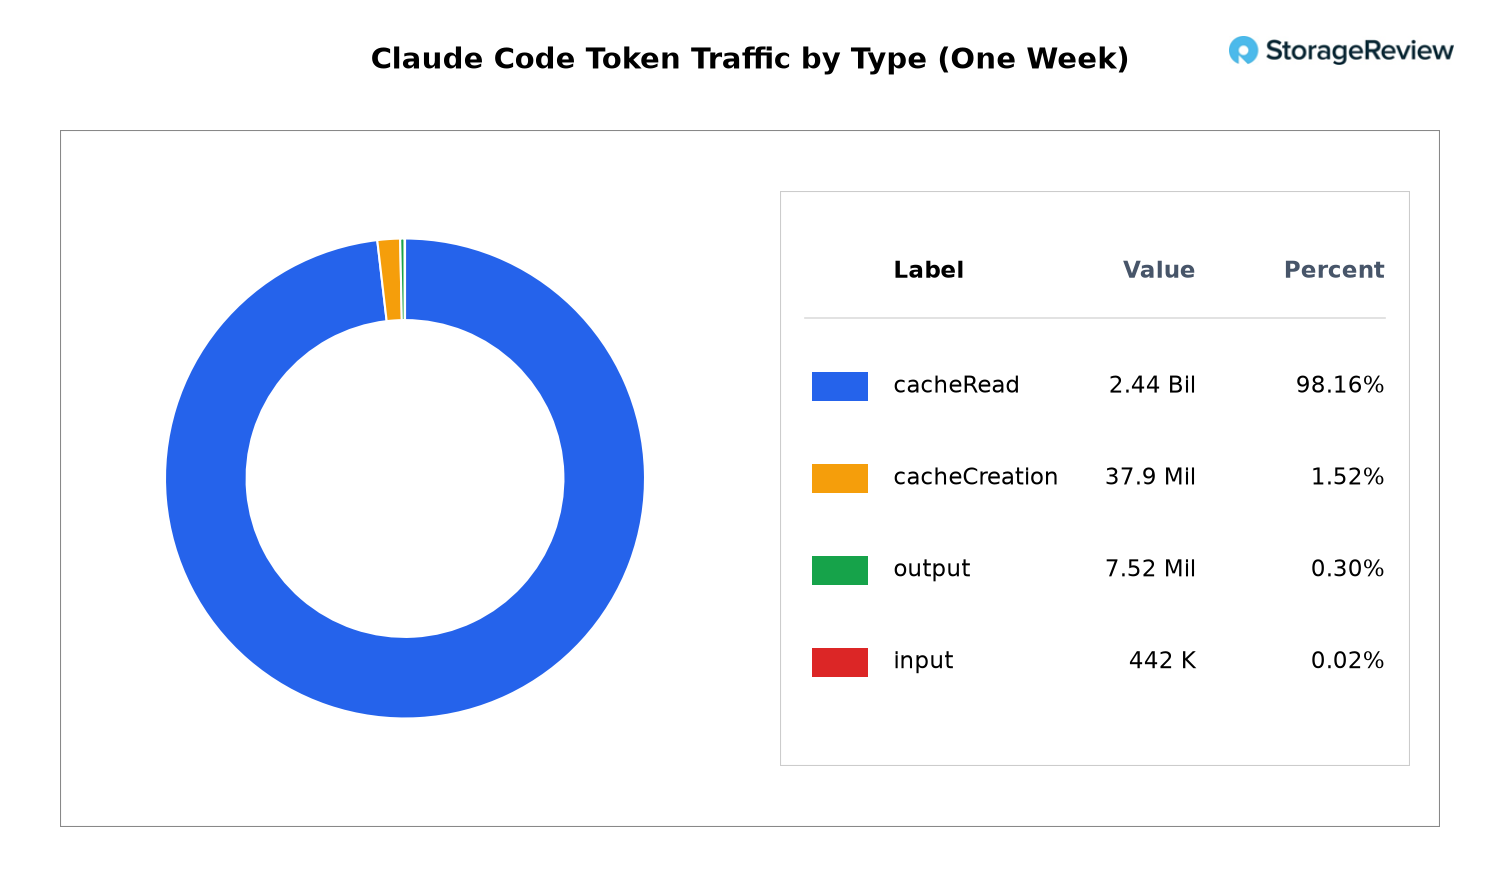
快取讀取佔所有令牌流量的 98.16%。快取建立(由於條目過期而重新預填先前已存在的前綴)佔 1.52%。輸出令牌佔 0.30%。真正的冷輸入令牌佔 0.02%。
在98%流量為快取讀取的工作負載中,如果不進行卸載就進行驅逐,表示系統需要重新預先填充大部分原本要執行的工作。瓶頸從解碼頻寬(通常是最佳化的階段)轉移到了預填充計算,而GPU已經在先前的輪次中完成了這些計算。事實上,基於同樣的原因,在規模化部署中,分離式服務架構運行的預填工作進程數量多於解碼工作進程的情況非常普遍:預填是關鍵的門控階段。
98% 這個數字代表的是一位用戶的流量組成。短回合聊天的工作負載會顯示更多冷流量。如果系統採用檢索增強技術,每次對話都會重新註入不同的文檔,也會發生這種情況。只要對話時間較長、前綴穩定且使用者不斷回到相同的上下文,這種整體趨勢就成立。
藏寶點在哪裡,以及裝滿後會發生什麼
這個快取實際存放在哪裡?空間不足時會發生什麼事?模型權重載入完畢後,剩餘的記憶體 (VRAM) 會變成鍵值快取空間,並分割成固定大小的區塊。引擎啟動時會告知你它能容納多少個令牌。在沒有鍵值卸載 (KV Offloading) 的標準配置中,這個快取池是快取唯一可以存放的地方。
GPU 伺服器成本高昂,而代幣是其產品,因此目標是確保伺服器全天候運作。這意味著要讓 GPU 始終保持負載,並維護一個小型請求佇列,以避免運算資源閒置,同時也要平衡佇列,使回應延遲保持在服務等級目標 (SLO) 範圍內。並非每個請求都會佔用其完整的上下文窗口,因此許多已完成的鍵值對 (KV) 會自行緩存在顯存 (VRAM) 中。但在持續高負載下,快取會逐漸填滿,一旦填滿,較舊的條目就會被清除以騰出空間。
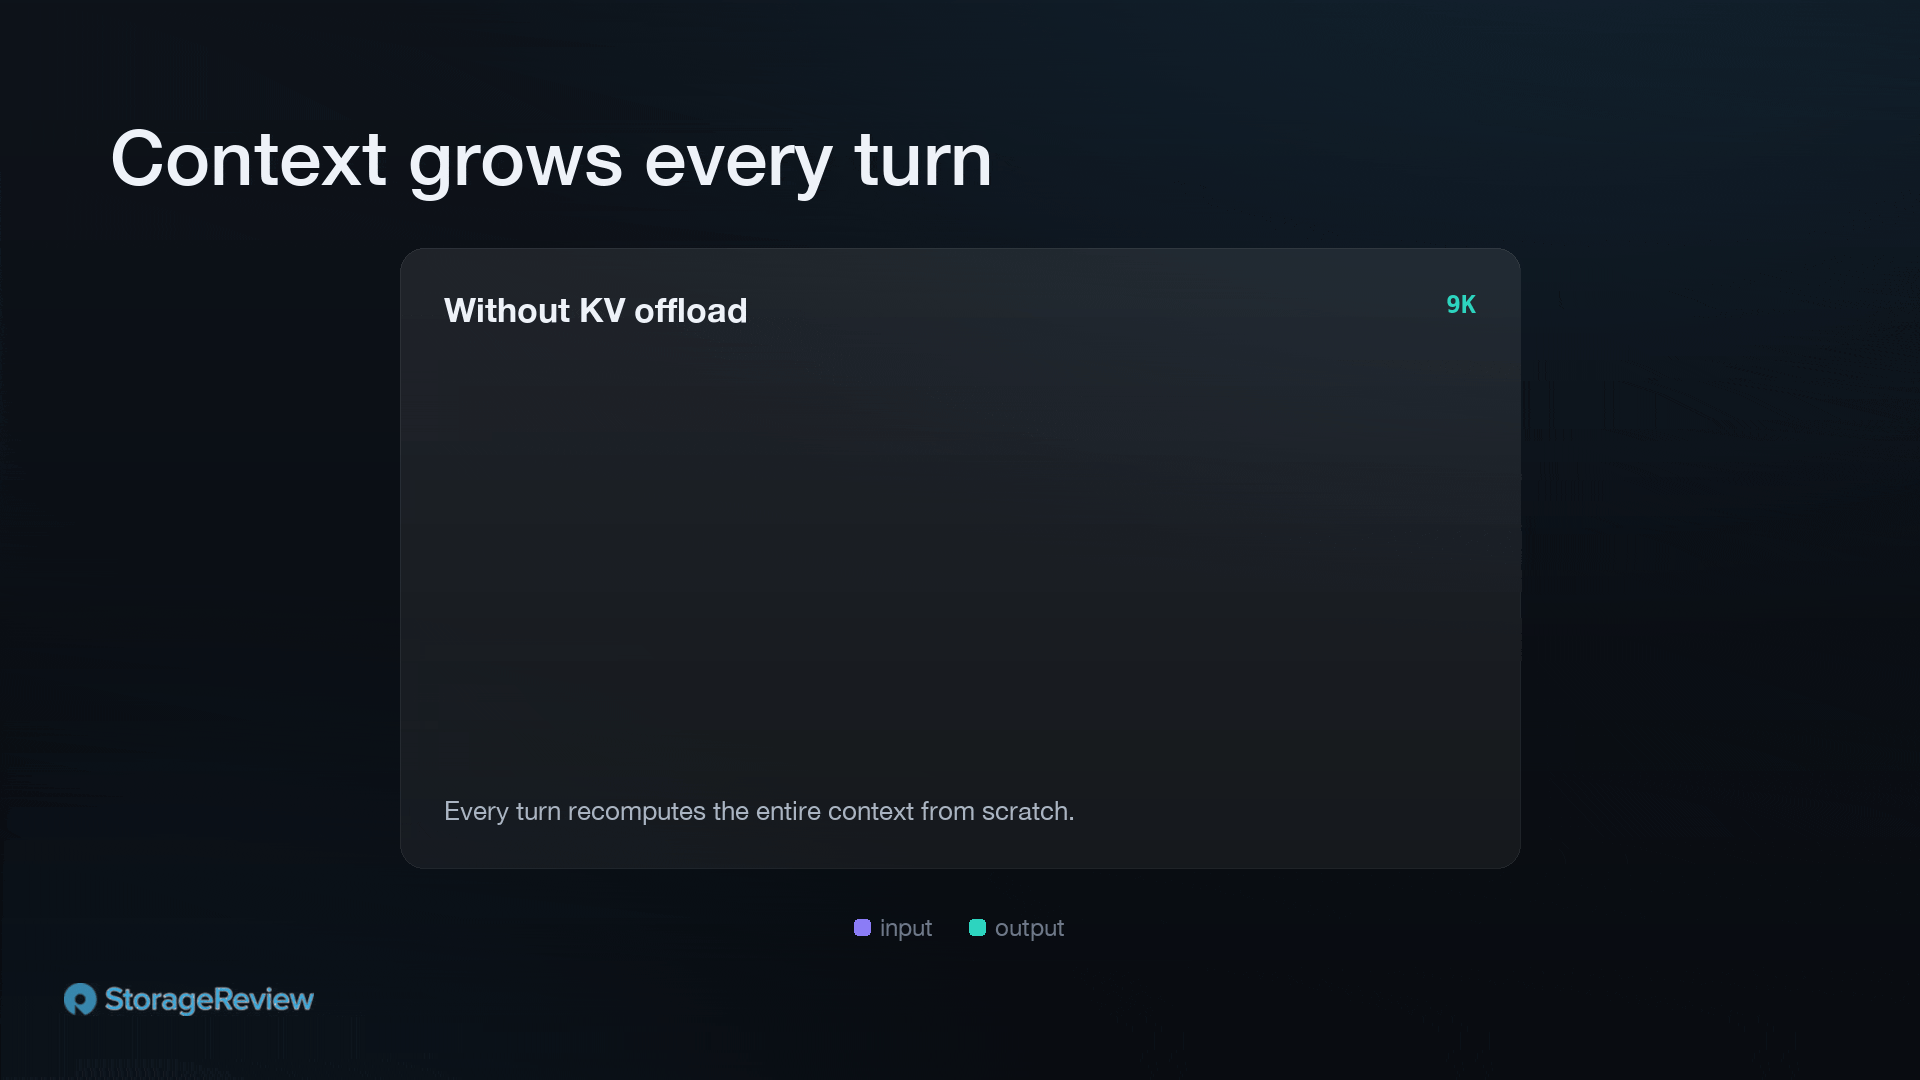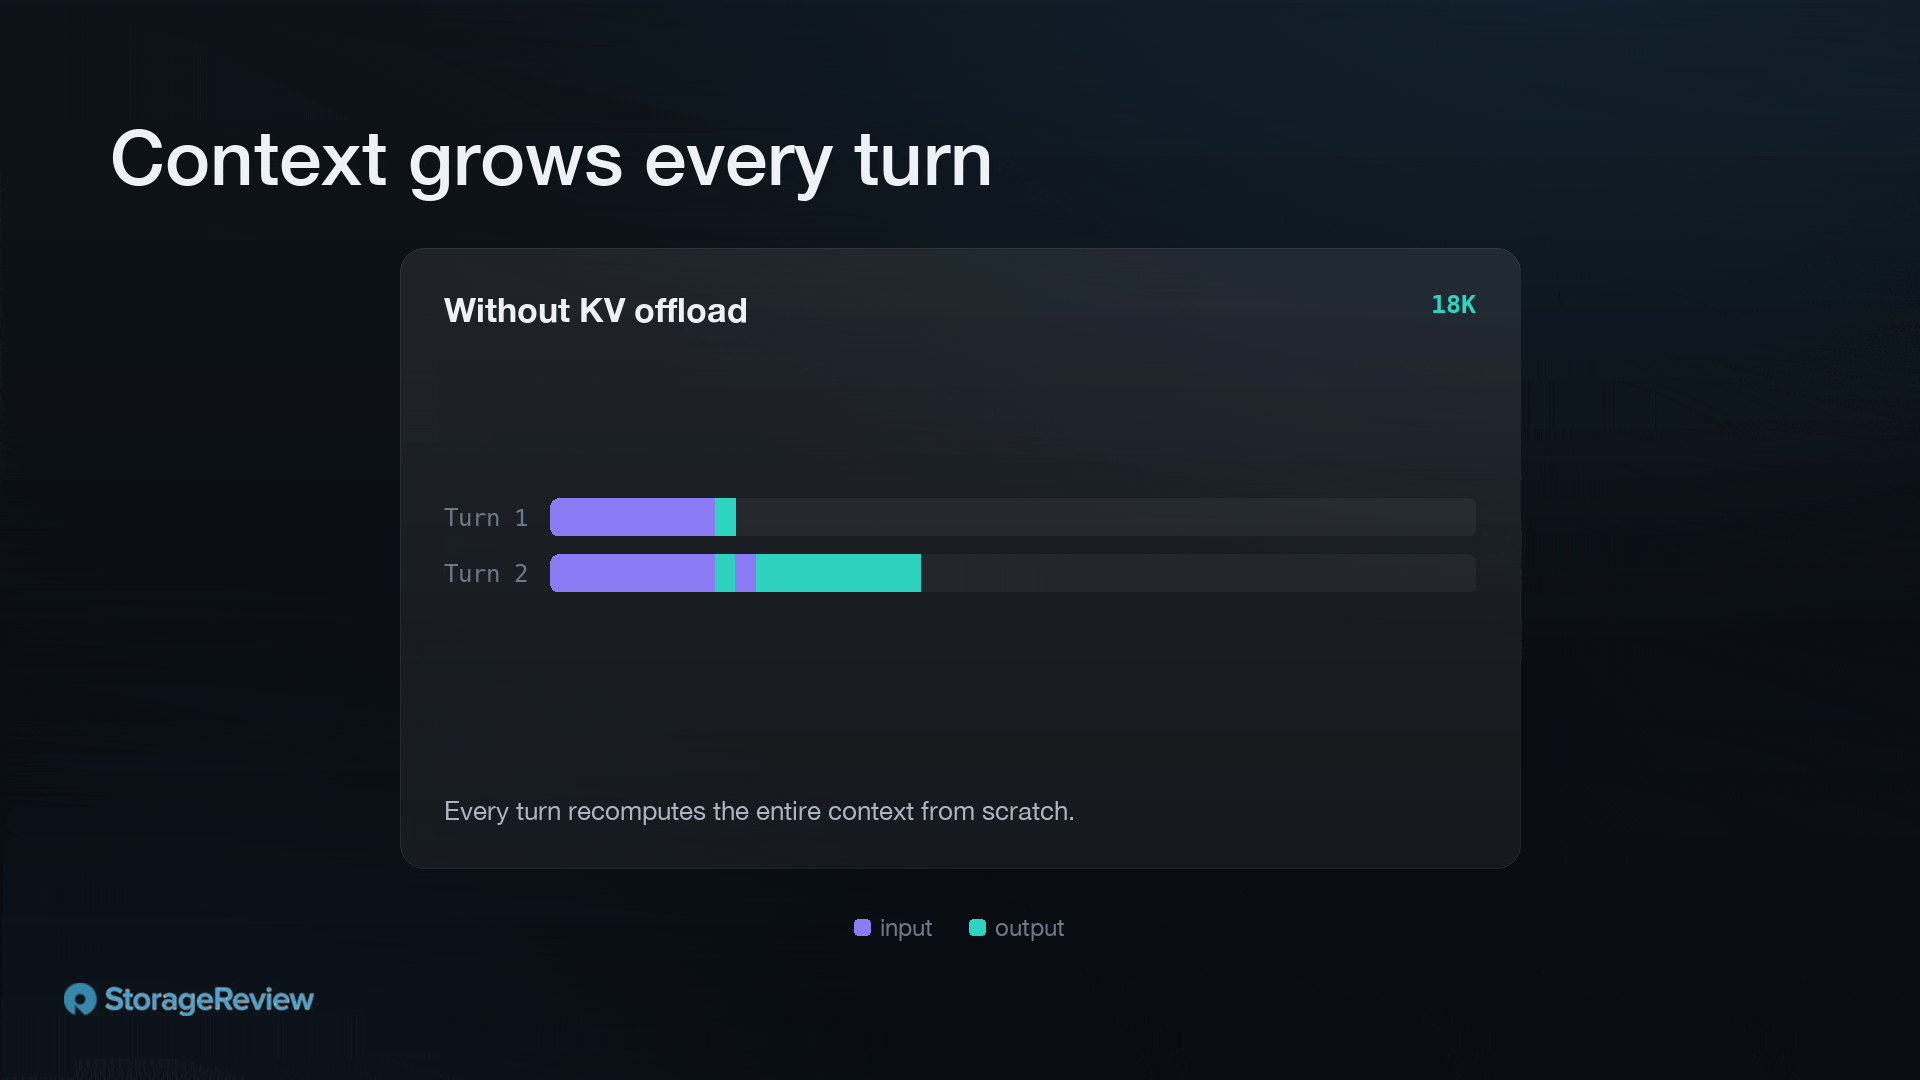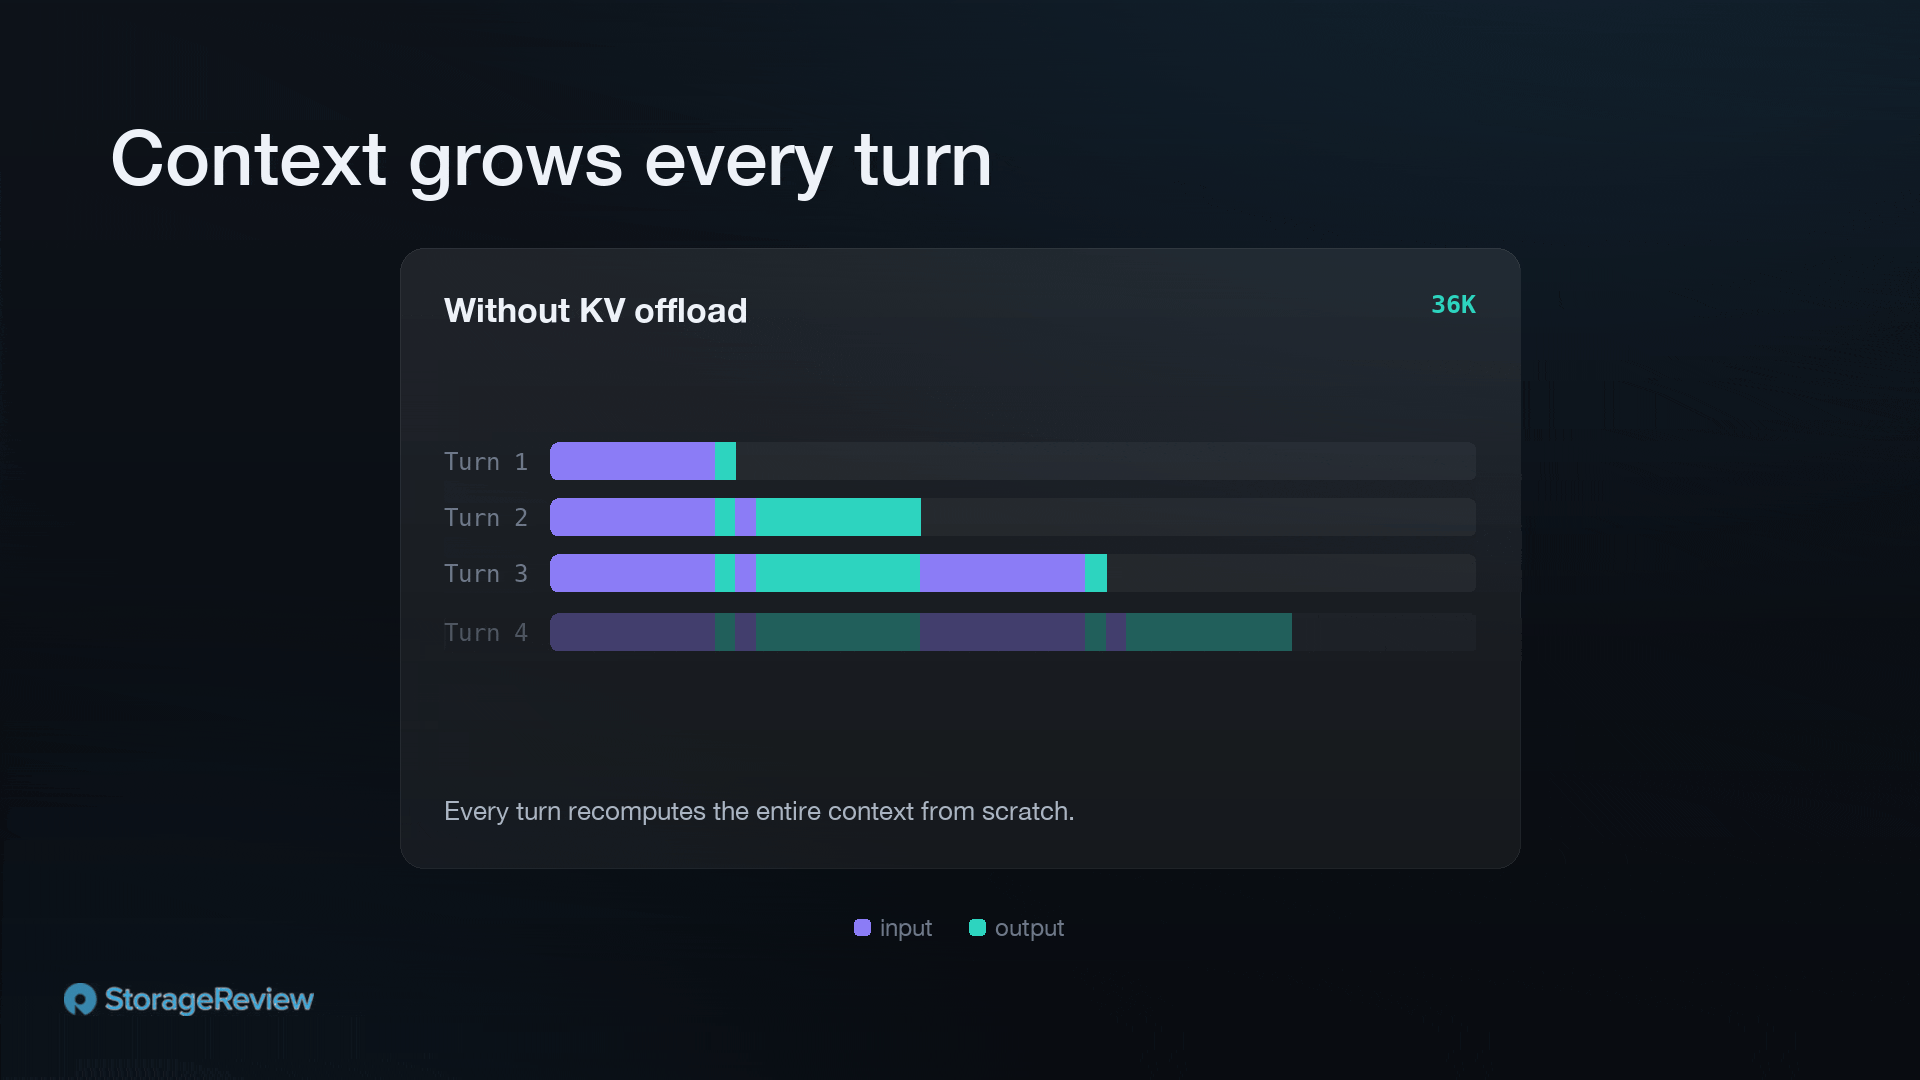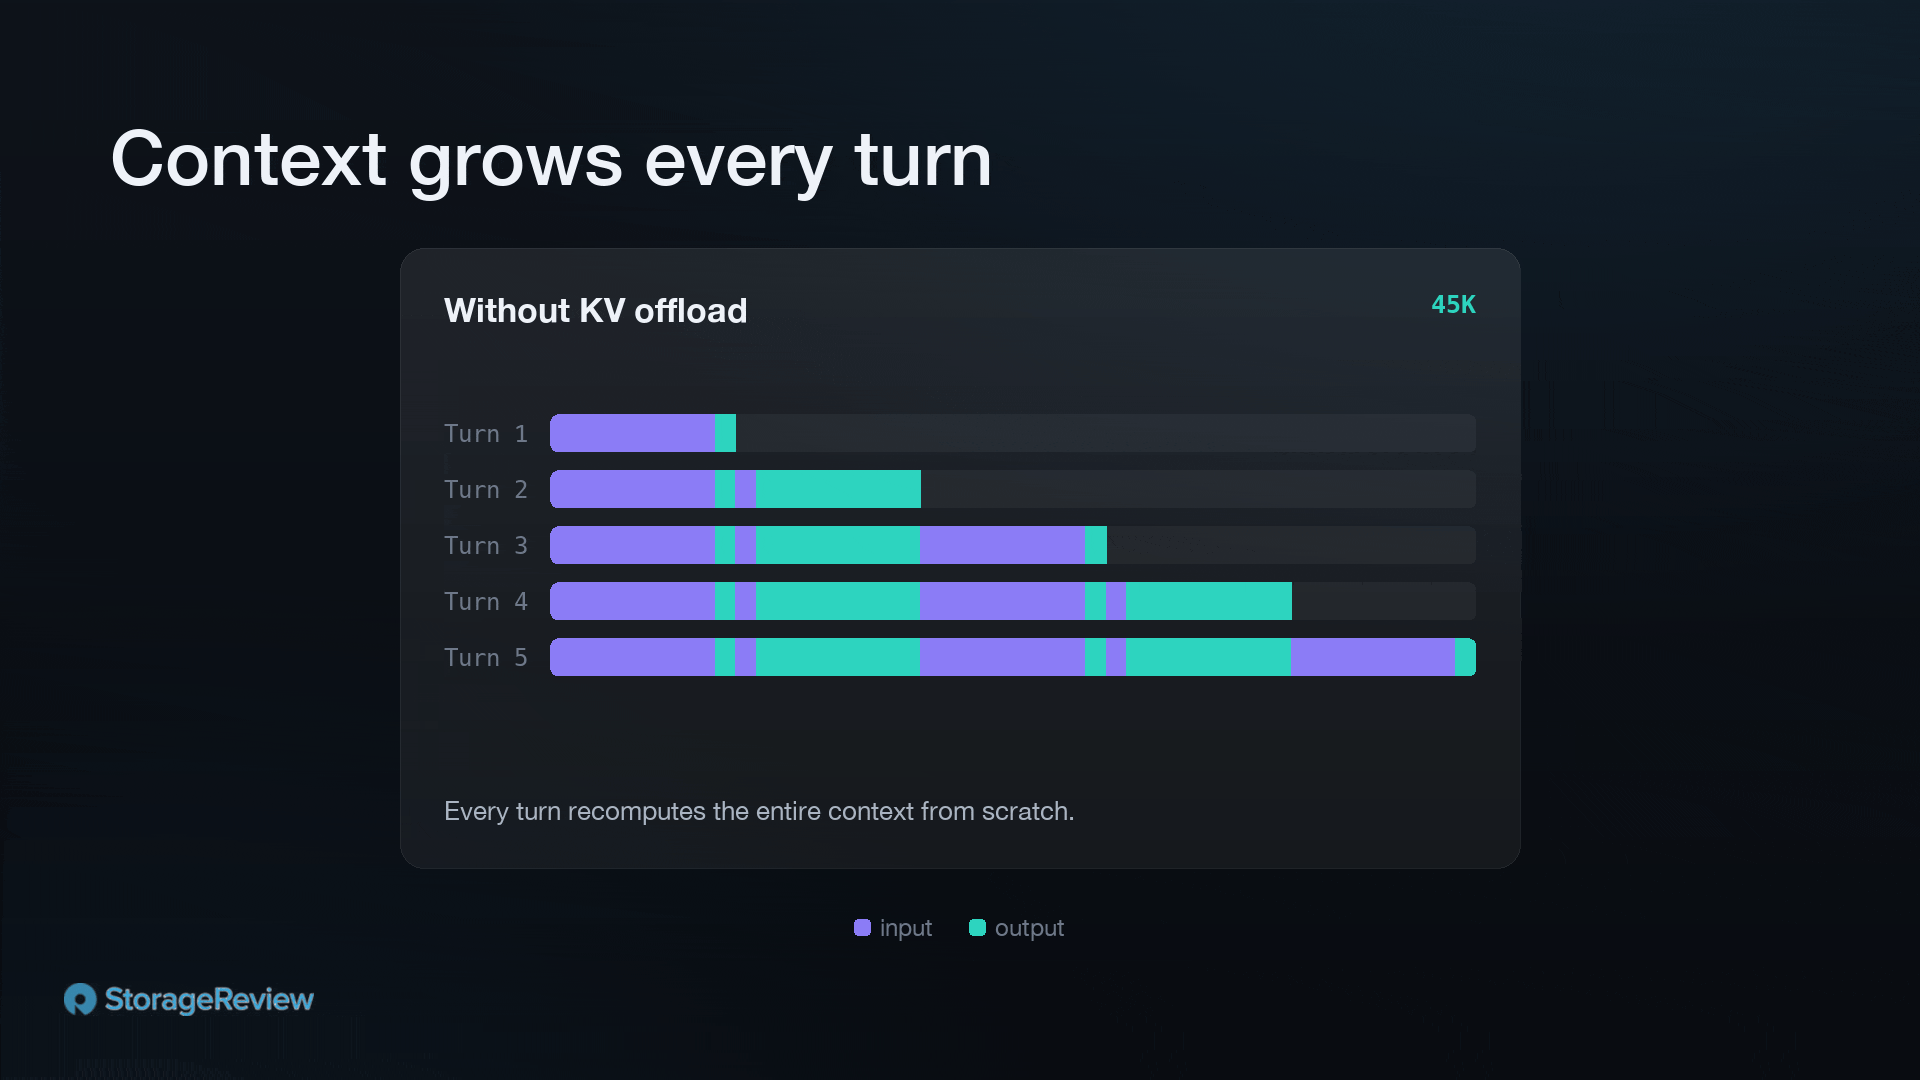
理想情況下,每個答案只需一次就能完成。但目前的模型還不夠完善,所以我們運行代理循環,在使用者之間或代理之間來回互動。當下一輪對話到來時,如果其鍵值尚未緩存,引擎會重新處理先前的所有對話內容,包括新的詞元。每個先前對話的上下文都會再次輸入模型,GPU 先前對這些詞元進行的計算會在每個後續對話中重複進行。這部分計算純粹是浪費。
KV快取卸載有哪些變化
卸載機制並非在顯存填滿時立即驅逐緩存,而是逐步向下層級地溢出緩存:從顯存到系統記憶體再到固態硬碟。熱工作集保留在顯存中;不再適合的條目被推送到系統內存,如果系統內存也滿了,則會再次推送到固態硬碟或網絡存儲層。真正的快取驅逐變得很少發生,而是由使用者設定的生存時間(TTL)驅動,而不是由記憶體壓力驅動。
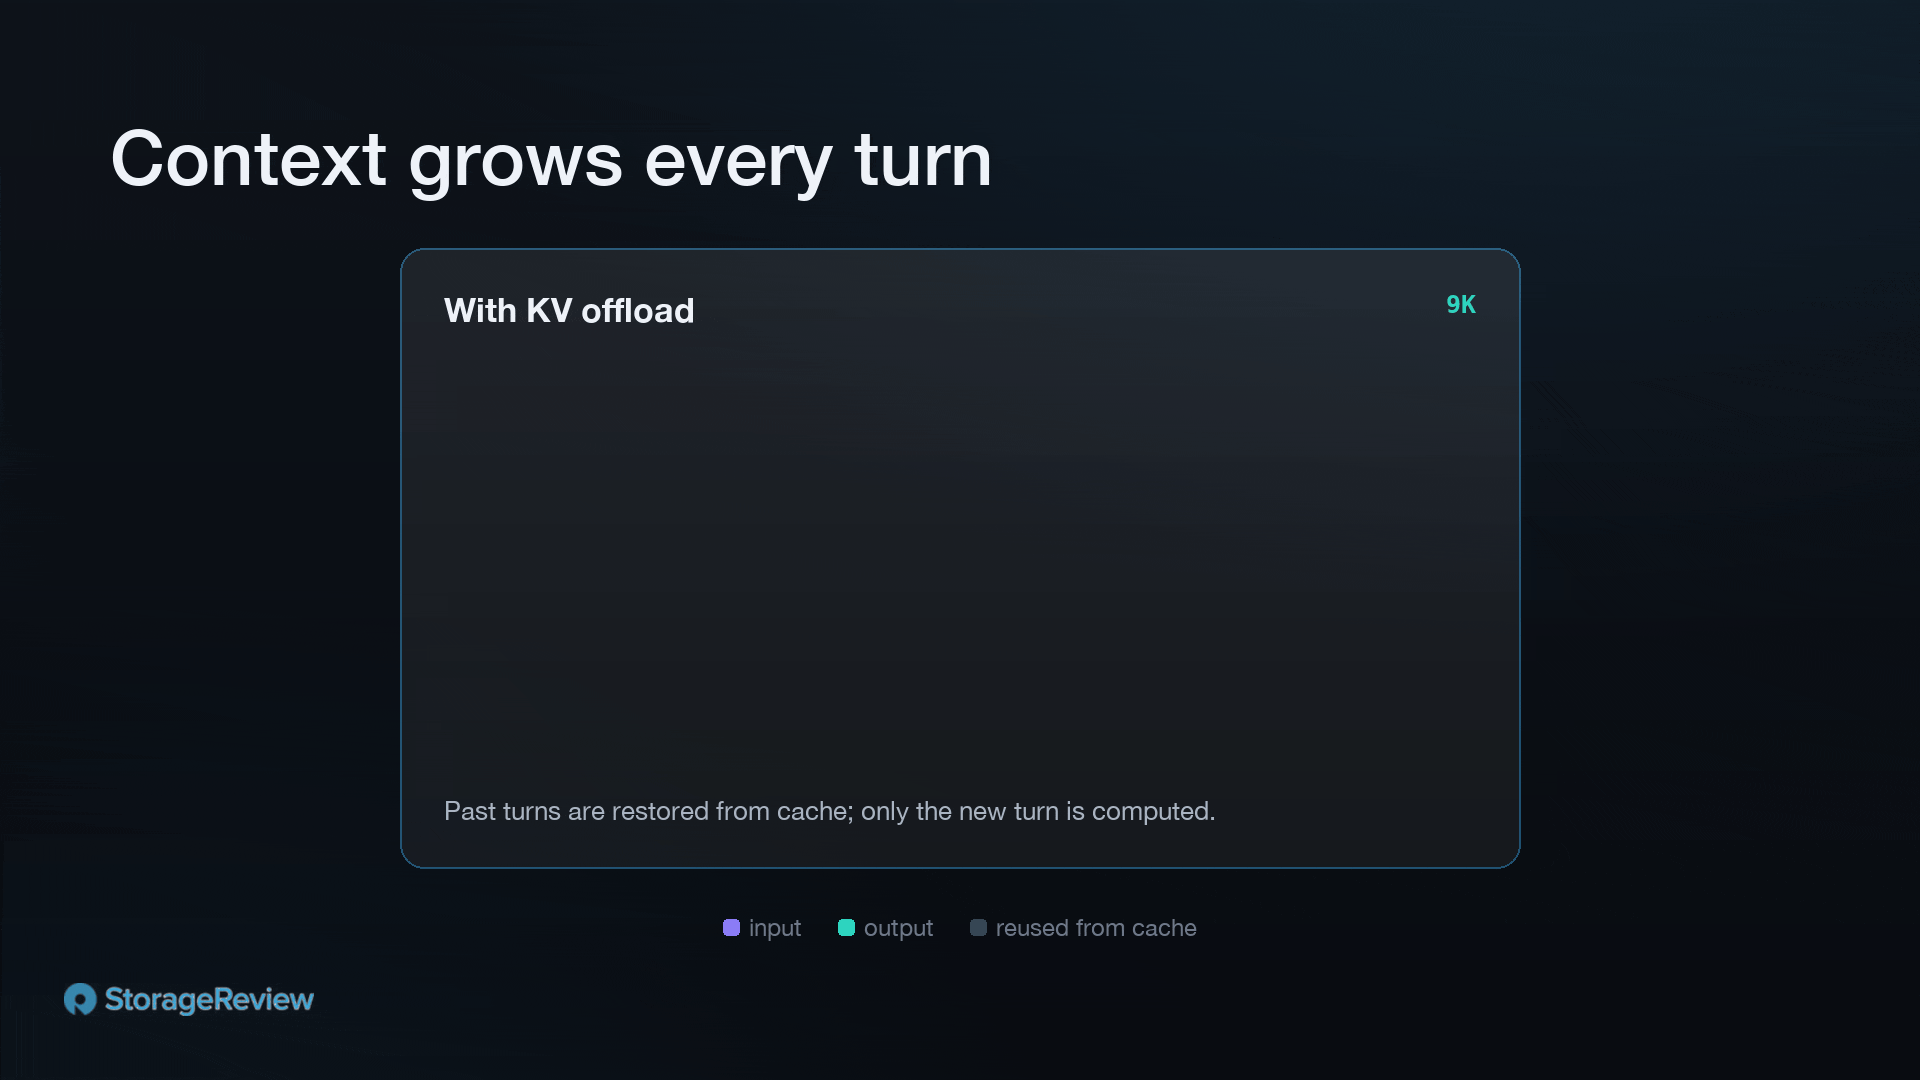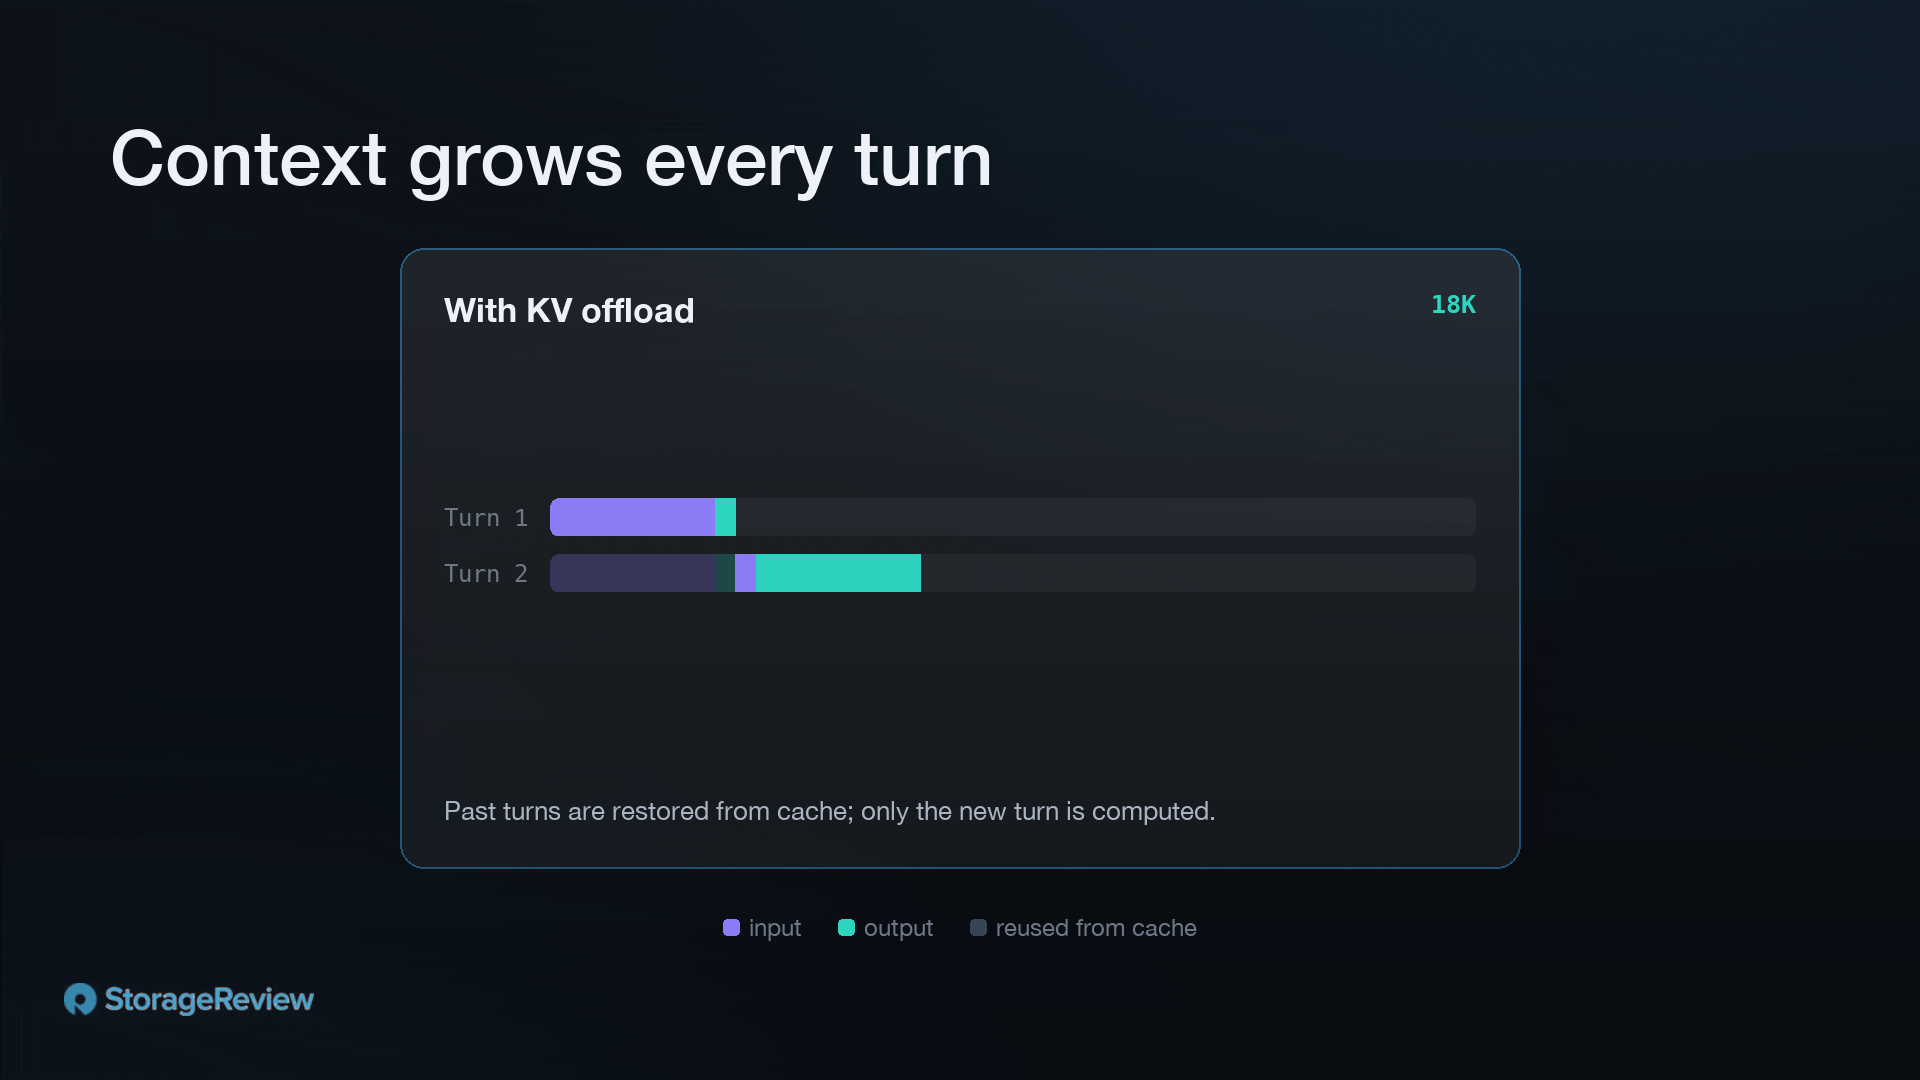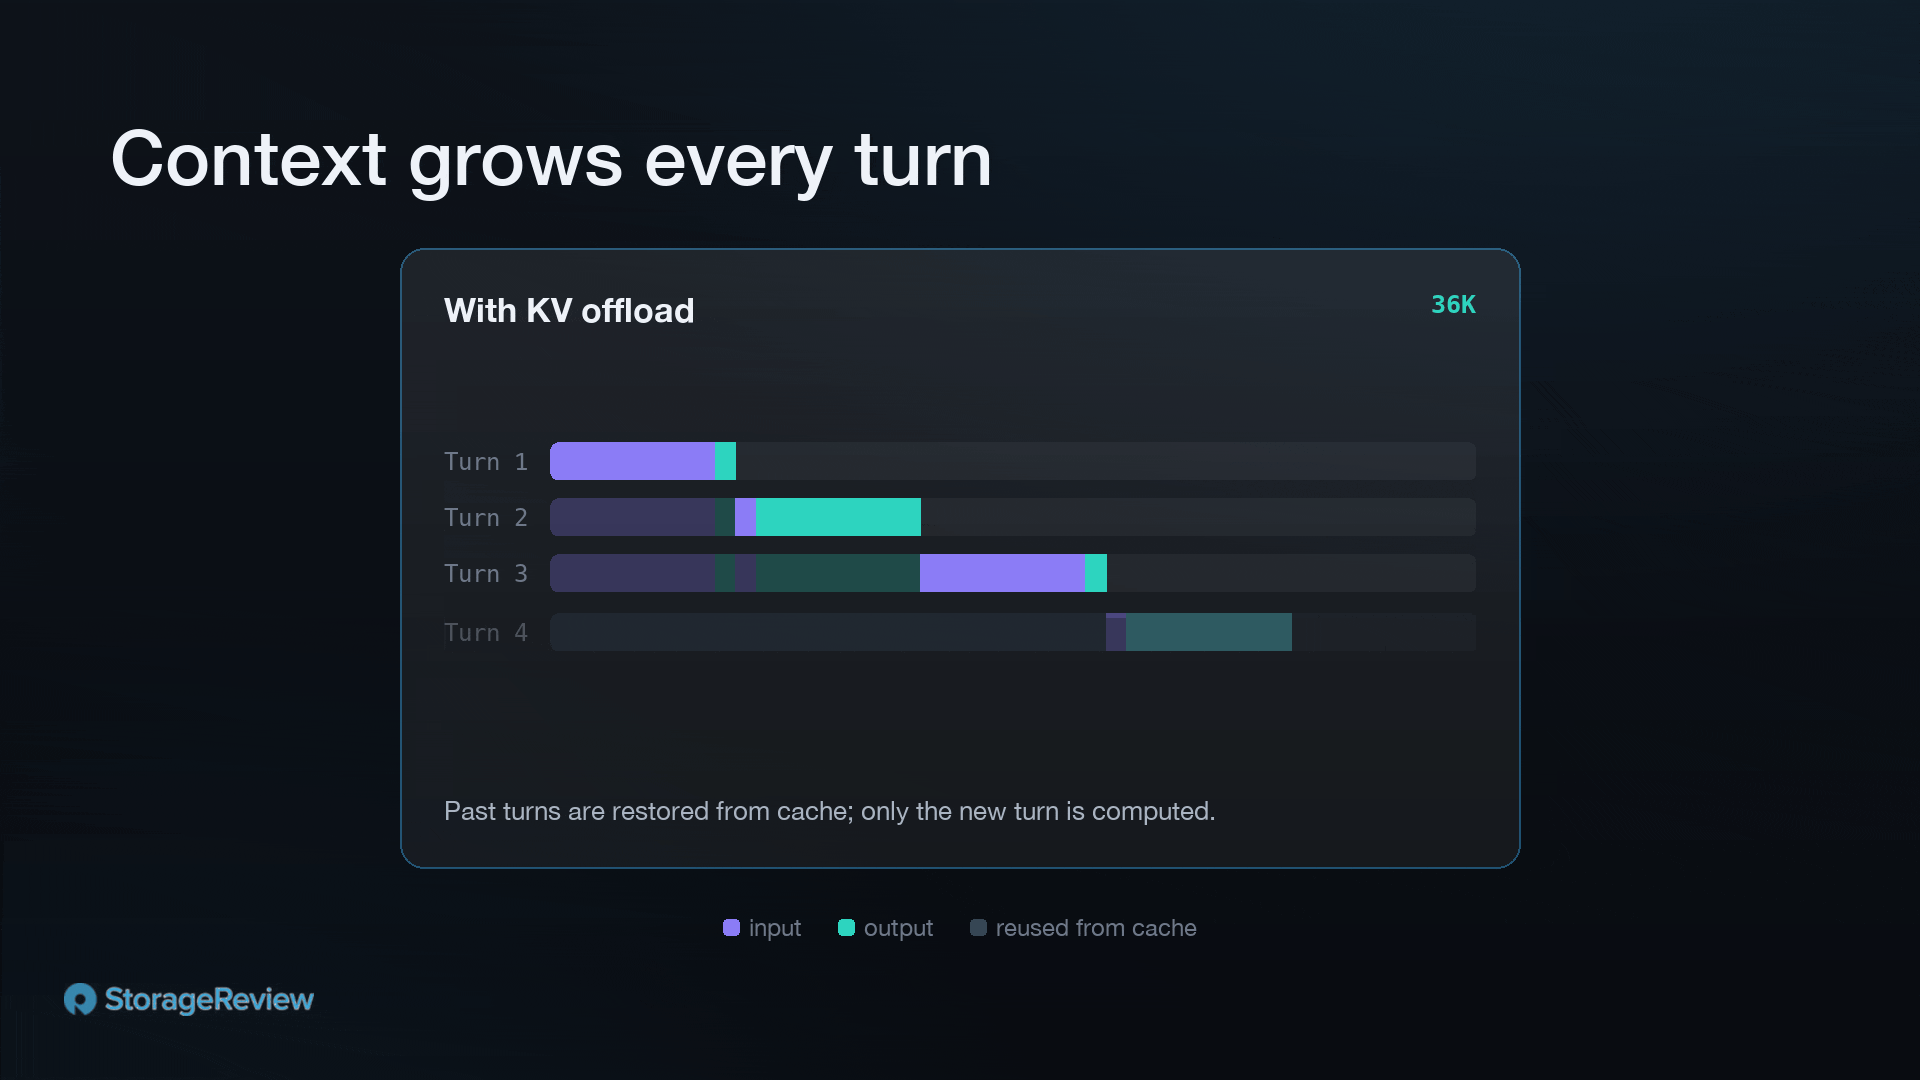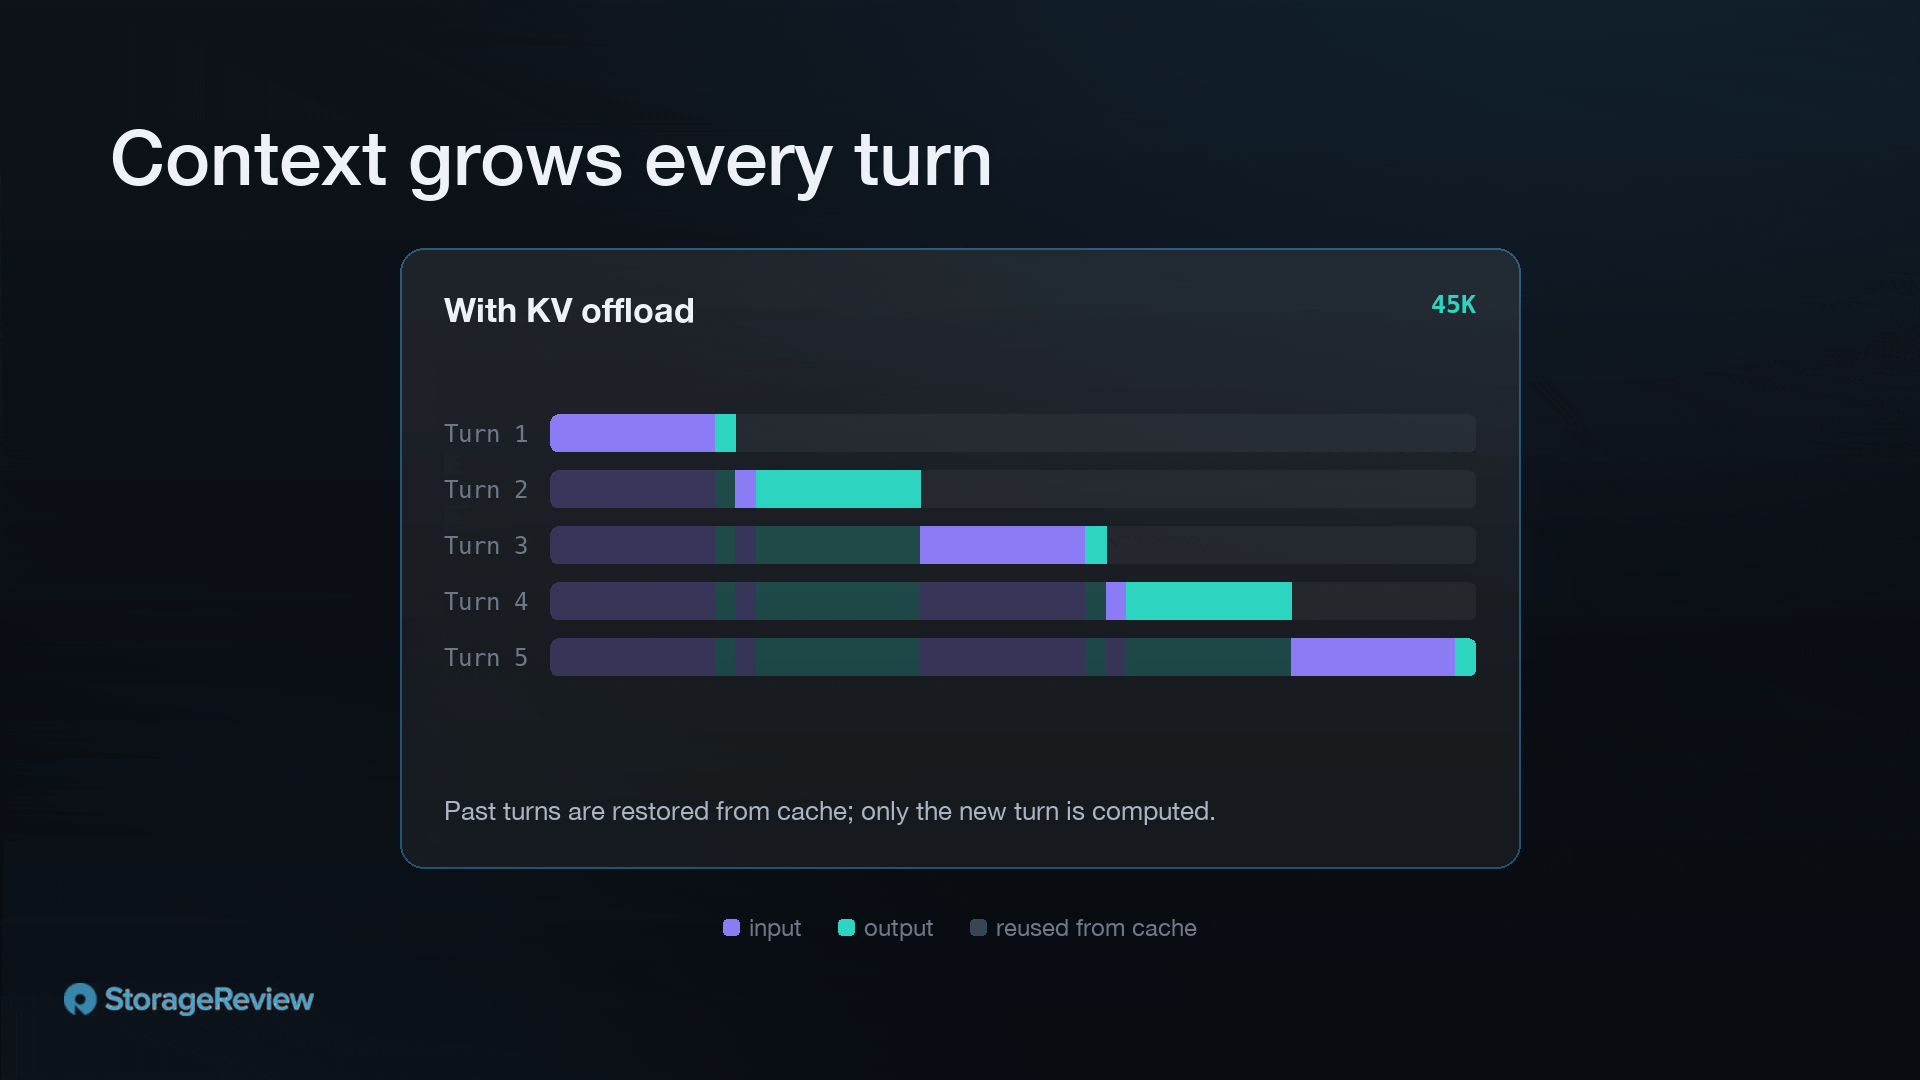
當下一回合開始時,我們不再重新計算數萬個上下文標記,而是從記憶體或快閃記憶體中恢復鍵值對 (KV)。從系統記憶體重新載入會帶來少量延遲,但比重新預填充便宜得多,速度也快得多。從 NVMe 重新載入比從 DRAM 讀取稍慢,但仍然比它所取代的重新計算快得多。儲存容量相對便宜;GPU 運算則不然,因此,在回合開始時犧牲一點重新載入的延遲來避免數秒的重新計算是完全值得的。
我們如何測試
我們在實驗室對此進行了測試。系統配置如下:
- 伺服器:戴爾 PowerEdge XE7740
- GPU:4塊NVIDIA RTX PRO 6000 Blackwell Server Edition(96GB)
- 系統記憶體:1TB DDR5(16 x 64GB 5200MT/s DDR5)
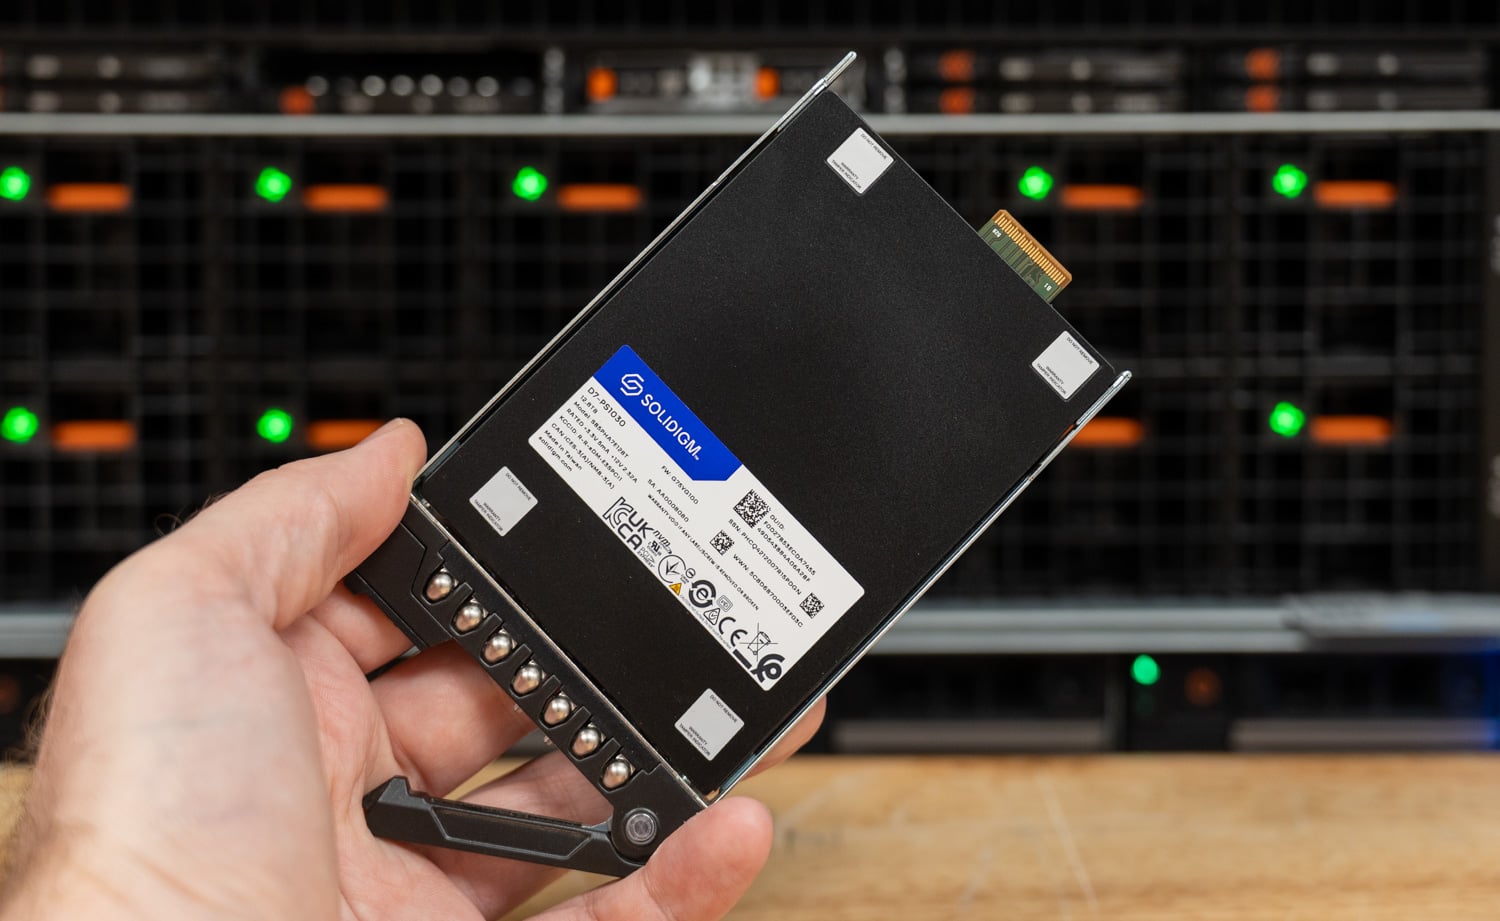
- 儲存:8塊Solidigm PS1030 12.8TB E3.S硬碟(RAID10)
- 服務堆疊:vLLM 0.22.0,LMCache 0.5.0
- 型號:MiniMax-M2.7
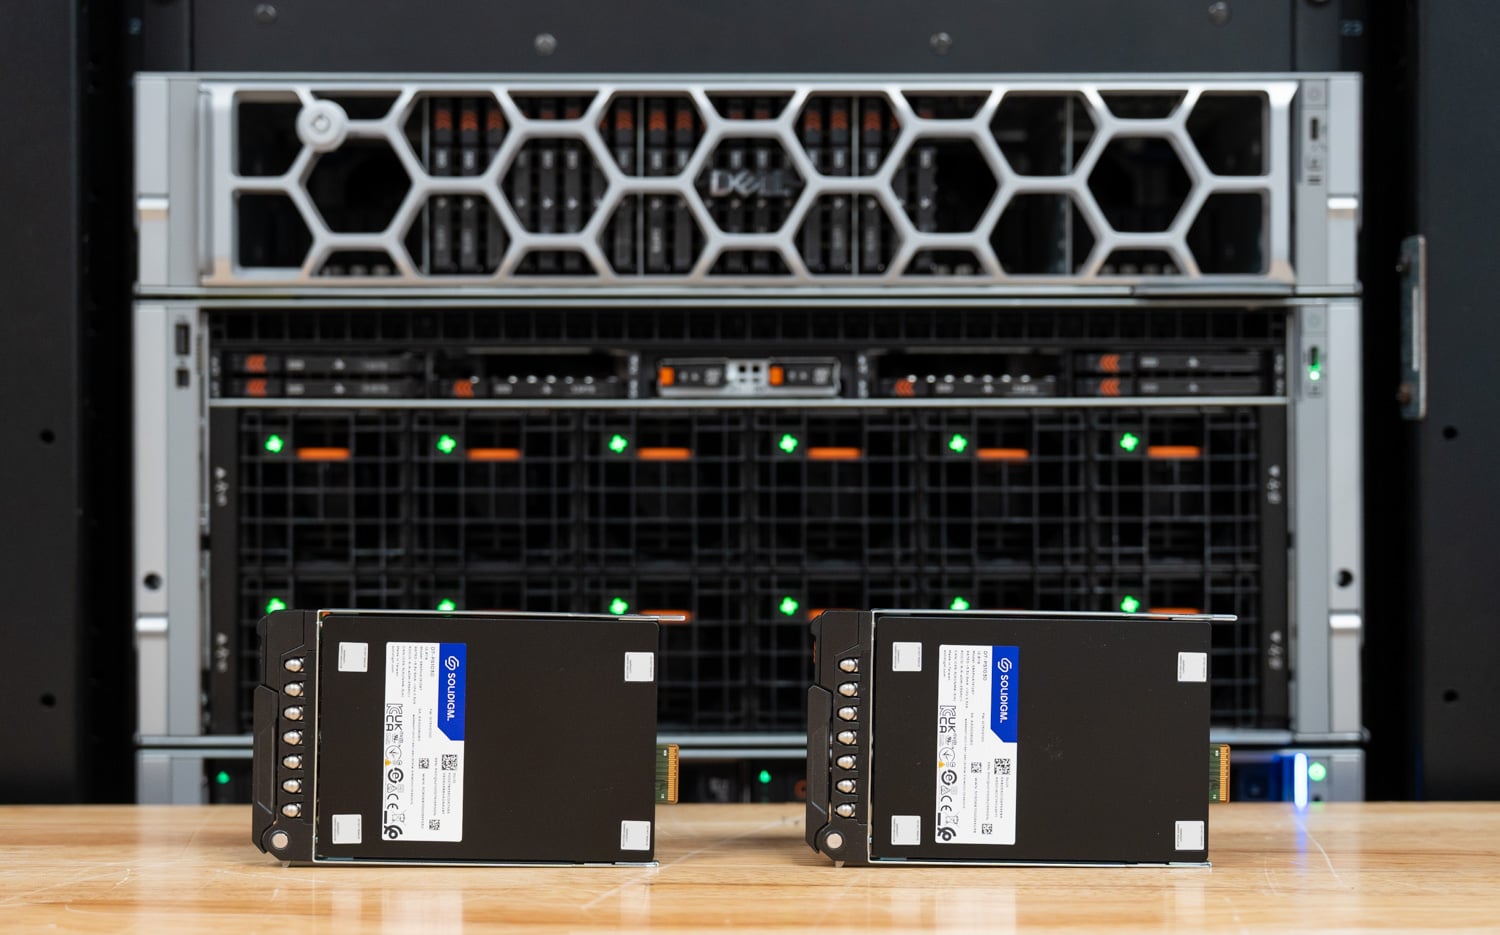
測試平台完美契合此工作負載。 Dell PowerEdge XE7740 專為企業級 AI 推理而設計,採用 PCIe Gen5 機箱,最多可支援 8 個雙寬 GPU。我們運行的四 GPU 配置是目前最暢銷的配置之一。它為各種推理部署提供了足夠的加速容量,同時在同一機箱內預留了擴展空間,可隨著需求增長擴展至八個 GPU。每塊 NVIDIA RTX PRO 6000 Blackwell 伺服器版顯示卡均配備 96GB GDDR7 記憶體,因此四塊顯示卡在 GPU 快取離開前即可提供足夠的記憶體。底層卸載層採用八塊 12.8TB Solidigm D7-PS1030 固態硬碟組成 RAID 10 陣列,Gen5 高耐久性快閃記憶體非常適合 KV 快取層產生的持續寫入操作。最後,我們選擇的 MiniMax-M2.7 型號在測試時是符合我們四 GPU 配置要求的頂級開源型號之一。
我們測試了三種配置:
- VRAM 基準,標準 vLLM,無卸載,其中任何能放入 VRAM 的內容都會被緩存,其餘內容都會被驅逐。
- 將 LMCache 卸載到系統內存,分配 512GB 用於卸載。
- 將 LMCache 卸載到快閃記憶體,以本機 RAID10 NVMe 陣列作為卸載層,前端配備 64GB RAM 暫存緩衝區。
我們基於真實的智慧體編碼流量而非固定的合成前綴掃描來模擬工作負載。這種流量預填充量大而解碼量小,前綴重用率很高。會話以泊松過程到達,速率為每分鐘 λ = 2.5 個會話。每個會話運行多個回合。在每個回合中,模型接收一個簡短的追加數據,通常是 250 到 600 個字元的工具或命令結果,偶爾會讀取一個 1,500 到 3,500 個詞元的檔案。它回覆一個簡短的回應,通常是 40 到 200 個字元的工具呼叫或簡要推理,偶爾會傳回一個 400 到 900 個字元的程式碼區塊。回合長度的抖動為 ±100 個字元。會話單調成長,最終達到 64k 個字元的上下文上限,這使其進入深度上下文狀態,此時工作集會超出顯存容量。所有三個層級都使用相同的初始負載,每個層級都有 3 分鐘的快取預熱時間。
關於內存配置的簡要說明:出廠的 XE7740 配備了 2TB 的 DDR5 內存,這是一款頂級配置,旨在滿足各種項目的需求。當時的定價是在 2026 年記憶體價格上漲之前,因此 2026 年之後,如此大容量的 DRAM 記憶體將成為非常昂貴的單品。相對於現今企業訂購四塊 GPU 的配置而言,原有的配置過於高階。為了使其更貼近實際需求,我們移除了 1TB 的內存,每個通道保留一根 DIMM 內存條,以保持最大的內存吞吐量。
關於快閃記憶體層的方法論說明:在運行中使用了 LMCache 的本機磁碟後端,並在陣列前端配備了所需的 64GB RAM 暫存緩衝區。在運行過程中,快閃記憶體上保留的鍵值對佔用空間遠遠超過了主機的總 DRAM 容量,因此持續的結果反映的是驅動器服務而非主機記憶體的使用情況。
性能
負載下的吞吐量
隨著 KV 工作集增長超過每一層所能容納的範圍,運行期間的總服務吞吐量會改變:
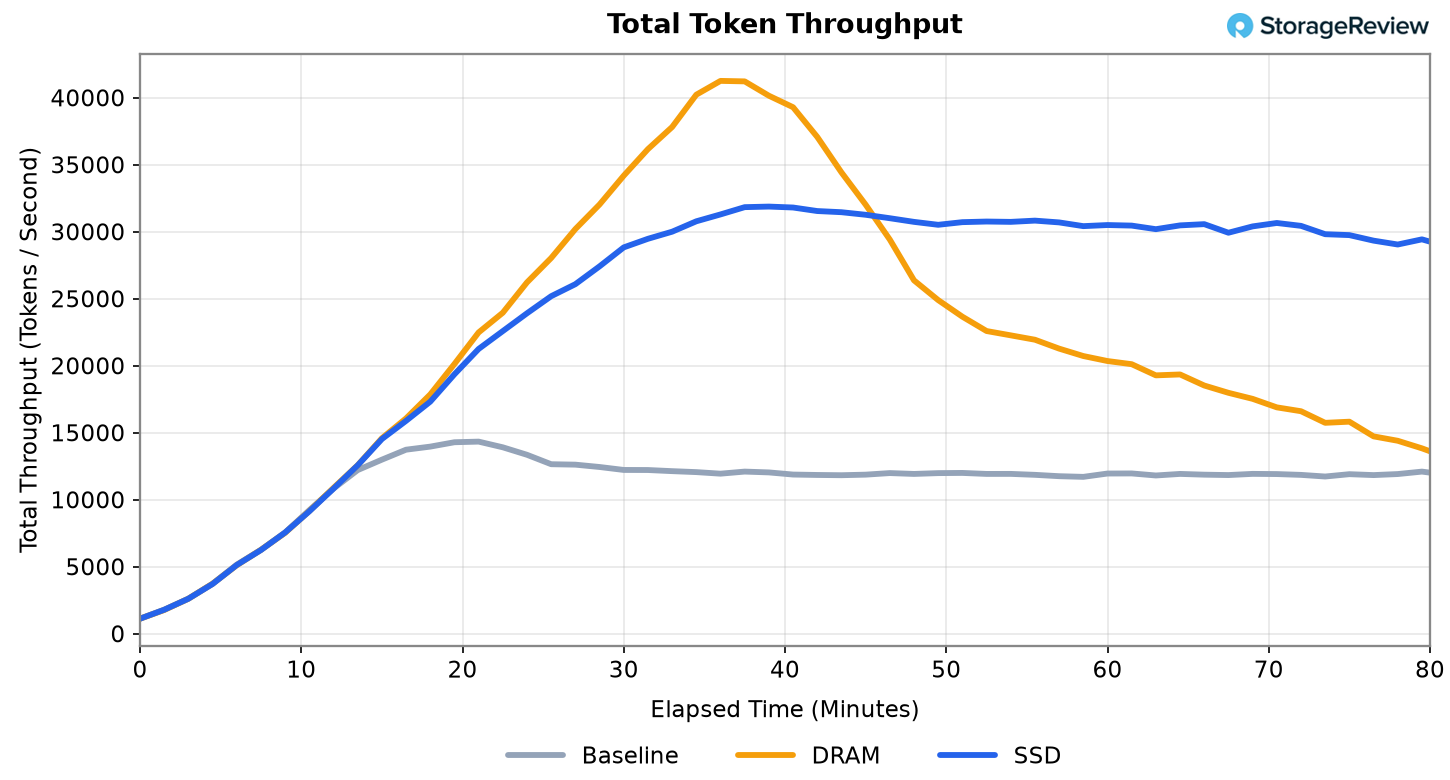
在快取仍在填充的前 10 分鐘,所有層級的效能同步提升,基本上沒有差異。之後,隨著記憶體層級逐漸填滿,它們開始各自獨立運作。僅使用顯存的基準測試首先出現瓶頸:一旦顯存飽和,其效能便穩定在每秒 12,000 個令牌左右。每個新會話都會取代一個舊會話,被取代的快取必須在會話返回時從頭開始重建,因此每秒更多的時間用於重新預先填充,而用於解碼的時間則相應減少。
DRAM 和 SSD 層級的效能持續攀升,遠遠超過瓶頸期,因為在快取填滿之前,它們幾乎直接從記憶體或磁碟提供每個前綴,而無需重新計算。基線層級用於重新預先填充的時間則用於產生新的令牌。
在峰值時,卸載功能在 DRAM 層實現了基準總服務吞吐量的 2.9 倍(+188%),在快閃記憶體層實現了 2.2 倍(+122%)。在工作集超出 VRAM 容量之前,三種配置的效能差距都在百分之一以內。由於沒有記憶體被驅逐,因此卸載功能無需進行任何恢復操作。只有當記憶體壓力迫使記憶體被驅逐時,卸載功能才能發揮作用,並且其優勢會隨著伺服器負載的增加而增強。
當DRAM快取填滿時,更大容量的快取層就顯得特別重要。在這種負載下,512GB的RAM快取大約在運作45分鐘後達到飽和,之後便開始進行快取驅逐。傳回的前綴資料會遺失並被重新預先填充,而這正是快取原本旨在避免的重複計算。 SSD層擁有TB級的容量,因此不會遇到這種瓶頸。超過這個臨界點後,快閃記憶體每秒可處理約30,000個令牌,而DRAM則約為17,000個,這意味著在RAM耗儘後,SSD的吞吐量優勢高達75%。換句話說,在達到飽和後,DRAM層僅能提供其峰值吞吐量的42%,而SSD層則能提供其峰值吞吐量的94%。整個過程都遵循這樣的容量階梯:VRAM 首先耗盡,512 GB DRAM 層稍後耗盡,而以 TB 而不是 GB 衡量的儲存層實際上永遠不會耗盡,因此即使在速度更快的儲存層不得不開始丟棄資料之後,它仍然可以繼續提供上下文資訊。
解讀總吞吐量資料時需要注意一點:它報告的每秒數萬個令牌並非GPU運算令牌的速率;很大程度上,這是卸載層的處理速率。總吞吐量統計的是每個請求攜帶的每個輸入預填充令牌和每個輸出解碼令牌。但由於快取的存在,命中時會從DRAM或快閃記憶體重新載入前綴的鍵值,而不是在GPU上重新預先填入。
將計數範圍限定為輸出令牌(即使用者實際等待的吞吐量部分),可以更清楚地反映情況:
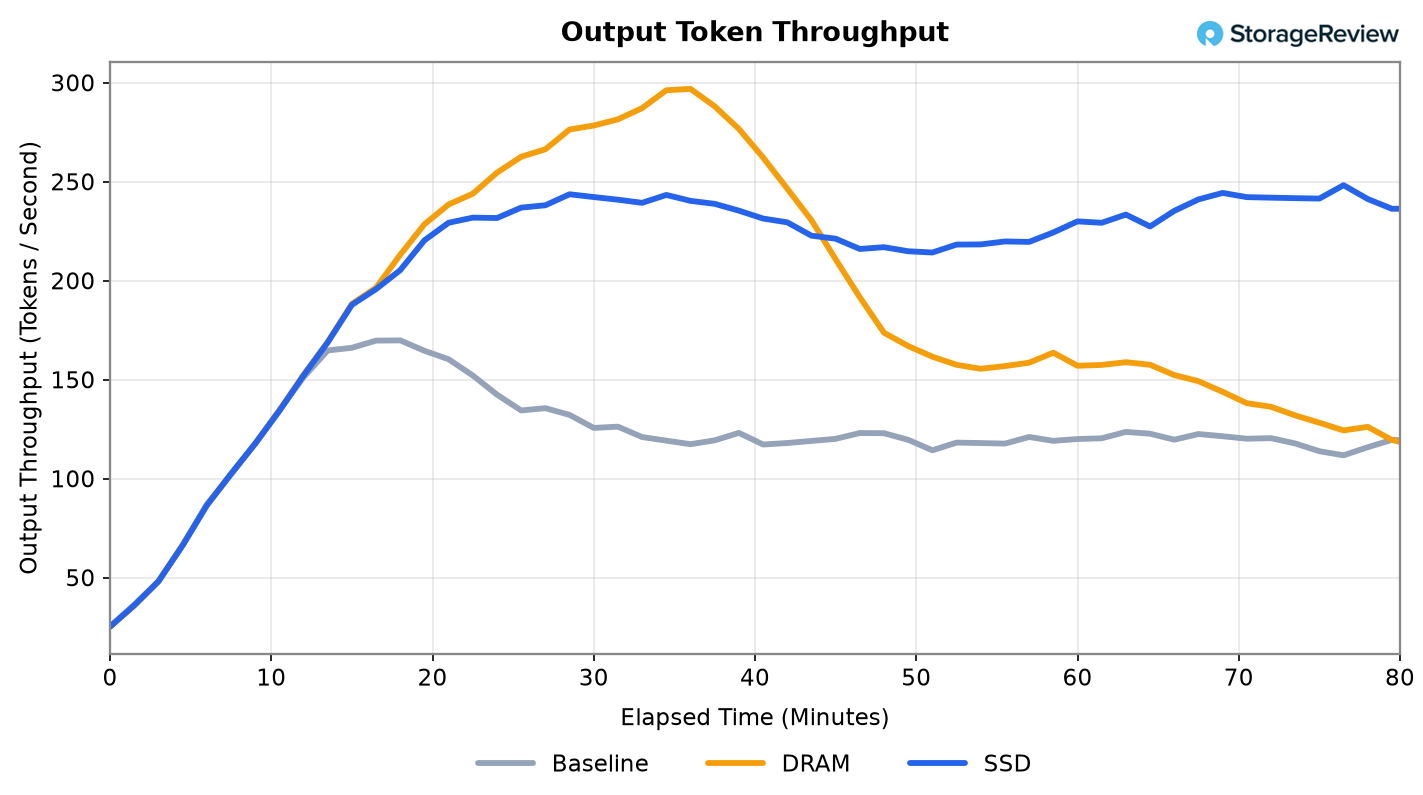
在輸出令牌時,三個層級在快取填充期間再次保持同步,然後在交叉點開始分離。 DRAM 層級的峰值接近每秒 300 個令牌,比基線提高了 75%,之後隨著快取開始被驅逐而回落;快閃記憶體層級在剩餘的運行時間內保持在每秒 250 個令牌左右,比基線提高了 46%。 RAM 和 SSD 層級的峰值保持在彼此 10% 左右的範圍內,直到 DRAM 達到飽和;之後,兩者之間的差距開始擴大。
首令牌延遲:用戶等待的是什麼
吞吐量衡量的是代幣的整體產量。首代幣獲取時間衡量的是單一用戶所感受到的等待時間:從點擊發送按鈕到收到第一個代幣所需的時間。我們繪製了運行期間的中位數,並隨著工作集的增長和每個層級的填充而進行分析。
在快取保持穩定期間,三個層級都能在大約半秒內返回第一個令牌。之後,它們的效能開始出現差異,其差異順序與吞吐量的變化順序相同。基準層率先出現問題:在運行初期,其延遲就超過了 10 秒,而 DRAM 層則在更長時間內保持 TTFT 低於 1 秒,直到其 512 GB 的容量在大約 45 分鐘時被填滿。隨後,隨著 DRAM 層開始驅逐快取並重新計算,其延遲急劇下降。 SSD 層的延遲下降最為平緩,並在運行的後半段始終保持最低值。
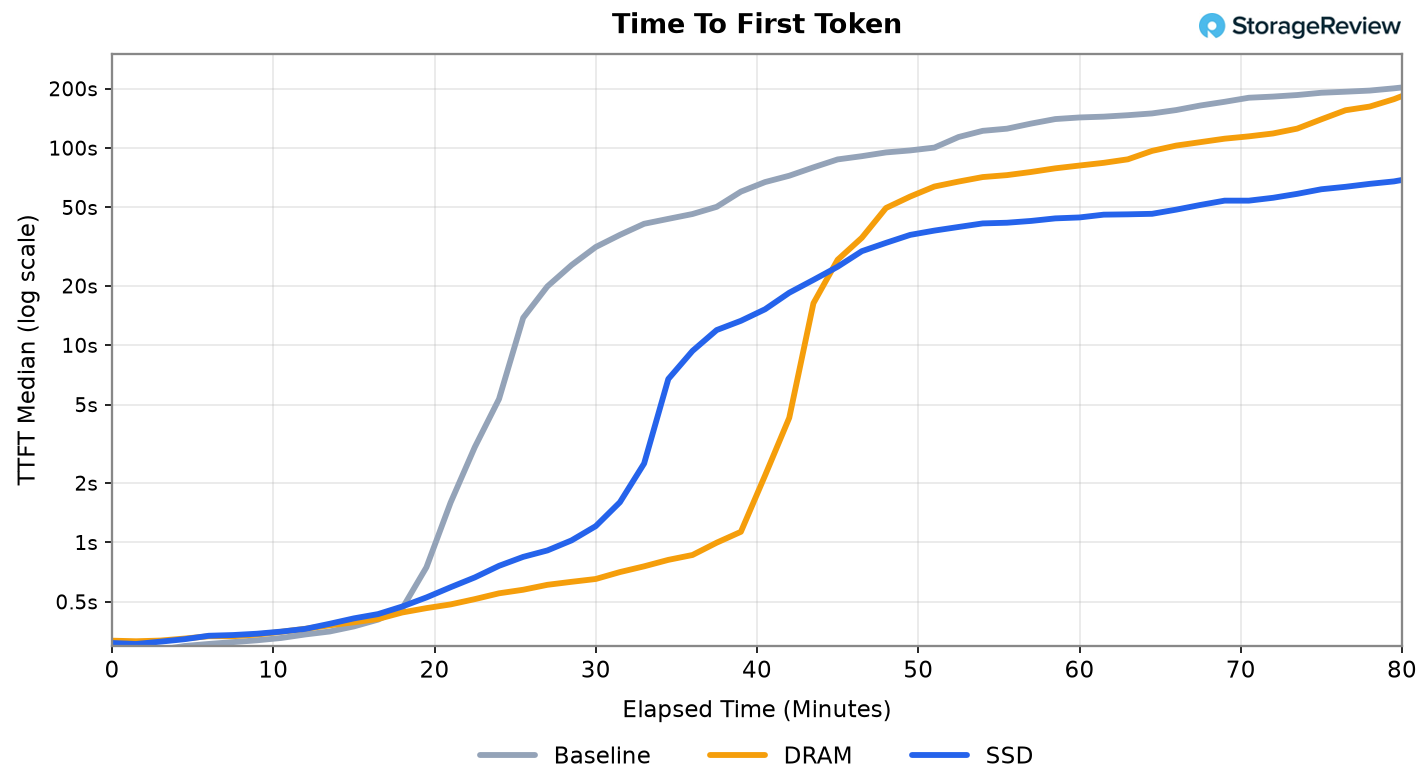
這種轉變就是分層儲存論點的縮影。 DRAM 在工作集位於該層級時是延遲方面的優勢者;一旦工作集不再位於該層級,快閃記憶體就成為延遲方面的優勢者,因為它仍然保存著 DRAM 層級已經開始丟棄的上下文資訊。
回訪用戶問題
上述延遲數據涵蓋了連續會話中的回合。使用者回傳的情況則有所不同:會話在對話過程中暫停,閒置約 15 分鐘後,再從中斷處繼續。我們用一個使用者群體來模擬這種情況,該群體在大約 20 回合後進入休眠狀態,並在 15 分鐘後被喚醒,這段時間足以讓繁忙的伺服器在其快取中循環處理其他流量。在每個層級的測量視窗內,都發生了 11 次這樣的喚醒。由於各層級的工作負載完全相同,因此每次運行中喚醒的都是相同的 11 個會話,從而可以對恢復回合進行直接比較。下圖繪製了每個層級在正常回合中首次令牌時間的中位數與恢復回合的中位數,須線標記了樣本中最差的恢復回合。
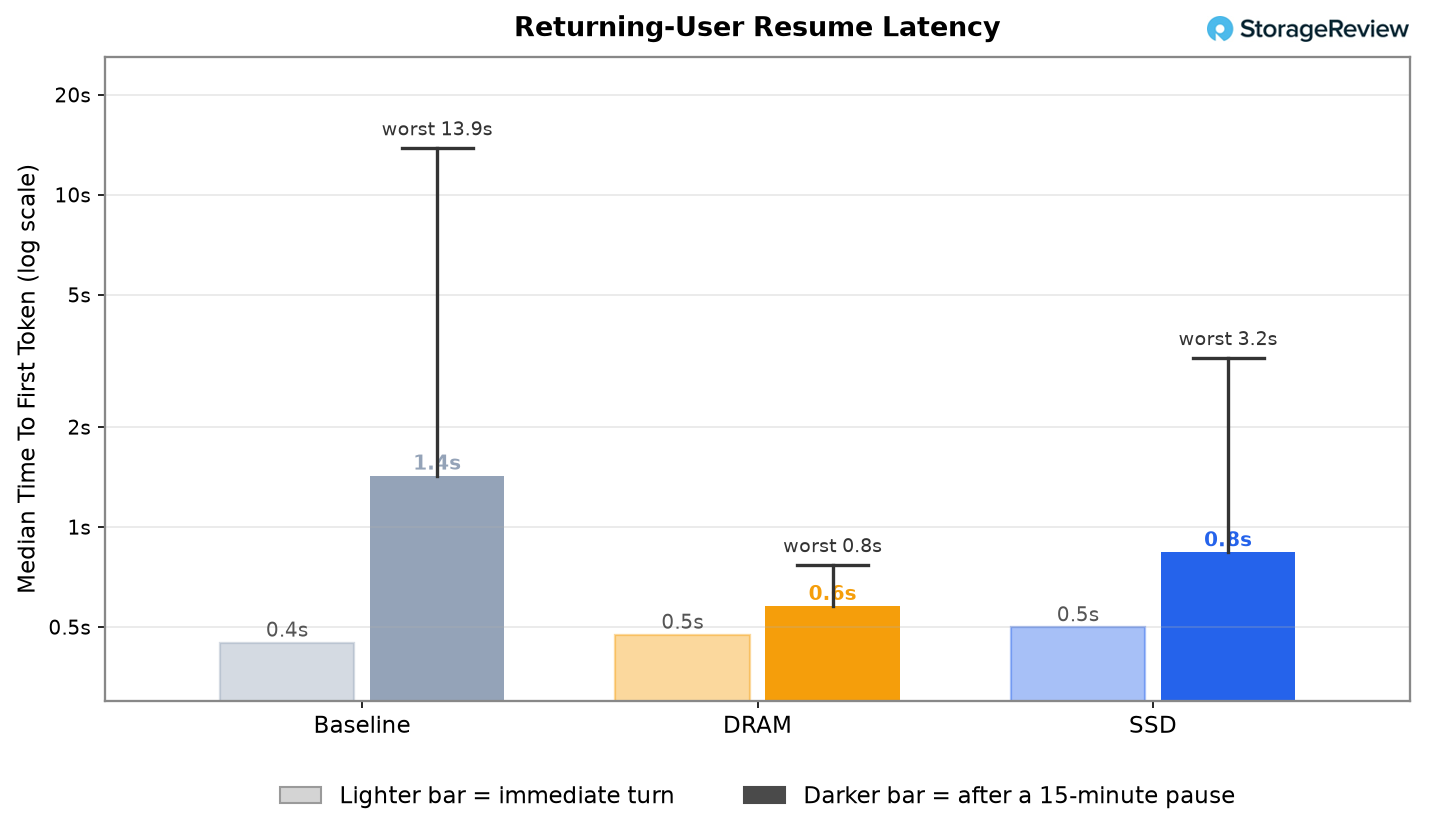
中位數的數據證實了機制的預測,各層級的順序也符合預期。 DRAM 效能領先:休眠會話恢復僅需 0.6 秒,略高於正常會話恢復所需的 0.5 秒。 SSD 位居第二,耗時 0.8 秒;我們知道 NVMe 讀取速度比 DRAM 讀取速度慢,這也是效能差異的原因之一。僅使用 VRAM 的基準測試速度最慢,耗時 1.4 秒;由於沒有可供卸載的數據,空閒會話的前綴資訊被從 GPU 記憶體中移除,用於處理即時流量,因此第一次恢復會話時需要重新計算該前綴資訊。最佳情況下,所有性能之間的差異也僅約為一秒。
最佳情況並非做出選擇的情況。每個層級中 11 次重啟的最差情況分別為:DRAM 上 0.8 秒,SSD 上 3.2 秒,基準層級 13.9 秒。等待第一個令牌 14 秒是否可以接受,或者是否構成嚴重的 SLO 違規,取決於特定服務。但對於任何互動式服務而言,答案都是後者,只有卸載層級才能將延遲控制在使用者可接受的範圍內。此外,隨著上下文的擴展,情況也會發生變化,因為重新計算的成本會隨著返回用戶累積的歷史資料而增加:在吞吐量測試的更深層上下文中,基準層級的延遲會遠遠超過 14 秒,而 DRAM 和 SSD 的重新加載時間仍然在可控範圍內。
選擇並調整 KV 快取的大小
兩種卸載方案的效能都遠遠超過僅使用顯存的基準方案,而且兩者的效能差距很小。差距之所以小,是因為吞吐量的提升僅來自於釋放顯存,而無論被驅逐的快取最終位於DRAM或SSD上,釋放的顯存量都相同。吞吐量並不關心快取來自哪個層級。延遲則取決於此,因為DRAM讀取速度比NVMe讀取速度更快,但與從頭開始重新計算相同的鍵值相比,這兩種方法的成本都很低。
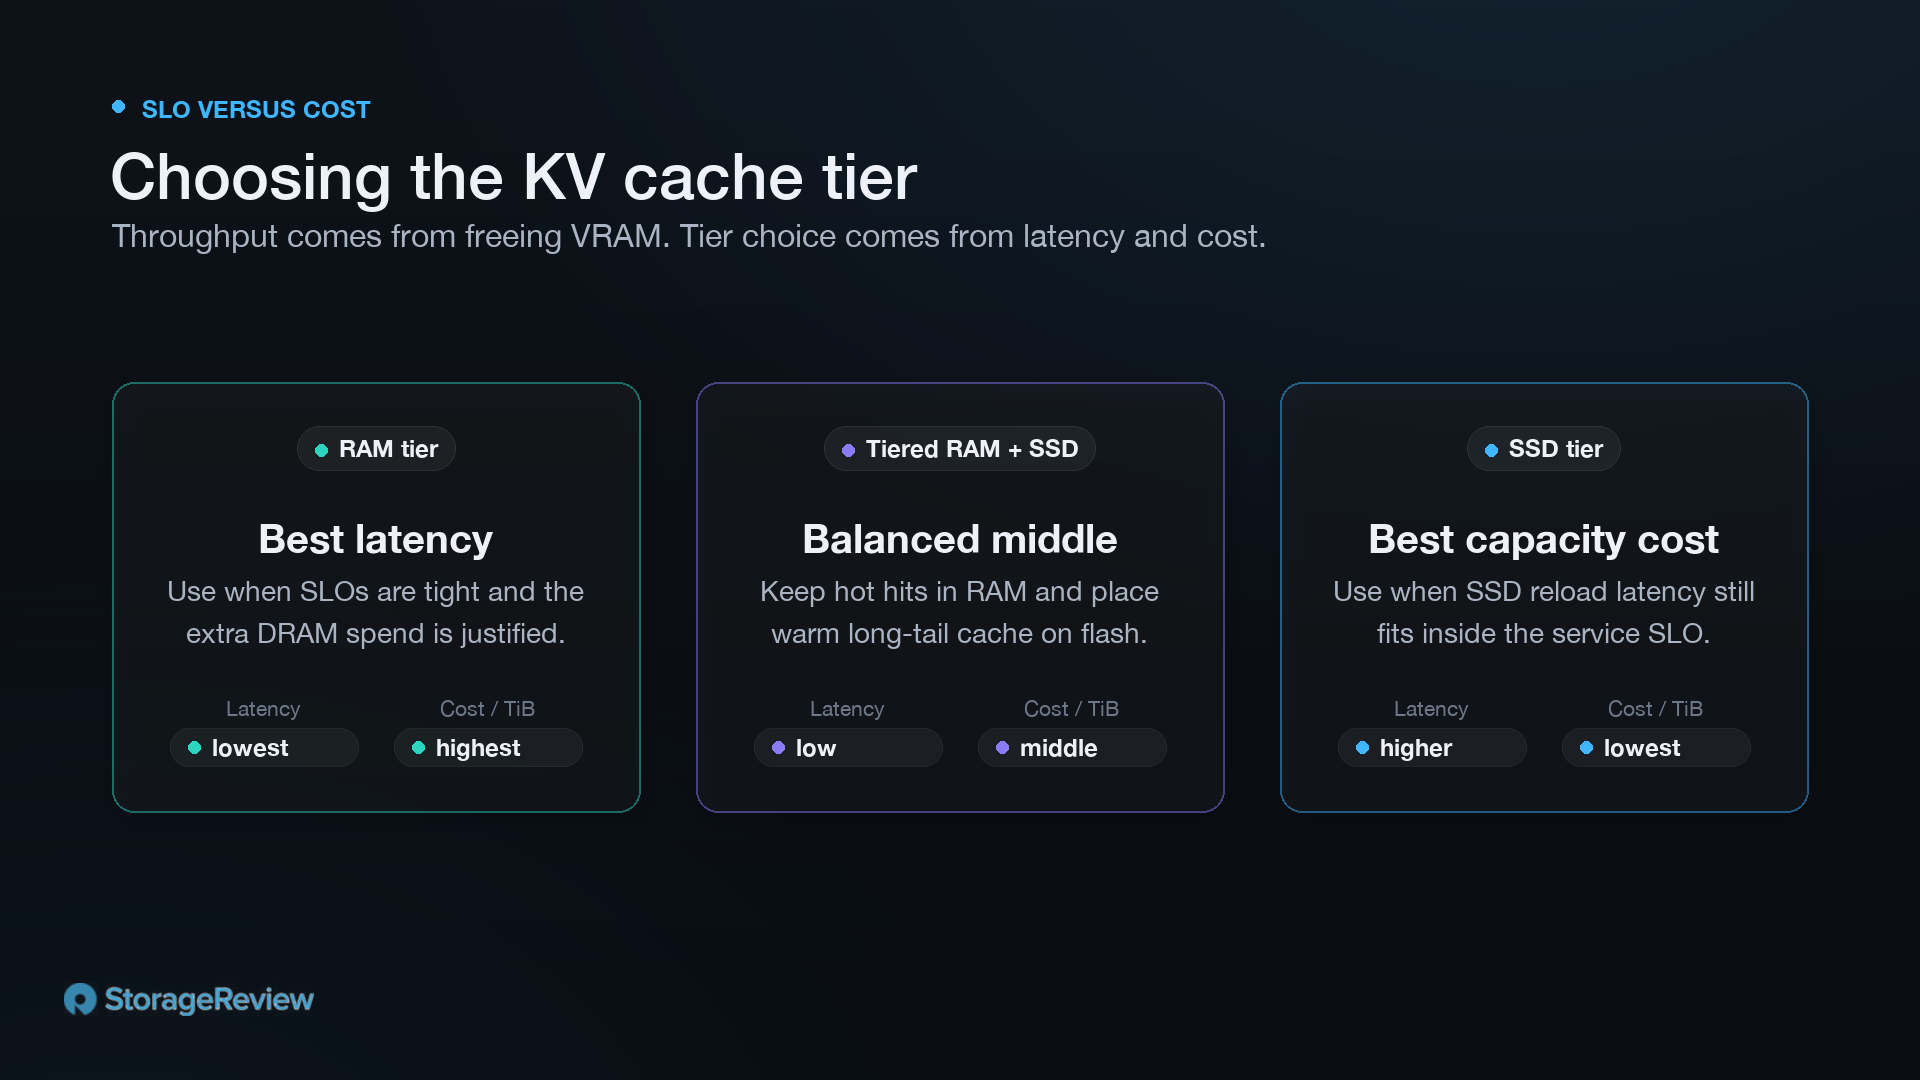
這兩種方案的選擇需要在服務速度最佳化 (SLO) 和成本之間進行權衡,具體取決於營運商的最佳化目標。將所有卸載的快取都放在 RAM 中可以獲得最佳延遲,但相比閃存,延遲提升相對較小,而資本支出卻很高。分層儲存則是折衷方案:較小的 RAM 層用於吸收對延遲要求較高的流量,而其後方的儲存層則用於存放那些無需在幾百毫秒內返回的較長尾快取。
另一種理解鍵值快取的方式是根據其大小。儲存層的大小取決於系統能夠維持的最大令牌吞吐量。系統需要保留的鍵值快取空間等於吞吐量乘以快取條目的生存時間 (TTL)。每個產生的令牌都會寫入一個鍵值快取條目,因此計算方法就是令牌到達速率乘以它們的保留時間。生產環境中的兩個預設 TTL 值分別為 5 分鐘和 1 小時。
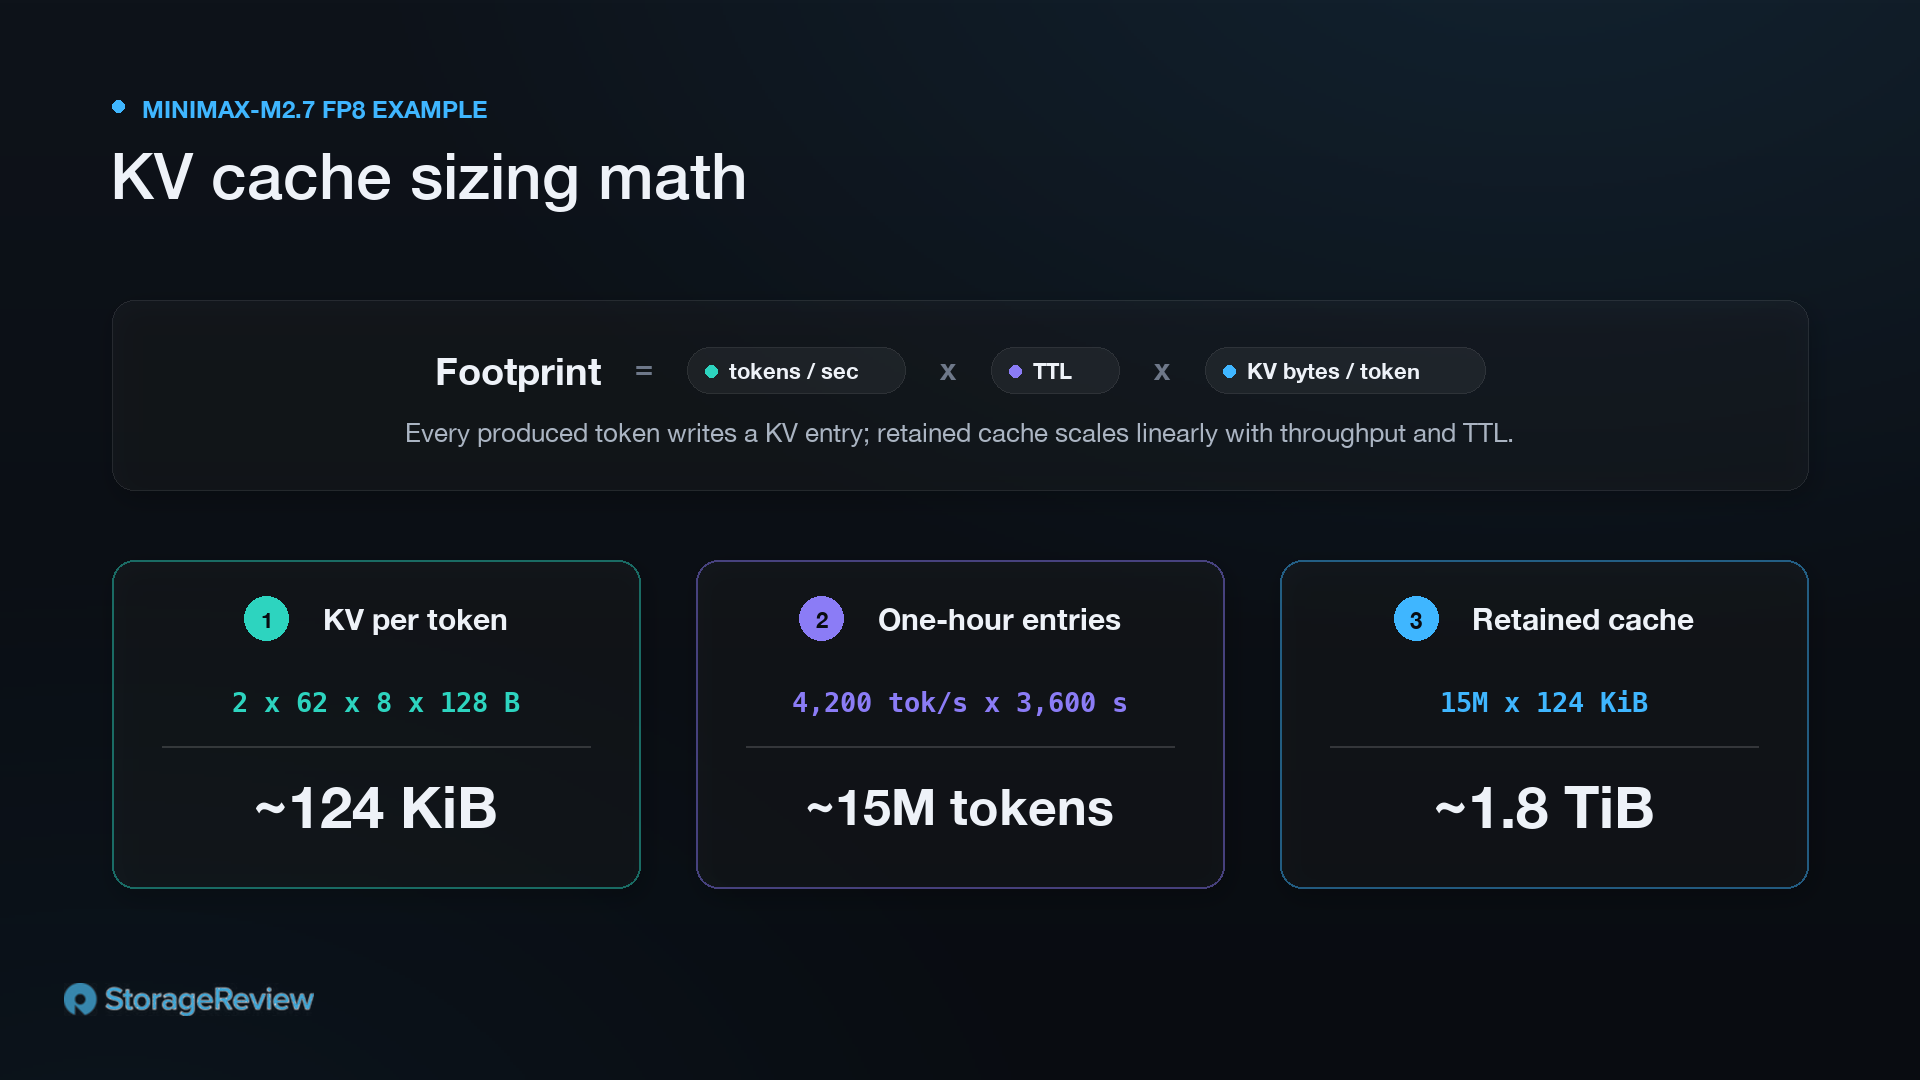
讓我們計算一下本文測試的 FP8 模式下 MiniMax-M2.7 的 KV 快取大小。假設每個 KV 元素佔用一個位元組,則每個 token 的 KV 快取大小為 2 × 62 × 8 × 128 位元組,約合 124 KiB。這適用於任何分組查詢注意力轉換器:每個 token 的 KV 快取大小為層數 × KV 頭數 × 頭維度 × 2(K 和 V 均為 2)× 資料類型位元組數,因此層數或 KV 頭數越多,每個 token 的寫入量就越大。在本文測試的中等運行點(RAM 層每秒處理約 4,200 個 token),一小時的快取保留時間大約會產生 1500 萬個 token,以每個 token 124 KiB 計算,大約需要 1.8 TB。這需要大量的 DRAM,從而增加建造成本。
考慮到這一點,SLO 要求和預算決定了快取層級的選擇。如果 SLO 夠寬鬆,使得 SSD 層級的重載延遲在其範圍內,那麼第二層 KV 快取就可以完全部署在儲存裝置上,前面只需連接所需的少量 RAM 暫存緩衝區即可。儲存成本並不高:在我們所有的測試中,KV 快取的峰值寫入速度在中等工作點下為 4.1 GB/s,讀取速度為 1.1 GB/s,而 fio 測得的峰值速度約為 114 GB/s。我們使用的 RAID10 陣列的頻寬還有大約 28 倍的餘裕,因此即使 XE7740 擴展到全部八個 GPU 並承擔更多並發負載,快閃記憶體也不會成為瓶頸。正是這種頻寬餘裕使得營運商可以根據容量而非速度來配置快取層級。每增加 1 TB 的 D7-PS1030 都會延長 TTL 和系統駐留的工作集,更大的駐留快取意味著可以避免更多的重新計算,並提供更多的令牌。
耐久性是定義此層級的限制因素。 KV卸載快取的寫入密集度非常高:模型產生的每個令牌都會寫入一個KV條目,TTL的頻繁更新會持續不斷地重寫該層級,因此硬碟實際上從未停止過寫入作業。在我們測試的八盤陣列中,持續寫入速度為1.9GB/s。在我們測試的RAID10佈局下,鏡像操作使媒體的寫入量翻倍,這意味著每塊12.8TB硬碟每天大約需要寫入3.2次,略高於D7-PS1030的3 DWPD持續寫入速率。對於主儲存而言,這樣的寫入速率是不合格的,但在此情況下是可以接受的。快取本身就是一次性的,磨損硬碟的故障模式是重新計算,而不是資料遺失。對於某些用戶來說,RAID0或許更適合此層級,它將資料條帶化分佈在所有八塊硬碟上,從而避免重複寫入,並將媒體寫入速率降低到約1.6 DWPD,完全符合額定值。無論如何,結論是:這種工作負載消耗的耐久性比機箱中的任何其他工作負載都快,專用高耐久性硬碟的容量只有該級別所需容量的一小部分,正是這種組合使得像 PS1030 這樣的以寫入為中心的大容量硬碟成為正確的選擇。
每美元代幣
效能部分錶明,快閃記憶體能夠保持大部分吞吐量,並且能夠維持DRAM在工作集超出記憶體容量後無法達到的首令牌延遲。而真正具有商業意義的是儲存層的成本。解決重複運算問題的簡單方法是在系統中增加昂貴的DRAM;只有當儲存層的單位容量成本顯著降低時,卸載策略才有效。
最明顯的差距在於容量,而非價格。 512GB DRAM 卸載層已填滿並開始進行資料驅逐;而以 TB 為單位衡量的快閃記憶體層則沒有。任何實際的 DRAM 預算都無法在 GPU 旁邊部署數十 TB 的 KV 緩存,因此,超過一定上下文長度後,選擇不再是高速 DRAM 與閃存之間的權衡,而是閃存與丟棄上下文之間的權衡——而丟棄上下文正是導致吞吐量和延遲損失的根本原因。
在價格方面,企業級快閃記憶體的每TB價格長期以來都遠低於DRAM,這種結構性差距源自於NAND的多層3D堆疊單元與DRAM的單晶體管單電容設計之間的差異。 2026年的記憶體短缺危機導致兩者價格均大幅上漲,而且NAND合約價格的上漲速度至少與DRAM一樣快,因此並非快閃記憶體價格下降而DRAM價格飆升的情況。即便在目前高企的價格水準下,每TB的差距依然存在,快閃記憶體仍然是唯一能夠以符合服務預算的價格提供TB級快取容量的儲存媒體。
吞吐量和成本的平衡點相同。在快閃記憶體效能超越DRAM的臨界點,其每秒可處理的代幣數量超過了DRAM層,而非更少。因此,快閃記憶體並非以吞吐量換取容量,而是以更低的每TB成本在儲存媒體上實現了更高的吞吐量。從每秒每美元的代幣數量來看,快閃記憶體的優勢非常顯著,而且隨著需要保留的上下文時間的延長,這種優勢會進一步擴大,因為DRAM的容量上限正是快閃記憶體的上限。
只要工作集適合,DRAM 仍然是合適的儲存層,連接器所需的薄 RAM 暫存緩衝區仍然位於快閃記憶體之前。但是,增加 GPU 或更多 DRAM 會增加每 TB 的成本,以購買工作負載所需的峰值效能,直到快取填滿為止。將資料卸載或分層儲存到快閃記憶體可以保留大部分效能,同時無限期地保持上下文信息,並且每 TB 的成本也更經濟實惠。然而,最終的決定取決於營運商正在優化的工作負載的 SLO 要求。
結語
對於推理工作負載而言,令牌經濟模型是關鍵所在。令牌是產品,而重新計算則是一種浪費:GPU 已經產生過一次上下文,現在卻要重新建構。代理服務面臨的風險最大,因為我們對 Claude Code 流量進行了一周的監控,結果顯示 98.16% 的令牌都是快取讀取,而 GPU 已經計算過這些上下文,否則每次驅逐都會重新建構。鍵值快取卸載將原本用於重建歷史記錄的預填充計算轉換為新的令牌。在 XE7740 上,在模型、GPU 和引擎配置保持不變的情況下,重負載下總服務吞吐量最高可達僅使用 VRAM 基準的 2.9 倍。當 DRAM 層被填滿並回退時,快閃記憶體以 DRAM 無法比擬的容量保持了吞吐量。
但這並不意味著DRAM就完全沒用了。對於短時、突發性工作負載,例如會話開啟、短暫運行並在快取超出記憶體容量之前關閉,DRAM是合適的儲存層,而鍵值快取卸載帶來的效能提升微乎其微。工作集大小合適,延遲也達到了最佳水平,而且無需進行任何快取驅逐操作。
但我們認為這種場景屬於例外,在這種情況下,只需一層 DRAM 記憶體就足夠了。如今,大多數生產環境中的推理任務運行時間長且持續不斷:多輪代理、大型上下文、穩定的並發性以及用戶返回同一會話。在這種情況下,工作集會超出營運商能夠配置的任何記憶體層,快取會被清除,GPU 會被重新啟用,用於重建先前產生的上下文。這是一種代價高昂的故障模式,而且很常見。
對於這些工作負載而言,將鍵值快取卸載到快閃記憶體上可以從兩個方面獲益。首先,它能讓GPU持續產生新令牌,而不是重複計算舊令牌(這正是本次評估所衡量的令牌經濟效率);其次,它將實現這一目標所需的容量部署在系統中最具成本效益的持久層級上。在配置清單上,最重要的影響在於它節省了多少資源:採用快閃記憶體作為快取的伺服器可以大幅減少DRAM的配置,而考慮到2026年記憶體的價格,這將是報價中最大的節省之一。令牌是最終產品,對於目前主導伺服器服務的長上下文工作負載而言,令牌高效的路徑就是避免重複產生相同令牌的路徑,而這條路徑正是透過快閃記憶體實現的。
Solidigm 人工智慧固態硬碟存儲
本報告由 Solidigm 贊助。 本報告中表達的所有觀點和意見均基於我們對所考慮產品的公正看法。


 Amazon