

Supermicro 今日聯合 IBM 和 NVIDIA 發布了一款 KV 快取儲存解決方案,將長上下文推理背後的鍵值狀態從 GPU 轉移到共享的全快閃層。該方案整合了基於 AMD EPYC 9005 處理器的 Supermicro Petascale 儲存伺服器、IBM Storage Scale、NVIDIA Dynamo 和 NVIDIA Spectrum-X 乙太網,並由 IBM 發布的經過驗證的參考架構(以 Redbook 的形式呈現)作為支援。該方案最顯著的優勢在於,在 130,000 萬個令牌的提示中,與需要從頭開始重新計算上下文的 GPU 相比,首次令牌產生時間縮短了 56 倍。
為什麼鍵值快取需要儲存層
推理過程分為兩個階段:預填充階段將提示訊息轉換為詞元,並將其傳遞給模型以產生中間鍵值狀態;解碼階段則根據這些狀態逐一產生回應詞元。將鍵值狀態保存在持久性快取中,可以讓系統在下一輪、下一個代理步驟或共享相同上下文的下一個請求中重複使用該狀態,從而避免重新計算。
代理工作流程、編碼助理、長上下文 RAG 和多輪應用程式會產生大量的這種狀態,從而迅速溢出 GPU 和 CPU 內存,這就是為什麼 Supermicro、IBM 和 NVIDIA 正在構建網絡存儲層的原因。
在這個設計中,NVIDIA Dynamo 管理快取層次結構並透過 NIXL 傳輸資料塊;IBM Storage Scale Erasure Code Edition 提供共用檔案層;而 Petascale 伺服器則提供快閃記憶體及其背後的 PCIe Gen5 通道。 Supermicro 表示,這三家公司在叢集層級上對高並發和嘈雜鄰居網路流量環境下的該堆疊進行了測試,並將測試結果定位為交鑰匙解決方案,包括工廠機架整合和現場部署,據稱可將部署時間從數週縮短至數天。
測試配置
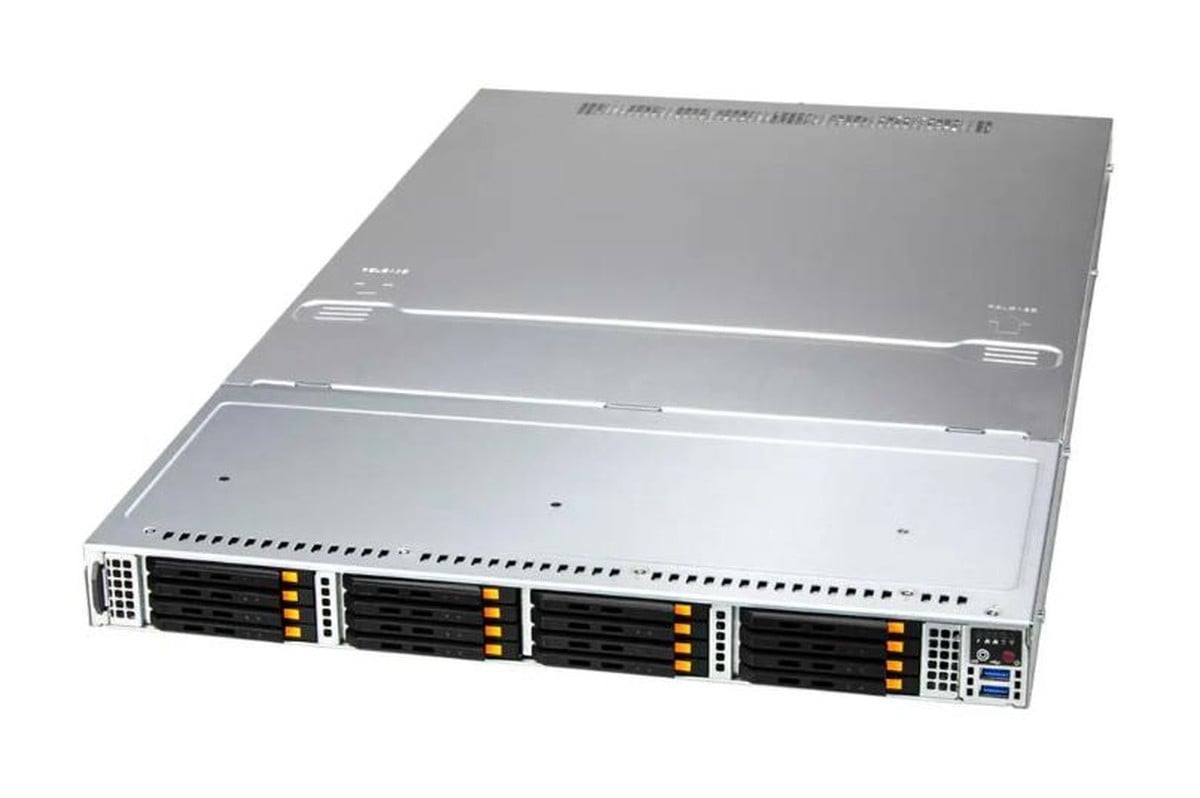
此參考架構採用八個 Supermicro ASG-1115S-NE316R Petascale 節點,每個節點均為 1U 系統,配備一顆 AMD EPYC 9535 處理器和 16 塊 Micron 7.68TB E3.S NVMe 固態硬盤,每個節點擁有 122.88TB 的原始節點,八個原始節點總計 983TB 的原始記憶體容量。每個節點用戶端配備一塊雙埠 200Gb NVIDIA BlueField-3 B3220 固態硬碟,後端儲存配備一塊 400Gb ConnectX-7 固態硬碟,採用脊葉式架構,並配備三台 Spectrum-X SN5600 交換器和 800Gb/s 上行鏈路。
儲存節點運行 RHEL 9.6 和 IBM Storage Scale ECE 6.0.0.1,採用 8+2P 糾刪碼佈局,IBM 根據先前的測試,表示該八節點層的讀取吞吐量為 315GB/s。
| 元件 | KV快取參考架構(經測試) |
|---|---|
| 儲存層 | |
| 儲存節點 | 8 個 Supermicro ASG-1115S-NE316R (1U,單插槽) |
| 每個節點的 CPU | AMD EPYC 9535,128 條 PCIe Gen5 通道(64 條用於 NVMe,64 條用於網路) |
| 每個節點的快閃記憶體容量 | 16款美光7.68TB E3.S NVMe固態硬碟(122.88TB原始容量) |
| 每個節點的網絡 | NVIDIA BlueField-3 B3220,雙埠 200Gb(客戶端) NVIDIA ConnectX-7 400Gb(儲存後端) |
| 交換 | 3 台 NVIDIA Spectrum-X SN5600,脊葉式架構,800Gb/s 上行鏈路 |
| 儲存軟體 | IBM Storage Scale 糾刪碼版本 6.0.0.1,8+2P RHEL 9.6 |
| 推理客戶端 | |
| 系統 | Supermicro SYS-212GB-FNR (NVIDIA MGX),Ubuntu 24.04 |
| 用於基準測試的GPU | 1塊NVIDIA RTX PRO 6000 Blackwell顯示卡,扣除權重和CUDA圖計算後,剩餘19.6GiB記憶體用於KV快取。 |
| 客戶網路 | 2 個 NVIDIA BlueField-3 B3140H 400Gb/s 顯示卡,客戶端頻寬最高可達 80GB/s |
| 模型和軟體 | openai/gpt-oss-120b (MXFP4) vLLM 0.14.1 NVIDIA Dynamo 0.9.0 與 NIXL NVIDIA AIPerf 基準測試用戶端 |
| 緩存分層 | 主機層和本機層均設定為零;所有 1.4 萬個快取令牌均由儲存擴充層提供服務。 |
基準測試用戶端是一台 Supermicro SYS-212GB-FNR MGX 系統,測試結果來自該系統中的一塊 NVIDIA RTX PRO 6000 Blackwell GPU,運行的是 vLLM 0.14.1 和 Dynamo 0.9.0 下的 MXFP4 格式的 openai/gpt-oss-120b-oss120b-1
在權重和 CUDA 圖之後,剩餘 19.6GiB 的 GPU 記憶體用於鍵值緩存,足以在 GPU 本身儲存約 1.14 萬個令牌。測試中,主機記憶體和本機層級均設為零,因此每個快取區塊都來自 Storage Scale,從而確保結果僅衡量儲存路徑本身,不受混合層級結構的影響。
首次代幣交付時間提高 56 倍,吞吐量提高 22 倍
在沒有快取的情況下,120B 型號的首次令牌處理時間 (TTFT) 從 10,000 個輸入令牌時的 0.572 秒增加到 130,000 個輸入令牌時的 32.14 秒,這是因為 GPU 需要重新計算完整的上下文。啟用儲存規模的鍵值快取後,TTFT 在相同範圍內保持在 0.193 秒到 0.57 秒之間,這與 130,000 個輸入令牌時的 56 倍數值以及 Supermicro 在其公告中提到的 0.377 秒的誤差範圍相符。 IBM、Supermicro 和 NVIDIA 進行了這些測試,我們並未進行測試或審查結果。
吞吐量測試透過 28 個並發連接發送了 200 個請求,這些請求來自 100 個不同的提示,總計 24 萬個令牌和 825GB 的鍵值快取數據,快取初始為空。重新計算基準測試的完成時間為每秒 0.19 個請求,耗時 1,048 秒;儲存擴充層在 46.94 秒內達到了每秒 4.26 個請求,效能提升了 22 倍,其中包括填充快取的冷啟動成本。
第三次運行增加了四個客戶端,它們透過同一交換矩陣推送 200GB/s 的無關網路流量。在快取配置下,每秒處理 3.6 個請求,200 個請求耗時 55.56 秒,比乾淨運行慢了約 9 秒,但仍是基線的 18 倍。 IBM 將這一小的效能損失歸因於 Spectrum-X 交換矩陣將快取流量與後台負載隔離。
「智能體人工智慧和長上下文應用依賴於在多個步驟中高效地重複使用上下文信息,而NVIDIA Dynamo有助於協調分佈式推理,從而使企業能夠從每個GPU獲得更高的可用吞吐量,」NVIDIA人工智慧推理產品負責人Shruti Koparkar表示。 “透過將NVIDIA Dynamo和Spectrum-X乙太網路與Supermicro Petascale儲存伺服器和IBM Storage Scale相結合,該KV快取解決方案創建了一個高效能的共享儲存層,可以減少冗餘計算,縮短首次令牌到達時間,並幫助客戶擴展彈性人工智慧推理服務。”
尺寸以及數字以外的內容
IBM 的容量規劃指南指出,對於 70 億至 340 億容量的儲存型號以及最多 64 個 GPU,四節點架構(4+2P)的可用容量為 67%;經測試,八節點架構(8+2P)的可用容量為 80%,適用於 700 億至 1200 億容量的存儲型號以及 100 至 100 個 GPUs的讀取頻寬;而對於容量更大的儲存型號以及 300 個或更多 GPU,需要 300GB/s 及以上讀取頻寬的儲存型號,16 個或更多節點架構(16+3P)的可用容量為 84%。 Storage Scale ECE 本身可擴充至 256 台儲存伺服器。
單GPU測試設定是主要缺陷。參考架構的設計容量足以支援數百個GPU,但論文中的所有結果都來自一塊RTX PRO 6000顯示卡,搭配IBM標稱速度為315GB/s的八節點983TB快閃記憶體層。因此,儲存端遠未達到飽和,而且這些測試也無法展現當整個GPU叢集同時拉取快取時,TTFT的效能表現。
Supermicro尚未公佈該解決方案的定價或上市日期,公告中也沒有提供GPU利用率數據。此方案與DDN在AI400X3M上整合的Dynamo KV快取加速方案類似,差異在於此方案運行在通用的Supermicro伺服器上,並透過乙太網路連接到IBM檔案系統。
「隨著人工智慧工作負載從訓練擴展到推理,企業和新雲端平台需要部署高吞吐量的推理工作負載,以應對智能體人工智慧和長上下文、多輪次生成式人工智慧等挑戰,因此需要消除瓶頸以提高GPU效率,」超微公司總裁兼執行長梁志強表示。 “我們與IBM和NVIDIA合作推出的解決方案清晰地展現了這些性能優勢。”



 Amazon