

NVIDIA 在史丹佛大學 Hot Chips 大會上清晰地傳達了這樣一個訊息:資料中心本身就是一台計算機,其效能極限更取決於互連結構,而非原始 FLOPS。在五場會議中,NVIDIA 將展示 Spectrum-XGS 乙太網路、第五代 NVLink 和 NVLink Fusion、CPO 驅動的光子交換機以及全新 DGX Spark 桌上型超級電腦如何協同工作。此次整合旨在將數以萬計的 GPU 打造成一個單一的、可產生收益的 AI 工廠。
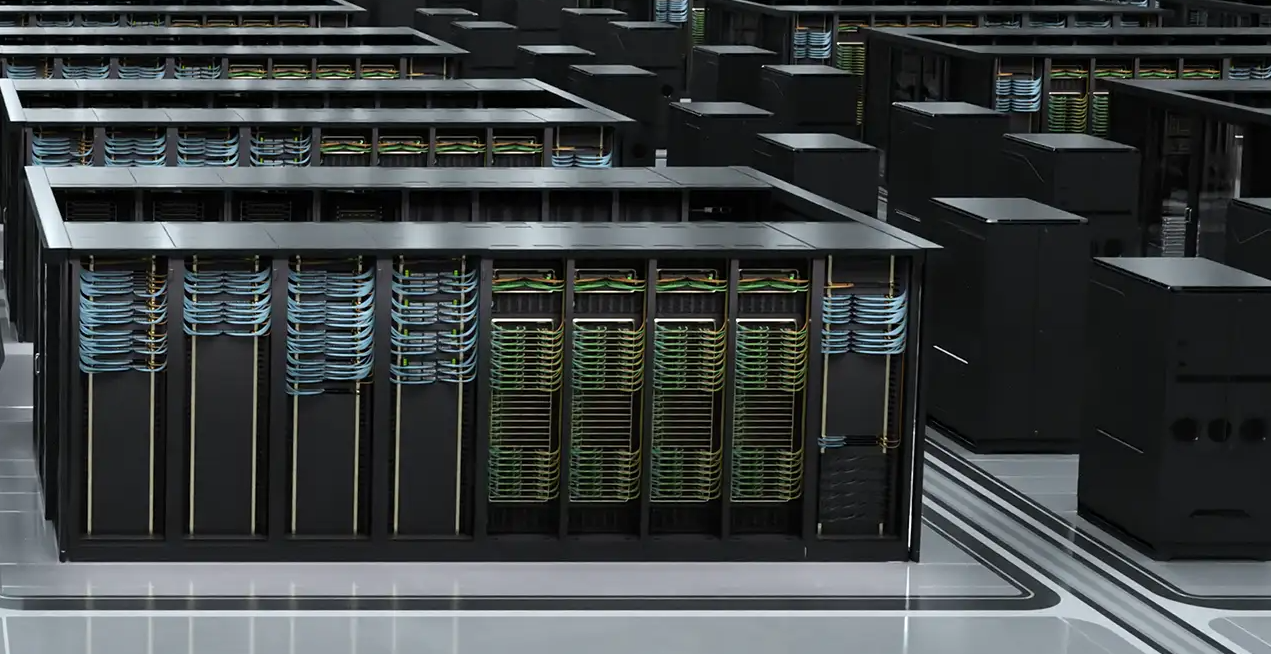
人工智慧工廠的三層結構
現代 LLM 是隱式分散式應用程式。它們在 GPU 之間傳輸數萬億個參數,以微秒級的節奏同步梯度更新,並且必須在極短的時間內將第一個令牌傳回給使用者。這些工作負載驅動著層級化的互連:
- 在機架內進行擴展,以便 GPU 能夠像單一大型處理器上的核心一樣運作。
- 跨機架橫向擴展,使叢集作為統一系統運作。
- 跨整個資料中心進行擴展,以實現地理冗餘、容量共享和法規遵循。
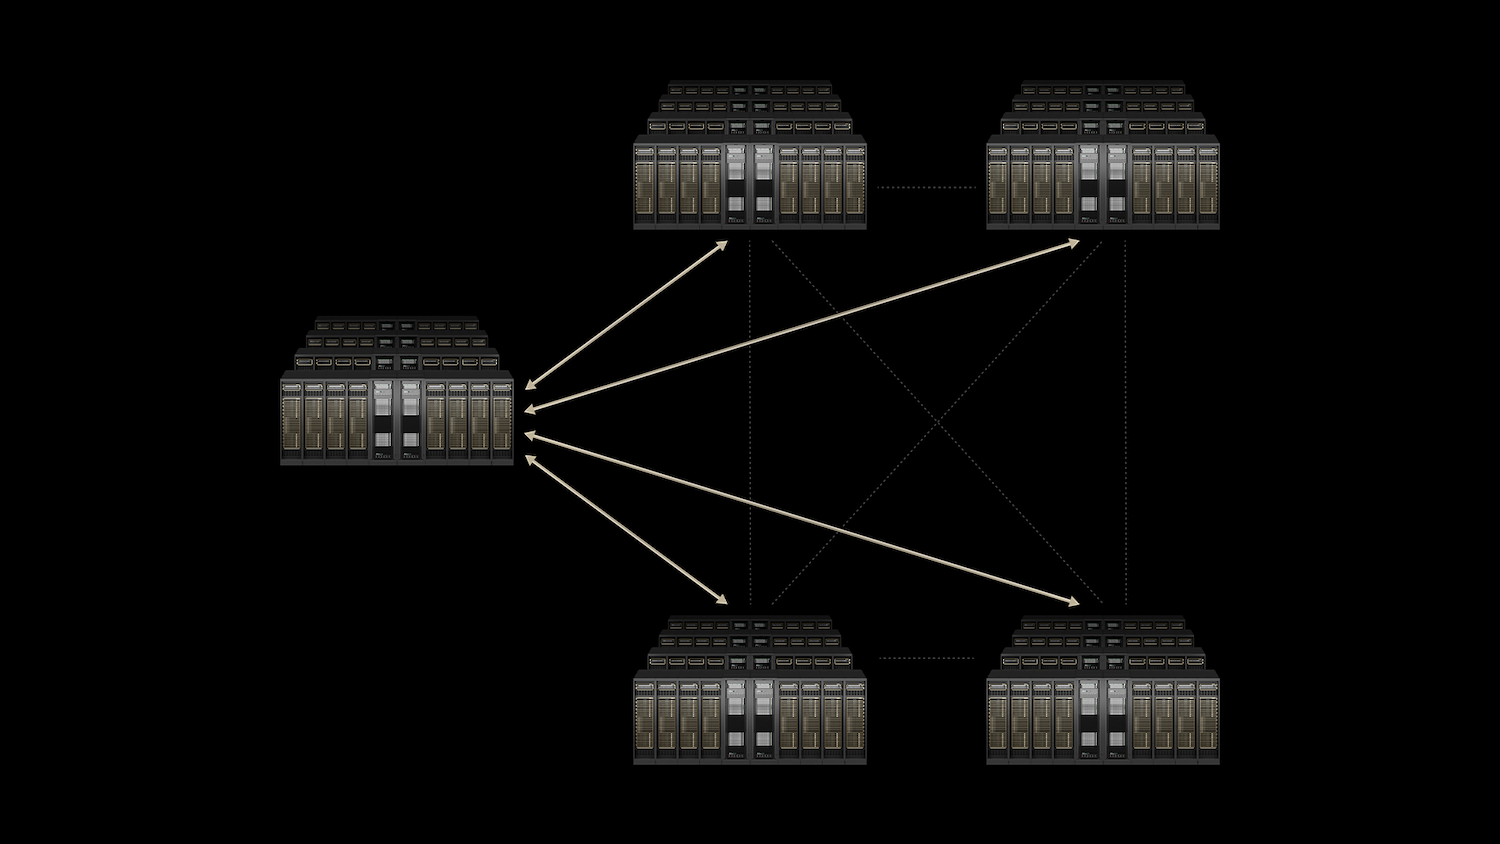
NVIDIA 的答案是垂直整合的堆疊。 NVLink 和 NVLink Switch 擁有縱向擴展域;Quantum InfiniBand 和 Spectrum-X 擁有橫向擴展域;全新的 Spectrum-XGS 乙太網路可在資料中心之間擴展無損、AI 調優的網路。共封裝光模組 (CPO) 降低了百萬 GPU 叢集可能遇到的功率和密度限制。
Spectrum-XGS 以太網
傳統乙太網路技術主要設計用於處理盡力而為的流量,這意味著它非常適合簡單的單一伺服器通訊。然而,隨著我們進入一個越來越依賴人工智慧的世界,我們發現自己面臨新的挑戰。
隨著人工智慧集群和多租戶推理系統的興起,網路效能的要求也發生了顯著變化。這些現代應用對可靠性和速度的要求是傳統乙太網路無法提供的。
具體來說,它們要求零抖動,這意味著延遲沒有變化,這對於即時處理至關重要。此外,確定性延遲可確保回應的可預測性和一致性,這對於依賴即時回饋的應用程式至關重要。最後,近線速吞吐量對於處理在微突發負載期間處理的大量資料至關重要,因為在微突發負載下,資料流量可能會意外激增。
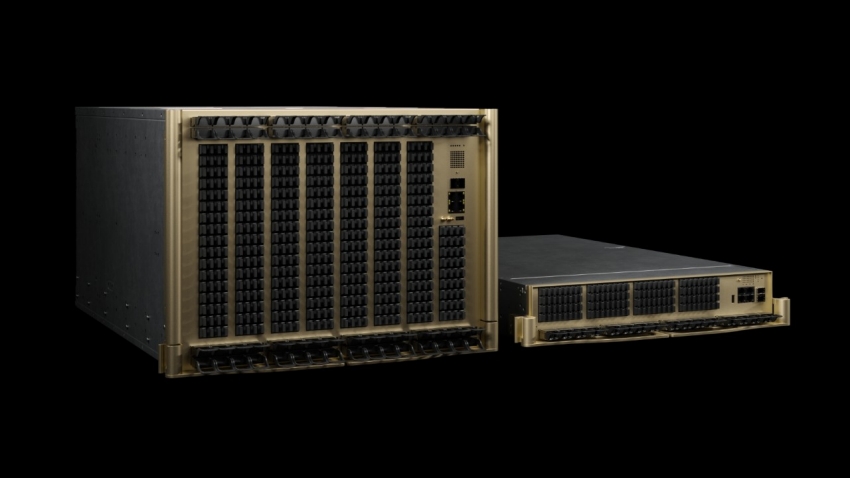
Spectrum-X是一款可在資料中心內無縫運行的解決方案,而 Spectrum-XGS 則將這項創新提升到了新的高度,將其功能擴展到多個資料中心。它整合了先進的基於 ASIC 的 Spectrum-6 或 -4 交換器以及超高速 800 Gb/s 超級網卡(具體而言是 BlueField-3 或 ConnectX-8 系列)。這些技術協同工作,能夠有效地管理擁塞並重新排序資料包,從而確保資料流的順暢。
該系統的獨特之處在於其智慧遙測技術,能夠從每個連接埠收集數據,並將其輸入交換器內的擁塞控制邏輯,從而實現即時流量整形。在生產集群中,這帶來了卓越的效能,在驚人的 95k GPU 規模下,吞吐量仍能維持在理論容量的 32% 以上。相較之下,傳統的 800 G 乙太網路則表現不佳,在出現集體衝突時,吞吐量僅能達到 60% 左右。
此外,Spectrum-XGS 保證符合標準,使 SONiC 和 Cumulus Linux 成為其生態系統不可或缺的組成部分。這意味著雲端和企業營運商可以保留其現有的自動化堆疊,同時受益於 InfiniBand 通常具備的卓越確定性。這些增強功能可提高 GPU 利用率並降低延遲,從而轉化為更高的每瓦令牌數和更嚴格的服務水準目標。此外,它還使營運商能夠在同一集群中引入新租戶,而不會出現效能下降,從而改變產業的格局。
NVLink 和 NVLink Fusion:機架作為一個巨大的 GPU
第五代 NVLink 在 NVL1.8 機架內提供高達 130TB/s 的點對點頻寬和 72TB/s 的聚合頻寬。這種增強的連接性使每個 GPU 只需一次跳躍即可與其他 GPU 直接通信,從而有效地將整個機架轉變為一致的記憶體域。由於經過十年精心調校的 NVIDIA 集體通訊庫 (NCCL),應用程式開發人員可以輕鬆實現近線速率,而無需為不同的拓撲編寫自訂通訊程式碼。
此外,近期發布的 NVLink Fusion 為超大規模運算架構帶來了令人興奮的可能性。這項創新使客製化 CPU 或 XPU 能夠透過 UCIe(用於加速器)或 NVLink-C2C(用於 CPU)無縫整合 NVLink SERDES 或晶片組,從而允許這些組件直接部署到 NVLink 架構上。 Fusion 的一大優勢在於其模組化 MGX 機架規格,並配備完善的供應鏈。這意味著目前供應 NVL72 機架的供應商也可以提供 Fusion 機架,從而顯著縮短了希望實施該技術的公司的產品上市時間。
在推理經濟學方面,NVLink 的影響在傳統的每瓦吞吐量與延遲帕累托邊界上顯而易見。透過從 PCIe 網格過渡到 NVLink 交換器節點,吞吐量和延遲均得到提升,並且可以透過升級到 NVLink 機架來實現進一步的提升。這意味著每千瓦時可以處理更多的用戶查詢,同時降低每個代幣產生的攤銷資本支出,使 NVLink 成為提升營運效率的強大工具。
第五代 NVLink 可在 NVL1.8 機架內提供 130 TB/s 的點對點頻寬和 72 TB/s 的聚合頻寬。借助 NVLink 交換機,每個 GPU 均可在單跳中互相訪問,從而使整個機架成為一個一致的內存域。集體操作透過 NCCL 運行,NCCL 是一個現已問世十年的庫,針對所有可能的拓撲進行了調整,並自動實現拓撲感知。因此,應用程式開發人員無需自訂通訊程式碼即可實現近線速。
共封裝光學元件 (CPO):突破 800 Gb/s 以上速率的功率壁壘
傳統的可插拔模組交換器已經成為網路標準一段時間了。然而,這些系統固有的低效率問題正日益凸顯。資料離開ASIC後,會沿著冗長的PCB走線傳輸,並經過多個連接器,最終到達DSP密集型的光模組。這個過程會導致嚴重的損耗,在電場中的損耗通常高達22dB,並且僅為恢復訊號,每個連接埠的功耗就高達30W。隨著我們向更高的資料速率邁進,例如目前的200G PAM4以及不久的將來雄心勃勃的1.6T,這種架構的局限性日益凸顯,導致功耗預算激增,面板密度也受到限制。
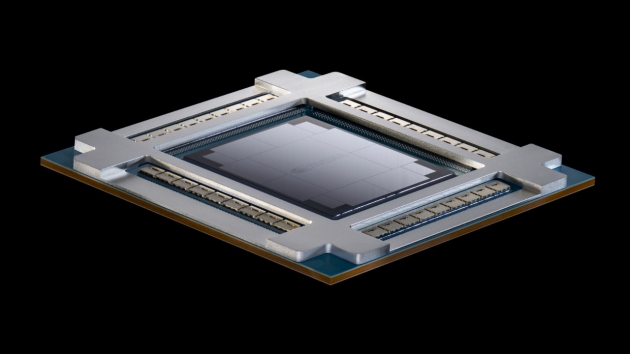
NVIDIA 的創新解決方案:用於 InfiniBand 的 Quantum-X 光子學和用於乙太網路的 Spectrum-X 光子學。透過將光學引擎直接整合到交換器封裝中,它們大幅縮短了電氣路徑長度。這不僅將損耗降至約 4 dB,還將連接埠功耗降至約 9 W,這是一個令人印象深刻的改進。
下週,我們將迎來兩款尖端液冷機箱的發布:128 連接埠型號,擁有高達 102.4 Tb/s 的吞吐量;以及 512 連接埠型號,將吞吐量進一步提升至 409.6 Tb/s。後者整合了光纖切換功能,確保每個連接埠都能無縫連接到正確的光纖束,無需繁瑣的手動連接。初步現場數據令人鼓舞,與傳統的可插拔式機殼相比,其能源效率顯著提高了 3.5 倍,平均故障間隔時間提高了約 10 倍。此外,每個叢集的啟動視窗速度提高了 1.3 倍,從而簡化了部署。
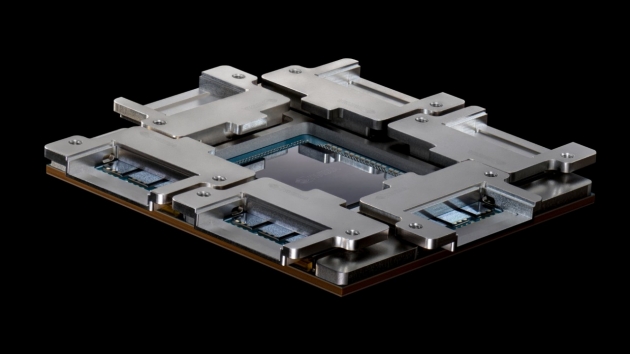
雖然這些先進的解決方案要到2026年才能面世,但設計工作已在進行中。這對於正在規劃千兆瓦級設施的營運商,或正在考慮建造百萬GPU國家實驗室的政府而言至關重要。 NVIDIA的CPO(相干光子學)技術清楚地定義了一條控制功率範圍並避免令人頭痛的光學元件維護難題的途徑,為高效能網路更有效率、更強大的未來鋪平了道路。
DGX Spark 和系統:從桌上型原型到機架規模生產
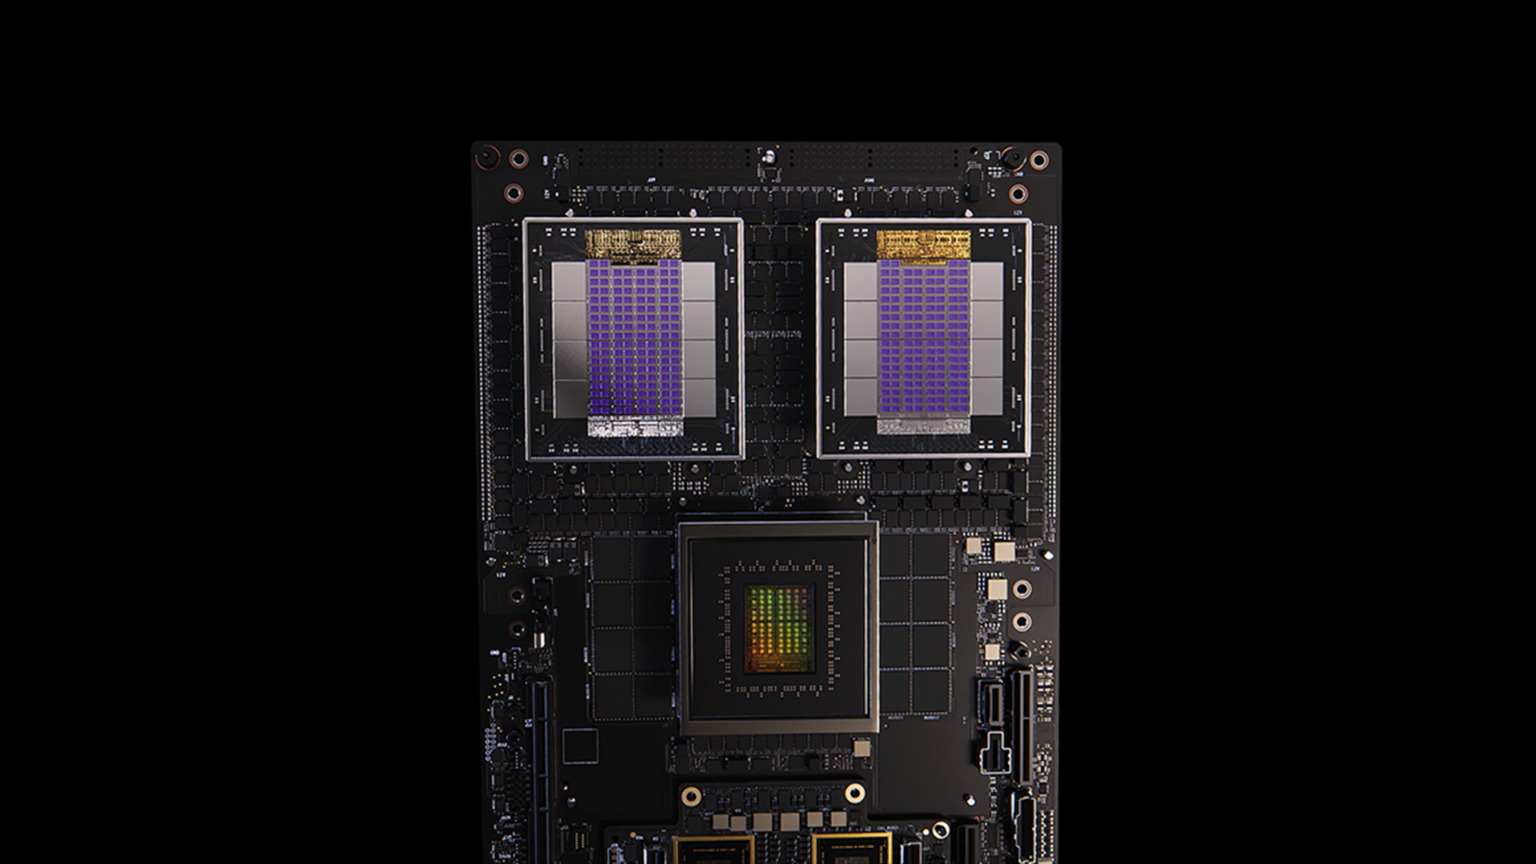
並非所有工作負載都從超大規模開始。 DGX Spark由全新的 GB10 超級晶片驅動,將 Blackwell Tensor Core、NVFP4(4 位元浮點)推理以及所有 CUDA-X 庫壓縮到一個桌面機箱中。開發人員可以在本地進行訓練、微調和 RAG 組合,然後在工作負載成熟後,將相同的容器遷移到 GB200 或 GB300 NVL72 機架上。
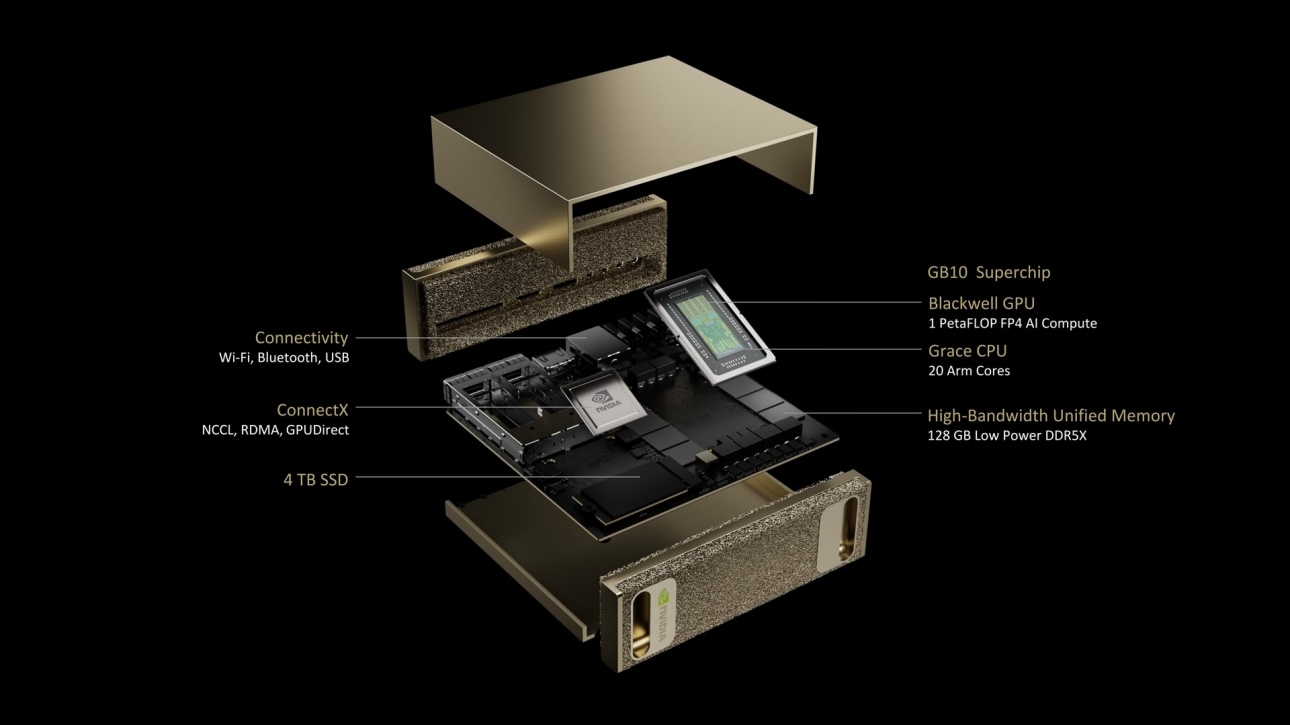
這種連續統一體讓企業能夠試運行代理AI、機器人感知或多模態生成任務,而無需佔用群集插槽。對於該領域而言,Spark就像一匹特洛伊木馬:在客戶實驗室裡放置一台,讓他們的研究人員親眼見證4位推理加速,然後擴展就會隨之而來。
軟體乘數:TensorRT-LLM、Dynamo 和 NIM 微服務
硬體互連設定了上限;軟體決定了實際工作負載的接近程度。 NVIDIA 將示範 TensorRT-LLM,該模型在 NVFP120 中運行 4 億參數的 GPT-OSS 模型,在長上下文中,其交互性是原版 TorchServe 的四倍。在 GB200 機架上,1 B 的 DeepSeek-R671 借助 Dynamo 的分解式管線調度程序,每 GPU 的吞吐量提高了 2.5 倍,且每個查詢的成本沒有增加。所有這些都以 NIM 微服務的形式呈現——容器化的端點,可以部署到 Kubernetes 叢集或本地裸機堆疊中。
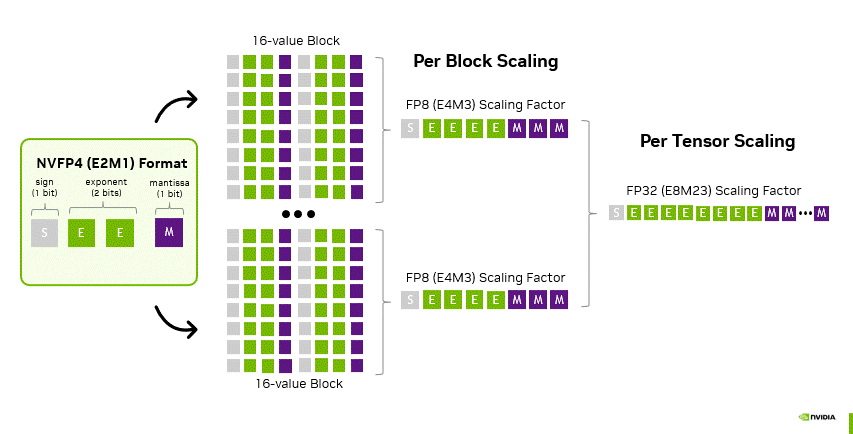
開源是整個堆疊的基礎。 RAPIDS 在 GPU 上端對端加速 ETL;CUTLASS 模板支援自訂高效能核心;NeMo 和 BioNeMo 擴展了 PyTorch,用於前沿 LLM 和蛋白質折疊訓練,同時保持 100% 開源軟體 (OSS)。對於擔心被鎖定的買家來說,NVIDIA 的訊息是「在重要之處開放,在關鍵之處優化」。
競爭和商業影響
NVIDIA 憑藉其垂直整合的策略,在科技領域佔據了獨特的地位,尤其與商業晶片交換器供應商和分散的加速器新創公司形成鮮明對比。這項策略使 NVIDIA 不僅能夠提供單一元件,還能提供包含參考架構的綜合解決方案。該架構由成熟的供應鏈、清晰的兩年路線圖以及名為 NIM 的高級 API 介面提供支持,從而簡化了開發人員的佈線複雜性。
對於超大規模企業而言,NVIDIA 的產品極具吸引力,因為它們注重確定性的服務等級協定 (SLA) 和最低營運風險。透過部署 NVLink 機架,這些企業可以獲得卓越的推理能力,這對於需要快速資料處理的應用至關重要。此外,Spectrum-X 技術有助於容量擴展,使超大規模企業能夠無縫擴展其基礎設施。 Spectrum-XGS 的推出允許區域聯合,從而提高跨地理分佈資料中心的資源分配效率。這種整合支援標準乙太網路控制平面的運行,確保現有基礎設施的兼容性和易管理性。
對於企業而言,NVIDIA 技術的吸引力在於其能夠最大化每機架收益。例如,Spectrum-X 系統顯著提升了 GPU 週期效率,據稱最高可達 35%。這意味著企業無需增加資本支出,即可實現更高的產出,無論是以代幣、影像或自動化操作的形式。因此,企業可以從現有投資中獲得更多價值,從而滿足當今競爭激烈的市場對效率和成本效益的需求。
底線
圍繞著「熱門晶片」的敘述標誌著計算技術領域,尤其是在人工智慧 (AI) 領域,發生了顯著轉變。它強調,網路如今已被視為運算領域的基礎加速器,其重要性堪比張量核心等技術進步。
NVLink 等技術至關重要,因為它們將伺服器機架轉變為緊密整合的邏輯晶片,從而提升效能和效率。 Spectrum-X 在促進廣泛網路的亞毫秒聚合方面發揮著至關重要的作用,而 Spectrum-XGS 則在全球擴展了這種高效能結構。此外,CPO 旨在確保功率和密度要求面向未來,滿足 AI 應用不斷變化的需求。另一方面,DGX Spark 在促進這些技術的採用方面發揮重要作用,鼓勵企業採用創新解決方案。
總的來說,這些進步有可能改變推理和訓練過程的經濟動態。這一點尤其重要,因為企業目前正處於十字路口,權衡是建立新的基礎設施、租用現有解決方案,還是推遲對大規模人工智慧能力的投資。 NVIDIA 的立場非常明確:企業應該投資建造自己的基礎設施,但重點是精心設計的網路框架——從銅線到光子交換機——以支援即將到來的由人工智慧驅動的工廠主導的時代。


 Amazon