

有些伺服器是現有功能的擴展,而有些則重新定義了預期。戴爾 PowerEdge R7725xd 就屬於後者。在我們最近的測試中,這款 2U 伺服器配置了 24 塊 Micron 9550 PRO PCIe Gen5 NVMe SSD 和四塊 2x 200GbE 網路卡,其原始儲存吞吐量超過了我們之前測試過的任何系統。在內部,該平台在整個 NVMe 儲存池中實現了超過 300 GB/s 的吞吐量。在網路方面,它使用標準的 RDMA 協定實現了 160 GB/s 的吞吐量,無需任何額外的複雜配置。
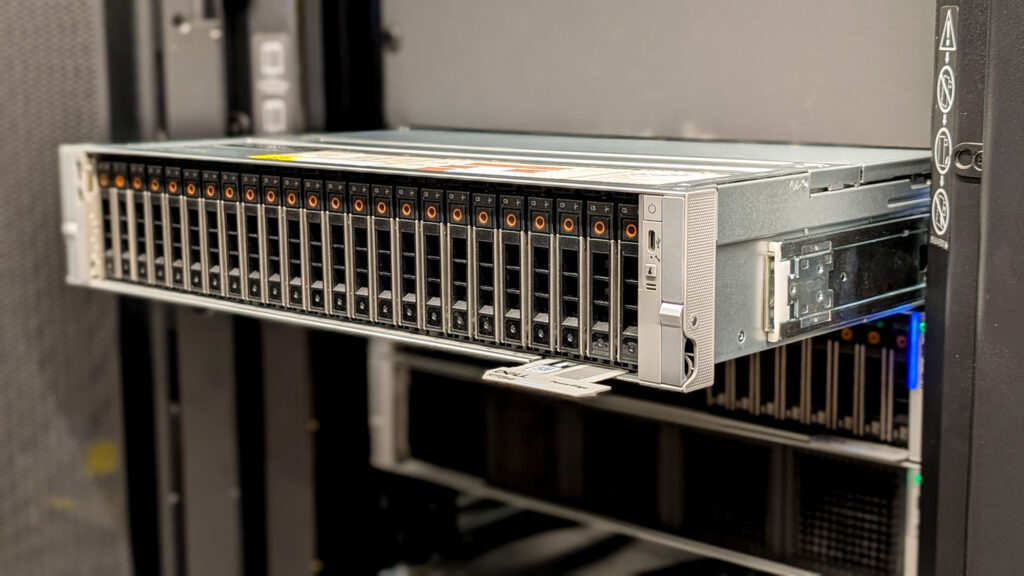
這不僅僅是一台速度更快的儲存伺服器,它是一個徹底改變資料密集型運算架構的系統。現代人工智慧訓練和推理流程的瓶頸通常不在於GPU的效能,而是在於資料暫存、串流、混洗和檢查點所創建的速度。如果儲存速度跟不上,大型GPU節點就會閒置。為了解決這些限制,團隊會使用快取、超容量儲存和複雜的層級結構,以確保加速器能夠足夠快地接收數據,從而反映其成本的合理性。
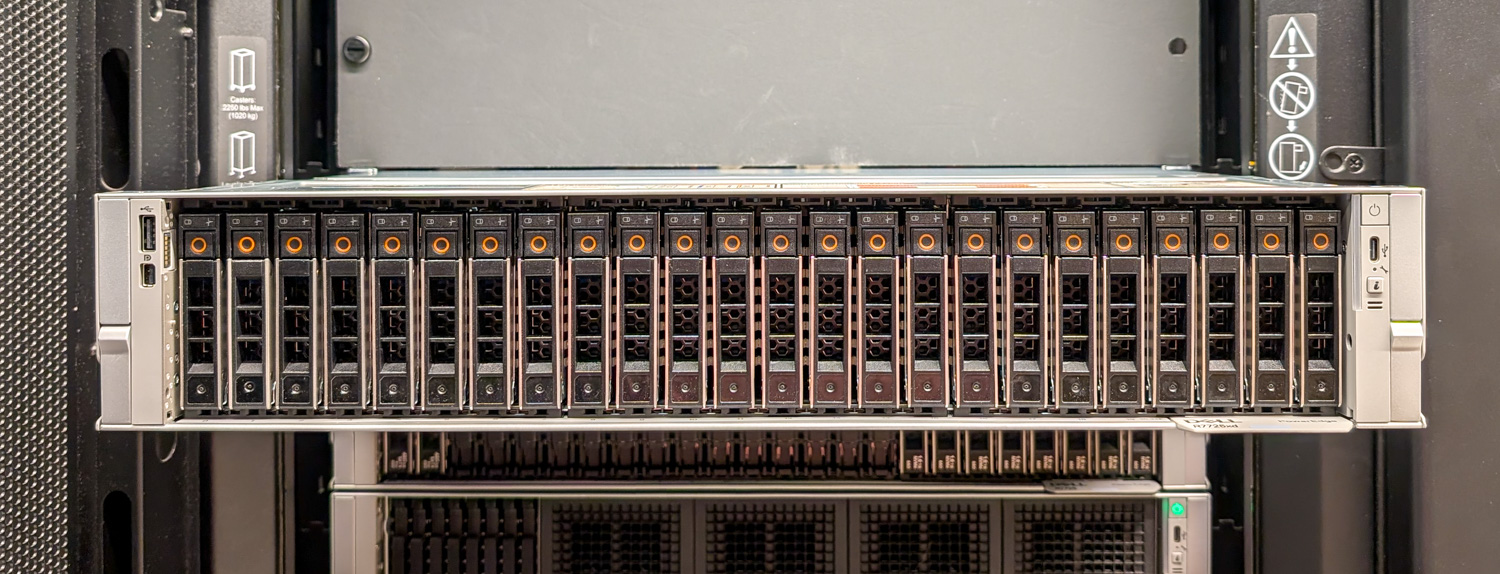
戴爾 PowerEdge R7725xd 從源頭解決了瓶頸問題。此伺服器採用 24 碟位 U.2 背板,每個硬碟都透過專用的 PCIe Gen5 x4 連結直接連接到 AMD EPYC CPU 複合體。沒有頻寬扇出,也沒有使用中板擴展器來降低並發性。由於硬體架構旨在聚合吞吐量而不會發生爭用,因此效能可以平滑擴展。在傳統的雙路配置中,CPU 透過 4 條 XGMI 連結進行路間通訊。在 R7725xd 中,每個 CPU 的其中一個連結被重新用於提供額外的 16 條 PCIe Gen5 通道,使伺服器總共擁有 160 條 PCIe Gen5 通道(前置 SSD 96 條,後置四個 PCIe 插槽 64 條)。搭配專為持續寫入工作負載和高耐久性而設計的 Micron 9550 PRO SSD,該系統將成為高吞吐量資料引擎,能夠支援檢查點密集型和連續串流工作負載。
我們在此架構之上疊加了PEAK:AIO,以利用並行提交路徑並在並發量增加時保持效率。最終不僅實現了峰值性能,而且在高負載下也能保持性能穩定。該平台既可以作為本地執行節點進行預處理、訓練或轉換,也可以透過網路為多個 GPU 系統提供高頻寬儲存服務。如果您想嘗試更多功能,還可以同時進行這兩種操作。
關鍵要點
- 單節點吞吐量空前: R7725xd 內部頻寬超過 300 GB/s,透過 NVMe-oF RDMA 傳輸頻寬達到 160 GB/s,在 2U 機箱內可與多節點儲存叢集相媲美。
- 真正的第五代架構,無交換機,無扇出: 所有 24 個 Micron 9550 PRO SSD 均可直接從 CPU 複合體獲得專用的 x4 PCIe Gen5 通道,從而實現無爭用的線速擴展。
- 搭載 AMD EPYC 9005 系列處理器: 雙 AMD EPYC 9575F 處理器提供持續高並發 I/O 所需的通道數、記憶體頻寬和 NUMA 拓撲結構。
- 專為人工智慧、分析和大量檢查點工作負載而設計: 該系統消除了阻礙現代 GPU 管線運作的 I/O 瓶頸,從而實現了連續、高頻寬的資料傳輸。
- PEAK:AIO 解鎖完全並行化: PEAK:AIO 的軟體堆疊在負載下保持佇列結構飽和,以極具吸引力的每 GB 美元比率提供企業級效能。
專為 NVMe 吞吐量而設計
在最新一代伺服器中,戴爾不再在高密度儲存伺服器設定中使用 PCIe 交換器。例如 PowerEdge R770 或 R7725 等型號提供 PCIe Gen5 x4 插槽,支援最多 16 個 SSD 配置,而在更大的儲存背板配置中則切換到 x2 插槽。上一代伺服器,例如 PowerEdge R760,在 24 盤位 NVMe 配置中會包含一個 PCIe 交換器。為了簡化配置並消除 PCIe 交換器帶來的複雜性,新一代伺服器採用了減少高密度儲存配置中 PCIe 通道數量的策略。直到 R7725xd 的出現,這策略才有所改變。
標準版 R7725 和 R7725xd 的差異在於平台如何分配 PCIe 根複合體資源。基礎版 R7725 將 PCIe 通道分配給儲存、GPU 擴充和通用 I/O。 「xd」版本則重新分配了這些資源,使 NVMe 子系統成為 PCIe 頻寬的主要使用者。 24 個 U.2 插槽直接連接到 CPU 的 PCIe Gen5 根複合體,每個 SSD 都有獨立的 x4 端點,而不是透過 PCIe 交換器或重定時器樹共用上行鏈路。這使得每個驅動器都擁有獨立的佇列結構和獨立的 DMA 路徑,從而連接到記憶體控制器。
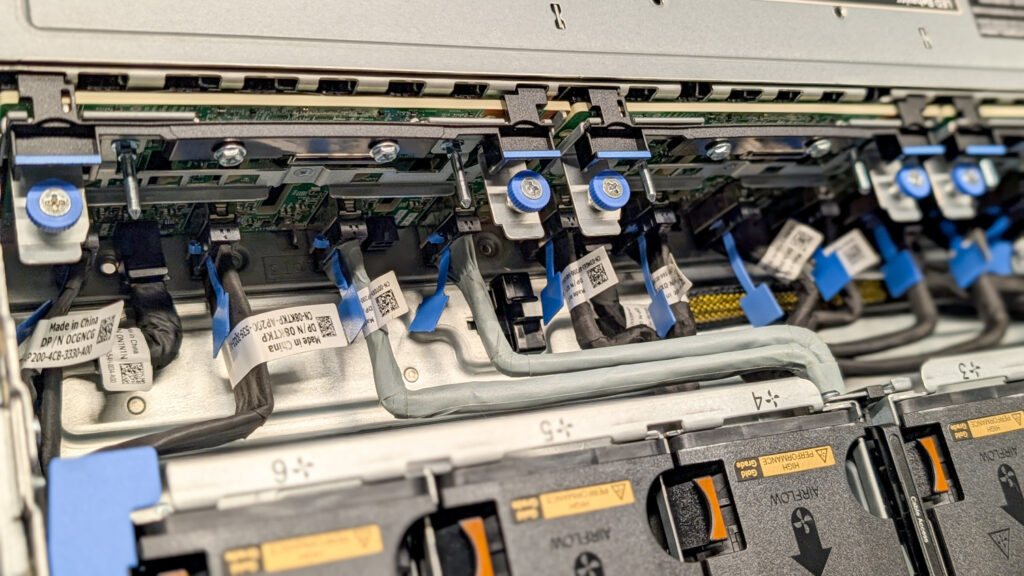
背板和轉接卡的拓樸結構體現了這個理念。戴爾將 NVMe 連接器和 PCIe 插槽分佈在兩個 AMD EPYC 處理器插槽上,因此每個處理器都直接擁有一部分磁碟機組。實際上,這創建了兩個對稱的 NVMe 域,每個域都具有本地延遲特性和完整的讀寫並發能力。當我們安裝四塊博通雙埠 200GbE 網路卡作為擴充卡時,插槽位置使得每塊網路卡都能位於與對應 NVMe 群組對齊的 PCIe 網域中。在 NVMe over RDMA 模式下,這意味著網路流量保持在處理相關驅動器 I/O 的插槽本地,避免了通常會增加延遲並在負載下消耗頻寬的插槽間 Infinity Fabric 跳轉。
良好的散熱性能也支援持續穩定的吞吐量。 U.2介面在密集型第五代硬碟配置中依然具有優勢,因為它為每個設備提供了明確的氣流通道和可預測的散熱片表面積。 R7725xd的高靜壓風扇模組和機殼風道確保所有24個硬碟位都能保持穩定的氣流,從而確保全盤寫入工作負載能夠持續運轉而不會出現降頻。機械設計與電氣設計相輔相成:由於該平台專為在負載下同時冷卻24個第五代硬碟而設計,因此每個硬碟都能保持全速性能。
這種結合了根複合體對齊、一致的非均勻記憶體存取 (NUMA) 通道佈局、插槽感知型網卡佈局以及熱穩定性 U.2 封裝的技術,使系統能夠大規模實現線速 I/O。該架構避免了效能瓶頸,並優化了效能。
戴爾 PowerEdge R7725xd iDRAC 10 概述
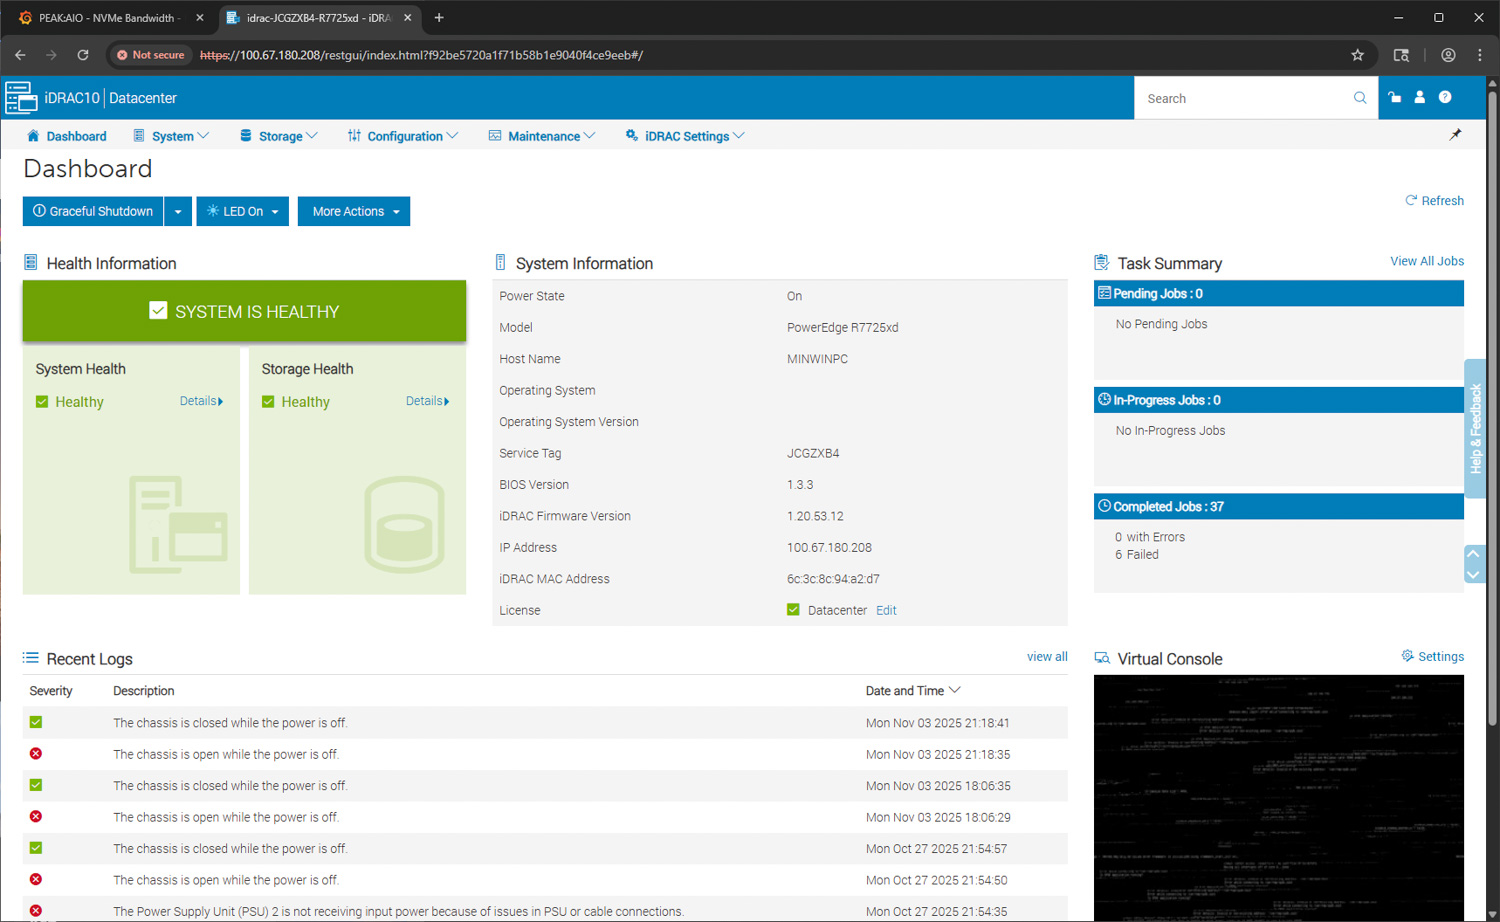
與許多其他我們評測過的第 17 代平台一樣,這一代 R7725xd 伺服器也採用了戴爾全新的 iDRAC 10 平台,該平台作為遠端管理、健康監控和帶外控制的中心樞紐。儀表板視圖可即時概覽系統整體運作狀況、儲存狀態和近期活動。在我們測試的這台伺服器上,系統和儲存運作狀況報告均為綠色,表示伺服器運作正常。關鍵系統訊息,例如型號、主機名稱、BIOS 版本、iDRAC 韌體等級、IP 位址和授權訊息,都顯示在介面右側。
儀錶板還包含一個任務摘要面板,顯示已完成、待處理和正在進行的操作。下方列出了最近的日誌,這些日誌記錄了機箱入侵事件和電源訊息,無需深入選單即可快速了解硬體狀態變化。虛擬控制檯面板位於右下角,可用於完全遠端 KVM 控制。
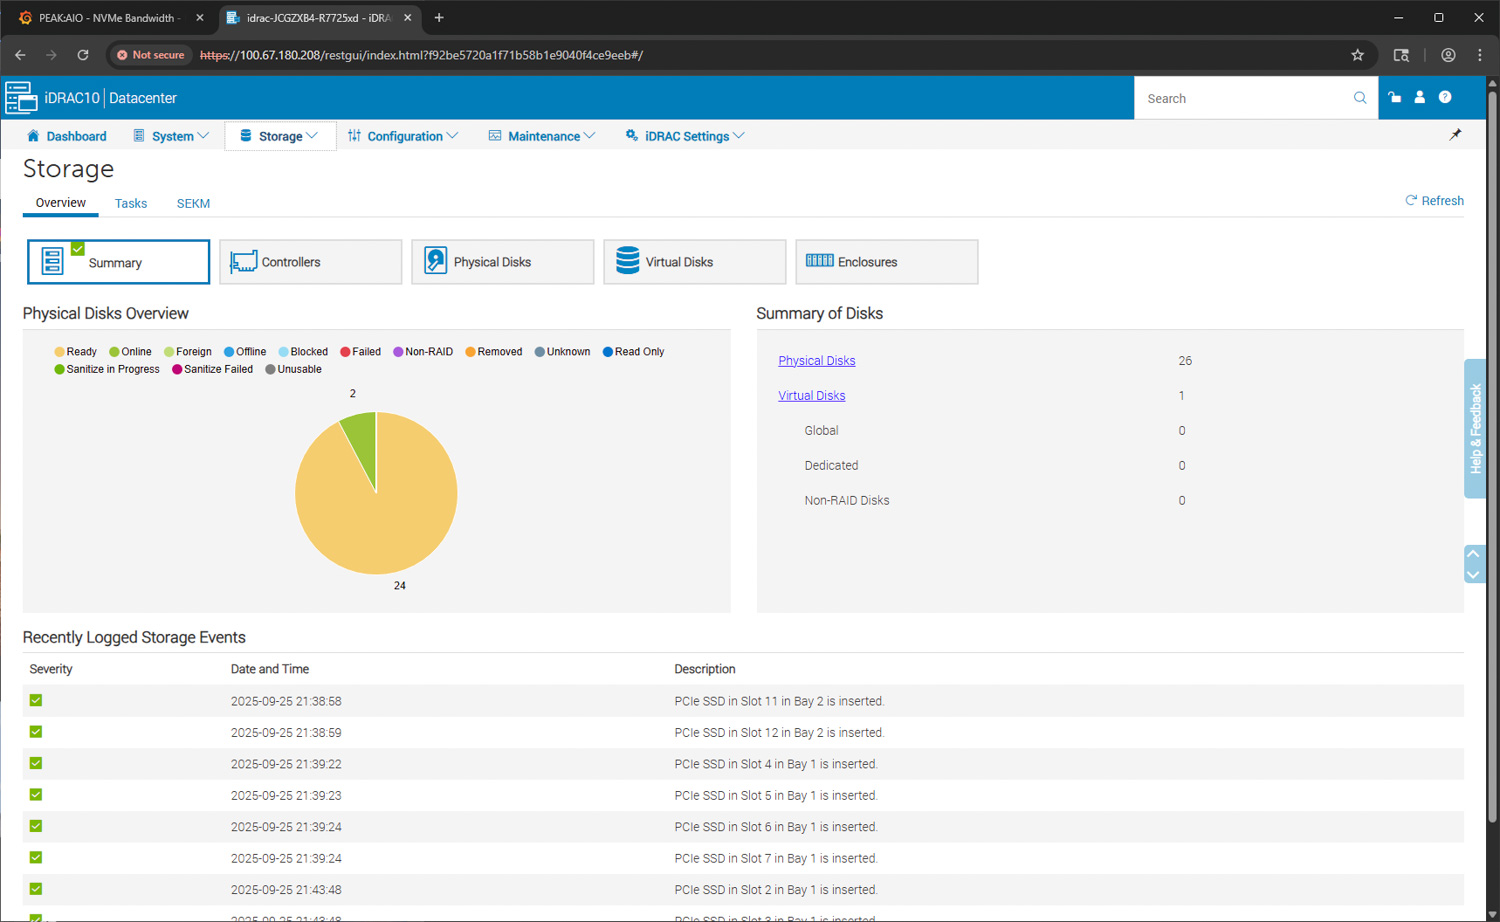
iDRAC 10 的儲存部分全面概述了 R7725xd 中安裝的所有實體磁碟。摘要面板顯示所有已連接驅動器的概覽數量,並附有可視化的圓餅圖,展示驅動器的狀態。在此配置中,24 個 NVMe SSD 處於活動狀態並顯示為就緒狀態,系統中還有兩個額外的啟動設備,與主前置 NVMe 儲存組分開。
右側的「磁碟概覽」面板將磁碟細分為實體磁碟和任何關聯的虛擬磁碟。由於 R7725xd 採用直接 NVMe 架構,沒有傳統的 RAID 控制器,因此所有驅動器均被報告為非 RAID 且可單獨尋址,這與系統針對大型 NVMe 池和 SDS 平台的設計相符。
在狀態摘要下方,「最近記錄的儲存事件」區域列出了每個 PCIe SSD 的插入日誌,並按托架和插槽進行組織。此記錄確認所有驅動器托架均已正確偵測到 SSD,並有助於識別安裝、佈線或熱插拔操作方面的任何問題。對於大型部署,這些日誌在追蹤驅動器配置或驗證容量是否已按預期填充時非常有用。
最後一張截圖顯示了 iDRAC10 中的 NVMe 設備詳細視圖。系統中安裝的每個 NVMe 驅動器都會列出其狀態、容量和托架位置。選擇單一驅動器即可查看其完整特性分析。
在本例中,磁碟機資訊面板顯示了完整的型號字串、裝置協定、外形尺寸和協商的 PCIe 設定。 NVMe 設備以 32 GT/s 的鏈路速度運行,並採用協商的 x4 連接,這證實了驅動器在系統的 PCIe Gen5 背板上以全頻寬運行。資訊部分還報告了耐久性百分比、可用備用狀態和協議類型,幫助管理員監控驅動器的健康狀況和預期壽命。
這種精細的驅動器報告在高密度 NVMe 配置中非常有價值,因為鏈路寬度、協商速度和媒體健康狀況會直接影響工作負載行為和儲存效能。
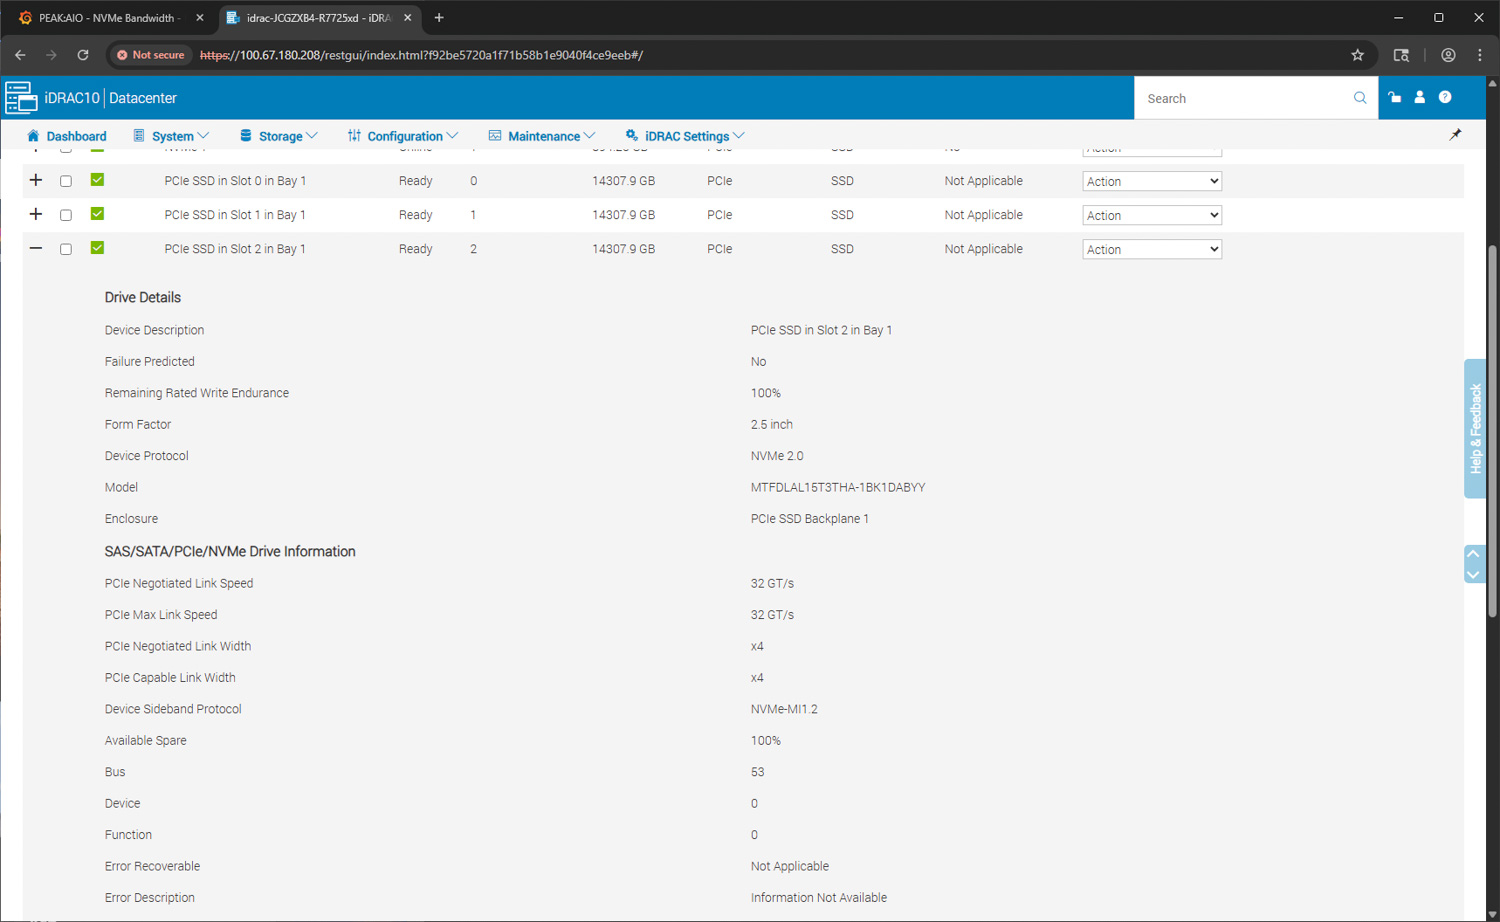
總體而言,iDRAC 10 介面提供了 R7725xd NVMe 儲存架構的清晰、以硬體為中心的視圖,使用戶能夠一目了然地輕鬆驗證鏈路健康狀況、驅動器狀態和系統完整性。
戴爾 PowerEdge R7725xd 性能
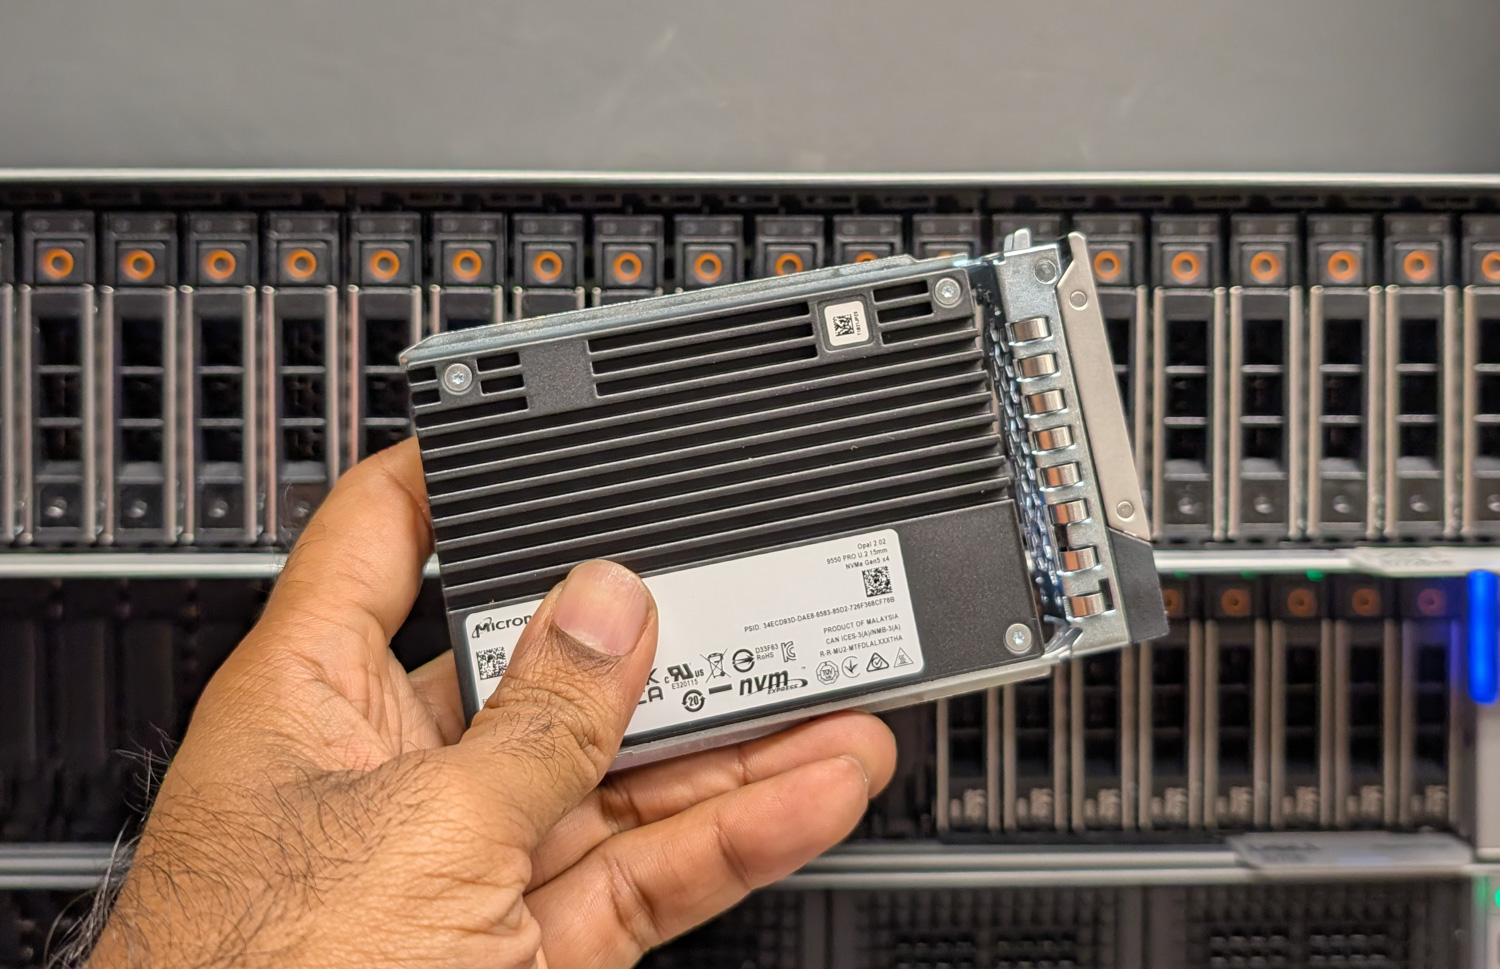
在測試之前,我們的系統配置了均衡且高效能的硬體。該系統配備了兩顆 AMD EPYC 9575F 處理器,每顆處理器擁有 64 個高頻核心,並搭配 24 條 32GB DDR5 內存,運行頻率為 6400 MT/s。儲存方面,機殼內裝滿了 24 個 15.36TB 的 Micron 9550 PRO U.2 NVMe 固態硬碟,每個硬碟都透過一條獨立的 PCIe Gen5 x4 通道連接。這提供了 368.64TB 的總原始容量,Micron 9550 PRO 固態硬碟的順序讀取速度高達 14,000 MB/s,順序寫入速度高達 10,000 MB/s。網路由四個博通 BCM57608 適配器處理,共提供八個 200Gb 端口,以及一個 BCM57412 OCP 網路卡,提供兩個額外的 10 千兆端口。
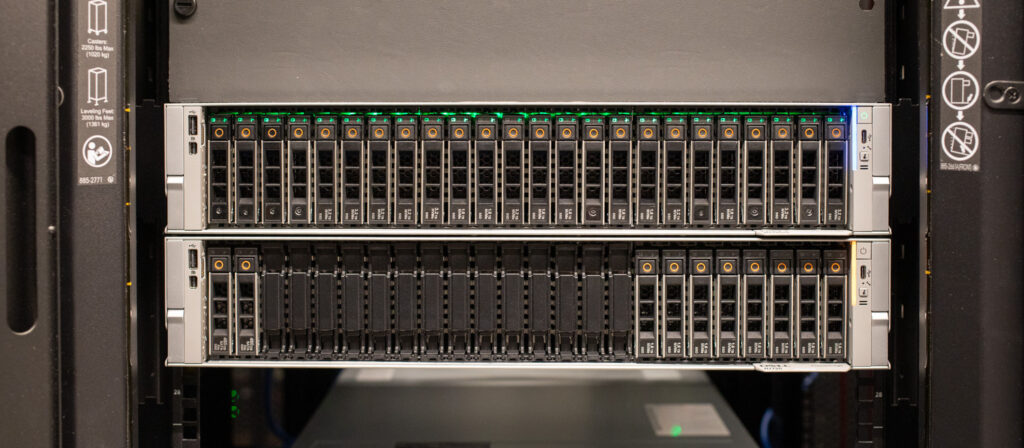
測試系統規格
- 中央處理器: 2顆AMD EPYC 9575F 64核心高頻處理器
- 內存: 24 個 32GB DDR5 內存,頻率 6400MT/s
- 貯存: 24 塊 15.36TB Micron 9550 PRO U.2 固態硬碟(每塊硬碟透過 4 條 PCIe Gen5 通道連接);目前支援高達 128TB 的硬碟,未來也將支援更高容量。
- 網絡: 4 個博通 BCM57608 2x200G 網路卡,1 個 BCM57412 2x10Gb OCP 網路卡
- 開關: 戴爾 PowerSwitch Z9664
FIO性能基準
為了衡量 PowerEdge R7725xd 的儲存效能,我們使用了業界標準指標和 FIO 工具。本節重點介紹以下 FIO 基準測試:
- 隨機 4K – 1M
- 連續 4K – 1M
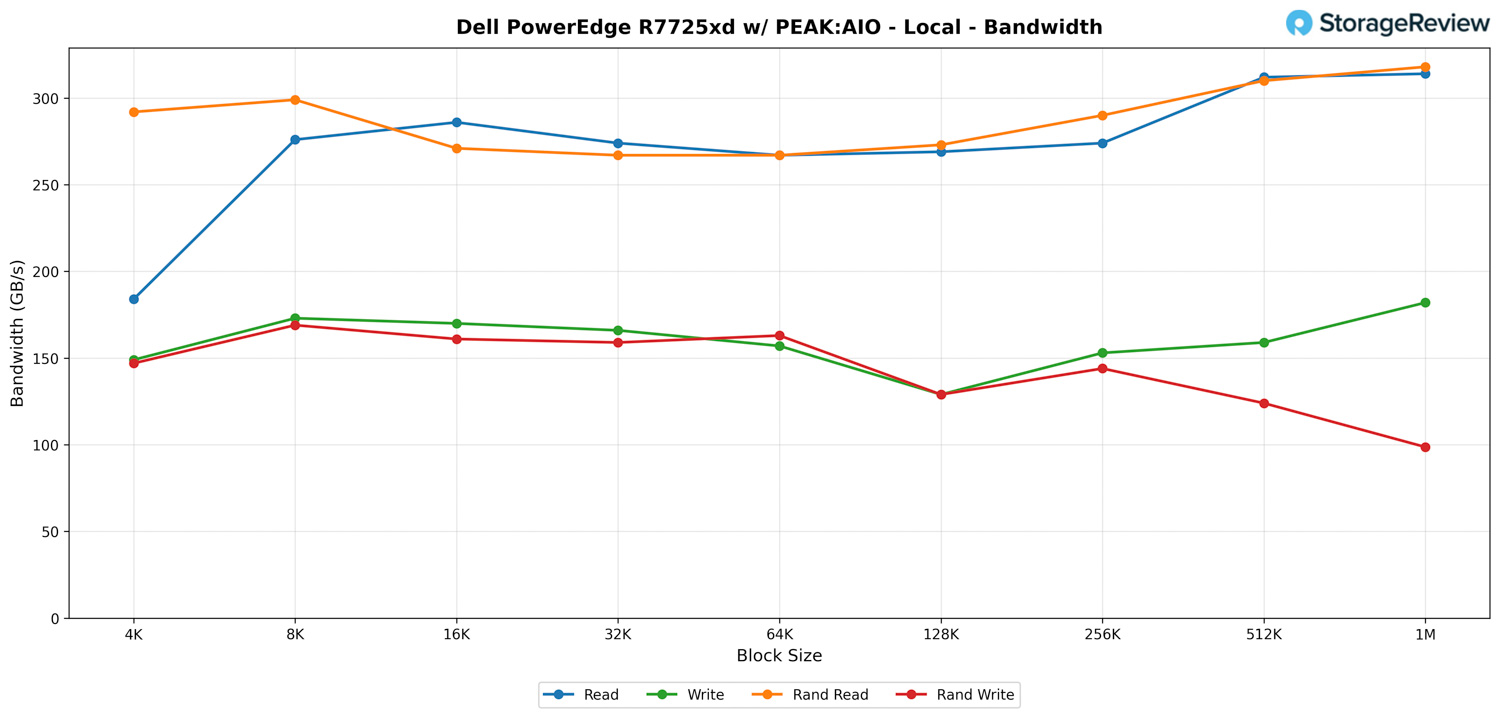
FIO – 本地 – 頻寬
在測試對戴爾 PowerEdge R7725xd 伺服器內部 24 個 PCIe Gen5 NVMe 固態硬碟的本地存取時,系統表現完全符合預期,因為每個硬碟都透過完整的 x4 通道 PCIe Gen5 連結連接到 CPU。由於沒有網路層參與,這就是戴爾 Gen5 儲存佈局的純粹內部吞吐量,以及 AMD EPYC 平台 PCIe 頻寬不受限制地發揮作用。
順序讀取速度從 4K 資料區塊的 184 GB/s 開始,並隨著資料區塊大小的增加而迅速提升。從 512K 到 1M,伺服器始終保持 312 到 314 GB/s 的穩定速度,這有力地表明系統能夠高效地將所有 24 × 4 個 Gen5 通道聚合為持續的讀取頻寬,而不會出現任何控制器瓶頸。
順序寫入速度曲線有所不同,但始終保持在預期範圍內。初始速度為 149 GB/s,隨後提升至 100 多 GB/s,在寫入 1 萬次時達到 182 GB/s。這與 Micron 9550 PRO SSD 的寫入特性以及跨多個獨立裝置進行高並行 NVMe 寫入所固有的開銷相符。
隨機讀取效能是另一個大亮點。該系統在最小區塊大小下速度接近 300 GB/s,在中等區塊大小下略有下降,然後在較大區塊大小下恢復到 200 多 GB/s 到 300 多 GB/s。在 1M 區塊大小下,隨機讀取速度最高可達 318 GB/s,這表明該平台能夠將混合操作均勻地分配到所有 24 個硬碟上。
隨機寫入速率較低,這對於分散在大型 NVMe 陣列上的元資料和寫入分配任務來說很常見。在測試的大部分時間裡,寫入速率保持在 140 到 160 GB/s 之間,在 1 M 時逐漸下降到略低於 100 GB/s。
FIO – 本地 – IOPS
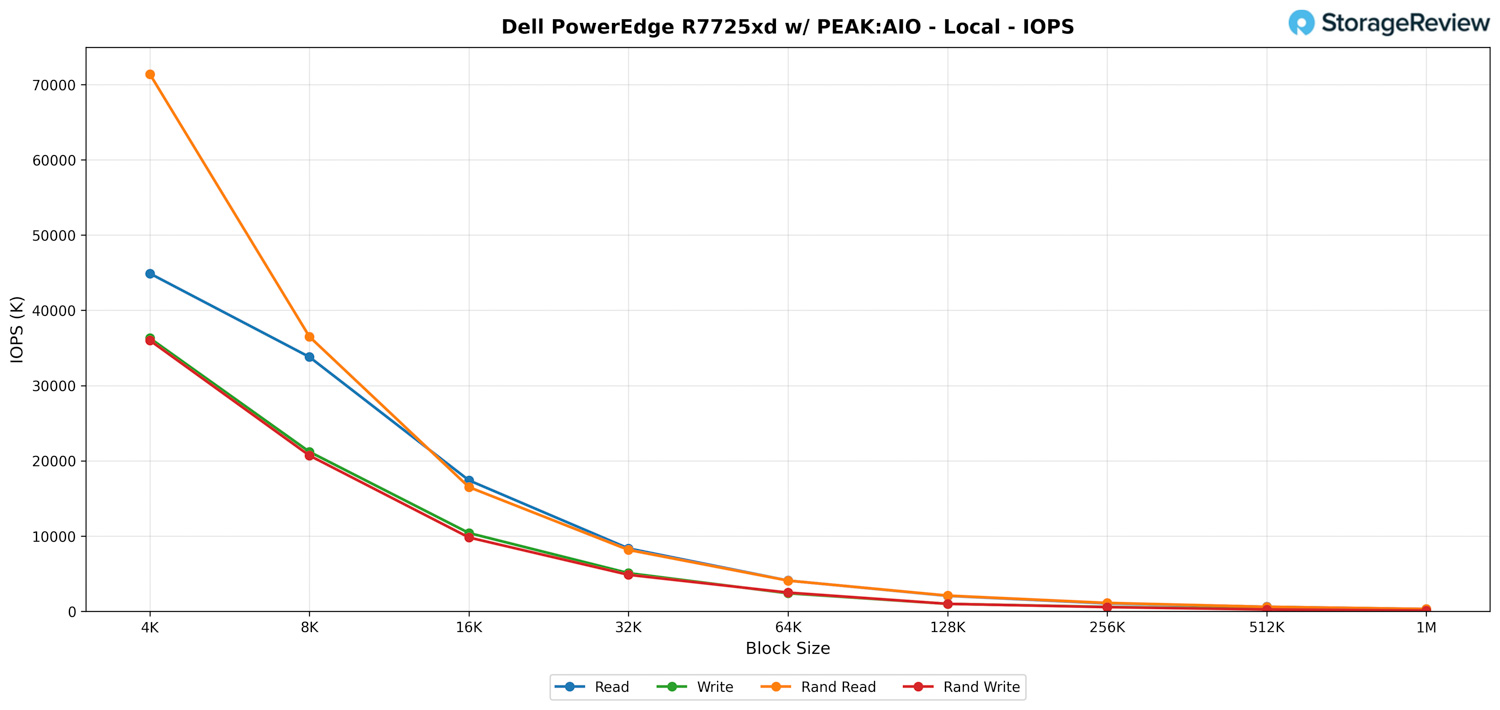
在考察 IOPS 方面,R7725xd 表現出強大的小塊效能,請求速率可達數千萬,之後更大的區塊大小才會將工作負載轉移到頻寬驅動的模式。
在 4K 資料區塊下,讀取 IOPS 達到 44.9 萬,寫入 IOPS 達到 36.3 萬。隨機讀取 IOPS 更高,達到 71.4 萬,這表示系統能夠有效率地將高佇列工作負載分配到所有磁碟機上。隨著資料區塊大小的增加,這些數值自然會逐漸下降,但在 8K、16K 和 32K 範圍內,效能提升的趨勢保持一致。
以 16K 和 32K 資料區塊劃分,讀取 IOPS 分別穩定在 17.4 萬和 8.35 萬,隨機讀取 IOPS 與之非常接近,分別為 16.5 萬和 8.15 萬。寫入效能符合預期,雖然略低,但在順序和隨機存取模式下均保持穩定。
當資料區塊大小達到 64K 及以上時,測試從純粹的 IOPS 測試轉變為更專注於頻寬的測試。 IOPS 降至百萬級,最終達到數十萬級。在 1M 區塊大小下,讀取 IOPS 約 300 萬,寫入 IOPS 約 174 萬,隨機操作的 IOPS 也大致相同。
總體而言,本地 IOPS 結果清楚地表明,該系統能夠跨小塊維持非常高的隊列深度工作負載,並且隨著傳輸量的增長和頻寬成為主要因素,其擴展性是可預測的。
PEAK:AIO:為什麼戴爾 PowerEdge R7725xd 適合這種工作負載
PEAK:AIO 專為需要極速、低延遲存取大型資料集的環境而設計,通常用於 AI 訓練、推理管線、金融建模和即時分析。該平台依賴高密度 NVMe 儲存、均衡的 PCIe 頻寬以及可預測的大規模延遲。為了滿足這些要求,底層硬體必須提供持續的吞吐量,並在並發高負載下保持穩定可靠的效能。
戴爾 PowerEdge R7725xd 伺服器與 PEAK:AIO 的理念完美契合。該系統的架構旨在最大限度地利用 PCIe Gen5 資源,將 24 個前置 U.2 NVMe 插槽的全部頻寬直接提供給 CPU,無需依賴傳統的 RAID 控制器。這種佈局使 PEAK:AIO 能夠獲得現代基於 NVMe 的資料管道所期望的並行性和低延遲特性。系統配置將 NVMe SSD 分為兩個 RAID 0 組。
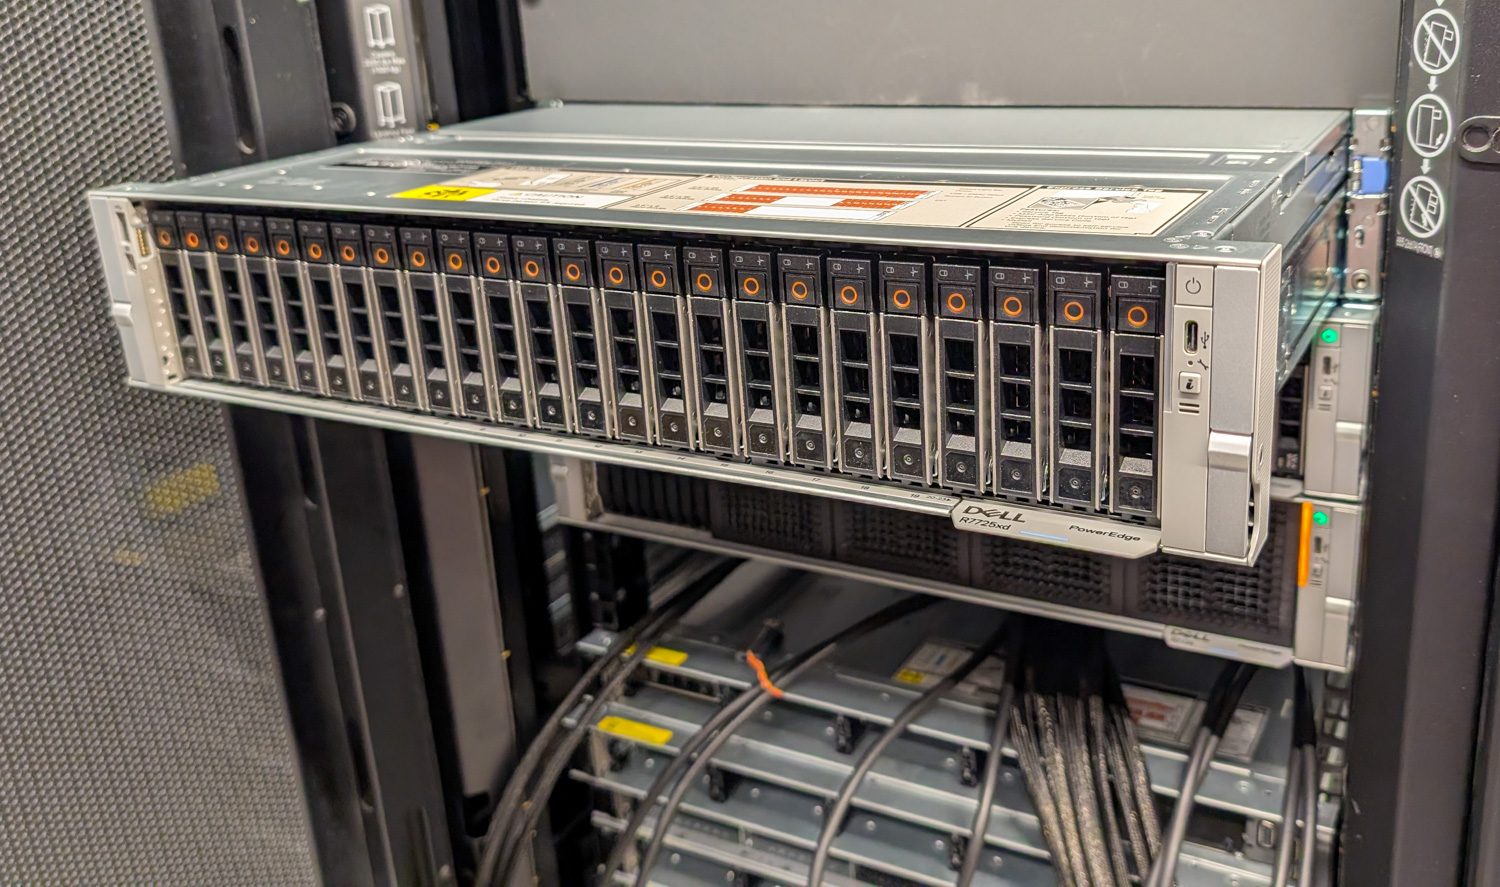
在測試場景中,我們使用了兩台連接到 R7725xd 的用戶端系統,每台系統都配備了 Broadcom BCM57608 雙 200G 網路卡。這樣就形成了四個 200G 上行鏈路,分別連接到每台客戶端,從而使 R7725xd 達到接近 PEAK:AIO 生產環境實際部署的高效能配置。這種網路頻寬使我們能夠充分測試 NVMe 子系統、PCIe 拓撲結構和 CPU 互連的效能,而不會在網路卡層出現瓶頸。
最終打造出的平台能夠有效滿足 PEAK:AIO 的工作負載需求。 R7725xd 提供高密度 NVMe 容量、PCIe Gen5 吞吐量、用於平行處理的雙 AMD EPYC 9005 處理器,以及足以支援多客戶端資料攝取(每個客戶端數百 Gbps)的網路能力。所有這些特性都是實現 PEAK:AIO 效能預期的基礎。
PEAK:AIO – NVMe-oF RDMA – 頻寬
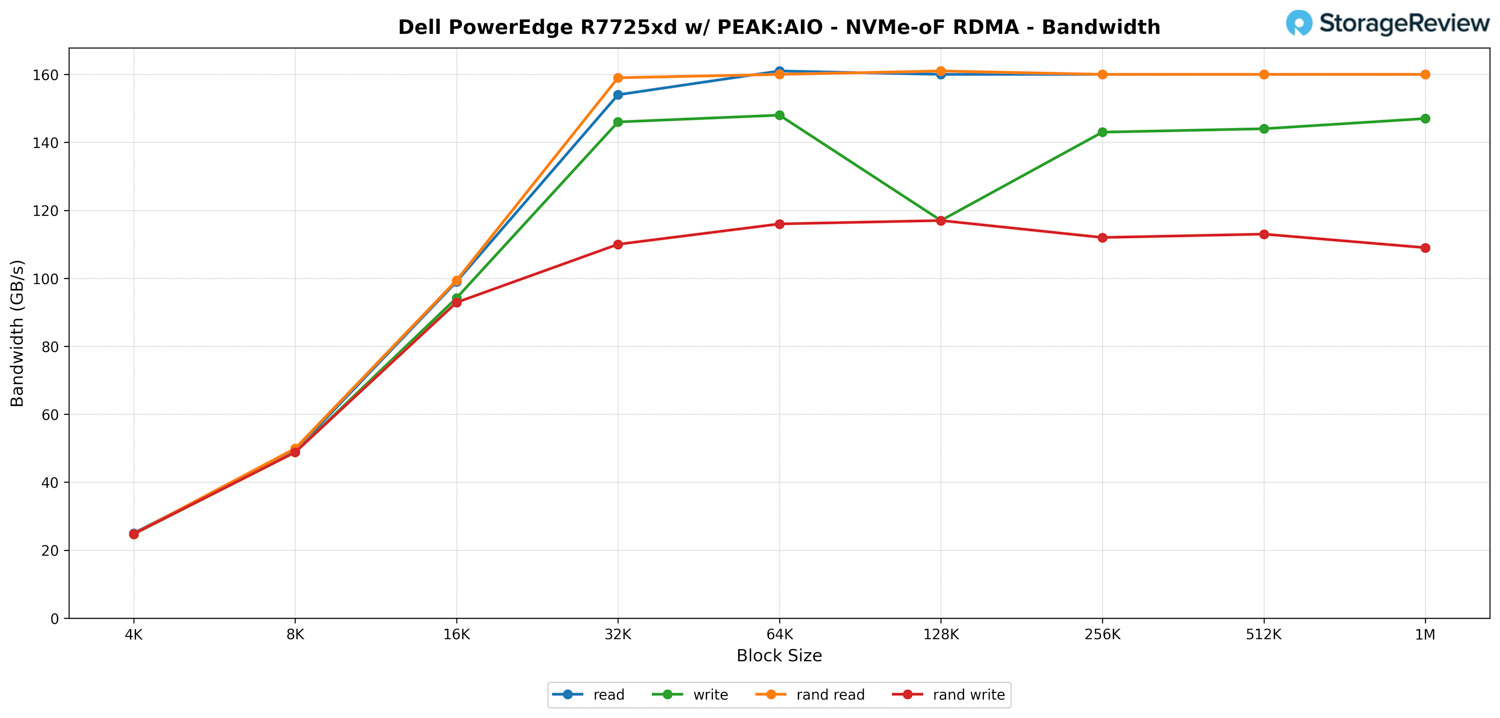
在配備 PEAK:AIO 的 PowerEdge R7725xd 伺服器上測試 NVMe-oF RDMA 頻寬後,整體趨勢與我們對擁有如此高 PCIe 和網路頻寬的系統所預期的完全一致。隨著塊大小的增加,吞吐量迅速提升,直到接近平台實際極限時趨於平穩。
在小資料區塊大小下,讀寫效能都徘徊在 20GB/s 左右,這是正常的,因為 4K 和 8K 的傳輸對 IOPS 路徑的消耗遠大於吞吐量路徑。一旦資料塊達到 16K 和 32K,管線效能就會提升。讀取速度在 32K 時躍升至約 154 GB/s,並持續攀升至 160 GB/s 左右,這與我們預期在四條 200 Gb/s 鏈路上進行雙客戶端部署時的效能表現相符。
隨機讀取效能幾乎與順序讀取效能完全一致。 PEAK:AIO 能夠很好地保持命令佇列的正常運轉,因此隨機讀取頻寬基本上與順序讀取頻寬保持一致,在 32K 到 1M 的資料範圍內穩定在 159 到 161 GB/s 左右。這表明在混合存取模式下,儲存堆疊並未出現瓶頸,並且 R7725xd 的 PCIe 拓撲結構能夠將負載均勻地分配到 24 個 Gen5 NVMe 固態硬碟上。
寫入效能曲線與讀取效能曲線相似,但峰值略低於讀取效能。順序寫入在中等大小的資料區塊下保持在 140 至 148 GB/s 的範圍內,在 128K 資料區塊時下降至約 117 GB/s,但隨著資料區塊大小的增加而恢復。隨機寫入的效能表現不同,其速度趨於穩定在 110 至 117 GB/s 左右,這對於引入額外開銷的混合隊列工作負載而言是正常的。
本節的關鍵在於,即使多個客戶端同時運行,R7725xd 也能在 NVMe-oF 上輕鬆維持極高的頻寬。一旦資料塊大小達到 32K 或更大,伺服器的網路和儲存頻寬就會持續飽和。這正是 PEAK:AIO 旨在挖掘的效能,這些結果有力地驗證了該平台在實際應用場景下的擴展能力。
PEAK AIO – NVMe-oF RDMA IOPS
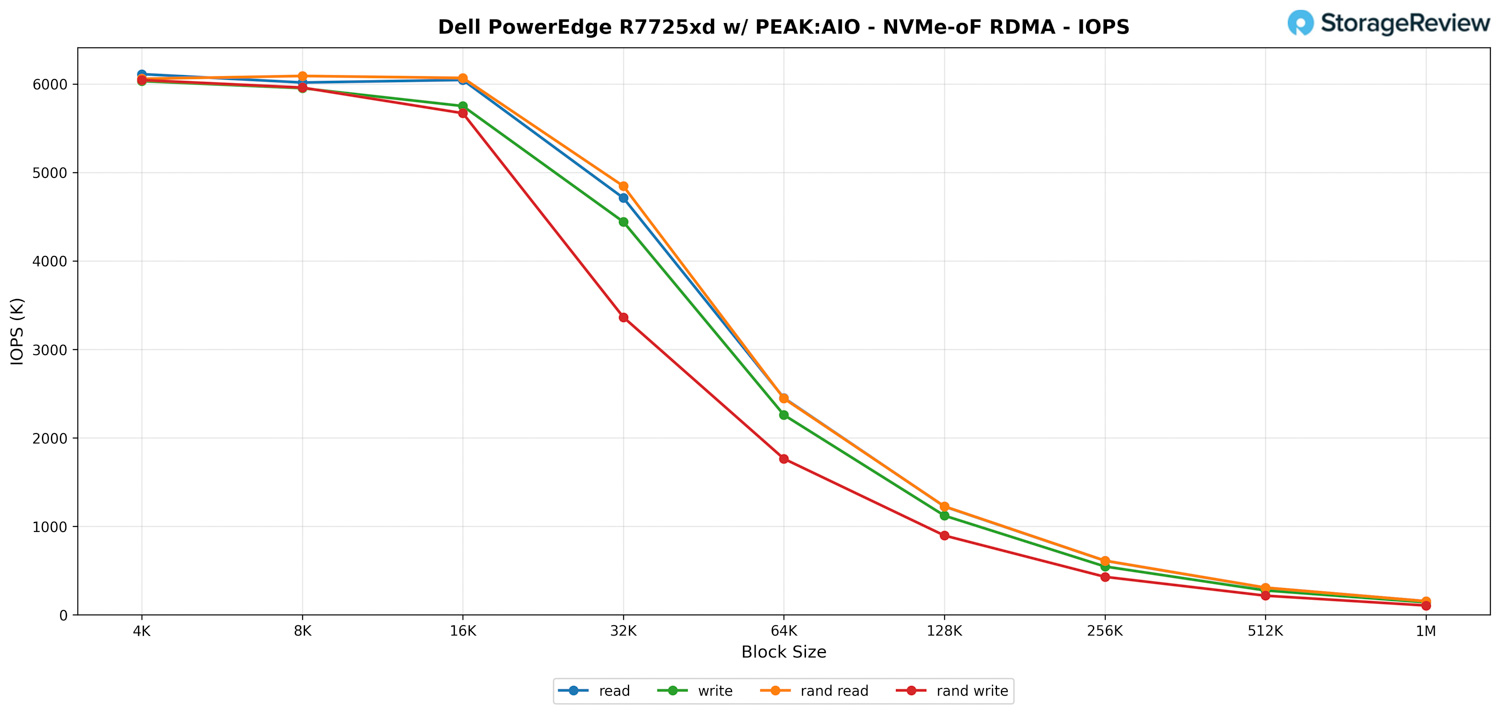
在 IOPS 方面,PowerEdge R7725xd 展現出強勁的小塊效能,儘管我們最初觀察到的數值低於預期;預計未來透過改進網路驅動程式支援可以解決這個問題。即便如此,整體擴展趨勢仍與 NVMe-oF RDMA 在區塊大小增加時的典型表現完全一致。
在最小區塊大小下,此系統在順序和隨機工作負載下均可提供超過 6 萬 IOPS。在 4K 和 8K 區塊大小下,讀取、寫入、隨機讀取和隨機寫入的效能大致相同,這表明前端用戶端、PCIe 基礎設施和 NVMe 驅動器本身都能輕鬆應對請求速率。
隨著資料塊大小的增加,IOPS開始出現預期的下降。在32KB時,讀取操作的IOPS約4.7萬,寫入操作略為落後,約4.4萬。隨機寫入受到的影響最大,下降到約3.3萬IOPS,這與混合存取模式引入的額外佇列和CPU開銷相符。
進入大數據塊階段後,IOPS 繼續以可預測的線性方式下降。當傳輸量達到 256K 和 512K 時,吞吐量成為主要指標,IOPS 自然下降到數十萬左右。在 1M 的資料區塊大小下,所有工作負載的 IOPS 都收斂到 140K-153K,這與我們在上一節中看到的頻寬資料一致。
GPUDirect儲存效能
我們對 R7725xd 進行的測試之一是 Magnum IO GPUDirect Storage (GDS) 測試。 GDS 是 NVIDIA 開發的一項功能,它允許 GPU 在存取儲存在 NVMe 磁碟機或其他高速儲存裝置上的資料時繞過 CPU。 GDS 無需透過 CPU 和系統記憶體路由數據,即可實現 GPU 與儲存裝置之間的直接通信,從而顯著降低延遲並提高數據吞吐量。
GPUDirect 儲存的工作原理
傳統上,當GPU處理儲存在NVMe磁碟機上的資料時,資料必須先經過CPU和系統記憶體才能到達GPU。這個過程會造成瓶頸,因為CPU充當了中間人,增加了延遲並消耗了寶貴的系統資源。 GPUDirect Storage透過允許GPU直接透過PCIe匯流排存取儲存裝置中的數據,消除了這種低效率。這種直接路徑減少了資料傳輸的開銷,從而實現了更快、更有效率的資料傳輸。
AI 工作負載,尤其是涉及深度學習的工作負載,是高度資料密集的。訓練大型神經網路需要處理數 TB 的數據,任何資料傳輸延遲都可能導致 GPU 無法充分利用並延長訓練時間。 GPUDirect Storage 透過確保資料盡快傳輸到 GPU,最大限度地減少空閒時間並最大限度地提高運算效率,解決了這項挑戰。
此外,GDS 對於涉及串流大型資料集的工作負載特別有利,例如視訊處理、自然語言處理或即時推理。透過減少對 CPU 的依賴,GDS 可以加速資料移動並釋放 CPU 資源用於其他任務,從而進一步增強整體系統效能。
除了原始頻寬之外,搭載 NVMe-oF (TCP/RDMA) 的 GPUDirect 還能提供超低延遲 I/O。這確保 GPU 永遠不會缺少數據,使該系統成為即時 AI 推理、分析管道和視訊回放的理想選擇。
GDSIO 順序讀取
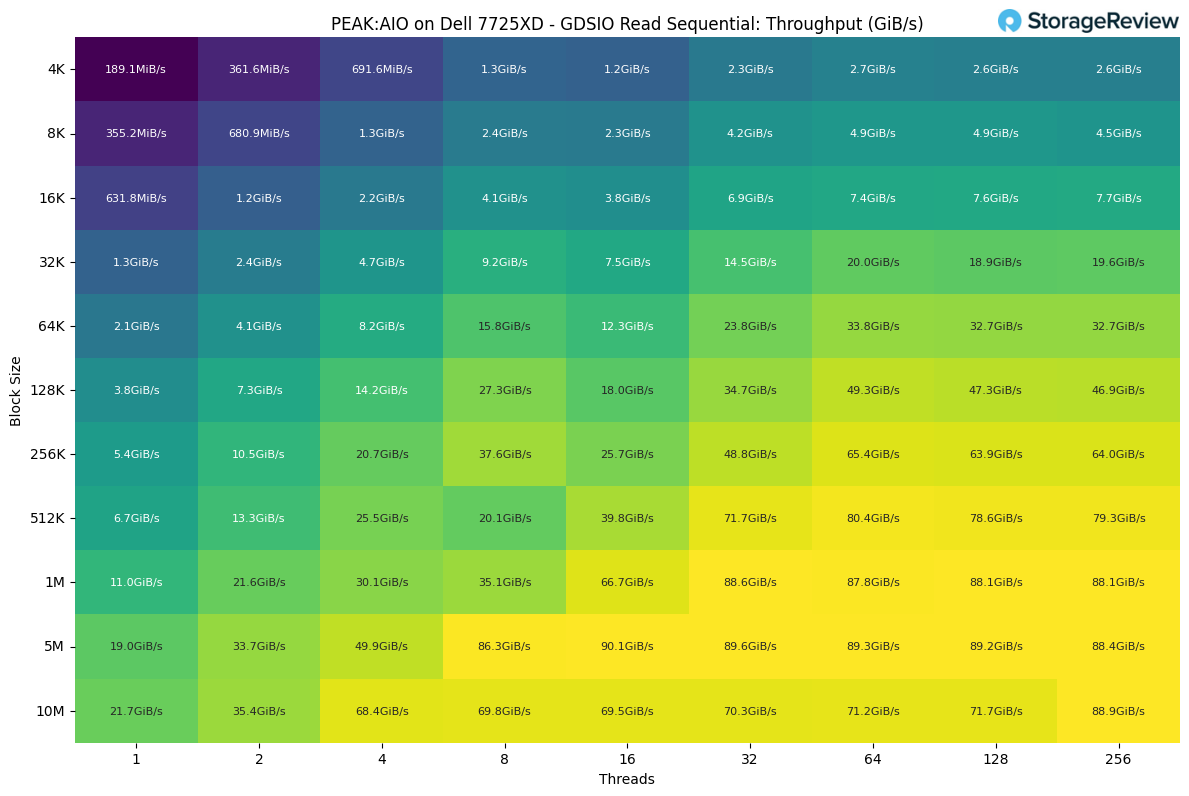
使用 GDSIO 對單一客戶端進行 PEAK:AIO 測試時,讀取吞吐量隨著區塊大小和執行緒數的增加呈現明顯的擴展模式。此客戶端透過兩個 400G 連結連接,因此其總吞吐量被限制在 90 GB/s。
在最小資料塊大小和低執行緒數的情況下,效能較為一般,單執行緒讀取 4K 資料的速度約為 189 MiB/s。一旦增加執行緒並行度,系統反應速度立即提升,在四執行緒下可達 691 MiB/s,隨著資料區塊大小的增加,速度更是突破數 GiB/s。
中等大小的資料塊對線程數的敏感度最高。在 32K 資料區塊時,吞吐量從單執行緒的 1.3 GiB/s 成長到 64 執行緒時的近 20 GiB/s,之後僅略有下降。 64K 和 128K 資料區塊也呈現類似的模式,系統吞吐量從低並行度下的個位數 GiB/s 成長到工作負載擴展後的 30 GiB/s 以上。
一旦資料塊大小增加,吞吐量便開始趨於平穩,因為系統已接近單一客戶端的效能極限。在 1 MiB 的資料塊大小下,單執行緒效能為 11 GiB/s,而多執行緒效能則約為 88 GiB/s。 5 MiB 和 10 MiB 的資料傳輸也呈現相同的平台期,無論測試是在 64、128 還是 256 個執行緒下運行,吞吐量都穩定在 89–90 GiB/s 左右。
GDSIO 順序寫入
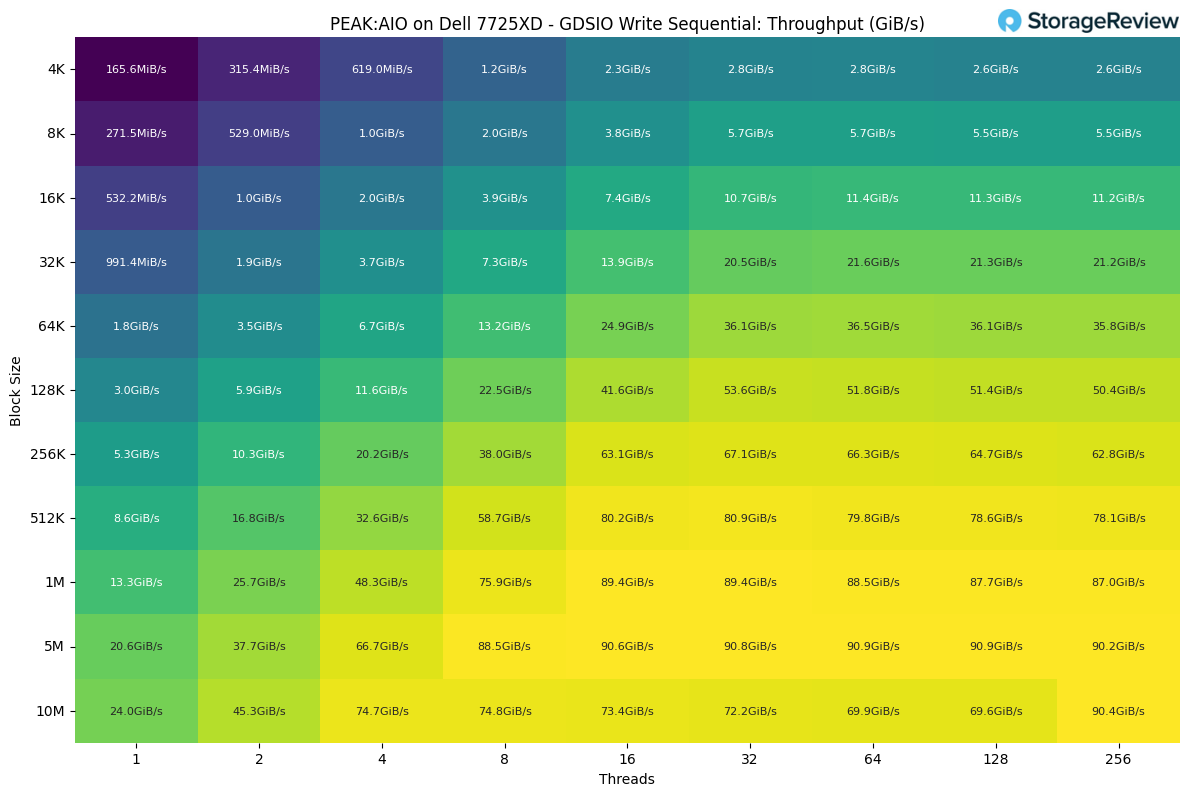
在寫入方面,其擴展行為與讀取類似,但在大多數區塊大小下效能略低,這對於順序寫入工作負載來說是預期之內的。在最小區塊大小下,單執行緒在 4K 區塊大小下的吞吐量為 165 MiB/s,並隨著並行度的增加而穩定提升。在四個執行緒時,吞吐量成長到略高於 619 MiB/s,而在八個執行緒時則超過 1 GiB/s。
隨著執行緒數的增加,中等大小的資料區塊的效能提升更為顯著。在 32K 資料區塊下,吞吐量從略低於 1 GiB/s 開始,隨著執行緒數的增加,吞吐量可提升至 21 GiB/s 以上。 64K 和 128K 資料區塊也延續了這一趨勢,吞吐量從個位數 GiB/s 提升至 30 GiB/s 和 50 GiB/s 左右,這得益於工作負載的並行化程度提高。
當傳輸資料量較大時,系統會達到其固有的寫入吞吐量上限。在 1 MiB 的傳輸量下,效能從單執行緒的 13.3 GiB/s 提升至多執行緒時的接近 90 GiB/s。 5 MiB 和 10 MiB 的測試也呈現類似的趨勢,無論系統運行在 64、128 或 256 個線程,結果都穩定在 90 GiB/s 左右。
重新定義第五代性能
戴爾 PowerEdge R7725xd 不只是一台儲存伺服器;它代表了機架內部頻寬傳輸方式的一次變革。透過取消 PCIe 交換機,並為每個 NVMe 硬碟提供直達 CPU 的路徑,戴爾打造了一個吞吐量可平滑擴展、散熱可控且並發性不再是挑戰而是優勢的系統。
當搭配美光9550 PRO SSD和PEAK:AIO的平行I/O軟體時,R7725xd可以從一個高密度NVMe機殼搖身一變,成為真正的資料引擎。它能夠充分利用本地PCIe架構,透過RDMA以線速為GPU提供數據,或同時承擔運算和儲存的雙重角色,所有這些都整合在一個2U的機箱內。
戴爾 PowerEdge R7225xd
實際上,這種配置可提供超過 300 GB/s 的本地吞吐量和 160 GB/s 的網絡吞吐量,其性能足以媲美多節點存儲集群,而復雜性和成本卻低得多。這充分展現了從晶片到軟體,整個技術堆疊的每一層都圍繞著效率和持續頻寬進行優化時所能達到的卓越性能。
R7725xd 為第五代單節點儲存效能樹立了新的標竿。對於正在建構下一代 AI 管線、高速分析或大量使用檢查點的訓練環境的企業而言,它展現了當系統瓶頸被徹底消除時所能達到的極致性能。
本報告由 Dell Technologies 贊助。 本報告中表達的所有觀點和意見均基於我們對所考慮產品的公正看法。


 Amazon