

NVIDIA GeForce RTX 5070 Ti 顯示卡將於 2 月 20 日上市,建議零售價為 $749 美元。由於 Ti 型號沒有 Founders Edition 版本,NVIDIA 為我們提供了一塊華碩 Prime GeForce RTX 5070 Ti 進行測試。它的定位略高於入門級 RTX 5070,性能接近RTX 5080。這使其成為遊戲玩家升級或希望以經濟實惠的價格進入入門級 AI 工作負載的用戶的理想選擇。
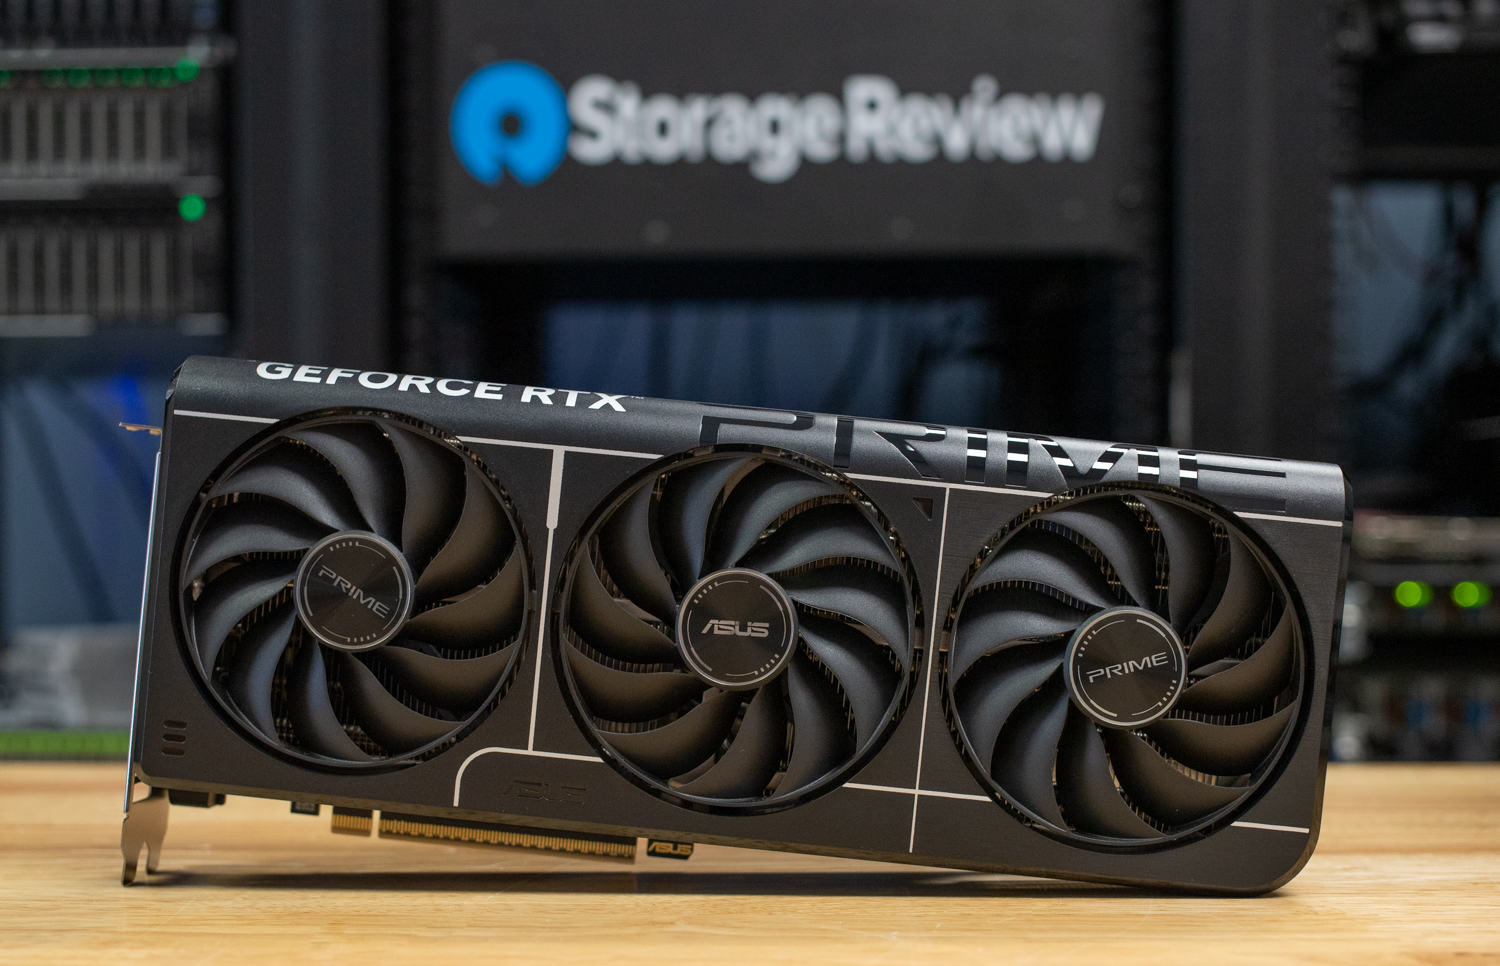
華碩Prime RTX 5070 Ti顯示卡配備了與RTX 5090和RTX 5080相同的先進AI功能,以親民的價格將NVIDIA的最新創新技術帶給玩家。它搭載DLSS 4多幀生成和光線重建技術,帶來流暢的性能和驚豔的視覺效果;NVIDIA Reflex 2和幀扭曲技術確保遊戲響應速度,提供低延遲,助力競技遊戲。全光線追蹤結合神經渲染技術,呈現栩栩如生的畫面,帶來更沉浸式的遊戲體驗。
ASUS Prime RTX 5070 Ti GPU 規格與比較
ASUS PRIME RTX 5070 Ti 配備 8,960 個 CUDA 核心,與 RTX 4070 Ti 的 7,680 個核心相比有顯著提升,但低於 RTX 5080 的 10,752 個核心。除了核心數量的增加之外,它還擁有 16GB 的 GDDR7 內存,這比 RTX 4070 Ti 的 12GB GDDR6 有了很大的改進。由於現代遊戲對高解析度紋理、複雜幾何圖形和光線追蹤效果的 VRAM 要求越來越高,因此升級至 16GB GDDR7 記憶體至關重要。
此外,增加的頻寬對於 DLSS 4 和神經渲染等 AI 增強遊戲功能特別有益,這些功能需要快速存取儲存在 VRAM 中的 AI 模型。利用 NVIDIA 的 AI 驅動 NPC 的遊戲也受益於擴展的記憶體容量,因為這些功能需要額外的 VRAM 來儲存其神經網路。憑藉增強的處理能力和更快的內存,RTX 5070 Ti 可為遊戲和 AI 加速應用程式提供出色的性能,而無需旗艦機型的功率和成本需求。
以下是我們最近評測過的卡片的完整規格。
| GPU比較 | NVIDIA RTX 4090 | NVIDIA RTX 5070 | 華碩 Prime NVIDIA RTX 5070 Ti | NVIDIA RTX 5080 | NVIDIA RTX 5090 |
| GPU名稱 | AD102 | GB205 | GB203 | GB203 | GB202 |
| 卓越的建築 | 艾達洛夫萊斯 | 布萊克威爾2.0 | 布萊克威爾2.0 | 布萊克威爾2.0 | 布萊克威爾2.0 |
| 進程大小 | 5納米 | 5納米 | 5納米 | 5納米 | 5納米 |
| 晶體管 | 76,300百萬 | 31,000百萬 | 45,600百萬 | 45,600百萬 | 92,200百萬 |
| 密度 | 125.3M/平方毫米 | 117.9M/平方毫米 | 120.6M/平方毫米 | 120.6M/平方毫米 | 123.9M/平方毫米 |
| 模具尺寸 | 609平方毫米 | 263平方毫米 | 378平方毫米 | 378平方毫米 | 744平方毫米 |
| 槽寬 | 三槽 | 雙槽 | 2.5插槽 | 雙槽 | 雙槽 |
| 尺寸 | 304 mm x 137 mm x 61 mm | 242毫米×112毫米 | 304 x 126 x 50毫米 | 304 mm x 137 mm x 48 mm | 304 mm x 137 mm x 48 mm |
| TDP | 450W¯¯ | 250W¯¯ | 300W¯¯ | 360W¯¯ | 575W¯¯ |
| 視頻連接 | 1個HDMI 2.1、3個DisplayPort 1.4a | 1 個 HDMI 2.1b、3 個 DisplayPort 2.1a | 1 個 HDMI 2.1b、3 個 DisplayPort 2.1b | 1 個 HDMI 2.1b、3 個 DisplayPort 2.1b | 1 個 HDMI 2.1b、3 個 DisplayPort 2.1b |
| 電源連接器 | 1x 16 針 | 1x 16 針 | 1x 16 針 | 1x 16 針 | 1x 16 針 |
| 總線接口 | PCIe 4.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 |
| 基地時鐘 | 2235 MHz | 2165 MHz | 2300 MHz | 2295 MHz | 2017 MHz |
| 提升時鐘 | 2520 MHz | 2510 MHz | 超頻模式:2482MHz 預設模式:2452MHz(加速時脈) |
2617 MHz | 2407 MHz |
| 記憶時鐘 | 1313 MHz(21 Gbps 有效) | 2209 MHz(28 Gbps 有效) | 1750 MHz(28 Gbps 有效) | 2366 MHz(30 Gbps 有效) | 2209 MHz(28 Gbps 有效) |
| 內存大小 | GB 24 | GB 12 | GB 16 | GB 16 | GB 32 |
| 內存類型 | GDDR6X | GDDR7 | GDDR7 | GDDR7 | GDDR7 |
| 內存總線 | 384位 | 192位 | 256位 | 256位 | 512位 |
| 內存帶寬 | 1.01 TB / s | 672.2 GB / s | 896.0 GB / s | 960.0 GB / s | 1.79 TB / s |
| CUDA核心 | 16,384 | 6,144 | 8960 | 10,752 | 21,760 |
| TMU | 512 | 192 | 280 | 336 | 680 |
| 個ROPs | 176 | 64 | 128 | 128 | 192 |
| SM 計數 | 128 | 48 | 70 | 84 | 170 |
| 張量核心 | 512 | 192 | 280 | 336 | 680 |
| RT核心 | 128 | 48 | 70 | 84 | 170 |
| L1緩存 | 128 KB(每個 SM) | 128 KB(每個 SM) | 128 KB(每個 SM) | 128 KB(每個 SM) | 128 KB(每個 SM) |
| L2緩存 | 72 MB | 40 MB | 64 MB | 64 MB | 88 MB |
| 像素率 | 443.5 G像素/秒 | 160.6 G像素/秒 | 313.9 G像素/秒 | 335.0 G像素/秒 | 462.1 G像素/秒 |
| 紋理速率 | 1,290 GTexel/秒 | 481.9 GTexel/秒 | 686.6 GTexel/秒 | 879.3 GTexel/秒 | 1,637 GTexel/秒 |
| FP16(半) | 82.58 兆次浮點運算 (1:1) | 30.84 兆次浮點運算 (1:1) | 43.94 兆次浮點運算 (1:1) | 56.28 兆次浮點運算 (1:1) | 104.8 兆次浮點運算 (1:1) |
| FP32(浮點) | 82.58 TFLOPS | 30.84 TFLOPS | 43.94 TFLOPS | 56.28 TFLOPS | 104.8 TFLOPS |
| FP64(雙) | 1,290 GFLOPS (1:64) | 481.9 GFLOPS (1:64) | 686.6 GFLOPS (1:64) | 879.3 GFLOPS (1:64) | 1.637 兆次浮點運算 (1:64) |
| 發行價(美元) | $1,599 | $549 | $749 | $999 | $1,999 |
若要深入了解 Blackwell 架構和 50 系列 GPU 的創新之處,請參閱我們先前對RTX 5080和RTX 5090系列顯示卡的兩篇評測。
構建和設計
這張卡尺寸為 12 x 5 x 2 英吋(304 x 126 x 50 毫米),長度與 Founders Editions RTX 5080 和 RTX 5090 相同,但採用更厚的 2.5 槽寬度設計。
為了散熱,華碩採用了三軸風扇設計,帶有雙滾珠軸承,以增強耐用性並保持一致的氣流。該設置由大型散熱器補充,熱管遍布整個卡並配有通風背板和側面,以最大限度地散熱。此外,當 GPU 溫度低於 50°C 時,所有三個風扇都會停止運行,從而可以在不太苛刻的任務或輕度遊戲期間實現靜音運行。一旦溫度超過 55°C,風扇就會自動重新啟動。
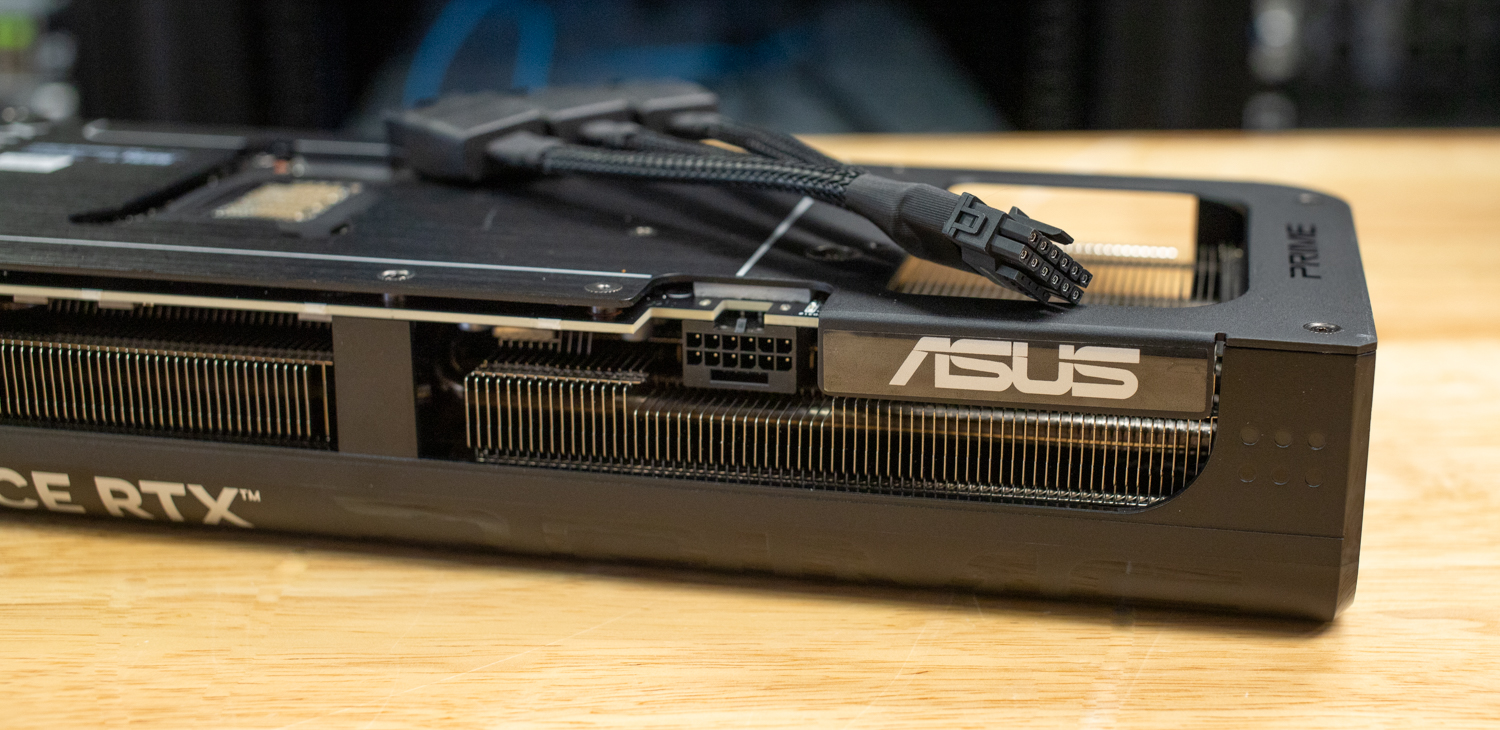 至於電源,與許多較新的卡一樣,該設備包含一個 12 針至 3x 8 針電源線,適合該卡 300W 的額定功率。上圖顯示了該設備的鋁製背板,它可以保護卡片並有助於後部組件的整體冷卻。背板也有助於提高卡片的剛性。
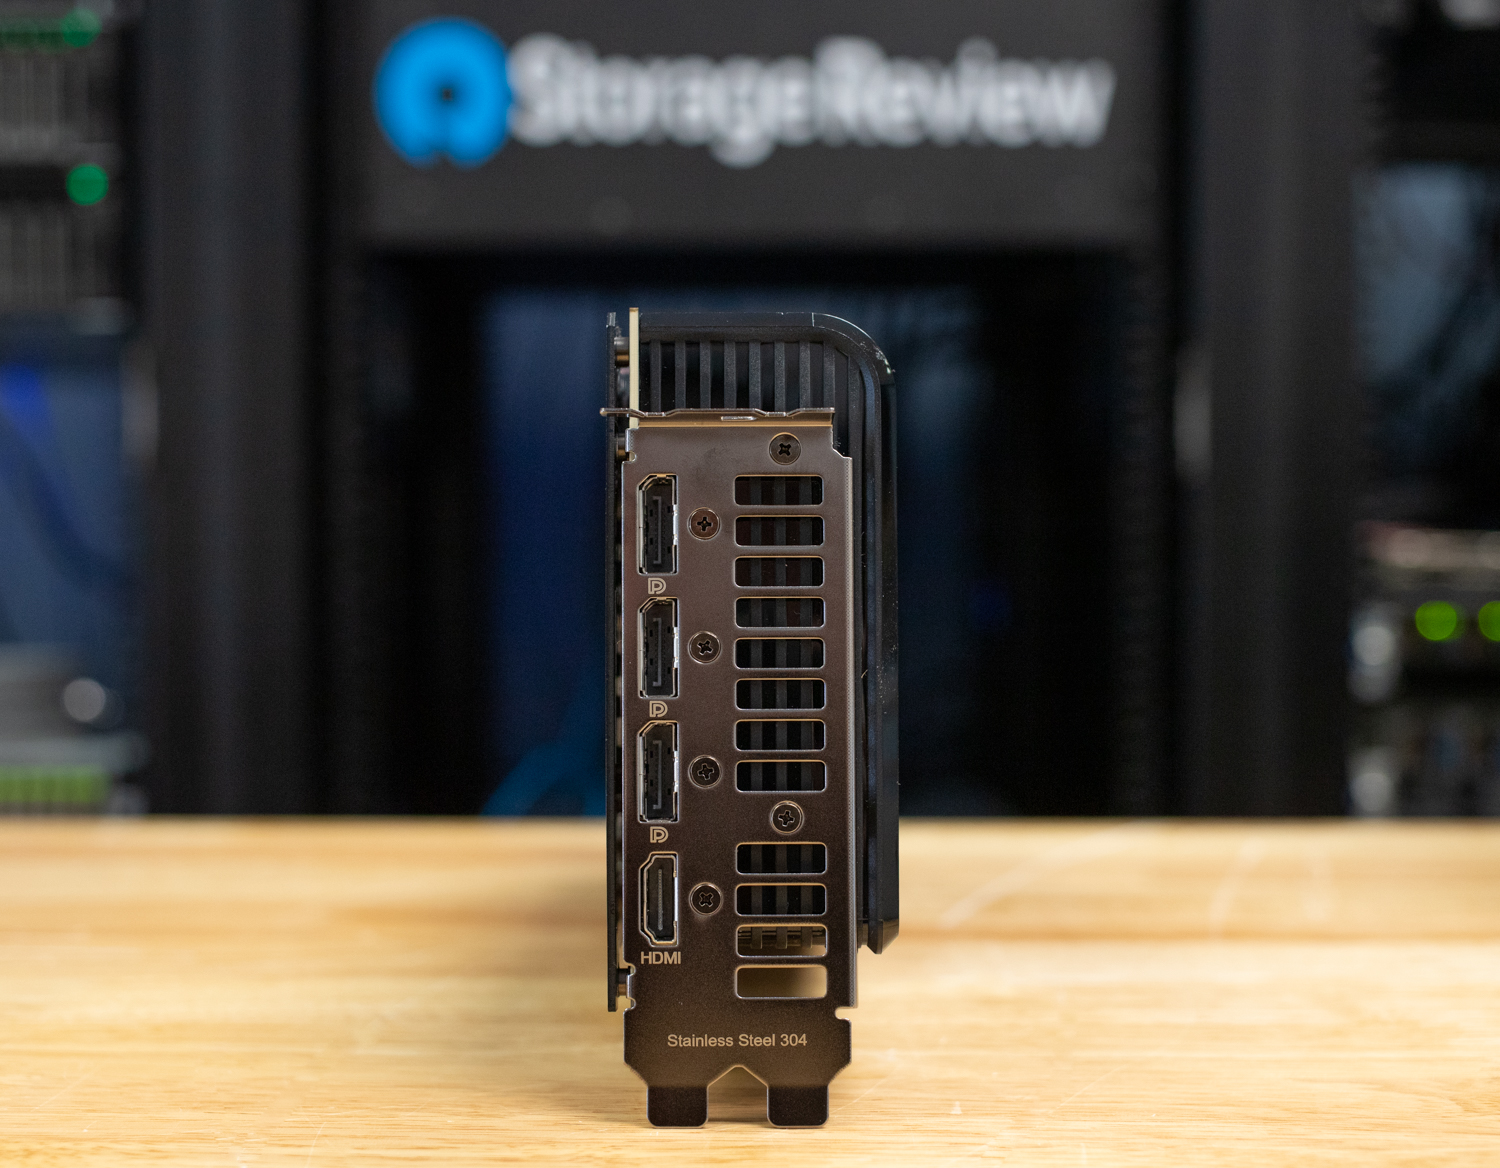
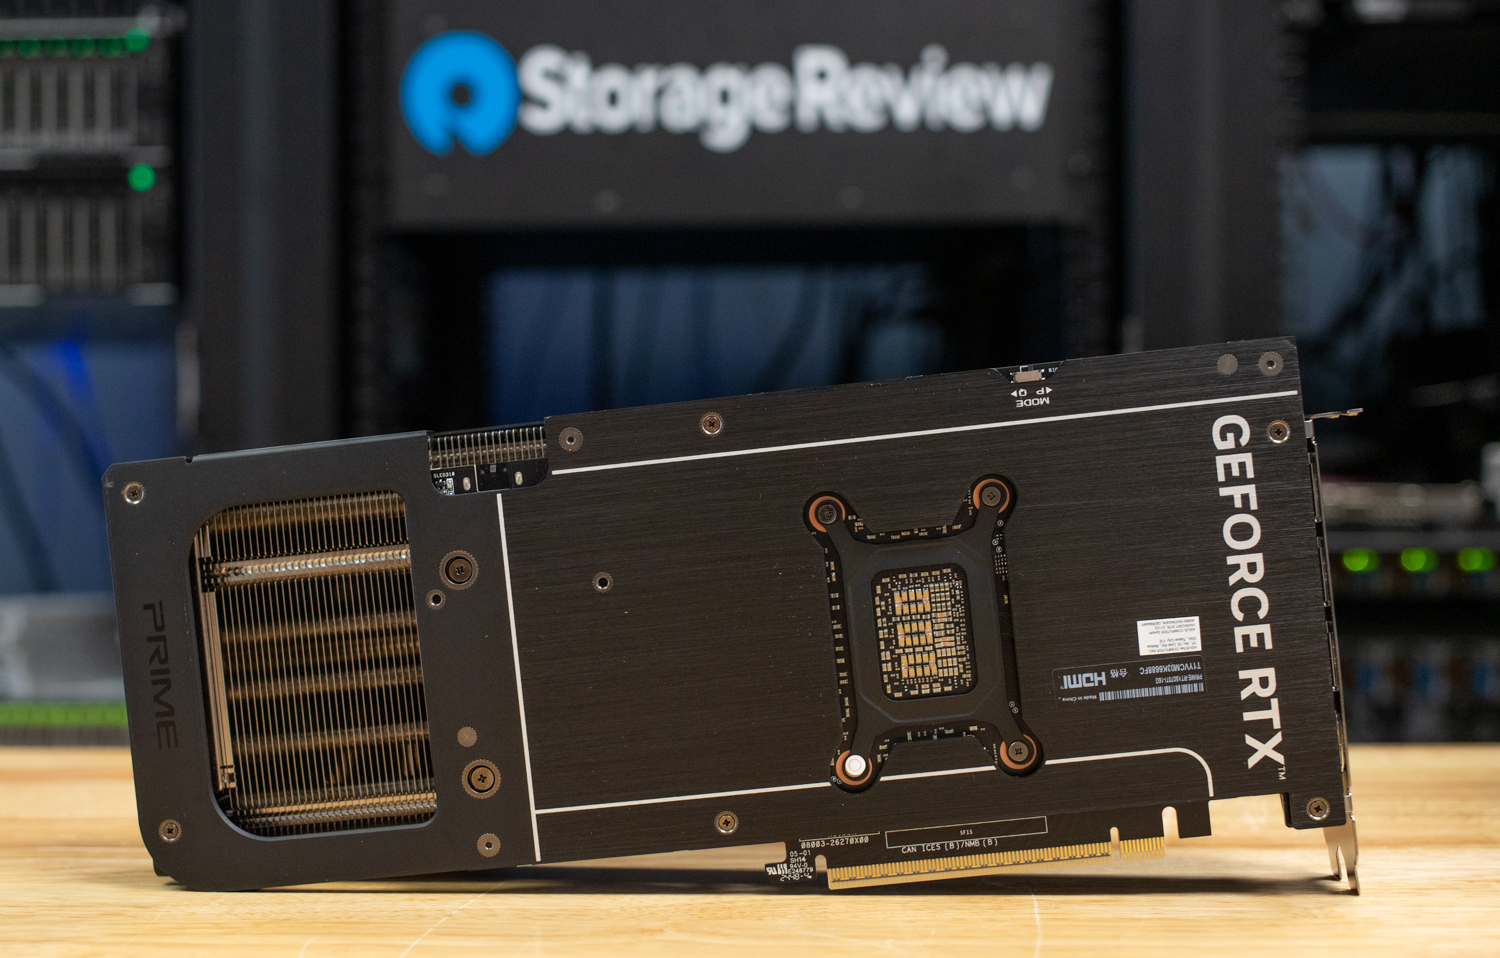
在卡片的背面,我們可以看到雙槽 304 不銹鋼背板,但需要注意的是,由於冷卻器的厚度,該卡佔用了 2.5 個槽。對於顯示連接,該卡提供 1x HDMI 2.1b 和 3x DisplayPort 2.1b,確保與一系列現代顯示器相容,以用於高解析度遊戲或專業工作。
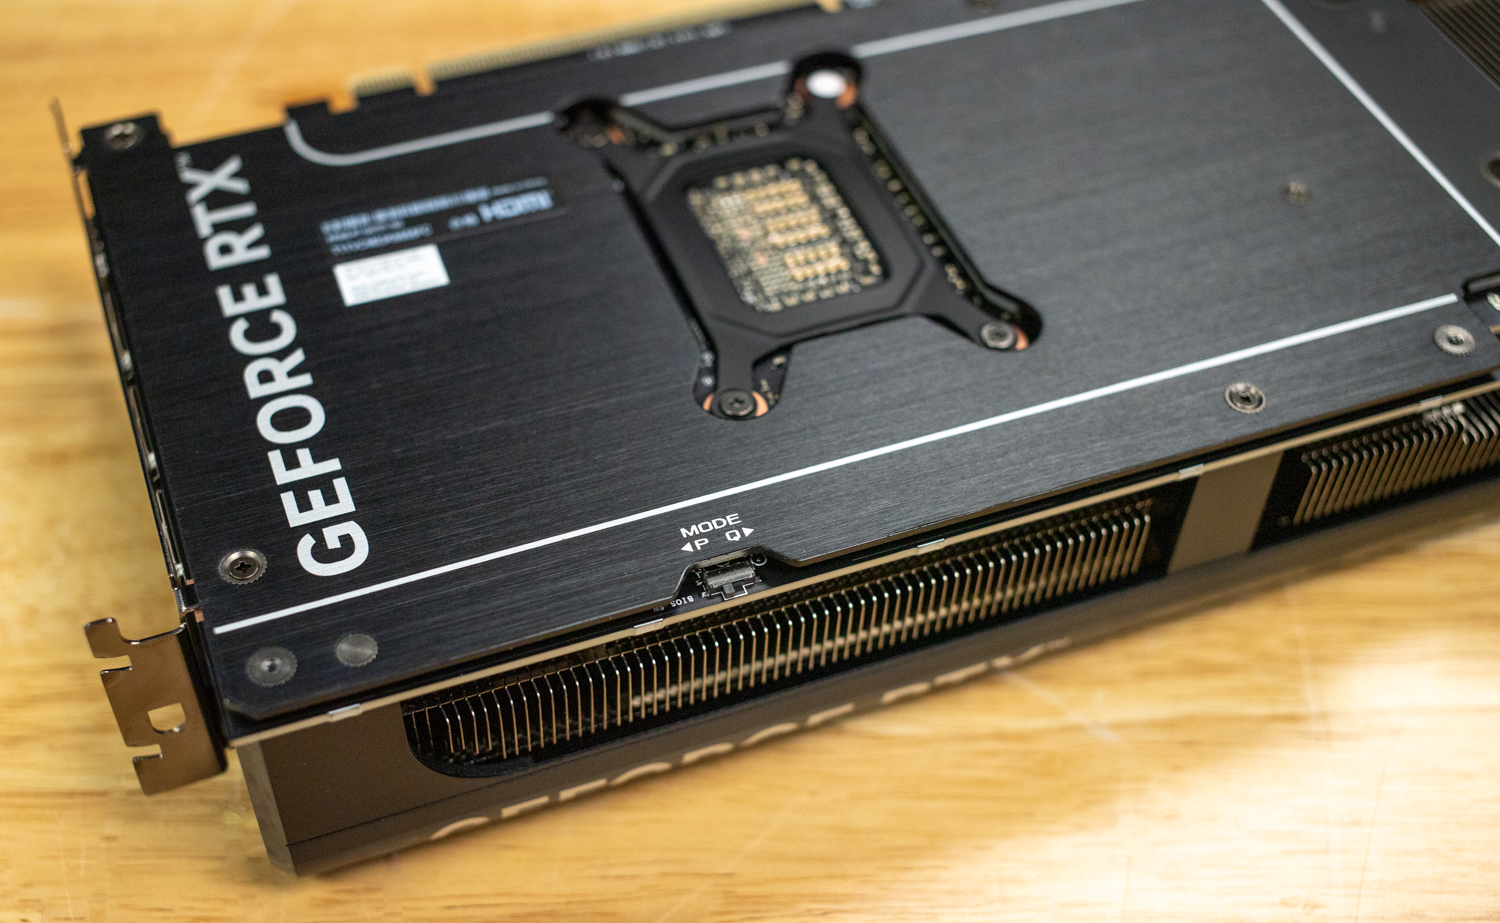
此卡的其他顯著特點包括可切換的 BIOS,透過卡片上的開關進行控制,可在「P」(效能)模式和「Q」(安靜)模式之間切換。該裝置還採用了相變導熱墊,旨在提高冷卻性能和與晶片接觸的導熱材料的壽命。最後,華碩提供 GPU Tweak III 軟體來微調顯示卡的效能以滿足特定要求。
基準測試:華碩 Prime RTX 5070 Ti
為了優化華碩 Prime GeForce RTX 5070 Ti,我們使用了高效能 AMD Threadripper 平台。該系統配備 64 核心 CPU 和客製化水冷循環,可確保 GPU 滿載運行,而不會出現 CPU 瓶頸。使用相同的配置來測試 Founders RTX 5080、RTX 5090 和 RTX 4090,以確保對所有卡片進行公平、一致的比較。需要注意的一個細微之處是,我們的測試是在此卡上以“P”模式進行的。
以下是完整的系統配置。
StorageReview AMD Threadripper 測試平台
- 主板: 華碩 Pro WS TRX50-SAGE WIFI
- 中央處理器: AMD 銳龍 Threadripper 7980X 64 核心
- 隨機存取存儲器: 32GB DDR5 4800MT/秒
- 貯存: 2TB 三星 980 Pro
- 操作系統: Windows 11 Pro for Workstations
- 司機: NVIDIA 571.86 GameReady 驅動程式
UL Procyon:人工智慧文字生成
Procyon AI 文字產生基準測試透過提供簡潔一致的評估方法,簡化了 AI LLM 效能測試。它允許對多個 LLM 模型進行重複測試,同時最大限度地降低大型模型規模和可變因素帶來的複雜性。此基準測試由 AI 硬體領域的領導企業共同開發,優化了本地 AI 加速器的使用,從而實現更可靠、更有效率的效能評估。以下測試結果均使用 TensorRT 進行測試。
| UL Procyon:人工智慧文字生成 | 華碩 Prime NVIDIA RTX 5070 Ti | NVIDIA RTX 5080 | NVIDIA RTX 5090 | NVIDIA RTX 4090 |
| Phi 總分 | 4,179 | 4,400 | 5,749 | 4,958 |
| Phi 輸出到第一個代幣的時間 | 0.290小號 | 0.277小號 | 0.244小號 | 0.255小號 |
| Phi 每秒輸出令牌 | 192.487 令牌/秒 | 209.459 令牌/秒 | 314.435 令牌/秒 | 244.343 令牌/秒 |
| Phi 總持續時間 | 15.771小號 | 14.908小號 | 10.280小號 | 12.872小號 |
| 米斯特拉爾總分 | 4,412 | 4,635小號 | 6,267 | 5,094 |
| 米斯特拉爾輸出第一個令牌的時間 | 0.374小號 | 0.347小號 | 0.297小號 | 0.322小號 |
| 米斯特拉爾每秒輸出令牌 | 160.167 令牌/秒 | 163.598 令牌/秒 | 255.945 令牌/秒 | 183.266 令牌/秒 |
| 米斯特拉爾總持續時間 | 19.480小號 | 18.933小號 | 12.593小號 | 17.010小號 |
| Llama3 總分 | 4,187 | 4,424 | 6,104 | 4,849 |
| Llama3 輸出第一個令牌的時間 | 0.306小號 | 0.283小號 | 0.234小號 | 0.259小號 |
| Llama3 每秒輸出令牌 | 131.853 令牌/秒 | 136.177 令牌/秒 | 214.285 令牌/秒 | 150.039 令牌/秒 |
| Llama3 整體持續時間 | 22.786小號 | 21.985小號 | 14.304小號 | 19.991小號 |
| Llama2 總分 | 4,284 | 4,790 | 6,591 | 5,013 |
| Llama2 輸出第一個令牌的時間 | 0.560小號 | 0.493小號 | 0.419小號 | 0.500小號 |
| Llama2 每秒輸出令牌 | 75.905 令牌/秒 | 83.653 令牌/秒 | 134.502 令牌/秒 | 92.853 令牌/秒 |
| Llama2 整體持續時間 | 39.545s | 35.703s | 23.018小號 | 32.448小號 |
在文字生成測試中,RTX 5070 Ti 是該系列中最實惠的顯示卡,但在 AI 文字生成方面,其效能卻出奇地接近 RTX 5080。 Phi 基準測試得分為 4,179 對 4,400,每秒令牌數(192.487 對 209.46)和總持續時間(15.77 秒對 14.91 秒)略有不同。 Mistral 和 Llama3 基準測試顯示出類似的趨勢,令牌吞吐量的差異可以忽略不計。 Llama2 的差距更大,5070 Ti 的得分分別為 4,284 和 4,790,每秒處理令牌數分別為 75.91 和 83.65 個。不過,在所有測試中,5070 Ti 的效能仍然接近 5080,這使其成為預算有限且希望進入 AI 文字產生工作負載的用戶的絕佳選擇。
UL Procyon: 人工智能圖像生成
Procyon AI 影像產生基準測試能夠持續且準確地衡量各種硬體(從低功耗 NPU 到高階 GPU)上的 AI 推理效能。它包含三個測試:針對高階 GPU 的 Stable Diffusion XL (FP16) 測試、針對中型效能 GPU 的 Stable Diffusion 1.5 (FP16) 測試以及針對低功耗裝置的 Stable Diffusion 1.5 (INT8) 測試。此基準測試會針對每個系統使用最佳推理引擎,確保結果的公平性和可比較性。
| UL Procyon:AI 影像產生(總分:越高越好) | 華碩 Prime NVIDIA RTX 5070 Ti | NVIDIA RTX 5080 | NVIDIA RTX 5090 | NVIDIA RTX 4090 |
| 穩定擴散 1.5 (FP16) — 總體得分 | 3,755 | 4,650 | 8,193 | 5,260 |
| 穩定擴散 1.5 (FP16) — 總時間 | 26.625小號 | 21.503小號 | 12.204小號 | 19.011小號 |
| 穩定擴散 1.5 (FP16) — 影像產生速度 | 1.664 秒/影像 | 1.344 秒/影像 | 0.763 秒/影像 | 1.188 秒/影像 |
| 穩定擴散 1.5 (INT8) — 總體得分 | 46,744 | 55,683 | 79,272 | 62,160 |
| 穩定擴散 1.5 (INT8) — 總時間 | 5.348小號 | 4.490小號 | 3.154小號 | 4.022小號 |
| 穩定擴散 1.5 (INT8) — 影像生成速度 | 0.669 秒/影像 | 0.561 秒/影像 | 0.394 秒/影像 | 0.503 秒/影像 |
| 穩定擴散 XL (FP16) — 總體得分 | 3,352 | 4,257 | 7,179 | 5,025 |
| 穩定擴散 XL (FP16) — 總時間 | 178.946小號 | 140.928s | 83.573小號 | 119.379小號 |
| 穩定擴散 XL (FP16) — 影像產生速度 | 11.184 秒/影像 | 8.808 秒/影像 | 5.223 秒/影像 | 7.461 秒/影像 |
在AI影像生成方面,RTX 5070 Ti表現不俗,但落後於RTX 5080,這是意料之中的。穩定擴散 1.5(FP16)在 1.664 秒內完成一張影像,而 5080 則需 1.344 秒,總分分別為 3,755 和 4,650。 INT8 變體稍微縮小了差距,但 5070 Ti 仍然落後,每張影像生成時間為 0.669 秒,而 5080 則需 0.561 秒。最顯著的差異出現在穩定擴散 XL (FP16) 中,其中 5070 Ti 拍攝每張影像需要 11.184 秒,而 5080 的速度明顯更快,為 8.808 秒。儘管排名較低,但對於想要進入 AI 驅動圖像生成的注重預算的用戶來說,5070 Ti 仍然是一個實用的選擇。
樂士馬克
Luxmark 是一個 GPU 基準測試,它使用開源光線追蹤渲染器 LuxRender 來評估系統在處理高度詳細的 3D 場景方面的效能。此基準測試適用於評估伺服器和工作站的圖形渲染能力,特別是對於視覺效果和建築視覺化應用程序,其中準確的光模擬至關重要。
| Luxmark(越高越好) | 華碩 Prime NVIDIA RTX 5070 Ti | NVIDIA RTX 5080 | NVIDIA RTX 5090 | NVIDIA RTX 4090 |
| 食物評分 | 12,073 | 13,637 | 23,141 | 17,171 |
| 霍爾分數 | 28,635 | 30,815 | 51,725 | 38,887 |
在 LuxMark 中,RTX 5070 Ti 表現穩定,與 5080 相比差距不大。差異相對較小,表明 12,073 Ti 仍然以更實惠的價格提供了強大的渲染能力。
Geekbench 6
Geekbench 6是一款跨平台基準測試軟體,用於衡量系統整體效能。 Geekbench 瀏覽器可讓您將任何系統與 Geekbench 6 進行比較。
| Geekbench(越高越好) | 華碩 Prime NVIDIA RTX 5070 Ti | NVIDIA RTX 5080 | NVIDIA RTX 5090 | NVIDIA RTX 4090 |
| GPU OpenCL 分數 | 246,875 | 265,397 | 374,807 | 333,384 |
在 Geekbench 中,RTX 5070 Ti 的 GPU OpenCL 得分為 246,875,具有穩定的遊戲、影片編輯和內容創作效能。它是一款強大的中端選擇,仍具有潛力,提供良好的性能,而價格卻不像 5080 或 5090 等高端型號那麼高。
的V-Ray
V -Ray基準測試使用先進的 V-Ray 6 引擎,測量 CPU、NVIDIA GPU 或兩者的渲染效能。它採用快速測試和簡單的評分系統,使用戶能夠評估和比較系統的渲染能力。對於尋求高效性能洞察的專業人士而言,它是一款必不可少的工具。
| V-Ray(越高越好) | 華碩 Prime NVIDIA RTX 5070 Ti | NVIDIA RTX 5080 | NVIDIA RTX 5090 | NVIDIA RTX 4090 |
| 虛擬路徑 | 8,018 | 9,311 | 14,764 | 10,847 |
最後,在 V-Ray 中,RTX 5070 Ti 的 V-Ray 分數為 0,018 vpaths,提供了不錯的渲染性能,略低於 5080 的 9,311 vpaths、5090 的 14,764 vpaths 和 4090 的 10,847 vpaths。雖然它顯示出渲染任務的潛力,但高端型號為更複雜的工作負載提供了更快的效能。
功耗基準測試
功耗是任何高端或低端運算平台的重要組成部分。每一代新的 GPU 在負載下都會消耗更多的電量,這意味著需要更大的電源和充足的氣流來冷卻。然而,效能方面還有另一個面向:更快的 GPU 可能會達到更高的峰值,但每個工作負載的持續時間會減少。
在 CES 2025 上,NVIDIA 重點展示了 Blackwell 架構的能源效率提升,我們迫不及待地想在 AI 驅動的工作負載下親眼見證它的實際表現。我們在測試實驗室中使用Quarch Mains Analyzer ,測量了執行Procyon AI Image Generator Stable Diffusion XL FP16 測試時系統的總功耗。此工作負載將每個 GPU 的功耗推至極限,每張生成的影像都有清晰的起始點和停止點。本節將比較新款 GeForce RTX 5090 與上一代 GeForce RTX 4090 與 RTX 6000 Ada 的測試結果。點擊此處連結查看GeForce RTX 5080 的詳細評測。
我們對華碩 PRIME RTX 5070 Ti 進行了功率測試,其功耗額定為 300W。在Procyon AI影像產生測試過程中,系統功耗從閒置狀態的231W上升到負載下的601W,增加了370W。負載下的平均功耗降至約 303W,這很有趣,因為該卡的額定功耗為 300W。
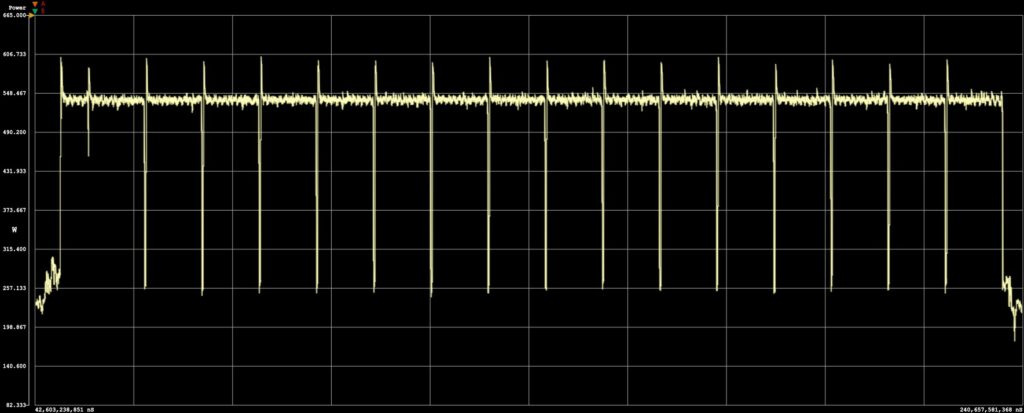
倒數第二張圖像僅用了 11.1 秒就生成,在此期間系統消耗了 1.66Wh。
結語
GeForce RTX 5070 Ti 的突出特點之一是其性能。它在 AI 工作負載中提供了強勁的成果,在許多基準測試中令人驚訝地接近 RTX 5080。對於那些希望物有所值的人來說,這是一個絕佳的選擇,尤其是它配備了 16GB GDDR7,與 GeForce RTX 5080 相匹配。
RTX 749 Ti 的售價為 5070 美元,在性能和功能之間實現了出色的平衡,對於注重預算的用戶來說是一個有吸引力的選擇。但是,該卡的功耗可能超過其額定的 300W,因此您可能需要更強大的電源和冷卻解決方案。此外,雖然它的性能令人欽佩,但在更苛刻的 AI 和渲染任務中確實落後於 RTX 5080 及更高型號。
對於那些尋求功能強大且價格實惠的 GPU 的人來說,強烈推薦華碩 Prime GeForce RTX 5070 Ti。它非常適合 1440p 或 4K 遊戲和入門級 AI 工作負載,具有卓越的價值和 16GB GDDR7,但價格卻不像高階型號那麼高。


 Amazon