

微軟 Surface Laptop Ultra for Business 是首款採用 NVIDIA 晶片的 Surface 筆記型電腦,也是我們評測的首款搭載 RTX Spark 處理器的系統。我們評測的這款機型配備了完整的晶片:一顆 20 核 Grace Arm CPU、一顆 6,144 核 Blackwell RTX GPU 以及 128GB LPDDR5X 統一內存,用戶最多可將 96GB 內存分配給 GPU。微軟面向消費者的商店列出的配置價格從 2,599.99 美元(18 核心 CPU、24GB 記憶體、512GB SSD)到 5,899.99 美元(20 核心 CPU、128GB 記憶體、1TB SSD)不等。我們評測的這款商用配置的價格在撰寫本文時尚未公佈。
本評測涵蓋了N1X在基準測試中的表現:包括本地AI、CPU、內存、遊戲性能、散熱和存儲,並與四款目前在售的x64筆記本電腦進行對比,這些筆記本電腦分別搭載了英特爾Panther Lake和Arrow Lake H處理器、AMD Strix Point處理器以及筆記本電腦 PROTX 50900RTX 50900RTX 50900。設計、顯示器、鍵盤、電池續航力以及其他硬體方面的體驗將在實驗室完成機殼測試後進行後續評測,因此本文主要介紹平台和測試數據。
這款20核心N1X處理器幾乎贏得了所有多執行緒CPU測試,通常領先30%甚至更多。它還允許用戶為NVIDIA GPU分配64GB顯存,比以往任何一款NVIDIA筆記型電腦GPU都要多,這使得它能夠以可用速度運行一個35億參數的模型。儘管如此,持續的全核雙精度計算在一個晚上就導致這台筆記型電腦的功耗下降了三次,此前的一台評測樣機也出現了同樣的問題,不得不更換。因此,散熱系統比以往更為關鍵。
關鍵要點
- 64GB 的 GPU 記憶體(可擴充至 96GB)會影響執行的程式: gpt-oss:20b 和 Qwen3.6-35B-A3B 的載入和產生速度均為每秒 58 至 89 個代幣;Blade 16 的 RTX 5090 在任何能裝下 24GB 記憶體的程式上速度都比它快 2.3 倍,但對於更大的型號則不適用。
- 該組中速度最快的多核心CPU: 在 Cinebench 2026 多核心測試中,其得分為 6,963,比 Razer Blade 16 高出 34%,比 Dell Pro Precision 5 16S 高出 47%,LLVM 編譯時間為 206 秒,而速度第二快的系統則需要 327 秒。
- 122GB/s 的記憶體頻寬,但會帶來延遲: STREAM Triad 達到了 122,114MB/s,比 Precision 5 16S 高出 48%,而 251 ns 的內存延遲和 172 ns 的核心間延遲是該組中最差的,並且在單線程工作中表現出來。
- 一項工作負載會導致斷電: 10 月 14 日,在 N=20000 的情況下進行全核 OpenBLAS LU 求解時,設備溫度達到 95°C 時斷電三次。此前,在其他測試中,該晶片曾在 98°C 下保持 31 分鐘。目前已有兩台 Surface Laptop Ultra 出現相同故障;日誌顯示問題出在電源供應或韌體保護機制上,而非過熱。
- Windows on Arm 支援隨機 I/O: 第五代 SK 海力士硬碟的順序讀取速度為 14.1GB/s,原始裝置讀取速度為 1.67M IOPS,但透過 NTFS 和 BitLocker 加密後,4K 隨機 I/O 速度接近 300K IOPS,低於 x64 系統的一半。
RTX Spark N1X 平台
RTX Spark 是 NVIDIA 為基於 N1X 超級晶片的 Windows PC 系列顯示卡命名的名稱,它是DGX Spark中 GB10 的筆記型電腦和緊湊型桌上型電腦版本。我們在六月的台北電腦展上報道了該系列顯示卡,並在上週的預售活動中公佈了其發布詳情,因此本節將重點介紹有助於理解測試結果的關鍵信息。

NVIDIA 提供兩款筆記型電腦版 N1X 處理器;頂級配置搭載 20 核心 Grace CPU、6,144 核心 Blackwell RTX GPU 以及最高 128GB LPDDR5X 記憶體;次頂級配置則搭載 18 核心 CPU 和 5,120 核心 GPU,最高記憶體為 64GB。兩款處理器的 TDP 均為 45 至 80W(CPU 和 GPU 的總功耗),而桌上型 N1X 和 GB10 的 TDP 則高達 140W。我們評測的 Surface 搭載的是 20 核心 CPU,Windows 系統顯示其由 10 個高速核心和 10 個能源效率核心組成,不支援 SMT(同步多執行緒)。
記憶體是這款平台區別於本次評測中所有 x64 筆記型電腦的關鍵所在:一塊 128GB 的 LPDDR5-9400 記憶體池透過 NVLink-C2C 技術為晶片的兩部分供電,在 256 位元介面下,9,400 MT/s 的讀寫速度相當於約 300GB 的讀寫速度。 Windows 系統將其識別為獨立顯示卡,具有固定的專用記憶體分配和共享記憶體池。
在我們的測試機上,我們將顯存分配設定為 64/64:測試套件測得 GPU 可用顯存為 62.5GB,這符合我們本地 AI 模型測試的兩個層級的要求。 LPDDR5X 記憶體容量可透過 NVIDIA 應用程式進行使用者調整,但顯然受限於購買系統時選擇的總容量。因此,如果您無法將相同容量的 AI 模型載入到記憶體中,那麼 32GB 或 48GB 的 Surface 在 AI 基準測試中將無法獲得相同的結果。
這款GPU採用Blackwell架構,配備第五代Tensor Core和第四代RT Core,一個第九代NVENC編碼器和一個第六代NVDEC編碼器,以及NVIDIA慣用的「高達1 petaflop」的FP4運算能力。微軟的腳註將其描述為考慮稀疏性情況下的理論FP4 TOPS。本次評測中所有NVIDIA端的測試均使用原生Arm64架構的llama.cpp和Ollama程序,並運行在CUDA環境下,驅動程式版本為32.0.16.1742。
Windows 是該平台的另一個重要組成部分。 Surface 運行的是基於 Arm64 架構的 Windows 11 專業版 26H1,因此 x64 應用程式透過 Prism 模擬器運作。我們使用原生 Arm64 二進位檔案建構了整個客戶端套件,讓 CPU 測試結果就能直接比較晶片本身的效能,而不是轉換層的效能。如果原生 Arm64 移植版本尚不成熟,或者 x64 建置是唯一選擇,我們會在結果中加以說明,因為這些情況會影響以下幾行的測試結果。
微軟 Surface Laptop Ultra 商用版規格

| 規格 | 微軟 Surface Laptop Ultra 商用版 |
|---|---|
| 平台概述 | |
| 處理器 | NVIDIA RTX Spark N1X,20 核心 Grace CPU 搭配 6,144 核心 Blackwell RTX GPU(測試機型) NVIDIA RTX Spark N1X,18 核心 Grace CPU 搭配 5,120 核心 Blackwell RTX GPU |
| NPU | NVIDIA NPU |
| 記憶體應用 | 24GB、32GB、48GB、64GB 或 128GB LPDDR5X 統一內存 128GB LPDDR5-9400,64/64GB 韌體分割(經測試) |
| 儲存 | 可拆卸固態硬碟:512B(PCIe Gen4)、1TB 或 2TB(PCIe Gen5) 1TB SK 海力士 HFS001TFM9X189N,第五代 x4(經測試) |
| 操作系統 | Windows 11 專業版 (Arm64);24GB 設定下為 Windows 11 家用版 |
| 顯示和 I/O | |
| 顯示螢幕 | 15 吋 PixelSense Ultra 觸控屏,解析度 3270 x 2180,最高 120Hz 更新率,100% DCI-P3 色域,支援 Dolby Vision IQ 1,000 尼特 SDR(典型值),2,000 尼特 HDR 峰值(微軟資料) |
| 連接埠數量 | 2 個 USB-C / USB4 接口 1 個帶磁吸連接的 USB-C / USB4 接口 1x HDMI 2.1b 1x USB-A 3.1 SD讀卡器 3.5mm耳機插孔 |
| 無線應用 | Wi-Fi 7(聯發科 MT7925)、藍牙 |
| 相機 | 1080p全高清 |
| 力量和體能 | |
| 電池續航力(微軟官方數據) | 最多可播放 15 小時本地視頻 最多 12 小時活躍網路使用時間 (預生產版 20 核心、64GB、1TB,亮度 150 尼特) |
| 充電 | USB-C;支援115W或更高功率的Surface或USB-C PD電源快速充電 |
| 重量 | 4.41磅(2.0公斤) |
| 顏色 | 白金,夜幕降臨 |
| 安全與定價 | |
| 安全性 | 安全核心 PC、Windows Hello、裝置加密(我們的裝置採用 BitLocker XTS-AES-128) |
| 價格(微軟消費者商店) | 售價從 2,599.99 美元(18 核、24GB、512GB)到 5,899.99 美元(20 核、128GB、1TB,測試機型) |


測試設定和方法
我們的評測機搭載了 RTX Spark N1X 顯示卡,配備 6,144 核心 Blackwell GPU、128GB LPDDR5-9400 記憶體(系統和 GPU 各佔 64% 記憶體)、1TB SK 海力士 Gen5 SSD 固態硬碟,運行 Windows 11 專業版 26H1 (Arm64H64 專業版作業系統。基準測試在最佳性能電源模式下進行,並連接電源。電池續航力測試結果將在後續硬體評測中一同發布。

在本次對比測試中,所有系統均運行了我們編寫的 Windows 用戶端基準測試套件 sr-client 1.2 的完整運行模式和峰值模式。每台系統均使用原廠 Windows 鏡像,並安裝了 OEM 提供的驅動程式和實用程序,設定為廠商的最佳效能模式,且已連接電源。此測試套件採用相同的實驗室設定:Windows 電源模式設定為“最佳效能”,顯示器亮度設定為 50%,所有睡眠和顯示器關閉計時器均已停用,Windows 防火牆和 UAC 提示也已關閉。測試過程全程無人值守;每個結果均為多次運行的中位數,如果測試結果的偏差超過 2%,則該套件會重新運行測試才會接受該結果。
該套件使用原生 Arm64 和 x64 二進位檔案編寫,支援所有開源工作負載,以便 Surface 能夠在晶片上與其他產品競爭。
| 系統 | 中央處理器 | 記憶體應用 | GPU 用於 GPU 和 AI 測試 | SSD | 作業系統和效能模式 |
|---|---|---|---|---|---|
| 微軟 Surface Laptop Ultra | NVIDIA RTX Spark N1X,20核心/20線程 | 128GB LPDDR5-9400(64/64 分割) | 6,144 核心 Blackwell RTX(整合式顯示卡,可用記憶體 62.5GB) | SK海力士HFS001TFM9X 1TB,第五代 x4 | Windows 11 專業版 26H1 (Arm64),最佳效能 |
| 戴爾專業版 Precision 5 16S | 英特爾酷睿Ultra X9 388H,16核心/16線程 | 64GB LPDDR5-8533 | 英特爾 Arc Pro B390(整合) | SK海力士PCB01 1TB,第五代 x4 | Windows 11 專業版 25H2 (x64),戴爾優化器 Ultra Performance |
| 戴爾 Pro 7 14 | AMD Ryzen AI 9 HX PRO 470,12核心/24線程 | 64GB LPDDR5-8000 | AMD Radeon 890M(整合式顯示卡,32GB VGM) | 三星 BM9C1a 1TB,第四代 x4 | Windows 11 專業版 25H2 (x64),戴爾散熱設定檔效能 |
| Razer Blade 16 | AMD Ryzen AI 9 HX 370,12核心/24線程 | 32GB LPDDR5-8000 | NVIDIA GeForce RTX 5090 筆記型電腦顯示卡,24GB | 三星 MZVL22T0 2TB,Gen4 x4 | Windows 11 家用版 25H2 (x64),Razer Synapse 效能 |
| 戴爾 Pro Max 14 Premium | 英特爾酷睿Ultra 9 285H,16核心/16線程 | 64GB LPDDR5-8400 | NVIDIA RTX PRO 2000 Blackwell 筆記型電腦顯示卡,8GB | SK海力士PC811 2TB | Windows 11 專業版 25H2 (x64),戴爾優化器 Ultra Performance |
表格中反覆出現三個標籤,前兩個標籤之間的差異對於理解人工智慧部分至關重要。 DNF 表示測試在該系統上啟動但未完成,或因失敗而被跳過,在本評測中,這適用於 Surface 的 OpenBLAS 運行和 Dell Pro 7 14 的代理 MLPerf 場景。
「未運行」表示測試套件拒絕啟動測試,因為硬體不符合要求,最常見的原因是模型超過了系統可提供的GPU內存;戴爾Pro Max 14 Premium的可用GPU內存僅為7.7GB,因此無法參加所有模型負載和代理測試,而Blade 16的24GB內存也使其低於我們的M級機型。 「不適用」表示此測試不適用,例如在不支援SMT的晶片上進行SMT單核心測試。
本地人工智慧效能
這些筆記型電腦上的本地AI性能歸根結底取決於兩個問題:GPU運行模型的速度,以及模型是否適合其記憶體。 Blade 16的RTX 5090在第一個問題上表現最佳,其24GB記憶體容量下所有適配的模型,產生令牌的速度約為Surface的2.3倍。 Surface則在第二個問題上表現出色,因為它將64GB的統一記憶體分配給了GPU,是唯一能夠以可用速度運行我們測試的M級模型的系統。
Pro Max 14 的 8GB RTX PRO 2000 顯示卡在小型 Surface 機型上可以跟上 Surface 的運行速度,但對於大型機型來說就太小了,而兩個集成 GPU 的 x64 系統雖然運行速度較慢,但可以運行所有程式。
MLPerf 用戶端 v2.0
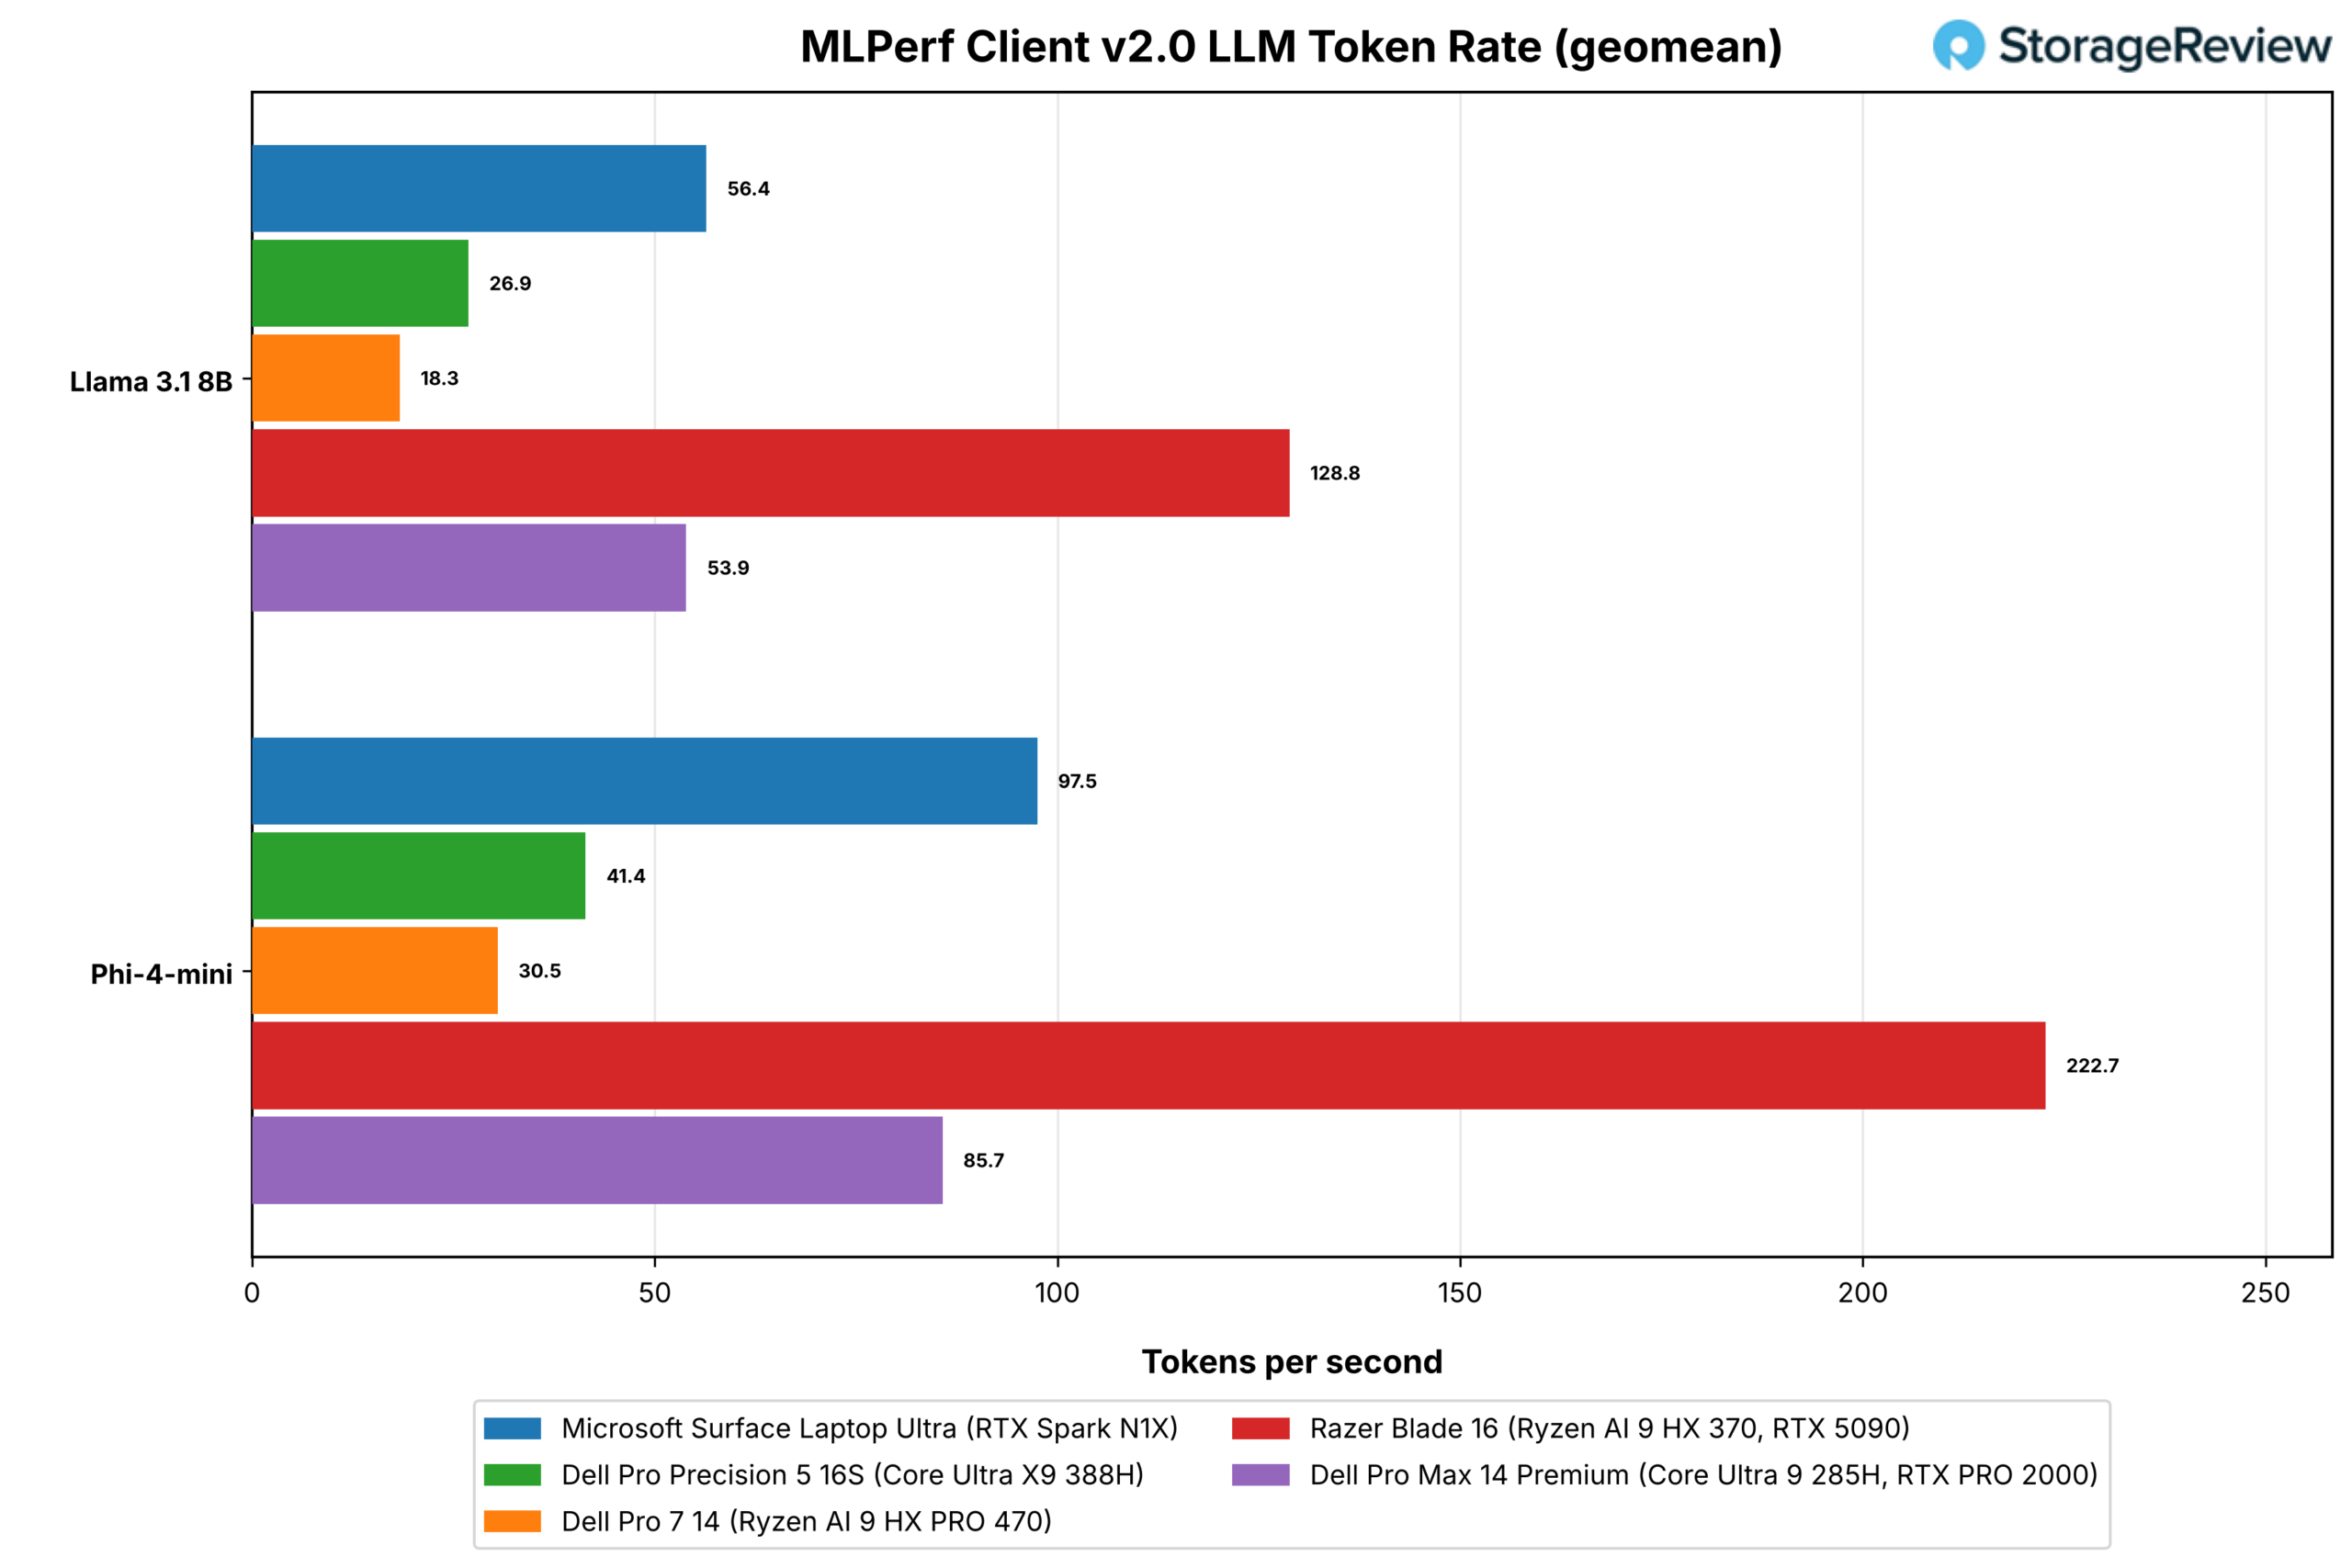
MLPerf 用戶端運行 Llama 3.1 8B 和 Phi-4-mini 引擎,測試五種提示類別(內容生成、創意寫作、摘要、結構化文字和程式碼分析),並報告首次詞元出現時間和首次詞元出現後的詞元出現率(以幾何平均值表示)。每個系統使用其廠商提供的 GPU 路徑:Precision 5 16S 使用 Intel OpenVINO,Pro 7 14 使用 AMD 的 Windows ML 和 DirectML,而三個 NVIDIA 系統則使用 llama.cpp 和 CUDA。因此,引擎各不相同,各行數據比較的是各平台出廠時的性能。
| MLPerf 用戶端 v2.0 | Surface Laptop Ultra | 戴爾專業版 Precision 5 16S | 戴爾 Pro 7 14 | Razer Blade 16 | 戴爾 Pro Max 14 Premium |
|---|---|---|---|---|---|
| Llama 3.1 8B,首次到達令牌的時間,幾何平均值(秒,越低越好) | 0.284 | 0.214 | 3.140 | 0.149 | 0.439 |
| Phi-4-mini,首次令牌到達時間,幾何平均值(秒,越低越好) | 0.127 | 0.181 | 1.954 | 0.074 | 0.212 |
| 數據分析代理,端到端(s,數值越低越好) | 52.6 | 84.7 | 地下城與勇士 | 27.8 | 61.8 |
| 數據分析代理,代幣速率(tok/s) | 48.9 | 25.6 | 地下城與勇士 | 108.3 | 45.4 |
| SWE Agent,端對端(s,數值越低越好) | 46.0 | 65.6 | 地下城與勇士 | 24.6 | 52.6 |
| SWE 代理,代幣速率(tok/s) | 46.4 | 25.0 | 地下城與勇士 | 102.5 | 42.8 |
Blade 16 在 Llama 3.1 8B 測試中速度達到 128.8 tok/s,在 Phi-4-mini 測試中速度達到 222.7 tok/s,分別是 Surface 的 56.4 tok/s 和 97.5 tok/s 的 2.3 倍。 Pro Max 14 的 RTX PRO 2000 顯示卡頻寬遠不及 5090,但在 Llama 3.1 測試中速度仍與 Surface 相差不到 5%,在 Phi-4-mini 測試中差距也小於 12%,這表明 N1X 集成顯示卡的性能表現與同尺寸機型的小型獨立顯卡相當。
在整合的 x64 GPU 中,Precision 5 16S 的 Arc Pro B390 在 Llama 3.1 上產生第一個令牌的速度很快,但令牌產生速度只有 Surface 的一半,而 Pro 7 14 的 DirectML 路徑速度最慢,第一個令牌的生成耗時 3.1 秒。
MLPerf 的代理場景分別運行 Llama 3.1 8B 作為軟體工程代理和資料分析代理,每個代理都會在多個回合中呼叫工具。 Blade 16 在 28 秒內完成了這兩個場景,耗時僅為 Surface 的一半,Precision 5 16S 的三分之一。 Pro 7 14 未能完成這兩個場景:即使為 GPU 預留了 32GB 內存,DirectML 在執行代理提示時仍然耗盡了內存,因此運行失敗,並被標記為 DNF(未完成)。
模型加載
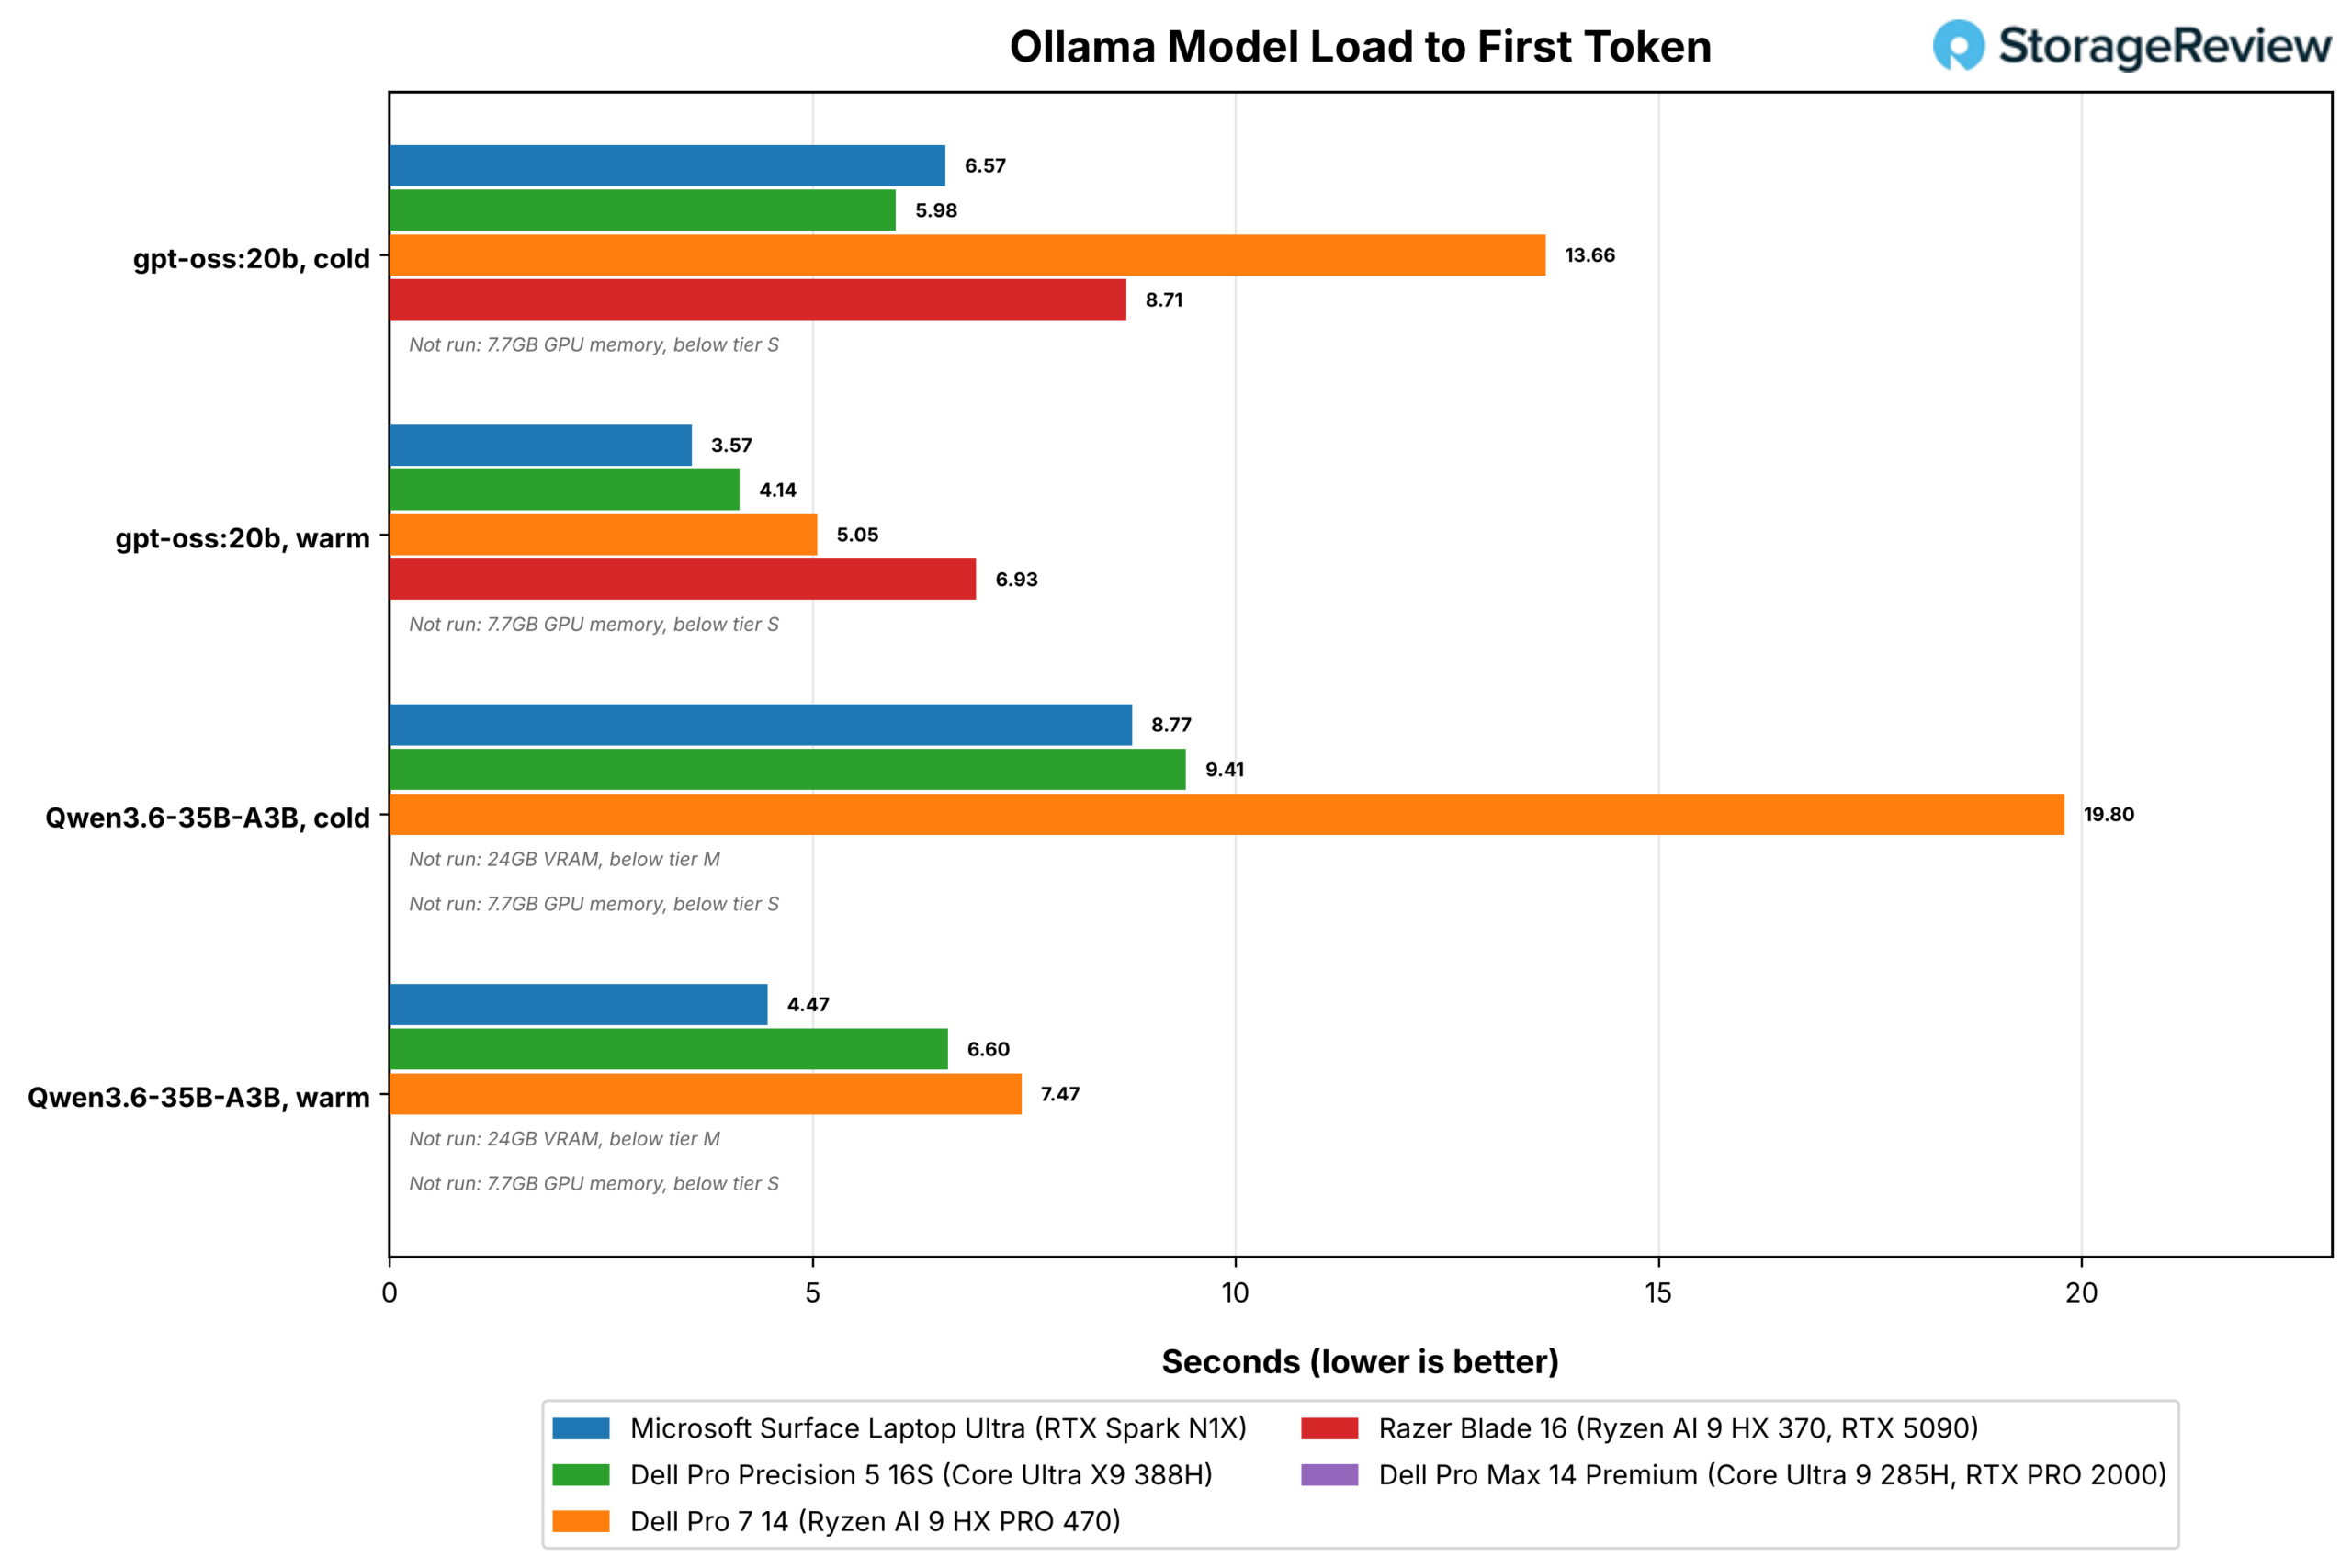
此測試記錄本地模型從 SSD 讀取到在 Ollama 中產生第一個令牌所需的時間,分別在冷啟動(檔案快取已清空)和熱啟動(檔案已在記憶體中)兩種情況下進行,並報告讀取過程中 SSD 的速度。 S 級測試在至少擁有 16GB GPU 可用記憶體的系統上使用 gpt-oss:20b 分區表(12.8GB);M 級測試在擁有約 40GB 或更多 GPU 可用內存的系統上添加了 Qwen3.6-35B-A3B 分區表(21.1GB)。交換分區測試載入 Qwen3.6 分區表,切換到 gpt-oss 分區表,並記錄傳回 Qwen3.6 分區表所需的時間。
| 模型載入(記憶體映射開啟) | Surface Laptop Ultra | 戴爾專業版 Precision 5 16S | 戴爾 Pro 7 14 | Razer Blade 16 | 戴爾 Pro Max 14 Premium |
|---|---|---|---|---|---|
| gpt-oss:20b,冷載期間的讀取吞吐量(MB/s) | 3,080 | 3,251 | 1,246 | 3,874 | 未運作(7.7GB GPU 記憶體) |
| Qwen3.6-35B-A3B,模型切換後重新載入(s,數值越低越好) | 5.01 | 13.38 | 22.38 | 未運作(24GB 顯示存,低於 M 級) | 未運作(7.7GB GPU 記憶體) |
冷加載測試是對儲存效能的考驗,兩款第五代系統均表現優異:Precision 5 16S 僅用 5.98 秒就完成了 gpt-oss:20b 的第一個令牌加載,而 Surface 則用了 6.57 秒。 Surface 在所有熱加載和 Tier M 測試中都勝出,並且在交換後僅需 5.0 秒即可恢復到 Qwen3.6 版本,而 Precision 則需要 13.4 秒,這得益於 Surface 將兩個模型都駐留在 64GB 的 GPU 內存中。 Blade 16 讀取模型檔案的速度最快,達到 3.9GB/s,但完成第一個令牌載入的時間較晚,這是因為權重需要透過 PCIe 傳輸到顯存,而統一記憶體系統則可以在讀取後立即將其載入到位。
Blade 16 和 Pro Max 14 缺少的幾行資料與記憶體有關。 Blade 16 的顯存只有 24GB,不符合 M 級內存的要求;而 Pro Max 14 的可用顯存僅為 7.7GB,根本達不到任何內存等級,因此測試套件沒有對它們進行相關測試。 Pro Max 14 的固態硬碟(其寫入問題已在儲存部分討論過)的讀取速度僅為 1.2GB/s,冷啟動耗時 13.7 秒。
編碼代理
Codex CLI 透過一個固定程式碼庫中的固定編碼任務驅動由 Ollama 提供的本機模型;當程式碼庫中的 11 個測試全部通過時,執行即告成功。我們報告三次運行的平均耗時、成功運行次數以及生成速率。用戶旁代理測試同時運行代理程式和 Speedometer,並報告與單獨運行相比,它們各自的速度下降了多少。如果代理商在您工作時運行,那麼速度下降的程度就至關重要。

| Codex CLI 編碼代理 | Surface Laptop Ultra | 戴爾專業版 Precision 5 16S | 戴爾 Pro 7 14 | Razer Blade 16 | 戴爾 Pro Max 14 Premium |
|---|---|---|---|---|---|
| S級,gpt-oss:20b 64K:運行時間(秒,數值越低越好) | 191.8 | 584.2 | 376.0 | 64.4 | 未運作(7.7GB GPU 記憶體) |
| S級:成功(3次) | 3 | 3 | 2 | 2 | 未運行 |
| Tier M,gpt-oss:20b 128K:運行時間(秒,數值越低越好) | 87.5 | 276.1 | 585.4 | 未運行(M級以下) | 未運行 |
| Tier M,gpt-oss:20b 128K:成功(共 3 次) | 2 | 2 | 3 | 未運行 | 未運行 |
| M級,Qwen3.6-35B-A3B 64K:牆內時間(秒,越低越好) | 88.6 | 351.7 | 678.2 | 未運行(M級以下) | 未運行 |
| M級,Qwen3.6-35B-A3B 64K:成功(共3次) | 3 | 3 | 3 | 未運行 | 未運行 |
| 代理人旁邊的速度表(分數) | 18.1 | 26.6 | 19.2 | 36.3 | 未運行 |
| 速度表在代理旁邊變慢(x,數值越低越好) | 1.92 | 1.61 | 1.92 | 1.06 | 未運行 |
| 速度表旁邊的代理減速(x,數值越低越好) | 1.10 | 1.00 | 1.11 | 1.05 | 未運行 |
Blade 16 以 137.9 tok/s 的速度在 64 秒內完成了 S 級任務,比 Surface 快三倍,比 Precision 5 16S 快九倍,儘管它在三次測試中只贏了兩次,而 Surface 和 Precision 都贏了三次。在 M 級任務中,Surface 在 90 秒內完成了兩項任務,比 Precision 5 16S 快三到四倍,比 Pro 7 14 快七到八倍,後者每項任務需要 10 到 11 分鐘。實際運行時間也取決於模型呼叫工具的次數,因此生成速率是更準確的硬體資料。
並發測試充分展現了獨立顯示卡的優勢。在執行代理程式的情況下,Blade 16 的瀏覽器得分下降了 6%,因為模型運行在 RTX 5090 顯示卡上,無需佔用 CPU 資源。而在 Surface 上,由於代理程式與其他元件共享整合式顯示卡和記憶體總線,Speedometer 分數幾乎減半,從 34.7 降至 18.1,Pro 7 14 的得分也下降了相同的幅度。代理程式本身在任何系統上對瀏覽器的佔用都微乎其微。
檢索增強生成
我們的 RAG 測驗使用 nomic-embed-text 嵌入了 20,963 段 SQuAD v1.1 文章,針對 2,000 個問題分別提取出前五段文章,並使用 Phi-4-mini 模型進行解答,根據答案與參考答案的完全匹配度和 F1 值進行評分。所有系統都運行相同的小型模型,因此這是純粹的速度比較。

| 抹布 | Surface Laptop Ultra | 戴爾專業版 Precision 5 16S | 戴爾 Pro 7 14 | Razer Blade 16 | 戴爾 Pro Max 14 Premium |
|---|---|---|---|---|---|
| 攝取牆壁時間,20,963 次(秒,越低越好) | 189.8 | 271.7 | 425.9 | 131.0 | 153.9 |
| 檢索查詢時間,p50(毫秒,數值越低越好) | 23.4 | 22.2 | 31.3 | 20.9 | 21.6 |
| 答案,Phi-4-mini 首次令牌到達時間,p50(秒,越低越好) | 0.161 | 0.855 | 1.527 | 0.109 | 0.260 |
| 回答,快速處理(tok/s) | 6,955 | 2,151 | 863 | 11,560 | 4,031 |
| 問題回答,p50(s,越低越好) | 0.235 | 0.997 | 1.688 | 0.159 | 0.341 |
| 答案 F1 (%) | 73.97 | 74.24 | 74.36 | 74.47 | 74.40 |
Blade 16 導入語料庫耗時 131 秒,回答典型問題只要 0.16 秒,比 Precision 5 16S 快六倍。 Pro Max 14 導入語料庫耗時 154 秒,排名第二,領先 Surface 的 190 秒,因為 8GB 記憶體對於嵌入式機型和 Phi-4-mini 來說已經足夠。所有系統的準確率均在 F1 的 0.5 個百分點以內,這與相同型號在 0 溫度下的預期結果一致,因此這些筆記型電腦在 RAG 測試中的唯一區別在於等待時間。
CPU性能
兩大平台決定了CPU的測試結果:Surface的20核心N1X處理器幾乎在所有多執行緒測試中都拔得頭籌,通常領先30%甚至更多;而戴爾Pro Precision 5 16S搭載的Core Ultra X9 388H處理器則是單線程速度最快的x64 CPU,並在Ppenhon、瀏覽器中表現和領先。相較之下,雷蛇Blade 16的Ryzen AI 9 HX 370處理器在Stockfish和GROMACS測試中勝出,並在大多數渲染和構建測試中位列第二;戴爾Pro 7 14和戴爾Pro Max 14 Premium則在全核性能測試中落後。
Cinebench 2026 和持續負載
Cinebench 2026 使用 Maxon 的 Redshift 引擎在 CPU 上渲染場景,並分別測試單核心、SMT 單核心(一個實體核心上執行兩個執行緒)和多核心的吞吐量。隨後,我們進行一個持續循環測試,重複多核心運行約 30 分鐘,並將穩定狀態的得分與第一次運行的得分進行比較,以此來展示筆記型電腦在過熱後表現下降的程度。

Surface 的多核心跑分達到 6,963 分,比 Blade 16 高出 34%,比 Precision 5 16S 高出 47%。單核跑分方面,Surface 以 558.5 分略勝 Precision 5 16S 一籌,後者為 534.8 分。兩款 AMD 晶片在單線程跑分方面表現落後,Blade 16 為 480.0 分,Pro 7 14 為 464.4 分,分別比 Surface 低 16% 和 20%。 SMT 單核心技術僅適用於這兩款產品,其中 Pro 7 14 的第二個執行緒分別提升了 33% 和 38% 的效能。
持續循環測試比原始分數更能反映各款筆記型電腦之間的差距。 Surface 完成十輪測試後得分 7,016 分,比初始得分高出 1%,CPU 溫度始終保持在攝氏 98 度,頻率為 3.28GHz;Blade 16 的表現也非常穩定。 Pro 7 14 和 Pro Max 14 的得分下降了約 2%,而 Precision 5 16S 在大約 10 分鐘後得分下降了 6.2%,並保持在這個水平。
| Cinebench 2026(分數越高越好) | Surface Laptop Ultra | 戴爾專業版 Precision 5 16S | 戴爾 Pro 7 14 | Razer Blade 16 | 戴爾 Pro Max 14 Premium |
|---|---|---|---|---|---|
| 單核 | 558.5 | 534.8 | 464.4 | 480.0 | 482.6 |
| SMT單核 | 不適用 | 不適用 | 617.1 | 661.3 | 不適用 |
| 多核心 | 6,963 | 4,739 | 4,028 | 5,179 | 4,160 |
| 持續循環,第一次 | 6,938 | 4,765 | 4,040 | 5,162 | 4,314 |
| 持續循環,穩態 | 7,016 | 4,468 | 3,976 | 5,206 | 4,228 |
| 穩態/首次通過 | 1.011 | 0.938 | 0.984 | 1.009 | 0.980 |
7-ZIP
7-Zip 的內建基準測試報告了 LZMA 壓縮和解壓縮吞吐量(以每秒千兆指令數為單位),分別在每個執行緒上測試一次,以及在單一核心上測試一次。

Surface 在所有線程測試中以 151.0 GIPS 的成績領先,比 Blade 16 高出 20%;其壓縮性能更是高達 156.9 GIPS,比排名第二的系統高出 35%。 Precision 5 16S 在單線程測試中以 9.8 GIPS 的成績領先。
Surface 的 7.16 GIPS 單執行緒效能資料需要特別說明。在這台機器上,一個核心在高負載下運行幾分鐘後,效能會下降到初始速度的 20% 左右,並保持這種狀態直到負載結束;7-Zip 的單執行緒測試運行時間足夠長,足以觸發這種現象(溫度在 47 到 67 攝氏度之間),因此過熱並非原因。同樣的情況也會延續到後續的 PyPerformance 和 Stockfish 單線程測試。
| 7-Zip,單線程(GIPS,數值越高越好) | Surface Laptop Ultra | 戴爾專業版 Precision 5 16S | 戴爾 Pro 7 14 | Razer Blade 16 | 戴爾 Pro Max 14 Premium |
|---|---|---|---|---|---|
| 總額 | 7.16 | 9.80 | 9.01 | 9.24 | 8.84 |
| 壓縮 | 4.62 | 8.71 | 6.72 | 7.28 | 7.02 |
| 解壓縮 | 9.70 | 10.88 | 11.31 | 11.20 | 10.73 |
混合器
Blender 4.5 使用 CPU 上的 Cycles 渲染器渲染三個標準基準場景(怪物、垃圾店和教室),並報告每分鐘的採樣數。

在所有三個場景中,排名順序保持不變:Surface、Blade 16,最後是Precision 5 16S。在Monster場景中,Surface以207.6取樣/分鐘的取樣率領先Blade 16 47%,而在負載最高的Classroom場景中,這一差距縮小至18%,取樣率達到93.2。 Pro 7 14和Pro Max 14互換了最後兩個名次。
HandBrake
HandBrake 使用 x265(HEVC,中等預設,品質 22)和 SVT-AV1(預設 8,品質 30)對 4K60 Big Buck Bunny 片段的 60 秒進行軟體編碼,並報告每秒幀數。

兩種編碼器對Surface的效能表現截然不同。其x265編碼的幀率達到41.7 fps,領先其他組別25%,但其原生Arm64 SVT-AV1編碼的幀率僅15.4 fps,約為x64系統幀率的五分之一。晶片上不可能出現x265編碼效能領先者的核心速度相差五倍的情況,因此差距在於SVT-AV1的Arm64程式碼路徑,這也是我們測試的軟體中,效能決定最終結果的最明顯例子。在x64系統中,Precision 5 16S的SVT-AV1編碼幀率最高,達到80.8 fps,Pro Max 14和Blade 16的幀率差距在5%以內。
LLVM 建構
此測試使用 Clang 和 Ninja 編譯器,以預設作業數編譯完整的 LLVM 21.1.4 程式碼樹。它是測試套件中耗時最長的全核心工作負載,對記憶體、儲存和 CPU 的要求都非常高。

Surface 編譯 LLVM 耗時 206.4 秒,比 Blade 16 的 327.0 秒快了 37%。 Precision 5 16S 的 340.1 秒資料是在關閉智慧型應用控制功能後重新測試得到的,因為該功能在第一次測試中阻止了工具的運作。 Pro 7 14 的編譯速度最慢,耗時 410.5 秒。
Stockfish、primesieve、Python 和瀏覽器
Stockfish 內建的基準測試工具以每秒百萬個節點為單位報告國際象棋搜尋速度。 primesieve 統計所有執行緒上小於 10^12 的質數,以及單一執行緒上小於 10^11 的質數,並以秒為單位記錄時間。 PyPerformance 執行三個 CPython 基準測試(go、nbody 和 regex_compile),每個測試都綁定到一個核心上,並報告每次迭代的平均時間。 Speedometer 3.1 則用於測量 Microsoft Edge 瀏覽器中 Web 應用程式的回應速度。
| 測試 | Surface Laptop Ultra | 戴爾專業版 Precision 5 16S | 戴爾 Pro 7 14 | Razer Blade 16 | 戴爾 Pro Max 14 Premium |
|---|---|---|---|---|---|
| Stockfish 基準測試,所有執行緒(Mnps,數值越高越好) | 15.51 | 14.81 | 14.71 | 17.96 | 12.01 |
| Stockfish 工作台,單線程(Mnps,數值越高越好) | 1.33 | 1.86 | 1.94 | 2.04 | 1.70 |
| primesieve 1e12,所有線程(s,越低越好) | 9.82 | 11.31 | 14.80 | 10.60 | 14.30 |
| primesieve 1e11,單線程(s,越低越好) | 12.03 | 9.56 | 6.66 | 6.67 | 9.82 |
| PyPerformance 的值為(毫秒,數值越低越好) | 123.9 | 69.2 | 75.9 | 75.2 | 74.1 |
| PyPerformance nbody(毫秒,數值越低越好) | 89.8 | 53.2 | 62.3 | 60.8 | 61.3 |
| PyPerformance 正規表示式編譯(毫秒,數值越低越好) | 94.1 | 65.1 | 71.1 | 69.7 | 69.8 |
| Speedometer 3.1,Edge(評分,越高越好) | 34.7 | 42.7 | 36.8 | 38.4 | 42.0 |
Stockfish 是 Surface 少數幾項未能獲勝的全核測試之一;Blade 16 在兩次測試中都領先,在所有線程上領先 16%,而 Surface 的單線程成績則受到了 7-Zip 慢核測試的影響。 primesieve 的結果則相反,Surface 在所有線程上以 9.82 秒的成績最快,而兩款 AMD CPU 在單線程上的速度比 Intel 系統快約 30%。
Precision 5 16S 在 Python 和瀏覽器測試中拔得頭籌,Pro Max 14 在 Speedometer 測試中與其差距不到 2%。 Surface 在所有四項測試中均墊底。它的 PyPerformance 測試與 7-Zip 在同一核心上運行,因此也繼承了核心性能低下的狀態;而 Speedometer 測試則是將 Edge 的 Arm64 版本與其他設備的 x64 版本進行對比,因此這些測試結果不僅反映了 Surface 的核心性能,也反映了其固件和軟體的性能。即使不考慮核心效能低下的問題,該平台的單執行緒測試結果也比 x64 平台落後 15% 到 30%,下文的記憶體延遲資料可以解釋部分原因。
GROMACS 和 OpenBLAS
GROMACS 在四種不同的執行緒佈局下,使用所有核心運行 benchMEM 分子動力學算例,並報告每天的模擬時間(以奈秒為單位);其中,最佳佈局最為突出。我們的 OpenBLAS 測試在所有核心上運行 HPL 風格的雙精度 LU 分解求解(三種問題規模)以及 DGEMM 矩陣乘法運算,並在最高核心類別上再次運行。這是這個測試套件中持續浮點運算量最大的任務。
| 測試 | Surface Laptop Ultra | 戴爾專業版 Precision 5 16S | 戴爾 Pro 7 14 | Razer Blade 16 | 戴爾 Pro Max 14 Premium |
|---|---|---|---|---|---|
| GROMACS benchMEM,最佳佈局(ns/天,數值越高越好) | 17.29 | 24.87 | 21.58 | 26.41 | 22.74 |
| GROMACS,每個等級每天 1 個執行緒(ns/天) | 17.21 | 25.01 | 21.58 | 26.59 | 0.84 |
| GROMACS,每個等級 2 個執行緒(ns/天) | 16.80 | 24.02 | 21.22 | 24.83 | 22.88 |
| OpenBLAS DGEMM M=8000,所有核心(GFLOPS,越高越好) | 地下城與勇士 | 527.4 | 358.6 | 455.4 | 367.5 |
| OpenBLAS DGEMM M=8000,頂級核心等級(GFLOPS) | 地下城與勇士 | 262.1 | 228.0 | 252.4 | 266.0 |
| OpenBLAS LU N=10000,所有核心 (GFLOPS) | 地下城與勇士 | 435.3 | 384.3 | 400.9 | 194.2 |
| OpenBLAS LU N=20000,所有核心 (GFLOPS) | 地下城與勇士 | 503.8 | 375.6 | 454.4 | 327.5 |
| OpenBLAS LU N=40000,所有核心 (GFLOPS) | 地下城與勇士 | 459.6 | 397.6 | 498.5 | 394.1 |
| OpenBLAS LU N=40000,頂級核心等級(GFLOPS) | 地下城與勇士 | 255.2 | 221.9 | 250.9 | 271.6 |
Blade 16 在所有 GROMACS 佈局中均以 26.4 ns/day 的速度領先,Precision 5 16S 落後 6%。 Surface 在其他方面表現出色,但在 GROMACS 的 Arm64 版本中速度最慢,只有 17.3 ns/day,這是因為 GROMACS 的 Arm64 版本缺少 x64 系統使用的 AVX2 核心。 Pro Max 14 在單執行緒/執行緒佈局下的 0.84 ns/day 速度是一個極端案例,因為它幾乎所有時間都耗費在執行緒間通訊上;其最佳佈局下的 22.7 ns/day 速度才是可供比較的參考值。
Surface 沒有 OpenBLAS 測試結果。全核心 N=20000 LU 求解將系統功耗降低了三倍,並且在兩台筆記型電腦上都出現了這種情況,因此我們在最後一次運行中跳過了該步驟,讓其他 29 台筆記型電腦完成測試;散熱部分對此問題進行了說明。在 x64 系統中,Precision 5 16S 在全核 DGEMM 測試中以 527 GFLOPS 的成績領先,並在兩個較小的 LU 求解測試中也取得了不錯的成績;Blade 16 獲得了最大求解結果,而 Pro Max 14 僅使用其最高核心數時速度最快,但其能降至上
記憶體頻寬和延遲
STREAM 測量持續記憶體頻寬。記憶體延遲使用 4KiB 頁上的 1GB 緩衝區,而核心間延遲測量每對核心之間的往返延遲。

| 延遲(納秒,越低越好) | Surface Laptop Ultra | 戴爾專業版 Precision 5 16S | 戴爾 Pro 7 14 | Razer Blade 16 | 戴爾 Pro Max 14 Premium |
|---|---|---|---|---|---|
| 記憶體延遲,4KiB 頁 | 251.1 | 115.5 | 146.7 | 129.6 | 170.7 |
| 核心到核心的平均值 | 171.6 | 88.2 | 49.7 | 57.0 | 58.3 |
| 核心間最大 | 362.6 | 129.4 | 74.6 | 95.9 | 153.1 |
Surface 的 LPDDR5-9400 內存,在 STREAM Triad 測試中實現了 122,114MB/s 的讀寫速度,在 Copy 測試中實現了 130,516MB/s 的讀寫速度,比 Precision 5 16S 高出 48%,約為兩款 AMD 的系統。如此高的頻寬是 N1X 處理器在渲染和編譯測試中勝出的重要原因之一。然而,代價是延遲:記憶體延遲為 251 ns,核心間平均延遲為 172 ns,這兩項指標均遠低於其他測試機型,這也是其單執行緒和對延遲敏感的測試結果主要受此影響的原因。 Precision 5 16S 的記憶體延遲最低,僅 116 ns,而 Pro 7 14 的核心間延遲最低,僅 50 ns。
遊戲和GPU編碼
SuperTuxKart 是本次測試套件中唯一的一款遊戲,在 1080p 解析度下,它的運作對 CPU 和驅動程式的佔用並不高,因此測試結果更反映了 CPU 和驅動程式的效能,而非 GPU 的效能。遊戲內建的基準測試程式在 1920×1080 解析度下以全螢幕模式運行,所有設定均設為最高,並關閉垂直同步。測試程式會將遊戲畫面鎖定在獨立顯示卡上(如有),並報告平均幀率以及遊戲本身典型的、基本穩定的幀率數據,這些數據反映了幀時間分佈中逐漸降低的幀率點。在 Surface 設備上,我們使用 Prism 模擬器運行了 x64 版本。

Surface 原生運行平均幀率為 235.9 fps,在模擬器下運行 x64 版本平均幀率為 264.6 fps,高於 Blade 16 的 200 fps。在這樣的幀率下,RTX 5090 的性能遠未達到極限;Blade 16 的性能則受限於其 CPU 和 OpenGL 驅動程序,並且它採用混合模式運行,顯示器連接到 Radeon 890M 顯示卡,這會導致每幀增加一份影像副本。
更有說服力的結果來自戴爾的機型,Precision 5 16S 整合的 Arc Pro B390 顯示卡平均幀率為 166.8 fps,而 Pro Max 14 的獨立 RTX PRO 2000 顯示卡平均幀率為 150.8 fps,Pro Max 14 的穩定性最低幀率在所有機型中僅為 53 fps。如果運行更大型的遊戲,5090 的性能將會遠超其他所有機型。
FFmpeg 使用各廠商的硬體編碼器(Intel QSV、AMD AMF 或 NVIDIA NVENC)將同一個 4K60 視訊片段以 8Mb/s 的碼率編碼為 HEVC,並透過 Windows Media Foundation 單獨進行編碼。
| 硬體 HEVC 編碼(幀率越高越好) | Surface Laptop Ultra | 戴爾專業版 Precision 5 16S | 戴爾 Pro 7 14 | Razer Blade 16 | 戴爾 Pro Max 14 Premium |
|---|---|---|---|---|---|
| GPU廠商編碼器,HEVC 8Mb/s | 135 (NVENC) | 128 (QSV) | 137(AMF) | 132 (NVENC) | 不適用(驅動程式版本低於 FFmpeg 建置所需版本) |
| 媒體基金會編碼器,HEVC 8Mb/s | 55 | 不適用(找不到 HEVC MF 編碼器) | 110 | 不適用(混合圖形) | 不適用(混合圖形) |
在這個位元率下,固定功能編碼器的效能幾乎可以互換,QSV、AMF 和 NVENC 的幀率範圍為 128 到 137 fps,其中 Surface 搭載的第九代 NVENC 單核心處理器幀率可達 135 fps。 Pro Max 14 沒有測試結果,因為其驅動程式版本 597.16 無法啟動 NVENC,該版本比其他兩台 NVIDIA 系統上的驅動程式版本 617.42 更舊。 Media Foundation 僅對 Pro 7 14 和 Surface 進行了測試;在 Precision 5 16S 上未發現 HEVC 編碼器,而我們跳過了兩台混合顯示卡系統,因為它們會選擇自己的適配器,無法與獨立 GPU 的性能掛鉤。
溫度和 OpenBLAS 關機
在最長的工作負荷下,Surface 的平均溫度為 92 至 97 攝氏度,完成 30 分鐘持續循環測試的速度比開始時快了 1%;Blade 16 的最高溫度為 98 至 99 攝氏度,結果相同。唯一會降溫的系統是 Precision 5 16S,但它的降溫是定時進行的。儘管 Surface 周圍環境溫度較高,但它的 OpenBLAS DNF 降溫過程並不平順:在測試套件中最繁重的浮點運算負載下,系統直接斷電。

我們可以監測什麼
sr-client 透過 LibreHardwareMonitor 和 Windows 效能計數器每隔幾秒鐘對感測器進行採樣,並彙總每次測試的數據,但不同平台上的覆蓋率差異比我們預期的要大。兩台 Intel 系統均未向 LibreHardwareMonitor 報告 CPU 溫度,導致測試套件在兩次測試之間以固定的時間間隔暫停。
CPU溫度和時脈頻率隨工作負載變化
| 工作負載(CPU 最大負載/平均負載,C) | Surface Laptop Ultra | 戴爾專業版 Precision 5 16S | 戴爾 Pro 7 14 | Razer Blade 16 | 戴爾 Pro Max 14 Premium |
|---|---|---|---|---|---|
| Cinebench 2026 | 98 / 88 | 無感應器 | 83 / 74 | 96 / 78 | 無感應器 |
| 7-ZIP | 98 / 65 | 無感應器 | 75 / 70 | 99 / 84 | 無感應器 |
| 魚乾 | 98 / 96 | 無感應器 | 69 / 68 | 92 / 90 | 無感應器 |
| 混合器 | 98 / 93 | 無感應器 | 76 / 70 | 95 / 87 | 無感應器 |
| HandBrake | 98 / 84 | 無感應器 | 82 / 72 | 92 / 86 | 無感應器 |
| LLVM 建構 | 98 / 92 | 無感應器 | 74 / 68 | 98 / 93 | 無感應器 |
| GROMACS | 98 / 96 | 無感應器 | 71 / 70 | 97 / 94 | 無感應器 |
| OpenBLAS | 地下城與勇士 | 無感應器 | 83 / 78 | 91 / 87 | 無感應器 |
| 流 | 98 / 92 | 無感應器 | 69 / 66 | 75 / 71 | 無感應器 |
| 超級卡丁車 | 90 / 80 | 無感應器 | 69 / 64 | 89 / 83 | 無感應器 |
| MLPerf 用戶端 | 93 / 77 | 無感應器 | 71 / 67 | 97 / 76 | 無感應器 |
| 編碼代理 | 86 / 78 | 無感應器 | 78 / 68 | 91 / 84 | 無感應器 |
Surface 在所有高負載全核測試中溫度都達到了 97 到 98 攝氏度,在 Stockfish、GROMACS 和 Blender 測試中的平均溫度也始終高於 93 攝氏度,這表明它在大部分測試中都處於滿載運行狀態。即使是記憶體測試 STREAM,溫度也達到了 98 攝氏度。 Blade 16 的溫度也幾乎一樣高,在 7-Zip 和 LLVM 建置測試中峰值溫度達到了 98 到 99 攝氏度,但在大多數測試中,它的平均溫度要低 5 到 10 攝氏度。 Pro 7 14 的溫度最低,全程最高溫度僅為 89 攝氏度,這與其較低的時脈頻率和較低的全核跑分相符。
| 工作負載(平均 CPU 時脈頻率,MHz) | Surface Laptop Ultra | 戴爾專業版 Precision 5 16S | 戴爾 Pro 7 14 | Razer Blade 16 | 戴爾 Pro Max 14 Premium |
|---|---|---|---|---|---|
| Cinebench 2026 | 2,952 | 3,792 | 3,879 | 4,158 | 3,734 |
| 7-ZIP | 2,405 | 3,936 | 3,767 | 4,014 | 3,710 |
| 混合器 | 3,174 | 3,665 | 3,086 | 3,729 | 3,469 |
| LLVM 建構 | 3,160 | 3,631 | 3,043 | 3,697 | 3,379 |
| GROMACS | 3,325 | 3,525 | 3,023 | 3,874 | 3,458 |
| 流 | 3,255 | 4,014 | 3,590 | 3,684 | 4,057 |
| MLPerf 用戶端 | 2,165 | 2,632 | 3,036 | 3,593 | 3,861 |
| 持續循環,穩態 | 3,276 | 3,294 | 2,914 | 3,742 | 3,393 |
在不同的架構上,時脈頻率的含義各不相同,因此請繼續閱讀下文,以了解晶片時脈頻率如何隨任務從輕負載到重負載而變化。 Surface 的全核頻率穩定在 3.2 至 3.3GHz,這是它在 98 攝氏度下能夠保持的頻率,而且其 20 個核心在這個頻率下仍然優於 12 核或 16 核 x64 處理器在更高頻率下的性能。 Blade 16 在幾乎所有測試中都保持了最高的時脈頻率,即使在溫度最高的測試中也保持在 3.6GHz 以上,因此它在與 Pro 7 14 相同的晶片系列下,在 Stockfish 和 GROMACS 測試中都領先,而 Pro 7 14 在持續全核負載下頻率會降至 2.8 至 3.1GHz。
持續循環測試最能清楚展現各韌體的運作策略。 Surface 在所有十次測試中溫度都保持在 98°C,最終溫度比第一次高出 1%;Blade 16 也達到了相同的溫度,但最終溫度為 94°C。此時兩款機型的散熱儲備都已耗盡,但它們也無需保留散熱儲備,因為它們的韌體能夠將時脈頻率穩定在極限狀態。
Precision 5 16S 是唯一一款效能下降的系統,而且每次下降的方式都相同:10 到 14 分鐘後,得分下降約 6% 並保持不變,第二次完整測試中,得分下降幅度精確到小數點後三位(0.938 對 0.939)。兩次測試中得分都在同一分鐘下降,這看起來像是戴爾韌體中存在長時間功率限制,而不是散熱系統性能下降。
Surface並非我們實驗室唯一一台運作溫度過高的RTX Spark筆記型電腦。其他搭載N1X處理器的筆記型電腦在全核心負載下溫度也達到了90多度,但到目前為止,它們都沒有故障。我們目前的推測(雖然無法證實)是,NVIDIA將N1X筆記型電腦的功耗和散熱目標設定得非常接近極限,因此能否達標取決於各OEM廠商的散熱設計和固件,而這正是Surface與其他筆記型電腦的不同之處。散熱性能是我們後續評測中需要重點關注的方面,因為散熱設計將成為區分不同平台性能的關鍵因素。

運行過熱和 OpenBLAS 關機
我們的 Surface Laptop Ultra 三次斷電,每次都是在全核心 OpenBLAS LU 求解器運行到 20 線程 N=20000 問題時發生的。為了讓其他 29 項測試順利完成,我們在最後一次運行中跳過了 OpenBLAS,因此 CPU 部分顯示「DNF」(未完成)。這是第二台出現類似故障的設備:第一台評測機在相同的工作負載下出現死機,送修後發現 OLED 顯示器在排氣口邊緣存在缺陷,並且 CPU 故障可以復現,最終被更換。
| 創建 | 運作中 | 損失前的最後一次閱讀 | 之後 |
|---|---|---|---|
| 約20:06 | 完整運行,26-openblas:兩次 N=10000 LU 的測試集均已完成(分別為 319.7 和 368.1 GFLOPS),然後在 20 個執行緒上進行 N=20000 的測試。 | CPU 溫度 95.7°C,主頻 3.2GHz(啟動時溫度 53°C) | 關機狀態,於21:11開機。 |
| 約21:30 | 復現步驟,第一輪:12 次 N=10000 次求解通過,N=20000 在 20 個執行緒上啟動,時間為 21:30:13 | 最高溫度區 95.2 攝氏度,3.1GHz | 於 21:31 自動重啟 |
| 約21:35 | 重現步驟 1:相同序列,N=20000,20 個線程,啟動時間 21:35:10 | 最高溫度區 95.5 攝氏度,3.2GHz | 22:05 回來 |
我們最初的想法是筆記型電腦運行溫度達到 98 攝氏度後過熱損壞;但實際情況似乎並非如此。 Surface 在持續循環測試中保持 98 攝氏度,並在 Cinebench 測試中保持 12 分鐘,期間未出現任何故障。 Windows 偵測到的是強制斷電,而非正常關機:每次重新啟動都會記錄 Kernel-Power 41 錯誤代碼(錯誤檢查代碼為 0),且沒有電源按鈕按下記錄,也沒有崩潰轉儲檔案、致命硬體錯誤記錄或過熱關機事件(通常過熱關機都會留下這些記錄)。
時間精確到秒:兩個復現程序在第一次運行中都失去了電源,在加載開始後 42 到 46 秒,在 N=20000 求解開始後 14 到 16 秒,並且在丟失電源之前,每次求解都通過了 HPL 殘差檢查,因此硬體在切割之前一直都在正確計算。
平台計數器兩次都達到了相同的峰值:PSYS 熱區並非溫度值,而是在負載下穩定上升,空閒時約為 1,000 至 1,200,兩次故障重現時讀數分別為 4,419 和 4,406。第一台 Surface 的 PSYS 讀數僅為 2,808,遠低於此值,因此這對於平台韌體的維護者來說是一個線索,而不是閾值。
故障原因也不確定,因為在第一次重啟後,完整運行的重試步驟成功通過了所有八種配置(N=40000 及以下),在 20 個線程上,N=20000 和 N=40000 的求解結果分別為 336 GFLOPS 和 370 GFLOPS,也就是說,這四次嘗試電。兩台機器都使用交流電源;這台機器的電池在斷電前後電量均為 100%。
兩台 Surface Laptop Ultra 出現完全相同的故障,記憶體配置不同(第一台為 96/32,第二台為 64/64),這表示問題出在該型號的電源管理、散熱設計或韌體在持續全核心 FP64 負載下的保護機制上,而非單一機器本身存在缺陷。我們已報告此問題,如有修復方案,我們將更新此評測。
重現關機過程
我們的複現步驟是在 20 個執行緒上執行 6 次 N=10000 LU 分解,在 10 個執行緒上執行 6 次,然後在 20 個執行緒上執行 N=20000 LU 分解。 OpenBLAS 提供了一個 LINPACK 基準測試程式(benchmark/linpack.c),它執行相同的操作:它填充一個隨機的 N x N 矩陣,使用 dgetrf 對其進行分解,使用 dgetrs 進行求解,並報告每個矩陣的 MFlops 值,因此任何人都可以重複此過程而無需使用我們的測試套件。
在 Windows on Arm 平台上,有兩個細節需要注意,首先是線程數:官方發布的 Windows on Arm OpenBLAS 版本最多只能使用 12 個線程,因此無法充分利用全部 20 個核心;必須使用 0.3.34 版本的源代碼構建該庫,並提高線程數限制。此外,基準測試的 Windows 計時器只能在 MinGW 風格的工具鏈下編譯,因此需要在 MSYS2 的 CLANGARM64 shell 中建置。以下是解壓縮後的 OpenBLAS 0.3.34 原始碼:
pacman -S --needed mingw-w64-clang-aarch64-clang mingw-w64-clang-aarch64-cmake mingw-w64-clang-aarch64-ninja cmake -S . -B build -G Ninja -DCMAPEKE_BUILD_TYPEKEW. -DNUM_THREADS=256 -DNOFORTRAN=1 -DC_LAPACK=1 -DBUILD_BENCHMARKS=ON -DBUILD_TESTING=OFF cmake --build build --target benchmark_linpack_DOUBLE
然後,在將 Windows 系統設定為「最佳效能」並連接電源的情況下,程式會重複每次斷電前的運作過程。在我們的 Surface 裝置上,斷電發生在最後一次 N=20000 求解過程中。
cd build OPENBLAS_LOOPS=6 OPENBLAS_NUM_THREADS=20 ./benchmark_linpack_DOUBLE.exe 10000 10000 1 OPENBLAS_LOOPS=6 OPENBLAS_NUM_THREADS=10 1 OPENBLAS_LOOPS=6 OPENBLAS_NUM_THREADS=10 1 OPENBLAS_LOOPS=6 OPENBLAS_NUM_THREADS=10 ./30000 OPENBLAS_NUM_THREADS=20 ./benchmark_linpack_DOUBLE.exe 20000 20000 1
兩次 OPENBLAS_LOOPS=6 運行透過十二次 N=10000 求解來預熱系統,與我們的複現結果相符,最後一個命令在所有 20 個核心上啟動 N=20000 求解,我們的 Surface 在 14 到 16 秒後失去電源。
存儲性能
儲存測試結果將五款固態硬碟分為三組。 Surface 的第五代 SK 海力士固態硬碟以 14.1GB/s 的順序讀取速度和 11.5GB/s 的順序寫入速度創下紀錄;Precision 5 16S、Pro Max 14 和 Blade 16 通過文件系統實現了 65 萬到 78 萬 IOPS 的三星 4K 而隨機 1919 2K BM 9199;固態硬碟的讀取速度與普通的第四代固態硬碟相當,但寫入速度僅為 120MB/s 左右,這與該硬碟採用的是 QLC 快閃記憶體有關。
fio 四角
我們的客戶端儲存測試使用 fio 對啟動磁碟區上的檔案進行讀寫操作,並透過 NTFS 和 BitLocker 加密,完全按照系統出廠時的設定進行,因此結果包含了作業系統和加密帶來的開銷。測驗分別在 QD32 下進行 128K 次順序讀寫,以及在 QD32 下進行 4K 次隨機讀寫,並分別運行 4 個、8 個和 16 個作業,取其中最佳結果。每個測試角落都使用 5GB 和 25GB 的資料進行測試,以檢驗當工作集超過磁碟機的最快快取時,測試結果是否仍然有效;25GB 的資料行才是最終的比較物件。


| fio,5GB 佔用空間 | Surface Laptop Ultra | 戴爾專業版 Precision 5 16S | 戴爾 Pro 7 14 | Razer Blade 16 | 戴爾 Pro Max 14 Premium |
|---|---|---|---|---|---|
| 順序讀取 128K QD32 (MB/s) | 14,175 | 10,275 | 3,747 | 7,099 | 7,025 |
| 順序寫入 128K QD32 (MB/s) | 11,475 | 8,909 | 123 | 5,248 | 6,645 |
| 隨機讀取 4K QD32,峰值(IOPS) | 307,738 | 778,080 | 363,988 | 700,883 | 756,704 |
| 隨機寫入 4K QD32,峰值(IOPS) | 284,680 | 676,963 | 25,465 | 651,651 | 697,110 |
兩塊第五代硬碟佔據了連續的讀寫行。 Surface 在 25GB 的讀寫速度分別達到了 14,134MB/s 和 11,461MB/s,Precision 5 16S 緊隨其後,讀寫速度分別為 9,216MB/s 和 9,009MB/s,而三第四代系統的讀取速度則集中在 7.7.0 至 217.0 /GB 之間。隨機 I/O 測試的結果則有所不同:Precision 5 16S、Pro Max 14 和 Blade 16 的讀寫速度均在 648K 至 780K IOPS 之間,而 Surface 的讀寫速度則停滯在 300K IOPS 左右,儘管配備了速度更快的硬碟,但其性能仍低於其他 x64 系統的一半。
原始設備資料行顯示了效能上限的來源:直接對實體磁碟重複執行 4K 隨機讀取操作,繞過 NTFS 和 BitLocker,Surface 的 SSD 實現了 1,670,736 IOPS,是檔案系統下結果的 5.6 倍,因此 300K 的上限是由 Windows on Arm 路徑本身決定的,而不是由硬碟本身的上限。最可能的開銷來自 BitLocker 的 XTS-AES-128 軟體,該軟體啟用了記憶體完整性,導致在執行這 4 個任務時 CPU 使用率達到了 57%。
x64 系統的效能損失較小,但仍損失了一些 IOPS:Pro Max 14 損失了 1.94 倍,Precision 5 16S 損失了 1.57 倍,Blade 16 損失了 1.43 倍。只有 Pro 7 14 沒有變化。
儲存延遲和模型負載上限
fio 在 25GB 空間上的完成延遲(以微秒為單位),以及 AI 模型負載測試用作上限的驅動器容量上限:DiskSpd 1MB 順序讀取模型檔案。
| 測試 | Surface Laptop Ultra | 戴爾專業版 Precision 5 16S | 戴爾 Pro 7 14 | Razer Blade 16 | 戴爾 Pro Max 14 Premium |
|---|---|---|---|---|---|
| 連續讀取 128K,p99(µs,越低越好) | 391 | 971 | 2,179 | 1,384 | 873 |
| 順序寫入 128K,p99(微秒,數值越低越好) | 766 | 3,490 | 120,062 | 889 | 1,036 |
| 隨機讀取 4K,16 個任務,平均值(微秒,數值越低越好) | 1,839 | 368 | 1,410 | 472 | 635 |
| 隨機寫入 4K,16 個任務,平均值(微秒,數值越低越好) | 1,984 | 444 | 23,703 | 470 | 636 |
| 原始隨機讀取 4K QD32,峰值,25GB (IOPS) | 1,670,736 | 1,224,270 | 361,344 | 993,050 | 1,472,021 |
| 模型負載驅動器上限,DiskSpd 1M 順序讀取 (MB/s) | 10,588 | 11,402 | 1,689 | 6,246 | 未運行(模型負載測試未通過) |
Surface 的順序延遲尾部最為集中,而 Precision 5 16S 的 4K 雙向平均延遲最低。 Surface 的 16 個作業隨機資料集還存在我們在 x64 系統上未曾見過的延遲尾部:p99.99 讀取延遲為 4.8 秒,寫入延遲為 5.6 秒,而平均值分別為 1.8 毫秒和 2.3 毫秒,這意味著透過 Windows on Arm 路徑,大約每 10,000 次。我們沒有將 Surface 的 4K p99 值列入表格,因為它們低於自身的平均值,這顯然是不正確的,我們需要在列印之前確認 fio 在 Arm64 平台上如何報告百分位數。
結語
Surface Laptop Ultra for Business 搭載的 RTX Spark N1X 是我們迄今為止在筆記型電腦中見過的最強大的多線程 CPU,它配備了 122GB/s 的內存頻寬和 64GB 的 GPU 顯存(可擴展至 96GB),這比以往任何筆記本電腦都為 NVIDIA GPU 配備了更大的顯存。它在 Cinebench、7-Zip、Blender、x265 和 LLVM 建置測試中均遙遙領先,順序讀取速度達到 14.1GB/s,順序寫入速度達到 11.5GB/s,創下新的儲存記錄。此外,它是唯一能夠以可用速度運行我們 350 億參數 M 級模型的系統,在 90 秒內即可完成編碼代理的 M 級任務,而 x64 整合系統則需要 5 到 11 分鐘。

這些限制僅適用於目前發布的平台。 Windows on Arm 的儲存路徑將隨機 I/O 限制在硬碟容量的五分之一,記憶體延遲是 x64 系統的兩倍。單執行緒效能落後於 x64 平台,一些 Arm64 移植版本(例如 SVT-AV1 和 GROMACS)的效能遠遜於其 x64 版本。此外,整合 GPU 還與其他系統元件共用記憶體匯流排,因此在執行代理程式時,桌面速度會降低一半。
對於一款配備 24GB 內存的機型來說,Razer Blade 16 的 RTX 5090 生成令牌的速度是 Surface 的 2.3 倍,並且在生成令牌的同時還能保持響應速度;Surface 的最佳使用場景是那些無法安裝在較小平台上的機型。
除了上述注意事項外,兩台 Surface Laptop Ultra 在相同的全核心雙精度負載下,均出現了與溫度無關的自動斷電現象,日誌顯示為硬斷電而非過熱保護。大多數使用者可能永遠不會在 20 個執行緒上執行 HPL 類型的求解器,而且這款筆記型電腦在其他所有持續測試中溫度都保持在攝氏 98 度,並未因此扣分。但工作站層級的筆記型電腦應該能夠承受最繁重的正常工作負載,在微軟或英偉達解釋斷電原因之前,這台機器的過熱保護機制仍是一個懸而未決的問題。
對於想要在本地運行 20 億到 35 億個模型、編譯大型樹狀圖或在筆記型電腦的 CPU 上進行渲染的開發人員或分析師來說,這款 Surface 中的 N1X 處理器能夠做到本次對比中任何 x64 筆記型電腦都無法做到的事情,而 128GB 配置更是完美地實現了這一目標。
對於那些工作內容僅限於單執行緒、瀏覽器密集型應用程式或使用配備 24GB 記憶體的獨立顯示卡的用戶來說,x64 架構的筆記型電腦可能是更好的選擇,而 Precision 5 16S 和 Blade 16 正好滿足了這一需求。實驗室完成機殼評測後,我們將帶來硬體體驗和電池續航時間的評測;同時,一旦收到廠商關於關機問題的回复,我們也會盡快發布評測結果。
排行榜: Surface Laptop Ultra for Business 在我們的“最佳本地 AI 筆記型電腦”排行榜的 RTX Spark 部分中進行了測試,與我們在新客戶端套件中測試過的其他 N1X 系統一起,並且在我們的“最佳商務筆記型電腦”排行榜的“其他測試產品”部分中也進行了測試。


 Amazon