

NVIDIA RTX PRO 4500 Blackwell 伺服器版是 NVIDIA 專為大多數企業現有伺服器打造的顯示卡。它是一款單槽被動散熱的 165W 顯示卡,配備 32GB GDDR7 顯存,並擁有完整的 Blackwell 架構特性:第五代 Tensor Core(支援 FP4)、第四代 RT Core、三個編碼器和三個解碼器,以及多實例 GPU 支持,可將顯存分割成兩個獨立的 16GB 分區。它取代了 L4,成為 NVIDIA RTX PRO 伺服器產品線的入門級產品,並且可以輕鬆安裝在 2U PowerEdge、ProLiant 或 ThinkSystem 伺服器中,無需擔心電源或散熱問題。

NVIDIA 對這款顯示卡的定位是「適配型」:大多數企業並非在建構人工智慧工廠;他們經營的是風冷式、老舊資料中心,機架功率有嚴格限制,他們需要的是一個無需全新伺服器層級的加速運算方案。或者,他們從事邊緣運算,RTX PRO 4500 更適合邊緣運算,能夠更好地滿足通常決定部署方案的工作負載和功率限制。
RTX PRO 6000 Blackwell佔據了該市場的頂端,擁有 96GB 記憶體和高達 600W 的功耗。 4500 系列沿用了相同的架構,但其他各項效能都縮減了近一半,因此,對於那些使用較小配置、任務量較小或預算有限(例如每瓦特成本較高)的用戶來說,他們可以選擇 Blackwell,而無需為他們用不到的性能空間付費。
此類GPU的工作負載已被充分理解:小型語言模型推理、視覺AI和視訊分析、向量搜尋和嵌入生成、轉碼以及vGPU 20下的虛擬工作站。它聲稱在小型和中型模型推理方面性能是L4緩存的5倍以上,在Nemotron模型上性能最高可達10倍。其首發夥伴包括NTT DATA(邊緣視訊)、Pacific Biosciences(定序)和諾基亞(AI-RAN基地台)。 AWS基於此建置了新的G7實例,以取代G6實例。
我們在先前的RTX PRO 4500 Edge 評測中,已經將這款顯示卡與 HPE ProLiant DL145 Gen11 伺服器內部的 L4 快取進行了比較測試,結果顯示其吞吐量為 L4 的 2.7 倍。本次評測將著重分析它與 350W 雙槽 L40S(兩年來一直是主流積體電路卡的標配)的效能差距,以及更高階的 RTX PRO 6000 在顯存和功耗方面有哪些提升。
為了找出答案,我們將 4500 放入戴爾 PowerEdge R770伺服器中,與 L40S 和 L4 進行對比,並添加了來自戴爾 Pro Max Tower T2的 RTX PRO 6000 Blackwell 數據,分別測試了其 600W 的默認功耗和 450W 的上限(與 GPU R70 的預設功率相匹配,並在兩種情況下運行了兩種長度的功耗,在兩種情況下運行了四種插槽(與 GPU R70 的預設功率相匹配)在兩種情況下運行了兩種長度(與 GPU R70 的預設值相匹配),並在兩種情況下運行了兩種長度的功耗(與 GPU R70 的預設功耗,並在兩種情況下運行兩種插槽(與 GPU R70 的預設功率相匹配)在兩種上下文下運行,並在兩種情況下運行了兩種長度的功耗,在兩種功能上) vLLM 線上服務。
簡單預覽一下,在典型的聊天和代理上下文長度下,4500 在 FP8 和 BF16 型號上與 L40S 保持同步,而功耗卻不到後者的一半;在 8K 輸入下,32GB 幀緩衝區顯示出其局限性;而 NVIDIA 在其 Blackwell 產品宣傳中主打的 NVFP4 精度,與此產品線的表現一致。
關鍵要點
- L40S 單槽吞吐量 165W: 在 512 個令牌的輸入和輸出下,4500 在我們運行的每個 FP8 和 BF16 模型上都與 L40S 持平或略勝一籌,在 Ministral 3 14B FP8 上為 1,107 對 995 個令牌/秒,在 Ministral 3 3B 上只有這張卡上的功率為 196 上功率為 19695 上為 28,0698,906 的功率,只有 286996 上只有 286869986 L40S 的 47%,插槽數量只有 L40S 的一半。
- 大約是它所取代的 L4 的 3 倍: 在短時間內,L4 的輸出吞吐量是 L4 的 2.8 倍至 3.6 倍,而 L4 的板載功耗是 L4 的 2.3 倍。
- 32GB 是有上限的: 在 8K 輸入時,4500 的效能比 L40S 低 17% 到 33%,其曲線在並發數為 8 時趨於平緩,而 L40S 的效能則持續攀升至 16。曲線趨於平緩是因為 KV 快取耗盡,而 32GB 是該快取的極限。
- NVFP4 是一款軟體產品,每張卡片上都有它的身影: 在 Qwen3.8-27B NVFP4 測試中,4500 在並發數為 32 時每秒可產生 320 個令牌,L40S 在完全沒有 FP4 硬體的情況下每秒可產生 480 個令牌,RTX PRO 6000 每秒可產生 621 個令牌。在此 vLLM 建置中,NVFP4 路徑在所有這些顯示卡上都無法隨記憶體頻寬的增加而擴展,而 MAMF 測試結果顯示,4500 的 FP4 硬體效能達到了 568.6 TFLOPS,而 FP8 硬體的效能僅為 280.1 TFLOPS。
- 更貴的卡能買到什麼: 由於戴爾 R770 GPU 插槽的功耗上限為 450W,RTX PRO 6000 在短時運行時的效能約為 4500 的兩倍,在 8K 解析度下約為 2.5 倍至 3.2 倍。其 600W 的額定功耗在此基礎上,短時運行時的性能提升了 1% 至 2%,長時間運行時的性能提升了 4% 至 9%,因此 6000 相較於 4500 的大部分性能提升都來自於顯存。
NVIDIA RTX PRO 4500 Blackwell 伺服器版規格
兩款顯示卡都名為 RTX PRO 4500 Blackwell,它們雖然相似,但並非完全相同的產品。工作站版於 2025 年 GTC 大會上發布,是一款 200W、雙槽、主動散熱的顯示卡,配備四個 DisplayPort 輸出介面和 896GB/s 的顯存頻寬。我們此次評測的伺服器版則於 2026 年 GTC 大會上亮相,是一款 165W、單槽、被動散熱、無顯示卡頭的顯示卡,顯存頻寬為 800GB/s。它犧牲了顯示輸出介面和部分時脈頻率,換取了資料中心級的功能:MIG、機密運算、第三個 NVENC 和 NVDEC 編碼器,以及 vGPU 20 支援。兩款顯示卡的核心配置相同,皆採用 10,496 核心 GPU 和 32GB GDDR7 ECC 記憶體。
NVIDIA 的數據顯示,該顯示卡採用台積電 4nm 定制矽片,面積為 378 平方毫米,包含 45.6 億個晶體管,配備 82 個第四代 RT 核心,相當於 82 個 SM 單元和 328 個 Tensor 核心。這些數據來自 GB203 晶片,與 RTX 5080 屬於同一晶片系列,只是尺寸略有不同。下方的 Tensor 核心資料是 NVIDIA 官方給出的稀疏模式下的峰值性能;密集模式下的性能減半,NVIDIA 自家的 peakTOPS 二進位檔案也證實了這一點,該顯卡的 FP8 性能為 805 TFLOPS,FP16 性能為 403 TFLOPS。
| 規格 | RTX PRO 4500 Blackwell SE | L4 | L40S | RTX PRO 6000 Blackwell SE |
|---|---|---|---|---|
| 平台概述 | ||||
| 卓越的建築 | 英偉達布萊克威爾 | 英偉達阿達洛夫萊斯 | 英偉達阿達洛夫萊斯 | 英偉達布萊克威爾 |
| CUDA核心 | 10,496 | 7,424 | 18,176 | 24,064 |
| RT核心 | 82(第四代) | 58(第三代) | 142(第三代) | 188(第四代) |
| GPU內存 | 32GB GDDR7 帶 ECC | 24GB GDDR6 | 48GB GDDR6 帶 ECC | 96GB GDDR7 帶 ECC |
| 存儲器接口 | 256-位 | 192-位 | 384-位 | 512-位 |
| 內存帶寬 | 800GB /秒 | 300GB /秒 | 864GB /秒 | 1,597GB /秒 |
| 性能(NVIDIA峰值數據,稀疏性下的Tensor速率) | ||||
| FP32 | 51 TFLOPS | 30.3 TFLOPS | 91.6 TFLOPS | 120 TFLOPS |
| FP16 / BF16 張量 | 406 TFLOPS | 242 TFLOPS | 733 TFLOPS | 1 浮點數 |
| FP8 張量 | 811 TFLOPS | 485 TFLOPS | 1,466 TFLOPS | 2 浮點數 |
| FP4 張量 | 1.6 浮點數 | 不支持 | 不支持 | 4 浮點數 |
| RT 核心效能 | 154 TFLOPS | 不在名單中 | 209 TFLOPS | 355 TFLOPS |
| 功率和外形尺寸 | ||||
| 最大電路板功率 | 165W | 72W | 350W | 高達 600W(可設定) |
| 外形 | 單槽位,FHFL 4.4“x 10.5” |
單槽位,HHHL | 雙槽,FHFL 4.4“x 10.5” |
雙槽,FHFL(空氣) 單槽,FHXL(液體) |
| 熱 | 被動 | 被動 | 被動 | 被動式(空氣)或液體 |
| 電源連接器 | 1 個 PCIe CEM5 16 針 | 插槽動力 | 1x 16 針 | 1 個 PCIe CEM5 16 針 |
| 互連線 | PCIe 5.0 x16 | PCIe 4.0 x16 | PCIe 4.0 x16 | PCIe 5.0 x16 |
| 重量 | 1,055g | 不在名單中 | 不在名單中 | 不在名單中 |
| 產品特性 | ||||
| 多執行個體 GPU | 最多 2 個 16GB | 沒有 | 沒有 | 最多 4 個 24GB |
| NVENC/NVDEC | 3x / 3x | 2x / 4x | 3x / 3x | 4x / 4x |
| 機密計算 | 支持 | 沒有 | 沒有 | 支持 |
| vGPU 支持 | 是的(vGPU 20) | 可以 | 可以 | 可以 |
設計和建造
4500 伺服器版是一款全高全長主機板,高 4.4 英寸,長 10.5 英寸,佔用一個插槽位。這與 L4 的半高半長設計截然不同。雖然 L4 仍然是其性能基準測試的對比對象,但 4500 伺服器版採用了全高半長 (FHFL) 的外形尺寸,以便為內存、16 針電源輸入接口以及僅靠機箱風道即可散熱 165W 的散熱片騰出空間。

這種外形尺寸是它與 L4 最大的區別。 L4 可以適合任何 HHHL 插槽,並從插槽獲取 72W 的功率,因此主要用於 1U 伺服器和小型邊緣伺服器。而 4500 是全高全長的,需要 16 針電源線。我們使用的主流 1U 伺服器(包括戴爾目前的 1U PowerEdge 系列)如果沒有這種接口,最多只能支援 HHHL 或 FHHL 擴充卡。
實際上,這是一張 2U 卡,或者說是為少數圍繞 FHFL 插槽構建的 1U 白盒機箱設計的卡,因此購買了 1U 或邊緣盒 L4 的商店無法直接替換。
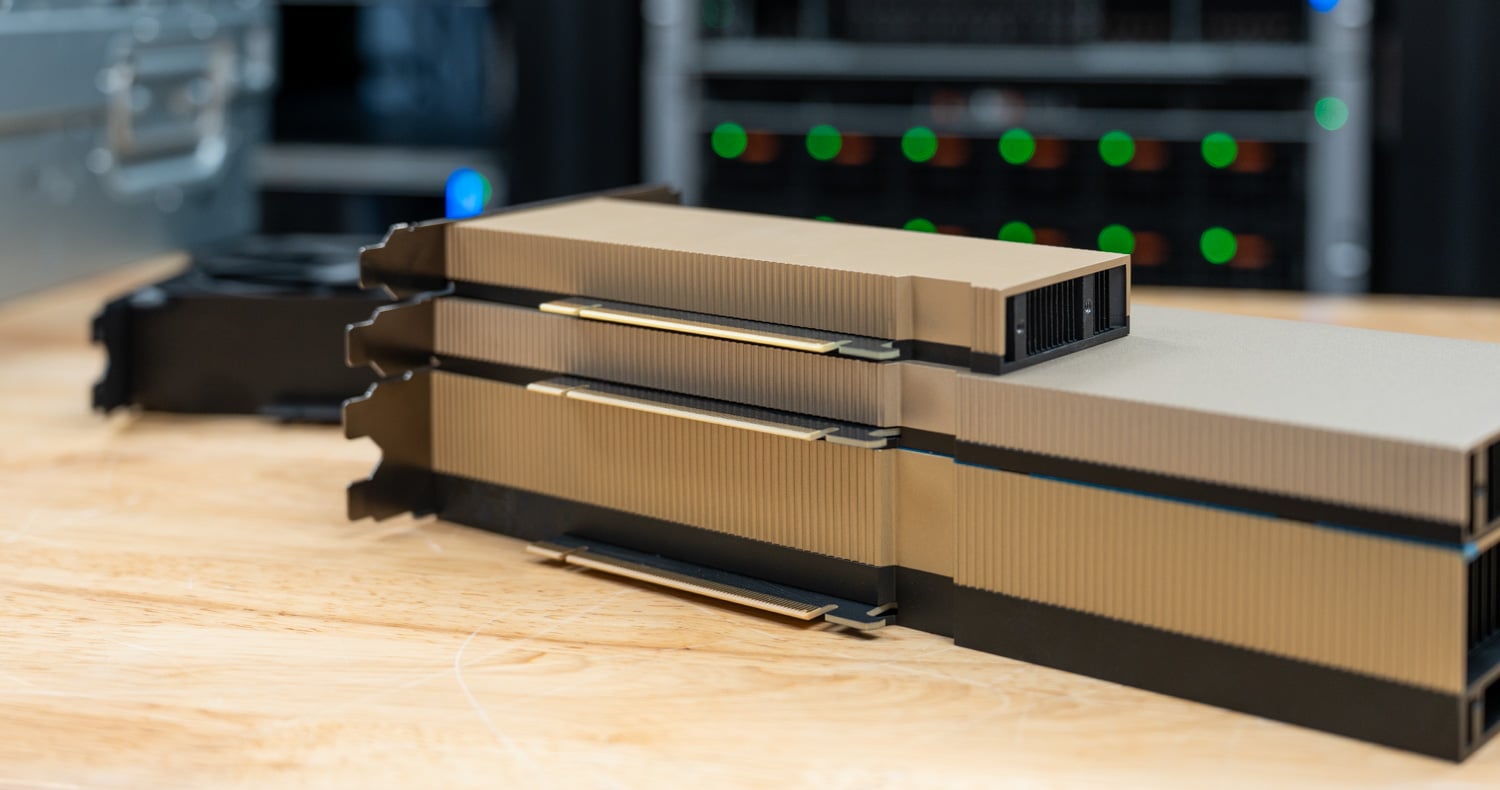
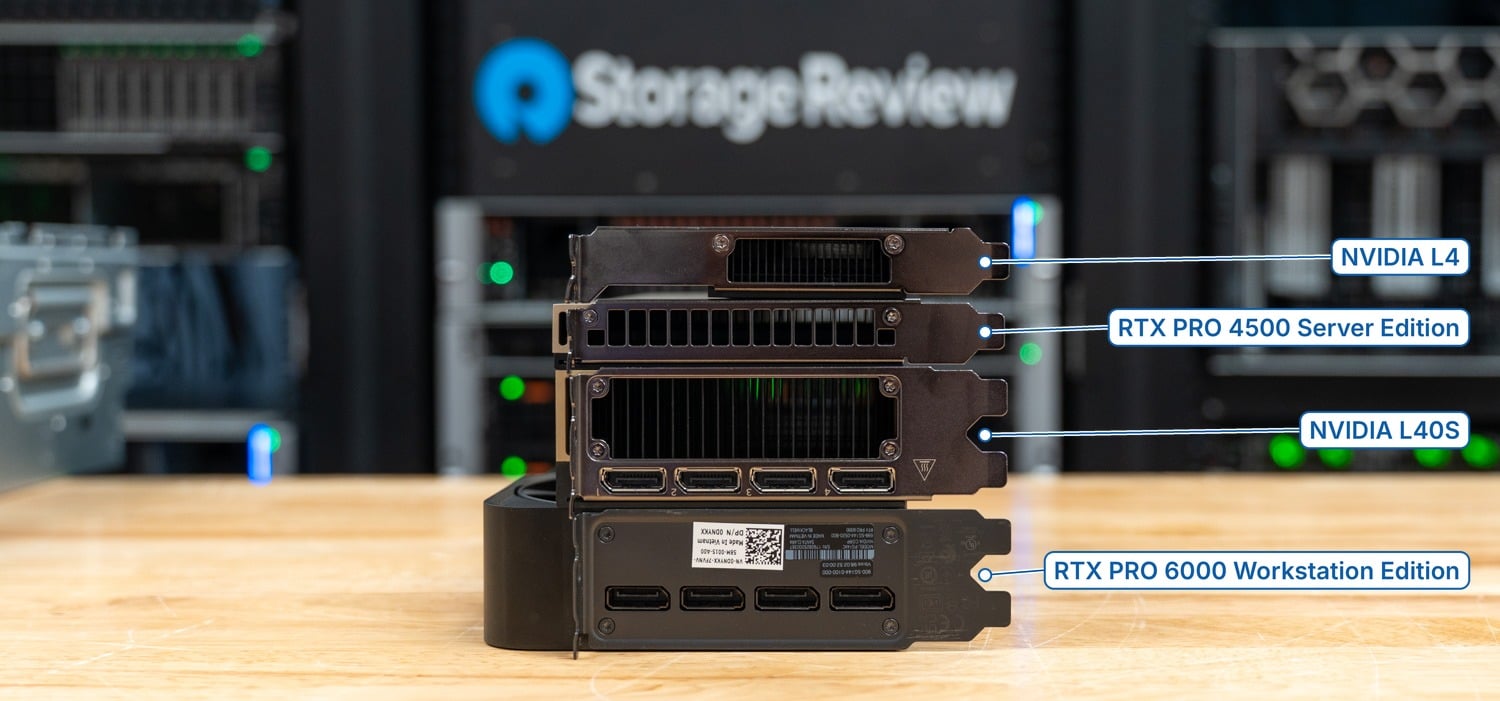
4500 顯示卡與 L4 顯示卡並排堆疊,上方是 L4 顯示卡,下方是 L40S 顯示卡,4500 顯示卡並排堆疊,上方是 L4 顯示卡,下方是 L40S 顯示卡,4500 顯示卡並排堆疊,上方是 L4 顯示卡,下方是 L40S 顯示卡,4500 顯示卡需要一個插槽,而 L40S 顯示卡需要兩個插槽,這就是為什麼一個 2U 伺服器可以安裝四個雙顯示卡,而八個這樣的寬卡,以及兩個卡
電源透過一個 PCIe CEM5 16 針介面提供,與 RTX PRO 6000 使用的介面相同,沒有輔助的 8 針介面。散熱完全被動,因此顯示卡依賴伺服器風扇,如果機殼內空氣流通不暢,顯示卡會降頻運行,這對於同類顯示卡來說是正常的,所有其他 GPU 也都有相同的要求。
此顯示卡沒有顯示輸出接口,因此圖形處理工作(無論是 vGPU 虛擬工作站還是渲染)都透過網路傳輸,擋板上設有通風孔。三個第九代 NVENC 和三個第六代 NVDEC 引擎在 L4 的基礎上增加了 4:2:2 H.264 和 HEVC 的編碼和解碼功能,NVIDIA 聲稱每個 NVDEC 引擎的 H.264 解碼吞吐量是 L4 的兩倍。下面的擋板照片清楚地展示了這種差異:L4 和 4500 只有通風孔,而 L40S 和 RTX PRO 6000 工作站版則各有四個 DisplayPort 輸出介面。
RTX PRO 4500 Blackwell 伺服器版適用於哪些場景
NVIDIA 的宣傳重點是這款顯示卡的“核心價值在於將 AI、計算、圖形和視訊加速功能整合於 165W 的被動式單槽設計中”,專為“機架密度、功耗和散熱是主要部署限制因素”的伺服器而設計。它位於 NVIDIA 所謂的 RTX PRO 伺服器產品組合的主流資料中心和邊緣運算領域,定位低於 RTX PRO 6000 Blackwell 伺服器版,但又不高於任何高階產品;它是 Blackwell 伺服器產品線的入門級產品。
與 L4 快取相比,NVIDIA 聲稱其 Nemotron Nano 模型在小型模型推理方面性能提升高達 10 倍(4500 上的 NVFP4 模型對比 L4 上的 FP8 模型),在 Cosmos Reason 2 的視頻摘要方面性能提升高達 4 倍,在 4K 分辨率下 15 倍率 15 倍。與 CPU 相比,NVIDIA 聲稱其在 Milvus 中使用 cuVS CAGRA 進行向量資料庫運算時效能提升高達 50 倍,在視覺 AI 方面效能提升高達 100 倍,這兩項測試均在配備八張顯示卡的 4500 伺服器上進行,而雙路 EPYC 9654 系統則進行了對比。
戴爾伺服器團隊告訴我們,他們認為4500系列顯示卡在主流機架中很受歡迎,因為三張32GB的4500顯示卡價格與一張96GB的6000系列顯示卡相近,在這種情況下,容量更大的顯示卡通常會更勝一籌。這款顯示卡適用於原本沒有獨立顯示卡或L4快取的伺服器,對於設計初就打算配備一張或多張6000系列顯示卡的伺服器來說,它並非最佳選擇。
測試設置
我們在戴爾 PowerEdge R770 伺服器上安裝了 4500、L40S 和 L4 三款顯示卡。該伺服器配置了兩顆英特爾至強 6787P 處理器(每顆 86 核心)和 2TB DDR5-6400 記憶體(32 個 DIMM 插槽),並執行 NVIDIA 驅動程式 595.71.05。測試運行使用了 NGC vLLM 26.08-py3 容器,該容器運行基於 CUDA 13.4.1 的 vLLM 0.27.1 版本,因此所有顯示卡的軟體堆疊完全相同。每張顯示卡均在其預設功耗限制下進行單獨測試,R770 伺服器能夠為每張顯示卡提供其額定功率:戴爾官方資料顯示,在該機箱中,L4 的功耗為 72W,4500 為 165W,L40S 為 350W。
我們戴爾Pro Max Tower T2工作站中使用的是RTX PRO 6000 Blackwell顯示卡,它與伺服器版RTX PRO 6000 Blackwell採用相同的封裝和驅動程式。 NVIDIA將工作站版和伺服器版RTX PRO 6000 Blackwell的功耗標為600W,並且在我們的測試中它們的效能表現也相同,因此我們將其作為伺服器版顯示卡進行測試。順便一提,我們之前也評測過搭載RTX PRO 6000伺服器版顯示卡的XE7740伺服器,如果您想深入了解這些顯示卡的效能擴充性,可以參考我們的評測文章。
我們對 6000 顯示卡進行了兩次測試:一次是預設的 600W 功耗,另一次是透過 nvidia-smi 工具驗證後設定的 450W 功耗上限。這是因為 450W 是 R770 主機板在 GPU 插槽中為 6000 顯示卡提供的最大功率,也是典型的 2U 伺服器使用者在 4500 和 6000 顯示卡之間進行選擇時應該參考的功率值。雖然 6000 顯示卡的宿主機平台有所不同,但在這種 GPU 密集型負載下,CPU 和 PCIe 拓樸結構對測試結果的影響遠小於功耗上限的影響。
我們使用 vLLM 的線上服務基準測試,並發等級分別為 1、2、4、8、16 和 32,並採用兩種請求形式:512 個輸入令牌和 512 個輸出令牌,模擬聊天和短代理輪次;以及 8,192 個輸入令牌和 1,024 個輸出令牌,模擬 RAG 和快取工作,其中預值配置。我們盡可能選擇與組別中最小的記憶卡相容的模型,因此 L4 的 24GB 容量設定了最低配置:Ministral 3 3B Reasoning 和 Ministral 3 8B Reasoning(BF16 編碼)、Ministral 3 14B Instruct(FP8 編碼)以及 Qwen3.8-27及以上容量的記憶卡,但不包括 L4。
我們報告每個並發等級的輸出令牌吞吐量,並引用總吞吐量(包括預填令牌),因為預填令牌會改變情況。
這裡沒有包含:只有 48GB 以上容量的卡才能容納的更大型號、MIG 分區、vGPU、視訊轉碼、計量電源、雙卡 4500 配置以及高於此級別的資料中心卡。
最大可實現 Matmul FLOPS (MAMF)
MAMF 是一項持續密集的 GEMM 測試,它會報告顯示卡在每個精度下達到的最佳矩陣乘法吞吐量,因此它是檢查 FP4 硬體在服務堆疊排除後是否正常工作的最簡單方法。 4500 在 BF16 下達到了 135.9 TFLOPS,在 FP8 下達到了 280.1 TFLOPS,在 NVFP4 下達到了 568.6 TFLOPS,精度每降低一級,吞吐量幾乎翻倍。與 NVIDIA 官方公佈的 202、406 和 811 TFLOPS 的密集峰值相比,這相當於每個精度下峰值的 67% 到 70%,並且與 NVIDIA 官方 cuBLAS 測試中該顯示卡的 133、275 和 534 TFLOPS 的資料相符。
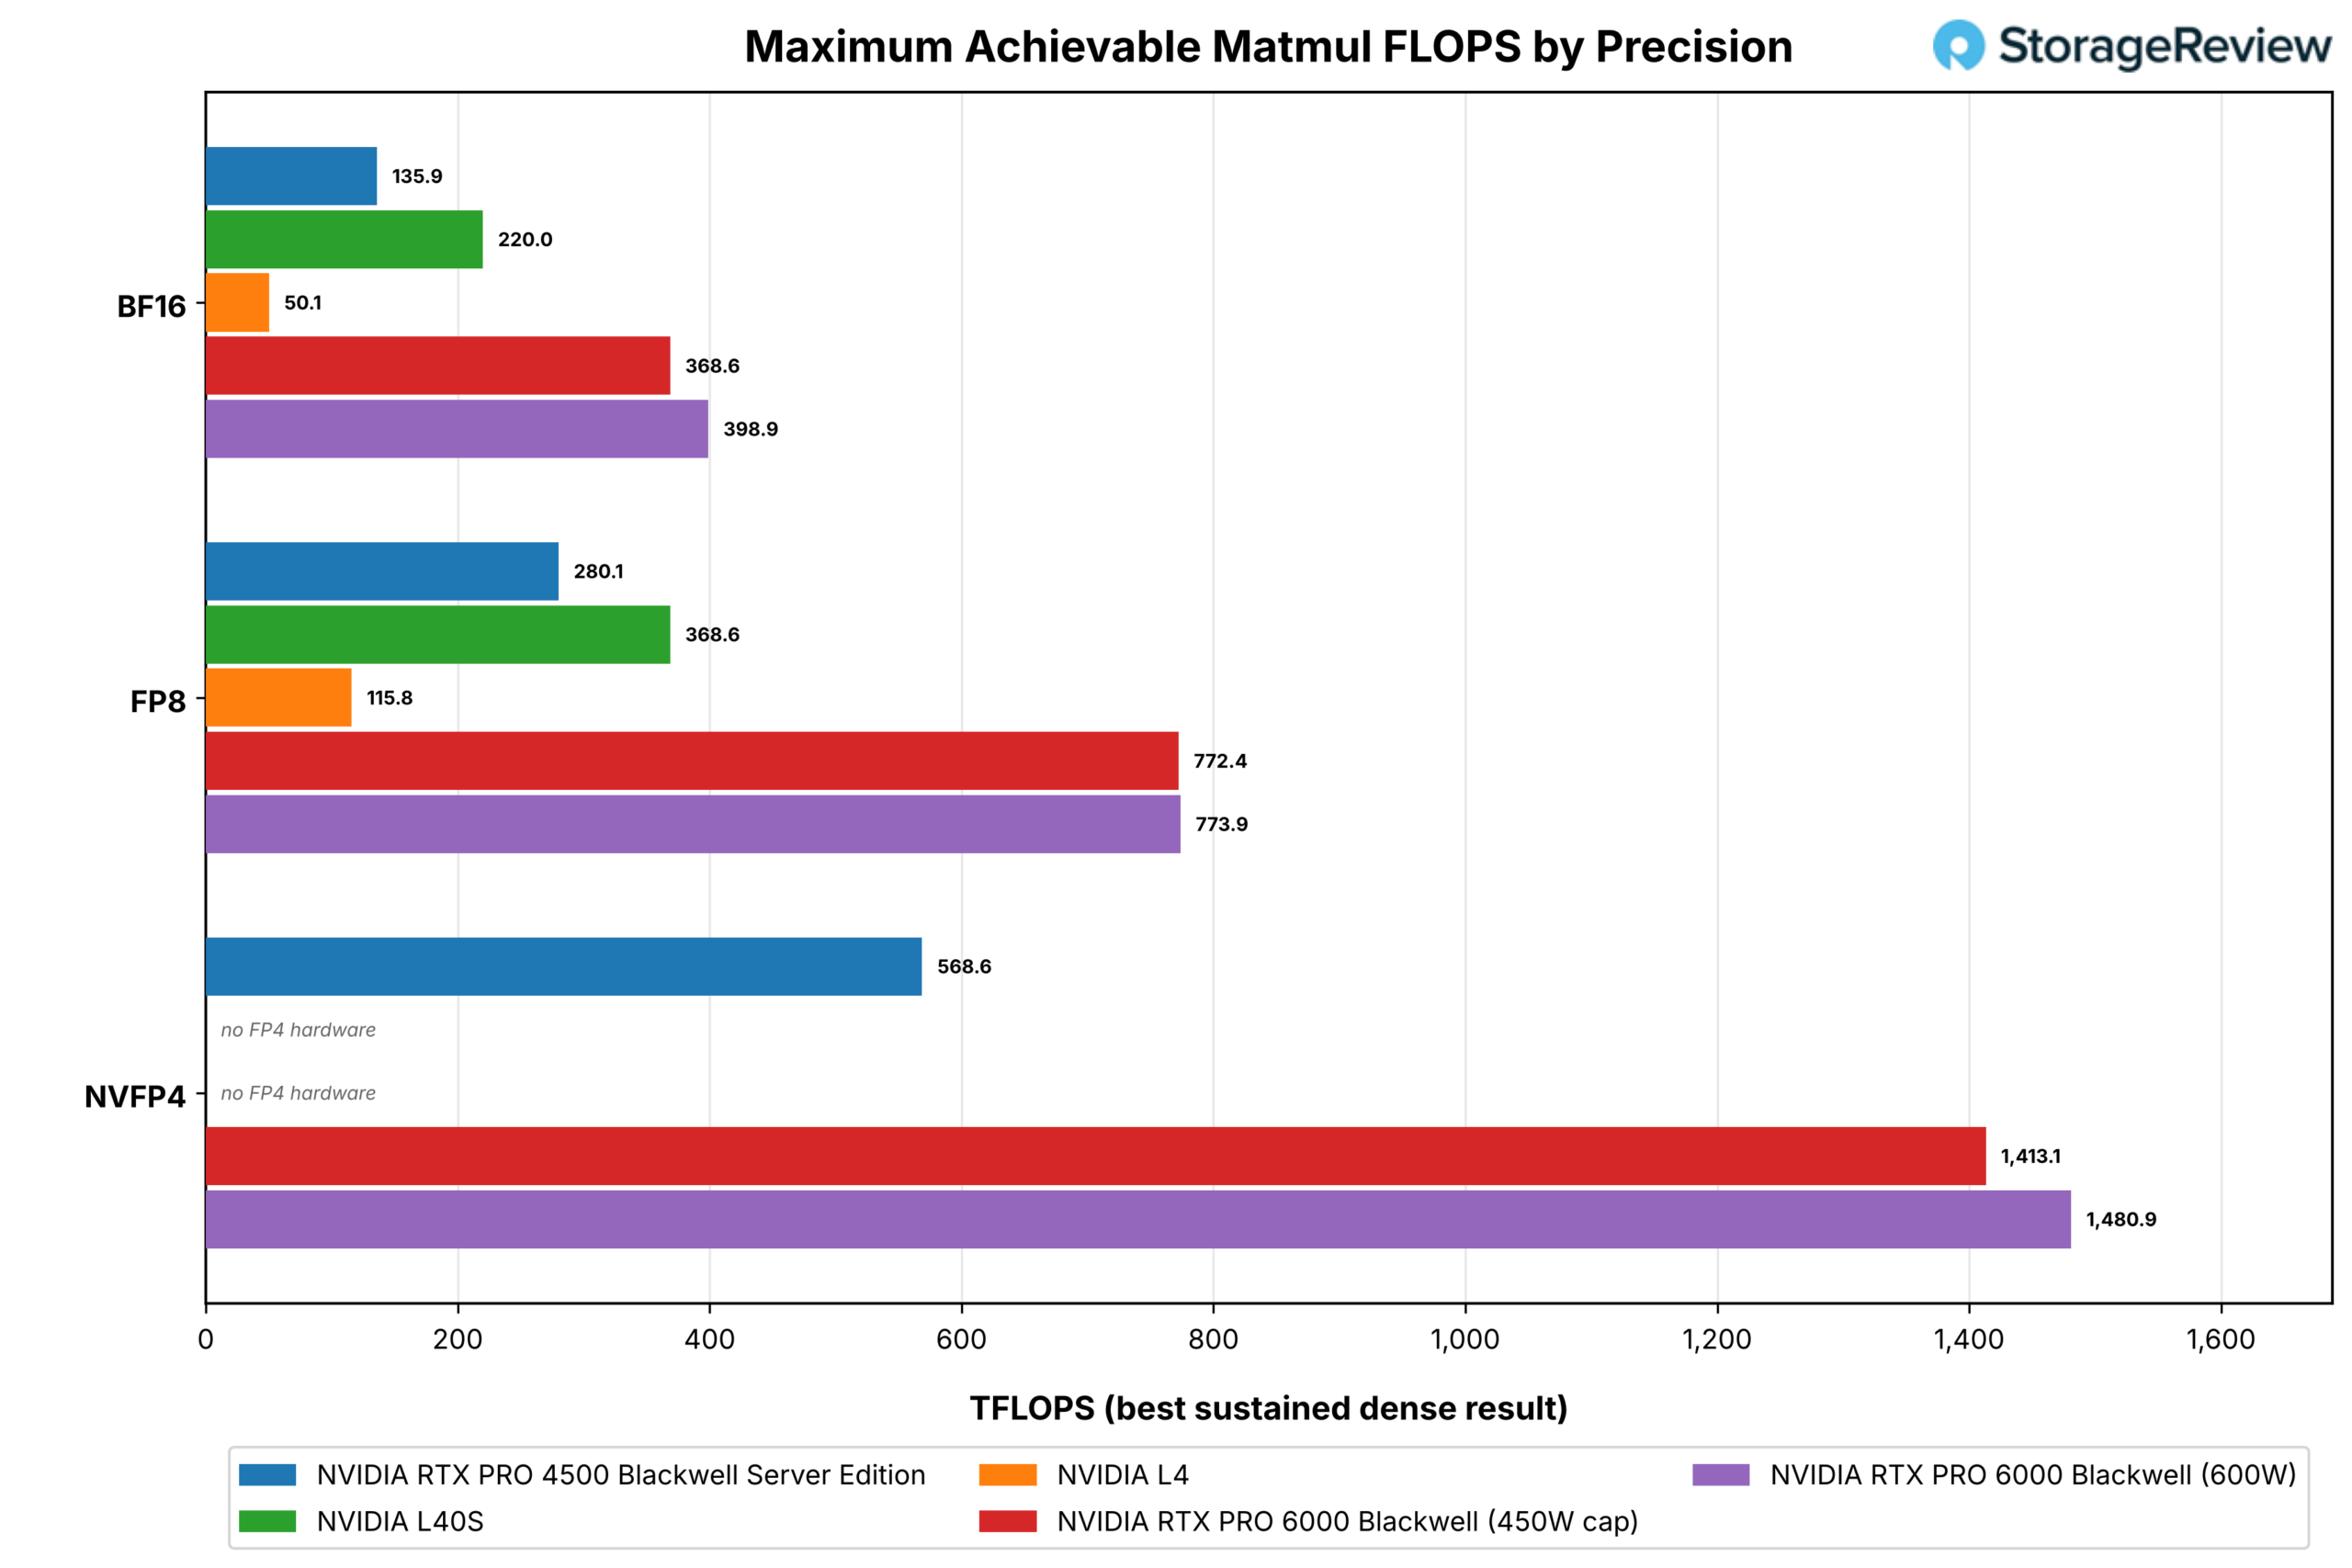
RTX PRO 6000 的效能提升與此類似,在 600W 功耗下分別達到 398.9、773.9 和 1,480.9 TFLOPS,是 4500 在三個精度下的 2.6 到 2.9 倍,這與晶片尺寸和功耗預算的預測相符。在 450W 功耗上限下,其性能分別達到 368.6、772.4 和 1,413.1 TFLOPS:FP8 性能沒有變化,BF16 性能下降了 8%,NVFP4 性能下降了 5%,這表明在此測試中,6000 的 FP8 50W,而其他上限低於 404 張功耗。 L40S 在 BF16 和 FP8 下分別達到 220.0 和 368.6 TFLOPS,L4 則分別達到 50.1 和 115.8 TFLOPS。兩張 Ada 卡都沒有 FP4 張量硬體。
一個有用的對比是4500的NVFP4性能與其他所有處理器的FP8性能:568.6 TFLOPS是L40S FP8性能上限的1.5倍,也是6000系列處理器性能上限的74%,而這還是在165W功耗下實現的。這就是FP4的優勢,而這個優勢體現在GEMM層面。接下來的vLLM服務測試結果表明,在目前版本中,FP4的效能尚未覆蓋整個服務堆疊,而MAMF測試結果表明,隨著NVFP4核心的逐步完善,服務效能將會持續提升。
vLLM 線上服務:簡短背景 (512/512)
4500 的優勢體現在以下幾個方面:在三款 FP8 和 BF16 型號的處理器上,並發數為 32 時,其在 Ministral 3 14B 上的吞吐量為 1,107 tokens/s,而 L40S 為 995 tokens/s;在 MiniBl 3801 上為 801745 70745 707475 7074747)。 1,005 tokens/s;在 Ministral 3 3B 上為 2,006 tokens/s,而 L40S 為 1,988 tokens/s。在所有這些測試中,功耗均為 165W 的 Blackwell 顯示卡都達到了或超過了功耗為 350W 的 Ada 顯示卡的效能水準。此外,從併發數 1 到 32,各款顯示卡的性能曲線幾乎完全重合,因此這並非峰值性能的體現。 L4 在相同型號處理器上的吞吐量分別為 364 tokens/s、279 tokens/s 和 704 tokens/s,這意味著 4500 的效能是其前代產品的 2.8 倍到 3.6 倍。

RTX PRO 6000 的表現展現了 Blackwell 平台其他顯示卡的實力。在 450W 的功耗限制下,它在三個相同的型號上分別達到了 2,161、2,042 和 4,069 個令牌/秒的吞吐量,分別是 4500 的 1.95 倍到 2.03 倍;在 600W 的滿功率下,則分別達到了 2,283、2130 450 個令牌/150 個令牌,分別是 450 個的2.06 倍到 2.1 倍。在所有型號上,兩款 6000 的性能曲線在並發數 16 之前幾乎完全重合,在並發數 32 時也僅有 2% 到 5% 的差距,因此從短期來看,最後增加的 150W 功耗帶來的提升微乎其微。與 4500 相比,這款顯示卡擁有三倍的顯存,並且在 R770 插槽中,其功耗更是達到了 2.7 倍,吞吐量卻達到了 4500 的兩倍。

總吞吐量(包括每個請求的 512 個預填充令牌)也遵循相同的順序:14B 型號的 4500 為 2,215 個令牌/秒,L40S 為 1,990 個令牌/秒,L4 為 727 個令牌/秒,而 6000 的功率個令牌/秒。與 L4 的差距在 8B 型號上最大,為 3.6 倍,在 3B 型號上最小,為 2.8 倍,而與 L40S 的差距從未超過 12%。

vLLM 線上服務:長上下文(8K/1K)
當輸入令牌數達到 8,192 個時,情況發生了變化,原因可以從曲線形狀看出。在 Ministral 3 14B FP8 架構上,4500 處理器在並發數為 8 時與 L40S 處理器基本持平,之後速度穩定在 180 個令牌/秒左右,而 L40S 處理器在並發數為 16 時速度繼續提升至 230 個令牌/秒並保持穩定。 8B 架構也呈現相同的趨勢:4500 處理器在並發數為 32 時速度為 185 個令牌/秒,而 L40S 處理器則為 277 個令牌/秒,4500 處理器在並發數為 8 時速度趨於穩定,L40S 處理器4500 處理器在並發數為 8 時速度趨於穩定,L40S 處理器在並發時趨於穩定速度。在 3B 架構上,兩款處理器的速度都在並發數為 16 時趨於穩定,分別為 384 個令牌/秒和 475 個令牌/秒。

原因在於鍵值快取容量:每個並發的 8K 請求都需要將其上下文駐留在卡上,而一旦權重加載完畢,32GB 的幀緩衝區所能容納的權重數量就比 48GB 的幀緩衝區少。當 vLLM 的鍵值空間耗盡時,它就無法再增加有效的並發,吞吐量曲線也隨之趨於平緩。僅此原因,在這些模型上,4500 在並發數為 32 時,效能就比 L40S 低 17% 到 33%;正如短上下文測試結果所示,計算能力並非瓶頸所在。 L4 快取容量為 24GB,吞吐量為 300GB/s,在所有模型上,從並發數為 4 開始,吞吐量就趨於平緩,介於 34 到 130 個 token/s 之間。

在這項測試中,6000 的 96GB 記憶體始終充足,其效能曲線在所有型號上都持續攀升至 32。在 450W 的功耗限制下,其效能分別達到 552、589 和 973 個 tokens/s,是 4500 的 2.5 倍到 3.2 倍;在 600W 的功耗限制下,其效能分別達到 608、639 和 1,033 個 tokens/50 倍到 1033 個到 1033 個到kens 的 250 倍。功耗限制的影響在這裡顯現出來:長上下文預填充使 6000 的計算密集型效能持續時間更長,因此在並發數為 16 和 32 時,受限於功耗限制的顯示卡效能損失為 4% 到 9%,而在短上下文預填時,效能損失僅為 2% 至 5%。無論如何,與 4500 的效能差距從 2 倍擴大到大約 3 倍,而記憶體而非功耗才是造成這一差距的主要原因。

如果您的工作負載是文件問答、長時間上下文的紅黃綠燈(RAG)處理,或者代理需要處理大量工具輸出,那麼記憶體是主要規格,4500 的 32GB 記憶體會成為並發瓶頸。但如果是聊天、分類或代理輪次較短的情況,則不會。在 8K/1K 測試條件下,總吞吐量主要取決於預填充,且排名順序相同:4500 在 14B 型號上的速度為 1,713 個令牌/秒,L40S 為 2,070 個令牌/秒,L4 為 381 個令牌/秒,而 6000 的功率個令牌/秒。
NVFP4:軟體設定上限
Qwen3.8-27B(NVFP4)是此組顯示卡中唯一一款採用Blackwell主導的FP4 Tensor硬體的型號,其效能曲線最為平緩。在短上下文測試中,並發數為32時,4500的輸出值為320 tokens/s;L40S、480和RTX PRO 6000的輸出值分別達到621 tokens/s(上限)和616 tokens/s(600W功耗下)。在並發數為1時,所有顯示卡在27B架構下的輸出值都在17到22 tokens/s之間,包含配備1.6TB/s GDDR7顯存的6000,而同一款顯示卡在14B FP8架構下單流輸出可達99 tokens/s。

L40S 沒有 FP4 張量硬件,因此 vLLM 通過反量化權重並以更高精度進行計算來運行 NVFP4 檢查點,這是一條受限於內存頻寬的路徑,其性能比 4500 高出 1.5 倍。 6000 與 4500 擁有相同的 FP4 硬件,頻寬是其兩倍,其性能在其他所有方面也比 4500 高出約 2 倍,並且其 450W 和 600W 版本在所有並發情況下的功耗差異均在 1% 以內,因此內核也不受功耗限制。
所有四個系列的模式都表明,單流吞吐量不會隨記憶體頻寬變化,並且無論底層 GPU 是什麼,並發 32 上限都只有 480 到 621,這表明此 vLLM 版本中的 NVFP4 核心路徑是每張卡的極限。

在 8K/1K 的幀速率下,4500 在並發數 32 時達到了 153 個令牌/秒,而 L40S 為 190 個令牌/秒,6000 在限制和未限制幀速率下分別為 402 個令牌/秒和 425 個令牌/秒。這些效能曲線與 FP8 和 BF16 型號所展現的受限於鍵值快取的效能曲線相同,6000 的 96GB 快取再次成為其效能持續提升而其他型號效能趨於平緩的原因。
NVIDIA 在這張顯示卡上實現了 FP4 效能,在 Llama 3.1 8B 測試平台下,2K/256 解析度時達到 1,221 tokens/s,在 Nemotron 3 Nano 30B A3B 測試平台下,TensorRT-LLM 模式下達到 905 tokens/s。因此,該硬體在 NVIDIA 的技術堆疊下能夠勝任。然而,目前的數據顯示,這張顯示卡的 NVFP4 效能與我們測試過的所有 GPU 的 vLLM 軟體效能基本上一致。因此,依賴 FP4 吞吐量的使用者應該在決定是否依賴該效能之前,先測試一下他們的伺服器架構。
每額定功率的吞吐量
本輪測試我們沒有測量功耗,因此本次效率計算是基於每張顯示卡的測試功耗上限。在Ministral 3 14B FP8測試平台,並發數為32時,RTX 4500的每瓦輸出令牌數為6.7個/秒,而L40S為2.8個/秒,L4為5.1個/秒,RTX PRO 6000在450W/秒,L4為5.1個/秒,RTX PRO 6000在450W個上限下為4.83個功率上限為R300個功耗,83個功率。在3B測試平台上,上述比例不變:RTX 4500為12.2個/秒,L40S為5.7個/秒,L4為9.8個/秒,RTX 6000在450W功耗上限下為9.0個/秒,RTX 6000在600W
就短時效能而言,4500 是該組中效率最高的顯示卡,只有功耗上限為 6000 的顯示卡能與之媲美。將 6000 的功耗降至 450W 會使其吞吐量損失 2% 到 5%,但能節省 25% 的功耗預算,因此其效率提升了四分之一。 L4 顯示卡在這項指標上仍然具有競爭力,因為 72W 的分母非常小,但它需要三倍於 4500 的插槽和伺服器數量才能達到相同的吞吐量,而 4500 的設計初衷正是為了解決這個問題。
在 8K/1K 的情況下,順序發生了變化:4500 在 14B 型號上每額定瓦特的吞吐量為 1.2 個令牌/秒,6000 的吞吐量為 1.2 個令牌/秒,600W 的 6000 為 1.0 個/秒,而 L40S 為 0.7 個令牌。一旦 4500 的 KV 快取耗盡,其吞吐量將停止增長,而其額定功率不會增加,因此從長遠來看,450W 的 6000 在效率上與其相當,並且每個插槽的工作負載是其 2.9 倍。
結語
RTX PRO 4500 Blackwell 伺服器版正如 NVIDIA 所言:它將 Blackwell 架構整合到了一個插槽、相同的功耗預算和機箱層級中,而先前 Blackwell 架構的顯示卡最高只能達到 L4 等級。在大多數主流伺服器運行的機型(包括小型和中型指令集以及聊天長度上下文的推理模型)上,這款單槽顯示卡能夠以不到 L40S 一半的功耗,提供 L40S 級別的吞吐量,並且性能是 L4 的三倍。
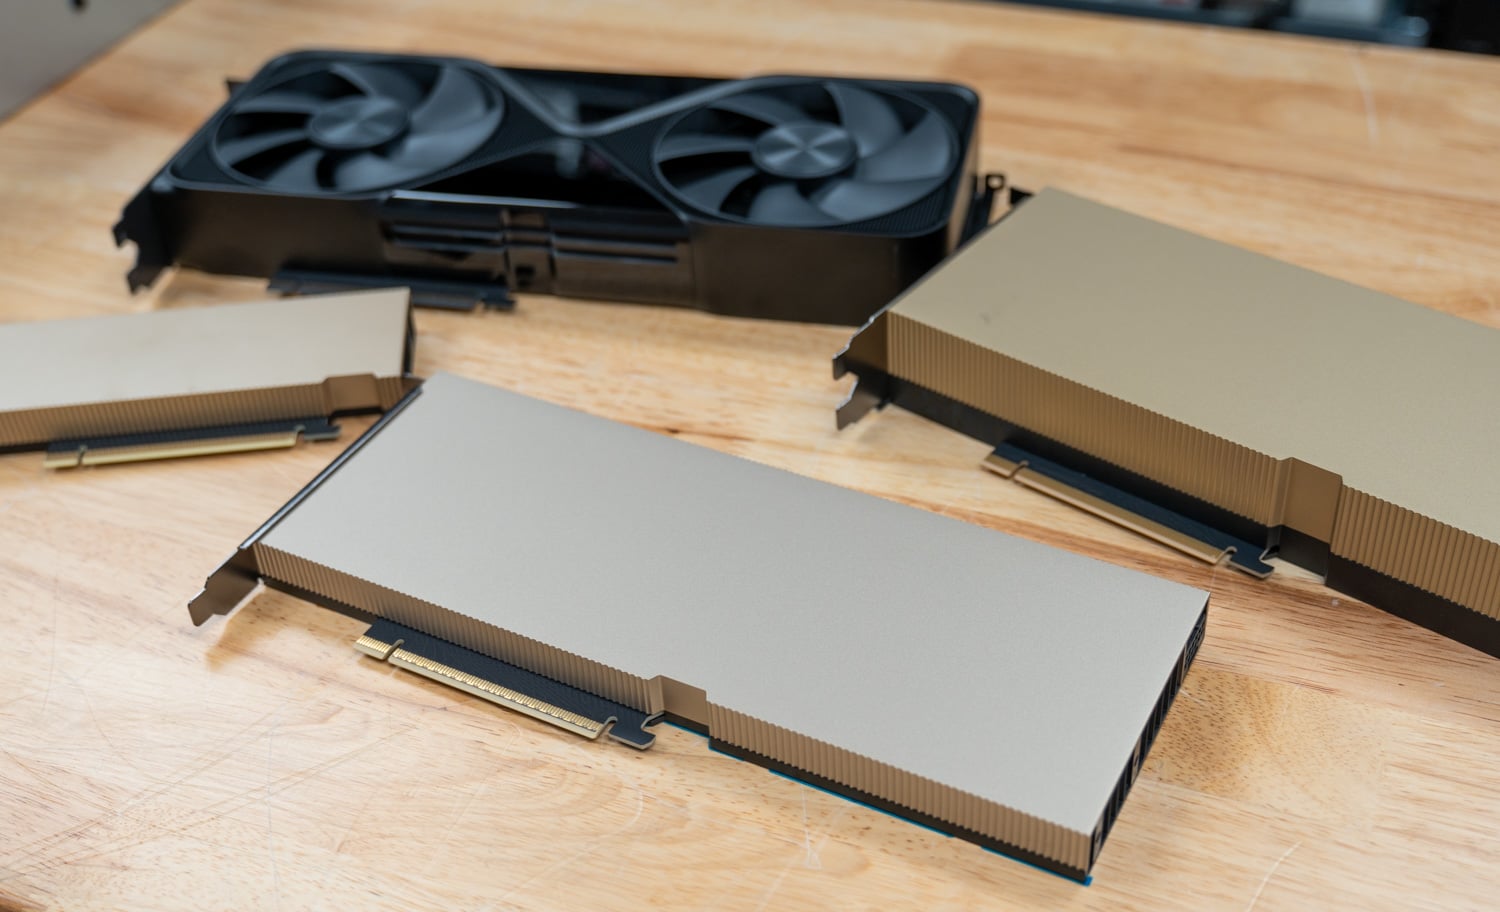
當然,凡事皆有限制。首先是內存:32GB 的內存容量對於這款顯示卡的目標型號來說足夠,但它限制了長時間並發處理的能力,而 L40S 的 48GB 內存,尤其是 6000 的 96GB 內存,則遠勝於它。即使在伺服器效能限制在允許範圍內的情況下,6000 在相同的請求模式下,效能也大約是 4500 的三倍。
NVFP4 是 Blackwell 的旗艦級精密晶片,在這個 vLLM 版本中,它的性能與沒有 FP4 硬體的顯示卡相當。儘管 MAMF 掃描顯示,在 GEMM 級別,FP4 硬體提供的速率是顯示卡 FP8 速率的兩倍,但 FP4 的優勢需要在您自己的堆疊上進行驗證。不過,顯然透過軟體可以獲得更大的提升。
對於擁有 2U 伺服器或支援 FHFL 卡的 1U 機箱,且需要在不改動電源或散熱的情況下增加推理、視覺 AI、轉碼或虛擬工作站容量的用戶來說,RTX PRO 4500 是一個絕佳的選擇。此外,對於仍在使用 L4 快取且 24GB 記憶體已無法滿足需求的使用者來說,RTX PRO 4500 也值得考慮。而對於那些工作負載具有長期上下文關聯性或需要多租戶部署,且每張顯示卡需要 48GB 或以上顯存的組織而言,RTX PRO 6000 則是更佳選擇。
NVIDIA 為這些顯示卡劃分了兩條清晰的泳道,做得很好,4500 填補了 L4 和 6000 之間的邊緣 AI 空白,同時功耗僅為 165W。
排行榜: RTX PRO 4500 Blackwell 伺服器版在我們最佳企業級 GPU排行榜上榮獲最佳單槽 GPU稱號,本次評測中的 L40S 和 RTX PRO 6000 資料也出現在該排行榜上。



 Amazon