

2026 年台北國際電腦展 (Computex 2026) 已拉開序幕,NVIDIA 一如既往地以黃仁勳的主題演講為展會定下了基調,演講內容涵蓋了公司未來的發展藍圖。其中很大一部分內容是我們之前已經見識過的資料中心 GPU 技術,例如 Vera Rubin 架構現已全面投產,以及關於智能體將重塑計算各個層面的理念——這些內容我們早已耳熟能詳。在此,我們不再贅述。
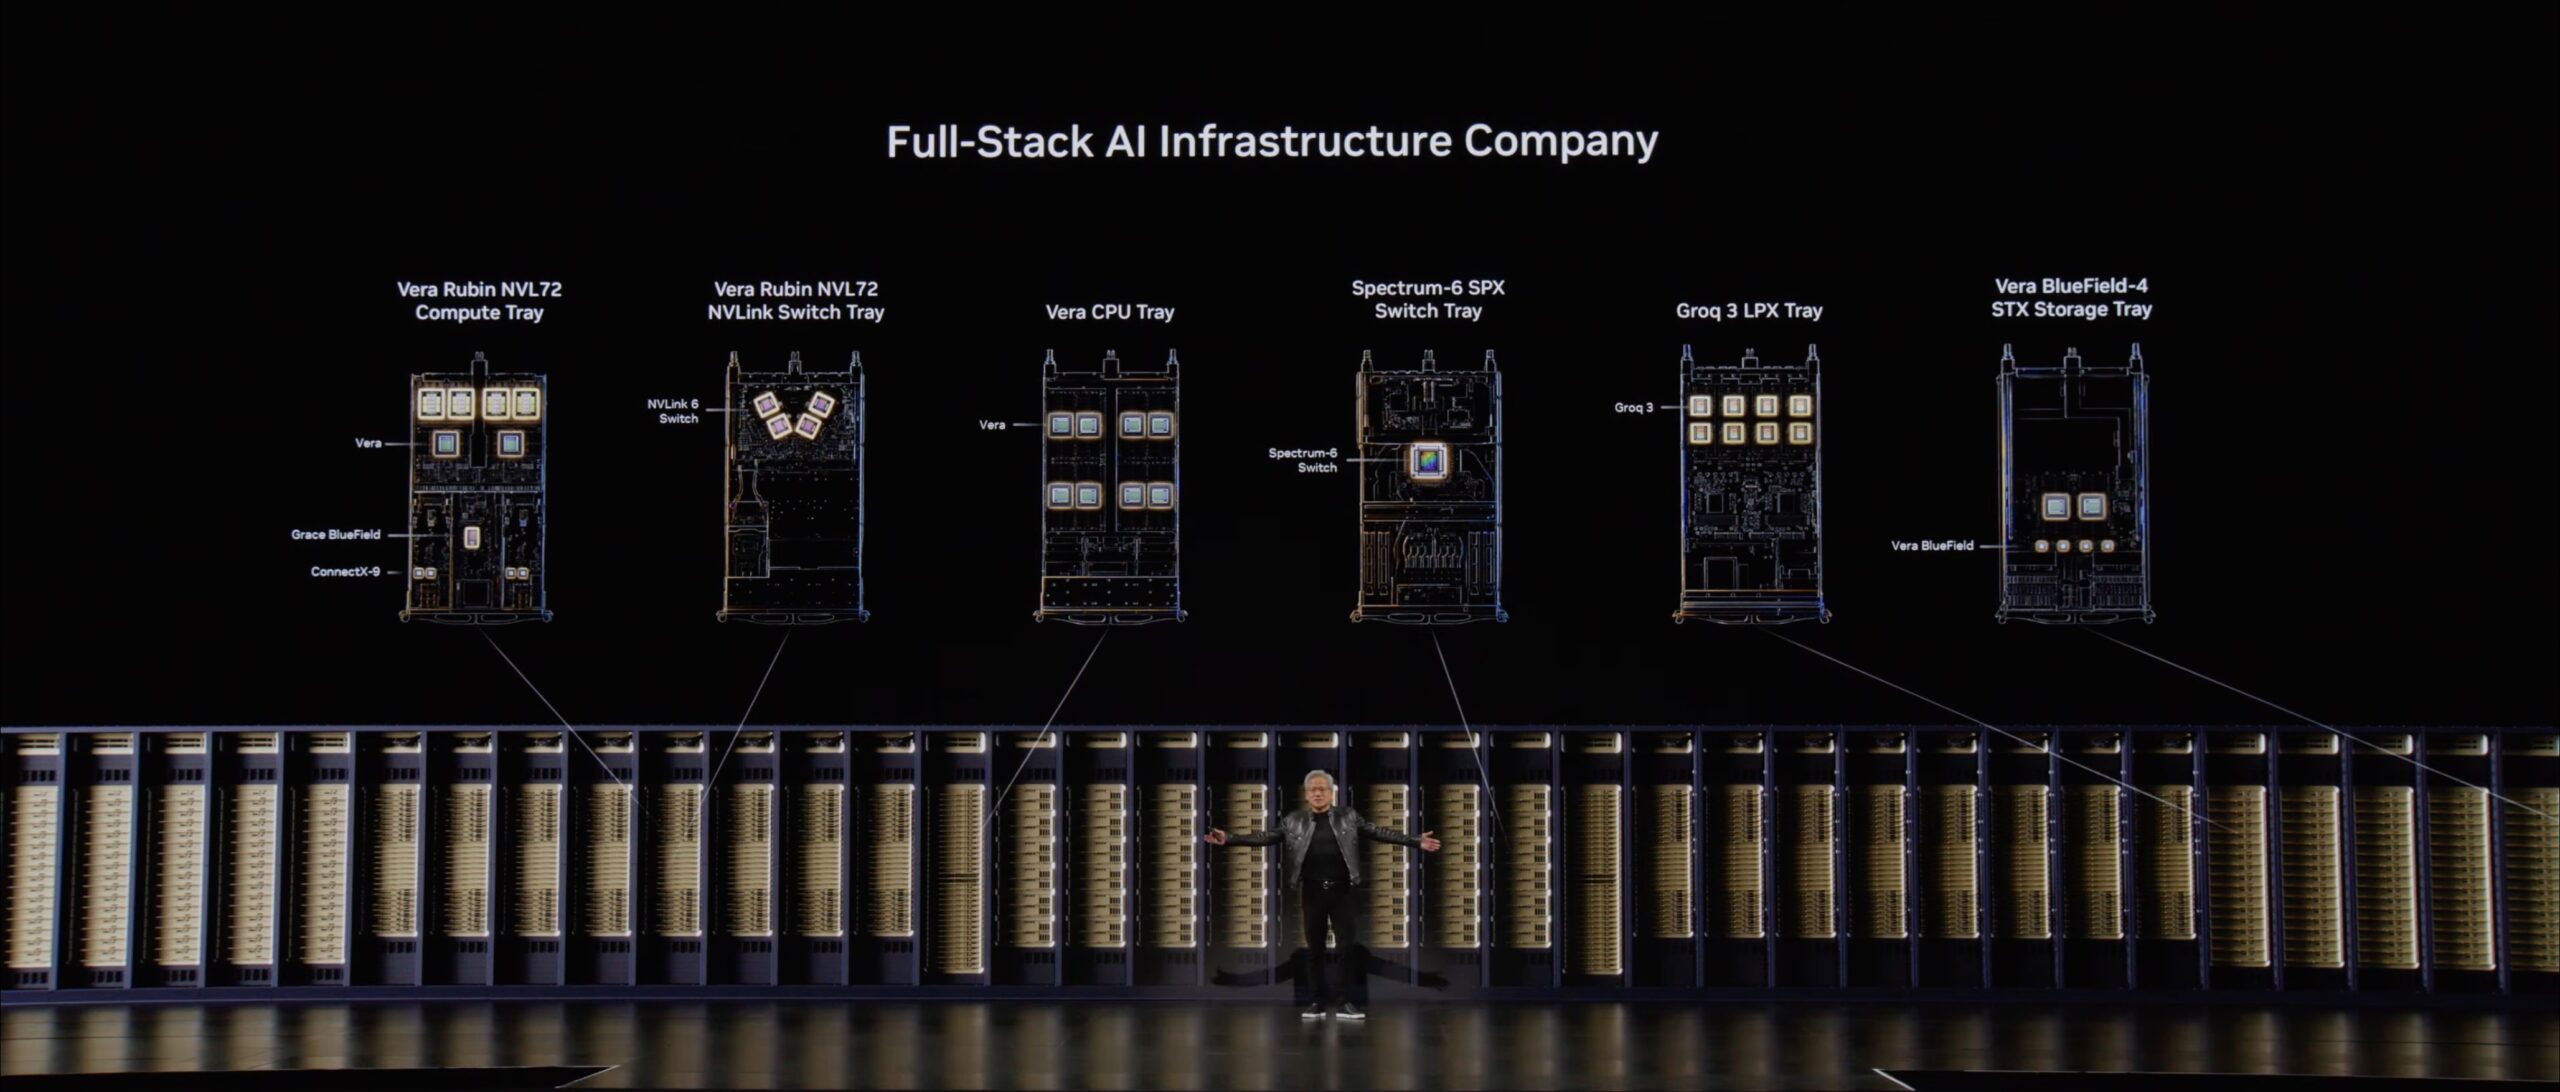
真正具有創新意義,也是本次主題演講對所有客戶端人員至關重要的原因,在於個人電腦(PC)。 NVIDIA 與微軟利用台北國際電腦展(Computex)宣布對 Windows 系統進行全面革新,此次革新涵蓋整個產品系列,而非僅限於單一裝置。不過,在此之前,我們不妨先仔細了解資料中心領域中的一些重要內容。
LPX機架詳解
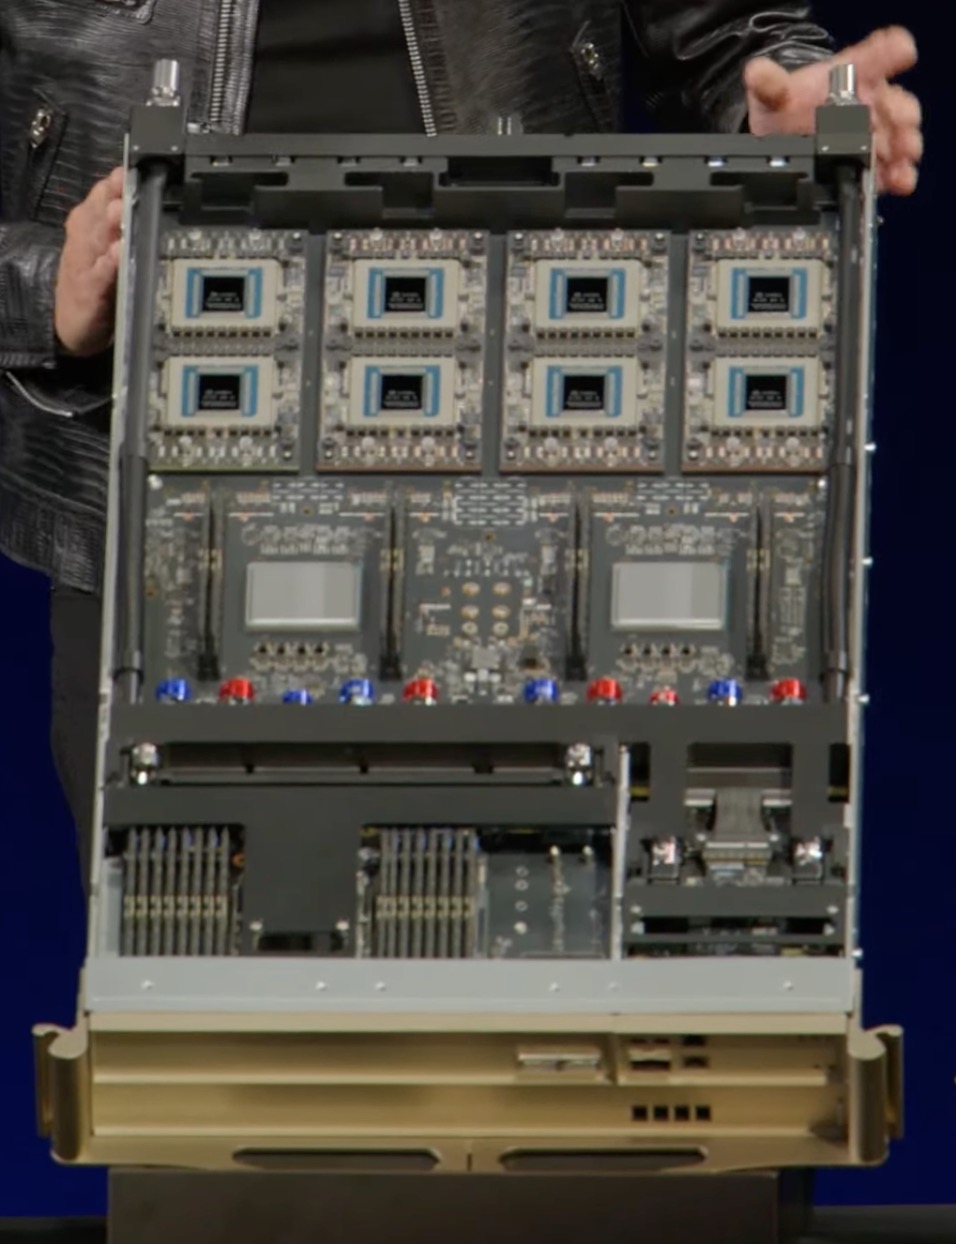
資料中心的一個變化引起了我們的注意。 LPX機架似乎有改動。系統似乎從1個OU擴展到了2個OU,而且四個Groq C2C鏈路的物理外觀也與我們之前報告的LPX機架有所不同。這次NVIDIA讓我們更仔細地觀察了機架。除了這兩個變化之外,機架外部並沒有其他明顯的不同,這讓我們非常好奇第二層究竟容納了什麼。
三層PC系列
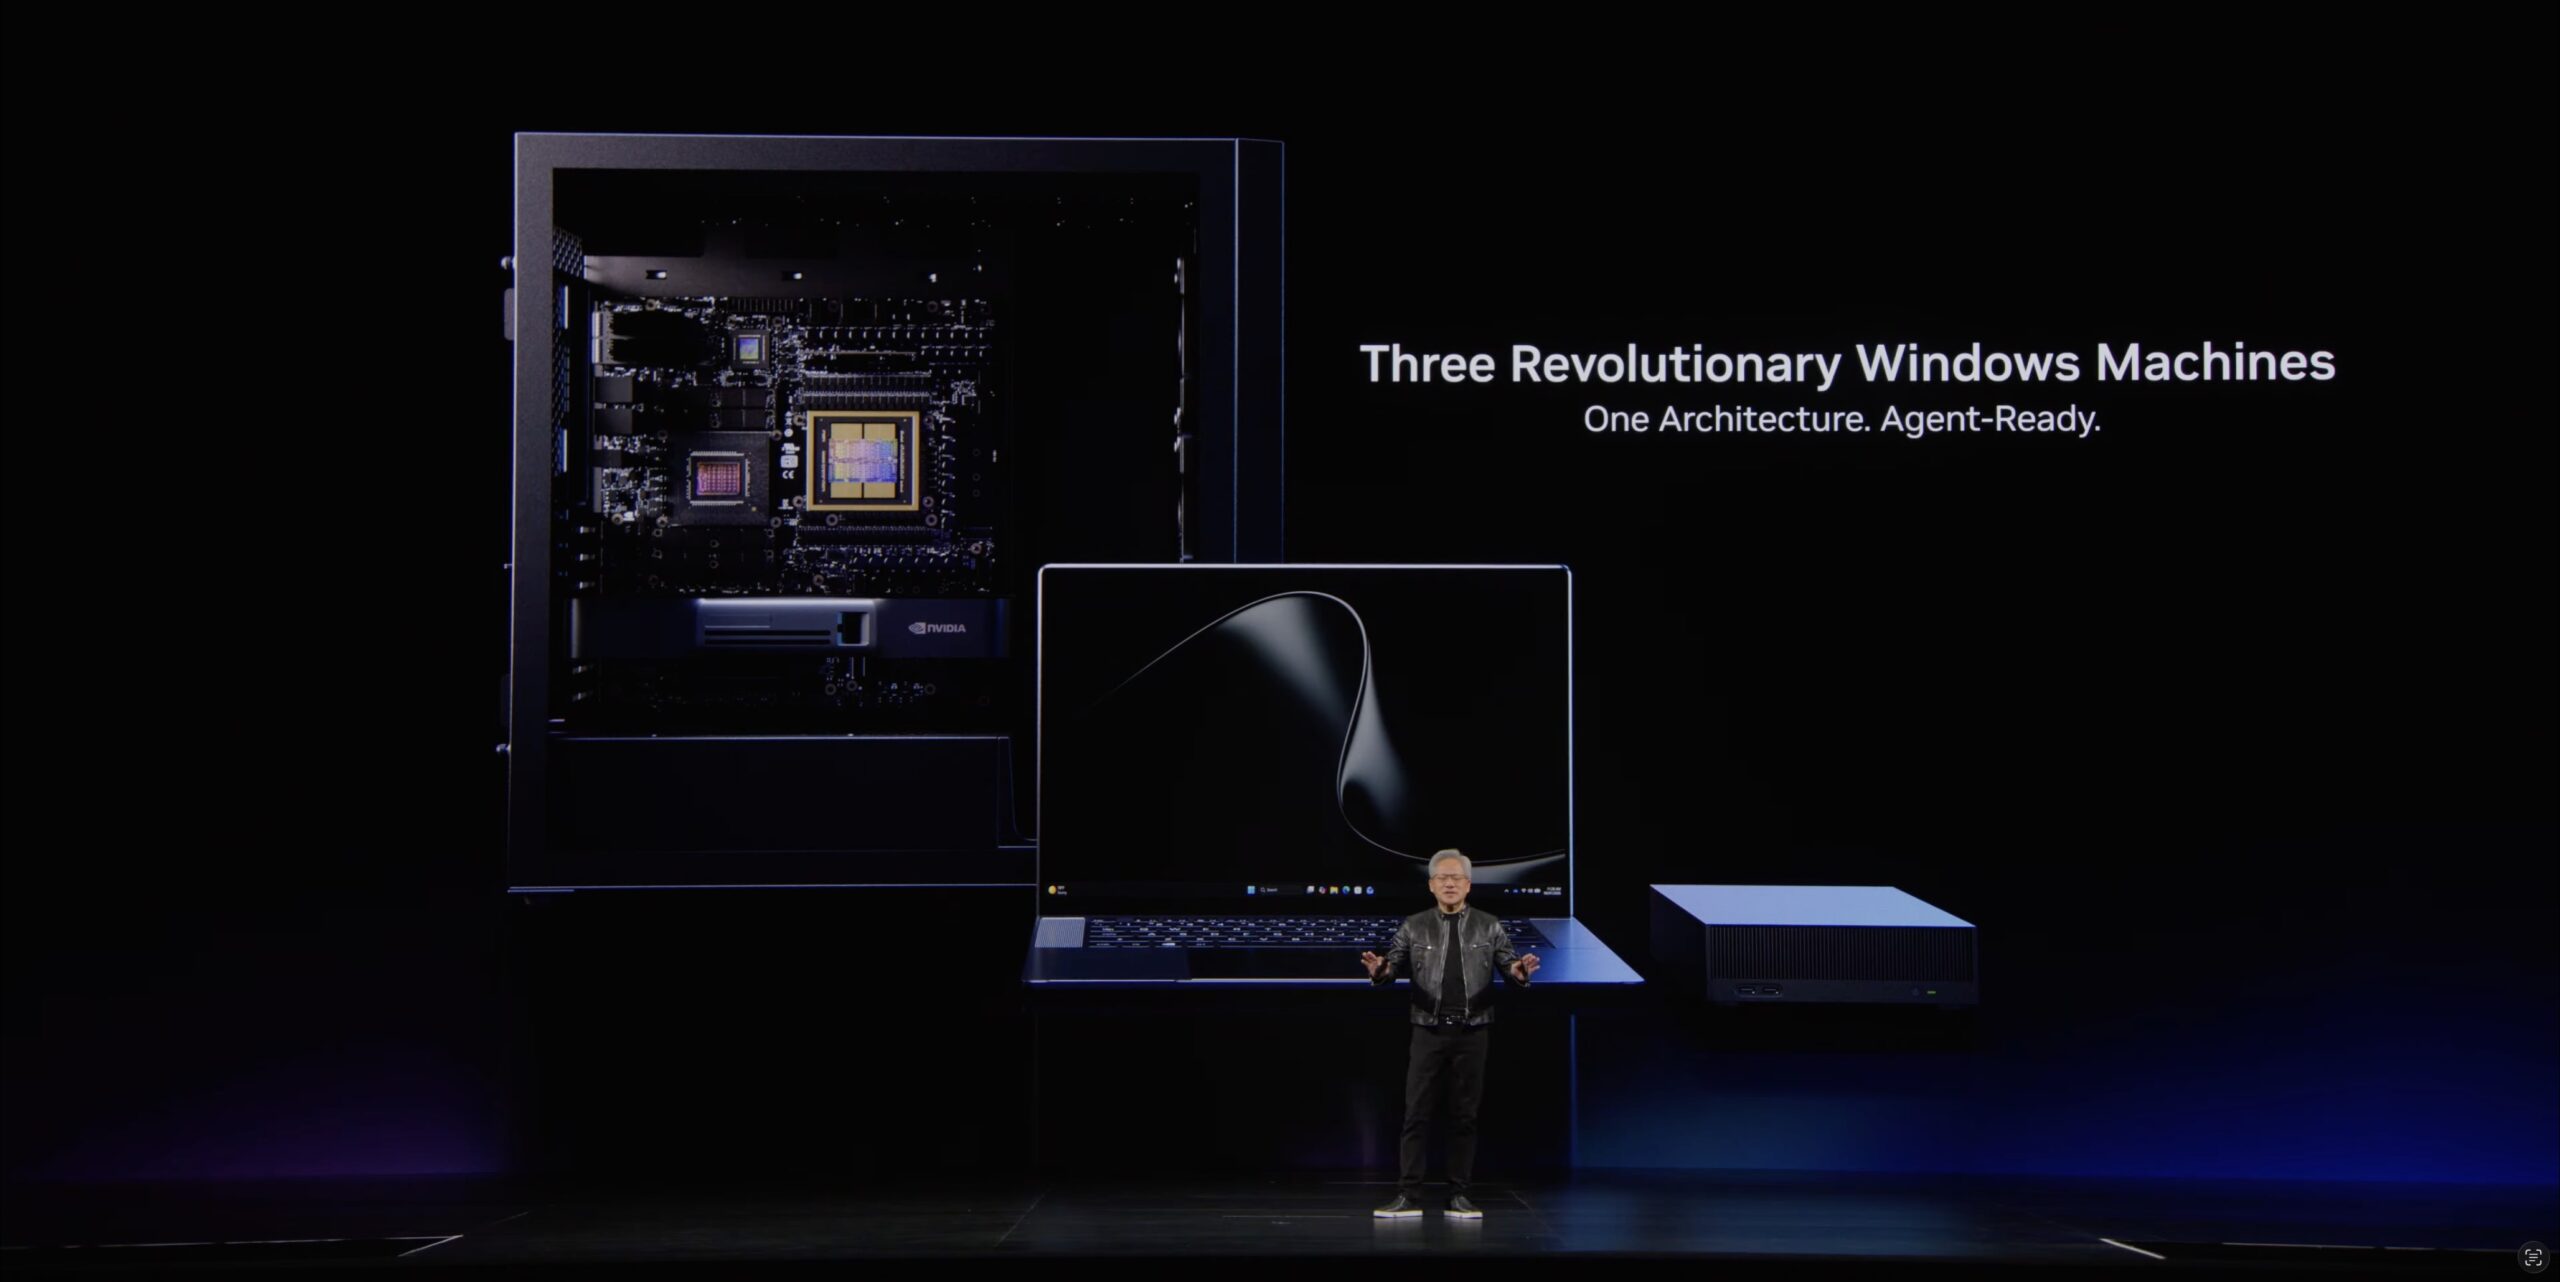
NVIDIA 發布了一系列用戶端裝置:筆記型電腦、桌上型電腦和工作站,全部基於 Spark 和 Blackwell 平台打造,並旨在支援 Windows 系統。 Jensen 將其描述為 40 年來首個完全重新設計的 PC 產品線。無論你是否認同這種說法,了解其產品結構都十分重要,因為每個產品層級都針對截然不同的使用者群體。我們將逐一介紹。
RTX Spark 筆記型電腦
這些筆記型電腦的核心是RTX Spark超級晶片,NVIDIA在發表會上以代號N1X展示了這款晶片,它由NVIDIA與聯發科合作開發。這款晶片採用台積電3nm工藝,擁有70億個晶體管,並將兩個晶片組融合到一個SoC中。 GPU部分採用大型Blackwell架構,擁有6,144個CUDA核心和第五代Tensor Core,支援FP4精度,FP4 AI效能達到1 petaflop。 GPU透過NVLink-C2C以600GB/s的速度(NVIDIA的資料約為PCIe Gen 5的5倍,但功耗更低)連接到20核心Grace CPU。內存方面,最高配備128GB統一內存,頻寬為300GB/s。
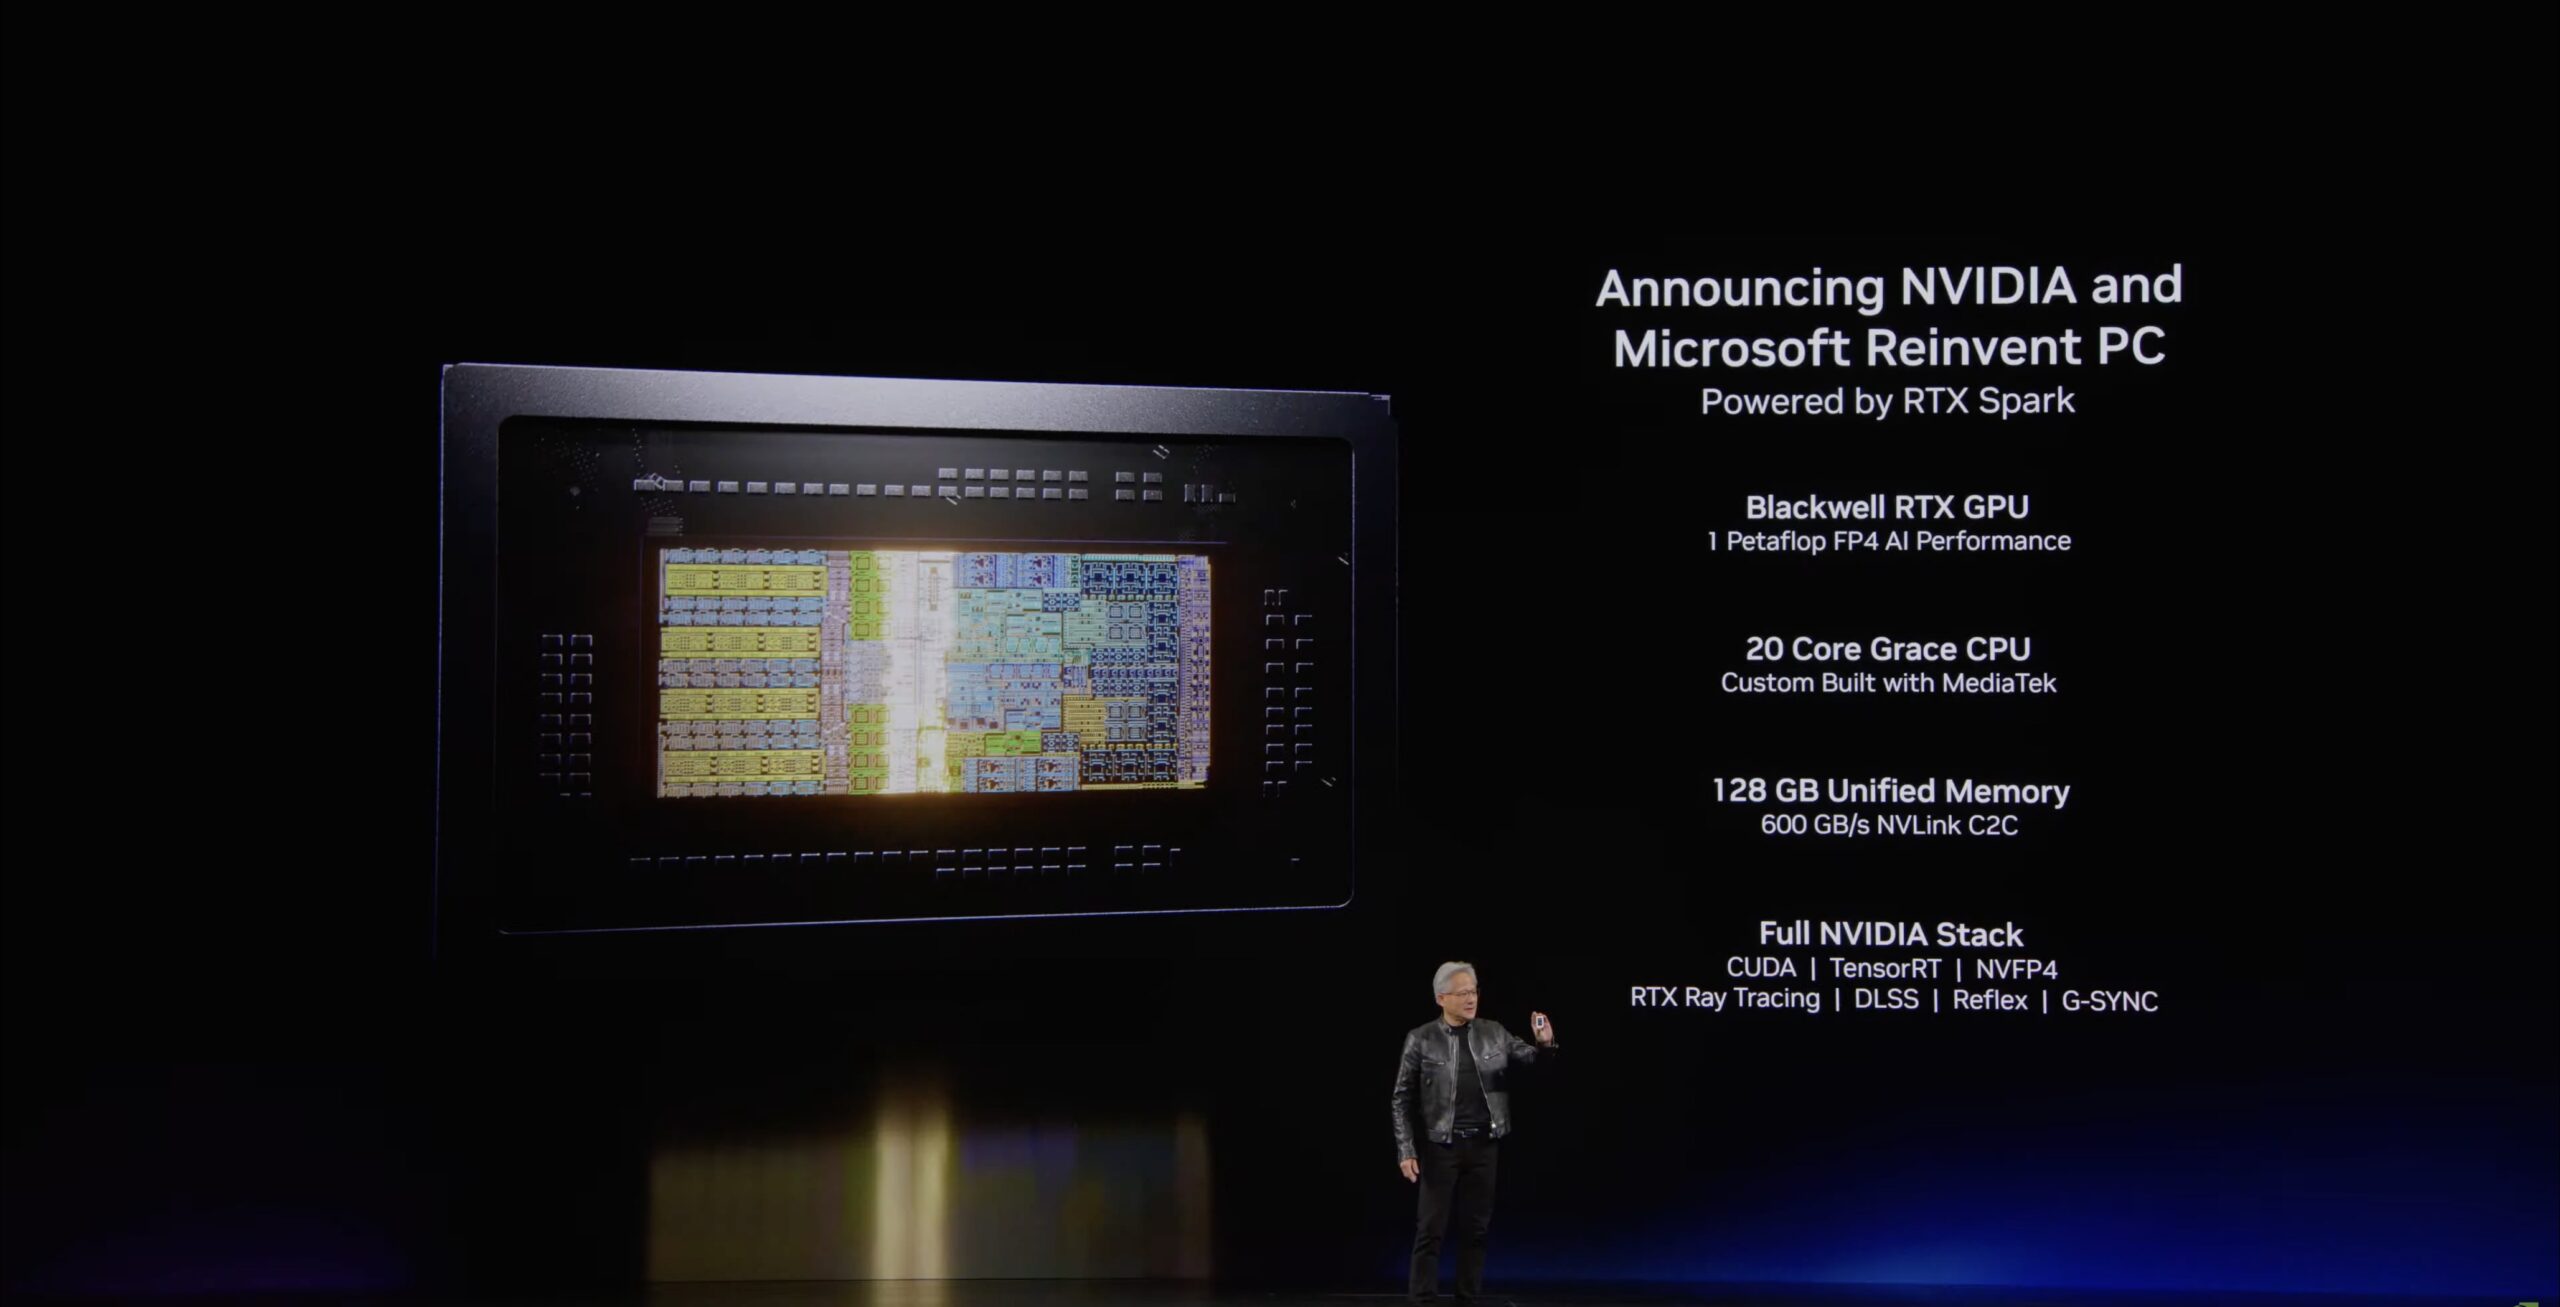
如果這看起來像是DGX Spark的規格表,那是因為它幾乎是。 NVIDIA在媒體問答環節中也明確表示,這款全規格晶片“基於與DGX Spark相同的系統”,但在硬體和軟體方面都針對不同的平台進行了最佳化。其定位是,DGX Spark專為Linux和AI開發者打造,而RTX Spark則是Windows優先的產品,它在同一晶片之上疊加了RTX遊戲和創作堆疊。 NVIDIA將其效能描述為“與RTX 5070筆電GPU處於同一等級”,但同時強調,由於採用統一記憶體的SoC與透過PCIe連接的獨立GPU的效能差異很大,因此效能比較會因工作負載而異。這正是我們最感興趣的DGX Spark體驗所在,也是我們預期這次發布與上次發表會有所不同的地方。在我們的DGX Spark測試中,最一致的發現之一是各個OEM廠商的設計方案之間的差異非常大。有些實現方式比其他實現方式設計得更好,但由於每個單元基本上都是基於相同的 NVIDIA 參考平台構建的,具有相同的功耗和散熱範圍,因此實際性能非常接近。
我們預計這種情況不會在這裡反映出來。 RTX Spark 顯示卡將應用於筆記型電腦,其中一些筆記型電腦的厚度僅為 14 毫米,重量僅 3 磅。 NVIDIA 確認,這些晶片的功耗範圍從個位數瓦到最高配置的約 80 瓦不等,每個 OEM 廠商都可以自由選擇自己的散熱方案,從均熱板到先進的熱管散熱。在如此纖薄的機身中,晶片的功耗幾乎肯定會受到限制,進而導致其散熱和頻率也受到限制。這並非貶低,而是物理定律使然。這意味著,如果 OEM 廠商能夠打造更出色的散熱方案,為晶片提供更高的持續功耗預算,並優化風扇曲線,那麼即使使用相同的晶片,也能在性能上真正超越更薄、更安靜的競爭對手。兩款搭載相同晶片和相同記憶體的筆記型電腦,其持續吞吐量也可能存在顯著差異,而找出哪家 OEM 廠商能夠真正讓晶片發揮全部效能,正是我們夢寐以求的測試。 RTX Spark 也涵蓋了整個晶片系列。 NVIDIA明確表示,將推出多個SKU,其中頂級配置版本(20個CPU核心,最高128GB記憶體)將位居榜首。整個產品系列記憶體容量從16GB到128GB不等。 NVIDIA預計,光是首批產品中,各大OEM廠商就將推出超過30款筆記型電腦和超過10款桌上型電腦,其中包括戴爾XPS 16 Creator Edition、惠普OmniBook和微軟Surface Laptop Ultra等知名產品。
兩項硬體細節讓我們感到樂觀。首先是網絡,或者更確切地說,是網絡功能的缺失。 DGX Spark 出廠時內建了 NVIDIA 的 ConnectX-7 網路和 200GbE 連接,這對於開發者叢集來說固然很好,但卻佔用了電路板空間、功耗和成本。 NVIDIA 已確認 RTX Spark 筆記型電腦將不會採用 CX7 晶片組。對於消費級 Windows 筆記型電腦而言,這是一個正確的決定,節省下來的電路板空間和功耗預算,讓我們期待看到這些設備配備性能更佳的儲存設備。 DGX Spark 的儲存雖然夠用,但從未成為亮點,而消費性筆記型電腦無需為網路晶片供電,因此完全有理由配備速度更快、容量更大的 NVMe 固態硬碟。其次是 I/O 介面。由於所有 DGX Spark 都使用相同的參考電路板,因此所有裝置都配備了相同的介面。在 DGX Spark 的統一性之後,我們期待看到真正意義上的、每個 OEM 廠商都能擁有多樣化的 I/O 介面。
電池續航力是筆記型電腦的最後一個關鍵問題,也是我們基準測試的重點。 NVIDIA 承諾筆記型電腦可以滿足全天辦公室和瀏覽網頁的需求,但也坦誠地表示,玩遊戲或運行高強度 AI 程式會在 45 分鐘到 1 小時內耗盡任何筆記型電腦的電量。我們迫不及待想要量化的是實際運行 AI 工作時的電池續航力。即使用戶不操作也能運行的智能體固然吸引人,但真正關鍵的是電池續航時間,而全天收發郵件和全天運行 1200 億字節模型之間的差距可能非常巨大。我們已經準備好了一整套客製化的個人 AI 運算基準測試,專門用於此類平台,我們計劃衡量實際的生產力提升,而不是僅僅相信行銷宣傳的數據。
RTX Spark 桌上型電腦
NVIDIA 確認,小型化的 RTX Spark 桌上型電腦將於今年秋季與筆記型電腦一同發布,並在發表會上展示了一款來自 MSI 的產品。說實話,乍一看,它就像一台 DGX Spark,而我們對它的了解也僅限於此。它的工業設計似乎與我們評測過的 DGX Spark 有所不同,但除此之外,NVIDIA 並未透露更多資訊。
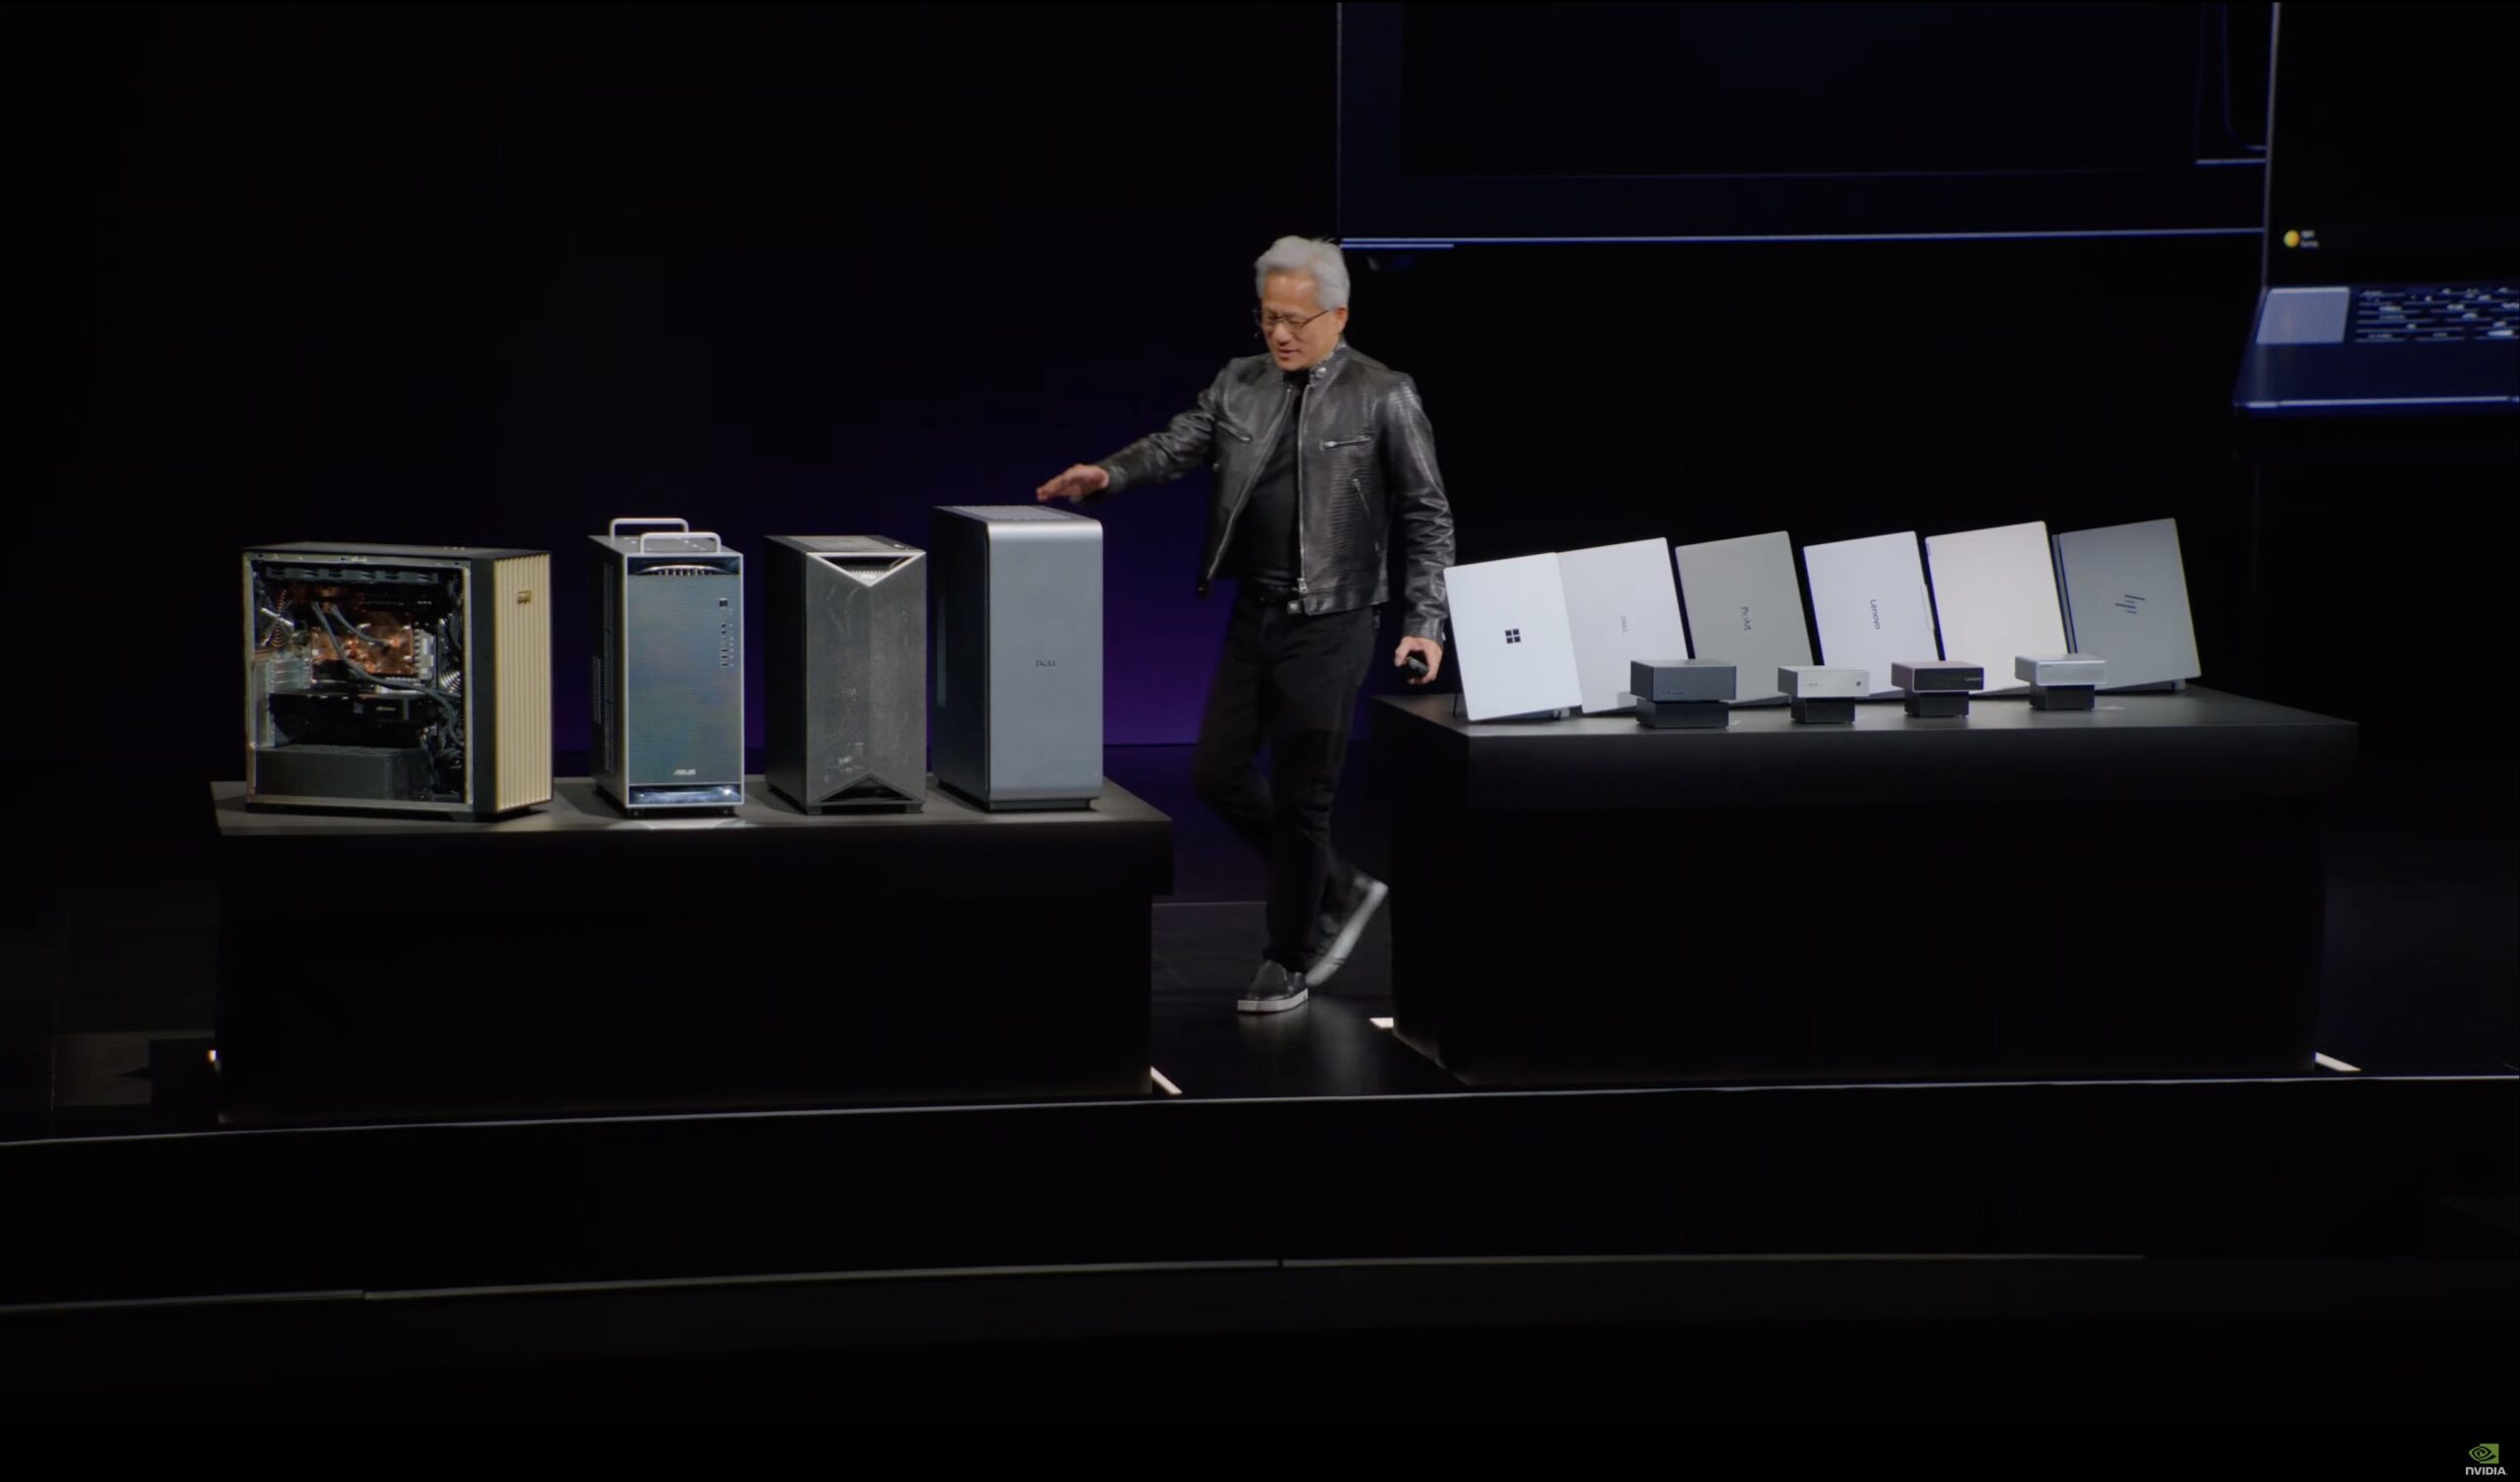
我們的問題顯而易見,但只能等到拿到硬體進行測試後才能解答。考慮到桌上型電腦的散熱空間應該比14毫米厚的筆記型電腦大得多,那麼它的持續性能與筆記型電腦和DGX Spark相比如何?桌上型電腦是否保留了DGX Spark的200G網絡,還是像筆記型電腦一樣為了降低價格而放棄了CX7晶片組?
DGX站
第三層是重頭戲,也是我們已經有所了解的機器。 NVIDIA 之前已經公開展示過 DGX Station,我們最近也有幸上手體驗了一台。由於其主要規格參數早已公開,我們在此就不贅述了,更多細節將在即將發布的評測文章中詳細介紹。
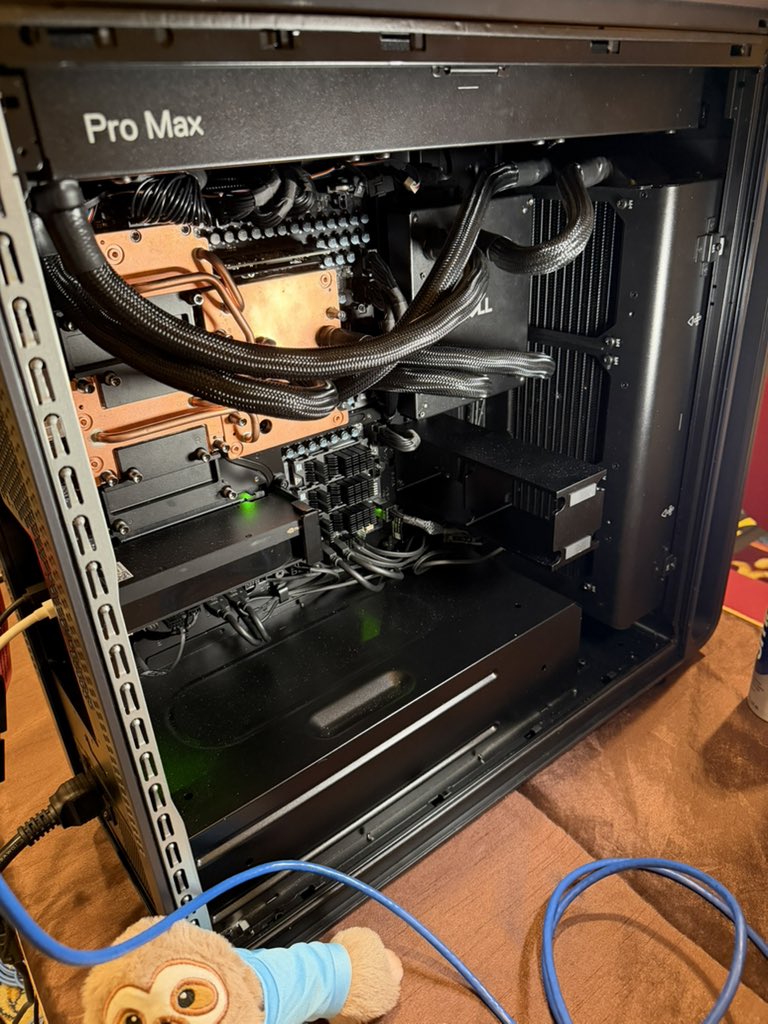
簡而言之:DGX Station for Windows 基於 GB300 Grace Blackwell Ultra 桌上型超級晶片,將 Blackwell Ultra GPU 與 72 核心 Grace CPU 結合。它擁有高達 748GB 的相干記憶體和高達 20 petaflops 的 FP4 運算能力,足以在本地運行萬億參數模型,並且正如 NVIDIA 所說,可以同時運行數百個代理程式。與消費級 Spark 設備不同,這款產品配備了速度高達 800Gb/s 的 ConnectX-8 超級網卡,並可選配 RTX PRO 6000 Blackwell 工作站 GPU。
最大的疑問是:微軟能做到嗎?
讓我們明確一下我們的立場。 DGX Spark 對 NVIDIA 來說是一項重大成功,我們對整個系列都非常樂觀。硬體設計無可挑剔,能源效率也達到了預期,NVIDIA 已經驗證了晶片的性能。我們對微軟能否支援這些設備持懷疑態度。
微軟最近頻頻登上新聞頭條,但都是因為負面新聞,用戶對Windows的發展方向越來越不滿。有些用戶甚至戲稱其為「微軟垃圾」(Microslop)。這些抱怨並不新鮮:Copilot被強行塞進作業系統的各個角落,人工智慧在整個技術堆疊中垂直整合,以及一些長期存在的做法,例如強制使用者使用OneDrive。此外,Windows on Arm平台也遠稱不上成熟。 NVIDIA則寄望於這次的情況有所不同,並列舉了多年來雙方在Prism模擬器上的合作,以及與所有主流反作弊廠商的合作。對於「為什麼Windows on Arm現在會成功?」這個問題,NVIDIA的回答基本上是:「因為大家終於都全力支持它了。」這或許不假,但上次我們也聽到了類似的說法。
我個人非常希望微軟能兌現承諾,因為它的優勢顯而易見。 RTX Spark 是一款效能強勁的遊戲本,大致相當於 RTX 5070 的水平。如果模擬和驅動程式方面的問題能夠解決,它最終可能會成為比 NVIDIA 自家獨立顯示卡筆記型電腦更經濟高效的遊戲替代方案。此外,我們也不能忽視 Linux 平台的優勢。由於晶片本身就具備強大的 Linux 支持,RTX Spark 應該能夠繼承 DGX Spark 強大的 Linux 支持,而 DGX Spark 正是憑藉這種強大的 Linux 系統才成為如此出色的小型遊戲本。我們非常好奇,微軟在 Windows 系統下進行的遊戲和圖形優化是否也能轉化為 Linux 系統下的遊戲效能提升。如果微軟搞砸了這樣一個優秀的平台,那麼憑藉其 Linux 平台的優勢,RTX Spark 的發布或許能夠真正開啟 Linux 桌面電腦普及之年。
更讓我們感到意外的是,NVIDIA竟然選擇在DGX Station上預先安裝Windows系統。這款產品最初發佈於2025年,當時我們和許多其他媒體的同行都認為這是一個天才之舉。軟體支援歷來落後於新硬件,往往要等上幾年,核心和工具鏈才能成熟到足以真正發揮晶片的性能。 DGX Station是頂級AI實驗室、研究人員和機構可以購買的,讓他們能夠在資料中心圍繞最新架構搭建起來之前就開始開發。問題在於,這款產品比預期晚了一年。雖然我們確實很享受使用這套系統的時光(撇開預生產階段的一些小問題不談,其中一些問題甚至讓我夜不能寐),但我們實在無法理解為什麼要在這樣一台明顯是為硬核AI而設計的機器上預裝Windows系統。 B300沒有RT核心,因此NVIDIA的許多工作站工作負載都將依賴可選的RTX PRO獨立顯示卡,B300只能專注於AI任務。我們非常好奇 DGX Station 上的 Windows 支援究竟如何,坦白說,我們懷疑微軟能否在這裡提供良好的體驗,並在單一主機上真正利用 B300 和 800G ConnectX-8 網路。
每一代,都推出全新產品系列
主題演講中給我們最深刻印象的細節並不是一個規格說明。
Jensen 將此 PC 產品線定位為永久性產品系列,承諾為未來每一代架構提供桌上型電腦、筆記型電腦和工作站,並聲稱 PC 產業 100% 都支援此方案。
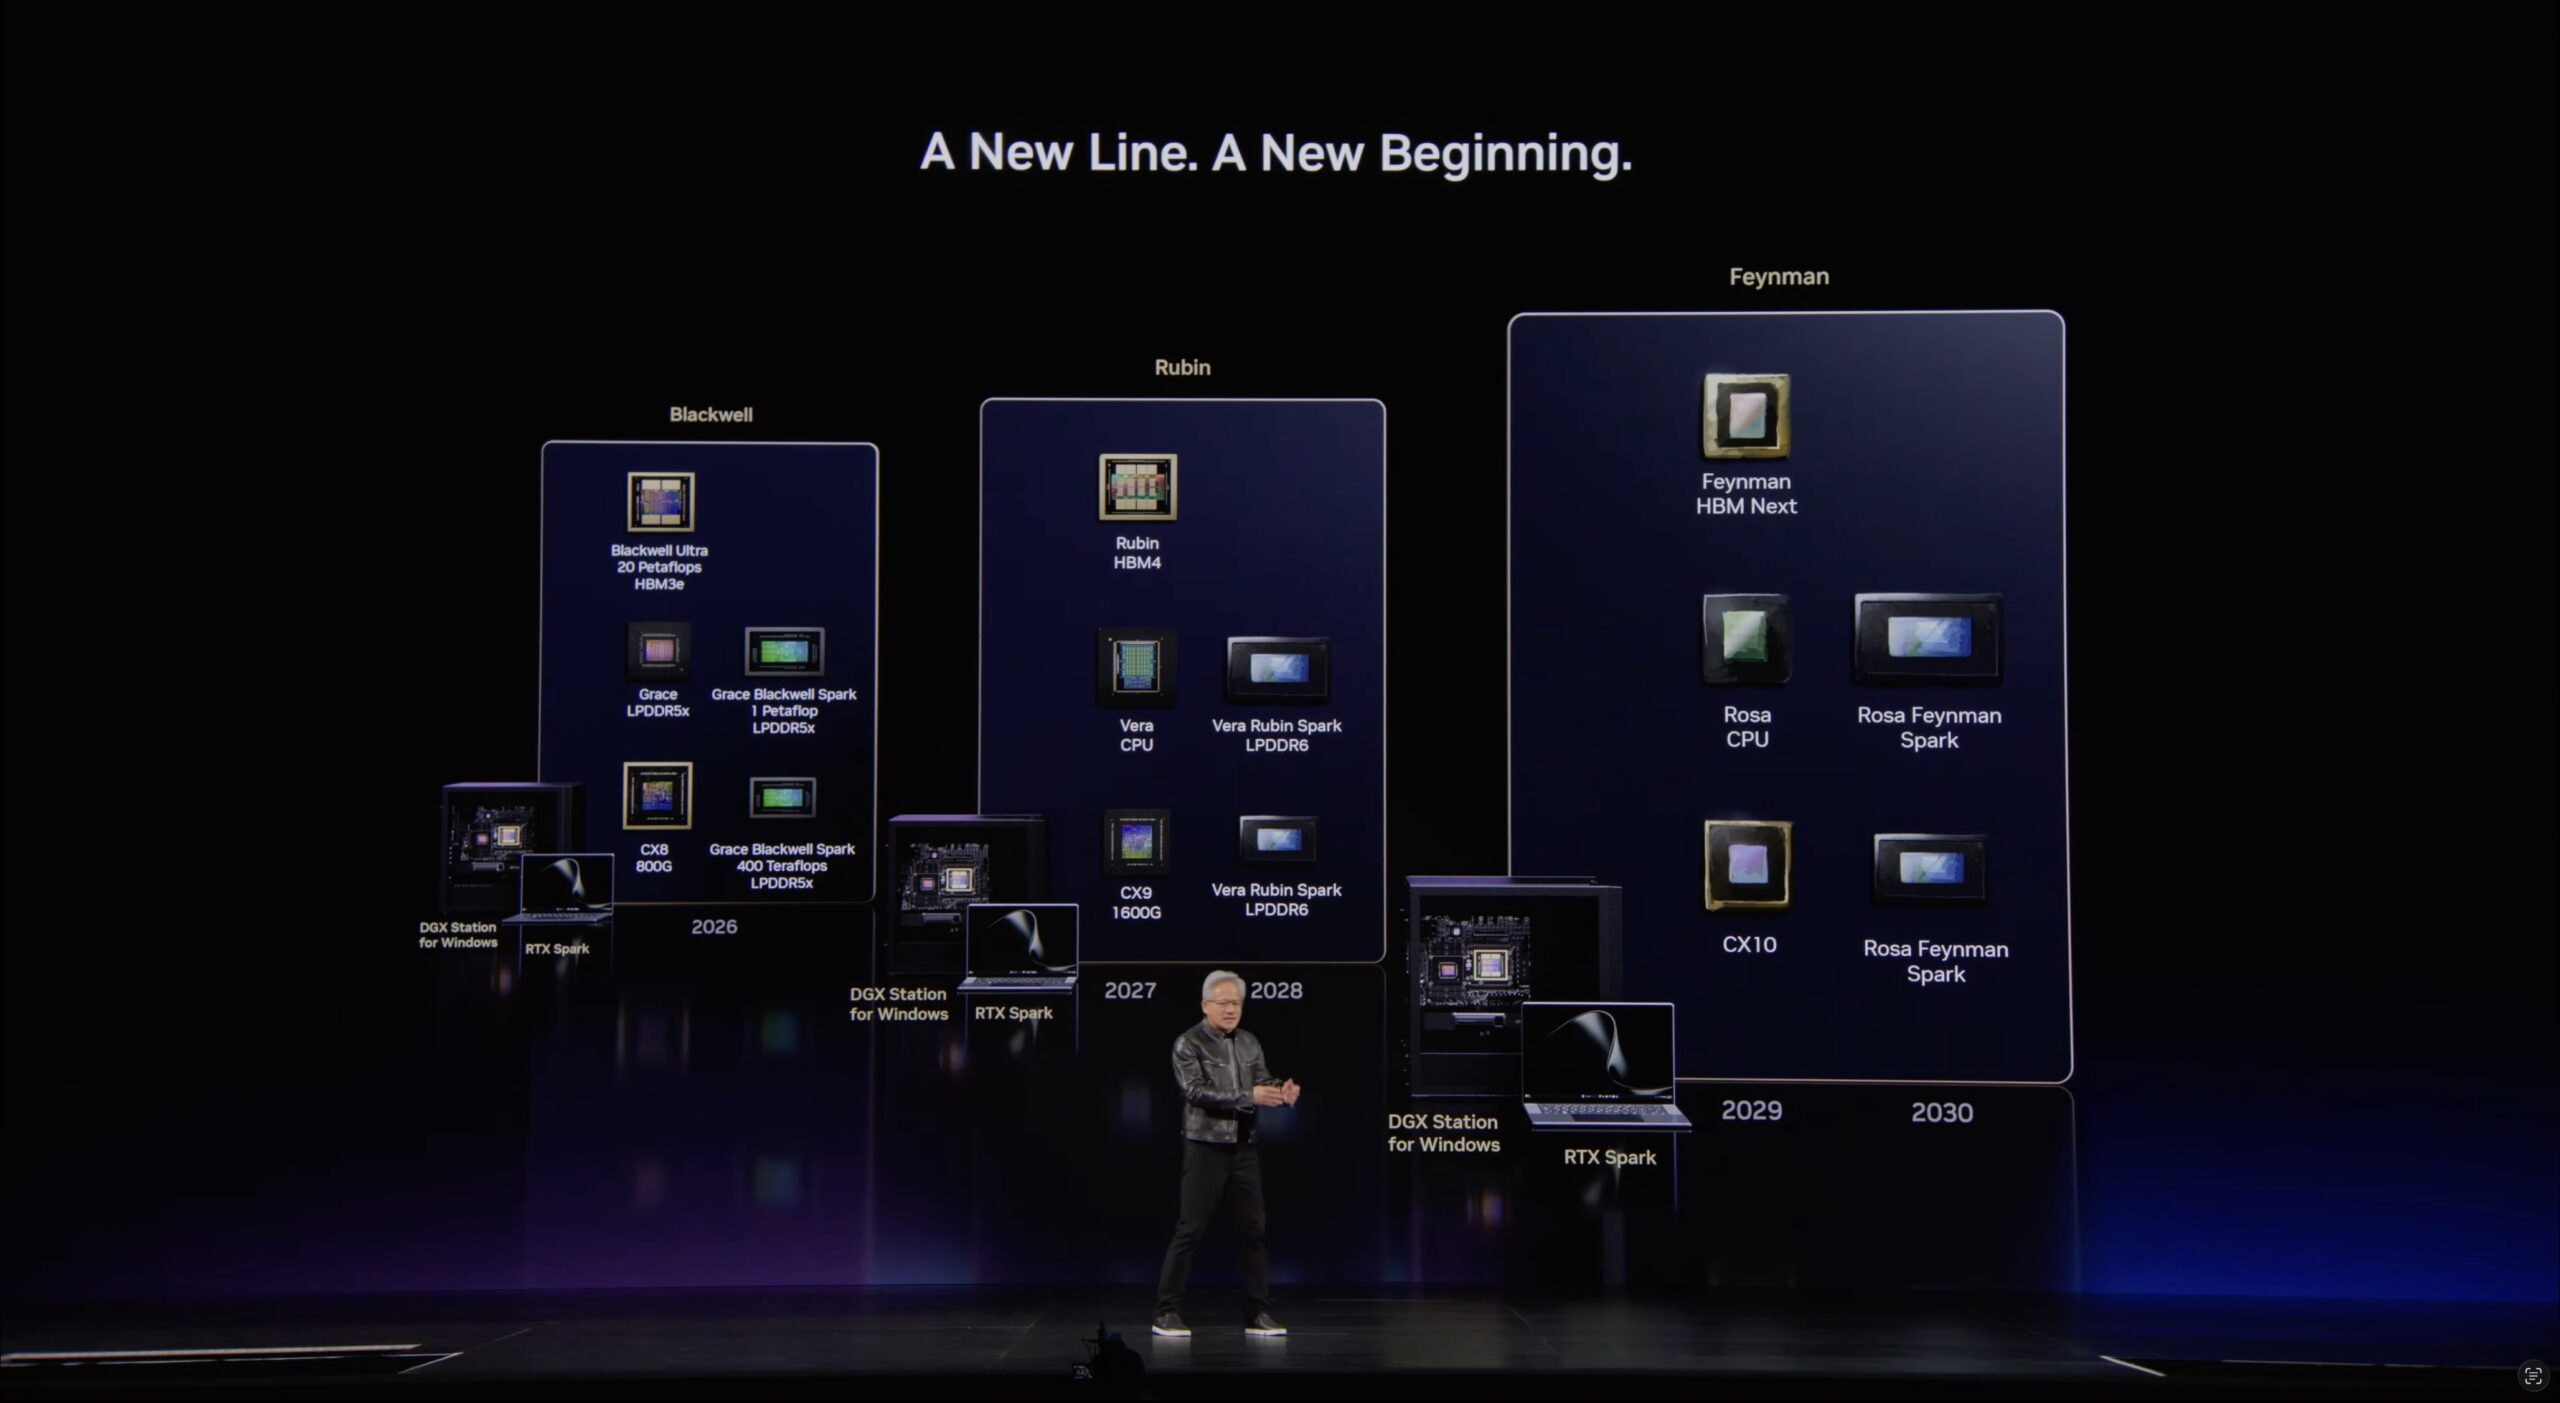
順便提一下,我們終於看到了之前提到的尺寸更小的400 TFlop N1 Grace Blackwell Spark Superchip。這款晶片最終會被應用到哪些類型的裝置中,值得我們拭目以待。
超越個人電腦:物理人工智慧
主題演講的後半部分重點轉向了實體人工智慧。這與上文提到的用戶端硬體截然不同,但它完善了台北電腦展的整體格局。英偉達也利用此次展會開源了大量實體人工智慧代理工具和技能,這些工具和技能發佈在 github.com/NVIDIA/skills 上,其中包括神經重建、視訊增強和缺陷影像生成等合成資料技能。包括台積電、富士康和 SK 海力士在內的製造合作夥伴已經在生產線上應用了這些技能。主要平台如下。
Isaac GR00T 參考人形機器人
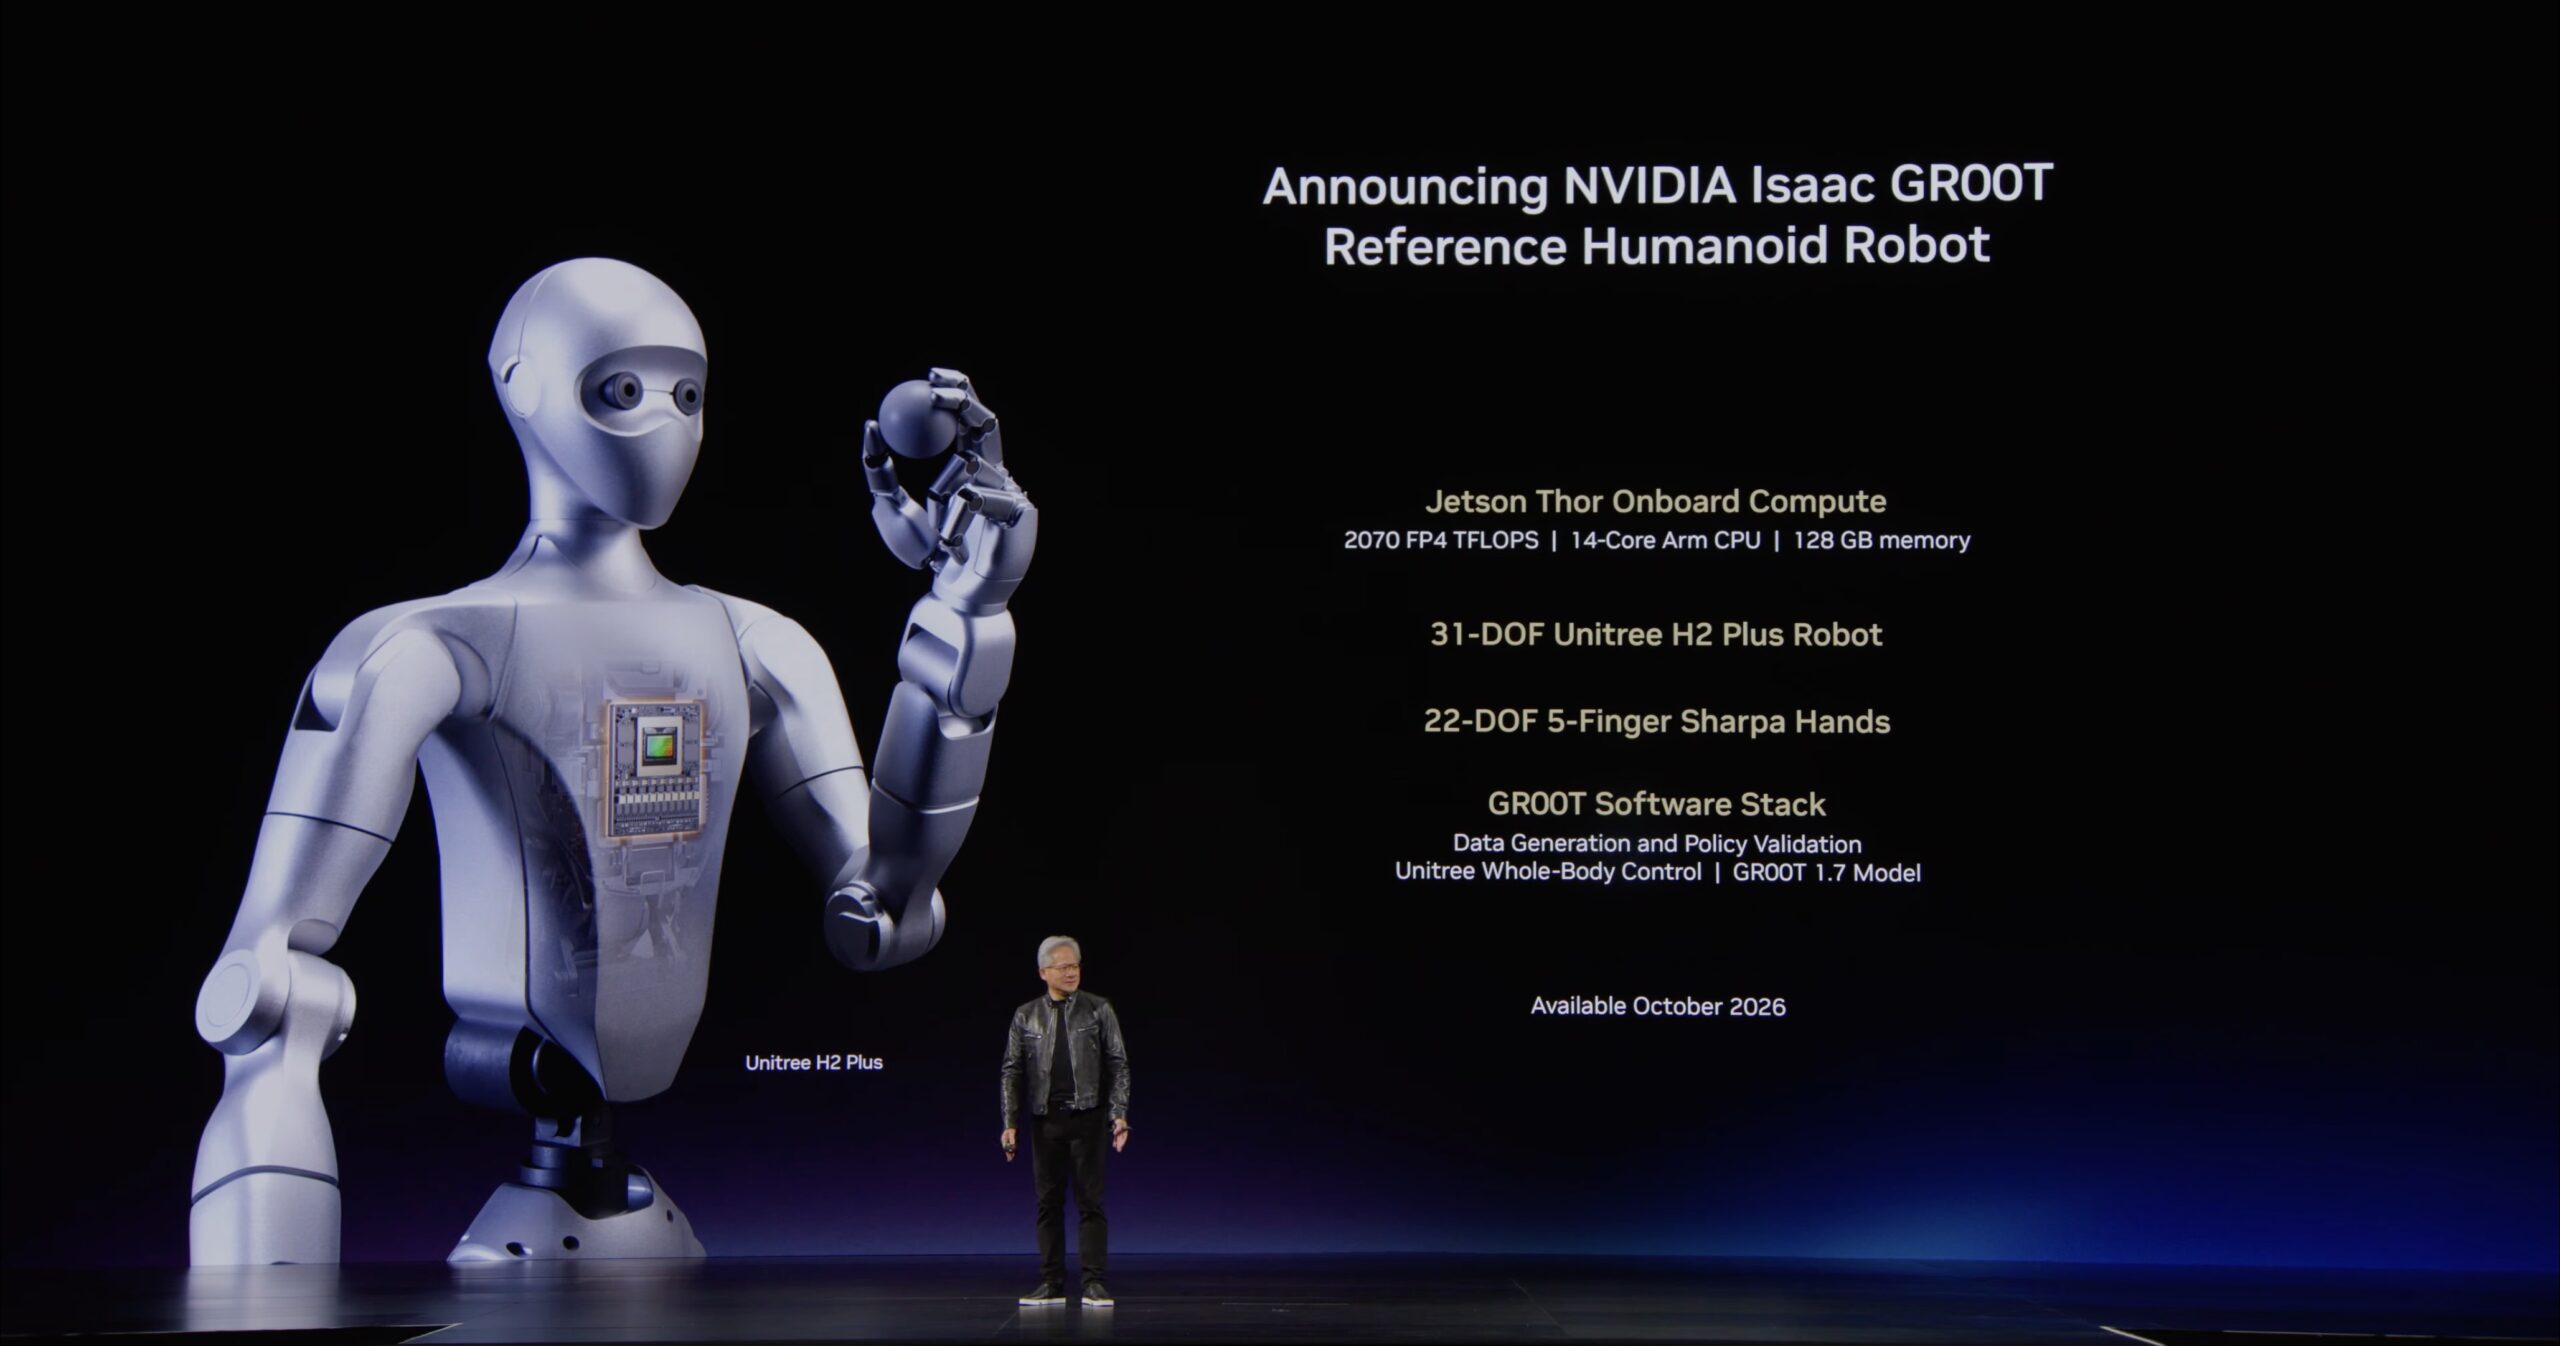
NVIDIA 發布了一款基於 Unitree H2 Plus 底盤的人形機器人開放參考設計,該機器人身高近 6 英尺(約 1.8 公尺),重 150 磅(約 68 公斤),擁有 75 個自由度,這得益於其雙 Sharpa Wave 五指觸覺機械手。機器人的執行器性能強勁,手臂扭矩高達 120 牛頓米,腿部旋轉角度可達 360°,額定有效載荷為 7 公斤,峰值負載可達 15 公斤。在感測方面,它配備了一個頭部立體攝影機(水平視野角 140 度)、用於操作的腕部攝影機、慣性測量單元,以及常見的 Wi-Fi 6 和藍牙 5.2 連接功能。機器人的大腦是英偉達的 Jetson AGX Thor T5000,配備 Blackwell GPU(FP4 運算速度達 2,070 萬億次浮點運算)、14 核 Arm CPU 和 128GB 統一內存,功耗可在 40 至 130 瓦之間配置,並由一塊約 1kWh 的電池供電時間約為三小時。從用於資料收集的 Isaac Teleop,到 Isaac Sim 和 Isaac Lab,再到用於部署的 GR00T 基礎模型和 Isaac ROS 中間件,整個技術堆疊都是開源的,研究人員可以完全掌控自己的資料。史丹佛大學、蘇黎世聯邦理工學院、加州大學聖地亞哥分校和 Ai2 等機構是早期採用者,Unitree 將於 2026 年底推出硬件,Unitree G1 參考工作流程也將很快在 GitHub 和 Hugging Face 上發布。 Jensen 以他一貫的宏大視角闡述了這項技術的意義,稱人形機器人是一個「價值數萬億美元的經濟機會」。
宇宙3
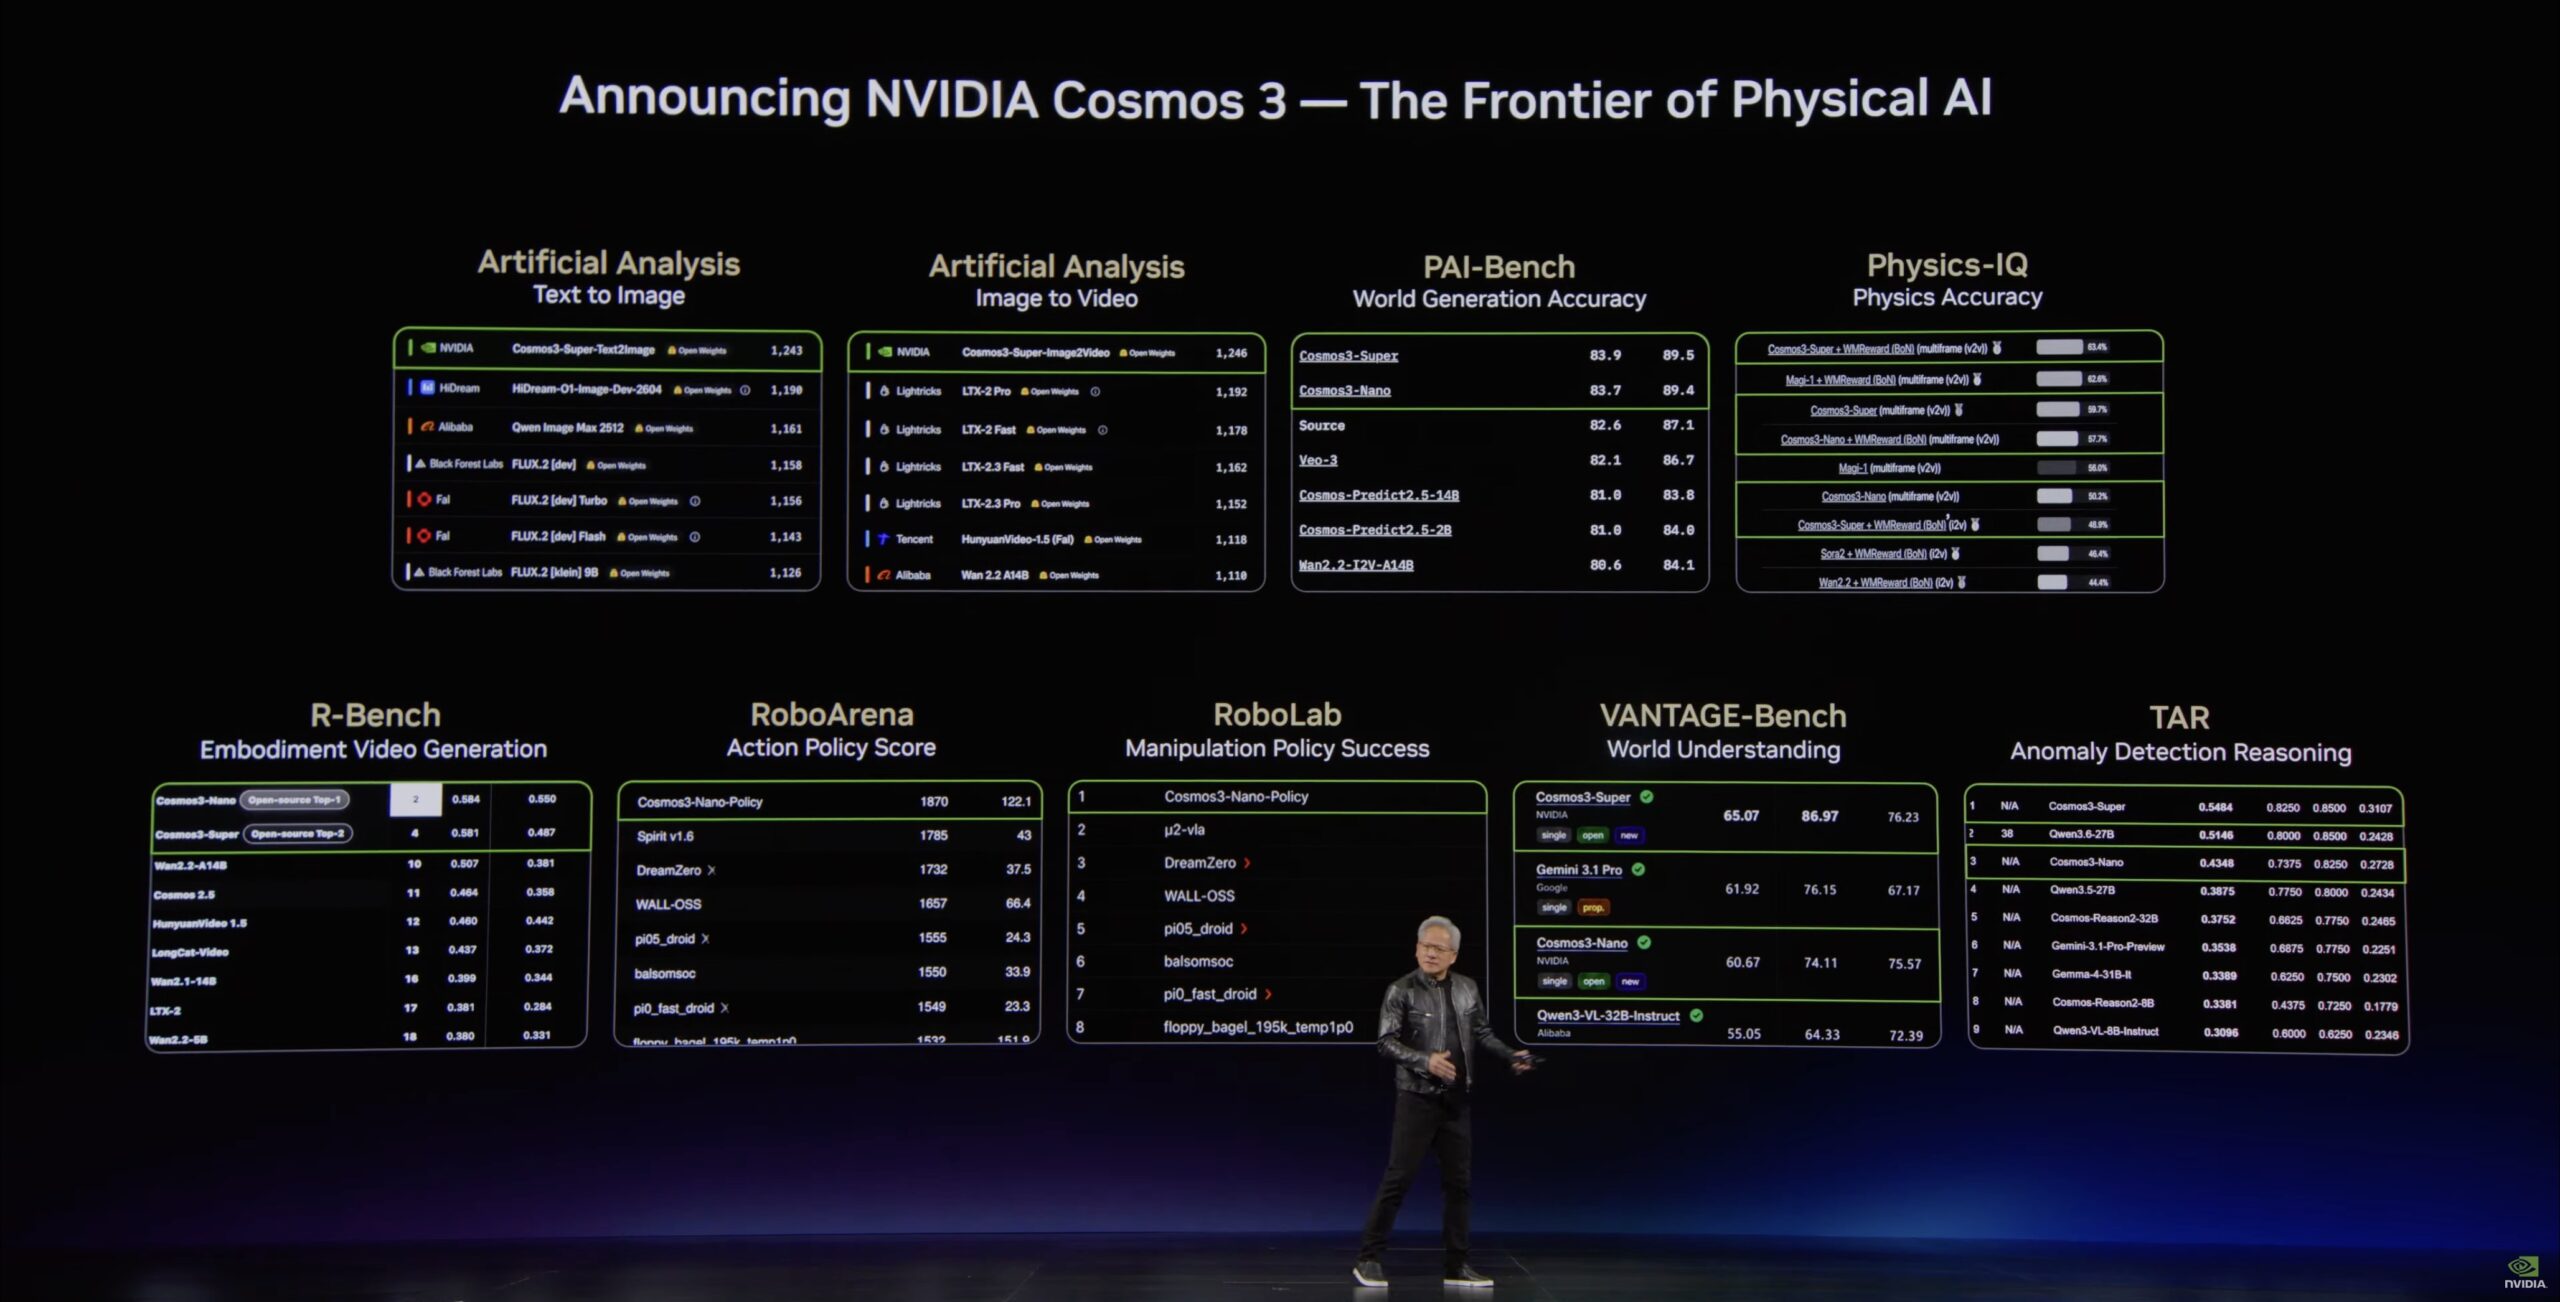
Cosmos 3 是 NVIDIA 面向實體 AI 的開放前沿基礎模型。這款融合了多種 Transformer 的全能模型,能夠在一個堆疊中處理文字、圖像、視訊、環境聲音和動作,並基於數十億個多模態樣本進行訓練。它扮演著三種角色:用於多模態推理的視覺語言模型、用於模擬物理環境的世界模型,以及用於訓練機器人執行特定任務的世界-動作模型的骨幹網路。 Cosmos 3 目前有三種版本:用於高精度機器人和 AV 後訓練的 Cosmos 3 Super、用於快速視頻和動作推理的 Cosmos 3 Nano,以及即將推出的用於實時推理的 Cosmos 3 Edge。 NVIDIA 表示,Cosmos 3 在眾多基準測試中均處於開放模型領域的領先地位,包括用於世界生成的 Physics-IQ 和 R-Bench、用於動作策略的 RoboLab 和 RoboArena,以及用於視覺理解的 VANTAGE-Bench,並且可以將物理 AI 的訓練和評估週期從數月縮短到數天。它以 NIM 微服務的形式在 Hugging Face、GitHub 和 build.nvidia.com 上提供,其聯盟成員包括 Agile Robots、Black Forest Labs、Runway 和 Skild AI,以及三星、LG 電子、理想汽車和斗山機器人等採用者。
Alpamayo 2 超級
NVIDIA 為自動駕駛領域推出了 Alpamayo 2 Super。這是一個基於 Cosmos 世界基礎模型構建的開放式 32 億參數推理視覺-語言-動作模型,能夠對 L4 級自動駕駛開發所需的整個駕駛流程進行推理、規劃和執行。它在前代 10 億參數版本的基礎上進行了擴展,實現了 360 度全方位感知。它不僅能夠產生宏觀駕駛決策,還能產生解釋這些決策的因果鏈軌跡,其推理自動標註功能可以將標註週期從數月縮短至數天。 NVIDIA 將其定位為教師模型,可將其提煉成更小的網絡,用於在 DRIVE AGX Thor 上進行車載部署。此外,NVIDIA 還為其配備了 AlpaGym(用於閉環強化學習)、OmniDreams(用於生成式場景創建)以及基於 Omniverse NuRec 的神經重建(用於將車隊數據轉換為 3D 場景)等配套工具。 Alpamayo 的早期版本下載量接近 400,000 萬次。這款新車型榮獲 COMPUTEX 最佳選擇獎,預計今年夏天在 GitHub 和 Hugging Face 上架。
驅動 Hyperion
如果說Alpamayo是大腦,那麼DRIVE Hyperion就是驅動它的車。我們之前已經介紹過Hyperion,所以這裡不再贅述,只要指出它是NVIDIA基於Halos安全系統和DriveOS打造的L4級自動駕駛參考平台,並搭載了DRIVE AGX運算模組。這次更引人注目的是它的合作夥伴。 Uber正在整合多個搭載Hyperion平台的車隊,包括今年稍後在慕尼黑啟動的無人駕駛計程車計畫。富士康和富士創計畫於2028年在台灣推出無人駕駛計程車,首先從高雄開始,然後擴展到整個亞洲。 VinFast正在將L4級自動駕駛汽車引入東南亞,Autobrains同時與VinFast和Uber合作,而HUMAIN則計劃將其推向沙烏地阿拉伯。正是這些合作夥伴,而非任何單一的技術規格,才讓Hyperion值得關注。
關閉的思考
NVIDIA 已經掌握了晶片技術,並正將其應用於各種產品,從 14 毫米厚的筆記型電腦到桌面級的 GB300,再到人形機器人的胸前,這一點我們相信。但規格表無法告訴我們的是,微軟能否讓 Windows on Arm 的硬體成本物有所值;OEM 廠商能否充分發揮 Spark 晶片的性能,還是會因為機身過薄而限制其發揮;以及官方宣稱的千萬億次浮點運算能力和電池續航時間是否真的如宣傳的那樣可靠。我們對硬體持樂觀態度,但對軟體(微軟的軟體,而非 Linux)持懷疑態度,在機器到達實驗室之前,我們將保持這兩種立場。屆時,基準測試結果也將出爐。


 Amazon