

在資料中心的大部分發展歷程中,NVIDIA 將 CPU 僅視為 GPU 的驅動晶片。其首款伺服器處理器 Grace 也遵循了這一模式。它採用了 Arm 現成的 Neoverse V2 內核,主要作為 Grace Hopper 和 Grace Blackwell 超級晶片的 CPU 部分進行銷售。這些超級晶片確實引入了該平台的一個重要組成部分:NVLink-C2C,它使 CPU 和 GPU 能夠以遠高於 PCIe 的頻寬相互存取彼此的記憶體。
Its successor, Vera, is far more ambitious. It is a clean-sheet design built around Olympus, NVIDIA’s custom Arm core. Olympus implements Armv9.2, and each Vera CPU features 88 cores and 176 threads. Alongside the new cores, the memory subsystem is the other highlight. Each CPU supports up to 1.5TB of LPDDR5X on SOCAMM modules, with an advertised peak bandwidth of 1.2TB/s per socket, which gives Vera the power efficiency of mobile-class DRAM while keeping the memory field-replaceable. Across the two sockets in our test server, that rating comes to 2.4TB/s, and we measured 2,073GB/s on STREAM Triad.
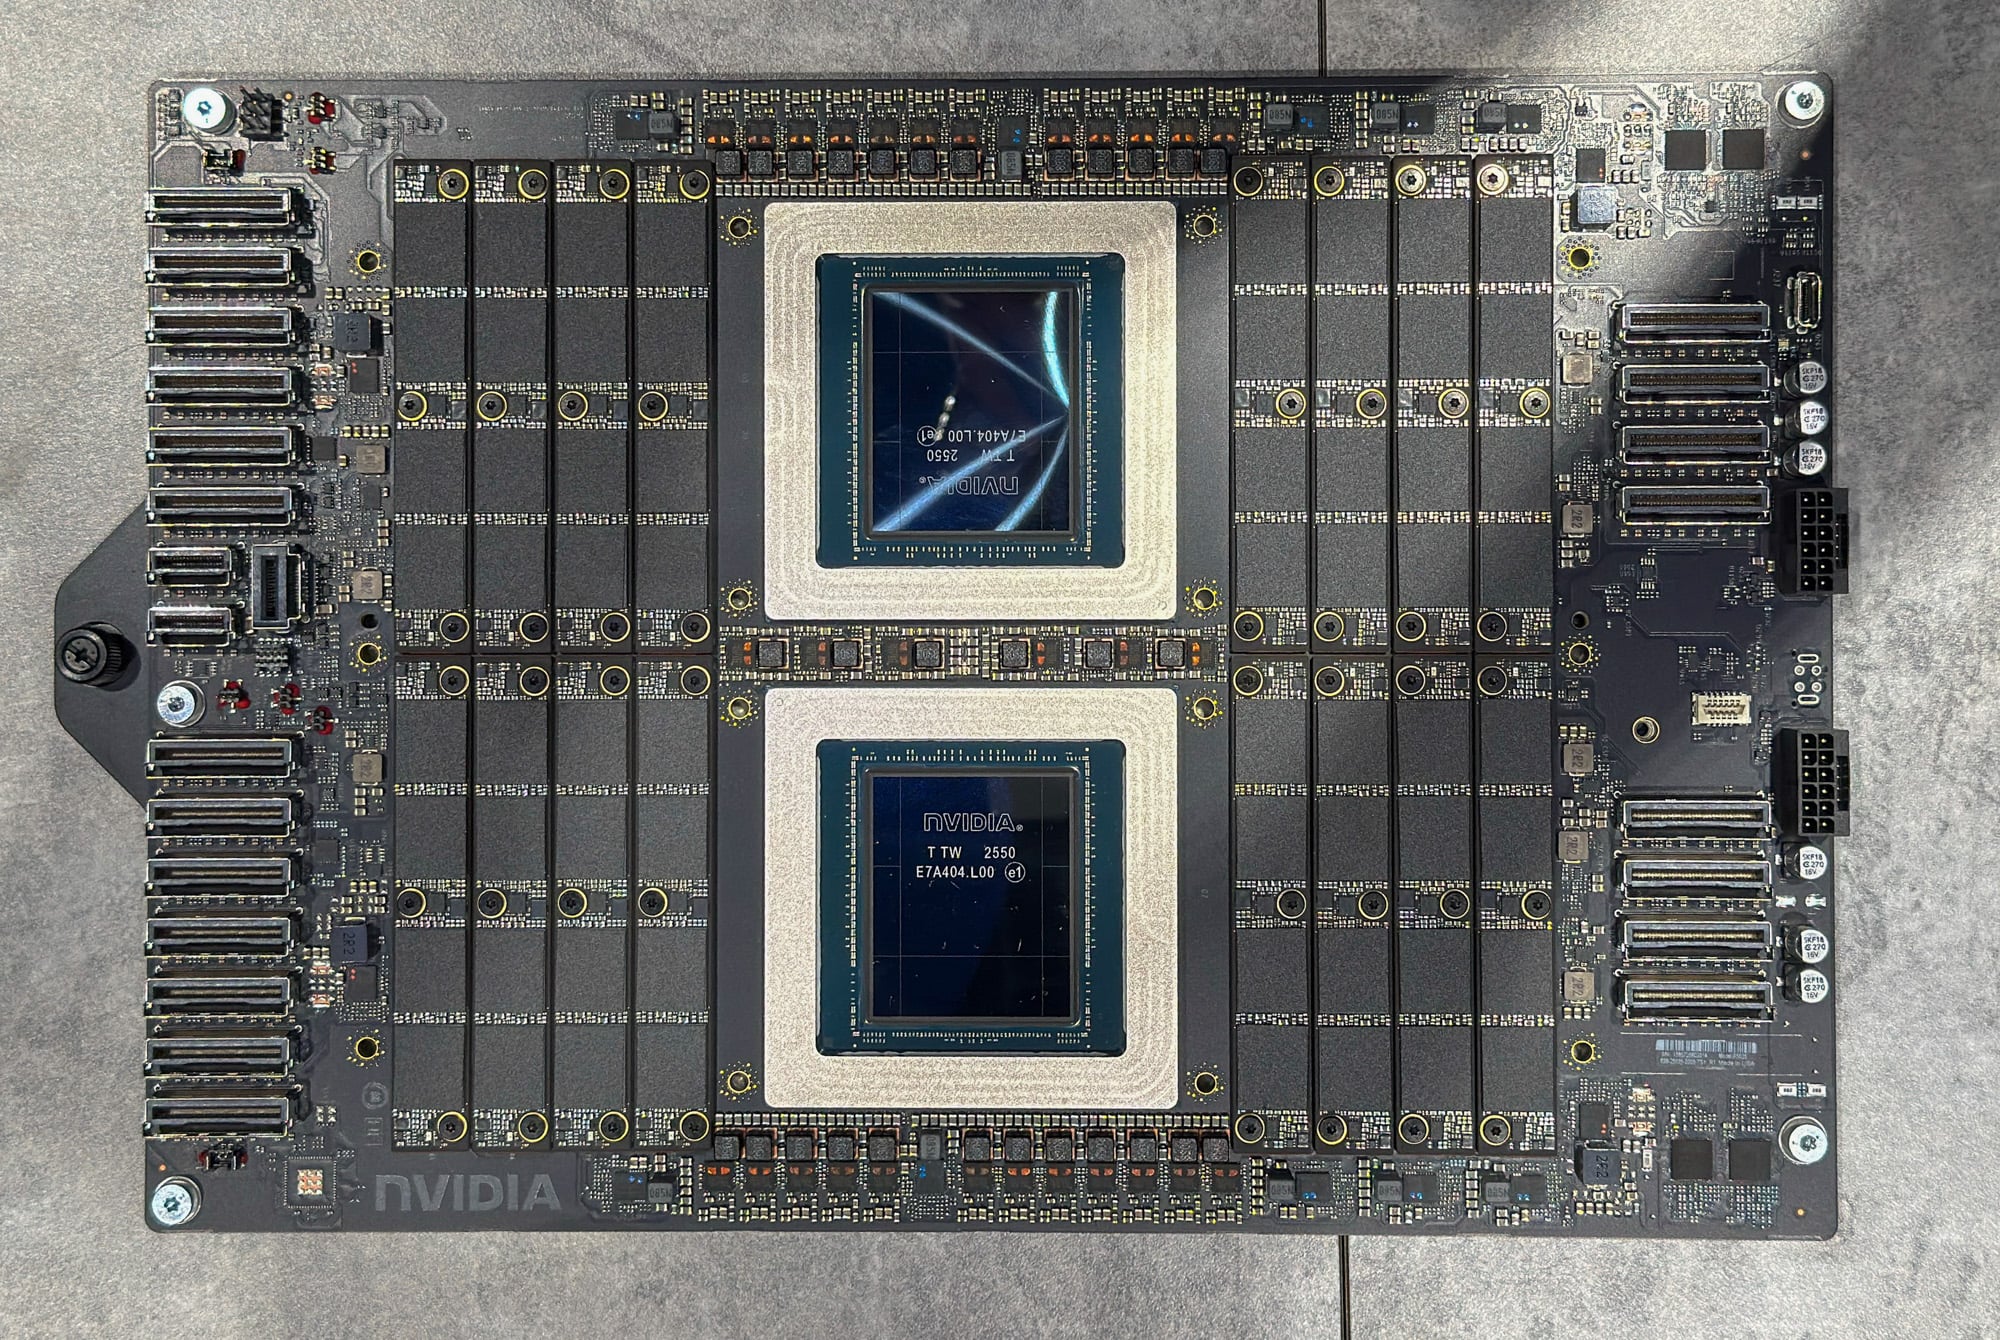
這種雄心壯志也體現在 Vera 的部署領域。它目前仍作為 Vera Rubin 系統中的超級晶片的一部分進行銷售,但 NVIDIA 也已將其擴展到 BlueField-4 STX 儲存平台以及用於代理沙箱的獨立 CPU 伺服器。 Vera 也獲得了 OEM 廠商、超大規模資料中心和網路資料中心營運商 (NCP) 的廣泛支援:戴爾、HPE 和 Supermicro 已將 Vera 伺服器新增至其產品線中,而超大規模資料中心和 NCP 也準備將其打造為主流產品。這種廣泛的可用性至關重要,因為正如我們的測試結果所示,Vera 是 x86 架構同類產品的有力競爭者,並且它為企業提供了第三個 CPU 供應商,有助於其供應鏈多元化。
關鍵要點
- 所有 x86 系統的記憶體頻寬都增加了一倍以上。 在 STREAM Triad 測試中,兩個 Vera 插槽的讀寫速度持續超過 2TB/s,是我們測試過的最佳 DDR5 伺服器的 2.3 倍。即使透過 NVLink-C2C 讀取另一個插槽的內存,Vera 的核心頻寬也超過了任何 x86 插槽從本地內存獲取的頻寬,並且在使用大頁內存時,本地延遲比 EPYC 9175F 低 13%。
- 一款面向廣大中階市場的均衡型晶片。 一顆 3.4GHz 的 Olympus 核心在 7-Zip 壓縮測試中比 5.0GHz 的 EPYC 9175F 快 12%,並且在三項單線程 Python 測試中贏得了其中兩項。在滿載情況下,Vera 僅使用不到一半的核心數,就能達到 EPYC 9965 63% 到 72% 的 7-Zip 吞吐量,在單線程性能上與 AMD 的單核性能專家不相上下,在整個系統吞吐量方面也與之匹敵。
- Vector 和加密技術是其明顯的弱點。 六條 128 位元 SVE2 管道無法與為其編寫的 512 位元 AVX-512 程式碼相媲美。在配置相同的 16 個核心上,Vera 運行 GROMACS benchMEM 的速度僅為 EPYC 9175F 的一半,EPYC 9965 的三分之二;單核心 AES-256-GCM 加密的速度約為 9175F 的三分之一。在整個系統中,擁有 384 個核心的 EPYC 9965 在 GROMACS benchPEP 和 AES 測試中均領先約 3 倍。
- 記憶體密集型高效能運算將頻寬轉化為速度。 在大型 OpenFOAM 網格上,Vera 的運行速度比 384 核心的 EPYC 9965 快 1.44 倍,比 240 核心的 Xeon 6978P 快 1.20 倍。在較小的網格上,由於更大的 x86 L3 快取對效能的影響更大,Vera 位居第二,與 9965 的差距在 12% 以內。
- 資料庫和分析技術之間已經存在競爭。 在單路 HammerDB TPROC-C 測試中,88 核心 Vera 處理器在 PostgreSQL 資料庫上的效能比 192 核心 EPYC 9965 處理器高出 26%,在 MariaDB 資料庫上高出 8%,但在 MySQL 資料庫上落後 19%,在 Village 資料庫上落後五個銀行在 67% VerXeon處理器上落後於五個引擎。 Vera 處理器在 ClickBench 熱測試中完成時間也比 EPYC 9965 處理器快 23%,並且在 256GB Valkey 工作集上處理的請求數量也高出 34%。
論文規範
| 規格 | NVIDIA Vera CPU |
|---|---|
| 計算與電力 | |
| 核心 | NVIDIA Olympus,Armv9.2,支援 SVE2 和 FP8 |
| 每個插槽的核心數和執行緒數 | 88 個核心,176 個執行緒(NVIDIA 空間多執行緒) |
| 時脈速度(實測) | 3.41GHz |
| TDP | 可配置功率:250W 至 450W |
| 散熱 | 空氣或液體 |
| 快取 | |
| L1 教學 | 每個核心 64KB |
| L1 數據 | 每個核心 96KB,6 路並行 |
| L2 | 每個核心 2MB,私有 |
| 系統級緩存(L3) | 每個插槽 164MB,Arm MPAM 分割區 |
| 布料 | 第二代可擴展一致性架構,3.4TB/s 二分 |
| 記憶體應用 | |
| 類型 | 每個插槽配備 8 個 SOCAMM2 模組,支援 LPDDR5X 記憶體。 |
| 控制器 | 8x 128 位元(總計 1,024 位元) |
| 速度 | 高達 9,600MT/s |
| 頻寬 | 每個插槽最高可達 1.2TB/s(廠商標稱值) |
| 容量 | 每個插槽容量為 256GB 至 1.5TB |
| 的I / O | |
| PCIe | 第六代,每個插槽 88 個通道(僅限 CPU 平台) x16、x8、x4、x2 分岔 |
| CXL | 3.1,第 3 類記憶體擴充和池化 |
| NVLink-C2C | 第二代、1.8TB/s 雙向、相干、認證加密 |
| 安全性 | |
| 機密計算 | Arm CCA 網域、RME-DA 和 RME-CDA、TDISP、每個虛擬機器的金鑰 |
為什麼英偉達想要進軍CPU產業
要了解 Vera 對 NVIDIA 的重要性,我們需要回顧一下公司的發展歷程。 NVIDIA 最初圍繞 GPU 建立資料中心業務,隨後擴展到維持 GPU 運作所需的基礎設施。在硬體方面,2020 年收購 Mellanox 帶來了連接伺服器並在伺服器間傳輸資料的網路技術。在軟體方面,CUDA、DOCA 以及更廣泛的軟體堆疊進一步拓展了 NVIDIA 在硬體編程和運作方面的影響力。這些優勢共同賦予了 NVIDIA 大部分加速運算平台的控制權。
但該平台仍需要通用CPU。作業系統必須由處理器來運行,資料必須由處理器來準備,應用程式必須由處理器來管理,並且必須協調發送到加速器的任務。在NVIDIA擴張的大部分時期,英特爾和AMD承擔了這個角色。這使得NVIDIA處境尷尬:它雖然可以提供GPU、網路和大部分軟體,但伺服器的核心處理器仍然依賴另一家公司的處理器。
Grace 的出現是改變現狀的第一步。它基於 Arm Neoverse V2 內核,為 NVIDIA 提供了一款資料中心 CPU,並透過 NVLink-C2C 技術將該 CPU 與 GPU 更緊密地連接起來。然而,Grace 仍然存在效能差距需要彌補。其記憶體頻寬和效率使其在 AI 主機 CPU 領域具有競爭力,但在大多數其他工作負載中,領先的 x86 處理器仍保持著顯著優勢。這種效能上的不平衡限制了 Grace 作為 EPYC 或 Xeon 伺服器通用替代品的吸引力。
Vera 透過以 NVIDIA 定制的 Olympus 內核取代 Grace 的 Neoverse V2 內核,並大幅提升記憶體頻寬和容量,彌補了這一差距。透過提供具有競爭力的 CPU 以及 GPU、DPU 和網路元件,NVIDIA 可以佔據每台伺服器更大的市場份額。這也使公司能夠更好地掌控其生態系統以及各組件的協同工作方式:CPU 核心、記憶體子系統、互連和 GPU 可以圍繞相同的需求進行設計。 Vera 的 CPU 到 GPU 的一致性連結(速率高達 1.8TB/s)正是這種整合的一個具體例證。
提高每個系統的資源利用率只是問題的一部分。強化學習 (RL) 和智能體人工智慧 (AI) 為 NVIDIA 提供獨立 CPU 系統提供了另一個理由。智能體的功能遠不止於生成響應。它會呼叫工具、檢索資訊、運行程式碼並檢查結果,然後決定下一步。大部分執行都在 CPU 上進行,而當下一個模型步驟依賴 CPU 任務的結果時,執行速度慢會延遲整個序列。因此,單核心效能、記憶體延遲以及負載下的可預測行為對於智慧體的反應速度至關重要。
奧林匹斯核心
這些要求與 Vera 的 88 個 Olympus 核心的設計理念高度契合,其核心設計圍繞著一個明確的優先事項:確保每個核心都能提供強勁的性能,並在整個插槽繁忙運行時保持這種性能。 Olympus 是 NVIDIA 對 Armv9.2 指令集的實現,取代了 Grace 中使用的 Neoverse V2 核心。這種區別至關重要:Arm 定義了處理器運行的指令,而 NVIDIA 則設計了獲取、調度和執行這些指令的機制。這種控制權使 NVIDIA 能夠根據目標對核心進行調優:在同時運行多個任務的同時,快速完成單一任務。
此目標的前半部始於每週期指令數 (IPC):即核心在每個時脈週期內平均完成的指令數量。時脈頻率決定了這些週期的發生頻率;微架構決定了每個週期內可以完成多少有效工作。 NVIDIA 聲稱其 IPC 比上一代產品提高了 1.5 倍。我們觀察到的最高時脈頻率為 3.41GHz,但 Vera 的架構強調在每個週期中提取更多工作,並在負載下保持這種效率。這種強調至關重要,因為對於編譯器、解釋器或資料庫操作等具有大量依賴步驟的程式而言,僅僅增加核心數量並不能加快這些步驟的執行速度。
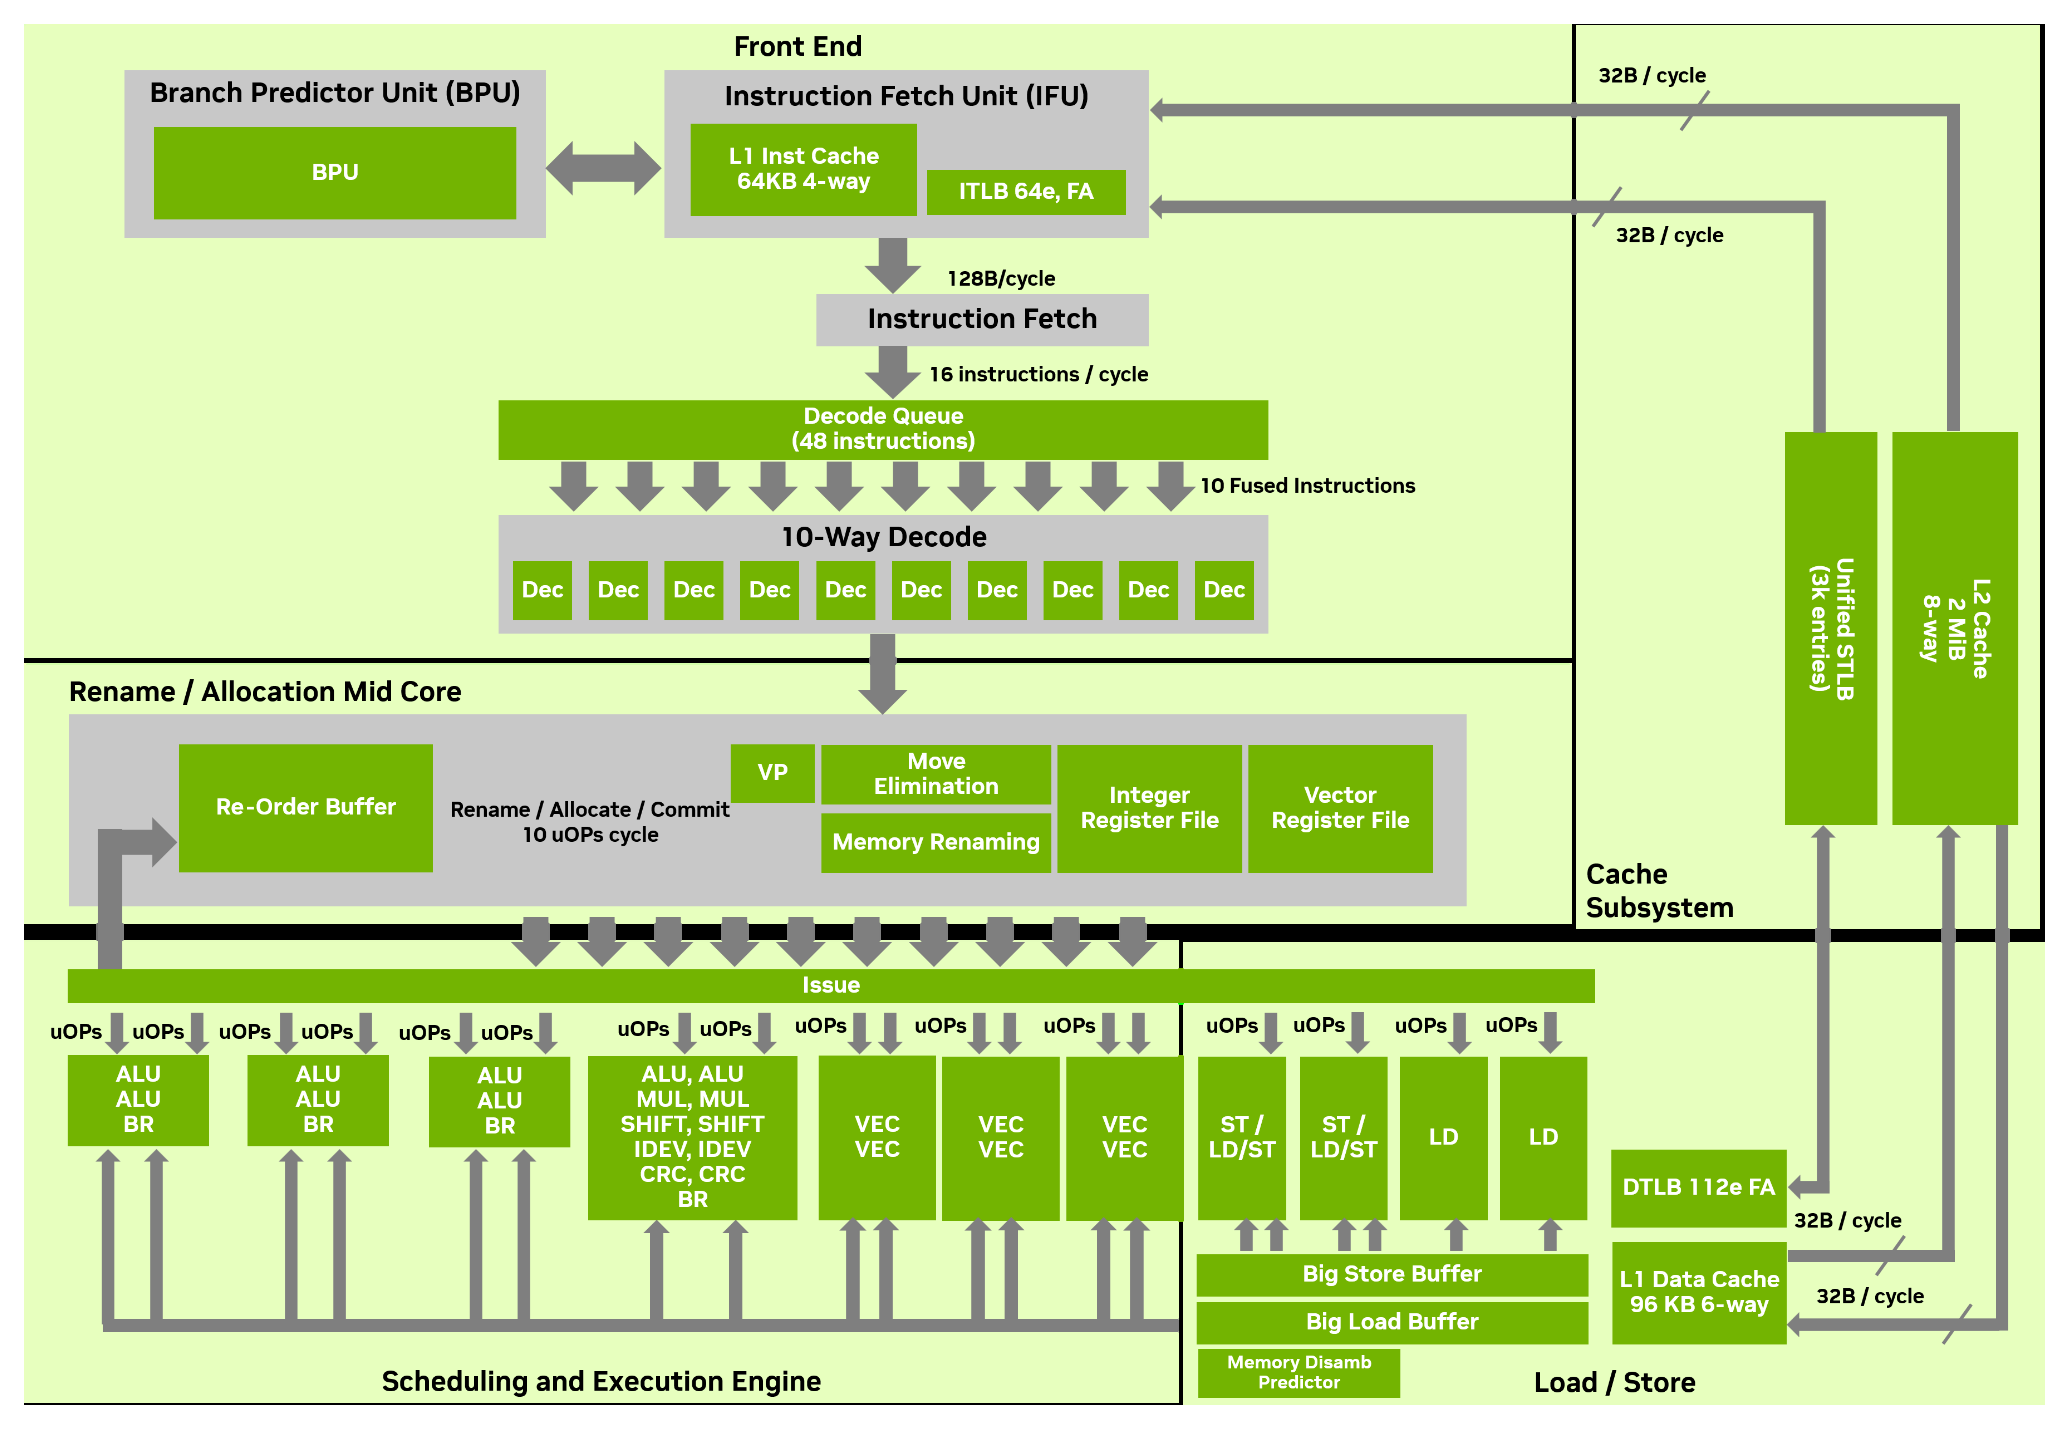
實現高效指令周期 (IPC) 的關鍵在於持續不斷地獲取有效指令。 Olympus 的前端(即核心中負責取得和解碼程式指令的部分)每個週期最多可以解碼十條指令。只有當前端持續獲得指令時,這種指令寬度才有意義,而當軟體頻繁地在程式碼路徑之間跳躍時,這一點就變得難以保證。因此,Olympus 將神經分支預測器與其他專用預測器結合,支援每個週期最多執行兩個分支。更精準的預測有助於核心取得所需的指令,從而減少執行錯誤路徑和錯誤後重新開始所花費的時間。
指令取得並解碼後,奧林巴斯處理器會採取亂序執行的方式,在先前的指令等待期間尋找可以執行的任務。例如,如果某個操作正在等待內存,那麼一個獨立的計算就可以在其前面執行。較大的指令視窗為處理器提供了更多找到這些獨立任務的機會。
即便如此,某些序列(例如上文所述的依賴鏈)仍然難以採用這種方法,因為每一步都需要前一步的結果。對於這些序列,Olympus 還採用了值預測技術,讓依賴操作從預測值開始,然後在實際結果可用時檢查該預測值。正確的預測可以減少這些依賴鏈上的有效等待時間;而錯誤的預測則需要修正並重新計算推測性工作。
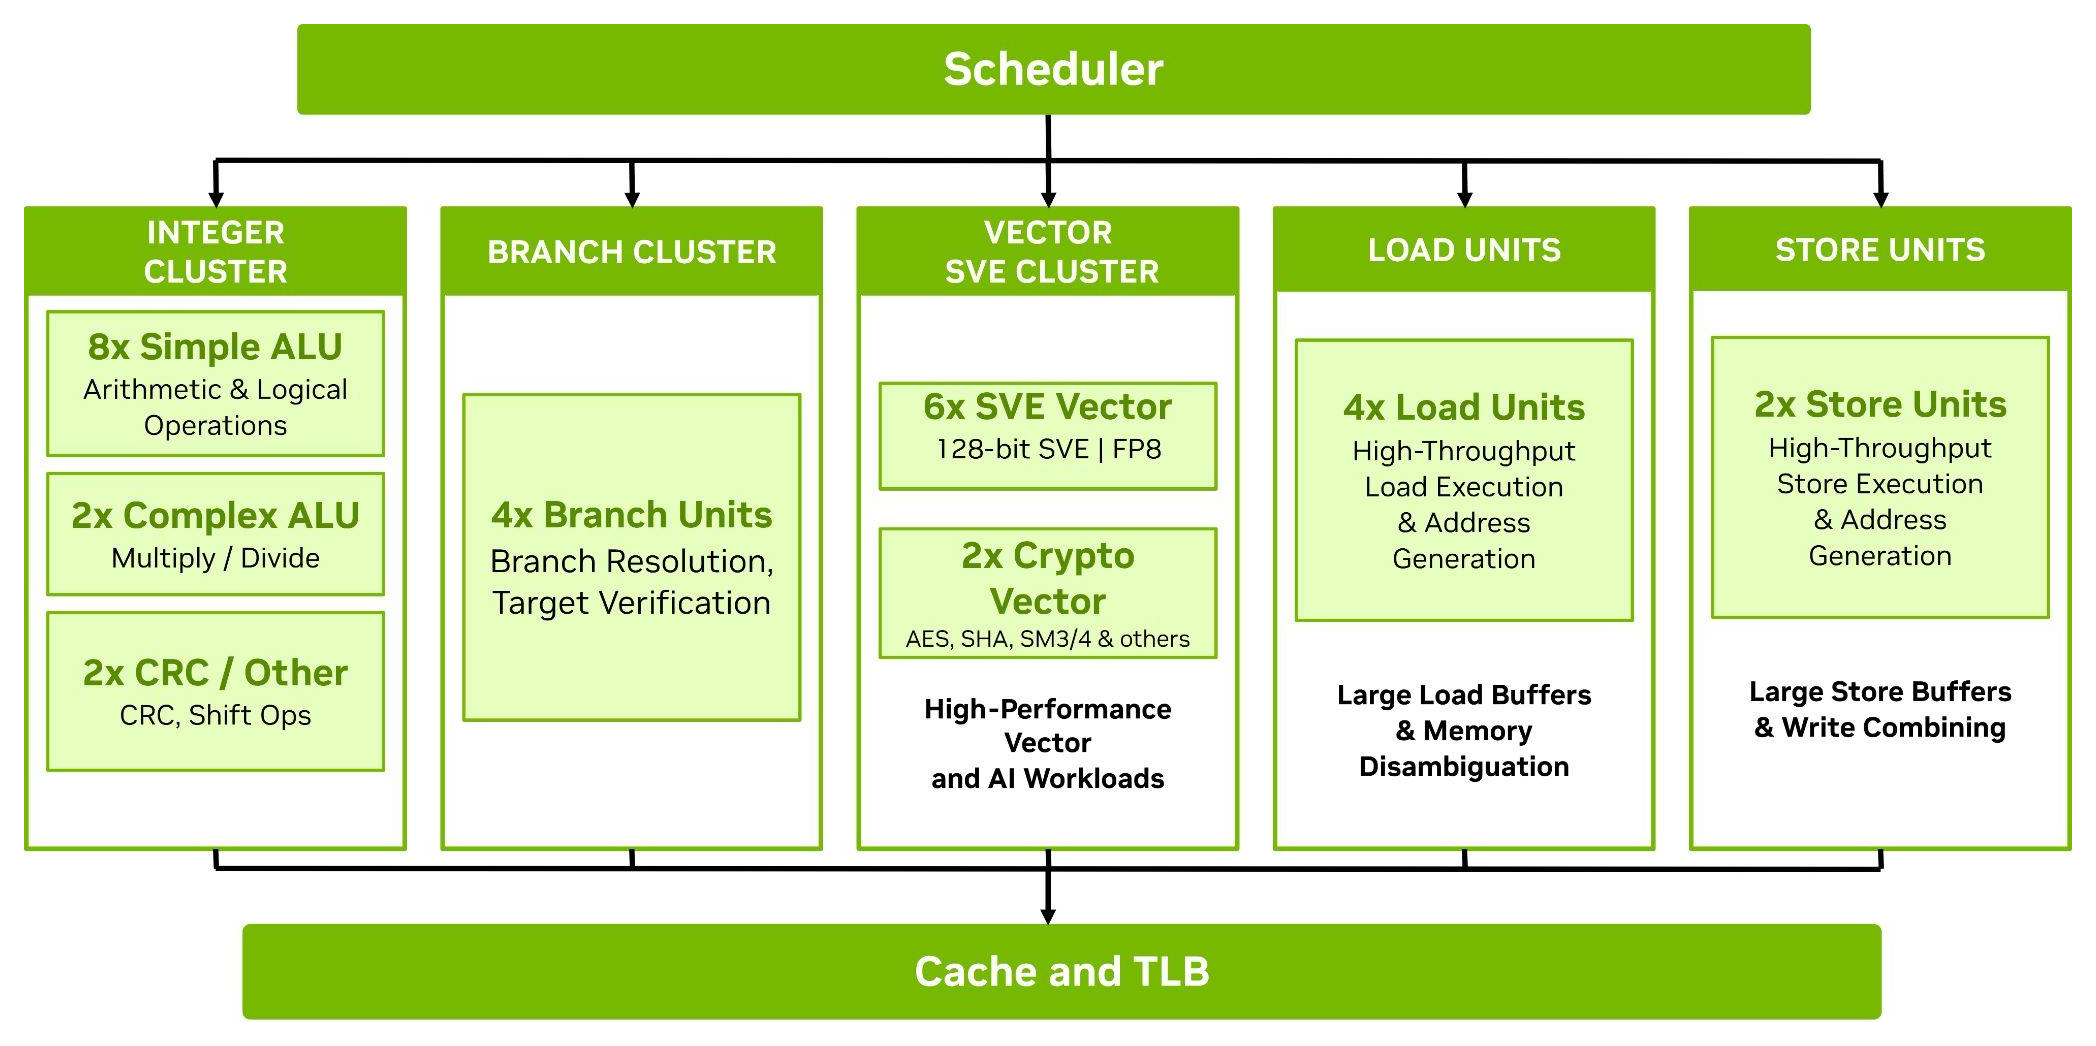
執行引擎需要足夠的容量才能將這些指令轉換為已完成的工作。 Olympus 將寬廣的整數執行資源與專用分支單元、四條加載管線和兩條儲存管線和兩條儲存管線結合。這些資源滿足不同的需求:整數單元處理算術運算、比較和邏輯運算;分支單元解析控制流;載入/儲存管線在核心和快取之間傳輸資料。這種平衡至關重要,因為如果指令僅僅因為執行或記憶體瓶頸而積壓,那麼更寬的解碼器就幾乎沒有任何意義。
除了這些標量資源外,Olympus 還擁有六條支援 SVE2 的 128 位元向量管線,其中兩條管線還支援 FP8 和加密功能。向量指令可以將操作應用於多個資料元素,因此非常適合數值計算、壓縮和資料處理。
奧林巴斯處理器在這方面做出了明顯的權衡:其 128 位元向量寬度小於競爭對手 x86 處理器透過 AVX-512 指令集提供的 512 位元寬度。對於優化的數值核心甚至詞法分析器而言,這種差異至關重要,儘管應用程式的效能還取決於特定指令的吞吐量、產生的程式碼以及資料供應。因此,像 GROMACS 這樣的科學應用仍然是對該設計優勢的單獨考驗。
無論是標量還是向量,所有這些執行資源都依賴資料的及時到達,因此將常用資料保存在靠近執行引擎的位置至關重要。每個核心都擁有一個 64KB 的指令快取、一個 96KB 的資料快取和一個 2MB 的私有二級快取。較小的一級快取可以快速存取最常用的指令和資料;較大的二級快取則可以在存取資料需要經過處理器更遠的路徑之前,保留更多核心的工作集。為每個核心配備充足的私有二級緩存,也是為了實現相同的核心目標:更多的工作可以在本地完成,從而減輕共享快取和主記憶體的壓力。
預取技術透過在指令請求資料之前將其載入到快取中,從而對快取起到補充作用。除了用於常規存取模式的預取器之外,Olympus 還包含一個用於間接存取(例如 A[B[i]])的圖預取器,其中一次查找提供另一次查找的索引。在了解這種關係之後,硬體可以在程式發出請求之前開始取得第二個資料。這有助於解決圖處理和其他不規則工作負載中常見的難題:處理器擁有充足的執行能力,但程式的運作取決於能否找到下一條資料。
奧林巴斯架構的最後一部分實現了目標的另一半:同時執行多個任務。每個核心支援兩個硬體線程,因此 Vera 每個插槽可支援 176 個線程。 NVIDIA 將其方案稱為空間多執行緒。核心可以將其資源分配給一個活動線程,也可以將資源分配給兩個活動線程,從而可以選擇將執行能力集中在一個指令流上,還是支援更多並發任務。
NVIDIA 的目標是減少兩個執行緒之間的干擾,從而在兩個執行緒都繁忙時提高效能的可預測性,而這種可預測性正是代理工作負載在高負載下所依賴的。由於這兩個執行緒仍然共享一個實體核心和更大的記憶體系統,因此資源分區並不能保證應用程式的延遲固定不變。
織物、內存和 I/O
除了單一核心之外,要保持88個寬核心的高效運行,僅僅依靠與DRAM的高速連接是不夠的。這些核心還需要交換資料、存取共享快取以及與外接設備通訊。 Vera透過NVIDIA第二代可擴展一致性架構(Scalable Coherency Fabric)連接這些資源。 Scalable Coherency Fabric是一個內部網狀結構,它還能確保共享資料的快取副本保持一致。核心、Scalable Coherency Fabric和164MB系統級快取位於同一個運算晶片上,而記憶體控制器和I/O則位於相鄰的晶片組上。 NVIDIA將此架構的二分頻寬標為3.4TB/s,這是衡量整個網狀結構流量容量的指標,與主記憶體頻寬無關。
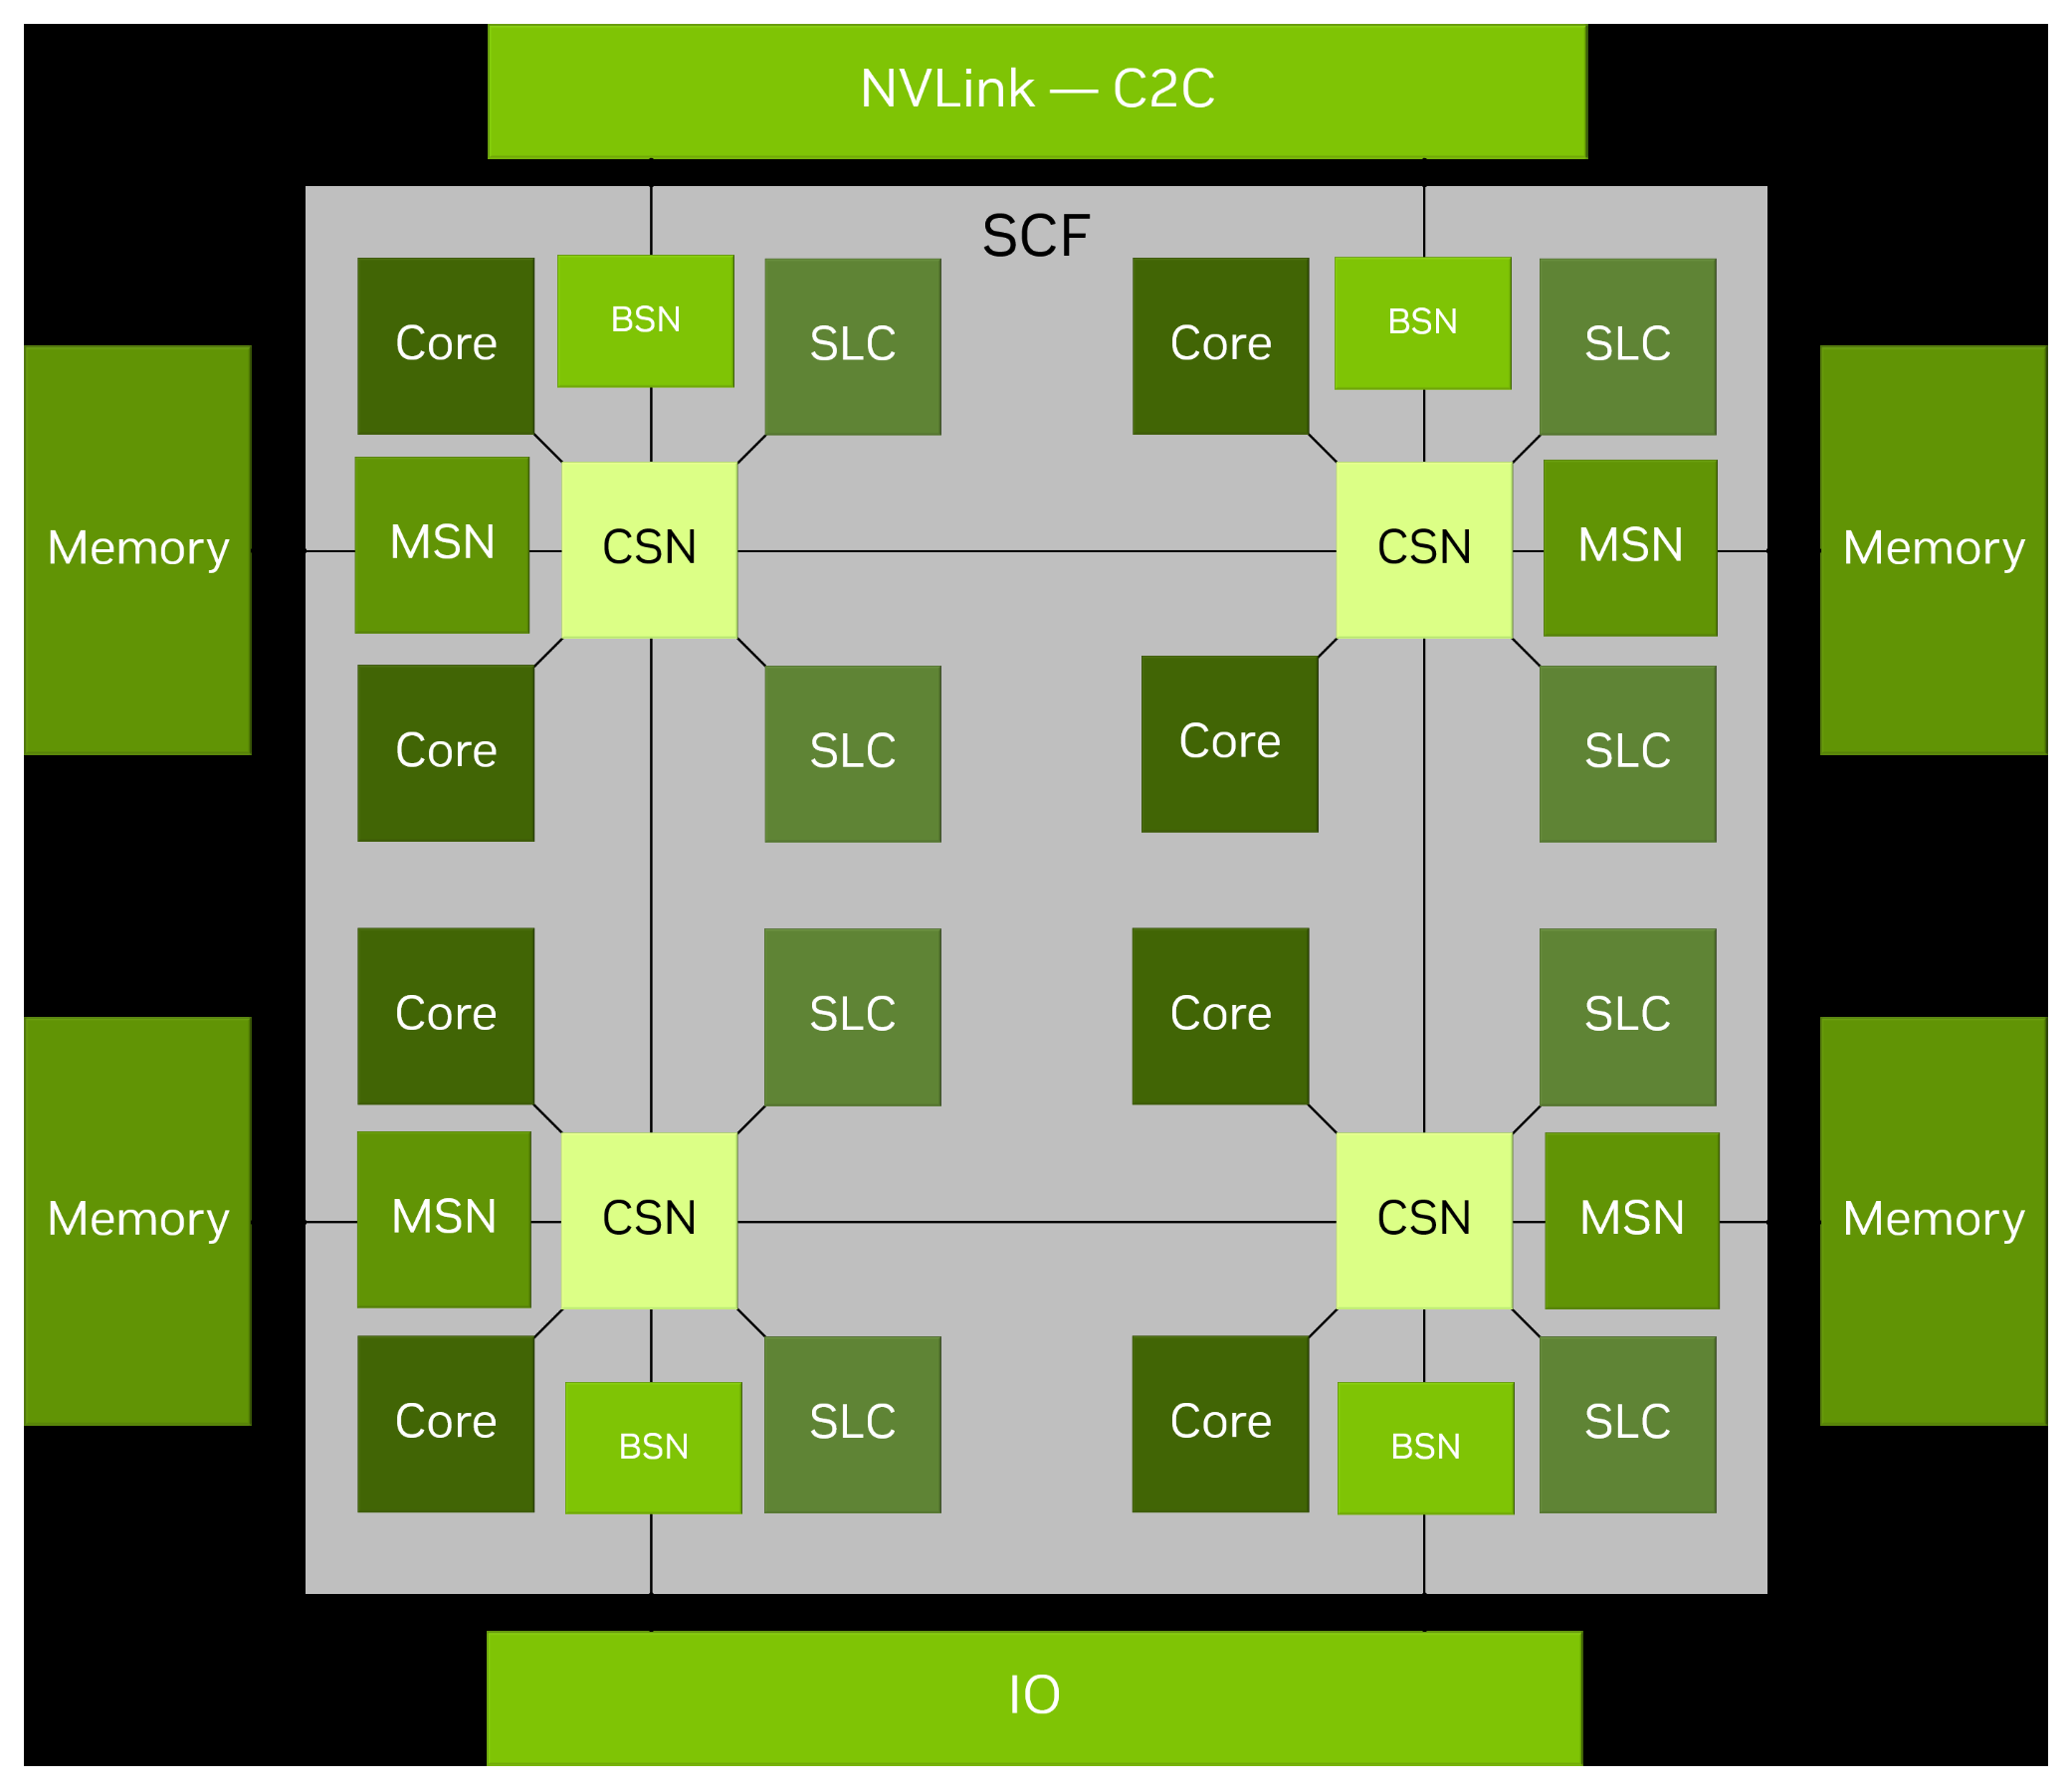
這種單晶片佈局避免了核心間通訊或存取共享快取時,各個運算晶片之間的資料傳輸。對於軟體而言,Vera 還為每個插槽提供一個 NUMA 節點:作業系統將每個插槽視為一組核心和本地連接的記憶體。這簡化了插槽內的元件佈局,但這並不意味著網格中每條路徑的延遲都相同。雙插槽伺服器仍然有兩個 NUMA 節點,存取另一個插槽的記憶體與存取本地記憶體仍然存在差異。
在每個插槽中,共享的系統級快取(L3)位於前面提到的私有 L2 快取之上。它使核心有機會在不存取 DRAM 的情況下重複使用數據,並提供整個插槽共享的快取容量。其 164MB 的容量相當可觀,但一些競爭對手的處理器提供更大的 L3 快取。當重複存取的工作集對於核心的 L2 快取來說過大,但可以放入更大的共享快取時,這一點就顯得尤為重要。高 DRAM 頻寬有助於資料必須從記憶體中獲取時的效能提升;但這並不能抵消避免直接存取記憶體所帶來的優勢。
由於該容量是共享的,Vera 還支援 Arm MPAM,允許系統軟體對共享快取容量進行分區,並管理工作負載之間的記憶體頻寬分配。
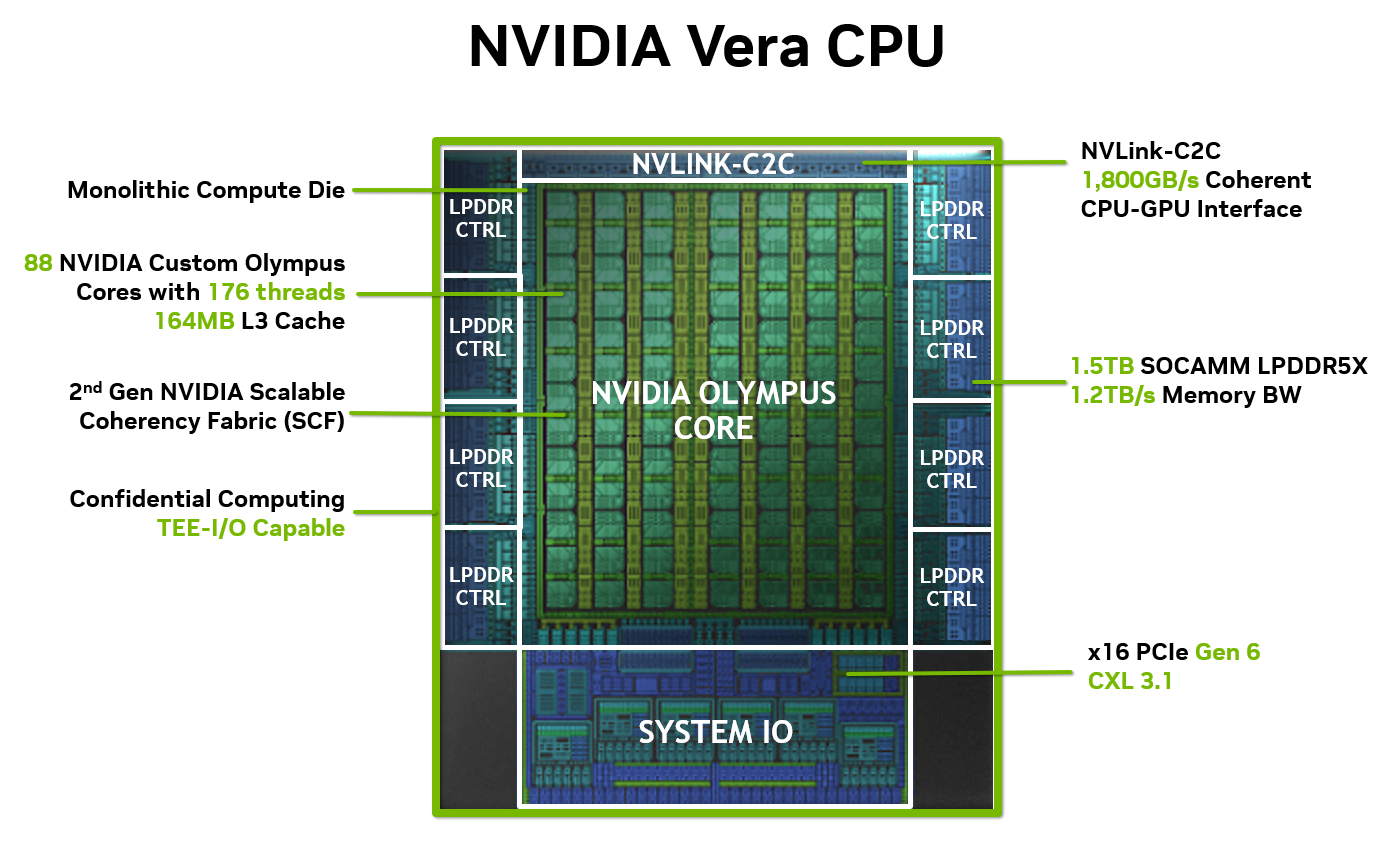
當存取請求到達主記憶體時,Vera 擁有相當大的頻寬。八個 128 位元 LPDDR5X 控制器提供 1,024 位元聚合接口,記憶體運行速度高達 9,600MT/s,每個插槽的額定容量為 1.2TB/s。記憶體安裝在八個可拆卸的 SOCAMM2 模組上,將 LPDDR5X 與現場可更換模組結合。這使得 Vera 擁有寬廣、高速的記憶體接口,而無需焊接記憶體。
原始頻寬只是問題的一部分。更有意義的是頻寬與共享頻寬的核心數量之間的關係。將額定頻寬 1.2TB/s 除以 88 個核心,得出每個物理核心約 13.6GB/s 的頻寬。這是一種描述處理器頻寬平衡的方法,並非每個執行緒的專用分配或保證。如果增加核心數量而記憶體頻寬沒有相應增加,則該比率會降低。
將我們測得的 STREAM 頻寬除以物理核心數,得出 Vera 的每個核心頻寬為 11.8GB/s,而 240 核心 Xeon 6978P 系統僅為 3.8GB/s。這具體反映了 Vera 相對於其運算資源而言,能夠提供顯著的記憶體吞吐量。
能效是同一設計選擇的一部分。 NVIDIA 估計,滿配的 LPDDR5X 記憶體子系統功耗約為 30W 至 40W,視記憶體容量而定。 LPDDR5X 的優勢在於,它能夠在提供如此高頻寬的同時,保持記憶體對伺服器總功耗的低佔用率,使系統能夠將更多的電力和散熱資源用於計算。
頻寬和效率並不能說明資料容量的大小,容量仍然是一個需要單獨考慮的因素。 NVIDIA 官方宣稱每個插槽最多可支援 1.5TB 的 LPDDR5X 直連內存,或兩個插槽共支援 3TB。對於需要將工作集駐留在記憶體中的工作負載而言,更高的傳輸速率無法彌補容量不足的問題。
如果直接連接的記憶體容量不足,Vera 的 I/O 介面可提供更多擴充途徑,並連接各種裝置。獨立的 CPU 平台每個插槽提供 88 條 PCIe Gen6 通道,用於網路連接、儲存和加速器,而 Vera Rubin 配置則提供 96 條通道。在記憶體方面,CXL 3.1 支援包括 Type 3 記憶體設備和記憶體池,允許記憶體容量擴展到 SOCAMM2 模組之外。擴展後的記憶體使用與直接連接的 LPDDR5X 不同的存取路徑,因此其效能必須單獨評估。
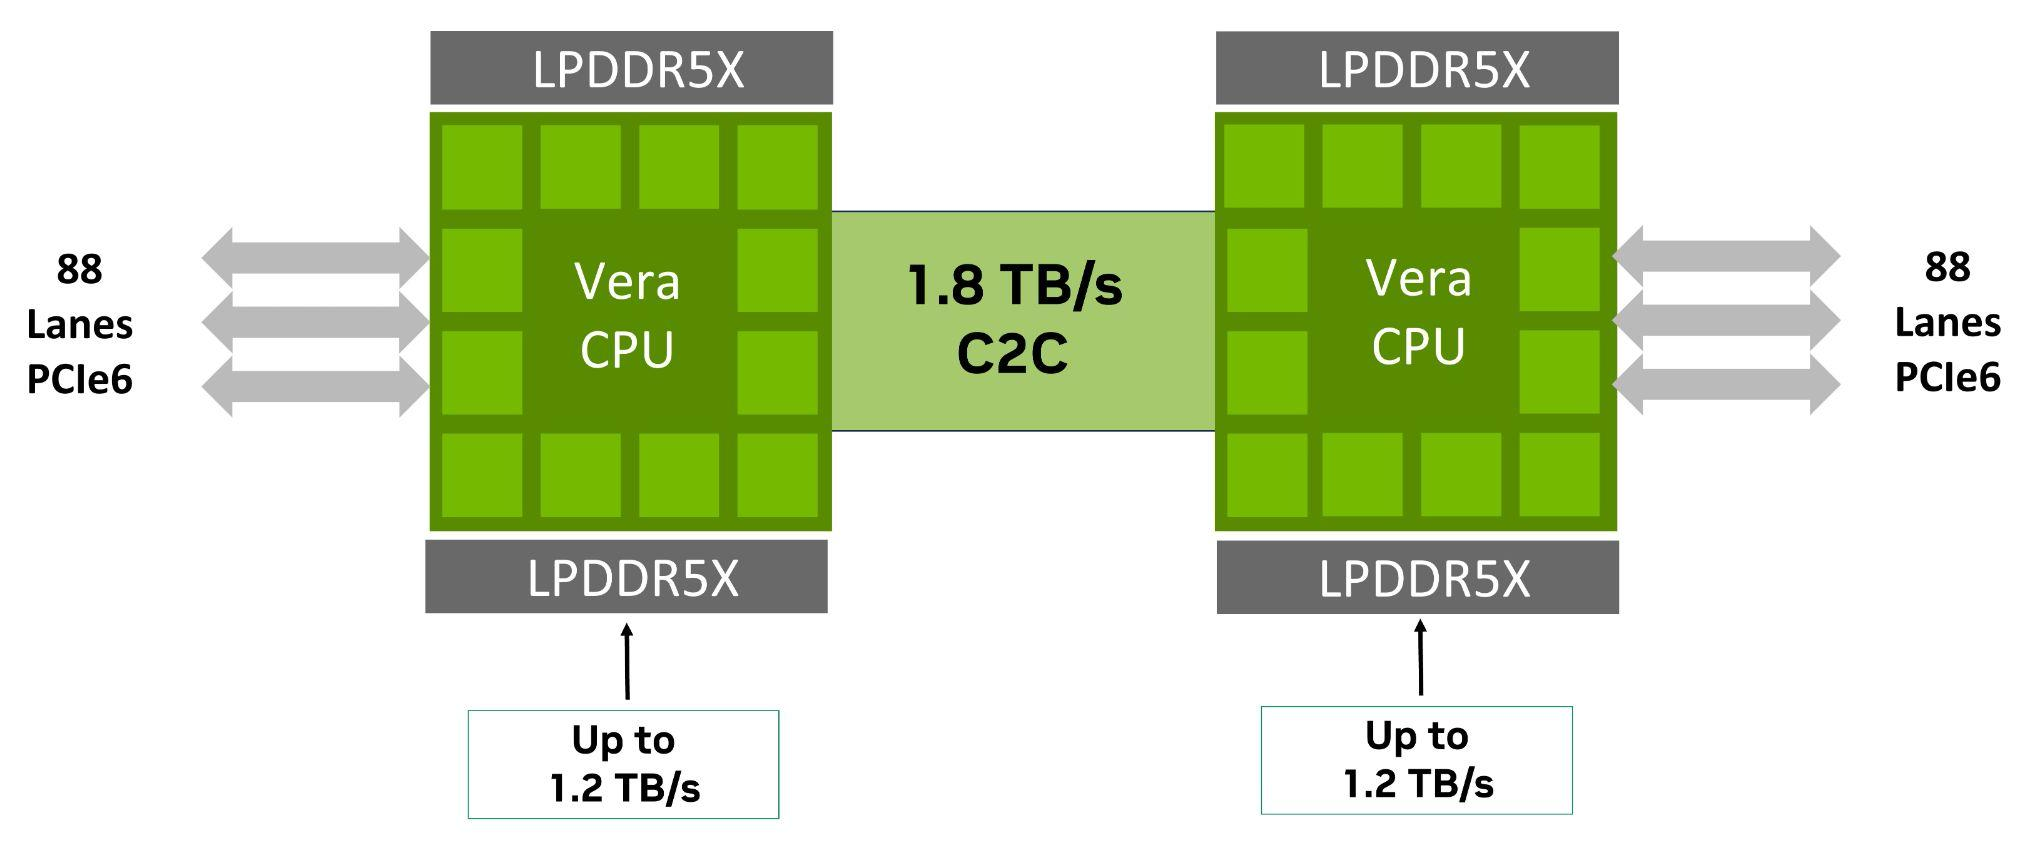
最後,在處理器間的通訊方面,Vera 採用了第二代 NVLink-C2C 技術,它是 Grace 超級晶片中引入的鏈路的升級版。此連結可將雙路伺服器中的兩顆 Vera CPU 連接起來,或將 Vera 與超級晶片中的 Rubin GPU 連接起來。此連結可提供高達 1.8TB/s 的雙向總頻寬,即每個方向 900GB/s,這體現了 NVIDIA 最初進軍 CPU 業務時所秉持的 CPU-GPU 緊密整合概念。
MGX Vera C2 參考伺服器內部結構
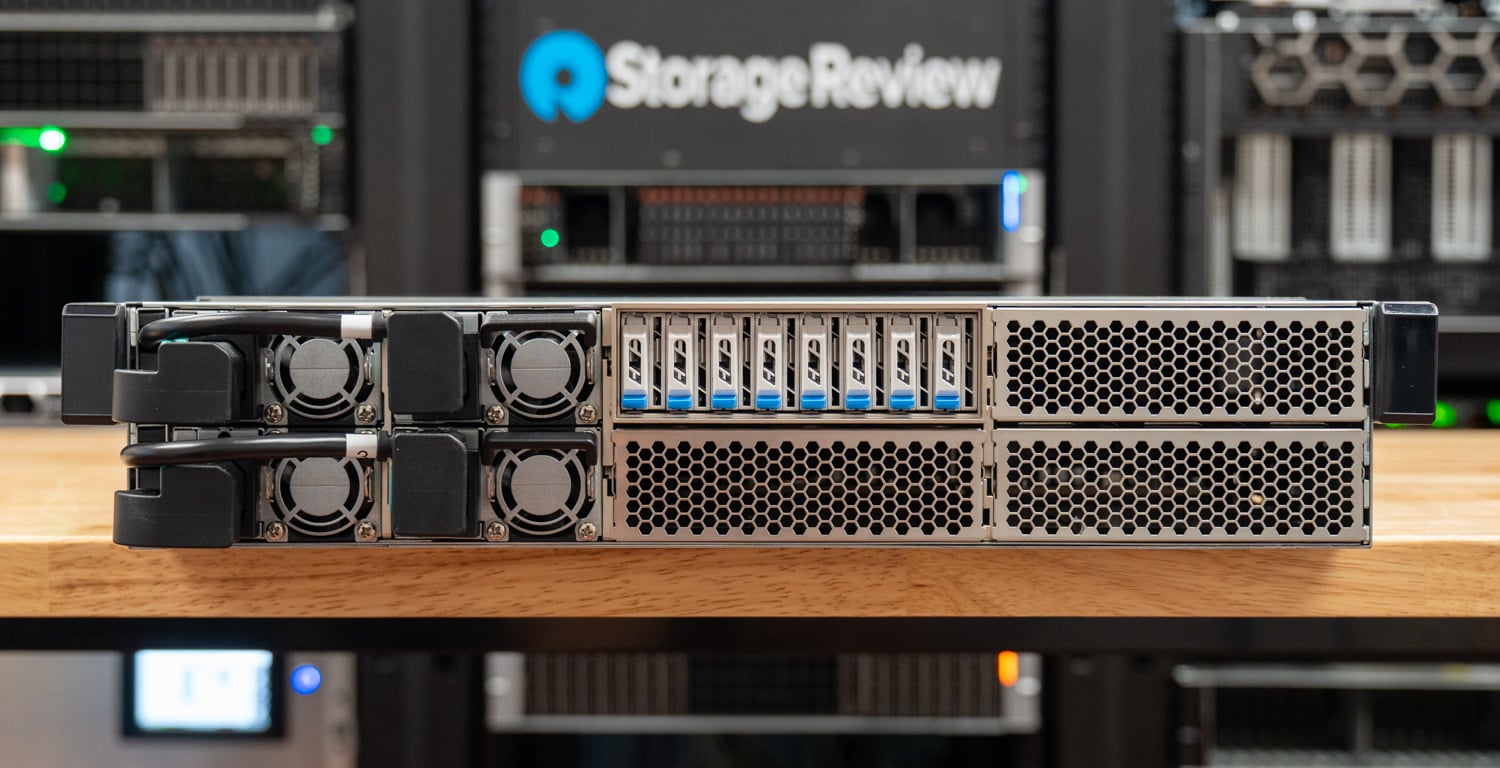
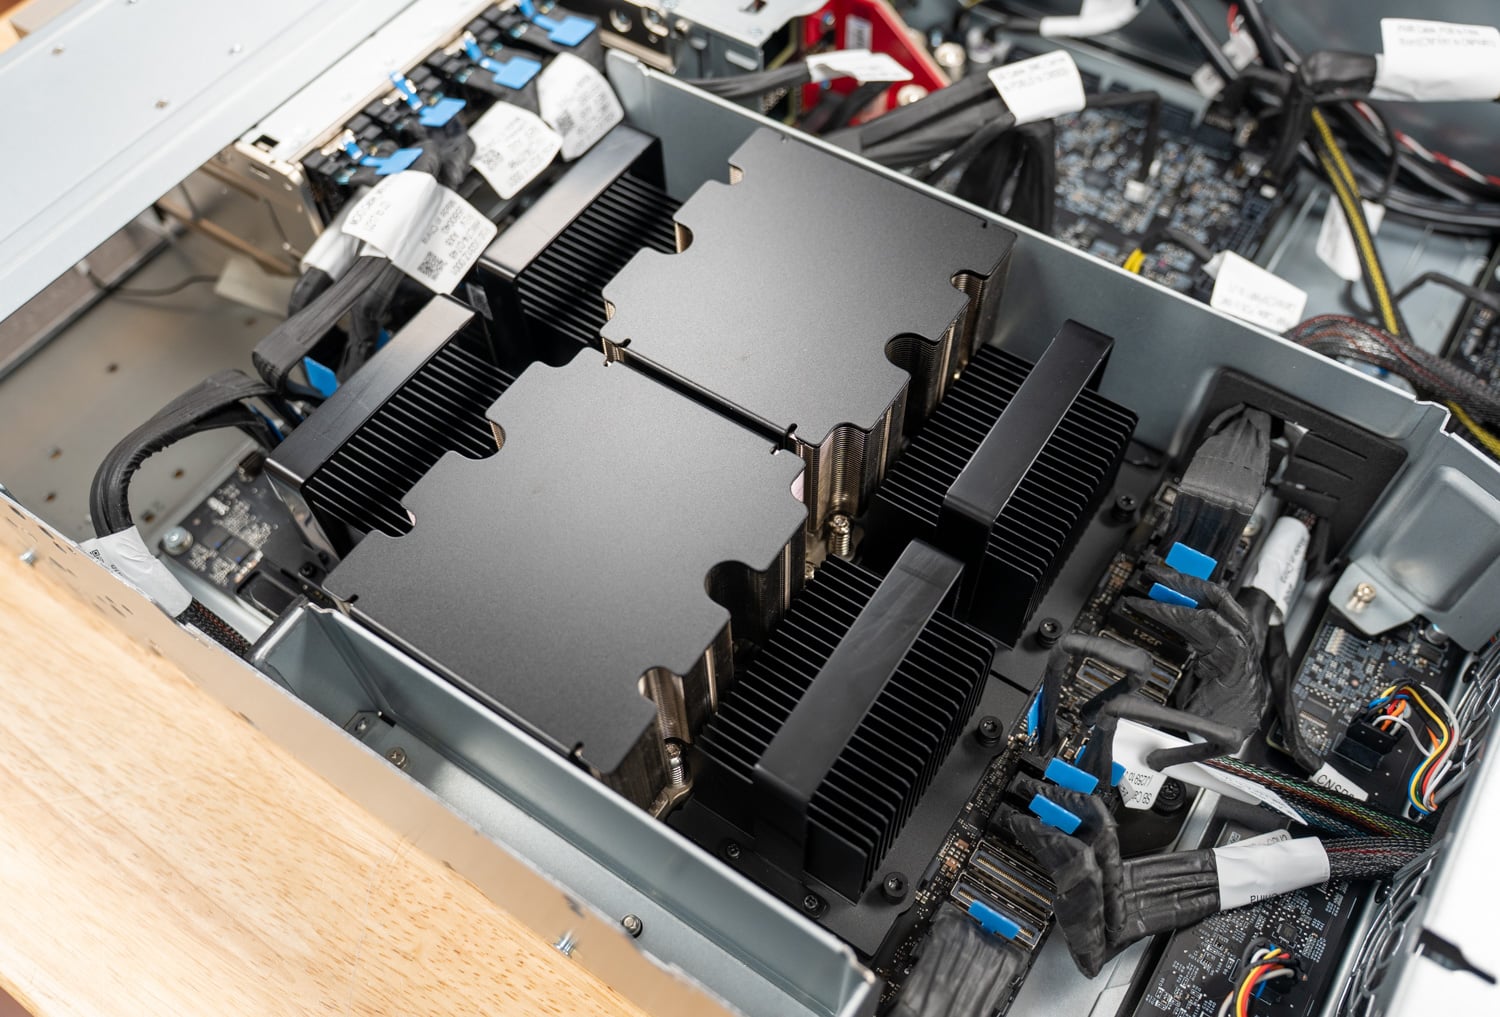
我們評測的樣機是NVIDIA的MGX Vera C2,這是一款雙路風冷2U參考伺服器,NVIDIA的合作夥伴正以此為基礎打造他們的首批Vera系統。前面板頂部排列著八個E1.S擴充槽,旁邊是四個熱插拔Delta電源,其餘部分則被蜂巢狀進氣口佔據。由於電源供應器從前面板安裝,因此後部空間可以用於機架中的I/O線纜,並留給PCIe轉接卡和管理I/O介面。
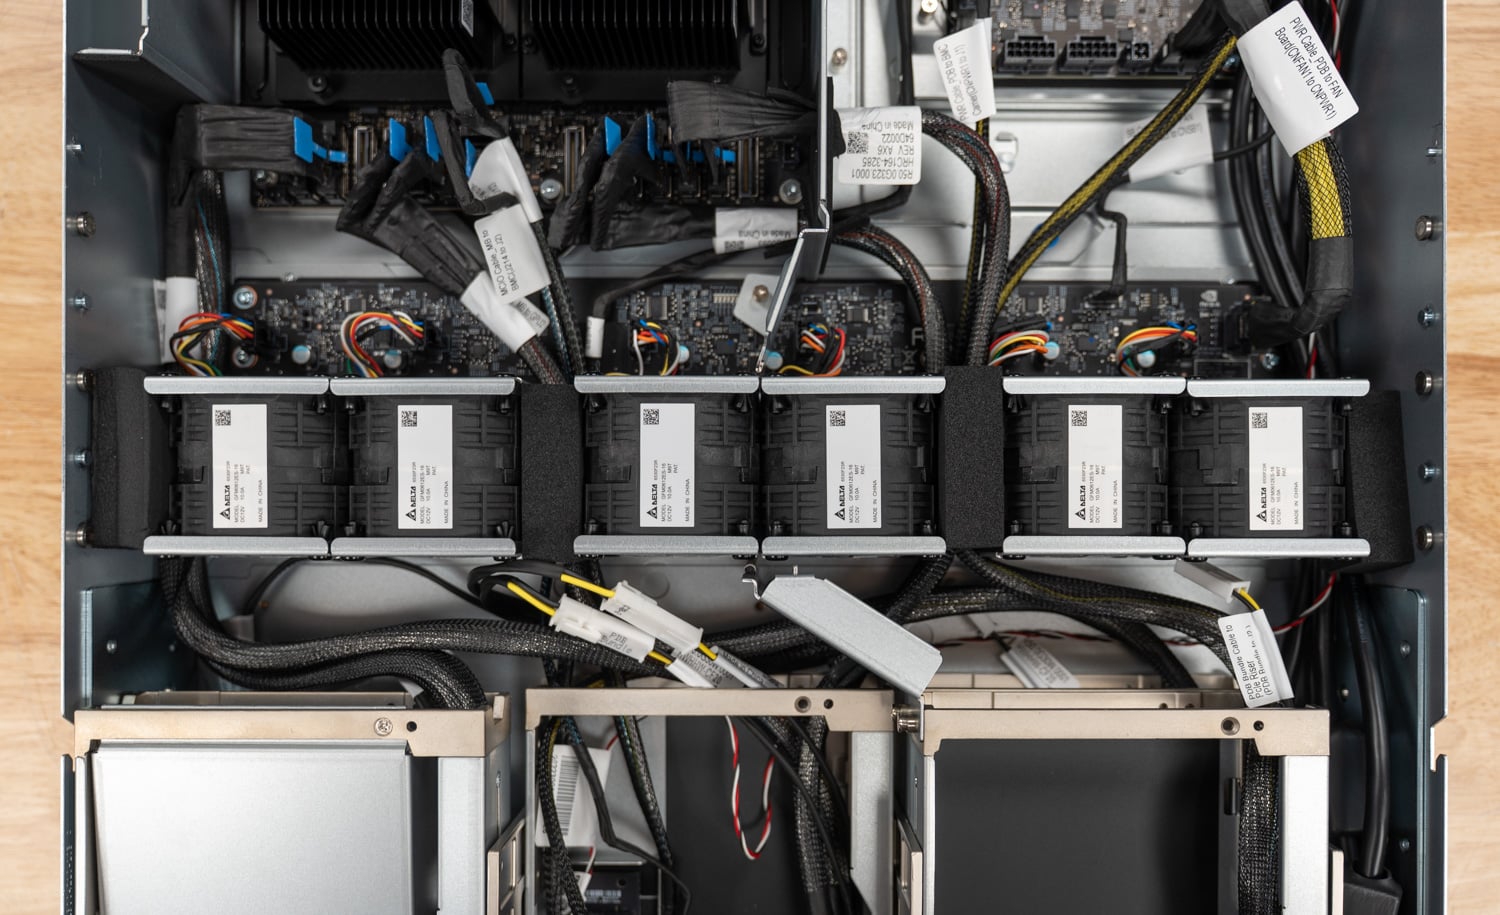
機殼內部,兩顆 Vera CPU 並排安裝在被動散熱片下方,兩側配有 SOCAMM2 散熱模組。機殼中央,硬碟位後方,由六個風扇模組組成的散熱牆,將空氣吹過兩個 CPU 插槽,每對風扇之間都設有泡棉塊,用於引導氣流。從散熱角度來看,這樣的佈局設計非常合理。
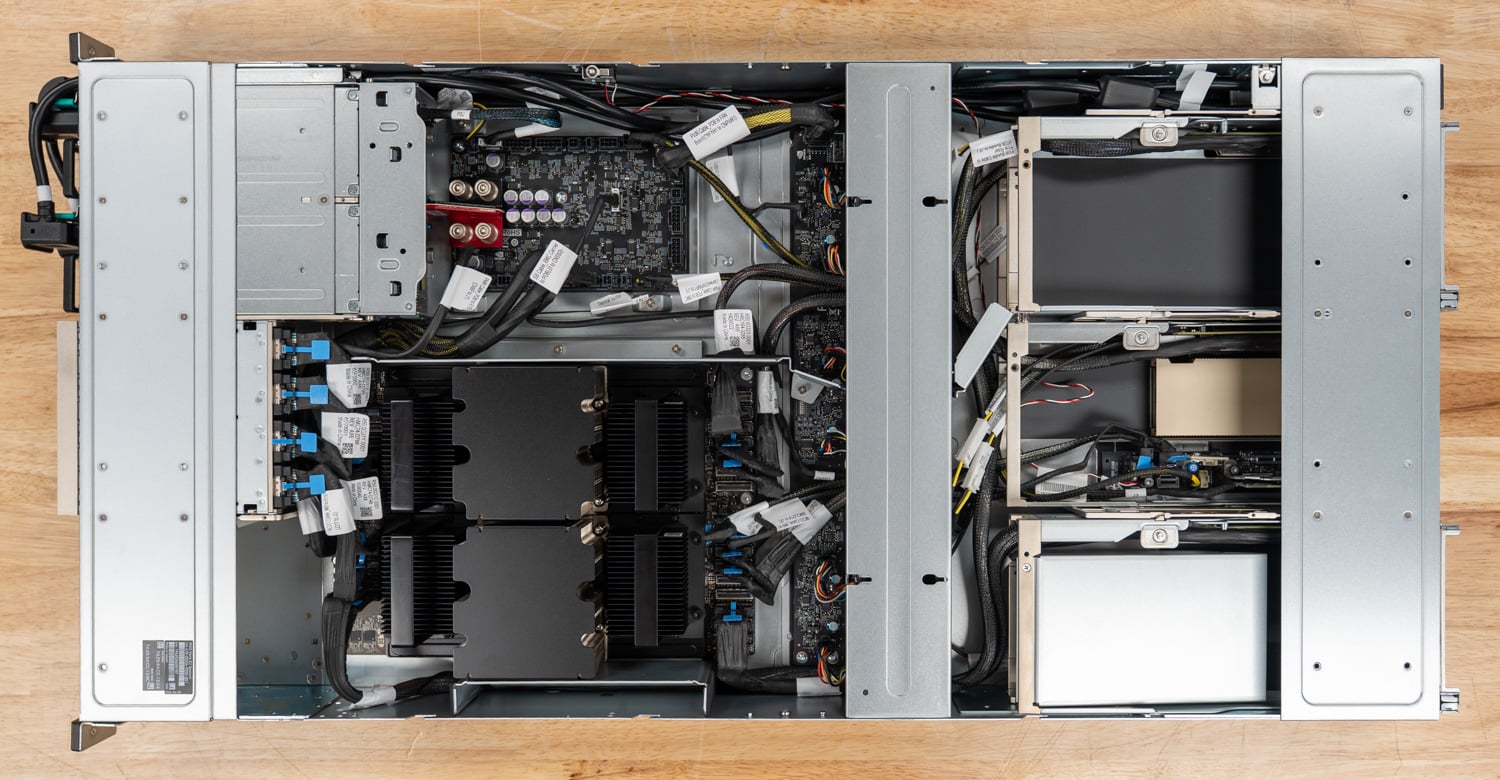
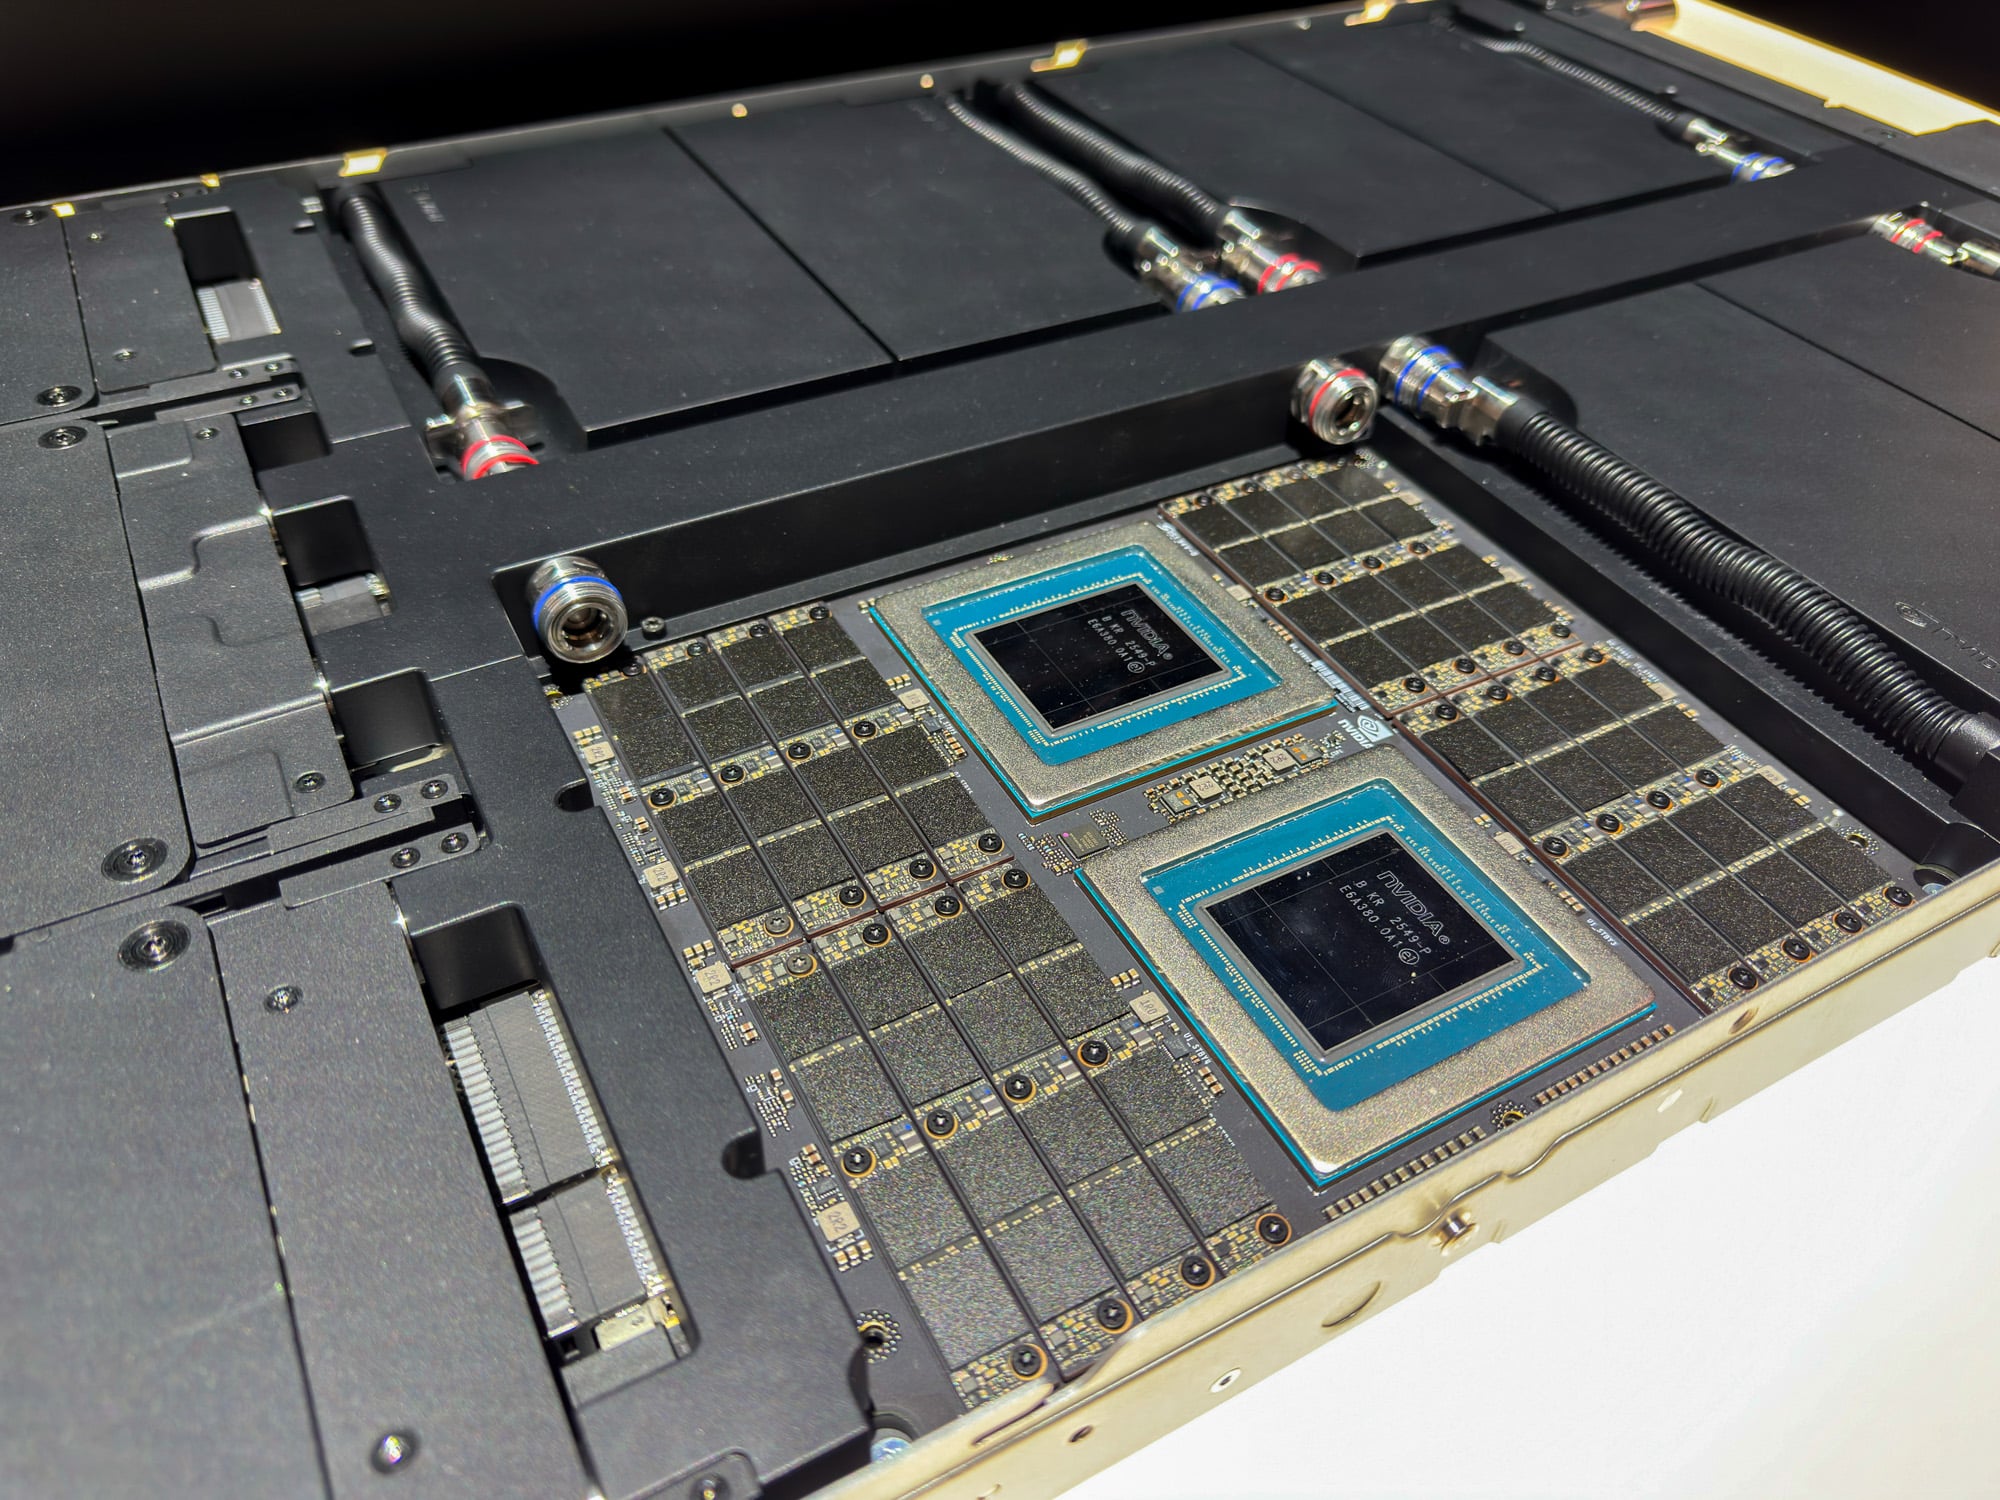
兩款處理器均直接安裝在PCB板上,沒有插槽,這與NVIDIA在其超級晶片中採用Vera架構的方式相同。 16個SOCAMM2插槽環繞著這兩個處理器,因此即使處理器不可更換,記憶體仍然可以現場更換;更換CPU則需要更換整個主機板。今年夏天,我們也評測了同一款主機板的液冷版本,該版本在主機板頂部鋪設了快速斷開式冷卻液管路,連接到處理器的散熱片,而SOCAMM2記憶體模組則採用風冷散熱。
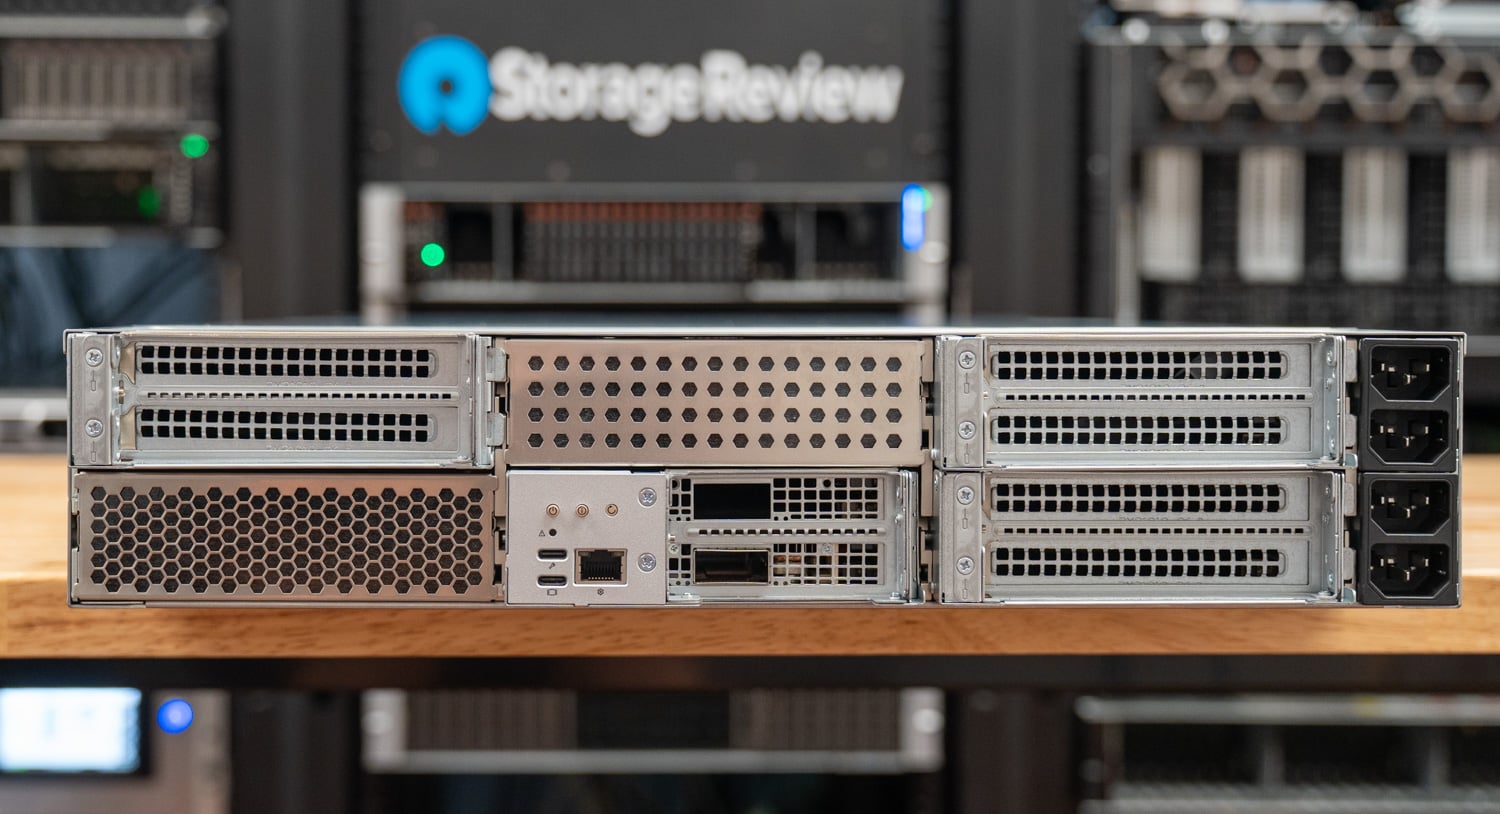
中間的擴充槽內裝有 NVIDIA ConnectX-8 轉接器,支援高達 800G 的網路連接;後面板則配備了 USB、DisplayPort 介面以及用於外管理的專用網路連接埠。
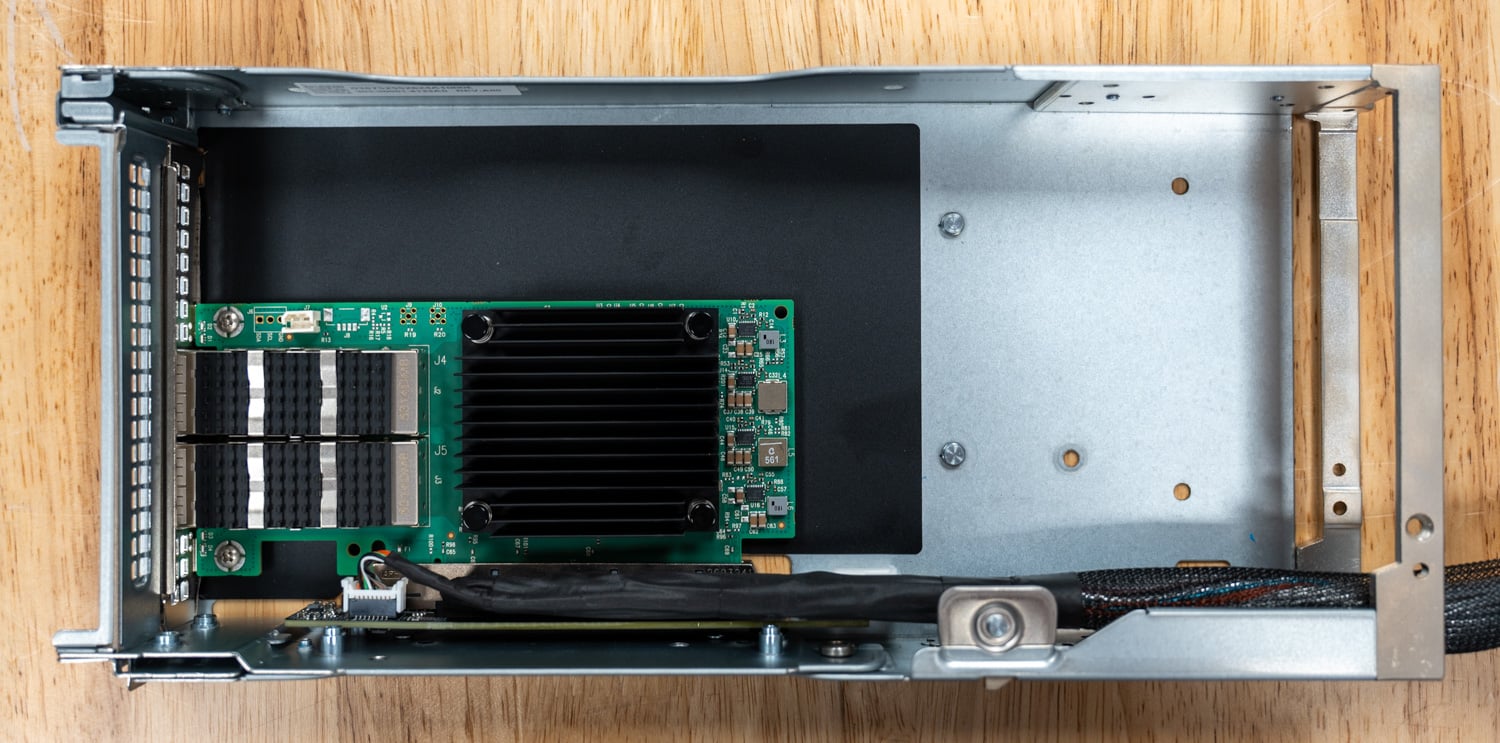
該平台採用高度模組化設計,支援多種儲存和後置 PCIe 配置,但這種靈活性是以增加維護時間為代價的。乍一看,其三個 FHFL PCIe 轉接卡似乎易於維護。但在典型的伺服器中,更換卡需要鬆開轉接卡,翻出支撐卡扣或旋下螺絲,然後才能將卡片滑出。
在 Vera 伺服器上,首先要取下風扇罩,移除一個或多個泡棉塊,然後斷開並取出延長線的電源線和 PCIe 線纜。只有這樣,整個延長線組件才能從機殼後方滑出。延長線滑出後,需要將其拆解才能接觸到顯示卡,更換顯示卡後再重新組裝。在普通伺服器上只需幾秒鐘就能完成的工作,在這裡每個延長線滑出需要 5 到 10 分鐘。
實際上,除非你準備好來回搬動,否則機架內維修是不可能的,因此大多數組件更換都需要將伺服器移到工作台上進行維修。
性能和基準
這些基準測試旨在檢驗 Vera 的設計如何轉化為實際效能,涵蓋從單一執行緒到使用整個系統的工作負載。我們的測試包括記憶體頻寬和延遲、科學計算、通用軟體和資料庫,展示了處理器如何應對其核心和記憶體系統的不同需求。
測試系統
| 系統 | NVIDIA MGX Vera C2 | 戴爾PowerEdge R7725 | 戴爾PowerEdge R7725 | 戴爾 PowerEdge R770AP | 戴爾PowerEdge R770 | 戴爾PowerEdge R760 |
|---|---|---|---|---|---|---|
| 處理器 | ||||||
| 中央處理器 | NVIDIA Vera | AMD EPYC 9965 | AMD 霄龍 9175F | 英特爾至強 6978P | 英特爾至強 6787P | 英特爾至強白金 8592+ |
| 套接字 | 2 | |||||
| 每個 CPU 的核心數/執行緒數 | 88 / 176 | 192 / 384 | 16 / 32 | 120 / 240 | 86 / 172 | 64 / 128 |
| 基地時鐘 | 3.4 GHz | 2.25 GHz | 4.2 GHz | 2.1 GHz | 2.0 GHz | 1.9 GHz |
| 最大時鐘 | 3.4 GHz | 3.7 GHz | 5.0 GHz | 3.9 GHz | 3.8 GHz | 3.9 GHz |
| 記憶體應用 | ||||||
| 型號 | 16x 96GB Micron SOCAMM2 | 24x 128GB | 24x 64GB | 32x 64GB | 16x 64GB | |
| 類型/速度 | LPDDR5X-9600 | DDR5-6400 | DDR5-5200 | DDR5-4800 | ||
| 總容量 | 1.5TB | 3TB | 1.5TB | 2TB | 1TB | |
| 儲存 | ||||||
| SSD | Solidigm D7-PS1010 7.68TB | Solidigm D7-PS1030 12.8TB | Micron 9550 PRO 7.68TB | Solidigm D7-PS1010 7.68TB | 三星 PM1745 6.4TB | 固力D7-P5520 3.84TB |
| SSD 連結 | PCIe Gen5 x4 | PCIe Gen5 x2 | PCIe Gen5 x4 | PCIe Gen4 x4 | ||
| Firmware / 硬體 | ||||||
| 系統BIOS | NV_SBIOS 06.07.01.06 | 1.5.3 | 1.2.1 | 1.8.5 | 2.8.2 | |
| BIOS設定檔 | 預設產品 | 性能 | ||||
| 軟件堆棧 | ||||||
| OS | Ubuntu的LTS 26.04.1 | Ubuntu的LTS 24.04.5 | ||||
| 核心 | 7.0.0-2022-nvidia-bos | 6.8.0-142 / 6.8.0 146的 | 6.8.0-147 | 6.8.0-138 | 6.8.0-142 / 6.8.0 146的 | 6.8.0-142 / 6.8.0 146的 |
| GCC | 15.2.0 | 13.3.0 | ||||
| glibc的 | 2.43 | 2.39 | ||||
| 打開 MPI | 5.0.10 | 4.1.6 | ||||
| OpenJDK的 | 11.0.32 | |||||
我們將 Vera 與五台配備理想記憶體配置的戴爾 PowerEdge 伺服器進行了比較,並使用相同的測試套件對它們進行了測試,涵蓋了 AMD 核心數最高、頻率優化的 EPYC 處理器以及當前和上一代 Xeon 處理器。
由於 GCC 15 才首次支援 Olympus 處理器,因此 Vera 運行的軟體堆疊比上述 x86 系統更新。除此之外,所有系統的基準測試版本、輸入參數和建置標誌都相同。
內存帶寬
Vera 與 x86 最大的區別在於內存,因此我們從內存入手進行測試。我們測試了 STREAM Triad,在 16GiB 記憶體陣列上,每個物理核心執行一個 OpenMP 執行緒。主測試使用了系統中的所有核心,每個執行緒的資料都放在同一個插槽上。然後,我們重複測試,這次插槽 0 的核心先讀取本地內存,再讀取遠端插槽的內存,並且每個核心都交替讀取兩個插槽上的頁面。下圖顯示了每個伺服器在關閉 SMT 的情況下,整個系統的 Triad 測試結果。
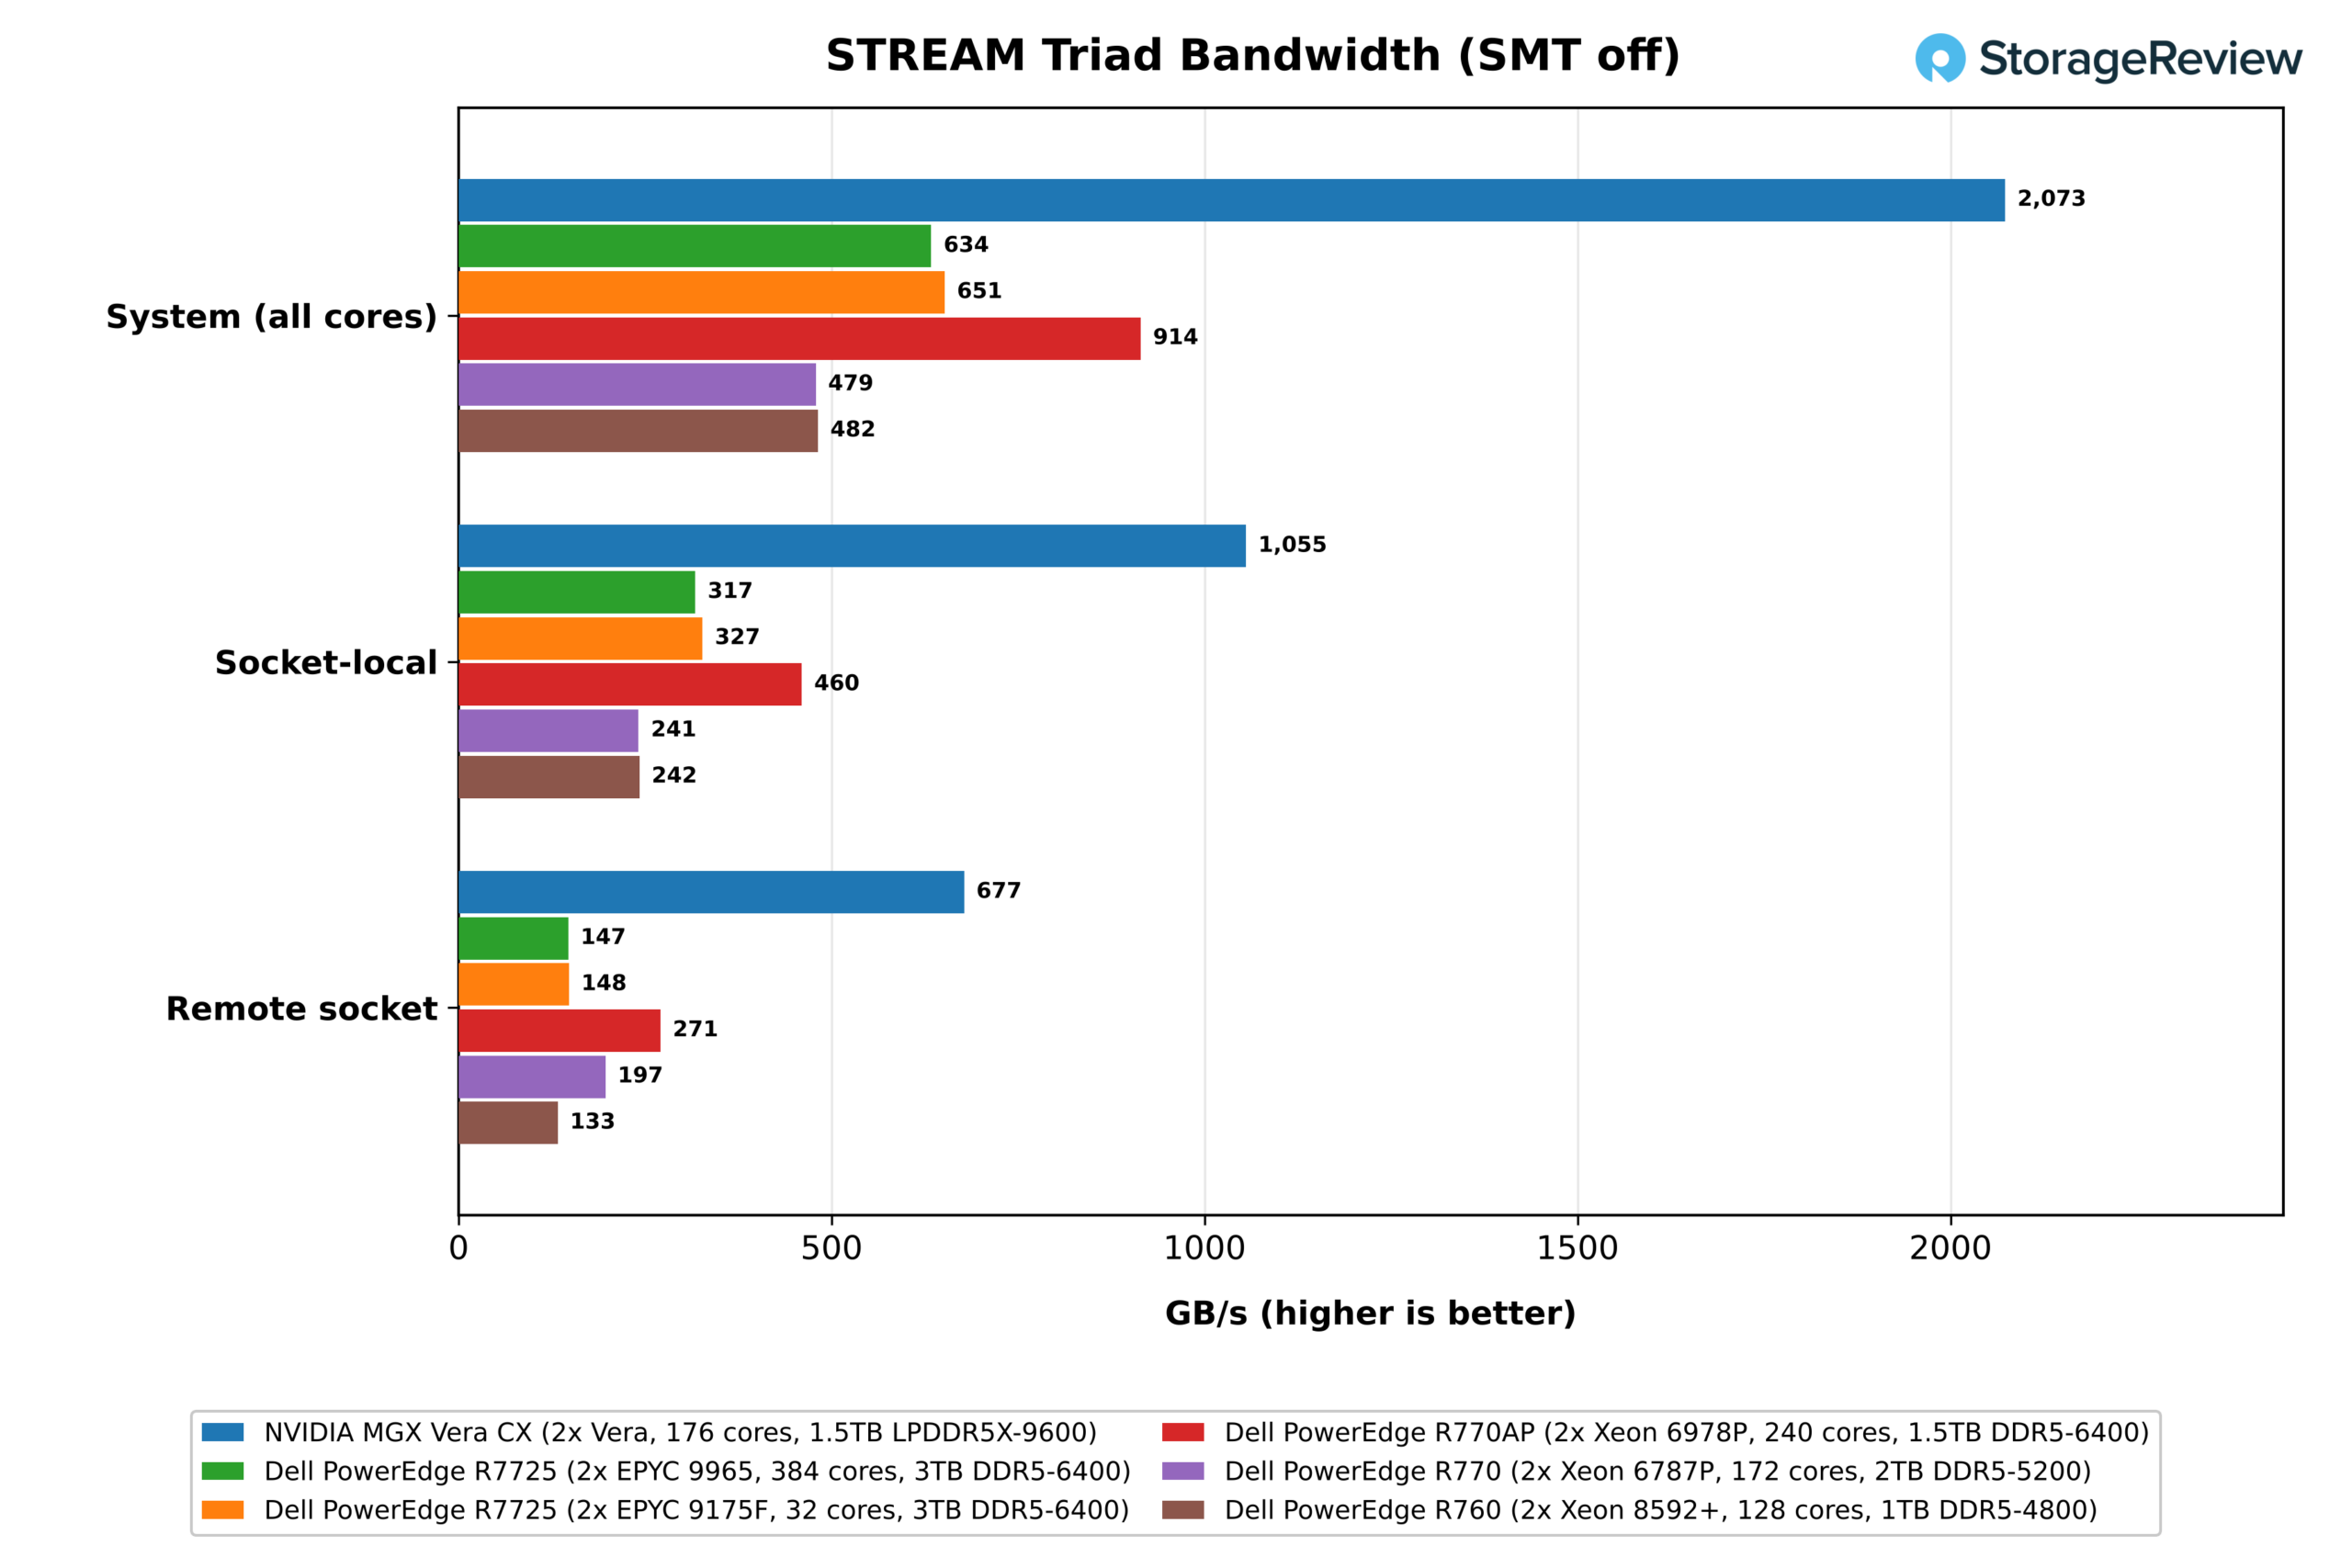
Vera 的記憶體吞吐量達到了 2,073GB/s,為其雙路 2.4TB/s 額定吞吐量的 86%。最接近的 x86 系統是 Xeon 6978P,其 24 通道 DDR5-6400 記憶體的吞吐量為 914GB/s,為其 1,229GB/s 理論峰值的 74%,領先 Vera 2.3 倍。兩款 EPYC 系統同樣採用 24 通道 DDR5-6400 內存,但實際吞吐量卻遠低於 Vera:32 核的 9175F 為 651GB/s,384 核的 9965 為 634GB/s,僅為峰值的 52%,僅為 Vera 3.3 倍。最後,Xeon 6787P 和 8592+ 在運行速度較慢的 DDR5-5200 和 DDR5-4800 時落後於其他處理器,分別達到 479GB/s 和 482GB/s。
EPYC 效能不足的部分原因在於 STREAM 計算流量的方式。此測試套件使用普通的 GCC 編譯器來建構 STREAM,而 GCC 編譯器不會產生串流儲存操作,因此,如果儲存作業未命中緩存,它會先從記憶體中讀取目標行。 STREAM 不會將這種讀取操作計入流量統計,這意味著無論這種讀取操作發生在何處,Triad 都會低估實際流量的四分之一。 AMD 的 Zen 架構核心會對每次儲存作業都進行運算。像 NVIDIA 早期的 Grace 這樣的 Arm 架構核心可以偵測到整行寫入操作並跳過讀取操作,而 Intel 最新的 Xeon 處理器在記憶體負載較高時可以跳過大部分讀取操作。
Phoronix 測試套件單獨建構的 STREAM 也指向了相同的結果。在關閉 SMT 的情況下,其 Copy 測試結果在 9965 上達到 832GB/s,在 9175F 上達到 873GB/s,約為測試套件構建結果(551GB/s 和 570GB/s)的 1.5 倍,這與 Copy 測試在移除額外讀取操作後的 9 倍
扣除未計入的讀取次數後,9965 的資料傳輸速度約為 845GB/s,約為峰值的 69%,Vera 在位元組傳輸量上的領先優勢縮小至約 2.5 倍。 6978P 的修正量要小得多,因此其 2.3 倍的對比結果在該系列產品中最為保守。
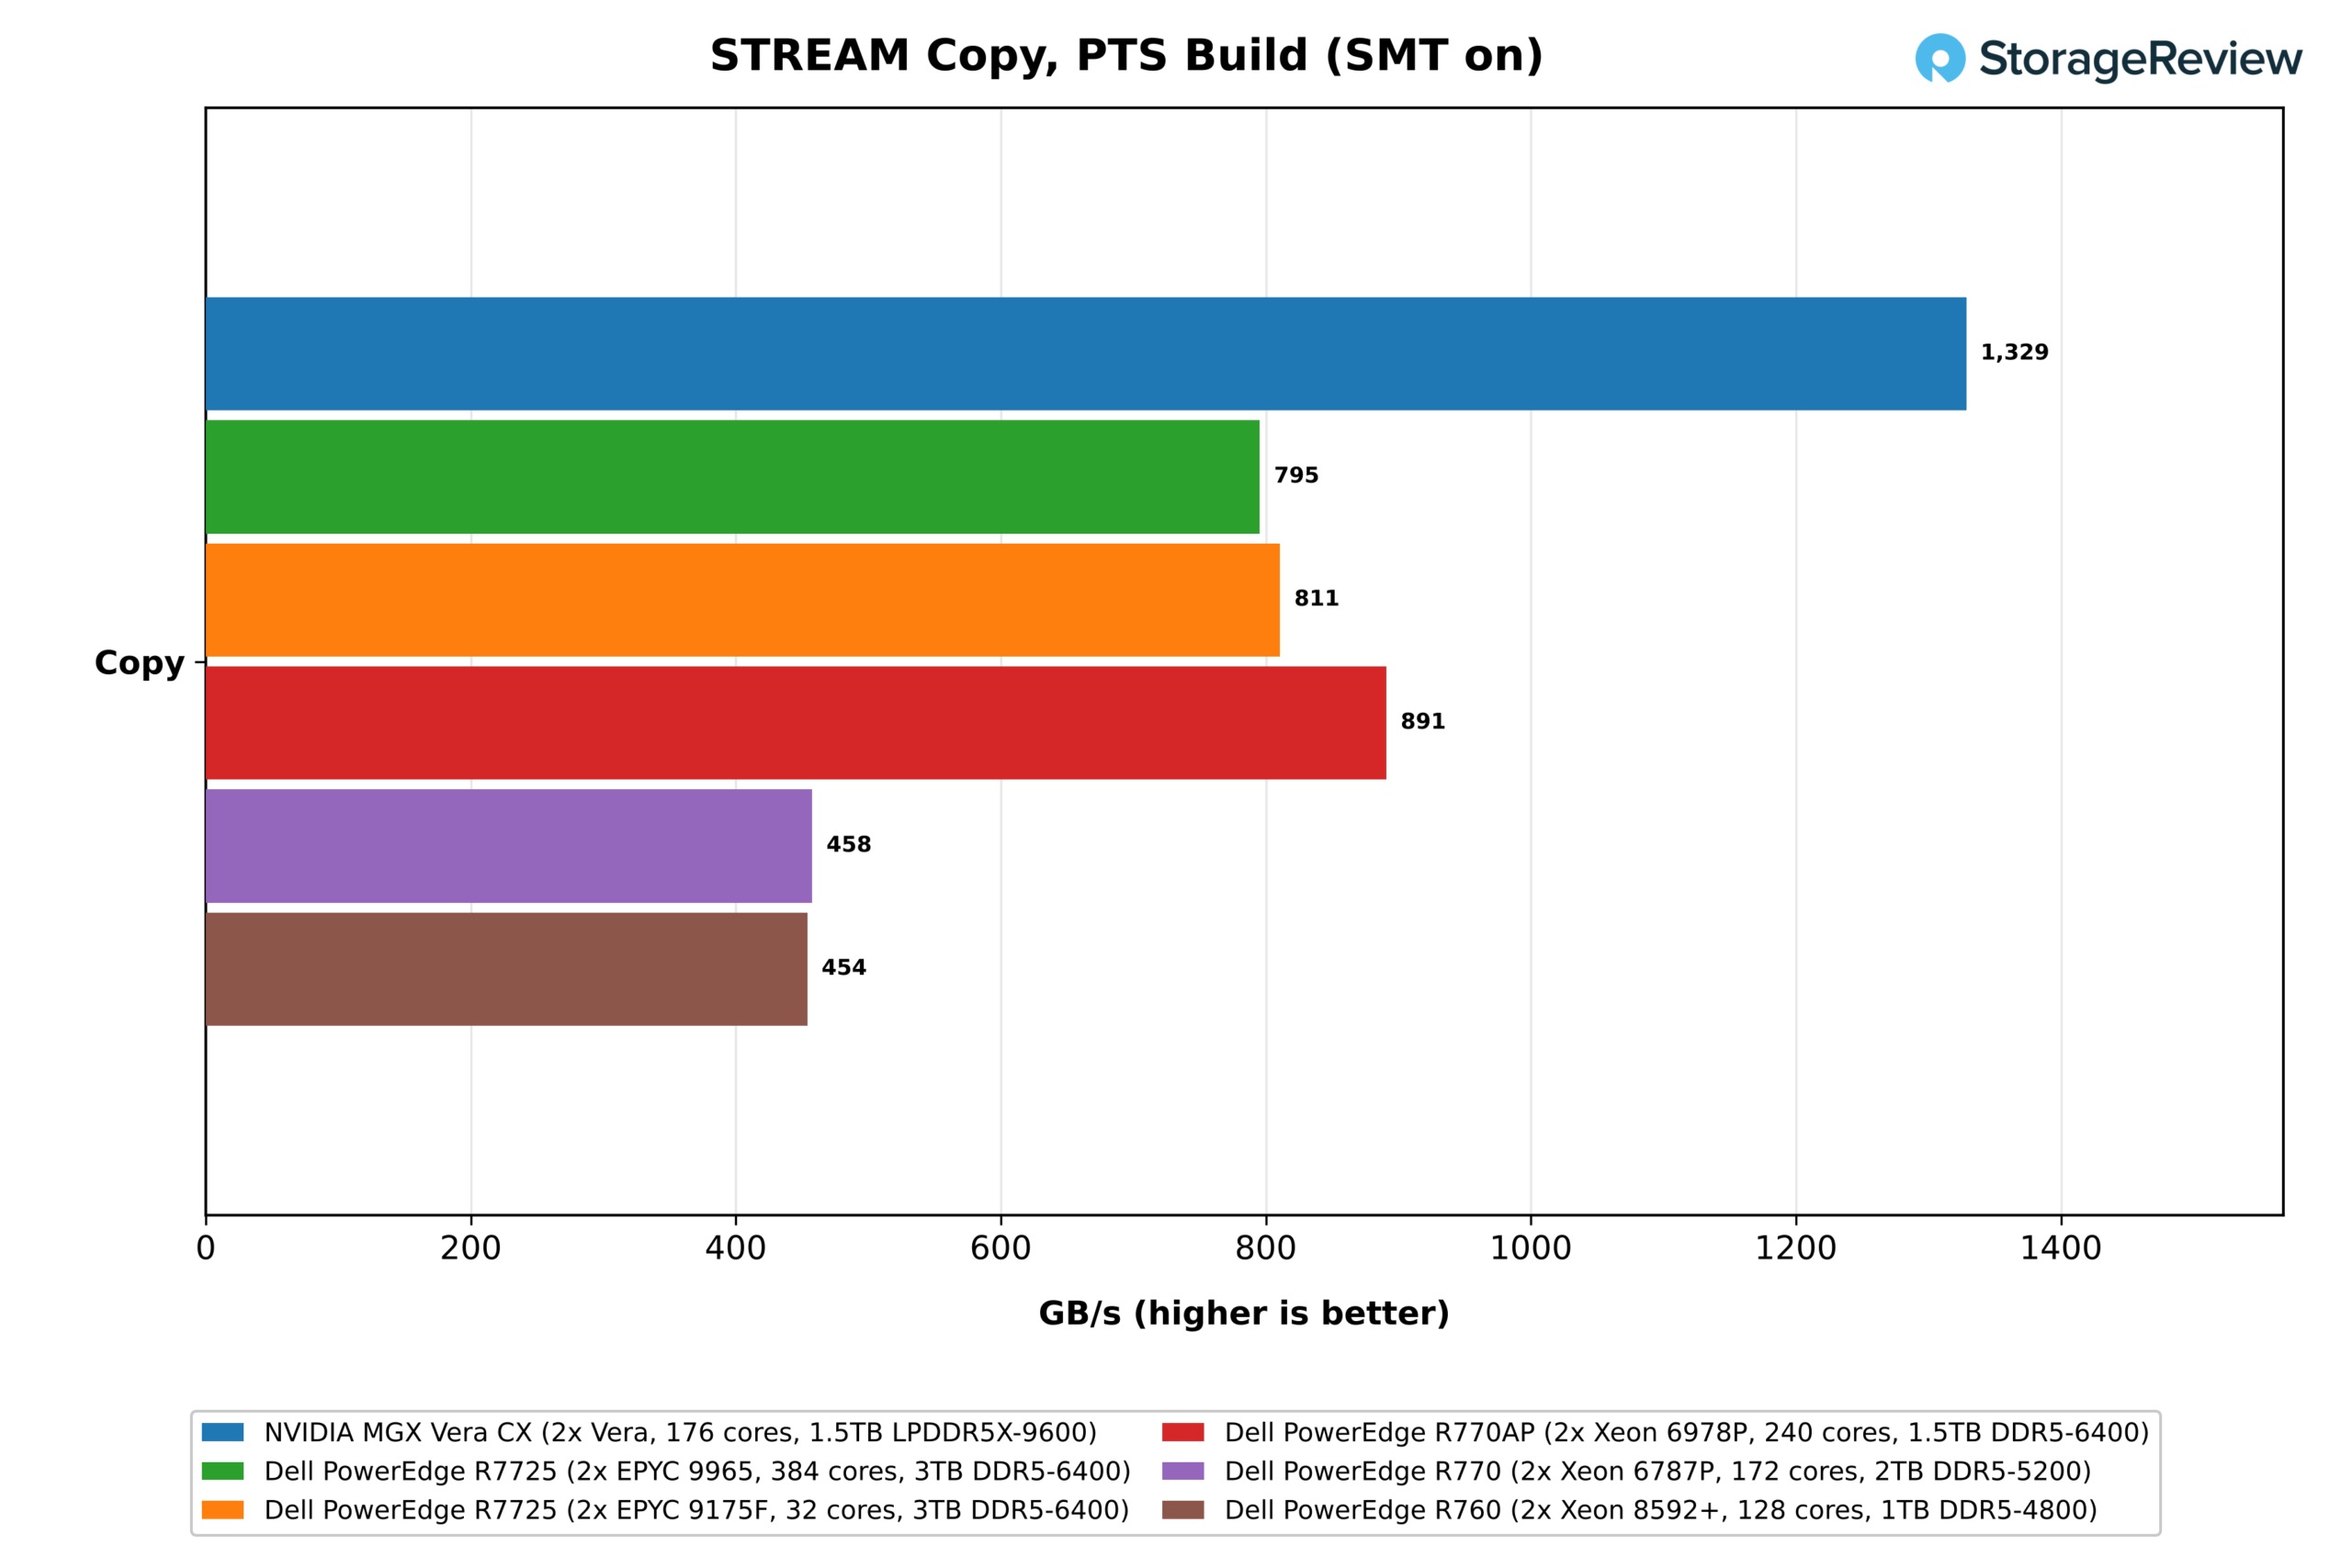
按插槽劃分測試結果,可以了解該架構如何處理非本地核心資料。插槽 0 的核心讀取本地記憶體的速度達到了 1,055GB/s,相當於每個插槽 1.2TB/s 額定速度的 88%,超過了測試集中任何一台 x86 伺服器。透過 NVLink-C2C 讀取另一個插槽的記憶體時,相同的核心保持了 677GB/s 的速度,相當於本地速度的 64%,而 Xeon 6978P 為 59%,EPYC 9175F 為 45%(遠端速度為 148GB/s,本地速度為 327GB/s)。因此,即使工作負載部署在錯誤的插槽上,也能獲得比任何 x86 插槽從本地記憶體讀取資料更高的頻寬,而 x86 插槽從本地記憶體讀取資料的速度在 6978P 上最高可達 460GB/s。
作為 Vera 的最終測試,我們使用 STREAM Triad 交錯頁跨兩個插槽進行了測試,這是非 NUMA 感知應用程式所遇到的情況,結果 Vera 達到了 1,372GB/s,是 6978P 整個系統結果的 1.5 倍。
潛伏
頻寬只是記憶體效能的一半。延遲決定了每次快取未命中時核心的等待時間,對於需要頻繁存取記憶體指標的程式碼來說,延遲尤其重要。我們使用 tinymembench 來測量延遲,該測試會記錄單一執行緒在 socket 0 上對 1GiB 緩衝區進行隨機讀取的耗時。 EPYC 9175F 是我們測試組中唯一一款有此測試結果的 x86 系統,因此我們選擇它作為對比對象。
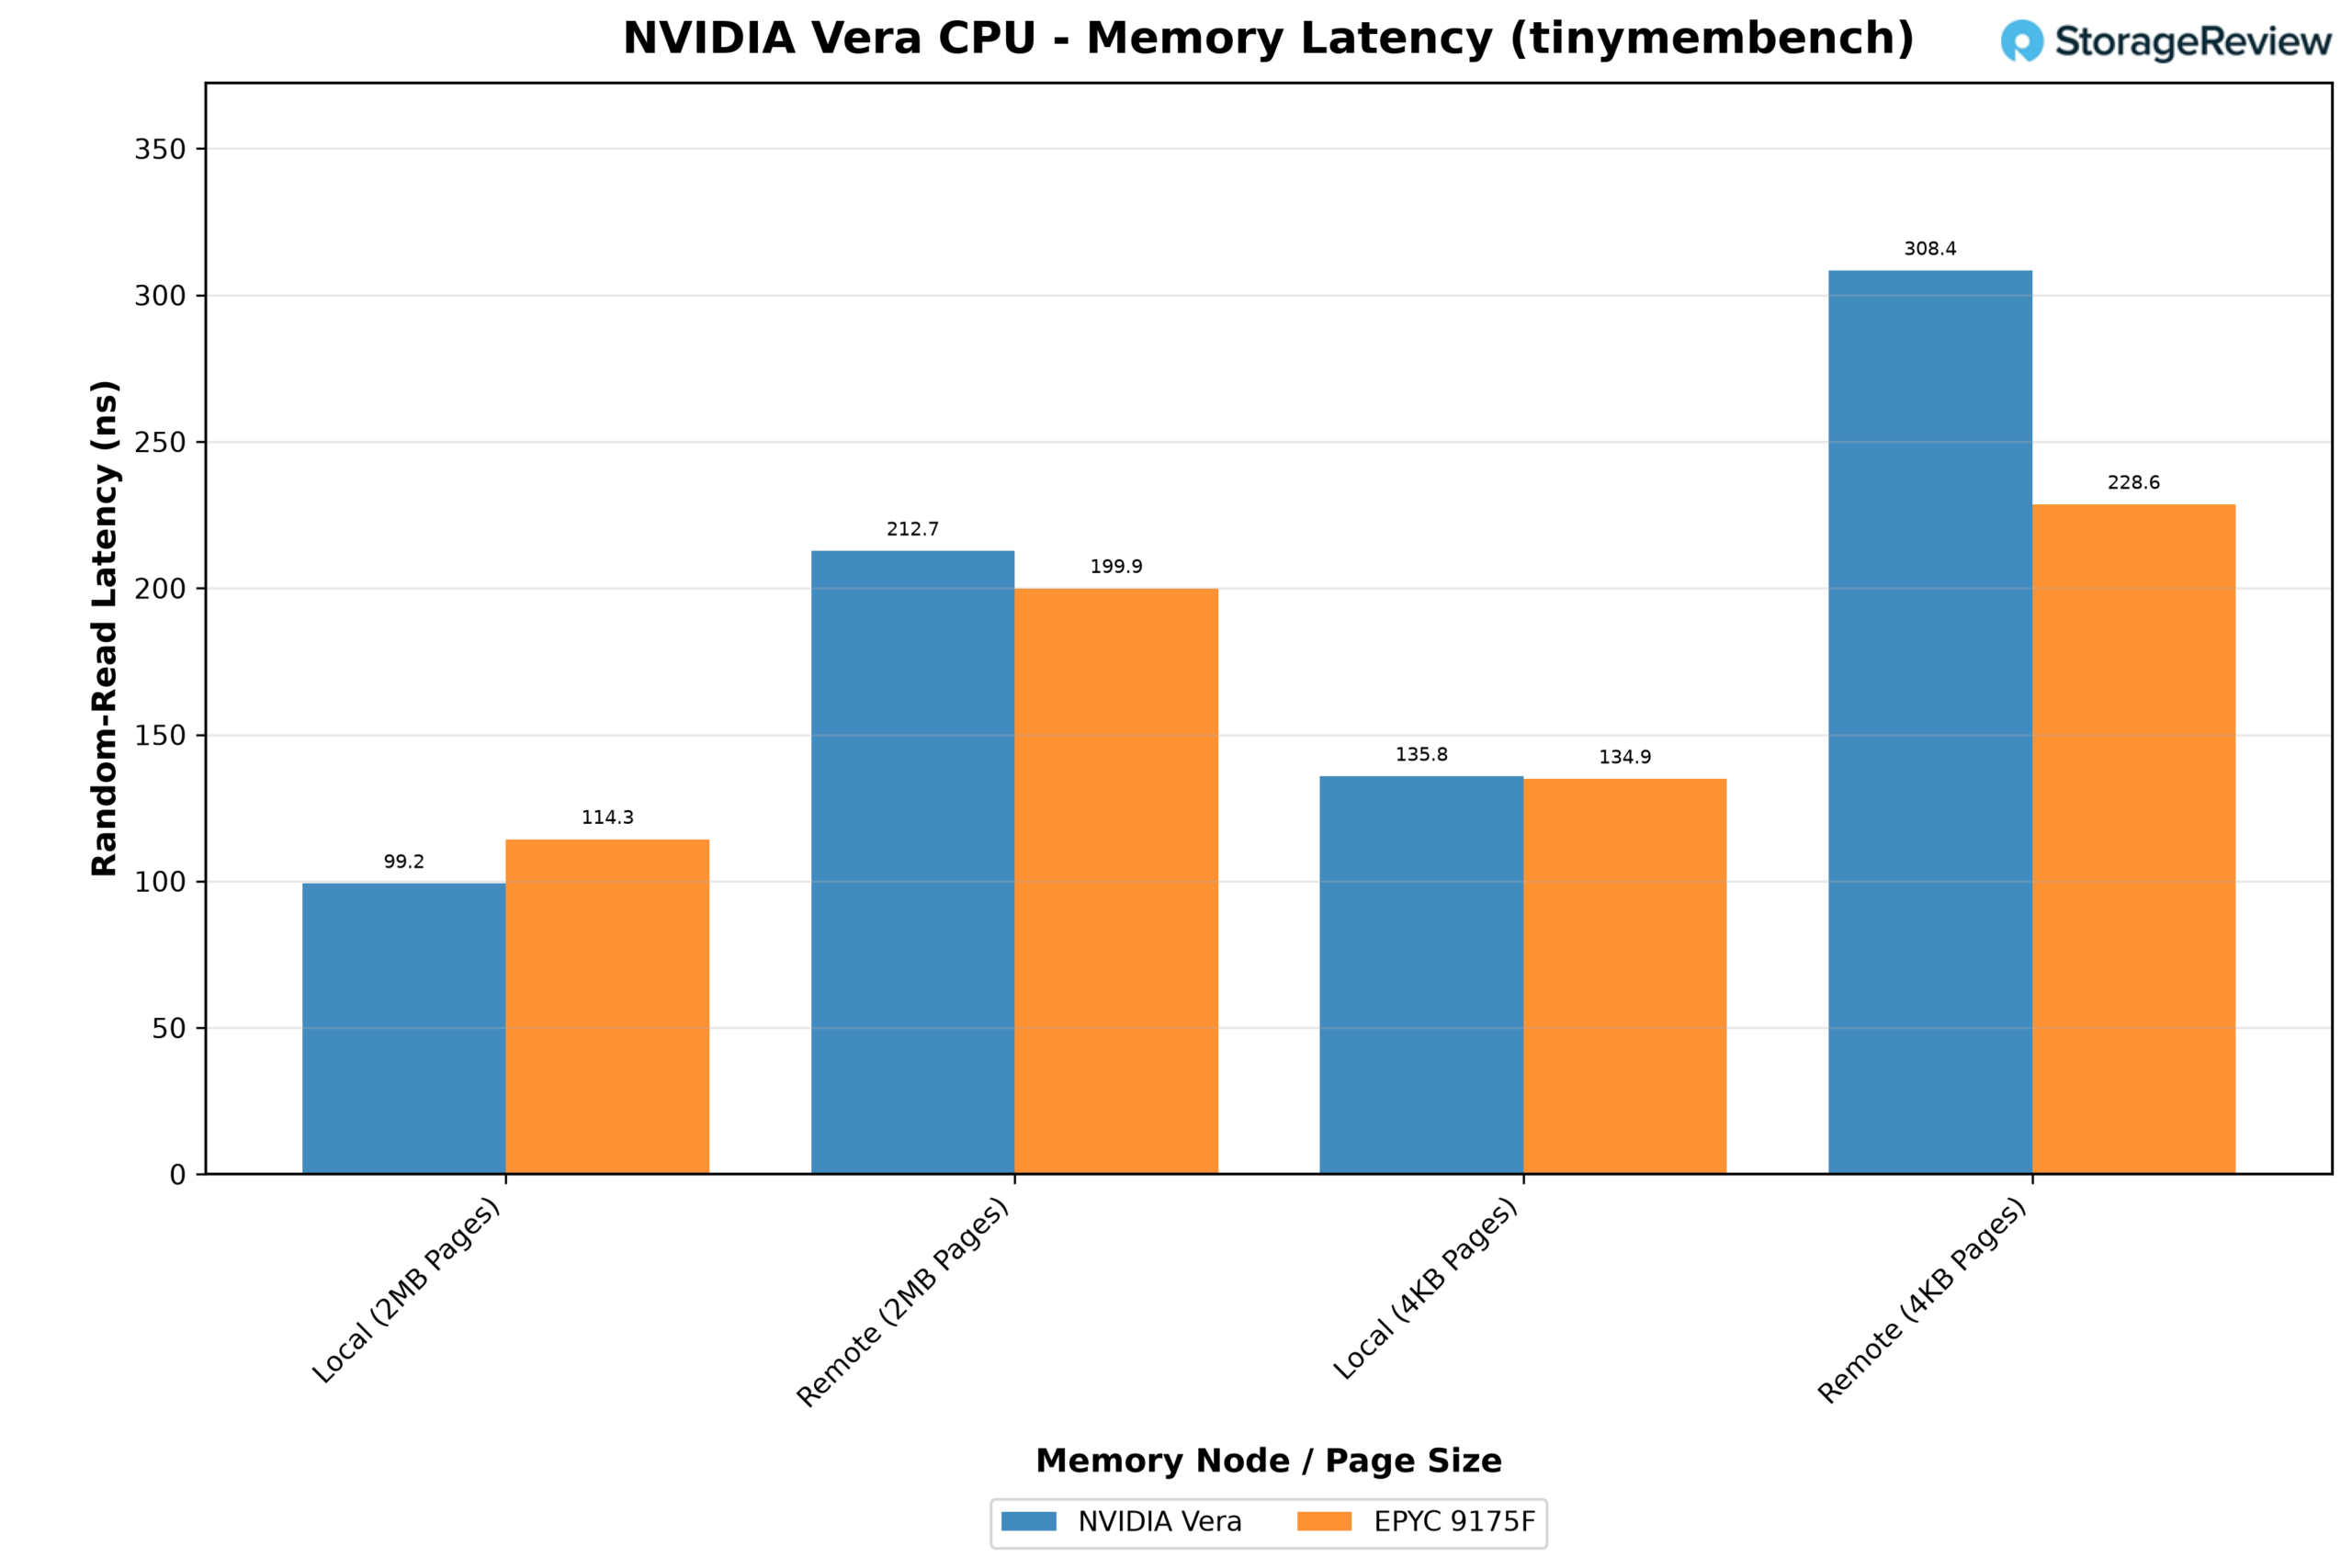
在讀取本地記憶體時,Vera 的速度比 EPYC 快。使用 2MB 大頁時,Vera 的本地讀取耗時 99.2ns,而 9175F 則為 114.3ns,Vera 快了 13%;使用標準的 4KB 頁面時,兩者的讀取速度基本上持平,約為 135ns。 NVLink-C2C 的缺點體現在跨插槽讀取資料上。 Vera 的遠端讀取耗時 212.7ns,約為本地讀取時間的 2.1 倍,而 EPYC 的遠端讀取耗時 199.9ns,僅為本地讀取時間的 1.75 倍。
Vera 對頁面大小也更加敏感。使用 4KB 頁面時,由於每次讀取都會出現位址轉換錯誤,其本地延遲上升了 37%,遠端延遲達到 308.4 奈秒,而 EPYC 的本地延遲僅上升了 18%,遠端延遲為 228.6 奈秒。在 Vera 上,我們會運行大頁模式。
高性能計算
頻寬和延遲描述的是記憶體系統本身的特性。科學應用則展示了當記憶體系統和核心協同工作時會發生什麼,而我們的兩項高效能運算測試則專注於CPU設計中截然不同的部分。
GROMACS 是一款分子動力學程式碼,其大部分時間都用於向量運算,每個 SIMD 通道的寬度都對應著手動編寫的熱循環。這使得它成為檢驗奧林巴斯部分所述權衡的最直接方法:即 x86 架構上的六個 128 位元 SVE2 管線與 512 位元 AVX-512 單元之間的權衡。 OpenFOAM 是一款計算流體動力學求解器,它處理大型稀疏矩陣,並且大部分時間都花費在記憶體等待上,因此它可以檢驗上述頻寬測量結果是否適用於實際應用。
GROMACS
我們使用 benchPEP 對 GROMACS 2025.3 進行了測試,這是一個包含 12 萬個原子的測試案例,在伺服器的每個實體核心上運行。此建置在 Vera 系統上使用 ARM_SVE 指令集,在所有 x86 系統上使用 AVX-512 指令集。由於測試套件的輸入被固定,並且禁用了 PME 調優,因此每個平台運行的都是相同的任務。
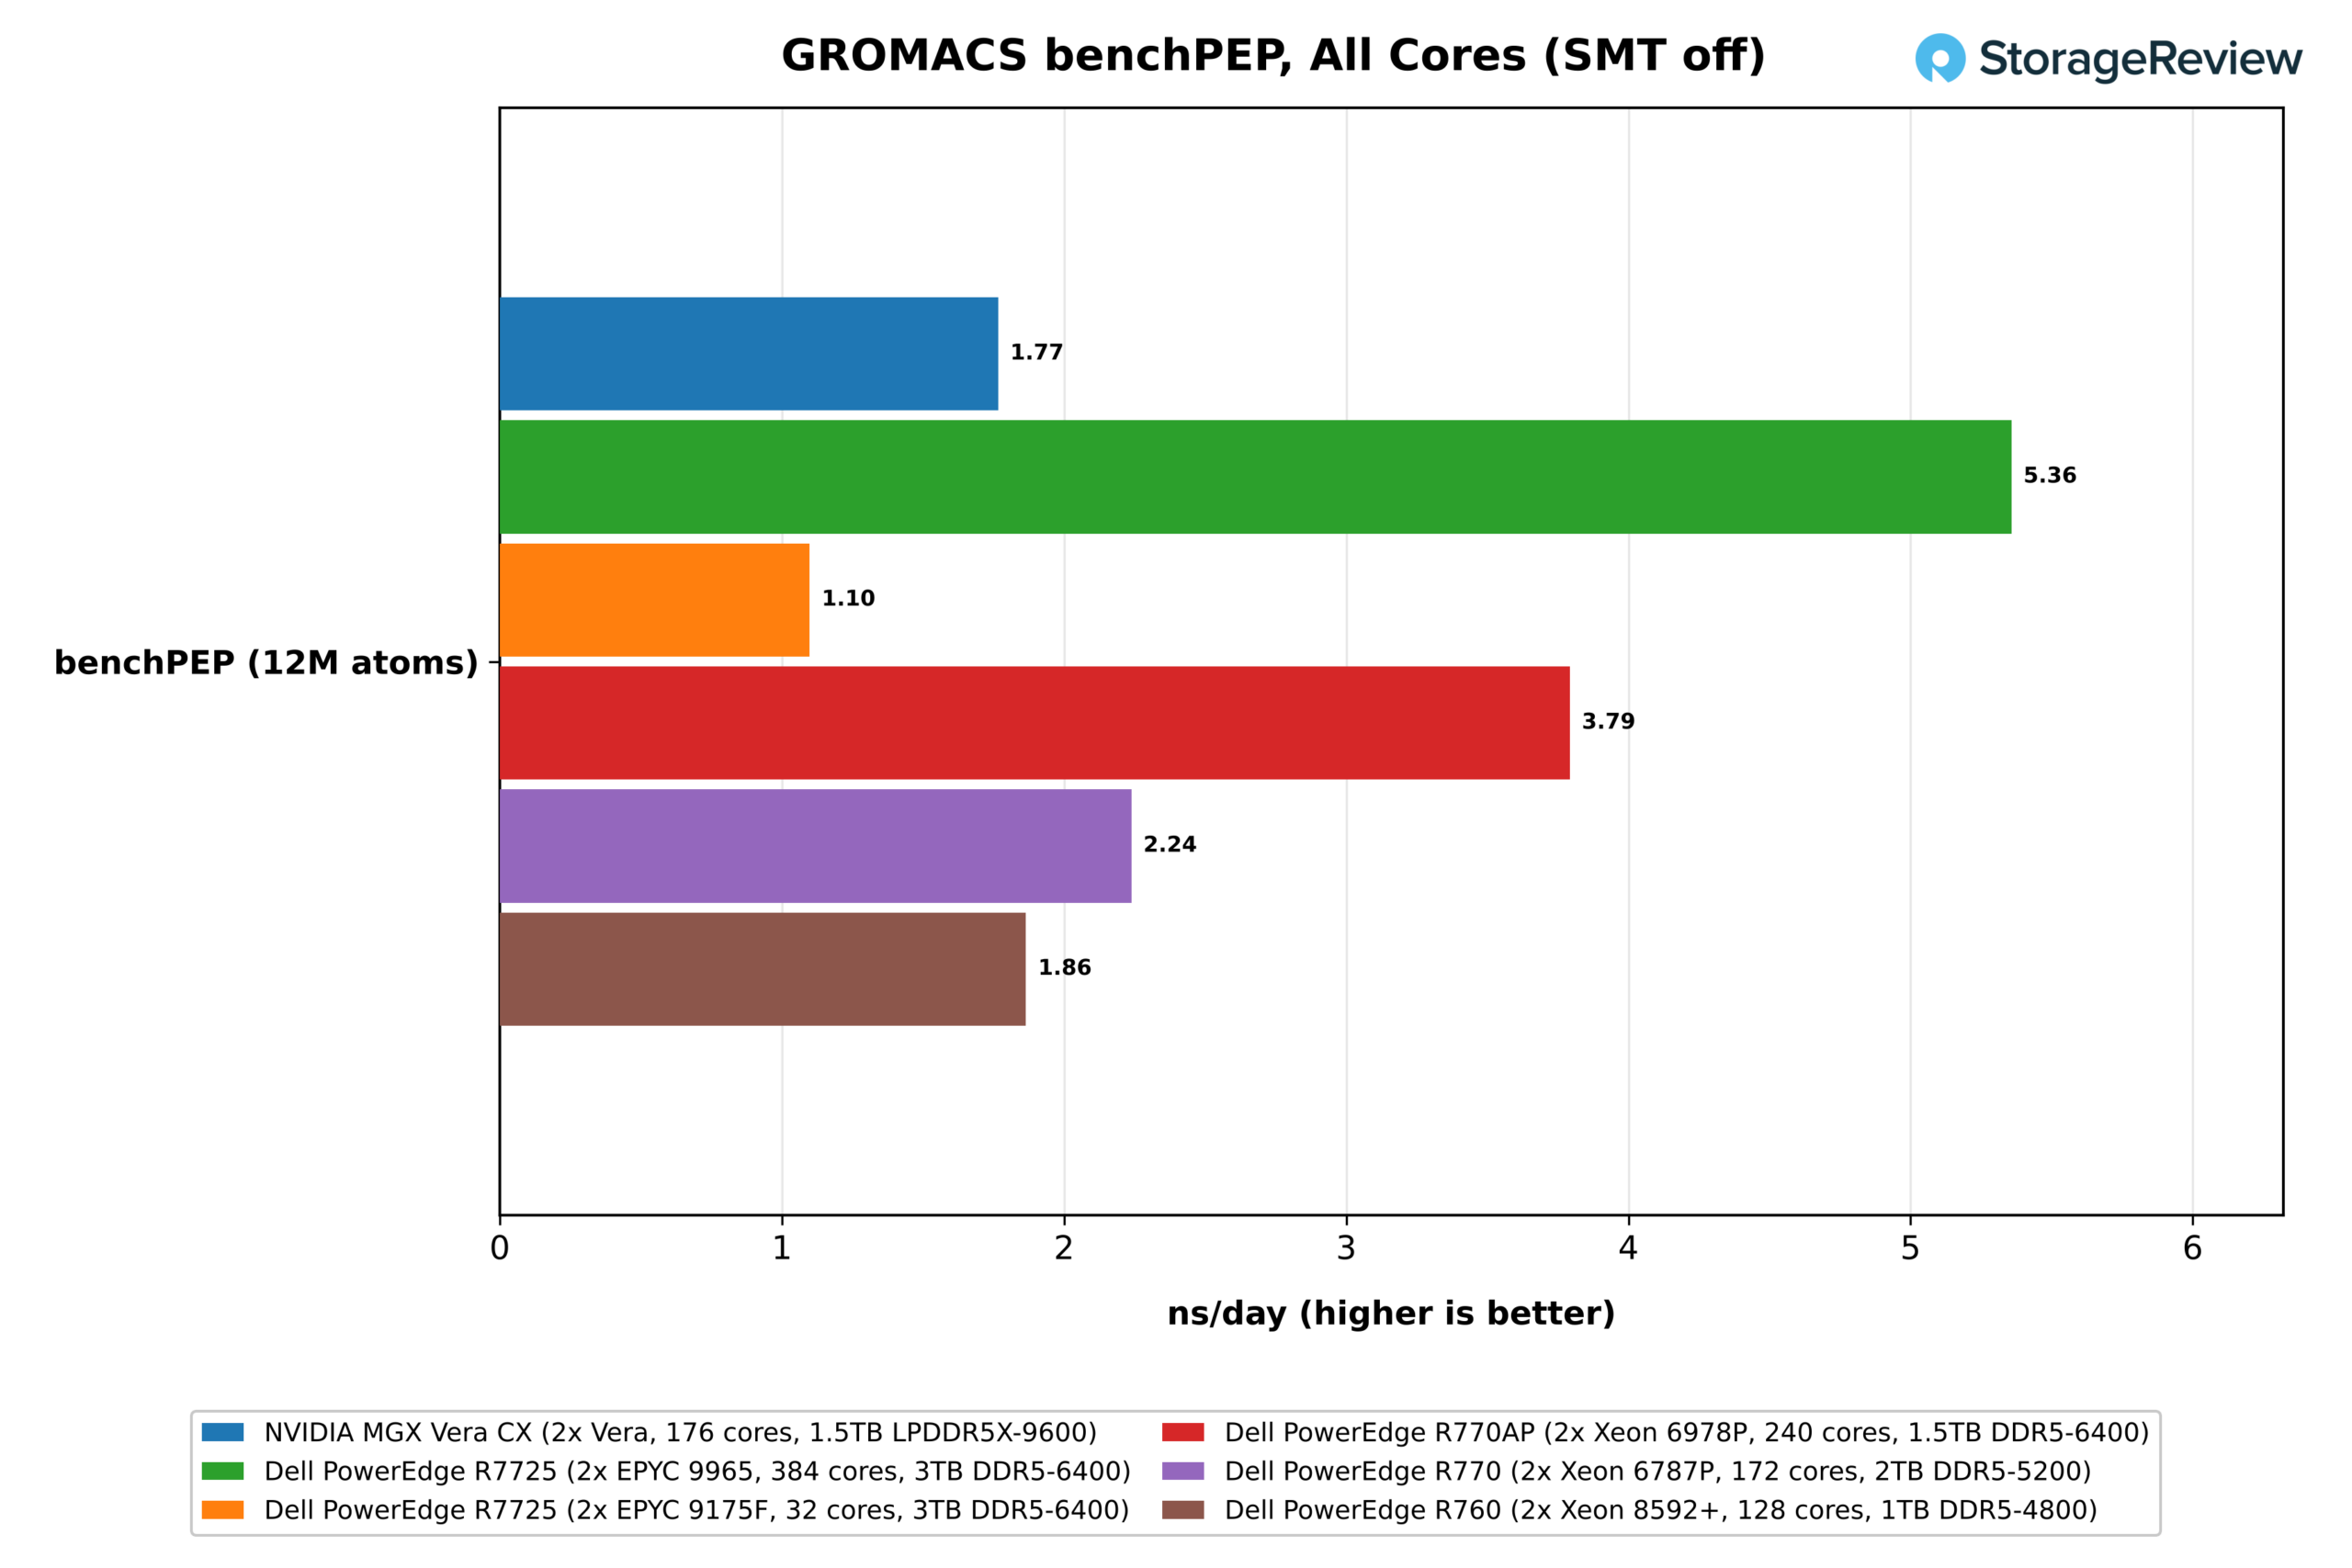
關閉SMT後,Vera在benchPEP測試中取得了1.77奈秒/天的成績。 384核的EPYC 9965以5.36奈秒/天的成績領先,是Vera的3.0倍;其次是240核心的Xeon 6978P,成績3.79奈秒/天(是Vera的2.1倍);172核心的Xeon 679奈秒/天(是Vera的2.1倍);172核心的Xeon 679奈秒/天(是Vera的2.1倍);172核心的Xeon 6787P2.2.38383832302303)。 128核的Xeon 8592+也以1.87奈秒/天的成績領先,只有32核的EPYC 9175F以1.10奈秒/天的成績落後於Vera。以核心數進行歸一化處理後,可以更清楚看出架構差異造成的效能差距有多大。 Vera 的單核心吞吐量為 0.0100 ns/天,而 6787P 為 0.0130,9965 為 0.0140,8592+ 為 0.0146,6978P 為 0.0158,因此與大型 x86 部分空間處理器的部分差距在於部分差距。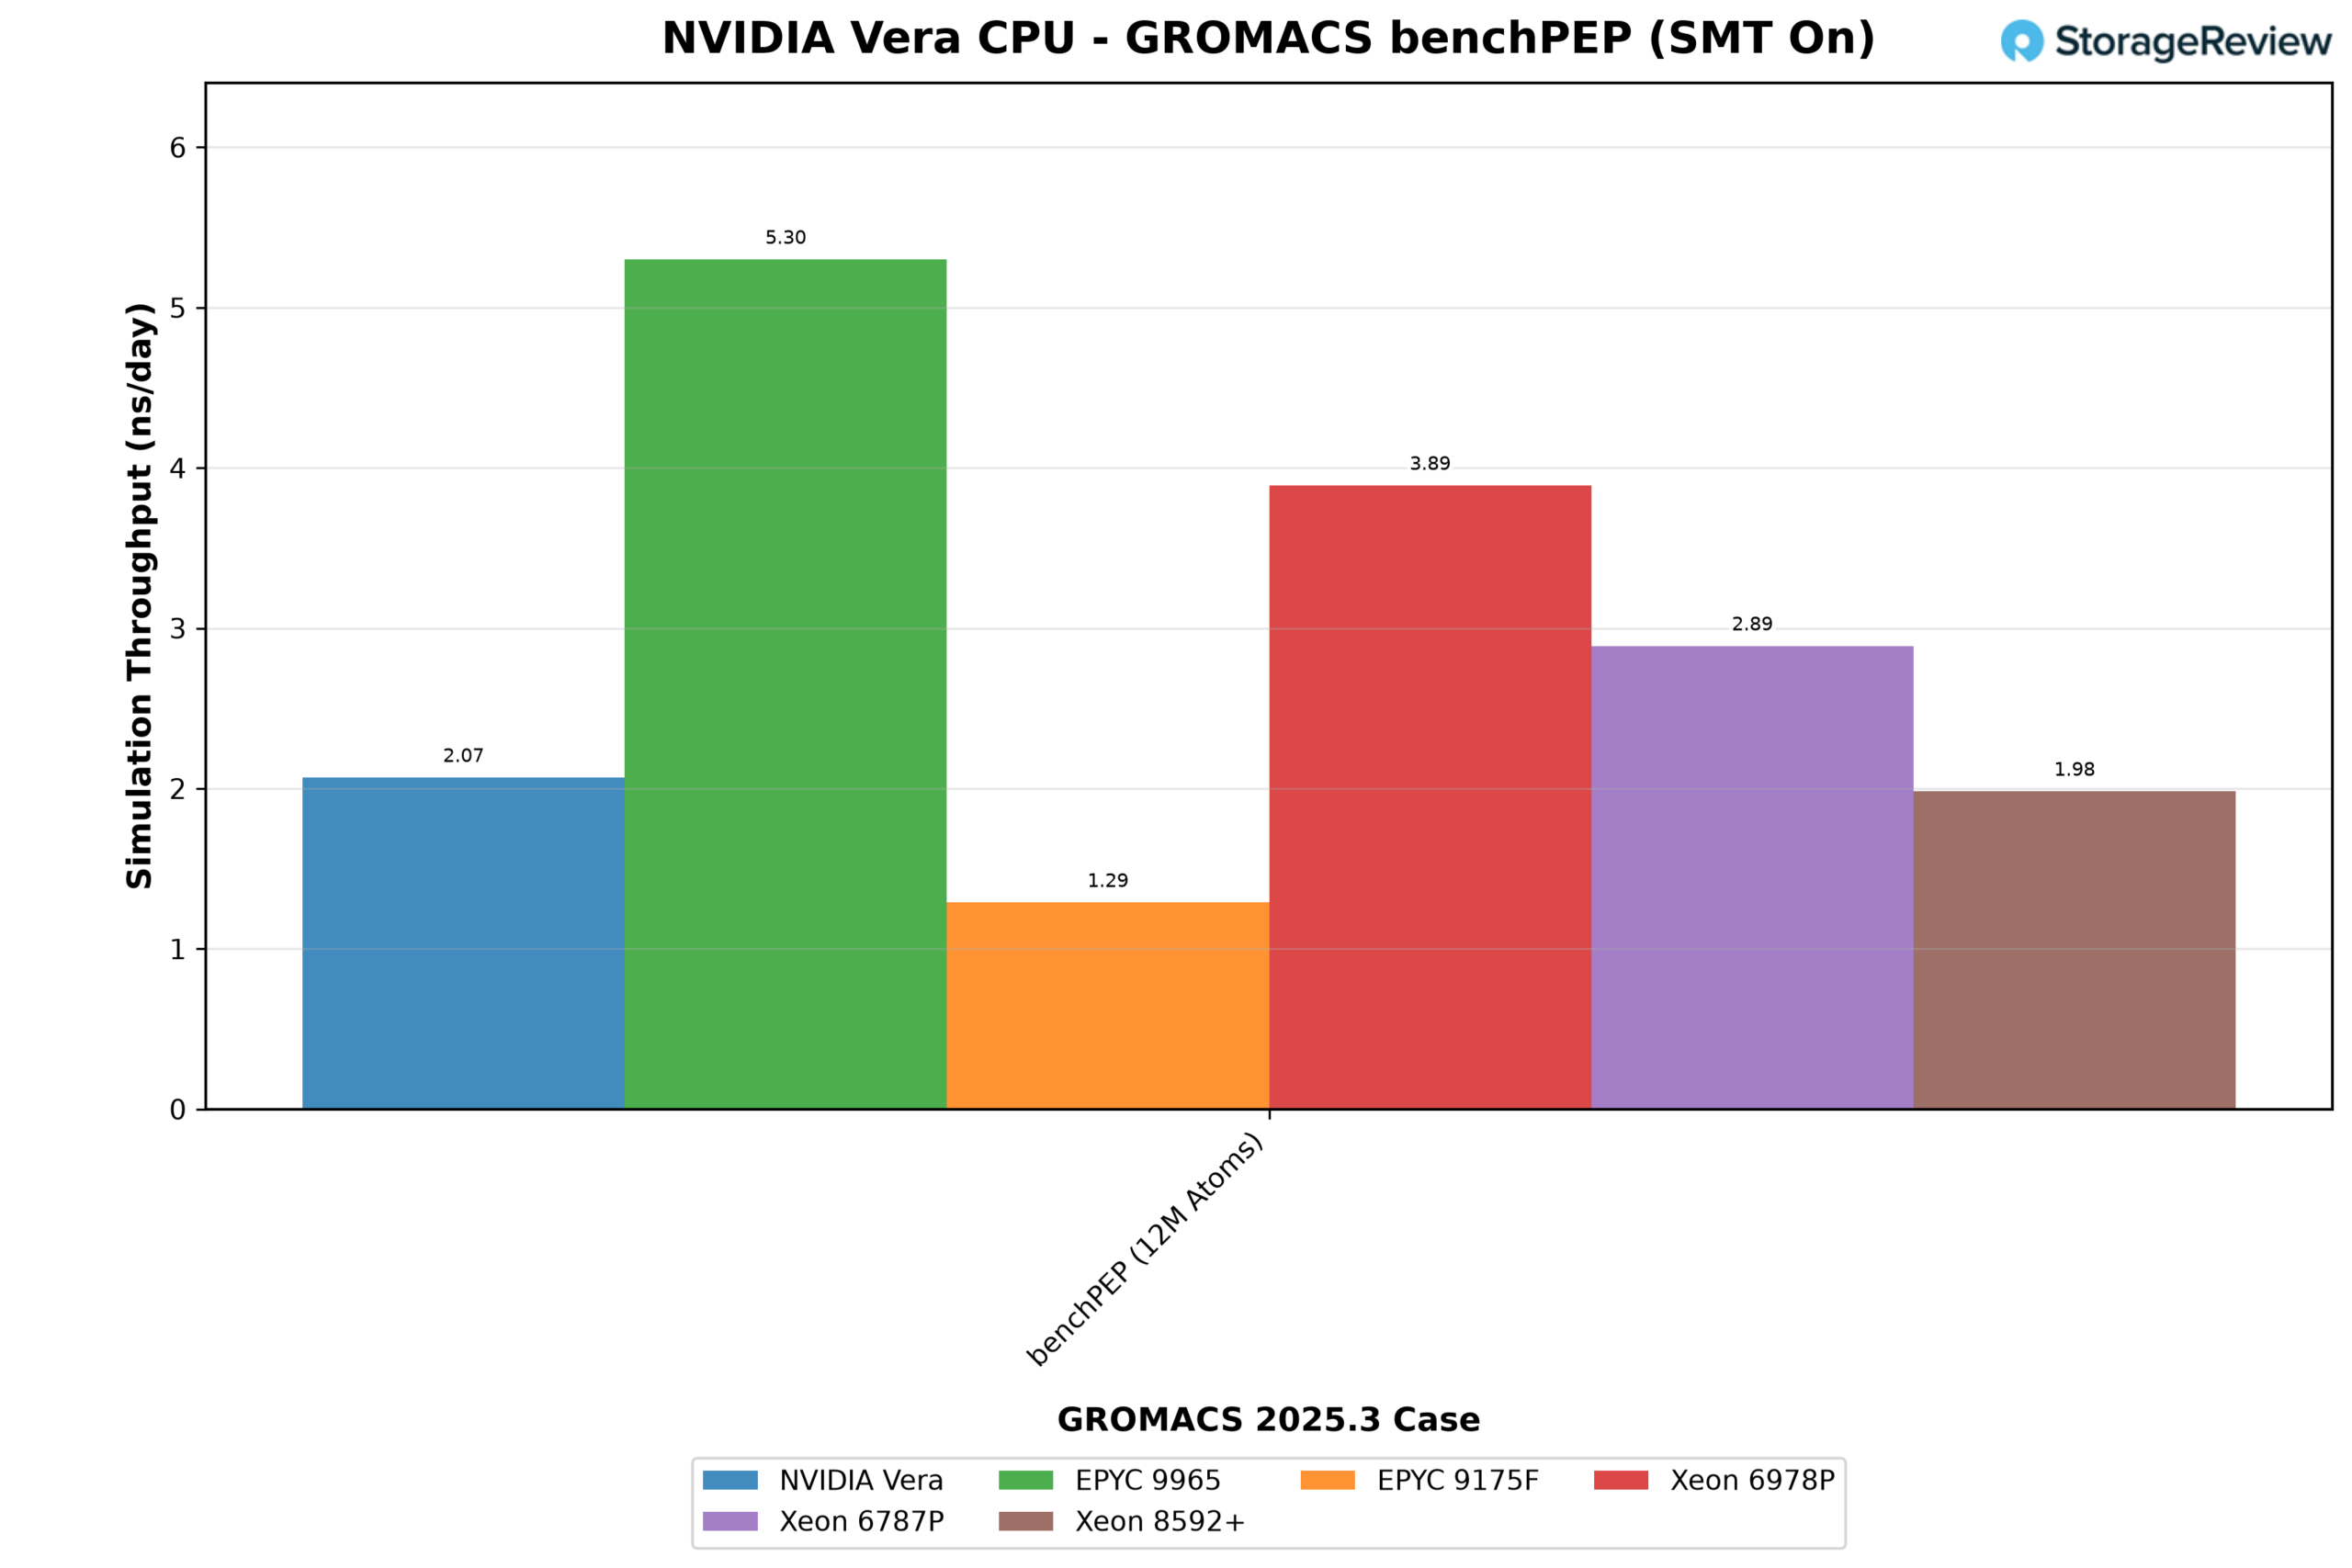
空間多執行緒技術彌補了部分效能差距,啟用該技術後,Vera 的測試結果提升了 17%,達到 2.07 奈秒/天,最佳佈局將所有 352 個硬體執行緒作為執行緒-MPI 進程運行。此提升幅度大於我們先前測試中 Xeon 6978P(3%)或 8592+(11%)啟用同步多執行緒技術後的提升幅度,而 EPYC 9965 啟用該技術後效能下降了 3.5%。由於資源在兩個執行緒之間進行劃分,每個進程都能獲得一部分核心資源,而求解器混合使用的向量運算和記憶體停頓似乎比單一進程更能有效地利用這些資源。
benchMEM 案例透過在每個平台上使用 16 個物理核心的插槽 0 運行 82,000 個原子的系統來隔離每個核心的差距,因此核心數量不在考慮範圍內,結果反映了向量吞吐量、快取和本地記憶體。
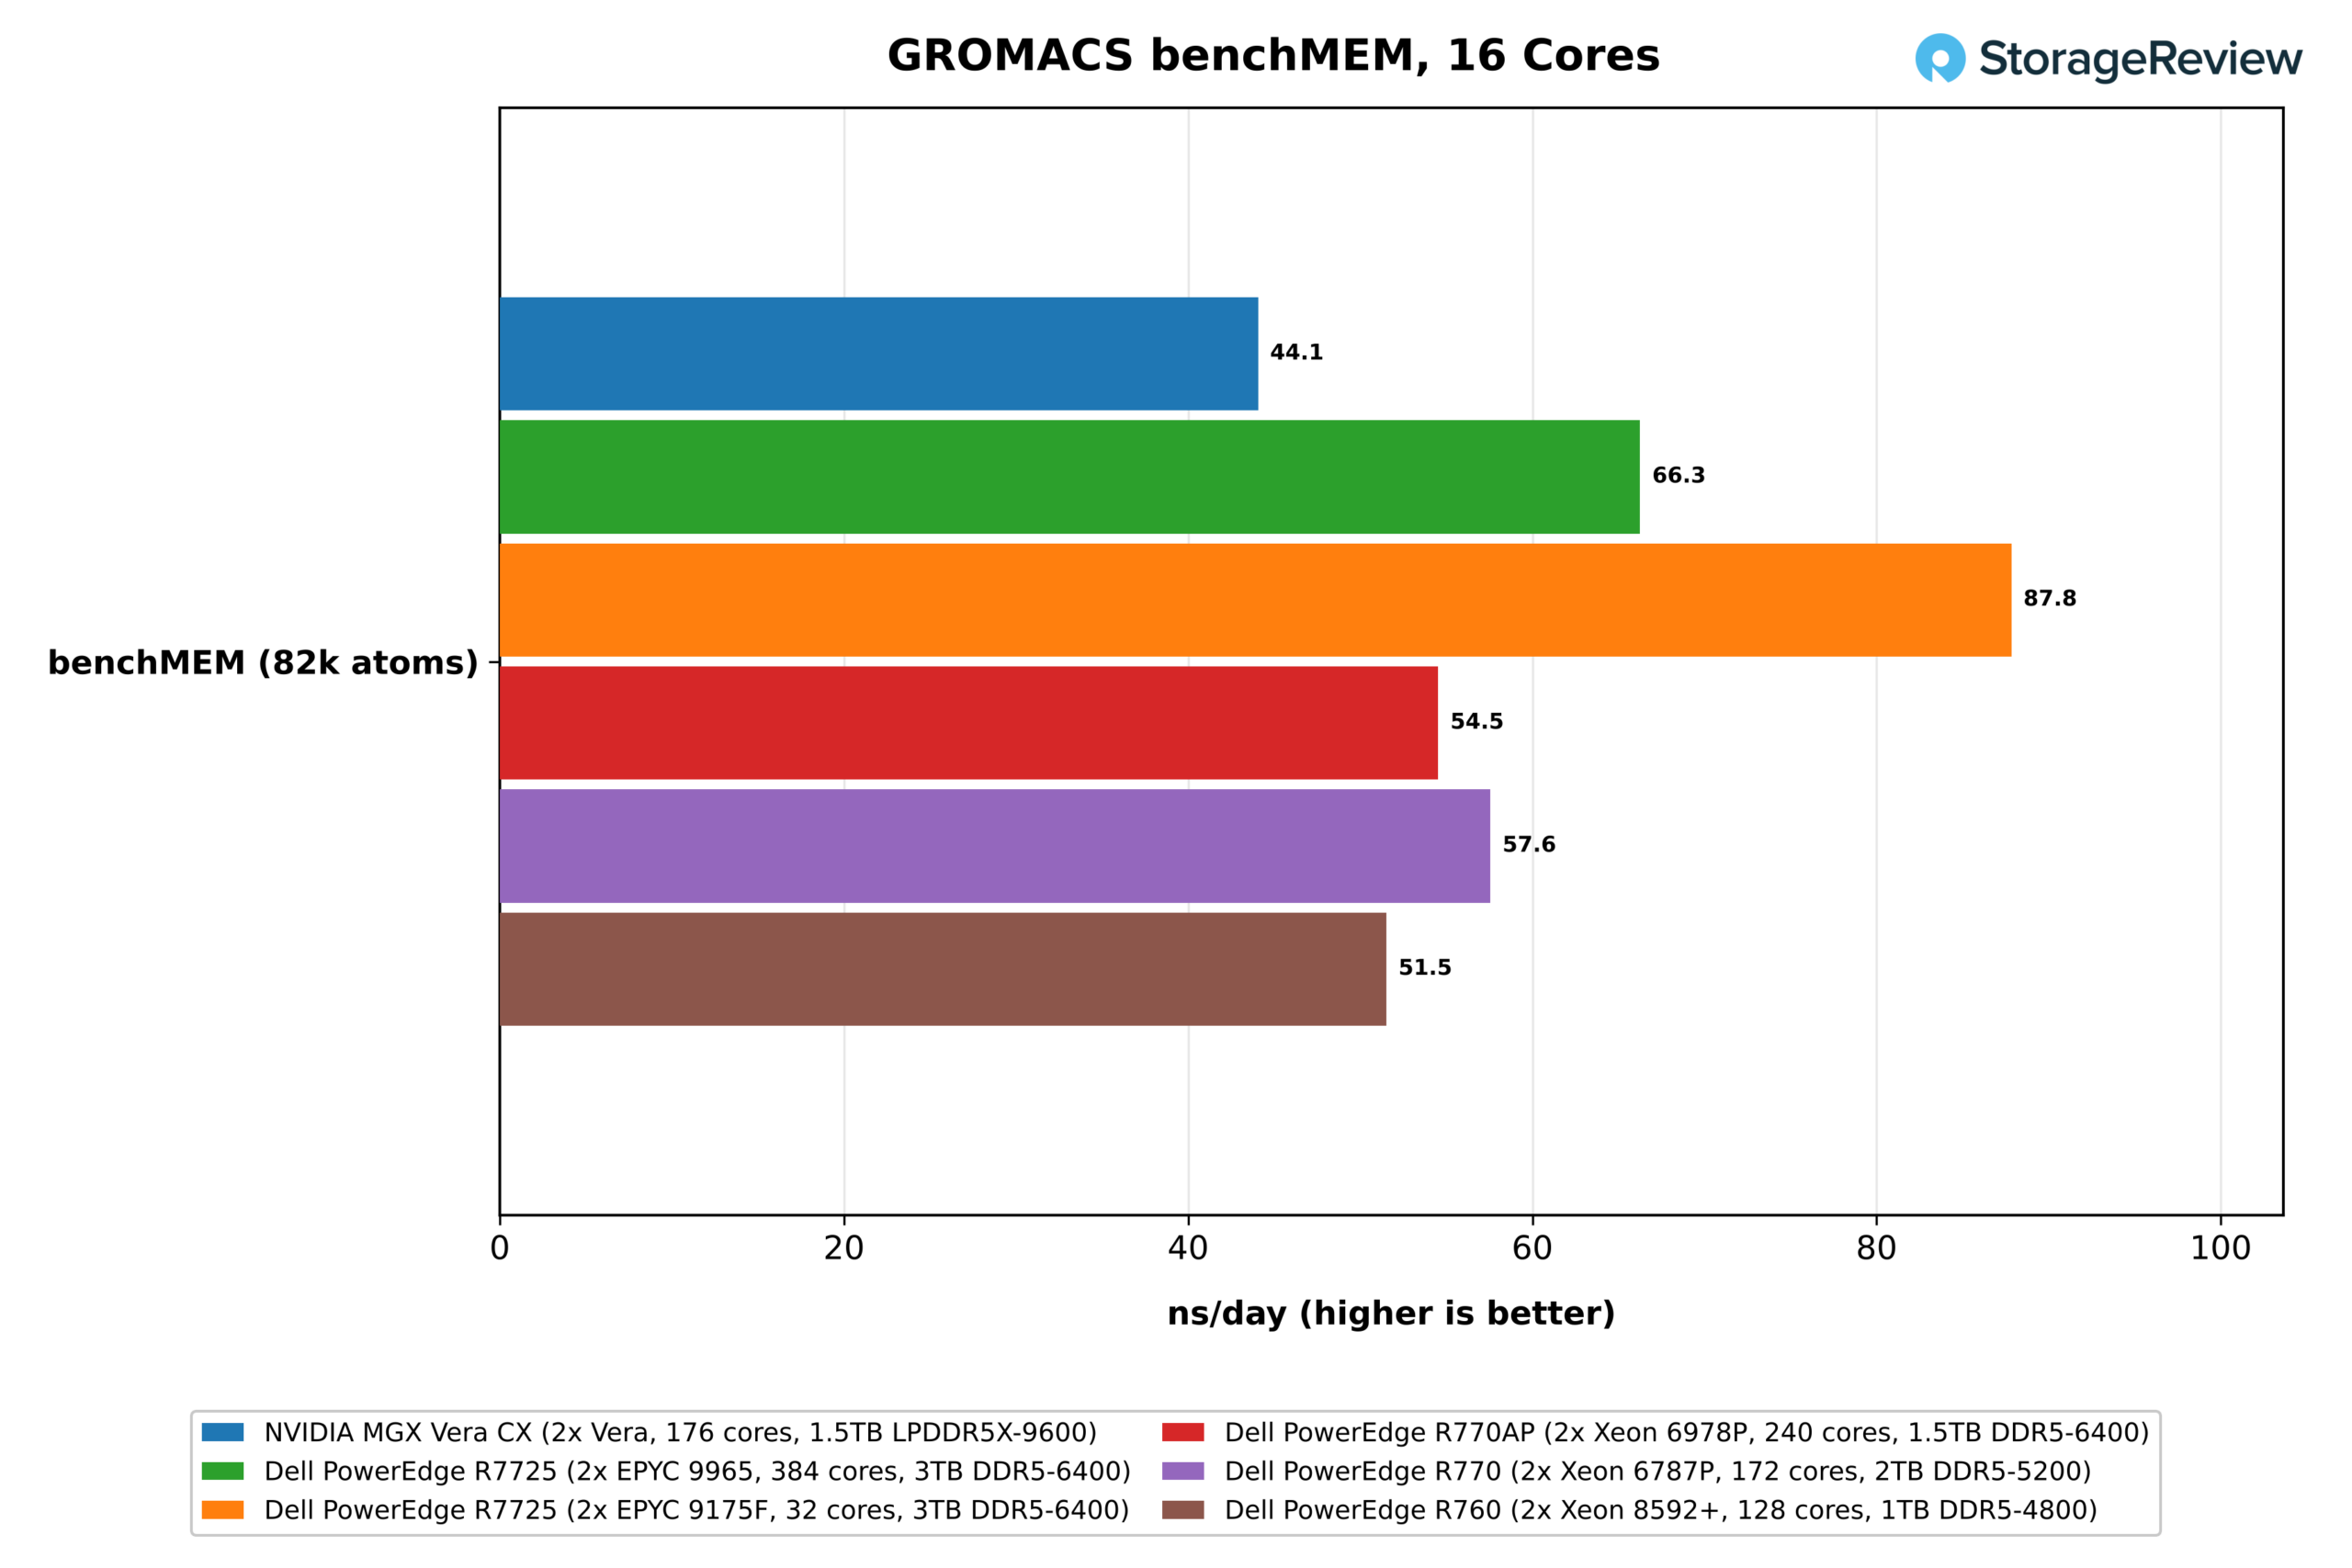
Vera 的測驗成績為 44.1 ns/天。 5.0GHz 的 EPYC 9175F 的成績是它的兩倍,達到 87.8 ns/天,而 EPYC 9965 的成績為 66.3 ns/天,是 Vera 的 1.5 倍,領先於 Xeon 6787P(57.6 ns/天)、69595.59595959.6 ns/595. ns/天)。
因此,即使16個Zen 5c核心共享一個32MB的L3緩存,而Vera核心可以使用其164MB的系統級緩存,16核Vera核心的Vera處理器也能完成大約三分之二的工作量。這使得我們能夠最清晰地衡量出,為512位元向量編寫的程式碼在處理128位元向量時的效能損失。 9175F相對於9965的進一步優勢與其時脈頻率優勢大致相符,分別為5.0GHz和3.7GHz。
OpenFOAM
OpenFOAM 將壓力從向量單元轉移到了記憶體系統。我們在 driverFastback 汽車空氣動力學案例上運行 OpenFOAM 13,每個物理核心使用一個 MPI 進程,並採用兩種網格尺寸:2.98 萬個單元的中等網格和 22.6 萬個單元的大型網格。
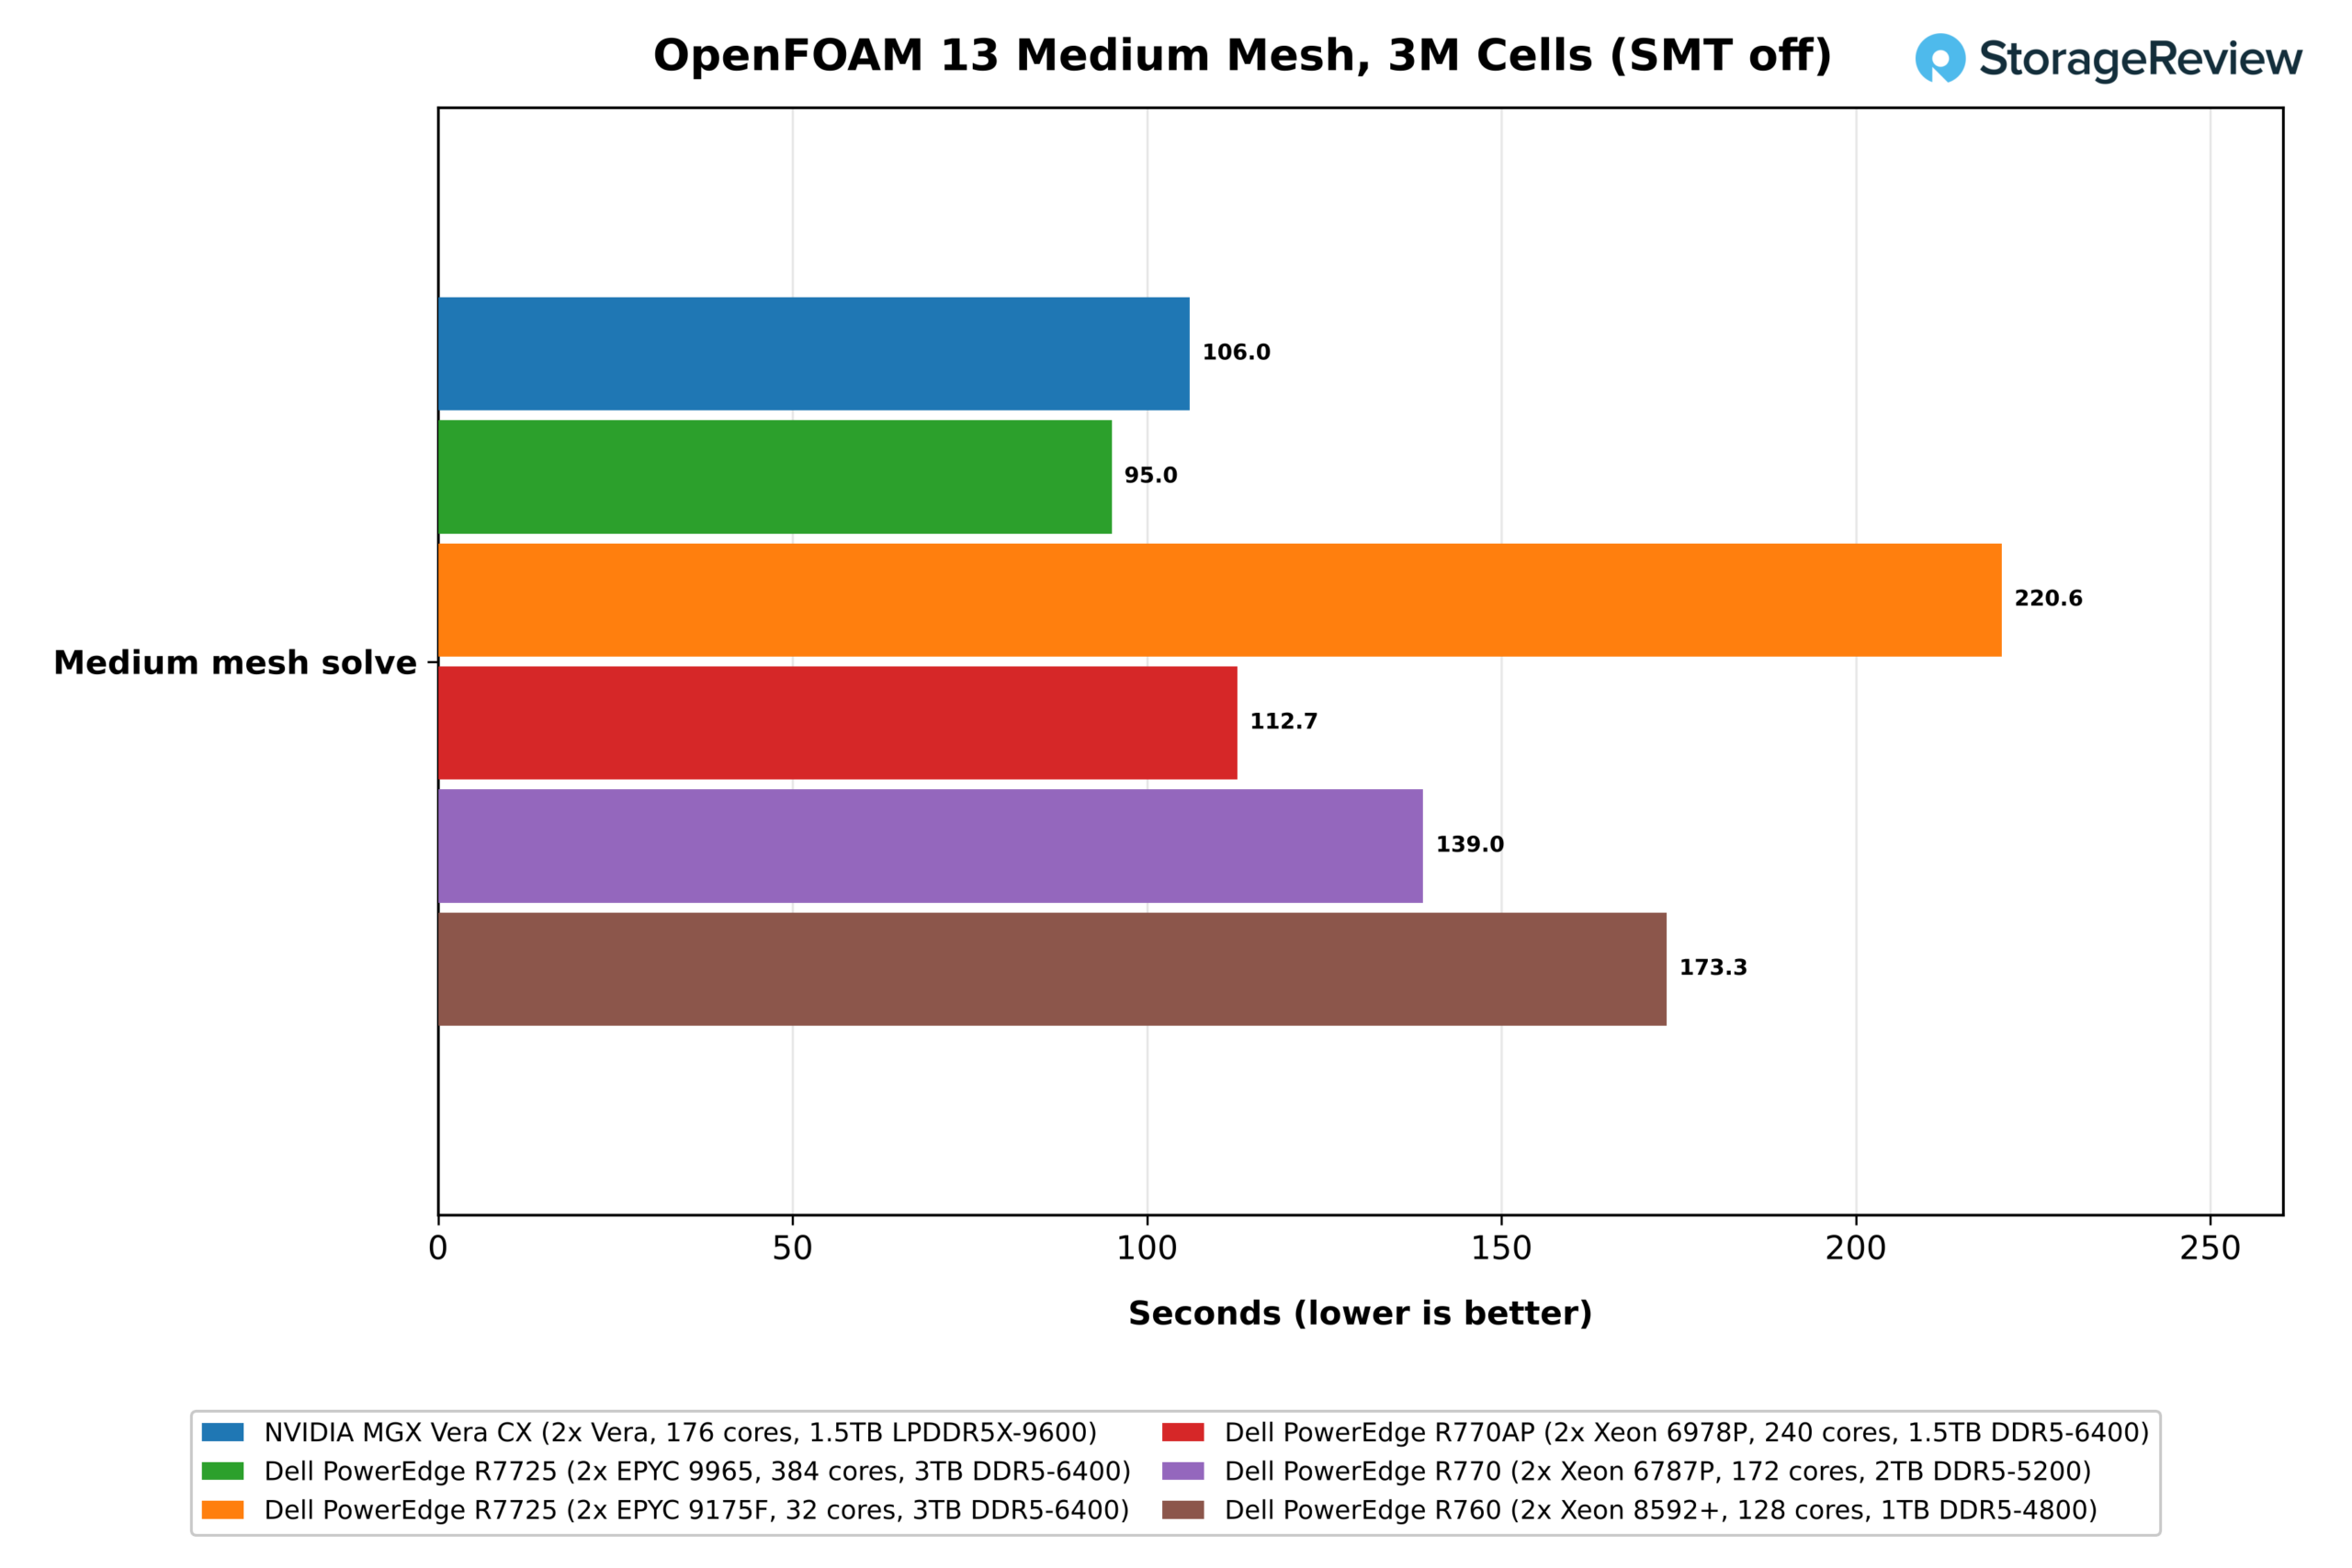
在 Vera 上,中等大小的網格求解耗時 106.0 秒,而 EPYC 9965 耗時 95.0 秒,Xeon 6978P 耗時 112.7 秒,6787P 耗時 139.0 秒,8592+ 耗時 173.3 秒,220.6 時耗時 32 時耗時 9175 秒。在這個規模下,擁有 384 個核心的 9965 勝出,Vera 耗時慢了 12%,但排名第二,比擁有 240 個核心的 Xeon 快 6%。由於網格單元只有 3 萬個,x86 架構處理器更大的 L3 快取可能承擔了更多的運算任務,因此核心數量才是關鍵。
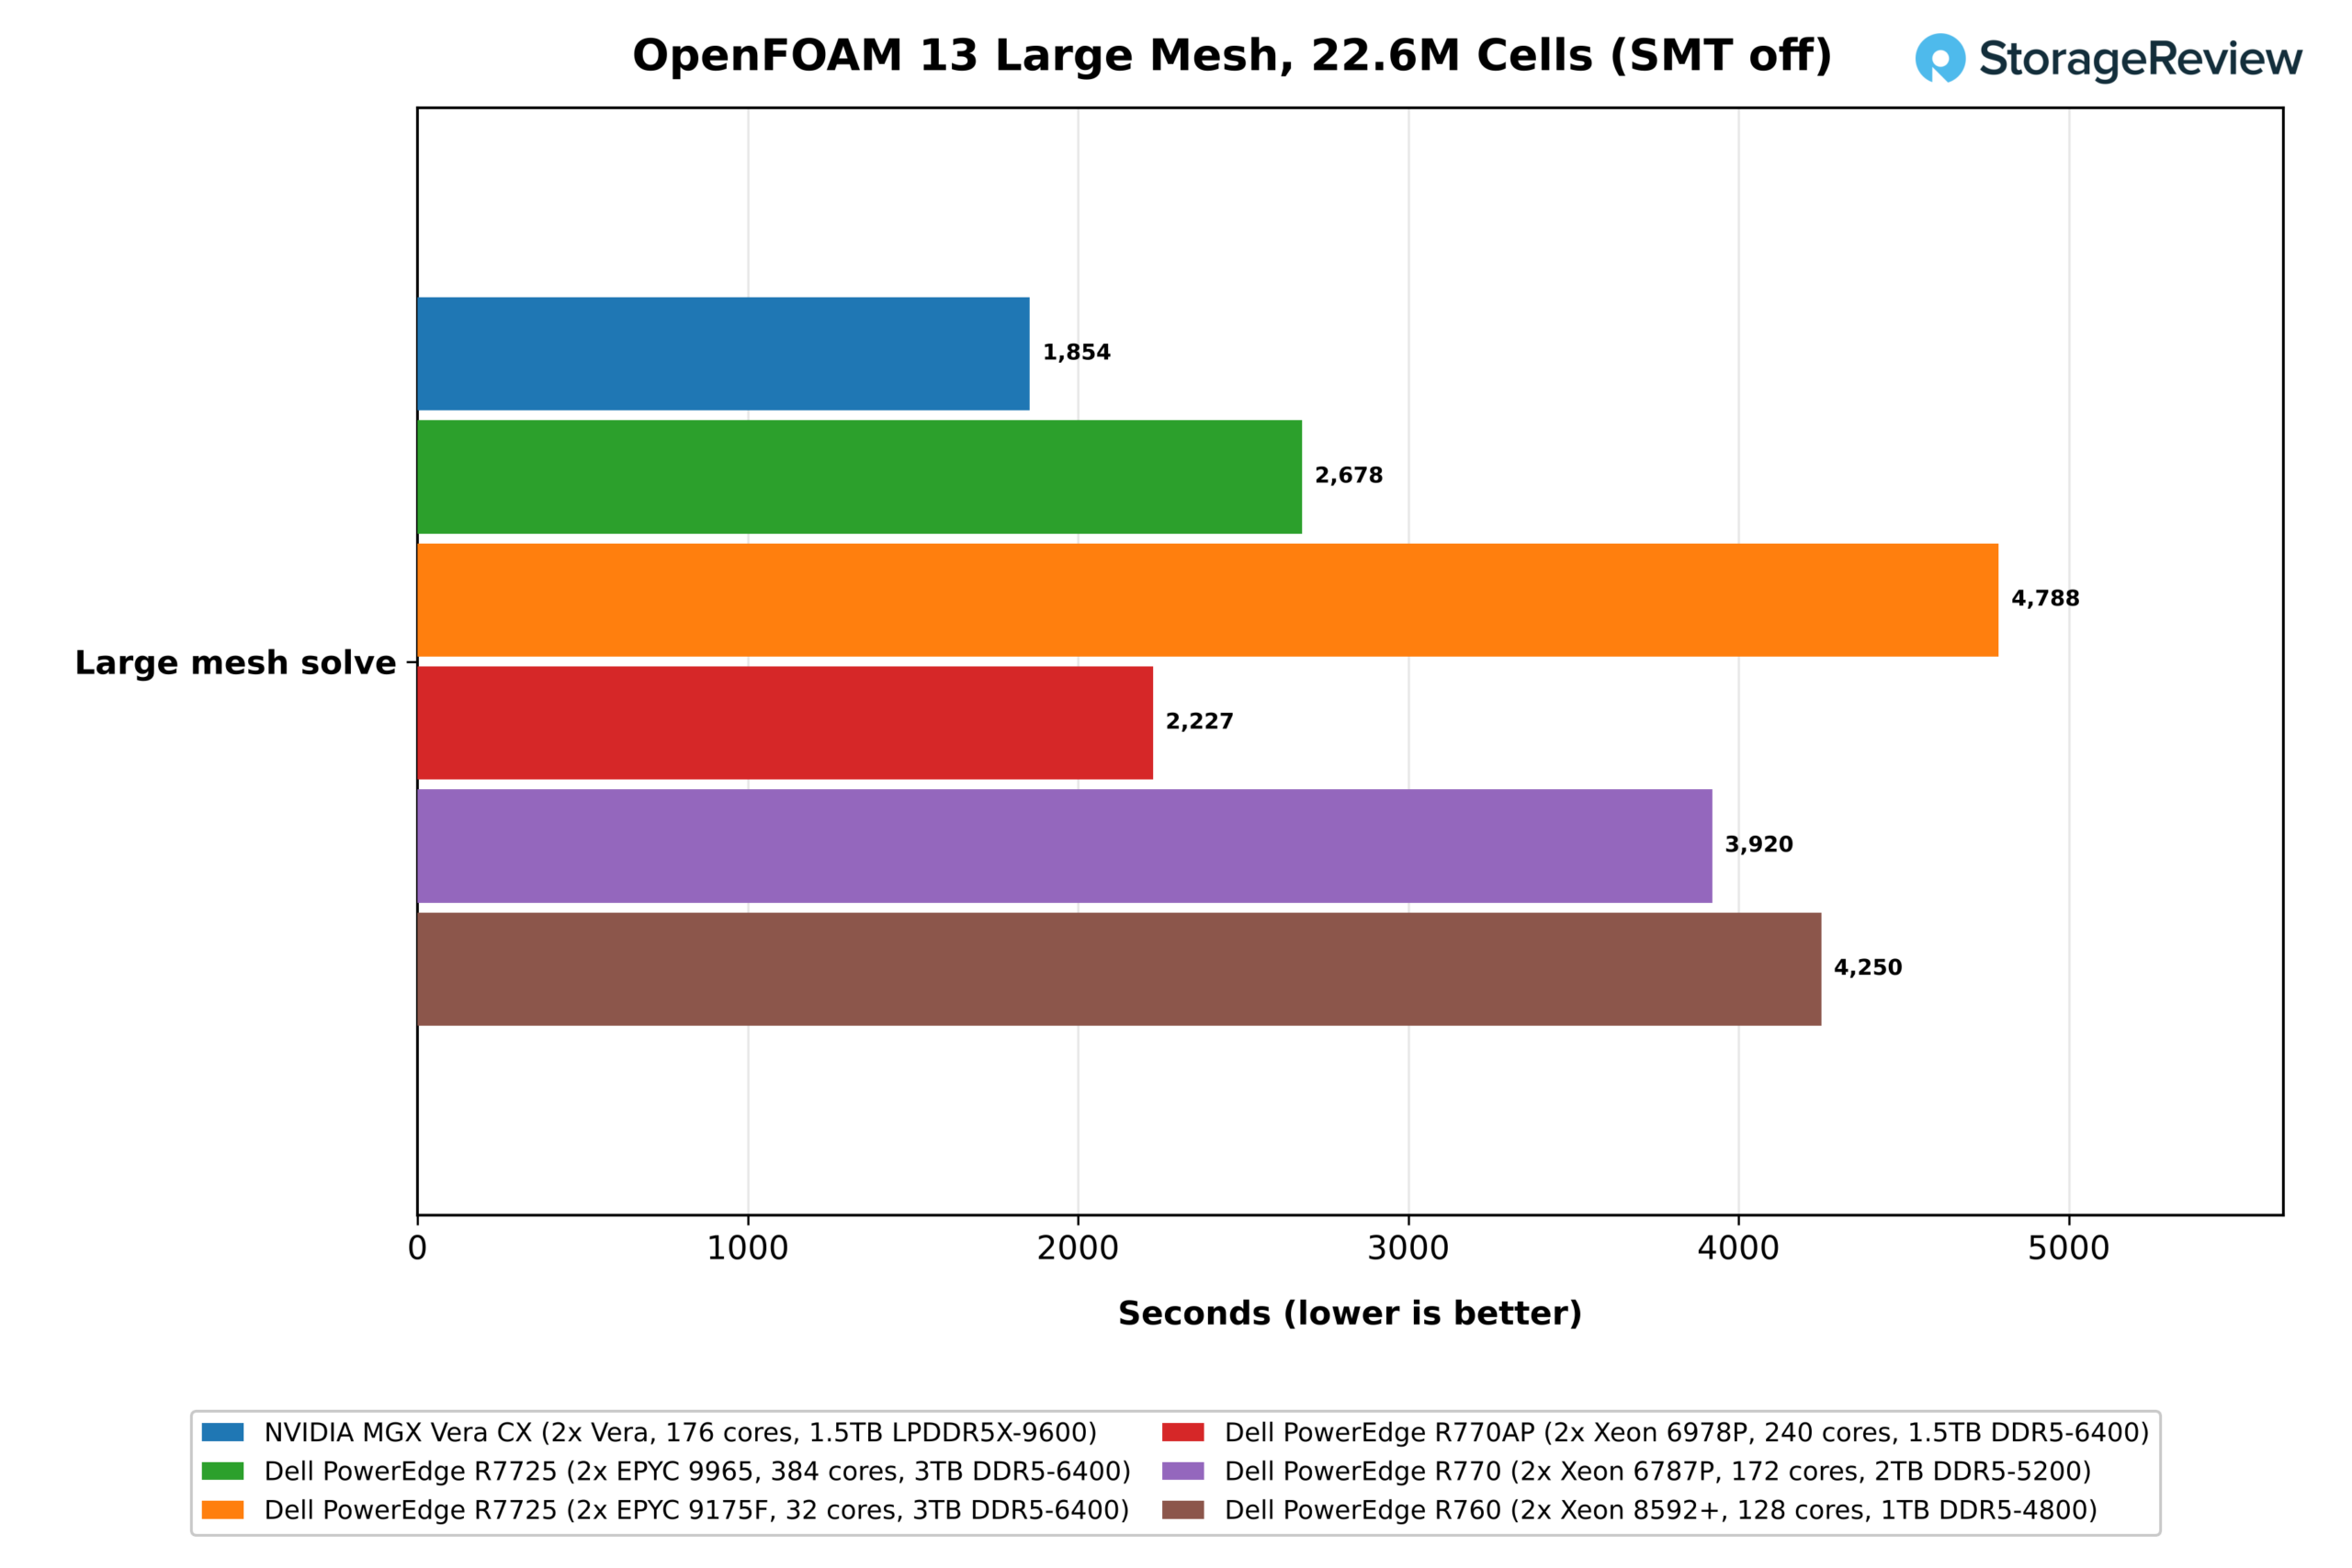
大型網格運算順序顛倒,Vera 僅用時 1,854 秒即可完成,而 Xeon 6978P 耗時 2,227 秒,EPYC 9965 耗時 2,678 秒,6787P 耗時 3,920 秒,8592+ 2678 秒,6787P 耗時 3920 秒,8592+ 耗時 4,250 秒,19894 秒。 Vera 的速度比 384 核心 AMD 伺服器快 1.44 倍,比 240 核心 Intel 伺服器快 1.20 倍。此外,Vera 的單路最大功耗控制在 450W 以內,而 9965 的單路最大功耗為 500W。
分析和記憶體數據
HPC 測試結果展示了 Vera 的頻寬對科學計算求解器的重要性。資料服務對同一記憶體系統的使用方式不同,我們的兩個測試也分別從相反的角度對記憶體系統進行測試。 ClickBench 執行分析查詢,掃描並聚合大量資料列,並將每個查詢分配到所有核心上,因此它更青睞那些擁有足夠頻寬來支援多個核心的系統。 Valkey 是一種記憶體鍵值儲存系統,它處理數百萬個小型請求,每個請求只讀取或寫入一個值,因此它更依賴單一核心處理請求的速度,以及一旦資料超出快取容量,記憶體延遲和頻寬的重要性。
點擊基準測試
我們使用 ClickHouse 26.8 平台,針對一個包含 100 億行資料的網站分析表,對 ClickBench 進行了 43 次查詢測試。其熱查詢總和(每次查詢都從頁面快取讀取資料)衡量的是系統能夠為列式掃描和聚合操作調配多少核心,以及記憶體能否有效地滿足這些操作的需求。冷查詢總和則包含了每次查詢首次執行前伺服器重新啟動和 SSD 讀取操作。
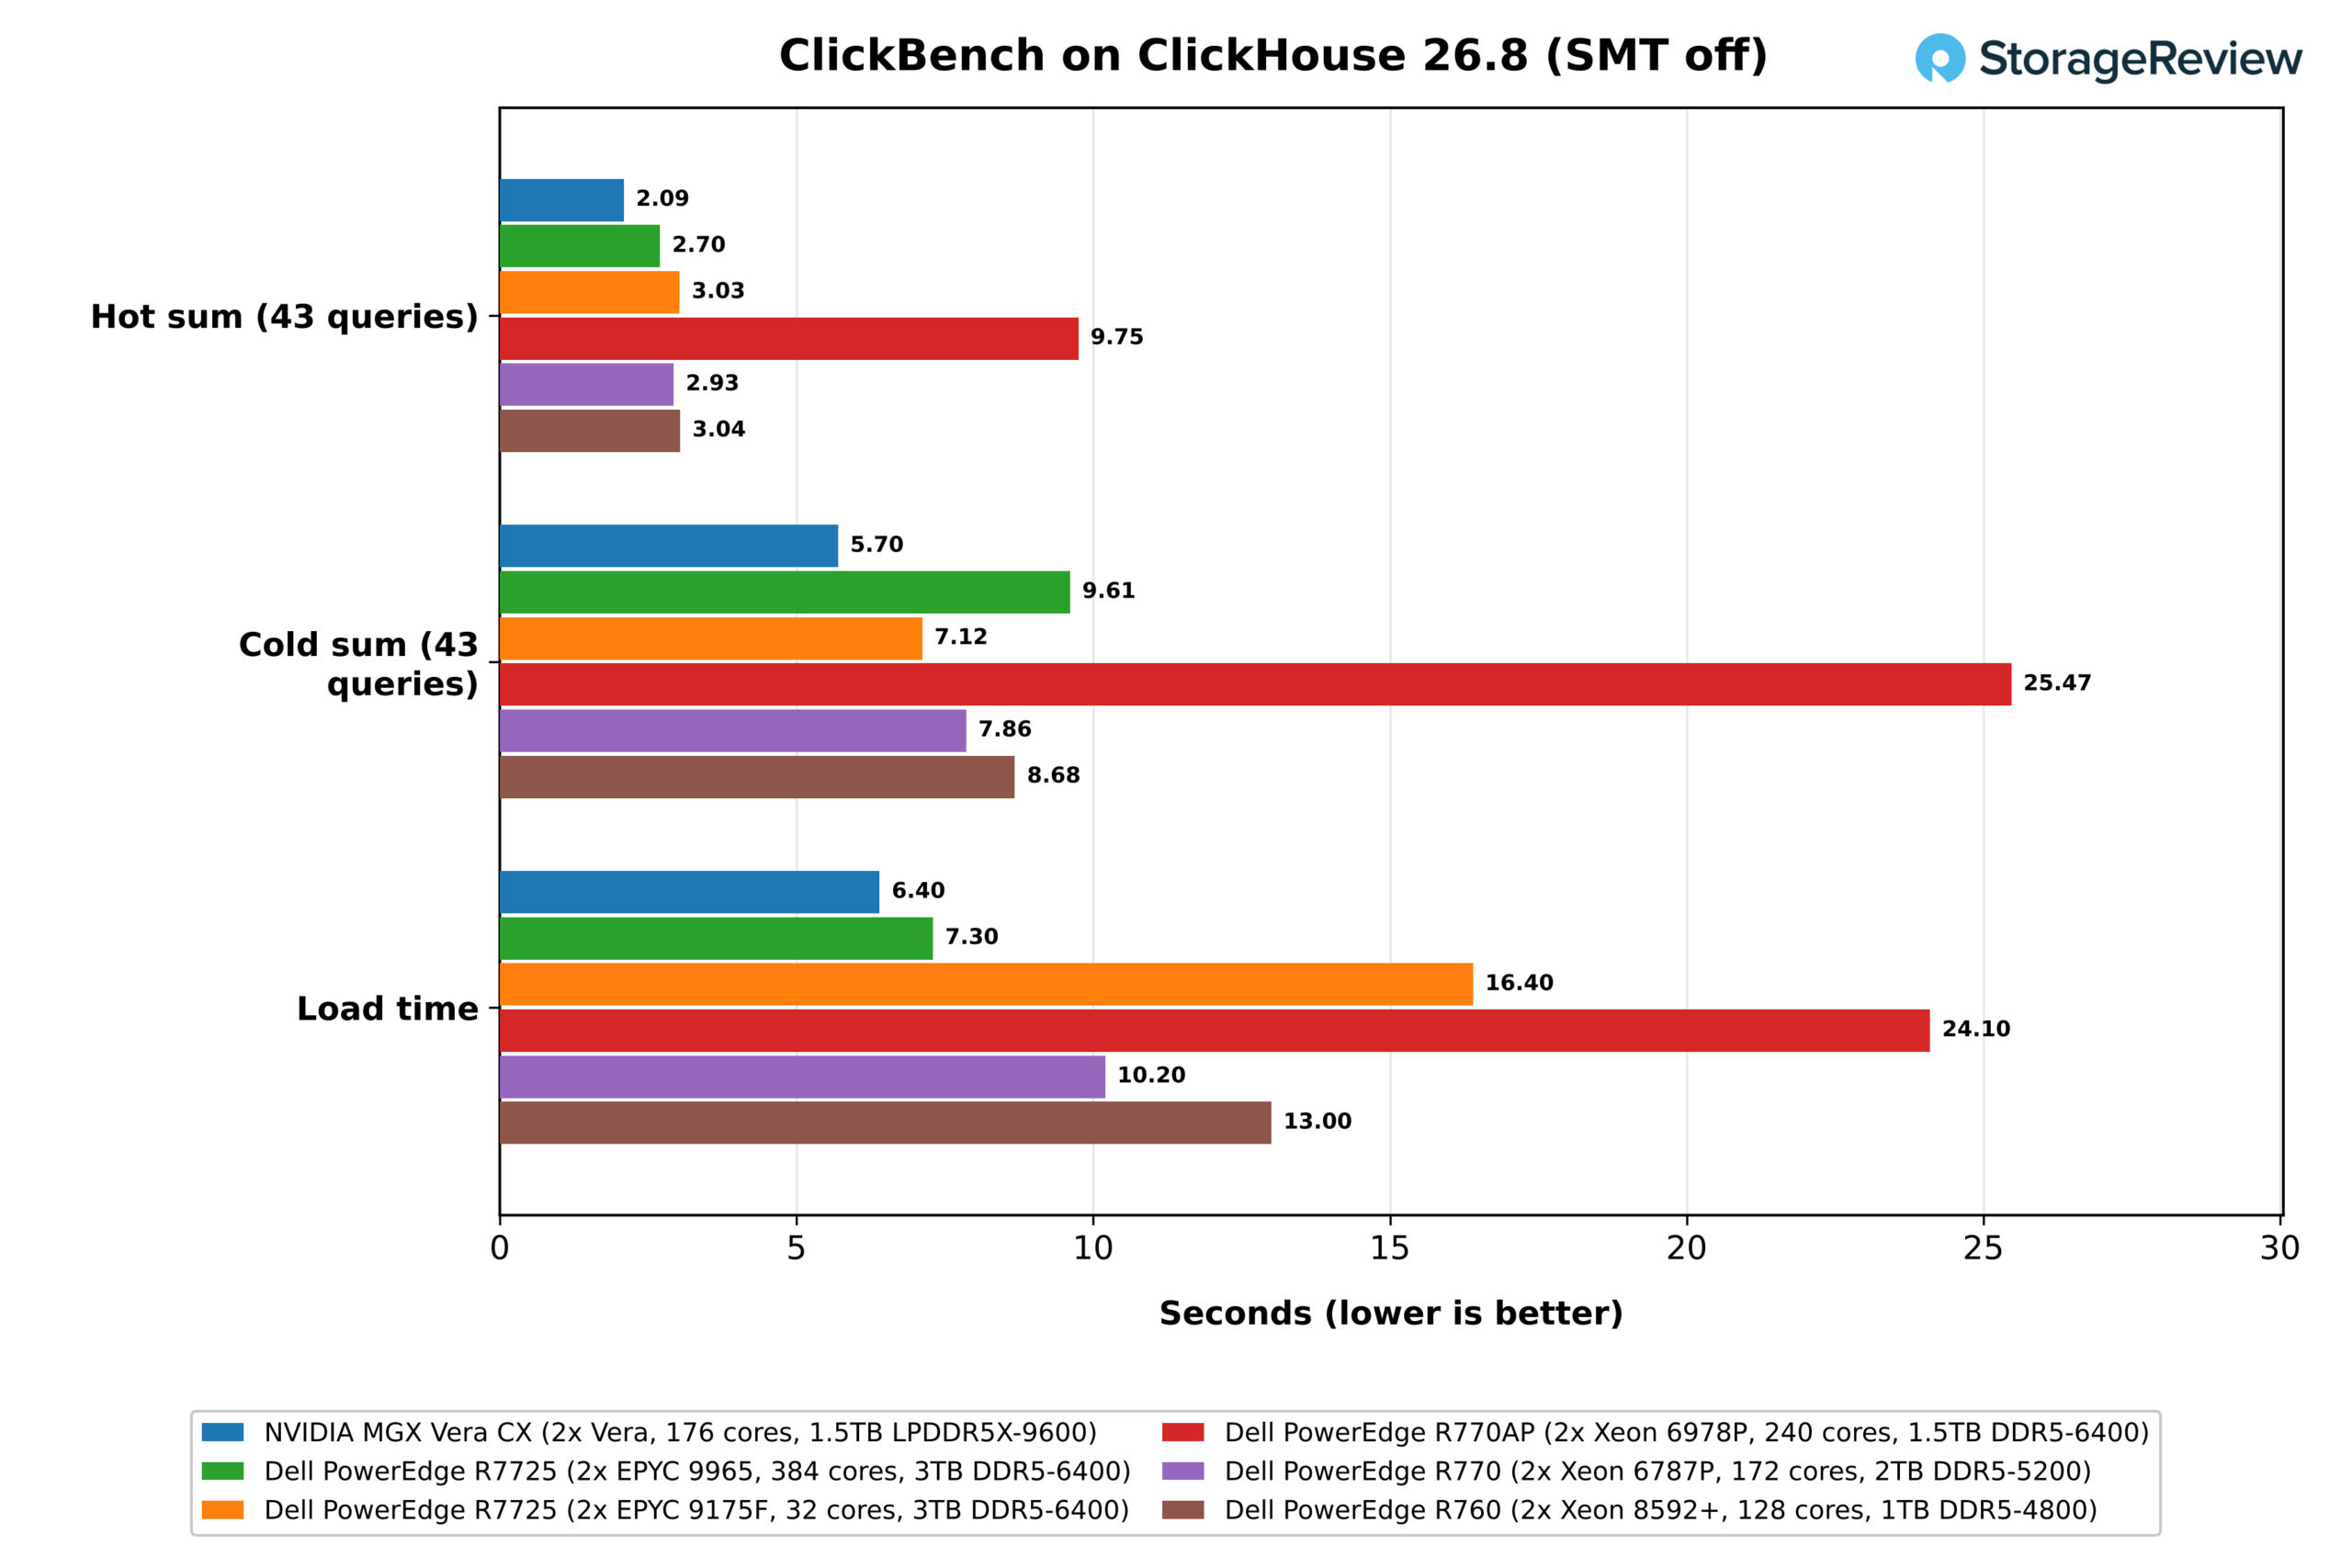
關閉SMT後,Vera以2.09秒的成績完成了熱循環測試,是我們測試組中最快的。 EPYC 9965緊跟在後,耗時2.70秒,是Vera的1.29倍。 Xeon 6787P、EPYC 9175F和Xeon 8592+的成績則在2.93秒到3.04秒之間,基本上持平。這種差異反映了核心數和頻寬之間的平衡。擁有384個核心的9965核心數充足,但每個核心的頻寬較低;32個核心的9175F則相反;而Vera擁有176個核心,頻寬是前兩者的三倍以上。
Vera 在冷啟動測試中也以 5.70 秒的成績領先,其次是 9175F(7.12 秒)、6787P(7.86 秒)、8592+(8.68 秒)和 9965(9.61 秒)。冷啟動測試更側重於存儲,並且驅動器鏈路也不同:Vera 和 6787P 使用 Gen5 x4,兩個 EPYC 系統使用 x2,而 8592+ 使用 Gen4。
Vera載入15GB資料集的速度也最快,只要6.4秒,而9965需要7.3秒,其他處理器則需要10.2到16.4秒。 Xeon 6978P的熱啟動時間為9.75秒,冷啟動時間為25.47秒,由於我們尚未查明原因,其性能遠遜於其他Xeon處理器,因此我們將其排除在排名之外。
啟用空間多執行緒後,Vera 的熱機運轉時間變為 2.31 秒,冷機運轉時間變為 6.09 秒,熱機運轉時間增加了 10%。將每個核心的資源分配給兩個線程,對 ClickHouse 的掃描來說,弊大於利。
瓦爾基
Valkey 在單一主執行緒上執行指令,I/O 執行緒只能在一定程度上提供幫助,因此部署規模的擴大是透過增加分片來實現的,因為給單一執行個體增加更多核心數收效甚微。因此,我們從兩個方面考察 Valkey:單一分片在匹配的核心數下的性能表現,以及每個分片在插槽中滿載時的性能表現。在這兩個測試中,客戶端都運行在同一台機器的另一個插槽上,因此不涉及網路卡。
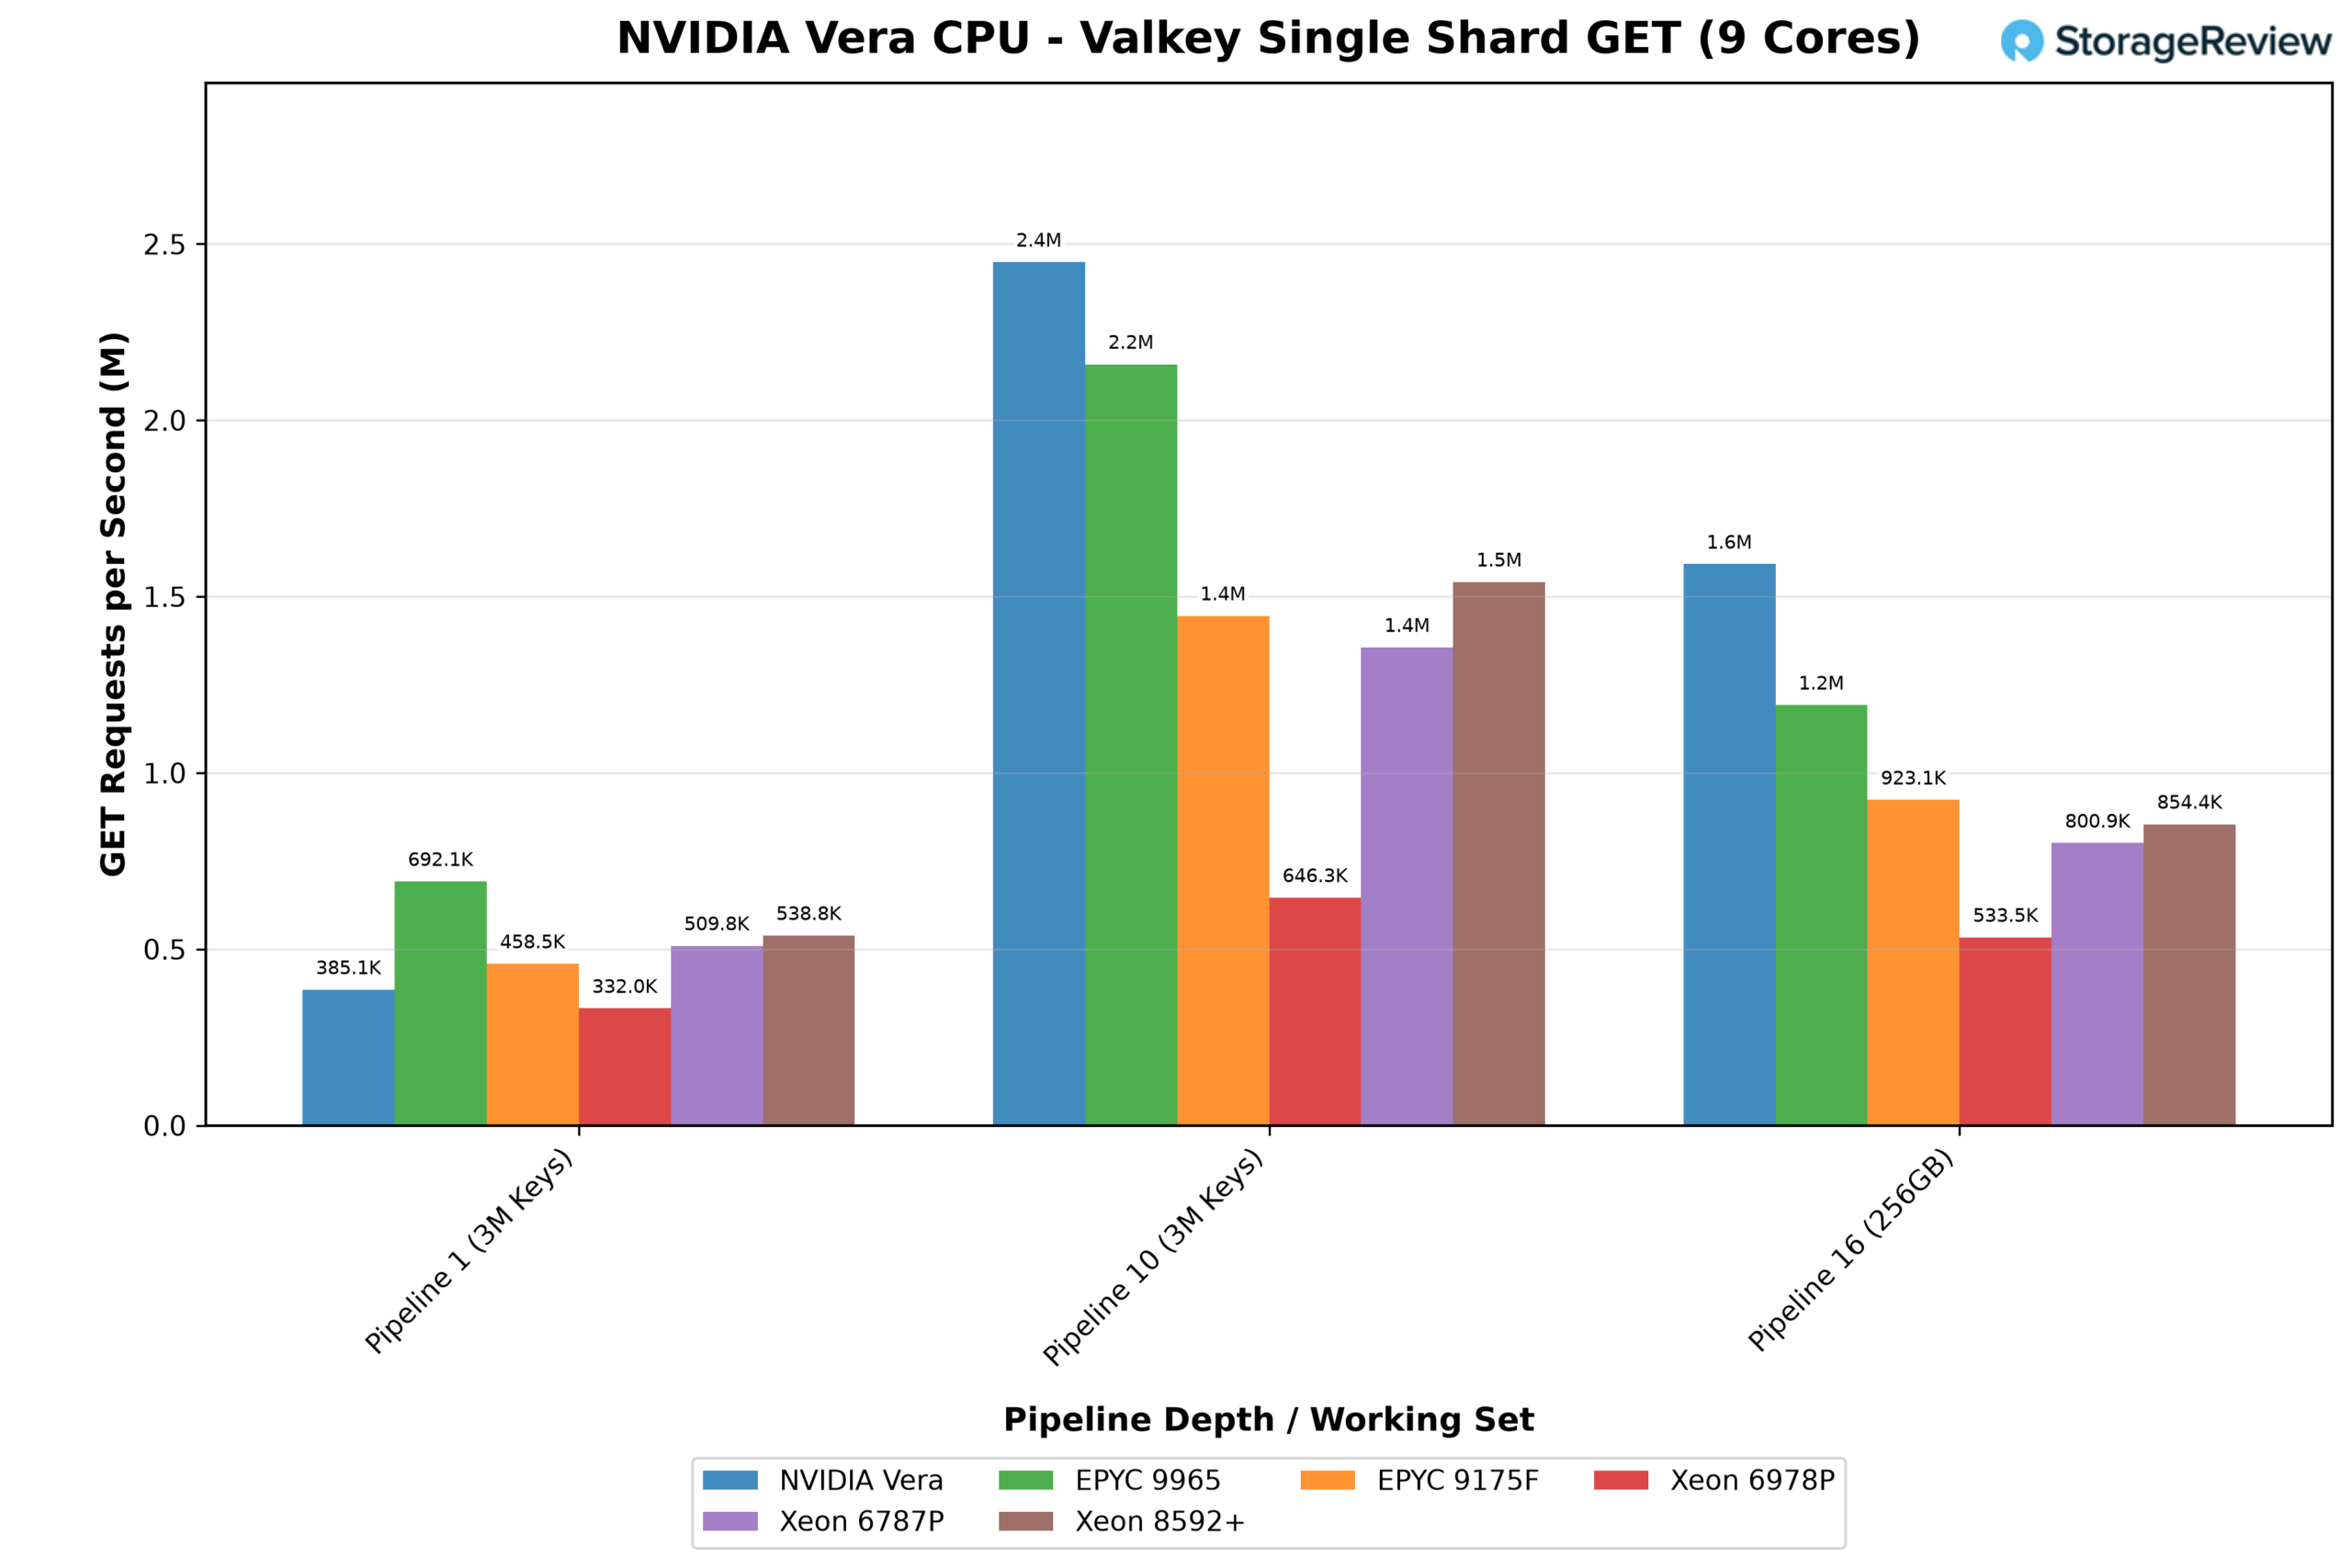
單分片測試在每個平台上都為一台 Valkey 伺服器分配了九個實體核心。它先以每次發送一個請求的方式處理一個包含 3 萬個鍵的資料集,然後以每次 10 個請求的批次進行處理,最後以每次 16 個請求的批次處理一個 256GB 的資料集(該資料集太大,任何快取都無法容納)。由於每次發送的請求都是逐一發送的,因此每個請求都必須完成往返才能發送下一個請求,而這正是 Vera 的弱點所在。它的分片每秒處理 385,000 萬個 GET 請求,僅優於 Xeon 6978P,而 EPYC 9965 則以每秒 692,000 萬個請求領先。 Vera 的 p99 延遲也較高,為 1.76 毫秒,而 9965 的延遲為 1.08 毫秒。
批量處理大大降低了往返成本,Vera 的性能因此脫穎而出。在 10 個請求的批次處理下,其分片每秒處理 2.45 萬個 GET 請求,比 9965 高出 13%,遠超所有 Xeon 處理器。 256GB 的資料集進一步拉大了差距。幾乎所有請求都載入到記憶體中,Vera 每秒處理 1.59 萬個 GET 請求,比 9965 高出 34%,而其他處理器的處理速度則在 0.53 萬到 0.92 萬之間。在兩次測試中,SET 請求的結果也呈現相同的趨勢。
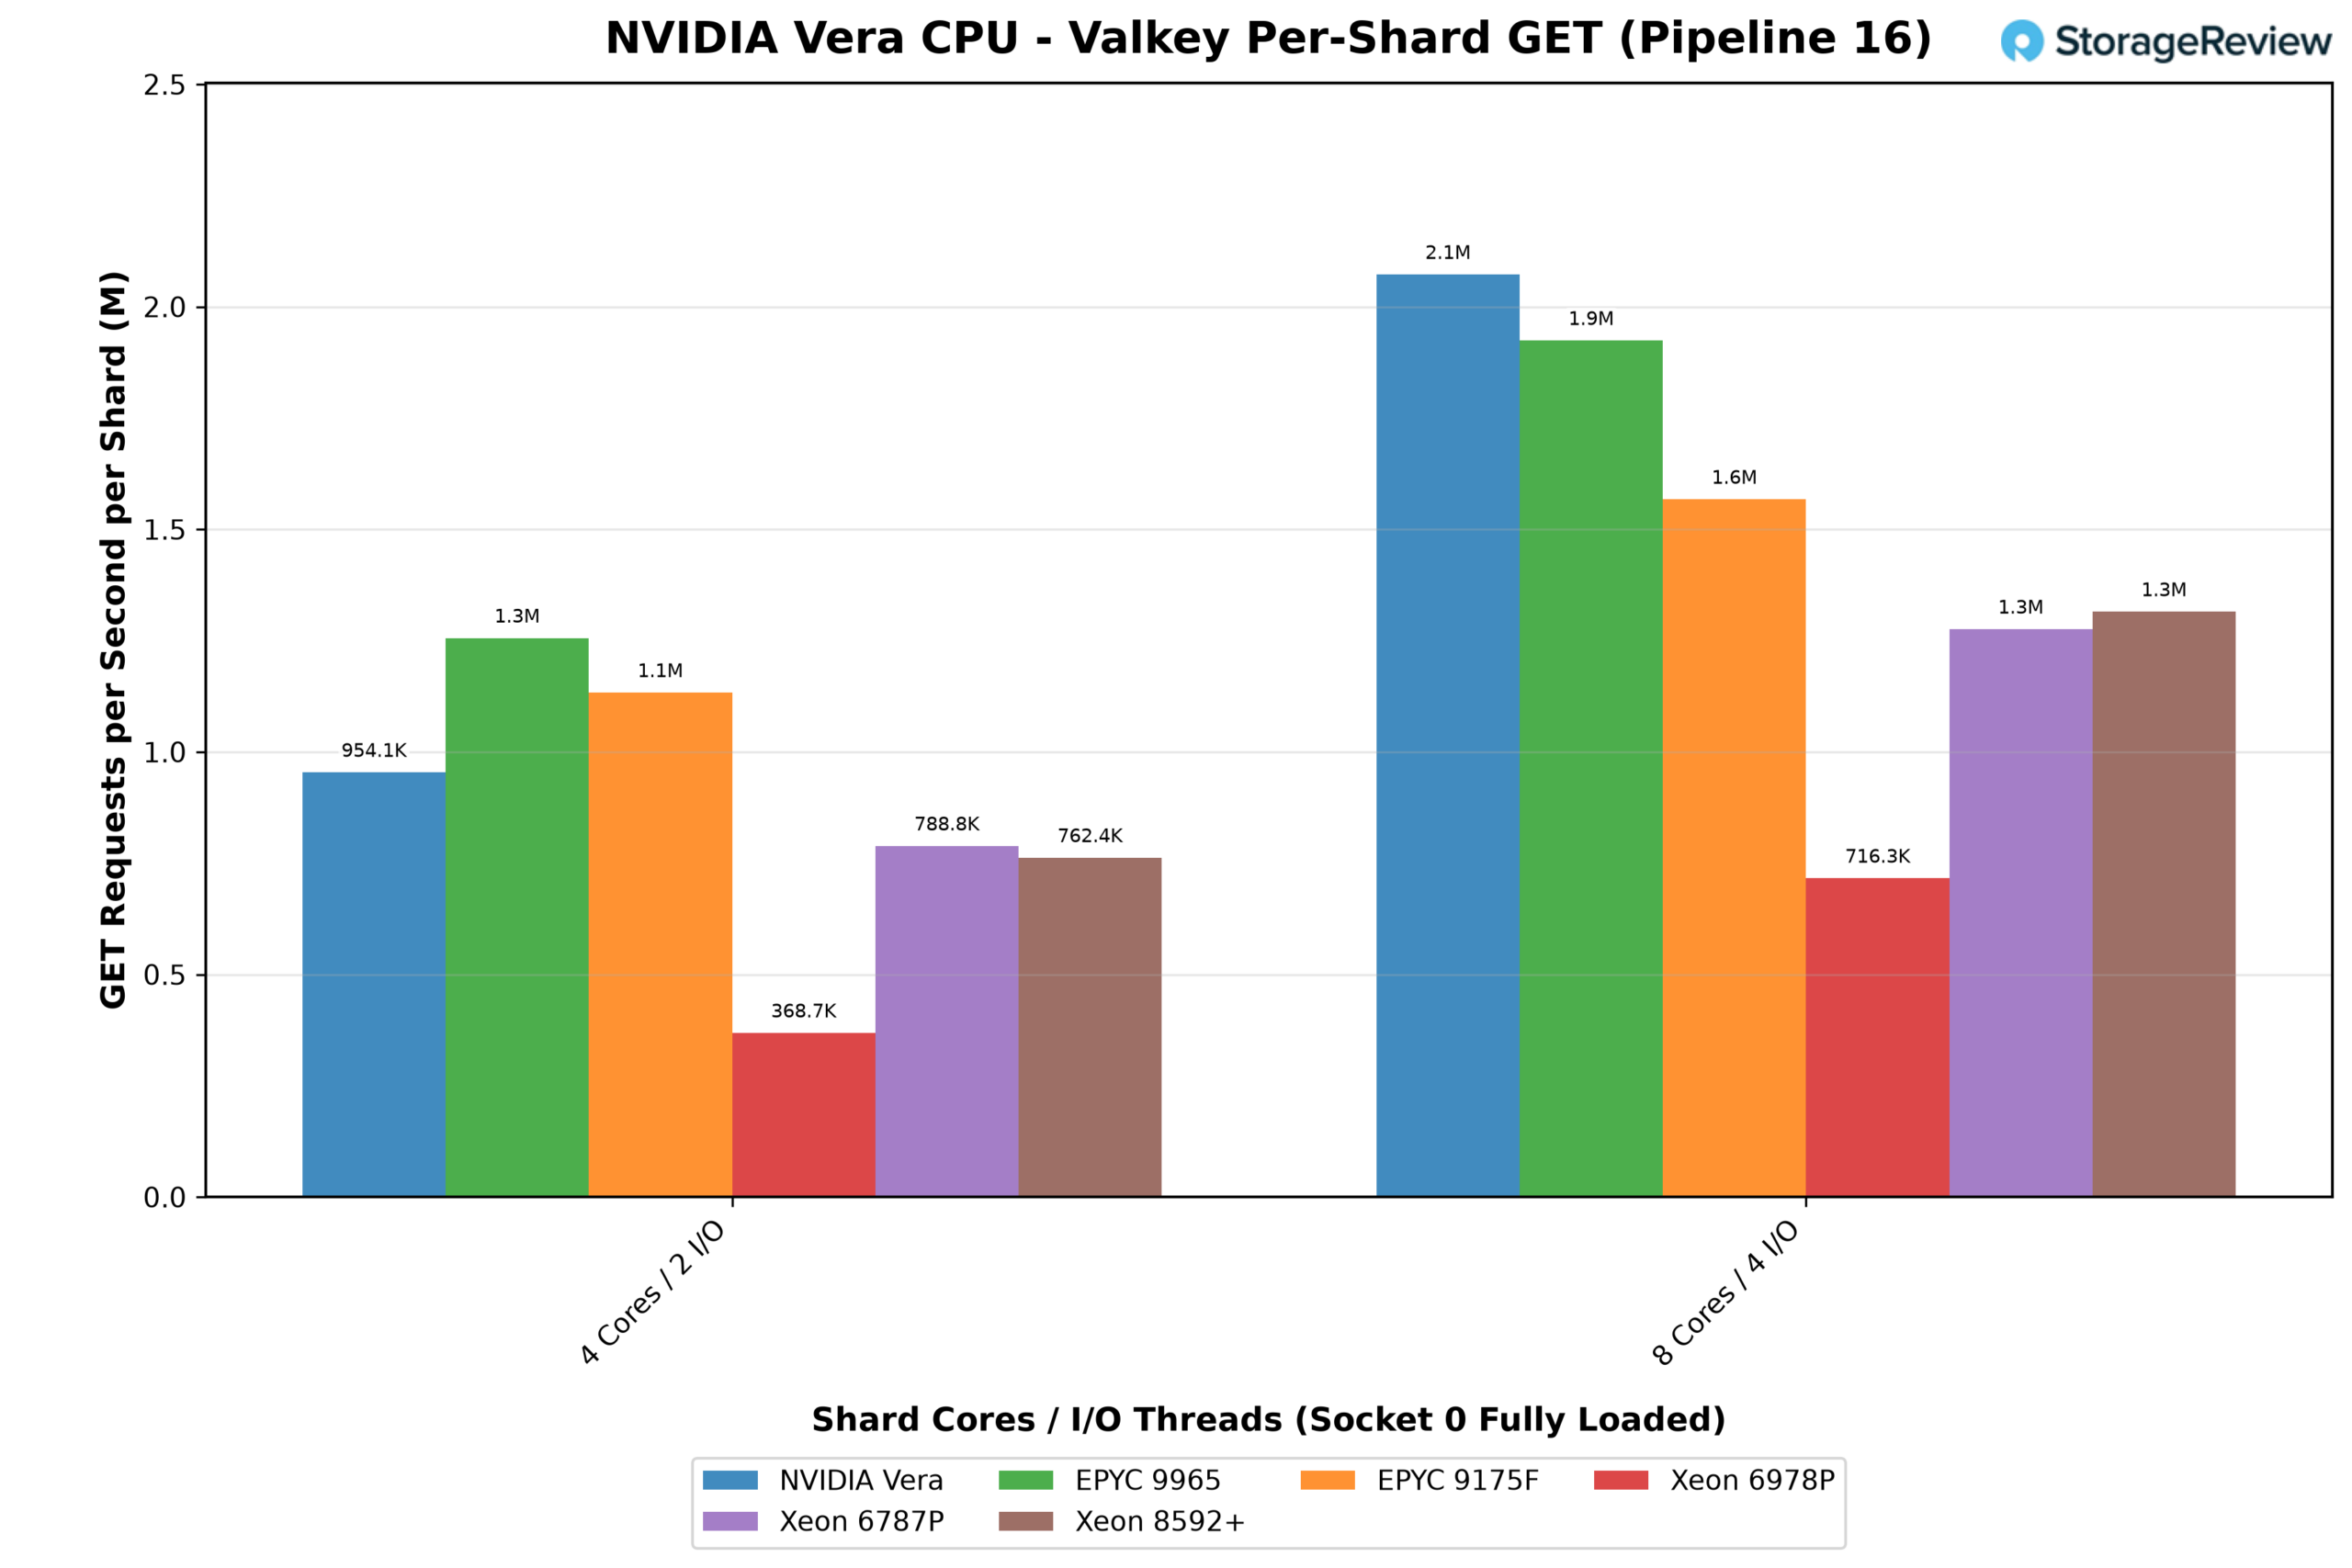
Socket 模式將 0 號插槽配置為相同的四核心或八核心分片,所有分片同時處理流量,這更接近專用 Valkey 主機的運作方式。在 8 核分片和 16 個分片的批次處理下,每個 Vera 分片每秒可處理 2.07 萬個 GET 請求,高於 9965 的 1.92 萬個,約為 Xeon 6787P 和 8592+ 的 1.6 倍,但其 p99 延遲約 205 毫秒,而 9.5 毫秒的延遲。
在較小的四核心分片測試中,AMD 表現更佳:9965 每個分片的 GET 請求數為 1.26 萬,而 Vera 為 95 萬,儘管 Vera 仍然領先所有 Xeon 處理器。在每次發送請求的情況下,無論分片大小如何,9965 的分片速度都比 Vera 快 1.5 到 1.7 倍,而 6787P 和 8592+ 在八核分片測試中也領先於 Vera。
密度決定了插槽總數:Vera 插槽可容納 11 個八核心分片,每秒處理 22.8 萬個 GET 請求;而 9965 的 192 個核心可容納 48 個四核分片,每秒處理 60.3 萬個請求。 Vera 在每個分片擁有八個或更多核心且要求批次處理時,能夠提供我們測試組中最快的分片速度,但 9965 的插槽可容納的分片數量是 Vera 的兩倍多。
單線程和吞吐量
Valkey 和 ClickBench 對記憶體系統的依賴程度與對核心的依賴程度相當。本節將重點介紹核心本身,以及先前提到的 Olympus 架構的兩個目標:快速完成單一任務,並在整個插槽繁忙時保持速度。 7-Zip、OpenSSL 和 Python 分別作為綁定到單一核心的單執行緒運行,展示了 Olympus 核心的獨立效能。然後,7-Zip 和 OpenSSL 在系統的每個執行緒上再次運行,展示了當所有核心都在爭用相同的快取和記憶體時,單核心速度還能保持多少。
7-ZIP
7-Zip 的 LZMA 壓縮是分支密集的整數程式碼,記憶體存取不可預測,這正是 Olympus 的 10 寬前端和圖形預取器所擅長的工作。
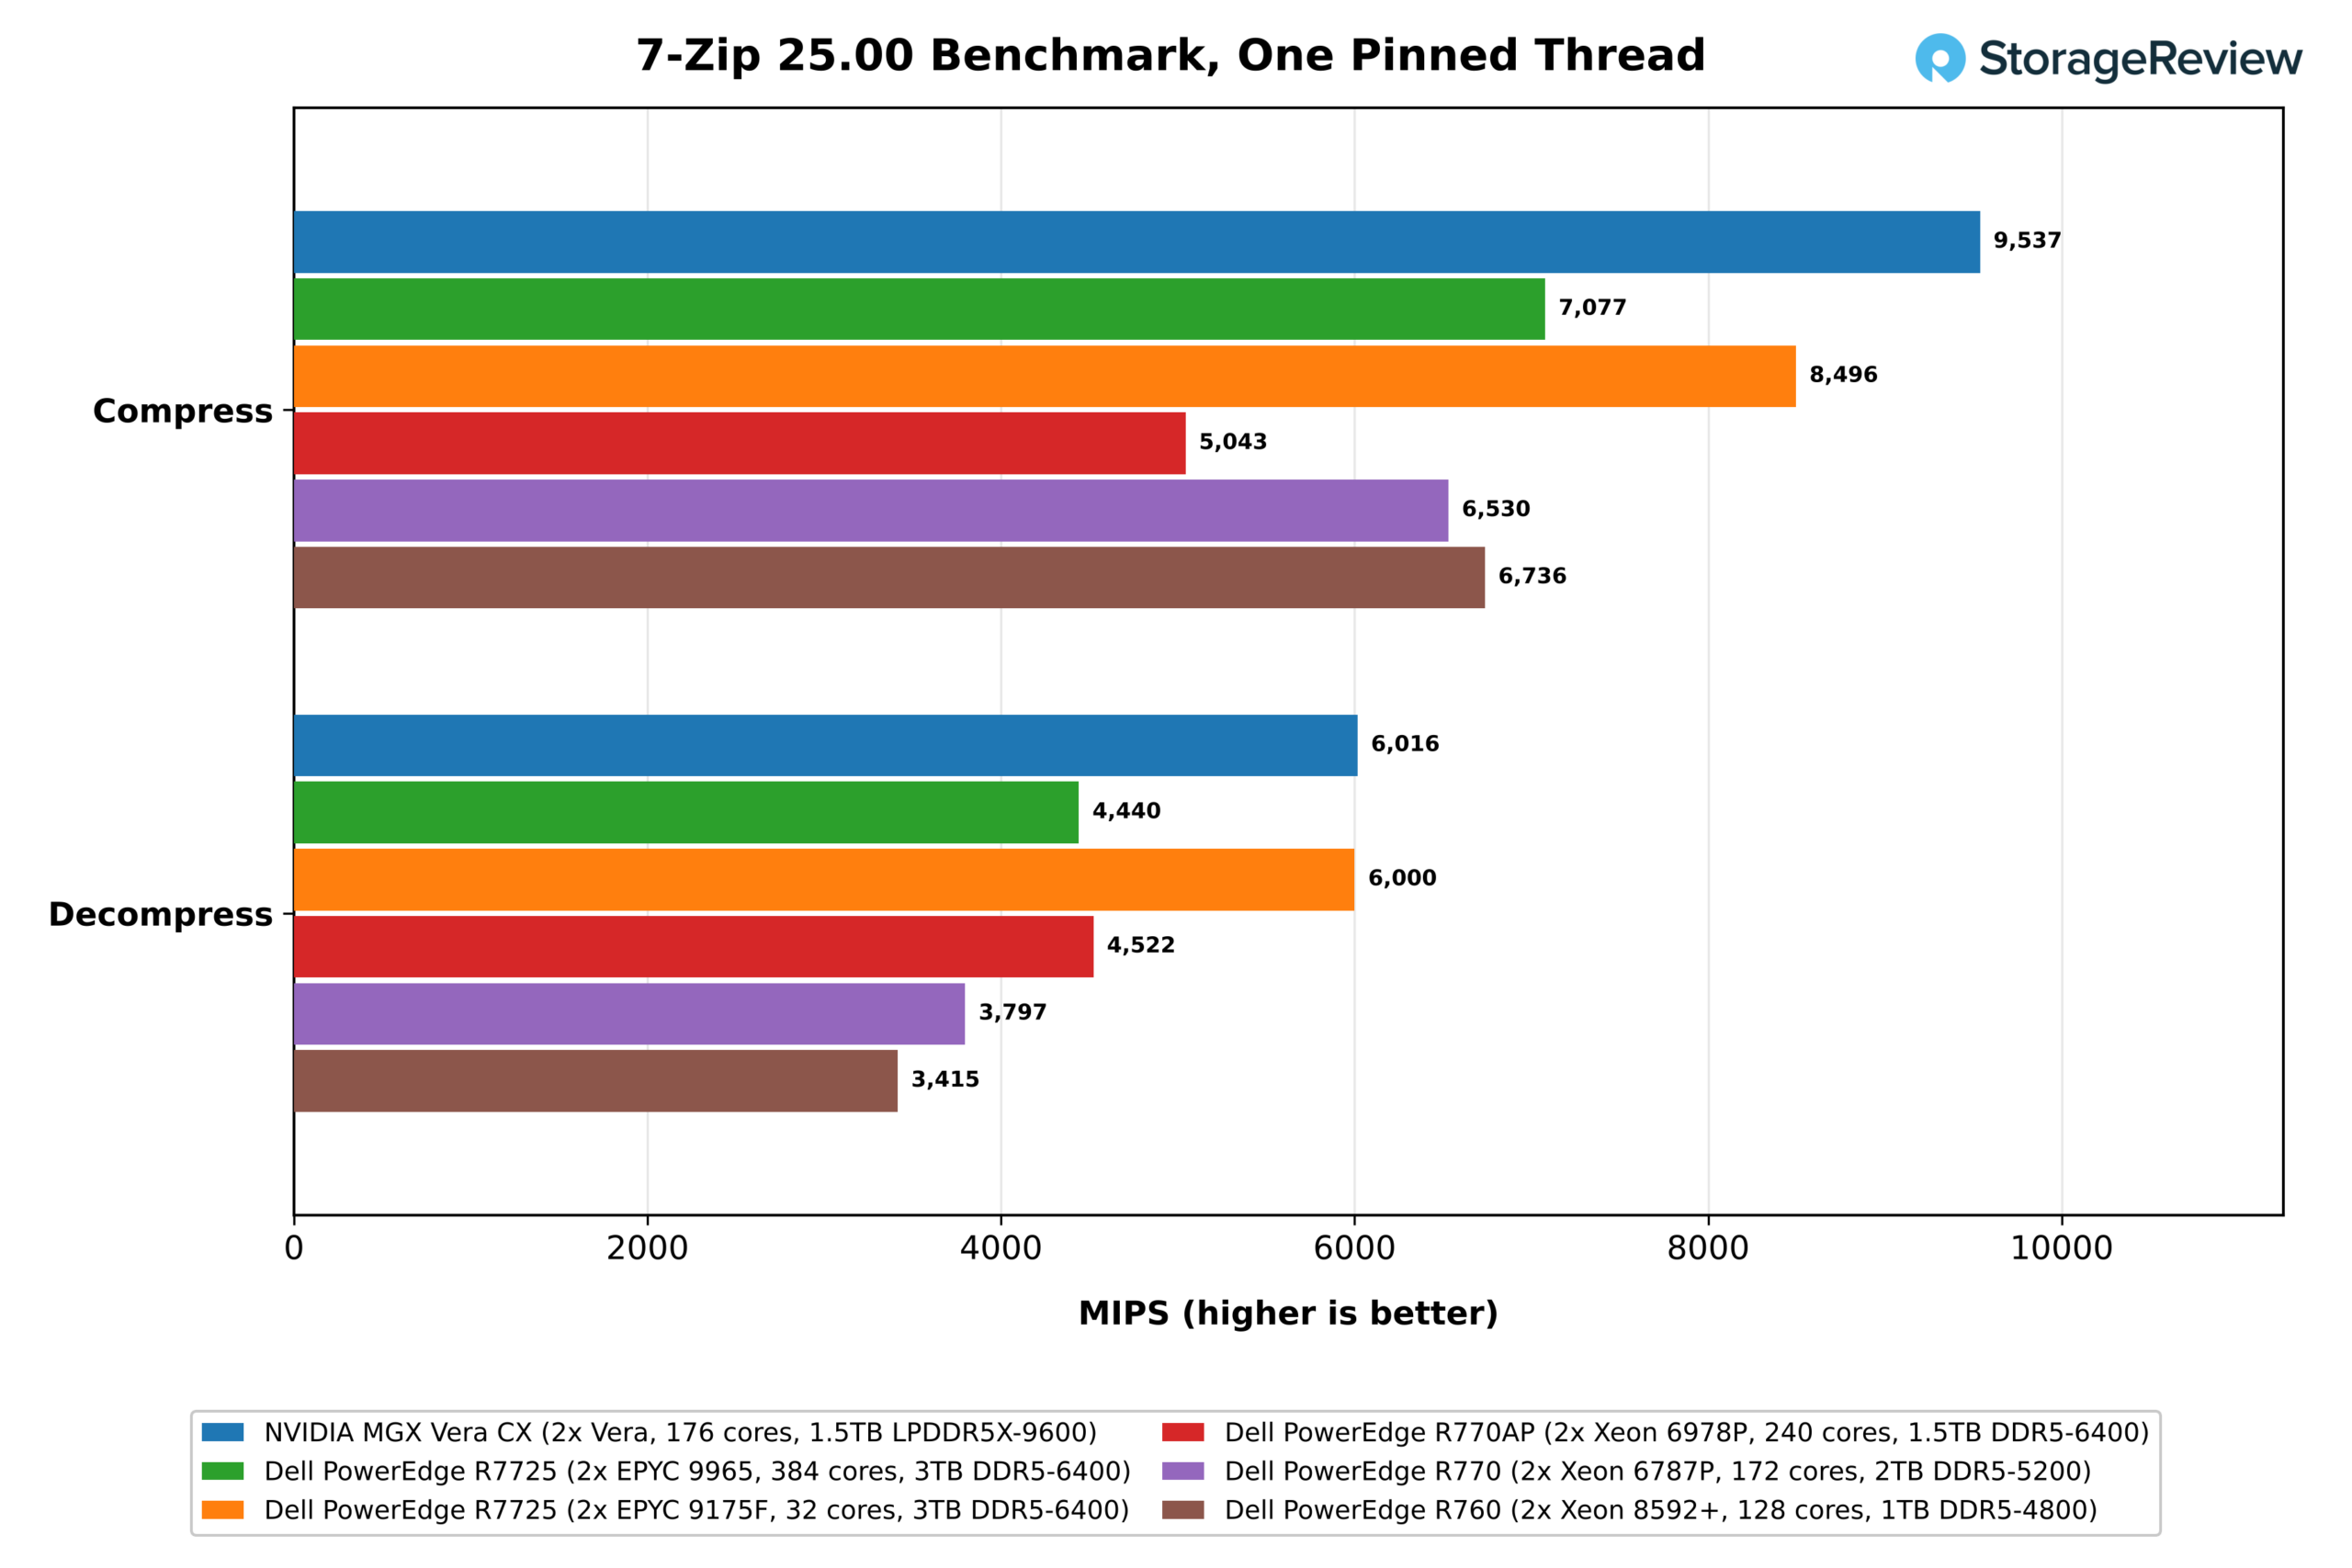
在單執行緒測試中,Olympus 是我們測試的所有處理器中壓縮速度最快的。它的壓縮率達到了 9,537 MIPS,比 5.0GHz 的 EPYC 9175F(本次測試中最快的 x86 核心)高出 12%,並且遠超 EPYC 9965 和所有 Xeon 處理器。在解壓縮測試中,兩者不分伯仲:Vera 為 6,016 MIPS,9175F 為 6,000 MIPS,其他系統均落後 20% 以內。
逐條執行緒運行可以顯示,當整個系統繁忙時,有多少領先優勢得以保留。
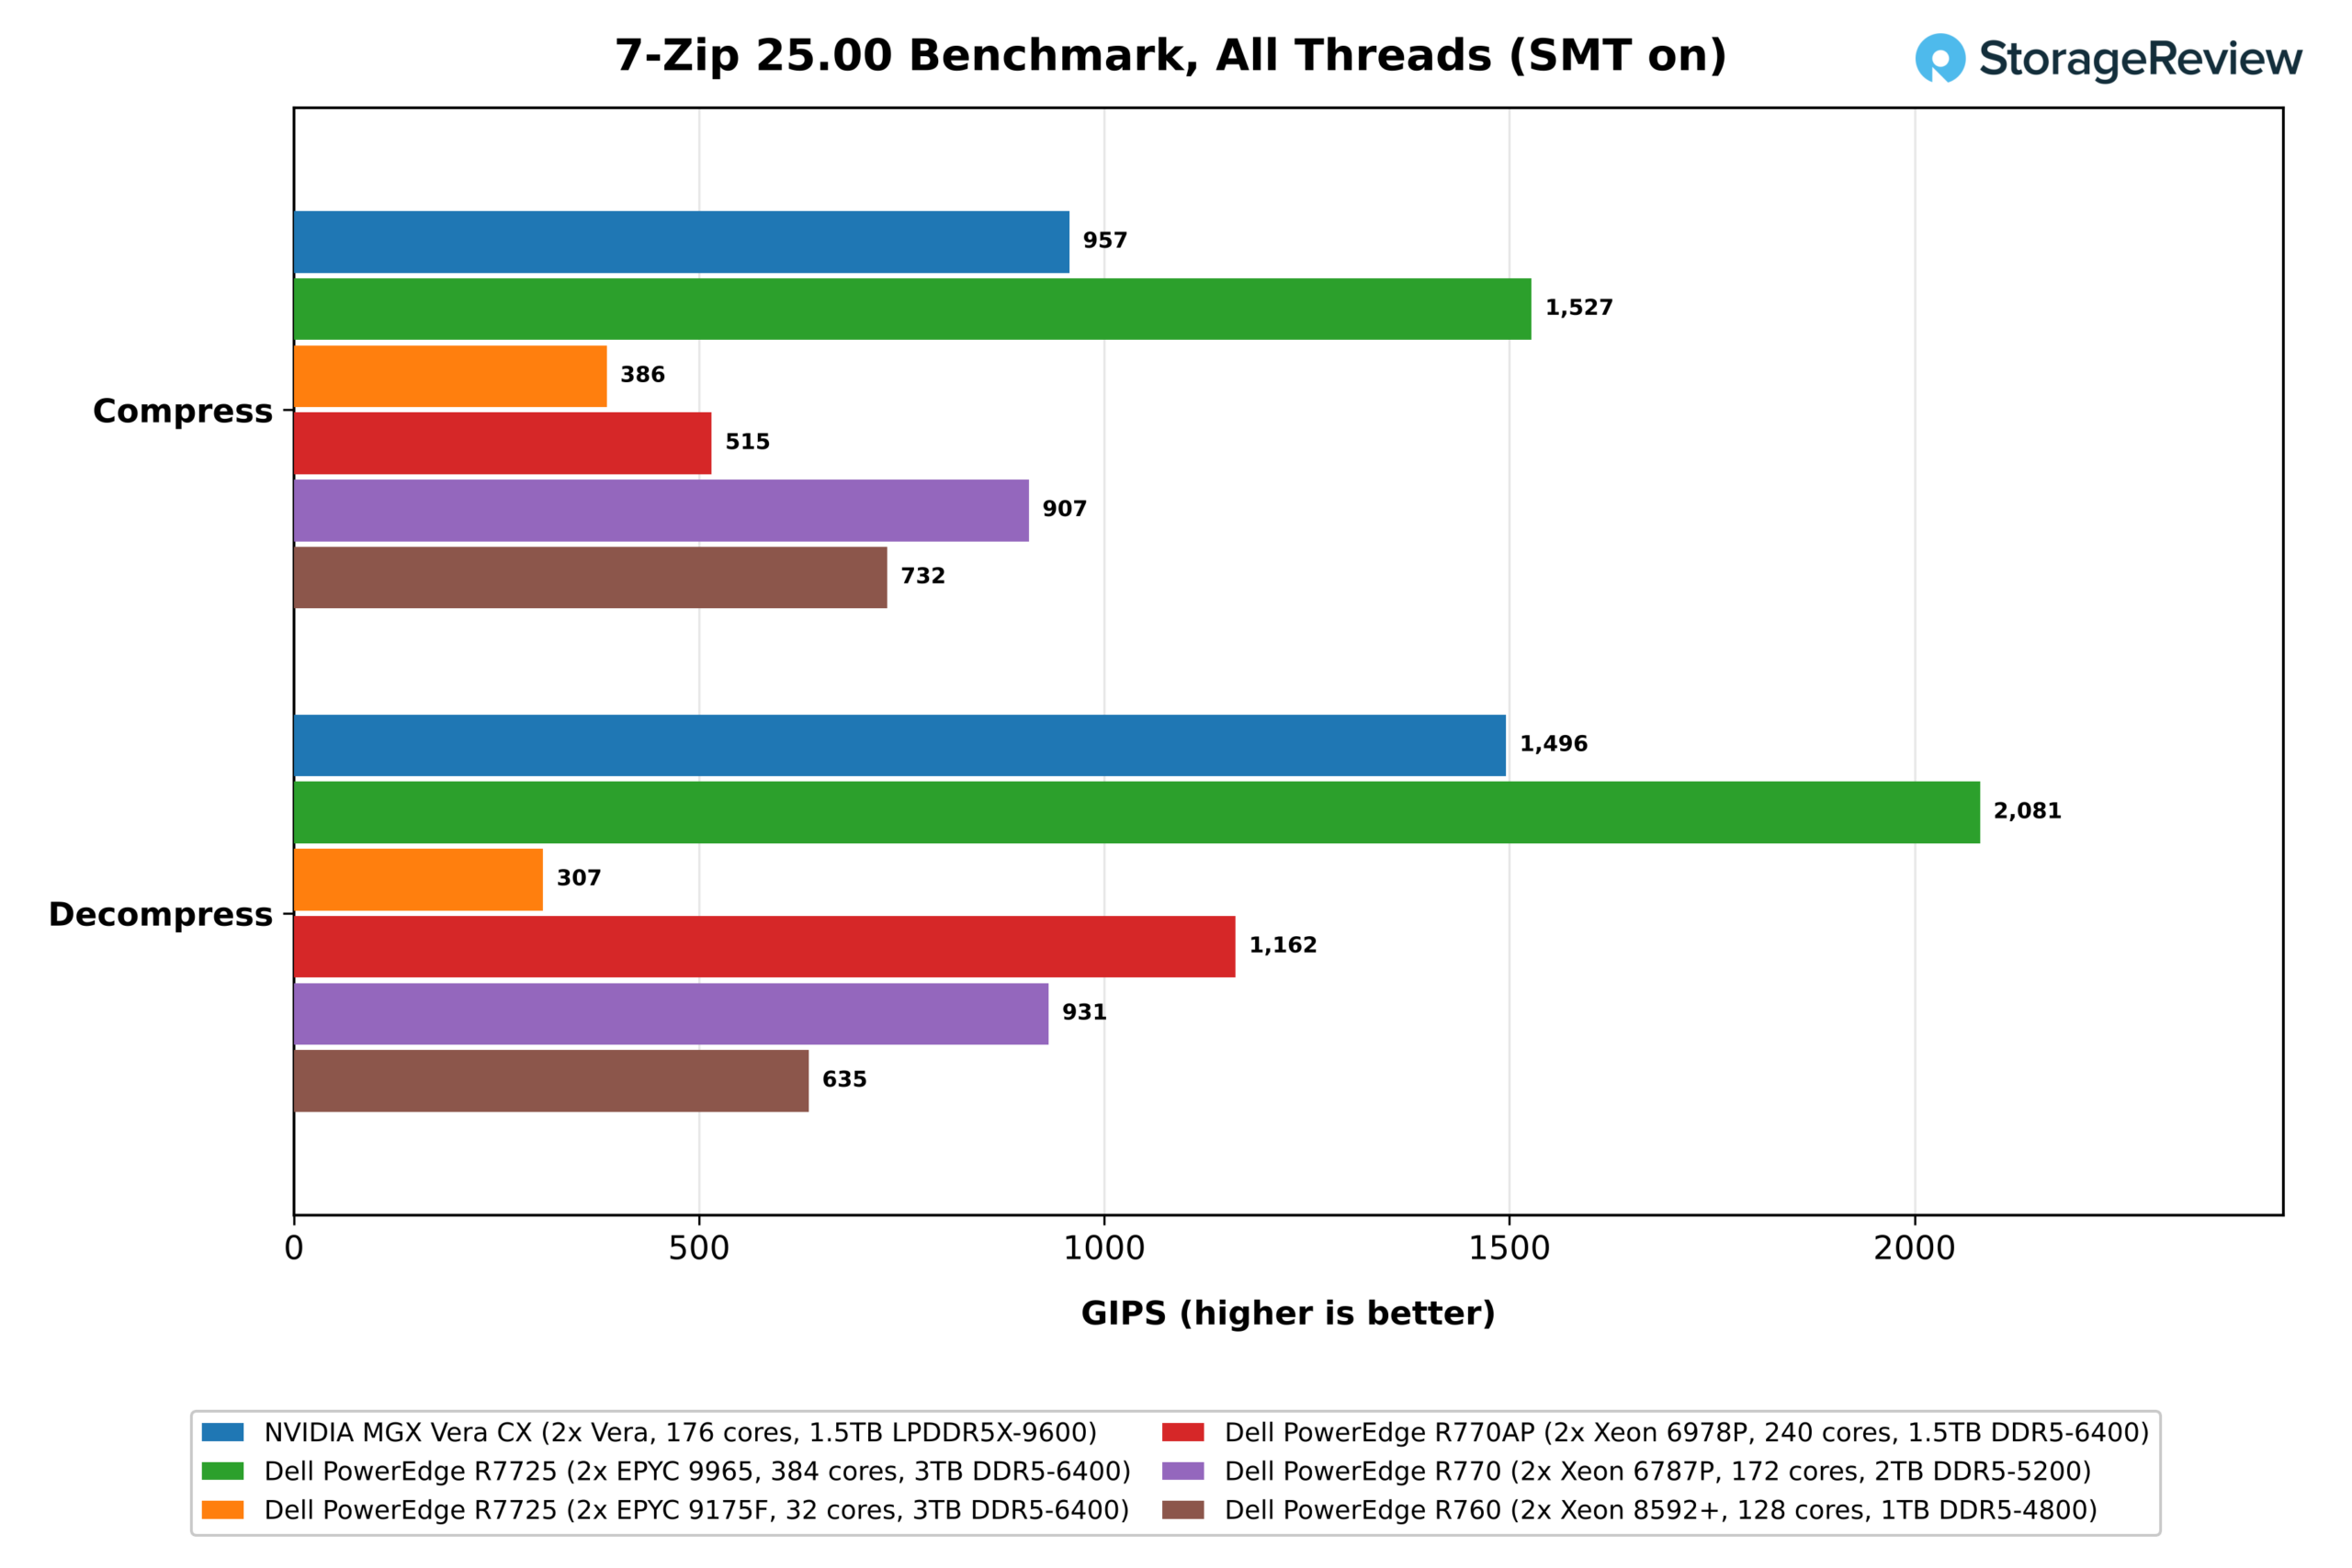
在所有執行緒都處於繁忙狀態的情況下,EPYC 9965 的 768 個執行緒以 1,527 GIPS 的壓縮速度和 2,081 GIPS 的解壓縮速度位居榜首。 Vera 的 352 個執行緒以 957 GIPS 和 1,496 GIPS 的壓縮速度和解壓縮速度位居第二,領先所有 Xeon 處理器,而 6787P 以 907 GIPS 和 931 GIPS 的成績緊隨其後。從每個物理核心的表現來看,Vera 的表現也相當出色。其每個核心的壓縮速度為 5.4 GIPS,與 6787P 和 8592+ 持平,並優於 9965 的 4.0 GIPS;其每個核心的解壓縮速度為 8.5 GIPS,比 9965 高出 57%,並且優於所有 Xeon 處理器。只有 32 核心的 9175F(每個插槽共享快取和記憶體的核心數遠少於 Vera)在壓縮和解壓縮兩項指標上都優於 Vera。
OpenSSL的
在 OpenSSL 的 AES-256-GCM 測試中,Vera 的表現最為遜色。 Olympus 的六個 128 位元 SVE2 管道中只有兩個可以執行加密指令,而 x86 部分則可以使用 VAES 在 512 位元暫存器上執行 AES 演算法。
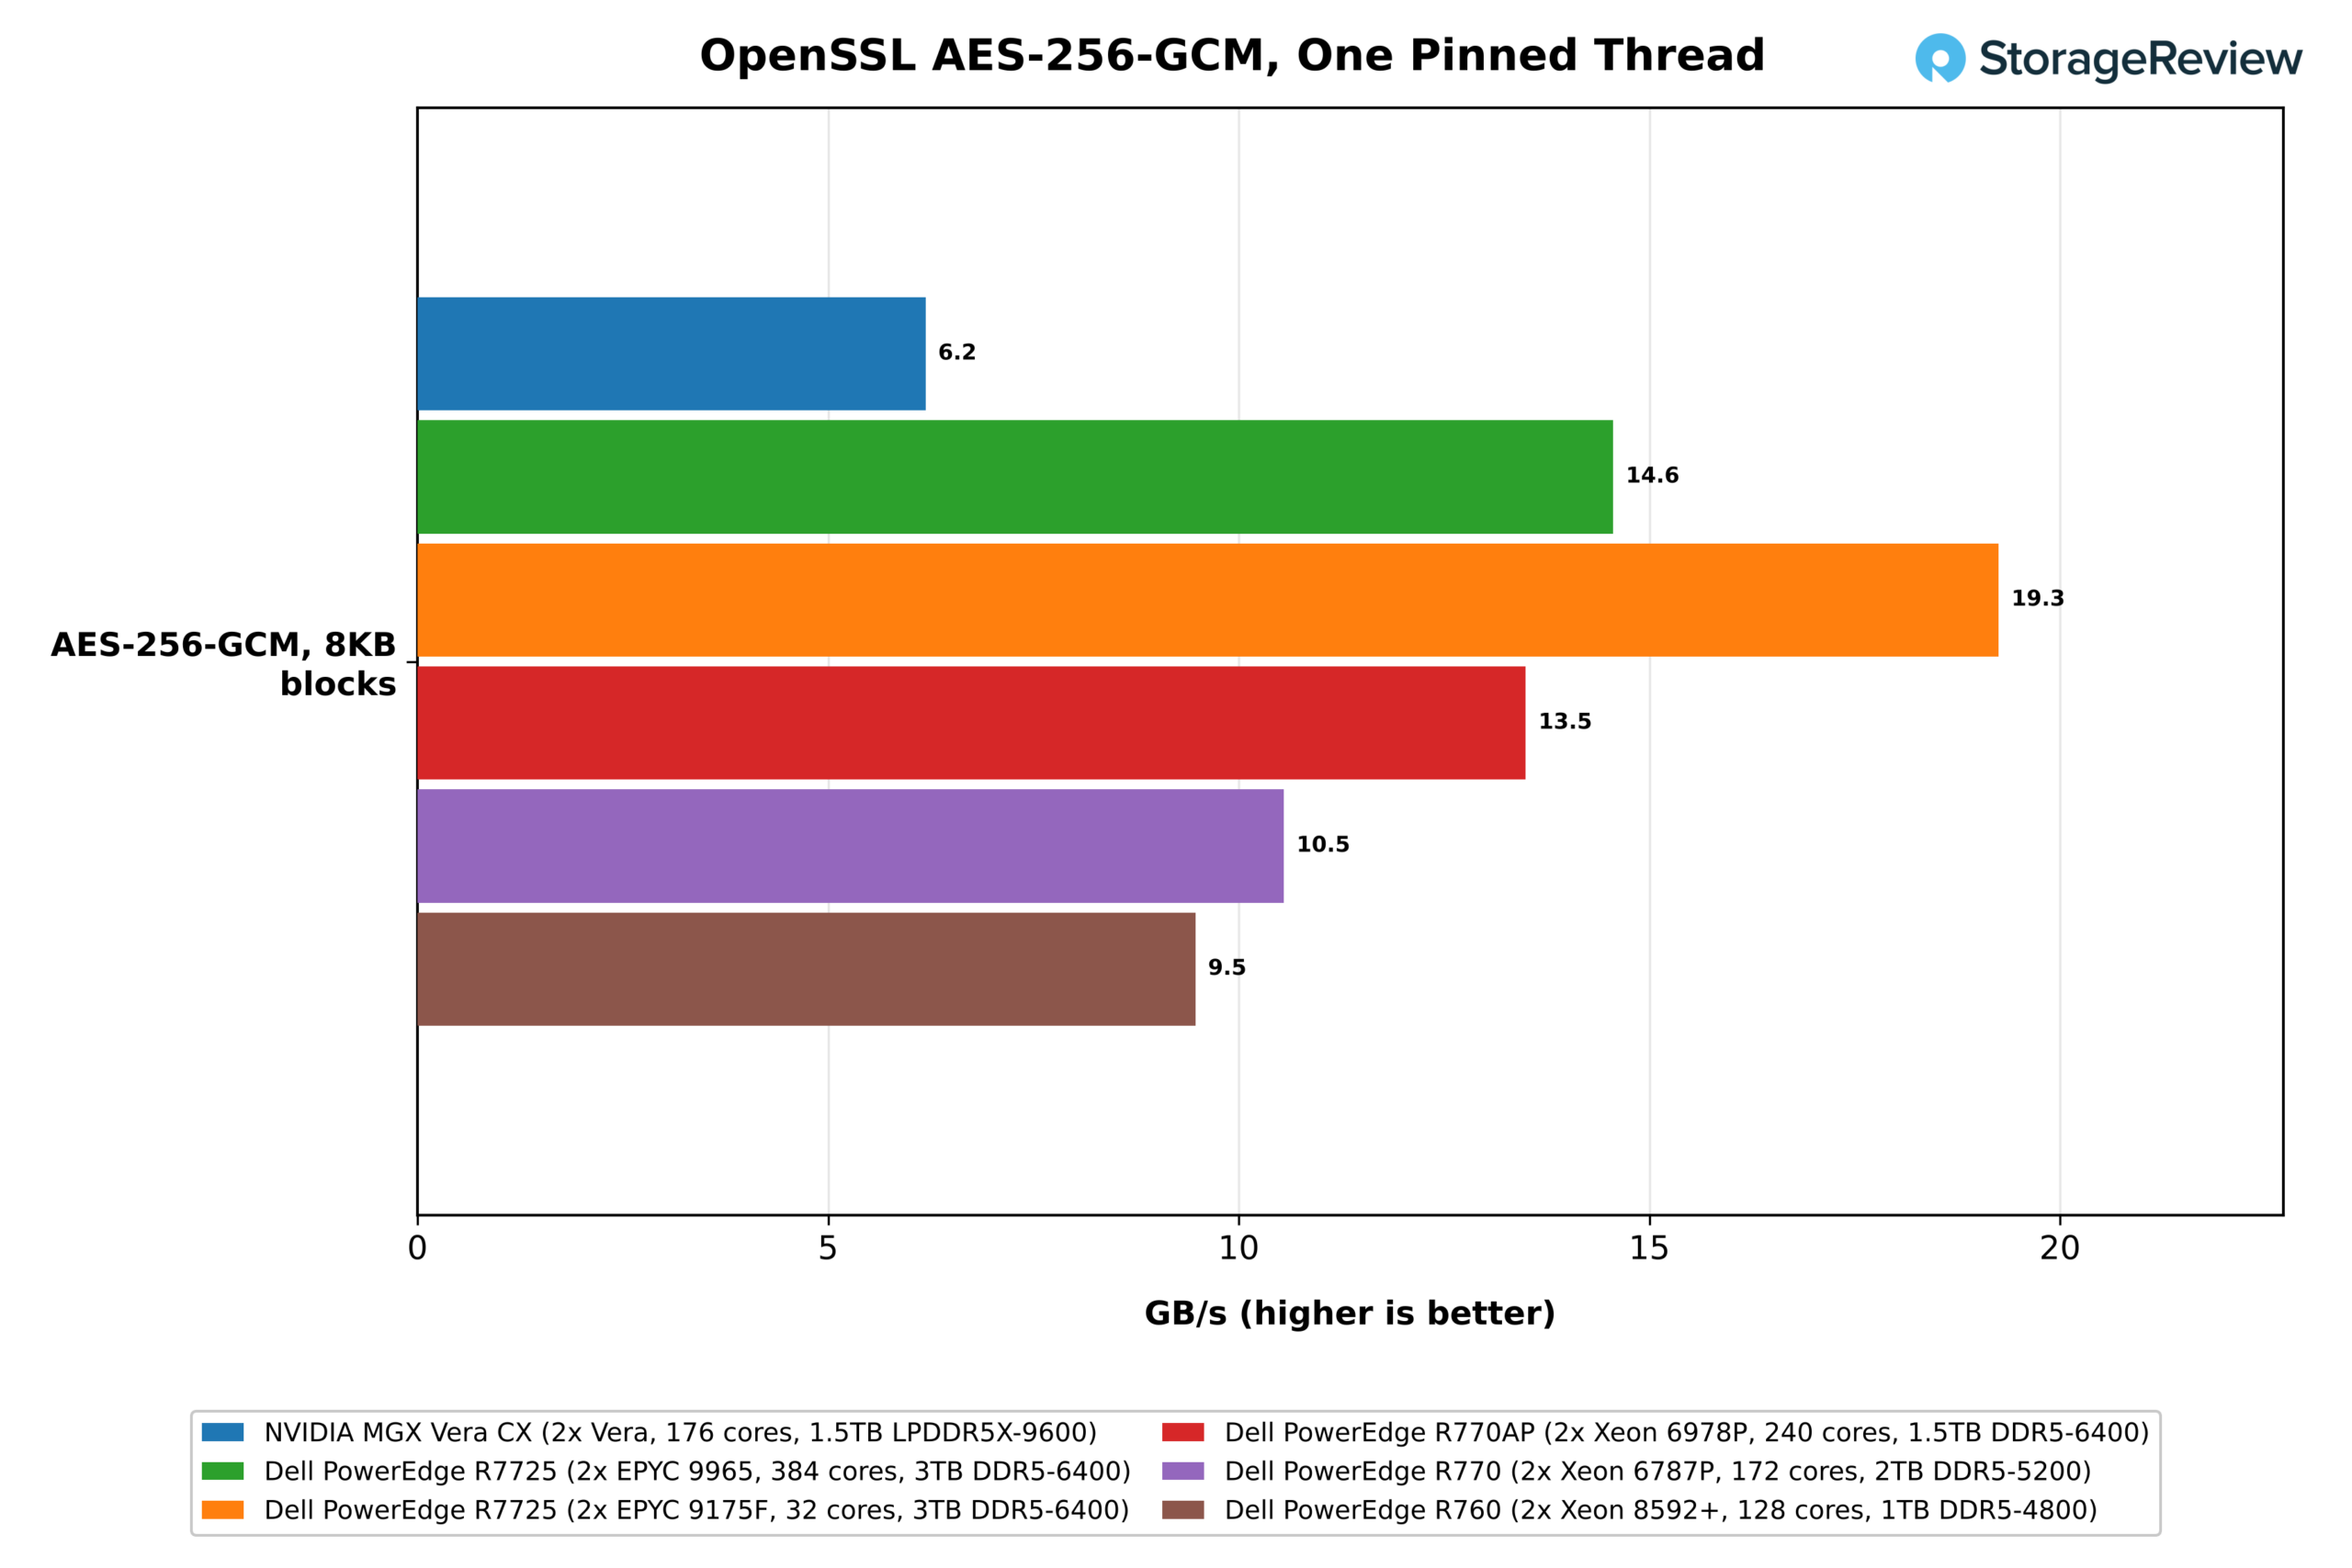
在單線程測試中,差距最為明顯。 Olympus 的單核加密速度為 6.2GB/s,約為 EPYC 9175F 的 19.3GB/s 的三分之一,遠低於 EPYC 9965 的 14.6GB/s 和 Xeon 6978P 的 13.5GB/s。
在每個執行緒中,x86 系統按核心數排列,這表示每個核心的不足之處讓 Vera 處於什麼位置。
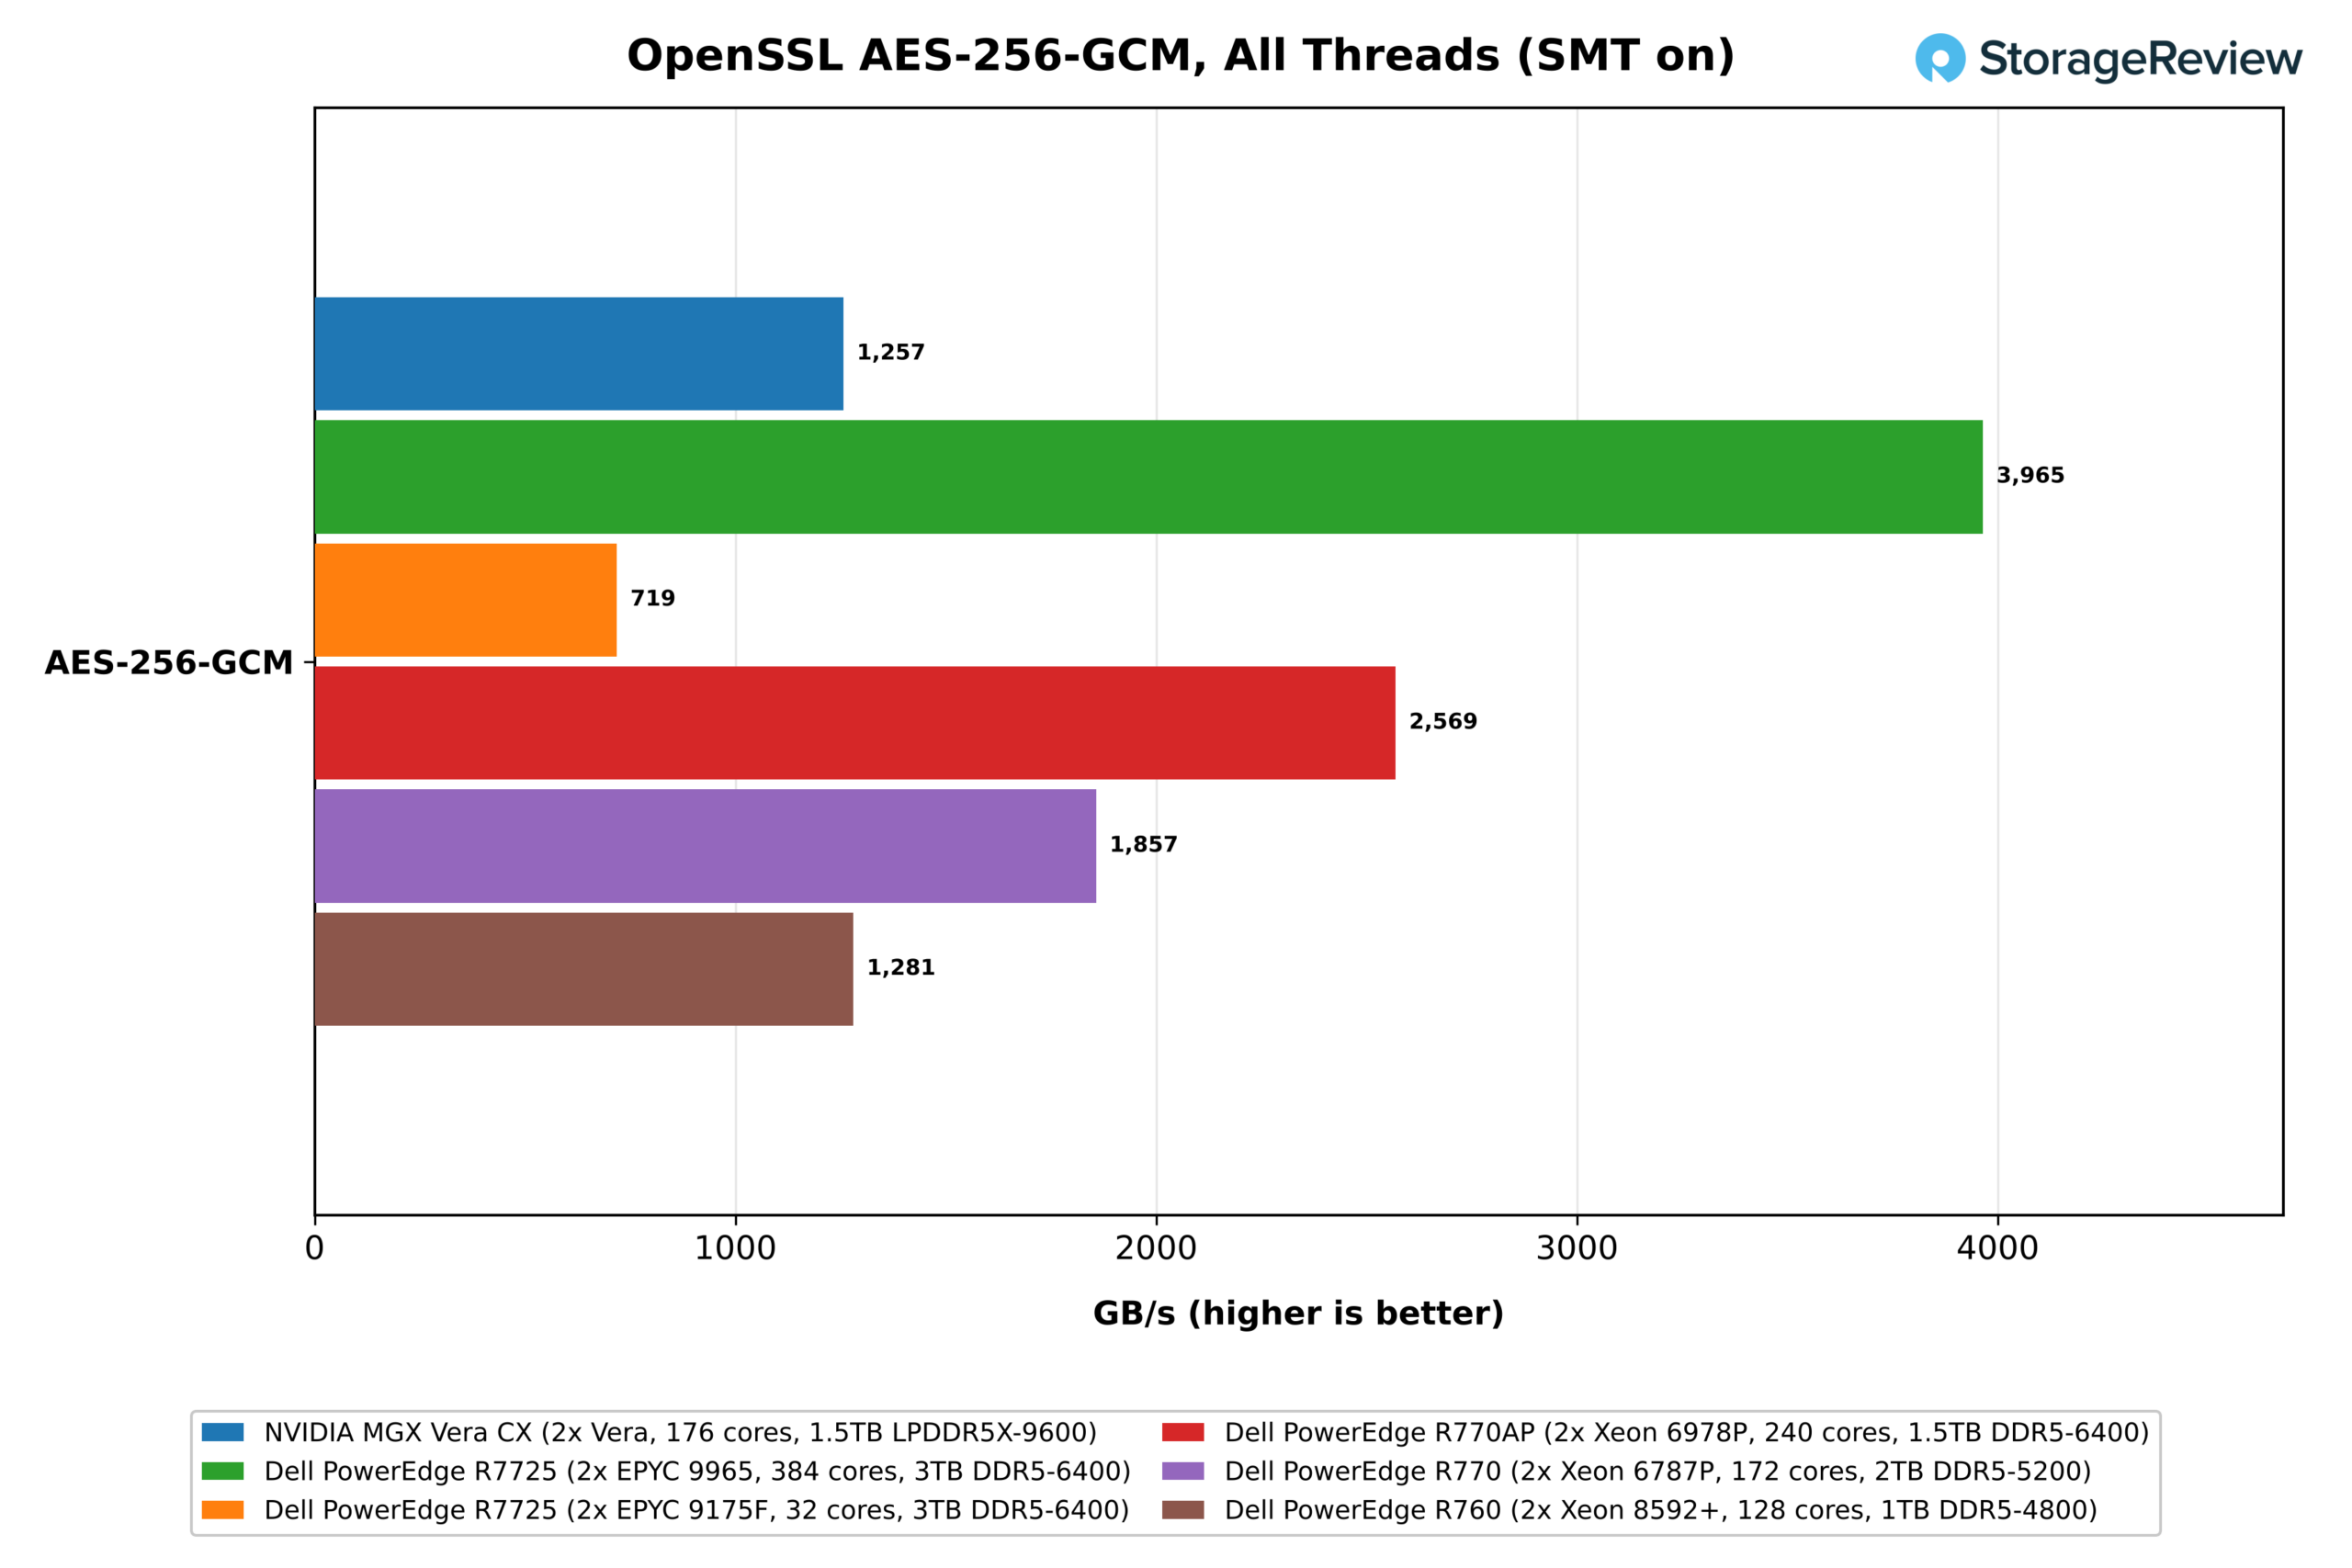
在所有 352 個線程都處於忙碌狀態的情況下,Vera 的讀寫速度達到了 1.26TB/s,與 128 核的 Xeon 8592+ 持平(1.28TB/s),僅領先於 32 核的 EPYC 9175F。 EPYC 9965 以 3.96TB/s 的速度領先,約為 Vera 的三倍,其次是 Xeon 6978P(2.57TB/s)和 6787P(1.86TB/s)。
蟒蛇
Python 是 NVIDIA Vera 所針對的智慧體沙箱的核心,pyperformance 提供了三個針對 Python 的單執行緒測試:go(一個物件密集型遊戲樹搜尋)、regex_compile(編譯正規表示式)和 nbody(一個浮點物理模擬)。這裡有一個軟體差異:Vera 運行的是 Ubuntu 26.04 上的 Python 3.14.4,而 x86 系統運行的是 Ubuntu 24.04 上的 Python 3.12.3,較新的版本帶來了解釋器速度的提升。
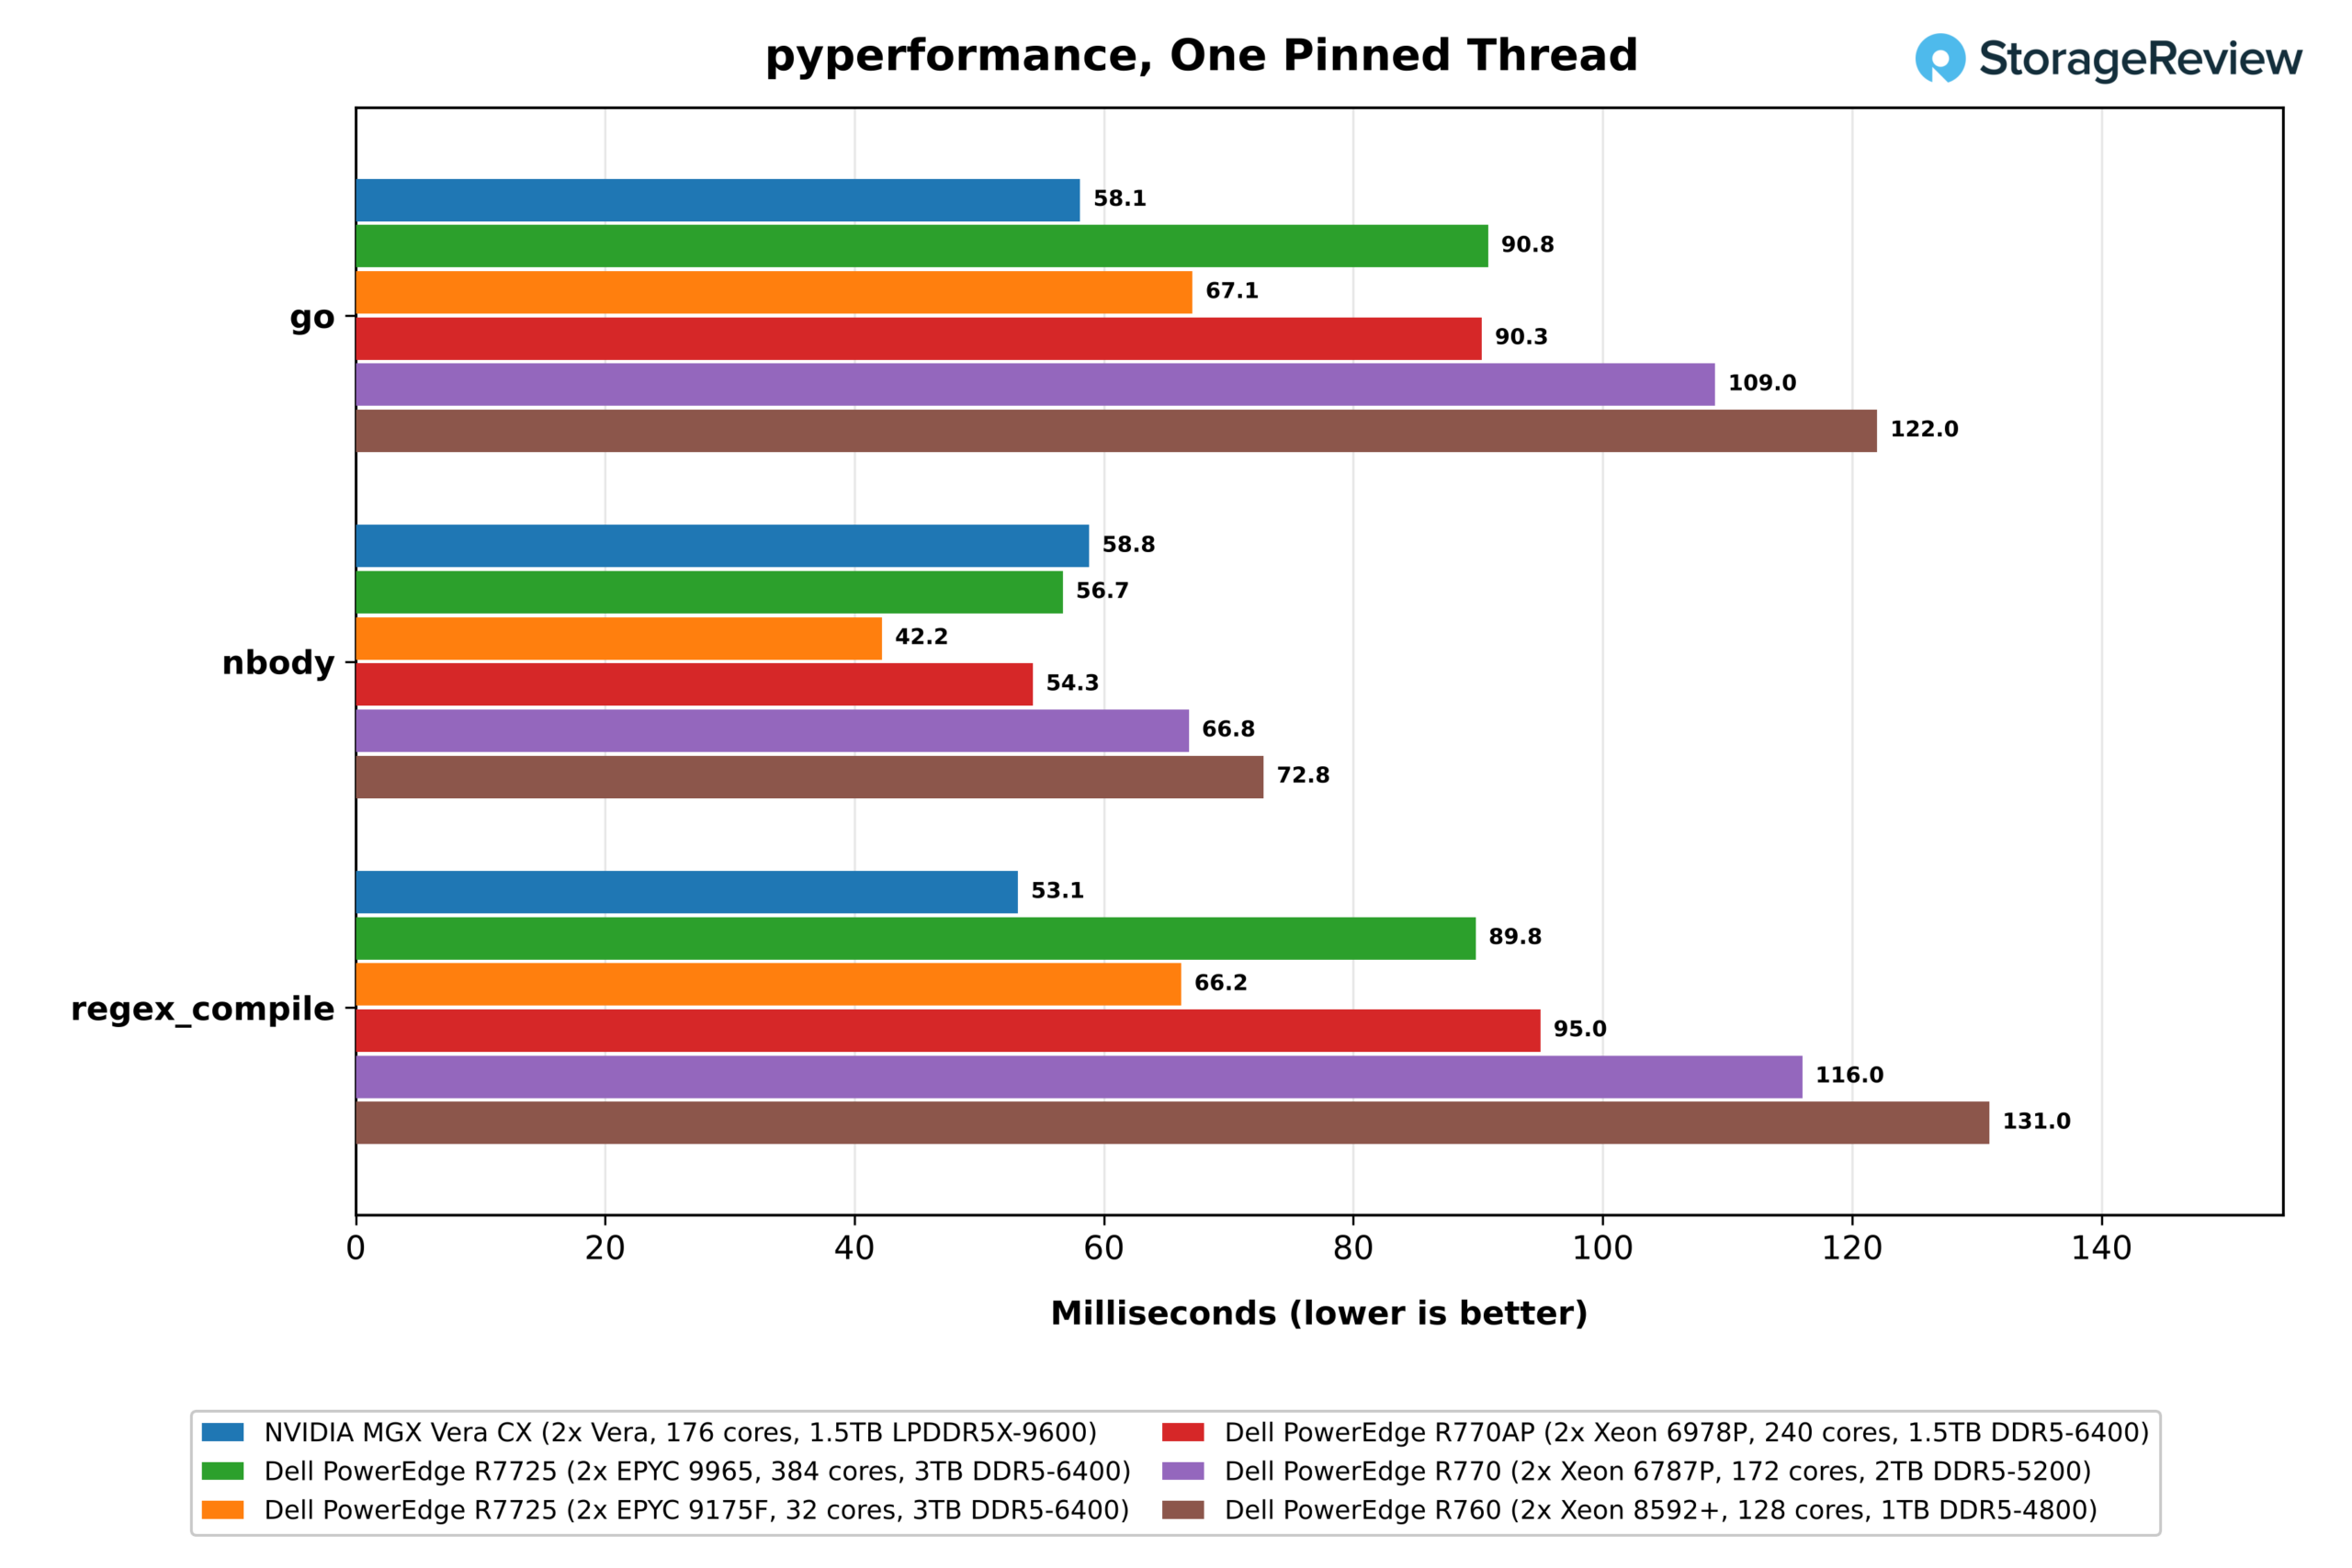
Vera 在兩項基於分支繁多、物件密集程式碼的測試中均勝出。 Go 語言的運行時間為 58.1 毫秒,比本次測試中最快的 x86 核心 EPYC 9175F 快 15%,比其他所有測試處理器快 1.6 到 2.1 倍。 regex_compile 測試的優勢更為明顯,運行時間為 53.1 毫秒,比 9175F 快 25%,比 EPYC 9965 快 1.7 倍。由於 Vera 也使用了較新的 Python 版本,因此請將這兩個優勢視為效能上限。
沒有人採取相反的做法,因為其短浮點循環和小工作集往往有利於高時脈頻率,5.0GHz 的 9175F 以 42.2 毫秒的成績勝出,比 Vera 的 58.8 毫秒快了 39%。即使 Vera 使用了更新的 Python 程序,Xeon 6978P 和 EPYC 9965 的成績也優於 Vera,分別為 54.3 毫秒和 56.7 毫秒。
Web 服務、JVM 和調度器延遲
最後一組測試涵蓋了應用程式周圍的軟體:Web 堆疊、Java 虛擬機器、Linux 調度器和編譯器工具鏈。這些結果不僅取決於每個核心的運行速度,還取決於每個系統運行的執行緒數,因此它們對 Olympus 本身的描述不如前面的章節那麼深入,但它們展示了 Vera 伺服器在日常伺服器軟體環境下的運作情況。
NGINX
NGINX 向運行在同一台機器上的 wrk 負載產生器提供 HTTPS 請求,因此客戶端和伺服器競爭相同的核心,結果更反映了 TLS 和 HTTP 協定棧,而不是原始的核心數。
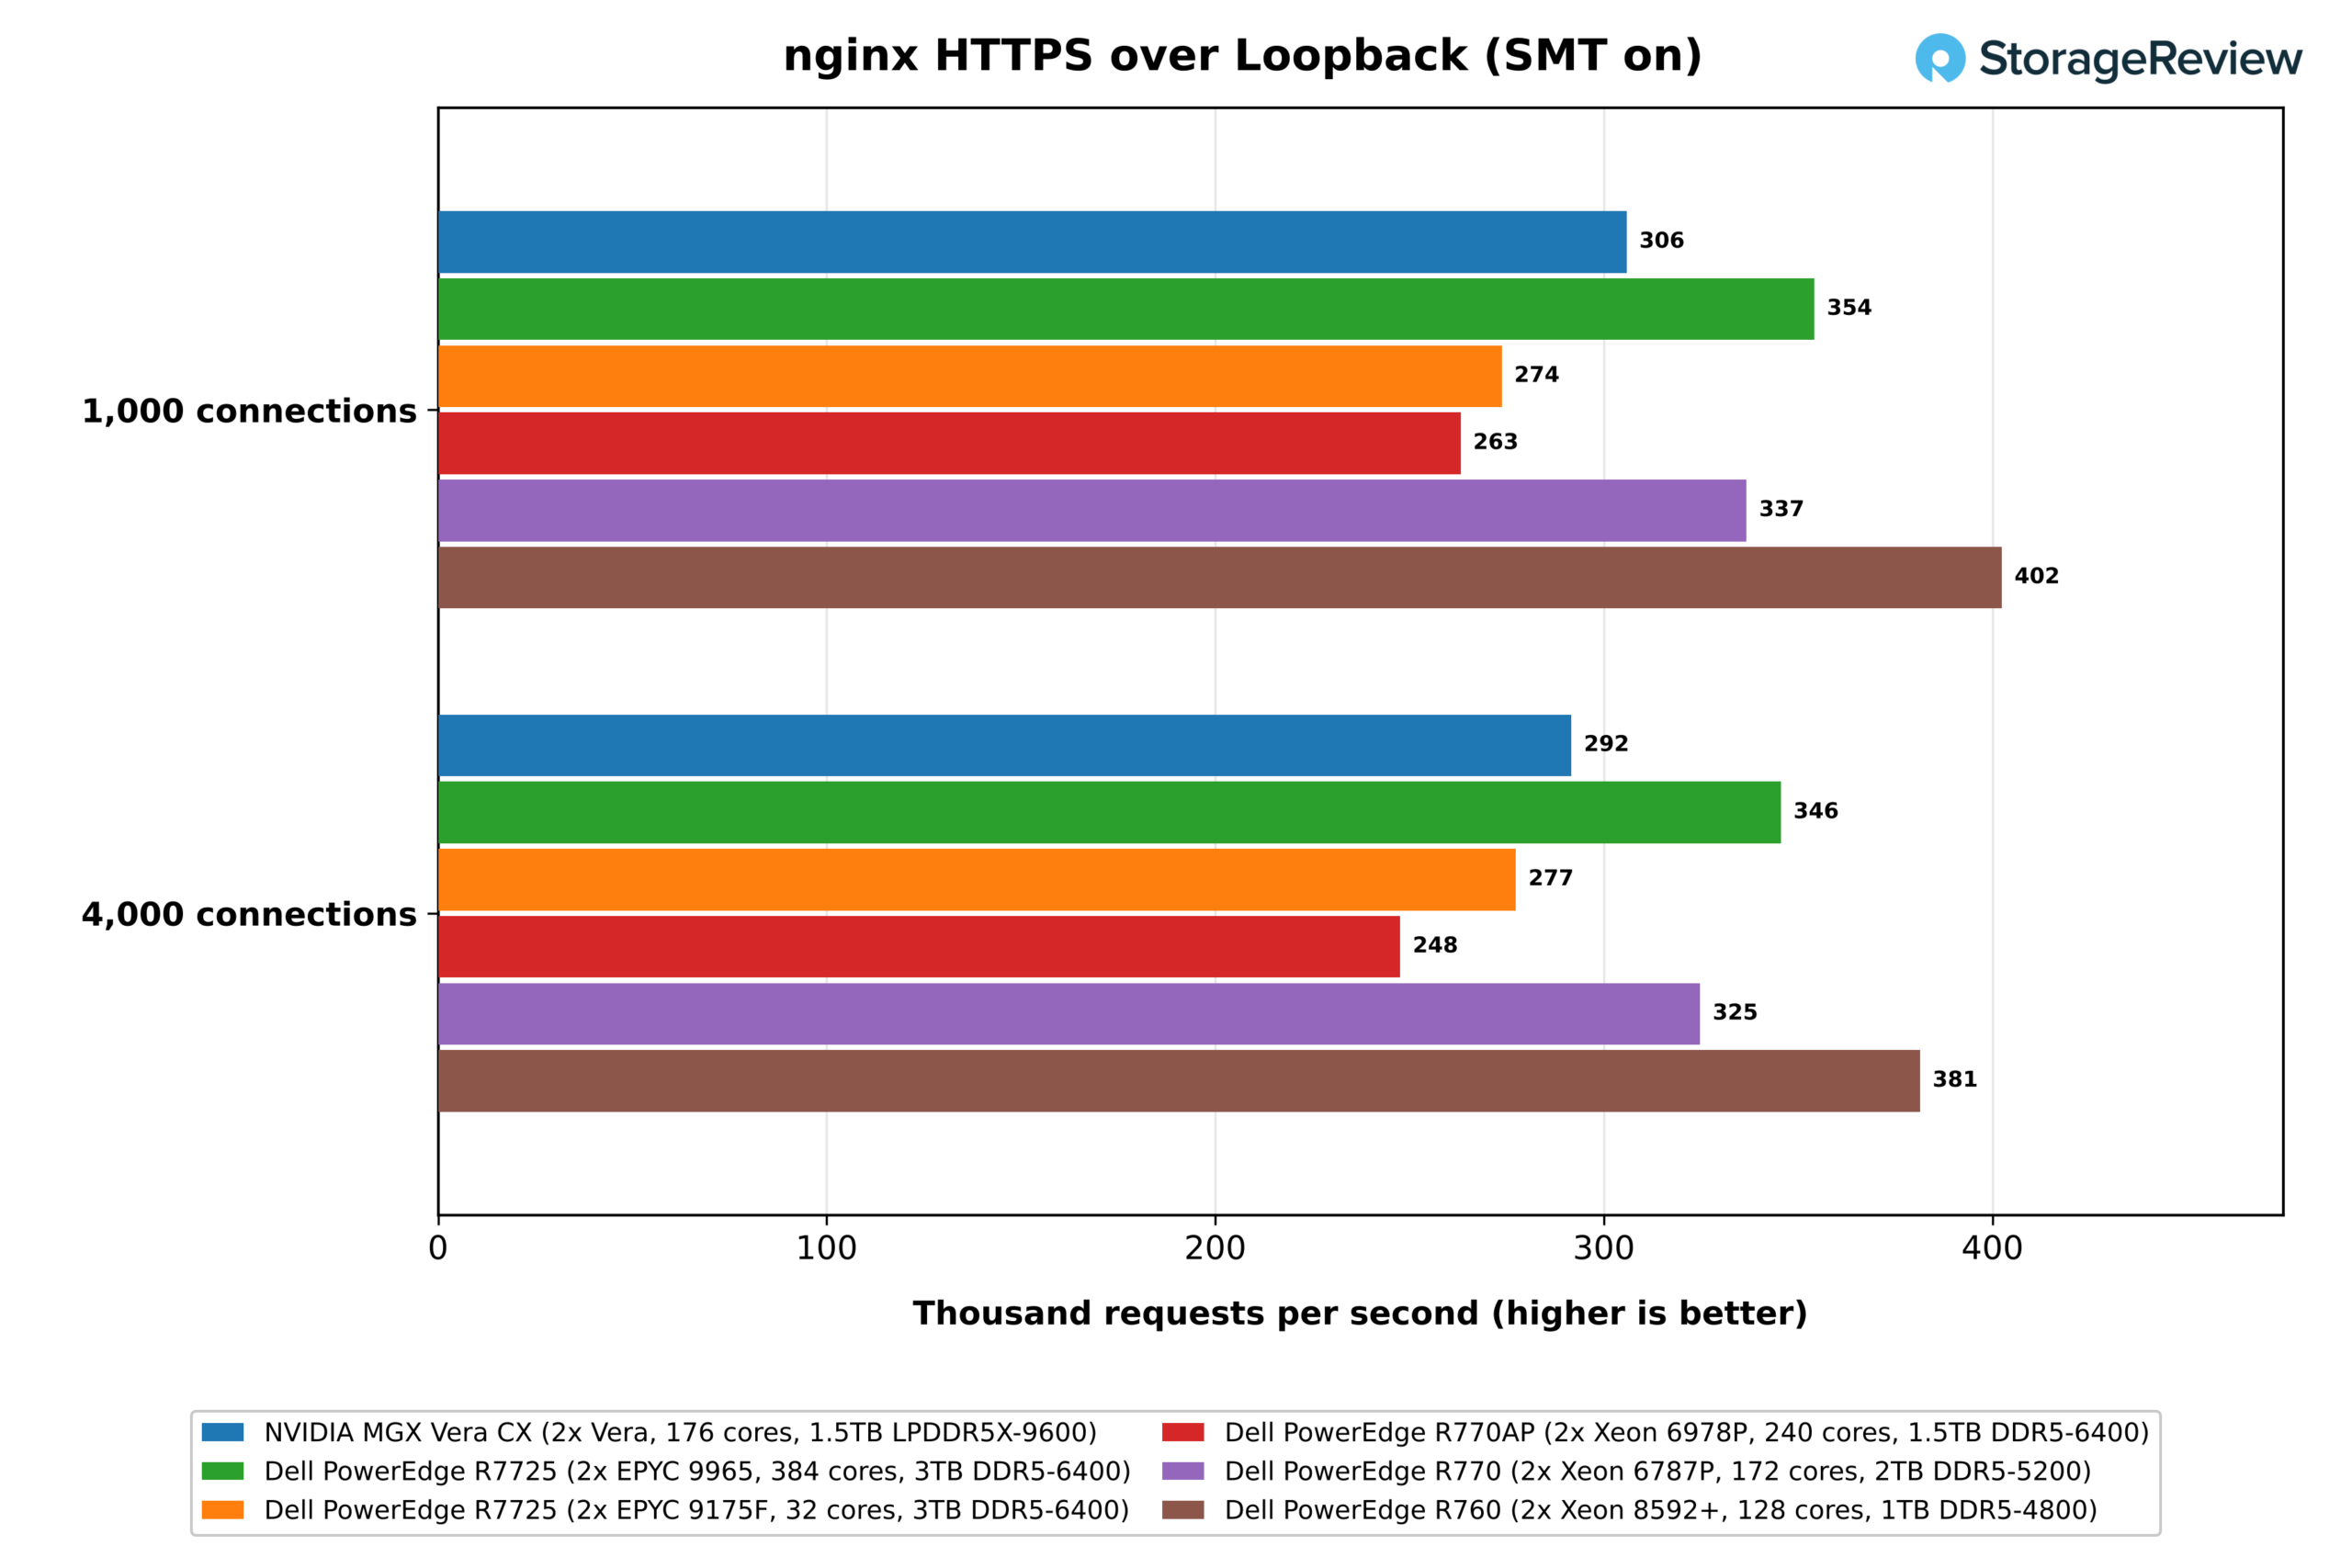
啟用SMT後,Vera在1,000個連線下每秒處理306,000個請求,在4,000個連線下每秒處理292,000個請求,效能處於中等水平,介於Xeon 6978P的263,000到Xeon 8592+的402,000之間。 EPYC 9965達到354,000,Xeon 6787P達到337,000,關閉SMT後,Vera的效能提升至330,000。 Vera的網路協定棧與x86系統相比毫不遜色。
文藝復興
Renaissance 使用 OpenJDK 11 執行 Java 工作負載。其 Finagle HTTP 測試用於測試 Scala 網路協定棧,Akka 測試用於測試 Actor 模型並發框架。這兩個測試都將工作負載分配到 JVM 可識別的每個邏輯 CPU 上,因此我們分別在啟用和停用 SMT 的情況下運行了它們。
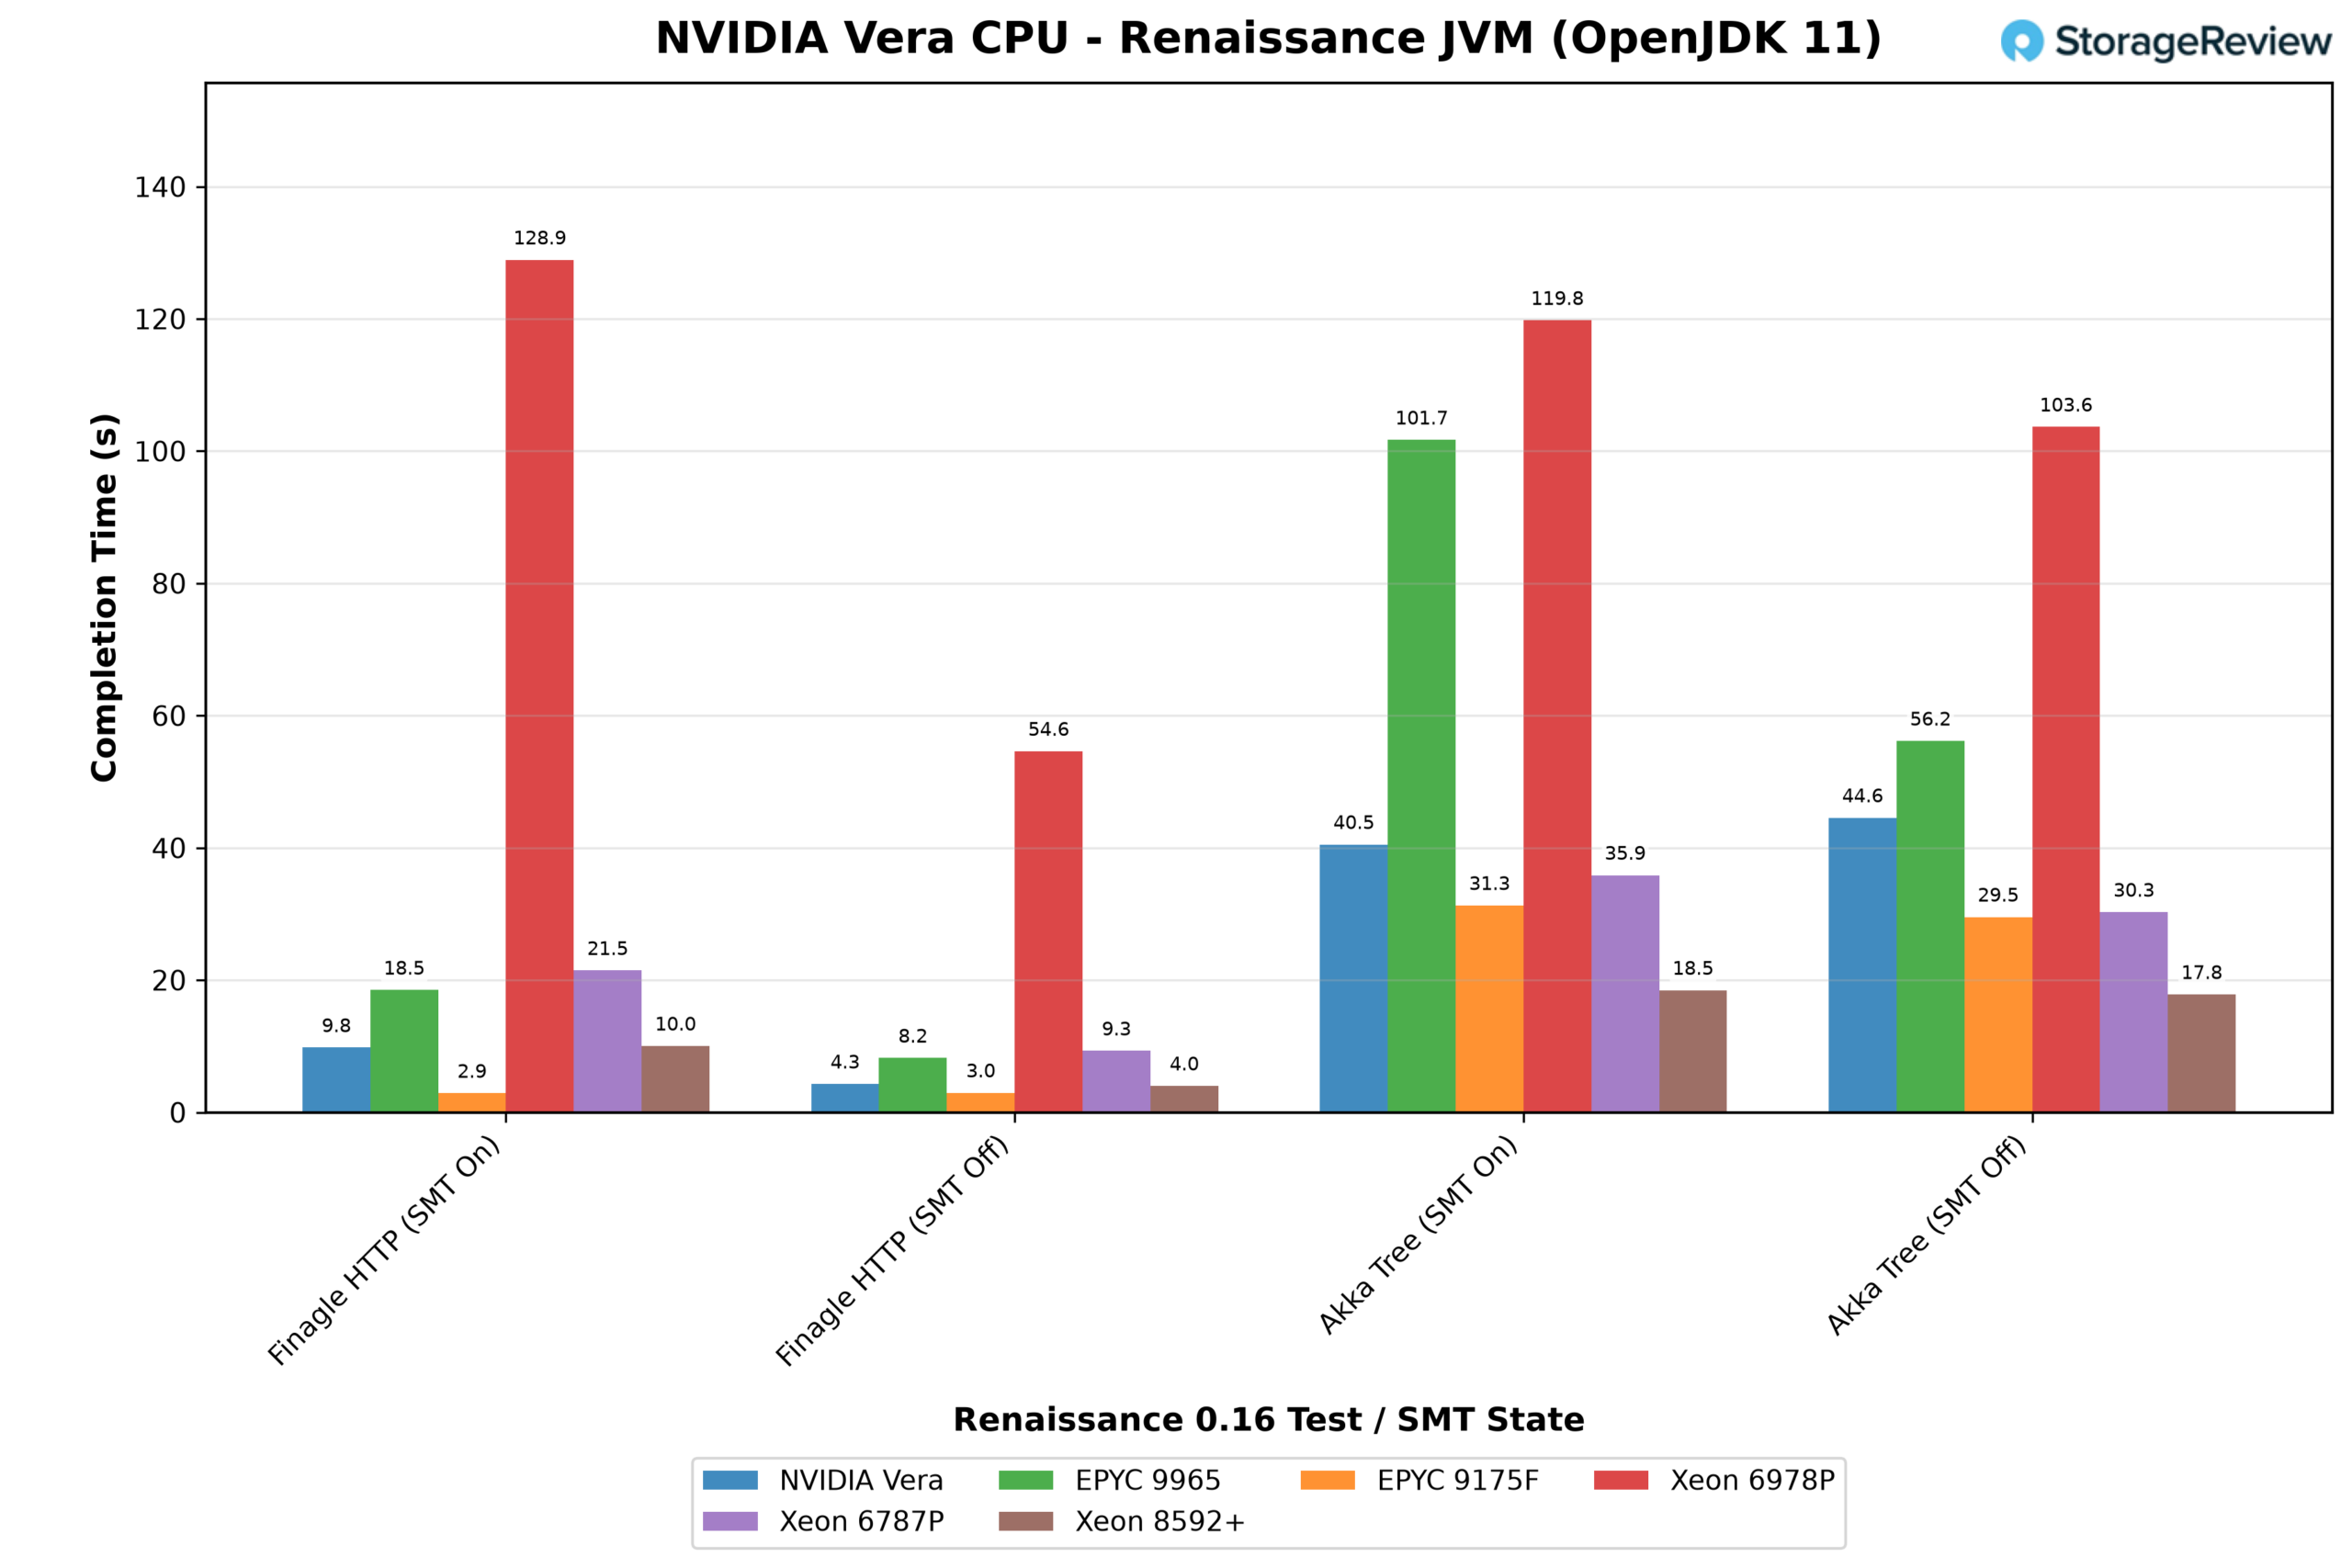
Finagle 演算法在執行緒數較少的情況下運行速度更快。關閉 SMT(同步多執行緒)後,執行緒數減半,Vera 的運行時間從 9.8 秒縮短至 4.3 秒,而配置更高的 x86 系統也獲得了類似的 2.3 倍至 2.5 倍的提升。而原本執行緒數就較少的 32 核心 EPYC 9175F 處理器,無論採用哪種方案,運行時間都約為 3 秒。
Akka 測試中,Xeon 8592+ 表現最佳,無論 SMT 是否開啟,其完成時間約為 18 秒;Vera 在開啟 SMT 的情況下耗時 40.5 秒;而配置最高的兩款系統 EPYC 9965 和 Xeon 6978P 則表現最慢,分別耗時 101.7 秒。在第三項 Renaissance 測試(遺傳演算法)中,除 6978P 外,所有系統在開啟 SMT 的情況下均在 1.6 至 2.6 秒之間完成,Vera 的耗時為 2.6 秒。
施本奇
schbench 測量 Linux 調度器喚醒工作執行緒的速度,在 4 個訊息執行緒的情況下,每個邏輯 CPU 大約運行一個工作執行緒;在 32 個訊息執行緒的情況下,每個 CPU 大約運行八個工作執行緒。由於工作執行緒數量會隨著系統規模的成長而成長,較大的伺服器會執行更多的工作,因此這些結果描述的是每台機器滿載執行時間的延遲,而不是同等條件下的比較。
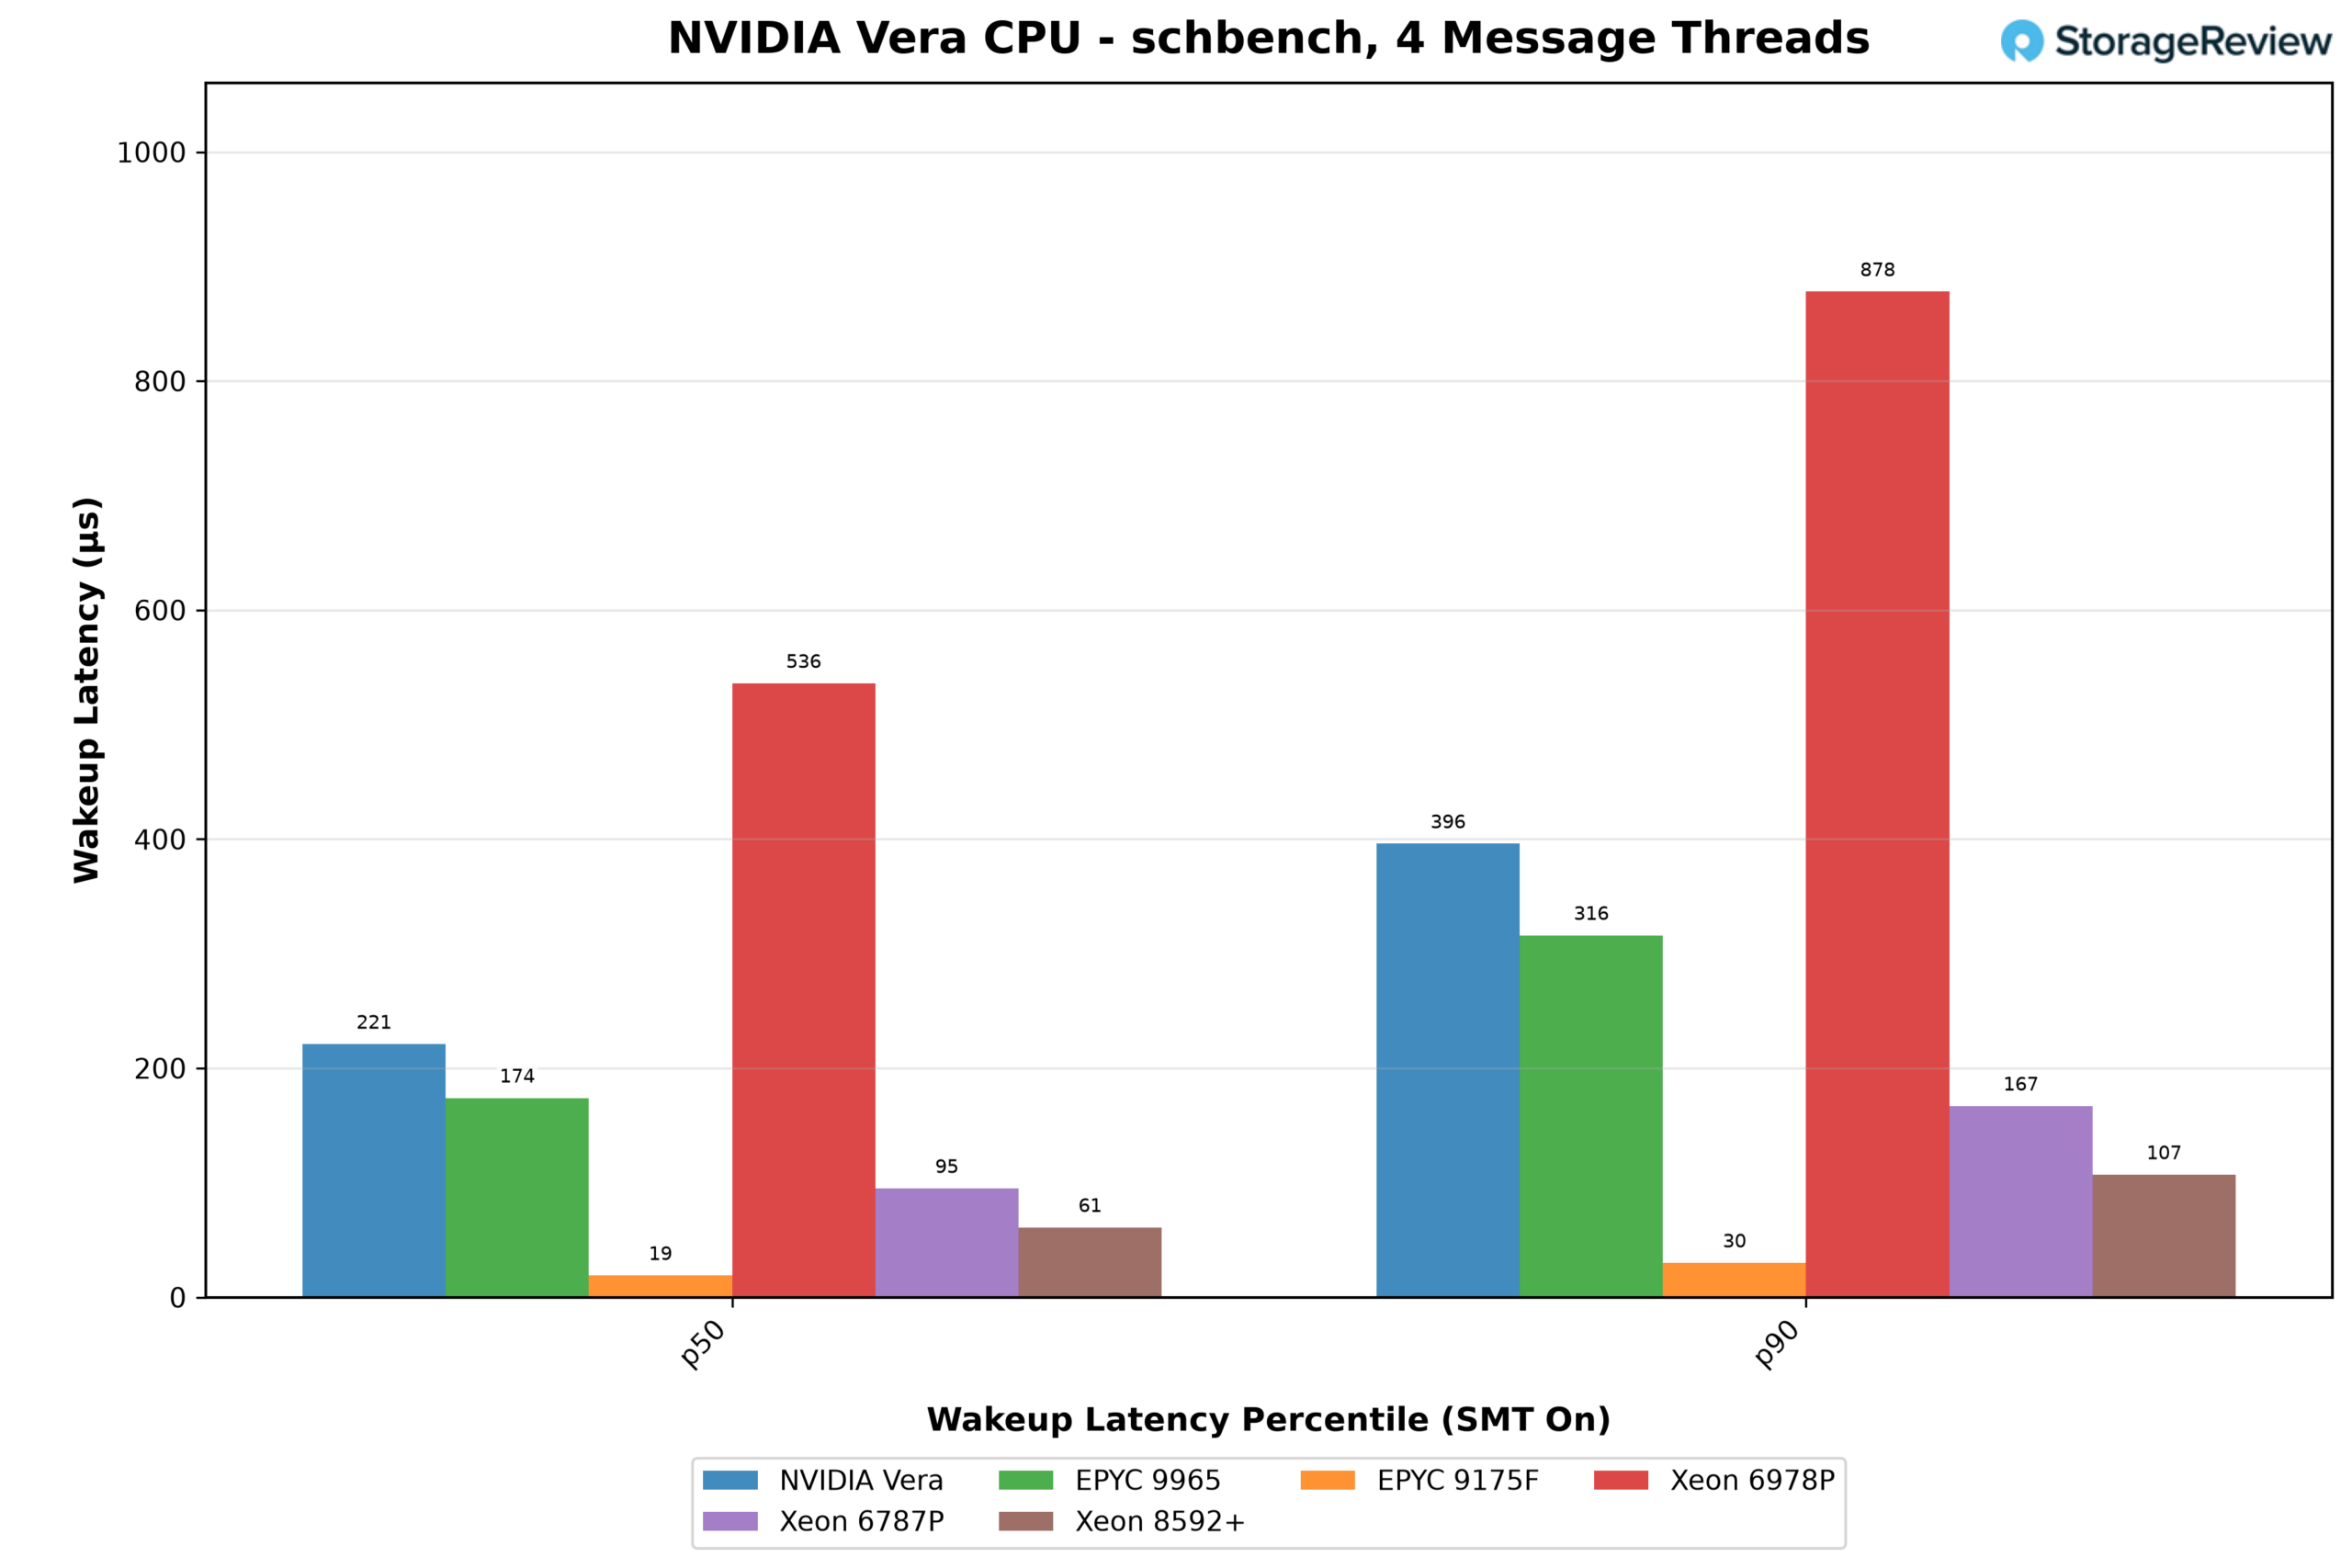
Vera 擁有 4 個訊息線程,其喚醒延遲中位數為 221 微秒,p90 延遲為 396 微秒,高於 Xeon 6978P(536 微秒和 878 微秒)之外的所有系統。最小的機器喚醒執行緒的速度最快,其中 32 核心 EPYC 9175F 為 19 微秒,128 核心 Xeon 8592+ 為 61 微秒。
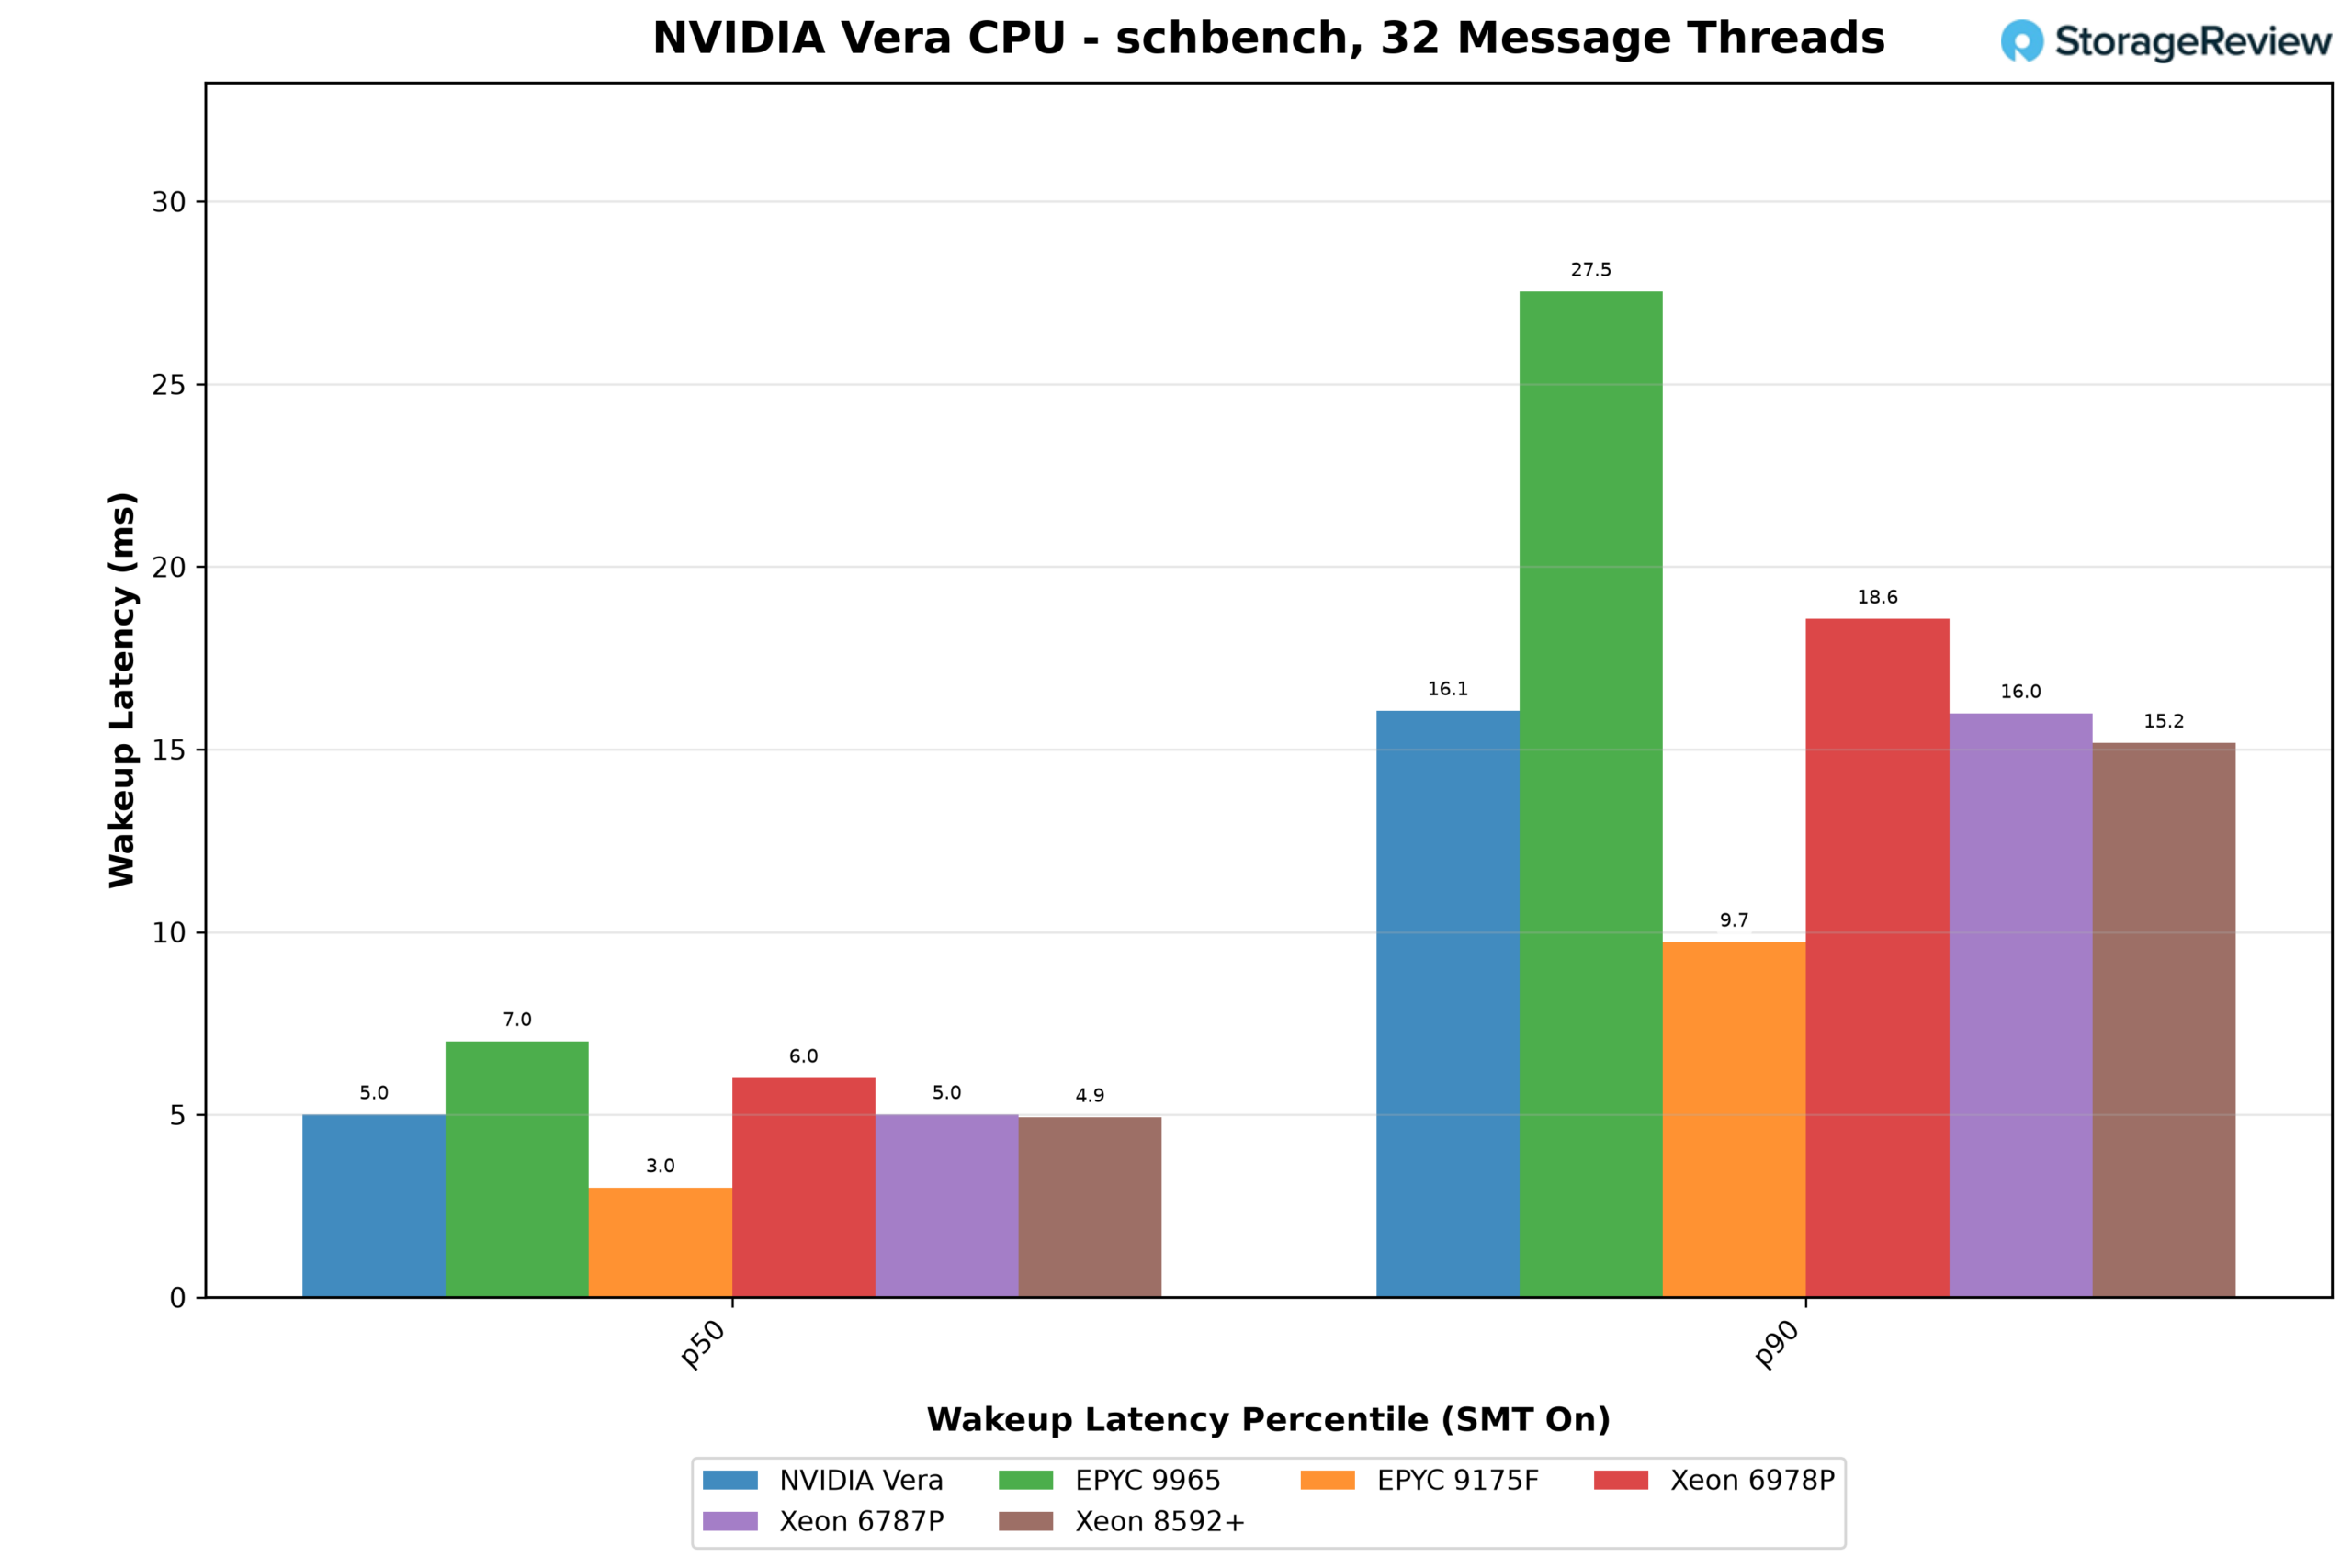
由於線程數過多(32 個線程),Vera 的效能排名下滑至中游。其 5.0 毫秒的中位數反應時間和 16.1 毫秒的 p90 反應時間與 Xeon 6787P 和 8592+ 持平,優於 Xeon 6978P 和 EPYC 9965(p90 反應時間為 27.5 毫秒)。只有 9175F 的速度明顯更快,分別為 3.0 毫秒和 9.7 毫秒。
Linux 核心建構
在本節中,我們沒有對 Linux 核心 allmodconfig 建置結果進行排名。 Vera 編譯的是 arm64 核心樹,其包含的模組和驅動程式與其它系統建構的 x86-64 核心樹不同,因此我們沒有嘗試交叉編譯。
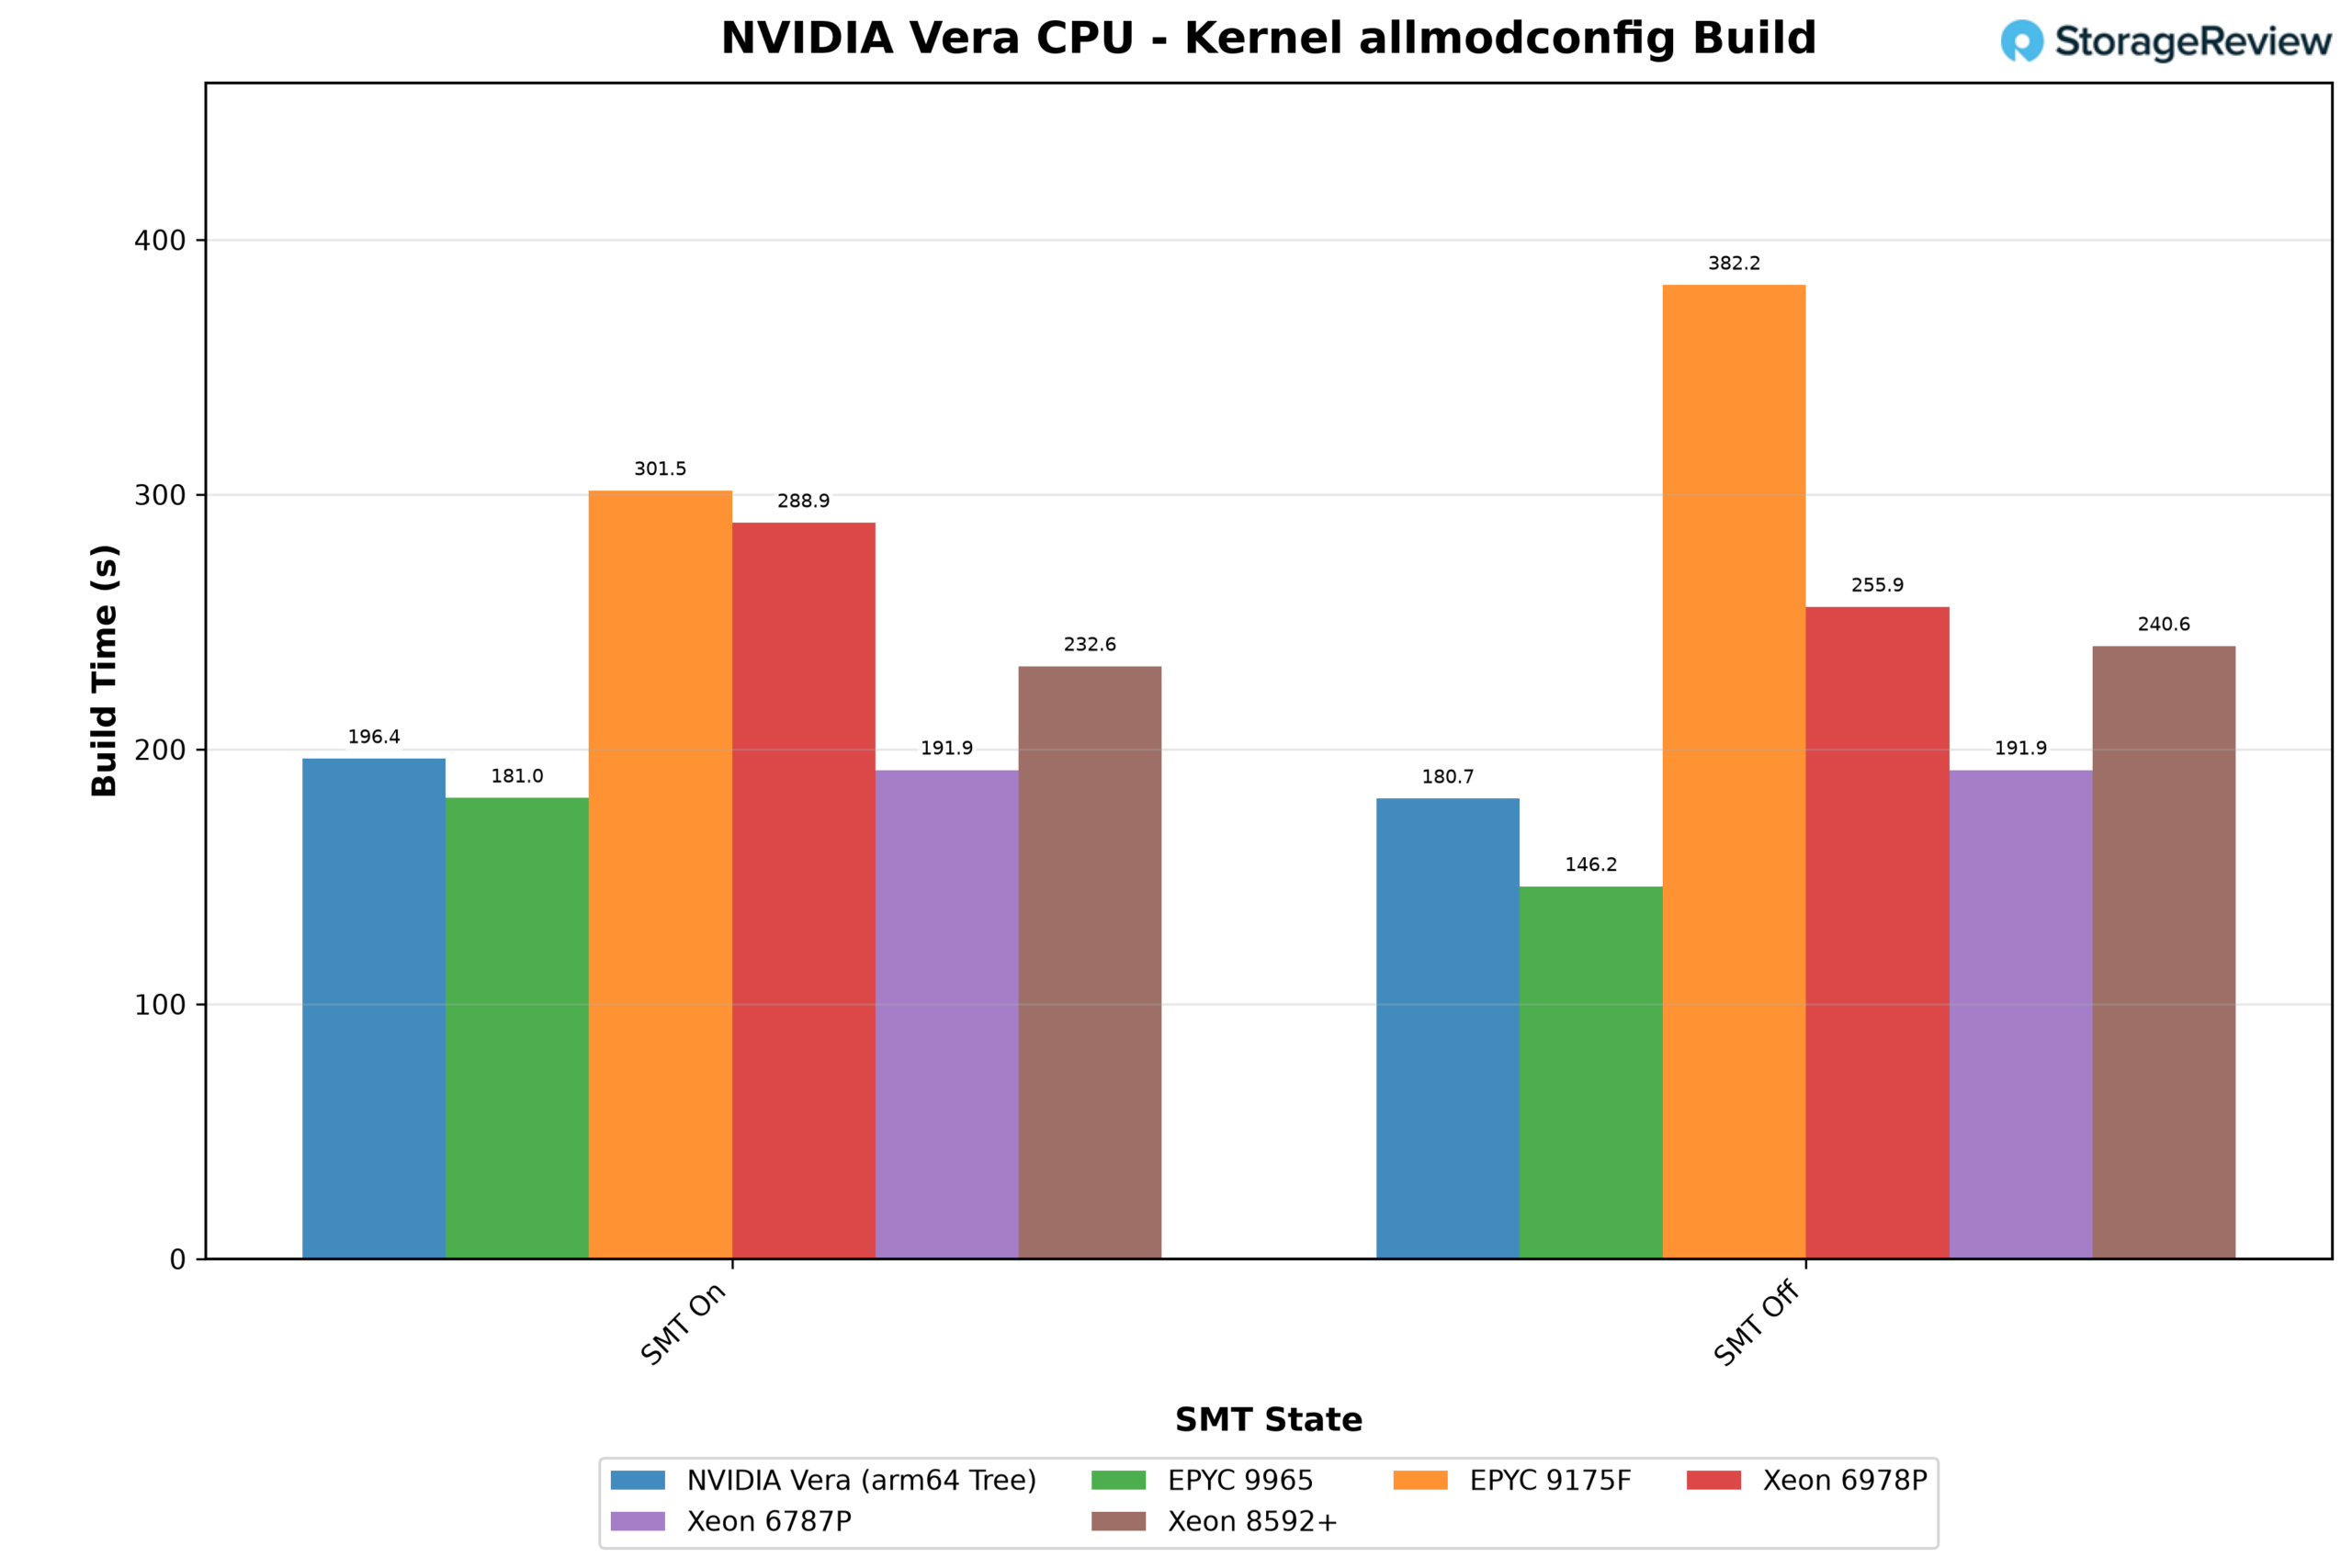
Vera 在關閉 SMT 的情況下建立樹耗時 180.7 秒,開啟 SMT 後耗時 196.4 秒,因此額外的執行緒反而減慢了建置速度。在所有 x86 系統中,建構原生樹所需的時間從 EPYC 9965 關閉 SMT 時的 146.2 秒到 32 核心 EPYC 9175F 的 382.2 秒不等。
錘數據庫
為了進行資料庫測試,我們邀請了 HammerDB 的建立者和維護者 Steve Shaw。 Shaw 在 Vera 伺服器、配備 EPYC 9965 處理器的 Dell PowerEdge R7725 伺服器以及配備 Xeon 6787P 處理器的 PowerEdge R770 伺服器上運行了 HammerDB 的 TPROC-C 工作負載。 TPROC-C 是 OLTP 基準測試,源自 TPC-C,但與已發布的 TPC 結果不具可比性。他在每台伺服器上測試了五種開源資料庫引擎:MariaDB 12.3.3 和 13.0.2、MySQL 26.7.0、VillageSQL 0.0.7 以及 PostgreSQL 18.6。資料庫規模隨核心數量的增加而擴展,每個實體核心最多可運行 16 個資料倉儲,單一 Vera 伺服器插槽最多可運行 1,408 個資料倉儲。
每個引擎分別在單路和雙路插槽上運行,單路運行時第二個插槽的 CPU 會被離線。所有系統在單路運行下的效能都優於雙路運行,這符合資料庫效能的典型特徵。在所有 15 對測試中,增加第二個插槽使峰值吞吐量降低了 23% 到 47%,在 Vera 上降低了 29% 到 45%。 Shaw 長期以來發現,開源資料庫在耗盡核心數之前就會達到擴展極限。超過這個極限後,在兩個插槽上保持快取一致性所需的成本將超過額外核心所帶來的成本。因此,我們將重點放在單路運行的結果,如下圖所示。
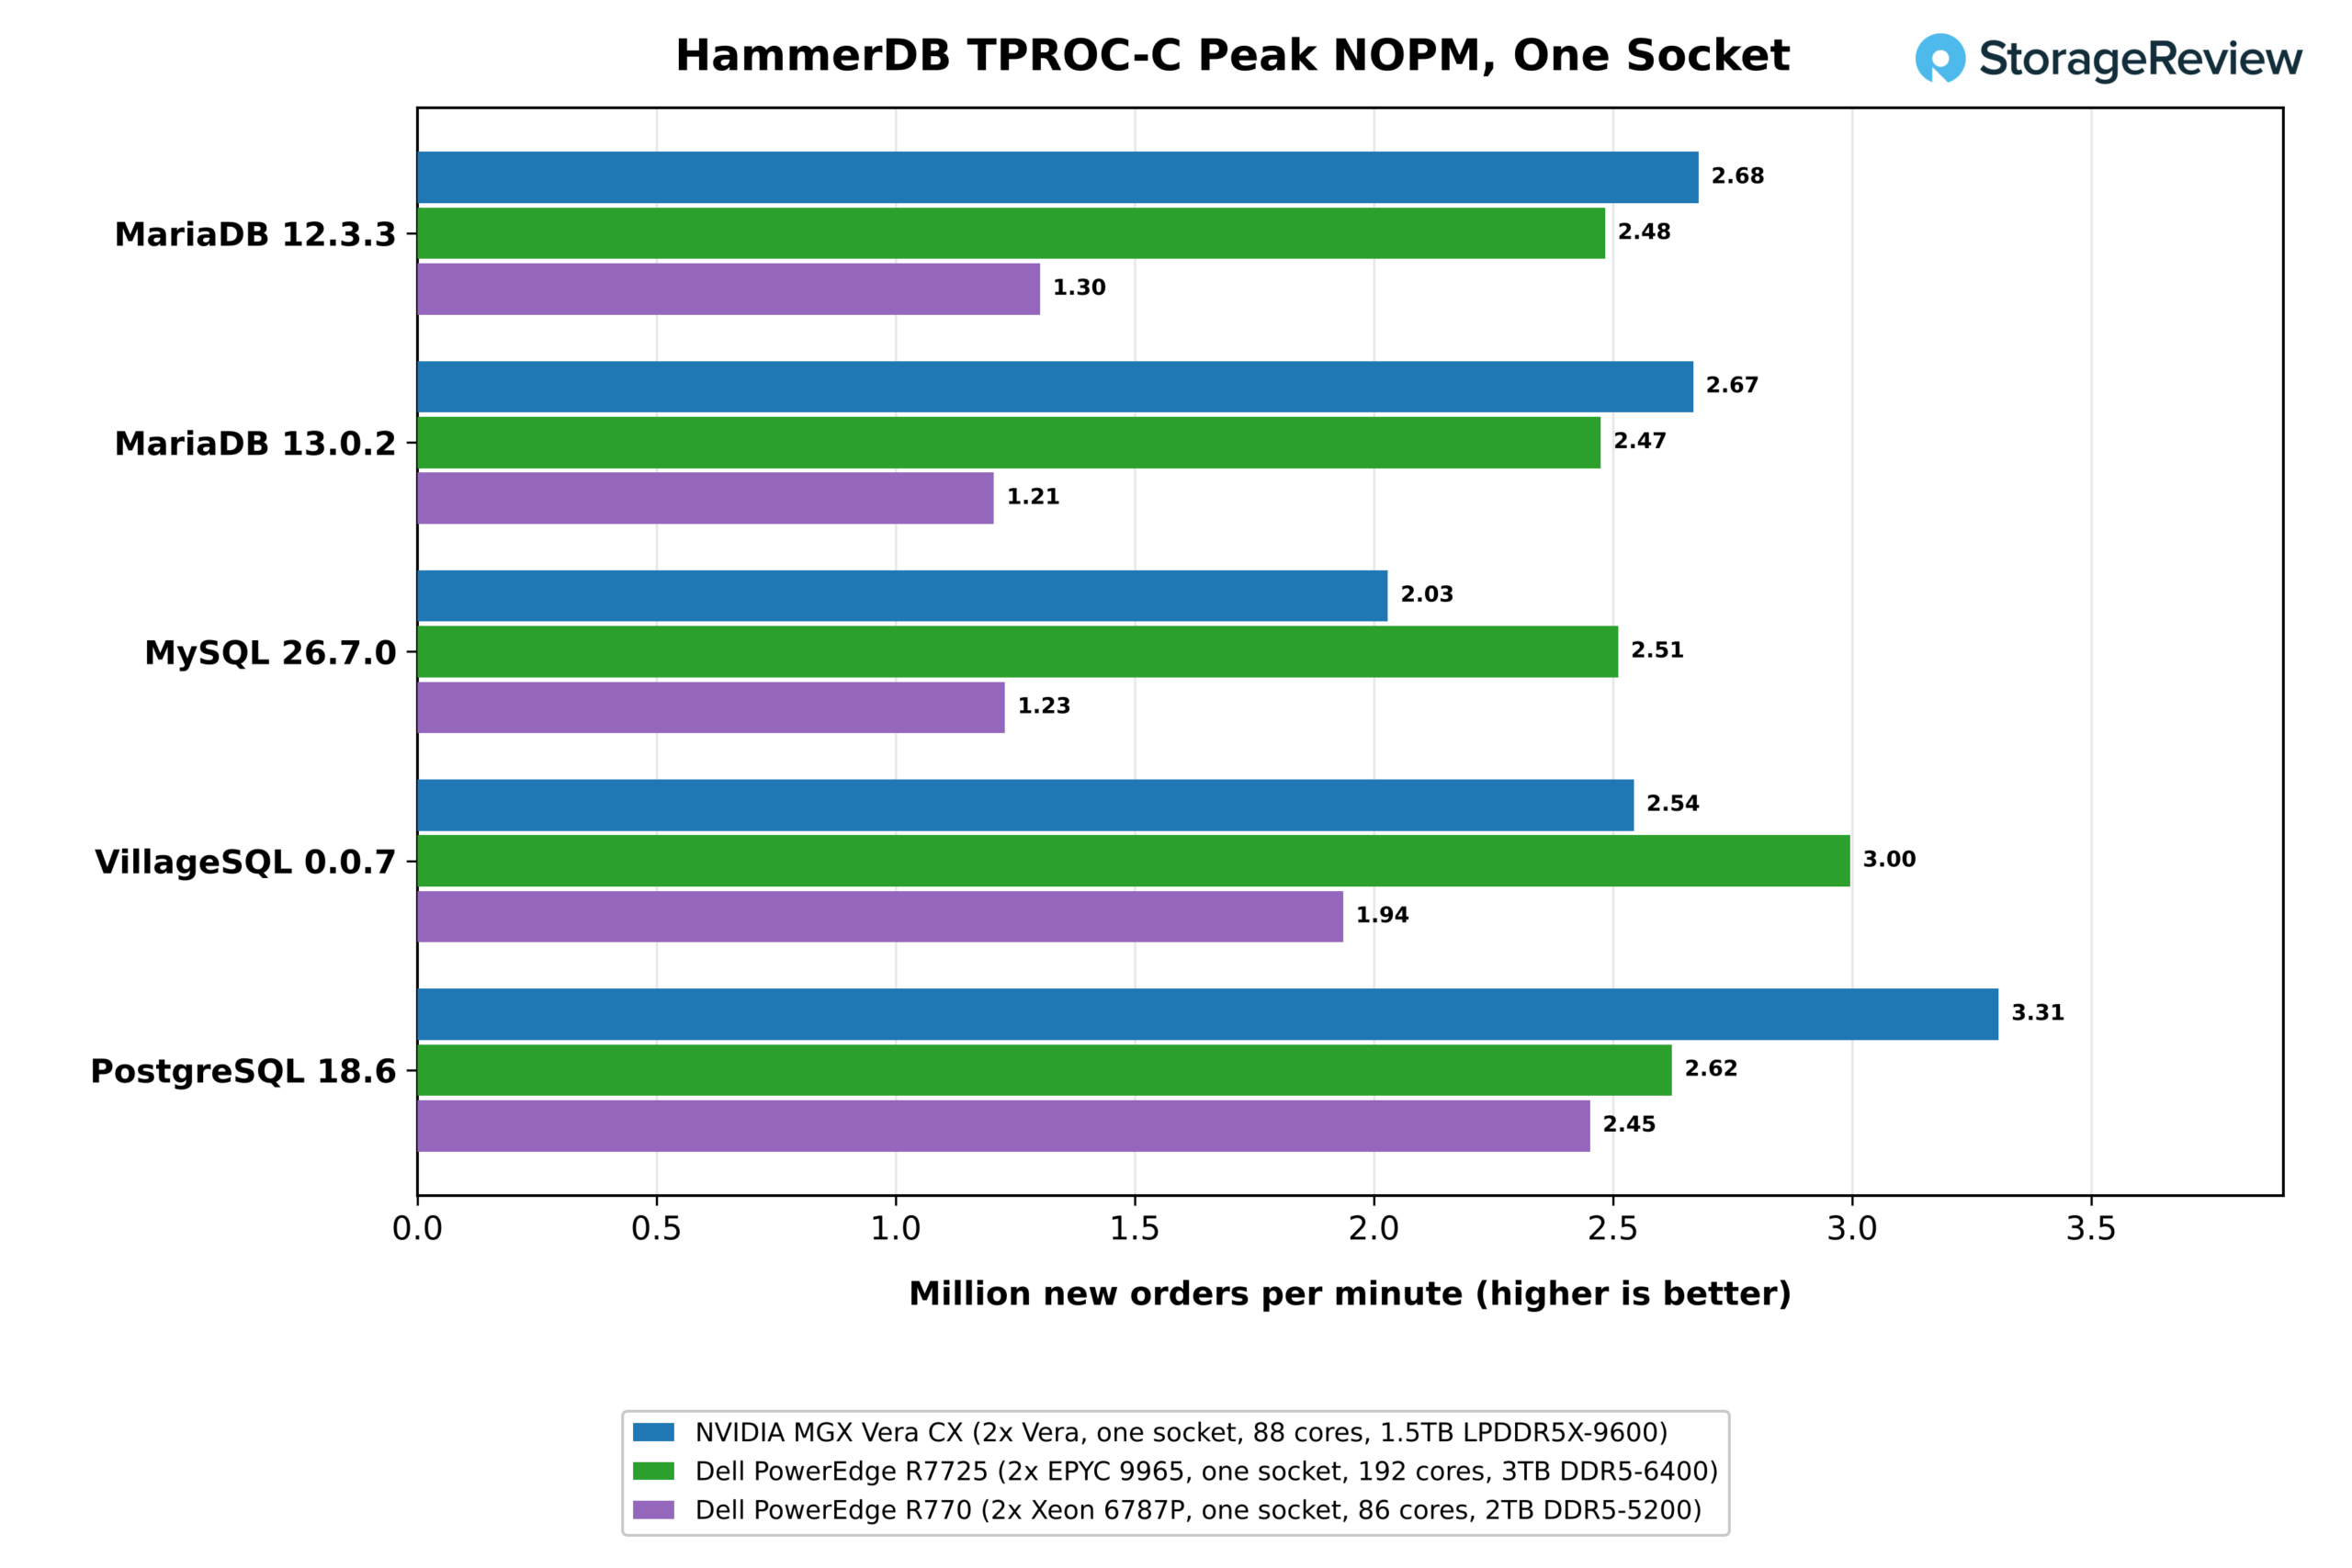
在單一插槽上,88 核心 Vera 在五個引擎中的三個上都領先。 PostgreSQL 18.6 為 Vera 帶來了最大的優勢,在 128 個虛擬用戶下,每分鐘新訂單數 (NOPM) 達到 3.31 萬,而 192 核 EPYC 9965 插槽和 86 核 Xeon 6787P 的成績分別為 2.62 萬和 2.45 萬。 MariaDB 的兩個版本也都領先 Vera,分別為 2.68 萬和 2.67 萬,而 EPYC 的成績分別為 2.48 萬和 2.47 萬。 AMD 在 MySQL 26.7.0 上保持領先,成績為 2.51 萬,而 Vera 為 2.03 萬;在 VillageSQL 上,成績為 3.00 萬,而 Vera 為 2.54 萬。 Xeon 在所有五個引擎上都落後於 Vera,成績為 2.45 萬,比 Vera 低 1.21 萬,其 MariaDB 的成績不到 Vera 的一半。
這種差異很可能與各引擎的擴展性有關。 PostgreSQL 的進程/連接模型和 MariaDB 的 InnoDB 都將工作負載分散到多個核心上,並處理大量的共享記憶體流量,這充分發揮了 Vera 處理器在 STREAM 測試中每個插槽超過 1TB/s 的本地頻寬優勢。 MySQL 和 VillageSQL 則更早遇到內部鎖定爭用,因此它們的測試結果更取決於每個核心清除臨界區的速度,而這正是 9965 的優勢所在。在 10 月的測試之後,Shaw 認為 Arm 是整體速度最快的平台,並表示 Arm“無疑已經成為具有競爭力的數據庫伺服器”,但他補充說,他之前測試過的一款單路 96 核 EPYC 處理器可能略勝一籌。
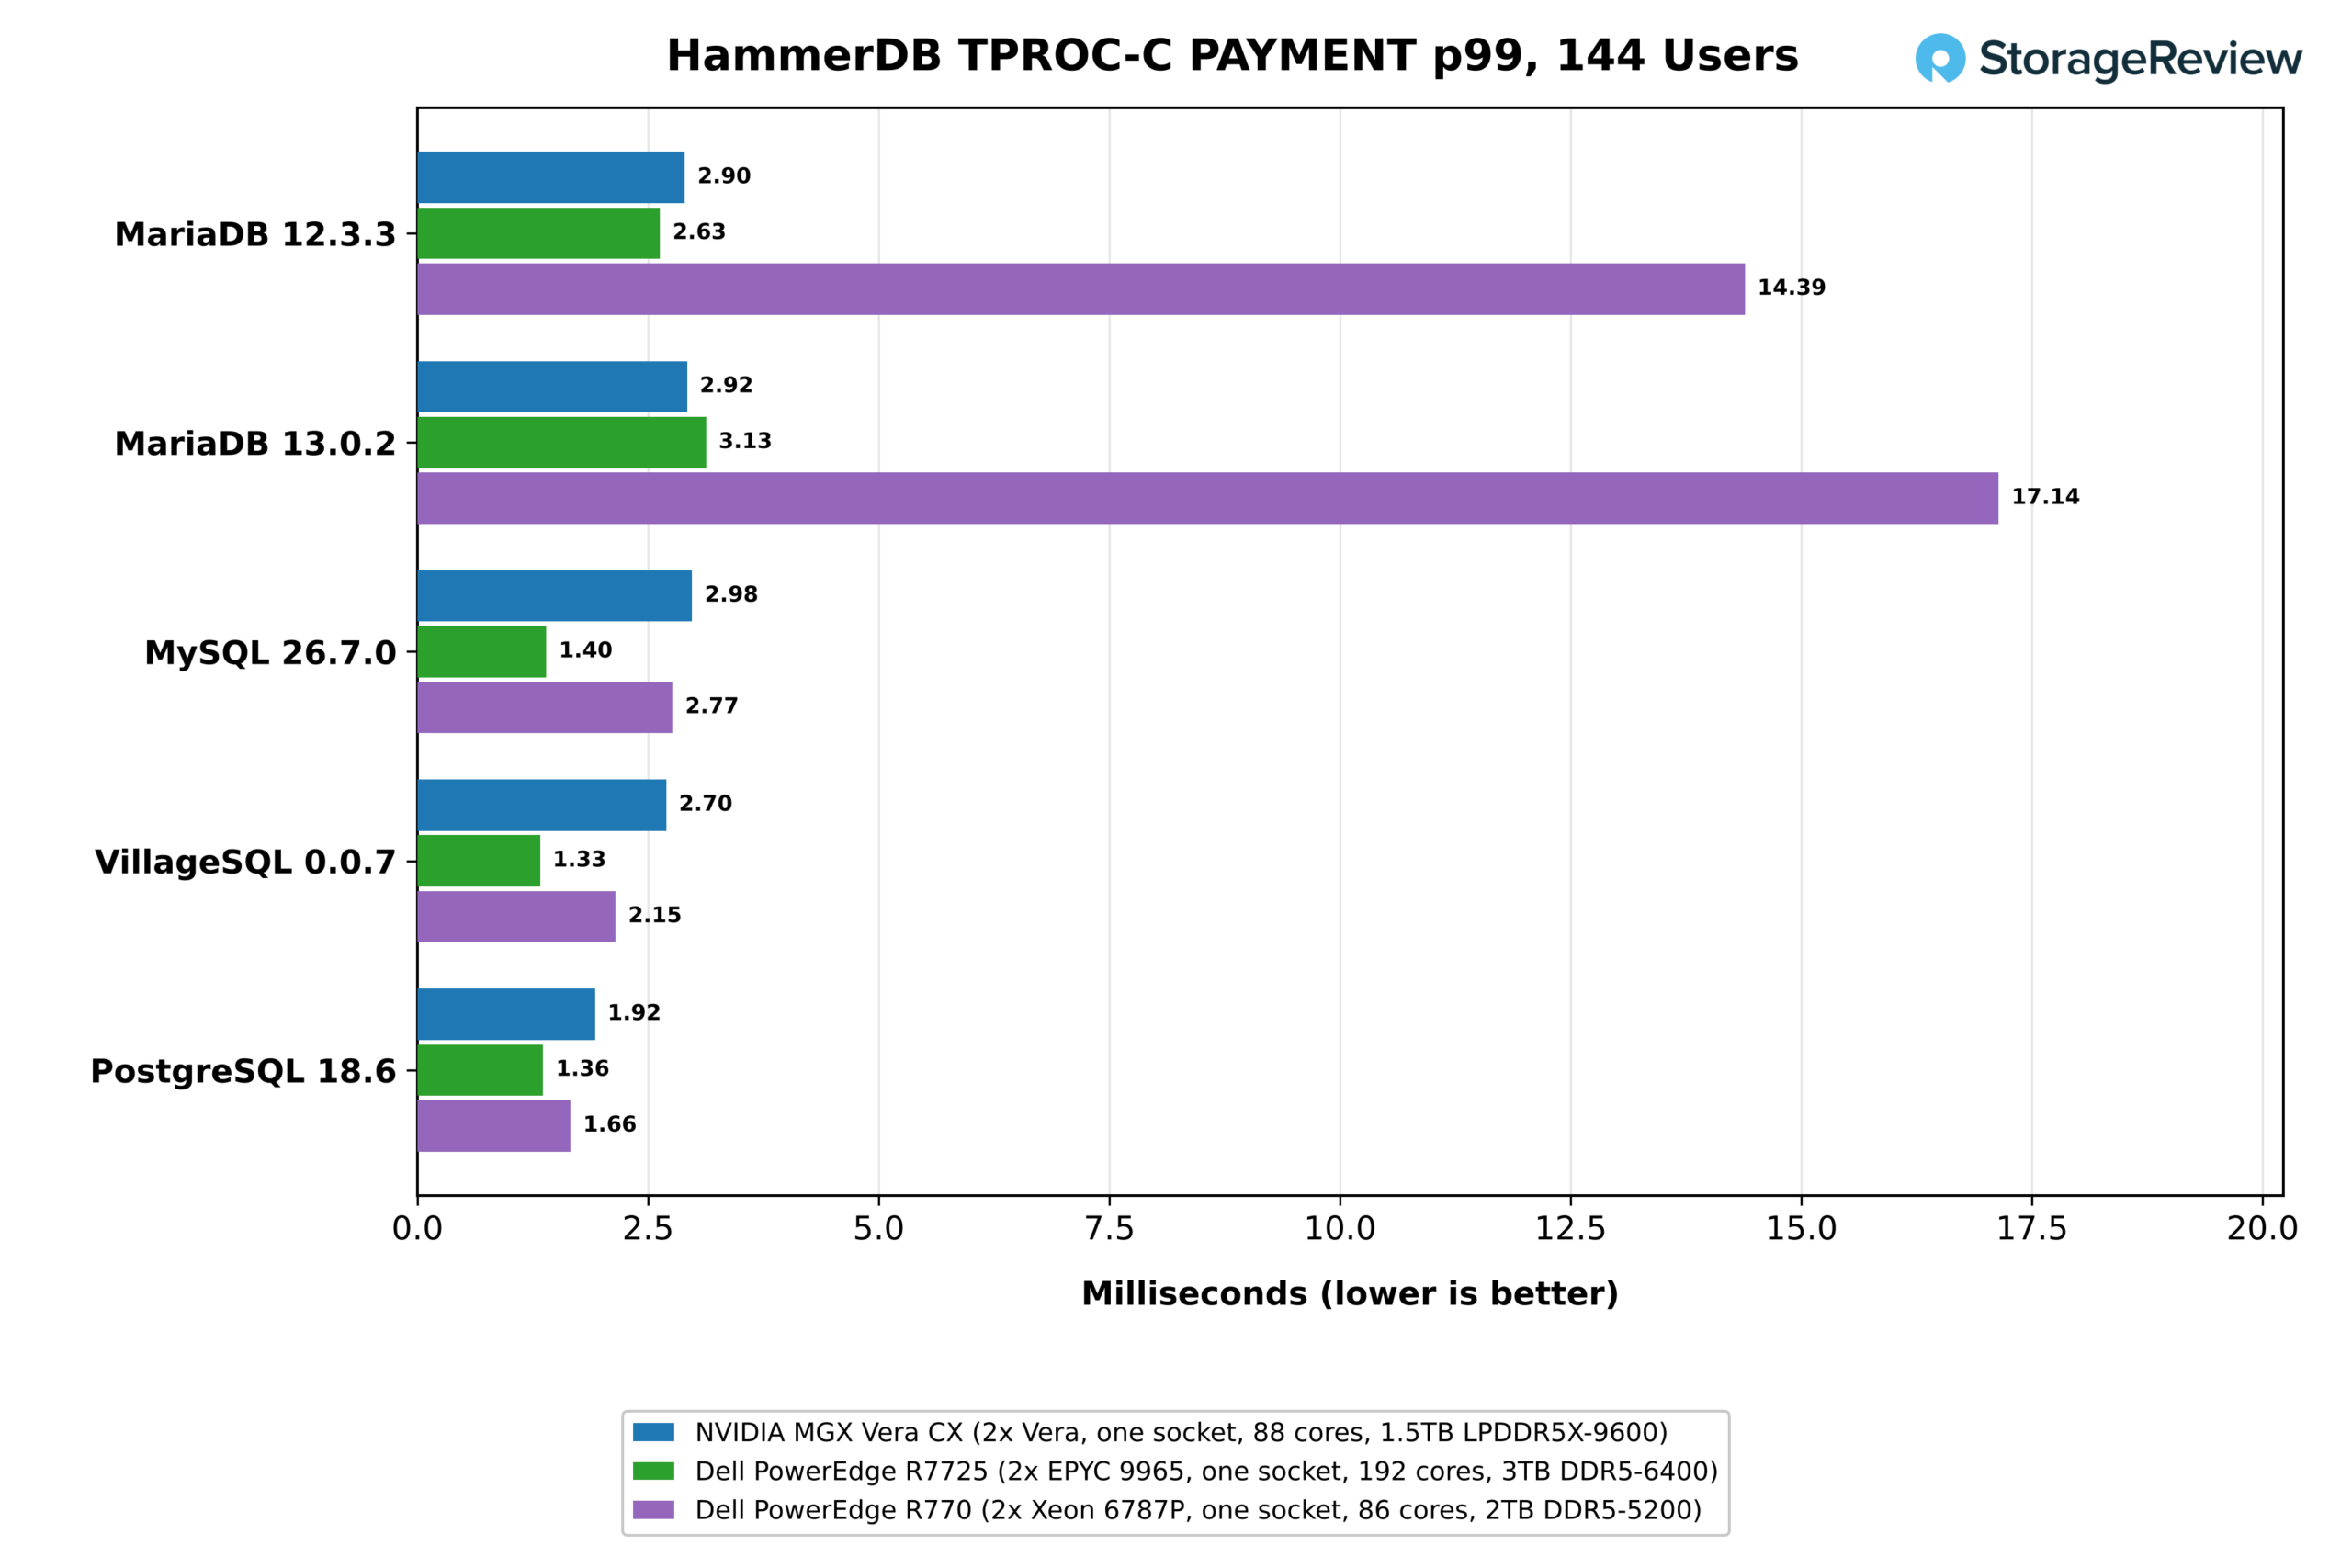
在 144 個虛擬使用者的相同負載下,尾延遲也呈現相同的分佈。 Vera 的 PAYMENT p99 延遲在 PostgreSQL 上為 1.92 毫秒,在 MySQL 上為 2.98 毫秒。 EPYC 9965 在 MySQL、VillageSQL 和 PostgreSQL 上的延遲在 1.33 毫秒到 1.40 毫秒之間,比 Vera 低 29% 到 53%,但在 MariaDB 13.0.2 上的延遲為 3.13 毫秒,低於 Vera 的 2.92 毫秒。 Xeon 6787P 的 MariaDB 尾延遲分別為 14.4 毫秒和 17.1 毫秒,比兩者高出數倍,這與其在相同負載下較低的吞吐量相符。引擎內部的鎖交接可能是導致 Vera 尾延遲較高的原因,這與 Valkey 的結果相呼應,在 Valkey 的測試中,一次發送一個請求也有利於 AMD。
11 月的測試驗證了 Shaw 的預判。他分別在 AMD 新款 256 核心 EPYC 9996 和 96 核心 EPYC 9686F 處理器的單路插槽上運行相同的工作負載,Vera 的插槽也參與了對比。 9996 和 Vera 互換了資料庫引擎,Vera 繼續運行 PostgreSQL 和 MariaDB,而 EPYC 在尾延遲方面領先,96 核處理器在 PostgreSQL 上略勝 Vera 一籌。完整測試結果請參閱我們的AMD EPYC Venice 評測。
「開源資料庫在 NVIDIA Vera 上的表現確實讓我印象深刻。很高興看到 Arm 能夠在資料庫效能的高端領域佔據一席之地,並為企業市場帶來極具吸引力的替代方案,」HammerDB 的創建者和維護者 Steve Shaw 在融資結束後表示。
結語
Vera並非在所有類別中都是最快的處理器,因為AMD針對市場的不同需求分別推出了專用產品。頻率優化的EPYC 9175F專為單核心速度而設計,即使在對時脈頻率要求較高的工作負載下也能勝任,例如Python的nbody演算法、單執行緒AES以及一次只能處理一個Valkey請求的任務。 EPYC 9965則專注於吞吐量,在那些與核心數量成正比的任務中表現出色,包括GROMACS、全線程7-Zip和AES,以及單一插槽可容納的Valkey分片數量。
Vera 的獨特之處在於其均衡性,以及它在各個領域與專業處理器之間的出色表現。在單執行緒測試中,Vera 在整數運算和三個 Python 測試中的兩個上與 9175F 效能持平甚至更優,在 7-Zip 壓縮速度上提升了 12%,運行 go 和 regex_compile 的速度分別提升了 15% 和 25%,但在浮點運算和加密方面略遜一算。
在整個系統範圍內,Vera 的全線程 7-Zip 速度達到了 9965 的 63% 到 72%,在中等大小的 OpenFOAM 網格測試中,其速度與 9965 的差距僅為 12%。在記憶體接管後,Vera 在大型網格測試和 ClickBench 測試中都超越了 9965。 Vera 能夠在單線程測試中保持如此接近單核領先水平,並在全系統吞吐量測試中保持領先水平,這正是它成為如此強大的通用處理器的原因。對於那些希望在不犧牲太多性能的高端或低端市場需求的中階平台用戶來說,Vera 是一個極具吸引力的選擇。
Vera 的記憶體頻寬遠超過我們測試過的任何 x86 系統。在 STREAM Triad 測試中,兩個 Vera 插槽的記憶體頻寬穩定在 2,073GB/s,是本次測試中效能最佳的 DDR5 伺服器的 2.3 倍。此外,NVLink-C2C 技術還能確保跨插槽的內存頻寬保持穩定:Vera 的核心可以以 677GB/s 的速度讀取另一個插槽的內存,比任何 x86 插槽讀取本地內存的速度都高。
記憶體密集工作負載測試結果如下:大型 OpenFOAM 網格的求解速度比 EPYC 9965 快 1.44 倍;ClickBench 熱測試耗時 2.09 秒,而 EPYC 9965 為 2.70 秒;256GB Valkey 工作集的運行速度均提升了 34%;連結成本體現在延遲:遠端讀取耗時約為本地讀取的 2.1 倍,而 EPYC 9175F 的這一倍數為 1.75 倍,因此 NUMA 感知記憶體佈局和巨頁記憶體仍然對 Vera 至關重要。
這些弱點出乎意料地輕微,而且直接源自於設計本身。六條 128 位元 SVE2 通道與為其編寫的程式碼中 512 位元 AVX-512 單元並不匹配,因此 Vera 的 16 核心晶片運行 GROMACS benchMEM 的速度只有 9175F 的一半,9965 的三分之二。如果只使用其中兩個通道處理加密,那麼單一 Olympus 核心對 AES-256-GCM 進行加密的速度大約只有 9175F 的三分之一。
Vera 的最終發展很大程度上取決於 OEM 合作夥伴。戴爾的PowerEdge R8822伺服器已於 10 月開始出貨,M9882 Vera CPU 機架預計將於 2027 年第一季上市;HPE 的ProLiant Compute DL394 Gen12將於今年秋季推出;Supermicro 的 256 核 Vera 機架已開始接受 12U72 風架系統;華碩、華擎、QCT、技嘉、微星、仁寶、富士康、和碩、緯創和聯想都已展示了 Vera 設計。 Oracle Cloud 的 Vera 實例已正式發布,CoreWeave、Nebius、Lambda 等其他雲端服務商也將陸續推出Vera 實例。
Vera 是我們測試過的首款能夠與 x86 旗艦級通用處理器相媲美的 Arm 伺服器處理器,也是首款將 2TB/s 記憶體頻寬整合到風冷雙路處理器中的處理器。對於廣大中階市場而言,它目前是一個可靠的選擇,NVIDIA 也憑藉其獨特的記憶體子系統進軍 CPU 市場。然而,對於向量密集型高效能運算 (HPC) 和加密密集型服務,x86 處理器仍然佔據領先地位。我們將對 OEM 系統進行與實驗室相同的測試,首先測試 NVIDIA 為這款處理器量身打造的代理沙箱環境。
自從這次評測以來,AMD 的 EPYC Venice 已經抵達我們的實驗室,我們在對AMD EPYC Venice SP7和Dell PowerEdge R9825 的評測中,將 256 核 EPYC 9996 與 Vera 進行了相同的測試,Vera 使用的是最新的韌體。
排行榜: NVIDIA Vera 在我們的最佳伺服器排行榜上名列最佳 Arm 實現榜首。


 Amazon