

Supermicro 的 JumpStart 專案已成為 AI 基礎架構採購前評估工具包中最實用的工具之一。 JumpStart 並非在共享環境中進行腳本化的演示,而是透過 SSH、IPMI 和 VNC 為符合條件的用戶提供免費、限時、裸機訪問真實生產伺服器的機會,使他們能夠在實際硬體上運行工作負載。去年 11 月,我們使用配備 NVIDIA HGX B200 的 X14 系統對該專案進行了深入報道,並清楚地了解了為期一周的集中存取能夠提供和無法提供的資訊。這次,Supermicro 提供了一套配備截然不同的加速器的 H14 8U 系統的存取權限。
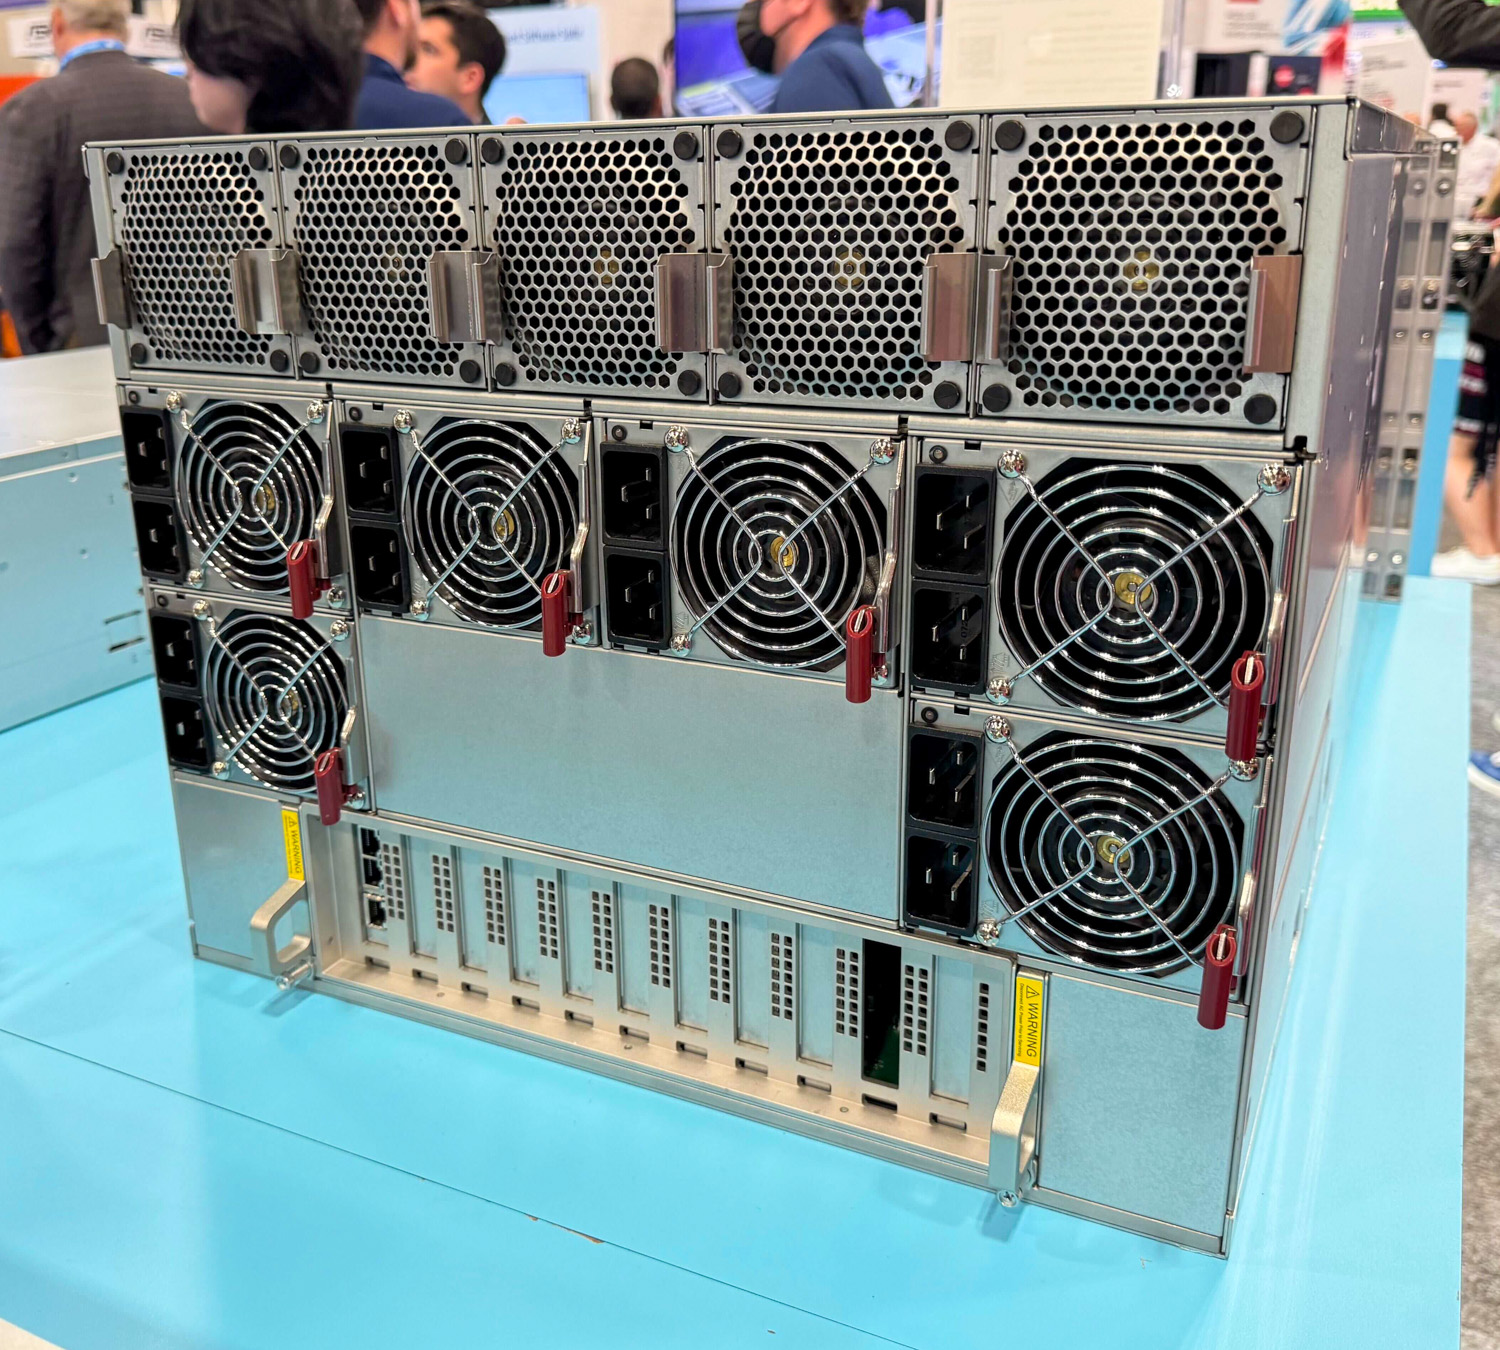
我們測試了AS-8126GS-TNMR系統,這是一個 8U 風冷平台,採用雙 AMD EPYC 9575F 處理器和八顆 AMD Instinct MI350X GPU。 MI350X 是 AMD 目前的旗艦級資料中心加速器,基於台積電 3nm 製程的第四代 CDNA 架構,每顆 GPU 配備 288GB HBM3e 記憶體。該伺服器的八顆 GPU 透過 AMD Infinity Fabric 互連,單節點總 GPU 記憶體容量達 2.3 TB,總頻寬為 1,024 GB/s。整個系統採用六個 5,250W 鈦金級電源,並採用 3+3 冗餘配置。此外,Supermicro 還為每顆 GPU 配備了專用的 400 Gbps 網絡,以滿足橫向擴展部署的需求。
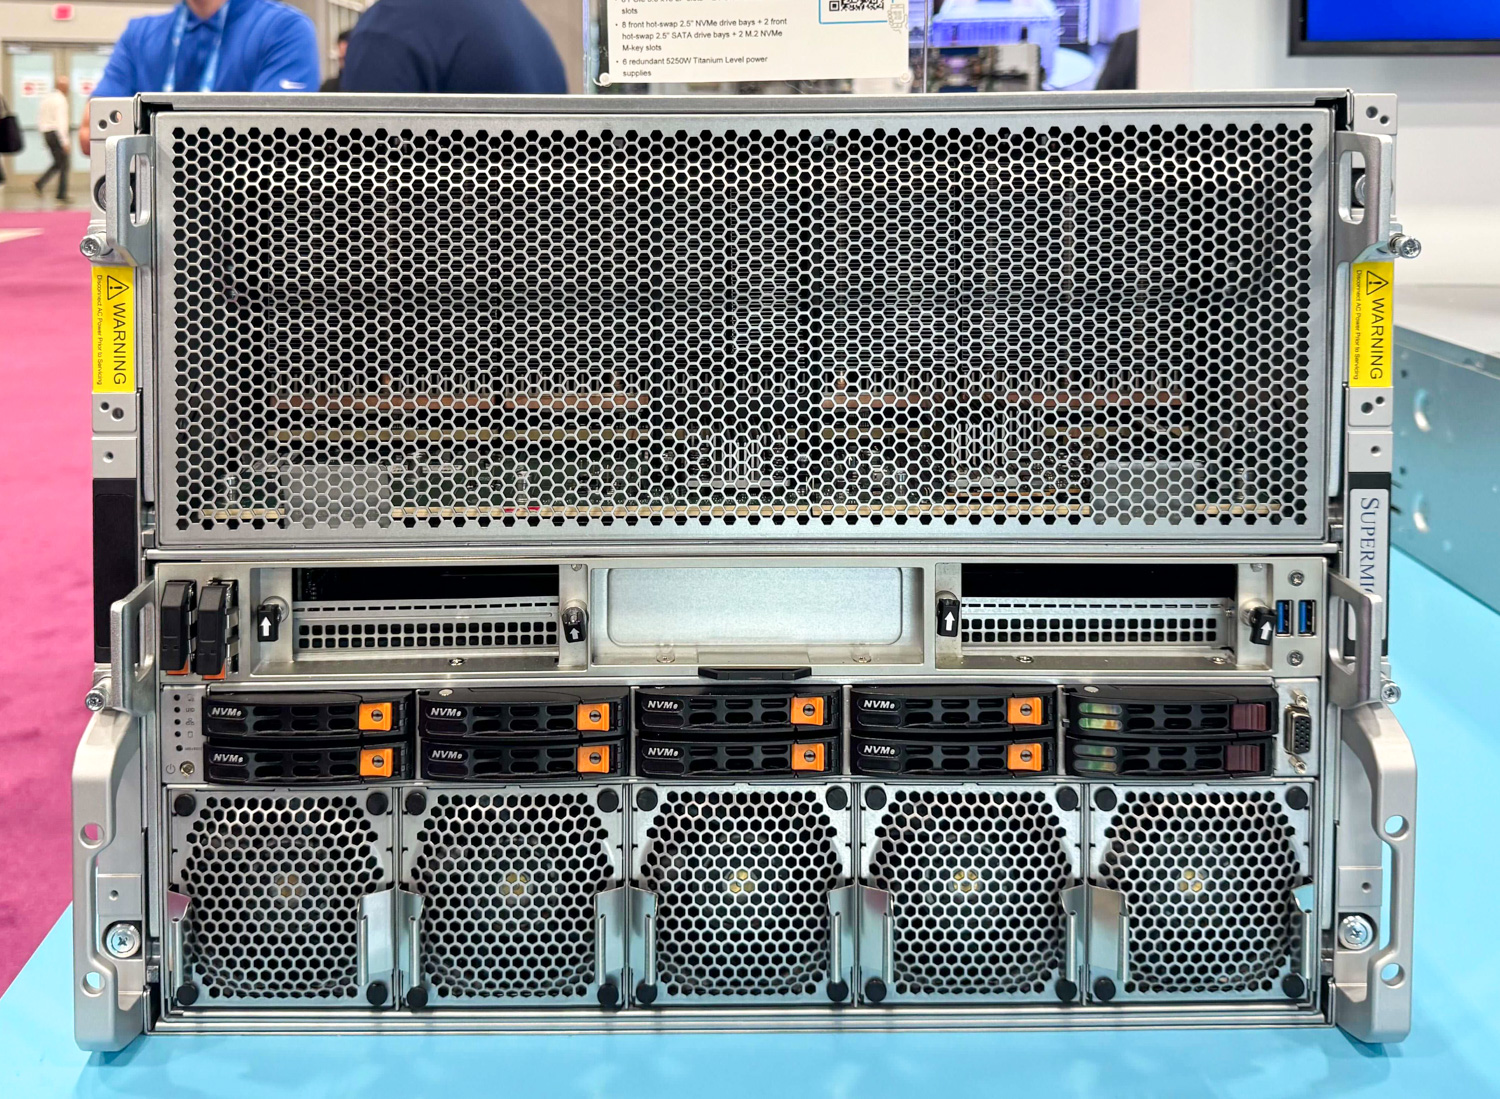
過去兩年,AMD 在資料中心 GPU 市場的地位發生了顯著變化,MI350X 系列顯示卡對 NVIDIA 的競爭威脅比以往任何 Instinct 產品都更為嚴峻。 ROCm 7 於 2025 年 9 月發布,目前已更新至 7.2 版本,它不僅原生支援 MI350X,還大幅提升了推理性能,更新了 HIP API 以彌補 CUDA 兼容性方面的不足,並擴展了框架支持,包括 PyTorch、JAX、TensorFlow、ONNX Runtime、LLM 和 SGLv。
vLLM 專案於 2025 年 12 月底新增了專用的 AMD ROCm CI 管線,使 AMD 硬體成為此推理堆疊中的一流平台,而非下游連接埠。該生態系統的普及程度也不容忽視:AMD 和 Meta於 2026 年 2 月宣布了一項多年、多代 6 吉瓦 GPU 部署協議,該協議基於 Meta 現有的 MI300 和 MI350 系列硬體生產部署。作為全球最大的 AI 基礎設施營運商之一,AMD 的這種承諾絕非無關緊要。
對於目前正在評估 AI 加速器基礎設施的組織而言,NVIDIA 硬體的交付週期仍然是一個令人擔憂的問題。關鍵在於 AMD 是否是一個可靠的替代方案,而不僅僅是替代方案。基於使用 ROCm 7.2.0 和目前 vLLM 進行的一週測試,答案與 18 個月前相比已截然不同。
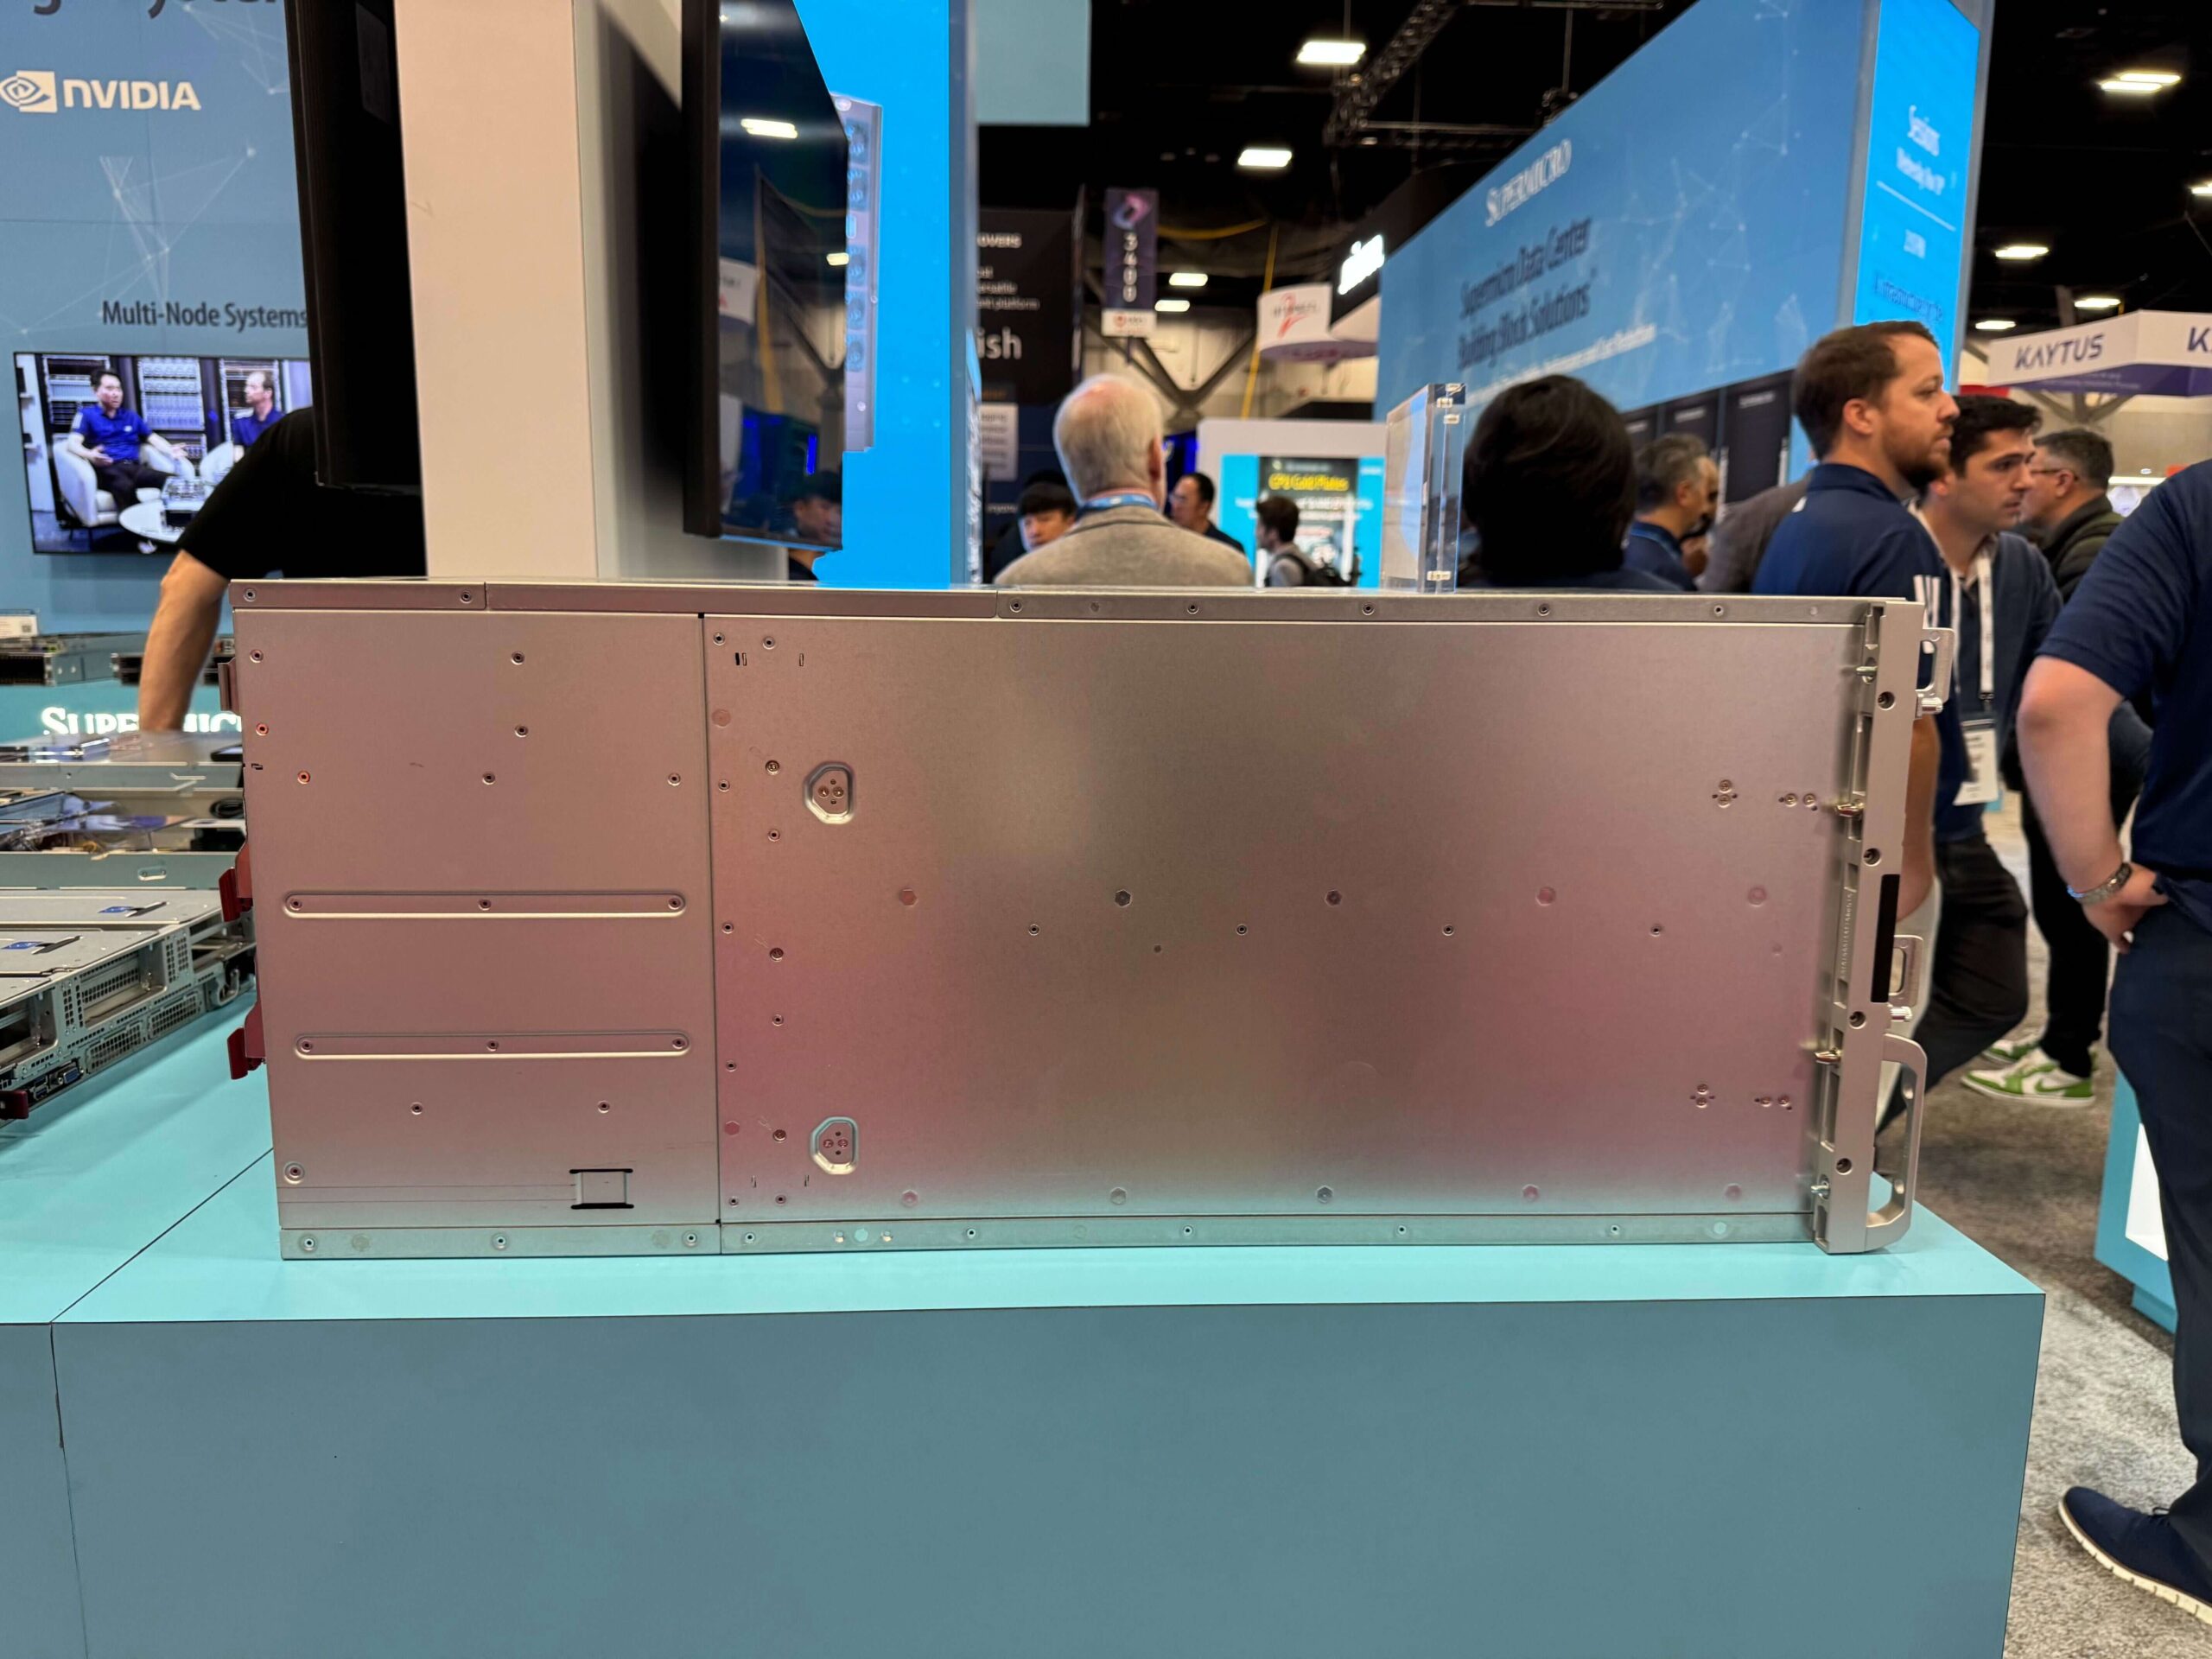
我們的測試涵蓋了一系列流行的模型;單一節點上的 2.3TB HBM3e 實現了對大參數模型的單一伺服器推理,包括 Moonshot 的 Kimi K2.5 和 MiniMax M2.5。
AMD Instinct MI350X:架構與世代改進
MI350X 代表了 AMD 迄今為止在 Instinct 產品線中架構上最具雄心的一次世代飛躍。了解背後的工程設計決策,對於解讀後續的效能測試結果至關重要。
CDNA 4 架構與流程節點過渡
MI350系列從MI300系列到MI350系列的根本性轉變在於加速運算晶片(XCD)採用了台積電的N3P製程節點,取代了上一代所使用的5nm製程。電晶體總數達到約1850億,比MI300系列增加了約21%,而功耗並未相應增加。
MI350X 沿用了 AMD 成熟的多晶片封裝策略。其核心 GPU 封裝包含八個加速運算晶片 (XCD) 作為主要運算引擎。每個 XCD 包含四個著色器引擎,每個著色器引擎配備八個活躍的 CDNA 4 計算單元,每個 XCD 提供 32 個計算單元,整個加速器共包含 256 個計算單元。
在CDNA 4封裝設計中,I/O晶片層也從四個晶片簡化為兩個。這種重組使AMD能夠將Infinity Fabric匯流排寬度增加一倍,從而提高雙向頻寬,同時降低總線頻率和工作電壓,進而降低功耗。
重新設計的計算單元和擴展的精度支持
借助 CDNA 4 計算單元的矩陣運算能力,效能得到了顯著提升:與 MI300 計算單元相比,MI350 計算單元在 16 位元 (BF16, FP16) 和 8 位元 (FP8, INT8) 運算方面,每個計算單元的吞吐量提高了 2 倍。
除了原始吞吐量的提升之外,CDNA 4 還引入了對 MI300 系列中不存在的低精度資料類型(特別是 FP6 和 FP4)的硬體支持,以及從上一代產品延續下來的 FP8 支援。
除了這些標準格式之外,MI350X 還增加了對 OCP 微縮放變體(MXFP4、MXFP6 和 MXFP8)的原生硬體支援。微縮放格式旨在提供低精度運算的吞吐量優勢,同時保持輸出品質更接近高精度基準,而這通常是標準量化所無法實現的。這並非 AMD 獨有的開發成果。 NVIDIA 的 NVFP4 格式也基於相同的微縮放原理,並在前沿模型部署中廣泛應用,OpenAI 的 GPT-OSS 系列就是基於這些格式建構的最傑出範例之一。 MI350X 的原生 MXFP4 支援使其能夠服務於這些以及類似的量化模型系列,而無需回退到軟體模擬或精度提升。
MI350X 在 MXFP4 和 MXFP6 下可提供 9.2 PFLOPs 的運算能力,而 OCP-FP8 下為 4.6 PFLOPs,FP16 下為 2.3 PFLOPs,峰值引擎時脈頻率為 2,200 MHz。對於可進行微縮量化的推理最佳化部署,其計算餘裕相對於 FP8 工作負載有效翻倍。此外,CDNA 4 計算單元中還新增了一個向量 ALU,支援 2 位元運算,並能夠將 BF16 的結果累積到 FP32 中,從而為主矩陣計算路徑之外的低精度向量工作負載提供了更大的靈活性。
記憶體子系統:HBM3e、無限快取和頻寬效率
MI350 系列顯示卡配備了大幅升級的記憶體子系統,包含八個 HBM3e 記憶體堆棧,每個 GPU 的總容量高達 288GB。每個 36GB 的堆疊由 12 個 24Gbit 的 HBM3e 晶片組成,每個引腳的傳輸速度均為 8Gbps。該架構保留了 AMD 的 Infinity Cache,這是位於 HBM 和 Infinity Fabric/L2 快取之間的記憶體端快取。它包含 128 個通道,每個通道配備 2MB 緩存,每個 GPU 的總緩存容量為 256MB。 AMD 也拓寬了 IOD 內部的網路匯流排,並降低了其工作電壓,與 MI300 系列相比,每瓦記憶體頻寬提高了約 1.3 倍。
MI350X 的顯存容量從 192GB 提升至 288GB,進一步鞏固了 AMD 在單 GPU 顯存容量方面的領先優勢,這對大型模型推理具有直接意義。每個 MI300X GPU 可獨立運作參數超過 500 億的模型。在配備八個 GPU 的伺服器上,總計 2.3TB 的 HBM3e 顯存消除了多節點分散式部署的需求,而多節點分散式部署通常會使萬億參數規模的模型部署變得複雜,正如本次評測中 Kimi K2.5 和 MiniMax M2.5 的結果所示。
靈活的分區和部署架構
MI350 系列支援每個插槽靈活的 GPU 分區,記憶體被劃分為兩個獨立的叢集。這種靈活性也適用於 XCD,四路 XCD 叢集可以拆分為雙路或單路模組,使晶片能夠支援諸如 CPX+NPS2 中 8 個 70 億模型實例之類的配置。對於在共享基礎架構上運行異質推理工作負載的組織而言,這種分區功能減少了每個模型層級對專用硬體的需求,並提高了混合部署環境中的資源利用率。
MI350 系列也維持了與 MI300 系列系統中使用的 UBB(通用基板)基礎架構的即插即用相容性。現有的伺服器機箱、電源和散熱基礎架構無需任何修改即可繼續使用,從而降低了已部署 MI300 的企業升級的難度。
MI355X:液冷版兄弟
MI350系列晶片有兩種型號,均採用相同的底層矽晶片,並針對不同的散熱工作環境進行了最佳化。本文測試的MI350X為風冷版本,而MI355X則是其液冷版本,專為高密度部署環境而設計,在這些環境中可以直接使用液冷散熱。
雖然兩款產品基於相同的基本硬件,但MI355X更高的運行功耗使其能夠維持更高的時脈頻率,從而在實際端到端工作負載下比MI350X性能提升約20%。 MI355X的總功耗上限為1,400W,而MI350X為1,000W;MI355X的最高時脈頻率為2.4GHz,而風冷版MI350X的最高時脈為2.2GHz。
從世代角度來看,MI355X 平台的理論峰值效能比 MI300X 提升高達 4 倍,在智能體和聊天機器人工作負載中,實際推理效能提升約為 4.2 倍,在內容生成場景中提升約為 3 倍。對於正在評估 MI350X 部署的組織而言,兩款產品之間 20% 的效能差異已達到效能上限。擁有 DLC 基礎設施的機構應評估 MI355X,以確定散熱方面的投入是否能為其特定的工作負載帶來足夠的吞吐量提升,然後再大規模部署風冷配置。
透過 Supermicro JumpStart 計畫造訪 AMD Instinct MI350X
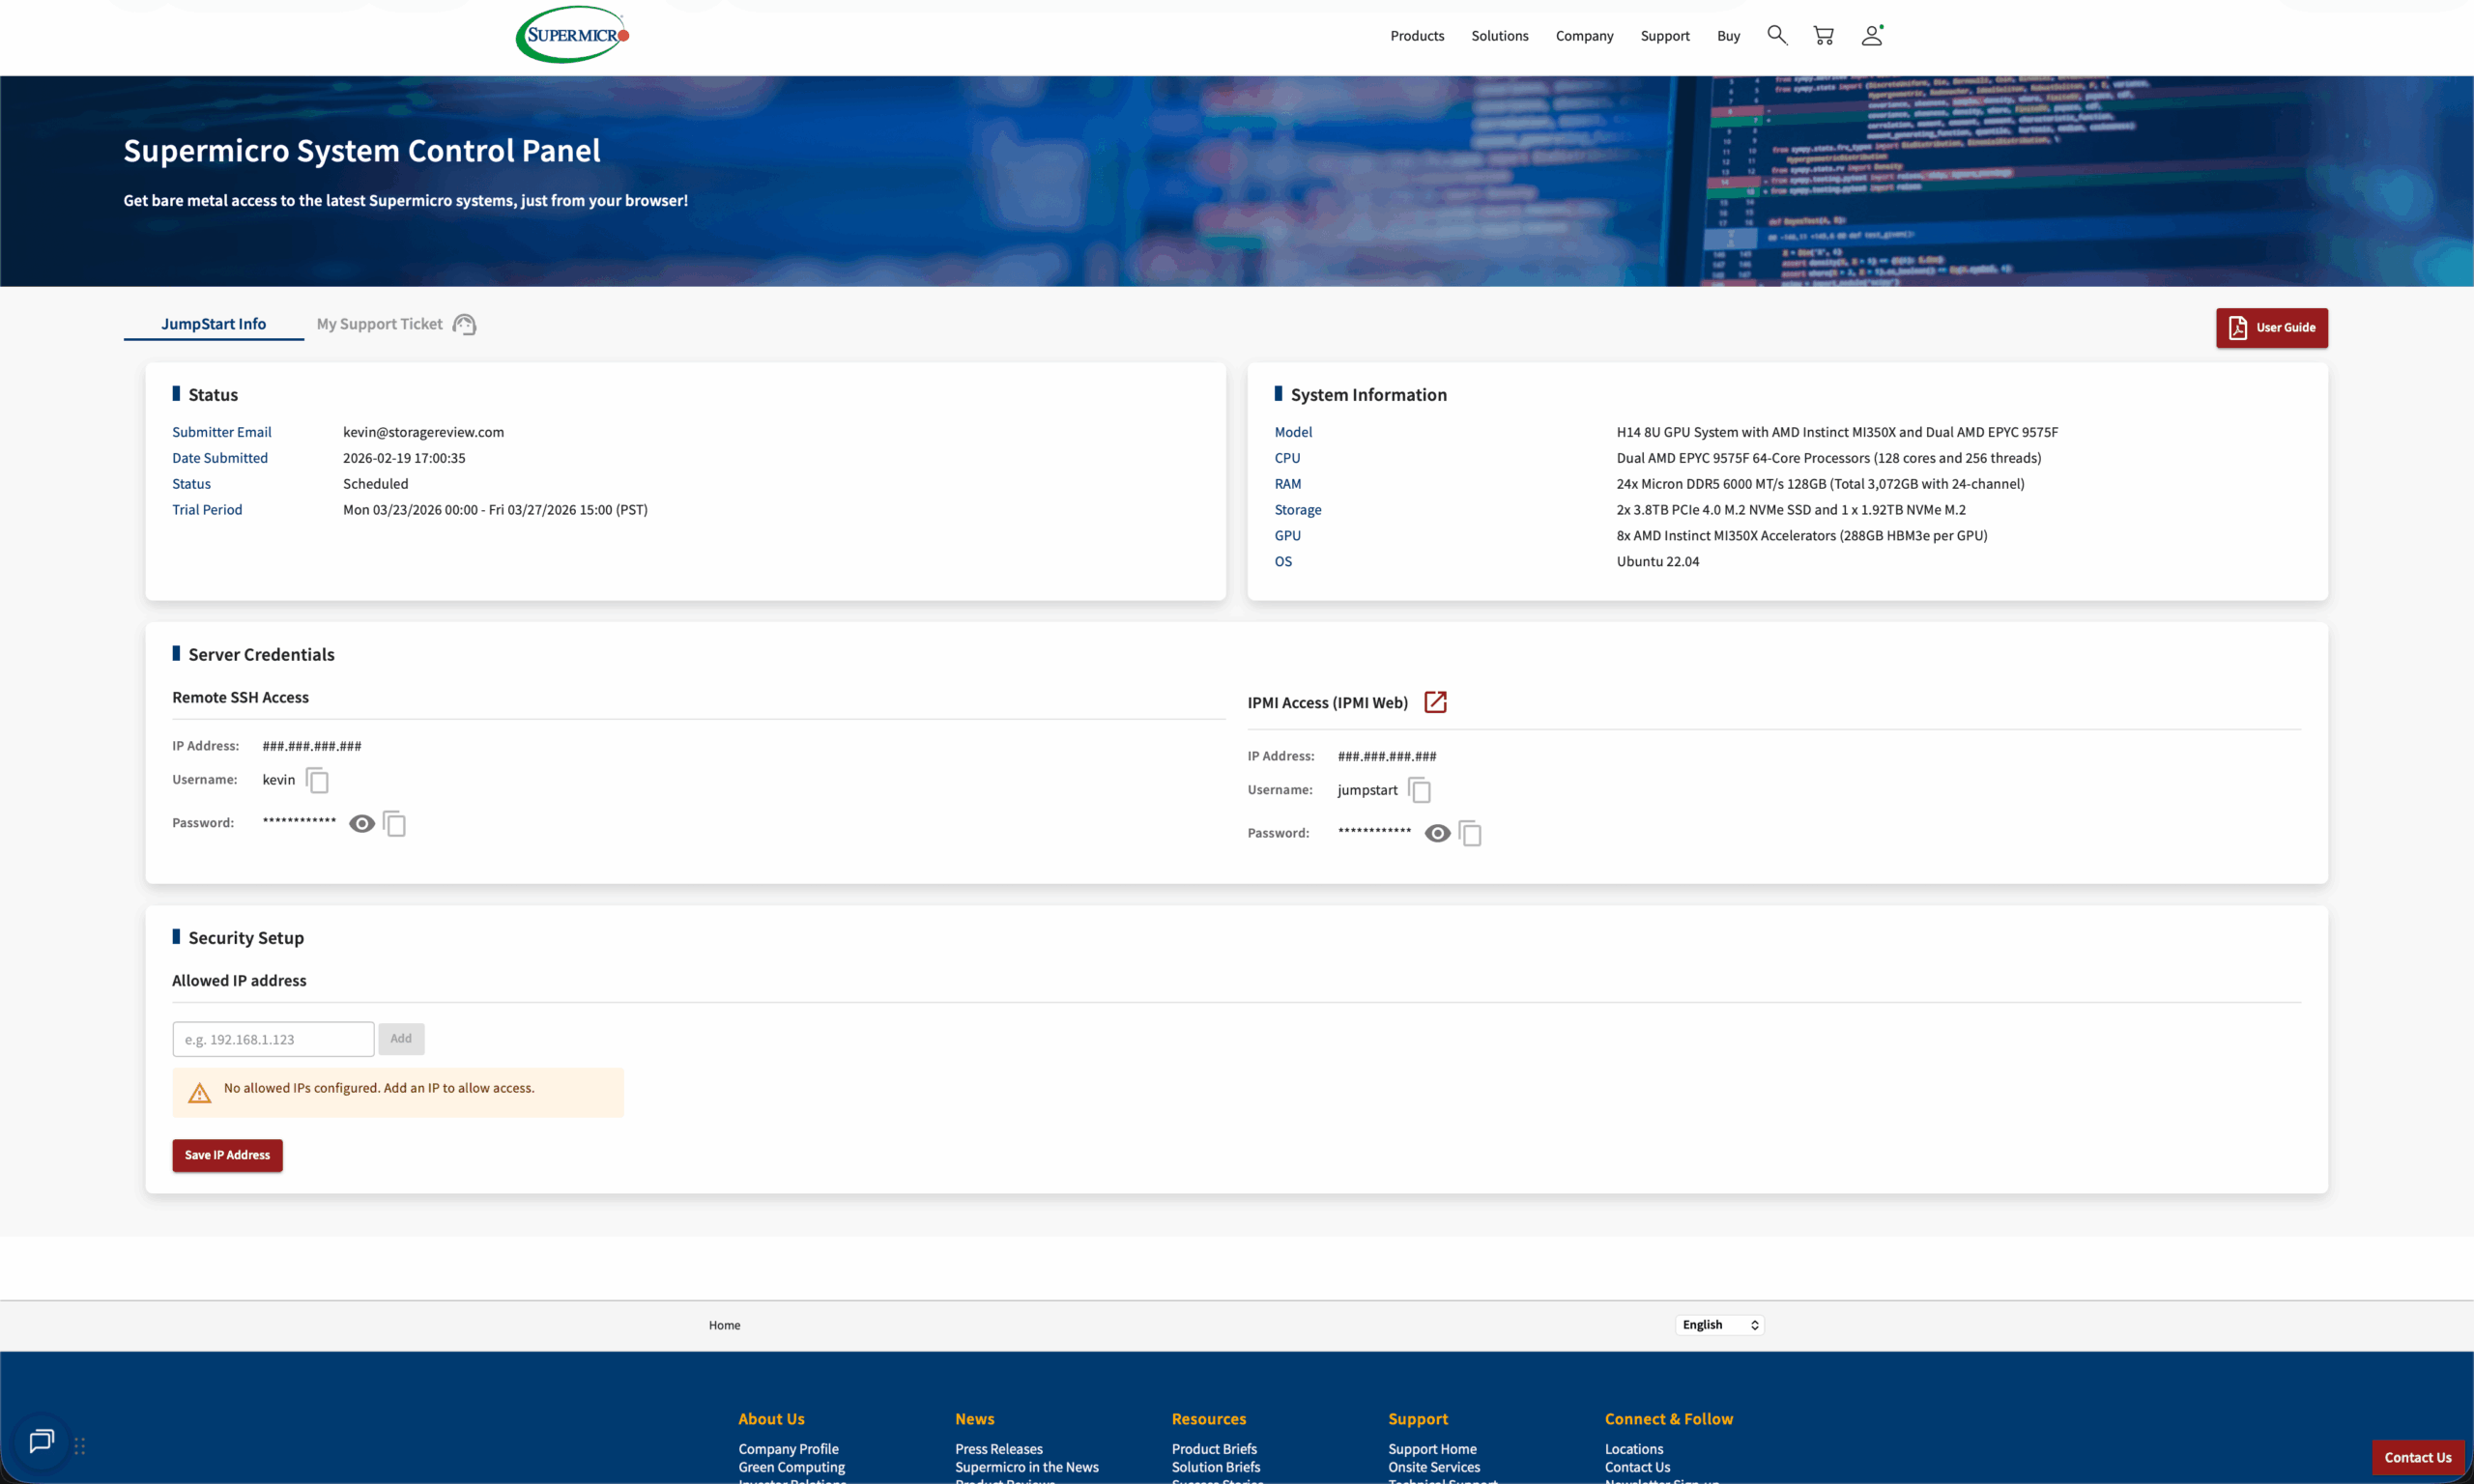
要開始使用 JumpStart 服務,需要在 Supermicro 的入口網站上註冊。符合資格的使用者可以在該網站上瀏覽可用的系統並預約使用時段。審核通過後,入口網站會提供 SSH 憑證、IPMI 存取權限以及基於 Web 的遠端控制台,供您在預約期間使用。系統預先安裝了 Ubuntu 系統,到貨即可使用。無需任何配置延遲,也無需任何技術支援即可開始使用。我們的預約時間為 2026 年 3 月 23 日至 27 日,讓我們在該平台上使用了一整週,這與我們之前使用 HGX B200 的 JumpStart 服務時長一致。
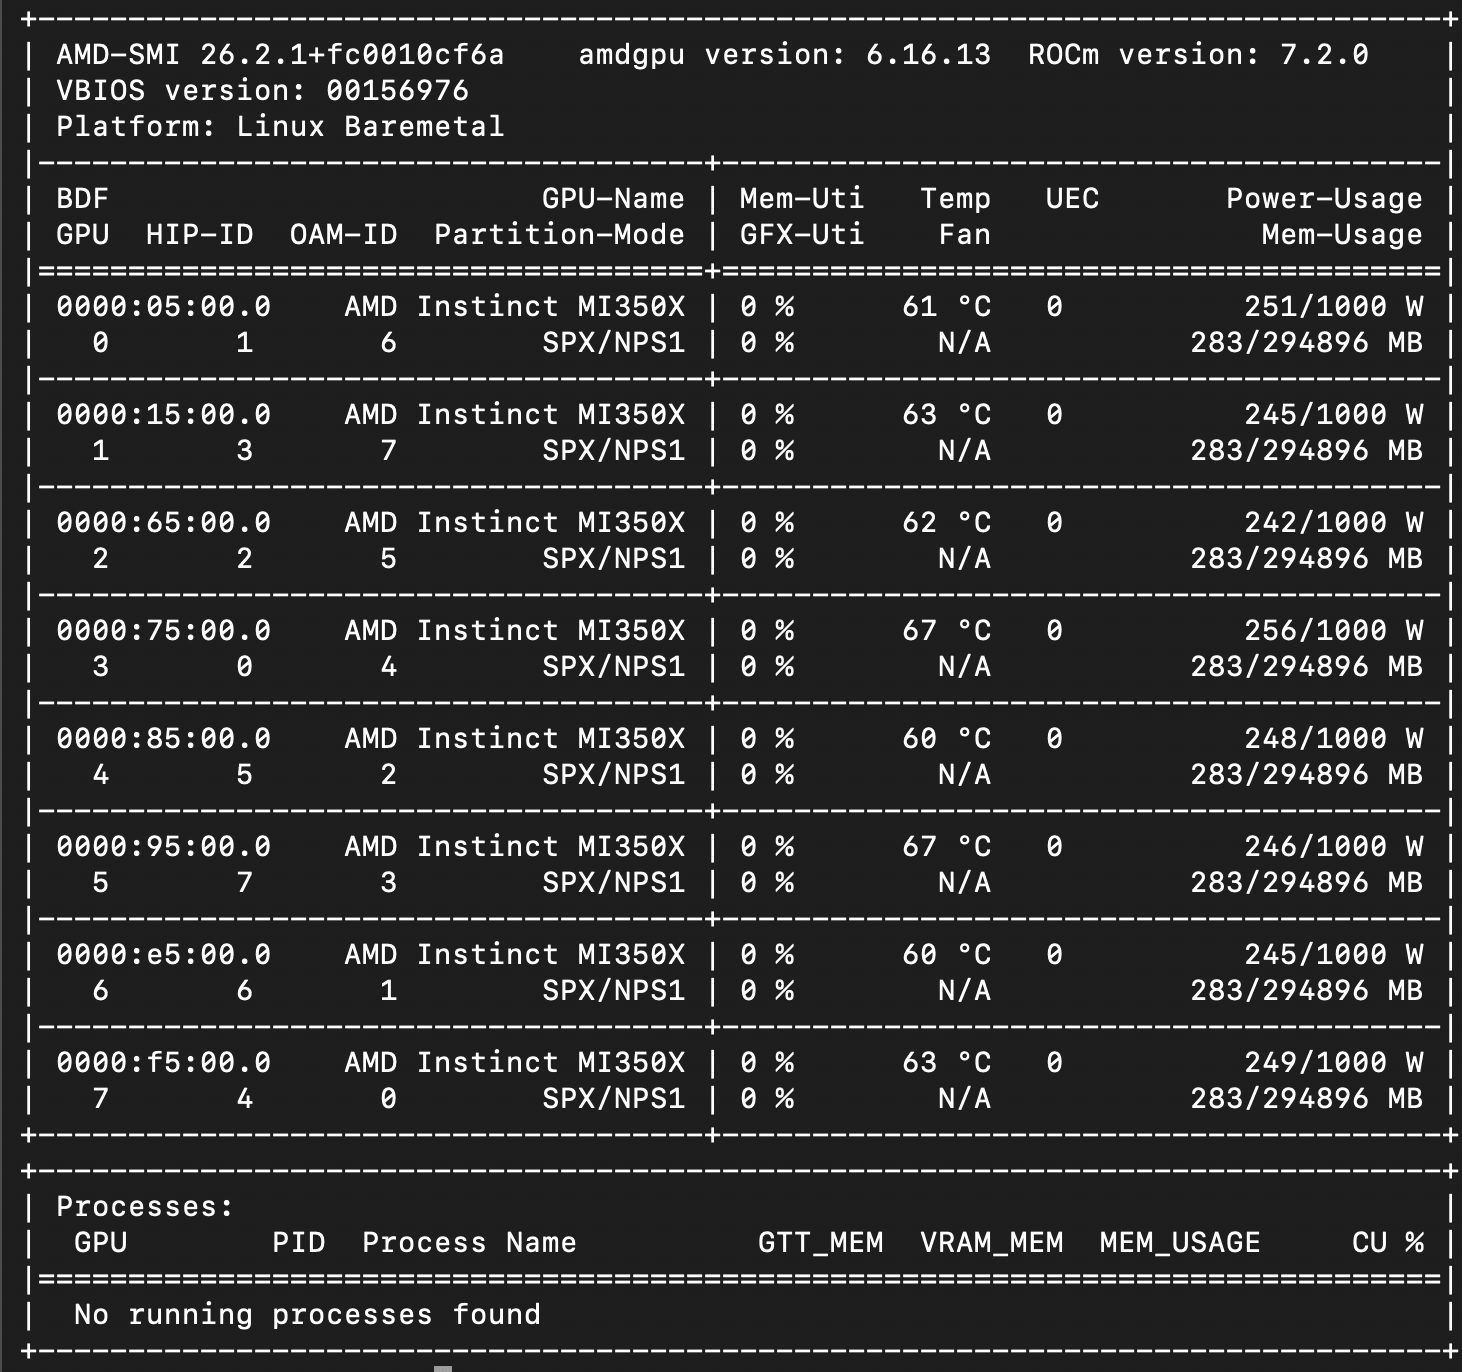
下面的螢幕截圖顯示了 H14 系統 jumpstart 的終端輸出,其中 AMD-SMI 工具顯示了八個 AMD Instinct MI350X GPU 及其運行的軟體版本。
AMD Instinct MI350X 效能測試結果
系統配置
- 底盤: 超微 H14
- 中央處理器: 雙路 AMD EPYC 9575F
- 內存: 3TB DDR5
- GPU: 八款 AMD Instinct MI350X
- 貯存: 2塊3.8TB PCIe 4.0 M.2 NVMe SSD和1塊1.92TB NVMe M.2
結果匯總
| 型號 | 精密 | 等於 (256/256) | 預填充-重(8k/1k) | 解碼密集型(1k/8k) |
|---|---|---|---|---|
| GPT-OSS 20B | NVFP4 | 62,247 | 123,714 | 32,468 |
| GPT-OSS 120B | NVFP4 | 33,538 | 84,018 | 20,602 |
| 駱駝 3.1 8B 指導 | BF16 | 51,467 | 77,658 * | 19,326 |
| 米斯特拉爾小型 3.1 24B | FP8 | 40,742 | 56,093 | 14,557 |
| 米斯特拉爾小型 3.1 24B | BF16 | 30,530 | 53,740 | 13,559 |
| Qwen3 Coder 30B A3B | BF16 | 34,980 | 51,550 | 11,782 |
| Qwen3 Coder 30B A3B | FP8 | 25,928 | 47,179 | 11,014 |
| MiniMax M2.5 | 區塊級縮放 FP8 | 14,391 | 23,689 | 6,068 |
| 基米 K2.5 | INT4 QAT + BF16 | 6,527 | 11,256 | 2,513 |
| 所有數值均以 tok/s 為單位,峰值吞吐量為 BS=256。 *Llama 3.1 8B 預填充重度在 BS=128 時達到高峰(77,658 tok/s);BS=256 時為 76,893 tok/s。 | ||||
Claude Code Serving – MiniMax M2.5
除了傳統的原始LLM推理基準測試之外,我們還想評估該硬體在智能體編碼工作流程中的效能,特別是支援多個並發的Claude Code會話以及本地託管的模型。此用例直接關係到開發團隊的生產力:在體驗下降之前,有多少工程師可以同時使用由單一節點提供的AI編碼助理?
為了驗證這一點,我們建立了一個基準測試框架,該框架會產生一個中等難度的編碼問題資料集(例如實作 LRU 快取、建置 CLI 待辦事項應用程式、編寫 Markdown 轉換器以及建置 REST API 等任務),並在各自的 Docker 容器中針對本機 vLLM 伺服器執行每個 Claude Code 會話。會話和推理端點之間有一個透明代理,用於捕獲每個 Claude Code 實例的請求指標。我們使用的模型是 MiniMax M2.5,透過 vLLM 在八塊 MI350X GPU 上運行。雖然 M2.5 在公開排行榜上並非排名最高的編碼模型,但它是一個功能強大的模型,許多用戶(包括我們的許多開發者朋友)都在本地運行該模型。
作為基準參考點,我們使用 Anthropic 的 Claude Opus 4.6 透過 OpenRouter.ai(最受歡迎的生產 API 存取路由服務之一)測得的平均輸出吞吐量。該基準值約為每個 API 請求每秒 37 個令牌。
我們測量了兩個關鍵指標:每個 Claude Code 會話每秒平均輸出令牌數(每個開發人員的體驗)和所有會話每秒總輸出令牌數(伺服器產生的總工作量)。
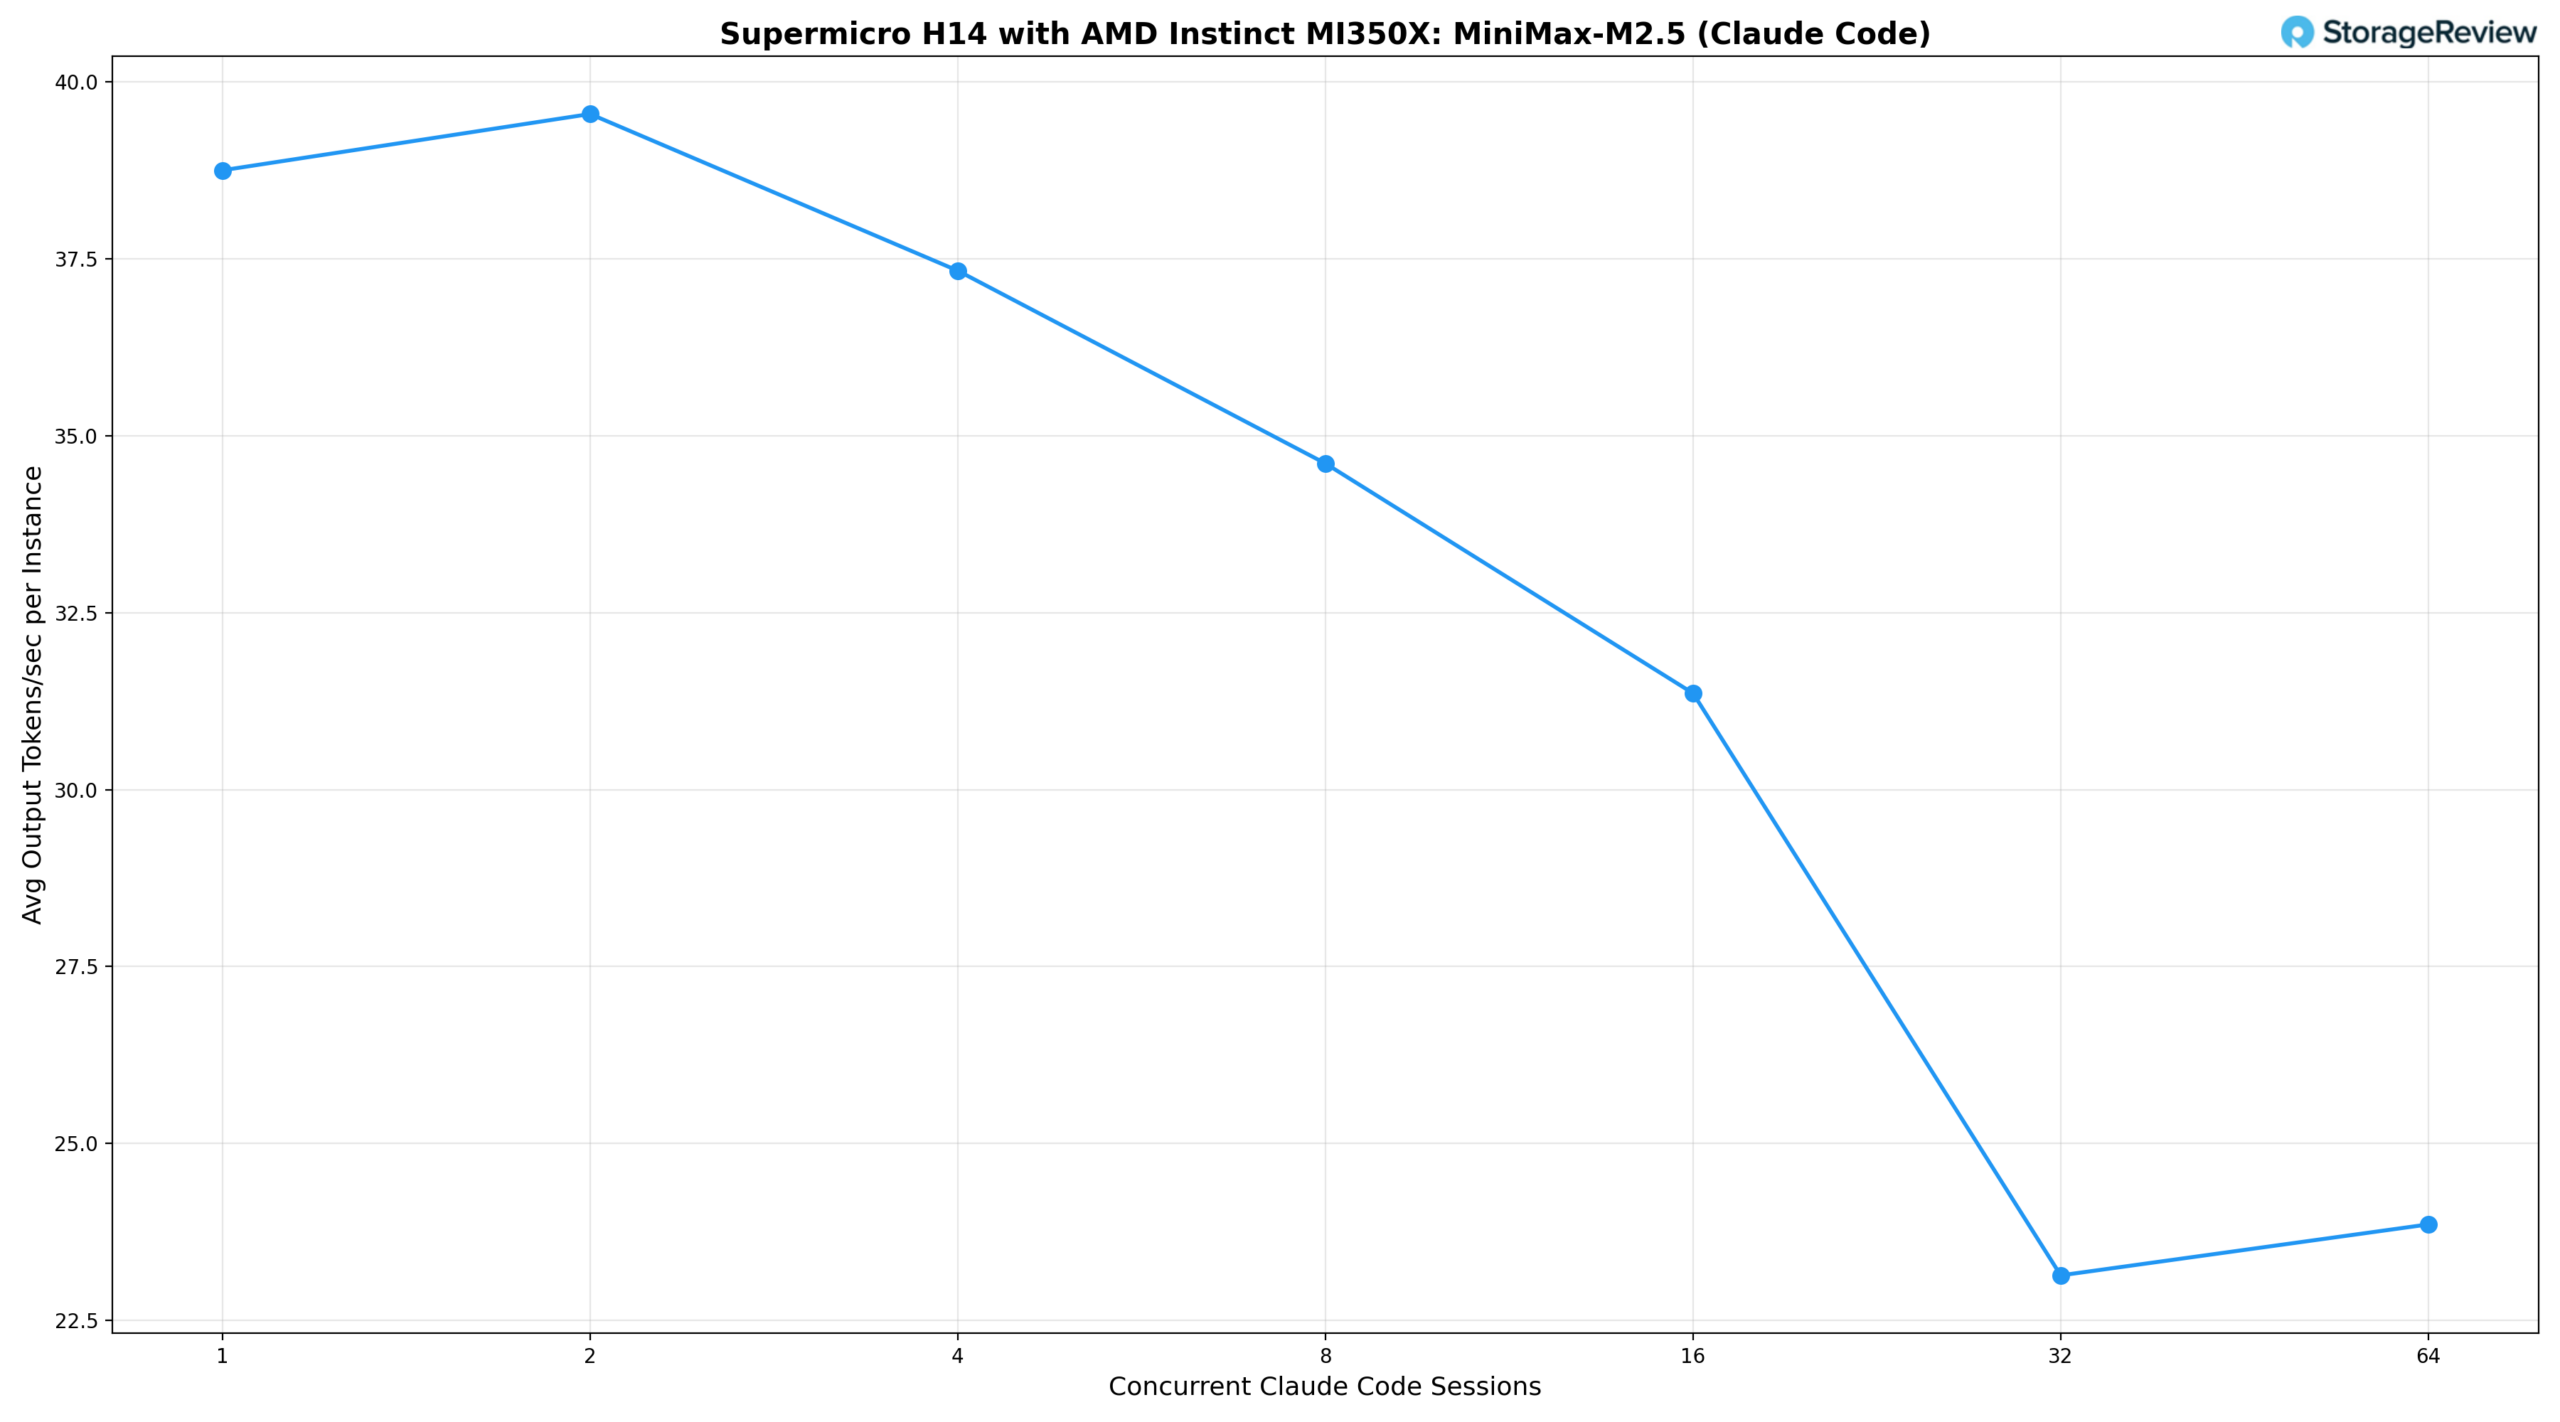
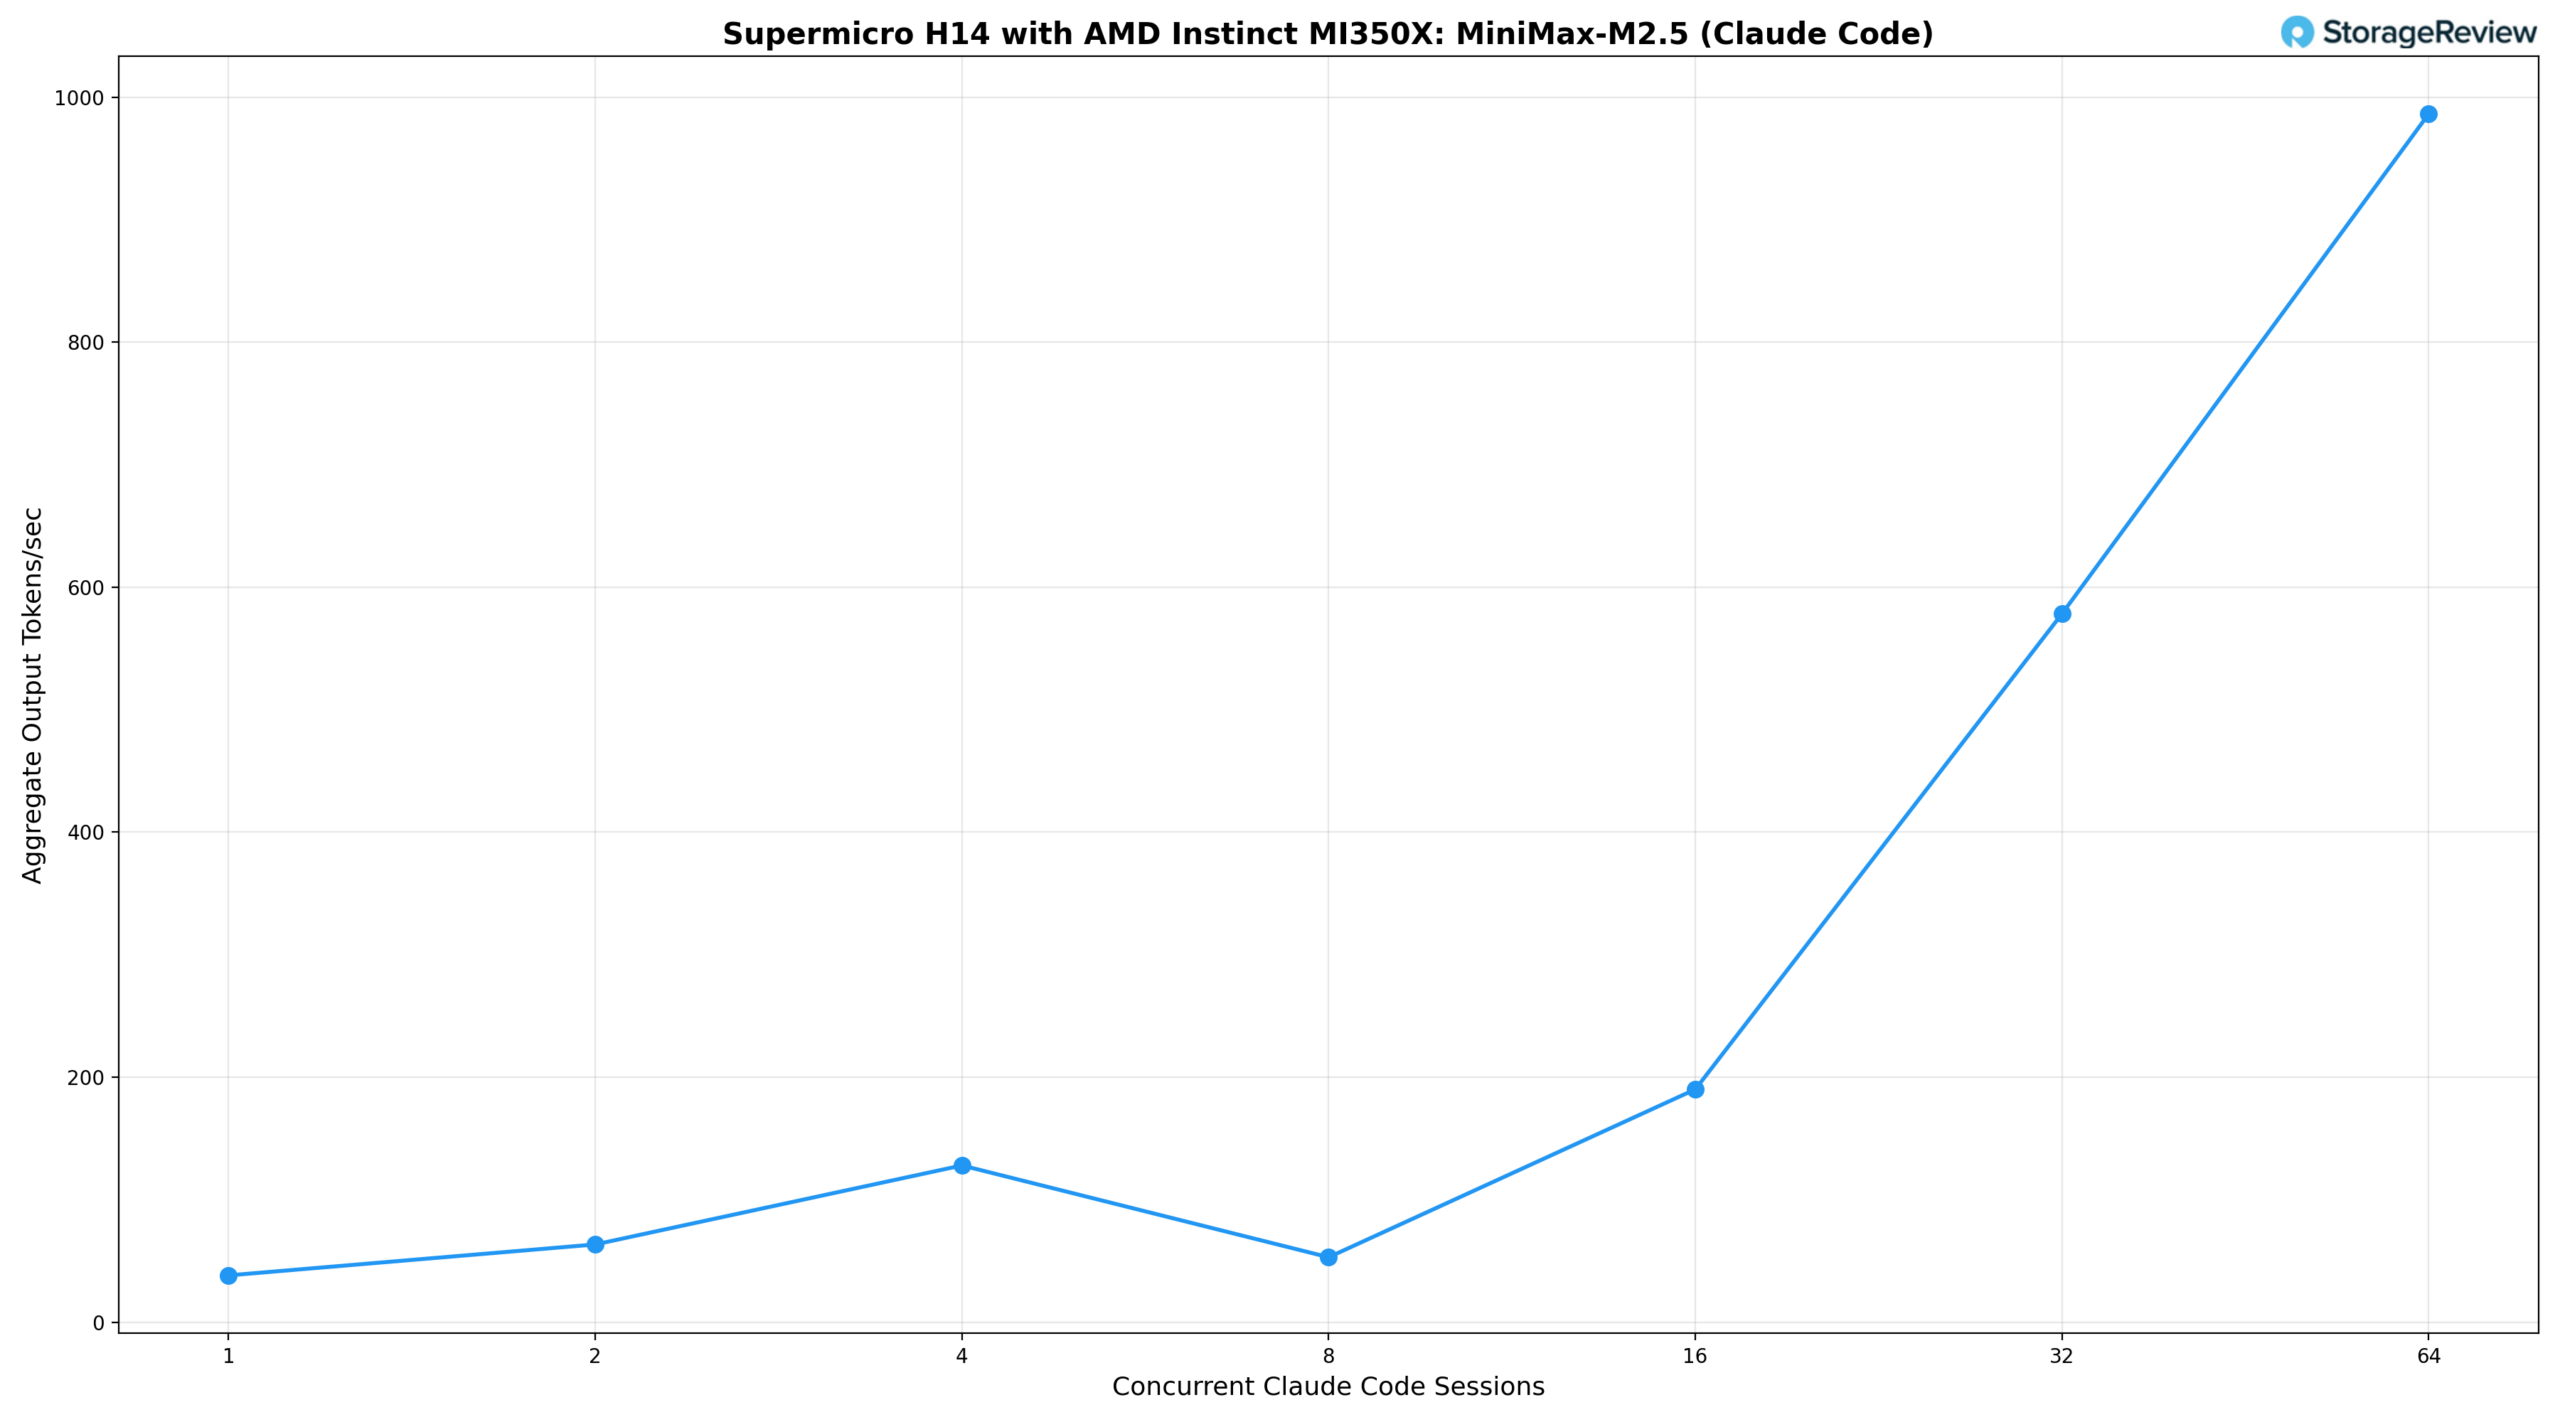
從結果來看,單一並發會話的單一使用者吞吐量為 38.8 tok/s,總吞吐量為 38 tok/s,略高於 OpenRouter 雲端基準。在雙並發會話時,隨著 vLLM 的批次開始分攤開銷,系統單用戶吞吐量略微提升至 39.5 tok/s,總吞吐量攀升至 63 tok/s。四並發會話的單一用戶吞吐量為 37.3 tok/s,與雲端基準持平,同時可同時服務四位開發者,總吞吐量達到 128 tok/s。從八並發會話開始,單一實例吞吐量開始下降:八並發會話時為單用戶 34.6 tok/s,十六並發會話時為 31.4 tok/s,總吞吐量為 190 tok/s,在三十二並發會話和六十四並發會話時分別穩定在單用戶 23 tok/s 左右,而總吞吐量/578/k tok這就是典型的批次吞吐量與互動性之間的權衡:系統可以透過批次處理更多請求來顯著提高總吞吐量,但每個用戶的回應時間都會變慢。即使有 64 個並髮用戶,每個開發者仍然可以獲得可用的互動體驗,儘管速度明顯慢於雲端基準水準。
對於正在權衡數十個同時進行的商業 API 訂閱成本與自託管基礎設施成本的組織而言,權衡顯而易見:單個 MI350X 節點可以為 16 至 32 名工程師的開發團隊提供服務,將每個用戶的響應速度保持在雲端基線的 60-85% 以內,同時提供 600 至 1,000 to 1,000 tok/s 的數據費用以及對模型選擇的完全控制等額外優勢。
vLLM 線上服務 – LLM 推理效能
vLLM 是 LLM 領域最受歡迎的高吞吐量推理和服務引擎之一。 vLLM 線上服務基準測試評估了該推理引擎在並發請求下的實際服務效能。它透過向運行中的 vLLM 伺服器發送請求來模擬生產環境的工作負載,並可配置請求速率、輸入/輸出長度和並發客戶端數量等參數。此基準測試可測量關鍵指標,包括吞吐量(每秒令牌數)、首令牌時間 (TTF) 和單次輸出令牌時間 (TPOT),可協助使用者了解 vLLM 在不同負載條件下的效能。
我們測試了涵蓋各種架構、參數規模和量化策略的一系列模型的推理效能,以評估不同並發配置下的吞吐量。
GPT-OSS 120位和20位
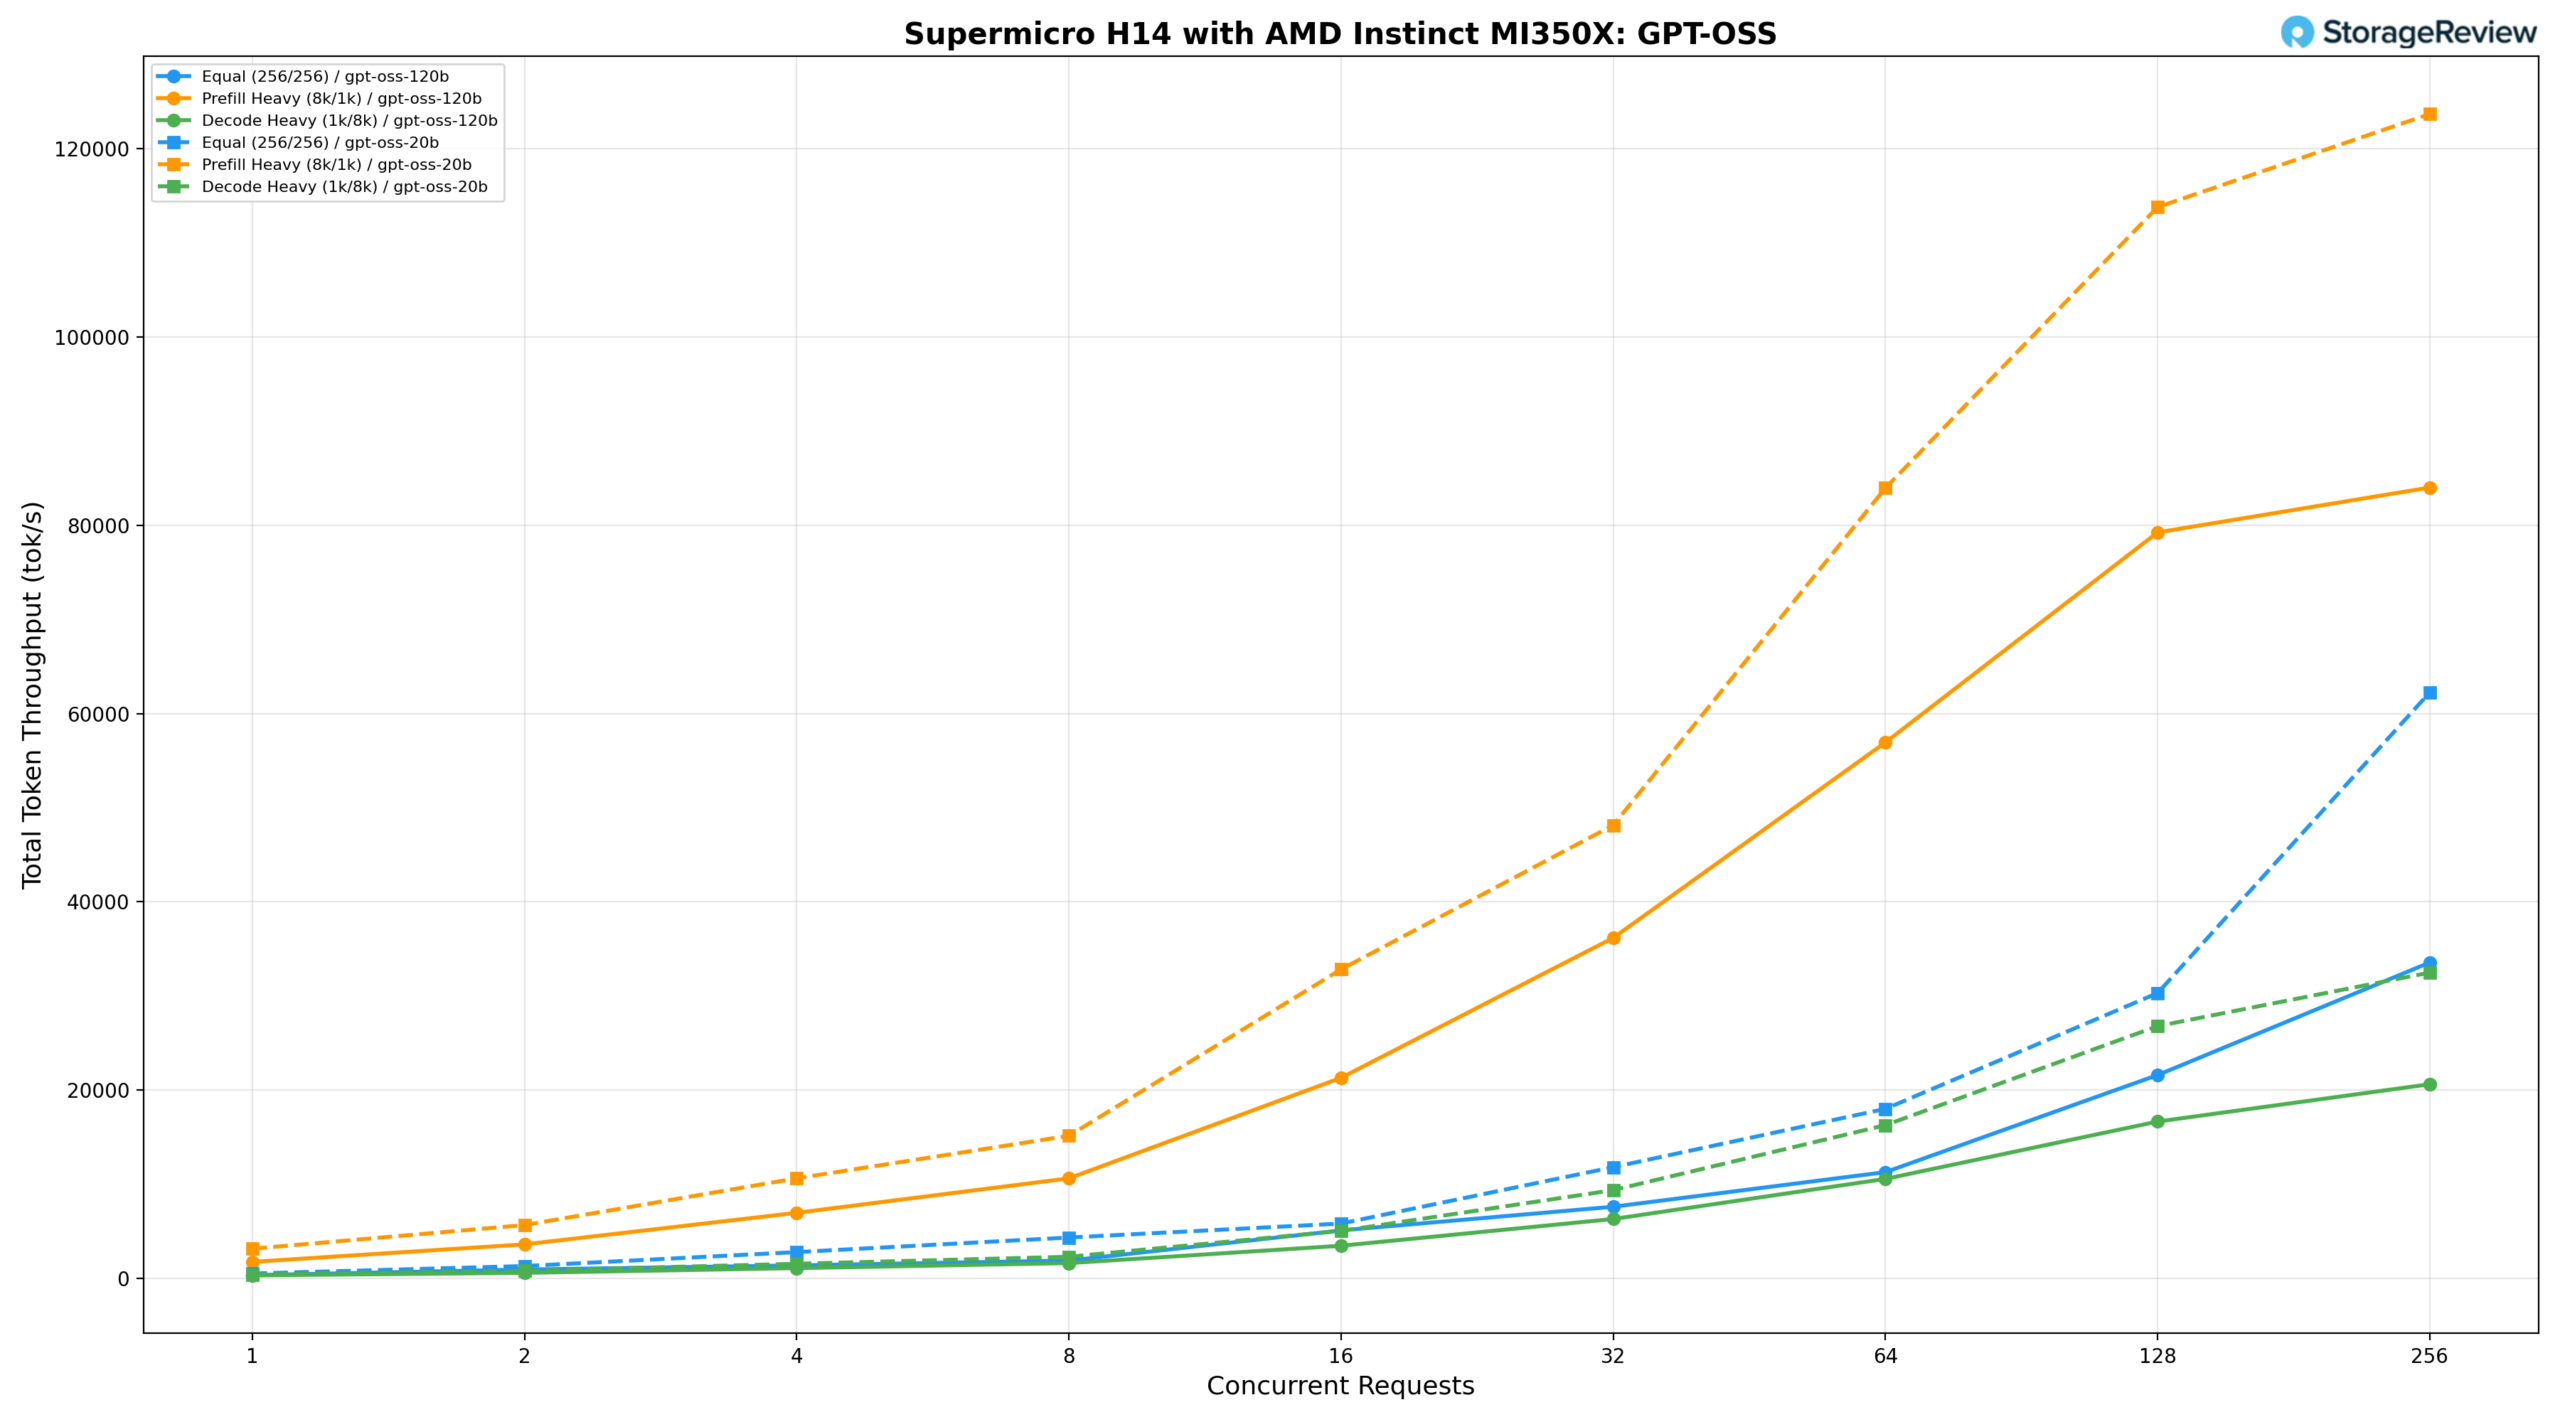
GPT-OSS 模型系列在 Supermicro H14 上分別以 120B 和 20B 配置進行了測試。
GPT-OSS 120B
在相同工作負載 (256/256) 下,120B 模型在 BS=1 時輸出速度為 313.42 tok/s,在 BS=64 時達到 11,261.72 tok/s,在 BS=256 時達到峰值 33,538.23 tok/s,在 BS=256 時達到峰值 33,538.23 tok/s。預填充較多 (8k/1k) 的初速為 1,724.84 tok/s,在 BS=32 時攀升至 36,156.80 tok/s,在 BS=128 時達到 79,247.76 tok/s,在 BS=256 時達到 79,247.76 tok/s,在 BS=256 時達到峰值 189.18989.189。解碼密集型(1k/8k)從 BS=1 時的 288.90 tok/s 增長到 BS=256 時的 20,602.52 tok/s,在較低的並發水平下延遲仍然得到很好的控制。
GPT-OSS 20B
在相同工作負載下,20B 模型在 BS=1 時吞吐量為 485.17 tok/s,在 BS=64 時達到 17,986.36 tok/s,在 BS=256 時達到峰值 62,247.52 tok/s。預填充密集型任務的吞吐量從 3,120.72 tok/s 開始,在 BS=32 時攀升至 48,132.52 tok/s,在 BS=64 時攀升至 83,968.71 tok/s,在 BS=256 時攀升至 123,714.50/714714 時達到峰值模型中達到峰值 123,714.50 的尺寸中達到峰值模型。解碼密集型運算速度從 BS=1 時的 378.20 tok/s 增長到 BS=256 時的 32,468.67 tok/s,在峰值並發時實現了 120B 解碼吞吐量的約 1.6 倍,同時保持了更緊湊的延遲特性。
Qwen3 Coder 30B A3B 指導與 FP8 指導
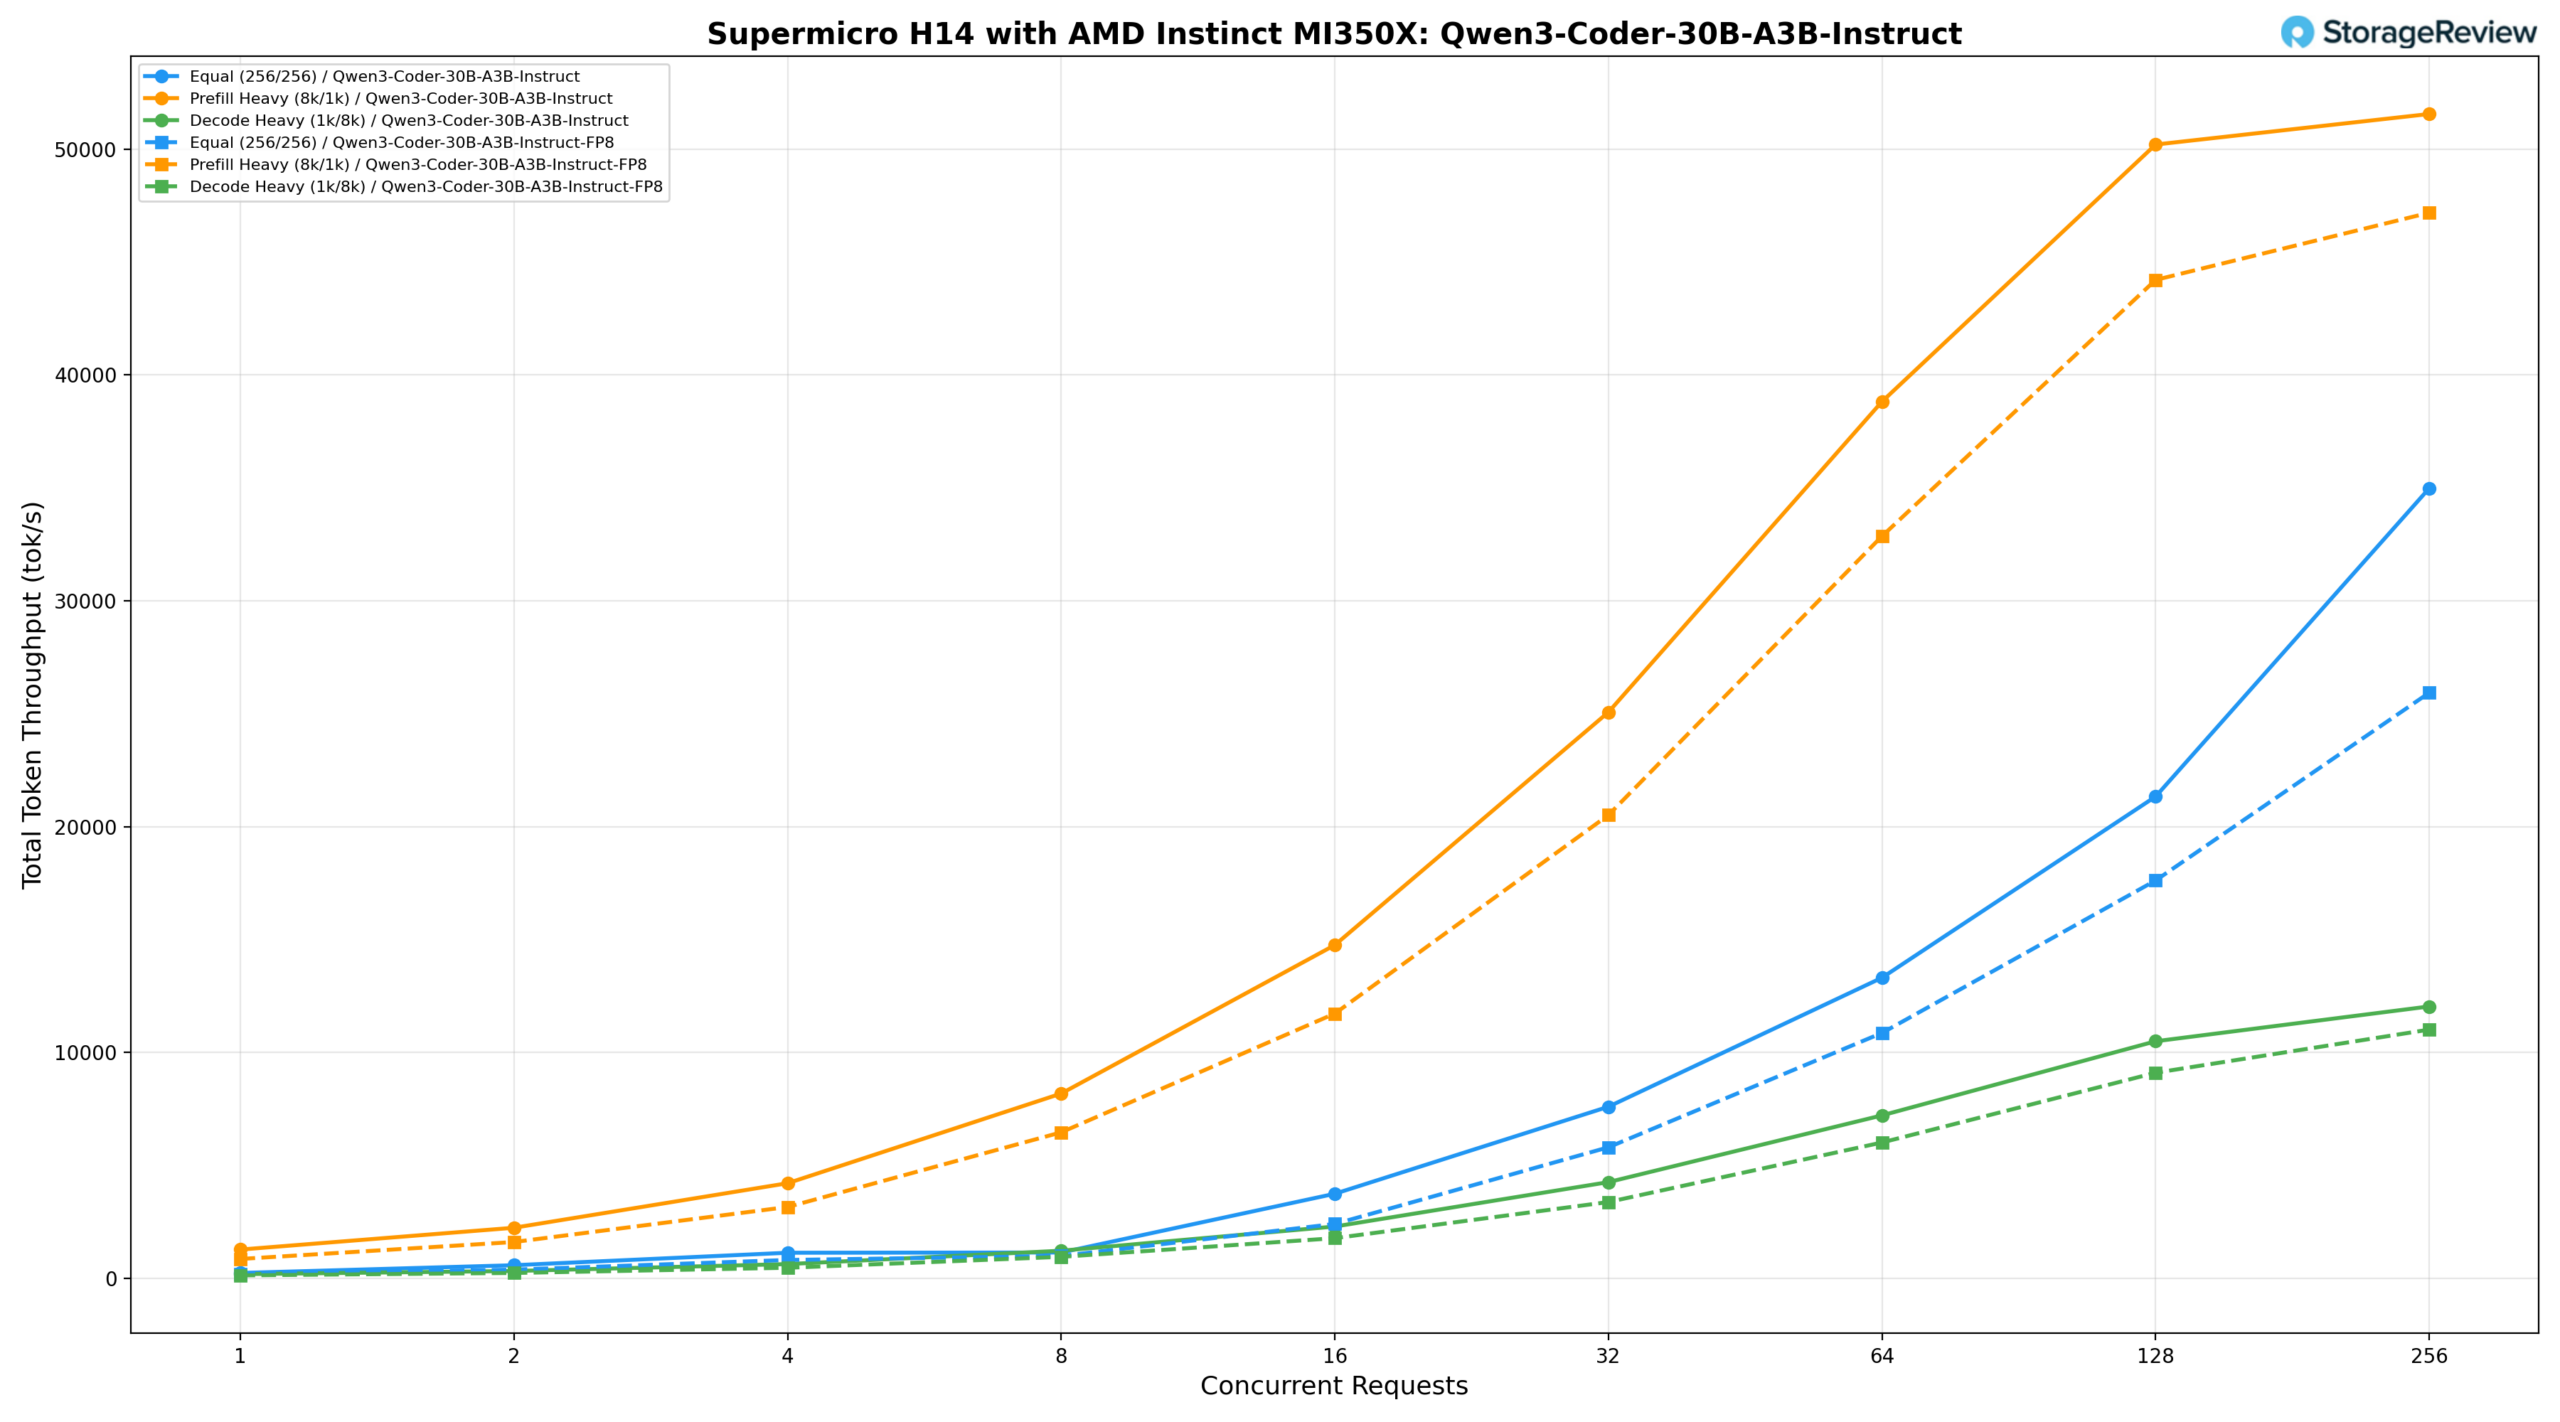
在 Supermicro H14 上對 Qwen3-Coder-30B-A3B-Instruct 進行了標準 (BF16) 和 FP8 精度測試。
Qwen3-Coder-30B-A3B-Instruct (BF16)
在 BF16 上,相同工作負載 (256/256) 在 BS=1 時達到 240.53 tok/s,在 BS=64 時達到 13,312.70 tok/s,在 BS=128 吞吐量時達到 21,333.79 tok/s,在 BS=128 吞吐量時達到 21,333.79 tok/s,峰值預填充密集型 (8k/1k) 的吞吐量從 1,276.76 tok/s 開始,在 BS=32 時攀升至 25,069.32 tok/s,在 BS=128 時攀升至 50,198.94 tok/s,峰值吞吐量在 BS=256 時攀升至 5056 5056 時。解碼密集型(1k/8k)從 BS=1 時的約 188 tok/s 穩步增長到 BS=256 時的 11,782 tok/s,在三種場景中保持了最緊湊的延遲特性。
Qwen3-Coder-30B-A3B-Instruct (FP8)
在相同工作負載下,FP8 變體在 BS=1 時速度為 188.92 tok/s,在 BS=64 時達到 10,866.27 tok/s,在 BS=128 時達到 17,617.60 tok/s,在 BS=256 時達到 17,617.60 tok/s,在 BS=256. BF16 的結果。預填充密集型變異體的初始速度為 860.07 tok/s,在 BS=32 時攀升至 20,513.77 tok/s,在 BS=128 時達到 44,205.46 tok/s,在 BS=256 時達到峰值 47,179.15 tok/s.15 tok/s.15 tok/s。解碼密集型任務從 BS=1 時的 133.79 tok/s 成長到 BS=256 時的 11,014.95 tok/s,持續擴展並始終接近 BF16。
Mistral Small 3.1 24B 指令 2503
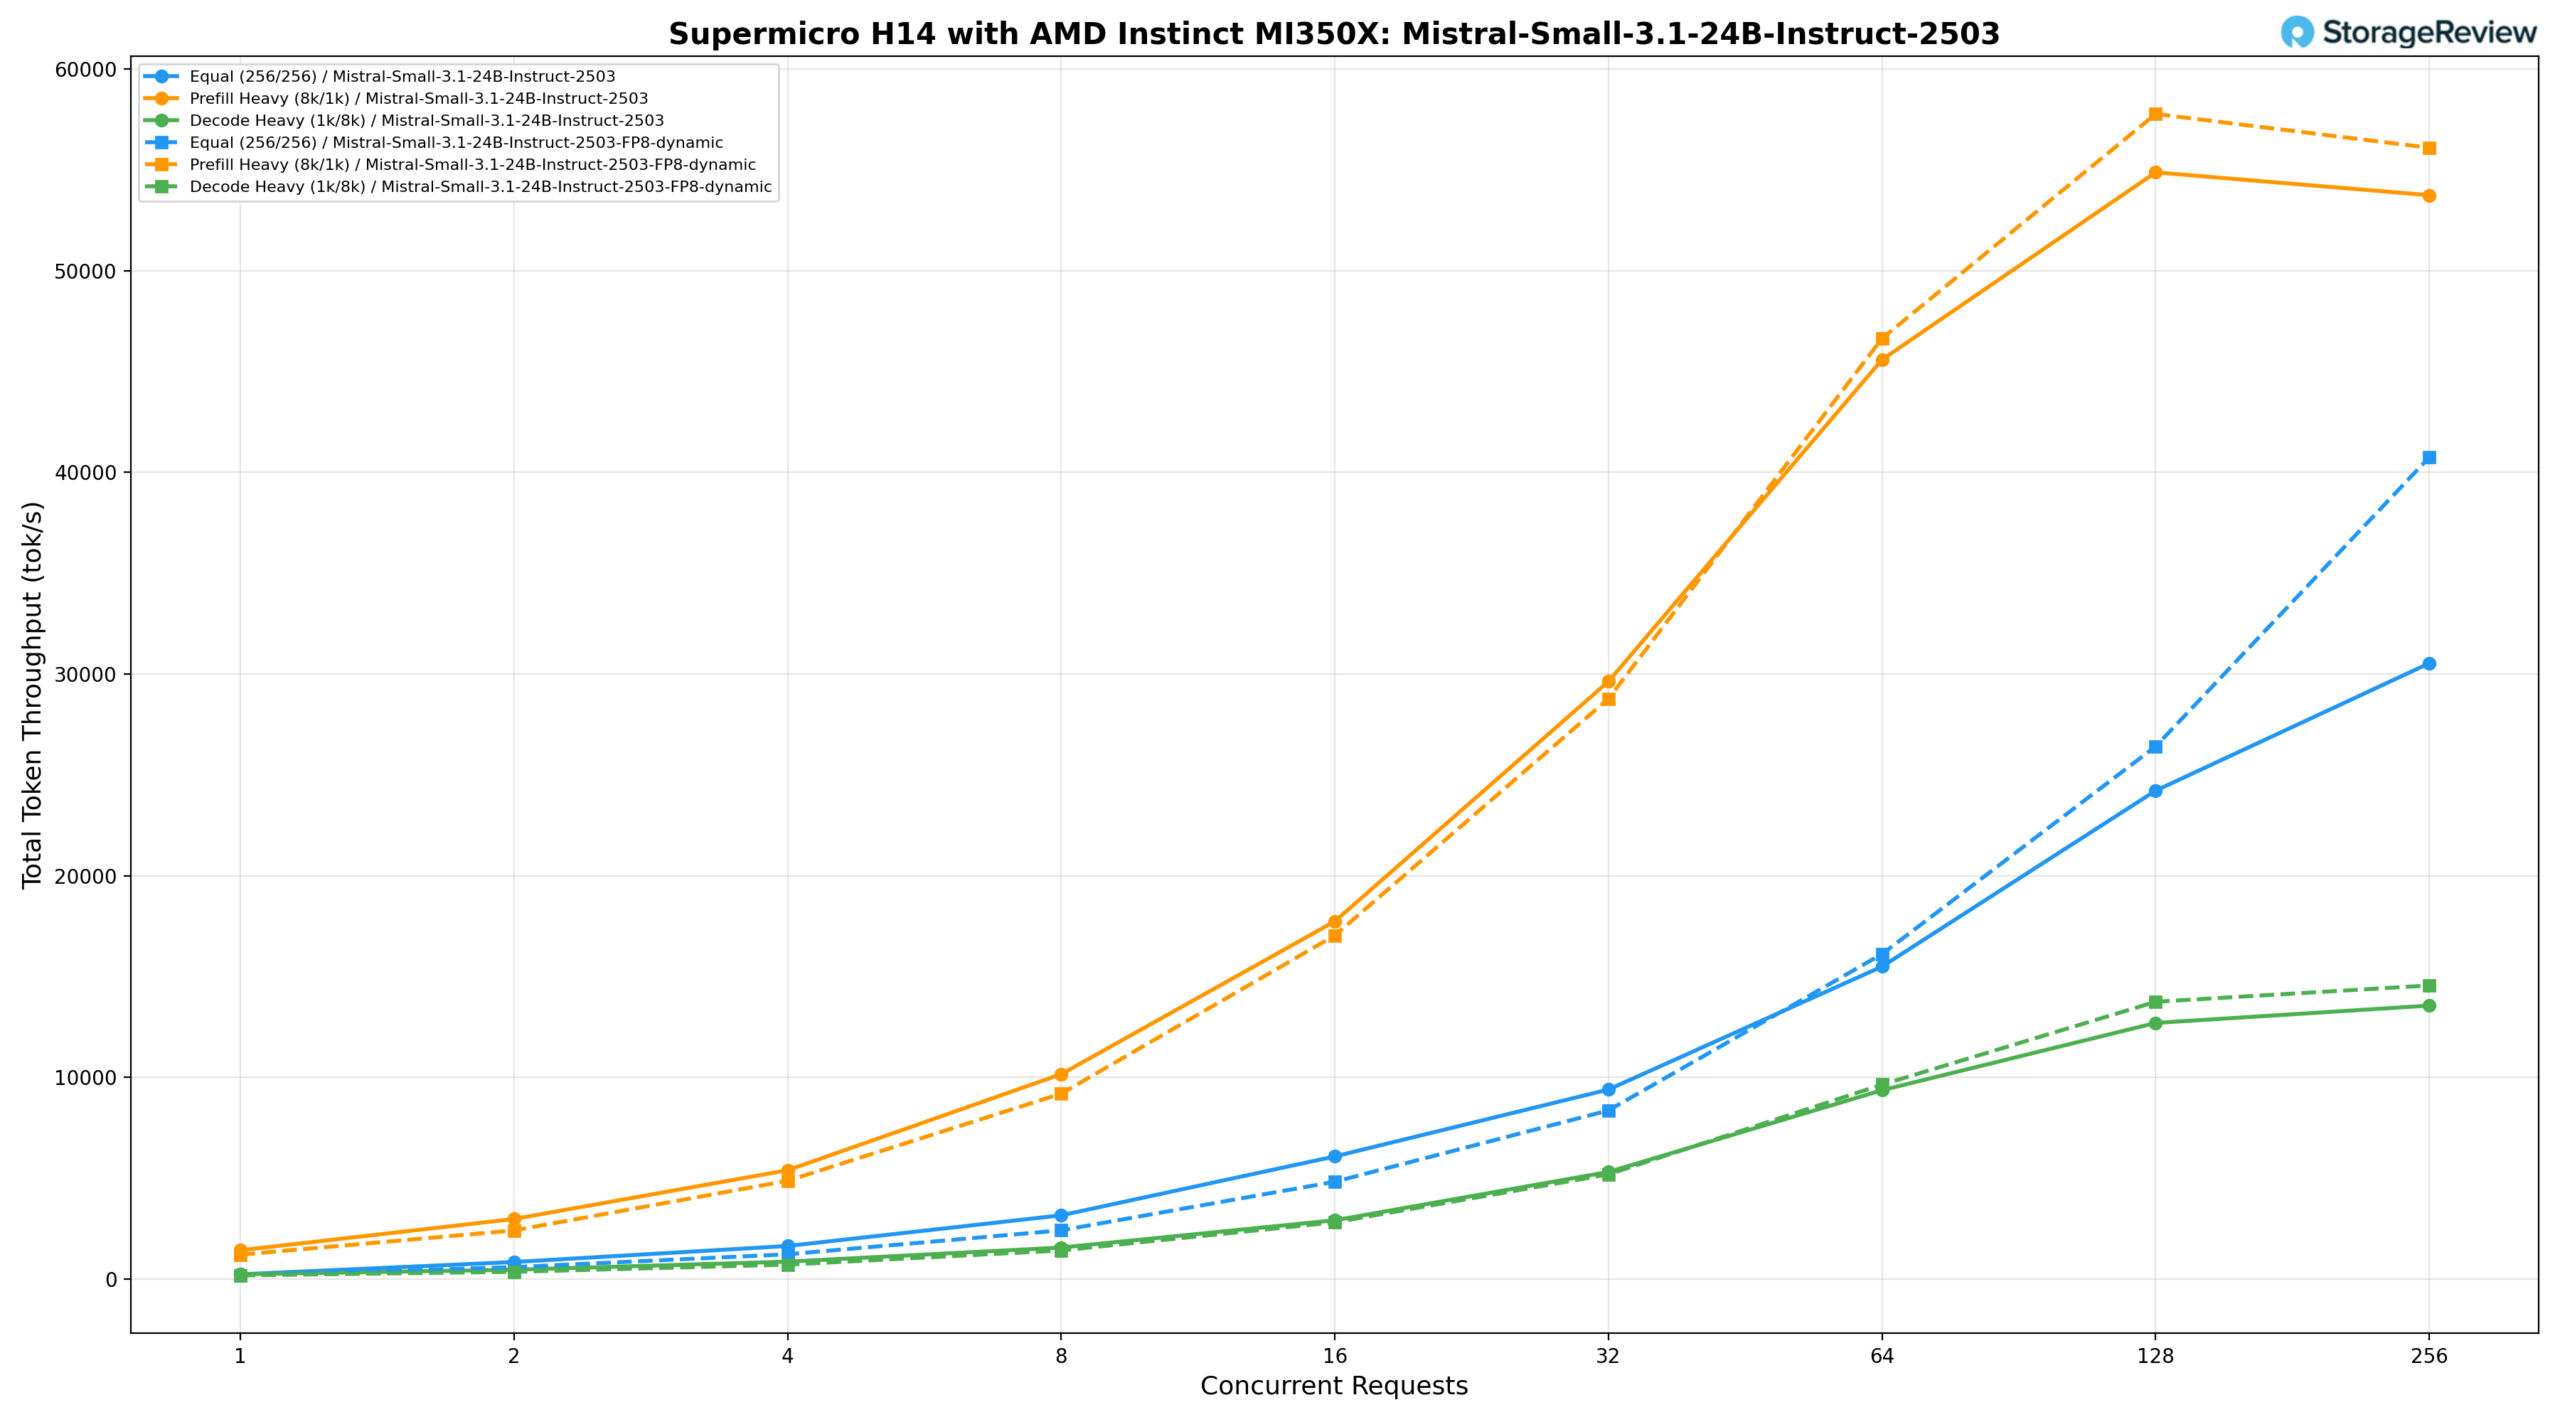
在 H14 上測試了 Mistral-Small-3.1-24B-Instruct-2503 的標準精度和 FP8 動態精度,結果表明在所有三種工作負載配置中均具有一致的擴展性。
Mistral-Small-3.1-24B-Instruct-2503 (BF16)
在 BF16 精度下,相同工作負載 (256/256) 在 BS=1 時達到 236.15 tok/s,在 BS=64 時達到 15,494.56 tok/s,在 BS=128 時達到 24,216.52 tok/s,在 BS=128 時達到 24,216.52 tok/s,在 BS=25 時達到峰值。預填充較多 (8k/1k) 的初速為 1,429.41 tok/s,在 BS=32 時攀升至 29,631.68 tok/s,在 BS=128 時達到 54,871.74 tok/s,在 BS=256 時達到 54,871.74 tok/s,在 BS=256 時達到峰值。解碼密集型(1k/8k)從 BS=1 時的 242.66 tok/s 增長到 BS=256 時的 13,559.19 tok/s,並在整個範圍內穩步增長。
Mistral-Small-3.1-24B-Instruct-2503 (FP8-動態)
在相同工作負載下,FP8動態變體在BS=1時速度為184.25 tok/s,在BS=64時達到16,113.95 tok/s,在BS=128時達到26,409.01 tok/s,在BS=256時達到峰值40,742.040,742.04/k/預填充重採樣變異的初始速度為1,210.06 tok/s,在BS=32時攀升至28,773.52 tok/s,在BS=128時達到57,765.02 tok/s,在BS=256時達到峰值56,093.09 tok/s/s,在BS=256時達到峰值56,093.09 至標準精度。解碼密集型資料從 BS=1 時的 183.94 tok/s 成長到 BS=256 時的 14,557.94 tok/s,在中段範圍內緊密跟踪,然後在 BS=128 和 BS=256 時略微領先。
駱駝 3.1 8B 指導
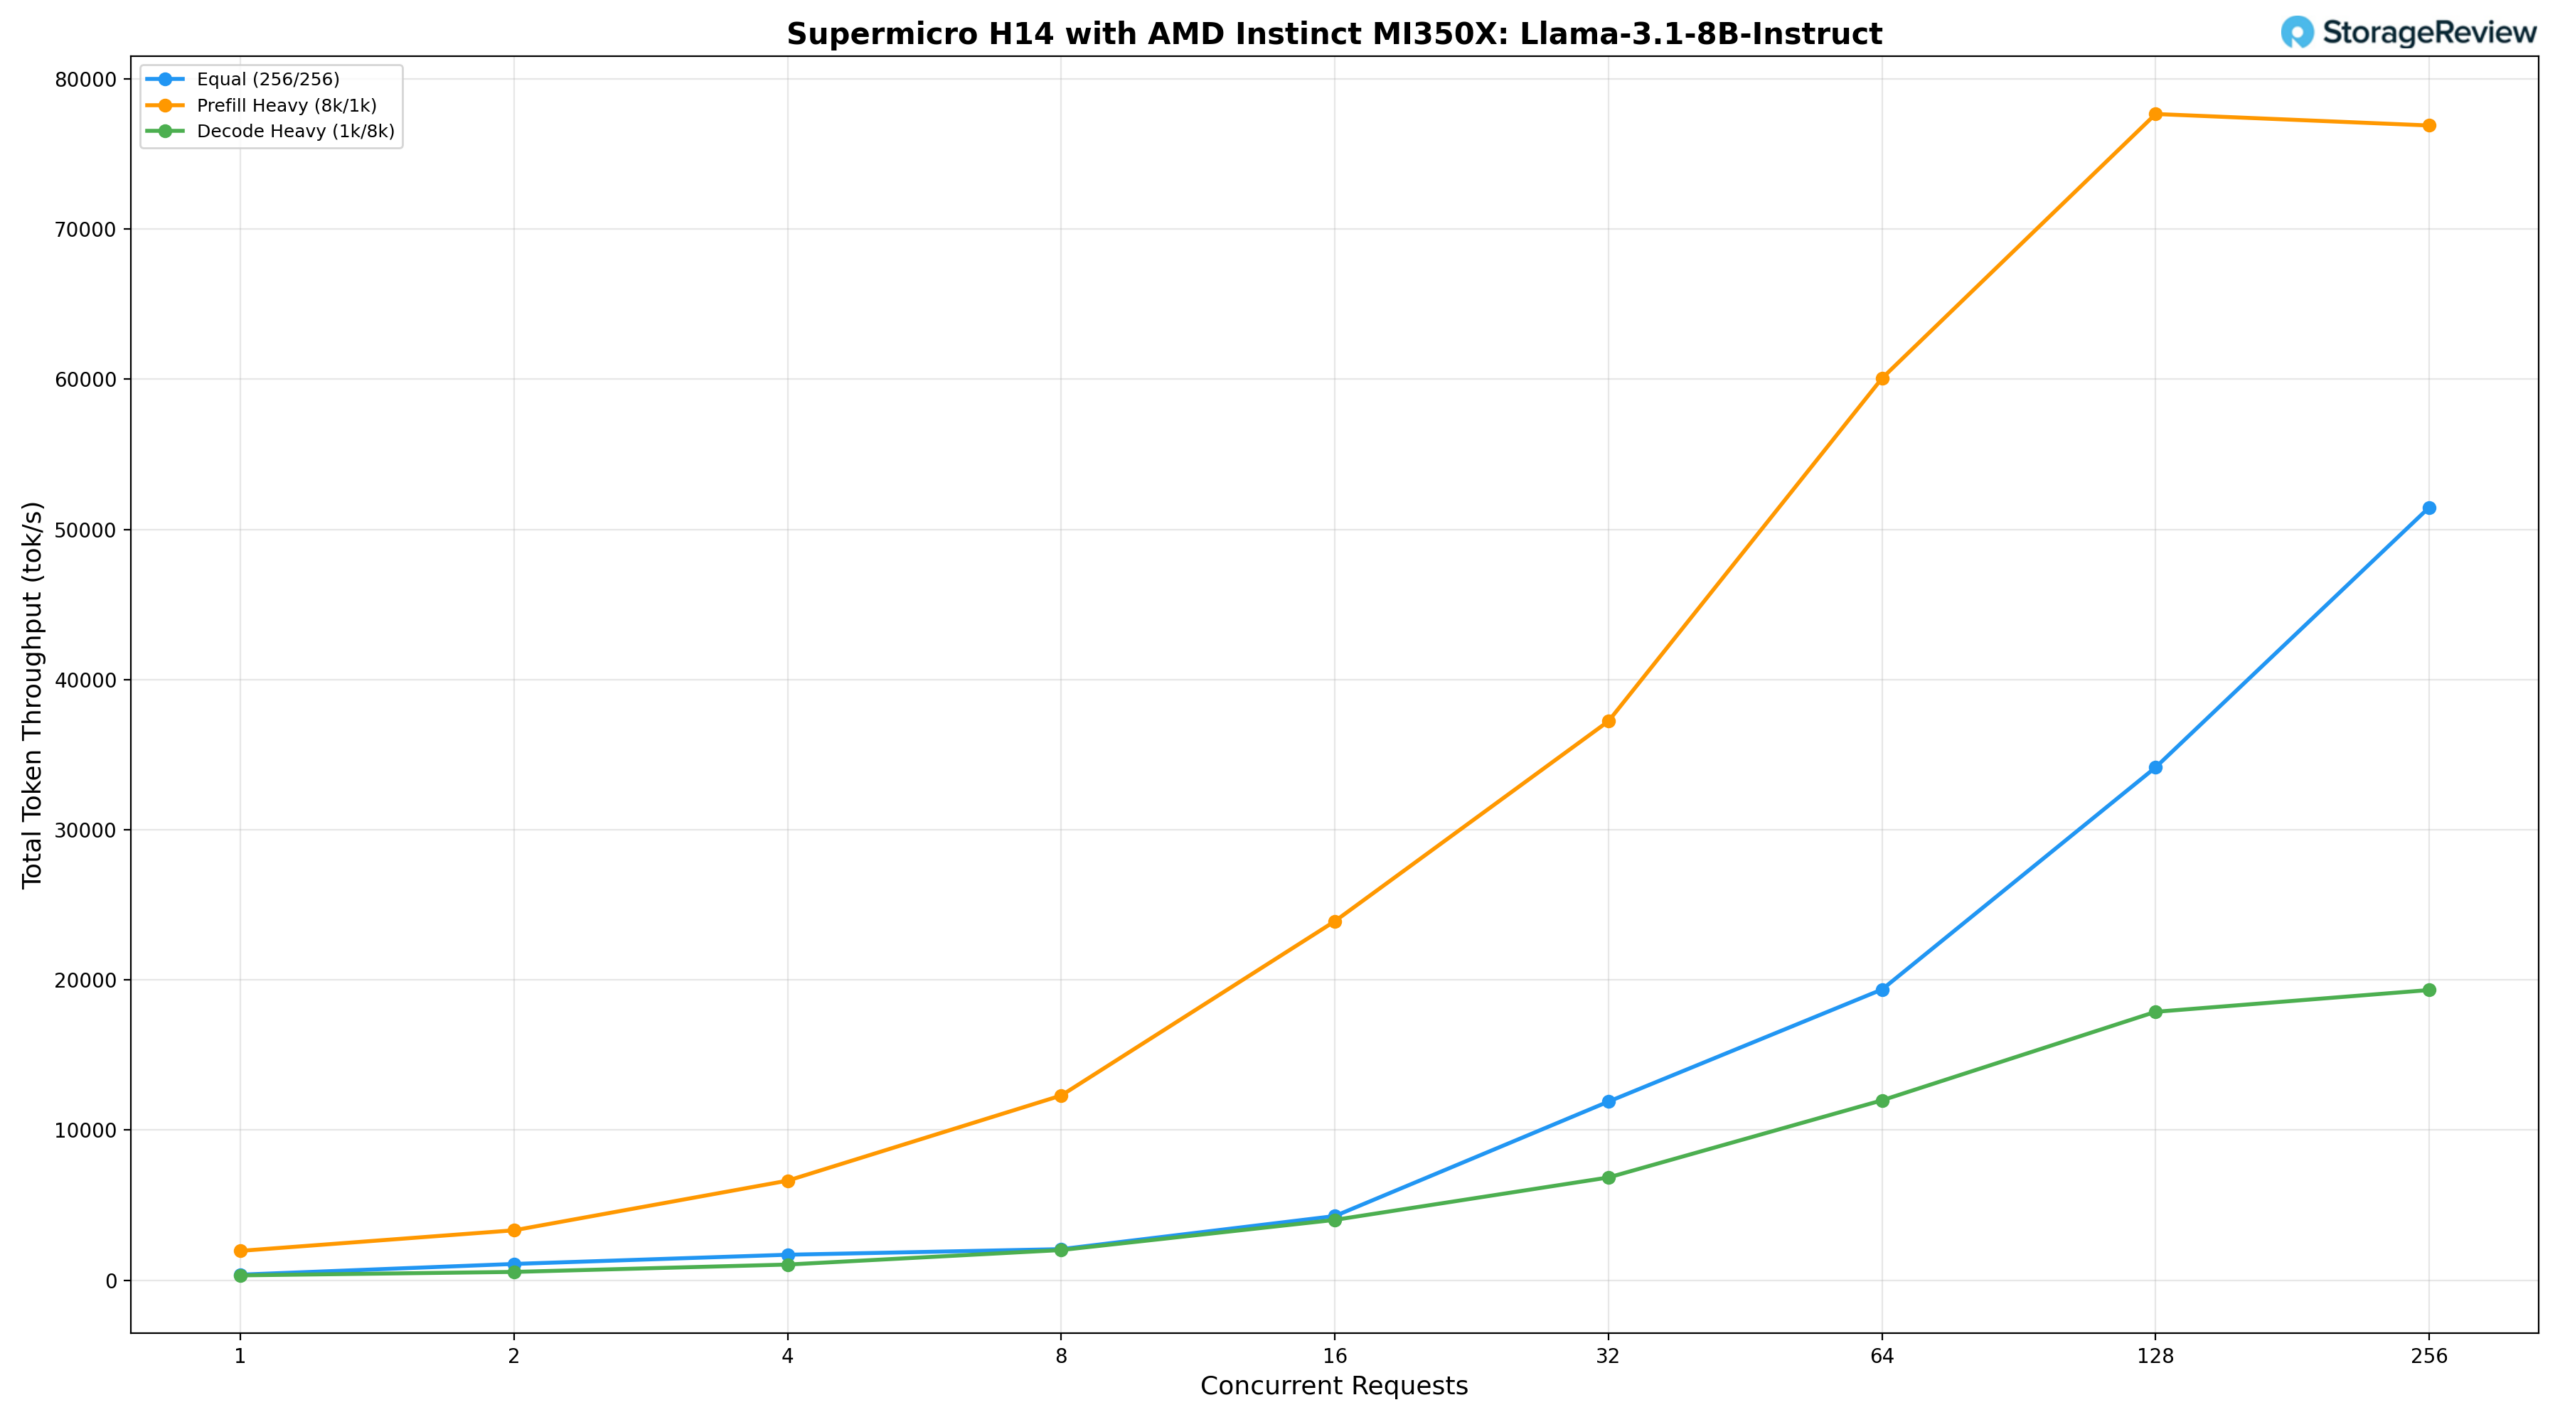
對於 Llama-3.1-8B-Instruct,我們看到,在 BS=1 時,等負載 (256/256) 的吞吐量為 373.26 tok/s,在 BS=64 時達到 19,363.33 tok/s,在 BS=128 時達到 19,363.33 tok/s,在 BS=128 時達到 19,363.33 tok/s,在 BS=128 時達到 35,15. 51,467.30 tok/s。預填充較多 (8k/1k) 的吞吐量起始值為 1,959.04 tok/s,在 BS=32 時攀升至 37,227.63 tok/s,在 BS=64 時達到 60,062.40 tok/s,在 BS=128 時達到 60,062.40 tok/s,在 BS=128 時達到峰值,在 585之後達到峰值,在 5050575之後。 BS=256 時降至 76,893.77 tok/s。解碼密集型(1k/8k)的初始速度為 326.48 tok/s,在 BS=128 時達到 17,877.52 tok/s,在 BS=256 時達到 19,326.35 tok/s,在並發範圍內保持比任何測試過的模型更低的單令牌。
MiniMax M2.5
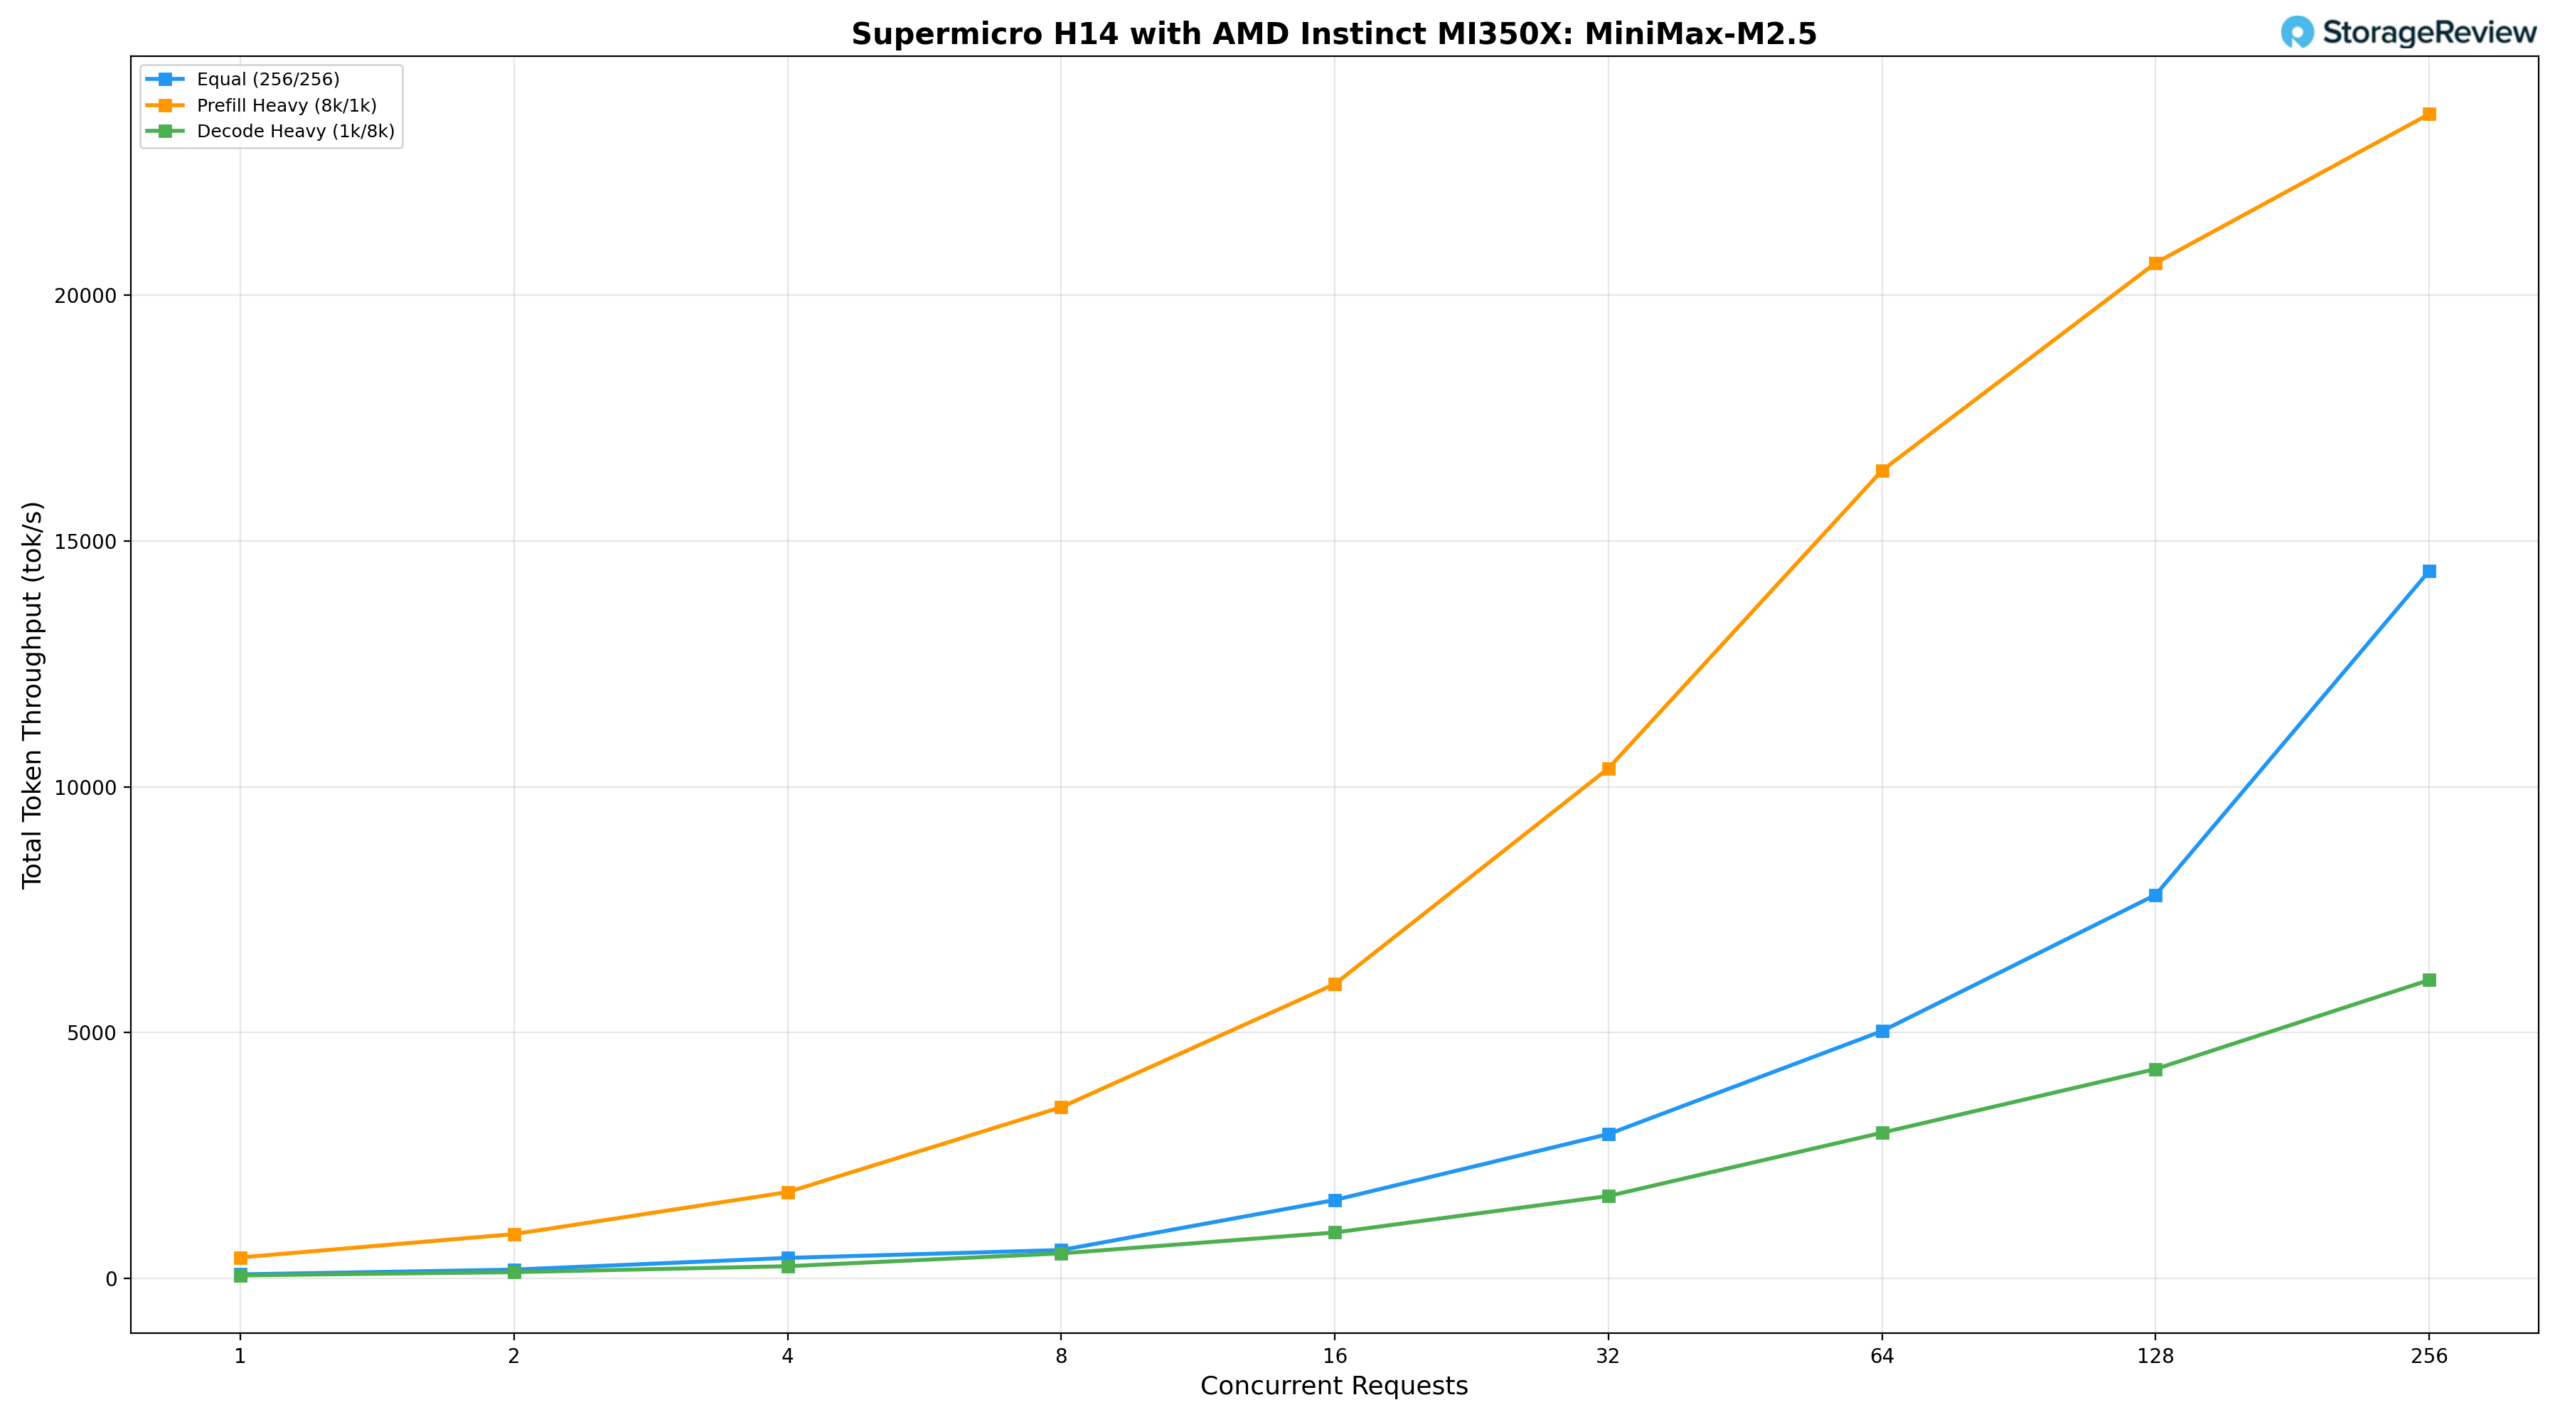
H14 上的 MiniMax-M2.5 完善了該系列產品線,其吞吐量介於 Kimi K2.5 和中型處理器之間,其特性體現了混合專家架構。在相同工作負載 (256/256) 下,BS=1 時吞吐量為 79.31 tok/s,BS=64 時達到 5,029.76 tok/s,BS=128 時達到 7,801.10 tok/s,BS=256 時達到 14,391.。預填充密集(8k/1k)在三種場景中展現出最強的擴展性,初始速度為 424.41 tok/s,在 BS=32 時攀升至 10,376.75 tok/s,在 BS=128 時攀升至 20,658.57 tok/s,在 BS=128 時攀升至 20,658.57 tok/s,並在 BS=25 時達到峰值。解碼密集型(1k/8k)的擴展性穩定,在 BS=128 時達到 4,257.68 tok/s,在 BS=256 時達到 6,068.70 tok/s,在整個並發範圍內提供了最穩定的延遲增長。
基米 K2.5
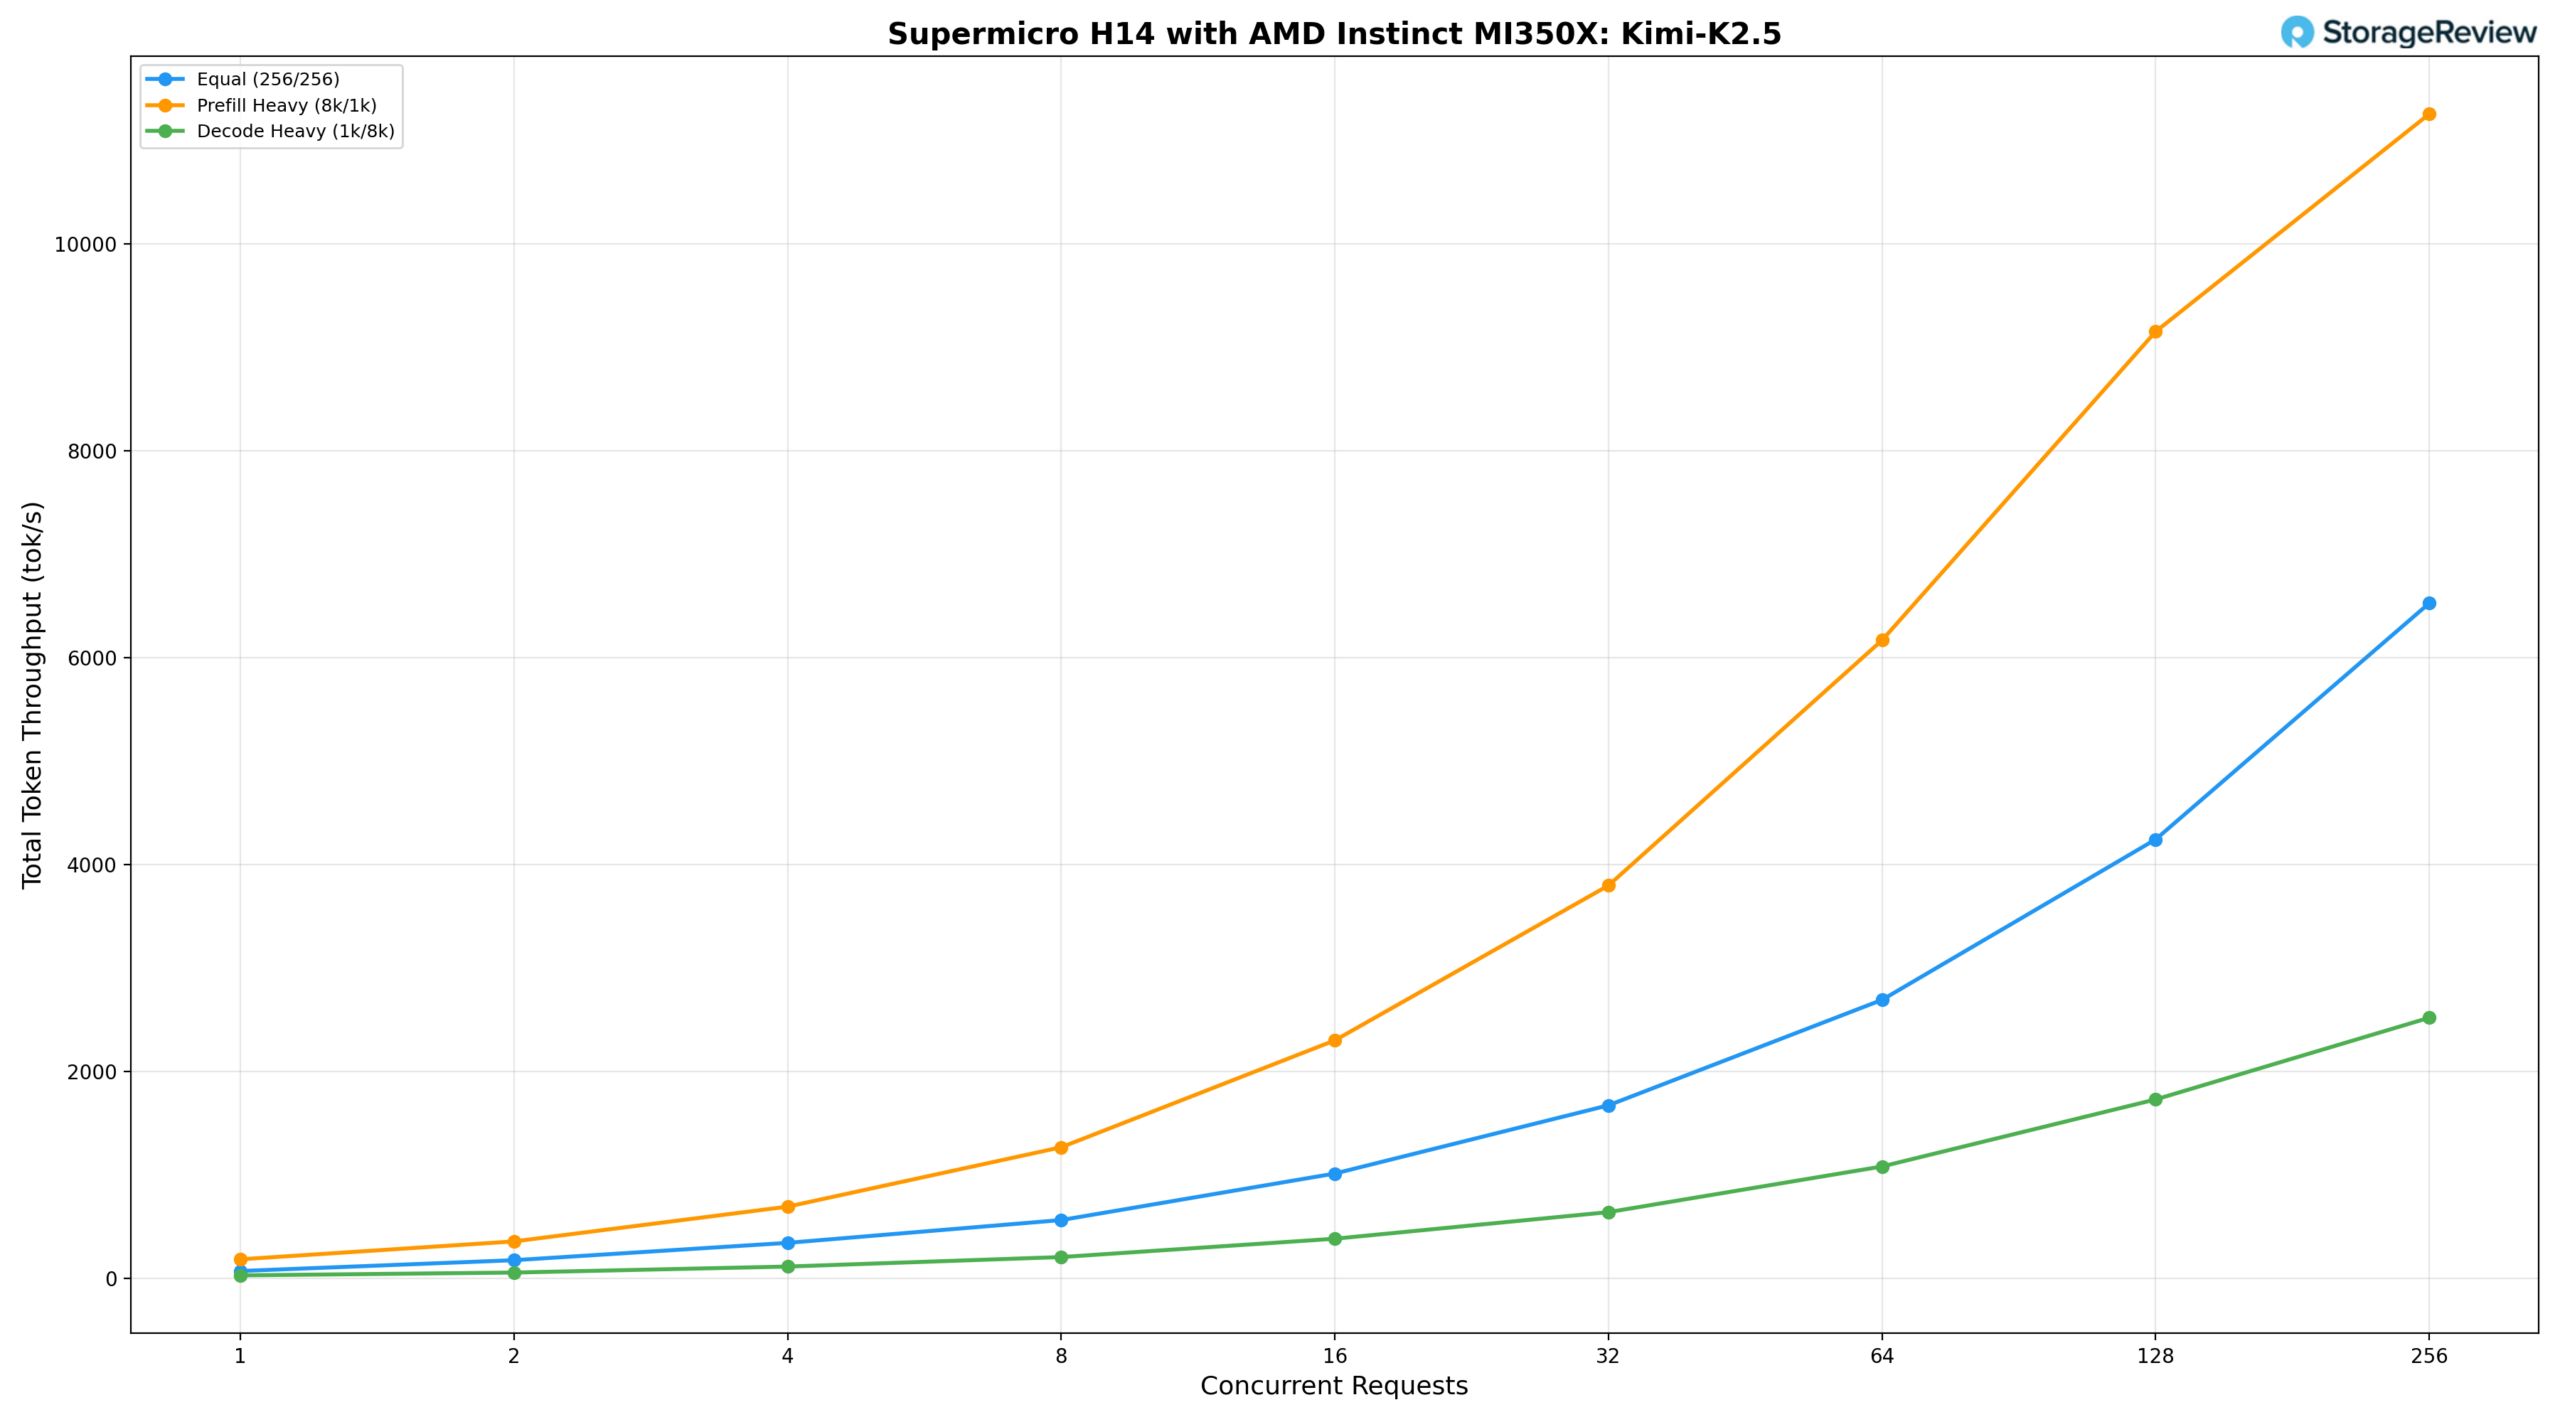
H14 上的 Kimi K2.5 1 兆參數模型是本次評測中測試的最大、最聰明的模型,其吞吐量也反映了這一重量。
相同工作負載 (256/256) 在批次深度 (BS) 為 1 時吞吐量為 72.06 tok/s,在 BS=64 時達到 2,693.07 tok/s,在 BS=128 時達到 4,244.27 tok/s,並在 BS=128 時達到 4,244.27 tok/s,並在 BS=128 時達到 4,244.27 tok/s,並在 BS=256 時達到峰值。預填充密集型 (8k/1k) 的吞吐量擴展性更強,從 185.29 tok/s 開始,在 BS=32 時達到 3,798.85 tok/s,在 BS=128 時達到 9,153.12 tok/s,並在 BS= 256 時達到峰值吞吐量 565256s。從 BS=128 到 BS=256 的階躍式增加帶來了顯著的延遲開銷,表明對於此模型大小,系統在滿批處理深度下已接近其記憶體和計算能力的極限。解碼密集型(1k/8k)從 BS=1 時的 29.88 tok/s 增長到 BS=256 時的 2,513.85 tok/s,在三種場景中實現了最緊湊的擴展曲線,同時在整個範圍內都表現出一致的吞吐量提升。
結語
AMD Instinct MI350X 在本文測試的工作負載配置文件中均展現出極具競爭力的推理性能,而 Supermicro AS-8126GS-TNMR 則提供了一個精心設計的平台來充分發揮其優勢。每個加速器配備 288GB HBM3e 顯存,八個 GPU 透過 Infinity Fabric 互連,單一節點即可提供 2.3TB 的總 GPU 顯存,足以支援 Kimi K2.5 和 MiniMax M2.5 等萬億參數模型,無需多節點分佈或模型分區等變通方案。這項能力顯著簡化了大規模推理的部署架構。
較小的模型也取得了優異的成績。 Llama 3.1 8B 在預填充密集型工作負載下吞吐量超過 77,000 tok/s,而 Mistral Small 3.1 24B 和 Qwen3 Coder 30B 等中端架構在整個並發範圍內均保持了高吞吐量和良好的延遲控制。總體而言,結果表明該硬體平台在負載下能夠實現可預測的擴展,而不是在高批次深度下效能急劇下降。
ROCm 7.2 對 AMD 推理軟體堆疊進行了顯著改進,尤其是在與 vLLM 0.18 配合使用時。這種組合帶來了比以往 ROCm 版本更穩定、性能更高的服務體驗,並擴展了框架支援範圍,同時減少了早期 Instinct 部署中存在的缺陷。 AMD 硬體生態系統的發展勢頭也值得關注:上游 vLLM 現在維護著專用的 AMD ROCm CI 管線,而 Meta 在 6 吉瓦規模下的多代部署承諾也表明,生產驗證遠不止於受控的基準測試環境。
Claude Code 的服務評估為原始吞吐量資料增添了實際應用價值。單一 MI350X 節點在支援多達 16 個同時編碼會話的情況下,仍能保持接近雲端基準的回應速度,並能與多達 64 個並髮用戶保持交互,同時還能產生近 1,000 tok/s 的總輸出。對於正在權衡商業 API 訂閱成本與自託管基礎設施成本的組織而言,在這種密度下,經濟效益顯而易見,此外,自託管基礎設施還具有數據本地化、免除按令牌計費以及不受限制的模型選擇等額外優勢。
Supermicro 的 JumpStart 計畫在基礎設施評估流程中持續發揮重要作用。該專案允許我們直接存取生產硬件,無需任何配置開銷,從而在整個測試期間,在真實環境下運行實際工作負載。對於進行加速器採購評估的團隊而言,這種程度的實際操作體驗遠比規格表比較或廠商精心策劃的演示更具參考價值。



 Amazon